Applications · ARTICLE · 2026
A production AI app isn't picking the right model: the seven layers nobody talks about
요약
Manthan Patel의 이 LinkedIn 게시글은 프로덕션 AI 앱의 정체를 코드베이스의 디렉토리 구조에서 찾는다. 좋은 모델을 고르는 일도, 영리한 프롬프트를 쓰는 일도 아니고, 실제 사용자가 몰려와도 유지되는 하나의 시스템으로 여러 레이어를 엮는 규율이 그 정체라는 주장이다.
주장을 뒷받침하는 자료는 실제 Next.js 앱의 파일 트리 한 장이다. Patel은 그 트리를 7개 레이어로 나눠 각각의 책임을 한 줄씩 붙이고, 마지막 자리에 .claude/ 디렉토리를 놓는다. 모델은 쉬운 10%이고 이 레이어들이 아무도 말하지 않는 90%라는 문장으로 글을 닫는다.
이 페이지를 읽을 때 자료의 크기를 먼저 알아 둘 필요가 있다. raw 본문이 2.6KB인 짧은 카드형 게시글이라 각 레이어의 설명이 불릿 두세 개에 그치고, 실험이나 비교 대상이 없다. 따라서 아래 서술은 게시글이 실제로 적은 내용과 도해가 보여 주는 내용에 한정하며, 게시글이 다루지 않은 부분은 한계 절에 따로 모았다.
배경
이 글은 정의를 부정으로 먼저 밀어낸다. 프로덕션 AI 앱이 무엇인지 말하기 전에 무엇이 아닌지를 다섯 번 반복해 열거하는 구성이다.
| 아니라고 부정한 것 | 무엇을 가리키는가 |
|---|---|
| picking the right model | 어떤 모델을 쓸지 고르는 선택 |
| a clever prompt | 잘 다듬은 지시문 하나 |
| a fine-tuned model | 자체 데이터로 추가 학습시킨 모델 |
| an agent framework | 에이전트를 조립해 주는 프레임워크 |
| a wrapper around an API | 모델 API를 감싼 얇은 호출 계층 |
다섯 항목의 공통점은 모두 모델 또는 모델 바로 옆에 붙는 한 겹이라는 것이다. Patel은 이 다섯 가지를 차례로 지운 뒤에야 남는 것을 지목한다. 남는 것은 레이어들을 하나의 시스템으로 엮어 실제 사용자를 받아 내는 규율이며, 그 작업은 각 레이어가 무엇을 하고 서로 어떻게 연결되는지를 이해하는 데서 시작한다는 것이 도입부의 결론이다.
이 도입부가 글 전체의 형식을 정한다. 뒤따르는 본문은 모델이나 프롬프트를 한 번도 다시 다루지 않고, 디렉토리 이름과 그 안에 무엇이 들어가는지만 나열한다.
핵심 개념
레이어는 이 글에서 아키텍처 다이어그램의 추상 계층이 아니라 저장소 최상위의 디렉토리 하나를 뜻한다. 각 레이어에는 이름과 디렉토리 경로가 함께 붙고, 책임이 한 줄로 규정된다. 개념을 도식으로 설명하는 대신 tree 명령의 출력을 그대로 논거로 삼는 방식이다.
얇은 표면은 사용자가 직접 만지는 레이어에 로직을 두지 않는다는 원칙이다. Patel은 첫 번째 레이어를 설명하며 이 레이어를 얇게 유지하고 진짜 로직은 더 깊은 곳으로 밀어 넣는 것이 개발자의 몫이라고 적는다. 두 번째 레이어를 UI가 아니라 실제 작업이 일어나는 곳이라고 부르는 것도 같은 원칙의 뒷면이다.
row-level security는 데이터베이스에서 행 단위로 접근 권한을 거는 방식이다. 사용자마다 볼 수 있는 행이 다르게 통제되므로, 조회 코드가 실수해도 남의 데이터가 나오지 않는다. 이 글은 이 장치를 두 곳에 배치한다. lib/security/에 한 번, 데이터베이스 쪽인 supabase/에 한 번이다.
되돌리기 가능한 상태는 클라이언트가 들고 있는 상태의 변경 이력을 남겨 이전 시점으로 돌아갈 수 있게 만든 구조다. Patel은 이것을 편집기의 Ctrl+Z가 깨지지 않는다는 사용자 관점의 결과로 설명한다.
migration의 버전 관리는 데이터베이스 스키마 변경을 파일로 남겨 순서대로 적용하는 방식이다. 변경이 코드와 함께 기록되므로 현재 스키마가 어떤 모양인지 추측할 필요가 없어진다는 것이 이 글이 든 이유다.
regression은 되던 기능이 변경 때문에 깨지는 것을 말한다. 이 글은 end-to-end 테스트와 단위 테스트를 CI에 연결해 두면 이것이 배포 전에 잡힌다고 적는다.
방법
7개 레이어는 다음과 같다. 이름, 디렉토리, 책임이 모두 게시글 본문에 명시된 그대로다.
| 순서 | 이름 | 디렉토리 | 게시글이 규정한 책임 |
|---|---|---|---|
| 1 | The Surface | app/ |
사용자가 만지는 모든 것을 실행하는 Next.js 라우터 |
| 2 | The Engine | lib/ |
UI가 아니라 실제 작업이 일어나는 곳 |
| 3 | The State Layer | stores/ |
되돌리기 가능한 클라이언트 상태 |
| 4 | The Building Blocks | components/, hooks/ |
UI primitive와 custom React hook |
| 5 | The Data Foundation | supabase/ |
auth와 Postgres, RLS를 dev 환경과 prod 환경으로 분리 |
| 6 | The Safety Net | e2e/, tests/ |
end-to-end 테스트와 단위 테스트, CI 연결 |
| 7 | The New Layer | .claude/ |
Claude에 전체 맥락을 주는 설정과 확장 |
이 표가 보여 주는 순서에는 방향이 있다. 사용자와 가장 가까운 화면에서 시작해 로직, 상태, 구성 요소, 데이터, 테스트로 내려가고, 마지막에 사람이 아닌 도구를 위한 레이어가 온다. 앞의 여섯 개가 웹 애플리케이션이면 대체로 갖추는 구성이라면, 일곱 번째만 이 글이 새로 세운 자리다.
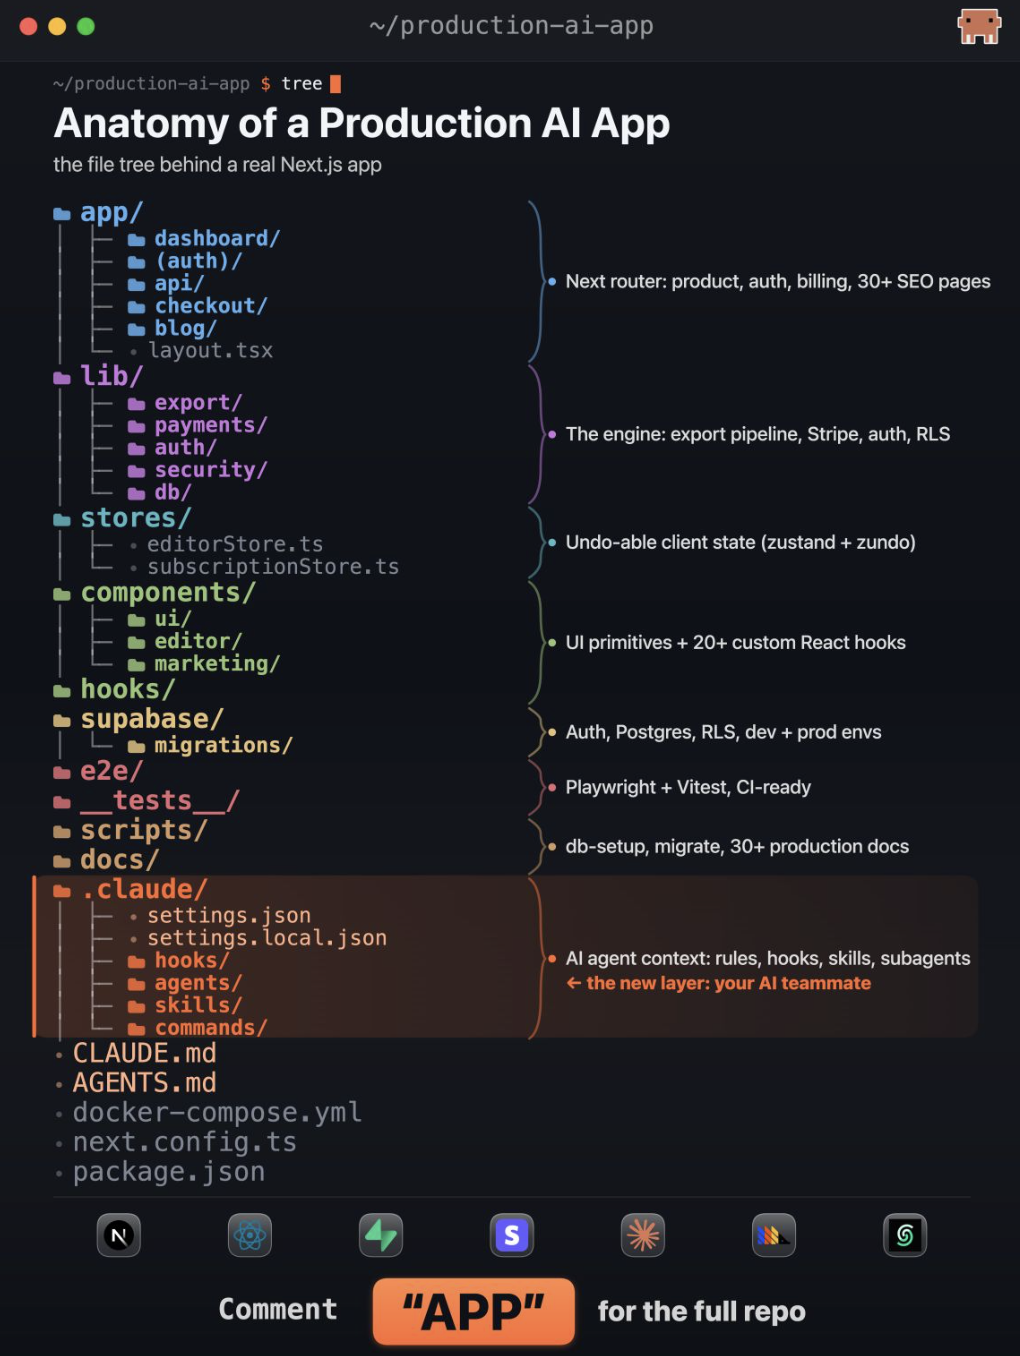
표면과 엔진
첫 번째 레이어인 app/는 Next.js 라우터이며 사용자가 만지는 모든 것을 실행한다. 제품 페이지, auth, billing, checkout, 그리고 30개 이상의 SEO 페이지가 여기에 놓인다고 게시글은 적는다. 그러나 이 레이어에 대한 지시는 무엇을 넣으라는 것이 아니라 무엇을 넣지 말라는 것이다. 얇게 유지하고 진짜 로직은 더 깊은 곳으로 밀어 넣으라는 문장이 이 레이어 설명의 마지막 줄이다.
두 번째 레이어인 lib/가 그 밀려 내려간 로직을 받는다. 게시글은 이곳을 UI가 아니라 실제 작업이 일어나는 곳이라고 부르고, 핵심 로직이 몇 개의 집중된 모듈에 놓인다고 설명한다.
| 모듈 | 게시글이 붙인 설명 |
|---|---|
export/ |
제품을 돈 낼 만한 것으로 만드는 파이프라인 |
payments/ |
실제 구독을 위해 연결한 Stripe |
security/ |
사용자가 자기 데이터만 보게 하는 row-level security |
세 모듈의 선정 기준은 기능 분류가 아니라 사업 위험이다. export/는 제품이 돈을 받을 근거이고, payments/는 실제로 돈이 오가는 경로이며, security/는 남의 데이터가 새지 않게 막는 자리다. 게시글이 이 셋만 이름을 붙여 열거한 이유는 밝히지 않지만, 세 항목 모두 잘못되면 사용자에게 즉시 드러나는 종류라는 공통점이 있다.
상태와 구성 요소
세 번째 레이어인 stores/는 zustand와 zundo로 만든 되돌리기 가능한 클라이언트 상태를 담는다. 게시글은 이 레이어에 파일 두 개를 지목한다.
| 파일 | 담는 것 | 게시글이 든 이유 |
|---|---|---|
editorStore.ts |
편집기의 모든 변경 이력 | 사용자가 Ctrl+Z를 눌러도 아무것도 깨지지 않게 하려고 |
subscriptionStore.ts |
plan limit과 billing 상태 | UI가 신뢰할 수 있는 값을 들고 있게 하려고 |
두 파일의 설명 방식이 서로 다르다. 앞쪽은 사용자가 겪는 결과로 설명되고, 뒤쪽은 UI가 그 값을 믿을 수 있다는 개발자 관점으로 설명된다. 상태 레이어를 두는 이유가 사용자 경험과 코드 신뢰성 양쪽에 걸쳐 있다는 뜻이다.
네 번째 레이어인 components/와 hooks/는 UI primitive와 20개 이상의 custom React hook을 모은다. 이 레이어의 목적은 재사용이며, 게시글은 그것을 화면을 복사해 붙여 넣는 방식과 대비시킨다. editor, marketing, dashboard를 각각 따로 만든 화면이 아니라 하나의 체계로 만든다는 서술이다.
데이터 기반과 안전망
다섯 번째 레이어인 supabase/는 auth와 Postgres, RLS를 담고 dev 환경과 prod 환경을 분리한다. 게시글은 이 레이어에 규칙 두 개를 붙인다. migration이 버전 관리되므로 스키마가 추측이 아니라는 것이 하나이고, 실제 사용자 데이터로는 절대 테스트하지 않는다는 것이 다른 하나다. 앞의 규칙이 스키마 변경의 재현성을 다룬다면 뒤의 규칙은 운영 데이터의 보호를 다룬다.
여섯 번째 레이어인 e2e/와 tests/는 두 종류의 테스트를 나눠 담는다. end-to-end는 Playwright, 단위 테스트는 Vitest다. 게시글이 강조하는 것은 도구 이름보다 연결 지점이다. CI에 연결해 두었기 때문에 regression이 배포되기 전에 잡힌다는 것이다.
다섯 번째와 여섯 번째 레이어는 표현이 닮아 있다. 실제 사용자 데이터로 테스트하지 않는다는 규칙과 배포 전에 잡는다는 규칙 모두, 문제가 사용자에게 도달하기 전에 경계를 하나 세워 둔다는 같은 발상이다.
일곱 번째 레이어
.claude/는 이 글이 새로 세운 자리다. 게시글은 그 안에 settings.json, hooks, agents, skills, commands가 들어가며 이것들이 Claude에 전체 맥락을 준다고 적는다. 여기에 더해 CLAUDE.md와 AGENTS.md가 저장소 루트에 있어 매 실행이 전체 그림에서 출발한다고 설명한다.
이 레이어가 앞의 여섯 개와 다른 점은 소비자다. app/부터 tests/까지는 사용자나 개발자, 또는 CI가 읽는 코드인 반면 .claude/는 코딩 에이전트가 읽는 설정이다. 그런데도 게시글은 이것을 별도 범주로 빼지 않고 같은 트리의 같은 높이에 놓는다.
도해는 이 배치를 시각적으로도 표시한다. 여덟 개 주석 묶음 가운데 .claude/만 배경색과 세로 막대로 강조되고, 그 옆에 "the new layer: your AI teammate"라는 주석이 따로 붙는다. 다른 묶음의 주석은 모두 같은 서식이다.
도해에만 있는 세부
도해는 본문이 이름만 언급한 디렉토리의 내부를 보여 준다. 아래는 트리에 실제로 표시된 항목이다.
| 묶음 | 트리에 표시된 하위 항목 | 도해의 주석 |
|---|---|---|
app/ |
dashboard/, (auth)/, api/, checkout/, blog/, layout.tsx |
Next router: product, auth, billing, 30+ SEO pages |
lib/ |
export/, payments/, auth/, security/, db/ |
The engine: export pipeline, Stripe, auth, RLS |
stores/ |
editorStore.ts, subscriptionStore.ts |
Undo-able client state (zustand + zundo) |
components/, hooks/ |
ui/, editor/, marketing/ |
UI primitives + 20+ custom React hooks |
supabase/ |
migrations/ |
Auth, Postgres, RLS, dev + prod envs |
e2e/, __tests__/ |
표시 없음 | Playwright + Vitest, CI-ready |
scripts/, docs/ |
표시 없음 | db-setup, migrate, 30+ production docs |
.claude/ |
settings.json, settings.local.json, hooks/, agents/, skills/, commands/ |
AI agent context: rules, hooks, skills, subagents |
도해와 본문이 정확히 맞지 않는 자리가 몇 군데 있다. 주석 묶음은 여덟 개인데 본문이 이름을 붙인 레이어는 일곱 개이며, scripts/와 docs/ 묶음은 레이어로 승격되지 않았다. lib/ 아래의 auth/와 db/, .claude/ 아래의 settings.local.json도 도해에만 있다. 트리 맨 아래 루트 파일 목록에는 CLAUDE.md와 AGENTS.md 외에 docker-compose.yml, next.config.ts, package.json이 함께 놓여 있다.
이 차이를 어떻게 읽어야 하는지에 대한 설명은 게시글에 없다. 일곱이라는 숫자가 트리를 실제로 센 결과가 아니라 서술을 위해 고른 값일 가능성이 있다.
결과
정량 결과가 없는 자료다. 실험도, 비교 대상도, 측정 절차도 제시되지 않으며 저자의 경험과 의견이 논거의 전부다.
제시된 유일한 수치 표현은 비유다. 모델은 쉬운 10%이고 이 레이어들이 아무도 말하지 않는 90%라는 문장이며, 두 비율이 무엇을 측정한 값인지는 밝히지 않는다. 이 비유가 글 전체에서 하는 일은 무게중심의 위치를 지정하는 것이다. 나머지 수치는 코드베이스의 규모를 나타내는 어림수뿐이다.
| 수치 | 대상 | 출처 |
|---|---|---|
| 30개 이상 | SEO 페이지 | 본문과 도해 |
| 20개 이상 | custom React hook | 본문과 도해 |
| 30개 이상 | production 문서 | 도해만 |
세 값 모두 정확한 수가 아니라 하한이며, 규모가 작지 않다는 인상을 주는 용도로만 쓰인다. 어떤 페이지가 SEO 페이지로 세어졌는지, 어떤 문서가 production 문서인지에 대한 기준은 없다.
결론은 처방 한 줄이다. 구조를 한 번 만들어 여러 프로젝트에 재사용하라는 것이다. 이 문장은 앞에서 제시한 트리가 특정 제품 하나의 산물이 아니라 옮겨 쓸 수 있는 형판이라는 전제를 담고 있다.
한계
자료의 크기 자체가 가장 큰 제약이다. raw 본문이 2.6KB이고 레이어마다 불릿 두세 개가 전부라, 각 레이어를 그렇게 나눈 근거와 다른 구성과 비교했을 때의 손익이 서술되지 않는다.
전제 스택에 강하게 묶여 있다는 점도 일반화를 막는다. Next.js, Supabase, Stripe, zustand, Playwright, Vitest를 쓰는 파일 트리 한 장이 논거의 전부여서, 다른 스택이나 다른 규모의 팀에 그대로 옮길 수 있는지는 확인할 수 없다.
핵심 주장의 검증이 빠져 있다. .claude/를 정식 레이어로 세웠을 때 무엇이 달라지는지에 대한 관찰이나 측정이 없고, 모델이 쉬운 10%라는 비율에도 근거가 붙어 있지 않다.
내부 구현은 이 자료로 확인할 수 없다. 디렉토리 이름과 파일명만 제시되고 코드 예시가 없으며, 도해 하단이 "Comment 'APP' for the full repo"로 안내하는 전체 저장소도 이 저장소에 포함되지 않는다.
자료 자체의 표기가 일관되지 않은 자리도 있다. 본문은 정체성을 규정하는 문장에서 The autonomy of a production AI app is ...라고 쓰지만 같은 게시글의 도해 제목은 Anatomy of a Production AI App이다. 본문이 일곱 번째 레이어를 ./claude/로 적는 것도 도해의 .claude/와 어긋난다. 게시 연도도 본문에 없어 2026은 확정값이 아니다.
이 저장소에서의 위치
이 게시글은 harness라는 용어를 한 번도 쓰지 않는다. 그런데도 일곱 번째 레이어의 구성 요소는 이 저장소가 harness라고 부르는 층과 그대로 겹친다. settings.json, 훅, 서브에이전트, 스킬, 커맨드, 그리고 루트의 메모리 파일이 모델을 감싸 실행 맥락을 공급한다는 구성이 같기 때문이다. 용어를 공유하지 않으면서 대상이 같은 자료이므로, 인접 페이지와 대조할 때는 무엇을 다르게 보는지가 읽을 거리가 된다.
| 인접 페이지 | 이 글과 겹치는 지점 | 이 글에만 있는 것 |
|---|---|---|
| Agent Harness Engineering 개괄과 학습 경로 | .claude/ 구성 요소를 앱의 정식 구조로 다룬다 |
웹 애플리케이션의 나머지 여섯 레이어와 나란히 놓은 배치 |
| Prompt → Context → Harness → Loop Engineering: 4단계 진화 개괄 | 최적화 단위가 모델과 프롬프트 바깥으로 옮겨 왔다고 본다 | 그 이동을 10%와 90%라는 비율 하나로 압축 |
| 더 이상 Claude를 프롬프팅하지 않습니다 >> 하지만 프롬프트는 여전히 중요합니다 | 프롬프트 자체가 작업의 중심이 아니라고 본다 | 대안을 단계 구분이 아니라 디렉토리 목록으로 제시 |
| I taught myself Claude Code from scratch (Manthan Patel, LinkedIn 2026) | 같은 저자의 LinkedIn 게시글이며 형식이 같다 | 목록 나열이 아니라 하나의 구조를 해부 |
표가 보여 주는 차이는 서술의 층위다. 인접 페이지들이 방법론이나 학습 경로를 다루는 반면 이 글은 저장소의 파일 배치라는 가장 구체적인 층에서 같은 주장을 편다. 짧고 근거가 얕다는 약점의 반대편에 그 구체성이 있다.
동명이인에 주의할 자료가 하나 있다. agents/patel-2026-beyond-the-prompt-claude-code의 저자는 Arpan Patel로, 이 글의 Manthan Patel과 다른 사람이다. 성이 같아 저자 계보로 묶기 쉬우므로 대조 시점에 확인이 필요하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| RLS (row-level security) | 데이터베이스 행 단위 접근 제어. 이 글에서는 사용자가 자기 데이터만 보게 만드는 장치로 쓰인다 |
| zundo | zustand와 함께 써서 클라이언트 상태를 되돌릴 수 있게 만드는 라이브러리. 게시글은 두 이름을 짝지어 제시할 뿐 내부 동작은 설명하지 않는다 |
| regression | 되던 기능이 변경 때문에 깨지는 것. CI에 연결한 테스트가 배포 전에 이를 잡는다 |
| migration | 데이터베이스 스키마 변경을 파일로 남겨 버전 관리하는 방식. 스키마가 추측이 아니게 되는 근거로 제시된다 |
| UI primitive | 화면을 조립하는 최소 단위 컴포넌트. 게시글은 이것과 custom hook을 묶어 하나의 레이어로 본다 |
관련 페이지
- Agent Harness Engineering 개괄과 학습 경로: 이 글이 일곱 번째 레이어로 세운
.claude/구성이 harness라는 이름으로 논의되는 지도 - Prompt → Context → Harness → Loop Engineering: 4단계 진화 개괄: 최적화 단위가 프롬프트에서 컨텍스트, harness, 루프로 옮겨 온 계보. 이 글의 10%와 90% 비유가 놓이는 자리
- 더 이상 Claude를 프롬프팅하지 않습니다 >> 하지만 프롬프트는 여전히 중요합니다: 프롬프트가 작업의 중심에서 물러났다는 같은 관찰을 단계 구분으로 정리한 글
- I taught myself Claude Code from scratch (Manthan Patel, LinkedIn 2026): 같은 저자의 다른 LinkedIn 게시글. 짧은 카드형 형식이 같다
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26):
.claude/운용을 상세히 다룬 글. 저자가 Arpan Patel로 이 글과 동명이인이다