Agents · ARTICLE · 2026
Meet Stripe's Knowledge AI Platform
요약
Stripe가 2026년 4월에 출시한 사내 에이전트 플랫폼 Kai의 설계와 도입 결과를 정리한 엔지니어링 블로그다. Kai는 Stripe's Knowledge AI Platform의 줄임말이고, 코딩 에이전트의 혜택에서 밀려나 있던 영업, 재무, 마케팅, 법무 직군을 대상으로 만들어졌다. 발행 시점 기준 전사 직원의 83%가 주간 활성 사용자다.
이 글의 핵심 주장은 지식 업무가 코딩 업무와 구조적으로 다르기 때문에 단일 에이전트가 아니라 플랫폼이 필요하다는 것이다. Stripe는 그 플랫폼을 세 계층으로 나눴다. 인터페이스에 종속되지 않는 API, 도메인 팀이 자기 에이전트를 직접 만들고 감시하는 Agent Studio, 그리고 외부 제품용 에이전트와 공유하는 실행 환경이다. 실행 환경의 agent harness는 LangChain의 deepagents로 만들었다.
읽을 때 염두에 둘 것은 이 글이 사내 배포 보고서라는 점이다. 공개 벤치마크나 eval 결과가 없고 모든 수치가 자체 집계이며, 이 시스템에서 가장 어려운 문제인 스킬 선택 방식은 후속 글로 미뤄져 있다.
배경
Stripe는 코딩 에이전트가 엔지니어링 조직을 바꾸는 동안 비개발자 직군이 그 흐름에서 밀려나 있다는 문제에서 출발했다. 영업 담당자, 재무 분석가, 기술 계정 관리자가 필요로 하는 작업은 데이터 웨어하우스 조회, 영업 통화 전 고객 계정 조사, 인시던트 분류, 매출 시나리오 모델링, 컴플라이언스 검토 준비였다. Claude Code나 Codex 같은 기존 도구는 Stripe의 데이터 보안 요건과 이 워크플로를 함께 충족하지 못했다.
코딩 업무와 지식 업무의 구조 차이
글이 제시하는 설계 근거의 출발점이다.
| 항목 | 코딩 업무 | 지식 업무 |
|---|---|---|
| 작업 형태 | 과제가 달라도 파일을 수정하고 테스트를 돌리고 커밋한다 | 과제마다 다르다 |
| 필요한 도구 | 대체로 동일하다 | 과제마다 다르다 |
| 데이터 | 저장소 안에 있다 | 웨어하우스, 문서, 협업 도구에 흩어져 있다 |
| 산출물 | 코드 변경 | 리포트, 대시보드, 문서, 분석 |
| 완료 조건 | 테스트 통과, 리뷰 승인 | 과제마다 정의가 다르다 |
코딩 업무는 형태가 균일해서 하나의 에이전트 아키텍처로 충분하다. 지식 업무는 그 반대쪽 끝에 있어서 같은 방식이 통하지 않는다는 것이 Stripe의 판단이다.
Kai 이전에 있었던 두 선택지
Stripe에는 이미 두 가지 선택지가 있었고 둘 다 한계가 드러났다.
| 선택지 | 무엇이었나 | 왜 부족했나 |
|---|---|---|
| NoCode Agent Builder | 누구나 도구를 쓰는 업무별 에이전트를 만들어 배포할 수 있는 사내 도구. 4,000개 이상의 에이전트가 만들어졌다 | 팀마다 개념적으로 비슷한 프롬프트를 서로 다른 품질로 작성했고, 마이크로 에이전트가 늘면서 모니터링과 유지보수가 감당하기 어려워졌다 |
| 코딩 에이전트 | 강력했고 일부 비개발자가 업무 방식을 바꿔 가며 썼다 | 보안 우려가 빠르게 드러났고, 비개발자를 지원해 본 적 없는 코드 품질 팀에 새로운 지원 부담이 생겼다 |
이 경험에서 Stripe는 지식 AI 플랫폼을 만들려면 세 가지를 동시에 풀어야 한다고 정리했다.
핵심 개념
harness는 모델을 감싸 도구, 검증, 상태를 제공하는 실행 환경을 말한다. Kai의 harness는 LangChain deepagents 위에 Stripe 전용 계층을 얹어 만들었고, 모델 호출 루프 바깥에서 파일, 샌드박스, 접근 제어를 책임진다.
agent loop는 모델 호출, tool call, 관찰을 반복하는 기본 순환이다. Kai에서 이 루프 하나가 세션 안에서 수백 번 돈다는 점이 설계 제약의 출발점이다.
기본 단위(primitive)는 더 작게 쪼개지 않고 조합의 재료로 쓰는 구성 요소를 뜻한다. Stripe가 Kai의 기본 단위를 애플리케이션이 아니라 API로 잡았다는 서술은, 웹 앱과 Slack이 둘 다 같은 서비스를 부르는 화면에 불과하다는 뜻이다.
가드레일은 에이전트의 행동 범위를 제한하는 안전 장치다. 코딩 에이전트에는 컴파일러, 테스트, git처럼 빠르고 검증 가능한 가드레일이 이미 있지만 지식 업무에는 그런 장치가 거의 없다는 것이 Stripe가 지적하는 비대칭이다.
멀티테넌트 가상 파일 시스템은 여러 세션이 각자의 파일 공간을 격리한 채 하나의 공유 저장소 위에서 산출물을 읽고 쓰게 하는 파일 계층이다. Kai의 세션은 이 위에서 리포트나 문서를 만들고 여러 턴에 걸쳐 고쳐 나간다.
방법
설계가 풀어야 했던 세 가지 문제
첫째, 전문성을 중앙화하지 않고 확장하는 문제다. 청구 에스컬레이션을 어떻게 분류하는지, 매출 시나리오를 어떻게 모델링하는지 아는 사람은 에이전트 인프라 팀에 없다. 그 전문성은 GTM, 재무, 마케팅, 법무, 데이터 과학 등 수십 개 도메인에 흩어져 있고, 각 도메인이 자기 도구와 데이터 소스와 품질 기준을 갖고 있다. Stripe가 다루는 제품과 국가의 수를 곱하면 복잡도는 더 커진다. Kai는 이 복잡도를 사용자에게 보이지 않게 모델링해야 한다.
둘째, 에이전트가 업무 현장으로 이동하는 문제다. 에이전트가 아는 것만큼 에이전트가 나타나는 자리가 중요하다. 모두가 브라우저 탭에서 일하지 않고 터미널에서 일하는 사람은 더 적다. 글이 드는 예는 재무 팀의 운영 예산 모델링 애플리케이션이다. 그 안에서 에이전트가 맥락을 읽고 관련 문서를 조사하고 유효한 변경안을 제안하고 차이를 요약해야 하는데, 사용자를 그 앱 밖으로 끌어내서는 안 된다.
셋째, 가드레일을 맨바닥에서 만드는 문제다. Stripe가 드는 구체적인 불변 조건은 서로 무관한 두 고객의 데이터를 하나의 분석에 결합해서는 안 된다는 규칙이다. 사용자가 두 맥락 각각에 정당한 접근 권한을 갖고 있더라도 같은 세션에 함께 나타나서는 안 된다. 격리 기준이 "이 사람이 인가 토큰으로 무엇에 접근할 수 있는가"가 아니라 "이 과제가 이 맥락에서 무엇을 볼 수 있어야 하는가"라는 점이 중요하다. 즉 인증 기반이 아니라 과제 맥락 기반의 격리다.
세 계층 구조
하나의 거대한 단일 에이전트로 이 제약을 전부 담을 수 없고, 도메인 팀마다 안전하고 성능 좋은 호스팅 인프라를 따로 만들게 하는 것도 확장되지 않는다. 그래서 Kai는 세 계층으로 나뉜다.
| 계층 | 역할 | 누가 쓰는가 |
|---|---|---|
| 인터페이스 독립 API | 여러 인터페이스에 같은 에이전트를 노출한다 | 사내 도구 개발자 |
| Agent Studio | 도메인 담당자가 스킬, 맞춤 에이전트, 도구 구성을 만들고 테스트하고 감시한다 | 도메인 팀 |
| 실행 환경 | 보안, 격리, 상태 유지를 실제로 보장한다 | 플랫폼 팀 |
첫째 계층, 인터페이스 독립 API
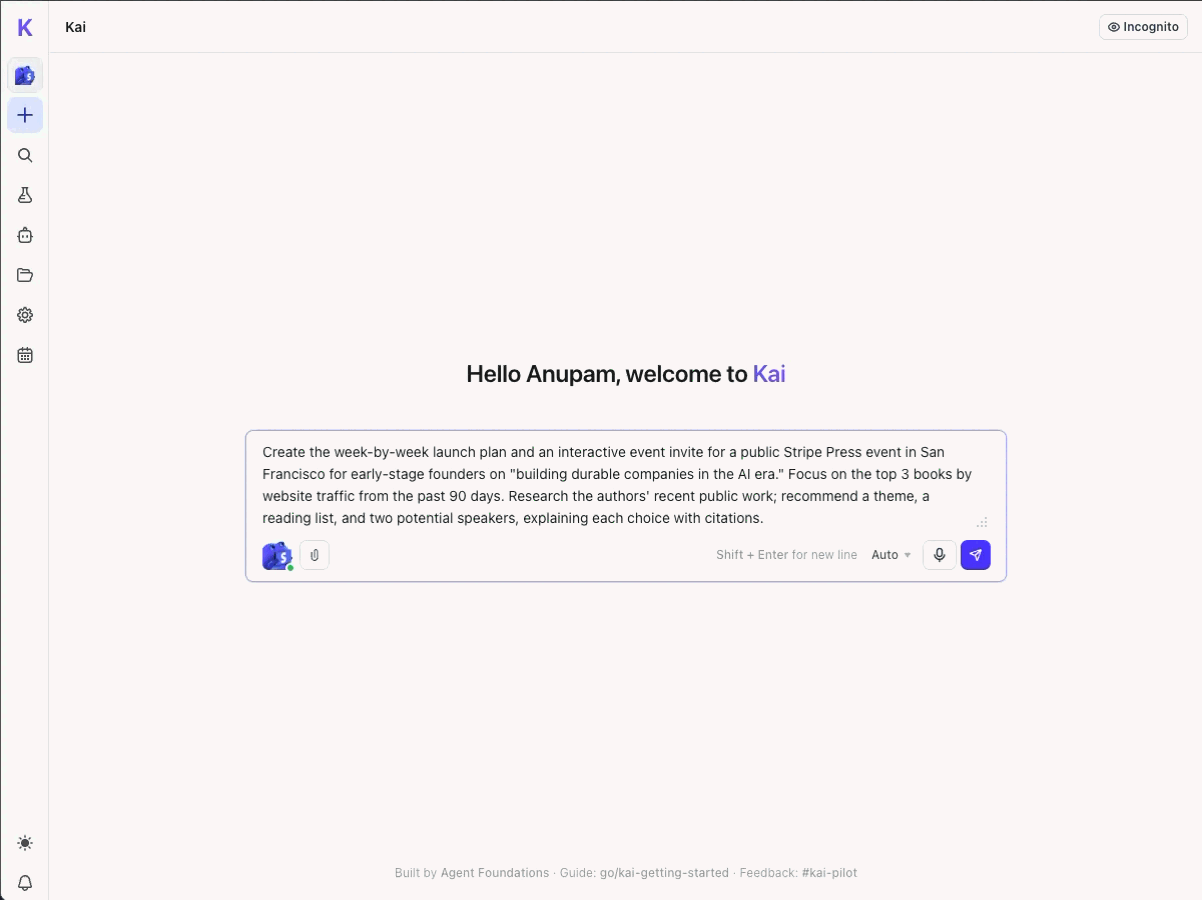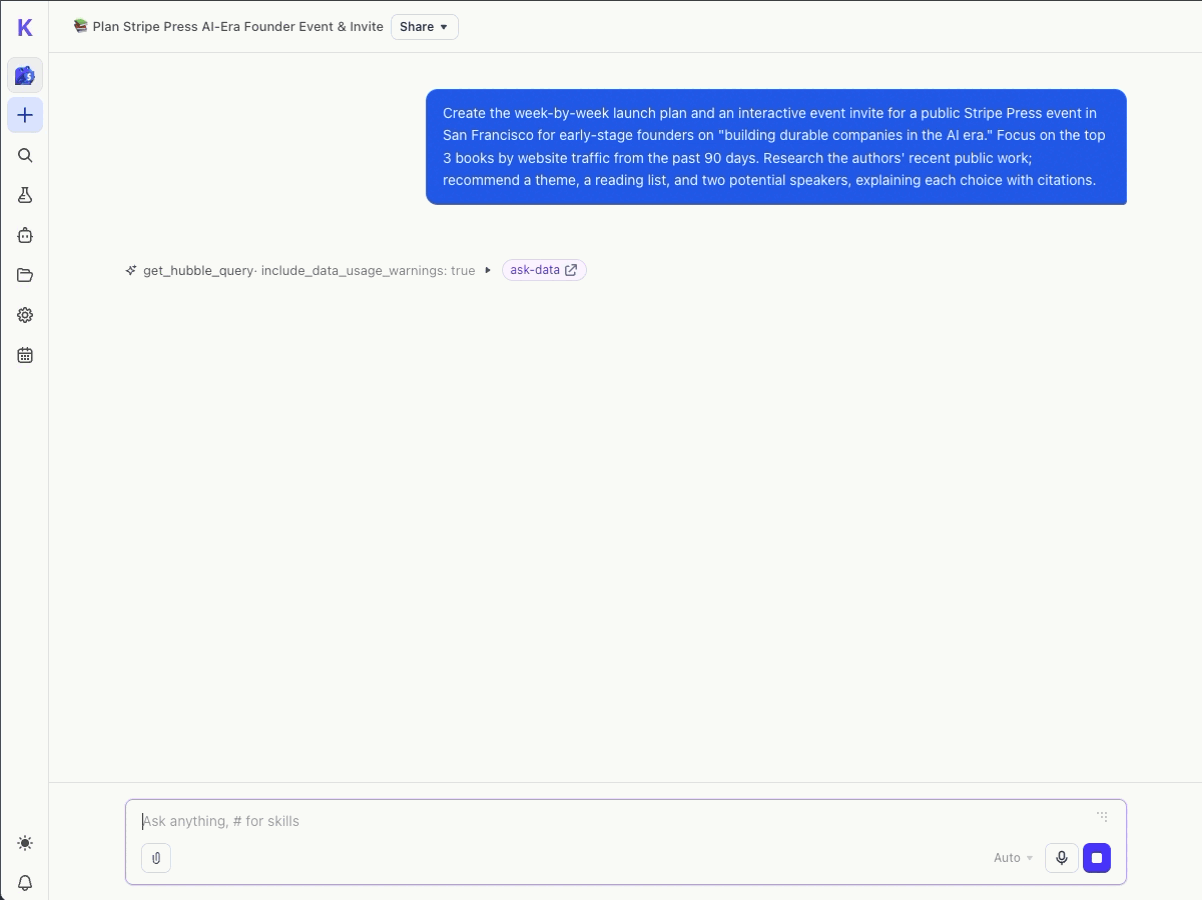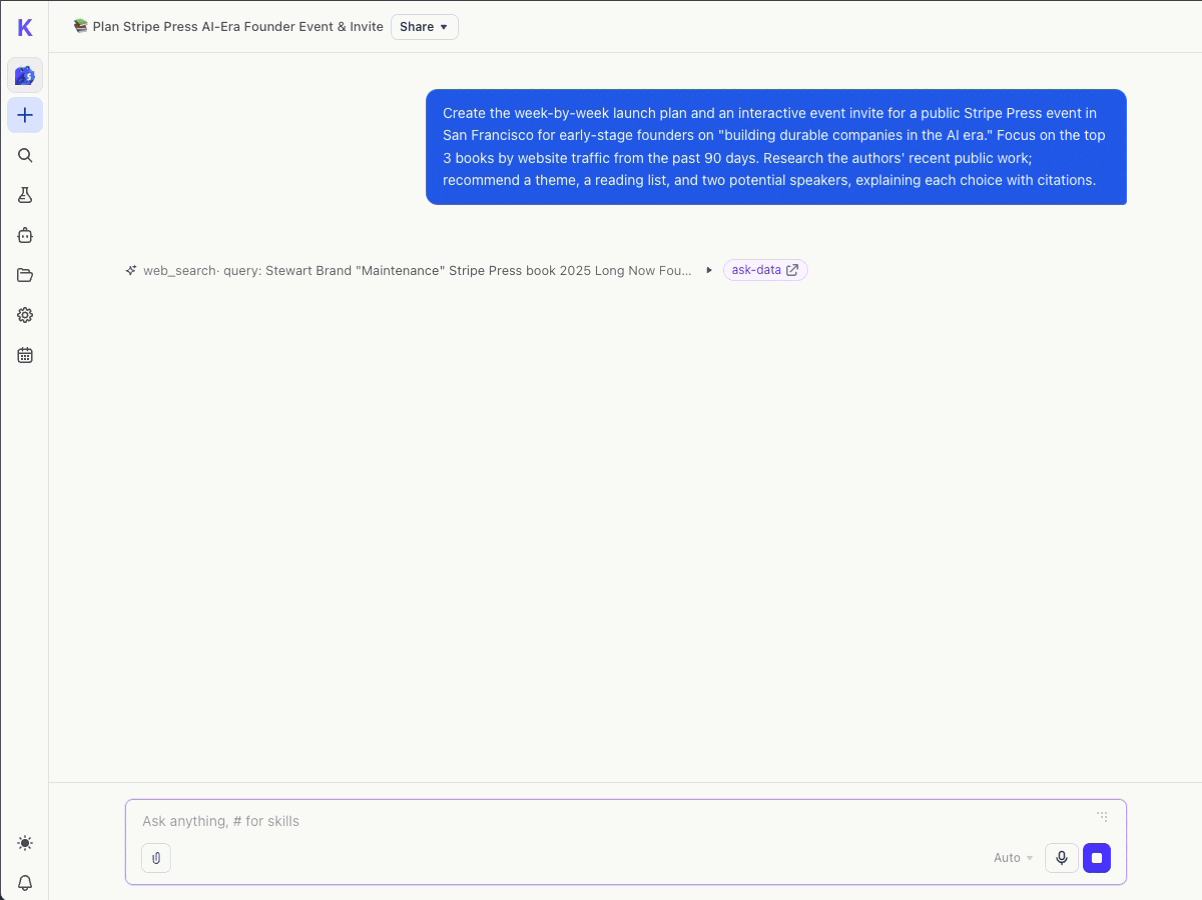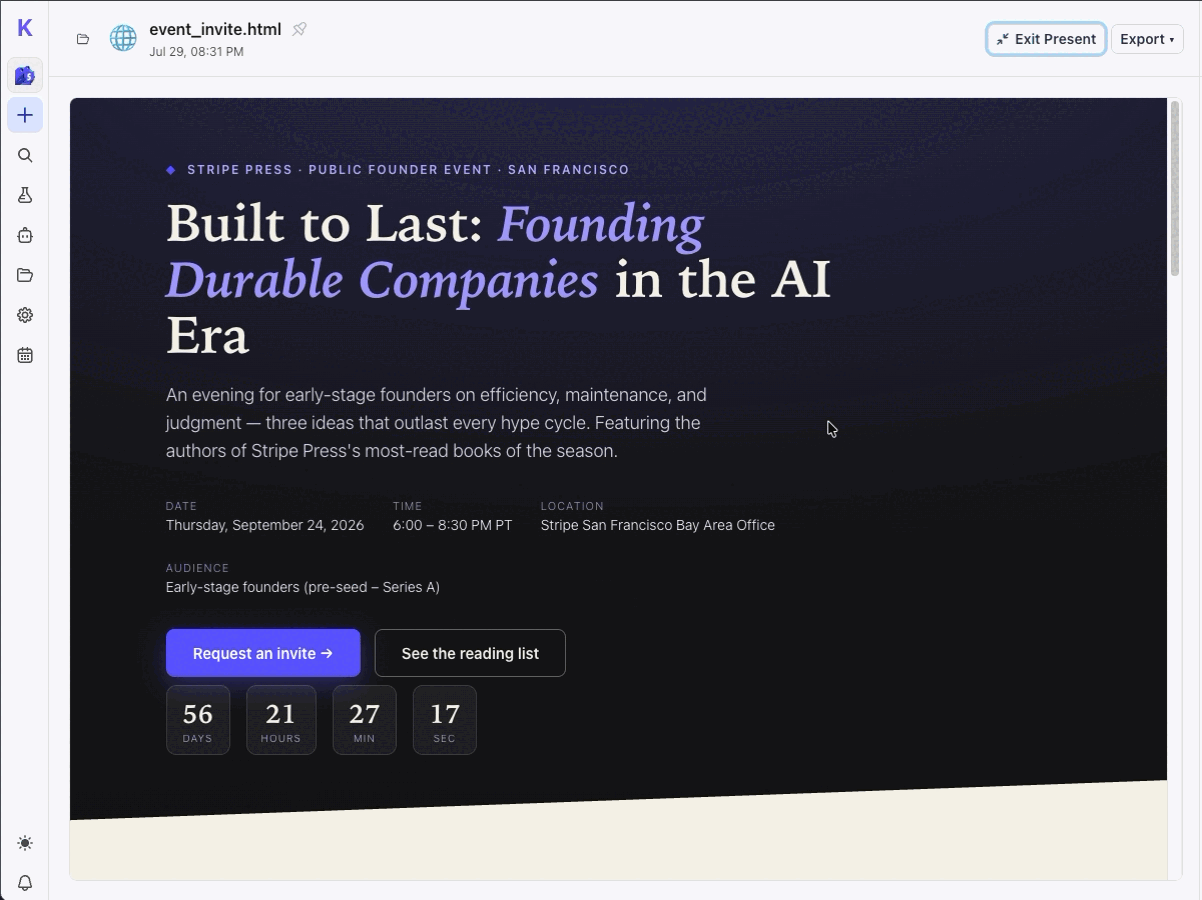
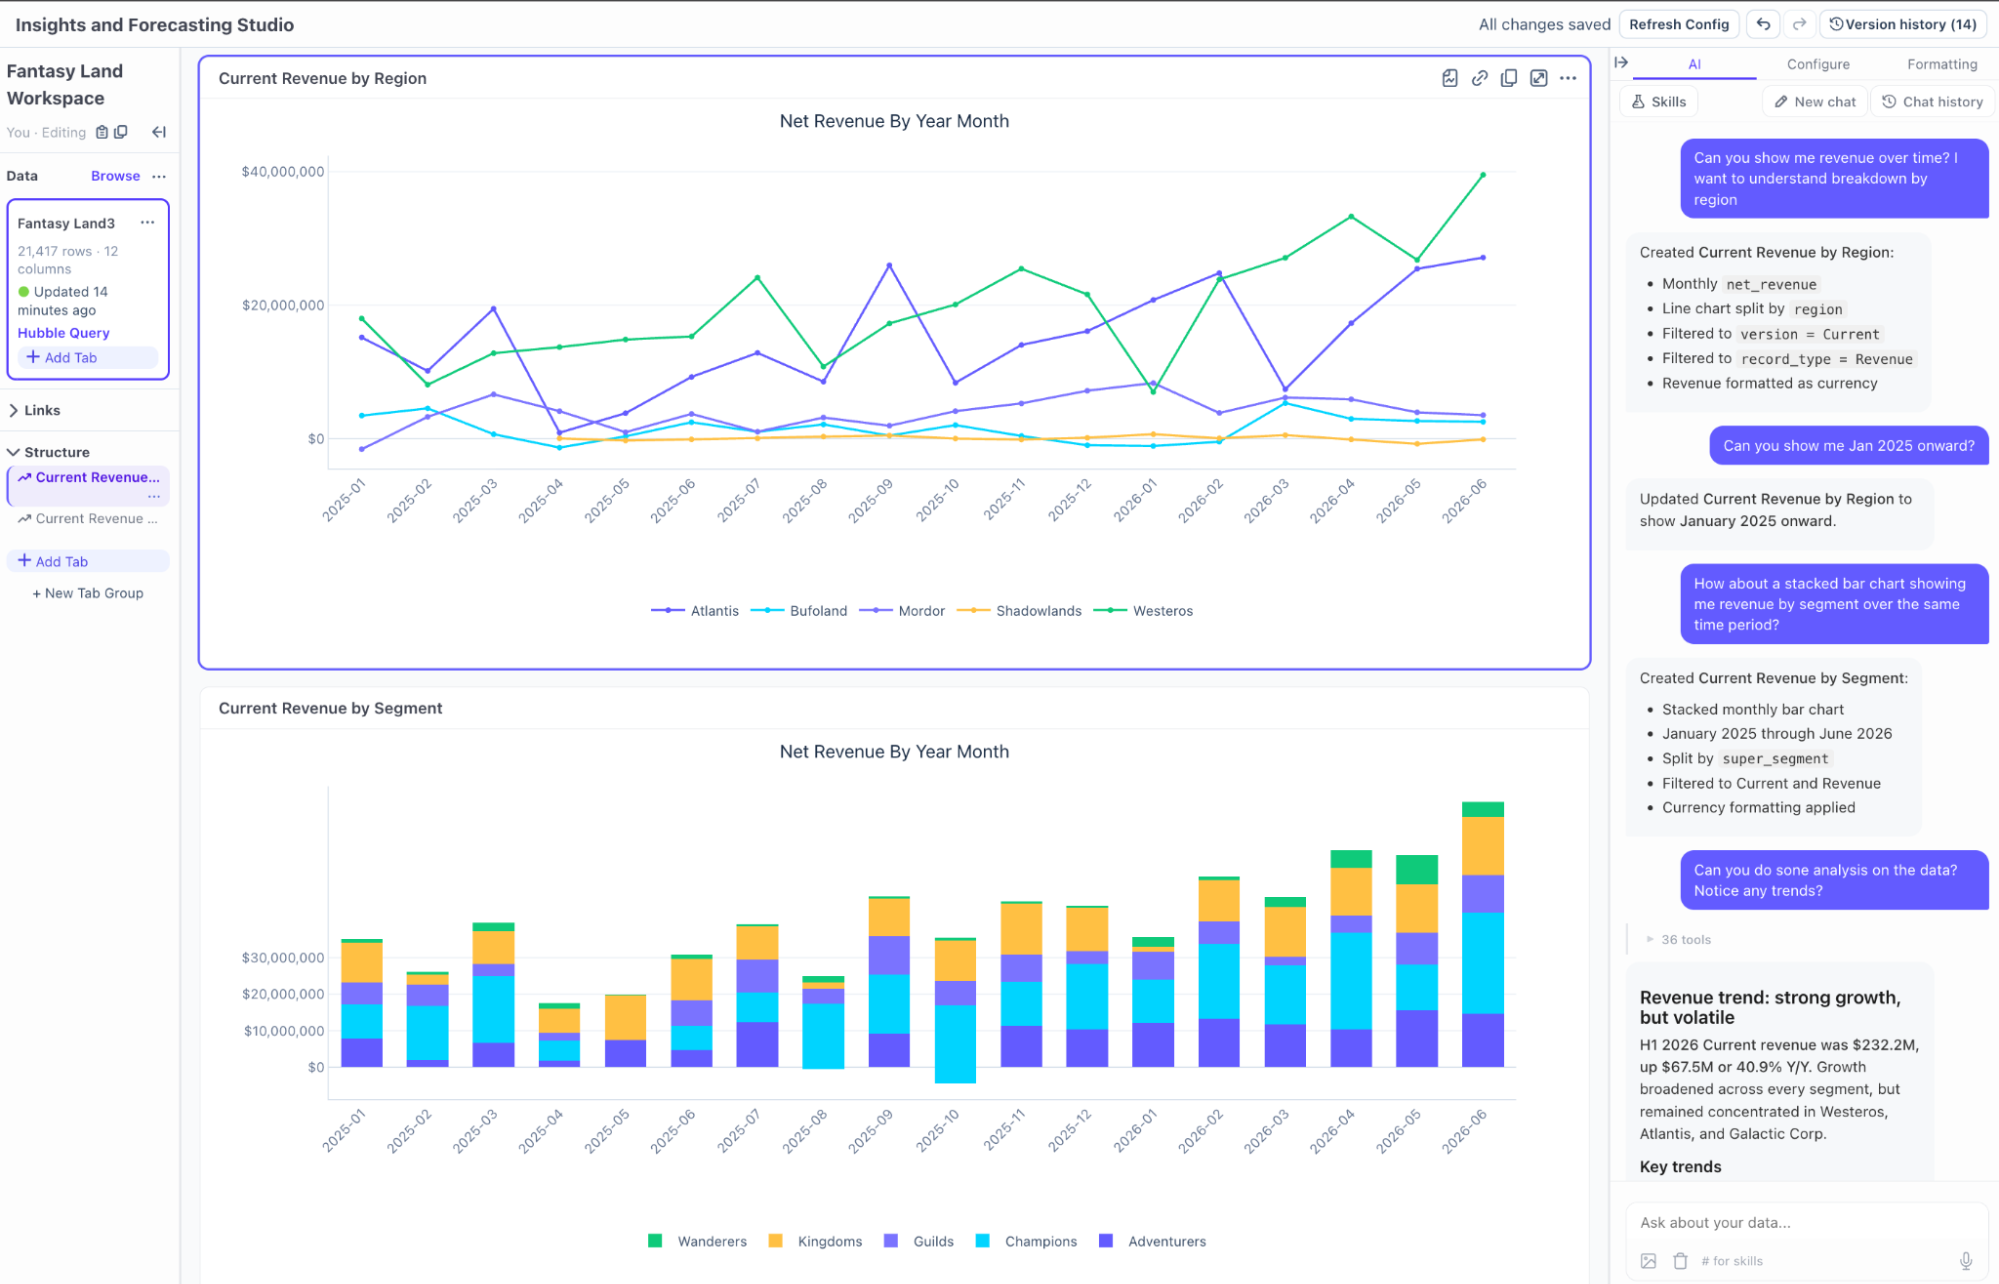
Kai는 자체 웹 애플리케이션과 Slack 연동을 함께 제공하지만, 기본 단위는 그 둘을 함께 구동하는 API다. 에이전트는 애플리케이션이 아니라 서비스이고, 각 인터페이스는 그 서비스를 목적에 맞게 보여 주는 화면이다.
- 대부분의 직원은 사내 호스팅 웹 애플리케이션으로 Kai를 쓴다. 설정할 인프라가 없어 입사 첫날부터 쓸 수 있다.
- 사내 도구는 API로 Kai를 내장할 수 있고 실제로 많은 도구가 그렇게 했다.
- Chrome 확장 프로그램이 웹 기반 서드파티 도구 안에서도 Kai 기능을 노출한다. 비즈니스 인텔리전스 플랫폼에서 일하는 직원은 그 애플리케이션을 벗어나지 않고 Kai에 질의(query)를 던진다.
독립형 에이전트 제품을 만들면 사용자를 원래 업무 흐름에서 끌어내 새 앱으로 보내야 한다. 그렇다고 인터페이스마다 별도 제품을 만들면 유지보수가 흩어지고 여러 도구를 오가는 사용자의 경험이 분절된다. 두 실패를 함께 피하려면 플랫폼이 사용자가 있는 자리로 가야 한다는 것이 이 선택의 근거다.
둘째 계층, Agent Studio
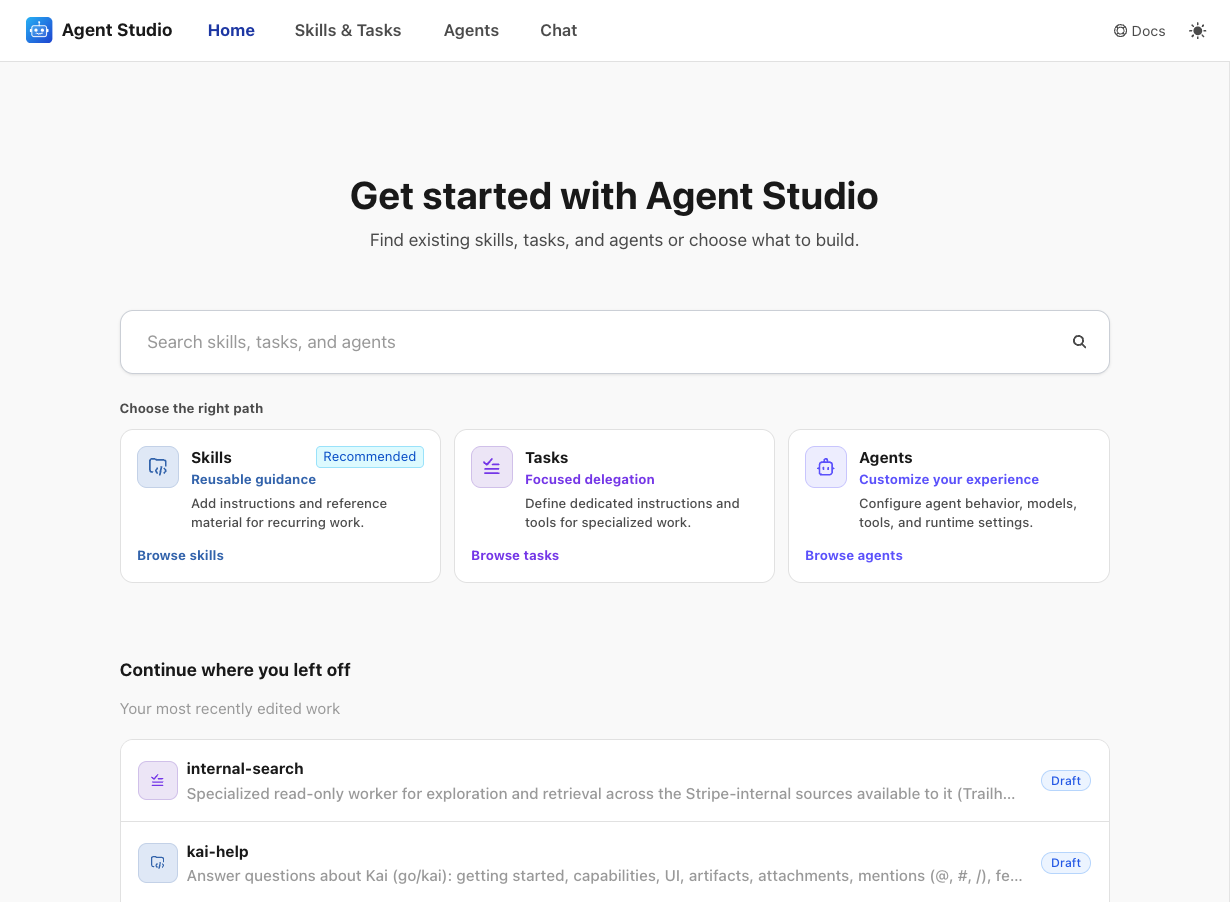
Agent Studio는 도메인 담당자를 위한 제어 계층이다. 팀은 여기서 자기 스킬, 맞춤 Kai 에이전트, 도구 구성을 만들고 테스트하고 감시한다.
예로 든 것은 GTM 팀이다. GTM 팀은 자기 워크플로에 맞춘 Kai 에이전트를 소유한다. 그 에이전트는 팀의 스킬을 기본으로 불러오고, 팀의 데이터 소스에 연결되며, 팀 사용자가 기대하는 형식으로 결과를 낸다.
Agent Studio가 해결하는 조직 문제는 병목이다. 각 자산 옆에 사용량 데이터와 품질 신호를 함께 보여 주므로, 도메인 담당자가 플랫폼 팀에 묻지 않고도 무엇이 작동하는지 확인한다. 4,000개의 마이크로 에이전트가 만들어졌지만 아무도 전체를 감시하지 못했던 NoCode Agent Builder 시절의 실패를 되풀이하지 않으려는 설계다.
셋째 계층, 실행 환경
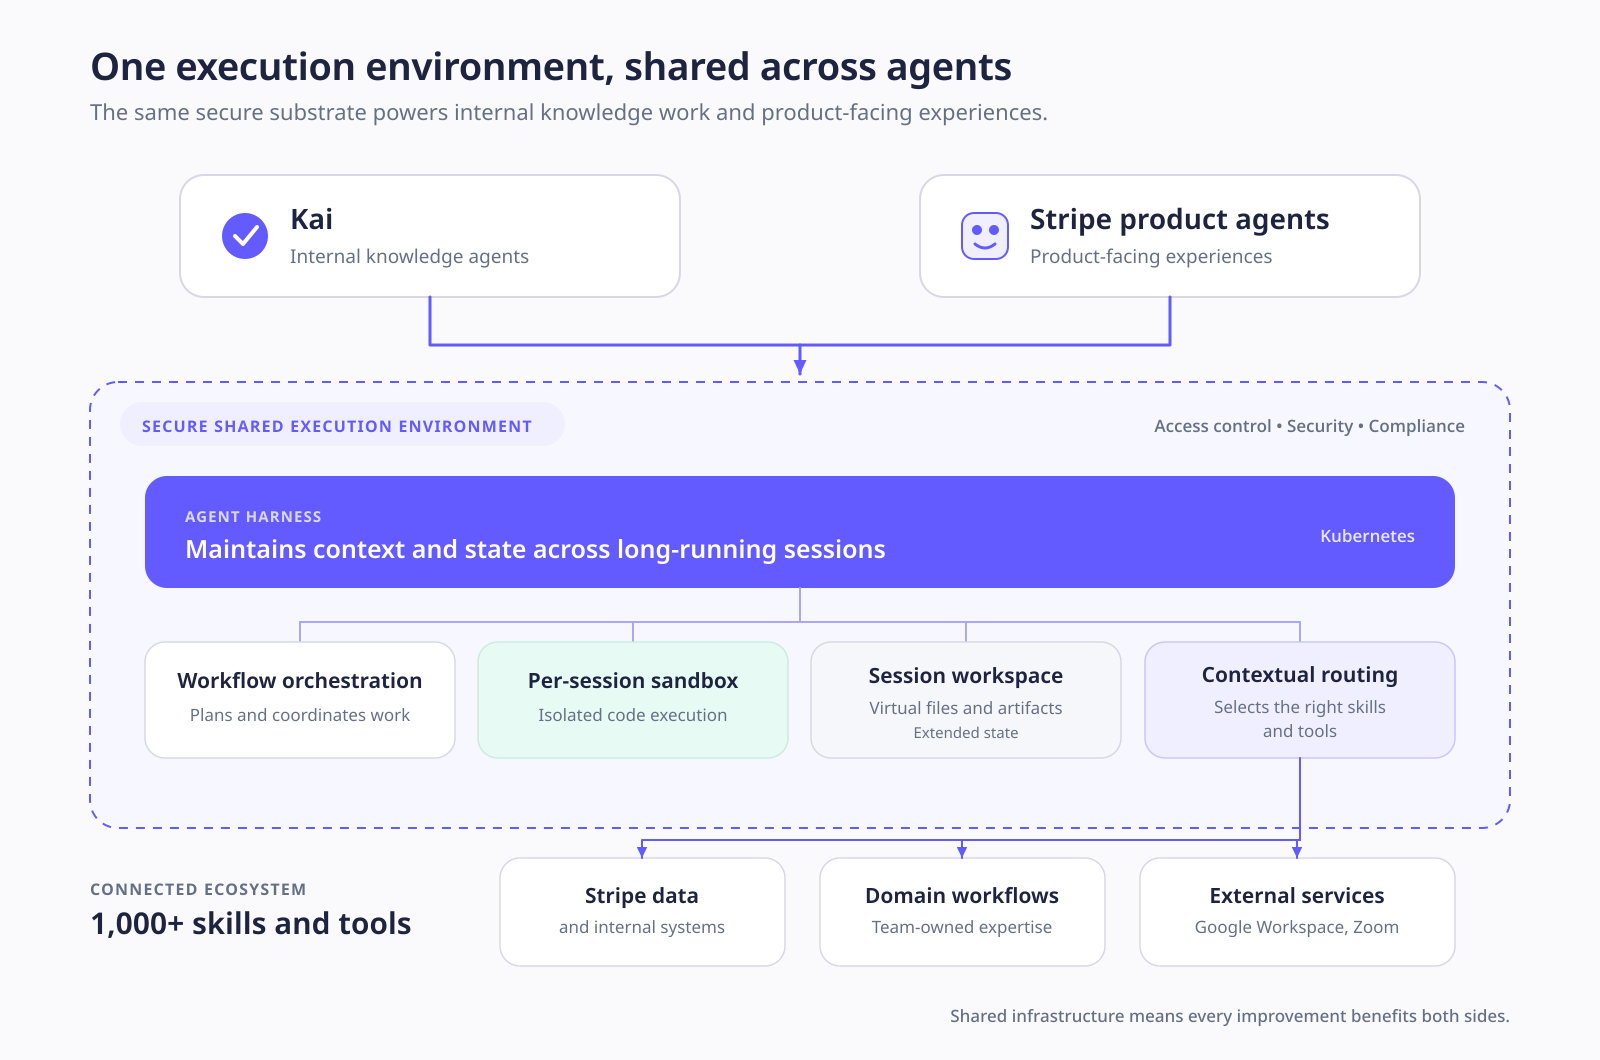
실행 환경은 플랫폼의 약속을 실제로 지키게 하는 계층이다. 여기서 가장 중요한 결정은 핵심 기본 단위를 Stripe의 제품용 에이전트와 의도적으로 공유했다는 것이다. 공유 대상은 agent harness, 샌드박스, 워크플로 오케스트레이션, 접근 제어 프레임워크 넷이다.
공유의 근거는 두 가지다. 사내 지식 업무도 외부 제품과 같은 민감 데이터를 다루고 같은 사용자를 상대하므로 같은 보안과 컴플라이언스 기준이 필요하다. 그리고 기반을 공유하면 실행 환경 개선이 사내 에이전트와 제품 에이전트에 동시에 반영되는 순환이 생긴다.
| 구성 요소 | 구현 |
|---|---|
| agent harness | LangChain의 deepagents로 구축했다 |
| 실행 기반 | Kubernetes 위에서 구동한다 |
| 격리 | 세션마다 별도의 보안 샌드박스를 둔다 |
| 파일 계층 | 멀티테넌트 가상 파일 시스템. 세션 안에서 에이전트가 산출물을 만들고 고쳐 나가는 자리다 |
| 코드 실행 | 분석과 데이터 처리에는 별도의 보안 코드 실행 샌드박스를 쓴다 |
긴 세션의 상태 유지
상태 유지 능력을 보이는 수치로 글은 하나를 든다. 최근 한 세션이 932턴에 도달했다는 것이다. 한 대화가 수백 턴, 수백 번의 tool call과 LLM 호출로 이어져도 시간 초과가 나거나 context window가 넘치지 않는다.
이 요구가 생기는 이유는 지식 업무의 성격이다. 지식 업무는 단일 질문이 아니라 이전 결과 위에 추론을 쌓는 반복 작업이고, 따라서 세션이 그 상태를 품질 저하 없이 들고 있어야 한다.
스킬 선택 문제
Kai는 1,000개가 넘는 스킬과 도구에 연결돼 있다. 여기에는 주요 지표를 추적하는 비즈니스 인텔리전스 대시보드, 사내 실행을 관리하는 프로젝트 관리 도구, 그리고 Zoom과 Google Workspace 같은 서드파티 서비스가 들어간다.
이 규모에서 올바른 스킬을 고르는 일을 글은 harness의 가장 흥미로운 부분이라고 말한다. 코딩 에이전트는 작업 대상 폴더 구조가 스킬과 컨텍스트를 자연스럽게 조직해 주지만, 지식 업무에는 그런 사전 구조가 없기 때문이다. Stripe는 이 문제를 hybrid RAG와 LLM을 결합한 접근으로 풀었다고만 밝히고 구체적인 방법은 후속 글로 미룬다. 미들웨어 수준의 실마리는 How Stripe Built Kai, its Company-Wide AI Agent, on Deep Agents에 일부 나온다.
결과
도입 지표
| 지표 | 값 |
|---|---|
| 출시 시점 | 2026년 4월 |
| 초기 확산 | 출시 2주 안에 Stripe 대부분이 사용 |
| 주간 활성 사용자 비율 | 83% |
| GTM 조직 커버리지 | 마케팅, 영업, 고객 성공 관리자, 기술 계정 관리자 포함 거의 전원 |
| 데이터 분석 중심 세션 | 하루 5,000건 이상 |
하루 5,000건 이상이 데이터 분석에 몰린다는 사실을 Stripe는 레버리지 지점으로 읽는다. 데이터 품질과 분석 계층에 관한 맥락만 제대로 연결하면 대부분의 질문에서 기본적으로 올바른 응답을 보장할 수 있기 때문이다.
업무 성과
수치는 두 묶음으로 나뉜다. 하나는 코호트 안 비교이고, 다른 하나는 같은 사람의 사용 주와 미사용 주를 비교한 개인 내 비교다. 후자를 쓴 이유는 "Kai를 쓰는 사람이 원래 성과가 좋다"는 선택 편향을 줄이기 위해서다.
| 비교 방식 | 대상 | 결과 |
|---|---|---|
| 코호트 안 비교 | GTM 신규 입사자 | Kai 사용량이 2.7배 높다 |
| 코호트 안 비교 | 같은 코호트의 집중 사용자 대 저사용자 | 성사 계약 가치가 80% 높다 |
| 개인 내 비교 | 같은 영업 담당자의 Kai 사용 주 대 미사용 주 | 영업 활동 2배, 생성 기회 17% 증가, 매출 기회 26% 증가, 계약 성사 39% 증가 |
| 전사 집계 | 행정 업무에서 매출 창출 업무로 이동한 시간 | 연간 25,000시간 |
직능별 정성 결과도 함께 적혀 있다. 재무와 운영 조직은 정리되지 않은 데이터를 분석하고 정기 요약을 생성하며 흩어진 맥락을 사용 가능한 산출물로 바꾸는 데 쓴다. 엔지니어링에서는 시스템 질문, 실행 요청 조사, 로그 분석, 계획 초안 작성, 그리고 더 전문화된 에이전트와 스킬 호출에 쓰인다.
인상적인 일화로 글이 드는 것은 Kai 소개 세션을 마치고 나온 비개발자가 곧바로 Asana, Slack, Jira를 하나로 모으는 자동 요약 프로세스를 함께 만들었다는 사례다.
세션 분포
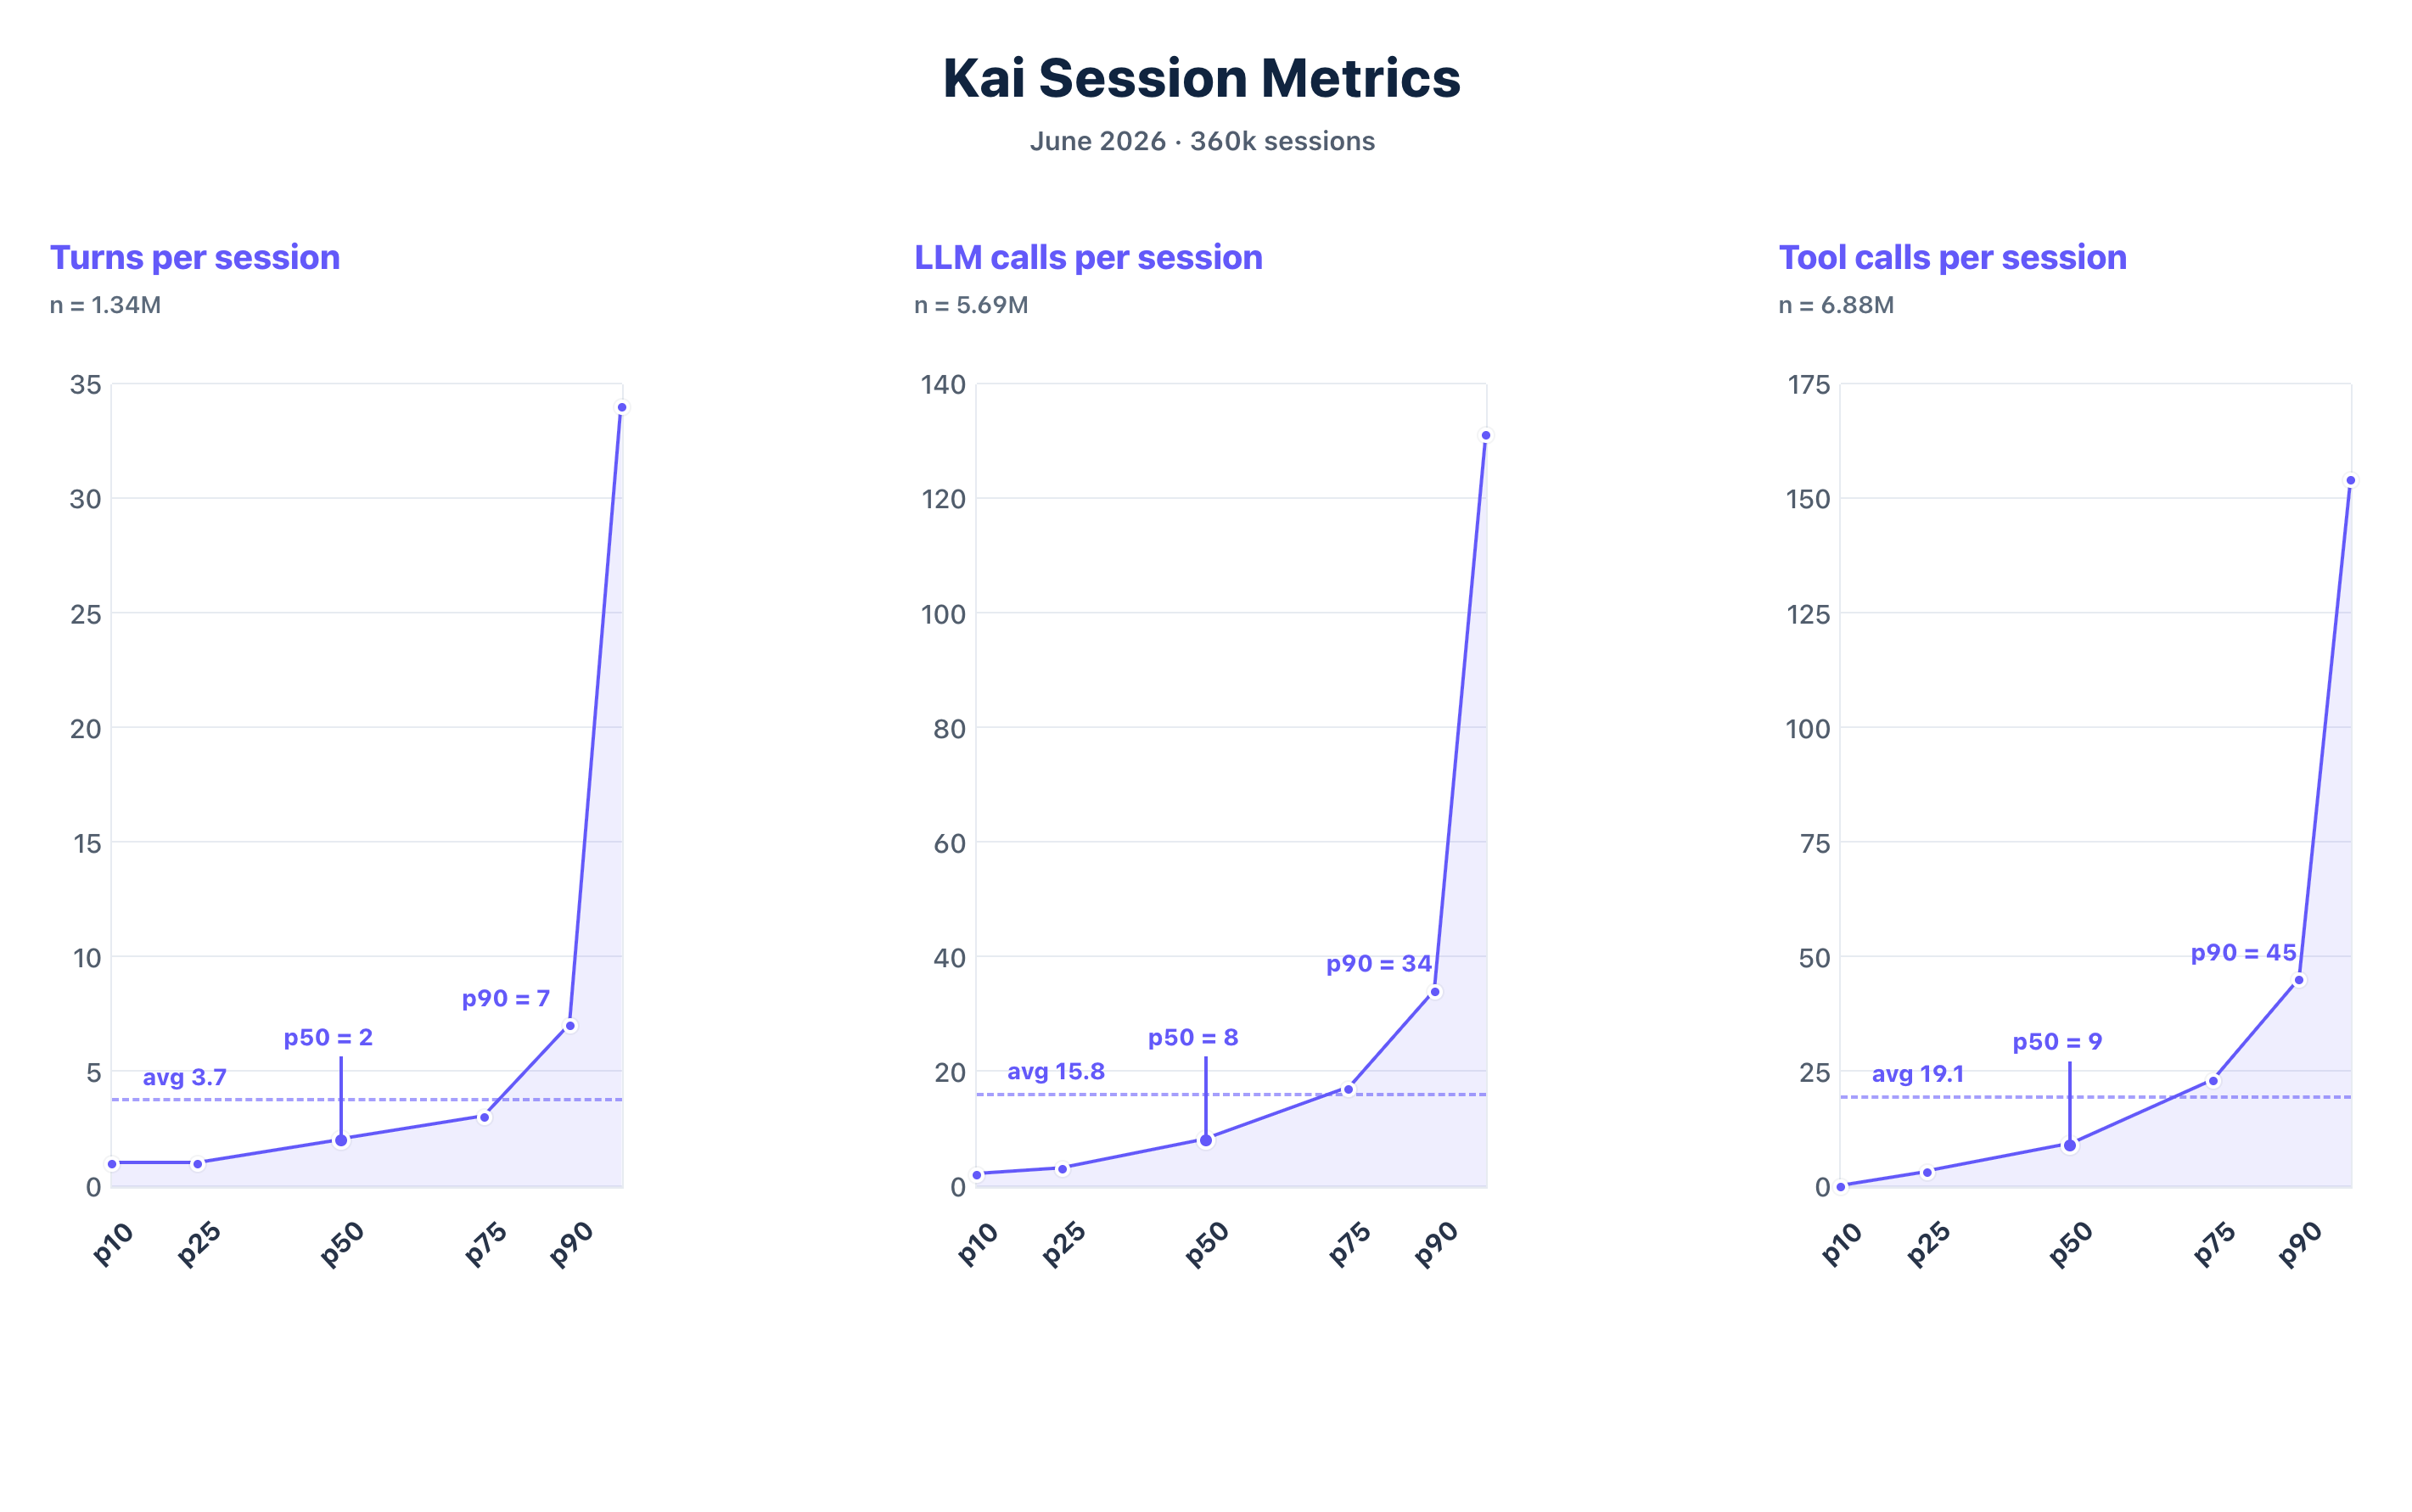
본문에는 없고 도식에만 있는 수치다. 2026년 6월 36만 세션을 집계했다.
| 지표 | 표본 수 | 평균 | p50 | p90 |
|---|---|---|---|---|
| 세션당 턴 수 | 134만 | 3.7 | 2 | 7 |
| 세션당 LLM 호출 수 | 569만 | 15.8 | 8 | 34 |
| 세션당 tool call 수 | 688만 | 19.1 | 9 | 45 |
세 지표 모두 평균이 p50보다 훨씬 크고 p90 위로 급격히 꺾인다. 즉 대부분의 세션은 두세 턴에서 끝나고, 소수의 긴 세션이 전체 호출량을 끌어올린다. 본문이 강조하는 932턴 세션은 이 꼬리의 극단값이다.
이 분포는 요약과 컨텍스트 관리 설계가 왜 필요한지를 설명한다. 중간값만 보면 컨텍스트 압박이 없어 보이지만, 시스템이 감당해야 하는 것은 p90 위의 세션이기 때문이다.
한계
글이 직접 밝힌 미해결 과제는 세 가지다.
| 과제 | 현재 상황 | 계획 |
|---|---|---|
| 상태 관리 | 범용 에이전트가 반복적으로 tool call을 하고 큰 문서를 내려받으면서 상태가 계속 쌓인다 | LLM에 실제로 보내는 활성 컨텍스트와 S3나 가상 파일 시스템에 두는 확장 컨텍스트를 계속 조정한다 |
| 자기 개선 | 스킬 품질을 사람이 관리한다 | Kai가 특정 스킬이 쓰인 trace를 검토하고 개선안을 제안하고 테스트한 뒤 스킬 소유자에게 변경안을 제출하는 품질 개선 루프를 개발 중이다 |
| 협업 | 세션 안에서 만든 맥락이 그 세션에 갇혀 있다 | 세션 간 공유와, 여러 사람 및 에이전트가 같은 산출물을 함께 다루는 협업을 지원하려 한다 |
자료 자체의 한계로 함께 기록해 둘 것은 넷이다.
- 재현 가능한 평가가 없다. 공개 벤치마크나 eval 결과가 없고 모든 수치가 사내 집계다.
- 영업 성과 수치의 해석이 열려 있다. 영업 활동이 2배 늘었는데 생성 기회 증가는 17%에 그치고 계약 성사는 39% 늘었다는 조합은 단순한 선형 효과로 설명되지 않는다. 전환율 개선과 활동량 증가가 함께 일어났다고 보면 설명되지만 글은 그 해석을 제공하지 않는다. 이 지점은 Stripe의 사내 업무용 AI 플랫폼, Kai (GeekNews)에 모인 커뮤니티 반응에서도 지적됐다.
- 가장 어려운 부분이 후속 글로 미뤄져 있다. 1,000개 이상의 스킬 중에서 올바른 것을 고르는 hybrid RAG와 LLM 방식이 이 시스템의 핵심인데 이 글에는 이름만 나온다.
- 모델 선택과 비용 정보가 없다. 어떤 모델을 쓰는지, 토큰 비용이 얼마인지, 세션당 지연 시간이 얼마인지에 관한 서술이 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Kai | Stripe's Knowledge AI Platform의 줄임말이자 사내 에이전트 플랫폼의 제품명 |
| Agent Studio | 도메인 담당자가 스킬, 맞춤 에이전트, 도구 구성을 만들고 테스트하고 감시하는 제어 계층 |
| NoCode Agent Builder | Kai 이전에 Stripe가 쓰던 노코드 에이전트 제작 도구. 4,000개 이상의 에이전트가 만들어졌다 |
| 인터페이스 독립 API | 웹 앱, Slack, 사내 도구가 모두 같은 에이전트 서비스를 부르도록 인터페이스에 종속되지 않게 설계한 API |
| 멀티테넌트 가상 파일 시스템 | 여러 세션이 각자의 파일 공간을 격리한 채 공유 저장소 위에서 산출물을 읽고 쓰게 하는 파일 계층 |
| 활성 컨텍스트와 확장 컨텍스트 | 실제로 LLM 요청에 실어 보내는 부분과 S3나 가상 파일 시스템에 두고 필요할 때만 꺼내는 부분을 구분한 Stripe의 용어 |
관련 페이지
- How Stripe Built Kai, its Company-Wide AI Agent, on Deep Agents: 같은 시스템을 LangChain 쪽에서 기술한 사례 연구. 미들웨어 구성, 개발 기간, 스킬 규모의 정량 한계가 그 글에 있다
- Stripe의 사내 업무용 AI 플랫폼, Kai (GeekNews): 이 글의 한국어 요약과 Hacker News 반응. 성과 수치와 발표 자료 완성도에 대한 반론이 모여 있다
- Agent Skills Overview (agentskills.io): Kai의 스킬 개념이 따르는 오픈 표준
- Effective Context Engineering for AI Agents: 활성 컨텍스트와 확장 컨텍스트를 나누는 접근의 배경이 되는 context engineering 논의
- 컴퍼니 브레인 만드는 법: 바로 복사해 쓰는 프롬프트 6종: 같은 문제를 훨씬 작은 조직 규모에서 프롬프트와 파일 규약으로 푸는 접근
- Agent Harness Engineering 개괄과 학습 경로: harness 설계 일반 논의