Agents · ARTICLE · 2025
Effective Context Engineering for AI Agents
요약
context engineering은 추론 중 context window에 들어갈 토큰 전체를 골라 유지하는 전략이다. Anthropic Applied AI 팀이 2025년 9월에 낸 이 글은 그 개념을 prompt engineering의 자연스러운 다음 단계로 자리매김한다.
출발점은 하나의 제약이다. LLM의 attention budget이 유한하기 때문에, 좋은 context engineering은 원하는 결과의 확률을 최대화하는 high-signal 토큰의 최소 집합을 찾는 일이 된다. 이 원칙이 글 전체를 관통한다.
글은 두 부분으로 나뉜다. 앞부분은 컨텍스트를 이루는 구성 요소별 지침이고, 뒷부분은 context window를 넘어서는 long-horizon 작업을 위한 기법이다.
| 부분 | 다루는 내용 |
|---|---|
| 컨텍스트의 해부 | system prompt의 적정 고도, tool 설계 요건, 예시 큐레이션 |
| 컨텍스트 확보 방식 | 미리 올리는 pre-inference retrieval과 런타임에 가져오는 just-in-time, 둘을 섞는 hybrid |
| long-horizon 기법 | compaction, structured note-taking, 서브에이전트 구조 |
정량 벤치마크는 없다. 근거는 needle-in-a-haystack 계열 연구, Claude Code와 Pokémon 플레이 사례, 그리고 Anthropic의 다른 글에 대한 참조로 제시된다.
배경
이 글의 배경은 언어 모델로 무언가를 만드는 일의 무게 중심이 옮겨갔다는 진단이다. 저자들은 그 이동을 질문의 교체로 표현한다. 예전 질문이 "프롬프트에 쓸 적절한 표현은 무엇인가"였다면, 지금 질문은 "어떤 컨텍스트 구성이 원하는 모델 행동을 낼 확률이 가장 높은가"다.
이 태도에 저자들은 thinking in context라는 이름을 붙인다. 특정 시점에 모델이 쥐고 있는 전체 상태와, 그 상태가 낼 수 있는 행동을 함께 고려한다는 뜻이다.
프롬프트에서 컨텍스트 상태로
prompt engineering이 초기에 작업의 대부분을 차지한 데는 이유가 있다. 일상 대화를 뺀 사용 사례가 대부분 one-shot 분류나 텍스트 생성이었고, 이런 과제에서는 프롬프트 한 번을 잘 쓰는 것이 곧 성능이었다.
여러 턴에 걸쳐 긴 시간 동안 동작하는 에이전트로 넘어가면 사정이 달라진다. 관리 대상이 프롬프트 하나에서 컨텍스트 상태 전체로 넓어진다. 여기에는 system instruction, tool 정의, MCP, 외부 데이터, message history가 모두 포함된다.
문제의 성격도 바뀐다. loop 안에서 실행되는 에이전트는 다음 추론 턴에 관련될 수 있는 데이터를 계속 만들어낸다. 따라서 이 정보를 주기적으로 정제해야 한다. 즉 context engineering은 계속 불어나는 후보 정보 가운데 한정된 context window에 넣을 것을 매 턴 고르는 일이다.
| 구분 | prompt engineering | context engineering |
|---|---|---|
| 대상 | 프롬프트, 특히 system prompt를 쓰고 조직하는 방법 | 추론 중 context window에 들어갈 토큰 전체 |
| 관리 범위 | 사람이 작성하는 지시문 | system instruction, tool 정의, MCP, 외부 데이터, message history |
| 시간 범위 | 한 번 쓰면 끝나는 개별 작업 | 매 턴 반복되는 큐레이션 |
| 전형적 과제 | one-shot 분류, 텍스트 생성 | 여러 턴에 걸쳐 긴 시간 동작하는 에이전트 |
저자들은 후자를 전자의 대체가 아니라 자연스러운 확장으로 본다. 즉 프롬프트를 잘 쓰는 문제가 사라진 것이 아니라, 프롬프트가 관리해야 할 전체 상태의 한 부분이 된 것이다.
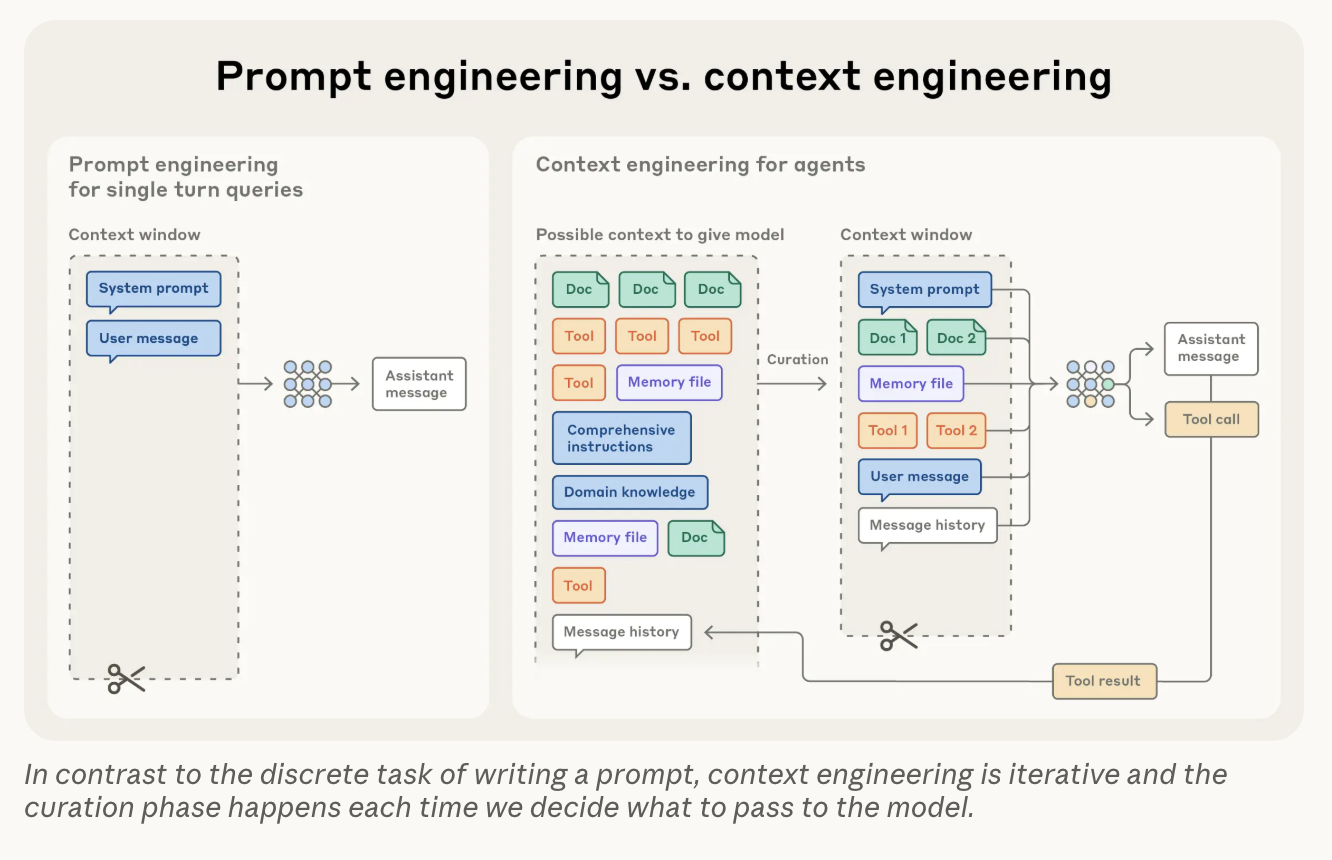
도식의 두 판이 이 차이를 보여준다. 왼쪽 prompt engineering은 큐레이션이 한 번 일어나고 끝난다. 오른쪽 에이전트에서는 후보 컨텍스트 더미와 context window 사이에 큐레이션 단계가 놓이고, tool 호출 결과가 message history로 되돌아오면서 이 단계가 매 턴 반복된다.
핵심 개념
context는 언어 모델에서 샘플링할 때 포함되는 토큰의 집합을 뜻한다. 여기서 engineering이 다루는 문제는 LLM의 내재적 제약에 맞서 그 토큰들의 효용을 최적화해 원하는 결과를 일관되게 얻어내는 일이다.
attention budget은 LLM이 대량의 컨텍스트를 파싱할 때 끌어다 쓰는 유한한 주의 자원을 뜻한다. 작업 기억 용량이 제한된 인간과 같은 구도이며, 새 토큰이 들어올 때마다 이 예산이 얼마씩 줄어든다.
context rot는 context window의 토큰 수가 늘수록 컨텍스트 안의 정보를 정확히 recall하는 능력이 떨어지는 현상이다. needle-in-a-haystack 계열 벤치마킹 연구가 이 개념을 드러냈다.
right altitude는 system prompt가 지향해야 할 적정 고도를 뜻한다. 너무 낮으면 취약한 하드코딩이 되고 너무 높으면 막연한 일반론이 되므로, 그 사이 지점을 노린다.
progressive disclosure는 에이전트가 탐색을 통해 필요한 컨텍스트를 점진적으로 발견하는 방식이다. 모든 정보를 미리 올려두는 대신 이해를 층층이 쌓아 올린다.
attention budget이 유한한 이유
context rot는 특정 모델의 결함이 아니다. 모델마다 성능 저하가 완만한 정도의 차이는 있지만 이 특성은 모든 모델에서 나타난다. 따라서 컨텍스트는 한계 효용이 체감하는 유한 자원으로 다뤄야 한다.
저자들은 이 attention 희소성의 뿌리를 아키텍처와 학습 조건에서 찾는다.
| 원인 | 작동 방식 | 결과 |
|---|---|---|
| Transformer 구조 | 모든 토큰이 컨텍스트 전체의 다른 모든 토큰을 참조할 수 있어, n개 토큰에 n제곱 개의 pairwise 관계가 생긴다 | 컨텍스트가 길어질수록 이 관계를 잡아내는 능력이 얇게 늘어나, 컨텍스트 크기와 attention 집중 사이에 긴장이 생긴다 |
| 학습 분포의 편향 | 학습 데이터에서 짧은 시퀀스가 긴 시퀀스보다 흔하다 | 컨텍스트 전역에 걸친 의존 관계를 다뤄 본 경험이 적고, 그 용도에 특화된 파라미터도 적다 |
| position encoding interpolation | 긴 시퀀스를 원래 학습한 짧은 컨텍스트에 맞춰 적응시켜 처리하게 한다 | 긴 시퀀스를 다룰 수 있게 되는 대신 토큰 위치 이해가 일부 저하된다 |
성능 저하의 형태
세 요인이 겹쳐 만드는 결과는 급격한 절벽이 아니라 performance gradient, 곧 완만한 성능 기울기다. 이 구분이 실무에서 중요하다.
모델은 긴 컨텍스트에서도 높은 능력을 유지한다. 다만 짧은 컨텍스트에서의 성능에 비해 두 영역의 정밀도가 낮아질 수 있다. 하나는 정보 검색이고 다른 하나는 long-range reasoning이다.
즉 컨텍스트를 늘려도 에이전트가 갑자기 못 쓰게 되는 것은 아니다. 대신 긴 컨텍스트에서 특정 사실을 정확히 짚어내야 하는 작업이 먼저 흔들린다.
방법
system prompt의 적정 고도
system prompt는 매우 명확하고 단순하며 직접적인 언어로 써야 한다. 그리고 에이전트에게 right altitude에 맞춰 생각을 제시해야 한다. 저자들은 이 지점을 두 가지 흔한 실패 사이의 Goldilocks zone이라 부른다.
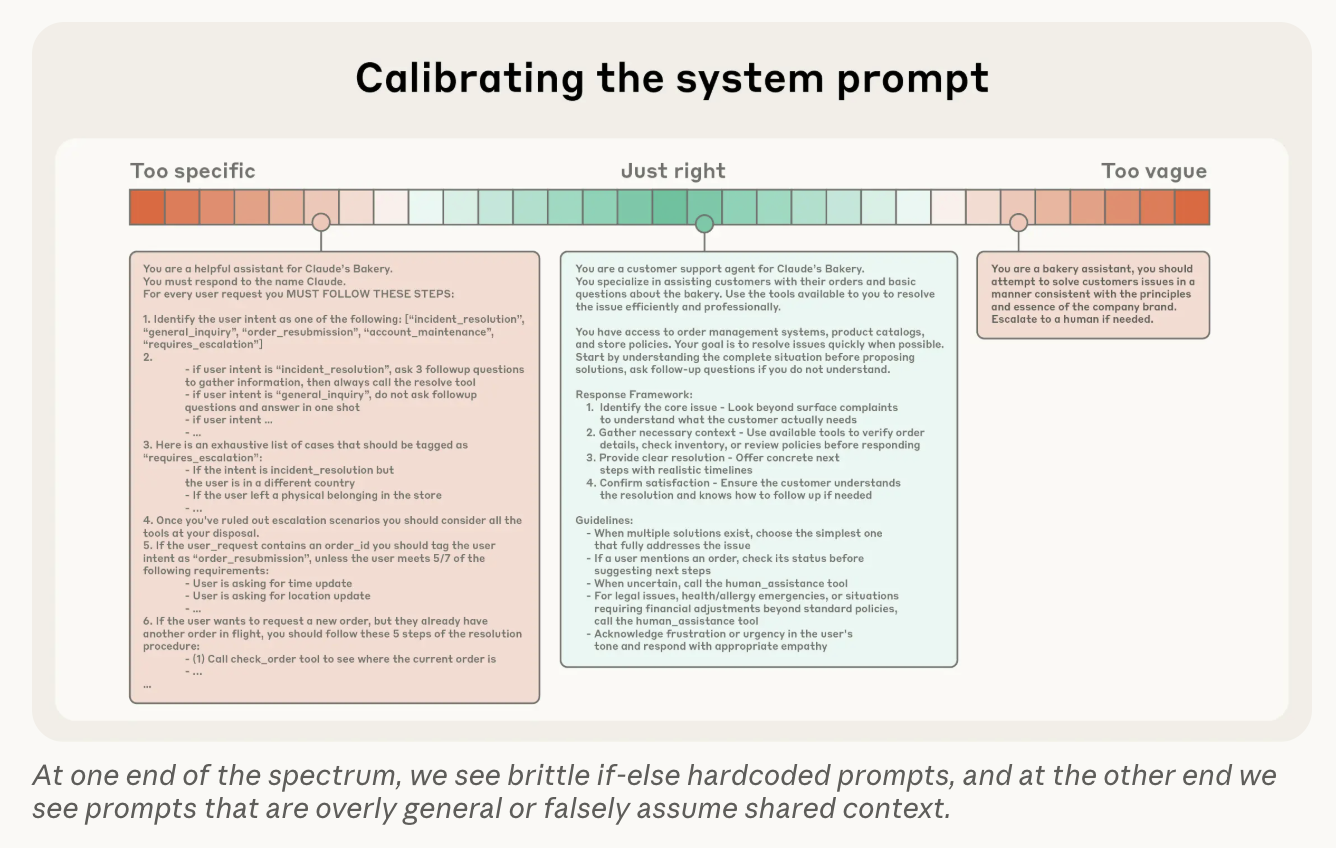
도식은 Claude's Bakery 고객 지원 에이전트라는 하나의 과제에 대해 세 가지 프롬프트를 나란히 놓는다. 세 프롬프트의 길이 차이가 크지만, 저자들이 문제 삼는 것은 길이가 아니라 고도다.
| 구간 | 증상 | 대가 |
|---|---|---|
| too specific | 정확한 에이전트 행동을 끌어내려고 복잡하고 취약한 로직을 프롬프트에 하드코딩한다. 도식의 왼쪽 예시는 의도를 다섯 범주로 분류하게 하고 escalation 대상 사례를 일일이 열거한다 | 취약성이 생기고 시간이 갈수록 유지 비용이 커진다 |
| just right | 행동을 효과적으로 이끌 만큼 구체적이면서, 강한 heuristic을 줄 만큼 유연하다. 도식의 가운데 예시는 역할과 접근 가능한 시스템을 밝히고, 4단계 응답 절차와 판단 지침을 준다 | 두 실패 사이의 균형점 |
| too vague | 막연한 상위 수준 지침만 주어 원하는 출력의 구체적 신호를 주지 못하거나, 공유 맥락을 잘못 가정한다 | 모델이 무엇을 해야 하는지 정하지 못한다 |
프롬프트 구조에 대한 권장은 구획을 나누는 것이다. XML 태그나 Markdown 헤더로 섹션을 구분한다.
| 구획 예시 | 담는 내용 |
|---|---|
<background_information> |
에이전트가 알아야 할 배경 정보 |
<instructions> |
따라야 할 지시 |
## Tool guidance |
어느 상황에 어느 tool을 쓸지에 관한 안내 |
## Output description |
출력의 형식과 성격 |
다만 저자들은 이 포맷의 비중에 유보를 둔다. 모델 능력이 올라갈수록 프롬프트 포맷 자체의 중요성은 낮아지고 있다고 본다.
구조를 어떻게 잡든 목표는 기대 행동을 온전히 규정하는 최소 정보량이다. 여기서 minimal이 짧다는 뜻은 아니다. 에이전트가 원하는 행동을 지키도록 충분한 정보를 앞서 줘야 한다.
권장 튜닝 절차도 함께 제시된다. 먼저 가장 좋은 모델에 minimal 프롬프트를 걸어 과제에서 어떻게 동작하는지 확인한다. 그다음 초기 테스트에서 발견한 실패 유형을 근거로 명확한 지시와 예시를 더해 성능을 올린다. 즉 프롬프트를 처음부터 두껍게 쓰지 않고, 실패가 관찰된 자리에만 살을 붙인다.
tool 설계
tool은 에이전트가 환경과 상호작용하며 새 컨텍스트를 끌어오는 수단이다. tool이 에이전트와 정보 및 행동 공간 사이의 계약을 정의하기 때문에, 효율을 촉진하는 것이 매우 중요하다. 효율은 두 방향에서 요구된다. 하나는 토큰 효율적인 정보를 돌려주는 것이고, 다른 하나는 효율적인 에이전트 행동을 유도하는 것이다.
| 요건 | 내용 |
|---|---|
| self-contained | 잘 설계된 코드베이스의 함수처럼 독립적으로 성립한다 |
| 에러에 강함 | 실패 상황에서도 견고하게 동작한다 |
| 용도가 명확함 | 어떤 상황에 쓰라는 것인지 오해 없이 드러난다 |
| 파라미터 품질 | 입력 파라미터도 서술적이고 모호하지 않으며, 모델이 원래 잘하는 방식에 맞춘다 |
| 기능 중복 최소 | tool 사이에 기능이 겹치지 않는다 |
저자들이 자주 본 실패 유형 가운데 하나는 tool set이 부푸는 것이다. 너무 많은 기능을 담거나, 어느 tool을 써야 할지 판단이 모호해지는 경우다. 판단 기준은 사람에게 물어보는 것이다. 사람 엔지니어조차 주어진 상황에서 어느 tool을 써야 한다고 단정하지 못하면, 에이전트가 더 잘하기를 기대할 수 없다.
tool 집합을 최소 실행 가능한 규모로 큐레이션하면 부수 효과도 따라온다. 긴 상호작용에서 컨텍스트를 유지하고 솎아내는 일이 더 안정된다. tool 설계의 세부는 이 글이 아니라 Anthropic의 다른 글 "Writing tools for AI agents – with AI agents"가 다룬다.
예시 큐레이션
few-shot prompting은 저자들이 계속 강하게 권하는 관행이다. 다만 실행 방식에 관해서는 흔한 습관을 반대한다.
반대하는 습관은 edge case 몰아넣기다. 팀들은 특정 과제에서 모델이 따라야 할 규칙을 모두 적으려고 예외 사례 목록을 프롬프트에 밀어 넣는데, 저자들은 이 방식을 권하지 않는다.
권하는 방식은 큐레이션이다. 에이전트의 기대 행동을 효과적으로 보여 주는 다양한 canonical 예시 집합을 고른다. LLM에게 예시는 천 마디 말에 해당하는 그림이라는 것이 그 근거다.
| 구분 | 비권장 | 권장 |
|---|---|---|
| 예시 선택 | 가능한 모든 edge case를 나열한다 | 기대 행동을 대표하는 canonical 예시를 고른다 |
| 늘리는 방향 | 규칙 개수를 늘린다 | 예시의 다양성을 확보한다 |
| 프롬프트 크기 | 목록이 길어질수록 커진다 | 최소 집합 원칙 안에 머문다 |
구성 요소 전반에 걸친 지침은 한 문장으로 모인다. 신중하게 고르고, 컨텍스트를 informative yet tight, 곧 정보는 충분하되 군더더기 없이 유지한다.
컨텍스트를 가져오는 두 방식
저자들은 에이전트를 단순하게 정의한다. LLM이 loop 안에서 자율적으로 tool을 사용하는 것이다. 고객과 일하면서 업계가 이 단순한 패러다임으로 수렴하는 것을 봤다고 적는다.
이 정의는 자율성의 확장과 짝을 이룬다. 기반 모델이 강해질수록 에이전트 자율성 수준도 함께 확장된다. 더 똑똑한 모델은 미묘한 문제 공간을 스스로 탐색하고 오류에서 회복한다.
컨텍스트 설계의 흐름도 이에 따라 바뀌고 있다. 많은 AI 네이티브 애플리케이션이 지금은 embedding 기반의 pre-inference 시점 retrieval로 에이전트가 추론할 컨텍스트를 미리 올린다. 업계가 더 agentic한 접근으로 옮겨가면서, 이 retrieval 시스템에 just-in-time 컨텍스트 전략을 덧붙이는 팀이 늘고 있다.
| 구분 | pre-inference retrieval | just-in-time |
|---|---|---|
| 로딩 시점 | 추론 전에 관련 데이터를 미리 처리한다 | 런타임에 tool로 동적으로 불러온다 |
| 보유 대상 | 처리된 데이터 본문 | 가벼운 식별자(file path, stored query, web link) |
| 대표 수단 | embedding 인덱스 | 파일 시스템 탐색, Bash 명령 |
| 강점 | 조회가 빠르다 | 컨텍스트에 실제로 필요한 것만 올린다 |
| 약점 | 인덱스가 낡을 수 있고 컨텍스트가 부푼다 | 런타임 탐색이 pre-computed 조회보다 느리다 |
Claude Code가 대용량 데이터베이스 분석에서 just-in-time 방식을 쓴다. 순서는 세 단계다. 모델이 목표를 좁힌 질의(query)를 작성하고, 결과를 저장하고, head와 tail 같은 Bash 명령으로 대량 데이터를 분석한다. 전체 데이터 객체를 컨텍스트에 올리는 일이 한 번도 없다.
저자들은 이 방식이 인간 인지를 닮았다고 본다. 사람은 정보 전체를 암기하지 않는다. 대신 파일 시스템, 받은 편지함, 북마크 같은 외부 조직화와 인덱스 체계를 만들어 두고 필요할 때 꺼내 쓴다.
식별자에는 저장 효율을 넘어서는 쓸모가 하나 더 있다. metadata 자체가 행동을 효율적으로 정제하는 수단이 된다. 명시적으로 주어졌든 직관적으로 읽히든 마찬가지다. 예를 들어 파일 시스템에서 동작하는 에이전트에게 tests 폴더의 test_utils.py는 src/core_logic/에 있는 같은 이름 파일과 다른 용도를 뜻한다.
| metadata 신호 | 읽히는 뜻 |
|---|---|
| 폴더 계층 | 파일이 놓인 자리로 용도를 구분한다 |
| naming convention | 이름이 목적을 암시한다 |
| 파일 크기 | 복잡도를 시사한다 |
| timestamp | 관련성의 대리 지표가 된다 |
에이전트가 데이터를 스스로 탐색해 가져오게 하면 progressive disclosure도 가능해진다. 각 상호작용이 다음 결정에 쓰일 컨텍스트를 낳고, 에이전트는 이해를 층층이 쌓아 올린다. 이때 working memory에는 꼭 필요한 것만 남기고, 지속성이 더 필요한 부분은 note-taking 전략에 맡긴다.
이렇게 스스로 관리하는 context window의 효과는 초점의 유지다. 에이전트가 방대하지만 관련 없을 수 있는 정보에 잠기는 대신, 관련 부분집합에 집중하게 된다.
트레이드오프도 분명하다. 런타임 탐색은 pre-computed 데이터 조회보다 느리다. 게다가 LLM이 자기 정보 지형을 효과적으로 탐색할 올바른 tool과 heuristic을 갖추도록 의견 있고 신중한 엔지니어링이 필요하다. 적절한 안내가 없으면 에이전트는 컨텍스트를 낭비한다. 저자들이 든 낭비 경로는 세 가지다.
| 낭비 경로 | 상황 |
|---|---|
| tool 오용 | 상황에 맞지 않는 tool을 불러 쓸모없는 출력을 컨텍스트에 쌓는다 |
| dead-end 추적 | 결론으로 이어지지 않는 경로를 계속 파고든다 |
| 핵심 정보 식별 실패 | 필요한 정보를 앞에 두고도 알아보지 못해 탐색을 반복한다 |
hybrid 전략
두 방식은 배타적이지 않다. 저자들은 어떤 환경에서는 가장 효과적인 에이전트가 hybrid 전략을 쓸 수도 있다고 본다. 속도를 위해 일부 데이터를 미리 가져오고, 그 외에는 에이전트 판단에 맡겨 자율 탐색을 이어가는 방식이다. 자율성의 적정 수준을 정하는 경계는 과제에 따라 달라진다.
Claude Code가 이 hybrid 모델의 사례다.
| 구성 요소 | 로딩 방식 | 효과 |
|---|---|---|
| CLAUDE.md | 앞단에서 그대로 컨텍스트에 넣는다 | 프로젝트 규칙과 관례를 항상 확보한다 |
glob과 grep primitive |
환경을 탐색해 파일을 just-in-time으로 가져온다 | 낡은 인덱스와 복잡한 syntax tree의 문제를 효과적으로 우회한다 |
마지막 항목이 hybrid를 고르는 실질적 이유다. 미리 만든 인덱스는 코드가 바뀌면 낡고, 구문 트리를 유지하려면 별도의 복잡성을 감당해야 한다. 검색 primitive로 그때그때 찾으면 두 문제가 함께 사라진다.
적용 범위에 관해서는 저자들이 유보적으로 말한다. hybrid 전략이 법률이나 금융 업무처럼 내용 변화가 덜한 맥락에 더 맞을 수 있다고 본다. 그리고 모델 능력이 나아질수록 agentic 설계는 똑똑한 모델이 똑똑하게 행동하도록 맡기고 사람의 큐레이션을 점차 줄이는 방향으로 갈 것이라 전망한다.
분야의 변화 속도가 빠른 만큼, 저자들이 제시하는 최선의 조언은 하나로 남는다. "do the simplest thing that works", 곧 통하는 가장 단순한 방법을 쓰는 것이다.
구성 요소별 권장의 요약
앞의 네 절이 다룬 지침을 구성 요소별로 모으면 다음과 같다. 모든 항목이 최소 집합 원칙의 적용이다.
| 구성 요소 | 권장 | 피할 것 |
|---|---|---|
| system prompt | 명확하고 직접적인 언어, right altitude, 섹션 구획, 기대 행동을 규정하는 최소 정보량 | if-else 하드코딩, 막연한 상위 지침, 공유 맥락의 잘못된 가정 |
| tool | self-contained하고 에러에 강하며 용도가 명확한 최소 실행 가능 집합 | 기능이 겹치거나 판단이 모호한 부푼 tool set |
| examples | 기대 행동을 대표하는 다양한 canonical 예시 | edge case 목록 몰아넣기 |
| 컨텍스트 확보 | 과제에 맞는 pre-inference와 just-in-time의 배합 | 통하는 가장 단순한 방법을 벗어난 과설계 |
| message history | 요약과 노트, 격리로 관련 부분집합만 유지 | 모든 이력을 그대로 누적 |
long-horizon 작업의 세 기법
long-horizon 작업은 행동 시퀀스의 토큰 수가 LLM의 context window를 초과하는 동안 에이전트가 일관성과 컨텍스트, 목표 지향 행동을 유지해야 하는 작업이다.
| 항목 | 내용 |
|---|---|
| 판정 기준 | 행동 시퀀스의 토큰 수가 context window를 초과한다 |
| 유지해야 하는 것 | 일관성, 컨텍스트, 목표 지향 행동 |
| 시간 규모 | 수십 분에서 여러 시간의 연속 작업 |
| 예시 과제 | 대규모 코드베이스 마이그레이션, 포괄적 리서치 프로젝트 |
이런 과제에는 context window 크기 한계를 우회하는 전용 기법이 필요하다.
더 큰 context window를 기다리는 것도 방법처럼 보인다. 그러나 저자들은 가까운 미래에는 크기와 무관하게 모든 context window가 context pollution과 정보 관련성 문제의 대상이 될 가능성이 높다고 본다. 다만 이 전망에는 조건이 붙는다. 적어도 가장 강한 에이전트 성능을 원하는 상황에서 그렇다는 것이다.
compaction
compaction은 context window 한계에 다가가는 대화의 내용을 요약하고, 그 요약으로 새 context window를 다시 시작하는 관행이다. 저자들은 장기 일관성을 끌어올리는 첫 번째 수단으로 이 기법을 든다. 핵심은 context window의 내용을 충실도 높게 압축해, 성능 저하를 최소화한 상태로 에이전트가 이어가게 하는 것이다.
Claude Code의 구현은 message history를 모델에 넘겨 가장 중요한 세부를 요약하고 압축하는 방식이다. 이때 모델이 남기는 것과 버리는 것이 갈린다.
| 처리 | 대상 |
|---|---|
| 보존 | 아키텍처 결정, 미해결 버그, 구현 세부 |
| 폐기 | 중복 tool 출력, 중복 메시지 |
| 추가 | 가장 최근 접근한 파일 5개 |
압축된 컨텍스트에 최근 파일 5개를 더해 이어가므로, 사용자는 context window 한계를 걱정하지 않고 연속성을 얻는다.
compaction의 기술은 무엇을 남기고 무엇을 버리는 선택에 있다. 지나치게 공격적인 compaction은 미묘하지만 결정적인 컨텍스트를 잃게 만들 수 있다. 나중에야 중요성이 드러나는 정보가 여기 해당한다.
구현자를 위한 권장 절차는 복잡한 에이전트 trajectory로 프롬프트를 신중히 튜닝하는 것이다. 순서가 정해져 있다. 먼저 recall을 최대화해 compaction 프롬프트가 trajectory의 모든 관련 정보를 잡게 한다. 그다음 불필요한 내용을 걷어내며 precision을 반복 개선한다.
걷어내기 쉬운 불필요 내용의 예로 tool 호출과 결과 지우기를 든다. message history 깊은 곳에서 이미 호출된 tool의 raw 결과를 에이전트가 다시 볼 필요는 없다는 판단이다. 저자들은 가장 안전하고 손이 덜 가는 compaction 형태 가운데 하나로 tool result clearing을 꼽으며, 최근 Claude Developer Platform 기능으로 출시됐다고 밝힌다.
compaction의 강도는 단계로 볼 수 있다. 아래로 갈수록 잃을 위험이 커지는 대신 확보하는 여유도 커진다.
| 강도 | 처리 대상 | 위험 |
|---|---|---|
| tool result clearing | 이미 소비된 tool 결과만 제거 | 낮다. 요약 판단이 개입하지 않는다 |
| 전체 요약 후 재출발 | message history 전체를 요약으로 대체 | 요약 프롬프트의 판단에 달린다 |
| 공격적 압축 | 요약을 더 짧게 줄인다 | 나중에야 중요성이 드러나는 맥락을 잃는다 |
structured note-taking
structured note-taking은 agentic memory라고도 불린다. 에이전트가 context window 밖 메모리에 노트를 주기적으로 기록하고, 나중에 그 노트를 context window로 다시 끌어오는 기법이다. 오버헤드가 적은 지속 메모리를 제공하는 것이 이 방식의 장점이다.
구현은 단순하다. Claude Code가 to-do list를 만드는 것, 커스텀 에이전트가 NOTES.md 파일을 유지하는 것이 그 예다. 이 단순한 패턴으로 에이전트는 복잡한 작업의 진행을 추적하고, 수십 번의 tool call을 거치며 잃어버릴 결정적 컨텍스트와 의존 관계를 유지한다.
저자들이 드는 사례는 코딩 밖의 영역이다. Claude가 Pokémon을 플레이한 기록이 메모리가 에이전트 능력을 바꾸는 방식을 보여준다. 에이전트는 수천 번의 게임 스텝에 걸쳐 정확한 집계를 유지한다. 원문이 인용한 목표 추적의 형태는 이렇다. 지난 1,234 스텝 동안 Route 1에서 Pokémon을 훈련시켰고, Pikachu는 목표 10레벨 가운데 8레벨을 얻었다.
주목할 점은 이 행동이 지시 없이 나타났다는 것이다. 메모리 구조에 관한 어떤 프롬프트도 주지 않았는데 에이전트는 세 가지를 스스로 만들었다.
| 스스로 만든 것 | 쓰임 |
|---|---|
| 탐색한 지역의 지도 | 어디를 이미 지나왔는지 기억해 같은 곳을 다시 헤매지 않는다 |
| 열어 놓은 핵심 성취의 기록 | 진행 단계를 확인해 다음 목표를 정한다 |
| 전투 전략 노트 | 상대에 따라 어느 공격이 잘 통하는지 배우는 데 쓴다 |
효과는 context reset 이후에 드러난다. 에이전트는 자기 노트를 읽고 여러 시간에 걸친 훈련 시퀀스나 던전 탐색을 이어간다. 요약 단계를 넘나드는 이 일관성이 long-horizon 전략을 가능하게 하는데, 모든 정보를 LLM의 context window에만 두고서는 불가능한 일이다.
Anthropic은 Sonnet 4.5 출시의 일부로 Claude Developer Platform에 memory tool을 public beta로 공개했다. 파일 기반 시스템으로 context window 밖에 정보를 저장하고 참조하기 쉽게 만드는 tool이다. 이를 통해 에이전트가 얻는 것은 세 가지다.
| 얻는 것 | 내용 |
|---|---|
| 지식 베이스 축적 | 시간이 지나며 알아낸 것을 파일로 쌓아 간다 |
| 세션 간 상태 유지 | 세션이 끊겨도 프로젝트 상태가 남는다 |
| 이전 작업 참조 | 모든 것을 컨텍스트에 두지 않고도 지난 작업을 다시 본다 |
서브에이전트 구조
서브에이전트 구조는 컨텍스트 한계를 우회하는 또 하나의 방법이다. 하나의 에이전트가 프로젝트 전체의 상태를 유지하려 애쓰는 대신, 전문화된 서브에이전트가 깨끗한 context window로 집중된 작업을 처리한다.
역할 분담이 명확하다. 메인 에이전트는 상위 수준 계획으로 조율하고, 서브에이전트는 깊은 기술 작업을 수행하거나 tool로 관련 정보를 찾는다.
토큰 사용의 비대칭이 이 구조의 핵심이다. 각 서브에이전트는 수만 토큰 이상을 쓰며 폭넓게 탐색할 수 있지만, 돌려주는 것은 응축해 정제한 요약뿐이며 그 크기는 보통 1,000에서 2,000 토큰이다.
| 역할 | 맡는 일 | 토큰 규모 |
|---|---|---|
| lead agent | 상위 수준 계획으로 조율하고 결과를 종합하고 분석한다 | 서브에이전트가 올린 요약만 받는다 |
| 서브에이전트 | 깊은 기술 작업을 수행하거나 tool로 관련 정보를 찾는다 | 탐색에 수만 토큰 이상, 반환은 1,000에서 2,000 토큰 |
즉 탐색 비용은 서브에이전트가 치르고, 상위로 올라오는 것은 결론에 가까운 소량이다.
이 방식이 이루는 것은 관심사의 명확한 분리다. 상세한 검색 컨텍스트는 서브에이전트 안에 격리되고, lead agent는 결과를 종합하고 분석하는 데 집중한다. 이 패턴은 Anthropic의 다른 글 "How we built our multi-agent research system"이 다루며, 복잡한 리서치 과제에서 single-agent 시스템 대비 상당한 개선을 보였다고 보고됐다.
세 기법의 비교
| 기법 | 컨텍스트를 다루는 방식 | 저장 위치 | 대표 구현 |
|---|---|---|---|
| compaction | 대화 이력을 요약으로 접어 새 window로 재출발한다 | 요약된 컨텍스트 자체 | Claude Code의 요약 압축, tool result clearing |
| structured note-taking | 노트를 밖에 기록하고 필요할 때 다시 끌어온다 | context window 밖 파일 | to-do list, NOTES.md, memory tool |
| 서브에이전트 구조 | 작업을 격리된 window로 나누고 요약만 회수한다 | 각 서브에이전트의 독립 window | 멀티에이전트 리서치 시스템 |
결과
이 글에는 정량 벤치마크가 없다. 실무 가이드이기 때문이며, 주장의 근거는 정성적으로 제시된다.
근거는 두 가지다. 하나는 needle-in-a-haystack 계열 벤치마킹 연구로, context rot를 드러냈고 저하 정도의 차이는 있으나 모든 모델에서 관찰된다는 점을 보여준다. 다른 하나는 멀티에이전트 리서치 시스템으로, 복잡한 리서치 과제에서 single-agent 대비 상당한 개선을 보였다.
세 기법의 선택 기준은 과제 특성이다.
| 기법 | 적합 상황 |
|---|---|
| compaction | 잦은 주고받기가 필요한 작업에서 대화 흐름을 유지한다 |
| note-taking | 명확한 milestone이 있는 반복적 개발에서 강점을 보인다 |
| 멀티에이전트 구조 | 병렬 탐색이 이득을 내는 복잡한 리서치와 분석을 다룬다 |
모델이 계속 나아져도 확장된 상호작용에서 일관성을 유지하는 문제는 더 효과적인 에이전트를 만드는 일의 중심에 남을 것이라고 저자들은 본다.
근거의 출처
이 글의 주장 가운데 여러 개는 Anthropic의 다른 글이나 플랫폼 기능을 근거로 삼는다. 어느 주장이 이 글 자체의 것이고 어느 것이 참조인지 구분해 두는 편이 인용할 때 안전하다.
| 참조 대상 | 이 글이 가져온 내용 |
|---|---|
| "Building effective AI agents" | 워크플로와 에이전트의 구분. 이 글은 그 위에서 에이전트를 loop 안의 자율적 tool 사용으로 다시 정의한다 |
| "Writing tools for AI agents – with AI agents" | tool 설계의 세부 지침. 이 글의 tool 절은 그 결론을 요약해 옮긴다 |
| "How we built our multi-agent research system" | 서브에이전트 구조가 single-agent 대비 상당한 개선을 보였다는 결과 |
| needle-in-a-haystack 계열 벤치마킹 연구 | context rot 개념 자체 |
| Claude Developer Platform | tool result clearing 기능, Sonnet 4.5와 함께 나온 memory tool public beta |
| memory와 context management cookbook | 글 마지막에 실무 팁과 모범 사례의 출처로 안내된다 |
저자들은 마무리에서 context engineering을 LLM으로 무언가를 만드는 방식의 근본적 전환으로 규정한다. 모델이 강해질수록 과제는 완벽한 프롬프트를 짜는 일이 아니라, 각 단계에서 모델의 제한된 attention budget에 어떤 정보를 넣을지 신중히 고르는 일이 된다는 것이다.
한계
정량 근거가 없다는 점이 가장 큰 한계다. 세 기법의 효과는 사례 서술과 다른 글에 대한 참조로 제시되며, 이 글 안에 측정값은 없다. 예를 들어 compaction이 성능 저하를 얼마나 줄이는지, 서브에이전트 구조가 토큰당 어떤 이득을 내는지를 재는 비교는 실리지 않았다.
context window 확대만으로는 문제가 해소되지 않는다. 가까운 미래에는 크기와 무관하게 context pollution과 정보 관련성 문제가 남을 가능성이 높다. 다만 이 진단은 가장 강한 에이전트 성능을 원하는 상황을 전제한다.
just-in-time 탐색에는 비용이 따른다. pre-computed 조회보다 느리고, tool과 heuristic을 제대로 갖추지 못하면 에이전트가 tool 오용이나 dead-end 추적, 핵심 정보 식별 실패로 컨텍스트를 낭비한다.
compaction의 위험은 과도한 압축이다. 나중에야 중요성이 드러나는 미묘하지만 결정적인 맥락을 잃을 수 있고, 무엇을 남길지에 관한 판단을 자동화하는 수단은 제시되지 않는다.
| 한계 | 성격 |
|---|---|
| 정량 근거 부재 | 세 기법의 효과가 사례와 참조로만 제시된다 |
| context window 확대의 한계 | 크기와 무관하게 context pollution이 남을 가능성이 높다 |
| just-in-time의 지연 | pre-computed 조회보다 느리고 tool 설계에 의존한다 |
| compaction의 정보 손실 | 남길 것을 고르는 판단을 자동화하는 수단이 없다 |
마지막으로 저자들은 기법 자체의 수명에 유보를 둔다. 모델이 강해질수록 prescriptive engineering의 필요는 줄고 에이전트 자율성은 커진다. 그래도 컨텍스트를 귀하고 유한한 자원으로 다루는 원칙은 신뢰할 수 있는 에이전트를 만드는 일의 중심에 계속 남는다고 정리한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| context engineering | 추론 중 context window에 들어갈 토큰 전체를 큐레이션하고 유지하는 전략. prompt engineering의 확장 |
| attention budget | LLM이 대량 컨텍스트를 파싱할 때 끌어다 쓰는 유한한 주의 자원. 토큰이 추가될 때마다 소모된다 |
| context rot | 토큰 수가 늘수록 컨텍스트 내 정보 recall 정확도가 떨어지는 현상 |
| right altitude | system prompt가 지향할 적정 고도. 취약한 하드코딩과 지나친 막연함 사이의 Goldilocks zone |
| just-in-time context | 데이터를 미리 로드하지 않고 가벼운 식별자만 두었다가 런타임에 tool로 동적으로 불러오는 전략 |
| tool result clearing | message history 깊은 곳의 tool 호출과 결과를 지우는 경량 compaction. Claude Developer Platform 기능 |
관련 페이지
- Harness Engineering (Team Attention, 2026): Prompt에서 Context를 거쳐 Harness로 가는 3레벨 진화를 그린 발표 자료. 이 글의 context engineering이 그 Level 2에 해당한다
- Equipping agents for the real world with Agent Skills: 같은 발행처의 Agent Skills 소개. progressive disclosure를 스킬 로딩 3레벨로 구체화한다
- Loop Engineering (Addy Osmani, 2026-06-07): loop 자체를 설계 대상으로 삼는 관점. 컨텍스트 큐레이션이 loop 안에서 반복되는 지점과 맞닿는다
- Agent Skills: 스킬로 워크플로를 강제하는 접근. just-in-time 컨텍스트와 progressive disclosure의 응용 사례다
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26): CLAUDE.md와 메모리 운영의 실전 가이드. 이 글이 든 hybrid 전략의 구체 사례를 다룬다