Agents · ARTICLE · 2026
Cutting LLM Token Costs with rtk, headroom, and caveman
요약
이 글은 코딩 에이전트의 토큰 사용량을 줄인다고 알려진 오픈소스 세 개를 저자 본인의 실제 사용 기록 위에서 다시 측정한 리포트다. 대상은 headroom, rtk, caveman이며 세 프로젝트 모두 60~90% 절감을 보고하고 GitHub 스타를 수만 개씩 모았다.
저자 Yongkyun은 두 번 측정했다. 각 도구가 설계된 콘텐츠만 골라 넣은 고정 페이로드에서 한 번, 그리고 자신의 Claude Code 세션 6억 1,400만 토큰(기준선 지출 $926.31)을 다시 계산해 넣은 재생(replay)에서 한 번이다. 첫 번째 측정에서는 공개 수치가 재현됐고 두 번째 측정에서는 세 도구를 합쳐 $34.12, 즉 지출의 3.7%만 줄었다.
저자는 공개 수치가 과장이라고 말하지 않는다. 마이크로벤치마크는 토큰 스트림 하나의 최선의 경우를 재고, 재생은 모든 스트림이 섞인 뒤 청구서에 실제로 닿는 몫을 잰다는 것이 이 글의 진단이다. 그 사이에 분모와 워크로드와 가격 책정이라는 세 계층이 놓여 있다.
배경
토큰 절감 도구의 홍보 수치와 사용자가 체감하는 청구액 사이에 간극이 있다는 문제의식이 이 글의 출발점이다. 세 도구는 서로 경쟁 관계가 아니라 서로 다른 지점에 붙는다. 따라서 어느 도구가 얼마나 절감하는지를 묻기 전에 에이전트가 토큰을 어디로 옮기는지를 먼저 정리해야 한다.
도입 판단에 이 구분이 필요한 이유는 세 도구가 모두 코드와 프롬프트와 명령 출력을 읽을 수 있는 자리에 앉기 때문이다. 절감폭이 크면 그만한 접근 권한을 내주는 선택이 정당화되지만, 절감폭이 작으면 같은 접근 권한이 순수한 비용이 된다. 저자가 마지막에 제시하는 판단 기준도 이 형태다.
세 도구가 나누어 맡는 토큰 스트림
에이전트 한 턴은 토큰을 세 곳으로 옮긴다. 모델은 input을 읽고 output을 만들며, output에 담긴 tool call이 실행돼 그 결과가 tool output으로 다음 input에 합쳐진다. input에는 시스템 프롬프트, 사용자 메시지, 이전 tool result가 들어가고 output에는 모델의 산문과 tool call이 들어간다.
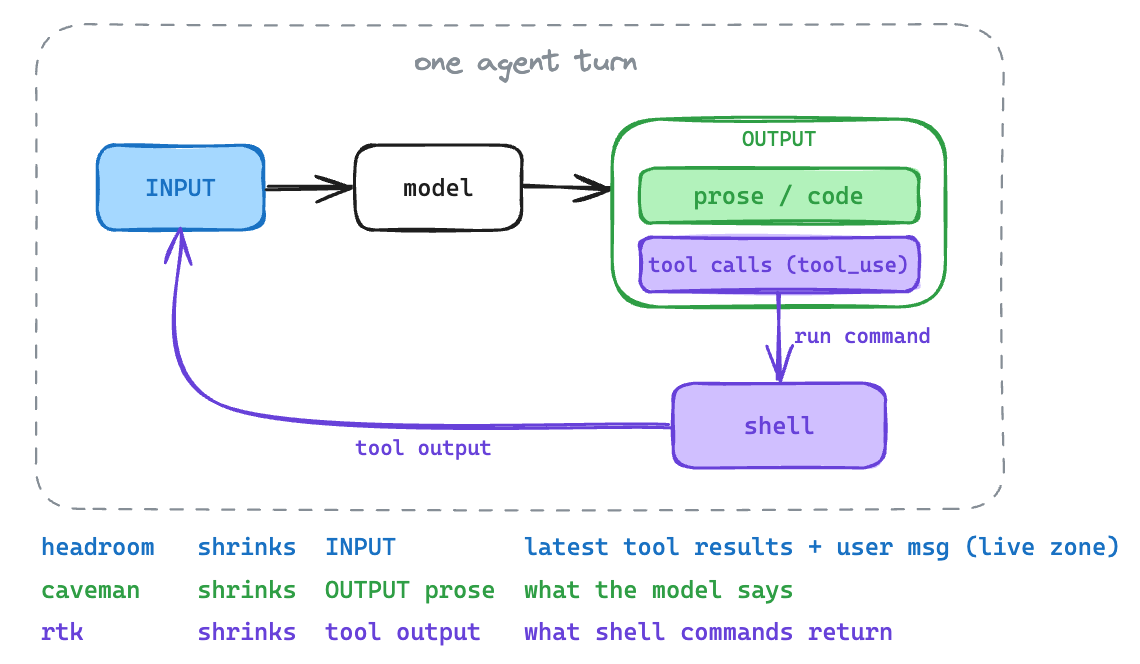
세 도구는 이 중 하나씩만 건드린다. 개입 지점이 다르므로 절감분이 어떤 요율로 청구되는 토큰에서 나오는지도 달라진다.
| 도구 | 담당 스트림 | 개입 방식 | 공개 절감률 |
|---|---|---|---|
| headroom | input (아직 캐시되지 않은 최신 tool result와 사용자 메시지) | API 프록시가 요청 본문을 다시 쓴다 | 토큰 60~95% 감소 |
| rtk | tool output (셸 명령이 반환하는 출력) | PreToolUse 훅이 명령을 래퍼로 바꿔 쓴다 |
인식하는 명령당 60~99% |
| caveman | output (모델이 쓰는 산문) | 훅이 프롬프트를 주입해 문체를 바꾼다 | 평균 65%, 산문 절반 |
핵심 개념
live zone은 headroom이 다시 쓸 수 있는 유일한 영역을 가리킨다. 요청 본문 중 마지막 캐시 마커까지는 이미 provider의 KV-cache에 들어가 있고, 가장 최근 사용자 메시지와 그 tool result만 아직 캐시되지 않았다. 이 캐시되지 않은 꼬리 부분이 live zone이다.
cache_read와 cache_create는 prompt caching이 만든 두 종류의 토큰이다. 어떤 페이로드가 처음 컨텍스트에 들어갈 때는 cache_create로 청구되고, 이후 턴마다 다시 전송될 때는 훨씬 싼 cache_read로 청구된다. 같은 토큰이라도 어느 종류로 청구되는지에 따라 단가가 열 배까지 벌어진다.
첫 턴 절감과 전체 세션 절감은 이 요금 구조에서 갈라져 나온 두 지표다. 모든 모델 턴은 컨텍스트 전체를 다시 보내므로, tool result 하나는 세션이 끝날 때까지 이후 모든 턴에서 계속 청구된다. 첫 턴 절감은 페이로드가 처음 등장할 때 압축기가 지운 양이고, 전체 세션 절감은 그 페이로드가 재전송되는 모든 턴을 합친 양이다. 한 번 압축하면 절감이 여러 번 쌓인다는 뜻이다.
반사실(counterfactual) 재생은 이 글의 두 번째 실험이 쓰는 방법이다. 어떤 도구를 켰다면 청구액이 얼마였을지를 이미 기록된 세션 로그에서 턴 단위로 다시 계산한다. 실제로 도구를 켜고 에이전트를 다시 실행하는 방식이 아니므로 과거 트래픽 구성을 그대로 유지한 채 비교할 수 있다.
compaction은 길어진 대화 이력을 요약으로 접어 context window 한계 안에서 세션을 이어가는 처리다. Claude Code는 컨텍스트가 차면 compaction으로 오래된 tool result를 지우는데, 이 동작이 전체 세션 절감의 상한을 결정한다.
방법
headroom의 콘텐츠 유형별 프록시 압축
headroom은 에이전트와 provider 사이에 앉는 API 프록시다. ANTHROPIC_BASE_URL을 headroom으로 가리키거나 headroom wrap claude로 실행하면 그 뒤로 오가는 모든 바이트를 본다.
설계의 중심은 live zone 경계다. headroom은 live zone 안의 블록만 압축하고 그보다 오래된 메시지는 손대지 않는다. 이렇게 해야 cached prefix가 그대로 적중한다. 경계를 무시하고 오래된 메시지까지 다시 쓰면 캐시가 깨지고, 그 결과 새로 만들어지는 cache_create 비용이 압축으로 아낀 몫보다 커진다.
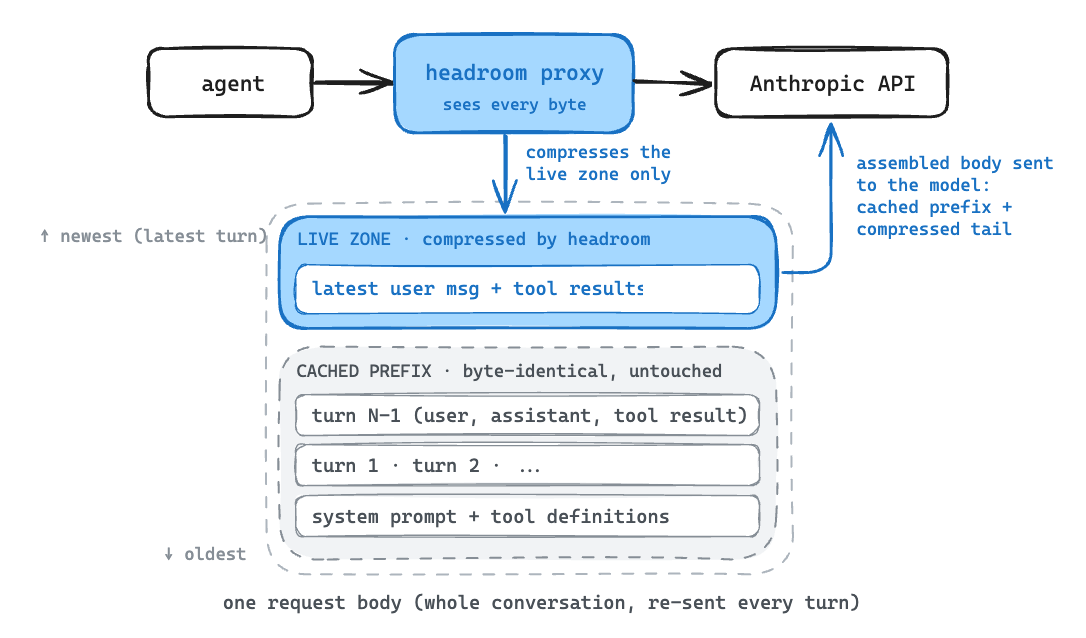
live zone 안에서는 라우터가 콘텐츠 블록을 하나씩 받아 유형을 판정하고 전용 압축기로 보낸다. 여기서 콘텐츠 블록은 tool result 하나 또는 메시지의 일부를 뜻한다. 라우터가 인식하는 유형은 7종이다.
| 콘텐츠 유형 | 압축 전략 | 방식 |
|---|---|---|
| 소스 코드 | CodeAware | AST를 이해하고 줄인다 |
| JSON 배열 | SmartCrusher | 반복 구조 레코드에서 중복을 지운다 |
| 검색 결과 | Search | 행을 점수화해 상위 서브셋만 남긴다 |
| 빌드 출력 | Log | 로그 전용 압축기 |
| git diff | Diff | diff 전용 압축기 |
| HTML | HTML | HTML 전용 압축기 |
| 평문 | Kompress | 학습된 평문 압축기 |
headroom은 더 빠른 Rust 프록시도 함께 제공한다. Rust 프록시는 JSON, 빌드 출력, 검색 결과, git diff 4종만 네이티브로 압축하고 나머지는 압축하지 않은 채 통과시킨다.
headroom의 행 선택과 복구 경로
검색 결과 압축이 headroom의 동작을 가장 잘 보여주는 예다. grep이나 ripgrep 덤프는 file:line:content 형태의 행 수백 개로 도착하고, 그중 상당수가 같은 매치를 조금씩 다른 위치에서 반복한다. 이런 입력에서 압축은 문장을 줄이는 일이 아니라 행을 지우는 일이다. 따라서 압축기는 어떤 행을 남길지만 정하면 된다.
행 선택은 두 단계로 나뉜다. 먼저 점수로 순위를 정하고, 그다음 몇 개를 남길지 따로 판단한다.
점수는 에이전트가 필요로 할 가능성이 높은 행이 위로 올라오게 설계됐다. 활성 질의(query)나 호출자가 지정한 키워드에 걸리면 점수가 오르고, 오류처럼 보이는 행은 더 오른다.
| 조건 | 가산점 | 비고 |
|---|---|---|
| 활성 질의와 일치 | +0.3 | 검색어가 행 내용에 등장 |
| 호출자 지정 키워드와 일치 | +0.4 | 호출 측이 넘긴 관심 키워드 |
| 오류 패턴과 일치 | +0.5에서 0.1씩 감소 | error, warning, 일반 중요도 순으로 검사하고 첫 일치에서 멈춘다 |
오류 부스트가 한 행에 한 번만 적용되므로 오류 행이 두 번 가산되는 일은 없다. 그럼에도 오류 행의 가산점이 단순 질의 일치보다 크기 때문에, 같은 질의에 걸린 행 중에서는 오류를 담은 행이 먼저 살아남는다.
남길 개수는 고정 top-N이 아니다. 압축기는 덤프가 담고 있는 실제로 구별되는 매치가 몇 개인지 세어 그만큼만 남긴다.
| 단계 | 판정 | 남기는 개수 |
|---|---|---|
| 1 | 항목이 8개 이하 | 전부 |
| 2 | SimHash로 근사 중복을 묶은 뒤 고유 항목이 3개 이하 | 그 고유 항목 수 |
| 3 | 그 밖의 경우 | 고유 bigram 커버리지 곡선에 Kneedle을 적용해 knee 지점까지 |
3단계는 매치를 하나씩 더해 가며 새 단어가 더 들어오는지 보고, 더 들어오지 않기 시작하는 지점에서 멈추는 방식이다. 거의 같은 행 1,000개가 실제로는 몇 개의 구별되는 매치일 뿐이라는 관찰을 그대로 쓴 것이다.
지우는 과정에서도 두 가지 정보는 반드시 남긴다. 파일별 첫 매치와 마지막 매치는 항상 보존해 검색이 훑은 범위 전체가 보이게 하고, 지운 행은 [... and N more matches in file] 마커로 몇 개가 잘렸는지 알린다. 이 마커가 있어야 에이전트는 중간의 고득점 묶음만 보고 전체를 봤다고 착각하지 않는다.
압축이 필요한 정보까지 지웠을 때를 대비한 복구 경로가 CCR(Compress-Cache-Retrieve)이다. 압축 전 원본을 콘텐츠 해시로 로컬 캐시하고 headroom_retrieve 도구를 주입해, 모델이 필요하다고 판단하면 전체 데이터를 되불러오게 한다. 원본 보관 기간은 5분이며 그 뒤에 요청하면 retrieve는 빈 결과를 돌려준다. 그 경우 모델은 압축본을 그대로 쓰거나 검색을 다시 실행한다. 압축본과 마커는 어느 경우에도 대화에 남아 있으므로 모델이 아무 정보 없이 멈추는 상황은 생기지 않는다.
headroom은 rtk도 함께 관리한다. headroom wrap claude는 rtk 바이너리를 내려받아 Claude Code 훅으로 등록한다. 프록시가 통신 구간의 요청을 압축하고 rtk가 CLI 쪽 셸 출력을 줄이므로, 두 스트림의 절감이 한 명령으로 함께 켜진다. 이 자동 설치는 나중에 보안 절에서 다시 문제가 된다.
rtk의 셸 출력 필터
rtk는 셸 명령이 실행되기 전에 가로챈다. PreToolUse 훅이 git status를 rtk git status로 바꿔 쓰고, 모델은 원래 명령을 실행한 것으로 안다. 바꿔 쓴 경로에서 rtk는 std::process::Command로 실제 바이너리를 인자를 분리해 셸을 거치지 않고 직접 실행한 뒤 출력을 필터링한다. 필터의 동작은 필요한 필드만 남기기, 관련 행 묶기, 반복 행 제거, 긴 출력 절단이며, 절단할 때는 복구 방법을 알리는 힌트를 붙인다.
ls 필터가 이 동작을 가장 명확하게 보여준다. 원본 ls -la는 항목마다 mode, owner, group, 바이트 크기, 날짜를 한 행씩 출력한다. rtk 저장소 자신의 루트에서 실행하면 37개 항목이 아래 형태로 나열된다.
total 632
drwxr-xr-x@  37 yongkyunlee  staff   1184 Jun 16 17:17 .
drwxr-xr-x@   7 yongkyunlee  staff    224 Mar 11 18:28 .claude
-rw-r--r--@   1 yongkyunlee  staff    251 Jun 16 17:17 .gitattributes
-rw-r--r--@   1 yongkyunlee  staff  98561 Jun 16 17:17 CHANGELOG.md
-rw-r--r--@   1 yongkyunlee  staff   7406 Jun 16 17:17 CLAUDE.md
rtk ls는 에이전트가 거의 쓰지 않는 열을 지우고 디렉토리를 슬래시와 함께 먼저 나열하며, 파일 크기를 사람이 읽는 단위로 바꾸고 마지막에 한 줄 요약을 붙인다.
.claude/
docs/
src/
tests/
CHANGELOG.md  96.3K
CLAUDE.md  7.2K
README.md  21.2K

Summary: 23 files, 10 dirs (13 .md, 2 .json, 1 .toml, 1 .yml, 1 .gitignore, +5 more)
-a를 주지 않으면 .git이나 target 같은 잡음 디렉토리도 걸러낸다. 개수 요약 한 줄이 남아 있으므로 에이전트는 목록이 잘렸다는 사실과 잘린 규모를 함께 알 수 있다.
안전 설계는 폴백 하나로 요약된다. 필터가 출력을 파싱하지 못하면 원본 출력을 그대로 통과시킨다.
| 상황 | rtk의 동작 |
|---|---|
| 필터가 출력을 파싱하지 못함 | 원본 명령 출력을 그대로 반환 |
| diff가 길어 잘림 | [full diff: rtk git diff --no-compact] 힌트를 함께 반환 |
| 필터가 없는 명령 | 원시 출력을 그대로 통과 |
따라서 rtk가 데이터를 지우는 것은 필터 방법을 아는 명령에서만이다. 이 보수적 설계 때문에 rtk의 위험은 데이터 유출보다 정확성 쪽에 놓인다.
적용 범위에는 한계가 하나 있다. Claude Code의 기본 Read, Grep, Glob 호출은 Bash 훅을 거치지 않는다. 그래서 rtk는 에이전트가 셸에서 직접 실행한 명령에만 작동한다. 이 한계가 나중에 재생 결과에서 절감폭을 결정하는 요인으로 다시 나타난다.
caveman이 프롬프트를 주입하는 방식
caveman은 앞의 두 도구와 접근이 다르다. 런타임에 페이로드를 변환하지 않고, 프롬프트를 주입해 모델의 발화 습관 자체를 바꾼다. 압축 대상이 데이터가 아니라 모델의 문체다.
주입은 두 개의 훅이 나눠 맡는다.
| 훅 이벤트 | 시점 | 주입 내용 |
|---|---|---|
SessionStart |
첫 턴 전 한 번 | SKILL.md 규칙집을 활성 강도에 맞게 걸러 숨겨진 시스템 컨텍스트로 붙여 넣는다 |
UserPromptSubmit |
메시지를 보낼 때마다 | 한 줄 분량의 짧은 알림만 다시 주입한다 |
두 번째 훅이 필요한 이유는 첫 주입이 항상 남아 있지 않기 때문이다. 대화가 길어지면 Claude Code가 오래된 컨텍스트를 compaction으로 접고 다른 플러그인이 자기 텍스트를 더한다. 둘 중 하나만으로도 원래 규칙이 context window 밖으로 밀려나고, 규칙이 사라지면 모델은 장황한 기본 문체로 되돌아간다. 재주입분을 한 줄로 작게 유지하는 것은 알림 자체가 토큰을 잡아먹지 않게 하려는 설계이며, 전체 규칙은 세션 시작 주입이 계속 담당한다.
규칙집이 무엇을 지우고 무엇을 남기는지는 명시적으로 나뉘어 있다.
| 지우는 것 | 남기는 것 |
|---|---|
| 관사, 채우기 표현, 인사말, 회피 어법 | 기술 용어, 코드 블록 |
| 긴 동의어(extensive 대신 big) | 파일 경로, API 이름 |
| 완전한 문장 형태(조각 문장 허용) | 오류 문자열 |
규칙집은 답변이 따라야 할 문장 형태까지 지정한다. 무엇을 지우라는 지시만으로는 모델이 어느 정도까지 줄여야 하는지 판단하지 못하기 때문이다.
Pattern: `[thing] [action] [reason]. [next step].`

Not: "Sure! I'd be happy to help you with that. The issue you're experiencing is likely caused by..."
Yes: "Bug in auth middleware. Token expiry check use `<` not `<=`. Fix:"
강도는 네 단계로 나뉘고 기본값은 full이다.
| 강도 | 동작 | 같은 질문에 대한 답변 형태 |
|---|---|---|
| lite | 전체 문장을 유지하고 채우기만 제거 | "Your component re-renders because you create a new object reference each render. Wrap it in useMemo." |
| full | 조각 문장까지 허용 (기본값) | "New object ref each render. Inline object prop = new ref = re-render. Wrap in useMemo." |
| ultra | 산문 단어를 축약하고 인과를 화살표로 표시 | "Inline obj prop → new ref → re-render. useMemo." |
| wenyan | 고전 중국어 수준까지 압축 | 절감 최대, 가독성 최소 |
ultra 단계는 config나 req처럼 산문 단어만 줄이고 실제 코드 심볼은 건드리지 않는다. 그리고 압축보다 우선하는 예외 규칙이 있다. 보안 경고, 되돌릴 수 없는 작업 확인, 순서가 있는 다단계 절차에서는 압축 문체를 끄고 전체 문장으로 쓴다. 이 규칙이 위의 모든 압축 규칙보다 우선하므로, 단어 하나가 실제 피해를 낳을 자리에서는 간결함이 이기지 않는다.
caveman이 줄이는 것은 output 토큰뿐이고 thinking 토큰은 건드리지 않는다. 프로젝트는 이를 "Brain still big. Mouth small."로 요약한다. 공개된 평균 65% 절감은 장황한 "helpful assistant" 기본값과 비교한 값이라, 어떤 간결화 지시를 줘도 나올 절감분이 섞여 있다. 저자는 "Answer concisely." 같은 평범한 baseline과 비교해 다시 측정했고 그 경우 중간값 50%가 나왔다.
측정 설계
저자는 각 변환을 살아 있는 에이전트를 통하지 않고 직접 측정했다. 이 선택에는 이유가 있다. 에이전트를 실제로 실행하면 설정 사이의 토큰 차이가 대부분 턴 수에서 나오고, 턴 수는 실행마다 달라져 압축기가 실제로 한 일을 가린다. 고정 페이로드에서는 결과가 결정적이므로 압축기의 기여만 분리해 볼 수 있다.
페이로드는 고정된 오픈소스 체크아웃 네 곳에서 캡처했다. 각 저장소에서 고빈도 심볼을 하나씩 grep해 거의 같은 매치 행이 수천 개 나오게 만들고, git diff는 대표 하위 디렉토리에 대한 실제 릴리스 구간을 하나씩 잡았다.
| 저장소 | 버전 | grep 대상 심볼 | git diff 구간 | ls -la 대상 |
|---|---|---|---|---|
| VS Code | 1.99 | registerSingleton |
챗 브라우저 코드 1.98에서 1.99 | src/vs/workbench/contrib/ |
| llama.cpp | b9692 | ggml_tensor |
ggml/src b9500에서 b9692 |
ggml/src/ |
| uv | 0.11.21 | 모든 pub fn |
uv-resolver crate 0.10에서 0.11.21 |
crates/ |
| ollama | 0.30.10 | 모든 func |
server/ v0.30.0에서 v0.30.10 |
server/ |
rtk는 위의 grep과 git diff에 ls -la와 git log --stat -50을 더해 저장소마다 네 명령을 실행했다. 각 도구는 자기가 담당하는 스트림에서만 측정했다. headroom은 tool result input에서, rtk는 셸 출력에서, caveman은 모델 산문에서다. caveman은 자체 산문 평가 프롬프트 10건을 쓰고, 각 답변을 스킬 없이 Answer concisely. 시스템 프롬프트만 준 답변과 비교했다. caveman의 자체 평가도 장황한 기본값이 아니라 이 간결한 대조군을 쓰므로, 측정값은 짧게 답하라고 요청하는 것 위에 스킬이 더하는 몫만 반영한다.
두 번째 실험은 실제 트래픽 재생이다. 트래픽은 저자 본인의 Claude Code 이력(~/.claude/projects)이며 13개 프로젝트 디렉토리에 걸친 2,182개 세션이 들어 있다. 한 프로젝트가 표본을 지배하지 않도록 디렉토리별로 층화해 500개를 뽑고, 빈 세션과 이상치 1건은 제외했다. 남은 500개 세션은 합쳐서 6억 1,400만 토큰이고 기준선 지출은 $926.31이다.
세 도구의 재생 방식은 신뢰도가 다르다. 이 차이가 결과 표를 읽는 방식을 정한다.
| 도구 | 재생 방식 | 근거 | 신뢰도 |
|---|---|---|---|
| headroom | 직접 측정 | 압축기가 페이로드의 순수 함수라 기록된 모든 tool result에 실제 압축기를 실행 | 가장 높다 |
| rtk | 추정 | 자체 공개 명령별 절감률(명령에 따라 60~99%)을 매칭될 셸 출력의 실제 토큰 크기에 적용 | 중간 |
| caveman | 추정 | 생성 중 문장을 줄이는 프롬프트라 완성된 텍스트에 재실행 불가. 코드 블록을 제외한 산문 토큰에 중간값 약 50%를 곱함 | 가장 느슨하다 |
caveman 추정이 가장 느슨한 이유는 실제 답변도 벤치마크와 같은 비율로 짧아진다고 가정하기 때문이다.
결과
최적 조건의 도구별 절감률
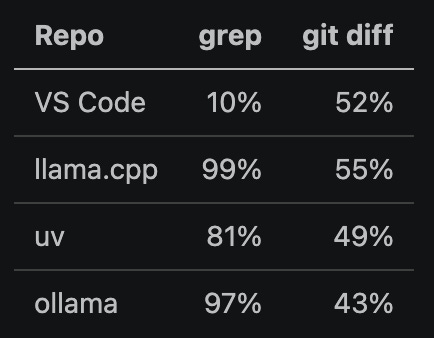
headroom은 grep 덤프에서 저장소별로 크게 갈렸다. 매치 행이 반복적이면 99%까지 줄지만, 이미 서로 구별되는 매치가 들어오면 지울 중복이 없어 10%까지 내려간다. git diff는 43%에서 55% 사이로 훨씬 좁은 범위에 모였다. grep과 git diff 여덟 값을 합친 중간값은 54%다.
| 저장소 | grep | git diff |
|---|---|---|
| VS Code | 10% | 52% |
| llama.cpp | 99% | 55% |
| uv | 81% | 49% |
| ollama | 97% | 43% |
rtk는 grep에서 가장 크게 줄인다. 매칭 행을 전부 반환하지 않고 묶은 개수를 돌려주기 때문이다. VS Code src/에 rg registerSingleton을 실행한 경우 69만 4천 토큰이 2,400 토큰으로 줄었다. 거의 같은 매치 행이 잘 접히므로 grep은 네 저장소 모두에서 99% 근처를 유지한다.
| 저장소 | grep | git diff | ls | git log |
|---|---|---|---|---|
| VS Code | 99.7% | 96% | 85% | 31% |
| llama.cpp | 99.3% | 97% | 72% | 52% |
| uv | 98.0% | 95% | 81% | 58% |
| ollama | 97.5% | 33% | 71% | 39% |
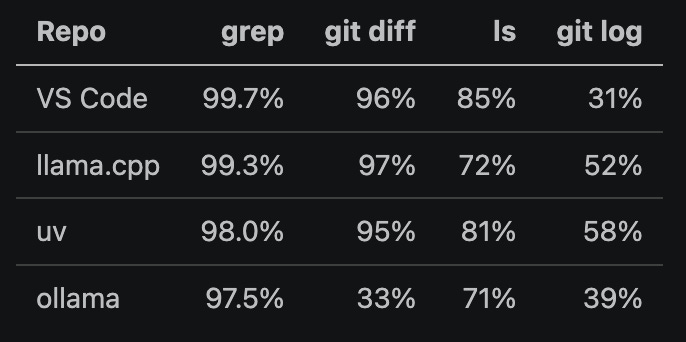
이 표에서 눈에 띄는 값은 ollama의 git diff 33%다. v0.30.0에서 v0.30.10 사이 server/ 변경이 작고 코드 밀도가 높아 지울 반복 행이 거의 없었다. 같은 명령이 다른 세 저장소에서는 95% 이상 줄었으므로, 같은 필터가 입력 성격에 따라 세 배 가까이 다른 결과를 낸다는 뜻이다. git log --stat -50은 반대로 어느 저장소에서도 60%를 넘지 못했다.
caveman은 산문 평가 10건에서 88%에서 0.4%까지 퍼졌고 중간값은 50%였다.
| 프롬프트 | 절감 |
|---|---|
| Explain database connection pooling | 88% |
| What's the point of a debouncer on a search input | 68% |
| Why am I getting CORS errors in the browser console | 58% |
| When should I use a queue vs a topic in messaging | 56% |
| Why does my React component re-render on every parent update | 55% |
| How does git rebase differ from git merge | 46% |
| How does a hash table handle collisions | 38% |
| What does the SQL EXPLAIN command tell me | 30% |
| What's the difference between TCP and UDP | 22% |
| How do I fix a memory leak in a long-running Node process | 0.4% |
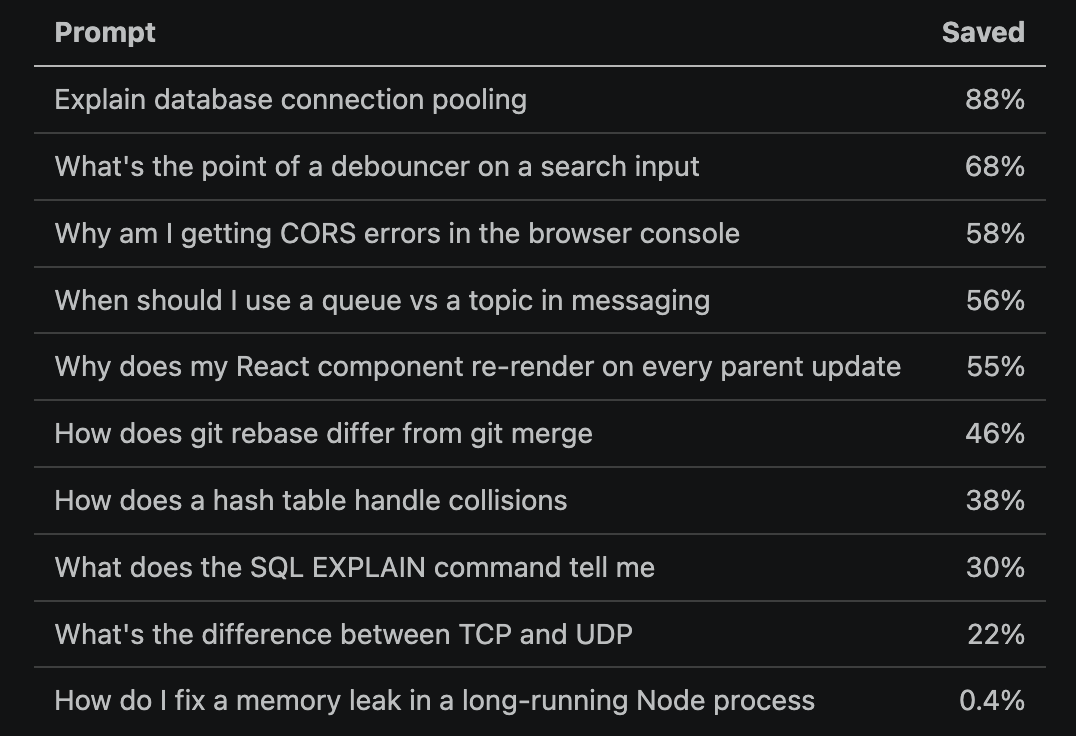
가장 작게 줄어든 항목은 Node 프로세스 메모리 누수 질문으로 0.4%에 그쳤다. 답변이 이미 간결해 지울 채우기 표현이 없었기 때문이다. 반대로 개념 설명형 질문(연결 풀링, 디바운서, CORS)이 표의 위쪽을 차지한다. caveman의 절감폭은 질문이 얼마나 설명형인지에 따라 정해진다.
세 도구 모두 자기를 위해 만들어진 콘텐츠에서는 공개된 절감률에 도달한다. 재현도 가능하다. 다만 이 수치는 모두 이상적 입력에서 스트림 하나만 따로 잰 값이다.
세 표를 나란히 놓으면 공통 패턴이 하나 보인다. 절감폭을 결정하는 것은 도구의 성능이 아니라 입력에 중복이 얼마나 있는지다. headroom과 rtk는 거의 같은 grep 행이 반복될 때 99%에 닿고 중복이 없는 diff나 이미 짧은 목록에서는 30~50%대로 내려간다. caveman도 설명형 답변에서 88%를 기록하고 이미 간결한 답변에서는 0.4%에 그친다. 재생 실험이 확인하려는 것은 이 중복이 실제 트래픽에 얼마나 있는지다.
500개 세션 재생
같은 도구들을 실제 트래픽에 재생한 결과는 크게 낮아진다.
| 도구 | 첫 턴 절감 | 전체 세션 절감 | USD | 지출 비중 | 방식 |
|---|---|---|---|---|---|
| headroom | 150만 1천 토큰 | 4,130만 토큰 | $25.61 | 2.8% | 직접 측정 |
| rtk | 28만 2천 토큰 | 840만 토큰 | $4.94 | 0.5% | 추정 |
| caveman | 11만 토큰 | 225만 토큰 | $3.58 | 0.4% | 추정 |
| 합계 | 원문 미표기 | 원문 미표기 | $34.12 | 3.7% | 미표기 |
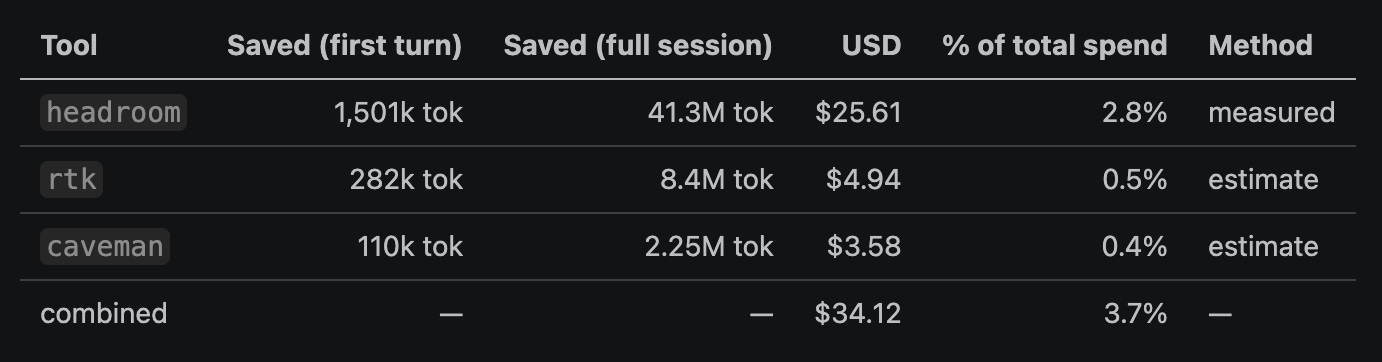
원문은 합계 행에서 두 토큰 열을 비워 두고 USD와 지출 비중만 합산한다. 세 도구가 서로 다른 스트림에 작용해 토큰 단위 합산의 의미가 분명하지 않기 때문으로 보이며, 이 표에서는 원문 표기를 그대로 따랐다.
수명 증폭과 compaction 상한
마이크로벤치마크가 보여주지 못하는 첫 번째 결과가 수명 증폭이다. headroom의 첫 턴 절감 150만 1천 토큰은 전체 세션에서 4,130만 토큰이 되어 약 27배로 늘어나고, 세 도구 평균은 약 26배다. 같은 압축 페이로드가 매 턴 cache_read 요율로 재전송되기 때문이며, 한 번 압축한 효과가 세션 길이만큼 반복된다는 의미다.
앞의 재생 표 두 열을 나눠 보면 도구별 배수도 계산된다. headroom은 약 27.5배, rtk는 약 29.8배, caveman은 약 20.5배이며 세 값의 평균이 원문이 제시한 약 26배와 맞는다. caveman의 배수가 낮은 것은 output 토큰이 이후 턴에서 cache_read로 재전송되기는 하지만 애초에 줄인 양이 작기 때문이다.
이 배수에는 단서가 붙는다. Claude Code는 컨텍스트가 차면 compaction으로 오래된 tool result를 지우는데, 500개 세션 전체에서 compaction 이벤트는 2건만 나타났다. 다시 말해 이 배수는 페이로드가 실제보다 오래 살아남는다고 가정한 상한이다. 실제로 compaction이 자주 일어나면 절감폭은 26배보다 작아진다. 저자는 이 방향의 오차가 "절감분은 작은 조각"이라는 결론을 오히려 강화한다고 덧붙인다.
rtk가 닿지 못하는 78%
두 번째 결과는 rtk의 적용 범위다. rtk는 tool output 토큰의 22%에만 닿았고 나머지 78%는 셸 훅을 우회하는 기본 도구로 흘렀다. 거의 전부가 Read 도구다.
이 78%를 되찾을 수 있는지가 자연스러운 후속 질문이 된다. 저자의 답은 이 코퍼스에서는 회수되는 양이 적다는 것이다. 우회 스트림의 78%가 파일 read인데, 파일 read에는 grep 덤프를 99% 접게 해주는 근사 중복 행이 없다. rtk의 파일 필터가 하는 일은 반복 행 제거와 절단뿐이고, 절단은 에이전트가 요청한 내용을 지운다. 그다음으로 큰 우회 스트림인 WebSearch, WebFetch, 서브에이전트 결과에는 rtk 필터가 아예 없다.
| 시나리오 | 추가 절감 | rtk의 지출 비중 |
|---|---|---|
| 현재 (셸 출력만) | 기준 | 0.5% |
| 현실적 경우 (공개 파일 read 규칙 적용) | 약 $5 | 약 1% |
| 낙관적 상한 (read가 grep 덤프만큼 압축된다고 가정) | 약 $25 | 상한 |
현실적 경우에서도 rtk의 절감은 지출의 약 1% 수준이다. 두 배로 늘어난 값이지만 여전히 작다.
토큰 감소와 청구액 감소를 가르는 세 계층
세 도구의 공개 수치와 재생 결과 사이의 간극은 세 계층으로 나뉜다. 저자는 이 중 어느 것도 홍보 수치의 과장에서 오지 않는다고 못 박는다. 각각이 서로 다른 워크로드에서 서로 다른 것을 재고 있을 뿐이다.
첫째 계층은 분모다. headroom README 표의 합성 코드 검색 페이로드 하나를 92% 압축하면 약 1만 6천 토큰이 지워진다. headroom은 이 1만 6천을 그 단일 페이로드 크기인 17,765토큰으로 나눠 92%를 얻는다. 재생은 같은 1만 6천을 세션 청구액 전체로 나눈다. 세션 청구액은 수백 턴에 걸쳐 있고 캐시와 output 비용이 지배하므로, 같은 절감분이 2.8%가 된다.
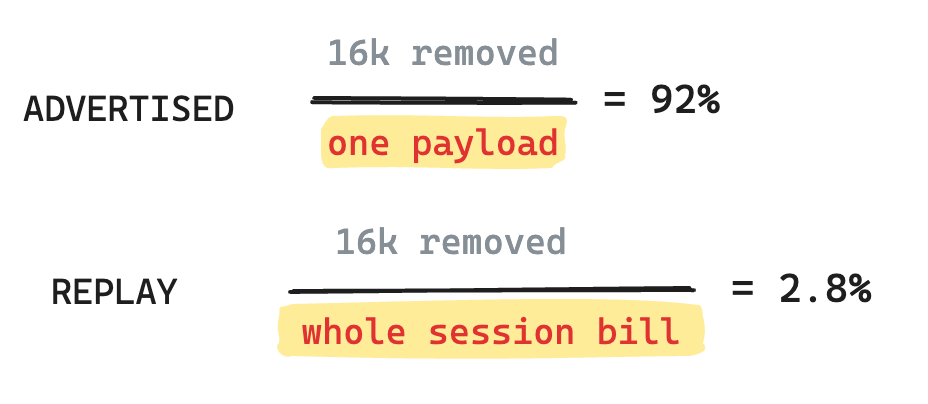
나머지 두 도구도 같은 방식으로 좁은 분모를 쓴다. rtk는 절감분을 인식한 셸 명령 하나로 나누고 caveman은 답변 하나의 산문으로 나눈다. 재생은 셋 모두를 세션 청구액 전체로 나눈다.
둘째 계층은 워크로드이며 세 계층 중 간극이 가장 크다. headroom의 압축률은 페이로드 유형에 좌우된다. 가장 강한 전략은 중복 행을 지우는 방식이라 JSON 배열이나 검색 덤프처럼 구조화되고 반복적인 데이터에서만 효과가 난다. headroom의 벤치마크 표는 전량 그 유형이며, 실제 트래픽에서 캡처한 것이 아니라 합성 생성물이다. "Code search (100 results) = 17,765 tokens" 행은 Elasticsearch 스타일 JSON 레코드 100개를 뽑아내는 생성기에서 나오는데, 이는 SmartCrusher가 80~95%까지 줄이는 바로 그 중복 덤프다.
저자 본인의 워크로드에서 나온 값은 훨씬 낮다.
| 지표 | 벤치마크 조건 | 저자의 실제 워크로드 |
|---|---|---|
| 활성화 비율 | 대상 페이로드 전량 | 페이로드의 45% |
| 절감률 중간값 | 80~95% | 25% |
| 고압축 전략 발동 | 표의 모든 행 | 2,781건 활성화 중 46건 |
대부분의 페이로드가 중복이 적은 평문과 소스 코드였기 때문이다. rtk와 caveman도 같은 방식으로 공개 워크로드를 비껴간다. rtk의 60~99%는 grep 결과나 디렉토리 목록 같은 중복 덤프를 가정하지만 tool output 토큰의 78%는 셸 훅에 닿지 않고, 닿는 것 중에도 몇 줄뿐인 출력이 많다. caveman의 50%는 턴이 대부분 산문이라고 가정하지만 실제 답변에는 스킬이 제외하는 코드 블록과 줄일 여지가 적은 짧은 답이 섞인다.
셋째 계층은 가격 책정이고 headroom의 수치가 빠뜨린 부분이다. 토큰은 균일하게 청구되지 않는다.
| 토큰 종류 | Opus 4.8 요율 (100만 토큰당) | 표본 지출에서의 비중 | 세 도구의 절감이 닿는가 |
|---|---|---|---|
| output | $25 | 29% | caveman만 |
| cache write (cache_create) | $6.25 | 42% | 닿지 않는다 |
| fresh input | $5 | 나머지 | 거의 닿지 않는다 |
| cache read | $0.50 | 나머지 | headroom과 rtk의 절감이 대부분 여기 |
표본의 $926 지출은 대부분 cache_create(42%)와 output(29%)이며 세 도구 어느 것도 이 두 스트림을 함께 바꾸지는 못한다. headroom과 rtk의 절감은 대부분 cache_read에 떨어진다. 둘 다 컨텍스트에 들어가 이후 매 턴 cache_read 요율로 재전송되는 tool result 페이로드를 압축하기 때문이다. 첫 등장은 cache write로 한 번 청구되지만 그 뒤의 많은 재읽기가 비용의 대부분을 차지한다. 결국 두 도구가 지우는 것은 청구서에서 가장 싼 토큰이며, cache read 요율은 fresh input의 10분의 1이다. caveman만 예외로, 모델이 쓰는 동안 output을 줄이고 output은 가장 비싼 토큰이다.
| 계층 | 벤치마크가 재는 것 | 재생이 재는 것 |
|---|---|---|
| 분모 | 단일 페이로드 또는 단일 명령 또는 단일 답변 | 세션 청구액 전체 |
| 워크로드 | 압축이 가장 잘 되는 콘텐츠 유형 | 실제 트래픽의 유형 구성 |
| 가격 책정 | 토큰 개수 | 토큰 종류별 단가 |
prompt caching이 개입하는 순간 "토큰 감소" 주장은 "청구액 감소" 주장과 같지 않아진다. 절감폭은 사용자의 청구액이 어느 스트림에 얼마나 놓여 있는지에 달려 있다.
워크로드에 따른 기대 절감
3.7%가 보편적인 수치가 아니라는 점은 저자가 직접 밝힌다. 절감폭은 사용자의 트래픽 구성에 좌우되므로, 자신의 워크로드가 어느 특성에 가까운지를 먼저 확인하는 것이 판단 순서가 된다.
| 워크로드 특성 | 절감이 커지는 도구 | 근거 |
|---|---|---|
| 셸과 grep 사용이 많다 | rtk | 셸 훅을 거치는 tool output 비중이 22%보다 커진다 |
| 반복 구조 tool result가 많다 | headroom | 중복 행을 지우는 고압축 전략의 발동 빈도가 올라간다 |
| 기본 Read 도구를 많이 쓴다 | 해당 없음 | 파일 read에는 접을 중복 행이 없고 rtk 훅도 거치지 않는다 |
| 답변이 설명형 산문 중심이다 | caveman | 지울 채우기 표현이 많고 output은 가장 비싼 토큰이다 |
| 세션이 길고 compaction이 드물다 | headroom과 rtk | 압축한 페이로드가 cache_read로 재전송되며 절감이 누적된다 |
반대로 청구액이 cache_create와 output에 몰려 있는 워크로드에서는 headroom과 rtk를 함께 켜도 움직일 수 있는 몫이 작다. 저자의 표본에서 이 두 종류가 지출의 71%를 차지했고, 그것이 3.7%라는 결과의 직접적인 원인이다.
보안 리스크
세 도구 모두 코드와 프롬프트와 명령 출력을 읽을 수 있는 자리에 앉는다. 저자는 이 자리를 두 개의 별개 질문으로 나눠 평가한다. 정직한 코드가 오늘 노출하는 것과, 손상된 버전이 내일 할 수 있는 것이다.
코드가 정직할 때
노출 정도는 각 도구가 앉는 자리와 데이터가 기기를 떠나는지에 따라 달라진다. 아래 순서는 요구하는 신뢰가 낮은 쪽부터다.
| 도구 | 자리 | 경계를 넘는 지점 | 남는 위험 |
|---|---|---|---|
| rtk | 로컬, 범위 좁음 | opt-in 텔레메트리 외 없음 | 정확성. 필터가 중요한 경고 행을 지울 수 있다 |
| caveman | 대부분 로컬 훅 | /caveman-compress가 파일 내용을 Anthropic API로 전송 |
모델이 컨텍스트를 다시 쓰는 것 자체 |
| headroom | 프록시, 최대 신뢰 지점 | 전체 프롬프트와 응답, API 키가 담긴 Authorization 헤더 |
CCR 캐시가 비압축 원본을 로컬 SQLite에 기록 |
rtk는 명령 stdout을 필터링하고 실제 바이너리를 인자를 분리해 실행하므로 셸 주입 표면이 없다. 토큰 메트릭은 로컬에 저장하고 네트워크 호출은 opt-in 텔레메트리 외에 없다. 여기서 실제 위험은 데이터 유출이 아니라 정확성이다. 중요한 경고 행 하나를 필터가 지우면 에이전트에게 불완전한 그림이 남고, 복구는 사용자가 --no-compact로 다시 실행하는지에 달린다.
caveman의 기본 모드는 프롬프트만 주입하고 /caveman-compress 워크플로만 경계를 넘는다. 이 경로의 방어는 잘 갖춰져 있다. .env*, *.pem, *.key, 그리고 .ssh나 .aws나 .kube 아래의 모든 것 같은 민감 경로를 거부하고 파일 크기 상한을 둔다. 모드 훅은 플래그 파일을 O_NOFOLLOW와 원자적 임시파일 rename으로 써서 symlink 덮어쓰기 공격을 막는다. 남는 위험은 압축이 곧 모델이 컨텍스트를 다시 쓰는 일이라는 점이다. CLAUDE.md를 잘못 다시 쓰면 이후 모든 세션이 조용히 오염된다.
headroom은 프록시로서 전체 프롬프트와 전체 응답과 API 키를 본다. 키는 그대로 전달하고 자체 내부 헤더는 전달 전에 제거하며 로그에서 키를 마스킹한다. 다만 CCR 캐시가 비압축 원본을 잠시 로컬 SQLite에 쓰므로 민감한 출력의 스냅샷이 디스크에 남는다.
세 도구가 공유하는 위험은 데이터가 기기를 떠나는 것이 아니다. 기본이 local-first라서다. 공유 위험은 조용한 손실 압축이 에이전트에게 부분적인 그림만 남기는 것이다. caveman은 모델이 스스로 압축하기를 신뢰하고, rtk는 원시 폴백이 붙은 허용 목록을 신뢰하며, headroom은 전문 압축기를 신뢰한다. 지워진 바이트를 되불러올 수 있는 도구는 headroom뿐이다.
릴리스가 손상됐을 때
앞의 순위는 코드가 표방하는 대로 동작한다는 가정 위에 있다. 이 가정을 놓으면 요구하는 신뢰가 큰 순서가 그대로 피해가 큰 순서가 된다. 세 프로젝트 모두 젊어서 최근 공급망 공격과 같은 방식으로 이후 릴리스가 손상될 수 있다.
| 사례 | 연도 | 침해 경로 |
|---|---|---|
| XZ Utils 백도어 | 2024 | 2년에 걸쳐 maintainer 권한을 얻은 기여자가 공개 소스에는 없던 백도어를 릴리스 tarball에 넣었다 |
| Shai-Hulud 웜 | 2025 | maintainer의 퍼블리시 계정을 탈취하고 오염된 버전을 수 시간 게시했다 |
| axios 침해 | 2026 | 같은 계정 탈취 경로 |
어느 쪽이든 읽은 코드가 항상 실행되는 코드는 아니다. 따라서 local-first는 오늘의 코드가 가진 성질일 뿐 보장이 아니다. 악성 버전은 한 줄로 네트워크 호출을 더할 수 있고, 위에서 정리한 데이터 노출 범위가 그대로 공격 수단이 된다.
| 도구 | 손상 시 가능한 일 | 추가 조건 |
|---|---|---|
| headroom | 전체 프롬프트와 응답과 API 키 탈취, 비공개 코드 복사, 응답 편집으로 에이전트 유도 | 노출이 가장 크다 |
| rtk | 셸 훅에서 임의 명령 실행, 명령 교체, 출력 외부 전송 | headroom wrap claude가 rtk를 대신 내려받으므로 사용자가 버전을 고르지 않을 수 있다 |
| caveman | 세션 시작과 모든 메시지에서 Node 훅 실행, 즉 프롬프트마다 코드 실행 | compress 워크플로가 이미 API를 호출하므로 전송 범위 확대나 민감 파일 필터 제거가 가능하다 |
저자는 마지막으로 판단 기준을 제시한다. 세 도구를 더하기 전에 작은 절감이 세 도구 모두에 그만한 접근과 신뢰를 주는 값을 하는지 스스로 정해야 한다는 것이다.
한계
이 리포트가 스스로 밝히는 한계는 세 가지다.
- rtk와 caveman은 과거 로그에 그대로 재실행할 수 없어 추정치다. 특히 caveman은 실제 답변도 벤치마크와 같은 비율로 짧아진다고 가정한다.
- 3.7%는 저자 개인의 Claude Code 이력에서 나온 값이라 보편적인 수치가 아니다. 셸과 grep 사용이 많으면 rtk에게 줄일 것이 늘고, 반복 구조 tool result가 많으면 headroom에게 줄일 것이 늘어난다.
- 26배에서 27배에 이르는 수명 배수는 500개 세션 중 compaction이 2건만 관찰된 상황의 상한이다. 실제 compaction이 잦으면 절감이 낮아진다.
이 페이지가 근거로 삼은 원문은 저자의 측정 리포트 본문이다. 세 도구의 제품 스펙, 설치 절차, 라이선스, 아키텍처 전수는 이 원문의 범위 밖이므로 각 도구의 1차 자료 페이지를 참고해야 한다. 특히 headroom의 아키텍처와 lifecycle 전체는 Headroom: The context compression layer for AI agents이 담당한다.
rtk와 caveman은 이 wiki에 1차 자료 페이지가 없다. 따라서 두 도구에 대한 이 페이지의 서술은 전부 저자가 저장소를 읽고 정리한 내용이며, 프로젝트 자체의 문서와 대조된 것이 아니다. 두 도구의 공개 절감률(rtk 60~99%, caveman 평균 65%)도 저자가 인용한 값으로만 확인된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| live zone | headroom이 압축할 수 있는 유일한 영역으로, 마지막 캐시 마커 이후 아직 캐시되지 않은 요청 꼬리 부분 |
| CCR (Compress-Cache-Retrieve) | 압축 전 원본을 콘텐츠 해시로 5분간 임시 캐시해두고 필요 시 headroom_retrieve 도구로 복원하는 가역 압축 경로 |
| cache_read / cache_create | prompt caching에서 이미 캐시된 prefix를 재사용할 때(cache_read)와 새로 캐시를 생성할 때(cache_create) 각각 다른 요율로 청구되는 토큰 종류 |
| SimHash | 근사 중복 문자열을 빠르게 묶는 해시 기법. headroom이 grep 결과에서 사실상 같은 매치를 하나로 세는 데 사용 |
| Kneedle | 곡선에서 증가가 꺾이는 knee 지점을 찾는 알고리즘. headroom이 고유 bigram 커버리지 곡선에 적용해 남길 매치 수를 정한다 |
| 반사실(counterfactual) 재생 | 어떤 도구를 켰다면 청구액이 얼마였을지를 기록된 로그에서 턴 단위로 다시 계산한 값 |
관련 페이지
- Headroom: The context compression layer for AI agents: headroom의 1차 자료 저장소 페이지. 아키텍처, 설치, 라이선스, 공개 벤치마크가 여기 있다. 이 페이지의 Figure 3은 headroom 공개 벤치마크가 아니라 저자가 직접 측정한 값이다
- Headroom 컨텍스트 압축 자료 지도와 근거 등급: headroom 저장소 하나와 소개글 넷, 독립 재측정 한 편(이 글)을 묶은 overview. overview가 정리한 "60~95% 절감" 주장이 이 글의 재생 실험에서 지출 2.8%로 나타난다
- How to Use Headroom: Compress AI Agent Context, Logs, and RAG Chunks: headroom의 다섯 사용 방식과 네이티브 compaction 비교. 이 글이 다루는 프록시 방식의 선택 기준을 보완한다
- Building Cost-Efficient Agents with Headroom: Context Compression for LLM Applications: 압축률을 달러로 환산한 소개글. 이 글의 재생 결과와 대조하면 분모 차이가 드러난다
- 토큰 소모량을 60~95%까지 줄여주는 Headroom 사용 방법: Cursor에서 headroom을 붙이는 실전 절차
- headroom: AI 에이전트 컨텍스트 압축 도구: headroom 압축 후 정확도 보존을 다룬 한국어 소개글
- How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks: 코딩 에이전트의 토큰 소비를 분석하고 예측한 논문. 이 글이 실측한 지출 구성과 같은 문제를 다룬다
- Effective Context Engineering for AI Agents: context engineering과 compaction의 설계 관점. 이 글의 수명 증폭과 compaction 상한을 이해하는 배경이 된다