Agents · PAPER · 2026
How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks
요약
이 논문은 코딩 에이전트가 문제 하나를 푸는 동안 토큰을 어디에 얼마나 쓰는지를 실측한 최초의 대규모 연구다. SWE-bench Verified의 실세계 GitHub 이슈 500건을 OpenHands 위에서 8개 frontier LLM으로 각 4회씩 실행하고, 총 1만 6천 회 실행의 trajectory를 라운드 단위로 분해했다.
논문이 제시하는 핵심 발견은 다섯 가지다.
| 발견 | 요지 |
|---|---|
| agentic 작업은 유일하게 비싸다 | code reasoning의 3500배, code chat의 1200배 토큰을 쓰고 그 비용은 output이 아니라 input 토큰에서 나온다 |
| 토큰 사용은 변동이 크고 확률적이다 | 같은 작업의 실행 간 총 토큰이 최대 30배까지 벌어진다 |
| 토큰을 더 써도 정확도가 오르지 않는다 | 정확도는 중간 비용에서 정점을 찍고 그 위에서는 포화한다 |
| 토큰 효율은 모델의 고유 특성이다 | 같은 문제 집합에서 Kimi-K2와 Sonnet-4.5는 GPT-5보다 평균 150만 토큰 이상 더 쓴다 |
| 전문가 난이도는 실제 비용과 약하게만 맞는다 | Kendall τb 0.32로 사람이 느끼는 복잡도와 에이전트가 실제로 쓰는 연산량 사이에 근본적 간극이 있다 |
여기에 실행 전 예측 실험이 붙는다. 에이전트 자신에게 자기 비용을 예측하게 하면 상관은 최고 0.39에 그치고, 여덟 모델 전부가 실제 비용을 과소추정한다.
논문이 제공하는 것은 두 가지다. 하나는 비용을 phase와 라운드 단위로 귀속시키는 분해 방법이고, 다른 하나는 upfront pricing이 아직 어려운 이유를 수치로 제시한 근거다.
배경
코딩 에이전트는 저장소를 읽고 이슈를 추론하며 tool을 호출해 최소한의 사람 개입으로 해결안을 내는 자율 시스템이다. 원래 코딩을 위해 만들어졌지만 tool use 능력과 long-horizon 작업 수행력 덕에 코딩 밖의 여러 도메인으로 쓰임이 넓어졌다.
문제는 가격 정책이다. 논문은 현행 코딩 에이전트 과금 방식에 두 가지 비판이 모인다고 정리한다.
| 비판 | 내용 |
|---|---|
| 투명성 부재 | 사용자는 작업이 끝날 때까지 최종 비용을 알 수 없다 |
| 완료 보장 부재 | 작업이 실패해도 소비된 토큰 비용은 그대로 청구된다 |
두 비판은 하나의 질문으로 수렴한다. 작업을 실행하기 전에 토큰 소비를 예측할 수 있는가. 실행 전 추정이 가능하다면 사용자는 예상 비용을 알고 모델을 고를 수 있고, 제공자는 더 명확한 가격 계층을 설계하고 예산 상한을 강제하며 큰 청구가 발생하기 전에 경고를 띄울 수 있다.
논문은 이 질문에 답하기 전에 먼저 세 가지 하위 질문을 던지고 순서대로 답한다.
- 에이전트는 토큰을 어디에 쓰는가.
- 어떤 모델이 토큰 효율이 좋은가.
- 에이전트는 실행 전에 자기 토큰 사용량을 예측할 수 있는가.
핵심 개념
라운드와 컨텍스트 누적
agentic coding에서 에이전트는 여러 라운드를 거쳐 문제를 푼다. 한 라운드는 LLM이 현재 프롬프트를 보고 응답을 만들고, tool call을 내고, 그 실행 결과를 받는 과정이다. 여기서 비용을 결정하는 핵심 성질은 직전까지의 전체 대화 이력이 변경 없이 다음 라운드의 프롬프트로 다시 들어간다는 점이다.
그래서 라운드가 늘어날수록 같은 내용이 반복해서 모델에 입력된다. 파일 하나를 5라운드째에 읽었다면 그 파일 내용은 6라운드, 7라운드, 그 이후 모든 라운드의 input에 계속 포함된다. 이것이 agentic 작업의 input 토큰이 다른 작업 유형과 다른 규모로 커지는 구조적 이유다.
토큰 종류와 단가
LLM 제공자는 토큰 종류마다 다른 단가를 매긴다. 같은 총 토큰 수가 언제 어떻게 쓰였는지에 따라 전혀 다른 금액이 되는 이유다.
| 토큰 종류 | 뜻 | 상대 단가 |
|---|---|---|
| output | 모델이 한 개씩 생성하는 토큰 | 가장 비싸다 |
| input (non-cached) | 처음 처리하는 새 프롬프트 | 중간 |
| cache creation | 나중에 재사용하려고 캐시에 기록하는 컨텍스트 | 중간 |
| cache read | 이미 캐시된 컨텍스트를 다음 라운드에서 가져오기 | 가장 싸다 |
prompt caching은 한 번 처리한 컨텍스트 덩어리의 처리 결과를 제공자가 재사용해 이후 읽기를 큰 폭으로 할인해 주는 장치다. Anthropic처럼 캐시를 명시적으로 노출하는 제공자는 cache creation과 cache read를 따로 과금하고, GPT-5 계열은 implicit caching으로 cached input만 자동 보고한다. 긴 trajectory가 컨텍스트를 계속 늘리는 agentic 작업에서 caching은 선택이 아니라 비용을 관리 가능한 범위에 두기 위한 필수 전략이 되었다.
비용 계산식
논문은 Appendix B에서 두 계열의 라운드 비용 식을 명시한다. Anthropic 계열은 네 항의 합이다.
Input_non-cached = Input_total - CacheRead
Cost_round = Input_non-cached x r_in
           + Output x r_out
           + CacheCreation x r_cache_create
           + CacheRead x r_cache_read
r_cache_create는 캐시 보존 기간에 따라 달라지는데, 논문은 5분 write rate를 전 구간에 일관되게 적용했다. GPT-5 계열은 cache creation 항이 없고 cached input을 base input 단가에 계수를 곱해 처리한다.
Input_non-cached = Input_total - CacheRead_implicit
Cost_round = Input_non-cached x r_in
           + CacheRead_implicit x 0.2 r_in
           + Output x r_out
자기예측
self-prediction은 작업을 실제로 실행할 그 에이전트가 실행 전에 자기 토큰 비용을 추정하는 태스크다. 논문이 별도 예측 모델을 두지 않고 이 설정을 고른 이유는 두 가지다.
- 특권적 접근: 실행 에이전트는 비용을 좌우하는 정보를 이미 손에 쥐고 있다. 탐색할 저장소 구조, 호출할 tool, 투입할 planning 깊이가 모두 그 안에 있다. 별도 예측기는 이 컨텍스트를 처음부터 다시 구성해야 한다.
- 배포 비용 없음: 추가 모델이나 학습 파이프라인, 별도 인프라가 필요 없다. 작업을 실행할 수 있는 에이전트라면 원리상 비용 추정도 할 수 있으므로 기존 시스템에 곧바로 결합할 수 있다.
논문은 이 능력을 비용 추정 하나에 국한된 문제로 보지 않는다. 자기 행동을 예측할 만큼 스스로를 추론할 수 있는 에이전트는 계획을 세우고 예산을 잡고 작업을 시도할 가치가 있는지 판단하고 언제 멈출지 아는 데도 유리하다는 것이다. 비용 추정은 그 행동적 자기 모델링 능력 가운데 직접 측정 가능한 한 사례다.
실험 설계
대상과 규모
| 항목 | 값 |
|---|---|
| 에이전트 프레임워크 | OpenHands |
| 벤치마크 | SWE-bench Verified (실세계 GitHub 이슈 500건) |
| 평가 모델 | frontier LLM 8종 |
| 문제당 실행 횟수 | 4회 독립 실행 |
| 보고 방식 | 문제별 4회 평균 |
| 수집 산출물 | 전체 실행 trajectory, inference log, 중간 산출물, 평가 결과, 메타데이터 |
각 문제에서 에이전트는 사람의 개입 없이 환경과 상호작용해 작업을 마친다. 논문은 구조화된 JSON trajectory를 파싱해 라운드마다 기록된 usage 정보에서 종류별 토큰, 금전 비용, action type을 뽑았다. tool 사용과 파일 접근 패턴 같은 기능적 행동을 토큰 수준 동역학과 함께 볼 수 있게 만든 설계다.
평가 모델
| 계열 | 모델 |
|---|---|
| Anthropic | Claude Sonnet-3.7, Claude Sonnet-4, Claude Sonnet-4.5 |
| OpenAI | GPT-5, GPT-5.2 |
| 오픈 웨이트 | Qwen3-Coder-480B-A35B-Instruct, Kimi-K2 |
| Gemini-3-Pro-Preview |
선정 기준은 아키텍처, 학습 패러다임, 배포 형태의 다양성과 함께 코딩 성능 및 실행 안정성이었다고 밝힌다.
난이도 라벨 처리
SWE-bench Verified는 전문 개발자가 예상한 소요 시간으로 난이도를 매긴 라벨을 함께 제공한다. 원래 네 등급인데 ">4 hours"에 문제가 3개뿐이라 "1–4 hours"와 합쳐 ">1 hour"로 보고했다. 최종적으로 "<15 min", "15 min – 1 hour", ">1 hour"의 세 집단이 된다.
5개 phase 분할
Claude Sonnet-4.5 실행 500건의 trajectory를 에이전트의 기능적 행동에 따라 다섯 단계로 나눴다.
| phase | 설명 | 라운드 비중 |
|---|---|---|
| Setup | 작업 계획, 환경 구성, 최초 재현 | 9.98% |
| Explore | 코드 검색, 파일 조사, 근본 원인 분석 | 30.37% |
| Fix | 코드 수정, 디버깅 반복, 패치 정제 | 33.53% |
| Validate | 테스트, 회귀 검사, 검증 | 16.59% |
| Closeout | 최종 확인, 정리, 요약 출력 | 9.53% |
Fix와 Explore가 전체 라운드의 63.9%로 약 3분의 2를 차지한다. 즉 에이전트가 보내는 시간의 대부분은 원인을 찾고 고치는 두 단계에 몰려 있다.
자기예측 프롬프트
예측 모드의 에이전트는 tool 호출과 상호작용 능력을 그대로 유지한다. 저장소를 살펴보고 예비 명령을 실행할 수 있지만, 수정을 구현하는 대신 토큰 추정치를 내라는 지시를 받는다. 개발자가 구현을 약속하기 전에 코드베이스를 훑어 공수를 가늠하는 과정을 모사한 설정이다. 프롬프트는 실제 코드 수정, 소스 파일 변경, 테스트 파일 생성, 커밋을 명시적으로 금지한다.
출력은 finish tool로 제출하는 JSON 하나다.
| 필드 | 내용 |
|---|---|
predicted_input_tokens |
LLM에 전달될 총 input 토큰 추정치 |
predicted_output_tokens |
LLM이 생성할 총 output 토큰 추정치 |
predicted_total_tokens |
위 둘의 합 |
confidence |
0에서 1 사이의 확신도 |
breakdown_by_phase |
저장소 복제, 최초 읽기, 테스트 설정, 디버깅, 코딩 반복, 검증, 검토 정리 단계별 분해 |
프롬프트는 단위를 토큰 정수로 못 박고 100단위나 1000단위 반올림을 금지해 step size 1을 요구한다. fine-grained 프롬프트에는 사람이 작성한 worked example 1개가 in-context 예시로 붙는다. 예산 제약 때문에 모델당 3회 독립 예측을 같은 500문제에 대해 수행했다.
평가 지표는 두 가지다.
| 지표 | 정의 |
|---|---|
| 상관 | 예측 토큰과 실제 토큰 사이의 Pearson r |
| 오버헤드 | 실제 작업 비용 대비 예측 비용의 비율 |
agentic 작업이 비싼 이유
세 작업 유형 비교
논문은 코드를 다루는 세 가지 작업 유형의 평균 토큰, 평균 비용, input/output 비율을 나란히 놓는다. code reasoning은 tool 상호작용 없이 한 번에 답하는 단일 라운드 문제 풀이이고, code chat은 코딩 문제를 놓고 여러 차례 주고받는 대화다.
| 작업 유형 | 데이터셋 | 평균 토큰 | 평균 비용 | input/output 비율 |
|---|---|---|---|---|
| code reasoning | CRUXEval | 1,190개 | $0.016 | 0.16 |
| code chat | Code-feedback ShareGPT | 3,390개 | $0.023 | 1.33 |
| agentic coding | SWE-bench Verified | 417만 개 | $1.857 | 153.85 |
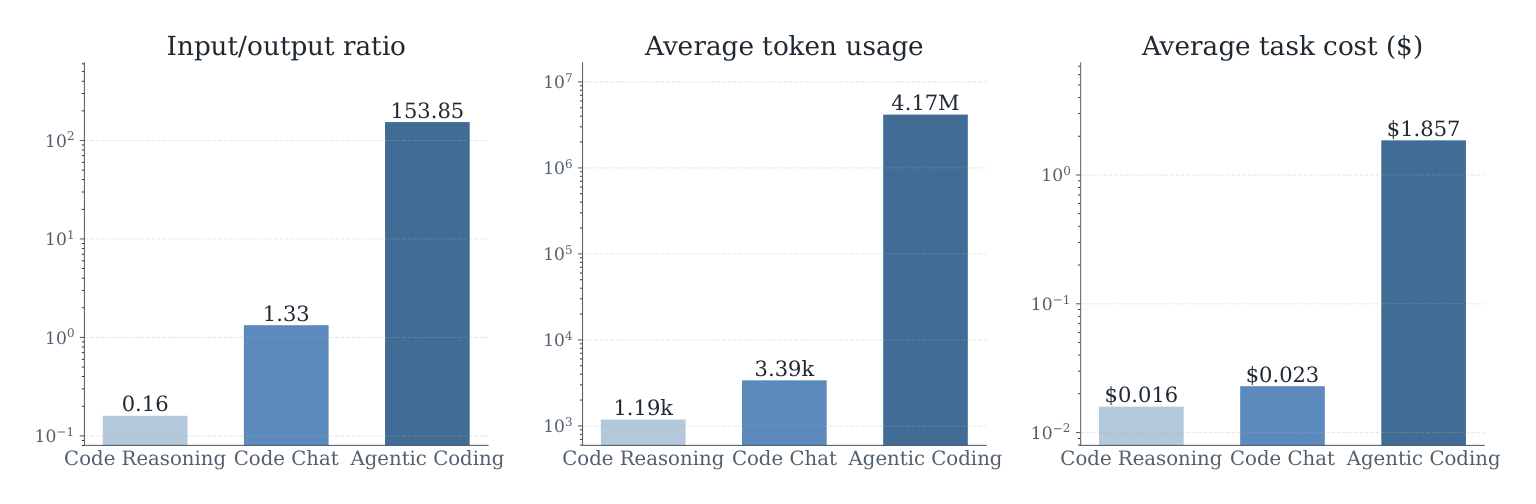
배율로 보면 agentic coding은 code reasoning의 3500배, code chat의 1200배 토큰을 쓴다. 초록은 이를 1000배 규모로 요약한다. 비용으로 환산하면 문제 하나당 평균 $1.857로, code chat의 $0.023보다 약 80배 크다.
input이 비용을 지배한다
세 유형을 가르는 지표는 총 토큰보다 input/output 비율이다. code reasoning의 0.16은 output이 input보다 많다는 뜻이고, code chat의 1.33은 둘이 비슷하다는 뜻이다. agentic coding의 153.85는 input이 output의 150배를 넘는다는 뜻이다.
이 비대칭이 나오는 경로는 두 가지다. 하나는 서로 다른 출처의 정보가 trajectory 동안 계속 누적되는 것이고, 다른 하나는 같은 컨텍스트가 라운드마다 모델에 반복 입력되는 것이다. token caching을 켜도 비용 차이는 남는다. 캐시는 단가를 낮추지만 라운드마다 컨텍스트를 다시 읽어야 하는 사실 자체는 바꾸지 못하기 때문이다.
이 결과가 논문 전체의 출발점이 된다. agentic 작업은 다른 작업 유형과 정도가 아니라 종류가 다르며, 따라서 별도의 비용 분석이 필요하다는 것이다.
토큰 비용의 변동성
문제 사이의 변동
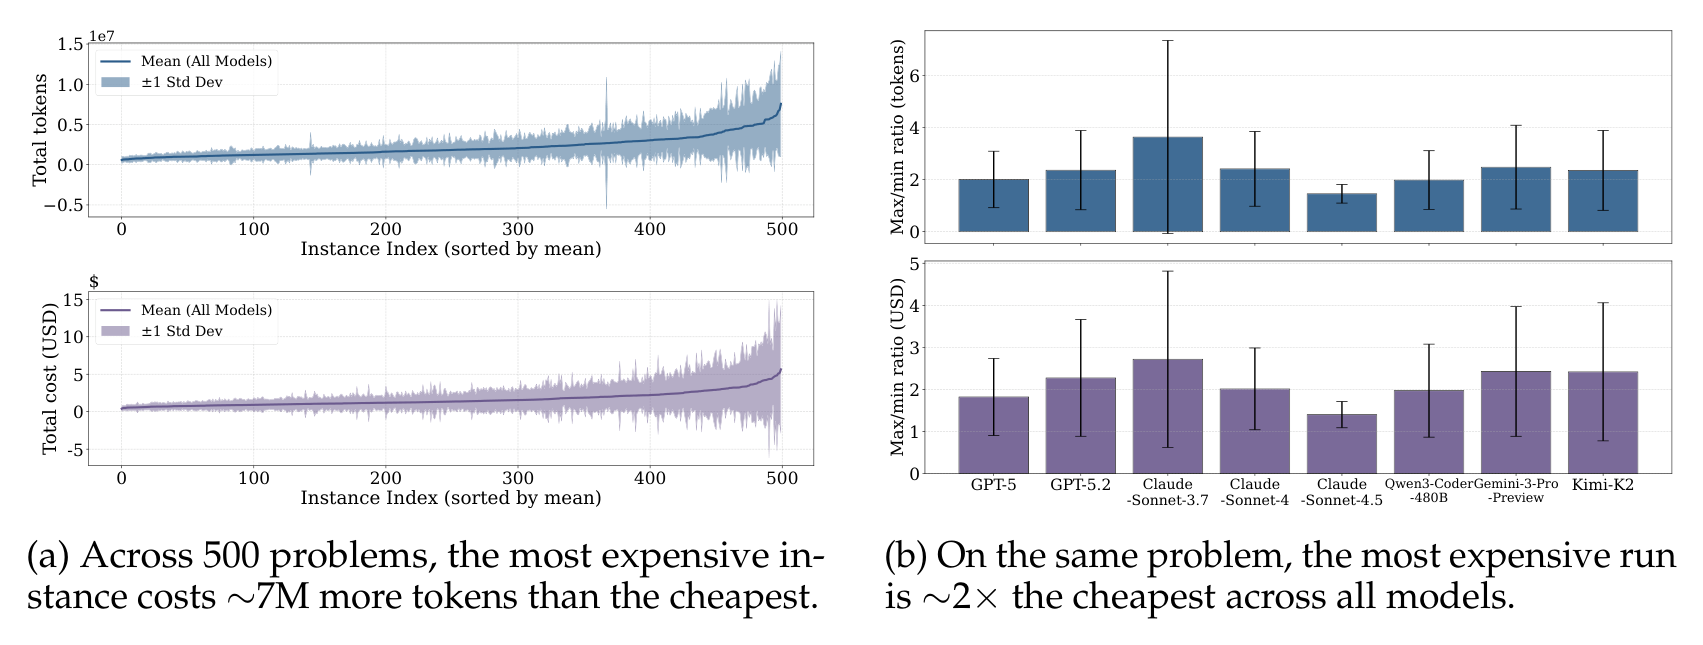
500문제를 평균 비용 순으로 세우면 분포의 오른쪽 꼬리가 두껍다. 가장 비싼 문제는 가장 싼 문제보다 평균 약 700만 토큰을 더 쓴다. 그리고 토큰 비용이 큰 문제일수록 실행 간 표준편차도 커진다. 복잡한 작업에서 에이전트 행동이 점점 불안정해진다는 뜻이다.
같은 문제를 다시 풀 때
같은 모델이 같은 문제를 4회 실행할 때 최대 비용과 최소 비용의 비율은 평균 약 2배다. 모델별로 나눠 보면 다음과 같다. 값은 Figure 2b에서 읽은 근사값이고 500문제 평균이다.
| 모델 | 최대/최소 비율 (토큰) | 최대/최소 비율 (USD) |
|---|---|---|
| GPT-5 | 약 2.0 | 약 1.85 |
| GPT-5.2 | 약 2.4 | 약 2.3 |
| Claude Sonnet-3.7 | 약 3.6 | 약 2.7 |
| Claude Sonnet-4 | 약 2.4 | 약 2.05 |
| Claude Sonnet-4.5 | 약 1.45 | 약 1.4 |
| Qwen3-Coder-480B | 약 2.0 | 약 2.0 |
| Gemini-3-Pro-Preview | 약 2.45 | 약 2.45 |
| Kimi-K2 | 약 2.35 | 약 2.4 |
Sonnet-4.5가 약 1.45배로 가장 안정적이고 Sonnet-3.7이 약 3.6배로 가장 불안정하다. 다만 오차 막대가 커서 Sonnet-3.7의 경우 문제별 표준편차의 상한이 7배를 넘는다. 초록이 말하는 "같은 작업의 실행 간 최대 30배 차이"는 이 평균값이 아니라 분포 꼬리에서 관측된 극단값이다. 두 수치를 혼동하면 변동성을 실제보다 크게 또는 작게 읽게 된다.
논문은 이 결과를 실행 전 비용 예측과 agent pricing이 근본적으로 어려운 이유로 제시한다. 같은 입력을 넣어도 결과 비용이 확률적으로 흔들리므로 인스턴스 단위 점 추정이 근본적으로 어려워진다는 것이다.
토큰을 더 쓴 실행이 더 정확하지 않다
문제 수준의 역관계
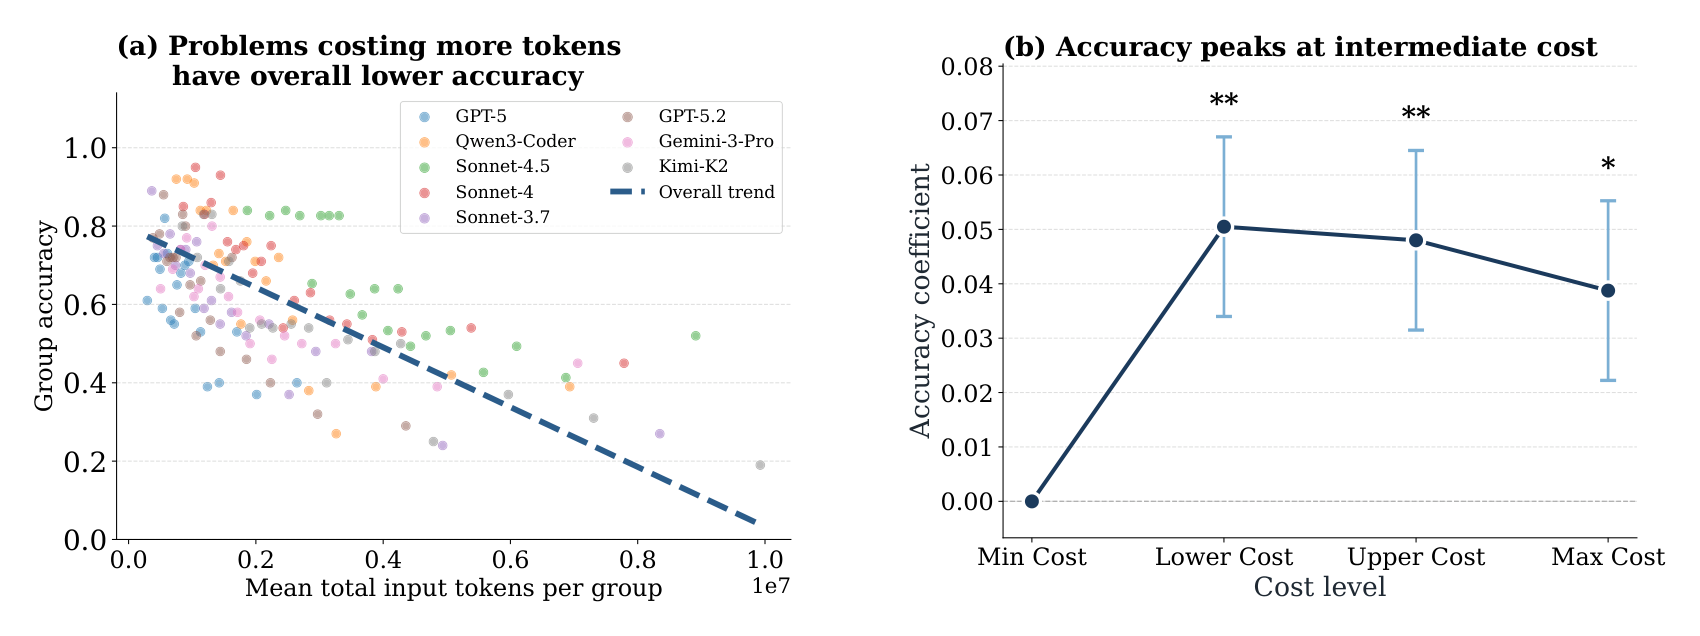
input 토큰을 많이 쓴 문제일수록 집단 정확도가 낮다. 이 패턴은 8개 모델 전부에서 일관되게 나타난다. 어려운 문제가 복잡하니 토큰을 더 쓰고 정답률도 낮다는 해석이 가장 자연스럽고, 논문도 그렇게 설명한다. output 토큰으로 다시 계산해도 같은 방향이다(Appendix A).
같은 문제 안의 4분위 비교
문제 난이도가 개입하지 않는 비교를 만들려면 같은 문제의 4회 실행을 비용 순으로 나눠야 한다. 논문은 이를 MinCost, LowerCost, UpperCost, MaxCost로 묶고 MinCost를 기준 범주로 삼아 mixed-effects 회귀로 정확도 계수를 추정했다.
| 비용 수준 | 정확도 계수 (MinCost 대비) | 유의성 |
|---|---|---|
| MinCost | 0 (기준) | 기준 |
| LowerCost | +0.050 | p<0.01 |
| UpperCost | +0.048 | p<0.01 |
| MaxCost | +0.039 | p<0.05 |
네 구간 모두 MinCost보다는 정확도가 높다. 그러나 정점은 LowerCost이고 그 위로는 계수가 완만히 낮아진다. 즉 최소 비용 실행은 확실히 손해지만, 중간 비용을 넘어 토큰을 더 쓰는 것은 이득으로 돌아오지 않는다. LowerCost와 MaxCost의 차이는 1.1%p로 크지 않으나 방향이 반대라는 점이 중요하다.
이 비단조 추세는 inverse test-time scaling 계열의 최근 결과와 일치한다. 추론 단계를 늘리거나 chain-of-thought를 길게 뽑아도 정확도가 반드시 오르지 않고, 오히려 distractor나 허위 상관, 비효율적 추론 순환을 증폭할 수 있다는 관찰이다. agentic 환경에서도 long-horizon이나 앙상블 방식 시스템에서 연산량 증가가 작업 해결로 안정적으로 이어지지 않는 효율과 성능의 교환 관계가 보고되어 왔다.
논문 안에서도 서술이 조금씩 다르다. 본문 3절과 Figure 3b 캡션은 "고비용에서 포화"로 쓰고, 서론은 "최고 비용 구간에서 하락"으로 쓴다. 계수 값을 기준으로 보면 MinCost 대비로는 끝까지 양수이고 LowerCost 정점 대비로는 하락이므로, 두 서술은 비교 기준이 다른 같은 사실이다.
고비용 실패의 행동 원인
정확도와 비용의 역관계 뒤에 무슨 행동이 있는지를 논문은 반복 파일 액션으로 설명한다. 같은 4분위 구간에 대해 반복 modify와 반복 view의 빈도 계수를 같은 방식으로 추정했다.
| 비용 수준 | 반복 modify 계수 | 반복 view 계수 | 유의성 |
|---|---|---|---|
| MinCost | 0 (기준) | 0 (기준) | 기준 |
| LowerCost | 0.98 | 0.61 | 미표시 |
| UpperCost | 1.88 | 1.17 | p<0.01 |
| MaxCost | 3.63 | 1.97 | p<0.001 |
MaxCost 실행은 MinCost 실행보다 같은 파일을 다시 고치는 횟수가 3.63회, 다시 읽는 횟수가 1.97회 많다. 비싸지만 실패한 실행에는 파일 접근과 재편집이 오가는 중복이 있고, 이 비효율적 탐색이 컨텍스트 길이와 토큰 사용을 부풀리면서도 진척에는 비례하지 않는다는 해석이다.
논문은 여기서 주장을 한정한다. 모든 고비용 실행이 중복 때문은 아니라고 명시하면서, 이 패턴이 정확도와 비용의 역관계에 대한 구체적 행동 설명 하나를 제공한다고만 말한다.
전문가 난이도와 실제 비용
사람이 어렵다고 본 문제와 에이전트가 비싸게 푼 문제는 얼마나 겹치는가. 논문은 SWE-bench Verified의 전문가 난이도 라벨과 실제 토큰 소비의 순위 상관을 재고, 정렬이 완전할 때 기대되는 색 배열과 실제 배열을 나란히 보여준다.
| 지표 | 값 |
|---|---|
| Kendall τb | 0.32 |
| 95% 신뢰구간 | 0.25에서 0.38 |
| "<15 min" 라벨인데 ">1 hour" 평균보다 비싼 작업 | 6.7% |
| ">1 hour" 라벨인데 "<15 min" 평균보다 싼 작업 | 11.1% |
| "<15 min" 집단 평균 토큰 | 약 180만 개 |
| ">1 hour" 집단 평균 토큰 | 약 300만 개 |
순위 단조 연관은 통계적으로 실재하지만 완만하고, 세 난이도 집단의 분포는 전 구간에서 크게 겹친다. 사람이 쉽다고 본 작업이 모델에게는 광범위한 추론과 탐색, tool 상호작용을 요구할 수 있고, 반대로 어려운 문제가 모델의 사전 지식이나 탐색 전략 덕에 효율적으로 풀리기도 한다. 결과적으로 사람이 매긴 난이도는 에이전트 자원 소비의 약한 예측자다.
논문의 결론은 사람이 매긴 난이도가 에이전트 자원 소비의 약한 예측자라는 것이다. 난이도 라벨만 보고 비용을 통제하려는 접근은 이 결과 위에서 근거가 약해진다.
모델별 토큰 효율
비용과 정확도의 교환 관계
500문제 전체 평균으로 모델을 놓으면 토큰 예산이 큰 모델이 대체로 정확도가 높다. 그러나 이 교환 관계를 다루는 솜씨는 모델마다 크게 다르다. 아래 값은 Figure 6a에서 읽은 근사값이다.
| 모델 | 평균 총 토큰 | 평균 정확도 |
|---|---|---|
| GPT-5 | 약 1.0M | 약 0.60 |
| GPT-5.2 | 약 1.35M | 약 0.63 |
| Claude Sonnet-3.7 | 약 2.0M | 약 0.60 |
| Gemini-3-Pro-Preview | 약 2.2M | 약 0.59 |
| Qwen3-Coder-480B | 약 2.35M | 약 0.66 |
| Claude Sonnet-4 | 약 2.8M | 약 0.69 |
| Claude Sonnet-4.5 | 약 2.8M | 약 0.72 |
| Kimi-K2 | 약 3.25M | 약 0.55 |
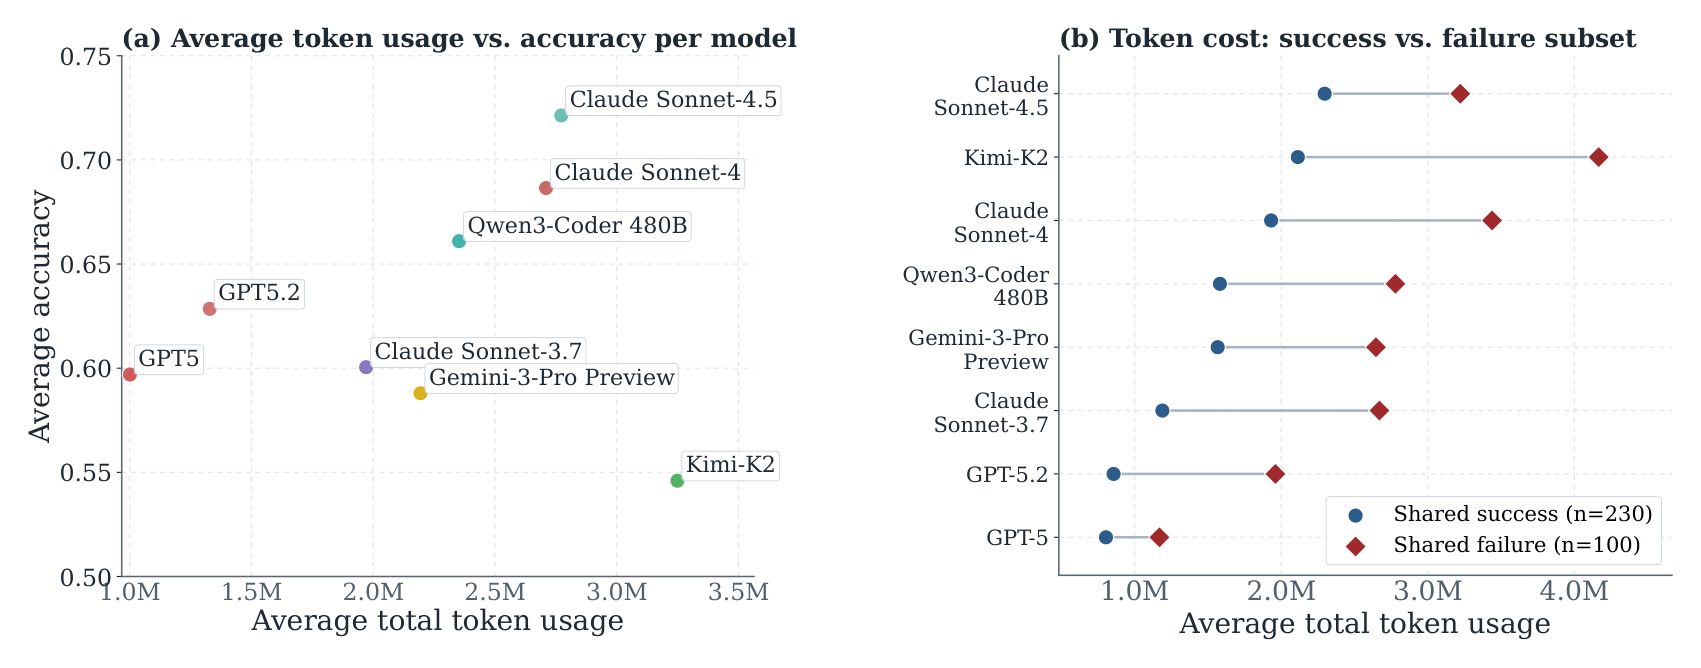
세 무리로 갈린다. GPT-5와 GPT-5.2는 낮은 비용으로 준수한 정확도를 낸다. Sonnet-4.5, Sonnet-4, Qwen3-Coder-480B는 고비용 구간에서 동작하며 그중 Sonnet-4.5가 가장 높은 정확도를 얻는다. Kimi-K2는 비용이 가장 크면서 정확도가 가장 낮은 outlier다. Sonnet-3.7과 Gemini-3-Pro-Preview는 중간 비용대에서 GPT-5와 비슷한 정확도에 머문다.
Sonnet-4.5는 GPT-5보다 정확도가 12%p 높지만 토큰은 약 2.8배 쓴다. 같은 작업을 얼마에 풀 것인지는 이 교환 관계 위에서 결정할 문제라는 뜻이다.
성공 subset과 실패 subset
토큰 격차가 모델의 성질인지 문제의 성질인지를 가리려면 문제를 고정해야 한다. 논문은 8개 모델이 모두 성공한 문제 230건과 모두 실패한 문제 100건을 따로 뽑아 비교했다. 이상적으로는 강한 모델이 쉬운 문제에서 토큰을 덜 쓰고 어려운 문제에서는 조기에 멈춰야 한다.
| 모델 | 공통 성공 (n=230) | 공통 실패 (n=100) | 증가폭 |
|---|---|---|---|
| GPT-5 | 약 0.8M | 약 1.2M | 약 0.4M |
| GPT-5.2 | 약 0.9M | 약 2.0M | 약 1.1M |
| Claude Sonnet-3.7 | 약 1.2M | 약 2.7M | 약 1.5M |
| Gemini-3-Pro-Preview | 약 1.6M | 약 2.65M | 약 1.1M |
| Qwen3-Coder-480B | 약 1.6M | 약 2.8M | 약 1.2M |
| Claude Sonnet-4 | 약 1.95M | 약 3.45M | 약 1.5M |
| Claude Sonnet-4.5 | 약 2.3M | 약 3.25M | 약 0.95M |
| Kimi-K2 | 약 2.1M | 약 4.2M | 약 2.1M |
두 subset 모두에서 모델별 토큰 사용량의 상대 순위가 유지된다. 격차가 문제 난이도 때문이거나 특정 모델이 더 어려운 문제를 맡은 탓이 아니라는 근거다. 같은 작업이 어떤 모델에게는 그저 더 비싸며, 이는 문제의 속성이 아니라 모델의 행동 성향이다. 논문은 이를 "토큰 효율은 모델의 내재적 특성"이라고 표현한다.
모든 모델이 실패 subset에서 토큰을 더 쓰지만 증가폭 차이가 크다. GPT-5는 약 0.4M만 늘고 Kimi-K2는 약 2.1M 늘어난다. 작업이 풀리지 않는다는 것을 알아채고 조기에 멈추는 신뢰할 만한 장치가 없어서, 진척 없이 탐색과 재시도와 컨텍스트 재독을 계속하기 때문이라고 해석한다. 초과 지출의 크기가 모델마다 다르므로 효율 격차는 체계적이며 실패 상황에서 증폭된다.
한 가지 유의할 점이 있다. 논문 본문은 GPT-5와 GPT-5.2를 함께 "0.5M 미만 증가"로 묶지만, Figure 6b에서 GPT-5.2의 증가폭은 약 1.1M으로 읽힌다. 0.5M 미만이라는 서술은 GPT-5에만 들어맞는다.
파일 액션 패턴
모델 수준 효율 차이가 어디서 생기는지를 논문은 더 미세한 행동 지표로 파고든다. 공통 성공 subset에서 파일 view 액션과 modify 액션의 평균 횟수, 그중 같은 파일에 대한 반복 횟수를 셌다.
| 모델 | view 전체 | view 반복 | modify 전체 | modify 반복 |
|---|---|---|---|---|
| Claude Sonnet-3.7 | 6.86 | 3.52 | 8.90 | 4.37 |
| Claude Sonnet-4 | 14.20 | 7.17 | 10.70 | 4.45 |
| Claude Sonnet-4.5 | 11.24 | 5.80 | 8.95 | 2.48 |
| Qwen3-Coder-480B | 15.42 | 7.93 | 10.20 | 3.18 |
| Gemini-3-Pro-Preview | 7.14 | 3.54 | 7.32 | 4.11 |
| Kimi-K2 | 15.27 | 7.92 | 14.02 | 7.05 |
| GPT-5 | 2.38 | 0.65 | 1.93 | 0.82 |
| GPT-5.2 | 3.18 | 1.10 | 2.00 | 0.87 |
절대 횟수 차이가 먼저 눈에 띈다. GPT-5는 파일을 평균 2.38회 보고 1.93회 고쳐서 같은 문제를 푼다. Kimi-K2는 15.27회 보고 14.02회 고친다. 6배 이상의 액션 수 차이가 그대로 토큰 차이로 이어진다.
반복 비율로 바꿔 보면 다음과 같다.
| 모델 | view 반복 비율 | modify 반복 비율 |
|---|---|---|
| Claude Sonnet-3.7 | 51% | 49% |
| Claude Sonnet-4 | 50% | 42% |
| Claude Sonnet-4.5 | 52% | 28% |
| Qwen3-Coder-480B | 51% | 31% |
| Gemini-3-Pro-Preview | 50% | 56% |
| Kimi-K2 | 52% | 50% |
| GPT-5 | 27% | 42% |
| GPT-5.2 | 35% | 44% |
토큰 효율이 좋은 GPT-5와 GPT-5.2는 view 반복 비율이 27%와 35%로 낮다. 다른 여섯 모델은 view 반복 비율이 50%에서 52% 사이에 몰려 있다. 논문 본문은 고비용 모델(Qwen3-Coder-480B, Sonnet-4, Kimi-K2)의 파일 액션 중 약 50%가 반복이라고 쓰는데, view 쪽에서는 정확하고 modify 쪽에서는 Kimi-K2만 50%에 닿는다. Sonnet-4.5는 view 반복이 52%인데 modify 반복은 28%로 여덟 모델 가운데 가장 낮다.
논문은 모델 효율이 액션 횟수만이 아니라 그 액션이 얼마나 효과적으로 수행되는지에 함께 달려 있다고 결론짓는다.
단계별 비용 구조
long-horizon 작업의 trajectory는 길고 복잡하다. 라운드를 거치며 컨텍스트가 누적되고, 서로 다른 action type이 뒤섞이고, 같은 파일을 반복해 읽고 쓴다. 비용 쪽에서는 토큰 종류마다 단가가 달라, 같은 총 토큰 수가 언제 어떻게 쓰였는지에 따라 전혀 다른 금액이 된다. 논문은 Claude Sonnet-4.5를 사례로 phase 수준과 라운드 수준의 두 단계로 비용을 분해한다.
phase별 토큰량
토큰량으로 보면 cache-read input이 다섯 phase 전부에서 압도적 최대 범주다. 아래는 Figure 8a의 로그 축에서 읽은 근사값이다.
| phase | output | cache creation | non-cached input | cache read |
|---|---|---|---|---|
| Setup | 약 1,600개 | 약 7,400개 | 약 7,600개 | 약 7.4만 개 |
| Explore | 약 6,000개 | 약 1.85만 개 | 약 1.9만 개 | 약 54만 개 |
| Fix | 약 8,500개 | 약 1.9만 개 | 약 1.95만 개 | 약 100만 개 |
| Validate | 약 3,800개 | 약 8,800개 | 약 9,000개 | 약 64만 개 |
| Closeout | 약 2,400개 | 약 4,400개 | 약 4,500개 | 약 42만 개 |
세 가지를 읽을 수 있다. 첫째, cache read가 어느 단계에서든 다른 범주보다 한 자리에서 두 자리 배율 크다. 이전 컨텍스트를 누적해 재사용하기 때문이다. 둘째, non-cached input과 cache creation은 거의 같은 값으로 붙어 움직인다. 새로 들어온 컨텍스트가 대화에 진입하는 즉시 캐시된다는 해석과 맞는다. 셋째, output은 절대량으로는 Fix에서 가장 크지만 같은 phase 안의 다른 범주와 비교한 상대 비중은 planning 생성이 몰린 Setup에서 가장 높다.
phase별 달러 비용
같은 데이터를 금액으로 환산하면 그림이 달라진다. 아래는 Figure 8b에서 읽은 근사값이며 단위는 USD다.
| phase | output | cache creation | non-cached input | cache read | 합계 |
|---|---|---|---|---|---|
| Setup | 0.027 | 0.029 | 0.024 | 0.023 | 약 0.103 |
| Explore | 0.094 | 0.070 | 0.056 | 0.162 | 약 0.382 |
| Fix | 0.130 | 0.072 | 0.058 | 0.303 | 약 0.563 |
| Validate | 0.060 | 0.034 | 0.028 | 0.195 | 약 0.317 |
| Closeout | 0.038 | 0.017 | 0.014 | 0.125 | 약 0.194 |
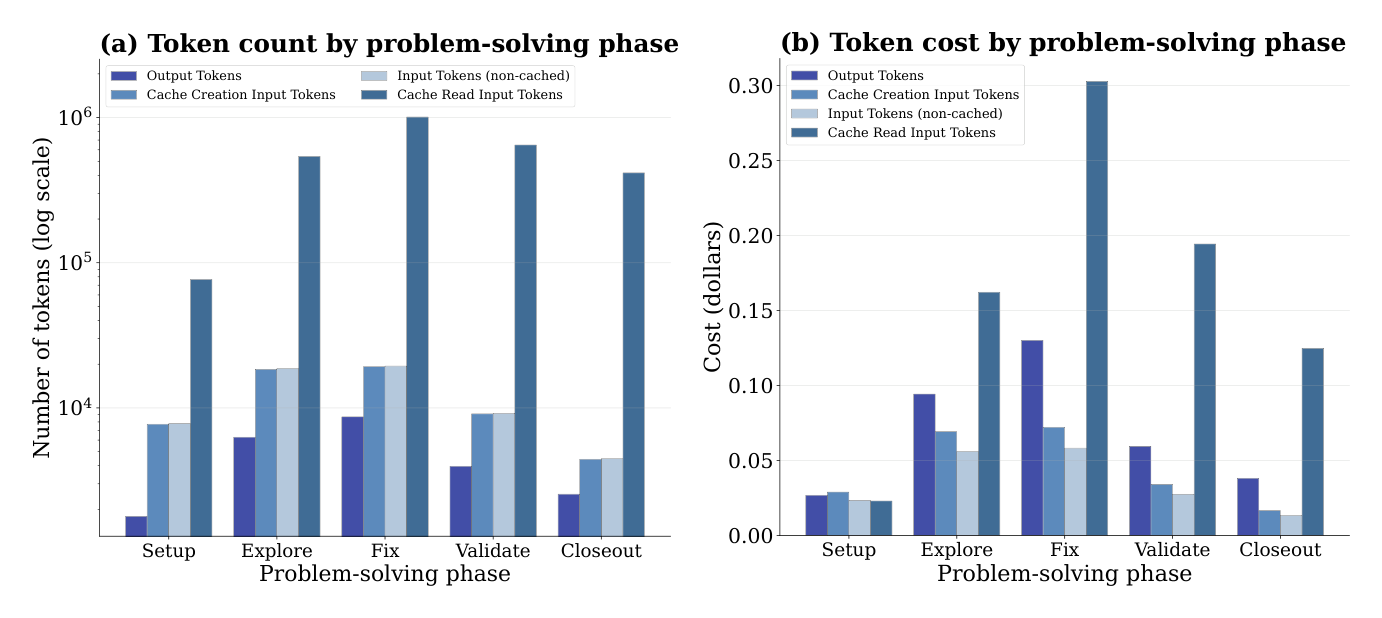
output 토큰은 cache read보다 토큰당 약 80배 비싸다. 그런데도 Explore부터 Closeout까지 네 단계에서는 cache read가 최대 비용 항목이다. 누적된 컨텍스트의 물량이 단가 차이를 압도할 만큼 크다는 뜻이다. Fix에서 cache read 하나가 $0.303으로 그 phase 총액의 절반을 넘는다.
Setup은 예외다. 네 항목이 $0.023에서 $0.029 사이에 몰려 있고 cache read가 오히려 가장 작다. 아직 누적할 컨텍스트가 없는 첫 단계라서다. 논문 본문은 "모든 phase에서 cache read가 지배적 비용 기여자"라고 쓰지만 Figure 8b의 Setup은 그 서술과 맞지 않는다. Figure 8 캡션이 쓴 "input 토큰이 토큰량과 비용을 모두 지배한다"는 표현이 세 input 항목의 합계 기준으로 정확하다. Setup에서도 input 합계 $0.076이 output $0.027보다 크다.
비용 배분으로 보면 Fix가 총액의 약 36%, Explore가 약 25%를 차지해 두 단계가 61%로 절반을 넘는다. 라운드 비중(Fix 33.53%, Explore 30.37%)과 대체로 맞아떨어지지만, Fix가 라운드 비중보다 비용 비중이 더 높은 것은 그 단계에서 컨텍스트가 이미 최대로 쌓여 있기 때문이다.
라운드별 동역학
논문은 astropy-7336 문제의 Sonnet-4.5 trajectory 31라운드를 사례로 라운드마다 비용을 네 종류로 쪼갠다. cache read 비용은 컨텍스트가 누적되며 완만히 증가해 라운드마다 비교적 안정적인 기준선을 만든다. Figure 9에서 읽으면 이 기준선은 1라운드 약 $0.001에서 30라운드 약 $0.011로 커진다.
라운드 총비용은 단조 증가와 거리가 멀다. 최소 약 $0.004(3라운드)에서 최대 약 $0.027(28라운드) 사이에서 오르내린다. 스파이크는 컨텍스트에 새 내용을 들이는 특정 액션에서 발생한다. 저장소 탐색, 파일 생성, 테스트 실행, 최종 요약이 그런 액션이다. 누적 컨텍스트 재사용 비용은 꾸준하고 예측 가능하며, 개별 라운드를 비싸게 만드는 것은 그 라운드에 에이전트가 컨텍스트에 무엇을 새로 넣기로 했는지다.
| 라운드 | 지배 비용 유형 | tool | 액션 요약 |
|---|---|---|---|
| 1 | output | think | 이슈에 대한 계획과 추론 |
| 10 | non-cached input | file_editor (view + create) | 테스트 파일 읽고 재현 스크립트 생성 |
| 17 | output | file_editor (create) | 디버깅용 테스트 스크립트 작성 |
| 23 | non-cached input | terminal (pytest) + file_editor | 테스트 실행과 검증 스크립트 생성 |
| 28 | non-cached input | terminal (pytest + cleanup) | 테스트 실행과 파일 정리 |
| 31 | output | finish | 수정 내용 최종 요약 |
라운드 10, 23, 28은 새 파일 열기, 테스트 실행, 산출물 정리처럼 tool call이 새 내용을 되돌려 주는 input 중심 라운드이고 non-cached input 비용이 급하게 오른다. 라운드 1, 17, 31은 계획과 편집처럼 에이전트 자신의 추론과 생성이 주도하는 output 중심 라운드다.
이 패턴은 phase의 기능적 역할과도 맞아떨어진다. Setup에서는 추론과 계획이라 output이 비용을 주도한다. Explore로 넘어가 저장소 조사와 코드 읽기가 대량의 내용을 context window로 끌어오면서 input이 비용을 넘겨받는다. Fix, Validate, Closeout에서는 스크립트 생성과 코드 수정 때문에 output이 다시 올라오고, input은 테스트 결과와 실행 출력을 읽는 비용을 반영한다.
실행 전 비용 예측
문제 설정
앞의 분석은 오늘의 agent pricing이 안고 있는 긴장을 드러낸다. 토큰 소비는 작업과 실행에 따라 넓게 흔들리고, 비용을 더 쓴다고 결과가 좋아지지도 않는다. 사용자는 미리 볼 수 없는 청구서에 서명하고, 끝내 실패한 실행에도 상당한 금액을 낸다. 제공자 쪽 문제는 다르지만 뿌리가 같다. 비용을 미리 가늠할 방법이 없으면 고객에게 예측 가능하게 느껴지면서 재무적으로도 지속 가능한 가격 계층을 설계하기 어렵고, 예산 상한을 강제하거나 비싼 실행을 사전에 잡아내기도 어렵다.
논문은 이 지점에서 agent token consumption prediction 문제를 정식화하고, 실행 에이전트 자신을 예측기로 쓰는 self-prediction 설정에서 8개 모델을 벤치마크한다.
상관과 오버헤드
| 모델 | input 상관 r | output 상관 r | 오버헤드 |
|---|---|---|---|
| Claude Sonnet-3.7 | 0.24 | 0.21 | 2.29 |
| Claude Sonnet-4 | 0.28 | 0.33 | 2.09 |
| Claude Sonnet-4.5 | 0.34 | 0.39 | 0.32 |
| Qwen3-Coder-480B | 0.21 | 0.21 | 0.52 |
| Gemini-3-Pro-Preview | 0.05 | 0.04 | 0.36 |
| Kimi-K2 | 0.38 | 0.12 | 0.19 |
| GPT-5 | 0.26 | 0.32 | 0.47 |
| GPT-5.2 | 0.24 | 0.26 | 0.05 |
상관은 우연 수준을 넘지만 약한 편에서 중간 정도에 머문다. Claude Sonnet 계열은 세대가 올라갈수록 상관이 꾸준히 개선되어 Sonnet-4.5의 output 예측에서 0.39로 전체 최고를 찍는다. GPT-5, GPT-5.2, Kimi-K2, Qwen3-Coder는 비슷한 수준에 모여 있고 Gemini-3-Pro-Preview는 input 0.05, output 0.04로 사실상 예측이 되지 않는다.
논문은 input 예측이 output 예측보다 일관되게 어렵다고 서술한다. 긴 trajectory에서 input 토큰의 규모와 증가 속도를 생각하면 놀랍지 않다는 설명이다. 표를 모델별로 보면 이 방향이 뚜렷한 것은 Sonnet-4, Sonnet-4.5, GPT-5, GPT-5.2의 네 모델이다. Sonnet-3.7과 Gemini-3-Pro-Preview는 차이가 0.01에서 0.03으로 미미하고, Kimi-K2는 input이 0.38로 오히려 훨씬 높다. Kimi-K2가 다른 모델보다 컨텍스트 팽창에 민감할 가능성을 논문은 예외로 언급한다.
오버헤드는 예측 자체도 agentic 작업이라 발생하는 추가 비용이다. 대부분의 모델에서 예측은 실행보다 훨씬 싸고 원래 작업 비용의 절반 미만에 머문다. 그러나 오버헤드와 정확도의 관계는 단조가 아니다.
| 관찰 | 근거 |
|---|---|
| 비싸게 예측해도 잘 맞히지 않는다 | Sonnet-3.7과 Sonnet-4는 작업 비용의 2배가 넘는 비용을 쓰고도 최고 상관을 얻지 못한다 |
| 싸게 예측하면서 잘 맞힐 수 있다 | Sonnet-4.5는 0.32배 비용으로 최고 상관 0.39를 낸다 |
| 오버헤드는 매우 낮출 수 있다 | GPT-5.2는 오버헤드를 6% 아래로 줄이면서 중간 수준 상관을 유지한다 |
논문은 이를 근거로 합리적인 연산량만으로도 더 나은 예측이 가능하며, 오버헤드를 비례해 늘리지 않고도 예측 정확도를 개선할 여지가 크다고 본다.
체계적 과소추정
상관은 예측과 실제 사이 연관의 강도를 재지만 방향은 재지 않는다. 논문은 과대추정인지 과소추정인지를 보려고 예측 분포와 실제 분포를 산점도로 겹쳐 놓았다.
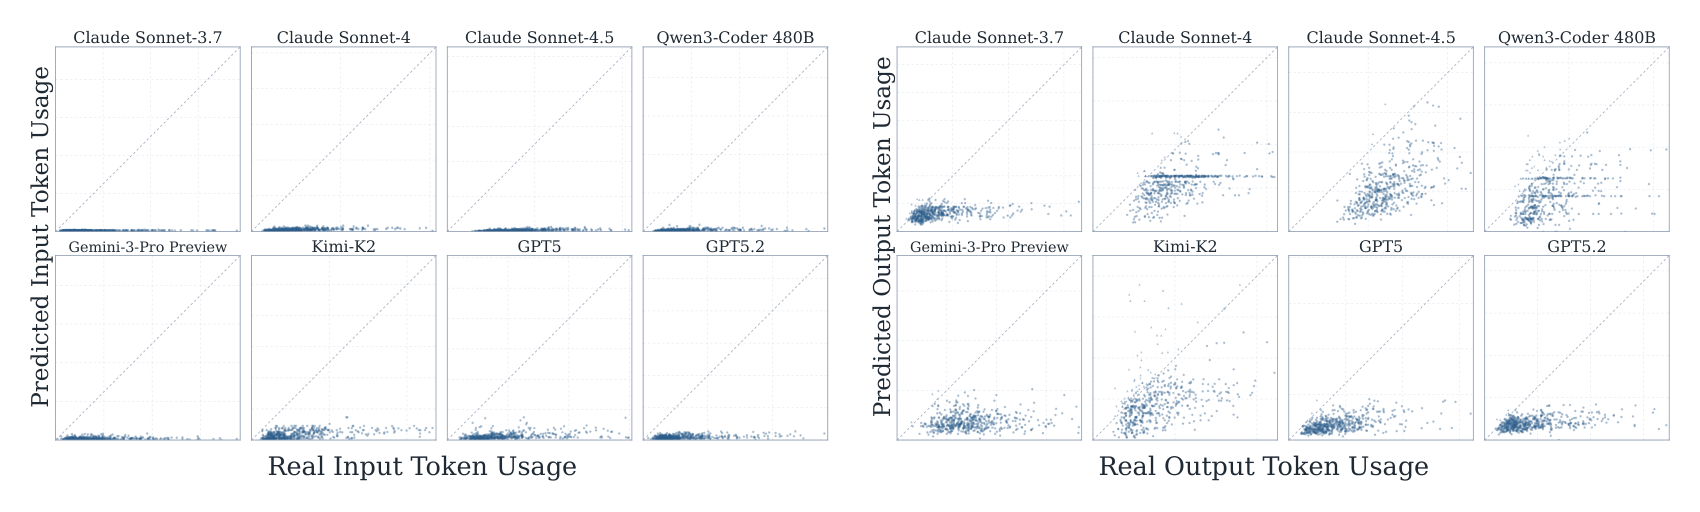
여덟 모델 모두에서 대부분의 점이 완전 보정선 아래에 놓인다. 즉 모델들은 자기가 필요할 토큰을 일관되게 적게 부른다. 편향은 input 토큰에서 특히 두드러진다. 실제 값이 수백만 단위로 커지는데도 예측은 낮은 구간에 눌린 채 거의 평평하다. output 예측에서는 점들이 대각선을 따라 어느 정도 퍼지지만, input 예측에서는 실제 값의 변화가 예측에 거의 반영되지 않는다.
in-context 예시를 뺀 대조 실험
과소추정이 프롬프트에 넣은 worked example 때문에 생긴 anchoring일 가능성을 논문은 별도 실험으로 검증한다(Appendix D). 예시 없이 다시 실행했더니 대부분의 모델이 토큰 추정 지시를 일관되게 따르지 못했다. 그래서 지시를 계속 지킨 Sonnet-4.5와 GPT-5.2 두 모델만 보고한다.
| 모델 | 토큰 종류 | 실제값 상관 | 예시 있을 때 상관 |
|---|---|---|---|
| Sonnet-4.5 | input | 0.1355 | 0.34 |
| Sonnet-4.5 | output | 0.1229 | 0.39 |
| GPT-5.2 | input | 0.1796 | 0.24 |
| GPT-5.2 | output | 0.2130 | 0.26 |
Sonnet-4.5는 상관이 3분의 1 수준으로 떨어지고 GPT-5.2도 낮아진다. 과소추정은 사라지지 않고 오히려 심해지며, 여전히 input 쪽이 더 심하다. 부수 지표도 함께 보고한다.
| 모델 | 토큰 종류 | 절대오차와 작업 비용의 상관 | 예측 비용과 작업 비용의 상관 |
|---|---|---|---|
| Sonnet-4.5 | input | 0.1155 | 0.1185 |
| Sonnet-4.5 | output | -0.4563 | 0.1185 |
| GPT-5.2 | input | 0.2243 | 0.2461 |
| GPT-5.2 | output | 0.0822 | 0.2461 |
결론은 하향 편향이 예시가 유도한 anchoring이 아니라는 것이다. 예시는 보정을 개선하는 역할을 하고, long-horizon 토큰 성장을 미리 내다보는 근본적 난이도는 예시 유무와 무관하게 남는다.
한계
- 모델 범위: 8개 frontier 모델은 기존 연구 기준으로 넓은 표본이지만 여전히 agentic 모델 지형의 일부다. 전체 실행 trajectory 수집이 연산 비용이 커서 포함 가능한 모델 수가 제약되었다. 관찰된 질적 패턴은 테스트한 모델 전반에서 일관되지만, 더 넓은 아키텍처와 에이전트 설계에서 검증하면 일반성이 강화된다. 논문은 이를 위해 실험 파이프라인을 공개했다.
- 단일 프레임워크와 단일 벤치마크: 모든 측정이 OpenHands와 SWE-bench Verified 조합 위에서 이뤄졌다. phase 분해와 라운드 분해는 그중 Claude Sonnet-4.5 실행만을 대상으로 한 사례 연구다.
- 인스턴스 단위 예측의 한계: 상관이 우연 수준을 넘지만 정확한 인스턴스 단위 비용 추정을 지탱하기에는 여전히 부족하다. 예측 자체가 지연과 오버헤드를 수반하므로, 실행 전에 광범위하게 탐색하는 모델일수록 대화형이나 시간 제약 환경에서 정당화하기 어렵다.
- 열린 문제: 정확성, 효율성, 실행과의 매끄러운 통합을 함께 달성하는 self-prediction은 아직 해결되지 않았다.
시사점
사용자 투명성
이상적으로는 에이전트 시스템이 실행 전에 예상 비용을 알려 주고 사용자가 정보에 근거해 결정하게 해야 한다. 현재 언어 모델의 점 추정 능력은 정확한 금액을 제시할 수준이 아니다. 그렇더라도 고비용 작업을 가려내는 coarse 신호는 얻을 수 있고, 그 정도만으로도 제공자가 할 수 있는 일이 있다.
| 가능한 조치 | 필요한 신호 수준 |
|---|---|
| 조기 경고 발송 | 고비용 구간에 들 가능성만 |
| 명시적 사용자 승인 요구 | 같음 |
| 대안 실행 모드 제안 | 같음 |
| 정확한 금액 사전 고지 | 인스턴스 단위 점 추정 (현재 불가) |
가격 설계
구독 모델은 일반 사용자의 토큰 소비가 예측 가능하고 유계인 제품에서 작동한다. agentic 작업은 이 가정을 깨뜨린다. 단순한 문제도 멀티스텝 추론과 tool use 때문에 큰 토큰 예산을 소진할 수 있다.
| 가격 방식 | 현재 평가 |
|---|---|
| 순수 upfront pricing | input 토큰 변동이 크고 trajectory가 확률적이라 어렵다 |
| consumption-based pricing | 실행 전 추정이 더 신뢰할 만해질 때까지 가장 현실적인 선택 |
| budget-aware tool-use policy | 런타임에서 토큰 제약을 강제해 비용 변동성을 줄이는 보완 장치 |
제공자에게 지속 가능하고 사용자에게 예측 가능한 가격 체계를 함께 만드는 일은 후속 연구의 열린 방향으로 남는다.
원문 안의 불일치
이 페이지를 쓰면서 원문 본문과 그림 수치가 어긋나는 곳을 세 군데 확인했다. 인용할 때 주의할 지점이므로 함께 적는다.
| 위치 | 본문 서술 | 그림 또는 표의 값 |
|---|---|---|
| 4절 실패 subset 증가폭 | GPT-5와 GPT-5.2 모두 0.5M 미만 증가 | Figure 6b에서 GPT-5는 약 0.4M, GPT-5.2는 약 1.1M |
| 5.2절 phase 비용 | 모든 phase에서 cache read가 지배적 비용 기여자 | Figure 8b의 Setup은 cache read가 네 항목 중 가장 작다 |
| Appendix B.2 GPT 단가 | cached input을 base input의 0.2배로 계산 | 같은 절이 인용한 단가표는 $1.250 대 $0.125로 0.1배 |
본문의 그림 참조 번호도 두 곳에서 밀려 있다. 3절이 "Figure 2a"와 "Figure 2b"로 참조한 두 결과는 실제로 Figure 3a와 Figure 3b의 내용이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| agentic coding | 에이전트가 저장소를 읽고 이슈를 추론하며 tool을 호출해 여러 라운드에 걸쳐 문제를 스스로 푸는 작업. 라운드마다 전체 대화 이력이 그대로 누적된다 |
| cache read / cache creation | prompt caching에서 이미 처리한 컨텍스트를 할인 단가로 가져오는 것이 cache read, 나중에 재사용할 컨텍스트를 캐시에 기록하는 것이 cache creation |
| inverse test-time scaling | 추론 단계나 토큰을 더 써도 정확도가 오르지 않거나 오히려 떨어지는 현상 |
| self-prediction | 실행 에이전트 자신이 실행 전에 자기 토큰 비용을 추정하는 태스크 |
| prediction overhead | 실제 작업 비용 대비 예측 비용의 비율. 1을 넘으면 예측이 실행보다 비싸다 |
| shared success / shared failure subset | 8개 모델이 모두 성공한 문제 집합(n=230)과 모두 실패한 문제 집합(n=100). 난이도를 통제해 모델 고유 효율을 비교한다 |
관련 페이지
- Cutting LLM Token Costs with rtk, headroom, and caveman: 같은 문제를 도구 쪽에서 다룬 실측 기록. 이 논문이 지목한 컨텍스트 누적 비용을 압축 도구로 줄이려는 접근이다
- Building Cost-Efficient Agents with Headroom: 컨텍스트 압축으로 비용을 줄이는 설계. input 토큰이 비용을 지배한다는 이 논문의 진단과 대응한다
- Effective Context Engineering for AI Agents: 유한한 컨텍스트에 무엇을 넣을지 고르는 설계 원칙. 라운드마다 컨텍스트가 재입력되는 구조를 전제로 읽으면 비용 함의가 분명해진다
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 실패를 trajectory 분석으로 분류한 연구. 실패 실행에서 토큰이 더 소비된다는 이 논문의 관찰과 짝지어 볼 수 있다
- Harness Updating Is Not Harness Benefit: 에이전트 역량 투입이 실제 이득으로 이어지는지를 통제 실험으로 검토한 연구. 토큰을 더 써도 정확도가 오르지 않는다는 문제의식이 겹친다
- Compiling Agentic Workflows into LLM Weights: 오케스트레이션을 가중치로 컴파일해 라운드 누적 input을 줄이려는 접근. 이 논문이 지목한 input 폭증 문제의 한 대안이다