Evaluations · ARTICLE · 2026
AI PRD는 무엇이 달라야 하는가
요약
이 글은 요즘IT(위시켓)에 2026년 6월 18일 게시된 김영욱의 해설 기사로, AI 기능의 PRD(제품 요구사항 정의서)가 기존 소프트웨어 PRD와 무엇이 달라야 하는지를 다룬다. 저자가 출간한 도서 <AI 프로덕트 매니지먼트>(한빛미디어, 2026)의 일부를 매체 독자에 맞춰 재가공한 글이며, 6편으로 이어지는 시리즈의 4편이다.
기존 PRD는 "사용자가 X를 하면 시스템은 Y를 한다"는 행동의 정의가 핵심이었다. 그 정의가 통했던 이유는 기존 소프트웨어가 결정론적 시스템이어서 같은 입력에 같은 출력이 나왔기 때문이다. AI 기능은 이 전제를 따르지 않는다. 저자의 표현으로는 같은 PRD 스타일을 쓸 경우 "만든 사람마다 결과가 달라질뿐더러, 심지어 같은 사람이 만들어도 매번 결과가 달라집니다". 그래서 AI PRD는 "어떤 답이 받아들여질 만한가"를 정의하고 "그것을 어떻게 판단할지"를 함께 설계해야 한다.
그 판단 기준을 담는 문서 요소가 Eval Plan이다. 글은 Eval Plan을 AI PRD의 "새로운 심장"이라고 부르고, 운영 방식을 네 가지로 설명한다. 스프레드시트 한 장으로 시작하는 Eval 셋, 20~30개에서 6개월 뒤 200줄로 자라는 성장 곡선, 규칙 기반과 LLM-as-a-Judge와 사람 평가로 이루어진 3층 피라미드, 그리고 프롬프트를 수정할 때마다 누적 Eval 셋 전체를 다시 실행하는 회귀 테스트다.
이어서 AI PRD에 반드시 들어가야 할 8가지 항목을 열거하고, 사용 1회마다 토큰 비용이 발생하는 AI 프로덕트에서는 가격 모델도 PRD에 적어야 한다고 주장한다. 결론은 기능 정의, Eval Plan, 성공 지표, 가격 모델이 하나의 시스템처럼 정합성을 가져야 한다는 것이다.
배경
레시피 비유
글은 집의 요리 노트와 미슐랭 레스토랑 레시피의 차이로 시작한다. 어머니의 노트에는 "소금 약간", "국간장 한 큰술", "불 줄여 한소끔 끓이기"가 적혀 있다. 어머니는 "약간"이 얼마인지 손끝의 감각으로 재고 "한소끔"이 어느 정도인지 냄비의 소리로 짐작하지만, 결과는 매번 맛있다.
미슐랭 별을 받은 셰프의 레시피는 같은 미역국이라도 표현이 다르다. "천일염 2.3g", "국간장 15ml", "75°C 유지하며 정확히 4분간 끓임"으로 적는다. 단위가 다르고 단어가 다르며, 무엇보다 읽고 그대로 따라 했을 때 같은 결과가 나오도록 정밀하게 정의되어 있다.
| 구분 | 어머니의 레시피 | 셰프의 레시피 |
|---|---|---|
| 표기 방식 | "소금 약간", "한소끔 끓이기" | "천일염 2.3g", "75°C 유지하며 정확히 4분간 끓임" |
| 재는 방법 | 손끝의 감각과 냄비의 소리 | 무게, 부피, 온도, 시간의 단위 |
| 전제하는 독자 | 이미 요리를 아는 사람 | 이 요리를 처음 보는 사람 |
| 문서의 성격 | 참고서 | 같은 결과를 만들어내도록 하는 설계도 |
저자는 두 문서가 같은 음식을 만드는 자료처럼 보이지만 사실 전혀 다른 문서라고 정리한다. "어머니의 레시피는 '이미 요리를 아는 사람을 위한 참고서'이고, 셰프의 레시피는 '이 요리를 처음 보는 사람도 같은 결과를 만들어내도록 하는 설계도'입니다."
이 대비에는 실무적 이유가 붙는다. 미슐랭 레스토랑 주방을 "소금 약간"으로 운영하면 서로 다른 셰프가 만들 때 맛이 완전히 달라지고, 그것은 레스토랑의 지속성을 해친다. 즉 정밀한 표기는 취향이 아니라 여러 사람이 같은 품질을 재현하기 위한 조건이다.
결정론적 시스템이라는 전제
기존 소프트웨어 PRD의 핵심은 행동의 정의다. 사용자가 결제 버튼을 누르면 결제 페이지가 뜨고, 카드 정보를 입력하고 확인을 누르면 결제가 처리된다. PRD는 이런 동작을 빠짐없이 적어두는 문서였다.
이 방식이 통했던 이유를 저자는 시스템의 성질에서 찾는다. "이런 메커니즘의 설계가 가능했던 이유는, 기존 소프트웨어가 결정론적(deterministic) 시스템이었기 때문입니다." 같은 입력에 같은 출력이 나오므로 무엇이 일어나야 하는지만 정의하면 충분했고, 행동이 정의되면 결과가 따라왔다.
AI 기능은 이 전제를 따르지 않는다. PRD를 기존 스타일로 쓰면 "만든 사람마다 결과가 달라질뿐더러, 심지어 같은 사람이 만들어도 매번 결과가 달라집니다". 뒤쪽 조건이 더 무거운데, 만드는 사람을 한 명으로 고정해도 결과의 재현이 보장되지 않는다는 뜻이기 때문이다.
따라서 문서가 정의하는 대상 자체를 바꿔야 한다는 것이 저자의 진단이다. "기존 PRD가 '단일 행동'을 정의했다면, AI PRD는 '허용 가능한 답변의 범위'를 정의합니다. 이게 두 문서의 가장 근본적인 차이입니다."
| 구분 | 기존 PRD | AI PRD |
|---|---|---|
| 전제하는 시스템 | 결정론적 시스템 (같은 입력에 같은 출력) | 같은 입력에도 매번 다른 답이 나오는 시스템 |
| 정의 대상 | 무엇이 일어나야 하는가 (단일 행동) | 어떤 답이 받아들여질 만한가 (허용 가능한 답변의 범위) |
| 함께 설계할 것 | (해당 없음) | 받아들여질 만한지를 어떻게 판단할지 |
정확하다는 말이 기준이 되지 못하는 이유
저자는 1편에서 다룬 에어캐나다 챗봇 사례를 다시 불러온다. 사용자가 "가족 사별로 인한 할인이 있나요?"라고 물었을 때 모델이 어떤 답을 낸다고 PRD에 정의해야 하는지를 묻는 대목이다.
여기서 흔히 쓰이는 문안이 "고객 지원 챗봇은 사용자의 질문에 정확하게 답한다"이다. 저자는 그 문장을 적어둔다고 답이 정확해지지 않는다고 지적하며, 그 문장이 답하지 못하는 물음 네 가지를 든다.
- "정확하다"의 기준은 무엇인가.
- 90%만 맞히면 정확한 것인가, 99%를 맞혀야 하는가.
- 어떤 질문에는 답하고 어떤 질문에는 답하지 말아야 하는가.
- 같은 질문에 매번 다른 답이 나오는 것은 버그인가, 기능인가.
네 물음은 모두 판정 기준을 요구한다. 정확도의 정의, 합격선의 수치, 답변 범위의 경계, 출력이 흔들리는 현상의 지위를 정하지 않으면 "정확하게 답한다"는 문장은 검증할 수 없는 선언에 머문다. 그래서 저자는 AI PRD에 기존 PRD에 없던 새로운 섹션이 필요하다고 보고, 그중 가장 중요한 것으로 Eval Plan을 지목한다.
두 문서의 항목별 비교
저자는 이 대목에 직접 만든 비교 도식을 넣는다. 도식은 다섯 항목을 좌우로 대비하며, 본문 산문에는 없는 내용을 담고 있다.
| 항목 | 기존 PRD | AI PRD |
|---|---|---|
| 완료 기준 | 명세대로 동작함 (이진 판단) | 허용 오차 범위 내 동작 (연속적 판단) |
| 성공 지표 | 사용자 행동 지표 중심 | 동작 지표와 품질 지표 병행 |
| 변경 관리 | 예측 가능한 케이스 명시 | 불완전성 인정과 모니터링 계획 |
| 예외 처리 | 코드 변경 시 업데이트 | 프롬프트나 모델 변경 시 재검증 필요 |
| 검증 방법 | 기능 테스트 (pass/fail) | Eval 기반 품질 평가 |
완료 기준의 대비가 이 표의 중심이다. 기존 PRD의 완료는 명세대로 동작하는지를 참과 거짓으로 가르는 이진 판단이고, AI PRD의 완료는 허용 오차 범위 안에 들어오는지를 보는 연속적 판단이다. 즉 완료 여부를 재려면 허용 범위를 먼저 정해야 하고, 그 범위를 문서에 적는 자리가 Eval Plan이다.
나머지 네 항목은 그 판단 방식의 변화가 문서 운영으로 이어지는 지점을 보여준다. 예외 처리는 코드 변경이 아니라 프롬프트나 모델 변경 시점에 재검증을 요구하고, 변경 관리는 모든 케이스를 미리 적는 대신 불완전성을 인정한 뒤 모니터링 계획을 두는 방식으로 바뀐다.
연관 시리즈
이 글은 <AI 프로덕트 매니지먼트 시리즈> 6편 가운데 4편이다. 시리즈 소개는 "새로운 시대의 AI 프로덕트가 기존의 프로덕트와 무엇이 다른지를 다룹니다"라고 밝히고, 대상 독자에 대해서는 "PM의 관점에서 말하지만, AI 프로덕트를 다루는 모두 참고할 만한 이야기를 묶었습니다"라고 적는다.
| 순서 | 다루는 주제 | 이 글에서의 참조 | 수집 여부 |
|---|---|---|---|
| 1편 | AI가 자꾸 틀리는 이유 | 에어캐나다 챗봇 사례의 출처 | 미수집 |
| 2편 | PM이 LLM을 어디까지 이해해야 하는지 | 직접 참조 없음 | 미수집 |
| 3편 | AI 기능을 프롬프트가 아니라 시스템으로 만드는 방법 | 시스템 프롬프트 초안 항목의 출처 | 미수집 |
| 4편 | AI PRD가 기존 PRD와 무엇이 달라야 하는지 | 이 페이지 | 이 페이지 |
| 5편 | 시장에서 이기는 AI 프로덕트의 지표와 운영법 | 성공 지표를 다음 편으로 미룬다 | 미수집 |
| 6편 | AI PM의 커리어 설계 | 직접 참조 없음 | 미수집 |
나머지 5편은 이 wiki에 수집되어 있지 않다. 이 글이 다른 편에 의존하는 대목은 세 곳이며, 위 표의 참조 열이 그 위치를 가리킨다.
핵심 개념
PRD는 제품 요구사항 정의서를 뜻한다. 이 글에서 기존 PRD와 AI PRD는 정의하는 대상이 다른 두 종류의 문서로 구분된다. 전자는 단일 행동을, 후자는 허용 가능한 답변의 범위와 그 판단 방법을 정의한다.
Eval은 AI 기능이 "잘 동작하고 있는가"를 판단하는 기준이자 도구다. 글은 evaluation의 줄임말로 소개하고 "이밸"이라고 읽는다. 기준이면서 동시에 도구라는 점이 중요한데, 합격의 정의(기준)와 그 정의를 실제 출력에 적용하는 수단(도구)이 하나의 이름으로 묶인다.
Eval 셋은 누적해서 관리하는 테스트 케이스의 집합이다. 글은 Eval Plan의 핵심을 "테스트 케이스의 모음"이라고 요약하며, 스프레드시트의 한 행이 케이스 하나에 해당한다.
Eval Plan은 그 기준과 도구를 PRD에 명시적으로 적어두는 문서다. 8가지 항목 가운데 평가 계획이 이에 해당하며, 글은 이를 AI PRD의 새로운 심장이라고 부른다.
LLM-as-a-Judge는 다른 LLM을 채점자로 써서 답의 품질을 평가하는 방식이다. Eval 피라미드의 중간층에 놓인다.
회귀 테스트는 소프트웨어에서 코드를 수정할 때마다 기존 기능이 망가지지 않았는지 자동으로 확인하는 절차다. AI 기능에서는 프롬프트를 수정할 때마다 누적된 Eval 셋 전체를 다시 실행해 점수가 떨어진 케이스가 없는지 확인하는 형태가 된다.
프롬프트 수렁(Prompt Swamp)은 A를 고치니 B가 깨지고 B를 고치니 C가 깨지는 상태다. 저자의 정의로는 "시간은 다 쓰는데 전체 성능은 그대로인 늪 같은 상태"이며, 근본 원인은 회귀 테스트의 부재다.
Eval Plan
Eval의 정의와 미슐랭 평가단 비유
Eval Plan은 Eval의 기준과 도구를 PRD에 명시적으로 적어두는 문서다. 저자는 서론의 미슐랭 비유를 평가 쪽으로 확장해 설명한다. 음식점이 미슐랭 별을 받으려면 평가단이 무엇을 보고 별을 매기는지 알아야 하고, 그 기준이 "신선도", "창의성", "일관성" 같은 항목이다.
AI 기능도 같다. 우리가 만든 챗봇이 잘 동작하고 있다고 말하려면 무엇을 기준으로 그렇게 판단할지를 먼저 정해야 한다. 기준이 없으면 "잘 동작한다"는 말은 그저 느낌일 뿐이다.
이름은 거창하지만 실체는 단순하다. 사용자가 입력할 만한 질문들을 모아두고, 각 질문에 대해 이런 답이면 합격이고 이런 답이면 불합격이라는 기준을 적어둔다. 저자는 실제로 많은 팀이 스프레드시트 한 장으로 시작한다고 적는다.
Eval 셋의 열 구성
Eval 셋의 한 행에는 다섯 열이 들어간다. 글은 고객 지원 챗봇의 "배송이 늦어요"라는 입력으로 예시를 든다.
| 열 | 내용 | 예시 |
|---|---|---|
| 입력 | 사용자 질문 | "배송이 늦어요" |
| 기대 출력 | 이 입력에 대해 받아들여질 만한 답 | 주문 번호 확인 후 배송 상태를 안내하고, 필요시 환불이나 교환 옵션을 제시 |
| 실제 출력 | 모델이 실제로 낸 답 | "죄송합니다. 배송이 지연되고 있는 점 양해 부탁드립니다" |
| 점수 | 실제 출력에 매긴 점수 | (자료에 예시 없음) |
| 합격 여부 | 해당 케이스의 합격 판정 | 불합격 |
이 열 구성은 배경 절의 두 물음과 대응한다. "어떤 답이 받아들여질 만한가"는 기대 출력 열에 적히고, "그것을 어떻게 판단할지"는 실제 출력을 기대 출력과 견주어 점수와 합격 여부를 매기는 과정으로 구체화된다.
합격과 불합격을 가르는 기준
예시에서 기대 출력은 정답 문장 하나가 아니라 답변이 갖춰야 할 요건으로 적혀 있다. 주문 번호 확인, 배송 상태 안내, 필요시 환불이나 교환 옵션 제시가 그 요건이다. 즉 문장이 조금 달라도 요건을 갖추면 받아들여질 만한 답이 된다.
불합격 판정의 이유도 명시된다. 실제 출력이 "죄송합니다. 배송이 지연되고 있는 점 양해 부탁드립니다"로 끝나면 불합격인데, 저자의 설명은 "사용자가 진짜로 알고 싶은 '내 주문은 어떻게 되는가'에 답을 안 해줬으니까요"이다.
이 판정 방식이 보여주는 것은 합격선이 문장의 유사도가 아니라 사용자 요구의 충족 여부에 있다는 점이다. 사과 표현 자체는 적절하고 어조도 문제가 없지만, 사용자가 알고 싶었던 정보가 빠졌기 때문에 불합격이 된다.
Eval 셋의 성장 곡선
저자는 Eval 셋의 크기를 고정된 목표가 아니라 시간에 따라 자라는 자산으로 설명한다.
| 시점 | 규모 | 저자의 서술 |
|---|---|---|
| 시작 | 20~30개 케이스 | "처음에는 20~30개 케이스로만 시작해도 충분합니다" |
| 운영 중 | 실패 케이스마다 1행 추가 | 새로운 실패 케이스가 발견될 때마다 스프레드시트에 한 줄씩 추가한다 |
| 6개월 후 | 200줄 | "6개월쯤 지나면 200줄짜리 단단한 Eval 셋이 만들어집니다. 이게 팀의 가장 큰 자산이 됩니다" |
20~30개라는 출발선은 Eval Plan의 도입 문턱을 낮추는 역할을 한다. 완벽한 평가 체계를 갖춘 뒤에 시작하는 것이 아니라, 스프레드시트 한 장과 케이스 수십 개로 시작한 뒤 실패가 발견될 때마다 행을 더한다.
다만 이 성장은 곧바로 다음 문제를 만든다. "Eval 셋이 200개가 넘어가면 새로운 문제가 생깁니다. 매번 사람이 200개를 다 읽고 채점할 수는 없다는 것입니다." 피라미드 구성은 이 문제의 답으로 도입된다.
Eval 피라미드
글은 3가지 평가 방식을 피라미드로 배치한다. 맨 아래가 규칙 기반, 중간층이 LLM-as-a-Judge, 꼭대기가 사람 평가다. 아래로 갈수록 빠르고 저비용이며, 위로 갈수록 정확하지만 느리고 비싸다.
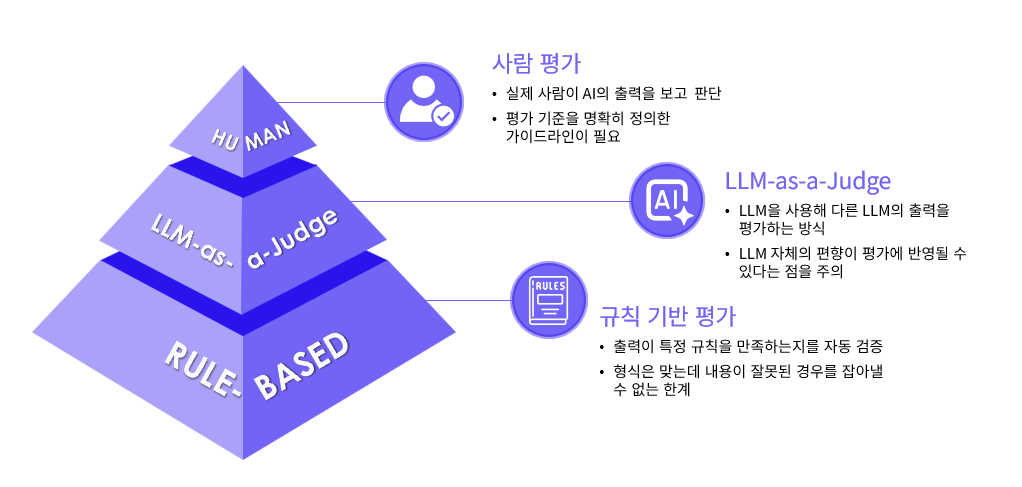
| 층 | 방식 | 채점 방법 | 장점 | 단점 |
|---|---|---|---|---|
| 맨 아래 | 규칙 기반(Rule-based) | 출력이 특정 규칙을 만족하는지 자동 검증 | 빠르고 비용이 거의 들지 않는다 | 미묘한 평가가 어렵고, 형식은 맞는데 내용이 잘못된 경우를 잡아낼 수 없다 |
| 중간층 | LLM-as-a-Judge | 다른 LLM을 채점자로 써서 답의 품질을 판단 | 사람보다 100배 빠르고 훨씬 저렴하다 | 채점자 LLM 자체의 편향이나 환각이 영향을 줄 수 있다 |
| 꼭대기 | 사람 평가(Human Eval) | 실제 사람이 답을 읽고 점수를 매긴다 | 가장 정확하다 | 가장 느리고 비싸다 |
규칙 기반 층이 다루는 것은 기계적으로 확인할 수 있는 조건이다. 글이 드는 규칙은 답에 특정 단어가 포함되어야 한다, 답이 100자를 넘으면 안 된다, 답에 회사 기밀이 포함되면 안 된다의 세 가지다. 채점이 빠르고 비용이 거의 들지 않는 대신, "답이 정말 사용자에게 도움이 되는가" 같은 미묘한 평가는 어렵다. 도식은 같은 한계를 다른 각도로 적는데, 형식은 맞는데 내용이 잘못된 경우를 잡아낼 수 없다는 서술이다.
LLM-as-a-Judge 층은 규칙으로 적기 어려운 품질을 다른 LLM에게 맡긴다. "이 답이 사용자 질문에 적절한가"를 사람 대신 LLM이 판단하는 방식이며, 사람보다 100배 빠르고 훨씬 저렴하다. 다만 채점자 역시 LLM이므로 그 모델의 편향이나 환각이 점수에 영향을 줄 수 있고, 저자는 이 층을 완전히 믿을 수는 없다고 선을 긋는다.
사람 평가 층은 가장 정확하지만 가장 느리고 비싸다. 그래서 적용 범위가 제한된다. 가장 까다로운 케이스나 새로 발견된 실패 패턴에만 선별적으로 적용하고, 도식은 여기에 조건을 하나 더한다. 실제 사람이 AI의 출력을 보고 판단하려면 평가 기준을 명확히 정의한 가이드라인이 필요하다는 것이다.
사람 평가가 필수인 자리도 지정된다. 저자는 "무엇보다 회귀 테스트의 '기준점'을 만들 때는 사람 평가가 필수입니다"라고 적는다. 회귀 테스트는 이전 점수와 새 점수를 견주는 절차이므로, 비교의 출발점이 되는 점수만큼은 사람이 매겨야 한다는 뜻이다.
세 층의 조합 운영
세 방식은 하나를 고르는 선택지가 아니라 함께 쌓아 운영하는 구성이다.
| 상황 | 사용하는 층 | 이유 |
|---|---|---|
| 일상 운영 | 규칙 기반과 LLM-as-a-Judge | 빠르게 실행할 수 있고 비용이 낮다 |
| 중요한 변경이 있을 때 | 위 두 층에 사람 평가를 추가 | 정확도가 필요한 시점에만 비싼 방식을 쓴다 |
| 회귀 테스트의 기준점 수립 | 사람 평가 | 비교의 출발점이 되는 점수라 정확도가 요구된다 |
이 조합에서 PM이 맡는 몫이 명확하다. "PM이 Eval Plan을 짤 때 '이 케이스는 어느 층으로 평가할 것인가'를 함께 정해두면, 출시 후 평가 비용이 통제됩니다." 즉 케이스별 평가 층 배정은 품질 설계인 동시에 비용 설계다.
회귀 테스트와 프롬프트 수렁
AI 기능을 만들어 본 PM이 흔히 겪는 상황이 있다. 어떤 케이스가 잘 안 된다고 프롬프트를 손봤더니 잘 되던 다른 케이스가 갑자기 망가지는 일이다. A를 고치니 B가 깨지고 B를 고치니 C가 깨지는 연쇄가 이어진다.
| 구분 | 내용 |
|---|---|
| 이름 | 프롬프트 수렁(Prompt Swamp) |
| 증상 | A를 고치니 B가 깨지고, B를 고치니 C가 깨진다 |
| 상태 정의 | "시간은 다 쓰는데 전체 성능은 그대로인 늪 같은 상태" |
| 근본 원인 | 회귀 테스트의 부재 |
| 대응 | 프롬프트를 수정할 때마다 누적된 Eval 셋 전체를 다시 실행해 점수가 떨어진 케이스가 없는지 확인한다 |
회귀 테스트 자체는 AI 고유의 기법이 아니다. 저자는 소프트웨어에서 코드를 수정할 때마다 기존 기능이 망가지지 않았는지 자동으로 확인하는 절차라고 소개한 뒤, AI 기능의 구현에서도 똑같이 필요하다고 적는다. 달라지는 것은 수정 대상이 코드가 아니라 프롬프트이고, 검사 단위가 테스트 케이스가 아니라 Eval 셋이라는 점이다.
회귀 테스트가 Eval 셋의 누적을 전제한다는 점도 중요하다. 이전에 합격했던 케이스가 스프레드시트에 남아 있어야 새 수정이 그 케이스를 깨뜨렸는지 확인할 수 있다. 따라서 Eval 셋 관리와 회귀 테스트 방식은 별개의 항목이 아니라 하나의 평가 계획 안에서 함께 정해진다.
Eval Plan을 PRD에 적는다는 것의 의미
저자는 Eval Plan을 문서에 명시하는 행위 자체에 의미를 부여한다. 그것은 "이 기능을 출시한 후에도 팀은 계속 같은 기준으로 성능을 측정할 것이며, 그 기준은 시간이 지나면서 더 단단해질 것"이라는 약속이다.
여기에 기간이 붙는다. "이 약속이 PRD에 적혀 있느냐 없느냐가, 6개월 후 그 기능의 운명을 가릅니다." 6개월은 앞서 나온 Eval 셋 성장 곡선의 기간과 같은 값이다. 저자는 두 대목에서 같은 기간을 들어 Eval 셋의 축적과 기능의 운명을 잇는다.
AI PRD에 반드시 들어가야 할 8가지
Eval Plan을 포함해 AI PRD에 빠뜨리지 말아야 할 항목이 8가지로 정리된다. 저자는 목록을 내놓기 전에 단서를 하나 단다. "일반 PRD에도 있는 항목들이지만, AI 맥락에서는 채워야 할 내용이 다릅니다." 즉 8가지는 새로 만들어진 항목이 아니라, 같은 이름의 항목에 채워 넣을 내용이 달라진 목록이다.
| 번호 | 항목 | 영문 이름 | 답해야 할 내용 |
|---|---|---|---|
| 1 | 기능 개요 | Feature Overview | 이 AI 기능이 풀려는 사용자 문제는 무엇인가 |
| 2 | 입출력 명세 | Input/Output Specification | 입력의 범위와 출력의 형식 |
| 3 | 시스템 프롬프트 초안 | System Prompt Draft | 모델이 따를 지시의 초안 |
| 4 | 품질 기준 | Quality Criteria | "이 정도면 합격"의 기준 |
| 5 | 실패 정의 | Failure Definition | 어떤 답이 나오면 실패인가 |
| 6 | 평가 계획 | Eval Plan | Eval 셋 관리, 평가 층 운영, 회귀 테스트 방식 |
| 7 | 모니터링 계획 | Monitoring Plan | 출시 후 무엇을 어떻게 추적할 것인가 |
| 8 | 리스크 및 제한사항 | Risks & Limitations | 기능의 한계와 위험 |
이 페이지에서는 앞의 다섯 항목을 기능과 합격 및 실패의 기준을 적는 부분으로, 뒤의 세 항목을 그 기준을 출시 전후에 확인하고 관리하는 방법을 적는 부분으로 묶어 설명한다. 이 구분은 설명의 편의를 위한 것이고 글 자체는 8가지를 한 목록으로 제시한다.
기능 개요와 입출력 명세
기능 개요는 AI를 쓰는 이유를 요구한다. "AI를 쓰고 싶어서"는 답이 되지 않고 "이 문제는 AI가 가장 잘 풀기 때문에"라는 답이 나와야 한다. 저자는 여기에 경고를 붙인다. "AI를 위한 AI는 가장 흔한 실패의 출발점입니다."
입출력 명세는 사용자가 보내는 입력의 형태와 시스템이 돌려주는 출력의 형태를 정한다. 글이 드는 질문은 세 가지이며, 정의하지 않았을 때의 결과도 함께 적힌다.
| 항목 | 정해야 할 것 | 정하지 않았을 때 |
|---|---|---|
| 형태 | 텍스트인가, 이미지인가 | 모델이 받는 "날것의 입력"이 무엇이 될지 통제할 수 없다 |
| 길이 | 입력과 출력의 길이는 어느 정도인가 | 같음 |
| 언어 | 어떤 언어를 지원하는가 | 같음 |
입력의 범위를 정하는 일은 곧 평가 대상의 범위를 정하는 일이기도 하다. 지원 언어와 입력 형태가 확정되어야 Eval 셋에 어떤 케이스를 넣을지 정할 수 있다.
시스템 프롬프트 초안
시스템 프롬프트 초안은 3편에서 다룬 시스템 프롬프트를 PRD 단계로 당기는 항목이다. 저자는 "엔지니어가 알아서 짤 거다"라고 미루지 않고 PM이 PRD에 초안 수준으로라도 명시하라고 요구하며, 그 이유를 "이게 곧 기능의 '인격'을 결정합니다"라고 적는다.
| 요소 | 내용 |
|---|---|
| 모델의 역할 | 모델이 어떤 역할로 답하는가 |
| 답변의 톤과 형식 | 어떤 말투와 형식으로 답하는가 |
| 참고해야 할 정보 | 답변할 때 참고할 정보 |
| 하지 말아야 할 것 | 금지 사항 |
| 막혔을 때의 출구 | 답할 수 없을 때 어떻게 빠져나가는가 |
다섯 요소 가운데 뒤의 두 가지는 실패 정의와 직접 이어진다. 하지 말아야 할 것은 실패로 규정된 답변을 미리 막는 장치이고, 막혔을 때의 출구는 모델이 답할 수 없는 상황에서 무리한 답을 내지 않도록 하는 장치다.
품질 기준과 실패 정의
품질 기준은 "이 정도면 합격"의 기준이고, 실패 정의는 어떤 답이 나오면 실패인지에 대한 명시적 정의다. 두 항목은 Eval 셋의 합격 여부 열이 근거로 삼는 기준을 문서에 적는 자리다.
| 항목 | 글이 드는 질문 또는 예시 |
|---|---|
| 품질 기준 | 사실관계는 어디까지 정확해야 하는가 |
| 품질 기준 | 톤은 어떠해야 하는가 |
| 품질 기준 | 답변의 길이는 어느 정도여야 하는가 |
| 실패 정의 | 환각 (사실과 다른 정보를 자신만만하게 답하는 경우) |
| 실패 정의 | 회사 정책과 어긋나는 약속 |
| 실패 정의 | 사용자에게 위험한 조언 |
품질 기준이 Eval Plan보다 앞에 놓이는 이유도 명시된다. "이 기준이 명확해야 다음에 나오는 Eval Plan을 짤 수 있습니다." 합격선이 정해져야 케이스별 합격과 불합격을 매길 수 있으므로, 문서 안에서도 품질 기준이 평가 계획의 입력이 된다.
실패 정의는 이 글에서 가장 무거운 항목이다. 저자는 에어캐나다 사례를 다시 불러와 원인을 이 항목의 부재로 지목한다. "에어캐나다 챗봇 사고는 이 '실패 정의'가 PRD에 없었기 때문에 일어났습니다. 무엇이 실패인지 모르면 막을 수도 없습니다."
평가, 모니터링, 리스크
평가 계획은 앞 절의 Eval Plan 그 자체다. 어떤 입력에 어떤 답이면 합격인지, Eval 셋을 어떻게 관리할 것인지, 평가를 어느 층으로 운영할 것인지, 회귀 테스트를 어떻게 실행할 것인지를 담는다.
모니터링 계획은 출시 후 기능이 잘 동작하는지 추적하는 방법이고, 리스크 및 제한사항은 기능의 한계와 위험이다. 글은 두 항목을 각각 세 가지 질문으로 구체화한다.
| 항목 | 질문 |
|---|---|
| 모니터링 계획 | 어떤 지표를 대시보드에 띄울 것인가 |
| 모니터링 계획 | 어떤 신호가 보이면 알람을 받을 것인가 |
| 모니터링 계획 | 어떤 주기로 Eval을 다시 실행할 것인가 |
| 리스크 및 제한사항 | 어떤 도메인에서는 잘 동작하지 않는가 |
| 리스크 및 제한사항 | 비용은 어떤 시나리오에서 폭발할 수 있는가 |
| 리스크 및 제한사항 | 규제 측면에서 어떤 위험이 있는가 |
모니터링 계획의 세 번째 질문은 Eval을 출시 전 한 번의 검사로 끝내지 않는다는 뜻이다. 회귀 테스트가 프롬프트 수정 시점의 재실행이라면, 모니터링 계획의 재실행은 출시 후 정해진 주기의 재실행이다.
지표 자체와 지표의 관찰 방법도 분리된다. 저자는 AI 프로덕트의 성공 지표를 5편으로 미루면서도 "그 지표를 '어떻게 관찰할 것인가'는 이미 PRD에 들어가야 합니다"라고 못 박는다.
리스크 항목에는 분량과 쓰임에 대한 관찰이 붙는다. "흔히 PRD의 가장 짧은 섹션이지만, 위기 상황에서 가장 자주 들춰지는 부분입니다." 세 질문 가운데 비용 폭발 시나리오는 다음 절의 가격 전략과 직접 이어진다.
절의 마무리는 서론의 비유를 다시 불러온다. "이 여덟 가지가 다 들어 있는 PRD라면, '미슐랭 셰프의 레시피'에 가깝습니다. 누가 만들든 비슷한 결과가 나오고, 만든 결과가 '잘 됐는지' 객관적으로 판단할 수 있습니다."
가격 전략
토큰 비용이 만드는 문제
가격은 비즈니스팀이 정하는 항목이라는 통념이 있고, 저자는 기존 SaaS에서는 그랬다고 인정한다. AI 프로덕트에서 달라지는 이유는 원가 구조다. 사용자 한 명이 한 번 쓸 때마다 실제 비용, 즉 토큰 비용이 발생하기 때문에 가격 모델이 제품 설계와 분리될 수 없다.
글이 드는 예시는 구체적이다. 기존 SaaS처럼 한 명당 월 9,900원으로 받았다가 그 사용자가 PDF를 계속 붙여 넣고 요약을 시키면, 한 달 만에 9,900원의 열 배가 넘는 비용이 나간다. 즉 정액 요금제와 사용량 비례 원가가 만나면 사용자가 많이 쓸수록 손실이 커진다.
이 구조는 제품 설계와 맞물린다. 저자는 PM이 PRD를 쓸 때 가격 모델을 어떻게 잡을지가 제품 설계에 직접 영향을 준다고 적는다. 즉 가격 모델은 출시 직전에 붙이는 항목이 아니라 요구사항 문서 안에서 함께 결정되는 항목이다.
세 가지 가격 모델
저자는 최근 AI 프로덕트의 가격 모델이 세 방향으로 진화하고 있다고 정리한다.
| 가격 모델 | 과금 단위 | 사례 |
|---|---|---|
| 사용량 기반(Usage-based) | 토큰이나 API 호출 단위 | OpenAI의 토큰 과금 |
| 성과 기반(Outcome-based) | "해결된 케이스 1건당" 같은 비즈니스 성과 | Zendesk나 Intercom의 AI 고객 지원 |
| 하이브리드(Hybrid) | 기본료에 사용량 추가 | 실제로 가장 많이 채택되는 방식 |
사용량 기반은 토큰 비용이라는 원가 구조를 그대로 가격에 옮긴 형태다. 성과 기반은 해결된 케이스 수처럼 사용자가 얻는 가치 단위로 과금한다. 하이브리드는 기본료 위에 사용량 과금을 더하며, 저자는 이 방식이 실제로 가장 많이 채택된다고 적는다.
가격 모델과 Eval Plan의 연결
가격 모델 선택은 PRD의 다른 항목으로 곧장 번진다. 성과 기반으로 간다면 PRD의 성공 지표도 성과 중심으로 설계되어야 하고, 그 성과의 정의가 다시 평가 계획으로 내려온다.
저자의 문장이 이 연결을 분명히 한다. "'해결된 케이스' 단위로 과금하기로 했다면, 무엇이 '해결'인지를 Eval Plan에서 먼저 정의해야 하니까요." 과금 단위가 곧 합격 판정의 단위가 되므로, Eval 셋의 합격 여부 열이 청구 금액을 결정하는 셈이다.
정합성이 깨졌을 때의 결과도 적힌다. "가격 모델과 성공 지표가 따로 노는 AI 프로덕트는, 팀이 무엇을 최적화해야 할지 모르는 상태로 출발하는 셈입니다."
시장 사례 대비
저자는 두 기업의 사례를 대비한다.
| 기업과 제품 | 가격 모델 | 평가 | 근거 |
|---|---|---|---|
| 세일즈포스 Agentforce | Flex Credits (사용량 기반) | 긍정적 | 고객사의 작업 시간을 큰 폭으로 줄이는 가치를 만들고 그것을 과금과 명확히 연결했다. "가치 창출과 가격 모델이 한 방향으로 정렬되니까 시장이 신뢰하기 쉽습니다" |
| 어도비 Firefly | (자료에 기술 없음) | 부정적 | "그 AI 투자가 어떻게 수익으로 이어질지를 시장에 명확히 설명하지 못했고, 주가는 큰 폭으로 떨어졌습니다" |
두 사례의 대비 기준은 가격 모델이 가치 창출과 같은 방향으로 정렬되어 있는지, 그리고 그 연결을 시장에 설명할 수 있는지다. 세일즈포스 쪽에서는 절감된 작업 시간이라는 가치와 Flex Credits라는 과금 단위가 이어지고, 어도비 쪽에서는 그 연결이 설명되지 않았다는 것이 저자의 판단이다.
저자가 이 대비에서 끌어내는 결론은 시점에 관한 것이다. 같은 AI 기능을 출시해도, PRD 단계에서 가격 모델과 가치 정의를 함께 짠 회사와 그렇지 않은 회사의 결과는 다르다.
결론
글의 마지막 절 제목은 "PRD는 약속이다"이다. 저자는 서론의 레시피로 돌아가, 어머니의 "소금 약간"과 셰프의 "천일염 2.3g"의 차이가 단순히 정밀도가 아니라 약속의 강도라고 정리한다. 처음 레시피를 쓰는 시점부터 누가 어떻게 만들든 같은 결과가 나오게 하겠다는 약속의 크기가 다르다는 것이다.
| 구분 | 약속하는 범위 |
|---|---|
| 기존 PRD | 이 기능을 만든다 |
| AI PRD | 이 기능이 어떻게 행동할지, 잘 동작하는지 어떻게 판단할지, 망가지면 어떻게 알아챌지, 비용이 폭발하지 않게 어떻게 막을지 |
약속의 범위가 넓어진 만큼 문서도 정밀해져야 하고, 그 약속의 한가운데에 Eval Plan이 놓인다. 저자의 표현으로 Eval Plan은 "잘 동작한다"는 말을 느낌이 아니라 측정 가능한 기준으로 바꿔주는 장치다.
핵심 명제는 세 문장으로 요약된다.
- "AI PRD에서는 기능 정의, Eval Plan, 성공 지표, 가격 모델이 모두 하나의 시스템처럼 정합성을 가져야 합니다. 어느 하나만 성격이 달라지면 그 PRD는 결국 작동하지 않습니다."
- "AI 시대의 PM은 '기능을 정의하는 사람'이 아니라 '기능의 행동 범위와 판단 기준을 함께 정의하는 사람'입니다."
- "그 정의가 한 장의 PRD에 담길 때, 비로소 AI 기능은 '운에 맡기는 기술'이 아니라 '관리 가능한 시스템'이 됩니다."
첫 문장은 본문에서 따로 다룬 요소들이 한 문서 안에서 서로 어긋나지 않아야 한다는 요구다. 둘째 문장은 PM의 역할 정의를 바꾼다. 기능을 정의하는 것에 더해 행동 범위와 판단 기준을 함께 정의하는 사람이 된다. 셋째 문장은 서론의 레시피 비유와 호응하는데, 처음 보는 사람도 같은 결과를 내도록 하는 설계도가 AI 기능을 관리 가능한 시스템으로 만든다는 뜻이다.
에어캐나다 사례는 마지막으로 한 번 더 호출된다. 그 사고도 무엇을 답하지 말아야 하는가가 PRD에 정의되어 있지 않았기 때문에 일어났고, 챗봇의 PRD에 Eval Plan이 있었다면 출시 전에 "여행 후 사별 할인 신청" 같은 케이스가 테스트되어 그 답이 회사 정책과 다르다는 점이 발견되었을 것이라고 저자는 적는다.
한계
저자가 자기 주장의 한계로 명시한 것은 없다. 아래는 자료에 기술이 없어 이 페이지에서 확인할 수 없는 항목이다.
| 항목 | 자료의 기술 범위 | 확인할 수 없는 것 |
|---|---|---|
| Eval 셋 | 열 구성, 규모(20~30개에서 200줄), 불합격 예시 한 건 | 점수 척도, 합격 여부를 가르는 임계값 |
| LLM-as-a-Judge | 편향이나 환각이 영향을 줄 수 있다, 사람보다 100배 빠르다 | 편향의 종류와 보정 방법, 100배라는 배수의 산출 근거 |
| 회귀 테스트 | Eval 셋 전체를 다시 실행한다는 절차 | 실행 도구와 자동화 방법 |
| 에어캐나다 챗봇 사례 | 원인 진단(실패 정의의 부재)과 질문 예시 | 사고의 경위. 1편에 있고 이 글에는 없다 |
| Agentforce | Flex Credits가 사용량 기반이라는 사실 | 과금 단가와 조건 |
| Firefly | 주가가 큰 폭으로 떨어졌다는 서술 | 변동 수치, 이 제품의 가격 모델 |
| 성과 기반 과금 | "해결된 케이스 1건당" 예시, 해결의 정의를 Eval Plan에 두라는 지침 | 정산 방식과 분쟁 처리 |
자료 자체의 내적 긴장도 한 건 있다. 1절 끝은 Eval Plan을 기존 PRD에 없던 새로운 섹션 가운데 가장 중요한 것으로 소개하는데, 3절 서두는 8가지 항목 전체를 두고 "일반 PRD에도 있는 항목들이지만, AI 맥락에서는 채워야 할 내용이 다릅니다"라고 적는다. 평가 계획이 8가지 안에 들어 있으므로 두 서술은 같은 항목을 신설 섹션과 기존 항목으로 각각 부른다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Eval | AI 기능이 잘 동작하고 있는가를 판단하는 기준이자 도구. evaluation의 줄임말이다 |
| Eval Plan | 그 기준과 도구를 PRD에 명시적으로 적어두는 문서. 글이 AI PRD의 새로운 심장이라고 부르는 항목 |
| Eval 셋 | 입력, 기대 출력, 실제 출력, 점수, 합격 여부를 한 행으로 관리하는 테스트 케이스의 누적 집합. 20~30개로 시작해 6개월이면 200줄까지 자란다 |
| Eval 피라미드 | 규칙 기반(맨 아래), LLM-as-a-Judge(중간층), 사람 평가(꼭대기)를 쌓아 운영하는 평가 방식의 배치 |
| LLM-as-a-Judge | 다른 LLM을 채점자로 써서 답의 품질을 평가하는 방식 |
| 회귀 테스트 | 수정할 때마다 기존 기능이 망가지지 않았는지 자동으로 확인하는 절차. AI 기능에서는 프롬프트 수정 때마다 누적 Eval 셋 전체를 다시 실행한다 |
| 프롬프트 수렁(Prompt Swamp) | A를 고치니 B가 깨지고 B를 고치니 C가 깨지는 상태. 근본 원인은 회귀 테스트의 부재다 |
| Flex Credits | 세일즈포스가 Agentforce에 적용한 사용량 기반 과금 방식의 이름 |
관련 페이지
- You Can Learn AI Agent Harness & Loop Engineering In 19 Min | LLM Ops, Eval, Tracing, RAG: harness와 LLMOps를 하나의 그림으로 잇는 영상. LLMOps 블록의 tracing과 eval을 다루며, 이 글은 그 eval을 PRD 단계의 문서 항목으로 옮기는 실무 프레임을 제공한다.
- How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks: 코딩 에이전트의 토큰 소비를 실측하고 과금 방식을 논한 논문. 이 글이 가격 전략의 전제로 삼는 사용 1회당 토큰 비용을 수치로 다룬다.
- AutoRAG: Automated Framework for optimization of Retrieval Augmented Generation Pipeline: QA 평가 데이터로 RAG 파이프라인의 모듈 조합을 자동 채점하는 프레임워크. 이 글의 Eval 셋 개념을 RAG 영역에서 도구로 구현한 사례다.