Evaluations · REPO · 2024
AutoRAG: Automated Framework for optimization of Retrieval Augmented Generation Pipeline
요약
AutoRAG는 Marker-Inc-Korea가 공개한 Python 패키지로, 사용자가 준비한 QA 데이터셋과 Corpus 데이터셋으로 여러 RAG module 조합을 자동 평가해 "내 데이터"에 맞는 RAG 파이프라인을 골라 준다. README는 이 도구를 "RAG AutoML tool for automatically finding an optimal RAG pipeline for your data"로 소개한다. 즉 RAG를 새로 제안하는 프레임워크가 아니라, 이미 있는 RAG 구성 요소 가운데 어떤 조합이 자기 데이터에서 가장 좋은 점수를 내는지 실험으로 결정해 주는 도구다.
작동 방식은 설정 YAML 한 장에 담긴다. 최상위 node_lines 아래 nodes, 그 아래 modules가 중첩되고, node마다 strategy.metrics로 평가 지표를 지정한다. Evaluator가 이 설정으로 trial을 실행하면 trial 폴더의 summary.csv에 node별 최적 module이 남고, 그 폴더를 그대로 코드 호출, API 서버, 웹 인터페이스로 배포한다. 최적화에 쓸 QA 데이터셋과 Corpus 데이터셋을 원본 문서에서 만드는 Parsing, Chunking, QA Creation 코드도 같은 패키지에 있다.
이 페이지의 근거는 저장소 README 한 편과 wiki/assets/에 남아 있는 docs 도식 6장이다. 2026년 6월 커밋 0507ad0이 전체 클론을 README 스텁으로 교체해 패키지 소스, 테스트, 문서, LICENSE 파일을 포함한 696개 파일이 로컬에 없다. 따라서 README가 외부 링크로 넘기는 지원 module 목록, 지표 정의, 폴더 구조, 하드웨어 요구 사항은 이 페이지에서 확인할 수 없다.
배경
README가 출발점으로 삼는 문제는 선택의 어려움이다. RAG 파이프라인과 module은 종류가 많지만, 그 가운데 어떤 것이 "your own data"와 "your own use-case"에 좋은지는 미리 알 수 없다. 모든 module을 직접 만들어 평가하는 일은 시간이 많이 들고 어렵다. 그러나 그 작업을 하지 않으면 어떤 파이프라인이 최선인지 끝내 알 수 없다.
AutoRAG는 이 반복 작업을 자동화한다. 사용자가 평가 데이터를 준비하면 여러 RAG module을 자동으로 평가해 최적 파이프라인을 찾고, README 표현으로는 "many RAG module combinations"를 간단한 방법으로 비교한다. 이 접근은 모델 선택과 하이퍼파라미터 탐색을 자동화하는 AutoML의 발상을 RAG 구성 요소 선택에 옮긴 것이다.
핵심 개념
QA 데이터셋과 Corpus 데이터셋은 최적화의 두 입력이다. QA 데이터셋(qa.parquet)은 질문과 정답으로, README는 정확하고 신뢰할 수 있는 평가와 최적화에 중요하다고 적는다. Corpus 데이터셋(corpus.parquet)은 RAG가 검색하는 문서 조각으로, RAG가 이 corpus에서 문서를 찾아 답을 생성하므로 성능에 결정적이다.
node line, node, module은 설정 YAML의 세 계층이다. node line은 실행 순서를 갖는 node의 묶음이고, node는 node_type으로 역할(lexical_retrieval, generator 등)을 정한 설정 단위이며, module은 그 역할을 구현하는 후보다. 한 node 아래 여러 module을 나열하면 AutoRAG가 그 후보들을 같은 지표로 평가한다.
strategy는 node마다 붙는 평가 방침 블록이다. README 예시에서는 metrics 키 하나로 그 node를 어떤 지표로 채점할지 정한다. retrieval 계열 node는 retrieval 지표를, prompt_maker와 generator는 생성 지표를 쓴다.
trial은 설정 하나를 한 번 실행한 결과 단위다. 실행이 끝나면 0, 1, 2처럼 숫자 이름의 trial 폴더가 생기고 그 안의 summary.csv가 평가 결과와 최적 RAG 파이프라인을 요약한다. 배포 단계는 이 trial 폴더를 입력으로 받는다.
방법
설치
README는 Python 3.10 이상을 권장하고 설치 옵션을 세 가지로 나눈다.
| 명령 | README가 적은 용도 |
|---|---|
pip install AutoRAG |
기본 설치 |
pip install "AutoRAG[gpu]" |
로컬 모델을 쓸 때 |
pip install "AutoRAG[gpu,parse]" |
parsing 기능까지 쓸 때 |
즉 로컬 모델을 쓰지 않으면 기본 설치로 충분하고, 로컬 모델이나 문서 parsing이 필요할 때 extra를 추가한다.
데이터 생성 단계
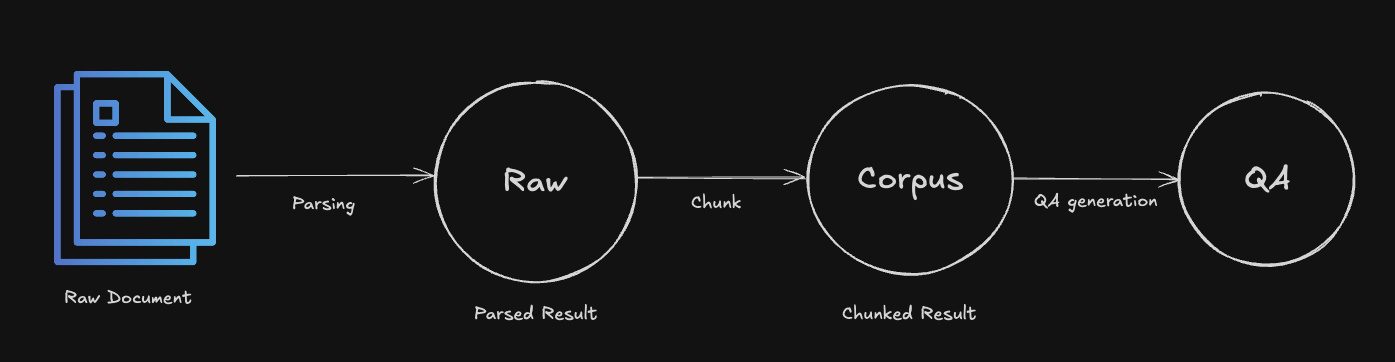
RAG 최적화 전에 QA 데이터셋과 Corpus 데이터셋이 있어야 한다. AutoRAG는 원본 문서에서 두 데이터셋을 만드는 과정을 Parsing, Chunking, QA Creation 세 단계로 나눈다.
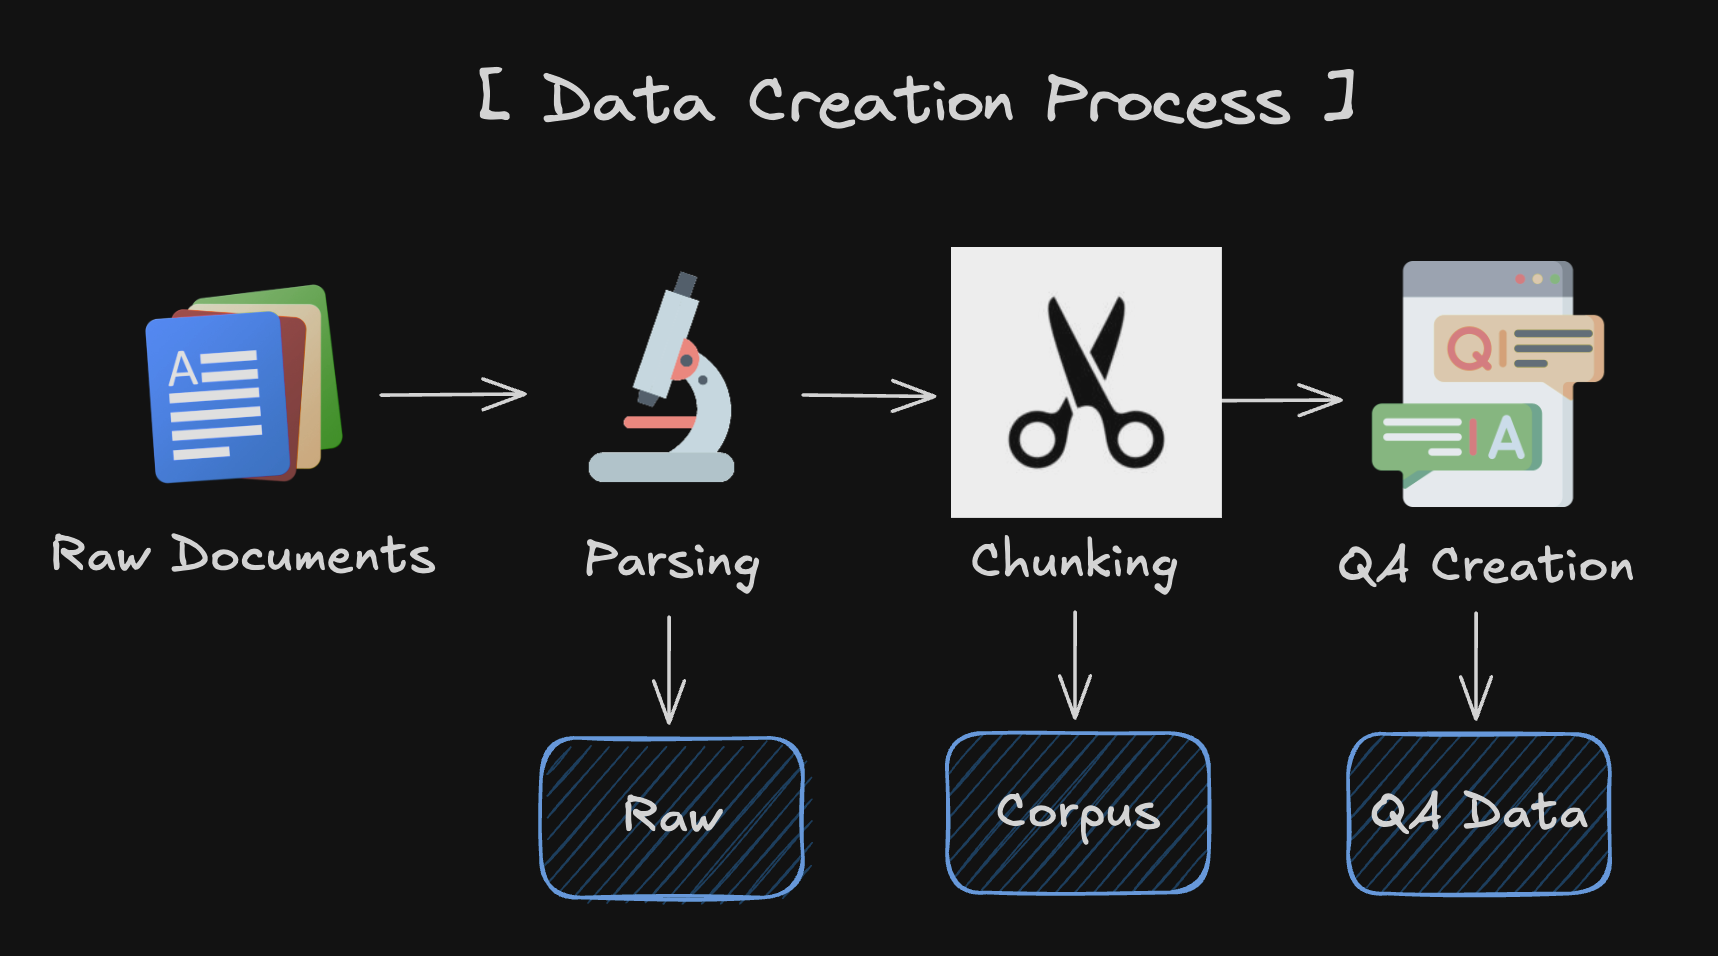
세 단계는 각각 산출물 하나를 낸다. Parsing은 Raw(파싱 결과), Chunking은 Corpus(chunking 결과), QA Creation은 QA를 만든다. Figure 5는 이 세 객체가 순서대로 변환되는 관계를 보여준다.
각 단계의 설정 키와 Python 진입점은 다음과 같다.
| 단계 | YAML 설정 (README 예시) | Python 진입점 | 산출물 |
|---|---|---|---|
| Parsing | module_type: langchain_parse, parse_method: pdfminer |
Parser(data_path_glob="your/data/path/*").start_parsing(yaml) |
parsed.parquet (Raw) |
| Chunking | module_type: llama_index_chunk, chunk_method: Token, chunk_size: 1024, chunk_overlap: 24, add_file_name: en |
Chunker.from_parquet(parsed_data_path=...).start_chunking(yaml) |
corpus.parquet (Corpus) |
| QA Creation | YAML 없음, Python 체인으로 작성 | Raw, Corpus 객체와 .batch_apply() 체인 |
qa.parquet과 corpus.parquet |
Parsing과 Chunking은 README가 "just a few lines of code"로 소개하는 대로 YAML 파일 경로 하나를 받는다. 다만 여러 module을 동시에 쓸 때는 제약이 붙는다. parse module을 여러 개 쓰면 parsed 결과마다 새 프로세스로 실행해야 하고, chunk module을 여러 개 쓰면 corpus 하나로 QA를 만든 뒤 나머지 corpus를 그 QA 데이터에 매핑해야 한다. chunk method가 다르면 QA가 가리키는 정답 조각인 retrieval_gt가 달라지므로 다시 매핑해야 하기 때문이다.
QA Creation은 README 코드에서 메서드 체인 하나로 표현된다. 호출 순서와 역할은 다음과 같다.
| 순서 | 호출 | 역할 (README 주석과 이름 기준) |
|---|---|---|
| 1 | Raw(raw_df) |
parsed.parquet을 읽은 DataFrame을 Raw 객체로 감싼다 |
| 2 | Corpus(corpus_df, raw_instance) |
corpus.parquet을 Raw와 연결한 Corpus 객체로 만든다 |
| 3 | .sample(random_single_hop, n=3) |
corpus에서 single hop 샘플을 뽑는다 |
| 4 | .map(lambda df: df.reset_index(drop=True)) |
인덱스를 재설정한다 |
| 5 | .make_retrieval_gt_contents() |
retrieval 정답 passage의 본문을 채운다 |
| 6 | .batch_apply(factoid_query_gen, llm=llm) |
질문을 생성한다 |
| 7 | .batch_apply(make_basic_gen_gt, llm=llm) |
기본 답을 생성한다 |
| 8 | .batch_apply(make_concise_gen_gt, llm=llm) |
간결한 답을 생성한다 |
| 9 | .filter(dontknow_filter_rule_based, lang="en") |
"모른다"류 답을 규칙으로 걸러낸다 |
| 10 | .to_parquet('./qa.parquet', './corpus.parquet') |
두 parquet 파일로 저장한다 |
LLM 호출이 필요한 단계(6, 7, 8)는 모두 batch_apply로 묶여 있어 같은 LLM 객체를 넘긴다. README 예시는 llama_index.llms.openai.OpenAI를 그 LLM으로 쓴다. 심볼의 import 경로는 데이터 생성 코드가 autorag.data.qa 아래 어떻게 나뉘어 있는지도 보여준다.
| 심볼 | 모듈 경로 |
|---|---|
dontknow_filter_rule_based |
autorag.data.qa.filter.dontknow |
make_basic_gen_gt, make_concise_gen_gt |
autorag.data.qa.generation_gt.llama_index_gen_gt |
Raw, Corpus |
autorag.data.qa.schema |
factoid_query_gen |
autorag.data.qa.query.llama_gen_query |
random_single_hop |
autorag.data.qa.sample |
설정 YAML의 3계층
RAG 최적화는 설정 YAML 한 장으로 정의한다. README는 처음에는 미리 만든 설정 파일을 쓰라고 강하게 권하고, 그 파일이 있는 sample_config/rag 폴더와 Sample YAML Guide, Make Custom YAML Guide 문서를 링크한다.
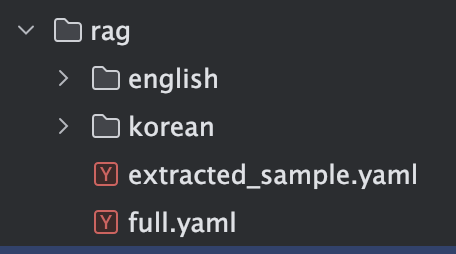
Figure 2의 폴더 트리에는 english와 korean 하위 폴더, 그리고 extracted_sample.yaml과 full.yaml 두 파일이 보인다. 언어별로 샘플 설정이 나뉘어 있다는 사실은 이 화면으로만 확인되며, README 본문은 한국어 지원을 따로 언급하지 않는다. 파일 내용은 raw에 없다.
YAML의 구조는 세 키로 중첩된다.
| 계층 | 키 | 항목이 갖는 하위 키 | README 예시 값 |
|---|---|---|---|
| node line | node_lines |
node_line_name, nodes |
retrieve_node_line, post_retrieve_node_line |
| node | nodes |
node_type, strategy, top_k(retrieval node만), modules |
lexical_retrieval, semantic_retrieval, hybrid_retrieval, prompt_maker, generator |
| module | modules |
module_type과 module별 파라미터 |
bm25, vectordb, hybrid_rrf, fstring, openai_llm |
README 예시 설정의 node 구성
README가 싣는 예시 YAML은 "three retrieval nodes, prompt_maker, and generator nodes"를 쓰는 설정이다. 원문은 다음과 같다.
node_lines:
  - node_line_name: retrieve_node_line
    nodes:
      - node_type: lexical_retrieval
        strategy:
          metrics: [ retrieval_f1, retrieval_recall, retrieval_ndcg, retrieval_mrr ]
        top_k: 3
        modules:
          - module_type: bm25
      - node_type: semantic_retrieval
        strategy:
          metrics: [ retrieval_f1, retrieval_recall, retrieval_ndcg, retrieval_mrr ]
        top_k: 3
        modules:
          - module_type: vectordb
            vectordb: default
      - node_type: hybrid_retrieval
        strategy:
          metrics: [ retrieval_f1, retrieval_recall, retrieval_ndcg, retrieval_mrr ]
        top_k: 3
        modules:
          - module_type: hybrid_rrf
            weight_range: (4,80)
  - node_line_name: post_retrieve_node_line
    nodes:
      - node_type: prompt_maker
        strategy:
          metrics:
            - metric_name: meteor
            - metric_name: rouge
            - metric_name: sem_score
              embedding_model: openai
        modules:
          - module_type: fstring
            prompt: "Read the passages and answer the given question. \n Question: {query} \n Passage: {retrieved_contents} \n Answer : "
      - node_type: generator
        strategy:
          metrics:
            - metric_name: meteor
            - metric_name: rouge
            - metric_name: sem_score
              embedding_model: openai
        modules:
          - module_type: openai_llm
            llm: gpt-4o-mini
            batch: 16
retrieval 계열 node는 metrics를 한 줄 목록으로 적고, prompt_maker와 generator는 metric_name 항목의 목록으로 적어 sem_score에 embedding_model 옵션을 붙인다. node 다섯 개의 설정을 표로 옮기면 다음과 같다.
| node line | node_type | strategy.metrics | top_k | module_type | module 파라미터 |
|---|---|---|---|---|---|
| retrieve_node_line | lexical_retrieval | retrieval_f1, retrieval_recall, retrieval_ndcg, retrieval_mrr | 3 | bm25 | 없음 |
| retrieve_node_line | semantic_retrieval | 위와 같음 | 3 | vectordb | vectordb: default |
| retrieve_node_line | hybrid_retrieval | 위와 같음 | 3 | hybrid_rrf | weight_range: (4,80) |
| post_retrieve_node_line | prompt_maker | meteor, rouge, sem_score (embedding_model: openai) |
없음 | fstring | prompt: "Read the passages and answer the given question. \n Question: {query} \n Passage: {retrieved_contents} \n Answer : " |
| post_retrieve_node_line | generator | 위와 같음 | 없음 | openai_llm | llm: gpt-4o-mini, batch: 16 |
이 예시는 node마다 module이 하나뿐이라 후보 비교가 일어나지 않는다. 대신 retrieval 세 방식(lexical, semantic, hybrid)이 각각 별도 node로 놓여 같은 네 지표로 평가된다는 점, 그리고 생성 쪽 두 node가 같은 세 지표를 공유한다는 점이 구조를 보여준다. hybrid_rrf의 동작과 weight_range: (4,80)의 뜻은 README가 설명하지 않는다.
docs 도식의 node line 구성
README는 node만 보여주는 구조도와 모든 node와 module을 보여주는 그림을 싣지만 둘 다 외부 이미지라 raw에 없다. 대신 wiki/assets에 남은 docs 도식 Figure 1이 node line 구성을 보여준다.
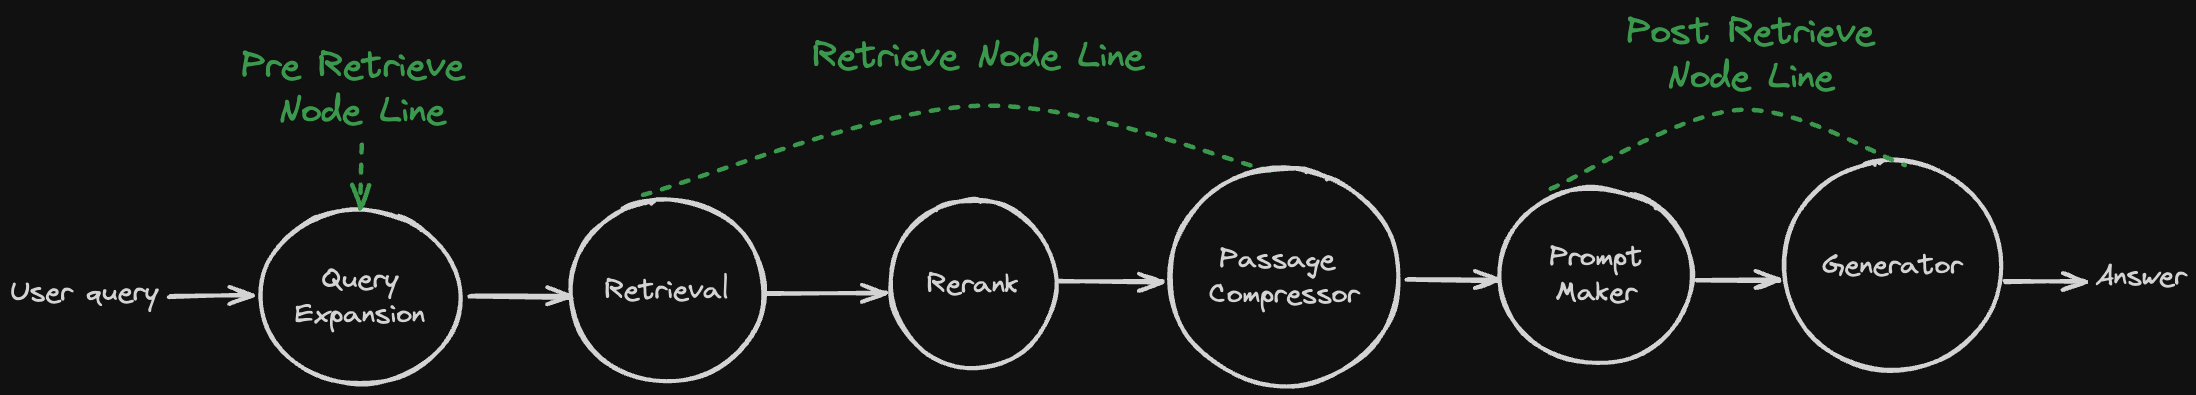
| node line | 포함 node (도식 순서) |
|---|---|
| Pre Retrieve Node Line | Query Expansion |
| Retrieve Node Line | Retrieval, Rerank, Passage Compressor |
| Post Retrieve Node Line | Prompt Maker, Generator |
도식은 사용자 질의가 Query Expansion에서 시작해 Generator의 답변으로 끝나는 직렬 흐름을 그린다. README 본문 예시에는 retrieve_node_line과 post_retrieve_node_line 두 node line만 나오므로, Pre Retrieve Node Line과 Rerank, Passage Compressor node는 도식과 Figure 11의 summary.csv 화면에서만 확인된다.
hybrid retrieval과 score fusion
README 예시의 hybrid_retrieval node는 lexical과 semantic 두 검색 결과를 합치는 자리다. docs 도식 Figure 8은 그 합치는 방식 하나를 단계별로 그린다.
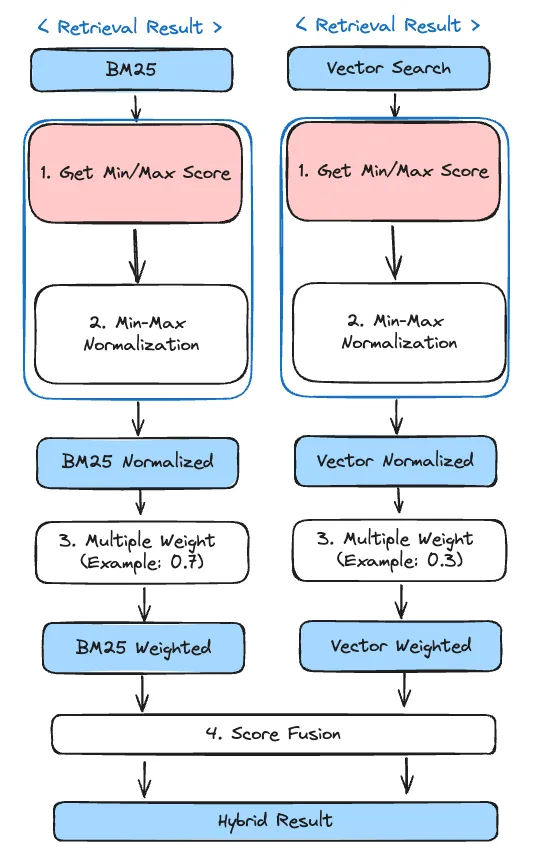
| 단계 | 처리 | 비고 |
|---|---|---|
| 1 | Get Min/Max Score | BM25 결과와 Vector Search 결과 각각에서 최소와 최대 점수를 구한다 |
| 2 | Min-Max Normalization | 두 결과의 점수를 같은 범위로 정규화한다 |
| 3 | Multiply Weight | 정규화 점수에 가중치를 곱한다 (도식 예시는 BM25 0.7, Vector 0.3) |
| 4 | Score Fusion | 가중 점수를 합쳐 Hybrid Result를 만든다 |
이 도식은 점수 정규화 기반 융합을 그린다. README 예시의 hybrid_rrf module이 이 방식인지, 아니면 다른 융합 module이 따로 있는지는 README가 설명하지 않으므로 Figure 8을 hybrid_rrf의 동작으로 읽을 수는 없다.
평가 지표
node별 지표는 strategy.metrics로 지정한다. README 예시에서 확인되는 지표는 두 묶음이다.
| node 종류 | strategy.metrics | 비고 |
|---|---|---|
| lexical_retrieval, semantic_retrieval, hybrid_retrieval | retrieval_f1, retrieval_recall, retrieval_ndcg, retrieval_mrr | 이름으로 보아 F1, recall, nDCG, MRR의 retrieval 버전이다 |
| prompt_maker, generator | meteor, rouge, sem_score | sem_score에는 embedding_model: openai가 붙는다 |
README는 지표 문서를 Retrieval Metrics, Retrieval Token Metrics, Generation Metrics 세 항목으로 나눠 외부 링크로 안내하고, node별 지표를 정리한 그림 두 장도 외부 이미지로 싣는다. 따라서 각 지표의 정의와 계산식, 그리고 Retrieval Token Metrics가 무엇을 재는지는 raw에서 확인할 수 없다.
실행
설정 YAML과 두 parquet 파일이 준비되면 실행 방법은 두 가지다.
| 방식 | 코드 또는 명령 |
|---|---|
| Python | Evaluator(qa_data_path='qa.parquet', corpus_data_path='corpus.parquet').start_trial('config.yaml') |
| CLI | autorag evaluate --config config.yaml --qa_data_path qa.parquet --corpus_data_path corpus.parquet |
Evaluator는 autorag.evaluator에서 import한다. 실행이 끝나면 현재 디렉토리에 여러 파일과 폴더가 생기고, 숫자 이름(0 등)의 trial 폴더 안에 summary.csv가 만들어진다. 폴더 구조 세부는 docs 링크로만 안내한다.
결과 확인
summary.csv는 평가 결과와 최적 RAG 파이프라인을 요약한다. docs 도식 Figure 11이 그 예시 화면이다.
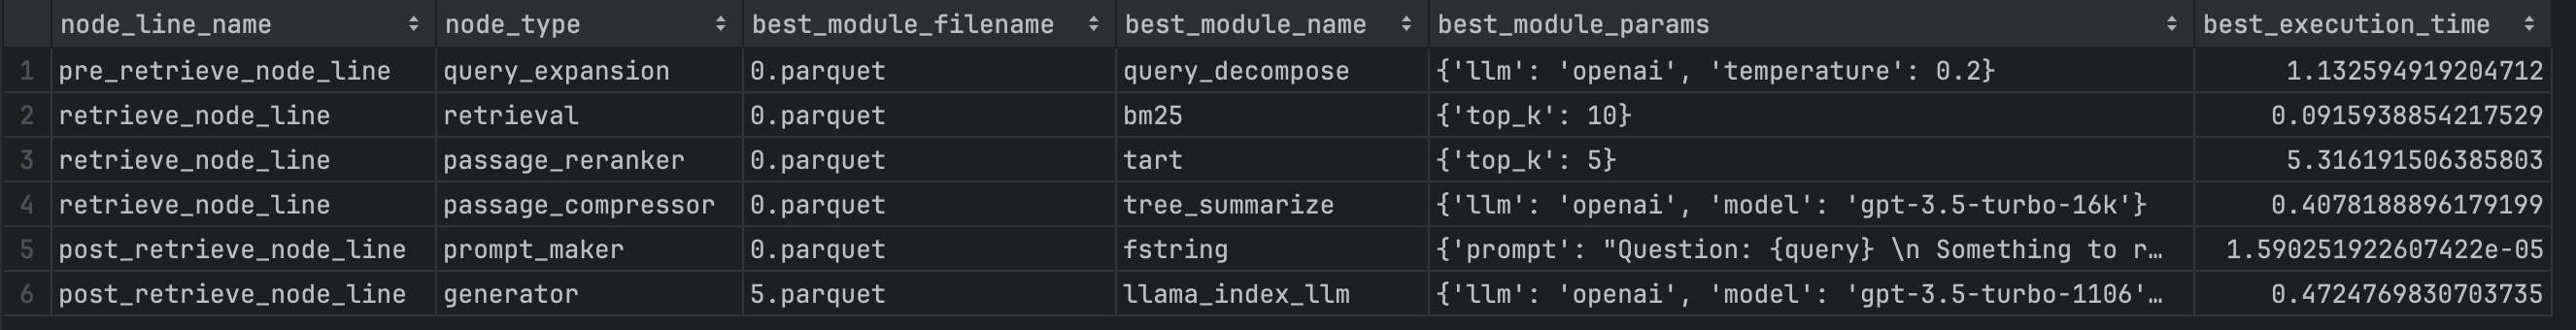
| node_line_name | node_type | best_module_filename | best_module_name | best_module_params | best_execution_time |
|---|---|---|---|---|---|
| pre_retrieve_node_line | query_expansion | 0.parquet | query_decompose | {'llm': 'openai', 'temperature': 0.2} |
1.133 |
| retrieve_node_line | retrieval | 0.parquet | bm25 | {'top_k': 10} |
0.0916 |
| retrieve_node_line | passage_reranker | 0.parquet | tart | {'top_k': 5} |
5.316 |
| retrieve_node_line | passage_compressor | 0.parquet | tree_summarize | {'llm': 'openai', 'model': 'gpt-3.5-turbo-16k'} |
0.408 |
| post_retrieve_node_line | prompt_maker | 0.parquet | fstring | {'prompt': "Question: {query} \n Something to r (화면에서 잘림) |
0.0000159 |
| post_retrieve_node_line | generator | 5.parquet | llama_index_llm | {'llm': 'openai', 'model': 'gpt-3.5-turbo-1106' (화면에서 잘림) |
0.472 |
행 하나는 node 하나에 대응하며 그 node의 최적 module 이름과 파라미터를 적는다. best_module_filename은 그 node의 결과 parquet 파일을 가리키는데, generator만 5.parquet이라 그 node에서는 후보가 여럿 평가됐음을 시사한다. best_execution_time은 module마다 크게 달라 passage_reranker(tart)가 5.316으로 가장 크고 prompt_maker(fstring)는 사실상 0이다. 이 값의 단위는 도식에 표시되지 않는다.
대시보드는 autorag dashboard --trial_dir /trial_dir로 띄운다. README가 싣는 샘플 대시보드 화면은 외부 이미지라 내용은 확인할 수 없다.
배포
trial 폴더(대시보드에 쓴 0, 1, 2 같은 폴더)만 있으면 최적 파이프라인을 세 방식으로 실행할 수 있다.
| 방식 | Python | CLI |
|---|---|---|
| 코드 호출 | Runner.from_trial_folder('/trial_dir').run('your question') |
없음 |
| API 서버 | nest_asyncio.apply() 뒤 ApiRunner.from_trial_folder('/trial_dir').run_api_server() |
autorag run_api --trial_dir /trial_dir --host 0.0.0.0 --port 8000 |
| 웹 인터페이스 | 없음 | autorag run_web --trial_path /trial_path |
Runner와 ApiRunner는 autorag.deploy에서 import한다. README는 run_api CLI가 extracted config YAML을 쓴다고 적고 그 추출 절차는 docs tutorial의 "extract pipeline and evaluate test dataset" 절로 넘긴다. API endpoint 문서는 ./docs/source/deploy/api_endpoint.md, 웹 인터페이스 문서는 deploy/web.md를 가리키는데 두 파일 모두 raw에 없다.
CLI 명령 정리
README에서 확인되는 autorag CLI 하위 명령은 네 개다.
| 명령 | 인자 | 용도 |
|---|---|---|
autorag evaluate |
--config, --qa_data_path, --corpus_data_path |
설정 YAML로 최적화 trial 실행 |
autorag dashboard |
--trial_dir |
trial 결과 대시보드 |
autorag run_api |
--trial_dir, --host, --port |
최적 파이프라인을 API 서버로 실행 |
autorag run_web |
--trial_path |
최적 파이프라인을 웹 인터페이스로 실행 |
같은 trial 폴더를 가리키는 인자 이름이 run_api는 --trial_dir, run_web은 --trial_path로 다르다.
튜토리얼과 데모
README는 코드 없이 써 볼 수 있는 경로를 세 종류 제공한다.
| 종류 | 항목 |
|---|---|
| YouTube | 튜토리얼 영상 1편 (기본 음소거, 음성 해설 있음) |
| Hugging Face Space | Naive RAG Chatbot, AutoRAG Data Creation, AutoRAG RAG Pipeline Optimization |
| Colab | Step 1 Basic of AutoRAG (파이프라인 최적화), Step 2 Data Creation, Step 3 Use Custom LLM & Embedding Model |
Hugging Face Space 세 개는 README 절 구성과 대응한다. Data Creation 절 상단에 데이터 생성 Space 배너가, RAG Optimization 절 상단에 파이프라인 최적화 Space 배너가 붙어 있다.
외부 문서 링크
README는 세부 정보를 상당 부분 외부 문서로 넘긴다. 어떤 정보가 어디에 있는지 알아야 raw의 범위를 판단할 수 있으므로 링크 대상을 정리한다.
| 정보 | README가 안내하는 위치 |
|---|---|
| 지원 parsing module, chunking module 목록 | Notion 페이지 2개 |
| 지원 node와 module 목록 | Notion 페이지 |
| 지원 지표 목록, Retrieval Metrics, Retrieval Token Metrics | Notion 페이지 3개 |
| Generation Metrics | GitHub user-attachments 이미지 |
| Sample YAML Guide, Custom YAML Guide, 폴더 구조, extract pipeline 절차 | 공식 문서 사이트 |
| API endpoint, 웹 인터페이스 | 저장소 안 docs/source/deploy/api_endpoint.md, deploy/web.md |
| Hardware Specs, Running AutoRAG, Tips/Tricks | Notion 페이지 3개 |
| TroubleShooting | Medium 글 |
결과
README에는 정량 결과가 없다. 벤치마크 점수, 다른 도구와의 비교, 실험 표가 하나도 실려 있지 않다. AutoRAG의 산출물은 사용자가 자기 데이터로 실행해 얻는 summary.csv이고, 그 형식은 Figure 11의 예시로만 확인된다. 정량 실험은 Citation 절의 논문(arXiv:2410.20878)에 있을 수 있으나 그 논문은 wiki에 없다.
README가 싣는 외부 반응은 회사 shoutout으로 LlamaIndex의 LinkedIn 포스트, 개인 shoutout으로 Shubham Saboo와 Kalyan KS의 LinkedIn 포스트다. 상단의 Trendshift 배지와 PyPI 다운로드 배지는 외부 이미지라 수치가 raw에 남아 있지 않다.
한계
한계는 README가 명시한 제약과, raw가 README 스텁이라 확인할 수 없는 항목으로 나뉜다.
| 구분 | 항목 | 내용 |
|---|---|---|
| README 명시 | 다중 parse module | parsed 결과마다 새 프로세스로 실행해야 한다 |
| README 명시 | 다중 chunk module | corpus 하나로 QA를 만들고 나머지 corpus를 QA에 매핑해야 하며, chunk method가 다르면 retrieval_gt를 다시 매핑해야 한다 |
| README 명시 | run_api CLI | extracted config YAML이 필요해 별도 추출 절차를 거친다 |
| README 명시 | 정량 결과 부재 | README 안에 벤치마크나 비교 수치가 없다 |
| raw 확인 불가 | 라이선스 | frontmatter는 Apache-2.0이지만 README 본문에 라이선스 조항도 배지도 없다 |
| raw 확인 불가 | 지원 목록과 지표 정의 | parsing, chunking, node, module 목록과 지표 정의가 모두 Notion 링크다 |
| raw 확인 불가 | 폴더 구조와 배포 세부 | trial 폴더 구조, API endpoint, 웹 인터페이스 문서가 docs 링크다 |
| raw 확인 불가 | 샘플 YAML 내용 | Figure 2는 폴더 트리만 보여준다 |
| raw 확인 불가 | 운영 요구 사항 | 하드웨어 요구 사항, 실행 팁, 문제 해결이 Notion과 Medium 링크다 |
| raw 확인 불가 | 한국어 지원 | README 본문에 언급이 없고 Figure 2의 korean 폴더명만 있다 |
| raw 확인 불가 | 화면 내용 | 대시보드와 웹 인터페이스 샘플 화면이 외부 이미지다 |
라이선스는 별도로 다룰 필요가 있다. frontmatter는 Apache-2.0으로 기록하고 있으나 README 본문에는 라이선스 조항 문장이 없고 라이선스 배지도 없다. 커밋 0507ad0이 삭제한 파일 목록에 LICENSE가 들어 있으므로 저장소에는 라이선스 파일이 있었지만, 현재 raw로는 검증할 수 없다. 인용하거나 사용하기 전에 저장소의 LICENSE 파일을 직접 확인해야 한다.
raw가 README 스텁이라 내부 구현 세부는 확인할 수 없다. 커밋 0507ad0이 삭제한 파일은 696개로, autorag/ 패키지 소스 180개, tests/ 271개, docs/ 186개(docs 도식 포함), sample_config/ 37개, sample_dataset/ 5개, .github/ 8개, 그리고 LICENSE, README.md, pyproject.toml 등 최상위 파일 9개다. 이 페이지의 이전 판이 적었던 패키지 디렉토리 트리, 지원 vector DB와 reranker 목록, 한국어 토크나이저 옵션, speed_threshold 같은 strategy 옵션, hybrid_cc의 정규화 방식은 모두 그 삭제된 파일에 근거한 것이라 이번 재작성에서 제외했다.
자료 안의 불일치도 하나 있다. README 예시의 retrieval node_type은 lexical_retrieval, semantic_retrieval, hybrid_retrieval 셋으로 나뉘는데 docs 도식 Figure 11의 node_type은 retrieval 하나다. 도식이 이전 버전의 화면으로 보이지만 날짜 정보가 없어 단정할 수 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| node line | 설정 YAML 최상위 node_lines 목록의 한 항목. node_line_name과 nodes를 갖는다. README 예시에는 retrieve와 post_retrieve, docs 도식에는 pre_retrieve까지 셋이 있다 |
| node | node_type으로 역할을 정하고 strategy, top_k, modules를 갖는 설정 단위 |
| module | node 아래 module_type과 파라미터로 지정하는 구현 후보. 예시는 bm25, vectordb, hybrid_rrf, fstring, openai_llm |
| strategy | node마다 붙는 평가 방침 블록. README 예시에서는 metrics 키만 쓴다 |
| retrieval_gt | QA 데이터가 가리키는 retrieval 정답. chunk method가 바뀌면 다시 매핑해야 한다 |
| trial 폴더 | start_trial 한 번의 결과 폴더. 이름은 0, 1, 2 같은 숫자이며 summary.csv를 담고 배포의 입력이 된다 |
관련 페이지
- AI PRD는 무엇이 달라야 하는가: AI 제품의 Eval Plan을 다루는 글. 그 글이 개념으로 제시하는 Eval 셋과 합격 기준을 AutoRAG는 QA 데이터셋과
strategy.metrics로 RAG 파이프라인에 적용한다. 다만 README는 회귀 테스트를 언급하지 않는다. - You Can Learn AI Agent Harness & Loop Engineering In 19 Min | LLM Ops, Eval, Tracing, RAG: 이 페이지를 평가 자동화 보완 자료로 역링크하는 영상 해설. AutoRAG README는 LLM-as-a-Judge 편향이나 채점 재현성 같은 평가 신뢰성 문제를 다루지 않으므로, RAG 구성 요소를 지표로 비교하는 도구 사례로만 참고한다.
인용
@misc{kim2024autoragautomatedframeworkoptimization,
  title={AutoRAG: Automated Framework for optimization of Retrieval Augmented Generation Pipeline},
  author={Dongkyu Kim and Byoungwook Kim and Donggeon Han and Matouš Eibich},
  year={2024},
  eprint={2410.20878},
  archivePrefix={arXiv},
  primaryClass={cs.CL},
  url={https://arxiv.org/abs/2410.20878},
}