Evaluations · PAPER · 2024
OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments
요약
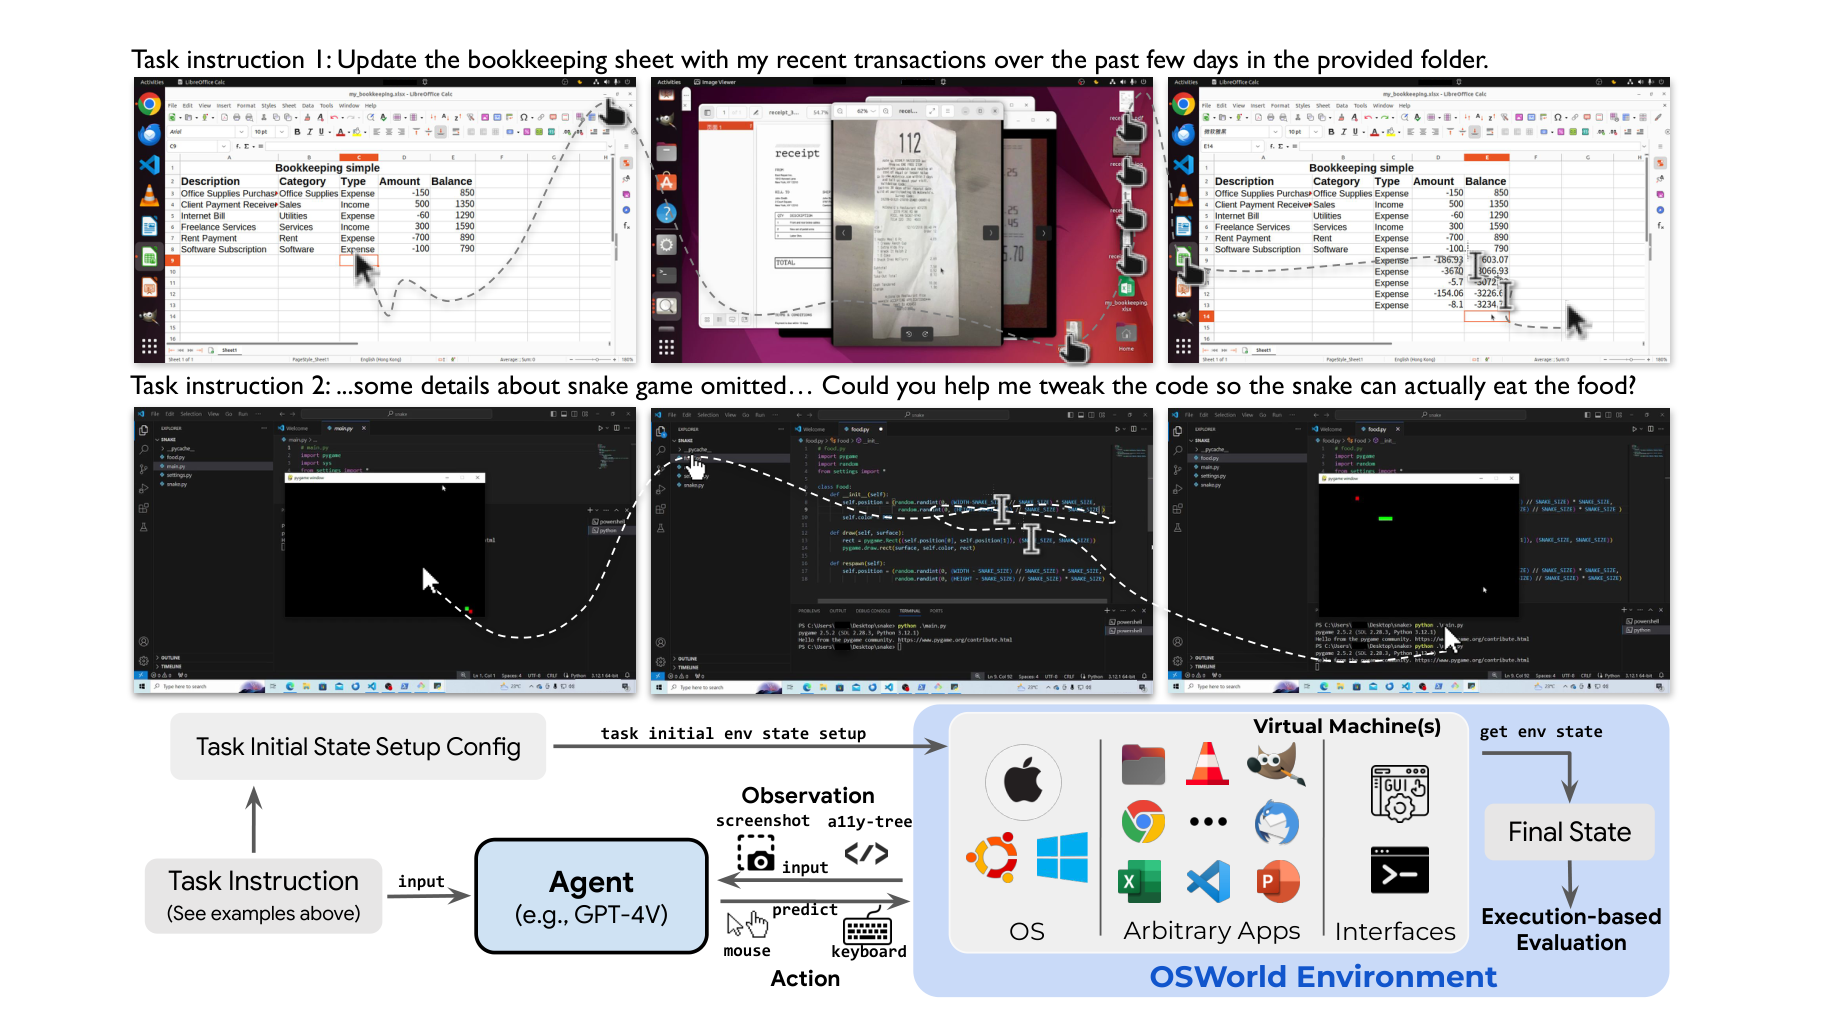
OSWorld는 가상 머신 안에서 실제 OS를 구동하고 agent에게 원본 screenshot과 자유로운 마우스, 키보드 제어권을 주는 실행 가능한 컴퓨터 환경이다. 웹 브라우저나 코딩처럼 특정 앱에 한정된 기존 환경과 달리 임의의 앱과 인터페이스가 걸린 task를 정의할 수 있고, task마다 초기 상태 설정과 실행 기반 채점 스크립트를 붙여 재현 가능한 평가를 지원한다.
이 환경 위에 저자들은 Ubuntu task 369개를 만들었다. 컴퓨터과학 전공 학생 저자 9명이 3개월 이상, 약 1,800 man-hour를 들여 task마다 지시문, 초기 상태 config, 채점 스크립트를 작성했고 고유한 채점 함수만 134개다. 사람은 이 task의 72.36%를 풀지만 가장 성적이 좋은 모델(a11y tree 입력 GPT-4)은 12.24%에 그친다. 실패 표본 550개 중 75% 이상에서 마우스 클릭 좌표 부정확이 나타났고, 창 위치를 바꾸거나 무관한 창을 띄우는 교란만으로도 성공률이 크게 하락했다.
배경
기존 벤치마크의 두 가지 한계
2024년 초 컴퓨터 조작 agent 연구의 벤치마크는 두 종류로 나뉘었고 각각 다른 한계가 있었다.
| 벤치마크 유형 | 예 | 한계 |
|---|---|---|
| 실행 환경 없는 시연(demonstration) 데이터셋 | Mind2Web, AitW, OmniAct | 다음 step 예측만 채점하며 정답을 하나로 가정하므로 다른 방식의 올바른 해법에 벌점을 준다. 상호작용 학습과 실제 탐색 같은 agent 개발 방법을 시험할 수 없다 |
| 특정 도메인의 실행 환경 | MiniWoB++, WebArena(웹), InterCode(코딩), AgentBench | 사람과 컴퓨터의 상호작용을 단순화한 관측과 action space를 쓰고 task 범위가 특정 앱이나 도메인에 갇힌다. 앱과 인터페이스를 넘나드는 실제 시나리오를 평가하지 못한다 |
사람의 컴퓨터 작업은 웹 탐색, 영상 편집, 파일 관리, 데이터 분석, 소프트웨어 개발처럼 GUI와 CLI를 오가며 여러 앱을 거친다. 이 다양성과 복잡성을 담는 실제 상호작용 환경이 없다는 것이 저자들이 짚은 출발점이다.
설계 목표
OSWorld는 앱별 시뮬레이터를 새로 만들지 않고도 사용자가 자기 agent task를 정의할 수 있는 통합 환경을 지향한다. 이를 위해 네 가지를 갖춘다.
- 실제 OS 위에서 자유로운 마우스와 키보드 제어를 허용하는 실행 환경
- task의 초기 상태를 재현하는 설정 기능
- 최종 환경 상태를 조회해 채점하는 실행 기반 평가
- 학습과 평가를 병렬화할 수 있는 상호작용 학습 지원
환경 자체는 Ubuntu, Windows, macOS를 지원한다고 적었지만 벤치마크는 Ubuntu에서 만들었고, Windows는 43개 분석용 task만 제공하며, macOS는 저작권 문제로 개발하지 않았다.
핵심 개념
agent task는 POMDP 로 형식화한다. POMDP는 상태를 부분적으로만 관측할 수 있는 순차 의사결정 문제를 뜻한다. 상태 공간 , 관측 공간 , action space , 전이 함수 , reward 함수 로 이루어지며, agent는 관측 를 받아 실행 가능한 action 를 내고 새 상태 과 새 관측 을 받는다. 종료 action(DONE, FAIL)이 나오거나 최대 step(실험에서는 15)에 닿으면 끝난다.
accessibility tree(줄여서 a11y tree)는 OS나 브라우저의 접근성 API가 화면 요소의 종류(버튼, 체크박스, 문단), 상태(체크 여부), 화면 위치를 프로그램이 읽을 수 있게 노출하는 트리다. 웹의 DOM이나 모바일 앱의 view hierarchy에 대응하는 데스크톱 구조이며, OSWorld는 이를 XML로 변환해 관측으로 제공한다.
grounding은 모델의 출력을 화면의 실제 위치나 요소에 대응시키는 일을 말한다. OSWorld에서 agent는 .click(300, 540)처럼 픽셀 좌표를 직접 내야 하므로, 계획이 맞아도 좌표가 어긋나면 실패한다. 이 논문의 핵심 발견은 현재 VLM의 병목이 계획보다 grounding에 있다는 점이다.
execution-based evaluation은 agent의 action 시퀀스를 정답과 대조하지 않고 최종 환경 상태를 실제로 조회해 채점하는 방식이다. 파일 내용, 앱 설정, 쿠키, 창의 텍스트를 읽어 판정하므로 다른 경로로 도달한 올바른 해법도 인정한다.
Set-of-Mark(줄여서 SoM)는 입력 이미지를 구획으로 나누고 번호나 마스크, 박스를 표시해 VLM의 grounding을 돕는 프롬프트 기법이다. 모델은 좌표 대신 번호를 지목하고 후처리가 이를 좌표로 옮긴다.
수행 불가 task(infeasible task)는 기능이 없어졌거나 애초에 존재하지 않아 완료할 수 없는 task다. 실제 사용자의 요청에서 가져왔으며 agent가 FAIL을 정확히 출력하면 reward를 준다.
방법
환경 인프라
OSWorld 환경은 호스트 머신에서 실행되고 task는 config 파일 하나로 정의된다. Coordinator가 config를 받아 VM 인스턴스를 만들고, Task Manager가 초기 상태를 구성하며, Simulator가 agent의 action 코드 문자열을 VM 안에서 실행한다. task가 끝나면 Task Manager가 후처리를 하고 데이터를 호스트로 가져온 뒤 채점 스크립트를 실행해 reward를 낸다.
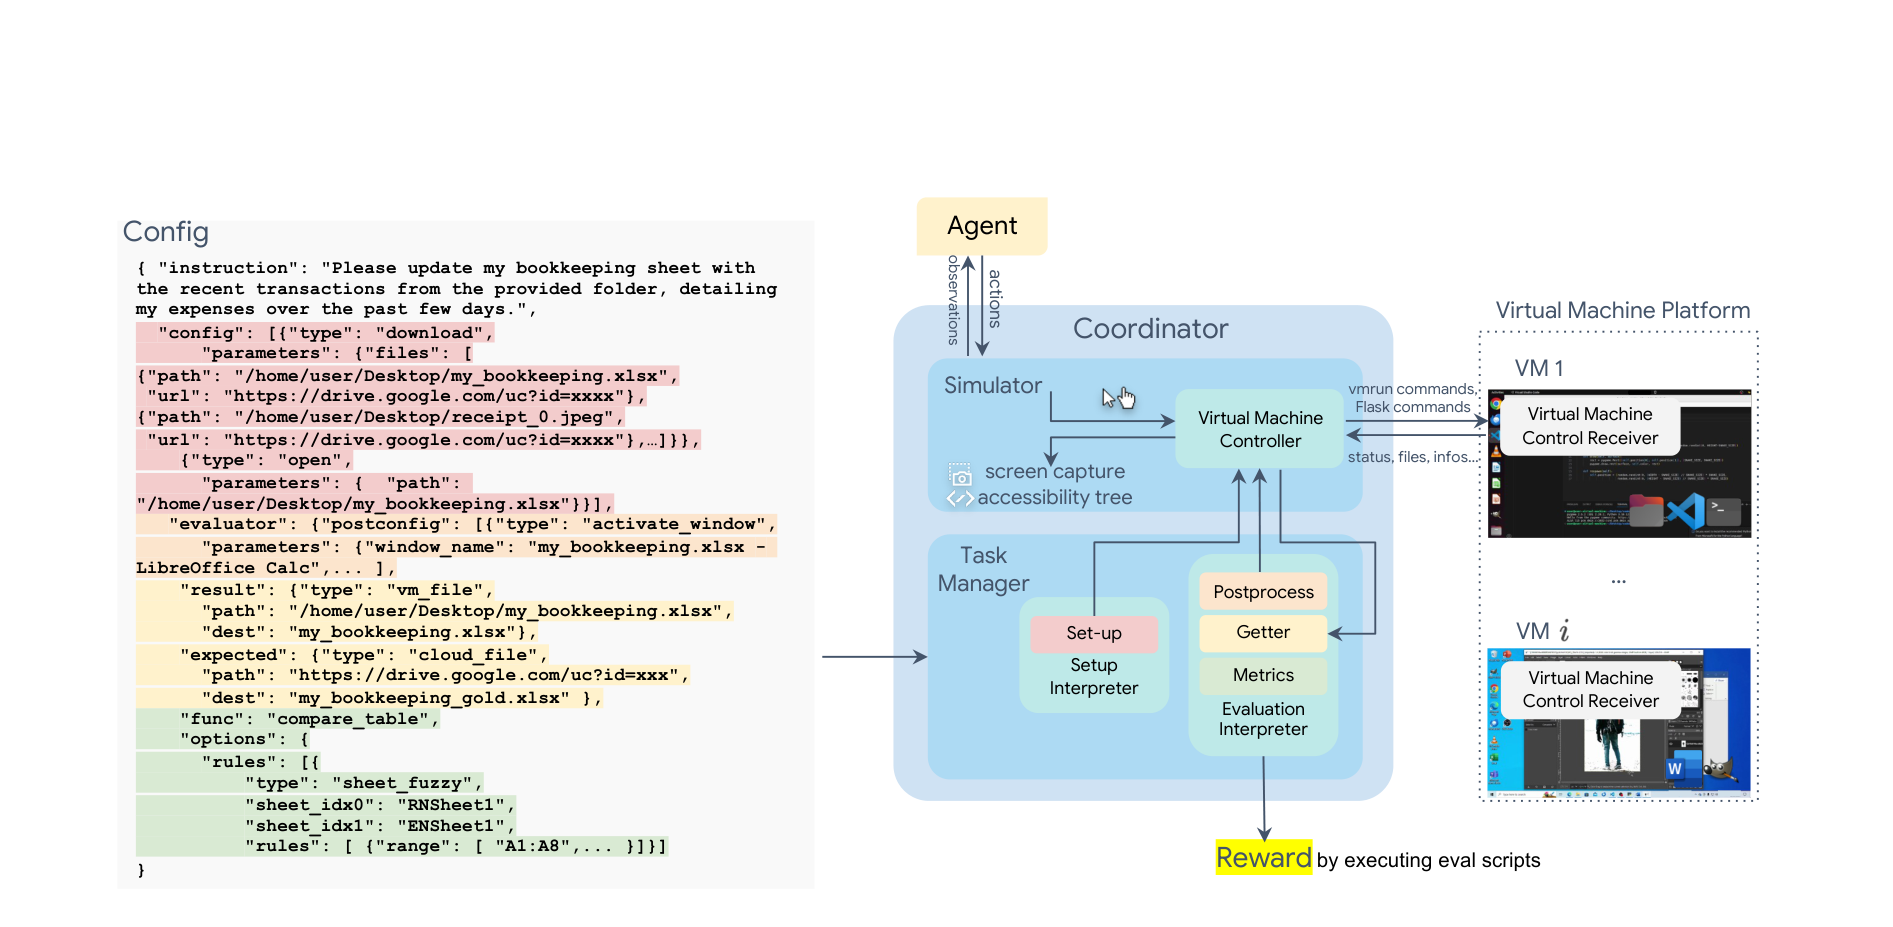
config 파일은 네 부분으로 이루어진다. Figure 2의 색 구분이 그대로 실행 단계에 대응한다.
| 구성 요소 | 색 | 실행 시점 | 역할 |
|---|---|---|---|
| config | 빨강 | 초기화 | 파일 다운로드, 앱 열기, 창 배치 |
| postconfig | 주황 | 채점 전 | 특정 창 활성화, 파일 저장 |
| result와 expected | 노랑 | 채점 | VM의 결과 파일, 클라우드의 정답 파일, Chrome 쿠키 같은 정보 획득 |
| func와 options | 초록 | 채점 | 채점 함수와 인자. 예를 들어 compare_table에 sheet_fuzzy 규칙과 비교 범위 |
가상 머신을 쓰는 이유는 격리와 복원이다. agent가 호스트에 되돌릴 수 없는 피해를 주지 못하게 막고 스냅샷으로 환경을 빠르게 초기화한다. Docker와 달리 VM은 자체 커널을 실행하므로 Windows, macOS, Linux와 x64, ARM 같은 하드웨어를 폭넓게 지원하고, headless 서버와 개인용 컴퓨터 모두에서 다중 프로세스로 학습과 평가를 수행할 수 있다. 한 호스트에서 VM 여러 대를 동시에 실행해 평가를 병렬화한다.
초기 상태 설정
많은 실제 요청은 앱을 막 실행한 시점이 아니라 소프트웨어가 이미 열려 있거나 작업이 진행되던 중간 시점에 생긴다. OSWorld는 이런 중간 상태를 재현하며, 이 자연스러움이 agent에게는 모델링과 탐색의 어려움으로 작용한다.
예시마다 VM 스냅샷을 통째로 저장하면 불필요한 하드웨어 상태까지 담겨 예시당 수 GB가 필요하다. 그래서 공통 스냅샷 하나에 config 기반 설정을 결합한 하이브리드 방식을 쓴다.
| 단계 | 필수 여부 | 내용 |
|---|---|---|
| 1. 에뮬레이터 시작 | 필수 | 지정한 VM을 실행하고 초기 시스템 설정을 담은 스냅샷으로 되돌린다 |
| 2. 파일 준비 | 선택 | 호스트가 직접 링크로 파일을 내려받아 LAN으로 VM에 올리고 앱으로 연다. OS task의 일부 초기 파일은 명령줄로 파일 시스템을 직접 조작해 만든다 |
| 3. 재처리 명령 | 선택 | 열린 Impress 파일을 5쪽으로 넘기거나 화면 가운데를 클릭해 메인 화면으로 돌아오는 task별 사전 조작 |
파일은 가능한 한 task 출처에서 구하고 공개되지 않은 파일은 시나리오에 맞게 재구성했다. 창 열기와 크기 조정은 앱과 OS의 API로 구현했고 API로 어려운 기능은 pyautogui로 다시 구현했다. 예시 하나의 setup 작성에 약 1 man-hour가 들었다.
관측 공간
관측은 세 종류를 구현했다. 전체 screenshot, a11y tree, 터미널 출력이다. 환경 녹화기도 구현했지만 agent 능력의 한계 때문에 모델링에는 쓰지 않았다.
| 관측 | 내용 | 획득 방법 |
|---|---|---|
| screenshot | 마우스 위치와 커서 모양까지 포함한 데스크톱 전체. 기본 해상도 1920×1080 | VM 화면 캡처 |
| a11y tree | 화면 요소의 태그, 이름, 텍스트, 위치, 크기를 담은 XML | Ubuntu는 pyatspi(ATSPI), Windows는 pywinauto |
| 터미널 출력 | 사용자 정의 스트림 | 자료에 획득 방법 없음 |
1920×1080을 기본으로 고른 이유는 2023년 인터넷 사용자 화면 해상도 통계에서 가장 흔한 값이고 16:9 비율이기 때문이다. 절대 픽셀 값 암기를 피하거나 해상도 일반화를 연구할 수 있게 VM 해상도 변경도 지원한다.
a11y tree의 문제는 크기다. 원본 XML은 요소와 중복 속성, 마크업이 많아 보통 100만 토큰을 넘는다. 그래서 다음 기준으로 노드를 걸러낸 뒤 태그, 이름, 텍스트, 위치, 크기만 탭으로 이어붙인 표 형태로 압축한다.
| 조건 (Table 13) | Ubuntu | Windows |
|---|---|---|
| 노드 태그 | document, item, button, heading, label, scrollbar, searchbox, textbox, link, tabelement, textfield, textarea, menu, alert, canvas, check-box, combo-box, entry, icon, image, paragraph, scroll-bar, section, slider, static, table-cell, terminal, text 등 | Ubuntu와 같음 |
| showing | True | 해당 없음 |
| visible | True | True |
| enabled 또는 editable 또는 expandable 또는 checkable | True | True |
| 이름, 텍스트, 이미지 존재 | True | True |
| 위치 | 0 이상 | 0 이상 |
| 크기 | 0 초과 | 0 초과 |
걸러낸 뒤에도 관측 한 번의 토큰 길이는 90퍼센타일이 6,343.60이다. 즉 관측 한 번의 약 90%를 담으려면 6,000 토큰 길이의 컨텍스트가 필요하다.
action space
action space는 마우스 이동, 클릭(좌, 우, 다중), 드래그, 키 입력, 단축키 등 사람이 컴퓨터에 하는 action 전체를 담는다. 구현은 pyautogui 라이브러리를 그대로 쓴다. agent는 문법이 맞는 pyautogui 파이썬 코드를 내야 하며, 기본 action을 for 루프 같은 프로그램 구조 안에 결합할 수 있어 표현력이 크게 오른다.
| 함수 (Table 2) | 설명 |
|---|---|
moveTo(x, y) |
마우스를 지정 좌표로 이동 |
click(x, y) |
지정 좌표를 클릭 |
write('text') |
현재 커서 위치에 텍스트 입력 |
press('enter') |
Enter 키 누름 |
hotkey('ctrl', 'c') |
Ctrl+C 단축키 |
scroll(200) / scroll(-200) |
200 단위 위로 / 아래로 스크롤 |
dragTo(x, y) |
지정 좌표로 드래그 |
keyDown('shift') / keyUp('shift') |
Shift 키 누른 채 유지 / 해제 |
| WAIT | agent가 기다려야 한다고 판단 |
| FAIL | agent가 task를 수행 불가로 판단 |
| DONE | agent가 task 완료로 판단 |
세 특수 action을 더한 이유는 두 가지다. 모바일 기기 연구에서 강조된 타이밍 문제와, task가 수행 불가인지 완료됐는지 판단하는 능력이다. MiniWoB++, CC-Net, WebArena 같은 기존 환경은 클릭과 타이핑, 웹 전용 action 몇 가지만 정의해 우클릭이나 ctrl을 누른 채 클릭하는 다중 선택을 표현하지 못했고, 저자들은 이것이 agent 학습 능력의 상한을 만든다고 지적한다. pyautogui는 xdotool, mouse, keyboard 같은 대안보다 OS 간 호환성이 좋았고, 프롬프트에서 action space 정의에 드는 토큰도 적다.
강화학습 연구용으로는 pyautogui를 유한한 action 클래스로 감싼 computer_13을 따로 만들었다. 13개 action 유형은 인자가 정해져 있어 학습하고 최적화할 action 집합이 유한하다.
| action 유형 (Table 8) | 인자 | 설명 |
|---|---|---|
| MOVE_TO | x, y | 커서를 지정 위치로 이동 |
| CLICK | button, x, y, num_clicks | 버튼 미지정 시 왼쪽 버튼, 좌표 미지정 시 현재 위치 클릭 |
| MOUSE_DOWN / MOUSE_UP | button | 버튼 누름 / 해제 |
| RIGHT_CLICK / DOUBLE_CLICK | x, y | 우클릭 / 더블클릭 |
| DRAG_TO | x, y | 왼쪽 버튼을 누른 채 지정 위치로 드래그 |
| SCROLL | dx, dy | 마우스 휠 스크롤 |
| TYPING | text | 텍스트 입력 |
| PRESS / KEY_DOWN / KEY_UP | key | 키를 눌렀다 뗌 / 누름 / 해제 |
| HOTKEY | keys | 키 조합 |
| WAIT / FAIL / DONE | 없음 | 특수 action. 13개 유형에 포함되지 않는다 |
실행 기반 채점
일반 컴퓨터 task는 단일 지표로 환원되지 않으므로 예시별 채점 지표를 설계했다. task마다 getter 함수, evaluator 함수, 인자를 골라 config를 조립한다. getter는 최종 환경에서 핵심 조각(수정된 파일, 창 요소에 표시된 텍스트)을 꺼내오고 evaluator가 그것으로 성공을 판정한다. 없는 함수는 새로 만들어 환경 함수 라이브러리에 추가하며, 그 결과가 134개의 고유한 채점 함수다.
| 초기 상태와 지시문 (Table 1) | 채점 스크립트 (단순화) |
|---|---|
| Amazon이 저장했을 쿠키를 모두 삭제해 컴퓨터를 정리 | get_cookie_data(env)로 쿠키를 얻고 도메인 규칙 .amazon.com으로 is_cookie_deleted 판정 |
| "Sheet 1"을 "LARS Resources"로 바꾸고 복사본을 "Sheet 2" 앞에 두고 "(Backup)" 접미사를 붙임 | VM의 결과 파일과 클라우드의 정답 파일을 얻어 sheet_name, sheet_data 규칙으로 compare_table |
| 등록금 미납자에게 보낼 메일 초안에 납부 기록의 이메일을 수신자 필드에 추가 | get_a11y_tree(env)로 작성 창의 트리를 얻고 수신자 필드 selector 규칙으로 check_a11y_tree |
채점에는 소프트웨어 내부 파일 포맷 해석, 전용 패키지 사용, 소프트웨어 권한에 맞춰 접근 경로를 미리 마련하는 사전 준비가 필요하다. Chrome과 VLC의 원격 디버깅 포트, VS Code의 확장이 그 예다. 논문 인용 수나 블로그 내용처럼 값이 실시간으로 바뀌는 task는 getter 안에 크롤러 스크립트 같은 동적 함수를 두어 채점 시점의 값을 가져와 비교한다.
| 앱 | 채점 방법 (부록 B.6) | 버전 |
|---|---|---|
| LibreOffice Calc, Writer, Impress | 결과 파일(xlsx, docx, pptx)을 정답과 비교하거나 페이지 스타일, 틀 고정, 로케일 같은 속성을 검사. openpyxl, python-docx, python-pptx를 쓰고 미지원 속성은 Office Open XML을 직접 파싱 | 7.3.7.2 (Ubuntu 22.04 기본) |
| Thunderbird | 프로필 폴더의 설정과 데이터 파일을 읽음. 계정 정보는 리버스 엔지니어링 도구 Firefox Decrypt로 복호화. 메일 작성 task는 보내기 전 작성 창을 a11y tree로 검사 | 115.6.0 |
| VLC | HTTP 인터페이스, 설정 파일 읽기, 결과 파일 비교, a11y tree 검사를 병용 | 자료에 없음 |
| Chrome | 호스트의 Playwright를 socat 포트 전달로 VM의 Chrome에 연결(원격 디버깅 포트). 일부 task는 웹 페이지 HTML 소스도 활용 | 자료에 없음 |
| VS Code | 파일 조작 task는 결과 파일을 정답과 비교. 앱 기능 task(색 테마, 워크스페이스, 설정 변경)는 직접 만든 확장의 명령과 settings JSON 값으로 내부 상태를 읽음 | 자료에 없음 |
| GIMP | 파일 조작 task는 pillow로 결과 이미지를 정답과 비교. 앱 기능 task는 GIMP 설정 파일을 읽음 | 자료에 없음 |
| Windows의 Excel, Word, PowerPoint | LibreOffice 채점 함수를 재사용 | 자료에 없음 |
| Windows의 Thunderbird, Chrome | Thunderbird는 프로필 폴더 구조 차이만 수정. Chrome은 socat을 Ncat으로 교체 | 자료에 없음 |
품질 관리는 여러 단계로 이루어진다.
- 주석자가 자기 테스트 케이스로 1차 확인한다.
- 예시마다 그 예시를 만들지 않은 다른 저자 두 명이 agent 역할로 직접 풀어보며 지시문 불명확, 완료 불가, 코너 케이스 크래시, 심각한 오탐과 미탐을 되돌려준다.
- 사람 성능 측정과 baseline 실험 단계에서 개인이 바뀌어 가며 세 번 더 지시문 정합성과 다른 해법에 대한 정확성을 검토한다.
이 검수에 4회에 걸쳐 400 man-hour 이상을 썼다. 예시 하나의 채점 개발과 검토에는 대학원생 기준 약 2 man-hour가 들었다.
OS와 앱 선택
OS 선택은 저작권과 공개 가능성으로 결정됐다. 2023년 데스크톱 OS 점유율은 Windows 69.5%, macOS 20.4%, ChromeOS 3.2%, Linux 3.1%이지만, Windows와 macOS는 폐쇄 소스라 직접 사용에 저작권 문제가 있고 ChromeOS는 Google 계정 의존이 커서 공개 벤치마크에 맞지 않는다. 그래서 오픈소스 앱이 풍부한 Ubuntu를 메인으로 골랐다. Windows용으로는 Microsoft Office 중심의 소규모 세트를 만들었고 라이선스 구매 후 활성화해 쓴다. macOS는 Apple 외 기기 설치가 불법이라 개발하지 않았다.
앱은 다섯 기준으로 골랐다.
| 기준 | 내용 |
|---|---|
| 가용성 | Ubuntu 22.04에서 쓸 수 있어야 한다 |
| 오픈소스 | 저작권 문제가 없는 라이선스여야 한다 |
| 인기 | 다운로드 수와 블로그, 튜토리얼의 추천 빈도가 높아야 한다 |
| 커뮤니티와 지원 자료 | 활발한 사용자 커뮤니티와 공식 문서가 task 수집과 agent 학습 자료가 된다 |
| 카테고리 다양성 | 실제 사용 사례를 폭넓게 대표해야 한다 |
결과적으로 여덟 종류의 앱과 기본 OS 앱이 선택됐다.
| 용도 | 앱 | 기능 |
|---|---|---|
| 일반 | Chrome | 웹 탐색 |
| 일반 | VLC | 미디어 재생 |
| 일반 | Thunderbird | 메일 관리 |
| 전문 | VS Code | 코딩 IDE |
| 전문 | LibreOffice Calc, Writer, Impress | 스프레드시트, 문서, 프레젠테이션 |
| 전문 | GIMP | 이미지 편집 |
| 기본 | 터미널, 파일 관리자, 이미지 뷰어, PDF 뷰어 | OS 기본 앱 |
각 앱의 예시는 상식, 고해상도 지각, 소프트웨어 단축키 숙련, 정밀한 마우스와 키보드 제어 같은 서로 다른 능력을 요구한다.
task 구성과 통계
지시문은 실제 사용자의 요청에서 가져왔다. 공식 가이드와 튜토리얼, TikTok과 YouTube의 팁 영상, WikiHow 같은 how-to 사이트, Reddit, Quora, Superuser, StackOverflow 같은 Q&A 포럼, Coursera와 Udemy 강의, 개인 블로그가 출처이며 조회 수와 추천 수로 본 인기, 유용성, 다양성을 기준으로 골랐다. 여러 앱이 협업하는 task는 인터넷에서 충분히 찾기 어려워 저자들이 기존 예시를 조합하거나 일상 시나리오에서 착안해 만들었다. 선정 후에는 다른 저자 두 명이 수행 가능성, 모호성, 출처 정합성을 교차 검토했다.
환경의 통합 능력을 보이기 위해 NL2Bash, Mind2Web, SheetCopilot, PPTC, GAIA에서 84개를 가져와 통합했다. 예시 수집에 약 400 man-hour가 들었다.
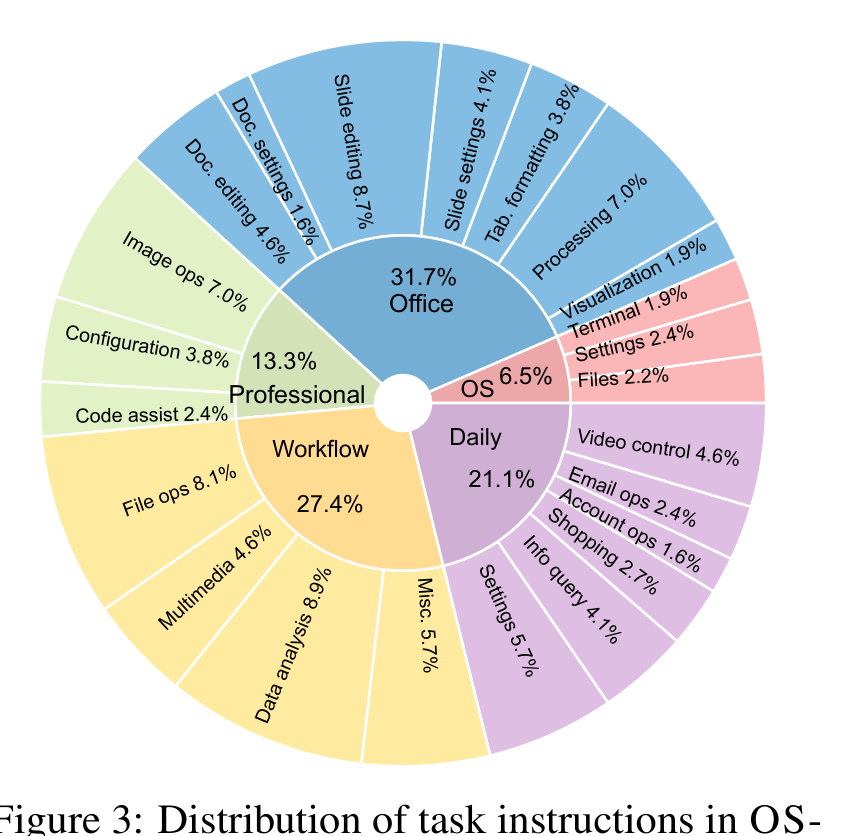
task는 소프트웨어 성격에 따라 다섯 카테고리로 묶는다. OS, Office(LibreOffice Calc, Impress, Writer), Daily(Chrome, VLC, Thunderbird), Professional(VS Code, GIMP), Workflow(여러 앱)다.
| 통계 (Table 3) | 값 |
|---|---|
| Ubuntu task 전체 | 369 (100%) |
| 멀티앱 워크플로 | 101 (27.4%) |
| 단일앱 | 268 (72.6%) |
| 외부 벤치마크 통합 | 84 (22.8%) |
| 수행 불가 | 30 (8.1%) |
| Windows 보충 task | 43 |
| 고유 초기 상태 | 302 |
| 채점 스크립트 | 134 |
| 앱 (Table 10) | OS | Calc | Impress | Writer | VLC | Thunderbird | Chrome | VS Code | GIMP | Workflow | 전체 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 예시 수 | 24 | 47 | 47 | 23 | 17 | 15 | 46 | 23 | 26 | 101 | 369 |
| 평균 지시문 토큰 | 22.38 | 33.30 | 25.19 | 35.30 | 35.82 | 34.07 | 22.07 | 20.78 | 16.23 | 51.24 | 33.36 |
| 수행 불가 | 5 | 1 | 0 | 1 | 3 | 1 | 3 | 5 | 10 | 1 | 30 |
| 통합 | 7 | 19 | 30 | 0 | 0 | 0 | 26 | 0 | 0 | 2 | 84 |
Workflow task의 평균 지시문이 51.24 토큰으로 가장 길고, GIMP는 수행 불가 task가 10개로 가장 많다.
| Windows 분석 세트 (Table 11) | Excel | Word | PPT | Workflow | 전체 |
|---|---|---|---|---|---|
| 예시 수 | 11 | 9 | 7 | 16 | 43 |
| 평균 지시문 토큰 | 19.45 | 21.44 | 21.86 | 47.57 | 32.48 |
Windows 세트에는 수행 불가 task와 통합 task가 없다. 지시문 임베딩을 t-SNE로 시각화하면(데이터셋당 300개 샘플링) OSWorld 군집이 Mind2Web, WebArena, Android 데이터 군집과 떨어져 있고 나머지 셋의 군집 중심은 서로 가깝다. 저자들은 이를 OSWorld의 의미 분포가 가장 넓다는 근거로 든다.
부록 B.8의 예시는 task가 요구하는 능력이 앱마다 다르다는 점을 보여 준다.
| 앱 (Table 12) | 지시문 (요지) | 필요한 능력 |
|---|---|---|
| OS | 현재 시스템에 Spotify 설치 | OS 지식, 방해 요소 무시 |
| Calc | "Names with duplicates" 열에서 고유한 이름만 순서대로 "Unique Names" 열에 입력 | 많은 요소, 긴 action에 걸친 추론 |
| Calc | 지점별 담당자 조회 표를 보고 다른 표의 담당자 이름 채우기 | 수식과 함수 지식 |
| Calc | 달력에서 주말 셀 배경을 빨강(#ff0000)으로 강조 | 상식 추론, 소프트웨어 요령 |
| Impress | 닫아 버린 왼쪽 슬라이드 패널 복구 | UI 배치 상상, 지시문 오타 극복 |
| Impress | 발표 시 두 화면 대신 한 모니터만 쓰도록 설정 | 비전문가 표현에서 원인 추론 |
| Writer | 바탕화면의 1.png를 커서 위치에 복사 | 커서 위치 파악, 바탕화면과 앱 전환 |
| Chrome | Amazon이 저장한 추적 정보 삭제 | 비전문가 표현 이해 |
| VLC | PDF 뷰어를 최소화하지 않고 단축키로 영상 일시정지 | 비전문가 표현의 지시 대상 이해, 소프트웨어 지식 |
| VLC | 거꾸로 된 영상을 바로잡아 1984_Apple.mp4로 저장 | 소프트웨어 지식, 공간 판단 |
| Thunderbird | "Promotions" 폴더를 만들고 제목에 discount가 포함된 메일을 자동 이동하는 필터 생성 | 소프트웨어 지식 |
| Thunderbird | /aws-bill.pdf를 메일에 첨부하되 닫거나 보내지 않기 | 파일 관리, 추가 제약 준수 |
| Thunderbird | 여러 계정을 한 번에 보는 통합 받은편지함 설정 | 사람도 탐색해야 하는 깊이 숨은 기능, 팝업 창 |
| VS Code | Python 누락 import 오류 보고 끄기 | 설정 지식, 오류 원인과 해법 추론 |
| VS Code | autoDocstring 확장 설치 | 확장 검색과 설치 |
| GIMP | 이미지 배경을 투명하게 | 정밀하고 복잡한 조작 |
| GIMP | 노란 삼각형을 선택해 그림 가운데로 이동 | 공간 지각과 추론, 정밀한 action 제어 |
| VLC + GIMP | src.mp4의 00:03부터 5초 구간으로 애니메이션 GIF 생성 | 복잡한 절차의 소프트웨어 지식, 다단계 처리 |
| Thunderbird + Writer + Chrome | Notes 폴더의 메일에 첨부된 docx에서 이미지를 추출해 Google Drive의 figures/ 폴더에 번호로 업로드 | docx 이미지 선택 추출, Google Drive 업로드 지식 |
| Chrome + Calc | Google Drive에 올라온 송장의 표 데이터를 추출해 바탕화면의 xlsx로 내보내기 | 표 데이터 추출, xlsx 내보내기 |
기존 벤치마크와의 비교
OSWorld는 특정 앱 대신 컴퓨터 환경 전체에 통용되는 원본 마우스와 키보드 action을 쓰고, screenshot을 포함한 멀티모달 관측을 제공하며, 학습과 평가 단계 모두에서 자유로운 탐색을 허용한다. 단일 앱 안의 상호작용만이 아니라 여러 앱을 넘나드는 task를 다루고, 유형별 공통 스크립트 대신 예시별 실행 기반 채점을 제공하며, 중간 초기 상태에서 task를 시작한다.
| 벤치마크 (Table 4) | 인스턴스 (템플릿) | 통제 가능 실행 환경 | 환경 확장성 | 멀티모달 | 크로스앱 | 중간 초기 상태 | 실행 기반 채점 함수 수 |
|---|---|---|---|---|---|---|---|
| GAIA | 466 | 없음 | - | 없음 | 없음 | 없음 | 0 |
| Mind2Web | 2350 | 없음 | - | 있음 | 없음 | 있음 | 0 |
| WebLINX | 2337 | 없음 | - | 있음 | 없음 | 있음 | 0 |
| PixelHelp | 187 | 없음 | - | 있음 | 없음 | 없음 | 0 |
| META-GUI | 1125 | 없음 | - | 있음 | 없음 | 없음 | 0 |
| AitW | 30,000 | 없음 | - | 있음 | 없음 | 있음 | 0 |
| OmniAct | 9802 | 없음 | - | 있음 | 없음 | 있음 | 0 |
| AgentBench | 1091 | 다중 격리 | 없음 | 없음 | 없음 | 없음 | 7 |
| InterCode | 1350 (3) | 코드 | 없음 | 없음 | 없음 | 없음 | 3 |
| MiniWoB++ | 125 | 웹 | 없음 | 있음 | 없음 | 없음 | 125 |
| WebShop | 12,000 (1) | 웹 | 없음 | 있음 | 없음 | 없음 | 1 |
| WebArena | 812 (241) | 웹 | 없음 | 있음 | 없음 | 없음 | 5 |
| VisualWebArena | 910 (314) | 웹 | 없음 | 있음 | 없음 | 없음 | 6 |
| WorkArena | 23,000 (29) | 웹 | 없음 | 있음 | 없음 | 있음 | 7 |
| WikiHow (Mobile-Env) | 150 (16) | 모바일 | 없음 | 있음 | 없음 | 없음 | 16 |
| AssistGUI | 100 | 없음 | 없음 | 있음 | 없음 | 있음 | 2 |
| OSWorld | 369 | 컴퓨터 | 있음 | 있음 | 있음 | 있음 | 134 |
비교 대상 16종 가운데 다섯 기준을 모두 만족하는 것은 OSWorld뿐이다. 채점 함수 수 134개는 두 번째로 많은 MiniWoB++의 125개보다 많고 WebArena의 5개와는 자릿수가 다르다. 인스턴스 수만 보면 AitW와 WorkArena가 훨씬 많지만 이들은 템플릿 기반이거나 실행 환경이 없다.
baseline 설정
먼저 VisualWebArena를 따라 (관측, action) 쌍을 few-shot 예시로 주는 프롬프트를 시도했지만 순수 screenshot 설정에서 2.79%로 성능이 낮았다. 히스토리 인코딩 부재와 프롬프트 방식 변화가 원인이라고 보고, 최근 관측과 action 3개를 user와 assistant 프롬프트가 번갈아 나오는 채팅 형태로 context window에 넣는 방식으로 바꿨다. context window는 모델이 한 번에 받아들일 수 있는 토큰 길이 한도이며, 이를 넘으면 입력 앞부분부터 잘라낸다.
| 설정 (부록 C.1) | 값 |
|---|---|
| GPT 모델 버전 | gpt-3.5-turbo-16k, gpt-4-0125-preview, gpt-4-vision-preview |
| Gemini 모델 버전 | gemini-pro, gemini-pro-vision |
| temperature / top_p | 1.0 / 0.9 |
| 최대 생성 토큰 | 1,500 |
| 최대 step | 15 (대부분의 task에 충분한 값) |
| 최대 시간 | task당 30분 (환경이 멈추는 경우 대비) |
| 히스토리 | 최근 관측과 action 3개 |
평가 대상은 오픈소스 Mixtral, CogAgent, Llama-3와 폐쇄 소스 GPT, Gemini, Claude, Qwen 계열이다. 폐쇄 소스 모델의 결과는 시간에 따라 바뀔 수 있다고 부록이 단서를 달았다. 입력 설정은 네 가지다.
| 입력 설정 | 입력 내용 | 모델이 내는 것 | 목적 |
|---|---|---|---|
| a11y tree | 걸러낸 a11y tree 텍스트 | 트리의 좌표를 이용한 pyautogui 코드 | 텍스트 기반 언어 모델이 컨텍스트만으로 추론하고 grounding할 수 있는지 |
| screenshot | 1920×1080 원본 screenshot | 좌표를 직접 예측한 pyautogui 코드 | 사람의 지각에 가장 가까운 입력에서 VLM의 좌표 예측 능력 |
| screenshot + a11y tree | 원본 screenshot과 단순화한 a11y tree | pyautogui 코드 | a11y tree 결합이 공간 grounding을 개선하는지 |
| Set-of-Mark | 번호 박스를 씌운 screenshot과 index, tag, name, text 메타데이터 표 | 좌표 대신 번호 태그를 쓴 코드 | SoM이 GUI grounding을 개선하는지 |
SoM 구현은 원 논문의 분할 모델 대신 걸러낸 a11y tree로 클릭 가능한 요소의 경계 박스를 잡아 번호를 붙이고, VisualWebArena와 UFO를 따라 메타데이터 표를 함께 준다. 이 메타데이터는 a11y tree 설정과 비슷하지만 좌표와 크기가 요소 index로 대체된다. 소프트웨어 생태계의 지원 수준에 따라 저품질이거나 오해를 부르는 박스가 생기기도 한다.
프롬프트는 pyautogui 코드만 코드 블록으로 반환하도록 요구한다. pyautogui.locateCenterOnScreen과 pyautogui.screenshot() 사용을 금지하고, 여러 줄을 낼 때 time.sleep(0.5) 간격을 두게 하며, 이전 step의 변수와 함수를 공유할 수 없다고 명시한다. FAIL은 쉽게 내지 말라고 지시하고 sudo 비밀번호도 프롬프트에 넣어 준다. SoM 프롬프트는 pyautogui.click(tag_2)처럼 좌표 자리에 태그를 쓸 수 있게 한다.
결과
사람 기준선
기본 소프트웨어 사용 능력은 있지만 해당 예시와 소프트웨어를 접한 적 없는 컴퓨터과학 전공 대학생이 전 예시를 풀었다. 비교를 위해 WebArena 100개도 같은 방식으로 측정했다.
| 지표 (Figure 4) | OSWorld | WebArena (100개 샘플) |
|---|---|---|
| 중위 완료 시간 | 111.94초 | 35.38초 |
| 정확도 | 72.36% | 88% |
OSWorld의 task는 시간이 세 배 이상 걸리고 900초 이상 걸린 예시도 상당수다. 정확도도 순수 웹 task보다 낮다. 저자들은 이를 OSWorld task가 더 높은 이해도와 숙련도를 요구한다는 근거로 든다.
메인 결과
전 설정 최고는 a11y tree 입력 GPT-4의 12.24%다. screenshot + a11y tree GPT-4V가 12.17%, SoM GPT-4V가 11.77%, a11y tree GPT-4o가 11.36%로 뒤를 잇는다. 순수 screenshot은 가장 강한 VLM인 GPT-4V와 Gemini-Pro-vision도 5.26%에서 5.80%에 머문다.
| 입력 (Table 5) | 모델 | OS | Office | Daily | Professional | Workflow | Overall |
|---|---|---|---|---|---|---|---|
| a11y tree | Mixtral-8x7B | 12.50% | 1.01% | 4.79% | 6.12% | 0.09% | 2.98% |
| a11y tree | Llama-3-70B | 4.17% | 1.87% | 2.71% | 0.00% | 0.93% | 1.61% |
| a11y tree | GPT-3.5 | 4.17% | 4.43% | 2.71% | 0.00% | 1.62% | 2.69% |
| a11y tree | GPT-4 | 20.83% | 3.58% | 25.64% | 26.53% | 2.97% | 12.24% |
| a11y tree | Gemini-Pro | 4.17% | 1.71% | 3.99% | 4.08% | 0.63% | 2.37% |
| a11y tree | Gemini-Pro-1.5 | 12.50% | 2.56% | 7.83% | 4.08% | 3.60% | 4.81% |
| a11y tree | Qwen-Max | 29.17% | 3.58% | 8.36% | 10.20% | 2.61% | 6.87% |
| a11y tree | GPT-4o | 20.83% | 6.99% | 16.81% | 16.33% | 7.56% | 11.36% |
| screenshot | CogAgent | 4.17% | 0.85% | 2.71% | 0.00% | 0.00% | 1.11% |
| screenshot | GPT-4V | 12.50% | 1.86% | 7.58% | 4.08% | 6.04% | 5.26% |
| screenshot | Gemini-ProV | 8.33% | 3.58% | 6.55% | 16.33% | 2.08% | 5.80% |
| screenshot | Gemini-Pro-1.5 | 12.50% | 6.99% | 2.71% | 6.12% | 3.60% | 5.40% |
| screenshot | Claude-3-Opus | 4.17% | 1.87% | 2.71% | 2.04% | 2.61% | 2.42% |
| screenshot | GPT-4o | 8.33% | 3.58% | 6.07% | 4.08% | 5.58% | 5.03% |
| screenshot + a11y tree | CogAgent | 4.17% | 0.85% | 2.71% | 0.62% | 0.09% | 1.32% |
| screenshot + a11y tree | GPT-4V | 16.66% | 6.99% | 24.50% | 18.37% | 4.64% | 12.17% |
| screenshot + a11y tree | Gemini-ProV | 4.17% | 4.43% | 6.55% | 0.00% | 1.52% | 3.48% |
| screenshot + a11y tree | Gemini-Pro-1.5 | 12.50% | 3.58% | 7.83% | 8.16% | 1.52% | 5.10% |
| screenshot + a11y tree | Claude-3-Opus | 12.50% | 3.57% | 5.27% | 8.16% | 1.00% | 4.41% |
| screenshot + a11y tree | GPT-4o | 41.67% | 6.16% | 12.33% | 14.29% | 7.46% | 11.21% |
| SoM | CogAgent | 4.17% | 0.00% | 2.71% | 0.00% | 0.53% | 0.99% |
| SoM | GPT-4V | 8.33% | 8.55% | 22.84% | 14.28% | 6.57% | 11.77% |
| SoM | Gemini-ProV | 4.17% | 1.01% | 1.42% | 0.00% | 0.63% | 1.06% |
| SoM | Gemini-Pro-1.5 | 16.67% | 5.13% | 12.96% | 10.20% | 3.60% | 7.79% |
| SoM | Claude-3-Opus | 12.50% | 2.72% | 14.24% | 6.12% | 4.49% | 6.72% |
| SoM | GPT-4o | 20.83% | 3.58% | 3.99% | 2.04% | 3.60% | 4.59% |
| 사람 | 75.00% | 71.79% | 70.51% | 73.47% | 73.27% | 72.36% |
어떤 설정을 쓰든 최고 성적은 사람의 6분의 1 수준이다. 저자들은 현재 LLM과 VLM이 컴퓨터 조수 역할과 거리가 멀다고 결론짓는다. 공통 벤치마크에서 GPT-4V와 경쟁한다고 알려진 Claude-3 Opus가 OSWorld에서는 크게 뒤지는 점도 주목할 결과로 든다.
앱별 상세 성공률
부록 C.5의 Table 14는 같은 실험을 앱 단위로 나눈다. Table 5의 Office는 Calc, Impress, Writer로, Daily는 VLC, Thunderbird(TB), Chrome으로, Professional은 VS Code(VSC), GIMP로 나뉜다.
| 입력 (Table 14) | 모델 | OS | Calc | Impress | Writer | VLC | TB | Chrome | VSC | GIMP | Workflow |
|---|---|---|---|---|---|---|---|---|---|---|---|
| a11y tree | Mixtral-8x7B | 12.50 | 0.00 | 0.39 | 4.34 | 10.22 | 6.67 | 2.17 | 8.69 | 3.85 | 0.10 |
| a11y tree | GPT-3.5 | 4.17 | 2.13 | 6.77 | 4.35 | 6.53 | 0.00 | 2.17 | 0.00 | 0.00 | 1.62 |
| a11y tree | Gemini-Pro | 4.17 | 0.00 | 2.13 | 4.35 | 12.41 | 0.00 | 2.17 | 0.00 | 7.69 | 0.63 |
| a11y tree | GPT-4 | 20.83 | 0.00 | 6.77 | 4.35 | 23.53 | 26.67 | 26.09 | 30.43 | 23.08 | 2.97 |
| a11y tree | Gemini-Pro-1.5 | 12.50 | 2.13 | 2.13 | 4.35 | 6.53 | 0.00 | 10.87 | 8.70 | 0.00 | 3.60 |
| a11y tree | Llama-3-70B | 4.17 | 0.00 | 0.39 | 8.70 | 6.53 | 0.00 | 2.17 | 0.00 | 0.00 | 0.63 |
| a11y tree | GPT-4o | 20.83 | 6.38 | 6.77 | 8.69 | 12.41 | 20.00 | 17.39 | 21.74 | 11.54 | 7.56 |
| a11y tree | Qwen-Max | 29.17 | 0.00 | 2.52 | 13.04 | 8.95 | 0.00 | 10.87 | 8.70 | 11.54 | 2.61 |
| screenshot | CogAgent | 4.17 | 0.00 | 0.00 | 4.34 | 6.53 | 0.00 | 2.17 | 0.00 | 0.00 | 0.00 |
| screenshot | Gemini-ProV | 8.33 | 0.00 | 6.77 | 4.35 | 12.41 | 0.00 | 6.52 | 8.70 | 23.08 | 2.08 |
| screenshot | GPT-4V | 12.50 | 0.00 | 2.52 | 4.35 | 18.34 | 0.00 | 6.52 | 0.00 | 7.69 | 6.04 |
| screenshot | Claude-3-Opus | 4.17 | 0.00 | 2.52 | 4.34 | 6.53 | 0.00 | 2.17 | 0.00 | 3.84 | 2.61 |
| screenshot | Gemini-Pro-1.5 | 12.50 | 0.00 | 13.16 | 8.70 | 6.53 | 0.00 | 2.17 | 0.00 | 11.54 | 3.60 |
| screenshot | GPT-4o | 8.33 | 0.00 | 6.77 | 4.35 | 16.10 | 0.00 | 4.35 | 4.35 | 3.85 | 5.58 |
| screenshot + a11y tree | CogAgent | 4.17 | 2.17 | 0.00 | 4.35 | 6.53 | 0.00 | 2.17 | 0.00 | 0.00 | 0.10 |
| screenshot + a11y tree | Gemini-ProV | 4.17 | 2.13 | 6.77 | 4.35 | 18.30 | 0.00 | 4.35 | 0.00 | 0.00 | 1.52 |
| screenshot + a11y tree | GPT-4V | 16.67 | 0.00 | 6.77 | 21.73 | 24.18 | 33.33 | 21.74 | 21.74 | 15.38 | 4.59 |
| screenshot + a11y tree | Claude-3-Opus | 12.50 | 2.13 | 4.65 | 4.34 | 18.30 | 0.00 | 2.17 | 8.69 | 7.69 | 0.99 |
| screenshot + a11y tree | Gemini-Pro-1.5 | 12.50 | 0.00 | 4.65 | 8.70 | 12.41 | 0.00 | 8.70 | 4.35 | 11.54 | 1.56 |
| screenshot + a11y tree | GPT-4o | 41.67 | 4.26 | 6.81 | 8.70 | 9.50 | 6.67 | 15.22 | 30.43 | 0.00 | 7.46 |
| SoM | CogAgent | 4.17 | 2.17 | 0.00 | 4.34 | 6.53 | 0.00 | 2.17 | 0.00 | 0.00 | 0.00 |
| SoM | Gemini-ProV | 4.17 | 0.00 | 0.39 | 4.34 | 6.53 | 0.00 | 0.00 | 0.00 | 0.00 | 0.63 |
| SoM | GPT-4V | 8.33 | 8.51 | 6.38 | 13.04 | 10.66 | 33.33 | 23.91 | 17.39 | 11.54 | 6.57 |
| SoM | Claude-3-Opus | 12.50 | 2.13 | 0.39 | 8.70 | 6.53 | 13.33 | 17.39 | 0.00 | 11.54 | 4.49 |
| SoM | Gemini-Pro-1.5 | 16.67 | 0.00 | 10.64 | 4.35 | 24.18 | 13.33 | 8.70 | 4.35 | 15.38 | 3.60 |
| SoM | GPT-4o | 20.83 | 0.00 | 6.77 | 4.35 | 6.53 | 0.00 | 4.35 | 4.35 | 0.00 | 3.60 |
| 사람 | 75.00 | 61.70 | 80.85 | 73.91 | 70.59 | 46.67 | 78.26 | 73.91 | 73.08 | 73.27 |
단위는 %다. Calc 열은 모델 설정 26개 중 16개가 0.00%이고 최고가 SoM GPT-4V의 8.51%다. 스프레드시트처럼 작은 요소가 빽빽한 GUI가 현재 agent에게 가장 어렵다는 뜻이다. 반대로 사람은 Thunderbird에서 46.67%로 가장 낮은데, 저자들은 이에 대한 해석을 적지 않았다.
도메인별 분산
agent 성능은 도메인에 따라 크게 흔들린다. CLI 성격이 강한 OS task는 상대적으로 좋고 GUI 클릭이 많은 Office task는 나쁘다. 모델과 설정에 따른 편향도 일관되지 않아 도메인 간 격차가 20%p를 넘기도 한다. 예를 들어 screenshot + a11y tree GPT-4o는 OS 41.67%와 Office 6.16%로 35%p 이상 차이가 난다. 여러 앱이 걸린 Workflow task는 대체로 5% 아래이고 최고가 SoM GPT-4V의 6.57%다.
반면 사람은 모든 도메인에서 70% 근처를 유지하며 편차가 5%p를 넘지 않는다. 저자들은 사람이 task를 이해하고 완수하는 방식이 현재 LLM과 VLM 기반 논리와 상당히 다를 수 있다고 해석한다.
a11y tree와 SoM의 효과
a11y tree의 효과는 모델마다 다르다. 다음 표는 Table 5의 Overall 값에서 계산한 차이다.
| 모델 | screenshot | screenshot + a11y tree | 차이 | SoM | SoM과 screenshot + a11y tree의 차이 |
|---|---|---|---|---|---|
| GPT-4V | 5.26% | 12.17% | +6.91%p | 11.77% | -0.40%p |
| GPT-4o | 5.03% | 11.21% | +6.18%p | 4.59% | -6.62%p |
| Claude-3-Opus | 2.42% | 4.41% | +1.99%p | 6.72% | +2.31%p |
| Gemini-ProV | 5.80% | 3.48% | -2.32%p | 1.06% | -2.42%p |
| Gemini-Pro-1.5 | 5.40% | 5.10% | -0.30%p | 7.79% | +2.69%p |
| CogAgent | 1.11% | 1.32% | +0.21%p | 0.99% | -0.33%p |
GPT-4V와 Claude-3는 a11y tree를 더하면 순수 screenshot보다 오른다. 저자들은 이 격차를 GUI 요소를 정확히 지각하고 추론하는 능력에 개선 여지가 크다는 신호로 읽는다. Gemini-Pro는 반대로 내려간다.
SoM은 GPT-4V에서 screenshot + a11y tree보다 성능이 낮았다. 고전적 이미지 이해 과제와 웹 agent에서 알려진 SoM의 효과와 어긋나는 결과다. 저자들은 OS task가 해상도가 높고 스프레드시트 셀처럼 요소가 훨씬 많아 경계 박스가 보조 역할보다 노이즈를 더 만든다고 추정한다. 좌표 수준의 세밀한 조작은 박스로 표현되지도 않는다. 부록 D.6은 SoM이 action space를 좁혀 탐색과 적응을 방해한다고 덧붙인다. VS Code에서 Python 플러그인의 코드 검사를 끄는 task에서 SoM 없는 agent는 settings.json을 편집해 성공했지만, SoM agent는 설정 화면의 체크박스를 찾다가 더 긴 action 경로와 클릭 오류로 실패했다. 전문 소프트웨어에서는 SoM의 요소 라벨링 자체에 오류가 있고, SoM 없는 agent는 a11y tree로 좌표를 계산해 조정할 수 있지만 SoM의 요소 블록은 task 중에 바꾸기 어렵다.
순수 screenshot 설정은 5.26%로 가장 낮지만 저자들은 장기적으로 이것이 최종 구성이라고 본다. 추가 정보가 필요 없는 유일한 설정이기 때문이다. a11y tree는 모든 소프트웨어가 잘 지원하지도 않고, 주변 화면을 통해 컴퓨터를 보는 것처럼 노이즈가 있는 조건에서는 얻을 수 없으며, 잎 노드만 해도 수만 토큰이라 추론 부담이 크다. 순수 시각 agent는 일반화가 강하고 물리 세계와 통합될 가능성도 크다고 전망한다.
난이도, 수행 가능성, 앱 수
5절의 분석은 별도 언급이 없으면 GPT-4V의 SoM 설정을 쓴다. 난이도는 사람의 완료 시간으로 나눴다.
| task 부분집합 (Table 6) | 기준 | 전체 대비 비율 | agent 성공률 | 사람 성공률 |
|---|---|---|---|---|
| Easy | 0~60초 | 28.72% | 16.78% | 84.91% |
| Medium | 60~180초 | 40.11% | 13.12% | 81.08% |
| Hard | 180초 초과 | 30.17% | 4.59% | 49.57% |
| Infeasible | 수행 불가 | 8.13% | 16.67% | 자료에 없음 |
| Feasible | 수행 가능 | 91.87% | 13.34% | 자료에 없음 |
| Single-App | 단일 앱 | 72.63% | 13.74% | 자료에 없음 |
| Multi-App Workflow | 여러 앱 | 27.37% | 6.57% | 자료에 없음 |
사람의 완료 시간이 길수록 agent 성공률이 떨어지며 180초를 넘는 task는 거의 풀지 못한다. 수행 불가 예시에서 운으로 맞힌 경우를 고려하면 더 그렇다. 사람은 같은 세 구간에서 84.91%, 81.08%, 49.57%로 같은 방향으로 하락하지만 불가능해지지는 않는다.
수행 불가 task(16.67%)가 수행 가능 task(13.34%)보다 약간 높지만 전체적으로 낮다. 순수 screenshot 설정의 Gemini-Pro처럼 일부 설정에서는 agent가 쉽게 FAIL을 내고 시도를 포기하는 경향이 있어 수행 불가 task에서 오탐이 생긴다. 따라서 수행 불가 판별보다 전체 성능 향상에 집중해야 한다는 것이 저자들의 결론이다.
단일앱 task의 평균 13.74%도 낮지만 멀티앱 워크플로 6.57%의 두 배가 넘는다. 단일앱 안에서는 GUI 집약적인 Office 앱이 가장 나쁘고 LibreOffice Calc 부분집합은 0%인 경우가 많다. 저자들은 소프트웨어 간 협업 능력과 특정 시나리오의 숙련도 향상이 필요하다고 본다.
해상도와 히스토리 길이
대부분의 VLM은 1080p, 2K, 4K보다 훨씬 낮은 해상도 데이터로 학습됐다. 저자들은 screenshot 설정과 SoM 설정에서 원본의 0.2, 0.4, 0.6, 0.8배로 다운샘플링해 10% 부분집합으로 측정했다. 출력 좌표는 여전히 원본 1080p 기준으로 요구된다.
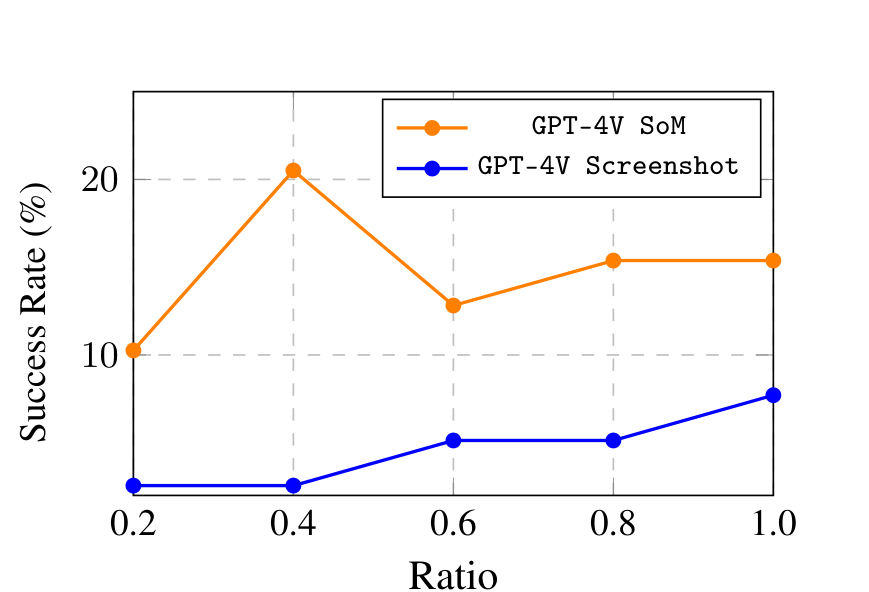
순수 screenshot은 해상도가 오를수록 성능이 직접 상승한다. 저자들은 screenshot 해상도와 출력 좌표의 불일치를 원인으로 추정한다. SoM은 다르다. 0.4배(768×432)에서 오히려 성능이 오르고 0.2배로 더 내리면 눈에 띄게 하락한다. 논문은 SoM에서 나타난 이 비단조 곡선의 이유를 적지 않았다.
히스토리 길이 실험은 a11y tree가 현재 기술 조건에서 성능에 결정적이라는 관찰에서 출발한다. document, item, button, heading, label 등 핵심 태그만 남기는 휴리스틱 규칙을 써도 LLM은 여전히 큰 컨텍스트가 필요하고, 현재 관측만 쓰면 agent가 같은 오류를 반복한다. 그래서 과거 N 라운드의 관측과 action을 함께 넣고 N을 1, 2, 3, 전부(가능한 최대)로 바꿨다.
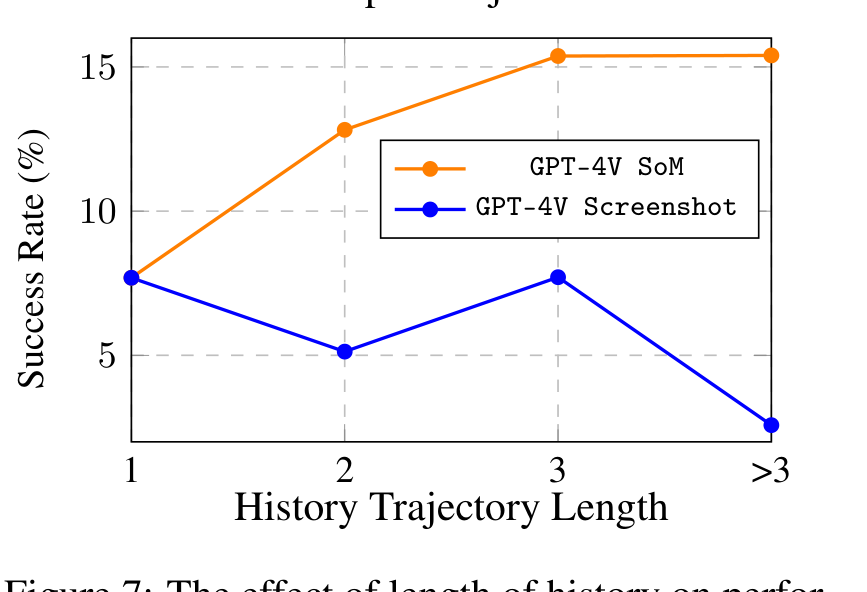
SoM은 히스토리가 늘수록 성능이 오른다. 반면 순수 screenshot 설정에서는 히스토리를 늘려도 나아지지 않는다. 저자들은 현재 VLM이 텍스트만큼 이미지에서 강건한 맥락 정보를 뽑아내지 못한다는 뜻으로 해석하고, 긴 컨텍스트 지원과 추론 효율, 효율적 메모리 저장을 위한 새 agent 구조가 디지털 agent에 큰 영향을 줄 것이라고 전망한다.
창 교란
현재 agent는 UI 배치와 노이즈에 강건하지 않다. SoM 설정에서 agent가 비교적 잘 푸는 28개 task(성공률 50.79%)를 골라 각 task 시작 시점에 창을 교란했다. 이렇게 원래 부분집합의 몇 배 되는 샘플을 만들어 측정했다.
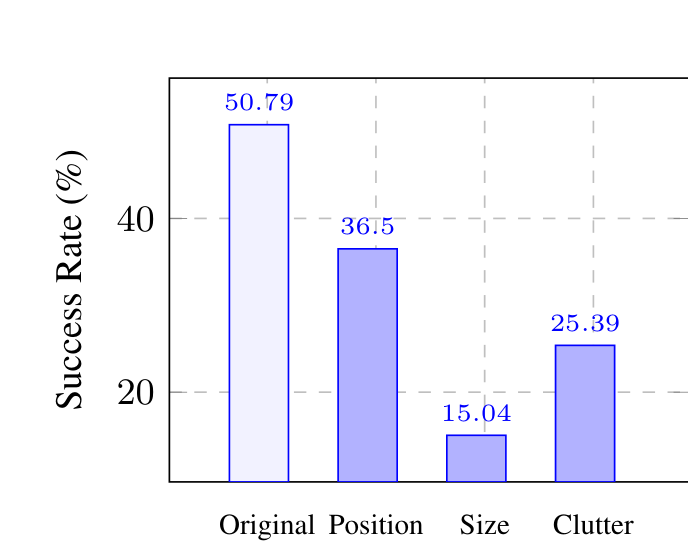
| 교란 조건 | 성공률 | 원본 대비 상대 하락률 (Figure 8 값에서 계산) |
|---|---|---|
| 원본 | 50.79% | - |
| 창 위치 변경 | 36.5% | 28% |
| 창을 최소 크기로 축소 | 15.04% | 70% |
| 무관한 앱을 열어 최대화 | 25.39% | 50% |
창 크기를 줄이는 교란의 하락폭이 가장 크다. agent는 창 사이를 어느 정도 전환하지만 중간 단계로 창을 최대화하지 못하고 다른 일에 막힌다. 창 사이를 이동하는 능력은 있지만 창 상태를 관리하는 포괄적 전략이 없다는 해석이다.
OS 간 전이
범용 디지털 agent는 OS가 바뀌어도 일관된 성능을 유지해야 한다. OS와 소프트웨어 생태계의 차이는 관측과 action space에 영향을 주어 성능 불확실성을 만든다. 저자들은 Windows에서 초기 상태 설정, 최종 채점, a11y tree와 screenshot 관측을 지원하도록 환경을 확장하고 기존 Ubuntu 부분집합을 예시별로 수정해 Windows로 옮겼다.
| OS (Table 7) | 성공률 | 상관계수 |
|---|---|---|
| Ubuntu | 4.88% | 0.7 |
| Windows | 2.55% |
GPT-4V screenshot 설정으로 측정한 결과다. 관측 공간이 다른데도 상관이 높으므로, 저자들은 OSWorld에서 얻은 통찰과 방법론이 Windows 환경으로 신뢰성 있게 옮겨진다고 해석한다.
정성 분석
GPT-4V 기반 agent는 복잡한 문제 해결이나 창의적 사고가 필요한 task를 풀기도 한다. 영상에서 자막 파일을 추출해 저장하는 task에서 agent는 화면을 왼쪽 VLC와 오른쪽 터미널로 나누고 ffmpeg를 두 번 실행했다. 한 번은 자막을 subtitles.srt로 뽑고 다른 한 번은 자막을 제거한 영상을 만들었다. 부록 D.1의 코드를 보면 Activities 메뉴에서 terminal을 검색해 열고 터미널 중앙을 클릭해 포커스를 잡은 뒤 명령을 입력했다.
반대로 단순한 task에서 실패하는 사례가 많다. "문서 제목을 가운데 정렬"이라는 요구를 grounding하지 못하고 무관한 단어를 선택하거나 무관한 메뉴를 여는 쓸모없는 action을 반복했다. 부록 코드를 보면 agent는 (400, 150)과 (340, 80)을 가운데 정렬 버튼이라 추정해 반복 클릭했다.
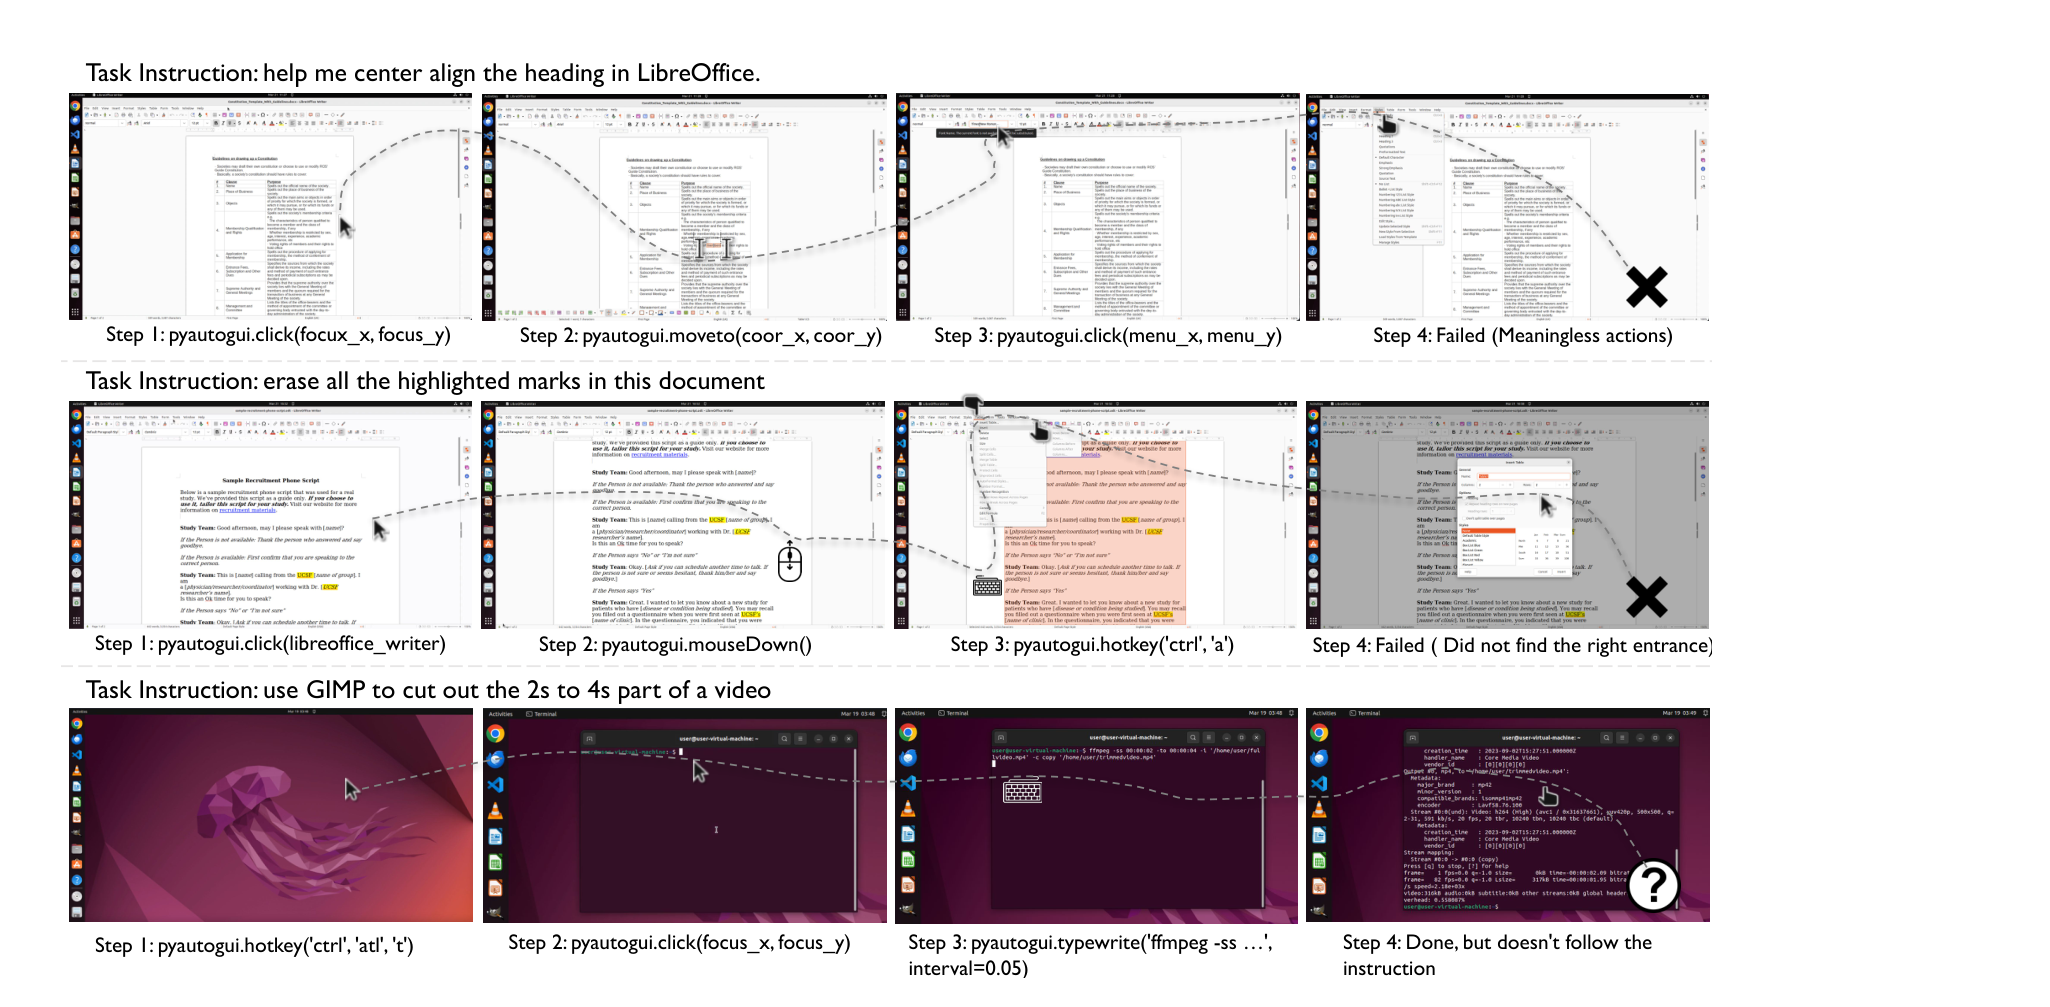
소프트웨어 사용 사전 지식도 부족하다. GIMP에서 "밝기를 낮춰"라는 지시에 어느 메뉴가 밝기 조정인지 몰라 Colors 메뉴의 항목 간격을 28픽셀로 가정하고 여러 항목을 무작위로 열고 닫다가 최대 step을 소진했다. Calc에서 회의 장소를 채우는 task에서는 셀마다 좌표를 클릭해 도시 이름을 입력하는 action을 15번째까지 반복한 끝에 실패했고, Chrome에서 Bing을 기본 검색 엔진으로 바꾸는 task에서는 설정 페이지에 도달한 뒤 Tab 키를 열 번 눌러 목록을 탐색하다 실패했다.
여러 설정에서 표본으로 뽑은 실패 예시 550개를 분석한 결과, GPT-4V agent의 오류는 다음 유형으로 정리된다.
| 오류 유형 | 빈도 | 내용 |
|---|---|---|
| 마우스 클릭 부정확 | 550개 중 75% 이상 | 코드 주석에 상세하고 정확한 단계를 계획하고도 올바른 좌표를 클릭하지 못한다. planning은 강하고 실행은 약하다 |
| 반복 클릭 | 클릭 부정확에서 파생 | 잘못 클릭하고 조정하고 다시 실패하며 step을 소진한다 |
| 환경 노이즈 딜레마(environmental noise dilemma) | 클릭 부정확에서 파생 | 의도치 않은 대상을 클릭해 팝업이 뜨거나 무관한 앱이 열린다. 전문 소프트웨어 사전 지식이 없어 action과 현재 상태의 불일치에 빠진 뒤 정상 상태로 돌아오는 방법을 모른다 |
| 웹 페이지 상식 부족 | 자료에 빈도 없음 | 실제 웹 페이지에서 팝업을 닫지 않거나 광고 콘텐츠에 이끌려 원래의 올바른 판단이 흔들린다 |
| 지시문 오해와 시각적 간과 | 자료에 빈도 없음 | 언어와 시각 처리 개선이 필요하다 |
사람과 agent가 어려워하는 task는 서로 다르다. 사람에게 직관적으로 쉬운 task가 agent에게는 어렵고, 사람이 힘들어하는 task가 agent에게는 쉬운 경우가 있다.
| 구분 | task 예 | 원인 |
|---|---|---|
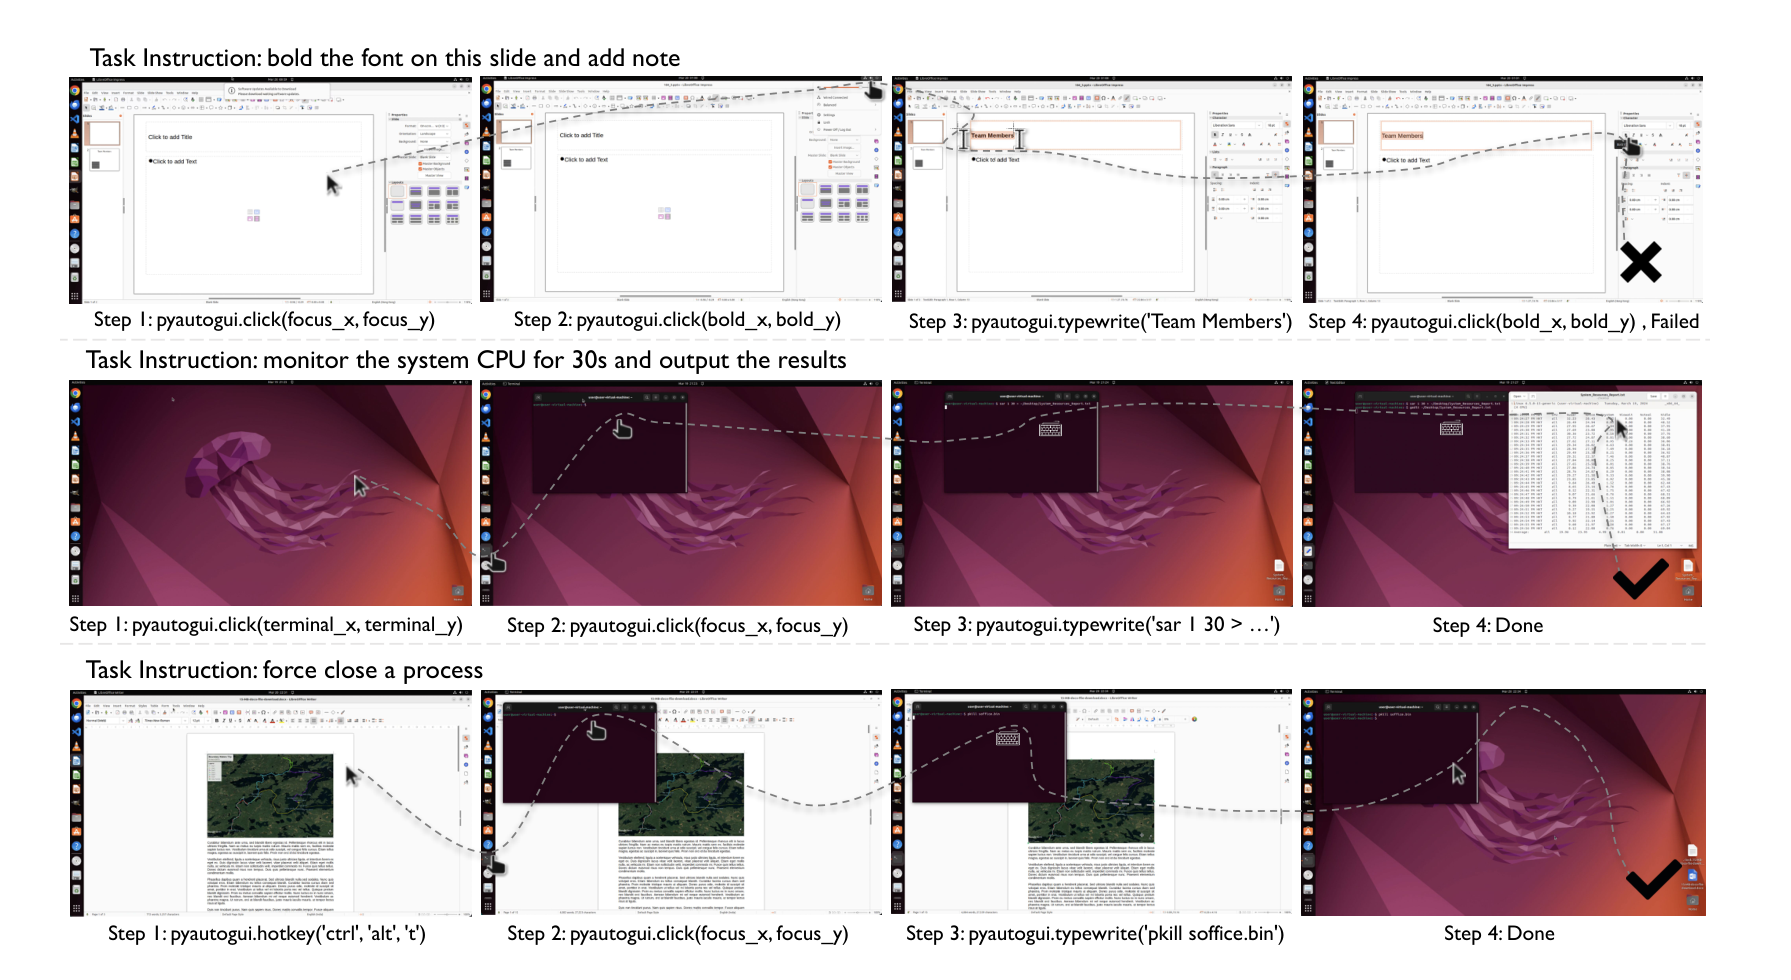
| 사람이 앞서는 task | "이 슬라이드 글꼴을 굵게 하고 노트를 추가", "문서의 형광펜 표시를 모두 지워" 같은 텍스트와 디자인 작업 | 인터넷에 소프트웨어 실행 과정 같은 세밀한 데이터가 없어 학습 과정도 없었고 grounding 능력이 부족하다. GUI 논리 이해 부족으로 선택과 스크롤 같은 조작도 서툴다 |
| agent가 앞서는 task | "시스템 CPU를 30초 감시하고 결과를 출력", "프로세스 강제 종료" 같은 코드로 풀리는 task | GUI 상호작용이 거의 없고 복잡한 코드와 명령 실행으로 완료할 수 있다 |
| 둘 다 비효율적인 task | 복사, 붙여넣기, 시트 일괄 편집처럼 기계적으로 반복되는 task | 사람은 실행 중 부주의한 실수를 자주 한다. agent는 API 부재나 API 관련 학습 데이터 부족으로 일괄 처리를 못 하고, 느린 응답으로 시간 초과나 최대 step 초과가 생긴다 |
코드로 푸는 방식이 지시와 어긋나기도 한다. "GIMP로 영상의 2초에서 4초 구간을 잘라내" task에서 agent는 터미널에서 ffmpeg로 잘라내 "GIMP 사용" 요구를 무시했다. 결과 파일은 만들어졌지만 지시를 따르지 않은 완료다.
Claude-3 Opus와 GPT-4V의 비교도 grounding 문제를 드러낸다. Claude-3 Opus는 GSM8K와 HumanEval 같은 벤치마크에서 GPT-4를 앞서지만 OSWorld에서는 같은 입력 설정의 GPT-4V보다 낮다.
| 입력 설정 | GPT-4V | Claude-3-Opus | 차이 |
|---|---|---|---|
| screenshot | 5.26% | 2.42% | 2.84%p |
| screenshot + a11y tree | 12.17% | 4.41% | 7.76%p |
| SoM | 11.77% | 6.72% | 5.05%p |
Claude는 만족스러운 고수준 해법을 내놓지만 grounding에 세부 환각이 섞인다. 파일 더블클릭을 열기가 아니라 선택으로 해석하고, Calc의 B열을 C열로 다루며, VS Code 치환 상자에 텍스트를 입력하고 전체 치환을 클릭하지 않았다. 사람의 planning과는 잘 맞지만 실행 grounding이 부족하다는 결론이다.
step 수 분포
부록 C.5는 GPT-4V가 네 설정에서 소비한 step 수 분포를 제시한다. a11y tree 설정은 4 step 근처에 몰리고, screenshot과 SoM 설정은 상한인 15 step 이상에 몰린다. 설정에 따라 agent가 실행하는 step 수와 종료를 결정하는 시점이 눈에 띄게 다르며, 이 행동의 세밀한 제어와 분석은 후속 연구 과제로 남긴다.
한계
저자가 명시한 한계
| 영역 | 내용 |
|---|---|
| 채점 오탐과 미탐 | 4회 검수와 400 man-hour 이상을 들였지만 완전히 없애지 못했다. 추가 시간 투자와 레드팀이 필요하다 |
| VLM 능력 | 훨씬 긴 컨텍스트의 효율적 처리, 앱 창 변화에 강건한 GUI grounding, 지시에 맞는 정확한 action 생성, 이미지 형태의 맥락 이해가 필요하다. 이미지로 히스토리를 인코딩할 수 있어야 그 위에 메모리와 반성을 구축할 수 있다. pre-training, 하류 fine-tuning, 모델 구조 자체의 개선이 필요할 수 있다 |
| agent 방법론 | 길고 가공되지 않은 관측과 action 기록을 다루는 새 인코딩 방식, 컨텍스트를 압축하는 효율적 메모리와 반성, 메모리를 통한 지식 grounding, 사용자 프로파일링에 기반한 개인화, GUI와 CLI 전용 프로토콜이 과제다 |
| 안전 | 범용 디지털 agent는 CAPTCHA 우회, 특허권 침해, 계정 남용, 취약점 악용에 쓰일 수 있다. 현재는 능력이 낮아 실험 중 유해 행동을 관찰하지 못했다. VM으로 격리하지만 격리 환경에서 agent 안전을 재는 신뢰할 만한 지표가 없고, 채점 함수는 task 완료 정확성만 보며 불필요하게 피해를 주는 action은 거의 살피지 않는다 |
| 데이터와 환경 | 의료, 교육, 산업, 교통 같은 전문 분야와 개인화 요구로 범위를 넓혀야 한다. a11y tree 품질은 앱마다 다르며 개발자가 a11y 규약을 지킨다는 보장이 없다. 컴퓨터 조작 데이터를 손쉽게 수집해 agent 능력으로 바꾸는 방법도 필요하다 |
자료의 내적 불일치
raw 재독에서 확인한 논문 내부의 불일치는 다음과 같다. 이 페이지는 본문 Table 5 값을 우선한다.
| 항목 | 내용 |
|---|---|
| Table 5와 Table 14의 Workflow 열 | Llama-3-70B(a11y tree) 0.93% 대 0.63%, GPT-4V(screenshot + a11y tree) 4.64% 대 4.59%, Gemini-Pro-1.5(screenshot + a11y tree) 1.52% 대 1.56%, Claude-3-Opus(screenshot + a11y tree) 1.00% 대 0.99%, Mixtral-8x7B와 CogAgent(screenshot + a11y tree) 0.09% 대 0.10% |
| Figure 17과 Figure 18 | 캡션과 이미지가 서로 바뀌어 있다. Figure 17 캡션은 나이키 스토어 클릭 오류를 설명하지만 그 위의 이미지는 항공편 검색 화면의 팝업과 쿠키 배너이고, Figure 18 캡션은 환경 노이즈를 설명하지만 그 위의 이미지는 나이키 즐겨찾기 오클릭 화면이다 |
| 창 교란 하락폭 | 본문은 "60%에서 80%가 넘는 하락"이라 적었지만 Figure 8 값으로 계산한 상대 하락률은 28%, 70%, 50%다 |
| 400 man-hour | 1,800 man-hour 내역의 재검토 400시간, 예시 수집 약 400시간, 4회 검수 400시간 이상이 각각 등장하며 포함 관계가 명시되지 않는다 |
| Table 5의 Office 열 | Claude-3-Opus(screenshot + a11y tree)만 3.57%이고 같은 값을 가진 다른 모델은 3.58%다. 반올림 차이로 보이나 확인할 수 없다 |
자료에 없어 확인할 수 없는 것
- 게재 학회. raw PDF 표지는 "Preprint. Under review."로 표기돼 있다.
- 코드 저장소 URL과 라이선스. raw에는 프로젝트 페이지 https://os-world.github.io만 있다. 구현 저장소는 xlang-ai/OSWorld에서 다룬다.
- VLC, Chrome, VS Code, GIMP의 버전. 부록은 LibreOffice 7.3.7.2와 Thunderbird 115.6.0만 적었다.
- 사람 평가자의 인원수와 task당 평가자 수.
- Table 6의 Infeasible, Feasible, Single-App, Multi-App Workflow 구간의 사람 성공률.
핵심 용어
| 용어 | 뜻 |
|---|---|
| accessibility tree (a11y tree) | OS나 브라우저의 접근성 API가 화면 요소의 종류, 상태, 위치를 프로그램이 읽을 수 있게 노출하는 트리. 원본은 보통 100만 토큰을 넘어 걸러서 쓴다 |
| execution-based evaluation | 최종 환경 상태를 실제로 조회해 채점하는 방식. 다른 경로의 올바른 해법도 인정한다 |
| getter / evaluator | 채점 config를 이루는 두 함수. getter가 최종 환경에서 파일, 창 텍스트, 쿠키 등을 꺼내면 evaluator가 성공을 판정한다 |
| Set-of-Mark (SoM) | 이미지 요소에 번호 박스를 씌워 모델이 좌표 대신 번호를 지목하게 하는 기법. OSWorld는 a11y tree로 박스를 잡는다 |
| infeasible task | 기능이 없어졌거나 애초에 존재하지 않아 완료할 수 없는 task. 369개 중 30개이며 FAIL을 정확히 내면 reward를 준다 |
| 환경 노이즈 딜레마 | 의도치 않은 대상을 클릭해 팝업이나 무관한 앱이 열린 뒤 정상 상태로 돌아오지 못하는 실패 유형 |
관련 페이지
- xlang-ai/OSWorld: 이 논문의 구현 저장소. 환경 패키지 구성과 개정판 OSWorld-Verified의 내역은 그 페이지가 다룬다
- MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers: 채점 설계가 대비되는 agent 벤치마크. OSWorld는 task마다 실행 채점 스크립트를 붙였고 MCP-Atlas는 최종 답에 담겨야 할 claim 목록으로 채점한다
- CUA-Gym: Scaling Verifiable Training Environments and Tasks for Computer-Use Agents: OSWorld를 평가 벤치마크로 쓰고 OSWorld 평가기 계약을 따르는 config 형식으로 학습 환경을 합성한 후속 연구
- Browser Use: Make websites accessible for AI agents: LLM이 웹 브라우저를 조작하게 하는 Python 패키지. OS 전체를 무대로 삼는 OSWorld와 평가 범위가 대비된다
- BrowserCode (browser-use): The browser-native agent: 좌표 클릭 대신 코드 실행으로 브라우저를 제어하는 agent. 이 논문이 보고한 마우스 클릭 부정확 문제와 설계 동기가 맞닿는다
- 용어집: Agents (Terminology Glossary): agent 도메인 용어의 canonical 표기