Evaluations · PAPER · 2026
MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers
요약
MCP-Atlas는 실제 운영 중인 MCP 서버 36개와 도구 220개 위에서 1,000개의 자연어 task로 LLM 에이전트의 tool use 능력을 재는 벤치마크다. tool use는 모델이 외부 도구를 호출해 행동 범위를 넓히는 능력을 말한다. Scale AI와 National University of Singapore의 저자들은 task를 자동 생성하지 않고 전문가가 직접 작성하고 검증했으며, 채점 기준을 특정 tool call 경로와의 일치가 아니라 최종 답에 담겨야 할 원자 단위 claim의 충족 여부로 두었다.
이 채점 설계 덕분에 벤치마크는 다른 경로로 같은 사실에 도달한 풀이에도 만점을 주고, 실패한 task에는 11개 유형의 자동 진단을 붙일 수 있다. 20개 프런티어 모델을 같은 조건에서 평가한 결과 최고 성적은 Muse Spark의 82.2%였고, 진단된 실패 약 6,900건 가운데 63.3%가 tool call 계열이 아니라 인지 계열이었다. 즉 현재 에이전트의 병목은 유효한 tool call을 만드는 능력보다 도구에 접근한 뒤 근거를 충분히 모았는지 판단하고 최종 답을 합성하는 단계에 있다.
배경
MCP는 LLM 에이전트가 외부 도구를 발견하고 호출하는 계층의 표준 인터페이스로 자리 잡았다. 서버 발견, 도구 열거, 타입이 있는 파라미터 전달, 결과 소비를 하나의 규약으로 제공하기 때문이다. 그러나 MCP 기반 배포가 빠르게 늘어난 것과 달리 그 위에서 동작하는 에이전트를 신뢰할 수 있게 평가하는 일은 여전히 어려운 과제로 남아 있다.
저자들은 실무 배포가 평가에 요구하는 조건을 세 가지로 본다. 첫째, 분기와 cross-server 조율이 있는 현실적인 multi-step 워크플로를 다룰 것. 둘째, mock 대체물이 아닌 실제 MCP 서버와 API를 폭넓게 쓸 것. 셋째, 에이전트의 장황함이나 문체와 분리된 구조적이고 재현 가능한 claim 수준 채점을 할 것. 기존 MCP 벤치마크는 이 가운데 한두 가지에서 진전을 냈지만 나머지에서 한계를 보였다.
기존 MCP 벤치마크의 절충
기존 MCP 벤치마크에는 지속적인 긴장이 있다. 평가 엄밀함을 최적화한 벤치마크는 규모가 작게 머물고, 규모를 달성한 벤치마크는 객관성이나 현실성에서 타협한다. 논문의 Table 1은 동시대 벤치마크 8종을 서버 수(#S), 도구 수(#T), task 수, 그리고 네 가지 설계 항목으로 비교한다.
| 벤치마크 | #S | #T | task 수 | cross-server | distractor | 자연어 프롬프트 | 실제 서버 |
|---|---|---|---|---|---|---|---|
| MCP-Universe | 11 | 133 | 231 | O | O | O | O |
| MCPEval | 5 | 19 | 676 | 부분 | 없음 | 부분 | O |
| MCP-Bench | 28 | 250 | 104 | O | O | O | O |
| Toolathlon | 32 | 604 | 108 | O | O | O | O |
| MCPMark | 5 | 약 50 | 127 | 없음 | 없음 | O | O |
| LiveMCPBench | 70 | 527 | 95 | O | O | O | O |
| MCPVerse | 65 | 552 | 미기재 | O | O | O | 혼합 |
| MCP-RADAR | 42 | 미기재 | 507 | 부분 | 없음 | 혼합 | 혼합 |
| MCP-Atlas | 36 | 220 | 1,000 | O | O | O | O |
네 항목을 모두 갖춘 벤치마크는 MCP-Universe, MCP-Bench, Toolathlon, LiveMCPBench, MCP-Atlas 다섯이다. 그중 task가 1,000개인 것은 MCP-Atlas뿐이고 나머지 넷은 95개에서 231개에 머문다. 반대로 task 수가 많은 MCPEval(676개)과 MCP-RADAR(507개)는 distractor가 없고 cross-server 조율이 부분적이다.
절충의 양상은 벤치마크 계열마다 다르다.
| 계열 | 벤치마크 | 택한 것 | 잃은 것 |
|---|---|---|---|
| 프로그램적 검증 | MCP-Universe, Toolathlon, MCPMark | 형식, 정적, 동적 evaluator와 실시간 ground truth 검증, 라이브 환경 전용 검증 스크립트 | 수작업 task 작성과 맞춤 검증기의 비용 때문에 task 250개 미만 |
| 자동 생성 | MCPEval | 676개 task 규모 | task 품질과 자연스러움 |
| 전체론적 LLM-as-a-Judge | MCP-Bench, LiveMCPBench | 규모 | 문체 편향. 장황한 응답과 간결한 정답이 다른 점수를 받아 재현성 하락 |
| 서버 범위 확장 | MCPVerse, MCP-RADAR | 넓은 서버 범위 | 부분적으로 합성이나 mock 구현에 의존해 실제 성능 예측력 제한 |
MCP-Universe가 제기한 unknown-tools 문제, 즉 에이전트가 도구를 호출하기 전에 어떤 도구가 관련 있는지 먼저 찾아내야 한다는 문제는 MCP-Atlas의 distractor 설계로 이어졌다.
평가 타당성을 위협하는 세 요소
MCP-Atlas는 기존 연구가 통제하지 않은 평가 타당성 위협 세 가지를 겨냥한다.
| 위협 | 내용 | MCP-Atlas의 대응 |
|---|---|---|
| 정제된 서버 동작 | mock 서버는 실제 세계의 오류 유형을 억제한다 | 실제 운영 서버만 사용해 rate limit, 페이지네이션, 스키마 불일치, 일시적 오류를 그대로 노출 |
| trajectory 일치 지표 | 유효한 대안 풀이에 벌점을 준다 | 최종 답의 claim 충족만으로 채점 |
| 깨끗한 도구 집합 | 진정한 도구 발견이 불필요해진다 | task마다 의미상 비슷한 distractor를 체계적으로 섞음 |
이 세 대응은 곧 논문의 세 설계 선택이다. 자동 생성 대신 체계적 수동 검증으로 규모와 품질을 함께 확보하고, 전체론적 judge 대신 claim 기반 부분 점수를 쓰며, 실제 서버만 쓰되 distractor를 체계적으로 심는다.
핵심 개념
claim은 정답이라면 최종 답에 담겨 있어야 하는 원자적 사실 진술이다. MCP-Atlas는 task마다 도구 출력에 근거한 claim 목록을 정의하고, 모델이 어떤 경로로 답에 도달했는지는 보지 않는다. 평균은 task당 4.7개이고 범위는 1개에서 23개다.
coverage는 task의 claim 점수를 평균낸 값이다. judge가 claim 하나를 충족(1.0), 부분 충족(0.5), 미충족(0.0)으로 매기면 coverage는 그 평균이 되고, 주 지표인 pass@0.75는 coverage 0.75 이상을 통과로 센다. coverage가 실수 값이므로 임계값을 바꾸는 것은 채점상의 결정이 아니라 보고상의 결정이다.
distractor는 task에 함께 노출되지만 풀이에는 필요 없는 도구다. 무작위 도구가 아니라 의미상 비슷한 카테고리에서 뽑기 때문에, 알려진 API를 실행하는 능력이 아니라 잡음 속에서 필요한 도구를 발견하는 능력을 잰다.
reference trajectory는 저자가 검증한 최소 정답 경로로, task마다 평균 9.8 step의 tool call 시퀀스다. 풀이 가능성 확인, 도구 의존성 검증, 실패 진단에만 쓰고 통과와 실패 판정에는 절대 쓰지 않는다. 무엇을 달성해야 하는가(claim)와 어떻게 달성하는가(trajectory)를 이렇게 분리한다.
harness는 모델을 감싸 도구, 검증, 상태를 제공하는 실행 환경이다. MCP-Atlas는 컨테이너화된 harness와 claim evaluator를 함께 공개하며, 제공사가 권장하는 네이티브 tool call 전략을 그대로 쓴다.
방법
서버 생태계와 환경 버킷
36개 서버는 전부 운영용 MCP 구현이고 합성 스텁은 없다. task는 실제 endpoint를 상대로 실행되므로 진짜 rate limit, 페이지네이션 경계, 스키마 버전 불일치, 일시적 오류 코드가 그대로 돌아온다. mock 환경이 설계상 제거하는 실패 조건을 의도적으로 남긴 것이다.
서버는 다섯 환경 버킷으로 묶인다. 논문의 Table 2는 비중을 범위로, 부록 B는 정확한 값으로 제시한다.
| 버킷 | 비중 (Table 2) | 비중 (부록 B) | 대표 서버 | 전형적 함정 |
|---|---|---|---|---|
| Basic | 30~35% | 32% | brave_search, exa, weather, maps | 질의 구성, 페이지네이션 |
| Productivity | 20~25% | 22% | filesystem, notion, slack, arxiv | 경로 범위, rate limit |
| Coding | 20~25% | 22% | git, github, code-executor, cli | 상태를 가진 연산, diff 범위 |
| Analytics | 10~15% | 12% | airtable, mongodb | 스키마 정렬, 타이핑 |
| Financial | 10~15% | 12% | twelvedata, alchemy | 기간 정렬, 심볼 |
부록 B의 Table 5는 36개 서버 전체와 각 서버를 필요로 하는 task 수를 싣는다. 여러 task가 서버 여러 개를 요구하므로 이 열의 합은 1,000을 넘는다. 상위 12개와 하위 4개는 다음과 같다.
| 서버 | task 수 | 버킷 | 서버 | task 수 | 버킷 |
|---|---|---|---|---|---|
| oxylabs | 155 | Basic | ddg-search | 92 | Basic |
| filesystem | 133 | Productivity | national-parks | 85 | Basic |
| exa | 108 | Basic | brave-search | 83 | Basic |
| wikipedia | 99 | Basic | cli-mcp-server | 78 | Coding |
| mongodb | 98 | Analytics | alchemy | 76 | Financial |
| airtable | 96 | Analytics | weather-data | 76 | Basic |
| mcp-code-executor | 93 | Coding | memory | 36 | Productivity |
| pubmed | 30 | Basic | weather | 26 | Basic |
| context7 | 4 | Coding |
검색과 filesystem 같은 범용 서버의 비중이 높다. 서버 선정 기준은 네 가지다. 안정적이고 문서화된 MCP 구현이 있을 것, 검색, 분석, 생산성, 금융, 코딩의 기능 카테고리에 걸쳐 다양할 것, distractor 선택이 의미를 갖도록 서버당 관련 도구가 여럿 있을 것, 현실적인 multi-step 워크플로에 적용 가능할 것이다.
컨테이너 격리
각 서버는 Docker 컨테이너로 패키징되어 네 가지 격리 조치를 받는다.
| 조치 | 내용 | 목적 |
|---|---|---|
| 샌드박스 파일시스템 | 명시적으로 쓰기 가능한 작업 디렉터리를 제외하면 읽기 전용 마운트 | 무단 쓰기 방지 |
| 허용 목록 egress | 그 서버가 정당하게 필요로 하는 상류 API로만 네트워크 제한 | 외부 접근 통제 |
| task 사이 재시작 | 컨테이너를 task마다 재시작 | task 간 상태 누출 방지 |
| 이미지 digest 고정 | 평가 실행을 특정 이미지 digest에 고정 | 상류 API drift를 제외한 동일 재현 |
이 구성 덕분에 같은 digest로 다시 실행하면 상류 API의 실제 변화를 제외하고는 동일한 서버 동작을 얻는다. 서버별 도구 카탈로그, 컨테이너 이미지 digest, 버전 고정 정보는 데이터셋과 함께 공개된다.
task 구조와 distractor
프롬프트는 단일 턴 자연어 요청이고 서버, 도구, 파라미터 이름을 하나도 대지 않는다. 따라서 모델은 task의 의미만으로 올바른 도구 사슬을 추론해야 한다. 노출되는 도구 집합과 필요한 도구의 관계는 다음과 같다.
| 항목 | 범위 | 평균 |
|---|---|---|
| task당 노출 도구 | 6~37개 | 15.2개 |
| 정답에 필요한 도구 | 2~8개 | 4.1개 |
| distractor | 나머지 | 11.1개 |
| 필요한 서버 수 | 2개 이상이 98.6% | 2.55개 |
| task당 claim | 1~23개 | 4.7개 |
| reference trajectory 길이 | 자료에 범위 없음 | 9.8 step |
즉 노출된 도구 15개 중 평균 11개는 풀이에 필요 없다. cross-server 조율은 기본값이어서 98.6%가 서버 두 개 이상의 도구를 요구하고, 정확히 두 개가 51.7%, 세 개가 38.2%, 네 개 이상이 8.7%다. 대부분의 task는 뒤쪽 tool call이 앞쪽 출력으로 parameterize되는 multi-hop 의존성을 가진다.
예시 task
부록 D.5의 예시는 이 구조를 보여준다. 프롬프트는 광고 효과 논문을 조사하면서 자사 광고 데이터와 비교하려는 사용자의 요청으로, Jane Castleman의 2024년 논문 초록을 가져오고 2015년에서 2023년 사이에 시작한 캠페인 중 참여율이 가장 높은 캠페인의 날짜와 지역을 알려 달라는 내용이다. 노출된 도구 15개 중 필요한 것은 3개다.
| 구분 | 도구 |
|---|---|
| task에 필요한 도구 (3개) | arxiv_search_papers, notion_API-post-search, notion_API-post-database-query |
| distractor (12개) | notion_API-retrieve-a-database, notion_API-retrieve-a-block, notion_API-retrieve-a-page, fetch_fetch, memory_read_graph, memory_search_nodes, slack_channels_list, slack_conversations_history, slack_conversations_replies, slack_conversations_search_messages, whois_whois_domain, whois_whois_tld |
reference trajectory는 세 단계다. arxiv 검색으로 초록을 가져오고, notion 검색으로 광고 데이터베이스를 찾고, database_id를 넣은 데이터베이스 질의로 캠페인 날짜를 조회한다. claim은 다섯 개로 논문 제목(C1), 초록 본문(C2), 참여율 15%로 동률인 캠페인이 세 개라는 사실(C3), 세 캠페인의 시작일 2022-06-24, 2019-09-20, 2017-09-09(C4), 세 캠페인의 지역 National, International, International(C5)이다. 이 예시는 프롬프트가 "arxiv"나 "notion"이라는 이름을 말하지 않아도 모델이 notion의 세 distractor 도구 대신 검색과 데이터베이스 질의를 골라야 함을 보여준다.
claim 기반 채점
evaluator judge는 task당 한 번이 아니라 claim당 한 번 호출된다. claim이 5개면 evaluator 호출도 5회 독립으로 이루어지고 task coverage는 그 5개 점수의 평균이다. 한 호출에서 모든 claim을 같은 응답에 대해 채점하면 컨텍스트 손실이 생기며, claim이 10개를 넘는 4%의 task에서 특히 그렇다.
부록 C의 evaluator 프롬프트는 수치 비교 기준을 명시한다.
| 수치 종류 | 허용 기준 |
|---|---|
| 소수 | 정확한 일치 불필요 |
| 일반 수치 | claim 수치의 5% 이내면 일치 |
| 백분율 | ±1%p 허용 |
| 표현만 다른 값 | "0.5", "50%", "half"는 같은 값으로 취급 |
| 과학 측정치 | 더 높은 정밀도 요구 가능 |
| 금융 수치 | 업무상 합리적 정밀도(백만 단위, 십억 단위는 센트까지 맞출 필요 없음) |
judge는 세 범주 라벨과 함께 구조화된 근거와 0.0에서 1.0 사이의 신뢰도 값을 출력한다. 프롬프트는 정밀도가 claim의 의미에 결정적이지 않은 한 정확한 수치 일치보다 같은 정보를 전달하는지에 집중하라고 지시한다.
judge 구성과 신뢰구간
모든 모델은 같은 task 프롬프트, 같은 노출 도구 집합, 같은 tool call 예산(task당 100회), 같은 채점 루브릭, 같은 최종 답 프로토콜에서 평가된다. 제공사 API가 서로 다른 네이티브 tool call 인터페이스를 노출하므로 저수준 어댑터는 제공사별로 다르지만, 모델별 demonstration, 재시도 방침, task 프롬프트, scaffold는 적용하지 않는다. scaffold는 모델 주위에 짜 놓은 보조 실행 구조를 뜻한다. 부록 H는 harness가 모델 평가 중 task당 최대 5회 재시도를 허용하고 도구 오류 요약을 모델 컨텍스트에 되돌려 주며, tool call 한도 100회에 도달하면 부분 응답도 채점한다고 밝힌다.
judge 편향을 모델 성능에서 분리하려고 세 LLM judge가 모든 task를 독립적으로 채점한다.
| 역할 | judge | 평균 pass rate |
|---|---|---|
| 주 judge | Gemini 3.1 Pro Preview | 65.4% (가장 후함) |
| 대조 judge | GPT-5.4 | 62.3% (가장 엄격) |
| 대조 judge | Claude Opus 4.6 | 63.9% (중간) |
95% 신뢰구간은 Efron의 비모수 부트스트랩으로 낸다. 모델마다 task별 coverage 점수에서 N=1000 task를 복원추출한 표본을 1만 번 뽑아 매번 pass@0.75를 다시 계산하고 2.5번째와 97.5번째 백분위를 취한다. 구간은 78.2% ± 2.5%처럼 반폭으로 보고한다.
실패 유형 분류
실패한 task는 11개 유형 taxonomy에서 주 실패 유형 하나를 배정받는다. 진단은 coverage가 0.75 미만인 task와 모델 쌍에만 실행되고, 진단 라벨은 사후 실패 분석에만 쓰이며 통과와 실패 채점에는 쓰이지 않는다. 부록 E의 Table 6은 유형마다 정의와 대표 사례를 싣는다.
| 계열 | 유형 (라벨) | 정의 | 대표 사례 |
|---|---|---|---|
| tool call | 인자 오류 (malformed_call) | 맞는 도구에 틀린 파라미터. 인자 누락, 잘못된 타입, 잘못된 값 | 스키마 필드가 Revenue_USD인데 mongodb_find를 열 이름 revenue로 호출 |
| tool call | 도구 오선택 (wrong_tool) | 맞는 도구가 있는데도 하위 task에 답할 수 없는 도구를 선택 | Airtable 데이터베이스에만 있는 사실을 wikipedia_search로 조회 |
| tool call | 도구 미사용 (no_tool_use) | 도구가 필요한데 아무 도구도 부르지 않고 내부 지식으로 답변 | 어떤 소스도 질의하지 않고 역사적 날짜를 직접 보고 |
| tool call | 오류 복구 실패 (err_recovery) | 도구가 오류를 돌려줬는데 적응하지 못함. 동일 재시도, 반복, 포기 | 백오프나 다른 서버 시도 대신 같은 호출을 다섯 번 반복 |
| 인지 | task 오해 (task_misunderstanding) | 물어본 것과 다른 질문에 답하거나 프롬프트의 핵심 요건을 놓침 | "12월 평균 매출"을 물었는데 연간 총매출을 반환 |
| 인지 | 잘못된 합성 (faulty_synthesis) | 맞는 도구 출력을 받았지만 결합이나 해석을 잘못함. 논리 오류는 아님 | 맞는 테이블의 맞는 행을 얻고 최종 답에서 엉뚱한 열을 평균 |
| 인지 | 응답 오독 (response_misparsing) | 유효한 도구 출력의 구조를 잘못 읽거나 엉뚱한 필드를 추출 | 레코드 10개 목록에서 엉뚱한 행을 고르거나 엉뚱한 필드를 읽음 |
| 인지 | 조기 종료 (early_termination) | task는 이해했지만 필요한 단계를 다 마치기 전에 정지 | 두 부분 답의 절반만 찾고 나머지 절반 없이 최종 답 생성 |
| 인지 | 환각 (hallucinated_fact) | 어느 도구 출력에도 없는 내용을 최종 답에 진술 | 도구는 인구 45,000을 반환했는데 답에는 54,000이라고 기재 |
| 인지 | 논리 오류 (logical_error) | 기반 데이터는 맞는데 multi-step 추론 사슬이 틀림 | 날짜와 레코드를 맞게 가져온 뒤 잘못된 조건으로 필터링 |
| 인지 | 제약 위반 (constraint_violation) | 프롬프트에 명시된 조건이나 필터를 무시 | "2017년에 지은 프리미엄 유닛만"이라 했는데 모든 연도의 모든 유닛을 조회 |
유형 사이의 경계는 judge 규칙으로 정한다. 응답 오독은 도구 출력에서 잘못된 필드나 행을 읽은 것이고 잘못된 합성은 전부 맞게 읽고 결합을 잘못한 것이다. 논리 오류는 multi-step 추론 사슬 자체가 틀린 것이고, 환각은 어느 도구 출력에도 없는 사실을 말한 것이며, 도구 미사용은 도구가 필요한 사실에 대해 도구를 아예 우회한 것이다. 인자 오류는 첫 번째 잘못된 파라미터 사용이고 오류 복구 실패는 같은 오류를 적응 없이 반복한 것이다. 잘못된 합성은 논리 오류, 응답 오독, 환각으로 더 잘 설명되지 않을 때만 쓴다.
진단 절차
진단 프롬프트는 reference trajectory를 포함한다. 놓친 claim을 채우기에 충분했던 도구 접근 가능 근거가 무엇인지 알아야 사후 귀인이 가능하기 때문이다. trajectory는 검증된 근거 흔적이지 유일한 목표 경로가 아니며, 대안 계획, 다른 도구 순서, 추가 호출, 병렬 호출, 다른 parameterization에 벌점을 주는 데 쓰이지 않는다.
| 단계 | 내용 |
|---|---|
| 1. 기대 행동 고정 | ground truth trajectory와 claim 목록으로 무엇이 일어났어야 하는지 확인 |
| 2. 실제 행동 검토 | 모델 trajectory를 턴 단위로 보며 전진 여부, 오류 후 동일 재시도 여부, 비생산적 도구 전환, 필요 데이터가 없는 상태의 정지를 평가 |
| 3. 놓친 claim 분석 | 채점기가 남긴 놓친 claim과 부분 claim의 이유를 직접 근거로 사용 |
| 4. 유형 매핑 | 계열을 먼저 정하고 그 계열에서 가장 구체적인 유형 선택 |
judge는 주 실패 하나와 기여 실패 전부를 같은 11개 어휘로 표시하고, 다른 실패를 유발한 실패에만 근본 원인 표시를 붙인다. 신뢰도는 trajectory와 채점기 근거가 한 유형을 명확히 가리키면 0.9에서 1.0, 두 번째 유형이 근접하면 0.6에서 0.8, 모호하면 0.6 미만으로 보정하며, 어떤 턴이나 문장에서 벗어났는지를 인용한 1~2문장 요약을 쓴다.
품질 관리와 task 작성 지침
task와 평가 harness의 품질은 다섯 층으로 유지된다.
| 층 | 내용 |
|---|---|
| 1 | 전문가가 구성된 MCP 환경에서 reference trajectory를 직접 실행 |
| 2 | 도메인 전문가가 정확성과 풀이 가능성을 검토 |
| 3 | 프롬프트에 도구와 서버 이름이 새지 않았는지 2차 검토 |
| 4 | claim 완결성과 trajectory 일관성을 LLM이 자동 검증 |
| 5 | 무작위 표본 수동 감사 |
task 작성 지침(부록 D)은 프롬프트에 세 요건을 요구한다. 외부 데이터가 있어야 풀리고 평가 기간 내내 유효한 정보에 의존할 것, 주관적 표현을 피하고 내부 시스템 구조나 의도된 풀이 경로를 드러내지 않는 대화체일 것, 간접 참조를 해소하거나 여러 소스에 걸쳐 데이터를 걸러야 하는 multi-step 요청일 것이다. 도구 환경은 최소 필요 근거를 주는 관련 도구, 선택 논리를 시험하는 그럴듯하지만 무관한 distractor, 그리고 불필요한 모호함 없이 도구 계열 간 근거 결합을 요구하는 multi-source 구성으로 꾸린다.
작성 단계의 검토자는 도구 선택, 도구 입력, 해석의 느슨한 3항목 체크리스트를 썼다. 이 체크리스트는 사후 실패 분석용 11개 유형 자동 진단과 별개다. task 하나당 작성, 검증, 문서화에 전문가 노동 평균 4.6시간이 들었고, 작성자와 검토자는 현지 임금 기준을 충족하거나 초과하는 계약 조건으로 보상받았다. 내부 작성 매뉴얼 전문은 운영 절차와 접근 제어 세부를 담고 있어 공개하지 않는다.
공개 split과 릴리스 구성
task는 재현성과 오염 모니터링을 위해 무작위로 500/500 공개와 비공개 subset으로 나뉜다. 공개 split은 전체 벤치마크의 도메인과 난이도 분포를 보존하며, task마다 task 식별자, 활성 도구 목록, 자연어 프롬프트, 근거 있는 사실 claim, reference trajectory를 담은 한 행으로 제공된다. 비공개 split은 같은 내부 스키마를 쓰지만 공개하지 않고 새 모델이 평가될 때의 리더보드 무결성용으로 보류한다.
| 구성 요소 | 공개 여부 | 라이선스 |
|---|---|---|
| 500개 task 공개 split (프롬프트, claim, trajectory, distractor 선택) | 공개 | CC BY 4.0 |
| 500개 task 비공개 split | 비공개 | 해당 없음 |
| 평가 harness, claim evaluator, 채점 파이프라인, 의존성 고정, reference client wrapper, 도표 재생성 스크립트 | 공개 | Apache 2.0 |
| 서드파티 MCP 서버 구현 | 상류 라이선스 유지, 저장소에 라이선스 목록 포함 | 각 상류 라이선스 |
| 도구 출력 | 상류 API 약관 적용. 선별된 claim 감사 발췌와 파생 점수만 공개 | 해당 없음 |
저장소에는 vendor 모델 자격 증명 없이 실행되는 로컬 smoke test가 있고, 전체 라이브 재평가에는 제공사 API 키와 일부 상류 MCP 서버의 서비스별 자격 증명이 필요하다. Croissant/RAI 메타데이터도 제출 시점에 함께 제공된다.
형식화
부록 J는 task를 튜플 τ = (G, C, T_expose, π*, C*)로 정의한다. G는 목표 명세, C는 자연어 맥락과 제약, T_expose는 에이전트에 제시되는 허용 도구 집합, π는 진단용 최소 의존 충족 tool call 시퀀스인 reference trajectory, C는 정답이 담아야 할 서로 겹치지 않고 독립적으로 검증 가능한 명제의 집합인 claim 목록이다. π*가 요구하는 도구 T_req가 target이고 T_expose에서 T_req를 뺀 나머지가 distractor다.
단일 턴 프롬프트가 주어지면 에이전트는 T_expose에서 tool call을 내고 환경은 잘 정의된 출력이거나 스키마 위반, rate limit 같은 오류 토큰을 돌려준다. 이 실행 trace를 쌓은 뒤 에이전트는 텍스트 답 Â를 내며, 상호작용은 유한 horizon POMDP를 이룬다. reward는 claim 기반 채점 함수 S(Â, C*)로 사후에 붙고, 통과와 실패는 S로만 결정되며 π*와 독립이다.
결과
전체 성능과 세 층 구조
20개 모델은 Anthropic, Google, OpenAI, Meta 네 독점 제공사와 Kimi, GLM 두 오픈소스 제공사에서 나왔다. 모든 모델이 1,000개 task 전체를 같은 노출 도구, tool call 예산, 프롬프트 템플릿, evaluator judge로 실행했다.
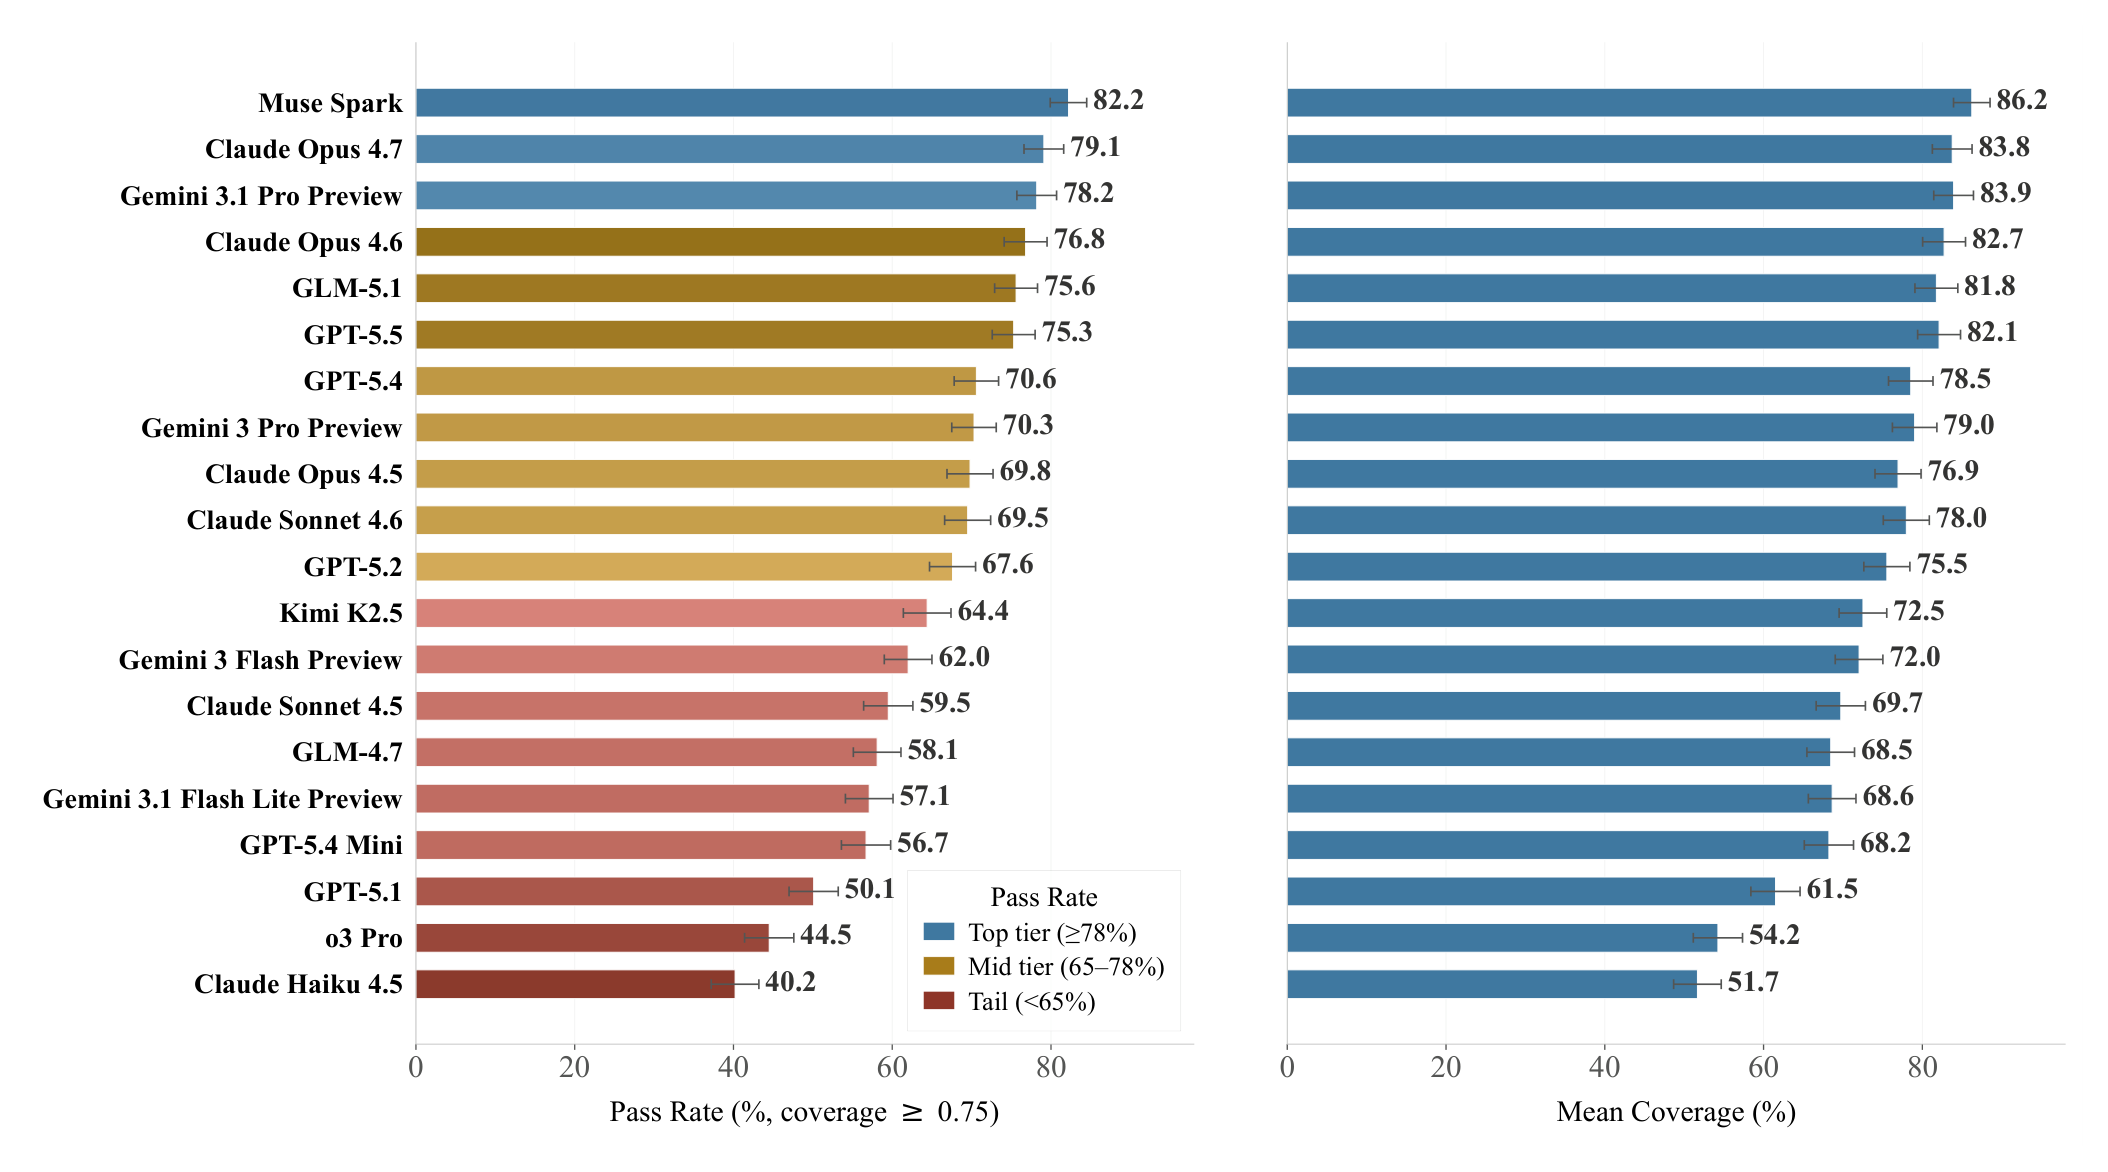
리더보드는 세 층으로 나뉜다.
| 층 | 기준 | 모델 (pass@0.75, 평균 coverage) |
|---|---|---|
| top tier | 78% 이상, 신뢰구간 겹침 | Muse Spark 82.2% (86.2), Claude Opus 4.7 79.1% (83.8), Gemini 3.1 Pro Preview 78.2% (83.9) |
| mid tier | 65~78% | Claude Opus 4.6 76.8% (82.7), GLM-5.1 75.6% (81.8), GPT-5.5 75.3% (82.1), GPT-5.4 70.6% (78.5), Gemini 3 Pro Preview 70.3% (79.0), Claude Opus 4.5 69.8% (76.9), Claude Sonnet 4.6 69.5% (78.0), GPT-5.2 67.6% (75.5) |
| tail | 65% 미만 | Kimi K2.5 64.4% (72.5), Gemini 3 Flash Preview 62.0% (72.0), Claude Sonnet 4.5 59.5% (69.7), GLM-4.7 58.1% (68.5), Gemini 3.1 Flash Lite Preview 57.1% (68.6), GPT-5.4 Mini 56.7% (68.2), GPT-5.1 50.1% (61.5), o3 Pro 44.5% (54.2), Claude Haiku 4.5 40.2% (51.7) |
두 결과가 두드러진다. 첫째, 오픈소스 GLM-5.1은 75.6%로 주 judge 기준 GPT-5.5와 통계적으로 동률이고 다른 GPT-5.x 변형보다 위에 있다. 저자들은 이를 에이전트 과제에서 오래 독점 모델에 유리했던 격차가 좁혀진 것으로 본다. 둘째, 수학과 코딩 벤치마크에서 선도적 추론 모델인 o3 Pro는 44.5%로 하위권에 머문다. 실패한 trajectory의 40.1%에 tool call이 하나도 없어, 외부 근거가 필요한 task와 기본 tool use 방침이 맞지 않는다는 신호다.
상위 세 모델은 78.2%에서 82.2% 사이에 몰려 있고 judge 간 범위가 2.1%p에서 4.6%p이므로, 최상위의 작은 순위 교체는 안정적 능력 격차가 아니라 evaluator 불확실성으로 읽어야 한다. 동시에 최고 모델도 task 다섯 개 중 하나 가까이를 실패하므로 현실적인 multi-server 워크플로에는 여전히 개선 여지가 있다.
실패 유형 분석
20개 모델에서 진단된 약 6,900건의 실패 중 63.3%가 인지 계열이고 36.7%가 tool call 계열이다. 이 분포는 MCP-Atlas가 유효한 tool call을 낼 수 있는지만 재는 벤치마크가 아님을 보여준다. 현재 에이전트의 지배적 실패는 도구에 접근한 뒤에 벌어진다. task를 이해하고, 근거가 충분히 모였는지 판단하고, 도구 출력에서 최종 답을 합성하는 단계다. tool call 실패는 리더보드 하위에서 여전히 중요하지만 남은 오류의 대부분을 설명하지는 않는다.
논문의 Table 3은 모델별로 진단된 전체 실패 가운데 tool call 계열 네 유형이 차지하는 비율을 싣는다. Tool%는 전체 실패 중 tool call 계열의 비중이다.
| 모델 | Tool% | 인자 오류 | 도구 오선택 | 도구 미사용 | 오류 복구 실패 |
|---|---|---|---|---|---|
| Claude Opus 4.7 | 34.6 | 11.8 | 1.7 | 9.1 | 12.0 |
| Claude Opus 4.6 | 28.5 | 9.0 | 11.7 | 4.4 | 3.4 |
| Claude Opus 4.5 | 29.9 | 6.4 | 8.8 | 4.6 | 10.2 |
| Claude Sonnet 4.6 | 28.9 | 8.6 | 12.4 | 3.1 | 4.9 |
| Claude Sonnet 4.5 | 37.3 | 6.4 | 8.8 | 6.4 | 15.8 |
| Claude Haiku 4.5 | 46.7 | 5.7 | 9.6 | 25.7 | 5.7 |
| Gemini 3.1 Pro Preview | 27.9 | 9.5 | 11.2 | 1.6 | 5.6 |
| Gemini 3 Pro Preview | 30.9 | 4.1 | 8.3 | 4.7 | 13.8 |
| Gemini 3 Flash Preview | 35.6 | 7.3 | 13.2 | 1.1 | 14.1 |
| Gemini 3.1 Flash Lite | 36.5 | 5.6 | 11.1 | 3.4 | 16.3 |
| GPT-5.5 | 33.2 | 11.6 | 4.0 | 13.0 | 4.6 |
| GPT-5.4 | 23.9 | 6.1 | 10.0 | 3.0 | 4.8 |
| GPT-5.2 | 33.6 | 4.5 | 7.5 | 8.8 | 12.9 |
| GPT-5.4 Mini | 29.5 | 2.7 | 7.4 | 6.2 | 13.2 |
| GPT-5.1 | 50.4 | 6.4 | 8.6 | 22.9 | 12.5 |
| o3 Pro | 57.6 | 3.9 | 6.6 | 40.1 | 6.9 |
| Muse Spark | 27.1 | 5.2 | 8.9 | 1.8 | 11.1 |
| GLM-5.1 | 37.3 | 13.9 | 3.4 | 9.2 | 10.8 |
| GLM-4.7 | 45.9 | 8.0 | 11.2 | 7.9 | 18.8 |
| Kimi K2.5 | 36.3 | 7.6 | 14.1 | 8.7 | 6.0 |
| 전체 | 36.7 | 6.9 | 9.0 | 10.5 | 10.3 |
가장 뚜렷한 tool use 실패는 하위 모델에서 나타난다. o3 Pro는 진단된 실패의 57.6%가 tool call 계열이고 실패 trajectory의 40.1%에 tool call이 전혀 없다. GPT-5.1과 Claude Haiku 4.5도 덜 극단적이지만 비슷한 근거 획득 실패를 보여 tool call 계열 비중이 각각 50.4%와 46.7%이고, 도구 미사용이 각각 22.9%와 25.7%다. 이 모델들은 근거 수집 단계에 들어가기 전에 실패하는 경우가 많다. 저자들은 기본 tool use 방침이 미지의 도구와 현실적 distractor가 있는 MCP 환경에 잘 보정되지 않았다고 해석한다.
Table 4는 같은 방식으로 인지 계열 일곱 유형의 비율을 싣는다. Cog%는 전체 실패 중 인지 계열의 비중이며 모델마다 Tool%와 합쳐 100%가 된다.
| 모델 | Cog% | task 오해 | 잘못된 합성 | 응답 오독 | 조기 종료 | 환각 | 논리 오류 | 제약 위반 |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 4.7 | 65.4 | 13.9 | 25.0 | 4.8 | 3.8 | 7.9 | 8.9 | 1.0 |
| Claude Opus 4.6 | 71.5 | 14.0 | 8.7 | 4.8 | 36.3 | 2.1 | 3.0 | 2.5 |
| Claude Opus 4.5 | 70.1 | 16.2 | 15.6 | 9.0 | 15.8 | 6.0 | 5.2 | 2.4 |
| Claude Sonnet 4.6 | 71.1 | 16.9 | 13.6 | 14.9 | 11.0 | 6.9 | 5.1 | 2.6 |
| Claude Sonnet 4.5 | 62.7 | 14.3 | 12.0 | 10.1 | 17.7 | 3.6 | 3.4 | 1.5 |
| Claude Haiku 4.5 | 53.3 | 10.2 | 8.0 | 7.7 | 17.0 | 4.2 | 4.1 | 2.1 |
| Gemini 3.1 Pro Preview | 72.1 | 13.7 | 7.2 | 3.0 | 42.8 | 1.6 | 2.6 | 1.2 |
| Gemini 3 Pro Preview | 69.1 | 17.3 | 12.8 | 8.9 | 18.6 | 5.6 | 3.5 | 2.3 |
| Gemini 3 Flash Preview | 64.4 | 14.2 | 10.5 | 10.7 | 14.1 | 8.5 | 4.3 | 2.1 |
| Gemini 3.1 Flash Lite | 63.5 | 13.1 | 9.9 | 10.5 | 20.8 | 3.4 | 3.1 | 2.7 |
| GPT-5.5 | 66.8 | 23.4 | 19.8 | 6.2 | 3.6 | 1.0 | 11.2 | 1.6 |
| GPT-5.4 | 76.1 | 15.0 | 11.2 | 4.8 | 41.4 | 0.5 | 2.0 | 1.1 |
| GPT-5.2 | 66.4 | 19.1 | 12.3 | 5.8 | 22.6 | 3.0 | 2.2 | 1.3 |
| GPT-5.4 Mini | 70.5 | 18.5 | 13.0 | 7.0 | 27.4 | 2.8 | 1.2 | 0.6 |
| GPT-5.1 | 49.6 | 12.0 | 7.9 | 7.1 | 16.5 | 2.6 | 2.0 | 1.5 |
| o3 Pro | 42.4 | 9.0 | 4.5 | 4.6 | 17.2 | 4.6 | 1.8 | 0.6 |
| Muse Spark | 72.9 | 17.2 | 16.9 | 11.7 | 11.4 | 7.1 | 5.2 | 3.4 |
| GLM-5.1 | 62.7 | 15.5 | 22.5 | 4.0 | 3.8 | 6.7 | 8.8 | 1.3 |
| GLM-4.7 | 54.1 | 16.8 | 8.2 | 7.0 | 14.1 | 2.2 | 4.2 | 1.7 |
| Kimi K2.5 | 63.7 | 17.1 | 12.1 | 9.9 | 13.7 | 4.7 | 4.7 | 1.4 |
| 전체 | 63.3 | 15.1 | 12.0 | 7.6 | 18.7 | 4.1 | 4.1 | 1.7 |
전체 평균에서 가장 큰 단일 유형은 조기 종료 18.7%이고 task 오해 15.1%, 잘못된 합성 12.0%가 뒤를 잇는다. 강한 모델에서는 병목이 tool call에서 근거 사슬을 완성하고 활용하는 단계로 옮겨 가고, 최신 프런티어 모델은 이 경계를 더 하류로 밀어낸다. 조기 종료는 한 상위 하위집단의 대표 실패다. Gemini 3.1 Pro Preview, GPT-5.4, Claude Opus 4.6은 진단된 실패의 각각 42.8%, 41.4%, 36.3%에서 조기 종료한다.
반면 더 새로운 GPT-5.5와 Claude Opus 4.7은 조기 종료를 각각 3.6%와 3.8%로 거의 없앴지만, 오류가 더 어려운 retrieval 이후 실패로 다시 나타난다. 잘못된 합성이 GPT-5.5에서 19.8%, Claude Opus 4.7에서 25.0%로 올라가고, GLM-5.1도 조기 종료 3.8%에 잘못된 합성 22.5%로 같은 양상이다. 에이전트가 워크플로를 끝까지 지속하지만 수집한 근거를 잘못 결합하거나 잘못 해석하거나 잘못 보고하는 새로운 프런티어 국면이다. 따라서 저자들은 다음 개선이 claim을 의식한 정지 기준뿐 아니라 최종 답을 수집된 도구 근거에 대조하는 trajectory 기반 verification에서 나올 것으로 본다.
효율 frontier
정확도만이 아니라 그 정확도에 드는 시간도 실무에서는 중요하다. Figure 2는 모델마다 task당 평균 벽시계 trajectory 시간과 pass rate를 함께 그린다.
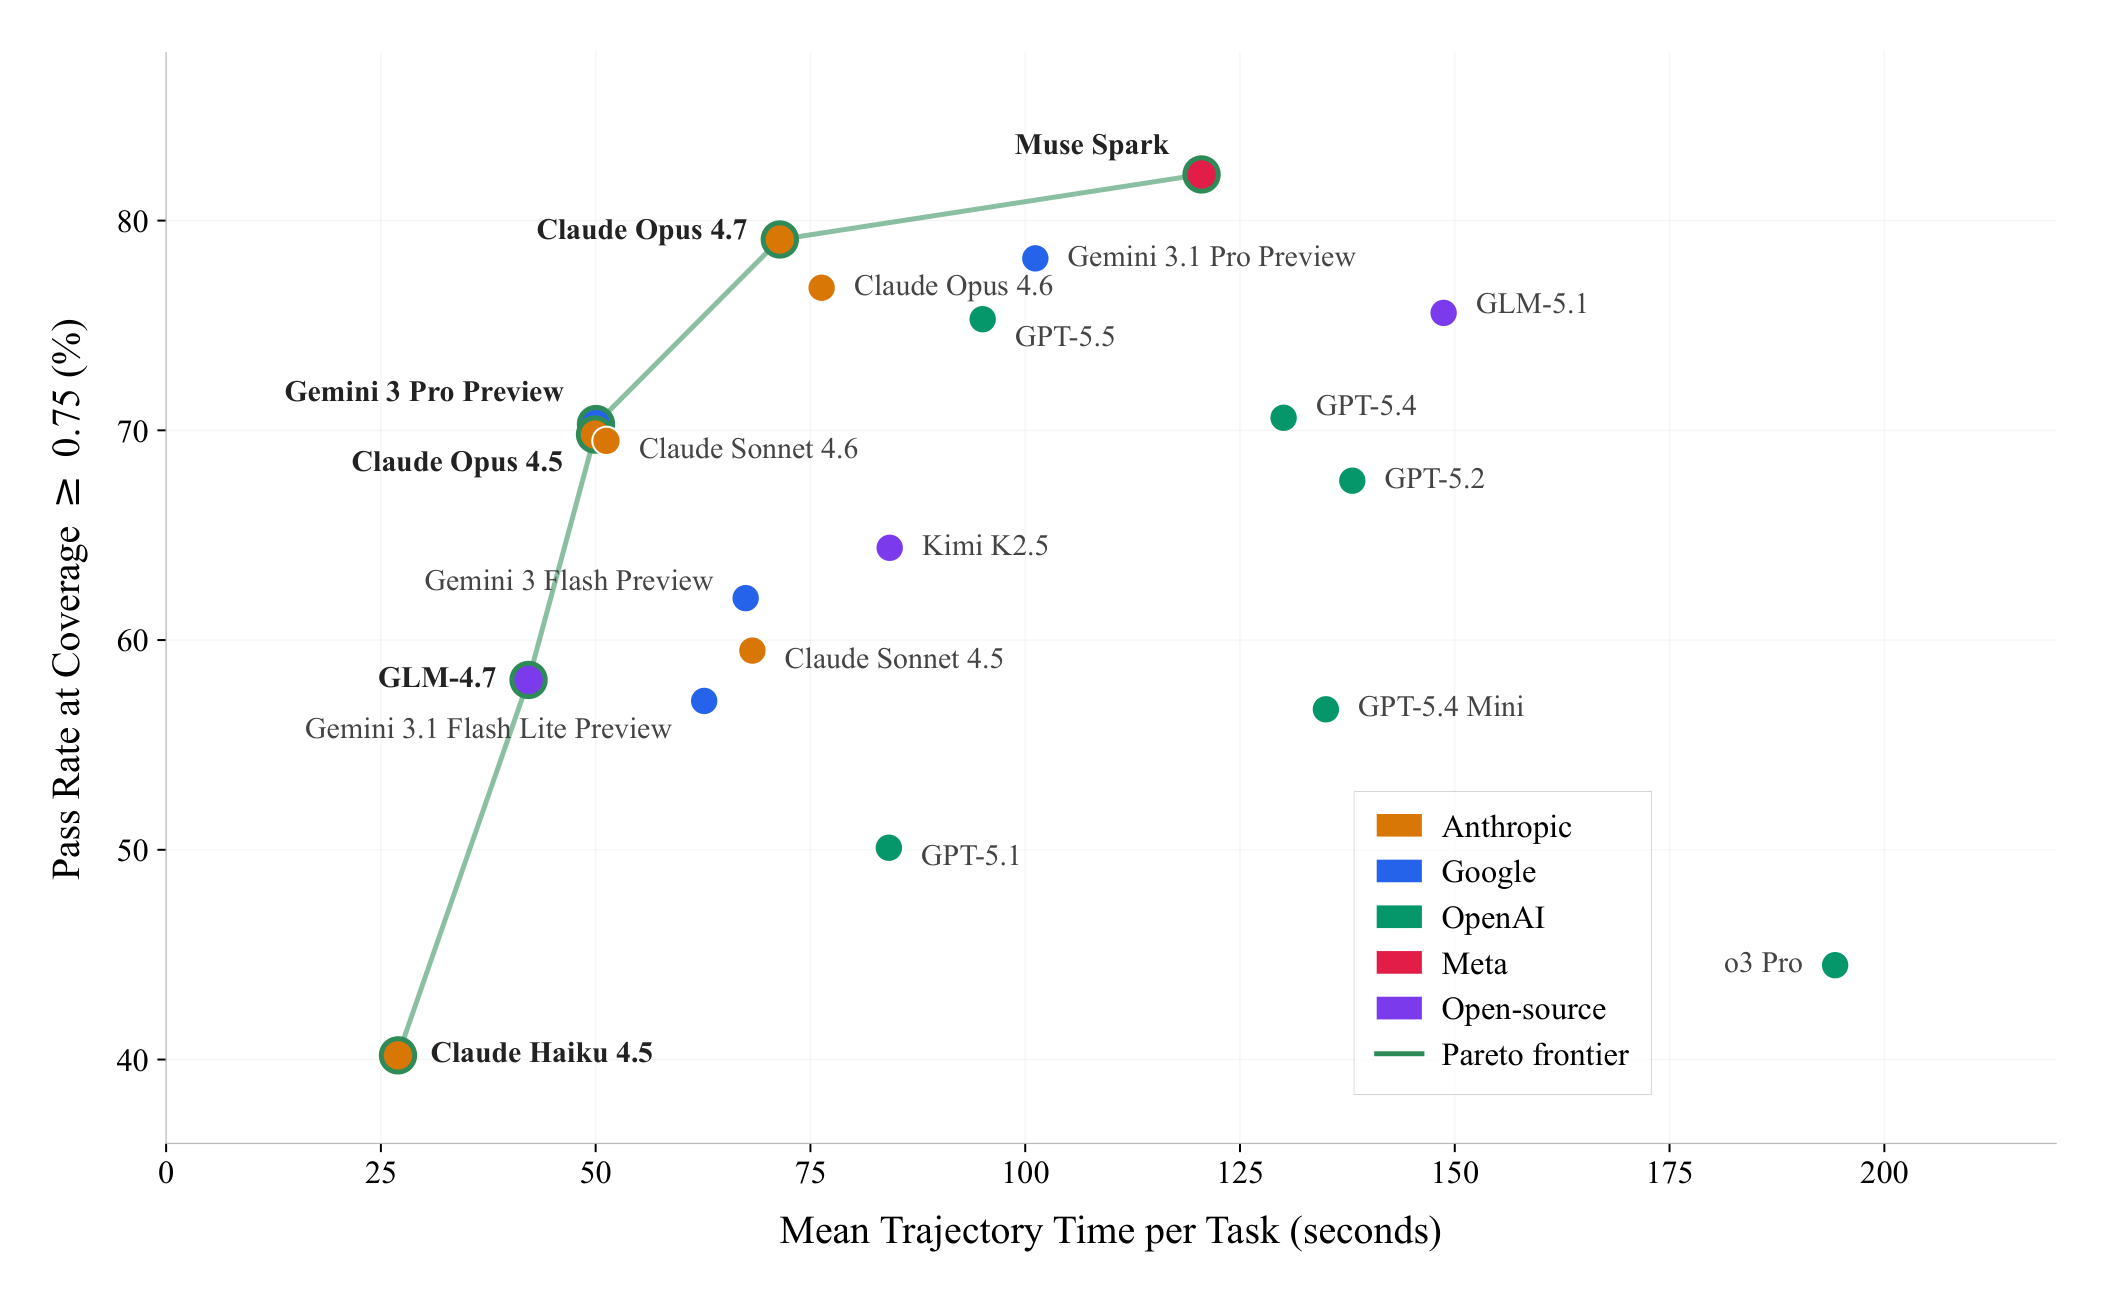
Pareto frontier 위에는 여섯 모델이 있다.
| 모델 | task당 평균 시간 | pass@0.75 | 위치 |
|---|---|---|---|
| Claude Haiku 4.5 | 27초 | 40.2% | 빠르지만 부정확한 끝 |
| GLM-4.7 | 42초 | 58.1% | |
| Claude Opus 4.5 | 약 50초 | 약 70% | |
| Gemini 3 Pro Preview | 약 50초 | 약 70% | |
| Claude Opus 4.7 | 71초 | 79.1% | |
| Muse Spark | 121초 | 82.2% | 최상단 |
여러 모델은 더 빠른 대안에 완전히 지배된다.
| 모델 | task당 평균 시간 | pass@0.75 | 지배 관계 |
|---|---|---|---|
| o3 Pro | 194초 | 44.5% | 가장 느리면서 가장 부정확한 편. 하위 절반의 모든 모델에 벽시계 효율에서 크게 뒤짐 |
| GPT-5.1 | 84초 | 50.1% | 더 빠르고 더 정확한 GLM-4.7에 지배 |
| GPT-5.4 Mini | 135초 | 56.7% | 상위 모델 GPT-5.4(130초, 70.6%)보다 느리면서 점수도 낮음 |
| GLM-5.1 | 149초 | 75.6% | 비슷한 정확도의 Claude Opus 4.6과 4.7의 약 두 배 시간 |
GPT-5.4 Mini의 사례는 벽시계 시간이 모델 추론이 아니라 tool call 왕복 지연에 지배되는 에이전트 환경에서는 "Mini"라는 이름이 빠른 실행으로 이어지지 않음을 보여준다. GLM-5.1은 강한 pass rate에도 벽시계 비용 탓에 frontier에 들지 못한다.
judge 간 일치도
부록 F의 Table 7은 20개 모델의 pass@0.75를 세 judge별로 싣고 judge 간 범위와 순위를 함께 보여준다.
| 모델 | Gemini 3.1 Pro | GPT-5.4 | Opus 4.6 | 범위 | 순위 (Gem/GPT/Opus) |
|---|---|---|---|---|---|
| Muse Spark | 82.2 | 79.1 | 79.6 | 3.1 | 1/1/1 |
| Claude Opus 4.7 | 79.1 | 75.1 | 74.5 | 4.6 | 2/3/5 |
| Gemini 3.1 Pro Preview | 78.2 | 75.8 | 76.4 | 2.4 | 3/2/2 |
| Claude Opus 4.6 | 76.8 | 73.3 | 74.8 | 3.5 | 4/4/4 |
| GLM-5.1 | 75.6 | 72.8 | 75.2 | 2.8 | 5/5/3 |
| GPT-5.5 | 75.3 | 72.0 | 71.9 | 3.4 | 6/6/6 |
| GPT-5.4 | 70.6 | 68.5 | 69.9 | 2.1 | 7/7/7 |
| Gemini 3 Pro Preview | 70.3 | 68.0 | 68.8 | 2.3 | 8/8/8 |
| Claude Opus 4.5 | 69.8 | 66.3 | 68.5 | 3.5 | 9/10/9 |
| Claude Sonnet 4.6 | 69.5 | 66.8 | 67.4 | 2.7 | 10/9/10 |
| GPT-5.2 | 67.6 | 65.2 | 66.2 | 2.4 | 11/11/11 |
| Kimi K2.5 | 64.4 | 59.9 | 63.0 | 4.5 | 12/12/12 |
| Gemini 3 Flash Preview | 62.0 | 57.4 | 59.4 | 4.6 | 13/13/13 |
| Claude Sonnet 4.5 | 59.5 | 56.6 | 59.0 | 2.9 | 14/14/14 |
| GLM-4.7 | 58.1 | 54.6 | 55.7 | 3.5 | 15/16/17 |
| Gemini 3.1 Flash Lite Preview | 57.1 | 54.3 | 56.1 | 2.8 | 16/17/16 |
| GPT-5.4 Mini | 56.7 | 54.9 | 57.7 | 2.8 | 17/15/15 |
| GPT-5.1 | 50.1 | 47.9 | 50.8 | 2.9 | 18/18/18 |
| o3 Pro | 44.5 | 41.3 | 43.6 | 3.2 | 19/19/19 |
| Claude Haiku 4.5 | 40.2 | 37.1 | 38.7 | 3.1 | 20/20/20 |
| 평균 | 65.4 | 62.3 | 63.9 | 3.2 |
모델별 점수 범위는 2.1%p에서 4.6%p다. 순위는 judge 사이에서 대체로 보존되고 몇 안 되는 변동은 촘촘한 상위 군집과 15위에서 17위 구간에 집중된다. 가장 큰 변동은 Claude Opus 4.7로, Gemini 3.1 Pro Preview에서 2위, GPT-5.4에서 3위, Claude Opus 4.6에서 5위다. 저자들은 이를 self-preference로 해석하지 않는다. Claude judge는 더 새로운 Anthropic 모델을 우대하지 않으며 오히려 Gemini 3.1 Pro Preview와 GLM-5.1을 그 위에 놓기 때문이다.
더 보수적인 해석은 상위 군집의 여러 모델이 judge 간 범위에 견줄 만한 간격으로 떨어져 있다는 것이다. 따라서 상위권의 작은 순위 교체는 견고한 능력 차이가 아니라 evaluator 불확실성으로 읽어야 하며, 주 리더보드에는 단일 주 judge를 쓰고 judge 간 범위를 보정 정보로 보고하는 방식이 뒷받침된다.
coverage 임계값 민감도
주 본문의 0.75 임계값은 리더보드 관례를 따른 보고상의 결정이다. 부록 G의 Table 8은 평균 coverage와 0.50, 0.75, 0.90 임계값 pass rate를 함께 싣는다.
| 모델 | 평균 coverage | pass@0.50 | pass@0.75 | pass@0.90 |
|---|---|---|---|---|
| Muse Spark | 0.862 | 89.6 | 82.2 | 71.2 |
| Claude Opus 4.7 | 0.838 | 89.5 | 79.1 | 63.2 |
| Gemini 3.1 Pro Preview | 0.839 | 90.6 | 78.2 | 61.8 |
| Claude Opus 4.6 | 0.827 | 88.6 | 76.8 | 61.1 |
| GLM-5.1 | 0.818 | 88.5 | 75.6 | 59.0 |
| GPT-5.5 | 0.821 | 90.2 | 75.3 | 56.4 |
| GPT-5.4 | 0.785 | 87.2 | 70.6 | 48.9 |
| Gemini 3 Pro Preview | 0.790 | 85.9 | 70.3 | 52.7 |
| Claude Opus 4.5 | 0.769 | 82.4 | 69.8 | 53.9 |
| Claude Sonnet 4.6 | 0.780 | 84.1 | 69.5 | 55.0 |
| GPT-5.2 | 0.755 | 81.4 | 67.6 | 50.6 |
| Kimi K2.5 | 0.725 | 78.6 | 64.4 | 47.9 |
| Gemini 3 Flash Preview | 0.720 | 78.2 | 62.0 | 47.5 |
| Claude Sonnet 4.5 | 0.697 | 75.7 | 59.5 | 45.0 |
| GLM-4.7 | 0.685 | 74.1 | 58.1 | 43.7 |
| Gemini 3.1 Flash Lite Preview | 0.686 | 75.1 | 57.1 | 40.2 |
| GPT-5.4 Mini | 0.682 | 76.8 | 56.7 | 36.4 |
| GPT-5.1 | 0.615 | 66.6 | 50.1 | 35.3 |
| o3 Pro | 0.542 | 58.4 | 44.5 | 31.6 |
| Claude Haiku 4.5 | 0.517 | 55.8 | 40.2 | 27.1 |
단일 대표 임계값을 쓰는 근거는 두 가지다. 첫째, 0.50과 0.75 사이의 Spearman 순위 상관이 ρ = 0.965로 높아 순위가 대체로 보존된다. 둘째, 두 pass rate의 절대 차이는 리더보드 상위에서 좁고 하위로 갈수록 넓어진다. Muse Spark는 89.6%에서 82.2%로 7.4%p 하락하지만 Claude Haiku 4.5는 55.8%에서 40.2%로 15.6%p 하락한다. 부분 점수는 엄격한 통과 기준보다 얻기 쉽고 그 격차는 전체 능력이 낮을수록 커지므로, 잘 동작하는 coverage 지표에서 기대되는 양상이다. pass@0.90에서는 상위 모델 사이의 격차가 더 벌어져 Muse Spark 71.2%와 Claude Opus 4.7 63.2%의 차이가 8.0%p다.
공개와 비공개 split 격차
공개 split에는 프롬프트, 도구 집합, claim, reference trajectory가 들어 있으므로 릴리스 이후의 격차는 암기의 직접 증거가 아니라 split 민감도와 노출 모니터링 신호로 해석해야 한다. 대부분의 모델이 공개 task에서 더 높은 점수를 받고 격차는 −0.8%p에서 +9.6%p에 걸치며, 격차는 전체 pass rate를 따라가지 않는다.
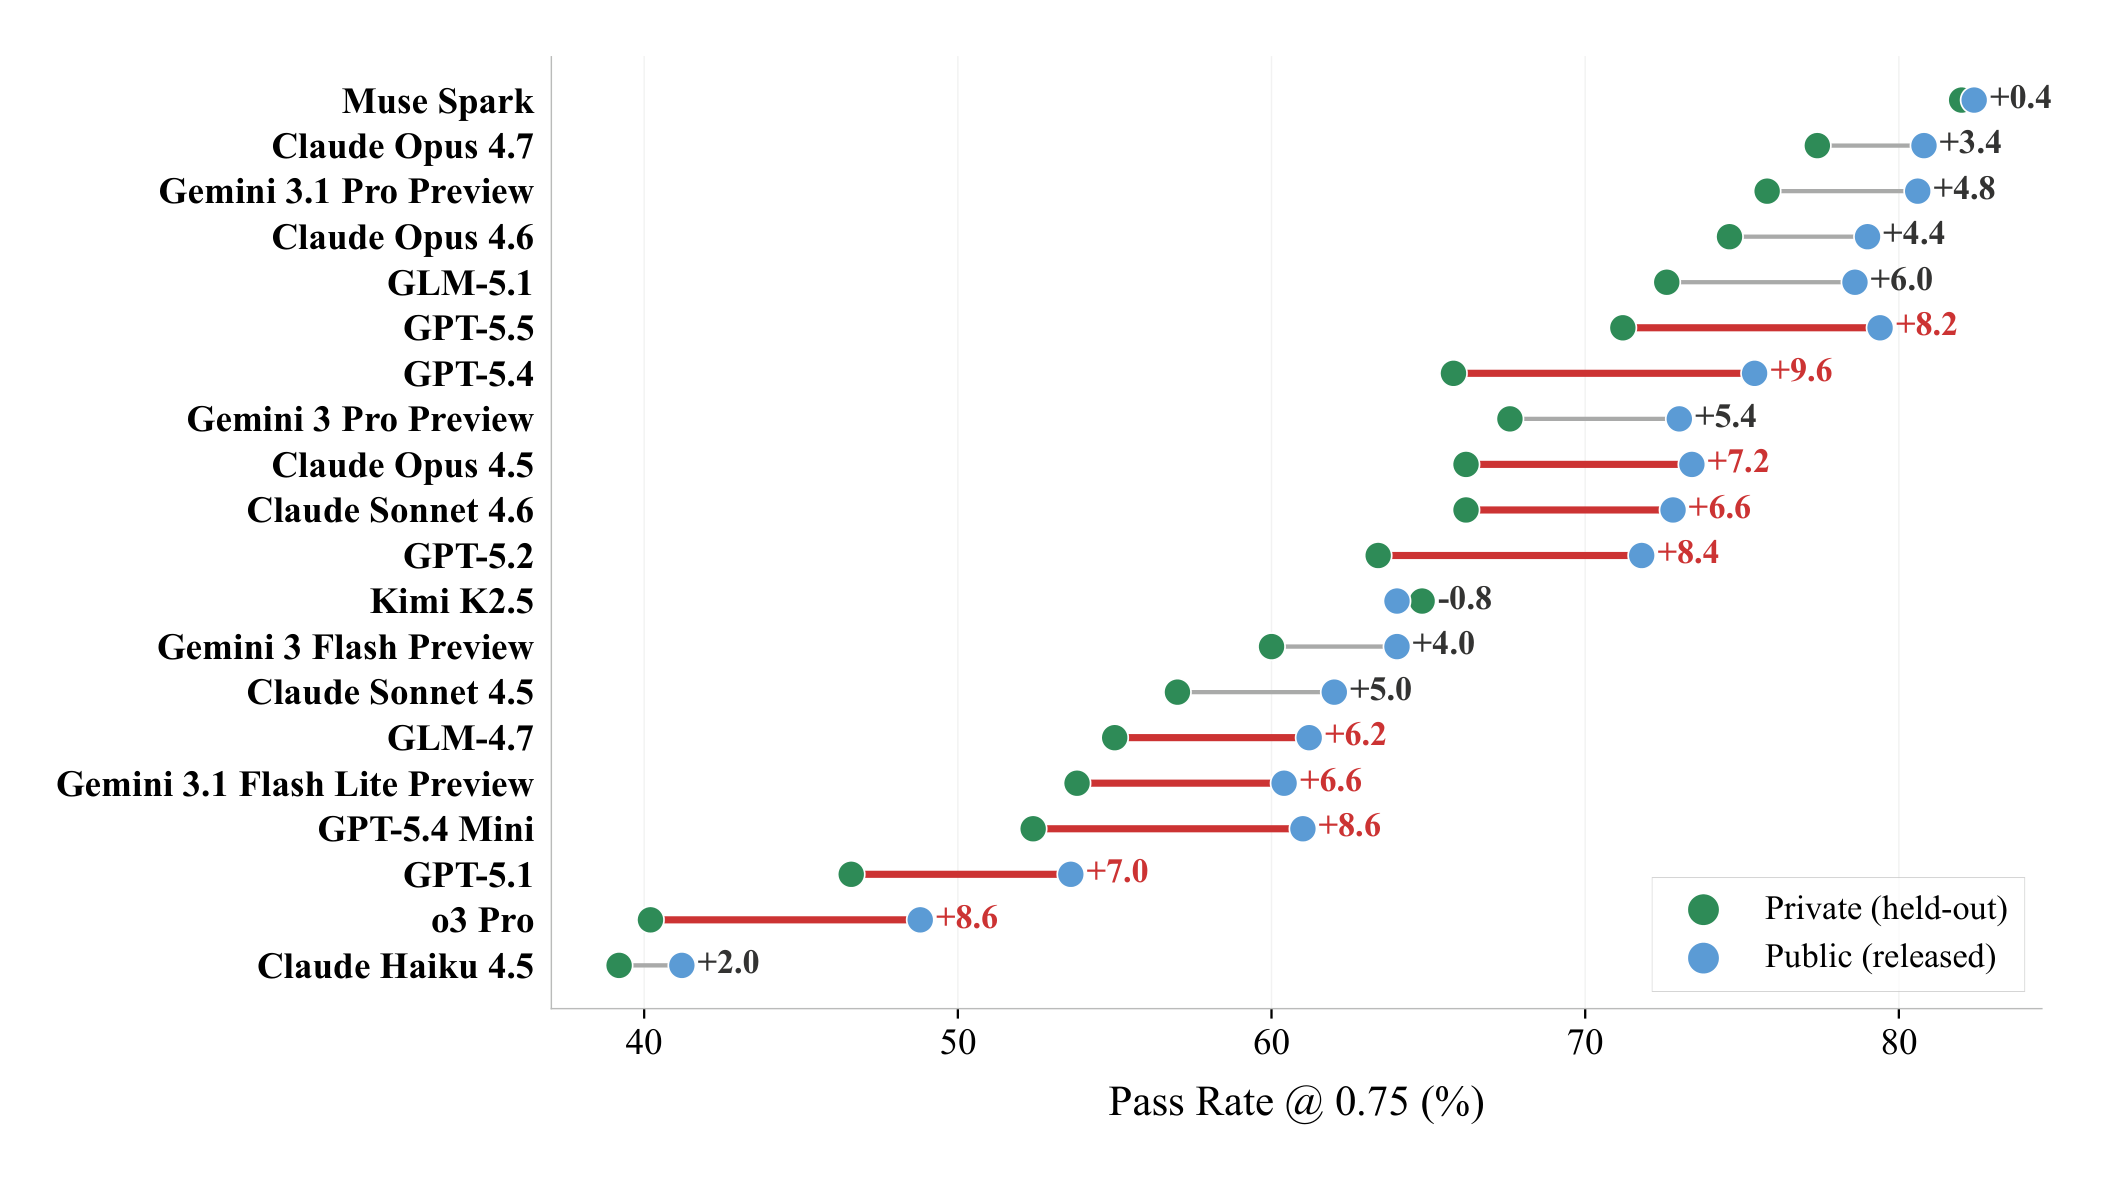
격차에는 제공사별 군집이 보인다.
| 제공사 | 평균 격차 (공개 − 비공개) | 모델별 격차 |
|---|---|---|
| OpenAI | +8.4%p (범위 +7.0~+9.6) | GPT-5.5 +8.2, GPT-5.4 +9.6, GPT-5.2 +8.4, GPT-5.4 Mini +8.6, GPT-5.1 +7.0, o3 Pro +8.6 |
| +5.2%p | Gemini 3.1 Pro Preview +4.8, Gemini 3 Pro Preview +5.4, Gemini 3 Flash Preview +4.0, Gemini 3.1 Flash Lite Preview +6.6 | |
| Anthropic | +4.8%p | Claude Opus 4.7 +3.4, Opus 4.6 +4.4, Opus 4.5 +7.2, Sonnet 4.6 +6.6, Sonnet 4.5 +5.0, Haiku 4.5 +2.0 |
| 오픈소스 | +3.8%p | GLM-5.1 +6.0, GLM-4.7 +6.2, Kimi K2.5 −0.8 |
| Meta | 자료에 평균 없음 | Muse Spark +0.4 |
집단 크기가 고르지 않은 작은 모델 수준 비교이므로 저자들은 이 패턴을 오염 증거가 아니라 감사 신호로 다루고, split 격차를 전체 점수와 나란히 감사 통계로 보고한다. Kimi K2.5만 비공개 성적이 공개보다 높고, Muse Spark의 격차 +0.4%p가 가장 작다.
재현 비용
부록 H는 리더보드 재현에 드는 비용을 밝힌다.
| 항목 | 값 |
|---|---|
| trajectory 수 | 20 모델 × 1,000 task = 2만 개 |
| 주 리더보드 evaluator 호출 | 약 9만 4,000회 (claim당 호출, 평균 4.7개) |
| 세 judge 민감도 연구 호출 | 약 28만 2,000회 |
| 모델 한 개의 1,000 task 실행 | 워크스테이션 한 대, 동시 클라이언트 8 |
| 주 evaluator의 1,000 task 채점 | 동시 요청 8~12개, 모델당 약 2시간 |
관측된 평균 trajectory 시간이 task당 27초에서 194초까지 벌어지므로 모델에 따라 전체 실행 시간도 2시간에서 18시간까지 차이가 난다.
한계
저자가 명시한 한계
부록 A는 결론을 제한하는 요인을 일곱 항목으로 밝힌다.
| 한계 | 내용 | 저자의 완화책 |
|---|---|---|
| judge 모델 상한 | 모든 평가가 LLM으로 이루어진다. 절대 pass rate는 2~5점의 judge 간 대역을 감안해 읽어야 하고, judge 버전이 바뀌면 수치도 움직인다 | 세 독립 judge, 사용한 judge를 항상 보고하고 버전 고정 권고 |
| 움직이는 생태계의 스냅샷 | 서버, 도구, API가 살아 있다. 현재 리더보드는 2026년 5월 시점이며 rate limit 정책, 인증 방식, 스키마 버전이 예고 없이 바뀌어 일부 task가 풀 수 없거나 사소하게 쉬워질 수 있다 | 컨테이너 버전 고정, 상류 drift 감지 시 재채점 공개. 개별 trajectory 수준 재현성은 상류 안정성에 묶임 |
| 영어 전용 프롬프트 | 1,000개 task 전부 영어이며 영어 서버 응답을 겨냥한다 | 비영어 tool use, 문자 처리, 현지화 실패는 범위 밖으로 명시 |
| 제공사별 harness 기본값 | anthropic-native, openai-responses-api 같은 권장 네이티브 tool call 전략을 쓰므로 harness가 제공사 간에 완전히 같지 않다 | 공개된 모범 사례를 따른다는 점을 명시 |
| tool call 예산 | task당 100회 상한 탓에 재시도 위주 복구가 필요한 장기 task의 소수 실패는 모델 능력이 아닌 상한에서 비롯된다 | 내부 테스트에서 예산 완화가 절대 수치는 올리지만 상대 순위는 바꾸지 않음 |
| claim 추출 오차 대역 | 전문가 작성과 자동 후보 생성 뒤 수동 검토로 만든 claim에 남은 잡음이 완벽한 에이전트의 달성 가능 pass rate에도 잡음을 만든다 | 일부 claim은 프롬프트의 모호한 해석 아래에서만 회복 가능함을 인정 |
| 진단의 reference trajectory 의존 | 서로 매우 다른 근거 경로가 여럿 있을 때 실패 라벨이 저자 제공 경로 쪽으로 기울 수 있다 | claim 기반 채점, 실패 이후에만 진단, trajectory를 정답이 아닌 충분한 근거 흔적으로 다루라는 지시 |
더 넓은 영향에 대해서도 저자들은 신중하다. 벤치마크는 배포 전에 신뢰성 격차를 드러내지만, 더 나은 평가는 오용, 무단 데이터 접근, 프라이버시 유출, 상류 이용 약관 위반이 가능한 환경에서 더 효과적으로 동작하는 에이전트 개발도 가속할 수 있다. 라이브 MCP 평가는 API drift, 라이선스 변경, 사용자가 harness를 개인 계정에 연결할 때의 민감 출력 노출 같은 상류 위험을 물려받는다. 그래서 MCP-Atlas는 안전 필수, 프라이버시 민감, 고위험 배포에 대한 안전 인증이 아니라 신뢰성과 실패 분석을 위한 진단 벤치마크로 쓰라고 명시한다.
향후 과제로는 단일 pass rate 대신 정확도, 효율, judge 민감도, split 격차, drift, 실패 유형을 묶은 진단 프로파일을 보고하는 관행, 그리고 멀티턴 명확화와 distractor ablation의 추가를 든다.
자료에서 확인할 수 없는 것
다음 항목은 논문에 기술이 없어 이 페이지에서 판단할 수 없다.
- distractor 수나 서버 수에 따른 성능 변화. 저자들이 distractor ablation을 향후 과제로 들었을 뿐 결과는 없다.
- 220개 도구의 개별 목록. 서버별 도구 카탈로그는 데이터셋과 함께 공개된다고만 적혀 있다.
- 11개 실패 유형의 자동 진단이 사람 라벨과 얼마나 일치하는지. 진단 judge의 정확도 검증 결과는 논문에 없다.
- 20개 모델의 평가 시점별 실제 API 버전. Table 9는 model ID와 reasoning 설정만 싣는다.
- 게재 학회. 논문은 arXiv 프리프린트로 제시되며 학회 정보는 raw에 없다.
자료 내적 불일치
컨테이너 재시작 시점의 기술이 두 곳에서 다르다. 3.1절은 재현성을 위해 "평가 실행 사이"에 재시작한다고 적었고, 부록 B는 task 간 상태 누출을 막기 위해 "task 사이"에 재시작한다고 적었다. 이 페이지는 더 구체적인 부록 B의 기술을 따랐다.
3.3절은 모델별 재시도 방침을 적용하지 않는다고 적었고, 부록 H는 harness가 task당 최대 5회 재시도를 허용한다고 적었다. 전자는 모델별 차등을, 후자는 모든 모델에 공통인 harness 동작을 가리키는 것으로 읽히지만 논문이 이 관계를 명시하지는 않는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| claim | task마다 정의된 원자적 사실 진술. 정답이라면 최종 답에 담겨 있어야 하는 채점 단위 |
| coverage | task의 claim 점수 평균. 충족 1.0, 부분 충족 0.5, 미충족 0.0을 평균낸 값이며 0.75 이상이면 통과 |
| distractor | task에 함께 노출되지만 풀이에 필요 없는 도구. 의미상 비슷한 카테고리에서 고른다 |
| reference trajectory | 저자가 검증한 최소 정답 경로. 풀이 가능성 확인과 진단에만 쓰고 채점에는 쓰지 않는다 |
| early termination | 인지 실패 중 하나. task는 이해했지만 필요한 단계를 다 마치기 전에 멈추는 것 |
| faulty synthesis | 인지 실패 중 하나. 도구 출력은 제대로 받았는데 최종 답으로 잘못 결합하거나 해석하는 것 |
관련 페이지
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments: 채점 설계가 대비되는 agent 벤치마크. OSWorld는 task마다 실행 기반 채점 스크립트를 붙였고 MCP-Atlas는 claim 목록을 붙였다
- MCP Server Architecture Patterns for LLM-Integrated Applications: 같은 MCP 계층을 서버 쪽에서 다룬 논문. 클라이언트가 tool의 자연어 설명만 읽고 무엇을 호출할지 고른다는 제약을, 이 벤치마크는 distractor 사이의 도구 발견 문제로 측정한다
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: agent loop의 정지 조건과 harness 일반론. 이 논문의 조기 종료 18.7%와 잘못된 합성 12.0%는 loop의 종료 판단과 verification 설계 문제로 읽을 수 있다
- Why Do Multi-Agent LLM Systems Fail?: MAST의 14개 실패 모드 taxonomy. 실패를 유형화해 집계한 접근이 같고, 이 논문은 단일 에이전트의 tool use 실패를 11개 유형으로 나눈다
- 용어집: Agents (Terminology Glossary): tool use, tool call, claim, coverage, distractor의 canonical 표기