Agents · PAPER · 2026
CUA-Gym: Scaling Verifiable Training Environments and Tasks for Computer-Use Agents
요약
CUA-Gym은 컴퓨터를 조작하는 에이전트의 강화학습 데이터를 사람 손 대신 코딩 에이전트로 만드는 파이프라인이다. 홍콩대 XLANG Lab과 Qwen Team이 함께 낸 연구로 arXiv 2605.25624v2에 2026-06-08 개정본이 올라 있다. 본문은 10페이지지만 부록을 합치면 82페이지이고 설계 결정의 근거는 대부분 부록에 있다.
문제 설정은 다음과 같다. 수학이나 코드에서 강화학습 데이터 한 건은 문제 서술과 채점 가능한 정답으로 끝난다. computer-use agent는 그렇지 않다. 지시문, 실행 가능한 초기 환경, 검증 함수 세 요소가 서로 아귀가 맞아야 하고 셋 모두 만만치 않은 공학 산출물이다. 논문은 이 튜플 하나를 손으로 만드는 데 전문가 몇 시간이 든다고 적는다.
CUA-Gym의 해법은 세 요소를 하나의 명세에서 함께 만들되 만드는 주체를 갈라놓는 것이다. Generator가 환경을 만들고 Discriminator가 채점 함수를 쓰는데, Discriminator는 Generator의 스크립트와 작업 디렉토리를 아예 볼 수 없다. 이 information barrier가 없으면 reward가 "task가 끝났는가"가 아니라 "내가 짠 setup 절차를 그대로 밟았는가"를 검사하게 되고, 그런 데이터로는 강화학습이 쓸 신호가 나오지 않는다.
산출물은 검증 튜플 32,112개와 환경 110개다. 환경은 데스크톱 앱 16종과 직접 합성한 mock 웹 앱 94종으로 구성된다. 이 데이터로 GSPO 학습한 CUA-Gym-A17B가 OSWorld-Verified 72.6%를 기록하고 학습에 쓰지 않은 WebArena에서도 오른다. 데이터를 1.4K에서 12K로 키우면 학습 곡선의 정점이 같이 올라가고 저자들은 포화 조짐을 찾지 못했다고 보고한다.
이 페이지는 논문의 방법과 평가를 다룬다. 파이프라인을 실제로 실행하는 명령과 설치 절차는 xlang-ai/CUA-Gym이 담당하고, 공개된 데이터의 구성과 운영 주의사항은 CUA-Gym Dataset (xlangai/CUA-Gym)이 담당한다.
배경
RLVR이 굳힌 레시피
RLVR은 reinforcement learning with verifiable rewards의 약어다. 정답을 코드로 채점할 수 있는 문제를 골라 policy를 그 채점 신호에 최적화시키는 post-training 방식이다. policy는 observation을 받아 다음 action을 정하는 함수를 말한다.
레시피는 이제 잘 알려져 있다. 대규모 학습 task를 절차적으로 합성해 결정적 reward 신호와 짝짓고, GRPO 같은 알고리즘으로 그 신호에 policy를 최적화한다. 수학, 소프트웨어 엔지니어링, 터미널 조작에서 이 방식이 성과를 냈다.
세 도메인이 공통으로 보고하는 사실이 하나 더 있다. 검증 가능한 학습 데이터의 공급량이 에이전트 역량의 속도 제한 요인이었고, 데이터와 성능의 스케일링 곡선이 현재 수량에서 아직 포화하지 않았다는 것이다.
넘어오지 못한 도메인
computer-use agent는 사람처럼 화면을 보고 마우스와 키보드로 데스크톱과 브라우저를 조작하는 에이전트다. 디지털 지식노동 전반을 자동화할 잠재력 때문에 같은 레시피를 옮기는 일이 자연스러운 다음 단계인데, 이 도메인의 RLVR 데이터는 희소하고 조각나 있으며 다른 도메인의 규모에 한참 못 미친다.
병목은 알고리즘이 아니라 구조다. 수학이나 코드에서 학습 인스턴스 하나는 문제 서술과 확인 가능한 답으로 환원된다. computer-use agent의 인스턴스는 튜플 이고 세 요소가 각각 별도의 공학 산출물이면서 서로 맞물려 동작해야 한다.
| 요소 | 정체 | 만들 때 드는 일 |
|---|---|---|
| 자연어 task 지시문 | 모호하지 않고 유일한 정답이 있으며 방법이 아니라 목표를 지시해야 한다 | |
| 재현 가능한 초기 환경 상태 | 파일과 앱 상태를 스크립트로 만들고 GUI가 뜬 상태까지 준비해야 한다 | |
| 최종 환경을 로 채점하는 함수 | 앱별 검증 인터페이스를 알아야 하고 부분 점수 분해를 설계해야 한다 |
비용은 앱 다양성에 비례해 누적된다. 새 앱이 하나 들어오면 그 앱의 setup 절차와 검증 인터페이스를 처음부터 익혀야 한다.
기존 접근 세 계열이 부딪힌 벽
논문은 확장 가능한 computer-use agent RLVR에 세 성질이 동시에 필요하다고 정리한다. 결정적으로 검증 가능한 reward, 넓은 앱 커버리지, 확장 가능한 task 다양성이다. 기존 접근은 어느 하나를 포기한다.
| 계열 | 대표 | 확보한 것 | 포기한 것 |
|---|---|---|---|
| 손으로 큐레이션한 벤치마크 | OSWorld 계열 | reward 충실도가 높다 | 앱 커버리지가 좁고 규모를 못 키운다 |
| 지도학습 데이터셋 | OpenCUA 계열 | 다양한 앱을 덮는다 | trajectory 수준 모방 목표만 주고 결과 reward가 없어 강화학습에 못 쓴다 |
| VLM-as-a-Judge 프레임워크 | ZeroGUI | 임의 task를 채점할 수 있다 | reward 노이즈가 policy 최적화를 불안정하게 만든다 |
| 코드 네이티브 웹 mock | GUI-Genesis, InfiniteWeb | 결정적 reward를 얻는다 | 브라우저 안에 갇혀 OS 수준 task와 앱 간 워크플로를 못 다룬다 |
VLM-as-a-Judge 쪽의 실패는 추측이 아니다. ZeroGUI 자신이 ablation으로 거짓 양성 reward가 강화학습을 불안정하게 만든다고 확인했다. 그래서 CUA-Gym은 프로그램 검증을 포기하지 않는 쪽을 택하고, 대신 프로그램 검증을 확장하는 문제를 풀기로 한다.
핵심 개념
검증 튜플
이 논문이 다루는 데이터 단위는 튜플이다. 튜플 하나가 학습 가능한 강화학습 인스턴스 하나에 해당한다.
| 기호 | 정체 | 산출 주체 |
|---|---|---|
| 자연어 task 지시문 | Task-Gen | |
| 초기 환경에 있어야 할 개체, 파일, 앱 상태를 열거한 컨텍스트 | Task-Gen | |
initial_setup.py가 만드는 재현 가능한 초기 상태 |
Generator | |
golden_patch.py가 만드는 정답 상태 |
Generator | |
최종 환경을 로 채점하는 reward.py |
Discriminator |
golden state는 task를 올바로 수행했을 때 도달해야 하는 정답 환경 상태를 말한다. 이 상태가 필요한 이유는 reward 함수의 방향을 검사할 수 있기 때문이다. 정답 상태에서 만점이 나오고 초기 상태에서 0점이 나오면 그 reward는 최소한 올바른 방향으로 민감하다.
information barrier
information barrier는 Generator의 스크립트와 작업 디렉토리를 Discriminator에게 감추는 프로세스 수준 격리다. 이 개념이 논문의 중심이다.
격리가 없는 경우를 생각해 보자. 한 에이전트가 golden 상태를 만드는 스크립트를 쓰고 이어서 채점 함수를 쓰면, 채점 함수는 자기가 방금 만든 산출물의 지문을 그대로 확인하는 코드가 되기 쉽다. 논문의 표현으로는 reward가 task 완료를 재는 대신 구성 절차를 재검사하게 된다. 그렇게 만들어진 튜플은 강화학습 신호를 거의 주지 못한다.
그래서 두 역할을 적대적으로 결합된 서브에이전트로 쪼개고 그 사이에 엄격한 정보 장벽을 세운다. reward 합성이 setup을 어떻게 만들었는지가 아니라 task 자체에 근거해야 한다는 제약을 구조로 강제하는 것이다.
state injection과 session isolation
mock 웹 앱을 고정된 복제본이 아니라 학습 환경으로 만드는 설계가 둘이다.
| 설계 | 하는 일 | 없으면 생기는 문제 |
|---|---|---|
| state injection | task가 자기 JSON 초기 상태를 reward.py와 함께 들고 온다 |
mock 구현 하나가 task 하나만 지원해 환경 개발이 task 수에 비례해 커진다 |
| session isolation | 모든 변경과 업로드와 리셋을 세션 id로 스코프한다 | 분산 rollout 워커들이 같은 백엔드에서 서로의 상태를 덮어쓴다 |
state injection의 결과가 중요하다. 인터페이스와 애플리케이션 코드는 그대로인데 주입된 상태가 메시지와 라벨과 안 읽은 수를 바꾸고, 그에 따라 그 mock에서 성립하는 task 분포 자체가 바뀐다. mock 구현 하나가 코드 수정 없이 서로 다른 수많은 task 세계를 호스팅한다.
trajectory slicing
trajectory slicing은 rollout 하나에서 오래된 스크린샷만 접어 여러 학습 샘플을 만드는 컨텍스트 관리 기법이다. rollout은 policy를 실행해 trajectory를 만들어내는 과정을 말한다.
필요한 이유는 산술이다. max_turns 100 에피소드에 턴당 최대 2,048 토큰 응답과 턴별 스크린샷을 더하면 약 20만 토큰까지 자라는데 하드 컨텍스트 상한은 14만 4천 토큰이다. 넘칠 때 그냥 잘라내면 성공과 실패가 결정되는 후반 턴의 지도 신호를 버리거나 형태가 안 맞는 배치를 조용히 만들어낸다.
방법
데이터 합성 루프의 전체 모양
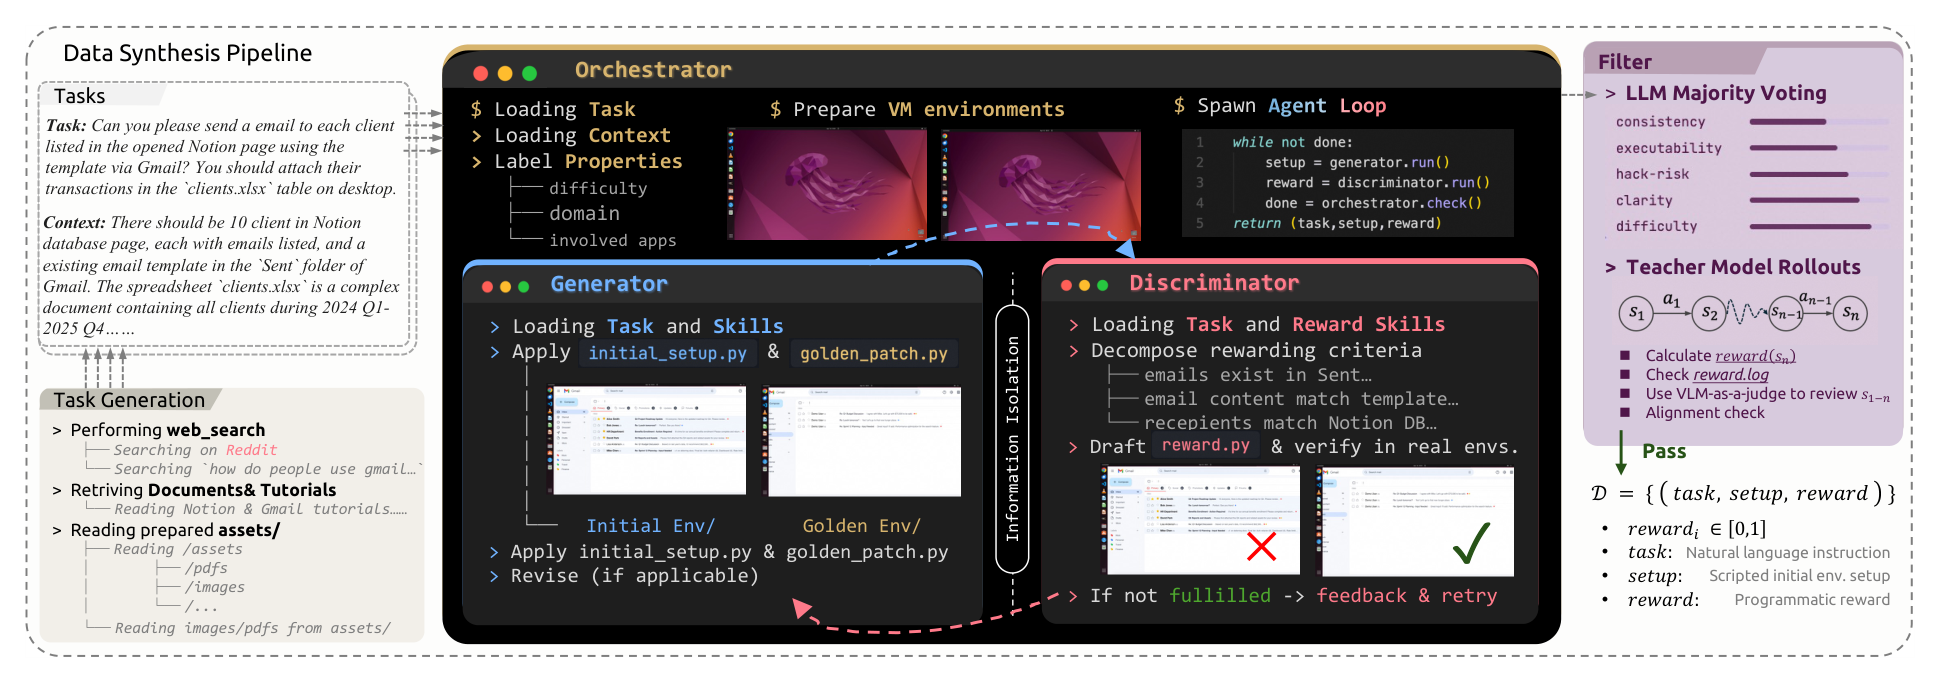
세 에이전트가 협력한다. 역할 분담과 격리 조건이 함께 정해져 있다.
| 역할 | 입력 | 산출 | 격리 |
|---|---|---|---|
| Orchestrator | task-gen 출력 JSON | VM 준비, 서브에이전트 spawn, 합의 조건 판정, 최종 튜플 기록 | 스크립트를 직접 쓰지 않는다 |
| Generator | , , 도메인 skill 파일 | initial_setup.py, golden_patch.py를 써서 두 VM에 실행 |
reward.py를 못 본다. REVIEW.md만 읽는다 |
| Discriminator | , , 도메인 skill 파일, 두 VM의 state-only API | task를 세부 판정 기준으로 쪼갠 뒤 합산해 점수를 내는 reward.py, 판정과 피드백을 담은 REVIEW.md |
Generator의 스크립트와 작업 디렉토리와 VM 파일시스템 접근이 전부 차단된다 |
Orchestrator의 시스템 프롬프트는 역할 경계를 금지 목록으로 못박는다. 스크립트를 생성하지 않고, 생성된 스크립트를 수정하지 않으며, 다섯 합의 조건을 넘어서는 품질 판단을 하지 않고, 적대적 루프를 건너뛰거나 단축하지 않는다. 정본 task 산출물 파일은 각 VM의 /home/user/에만 존재하며 로컬 파일시스템으로 절대 내려받지 않는다는 조항도 있다. 프롬프트 자체가 이 격리를 "파이프라인의 부하를 지탱하는 보안 보증"이라고 표현한다.
task 생성
지시문만으로는 그 지시문이 성립하는 환경이 결정되지 않는다. "Notion 페이지의 고객 전원에게 템플릿으로 메일을 보내라"는 지시문은 Notion에 고객이 있고 메일함에 템플릿이 있는 환경을 전제한다. 그래서 각 task를 지시문과 컨텍스트의 쌍 로 만든다. 컨텍스트의 근거는 실제 사용 패턴을 조사한 웹 리서치, 소프트웨어 문서, 미리 준비된 에셋 파일 세 가지다.
앱마다 기능 분류 트리(feature taxonomy tree)를 만든다. 내부 노드가 관련 기능을 묶고 리프가 원자적 UI 기능에 대응한다. libreoffice_calc 아래 formatting 아래 conditional_formatting 같은 경로다. 트리는 공식 문서와 LLM 웹 리서치로 부트스트랩하고 커버리지와 샘플러 처리 가능성을 저울질해 크기를 제한한다.
| 제약 | 값 |
|---|---|
| 트리 깊이 | 4 이하 |
| 노드당 분기 | 12 이하 |
| 리프 주석 | 한 줄 기능 설명과 관련 UI 요소 목록. 둘 다 task 합성 시점에 Generator에 노출된다 |
libreoffice_calc 트리는 최상위 서브트리 9개에 리프 147개이고 formatting 하나가 리프 21개쯤을 차지한다. 리프의 범위는 지시문 하나가 인접 primitive 한두 개를 노리는 정도로 좁게 잡는다. 예를 들어 number_format 리프에는 "D열을 유로 기호와 소수 둘째 자리와 천 단위 구분자가 있는 통화 형식으로 지정하라" 같은 지시문이 달린다.
트리 위에서 task를 다섯 차원으로 뽑는다. 샘플러는 셀별 누적 개수를 유지하며 역빈도 가중으로 덜 채워진 셀 쪽으로 편향시킨다.
| 차원 | 값 |
|---|---|
| platform | desktop / web / cross |
| domain | O*NET에 맞춘 10개 카테고리 |
| difficulty | easy(원자 action 3개 이하) / medium(3에서 10 step) / hard(장기 planning 필요) |
| scenario | commercial / educational / scientific / personal |
| task type | single-application / cross-application |
매트릭스는 세 번 훑는다. 각 패스가 노리는 결함이 다르다.
| 패스 | 목적 | 규약 |
|---|---|---|
| Pass 1 (breadth) | 기능 커버리지 최대화 | 트리 전역을 균일 샘플링하고 모든 리프가 최소 25개 task를 받도록 산출량을 맞춘다 |
| Pass 2 (gap-fill) | 과소 대표 셀 보충 | Pass 1 결과의 사후 커버리지 분석으로 셀을 고른다. cross-application과 hard 분포를 의도적으로 올린다 |
| Pass 3 (edge cases) | 경계 조건 | 단발 해결 한계에 걸친 task, 비정상 순서로 앱을 섞은 task, drag와 hotkey chord와 다중 창 이동 같은 희귀 primitive를 강제하는 task |
생성된 지시문은 중복 방지 검사 세 가지를 통과해야 한다. 어느 검사든 걸리면 "diversify" 지시를 붙여 재합성을 요청한다.
| 검사 | 임계 |
|---|---|
| 문장 임베딩 코사인 유사도 | 0.85 이상이면 근접 중복으로 표시 |
| 토큰 4-gram 중첩 | 기존 task와 4-gram을 50% 넘게 공유하면 거부 |
| 슬롯 템플릿 다양성 | 같은 지시문 템플릿을 앱당 3개 인스턴스까지만 허용 |
샘플러는 아래 네 항목을 하드 제약으로 강제한다고 명시한다. 마지막 항목은 논문 안에서 산술이 성립하지 않는다.
| 제약 | 값 |
|---|---|
| 도메인 카테고리 최대 비중 | 21% 이하 |
| hard task 비중 | 40% 이상 |
| cross-application task 비중 | 35% 이상 |
| 앱당 검증 튜플 | 1,000개 이상, 단일 앱이 코퍼스의 15% 초과 금지 |
Task-Gen 프롬프트는 나쁜 지시문의 유형도 명시적으로 금지한다. "스프레드시트를 보기 좋게 서식하라" 같은 모호한 지시, "다음 연산을 실행하라" 같은 기계적 지시, 유일한 정답이 없는 개방형 지시, 실행 불가능한 지시, 그리고 "DSUM 함수를 써서 총매출을 계산하라"처럼 방법을 알려주는 지시다. 마지막 금지가 특히 의도적이다. 목표를 지시하고 방법은 지시하지 않는다.
다섯 합의 조건과 금지 패턴
루프는 튜플 이 다음 다섯을 동시에 만족할 때만 통과시킨다. C1과 C2가 환경 산출물의 형식 정합성을 보장하고, C3과 C4가 reward 함수가 두 끝점에서 올바른 방향으로 민감함을 보장하며, C5가 reward가 산출물 동일성이 아니라 task 의미를 검사함을 보장한다.
| 조건 | 내용 |
|---|---|
| C1 | initial_setup.py가 에서 예외 없이 완주 |
| C2 | golden_patch.py가 에서 예외 없이 완주 |
| C3 | |
| C4 | |
| C5 | reward.py에 금지 패턴이 하나도 없다 |
C5의 금지 패턴은 여섯 가지다. Discriminator가 쓴 reward.py는 작성 시점에 정적 스캔을 받고 하나라도 걸리면 라운드를 중단한다. 검사는 정규식과 Python AST 순회를 함께 쓴다.
| 금지 패턴 | 내용 |
|---|---|
| 직접 부울 대입 | 계산 없이 검증 플래그에 값을 넣는다. chart_verified = True 같은 형태 |
| placeholder 검증 | 플래그에 상수를 넣고 중간 평가 없이 조건부로 점수에 더한다 |
| 하드코딩 성공 | 환경을 보지 않고 성공 경로에서 0.5나 1.0 같은 상수를 반환한다 |
| 존재 여부만 채점 | 내용 검사 없이 os.path.exists(...) 만으로 점수를 준다 |
subprocess 사용 |
외부 프로세스를 불러 채점한다. 재현 불가능하고 위조가 쉽다 |
| 주석만으로 검증 | # assume X is correct 같은 주석 뒤에 실제 검사 코드 없이 점수를 올린다 |
라운드 상한은 다. 실패한 라운드마다 Discriminator가 실패 조건, 관측된 값, 걸린 금지 패턴, 자유 서술 권고를 담은 REVIEW.md를 낸다. Generator는 이것만 피드백으로 받아 스크립트를 고친다.
저자들은 를 올리지 않는 이유를 명시한다. 5라운드까지 수렴하지 않는 튜플은 모호한 지시문과 어떤 스크립트 수정으로도 고쳐지지 않는 명세로 압도적으로 채워져 있다. 그런 사례는 Pass 2의 gap-fill로 넘기는 편이 내부 루프를 더 돌리는 것보다 비용 대비 효과가 크다.
정보 격리의 강제 범위
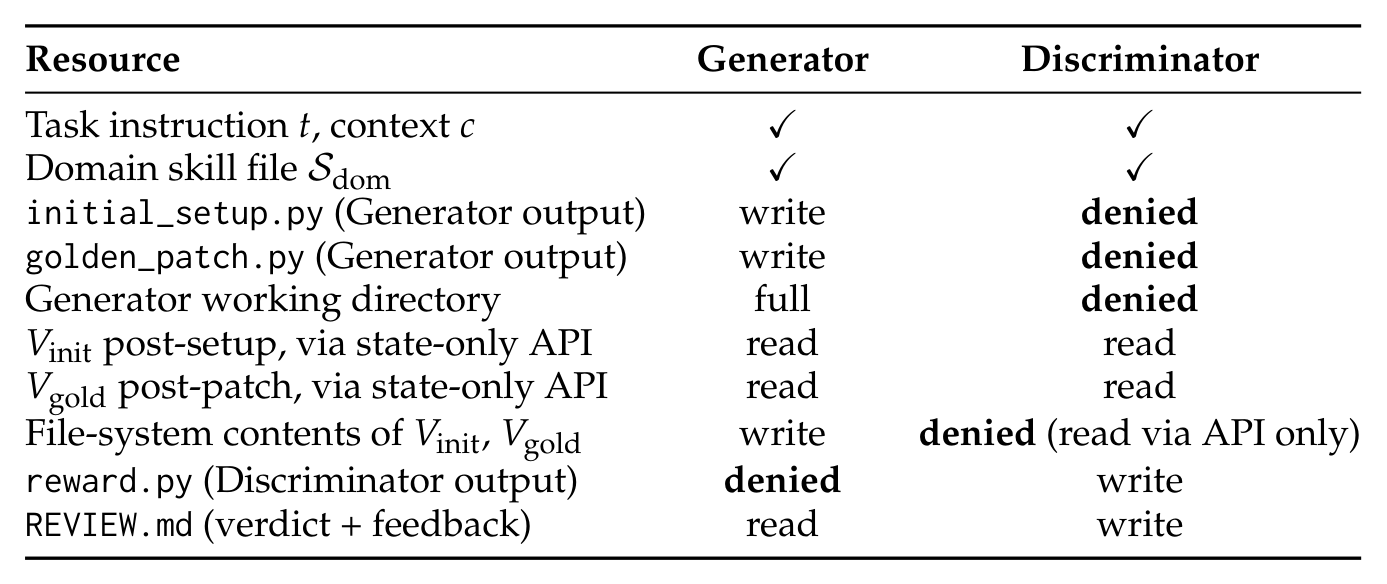
행렬을 자원별로 옮기면 다음과 같다.
| 자원 | Generator | Discriminator |
|---|---|---|
| task 지시문 , 컨텍스트 | 접근 | 접근 |
| 도메인 skill 파일 | 접근 | 접근 |
initial_setup.py |
write | denied |
golden_patch.py |
write | denied |
| Generator 작업 디렉토리 | full | denied |
| setup 이후 , state-only API 경유 | read | read |
| patch 이후 , state-only API 경유 | read | read |
| , 의 파일시스템 내용 | write | denied (API로만 read) |
reward.py |
denied | write |
REVIEW.md |
read | write |
두 에이전트가 공유하는 것은 task와 도메인 skill 파일뿐이다. 갈리는 것은 Generator가 만든 산출물이다. Discriminator는 두 VM의 파일시스템도 직접 못 읽고 state-only API를 거친다. 반대 방향도 막혀 있다. Generator는 reward.py를 못 보고 Discriminator가 쓴 REVIEW.md의 판정과 피드백만 읽는다.
구현은 프로세스 수준이다. 두 프로세스가 서로 겹치지 않는 파일시스템 뷰를 가진 별도 작업 디렉토리에서 실행되고 프로세스 사이 통신은 Orchestrator만 중개한다. Orchestrator가 Discriminator의 샌드박스 디렉토리에 복사해 주는 것은 task_config.json과 두 VM의 접속 정보뿐이며 setup 스크립트와 산출물 파일은 복사하지 않는다.
두 단계 데이터셋 필터
루프가 수렴했다는 건 튜플이 자기들끼리 앞뒤가 맞는다는 뜻이다. 그렇다고 지시문이 모호하지 않다거나 어떤 policy든 풀 수 있다는 뜻은 아니다. 이런 문제는 rollout을 돌려봐야 드러난다. 그래서 통과한 튜플 전부를 독립된 두 단계 필터에 한 번 더 태운다.
1단계는 서로 다른 foundation model 계열에서 뽑은 비평자 명의 다수결이다. 계열을 섞는 이유는 계열별 편향 상관을 줄이는 것이다. 각 비평자가 네 요소 튜플을 받아 아홉 필드의 구조화 JSON 판정을 낸다.
| 필드 | 내용 |
|---|---|
| verdict | keep / modify_query / reject |
| severity | P0에서 P3 |
| can_fix_with_query_only | 지시문 수정만으로 고칠 수 있는지 |
| query_issues | 지시문 자체의 문제 목록 |
| setup_reward_risks | setup과 reward 쪽 위험 |
| training_pool_fit | 학습 풀에 넣기 적합한지 |
| confidence | 판정 확신도 |
| reasoning_summary | 판단 근거 요약 |
| revised_query | 수정 제안 지시문 |
severity 등급이 판정의 뼈대다.
| severity | 판정 | 내용 |
|---|---|---|
| P0 | reject | setup, reward, 환경의 치명적 결함. 지시문 수정으로 못 고치는 세 요소 불일치 |
| P1 | modify-query | 지시문에 필수 컨텍스트가 없거나, 해로운 모호성이 있거나, 평가를 편향시키는 방식으로 절차를 누설한다 |
| P2 | keep-or-modify | 치명적이지 않은 품질 문제. 사용 가능하지만 이상적이지는 않다 |
| P3 | keep | 표면 문체 외에는 유의미한 문제가 없다 |
집계 규칙은 과반, 즉 명이 keep이나 modify_query를 내면 통과다. modify_query가 다수면 수정 의견 중 confidence가 가장 높은 revised_query를 정본으로 채택하고, keep이 다수면 원래 지시문을 유지하며, 동수면 기본값이 거부다. 튜플별 severity는 어떤 비평자든 부여한 최고 severity로 기록해 최악 기준 품질 등급을 릴리스 메타데이터에 남긴다.
2단계는 teacher rollout이다. Claude Sonnet 4.6을 튜플마다 회 실행하고 rollout마다 두 점수를 매긴다.
| 점수 | 근거 | 강점 | 약점 |
|---|---|---|---|
| 파일 내용, 구조화 상태 diff, 라이브러리 introspection | 환경 상태에 근거해 분산이 작다 | reward 작성자가 계측하기로 선택한 것만 본다 | |
| 최종 상태 스크린샷, 지시문, 에서 뽑은 수용 기준 체크리스트 | 프로그램 reward가 놓치는 표면 실패를 잡는다 | 이진 판정이고 시각 판단에 의존한다 |
이 잡는 실패의 예가 구체적으로 적혀 있다. 데이터는 맞게 로드됐지만 색상 테마가 틀린 UI, 값은 맞지만 축 레이블이 없는 차트다. 두 점수의 일치는 reward가 task 의도에 충실하다는 강한 신호이고, 계속되는 불일치는 reward가 너무 좁거나 task 자체가 과소 명세라는 신호다.
| 회 평균 조건 | 판정 |
|---|---|
| 두 평균이 모두 구간이고 차이가 미만 | 수용 |
| 두 평균이 모두 0 | 풀 수 없을 가능성이 높다. 코퍼스에서 제거 |
| 두 평균이 첫 시행부터 모두 1 | 지나치게 쉬울 가능성이 높다. 쉬운 꼬리 통제를 위해 down-sampling |
| 두 평균의 차이가 이상 | 불일치 구간을 강조한 피드백으로 Discriminator에 반송 |
반송된 튜플은 정련 후 teacher rollout에 재진입하고 두 번의 패스에서도 수렴하지 못하면 오프라인 분석 버킷으로 내린다.
| 단계 | 거부 개수 | 주로 걸리는 실패 유형 |
|---|---|---|
| LLM 다수결 | 약 3,100개 | 루프의 합의 조건을 통과하지만 종단 비평에서 실패하는 정적 명세 오류 |
| teacher rollout | 1,278개 | 실제 에이전트 행동에서만 드러나는 실행 불가능성과 자명함 |
두 단계가 전체 필터 손실에 대략 70대 30으로 기여한다. 이 필터가 루프 수준 일관성과 종단 학습 유용성 사이의 간극을 메우는 부분이다.
환경 층 CUA-Gym-Hub
task 다양성의 상한은 환경 다양성이다. 기존 벤치마크는 데스크톱 앱 몇 개가 전부고 실제 웹사이트는 강화학습 환경으로 쓸 수 없다. 인증과 rate limit과 재현되지 않는 상태 때문에 프로그램으로 주입하거나 조회하거나 리셋하는 일이 불가능하다.
그래서 mock 웹 앱 94종을 직접 합성했다. 각각은 단일 페이지 앱이고 세션 상태를 조회하고 주입하고 리셋할 수 있는 통합 HTTP API를 노출한다. 이 설계가 데이터 합성 파이프라인이 각 세션을 샌드박스 단위로 취급하고 상태 전이를 구조화된 diff로 회수할 수 있게 만들며, 그 diff가 reward 계산에 명확한 기반을 준다.
논문은 CUA-Gym-Hub를 벤치마크가 아니라 재사용 가능한 환경 층으로 위치시킨다. 같은 리셋 가능한 애플리케이션들이 여러 생성 task와 reward 함수와 post-training 레시피를 지탱할 수 있다는 뜻이다.
mock 합성 멀티에이전트 파이프라인
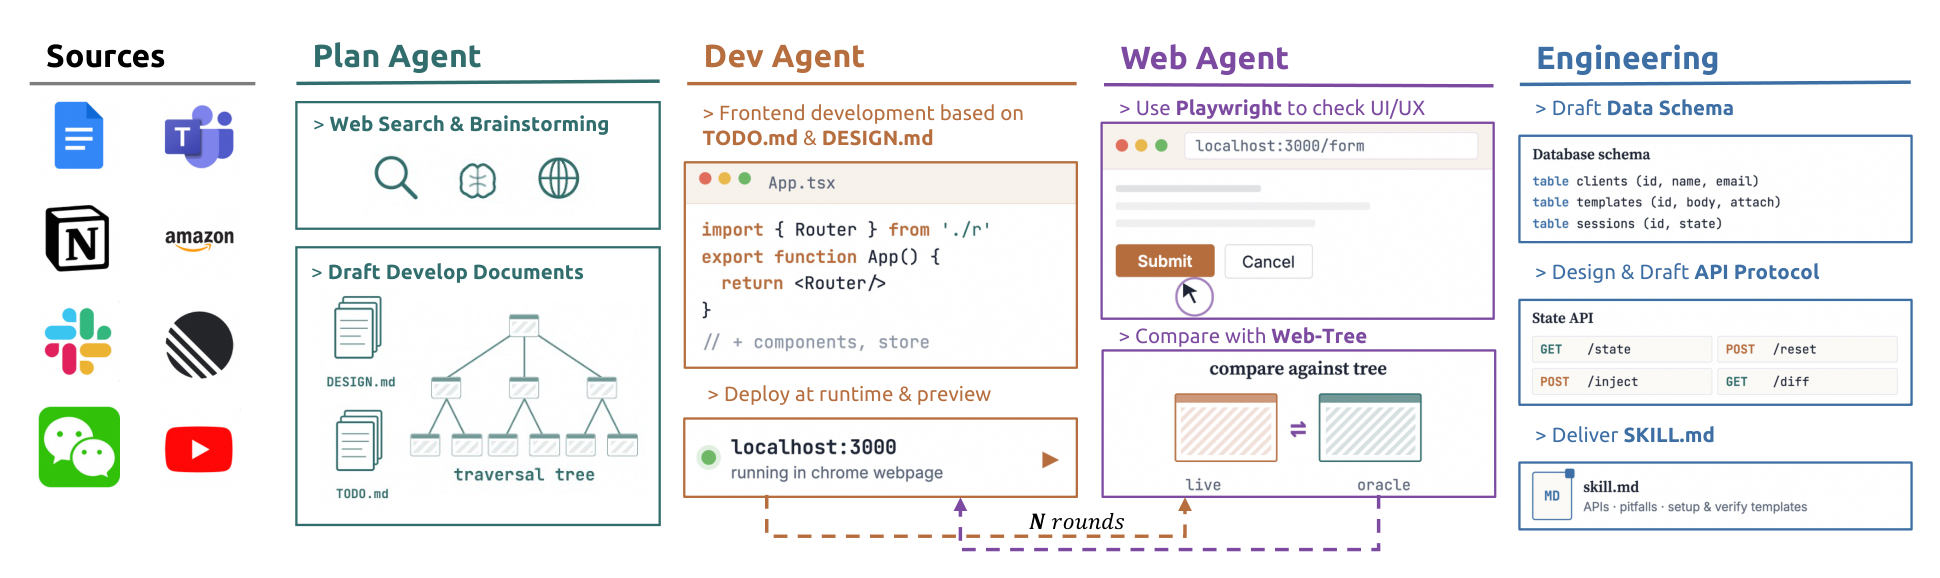
세 에이전트가 직접 메시지를 주고받지 않고 파일로만 조율한다.
| 에이전트 | 하는 일 | 산출 |
|---|---|---|
| Plan Agent | 문서 크롤과 스크린샷 수집과 사용자 역할별 기능 목록화로 대상 앱을 파악 | DESIGN.md(색상 팔레트, 타이포그래피, 여백 토큰, 컴포넌트 스타일), assets/README.md(UI 레이아웃 서술과 주요 워크플로), assets/data_model.md(인메모리 상태의 entity 정의), TODO.md(P0/P1/P2 작업 큐) |
| Dev Agent | 명세대로 Vite와 React 기반 단일 페이지 앱을 고정 레이아웃으로 구현 | src/App.jsx(라우팅), src/context/AppContext.jsx(전역 상태), src/utils/dataManager.js(상태 초기화와 localStorage 영속), src/utils/stateTracker.js(diff 계산), vite.config.js(state API 플러그인) |
| Web Agent | headless Playwright로 배포된 mock을 구동하며 TODO.md의 모든 인터랙티브 요소를 눌러보고 실제 DOM을 기준과 대조 |
TEST.md(기능과 시각 버그 리포트), AUDIT.md(죽은 핸들러, 추적되지 않는 상태 변경, diff API 누락 항목) |
검증 기준은 Plan Agent가 쓴 UI 레이아웃 트리다. Plan Agent의 역할 명세는 인증 흐름과 실제 네트워크 통신과 localStorage를 넘는 영속을 명시적으로 배제한다. mock의 계약은 참조 서비스의 기능적 복제본이 아니라 충실한 상호작용 샌드박스가 되는 것이다.
Dev Agent의 작업 우선순위는 AUDIT P0, TEST P0, AUDIT P1, TODO P0, TODO P1, TODO P2 순서로 고정된다. 코드 정합성 회귀를 새 기능 작업보다 먼저 처리하려는 순서다. 루프는 TEST.md와 AUDIT.md가 모두 P0과 P1을 0건으로 보고할 때까지, 또는 mock당 라운드 예산이 소진될 때까지 반복한다. 각 라운드는 Web Agent 테스트 패스, Dev Agent 수정 패스, Web Agent 재테스트로 구성된다. Plan Agent는 근본적 명세 공백이 드러날 때만 다시 개입한다. 실제 스크린샷에는 있는 기능이 TODO.md에 없는 경우가 그 예다. 라운드 예산 안에 수렴하지 못한 mock은 수동 검토 대상으로 표시하고 해결될 때까지 공개 묶음에서 제외한다.
최종 산출물에는 API와 함정과 검증 템플릿을 정리한 SKILL.md가 붙고 이게 그대로 task 합성 파이프라인의 입력이 된다.
통합 state API
mock마다 네 엔드포인트를 구현한다. SPA와 같은 오리진에 공존하는 Vite 미들웨어 플러그인이라 별도 프로세스가 필요 없다.
| 엔드포인트 | 용도 | 응답 |
|---|---|---|
POST /post?sid=<sid> |
상태 주입과 생명주기 제어 | success, sid, state_id 해시 |
GET /go?sid=<sid> |
구조적 상태 조회. reward.py가 쓰는 주 인터페이스 |
initial_state, current_state, state_diff |
GET /state?sid=<sid> |
원시 현재 상태. diff 추상화가 필요 없을 때 쓰는 저수준 조회 | stored_state, has_custom_state, sid |
POST /upload?sid=<sid> |
첨부가 필요한 task용 파일 업로드 | 파일별 URL |
POST /post의 action 네 가지가 초기 상태와 진행 상태를 갈라 쓴다.
| action | 의미 | 호출 주체 |
|---|---|---|
set |
세션의 initial 스냅샷에 상태를 쓴다 | initial_setup.py |
set_current |
initial 스냅샷을 건드리지 않고 current 스냅샷에만 쓴다 | golden_patch.py, 진행 중 상태가 필요한 드문 경우의 initial_setup.py |
merge |
set_current와 같지만 기존 current 스냅샷을 대체하지 않고 깊은 병합을 한다 |
위와 같음 |
reset |
initial과 current 스냅샷을 모두 지우고 기본 시드 데이터를 다시 로드한다 | 세션 정리 |
모든 호출은 세션 식별자 sid를 질의 파라미터로 실어 상태 읽기와 쓰기를 세션별 저장 이름공간으로 스코프한다. 트레이너는 rollout마다 새 sid(UUIDv4)를 만들어 VM 안의 알려진 경로에 기록하고, 이후 initial_setup.py와 에이전트 호출과 reward.py가 같은 세션을 공유한다. 세션 상태의 TTL은 마지막 접근으로부터 한 시간이고 만료 세션은 개입 없이 회수된다.
/go가 돌려주는 state_diff는 initial과 current 스냅샷의 키 경로 비교이고 reward 작성에 맞춘 규칙이 셋이다.
| 규칙 | 내용 | 이유 |
|---|---|---|
| 객체는 재귀 비교 | 중첩 객체까지 구조적으로 내려간다 | 깊은 상태 변경을 놓치지 않는다 |
| 배열은 전체 표시 | 순서 있는 시퀀스로 취급해 어느 인덱스든 차이가 나면 배열 전체를 변경으로 표시한다 | 에이전트가 편집이 아니라 재배열만 했을 때 부분 일치가 거짓으로 성립하는 것을 막는다 |
| 휘발성 필드 마스킹 | lastViewedAt이나 계산된 UI 상태 캐시는 diff 전에 가린다 |
단순 열람 action이 diff를 오염시키지 않게 한다 |
diff 표현은 중첩이 아니라 평평한 키 경로 문자열이다. 개별 필드에 선형 assertion을 쓰는 reward 작성자가 소비하기 때문이다. 웹 mock task의 정본 reward.py 패턴은 /go를 한 번 호출해 state_diff를 받고, channels[0].name이 engineering으로 바뀌었으면 0.25점, messages.engineering[0].content가 바뀌었으면 0.25점처럼 부분 점수 assertion을 누적한다.
상표와 트레이드 드레스 준수
인벤토리의 식별자(slack, gmail, shopify_admin 등)는 합성 대상을 실제 참조에 고정해 Plan과 Web 에이전트를 grounding하기 위한 내부 개발 라벨이다. 공개 산출물에는 여섯 가지 준수 조치가 적용된다.
| 조치 | 내용 |
|---|---|
| 일반 식별자로 개명 | slack은 team-chat-mock, gmail은 mail-mock, shopify_admin은 ecommerce-admin-mock. 내부 이름과 공개 식별자의 매핑 표를 함께 배포하고 지시문과 파일 경로와 config.json은 공개 식별자만 참조한다 |
| 브랜드 자산 미포함 | 실제 로고와 브랜드 아이콘 세트와 독점 일러스트를 넣지 않고 브랜드 식별색은 큐레이션한 12색 중립 팔레트로 교체한다 |
| UI 문구 신규 작성 | 마케팅 문구와 마이크로카피와 플레이스홀더 일러스트를 Dev Agent가 새로 쓴다 |
| 참조 스크린샷 미배포 | Plan Agent가 리서치 중 수집한 스크린샷은 합성 기간에만 로컬에 두고 어떤 산출물에도 포함하지 않는다 |
| 약관 민감 분야 추가 검토 | 금융과 의료와 정부 포털 mock은 릴리스 매니페스트에 추가 인간 검토 대상으로 표시한다. 약관이 기능적 재현조차 금지하면 공개에서 빼고 같은 카테고리의 일반 대체물로 교체한다 |
| 공시 문서 배포 | mock별 공개 식별자, 기능 범주, 적용한 준수 조치, 약관 검토 결과를 담은 문서를 데이터셋 카드와 함께 낸다 |
논문이 내부 이름을 유지하는 이유는 인벤토리의 가독성과 부록 상호 참조의 추적 가능성이다. 저자들은 논문에 나오는 모든 실제 제품명을 대응 일반 mock 카테고리의 내부 라벨로 읽으라고 명시한다.
mock의 구조 통계
공개 프로덕션 묶음은 mock 94개이고 소스 트리에는 새 mock의 출발점으로 쓰는 템플릿 스캐폴드 5개가 추가로 남아 있다. 부록 통계는 이 99개 디렉토리 전체를 측정한 값이다. 94개로 한정하면 모든 항목에서 평균이 3% 미만으로 움직이므로 저자들은 투명성을 위해 포함 수치를 보고한다.
| 항목 | 평균 | p10 | p25 | p50 | p75 | p90 | p99 | 최대 |
|---|---|---|---|---|---|---|---|---|
| 소스 LOC | 6,127 | 4,237 | 4,828 | 5,663 | 7,196 | 9,180 | 13,095 | 13,095 |
| route 컴포넌트 | 15.0 | 4 | 8 | 14 | 20 | 27 | 60 | 60 |
| 데이터 모델 entity | 5.9 | 3 | 3 | 5 | 7 | 10 | 23 | 23 |
측정 정의는 명시되어 있다. LOC는 src/ 아래 JavaScript와 TypeScript와 CSS와 HTML 파일을 합산하고 node_modules와 빌드 산출물은 제외한다. route 수는 SPA의 React Router 설정에 있는 <Route> 선언 수이고, entity 수는 SCHEMA.md나 src/utils/dataManager.js에 선언된 최상위 entity 수다.
| 소스 LOC 구간 | mock 수 | 비율 |
|---|---|---|
| 1,000 미만 | 1 | 1.0% |
| 1,000에서 2,500 | 1 | 1.0% |
| 2,500에서 5,000 | 31 | 31.3% |
| 5,000에서 10,000 | 59 | 59.6% |
| 10,000에서 20,000 | 7 | 7.1% |
| 20,000 이상 | 0 | 0.0% |
91%가 2,500에서 10,000 LOC 구간에 들어간다. 저자들은 이를 "작은 타입 지정 인메모리 스키마 위에 탐색 가능한 화면 10에서 20개를 구현하는 자기완결 SPA"라는 설계 제약과 일관된 결과로 읽는다. 10,000 LOC를 넘는 이상치(aws_console_mock, Canvas-LMS_mock, expedia_mock)는 기능 표면이 더 넓은 앱이고, 가장 작은 두 개는 계보 보존용으로 남긴 템플릿 스캐폴드다.
대표 mock 세 사례
부록은 스키마 형태와 검증 방식이 서로 다른 세 mock을 예로 든다. 같은 파이프라인이 어떤 종류의 앱까지 다루는지 보여주는 자료다.
| mock | 스키마 성격 | 검증 방식의 특징 |
|---|---|---|
| Slack | 채널 트리와 채널별 순서 있는 메시지 목록(발신자, 타임스탬프, 스레드 부모, 반응, 첨부, 편집 플래그), 최상위 currentUser 참조와 평평한 users 목록 |
인증 스캐폴딩 없이 사용자 전환 task를 노출한다. 검증 가능한 상호작용은 채널 생성과 보관, 메시지 게시와 편집, 스레드 답글, 반응 추가와 제거, 다이렉트 메시지 생성이다. presence와 push 알림과 워크스페이스 관리 정책은 없어 그런 task는 다른 카테고리로 넘긴다 |
| Jira | 프로젝트, 스프린트, 보드, 이슈, 이슈 상태 워크플로(To Do에서 In Progress, In Review, Done) | 개체 간 불변식을 데이터 모델에 강제한다. 이슈의 스프린트 소속은 스프린트의 프로젝트와 일관해야 하고, 상태 전이는 설정된 워크플로 그래프를 따라야 하며, 보드 열 소속은 독립 필드가 아니라 이슈 상태의 파생 뷰다. 다단계 task는 개별 UI 이벤트를 추적하지 않고 issues 컬렉션의 diff를 검사해 검증한다 |
| Salesforce | Leads, Contacts, Accounts, Opportunities. lead에서 opportunity로의 전환 흐름이 약 25개 필드에 걸친 다단계 폼 | 검증이 경로 수준이 아니라 값 수준이다. 올바른 필드 집합이 올바른 타입과 값 제약으로 채워졌는지만 diff에서 확인하고 에이전트는 어떤 UI 경로를 써도 된다. 저자들은 이 분리가 시각적으로 낯선 에이전트도 필드를 제대로 식별하면 폼 중심 task를 풀 수 있는 이유라고 설명한다 |
도메인 skill 파일과 bitter lessons
앱 도메인마다 SKILL.md가 붙고 합성 시점에 Generator와 Discriminator 양쪽이 로드한다. 표준 구조는 여섯 절이다.
| 절 | 내용 |
|---|---|
| 1 | 도메인 개념과 Python 라이브러리. libreoffice_writer는 python-docx, libreoffice_calc는 openpyxl |
| 2 | 상태와 파일시스템 레이아웃. 문서와 설정의 정본 경로 |
| 3 | 흔한 task 컨텍스트로 파라미터화한 initial_setup.py 템플릿 |
| 4 | 대응 파라미터 슬롯을 가진 golden_patch.py 템플릿 |
| 5 | 점진적 부분 점수 분해를 보여주는 reward.py 채점 패턴 |
| 6 | bitter lessons. 개발 중 관측한 함정을 큐레이션한 목록 |
3절의 템플릿에는 GUI 시작 헬퍼가 들어 있다. headless VM에서 명시적 디스플레이 없이 GUI 앱을 띄우면 조용히 실패하기 때문에 모든 실행이 DISPLAY=:0을 설정하고 스크립트가 깨끗하게 종료할 수 있도록 비차단 Popen을 쓴다.
6절이 이 포맷의 가장 특징적인 부분이다. libreoffice_calc의 bitter lessons는 12항목이고 몇 가지를 옮기면 다음과 같다.
| 함정 | 내용 |
|---|---|
| 수식 값 | openpyxl은 수식을 계산하지 않는다. cell.value는 "=SUM(A1:A10)" 문자열을 돌려준다. 마지막 캐시 값을 얻으려면 data_only=True가 필요하고 그러려면 파일이 한 번은 Calc나 Excel에서 열려 있었어야 한다 |
| 색상 표기 | 항상 8자 ARGB를 쓴다. PatternFill(start_color="4472C4")는 조용히 "004472C4"가 되어 알파 00의 투명색이 된다. "FF4472C4"로 쓰고 읽을 때도 8자 형태로 비교한다 |
| 배경색 필드 | 보이는 배경은 fgColor이지 bgColor가 아니다 |
| 병합 셀 | merge_cells("A1:D1") 이후 B1과 C1과 D1은 값이 None인 MergedCell이 된다. 좌상단 셀만 스타일을 지정한다 |
| golden 파일 생성 | 초기 파일이 있으면 처음부터 다시 만들지 않고 복사한 뒤 수정한다. 메타데이터와 인쇄 설정과 보이지 않는 속성이 보존된다 |
| 필터 | ws.auto_filter.ref는 범위만 지정하고 행을 실제로 숨기지 않는다. 필터는 LibreOffice에서 파일을 열 때만 적용된다 |
| 반전된 불리언 | DataValidation의 showDropDown=False가 드롭다운을 표시하라는 뜻이다 |
| 스타일 불변성 | 대입 후 스타일은 바꿀 수 없다. cell.font.bold = True가 아니라 새 Font 객체를 만들어 대입한다 |
각 항목은 초기 개발의 특정 디버깅 사례에서 나왔다. 없으면 LLM 서브에이전트가 적대적 라운드를 낭비하며 다시 발견할 종류의 함정이다. bitter lessons는 파이프라인과 함께 버전 관리되고 거부 로그에 반복 실패 유형이 나타날 때마다 새 항목이 추가된다.
출력 번들과 OSWorld 호환
검증된 튜플은 output/final/<task_id>/ 아래 자기완결 디렉토리로 나온다.
| 파일 | 내용 |
|---|---|
config.json |
OSWorld 평가기 계약 |
meta.json |
task 분류 필드, 난이도, 출처 패스 |
initial_setup.py |
깨끗한 VM에서 을 만든다 |
golden_patch.py |
깨끗한 VM에서 를 만든다 |
reward.py |
을 구현한다 |
REVIEW.md |
최종 수용 라운드의 Discriminator 판정 |
task_config.json |
자연어 task 지시문과 컨텍스트 |
config.json은 OSWorld 평가기 계약을 그대로 따르며 VM 이미지, 스냅샷 식별자, action observation 타입(a11y_tree 또는 screenshot), step 예산, reward.py를 가리키는 실행 후 평가기 진입점 목록 필드를 갖는다. 스키마 확장을 하나도 넣지 않은 것이 명시적 설계 목표였다. 그래서 CUA-Gym 튜플을 OSWorld 벤치마크 항목으로 그대로 쓸 수 있고 이 레이아웃은 OSWorld 평가기와 SFT teacher rollout 파이프라인과 강화학습 트레이너가 수정 없이 소비한다.
학습 scaffold
에이전트는 원본 스크린샷을 보고 XML로 감싼 tool call로 action을 낸다. rollout의 각 step은 이미지 observation 하나와 <tool_call> 블록 하나를 짝짓는다. policy는 한 블록 안에 여러 primitive action을 낼 수 있다.
| 항목 | 값 |
|---|---|
| 스크린샷 해상도 | VM native. OSWorld 데스크톱 task는 1000 곱하기 1000, 웹 task는 native 뷰포트 |
| vision 토큰 예산 | 최소 65,536 픽셀에서 최대 2,097,152 픽셀. 이 범위에서 종횡비를 유지하는 가장 가까운 크기로 리사이즈 |
| 추가 전처리 | 크롭도 saliency 마스킹도 적용하지 않는다 |
| 노출 함수 | computer_use 하나 |
action primitive는 네 묶음 19종이다.
| 묶음 | primitive |
|---|---|
| Pointer | left_click, right_click, middle_click, double_click, triple_click, left_click_drag, mouse_move, left_mouse_down, left_mouse_up |
| Keyboard | type, key, key_down, key_up |
| Navigation | scroll, hscroll, screenshot, wait |
| Control | terminate(에피소드 성공 또는 실패 선언), call_user(설명 요청. 평가 시점에만 쓰고 강화학습 중에는 쓰지 않는다) |
시스템 프롬프트는 모든 rollout과 task에서 고정이다. tool call 문법과 응답 형태와 종료 의미를 세우지만 task 특정 정보는 담지 않고, task 지시문은 첫 user 메시지로 공급된다. 응답 형태 규칙은 단순하다. 비종료 UI step에서는 한 문장짜리 Action 서술과 <tool_call> 블록 하나만 출력하고 tool call 뒤에는 아무것도 붙이지 않는다.
실패 복구는 세 유형을 rollout 중단 없이 처리한다.
| 실패 | 처리 |
|---|---|
| 형식이 깨진 tool call XML | 다음 user 턴에 파서 오류 메시지를 실어 재프롬프트 |
| VM 쪽 action 실패 | 오류 문자열을 반환해 모델이 일반 환경 응답으로 관측하게 한다 |
| 샘플러 쪽 예외(타임아웃, 서버 연결 끊김) | 지수 백오프로 최대 5회 재시도. 그래도 실패하면 rollout을 실패로 표시하고 over-sampling 필터가 버린다 |
trajectory slicing의 구성과 대안 비교
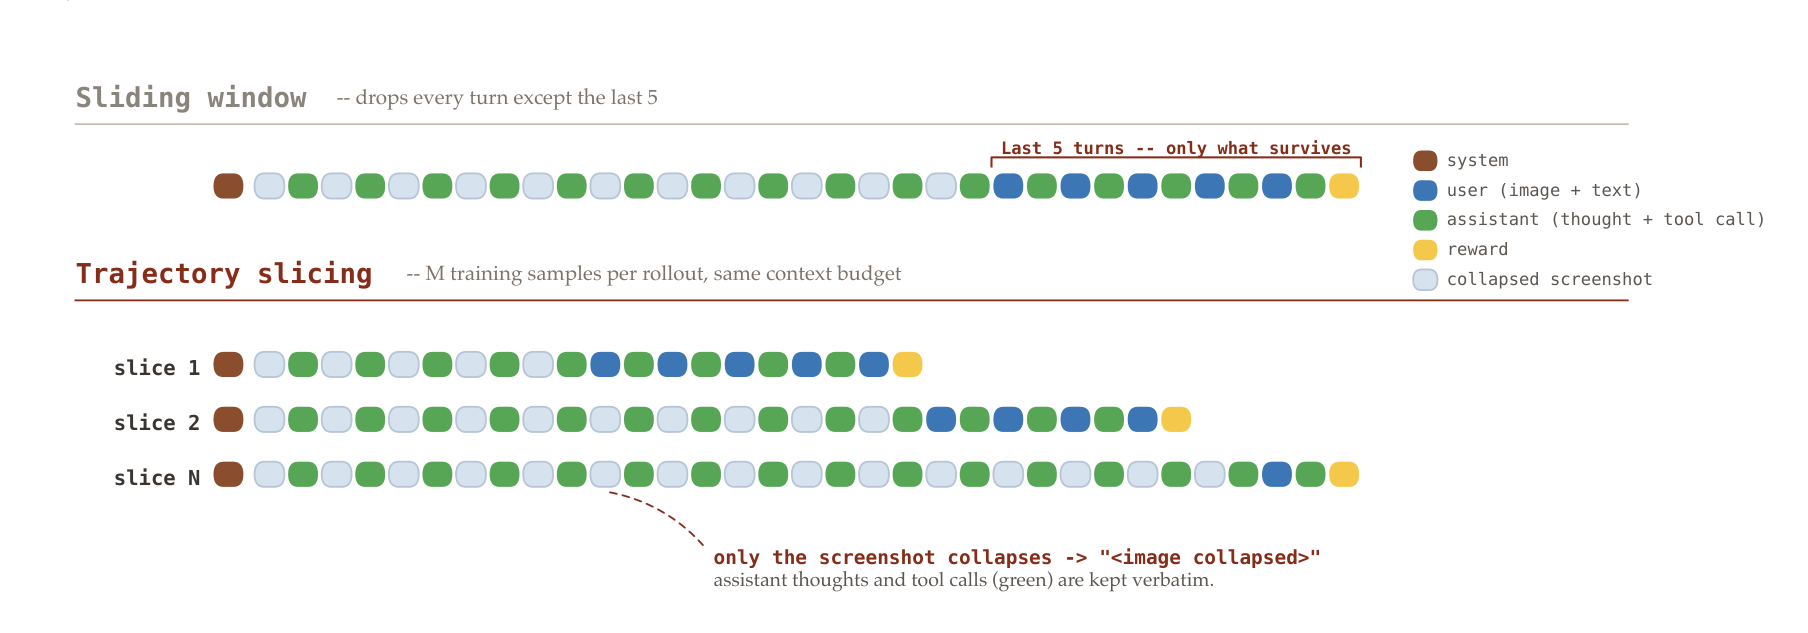
slice는 traj_slice_interval 10 턴쌍마다 하나씩 나오고 정수 collapsed_length로 인덱싱된다. slice의 prompt 부분은 시스템 메시지 다음에 앞쪽 collapsed_length 턴쌍이 오는데 그 턴쌍들의 스크린샷은 "<image collapsed>" 짧은 플레이스홀더 텍스트로 대체된다. response 부분은 rollout의 현재 지점까지 이어지는 이후 모든 턴이고 멀티모달 observation을 온전히 보존한다. 첫 slice는 collapsed_length가 0이라 trajectory를 원형 그대로 담는다. 이후 slice는 점점 더 오래된 턴을 텍스트 플레이스홀더로 보며 새 observation을 위한 컨텍스트 예산을 확보한다.
| 대상 | loss_mask |
|---|---|
| prompt 부분의 모든 토큰 | False. gradient가 흐르지 않는다 |
| response 부분의 user 또는 tool 메시지 | False. 환경 observation이지 policy 출력이 아니다 |
| response 부분의 assistant 메시지 | True. 단 캐시된 로그확률이 없는 경우(오래된 policy 버전으로 rollout됐다는 표시)와 한 메시지에 tool call이 10개를 넘는 경우(형식 오류 방어)는 제외 |
각 slice는 부모 trajectory의 전체 에피소드 reward를 동일하게 복제받고 slice 사이로 나누거나 할인하지 않는다. 근거는 둘이다. reward는 최종 환경 상태의 속성이지 개별 턴의 속성이 아니고, 그룹 정규화 advantage 추정은 prompt별로 적용되므로 slice 사이 동일 reward는 같은 advantage 신호에 대한 관측을 더 주는 것에 그친다. 접은 뒤에도 예산을 넘는 slice는 전량 마스킹 패딩인 dummy slice로 바뀐다. gradient에는 기여하지 않고 dataloader가 요구하는 배치 형태만 보존한다. 논문 실행에서는 slice의 1% 미만이었다.
| 방식 | 동작 | 문제 |
|---|---|---|
| truncation | 컨텍스트 초과 지점에서 trajectory를 버린다 | 성공과 실패가 결정되는 후반 턴의 지도 신호를 정확히 버려 policy를 앞쪽 턴 행동으로 편향시킨다 |
| summarization | prefix를 LM 생성 요약으로 대체한다 | truncation보다 신호는 보존하지만 학습 샘플마다 LM 호출이 추가되고, 요약 품질 분산이 gradient에 유입되며, 스크린샷 픽셀에서 grounding된 좌표로 가는 결정적 대응이 사라진다 |
| trajectory slicing | 오래된 스크린샷만 결정적 플레이스홀더로 접는다 | 플레이스홀더가 완전히 결정적이고 gradient는 모든 slice의 합집합에서 전체 trajectory에 대해 계산된다. 재사용 가능한 prefix가 명시적으로 남아 인접 slice의 policy 로그확률 계산에서 KV 캐시를 재사용할 수 있다 |
slicing이 summarization과 같은 컨텍스트 완화를 얻으면서 추가 추론 비용도 손실 압축도 치르지 않는다는 것이 저자들의 주장이다.
GSPO와 하이퍼파라미터
GSPO(Group Sequence Policy Optimization)는 중요도 비율을 토큰이 아니라 시퀀스 단위로 잡는 강화학습 알고리즘이다. mixture-of-experts 모델의 학습에서 더 안정적이다. policy 가 개 rollout을 내면 각각 을 받는다. 본문 식(1)은 그룹 정규화 advantage 로 가중된 clipped surrogate에서 참조 policy에 대한 KL 페널티 를 뺀 목적함수를 최대화하는 형태로 적혀 있다. 시퀀스 단위 중요도 비율은 trajectory 길이 로 기하평균을 낸 형태다.
| 기호 | 값 | 설명 |
|---|---|---|
| 16 | prompt당 rollout 수 | |
| 20 | over-sampling 목표. prompt당 유효 rollout 앞 16개만 남기고 타임아웃과 형식 오류는 버린다 | |
| 0.2 | 중요도 비율 clipping 범위. 양쪽 clip이 같다 | |
| 0 | 참조 policy KL 페널티. 보고된 실행에서는 KL 항과 참조 모델을 전부 비활성화했다 | |
| learning rate | $1 \times 10^{-6}$ | AdamW, 상수 스케줄, warmup 없음 |
| (0.9, 0.999, $10^{-8}$) | AdamW 파라미터 | |
| weight decay | 0.01 | bias와 norm이 아닌 모든 파라미터 |
| batch size | prompt 128개 | 외부 GSPO 배치 |
| mini-batch size | prompt 32개 | 내부 gradient 누적 step |
| PPO epochs | 1 | 외부 배치당 옵티마이저 패스 1회 |
| total steps | 1,000 | 전체 학습 실행의 외부 배치 갱신 수 |
| rollout temperature | 1.0 | 학습 rollout 샘플링 |
| eval temperature | 0.6 | 검증 rollout 샘플링 |
| top-p / top-k | 0.95 / 무제한 | 평가 시 nucleus 샘플링 |
| max new tokens / turn | 2,048 | 턴당 응답 상한 |
| max context length | 144K | 하드 컨텍스트 상한. 넘으면 trajectory slicing 발동 |
| max prompt length | 8K | slice당 초기 prompt 예산 |
보조 손실로는 저품질 이중언어 출력의 가중을 낮추는 중국어 토큰 페널티(계수 0.5)를 적용하고, 형식과 언어와 무한 반복 페널티는 비활성화하며 그룹 필터링도 비활성화한다. 엔트로피 보너스는 전 구간 0이다.
이라 참조 policy를 메모리에 올리지도 학습 중 평가하지도 않는다. 노드당 GPU 메모리가 확보되어 rollout 인스턴스가 경합 없이 24개 규모로 동작한다. 저자들은 초기 프로토타이핑에서 를 재평가했고 보고된 데이터 규모에서는 학습 안정성 이득도 task 성공률 개선도 관측하지 못했다고 밝힌다.
advantage 정규화는 부록 쪽이 더 구체적이다. 부록 C.3.3은 prompt별 그룹 단위로 로 계산한다고 적고 표준편차 정규화를 의도적으로 비활성화한다(divide_by_std=False). 점진적 reward가 이미 고정 척도 위에 있고, 로 나누면 그룹이 거의 균일한(전부 성공하거나 전부 실패하는) prompt에서 노이즈가 증폭되기 때문이다. 분산이 0인 그룹에는 평균 중심화한 advantage를 그대로 두면 0이 되어 gradient에 기여하지 않는다. 이 서술은 본문 식(1)의 와 어긋난다.
인프라와 실행 비용
강화학습 실행은 NVIDIA H200 SXM GPU(각 141GB HBM3e)를 노드당 8장씩 쓰고 고대역폭 NVLink와 NVSwitch로 연결한다.
| 구성 | GPU | 노드 | 대상 backbone | 파이프라인 깊이 |
|---|---|---|---|---|
| turbo | 192 | 24 | Qwen3.5-35B-A3B | PP 2 |
| plus | 512 | 64 | Qwen3.5-397B-A17B | PP 8 |
각 클러스터는 verl의 분리형 트레이너 인프라로 학습 서브클러스터와 rollout 서브클러스터로 균등 분할된다. plus는 학습 노드 32개와 rollout 노드 32개를 짝지우고 turbo는 24노드 규모에 같은 균형 분할을 적용한다. 두 서브클러스터는 dispatch ratio 2.35의 맞춤 dispatch 층으로 통신하고 rollout과 학습 사이 policy 버전 격차는 최대 4 step으로 제한한다. 학습 병렬화는 두 구성이 TP 2, EP 8, CP 4를 공유하고 파이프라인 깊이만 다르다. rollout 서빙은 TP 8에 데이터 병렬 복제 4배, attention 백엔드 fa3, sglang을 쓰며 speculative decoding은 3 step과 draft token 4개로 전 구간 활성이다.
rollout은 내부 라우터 뒤에 놓인 OSWorld 가상 머신 2,000개 중 하나에 접속한다. rollout 요청이 task 지시문과 에이전트 step 상한을 제출하면 라우터가 유휴 인스턴스를 골라 task의 config.json이 지정한 스냅샷을 복원하고 step별 스크린샷과 reward 스트림을 트레이너에 돌려준다. 에피소드 종료 후 VM은 깨끗한 스냅샷으로 리셋되고 풀로 반환된다. 풀 크기 2,000으로 학습 step당 평균 VM 사용률이 75%를 넘고 rollout 지연이 학습 병목이 되지 않는다.
| 실행 | 클러스터 | 벽시계 시간 | 누적 비용 |
|---|---|---|---|
| Qwen3.5-35B-A3B 1,000 step | turbo(192 GPU) | 약 5일 | 약 23,040 GPU시간 |
| Qwen3.5-397B-A17B 1,000 step | plus(512 GPU) | 약 5일 | 약 61,440 GPU시간 |
비용은 rollout이 지배하고 트레이너는 에피소드 완료를 기다리며 상대적으로 유휴 상태다. 1.4K와 3K의 소규모 데이터 ablation은 비례해 빨리 끝나지만 step당 연산은 같다. 실행 사이에 달라지는 것은 step 수가 아니라 trajectory 양이다.
데이터셋
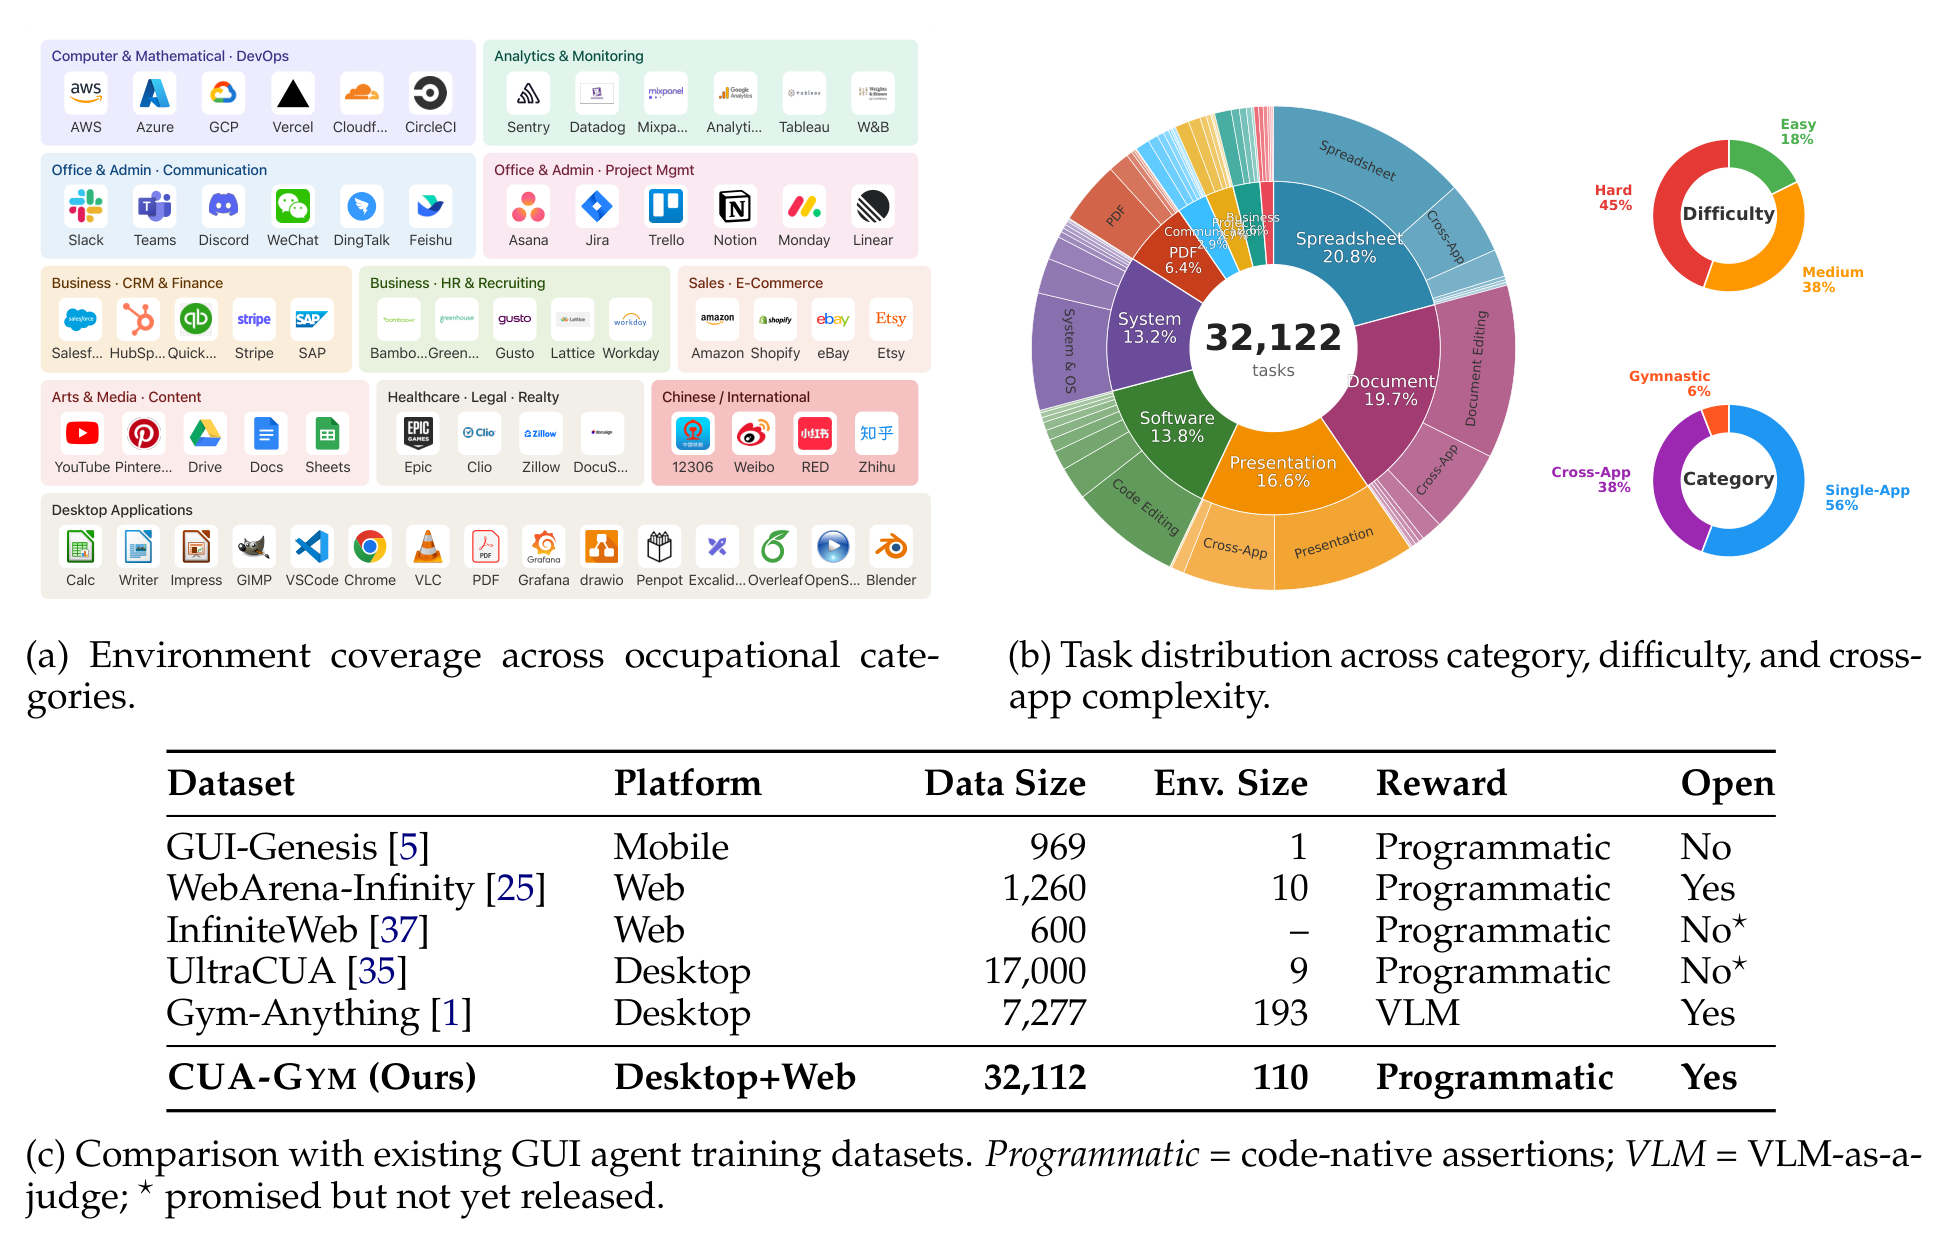
환경 풀의 근거
환경 풀의 근거는 두 외부 자료다. O*NET의 표준 직업 분류(SOC) 대분류가 웹 앱 94종의 카테고리를 정하고, Anthropic Economic Index의 소프트웨어 사용 분포가 카테고리 안에서 어떤 제품을 고를지 정한다. 데스크톱 쪽은 웹으로 표현 못 하는 OS 수준 워크플로를 메운다.
SOC 대분류와 앱 카테고리의 매핑은 다대다다. 한 SOC 대분류가 여러 앱 카테고리에 걸치고, 한 앱 카테고리가 여러 SOC 대분류에 봉사한다.
| SOC 대분류 | 대응 mock 앱 카테고리 |
|---|---|
| Management | CRM, 프로젝트 관리, 커뮤니케이션, 분석 |
| Business and Financial Operations | 회계, 결제, 마케팅 분석, CRM |
| Computer and Mathematical | 코드 호스팅, CI/CD, 모니터링, 클라우드 콘솔, 인프라 |
| Architecture and Engineering | 클라우드 인프라, CAD와 다이어그램, 프로젝트 관리 |
| Life, Physical, and Social Science | 문서 협업, 논문 리뷰, 분석 |
| Community and Social Service | 커뮤니케이션, 일정 관리, 문서 협업 |
| Legal | 문서 서명, 사건 관리, 법률 리서치 |
| Educational Instruction and Library | 학습 관리, 문서 협업, 일정 관리 |
| Arts, Design, Entertainment, Sports | 디자인 도구, 소셜 미디어, 콘텐츠 발행 |
| Healthcare Practitioners and Technical | EHR 시스템, 의료 영상, 일정 관리 |
| Sales and Related | CRM, 전자상거래 관리, 마케팅 분석 |
| Office and Administrative Support | 메일, 일정 관리, 문서 협업, HRIS |
| Transportation and Material Moving | 예약, 여행 계획, 전자상거래 |
| Government and Civil Service | 정부 포털, 세무, 신원 확인 |
지식노동 비중이 큰 직업군(Management, Business, Computer, Sales)이 상대적으로 더 많은 환경을 받는다. Anthropic Economic Index 가중이 그 직업군의 소프트웨어 사용 강도를 반영하기 때문이다. 카테고리별 사용 빈도 를 포함 대상 전체로 정규화한 가 합성 예산이 되고, 포함 임계 아래(가중 사용량 1% 미만) 카테고리 꼬리에는 공학 예산을 쓰지 않는다. 포함된 카테고리 안에서는 사용 빈도 내림차순으로 예산이 소진될 때까지 앱을 고른다. 저자들은 이 절단을 "꼬리 전체를 낮은 충실도로 덮기보다 분포의 머리를 높은 충실도로 덮는 보수적 선택"이라고 설명한다.
카테고리 인벤토리
| 카테고리 | 열거된 앱 수 | 예시 |
|---|---|---|
| Communication / messaging | 9 | slack, microsoft_teams, discord, gmail, outlook_web |
| Social / publishing | 10 | twitter, instagram, linkedin, reddit, weibo, youtube |
| Project management | 6 | jira, asana, trello, monday, linear, notion |
| Document collaboration | 8 | google_docs, google_sheets, google_drive, airtable, miro |
| Code hosting / DevOps | 7 | github, gitlab, vercel, circleci, sentry, postman, wandb |
| Cloud / infrastructure | 5 | aws_console, azure, aliyun, cloudflare, datadog |
| E-commerce / marketplace | 8 | amazon, ebay, shopify_admin, woocommerce, uber_eats |
| Travel | 5 | booking_com, expedia, tripadvisor, google_flights, 12306 |
| Finance / payments | 6 | paypal, robinhood, coinbase, stripe_dashboard, quickbooks |
| HR / hiring | 6 | workday, bamboohr, greenhouse, gusto, lattice, adp |
| CRM / customer service | 5 | salesforce, hubspot, Zendesk, ServiceNow, SAP |
| Marketing / ads | 5 | hubspot_marketing, klaviyo, mailchimp, meta_ads, google_ads |
| Analytics | 6 | google_analytics, mixpanel, amplitude, hotjar, tableau |
| Healthcare / legal | 7 | epic-health, PACS-viewer, clio, westlaw, docusign |
| Government / education | 4 | california_tax, usa-gov, visa_portal_ds160, Canvas-LMS |
| Real estate / utilities | 1 | zillow |
데스크톱 쪽은 오피스 생산성과 웹 브라우징과 이미지 편집과 개발 도구와 미디어를 덮는다. Figure 6a의 데스크톱 상자에는 Calc, Writer, Impress, GIMP, VSCode, Chrome, VLC, PDF 뷰어, Grafana, drawio, Penpot, Excalidraw, Overleaf, Blender 등이 올라 있다.
task 분포
task 구성은 카테고리별로 고르게 퍼져 있고 어려운 쪽으로 기울어 있다. 어느 카테고리도 21%를 넘지 않고 hard가 45%, 앱을 넘나드는 cross-app이 38%다. Figure 6b의 category 도넛은 Single-App 56%, Cross-App 38%, Gymnastic 6%로 나뉘는데 세 번째 항목의 정의는 논문 어디에도 나오지 않는다.
| 시나리오 | task 수 | 비율 |
|---|---|---|
| Spreadsheet & Data | 6,684 | 20.8% |
| Document Writing | 6,314 | 19.7% |
| Presentation Design | 5,328 | 16.6% |
| Software Engineering | 4,434 | 13.8% |
| System Administration | 4,225 | 13.2% |
| PDF & Publishing | 2,055 | 6.4% |
| Communication & Email | 939 | 2.9% |
| Project & Task Management | 879 | 2.7% |
| Business Operations | 840 | 2.6% |
| Creative & Media | 412 | 1.3% |
상위 다섯 시나리오가 코퍼스의 84%를 덮는다. 시나리오 안에서 task는 여러 구성 앱에 퍼진다. Spreadsheet & Data는 libreoffice_calc와 데이터 분석 mock 웹사이트와 Calc가 들어가는 cross-application 조합을 함께 덮는다.
| 도메인 | Easy | Medium | Hard | 합계 |
|---|---|---|---|---|
| Cross-Desktop | 300 | 1,198 | 6,030 | 7,528 |
| Spreadsheet | 993 | 2,627 | 1,952 | 5,572 |
| Document Editing | 881 | 2,070 | 1,165 | 4,116 |
| Presentation | 889 | 1,541 | 737 | 3,167 |
| System & OS | 1,110 | 1,388 | 311 | 2,809 |
| Code Editing | 690 | 1,130 | 660 | 2,480 |
| Desktop × Web | 0 | 84 | 1,917 | 2,001 |
| 113 | 946 | 757 | 1,816 | |
| Cross-Web | 0 | 53 | 376 | 429 |
| E-Commerce | 166 | 191 | 27 | 384 |
| Cloud & Productivity | 93 | 166 | 116 | 375 |
| Social Media | 127 | 191 | 21 | 339 |
| Project Management | 82 | 135 | 58 | 275 |
| Communication | 65 | 120 | 37 | 222 |
| Business & CRM | 37 | 87 | 71 | 195 |
| Media | 80 | 68 | 2 | 150 |
| Development Tools | 28 | 55 | 65 | 148 |
| Image Editing | 30 | 53 | 23 | 106 |
| 합계 | 5,684 | 12,103 | 14,325 | 32,112 |
이 표로 보면 hard가 44.6%, medium이 37.7%, easy가 17.7%다. 편중은 여러 앱을 쓰는 도메인에서 가장 뚜렷하다. Cross-Desktop은 80.1%가 hard, Cross-Web은 87.6%, Desktop × Web은 95.8%다. 상태 추적과 컨텍스트 전환 부담이 추가되기 때문이다. 반면 단일 앱 도메인은 난이도 기울기가 완만하다. Spreadsheet는 easy 17.8%, medium 47.2%, hard 35.0%다.
지시문의 표면 통계
각 task 지시문의 첫 명령형 동사를 세면 에이전트가 grounding해야 하는 action 어휘가 드러난다. "I want to"나 "Please" 같은 군더더기 절은 건너뛴다.
| 동사 | 빈도 | 동사 | 빈도 | 동사 | 빈도 |
|---|---|---|---|---|---|
| open | 4,585 | insert | 562 | remove | 227 |
| create | 2,728 | build | 440 | export | 183 |
| set | 1,448 | read | 427 | check | 170 |
| add | 1,028 | change | 361 | find | 139 |
| use | 906 | write | 290 | ||
| extract | 891 | convert | 265 | ||
| configure | 728 | ||||
| apply | 605 |
표면 편집 동사(open, create, set, add, insert, change, remove)가 머리를 차지하고 중간 빈도는 구성(build, configure, apply), 추출(extract, export, convert), 확인(check, find, read)을 덮는다. 표시되지 않은 꼬리에는 merge, flatten, normalize, reconcile, annotate처럼 각각 50개 미만 task에 나오는 동사가 이어진다.
| 앱 쌍 | 빈도 | 앱 쌍 | 빈도 | 앱 쌍 | 빈도 |
|---|---|---|---|---|---|
| pdf + writer | 3,173 | impress + pdf | 1,381 | files + pdf | 316 |
| calc + writer | 3,129 | calc + pdf | 1,003 | files + terminal | 315 |
| impress + writer | 2,056 | files + writer | 534 | calc + files | 313 |
| calc + impress | 1,576 | terminal + vscode | 412 | calc + vscode | 294 |
| vscode + writer | 364 | terminal + writer | 272 | ||
| files + vscode | 268 |
cross-app task는 12,311개로 코퍼스의 38.3%다. 쌍은 지시문의 키워드 일치로 검출하고 한 지시문이 세 개 이상 앱을 언급하면 여러 쌍에 동시에 기여한다. 네 개 앱을 언급하는 지시문 하나가 여섯 쌍을 모두 올린다. 문서 생산 삼중항(calc와 writer와 pdf, impress와 writer와 pdf)이 cross-app 트래픽의 큰 부분을 차지하는데, 지식노동 파이프라인이 PDF 산출물로 끝나는 일이 많다는 경험적 현실을 반영한다. 개발자 쌍(terminal과 vscode, files와 vscode)이 더 작지만 특징적인 군집을 이루고, 웹 mock 쌍은 표시되지 않았지만 salesforce와 gmail과 slack과 notion 계열에 집중된다.
| 지시문 길이(단어) | task 수 | 비율 |
|---|---|---|
| 0에서 29 | 10,988 | 34.2% |
| 30에서 59 | 11,010 | 34.3% |
| 60에서 99 | 6,073 | 18.9% |
| 100에서 149 | 2,775 | 8.6% |
| 150에서 249 | 1,042 | 3.2% |
| 250 이상 | 234 | 0.7% |
요약 통계는 평균 54.1, p10 17, p25 24, p50 41, p75 69, p90 108, p99 237, 최대 390이다. 30단어 미만 지시문은 보통 익숙한 산출물에 대한 단일 step action이고 100단어 이상 지시문은 조건 분기 여럿과 명시적 수용 기준을 담은 다단계 워크플로를 인코딩한다.
기존 데이터셋과의 비교
| 데이터셋 | 플랫폼 | 데이터 수 | 환경 수 | reward | 공개 |
|---|---|---|---|---|---|
| GUI-Genesis | Mobile | 969 | 1 | Programmatic | 아니오 |
| WebArena-Infinity | Web | 1,260 | 10 | Programmatic | 예 |
| InfiniteWeb | Web | 600 | 미보고 | Programmatic | 아니오(공개 예정) |
| UltraCUA | Desktop | 17,000 | 9 | Programmatic | 아니오(공개 예정) |
| Gym-Anything | Desktop | 7,277 | 193 | VLM | 예 |
| CUA-Gym | Desktop+Web | 32,112 | 110 | Programmatic | 예 |
Programmatic은 코드 네이티브 assertion, VLM은 VLM-as-a-Judge를 뜻한다. 원문 표의 별표는 공개를 약속했으나 아직 공개되지 않았다는 표시여서 위 표에서는 "아니오(공개 예정)"로 옮겼다. 환경 수만 보면 Gym-Anything이 193개로 더 많은데 reward가 VLM-as-a-Judge다. 프로그램 검증과 데스크톱 및 웹 동시 커버리지를 함께 갖춘 것으로는 CUA-Gym이 가장 크다는 것이 저자들의 주장이다.
결과
실험 설정
CUA-Gym에서 10,858개 검증 튜플을 뽑아 RLVR 학습 세트로 쓴다. 80개가 넘는 환경의 task를 덮는다.
| 항목 | 값 |
|---|---|
| RLVR 학습 세트 | 검증 튜플 10,858개, 환경 80개 이상 |
| SFT 워밍업 코퍼스 | trajectory 3,578개 |
| teacher | Claude Sonnet 4.6 |
| teacher 샘플링 | task당 4개, temperature 1.0 |
| 필터 | 최종 reward 인 trajectory만 유지. teacher rollout의 약 50%가 버려진다 |
| SFT 재가중 | 없음. 도메인 재균형도 적용하지 않는다 |
SFT는 assistant 토큰에 표준 교차 엔트로피를 적용하고 user와 system과 tool 메시지를 마스킹한다.
| SFT 설정 | 값 |
|---|---|
| 옵티마이저 | AdamW |
| learning rate | $7 \times 10^{-6}에서 $7 \times 10^{-7} 로 코사인 감쇠 |
| weight decay | 0.01 |
| batch size | prompt 512개 |
| epoch | 1 |
| 시퀀스 길이 | 256K |
| 정밀도 | bf16 혼합 정밀도, matmul 경로는 FP8 가중치 |
| GPU | 512장 |
trajectory slicing을 SFT에도 동일하게 적용해 SFT와 강화학습의 데이터 형태를 맞춘다. 모델은 Qwen3.5-35B-A3B와 Qwen3.5-397B-A17B 두 규모다.
종합 성적
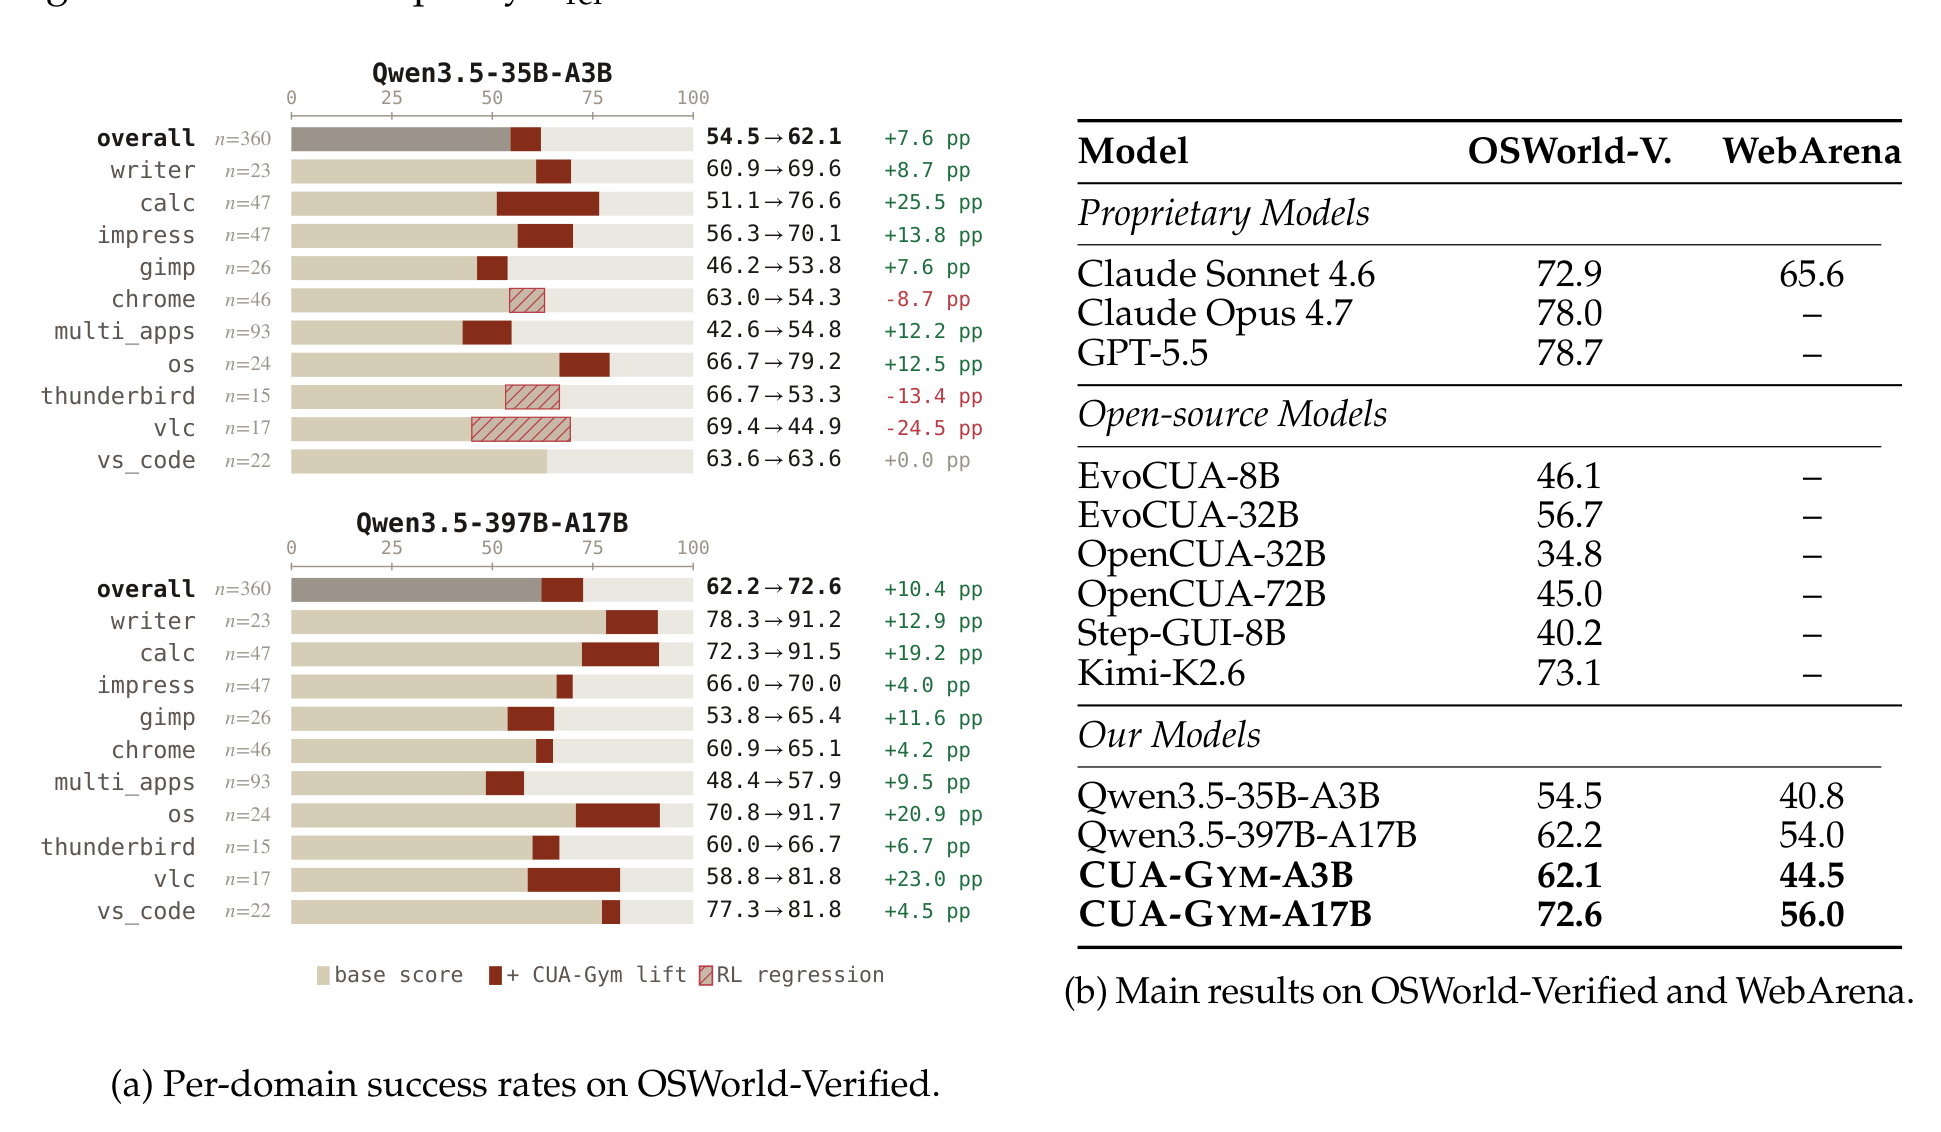
| 구분 | 모델 | OSWorld-Verified | WebArena |
|---|---|---|---|
| 상용 | Claude Sonnet 4.6 | 72.9 | 65.6 |
| 상용 | Claude Opus 4.7 | 78.0 | 미보고 |
| 상용 | GPT-5.5 | 78.7 | 미보고 |
| 오픈소스 | EvoCUA-8B | 46.1 | 미보고 |
| 오픈소스 | EvoCUA-32B | 56.7 | 미보고 |
| 오픈소스 | OpenCUA-32B | 34.8 | 미보고 |
| 오픈소스 | OpenCUA-72B | 45.0 | 미보고 |
| 오픈소스 | Step-GUI-8B | 40.2 | 미보고 |
| 오픈소스 | Kimi-K2.6 | 73.1 | 미보고 |
| 자체 | Qwen3.5-35B-A3B (base) | 54.5 | 40.8 |
| 자체 | Qwen3.5-397B-A17B (base) | 62.2 | 54.0 |
| 자체 | CUA-Gym-A3B | 62.1 | 44.5 |
| 자체 | CUA-Gym-A17B | 72.6 | 56.0 |
RLVR이 두 규모 모두에서 base를 끌어올린다. 작은 쪽이 54.5에서 62.1로 +7.6%p, 큰 쪽이 62.2에서 72.6으로 +10.4%p다. GUI 에이전트의 강화학습 이득은 보통 모델이 커질수록 줄어드는데 여기서는 큰 쪽에서도 유지된다. 저자들이 짚는 대목이 이 지점이다. CUA-Gym-A3B는 총 파라미터가 약 10분의 1인 채로 Qwen3.5-397B-A17B base와 맞먹는다.
최상급 주장의 조건
논문의 최상급 주장은 규모 조건이 붙은 형태다. "각자의 규모대에서 오픈소스 CUA 중 state-of-the-art"다. 이 조건을 떼면 주장이 성립하지 않는다. 같은 표에서 오픈소스로 분류된 Kimi-K2.6이 73.1로 CUA-Gym-A17B의 72.6보다 0.5%p 높다. 인용할 때 규모 조건을 함께 옮겨야 하는 이유다.
WebArena 전이
WebArena는 학습에 쓰지 않은 홀드아웃 브라우저 벤치마크이고 그 사이트 클론들은 학습에 쓴 94개 mock과 겹치지 않는다. 여기서도 두 모델 모두 오른다. CUA-Gym-A3B가 40.8에서 44.5로 +3.7%p, CUA-Gym-A17B가 54.0에서 56.0으로 +2.0%p다.
저자들은 이 전이를 웹 mock 파이프라인이 합성 mock에 과적합되지 않고 브라우저 환경 전반으로 옮겨가는 능력을 길러준다는 근거로 읽는다. 데스크톱과 웹을 함께 놓은 CUA-Gym의 위치 설정을 뒷받침하는 결과다.
도메인별 편차
전체 task 360개를 도메인 10개로 나눈 성공률이다. Figure 5 캡션은 학습 후 도메인별 점수가 run-4 체크포인트 분해에서 나왔다고 밝힌다.
| 도메인 | n | A3B base | A3B 학습 후 | 변화 | A17B base | A17B 학습 후 | 변화 |
|---|---|---|---|---|---|---|---|
| overall | 360 | 54.5 | 62.1 | +7.6%p | 62.2 | 72.6 | +10.4%p |
| writer | 23 | 60.9 | 69.6 | +8.7%p | 78.3 | 91.2 | +12.9%p |
| calc | 47 | 51.1 | 76.6 | +25.5%p | 72.3 | 91.5 | +19.2%p |
| impress | 47 | 56.3 | 70.1 | +13.8%p | 66.0 | 70.0 | +4.0%p |
| gimp | 26 | 46.2 | 53.8 | +7.6%p | 53.8 | 65.4 | +11.6%p |
| chrome | 46 | 63.0 | 54.3 | -8.7%p | 60.9 | 65.1 | +4.2%p |
| multi_apps | 93 | 42.6 | 54.8 | +12.2%p | 48.4 | 57.9 | +9.5%p |
| os | 24 | 66.7 | 79.2 | +12.5%p | 70.8 | 91.7 | +20.9%p |
| thunderbird | 15 | 66.7 | 53.3 | -13.4%p | 60.0 | 66.7 | +6.7%p |
| vlc | 17 | 69.4 | 44.9 | -24.5%p | 58.8 | 81.8 | +23.0%p |
| vs_code | 22 | 63.6 | 63.6 | +0.0%p | 77.3 | 81.8 | +4.5%p |
A3B에서 calc가 51.1에서 76.6으로 가장 크게 올랐다. 반면 vlc는 69.4에서 44.9로 24.5%p, thunderbird는 66.7에서 53.3으로 13.4%p, chrome은 63.0에서 54.3으로 8.7%p 하락했다. 전체 점수는 올랐지만 균일하지 않다.
A17B에서는 이 하락이 사라진다. vlc가 58.8에서 81.8로 뒤집히고 thunderbird와 chrome도 모두 오른다. 작은 모델에서는 학습 데이터가 두터운 도메인으로 능력이 쏠리며 얇은 도메인을 깎아먹는 양상으로 보인다. task 수가 vlc 17개, thunderbird 15개로 작은 것도 변동 폭을 키우는 요인이다.
한 가지 주의가 필요하다. Figure 5 캡션은 A3B에서 가장 큰 이득이 libreoffice_calc와 multi_apps와 vs_code에 나타난다고 적는데, 같은 그림의 vs_code는 +0.0%p로 열한 도메인 중 이득이 가장 작다. 캡션과 그림 데이터가 어긋나므로 그림 수치를 기준으로 삼는다.
데이터 스케일링
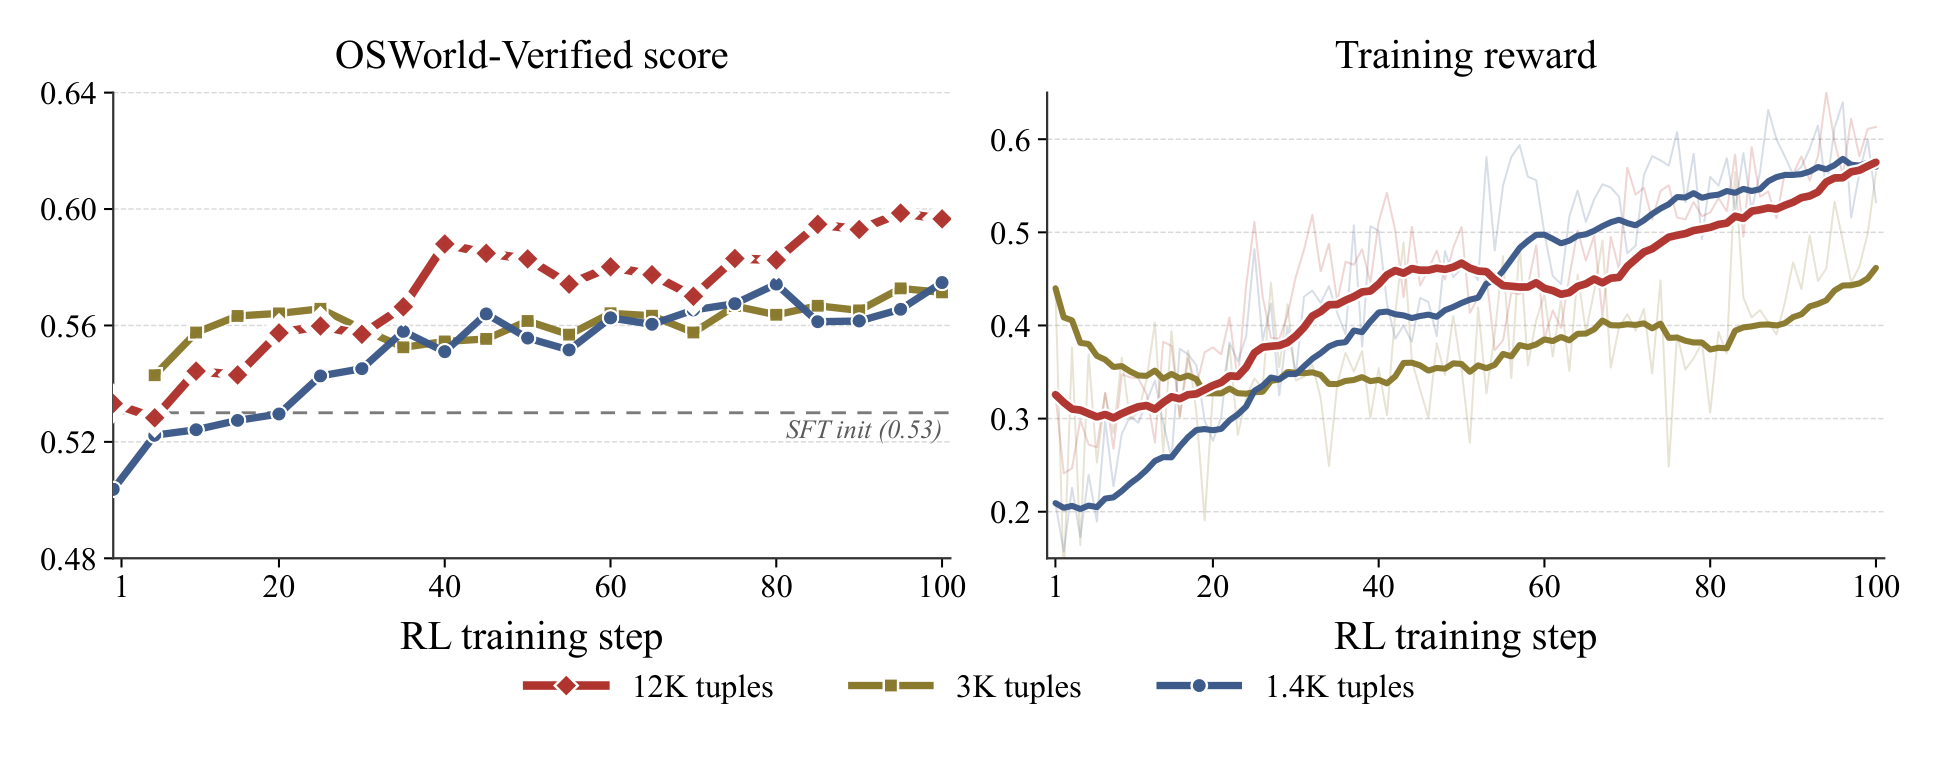
세 부분집합은 약 1,400개, 3,000개, 1만 2,000개 튜플이고 모두 같은 SFT 체크포인트에서 출발한다. 그래프는 강화학습 step 100까지를 담는다.
논문의 서술은 세 항목이다.
| 관측 | 내용 |
|---|---|
| 정점 | 12K가 가장 높은 정점에 도달한다 |
| 이탈 시점 | 12K가 SFT 기준선에서 가장 일찍 벌어져 더 높은 대역을 유지한다 |
| 소규모 실행 | 3K와 1.4K는 기준선 근처에서 평평해진다 |
저자들은 추가 데이터의 한계 가치가 점근 정점과 학습 곡선 전체 형태 두 방향에서 동시에 나타난다고 서술하고, 12K 곡선에 포화로 꺾이는 지점이 아직 보이지 않는다는 점을 강조한다. 이 파이프라인으로 접근 가능한 데이터 스케일링 구간이 아직 소진되지 않았다는 뜻이다.
이 실험에는 두 번째 용도가 있다. 세 실행 모두 SFT 기준선에서 단조 증가했고 RLVR에서 흔한 진동이나 붕괴, reward와 성공률의 탈동조가 없었다. 악용 가능한 reward 함수는 강화학습 최적화에서 특징적 불안정을 유발하는 것으로 알려져 있으므로, 이 안정성은 information barrier 설계가 실제로 작동했다는 간접 진단이 된다.
한 가지 서술은 그림과 맞지 않는다. 본문은 "세 곡선의 상대 순서가 학습 내내 보존된다"고 적지만 그림에서는 step 35 이전 구간에서 3K가 12K보다 높고, reward 패널의 step 100 시점에는 1.4K가 12K와 비슷하거나 위에 있다. 최종 정점 순서는 데이터 규모와 일치하지만 순서가 학습 전 구간에서 보존된다는 서술은 성립하지 않는다.
환경 스케일링
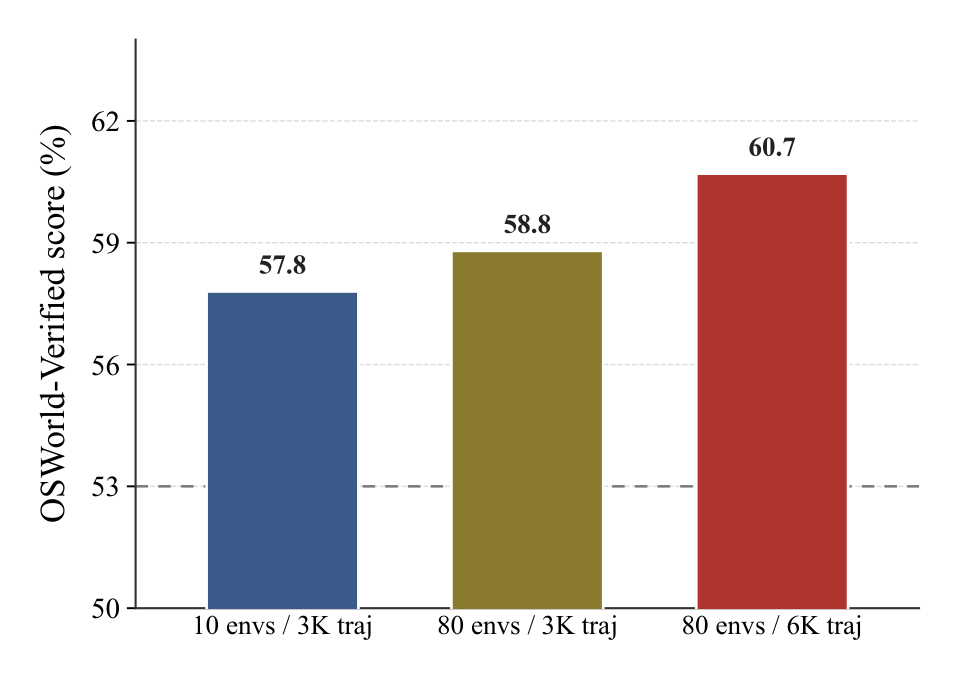
환경 수준 ablation은 강화학습으로 하기엔 너무 비싸서 teacher distillation으로 대신했다. 이 설정에는 부수 효과가 있다. CUA-Gym 데이터가 강화학습 인프라를 요구하지 않는 post-training 레시피에서도 소비 가능함을 보인다.
방식은 다음과 같다. Claude Sonnet 4.6을 CUA-Gym task에 실행해 인 trajectory만 남겨 teacher 시연 데이터(demonstration) 풀을 만들고, 같은 Qwen3.5-35B-A3B base를 표준 SFT로 학습시킨다. 세 학생은 SFT 하이퍼파라미터가 동일하고 학습 세트 구성만 다르다.
| 조건 | 환경 수 | trajectory 총량 | 환경당 trajectory | OSWorld-Verified |
|---|---|---|---|---|
| narrow | 10 | 3K | 300 | 57.8 |
| mid | 80 | 3K | 38 | 58.8 |
| broad | 80 | 6K | 75 | 60.7 |
두 비교가 서로 다른 요인을 분리한다. narrow와 mid는 데이터 총량을 고정하고 환경 다양성만 바꾸며, mid와 broad는 환경 커버리지를 고정하고 trajectory 양만 바꾼다.
| 비교 | 변화 | 효과 |
|---|---|---|
| narrow에서 mid | 환경 10개에서 80개, 데이터 고정 | +1.0%p |
| mid에서 broad | trajectory 3K에서 6K, 환경 고정 | +1.9%p |
| narrow에서 broad | 환경과 데이터 동시 확대 | +2.9%p |
논문은 두 방향을 서로 보완하는 관계로 읽고 CUA-Gym-Hub의 공학 투자가 정당화되는 이유를 "trajectory 양만으로는 다양한 노출을 대신할 수 없기 때문"이라고 적는다. 이 결론에는 설계상 확인되지 않은 부분이 있다. "환경 10개에 trajectory 6K" 조건이 없어서 trajectory 양만 늘렸을 때 어디까지 회복되는지는 이 ablation으로 판정되지 않는다. 빈 칸이 정확히 그 주장을 검증할 조건이다.
Figure 8 캡션도 조건을 부분만 적는다. "broad가 환경당 trajectory를 4배 적게 쓰면서 narrow를 앞선다"고 쓰는데 총량으로는 broad가 narrow의 두 배(6K 대 3K)를 쓴다. 환경당 비교로는 맞지만 총량 조건을 함께 옮겨야 한다.
창발한 action batching
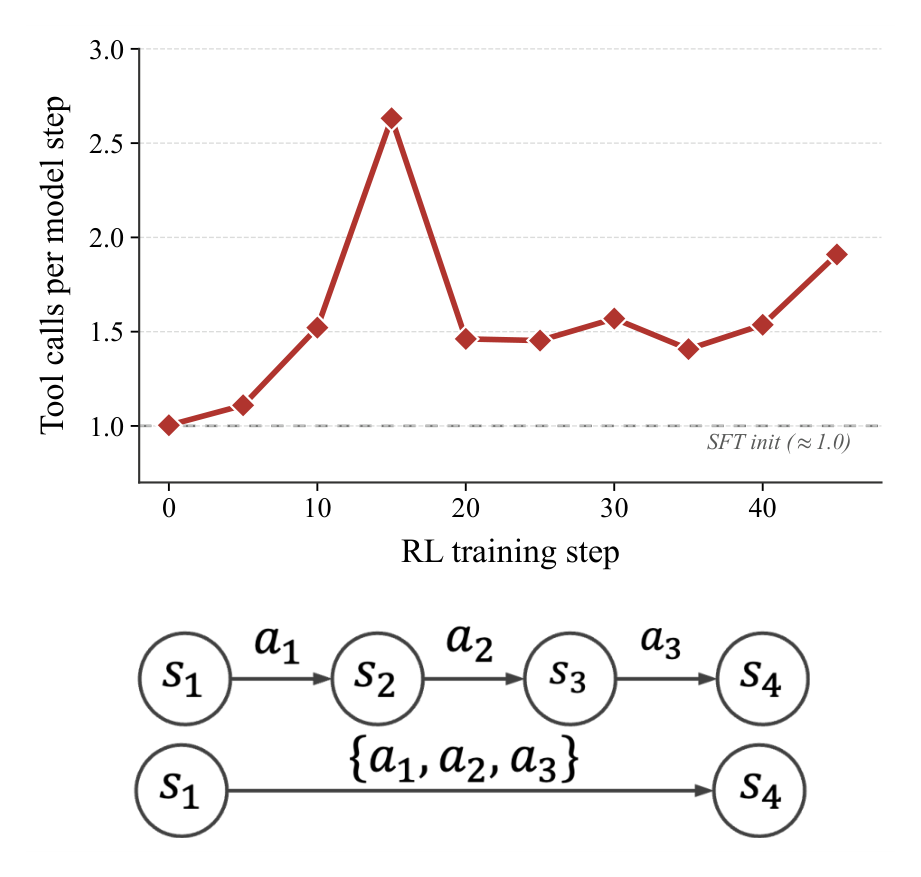
최적화 대상이 아니었는데 나타난 행동이다. SFT 초기 policy는 step당 tool call을 약 1개 내는데 강화학습이 진행되면 이 값이 1.4에서 1.9 사이 대역으로 안정화되고, 같은 task 성능에서 trajectory 길이가 33%에서 45% 짧아진다.
원인은 그룹 정규화 advantage 하의 step 예산 압박으로 본다. 고정된 task별 예산 안에 끝낸 trajectory가 타임아웃된 것보다 높은 상대 reward를 받는다. 따라서 GSPO는 메뉴 순회와 폼 채우기와 키보드 및 클립보드 연쇄 같은 결정적 하위 시퀀스를 한 턴에 몰아넣는 policy를 자연히 고르게 된다.
그래프에는 본문이 언급하지 않는 구간이 하나 있다. step 15에서 2.63까지 올라간 과도 정점이다. 이후 1.4 근처로 내려와 자리 잡는다. 본문은 이를 "약 1개에서 안정적 1.4에서 1.9 대역으로의 지속적 증가"라고만 서술한다.
batching의 미시 구조
부록 D.1이 이 행동을 정량화한다. Qwen3.5-397B-A17B 규모 강화학습 체크포인트를 학습 step 30 시점에 OSWorld-Verified 테스트 분할에서 rollout 1,105회 실행해 총 22,361 model step의 <tool_call> 스트림을 원문 그대로 파싱했다. 이 분포에서 평균은 step당 1.41개다.
| step당 tool call 수 | 비율 |
|---|---|
| 1개 | 69.6% |
| 2개 | 26.7% |
| 3개 | 2.4% |
| 4개 | 0.8% |
| 5개 이상 | 0.5% |
trajectory 단축 효과의 대부분은 2개 묶음에서 온다. 더 긴 묶음은 policy가 국소적으로 결정적이라고 내재화한 연쇄에만 선택적으로 배치된다.
| 길이 | 빈도 | 시퀀스 |
|---|---|---|
| 2 | 3,942 | type → key |
| 2 | 1,052 | mouse_move → scroll |
| 2 | 315 | wait → screenshot |
| 2 | 303 | left_click → screenshot |
| 3 | 158 | type → key → screenshot |
| 3 | 119 | key_down → left_click → key_up |
| 2 | 99 | mouse_move → left_click_drag |
| 2 | 96 | key → screenshot |
| 3 | 54 | mouse_move → scroll → screenshot |
| 4 | 51 | type → key → wait → screenshot |
| 4 | 35 | left_click → type → key → screenshot |
| 3 | 33 | left_click → wait → screenshot |
지배적인 두 패턴은 결정적 입력 연쇄와 연속 스크롤 전주곡이고 둘이 합쳐 전체 묶인 step의 약 75%를 차지한다. 다음 단계는 action과 관측을 짝지은 쌍인데, policy가 결정적 환경 조작과 새 observation을 같은 턴에 끼워 왕복 한 번을 절약한다. 세 개 묶음의 폼 채우기 패턴과 네 개 묶음의 매크로가 긴 꼬리에 나타난다.
보완적 관점이 action별 solo rate다. 그 action이 model step에 단독으로 나타난 비율이다.
| action | 단독 | 전체 | solo 비율 |
|---|---|---|---|
right_click |
144 | 147 | 98.0% |
double_click |
328 | 346 | 94.8% |
triple_click |
630 | 666 | 94.6% |
left_click |
10,132 | 11,187 | 90.6% |
screenshot |
1,023 | 2,319 | 44.1% |
key |
2,351 | 7,356 | 32.0% |
wait |
160 | 615 | 26.0% |
type |
738 | 5,199 | 14.2% |
mouse_move |
55 | 1,279 | 4.3% |
scroll |
0 | 1,112 | 0.0% |
key_down |
0 | 153 | 0.0% |
key_up |
0 | 153 | 0.0% |
left_click_drag |
0 | 104 | 0.0% |
표의 위쪽과 아래쪽이 성격이 갈린다. 포인터 클릭 변종은 94%에서 98% 비율로 단독으로 나온다. 이 action들이 컨텍스트 메뉴나 선택 상태를 드러내고 그 이후 UI를 예측하기 어렵다는 가설과 일관된다. left_click도 90.6%로 높은데 개별 클릭이 보통 화면 전환을 일으켜 policy가 다음 수를 정하기 전에 다시 관측할 필요가 있기 때문이다.
반대로 scroll과 key_down과 key_up과 left_click_drag는 단독으로 나오는 일이 아예 없다. 단독으로는 의미가 없고 더 큰 제스처의 기계적 하위 구성요소로만 존재한다. mouse_move → scroll 연쇄, 수식 키를 누른 상태의 클릭, 드래그 선택이 그 예다. 저자들은 policy의 배치 행동이 "기계적 제스처의 하위 구성요소와 결정적 연쇄는 묶고, 결과가 확률적 UI 상태에 의존하는 action 사이에서는 배치를 유보한다"는 원칙과 맞아떨어진다고 읽는다.
의미는 두 방향이다. 40% 수준의 trajectory 단축은 학습 중 rollout 비용과 배치 시 추론 지연을 직접 줄이고, 이는 구조 변경도 reward shaping 개입도 없이 순전히 강화학습에서 나온 효율 이득이다. 더 넓게는 task 수준 역량을 넘어서는 구조적 효율 행동이 verifiable reward만으로 창발할 수 있음을 보인다. 추론 중심 강화학습에서 관측된 검증과 자기반성의 자발적 창발과 나란한 현상이 action 실행 영역에서 나타난 것으로 저자들은 위치를 잡는다.
생성 비용
Task-Gen과 Generator와 Discriminator와 Filter 네 LLM 구동 단계를 합산하면 수용된 튜플 하나가 Claude Sonnet 4.6 입력 토큰 약 1만 개와 출력 토큰 약 5,000개를 소비한다. 입력 합계는 Generator와 Discriminator의 시스템 프롬프트와 REVIEW.md 누적 컨텍스트가 지배하고, 출력은 Discriminator의 reward 스크립트와 Generator의 setup 및 golden patch가 지배한다.
| 항목 | 튜플당 | 코퍼스 32,112개 기준 |
|---|---|---|
| LLM 비용 | 입력 100만 토큰당 3달러, 출력 100만 토큰당 15달러 기준 0.030 + 0.075, 약 0.11달러 | 수용 비율에 따라 약 3,300에서 3,500달러 |
| VM 비용 | 벽시계 약 45분, Aliyun ECS g8i.xlarge(4 vCPU, 16GB RAM) 인스턴스시간당 약 0.21달러를 2대 유지해 약 0.32달러 | 약 1만 달러 |
VM 시간이 검증 튜플의 한계 비용에서 LLM 비용보다 약 3배 크다. 이중 VM 실행 단계의 내부 분해는 다음과 같다.
| 단계 | 소요 |
|---|---|
| 스냅샷 복원 | 약 2분 |
initial_setup 실행 |
약 10분. 데이터 픽스처 다운로드가 긴 꼬리를 만든다 |
golden_patch 실행 |
약 8분 |
| reward 실행(post-config 포함) | 약 15분. 문서 재렌더와 assertion 파싱이 지배한다 |
| teardown(디스크 이미지 리셋 포함) | 약 10분 |
두 비용을 합치면 코퍼스 전체의 합성 비용이 대략 1만 3천 달러 규모다. 사람이 튜플 하나에 몇 시간을 쓰는 기존 방식과 비교하기 위한 기준선으로 읽을 수 있다.
한계
논문이 명시한 한계
| 한계 | 내용 |
|---|---|
| 최종 상태만 검증 | reward가 검증하는 것은 에이전트가 도달한 마지막 환경 상태지 거기까지 간 과정이 아니다. reward 작성을 확장 가능하게 유지하는 선택이지만, 깔끔하게 편집한 경우와 기존 내용을 지워버렸다가 같은 최종 상태를 다시 만든 경우를 구분하지 못한다 |
| reward hacking 잔여 경로 | information barrier와 금지 패턴 스캔이 위험을 줄이지만 형식적으로 배제하지는 못한다. 지나치게 느슨한 의미 검사나 성공과 상관관계만 있는 상태 프록시 같은 경로가 남는다 |
| mock의 근사성 | 인증 흐름, 서드파티 연동, 네트워크 지연, rate limit, 드문 서버측 장애 상태는 현재 mock 표면 밖이다 |
| 단일 시드 | 가장 큰 강화학습 실행은 연산 비용 때문에 시드 하나로만 보고했다. 저자들은 이를 "검증된 task와 환경 규모가 이 구간에서 가치 있다"는 근거로 읽되 파이프라인의 최종 천장이나 배포 견고성을 말하는 근거로는 읽지 말라고 명시한다 |
논문이 다루지 않은 범위
작은 모델의 도메인 하락이 별도 절로 다뤄지지 않는다. A3B에서 vlc가 24.5%p, thunderbird가 13.4%p, chrome이 8.7%p 떨어졌는데 한계 절에는 이 현상이 없다. 데이터를 어떻게 구성하고 도메인을 어떻게 균형 잡을지가 과제로 남는다.
환경 다양성과 데이터 양의 상호작용도 ablation 설계가 절반만 덮는다. 앞서 본 대로 "환경 10개에 trajectory 6K" 조건의 빈 칸이 정확히 논문의 결론 문장을 검증할 자리다.
Figure 6b의 category 도넛에 있는 "Gymnastic 6%" 항목은 정의가 논문 어디에도 나오지 않는다. Single-App과 Cross-App은 A.2.2의 task type 차원에 대응하지만 세 번째 항목은 대응하는 서술이 없다.
논문 내적 불일치
부록까지 대조하면 본문과 표와 그림 사이에 어긋나는 지점이 여럿 나온다. 수치를 인용할 때 어느 쪽을 기준으로 삼을지 미리 정해두는 편이 안전하다.
| 항목 | 한쪽 | 다른 쪽 | 판단 |
|---|---|---|---|
| 코퍼스 총량 | 본문과 Figure 6c와 Table 9와 Table 10이 32,112 | Figure 6b 도넛 중심 라벨과 Table 13 합계가 32,122 | 32,112를 쓴다. Table 10의 행 합계가 정확히 32,112로 맞는다 |
| advantage 정규화 | 본문 식(1)이 | 부록 C.3.3이 , divide_by_std=False |
부록을 쓴다. 구현 설정값이 명시되어 있다 |
| KL 페널티 | 본문 식(1)에 항이 있다 | Table 6이 , 참조 모델을 아예 로드하지 않는다 | 보고된 실행에는 KL 항이 없다 |
| mock 앱 수 | 본문과 Table 3 캡션이 94종 | Table 3이 열거하는 식별자를 세면 98개 | 공개 규모는 94로 보고된 값을 쓴다. 열거 개수 차이의 원인은 논문에 설명이 없다 |
| Figure 10과 Table 3 | Figure 10이 figma를 32종 중 하나로 표시 |
Table 3의 전체 목록에 figma가 없다 |
목록 쪽이 전체 인벤토리로 선언되어 있어 어긋난다 |
| 데이터 스케일링 순서 | 본문이 "세 곡선의 상대 순서가 학습 내내 보존된다" | Figure 7에서 step 35 이전에는 3K가 12K보다 높다 | 그림을 쓴다. 최종 정점 순서는 데이터 규모와 맞지만 "내내 보존"은 성립하지 않는다 |
| SFT 초기값 | Figure 5가 A3B base 54.5를 "SFT-initialized base"로 지칭 | Figure 7이 SFT init을 0.53으로 표시 | 두 값이 다르다. Figure 5b의 54.5는 Qwen3.5-35B-A3B base 항목으로도 올라 있다 |
| Figure 5 캡션의 최대 이득 | 캡션이 libreoffice_calc와 multi_apps와 vs_code를 최대 이득으로 지목 |
같은 그림의 A3B vs_code는 +0.0%p로 가장 작다 |
그림 수치를 쓴다 |
| Figure 5 패널 구성 | 캡션이 (a)를 A3B 대 base 비교로만 서술 | 그림에는 A3B와 A17B 두 패널이 있다 | 그림에 두 패널이 있다 |
| 리프당 task 최소치 | A.2.3이 "모든 리프가 최소 25개 task" | A.2.6이 "Pass 1은 리프당 지시문 2개를 목표로 A.2.5의 리프별 최소치를 만족" | 어긋난다. 게다가 A.2.5에는 리프별 최소치 조항이 없다 |
| 앱당 튜플 하드 제약 | A.2.5가 "앱당 검증 튜플 1,000개 이상" | 환경 110개에 1,000개면 11만 개로 코퍼스 32,112개를 넘는다 | 산술이 성립하지 않는다 |
| 도메인 카테고리 수 | A.2.2가 "O*NET에 맞춘 10개 카테고리" | Table 2가 SOC 대분류 14종을 매핑한다 | 두 값이 다르다 |
| Table 10 행 구성 | 캡션이 "task 10개 미만인 두 도메인(Other, Web Browsing)을 행에서 뺐다" | 행 합계가 정확히 32,112로 전체 코퍼스와 같다 | 뺐다면 합계가 전체보다 작아야 한다 |
| Table 9 합계 | 시나리오별 값을 더하면 32,110 | 코퍼스는 32,112 | 2개 차이가 남는다 |
| Table 11 항목 수 | 캡션이 "top-20 명령형 동사" | 실제 열거는 18개 | 2개가 비어 있다 |
| state API | Figure 2가 GET /state, POST /reset, POST /inject, GET /diff |
부록 B.3.1이 POST /post, GET /go, GET /state, POST /upload |
부록을 쓴다. 엔드포인트 계약이 명세 형태로 적혀 있다 |
| 환경 스케일링 결론 | 본문이 "trajectory 양만으로는 다양한 노출을 대신할 수 없다" | ablation에 "환경 10개에 trajectory 6K" 조건이 없다 | 설계상 확인되지 않는 추론이다 |
| Figure 8 캡션 | "broad가 trajectory를 환경당 4배 적게 쓰면서 narrow를 앞선다" | broad는 총량으로는 narrow의 2배(6K 대 3K)를 쓴다 | 환경당 비교로는 맞지만 총량 조건을 함께 적어야 한다 |
| Figure 9 서술 | 본문이 "1개에서 1.4에서 1.9 대역으로의 지속적 증가" | 그림에 step 15의 2.63 과도 정점이 있다 | 그림에 과도 구간이 있다 |
| 데스크톱 앱 수 | 본문이 16종(94 + 16 = 110) | Figure 6a의 Desktop Applications 상자에 아이콘 15개 | 그림은 대표 표시일 수 있으나 개수가 다르다 |
| 최상급 주장 | 초록과 서론이 오픈소스 state-of-the-art를 주장 | Figure 5b에서 오픈소스 Kimi-K2.6이 73.1로 CUA-Gym-A17B의 72.6보다 높다 | "각자의 규모대에서"라는 조건을 반드시 함께 옮긴다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| RLVR | reinforcement learning with verifiable rewards. 코드로 채점 가능한 reward를 쓰는 강화학습 post-training |
| information barrier | Generator의 스크립트와 작업 디렉토리를 Discriminator에게 감추는 프로세스 수준 격리. reward가 setup 절차 대신 task 의미를 검사하게 만드는 장치 |
| golden state | task를 올바로 수행했을 때 도달해야 할 정답 환경 상태. reward 함수의 방향을 검사하는 기준점 |
| state injection | task별 JSON 초기 상태를 주입해 같은 mock 구현으로 여러 task 세계를 만드는 설계 |
| trajectory slicing | rollout 하나에서 오래된 스크린샷만 결정적 플레이스홀더로 접어 여러 학습 샘플을 만드는 컨텍스트 관리 기법 |
| GSPO | Group Sequence Policy Optimization. 중요도 비율을 토큰이 아니라 시퀀스 단위로 잡는 강화학습 알고리즘 |
| action batching | 한 턴에 여러 tool call을 묶어 내보내는, 학습 중 창발한 행동 |
| solo rate | 어떤 action이 model step에 단독으로 나타난 비율. 묶여도 안전한 action을 가르는 지표 |
관련 페이지
- xlang-ai/CUA-Gym: 공식 코드 저장소. 이 페이지가 다루는 파이프라인을 실제로 실행하는 명령과 mock 상태 API 규약과 자체 배포 절차를 담당한다
- CUA-Gym Dataset (xlangai/CUA-Gym): Hugging Face 배포판. 공개된 데이터의 구성과 릴리스 통계와 실행 안전 주의사항을 담당한다
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments: 이 논문의 주 평가 벤치마크 원 논문. 2024년의 12.24%가 출발점이었다는 대비가 여기서 나온다
- xlang-ai/OSWorld: OSWorld 논문 저자 조직(xlang-ai)의 환경과 벤치마크 저장소. OSWorld-Verified 개정 내역과 이전 버전 점수를 직접 비교하면 안 되는 이유를 담고 있다
- Agent Lightning v1.0: Towards Harnessed Agentic RL: harness를 학습 루프에 끌어들일 때 생기는 advantage 계산과 loss normalization 문제를 정리한 연구. CUA-Gym의 trajectory slicing과 표준편차 정규화 비활성화 결정이 같은 문제 공간에 있다
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: 에이전트가 harness를 스스로 갱신할 때 역량 예산을 어디에 쓸지 가른 연구. CUA-Gym이 코딩 에이전트 harness로 데이터를 만든다는 점과 맞물린다
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 시스템의 실패 유형 분류. Orchestrator와 Generator와 Discriminator 3자 구조의 위험 지점을 짚는 데 참고
- Compiling Agentic Workflows into LLM Weights: 오케스트레이션을 모델 가중치로 컴파일하는 방향. CUA-Gym이 scaffold를 유지한 채 policy만 학습시키는 것과 대비된다
- 용어집: Agents (Terminology Glossary): tool call과 오케스트레이션과 서브에이전트 표기 기준
- 용어집: Physical AI (Terminology Glossary): policy와 reward와 rollout과 trajectory와 시연 데이터 표기 기준