LLMs · REPO · 2026
Laya
요약
Laya는 텍스트를 생성하지 않고 타입이 정해진 질문에 확률로 답하는 decision model이자 그 Python 패키지다. 입력 state 하나와 choice, score, noul 세 타입의 질문 묶음을 받아 질문 전체를 한 번의 forward pass로 처리하고, 레이블이나 수준이나 참일 확률을 반환한다. T4 GPU에서 질문 하나에 33ms, 묶어서 처리하면 질문당 7.2ms가 걸린다.
저장소는 TypeSafe AI가 닫힌 API로 공개한 Jev를 공개 가중치로 재현하려는 프로젝트로 읽힌다. 질문 타입 이름, HTTP 프로토콜(POST /v1/systemone), 응답 스키마, RLCD라는 학습 이름을 Jev와 공유하고, 벤치마크 절 대부분이 Jev의 공개 수치와 비교한다. 다만 Jev 수치는 제3자가 공개한 값이며 저장소가 직접 측정하지 않았다고 README와 BENCHMARKS가 반복해서 밝힌다.
배포 단위는 세 checkpoint와 Router다. 영어용 ModernBERT-large, 다국어용 mmBERT-base, 특정 결정 워크플로에 fine-tuning한 ModernBERT-large를 두고, Router가 입력의 문자 체계와 언어를 보고 요청마다 checkpoint를 고른다. 그 위에 batch 처리, 긴 문서 스캔, JSON schema 결정, 신뢰도 기반 기권, LangChain과 MCP 통합, Jev 호환 서버가 올라간다.
README의 특징은 강점만큼 한계를 길게 적는다는 점이다. 기본 checkpoint는 typed-decisions 벤치마크에서 zero-shot으로 무작위 수준에 가깝고, 20개 넘는 선택지에서는 Jev에 크게 뒤지며, 두 checkpoint 모두 과신(over-confident) 상태로 배포된다. 저자는 Laya를 zero-shot 결정 엔진이 아니라 fine-tuning으로 특화할 빠른 기반이라고 규정한다.
배경
LLM에게 분류나 라우팅을 맡기면 문자열을 생성한 뒤 그것을 다시 파싱해야 한다. 생성 결과가 정해진 레이블 밖으로 벗어날 수 있고, 답을 얼마나 믿을지에 대한 숫자도 따로 얻기 어렵다. 또한 토큰을 하나씩 생성하므로 짧은 판단 하나에도 수백 ms가 든다.
TypeSafe AI의 Jev는 이 문제를 "System One model"이라는 범주로 풀었다. 분류, 라우팅, 점수화처럼 확장된 추론이 필요 없는 판단을 타입이 정해진 질문으로 표현하고, 모델이 선택지별 calibration된 확률을 병렬로 반환하게 했다. calibration은 모델이 낸 확률값이 실제 정답률과 맞도록 맞추는 성질이다. 예를 들어 0.9로 답한 판단이 실제로 약 90% 맞으면 calibration이 잘 된 것이다.
Jev는 닫힌 API이고 입력 100만 토큰당 0.042달러를 받는다. Laya는 같은 인터페이스를 Apache 2.0 가중치로 제공하며 자체 호스팅 비용 외에는 무료다. 그래서 저장소의 서버는 Jev의 wire protocol을 그대로 따르고, 기존 Jev 클라이언트(예: Haskell의 hs-jev)는 baseUrl만 바꾸면 Laya를 호출할 수 있다.
핵심 개념
non-autoregressive는 토큰을 하나씩 이어 붙여 생성하지 않고 입력 전체를 한 번 읽어 출력을 내는 방식을 말한다. Laya는 인코더 위에 decision head를 올린 구조라 생성 단계가 없다. README는 이 점 때문에 파싱할 문자열도, 환각으로 만들어질 문자열도 없다고 설명한다.
state는 판단 대상이 되는 입력이다. 문자열, 사전, 목록 모두 가능하며 이메일, 지원 티켓, JSON 문서가 대표적이다. 질문은 state에 대해 무엇을 판단할지를 타입과 함께 적은 것이다.
checkpoint는 학습을 마친 모델 가중치와 설정을 묶은 배포 단위다. Laya의 각 checkpoint는 model.safetensors와 rl_agent_config.json을 함께 담고, rl_agent_config.json에 temperature와 option layout 같은 설정이 들어간다.
RLCD는 strictly proper scoring rule을 reward로 쓰는 강화학습으로 결정 확률을 학습하는 방법이다. strictly proper scoring rule은 모델이 자기가 믿는 확률을 그대로 보고할 때만 기대 점수가 최대가 되는 채점 규칙이다(Brier score, log score 등). README는 이 학습 때문에 confidence가 통계적 의미를 갖는다고 쓰지만, 같은 README가 배포 상태의 checkpoint는 과신한다고도 적는다.
ECE(expected calibration error)는 확률 구간별로 평균 confidence와 실제 정확도의 차이를 평균한 지표다. 0에 가까울수록 calibration이 좋다. temperature scaling은 softmax 앞의 logit을 하나의 상수(temperature)로 나눠 분포를 평평하게 하거나 뾰족하게 해서 ECE를 줄이는 사후 보정이다. temperature가 양수인 한 argmax는 바뀌지 않으므로 정확도는 그대로다.
방법
세 가지 질문 타입
Laya의 질문은 type, instructions, criteria 세 필드로 쓴다. 질문 타입은 아래 세 가지뿐이고, 나머지 기능은 모두 이 세 primitive를 조합해 만든다. 소프트웨어 문맥의 primitive는 더 작게 나누지 않고 조합의 재료로 쓰는 기본 구성 요소를 말한다.
| primitive | 출력 | criteria 형식 | 용례 |
|---|---|---|---|
choice |
선택 레이블, 선택지별 확률, confidence | 레이블과 설명의 사전 | 부서 라우팅, intent 분류, 주제 분류 |
score |
서열 척도의 기대 수준, 분포, confidence | 수준 설명의 목록 | 불만 수준, 티켓 긴급도, 피해 심각도 |
noul |
P(true), 0.0~1.0 | 생략 가능, 쓰면 true와 false 키 |
피싱, 스팸, jailbreak, 이탈 위험 |
README의 빠른 시작 예제는 세 타입을 한 호출에 섞는다. 이중 청구와 환불을 요구하며 해지를 언급하는 메시지에 대해 department(billing, technical, other 중 선택), urgency(not urgent, soon, blocking 세 수준), churn_risk(해지 위협 여부)를 묻는다. 결과는 department가 billing이고 churn_risk가 참일 확률이며, routing.model은 english다.
응답 구조는 일정하다. result["answers"][qid]에 타입별 값이 들어가고, 같은 사전에 confidence와(choice, score의 경우) probabilities가 붙는다. score의 값은 수준별 확률의 기대값이라 정수가 아닐 수 있다. 예를 들어 0~2 척도에서 1.84처럼 나온다. result["routing"]은 어느 checkpoint가 어떤 이유로 답했는지를 담는다.
noul은 Bernoulli에서 온 이름으로 참과 거짓 두 slot을 채점해 두 번째 slot의 확률을 돌려준다. 모델에 보이는 두 slot의 표시 텍스트는 기본이 false와 true이고, labels 사전으로 표시 텍스트만 바꿀 수 있다. labels는 정확히 false, true 두 키를 가져야 하며 값은 서로 다른 비어 있지 않은 문자열이어야 한다. 표시를 B와 A로 바꿔도 반환값은 여전히 P(true)다.
noul의 criteria 키 검사는 실제 버그에서 나왔다. 예전에는 {"yes": ..., "no": ...} criteria가 조용히 버려지고 기본 표시 텍스트로 답해, 영어 checkpoint가 명백한 긍정 리뷰 3건 중 2건을 틀렸다(#156). 지금은 true, false 외의 키를 거부한다.
세 checkpoint의 역할 분담
세 checkpoint는 인코더와 context 길이와 용도가 다르다.
| checkpoint | 인코더 | 파라미터 | 기본 context | 용도 |
|---|---|---|---|---|
laya |
ModernBERT-large | 4억 2,100만 | 512 | 영어 |
laya-multilingual |
mmBERT-base | 3억 2,200만 | 1,024 (최대 8,192) | 100개 이상 언어, 영어 checkpoint보다 약 2배 빠름 |
laya-typed-decisions |
ModernBERT-large | 4억 2,100만 | 1,024 | typed-decisions 워크플로 |
세 checkpoint를 모두 받으면 약 2.3GB다. 영어 checkpoint는 영어에서 가장 정확하지만 비영어에서 붕괴하고, 다국어 checkpoint는 영어에서 조금 약한 대신 51개 언어 중 48개에서 무작위의 3배를 넘는다. typed-decisions checkpoint는 송장 처리, 보안 사고, 고객 서비스, agent trace 관측 네 워크플로의 결정 데이터로 fine-tuning한 모델이다.
Router의 판정
Router가 판정하는 질문은 하나다. 영어 checkpoint가 이 state를 읽을 수 있는지를 묻는다. 내장 검출기는 문자 체계 비율과 기능어 휴리스틱만 쓰는 순수 Python 코드라 외부 의존성이 없고 0.5ms 미만에 끝난다.
판정 순서는 다음과 같다. 앞 단계가 결정하면 뒤 단계는 실행되지 않는다.
- 호출자가
model=이나task=로 checkpoint를 지정한다. - 질문 id가 typed-decisions 워크플로와 일치한다 (
auto_task_detection사용 시). - 명시적
lang=이 언어를 정한다. lang_guess가 영어인지 아닌지를 알려 준다.- 내장 검출기가 문자 체계와 언어를 판정한다.
- 단서가 없으면
default로 간다.
result["routing"]은 model, repo, reason, detection, workflow 다섯 키를 항상 담는다. 예를 들어 힌디어 입력의 reason은 데바나가리 문자가 100%라 영어 checkpoint가 읽을 수 없다는 설명이고, 독일어 입력은 라틴 문자지만 언어가 'de'로 보인다는 설명을 받는다. 1~4단계에서 결정되면 detection은 None이다. router.route(...)를 쓰면 forward pass 없이 이 판정만 얻는다.
짧은 라틴 문자 텍스트는 판정이 어렵다. "Quero cancelar"나 "Esqueci minha senha" 같은 문장에는 언어를 특정할 단서가 거의 없다. 0.4.0부터 이런 텍스트는 다국어 checkpoint로 간다. 영어 트래픽이 많은 서비스라면 Router(default="english")나 서버 환경변수 LAYA_DEFAULT_MODEL=english로 되돌린다. README는 영어에서 영어 checkpoint가 0.820, 다국어 checkpoint가 0.710이므로 손익분기가 영어 트래픽 약 62%라고 계산한다.
이미 언어 식별 모델(fastText, CLD3 등)을 운영한다면 lang_guess로 그 결과를 넘긴다. 언어 코드나 state를 받는 callable 모두 허용된다. 이 힌트는 영어 여부만 결정한다. en, eng, english로 시작하는 코드는 영어 checkpoint로, 다른 언어 코드는 다국어 checkpoint로 보낸다. None이나 언어를 가리키지 않는 코드는 기권해 내장 검출기로 넘긴다.
기권 대상 코드에는 C, POSIX, C.UTF-8, und, zxx, mul이 있다. C.UTF-8은 공식 Python Docker 이미지의 기본 $LANG이라, 예전에는 $LANG을 그대로 넘기면 모든 요청이 다국어 checkpoint에 고정되는 문제가 있었다. en_US와 en_US.UTF-8은 영어로 읽으므로 사용자 환경의 $LANG은 그대로 넘겨도 된다.
메모리 관리와 preload
checkpoint를 새로 만드는 비용은 초 단위이고 언어 검출 비용은 마이크로초 단위다. 그래서 Router의 기본 설정은 lazy 적재에 max_loaded=2로, 자동 라우팅이 고르는 english와 multilingual 두 개를 LRU 방식으로 상주시킨다. 한 언어만 들어오는 서비스는 두 번째 checkpoint를 만들지 않으므로 비용이 없다.
| 배포 방식 | 요청당 지연 | 모델 재적재 |
|---|---|---|
Router() (lazy, max_loaded=2) |
언어별 첫 적재 이후 전환 시 검출만(1ms 미만) | 언어가 처음 나타날 때 1회 |
Router(max_loaded=1) |
언어 전환마다 7~10초 | 전환마다 1회 |
Router(preload=True) |
GPU 32.8ms, CPU 193~464ms | 없음 |
max_loaded=1의 재적재 비용은 CPU 중앙값 7.4초, T4 10.3초였다. Figure 3의 오른쪽 아래 막대는 같은 현상을 혼합 언어 작업 부하로 보여 준다. 비영어 비율이 10%, 30%, 50%로 늘수록 lazy 설정이 호출당 2,316ms, 3,594ms, 3,574ms로 늘어나는 반면 preload 설정은 1,005ms, 890ms, 745ms를 유지해 2.3~4.8배 차이가 난다.
서버라면 preload가 정답이라고 README는 쓴다. 토크나이저는 프로세스당 한 번만 파싱해 재사용하지만(다국어 tokenizer.json만 34MB, 어휘 25만 6천 개), 재적재 자체는 여전히 가중치를 다시 읽는다. 이미 만든 agent가 있으면 router.attach("english", existing_agent)로 붙여 VRAM 중복을 피한다.
Batch 처리와 길이 정렬
predict는 호출당 state 하나를 처리하므로 GPU의 batch 차원 대부분이 놀게 된다. 같은 질문으로 많은 state를 채점할 때는 predict_batch가 state들을 공유 forward pass에 넣는다. 결과는 입력 순서대로 정렬되고 형태도 predict와 같다. batch_size로 한 pass의 크기를 제한해 최대 메모리를 묶을 수 있다.
길이 정렬(sort_by_length=True)은 padding 낭비를 줄인다. forward pass는 안에 든 모든 state를 가장 긴 state 길이로 padding하므로, 두 줄짜리 요청이 두 문단짜리 요청과 같은 pass에 들어가면 계산 대부분이 padding에 쓰인다. 길이가 비슷한 state끼리 먼저 묶으면 이 낭비가 줄어든다. 이 옵션은 1 < batch_size < len(states)일 때만 의미가 있다.
| 조건 | 정렬 전 | 정렬 후 | 배율 |
|---|---|---|---|
CLI, Yelp 리뷰 128건(69~2,293자), --batch-size 8, Apple silicon |
41.25초 | 29.23초 | 1.42배 (네 쌍 1.39~1.44배), 결정 128건 동일 |
웹 서버, 리뷰 64건, batch_size: 8, MPS |
5.35초 | 3.04초 | 1.77배, 레이블 64/64 동일 |
ONNXAgent, 지원 티켓 80건, Apple M1, batch_size=4 |
53.7초 | 36.3초 | 약 1.48배, 결정 변화 0/80 |
| research, 합성 다국어 티켓 1만 건 | 2.15배 |
웹 서버 사례에서 batch_size: 8만 준 경우는 4.95초였다. 즉 크기를 정한 batch 자체의 이득은 작고, 1.66배의 추가 이득은 길이 정렬에서 나온다.
GPU에서는 batch가 처리량을 크게 올린다. RTX 5060 Ti에서 결정당 지연이 하나씩 처리할 때 약 10ms에서 batch로 약 1ms가 됐다(9~10배). CPU에서는 batch 크기만 키워서는 빨라지지 않을 수 있고, 길이 정렬이 padding을 줄여 도움이 된다. batch 모양이 바뀌면 부동소수점 결과가 미세하게 달라질 수 있으므로 결정 경계 근처의 임계값은 실제 작업 부하로 확인해야 한다.
Router 수준의 predict_batch는 한 단계를 더 한다. 전체 요청을 먼저 라우팅하고, checkpoint별로 묶은 뒤 같은 질문 스키마와 같은 토큰 예산끼리 다시 묶어 Agent.predict_batch()로 보내고, 결과를 원래 순서로 돌려놓는다. max_loaded=1처럼 상주 checkpoint가 적을 때 언어가 섞인 요청을 순서대로 처리하면 checkpoint 교체가 반복되는데, 이 묶음 처리가 그 교체를 줄인다.
긴 문서 처리
기본 predict는 max_len을 넘는 state를 window 하나로 자르고 나머지를 조용히 버린다. 일반 state는 첫 window를, 대화 목록은 마지막 window를 남긴다. 긴 계약서나 스레드에서 결정적 문장이 뒤쪽에 있으면 이 잘림 때문에 답이 틀린다.
predict_long은 state를 겹치는 window로 나눠 전부 채점하고 질문별로 집계한다. 집계 규칙은 질문 타입마다 다르다.
| 타입 | 집계 규칙 | 이유 |
|---|---|---|
noul |
가장 강한 window | 어느 window든 지지하면 진술이 성립한다 |
choice, score |
가장 확신이 높은 window | 평균을 내면 중립적인 다수 window가 결정적 구간을 본 한 window를 이긴다 |
기본 window 크기는 max(64, max_len - head_max_len - 8)이다. 영어 checkpoint는 512/192 기본값에서 312 토큰, 나머지 두 checkpoint는 1,024/256에서 760 토큰이 된다. window를 작게 하면 짧은 결정적 구간이 window에서 차지하는 비율이 커져 잘 잡히고, 크게 하면 맥락과 처리량에 유리하다.
반환 확률은 결정한 window의 값이지 문서 전체에 대해 calibration된 값이 아니다. noul의 최댓값은 신호가 없어도 window 수가 늘수록 올라가고, choice는 결정적인 구간이 없으면 확신이 높은 중립 window를 고를 수 있다. 그래서 각 답에 answer["window"](index, token_start, token_end, count)를 붙여 답이 어느 구간에서 나왔는지 확인하게 한다. 예시 출력에서는 14개 window 중 13번째, 4,680~5,432 토큰 구간이 환불 질문을 결정했다.
다른 방법은 다국어 checkpoint의 context를 넓히는 것이다. laya-multilingual은 RoPE 기반 mmBERT 인코더라 max_len=8192로 8,192 토큰까지 읽는다. 배포 기본값 1,024는 긴 문서를 자르므로 직접 지정해야 하고, 영어 위주의 긴 문서는 Router가 영어 checkpoint로 보내므로 model="multilingual"도 함께 지정한다.
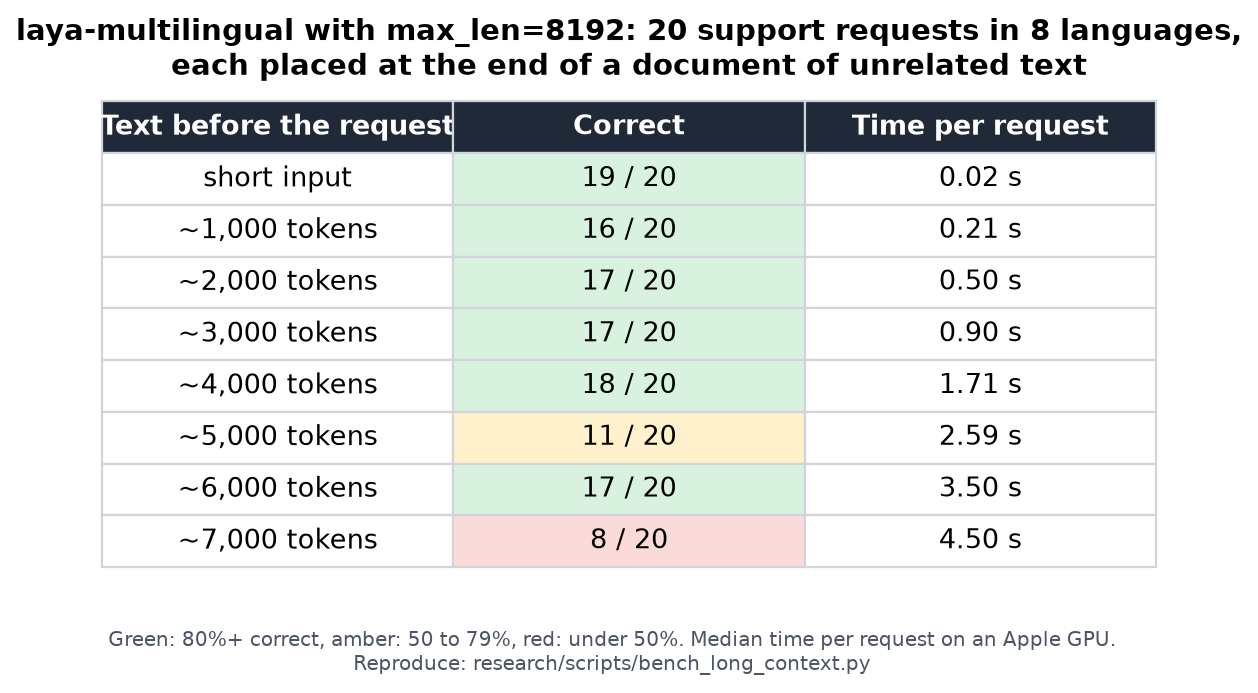
측정 결과 앞쪽 텍스트가 약 4,000 토큰까지는 20건 중 16~18건을 맞혔다. 약 5,000 토큰에서 11건, 약 6,000 토큰에서 17건, 약 7,000 토큰에서 8건으로 그 너머는 변동이 크다. 짧은 입력은 max_len=8192에서도 답이 같고 속도도 같다. 속도는 상한이 아니라 실제 입력 길이를 따르며, 4,000 토큰 입력은 Apple GPU에서 약 1.7초다.
토큰 예산과 많은 선택지
입력 시퀀스는 두 부분으로 나뉜다. 질문과 선택지를 렌더링한 head와, 남은 공간에 들어가는 state다. head 예산의 상한이 head_max_len이다. 이 값은 상한일 뿐 실제 head 길이가 아니어서, 렌더러는 필요한 만큼만 head를 채우고 state 공간은 실제 head 길이로 계산한다(room = max_len - head_len - 1).
선택지가 적으면 상한 기준 계산은 state 공간을 과소평가한다. 영어 checkpoint(max_len 512, head_max_len 192)에서 예시 부서 질문은 48 토큰 head를 만들어 state에 463 토큰을 남긴다. 상한으로 계산한 320 토큰보다 많다. 다국어 checkpoint에서는 같은 질문이 45 토큰 head, state 978 토큰이다.
선택지가 많으면 반대로 과대평가한다. 선택지당 토큰은 max(4, (head_max_len - 16) // k)로 최소 4 토큰이 보장되므로, 대략 head_max_len / 4개를 넘으면 head가 상한보다 커진다. 이때 상한 기준으로 state를 맞춰 넣으면 잘린다.
| 설정 | 선택지 k | head | 실제 state 공간 | 상한 기준 계산값 |
|---|---|---|---|---|
laya, max_len=512 |
77 | 319 | 192 | 320 |
laya, max_len=512 |
100 | 411 | 100 | 320 |
laya-multilingual, max_len=1024 |
100 | 411 | 612 | 768 |
예산 문제는 정확도에도 직접 나타난다. 77개 레이블의 Banking77에서 선택지당 3~4 토큰밖에 받지 못하면 레이블 텍스트가 서로 구분되지 않는다. README는 많은 선택지를 다루는 방법으로 네 가지를 든다.
- 예산 확대:
head_max_len=512,max_len=1024이상으로 늘린다. 요청 단위로도 줄 수 있어 넓은 질문 하나만 예산을 키울 수 있다. - 임베딩 shortlist:
predict_shortlist가 임베딩 유사도 top-k 레이블만 남겨 한 번 forward pass한다.embed_fn_from_agent는 이미 적재한 인코더를 mean-pooling해 쓰므로 추가 모델이 필요 없다. - 수동 분할: 레이블 집합을 거친 질문과 세부 질문 두 단계로 나눈다.
- tournament:
predict_tournament가 레이블을 최대 16개씩 묶어 모든 묶음을 같은 forward pass에서 답하고, 묶음 승자끼리 다시 묻는다. 256개 레이블까지predict두 번으로 끝나고 임베딩 모델이 필요 없다.
tournament의 측정값은 다음과 같다. 영어 checkpoint, 각 데이터셋 전체 테스트 분할 기준이며 지연은 질문 하나의 약 2배다.
| 데이터셋 | 레이블 수 | 기본 | tournament | ECE 변화 |
|---|---|---|---|---|
| BANKING77 | 77 | 0.430 | 0.610 | 0.30 |
| CLINC150 | 150 | 0.625 | 0.876 | (같은 범위) |
| MASSIVE intent | 60 | 0.515 | 0.569 | (같은 범위) |
레이블이 늘린 예산 안에 잘리지 않고 들어가면 예산 확대가 tournament보다 낫다. MASSIVE의 60개 레이블은 head_max_len=512에서 0.622, tournament에서 0.590이었다(500행). CLI의 --head-max-len도 같은 효과를 보인다. MASSIVE-INTENT 58개 레이블을 한 질문으로 쓰면 기본 192 토큰에서 24/58, 384 토큰에서 34/58을 맞혔고 요청당 시간은 CPU에서 약 1.4배였다. 더 넓히면 state 공간이 줄어 정확도가 다시 떨어진다.
shortlist는 매 요청마다 바뀌지 않는 선택지 텍스트를 다시 임베딩한다. cached_embed_fn이 최대 4,096개 항목의 LRU 캐시로 이를 피하며, 768차원 인코더 기준 약 12MB를 쓴다. Issue #102 제보자는 top-20 zero-shot shortlist로 BANKING77이 54.3%에서 60.8%로 올랐다고 보고했지만 저장소는 이 수치를 재측정하지 않았다고 밝힌다.
HTTP 서버는 별도로 질문당 choice 선택지를 100개로 제한한다(MAX_CHOICE_OPTIONS = 100, 초과 시 413). 앞 표가 보여 주듯 100개는 이미 head가 상한을 넘는 영역이다.
선택지 순서 편향과 해결 방법
선택지가 놓인 위치가 답을 바꾼다. 저장소는 텍스트가 완전히 같은 선택지 5개를 영어 checkpoint에 보여 주고 slot별 logit을 쟀다. 결과는 [+1.68, +1.47, +0.11, -1.35, -1.91]로, 내용이 같은데도 앞쪽 slot이 크게 유리했다. 다국어 checkpoint는 score에서 반대 방향으로 기운다(#131).
첫 번째 해결책은 호출 쪽 평균이다. 모든 질문 타입은 option_order라는 순열을 받아 선택지를 어느 slot에 둘지 정한다. 확률은 항상 원래 선택지 순서로 반환되므로 이 키는 표시만 바꾼다. k개 선택지라면 k개 회전 순서를 k개 질문으로 넣고 확률을 평균 낸다. Laya는 한 요청의 질문을 한 forward pass에서 처리하므로 이 비용은 k번의 forward pass가 아니라 k개의 행이다. 62개 은행 intent를 20개로 shortlist한 49개 state에서 표시 순서에 따라 답이 바뀌는 비율이 16.3%에서 6.1%로 줄었다.
두 번째 해결책은 순서 불변 checkpoint다. option_layout: "parallel"로 학습하면 모든 선택지가 같은 position id에서 시작하고, 선택지끼리 attention하지 못하며, 지시문의 [SEP]과 state는 가장 긴 선택지 뒤에서 이어진다. decision head에는 위치 인코딩이 없으므로 순서를 바꾸면 logit의 순서만 바뀐다. 아이디어는 Parallel Context Windows(Ratner et al., 2023)가 긴 context에 쓴 방법을 선택지에 적용한 것이다.
| layout | 정확도(원래 순서) | 정확도(섞음) | ECE | 섞어도 같은 답 |
|---|---|---|---|---|
| sequential | 0.779 | 0.767 | 0.153 | 91.7% |
sequential + shuffle_options |
0.757 | 0.750 | 0.136 | 95.0% |
| parallel | 0.764 | 0.764 | 0.143 | 100% |
이 표는 convaiinnovations/laya에서 typed-decisions로 4 epoch fine-tuning한 결과다(T4 한 장, 테스트 결정 2,000건, 각 질문을 무작위 option_order로 다시 물음). parallel layout은 원래 순서 정확도를 0.015 잃는 대신 순서를 섞어도 답이 100% 같다. 다만 arm마다 seed가 하나이고, 같은 레시피의 sequential arm이 두 번 실행 사이에 0.008 움직였다는 점을 README가 함께 적는다.
배포된 세 checkpoint는 모두 기본 sequential layout이다. parallel layout은 laya.train의 TrainConfig(option_layout="parallel")로 직접 학습해야 하고, transformers 5 이상과 eager backend가 필요하다. ONNX 런타임, TileLang fast path, compile=True는 이 checkpoint를 거부한다.
Confidence와 기권 게이트
Laya의 답에는 두 종류의 신뢰도 숫자가 붙는다. 둘의 차이를 모르면 임계값을 잘못 건다.
| 필드 | 정의 | 용도 |
|---|---|---|
confidence |
1에서 정규화 entropy를 뺀 값 | 분포가 얼마나 한 선택지에 몰렸는지 |
answer_confidence |
보고된 답의 확률 max(p) |
temperature scaling이 적합하는 값, 모든 타입 공통의 calibration된 숫자 |
Jev의 confidence는 (n·p_max − 1)/(n − 1)이라 Laya의 confidence와 정의가 다르다. 따라서 Jev에서 쓰던 임계값을 그대로 옮기면 안 된다. 게이트에는 answer_confidence를 쓰라고 README는 권한다.
answer_confidence도 선택지 수에 따라 의미가 달라진다. T4 실행에서 laya의 평균 max(p)는 3지선다 XNLI에서 0.7677, 20지선다 MASSIVE에서 0.9659였다. laya-multilingual은 반대로 0.9152와 0.8055였다. 같은 필드인데 두 checkpoint의 방향이 반대이므로, 평평한 임계값 하나는 질문 모양마다 다른 정확도 목표에서 기권하게 된다.
min_confidence는 이 문제를 반영한 선택형 기권 장치다. predict, predict_batch, system_one, decide, decide_batch에 숫자 하나나 bucket별 사전으로 준다. bucket은 세 답 타입과 네 선택지 대역(2, 3-5, 6-10, 11+)의 조합 12개에 "default"를 더한 것이다. 사전에 없는 bucket은 "default"로 가고, "default"도 없으면 그 bucket은 0.0으로 게이트하지 않는다. 어떤 답도 만들 수 없는 키는 검증 단계에서 거부한다.
임계값은 고르지 말고 적합하라는 것이 README의 지침이다. fit_abstention_thresholds가 temperature 적합과 같은 (qtype, logits, target) 기록을 받아 target_error에 맞는 bucket별 임계값 사전을 반환한다. serving agent에 binning_map이 있으면 함께 넘겨야 한다. 런타임은 게이트 전에 answer_confidence를 binning으로 재보정하기 때문이다. 실측 예로 binning 없이 적합한 임계값은 coverage 50%에서 오류 9.8%를 지켰지만, binning된 confidence와 비교하자 답의 94.5%를 통과시키며 오류 25.6%를 냈다.
게이트를 걸면 모든 답이 abstention 상태를 보고한다.
abstention |
의미 |
|---|---|
passed |
게이트가 실행되었고 answer_confidence가 임계값을 넘었다 |
abstained |
게이트가 실행되었고 임계값 아래였다 (low_confidence: True) |
unevaluated |
게이트가 실행되었지만 쓸 수 있는 confidence가 없었다 (NaN, 누락, bool) |
low_confidence는 게이트가 발동할 때만 쓰이므로 그 부재만으로는 "게이트를 통과함"과 "게이트가 없었음"을 구분할 수 없다. 기권 비율을 계산하거나 게이트가 실제로 적용됐는지 증명하려면 abstention이 필요하다. abstention_threshold는 그 답의 bucket에 적용된 임계값을 남겨, 여러 질문 모양이 섞인 로그도 나중에 다시 나눠 볼 수 있다. min_confidence를 주지 않으면 응답은 이전과 바이트 단위로 같다. 호출하지 않은 기능 때문에 스키마가 바뀌지 않게 한 의도적 설계다.
임계값은 연산 정밀도에도 영향을 받는다. CUDA compute capability 8 이상에서는 checkpoint의 amp_dtype인 bf16을 쓰는데, 60개 state와 checkpoint당 288개 질문에서 bf16은 fp32 대비 확률을 최대 0.073 움직이고 864개 argmax 중 3개를 뒤집었다. fp16은 0.019 이내에 뒤집힘이 없었고 지연은 같았다(LAYA_CUDA_AMP=fp16). 그래서 임계값은 실제 서빙하는 dtype에서 적합하고 측정해야 한다.
load 시점에 temperature는 [0.5, 5.0]으로 clamp되고, 유효하지 않거나 유한하지 않은 값은 중립값 1.0으로 대체된다. 경고가 영향을 받은 항목을 보고하고 원래 값은 agent.temperature_raw에 남는다. 이 fallback은 load 실패를 막을 뿐 calibration을 보장하지 않는다.
Schema 기반 결정
질문 사전을 손으로 쓰는 대신 원하는 출력 모양을 JSON schema나 pydantic 모델로 줄 수 있다. agent.decide(text, schema=...)는 enum 문자열을 choice로, 범위가 있는 정수를 score로, boolean을 noul로 옮겨 한 번의 forward pass로 답하고, schema 모양의 값을 돌려준다. README의 예시는 이중 청구 환불 요청에 대해 {"department": "billing", "urgency": 2, "needs_human": True}를 반환한다.
return_details=True면 필드별 confidence와 확률이 함께 오고, min_confidence에 걸린 필드는 None이 된다. decide_batch는 schema를 한 번만 계획하고 state들이 forward pass를 공유한다.
| 조건 | 하나씩 | batch | 배율 |
|---|---|---|---|
| 영어 티켓 8건, 한 checkpoint, MPS | 2,624ms | 723ms | 3.6배 |
| 영어와 독일어 16건, Router, MPS | 2,977ms | 1,903ms | 1.6배 |
| 같은 두 작업 부하, CPU | 1.6배, 2.0배 |
두 장치 모두에서 batch 결과는 하나씩 처리한 결과와 8/8, 16/16 일치했다.
프리셋
Laya는 바로 쓸 수 있는 질문 묶음 다섯 개를 제공한다.
| 프리셋 함수 | 용도 |
|---|---|
router_questions() |
요청을 작은 모델과 frontier 모델 중 어디로 보낼지 결정 |
guard_questions() |
jailbreak, prompt injection, 유출 탐지 |
moderation_questions() |
유해성, 괴롭힘, 위협 |
triage_questions() |
지원 티켓의 intent, 긴급도, 불만, 이탈 위험 |
email_questions() |
이메일 분류, 스팸, 피싱, 긴급도, 회신 필요 여부 |
jailbreak는 안전 학습을 우회해 모델이 거부해야 할 요청에 응하게 만드는 공격이고, prompt injection은 입력 안에 숨긴 지시로 모델이 원래 지시를 벗어나게 만드는 공격이다. guard_questions()는 이런 입력을 LLM에 넘기기 전에 거르는 가드레일 용도다. 다만 결과 절이 보여 주듯 jailbreak 탐지 정확도는 0.71~0.76 수준이다.
서빙과 통합
Laya는 같은 결정 기능을 여러 경로로 노출한다.
| 경로 | 구성 | 특징 |
|---|---|---|
| CLI | laya "텍스트" --preset triage |
라우팅만 하면 다운로드 없이 ms 단위, --batch, --json, --min-confidence 지원 |
| 웹 GUI | examples/server.py |
두 창 playground와 /predict, /predict/batch JSON API |
| HTTP 서버 | laya-serve |
Jev 호환 /v1/systemone, /v1/systemone/batch(최대 64 state), 환경변수 설정, Bearer 인증 |
| MCP 서버 | laya-mcp-server |
stdio로 도구 8개 제공 |
| LangChain, LangGraph | LayaRouter, LayaGuardrail, LayaDecision |
조건부 edge 라우팅, 가드레일, schema 결정 |
| JavaScript | laya-ts, laya-client |
ONNX 로컬 추론 또는 laya-serve HTTP 호출 |
| Nix | flake와 NixOS 모듈 | 강화된 DynamicUser systemd unit |
MCP는 모델이 외부 도구와 데이터 원천에 표준화된 방식으로 접근하게 하는 프로토콜이다. laya-mcp-server는 laya_predict, laya_predict_batch, laya_route, laya_route_batch, laya_decide, laya_shortlist, laya_preset, laya_status 여덟 도구를 제공해 Claude Desktop이나 Cursor 같은 클라이언트가 타입 판단을 tool call로 부르게 한다. 다국어 티켓 16건에서 batch 도구 한 번이 laya_predict 16번보다 MPS에서 2.1~2.3배, CPU에서 약 1.25배 빨랐고 결정 뒤집힘은 0/16이었다. LAYA_BASE_URL을 주면 예측은 공유 laya-serve로 HTTP 호출하고 라우팅만 로컬에서 한다.
LangChain 통합은 batch 경로에서 의미가 크다. batch()와 abatch()가 목록 전체를 predict_batch로 보내 LangChain 기본 thread pool의 입력당 호출을 대체한다. MPS에서는 동시 torch forward가 프로세스를 중단시키므로 이 대체가 성능뿐 아니라 안정성 문제이기도 하다. Apple M 시리즈에서 16건 라우팅 batch 2.2배, 다국어 24건 Router 2.2배, guard 프리셋 1.8배였고 CPU에서는 하나씩 처리 대비 2.22.4배, thread pool 대비 1.11.5배였다.
HTTP 서버를 Jev 클라이언트에 연결할 때는 세 가지가 다르다.
- 선택지 수: Jev는 질문당 255개를 지원하지만 Laya는 토큰 예산과 100개 가드가 상한이다. 20개 정도를 넘으면 선택지 설명이 잘린다.
- score 수준: 모든 수준에 설명이 있어야 한다.
null수준은 422로 거부한다. - confidence: 앞에서 본 대로 정의가 다르다.
훅 인자 다섯 개(hooks, on_predict_start, on_predict_end, hooks_raise, hooks_timeout)는 서버 쪽에 있어야 하는 callable이라 HTTP 본문으로 오면 422로 거부한다.
예측 훅과 평가 harness
예측 훅(prediction hook)은 결정 과정을 고치지 않고 관찰하거나 바꾸는 확장 지점이다. 훅은 일반 callable이거나 on_predict_start, on_predict_end, on_route, on_load, on_evict, on_error 중 일부를 구현한 객체다. start 훅은 state와 질문을 바꾸거나 ctx.skip(...)으로 캐시된 답을 내고, end 훅은 결과를 바꾼다. 감사 로그, 추론 전 PII 제거, 캐시, 메트릭, 라우팅 재정의에 쓴다. Router에 건 훅은 batch에서도 요청마다 한 번씩 실행되므로 PII 제거 훅이 모든 state를 모델보다 먼저 고친다.
laya-evals는 품질 변화를 손 검사가 아니라 검토 가능한 diff로 만드는 평가 harness다. harness는 모델을 감싸 실행과 검증을 제공하는 환경을 말한다. torch 없이 Python과 numpy만으로 레이블된 데이터셋을 채점하고, choice_accuracy, noul_accuracy, score_mae, ece, mean_confidence, 지연을 전체와 slice별로 보고한다. --min-accuracy, --max-ece, baseline 비교가 실패하면 0이 아닌 종료 코드를 내므로 CI에 그대로 넣을 수 있다.
GPU fast path
laya[fast]는 forward를 TileLang 융합 커널로 바꾼다. 융합 대상은 GEMM과 bias/activation epilogue, GEMM과 GEGLU, residual과 LayerNorm, in-place RoPE, packed QKV를 직접 읽는 sliding-window flash attention이다. 가중치를 bf16으로 상주시키고 (batch, length) bucket마다 CUDA graph를 캡처해, 질문 하나를 처리할 때 Python에서 약 200개 커널을 띄우던 비용을 없앤다.
수치 차이는 작다. 60개 state 고정 집합에서 fast path는 fp32 forward와 최대 0.046, 기본 bf16 경로와 최대 0.076 차이였고 질문 타입별 argmax 일치는 47/48 이상이었다. fp16으로 실행하면 fp32와의 차이가 0.009 이내로 줄어 bf16보다 3~10배 가깝다. CPU와 MPS, 또는 tilelang이 없으면 기본 forward를 쓴다.
compile=True는 load 시 agent.warmup()을 실행해 그래프 컴파일을 시작 시점으로 옮긴다. 시작에 수십 초가 걸릴 수 있다. 자동 warm-up이 실패하면 경고만 내고 compile 설정을 유지하며 eager로 자동 전환하지 않는다. compile_cache=True는 컴파일 결과를 ~/.cache/laya/torchinductor에 남겨 재시작 후에도 쓴다.
설치와 플랫폼
Python 3.10 이상이 필요하다. huggingface_hub 1.x, transformers 5.x, torch 2.14가 모두 3.10을 요구하기 때문이다. 장치는 CUDA, MPS, XPU, CPU 순서로 자동 선택되며, CUDA는 mixed precision을, CPU와 MPS는 fp32를 쓴다.
Intel Mac은 별도 고정이 필요하다. PyTorch가 macOS x86_64 wheel을 2.2.2에서 멈췄고, transformers 5.x는 torch 2.4 이상을 요구하며, torch 2.2.2는 NumPy 1.x로 빌드됐다. 그래서 그대로 설치하면 실행할 수 없는 조합이 잡힌다. numpy<2, torch==2.2.2, transformers==4.57.6으로 고정하면 build_model이 mmBERT의 rope_parameters(두 base 모두 160000)를 4.x 속성으로 옮겨 transformers 5 checkpoint를 그대로 읽는다.
저장소 개발 기기(Intel Mac Pro, AMD Radeon Pro Vega II, MPS)의 측정값은 다음과 같다. 짧은 이메일에 질문 4개, warm-up 후 10회 중앙값이다.
| checkpoint | CPU (28 스레드) | MPS |
|---|---|---|
laya |
453ms (질문당 113ms) | 146ms (질문당 37ms) |
laya-multilingual |
192ms (질문당 48ms) | 121ms (질문당 30ms) |
laya-typed-decisions |
441ms (질문당 110ms) | 145ms (질문당 36ms) |
MPS는 56코어 CPU보다 1.6~3배 빠르고 T4 기준값과 비슷하다. CPU는 16 스레드 근처가 가장 빠르며 기본 28 스레드는 과다 할당이다. 첫 MPS 호출은 Metal 커널 컴파일에 약 13초가 든다.
Fine-tuning
README는 fine-tuning에 가치 대부분이 있다고 쓴다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계다. 저장소는 두 가지 학습 경로를 제공한다.
| 경로 | 환경 | 내용 |
|---|---|---|
| Kaggle 노트북 | 무료 2xT4, DDP | 데이터셋 구축, RLCD 학습, temperature 적합, 평가, Hub 업로드 |
| Apple Silicon 스크립트 | MPS, CPU fallback | 단일 프로세스, micro-batch와 gradient accumulation |
RLCD 학습은 proper scoring rule을 reward로 쓰고 GRPO 방식 policy gradient로 갱신한다. RL 문맥의 policy는 입력을 받아 출력을 정하는 함수이며, 여기서는 decision head가 내는 선택지 분포에 해당한다. 2xT4에서 약 3만 개 질문, 4 epoch에 4~5시간이 걸린다. 16GB MacBook에서는 --micro-batch 1 --grad-accum 32 같은 설정으로 실행하고, 인코더와 decision head 모두 gradient checkpointing으로 activation 메모리를 줄인다.
temperature 처리에 주의점이 있다. 노트북은 타입별(choice, score, noul) temperature 하나를 적합하고 상속된 temperature_by_options를 지운다. 이 bucket 값을 남겨 두면 추론 시 우선 적용되어 새 적합을 덮는다. 또한 노트북의 calibration 표본은 학습 항목에서 나오므로, 개선을 주장하려면 별도의 held-out 데이터로 평가하라고 README는 적는다.
브라우저 에이전트 사례(docs/finetune_browser_agent.md)는 특화의 효과를 보여 준다. 16GB GPU 한 장과 유료 API 없이 Laya를 browser-use/jev-ultrafast의 operation과 target 결정기로 학습했다. 후보 약 45개 중 element top-1 정확도가 zero-shot 0.10에서 0.66으로, 실제 과제 성공률이 0%에서 62%로 올랐고 단계당 17~23ms였다.
결과
Routing이 필요한 이유
Router의 근거는 영어 checkpoint가 비영어에서 틀리면서도 확신한다는 측정이다. T4 공유 벤치마크(17,416 질문, seed 13, choice 질문당 선택지 20개, 언어별 첫 300 테스트 행)의 결과는 다음과 같다.
| 과제 | laya |
laya-multilingual |
Router |
|---|---|---|---|
| MASSIVE intent, 영어 | 0.783 | 0.657 | 0.783 |
| MASSIVE intent, 다른 13개 언어 | 0.306 | 0.451 | 0.451 |
| MASSIVE scenario, 영어 | 0.603 | 0.560 | |
| MASSIVE scenario, 다른 언어 | 0.281 | 0.439 | |
| XNLI, 영어 | 0.860 | 0.843 | 0.860 |
| XNLI, 다른 14개 언어 | 0.521 | 0.731 | 0.731 |
| 사용 가능 언어(무작위 3배 초과) | 23/51 | 48/51 | 48/51 |
| 지연, 질문 1개 (T4) | 39.5ms | 32.8ms | 32.8ms |
| 지연, 질문 10개 batch | 158.6ms | 72.3ms | 72.3ms |
Router는 영어에서 영어 checkpoint의 정확도를, 비영어에서 다국어 checkpoint의 정확도를 그대로 가져온다. 비영어 XNLI에서 영어 checkpoint 대비 0.210 높다.
영어 checkpoint의 실패는 조용하다. 크메르어에서 정확도 0.000에 raw confidence 0.952(clamp 이후 0.705)를 냈고, 평균 confidence는 어떤 정확도 수준에서도 0.885(clamp 이후 0.621) 아래로 내려가지 않았다. 모델 자신의 confidence가 경고를 주지 않으므로 confidence 게이트로는 이 실패를 막을 수 없다. 그래서 라우팅을 forward pass 이전에 해야 한다는 것이 README의 결론이다.
51개 언어
MASSIVE intent 20지선다(무작위 0.050), 51개 언어, 5,100 사례의 결과다.
laya |
laya-multilingual |
|
|---|---|---|
| macro 정확도 | 0.2269 | 0.4008 |
| macro ECE | 0.5709 | 0.3911 |
| 무작위 3배 초과 언어 | 23/51 | 48/51 |
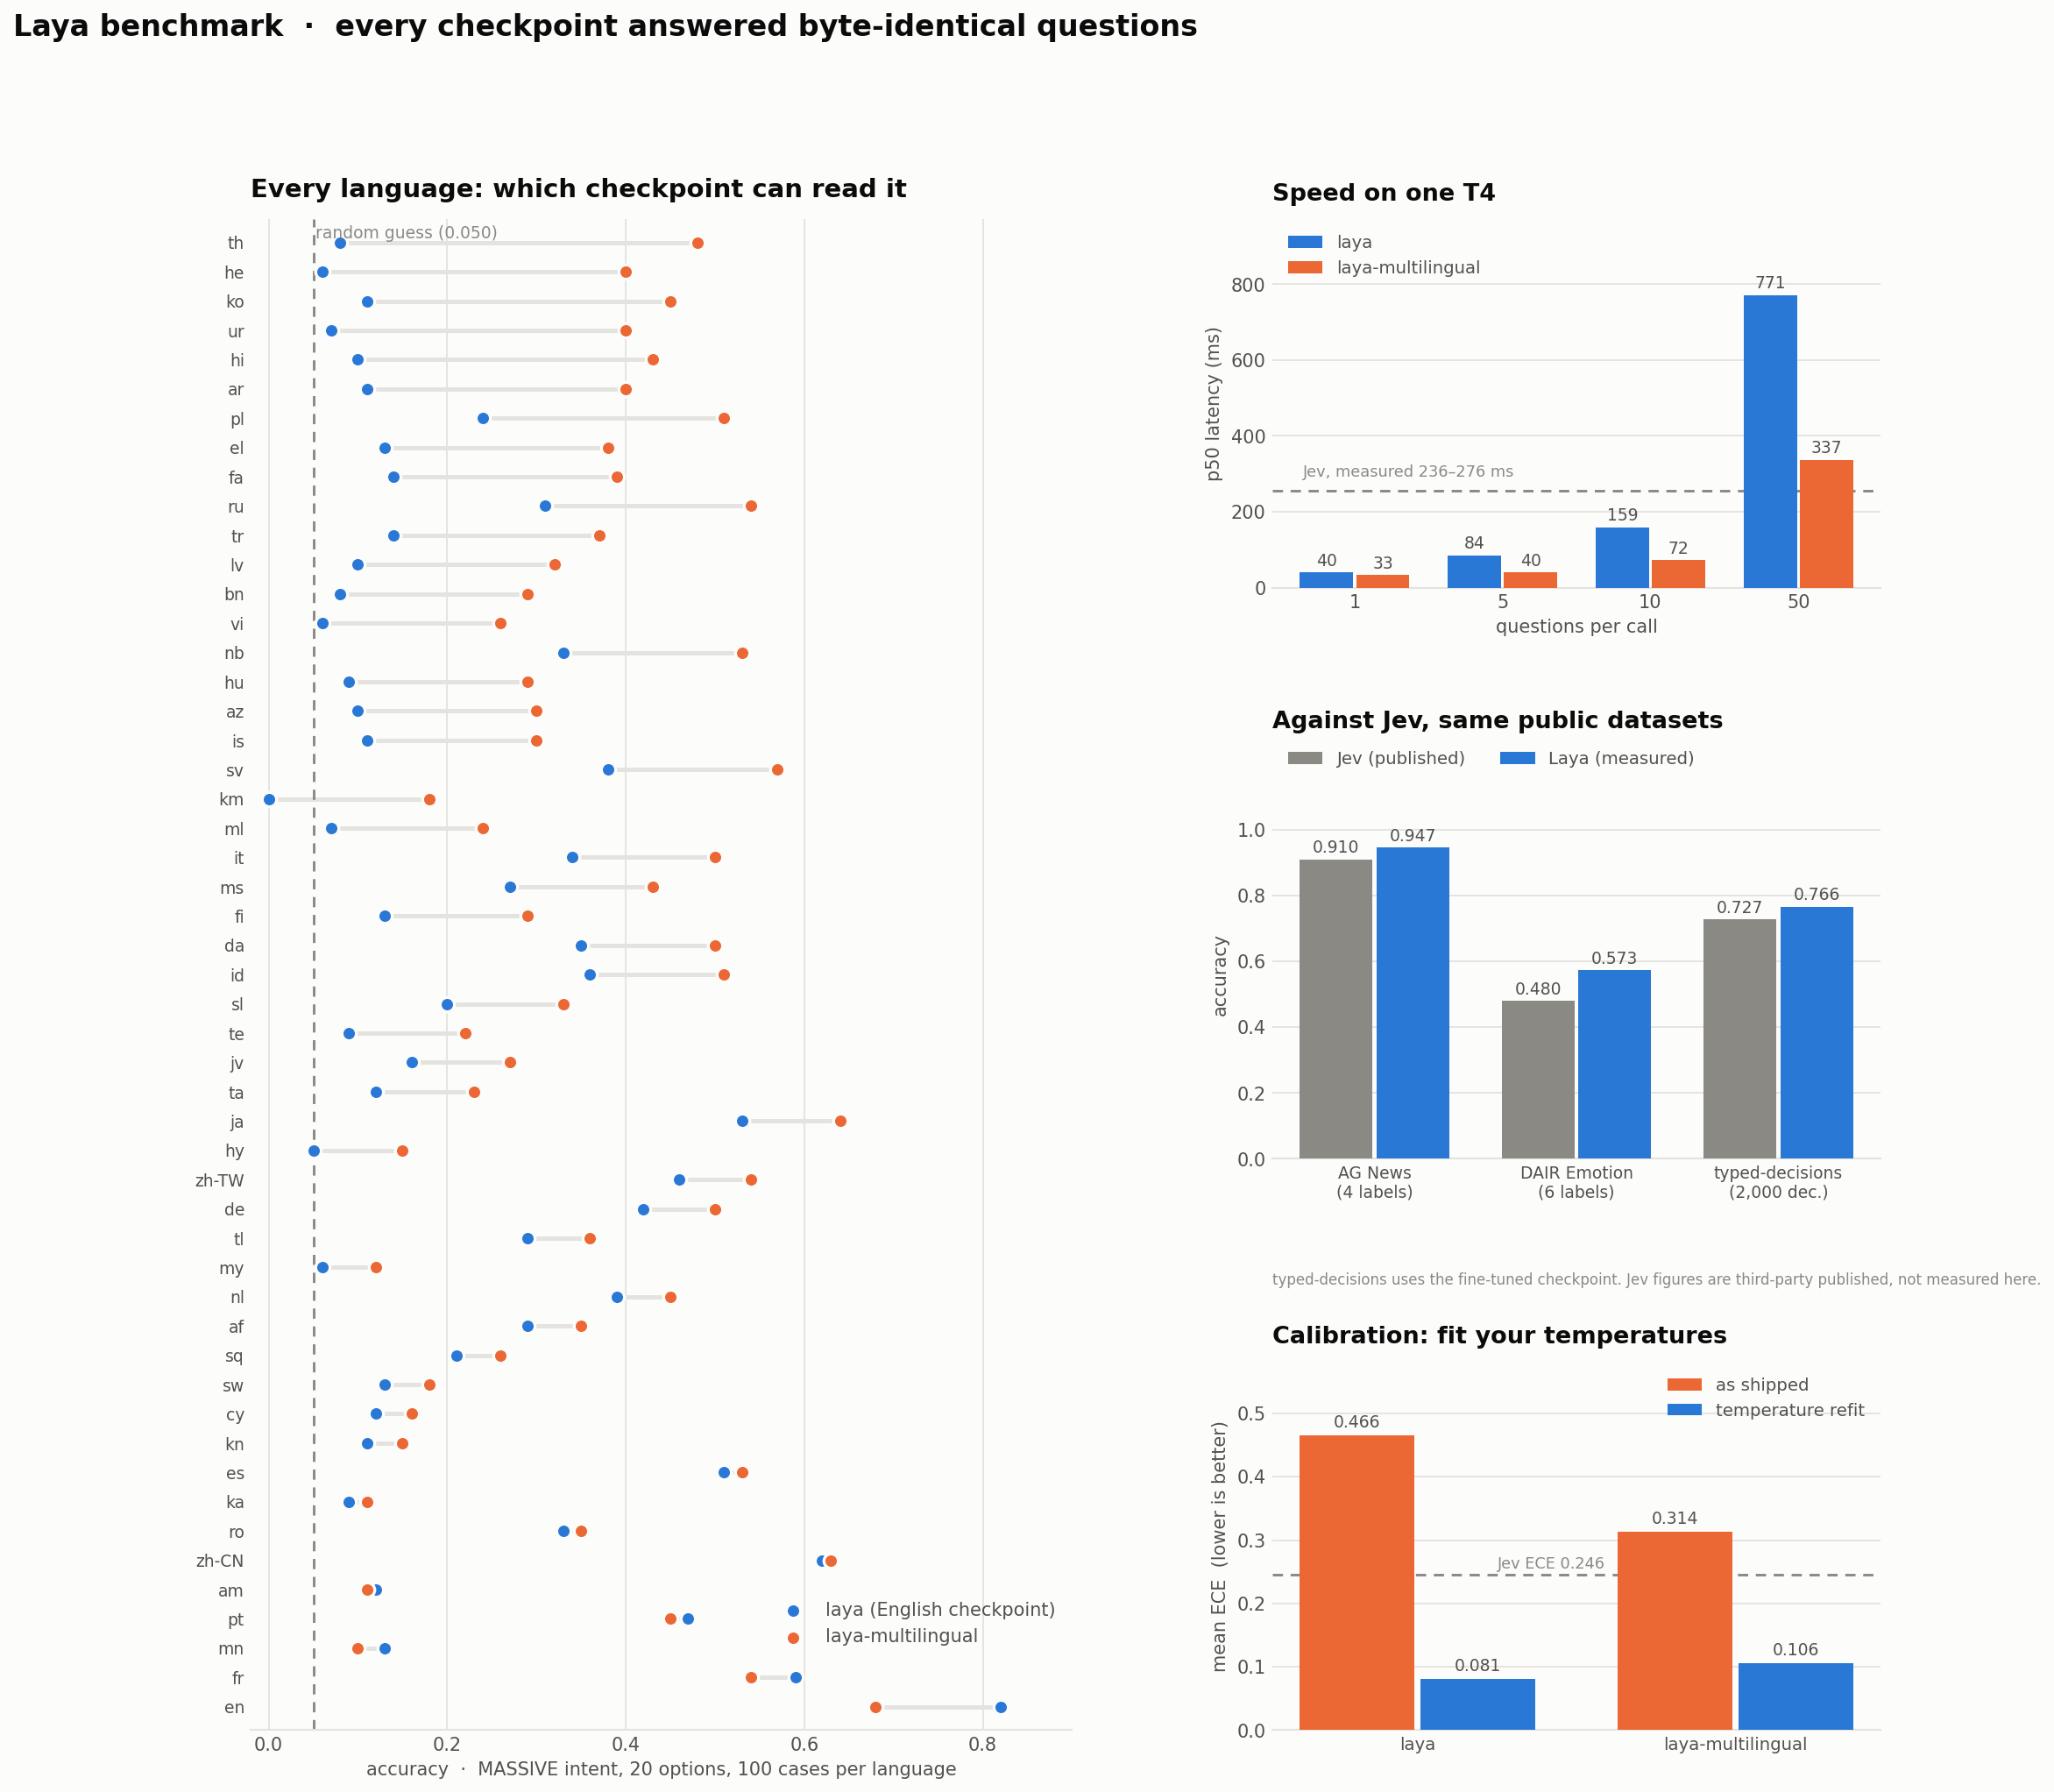
다국어 열은 재측정값이다. 0.2.0에서 측정한 committed 파일의 다국어 절반(macro 0.3661, 45/51)은 0.2.0, 0.3.7, 0.3.20 버전과 x86 CPU, Apple M5 CPU와 MPS 어디서도 재현되지 않았고 모두 0.4008로 나왔다(#208). 0.05 이상 움직인 16개 언어 중 15개가 올랐다. 예를 들어 벵골어는 0.29에서 0.45로, 칸나다어는 0.15에서 0.30으로 올랐고 스웨덴어만 0.57에서 0.49로 내렸다. 영어 checkpoint 열은 마지막 자리까지 재현됐다. 따라서 두 checkpoint의 격차는 committed 표가 보여 준 것보다 크다. Figure 2의 언어별 점과 Figure 3의 "45 / 51"은 이 재측정 이전 그림이다.
routing 이득이 큰 언어는 비라틴 문자 언어다. 태국어가 +0.400(0.080→0.480)으로 가장 크고, 벵골어와 페르시아어 +0.370, 힌디어와 한국어 +0.360(한국어 0.110→0.470)이 뒤따른다. 영어만 영어 checkpoint가 앞선다(0.820 대 0.710). 영어 checkpoint의 macro ECE는 temperature clamp 이전 0.7331에서 이후 0.5709로 내려갔고 정확도는 그대로였다.
Jev와의 비교
| 항목 | Jev 1.13.0 | Laya (routed) | 차이 |
|---|---|---|---|
| typed-decisions, 결정 2,000건 | 0.727 | 0.766 | +0.039 |
| AG News, 4 레이블 | 0.910 | 0.950 | +0.040 |
| DAIR Emotion, 6 레이블 | 0.480 | 0.595 | +0.115 |
| Banking77 (Jev 72개, Laya 77개) | 0.870 | 0.425 | Jev가 0.445 높음 |
| ECE (낮을수록 좋음) | 0.246 | 0.081 | temperature 적합 후 3배 |
| p50 지연, 질문 1개 | 236~276ms | 32.8ms | 7.8배 |
| 사용 가능 언어 | 공개 벤치마크 없음 | 48/51 | |
| 가중치 | 닫힌 API | Apache 2.0 | |
| 비용 | 100만 토큰당 0.042달러 | 자체 호스팅 0달러 |
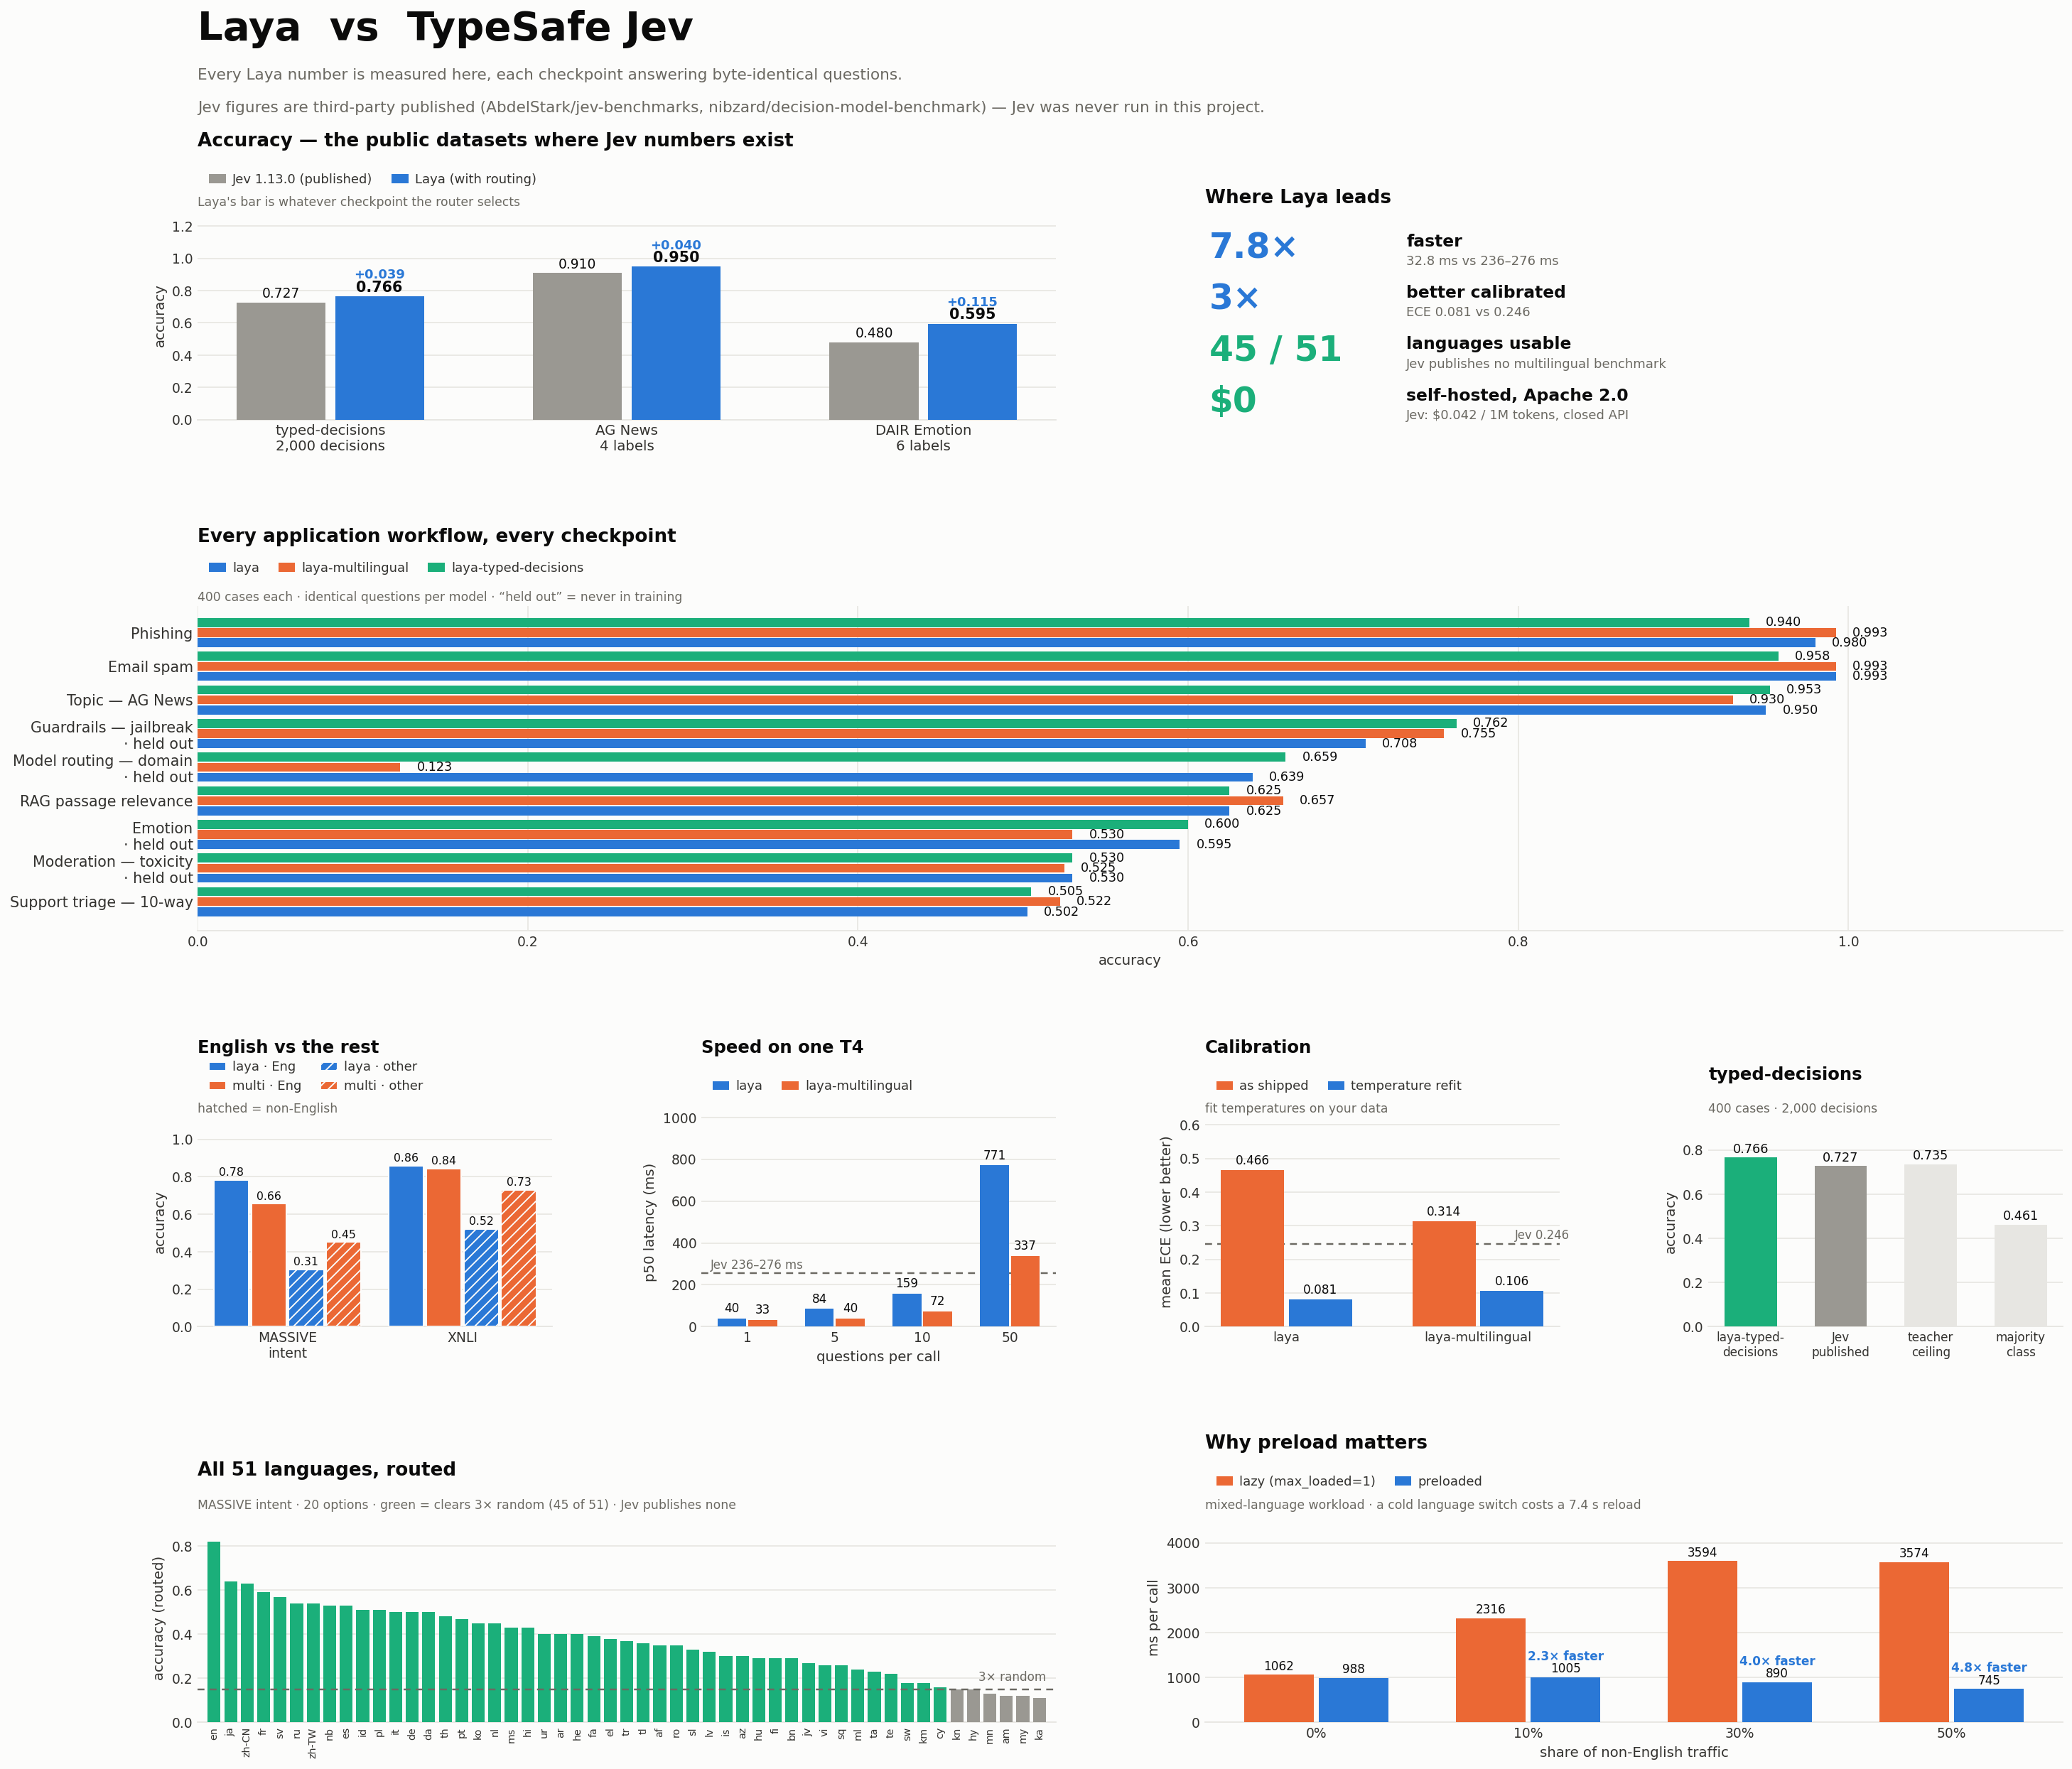
Laya 수치는 Router().predict(...)가 실제로 고른 checkpoint의 결과이고 세 checkpoint 중 최고를 고른 값이 아니다. 비교 해석에는 두 가지 단서가 붙는다. 첫째, Jev 수치는 제3자가 공개한 값이라 표본 크기와 프롬프트가 다르다. 둘째, typed-decisions 0.766은 그 벤치마크의 학습 분할로 fine-tuning한 checkpoint의 값이다.
Jev가 앞서는 곳도 README가 따로 정리한다.
| 항목 | Jev | Laya | 원인 |
|---|---|---|---|
| 20개 초과 선택지 (Banking77) | 0.870 | 0.425 | 선택지당 3~4 토큰의 예산 상한 |
| soft accuracy (typed-decisions) | 0.580 | 0.471 | argmax는 낫지만 teacher 분포와의 일치는 낮음 |
| raw ECE (temperature 적합 전) | 0.144 | 0.213 | 도메인 temperature 적합 후에야 0.081 |
Banking77에서 영어와 다국어 checkpoint가 정확히 0.425로 같은 값을 낸 것은 모델 능력이 아니라 예산 상한이 원인이라는 해석의 근거다. typed-decisions checkpoint도 0.492에 그친다. 반대로 DAIR Emotion에서 Jev는 예시의 16%에서 정답 레이블에 확률 0을 줬고, README는 이를 confidence로 분기하는 시스템에 치명적인 실패라고 평가한다.
typed-decisions
400 사례, 결정 2,000건, 워크플로 4개의 결과다. soft acc는 teacher의 전체 확률 분포와의 일치, Brier는 확률 예측의 제곱 오차, score MAE는 서열 답의 평균 절대 오차다.
| 모델 | 정확도 | soft acc | Brier | ECE | score MAE |
|---|---|---|---|---|---|
laya-typed-decisions |
0.766 | 0.471 | 0.062 | 0.213 | 0.242 |
laya |
0.362 | 0.331 | 0.315 | 0.174 | 0.694 |
laya-multilingual |
0.352 | 0.328 | 0.463 | 0.314 | 0.760 |
| Jev 1.13.0 (공개) | 0.727 | 0.580 | 0.148 | 0.144 | 0.391 |
| teacher 자기 일치 상한 | 0.735 | ||||
| 질문별 최빈 클래스 | 0.461 | ||||
| 무작위 | 0.318 |
fine-tuning한 checkpoint는 Jev보다 0.039 높고 teacher 자기 일치 상한(0.735)도 넘는다. Brier는 Jev보다 2.4배, score MAE는 1.6배 좋다(Brier는 BENCHMARKS에 0.061로 적혀 있다). 네 워크플로 모두에서 앞서며 각각 송장 처리 0.804, 보안 사고 0.766, 고객 서비스 0.764, agent trace 관측 0.730이다. primitive별로는 noul 0.857, choice 0.733, score 0.723이다.
반면 기본 checkpoint 두 개는 최빈 클래스 baseline(0.461)보다 낮다. baseline은 새 방법의 효과를 재기 위해 비교 대상으로 두는 기본 설정을 말한다. 0.362와 0.352는 무작위 0.318과 크게 다르지 않으므로, 이 벤치마크의 능력은 전부 fine-tuning에서 나온다. 또한 0.766 행과 워크플로별 수치에는 아직 committed 결과 파일이 없다고 README가 적는다.
응용 워크플로
실제 레이블 데이터 각 400 사례, 세 checkpoint의 결과다. held out은 해당 데이터가 Laya 학습 혼합에 없었다는 뜻이다.
| 주제 | laya |
laya-multilingual |
laya-typed-decisions |
데이터 |
|---|---|---|---|---|
| 이메일 스팸 | 0.993 | 0.993 | 0.958 | 학습 포함 |
| 피싱 | 0.980 | 0.993 | 0.940 | 학습 포함 |
| LLM 가드레일 (jailbreak) | 0.708 | 0.755 | 0.762 | held out |
| moderation (유해성) | 0.530 | 0.525 | 0.530 | held out |
| RAG passage 관련성 | 0.625 | 0.657 | 0.625 | 학습 포함 |
| 지원 triage (10개 큐) | 0.502 | 0.522 | 0.505 | 학습 포함 |
| 모델 라우팅 (도메인) | 0.639 | 0.123 | 0.659 | held out |
강한 영역은 스팸과 피싱이다. 정확도 0.99 수준에 ECE도 약 0.01이지만 둘 다 학습 데이터에 있었다. 약한 영역은 moderation이다. held-out toxic-chat에서 0.530, macro-F1 0.400으로 균형 분할에서 무작위를 겨우 넘는다. 데모 Space의 Moderation 탭은 골라 둔 예시에서만 동작하고 실제 트래픽에서는 그렇지 않다고 README가 직접 적는다. jailbreak 탐지 0.708~0.762는 서로 무관한 두 데이터셋에서 일관됐다(deepset prompt-injections 0.698). 모델 라우팅에서 다국어 checkpoint가 0.123으로 크게 하락한 점도 눈에 띈다.
영어 과제 결과는 다음과 같다.
| 과제 | laya |
laya-multilingual |
비고 |
|---|---|---|---|
| AG News | 0.947 | 0.937 | 학습 포함 |
| BoolQ | 0.830 | 0.787 | 학습 포함 |
| DAIR Emotion | 0.573 | 0.513 | held out |
| prompt-injections | 0.698 | 0.578 | held out, n=116 |
| SST-5 (서열) | 0.372 | 0.282 | held out |
SST-5의 0.372는 서열 score가 가장 약한 primitive라는 판단의 근거다.
속도
| 호출당 질문 수 | laya |
laya-multilingual |
|---|---|---|
| 1 | 39.5ms | 32.8ms |
| 5 | 84.5ms | 40.1ms |
| 10 | 158.6ms (질문당 15.9ms) | 72.3ms (질문당 7.2ms) |
| 50 | 771ms | 337ms (질문당 6.8ms) |
T4 한 장의 batch 처리량은 초당 103~332 질문이다. 질문을 한 호출에 많이 넣을수록 질문당 비용이 줄어든다. 즉 하나의 state에 대해 여러 판단을 묶어 묻는 사용 방식이 이 모델에 맞다.
하드웨어마다 성질이 다르다.
| 환경 | 측정 | 해석 |
|---|---|---|
| NVIDIA GB10 (DGX Spark), typed-decisions | 질문 1개 p50 100.2ms, 50개 443.1ms | 질문당 약 7.0ms로 T4의 절반이지만 호출당 고정 오버헤드 약 93ms(원인 미규명) |
| Ryzen 9 6900HX 노트북 CPU | 기본 스레드 9,396ms, intra 8과 inter 1로 783ms | 12배. inter-op 스레드는 1로 고정, intra-op 8에서 p50 329ms |
| Intel Arc B390 (XPU) | 질문 1개 29.7ms, 10개 96.9ms | CPU 대비 9.7배에서 26.9배, T4보다 약간 빠름 |
| Apple M1 Pro (MPS) | fp16이 english에서 요청당 20~30ms, multilingual에서 약 10ms 느림 | long english 8행에서만 fp16 우세 |
| AWS m7a.xlarge (EPYC 4코어) | english 질문 1개 580ms, multilingual 193ms | CPU에서는 질문 batch 이득이 작음, 최대 RSS 9.3GiB |
독립 NVIDIA 용량 연구는 SAM.gov 공고 1,000건에 요청당 질문 3개를 묻는 서비스로 측정했다. ONNX Runtime의 TensorRT FP16 경로로 H100 NVL은 p99 130ms 이하에서 초당 175 결정, p99 50ms 이하에서 105 결정을 냈다. TensorRT는 H100의 130ms 용량을 93에서 175 결정으로 올렸다. RTX PRO 6000은 eager FP16과 TensorRT 모두 146 결정이었고, RTX PRO 5000은 15와 42 결정이었다. 63개 parity 질문에서 모든 backend와 정밀도가 FP32 답을 재현했다(74/74 행). RTX PRO 6000 한 장으로 24시간 1,000만 결정 곡선을 압축 재생하자 138,863 요청, 오류 0, 전체 p99 111ms였고 피크 구간 두 곳이 132ms와 144ms를 기록했다. 130ms를 계속 지켜야 한다면 약 25%의 여유 용량이 필요하다는 뜻이다.
GPU fast path는 작은 요청에서 효과가 크다. RTX 4070 Ti SUPER의 agent.predict() 종단 간 측정이다.
| checkpoint | 조건 | 기본 | fast | 배율 |
|---|---|---|---|---|
laya |
질문 1개, 72 토큰 | 17.7ms | 4.6ms | 3.8배 |
laya |
질문 30개, 512 토큰 | 327.5ms | 232.1ms | 1.4배 |
laya-multilingual |
질문 1개, 72 토큰 | 14.1ms | 2.8ms | 5.1배 |
laya-multilingual |
질문 30개, 966 토큰 | 320.7ms | 187.6ms | 1.7배 |
작은 요청은 커널 실행 오버헤드가 지배하고 CUDA graph가 이를 없앤다. 큰 batch는 GEMM이 지배하며 융합 커널은 약 80 TFLOPS로 cuBLAS와 비슷하다. 이득은 융합 epilogue와 sliding-window attention에서 오며, 후자는 L=1024에서 dense mask SDPA보다 16배 빠르다.
Calibration
| 배포 상태 ECE | temperature 재적합 ECE | |
|---|---|---|
laya |
0.466 | 0.081 |
laya-multilingual |
0.314 | 0.106 |
(질문 타입, 선택지 수)마다 temperature 하나를 held-out 데이터로 재적합하면 두 checkpoint 모두 Jev의 0.246보다 낮아진다. BENCHMARKS는 이것을 가장 가치가 큰 단일 개선으로 꼽는다.
과신 방향이 항상 같지는 않다. 라우팅 과제 하나(laya_router 180건, 3단계 choice, zero-shot)에서는 거의 모든 설정이 과소확신이었다. root checkpoint는 평균 P(chosen) 0.562에 정확도 0.744, typed-decisions checkpoint는 0.501에 0.694였다. 방향이 과제에 따라 달라지므로 어느 쪽이든 자기 데이터로 temperature를 적합하라는 것이 결론이다. 중국어 커뮤니티 평가에서는 noul:2 bucket의 raw 적합값이 10.23으로 clamp 상한 5를 넘었다. 즉 중국어 이진 판단의 과신은 현재 clamp가 허용하는 보정 범위 밖에 있다.
선택지 순서 강건성
선택지를 섞었을 때 답이 바뀌는 비율이다. Jev는 0.13으로 측정됐다.
| suite | laya |
laya-multilingual |
|---|---|---|
| massive_intent.en (20지선다) | 0.150 | 0.230 |
| en.emotion | 0.040 | 0.090 |
| xnli.en (3지선다) | 0.000 | 0.015 |
선택지가 적으면 순서에 거의 영향을 받지 않지만 20지선다에서는 두 checkpoint 모두 Jev보다 덜 안정적이다. 중국어 zh-decision-bench에서는 뒤집힘 비율이 고객 서비스 28%, 음성 라우팅 10.6%였다. 이 결과가 앞 절의 option_order 평균과 parallel layout이 필요한 이유다.
한계
README의 "Honest limits" 절과 BENCHMARKS의 "Limits, stated plainly" 절은 아래 항목을 명시한다.
| 한계 | 내용 | 대응 |
|---|---|---|
| zero-shot 성능 | typed-decisions에서 기본 checkpoint 0.362와 0.352, 무작위 0.318, 최빈 클래스 0.461 | 자기 도메인 데이터로 fine-tuning |
| boolean 단어 레이블 | true/false, yes/no choice 키를 쓰면 설명이 아니라 레이블을 따라갈 수 있음 |
의미 있는 레이블이나 A/B 같은 불투명 레이블 |
| 부정문 | 의미 있는 키로도 안전하지 않음 | 서빙하는 checkpoint와 문구로 검증 |
| 많은 선택지 | 20개 정도를 넘으면 토큰 예산 때문에 하락 | 예산 확대, shortlist, tournament, 질문 분할 |
score |
가장 약한 primitive (SST-5 0.372) | 영어 score는 영어 checkpoint로 |
noul 레이블 추종 |
영어 checkpoint에서 레이블 쌍이 답을 지배할 수 있음 | criteria 지정, labels 재정의, 2지선다 choice |
다국어 score 위치 편향 |
첫 수준을 거의 고르지 않음 | 영어 score는 model="english" |
act_probability |
거의 항상 1.0, 정답 AUROC 0.30 | confidence로 게이트 (AUROC 0.77) |
| moderation | held-out에서 0.530 | 실제 트래픽에 쓰지 않음 |
| calibration | 두 checkpoint 모두 과신 배포, 다국어는 temperature 없음 | held-out 데이터로 temperature 적합 |
| 언어 | laya는 비영어에서 붕괴, laya-multilingual은 영어에서 약함 |
Router 사용 |
부정문 사례는 구체적이다. #377의 해지 예시 다섯 개를 Laya 0.3.20 CPU로 실행하면서 no_action과 cancel_account 키를 썼다. 부정 요청 4건에 대해 laya는 4건 모두, laya-multilingual은 2건을 cancel_account로 골랐고, 다국어 답 하나는 그 레이블에 확률 0.9998을 줬다. 긍정 대조군은 두 checkpoint 모두 통과했다. README는 이것이 좁은 해지 예시일 뿐 모든 부정 state가 실패한다는 증거는 아니라고 단서를 단다.
noul의 레이블 추종 문제는 criteria 유무에 따라 달라진다. criteria 없는 noul은 모든 state에 같은 일반 선택지 쌍("no, the statement does not hold"와 "yes, the statement holds")을 렌더링하는데, 영어 checkpoint에서는 이 쌍이 결정 전체를 좌우해 state와 무관하게 "no"를 답한다. 다국어 checkpoint에서는 criteria 없는 형식도 state를 읽는다.
향후 과제로는 위치 균형을 맞춘 재학습, 학습 중 더 공격적인 선택지 순서 섞기, noul 레이블 문제를 고친 재학습 checkpoint가 언급된다. 또한 typed-decisions 0.766과 워크플로별 수치는 결과 파일이 아직 커밋되지 않아 재현 경로가 다른 수치보다 약하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| System 1 decision engine | 확장된 추론 없이 빠르게 내리는 판단을 한 번의 forward pass로 처리하는 모델이라는 Laya의 자기 규정 |
choice / score / noul |
레이블 하나 고르기, 서열 수준 기대값, 참일 확률 P(true)를 내는 세 질문 타입 |
| RLCD | strictly proper scoring rule을 reward로 쓰는 강화학습으로 calibration된 결정 확률을 학습하는 방법 |
Router |
문자 체계와 언어를 검출해 요청마다 영어, 다국어, typed-decisions checkpoint 중 하나를 고르는 진입점 |
head_max_len |
질문과 선택지 렌더링에 허용하는 토큰 상한. 실제 head 길이와 달라 state 공간 계산에 주의가 필요하다 |
answer_confidence |
보고된 답의 확률 max(p). temperature scaling이 적합하고 기권 게이트가 읽는 값 |
관련 페이지
- Introduction - TypeSafe AI: Laya가 인터페이스를 따르는 Jev의 공식 문서 도입부. Choice, Score, Noul primitive와 질문 분해 설계를 다룬다.
- Jev - 문장 대신 판단과 확률을 반환하는 AI 모델 (GeekNews): Jev 발표 요약과 커뮤니티 토론. RLCD, 가격, 속도, 평가 설계의 편향 단서를 정리한다.
- classifier.dev: Zero-shot text classification over plain HTTP: Jev를 분류 API 뒷단으로 쓴 저장소. Laya의 Jev 호환 서버로 교체할 수 있는 사용 사례다.