LLMs · ARTICLE · 2026
You could have invented transformers from memory
요약
이 글은 Transformer를 이루는 세 가지 층, 즉 linear layer, MLP, self-attention을 모두 같은 종류의 장치로 본다. 세 층은 key와 value의 쌍을 저장해 두었다가, 질의(query)가 들어오면 질의와 비슷한 key를 찾아 그 value를 돌려주는 associative memory라는 관점이다. 세 층의 차이는 "얼마나 비슷한지"를 나타내는 유사도 점수를 어떻게 변형하느냐 하나뿐이다.
저자 Alex Wang은 이 관점 위에서 간섭 대 신호 비(interference-to-signal ratio)라는 단일 지표로 각 층이 메모리를 몇 개까지 깨끗하게 꺼낼 수 있는지를 어림한다. key 차원이 64일 때 그 용량은 다음과 같이 커진다.
| 단계 | 장치 | 용량() |
|---|---|---|
| 출발점 | outer product linear layer | 약 64개 |
| 중간 | squared ReLU MLP | 약 2,700개 |
| 도착점 | self-attention | 약 120만 개 |
이 수치 사슬을 따라가면 MLP와 self-attention이 "기억을 더 잘 꺼내려는 시도"에서 자연스럽게 나오는 구조라는 점이 드러난다. 제목의 "Transformer를 직접 발명할 수도 있었다"는 이 흐름을 가리킨다. 끝으로 long context 모델이 attention logit을 context 길이의 로그에 비례해 키우는 이유도 같은 지표로 설명한다.
배경
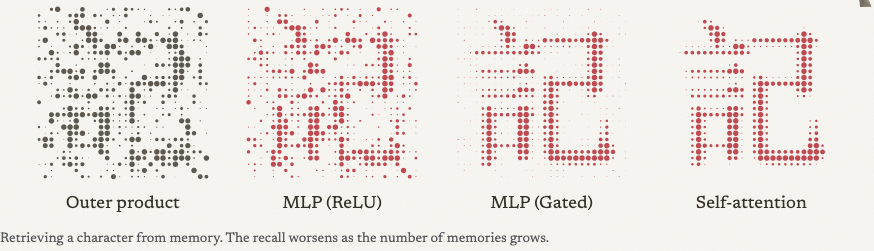
대형 언어 모델은 세계 곳곳의 사소한 사실까지 기억해 낸다. 저자는 보드게임 모임에 늦어 운전하면서 Astra에게 Dune: Imperium의 규칙을 다시 설명해 달라고 했고, 그 설명만으로 게임을 할 수 있었다는 경험으로 글을 연다. 이렇게 모델의 방대한 지식은 당연한 것처럼 쓰이지만, 모델이 그 많은 정보를 어떻게 기억하고 얼마나 많이 담을 수 있는지는 따로 설명이 필요하다.
이 글의 출발점은 좋은 메모리 장치의 조건을 "저장량"이 아니라 "꺼낼 수 있는 능력"으로 정의하는 것이다. 사실을 무한히 저장해도 필요할 때 꺼내지 못하면 쓸모가 없기 때문이다. 그리고 저장한 메모리가 많아질수록 하나를 꺼낼 때 다른 메모리들이 끼어드는 간섭이 커진다. 따라서 글 전체는 간섭이 얼마나 큰지를 재는 숫자 하나를 중심으로 전개된다.
핵심 개념
메모리와 memory store
이 글에서 메모리 하나는 key와 value의 쌍이다. key 는 차원 벡터로 "이 메모리를 찾을 때 쓰는 주소"이고, value 는 차원 벡터로 "찾았을 때 돌려받고 싶은 내용"이다. memory store는 이런 쌍을 개 담고 있는 함수 다.
| 기호 | 뜻 | 쉬운 그림 |
|---|---|---|
| 번째 key, 길이 1로 정규화 | 사물함에 붙은 이름표 | |
| 번째 value | 사물함 안의 물건 | |
| 저장된 메모리 개수 | 사물함 개수 | |
| key 벡터의 차원 | 이름표에 쓸 수 있는 글자 칸 수 | |
| 질의 벡터 | 찾으러 온 사람이 부르는 이름 | |
| recall 결과 | 실제로 손에 쥐게 되는 물건 |
recall은 질의 를 넣어 를 받아 내는 동작을 말한다. 평가 지표인 recall과는 다른 뜻이며, 이 페이지에서는 "저장한 것을 다시 꺼내기"라는 뜻으로만 쓴다. 좋은 store는 나 와 비슷한 벡터로 질의했을 때 를 돌려준다.
associative memory는 이처럼 정확한 주소가 아니라 유사도로 내용을 찾는 메모리를 말한다. 컴퓨터의 일반 메모리가 "37번지"처럼 정확한 번지로만 값을 찾는 것과 달리, associative memory는 "37번지와 비슷한 곳"을 불러도 가장 그럴듯한 내용을 돌려준다.
신호와 간섭
recall 결과는 두 부분의 합으로 나뉜다. 하나는 찾으려던 목표 메모리의 value로, 이것이 신호(signal)다. 다른 하나는 목표가 아닌 나머지 메모리들의 value가 조금씩 섞여 들어온 부분으로, 이것이 간섭(interference)이다.
쉬운 그림. 시끄러운 방에서 친구 한 명의 목소리를 듣는 상황과 같다. 친구 목소리가 신호이고, 방 안 다른 사람들의 웅성거림이 간섭이다. 방에 사람이 적으면 친구 목소리가 잘 들리지만, 사람이 많아지면 웅성거림이 커져 결국 친구 목소리를 덮는다.
간섭 대 신호 비와 용량
간섭 대 신호 비는 간섭 벡터의 길이를 신호 벡터의 길이로 나눈 값이다.
이 값이 0이면 완벽한 recall이고, 1이면 잡음이 신호만큼 커서 무엇을 꺼냈는지 알 수 없는 상태다. 저자는 이 비가 1에 닿기 직전까지 담을 수 있는 메모리 수를 그 store의 용량(capacity)으로 정의한다. 글 전체가 이 숫자 하나로 여러 층을 비교한다.
방법
글은 가장 단순한 store에서 출발해 간섭을 줄이는 아이디어를 하나씩 적용하며 MLP와 self-attention에 도달한다. 단계마다 수식, 그 수식의 뜻, 비유 순으로 정리한다.
1단계 outer product store
가장 기본적인 store는 메모리를 outer product로 더해 행렬 하나에 쌓는다.
는 key를 행으로 쌓은 행렬, 는 value를 행으로 쌓은 행렬이다. 새 메모리 를 저장하는 방법은 에 를 더하는 것뿐이다. 즉 저장은 덧셈 한 번으로 끝난다.
쉬운 그림. outer product 는 "이 이름표가 오면 이 물건을 내놓아라"라는 규칙 하나를 행렬 모양으로 적은 쪽지다. 는 이런 쪽지 장을 한 장의 종이에 겹쳐 덧칠한 것이다. 쪽지를 겹칠수록 글씨가 서로 번진다.
이 누적 방식은 문헌에서 Hebbian learning이라고도 부른다. 함께 활성화되는 입력(key)과 출력(value) 사이의 연결(가중치)을 강화한다는 뜻이다. 같은 store가 linear attention의 상태, 즉 fast weights로도 쓰인다. linear attention에서는 토큰마다 를 행렬에 더하고 이후 토큰이 그 행렬에 질의한다(Katharopoulos et al., Schlag, Irie & Schmidhuber).
gradient descent 한 걸음도 메모리 저장이다
저자는 여담으로 학습 자체가 이 저장 연산과 같다는 점을 보인다. 손실 을 가진 신경망 안의 linear layer 에서 출력에 대한 그래디언트를 라 하면, 가중치에 대한 그래디언트는 이다. 따라서 학습률 로 한 걸음 내려가면
가 되고, 이는 key가 , value가 인 메모리를 outer product로 하나 더하는 것과 형태가 같다. Irie, Csordás & Schmidhuber는 이 관점을 확장해 gradient descent로 학습된 linear layer를 학습 입력 전체에 대한 attention으로 표현했다.
recall 연산
질의는 행렬 곱 하나다.
오른쪽 식을 읽으면 동작이 드러난다. 질의 를 모든 key와 내적해 유사도 를 구하고, 그 유사도를 가중치로 삼아 value를 모두 더한다. 즉 recall은 유사도 기반 조회다.
간섭이 생기는 원리
key를 길이 1로 정규화하면() 저장된 key 로 질의한 결과가 깔끔하게 나뉜다.
첫 항은 목표 value 그 자체이고, 둘째 항은 다른 key가 질의와 조금이라도 비슷한 만큼 그 value가 섞여 든 양이다. 모든 key가 서로 직교하면 이라 간섭이 사라진다. 그러나 차원 공간에는 서로 직교하는 방향이 개뿐이다. 따라서 개를 저장하면 완벽한 recall은 불가능하다.
쉬운 그림. 칸막이 방이 개 있는 건물을 떠올린다. 메모리마다 방을 하나씩 주면 소리가 섞이지 않는다. 하지만 방보다 메모리가 많아지면 몇몇은 방을 같이 써야 하고, 그때부터 소리가 섞인다.
random walk 어림
저자는 용량을 다음 논증으로 어림한다.
- 간섭 항은 목표를 뺀 개다.
- key가 무작위 단위 벡터면 서로 다른 두 key의 유사도 는 대략 크기다. 고차원에서 무작위 두 방향은 거의 직교하지만 완전히 직교하지는 않기 때문이다.
- value도 무작위이고 길이가 비슷하면, 간섭 항들은 방향이 제각각인 작은 걸음들을 이어 붙인 random walk처럼 더해진다. random walk에서 걸음 뒤의 거리는 이 아니라 에 비례한다.
- 따라서 간섭의 제곱 길이는 신호의 약 배이고, 길이 비는 다음과 같다.
이 값을 1로 두면 용량 를 얻는다. 즉 key 차원만큼 저장하면 간섭이 신호만큼 커진다.
쉬운 그림. 술래 한 명이 친구를 부르는데 방 안의 나머지 사람들이 각자 아무 방향으로 작게 한 마디씩 한다. 그 소리들은 서로 일부 상쇄되므로 사람이 4배 늘어도 웅성거림은 2배만 커진다. 그래도 사람이 계속 늘면 결국 친구 목소리와 같은 크기가 된다.
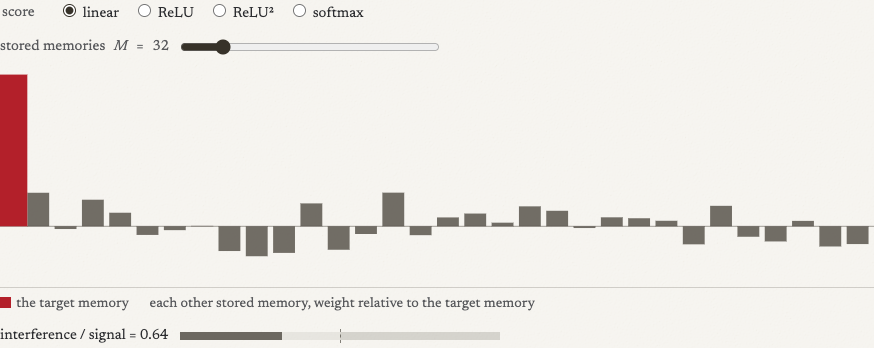
숫자로 확인하면, 에서 개를 저장했을 때 어림식은 을 준다. 원문의 인터랙티브 막대 그림은 같은 조건에서 실제 비를 0.64로 표시한다.
간섭을 줄이는 세 가지 방법
용량 아래에서도 outer product store의 간섭은 작지 않다. 각주에 따르면 이 결론은 깨끗한 value 벡터를 통째로 꺼내야 할 때의 이야기다. value가 고정된 후보 중 정답 쪽만 가리키면 되는 경우(예를 들어 가장 그럴듯한 다음 토큰 고르기)에는 recall 결과가 오답보다 정답에 조금만 더 가까워도 되므로, 행렬이 약 개의 사실을 담을 수 있다(Nichani, Lee & Bietti).
간섭을 줄이는 길은 다음 세 가지다.
| 방법 | 아이디어 | 이어지는 구조 |
|---|---|---|
| 차원 키우기 | linear store의 용량이 에 비례하므로 를 키운다 | 하드웨어 제약이 상한을 정한다 |
| 더 신중하게 저장하기 | 다른 메모리를 고려해 서로의 간섭을 상쇄하도록 가중치를 정한다 | optimal linear store, 용량 약 2배 |
| 더 선택적으로 꺼내기 | 질의와 덜 비슷한 key의 기여를 nonlinearity로 억누른다 | MLP와 self-attention |
outer product store는 메모리를 하나씩 따로 더하므로 간섭을 상쇄하는 장치가 없다. 그리고 linear store에서는 질의와 거의 무관한 key도 유사도에 비례해 조금씩 끼어든다. 두 번째와 세 번째 방법은 각각 이 두 약점을 겨냥한다.
2단계 optimal linear store
outer product store는 각 메모리를 다른 메모리와 무관하게 적는다. 이를 개선하려면 모든 메모리를 한꺼번에 가장 잘 맞추는 를 고르면 된다. 이는 linear regression 문제다.
일 때 least squares 해는 다음과 같다.
식의 앞부분 는 outer product store 그대로다. 달라진 점은 질의를 key와 비교하기 전에 을 곱한다는 것 하나다. 는 key들의 공분산이므로 그 역행렬을 곱하면 공분산의 영향이 되돌려진다. 이 처리를 whitening이라 하며, 많은 key가 공유하는 방향이 과대평가되지 않게 만든다.
쉬운 그림. 이름표 대부분이 "김"으로 시작하는 사물함을 생각한다. "김"이 들어간 이름을 부르면 사물함 수십 개가 동시에 대답한다. whitening은 모두가 공유하는 "김" 부분의 목소리를 낮추고 이름의 나머지 부분으로 구별하게 만든다.
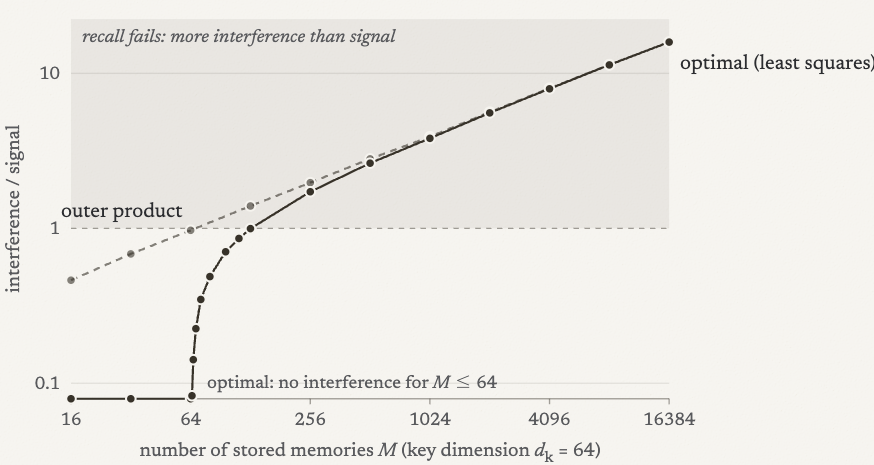
결과는 저장 개수에 따라 두 구간으로 나뉜다.
| 구간 | 결과 | 이유 |
|---|---|---|
| 간섭 0, 완벽한 recall | key가 일차독립이면 regression이 모든 메모리를 정확히 맞춘다. key가 서로 직교하지 않아도 된다 | |
| 비 | 쓸 수 있는 방향이 개뿐이라 간섭이 생기기 시작한다 |
비 은 에서 1이 된다. 따라서 optimal store의 용량은 outer product store의 2배다.
유도 과정
저자가 여담 상자에 적은 유도를 단계별로 옮기면 다음과 같다.
- 인 경우. key가 일차독립이면 key끼리 내적한 행렬 가 역행렬을 가지며, 가 모든 메모리를 정확히 맞춘다. 이면 해가 무한히 많고 이 해는 그중 크기가 가장 작은 min-norm 해다. 의 행 는 행들의 dual basis로, 가 일 때만 1이고 나머지는 0이다. 따라서 이고 간섭이 없다.
- 인 경우. 목적함수의 그래디언트를 0으로 두면 를 얻는다. 두 경우의 해는 모두 pseudoinverse를 써서 로 묶을 수 있다.
- 간섭 분석. 로 두면 다. 는 차원 공간 안의 차원 부분공간으로의 projection 행렬이다.
- 신호 크기. trace의 순환성에 따라 다. random key에서는 특별한 key가 없으므로 이다.
- 간섭 크기. projection은 를 만족하므로 이다.
- 비. 이다.
outer product의 와 비교하면 루트 안의 이 차이다. 이 은 optimal store가 개 분량의 간섭을 상쇄한다는 뜻이다. 상쇄량이 고정이므로 이 아주 커지면 두 store의 차이는 줄어든다.
optimal store도 여전히 유사도에 대해 linear이므로 작은 유사도와 큰 유사도를 같은 배율로 다룬다. 이 한계를 넘으려면 recall 방식 자체를 바꿔야 한다.
3단계 MLP는 nonlinear memory store다
linear store의 recall은 다. 유사도 가 작을 때 그 항을 더 눌러 줄 수 있다면 관련 없는 key가 끼어드는 간섭이 줄어든다. 그래서 각 유사도에 nonlinear 함수 를 씌운 뒤 가중합한다.
이 식은 2층 MLP와 정확히 같다. 첫 가중치 행렬 의 행이 key, 둘째 가중치 행렬 의 열이 value, 가운데 activation이 다. 즉 MLP는 "유사도에 필터를 건 메모리 장치"로 첫 원리에서 다시 유도된다.
| MLP 구성 요소 | memory store에서의 역할 |
|---|---|
| 첫 가중치 행렬의 행 | key |
| activation | 유사도를 변형하는 gating 함수 |
| hidden unit 하나 | 메모리 하나 |
| 둘째 가중치 행렬의 열 | value |
이 유사성은 Sukhbaatar et al.이 지적했고, Geva et al.은 학습된 Transformer의 feedforward layer가 실제로 이렇게 동작하며 key가 입력의 알아볼 수 있는 패턴에 반응한다는 것을 발견했다.
gating 함수 고르기
이상적인 는 유사도가 0 근처이거나 음수일 때 그 항을 억눌러 간섭을 줄인다.
| activation | 동작 | 간섭에 미치는 효과 |
|---|---|---|
| ReLU | 음수 유사도를 0으로 만든다. bias를 더하면 문턱을 옮길 수 있다 | random key의 유사도는 절반이 음수라 가중치 절반이 0이 된다. 간섭 분산이 절반이 되어 간섭이 배 줄어든다 |
| squared ReLU | ReLU 뒤에 제곱한다 | 0 근처 유사도를 더 누른다. 0.1은 0.01이 되고 1은 1로 남는다 |
squared ReLU는 덜 알려졌지만 대규모 모델에서 검증된 MLP activation 개선 중 하나다(So et al.). 또 이므로, squared ReLU MLP는 gate와 입력 projection이 가중치를 공유하는 GLU MLP와 같다. 현재 언어 모델이 쓰는 SwiGLU MLP는 gate에 별도 가중치를 주고 ReLU 대신 Swish를 쓰는 변형이다.
쉬운 그림. 제곱은 "작은 목소리는 훨씬 더 작게, 큰 목소리는 그대로" 만드는 볼륨 조절기다. 친구 목소리 크기를 1, 남의 웅성거림을 0.1이라 하면 제곱 뒤에는 1과 0.01이 된다. 차이가 10배에서 100배로 벌어진다.
실제 MLP의 superposition
학습된 MLP는 사실을 superposition으로 저장한다. 많은 사실이 같은 가중치를 나눠 쓰고 출력은 여러 메모리의 혼합이다. hidden unit 하나가 메모리 하나라는 위 대응은 개념 모형이며, 실제 저장 방식은 더 촘촘하다.
- Garcia et al.은 GLU MLP의 hidden unit이 입력의 random feature 를 계산하고, 둘째 가중치 행렬이 그 feature 위의 outer product store 가 되는 MLP를 명시적으로 구성했다. 이 MLP는 hidden unit 수보다 훨씬 많은 사실을 저장한다.
- 한편 학습된 Transformer의 ReLU MLP는 입력 하나에 hidden unit의 1% 정도만 활성화하기도 한다(Li et al.). 즉 recall 한 번은 전체 메모리 중 작은 일부만 쓴다.
Transformer 저자들의 삭제된 문단
원 Transformer 논문도 같은 연결을 적었지만 arXiv v2와 v3에만 남아 있다. 그 판본에서 Vaswani et al.은 feedforward layer를 "일종의 attention"으로 설명했다. 두 가중치 행렬의 행이 key와 value이고 softmax 대신 ReLU를 쓴다는 해석이다.
저자들은 feedforward layer를 학습 가능한 key-value 파라미터에 대한 attention으로 바꾸는 실험도 했고 번역 품질은 비슷했다. 한 버전은 조금 낮고 다른 버전은 조금 높았으며, 앞의 버전은 학습이 약 30% 느렸다. 이 문단은 이후 모든 버전에서 삭제됐다.
4단계 거듭제곱으로 간섭 더 줄이기
제곱이 효과적인 이유는 작은 유사도를 큰 유사도보다 훨씬 많이 줄이기 때문이다. 이를 일반화해 를 쓴다.
- 신호: 목표 key의 유사도는 1이고 이므로 그대로다.
- 간섭 항 하나: 유사도 가 로 줄어든다.
- 합산: 개 간섭 항이 random walk로 더해진다.
즉 거듭제곱 차수 를 하나 올릴 때마다 용량에 가 한 번 더 곱해진다. 용량이 차수에 대해 기하급수적으로 커진다.
쉬운 그림. 에서 남의 목소리 0.125(=1/8)는 제곱하면 0.0156, 세제곱하면 0.002가 된다. 차수를 올릴수록 웅성거림이 급격히 작아져 더 많은 사람이 있어도 친구 목소리가 들린다.
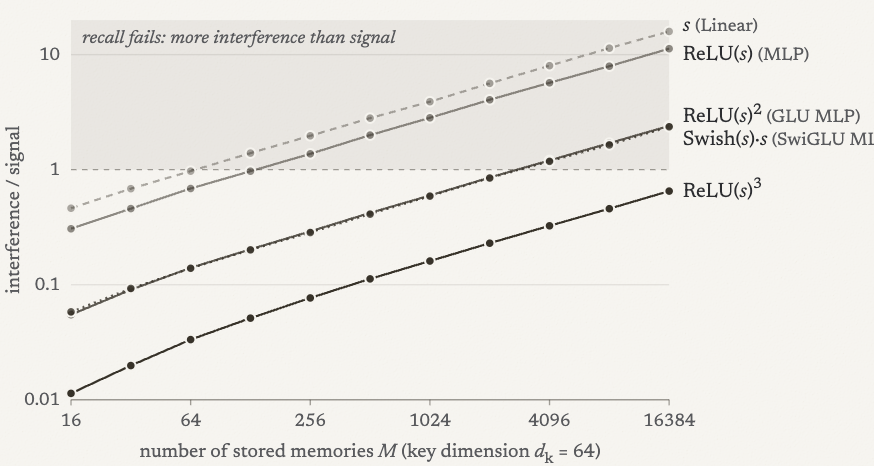
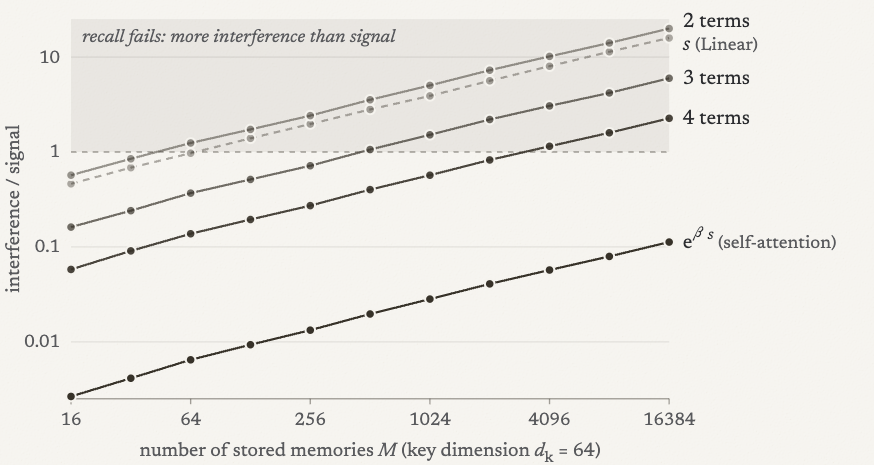
원문은 다섯 가지 로 같은 실험을 반복했다. 간섭이 으로 자라므로 log-log 그래프에서 선들은 거의 평행하고 높이만 다르다. 각 선이 1을 지나는 지점이 용량이다.
| 간섭 감소 원리 | 용량 공식 | 에서 | |
|---|---|---|---|
| Linear | 없음 | 64 | |
| ReLU | 음수 유사도 제거로 배 감소 | 128 | |
| squared ReLU (GLU MLP) | 간섭 항이 약 에서 약 로 | 약 2,700 (linear의 약 40배) | |
| SwiGLU, gate 가중치 공유 | 약 | squared ReLU와 거의 같다 | |
| cubed ReLU | 간섭 항이 약 로 | 약 35,000 |
5단계 self-attention은 무한 차수 메모리다
거듭제곱 하나를 고르는 대신 모든 차수를 한꺼번에 쓰면 용량을 극한까지 키울 수 있다. exponential이 바로 모든 거듭제곱의 가중합이다.
sharpness 는 높은 차수 항에 얼마나 비중을 줄지 정하는 배율이다. self-attention은 를 쓴다. Transformer는 유사도를 로 나누는데, 실제 query와 key의 길이가 약 라 일치하는 쌍의 내적이 약 다. 이 글의 key는 길이 1이라 일치 쌍의 유사도가 1이므로, 를 곱하는 것이 Transformer의 나눗셈과 같은 효과를 낸다.
쉬운 그림. exponential은 제곱, 세제곱, 네제곱 볼륨 조절기를 전부 겹쳐 단 것과 같다. 는 그 조절기를 얼마나 세게 돌릴지 정하는 다이얼이다. 다이얼을 올리면 가장 큰 목소리 하나만 남고 나머지는 사실상 사라진다.
급수를 자르면
exponential의 효과를 확인하려고 저자는 Taylor 급수를 몇 항에서 자른 버전과 비교했다.
| 사용한 항 | 용량 | 해석 |
|---|---|---|
| 2항 () | 약 40 | 상수항 1이 모든 key에 가중치 약 1을 줘서 linear(64)보다 나쁘다 |
| 3항 | 약 450 | 제곱 항이 더해져 크게 개선 |
| 4항 | 약 3,100 | squared ReLU(약 2,700)와 비슷 |
| 전체 exponential | 그래프 범위 밖 | M=16384에서도 비가 0.1 근처 |
용량 유도
저장된 key 로 질의하면 목표 메모리의 유사도는 1이고 가중치는 다. 다른 메모리의 가중치는 이며, random 단위 key에서 유사도 는 평균 0, 분산 인 Gaussian에 가깝다. 원문의 유도 사슬을 한 줄씩 풀면 다음과 같다.
| 단계 | 식 | 근거 |
|---|---|---|
| 1 | 간섭 항이 random walk로 더해진다 | |
| 2 | ||
| 3 | 나머지 개에 대한 평균으로 바꾼다 | |
| 4 | 이면 | |
| 5 | 정리 |
비를 1로 두면 용량은
이다. 가 보다 충분히 작은 한 용량은 에 대해 지수적으로 자란다. 앞 단계의 용량이 의 다항식이었던 것과 성격이 다르다.
을 대입하면 지수가 이므로 용량은 만 개다. 이는 linear store의 약 2만 배이며, 같은 실험을 더 길게 실행한 결과도 약 120만 개였다.
softmax로 정규화하는 이유
exponential을 그대로 계산하면 작은 수는 underflow, 큰 수는 overflow가 날 수 있다. 그런데 위 유도에서 보듯 간섭은 가중치 사이의 비율에만 의존한다. 따라서 모든 가중치를 그 합으로 나눠도 간섭 대 신호 비는 변하지 않으며 수치적으로는 안정해진다.
이것이 self-attention이다. Transformer 표기로는 유사도가 이고 인데, 저자는 를 key 쪽에 접어 넣어 식을 단순화했다.
쉬운 그림. softmax의 분모는 "모든 목소리 크기의 합이 1이 되도록 전체 볼륨을 맞추는 장치"다. 전체 볼륨을 바꿔도 친구 목소리와 웅성거림의 비율은 그대로이므로 들리는 정도는 변하지 않는다.
parametric과 non-parametric
MLP와 self-attention은 같은 틀이지만 메모리가 어디서 오는지가 다르다.
| 구분 | MLP | self-attention |
|---|---|---|
| key와 value의 출처 | 학습된 가중치 | context 안의 토큰에서 계산 |
| 메모리 개수 | hidden unit 수로 고정 | context 길이 |
| 성격 | parametric | non-parametric |
self-attention에서는 토큰 하나가 메모리 하나를 저장한다. 메모리가 파라미터가 아니고 context가 길어질수록 store도 커지므로 non-parametric memory store다.
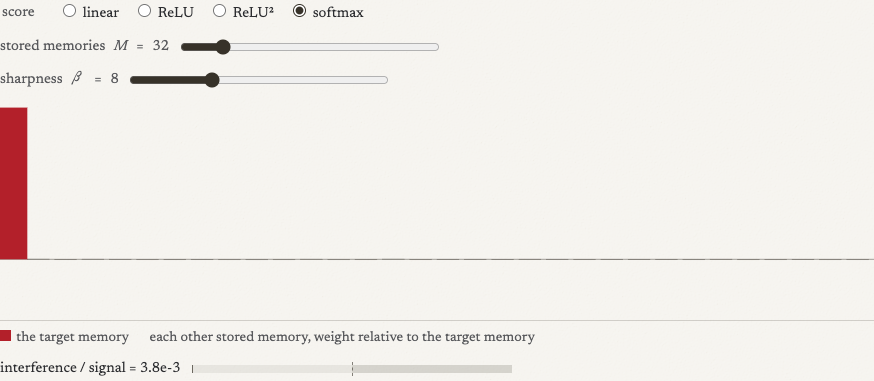
Figure 2와 Figure 6을 나란히 보면 차이가 분명하다. 같은 32개 메모리에서 linear store의 비는 0.64, softmax store의 비는 0.0038로 약 170배 작다. 원문 설명에 따르면 이 두 배가 될 때마다 recall을 유지하려면 가 조금씩 더 필요하며, 이 관찰이 다음 단계의 출발점이다.
6단계 long context에서 β 키우기
는 덜 비슷한 key를 얼마나 세게 누를지 정하므로, key-value 쌍이 늘어나면 도 함께 키우면 된다. 그러나 를 무작정 크게 하면 두 가지 문제가 생긴다.
- 이면 softmax가 가장 비슷한 key 하나만 고르는 hard argmax가 되고, argmax는 미분할 수 없다.
- 그 전에도 매우 큰 는 softmax를 포화시켜 다른 key로 가는 그래디언트를 사라지게 한다. 따라서 학습이 잘 되지 않는다.
그래서 는 이 요구하는 만큼만 키운다. long context 모델이 attention logit을 에 비례해 키우는 기법이 바로 이 일을 한다. 여러 변형이 있으며, 모두 기준 길이 (보통 학습 때의 길이)에서 가 학습된 값을 유지하도록 맞춘다.
| 규칙 | logit 배율 | 특징 |
|---|---|---|
| Su (2021) | 모든 길이에서 | attention entropy를 과 무관하게 일정하게 유지하는 조건에서 유도 |
| Scalable-Softmax (SSMax) | , 는 학습 | Su와 같은 형태 |
| Qwen LogN-Scaling | 일 때만 | 원래 Qwen 모델이 사용 |
| YaRN attention scaling (Qwen2.5-1M) | 처럼 자라 가장 가파르다 |
쉬운 그림. 방에 사람이 많아질수록 집중 다이얼을 조금씩 더 올린다. 사람 수가 두 배가 될 때 다이얼은 한 칸만 올리면 된다(로그 비례). 다이얼을 처음부터 끝까지 올려 두면 친구 한 명만 들리지만, 그 상태에서는 누가 친구인지 배우는 학습 신호가 끊긴다.
저자는 , 로 각 규칙을 실험했다.
| 규칙 | 결과 |
|---|---|
| 고정 | 저장 개수가 늘수록 비가 계속 올라 약 100만에서 200만 개 사이에서 1에 닿는다 |
| Qwen, Su, SSMax () | 이후 서로 일치하고, store가 커질수록 비가 오히려 줄어 200만 개에서 약 0.004 |
| YaRN | 더 빨리 자라는 배율 덕분에 약 까지 내려간다 |
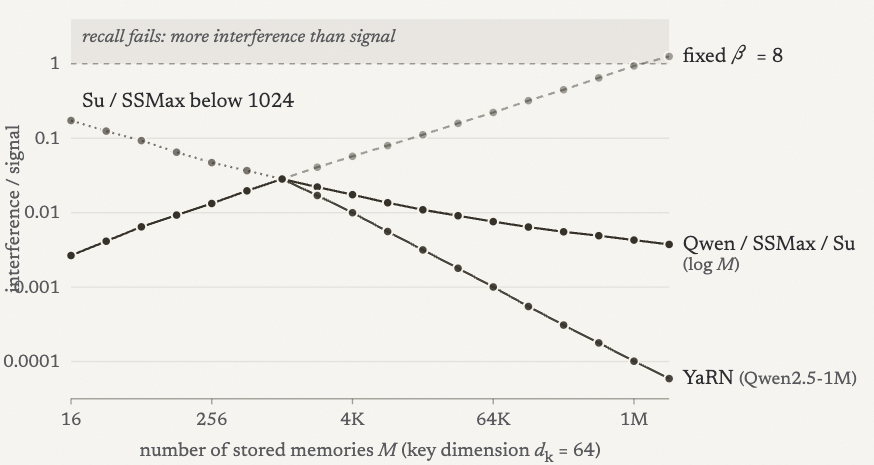
어느 규칙이든 를 에 맞춰 키우면 key가 서로 다른 메모리를 사실상 제한 없이 저장할 수 있다. 즉 long context 기법의 logit 스케일링은 "메모리가 많아질수록 집중도를 조금씩 올려 간섭을 억제하는 장치"로 해석된다.
결과
원문 결론 표를 옮기면 다음과 같다. 모두 저장된 key로 질의하고 key와 value가 random이라는 조건이다.
| memory store | 용량 | 에서 용량 | |
|---|---|---|---|
| Outer product | 64 | ||
| Optimal linear | 128 | ||
| ReLU MLP | 128 | ||
| Squared ReLU (GLU MLP) | 약 2,700 | ||
| SwiGLU MLP | 약 | 약 2,900 | |
| Cubed ReLU | 약 35,000 | ||
| Self-attention, | 약 120만 | ||
| Self-attention, | 실험 범위에서 도달하지 않음 | 200만 초과 |
표의 모든 행은 같은 골격 를 공유하고 만 다르다. 가 작은 유사도를 더 세게 누를수록 용량의 성장 방식이 바뀐다. linear와 ReLU는 에 비례하고, 거듭제곱은 , exponential은 의 지수 함수다. 따라서 라는 같은 크기의 key로도 linear layer와 self-attention의 용량 차이가 약 2만 배에 이른다.
Transformer가 MLP와 self-attention을 함께 쓰는 이유도 이 표로 읽을 수 있다. MLP는 학습으로 굳힌 장기 지식을 parametric하게 담고, self-attention은 지금 읽고 있는 context를 거의 무제한에 가까운 용량으로 담는다.
한계
저자는 이 용량 추정이 신경망 구조를 보는 여러 관점 중 하나일 뿐이라고 밝힌다.
- 단일 층이 random 벡터를 몇 개까지 recall하는지만 센다. 여러 층의 상호작용은 다루지 않는다.
- 학습 데이터를 전혀 고려하지 않았다. 실제로 key와 value에 무엇이 표현되는지는 학습 데이터가 정한다.
- 실험은 저장된 key로 정확히 질의하는 경우와 random key, random value 가정 위에 있다.
학습된 층의 저장량을 비트 단위로 잰 연구는 별도로 있다.
| 연구 | 결과 |
|---|---|
| Morris et al. | GPT 계열 모델은 파라미터당 약 3.6비트를 암기한다. 용량이 차면 일반화를 시작하고 학습 예시별 암기량이 줄어든다 |
| Allen-Zhu & Li | 언어 모델은 int8로 양자화해도 파라미터당 약 2비트의 사실 지식을 저장한다 |
후속 방향
저자는 이 관점과 연결되는 연구 주제를 일곱 가지로 정리했다.
| 주제 | 언급된 연구 |
|---|---|
| 층 하나가 담는 정보량 | Nichani, Lee & Bietti, Barnfield et al.(linear store), Dugan et al., Garcia et al.(사실 저장 MLP), Zhong et al.(이 글의 비 추정에 영감) |
| Hopfield network와 지수 용량 memory | Krotov & Hopfield(dense associative memory), Demircigil et al., Ramsauer et al.(attention과 연결), Krotov et al. 리뷰 |
| 추론 중 갱신되는 단기 메모리 | fast weights, Mamba, Mamba-2, DeltaNet, Gated DeltaNet, TTT layers, Titans, MesaNet, test-time regression |
| MLP를 보완하거나 대체하는 거대 sparse 메모리 | product-key memories, Memory Layers at Scale, UltraMem, Mixture of A Million Experts, Engram |
| 가중치 밖에 덧붙이는 non-parametric 메모리 | kNN-LM, RETRO, Memorizing Transformers, growing nonparametric networks |
| 학습된 모델 안의 메모리 찾기와 편집 | Geva et al., Bietti et al., ROME, MEMIT |
| 단기 메모리 압축과 장기 메모리 전환 | KVzip, gist tokens, Cartridges, attention matching |
이 밖에 continual learning 방법으로 sparse memory finetuning을 든다. 저자는 regression 목표로 forward pass 중의 단기 메모리를 설계하는 자신의 test-time regression 연구도 함께 소개한다. 글은 자신의 기억이 얼마나 제한적인지 체감하기에 메모리라는 주제에 끌리며, 기계가 기억하는 방식을 이해하면 스스로에 대해서도 배울 수 있으리라 기대한다는 말로 끝난다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| associative memory | 정확한 주소 대신 질의와 key의 유사도로 value를 꺼내는 메모리 |
| memory store | 개의 key-value 쌍을 담고 질의 에 를 돌려주는 함수. linear layer, MLP, self-attention이 모두 해당한다 |
| 간섭 대 신호 비 (interference-to-signal ratio) | recall 결과에 섞인 다른 메모리의 크기를 목표 value 크기로 나눈 값 |
| 용량 (capacity) | 간섭 대 신호 비가 1에 닿을 때의 저장 개수 |
| sharpness | softmax 안에서 유사도에 곱하는 배율. 클수록 덜 비슷한 key를 세게 누른다 |
| non-parametric memory | 저장 내용이 학습된 파라미터가 아니라 입력 context에서 오는 메모리. self-attention이 해당한다 |
관련 페이지
- Scalable Diffusion Models with Transformers: U-Net을 Transformer backbone으로 바꾼 DiT. 이 글이 해부한 self-attention과 MLP 블록을 그대로 쌓은 구조다
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: HippoRAG 2. 이 글의 후속 방향 중 "가중치 밖에 덧붙이는 non-parametric 메모리"에 해당하는 RAG 기반 continual learning 접근이다
- TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate: TurboQuant. self-attention의 메모리 저장소인 KV cache를 양자화해 압축하는 방법을 다룬다