LLMs · ARTICLE · 2026
Looped Transformer: 가중치를 공유하는 깊이 반복과 GPT-6 Astra 논쟁
요약
looped transformer는 같은 transformer block 묶음에 토큰의 중간 표현을 여러 번 통과시키되, 반복 사이에 가중치를 공유하는 아키텍처다. block을 새로 쌓지 않고도 계산 깊이를 늘릴 수 있으므로 모델 크기와 계산 깊이를 따로 조절할 수 있다. recurrent depth, recursive transformer라고도 부르며, 기본 발상은 2018년 Universal Transformer까지 거슬러 올라간다.
이 주제는 2026년 9월 1일 The Information이 OpenAI의 GPT-6 Astra가 recurrent depth를 쓴다고 보도하면서 크게 주목받았다. looping은 추론의 일부를 사람이 읽을 수 있는 텍스트에서 읽을 수 없는 내부 벡터로 옮기므로, 이 보도는 곧 AI 안전 논쟁으로 번졌다.
이 페이지는 세 자료를 합쳐 정리한다.
| 자료 | 발행일 | 이 페이지에서 맡는 부분 |
|---|---|---|
| Sebastian Raschka, "GPT-6 Astra, Looped Transformers, and Hidden Reasoning" | 2026-09-09 | Astra 출시 후 인상, Nanbeige4.2-3B 중심의 구조와 비용 분석, 반복 횟수 결정 방식, reasoning trace 논쟁에 대한 저자 의견, 최신 논문 4편 |
| Tosea.ai, "What Is a Looped Transformer?" | 2026-09-02 | Huginn의 반복 횟수별 벤치마크, 연구 계보, 프런티어 연구소의 동기, CoT monitorability 논쟁, Astra 주장의 확인 상태 |
| 라온피플, "Looped Transformer: 모델 크기는 그대로, 생각은 더 깊게" | 2026-09-11 | 생각할 시간을 늘리는 세 방법 구분, prelude, core, coda 식 풀이, 적응형 계산 깊이, 엣지 장치 관점과 적용 영역 |
세 자료의 공통 결론은 looping이 "작은 모델이 큰 모델을 공짜로 이기는 기술"이 아니라는 것이다. 저장할 파라미터는 줄지만 연산량은 줄지 않고, 반복은 새 지식을 만들지 않으며, 그 대신 이미 아는 정보를 여러 단계에 걸쳐 조합하는 능력을 키운다.
배경
생각할 시간을 늘리는 세 가지 방법
최근 LLM은 test-time compute를 늘려 추론 능력을 끌어올리는 방향으로 가고 있다. test-time compute는 학습이 끝난 모델이 답을 내는 시점에 쓰는 연산량을 뜻한다. 사람은 쉬운 문제에 1초, 어려운 문제에 1분을 쓰지만, 일반 Transformer는 질문 난도와 무관하게 토큰 하나를 만드는 계산 깊이가 같다. 라온피플 글은 연산을 늘리는 방법을 세 가지로 구분하고, 셋이 서로 영향을 주지만 같은 자원은 아니라고 강조한다.
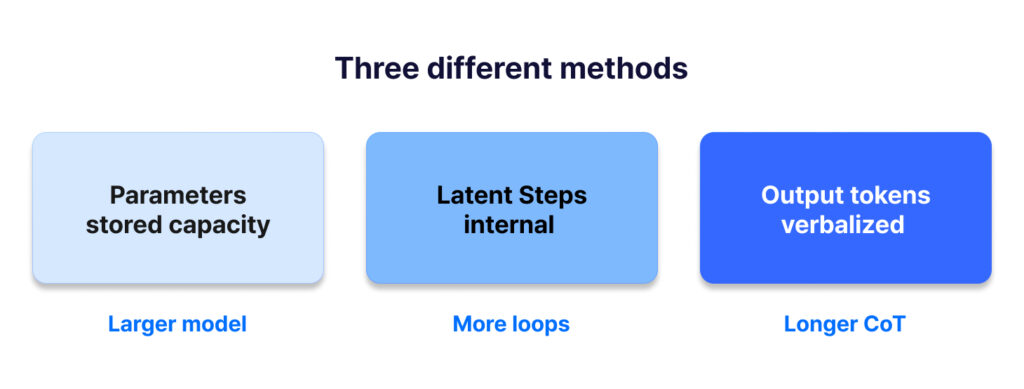
| 방법 | 늘리는 자원 | 대표 사례 | 비용 |
|---|---|---|---|
| 모델을 키운다 | 파라미터 수 | 더 큰 모델 | 모델 파일과 실행 메모리가 함께 커진다. 질문 후 생각할 시간을 늘리기보다 처음부터 큰 두뇌를 준비하는 방식이다 |
| 내부 계산 단계를 늘린다 | 반복 횟수 | looped transformer | 파라미터는 그대로이고 연산량과 응답 시간이 늘어난다 |
| 중간 추론을 글로 쓴다 | 출력 추론 토큰 수 | CoT, OpenAI o 시리즈, DeepSeek-R1 | 글이 길어지는 만큼 응답 시간과 비용이 늘고, 더 생각하려면 반드시 문장으로 꺼내야 한다 |
chain-of-thought(CoT)는 모델이 최종 답 전에 중간 풀이 과정을 텍스트 토큰으로 먼저 생성하는 방식이다. 여기서 "토큰 하나를 처리하는 깊이가 정해져 있다"는 말은 총 계산량이 아니라 신경망의 기본 깊이를 가리킨다. CoT로 답을 길게 쓰면 그 깊이를 여러 번 반복할 뿐, 한 번의 깊이가 깊어지지는 않는다. 따라서 "추론 문장을 열 개 생성했으니 신경망이 열 배 깊어진 것과 같다"고 계산할 수 없다.
라온피플 글은 세 방법을 한 문장으로 대비한다. 파라미터 수는 모델 크기를, CoT는 생각을 말로 풀어내는 시간을, looped transformer는 말로 꺼내기 전 내부에서 되풀이하는 계산을 늘린다.
표준 Transformer에서 깊이가 고정된다는 의미
표준 Transformer는 서로 다른 layer의 stack이다. 64층 모델은 가중치 64세트를 갖고, 모든 토큰이 64층을 정확히 한 번 지난다. 깊이는 학습 시점에 정해지므로 추론 시 직렬 계산을 늘리는 유일한 방법은 토큰을 더 생성하는 것, 즉 CoT다.
Tosea 글은 CoT monitorability 입장 논문(arXiv 2507.11473)의 표현을 인용해 이 구조적 의미를 설명한다. 표준 Transformer에서 chain-of-thought는 정보가 뒤 layer에서 앞 layer로 흐를 수 있는 유일한 길이다. 따라서 토큰 수가 고정돼 있으면 가장 긴 정보 흐름은 반드시 CoT를 거친다. looping은 텍스트로 드러나지 않는 두 번째 경로를 추가하며, 이 점이 이후 안전 논쟁의 출발점이 된다.
핵심 개념
looped transformer의 정의
Raschka의 정의에 따르면 looped transformer는 중간 표현을 같은 transformer block에 한 번이 아니라 여러 번 통과시키는 아키텍처 변형이다. block을 더 추가하는 것과의 차이는 반복 사이에 가중치가 같다는 점이다. 예를 들어 공유 block을 4회 실행하면 block 4개를 쌓은 것과 비슷한 직렬 계산을 얻지만 가중치는 한 벌만 저장한다. 32회 실행하면 펼친 계산 깊이(materialized depth)는 32개 복사본 수준으로 커지고 파라미터 수는 그대로다.
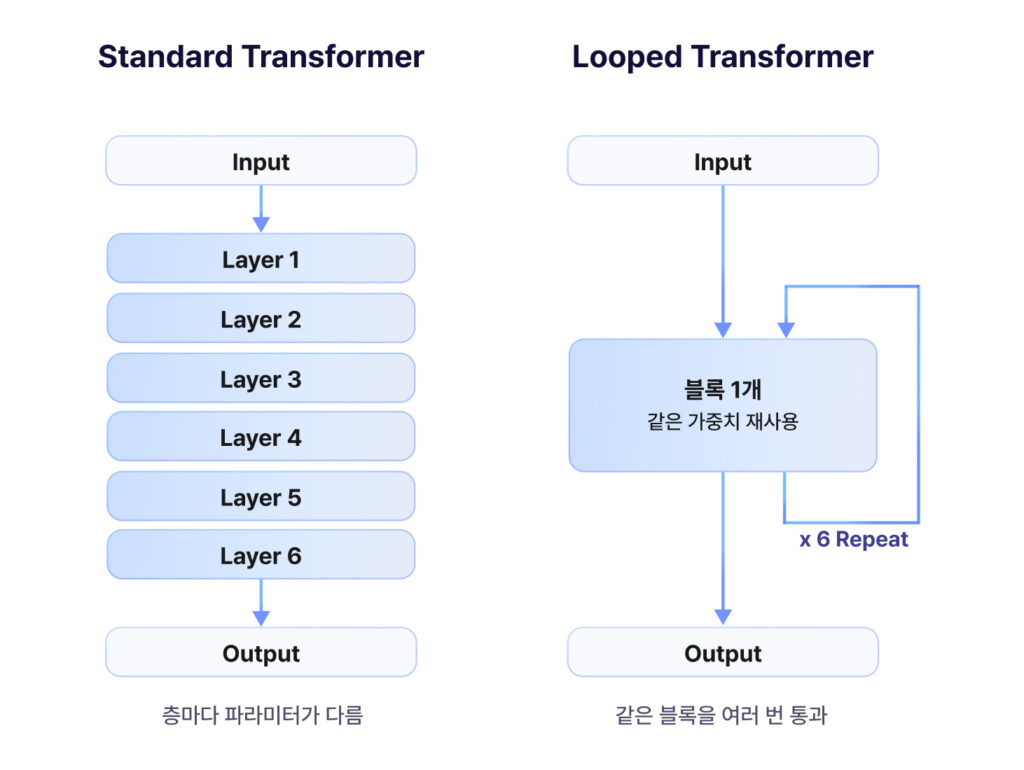
Raschka는 글 전체에서 다음 세 용어를 구분해 쓴다. 이 구분이 있어야 "깊이"와 "파라미터"를 따로 셀 수 있다.
| 용어 | 뜻 |
|---|---|
| transformer block | attention, feedforward 모듈, normalization, shortcut 연결을 담은 단위. 논문에서는 흔히 transformer layer라 부른다 |
| stack | transformer block의 연속 |
| block application | 입력을 transformer block에 한 번 통과시키는 것. looping의 유효 깊이를 세는 단위다 |
looping이 가져오는 두 가지 결과
Tosea 글은 looping의 결과를 두 가지로 요약하고, 두 번째가 논쟁의 전부이고 첫 번째가 매력의 전부라고 적는다.
- 연산량이 실행 시점의 조절 장치가 된다. 같은 checkpoint가 재학습 없이 반복 횟수만 바꿔 토큰당 계산을 늘리거나 줄인다. 모델이 아무것도 적지 않아도 되는 test-time compute scaling이다.
- 추론이 말로 남지 않는다. 각 반복은 문장이 아니라 벡터를 다듬는다. CoT 모델에서는 직렬 추론의 모든 단계가 읽을 수 있는 토큰으로 바뀌어야 하지만, looped 모델에서는 그 변환이 선택 사항이다.
반복 대상은 hidden state다
hidden state는 신경망의 중간 층이 계산해 다음 층으로 넘기는 내부 벡터다. looped transformer가 반복하는 것은 입력 문장이나 이미 생성한 단어가 아니라 이 hidden state, 즉 모델이 처리 중인 잠재 표현이다. 라온피플 글은 직관적 비유로 첫 반복이 문제 조건을 파악하고, 두 번째가 조건을 연결해 풀이를 시도하고, 세 번째가 풀이를 다듬는 과정을 든다. 다만 실제 반복마다 이런 역할이 정해져 있지는 않으며, 앞선 계산 결과를 바탕으로 다음 계산을 이어 간다는 점에서 같은 문제를 처음부터 다시 푸는 것과 다르다고 덧붙인다.
RNN과의 차이
RNN도 같은 가중치를 반복해서 쓰므로 looped transformer와 비슷해 보인다. 두 구조의 차이는 반복의 대상과 방향이다. RNN은 문장을 왼쪽에서 오른쪽으로 읽으며 이전 토큰까지의 상태와 새 토큰을 결합해 다음 상태를 만든다. 반면 looped transformer는 문맥 전체를 담은 잠재 표현을 같은 core에 반복 통과시키며, 토큰 사이 정보 전달은 여전히 attention이 맡는다.
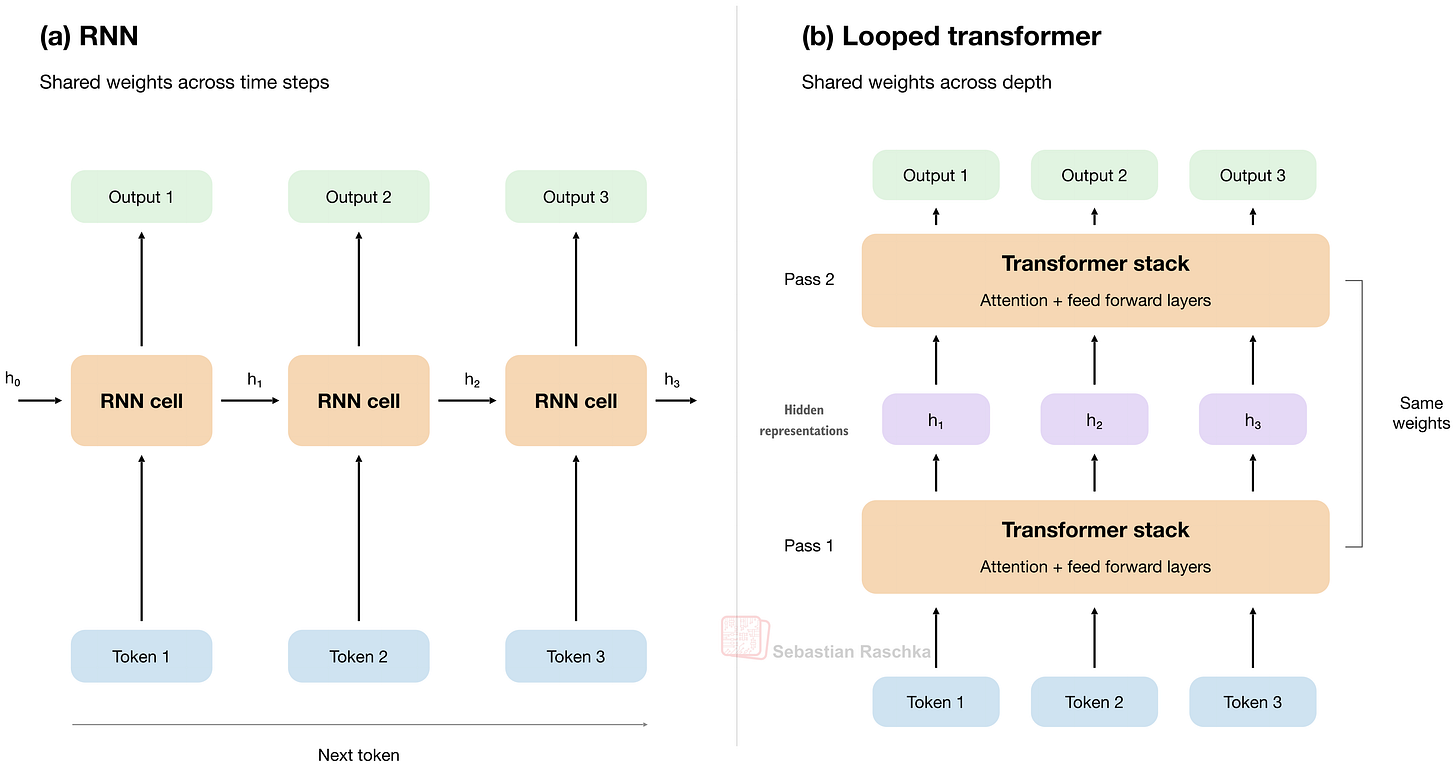
| 구분 | 전통적인 RNN | looped transformer |
|---|---|---|
| 반복하는 대상 | 이전 상태와 다음 토큰 | 문맥을 담은 잠재 표현 |
| 반복 방향 | 토큰의 시간, 위치 방향 | 신경망의 깊이 방향 |
| 반복의 역할 | 토큰을 순서대로 읽으며 상태를 갱신한다 | 같은 표현을 한 단계 더 정제한다 |
| 반복 횟수 | 주로 입력 길이로 결정된다 | 계산 예산이나 종료 조건으로 결정된다 |
| 토큰 간 정보 전달 | hidden state를 다음 step으로 전달한다 | attention |
깊이가 순환한다는 이 성질 때문에 looped transformer를 recurrent-depth 모델이라고 부른다. Raschka는 비유가 헷갈린다면 looped transformer를 "가중치 공유를 곁들여 모델을 키우는 것"으로 생각해도 충분하다고 적는다.
CoT와의 차이
CoT는 중간 과정을 텍스트로 생성하므로 후속 도구가 읽을 수 있고 사람이 검토할 단서가 생긴다. 그러나 텍스트는 모델 내부 상태 전체가 아니며, 긴 추론 토큰은 지연 시간과 컨텍스트 사용량을 늘린다. looped transformer는 중간 과정을 문장으로 만들지 않아 말로 표현하기 어려운 정보까지 활용할 수 있다. 반면 계산 과정이 수치 내부 상태에만 남으므로 사람이 그 내용을 직접 읽을 수 없다.
라온피플 글은 이 대비에 주의 사항을 붙인다. CoT가 보인다고 실제 인과적 추론 과정이 그대로 공개되는 것은 아니고, 잠재 반복이 보이지 않는다고 검증이 불가능한 것도 아니다. 두 경우 모두 외부 근거 검색, 도구 실행 기록, 테스트, 제약 검사 같은 별도 검증층이 필요하다. 즉 내부에서 더 깊게 계산할 수 있다는 것과 그 과정을 사람에게 설명할 수 있다는 것은 별개 문제다.
방법
고정 반복의 예시인 Nanbeige4.2-3B
Raschka는 2026년 7월 공개된 open-weight LLM Nanbeige4.2-3B(arXiv 2607.22083)를 가장 단순한 예로 든다. 겉모양은 일반 Transformer와 같지만, stack 끝에서 처음으로 되돌아가는 화살표가 하나 더 있다.
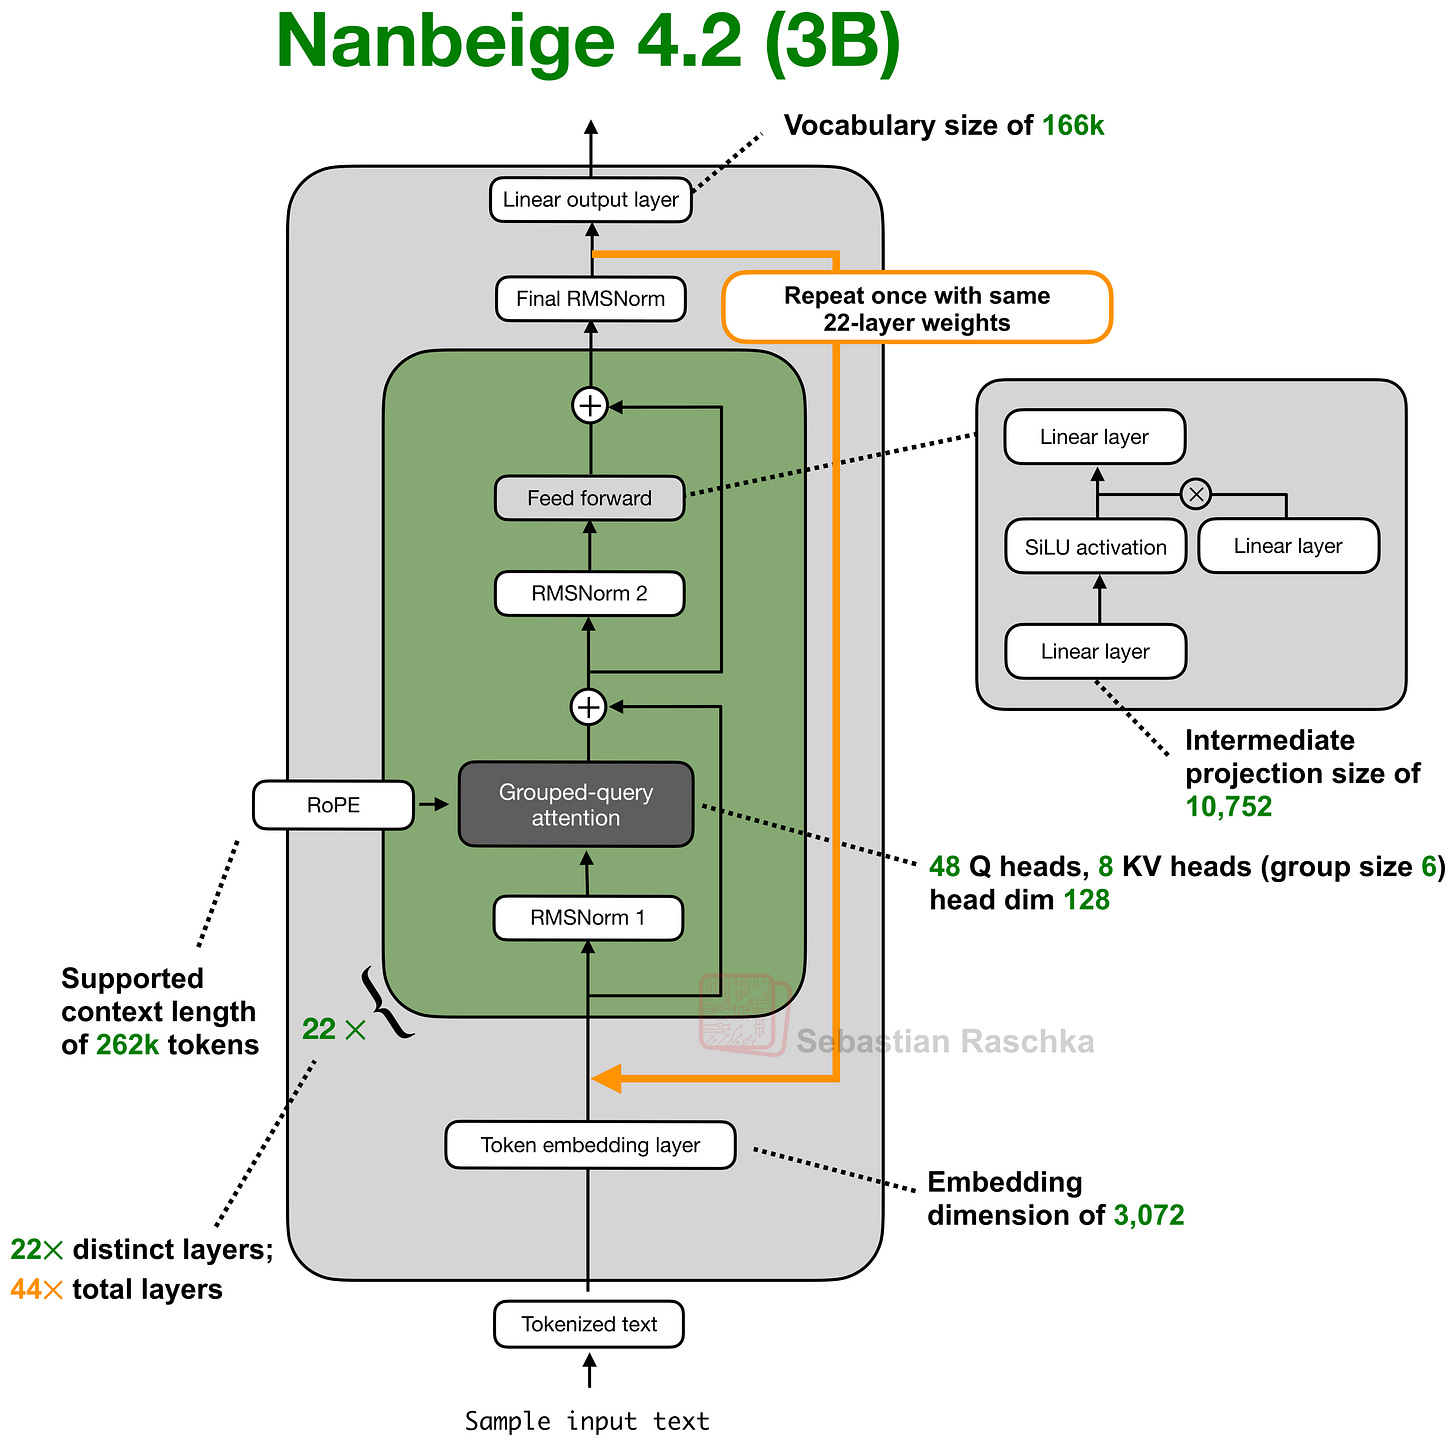
계산 흐름은 다음과 같다.
- 입력 텍스트를 토큰화하고 임베딩 벡터로 바꾼다.
- 임베딩이 각자 가중치가 다른 22개 block을 지난다.
- 첫 pass가 끝난 hidden state를 같은 22개 block에 다시 통과시킨다. block 1부터 block 22까지 차례로 한 번 더 적용한다.
- 마지막 RMSNorm과 출력층이 다음 토큰 확률을 낸다.
이 계산을 펼치면 block application은 44회다. 23번째 application은 block 1의 가중치를, 24번째는 block 2의 가중치를 쓴다. 즉 transformer 가중치를 한 벌도 추가하지 않고 유효 깊이를 22에서 44로 늘린다. 그림에 적힌 구성은 어휘 약 16만 6천 개, 지원 context 26만 2천 토큰, 임베딩 차원 3,072, Grouped-query attention(Q head 48개, KV head 8개, head dim 128), feedforward 중간 projection 10,752다.
반복을 2회로 정한 이유에 대해 Nanbeige 논문은 자세히 설명하지 않고, 2회가 가장 효율적인 설정이었다고만 밝힌다. 3회로 늘리면 성능이 조금 오르지만 추가 연산 비용만큼의 가치가 없었다. 기술 보고서는 두 가지 선택을 더 보고한다.
- 처음부터 looped 아키텍처로 학습한 쪽이, 이미 pre-training된 Transformer를 upcycling으로 변환한 쪽보다 좋았다.
- pass를 2회보다 늘리면 이득은 작은데 학습이 느려지고 최적화가 불안정해졌다.
looping의 비용 구조
looping은 모델을 키우는 대안이다. 22개 block을 두 번 쓰는 모델은 44개 일반 block을 쓰는 모델보다 transformer block 파라미터가 약 절반이고, 그만큼 가중치 저장 메모리가 줄어든다. 그러나 연산량과 KV cache는 줄지 않는다. KV cache는 이전 토큰의 attention key와 value를 저장해 두고 다음 토큰을 생성할 때 재사용하는 장치다.
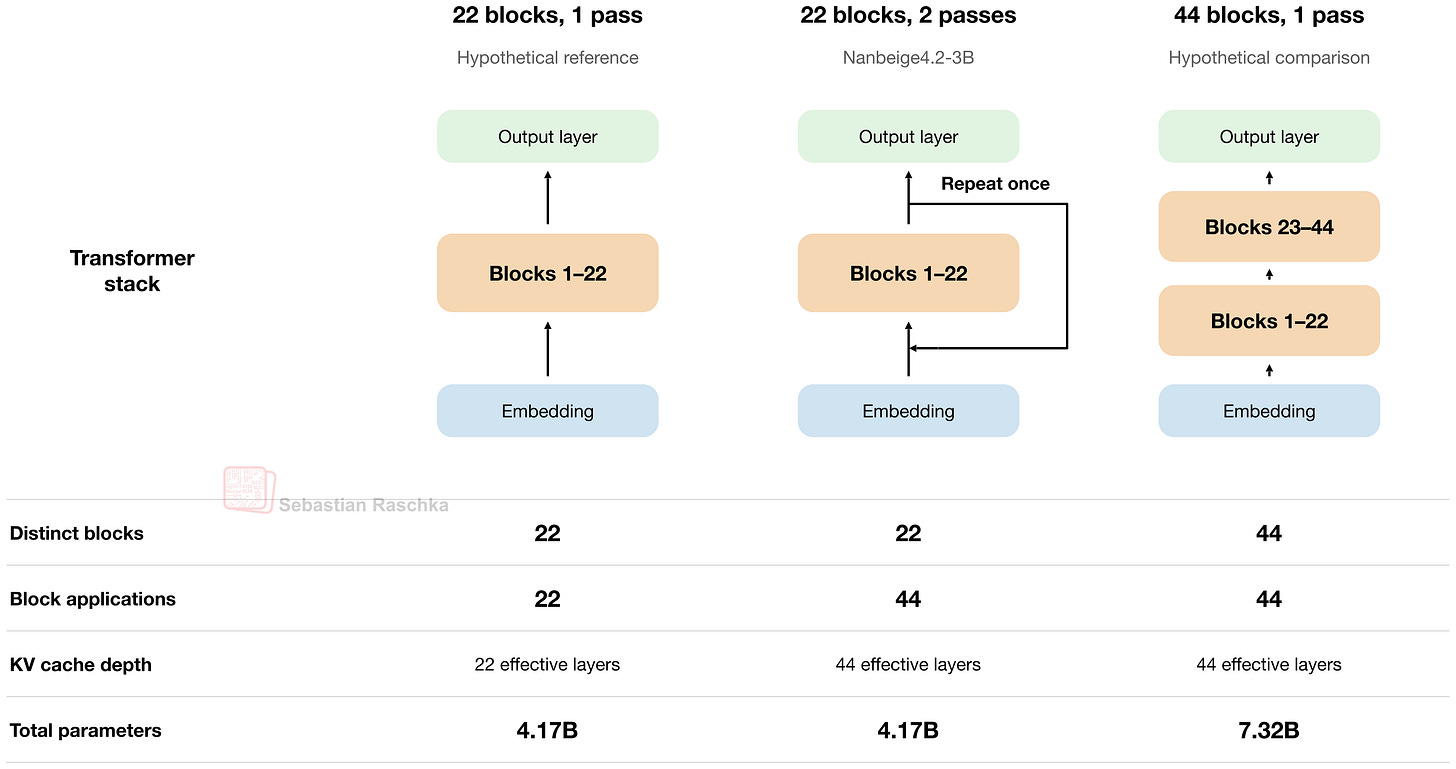
| 구성 | 고유 block | block application | KV cache 깊이 | 전체 파라미터 (그림 기준) |
|---|---|---|---|---|
| 22 block, 1 pass (가상 기준) | 22개 | 22회 | 22층 | 4.17B |
| 22 block, 2 pass (Nanbeige4.2-3B) | 22개 | 44회 | 44층 | 4.17B |
| 44 block, 1 pass (가상 비교) | 44개 | 44회 | 44층 | 7.32B |
표에서 looping 구성은 연산과 KV cache에서 44 block 모델과 같고, 파라미터에서만 22 block 모델과 같다. 비용 항목별로 보면 다음과 같다.
| 비용 항목 | looping의 효과 |
|---|---|
| 가중치 저장 메모리 | transformer block 부분이 약 절반으로 준다. 단 임베딩층과 출력층은 이 비교에서 별개다. Nanbeige4.2-3B에서 두 층은 전체 3B 파라미터의 약 25%이며, 두 층의 가중치를 공유하면 12.5%로 줄일 수 있다 |
| forward 연산 | 44회 block application을 수행하므로 44 block 모델과 비슷하다 |
| 학습 비용 | gradient가 공유 stack의 두 반복 모두로 흐른다. optimizer가 갱신할 고유 파라미터만 적고 backpropagation은 44회 application 전체를 지난다 |
| KV cache | 줄지 않는다. 두 번째 pass에 들어오는 중간 상태가 첫 pass와 달라 key와 value도 달라진다 |
KV cache가 줄지 않는 이유는 구체적인 예로 확인할 수 있다. block application 1과 23은 같은 block 1의 가중치를 쓰지만 입력이 다르므로 각자 KV cache 항목이 필요하다. Nanbeige 연구진은 pass 사이에 KV cache를 공유하는 실험도 했다. cache 크기는 절반이 됐지만 성능이 떨어져, 공개 버전은 cache를 pass마다 분리한 쪽이다.
Tosea 글과 라온피플 글도 같은 결론을 낸다. block을 32회 실행하면 block 32개 분량의 연산이 든다. 절약은 FLOPs가 아니라 저장 가중치에서, 그리고 같은 직렬 깊이를 얻으려고 CoT 토큰 수백 개를 생성하지 않아도 된다는 데서 나온다.
반복 횟수를 정하는 방식
반복 횟수는 아키텍처 설계에서 따로 정해야 하는 선택지다. Nanbeige처럼 고정할 수도 있고, 토큰마다 다르게 정할 수도 있다. 자료에 등장하는 방식은 다음과 같다.
| 모델 | 반복 단위 | 반복 횟수 결정 방식 |
|---|---|---|
| Nanbeige4.2-3B | 22 block stack | 2회 고정 |
| Universal Transformer (2018) | 단일 block | 고정, 또는 adaptive halting |
| Ouro-Thinking 2.6B (ByteDance) | 48 block stack | 4회. 학습된 exit gate가 출력 pass를 고른다 |
| Mixture-of-Recursions (2025) | 첫 block과 마지막 block 사이의 recursion block | 토큰별 학습된 router |
| Huginn (Geiping et al. 2025) | 앞 2 block과 뒤 2 block 사이의 공유 4 block | 학습 시 무작위 샘플링, 추론 시 사용자가 예산 지정, KL 기반 조기 종료 |
Universal Transformer의 adaptive halting
Universal Transformer는 stack이 아니라 단일 block을 반복 적용한다. 반복 횟수를 고정할 수도 있지만 adaptive halting도 제안했다. adaptive halting에서는 작은 학습 함수가 매 단계 위치마다 halting probability를 내고, 연속 반복에서 이 확률을 더해 합이 임계값을 넘으면 그 위치의 반복을 멈춘다. 계산이 끝없이 늘지 않도록 최대 반복 횟수도 상한으로 둔다.
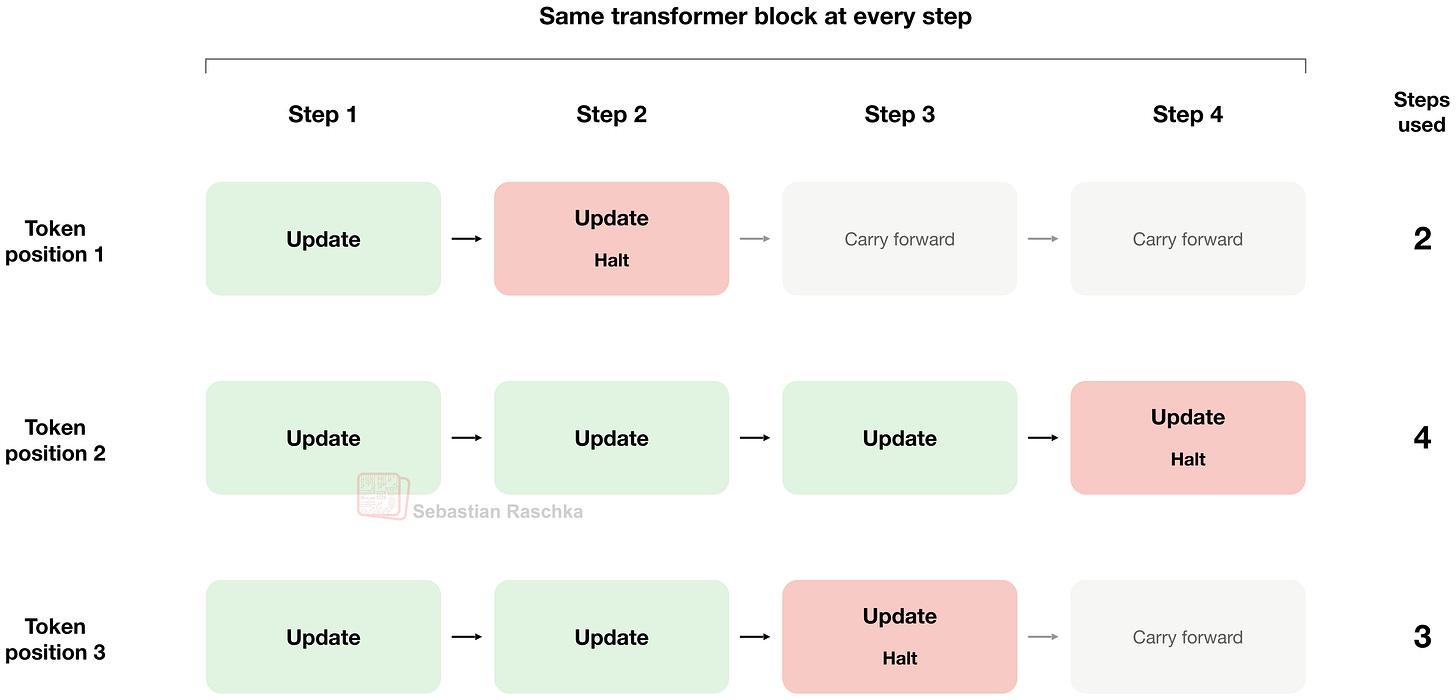
그림의 예에서 토큰 위치 1은 2 step, 위치 2는 4 step, 위치 3은 3 step을 쓴다. 먼저 멈춘 위치는 이후 step에서 갱신 없이 상태를 그대로 전달한다. 따라서 모델은 추가 계산이 도움이 되는 토큰에 연산을 집중할 수 있다. 라온피플 글은 이 장치를 Adaptive Computation Time(ACT)이라는 이름으로 소개한다.
Ouro의 exit gate
ByteDance의 Ouro-Thinking 2.6B는 48개 block stack을 4회 적용한다. block application은 192회이고 저장하는 가중치는 48개 block분이다. Nanbeige보다 극단적인 설정이다. 여기에 학습된 exit gate가 출구별 확률을 내고, 누적 확률 임계값으로 어느 pass의 결과를 출력으로 쓸지 정한다. Universal Transformer의 adaptive halting 발상을 빌린 것이다.
다만 Raschka는 실용상 단서를 단다. 공개된 Hugging Face 구현은 설정된 모든 pass를 계산한 뒤 출력을 고르므로, 실제로는 반복이 4회로 고정돼 있다.
Mixture-of-Recursions의 router
Mixture-of-Recursions(MoR, arXiv 2507.10524)는 Universal Transformer를 정교하게 발전시킨 방식이다. 반복되는 stack을 recursion block이라 부르고, 이를 별도의 첫 block(Layer 0)과 마지막 block(Layer L-1) 사이에 둔다. 혁신은 토큰마다 반복 횟수를 정하는 방법에 있다.
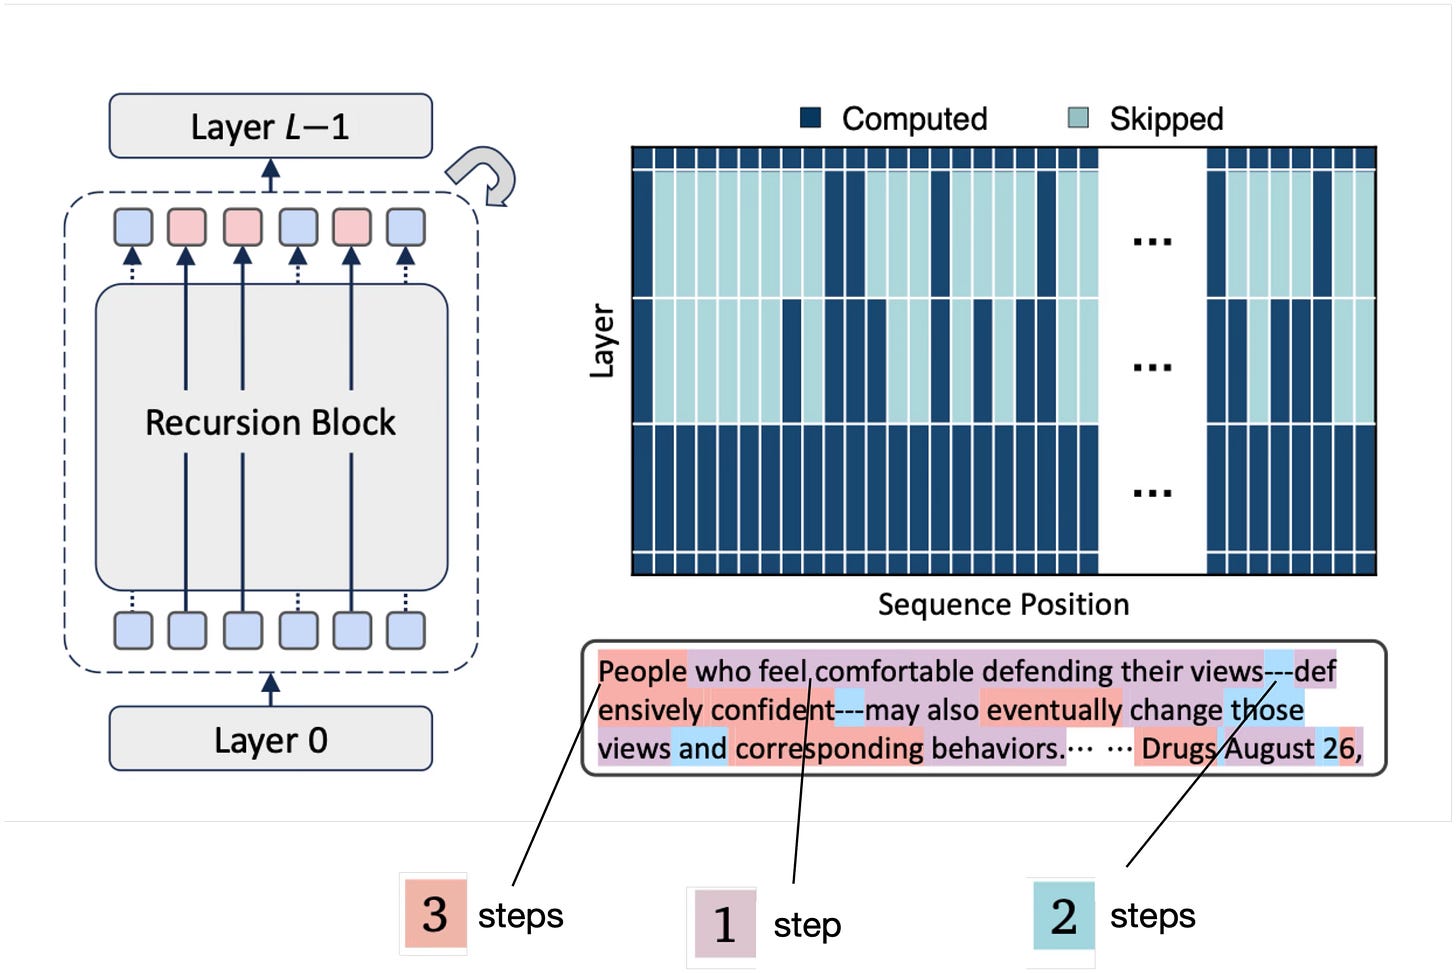
mixture-of-experts는 입력마다 일부 전문 모듈만 활성화하는 구조다. MoR의 router는 mixture-of-experts의 라우팅과 비슷하지만, 어느 전문가로 보낼지가 아니라 공유 stack을 몇 번 적용할지를 정한다. router는 문맥 정보를 담은 토큰의 hidden representation을 입력으로 받는다. 따라서 같은 단어라도 위치와 앞 문맥에 따라 반복 횟수가 달라진다. 예를 들어 그림의 "People"이 항상 3회 반복되는 것은 아니다.
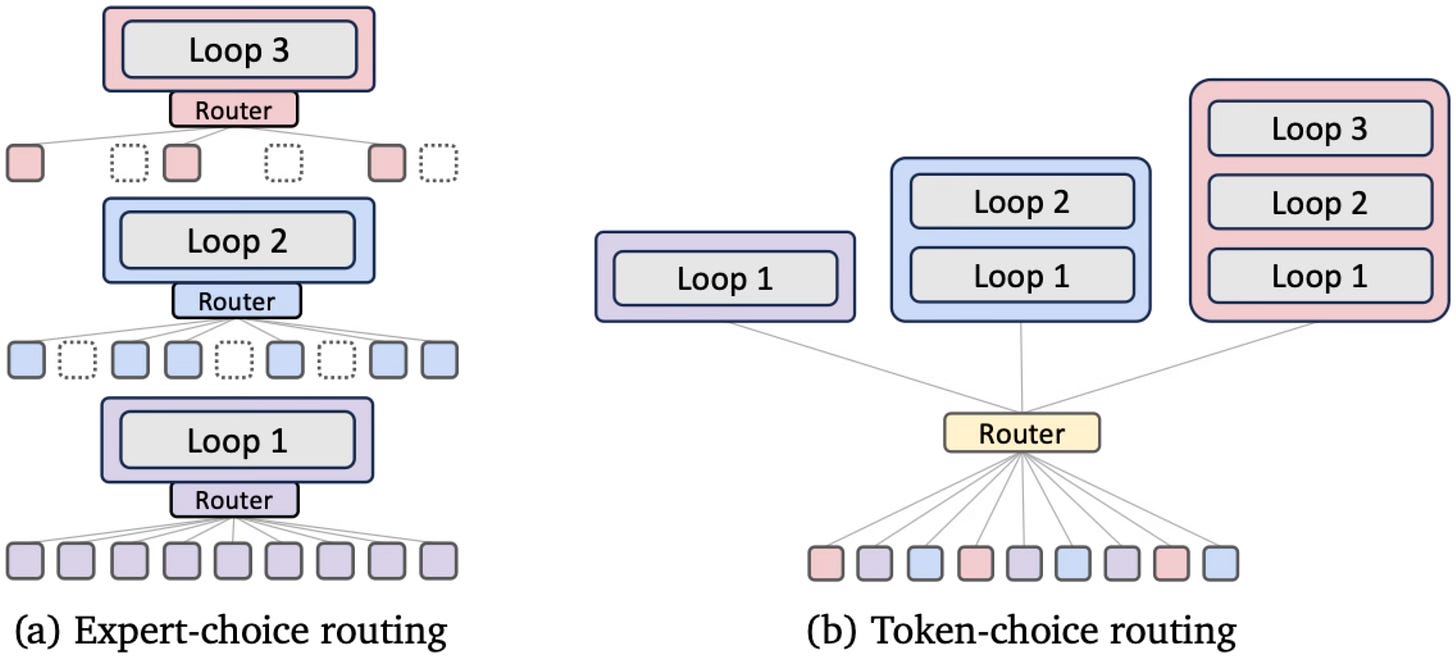
| 라우팅 방식 | 결정 시점 | 동작 |
|---|---|---|
| expert-choice routing | recursion step마다 | 각 step이 처리할 토큰을 고른다. 빠진 토큰은 이후 step에서 제외된다 |
| token-choice routing | 처음 한 번 | router가 각 토큰을 1회, 2회, 3회 경로 중 하나에 배정한다 |
두 방식 모두 Nanbeige처럼 반복 사이에 transformer 가중치를 공유하고, 추가 유연성은 토큰별 계산량 선택에서 나온다. 모델과 router는 함께 학습되므로 모델은 학습 중에 서로 다른 경로로 동작하는 법을 배운다.
적응형 종료 기준의 일반 원리
라온피플 글은 적응형 계산 깊이(adaptive depth)를 별도 절로 다룬다. "대한민국의 수도는?"처럼 답이 분명한 질문에 많은 반복을 쓰는 것은 비효율적이다. 한 문장 안에서도 조사나 문장부호는 쉽게 결정되지만, 계산 결과나 핵심 결론은 더 많은 검토가 필요하다. 모든 토큰에 16회 같은 고정 횟수를 적용하면 구현은 쉽지만 쉬운 토큰에도 불필요한 연산이 생긴다.
모델은 정답을 직접 알 수 없으므로 내부 상태가 얼마나 안정됐는지를 보고 종료를 판단한다. 대표적인 기준은 다음 네 가지다.
- 반복 전후의 다음 토큰 확률이 거의 달라지지 않는가
- 가장 가능성이 높은 토큰이 여러 번 반복해도 그대로인가
- 모델 내부의 잠재 표현이 더 이상 크게 변하지 않는가
- 별도로 학습된 종료 장치가 계산을 멈춰도 된다고 판단하는가
다만 내부 상태가 안정됐다고 정답이 확정된 것은 아니다. 모델이 틀린 답으로 빠르게 수렴할 수도 있고, 올바른 답을 찾는 동안 상태가 계속 변할 수도 있다. 기준이 느슨하면 너무 일찍 멈추고 엄격하면 불필요한 반복이 늘어나므로, 최소와 최대 반복 횟수를 종료 기준과 함께 설정해야 한다.
Huginn의 prelude, core, coda 구조
가장 명확한 공개 구현은 Geiping et al. "Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach"(arXiv 2502.05171)다. ELLIS Institute Tübingen, University of Maryland, Lawrence Livermore National Laboratory가 참여했고, 3.5B 파라미터 모델 Huginn을 8,000억 토큰으로 학습했다. Oak Ridge의 Frontier 슈퍼컴퓨터를 썼다.
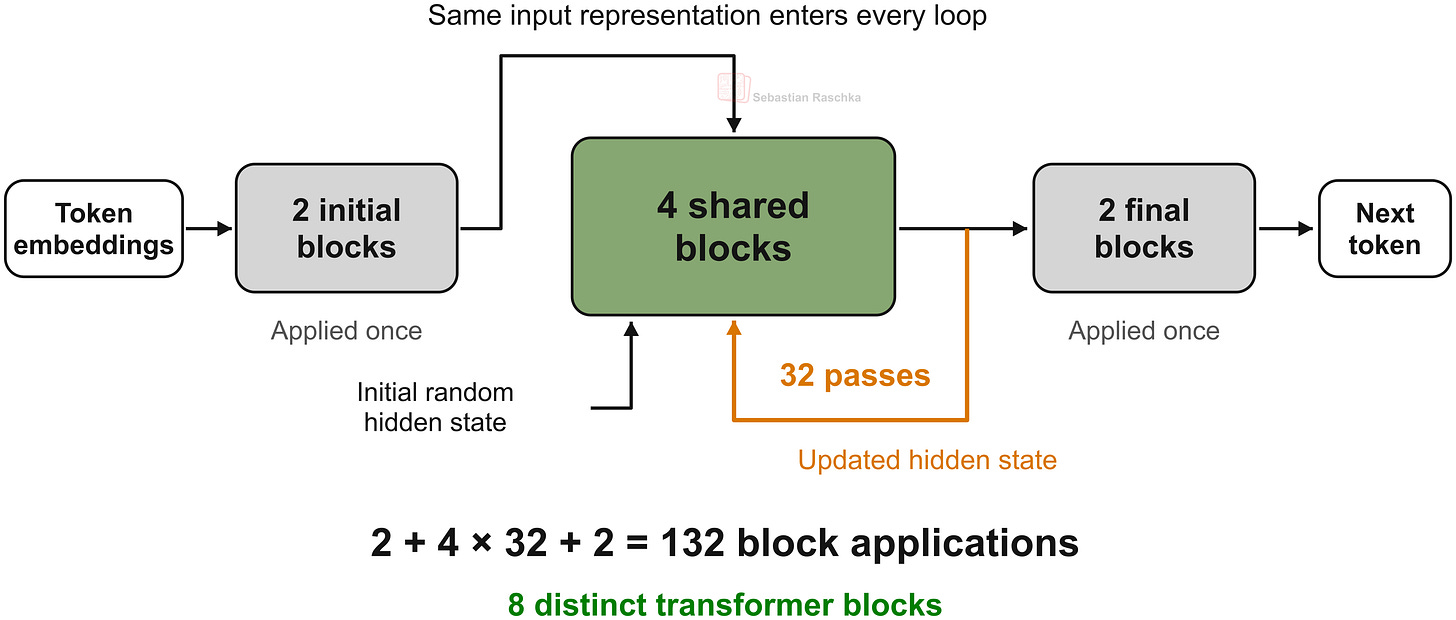
| 구성 | 역할 | 식 (라온피플 표기) |
|---|---|---|
| Prelude (P) | 몇 개의 일반 transformer layer가 입력 토큰을 latent 공간의 내부 표현으로 바꾼다 | e = P(x) |
| Core (R) | 이전 latent 상태와 원래 입력 표현을 연결해 학습된 선형 projection(adapter 행렬)으로 합친 뒤 transformer layer에 통과시킨다. r회 반복한다 | s_i = R(e, s_{i-1}) |
| Coda (C) | 마지막 latent 상태를 next-token 확률로 디코딩한다 | p = C(s_r) |
Raschka의 그림 기준으로 앞 2 block과 뒤 2 block은 한 번씩 적용되고 공유 4 block이 32회 반복되므로, block application은 2 + 4×32 + 2 = 132회이고 고유 block은 8개다. Nanbeige와 비교하면 반복 stack을 앞뒤 block이 감싸는 sandwich 구조이고, 매 반복마다 초기 입력 표현이 다시 들어간다는 점이 다르다.
두 설계 세부가 반복을 안정시킨다.
| 장치 | 내용 | 역할 |
|---|---|---|
| 무작위 초기 상태 | core의 첫 hidden state를 무작위로 시작한다 | 시작점과 무관한 정상 상태로 수렴하는 성질(path independence)을 유도한다 |
| 입력 재주입(input injection) | 원래 입력 표현 e를 매 반복마다 core에 다시 입력한다 | 반복을 거듭하는 동안 모델이 무엇을 풀고 있었는지 잃어버리지 않게 한다 |
Tosea 글에 따르면 두 장치는 "deep thinking" 문헌에서 왔고, 이 장치가 없으면 공유 block 반복은 붕괴하거나 발산하기 쉽다.
Huginn은 학습 중 반복 횟수를 무작위로 샘플링해 모델이 다양한 계산량에 대비하게 한다. 추론 시에는 모델을 실행하는 쪽이 8회, 32회, 64회 같은 고정 예산을 고른다. 여기에 토큰별 adaptive stopping도 있다. 연속 두 반복의 next-token 분포 사이 KL-divergence가 임계값보다 작으면, 즉 두 분포가 충분히 비슷하면 반복을 멈춘다. 라온피플 글은 이 기능이 충분히 학습된 완성형 기능이라기보다 학습 후 종료 규칙을 적용한 개념증명에 가깝고, 다양한 과제에서의 안정성은 더 검증해야 한다고 평가한다.
논문 저자들은 recurrent depth를 세 번째 scaling 방향으로 본다. pre-training은 파라미터를, CoT는 토큰을, recurrent depth는 직렬 계산을 직접 늘린다. 이 설계는 실제 파라미터보다 펼친 파라미터가 많은 "compute-heavy" 구조이며, 파라미터는 많고 계산은 가벼운 mixture-of-experts와 거울상이다. 논문은 "recurrent-depth 구성은 추론 패턴 학습에 뛰어나고, MoE는 복잡한 정보의 저장과 검색에 뛰어나다"고 적는다. Tosea 글은 이를 근거로 looping과 sparsity가 경쟁 관계가 아니라 보완 관계라고 강조한다.
제목에 latent reasoning이 들어 있지만 모델은 여전히 텍스트 CoT를 생성할 수 있다. looping은 각 출력 토큰 전에 계산을 더할 뿐이다. 논문 7절은 수치 추론 프롬프트에서 latent 상태가 한 점으로 수렴하지 않고 회전 궤적을 그리는 "orbiting" 현상도 기록한다.
연구 계보
recurrent depth는 2026년의 발명이 아니다. Tosea 글은 이 맥락이 Astra 보도에 얼마나 놀라야 하는지 판단하는 데 중요하다고 본다.
| 연도 | 연구 | 기여 |
|---|---|---|
| 2018 | Universal Transformers (Dehghani et al.) | 공유 transformer block 하나를 halting 장치와 함께 반복 적용한 최초의 weight-tied Transformer |
| 2019 | ALBERT | 압축 기법으로서의 cross-layer 파라미터 공유. 공유 block이 품질을 해치지 않음을 보였다 |
| 2024 | Coconut (Hao et al.) | 마지막 hidden state를 다음 입력 임베딩으로 되먹이는 "continuous thought". 한 경로에 고정하지 않고 너비 우선 탐색처럼 추론한다 |
| 2025 | Huginn (Geiping et al.) | 3.5B 파라미터, 8,000억 토큰으로 latent recurrence를 확장했다. test-time loop scaling으로 약 50B materialized 파라미터 수준까지 보였다 |
| 2025 | Mixture-of-Recursions (Bae et al.) | 경량 router로 토큰마다 다른 recursion 깊이를 준다 |
| 2025 | Ouro / LoopLM (ByteDance et al.) | 7.7T 토큰으로 학습한 1.4B와 2.6B looped 모델을 공개했다. entropy 정규화 목적함수로 깊이 배분을 학습하며 최대 12B 모델과 대등하다고 보고했다 |
| 2025 | Beyond Parameters (Zhu et al.) | looping이 memorization과 reasoning에 주는 영향을 분리해 측정했다 |
| 2026 | Nanbeige4.2-3B | 22 block stack을 2회 반복하는 open-weight 모델 |
| 2026 | SMELT | 연산량과 KV cache를 맞춘 조건에서 MoE looped transformer의 scaling law를 측정했다 |
| 2026 | Full-bandwidth transformer | 토큰 위치 방향으로 이전 토큰의 최종 hidden state를 되먹이는 latent feedback을 연구했다 |
Ouro는 Astra 보도에서 가장 많이 인용된 결과다. looping을 사후에 덧붙이지 않고 pre-training에 넣었으며, 이득의 원인을 원시 용량이 아니라 "우수한 지식 조작 능력"으로 설명한다.
결과
반복 횟수만 바꾼 Huginn 벤치마크
Tosea 글은 Huginn 논문의 통제 실험 수치를 옮긴다. 같은 가중치, 같은 8,000억 토큰 학습에서 테스트 시 반복 횟수 r만 바꾼 결과다 (Geiping et al. Table 1, 2, 4).
| Benchmark | r = 1 | r = 8 | r = 16 | r = 32 |
|---|---|---|---|---|
| ARC-E | 34.89 | 65.11 | 69.49 | 69.91 |
| ARC-C | 24.06 | 35.15 | 37.71 | 38.23 |
| HellaSwag | 29.34 | 58.54 | 64.67 | 65.21 |
| MMLU | 23.60 | 25.29 | 31.25 | 31.38 |
| OpenBookQA | 26.80 | 35.40 | 37.60 | 38.80 |
| PiQA | 55.33 | 73.45 | 75.79 | 76.22 |
| SciQ | 47.1 | 92.10 | 93.90 | 93.50 |
| GSM8K CoT (flexible / strict) | 0.00 / 0.15 | 해당 없음 | 해당 없음 | 34.80 / 42.08 |
반복 1회에서 모델은 대부분 과제에서 무작위 수준을 겨우 넘고, 32회에서는 그럴듯한 소형 모델이 된다. 예를 들어 ARC-E는 34.89점에서 69.91점으로, SciQ는 47.1점에서 93.50점으로 오른다. 바뀐 것은 같은 block의 실행 횟수뿐이므로, Tosea 글은 이를 latent recurrence가 실제 계산을 수행한다는 가장 깔끔한 증거로 평가한다.
그러나 이득은 포화하고 과제마다 다르다.
- r = 16에서 32로 연산을 두 배로 늘려도 ARC-E는 0.42점 오르고 SciQ는 93.90점에서 93.50점으로 오히려 떨어진다.
- 논문 Figure 1에 따르면 OpenBookQA 같은 쉬운 과제는 빨리 수렴하고 GSM8K는 계속 오른다. Raschka도 HellaSwag는 약 8회 이후 평탄해지고 GSM8K와 HumanEval은 더 많은 반복에서 이득을 본다고 적는다.
- 라온피플 글에 따르면 공개 모델에서는 일부 추론 벤치마크에서 대략 64단계 부근까지 개선이 관찰됐다.
즉 looping은 직렬 추론이 병목인 과제에서 효과가 크고, 그렇지 않은 과제에서는 효과가 거의 없다. Tosea 글은 "반복을 늘리면 고르게 좋아진다"는 주장이 매우 치우친 분포의 평균을 파는 것이라고 지적한다.
데이터 품질과 고정 깊이 baseline 대조
looping이 데이터 scaling law를 뒤집지는 않는다. Huginn r = 32는 ARC-E 69.91점, MMLU 31.38점이다. 4T 토큰의 정제 데이터로 학습한 OLMo-2-1124-7B는 각각 82.79점, 60.56점이다. 다만 Huginn은 3.5B 파라미터와 0.8T 토큰에 비해 높은 성능을 내, 대부분 지표에서 Pythia-12B를 이기고 HumanEval에서 OLMo-7B를 23.17점 대 12.80점으로 앞선다.
아키텍처 효과를 가장 직접 보여 주는 것은 Table 4의 대조 실험이다. 같은 데이터와 설정으로 1,800억 토큰을 학습한 recurrent 모델과 고정 깊이 baseline을 비교했다.
| 지표 | recurrent 모델 | 고정 깊이 baseline | 차이 |
|---|---|---|---|
| ARC-E | 53.62 | 46.42 | +7.20점 |
| GSM8K CoT | 9.02 | 1.82 | +7.20점 |
학습 레시피가 같으므로 격차는 아키텍처에서 나왔다고 해석할 수 있다.
같은 학습 연산에서의 비교
Mixture-of-Recursions 논문은 Vanilla Transformer, 고정 recursion(Recursive), MoR을 모델 크기와 학습 연산 예산별로 비교한다. Raschka가 정리한 결과는 다음과 같다.
| 조건 | 결과 |
|---|---|
| 가장 작은 모델(135M) | Vanilla Transformer가 가장 좋다 |
| 더 큰 모델 | MoR이 따라잡아, 특히 작은 학습 예산에서 자주 앞선다 |
| 가장 큰 예산 | 여러 곡선이 매우 가깝다 |
같은 학습 연산이 같은 학습 토큰 수를 뜻하지는 않는다. MoR은 일부 계산을 건너뛰므로 같은 예산 안에서 더 많은 토큰을 처리할 수 있다. Raschka는 모델이 충분히 크면 looped transformer가 고정 연산 예산에서 품질을 올릴 수 있다고 정리하며, 135M 모델만 봤다면 반대 결론을 냈을 것이므로 규모 있는 실험이 중요하다고 덧붙인다.
SMELT(arXiv 2609.01343, 2026년 9월)는 이 비용 비교를 더 엄밀하게 다룬다. 토큰당 연산량, 비임베딩 총 파라미터, KV cache 요구량을 거의 같게 맞춘 상태에서 looped와 일반 Transformer를 비교한다.
- mixture-of-experts 아키텍처에서 transformer block의 가운데 절반을 두 번 적용한다. Nanbeige와 비슷하되 Huginn처럼 앞뒤 block이 감싼다.
- 추가 block application의 연산을 상쇄하려고 hidden dimension을 줄이고, 줄어든 파라미터는 expert를 추가해 회복한다. attention head 구성도 조정해 KV cache를 맞춘다.
- 비임베딩 파라미터 54B까지 실험했다. 적합한 scaling 곡선에서 같은 validation loss에 도달하는 데 학습 연산이 약 6.8~18% 덜 든다고 추정한다.
Raschka는 이 결과를 looping이 연산 측면에서 가치가 있다는 답으로 읽는다. 같은 연산 예산에서 조금 더 나은 모델을 준다는 뜻이다.
저장 능력과 문제 해결 능력의 분리
Zhu et al. "Beyond Parameters: Exploring Virtual Logic Depth for Scaling Laws"(arXiv 2506.18233, 2025년 6월)는 LLM의 memorization과 reasoning을 따로 측정한다. 이 결과는 looping이 무엇을 늘리고 무엇을 늘리지 않는지를 가장 명확하게 보여 준다.
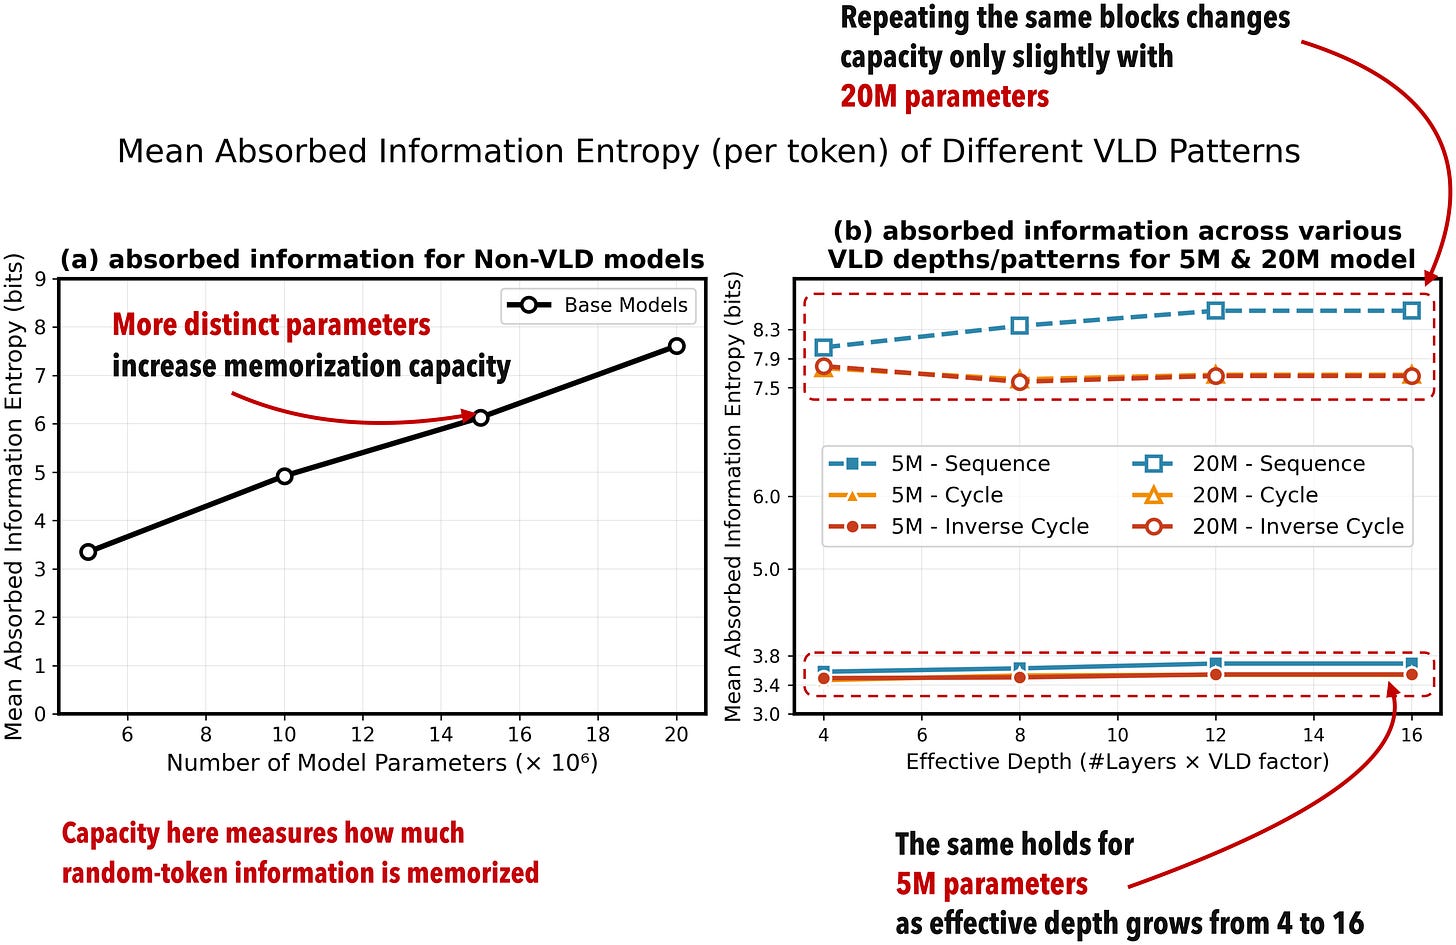
| 실험 | 결과 | 해석 |
|---|---|---|
| memorization | base model의 토큰당 흡수 정보량은 파라미터 5M에서 약 3.4 bit, 20M에서 약 7.6 bit로 커진다. 반면 block 반복으로 effective depth를 4에서 16으로 늘려도 5M 모델은 약 3.4 |
looping은 계산 장치이지 저장 장치가 아니다. 지식을 더 담거나 더 많이 꺼내게 하지 않는다 |
| reasoning | block 재사용이 파라미터 추가 없이 다단계 수학 문제 성능을 올린다 | 저장 공간이 늘지 않아도 추가 계산이 문제 해결을 돕는다 |
Raschka는 정보 검색이 일단 저장된 뒤에는 비교적 단순한 작업이므로 첫 결과가 자연스럽다고 본다. 다만 모델을 키워도 reasoning이 좋아지므로, looping만의 고유한 이점이라기보다 파라미터 없이 얻는 이점이라는 점에 의미가 있다.
라온피플 글은 Ouro 결과를 같은 방향으로 해석한다. Ouro 1.4B와 2.6B는 연구진이 평가한 여러 벤치마크에서 최대 12B 비교 모델과 비슷한 결과를 보였고, 통제 실험에서 이 성능은 지식을 더 저장해서가 아니라 학습한 지식을 여러 단계에 걸쳐 조합하는 능력이 좋아져서인 것으로 나타났다. 즉 12B만큼 많이 기억하게 된 것이 아니라, 아는 내용을 반복해 검토하고 조합해 일부 문제에서 비슷한 답을 낸 것이다. 2.6B가 12B와 비슷하다면 혁신인가라는 물음에 글은 "조건부로 그렇다"고 답한다.
latent feedback과 reasoning 길이
Full-bandwidth transformer(arXiv 2608.08888, 2026년 8월)는 깊이 방향이 아니라 토큰 위치 방향의 recurrence를 연구한다. 각 decoding step에서 이전 토큰의 최종 hidden state와 새로 샘플링된 토큰의 임베딩을 학습된 gate로 합쳐 다음 forward pass의 입력으로 쓴다. 다음 토큰의 계산이 stack 맨 아래에서 이전 토큰의 최종 표현에 접근하므로 Huginn과 다소 비슷하다.
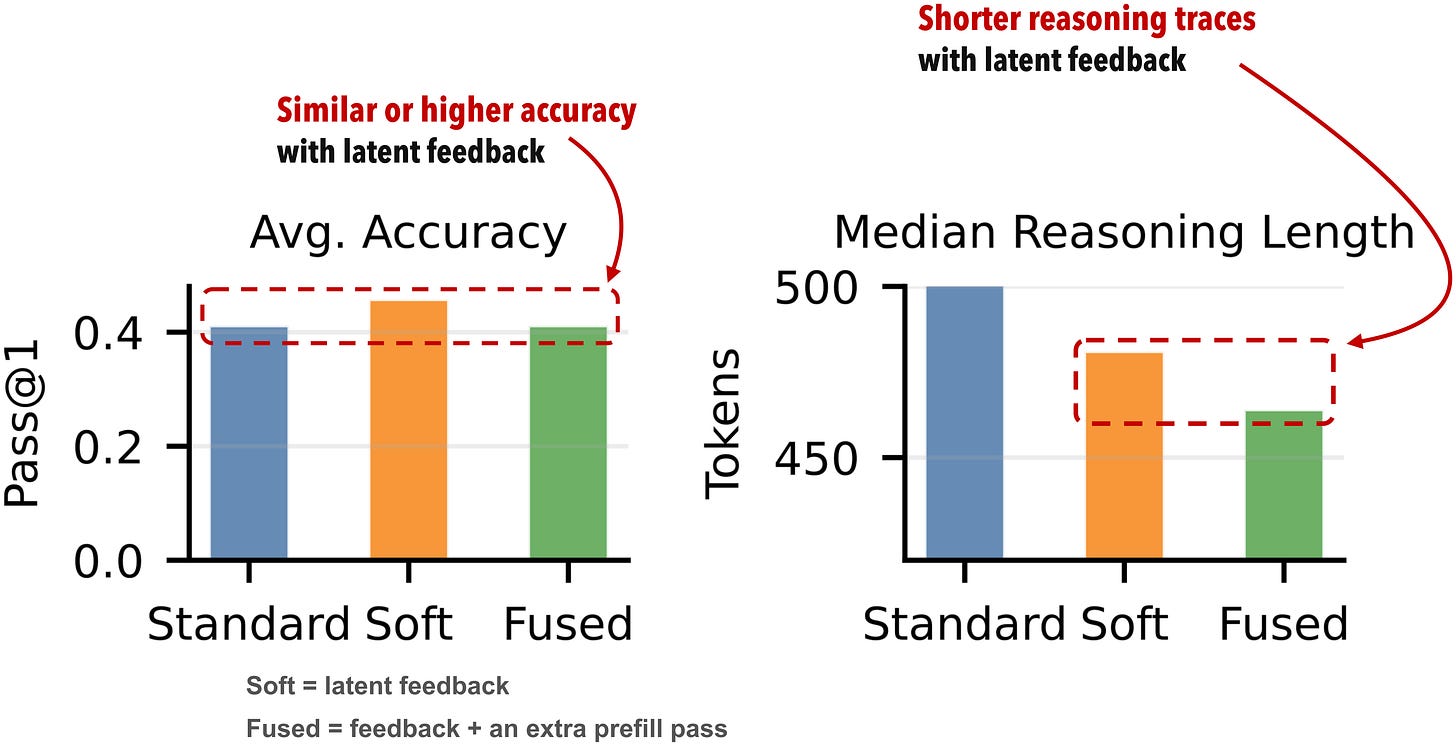
| 설정 | 평균 Pass@1 (그림 기준) | 중간 reasoning 길이 (그림 기준) |
|---|---|---|
| Standard | 약 0.41 | 약 500 토큰 |
| Soft (latent feedback) | 약 0.46 | 약 480 토큰 |
| Fused (feedback과 추가 prefill pass) | 약 0.41 | 약 463 토큰 |
1B base model에서 latent feedback은 MATH500의 reasoning trace를 줄이면서 정확도를 유지하거나 올렸다. 그러나 instruction tuning 후에는 단축 효과가 사라진다. Raschka는 이 결과가 looping이 reasoning trace를 짧게 만드는가라는 논쟁과 직접 연결된다고 본다. 동시에 두 가지 한계를 지적한다. 짧아진 trace가 덜 충실한지는 확인하지 않았고, block을 더 쌓는 일반적인 방식으로 모델을 키울 때도 비슷한 효과가 나는지 비교하지 않았다.
프런티어 연구소가 looping을 원하는 이유
Tosea 글은 경제적 동기를 구체적으로 정리한다. CoT scaling은 비용이 누적된다. 추가 추론 단위마다 토큰을 직렬로 생성해야 하고, 이후 모든 토큰이 그 토큰을 attention으로 참조하며, KV cache에 보관해야 한다. latent recurrence는 추가 출력 토큰, context 증가, cache 부담 없이 직렬 깊이를 얻는다.
| 동기 | 내용 |
|---|---|
| 추론 비용 | CoT 토큰 생성 없이 직렬 깊이를 얻는다 |
| 서빙 효율 | looping하는 작은 모델이 큰 모델과 맞먹으면 replica당 가중치 적재 대역폭과 메모리가 줄어든다 |
| 제품 구성 | 반복 횟수가 실행 시점 파라미터이므로 같은 checkpoint로 저가 티어와 고가 티어를 함께 제공한다 |
| 능력 | 공간 추론이나 수치 직관처럼 말로 잘 표현되지 않는 계산을 다음 토큰 하나로 강제하지 않아도 된다 |
엣지와 온디바이스 관점
라온피플 글은 looping을 엣지 장치 관점에서 평가한다. 엣지 장치에서는 모델이 메모리에 들어가는지가 첫 관문인 경우가 많다. 가중치 공유는 같은 유효 깊이를 서로 다른 층으로 구현하는 모델보다 저장 용량과 파라미터 메모리를 줄일 가능성이 있고, 반복 횟수를 장치의 전력과 지연 예산에 맞출 수 있어 제품군 설계에도 유리하다.
다만 "가중치를 한 번 읽어 여러 번 재사용하므로 공짜에 가깝다"는 표현은 과하다. core 전체가 온칩 캐시에 들어가지 않으면 반복마다 메모리 계층에서 가중치를 다시 가져올 수 있다. 실제 이득은 칩의 캐시, 메모리 대역폭, 연산 집약도, 커널 최적화에 달려 있으므로, 이는 가능성이 있는 하드웨어 가설이지 자동으로 보장되는 성능이 아니다. 글이 제시하는 엣지 평가 체크리스트는 다음 6개다.
- 모델 파일과 실행 메모리
- 목표 정확도까지 필요한 평균, 최대 반복 수
- 첫 토큰 지연과 토큰 처리량
- 전력과 발열
- 반복 종료의 안정성
- 기존 런타임의 지원 여부
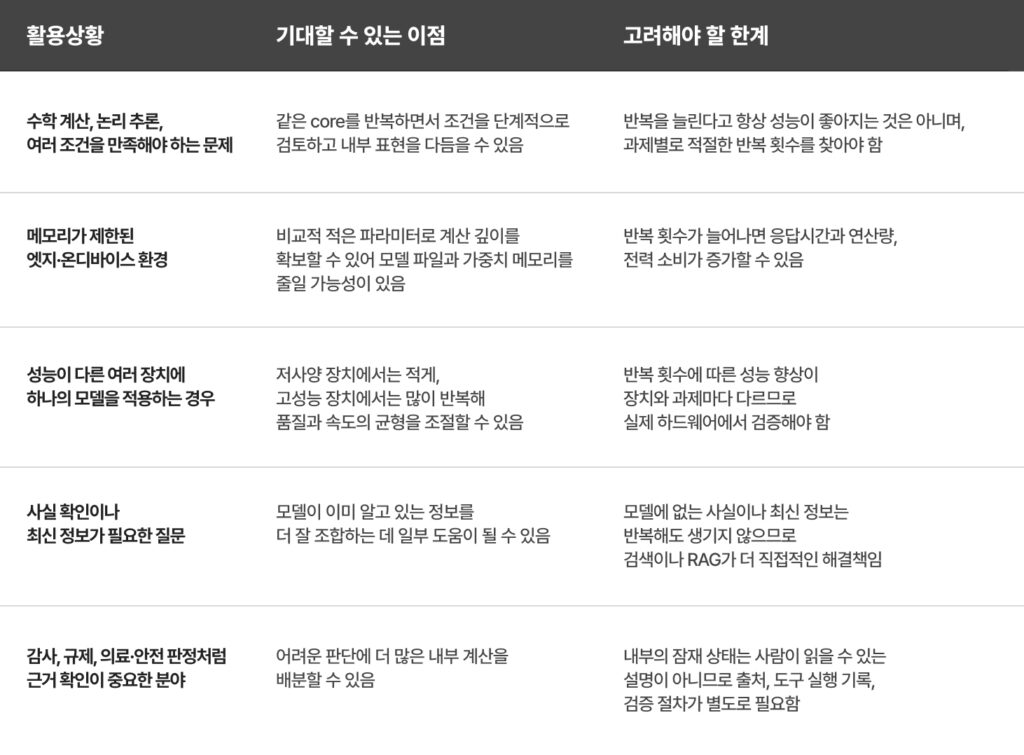
| 활용 상황 | 기대할 수 있는 이점 | 고려해야 할 한계 |
|---|---|---|
| 수학 계산, 논리 추론, 여러 조건을 만족해야 하는 문제 | 같은 core를 반복하며 조건을 단계적으로 검토하고 내부 표현을 다듬는다 | 반복을 늘린다고 항상 좋아지지 않으며 과제별 적절한 반복 횟수를 찾아야 한다 |
| 메모리가 제한된 엣지, 온디바이스 환경 | 적은 파라미터로 계산 깊이를 확보해 모델 파일과 가중치 메모리를 줄일 가능성 | 반복이 늘면 응답 시간, 연산량, 전력 소비가 증가할 수 있다 |
| 성능이 다른 여러 장치에 하나의 모델을 적용 | 저사양에서는 적게, 고사양에서는 많이 반복해 품질과 속도 균형을 조절한다 | 반복에 따른 향상이 장치와 과제마다 달라 실제 하드웨어에서 검증해야 한다 |
| 사실 확인이나 최신 정보가 필요한 질문 | 이미 아는 정보를 더 잘 조합하는 데 일부 도움이 된다 | 모델에 없는 사실은 반복해도 생기지 않으므로 검색이나 RAG가 더 직접적이다 |
| 감사, 규제, 의료와 안전 판정처럼 근거 확인이 중요한 분야 | 어려운 판단에 더 많은 내부 계산을 배분한다 | 잠재 상태는 사람이 읽는 설명이 아니므로 출처, 도구 실행 기록, 검증 절차가 별도로 필요하다 |
looped transformer는 정답에 필요한 정보가 모델 안에 있고 그 정보를 여러 단계에 걸쳐 조합해야 하는 문제에 가장 잘 맞는다. 반면 새로운 정보를 찾아야 하거나 판단 과정을 사람이 직접 확인해야 하는 작업에서는 검색, 외부 도구, 검증 시스템과 함께 써야 한다.
GPT-6 Astra와 looping 논쟁
Astra 개관
Raschka는 Astra를 지금까지 써 본 모델 중 가장 좋은 모델로 평가한다. GPT-5.6 대비 글쓰기, 수학, 코딩 등 거의 모든 범주에서 앞서지만, 특히 3D 렌더링과 애니메이션 같은 그래픽 과제에서 상대적으로 더 뛰어나다.
| 관찰 | 내용 |
|---|---|
| ARC-AGI-3 | Astra 99.9%, GPT-5.6 Sol 7.8%. 단 OpenAI는 harness 설정 두 가지를 바꿔 GPT-5.6 Sol 점수를 13.3%에서 38.3%로 올렸다는 글도 따로 냈다 |
| Artificial Analysis Coding Agent Index v1.4 | Astra가 최전선이지만 큰 격차로 앞서지는 않는다 |
| Artificial Analysis Intelligence Index v4.2 | 코딩 외 과제를 섞은 종합 지수에서도 같은 경향이다 |
| 학습 규모 | NVIDIA CEO 발언에 따르면 Grace Blackwell GPU 약 10만 개로 학습했다 |
| Path to Astra (OpenAI 공식) | Preparedness Framework에서 Critical 사이버보안 임계값에 도달한 첫 모델이며, 추가 CoT monitoring과 함께 배포한다 |
harness는 모델을 감싸 tool call, 환경 실행, 평가를 담당하는 실행 틀이다. Artificial Analysis의 독립 평가는 GDPval-AA와 AA-Briefcase에 오픈소스 최소 harness인 Stirrup을 공통으로 쓰고, Terminal-Bench v2.1에는 Terminus 2, τ³-Banking에는 τ-Bench harness를 쓴다. 공통 harness는 같은 조건 비교를 가능하게 하지만, 모델은 대개 하나의 주력 harness를 염두에 두고 학습된다. 따라서 Raschka는 agentic 평가가 Astra의 주력 harness 성능을 과소평가할 수 있다고 본다.
Astra가 가장 돋보이는 영역은 Codex/ChatGPT 앱으로 로컬 컴퓨터의 소프트웨어를 조작하는 computer use다. OpenAI가 Mac Mini와 Mac Studio 수만 대를 강화학습용으로 샀다는 보도도 있다. 여기서 Mac은 모델을 학습시키는 하드웨어가 아니라 모델이 macOS 사용법을 배우는 환경이다. 학습 흐름은 과제 제시, 스크린샷 제공, 마우스와 키보드 동작 예측, Mac에서 실행, 갱신된 스크린샷 제공을 성공이나 실패까지 반복하고, 그 결과를 verifier와 함께 강화학습 피드백으로 쓰는 방식이다. Raschka는 이를 RLVR과 유사하다고 본다. RLVR은 기계적으로 검증할 수 있는 결과를 reward로 삼아 모델을 강화학습시키는 기법이다. 저자는 computer use 학습이 패러다임 전환은 아니며 Astra도 여전히 reasoning trace를 생성하는 reasoning model이라고 강조한다.
Astra가 looping을 쓴다는 근거
The Information은 공식 출시 이틀 전 내부 정보를 인용해 Astra가 recurrent depth를 쓴다고 보도했다. 공식 확인은 없고, Astra는 open-weight가 아니므로 외부에서 검증할 수도 없다. Raschka는 다음 근거로 사용 가능성이 높다고 본다.
- The Information 보도가 있다.
- 과거 연구에서 유망했던 기법이다.
- OpenAI 수석 과학자 Jakub Pachocki가 "Astra를 포함한 현재 최전선 모델의 계산 그래프 깊이는 GPT-4의 두 배 이내"라고 말했다.
다만 세 번째 발언은 looping을 명시적으로 확인하지 않으며, 일반 block을 두 배로 쓴다는 뜻일 수도 있다. Raschka는 Astra 성능의 주된 원인이 개선된 학습 레시피와 학습 데이터이며, The Information이 looping의 기여를 과대평가했다고 본다.
Tosea 글은 Astra 관련 주장을 확인 상태별로 분류한다.
| 주장 | 상태 | 출처 |
|---|---|---|
| Critical 사이버보안 임계값에 도달한 첫 모델 | 확인 | OpenAI Path to Astra, 2026-09-01 |
| ExploitBench 100%, 평가 중 zero-day 2건 발견 | 확인 | 같은 글 |
| 허용되지 않은 사이버 요청 거부율 91.5% (GPT-5.6 Sol 59%) | 확인 | 같은 글 |
| 추가 CoT monitoring과 함께 배포 | 확인 | 같은 글 |
| 계산 그래프 깊이가 GPT-4의 두 배 이내 | 확인 (측정 근거 미공개) | Pachocki, 2026-09-02 |
| recurrent depth 또는 looped layer 사용 | 보도, 공식 미확인 | The Information, 2026-09-01 |
| 읽을 수 있는 CoT 보존을 위해 loop 깊이를 의도적으로 제한 | 보도 | The Information의 익명 소식통 |
| Astra가 "GPT-6"이다 | 추측 | 공식 발표 없음 (Tosea 글 작성 시점) |
Tosea 글은 Astra 출시 전인 9월 2일에 쓰였으므로 "GPT-6" 명칭을 추측으로 분류했다. 일주일 뒤 Raschka 글은 출시된 모델을 GPT-6 Astra로 부른다.
CoT monitorability 논쟁
reasoning trace는 모델이 답에 이르기까지 생성한 중간 추론 텍스트의 기록이다. monitorability는 이 trace로 모델의 의도와 행동을 감시할 수 있는 정도를 말한다. 2025년 7월 OpenAI, Google DeepMind, Anthropic, UK AI Security Institute, METR, Apollo Research, Redwood Research 소속 연구자 41명이 "Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety"에 공동 서명했다. 현재 모델은 긴 추론을 텍스트로 외부화해야 하므로 의도를 들여다볼 창이 생기고, 그 창을 보호할 가치가 있다는 주장이다.
이 논문의 "Novel architectures" 소절은 연속 latent 공간에서 추론의 직렬 깊이를 늘리는 아키텍처를 다루며 Coconut(Hao 2024)과 recurrent depth(Geiping 2025)를 이름으로 인용한다. 그런 latent reasoning 모델은 생각을 말로 꺼낼 필요가 없어 CoT의 안전 이점을 잃을 수 있다는 내용이다. 공저자에는 Mark Chen, David Farhi, Aleksander Mądry, Wojciech Zaremba, Bowen Baker, 그리고 Jakub Pachocki가 있다. Astra에 쓰였다고 보도된 아키텍처 계열이 13개월 전 OpenAI 수석 과학자가 서명한 논문에서 monitorability 위험으로 지목됐기 때문에 반발이 거셌다.
| 인물 | 입장 |
|---|---|
| Steven Adler (전 OpenAI 안전 연구자) | OpenAI가 AI 업계에 존재하는 몇 안 되는 레드라인 하나를 어기는 것으로 보인다고 썼다 |
| Gary Marcus | "Red Alert" 제목의 글을 냈다 |
| Jakub Pachocki (9월 2일) | 혼란스러운 보도로 촉발된 unmonitorability 경쟁을 막고 싶다. 계산 그래프 깊이는 GPT-4의 두 배 이내다. OpenAI는 첫 reasoning model부터 CoT monitoring을 보존하고 활용해 왔다. 이 기법은 취약하고 아키텍처 변화와 무관한 이유로 나빠지는 추세이며, 강화하는 것이 현재 연구의 핵심 목표다 |
| Geoffrey Irving (UK AISI) | 회로 깊이 제한으로 의미 있는 효과를 보려면 제한이 매우 낮아야 한다. 깊이가 수백 수준이면 가짜 제한이며, 오류율 없이 "CoT를 감시한다"고 말하는 것과 같다 |
| Irving 후속 | GPT-4의 두 배 이내라는 제한은 자신이 반박하던 시나리오보다 엄격하다고 인정했다 |
Tosea 글은 Pachocki의 답을 회피가 아니라 실질적 주장으로 평가한다. 반복 횟수 제한, GPT-4 수준의 총 직렬 깊이, 읽을 수 있는 CoT 보존이라는 내용을 담았기 때문이다. 안전 커뮤니티의 반대도 looping 자체를 금지하라는 것이 아니라, "제한했다"는 말에 숫자가 붙어야 의미가 있다는 것이다. OpenAI는 숫자를 붙였지만 측정 근거는 공개하지 않았다.
monitorability 논문 스스로도 단서를 단다. 현재 형태의 CoT를 지키겠다는 강한 약속이 더 효과적인 안전 개입과 상충할 수 있고, CoT monitoring은 기존 안전 연구의 대체가 아니라 추가로만 써야 한다고 권한다. 논문이 제안한 중간 경로인 "추론의 일부 가시성을 유지하면서 latent 계산을 활용하는 하이브리드"는 OpenAI 설명대로라면 Astra가 하는 일과 비슷하다. 그럼에도 Tosea 글은 Astra의 안전 장치가 CoT monitoring에 직접 기대는 반면 아키텍처 추세는 그 기반을 약하게 만드는 방향이라, 두 흐름이 반대 방향으로 당기고 있다고 지적한다.
looping이 reasoning trace를 숨기는가
Raschka의 결론은 looped transformer가 chain-of-thought를 숨기는 주요 요인이 아니라는 것이다. 근거는 다음과 같다.
- 최종 사용자에게는 차이가 크지 않다. OpenAI는 o1부터 reasoning trace 대부분을 사용자에게 숨겨 왔다. 해석 가능성 우려는 주로 모델 개발자 쪽 문제다.
- reasoning model은 최종 답 전에 일반 텍스트 토큰으로 중간 단계를 생성한다. 원문 예시는 합이 10이고 곱이 21인 두 수를 묻는 문제다. 모델은 5와 5를 시도해 곱이 25임을 확인한 뒤 되돌아가(backtracking) 3과 7을 검산한다. 중간 단계는 scratch pad 역할을 하며, 최종 답은 trace보다 훨씬 짧을 수 있다.
- looping도 계산을 더하므로, 내부 계산이 많은 모델은 외부 thinking 토큰이 덜 필요하다는 주장은 가능하다.
- OpenAI 벤치마크에서 Astra는 effort 수준 전체로 보면 GPT-5.6 Sol보다 토큰을 반드시 덜 쓰지는 않는다. 다만 같은 정확도에서는 더 적게 쓴다.
- 토큰이 적은 것은 모델이 실수와 backtracking을 덜 해서일 수 있다. GPT-5.6 Luna는 비슷한 성능에서 Sol보다 토큰을 80% 더 쓰지만, Sol이 훨씬 덜 해석 가능하다고 우려하는 사람은 없다.
- reasoning trace가 모델 내부를 충실히 기술한다는 보장은 원래 없다(arXiv 2305.04388). Raschka가 보는 유일한 타당한 우려는 looped 모델이 일반 모델보다 가짜 trace를 더 자주 내는 경우인데, 그런 증거는 없다.
- Astra system card는 reasoning trace의 monitorability가 Sol 대비 약간 후퇴했다는 증거를 적었다. 주로 짧고 정보가 적은 trace와 관련되며, looping이 근본 원인이라는 근거는 아니다.
Raschka는 Pachocki의 "confused reporting"이 The Information 기사를 가리키며, looping이 CoT 변화와 무관하다는 함의로 읽는다. 그리고 짧은 reasoning trace를 더 유능한 모델의 부수 효과로 본다. 실수가 적고 아키텍처 내부에서 더 많은 계산을 쓸 수 있는 모델은 trace를 scratch pad로 덜 쓴다. 대학 수학 시험에서 잘 준비한 학생이 연습장을 덜 쓰고 덜 되돌아가는 것과 같다는 비유다.
한계
세 자료가 공통으로 지적하는 looped transformer의 한계는 다음과 같다.
| 한계 | 내용 |
|---|---|
| 연산량 | 저장 파라미터만 줄고 연산량과 KV cache는 줄지 않는다. 반복을 늘리면 응답 시간과 처리량 비용이 증가한다 |
| 지식 | 반복은 새로운 지식을 주입하지 않는다. 폭넓은 사실 지식이 필요한 문제에서는 여전히 큰 모델이 유리할 수 있다 |
| 포화 | 반복 이득은 과제마다 다르고 포화한다. 대부분 벤치마크는 깊이 제한 과제가 아니다 |
| 데이터 | 아키텍처가 데이터 품질의 우위를 대체하지 않는다 (Huginn 대 OLMo-2-1124-7B) |
| 적응형 종료 | 종료 기준이 다양한 과제에서 안정적으로 작동하는지 검증이 부족하다. Ouro 공개 구현은 사실상 4회 고정이다 |
| 학습 | 반복을 늘리면 학습이 느려지고 최적화가 불안정해질 수 있다 (Nanbeige) |
| 해석 가능성 | 잠재 상태는 사람이 읽는 근거가 아니다. 근거 추적이 필요한 응용에는 별도 검증층이 필요하다 |
| 규모 | Huginn과 Ouro는 연구 단계의 소형 모델이며, 비교 모델, 데이터, 벤치마크가 달라 상용 시스템의 우위를 곧바로 뜻하지 않는다 |
Astra에 대한 논의에도 한계가 있다. looping 사용은 보도일 뿐 공식 확인이 없고, "GPT-4의 두 배 이내"라는 깊이 제한의 측정 근거도 공개되지 않았다. reasoning trace 단축이 해석 가능성 저하인지 능력 향상의 부수 효과인지는 실험으로 확정되지 않았으며, Full-bandwidth transformer 연구도 이 질문에 답하지 못한다.
라온피플 글의 결론은 이 한계를 반영한 실용적 관점이다. looped transformer는 제한된 파라미터 예산 안에서 필요한 문제에 계산을 더 배분하려는 설계 선택이다. 메모리는 작지만 연산 여유가 있는 엣지 장치에서는 파라미터 대신 시간을 쓰는 교환이 합리적일 수 있으며, 다음 단계는 논문 속 최고 점수가 아니라 실제 목표 장치에서 정확도, 지연, 전력 곡선을 그리는 일이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| looped transformer (recurrent depth) | 같은 transformer block 묶음에 중간 표현을 여러 번 통과시키고 반복 사이에 가중치를 공유하는 구조 |
| block application | 입력을 transformer block에 한 번 통과시키는 것. looping의 유효 깊이를 세는 단위 |
| prelude / core / coda | Huginn의 세 구성 요소. 입력 임베딩, 반복 block, 출력 디코딩 |
| 입력 재주입(input injection) | 매 반복마다 원래 입력 표현을 core에 다시 입력하는 장치 |
| adaptive halting | 위치별 halting probability 누적합이 임계값을 넘으면 그 위치의 반복을 멈추는 방식 |
| expert-choice routing / token-choice routing | Mixture-of-Recursions의 두 라우팅 방식. 단계마다 토큰을 고르는가, 처음에 경로를 배정하는가의 차이 |
| CoT monitorability | CoT 텍스트로 모델의 의도를 감시할 수 있는 가능성. latent reasoning이 위협 요인으로 지목됐다 |
관련 페이지
- OpenAI, GPT-5.6 Sol·Terra·Luna 프리뷰 공개: 새 네이밍 체계와 강화된 안전 스택: Astra의 비교 대상인 GPT-5.6 Sol, Terra, Luna 라인업과 Preparedness 분류
- Stealing Reasoning Traces from Proprietary LLM APIs: 상용 모델이 reasoning trace를 숨기거나 암호화하는 맥락과 그 보안 문제
- You could have invented transformers from memory: Transformer 구성 요소(MLP, self-attention)를 associative memory로 보는 해설. looping이 저장 용량을 늘리지 않는다는 결과와 함께 읽을 수 있다
- Agent Harness Engineering 개괄과 학습 경로: Astra 평가에서 쟁점이 된 harness의 개념과 설계