LLMs · PAPER · 2023
Looped Transformers are Better at Learning Learning Algorithms
요약
이 논문은 Transformer 블록 하나를 여러 번 반복 적용하는 looped transformer가 반복 알고리즘을 흉내 내는 데 표준 Transformer보다 효율적이라는 것을 실험으로 보인다. University of Wisconsin, Madison의 Liu Yang, Kangwook Lee, Robert D. Nowak, Dimitris Papailiopoulos가 2023년 11월 arXiv에 공개했고 ICLR 2024에 실렸다.
looped transformer는 적은 수의 Transformer 층을 가중치를 공유한 채 여러 번 통과시키는 구조를 말한다. 이 논문은 1층 GPT-2 블록 하나를 반복한다. 저자들은 매 반복마다 원래 prompt를 다시 더하는 입력 주입(input injection)과, 마지막 몇 회 반복만 손실에 반영하는 truncated loss를 결합한 학습법을 제안한다.
이 학습법으로 만든 0.79M 파라미터의 1층 looped transformer는 9.48M 파라미터의 12층 표준 Transformer와 선형 회귀에서 같은 성능을 낸다. 즉 파라미터를 10% 미만만 쓴다. 희소 선형 회귀, 결정 트리, 2층 ReLU 신경망에서도 표준 Transformer와 같거나 더 낫고, 희소 선형 회귀에서는 예시가 적은 구간에서 Lasso보다도 오차가 작다.
이 결과가 중요한 이유는 두 가지다. 첫째, in-context learning의 작동 원리를 "Transformer가 내부에서 반복 최적화 알고리즘을 실행한다"는 관점으로 볼 때, 반복 구조를 명시적으로 준 모델이 더 적은 자원으로 같은 일을 한다는 실증 근거가 된다. 둘째, 반복 횟수를 늘려 계산을 더 쓰는 대신 파라미터를 줄이는 설계 방향을 구체적인 학습 레시피로 제시한다.
배경
in-context learning과 함수 학습 실험
in-context learning은 가중치를 갱신하지 않고 prompt 안의 예시만으로 새 과제를 푸는 능력이다. GPT-3, PaLM 같은 대형 언어 모델이 이 능력을 보이면서 많은 연구가 나왔지만, 그 내부 메커니즘은 아직 분명하지 않다.
Garg et al.(2022)은 이 문제를 통제된 실험으로 옮겼다. Transformer를 처음부터 학습시켜, prompt에 (x, f(x)) 쌍 여러 개와 질의 x_test를 주고 f(x_test)를 맞히게 한다. f는 매 prompt마다 선형 함수나 결정 트리 같은 함수 클래스에서 새로 뽑는다. 따라서 모델은 특정 함수를 외우는 것이 아니라 "예시에서 함수를 추정하는 학습 알고리즘" 자체를 배워야 한다. 이 실험에서 Transformer는 기존 solver와 같거나 더 나은 성능을 보였다.
후속 연구는 Transformer가 무엇을 배웠는지 해석하려 했다. Akyürek et al.(2022)은 선형 회귀를 푸는 Transformer를 기존 학습 알고리즘의 암묵적 구현으로 해석했다. von Oswald et al.(2022)은 linear self-attention만 쓰는 1층 Transformer가 선형 회귀에서 gradient descent 한 단계를 학습한다는 것을 실험으로 보였다.
단순화된 구조와 실제 모델 사이의 간극
von Oswald et al.(2022)의 이론은 softmax가 없는 linear attention처럼 크게 단순화한 구조를 다룬다. 실제로 쓰는 표준 디코더 Transformer와는 차이가 크다. 저자들은 표준 디코더 Transformer를 작은 구조 변경만으로 처음부터 학습시켜 학습 알고리즘을 효과적으로 재현하는 문제가 여전히 열려 있다고 본다.
반복 알고리즘과 Transformer 구조의 불일치
전통적 기계학습은 선형 회귀를 흔히 반복 알고리즘으로 푼다. 선형 회귀 min_w ||Xw - y||^2의 닫힌 형태 해는 (X^T X)^{-1} X^T y이고, 이 해를 한 번의 forward pass로 근사하려면 역행렬을 계산해야 한다.
역행렬은 행렬 곱보다 Transformer가 배우기 어렵다(Charton 2021, von Oswald 2022). 역행렬 연산에 더 많은 층과 head가 필요하기 때문이다(Giannou 2023). 반면 gradient descent는 행렬 곱 X^T(Xw - y)만 쓰고, 이를 여러 번 반복한다.
표준 Transformer에는 같은 연산을 반복하는 구조가 없다. 층마다 다른 가중치를 쓰므로, 반복 알고리즘을 흉내 내려면 반복 횟수만큼의 층을 각각 따로 학습해야 한다. looped transformer는 같은 블록을 반복하므로 이 불일치를 구조적으로 해소한다. 또한 과제를 단순한 하위 단계로 쪼개 반복하므로 파라미터를 크게 줄일 수 있다.
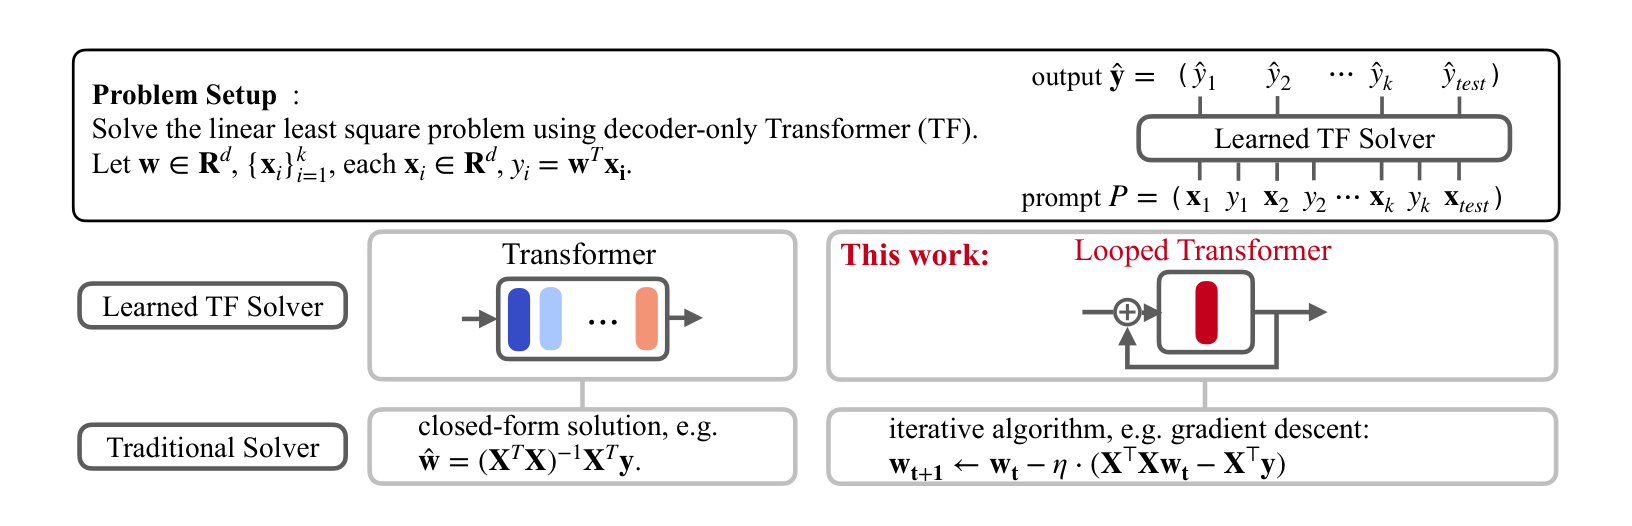
연구 질문은 "looped transformer가 비재귀 표준 Transformer보다 반복 학습 알고리즘을 더 효율적으로 흉내 낼 수 있는가"이다. 저자들은 시험한 함수 클래스 범위 안에서는 그렇다고 답한다.
핵심 개념
looped transformer는 Transformer 층 몇 개를 하나의 블록으로 묶고, 그 블록을 같은 가중치로 여러 번 통과시키는 구조다. 이 논문에서는 1층 블록을 반복하므로, b회 반복한 모델은 가중치를 공유하는 b층 Transformer와 같은 실효 깊이를 갖는다.
input injection은 매 반복의 입력에 원래 prompt P를 다시 더하는 설계다. 수식으로는 Y_{t+1} = M(Y_t + P)이고 Y_0은 영 텐서다. 반복이 길어져도 원래 입력 정보가 매번 다시 들어오므로 출력이 입력과 무관한 값으로 흘러가지 않는다.
weight-tying은 입력 주입 없이 Y_{t+1} = M(Y_t), Y_0 = P로 같은 가중치만 반복하는 기존 형식이다. ALBERT와 Universal Transformer가 이 형식을 쓰며, 반복 횟수를 유한하게 제한한다.
fixed-point solution은 반복을 계속해도 출력이 더 이상 바뀌지 않는 해를 뜻한다. gradient descent가 수렴하면 같은 갱신을 계속 적용해도 해가 그대로인 것과 같다. 이 논문이 원하는 looped transformer는 학습한 반복 횟수를 넘겨 추론해도 이 해에 머물러야 한다.
truncated loss는 b회 반복 중 마지막 T회의 출력만 손실에 반영하는 학습 목표다. 앞쪽 반복에는 그래디언트를 흘리지 않으므로 메모리를 줄인다. 이 논문에서 b는 학습 시 펼치는 최대 반복 횟수, T는 손실을 계산하는 반복 구간의 길이다.
방법
문제 설정
함수 클래스 F 위의 분포에서 함수 f를 하나 뽑고, 입력 분포에서 예시 x_1부터 x_k와 질의 x_test를 뽑는다. prompt는 다음과 같다.
P = (x_1, f(x_1), ..., x_k, f(x_k), x_test)
학습 시스템 M은 f를 직접 보지 못하고 prompt만 보고 f(x_test)를 예측한다. 성능은 제곱 오차 (M(P) - f(x_test))^2로 잰다.
모델은 GPT-2 디코더다. 비교 대상인 표준(unlooped) Transformer는 Garg et al.(2022)의 설정대로 12층이고, looped transformer는 1층이다. 층 수만 다르고 나머지 구조는 같다.
학습 목표
저자들은 반복 알고리즘을 흉내 내는 looped transformer가 갖춰야 할 성질을 두 가지로 정한다.
- 반복이 진행될수록 성능이 유지되거나 좋아진다.
- 반복을 무한히 계속해도 성능이 나빠지지 않는다.
이를 위해 prompt의 모든 앞부분에서 예측하도록 학습한다. i개 예시를 가진 앞부분을 P^i = (x_1, f(x_1), ..., x_i, f(x_i), x_{i+1})로 두면, t회 반복 후의 출력은 다음과 같다.
Y_t(P^i | θ) = M_θ(M_θ(... M_θ(Y_0^i + P^i) + P^i) ... + P^i)
손실(식 1)은 반복 b_0부터 b까지의 출력에 대해, 모든 앞부분 i = 0..k의 제곱 오차를 평균한 값의 기댓값이다. 여기서 b_0 = max(b - T, 0)이므로 마지막 T회 반복만 손실에 기여한다. 이 truncated loss는 순환 신경망의 truncated backpropagation through time에서 착안해 계산을 줄인다.
입력 주입
일반적인 looped transformer는 Y_{t+1} = M(Y_t; P)로 쓸 수 있다. 입력을 어떻게 다시 넣느냐에 따라 두 형식이 갈린다.
| 형식 | 갱신 식 | 반복이 길어질 때 |
|---|---|---|
| weight-tying (ALBERT, Universal Transformer) | Y_{t+1} = M(Y_t), Y_0 = P | 초기 입력의 영향이 사라져 해가 사실상 무작위가 된다 (Bai 2019, Bansal 2022) |
| 입력 주입 (이 논문) | Y_{t+1} = M(Y_t + P), Y_0 = 0 | 매 반복마다 prompt가 들어오므로 입력에 고정된 해를 유지한다 |
저자들은 입력 주입이 덧셈에만 한정되지 않는다고 덧붙인다. 즉 덧셈은 가장 단순한 선택이고, 핵심은 매 반복에 원래 입력 정보를 다시 공급하는 것이다.
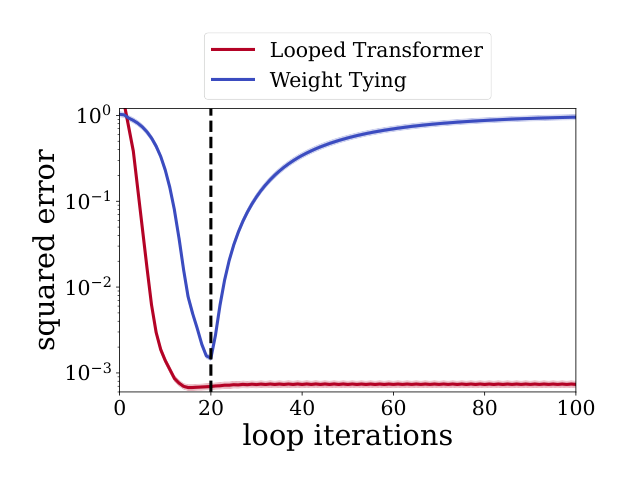
Figure 3에서 두 모델 모두 학습 범위인 20회 근처까지는 오차가 낮아진다. 그러나 weight-tying 모델은 20회를 넘기면 오차가 빠르게 커져 100회에서는 처음 수준으로 돌아가고, 입력 주입 모델은 100회까지 낮은 오차를 유지한다. 따라서 입력 주입은 학습 범위 밖에서도 발산하지 않는 fixed point를 찾기 위한 첫 번째 조건이다.
반복 횟수 b와 손실 구간 T의 선택
b회 반복의 출력을 얻으려면 블록을 b번 연속 실행해야 한다. 따라서 b는 가중치를 공유하는 b층 Transformer의 깊이에 해당하며, 두 변수 모두 trade-off를 갖는다.
| 변수 | 크게 하면 | 작게 하면 |
|---|---|---|
| b (최대 반복 횟수) | 학습과 추론 시간이 늘지만 학습 범위 밖에서도 발산하지 않는 fixed point를 찾기 쉽다. 일정 값을 넘으면 수렴 속도가 오히려 느려진다 | 모델의 잠재력이 제한되고 학습 반복 횟수 이후 발산한다 |
| T (손실 구간 길이) | 그래디언트가 요동해 학습이 불안정하다. 순환 모델 학습 문헌(Jaeger 2005)에 기록된 현상이다 | 메모리를 덜 쓰지만 성능이 떨어진다 |
선형 회귀에서 b ∈ {12, 20, 30, 40, 50}, T ∈ {5, 10, 15}를 탐색했다.
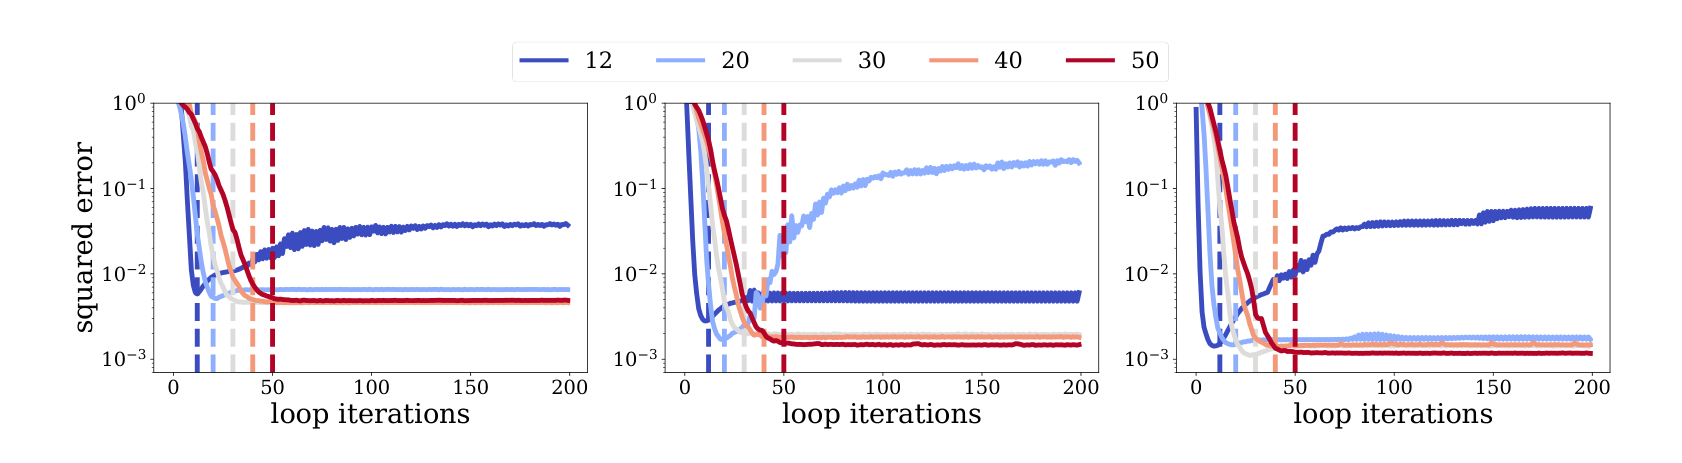
Figure 4에서 읽히는 경향은 다음과 같다.
- b가 작으면(12, 20) 학습 반복 횟수 이후 오차가 다시 커진다. 즉 fixed point가 안정적이지 않다.
- b=12는 12층 표준 Transformer와 실효 깊이가 같지만 그 성능을 재현하지 못한다. 실효 깊이가 같다고 같은 표현을 배우지는 않는다는 뜻이다.
- looped transformer는 학습한 b에 도달하기 전에 포화하는 fixed point를 찾는다. 손실이 b단계 안에 목표에 도달하도록 요구하기 때문이며, 그 결과 b가 작을수록 fixed point에 빨리 수렴한다.
- 일정 b를 넘으면 수렴 속도는 b와 무관하게 포화한다. 예를 들어 T=15에서 b=40과 b=50의 수렴 속도는 비슷하다.
저자들의 목표는 학습 분포 안의 과제를 효율적으로 푸는 것이다. 따라서 학습 반복 이후 발산을 막는 최소 b를 고르고, 메모리를 아끼기 위해 작은 T를 선호한다. 이 기준으로 선형 회귀에는 b=20, T=15를 채택했다.
모델 구성
| 항목 | 표준 Transformer | looped transformer |
|---|---|---|
| 구조 | GPT-2 디코더, 12층 | GPT-2 디코더, 1층 |
| 임베딩 차원 D | 256 | 256 |
| attention head 수 h | 8 | 8 |
| 파라미터 수 | 9.48M | 0.79M |
| optimizer | Adam, learning rate 0.0001 | 동일 |
| 명시적 정규화 | weight decay, gradient clip, data augmentation 없음 | 동일 |
정규화를 모두 뺀 이유는 Garg et al.(2022)의 Transformer 학습법과 공정하게 비교하기 위해서다. 저자들은 정규화를 쓰면 큰 T의 불안정성을 줄일 수 있다고 보지만, 비교의 공정성을 위해 의도적으로 생략했다.
실험 설정
기본 과제는 문제 차원 d=20, in-context 예시 k=40인 선형 함수다. 함수 파라미터 w와 입력 x_i는 모두 표준정규분포 N(0, I_d)에서 뽑는다.
- 평가는 prompt 1,280개로 하고, bootstrap 1,000회로 90% 신뢰구간을 보고한다.
- 오차가 문제 차원에 따라 달라지지 않도록 Garg et al.(2022)처럼 차원으로 정규화한다.
- d와 k는 Garg et al.(2022)의 학습 curriculum을 따라 작은 값에서 시작해 늘린다.
b의 스케줄링
d와 k의 curriculum에 더해, 학습 중 b도 점점 키운다. 그 결과 손실 구간은 처음에 [1, T]에서 시작해 점차 [b - T, b]로 옮겨 간다.
저자들은 이 방식을 curriculum learning이라고 부르지 않는다. curriculum learning은 쉬운 과제에서 어려운 과제로 옮겨 가는 것인데, 반복 1회부터 T회 사이에 목표를 맞히는 쪽이 오히려 [b - T, b] 구간보다 어렵기 때문이다. 대신 반복 구조를 가진 모델의 학습을 시동하는 장치로 본다.
부록 E에서 네 함수 클래스로 스케줄링 유무를 비교했다. 대부분 차이가 없지만 결정 트리에서는 스케줄링이 약간 낫다. 그래서 모든 실험에서 스케줄링을 적용했다.
결과
선형 회귀 (학습 분포 안)
b=20, T=15로 학습한 looped transformer는 표준 Transformer와 성능이 일치하고, 최적 해인 최소제곱(ordinary least squares)에도 거의 근접한다. 파라미터는 표준 Transformer의 1/12만 쓴다.
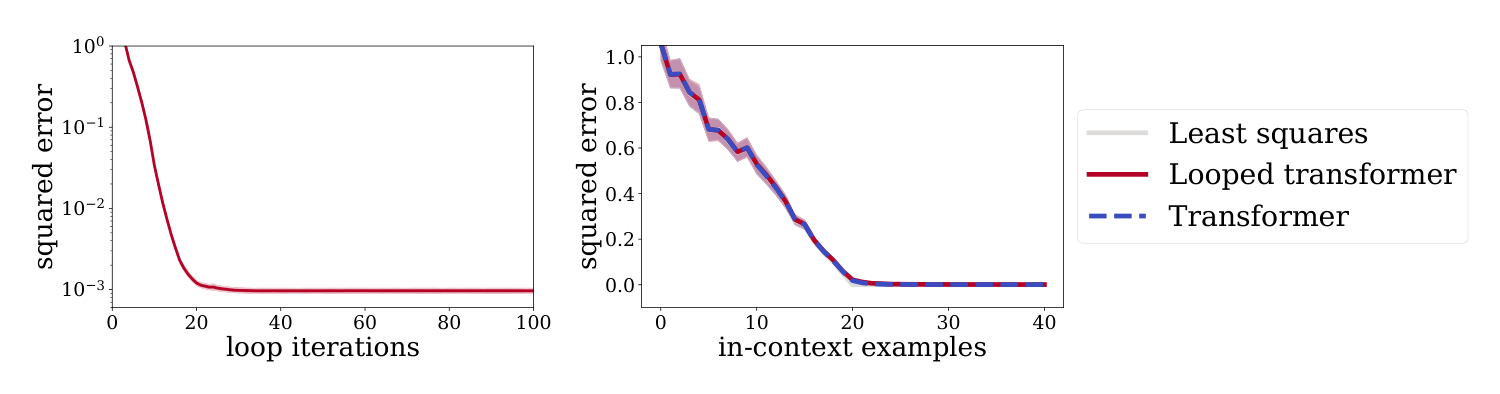
Figure 2 왼쪽은 30회 반복으로 학습한 모델이 반복 20회 근처에서 오차 약 10^-3에 도달한 뒤 100회까지 그대로 머무는 것을 보여 준다. 즉 학습 범위를 3배 넘게 추론해도 발산하지 않는다. 오른쪽에서는 예시가 20개(문제 차원 d와 같은 수)를 넘으면 세 방법 모두 오차가 0에 가까워지며, looped transformer 곡선이 나머지 둘과 거의 겹친다.
표본 효율
학습 중 함수를 매번 새로 생성하지 않고, 학습 데이터셋을 미리 고정해 만든 뒤 서로 다른 prompt 수를 바꿔 가며 학습했다. 이 설정에서는 같은 prompt를 여러 번 볼 수 있다. curriculum의 영향을 분리하기 위해 이 실험에서는 curriculum을 끄고 d=10, k=20을 썼다.
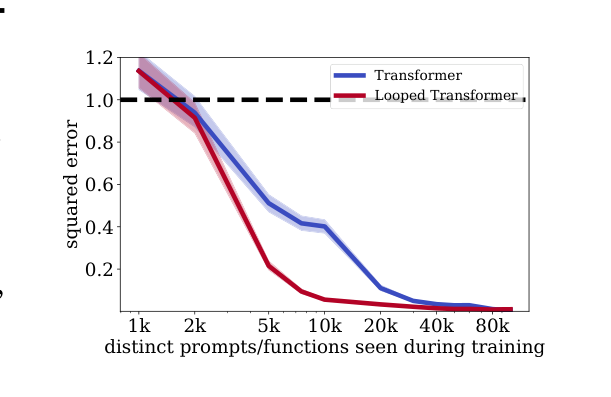
looped transformer는 파라미터가 적어 더 적은 수의 서로 다른 prompt로 함수를 학습한다. Figure 5에서 prompt 5천 개일 때 looped transformer의 오차는 약 0.2인 반면 표준 Transformer는 약 0.5이고, 표준 Transformer가 비슷한 수준에 도달하려면 약 2만 개가 필요하다.
부록 C는 같은 실험을 d=5(k=10)와 d=20(k=40)으로 넓혔다. looped transformer는 b=30, T=15에 b 스케줄링 없이 학습했고, learning rate는 d=5에서 0.0001, d=10에서 {0.00001, 0.0001}, d=20에서 {0.00001, 0.0001, 0.001} 중 가장 좋은 값을 골랐다. 모든 차원에서 looped transformer의 표본 효율이 더 높았다.
분포 밖 평가와 inductive bias
inductive bias는 학습 데이터만으로 결정되지 않는 상황에서 모델이 특정 형태의 해를 선호하는 경향을 말한다. 선형 회귀로 학습한 두 모델을 입력 분포가 바뀐 세 조건에서 평가하면 looped transformer의 inductive bias가 드러난다.
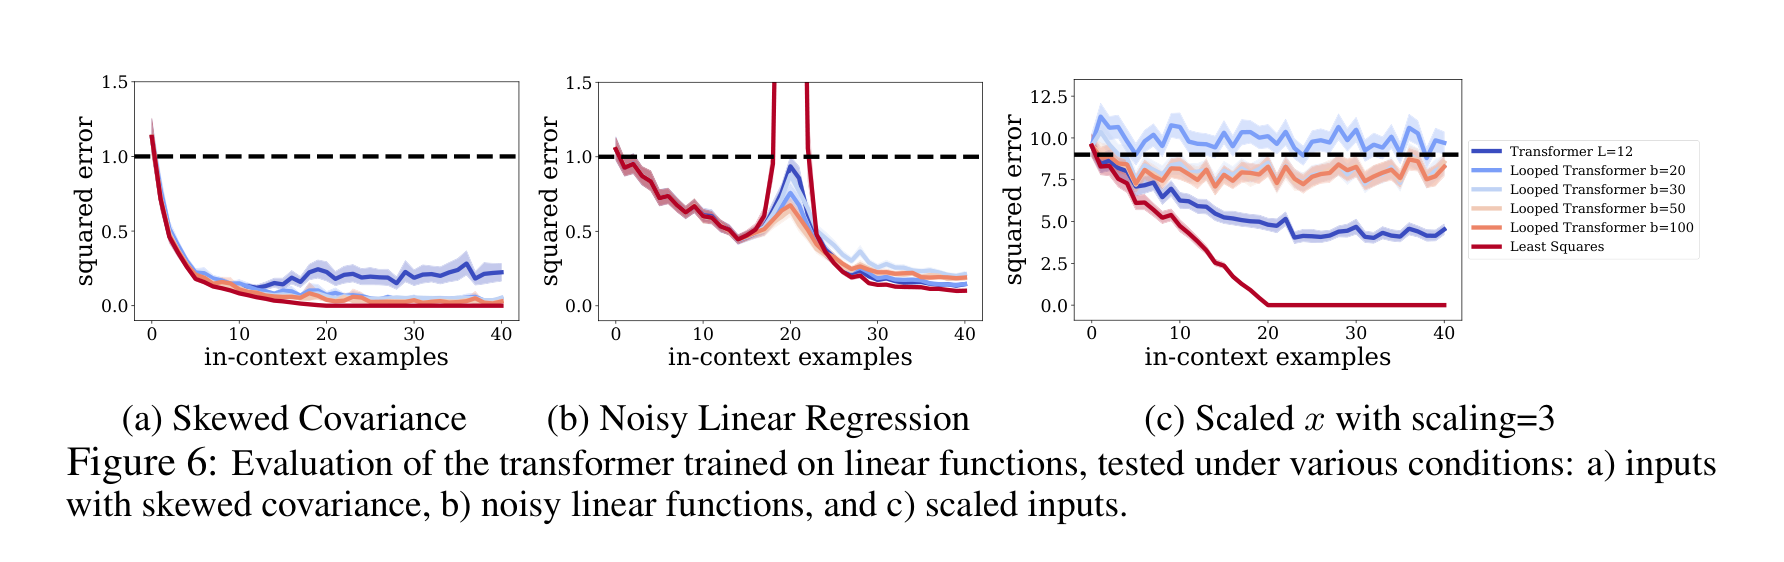
| 조건 | looped transformer의 결과 | 해석 |
|---|---|---|
| (a) 공분산이 치우친 입력 | 표준 Transformer보다 오차가 낮다 | 단순한 해를 선호하는 inductive bias가 유리하게 작용한다 |
| (b) 잡음이 섞인 선형 회귀 | 예시 수가 d와 같을 때 생기는 double descent 봉우리가 낮다 | 기본 모델에 약한 정규화를 건 것과 비슷한 효과다 |
| (c) 입력을 3배로 키운 경우 (x = 3z, z ~ N(0, I)) | 표준 Transformer보다 오차가 높다 | 단순성 편향이 입력 스케일 변화에는 불리하다 |
looped transformer는 입력 분포가 바뀌어도 성립하는 참 알고리즘을 익힌 것이 아니다. 대신 표준 Transformer보다 단순한 해를 선호하는 편향을 가진다. Bhattamishra et al.(2022)이 무작위 Transformer에서 보고한 불리언 함수의 낮은 민감도 편향과 같은 계열의 현상이다.
부록 D는 분포 밖 조건을 여섯 가지로 넓히고 층 수가 다른 표준 Transformer(L=1, 4, 12, 20)와 비교했다.
- 잡음이 섞인 출력에서는 looped transformer가 층이 적은 L=4 Transformer와 비슷하게 행동한다. L=4 Transformer도 봉우리가 낮고, b가 클수록 looped transformer가 이 경향에 가까워진다.
- 치우친 공분산, d/2차원 부분공간에 놓인 입력, 예시와 질의가 서로 다른 orthant에 있는 경우는 표준 Transformer의 L이 클수록 좋다. 이 조건들에서 looped transformer는 최대 L=20 Transformer와 같거나 더 낫다.
- 질의가 예시와 직교하거나 예시 중 하나와 같은 경우에는 두 모델이 비슷하다.
- 추론 시 x나 w를 1/3, 1/2, 2, 3배로 바꾸면 looped transformer는 층이 적은 Transformer와 비슷하다. 예를 들어 x를 2배로 키우면 L=4 Transformer와 비슷한 오차를 낸다.
선형 회귀에서는 b가 20보다 작으면 fixed point를 찾지 못하므로 이 비교에서는 b ≥ 20 모델만 포함했다.
구조 변형
층 수 L, 임베딩 차원 D, head 수 h를 바꿔 looped transformer의 반응을 살폈다. 모두 b=30, T=15로 학습했다.
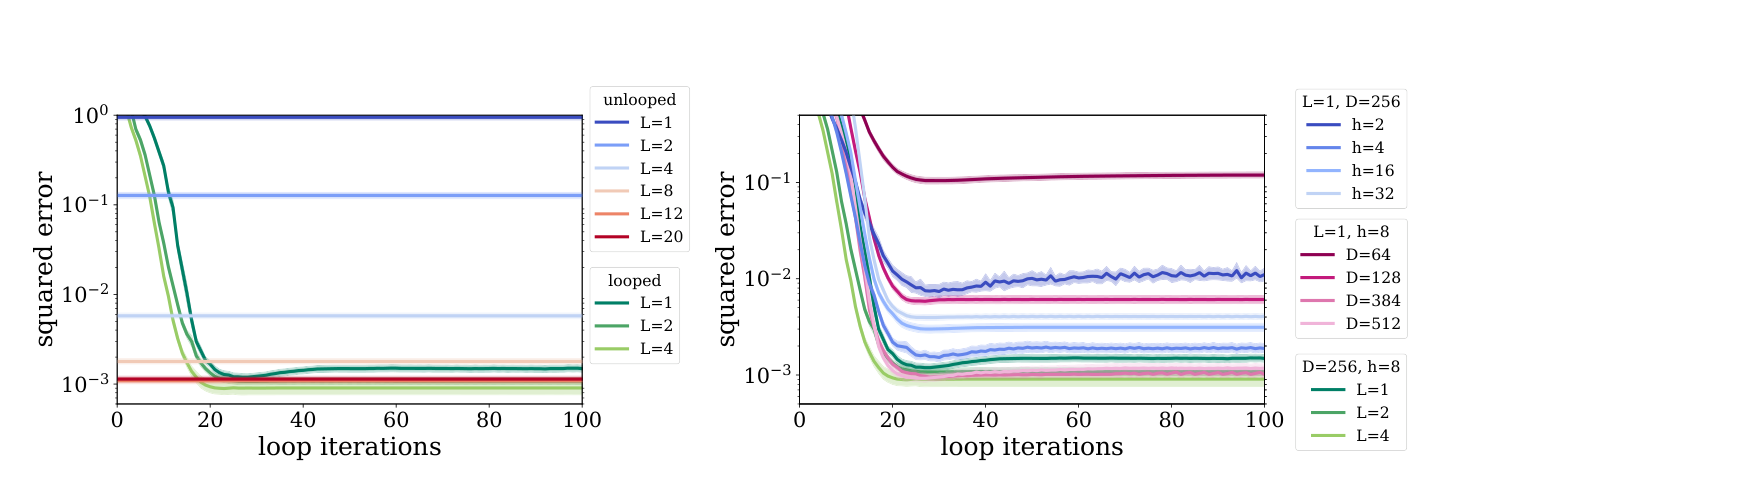
| 변형 | 관찰 |
|---|---|
| 층 수 L (두 모델 비교) | L이 클수록 빨리 수렴한다. L층 표준 Transformer를 따라잡으려면 looped transformer는 L회보다 많이 반복해야 한다. 1층 looped transformer는 약 20회 반복해야 8층 Transformer 성능에 도달한다 |
| 임베딩 차원 D (L=1, h=8) | D가 커질수록 수렴이 좋아지고 D=256에서 포화한다 |
| 층 수 L (D=256, h=8) | 최종 수렴 성능은 비슷하고 수렴 속도만 다르다 |
| head 수 h (L, D 고정) | h가 2에서 8로 늘면 오차가 줄고, 8에서 32로 늘면 다시 커진다 |
head 수의 비단조 경향은 GPT-2 표준 구현(nanoGPT)에서 head당 차원이 D/h로 정해지기 때문이다. D가 고정이면 head 수를 늘릴수록 head 하나의 차원이 줄어 둘 사이에 trade-off가 생긴다.
1층 looped transformer가 8층 Transformer를 따라잡는 데 20회가 필요하다는 관찰은, 실효 깊이 기준으로 looped transformer가 더 깊어야 한다는 뜻이다. 저자들은 이를 두 모델이 층(반복)마다 서로 다른 표현을 학습한다는 신호로 해석하고, probing으로 확인한다.
층별 표현의 probing
model probing은 중간 층 출력에서 특정 목표값을 작은 모델로 복원해, 그 층이 어떤 정보를 담고 있는지 재는 분석법이다. 저자들은 Akyürek et al.(2022)과 Alain and Bengio(2016)의 방법을 따른다.
probing 절차는 다음과 같다.
- t번째 층(또는 t회 반복)의 출력 Y_t(시퀀스 길이 k × 임베딩 D)를 얻는다.
- 학습 가능한 벡터 s로 시퀀스 방향 가중치 α = softmax(s)를 만들고 Z_t = α^T Y_t로 하나의 벡터로 합친다.
- 은닉 64개의 2층 MLP(ReLU)로 Z_t에서 목표값을 복원하고, 평균 제곱 오차를 문제 차원 d로 나눈다.
- 층마다, 문맥 길이마다 별도의 s와 MLP를 학습하고 문맥 길이에 걸쳐 평균한다.
목표값은 gradient 성분 X^T y와 최소제곱 해 w_ols 두 가지다. 설정은 D=256, d=20이고 probe는 Adam으로 학습하며 learning rate는 {0.01, 0.001, 0.0001} 중 가장 좋은 0.001을 썼다.
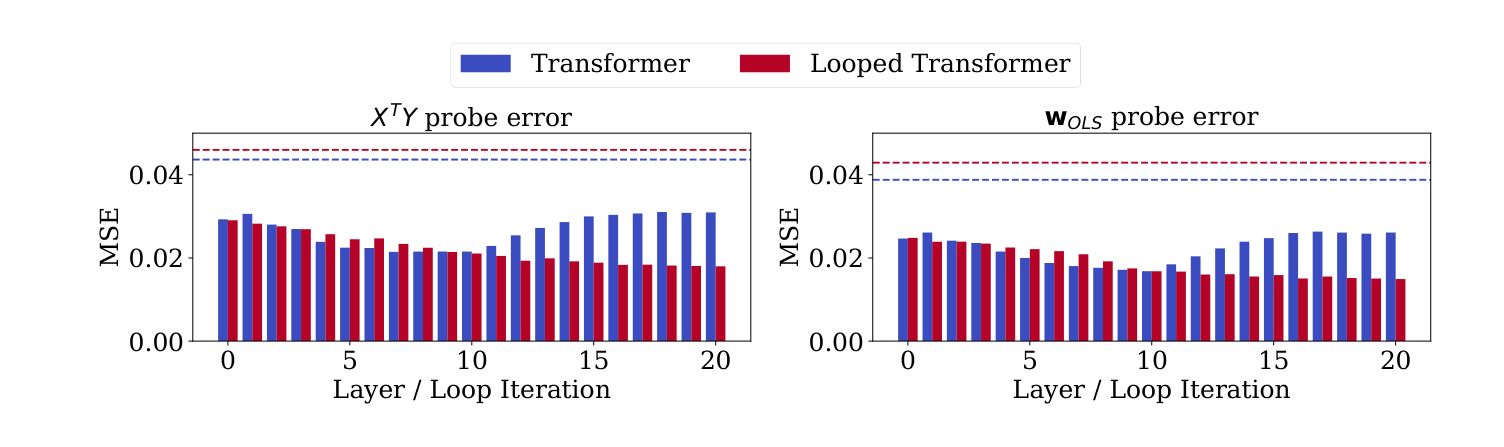
두 모델의 표현 변화는 뚜렷하게 다르다.
- 표준 Transformer는 초반 층에서 X^T y와 w_ols 관련 표현을 담고 10층 근처에서 가장 잘 복원한다. 그 이후에는 다른 통계로 초점을 옮겨 probe 오차가 다시 커진다.
- looped transformer는 반복할수록 두 목표의 표현을 꾸준히 개선해, 20회 근처에서 표준 Transformer의 최저점보다 낮은 오차에 머문다.
control task는 함수 파라미터 w를 1로 고정해 probe가 입력 X의 통계만 배우게 한 대조 실험이다. 추론 때 w를 무작위로 뽑으면 이 probe의 오차가 점선 수준이 된다. 실제 probe 오차가 이 점선보다 확연히 낮으므로, probe가 각 층의 in-context 정보를 실제로 활용하고 있음을 알 수 있다.
복잡한 함수 클래스
선형 회귀보다 복잡한 세 함수 클래스로 실험을 넓혔다. 설정은 Garg et al.(2022)을 따른다.
| 함수 클래스 | 설정 | 학습할 파라미터 규모 |
|---|---|---|
| 희소 선형 함수 | d=20, k=100, d개 성분 중 s=3개만 0이 아님 | 비영 성분 3개 |
| 결정 트리 | 깊이 4의 이진 트리, d=20. 내부 노드는 무작위로 고른 입력 좌표의 부호로 좌우를 정하고, 잎 값은 N(0, I)에서 뽑는다 | 2^{depth+1} - 1 = 31개 |
| 2층 ReLU 신경망 | 은닉 뉴런 100개, d=20, 가중치는 N(0, I) | 21 × 100개 |
입력과 파라미터는 모두 N(0, I_d)에서 뽑는다.
함수 클래스별 b의 영향
선형 회귀에서 관찰한 b와 T의 경향은 다른 함수에서도 유지되지만 최적값은 과제마다 다르다. T=10으로 고정하고 b를 바꾼 결과가 Figure 9다.
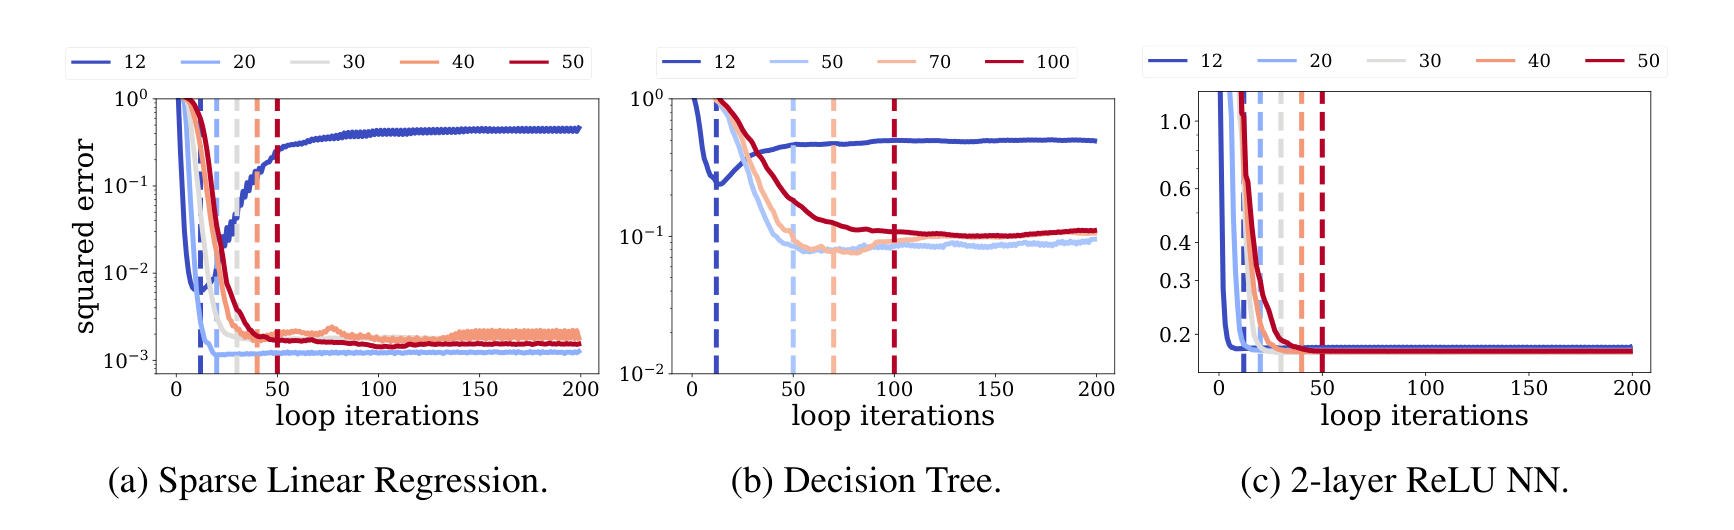
- T=10에서 선형 회귀는 b=20일 때 발산하지만, 희소 선형 회귀는 같은 b에서 fixed point로 수렴한다. 파라미터가 더 많은 과제일수록 안정적으로 수렴하려면 큰 b와 T가 필요하다.
- 결정 트리는 학습할 파라미터가 31개라 더 큰 b가 필요하다.
- 2층 ReLU 신경망은 파라미터가 2,100개로 가장 많고 학습이 어렵다고 알려져 있지만(Chen 2022) b=12면 충분하다. 저자들은 그 이유를 밝히지 못했고, b가 looped transformer에게 과제가 얼마나 어려운지를 나타내는 지표일 것이라고 추측한다.
부록 B의 전수 탐색(선형, 희소 선형, 2층 ReLU는 b ∈ {12, 20, 30, 40, 50}, 결정 트리는 b ∈ {12, 50, 70, 100}, 모두 T ∈ {5, 10, 15})은 과제와 무관하게 같은 패턴을 보였다.
- T가 작을수록 in-context 해의 평균 제곱 오차가 크다.
- T를 고정하면 b가 클수록 fixed point를 찾기 쉽고, 성능은 일정 b까지 좋아진 뒤 포화한다.
- T=20 같은 큰 값은 안정화 기법 없이 학습하면 불안정하지만, weight decay, mixed precision, gradient norm clip을 쓰면 안전하게 학습된다.
표준 Transformer와 기준 solver 비교
하이퍼파라미터 탐색으로 고른 최적값은 희소 선형 함수 b=20, T=10, 결정 트리 b=70, T=15, 2층 ReLU 신경망 b=12, T=5다. 이 설정으로 학습한 looped transformer를 표준 Transformer와 기존 solver들과 비교했다.
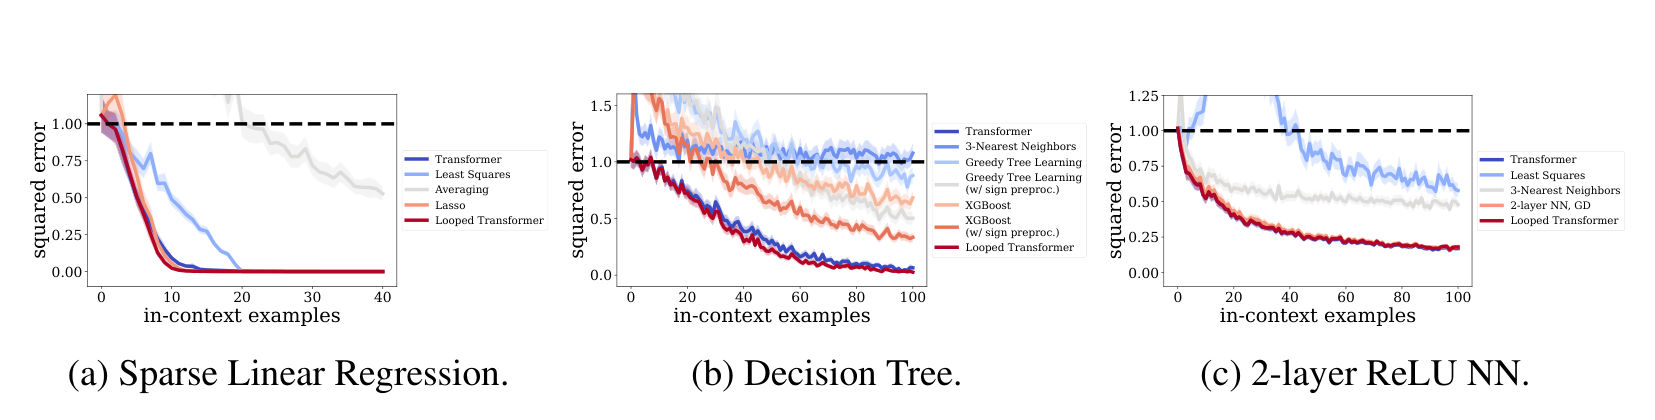
| 과제 | 비교 대상 | 결과 |
|---|---|---|
| 희소 선형 회귀 | 표준 Transformer, 최소제곱, Averaging, Lasso | looped transformer가 표준 Transformer와 Lasso보다 예시 수 대비 오차가 빨리 줄어든다 |
| 결정 트리 | 표준 Transformer, 3-Nearest Neighbors, Greedy Tree Learning, XGBoost (부호 전처리 유무) | 표준 Transformer와 일치한다 |
| 2층 ReLU 신경망 | 표준 Transformer, 최소제곱, 3-Nearest Neighbors, gradient descent로 학습한 2층 신경망 | 표준 Transformer와 일치한다 |
희소 선형 회귀에서 "더 낫다"는 최종 해의 정밀도가 아니라 예시 수에 따른 추세를 뜻한다. 예시 40개에서의 최종 오차는 다음과 같다.
| 방법 | 예시 40개에서의 오차 |
|---|---|
| 최소제곱 | 8.21e-14 |
| Lasso (α=0.01) | 1.32e-04 |
| looped transformer | 6.12e-04 |
| 표준 Transformer | 0.0017 |
즉 예시가 충분하면 Lasso가 looped transformer보다 정밀하다. 그러나 예시가 10개 미만인 구간에서는 looped transformer의 오차가 Lasso보다 작다. Lasso의 ℓ1 계수 α는 {1e-4, 1e-3, 0.01, 0.1, 1}에서 탐색해 가장 좋은 0.01을 골랐다. 저자들은 이 이득을 더 희소한 해를 선호하는 looped transformer의 inductive bias로 추측한다. 희소한 문제에서는 이 편향이 성능을 끌어올린다.
희소도에 따른 비교
희소 선형 회귀의 이득을 더 살피기 위해 비영 성분 수 s를 1, 3, 6, 9, 12로 바꿔 과제 난이도를 조절했다. 모든 희소도를 다루도록 b=30, T=15로 학습했다.
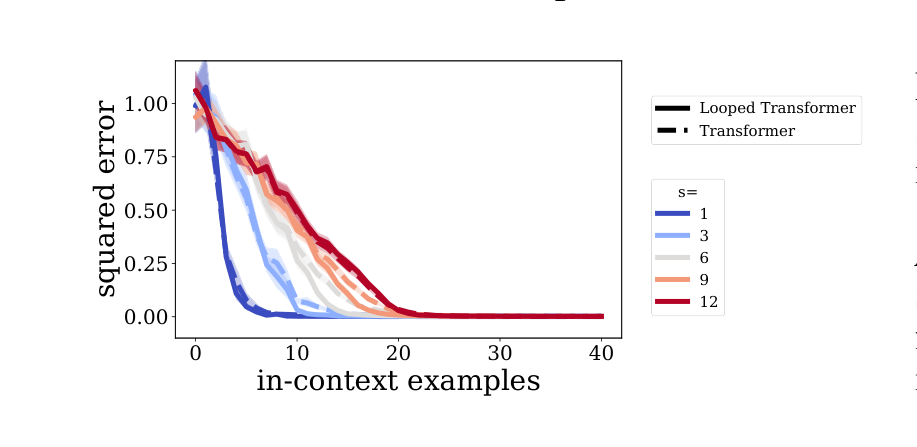
모든 희소도에서 looped transformer가 표준 Transformer와 같거나 더 낫다. 차이는 예시 수가 적을 때 크고, 예시가 20개를 넘으면 두 모델 모두 오차가 0에 가까워진다. s가 클수록 같은 오차에 도달하는 데 필요한 예시 수가 늘어나, 희소도가 실제로 과제 난이도를 조절하고 있음을 보여 준다.
OpenML 실제 데이터
합성 함수가 아닌 실제 데이터에서도 검증하기 위해 OpenML의 10개 데이터셋을 썼다. 모두 0/1 이진 레이블이며 입력은 수치 feature만 쓴다(데이터셋별 feature 5개에서 14개, 샘플 3,107개에서 9,517개).
평가는 leave-one-out 방식이다. 9개 데이터셋에서 무작위로 고른 데이터셋의 k+1개 샘플로 prompt를 만들어 학습하고, 학습에 쓰지 않은 나머지 1개 데이터셋에서 in-context 예시 k개를 뽑아 테스트한다. 테스트 샘플 자신은 예시에서 뺀다. 두 모델 모두 임베딩 256, head 8이고 표준 Transformer는 12층, looped transformer는 1층(b=30, T=15)이다.
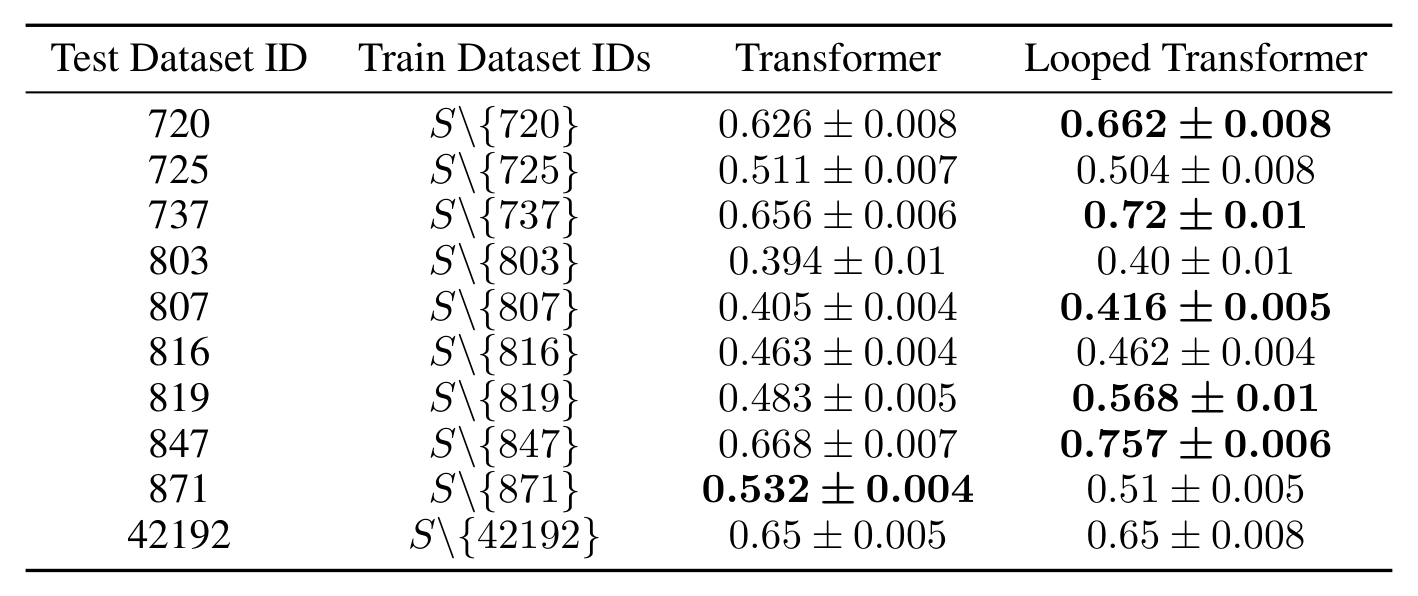
| Test ID | 데이터셋 | 표준 Transformer | looped transformer |
|---|---|---|---|
| 720 | abalone | 0.626 ± 0.008 | 0.662 ± 0.008 |
| 725 | bank8FM | 0.511 ± 0.007 | 0.504 ± 0.008 |
| 737 | space ga | 0.656 ± 0.006 | 0.72 ± 0.01 |
| 803 | delta ailerons | 0.394 ± 0.01 | 0.40 ± 0.01 |
| 807 | kin8nm | 0.405 ± 0.004 | 0.416 ± 0.005 |
| 816 | puma8NH | 0.463 ± 0.004 | 0.462 ± 0.004 |
| 819 | delta elevators | 0.483 ± 0.005 | 0.568 ± 0.01 |
| 847 | wind | 0.668 ± 0.007 | 0.757 ± 0.006 |
| 871 | pollen | 0.532 ± 0.004 | 0.51 ± 0.005 |
| 42192 | compas-two-years | 0.65 ± 0.005 | 0.65 ± 0.008 |
looped transformer는 10개 중 6개 데이터셋에서 정확도가 높고, 3개에서 약간 낮으며, 1개에서 같다. 가장 큰 향상은 wind(0.668에서 0.757, 8.9%p)와 delta elevators(0.483에서 0.568, 8.5%p)다. 낮은 쪽의 최대 차이는 pollen의 2.2%p다. 따라서 1/12 파라미터의 looped transformer가 실제 표 데이터에서도 표준 Transformer와 대등하거나 더 낫다.
결과의 종합
여러 실험은 하나의 그림으로 모인다. looped transformer는 입력 주입과 적절한 b, T로 학습하면 학습 범위를 넘어서도 안정적인 fixed point에 머물며, 학습 분포 안에서는 반복 최적화 알고리즘처럼 동작한다. probing 결과는 이 모델이 반복마다 목표 통계의 표현을 꾸준히 다듬는다는 점을 보여 주며, 표준 Transformer가 중간 층 이후 표현을 바꾸는 것과 대조된다.
파라미터가 적다는 점은 두 방향으로 작용한다. 표본 효율이 높아지고 희소한 해를 선호하는 편향이 생기는데, 이 편향은 희소 선형 회귀와 치우친 공분산 입력에서는 이득이고 입력 스케일이 커지는 분포 변화에서는 손해다.
한계
저자들이 논의 절에서 밝힌 한계와 향후 방향은 다음과 같다.
- 학습 분포 안에서만 알고리즘을 흉내 낸다. looped transformer는 학습 분포 안에서는 fixed-point 반복법을 흉내 내지만, 그 해에는 고유한 오차 하한(error floor)이 있고 분포 밖 prompt에서는 성능이 제한된다. 즉 어떤 입력 분포에도 일반화하는 실제 알고리즘을 찾은 것이 아니다. 기존 알고리즘 수준의 일반화를 갖춘 solver를 만드는 것은 향후 과제다.
- b와 T의 튜닝 비용. 최적값은 발산을 막는 최소값을 하이퍼파라미터 탐색으로 찾아 정한다. b는 학습 시 b회 펼쳐야 하므로 forward pass 시간을, T는 T회분 손실을 계산하므로 학습 메모리를 정한다. fixed point 근사만이 목표라면 큰 b, 적절한 T, 그리고 mixed precision, gradient clipping, weight decay 같은 정규화를 써서 집중적인 튜닝을 피할 수 있다고 저자들은 제안한다.
- 표현력 분석 부재. Bai et al.(2019)의 정리 3은 임의의 L층 신경망을 weight-tied, input-injected 네트워크로 표현할 수 있음을 보였고, Giannou et al.(2023)은 인코더 looped transformer가 범용 컴퓨터로 동작할 수 있음을 보였다. 이 논문은 디코더 looped transformer의 실험적 검증과 학습법에 집중했으며 그 표현력 분석은 남겨 둔다.
- 설명되지 않은 관찰. 2층 ReLU 신경망이 파라미터가 많은데도 작은 b로 충분한 이유는 밝혀지지 않았다.
- 실험 범위. 결론은 시험한 함수 클래스(선형, 희소 선형, 결정 트리, 2층 ReLU 신경망)와 OpenML 표 데이터에 한정된다. 언어 모델링 같은 대규모 과제에서의 효과는 다루지 않는다.
후속 방향
저자들은 b와 T를 과제 난이도의 지표로 쓰자고 제안한다. 본질적으로 복잡한 과제일수록 fixed point로 수렴하려면 큰 b와 T가 필요하고, 단순한 과제는 작은 값으로 충분하기 때문이다.
이 관찰을 확장하면 난이도가 섞인 실제 환경에서는 적응형 looping 전략이 유용할 수 있다. 저자들이 드는 후보는 두 가지다.
- Universal Transformer(Dehghani 2018)처럼 토큰 단위로 반복 횟수를 다르게 정하는 방식
- in-context multi-task 추론에서 과제마다 반복 횟수를 달리하는 방식
관련 연구와의 위치
| 계열 | 대표 연구 | 이 논문과의 관계 |
|---|---|---|
| 가중치 공유 모델 | RNN, LSTM, Transformer-XL, Block-Recurrent Transformer, ALBERT, Perceiver, Universal Transformer | 층 사이 가중치를 공유하지만 유한한 층이나 halting 기준을 둔다. 이 논문은 입력 주입과 truncated loss로 학습 범위 밖까지 안정된 반복을 얻는다 |
| deep implicit model | Deep Equilibrium Models(Bai 2019), Jacobian 정규화(Bai 2021) | 함수를 무한히 반복한 극단으로, black-box solver로 fixed point를 찾는다. 하이퍼파라미터 튜닝이 많고 학습이 불안정하다 |
| Transformer의 수학과 추론 과제 | Zhang 2023b, Ongie 2020, Charton 2022 등 | 대부분 유한한 상태나 선택지를 다룬다. 회귀는 연속 출력 공간이라 성격이 다르다 |
| in-context 함수 학습 | Garg 2022, Akyürek 2022, Raventós 2023 | Garg 2022와 같은 디코더 구조와 non-linear attention을 그대로 쓴다 |
| in-context learning 이론 | von Oswald 2022, Ahn 2023, Zhang 2023a, Mahankali 2023, Fu 2023, Giannou 2024 | linear attention 구조에서 gradient descent나 고차 최적화를 구현함을 보였다. 이 논문은 실제 디코더에서 반복 구조를 학습법으로 유도한다 |
| looped transformer 이론 | Giannou 2023 (Looped Transformers as Programmable Computers) | 같은 연구 그룹의 선행 연구로, 이론적 구성을 실제로 학습 가능한 모델로 옮긴다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| looped transformer | 적은 수의 Transformer 층을 가중치를 공유한 채 여러 번 반복 적용하는 구조. 이 논문은 1층 블록을 반복한다 |
| input injection | 매 반복 입력에 원래 prompt P를 다시 더하는 설계, Y_{t+1} = M(Y_t + P) |
| weight-tying | 입력 주입 없이 같은 가중치만 반복하는 기존 형식. 반복이 길어지면 초기 입력 정보를 잃는다 |
| fixed-point solution | 반복을 계속해도 출력이 바뀌지 않는 해. 학습 반복 횟수를 넘겨도 발산하지 않는 상태 |
| b와 T | b는 학습 시 펼치는 최대 반복 횟수, T는 손실을 계산하는 마지막 반복 구간 길이 |
| model probing | 중간 층 출력에서 목표값을 작은 모델로 복원해 그 층이 담은 정보를 재는 분석법 |
관련 페이지
- You could have invented transformers from memory: self-attention을 associative memory로 해석하는 해설로, Transformer 층이 내부에서 어떤 연산을 하는지에 대한 다른 관점을 제공한다
- Recursive Language Models (RLM): 모델이 자기 자신을 재귀 호출해 긴 입력을 처리하는 추론 패러다임으로, 반복 계산으로 능력을 늘린다는 발상을 시스템 수준에서 적용한다
- Introducing S1: In-Context Learning for Robotics: 로봇 policy에 in-context learning을 적용한 사례로, 이 논문이 다루는 in-context learning을 물리 세계 과제로 옮긴다