Agents · PAPER · 2026
Agent Lightning v1.0: Towards Harnessed Agentic RL
요약
Agent Lightning v1.0은 배포할 때 쓰는 agent harness가 agent loop를 그대로 소유한 채 강화학습을 진행하는 방식을 harnessed agentic RL로 명명하고, 그 구도에서만 생기는 네 가지 공학 문제를 정리한 Microsoft 중심 연구다. 논문은 retokenization, advantage 계산, loss normalization, 학습 백엔드 스케줄링을 문제로 지목하고, 각각에 대한 자기 선택을 약 3,500줄짜리 프레임워크에 구현해 세 가지 agent 설정에서 검증했다.
실용적 성과도 함께 낸다. 학습 예제 약 6,000건과 크지 않은 연산으로 Qwen3.5-9B의 SWE-bench Verified 점수를 41.8%에서 56.4%로 14.6%p 올렸고, 데이터 정제 파이프라인과 reward hacking 차단책을 포함한 코딩 agent 학습 레시피 전체를 공개했다.
이 페이지의 가치는 벤치마크 수치보다 문제 정의 쪽에 있다. 논문이 지목한 네 문제는 harness를 학습 루프에 끌어들이는 모든 프레임워크가 마주하는 것이고, 기존 프레임워크들이 서로 다른 답을 조용히 택하고 있었다는 지적이 이 논문의 핵심 기여다.
배경
학습 프레임워크가 agent loop를 소유하던 시기
초기 RL 프레임워크는 agent loop를 학습 프레임워크 안에 직접 구현하도록 요구했다. verl, AReaL, slime이 그런 구조였고, 고전적 ReAct식 Markov 형식화를 따라 학습 엔진이 환경 상호작용 루프를 소유했다.
이 구조에서는 독립적으로 관리되는 harness를 재사용하기 어렵다. harness는 모델을 감싸 도구, 검증, 상태를 제공하는 실행 환경이다. mini-SWE-agent, OpenHands, OpenCode, Claude Code, Codex, OpenClaw, Hermes 같은 실제 harness는 구현이 복잡하고 자체 의존성을 갖고 있어서, 학습 스택 안에 다시 구현하는 비용이 크다.
결과적으로 학습에 쓰는 agent loop와 배포에 쓰는 agent loop가 갈라진다. 학습 때는 프레임워크가 재구현한 단순화된 루프를, 배포 때는 실제 harness를 쓰게 되므로 학습과 실사용 사이에 간극이 생긴다.
프록시 방식의 등장
2025년 Agent Lightning 원본이 학습과 agent 실행을 분리하는 구조를 제안해 이 간극을 좁혔다. agent를 거의 고치지 않고 LLM 엔드포인트만 프록시로 바꾸면 임의의 harness가 RL 학습에 붙는 방식이다.
이후 verl Uni-Agent, AReaL 2.0, slime v0.3.0, Polar가 같은 프록시 방식을 채택했다. 그런데 프록시를 두면 학습 엔진이 관측할 수 있는 것이 LLM 요청과 응답 쌍의 나열로 줄어든다. 이 나열을 어떻게 학습 sample로 조립할지가 열린 문제로 남았고, 프레임워크들은 각자 다른 답을 택했다.
이 논문의 v1.0은 원본 프레임워크를 전면 재구현한 후속 버전이다. 논문이 쓴 표현은 "a complete refactoring of the original Agent Lightning"이며, 재구현 대상은 소프트웨어이지 이전 논문의 서술이 아니다.
핵심 개념
harnessed agentic RL은 배포 시점 harness를 그대로 쓰면서 진행하는 강화학습을 말한다. 컨텍스트 구성, tool 실행, agent와 환경의 상호작용 루프를 학습기가 아니라 harness가 소유하고, 학습 시스템은 서비스 경계 너머에서 발생한 모델 호출만 관측하고 최적화한다.
rollout은 policy를 실행해 trajectory를 만드는 과정, 즉 agent 실행 한 번을 뜻한다. 학습 sample은 그 실행에서 조립해 낸 학습용 토큰 시퀀스다. 기존 agentic RL에서는 rollout 하나가 학습 sample 하나에 정확히 대응했는데, harnessed agentic RL에서는 이 대응이 깨진다.
policy는 observation을 받아 action을 정하는 함수다. harnessed 구도에서 이 policy는 환경을 직접 보지 않고, harness가 구성해 건네준 프롬프트만 보고 응답을 생성한다.
POMDP 형식화가 갈리는 지점
두 구도 모두 partially observable Markov decision process로 형식화되지만, 무엇이 latent state이고 무엇이 model 입력인지가 다르다.
기존 agentic RL에서는 latent state가 주로 환경 상태다. policy가 (de)tokenizer라는 투명한 계층을 거쳐 환경과 거의 직접 맞닿아 있고, 모델이 action 토큰을 내면 환경이 observation을 반환하며 그것이 기존 히스토리에 붙는다. 토큰 히스토리가 p_t = (p_{t-1}, a_{t-1}, o_t)로 한 줄로 계속 늘어나므로, rollout 하나가 선형 토큰 시퀀스 하나를 자연스럽게 이룬다.
harnessed agentic RL에서는 latent state가 s_t = (s_harness_t, s_env_t)로 harness 상태와 환경 상태를 함께 담는다. harness가 message 수준 컨텍스트 C_msg_t = Context_H(s_harness_t)를 만들고, 그것을 chat template과 tokenizer에 통과시켜 실제 프롬프트 p_tok_t = Tok(Template(C_msg_t))를 얻는다. 학습 엔진이 보는 것은 호출별 프롬프트와 응답 쌍의 나열 ((p_1,a_1), (p_2,a_2), ...)뿐이고, 그 사이의 harness 동작과 환경 전이는 보이지 않는다.
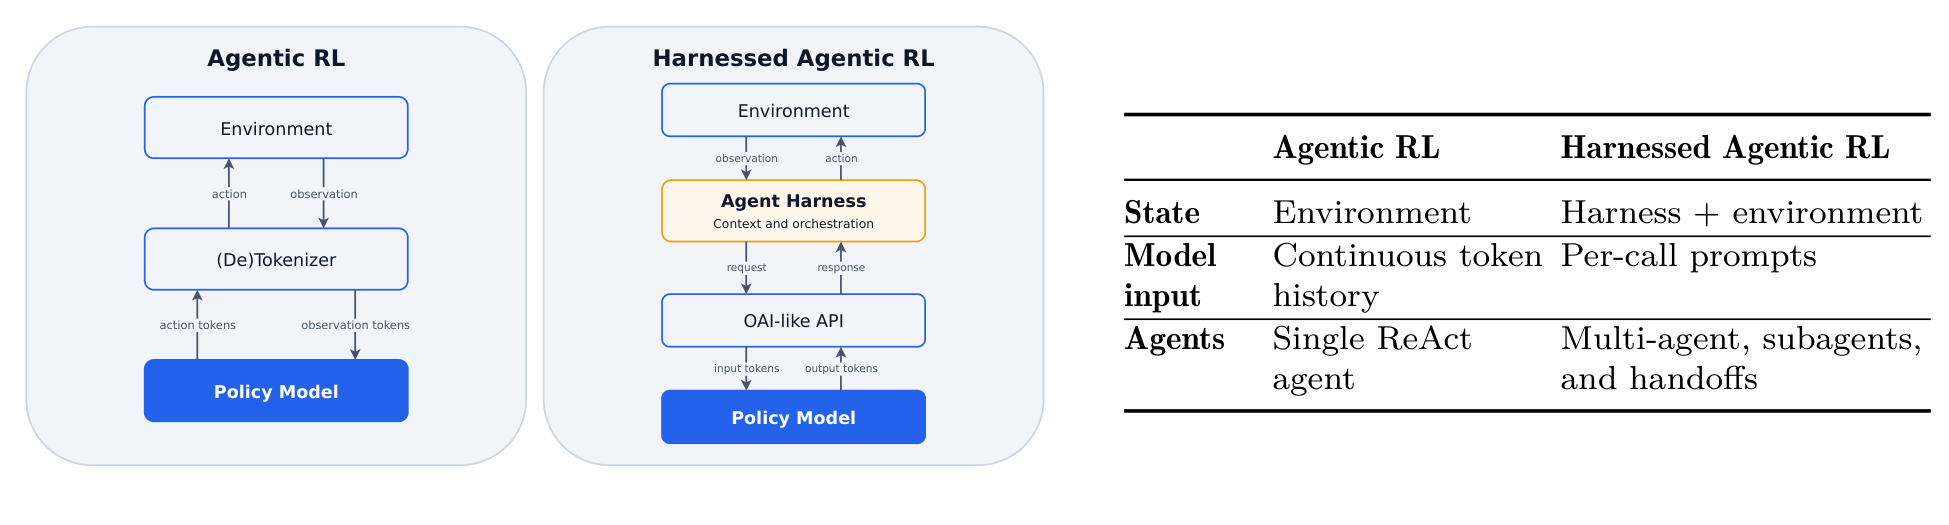
| 비교 항목 | 기존 agentic RL | harnessed agentic RL |
|---|---|---|
| latent state | 환경 상태 | harness 상태와 환경 상태 |
| model 입력 | 연속적으로 늘어나는 토큰 히스토리 | 호출마다 따로 구성된 프롬프트 |
| agent 구성 | 단일 ReAct agent | 멀티에이전트, 서브에이전트, handoff |
| 루프 소유자 | 학습 엔진 | agent harness |
| rollout과 학습 sample | 1대 1 대응 | 실행 후에 결정되는 1대 N |
여기서 하나의 제약이 파생된다. 학습을 위해 시퀀스를 어떻게 재구성하든, 기록된 각 action이 실제로 샘플링될 때 조건으로 삼았던 프롬프트를 보존해야 한다. 인접한 프롬프트 사이에 정확한 토큰 prefix 관계가 성립한다고 가정할 수는 없다.
방법
논문의 2절이 네 가지 문제를 차례로 다루고, 3절과 부록이 Agent Lightning v1.0의 답을 제시한다. 아래도 같은 순서를 따른다.
네 문제는 하나의 원인에서 갈라져 나온다. rollout 하나가 만드는 학습 sample 개수가 실행이 끝난 뒤에야 정해지고, 그 개수가 harness 내부 사정에 좌우된다는 점이다.
| 문제 | harnessed 구도에서만 생기는 이유 | Agent Lightning v1.0의 선택 |
|---|---|---|
| retokenization과 sample 병합 | harness는 텍스트로 대화하고 학습은 토큰 위에서 진행돼, 텍스트가 같아도 토큰 경계가 어긋난다 | best-effort 병합. 토큰 prefix 조건이 맞을 때만 잇는다 |
| advantage 계산 | rollout 하나가 여러 sample로 갈려 GRPO 그룹 baseline의 분모가 달라진다 | rollout 단위로 baseline과 advantage를 계산한다 |
| loss normalization | 배치의 sample 개수가 유동적이라 정규화 분모가 흔들린다 | rollout 단위 token-mean 손실을 쓴다 |
| 학습 백엔드 스케줄링 | 가변 작업량을 고정된 GPU 워커에 배분해야 하고 rollout 경계를 지켜야 한다 | 시퀀스마다 rollout 식별자와 프롬프트 그룹 식별자를 유지한다 |
앞의 세 문제에서 기존 프레임워크의 선택이 갈린다. 논문이 정리한 대비를 한 표로 모으면 이렇다.
| 프레임워크 | 버퍼 토큰 치환 | advantage 단위 | loss normalization | agent 실행 환경 |
|---|---|---|---|---|
| verl Uni-Agent | 한다 | rollout 단위 | 명시 없음 | Modal Sandbox, Volcano veFaas |
| AReaL 2.0 | 한다 | sample 단위 | 명시 없음 | 명시 없음 |
| slime v0.3.0 | 하지 않는다 | sample 단위 | rollout 단위 token-mean | E2B |
| Polar | 하지 않는다 | rollout 단위 | 명시 없음 | 명시 없음 |
| Agent Lightning v1.0 | 하지 않는다 | rollout 단위 | rollout 단위 token-mean | 자체 호스팅 Kubernetes |
이 표에서 "명시 없음"은 논문이 해당 프레임워크의 선택을 언급하지 않은 자리다. 논문의 지적도 이 공백을 향한다. 이 선택들이 알고리즘 정확성과 학습 안정성에 영향을 주는데도 대개 문서화되지 않은 채 남아 있다는 것이다.
retokenization이 토큰 prefix 조건을 깨는 세 경로
harness는 텍스트 메시지로 API와 대화하는데, RL 학습은 정확한 토큰 ID와 rollout 시점의 log probability 위에서 진행된다. 이 층 차이가 첫 번째 문제의 출발점이다.
대부분의 프레임워크는 다음 프롬프트 p_{i+1}이 앞선 프롬프트와 응답 (p_i, a_i)를 토큰 수준 prefix로 그대로 포함할 때 두 호출을 병합한다. 병합이 되면 공유 prefix를 한 번만 계산하므로 효율적이다.
문제는 텍스트 수준 prefix 조건이 성립해도 토큰 수준 조건이 따라오지 않는다는 점이다. 저자들이 관찰한 경로는 세 가지다.
| 경로 | 내용 | 논문이 든 사례 |
|---|---|---|
| chat template의 비합성성 | 전체 메시지 이력을 렌더한 결과가 부분들을 각각 렌더해 이어붙인 것과 다르다. template이 메시지 경계에 구분자나 개행을 삽입하거나, 원래 생성에 있던 마커를 빼기도 한다 | Qwen chat template이 앞선 <think> 마커를 제거해 prefix 연속성이 깨졌다 |
| decode와 retokenize의 표류 | 토큰 디코딩이 단사(injective)가 아니어서, 샘플링된 토큰을 텍스트로 바꾼 뒤 다시 토큰화하면 원래 토큰 ID로 복원되지 않는다 | having이 h와 aving으로 샘플링됐는데 나중 프롬프트에서 hav와 ing으로 다시 쪼개진다 |
| 추론 시점 출력 변환 | tool call과 structured output 처리기가 응답을 파싱, 정규화, 복구, 재직렬화한 뒤 harness로 반환한다 | 공백, 구분자, JSON 구조, 잘못된 문법이 바뀌어 텍스트 수준에서도 응답이 달라진다 |
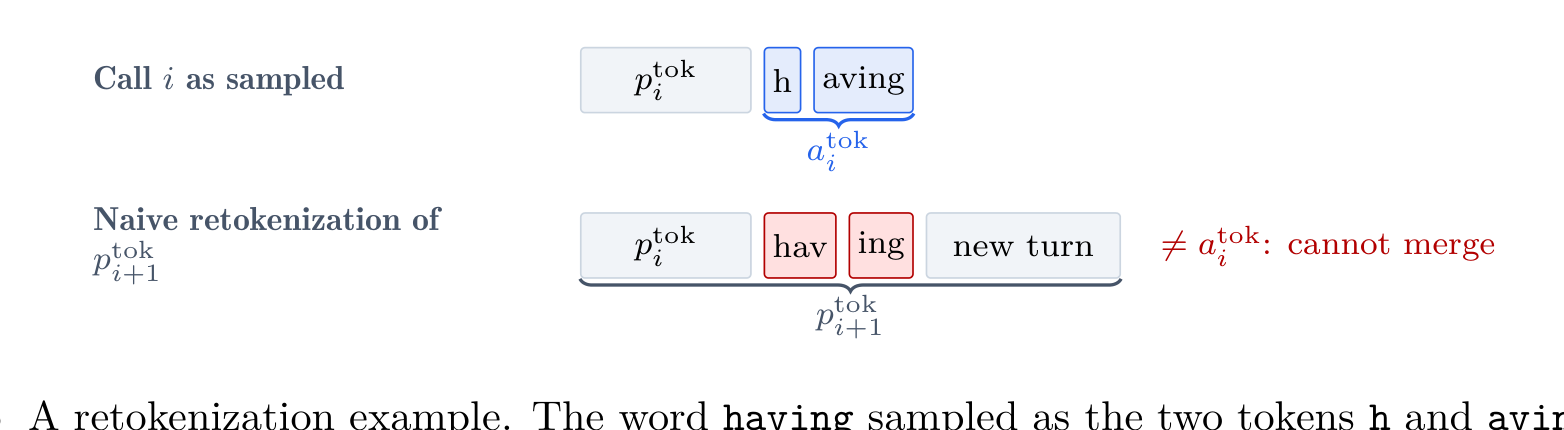
세 번째 경로는 나머지 둘보다 무겁다. 토큰 경계만 어긋나는 것이 아니라 텍스트 자체가 달라지므로, 샘플링된 토큰 ID가 표현하는 응답과 나중 프롬프트에 들어간 응답이 서로 다른 문자열이 된다.
여기에 harness의 정상 동작도 더해진다. harness가 서브에이전트를 띄우거나 컨텍스트를 요약하면 프롬프트 이력 자체가 갈라져, 텍스트 수준 prefix 조건조차 성립하지 않는다.
병합 전략 네 가지의 절충
논문은 깨진 prefix 연속성을 다루는 방식을 네 가지로 정리하고, 각각의 대가를 명시한다.
| 전략 | 방식 | 장점 | 대가 | 채택 |
|---|---|---|---|---|
| 호출 독립 학습 | 인접 호출과의 관계를 가정하지 않고 각 호출 (p_tok_i, a_tok_i)에서 손실을 계산한다 |
토큰 수준 정확성이 보장된다 | 호출 사이에 공유되는 긴 프롬프트 prefix를 반복 계산한다 | 기준선 |
| 버퍼 토큰 치환 | 프록시가 각 호출의 텍스트와 토큰을 보관했다가, 새 요청 텍스트가 이력과 정확히 일치하면 해당 구간을 보관된 토큰으로 바꾼다 | prefix 조건이 항상 성립해 병합률이 오른다 | 실제로 모델이 조건으로 삼은 프롬프트를 바꿔 off-policy 불일치가 생긴다 | AReaL 2.0, verl Uni-Agent |
| prefix 공유 트리 학습 | 공통 토큰 prefix를 한 번만 표현하고, 분기 인식 causal attention mask로 각 토큰이 자기 조상과 같은 분기의 앞 토큰만 참조하게 한다 | 독립 시퀀스 학습과 같은 결과를 내면서 prefix 계산을 재사용한다 | 트리 패킹, 커스텀 attention mask나 커널, 분할, 분산 그래디언트 처리까지 백엔드를 크게 고쳐야 한다 | 미채택 |
| best-effort 병합 | 관측된 토큰 ID가 prefix 조건을 만족할 때만 잇고, 실패하면 현재 시퀀스를 닫고 새로 시작한다 | rollout 시점 프롬프트를 보존하면서 표준 dense causal 커널로 동작한다 | retokenization 표류가 병합률을 낮춘다 | Agent Lightning v1.0 |
저자들이 가장 강하게 문제 삼는 것은 버퍼 토큰 치환이다. 실제 다음 프롬프트가 재구성된 응답 â_tok_i를 담아 p_tok_{i+1} = p_tok_i ∥ â_tok_i ∥ Δ_{i+1} 형태인데, 이 구간을 원래 샘플링된 a_tok_i로 바꾸면 p̃_tok_{i+1} = p_tok_i ∥ a_tok_i ∥ Δ_{i+1}이 되고 두 프롬프트는 같지 않다.
그런데 다음 응답 a_tok_{i+1}은 치환된 p̃가 아니라 실제 프롬프트 p를 조건으로 샘플링된 것이다. 치환된 프롬프트 아래서 그 응답을 학습시키면 off-policy 불일치가 들어온다. 저자들의 결론은 정확한 토큰 prefix 겹침을 병합에 쓰는 것이 rollout 때 실제로 소비된 프롬프트를 보존할 때만 정당하다는 것이다. slime과 Polar는 이 치환을 하지 않는다.
Agent Lightning v1.0은 best-effort 병합을 호출 독립 재계산과 백엔드 부담이 큰 트리 학습 사이의 중간 지점으로 택했다.
advantage를 rollout 단위로 낼 것인가
rollout 하나가 만들어내는 학습 sample 개수 N_ρ는 실행과 sample 구성이 끝난 뒤에야 정해진다. 원인은 retokenization만이 아니다. harness가 서브에이전트를 띄워 선형 이력을 공유하지 않는 분기를 만드는 것, 컨텍스트를 요약해 앞선 토큰 prefix를 새것으로 교체하는 것도 sample을 쪼갠다.
이것은 드문 예외가 아니다. 논문의 코딩 agent 학습에서 rollout의 36%만 sample 하나로 남았고 rollout당 평균은 2.41개였다. 즉 절반이 훨씬 넘는 rollout이 여러 sample로 갈라진다.
reward는 여전히 결과 기반이고, 한 rollout에서 나온 모든 sample에 같은 값이 부여된다. 그래서 advantage를 계산할 때 그룹 통계를 어느 단위로 낼지가 갈린다.
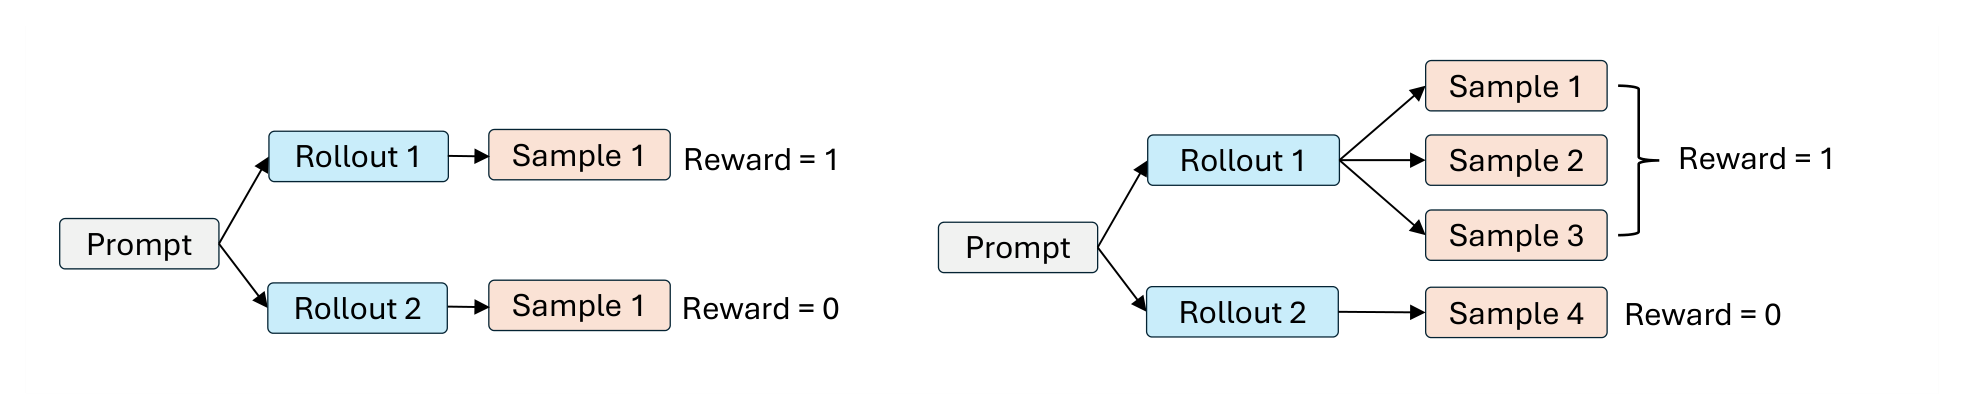
Figure 4의 예시가 차이를 구체적으로 보여 준다. 같은 프롬프트에서 나온 GRPO 그룹에 rollout 1(reward 1)과 rollout 2(reward 0)가 있다고 하자. 기존 방식이라면 각 rollout이 sample 하나이므로 baseline은 (1 + 0) / 2 = 1/2로 논란의 여지가 없다. harnessed 방식에서 rollout 1이 sample 세 개로, rollout 2가 sample 한 개로 갈리면 계산이 갈라진다.
| 계산 단위 | baseline | 채택 프레임워크 |
|---|---|---|
| rollout 단위 | (1 + 0) / 2 = 1/2 | verl Uni-Agent, Polar, Agent Lightning v1.0 |
| sample 단위 | (1 + 1 + 1 + 0) / 4 = 3/4 | slime, AReaL 2.0 |
저자들은 rollout 단위가 더 원칙적인 선택이라고 본다. 근거는 두 가지다. retokenization은 우발적으로 벌어진 일이므로 그것이 rollout을 여러 sample로 쪼갰다는 이유만으로 advantage 배정이 달라져서는 안 된다. 서브에이전트 생성과 컨텍스트 요약도 harness 내부 사정이므로 그룹 전체의 baseline을 움직일 근거가 되지 못한다.
다만 rollout 안의 sample들 사이에 credit을 어떻게 나눌지는 향후 과제로 남긴다. 지금은 rollout이 받은 reward를 그 안의 모든 sample에 그대로 부여하는 방식이다.
loss normalization
sample 개수가 유동적이면 정규화 분모도 흔들린다. 배치에 rollout R개가 있고 rollout ρ가 sample N_ρ개를 내며 그중 j번째 sample이 응답 토큰 L_{ρ,j}개를 갖는다고 두면, 기존 정규화 세 가지가 서로 다른 값을 낸다.
| 정규화 | 계산 방식 | 출처 |
|---|---|---|
| token-mean | 배치 전체 토큰의 손실 합을 전체 응답 토큰 수로 나눈다 | DAPO |
| seq-mean-token-mean | sample마다 평균을 낸 뒤 배치의 sample 개수로 균등 평균한다 | GRPO |
| rollout 단위 token-mean | rollout의 응답 토큰을 먼저 모아 평균 낸 뒤 rollout 개수로 균등 평균한다 | slime |
논문의 Figure 5가 든 배치 예시로 계산해 보면 차이가 눈에 보인다. rollout A가 길이 50과 100인 sample A1, A2를, rollout B가 길이 30인 sample B1, B2, B3를, rollout C가 길이 40인 sample C1을 냈다고 하자. 기호는 각 sample 안의 토큰별 손실 합을 뜻한다.
| 정규화 | 이 배치에서의 계산 |
|---|---|
| token-mean | (A1+A2+B1+B2+B3+C1) / (50+100+30+30+30+40) |
| seq-mean-token-mean | (1/6) × (A1/50 + A2/100 + B1/30 + B2/30 + B3/30 + C1/40) |
| rollout 단위 token-mean | (1/3) × ((A1+A2)/150 + (B1+B2+B3)/90 + C1/40) |
저자들의 판단은 advantage 때와 같은 원칙에서 나온다. sample 개수가 그래디언트 정규화를 좌우해서는 안 된다는 것이다. seq-mean-token-mean은 이 원칙에 어긋난다. 위 예시에서 sample 세 개를 낸 rollout B가 sample 하나를 낸 rollout C보다 세 배의 비중을 갖기 때문이다.
이론상으로는 token-mean과 rollout 단위 token-mean 둘 다 원칙에 맞는다. 실무에서 저자들은 token-mean이 긴 시퀀스에 민감하다는 것을 관찰했다. 부정적인 긴 sample이 배치에 몰리면 학습 후반이 불안정해진다. 그래서 rollout 단위 token-mean을 최종 선택으로 삼는다.
학습 백엔드 스케줄링
배치가 몇 개의 sample을 어떤 길이로 내놓을지는 harness 실행과 sample 구성이 끝나야 알 수 있다. 반면 GPU 수와 data parallel, tensor parallel, pipeline parallel 구성은 학습 전 기간에 걸쳐 고정돼 있다. 백엔드는 매 iteration마다 가변 작업량을 고정된 워커 집합에 배분해야 한다.
sample 구성이 끝나면 백엔드는 시퀀스들을 물리 텐서 배치로 펼칠 수 있다. 다만 이 변환이 통계적 출처를 보존해야 한다. 학습 배치는 B_train = ⋃_{ρ∈B_rollout} {(S_{ρ,j}, ρ, g_ρ) | 1 ≤ j ≤ N_ρ} 형태로, 각 시퀀스가 자기 rollout 식별자 ρ와 같은 프롬프트에서 나온 rollout 그룹의 식별자 g_ρ를 계속 유지한다. 펼치기는 물리 표현만 바꿀 뿐이며, rollout 소속을 바꾸거나 시퀀스를 많이 냈다는 이유만으로 특정 rollout에 추가 통계 가중치를 주어서는 안 된다.
rollout 경계는 배치 스케줄링도 제약한다. N_ρ를 실행 전에 알 수 없으므로 행 기반 텐서 배치, data parallel 분할, micro-batch 일정을 프롬프트 수나 rollout 수만으로 미리 계획할 수 없다.
한 rollout에서 나온 시퀀스들은 같은 optimizer 갱신 안에 머물러야 한다는 제약도 붙는다. 나뉘면 한 rollout의 부분들이 서로 다른 policy 버전 아래서 평가되는 within-rollout policy skew가 생긴다.
시스템 구성
학습기와 harness를 분리하면 rollout 생애주기 전체를 소유한 프로세스가 없어진다. 학습기는 모델 추론과 최적화를, harness는 컨텍스트 구성, 제어 흐름, tool use, 환경 상호작용을 각각 가진다.
이 분리가 만드는 운영 조건이 까다롭다. agent 실행은 원격에서 진행될 수도 있고, API 요청이나 워커 프로세스 하나보다 오래 살 수도 있고, 학습 프로세스와 무관하게 실패할 수도 있다. 그래서 지속적인 rollout 상태, 외부 실행, 부분 실패, 자원 사용을 조율하되 harness 로직을 학습기 안으로 다시 끌어오지 않는 경량 control plane이 필요하다.
Agent Lightning v1.0은 이 control plane을 선언적 rollout 추상화와 reconciliation 루프로 구성한다. 학습기가 API Gateway를 통해 rollout을 선언하고, Rollout Controller가 그 상태를 실제 실행과 계속 맞춰 간다.
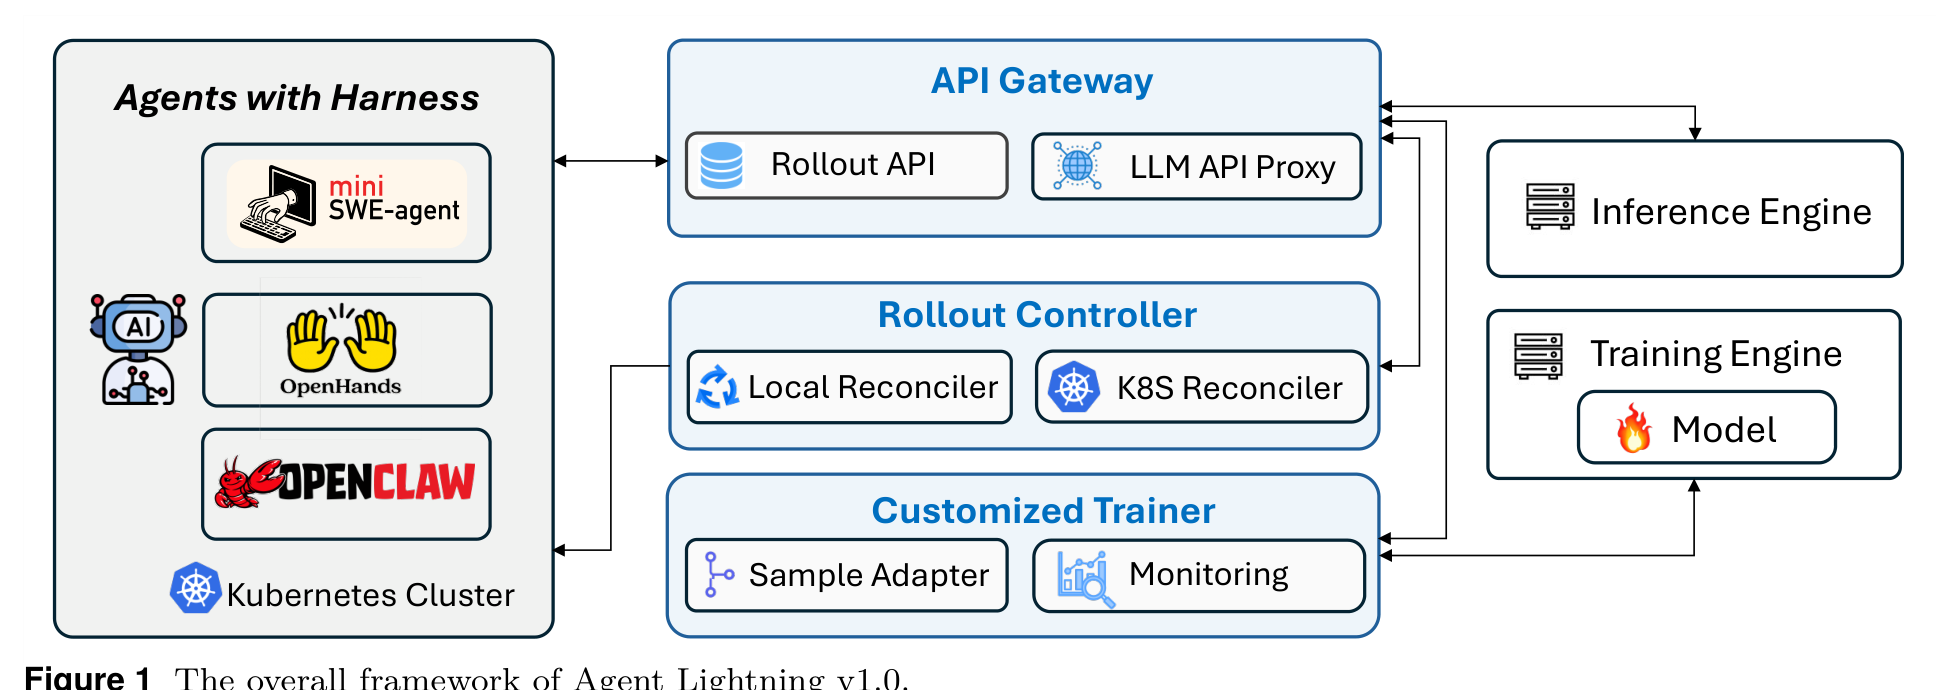
| 컴포넌트 | 역할 | 내부 구성 |
|---|---|---|
| API Gateway | rollout, 모델, 이벤트를 저장하고 harness가 보낸 LLM 호출을 학습기가 등록해 둔 엔드포인트로 넘긴다. 생애주기 상태와 append-only 이벤트의 진실의 원천(source of truth)이다 | Rollout API, LLM API Proxy |
| Rollout Controller | Gateway에서 rollout을 polling해 해당 agent 작업을 Kubernetes Job이나 로컬 프로세스 풀로 띄우고 상태를 Gateway에 다시 보고한다 | K8S Reconciler, Local Reconciler |
| Customized Trainer | VERL 위에 구현돼 rollout을 등록하고 종료 상태에 이를 때까지 기다렸다가 기록된 이벤트를 모아 학습 sample로 조립한다 | Sample Adapter, Monitoring |
이 연결이 만드는 결과가 세 가지다. 학습기는 rollout을 만들고 trajectory를 모으는 일만 한다. 어떤 harness든 LLM 엔드포인트를 프록시로 바꾸기만 하면 붙는다. 학습 자원과 실행 자원을 독립적으로, 심지어 다른 위치에 둘 수 있다.
Kubernetes도 rollout 추상화의 일부가 아니라 교체할 수 있는 실행 백엔드가 된다. 로컬 프로세스 풀로 바꿔도 상위 추상화는 그대로다.
control plane은 신뢰성과 관측성도 명시적으로 규정한다. control plane 연산은 idempotent하고, 생성 시도는 기록되고 명시적으로 해소되며, rollout 식별자 하나가 모델 요청, reward, 커스텀 이벤트, 실행 로그를 한 진단 기록으로 묶는다.
collocated async RL
동기 방식 RL은 배치 안의 모든 rollout이 끝나야 갱신이 시작된다. 결국 가장 느린 rollout을 기다리게 되고 그동안 많은 GPU가 유휴 상태로 남는다.
AReaL이 제안한 비동기 방식은 rollout용과 갱신용 머신 풀을 나눠 이 문제를 푼다. rollout GPU가 갱신 중에도 계속 일할 수 있다. 대가는 두 가지다. 전체 GPU가 더 필요하고, rollout 큐와 갱신 큐를 따로 관리해야 한다. 두 큐가 실제로는 서로 다른 속도로 진행되기 때문에 관리 복잡도가 올라간다.
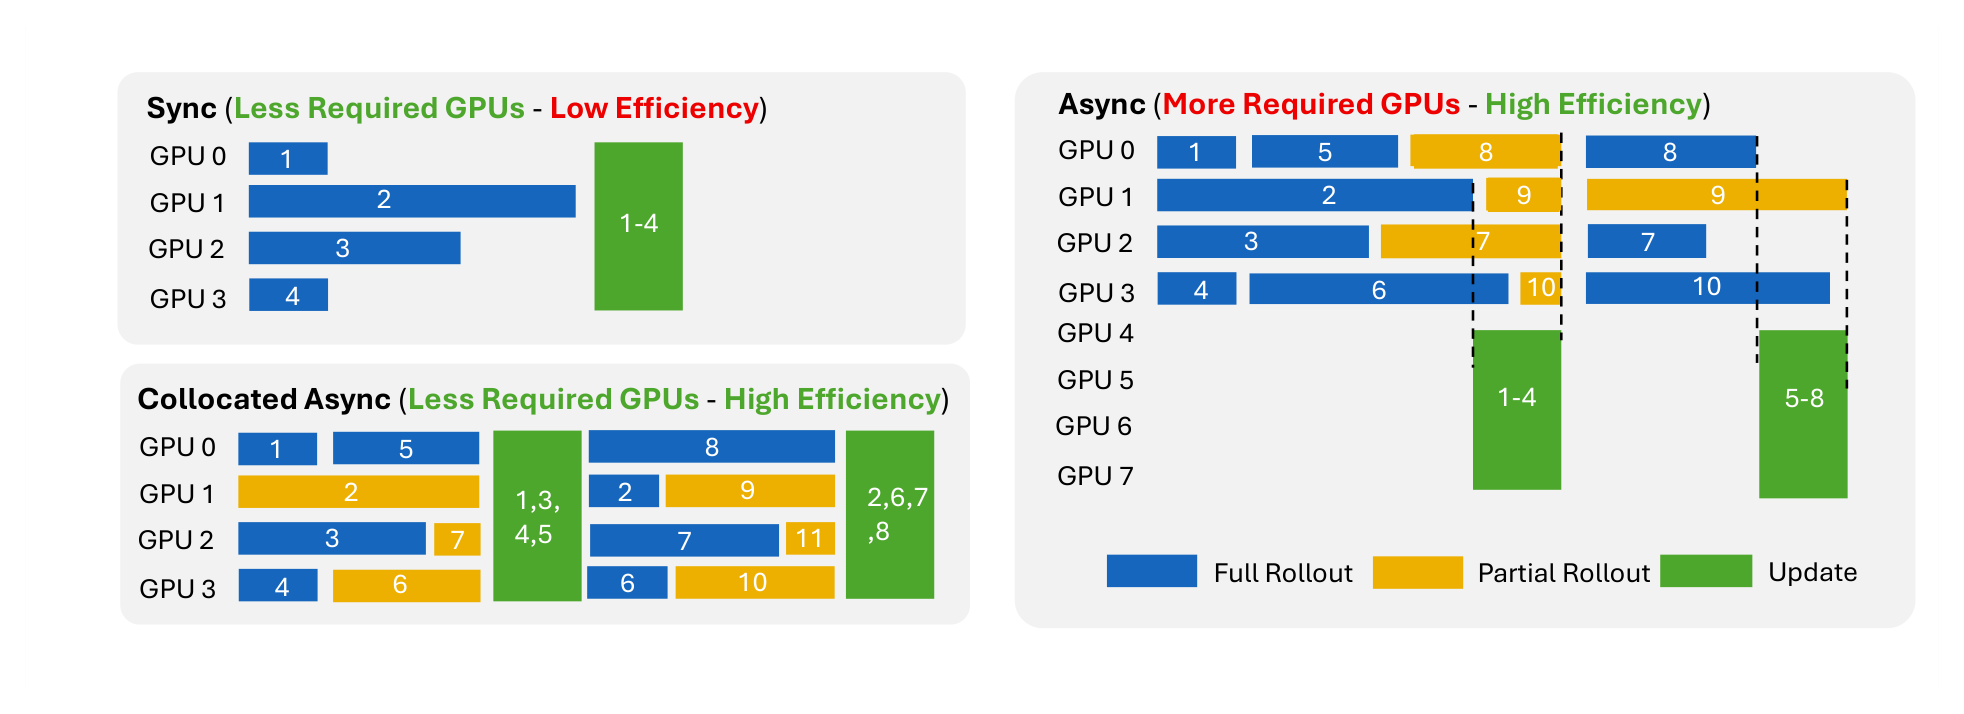
collocated async는 rollout과 가중치 갱신이 같은 GPU 풀을 시분할하는 방식이다. rollout 데이터가 충분히 모이면 갱신 단계가 시작되고, 그 시점에 API Gateway가 새 요청 접수를 멈추고 진행 중인 것만 마무리한다. 이후 도착한 요청은 시스템이 rollout 단계로 복귀할 때까지 대기시킨다. 그래서 단계 전환이 harness 쪽에서는 보이지 않는다.
| 방식 | GPU 풀 | 가장 느린 rollout 대기 | Figure 6의 GPU 수 |
|---|---|---|---|
| sync | 단일 (rollout과 갱신 순차) | 대기한다 | 4장 |
| async | rollout용과 갱신용 분리 | 대기하지 않는다 | 8장 |
| collocated async | 단일 (시분할) | 대기하지 않는다 | 4장 |
GPU 절감의 비교 대상을 논문이 두 문장에서 다르게 적는다. 설계 논리를 설명하는 문장은 비동기 방식보다 GPU를 덜 쓴다고 하고, 실험 결과 문장은 동기 방식 대비 종단 간 약 2배 속도에 GPU도 덜 쓴다고 한다. Figure 6이 동기 방식과 같은 GPU 4장을 배치하므로 앞 문장이 정합적이다. 즉 속도 이득은 동기 방식 대비이고 GPU 이득은 비동기 방식 대비로 읽는 것이 맞다.
네트워크 문제 대응
harnessed agentic RL에서는 agent와 학습 엔진이 분리돼 있어 두 종류의 호출이 네트워크를 거친다. 학습기나 Rollout Controller가 API Gateway를 부르는 호출, 그리고 harness가 프록시를 거쳐 LLM 추론 엔드포인트를 부르는 호출이다. 둘 다 네트워크 중단을 겪을 수 있고 호출한 쪽은 보통 재시도한다.
- Gateway의 rollout 엔드포인트는 전부 idempotent하게 설계했다. 같은 호출을 몇 번 반복해도 한 번 부른 것과 결과가 같으므로, 재시도가 상태를 훼손할 걱정 없이 자유롭게 재시도할 수 있다.
- LLM API 호출은 같은 방식이 통하지 않는다. 재시도마다 새 생성 요청이고 응답도 달라질 수 있기 때문이다. 대신 Customized Trainer가 sample을 조립할 때 프롬프트가 같은
model_request이벤트를 중복 제거한다. 한 rollout에 같은 프롬프트로 여러 호출이 기록돼 있으면 가장 최근 것만 남기고, 재시도되거나 대체된 앞의 것들을 버린다.
Kubernetes 실행과 모니터링
RL 학습의 rollout 단계에서는 많은 agent를 동시에 실행해야 하므로 상당한 연산 자원이 필요하다. 기존 harnessed agentic RL 프레임워크는 대개 상용 샌드박스 서비스로 이 수요를 감당한다. verl Uni-Agent는 Modal Sandbox와 Volcano veFaas를, slime은 E2B를 쓴다.
저자들은 이런 서비스가 편리한 대신 RL 학습 규모에서는 비용 부담이 크다고 본다. 그래서 Agent Lightning v1.0은 Rollout Controller를 통해 agent를 Kubernetes 클러스터에서 직접 실행한다. agent 실행 하나가 표준 Kubernetes Job으로 스케줄되므로, 사용자는 상용 샌드박스 제공자 대신 자체 호스팅이나 온프레미스 연산에만 의존할 수 있고 학습 스택 전체가 오픈소스로 남는다.
학습 중에는 agent 자체가 reward hacking, 이상 행동, 네트워크 연결 문제를 일으킬 수 있다. rollout을 사람이 하나씩 들여다보는 것은 비효율적이어서, Customized Trainer에 학습과 검증 rollout을 Kubernetes pod 로그와 함께 기록하는 모니터링 시스템을 두었다. 이 기록을 AI agent가 자동으로 점검해 문제를 찾게 했고, 실제로 reward hacking 사례 여러 건을 이 경로로 발견했다.
컴포넌트 내부
API Gateway는 rollout, 모델, 이벤트 세 객체를 저장하는 단일 stateful 서비스다. 의도적으로 가볍게 유지하고 최소한의 API만 노출한다.
| 객체 | 내용 |
|---|---|
| rollout | agent 실행 하나. 고유 rollout ID로 식별되며 학습 예제에서 파생된 input, status, 사용자 정의 metadata를 담는다. status는 queuing과 running을 거쳐 succeeded나 failed로 끝나는 상태 기계를 따른다 |
| model | LLM 추론 엔드포인트를 name과 주소로 식별한다. 학습기가 등록하면 Gateway가 harness 요청을 해당 추론 서버로 라우팅한다 |
| event | rollout에 임의 데이터를 붙인다. 기본으로 모든 LLM 상호작용마다 model_request 이벤트를, agent가 rollout 끝에 한 번 보고하는 스칼라 reward를 reward 이벤트로 남긴다. 사용자 정의 타입도 가능하다 |
model_request 이벤트에는 프롬프트 토큰 ID, 응답 토큰 ID, 응답 log probability가 들어간다. 학습에 필요한 세 요소를 호출 단위로 남기는 구조다.
rollout과 학습 예제는 1대 1이 아니다. GRPO는 같은 예제에서 각자의 ID와 trajectory를 가진 독립 rollout 여러 개를 만든다.
Gateway의 엔드포인트는 두 종류로 나뉜다. rollout API로 학습기가 rollout을 배치 생성하고, Rollout Controller가 대기 중인 rollout을 polling해 agent를 띄우고 진행에 따라 상태를 갱신하며, reward와 사용자 정의 이벤트도 같은 경로로 올린다. proxy API는 harness의 LLM 호출을 학습기가 등록해 둔 모델 엔드포인트로 넘긴다.
harness 쪽 통합 비용이 낮은 이유가 여기 있다. OpenAI 호환 클라이언트를 프록시로 가리키기만 하면 되고, 프록시 경로에 rollout ID가 박혀 있어 모든 호출이 자기 rollout에 자동으로 귀속된다.
부록 Table 1이 엔드포인트 전체를 나열한다. 규모가 작다는 점 자체가 설계 의도를 드러낸다.
| API | 메서드와 경로 | 용도 |
|---|---|---|
| rollout | POST /api/rollouts |
rollout을 배치 생성한다 |
| rollout | GET /api/rollouts |
rollout을 조회한다. 상태로 필터링할 수 있다 |
| rollout | GET /api/rollouts/{rollout_id} |
rollout 하나를 조회한다 |
| rollout | PATCH /api/rollouts/{rollout_id} |
rollout 상태를 갱신한다 |
| rollout | POST /api/rollouts/{rollout_id}/attempt/{attempt_id}/events |
rollout 시도에 이벤트를 추가한다 |
| rollout | GET /api/rollouts/{rollout_id}/events |
rollout 이벤트를 읽는다 |
| rollout | POST /api/models |
모델 엔드포인트를 등록한다 |
| rollout | DELETE /api/models |
등록된 모델 엔드포인트를 모두 제거한다 |
| proxy | POST /proxy/rollout/{rollout_id}/attempt/{attempt_id}/mode/{mode}/openai/v1/chat/completions |
OpenAI 호환 모델 호출을 전달한다 |
경로에 attempt_id가 들어 있는 것도 눈여겨볼 지점이다. rollout 하나에 여러 실행 시도가 있을 수 있고, 이벤트가 시도 단위로 기록되므로 재시도와 실패를 구분해 추적할 수 있다.
Rollout Controller의 기본 백엔드는 K8s Reconciler다. Kubernetes Job이 없는 대기 rollout마다 사용자 제공 템플릿으로 Job을 만들고, Kubernetes API를 watch해 종료 상태가 낮은 지연으로 전파되게 하며, 주기적으로 관리 중인 Job 전체를 list해 놓친 watch 이벤트를 복구한다. 표준 Kubernetes controller 패턴이다.
디버깅용으로는 Local Reconciler를 함께 제공한다. 로컬 프로세스 풀에 agent를 띄우는데, 프로세스 핸들을 직접 들고 있으므로 주기적 polling만으로 충분하고 별도 watch 장치가 필요 없다.
상태 정합성은 Gateway의 rollout status를 정답으로 둔다. Kubernetes에서 관측한 실행 상태는 네트워크 실패나 갱신 지연 때문에 뒤처질 수 있다. K8s Reconciler는 다음 주기에 동기화를 다시 시도하기만 하고, 통신이 회복되면 두 쪽이 수렴한다. 이 설계가 보장하는 수준은 best-effort eventual consistency다.
Customized Trainer는 VERL 위에 두 부분으로 구성된다. Dedicated Sample Adapter가 2절 난제에 대한 설계 선택을 그대로 구현한다.
| 항목 | Sample Adapter의 구현 |
|---|---|
| sample 병합 | 서버 쪽 요청 버퍼를 두지 않고, 나중 프롬프트가 앞선 요청과 응답의 정확한 토큰 수준 prefix일 때만 두 요청을 하나의 학습 sample로 병합한다 |
| advantage 계산 | baseline과 advantage를 rollout 단위로 계산한다 |
| loss normalization | rollout 단위 token-mean 손실을 구현해, sample 개수와 무관하게 모든 rollout이 같은 가중치를 갖게 정규화한다 |
요청 버퍼를 두지 않은 것은 단순성만을 위한 선택이 아니다. 학습을 배포와 일치시키려는 의도가 함께 있다. 버퍼가 있으면 프록시가 프롬프트를 손대므로 학습 때의 입력과 배포 때의 입력이 달라진다.
Trajectory Monitoring은 모든 학습과 검증 rollout의 input, status, 모델 요청, reward, 토큰과 turn 통계, 커스텀 이벤트를 노출하고 실행 로그는 Kubernetes에 남긴다. 사람이 직접 보거나 AI agent를 붙여 이상 행동을 진단할 수 있게 한 장치다.
결과
세 가지 실전 학습 설정에서 프레임워크를 검증한다. 각각 Search-R1, LLM-in-Sandbox, SWE-smith의 설정을 따랐고, 설계 선택의 비교 검증은 코딩 agent 설정에서만 진행했다.
| 설정 | policy | 알고리즘 | harness와 데이터 | 검증 reward |
|---|---|---|---|---|
| search agent | Llama-3.2-3B-Instruct | GRPO | Search-R1 설정, HotpotQA 학습 split | 25.1% → 41.7% (16.6%p) |
| instruction-following agent | Qwen3-4B-Instruct-2507 | RLOO | LLM-in-Sandbox harness, Instruction Pre-Training 데이터 | 51.9% → 70.2% (18.3%p) |
| 코딩 agent | Qwen3.5-9B | GRPO | mini-SWE-agent, SWE-smith 파생 6,000건 | 최고 38.2% (step 128). SWE-bench Verified는 41.8% → 56.4% |
search agent
Search-R1 설정을 따라 추론과 검색 엔진 질의를 번갈아 하며 검색된 passage로 지식 집약 질문에 답하는 agent를 학습했다. 학습에는 HotpotQA의 학습 split을 썼다.
평가는 여섯 데이터셋에서 50개씩 뽑아 구성했다. HotpotQA, 2WikiMultiHopQA, MuSiQue, Bamboogle, TriviaQA, Natural Questions다. 학습 배치 크기는 512, 프롬프트당 rollout 4개이며 10 학습 step마다 평가한다. reward 지표는 exact match다.
학습 reward는 꾸준히 오르고, 검증 reward는 25.1%에서 41.7%로 16.6%p 상승했다.
instruction-following agent
LLM-in-Sandbox 설정을 따라 컴퓨터 샌드박스로 외부 자원에 접근하고 파일을 관리하고 코드를 실행하며 코딩이 아닌 여러 과제를 푸는 agent를 학습했다. harness는 원저자들이 제공한 것을 그대로 썼다.
데이터는 Instruction Pre-Training이 공개한 데이터셋을 학습 80%와 평가 20%로 나눠 썼다. 학습 배치 크기는 8, 프롬프트당 rollout 8개이며 20 학습 step마다 평가한다.
배치 단위 학습 reward는 노이즈가 크지만 검증 reward는 뚜렷한 상승 추세를 보이며 51.9%에서 70.2%로 18.3%p 올랐다.
코딩 agent의 데이터 정제
이 논문에서 비중이 가장 큰 실험이고, 재현 가능한 레시피를 남기는 것이 목표다. policy는 Qwen3.5-9B, harness는 mini-SWE-agent를 써서 저장소 환경과 상호작용하고 명령을 실행하고 코드 변경을 만든다.
SWE-smith는 실제 Python 저장소에 버그를 심어 만든 대규모 실행 가능 소프트웨어 공학 과제 데이터셋이다. 128개 저장소에서 뽑은 59,136개 과제에 problem statement, 코드 패치, 해결을 검증하는 테스트가 딸려 있다.
Docker 이미지 용량이 선택 이유로 제시된다. SWE-smith는 295GB인데 R2E-Gym은 4TB, SWE-Gym은 6TB가 필요하다. 크지 않은 연산 자원으로 재현 가능한 예제를 만들려는 목표에 맞는 선택이다.
과제 하나의 진행은 이렇다. 저장소를 해당 문제 브랜치로 바꾼 뒤 agent에게 코드베이스를 수정하게 하고, 과제별 테스트 스위트를 실행해 제출된 변경이 문제를 해결했는지 판정한다.
공개 데이터에서 저자들이 찾은 문제는 세 가지다.
| 문제 | 규모 |
|---|---|
| problem statement가 비어 있다 | 59,136건 중 18,033건 |
| 문제 브랜치가 제공된 Docker 이미지에 없다 | 1,265건 |
| 테스트 스위트가 지나치게 크다 | python-jsonschema는 7,000개 넘는 테스트를 실행해 CPU와 메모리를 크게 소모한다 |
정제는 두 단계로 진행된다. 규칙 기반 제거를 먼저 하고, 모델 기반 난이도 필터를 이어 적용한다.
| 단계 | 조치 | 결과 |
|---|---|---|
| 규칙 기반 제거 | problem statement가 비었거나 문제 브랜치가 없거나 테스트가 200개를 넘는 과제를 제거한다 | 난이도 분포가 여전히 한쪽으로 크게 치우쳐 학습 신호가 부족하다 |
| 모델 기반 난이도 필터 | 모든 후보에 Qwen3.5-9B를 네 번 실행해, 네 번 모두 성공한 과제는 제거하고 성공과 실패가 섞인 과제만 남긴다 | 약 5,000건 |
| 난이도 보강 | 네 번 모두 실패한 과제 1,000건을 추가해 결과 집합이 너무 쉬워지는 것을 막는다 | 학습 약 6,000건, 테스트 400건 |
reward hacking 차단
학습 중 agent가 의도된 문제 해결 과정을 우회해 정답 소스를 직접 얻는 행동이 관찰됐다. 모니터링 기록을 AI agent가 점검하는 경로로 찾아낸 사례들이다.
| 우회 행동 | 수단 |
|---|---|
| gold commit 조회 | Git 히스토리에서 정답 커밋을 찾아낸다 |
| 상위 저장소 소스 취득 | wget이나 curl로 GitHub 원본을 받아온다 |
| 패키지 소스 취득 | pip으로 패키지 소스를 내려받는다 |
| 라이브러리 경유 취득 | urllib 같은 Python 네트워킹 라이브러리로 소스를 내려받는다 |
대응은 두 가지 계층으로 걸었다. 첫째로 Git 명령을 비활성화하고 .git 디렉토리를 agent에게서 숨겨 커밋 이력을 볼 수 없게 했다. 둘째로 Kubernetes 네트워크 정책으로 일반 외부 접속을 차단하고 명시적으로 화이트리스트에 올린 서비스만 허용했다.
두 조치를 함께 걸면 agent가 제공된 problem statement와 로컬 정보만으로 과제를 풀 수밖에 없다. 앞의 네 우회 행동 가운데 첫 번째는 Git 차단이, 나머지 세 개는 네트워크 정책이 막는 구조다.
설계 선택의 검증
advantage와 loss normalization을 rollout 단위로 계산해야 한다는 주장을 코딩 agent 학습에서 검증한다. 세 설정 모두 같은 GRPO 목적함수를 쓰고 아래 두 지점만 다르다.
| 설정 | advantage | loss normalization | 최고 검증 reward |
|---|---|---|---|
| Sample-level Advantage | sample 단위 | token-mean | 35.0% |
| Rollout-level Advantage | rollout 단위 | token-mean | 33.1% |
| Rollout-level Advantage + Rollout-level Norm | rollout 단위 | rollout 단위 token-mean | 38.2% (step 128) |
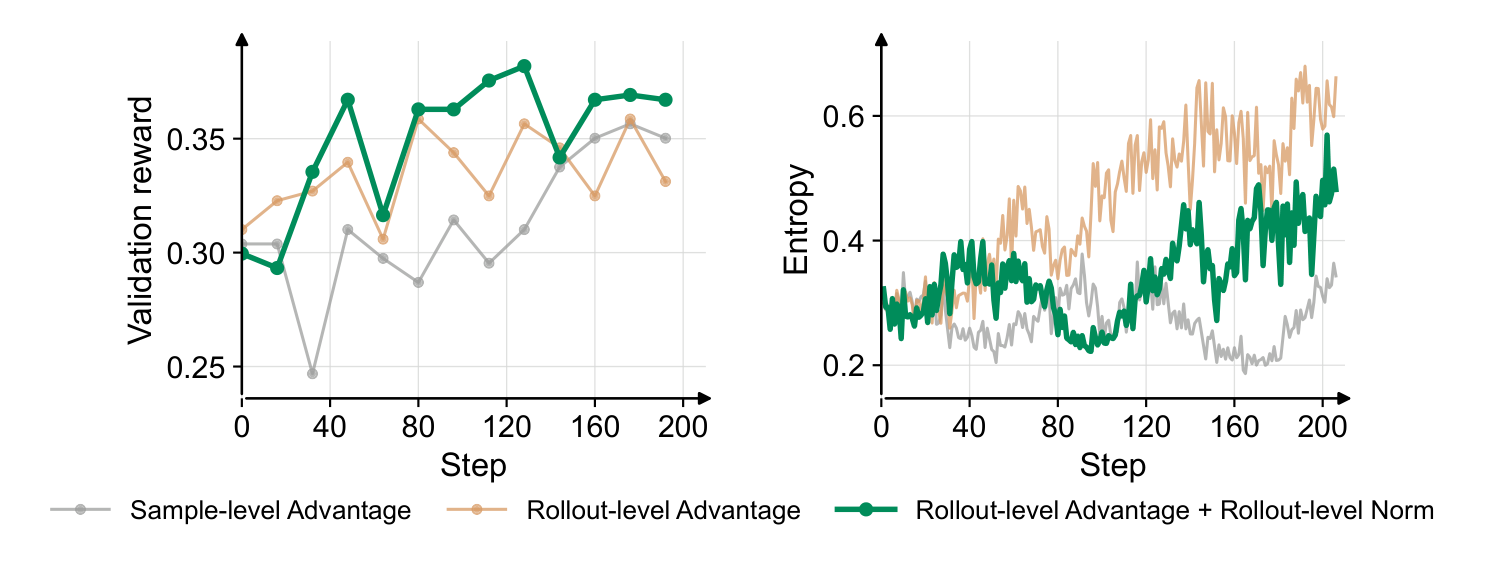
수치가 말하는 바는 두 선택이 짝을 이룬다는 것이다. advantage만 rollout 단위로 바꾸면 35.0%에서 33.1%로 오히려 1.9%p 떨어진다. loss normalization까지 함께 바꿔야 38.2%로 올라 기준선을 3.2%p 앞선다.
policy entropy 곡선도 같은 방향을 가리킨다. 세 번째 설정의 entropy는 advantage만 고친 설정보다 완만하게 늘고 학습 전 기간에 걸쳐 더 안정적이었다. 저자들은 loss normalization이 교정된 rollout advantage가 유발하는 entropy 상승을 억제하면서 검증 reward를 올린다고 해석한다.
한 가지 유보할 점이 있다. Figure 9의 곡선을 눈으로 읽은 최고점은 본문이 적은 35.0%와 33.1%보다 다소 높게 보인다. 두 baseline 곡선 모두 step 175 부근에서 0.355 근처까지 오르며, 논문은 본문 수치를 어느 시점 기준으로 뽑았는지 명시하지 않는다.
같은 Rollout-level Advantage + Rollout-level Norm 체크포인트를 SWE-bench Verified에서 재면 step 208에서 41.8%가 56.4%로 올라 14.6%p 상승했다. 학습에 쓴 데이터가 약 6,000건이고 추가 지도학습 없이 RL만 적용한 결과다.
rollout 병합 실태
코딩 agent trajectory는 길이 편차가 커서, rollout 단위 advantage 설정들은 padding 낭비를 줄이려고 가능한 곳마다 trajectory를 학습 행으로 병합한다. 그 결과 rollout당 sample 개수가 유동적이 된다.
측정 결과는 두 수치로 요약된다. 평균적으로 rollout의 36%만 완전히 병합된 단일 행으로 남고, rollout당 2.41개의 학습 sample이 나온다. 앞서 다룬 advantage와 loss normalization 문제가 이론적 우려가 아니라 상시 조건이라는 근거다.
논문 안에 표기 불일치가 하나 있다. 6쪽 본문은 같은 값을 2.4로 적고, 14쪽 본문과 Figure 10은 2.41로 적는다. Figure 10의 평균선 표기가 더 구체적이므로 2.41을 기준으로 삼는 것이 안전하다.
한계
rollout 안의 여러 sample 사이에 reward를 어떻게 나눠 줄지는 논문이 직접 미해결로 남겨 둔 지점이다. 지금은 rollout이 받은 결과 기반 reward를 그 안의 모든 sample에 그대로 부여하고, 더 나은 credit assignment 설계는 향후 과제로 넘긴다.
token-mean loss가 긴 시퀀스에 민감하다는 관찰도 원인 분석까지 가지는 않는다. 부정적인 긴 sample이 배치에 몰리면 학습 후반에 불안정해진다는 경험적 서술에 그친다.
상태 정합성 보장 수준도 약하다. Rollout Controller와 Kubernetes 사이는 best-effort eventual consistency만 보장하므로, 통신이 회복되지 않는 동안에는 Gateway가 보는 상태와 실제 실행 상태가 계속 어긋난 채 남는다.
설계 선택을 뒷받침하는 비교 실험은 코딩 agent 한 설정에서만 했다. search agent와 instruction-following agent 실험은 프레임워크가 동작한다는 것을 보이는 데 가깝고, advantage나 normalization 변형을 비교하지 않는다.
모델 규모도 3B, 4B, 9B에 머물러 있다. 코딩 agent harness는 mini-SWE-agent 하나만 썼으므로, 임의의 harness를 지원한다는 주장 자체는 여러 harness로 검증되지 않았다.
문제 개수 표기도 논문 안에서 갈린다. abstract는 retokenization, sample merging, advantage calculation, loss normalization, training backend scheduling 다섯 개를 나열하고, 결론과 2절 소절 구성은 sample merging을 retokenization에 합쳐 네 개로 적는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| harnessed agentic RL | 배포 시점 harness가 agent loop를 소유한 채로 진행하는 강화학습. 학습 시스템은 서비스 경계 너머로 LLM 호출만 관측하고 최적화한다 |
| retokenization | 텍스트를 다시 토큰화하는 과정. 같은 문자열이라도 토큰 경계가 달라질 수 있어 호출 간 토큰 prefix 조건을 깨뜨린다 |
| best-effort sequence merging | 토큰 prefix 조건이 성립할 때만 인접 호출을 잇고 어긋나면 시퀀스를 끊는 병합 전략. Agent Lightning v1.0의 선택 |
| rollout-level advantage | GRPO 그룹 baseline을 sample이 아니라 rollout 단위로 계산하는 방식 |
| rollout-level token-mean loss | rollout 안의 응답 토큰을 먼저 모아 평균 낸 뒤 rollout 개수로 균등 평균하는 정규화 |
| within-rollout policy skew | 한 rollout에서 나온 시퀀스들이 서로 다른 optimizer 갱신에 나뉘어 다른 policy 버전 아래서 평가되는 현상 |
| collocated async RL | rollout과 가중치 갱신이 같은 GPU 풀을 시분할하는 비동기 방식 |
관련 페이지
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: "루프를 누가 소유하는가"를 분석 기준으로 세운 서베이. 이 논문은 같은 질문을 학습 쪽으로 옮겨 harness가 루프를 쥔 채로 RL을 진행할 때 생기는 문제를 다룬다
- CUA-Gym: Scaling Verifiable Training Environments and Tasks for Computer-Use Agents: agent RL 학습 환경과 데이터를 스케일링하는 쪽의 연구. 이 논문이 학습 시스템 층이라면 CUA-Gym은 데이터와 환경 층이다
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 갱신이 곧 이득은 아니라는 관찰. 배포 harness를 학습에 끌어들이는 이 논문의 전제와 함께 읽을 만하다
- Agent Harness Engineering 개괄과 학습 경로: harness 엔지니어링 허브