Agents · PAPER · 2026
Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents
요약
이 논문은 self-evolving LLM agent의 성능 향상이 어디에서 오는지를 두 개의 별도 능력으로 갈라 측정한다. 하나는 실행 기록을 보고 유용한 harness 수정을 만들어내는 능력(harness-updating)이고, 다른 하나는 그렇게 수정된 harness로부터 실제로 이득을 얻는 능력(harness-benefit)이다.
Penn State, UC Santa Cruz, Amazon, Emory, UIUC, Northeastern의 공동 연구이며 arXiv 2605.30621로 2026년 5월 28일 공개되었다. 실험은 LLM 7종과 agentic benchmark 3종을 격자로 조합해 agent 쪽과 evolver 쪽을 독립적으로 바꿔가며 진행했다.
결과는 두 능력이 base capability와 서로 다른 방식으로 어긋난다는 것이다. base capability는 harness evolution 없이 초기 상태에서 그 모델이 보이는 task 해결 성능을 뜻한다.
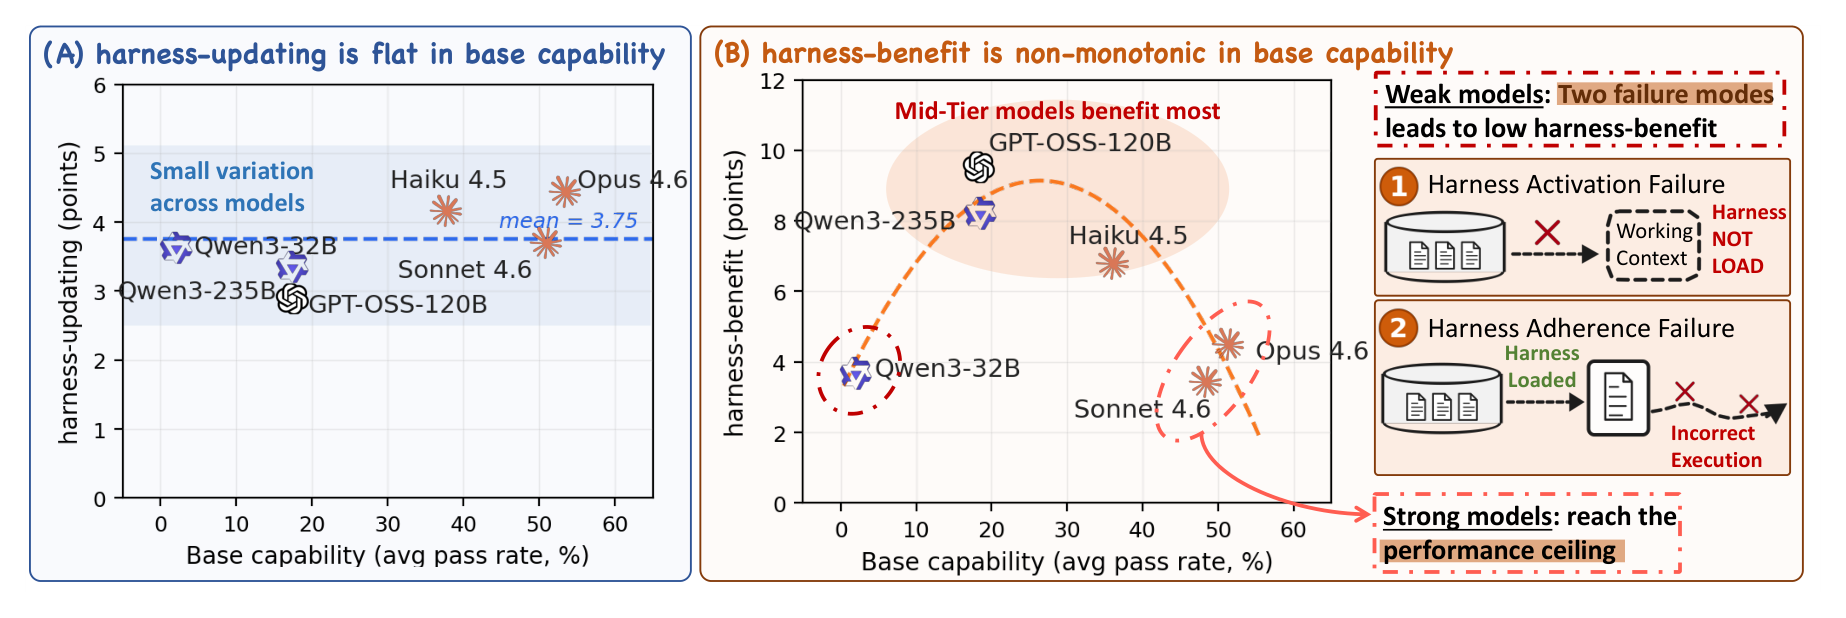
harness-updating은 base capability와 거의 무관하게 평평하다. 9B 오픈모델인 Qwen3.5-9B가 만든 skill이 Claude Opus 4.6이 만든 skill과 절차상 동일하고 성능 이득도 같다.
반면 harness-benefit은 base capability에 비단조로 반응한다. 중간 등급 모델이 가장 많이 얻고, 가장 약한 모델은 개선 여지가 가장 크면서도 거의 얻지 못한다.
약한 모델이 이득을 못 얻는 이유는 두 가지 실패로 분해된다. skill을 컨텍스트로 불러오는 데 실패하거나(activation), 불러왔는데도 그 지침을 따르지 못한다(adherence). 이 진단에서 나오는 설계 지침은 명확하다. 성능 예산을 evolver가 아니라 task를 푸는 agent에 배정하고, harness 호출과 긴 작업에서의 지침 준수를 agent 학습의 일차 목표로 삼는 것이다.
배경
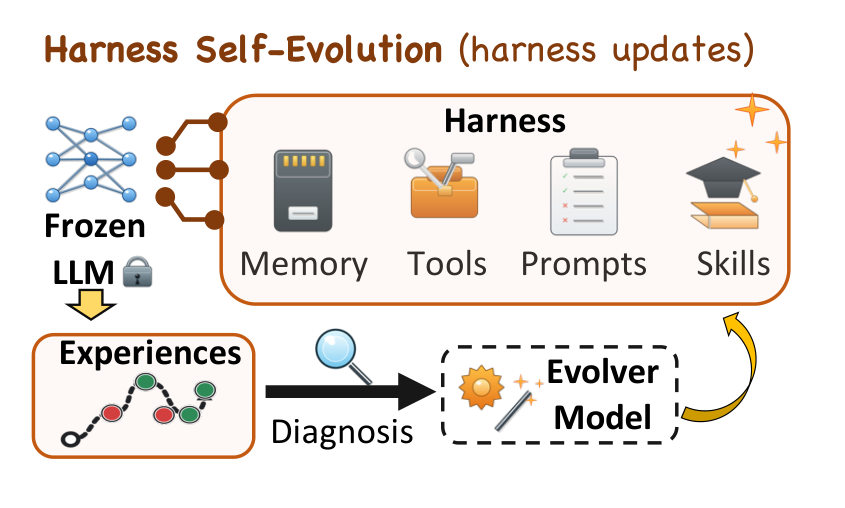
오늘날 LLM agent의 동작은 모델만으로 결정되지 않는다. 모델을 둘러싼 외부 실행 환경이 함께 결정한다. 이 외부 환경이 harness다. harness는 모델을 감싸 도구와 검증과 상태를 제공하는 실행 환경이며, 프롬프트, 스킬, 메모리, tool 인터페이스가 그 구성 요소다.
harness는 지금까지 대부분 사람이 손으로 설계했다. 그러나 배포 환경에서 수동 설계는 오래 유지되기 어렵다. task 분포가 이동하고, 예상하지 못한 경계 사례가 나타나며, 유용한 절차는 시스템이 실제 task를 처리해 본 뒤에야 발견되기 때문이다.
자연스러운 대응은 실행 기록으로부터 harness를 자동 갱신하는 것이다. 실패, 피드백, trajectory, 성공한 절차를 harness에 되쓰고 이후 task에서 재사용한다. 논문은 이 설정을 harness evolution이라 부른다. 모델 가중치는 고정되고 외부 harness만 시간에 따라 수정된다.
문제는 이 계열 연구의 평가 방식에 있다. 기존 평가는 "이 self-evolution 방법이 agent 성능을 실제로 개선하는가"라는 end-to-end 질문만 던진다. 이 질문은 중요하지만 개선의 출처를 감춘다.
end-to-end 점수 하나에 세 가지 원천이 섞여 들어간다. 첫째는 agent가 초기 harness 아래에서 이미 가진 base capability다. 둘째는 evolver가 더 나은 harness 수정을 만들어낸 기여다. 셋째는 agent가 그 수정을 task 해결에 활용한 기여다. 세 원천을 분리하지 않으면 두 가지 실무 질문이 답 없이 남는다. 어떤 모델이 유용한 harness 수정을 만드는지, 그리고 어떤 모델이 그 수정으로 가장 많이 얻는지다.
이 논문은 그 분리를 실험 설계로 수행한다. agent와 evolver를 독립적으로 바꿔 가며 두 능력을 따로 측정하고, 각각이 base capability를 그대로 따라가는지 검증한다.
선행 연구에서의 위치
이 논문은 새로운 harness 표현이나 새로운 갱신 방법을 제안하지 않는다. 기존 방법들이 이미 만들어 놓은 설정 위에서 평가 방식을 바꾼다. 그래서 선행 연구 두 계열과의 관계를 알아야 기여의 성격이 보인다.
harness가 담는 것
첫 번째 계열은 harness에 무엇을 담을지를 연구한다. frozen backbone을 둘러싸고 reasoning, tool use, 메모리 접근, 스킬 호출, 환경 상호작용을 형성하는 외부 층을 어떤 artifact로 구성하느냐가 갈리는 지점이다.
| artifact | 역할 | 대표 연구 |
|---|---|---|
| 프롬프트 | 상시 행동 규칙, task policy, 추론 절차를 자연어로 인코딩한다 | Zhou et al. 2022, Yao et al. 2022(ReAct), Yang et al. 2024b(SWE-agent), Pan et al. 2026 |
| tool | 외부 서비스를 노출하고 action schema와 호출 형식과 검증 규칙을 규정한다 | Hou et al. 2025, Qin et al. 2024, Liu et al. 2025, Lin et al. 2025, 2026a |
| 메모리 | 과거 observation, 사실, task 결과, 재사용 가능한 전략을 저장한다 | Ouyang et al. 2025, Xu et al. 2026, Fang et al. 2026(LightMem) |
| 스킬 | 재사용 절차를 호출 가능한 모듈이나 task별 안내 artifact로 패키징한다 | Li et al. 2026b(SkillsBench), Liu et al. 2026 |
| 코드 | harness 자체를 tool과 validator와 오케스트레이션 로직과 프롬프트 조립을 구현하는 실행 소스로 취급한다 | Ning et al. 2026, Lee et al. 2026(Meta-harness) |
이 연구들의 공통 성과는 harness를 수동적 컨텍스트가 아니라 편집 가능한 agent 상태로 확립한 것이다. 이 논문은 표현 자체를 바꾸지 않고, 그 상태를 갱신하고 갱신에서 이득을 얻는 모델 능력으로 초점을 옮긴다.
harness가 갱신되는 방식
두 번째 계열은 harness를 실행 경험으로부터 어떻게 갱신할지를 연구한다. 초기 시스템은 task 시도 수준에서 작동했다. Reflexion은 앞선 시도의 언어적 자기 반성을 저장하고, Self-Refine은 자기 피드백으로 출력을 반복 개선하며, ExpeL은 학습 trajectory에서 재사용 가능한 자연어 통찰을 추출한다. 이 방법들은 언어 피드백이 이후 행동을 개선함을 보였으나 남는 artifact가 단일 텍스트 반성이나 교훈이라는 한계가 있었다.
이후 방법들은 지속적 harness 구성 요소 자체를 갱신 단위로 삼는다.
| 갱신 수준 | 대표 방법 | 갱신하는 대상 |
|---|---|---|
| 프롬프트 | PromptWizard, ACE, GEPA | 피드백 기반 비판과 합성으로 프롬프트를 정제하고, contextual playbook을 생성과 반성과 큐레이션으로 진화시키며, trajectory 수준 반성으로 프롬프트를 진화시킨다 |
| 메모리 | EvolveR, MemEvolve, MemMA, Evo-memory | 오프라인 전략 distillation과 온라인 retrieval을 연결하고, 메모리 시스템의 메타 진화를 다루며, 구성과 retrieval과 피드백 기반 수리로 긴 작업의 메모리를 개선한다 |
| 스킬과 워크플로 | Voyager, AWM, SkillRL, EvoSkill, AutoSkill | 실행 가능한 스킬을 축적하고, 성공 trajectory에서 워크플로를 유도하며, 강화학습으로 skill library를 재귀 확장하고, agent 경험에서 스킬을 자동 발견한다 |
| tool | Chen et al. 2025, Li et al. 2026a(Yunjue Agent) | agent가 tool과 tool use 지식을 합성하고 수정하고 축적한다 |
평가 방식의 공백
두 계열의 성과를 인정하면서 이 논문이 지적하는 공백은 평가에 있다. 기존 평가는 하나의 갱신 절차와 하나의 agent와 하나의 벤치마크에 대한 end-to-end 이득을 보고한다. 그 점수 하나에 base capability와 harness-updating과 harness-benefit 세 원천이 뒤섞인다.
이 논문의 기여는 그 셋을 분리하는 측정 설계다. agent와 evolver를 독립적으로 바꿔 두 능력을 따로 재고, 어느 쪽이 base capability를 그대로 따라가는지 검증한다. SEA-Eval(Jiang et al. 2026)이 self-evolving agent를 episodic 평가 너머로 평가하려는 같은 방향의 벤치마크다.
핵심 개념
harness와 harness state
agent harness는 LLM이 task를 수행하도록 배포될 때 그 모델을 둘러싼 비파라미터 컨텍스트와 인프라 전체를 뜻한다. 논문은 evolution step 의 agent를 로 정의한다. 는 모델 backbone이고 는 그 시점의 harness state다. 는 학습되지 않고 의 편집 가능한 부분만 갱신되며, tool 인터페이스와 실행 정책 같은 구성 요소는 고정된다.
evolver
evolver는 agent의 실행 기록을 harness 수정으로 변환하는 절차를 말한다. 최근 self-evolving agent 시스템은 이 절차를 LLM agent로 구현하는 경우가 많고, 이 논문도 그렇게 한다. 형식적으로는 이전 harness 과 누적 실행 증거 를 받아 수정안을 내고 반영한다.
는 수정안을 기존 harness에 반영하는 commit 연산이다.
solve-evolve 루프
evolution protocol은 task 해결과 harness 갱신 사이를 오가는 반복 루프다. 초기 harness 에서 출발해 step 동안 다음을 반복한다.
- step 에 agent 이 task batch 를 받는다.
- 각 task 에 대해 를 낸다. 는 실행 trajectory이고 는 최종 출력이다.
- 실행 증거 를 모은다.
- evolver가 과 로부터 를 만든다.
- 다음 step으로 넘어가고, 회 반복 후 최종 harness 를 얻는다.
세 가지 측정량
논문의 핵심 장치는 세 지표다. base capability는 초기 harness 아래에서의 task 해결 성능이며, evolution 없이 그 모델이 얻는 기준선이다.
| 지표 | 정의 | 집계 방식 | 무엇을 재는가 |
|---|---|---|---|
| base capability | 단일 값 | evolution 없는 기준 pass rate | |
| pairwise evolution gain | 단일 조합 | 특정 agent와 evolver 조합의 순수 이득 | |
| harness-updating | anchor agent set 위 평균 | 평균 | 이 evolver가 얼마나 유용한 수정을 만드는가 |
| harness-benefit | anchor evolver set 위 최댓값 | 최댓값 | 이 agent가 최선의 evolver와 짝지을 때의 이득 상한 |
집계 방식의 차이가 두 지표의 해석을 갈라놓는다. updating은 평균이므로 특정 agent에서만 잘 작동하는 evolver는 값이 희석된다. benefit은 최댓값이므로 최선의 짝과 만났을 때의 상한을 잰다. 뒤에서 보듯 최댓값 집계는 일부 조합에서 발생하는 성능 하락을 표에서 감추는 효과도 낸다.
여기서 는 agent 의 task set 위 성능을 재는 채점 함수이며 세 벤치마크 모두 pass rate를 쓴다.
anchor set
anchor set은 한 능력을 계산할 때 다른 한쪽을 고정하는 기준 모델 집합이다. 이 논문은 {Opus 4.6, Sonnet 4.6, Qwen3-235B} 세 모델을 양쪽 anchor로 쓴다. evolver 능력을 볼 때는 이 세 모델을 agent로 고정하고 evolver 7종을 바꾸며, agent 능력을 볼 때는 이 세 모델을 evolver로 고정하고 agent 6종을 바꾼다.
in-situ evaluation
in-situ evaluation은 evolution을 구동하는 task stream을 평가 집합으로도 함께 쓰는 설정을 뜻한다. 이 설정에서는 점수가 오염될 위험이 있으므로 채점 시점을 못 박는다. step 의 각 task 는 시도 시점의 harness 아래에서 채점되고, 그 점수는 실행 결과가 증거 에 들어가 를 만들기 전에 확정된다. 따라서 개별 task의 점수는 자기 자신이 유발한 harness 수정의 영향을 받지 않는다.
procedurally isomorphic
procedurally isomorphic은 두 skill이 표현 층위에서는 달라도 단계 순서와 조건과 의도가 동일한 상태를 가리킨다. 논문은 9B evolver와 frontier evolver가 만든 skill 사이의 관계를 이 용어로 서술하며, 이것이 첫 번째 발견의 메커니즘 설명이 된다.
실험 설계
벤치마크 3종
세 벤치마크는 서로 다른 agent 능력을 덮도록 골랐다. 긴 작업의 코드 수정, 여러 서버에 걸친 tool 조율, 여러 도메인에 걸친 스킬 기반 실행이다.
| Substrate | task 수 | 도메인 | task마다 주어지는 자원 |
|---|---|---|---|
| SWE-bench Verified | 500 | 12개 repository | codebase 스냅샷, issue 설명, 숨겨진 테스트 스위트 |
| MCP-Atlas | 500 | 36개 MCP 서버 | 220개 tool(서버 사이 공유), task마다 3개에서 6개 tool call 필요 |
| SkillsBench | 86 | 11개 task 도메인 | workspace 파일, 결정적 verifier |
SWE-bench Verified는 실제 GitHub issue에서 뽑아 사람이 검증한 부분집합이고 500 task 전량을 사용한다. 풀이자는 issue를 해결하는 패치를 만들어야 하고, 그 패치가 숨겨진 테스트 스위트를 만족하면 통과다.
MCP-Atlas는 실제 Model Context Protocol 서버 위에서 여러 서버에 걸친 tool use 역량을 재는 벤치마크다. 각 task는 자연어 요청이며 완수에는 36개 서버가 노출하는 220개 tool 가운데 3개에서 6개를 골라 순서대로 호출해야 한다. 저자가 공개한 500 task 부분집합을 쓴다.
SkillsBench는 소프트웨어, 데이터 분석, 문서 처리, 오디오 합성 등 11개 도메인의 86 task로 구성되고 task마다 결정적 verifier가 붙는다. 원 벤치마크는 큐레이션된 skill을 함께 배포하지만 이 논문의 설정은 다르다. no-evolution 기준선을 빈 skill 집합에서 출발시키고, evolved 조건은 앞선 in-situ task에서 evolver가 만든 skill만 사용한다. 그래서 SkillsBench의 base pass rate가 다른 두 벤치마크보다 크게 낮게 나온다.
채점 함수
세 metric 모두 pass rate를 채점 함수로 쓰지만 task 단위 점수 산출은 벤치마크 관례를 따른다.
| 벤치마크 | task별 점수 | 집계 |
|---|---|---|
| SWE-bench Verified | fail-to-pass와 pass-to-pass 스위트를 모두 통과하면 1, 아니면 0 | task 평균이 표준 pass rate |
| MCP-Atlas | 최종 답이 만족한 reference claim 비율로 0에서 1 사이 | 이진화한 strict pass rate와 연속 claim-fulfillment 평균을 함께 보고 |
| SkillsBench | task별 이진 점수를 5회 시행 평균 | task와 시행 전체 평균이 주 지표 (TerminalBench 관례) |
점수는 백분율로, 이득은 %p로 보고한다.
모델 7종과 역할 배분
모델 집합은 오픈소스와 클로즈드소스를 여러 등급에 걸쳐 고르되, agent 쪽과 evolver 쪽에 배정되는 집합이 다르다.
| 모델 | 계열 | agent 쪽 | evolver 쪽 |
|---|---|---|---|
| Claude Opus 4.6 | 클로즈드 | 사용 | 사용 |
| Claude Sonnet 4.6 | 클로즈드 | 사용 | 사용 |
| Claude Haiku 4.5 | 클로즈드 | 사용 | 사용 |
| Qwen3-235B-A22B | 오픈 | 사용 | 사용 |
| Qwen3-32B | 오픈 | 사용 | 사용 |
| GPT-OSS-120B | 오픈 | 사용 | 사용 |
| Qwen3.5-9B | 오픈 | 미사용 | 사용 |
Qwen3.5-9B는 논문에서 가장 작은 모델이며 evolver 쪽에만 추가했다. 훨씬 작은 오픈모델도 유용한 harness 수정을 만들어낼 수 있는지 확인하려는 목적이다. 모든 모델은 공식 API나 추론 엔드포인트로 호출하며 evolution 중 어떤 가중치도 갱신되지 않는다.
고정 요소와 편집 허용 범위
비교의 공정성을 위해 backbone 외 모든 요소를 못 박는다.
| 항목 | 설정 |
|---|---|
| 프롬프트 템플릿 | agent와 evolver 모두 페어 사이 공통 |
| trajectory window | 모든 페어 동일 |
| 초기 harness | 벤치마크별 동일 |
| task stream | 페어 사이 동일 |
| evolution budget , task별 turn 상한 | 동일 |
| 변수 | LLM backbone만 |
편집 허용 범위는 벤치마크마다 다르다.
| 벤치마크 | 편집 허용 | 읽기 전용 |
|---|---|---|
| SWE-bench Verified | skills/ |
tools/, 평가 파일 |
| SkillsBench | skills/ |
tools/, 평가 파일 |
| MCP-Atlas | skills/, prompts/system.md, memory/(추가 전용 JSONL) |
tools/, 평가 파일 |
이 권한 블록은 매 cycle evolver에게 전달되고, evolver의 시스템 프롬프트 자체는 벤치마크와 backbone에 걸쳐 고정된다. 그 프롬프트는 편집 가능한 artifact 디렉토리 네 종류를 설명하고, task별 임시 패치보다 재사용 가능한 간결한 수정을 우선하며, 평가 스크립트와 숨겨진 테스트와 모델 가중치는 건드리지 못하게 명시한다.
evolver 프롬프트는 매 cycle 고정된 사용자 메시지 wrapper와 함께 전달된다. wrapper에는 cycle 인덱스, 편집 가능한 범위를 명시한 권한 블록, 그리고 정규화된 실행 증거 payload가 들어간다. payload는 해당 batch의 task 식별자, trajectory, 출력, 점수, 채점 피드백을 JSON으로 담는다. 형식은 벤치마크와 backbone에 걸쳐 같고 task 증거와 편집 범위만 바뀐다.
evolver에게 주는 지시는 네 가지다. 증거에서 반복되는 실패와 재사용 가능한 패턴을 찾고, 허용된 artifact만 편집하며, 넓은 재작성보다 작고 표적화된 수정을 택하고, 마치기 전에 변경 결과를 점검하라는 것이다. 스킬은 이후 task에 도움이 될 가능성이 있을 때만 만들거나 고치고, 프롬프트와 메모리 항목은 실행 가능하고 중복되지 않게 유지하라는 조건도 붙는다.
task를 푸는 agent 쪽 프롬프트는 벤치마크마다 하나씩만 쓴다. SWE-bench Verified용은 828바이트 절차 안내로 GitHub issue 패치에 범위를 한정하고 최소한의 집중된 수정을 권한다. MCP-Atlas용은 1,309바이트 안내로 tool call로만 task를 해결하고 사용자에게 되묻지 않도록 지시한다. SkillsBench는 원 논문 설정을 따라 agent에 시스템 프롬프트를 아예 주지 않는다.
anchor set 선택의 함의
anchor set을 어떻게 골랐는지가 두 지표의 해석 범위를 정한다. 이 논문은 Opus 4.6과 Sonnet 4.6과 Qwen3-235B 세 모델을 agent 쪽 anchor와 evolver 쪽 anchor로 동시에 쓴다.
두 가지 제약이 여기서 나온다. 첫째, harness-updating은 이 세 모델을 agent로 삼은 평균이므로 Haiku 4.5나 Qwen3-32B 같은 다른 등급 agent를 잘 돕는 evolver가 있어도 그 값에 반영되지 않는다. 둘째, harness-benefit은 세 anchor evolver 중 최댓값이므로 나머지 네 evolver가 더 큰 이득을 만들 여지는 측정 밖에 있다.
anchor 세 모델 중 Qwen3-235B가 세 벤치마크 모두에서 가장 약하다. 그래서 극단 조합 비교에서 약한 쪽 agent는 항상 Qwen3-235B이고 강한 쪽은 항상 Opus 4.6이다. 이 배치를 알고 보면 뒤에 나오는 격차 수치가 6개 모델 전체의 최대 격차가 아니라 anchor 세 모델 안에서의 격차라는 점이 분명해진다.
세 가지 관측 지표
약한 모델의 실패를 분해하기 위해 SkillsBench에서 세 지표를 함께 측정한다.
| 지표 | 정의 | 무엇을 잡는가 |
|---|---|---|
| Skill-Load Rate (SLR) | trajectory 중 skill을 하나 이상 유효하게 컨텍스트로 로드한 비율 | activation |
| Harness-Following Rate (HFR) | skill이 로드된 trajectory 중 그 지침을 따랐다고 판정된 비율 | adherence |
| Loaded-Pass Rate (LPR) | skill이 로드된 trajectory의 통과 비율 | activation 이후의 결과 |
SLR은 형식 검사를 통과하는 유효한 단일 키 load action이 있어야 카운트한다. 다른 키와 함께 묶여 들어온 load 요청은 로드로 세지 않으며, 이 규칙이 뒤에 나오는 threejs 사례의 실패 지점이다.
HFR은 로드된 trajectory 수 대비 지침을 따랐다고 판정된 수 의 비율이다.
판정 파이프라인
HFR은 LLM 판정으로 매기므로 판정 절차 자체를 설계해야 한다. 판정 모델은 Claude Sonnet 4.6이고, 모든 trajectory는 모델 계열 토큰(Claude, Opus, Sonnet, Haiku, Qwen, GPT-OSS)을 <MODEL>로 치환한 blinded 상태로 입력된다. 계열 편향을 막는 장치다.
1단계는 rubric 고정이다. SKILL.md 본문에서 명령형이나 규범형 문장이 직접 함의하는 절차 지시만 추출해 JSON으로 잠근다. 조언, 근거 설명, 예시, 동기 부여 문장은 지시로 뽑지 않고 목표 개수는 3개에서 8개다.
{
  "skill_id": "<skill folder name>",
  "instructions": [
    {"id": "step_1", "source_span": "<exact quote, max 250 chars>", "text": "<imperative paraphrase>",
     "type": "required|conditional|optional", "trigger": null,
     "success_criteria": "...", "violation_criteria": "..."}
  ]
}
2단계는 trajectory 판정이다. 고정된 rubric을 blinded trajectory에 적용해 지시별로 여섯 가지 verdict 중 하나를 낸다.
| verdict | 뜻 |
|---|---|
FOLLOWED |
성공 기준을 명시적으로 만족했다. turn 인덱스와 action 인용을 함께 낸다 |
VIOLATED_COMMISSION |
지시를 직접 거스르는 action을 했다 |
VIOLATED_OMISSION |
필수이거나 조건이 발생했고 실행할 시간이 있었는데 하지 않았다 |
REQUIRED_BUT_UNOBSERVED |
필수지만 trajectory가 너무 일찍 끝나 관찰할 수 없었다 |
NOT_APPLICABLE |
조건부인데 조건이 발생하지 않았거나 선택 지시를 택하지 않았다 |
INSUFFICIENT_EVIDENCE |
trajectory가 모호해 판정할 수 없다 |
위반 verdict에는 위반이 처음 가능했던 turn, 위반이 확정된 turn, 위반 유형(commission, omission, premature_stop, wrong_strategy)을 함께 기록한다. 위반이 언제 일어났는지를 남겨야 긴 작업에서의 준수 하락을 시점별로 분석할 수 있다.
구간별 준수 판정은 HFR 판정과 별도 호출로 수행하며 같은 rubric과 blinded trajectory를 입력받는다. trajectory를 turn 위치 기준 다섯 구간으로 나눈다.
| 구간 | 정의 |
|---|---|
skill_loaded |
turn 1 |
first_action |
그 다음 첫 action turn |
midpoint |
전체 turn의 가운데 50% |
pre_final |
마지막 turn을 뺀 뒤쪽 25% |
final_validation |
마지막 turn |
각 구간에서 그 구간에 유효한 rubric 지시를 얼마나 따랐는지 0에서 1 사이 점수를 매긴다. 1.0은 관찰 가능한 모든 유효 지시를 따랐다는 뜻이다. 뒤에 나오는 drift 분석은 이 다섯 구간 중 세 개를 대표로 쓴다.
harness-updating의 평탄성
evolver별 이득 비교
agent 세 모델을 고정하고 evolver 7종을 바꿔 측정한 결과다. 값은 anchor agent 3개 위 평균 이득이며 단위는 %p다.
| Evolver | SWE | MCP | SB |
|---|---|---|---|
| Opus 4.6 | 7.4 | 3.6 | 2.3 |
| Sonnet 4.6 | 7.4 | 2.6 | 1.2 |
| Haiku 4.5 | 8.0 | 2.3 | 2.7 |
| Qwen3-235B | 8.2 | 0.6 | 1.5 |
| Qwen3-32B | 7.8 | 2.3 | 0.7 |
| Qwen3.5-9B | 6.8 | 1.0 | 3.8 |
| GPT-OSS-120B | 5.9 | 1.9 | 1.5 |
| spread (최대 − 최소) | 2.3 | 3.0 | 3.1 |
두 가지 패턴이 함께 나타난다. 첫째, 최고와 최저 evolver의 차이가 어느 벤치마크에서도 3.1%p를 넘지 않는다. 둘째, 모든 벤치마크에서 이기는 모델이 없다. Qwen3-235B가 그 재배열을 잘 보여준다. SWE에서 8.2%p로 1위인데 MCP에서는 0.6%p로 최하위다.
모델 크기도 예측력이 없다. 가장 작은 evolver인 Qwen3.5-9B가 SkillsBench에서 3.8%p로 1위이며, Opus 4.6(2.3%p)과 Qwen3-235B(1.5%p)를 모두 넘어선다. 9B 모델이 frontier 모델보다 더 유용한 skill을 쓴 경우가 실제로 존재한다는 뜻이다.
평균값의 구성
벤치마크 사이 절대값 차이가 크다는 점은 따로 볼 필요가 있다. SWE의 이득은 5.9%p에서 8.2%p 사이인데 MCP는 0.6%p에서 3.6%p, SkillsBench는 0.7%p에서 3.8%p다. 이 차이는 evolver의 성능이 아니라 평균을 이루는 세 항의 구성에서 온다.
각 벤치마크의 1위 evolver를 anchor agent별로 분해하면 구성이 드러난다. 값은 Table 5의 셀에서 기준선을 뺀 개별 이득(%p)이다.
| 벤치마크 | 1위 evolver | Opus 4.6 agent | Sonnet 4.6 agent | Qwen3-235B agent | 평균 |
|---|---|---|---|---|---|
| SWE | Qwen3-235B | +2.4 | +2.8 | +19.3 | 8.2 |
| MCP | Opus 4.6 | +3.4 | +3.2 | +4.3 | 3.6 |
| SB | Qwen3.5-9B | +1.1 | +7.0 | +3.4 | 3.8 |
SWE의 큰 평균값은 Qwen3-235B agent 한 항이 만든다. 이 agent는 base pass rate가 20.7%로 다른 두 anchor의 73.2%와 74.2%보다 훨씬 낮아 개선 여지가 크고, evolution 후 38%에서 40% 구간으로 올라간다. 강한 두 agent는 같은 evolver 아래에서 2%p대만 움직인다.
MCP는 세 항이 3.2%p에서 4.3%p로 고르게 분포한다. SkillsBench는 다시 편중되지만 방향이 다르다. Qwen3.5-9B evolver의 1위는 Sonnet 4.6 agent에서 나온 +7.0%p가 만든 것이고, 그 조합은 Table 5에서 Sonnet 4.6 agent가 얻은 유일한 큰 이득이다.
세 벤치마크의 절대값을 나란히 비교할 때는 이 구성 차이를 함께 봐야 한다. 같은 3.6%p라도 세 agent가 고르게 얻은 값과 한 agent가 몰아 얻은 값은 의미가 다르다.
전체 조합 행렬
평균값 뒤의 개별 셀을 보면 패턴이 더 분명해진다. 각 셀은 해당 anchor agent와 evolver 조합의 pass rate(%)이고 NONE은 evolution 없는 기준선이다.
| Evolver | Opus 4.6 | Sonnet 4.6 | Qwen3-235B | |
|---|---|---|---|---|
SWE NONE |
74.2 | 73.2 | 20.7 | 기준 |
| Opus 4.6 | 76.4 | 76.0 | 38.0 | 7.4 |
| Sonnet 4.6 | 76.8 | 75.6 | 37.8 | 7.4 |
| Haiku 4.5 | 77.8 | 74.8 | 39.4 | 8.0 |
| Qwen3-235B | 76.6 | 76.0 | 40.0 | 8.2 |
| Qwen3-32B | 76.2 | 75.4 | 39.8 | 7.8 |
| Qwen3.5-9B | 76.4 | 73.2 | 38.8 | 6.8 |
| GPT-OSS-120B | 75.2 | 75.6 | 35.0 | 5.9 |
MCP NONE |
61.0 | 54.0 | 25.0 | 기준 |
| Opus 4.6 | 64.4 | 57.2 | 29.3 | 3.6 |
| Sonnet 4.6 | 64.6 | 57.0 | 26.1 | 2.6 |
| Haiku 4.5 | 64.4 | 58.2 | 24.2 | 2.3 |
| Qwen3-235B | 61.6 | 55.8 | 24.3 | 0.6 |
| Qwen3-32B | 63.8 | 57.4 | 25.7 | 2.3 |
| Qwen3.5-9B | 62.6 | 55.6 | 24.9 | 1.0 |
| GPT-OSS-120B | 62.6 | 55.6 | 27.6 | 1.9 |
SB NONE |
25.6 | 24.4 | 4.7 | 기준 |
| Opus 4.6 | 30.2 | 27.9 | 3.5 | 2.3 |
| Sonnet 4.6 | 29.1 | 25.6 | 3.5 | 1.2 |
| Haiku 4.5 | 31.4 | 25.6 | 5.8 | 2.7 |
| Qwen3-235B | 31.4 | 22.1 | 5.8 | 1.5 |
| Qwen3-32B | 30.2 | 22.1 | 4.6 | 0.7 |
| Qwen3.5-9B | 26.7 | 31.4 | 8.1 | 3.8 |
| GPT-OSS-120B | 31.4 | 22.1 | 5.8 | 1.5 |
이 행렬에는 논문 본문이 서술하지 않은 사실이 하나 들어 있다. 63개 셀 가운데 9개가 evolution 없는 기준선보다 낮다. SWE에서는 하락 셀이 없고 Sonnet 4.6 agent에 Qwen3.5-9B evolver를 붙인 조합만 73.2로 동률이다. MCP의 하락 3건은 모두 Qwen3-235B agent에서 나오고(24.2, 24.3, 24.9 대 기준선 25.0), SkillsBench의 하락 6건은 Sonnet 4.6 agent 3건(모두 22.1 대 24.4)과 Qwen3-235B agent 3건(3.5, 3.5, 4.6 대 4.7)이다. harness evolution이 항상 개선을 보장하지는 않으며, base가 낮은 SkillsBench에서 회귀가 가장 잦다.
flink-query 사례
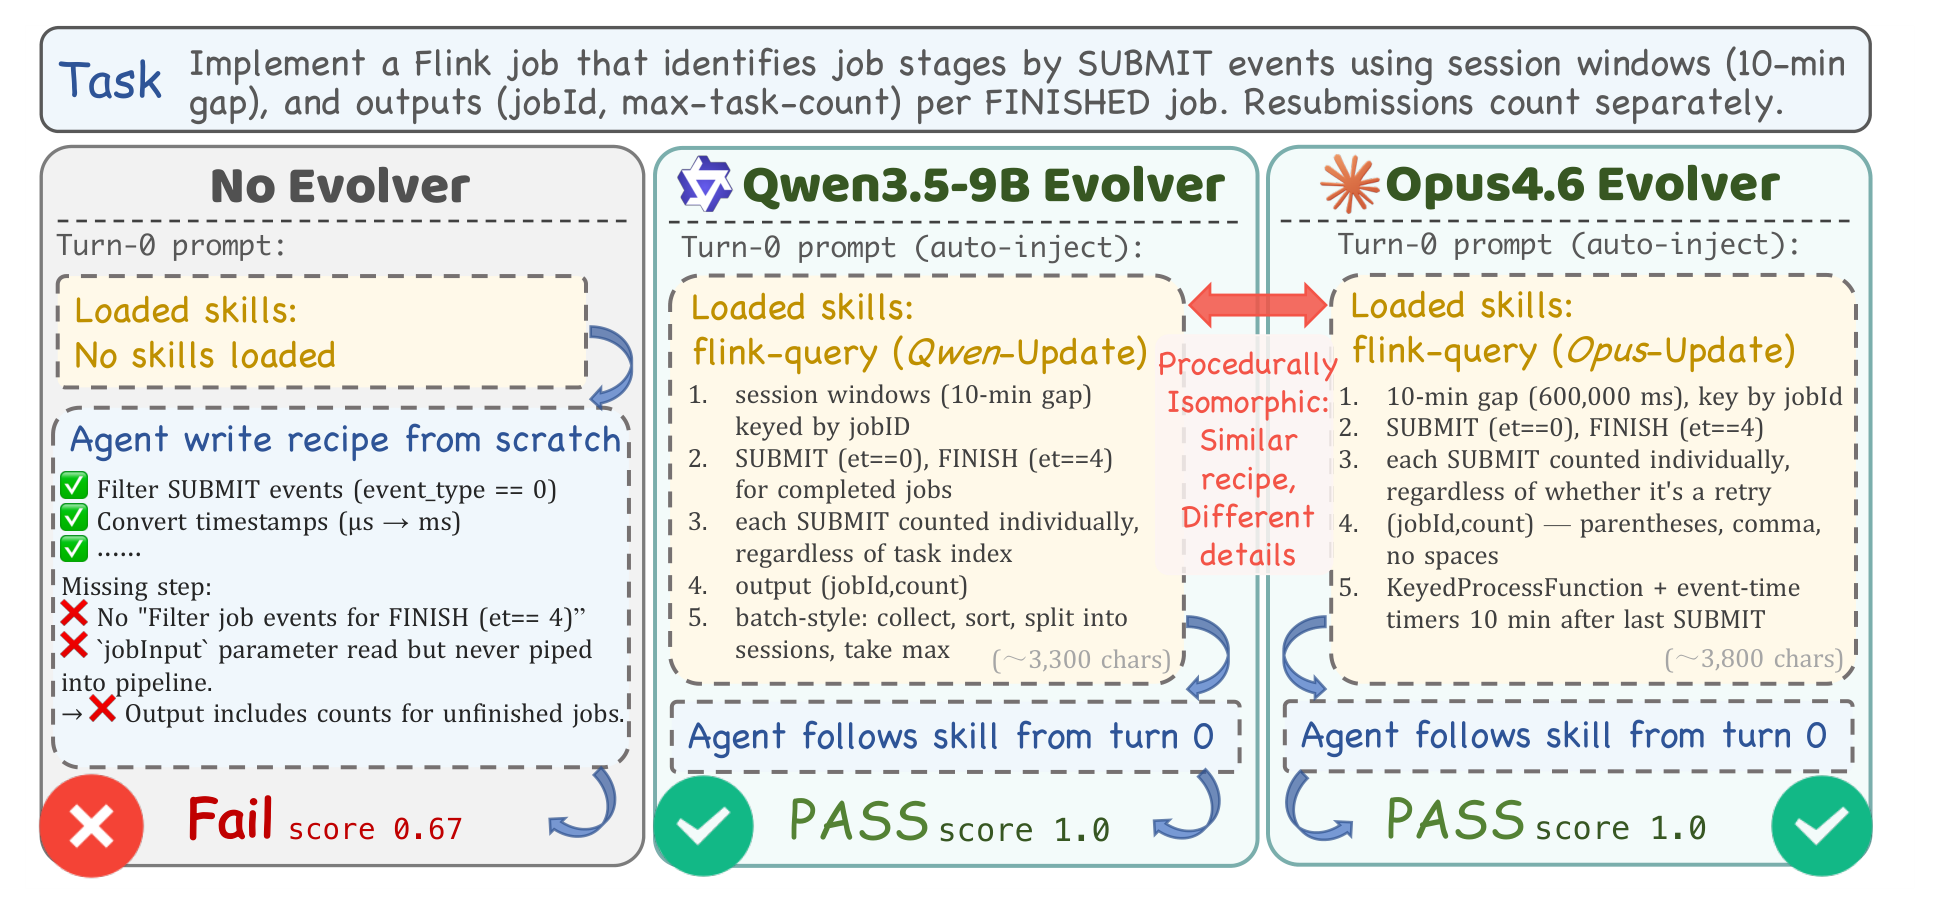
평균값이 비슷하다는 사실만으로는 두 evolver가 같은 일을 했다고 말할 수 없다. 논문은 SkillsBench의 flink-query task를 열어 절차 수준에서 대조한다. task는 SUBMIT 이벤트로 job 단계를 식별하는 Flink job을 10분 gap session window로 구현하고, FINISHED job마다 (jobId, max-task-count)를 출력하는 것이다. 재제출은 별도로 센다.
agent backbone은 Opus 4.6으로 고정하고 evolver 조건만 세 가지로 바꾼다.
| 조건 | agent가 한 일 | 점수 |
|---|---|---|
| evolver 없음 | SUBMIT 이벤트 필터(event_type == 0)와 타임스탬프 변환(마이크로초에서 밀리초)은 했으나 FINISH 이벤트 필터(et == 4)를 누락하고, jobInput 파라미터를 읽고도 파이프라인에 연결하지 않아 미완료 job 카운트가 출력에 섞였다 |
0.67 |
| Qwen3.5-9B가 만든 skill (약 3,300자) | turn 0부터 skill을 따라 다섯 단계를 수행했다 | 1.0 |
| Opus 4.6이 만든 skill (약 3,800자) | turn 0부터 skill을 따라 같은 다섯 단계를 수행했다 | 1.0 |
evolver 없는 조건의 실패를 자세히 보면 이 task가 무엇을 요구하는지 드러난다. agent는 SUBMIT 이벤트를 걸러내고 타임스탬프 단위를 맞추는 앞부분은 스스로 해냈다. 빠뜨린 것은 완료 판정 단계다. FINISH 이벤트를 걸러내지 않았으므로 아직 끝나지 않은 job의 카운트가 결과에 섞였고, 입력 파라미터를 읽어 놓고도 파이프라인에 연결하지 않았다. 0.67점은 부분 점수이며 절차의 마지막 조건 하나가 빠진 상태를 뜻한다.
skill이 채워 준 것도 바로 그 조건이다. 두 evolver가 만든 skill 모두 FINISH 판별을 명시적 단계로 적어 두었다. 이 사례가 보여주는 harness의 기여는 새로운 능력을 주는 것이 아니라 agent가 스스로 도달하지 못한 절차 조건을 미리 적어 두는 것이다.
두 skill의 내용을 나란히 놓으면 표현만 다르다.
| 단계 | Qwen3.5-9B 판본 | Opus 4.6 판본 |
|---|---|---|
| 1 | jobID로 키를 잡은 10분 gap session window | jobId로 키를 잡은 10분(600,000밀리초) gap |
| 2 | SUBMIT(et == 0)과 FINISH(et == 4)로 완료 job 판별 |
SUBMIT과 FINISH 판별 |
| 3 | task index와 무관하게 SUBMIT을 개별 집계 | 재시도 여부와 무관하게 SUBMIT을 개별 집계 |
| 4 | (jobId, count) 출력 | 괄호와 쉼표를 붙이고 공백을 넣지 않은 (jobId,count) 형식 |
| 5 | 수집하고 정렬한 뒤 세션으로 분할해 최댓값을 취하는 배치 방식 | 마지막 SUBMIT 후 10분 event-time timer를 쓰는 KeyedProcessFunction |
부록 C.2는 두 skill이 SUBMIT 필터, FINISH 필터, SUBMIT 개별 집계, (jobId, count) 출력, 10분 session window 적용이라는 같은 다섯 단계를 담고 있으며 차이는 세션화 구현 표현뿐이라고 정리한다. 9B 오픈모델 evolver가 frontier evolver와 동일한 절차 내용에 도달한다는 것이 첫 번째 발견의 메커니즘이다.
agent 안쪽 변동과 agent 사이 격차
evolver를 7개 바꿔도 한 agent 안에서의 점수 변동폭은 agent 사이 base capability 차이보다 훨씬 작다.
| 벤치마크 | agent 안쪽 최대 변동폭 | 해당 agent | Opus 4.6 대 Qwen3-235B base capability 격차 | 논문이 명시한 배수 |
|---|---|---|---|---|
| SWE | 5.0%p | Qwen3-235B | 53.5%p | 11배 |
| MCP | 5.1%p | Qwen3-235B | 36.0%p | 명시 없음 |
| SB | 9.3%p | Sonnet 4.6 (22.1%에서 31.4%) | 20.9%p | 2.2배 |
SkillsBench가 세 벤치마크 중 가장 좁지만 부등호 방향은 유지된다.
극단 조합 비교는 이 결론을 더 강하게 만든다. 각 벤치마크에서 가장 약한 anchor agent에 그 agent의 최선 evolver를 붙이고, 가장 강한 anchor agent에 그 agent의 최악 evolver를 붙여 맞대 본다.
| 항목 | SWE | MCP | SB |
|---|---|---|---|
| 약한 anchor agent | Qwen3-235B | Qwen3-235B | Qwen3-235B |
| 의 최선 evolver | Qwen3-235B | Opus 4.6 | Qwen3.5-9B |
| 의 점수 | 40.0 | 29.3 | 8.1 |
| 강한 anchor agent | Opus 4.6 | Opus 4.6 | Opus 4.6 |
| 의 최악 evolver | GPT-OSS-120B | Qwen3-235B | Qwen3.5-9B |
| 의 점수 | 75.2 | 61.6 | 26.7 |
| 격차 | 35.2%p | 32.3%p | 18.6%p |
강한 agent에 최대한 불리한 조건을 줘도 18.6%p에서 35.2%p 우위가 유지된다. SkillsBench에서는 Qwen3.5-9B가 양쪽에 동시에 등장한다. Qwen3-235B에게는 최선 evolver이면서 Opus 4.6에게는 최악 evolver이기 때문이다. 같은 evolver가 어떤 agent와 만나느냐에 따라 최선과 최악을 오간다는 사실 자체가 evolver 정체성의 설명력이 약함을 보여준다.
이 절의 결론은 하나로 모인다. evolution 이후 성능은 evolver 쪽이 아니라 agent 쪽에서 제한된다.
harness-benefit의 비단조성
벤치마크별 정점 모델
evolver 세 모델을 고정하고 agent 6종을 바꿔 측정한 결과다. Base는 evolution 없는 pass rate(%)이고 Δ는 anchor evolver 3개 위 최대 이득(%p)이다.
| Model | SWE Base | SWE Δ | MCP Base | MCP Δ | SB Base | SB Δ |
|---|---|---|---|---|---|---|
| Qwen3-32B | 3.6 | 4.4 | 3.6 | 1.0 | 0.0 | 5.8 |
| Qwen3-235B | 20.7 | 19.3 | 25.0 | 4.3 | 4.7 | 1.1 |
| GPT-OSS-120B | 26.2 | 15.8 | 28.0 | 7.0 | 0.0 | 7.0 |
| Haiku 4.5 | 66.0 | 2.4 | 42.4 | 3.6 | 5.8 | 15.1 |
| Sonnet 4.6 | 73.2 | 2.8 | 54.0 | 3.2 | 24.4 | 3.5 |
| Opus 4.6 | 74.2 | 2.6 | 61.0 | 3.6 | 25.6 | 5.8 |
이득이 base capability에 따라 단조 증가하지 않는다. SWE에서는 base 20.7%인 Qwen3-235B가 19.3%p로 정점이고, 더 약한 Qwen3-32B는 4.4%p, 더 강한 Opus 4.6은 2.6%p에 머문다. MCP에서는 정점이 base 28.0%인 GPT-OSS-120B(7.0%p)로 이동하고 역시 양쪽 끝이 작다.
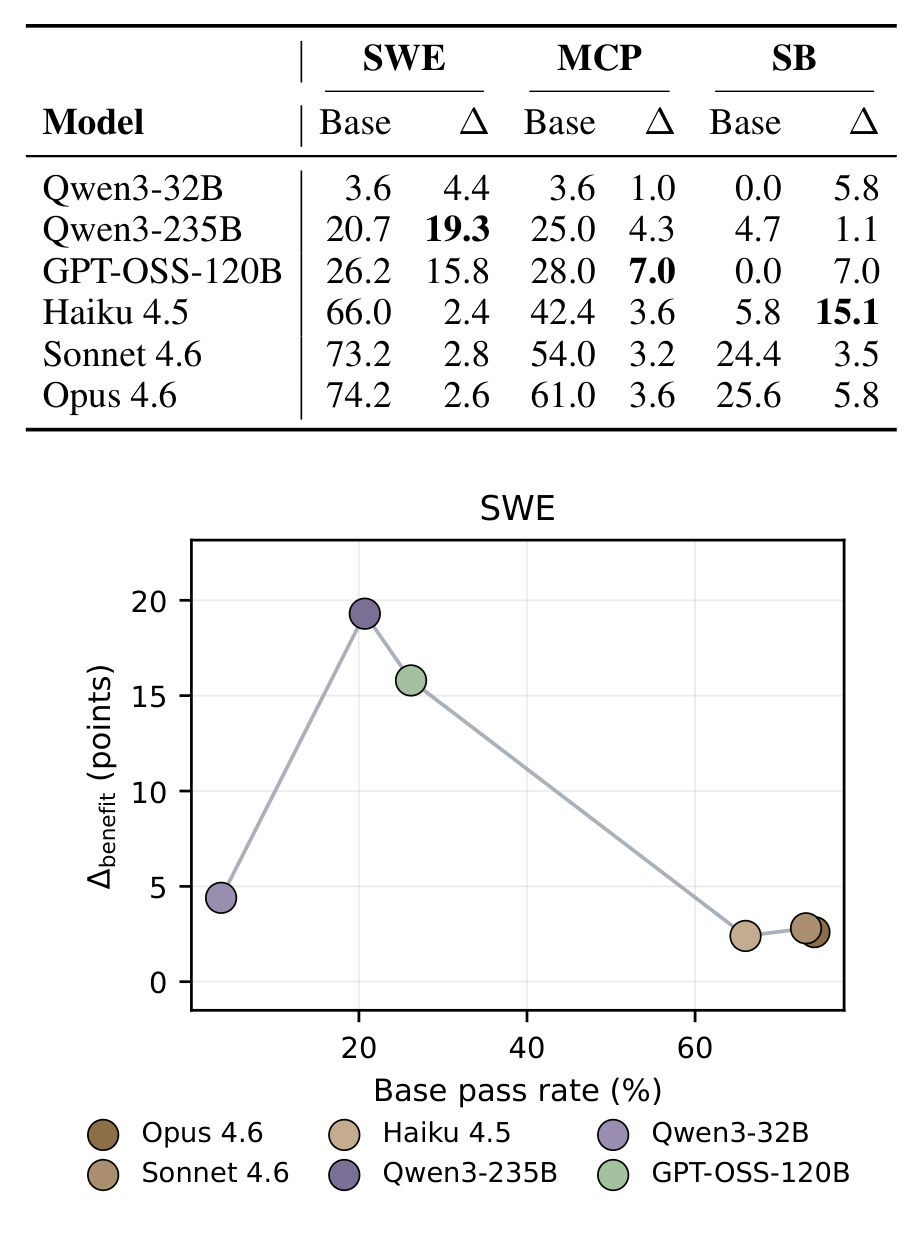
곡선의 양 끝은 서로 다른 이유로 낮다. 높은 쪽의 작은 이득은 ceiling effect와 부합한다. 강한 모델은 초기 harness 아래에서 이미 많은 task를 풀기 때문에 더 개선할 여지가 좁다. 낮은 쪽은 이 설명이 통하지 않는다. Qwen3-32B는 base capability 위로 남은 개선 여지가 가장 큰데도 가장 적게 얻으므로 별개의 병목이 있다.
벤치마크 사이 패턴 강도는 다르다. SWE와 MCP가 비단조 패턴의 가장 뚜렷한 증거를 제공하고, SkillsBench는 base pass rate가 낮은 구간에서 변동이 크다. SkillsBench에서 Qwen3-32B와 GPT-OSS-120B의 base pass rate가 0.0%, Qwen3-235B가 4.7%, Haiku 4.5가 5.8%인데, 출발점이 비슷한데도 Haiku 4.5는 15.1%p를 얻고 Qwen3-235B는 1.1%p만 얻는다. base pass rate가 낮은 구간은 task 도메인에 따라 변동이 클 수 있다는 뜻이다.
곡선 양 끝의 서로 다른 원인
비단조 곡선은 한 가지 메커니즘으로 만들어지지 않는다. 왼쪽 끝과 오른쪽 끝이 서로 다른 이유로 낮으며, 가운데가 높은 것은 두 제약이 모두 느슨한 구간이기 때문이다.
| 구간 | 대표 모델 | 이득이 작거나 큰 이유 | 검증 방법 |
|---|---|---|---|
| 약한 등급 | Qwen3-32B | 개선 여지는 가장 크지만 harness를 컨텍스트로 가져오지 못하거나 가져와도 따르지 못한다 | SLR과 HFR 측정, 사례 분석 |
| 중간 등급 | GPT-OSS-120B, Qwen3-235B | harness를 활용할 만한 실행 능력이 있고 개선 여지도 남아 있다 | 두 제약이 모두 완화된 구간 |
| 강한 등급 | Sonnet 4.6, Opus 4.6 | 초기 harness에서 이미 많은 task를 풀어 개선 여지가 좁다 | base pass rate 73%에서 74% 수준 |
오른쪽 끝의 설명은 base pass rate 자체로 확인된다. SWE에서 Opus 4.6의 base pass rate가 74.2%이므로 남은 여지가 25.8%p뿐이고, 그 안에서 2.6%p를 얻는다.
왼쪽 끝은 이 논리로 설명되지 않는다. Qwen3-32B의 SWE base pass rate는 3.6%로 남은 여지가 96.4%p인데 실제 이득은 4.4%p에 그친다. 개선 여지의 크기가 이득을 예측하지 못하므로 별개의 제약이 있다는 결론이 나오고, 그 제약을 찾는 것이 다음 절의 분석이다.
agent 쪽 전체 행렬
각 셀은 task를 푸는 모델이 해당 evolver 아래에서 낸 pass rate(%)다.
| 벤치마크 | Evolver | Qwen3-32B | Qwen3-235B | GPT-OSS-120B | Haiku 4.5 | Sonnet 4.6 | Opus 4.6 |
|---|---|---|---|---|---|---|---|
| SWE | NONE |
3.6 | 20.7 | 26.2 | 66.0 | 73.2 | 74.2 |
| SWE | Opus 4.6 | 8.0 | 38.0 | 37.2 | 65.0 | 76.0 | 76.4 |
| SWE | Sonnet 4.6 | 7.6 | 37.8 | 37.6 | 68.4 | 75.6 | 76.8 |
| SWE | Qwen3-235B | 8.0 | 40.0 | 42.0 | 65.4 | 76.0 | 76.6 |
| SWE | 4.4 | 19.3 | 15.8 | 2.4 | 2.8 | 2.6 | |
| MCP | NONE |
3.6 | 25.0 | 28.0 | 42.4 | 54.0 | 61.0 |
| MCP | Opus 4.6 | 4.6 | 29.3 | 35.0 | 46.0 | 57.2 | 64.4 |
| MCP | Sonnet 4.6 | 4.0 | 26.1 | 32.0 | 42.8 | 57.0 | 64.6 |
| MCP | Qwen3-235B | 2.8 | 24.3 | 29.1 | 41.0 | 55.8 | 61.6 |
| MCP | 1.0 | 4.3 | 7.0 | 3.6 | 3.2 | 3.6 | |
| SB | NONE |
0.0 | 4.7 | 0.0 | 5.8 | 24.4 | 25.6 |
| SB | Opus 4.6 | 3.5 | 3.5 | 7.0 | 20.9 | 27.9 | 30.2 |
| SB | Sonnet 4.6 | 3.5 | 3.5 | 4.6 | 18.6 | 25.6 | 29.1 |
| SB | Qwen3-235B | 5.8 | 5.8 | 7.0 | 15.1 | 22.1 | 31.4 |
| SB | 5.8 | 1.1 | 7.0 | 15.1 | 3.5 | 5.8 |
회귀가 나타나는 조합
이 최댓값 집계라서 표 맨 아랫줄만 보면 성능이 떨어진 조합이 보이지 않는다. 개별 셀을 기준선과 대조하면 54개 셀 중 8개가 기준선 아래로 내려간다.
| 벤치마크 | agent | evolver | evolution 이후 | 기준선 | 변화 |
|---|---|---|---|---|---|
| SWE | Haiku 4.5 | Opus 4.6 | 65.0 | 66.0 | −1.0%p |
| SWE | Haiku 4.5 | Qwen3-235B | 65.4 | 66.0 | −0.6%p |
| MCP | Qwen3-32B | Qwen3-235B | 2.8 | 3.6 | −0.8%p |
| MCP | Qwen3-235B | Qwen3-235B | 24.3 | 25.0 | −0.7%p |
| MCP | Haiku 4.5 | Qwen3-235B | 41.0 | 42.4 | −1.4%p |
| SB | Qwen3-235B | Opus 4.6 | 3.5 | 4.7 | −1.2%p |
| SB | Qwen3-235B | Sonnet 4.6 | 3.5 | 4.7 | −1.2%p |
| SB | Sonnet 4.6 | Qwen3-235B | 22.1 | 24.4 | −2.3%p |
Qwen3-235B evolver가 하락 8건 중 5건에 관여한다. 같은 모델이 SWE에서는 harness-updating 1위(8.2%p)였다는 점과 함께 보면, 한 evolver의 유용성이 벤치마크와 짝 agent에 따라 뒤집힌다는 앞 절의 관찰과 일관된다. 논문은 이 회귀를 별도로 분석하지 않으므로 원인 규명은 남은 과제다.
weak-tier의 두 실패 모드
약한 모델의 낮은 이득은 SkillsBench 심층 분석에서 두 실패로 분해된다. 하나는 관련 harness artifact를 작업 컨텍스트로 가져오지 못하는 activation 실패이고, 다른 하나는 가져왔음에도 그 지침을 충실히 따르지 못하는 adherence 실패다.
세 지표로 본 분리
| Model | SLR (activation) | HFR (adherence) | LPR (결과) |
|---|---|---|---|
| Qwen3-32B | 0.251 | 0.142 | 0.023 |
| GPT-OSS-120B | 0.446 | 0.442 | 0.040 |
| Haiku 4.5 | 0.794 | 0.600 | 0.099 |
| Qwen3-235B | 0.961 | 0.350 | 0.022 |
| Sonnet 4.6 | 0.959 | 0.730 | 0.145 |
| Opus 4.6 | 0.957 | 0.757 | 0.177 |
행 순서는 SkillsBench base capability 순이다. 강한 세 모델의 SLR은 0.957에서 0.961 구간에 몰려 있고, GPT-OSS-120B는 0.446, Qwen3-32B는 0.251로 내려간다. adherence 쪽 격차도 크다. Opus 4.6이 0.757인데 Qwen3-32B는 0.142다.
Qwen3-235B가 두 능력의 분리를 가장 선명하게 보여준다. SLR이 0.961로 Opus 4.6과 사실상 같은데 HFR은 0.350에 그치고, LPR은 0.022로 Opus의 0.177 대비 8분의 1 수준이다. harness를 컨텍스트에 넣는 것과 그 harness를 따르는 것이 서로 다른 능력이며, 로드에 성공하는 것만으로는 이득이 보장되지 않는다.
세 지표를 함께 읽는 방법
세 지표는 순차적 관문으로 읽어야 한다. skill이 컨텍스트에 들어와야(SLR) 지침을 따를 기회가 생기고, 지침을 따라야(HFR) 통과로 이어질 여지가 생기며, 통과 여부가 LPR로 남는다. 앞 관문에서 걸리면 뒤 관문의 값은 남은 표본에서만 계산된다.
이 구조 때문에 지표 하나만 보면 진단이 어긋난다. Qwen3-235B는 SLR만 보면 최상위 세 모델과 구분되지 않지만 HFR과 LPR에서 갈라진다. 반대로 GPT-OSS-120B는 SLR과 HFR이 0.446과 0.442로 비슷해 두 관문에서 같은 정도로 손실이 나는 형태다.
각 지표가 못 잡는 것도 있다. SLR은 로드 시점만 보므로 필요한 skill이 아니라 엉뚱한 skill을 로드했는지는 구분하지 않는다. HFR은 로드된 trajectory에서만 계산되므로 로드 실패가 많은 모델의 HFR은 적은 표본에 기댄 값이다. LPR은 통과 여부만 보므로 skill과 무관하게 통과한 경우와 skill 덕에 통과한 경우를 나누지 않는다. 이 논문이 세 지표를 함께 보고하고 사례 분석을 덧붙인 이유가 이 한계에 있다.
activation 실패
threejs task는 Three.js 파일의 createScene()을 파싱해 3D 객체의 부품 단위 구조를 뽑고 부품별 OBJ 파일을 내보내는 작업이다. threejs skill이 카탈로그에 등재되어 있으므로 agent는 이를 로드하면 된다.
| 모델 | turn 0 출력 | 결과 | 점수 |
|---|---|---|---|
| Qwen3-235B | {"load_skill":"threejs"} 단일 키 |
turn 1에 skill 본문(mesh baking, part partitioning, per-link OBJ export, URDF articulation)이 컨텍스트에 들어와 turn 2 이후 skill을 따랐다 | 1.0 |
| Qwen3-32B | analysis, plan, load_skill 세 키를 묶은 composite action |
형식 검사가 단일 키만 받으므로 malformed로 거부되고 parser error가 발생해 skill 본문이 끝까지 컨텍스트에 들어오지 못했다. agent는 절차 안내 없이 진행했다 | 0.0 |
Qwen3-32B의 출력 안에는 올바른 판단이 들어 있었다. analysis 값은 "the threejs skill contains workflows for parsing Three.js scenes"였고 plan의 첫 항목은 "Load the threejs skill"이었다. 즉 어떤 skill이 필요한지는 알았고, 그 의도를 runner가 기대하는 형식으로 옮기지 못했다.
부록 D.1은 이 실패의 위치를 action-protocol 계층이라고 못 박는다. 이해의 문제가 아니라 출력 형식 규약의 문제다.
adherence 실패
pg-essay-to-audiobook task는 Paul Graham 에세이 두 편을 TTS 오디오북 MP3로 변환하는 작업이다. skill 본문은 paulgraham.com 수집과 MP3 합성 요건을 적고, kokoro에서 edge-tts, pyttsx3, espeak, gTTS로 내려가는 fallback chain을 절차 안내로 제시한다. 채점 기준은 audiobook.mp3가 존재하고 크기가 0이 아니며 유효한 재생 길이를 갖는 것이다. 두 agent 모두 이 skill을 로드하는 데 성공했다.
Qwen3-32B의 실패 경과는 다음과 같다.
| turn | 동작 |
|---|---|
| T0 | {'load_skill':'pg-essay-audiobook'}으로 로드 성공 |
| T1 | 본문을 완성된 스크립트로 오독하고 python3 audiobook_script.py를 실행해 FileNotFoundError를 만났다 |
| T2에서 T7 | externally-managed 환경에서 pip install 시도를 반복해 실패했다 |
| T8 | which espeak이 성공했는데도 본문의 fallback chain을 건너뛰었다 |
| T10 | 유효한 산출물 없이 task_complete=true와 "No TTS tools available"을 내며 종료했다 |
같은 skill로 통과한 GPT-OSS-120B의 경과와 대조된다.
| turn | 동작 |
|---|---|
| T0에서 T11 | skill 본문 없이 자체 TTS 스크립트를 작성했다 |
| T12 | {"load_skill":"pg-essay-to-audiobook"}을 내 본문을 컨텍스트에 넣었다 |
| T13 | 본문을 절차 안내로 읽었다 |
| T16 | fallback chain의 첫 항목인 pyttsx3를 시도했다 |
| T17 | espeak와 ffmpeg를 설치했다 |
| T19 | subprocess와 espeak 조합으로 전환해 본문의 chain을 따랐다 |
| T21 | 깨진 paulgraham URL을 고쳤다 |
| T23 | audiobook.mp3를 써서 채점을 통과했다 |
차이는 skill 본문을 무엇으로 읽었는지에서 갈린다. Qwen3-32B는 본문을 그대로 실행하면 되는 스크립트로 취급했고, 첫 단계가 실패하자 대체 경로가 있다는 사실을 활용하지 못한 채 종료했다. GPT-OSS-120B는 같은 본문을 조건에 따라 분기하는 절차로 읽어 첫 항목이 막히면 다음 항목으로 옮겼다. 부록 D.1은 이 실패의 위치를 절차 실행 계층이라고 정리한다.
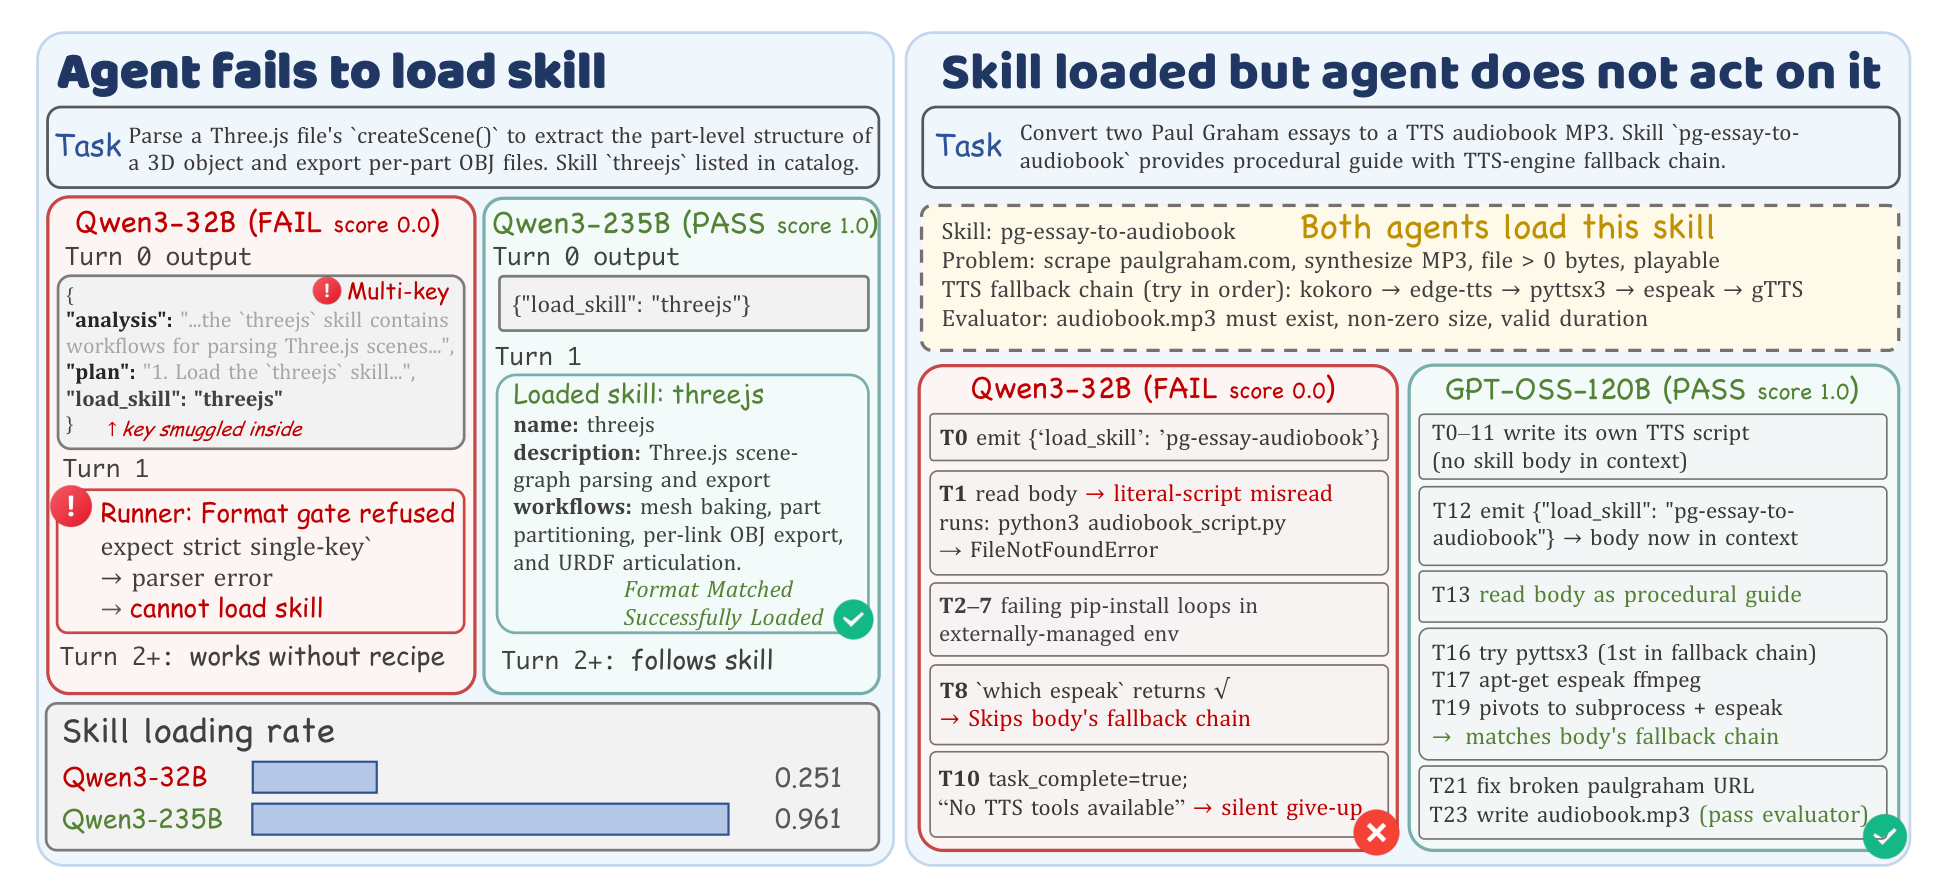
두 사례의 공통점은 결함의 위치다. Qwen3-32B는 threejs에서 올바른 skill을 골랐고 pg-essay-to-audiobook에서 skill의 첫 단계를 따랐다. 약한 모델은 harness를 읽지 못하는 것이 아니라 harness 아래에서 동작하지 못한다.
구간별 준수 하락
adherence 실패가 로드 시점의 오독인지, 아니면 작업이 길어지면서 누적되는 문제인지 가리기 위해 구간별 준수 점수를 측정했다. 대표 모델은 약한 등급 Qwen3-32B, 중간 등급 GPT-OSS-120B, 강한 등급 Opus 4.6이다.
| 구간 | Qwen3-32B | GPT-OSS-120B | Opus 4.6 |
|---|---|---|---|
| harness loaded | 0.52 | 0.67 | 0.89 |
| mid turn | 0.22 | 0.48 | 0.79 |
| final turn | 0.13 | 0.43 | 0.80 |
| drift (load에서 final까지) | −0.39 | −0.24 | −0.09 |
Qwen3-32B는 로드 직후 0.52에서 마지막 검증 시점 0.13으로 급격히 하락하고, GPT-OSS-120B는 0.67에서 0.43으로 완만하게 하락한다. Opus 4.6은 0.89에서 0.80으로 사실상 평평하며, 중간 구간에서 0.79로 내려간 뒤 마지막에 0.80으로 회복한다.
하락 폭이 등급에 따라 단계적으로 커진다는 점이 진단의 근거다. 약한 모델은 harness를 로드 시점에 잘못 읽는 것이 아니라 trajectory가 진행될수록 준수 수준을 점진적으로 잃는다. 즉 병목은 긴 작업에서의 지침 준수 능력이다.
설계 지침
논문은 세 가지 지침을 결론으로 제시한다.
| 지침 | 근거 수치 |
|---|---|
| 성능 예산을 evolver가 아니라 task를 푸는 agent에 배정하라 | evolver 사이 최대 격차 3.1%p 대 agent 사이 base capability 격차 36.0%p(MCP), 극단 조합에서도 강한 agent가 18.6%p에서 35.2%p 우위 |
| harness 호출을 학습 대상에 포함하라 | Qwen3-32B의 skill 로드율 25.1% 대 강한 등급 약 96% |
| 긴 작업에서의 지침 준수를 두 번째 학습 목표로 삼아라 | drift −0.39 대 −0.09로 약 4배 차이 |
첫 번째 지침의 실무적 함의는 evolver를 키우는 투자의 수익이 작다는 것이다. evolver를 frontier 모델로 바꿔도 얻는 것은 최대 3.1%p이므로, 같은 예산이면 task를 푸는 쪽 모델을 올리는 편이 효과가 크다. 뒤집어 보면 evolver 자리에는 작고 저렴한 모델을 배치할 여지가 있다. Qwen3.5-9B가 SkillsBench에서 1위를 차지하고 Opus와 절차상 동일한 skill을 쓴 사례가 그 근거다.
두 번째와 세 번째 지침은 agent 학습의 목표를 바꾸라는 요구다. harness 호출은 지금까지 형식 준수 문제로 취급되었지만, 로드율 25.1%와 약 96% 사이 격차가 최종 성능을 좌우하는 규모라면 일차 학습 대상으로 다뤄야 한다. 긴 작업에서의 준수도 마찬가지다. 로드에 성공한 뒤에도 준수 수준이 크게 하락하면 harness에 투자한 노력이 회수되지 않는다.
자체 시스템에 옮길 때의 측정 항목
이 논문의 지표는 그대로 운영 시스템의 계측 항목이 된다. harness를 붙여 놓고 성능이 오르지 않을 때, 어느 관문에서 손실이 나는지를 먼저 확인하는 순서다.
| 확인할 것 | 대응 지표 | 값이 낮을 때의 해석 |
|---|---|---|
| agent가 관련 skill을 컨텍스트로 가져오는가 | SLR | 출력 형식 규약이나 skill 카탈로그 노출 방식의 문제일 수 있다 |
| 가져온 skill의 지침을 따르는가 | HFR | 지침을 절차가 아니라 완성물로 오독하는 유형인지 확인한다 |
| 지침을 따른 실행이 통과로 이어지는가 | LPR | skill 내용 자체의 품질을 의심할 지점이다 |
| 긴 작업의 후반까지 준수가 유지되는가 | 구간별 준수 점수 | 컨텍스트에서 지침이 밀려나는지, 재확인 단계가 없는지 본다 |
evolver 쪽 계측은 우선순위가 낮다. evolver를 바꿔 얻는 최대 이득이 3.1%p이므로, evolver 모델 선택을 조정하기 전에 위 네 항목을 먼저 보는 편이 효과가 크다.
한계
논문이 6절에서 명시한 한계는 두 가지다.
- 가중치를 바꾸는 적응 방법은 평가 범위 밖이다. 이 연구는 모델 가중치를 고정하고 외부 harness artifact 갱신만으로 적응하는 설정을 다루므로, fine-tuning, 강화학습, 그리고 가중치 업데이트와 harness 업데이트를 결합한 하이브리드 방법의 능력 분해는 후속 과제다.
- 모델 집합이 대표적이지만 망라적이지는 않다. 오픈소스와 클로즈드소스를 여러 등급에 걸쳐 포함했으나, 모델 계열과 규모와 학습 레시피와 배포 비용을 더 넓게 훑는 격자가 있어야 두 능력의 변화를 더 분명히 알 수 있다.
7절 Ethics Statement는 배포 관점의 위험을 별도로 짚는다. 갱신된 harness는 이후 task에 계속 남기 때문에 잘못된 교훈, 안전하지 않은 tool use 규칙, 편향된 지시, 민감 정보가 harness에 기록되어 재사용될 수 있다. 이 연구의 평가 환경에서는 harness 갱신을 로그로 남기고 evolver가 평가 스크립트와 모델 가중치를 수정하지 못하도록 제약했다. 저자들은 이런 통제가 벤치마크 환경을 감사 가능하게 만들지만 실제 배포의 안전을 보장하지는 않는다고 밝히며, 프라이버시와 데이터 보관 동의, 갱신 되돌리기, 감사 가능성, 사람의 감독을 설계 요건으로 다뤄야 한다고 정리한다.
논문이 한계로 분류하지는 않았으나 결과 해석 범위를 좌우하는 설정상 제약이 하나 더 있다. harness representation 자체가 고정되어 있다는 점이다. 편집 허용 범위가 skill과 일부 prompt, memory에 한정되고 tools/는 전 벤치마크에서 읽기 전용이다. 따라서 tool 자체를 진화시키는 setting에서 두 능력이 같은 패턴을 보일지는 이 실험이 답하지 않는다.
설정에서 파생되는 제약이 두 가지 더 있다. 첫째는 in-situ evaluation의 대가다. evolution을 구동하는 task stream이 평가 집합을 겸하므로 별도의 보류 집합이 없다. 개별 task의 점수가 자기 자신의 harness 수정에 오염되지 않는다는 것은 보장되지만, 학습에 쓰이지 않은 새 task로 일반화되는지는 이 설계가 측정하지 않는다. 갱신된 harness가 앞선 task에 특화되었을 가능성은 열려 있다.
둘째는 SkillsBench 설정 변경의 영향이다. 원 벤치마크가 함께 배포하는 큐레이션 skill을 걷어내고 빈 skill 집합에서 출발시켰기 때문에 base pass rate가 0.0%에서 25.6%로 매우 낮게 형성된다. 낮은 base pass rate 위에서 계산한 이득은 몇 개 task의 통과 여부에 크게 흔들리며, 논문 스스로 SkillsBench의 base pass rate가 낮은 구간에서 변동이 크다고 서술한다. 세 벤치마크 중 SkillsBench 결과에 가중치를 덜 두는 편이 안전하다.
또한 앞서 본 회귀 셀은 논문이 다루지 않은 공백이다. evolver 쪽 63개 셀 중 9개, agent 쪽 54개 셀 중 8개가 evolution 없는 기준선보다 낮은데, 어떤 조건에서 harness 갱신이 성능을 떨어뜨리는지는 분석되지 않았다.
후속 방향
논문의 발견을 그대로 이어 가면 네 가지 작업이 남는다.
- agent 사후 학습 레시피. activation과 adherence 격차를 줄이려면 skill 호출을 reward로 쓰거나 긴 작업의 지침 준수를 강화학습 목표로 삼는 학습 설계가 필요하다. 논문은 두 능력을 학습 목표로 지목했을 뿐 레시피는 제시하지 않는다.
- 작은 evolver의 실무 배치. 9B 모델이 frontier 모델과 절차상 동일한 skill을 쓴다면 추론 비용을 낮추는 evolver로 배치할 수 있다. 다만 SkillsBench 한 task의 사례 하나로 확인된 것이라 더 넓은 검증이 필요하다.
- 역할별 학습 분리. agent는 harness-benefit에, evolver는 harness-updating에 각각 최적화하는 구성이 가능한지 확인하는 작업이다. 두 능력이 base capability와 서로 다르게 어긋난다는 발견이 이 분리의 근거가 된다.
- 회귀 조건의 특징화. harness 갱신이 기준선보다 낮은 점수를 만드는 조건을 규명하는 작업이다. 하락 셀이 특정 evolver와 base pass rate가 낮은 벤치마크에 몰린다는 관찰이 출발점이 될 수 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| harness self-evolution | 모델 가중치를 고정한 채 실행 기록에 따라 harness만 반복 갱신하는 설정 |
| evolver | 이전 harness와 실행 증거로부터 수정안을 만드는 절차. 이 논문에서는 LLM agent로 구현한다 |
| harness-updating capability | evolver가 anchor agent 집합 위에서 만들어내는 평균 이득. 유용한 수정을 만드는 능력을 잰다 |
| harness-benefit capability | agent가 anchor evolver 집합 위에서 얻는 최대 이득. 갱신된 harness로 이득을 얻는 능력을 잰다 |
| harness activation failure | 관련 harness artifact를 작업 컨텍스트로 가져오지 못하는 실패. 출력 형식 규약 계층의 문제다 |
| harness adherence failure | harness가 로드되었음에도 그 지침을 따르지 못하는 실패. 절차 실행 계층의 문제다 |
| procedurally isomorphic | 두 skill이 표현은 달라도 단계 순서와 조건과 의도가 동일한 상태 |
| in-situ evaluation | task가 실행 증거로 쓰이기 전 시점의 harness 아래에서 채점되는 평가 설정 |
관련 페이지
- Harness Engineering (Team Attention, 2026): 같은 harness 개념을 처방적 엔지니어링 관점에서 다룬다. Claude Code 도구 매핑으로 harness 설계 방법을 제시하며, 이 논문은 agent 안쪽 변동 5.1%p 대 agent 사이 격차 36.0%p라는 정량 근거를 더한다.
- Memory Intelligence Agent (MIA): 워크플로 메모리와 파라미터 메모리를 분리하고 두 단계 강화학습으로 학습한다. 이 논문이 진단한 activation과 adherence 실패를 학습으로 우회하는 방향의 사례다.
- Compiling Agentic Workflows into LLM Weights: 지속적 구조는 가중치에, 일시적 상태는 프롬프트에 둔다는 명제로 harness를 모델 가중치로 컴파일한다. 호출과 준수가 어렵다는 이 논문의 측정이 그 접근에 동기를 보탠다.
- TaskMem: Task-Focused Memorization for Multimodal Agents: 장기 메모리를 학습 가능한 memorization policy로 재정식화해 adapter 벡터로 흡수한다. skill을 컨텍스트에 로드해 따르게 하는 경로 자체를 줄이려는 시도다.
- RAG, LLM Wiki, or GBrain? 에이전트 메모리 결정 프레임워크 (Liu): retrieve, compile, act 세 기준의 결정 프레임워크를 제시한다. act 기준이 이 논문의 SkillsBench 설정과 대응하고, 하나의 skill에 하나의 실행 레시피를 담으라는 권고는 절차 동형성 관찰과 부합한다.
- AKB: Agent Knowledge Base: MCP를 전제로 한 agent knowledge base다. 이 논문의 로드율 측정은 약한 모델을 외부 저장소와 결합할 때 호출을 학습시키지 않으면 저장소가 쓰이지 않는다는 운영 시사점을 준다.
- Harness²: 개방형 작업을 위한 recursive agent harnessing: 정답 없이 실행 대조로 harness를 고치는 Harness²다. 약한 실행자(GLM-5)가 더 큰 이득을 얻었다는 결과가 이 논문의 수혜 능력 측정과 대비된다.