Agents · PAPER · 2026
Harness²: 개방형 작업을 위한 recursive agent harnessing
요약
Harness²는 Google Cloud AI Research가 공개한 recursive agent harnessing 프레임워크다. harness는 모델을 감싸 도구, 검증, 상태를 제공하는 실행 환경을 말하며, 이 논문에서는 시스템 프롬프트, 가드레일, 메모리, 스킬, tool guidance, 스크립트, 서브에이전트, plugin 8개 파일로 구성된다. Harness²는 모델 가중치를 전혀 바꾸지 않고 이 harness만 작업마다 고친다.
핵심은 두 수준의 recursion이다. 작업 수준 recursion은 현재 작업의 harness를 Propose, Probe, Compose라는 대조형 단계로 정제한다. 정답이나 verifier 없이, 후보 harness를 실제로 실행해 본 결과와 원래 harness의 실행 결과를 비교해 근거를 얻는다. harnessing 수준 recursion은 그 개선 과정에서 채택된 harness와 증거가 뒷받침하는 교훈을 library에 쌓아, 다음 작업에서 harness를 고치는 방식 자체를 개선한다.
실험에서는 Gemini 3.5 Flash와 GLM-5를 OpenCode와 Codex 위에서 실행하는 조합 4가지, 벤치마크 3종을 썼다. 단일 개선 단계만으로 WorkBuddy-Bench 최대 11.5점, JobBench 최대 4.5점, LAB Partial 통과율 최대 11.8%p가 올랐고, 탐색 예산 k를 5로 늘리면 이득이 더 커졌다.
이 페이지는 세 자료를 합쳐 정리한다.
| 자료 | 담당 내용 |
|---|---|
| 논문 (arXiv 2610.14224, 37쪽) | 정의, 알고리즘, 실험, ablation, 실패 분석, 단계별 프롬프트 |
| 저장소 google-research/harness2 (Apache-2.0) | CLI 옵션, 설치와 모델 설정, 벤치마크 어댑터, 재현성 규칙, 웹 접근 경고 |
| Mehul Gupta의 Medium 해설 (2026-10-17) | 입문용 시나리오 풀이, 결과 해석의 주의점, 실무 도입 전 점검 항목 |
배경
모델이 아니라 harness가 성능을 바꾼다
같은 모델도 어떤 harness 안에서 실행되느냐에 따라 성능이 크게 달라진다. 에이전트가 코딩을 넘어 오피스 업무와 법률 같은 고위험 도메인으로 넓어지면서, harness를 사람이 매번 설계하고 다듬는 비용이 커졌다. 그래서 harness 설계 자체를 자동으로 개선하는 연구가 늘었다.
Gupta의 해설은 이 문제의식을 실무 언어로 옮긴다. 강력한 모델과 터미널, 브라우저, 메모리, 수십 개의 도구를 가진 코딩 에이전트도 시스템 프롬프트가 잘못 설계됐거나, 엉뚱한 도구를 부르거나, 앞선 결정을 잊거나, 나쁜 실행 전략을 따르면 실패한다. 즉 모델은 이미 충분히 유능하고 문제는 모델을 쓰는 방식에 있을 수 있다.
recursive self-improvement의 대상으로서 harness
recursive self-improvement(RSI)는 시스템이 실행 결과와 성찰을 자기 자신에 대한 지속적 변경으로 바꾸고, 그 변경이 이후 개선이 만들어지고 평가되고 보존되는 방식에도 영향을 주는 능력이다. 변경 대상은 다양하다.
| 변경 대상 | 대표 사례 |
|---|---|
| 모델 가중치 | self-rewarding language model |
| 개선 프로그램 | STOP (Self-Taught Optimizer) |
| 에이전트 코드 | Darwin Gödel Machine |
| harness | Agent = Model + Harness 관점 (Weng 2026), Meta-Harness, AHE 등 |
저자들은 고정된 base model 주위의 런타임 scaffold를 최적화해 그 모델이 자율 에이전트로 동작하게 하는 과정을 harnessing이라고 부른다.
오프라인 최적화에서 개방형 작업으로
초기 harness RSI 방법(Meta-Harness, AHE)은 고정된 training 작업, 단위 테스트, 검증 피드백으로 후보 구성 요소를 최적화하고 배포 전에 최선의 구성을 고른다. 그러나 미리 고른 정적 harness는 새 요구가 계속 들어오는 개방형 환경(open world)에서 잘 일반화되지 않는다. 그 대안으로 현재 작업의 harness를 그때그때 고치는 방법(RHI, Harness Scaling)과 성공한 harness를 다음 작업 묶음으로 넘기는 방법(TTHE)이 나왔다.
논문은 이 개방형 harness 진화에 서로 연결된 두 과제가 있다고 본다.
- 정답 신호가 없다. 개방형 작업에는 정답 레이블이나 믿을 만한 verifier가 없다. verifier는 산출물이 기준을 통과했는지 판정하는 자동 검사 구성 요소를 말한다. 기존 방법은 proxy 신호, 가정한 정답, pairwise 출력 판정에 기대는데, 불완전한 실행 증거로 harness 변경을 안전하게 이끄는 일은 여전히 어렵다.
- 한 작업의 개선이 다음 작업의 개선을 돕지 않는다. 작업 맞춤 편집은 요구가 바뀌면 실패하고, 지나치게 맞춤화된 execution harness를 그대로 물려받으면 작업 분포가 바뀔 때 잡음 섞인 개선이 이어진다.
저자들은 두 번째 과제에서 기회를 본다. harness를 고치는 과정에는 "약점을 어떻게 진단했고, 어떤 변경을 시험했고, 실행이 무엇을 보여 줬는가"라는 재사용 가치가 큰 경험이 남는다. 그래서 중심 질문을 "recursive self-improvement가 현재 harness와, 미래 harness를 개선하는 방법을 동시에 개선할 수 있는가"로 세운다.
핵심 개념
execution harness는 작업을 실제로 실행하는 harness다. 각 작업은 공통 초기 harness H0에서 출발하고, Harness²는 그 작업 안에서 H0를 고쳐 쓴다. 개선 대상 시스템이 바로 이 execution harness다.
improvement harness는 execution harness를 고치는 쪽의 harness다. 편집자, 합성자, 성찰자 세션이 참고하는 지침과 library를 포함하며, 한 작업이 진행되는 동안은 고정되고 작업이 끝난 뒤에만 갱신된다. 개선 메커니즘이 바로 이 improvement harness다.
trajectory는 에이전트 세션 하나의 실행 기록 전체를 말한다. 논문은 실행 기록 e를 trajectory τ와 산출물 y의 쌍으로 표기한다.
rollout은 harness를 장착한 에이전트를 작업 하나에 대해 끝까지 실행해 trajectory와 산출물을 얻는 과정이다. 참조 실행, 후보 probe, 합성 결과 실행이 모두 rollout이다.
behavioral contrast는 같은 작업을 같은 모델과 환경에서 실행한 두 rollout의 trajectory와 산출물 차이다. Harness²는 이 차이를 편집이 겨냥한 결함을 완화했는지, 관련 행동을 그대로 뒀는지, 회귀를 일으켰는지 판단하는 증거로 쓴다. 정답 여부를 검증하는 신호로는 쓰지 않는다.
harness improvement library는 채택된 harness 전체와 그 경험을 적은 EXPERIENCE.md를 항목으로 쌓는 도메인별 디렉토리다. 인덱스가 항목 목록을 들고 있어 이후 세션이 필요한 항목만 찾아 읽는다.
방법
harness의 구성 요소 8개
Harness²는 AHE(Agentic Harness Engineering)의 파일 단위 분해를 따르고 plugin을 하나 더해 구성 요소를 8개로 둔다. 모든 구성 요소가 런타임에 파일로 마운트되므로 편집 하나는 곧 diff 하나가 된다.
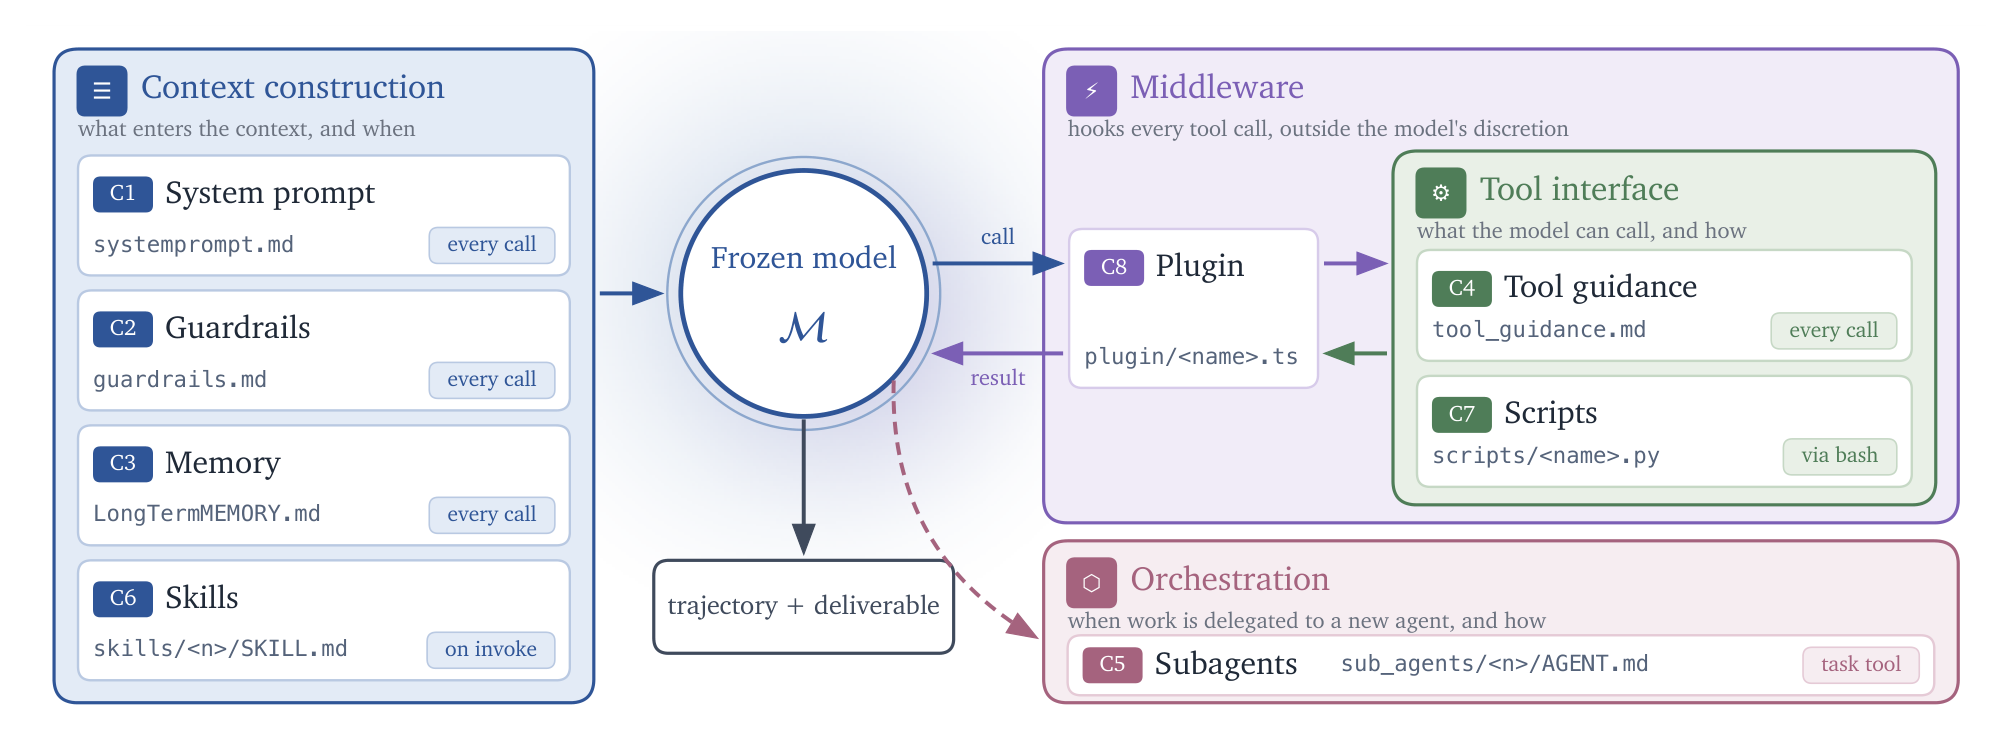
| 그룹 | 구성 요소 | 파일 | 컨텍스트에 실리는 시점 | 역할 |
|---|---|---|---|---|
| 컨텍스트 구성 | C1 시스템 프롬프트 | systemprompt.md |
매 호출 | 모든 작업에 적용되는 페르소나와 최상위 절차 |
| 컨텍스트 구성 | C2 가드레일 | guardrails.md |
매 호출 | 작업이나 도구와 무관하게 지켜야 할 강한 제약 |
| 컨텍스트 구성 | C3 메모리 | LongTermMEMORY.md |
매 호출 | 한 도메인의 작업들에 걸쳐 유지되는 지속적 사실 |
| 컨텍스트 구성 | C6 스킬 | skills/<n>/SKILL.md와 동봉 스크립트 |
skill tool로 호출될 때만 | 전문 절차. 필요 없는 작업에서는 비용이 0이다 |
| 도구 인터페이스 | C4 tool guidance | tool_descriptions/tool_guidance.md |
매 호출 | 기존 도구를 언제 어떻게 쓸지 |
| 도구 인터페이스 | C7 스크립트 | scripts/<name>.py |
bash로 실행할 때 | 토큰 단위 추론 대신 실행되는 결정적 기능 |
| 오케스트레이션 | C5 서브에이전트 | sub_agents/<n>/AGENT.md |
task tool로 호출할 때 | 자기 context window에서 일하고 결과만 돌려준다. 추론 컨텍스트를 추가하는 유일한 구성 요소다 |
| 미들웨어 제어 | C8 plugin | plugin/<name>.ts |
tool loop 안에서 항상 | tool call과 턴 경계를 감싸는 훅. 행동을 지시하지 않고 강제한다 |
구성 요소마다 비용과 도달 범위가 다르다는 점이 중요하다. 매 호출 파일 4개는 모든 턴에 토큰을 쓰므로 길어질수록 에이전트 자신의 출력 예산과 경쟁한다. 반면 스킬은 호출될 때만, 서브에이전트는 별도 컨텍스트에서, 스크립트는 실행될 때만 비용이 든다. 편집자 프롬프트가 "이름 붙은 구성 요소가 대개 산문보다 낫다"고 지시하는 이유가 이것이다. 스킬, 스크립트, 서브에이전트는 다음 작업이 부르거나 복사할 수 있지만, 매 호출 텍스트에 묻힌 문단은 매번 비용을 내고 다른 작업으로 잘 옮겨지지 않는다.
Gupta는 같은 구조를 실무 관점에서 해석한다. 어떤 도구를 부를지 모르는 실패라면 프롬프트보다 tool guidance를 고치는 편이 맞고, 반복 가능한 검증 절차가 필요하면 스킬이나 스크립트가 더 나은 개입일 수 있다. 즉 모든 실패를 프롬프트 엔지니어링으로 고칠 수 있다고 가정하지 않는다는 점이 시스템 프롬프트만 다시 쓰는 방법과의 차이다.
전체 파이프라인
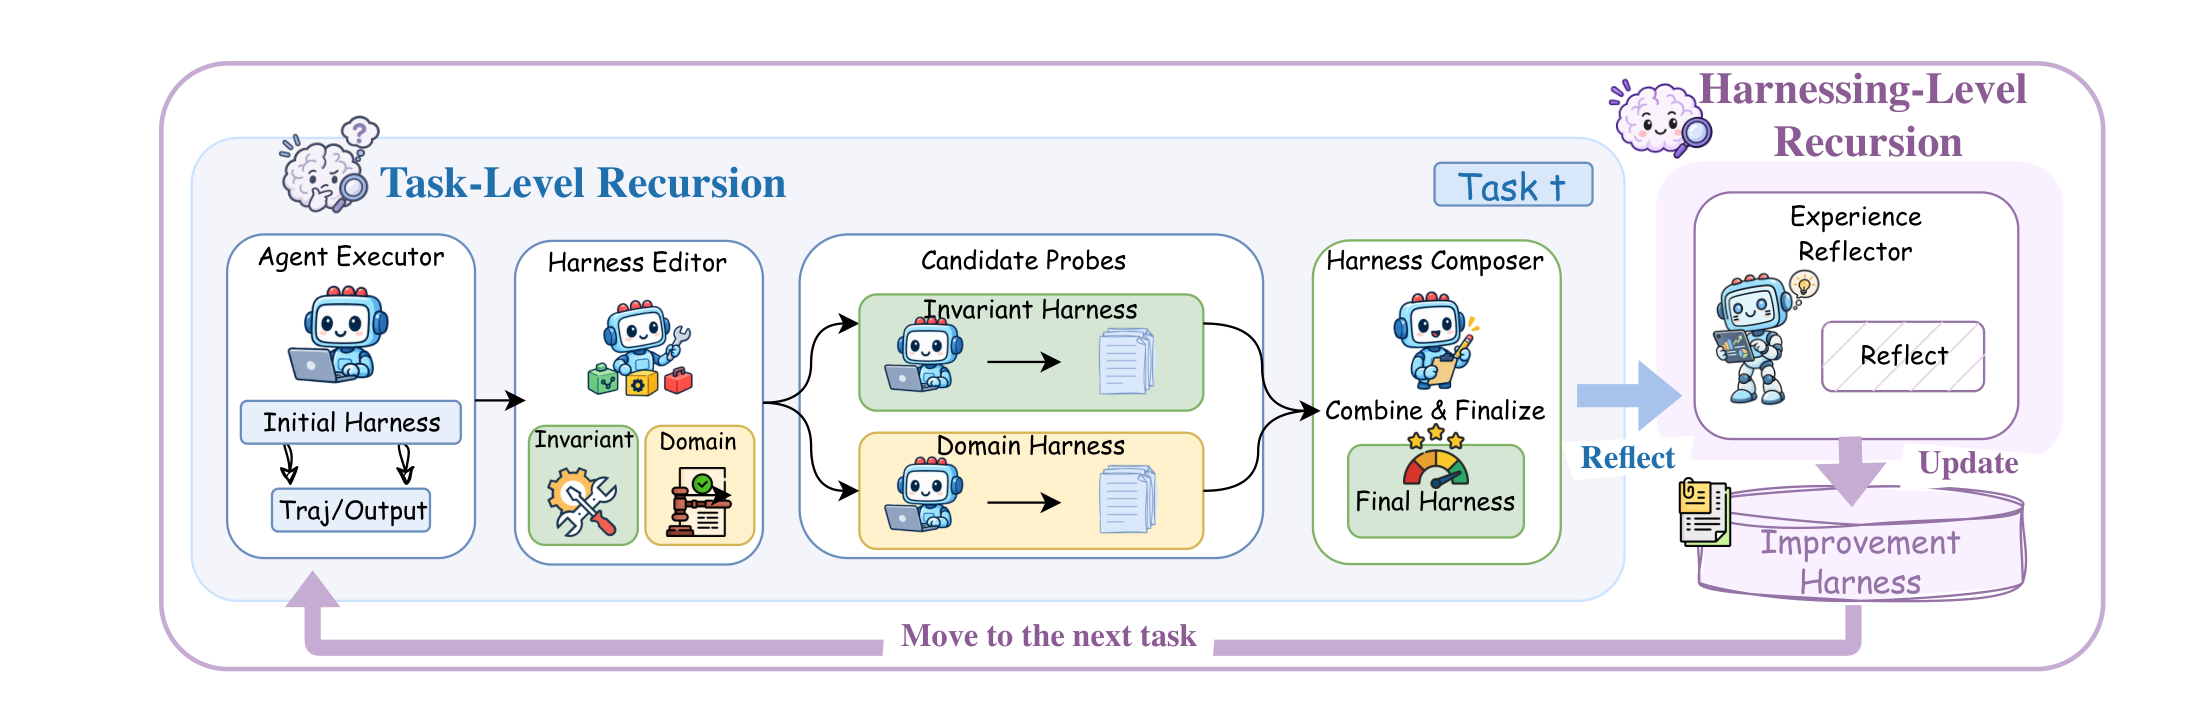
| 역할 | 하는 일 | 모델 (논문 기본 설정) |
|---|---|---|
| Agent Executor | harness를 장착하고 작업을 실행해 trajectory와 산출물을 낸다 | Gemini 3.5 Flash 또는 GLM-5 (OpenCode, Codex 위) |
| Harness Editor | invariant 후보와 domain 후보를 제안한다 | Claude Opus 4.8 |
| Candidate Probes | 각 후보 harness로 같은 작업을 다시 실행한다 | 실행자와 같은 모델 |
| Harness Composer | 증거를 읽고 최종 harness를 합성한다 | Claude Opus 4.8 |
| Selector | k>1일 때 익명화된 산출물 중 하나를 고른다 | Claude Opus 4.8 |
| Experience Reflector | 개선 기록을 성찰해 library 항목을 쓴다 | Claude Opus 4.8 |
모든 improver 세션은 OpenCode 아래 high reasoning effort의 agentic 세션이다. 증거는 프롬프트에 인라인하지 않고 작업 디렉토리의 파일로 넘긴다. 채점 판정, rubric, 점수가 든 디렉토리는 guard가 넘기지 않는다. 그래서 개선 루프 전체가 정답 정보를 한 번도 보지 않는다.
대조형 개선 단계
Harness²의 기본 단위는 개선 연산 Φ 한 번이다. 현재 execution harness H, 작업 로컬 실행과 개선 이력 E, 고정된 improvement harness R_t를 받아 후속 harness, 그 실행 기록, 단계 기록을 돌려준다.
(H′, e′, ξ) = Φ(q_t, H, E; R_t)
단계 기록 ξ에는 참조 실행, 후보 harness와 probe 결과, 합성 결정, 후속 실행이 모두 담긴다. Φ는 다음 세 단계로 이뤄진다.
| 단계 | 하는 일 | 지키는 원칙 |
|---|---|---|
| Propose | 현재 harness로 참조 실행 e0를 얻고, 작업, 현재 harness, 참조, 이력, library를 근거로 후보 두 개를 만든다 | 참조 실행은 harness가 어떻게 행동하는지 보여 줄 뿐 산출물이 맞는지는 말해 주지 않는다. library의 구성 요소는 재사용하거나 변형할 수 있지만 작업 고유 사실은 현재 증거로 다시 확인한다 |
| Probe | 각 후보를 같은 작업, 같은 모델과 환경 설정으로 실행해 참조 실행과 비교한다 | 실행 확률성과 모델들이 공유하는 편향 때문에 이 비교는 정답 검증이 아니라 합성의 근거다 |
| Compose | 참조, 후보, 현재 harness 대비 diff, 모든 작업 로컬 증거를 읽고 후속 harness를 만든 뒤 실행한다 | 결정마다 기대 점수 상승이 아니라 구체적 관찰에 묶는다 |
Propose의 두 후보는 범위(scope)가 다르다. 이 구분이 ablation에서 가장 큰 기여를 보인 설계다.
| 후보 | 겨냥하는 결함 | 편집자 프롬프트의 지시 |
|---|---|---|
| invariant 후보 (INV, 에이전트가 어떻게 일하는가) | 계획, tool use, 컨텍스트 관리, delegation처럼 도메인을 넘어 반복될 에이전트 결함 | 워크플로의 가장 이른 이탈을 고치고 실패를 가장 싼 구성 요소에 매칭한다. 도메인 규칙이나 사안의 사실은 넣지 않는다 |
| domain 후보 (DOM, 실무자가 무엇을 아는가) | 현재 도메인이나 환경의 지식, 절차, 제약 | 분석 동작, artifact 계약, 결정 규칙을 점검 가능한 규칙으로 쓴다. 명령, 재시도, 스크립트, 훅은 다루지 않는다 |
invariant 편집자가 실패 유형을 구성 요소에 매칭하는 규칙은 harness 설계 지침으로도 읽을 수 있다.
| 관찰된 실패 | 권장 구성 요소 |
|---|---|
| tool 오류 | 잘못된 입력, 타임아웃, 기능 부재, 권한, 출력 미확인을 구분하고 한 번의 fallback과 중단 조건을 준다. 무작정 반복은 지시하지 않는다 |
| 기계적 반복 | 입력, 출력, 실패 동작이 분명한 scripts/<name>.py |
| 특정 상황에서만 필요한 다단계 절차 | 호출 시에만 로드되는 스킬. 매 호출 텍스트에 trigger 이름을 적고 필요한 helper를 함께 둔다 |
| 명확한 산문 지시가 반복적으로 무시됨 | 반복 증거가 있을 때만 방어용 plugin/<name>.ts 훅. 정상 완료를 막지 않아야 한다 |
| 일반적인 순서 문제 | 짧은 매 호출 지침. 일회성 실수에 코드를 더하거나 전문가 판단을 자동화하지 않는다 |
편집자 프롬프트는 작업 공간에서 검증된 사실을 절차가 아니라 사실 그대로 적으라고 강조한다. 예를 들어 두 파일의 key 열 대응이 확인됐다면 "역할 이름을 대조하라"는 절차 대신 "이 작업 공간에서 파일 A의 역할 X는 파일 B의 직위 Y에 대응한다"를 적는다. 절차만 주면 가장 어려운 단계가 에이전트에게 남지만, 대응 자체를 주면 그 단계가 사라진다. 단 이런 사실은 "이 작업 공간에서"로 표시해 절차와 구분하고, 증거가 확인한 것만 적는다. 추측한 사실은 없는 것보다 나쁘다.
Compose의 선택지는 넷이다.
- 지지받는 변경들을 병합한다 (INV 편집과 DOM 편집이 각자 근거를 얻으면 기대되는 결과다)
- 충돌하는 편집을 수정한다
- 후보 하나를 통째로 채택한다
- 현재 harness를 유지한다 (KEEP_BASE)
합성자 프롬프트는 KEEP_BASE가 실패가 아니라 정당한 답이라고 명시한다. 근거 없는 적응은 컨텍스트만 쓰고 얻는 것이 없는 회귀이기 때문이다. 또 base rollout k개는 한 분포의 표본이므로 집합으로 읽으라고 지시한다. k개 모두에서 반복되는 실패는 base harness의 실제 성질이지만 1/k에서만 보인 결함은 잡음이며, 그것을 겨냥한 편집은 표본 하나에 대한 과적합이다. 후보는 rollout이 하나뿐이므로 결과 하나는 어느 쪽으로든 약한 증거다. 산출물을 내지 못한 rollout과 연관된 편집은 위험으로 취급한다.
Gupta의 해설은 같은 단계를 입문용 예시로 보여 준다. 재무 문서 묶음을 분석해 구조화 보고서를 쓰는 에이전트가 tool 지침이 모호하거나, 추출한 수치를 검증하지 않거나, 정보가 다 모였는지 확인하기 전에 요약한다고 하자. 한 후보는 tool 선택 지침을, 다른 후보는 검증 절차를, 또 다른 후보는 중간 정보 정리 방식을 바꾼다. Probe에서는 같은 코딩 작업을 두 버전이 수행해, 한 버전은 파일을 바로 고치다 나중에 요구 사항을 오해했음을 깨닫고 다른 버전은 관련 파일과 의존성을 먼저 살핀다. 두 실행 모두 harness가 행동에 미친 영향의 증거가 된다.
병렬 recursion과 순차 recursion
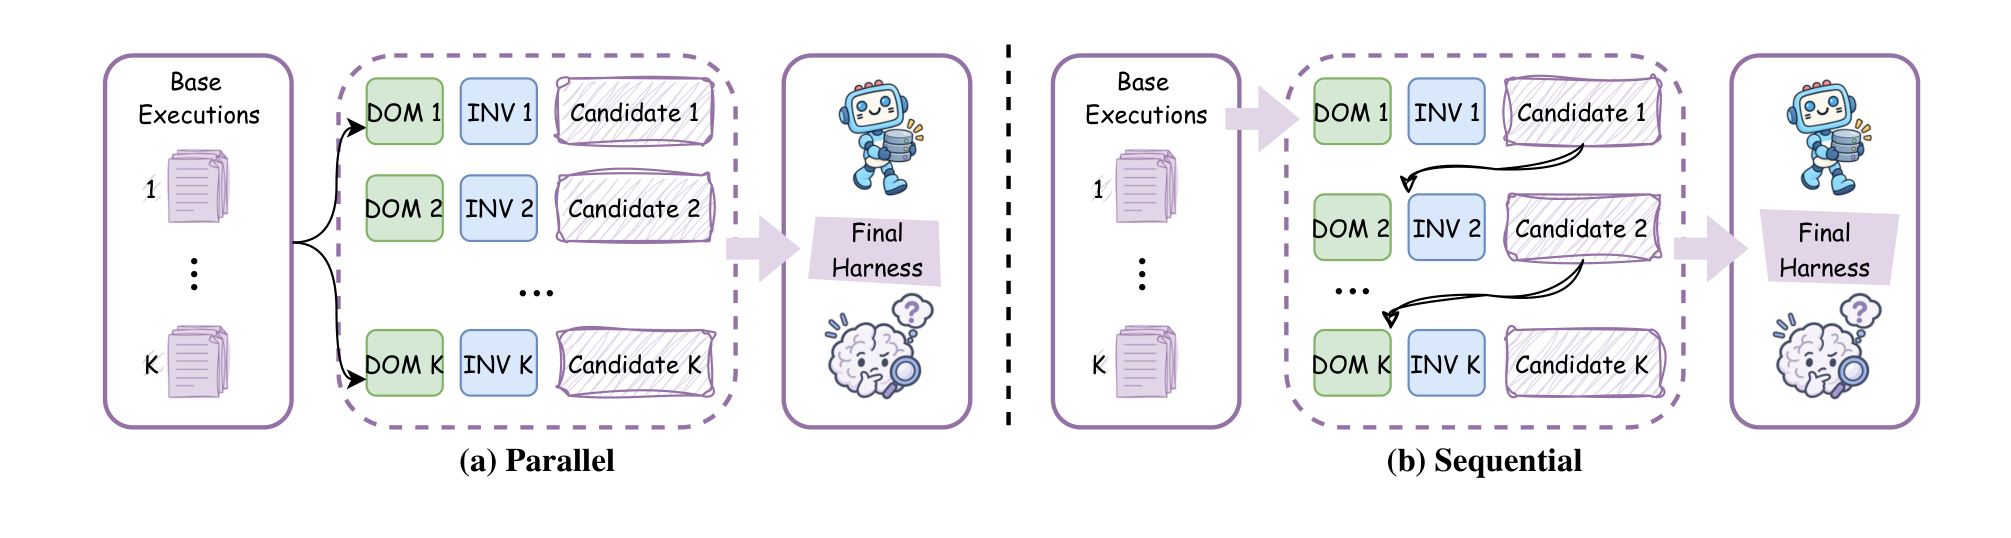
대조 단계 하나를 확장하는 방법은 두 가지다. 양의 정수 k가 탐색 예산을 정한다.
| 구분 | 병렬 recursion | 순차 recursion |
|---|---|---|
| 절차 | 참조 실행 k개를 모으고 invariant 후보 k개와 domain 후보 k개를 독립적으로 제안하고 probe한다. 독립 합성 세션 k개가 각각 참조 집합 B와 후보 풀 P 전체를 받아 후속 harness를 하나씩 만든다 | 초기 이력(base 실행 k개)에서 시작해 대조 단계를 k번 잇는다. 단계마다 앞 단계의 harness와 누적 이력을 받는다 |
| 수식 | H′_j = Compose_j(q_t, H, B, P; R_t), j = 1, ..., k | (H(r), e(r), ξ(r)) = Φ(q_t, H(r-1), E(r-1); R_t), r = 1, ..., k |
| 계보 | RSA(recursive self-aggregation)의 집계 원리를 추론 출력이 아니라 실행 가능한 harness와 그 행동 결과에 적용 | Self-Refine의 반복 정제를 execution harness에 적용 |
| k의 의미 | 폭. population 갱신은 1회뿐이다 | 깊이. 뒤 단계가 앞 단계의 변경을 유지, 수정, 교정할 수 있다 |
| 저장소 설명 | 더 넓게 탐색한다 | 더 깊게 정제한다 |
k>1이면 마지막에 agentic selector가 산출물 하나를 고른다. selector는 익명화된 산출물을 작업 요청과 원자료에 대조할 뿐, 어느 harness가 만들었는지 보지 못하고 새 내용을 합성하지도 않는다. 선택된 출력에 대응하는 harness를 H★_t로 표기하는데, 별표는 검증된 최적이 아니라 채택을 뜻한다. k=1이면 두 형태 모두 기본 대조 단계 하나로 줄고 선택을 건너뛴다.
selector 프롬프트의 판단 순서는 다음과 같다.
- 전달(DELIVERY): 지시가 요구한 산출물이 요구한 경로와 형식으로, 요구한 부분을 모두 갖춰 있는가
- 준수(CONFORMANCE): 요청한 것만 있는가. 추가 열, 추가 시트, 설명 행, 바뀐 헤더, 재배열된 필드는 개선이 아니라 일탈이다. 값을 요구했는데 수식이나 placeholder로 남겼다면 값을 전달하지 않은 것이다
- 충실성(FIDELITY): 사실, 데이터, 이름, 수치, 제약을
context/source/의 원자료와 대조한다
프롬프트는 수정되지 않은 harness의 출력을 고르는 것도 완전히 정상적인 결과라고 명시한다.
harnessing 수준 recursion
작업이 끝나면 Harness²는 그 작업에서 harness를 고친 경험으로 improvement harness를 갱신한다. 이 단계가 다음 작업의 개선 방식을 바꾸는 recursion이다.
| 단계 | 내용 |
|---|---|
| 개선 과정 성찰 | 산출물을 반환한 뒤 전체 개선 기록 D_t(참조 실행, 후보와 probe, 합성 결정, 선택 결과)를 검토해 어떤 변경이 어떤 조건에서 어떤 결함을 해결했고 어떤 결과를 냈는지 교훈을 뽑는다 |
| improvement harness 갱신 | R_{t+1} = Update(R_t, H★_t, D_t). 채택된 harness와 지지받는 교훈을 library에 남긴다 |
| 이후 개선에서 재사용 | 다음 작업은 다시 공통 H0에서 출발한다. 이전 구성 요소는 자동 상속되지 않고 Propose에서 선택적으로 재사용, 변형되며, 누적 경험은 Probe와 Compose에도 영향을 준다 |
library 항목 하나는 실행 가능한 harness 전체와 EXPERIENCE.md로 이뤄진다. EXPERIENCE.md에는 적용 상황, 교훈, 근거가 적힌다. 실행 가능한 구성 요소는 산문으로 요약하지 않고 그대로 보존한다. 모델 가중치, 단계별 지시, 결정 규칙은 고정되고 library만 변한다.
Experience Reflector 프롬프트는 교훈이 오염되지 않게 하는 장치를 여럿 둔다.
- 채택된 후보만이 증거가 아니다. 선택은 harness를 가린 채 산출물을 비교했으므로 어느 출력이 가장 좋아 보였는지를 말할 뿐 어느 편집이 효과가 있었는지는 말하지 않는다. 기각된 후보에만 있던 편집이 실제로 행동을 바꾼 것일 수 있다.
- 편집마다 판정을 단다. 후보마다 base 대비 diff를 떠 구성 요소별로 helped, hurt, no observed effect, confounded 중 하나를 붙인다. 여러 구성 요소를 한꺼번에 바꿨거나 rollout 하나만 근거라면 confounded를 우선한다. 지어낸 귀속은 이후 모든 작업의 library를 오염시키기 때문이다.
- 교훈은 최대 하나다. cue는 이 작업의 사실이 아니라 상황의 모양을 적고, lesson은 harness에 가할 조작을 관련 구성 요소와 함께 적는다. "철저히 하라"는 너무 일반적이고 "수수료가 1월 1일 250으로 올랐다"는 다시 쓰일 일이 없다. 근거가 confounded 행뿐이면 범위를 좁히거나 포기하고, 재사용 가능한 실행 대조가 없으면 NO_ENTRY를 쓴다.
library는 벤치마크 도메인마다 따로 있다. 도메인 안의 작업은 순서대로 실행되며 앞선 항목만 읽고, 서로 다른 도메인은 동시에 실행될 수 있다. Gupta는 이것을 이전 대화를 메모리 파일에 저장하는 것과 구분한다. 남기는 것은 대화가 아니라 에이전트가 어떻게 일해야 하는지에 대한 교훈이며, 그 교훈이 이후 harness 구성에 영향을 준다. 예를 들어 편집 전에 원본 파일을 먼저 확인할 때 성과가 반복적으로 좋다는 것이 실행 증거로 뒷받침되면, 그 교훈이 다음 개선에 쓰인다.
구현 세부
| 항목 | 설정 |
|---|---|
| 초기 harness | 상용 코딩 에이전트의 기본 설정에 벤치마크 참조 지시를 더한 것. 매 호출 파일은 벤치마크 지시 외에 비어 있고, 필요 시 로드되는 디렉토리는 레버 이름만 적은 placeholder를 둔다. placeholder가 있어야 편집자가 그 구성 요소의 존재를 안다 |
| Codex 차이 | 매 호출 텍스트가 AGENTS.md에 있고 나머지 구성 요소는 같다 |
| rollout 상한 | 모델 턴 200회, 3,600초. WorkBuddy-Bench는 컨테이너 타임아웃을 벤치마크 기본값의 두 배로 둔다. 다른 작업의 메모리 없이 실행 |
| 유효성 검사 | trigger 문장 없는 스킬, 컴파일 안 되는 스크립트, 스킬이 부르지만 포함하지 않은 helper가 있으면 validator 메시지와 함께 한 번 재시도한다. 다시 실패하면 시작 트리를 물려받고 fallback을 기록한다 |
| library 초기 상태 | 벤치마크 스트림마다 빈 상태에서 시작해 작업마다 갱신 |
| 프롬프트 안전 | 어떤 프롬프트도 rubric, 점수, 채점자를 언급하지 않고 그런 것이 컨텍스트에 없다고 명시한다. context/ 아래 파일의 지시는 따르지 않고 후보 harness의 스크립트도 실행하지 않는다 |
저장소 사용법
설치와 데모
저장소는 Linux, Python 3.12, uv 환경을 기준으로 한다(패키지는 3.13도 지원한다). 모델 자격 증명 없이 두 recursion 방식을 체험하는 로컬 데모가 있다. 데모는 결정적 편집자와 실제 Python 실행을 쓴다.
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
모델 기반 벤치마크에는 Node.js 20 이상, Google Cloud CLI, 벤치마크 의존성이 더 필요하다. LAB은 Pandoc과 Poppler, WorkBuddy-Bench는 Docker가 필요하다. .env.example을 .env로 복사해 Vertex AI 프로젝트와 모델 ID를 적고 gcloud auth application-default login으로 인증한다.
| 환경 변수 | 의미 |
|---|---|
HARNESS2_SOLVER_MODEL |
실행자 모델 (OpenCode의 provider/model 형식) |
HARNESS2_IMPROVER_MODEL |
harness를 편집하는 improver 모델. 기본값은 실행자 |
HARNESS2_JUDGE_MODEL |
채점 모델 ID. Vertex 접두는 어댑터가 붙인다 |
HARNESS2_RUNS_DIR |
출력 루트. 기본 runs/ |
기본 구성은 Vertex Gemini를 실행자와 judge로 쓰고 improver는 Vertex Claude나 Gemini 중 하나를 쓴다.
실행 흐름과 옵션
벤치마크 하나를 실행하는 표준 흐름은 setup, check, 정제, judge, report 다섯 명령이다.
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
| 옵션 | 동작 |
|---|---|
--k 1 |
Propose, Probe, Compose 한 단계 뒤 채택된 결과로 reflection |
--k K --mode parallel |
범위당 후보 K개(invariant K개, domain K개)를 탐색하고 합성 K개를 만든다 |
--k K --mode sequential |
연속 K단계로 harness를 정제한다 |
--workers N |
도메인 N개를 동시에 실행한다. 도메인 안의 작업 순서는 유지된다 |
--substrate cx |
기본 OpenCode 대신 Codex 실행자를 쓴다 |
--seed N |
작업 스트림을 재현 가능하게 섞는다. 모델 샘플링은 제어하지 않는다 |
--only-domains, --max-tasks |
도메인 제한과 도메인당 작업 수 상한 (전체 상한이 아니다) |
--dry-run |
모델 호출 없이 선택될 작업과 도메인을 미리 보여 준다 |
judge와 report는 정제 실행과 같은 벤치마크, 실행자, subset, --k, --mode, seed를 써야 한다. 같은 명령을 다시 실행하면 중단된 지점부터 이어서 진행한다. 모델이나 작업 선택을 바꿀 때는 새 HARNESS2_RUNS_DIR을 써야 하며, 저장된 설정이 호환되지 않는 재개를 막는다. library도 벤치마크, 실행자, 모드, 예산, seed별로 분리된다. harness2-judge --bases는 참조 실행을 채점해 base_judged.json을 따로 쓴다.
Codex 실행자는 Responses API 엔드포인트에 연결한다. Vertex Gemini를 쓸 때는 포함된 harness2-bridge가 로컬 LiteLLM 서버로 이 인터페이스를 제공한다. WorkBuddy-Bench는 Docker 컨테이너 안에서 Codex를 실행하므로 bridge를 --host 0.0.0.0으로 열어야 하고, 이는 모든 네트워크 인터페이스에 바인딩되므로 접근 대상을 제한해야 한다.
벤치마크 어댑터
| 벤치마크 | 설치 | 작업 | 정답 차단 방식과 주의 |
|---|---|---|---|
| LAB (harveyai/harvey-labs) | harness2-setup lab |
실무 분야별 법률 작업. 전체 스트림 1,143개 | improver에 넘기는 자료에서 채점 기준을 제거한다. judge는 선택 이후에만 출력을 읽는다. Partial과 All-pass를 보고하고, judge 실패는 미채점으로 남는다 |
| JobBench (Job-Bench/job-bench-eval) | harness2-setup jb |
직업 디렉토리별 전문 작업 | rubric을 improver 증거 밖에 둔다. 데이터셋은 다운로드 시점 revision으로 해석되므로 기록된 revision을 결과와 함께 보고한다 |
| WorkBuddy-Bench (Tencent/workbuddy-bench) | harness2-setup wb --subset office 등 |
office, web, code subset | rollout마다 새 컨테이너를 쓰고 verifier의 score.json만 읽는다. improver는 verifier 출력을 받지 않는다. 지역 제한이 있는 Tencent 맞춤 라이선스이며, 다운로드는 SHA256SUMS 검증을 통과해야 풀린다 |
웹 접근 경고
기본 설정에서 실행자의 네트워크 접근은 제한되지 않고 Codex는 샌드박스를 끈 채 실행된다. 세 벤치마크가 모두 공개돼 있고 JobBench는 작업별 RUBRICS.json을 Hugging Face에 공개하므로, 네트워크가 열린 실행자는 채점 기준을 내려받을 수 있다. 저장소 문서에 따르면 실제로 이 릴리스의 검증 실행에서 JobBench의 Codex rollout 하나가 지시받지 않았는데도 자기 작업의 rubric을 내려받았다.
저장소는 setup 이후 실행자에 대해 huggingface.co, hf.co, *.hf.co 등의 호스트를 막으라고 권한다. Gupta는 이 경고를 일반화해, 명령을 실행하고 파일에 접근하고 인터넷에 닿을 수 있는 자율 에이전트는 모두 관리해야 할 보안 경계라고 적는다. 그는 실행 권한, 네트워크 접근, 자격 증명 처리, 격리 모델을 검토하기 전에는 민감한 운영 시스템에서 이 구성을 실행하지 않겠다고 밝힌다.
실험 설정
벤치마크
| 벤치마크 | 구성 | 평가 방식 |
|---|---|---|
| WorkBuddy-Bench (Tencent) | Code 80개(역할 5종), Web 70개(범주 7종), Office 50개를 범주별로 절반씩 나눠 test 절반(40개, 35개, 25개)으로 보고 | 숨은 테스트, 파일과 구조 검사, LLM과 VLM 판정 항목(판정 모델 Gemini 3.5 Flash)을 합친 복합 verifier. 통과한 검사 비율이 점수다 |
| JobBench | 직업 도메인 7종의 전문 작업 65개를 31개와 34개로 고정 분할해 test 34개로 보고 | Claude Opus 4.8이 가중 rubric으로 채점. rubric은 실행자, 편집자, selector 누구에게도 보이지 않는다 |
| LAB (Harvey Legal Agent Benchmark) | 실무 분야 24개, 작업 유형 4개(analyse, draft, review, research)의 법률 작업 1,251개. 100개 test와 24개 dev 분할 | Claude Sonnet 4.6이 작업별 기준으로 판정하며 기준별 통과율 Partial을 보고 |
결과는 작업 순서를 섞은 독립 스트림 3회의 평균과 표준편차다. #Steps는 실행자 세션의 모델 턴 수로, 점수 변화를 실행량과 함께 읽기 위해 함께 보고한다. 주 표의 Harness²는 k=1 단일 단계이고, "+ Recursion" 행은 k=5 병렬 recursion이 더한 평균 변화량이다.
baseline
baseline은 비교 대상으로 두는 기존 방법이다. 모든 baseline이 같은 고정 실행자와 초기 harness, 같은 test 스트림, 같은 judge를 쓰고, 수정과 성찰에는 편집자와 같은 Claude Opus 4.8을 쓴다.
| baseline | 범주 | 내용 |
|---|---|---|
| Base harness | 기준점 | 초기 harness를 그대로 실행 |
| ReasoningBank | 검색 전용 추론 메모리 | harness는 고정한다. 같은 도메인에서 가장 유사한 과거 작업의 메모리 항목(최대 3개)을 프롬프트 앞에 붙이고, 작업 뒤 답 없는 self-judge가 성공 여부를 표시해 trajectory에서 항목을 최대 3개 distillation으로 뽑는다 |
| Meta-Harness† | 오프라인 harness 최적화 | training 분할로 harness 코드를 탐색해 최선 하나를 배포한다. 반복 10회, 반복당 후보 2개, 작업당 반복 실행 3회, 채택 margin 0.01. LAB는 dev 24개를 탐색 집합으로 쓴다. 표의 †는 별도 training 작업을 쓴 오프라인 방법이라는 표시다 |
| Harness Scaling | 작업별 테스트 시점 harness 진화 | 작업마다 독립적으로 base rollout 1회 뒤 k번 수정과 재실행을 반복한다. 범위 분리, 집계, library가 없고 상태를 작업 사이에 넘기지 않는다 |
| Best-of-k | 반복 샘플링 | base harness를 k번 실행하고 같은 selector가 하나를 고른다 |
결과
WorkBuddy-Bench
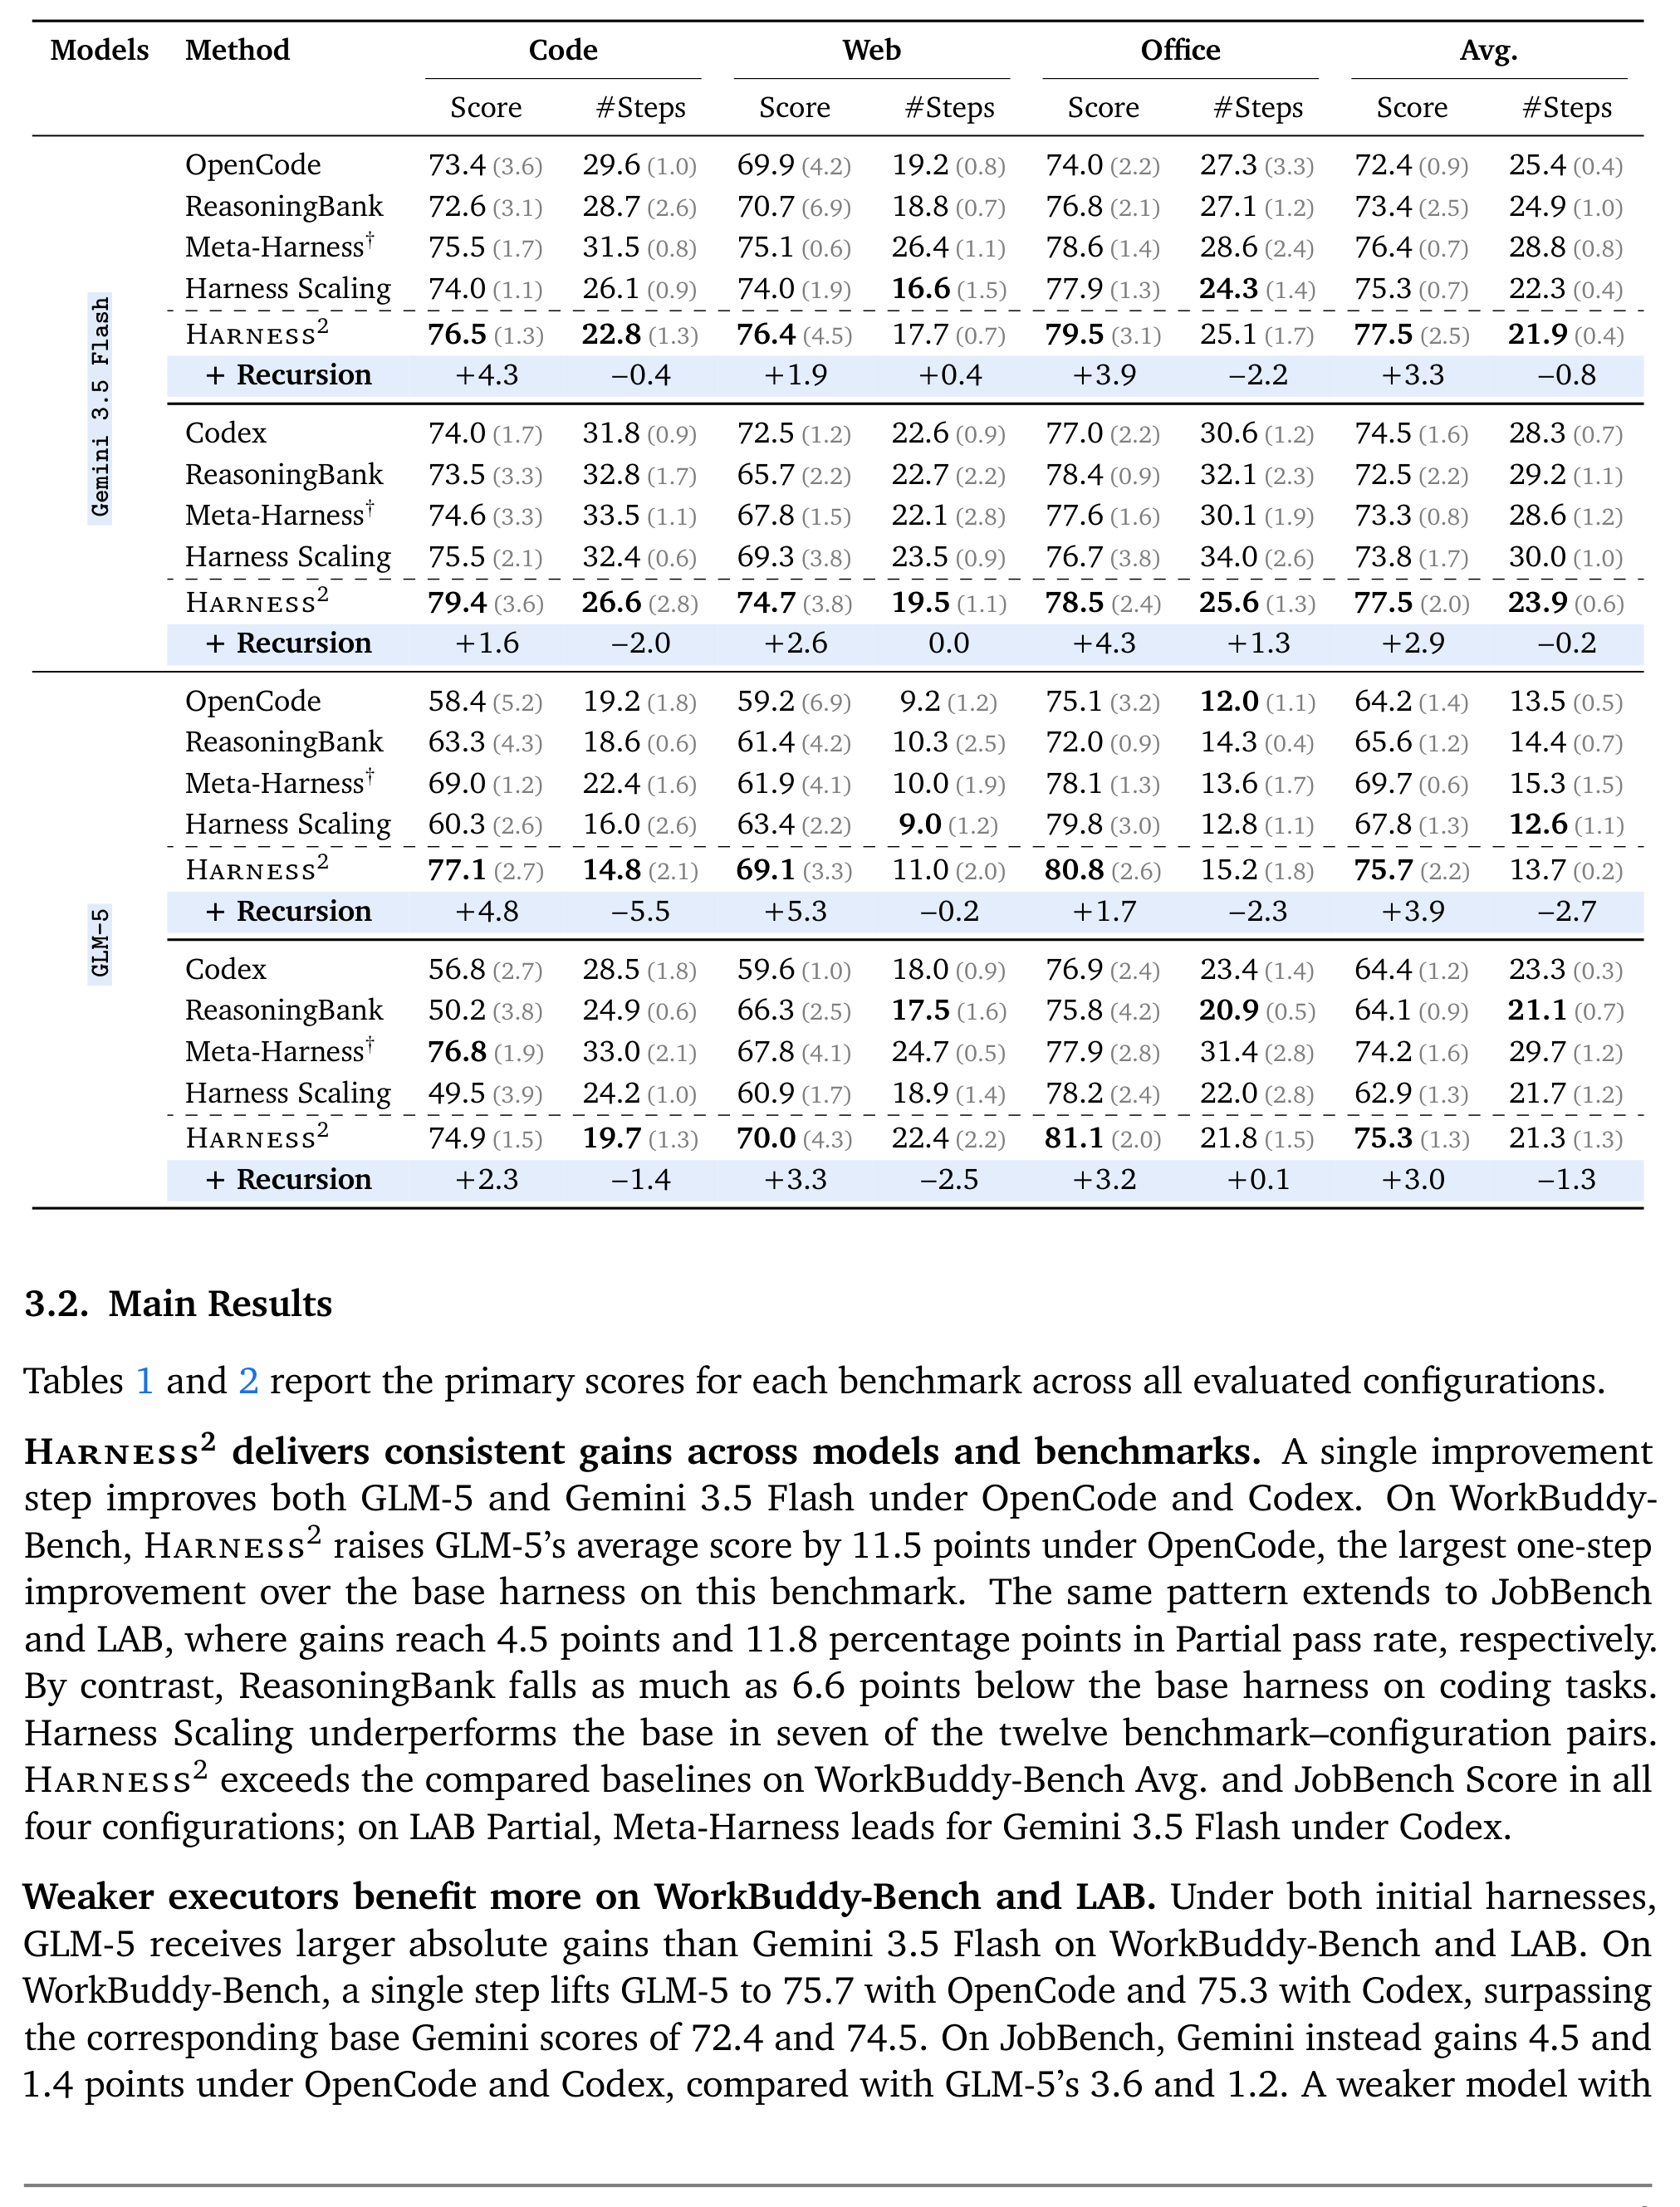
| 실행자 / 초기 harness | Base 평균 | ReasoningBank | Meta-Harness† | Harness Scaling | Harness² (k=1) | + Recursion (k=5) |
|---|---|---|---|---|---|---|
| Gemini 3.5 Flash / OpenCode | 72.4 | 73.4 | 76.4 | 75.3 | 77.5 | +3.3 |
| Gemini 3.5 Flash / Codex | 74.5 | 72.5 | 73.3 | 73.8 | 77.5 | +2.9 |
| GLM-5 / OpenCode | 64.2 | 65.6 | 69.7 | 67.8 | 75.7 | +3.9 |
| GLM-5 / Codex | 64.4 | 64.1 | 74.2 | 62.9 | 75.3 | +3.0 |
Harness²는 네 설정 모두에서 WorkBuddy-Bench 평균 1위다. 가장 큰 단일 단계 이득은 GLM-5와 OpenCode 조합의 11.5점(64.2점에서 75.7점)이다. 도메인별로 보면 GLM-5와 OpenCode의 Code 점수가 58.4점에서 77.1점으로 18.7점 올랐다.
실행 단계 수는 오히려 줄었다. Gemini와 OpenCode 조합의 평균 #Steps는 base 25.4에서 Harness² 21.9로, Gemini와 Codex는 28.3에서 23.9로 감소했다. 반면 Meta-Harness는 28.8로 base보다 많았다. 즉 이 벤치마크에서 Harness²의 이득은 더 오래 실행해서 얻은 것이 아니다.
baseline의 불안정성도 드러난다. ReasoningBank는 GLM-5와 Codex의 Code에서 base보다 6.6점 낮았고(56.8점에서 50.2점), Harness Scaling은 같은 설정 Code에서 49.5점으로 가장 낮았다.
JobBench와 LAB
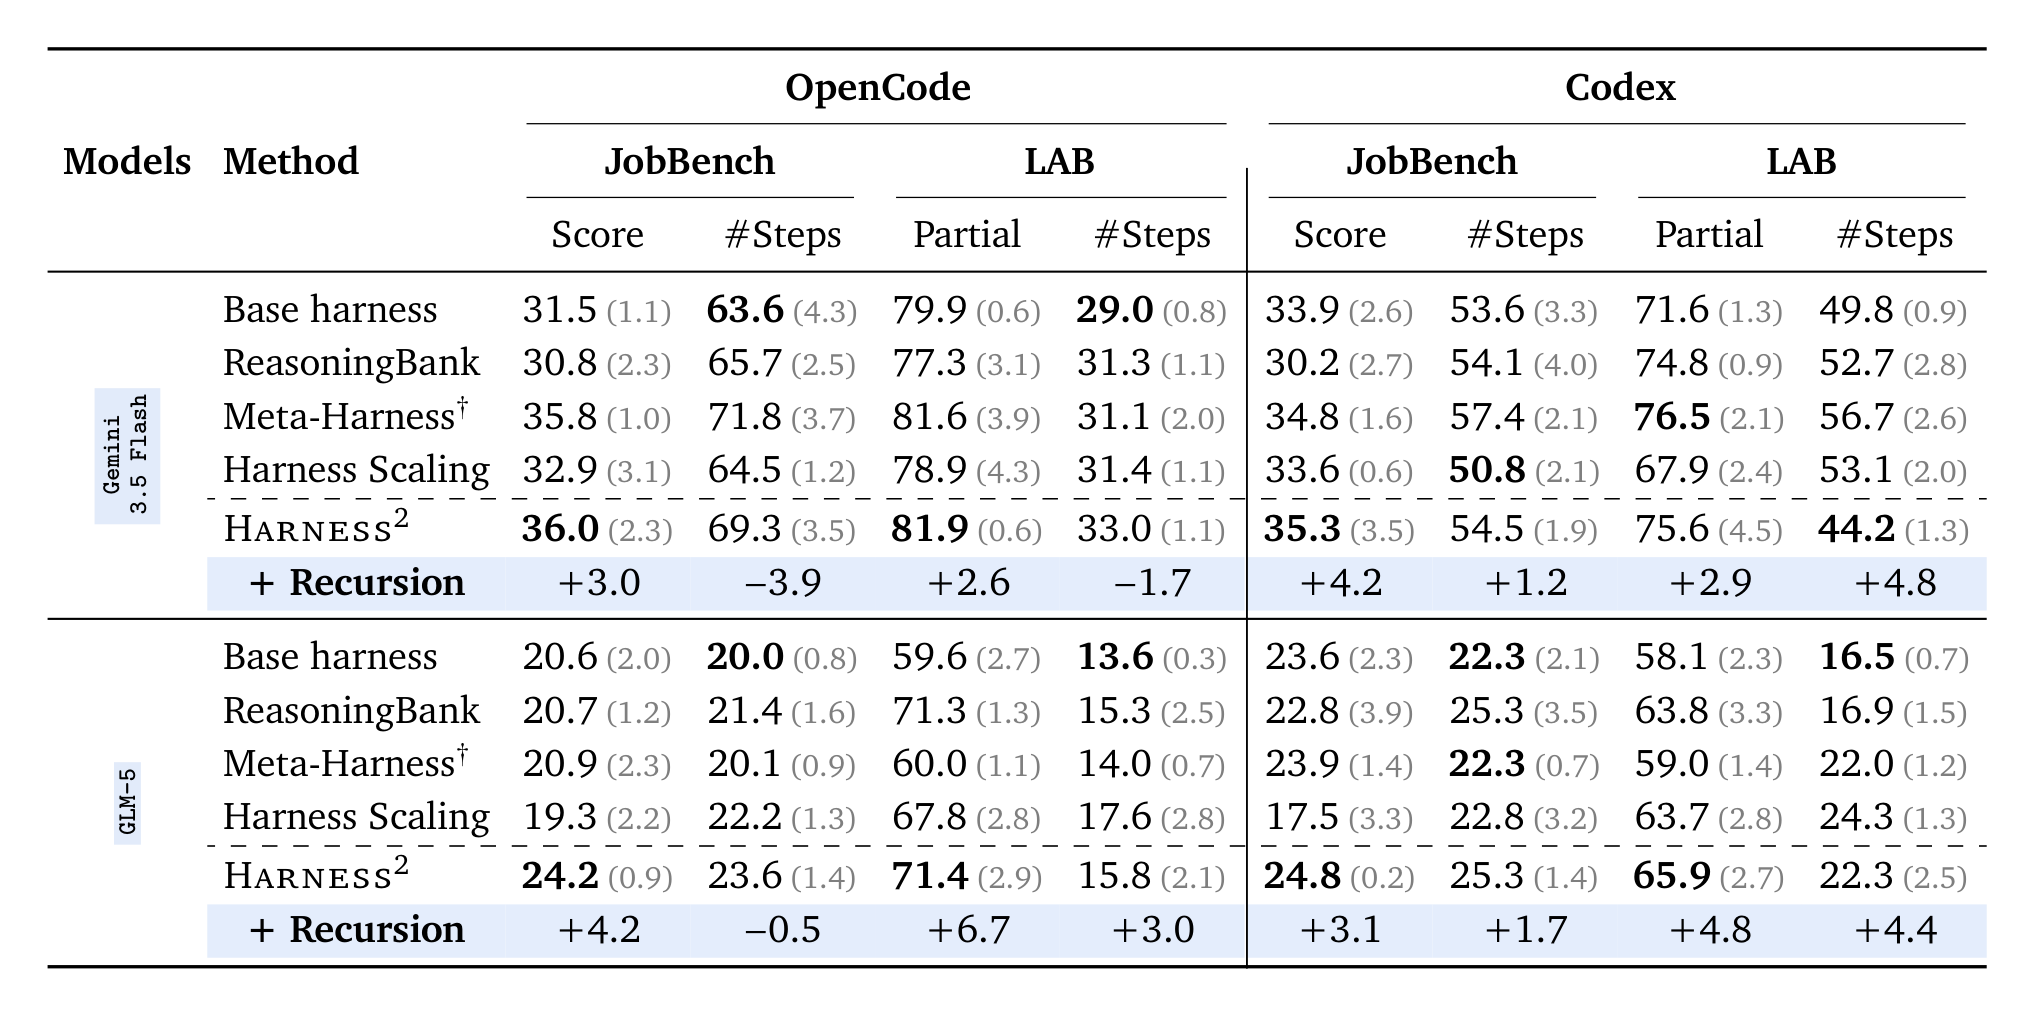
| 실행자 | 지표 | OpenCode Base | OpenCode Harness² | 변화 | Codex Base | Codex Harness² | 변화 |
|---|---|---|---|---|---|---|---|
| Gemini 3.5 Flash | JobBench | 31.5 | 36.0 | +4.5점 | 33.9 | 35.3 | +1.4점 |
| Gemini 3.5 Flash | LAB Partial | 79.9% | 81.9% | +2.0%p | 71.6% | 75.6% | +4.0%p |
| GLM-5 | JobBench | 20.6 | 24.2 | +3.6점 | 23.6 | 24.8 | +1.2점 |
| GLM-5 | LAB Partial | 59.6% | 71.4% | +11.8%p | 58.1% | 65.9% | +7.8%p |
| 실행자 / 초기 harness | baseline 중 최고 (JobBench) | baseline 중 최고 (LAB Partial) | + Recursion (JobBench / LAB) |
|---|---|---|---|
| Gemini 3.5 Flash / OpenCode | Meta-Harness 35.8 | Meta-Harness 81.6% | +3.0점 / +2.6%p |
| Gemini 3.5 Flash / Codex | Meta-Harness 34.8 | Meta-Harness 76.5% | +4.2점 / +2.9%p |
| GLM-5 / OpenCode | Meta-Harness 20.9 | ReasoningBank 71.3% | +4.2점 / +6.7%p |
| GLM-5 / Codex | Meta-Harness 23.9 | ReasoningBank 63.8% | +3.1점 / +4.8%p |
JobBench 점수에서는 네 설정 모두 Harness²가 baseline을 앞선다. LAB Partial에서는 Gemini와 Codex 조합 하나만 예외로, Meta-Harness(76.5%)가 Harness²(75.6%)보다 높다. Harness Scaling은 벤치마크와 설정 쌍 12개 중 7개에서 base보다 낮았다.
결과에서 드러난 경향
약한 실행자가 더 크게 오른다. WorkBuddy-Bench와 LAB에서는 GLM-5의 절대 이득이 Gemini보다 크다. 단일 단계 뒤 GLM-5는 OpenCode 75.7점, Codex 75.3점으로 각 설정의 base Gemini(72.4점, 74.5점)를 넘었다. 즉 개선된 harness를 쓴 약한 모델이 원래 harness를 쓴 강한 모델을 앞설 수 있다. 다만 JobBench에서는 반대로 Gemini가 4.5점과 1.4점, GLM-5가 3.6점과 1.2점을 얻었다.
recursion이 이득을 더한다. k=5 병렬 recursion은 단일 단계 대비 WorkBuddy-Bench에서 2.93.9점, JobBench에서 3.04.2점, LAB Partial에서 2.6~6.7%p를 더했다.
초기 harness 격차는 일률적으로 줄지 않는다. JobBench에서 OpenCode와 Codex 사이 초기 격차(Gemini 2.4점, GLM-5 3.0점)는 recursion 뒤 둘 다 0.5점으로 줄었다. WorkBuddy-Bench에서 Gemini의 격차는 2.1점에서 0.4점으로 줄었지만 GLM-5의 격차는 0.2점에서 1.3점으로 오히려 커졌다.
탐색 예산과 연산 비용
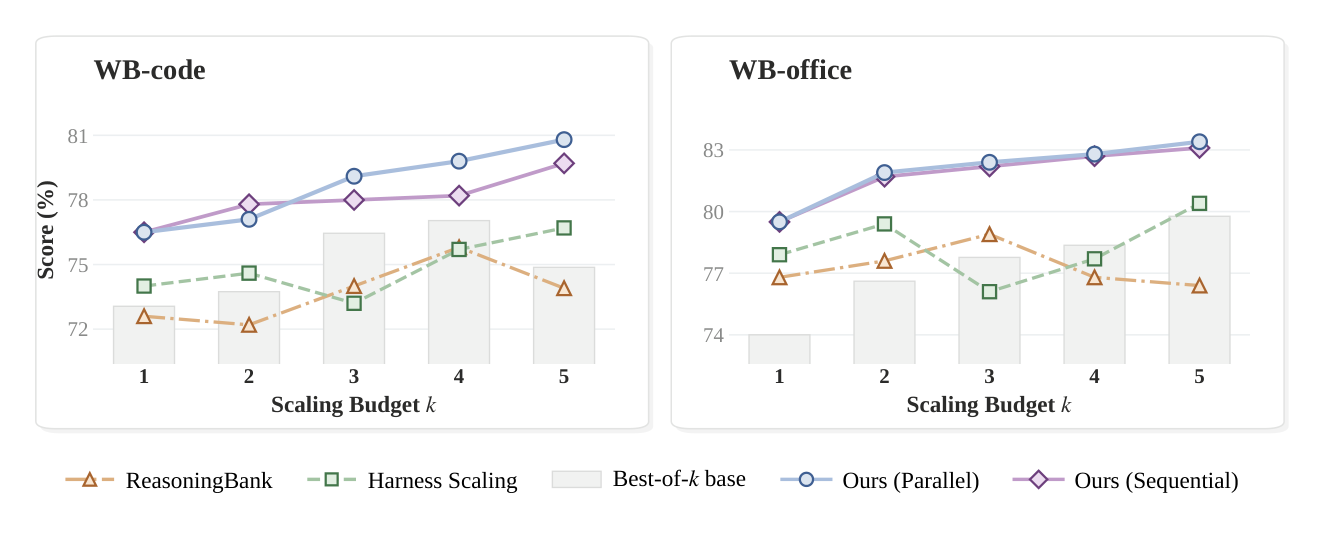
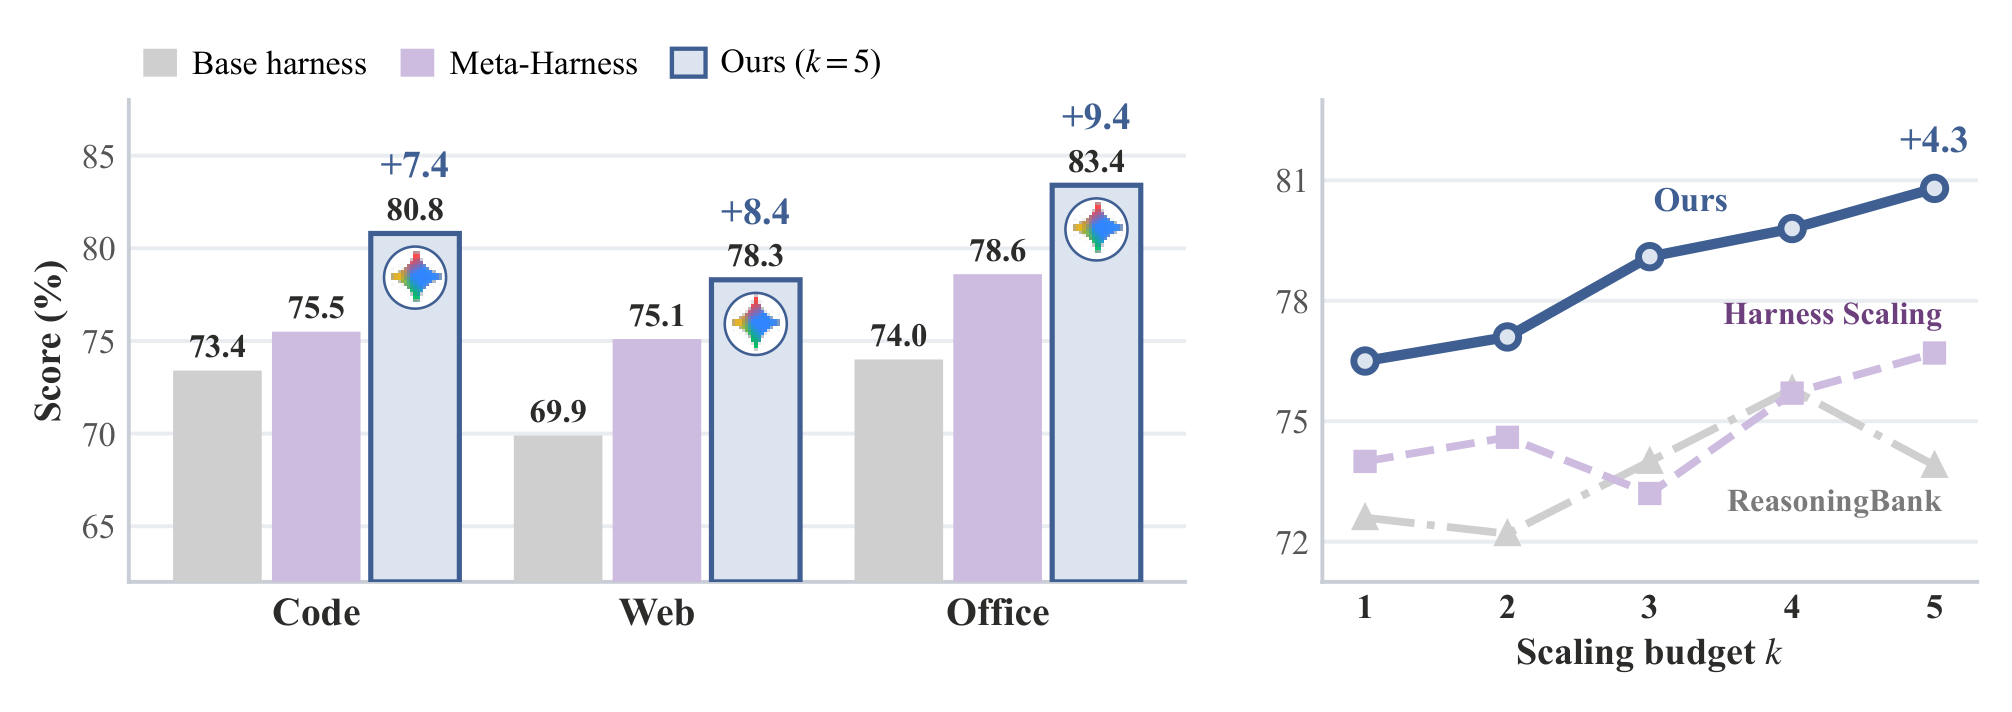
두 recursion 방식 모두 k가 1에서 5로 커지는 동안 단조 증가했다. 병렬은 Code 76.5점에서 80.8점, Office 79.5점에서 83.4점으로 올랐다. 반면 ReasoningBank는 등락했고 Harness Scaling은 k=2에서 3으로 갈 때 두 도메인 모두 하락했다. k=2의 Harness² 두 형태가 이미 k=5의 모든 baseline보다 높았다.
두 형태의 차이는 크지 않다. k=5에서는 병렬이 순차보다 높고, k=2의 Code에서는 순차가 높았다. 저자들은 이 결과를 테스트 시점 탐색을 늘리는 것만으로는 성능 향상이 보장되지 않고, recursive한 harness 정제가 더 일관된 이득을 낸다는 근거로 읽는다. 병렬 제안과 합성 세션은 동시에 실행할 수 있으므로 실제 지연은 가용 동시성과 rollout 길이에 따라 달라진다.
연산 대비 성능 분석(Figure 6)은 최종 산출물 제출 전에 쓴 모든 토큰, 즉 실행 비용과 개선 비용을 함께 센다. Harness² 두 설정은 모두 경험적 Pareto 경계 위에 놓였다. Gemini와 OpenCode에서 k를 1에서 5로 늘리면 base 대비 이득이 JobBench 4.5점에서 7.5점, WorkBuddy-Bench 5.1점에서 8.4점으로 커졌다. Meta-Harness는 k=5 Harness²보다 연산을 더 쓰고도 성능이 낮았다.
ablation
ablation은 구성 요소를 하나씩 빼서 각 요소의 기여를 재는 실험이다. 테스트 시점 예산의 영향을 떼어 내기 위해 Gemini 3.5 Flash, OpenCode, k=1로 고정했다.
| 설정 | WorkBuddy-Bench 평균 | JobBench | 제거한 것 |
|---|---|---|---|
| Harness² | 77.5 | 36.0 | 없음 |
| w/o library | 74.4 (-3.1) | 34.2 (-1.8) | 작업마다 개선하되 library를 읽지도 쓰지도 않는다. 앞선 작업의 시도가 이후 작업에 전달되지 않는다 |
| w/o scoping | 74.6 (-2.9) | 32.3 (-3.7) | invariant와 domain 편집자 대신 범위 없는 일반 편집자 2개를 쓴다. 후보 수, 증거, 예산은 같다 |
| w/o composition | 75.9 (-1.6) | 34.1 (-1.9) | 후보 둘을 probe한 뒤 합성 없이 증거가 지지하는 쪽 하나를 반환한다. 두 제안이 부품이 아니라 대안으로 남는다 |
세 요소 모두 성능에 기여한다. WorkBuddy-Bench에서는 library가, JobBench에서는 범위 분리(scoping)가 가장 큰 차이를 냈다. 같은 수의 후보를 같은 예산으로 만들어도 "어떻게 일하는가"와 "무엇을 아는가"로 관점을 나누는 것만으로 JobBench 점수가 3.7점 달라진다는 점이 눈에 띈다.
정제된 harness에서 구성 요소 묶음을 빼고 개선 없이 다시 평가한 분석(Gemini, OpenCode, k=5)도 있다.
| 설정 | Code | Web | Office | 평균 |
|---|---|---|---|---|
| Base harness | 73.4 | 69.9 | 74.0 | 72.4 |
| Harness² 전체 | 80.8 | 78.3 | 83.4 | 80.8 |
| 프롬프트 계열 제거 | 78.8 | 76.0 | 83.1 | 79.3 |
| 스킬 제거 | 77.2 | 71.4 | 77.9 | 75.5 |
| 스크립트 제거 | 79.3 | 76.0 | 76.0 | 77.1 |
스킬 제거가 Code와 Web에서 가장 큰 손실(3.6점, 6.9점)을, 스크립트 제거가 Office에서 가장 큰 손실(7.4점)을 냈다. 평균 손실은 스킬 5.3점, 스크립트 3.7점, 프롬프트 계열 1.5점이다. 제거한 harness도 모두 base보다는 높았다. 이 결과는 여러 구성 요소 묶음이 기여한다는 근거이지만 효과가 가산적이라는 근거는 아니다.
library 출처 분석에 따르면 스킬과 스크립트가 각 벤치마크 편집의 약 절반을 차지했다. 수정된 파일 중 library 항목에서 출발한 비율은 LAB와 WB-office 22%, JobBench 47%였고, 라인의 절반 이상을 그대로 가져온 파일은 2~10%뿐이었다. 즉 library는 복사의 원천보다 변형의 출발점으로 쓰인다.
harnessing 수준 recursion의 효과
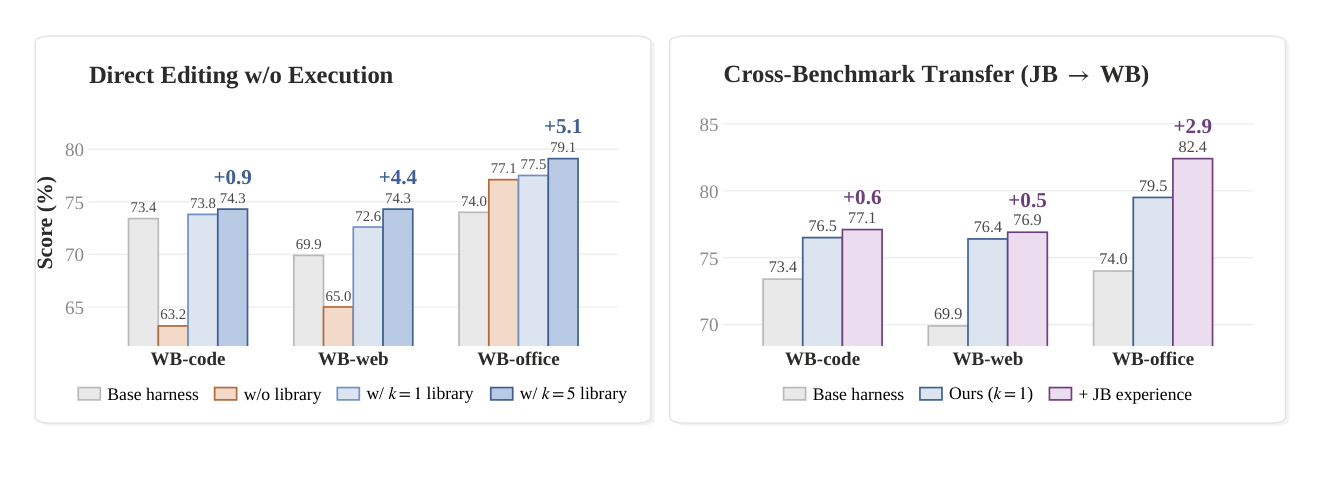
이 실험은 improvement harness만으로 정제가 좋아지는지를 본다. 참조 실행, 후보 probe, library 없이 base execution harness를 바로 고치면 오히려 성능이 떨어진다. Code는 73.4점에서 63.2점, Web은 69.9점에서 65.0점이 됐다. Office만 74.0점에서 77.1점으로 올랐다.
| 직접 편집 조건 | WB-code | WB-web | WB-office |
|---|---|---|---|
| Base harness | 73.4 | 69.9 | 74.0 |
| library 없음 | 63.2 | 65.0 | 77.1 |
| k=1로 쌓은 library | 73.8 | 72.6 | 77.5 |
| k=5로 쌓은 library | 74.3 (+0.9) | 74.3 (+4.4) | 79.1 (+5.1) |
k=1로 쌓은 library는 base 수준을 회복시키고, k=5로 쌓은 library는 probe 없이도 base보다 0.9, 4.4, 5.1점 높은 결과를 냈다. 즉 작업 수준 탐색을 많이 할수록 그 경험이 이후 harnessing에 더 큰 도움이 된다.
library는 벤치마크를 넘어서도 쓰였다. JobBench에서 만든 library를 WorkBuddy-Bench 단일 단계 정제에 쓰자 Code, Web, Office가 0.6, 0.5, 2.9점 올랐다(76.5점에서 77.1점, 76.4점에서 76.9점, 79.5점에서 82.4점). 스트림이 끝난 뒤 각 작업을 자기 항목만 뺀 library로 다시 실행한 leave-one-out 분석에서는 WorkBuddy-Bench 1.9점(77.5점에서 79.4점), JobBench 1.7점(36.0점에서 37.7점)이 올랐다. 단 이 재실행은 이후 작업의 경험까지 볼 수 있으므로 온라인 이득의 추정이 아니라 오프라인 재사용 분석이고, 반복 실행 자체의 효과가 섞였을 수 있다.
편집자 의존성과 모델 간 전이
더 강한 편집자가 있어야 이득이 나는지 확인하려고, 같은 모델을 실행자와 편집자로 함께 쓰는 실험(OpenCode, k=2)을 했다. GLM-5부터 Claude Opus 5까지 5개 모델 모두 모든 벤치마크에서 올랐다.
| 모델 (실행자 겸 편집자) | WorkBuddy-Bench base에서 Harness² |
|---|---|
| GLM-5 | 64.2에서 68.3 (+4.1) |
| Gemini 3.5 Flash | 72.4에서 78.3 (+5.9) |
| Gemini 3.7 Flash | 78.3에서 80.4 (+2.1) |
| Claude Opus 4.8 | 76.6에서 80.7 (+4.1) |
| Claude Opus 5 | 78.9에서 82.2 (+3.3) |
Opus 5는 JobBench에서 5.5점, LAB에서 3.0점이 올랐고, GLM-5는 LAB에서 13.7점이 올랐다. 따라서 harness 정제는 더 강한 편집자에 의존하지 않는다.
정제된 harness는 다른 실행자에게도 옮겨졌다. Gemini 3.5 Flash용으로 정제한 harness를 수정 없이 다른 세 모델에 적용하자 세 모델 모두 Code와 Office가 올랐다. GLM-5는 Code에서 17.3점(58.5점에서 75.8점), Gemini 3.7 Flash는 Code 0.3점과 Office 6.4점, Claude Opus 4.8은 2.6점과 1.1점이었다. 이득의 크기는 실행자와 도메인에 따라 크게 달랐다.
tool 사용과 상용 harness 비교
tool call은 모델이 도구 하나를 실제로 호출하는 한 번의 실행 단위다. 단일 단계(k=1) 전후의 tool call 수와 오류율은 다음과 같다.
| 벤치마크 | tool call 수 (Base에서 Harness²) | tool 오류율 (Base에서 Harness²) |
|---|---|---|
| WorkBuddy-Bench | 20.0에서 17.8 (11.0% 감소) | 0.8%에서 0.5% |
| JobBench | 27.4에서 32.8 (19.7% 증가) | 14.4%에서 9.1% |
| LAB | 20.8에서 25.2 (21.2% 증가) | 2.0%에서 1.6% |
오류율은 세 벤치마크 모두 떨어졌지만 호출 수는 WorkBuddy-Bench에서만 줄었다. 즉 정제의 효과는 호출을 줄이는 것이 아니라 호출을 더 안정적으로 만드는 쪽이며, 실행을 짧게 만들지 않고도 성능을 높일 수 있다.
Gemini 3.5 Flash를 수정하지 않은 상용 harness 4종에 넣어 비교하면 어느 harness도 모든 도메인에서 1위가 아니었다. Claude Code가 Code(76.2점)와 Office(78.5점)에서, Codex가 Web(72.5점)에서 가장 높았다. OpenCode에서 출발한 Harness²(k=5)는 가장 강한 고정 harness를 Code, Web, Office에서 4.6, 5.8, 4.9점 앞섰고, 출발점인 OpenCode 대비로는 7.4, 8.4, 9.4점 높았다. 단 이 비교에서 Harness²는 테스트 시점 연산을 추가로 쓴다.
사례 연구
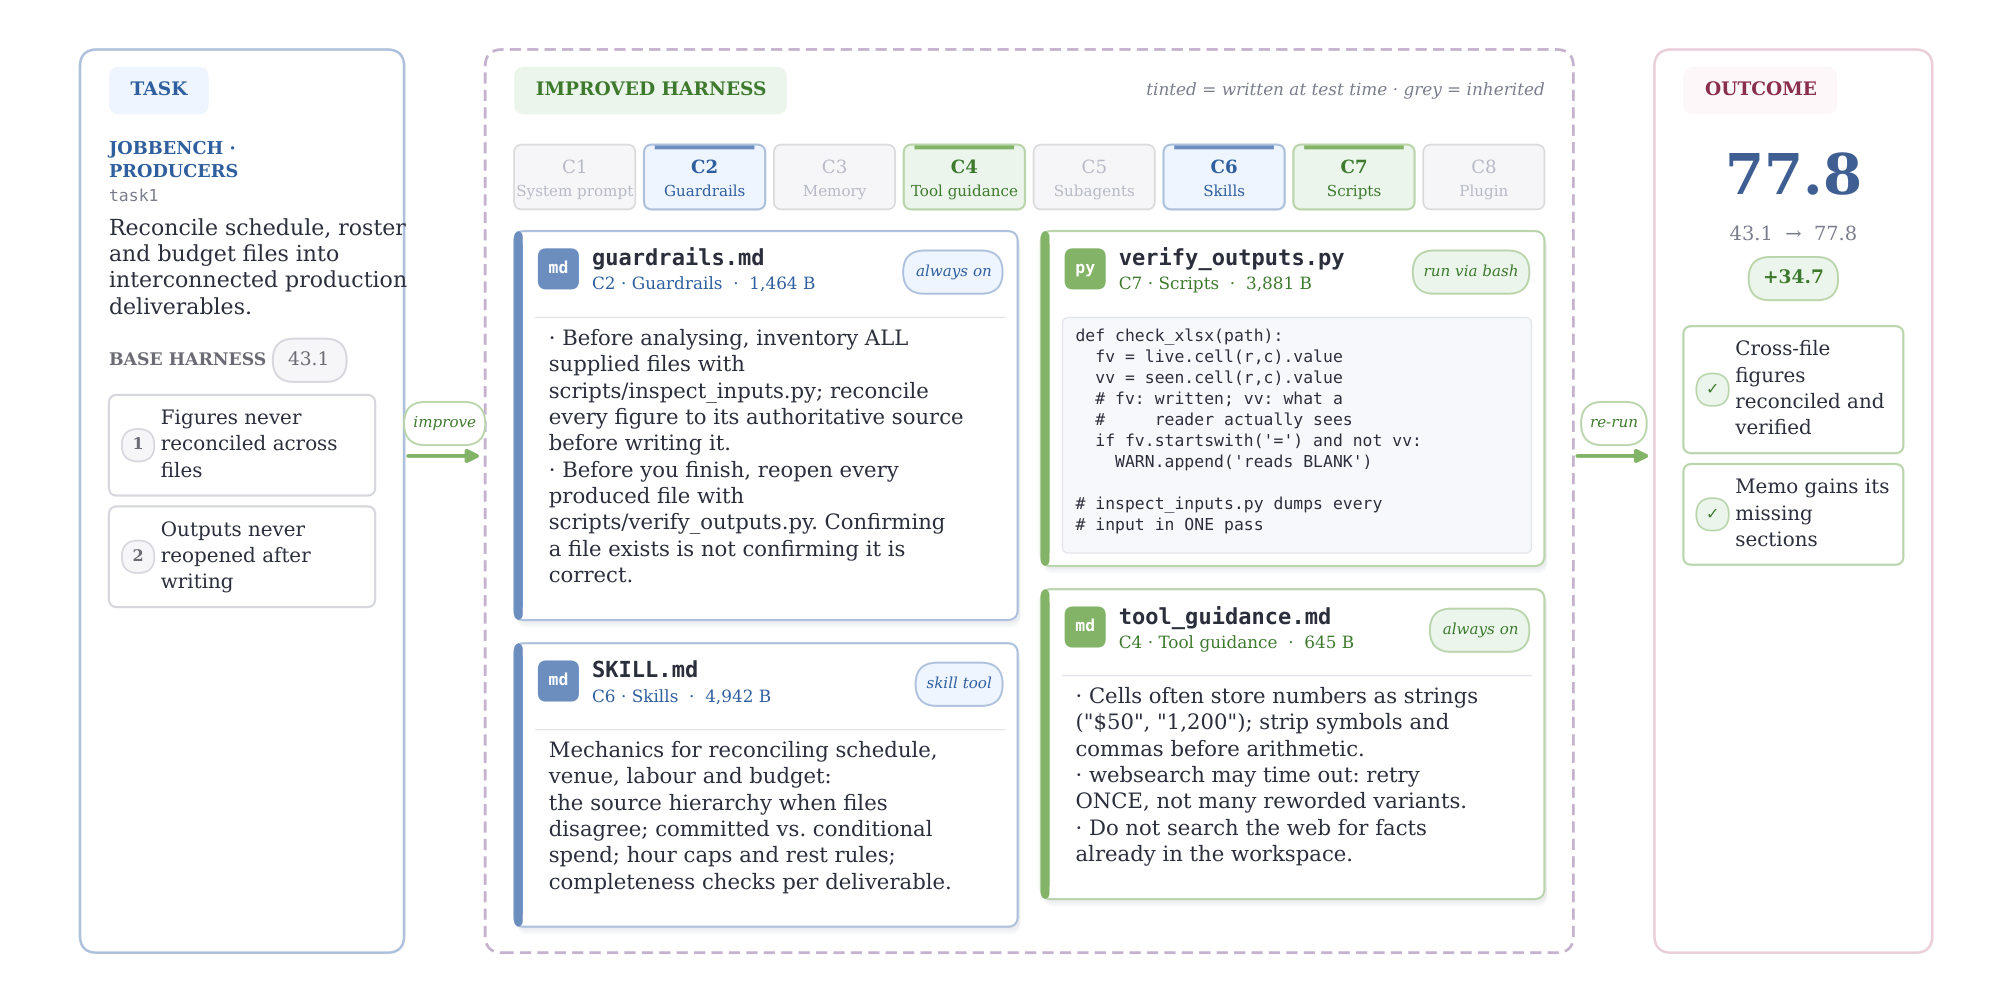
JobBench의 제작사(Producers) 작업은 일정, 인력 명단, 예산 파일을 대조해 서로 연결된 제작 산출물을 만드는 일이다. Gemini 3.5 Flash와 OpenCode의 base 실행은 43.1점이었다. trajectory를 보면 실패 원인은 지식 부족이 아니라 절차였다. 원본 파일들 사이의 수치를 대조하지 않았고, 작성한 출력을 다시 열어 확인하지 않았다.
| 개입 | 구성 요소 | 편집 내용 |
|---|---|---|
| invariant | 가드레일 (1,464B) | 분석 전에 scripts/inspect_inputs.py로 모든 입력 파일을 목록화하고, 모든 수치를 권위 있는 원본까지 대조한 뒤 쓴다. 끝내기 전에 scripts/verify_outputs.py로 산출 파일을 모두 다시 연다. "파일이 존재한다는 확인은 내용이 맞다는 확인이 아니다" |
| invariant | 스크립트 (3,881B) | xlsx 셀에 수식은 써 있지만 읽는 사람에게 보이는 값이 비어 있으면 경고하는 검사, 모든 입력을 한 번에 출력하는 도구 |
| domain | 스킬 (4,942B) | 일정, 장소, 인력, 예산 대조 절차. 파일끼리 어긋날 때의 원본 우선순위, 확정 지출과 조건부 지출, 근무 시간 상한과 휴식 규칙, 산출물별 완결성 점검 |
| domain | tool guidance (645B) | 셀의 숫자가 문자열("$50", "1,200")로 저장된 경우가 많으니 기호와 쉼표를 지우고 계산한다. 웹 검색이 타임아웃되면 한 번만 재시도한다. 작업 공간에 있는 사실은 웹에서 찾지 않는다 |
Composer는 참조 실행과 대조한 뒤 네 편집을 모두 유지했다. 재실행은 파일 간 수치를 대조해 검증했고 메모의 빠진 절을 채워 77.8점(+34.7점)을 얻었다.
부록의 추가 사례는 진단된 행동에 따라 바뀌는 구성 요소가 달라진다는 점을 보여 준다.
| 사례 | 진단 | 편집 | 점수 |
|---|---|---|---|
| WB Code, 라우터 매칭 테스트 | tool call을 일반 텍스트로 써서 아무것도 실행되지 않고 턴이 끝남 | tool guidance 하나(1,023B)로 가짜 호출 금지 | 60.0에서 100.0 |
| WB Office, 채널별 분기 비교 | 집계 단위를 잘못 잡아 어떤 채널 행도 key와 맞지 않음 | 집계 단위와 파생 필드를 고정하는 스킬, 입력을 읽기 전용으로 두고 정제 규칙을 먼저 적용하는 가드레일 | 23.6에서 100.0 |
| WB Web | 첫 렌더 시점에 페이지 상태가 고정돼 재매핑과 내보내기가 낡은 값을 씀 | 상태를 변경마다 재계산하는 스킬, 오프라인 열람 확인 스크립트, 네트워크 의존 금지 가드레일 | 64.0에서 100.0 |
| LAB 중재 절차 명령 검토 | 수정 표시가 Word 변경 추적 층에만 있어 텍스트로 읽으면 사라짐 | 삭제는 취소선, 삽입은 굵게 본문 서식으로 남기는 스킬과 redline 작업이면 그 스킬을 부르는 가드레일(156B) | 44.4에서 94.5 |
| JobBench 사회과학 연구 보조 (Claude Opus 5가 실행자 겸 편집자) | 연구가 예산을 다 써서 마감 직전까지 파일이 작성되지 않음 | 8개 구성 요소 전부 작성. 산출물 없이 tool call이 25회 쌓이면 tool 결과에 경고를 덧붙이는 plugin, 자기 컨텍스트에서 인용 가능한 작은 표만 돌려주는 서브에이전트, 도메인 지속 사실 메모리 등 | 72.0에서 100.0 |
마지막 사례의 plugin 주석은 plugin을 쓰는 이유를 요약한다. "지시는 건너뛸 수 있지만 tool 결과에 덧붙은 줄은 건너뛸 수 없다." 산문 지시가 반복해서 무시될 때만 plugin을 쓰라는 편집자 규칙과 맞물리는 사례다.
한계
실패 사례
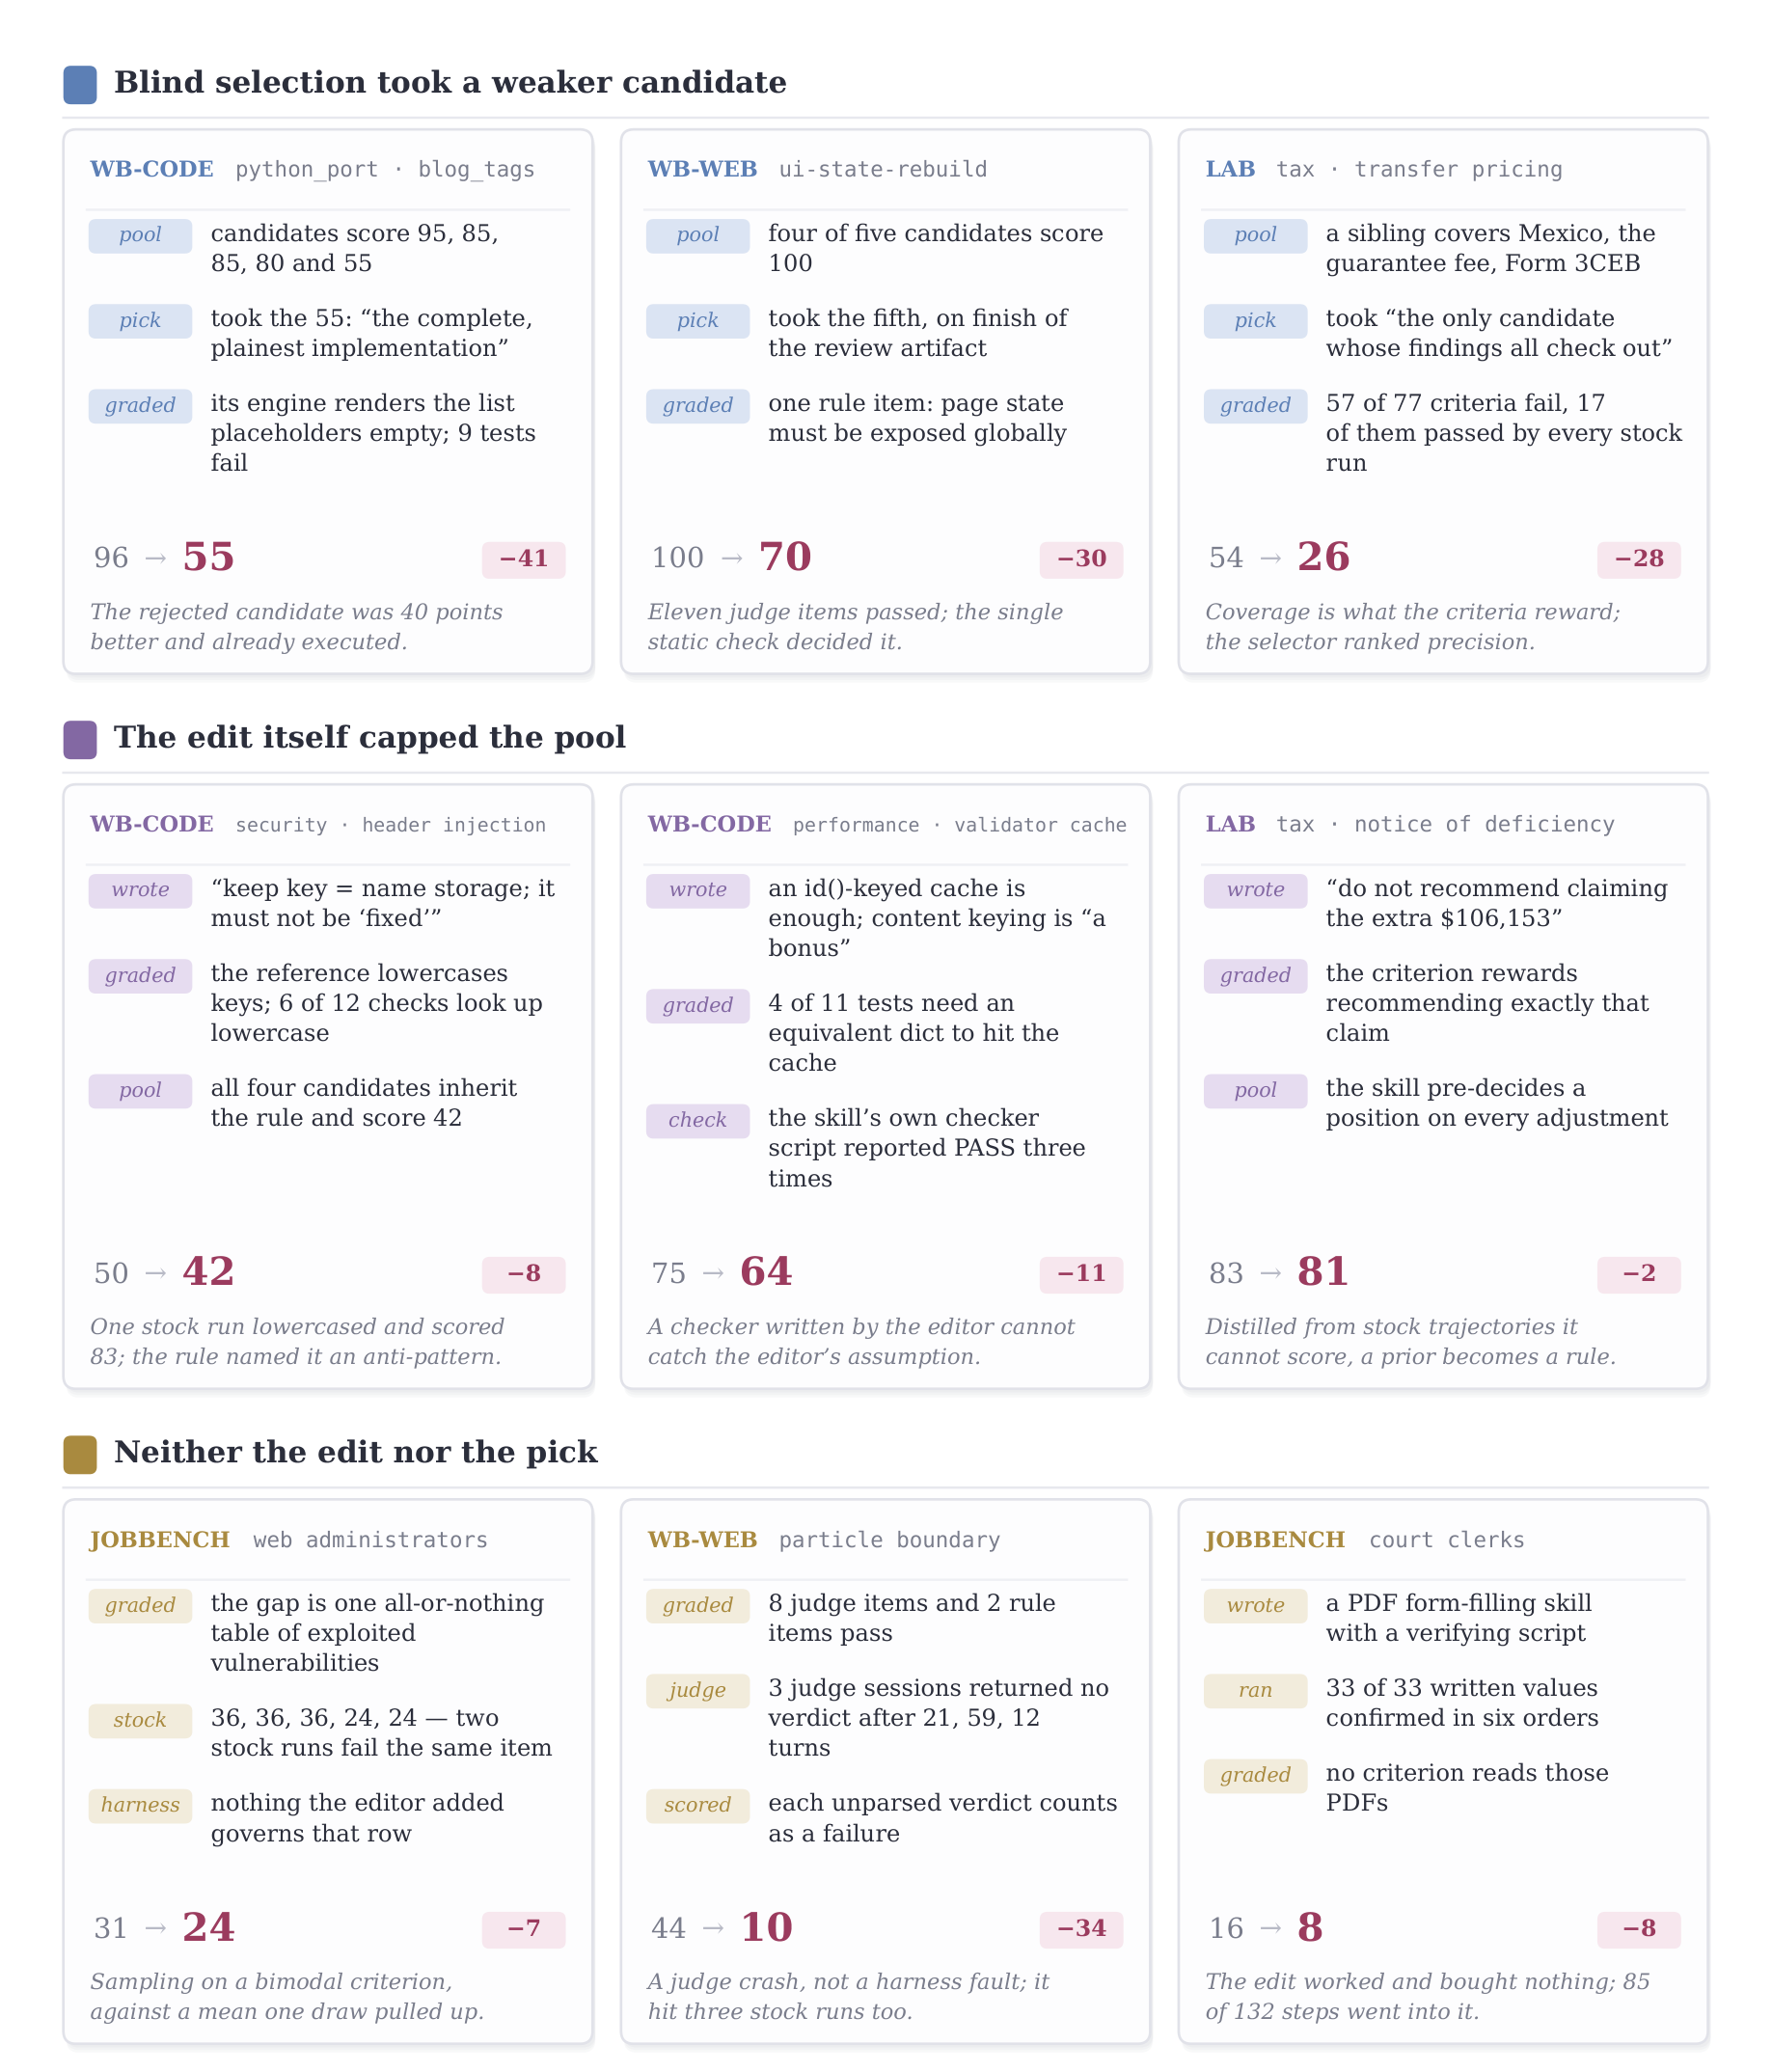
논문은 참조보다 점수가 낮아진 9건을 세 범주로 나눈다. 점수는 사후 평가이며 파이프라인은 이 값을 보지 못한다.
| 범주 | 사례 | 점수 | 원인 |
|---|---|---|---|
| 맹목 선택이 약한 후보를 고름 | WB-code python_port | 96에서 55 | 95, 85, 85, 80, 55점 후보 중 "가장 완전하고 평이한 구현"이라며 55점을 골랐다. 기각된 후보가 40점 높았고 이미 실행돼 있었다 |
| WB-web ui-state-rebuild | 100에서 70 | 다섯 중 넷이 100점인데 다섯째를 골랐다. 판정 항목 11개는 통과했고 정적 검사 1개가 결과를 갈랐다 | |
| LAB 이전가격 | 54에서 26 | 기준은 coverage를 보상하는데 selector는 precision을 우선했다. 기준 77개 중 57개 실패 | |
| 편집 자체가 후보 풀의 상한을 막음 | WB-code header injection | 50에서 42 | "key는 이름 그대로 저장하고 고치지 말 것"이라는 규칙을 후보 넷이 모두 물려받았다. 참조는 소문자로 바꾸는 쪽이 정답이었고, 소문자로 바꾼 기본 실행 하나는 83점이었다 |
| WB-code validator cache | 75에서 64 | id() 기반 캐시면 충분하다는 가정을 적었다. 편집자가 직접 쓴 검사 스크립트는 세 번 PASS를 냈다. 편집자가 쓴 검사기는 편집자의 가정을 잡지 못한다 | |
| LAB 결손 통지 | 83에서 81 | 채점할 수 없는 기본 trajectory에서 distillation으로 얻은 사전 판단이 규칙이 됐다 | |
| 편집도 선택도 원인이 아님 | JobBench 웹 관리자 | 31에서 24 | 전부 아니면 전무인 기준 하나에서 생긴 샘플링 변동. 기본 실행도 36, 36, 36, 24, 24점으로 갈렸다 |
| WB-web particle boundary | 44에서 10 | 판정 세션 3개가 판정 없이 끝나 실패로 집계됐다. harness 결함이 아니라 judge 장애이며 기본 실행 3개도 같은 문제를 겪었다 | |
| JobBench 법원 서기 | 16에서 8 | PDF 양식 작성 스킬은 정확히 작동했지만 그 PDF를 읽는 기준이 없었고, 132단계 중 85단계를 그 일에 썼다 |
저자들은 세 가지 개선 방향을 든다. coverage와 precision을 균형 있게 보는 선택, 후보들이 공유하는 가정을 의도적으로 시험하는 probe, 편집 효과와 결과 변동을 구분하기 위한 반복 실행이다.
비용과 신호의 한계
| 한계 | 내용 |
|---|---|
| 정제 비용 | 제안, probe, 합성마다 추가 실행과 편집자 세션이 든다. 예산을 늘리면 추론 비용이 늘고, 병렬 세션은 지연을 줄일 뿐 추가 연산을 없애지 못한다. 실험은 제한된 예산 범위의 trade-off만 보였다 |
| 실행 기반 피드백 | 정답 감독 없이 behavioral contrast와 모델 판단에 의존하므로 실행 변동성과 모델 공통 편향에 민감하다. 채택된 변경이 정확하다거나 다른 작업으로 전이된다는 보장이 없다 |
| 연산 비교의 범위 | 상용 harness 비교에서 Harness²는 테스트 시점 연산을 추가로 쓴다 |
Gupta는 해설에서 결과를 읽을 때의 주의점을 덧붙인다.
- 보고된 이득은 평가 설정 전체의 최대치이며 모든 모델이나 벤치마크에서 보장되는 개선이 아니다. 세 벤치마크의 점수 척도도 서로 달라 직접 비교할 수 없다.
- 벤치마크 결과는 baseline harness, 작업 선택, 평가 절차, 정제량에 좌우된다. 한 baseline 대비 개선이 운영 환경에서 같은 효과를 보장하지 않는다.
- 비싼 실행을 많이 거쳐 얻은 높은 점수가 거의 비슷한 성능의 단순한 구성보다 낫다고 단정할 수 없다.
- 모델이 문제를 추론하지 못하거나, 필요한 지식이 없거나, 지시를 안정적으로 따르지 못한다면 harness 수정만으로는 부족하다. harness 최적화와 모델 학습은 관련 있지만 다른 문제를 푼다.
그가 실제 도입 전에 하겠다고 적은 점검은 세 가지다. held-out 작업으로 baseline과 정제 harness를 비교하고, 성공 작업당 비용을 보고하고, 여러 작업 도메인에서 개선이 유지되는지 확인한다.
후속 방향
- improvement harness 관리: 현재 library는 단순 인덱스 구조다. 항목이 늘면 겹치는 구성 요소를 통합하고, 낡은 경험을 고치고, 현재 작업과 증거에 맞춰 retrieval을 정교하게 만들어야 한다.
- 적응형 recursion: 지금은 recursion 형태와 예산을 미리 정한다. 작업 난이도와 기존 경험의 관련성에 따라 탐색을 배분하거나, 추가 probe가 새 증거를 거의 내지 않을 때 멈추는 방식이 가능하다.
관련 연구와의 위치
논문은 harness 개선 방법 28종을 여섯 기준으로 비교한다(Table 4). 기준은 개선 대상, 단계(오프라인, 병행, 온라인), 외부 정답 감독(Label), 작업이나 배치 단위의 한 번 통과 갱신(Streaming), 명시적 테스트 시점 스케일링 연구(Scaling), 실행 artifact를 넘어선 편집 지침이나 편집자 파라미터의 지속 갱신(Improver Update)이다.
| 계열 | 대표 방법 | Harness²와의 차이 |
|---|---|---|
| 프롬프트와 워크플로 최적화 | DSPy, GEPA, ADAS, AFlow | 오프라인에서 정답 감독으로 최적화한다 |
| 오프라인 harness 최적화 | Meta-Harness, AHE, AI4AI, DarwinX, HarnessX, HarnessCompass, HSI | 고정 training 작업과 평가 피드백으로 탐색하므로 배포 중 처음 만난 요구를 반영하지 못한다 |
| 오프라인 준비와 테스트 시점 적응 병행 | MemoHarness, Harness-R1, JIT-Agent, Recuris | 진단 경험 bank나 편집자 학습 같은 오프라인 준비가 필요하다 |
| 온라인 방법 | ReasoningBank, RHI, Harness Scaling, TTHE, Evo-Harness, Adaptive Auto-Harness, Continual Harness, HCL | 정답이나 proxy 신호를 쓰거나, 스트리밍이 아니거나, improver를 갱신하지 않는 등 네 조건 중 일부가 빠진다 |
Table 4에서 정답 감독 없음, 스트리밍, 스케일링 연구, improver 갱신 네 조건을 모두 갖춘 행은 Harness²뿐이다. 저자들은 차별점이 이 중 하나가 아니라, 두 harness를 레이블 없이 작업 스트림에서 정제하는 것과 작업 수준 탐색에서 배우는 것을 결합한 데 있다고 적는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| harnessing | 고정된 base model 주위의 런타임 scaffold를 최적화해 그 모델이 자율 에이전트로 동작하게 하는 과정 |
| execution harness / improvement harness | 작업을 실행하는 harness와, 그 harness를 고치는 과정을 이끄는 harness. 후자는 작업 중 고정되고 작업 뒤 library로 갱신된다 |
| Propose, Probe, Compose | 후보 제안, 같은 조건 실행과 대조, 증거 기반 합성으로 이뤄진 대조형 개선 단계 |
| behavioral contrast | 후보 실행과 참조 실행의 trajectory와 산출물 차이. 정답 검증이 아니라 합성 근거로 쓴다 |
| invariant 후보 / domain 후보 | 도메인을 넘어 반복되는 에이전트 결함을 겨냥한 후보와, 현재 도메인의 지식, 절차, 제약을 겨냥한 후보 |
| harness improvement library | 채택된 harness 전체와 EXPERIENCE.md를 항목으로 쌓는 도메인별 디렉토리 |
관련 페이지
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 자기진화를 evolver의 갱신 능력과 agent의 수혜 능력으로 분해한 측정 연구다. Harness²가 약한 실행자에서 더 큰 이득을 보인 결과와 함께 읽으면 갱신과 수혜를 구분하는 관점을 얻는다.
- Agent Harness Engineering 개괄과 학습 경로: harness 자료들을 역할 분담과 근거 등급으로 묶은 개괄이다. Harness²는 harness를 사람이 아니라 자동 루프가 고치는 사례로 위치한다.
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: 분석 단위를 agent loop로 옮긴 서베이로, 스킬과 harness를 루프 관점에서 정리한다.
- Agent Lightning v1.0: Towards Harnessed Agentic RL: harness를 고정한 채 모델을 RL로 학습하는 반대 방향의 접근이다. Harness²는 모델을 고정하고 harness를 바꾼다.
- Agent Skills: 스킬을 호출 시에만 로드되는 절차로 다루는 관점이 Harness²의 스킬 구성 요소 설계와 겹친다.
- Prompt → Context → Harness → Loop Engineering: 4단계 진화 개괄: prompt, context, harness, loop 네 단계 진화 지도에서 harness 단계의 자동화 사례로 연결된다.