Agents · ARTICLE · 2026
The Art of Loop Engineering (Sydney Runkle, 2026-06-16)
요약
LangChain의 Sydney Runkle이 2026년 6월 16일 자사 블로그에 발행한 글이다. 에이전트를 신뢰할 수 있게 만드는 것은 더 나은 언어 모델이 아니라 모델을 둘러싸고 과제에 맞춰 설계한 실행 골격이라는 것이 출발 명제다. 그 골격을 네 겹의 루프로 분해하고 각 겹에 이름과 구현 도구를 붙인 것이 이 글의 내용이다.
네 루프는 나란히 놓인 목록이 아니라 안쪽을 바깥이 감싸는 중첩 구조다. 가장 안쪽의 agent loop이 일을 처리하고, verification loop이 그 출력을 채점하며, event driven loop이 전체를 조직 인프라에 연결해 자율 기동시키고, 마지막으로 hill climbing loop이 실행 기록을 읽어 안쪽 구조 자체를 고친다.
| 층 | 자동화하는 대상 | LangChain 구현 |
|---|---|---|
| Loop 1 agent | 작업 수행 | create_agent |
| Loop 2 verification | 품질 판정 | RubricMiddleware, after_agent 훅 |
| Loop 3 event driven | 기동과 통합 | LangSmith Deployment, Fleet channel |
| Loop 4 hill climbing | 개선 자체 | LangSmith Engine |
네 번째 층이 이 글의 무게중심이다. 앞의 세 루프가 실행을 자동화한다면 hill climbing은 개선 자체를 자동화하고, 복귀 경로가 시작점이 아니라 안쪽 agent loop으로 파고든다는 점에서 다른 층과 성격이 다르다. 저자는 그동안 관심이 몰렸던 loop 1과 loop 2에서 loop 3과 loop 4로 무게를 옮기라고 권한다.
이 글은 LangChain 자사 블로그에 실린 제품 서사이며 정량 벤치마크가 없다. 네 루프의 구획은 유용하지만, verification과 hill climbing이 품질을 얼마나 끌어올리는지는 측정치가 아니라 서술로만 제시된다. 따라서 효과를 재는 근거가 아니라 에이전트 시스템을 층으로 나눠 보게 하는 설계 프레임으로 읽는 것이 적절하다.
배경
글의 전제는 에이전트의 가치가 어디서 나오는지에 대한 진단이다. 에이전트가 유용한 이유는 실제 환경에서 action을 실행해 일을 자동화하기 때문이다. 그러나 그 실행이 믿을 만해지려면 우수한 언어 모델만으로는 부족하고, 과제에 맞춰 신중하게 구성한 실행 골격이 함께 있어야 한다.
가장 기본이 되는 골격은 단순하다. 저자는 이를 직접 인용으로 못박는다. "The core agent algorithm is simple: give the LLM context and let it call tools in a loop until it's done." 모델에 컨텍스트를 주고 작업이 끝날 때까지 루프 안에서 tool을 호출하게 두는 것이 전부라는 뜻이다.
문제는 이 기본 루프 하나로는 실제 시스템이 성립하지 않는다는 점이다. 정교한 에이전트 시스템에서는 여러 루프가 동시에 작동한다. 저자는 선행 논의 loopcraft: the art of stacking loops가 여러 루프를 층으로 쌓고 확장해 더 유능한 에이전트를 만드는 방법을 다뤘다고 소개하며, 자신의 글을 그 논의의 연장선에 놓는다. 다만 이 선행 논의에는 URL이나 저자 표기가 붙어 있지 않다.
핵심 개념
본문을 읽는 데 필요한 용어를 먼저 정리한다.
loop engineering은 개별 프롬프트가 아니라 에이전트를 반복 구동하는 루프 구조 자체를 설계 대상으로 삼는 관점이다. 저자가 인용하는 선행 논의는 같은 접근을 loopcraft라고 부르며, 여러 루프를 층으로 쌓아 더 유능한 에이전트를 만든다는 발상을 공유한다.
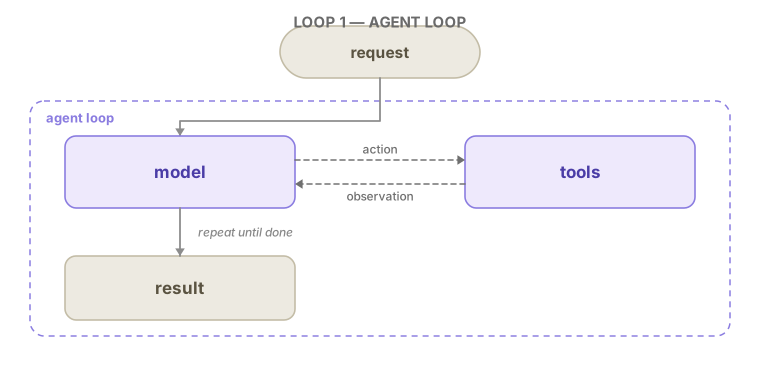
agent loop은 모델이 작업을 마칠 때까지 tool을 반복 호출하는 가장 안쪽 순환이다. 모델과 tool 집합만 있으면 성립하며, 여기서 tool은 에이전트가 실제 시스템에 action을 가하는 통로다.
grader는 에이전트의 출력을 정해진 기준에 대고 평가하고, 기준에 못 미치면 개선용 피드백을 붙여 결과를 되돌리는 컴포넌트다. 판정 방식은 두 가지로, 규칙으로 결정되는 deterministic 방식과 LLM이 평가하는 방식이 있다.
integrations layer는 에이전트를 조직 인프라에 연결해 백그라운드에서 자율적으로 동작하게 만드는 층이다. 저자는 에이전트 개발에서 결정적인 구성 요소로 이 층을 지목한다.
heartbeat는 스케줄 기반 트리거의 흔한 구현이다. 정해진 주기로 에이전트를 깨워, 요청을 기다리는 도구가 아니라 늘 깨어 있고 앞서 움직이는 보조자로 성격을 바꾼다.
trace는 에이전트가 한 번 실행될 때 남기는 기록이다. 모델이 취한 action, tool call, grader의 판정 등이 담긴다. 저자는 이 기록 안에 성능의 강점과 약점을 알려주는 신호가 들어 있다고 본다.
harness는 모델을 둘러싼 프롬프트와 tool과 grader 같은 실행 골격을 가리킨다. 네 번째 루프가 개선하는 대상이 바로 이 harness다.
docs writer agent는 글 전체를 관통하는 러닝 예제다. 사내 문서 개선 요청을 받아 저장소를 고치고 pull request를 내는 사내 문서화 에이전트로, 네 층이 하나씩 더해질 때마다 같은 에이전트가 어떻게 달라지는지를 보여주는 역할을 한다.
네 단계 루프 스택
원문 말미의 종합 표를 옮기면 다음과 같다. 각 행이 한 층이고, 아래로 갈수록 바깥 층이다.
| Loop | 기능 | 효과 | LangChain 도구 |
|---|---|---|---|
| 1. Agent loop | 모델이 작업이 끝날 때까지 tool을 반복 호출한다 | 일을 자동화한다 | create_agent와 지원 모델 |
| 2. Verification loop | 에이전트를 실행하고 출력을 rubric으로 채점해 미달이면 피드백과 함께 재시도한다 | 품질과 정확성을 보장한다 | RubricMiddleware |
| 3. Event driven loop | 이벤트가 에이전트를 기동해 실제 시스템을 수정한다 | 자동화된 일을 넓게 실행한다 | LangSmith Deployment의 스케줄과 webhook, 또는 Fleet channel |
| 4. Hill climbing loop | production trace를 분석 에이전트가 읽고 harness 설정을 다듬는다 | harness를 지속 개선한다 | LangSmith Engine |
표의 도구 열은 원문 표를 그대로 옮긴 것이다. 본문에서는 loop 2의 구현으로 RubricMiddleware 외에 create_agent의 after_agent 훅도 함께 제시되므로, 실제 선택지는 표보다 하나 더 넓다.
네 층의 관계를 한 문장으로 옮기면 agent loop을 verification loop이 감싸고, 그 전체를 event driven loop이 감싸며, 다시 그 바깥을 hill climbing loop이 감싼다. 아래 각 절의 도식이 이 포개짐을 단계별로 보여주며, 네 번째 절의 일반형 도식이 네 겹을 한 장에 담은 전체도다.
층을 구별하는 실질적인 기준은 무엇이 루프를 시작하고 한 바퀴가 끝난 뒤 제어가 어디로 가느냐다. 본문 서술과 도식을 종합하면 다음과 같이 정리된다.
| 층 | 루프를 시작하는 것 | 한 바퀴가 끝난 뒤 제어가 가는 곳 |
|---|---|---|
| Loop 1 agent | 사용자의 요청 | 작업이 끝나면 result를 내고 종료한다 |
| Loop 2 verification | agent loop이 낸 result | 통과하면 done, 미달이면 피드백과 함께 모델로 되돌아간다 |
| Loop 3 event driven | 새 문서 도착, 스케줄 발동, webhook 도착 같은 이벤트 | system update가 new events가 되어 다시 trigger로 돌아온다 |
| Loop 4 hill climbing | 실행이 쌓아 놓은 trace | 시작점이 아니라 안쪽 agent loop으로 진입해 구조를 바꾼다 |
앞의 세 행은 모두 제어가 같은 층의 시작점이나 그 안쪽 입력으로 되돌아온다. 네 번째 행만 복귀 지점이 다른 층에 있고, 그것이 hill climbing을 나머지와 구분 짓는 성질이다.
아래 도식 8장은 원본 글의 그림을 같은 구조의 SVG로 재현한 것이다. 원본이 루프마다 일반형과 docs writer 예시형을 한 쌍으로 두므로 8장이 되며, 생성기는 scripts/build_loop_diagrams.py다.
방법
글은 사내 문서화 에이전트(docs writer agent) 하나를 러닝 예제로 두고 네 층을 차례로 입힌다. 같은 에이전트가 층이 늘 때마다 어떻게 달라지는지 따라가는 구성이다.
agent loop
첫 번째 층에서 에이전트는 모델 하나와 tool 집합으로만 구성된다. 모델이 작업을 마칠 때까지 tool을 연달아 호출하는 것이 이 루프의 전부다.
LangChain의 create_agent 함수가 제공하는 것이 바로 이 구조다. 모델을 고르고 tool을 넣으면 동작하는 agent loop이 만들어진다. 도식에서 보이듯 모델은 action으로 tool을 부르고 observation을 받아 다시 판단하며, 이 왕복을 작업이 끝날 때까지 반복한 뒤 result를 낸다.
문서화 에이전트를 이 층에 놓으면 다음 순서로 동작한다. 문서 개선 요청을 받고, 모델이 계획을 세우고 수정안 초안을 작성하며, tool을 활용해 저장소를 clone하고 파일에 접근하고 문서를 작성하고 pull request를 생성한다.
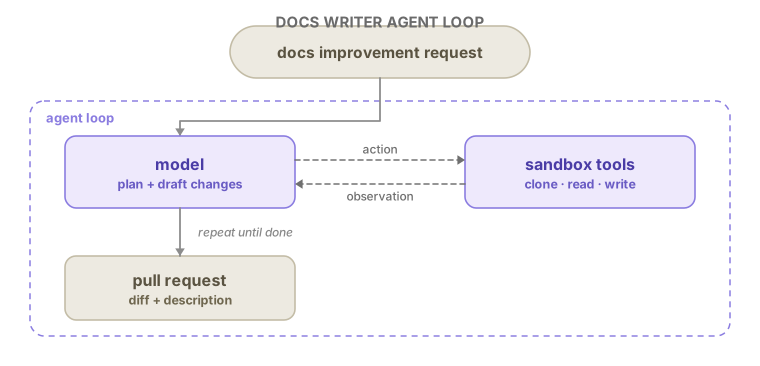
이 층만으로도 일은 처리된다. 다음 층이 필요해지는 이유는 처리된 일의 품질이 매번 같지 않기 때문이다.
verification loop
두 번째 층은 첫 번째 층의 약점에서 출발한다. agent loop은 일을 처리하지만 초기 출력이 품질이나 일관성 기준을 매번 충족하지는 않는다. 일관성이 중요한 경우라면 agent loop을 verification 구조로 감싸, 출력을 평가하고 기준에 못 미칠 때 피드백을 반환하는 방식이 유효하다.
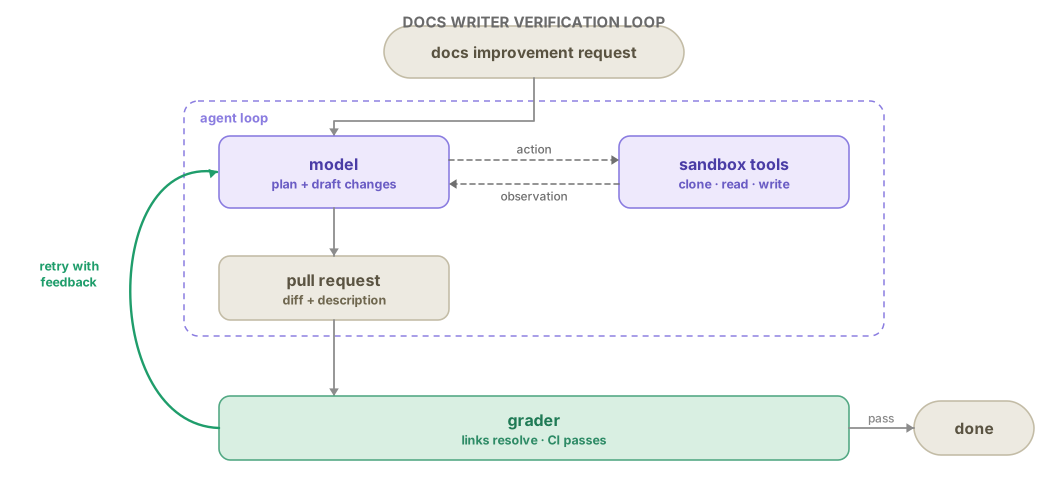
이 층이 도입하는 구성 요소가 grader다. grader는 result를 받아 기준에 대고 채점하고, 통과하면 done으로 보내고 미달이면 피드백을 붙여 모델에 되돌린다. 판정 방식은 규칙으로 결정되는 deterministic 방식과 LLM 기반 평가 방식 중에서 고른다.
| 판정 방식 | 성격 | 적합한 대상 |
|---|---|---|
| deterministic | 규칙으로 통과 여부가 결정된다 | 링크 작동, CI 통과처럼 기계로 확인 가능한 기준 |
| LLM 기반 평가 | 모델이 rubric에 대고 판단한다 | 기계 규칙으로 환원하기 어려운 품질 기준 |
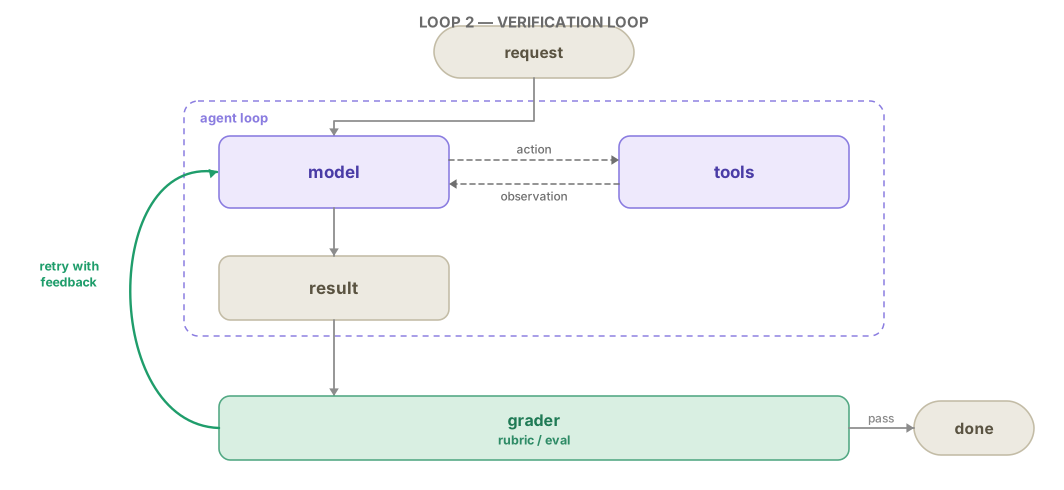
구현은 저자의 직접 인용으로 제시된다. "RubricMiddleware handles this pattern, or you can wire it up with an after_agent hook on create_agent." 즉 전용 미들웨어를 쓰거나 create_agent의 훅에 직접 배선하는 두 경로가 있고, 어느 쪽이든 사람이 매번 개입하지 않아도 체계적인 품질 점검이 이뤄진다.
문서화 에이전트에서는 채점 장치가 매 시도 뒤에 테스트를 실행해 세 가지를 확인한다.
- 하이퍼링크가 정상 작동하는가
- 지속적 통합(CI) 검사가 통과하는가
- 수정 범위가 명시적으로 요청된 것에만 머물러 있는가
세 항목의 공통점은 사람이 눈으로 확인하던 일이라는 것이다. 저자는 이 절차가 사람의 검토를 요구하는 오류 부류 전체를 미리 걷어낸다고 본다.
대가도 명시된다. verification은 실행마다 지연과 운영 비용을 추가한다. 저자는 이 교환이 속도보다 품질이 우선하는 상황에서 값어치를 하며, 대부분의 production 배포가 그런 상황이라고 평가한다. 반대로 말하면 속도가 우선인 용도에서는 이 층을 두는 판단이 달라질 수 있다.
여기까지의 두 층은 사람이 요청을 넣어야 움직인다는 공통 제약을 갖는다. 일을 처리하고 품질도 확인하지만, 시작 신호는 여전히 사람이 준다. 다음 층이 손대는 것이 바로 그 시작 신호다.
event driven loop
세 번째 층은 에이전트를 조직 안으로 들여놓는다. 저자가 에이전트 개발의 결정적 구성 요소로 지목하는 integrations layer가 이 층이고, 하는 일은 에이전트를 조직 인프라에 연결해 백그라운드에서 자율적으로 동작하게 만드는 것이다.
동작 방식은 직접 인용으로 서술된다. "The event-driven loop connects your agent to your ecosystem." 이어지는 문장은 이벤트가 발생하는 세 경우를 나열한다. 새 문서가 도착하거나, 스케줄이 발동하거나, webhook이 도착하는 경우이며, 그때 에이전트가 실행된다. 사람이 수동으로 호출하는 대신 에이전트가 더 큰 시스템 안에서 계속 동작하는 구성 요소가 된다는 뜻이다.
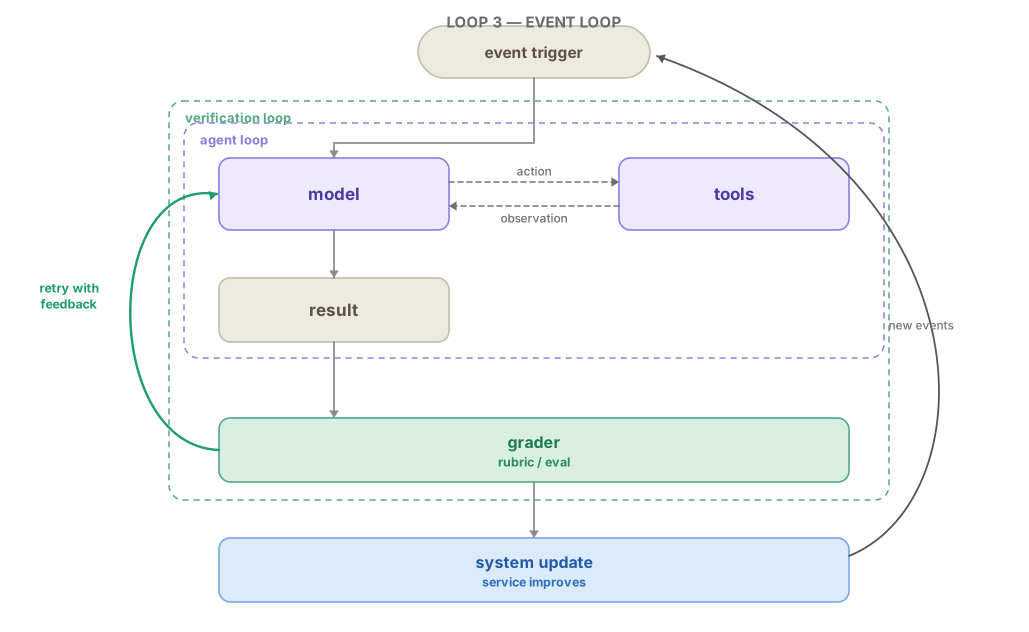
도식에서 주목할 지점은 순환의 닫힘이다. event trigger가 안쪽의 verification loop 전체를 기동하고, 그 결과인 system update가 다시 new events가 되어 trigger로 돌아온다. 에이전트의 산출물이 다음 기동의 입력이 되므로, 사람이 매번 시작 버튼을 누르지 않아도 순환이 이어진다.
LangChain 쪽 구현은 두 갈림이다.
| 구현 | 담당 |
|---|---|
| LangSmith Deployment | 트리거 인프라. 예약 실행과 webhook 연동을 지원한다 |
| Fleet | no-code 에이전트 구축 플랫폼. channel과 스케줄로 이벤트 기동과 정기 기동을 관리한다 |
스케줄 트리거의 흔한 구현이 heartbeat다. heartbeat는 에이전트를 늘 깨어 있고 앞서 움직이는 보조자로 바꾼다. 요청이 올 때만 반응하는 도구와 달리, 주기가 올 때마다 스스로 확인할 거리를 찾는 성격이 된다.
문서화 에이전트는 Fleet 위에서 동작한다. 실제 배선은 channel을 사용해, 사내 #docs-plz Slack 채널에 메시지가 올라올 때마다 docs 에이전트를 깨우는 방식이다. 결과인 docs enhancement가 병합되어 공개되면 그것이 다시 새 요청을 부르는 순환이 만들어진다.
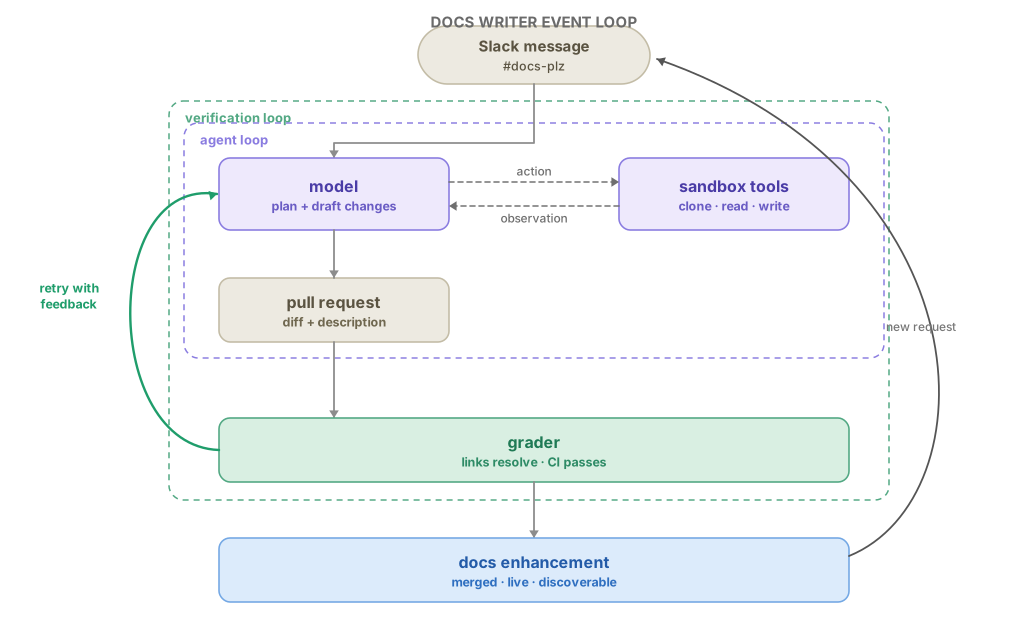
세 층을 갖추면 에이전트는 사람이 지켜보지 않아도 일을 찾아 처리하고 품질까지 확인한다. 그러나 세 층이 아무리 많이 순환해도 순환하는 방식 자체는 처음 설계한 그대로 남는다. 네 번째 층이 겨냥하는 것이 이 고정된 부분이다.
hill climbing loop
네 번째 층에서 자동화의 대상이 바뀐다. 앞의 세 루프가 실행을 자동화한다면, 이 층은 개선 자체를 자동화한다. 저자는 네 번째를 가장 중요할 수 있는 층으로 꼽는다.
재료는 trace다. 에이전트가 한 번 실행될 때마다 모델의 action, tool call, grader의 판정 등을 담은 기록이 남고, 저자는 이 기록에 성능의 강점과 약점에 대한 유용한 신호가 들어 있다고 본다. 앞의 세 층을 갖춰 놓으면 이 재료가 자동으로 쌓인다는 점이 중요하다.
hill climbing 장치는 분석 에이전트를 실행해 이 trace들을 살펴보고, 거기서 얻은 발견으로 harness 설정을 고친다. 여기서 고침의 단위는 harness를 다시 만드는 것이 아니라 설정을 개선하는 것이다. 수정 대상은 세 가지다.
- 프롬프트 조정
- tool 변경
- grader 개선
이 루프가 앞의 세 루프와 구조적으로 다른 지점은 복귀 경로다. 보통의 루프는 한 바퀴를 마치면 시작점으로 되돌아간다. 반면 hill climbing의 반환 경로는 시작점으로 가지 않고 안쪽으로 파고들어 agent loop 자체를 업그레이드한다. 따라서 바깥 루프가 한 바퀴 순환할 때마다 안쪽 장치의 효율이 올라간다.
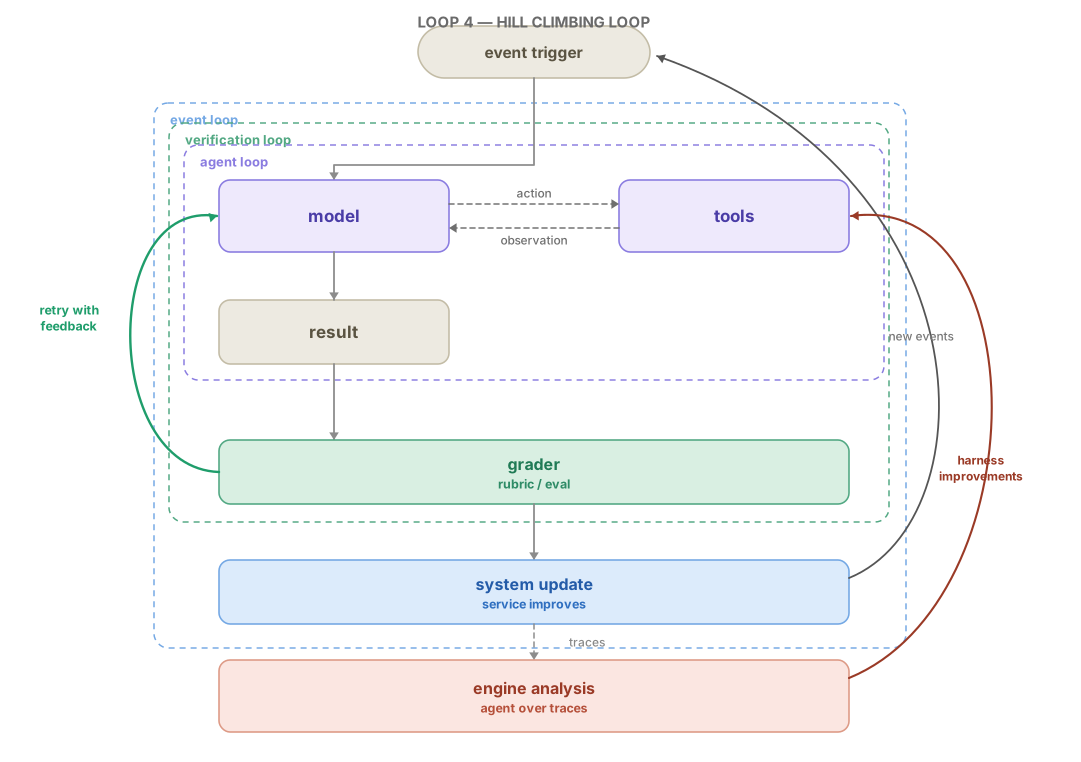
전체도를 보면 네 겹이 어떻게 맞물리는지가 한눈에 들어온다. 바깥에서부터 event loop, verification loop, agent loop이 차례로 포개져 있고, 가장 바깥에서 traces가 engine analysis로 흘러 harness improvements라는 화살표로 안쪽 tools와 agent loop에 닿는다.
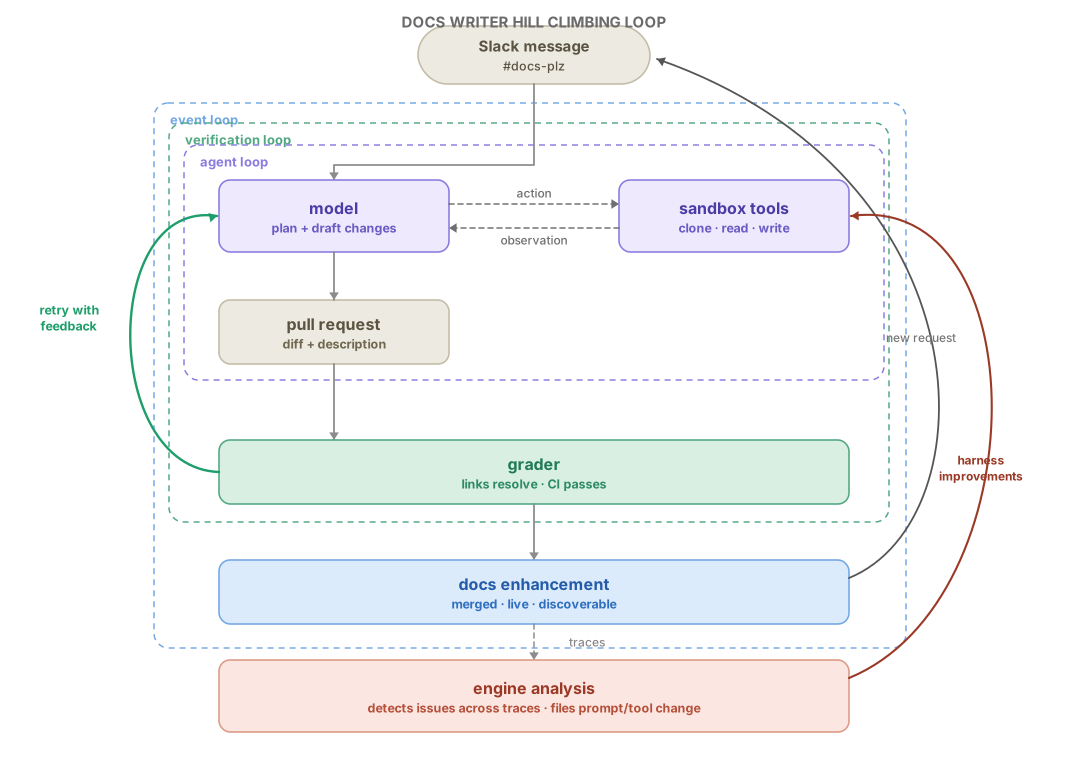
LangSmith에서는 trace 검토 도구인 Engine으로 이 네 번째 루프를 구성한다. 문서화 에이전트로 확장하면 Engine이 docs 에이전트의 trace를 분석해 문제를 식별하고, 여러 trace가 같은 문제를 가리킬 때 해당 프롬프트나 tool의 수정을 요청하는 알림을 발행한다. 한 번의 실패가 아니라 반복되는 실패를 신호로 삼는다는 점이 판정 기준이다.
개선 대상의 확장
저자는 마지막에 개선 대상을 넓힐 여지를 짚는다. 프롬프트와 tool 설정은 손대기 쉬운 표적이지만 전체 그림의 일부일 뿐이라는 것이다.
self-hosted 모델을 운영하는 조직이라면 hill climbing 장치가 trace와 평가 정보를 강화학습 기반 fine-tuning(RL fine-tuning)으로 흘려보내, 그 정보를 모델 자체를 개선하는 학습 재료로 쓸 수 있다. 메모리 구조나 학습된 스킬 같은 부수 요소도 같은 방식으로 다룰 수 있다.
핵심은 구조와 대상의 분리다. 반복 구조 자체는 그대로 유지되고, 최적화 대상이 무엇인지만 유연하게 바뀐다. 다만 이 확장은 전망으로 제시될 뿐 본문에 구현 사례나 결과가 붙지 않는다.
러닝 예제의 단계별 확장
같은 문서화 에이전트가 네 층을 거치며 무엇을 더 갖추게 되는지를 모으면 아래와 같다. 층이 하나 늘 때마다 에이전트가 아니라 에이전트를 둘러싼 장치가 늘어난다는 점이 이 표에서 드러난다.
| 층 | docs writer에 더해지는 것 | 대응 도식 |
|---|---|---|
| Loop 1 | 모델이 계획과 초안을 만들고 clone, read, write tool을 거쳐 pull request를 생성한다 | Figure 1b |
| Loop 2 | 매 시도 뒤 테스트를 실행해 링크 작동, CI 통과, 요청 범위 준수를 확인하고 미달이면 재시도시킨다 | Figure 2b |
| Loop 3 | 사내 #docs-plz Slack 채널의 메시지를 Fleet channel이 받아 에이전트를 깨운다 |
Figure 3b |
| Loop 4 | Engine이 trace를 분석해 반복되는 문제를 찾고 프롬프트나 tool 수정 알림을 발행한다 | Figure 4b |
첫 층에서 넷째 층으로 가는 동안 모델 자체는 바뀌지 않는다. 바뀌는 것은 채점 장치, 기동 경로, 분석 장치이며 이것이 글의 출발 명제인 "성능은 모델이 아니라 둘레의 골격에서 나온다"를 예제 수준에서 되짚는다.
사람의 개입 지점
자동화가 사람의 참여를 없앨 필요는 없다는 것이 이 절의 전제다. 저자는 모든 레벨에 사람의 판단이 의미 있게 기여하는 자연스러운 자리가 있다고 본다.
근거로 드는 대비는 문서 품질이다. 자동 grader는 링크가 작동하는지 검증할 수 있지만, 그 글이 독자층에 적합한지 알아보는 일에는 사람의 관점이 필요하다. 축적된 시각과 경험과 분별에서 나오는 이런 종류의 판단이 사람의 검토가 정당성을 얻는 지점이라는 것이다.
역량 가운데 일부는 프롬프트 명세나 tool 정의 안에 부호화해 둘 만하다. 그러나 결과가 무거운 활동에는 사람의 직접 검토가 필요하다. 저자가 드는 예는 금전이 오가는 거래와 데이터베이스에 영향을 주는 조작이다.
이 구분은 앞 절들의 자동화 논의와 짝을 이룬다. 자동화할 대상은 규칙으로 옮겨 적을 수 있는 판단이고, 사람에게 남기는 대상은 규칙으로 옮기기 어려운 판단과 되돌리기 어려운 조작이다. 앞의 기준이 grader 설계를, 뒤의 기준이 검토 지점 배치를 결정한다.
LangChain은 이 검토 지점을 각 층에 넣기 쉽게 만들었다고 서술하며 네 항목을 열거한다.
| 지점 | 사람이 하는 일 |
|---|---|
| agent loop 안 | 결과가 무거운 조작이나 tool use 앞에 "human input" 요구를 배치한다 |
| verification 층 안 | 중요한 워크플로에서 사람을 grader로 지정한다 |
| application 층 안 | 최종 사용자에게 결과를 전송하기 전에 사람의 승인을 받는다 |
| hill climbing 층 안 | harness 개선안을 적용하기 전에 사람의 평가를 거치게 한다 |
이 목록은 앞서 제시한 네 루프와 정확히 겹치지 않는다. event driven loop에 해당하는 항목이 없고 그 자리에 application 층이 들어와 있기 때문이다. 본문은 모든 레벨에 검토 지점을 둔다고 적지만 실제 열거는 이렇게 어긋난다.
LangChain은 자사 오픈소스 도구가 "human in the loop"을 "first class primitive"로 자리매김한다고 표현한다.
결과
이 글에는 정량 결과가 없다. 처리량 증가나 결함률 감소 같은 측정치, 실험 설계, 비교군이 모두 제시되지 않는다. 네 루프의 효과는 문서화 에이전트라는 단일 러닝 예제로 서술될 뿐이다.
본문에서 검증 가능한 진술은 도구 기능에 관한 것들이다.
| 도구 | 확인 가능한 기능 |
|---|---|
create_agent |
모델과 tool을 묶어 기본 agent loop을 구성한다 |
RubricMiddleware, after_agent 훅 |
채점 패턴을 구현한다 |
| LangSmith Deployment | 예약 실행과 webhook 연동을 지원한다 |
| Fleet channel과 스케줄 | 이벤트 기반 기동과 정기 기동을 관리하며 Slack 채널 메시지를 트리거로 쓸 수 있다 |
| LangSmith Engine | trace 분석으로 harness 개선 지점을 표면화하고, 반복되는 문제에 수정 요청 알림을 발행한다 |
이 자료의 값은 측정된 효과가 아니라 구획과 명명에 있다. 흩어져 있던 실행, 채점, 기동, 개선을 네 개의 층으로 나누고 각 층에 도구를 붙였다는 점이 기여다.
따라서 이 글에서 확인할 수 있는 것과 확인할 수 없는 것을 구분해 두는 편이 좋다. 확인할 수 있는 것은 각 층의 역할 정의, 층 사이의 중첩 관계, 그리고 LangChain 제품군이 어느 층을 담당한다고 주장하는지다. 확인할 수 없는 것은 층을 하나 더 두었을 때 품질이 얼마나 오르는지, 지연과 비용이 얼마나 늘어나는지, 그리고 이 구획이 LangChain 밖의 스택에서도 같은 방식으로 성립하는지다.
한계
한계는 두 종류로 나뉜다. 하나는 저자가 프레임 안에서 남겨 둔 미완의 부분이고, 다른 하나는 이 글을 근거로 쓸 때 밖에서 붙여야 할 유보다.
- 2차 자료이자 제품 서사. LangChain 자사 블로그라 네 루프가 자사 제품 라인업(
create_agent, LangSmith, Fleet)에 맞춰 정렬돼 있다. 도구 중립적 프레임워크라기보다 제품 내러티브에 가깝다. - 정량 근거 부재. verification과 hill climbing이 품질을 얼마나 끌어올리는지 수치가 없다. 지연과 비용 증가도 값어치를 한다는 정성 평가에 머문다.
- loop 4의 미성숙. hill climbing, 특히 RL fine-tuning으로의 확장은 self-hosted 모델을 운영하는 조직에 한정된 전망으로만 제시된다.
- human-in-the-loop 목록의 불일치. 본문은 모든 레벨에 검토 지점을 둔다고 적지만, 열거된 네 항목에는 event driven loop이 빠지고 대신 application 층이 들어간다. 네 루프 프레임과 검토 지점 목록이 일대일로 맞지 않는다.
- attribution 부재. 저자는 저명한 기술자들이 독립적으로 같은 결론에 도달했다고 적지만 구체 인물이나 링크를 달지 않는다. 선행 논의로 인용한
loopcraft: the art of stacking loops도 URL 없이 제목만 언급된다. - 수집본의 표현 신뢰도. 이 wiki가 근거로 삼은
raw/본문은 클라이언트 렌더링 페이지를 fetch한 결과다. 큰따옴표로 인용한 문장 밖의 표현은 원문 그대로가 아니므로, 어휘 수준의 인용이 필요하면 원문 URL을 확인해야 한다.
전략적 권고
글의 마무리는 어디에 힘을 쏟을지에 대한 제안이다. 저자는 그동안 개발의 관심이 loop 1과 loop 2에 몰려 있었다고 진단하고, 전략적 무게를 loop 3과 loop 4로 옮겨야 한다고 본다.
이유는 우위가 쌓이는 자리가 다르기 때문이다. 실행과 품질은 도구가 보편화되면 따라잡히지만, 에이전트를 자사 운영 시스템에 통합하고 그 시스템이 목표에 맞춰 점점 나아지게 만드는 일은 조직마다 결과가 달라진다.
본문이 우위의 경로로 지목하는 것은 두 가지다. 하나는 에이전트를 조직의 운영 시스템 안에 통합하는 일이고, 다른 하나는 그렇게 통합된 시스템이 조직의 목표에 맞춰 점차 더 나은 성능을 갖추게 하는 일이다. 앞의 것이 loop 3에, 뒤의 것이 loop 4에 대응한다. 두 항목 모두 도구 도입만으로 완결되지 않고 조직의 인프라와 목표 정의에 의존한다는 공통점이 있다.
본문은 저명한 기술자들이 독립적으로 같은 관찰에 도달했다고 적으며 한 문장으로 요약한다. 에이전트의 역량은 근본적으로 그 둘레에 구축된 루프 구조에 있다는 것이다. 다만 앞서 적었듯 이 관찰의 출처는 특정되지 않는다.
조직 차원의 함의는 업계 인사들의 진술을 인용해 제시된다. 학습 장치를 일찍 갖춰 사람의 판단과 연산 자원이 서로를 강화하게 만든 기업이, 경쟁자가 따라잡기 어려운 우위를 확보한다는 내용이다. 이 문장 역시 화자가 특정되지 않으므로 근거보다는 전망으로 읽는 편이 안전하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| agent loop | 모델이 작업을 마칠 때까지 tool을 반복 호출하는 가장 안쪽 루프. create_agent가 제공한다 |
| grader | 출력을 기준에 대고 채점하고 미달이면 피드백을 붙여 되돌리는 컴포넌트. deterministic 방식과 LLM 기반 평가 방식이 있다 |
| integrations layer | 에이전트를 조직 인프라에 연결해 백그라운드 자율 동작을 가능하게 하는 층 |
| heartbeat | 스케줄 기반 트리거의 흔한 구현. 에이전트를 늘 깨어 있고 앞서 움직이는 보조자로 만든다 |
| trace | 한 번의 실행이 남기는 기록. 모델의 action, tool call, grader 판정 등이 담기며 hill climbing의 입력이 된다 |
| harness | 모델을 둘러싼 프롬프트, tool, grader 등의 실행 골격. hill climbing이 개선하는 대상이다 |
관련 페이지
- Loop Engineering (Addy Osmani, 2026-06-07): 같은 loop engineering 용어를 코딩 에이전트 관점에서 본 자매 에세이. Osmani의 5+1 구성 요소가 루프를 무엇으로 채우는지라면, Runkle의 4 루프 스택은 루프를 어떤 층으로 겹치는지를 다룬다. Osmani의 verification distance가 이 글의 loop 2에 대응한다.
- 또 새로운 용어? Loop Engineering: Claude Code, RLM, Dynamic Workflow (Jeongmin Lee, LinkedIn 2026-06-09): loop engineering을 RLM 이론과 Claude Code의 dynamic workflow에 묶은 한국어 카드 포스트. 같은 흐름을 모델과 이론 쪽에서 본 시각이다.
- Harness Engineering (Team Attention, 2026): 프롬프트에서 컨텍스트, harness로 이어지는 3단계 진화 모델. 이 글의 hill climbing이 그 모델의 개선 항목에 대응한다.
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 자기 개선의 이득을 측정 관점에서 비판한다. loop 4가 실제로 가치를 더하는지 따져볼 때 짝지어 읽는다.
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26): 자기 검증과 서브에이전트와 worktree 등 loop 2와 loop 3의 실무 구현을 Claude Code 사례로 푼 가이드.
- Prompt → Context → Harness → Loop Engineering: 4단계 진화 개괄: 프롬프트에서 컨텍스트, harness, 루프로 이어지는 4단계 진화를 묶은 상위 진입점. 이 페이지는 그 사다리의 마지막 칸에 놓인다.
- Loop Engineering 도메인 이식 개괄: 같은 프레임이 코딩 밖 도메인으로 옮겨가는지 검토한 개괄. 이 글의 네 층 구획을 도메인별로 다시 대조할 때 쓴다.
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: 같은 전환을 제어 전략과 스킬과 harness 항목으로 정리한 서베이. 블로그의 네 층 구획을 학술 분류와 맞춰 볼 때 쓴다.