Agents · PAPER · 2026
MCP Server Architecture Patterns for LLM-Integrated Applications
요약
이 논문은 프로덕션에 배포된 MCP 서버 15개를 질적 코딩(qualitative coding)해 되풀이되는 서버측 아키텍처 패턴 5종과 anti-pattern 4종을 GoF 형식으로 정리한 산업 경험 논문(industry experience paper)이다. 코퍼스는 Celabe가 운영하는 ANSYR 음성 AI 플랫폼의 프로덕션 서버 5개와 공식 modelcontextprotocol/servers 레지스트리의 공개 서버 10개로 절반씩 구성된다.
패턴 5종은 Resource Gateway, Tool Orchestrator, Stateful Session Server, Proxy Aggregator, Domain-Specific Adapter다. 각 패턴은 Repository, Facade, Session, Proxy, Adapter라는 고전 설계 패턴을 조상으로 두고, 저자들이 기여로 내세우는 것은 구조 골격이 아니라 LLM-client delta다. LLM-client delta는 클라이언트가 문서를 참조하지 않고 tool의 자연어 설명을 읽어 무엇을 호출할지 고른다는 제약이 고전 패턴에 추가로 만들어내는 차이를 뜻한다.
이 제약에서 논문의 실무 결과가 나온다. ANSYR 프로덕션 로그를 분석한 결과 단일 context에 노출한 tool이 10개에서 15개 사이를 지나면 Claude Haiku 4.5의 tool 선택 정확도가 90% 아래로 내려간다. Claude Sonnet 4는 20개까지 90% 이상을 유지하다 30개에서 내려간다. 따라서 논문이 결론에서 제시하는 tool 10개에서 15개라는 예산은 Haiku급 모델에 대한 값이며, 모델과 무관한 상수가 아니다.
정량 결과는 세 가지다. taxonomy의 rater 간 신뢰도는 Cohen's κ=0.76으로 "substantial" 구간이고 불일치가 세 경계에 집중된다. 전송 지연은 프로토콜 계층이 아니라 network RTT에 지배된다. 그리고 tool 수가 정확도와 지연을 동시에 밀어 올린다.
배경
MCP가 표준화한 것
MCP 이전에 LLM을 외부 시스템에 붙이는 일은 프롬프트 템플릿 안에 function calling schema를 손으로 짜고 새 모델마다 접착 코드를 다시 구현하는 작업이었다. MCP는 이 작업을 client-server 프로토콜로 표준화한다. MCP 서버가 tools, resources, prompts를 MCP 규격을 지키는 어떤 클라이언트에도 노출하고, 서버 하나가 Claude, GPT-4, Gemini에서 수정 없이 동작한다.
프로토콜은 JSON-RPC 2.0 위에 3개 primitive를 정의한다.
| primitive | 정의 | 정적 대 동적 |
|---|---|---|
| Tools | 이름, 자연어 설명, JSON Schema 입력 명세를 갖는 호출 가능 함수 | 호출마다 실행된다 |
| Resources | LLM이 읽을 수 있는 URI 주소 엔드포인트 | 정적(파일, 문서)일 수도 동적(실시간 DB 질의)일 수도 있다 |
| Prompts | 서버측에서 관리하는 파라미터화 템플릿 | 요청 시 사용자나 에이전트에게 노출된다 |
전송은 2종이다.
| 전송 | 용도 | 형태 |
|---|---|---|
| stdio | 로컬 in-process 통신 | 표준 입출력 |
| streamable-http | 원격 서버 | HTTP에 server-sent events 옵션 |
저자들이 프로토콜의 의도를 설명할 때 반복해서 드는 유비는 LSP(Language Server Protocol)다. 두 프로토콜의 대응 관계를 놓으면 MCP가 무엇을 표준화하려는지가 분명해진다.
| 역할 | LSP | MCP |
|---|---|---|
| host | 에디터(VS Code, Neovim, Emacs) | LLM 클라이언트(Claude, GPT-4, Gemini) |
| provider | 언어 서버 | MCP 서버 |
| 표준화한 인터페이스 | 에디터와 언어지능 도구 사이 | 에이전트와 능력 제공자 사이 |
| 얻는 효과 | 같은 언어 서버가 여러 에디터에서 수정 없이 동작한다 | 같은 MCP 서버가 여러 에이전트에서 수정 없이 동작한다 |
| 이전 상태 | 에디터별 플러그인 | 모델별 function calling schema와 접착 코드 |
Anthropic이 2024년 11월에 MCP를 발표한 뒤 몇 달 안에 GitHub과 MCP 레지스트리에 수백 개 서버가 등장했다. 반면 실무자가 좋은 설계 결정을 내리도록 돕는 아키텍처 지침과 생태계가 프로덕션에서 어떻게 구조화되고 있는지에 대한 유지보수 관점의 서술은 비어 있었다. 이 빈틈이 논문의 출발점이다.
실무에서 반복되는 네 가지 질문
저자들은 현장에서 되풀이되는 질문 4개를 문제의식으로 제시하고, 각 질문에 패턴 하나를 대응시킨다.
| 질문 | 대응 패턴 |
|---|---|
| tool을 어떻게 분해해야 하는가. 언제 tool 하나가 둘이 되는가 | Tool Orchestrator와 God Tool anti-pattern |
| 서버측 상태는 언제 정당화되고 어떻게 관리해야 하는가 | Stateful Session Server |
| 운영자가 여러 서버의 능력을 어떻게 집계해야 하는가 | Proxy Aggregator |
| 서버가 복잡한 API를 그대로 노출하지 않고 감싸야 하는 시점은 언제인가 | Domain-Specific Adapter |
이 질문들은 MCP 고유의 것이 아니다. 저자들의 정리에 따르면 이들은 LLM 클라이언트라는 특정 제약을 통과한 API 설계 질문이다. LLM은 문서를 열거나 schema를 뜯어보지 않고 자연어 설명을 읽어 tool을 고른다. 그리고 사람 개발자와 달리 schema 복잡도에 민감하다. 따라서 사람 엔지니어에게는 자명한 tool이라도 설명이 없거나 잘 쓰이지 않았으면 LLM에게는 보이지 않거나 모호해진다.
선행 연구가 비워 둔 자리
선행 연구는 세 계열로 나뉘고, 이 논문이 채우는 자리는 그중 어디에도 없다.
| 계열 | 대표 연구 | 초점 |
|---|---|---|
| LLM tool use와 에이전트 아키텍처 | ToolBench 계열 suite, function calling 벤치마크, ReAct, AutoGPT 계열 루프, LangChain, computer use | 클라이언트측. 에이전트가 어떤 tool을 부를지 결정하는 문제 |
| MCP 자체 연구 | Hou et al.(보안 위협 서베이), Hasan et al.(공개 서버의 보안과 유지보수성 smell 마이닝), Guo et al.(8,000개 이상 규모 생태계 측정) | 생태계가 무엇을 담고 어디가 취약한지 |
| 이 논문 | 15개 서버 코퍼스의 질적 코딩 | 서버측. 능력 카탈로그를 어떻게 구조화하고 명명하고 묶는지 |
패턴 방법론은 Gamma et al.(GoF), Fowler의 엔터프라이즈 애플리케이션 패턴, Hohpe and Woolf의 통합 패턴에서 구조화 서술 형식을 차용했다. 저자들은 구조 골격이 새롭다고 주장하지 않는다. 각 골격은 고전 소프트웨어 아키텍처에 명확한 조상을 갖고, 기여는 클라이언트가 자연어 설명을 읽어 연산을 고를 때 생기는 delta다. 이 제약은 REST, GraphQL, LSP 어디에도 없고, anti-pattern과 tool 수 한계가 애초에 등장하는 이유도 이 제약이다.
이 논문의 anti-pattern은 Hasan et al.의 유지보수성 smell과 같은 서버들을 보는 상보적 관점이다. 즉 서로 대체하지 않고 서로 다른 층을 본다.
핵심 개념
LLM-client delta
LLM-client delta는 이 논문이 기여 단위로 삼는 개념으로, 고전 패턴을 LLM 클라이언트 아래에서 다시 놓았을 때 추가로 생기는 차이를 뜻한다. 조상 패턴의 구조는 그대로 두고 delta만 카탈로그의 알맹이로 세우는 것이 서술 전략이다.
| MCP 패턴 | 고전 조상 | LLM-client delta |
|---|---|---|
| Resource Gateway | Repository / REST | resource를 LLM retrieval 관점에서 명명한다 |
| Tool Orchestrator | Facade / Mediator | tool 집합 크기를 선택 정확도에 맞춘다 |
| Stateful Session Server | Session / Memento | 상태가 암묵적이며 프롬프트에 없다 |
| Proxy Aggregator | Proxy / API gateway | context에 맞게 tool을 분할한다 |
| Domain-Specific Adapter | Adapter (GoF) | 검증을 자연어 가드레일로 구현한다 |
delta 열을 보면 다섯 항목이 두 종류로 갈린다. Resource Gateway와 Domain-Specific Adapter의 delta는 명명과 서술의 문제이고, Tool Orchestrator와 Proxy Aggregator의 delta는 tool 수 예산의 문제다. Stateful Session Server의 delta는 성격이 또 다르다. 상태가 프롬프트에 나타나지 않으므로 LLM도 분류하는 사람도 그것을 볼 수 없다는 가시성의 문제다.
패턴마다 GoF 관례에 따라 별칭이 붙는다. 별칭은 같은 구조가 현장에서 어떤 이름으로 불리는지를 알려준다.
| 패턴 | 별칭 |
|---|---|
| Resource Gateway | Data Facade, Context Provider |
| Tool Orchestrator | Action Hub, Workflow Facade |
| Stateful Session Server | Conversational Context Server |
| Proxy Aggregator | MCP Router, Multi-Server Facade |
| Domain-Specific Adapter | Semantic Layer, Domain Translator |
composite tool
composite tool은 완결된 다중 시스템 워크플로를 내부에서 처리하고 단일 요약만 반환하는 tool을 말한다. Tool Orchestrator 패턴의 구성 단위이며, LLM에게 보이는 연산 수를 하나로 줄이는 것이 목적이다.
티켓 생성 흐름을 예로 들면, 개별 API를 tool 3개로 노출하는 대신 create_and_notify_ticket 하나만 노출한다. 서버가 내부에서 Jira 이슈 생성, Slack 통보, 이메일 발송을 순차 수행하고 LLM에는 결과 문장 하나만 돌려준다. 즉 LLM의 추론 부담과 tool 수를 동시에 줄이는 대신, 부분 실패 처리 책임을 서버가 지게 된다.
retrieval-over-tools와 두 집계 변형
retrieval-over-tools는 전체 tool을 나열하지 않고 요청별로 관련 tool 후보만 검색해 노출하는 기법을 뜻한다. Proxy Aggregator의 두 변형 중 scoped 변형의 핵심이며, 논문의 tool 수 결과가 곧바로 이 기법을 가리킨다.
| 변형 | 노출 범위 | 장점 | 문제 |
|---|---|---|---|
| static-merge | 모든 upstream tool의 union을 한 번에 노출한다 | 클라이언트 설정이 단순해진다 | 가시 tool 수가 올라가, 병합 카탈로그가 정확도 예산을 넘으면 선택 정확도가 떨어진다 |
| scoped | 현재 과제에 관련된 upstream tool의 subset만 노출한다. 요청별로 후보를 검색한다 | tool 수를 예산 안에 유지한다 | 요청별 tool retrieval 단계 자체가 빠르고 정확해야 한다 |
두 변형의 차이는 구조가 아니라 노출 정책이다. 저자들은 집계가 context를 tool 수 한계 밖으로 밀어낼 상황이면 언제든 scoped 변형을 선택하라고 권고한다.
패턴과 primitive의 대응
다섯 패턴이 세 primitive를 고르게 쓰지는 않는다. 논문의 해법 서술을 primitive 기준으로 다시 배열하면 각 패턴이 어떤 노출 수단에 기대는지가 드러난다.
| 패턴 | 주로 쓰는 primitive | 근거 |
|---|---|---|
| Resource Gateway | Resources 중심, 안전하지 않은 파라미터 질의만 Tools | 해법이 읽기를 Resources로, 파라미터화 질의를 Tools로 나누라고 명시한다 |
| Tool Orchestrator | Tools | composite tool 하나로 워크플로를 감싼다 |
| Stateful Session Server | Tools | session ID를 tool 인자와 응답으로 운반한다 |
| Proxy Aggregator | Tools | upstream의 listTools() 결과를 병합하고 이름을 접두한다 |
| Domain-Specific Adapter | Tools | 사람이 읽는 tool 설명이 해법의 첫 요소다 |
Prompts primitive는 배경 절에서 정의되지만 다섯 패턴의 해법 서술에 등장하지 않는다. 즉 이 논문의 패턴 카탈로그는 Tools와 Resources를 다루는 설계 어휘이며, Prompts를 중심에 둔 패턴은 다루지 않는다.
seam
seam은 그 자리를 편집하지 않고 동작을 바꿀 수 있는 위치를 뜻한다. 논문은 다섯 패턴을 설계 형태로만 보지 않고 변경을 국소화하는 seam으로 다시 읽어, 유지보수와 진화 관점의 값을 각 패턴에 붙인다.
seam 관점은 패턴 선택의 비용 계산을 바꾼다. 패턴 하나를 도입하면 network hop이나 세션 저장소 같은 비용이 즉시 생기는데, 그 비용을 회수하는 자리가 최초 구현이 아니라 이후의 변경이기 때문이다.
산업 경험 논문의 근거 구조
이 논문은 강도가 다른 네 층의 근거를 쌓는다. 논문이 그 차이를 절마다 명시하므로, 인용할 때 어느 층에서 나온 주장인지 구분하는 것이 중요하다.
| 층 | 근거 | 강도 |
|---|---|---|
| 패턴 카탈로그 | 15개 서버의 소스 코드와 배포 설정을 2주기 질적 코딩 | 단일 코더 open coding에 2차 검증. 독립 dual coding 아님 |
| 신뢰도 측정 | held-out 서버 54개를 독립 LLM rater 2인이 분류 | 정량. 다만 두 rater 모두 LLM |
| 전송 지연 | in-host 2행은 종단 측정, cross-host 3행은 모델값 | 5행 중 2행만 직접 측정 |
| tool 수 결과 | ANSYR 프로덕션 로그의 회고 분석 | 관찰 데이터. 새 통제 실험 아님 |
방법
코퍼스 15개 서버
패턴 카탈로그는 독립 개발된 MCP 서버 15개에서 도출했다. 프로덕션 5개는 ANSYR 음성 AI 플랫폼에서 2024년 말부터 2025년 초 사이에 배포된 서버이고, 지식재산 사유로 Server-A부터 Server-E까지 익명 핸들을 쓰되 배포 카테고리와 primary pattern은 공개했다.
| 서버 | 카테고리 | Primary pattern |
|---|---|---|
| Server-A | Voice-tool aggregator | Tool Orchestrator |
| Server-B | Per-call dialogue session | Stateful Session Server |
| Server-C | Telephony / SIP adapter | Domain-Specific Adapter |
| Server-D | Customer/CRM read gateway | Resource Gateway |
| Server-E | Multi-tenant aggregator | Proxy Aggregator |
공개 10개는 공식 modelcontextprotocol/servers 레지스트리에서 GitHub 전체 경로로 표기했다.
| 서버 | 카테고리 | Primary pattern |
|---|---|---|
filesystem |
Local files | Resource Gateway |
postgres |
Relational DB | Resource Gateway |
sqlite |
Embedded DB | Resource Gateway |
github |
VCS / issue API | Tool Orchestrator |
slack |
Messaging API | Tool Orchestrator |
brave-search |
Web search | Tool Orchestrator |
fetch |
Generic HTTP | Tool Orchestrator |
puppeteer |
Browser automation | Stateful Session Server |
memory |
Per-session KV store | Stateful Session Server |
git |
Repository state | Stateful Session Server |
두 절반을 합치면 패턴 분포가 고르지 않다. 프로덕션 서버가 다섯 패턴을 하나씩 나눠 갖는 반면 공개 서버는 세 패턴에만 몰린다.
| Primary pattern | 프로덕션 | 공개 | 합계 |
|---|---|---|---|
| Resource Gateway | 1 | 3 | 4 |
| Tool Orchestrator | 1 | 4 | 5 |
| Stateful Session Server | 1 | 3 | 4 |
| Domain-Specific Adapter | 1 | 0 | 1 |
| Proxy Aggregator | 1 | 0 | 1 |
Domain-Specific Adapter와 Proxy Aggregator는 코퍼스 전체에서 프로덕션 서버 각 1개에만 배정되어 있다. 반면 §III-B의 승격 조건은 후보가 최소 2개 서버에서 독립적으로 등장해야 한다는 것이다. 따라서 이 두 패턴의 승격 근거는 Table II만으로 확인되지 않고, Known Uses 목록의 외부 사례나 코드 리뷰 관찰에 기대게 된다.
기계 판독 코퍼스는 타임스탬프와 primary pattern 배정을 담아 재현 패키지의 corpus.json으로 공개되어 있다.
코딩 프로토콜
데이터 추출은 서버마다 고정된 소스에서 5개 artifact를 뽑는 방식이다. 추출 대상을 미리 고정한 것은 서버 간 비교 가능성을 확보하기 위해서다.
| # | artifact | 추출 대상 |
|---|---|---|
| i | tool, resource, prompt 등록 | 소스 코드의 setRequestHandler 호출과 JSON schema |
| ii | 전송 설정 | 서버가 stdio와 streamable-http 중 무엇을 쓰는지 |
| iii | 서버측 세션과 상태 처리 | 세션 저장소 유무와 만료 처리 |
| iv | 다른 MCP 서버로의 위임 | upstream 연결과 라우팅 |
| v | 도메인 검증과 비즈니스 로직 | 입력 정규화, 업무 규칙 |
소스는 절반마다 다르다. 공개 10개는 GitHub 저장소의 소스 코드, README, 공개 문서에서, 프로덕션 5개는 소스와 배포 설정에서 가져왔다. 저자들은 README 산문만 신뢰하지 않는다고 명시하는데, README가 관심 대상인 구조적 결정을 자주 누락하기 때문이다.
질적 코딩은 Saldaña의 2주기 절차를 따른다.
| 주기 | 절차 | 수행 |
|---|---|---|
| 1차 | open coding. 추출된 artifact마다 되풀이되는 구조적 결정에 라벨을 붙인다 | 1저자 |
| 2차 | pattern coding. 1차 코드를 공유 구조와 공유 문제로 묶어 후보 패턴을 만든다 | 1저자 |
| 검증 | 결과 taxonomy를 코퍼스에 대조해 독립 검토하고 불일치를 논의로 해소한다 | 2저자와 공동 |
승격 조건은 두 개를 함께 만족해야 한다. 후보가 최소 2개 서버에서 독립적으로 등장하고, 자명한 선행 해법이 없는 문제를 다루는 것이다. 2저자의 검토는 독립 dual coding이 아니라 verification pass이므로, 저자들은 rater 간 신뢰도를 held-out 코퍼스와 독립 rater 2인으로 따로 측정한다.
패턴 1 Resource Gateway
Resource Gateway는 LLM 에이전트가 백엔드에서 구조화 데이터를 읽어 응답 근거로 삼아야 할 때 쓰는 패턴이다. 대상 백엔드는 데이터베이스, 문서 저장소, 서드파티 API다.
문제는 세 가지를 동시에 만족시키는 것이다. 백엔드 데이터를 queryable하게 노출하고, 신뢰할 수 없는 데이터를 통한 prompt injection을 막고, 백엔드 schema 변경에 일관되게 대응해야 한다.
해법은 모든 데이터 접근을 중개하는 gateway로 서버를 구성하는 것이다. 노출 방식은 파라미터의 안전성에 따라 갈린다.
| 접근 유형 | 노출 primitive | 이유 |
|---|---|---|
| 읽기 연산(목록 조회, ID 조회) | Resources | URI 템플릿으로 안전하게 표현된다 |
| 파라미터화 질의 | Tools | 질의 파라미터를 열린 URI 템플릿에 넣으면 안전하지 않다 |
그리고 백엔드 응답이 LLM에 닿기 전에 주입된 콘텐츠를 제거하거나 이스케이프하는 sanitization layer를 삽입한다. sanitization layer는 이 패턴의 선택 사항이 아니라 필수 구성이다.
Listing 1은 MongoDB 문서를 노출하는 구현을 보여준다. 목록 핸들러는 _id, title, updatedAt만 projection해 문서 목록을 만들고 각 항목에 doc://${d._id} 형태의 URI와 application/json mimeType을 붙인다. 읽기 핸들러는 URI에서 doc:// 접두를 떼어 문서를 조회한 뒤 sanitize(JSON.stringify(doc))로 감싸 반환한다. 즉 sanitize가 목록 경로가 아니라 읽기 경로에 놓이는데, 실제 문서 본문이 흐르는 경로가 읽기이기 때문이다.
| 구분 | 내용 |
|---|---|
| 이점 | 접근 제어의 단일 강제 지점을 확보한다. 백엔드 schema가 바뀌어도 LLM에는 안정된 인터페이스가 유지된다. prompt injection 위험이 한 계층에 격리된다 |
| 부담 | 읽기마다 network hop이 하나 늘어난다. 백엔드 schema 변경이 MCP 서버로 전파된다. 복잡한 join이나 집계를 resource로 표현하기 어색해진다 |
| Known Uses | 데이터베이스 커넥터(PostgreSQL, MongoDB), 문서 저장소 브리지(Notion, Google Drive), REST API 래퍼(GitHub, Jira, Linear) |
패턴 2 Tool Orchestrator
Tool Orchestrator는 LLM 에이전트가 여러 외부 시스템에 걸친 동작을 수행해야 할 때 쓰는 패턴이다. 논문이 드는 예는 티켓을 만들고 담당자에게 알리고 채널에 게시하는 한 흐름이다.
문제는 LLM에게 세 가지 부담을 지우지 않으면서 다중 시스템 워크플로를 노출하는 것이다. 각 시스템의 API를 이해하는 부담, 호출 사이의 중간 상태를 관리하는 부담, 부분 실패를 처리하는 부담이다.
해법은 완결된 워크플로를 캡슐화한 composite tool을 노출하는 것이다. tool 하나가 내부에서 모든 sub-call을 수행하고 단일 요약을 반환한다. LLM은 연산 하나만 보고 오케스트레이션은 서버가 담당한다.
Listing 2는 create_and_notify_ticket tool 하나가 API 호출 3개를 순차 수행하는 구조다.
| 순서 | 내부 호출 | 역할 |
|---|---|---|
| 1 | jira.createIssue({ title, description }) |
티켓 생성 |
| 2 | slack.postMessage(assignee.slackId, ...) |
담당자 채널 통보 |
| 3 | email.send(assignee.email, ...) |
담당자 이메일 발송 |
세 호출이 끝나면 Created ${ticket.key}, notified ${assignee.name} 형태의 텍스트 하나만 LLM에 반환된다. 즉 LLM 관점에서 이 워크플로의 내부는 완전히 감춰진다.
| 구분 | 내용 |
|---|---|
| 이점 | LLM의 추론 부담이 줄어든다. 다단계 연산에 트랜잭션에 준하는 의미를 부여할 수 있다. LLM이 추론할 필요 없는 API 표면을 은닉한다 |
| 부담 | 워크플로가 바뀔 때 개별 sub-tool의 재사용이 어려워진다. 부분 실패 처리 책임이 LLM에서 서버로 옮겨온다. 워크플로 로직이 tool과 그것을 서술하는 문서 두 곳에 인코딩된다 |
| Known Uses | CI/CD 자동화 서버, DevOps 워크플로 도구, 고객지원 액션 허브 |
부담의 세 번째 항목은 유지보수 관점에서 특히 무겁다. 로직이 두 곳에 있으면 한쪽만 바뀌어 어긋나기 쉬운데, LLM은 그 두 곳 중 문서 쪽만 읽고 tool을 고르기 때문이다.
패턴 3 Stateful Session Server
Stateful Session Server는 LLM 에이전트가 다중 턴 상호작용을 수행하고 뒤 호출이 앞에서 세운 상태에 의존할 때 쓰는 패턴이다. 논문이 드는 상태의 예는 열린 파일, 진행 중인 데이터베이스 트랜잭션, 인증된 사용자다.
문제는 MCP tool call이 기본적으로 stateless request-response라는 점이다. 한 세션 안의 여러 호출에 걸쳐 유지되어야 하는 상태를 프로토콜이 직접 제공하지 않으므로 서버가 관리해야 한다.
해법은 session identifier를 연결 시점에 생성해 모든 tool 응답에 포함시키고 이후 모든 호출이 이를 운반하게 하는 것이다. 서버는 per-session 컨텍스트를 보관한다.
| 배포 형태 | 세션 저장소 |
|---|---|
| 단일 인스턴스 | 메모리 |
| 수평 확장 | Redis 등 분산 저장소 |
세션은 비활성 시 만료된다. 만료 처리가 없으면 부담 항목의 메모리 누수로 이어진다.
Listing 3은 코드 편집 흐름의 구현이다. Map<string, SessionContext>를 세션 저장소로 두고 req.params.arguments._sessionId로 세션을 찾는다.
| tool | 동작 | 반환 또는 오류 |
|---|---|---|
open_file |
파일을 읽어 filePath, content, 빈 edits 배열을 세션에 저장한다 |
열린 문자 수를 반환한다 |
edit_file |
세션의 edits 배열에 편집을 추가한다 |
세션에 열린 파일이 없으면 No file open in this session 오류를 던진다 |
edit_file의 오류 처리가 이 패턴의 취약점을 그대로 드러낸다. 세션 ID를 LLM이 실어 보내야 하는데 그 보장이 없으므로, 서버는 세션이 없는 호출을 상시 방어해야 한다.
| 구분 | 내용 |
|---|---|
| 이점 | 다중 턴 워크플로가 자연스러워진다. 중복 데이터 전송이 제거된다. 트랜잭션 의미를 확보할 수 있다 |
| 부담 | 세션을 회수(reap)하지 않으면 메모리가 누수된다. 수평 확장에 분산 세션 저장소가 필요하다. LLM이 session ID를 확실히 전달한다는 보장이 없다 |
| Known Uses | 코드 편집 에이전트(open, edit, save 순서), 데이터베이스 트랜잭션 서버, 다단계 폼 어시스턴트 |
패턴 4 Proxy Aggregator
Proxy Aggregator는 LLM 에이전트가 서로 다른 여러 MCP 서버의 능력이 필요할 때 쓰는 패턴이다. 도입 동기는 두 가지로, 클라이언트 설정이 유지 가능한 서버 연결 수를 제한하는 경우와 운영자가 서버 fleet 전체에 중앙화된 인증과 로깅을 걸어야 하는 경우다.
문제는 여러 upstream MCP 서버를 단일 엔드포인트로 제시하면서 세 가지를 잃지 않는 것이다. 서버별 정체성, 버전관리, 실패 격리다.
해법은 upstream N개에 연결하는 proxy 서버를 만들고 tool 이름을 서버별 namespace로 접두해 충돌을 막고 각 호출을 올바른 upstream으로 라우팅하는 것이다. Listing 4가 이 구조를 두 단계로 보여준다.
| 단계 | 구현 |
|---|---|
| 병합 | upstream마다 listTools()를 부른 뒤 각 tool 이름을 ${s.namespace}__${t.name} 형태로 바꾼다. 예를 들어 github__create_pr이 된다 |
| 라우팅 | 호출 시 req.params.name.split('__')으로 namespace를 떼어 해당 upstream을 찾고 남은 이름으로 callTool을 넘긴다 |
Listing 4가 보여주는 것은 static-merge 변형의 핵심이고, scoped 변형은 그 위에 요청별 필터를 한 층 겹친다. 두 변형의 차이는 앞선 핵심 개념 절의 비교표와 같다.
| 구분 | 내용 |
|---|---|
| 이점 | 클라이언트 설정이 단순해진다. 중앙화된 인증과 감사 로깅이 가능하다. 대규모 서버 fleet 전반의 tool 발견을 지원한다 |
| 부담 | 단일 실패 지점이 도입된다. 모든 호출에 network hop이 하나 추가된다. namespace 충돌에 신중한 거버넌스가 필요하다. upstream 서버 실패가 집계 지점을 통해 드러난다. scoped 변형은 요청별 tool retrieval 단계를 추가하며 그 단계 자체가 빠르고 정확해야 한다 |
| Known Uses | 엔터프라이즈 MCP 게이트웨이, 개발자 플랫폼 aggregator, 멀티도메인 AI 어시스턴트 백엔드 |
부담의 두 번째 항목은 뒤의 전송 지연 결과와 직접 연결된다. network hop 하나가 modeled 값에서 p50 기준 약 32 ms를 더하기 때문이다.
패턴 5 Domain-Specific Adapter
Domain-Specific Adapter는 기존 시스템이 유용하지만 LLM에 적대적인 API를 갖고 있을 때 쓰는 패턴이다. 논문이 드는 적대성의 형태는 기계 판독용 식별자, 저수준 연산, 복잡한 인증 흐름, 상당한 후처리가 필요한 출력 형식이다.
문제는 복잡한 저수준 API를 LLM이 정확히 쓸 수 있는 형태로 번역하면서 비즈니스 로직을 서버에 재구현하지 않는 것이다. 재구현을 피해야 하는 이유는 로직이 두 곳에 생기면 유지보수 부담이 커지기 때문이다.
해법은 기존 API를 감싸는 semantic adapter를 만들고 4개 요소를 더하는 것이다.
| 보강 요소 | 내용 | 효과 |
|---|---|---|
| 사람이 읽는 tool 설명 | 무엇을 하고 언제 쓰는지를 서술한다 | LLM의 선택을 안내한다 |
| 입력 정규화 | 자연어 날짜, 이름, 모호한 식별자를 받아들인다 | LLM이 기계 식별자를 만들어내지 않아도 된다 |
| 출력 강화 | ID를 표시명으로 해석해 돌려준다 | LLM이 후처리 없이 결과를 쓸 수 있다 |
| 에러 번역 | API 에러 코드를 평문 영어로 바꾼다 | LLM이 실패 원인을 읽고 판단할 수 있다 |
네 요소는 모두 같은 방향을 향한다. 기계가 읽기 좋은 표면을 사람이 읽기 좋은 표면으로 바꾸는 것이며, LLM이 자연어를 읽는 클라이언트라는 전제에서 나온다.
| 구분 | 내용 |
|---|---|
| 이점 | 설명이 정확해지면 LLM tool 선택 정확도가 개선된다. API 복잡도가 adapter에 격리된다. 백엔드 API 버전관리를 adapter 계층에서 흡수할 수 있다 |
| 부담 | 하부 API가 바뀔 때 adapter를 갱신해야 한다. 하부 API가 이미 LLM 친화적일 때 과설계 위험이 실재한다 |
| Known Uses | CRM 어댑터(Salesforce, HubSpot), 금융 데이터 커넥터, 헬스케어 레코드 시스템 |
이 패턴에는 코드 listing이 붙지 않는다. 다섯 패턴 중 유일한 경우인데, 해법의 알맹이가 코드 구조가 아니라 설명과 정규화의 내용이기 때문으로 읽힌다.
다섯 패턴의 이점과 부담 대조
패턴별 절에서 나눠 본 이점과 부담을 한 곳에 모으면 선택 기준이 드러난다. network hop을 추가하는 패턴이 둘, 상태를 물려받는 패턴이 하나, 코드 갱신 책임을 지는 패턴이 하나다.
| 패턴 | 추가 비용의 성격 | 가장 큰 이점 |
|---|---|---|
| Resource Gateway | 읽기마다 network hop 하나 | prompt injection 위험의 단일 격리 지점 |
| Tool Orchestrator | 부분 실패 처리 책임과 로직 중복 | LLM 추론 부담 감소와 API 표면 은닉 |
| Stateful Session Server | 세션 저장소 운영과 회수 | 다중 턴 워크플로의 자연스러운 표현 |
| Proxy Aggregator | 단일 실패 지점과 호출마다 network hop 하나 | fleet 전체의 인증과 감사 단일화 |
| Domain-Specific Adapter | 하부 API 변경 추적 | LLM 대면 표면의 안정화 |
anti-pattern 네 가지
anti-pattern의 위치를 정확히 잡는 것이 중요하다. 저자들은 이 4개가 파생 코퍼스의 어떤 서버에서도 지배적 구조가 아니었다고 명시하며, 잘 관리되는 서버는 이들을 피한다고 적는다.
기록 경로는 두 가지다. 프로덕션 서버의 개발과 코드 리뷰 과정에서 LLM tool use를 저해하는 반복적 국소 실수로 기록하고, 각각을 공개 저장소의 issue와 pull request 논의에 교차 확인했다. 보고 이유는 어떤 서버도 하나로 정의되지 않지만 실무자에게는 이 단위가 유용하다는 것이다.
| anti-pattern | 증상 | 실패 메커니즘 | 알려진 수정 |
|---|---|---|---|
| The God Tool | do_anything(action: string, params: object)처럼 크고 미분화된 schema를 tool 하나가 받는다 |
LLM이 "action" 인자의 의미를 추론해야 해 tool 선택 정확도가 크게 하락한다 | 분해한다. 구별되는 연산마다 정밀한 schema와 설명을 갖는 고유 tool을 준다 |
| Unsanitized Resource Content | 사용자 생성 콘텐츠(댓글, 문서 본문, 폼 입력)를 sanitization 없이 resource 응답에 그대로 반환한다 | "Ignore previous instructions and…"를 담은 문서를 LLM이 데이터가 아니라 지시로 처리한다 | 외부에서 온 모든 콘텐츠를 MCP 응답에 들어가기 전에 sanitize한다 |
| Synchronous Long-Running Operations | 영상 인코딩, 대용량 파일 처리 등 수 초 이상 걸리는 연산을 동기 tool로 노출한다 | MCP에는 내장 async 콜백 메커니즘이 없어 클라이언트가 timeout된다 | job ID를 동기 반환하고 별도 poll_job(id) tool을 노출한다 |
| Missing or Vague Tool Descriptions | send_message라는 이름만 있고 설명이 없거나, 설명이 이름을 되풀이할 뿐이다 |
LLM은 schema를 검사하지 않고 설명을 읽어 tool을 고른다 | tool이 무엇을 하고 언제 쓰며 무엇을 반환하는지를 처음 보는 사람에게 설명하듯 쓴다 |
네 항목은 각각 대응하는 패턴을 뒤집은 형태로 읽을 수 있다.
| anti-pattern | 대응 패턴 | 뒤집힌 지점 |
|---|---|---|
| The God Tool | Tool Orchestrator | Tool Orchestrator는 여러 API 호출을 tool 하나로 묶어 tool 수를 줄인다. God Tool은 서로 다른 연산을 인자 하나로 묶어 의미를 지운다. 두 방향 모두 tool 수를 줄이지만 전자는 워크플로 단위로, 후자는 무관한 연산 단위로 묶는다 |
| Unsanitized Resource Content | Resource Gateway | Resource Gateway의 필수 구성인 sanitization layer를 뺀 결과다 |
| Synchronous Long-Running Operations | 해당 패턴 없음 | 프로토콜에 async 콜백이 없다는 제약을 무시한 경우다. 다섯 패턴 중 어느 것을 골라도 이 실수는 별도로 방어해야 한다 |
| Missing or Vague Tool Descriptions | Domain-Specific Adapter | Domain-Specific Adapter의 첫 보강 요소인 사람이 읽는 tool 설명을 생략한 경우다 |
God Tool과 Tool Orchestrator를 가르는 기준이 실무에서 가장 미묘하다. 둘 다 tool 수를 줄이는 방향이지만, 묶는 단위가 하나의 완결된 워크플로인지 서로 무관한 연산의 집합인지가 다르다. 앞선 실무 질문 목록의 첫 항목, 즉 언제 tool 하나가 둘이 되는가가 정확히 이 경계를 묻는 질문이다.
결과
실험 세 가지의 설계
질적 패턴 서술을 보완하려고 실험 3개를 수행했고 모두 재현 패키지에서 재현 가능하다. 세 실험의 근거 강도가 다르므로 설계를 먼저 정리한다.
| 실험 | 절 | 표본 | 설계 | 산출 지표 |
|---|---|---|---|---|
| 분류 신뢰도 | §VI-A | held-out 서버 54개 | 독립 LLM rater 2인이 architecture-neutral 설명을 분류한다 | Cohen's κ, raw agreement, 저자 라벨 일치율 |
| 전송 지연 | §VI-B | 구성 5개 | in-host 2개는 종단 측정, cross-host 3개는 모델값 | p50, p95, p99 |
| tool 수와 정확도 | §VI-C | 버킷 8개, 버킷당 200턴 | ANSYR 프로덕션 로그 회고 분석 | 선택 정확도, median 지연 |
분류 신뢰도
이 실험이 묻는 것은 두 가지다. 다섯 패턴 taxonomy를 독립 rater가 신뢰성 있게 적용할 수 있는지, 그리고 경계가 어디서 흐린지다.
held-out 코퍼스는 공식 MCP 레지스트리와 인기 커뮤니티 서버에서 뽑은 54개로 패턴 도출에 쓰인 서버를 하나도 포함하지 않았다. 각 서버에는 아키텍처를 명명하지 않고 무엇을 하는지만 서술하는 architecture-neutral description을 붙였다. 논문이 드는 예시는 "stage changes, commit, show diffs, and switch branches in a repository"다.
| 설계 요소 | 값 |
|---|---|
| rater | Claude Haiku 4.5, Claude Sonnet 4 (독립 2인) |
| temperature | 0 (재현성 확보) |
| rater에게 준 정보 | 패턴 정의 5개만 |
| 설명 유형 | architecture-neutral (아키텍처명 비공개) |
저자들은 아키텍처를 스스로 명명하는 canonical 설명을 분류하는 더 쉬운 프로토콜을 의도적으로 피했다. 저자가 쓴 canonical 설명으로 진행한 파일럿은 97%를 기록했는데, 저자들의 해석은 그 값이 taxonomy가 현실적 입력에서 살아남는지가 아니라 설명 문구를 측정한 결과라는 것이다.
| 지표 | 값 |
|---|---|
| rater 간 Cohen's κ | 0.76 (bootstrap 95% CI [0.62, 0.88]) |
| rater 간 raw agreement | 81.5% |
| 저자 의도 라벨 일치 (Haiku 4.5) | 68.5% |
| 저자 의도 라벨 일치 (Sonnet 4) | 75.9% |
| canonical 설명 파일럿 | 97% |
| held-out 서버 수 | 54 |
두 수치의 간격이 이 실험의 핵심이다. rater 간 일치는 0.76으로 "substantial" 구간이므로 독립 rater가 taxonomy를 서로 비슷하게 적용한다. 반면 저자 의도 라벨과의 일치는 68.5%에서 75.9%로 더 낮다. 즉 rater들은 서로 일관되지만 저자가 의도한 라벨과는 체계적으로 다른 방향으로 일관된다.
경계 모호성 세 곳
불일치는 흩어지지 않고 세 경계에 집중된다. 저자들이 이 국소화를 신뢰도 실험의 부산물이 아니라 기여 항목으로 세우는 이유는, 흩어진 오류와 달리 집중된 오류는 taxonomy를 수정할 지점을 알려주기 때문이다.
| # | 경계 | 증상 | 원인 |
|---|---|---|---|
| 1 | Statefulness는 기능에서 안 보인다 | 모든 stateful 서버(git, puppeteer, playwright, selenium 등)가 Tool Orchestrator로 읽힌다 |
능력 목록은 동작을 열거하되 서버측 세션 상태를 드러내지 않는다 |
| 2 | Domain logic은 안 보인다 | 도메인 어댑터(kubernetes, salesforce, shopify, fhir)가 Tool Orchestrator와 Resource Gateway로 갈린다 |
검증과 업무 규칙이 기능 설명에 드러나지 않는다 |
| 3 | read-style tool은 gateway를 닮는다 | 검색 지향 orchestrator(sentry, notion)가 Resource Gateway로 재분류된다 |
읽기 위주 표면이 gateway와 구별되지 않는다 |
세 경계는 모두 같은 구조를 갖는다. 기능 목록에 드러나지 않는 속성이 패턴 구분의 기준일 때 분류가 갈린다는 것이다. 따라서 권고도 두 가지로 나온다.
| 권고 | 내용 |
|---|---|
| taxonomy 수정 | statefulness와 domain-logic을 상호배타 카테고리가 아니라, 서버가 primary structural pattern과 함께 지닐 수 있는 cross-cutting attribute로 취급한다 |
| 분류 절차 수정 | 패턴 배정을 능력 목록만이 아니라 구현 신호에 근거한다 |
첫 권고는 앞선 LLM-client delta 표의 Stateful Session Server 행과 정확히 맞물린다. 상태가 프롬프트에 없다는 delta가 곧 분류하는 사람에게도 보이지 않는다는 뜻이기 때문이다.
이 권고를 받아들이면 패턴 배정의 문법이 바뀐다. 서버 하나에 패턴 하나를 배정하는 대신, primary structural pattern 하나에 cross-cutting attribute 두 개를 옵션으로 붙이는 형태가 된다.
| 배정 요소 | 값의 범위 | 결정 근거 |
|---|---|---|
| primary structural pattern | Resource Gateway, Tool Orchestrator, Stateful Session Server, Proxy Aggregator, Domain-Specific Adapter 중 하나 | 구현 신호(등록 코드, 전송 설정, upstream 위임) |
| statefulness 속성 | 있음 또는 없음 | 서버측 세션 저장소와 만료 처리의 존재 |
| domain-logic 속성 | 있음 또는 없음 | 입력 정규화와 업무 규칙 검증의 존재 |
경계 (3)은 이 문법으로도 해소되지 않는다. read-style tool이 gateway를 닮는 문제는 속성의 가시성이 아니라 Tools와 Resources 중 무엇으로 노출했는지의 문제이며, 이 역시 기능 설명에는 드러나지 않는 구현 신호다.
전송 지연
전송 지연 실험은 구성 5개의 p50, p95, p99를 보고한다. 표를 읽을 때 Method 열을 먼저 확인해야 하는데, 5행 중 2행만 직접 측정이기 때문이다.
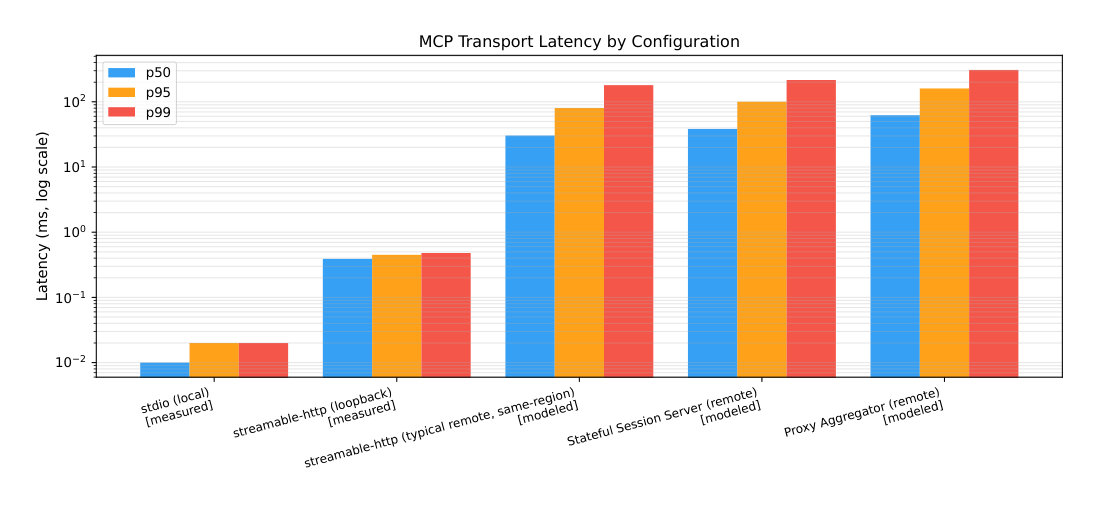
| Transport | Method | p50 | p95 | p99 |
|---|---|---|---|---|
| stdio (local) | measured | 0.01 ms | 0.02 ms | 0.02 ms |
| streamable-http (loopback) | measured | 0.39 ms | 0.45 ms | 0.48 ms |
| streamable-http (same-region remote) | modeled | 30.4 ms | 80.4 ms | 180.4 ms |
| Stateful Session Server (remote) | modeled | 38.4 ms | 100.4 ms | 216.4 ms |
| Proxy Aggregator (remote, single hop) | modeled | 62.4 ms | 160.4 ms | 308.4 ms |
measured 2행의 설계는 다음과 같다. 최소 JSON-RPC 2.0 echo 서버를 stdio와 loopback streamable-http로 각각 호출하며, 후자는 로컬 http.server에 HTTP POST를 보낸다.
| 설계 요소 | 값 |
|---|---|
| 호출 수 | 전송당 100회 |
| warm-up | 10회 (측정에서 제외) |
| 목적 | LLM 왕복을 배제해 프로토콜 오버헤드만 분리 |
핵심 발견은 전송 오버헤드가 프로토콜 계층이 아니라 network RTT에 지배된다는 것이다. in-host 전송인 stdio와 loopback streamable-http는 1 ms를 훨씬 밑돈다. 두 전송의 격차는 실재하지만, 호스트 경계를 넘는 배포에서는 same-region network RTT가 두 프로토콜 자체 오버헤드보다 2배에서 3배의 자릿수만큼 크므로 무의미해진다.
따라서 아키텍처상 중요한 선택은 어떤 전송 인코딩을 쓰는지가 아니라 두 가지다.
| # | 결정 |
|---|---|
| a | 서버가 클라이언트와 co-located인지 |
| b | downstream fan-out(Proxy Aggregator)이 network hop을 하나 더 추가하는지 |
이 결론은 Proxy Aggregator의 부담 항목과 같은 것을 다른 각도에서 말한다. 집계 지점을 두는 비용이 설정 복잡도가 아니라 지연으로 드러난다는 것이다.
패턴별 부담 목록에 흩어져 있던 network hop 항목을 지연 결과와 함께 놓으면 비용의 크기가 잡힌다.
| 패턴 | 추가되는 hop | 발생 시점 | modeled p50 기준 비용 |
|---|---|---|---|
| Resource Gateway | 백엔드로 향하는 hop 하나 | 읽기마다 | 표에 별도 행이 없다. 백엔드가 원격이면 캘리브레이션 상수 수준을 예상할 수 있다 |
| Stateful Session Server | 없음. 다만 원격 배포 시 세션 조회가 경로에 들어간다 | 호출마다 | 30.4 ms에서 38.4 ms로 약 8 ms 증가 |
| Proxy Aggregator | upstream으로 향하는 hop 하나 | 호출마다 | 30.4 ms에서 62.4 ms로 약 32 ms 증가 |
| Tool Orchestrator | sub-call 수만큼 | composite tool 호출마다 | 표에 행이 없다. 내부 호출은 서버에서 백엔드로 향하므로 MCP 전송 지연과 별개다 |
Tool Orchestrator 행이 표에 없다는 점이 오히려 이 패턴의 값을 설명한다. sub-call을 서버 안에서 처리하면 왕복이 클라이언트와 서버 사이가 아니라 서버와 백엔드 사이에서 일어나고, LLM이 여러 tool을 순차 호출하는 경우와 달리 MCP 왕복을 한 번만 소비한다.
모델값 세 행의 구성
modeled 3행은 다중 호스트 배포가 필요해 계측하지 않은 cross-host 경로를 대상으로 한다. 구성 방식은 측정된 loopback 오버헤드에 명시적 network RTT 캘리브레이션 상수를 더하는 것이다.
| 백분위 | 캘리브레이션 상수 |
|---|---|
| p50 | 약 30 ms |
| p95 | 약 80 ms |
| p99 | 약 180 ms |
상수의 출처는 MCP Python SDK 벤치마크와 pipecat 통합 데이터가 보고한 전형적 same-region 클라우드 HTTPS 왕복 분포다. 행별 캘리브레이션 출처는 논문 본문이 아니라 재현 패키지에 기재되어 있다. Method 열이 이 구분을 모든 행에 명시하고, 논문은 같은 구분을 산문 주장 전반에 유지한다.
modeled 3행을 첫 modeled 행 기준으로 분해하면 추가 오버헤드가 드러난다.
| 구성 | p50 추가분 | p95 추가분 | p99 추가분 |
|---|---|---|---|
| streamable-http (same-region remote) | 기준 | 기준 | 기준 |
| Stateful Session Server (remote) | +8 ms | +20 ms | +36 ms |
| Proxy Aggregator (remote, single hop) | +32 ms | +80 ms | +128 ms |
Proxy Aggregator의 추가분은 캘리브레이션 상수와 거의 같은 크기다. 즉 upstream으로 향하는 hop 하나가 클라이언트에서 proxy로 향하는 hop과 비슷한 비용을 갖는다는 모델이다. 다만 이 추가분의 산출 근거는 논문 본문에 없고 재현 패키지에만 있다.
tool 수와 선택 정확도
이 실험이 논문에서 실무적 무게가 가장 큰 결과다. ANSYR 음성 AI 플랫폼의 2025년 1분기 프로덕션 텔레메트리를 관찰 데이터로 보고하며, 논문을 위한 새 통제 실험이 아니라 프로덕션 로그의 회고 분석이다.
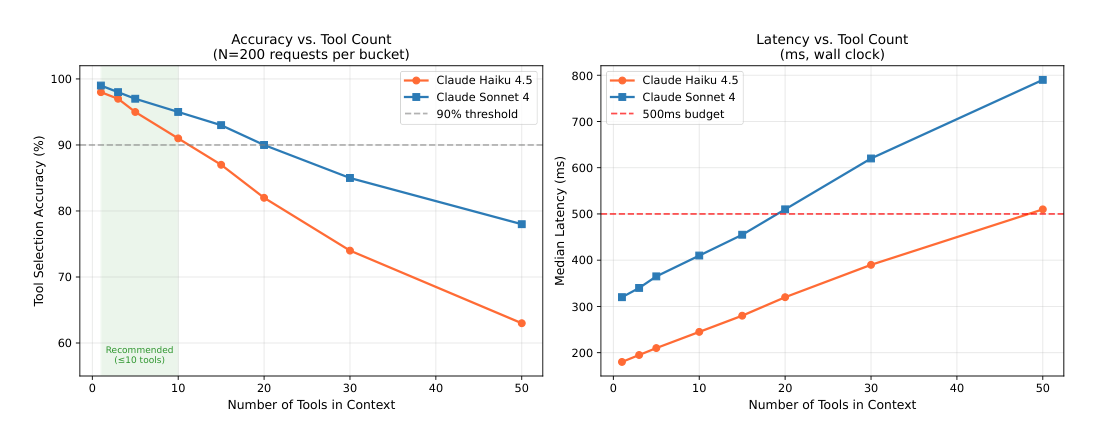
| 설계 요소 | 값 |
|---|---|
| tool 수 버킷 | 1, 3, 5, 10, 15, 20, 30, 50 (8개) |
| 버킷당 표본 | 프로덕션 세션 턴 200개 |
| 모델 배정 | 테넌트 설정에 따라 Claude Haiku 4.5 또는 Claude Sonnet 4가 각 턴을 처리 |
| ground truth | 통화 후 품질 리뷰에서 사람 운영자가 정답으로 확인한 tool. 상시 프로덕션 감사 단계다 |
| 신뢰구간 | Wilson 95% CI가 모든 버킷에서 ±4%p 이내 |
| 공개 | 버킷별 수치와 출처를 tool_count_telemetry.csv로 공개 |
논문 산문이 명시하는 정확도 수치는 네 개다. Haiku는 tool 10개에서 15개 사이에서 90% 문턱 아래로 내려가고 그 두 지점의 값이 91%와 87%다. Sonnet은 20개까지 90% 이상을 유지하다 30개에서 내려간다. 나머지 버킷 값은 Fig. 2 그래프에만 존재한다. 크롭을 판독해 여덟 버킷을 채우면 다음과 같다.
| tool 수 | Haiku 4.5 정확도 | Sonnet 4 정확도 | 두 모델 차이 |
|---|---|---|---|
| 1 | 약 98% | 약 99% | 약 1%p |
| 3 | 약 97% | 약 98% | 약 1%p |
| 5 | 약 95% | 약 97% | 약 2%p |
| 10 | 91% | 95% | 4%p |
| 15 | 87% | 약 93% | 약 6%p |
| 20 | 약 82% | 약 90% | 약 8%p |
| 30 | 약 74% | 약 85% | 약 11%p |
| 50 | 약 63% | 약 78% | 약 15%p |
곡선의 모양이 두 가지를 말한다. 첫째, 두 모델 모두 tool 수가 늘면 정확도가 단조 감소하고 감소 폭이 뒤로 갈수록 커진다. 둘째, 두 모델의 격차가 tool 1개에서 약 1%p였다가 50개에서 약 15%p로 벌어진다. 즉 모델 성능 차이는 tool 수가 적을 때는 거의 드러나지 않고 카탈로그가 커질 때 증폭된다.
tool 수와 median 지연
Fig. 2의 오른쪽 패널은 정확도와 함께 median 지연을 보여준다. 산문이 명시하는 값은 tool 10개 지점의 두 개, Haiku 245 ms와 Sonnet 410 ms다. 나머지는 그림 판독 값이다.
| tool 수 | Haiku 4.5 median 지연 | Sonnet 4 median 지연 |
|---|---|---|
| 1 | 약 180 ms | 약 320 ms |
| 3 | 약 195 ms | 약 345 ms |
| 5 | 약 210 ms | 약 365 ms |
| 10 | 245 ms | 410 ms |
| 15 | 약 280 ms | 약 455 ms |
| 20 | 약 320 ms | 약 510 ms |
| 30 | 약 390 ms | 약 620 ms |
| 50 | 약 510 ms | 약 790 ms |
오른쪽 패널에는 산문이 언급하지 않는 500 ms 예산선이 그려져 있다. 이 선을 함께 보면 두 모델의 권장 범위가 정확도 곡선만 볼 때와 다르게 정리된다.
| 모델 | 정확도가 90% 아래로 내려가는 구간 | 500 ms 예산을 넘는 지점 | 두 제약을 함께 만족하는 최대 tool 수 |
|---|---|---|---|
| Haiku 4.5 | tool 10개와 15개 사이 | tool 50개 부근 | 약 10개 (정확도가 먼저 걸린다) |
| Sonnet 4 | tool 20개와 30개 사이 | tool 20개 부근 | 약 15개 (지연이 먼저 걸린다) |
Sonnet 4의 정확도 여유는 지연 예산으로 상쇄된다. tool 20개 지점에서 Sonnet의 정확도는 약 90%로 아직 문턱에 걸쳐 있지만 median 지연은 이미 약 510 ms로 500 ms 예산을 넘는다. 반면 같은 지점에서 Haiku는 약 320 ms에 머문다. 따라서 지연 제약이 있는 음성 배포에서 두 모델의 실효 권장 범위 차이는 정확도만 볼 때보다 좁아진다. 이 대조는 논문 산문에 없고 그림에서만 읽을 수 있다.
패턴 선택으로 이어지는 함의
Resource Gateway와 Tool Orchestrator 패턴에 대한 함의는 직접적이다. 단일 MCP 서버가 tool을 약 10개에서 15개보다 많이 노출하면 scoped Proxy Aggregator 변형으로 tool 공간을 분할해 한 context에 관련 subset만 보이게 해야 한다.
여기서 논문이 강조하는 단서가 하나 붙는다. 단순 static merge는 문제를 개선하기보다 악화시키므로, 완화책은 집계 자체가 아니라 선택적 노출이다. 즉 Proxy Aggregator를 도입했다는 사실만으로는 tool 수 문제가 해결되지 않고 어느 변형을 골랐는지가 결과를 가른다.
선행 연구와의 정합
이 문턱은 더 큰 규모에서 문서화된 효과의 보수적 시작점이다. 세 연구를 나란히 놓으면 저하가 시작되는 지점과 저하가 심해지는 지점이 구분된다.
| 연구 | 보고한 관계 | 관측 규모 |
|---|---|---|
| 이 논문 (§VI-C) | Haiku 4.5는 tool 10개와 15개 사이, Sonnet 4는 20개와 30개 사이에서 90% 아래로 내려간다 | tool 1개에서 50개 |
| Gan and Sun (RAG-MCP) | 후보 tool 약 30개까지만 tool 선택 성공률이 90%를 넘고 약 100개를 지나면 크게 저하된다 | tool 약 100개 이상 |
| Kate et al. (LongFuncEval) | tool 카탈로그가 커질 때 정확도가 7%에서 85%까지 하락한다 | long context 모델 |
이 논문의 기여는 지연 제약이 있는 음성 배포에서 저하가 시작되는 지점을 국소화한 것이다. 그리고 Gan and Sun의 retrieval 기반 완화책은 저자들이 권고하는 Proxy Aggregator 분할의 구체적 사례에 해당한다.
실무 지침
횡단 관심사
패턴과 별개로 모든 MCP 서버에 걸치는 관심사가 네 가지다. 논문은 각각에 짧은 지침을 붙인다.
| 관심사 | 지침 |
|---|---|
| 인증 | streamable-http는 Bearer 토큰 인증을 지원한다. tool 핸들러 안이 아니라 전송 계층에서 인증한다. 토큰을 특정 tool 집합으로 스코핑한다. 모든 tool call을 caller identity와 함께 로깅한다 |
| 에러 핸들링 | 가능하면 예외를 던지지 않고 tool 에러를 structured error content로 반환한다. LLM이 에러를 보고 재시도할지 판단하며 사용자에게 에스컬레이션할지 결정할 수 있다 |
| 버전관리 | 서버의 initialize 응답에 version 필드를 포함한다. tool schema의 breaking change는 major 버전을 올린다. 즉시 클라이언트 갱신을 강제하지 않고 마이그레이션 창 동안 구 schema를 살려 둔다 |
| 관찰가능성 | tool call마다 tool 이름, 입력 해시, 지연, 출력 크기, 에러 코드를 로깅한다. 이 로그가 LLM 오작동의 주된 디버깅 표면이다 |
인증과 관찰가능성 항목은 로깅에서 만난다. 인증 절은 호출 로그 없이 LLM 동작을 디버깅하는 것이 매우 어렵다고 적고, 관찰가능성 절은 로그가 주된 디버깅 표면이라고 적는다. 두 문장이 같은 이유로 caller identity와 호출 세부를 함께 남기라고 요구한다.
에러 핸들링 지침은 anti-pattern과도 연결된다. structured error content는 Domain-Specific Adapter의 에러 번역 요소를 프로토콜 층에서 받쳐 주는 형태다.
구조 선택 결정 목록
구조를 고르는 실무자에게 카탈로그는 다섯 개 결정으로 줄어든다. 논문이 §VIII-C에서 제시하는 순서를 그대로 옮기면 다음과 같다.
| # | 결정 | 근거 절 |
|---|---|---|
| 1 | 읽기 위주 백엔드 데이터는 sanitization layer를 갖춘 Resource Gateway로 노출한다 | 패턴 1 |
| 2 | 다중 시스템 워크플로는 Tool Orchestrator로 캡슐화한다 | 패턴 2 |
| 3 | 턴이 진짜로 앞선 상태에 의존할 때만 Stateful Session Server를 선택하고, 선택했다면 세션 회수 비용을 예산에 넣는다 | 패턴 3 |
| 4 | fleet 집계는 static merge가 아니라 scoped Proxy Aggregator 변형으로 한다 | 패턴 4와 tool 수 결과 |
| 5 | 어떤 단일 context도 tool 10개에서 15개 정확도 예산 아래로 유지한다 | tool 수 결과 |
세 번째 항목의 조건절이 특히 중요하다. Stateful Session Server는 다섯 패턴 중 유일하게 도입 자체를 억제하는 방향으로 서술되며, 이유는 상태가 클라이언트에도 taxonomy에도 보이지 않으면서 운영 부담을 남기기 때문이다.
유지보수 관점의 seam과 부담
논문이 패턴의 비용을 회수하는 자리로 지목하는 것은 최초 구현이 아니라 유지보수와 진화 관점이다. 각 패턴은 변경을 국소화하는 seam이면서 동시에 저자가 물려받는 부담을 함께 지닌다.
| 패턴 | seam으로서의 값 | 물려받는 부담 |
|---|---|---|
| Domain-Specific Adapter | upstream API 변동을 흡수해 LLM 대면 표면을 안정시킨다 | 하부 API 변경을 추적해야 한다 |
| Proxy Aggregator | fleet을 버전관리하고 인증하고 감사할 단일 지점이다 | 단일 실패 지점과 namespace 거버넌스가 생긴다 |
| Resource Gateway | 백엔드 schema 마이그레이션을 한 계층에 가둔다 | 백엔드 변경이 이 계층으로 전파된다 |
| Stateful Session Server | 다중 턴 상태를 한 곳에 모은다 | 세션 저장소를 회수하지 않으면 누수된다. statefulness는 클라이언트에도 taxonomy 자체에도 보이지 않으므로 명시적으로 문서화해야 한다 |
| 공통 | tool 설명이 선택을 결정한다 | tool 설명은 코드처럼 리뷰하지 않으면 동작과 어긋나는 load-bearing 산출물이다 |
이 관점에서 anti-pattern 4종은 일회성 실수가 아니라 반복되는 유지보수성 smell이며, 저자들은 이 지점에서 Hasan et al.의 smell 카탈로그와 직접 연결된다고 적는다.
LLM 클라이언트를 위한 API 설계
패턴들이 시사하는 결론은 MCP 서버 설계가 근본적으로 하나의 특이한 제약을 가진 API 설계 문제라는 것이다. 클라이언트가 어떤 API를 부를지 문서를 참조해서가 아니라 자연어 설명을 읽어서 추론한다.
이는 통상의 API 설계 가정을 뒤집는다. 정밀하고 정보 밀도 높은 설명은 선택 사항이 아니라 필수이며, tool이 올바르게 쓰이는지를 직접 결정한다. 저자들은 tool 설명을 코드가 동작한 뒤 빠르게 써 두는 문서 주석으로 취급하는 실무자는 서버가 기대만큼 동작하지 않는 것을 보게 된다고 적는다.
LSP 유비도 같은 맥락에 놓인다. MCP는 host(에디터 또는 LLM 클라이언트)를 provider(언어 서버 또는 MCP 서버)에서 디커플링해 provider가 여러 host에서 재사용되게 하려는 LSP의 의도를 반영한다. LSP는 언어지능을 에디터별 플러그인에서 공유 생태계로 바꿨다. MCP가 LLM 능력에 대해 같은 일을 할지는 좋은 구현을 안내할 패턴 어휘가 등장하는지에 부분적으로 달려 있고, 저자들은 이 논문이 그 씨앗을 놓으려 한다고 밝힌다.
지침을 한 표로 압축
앞의 네 절을 서버 하나를 설계할 때 확인할 항목으로 압축하면 다음과 같다. 앞 세 열은 논문의 지침이고 마지막 열은 근거가 되는 절이다.
| 확인 항목 | 기본값 | 벗어날 조건 | 근거 |
|---|---|---|---|
| 단일 context의 tool 수 | 10개 이하 | 없음. 초과하면 scoped 집계로 분할한다 | tool 수 결과 |
| 집계 변형 | scoped | 병합 카탈로그가 예산 안에 확실히 들어올 때만 static-merge | 패턴 4와 tool 수 결과 |
| 서버 배치 | 클라이언트와 co-located | 중앙화된 인증과 감사가 co-located 배치보다 중요할 때 | 전송 지연 결과 |
| 서버측 상태 | 두지 않는다 | 턴이 진짜로 앞선 상태에 의존할 때만 도입하고 회수 비용을 예산에 넣는다 | 패턴 3과 구조 선택 목록 |
| 외부 콘텐츠 | MCP 응답 진입 전 sanitize | 없음 | 패턴 1과 anti-pattern 2 |
| 인증 위치 | 전송 계층 | 없음 | 횡단 관심사 |
| 장시간 연산 | job ID 반환과 별도 polling tool | 없음 | anti-pattern 3 |
| tool 설명 | 코드와 함께 리뷰한다 | 없음 | anti-pattern 4와 유지보수 관점 |
한계
논문이 명시한 네 가지
저자들은 §VIII-D에서 네 가지 한계를 스스로 열거한다.
| # | 한계 | 완화 여부 |
|---|---|---|
| 1 | 파생 코퍼스가 한 조직의 서버 15개와 공식 공개 레지스트리다. 최근 측정 연구가 공개 MCP 서버 8,000개 이상을 카탈로그했고, 그 규모의 층화 복제는 시도하지 않았다 | 미완화 |
| 2 | taxonomy를 단일 코더 open coding과 2차 검증으로 도출했고 독립 dual coding이 아니다 | held-out rater 간 연구(κ=0.76, N=54)로 부분 완화. 파생 코퍼스의 완전한 독립 dual coding은 향후 과제다 |
| 3 | 분류 코퍼스가 합성 및 실제 파생 서버 설명이고 실행 중 서버 자체가 아니다. 프로덕션 서버에 대한 분류 정확도는 다를 수 있다 | 미완화 |
| 4 | 전송 지연표 5행 중 3행이 종단 측정이 아니라 모델값이다 | 과도한 주장을 피하려고 행마다 방법론을 명시 |
타당성 위협 네 범주
§VIII-E는 한계를 타당성 범주별로 다시 정리한다. 앞 절의 한계 목록과 겹치지만 어느 종류의 결론이 얼마나 흔들리는지를 구분해 준다.
| 범주 | 내용 |
|---|---|
| Construct validity | 신뢰도 연구가 held-out 서버에 독립 LLM rater 2인을 써 단일 rater 편향을 완화하지만, 두 rater 모두 LLM이라 blind spot을 공유할 수 있다. 독립 human dual-coding은 향후 과제다 |
| Internal validity | modeled 행은 측정된 loopback 오버헤드와 network RTT 상수를 합성한 값이다. 상수는 same-region 클라우드 텔레메트리로 캘리브레이션했으나 cross-region이나 혼잡 경로 배포는 절대값이 상당히 달라진다. 구성 간 상대 순서는 절대값보다 안정적이다 |
| External validity | ANSYR 프로덕션 서버 5개가 모두 하나의 응용 도메인, 즉 단일 산업의 음성 AI에서 나왔다. 운영 프로파일이 다른 도메인에서는 패턴이 달라질 수 있다 |
| Conclusion validity | 신뢰도 코퍼스 N=54가 rater 간 κ의 bootstrap 95% CI를 [0.62, 0.88]로 만든다. "substantial" 일치이지만 54개 표본만으로 카탈로그가 전체 설계 공간을 포괄한다고 과대 해석해서는 안 된다 |
Internal validity 항목의 마지막 문장이 modeled 행을 인용할 때의 지침이다. 절대값보다 구성 간 순서가 안정적이므로, "Proxy Aggregator가 co-located 배포보다 느리다"는 주장은 유지되고 "p50이 62.4 ms다"는 주장은 배포 조건에 따라 흔들린다.
관찰 데이터의 단서 조항
tool 수 결과에는 §VI-C가 별도의 caveats 문단을 붙인다. 이 결과가 논문의 실무 결론을 지탱하므로 단서를 함께 인용해야 한다.
| # | 단서 |
|---|---|
| 1 | 데이터가 관찰 데이터이며 한 조직의 프로덕션 tool 표면에서 나왔다 |
| 2 | 의미가 겹치는 tool이 많은 인벤토리에서는 결과가 다를 수 있다 |
| 3 | 의도적으로 모호한 설명을 가진 tool에서도 결과가 다를 수 있다 |
| 4 | 프로덕션 세션 로그 자체는 공개하지 않았으므로 공개 코드만으로 그림을 재도출할 수 없다 |
두 번째와 세 번째 단서는 anti-pattern 목록과 맞물린다. Missing or Vague Tool Descriptions가 많은 서버에서는 tool 10개에서 15개 예산이 더 낙관적인 값일 수 있다는 뜻이다.
논문 내적 불일치와 미기재 항목
원문을 다시 읽으며 확인한 어긋남과 근거 미기재 항목이다. 인용할 때 주의할 지점이므로 남긴다.
| 항목 | 내용 |
|---|---|
| Toolformer와 ToolBench의 인용 어긋남 | §II-C 본문은 "evaluation benchmarks (ToolBench-style suites [11], …)"라고 쓰지만 참고문헌 [11]은 Schick et al.의 Toolformer(NeurIPS 2023)다. ToolBench 자체는 참고문헌 목록에 없다 |
| modeled 행의 반올림 | streamable-http remote의 p95는 loopback 0.45 ms와 상수 80 ms의 합이 80.45 ms인데 표는 80.4 ms로 적는다. p99도 0.48과 180의 합 180.48을 180.4로 적어 반올림이 아닌 절단으로 보인다 |
| modeled 행의 추가 오버헤드 미기재 | 본문은 modeled 행을 loopback 오버헤드에 network RTT 상수를 더한 값으로 정의하지만, Stateful Session Server와 Proxy Aggregator 행은 첫 modeled 행보다 각각 8 ms에서 36 ms, 32 ms에서 128 ms 더 크다. 이 추가분의 근거는 본문에 없고 행별 캘리브레이션 출처가 재현 패키지에 있다고만 적힌다 |
| 패턴 승격 조건과 코퍼스 표의 긴장 | §III-B는 후보가 최소 2개 서버에서 독립적으로 등장해야 승격된다고 하지만, Table II는 Domain-Specific Adapter와 Proxy Aggregator를 각각 프로덕션 서버 1개에만 배정한다. 공개 서버 10개에는 두 패턴이 primary pattern으로 배정된 서버가 없다 |
| 경계 모호성 예시의 코퍼스 초과 | §VI-A 경계 (1)이 예시로 든 playwright와 selenium은 held-out 54개 코퍼스 소속이며 Table II의 파생 코퍼스 15개에는 없다 |
| tool 예산의 모델 조건 | 결론은 tool 10개에서 15개 문턱을 "for current Haiku-class models"로 한정한다. Sonnet 4는 20개까지 90% 이상을 유지하므로 문턱을 모델 무관하게 인용하면 조건이 빠진다 |
| 500 ms 예산선의 미서술 | Fig. 2 오른쪽 패널의 500 ms 예산선과 그 선을 기준으로 한 두 모델 대조는 그림에만 있고 산문에는 없다 |
후속 방향
논문은 후속 방향을 두 곳에서 제시하고 두 목록이 완전히 겹치지 않는다. §VIII-C는 연구자를 향한 세 질문이고 §IX 결론은 생태계 성숙을 전제로 한 세 방향이다.
| 출처 | 제시한 방향 |
|---|---|
| §VIII-C | 생태계 규모에서 파생 코퍼스의 독립 human dual-coding |
| §VIII-C | 진짜 taxonomy 모호성과 LLM 공유 blind spot을 분리할 Claude 2종 이상의 multi-model rater 패널 |
| §VIII-C | 패턴 선택을 측정된 지연과 신뢰도에 잇는 예측 연구. 카탈로그를 서술적 어휘에서 경험적 도구로 바꾼다 |
| §IX | 더 크고 도메인이 다양한 코퍼스에서 taxonomy의 독립 inter-coder 검증 |
| §IX | 패턴 변형별 LLM tool 선택 정확도의 정량 평가 |
| §IX | MCP 서버 공격 표면의 보안 분석, 특히 resource를 통한 prompt injection |
두 목록에서 공통인 것은 독립 inter-coder 검증 하나다. 나머지 네 방향은 한쪽에만 등장하는데, §IX의 보안 분석 방향은 §VIII-C에 없고 §VIII-C의 예측 연구 방향은 §IX에 없다. 세 방향씩이라는 형식은 같지만 내용이 다르므로, 이 논문의 후속 방향을 인용할 때는 어느 절을 따르는지 밝히는 편이 정확하다.
재현 패키지
MIT 라이선스로 https://github.com/rodriguescarson/mcp-patterns-icsme2026 에 공개되어 있다.
| 파일 | 내용 |
|---|---|
corpus.json |
열거된 파생 코퍼스 15개 |
kappa_eval.py |
54개 서버 신뢰도 코퍼스와 2-rater 분류 스크립트 |
transport_bench.py |
전송 벤치마크 |
prompts/classification_prompt.txt |
분류 프롬프트 템플릿 |
tool_count_telemetry.csv |
관찰 tool 수 텔레메트리 |
requirements.txt |
의존성 매니페스트 |
results_kappa.json |
rater별 서버 단위 예측, rater 간 κ와 bootstrap CI, rater별 저자 라벨 일치율 |
results/transport_measured.json |
전송 raw 샘플 |
두 rater는 결정성을 위해 temperature 0으로 질의했고 모델 식별자는 claude-haiku-4-5-20251001과 Claude Sonnet 4다. 다만 프로덕션 세션 로그 자체는 포함되지 않으므로 Fig. 2를 코드만으로 재도출할 수는 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| LLM-client delta | 고전 패턴 대비 "LLM이 자연어 설명을 읽고 연산을 고른다"는 제약이 추가로 만들어내는 차이. 이 논문이 기여 단위로 내세우는 개념이다 |
| composite tool | 완결된 다중 시스템 워크플로를 내부에서 처리하고 단일 요약만 반환하는 tool. Tool Orchestrator의 구성 단위다 |
| retrieval-over-tools | 전체 tool을 나열하지 않고 요청별로 관련 tool 후보만 검색해 노출하는 기법. scoped Proxy Aggregator의 핵심이다 |
| sanitization layer | 백엔드나 외부 콘텐츠에 주입된 지시를 LLM 도달 전에 제거하거나 이스케이프하는 계층. Resource Gateway의 필수 구성이다 |
| architecture-neutral description | 아키텍처를 명명하지 않고 서버가 무엇을 하는지만 서술하는 분류 실험용 설명. 아키텍처를 스스로 밝히는 canonical 설명과 대비된다 |
| structured error content | 예외를 던지는 대신 tool 에러를 구조화된 내용으로 반환하는 방식. LLM이 재시도와 에스컬레이션을 판단할 수 있게 한다 |
관련 페이지
- MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers: 같은 MCP 계층을 클라이언트 쪽에서 평가한 벤치마크다. 이 논문의 Missing or Vague Tool Descriptions anti-pattern이 거기서는 distractor 사이의 도구 발견 문제로 측정된다
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26): Claude Code의 외부 시스템 연결 절이 MCP 서버 운용을 클라이언트 설정 관점에서 다룬다. 이 논문의 Proxy Aggregator 결정이 Claude Code 쪽에서는 서버 연결 수 제약으로 나타난다
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 실패 taxonomy다. tool use와 정보 은폐 같은 실패 모드가 이 논문의 God Tool과 Missing or Vague Tool Descriptions와 클라이언트, 서버 양면에서 맞닿는다
- Compiling Agentic Workflows into LLM Weights: agentic 워크플로를 모델 가중치로 compile하는 접근이다. Tool Orchestrator가 워크플로를 서버측 composite tool로 캡슐화하는 것과 대비되는 클라이언트측 전략이다
- Memory Intelligence Agent (MIA): 에이전트 메모리를 다룬다. Stateful Session Server의 서버측 세션 상태와 에이전트 장기 메모리의 경계를 함께 보면 좋다
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: Direct Corpus Interaction을 제안한다. retrieval-over-tools와 마찬가지로 무엇을 context에 노출할지를 retrieval 문제로 보는 관점이다
- CUA-Gym: Scaling Verifiable Training Environments and Tasks for Computer-Use Agents: 검증 가능한 학습 환경을 대규모로 합성한다. 이 논문의 tool 수 예산이 학습 데이터 쪽에서는 환경 인벤토리 설계 문제로 나타난다
- REA: 무엇이든 리버스 엔지니어링하라: 분석 도구 하나가 아니라 분석 대상 23종을 기준으로 여러 리버스 엔지니어링 도구를 묶은 MCP 서버 사례다. 결과를 Evidence 레코드로 고정해 반환한다