Agents · PAPER · 2025
Why Do Multi-Agent LLM Systems Fail?
요약
MAST는 여러 LLM agent가 협업하는 시스템이 실패하는 방식을 14개 실패 모드(failure mode)와 3개 카테고리로 정리한 첫 경험적 분류체계(taxonomy)다. UC Berkeley와 Intesa Sanpaolo 연구진이 7개 오픈소스 MAS 프레임워크에서 1,642개 실행 trace를 모아 라벨링했고, 그 데이터셋을 MAST-Data라는 이름으로 공개했다.
이 논문의 결론은 실패의 원인이 기반 모델의 한계보다 시스템 설계와 agent 조직 구조에 있다는 것이다. 같은 GPT-4o를 쓰면서 ChatDev의 role specification만 다듬어도 작업 성공률이 9.4%p 올랐고, topology를 바꾸면 15.6%p 올랐다.
따라서 이 페이지는 MAS를 만드는 사람이 실패를 진단할 때 쓰는 공통 어휘집으로 읽는 것이 적절하다. 분류체계 자체보다도 "어느 실패가 어느 시스템에서 왜 많이 나오는가"를 데이터로 보여주는 부분이 실무에 바로 쓰인다.
배경
MAS에 대한 기대와 실제 성능 사이에는 큰 간극이 있다. 여러 agent를 붙여도 단일 agent 프레임워크나 best-of-N 샘플링 같은 단순한 베이스라인 대비 성능 이득이 미미한 경우가 많다는 관찰이 이 연구의 출발점이다.
문제는 실패의 원인을 부를 이름이 없었다는 점이다. 전통적인 소프트웨어는 stack trace로 근본 원인을 좁힐 수 있지만, MAS의 실패는 agent 간 대화가 얽히면서 개별 모델의 행동과 전체 설계가 함께 작용한 결과로 나타난다.
여기에 표준 정의의 부재가 겹친다. 같은 증상을 두고 어떤 사람은 컨텍스트 관리 문제로, 어떤 사람은 조정 실패로 부르면 시스템 간 비교가 성립하지 않는다. 저자들이 분류체계를 먼저 만들고 데이터셋을 나중에 만든 이유가 여기에 있다.
논문은 이 상황을 조직 이론에 빗댄다. 유능한 개인들로 구성된 조직도 구조가 잘못되면 크게 실패한다는 Normal Accidents(Perrow 1984)의 관점을 MAS에 그대로 적용하면, 모델 성능 개선만으로는 닿지 않는 실패 영역이 존재한다는 가설이 나온다.
핵심 개념
이 논문을 읽는 데 필요한 개념은 대부분 정의가 짧다. 다만 정의를 흘려보내면 이후의 수치 해석이 어려워지므로 먼저 정리한다.
agent는 프롬프트로 주어진 초기 상태, 대화 기록으로 유지되는 상태, tool use를 포함한 환경 상호작용 능력을 갖춘 인공 entity를 뜻한다. MAS는 이런 agent들이 오케스트레이션을 통해 상호작용하도록 묶은 집합이며, task decomposition과 병렬화, context isolation, 전문 모델 ensembling, 다양한 추론(reasoning) 토론을 지원한다.
trace는 MAS가 task 하나를 처리하면서 남긴 agent 간 대화와 tool 실행의 전체 기록이다. 이 논문이 다루는 trace는 한 건당 평균 15,000줄이 넘어, 사람이 하나를 끝까지 읽는 데만 상당한 시간이 든다.
Grounded Theory는 가설을 먼저 세우지 않고 데이터에서 개념이 떠오르게 하는 질적 연구 방법론이다. open coding으로 관찰된 행동에 라벨을 붙이고, 사례를 계속 비교하며 정의를 다듬고, 새로운 통찰이 더 나오지 않는 theoretical saturation 지점에서 멈춘다.
annotator는 trace를 읽고 어떤 실패 모드가 나타났는지 라벨을 붙이는 주체다. 사람 annotator 여럿이 같은 trace에 얼마나 같은 라벨을 붙이는지는 Cohen's κ로 재며, 값이 1에 가까울수록 일치도가 높다. 이 논문은 최종 라운드에서 0.88을 달성했고 이를 정의가 명확하다는 근거로 삼는다.
verification은 산출물이 요구를 만족하는지 확인하는 단계를 가리킨다. MAS에서는 별도의 verifier agent가 맡거나 코드 실행 결과로 대신하는데, 이 논문은 그 verification이 얕게 수행되는 문제를 하나의 카테고리로 떼어낸다.
topology는 agent들이 서로 어떤 순서와 방향으로 연결되는지를 정한 대화 구조다. star topology는 supervisor 하나가 주변 agent와 각각 대화하는 형태이고, hierarchical workflow는 단계별로 상위와 하위 agent가 이어지는 형태다.
theory of mind는 상대가 무엇을 알고 무엇을 필요로 하는지 추정하는 능력을 말한다. 이 논문은 agent 간 정보 전달 실패의 근본 원인을 메시지 포맷이 아니라 이 능력의 부재로 지목한다.
MAST 분류체계
세 카테고리
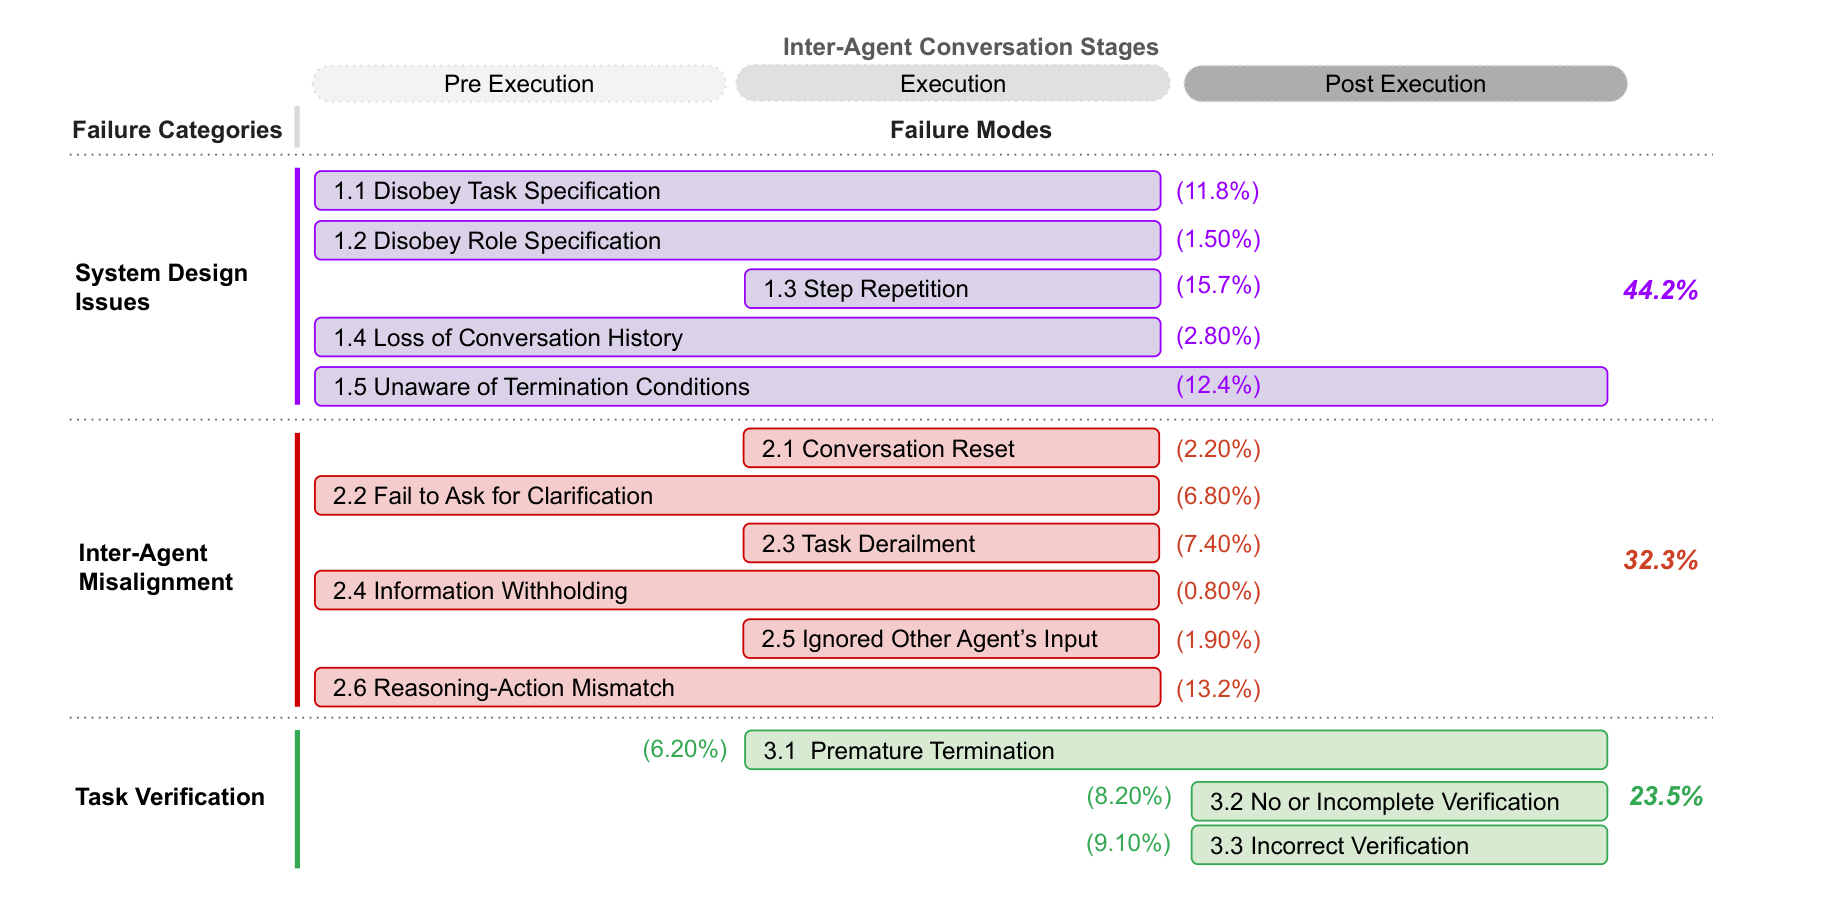
MAST는 14개 실패 모드를 세 카테고리로 묶는다. 카테고리는 실패의 성격을 기준으로 나뉘며, 각 모드는 근본 원인이 주로 발생하는 실행 단계에 매핑된다.
| 카테고리 | 정의 | 1,642개 trace 비중 |
|---|---|---|
| FC1. System Design Issues | 시스템 아키텍처 결정과 모호한 프롬프트 명세에서 비롯하는 실패 | 44.2% |
| FC2. Inter-Agent Misalignment | agent 간 정보 흐름과 조정이 끊기면서 생기는 실패 | 32.3% |
| FC3. Task Verification | verification이 부실하거나 조기 종료가 일어나는 실패 | 23.5% |
FC1의 근본 원인은 실행 이전 단계에 있다. 실패는 실행 중에 관측되지만 아키텍처, 프롬프트 지시, 상태 관리에 대한 사전 결정이 원인이라는 뜻이다.
FC2는 실행 단계에 집중된다. 같은 프레임워크 안에서 자연어로 통신하는 agent들 사이에서도 발생한다는 점이 중요하다.
FC3는 실행 이후 단계에 걸린다. 결과물의 품질 관리가 목적이므로 verifier의 유무보다 verifier가 무엇을 보는지가 관건이다.
14개 실패 모드
각 모드의 정의와 발생 비중은 다음과 같다. 비중은 1,642개 trace 전체에서 해당 모드가 관측된 비율이다.
| ID | 이름 | 정의 | 비중 |
|---|---|---|---|
| FM-1.1 | Disobey Task Specification | task에 명시된 제약이나 요구를 지키지 않는다 | 11.8% |
| FM-1.2 | Disobey Role Specification | 배정된 role의 책임과 제약을 벗어나 다른 agent처럼 행동한다 | 1.50% |
| FM-1.3 | Step Repetition | 이미 끝낸 단계를 불필요하게 반복한다 | 15.7% |
| FM-1.4 | Loss of Conversation History | 컨텍스트가 예기치 않게 잘려 이전 대화 상태로 회귀한다 | 2.80% |
| FM-1.5 | Unaware of Termination Conditions | 상호작용을 끝내야 할 기준을 인식하지 못한다 | 12.4% |
| FM-2.1 | Conversation Reset | 대화가 예고 없이 다시 시작되어 진행 상황을 잃는다 | 2.20% |
| FM-2.2 | Fail to Ask for Clarification | 정보가 불충분한데도 되묻지 않고 잘못된 가정으로 진행한다 | 6.80% |
| FM-2.3 | Task Derailment | 원래 목표에서 점차 벗어나 관련 없는 행동으로 이어진다 | 7.40% |
| FM-2.4 | Information Withholding | 알고 있는 중요한 정보를 다른 agent에게 전달하지 않는다 | 0.80% |
| FM-2.5 | Ignored Other Agent's Input | 다른 agent의 입력이나 권고를 충분히 고려하지 않는다 | 1.90% |
| FM-2.6 | Reasoning-Action Mismatch | 추론 내용과 실제 실행한 action이 어긋난다 | 13.2% |
| FM-3.1 | Premature Termination | 필요한 정보 교환이나 목표 달성 전에 task를 끝낸다 | 6.20% |
| FM-3.2 | No or Incomplete Verification | 결과 확인을 생략하거나 일부만 수행한다 | 8.20% |
| FM-3.3 | Incorrect Verification | 반복 과정에서 핵심 정보나 결정을 제대로 교차 확인하지 못한다 | 9.10% |
비중 상위 세 모드는 FM-1.3 Step Repetition(15.7%), FM-2.6 Reasoning-Action Mismatch(13.2%), FM-1.5 Unaware of Termination Conditions(12.4%)다. 세 모드 모두 모델의 지식 부족이 아니라 실행 흐름의 제어와 관련된다.
카테고리별 대표 사례
FC1의 사례로 논문은 ChatDev의 Wordle 과제를 든다. "매일 5글자 단어를 제공하는 표준 Wordle 게임"을 요청하면 고정 단어 사전을 쓴 코드가 나오는데, "고정 단어 목록 없이 매일 새 단어를 무작위로 고르라"고 명시해도 여전히 고정 목록을 쓴 코드와 새로운 오류가 나온다.
이 관찰이 중요한 이유는 원인을 프롬프트 품질만으로 돌릴 수 없기 때문이다. 사용자 프롬프트를 구체화해도 결과가 개선되지 않으므로 명세를 해석하는 MAS의 설계 자체가 원인이라는 결론이 나온다.
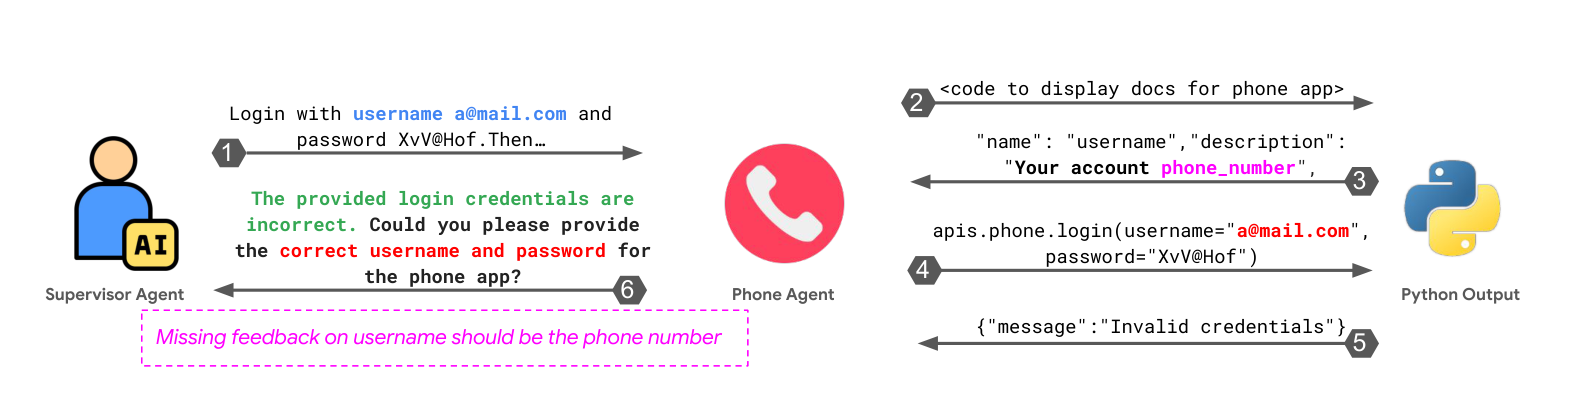
FC2의 사례는 AppWorld 기반 시스템에서 나왔다. Phone Agent가 API 문서를 읽어 username 필드에 전화번호가 들어가야 한다는 사실을 확인하고도 이를 Supervisor Agent에게 전달하지 않고, Supervisor도 되묻지 않아 로그인 시도가 반복해서 실패한다.
FC3의 사례는 ChatDev가 생성한 체스 프로그램이다. 코드가 컴파일되고 남은 TODO 주석이 없다는 표면적 확인은 통과하지만, 실제 게임 규칙을 검증하지 않아 런타임 오류가 남는다. review 단계가 있는 시스템에서도 이런 결과가 나온다는 점이 verifier의 존재만으로는 부족하다는 근거가 된다.
세 가지 인사이트
저자들은 각 카테고리에서 하나씩 인사이트를 뽑는다.
- Insight 1 (FC1): MAS 실패는 기반 모델의 한계만으로 설명되지 않는다. 잘 설계된 MAS는 같은 모델로도 더 나은 성능을 낸다.
- Insight 2 (FC2): 컨텍스트나 통신 프로토콜 중심의 해법으로는 FC2 실패를 잡기 어렵다. Model Context Protocol과 Agent to Agent 같은 표준은 서로 다른 제공자의 메시지 포맷을 통일하지만, 관측된 오류는 같은 프레임워크 안에서 자연어로 대화하는 agent 사이에서도 발생한다. 필요한 것은 상대의 정보 요구를 추정하는 social reasoning 능력이다.
- Insight 3 (FC3): multi-level verification이 필요하다. 최종 단계의 low-level 체크 하나로는 부족하며, 낮은 수준의 정확성과 높은 수준의 목표 달성을 함께 확인해야 한다.
Insight 3을 뒷받침하는 실험이 개입 case study다. ChatDev에 상위 수준의 task 목표 verification 단계를 추가하자 ProgramDev 성공률이 15.6%p 올랐다.
데이터셋 구축 방법
원본 trace 수집과 Grounded Theory 분석
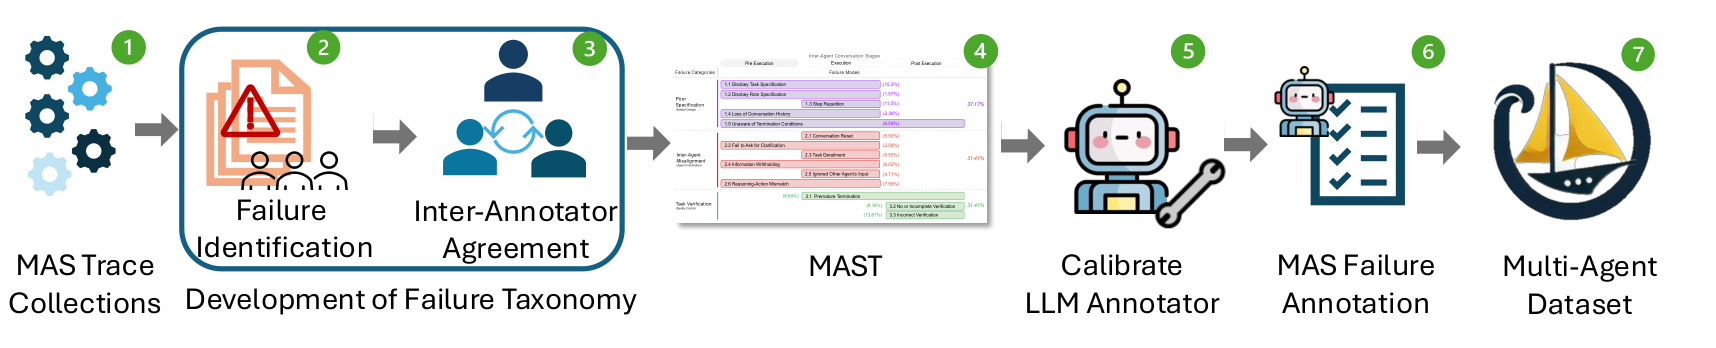
첫 단계는 5개 프레임워크(HyperAgent, AppWorld, AG2, ChatDev, MetaGPT)에서 150개 trace를 모으는 일이다. 시스템 목적과 상호작용 패턴이 서로 다르도록 theoretical sampling으로 골랐고, 과제 영역은 프로그래밍과 수학 문제 풀이 두 가지다.
expert 6인이 이 trace를 읽으며 open coding, constant comparative analysis, memoing, theorizing을 반복했다. 투입 시간은 1인당 20시간을 넘는다.
라벨 표준화
정의가 사람마다 다르게 읽히면 데이터셋의 라벨이 일관되지 않는다. 저자들은 3인의 expert가 무작위로 고른 5개 trace를 독립 라벨링한 뒤 불일치를 논의로 해소하고, 그 결과로 정의를 수정하거나 모드를 추가하고 병합하는 과정을 3라운드 반복했다.
불일치 해소 논의에만 총 10시간이 들었고 최종 Cohen's κ는 0.88이다. 라벨링 시간은 여기에 포함되지 않는다.
LLM annotator
1,600개가 넘는 trace를 사람이 라벨링하기는 어렵다. 저자들은 OpenAI o1에 실행 trace와 MAST 정의, 사람이 라벨링한 few-shot 예시를 함께 넣어 실패 모드를 분류하는 LLM-as-a-Judge 파이프라인을 만들었다.
| Model | Accuracy | Recall | Precision | F1 | Cohen's κ |
|---|---|---|---|---|---|
| o1 (zero-shot) | 0.89 | 0.62 | 0.68 | 0.64 | 0.58 |
| o1 (few-shot) | 0.94 | 0.77 | 0.833 | 0.80 | 0.77 |
few-shot 예시를 넣는 것만으로 κ가 0.58에서 0.77로 0.19 올랐다. recall도 0.62에서 0.77로 오르는데, 정의만 주면 LLM이 실패를 놓치는 쪽으로 기운다는 뜻이다.
일반화 검증과 최종 구성
대규모 수집 전에 분류체계와 annotator가 새 시스템에도 통하는지 확인한다. 초기 개발에 쓰이지 않은 OpenManus와 Magentic-One, 그리고 MMLU와 GAIA 벤치마크에서 추가 IAA를 돌린 결과 κ=0.79가 나왔다.
최종 MAST-Data는 18개 설정에서 모은 1,642개 trace다. HE는 사람이 작업 성공 여부를 확인한 설정, HA는 사람이 실패 모드를 라벨링한 설정, LA는 LLM annotator가 라벨링한 설정을 뜻한다.
| MAS | Benchmark | LLM | 라벨링 | trace 수 |
|---|---|---|---|---|
| ChatDev | ProgramDev | GPT-4o | HE, HA, LA | 30 |
| MetaGPT | ProgramDev | GPT-4o | HE, HA, LA | 30 |
| HyperAgent | SWE-Bench Lite | Claude 3.7 Sonnet | HE, HA, LA | 30 |
| AppWorld | Test-C | GPT-4o | HE, HA, LA | 30 |
| AG2 (MathChat) | GSM-Plus | GPT-4 | HE, HA, LA | 30 |
| Magentic-One | GAIA | GPT-4o | HE, HA, LA | 30 |
| OpenManus | ProgramDev | GPT-4o | HE, HA, LA | 30 |
| ChatDev | ProgramDev-v2 | GPT-4o | LA | 100 |
| MetaGPT | ProgramDev-v2 | GPT-4o | LA | 100 |
| MetaGPT | ProgramDev-v2 | Claude 3.7 Sonnet | LA | 100 |
| ChatDev | ProgramDev-v2 | Qwen2.5-Coder-32B-Instruct | LA | 100 |
| MetaGPT | ProgramDev-v2 | Qwen2.5-Coder-32B-Instruct | LA | 100 |
| ChatDev | ProgramDev-v2 | CodeLlama-7b-Instruct | LA | 100 |
| MetaGPT | ProgramDev-v2 | CodeLlama-7b-Instruct | LA | 100 |
| AG2 (MathChat) | OlympiadBench | GPT-4o | HE, LA | 206 |
| AG2 (MathChat) | GSM-Plus | Claude 3.7 Sonnet | HE, LA | 193 |
| AG2 (MathChat) | MMLU | GPT-4o-mini | HE, LA | 168 |
| Magentic-One | GAIA | GPT-4o | HE, LA | 165 |
여기에 IAA 과정에서 3인의 expert가 각각 라벨링한 21개 trace를 MAST-Data-human으로 따로 공개한다. 자동 라벨과 사람 라벨을 비교하려는 후속 연구를 위한 자산이다.
대상 시스템과 실패율
7개 MAS는 구조가 서로 다르다. 이 차이가 뒤의 실패 프로파일 차이를 만든다.
| MAS | agentic 구조 | 목적 |
|---|---|---|
| MetaGPT | Assembly Line | 소프트웨어 회사 role의 표준 운영 절차를 프롬프트에 인코딩해 개방형 애플리케이션을 만든다 |
| ChatDev | Hierarchical Workflow | 설계, 코딩, QA 단계를 회사 role 시뮬레이션으로 재현한다 |
| HyperAgent | Hierarchical Workflow | Planner가 Navigator, Editor, Executor 자식 agent를 조율하는 소프트웨어 공학 팀 |
| AppWorld | Star Topology | Gmail, Spotify 같은 서비스별 tool 호출 agent를 supervisor가 오케스트레이션한다 |
| AG2 | agentic framework | agent와 그 상호작용을 구성하는 오픈소스 프로그래밍 프레임워크 |
| Magentic-One | Star Topology | 웹과 파일 환경을 오가는 개방형 과제용 범용 시스템 |
| OpenManus | Hierarchical | Manus에서 착안한 오픈소스 협업 agent 프레임워크 |
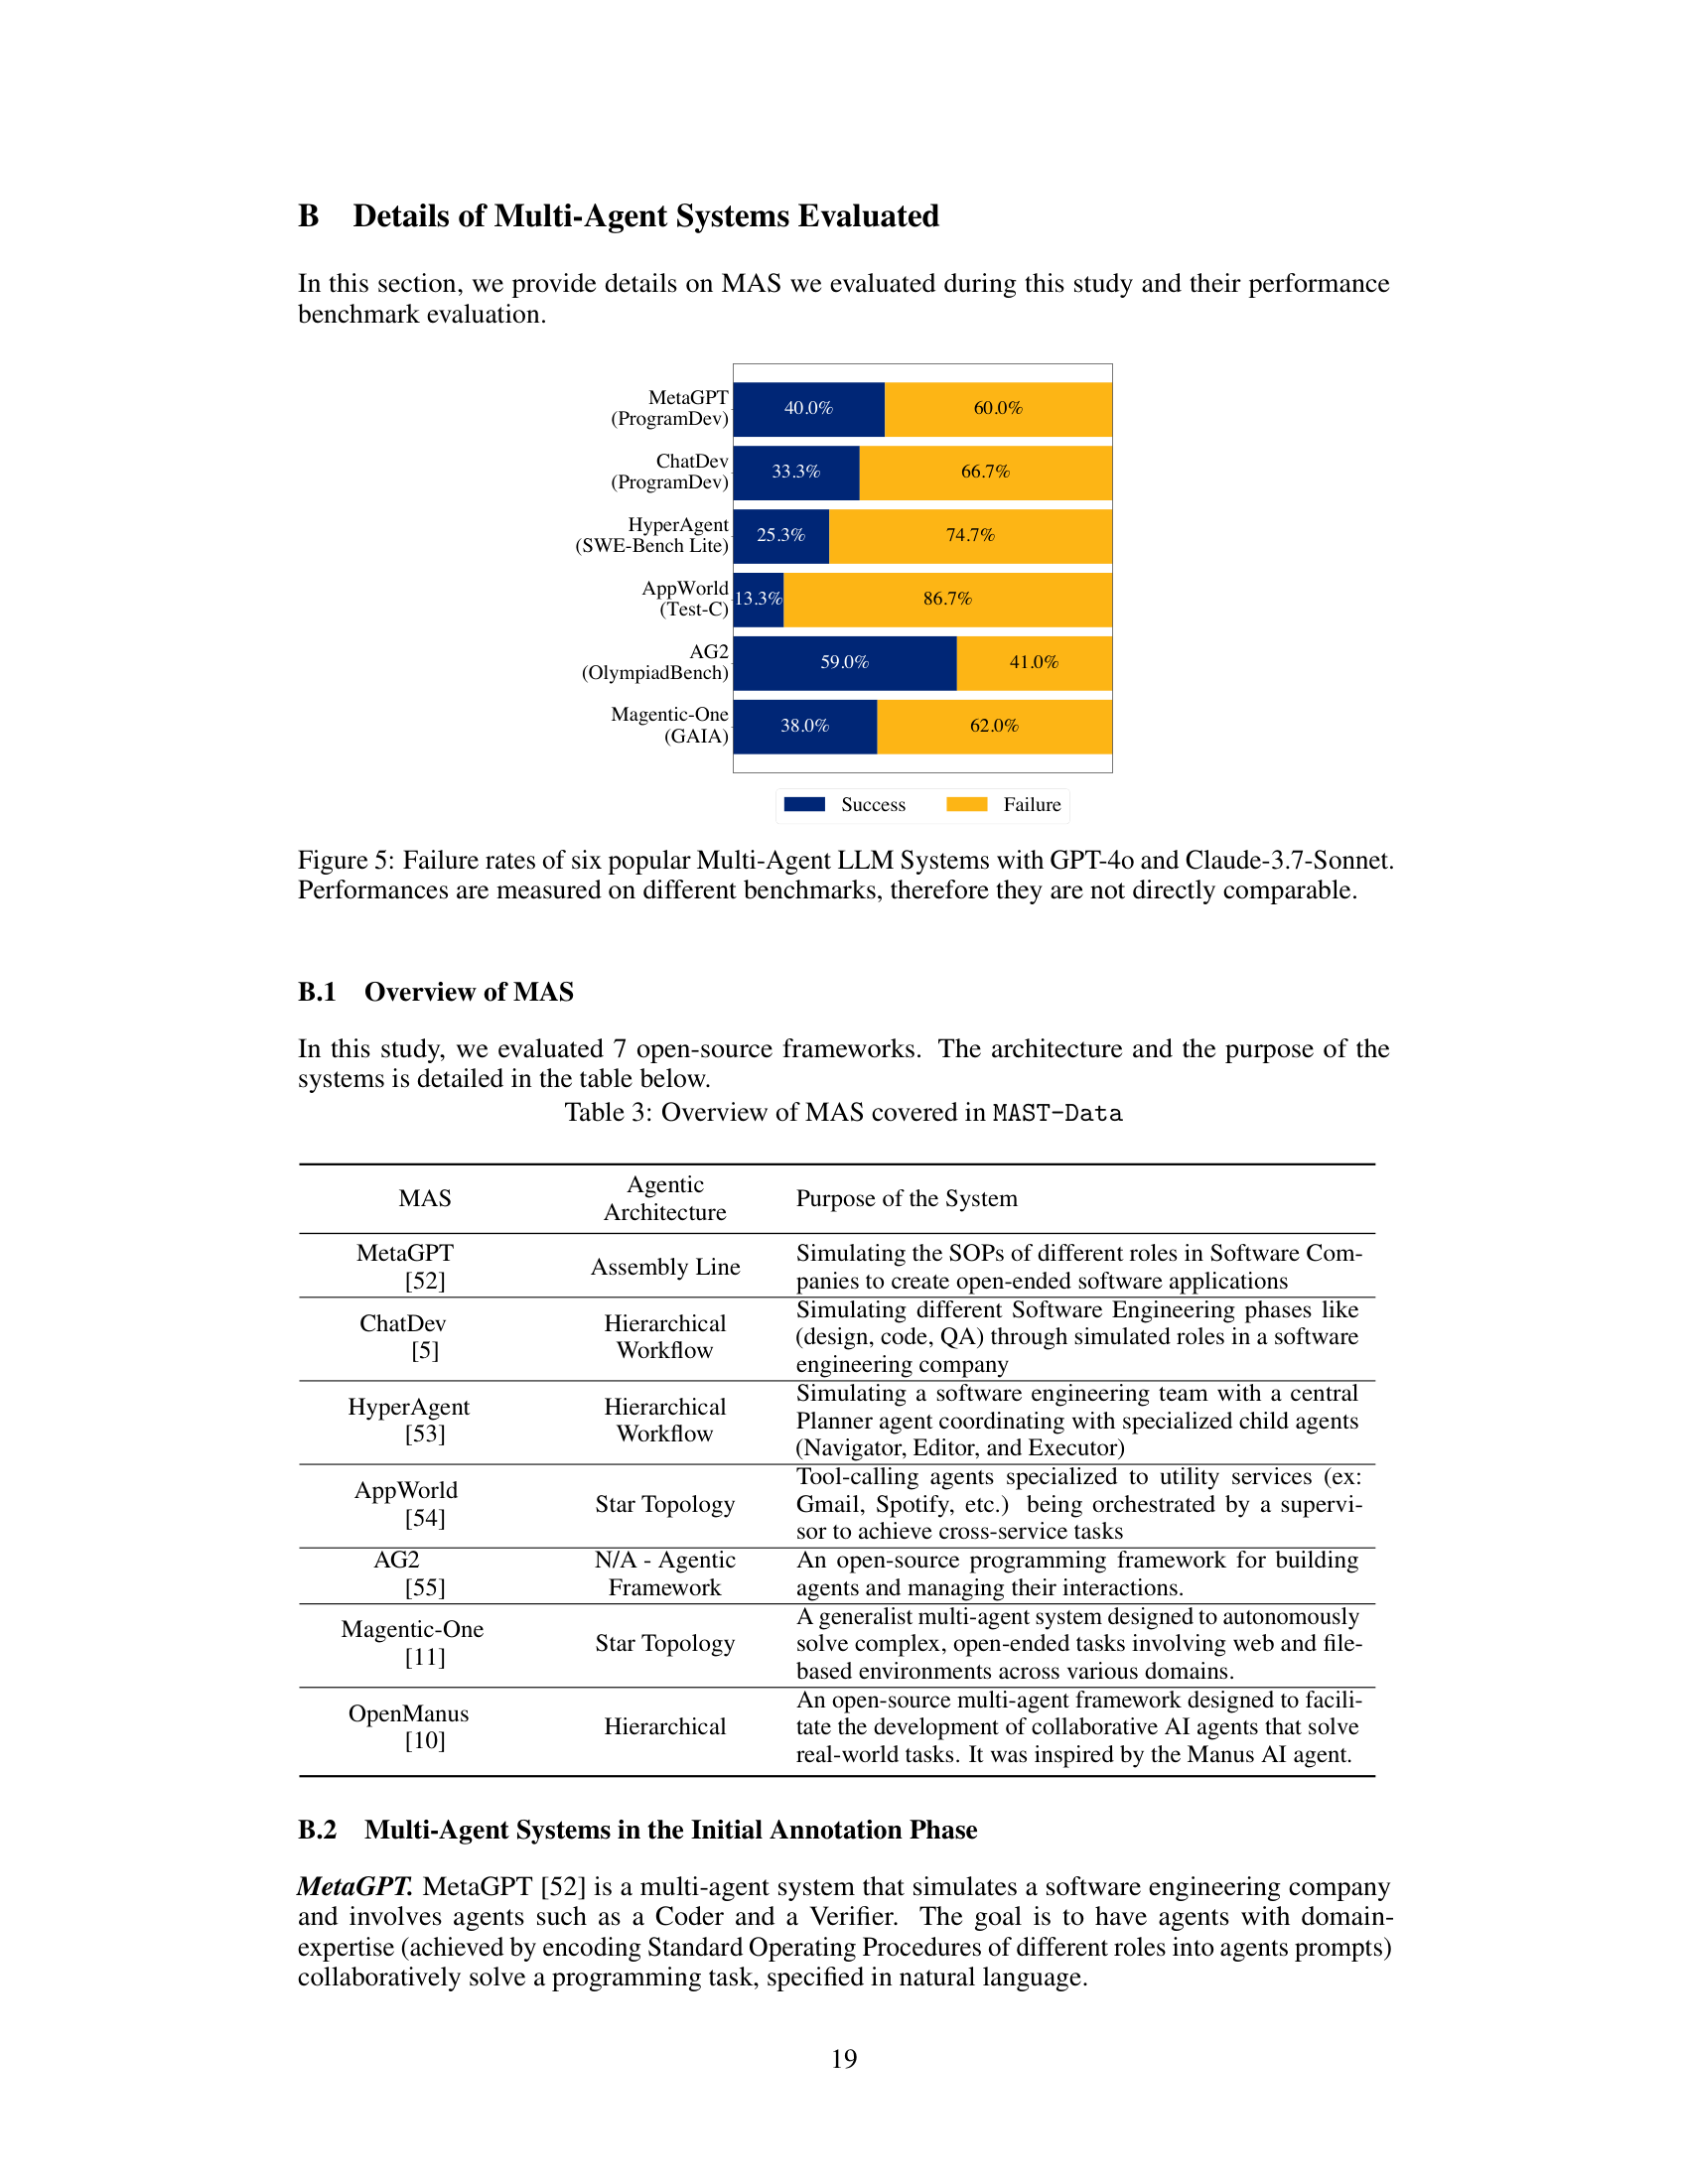
이 시스템들의 절대 성능은 낮다. 벤치마크가 서로 달라 시스템 간 직접 비교는 성립하지 않지만, 실패율이 41.0%에서 86.7% 구간에 있다는 점은 공통이다.
| MAS | Benchmark | 성공률 | 실패율 |
|---|---|---|---|
| AppWorld | Test-C | 13.3% | 86.7% |
| HyperAgent | SWE-Bench Lite | 25.3% | 74.7% |
| ChatDev | ProgramDev | 33.3% | 66.7% |
| Magentic-One | GAIA | 38.0% | 62.0% |
| MetaGPT | ProgramDev | 40.0% | 60.0% |
| AG2 | OlympiadBench | 59.0% | 41.0% |
closed-source 시스템은 이 표에 넣지 못했다. Manus는 기반 모델이 공개되지 않고 전체 실행 trace에 접근할 수 없어 fine-grained 라벨링이 불가능하다. 사람이 작업 성공 여부만 평가한 결과 ProgramDev에서 60%가 나왔다.
결과
시스템별 실패 프로파일
시스템마다 자주 나오는 실패 모드가 다르다. 각 시스템의 첫 30개 trace, 총 210개를 대상으로 본 카테고리 비중은 FC1 41.8%, FC2 36.9%, FC3 21.3%다.
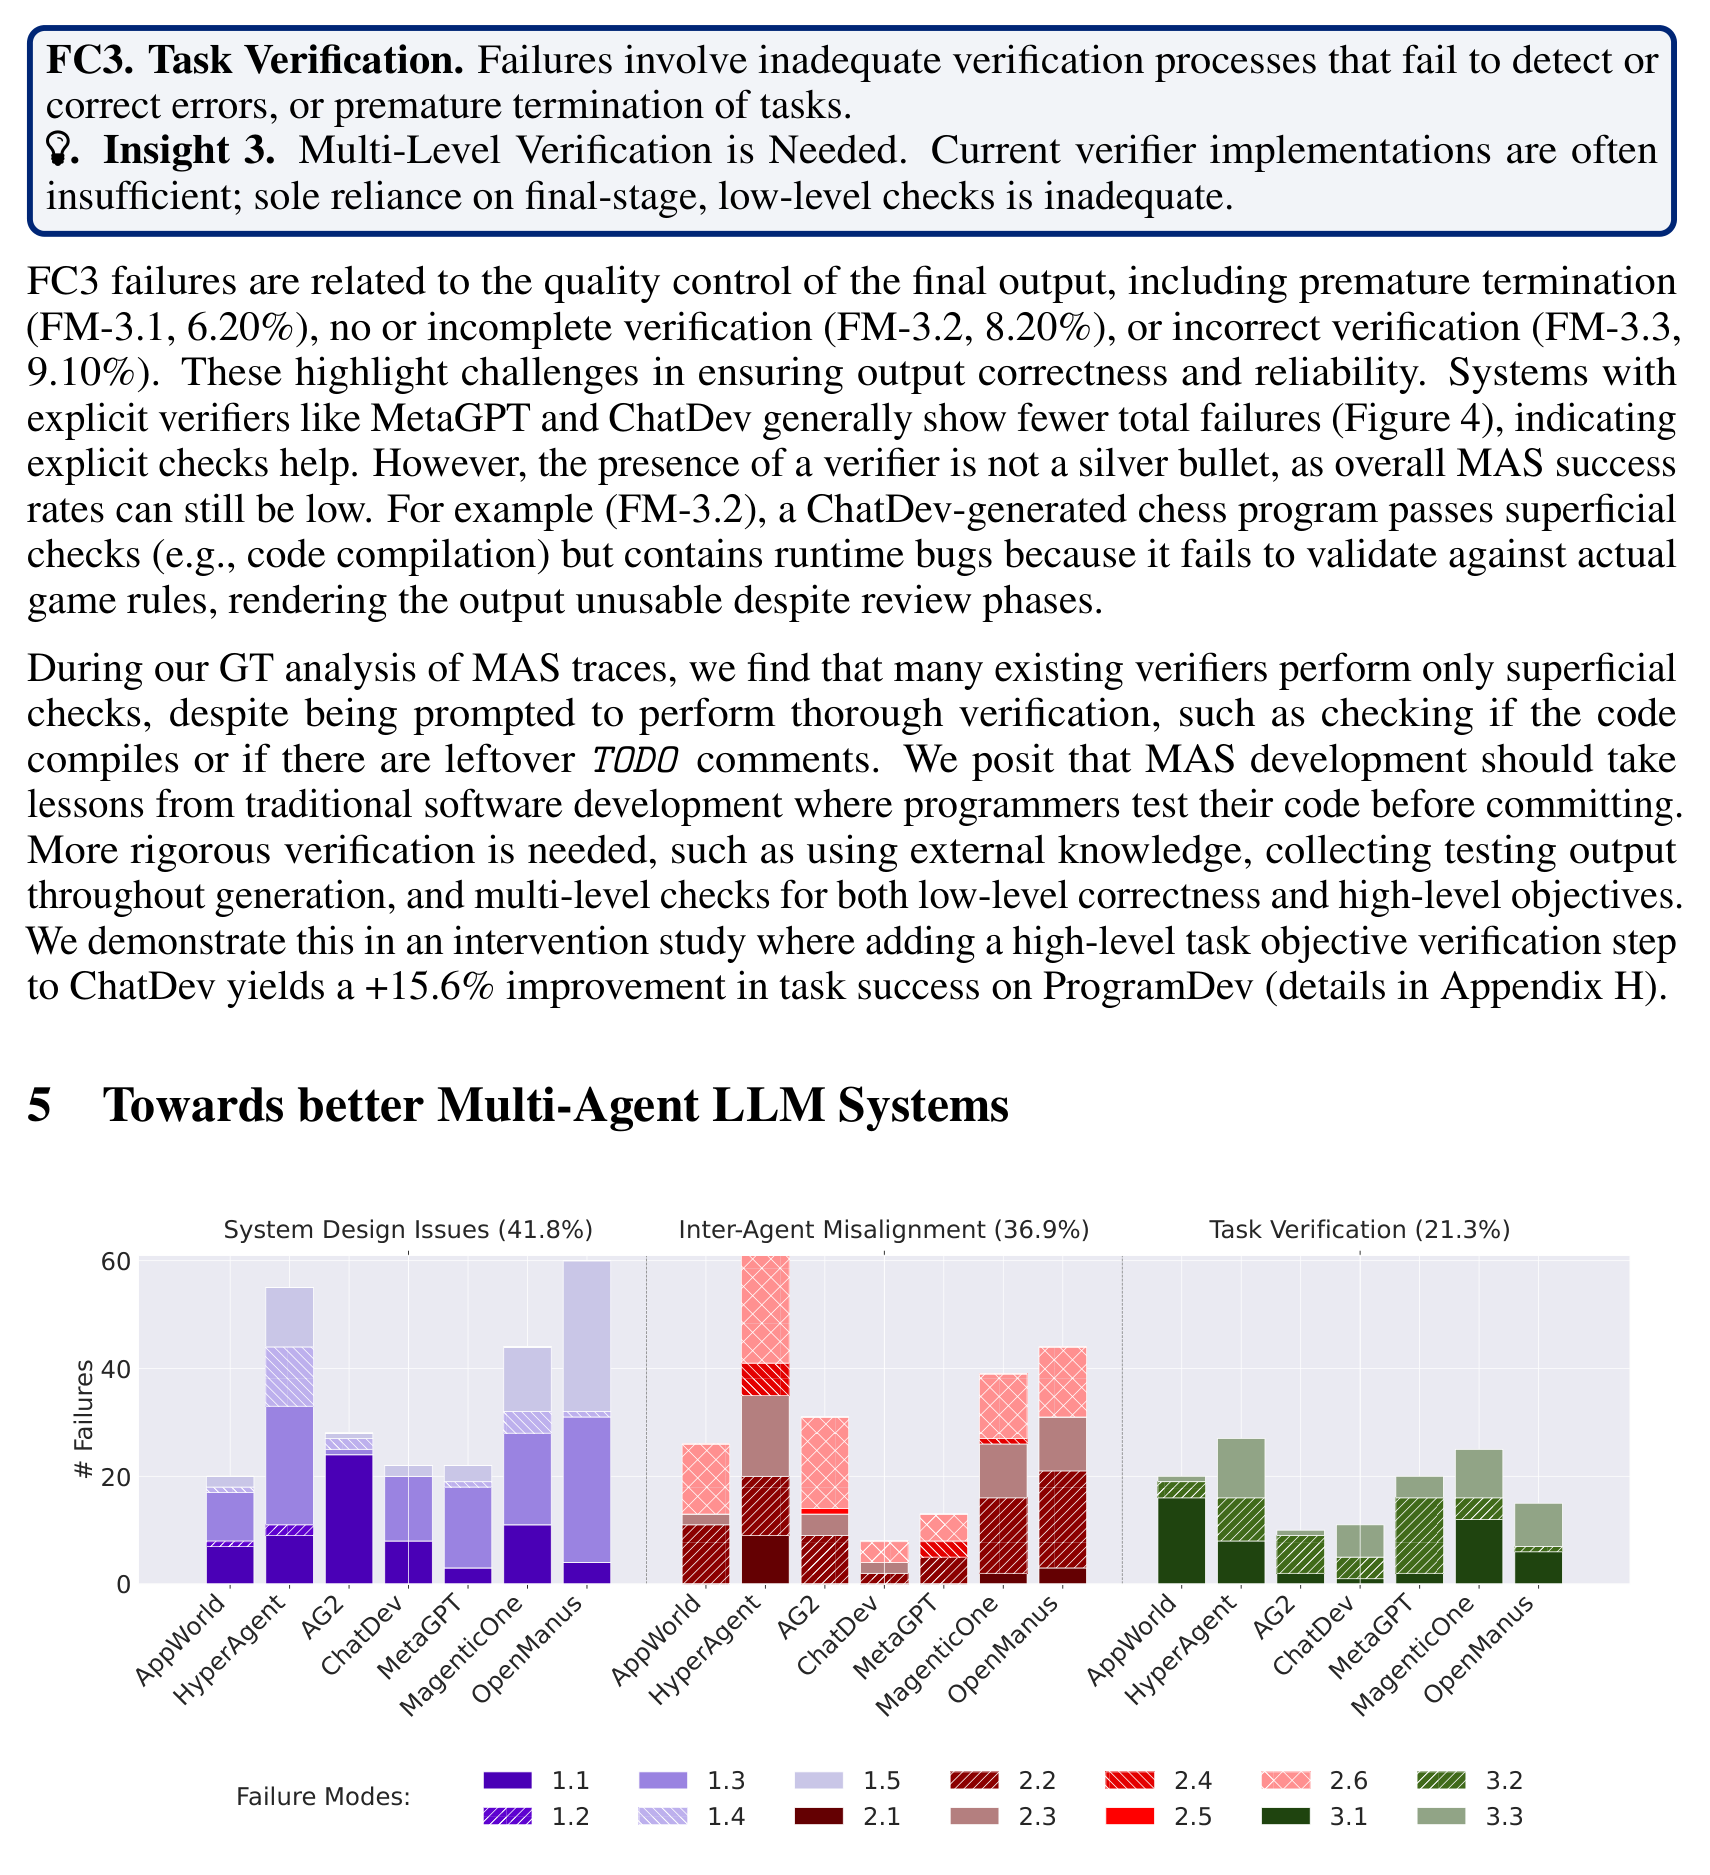
프로파일 차이는 아키텍처와 연결된다.
- AppWorld는 FM-3.1 Premature Termination이 잦다. star topology에 미리 정의된 워크플로가 없어 종료 조건이 분명하지 않은 점이 원인으로 지목된다.
- OpenManus는 FM-1.3 Step Repetition으로 기운다.
- HyperAgent는 FM-1.3과 FM-3.3 Incorrect Verification이 지배적이다.
같은 해법을 모든 시스템에 적용하는 방식이 통하지 않는다는 뜻이다. 개선 작업은 해당 시스템의 지배적 실패 모드에서 시작해야 한다.
기반 모델 선택의 효과
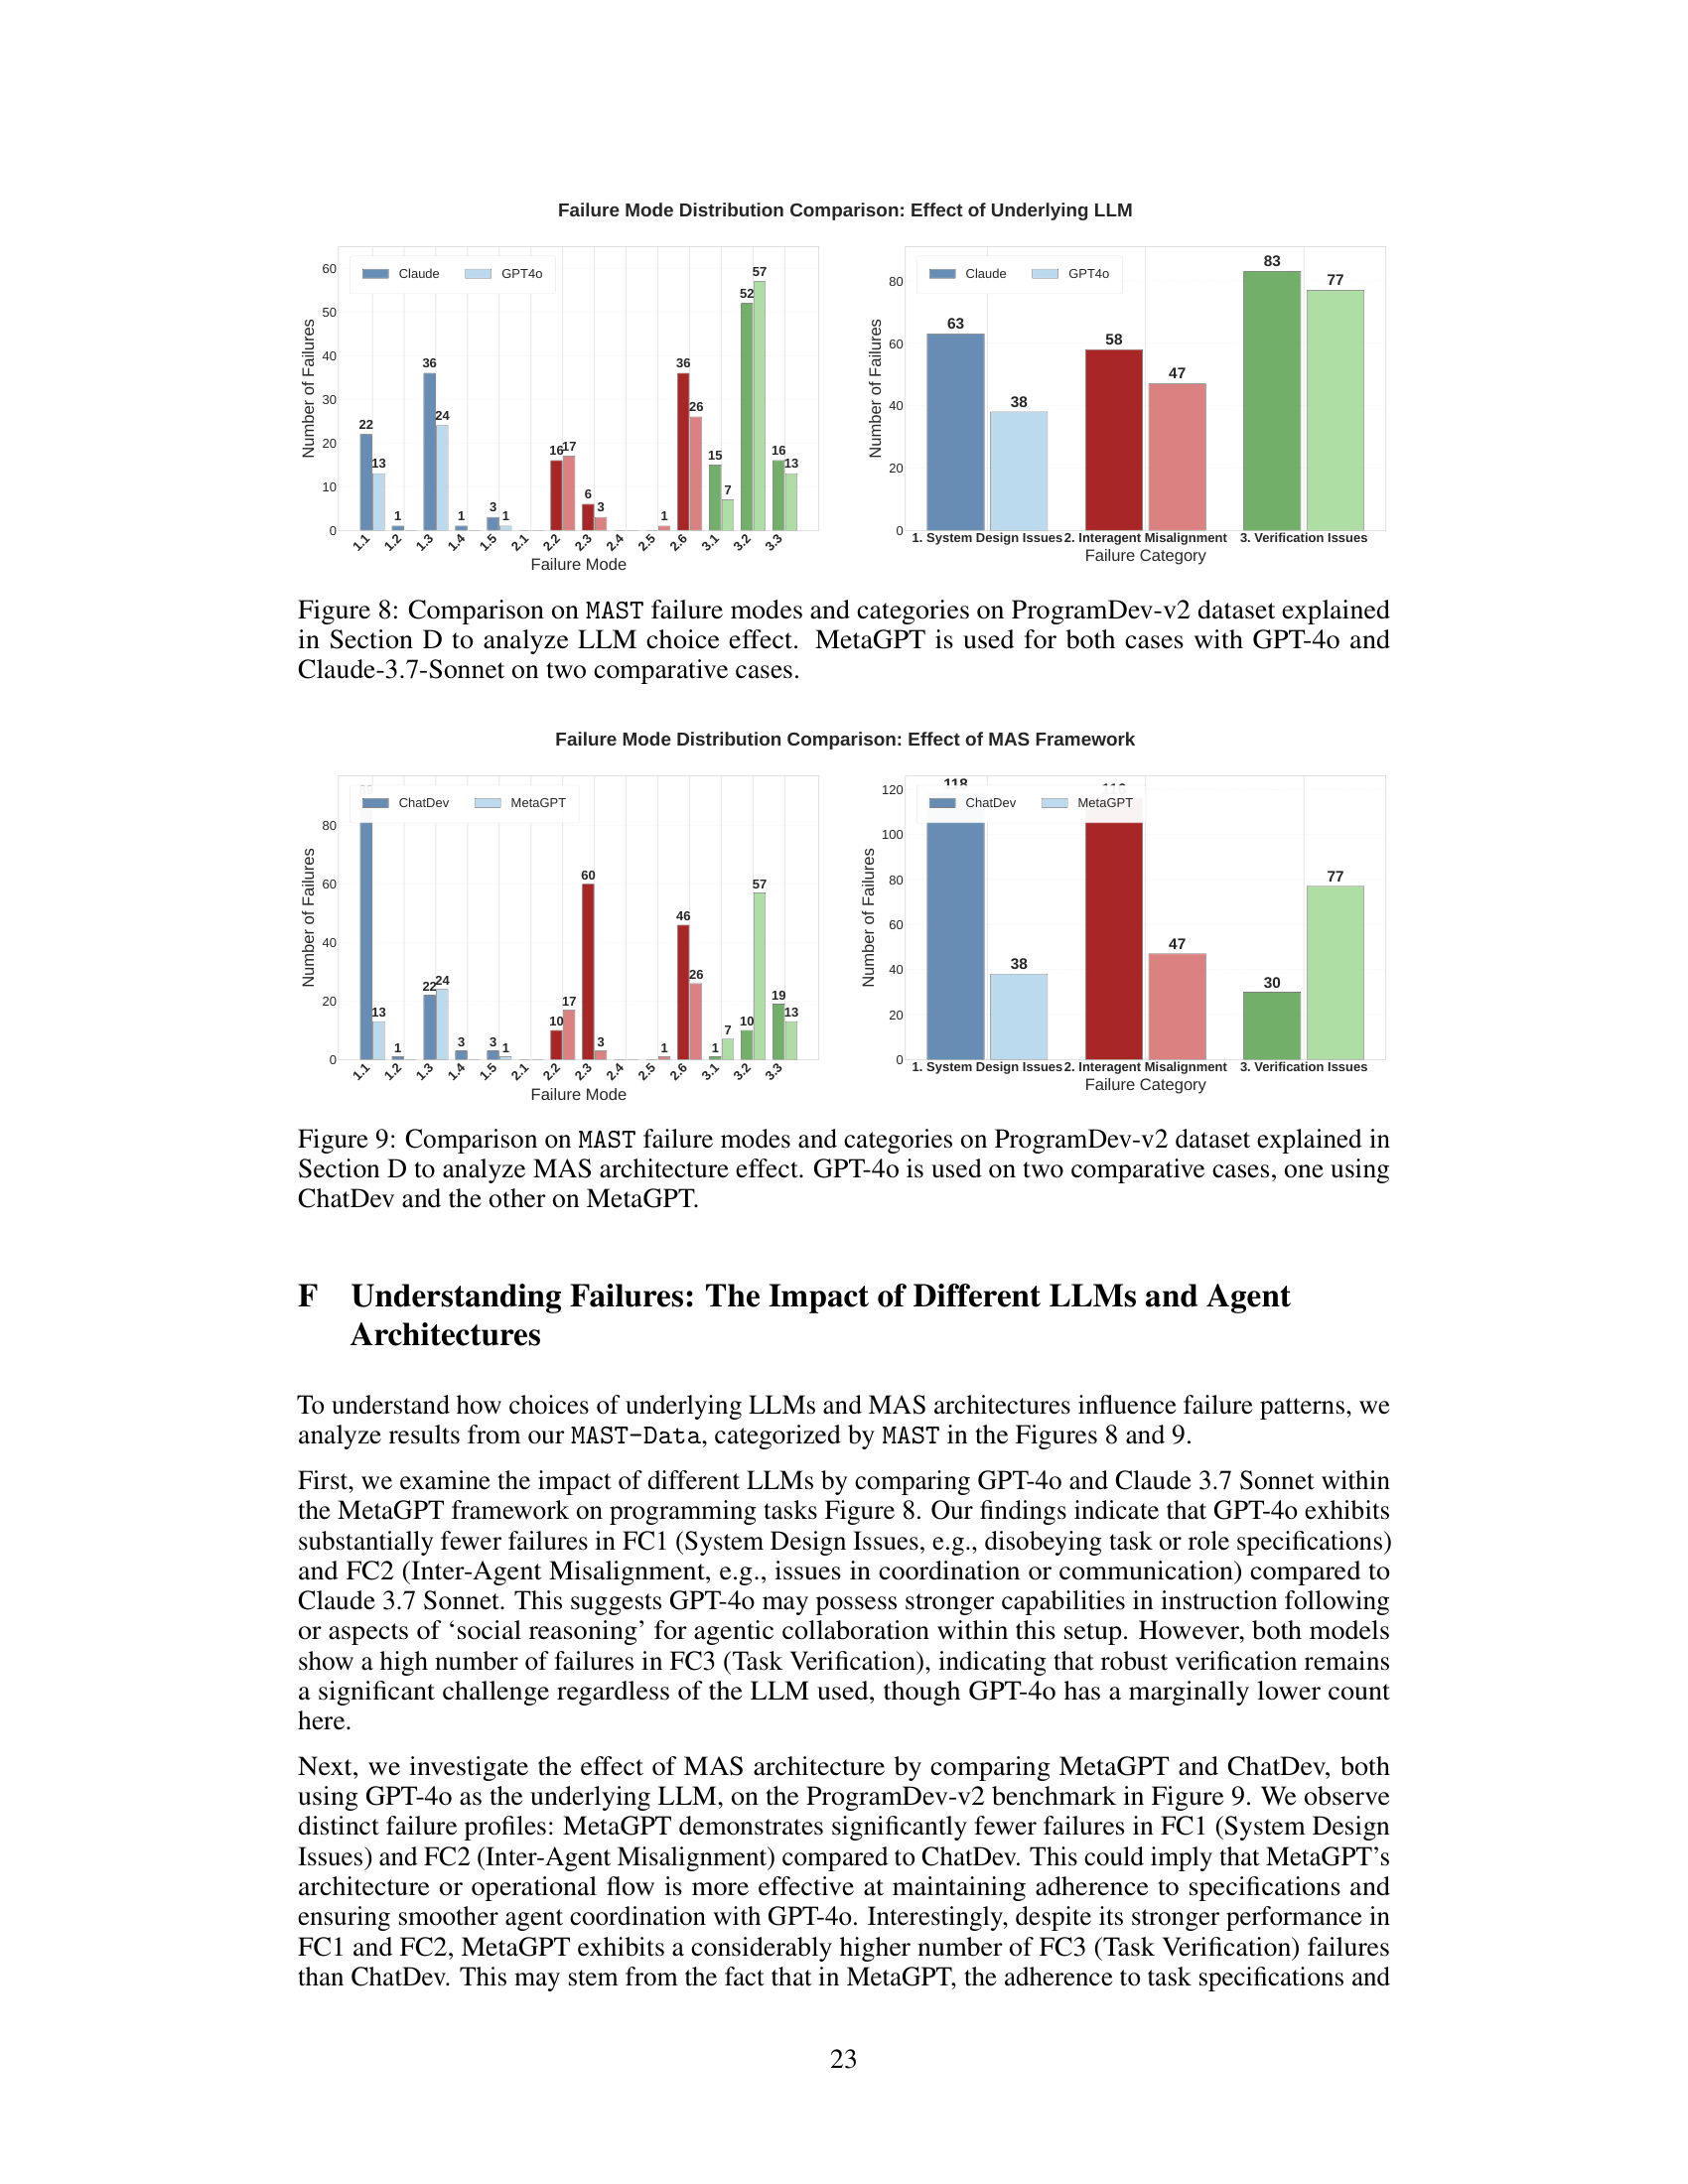
MetaGPT와 ProgramDev-v2를 고정하고 기반 모델만 바꾸면 실패 분포가 달라진다.
| 카테고리 | Claude 3.7 Sonnet | GPT-4o |
|---|---|---|
| FC1 System Design Issues | 63건 | 38건 |
| FC2 Inter-Agent Misalignment | 58건 | 47건 |
| FC3 Task Verification | 83건 | 77건 |
GPT-4o는 FC1에서 39% 적게 실패한다. 논문은 이를 instruction following과 협업 상황의 social reasoning이 더 강하다는 신호로 읽는다.
반면 FC3는 두 모델 모두 높다. 83건과 77건으로 차이가 크지 않으므로, verification의 부실함은 기반 모델을 바꿔서 해결되는 문제가 아니다.
아키텍처 선택의 효과
이번에는 GPT-4o를 고정하고 MetaGPT와 ChatDev를 비교한다.
| 카테고리 | ChatDev | MetaGPT |
|---|---|---|
| FC1 System Design Issues | 118건 | 38건 |
| FC2 Inter-Agent Misalignment | 116건 | 47건 |
| FC3 Task Verification | 30건 | 77건 |
MetaGPT는 FC1과 FC2에서 60%에서 68% 적게 실패한다. 표준 운영 절차를 프롬프트에 인코딩해 role 준수를 강제하는 설계가 명세 위반과 조정 실패를 줄인다.
반대로 FC3는 ChatDev가 훨씬 적다. ChatDev의 아키텍처에는 code review와 system testing 단계가 명시적으로 들어 있어 verification 실패를 잡아낸다.
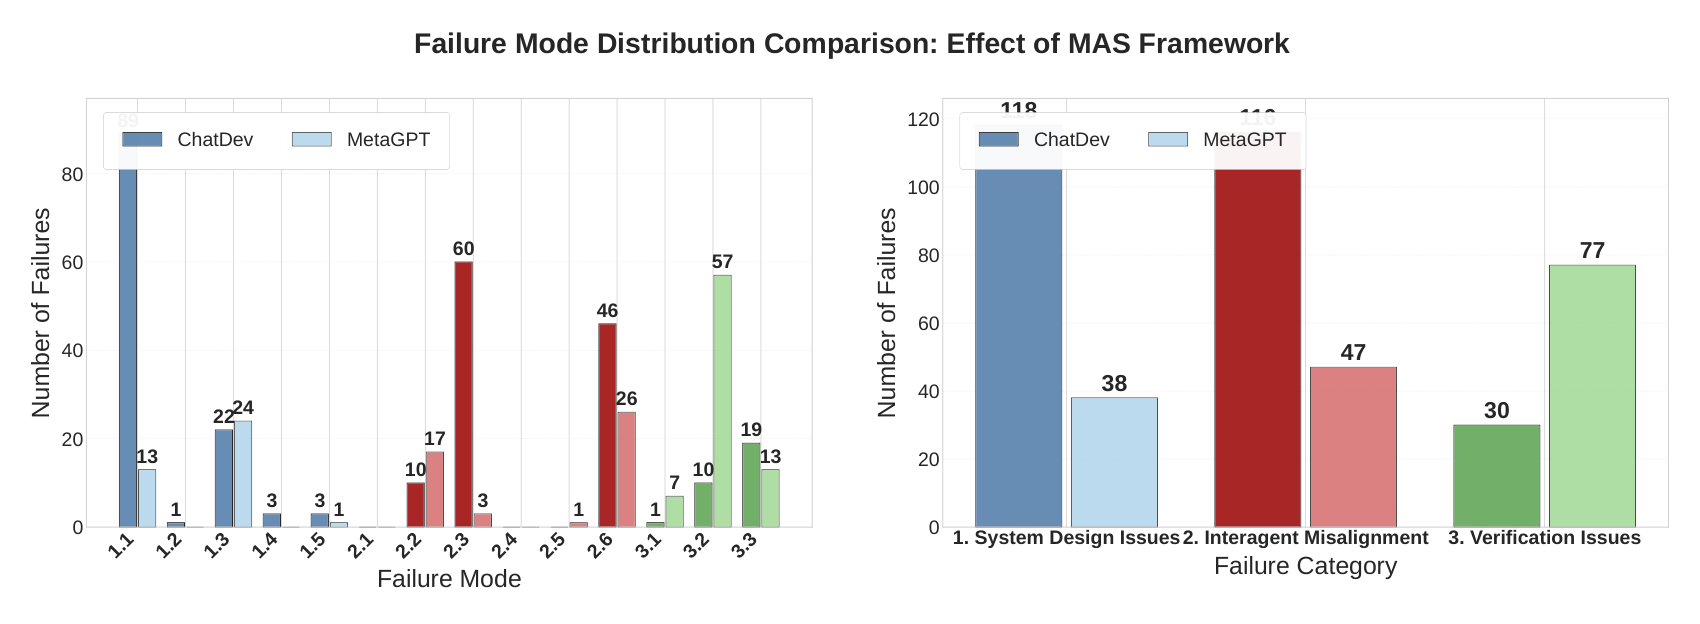
두 비교를 함께 놓으면 모델 선택과 아키텍처 선택이 서로 다른 카테고리를 건드린다는 그림이 나온다. 모델을 바꾸면 FC1이 움직이고, 아키텍처를 바꾸면 FC1과 FC3가 반대 방향으로 함께 움직인다.
벤치마크 난이도와 실패율
AG2와 GPT-4o를 고정하고 벤치마크만 바꾼 결과다. 값은 trace 수로 정규화한 발생률이다.
| Benchmark | FC1 | FC2 | FC3 |
|---|---|---|---|
| GSM | 0.53 | 1.33 | 0.37 |
| MMLU | 1.06 | 1.01 | 0.60 |
| OlympiadBench | 1.19 | 1.21 | 0.67 |
어려운 벤치마크일수록 실패율이 높아진다. MMLU와 OlympiadBench는 프로파일이 비슷한 반면, GSM은 FC1이 절반 수준으로 낮고 FC3도 가장 낮다. 문제가 쉬우면 명세 해석과 verification에서 어긋날 여지가 줄어든다는 해석이 가능하다.
개입 case study
저자들은 MAST를 진단 도구로 쓸 수 있는지 확인하려고 두 시스템에 개입을 적용했다. 개입은 프롬프트 개선과 topology 재설계 두 가지다.
AG2 MathChat
베이스라인은 Student agent와 Python 코드를 실행하는 Assistant agent가 협업하는 구성이다. 평가는 GSM8K에 적대적 변형을 가한 GSM-Plus에서 무작위로 고른 200문제로 하고, 일관성 확인을 위해 6회 반복한다.
첫 번째 개입은 프롬프트에 구조를 부여하고 verification 전용 섹션을 넣는 것이다. 두 번째 개입은 agent 구성을 세 role로 나누는 것으로, chain-of-thought로 푸는 Problem Solver, Python 코드를 작성하고 실행하는 Coder, 논의를 검토해 답을 확정하거나 재논의를 요구하는 Verifier로 구성한다. 이 설정에서는 Verifier만 대화를 종료할 수 있다.
ChatDev
ChatDev의 첫 번째 개입은 role별 프롬프트를 다듬어 위계와 role 준수를 강제하는 것이다. CPO agent가 제약을 충분히 다루지 않은 채 CEO와의 논의를 먼저 끝내는 사례가 관측되었기 때문에, 상위 agent만 대화를 확정할 수 있게 바꿨다. verifier의 role specification도 과제별 경계 사례를 보도록 구체화했다.
두 번째 개입은 프레임워크의 topology를 directed acyclic graph에서 순환 그래프로 바꾸는 것이다. CTO agent가 모든 review가 충족되었다고 확인해야 종료되며, 무한 반복을 막기 위해 최대 반복 횟수를 둔다.
개입 결과
| 설정 | AG2 GSM-Plus (GPT-4) | AG2 GSM-Plus (GPT-4o) | ChatDev ProgramDev-v0 | ChatDev HumanEval |
|---|---|---|---|---|
| Baseline | 84.75 | 84.25 | 25.0 | 89.6 |
| 프롬프트 개선 | 89.75 | 89.00 | 34.4 | 90.3 |
| topology 재설계 | 85.50 | 88.83 | 40.6 | 91.5 |
값은 성공률(%)이며 AG2는 6회 반복의 평균으로 표준편차가 1.18에서 1.94 사이다. GPT-4에서는 topology 변경의 Wilcoxon 검정 p값이 0.4로 유의하지 않았고, GPT-4o에서는 프롬프트와 topology 모두 p값 0.03으로 유의했다.
ChatDev에서는 topology 재설계가 25.0%에서 40.6%로 15.6%p 올라 가장 큰 개선을 만들었다. 프롬프트 개선만으로도 9.4%p가 오른다.
같은 개입이 시스템과 모델에 따라 다르게 작동한다는 점이 이 실험의 핵심이다. AG2에서는 GPT-4를 쓸 때 프롬프트 개선이 더 효과적이었고, ChatDev에서는 topology 재설계가 더 효과적이었다.
절대 수준도 함께 봐야 한다. ChatDev의 ProgramDev-v0 성공률은 개선 후에도 40.6%에 머문다. tactical 개입만으로는 신뢰성을 확보하기 어렵다는 근거다.
부록의 주요 분석
카테고리와 모드의 독립성
카테고리 사이의 상관은 0.17에서 0.32로 낮다. FC1과 FC2가 0.32, FC2와 FC3가 0.28, FC1과 FC3가 0.17이다. 세 카테고리가 서로 다른 국면을 잡고 있다는 근거가 된다.
모드 수준에서는 상관이 더 높다. 최대값은 FM-1.4 Loss of Conversation History와 FM-2.1 Conversation Reset 사이의 0.63이고, FM-1.3과 FM-1.5가 0.55, FM-2.2와 FM-2.3이 0.52로 뒤를 잇는다. 증상이 비슷한 모드를 LLM annotator가 섞어버릴 위험이 여기서 나온다.
open-source 모델의 실패
MetaGPT와 ChatDev에 Qwen2.5-Coder-32B-Instruct와 CodeLlama-7b-Instruct를 넣어 400개 trace를 분석한 결과다.
| 실패 모드 | Qwen ChatDev | Qwen MetaGPT | CodeLlama ChatDev | CodeLlama MetaGPT |
|---|---|---|---|---|
| FM-1.1 | 35 | 12 | 76 | 94 |
| FM-1.2 | 4 | 1 | 45 | 12 |
| FM-1.3 | 96 | 35 | 97 | 99 |
| FM-1.4 | 1 | 0 | 46 | 23 |
| FM-1.5 | 94 | 3 | 97 | 76 |
| FM-2.1 | 2 | 0 | 50 | 9 |
| FM-2.2 | 1 | 4 | 16 | 15 |
| FM-2.3 | 9 | 0 | 76 | 57 |
| FM-2.4 | 0 | 0 | 2 | 0 |
| FM-2.5 | 2 | 12 | 42 | 40 |
| FM-2.6 | 20 | 16 | 93 | 18 |
| FM-3.1 | 1 | 47 | 25 | 26 |
| FM-3.2 | 16 | 51 | 67 | 55 |
| FM-3.3 | 12 | 32 | 69 | 56 |
두 가지가 드러난다. 첫째, 두 open-source 모델 사이의 격차가 크다. CodeLlama-7b는 거의 모든 모드에서 Qwen2.5-Coder-32B보다 많이 실패하며, 특히 FM-2.1 Conversation Reset과 FM-2.3 Task Derailment에서 차이가 두드러진다. 둘째, 두 모델 모두 GPT-4o와 Claude 3 계열보다 실패 빈도가 높다.
성공한 실행 안의 실패
성공한 trace에도 실패 모드는 나타난다. 아래는 ChatDev와 MetaGPT를 성공 실행과 실패 실행으로 나눠 본 발생률의 일부다.
| 실패 모드 | ChatDev 성공 | ChatDev 실패 | MetaGPT 성공 | MetaGPT 실패 |
|---|---|---|---|---|
| FM-1.1 | 20.0% | 25.0% | 33.3% | 16.7% |
| FM-1.3 | 20.0% | 20.0% | 16.7% | 22.2% |
| FM-1.5 | 0.0% | 10.0% | 0.0% | 11.1% |
| FM-2.1 | 0.0% | 5.0% | 0.0% | 5.6% |
| FM-2.4 | 0.0% | 5.0% | 0.0% | 5.6% |
| FM-3.1 | 0.0% | 5.0% | 0.0% | 5.6% |
| FM-3.2 | 10.0% | 10.0% | 16.7% | 5.6% |
| FM-3.3 | 20.0% | 25.0% | 16.7% | 27.8% |
FM-1.5와 FM-2.4는 실패 실행에서만 관측된다. 종료 조건을 인식하지 못하거나 중요한 정보를 전달하지 않으면 task가 끝나지 않을 가능성이 높다는 뜻이다.
반면 FM-3.2와 FM-3.3은 성공 실행에도 자주 나온다. 작업은 완료되지만 verification 절차에는 결함이 남아 있는 상태이며, 이런 구조적 약점은 성공률만 보는 지표로는 드러나지 않는다.
개입이 실패 분포에 남긴 흔적
MAST는 성공률 뒤에 가려진 변화를 보게 해준다. 아래는 LLM annotator가 센 카테고리별 실패 건수다.
| 시스템 | 설정 | FC1 | FC2 | FC3 |
|---|---|---|---|---|
| AG2 | Original | 625 | 692 | 305 |
| AG2 | 프롬프트 개입 | 687 | 796 | 335 |
| AG2 | topology 개입 | 171 | 205 | 86 |
| ChatDev | Original | 424 | 447 | 209 |
| ChatDev | 프롬프트 개입 | 372 | 403 | 176 |
| ChatDev | topology 개입 | 355 | 376 | 169 |
두 시스템 모두 topology 개입이 가장 낮은 건수를 만든다. AG2에서는 그 폭이 특히 커서 FC1이 625건에서 171건으로 줄었다.
AG2의 프롬프트 개입에서는 건수가 오히려 늘었다는 점도 기록해 둘 만하다. 같은 개입이 Table 5의 성공률은 84.25%에서 89.00%로 올렸으므로, 성공률과 실패 모드 건수가 항상 같은 방향으로 움직이지는 않는다.
annotator 운영 비용
LLM annotator의 API 비용은 trace 한 건당 평균 1.8달러다. trace 길이에 크게 좌우되므로 프레임워크별로 10배 넘게 벌어진다.
| MAS | trace 한 건당 평균 비용 |
|---|---|
| AppWorld | 0.3740달러 |
| HyperAgent | 0.9695달러 |
| AG2 | 1.1656달러 |
| Magentic-One | 1.3056달러 |
| ChatDev | 2.1272달러 |
| MetaGPT | 2.4455달러 |
| OpenManus | 4.1409달러 |
1,642개 trace를 라벨링하는 비용이 수천 달러 규모라는 뜻이다. 사람 expert 6인이 150개 trace에 120시간을 쓴 초기 분석과 비교하면 규모 확장의 이유가 분명해진다.
해결 전략
논문은 개선 방향을 tactical 접근과 structural 전략으로 나눈다. tactical 접근은 특정 실패 모드를 겨냥한 국소적 수정이고, structural 전략은 시스템 전체에 영향을 주는 재설계다.
| 실패 카테고리 | Tactical 접근 | Structural 전략 |
|---|---|---|
| System Design Issues | 명확한 role과 task 정의, 추가 논의 유도, self-verification, 대화 패턴 설계 | 종합적 verification, confidence 정량화 |
| Inter-Agent Misalignment | cross-verification, 대화 패턴 설계, 상호 모호성 해소, 모듈형 agent 설계 | 표준화된 통신 프로토콜, 확률적 confidence 측정 |
| Task Verification | self-verification, cross-verification, verification을 위한 topology 재설계 | 종합적 verification과 unit test 생성 |
structural 전략에서 저자들이 가장 무게를 두는 항목은 verification이다. 소프트웨어에서는 unit test 생성이 도움이 되지만 모든 경계 사례를 덮는 보편적 검증 장치를 만들기는 어렵고, 도메인마다 필요한 방식이 다르다. 코딩은 테스트 커버리지, 질의응답은 검증된 데이터 대조, 추론은 기호적 검증이 필요하다.
통신 프로토콜 표준화가 그다음이다. LLM 기반 agent는 대부분 비구조적 텍스트로 대화하므로 모호성이 생기며, 의도와 파라미터를 명시하면 상호작용 중간과 사후에 형식적 일관성 검사를 할 수 있다.
확률적 confidence 측정과 메모리, 상태 관리도 함께 제안된다. agent가 confidence가 임계값을 넘을 때만 행동하고 낮으면 추가 정보를 모으도록 설계하는 방식, 그리고 MemGPT나 TapeAgents처럼 상태를 구조화해 기록하고 되짚는 방식이다.
한계
- 분류체계의 망라성을 주장하지 않는다. MAST는 MAS 실패 이해를 통일하기 위한 첫 단계라는 위치이며, 모든 실패 패턴을 덮는다고 보지 않는다.
- 환각(hallucination)과 instruction following처럼 기반 모델 자체의 한계에서 오는 실패는 분류 대상에서 의도적으로 비켜나 있다. 설계와 조정, verification 개선으로 다룰 수 있는 영역에 집중한 선택이다.
- closed-source MAS는 분석하지 못한다. Manus는 기반 모델과 전체 실행 trace가 공개되지 않아 fine-grained 라벨링이 불가능하고, 사람이 확인한 작업 성공률만 남는다.
- LLM annotator는 증상이 비슷한 모드를 섞을 수 있다. 모드 간 상관이 최대 0.63으로 중간 수준이라 서로 다른 근본 원인이 하나로 합쳐질 위험이 남는다.
- tactical 개입의 효과는 9.4%p에서 15.6%p 사이에 그친다. 개선 후에도 ChatDev의 ProgramDev-v0 성공률은 40.6%이므로, 신뢰성 확보에는 구조적 재설계가 필요하다.
- 부록 그림과 본문 서술이 어긋나는 부분도 있다. Figure 9의 막대값은 FC3에서 ChatDev 30건, MetaGPT 77건인데 본문은 이 격차를 1.56배로 적는다. 인용할 때는 원 논문의 그림을 확인하는 편이 안전하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| MAST | 이 논문이 제안한 MAS 실패 분류체계. 14개 fine-grained 실패 모드를 3개 카테고리로 묶는다 |
| MAST-Data | 7개 MAS와 4개 모델 패밀리에서 모은 1,642개 annotated trace 데이터셋. 사람이 라벨링한 21개 trace는 MAST-Data-human으로 따로 공개된다 |
| FC / FM | Failure Category와 Failure Mode의 약어. FC는 3개, FM은 14개다 |
| Grounded Theory | 사전 가설 없이 데이터에서 이론을 귀납적으로 끌어내는 질적 연구 방법론. 새 통찰이 나오지 않는 theoretical saturation에서 멈춘다 |
| Inter-Annotator Agreement | 여러 annotator가 같은 대상에 같은 라벨을 붙이는 정도. Cohen's κ로 재며 이 논문은 0.88을 달성했다 |
| LLM-as-a-Judge | LLM을 채점자나 라벨러로 쓰는 패턴. 이 논문은 o1에 few-shot 예시를 주어 κ=0.77을 얻었다 |
| theory of mind | 다른 agent가 무엇을 알고 무엇을 필요로 하는지 추정하는 능력. FC2 실패의 근본 원인으로 지목된다 |
| agentdash | MAST annotator를 그대로 쓸 수 있게 만든 파이썬 라이브러리. trace 문자열을 넣으면 검출된 실패 모드와 요약을 반환한다 |
관련 페이지
- Compiling Agentic Workflows into LLM Weights: agent 워크플로 컴파일과 MAS 설계가 맞닿는 지점. MAST가 지적한 FC1 실패를 구조 수준에서 다루려는 접근이다.
- Memory Intelligence Agent (MIA): FC2와 FM-1.4가 가리키는 컨텍스트 관리 문제를 agent 메모리 관점에서 다룬다.
- Recursive Language Models (RLM): 단일 agent 확장과 MAS를 비교하는 맥락. MAS의 성능 이득이 작다는 이 논문의 문제의식과 이어진다.
- MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers: MCP tool use 벤치마크의 11종 실패 분류. MAST와 마찬가지로 실패를 유형화했고, 인지 계열이 63.3%로 tool call 계열을 앞선다.
- The Art of Loop Engineering (Sydney Runkle, 2026-06-16): verification 루프를 설계 대상으로 보는 관점. MAST의 Insight 3과 문제의식이 겹친다.