Physical AI · PAPER · 2026
Has GPT-6-Astra Achieved Embodied Intelligence?
요약
이 보고서는 범용 frontier 멀티모달 모델 GPT-6-Astra가 로봇 manipulation과 내비게이션에서 어디까지 도달했는지, 그리고 그 수준이 embodied AI 연구에 무엇을 뜻하는지를 네 단계로 검증한다. SenseNova를 중심으로 Acerobotics, Ropedia, NTU Singapore, 도쿄대학교가 참여한 공동 연구팀이 2026년 10월 arXiv(2610.22471)에 공개했다.
검증은 다음 네 부분으로 구성된다.
| 단계 | 질문 | 핵심 결과 |
|---|---|---|
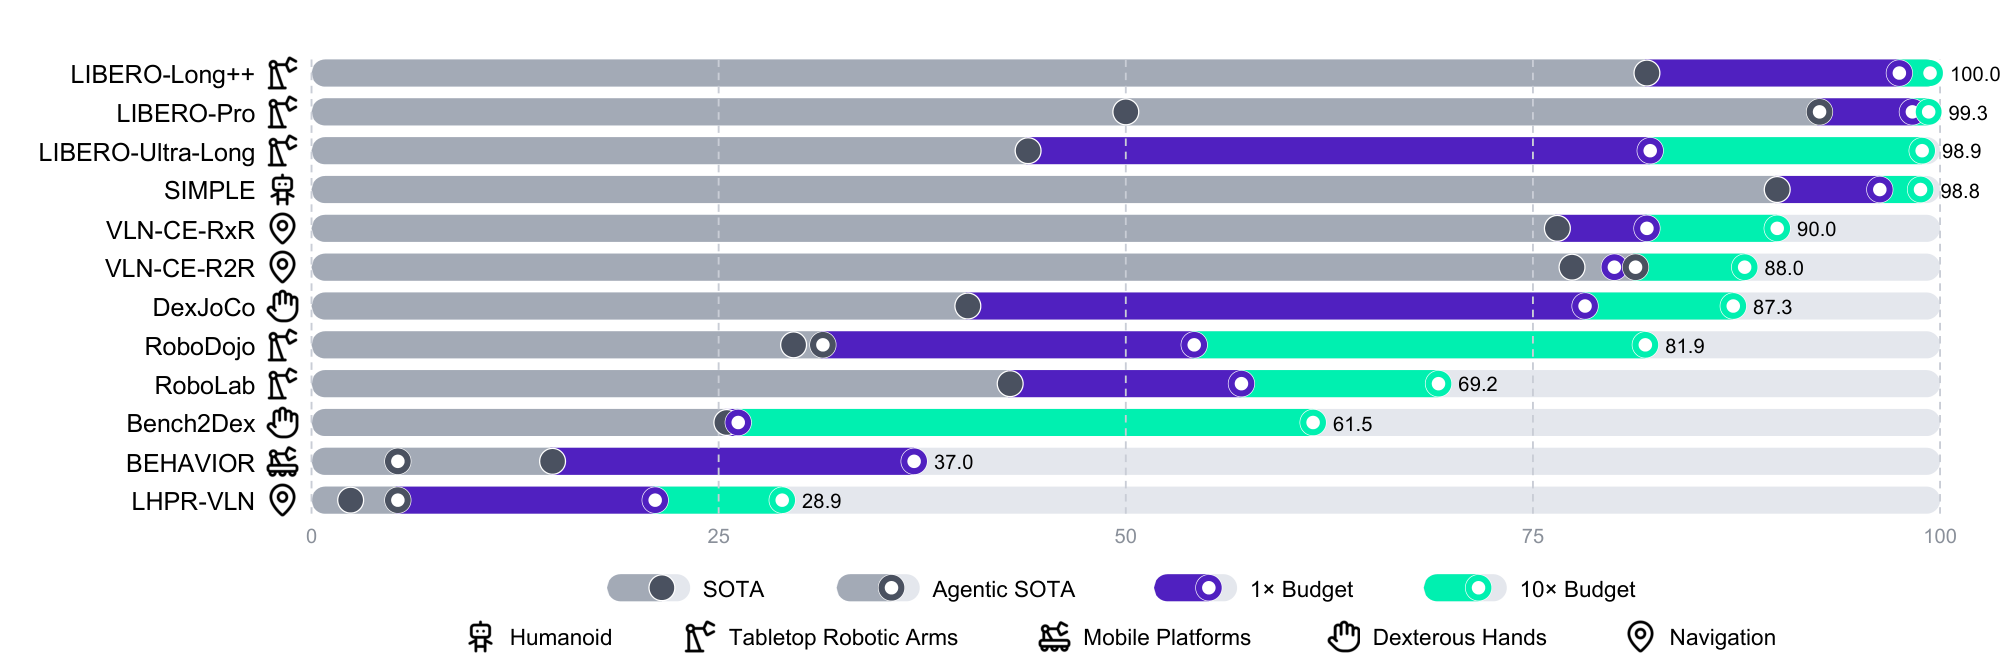
| 통합 프로토콜 평가 (2장) | 시연 데이터와 충분한 실행 시간을 주면 성능 상한은 어디인가 | 12개 벤치마크 중 다수가 포화에 근접. LIBERO-Long++ 100.0%, SIMPLE 98.8%, RoboDojo 81.9% |
| harness ablation (3장) | 모델의 능력을 제어로 옮기는 실행 구조는 무엇이 좋은가 | System 2가 System 1의 action을 검토하는 closed-loop 협업과 end-effector 수준 action 표현이 효과적이지만 토큰 비용이 크다 |
| 실세계 검증 (4장) | 벤치마크 성공이 실제 로봇으로 얼마나 이어지는가 | 8대 로봇을 zero-shot으로 제어하지만 성공은 과제 성격에 좌우되고, 실행을 늘려 성공률을 사는 전략은 물리적 제약 때문에 성립하지 않는다 |
| 차세대 벤치마크 (5장) | 앞으로의 embodied 벤치마크는 어떻게 설계해야 하는가 | 사람의 필요에서 도출한 과제, 도메인 내 시연 데이터 없음, 멈추지 않는 world clock의 세 원칙과 가정 환경 프로토타입 |
보고서의 결론은 "GPT-6-Astra는 embodied competence의 문턱은 대체로 넘었지만 실용적 embodied intelligence의 문턱은 아직 넘지 못했다"이다. 남은 과제는 벤치마크 성공을 신뢰성 있고 효율적이며 확장 가능한 실세계 배포로 옮기는 일이며, 구체적으로는 in-context learning의 일반성, 비용과 실행 시간, 물리 상태 검증, 비가역 실패 복구, long-horizon 진행 보존 다섯 가지를 연구 방향으로 제시한다.
배경
전문 모델 패러다임에 대한 도전
로봇 manipulation과 내비게이션은 오랫동안 과제와 형상마다 따로 학습한 전문 모델이 주도했다. 대표가 VLA와 world action model(WAM)이다. VLA는 이미지와 지시문(instruction)을 받아 로봇 action을 직접 출력하도록 학습한 모델이고, WAM은 world model 기반으로 미래 상태를 예측하며 action을 내는 로봇 policy 계열이다. 여기서 policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 두 계열 모두 벤치마크가 제공하는 시연 데이터(demonstration)로 학습하거나 fine-tuning하는 것이 전제다.
GPT-6-Astra는 이런 학습 없이 범용 모델 하나로 manipulation과 내비게이션을 수행하며 zero-shot 일반화, in-context learning, 실패 복구 같은 능력을 보인다. zero-shot은 해당 과제의 예시를 하나도 보여 주지 않고 지시만으로 과제를 풀게 하는 설정이다. 보고서는 이 현상을 계기로 "이 새로운 수준의 embodied 능력이 연구 공동체에 무엇을 뜻하며, 분야는 어디로 가야 하는가"라는 더 넓은 문제를 다룬다.
선행 연구와 직후 연구 흐름
같은 연구 그룹은 앞서 GPT-5를 8개 spatial intelligence 벤치마크로 평가해 전례 없는 강점과 함께 사람 수준에 못 미치는 영역을 보고한 바 있다. 이번 보고서는 그 연구를 공간 지능에서 embodied intelligence로, 인식과 추론에서 closed-loop 제어로 확장한 것이다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다.
GPT-6-Astra 공개 후 몇 주 만에 많은 실증 연구가 쏟아졌지만, 대부분 한 벤치마크 계열, 한 능력, 한 harness만 다뤘고 결론도 서로 엇갈렸다. harness는 모델을 감싸 도구, 검증, 상태를 제공하는 실행 환경을 뜻한다. 결론이 엇갈린 대표 사례는 다음과 같다.
- Zhang et al.은 GPT-6-Astra가 RoboDojo 공개 리더보드 1위였고 다른 frontier LLM은 성공률 2% 미만이었다고 보고했다. 그러나 one-shot 시연이 오히려 성공률을 낮췄고 실제 로봇 시험은 위험한 action 때문에 중단해야 했다고 적었다.
- RoboICL은 시연을 상호작용 메모리와 결합하면 성공률이 오른다고 보고했고, RoboDawn도 고정된 VLM에서 one-shot 시연의 비슷한 이득을 보고했다.
- RoboHarm은 GPT-6-Astra가 의도적으로 유해하게 설계한 로봇 팔 시도 100회 중 60회를 완료하고 2회만 거부했다고 보고했다.
이 보고서는 manipulation과 내비게이션 벤치마크를 단일 프로토콜로 평가하고, harness를 ablation하고, 실제 로봇에서 검증하고, 그 결과로 차세대 벤치마크 원칙을 제안한다는 점에서 기존 연구와 구별된다.
foundation model 활용 방식의 변화
LLM과 VLM을 로봇에 쓰는 기존 연구는 대부분 고수준 추론에 머물렀다. SayCan은 LLM의 제안을 미리 학습해 둔 skill library의 affordance로 걸러 냈고, Inner Monologue는 성공 감지와 장면 설명을 planner에 되먹였다. Code as Policies는 인식과 제어 API를 호출하는 프로그램을 쓰게 했고, VoxPoser와 ReKep은 3D value map이나 관계형 keypoint 제약을 만들어 motion planner가 최적화하게 했다. Gemini Robotics-ER은 embodied 추론 전용으로 학습한 모델이다.
이 시스템들에서 foundation model은 "무엇을" 할지를 정하고, 미리 정의한 skill 집합이나 planner, 별도 학습한 controller가 "어떻게" 할지를 정한다. 반면 이 보고서는 frontier 모델이 end-effector action을 직접 내는 controller 자체가 될 수 있는지를 묻는다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이다.
핵심 개념
in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력이다. 이 보고서에서는 ICL로 줄여 부르며, GPT-6-Astra가 훈련 시연 데이터를 직접 분석해 노트와 코드를 작성한 뒤 그 결과물을 테스트 때 읽는 방식으로 구현한다.
knowledge package는 ICL 준비 단계에서 GPT-6-Astra가 작성해 테스트 전에 고정하는 자료 묶음으로, 보고서는 기호 K로 표기한다. 과제 안내, 동작 참조, 시각 참조, 실행 코드, 완료 검사와 복구 절차, 메타데이터가 들어간다. 가중치를 바꾸지 않으면서 학습형 policy가 쓰는 것과 같은 정보를 활용하게 하는 장치다.
step budget은 한 episode 안에서 허용하는 action step 수의 상한이다. 각 벤치마크의 공식 한도를 1배(표준 budget)로 두고, 최대 10배까지 늘린 한도를 확장 budget이라 부른다. 확장은 리셋이 아니라 같은 episode를 이어 가는 것이다.
System 1과 System 2는 dual-process theory에서 빌린 구도다. 이 보고서에서 System 2는 느리고 숙고적인 추론 모델(GPT-6-Astra)이고, System 1은 과제에 맞춰 학습된 빠른 policy(π0.5 같은 VLA)다. 여기에 System 0은 로봇 형상에 의존하는 저수준 실행 층을 가리키며, 상위 policy가 형상별 구동 방식을 직접 배우지 않아도 되게 한다. humanoid의 whole-body controller나 locomotion controller가 System 0에 해당한다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. 이 보고서에서는 GPT-6-Astra가 결정 한 번에 내보내는 end-effector action의 개수를 L로 표기하고, 고정 chunk와 모델이 L을 스스로 고르는 adaptive chunk를 비교한다.
active vision은 다음 action에 필요한 observation을 얻기 위해 카메라 시점을 의도적으로 옮기는 행동이다. 실세계 실험에서 GPT-6-Astra가 학습 없이 스스로 보인 능력으로, 시점이 action space의 일부가 된다는 점이 핵심이다.
world clock은 에이전트가 숙고하는 동안에도 계속 흐르는 시뮬레이션 시간이다. 기존 시뮬레이터는 모델이 생각하는 동안 환경을 멈추지만, 실제 로봇처럼 시간이 흐르게 하면 추론 지연이 성능의 일부가 된다. 보고서가 제안하는 차세대 벤치마크의 세 번째 원칙이다.
방법
평가 대상 벤치마크
보고서는 12개 평가 설정을 다섯 분류로 묶어 평가한다. 모든 평가에서 GPT-6-Astra의 모델 가중치는 고정된다.
| 분류 | 벤치마크 | 특징 |
|---|---|---|
| 탁상 manipulation | RoboDojo, RoboLab, LIBERO-Long++, LIBERO-Ultra-Long, LIBERO-PRO | 정밀 양손 조작부터 조합형 long-horizon 과제, 교란 강건성까지 |
| dexterous manipulation | Bench2Dex, DexJoCo | 다지 손을 쓰는 접촉이 많은 과제 |
| humanoid loco-manipulation | SIMPLE | 보행과 조작을 함께 하는 humanoid 과제 |
| long-horizon 가정 활동 | BEHAVIOR | 여러 방과 가전에 걸친 긴 가정 작업 |
| vision-language navigation | VLN-CE R2R, VLN-CE RxR, LHPR-VLN | 자연어 경로 지시를 따르는 내비게이션 |
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 이 분류에서 BEHAVIOR와 LHPR-VLN이 가장 낮은 성공률을 보이는데, 많은 단계에 걸쳐 subgoal을 추적해야 하기 때문이다.
통합 프로토콜의 두 원칙
통합 프로토콜은 두 원칙 위에 선다.
첫째, 훈련 세트에 성공 시연이 있으면 ICL을 허용한다. 기존 학습형 로봇 policy는 벤치마크가 제공하는 시연 데이터로 학습하거나 fine-tuning한다. GPT-6-Astra에게 이 시연을 주지 않고 평가하면 서로 다른 정보 조건에서 비교하는 셈이 된다. 따라서 학습형 policy가 쓰는 과제 관련 정보를 GPT-6-Astra도 컨텍스트 준비를 통해 쓸 수 있게 해 두고, 그 조건에서의 능력을 측정한다.
둘째, step budget을 크게 늘린다. 평가 중 GPT-6-Astra는 실패한 action을 알아채고 전략을 바꿔 다시 시도하는 경우가 많다. 엄격한 step 한도는 이 회복 과정이 성공하기 전에 episode를 끊어 버린다. 보고서는 표준 step 한도가 GPT-6-Astra의 능력을 크게 과소평가할 수 있다고 보고, 1배와 10배 두 조건을 모두 보고한다.
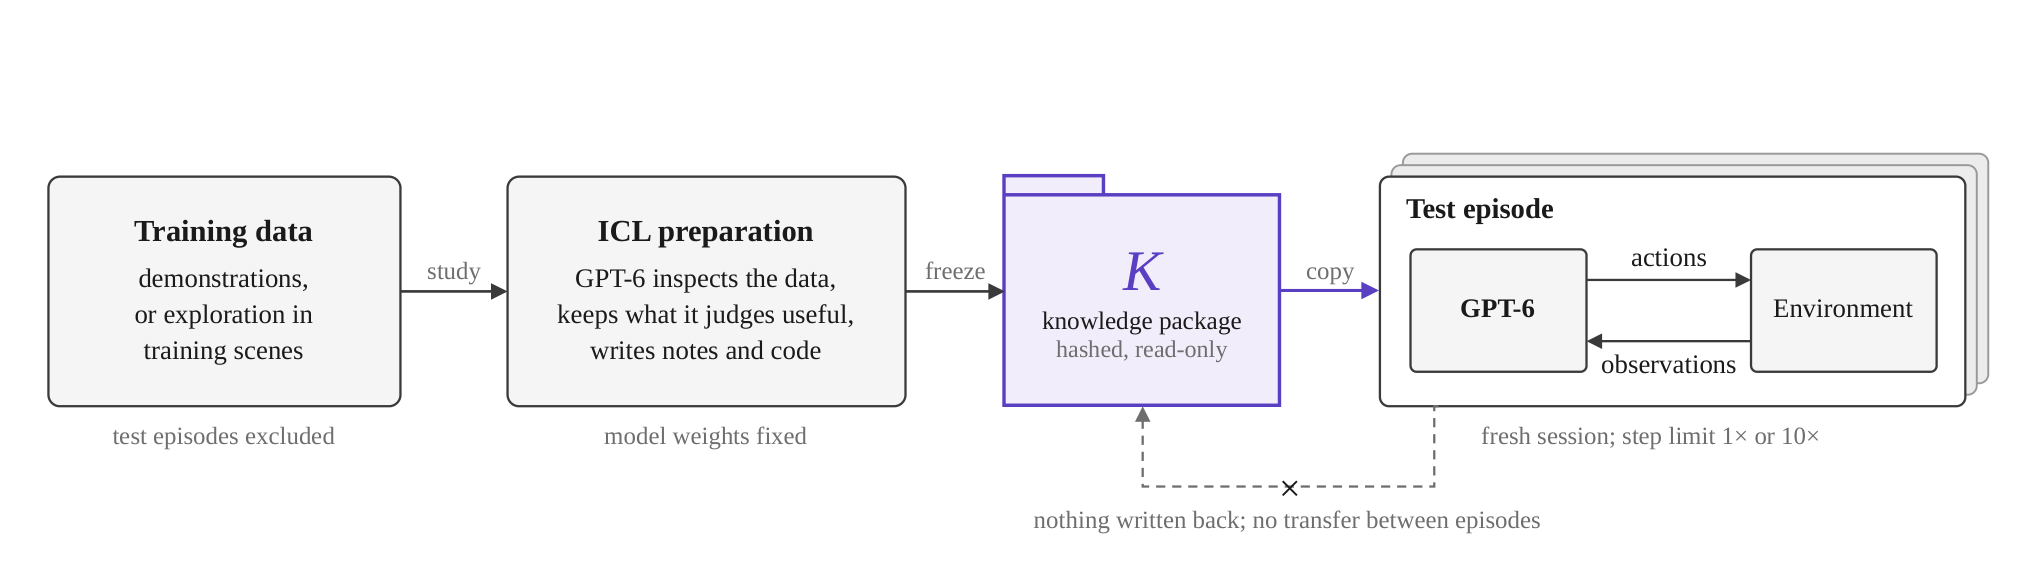
프로토콜은 시연을 활용한 준비 단계와 테스트 시점 상호작용을 분리한다. 단계별 규칙은 다음과 같다.
| 단계 | 규칙 |
|---|---|
| ICL 준비 | 과제마다 별도로 수행한다. 벤치마크에 맞는 observation과 시연 action으로 표현된 훈련 시연 데이터를 분석해 과제별 노트와 재사용 코드를 만든다. held-out 테스트 episode와 평가자 전용 정보는 제외한다. 모델 가중치는 바뀌지 않는다 |
| 패키지 고정 | 준비 결과를 knowledge package K로 묶어 hash를 남기고 읽기 전용으로 고정한다. 그 과제의 모든 테스트 episode에 같은 K를 제공한다 |
| episode 실행 | 지시문, K, 허용된 observation과 action 인터페이스를 가진 새 세션에서 시작한다. 결정 시점마다 현재 observation을 보고 다음 action 또는 action 시퀀스를 정하고, 환경이 실행해 새 observation을 돌려준다 |
| 기록 유지 | episode 안에서는 상호작용 기록을 유지해 실수를 진단하고 복구를 시도할 수 있다. K와 가중치는 갱신하지 않고 episode 사이에 정보를 넘기지 않는다 |
| 조건 통제 | observation 접근, action 의미, control frequency, 성공 기준은 budget 조건과 무관하게 같다 |
확장 budget에서는 1배 결과와 함께 2배부터 10배까지의 누적 cutoff 성공률을 보고한다. 연장은 같은 episode를 이어 가므로 상호작용 기록과 환경에 쌓인 결과(쏟아진 액체, 떨어진 부품 등)가 그대로 남는다. 추가 시도는 리셋이 아니라 그 episode 안에서 일어난다. episode는 검증된 성공, 해당 terminal failure, budget 소진 중 하나로 끝난다. 표준 budget 결과를 별도 비교점으로 남겨 두기 때문에 추가 상호작용의 기여를 분리해 볼 수 있다.
knowledge package의 구성
보고서는 GPT-6-Astra에게 어떤 시연, 프레임, 상태와 action 기록을 살펴보고 저장하라고 지정하지 않았다. 각 벤치마크의 허용 훈련 데이터와 도구 인터페이스 안에서 무엇을 볼지, 무엇을 남길지는 모델이 스스로 정했다. 그런데도 벤치마크 전반에서 여섯 구성 요소가 반복해서 나타났다.
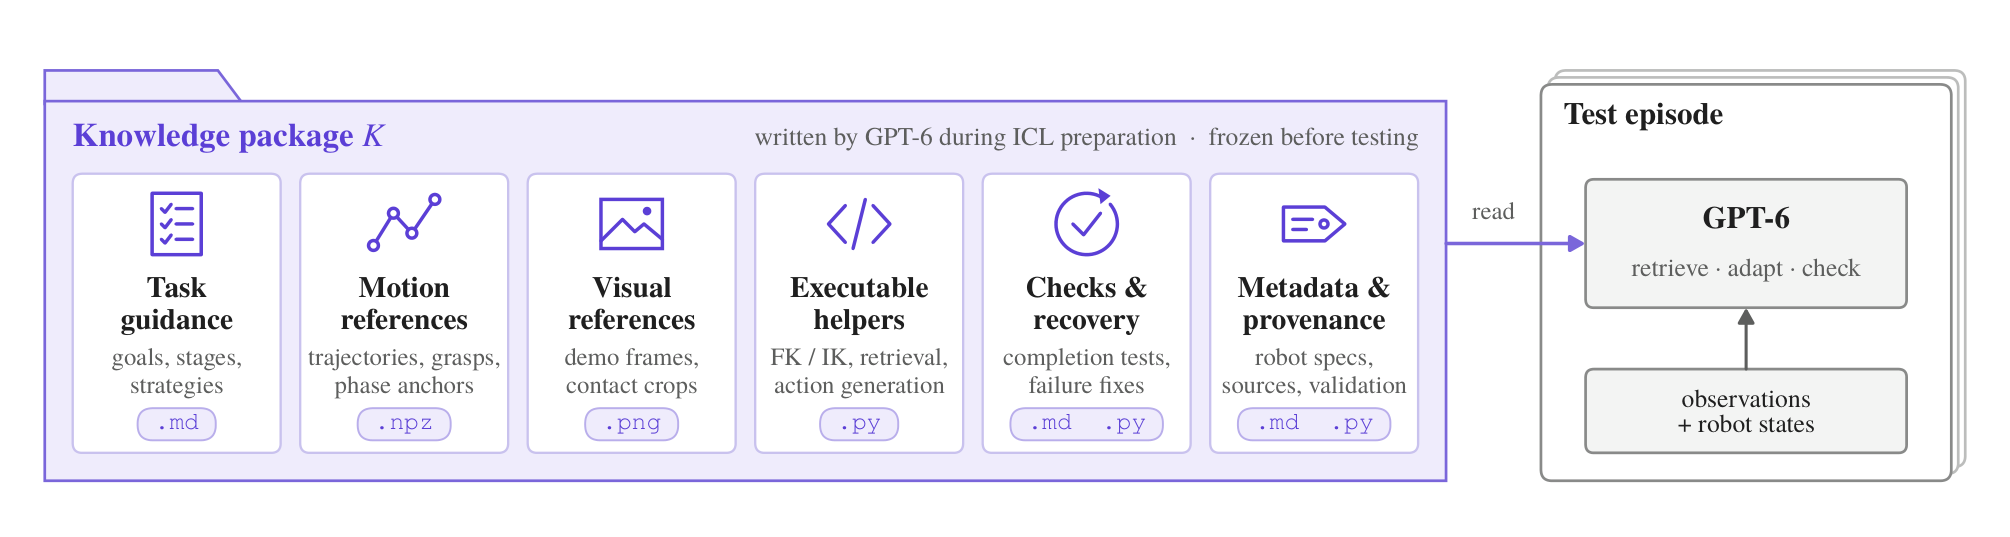
| 구성 요소 | 담는 내용 | 대표 파일 형식 | 테스트 시 역할 |
|---|---|---|---|
| Task guidance | 과제 목표, 실행 단계, 전략, subtask 순서, 물체 역할, 제약 | .md | 저장된 참조를 고르고 쓰는 기준을 준다 |
| Motion references | 시연에서 뽑은 trajectory, grasp 구성, phase anchor | .npz | 관련 구간이나 자세를 검색해 현재 장면과 로봇 상태에 맞춘다 |
| Visual references | 선택한 시연 프레임, 접촉 부위 crop, 중간 상태 이미지 | .png | 동작 해석과 현재 observation 비교를 돕는다 |
| Executable helpers | forward/inverse kinematics, 참조 검색, action 생성 Python 코드 | .py | 참조와 현재 기하 추정을 후보 action으로 바꾼다 |
| Checks & recovery | grasp, subtask, 전체 과제 성공을 확인할 수 있는 근거, 실패 증상과 교정 action의 대응 | .md, .py | 완료를 판정하고 접근 수정이나 대체 grasp 선택 같은 복구를 안내한다 |
| Metadata & provenance | 로봇 사양, 인터페이스 규약, 출처 기록, 검증 노트 | .md, .py | 저장된 상태와 action의 해석 방법과 오프라인 검증 범위를 기록한다 |
여기서 trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 공통 구조 안에서도 보관 내용의 비중은 벤치마크의 요구에 따라 다르다.
| 벤치마크 | 주로 보관한 내용 |
|---|---|
| Bench2Dex, DexJoCo | 손 구성, phase별 동작 예시, dexterous 제어 helper |
| LIBERO-Long++, LIBERO-Ultra-Long | 조합 가능한 atomic skill 중심으로 정리한 시연 |
| LIBERO-PRO | 탐색에서 얻은 텍스트 전략과 복구 지식 |
| SIMPLE | 수치 훈련 trajectory 전체와 현재 피드백에 맞춰 action chunk를 추출, 수정하는 helper |
| LHPR-VLN, VLN-CE | 훈련 장면 연습에서 얻은 내비게이션 전략, 랜드마크 참조, 정지 안내, 복구 노트 |
| BEHAVIOR | 물체별 grasp affordance, 양손과 도구 접촉 기하, 조건부 검증과 복구 절차 |
affordance는 물체가 허용하는 상호작용 가능성을 뜻한다. 예를 들어 손잡이는 잡기를, 버튼은 누르기를 허용한다.
knowledge package의 사용 방식
사후 사용 분석에서 모든 감사 대상 벤치마크에 공통 흐름이 나타났다. GPT-6-Astra는 과제 안내를 읽고, 준비해 둔 helper로 후보 동작을 검색하고, 시각 참조와 대조해 실행을 검사한다. 수치 시연은 helper 내부에서 자주 불러와 저장된 예시를 action 생성에 직접 잇는다. DexJoCo에서는 controller와 시각 참조를 초기 실행과 연장 실행 모두에서 반복적으로 사용했다.
핵심은 시연을 그대로 재생하지 않고 현재 장면에 맞춰 고친다는 점이다. 두 사례가 이를 보여 준다.
- Bench2Dex Ball Box Loading에서는 참조 관절을 재매핑하고 작업 공간 높이 차이 4~5 cm를 보정하면서도 시연의 양손 지지 기하를 유지했다.
- DexJoCo Photograph에서는 물체가 미끄러진 뒤 다른 참조 집기 동작을 골라 다시 시도했다.
따라서 패키지는 피드백 아래에서 action을 제안하고, 조정하고, 수정하는 재사용 자원으로 쓰인다. 다만 보고서는 이 분석이 개별 구성 요소의 인과적 기여까지 분리하지는 않는다고 명시한다.
harness ablation 설계
2장 결과는 추가 상호작용이 과제 완료를 크게 높이지만 그 효과가 에이전트가 상호작용을 얼마나 잘 쓰는지에 달려 있음을 보여 준다. 또 긴 실행은 큰 추론 비용을 낳고 물리적 검증, 복구, 진행 보존 실패를 확실히 해결하지 못한다. 그래서 3장은 GPT-6-Astra의 추론을 observation, action, 피드백에 잇는 harness 자체를 통제 실험으로 분석한다. ablation은 구성 요소를 하나씩 빼거나 바꿔 각 요소의 기여를 재는 실험이다.
실험은 모두 RoboDojo 42개 과제에서 과제마다 seed를 달리한 3회 실행으로 평가했다(ICL 설정만 2장의 Table 5를 따른다). 부분 완료를 반영한 점수와 완전 성공률을 함께 보고하고, Generalization, Precision, Long-Horizon, Memory, Open 다섯 범주로 나눈다. 비용 지표는 GPT-6-Astra와 보조 에이전트의 입력과 출력 토큰을 합한 episode당 평균 토큰이다.
System 1과 System 2 협업. GPT-6-Astra를 System 2로, RoboDojo로 fine-tuning한 π0.5를 System 1로 둔다. 이 구도는 dual-system VLA, 즉 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 구조와 같은 발상이다. 비교 설정은 다음과 같다.
| 설정 | 동작 방식 |
|---|---|
| standalone VLA | GPT 감독 없이 π0.5만 실행한다 |
| open-loop 협업 | GPT가 subgoal을 지정하고 VLA가 joint action 시퀀스를 바로 실행한다 |
| closed-loop 협업 (L=1) | VLA가 제안한 action을 forward kinematics로 후보 EEF 동작으로 바꾸고, GPT가 실행 전에 수락, 수정, 거부한다 |
| closed-loop 협업 (L=4) | GPT 호출 한 번에 VLA가 제안한 EEF action 4개를 함께 검토한다 |
| ICL | 2장의 knowledge package를 쓰는 직접 제어 에이전트 |
| ICL + VLA closed-loop | knowledge package와 closed-loop 협업(L=2)을 결합한다 |
open-loop 실행은 한 번 계산한 action 묶음을 중간 피드백 없이 끝까지 내보내는 방식이다. 반대로 closed-loop 협업은 매 실행 전에 System 2가 개입한다.
action 표현과 chunking. 기준선은 RoboRSI 에이전트 프레임워크다. GPT-6-Astra는 RGB 이미지와 로봇 상태를 보고 결정마다 절대 Cartesian end-effector(EEF) action 하나를 낸다. 비교 대상은 다음 네 가지다.
| 설정 | 내용 |
|---|---|
| directional motion command | 절대 목표 대신 상대 이동 방향과 거리를 지정한다 |
| joint angle | 관절 각도를 직접 제어한다 |
| fixed action chunk (L=4) | 결정마다 EEF action 4개를 고정으로 낸다 |
| adaptive action chunk | 모델이 결정마다 L을 1~4 중에서 고른다 |
에이전트 구성 요소 (부록 D.1). 기준선에 다음 네 요소를 하나씩 추가해 비교한다.
| 구성 요소 | 역할 |
|---|---|
| planning subagent | 과제를 subgoal과 완료 기준으로 분해하고 결과를 main 에이전트 컨텍스트에 넣는다 |
| execution subagent | main 에이전트의 subgoal로부터 EEF action을 생성한다 |
| feedback subagent | 실행 결과를 평가해 계속, 조정, 재시도를 제안한다 |
| history compression | 최근 4턴만 그대로 두고 이전 상호작용은 2,000토큰 상한의 rolling summary로 통합한다 |
실세계 변형 프로토콜
시뮬레이션 프로토콜은 두 가정에 기댄다. 하나는 테스트 과제의 성공 시연 데이터가 이미 있다는 가정이고, 다른 하나는 추가 실행 step에 비용이 없다는 가정이다. 실제 로봇에서는 둘 다 성립하지 않는다. 새 과제는 대개 시연 없이 주어지고, 실제 하드웨어에서는 과제에 걸리는 시간이 토큰 비용뿐 아니라 안전, 하드웨어 상태, 사람의 노동까지 좌우한다. 그래서 4장은 세 가지를 바꾼 실세계 변형을 쓴다.
| 변경 | 시뮬레이션 프로토콜 | 실세계 변형 |
|---|---|---|
| 컨텍스트 | 훈련 시연에서 만든 knowledge package | 시연과 패키지 없음(zero-shot). 사람이 적어 준 구조화된 사전 지식만 제공 |
| 사전 지식 내용 | 해당 없음 | tool schema, joint limit, 카메라 배치, 안전 제약, dexterous hand 개폐 preset. 일부 플랫폼에는 허용 grasp 지점 같은 과제 수준 안내. pick, place, insert 같은 고수준 semantic skill은 어떤 플랫폼에도 주지 않음 |
| budget | action step 수 (1배, 10배) | wall-clock 시간, 보통 60분 (플랫폼별 예외는 부록) |
| 성공 판정 | 벤치마크 자동 판정 | 사람이 물리적 결과로 판정. 모델의 완료 선언은 쓰지 않음. 운영자가 비상 정지 버튼을 계속 쥠 |
천 접기 같은 변형 물체 과제는 플랫폼을 가로지르는 공통 품질 기준을 정하기 어렵다. 그래서 이런 과제의 성공률은 같은 품질 수준이 아니라 과제를 끝까지 수행했는지를 나타낸다.
플랫폼은 다섯 형상 분류의 8대이며, 분류마다 묻는 질문이 다르다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻하며, 보고서는 단순한 embodiment에서 복잡한 embodiment 순으로 배치했다.
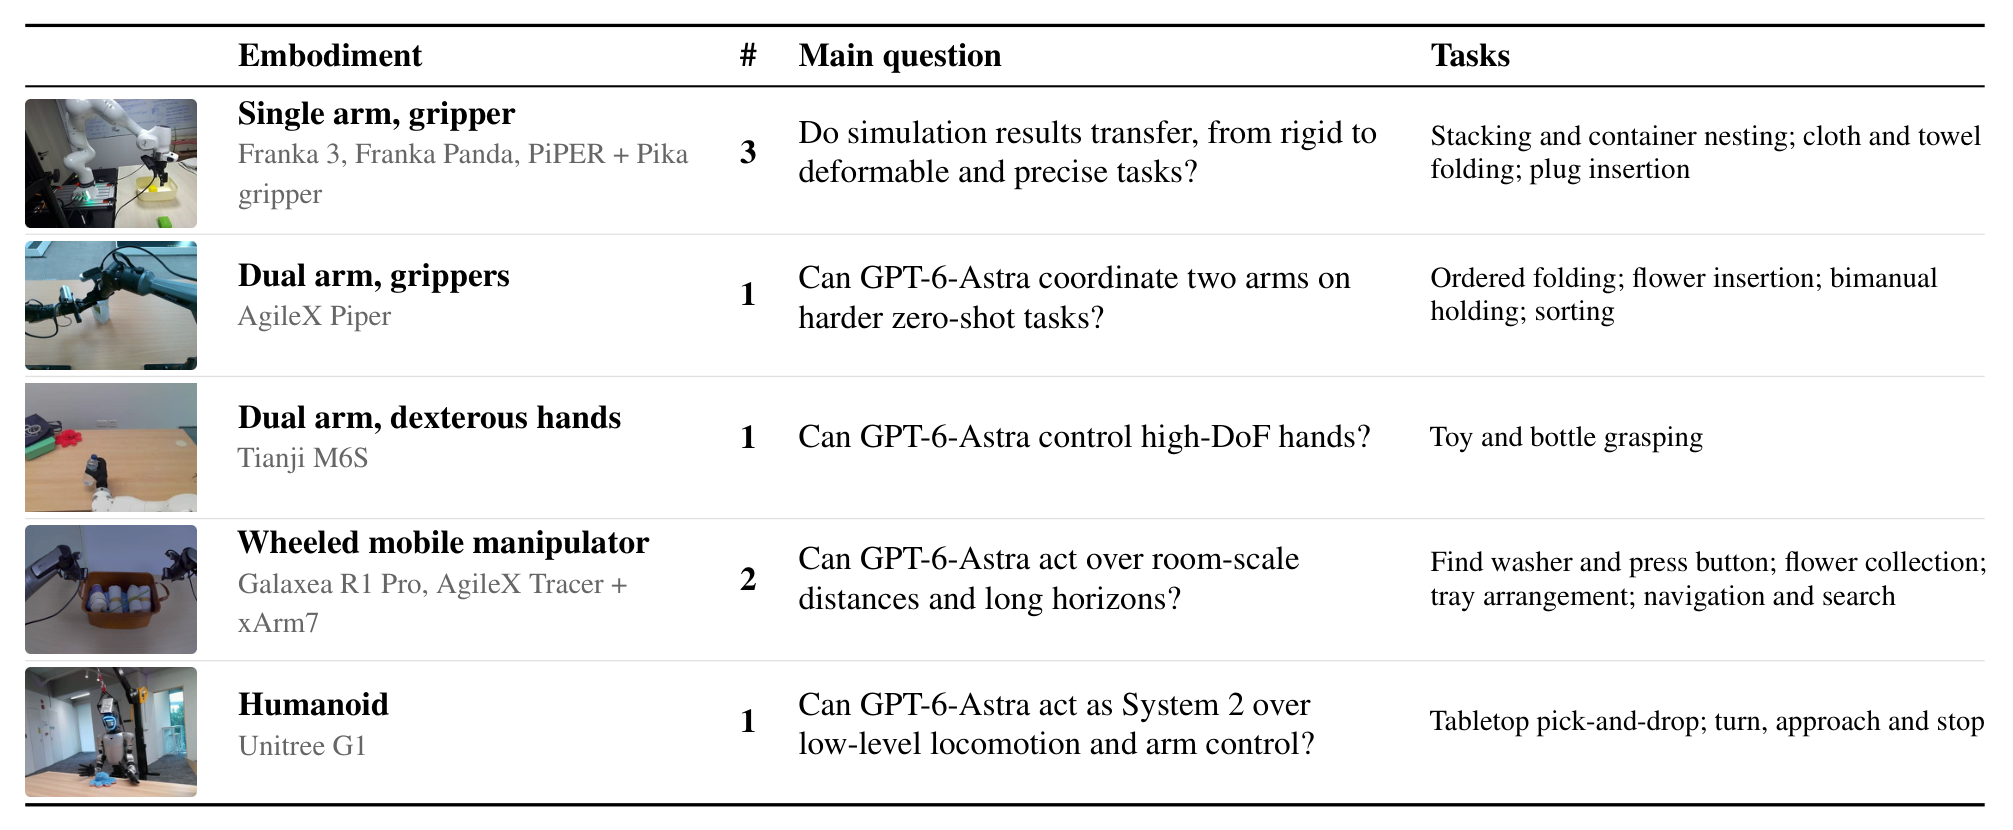
| 형상 분류 | 플랫폼 | 대수 | 주요 질문 | 과제 |
|---|---|---|---|---|
| 단일 팔, 그리퍼 | Franka 3, Franka Panda, PiPER + Pika gripper | 3 | 시뮬레이션 결과가 강체에서 변형 물체, 정밀 과제로 전이되는가 | 쌓기, 그릇 포개기, 천과 수건 접기, 플러그 삽입 |
| 양팔, 그리퍼 | AgileX Piper | 1 | 두 팔을 조율해 더 어려운 zero-shot 과제를 하는가 | 순서 있는 접기, 꽃 꽂기, 양손 들기, 분류 |
| 양팔, dexterous hand | Tianji M6S | 1 | 고자유도 손을 제어하는가 | 장난감과 병 잡기 |
| 바퀴형 모바일 manipulator | Galaxea R1 Pro, AgileX Tracer + xArm7 | 2 | 방 규모 거리와 long-horizon에서 동작하는가 | 세탁기 찾아 버튼 누르기, 꽃 모으기, 쟁반 정리, 내비게이션과 탐색 |
| humanoid | Unitree G1 | 1 | 저수준 locomotion과 팔 제어 위의 System 2로 동작하는가 | 탁상 집어 떨어뜨리기, 회전 후 접근과 정지 |
차세대 벤치마크 원칙
5장은 앞 장들의 결과에서 출발한다. GPT-6-Astra의 기존 벤치마크 성적은 벤치마크가 허용하는 조건에 크게 의존했다. 시연 데이터에 대한 in-context 접근과 실패에 비용이 없는 확장 budget이 성공률을 올렸고(2장), 학습형 policy용으로 만든 action 인터페이스에 범용 에이전트를 어떻게 맞추느냐도 성능을 좌우했다(3장). 이런 조건은 대부분의 embodied 벤치마크가 imitation learning policy를 위해 설계됐기 때문에 생긴다. 과제 시연을 모으고, policy를 맞추고, 같은 과제의 held-out episode로 평가하는 구조다.
실제 로봇에서는 새 과제의 시연도, 추가 시간도 공짜가 아니다(4장). 따라서 범용 에이전트에게 기존 벤치마크는 "벤치마크가 제공하는 것을 얼마나 잘 활용하는가"를 일부 측정한다. 벤치마크가 포화될 때의 통상적 대응인 난이도 상향으로는 이 문제가 바뀌지 않는다. 보고서는 대신 벤치마크의 설계와 판정 방식을 바꾸는 세 원칙을 제안한다.
목표 설정. 언어 에이전트 평가에서 흔해진 프로토콜, 즉 에이전트가 어떤 수단으로든 환경에서 행동하고 결과로 채점받는 방식을 따른다. 에이전트는 로봇 센서로만 세계를 지각하고, 하드웨어가 노출한 명령으로만 행동하며, 계속 진행하는 세계에서 단일 배포 단위로 평가된다. 그 인터페이스 위에 에이전트가 쌓는 모든 것은 평가 대상 시스템의 일부다.
기존 판정 방식의 가정. 현재 embodied 벤치마크는 planning 도메인 언어처럼 성공을 판정한다. PDDL에서 영향을 받은 BDDL은 장면 물체에 대한 목표 조건을 적고, 그 조건이 한 상태에서 참이면 성공으로 본다. 이런 목표는 고전 planning의 가정을 물려받는다.
- 완전히 명세된 목표와 이진 성공
- 에이전트의 action으로만 변하는 세계
- step 단위로 세는 시간
- 주어진 world model
PDDL 확장들이 이 중 일부를 완화했지만 embodied 벤치마크는 그것을 거의 채택하지 않았다. 아래 세 원칙은 각각 이 가정 중 하나 이상을 깬다.
| 원칙 | 핵심 내용 | 깨는 가정 |
|---|---|---|
| 사람의 필요에서 도출한 과제 | 사람이 말할 법한 요청으로 과제를 주고 결과의 효용으로 평가한다. 명시 요청(Intent)과 말하지 않은 의무(Duty)를 같은 배포에 두고 world clock 마감을 건다 | 완전 명세 목표, 이진 성공 |
| 테스트 시점에 쌓는 경험 | 도메인 내 훈련 episode와 장면 특화 시연을 주지 않는다. 판정 술어는 에이전트가 볼 수 없는 물리량으로 정의하고 탐색에도 world time과 부작용을 부과한다 | 주어진 world model |
| 멈추지 않는 세계 | observation 후 다음 명령까지의 시간(추론, tool use, 통신)을 이전 명령 아래에서 시뮬레이션한다. 판정자는 완료 선언 이후까지 전체 trajectory를 본다 | step 단위 시간, 에이전트만 세계를 바꿈 |
원칙 1. 사람의 필요에서 도출한 과제. 기존 벤치마크 과제는 시연을 모을 수 있어야 하므로 로봇이 성공할 수 있다고 보여 줄 수 있는 과제다. zero-shot으로 새 집에서 동작하는 generalist policy조차 로봇 관점에서 고른 과제로 평가받는다. 반면 배포된 로봇은 어떤 로봇도 해 본 적 없는 일이라도 사람이 필요로 하는 일을 해야 한다. 보고서는 BEHAVIOR-1K를 따라 과제를 이런 필요에서 도출하고 사람이 말하는 그대로 진술하자고 제안한다.
이런 과제는 에이전트가 자기 embodiment의 한계를 아는지도 시험한다. 예를 들어 천장 전구를 갈아야 할 때 humanoid는 발 받침대를 가져올 수 있지만 바퀴형 로봇은 도움을 요청해야 한다. 또 실제 필요에는 어떤 지시문도 말하지 않는 의무가 따른다. 켜 둔 레인지, 흐르는 수도, 에이전트 자신이 열어 둔 수납장이 그 예다. 이런 의무는 지시 없는 정리, 에이전트가 만든 위험 완화, 퍼지는 위험에서 물체 구하기 같은 좁은 형태로 연구됐다. 그러나 실제 배포에서는 로봇이 다른 일을 하는 도중에 나타나므로, 에이전트는 이를 스스로 알아채고 하던 일을 멈출지 결정해야 한다. 그래서 의무(Duty)를 명시 요청(Intent)과 같은 배포에 두고 world clock 마감을 건다.
필요로 진술된 요청은 목표로 판정할 수 없다. "아침 만들어 줘"는 계층적 planning의 고수준 action처럼 토스트 한 조각부터 완전한 식사까지 여러 refinement를 허용한다. 목표 공식은 그중 작성자가 고른 하나만 남긴다. refinement마다 사람에게 주는 가치가 다르므로, 만족한 목표 술어의 비율로 계산하는 부분 점수 대신 결과에 대한 효용 함수가 필요하다.
고정 검사가 지시문과 모순되는 경우도 있다. Bench2Dex의 condiment-box-loading 과제는 조미료 세 개를 상자에 넣으라고 지시하지만, 성공 검사는 간장 병과 식초 병이 세워져 있을 것까지 요구하며 이는 지시문에 없다. 유능한 에이전트는 검사가 예상하지 못한 방식으로 요청을 만족하거나 요청보다 약한 검사를 악용할 수도 있다. 따라서 판정자 자체를 사람이 대안 결과를 어떻게 순위 매기는지와 대조해 검증해야 한다.
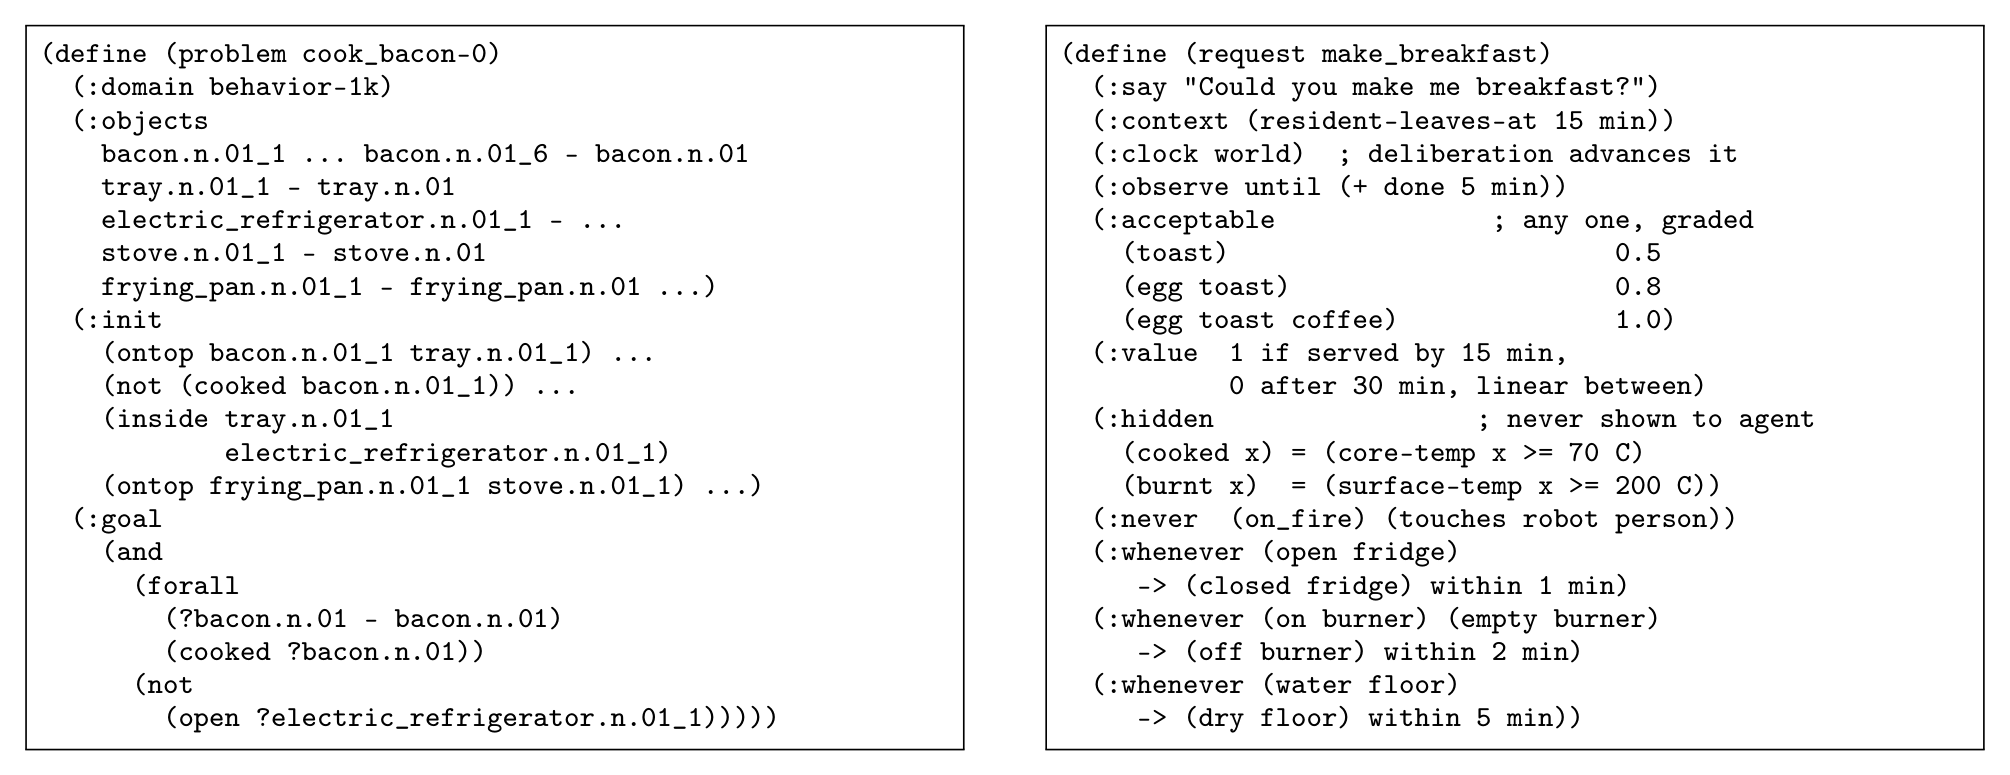
두 명세의 차이는 다음과 같다.
| 항목 | BEHAVIOR-1K cook_bacon (왼쪽) | 제안 요청 명세 make_breakfast (오른쪽) |
|---|---|---|
| 과제 진술 | 베이컨 6개가 모두 cooked이고 냉장고가 닫혀 있다 | "Could you make me breakfast?" 발화와 거주자 15분 후 외출이라는 컨텍스트 |
| 성공 판정 | 매 step 현재 상태로 목표를 검사해 처음 참이 되는 순간 성공 | 허용 결과 중 하나면 점수. 토스트 0.5, 달걀과 토스트 0.8, 달걀과 토스트와 커피 1.0 |
| 시간 | step 단위 | world clock. 숙고도 시간을 진행시킨다. 15분 안에 제공하면 가치 1, 30분 후 0, 그 사이 선형 감쇠 |
| 판정 술어 | 에이전트도 아는 이산 술어 | 판정자만 아는 물리량. 심부 온도 70°C 이상이면 익음, 표면 온도 200°C 이상이면 탐 |
| 금지 조건 | 없음 | 화재 금지, 로봇과 사람의 접촉 금지 |
| 의무 | 냉장고 닫힘만 최종 상태로 검사 | 냉장고가 열리면 1분 내 닫기, 빈 버너가 켜지면 2분 내 끄기, 바닥에 물이 있으면 5분 내 닦기 |
| 관찰 범위 | 목표가 참이 되는 순간까지 | 완료 선언 후 5분까지 |
왼쪽 명세에는 맹점이 있다. 버너를 끌 필요가 없고, cooked는 물체의 최고 온도가 임계를 한 번 넘으면 계속 참이므로 탄 베이컨도 익은 것으로 친다. 오른쪽의 :never와 :whenever 절은 absence와 bounded-response 명세 패턴으로, metric temporal logic과 signal temporal logic으로 표현할 수 있으며 world clock 위의 전체 trajectory에 걸쳐 검사한다. 오른쪽에서는 한 번도 타지 않은 음식만 제공된 것으로 친다. 보고서는 모든 상수가 예시용이라고 밝힌다.
원칙 2. 테스트 시점에 쌓는 경험. 새 과제의 시연은 배포 시 없는 경우가 많고, 시연은 에이전트가 배울 수 있는 범위도 제한한다. 운영자 시점에서 기록한 시연은 가림을 해소하려고 카메라를 움직이는 경우가 드물지만, 자기 embodiment를 이해하는 에이전트는 시점을 action의 일부로 만들 수 있다(4장 발견 2). 그래서 벤치마크는 도메인 내 훈련 episode나 장면 특화 시연을 주지 않아야 한다. 에이전트는 낯선 집과 embodiment에서 자기 탐색으로 사전 지식을 실제 환경에 연결해야 한다. 집 구조를 파악하고, affordance를 시험하고, 제각각인 가전 사용법을 알아내며, 어떤 시연자도 쓰지 않은 전략을 찾을 수도 있다.
planning 언어는 반대로 주어진 world model을 전제하며 벤치마크 목표에도 그 흔적이 남는다. cooked나 toggled_on 같은 술어는 어떤 변수가 중요한지 에이전트에게 알려 준다. 그러나 실제 에어프라이어에는 돌리는 타이머만 있고 토스터 다이얼은 연속적인 결과를 낸다. 따라서 판정자는 술어를 에이전트에게 감춘 물리량으로 정의하고, 탐색에도 다른 action과 똑같이 world time과 부작용을 부과해야 한다. 경험은 한 배포 안의 요청 사이에서는 이어지고 배포 사이에서는 리셋되므로, 평가 단위는 배포이며 에이전트가 그 안에서 얼마나 빨리 능숙해지는지가 관심 대상이다.
원칙 3. 멈추지 않는 세계. 시뮬레이션에서 확장 step budget이 비용 없이 성공률을 올리는 이유는 시뮬레이터가 모델이 숙고하는 동안 멈추기 때문이다. RoboDojo의 표준 budget은 명령된 동작 시간으로 8~76초에 해당하지만 평균 계산 시간은 55분이다. 실제 로봇에서는 그 시간이 세계에서 흐르며, G1에서 GPT-6-Astra는 실행 시간의 약 90%를 숙고에 쓴다.
보고서는 환경이 추론 중에도 계속 변하는 최근 평가를 따라 세계가 에이전트를 기다리지 않게 하자고 제안한다. observation과 다음 명령 사이의 시간은 추론이든 tool use든 통신이든 실제 로봇처럼 이전 명령 아래에서 시뮬레이션한다. 호스트의 시뮬레이션과 렌더링 시간은 부과하지 않는다. 판정자는 에이전트가 완료를 선언한 뒤 일정 시간까지 포함해 world clock 위의 전체 trajectory를 관찰해야 한다. 최종 상태 목표로는 익었다가 타 버린 달걀을 볼 수 없기 때문이다.
의무는 trajectory 제약이 된다. 처음부터 끝까지 피해야 하는 조건이거나, 일단 촉발되면 마감 안에 복원해야 하는 조건이다. PDDL3가 plan에 대한 이런 제약을 표현하고 PARTNR과 IS-Bench가 embodied 과제에서 순서와 촉발형 안전 조건을 검사하지만 마감은 없다. 시간은 결과의 가치도 정한다. 15분 뒤 외출하는 거주자에게는 1시간 걸린 완전한 아침보다 10분 만에 나온 달걀과 토스트가 낫다. 따라서 판정자는 무엇을 언제 달성했는지에 함께 의존하는 효용을 부여해야 하며, 이로써 에이전트의 사고 시간이 성능의 일부가 된다.
가정 proof of concept 구축
보고서는 세 원칙을 가정 환경에 구현했다. 가정은 요청이 열려 있고, 집안일이 여러 방과 가전에 걸쳐 많은 단계로 이어지며, 작업 대부분이 접촉이 많고, 로봇이 일하는 동안에도 집이 계속 변한다. 이 조건들은 GPT-6-Astra가 여전히 부족한 지점과 겹친다.
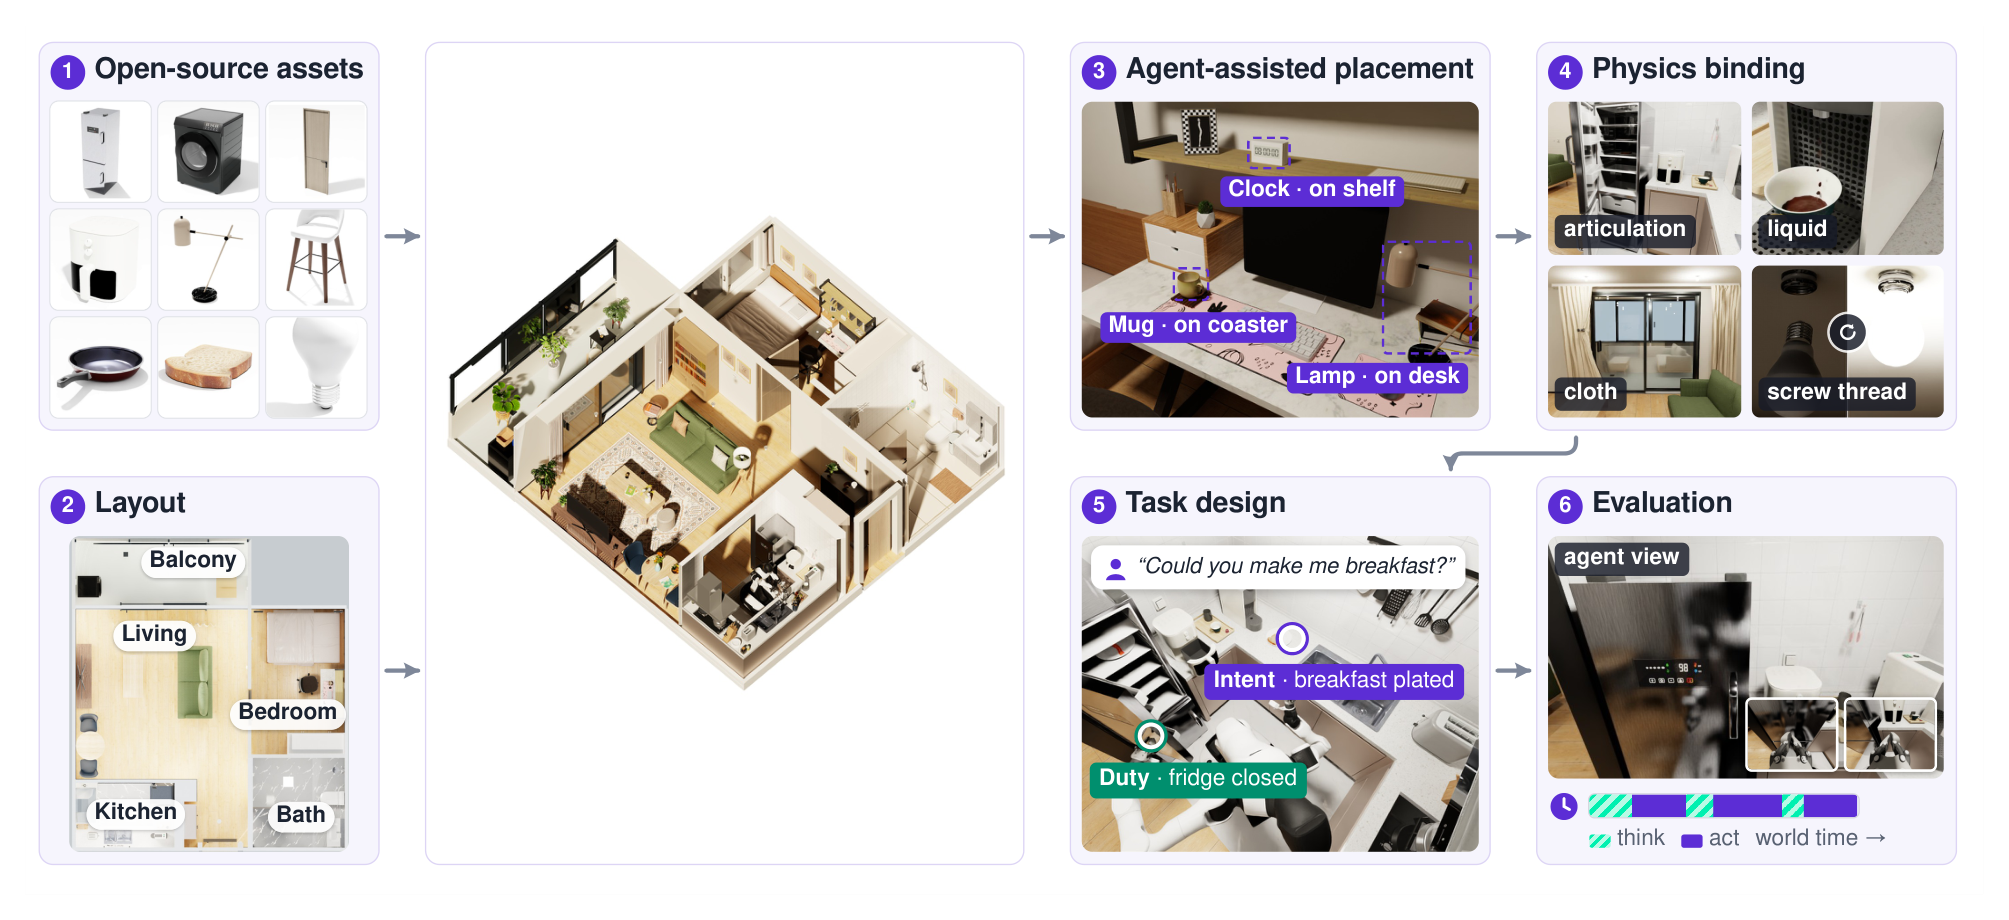
NVIDIA Isaac Sim에서 재현 가능한 파이프라인으로 완전 상호작용 원룸 아파트를 만들었다. 절차는 다음과 같다.
- 공개 asset 수집: 공개된 3D asset을 모은다.
- 배치도: 평면도로 발코니, 거실, 침실, 주방, 욕실을 구성한다.
- 에이전트 보조 배치: 코딩 에이전트가 사람 검토 아래 일상 물건을 실제 규모로 이름 붙은 지지면에 놓는다(컵은 코스터 위, 시계는 선반 위, 램프는 책상 위).
- 물리 연결: 모든 부품에 articulation, 접촉, position-based fluid, 천, 나사산, 일상 가전의 가열과 조리 과정을 연결한다.
- 과제 설계: 과제는 필요만 진술한다. "아침 좀 만들어 줄래?"라고 하면 Intent는 아침이 차려지는 것, Duty는 냉장고를 닫아 두는 것이다. 에이전트는 냉장고, 에어프라이어, 토스터 사용법을 스스로 알아내야 한다.
- 평가: 에이전트는 로봇 탑재 카메라로만 보고, 생각과 행동 모두 world time을 진행시킨다.
판정 결과의 의미는 그 뒤의 물리가 얼마나 정확한지에 달려 있다. 그래서 환경은 causal fidelity를 목표로 만들었다. causal fidelity는 에이전트 결정이 의존하는 물리 현상을 올바른 인과로 시뮬레이션하는 성질이다. 물체의 질량과 마찰부터 버너에서 팬을 거쳐 음식으로 흐르는 열까지, 에이전트 결정이 의존하는 모든 것을 올바른 원인과 결과로 시뮬레이션하고 실세계 참조에 근거시킨다.
실험 설정은 4장의 zero-shot 설정을 따른다. GPT-6-Astra는 AgiBot G2를 로봇 자체 인터페이스로 제어하고, 탑재 카메라와 proprioception만 받으며, 시연 없이 embodiment 설명만 받는다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. 질문은 2장 벤치마크를 거의 포화시킨 모델이 벤치마크가 아무것도 제공하지 않을 때 5.1절의 요구를 충족하는가이다.
결과
벤치마크별 성공률
통합 프로토콜에서 GPT-6-Astra는 기존 방법을 큰 차이로 앞섰다. GPT-6-Astra를 기반으로 한 최근 agentic 방법도 마찬가지로 앞섰다. 아래 표는 Figure 1의 원표(Table 2)이며 단위는 %다.
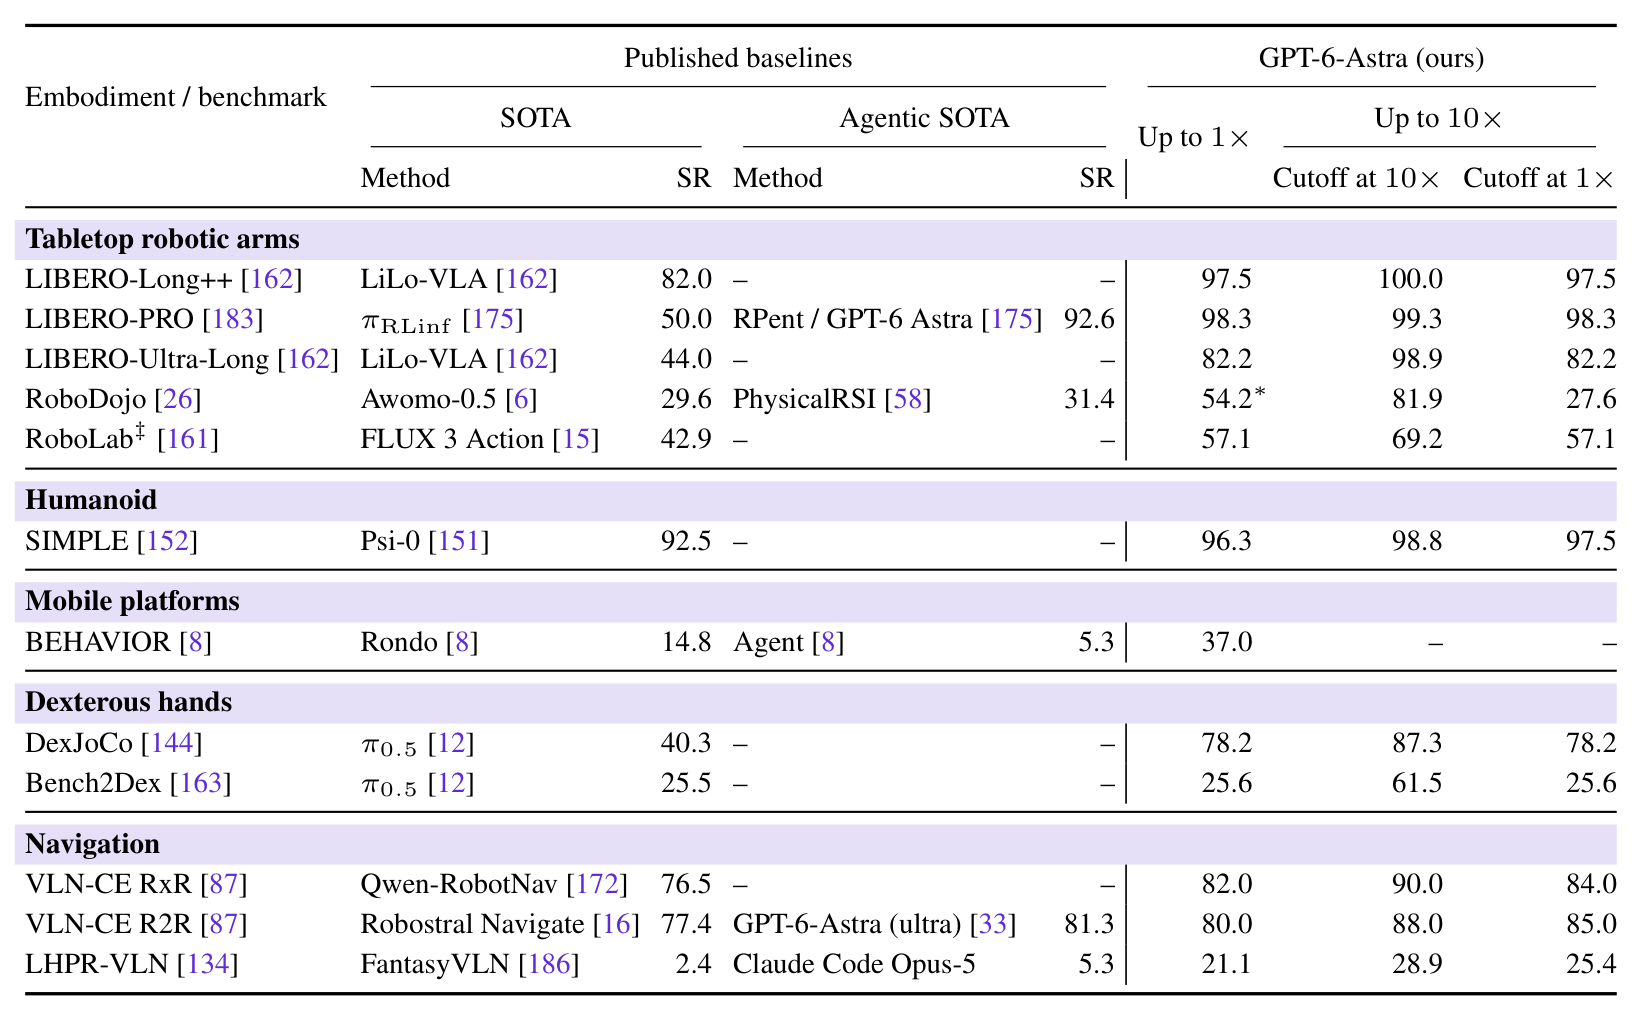
| 분류 | 벤치마크 | SOTA (방법) | Agentic SOTA (방법) | 1배 | 10배 누적 | 10배 실행의 1배 cutoff |
|---|---|---|---|---|---|---|
| 탁상 | LIBERO-Long++ | 82.0 (LiLo-VLA) | 없음 | 97.5 | 100.0 | 97.5 |
| 탁상 | LIBERO-PRO | 50.0 (πRLinf) | 92.6 (RPent / GPT-6 Astra) | 98.3 | 99.3 | 98.3 |
| 탁상 | LIBERO-Ultra-Long | 44.0 (LiLo-VLA) | 없음 | 82.2 | 98.9 | 82.2 |
| 탁상 | RoboDojo | 29.6 (Awomo-0.5) | 31.4 (PhysicalRSI) | 54.2 (VLA 사용) | 81.9 | 27.6 |
| 탁상 | RoboLab (zero-shot) | 42.9 (FLUX 3 Action) | 없음 | 57.1 | 69.2 | 57.1 |
| humanoid | SIMPLE | 92.5 (Psi-0) | 없음 | 96.3 | 98.8 | 97.5 |
| 모바일 | BEHAVIOR | 14.8 (Rondo) | 5.3 (Agent) | 37.0 | 미실시 | 미실시 |
| dexterous | DexJoCo | 40.3 (π0.5) | 없음 | 78.2 | 87.3 | 78.2 |
| dexterous | Bench2Dex | 25.5 (π0.5) | 없음 | 25.6 | 61.5 | 25.6 |
| 내비게이션 | VLN-CE RxR | 76.5 (Qwen-RobotNav) | 없음 | 82.0 | 90.0 | 84.0 |
| 내비게이션 | VLN-CE R2R | 77.4 (Robostral Navigate) | 81.3 (GPT-6-Astra ultra) | 80.0 | 88.0 | 85.0 |
| 내비게이션 | LHPR-VLN | 2.4 (FantasyVLN) | 5.3 (Claude Code Opus-5) | 21.1 | 28.9 | 25.4 |
표 읽는 법에 몇 가지 주의가 필요하다. 1배 열은 10배 실행과 별도로 수행했고 각 budget을 컨텍스트에 알려 주었다. 반면 마지막 열은 10배 실행에서 1배 시점까지의 결과를 잘라 본 값이다. 기존 결과는 모두 표준 budget 기준이다. RoboDojo 1배 54.2%는 VLA를 함께 쓴 결과이며, RoboLab은 훈련 세트가 없어 zero-shot 결과다. BEHAVIOR는 공식 budget이 이미 길어 10배로 늘리지 않았다. SOTA 기준일은 2026년 10월 12일이다.
표준 1배 budget에서도 GPT-6-Astra는 대부분 설정에서 기존 최고 결과와 같거나 높다. 차이가 가장 큰 곳은 LIBERO-Ultra-Long(44.0%에서 82.2%)과 DexJoCo(40.3%에서 78.2%)로, 기존 최고 성공률의 거의 두 배다. 반면 Bench2Dex는 1배에서 기존 최고와 거의 같고(25.5% 대 25.6%), 10배로 가야 61.5%로 크게 앞선다.
ICL의 효과
ICL의 기여를 분리하기 위해 SIMPLE에서 zero-shot과 ICL 조건을 비교했다.
| 지표 | zero-shot | ICL | Psi-0 (참고) |
|---|---|---|---|
| Common-4 성공률 | 85/120 (70.8%) | 109/120 (90.8%) | 108/120 (90.0%) |
| 6과제 성공률 (참고용, 분모 상이) | 110/167 (65.9%) | 111/126 (88.1%) | 154/180 (85.6%) |
| 평균 action step (둘 다 성공한 81 episode) | 376.9 | 210.4 | 없음 |
| 평균 테스트 토큰 | 264만 개 | 640만 개 | 없음 |
| 평균 테스트 시간 | 47.0분 | 31.4분 | 없음 |
| ICL 준비 비용 (과제당 1회) | 없음 | 834만 토큰, 90.4분 | 없음 |
과제 수준 ICL은 표준 budget 성공률을 70.8%에서 90.8%로 20.0%p 올렸고, 성공 episode의 action step을 44.2% 줄여 실행 시간도 47.0분에서 31.4분으로 단축했다. 다만 episode당 토큰은 패키지를 읽느라 264만 개에서 640만 개로 늘었다. 즉 ICL은 시간을 줄이고 토큰을 늘리는 방향으로 비용 구조를 바꾼다. Common-4는 XMovePick, BendPick, Handover, Tabletop 네 과제의 120 episode 전체다.
ICL의 이득은 훈련 데이터가 테스트 과제를 얼마나 가깝게 덮는지에 달려 있다.
| 조건 | 벤치마크 | 결과 |
|---|---|---|
| 테스트가 훈련 분포를 가깝게 따름 | LIBERO 계열, SIMPLE, VLN-CE | 패키지가 시연 동작이나 경로를 거의 그대로 검색, 조정해 포화에 근접 |
| 과제는 어렵지만 참조가 잘 덮음 | DexJoCo | 접촉이 많은 dexterous 과제를 phase별 동작 참조와 controller helper가 덮어 78.2% |
| 훈련 세트 없음 | RoboLab | 과제 수준 패키지를 만들 수 없어 성공률이 중간 수준(57.1%)에 머묾 |
step budget 확장의 효과
훈련 데이터 범위와 별개로 과제 자체의 요구가 1배 성능을 제한한다. ICL을 써도 1배에서 크게 미해결인 벤치마크는 RoboDojo, Bench2Dex, BEHAVIOR, LHPR-VLN 네 개다. RoboDojo와 Bench2Dex는 반복 교정이 필요한 정밀 양손 또는 dexterous manipulation이고, BEHAVIOR와 LHPR-VLN은 여러 단계에 걸쳐 subgoal을 추적해야 하는 긴 가정 manipulation이나 내비게이션이다.
모델 가중치와 ICL 패키지를 고정한 채 budget을 10배로 늘린 결과는 다음과 같다.
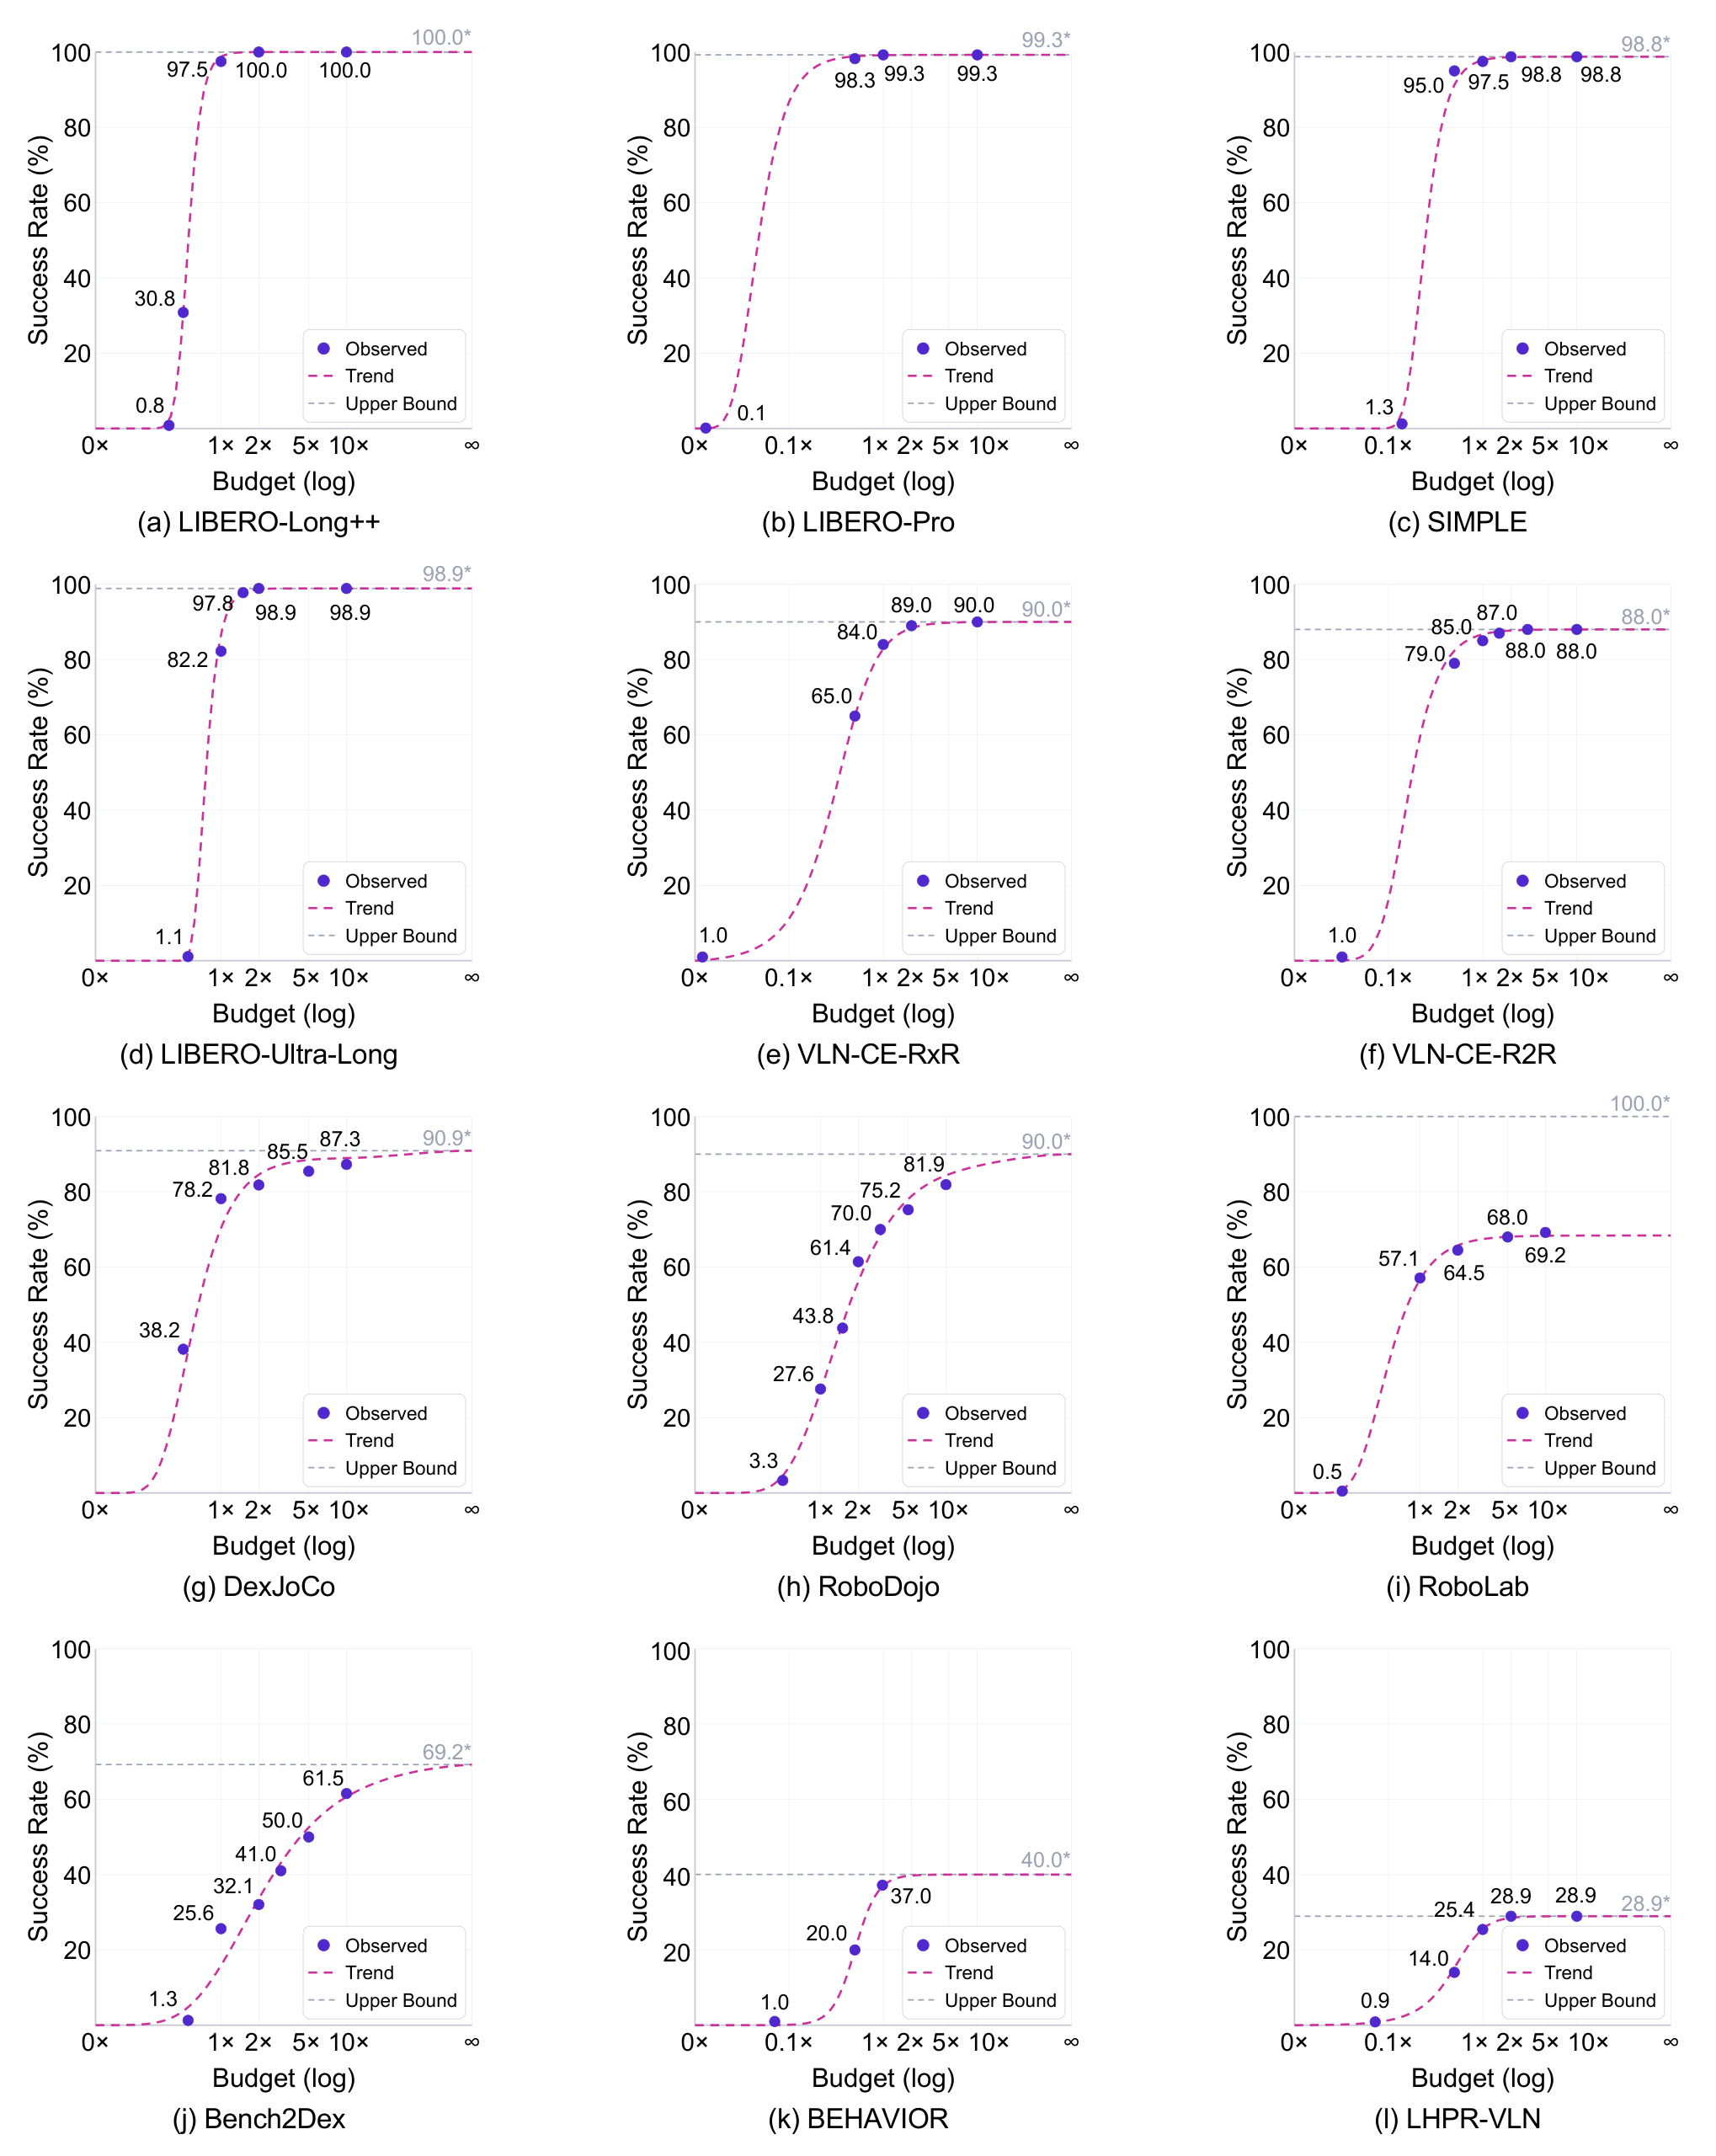
| 벤치마크 | 1배 → 10배 | 해석 |
|---|---|---|
| RoboDojo | 27.6% → 81.9% (약 3배) | 1배에서 끝나지 않은 episode의 약 4분의 3이 완료됐다. Precision 그룹이 가장 크게 올랐다 |
| Bench2Dex | 25.6% → 61.5% (2배 이상) | 표준 budget이 생산적인 실행과 복구를 중간에 끊고 있었다 |
| LHPR-VLN | 25.4% → 28.9% | 소폭 상승에 그쳐 여전히 모든 설정 중 최저다 |
| DexJoCo, VLN-CE | 약 90% | 이미 높은 벤치마크도 추가 상호작용으로 이득을 얻었다 |
| LIBERO 계열, SIMPLE | 95% 초과 | 포화에 근접했다 |
RoboDojo와 Bench2Dex의 큰 상승은 표준 budget이 회복 중인 실행을 끊었다는 뜻이다. 반대로 LHPR-VLN의 소폭 상승은 많은 단계에 걸친 subgoal 추적 같은 long-horizon 내비게이션의 요구가 상호작용을 늘리는 것만으로는 해결되지 않음을 보여 준다. Figure 4의 회색 상한선(RoboDojo 90.0%, Bench2Dex 69.2%, DexJoCo 90.9%, LHPR-VLN 28.9% 등)은 budget을 소진한 모든 episode가 무한 budget에서는 성공한다고 가정한 낙관적 값이다. LHPR-VLN은 10배 결과가 이미 상한과 같아 budget을 더 늘려도 오를 여지가 없다.
비용과 시간
강한 성능은 큰 토큰과 시간 비용을 동반한다. 이 비용은 GPT-6-Astra가 거의 푸는 벤치마크에서도 줄지 않는다.
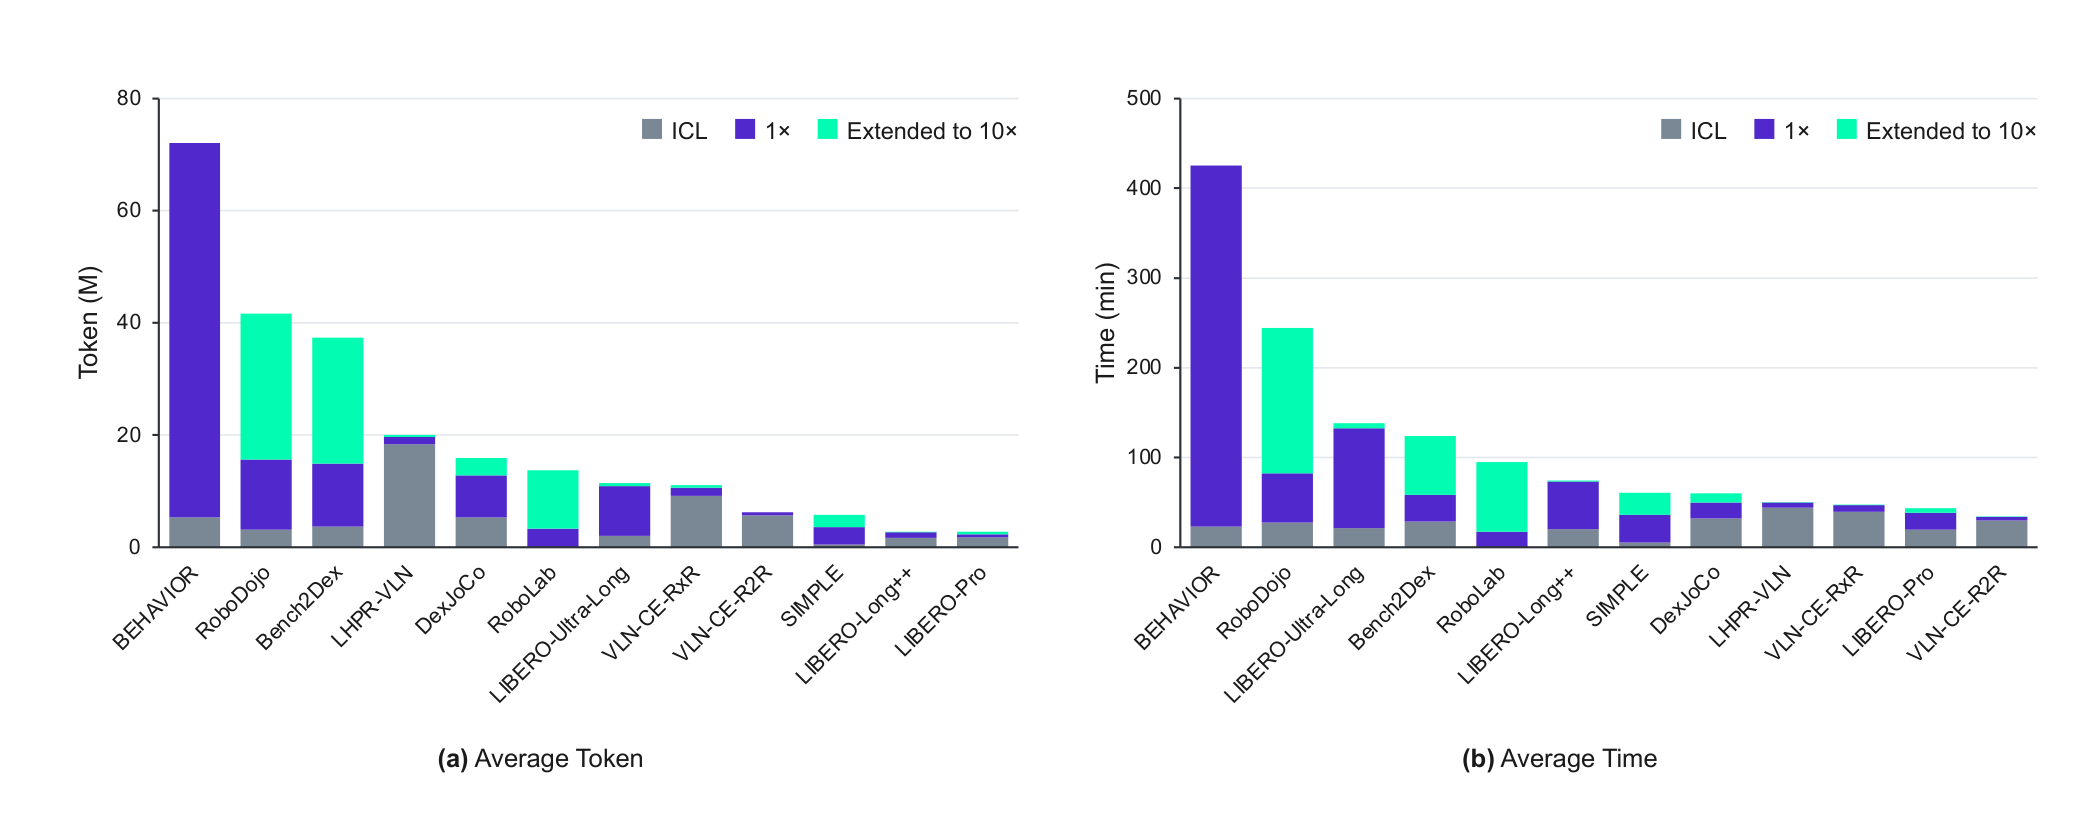
소비 토큰의 약 98%는 캐시된 입력 토큰이다. 그래서 보고서는 "100만 토큰 ≈ 1 USD"를 비용 추정 경험칙으로 쓴다. 10배 연장분이 생각보다 작아 보이는 이유는 연장 실행이 성공이나 terminal failure로 일찍 끝나 10배를 다 쓰지 않기 때문이다. 즉 비용은 실제로 실행한 step을 반영한다.
| 사례 | 비용 |
|---|---|
| LIBERO-Long++ (1배 성공률 97% 초과) | episode당 약 100만 토큰, 거의 1시간의 추론과 tool use |
| LIBERO-Ultra-Long | episode당 약 900만 토큰, 거의 2시간 |
| RoboDojo 확장 budget | episode 하나에 평균 3시간 이상 |
| RoboDojo 표준 budget의 실제 시간 구성 | 명령된 동작은 8~76초, 평균 계산 시간은 55분 |
| BEHAVIOR | 과제당 약 7,200만 토큰, 400분 이상으로 최대 |
확장 budget의 추가 비용은 결국 실패하는 어려운 episode에 몰린다. 더 중요한 점은 추론 지연이 action step budget에 포함되지 않는다는 것이다. 따라서 이 비용은 실시간 제어가 필요한 환경의 배포를 직접 제한한다. RoboDojo의 사례처럼 로봇이 실제로 움직이는 시간보다 모델이 생각하는 시간이 수십 배 길다.
RoboDojo 그룹별 결과
RoboDojo는 다섯 그룹 42개 과제로 구성되며, 본 연구는 과제당 5 episode, 총 210 episode를 평가했다. 기존 GPT-6-Astra 결과는 RoboDojo 팀(Zhang et al.)의 보고다. 점수는 부분 완료를 반영한 값이고 성공률은 완전 완료 비율이다.
| 그룹 | 기존 GPT-6-Astra (점수 / 성공률) | Awomo-0.5 | 본 연구 1배 | 본 연구 10배 | 토큰 1배 / 10배 (백만) | 시간 1배 / 10배 (분) |
|---|---|---|---|---|---|---|
| Generalization | 35.32 / 32.67 | 37.70 / 30.89 | 34.92 / 28.33 | 81.42 / 75.00 | 15.58 / 52.47 | 82.2 / 329.2 |
| Precision | 12.65 / 4.00 | 39.66 / 33.50 | 28.62 / 15.00 | 91.00 / 87.50 | 9.17 / 37.86 | 35.4 / 198.0 |
| Long-Horizon | 21.45 / 8.25 | 40.36 / 26.75 | 41.37 / 20.00 | 95.00 / 90.00 | 16.71 / 38.42 | 66.9 / 195.8 |
| Memory | 43.03 / 38.67 | 42.27 / 41.22 | 73.67 / 70.00 | 96.67 / 96.67 | 10.11 / 10.55 | 27.1 / 29.8 |
| Open | 34.36 / 31.00 | 24.09 / 22.92 | 17.63 / 15.00 | 73.00 / 67.50 | 8.64 / 39.91 | 42.1 / 227.2 |
Precision 그룹은 1배 15.00%에서 10배 87.50%로 72.50%p 올라 budget 확장의 이득이 가장 크다. Memory 그룹은 1배에서 이미 70.00%로 높고 토큰과 시간이 거의 늘지 않았다. Open 그룹은 과제 특화 시연이 없어 다른 네 그룹에서 만든 일반 패키지에 기대며, 1배와 10배 모두 가장 낮다. 이는 ICL 패키지의 과제 특화성을 보여 주는 직접 증거다.
과제별로 보면 비용 분포가 크게 치우친다. Store laptop and headphones는 10배에서도 성공률 0%(점수 40)로 남았고 10배 평균 시간이 1,125.3분이었다. Fasten screws는 10배 평균 1억 7,863만 토큰과 922.5분이 들었고 성공률은 60%였다. Make toast도 10배 평균 1억 2,847만 토큰과 786.0분이 들어 성공률 40%에 그쳤다. 반면 Plug in charger는 10배 평균 722만 토큰으로 100%를 달성했다.
RoboLab 결과
RoboLab은 RoboLab-120 과제 라이브러리(120개 언어 조건 과제)를 쓰는 고충실도 시뮬레이션 벤치마크로, 시각 인식, 관계 이해, 절차 추론 세 역량을 세 난이도로 평가한다. 훈련 세트가 없으므로 GPT-6-Astra는 ICL 없이 평가했다.
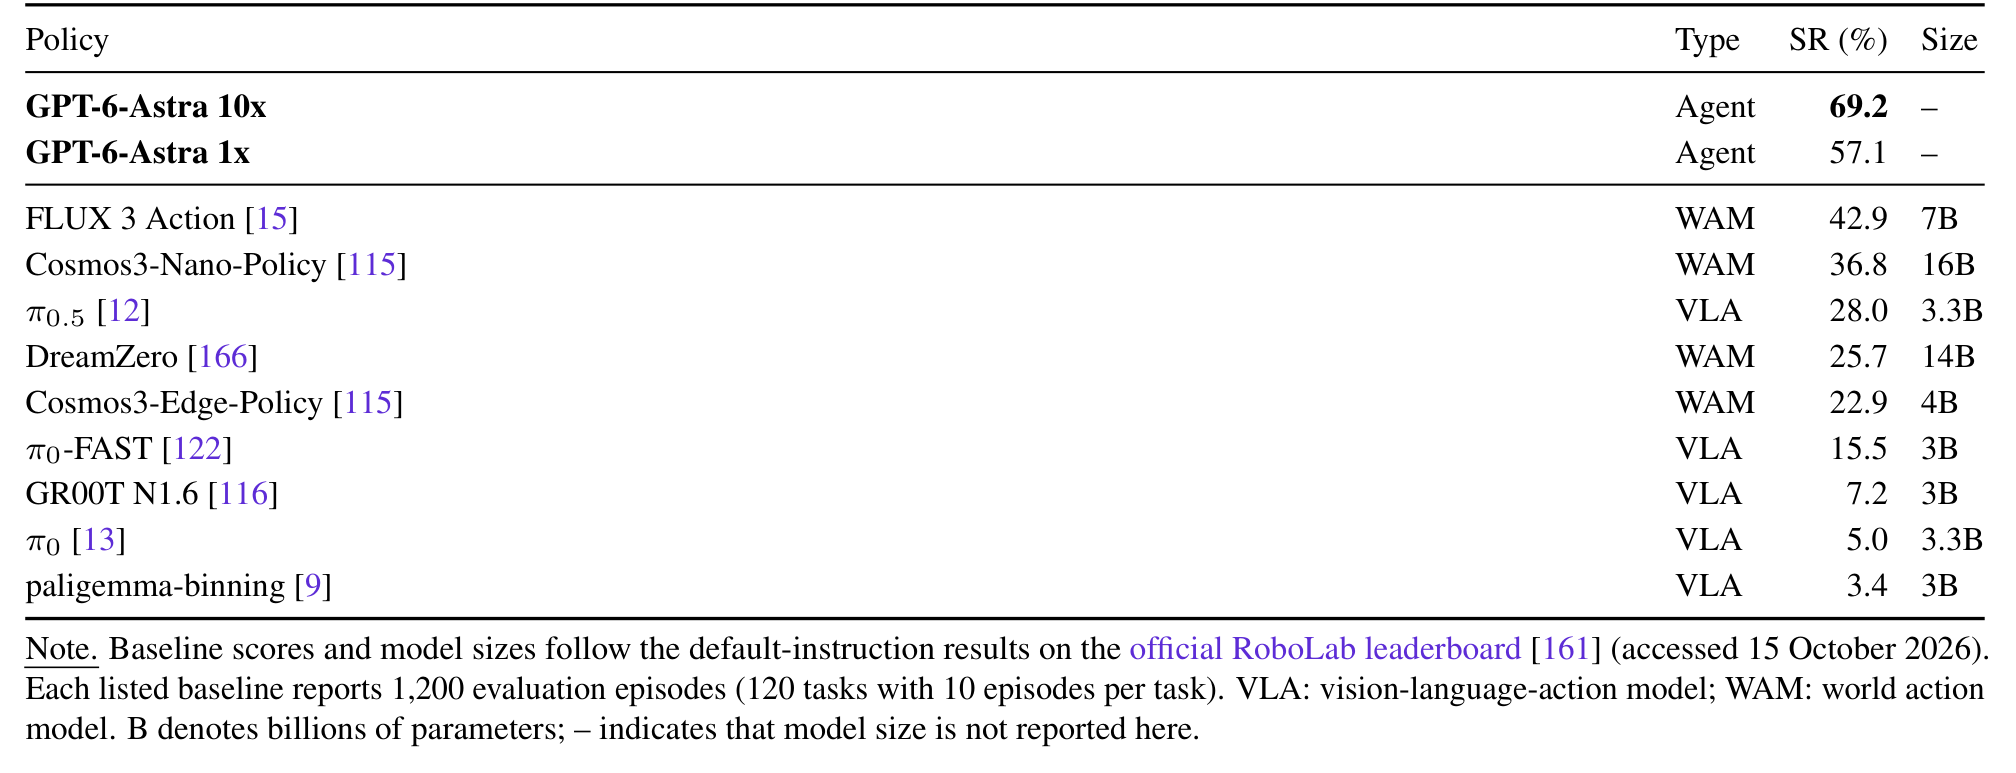
| policy | 유형 | 성공률 | 크기 |
|---|---|---|---|
| GPT-6-Astra 10배 | Agent | 69.2% | 미공개 |
| GPT-6-Astra 1배 | Agent | 57.1% | 미공개 |
| FLUX 3 Action | WAM | 42.9% | 7B |
| Cosmos3-Nano-Policy | WAM | 36.8% | 16B |
| π0.5 | VLA | 28.0% | 3.3B |
| DreamZero | WAM | 25.7% | 14B |
| Cosmos3-Edge-Policy | WAM | 22.9% | 4B |
| π0-FAST | VLA | 15.5% | 3B |
| GR00T N1.6 | VLA | 7.2% | 3B |
| π0 | VLA | 5.0% | 3.3B |
| paligemma-binning | VLA | 3.4% | 3B |
GPT-6-Astra는 1배에서도 모든 기준선을 앞서지만 절대 성공률은 중간 수준이다. 기준선은 공식 리더보드의 기본 지시문 결과(각 1,200 episode)이므로, 이 표는 같은 추론 비용 조건의 비교가 아니다. 표 안에서는 WAM 계열이 VLA 계열보다 대체로 높은 경향도 보인다.
LIBERO 계열 세부
LIBERO-PRO는 네 LIBERO suite에 과제를 보존하는 교란을 가해 Task와 Swap 변형으로 나눈 벤치마크다. 8개 suite, suite당 10과제, 과제당 10개 고정 초기 상태로 800 episode 전체를 평가했다. 패키지는 정확한 base task로 골라 고정했으며, Task와 Swap 과제군 노트에 별도 공개 탐색 단계에서 추출한 전역 전략, 인식, 검증, 복구 노트를 결합했다. 평가 trajectory, 결과, 현재 초기 상태, 재사용 가능한 픽셀이나 좌표, action 시퀀스는 들어 있지 않다.
| 항목 | 값 |
|---|---|
| observation | 고정 3인칭 agentview 카메라와 Panda 손목 카메라(기본 256×256, 검사용 1024×1024 렌더), 측정된 end-effector pose와 그리퍼 상태 |
| action | 20Hz 7차원 OSC-pose 명령. 평행 이동 3, axis-angle 회전 3, 그리퍼 1. 단위 평행 이동 5 cm, 단위 회전 0.5 rad |
| 1배 경계 | 환경 step 10,000 또는 planner 턴 100 중 먼저 오는 쪽 |
| 1배 결과 | 786/800 (98.25%). 기존 최고 RPent/GPT-6-Astra(low reasoning) 92.63%보다 5.62%p 높음 |
| 10배 결과 | 794/800 (99.25%) |
| 오류 분포 | 6개 suite에서 99~100%. 오류는 Long Task(1배 97%)와 Long Swap(1배 90%)에 집중 |
| 최난 과제 | Yellow-white mug in microwave, Swap 변형 1배 30%, 10배 70%. 10배 평균 1,451만 토큰, 164.0분 |
이 설정은 최대 reasoning effort와 직접 로봇 제어를 쓰고 VLA와 SAM3는 끈 구성이다. 토큰 수치는 117 episode의 사용량 계측이 부분적이어서 하한이다.
LIBERO-Long++와 LIBERO-Ultra-Long은 시각적 혼잡과 재배열된 skill 순서 아래에서 조합형 manipulation을 평가한다. Long++는 6개 시나리오의 원래 순서와 재배열 순서로 12개 구성, Ultra-Long은 3개 시나리오와 원래 순서 및 두 재배열로 9개 구성이며, 구성당 무작위 리셋 10회로 각각 120 episode와 90 episode를 평가했다. 패키지는 공개된 atomic skill 훈련 split(trajectory 4,050개, atomic skill당 150개, transition 351,999개)으로만 만들었다.
| 구성 | 1배 성공률 | 10배 성공률 | episode당 1배 토큰 | episode당 1배 시간 |
|---|---|---|---|---|
| Long++ Original | 98.3% | 100.0% | 104만 | 56.8분 |
| Long++ Reordered | 96.7% | 100.0% | 104만 | 49.4분 |
| Long++ 평균 | 97.5% | 100.0% | 104만 | 53.1분 |
| Ultra-Long Original | 63.3% | 100.0% | 919만 | 185.9분 |
| Ultra-Long Variant 1 | 93.3% | 96.7% | 837만 | 84.0분 |
| Ultra-Long Variant 2 | 90.0% | 100.0% | 911만 | 62.8분 |
| Ultra-Long 평균 | 82.2% | 98.9% | 889만 | 110.9분 |
Long++ Reordered 구성에서 LiLo-VLA를 제외한 두 기존 기준선은 성공률 0%였지만, GPT-6-Astra는 순서가 바뀌어도 성능이 거의 떨어지지 않았다(98.3%에서 96.7%).
남은 실패 유형
ICL과 확장 budget의 큰 이득에도 몇 가지 한계와 반복되는 실패 유형이 남는다. 보고서는 방법론의 한계 두 가지(전이와 비용)와 episode 영상과 에이전트 로그에서 확인한 행동상 실패 세 가지를 구분한다. 인프라 중단은 실패로 채점했지만 행동 분석에서는 따로 다뤘다.
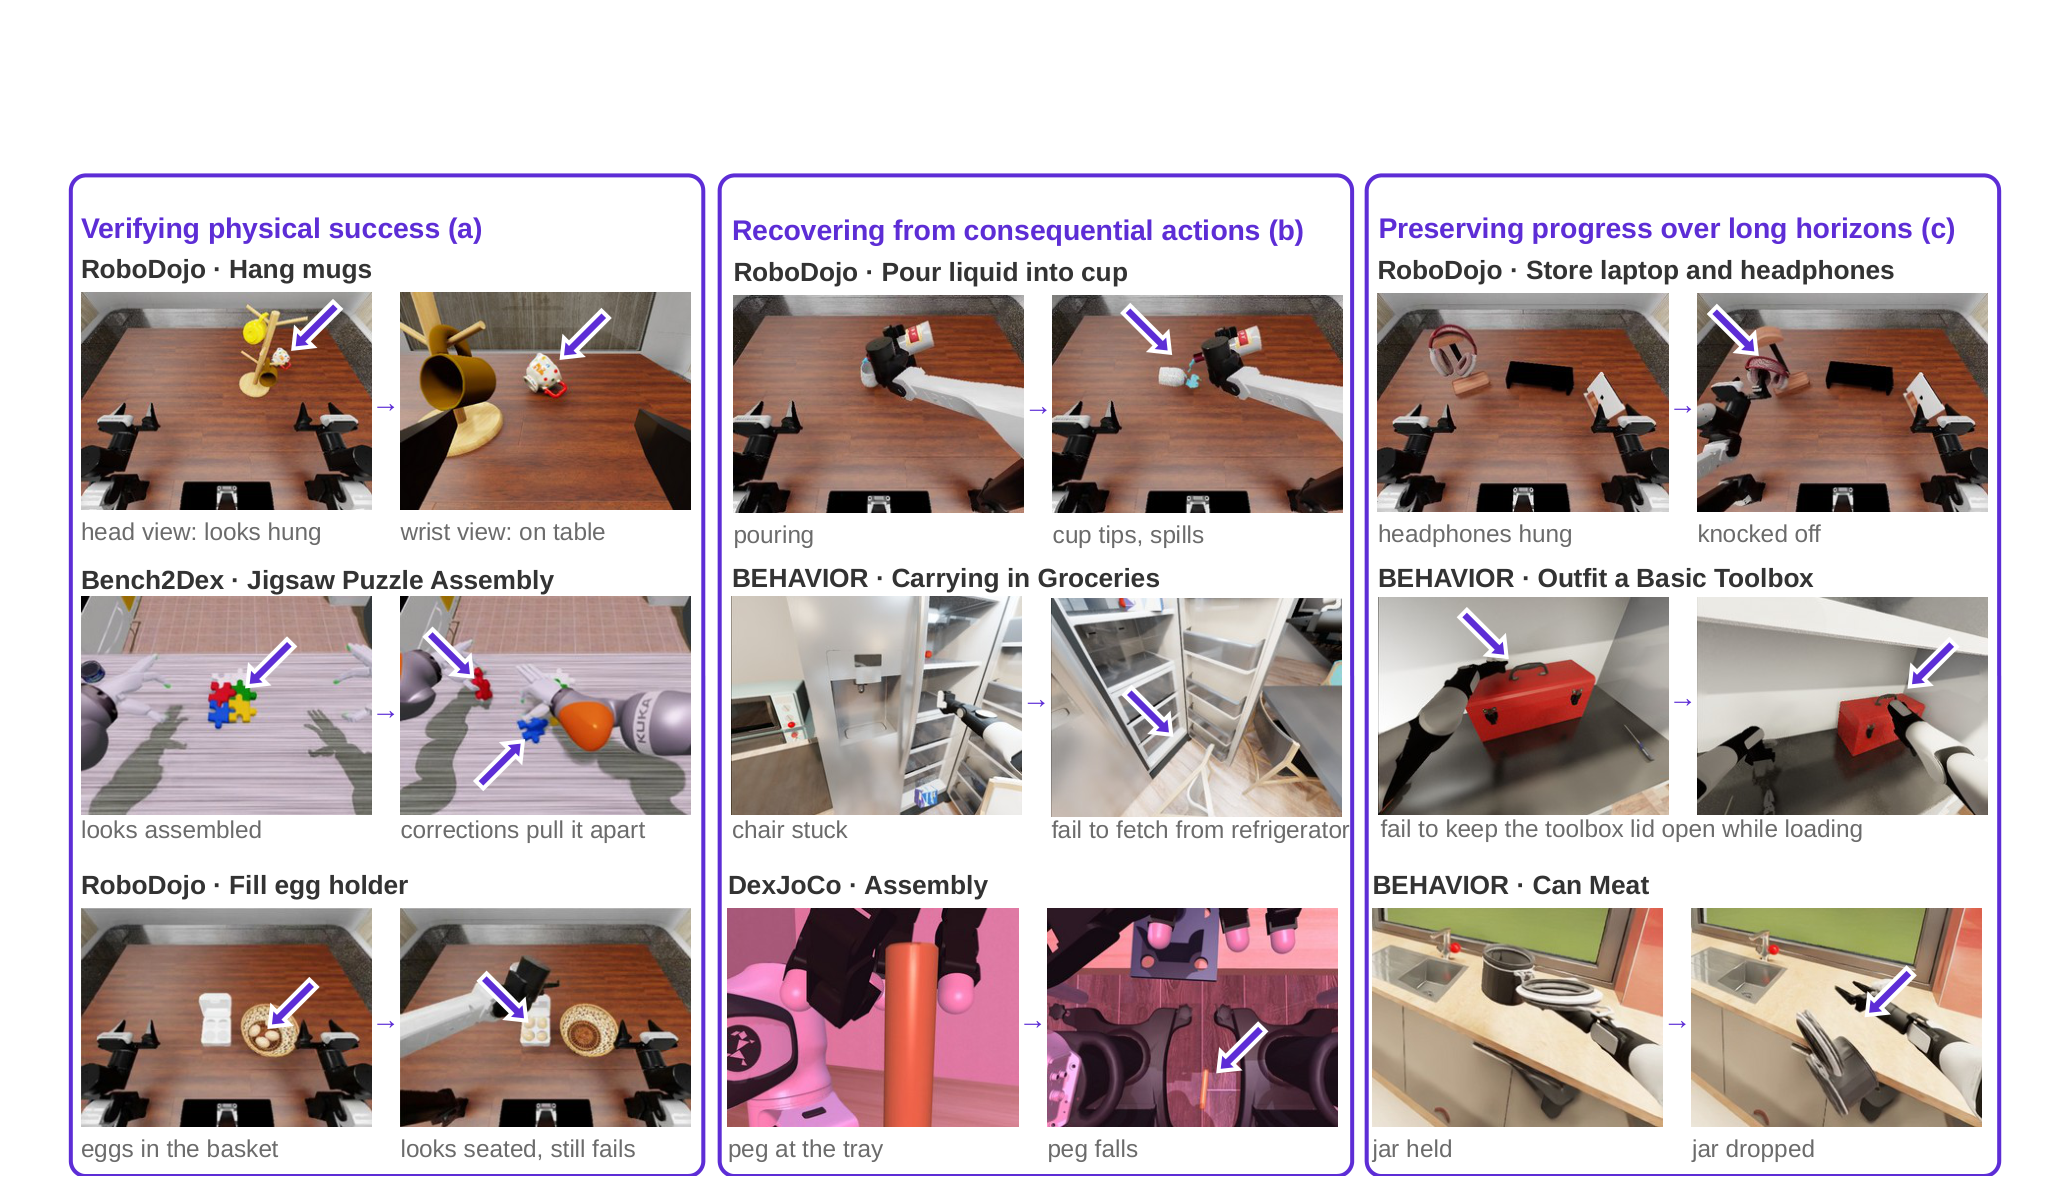
ICL 패키지는 과제 특화적이어서 전이가 제한된다. 패키지는 각 벤치마크의 훈련 데이터로 만들어 주로 과제 수준 안내, 동작 참조, helper를 담는다. 그래서 테스트 과제가 원 데이터에서 멀어지면 이득이 약해진다. RoboDojo Open 그룹은 다른 네 그룹에서 만든 패키지에 기대며, 추가 상호작용의 이득은 얻지만 모든 그룹 중 성공률이 가장 낮다. RoboLab도 패키지를 만들 훈련 세트가 없어 기준선은 앞서지만 절대 성공률은 중간이다. 원 과제를 넘어 일반화하는 패키지를 만드는 일은 열린 방향이다.
물리적 성공을 검증하지 못한다. GPT-6-Astra는 과제가 아직 끝나지 않았음은 알아채지만 어떤 물리 조건이 충족되지 않았는지는 찾지 못해 교정이 수렴하지 않는다.
| 사례 | 일어난 일 |
|---|---|
| Bench2Dex Jigsaw Puzzle Assembly | 네 조각이 요구된 직사각형을 이뤘다고 보고하면서도 episode가 끝나지 않았음을 인지하고 잔여 오프셋을 계속 조정했다. 그러나 교정이 남은 틈을 메우지 못하고 조각을 다시 벌려 놓았다 |
| RoboDojo Hang mugs | 머리 카메라에서 컵 손잡이와 못이 겹쳐 보이는 것을 걸린 증거로 삼았지만 못이 손잡이를 통과했는지는 확인하지 않았다. 손목 카메라로 보면 컵은 테이블 위였다. 이후 재grasp에서도 손가락이 닫힌 것을 일어나지 않은 접촉으로 오인했다 |
| RoboDojo Fill egg holder | 바구니에서 달걀 네 개를 모두 홀더로 옮기고 손을 뺀 뒤에도 안착해 있다고 보고했지만 episode는 부분 점수만 받은 실패로 끝났다 |
시각적 그럴듯함과 자가 보고된 진행이 실제 완료 조건과 어긋나면 반복 교정이나 성급한 확신이 이어진다. 신뢰성 있는 실행에는 과제의 실제 접촉, 지지, 정렬 제약을 판별하는 검사가 필요하다.
결과가 큰 action에서 복구하지 못한다. 각 시도는 복구가 출발해야 할 상태를 바꾸며, 어떤 변화는 되돌릴 수 없다. RoboDojo Pour liquid into cup에서는 episode 초반에 컵이 넘어져 액체가 테이블에 쏟아졌다. GPT-6-Astra는 컵을 세우고 다시 따랐지만 쏟아진 것은 되돌릴 수 없었고 episode는 budget 대부분을 남긴 채 끝났다. DexJoCo Assembly에서는 못이 손에서 미끄러져 바닥에 떨어지자 닿을 수 없다고 판단하고 budget이 많이 남았는데도 팔을 멈췄다.
실패한 단계가 이후 단계의 선행 조건일 때 복구 비용이 특히 크다. 용기 열기나 물체 고정 같은 단계가 성공하기 전에는 하위 subtask가 진행되지 않고, 반복 재시도가 과제 진척 없이 budget을 소모한다. 이런 의존 관계는 BEHAVIOR와 LHPR-VLN 같은 long-horizon 벤치마크에서 특히 흔하다. LHPR-VLN에서는 중간 목적지에 도달하려다 막혀 내비게이션 계획을 잃고 목적 없는 탐색으로 빠지는 경우가 있었다.
따라서 추가 budget은 복구 경로가 아직 존재할 때만 도움이 되며, 성공적 복구는 대개 반복이 아니라 의미 있는 전략 변경이었다. DexJoCo Fold Glasses에서 GPT-6-Astra는 측면 접근으로 바꾸고 시험 들기로 grasp를 확인한 뒤 표준 budget을 넘겨 과제를 완료했다.
long-horizon에서 진행 상태를 유지하지 못한다. long-horizon 과제는 뒤의 action을 실행하는 동안 앞의 진행이 그대로 유지돼야 하고, 작은 편차가 단계를 거치며 누적된다. RoboDojo Store laptop and headphones에서 GPT-6-Astra는 노트북을 넣고 헤드폰을 거치대에 건 뒤 이어컵 하나를 조정하러 돌아갔다. 그 교정이 헤드밴드를 거치대에서 빼냈고 budget이 끝날 때까지 다시 걸지 못했다. BEHAVIOR can_meat에서는 조리대 옆에 들고 있던 병이 다음 동작 중 기울어 바닥에 떨어져 진행을 다시 쌓아야 했다. 이런 직접적 교란 외에도 grasp, 배치, 내비게이션의 작은 오차가 연속 단계에 누적되어 이후 action의 조건을 바꾸고, GPT-6-Astra가 위치를 다시 파악하고 앞선 실수를 고치게 만든다.
신뢰성 있는 long-horizon 실행에는 완료한 subgoal을 영구 해결로 취급하지 않고 앞서 확립한 조건을 추적하고 재확인하는 능력이 필요하다. 세 행동상 실패는 과제 관련 검증, 비가역 결과와 선행 조건 의존성을 고려한 복구 전략, 앞선 진행의 지속적 추적이 필요하다는 결론으로 이어진다.
harness ablation 결과
harness 실험 결과는 Figure 7과 Table 13에 정리돼 있다. Figure 7은 기준점(성공률 15.56%, 256만 토큰)을 중심으로 비용과 성공률의 네 사분면을 나눈다.
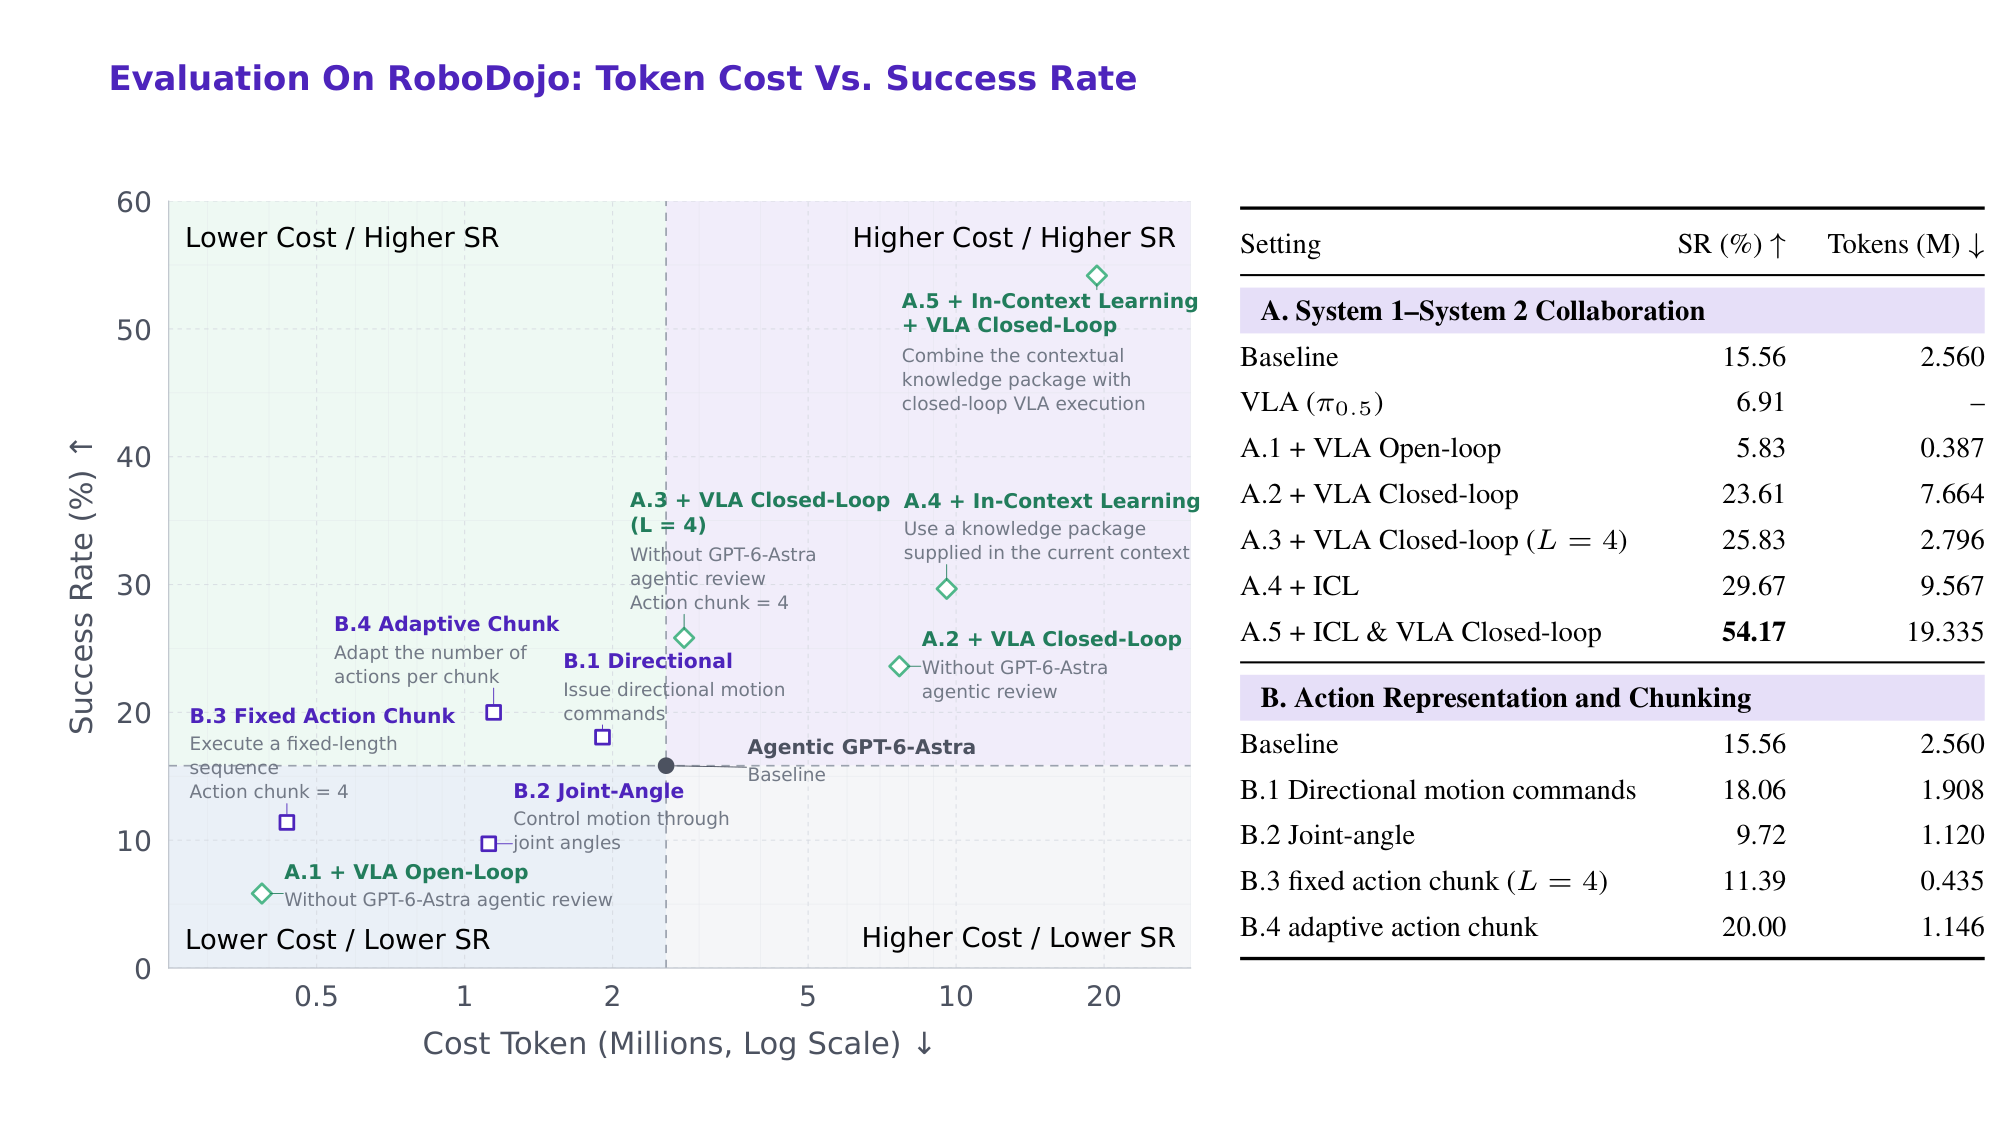
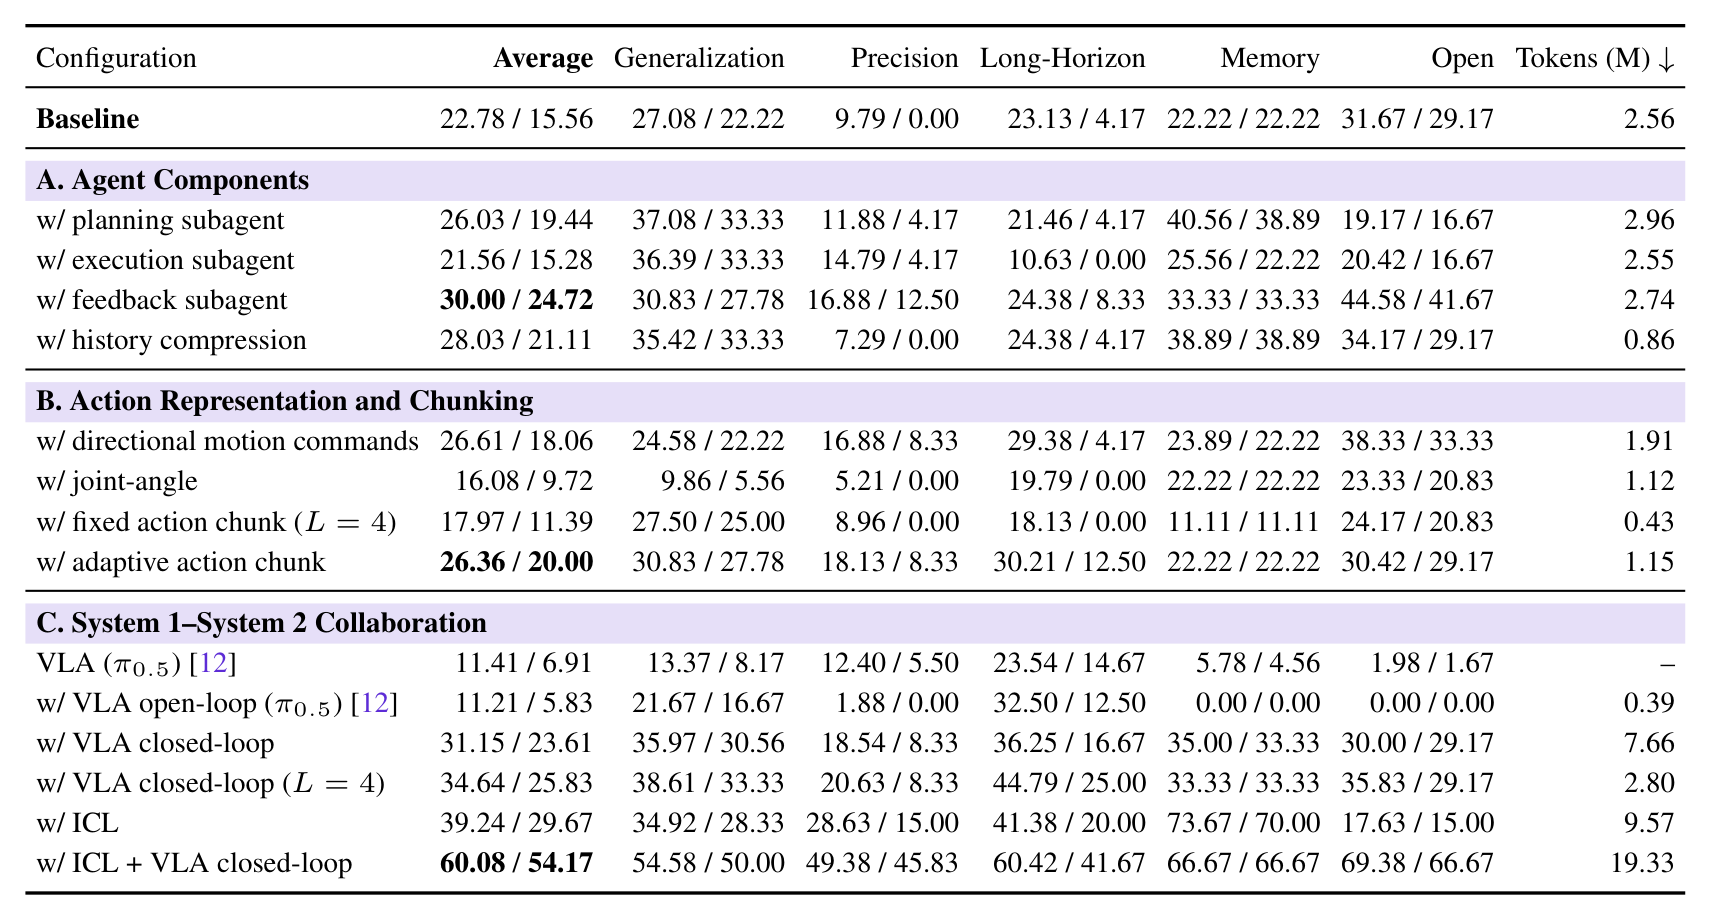
| 설정 | 평균 점수 / 성공률 (%) | 토큰 (백만) |
|---|---|---|
| Baseline (RoboRSI) | 22.78 / 15.56 | 2.56 |
| + planning subagent | 26.03 / 19.44 | 2.96 |
| + execution subagent | 21.56 / 15.28 | 2.55 |
| + feedback subagent | 30.00 / 24.72 | 2.74 |
| + history compression | 28.03 / 21.11 | 0.86 |
| + directional motion command | 26.61 / 18.06 | 1.91 |
| + joint angle | 16.08 / 9.72 | 1.12 |
| + fixed action chunk (L=4) | 17.97 / 11.39 | 0.43 |
| + adaptive action chunk | 26.36 / 20.00 | 1.15 |
| VLA (π0.5) 단독 | 11.41 / 6.91 | 없음 |
| + VLA open-loop | 11.21 / 5.83 | 0.39 |
| + VLA closed-loop | 31.15 / 23.61 | 7.66 |
| + VLA closed-loop (L=4) | 34.64 / 25.83 | 2.80 |
| + ICL | 39.24 / 29.67 | 9.57 |
| + ICL + VLA closed-loop | 60.08 / 54.17 | 19.33 |
System 1과 System 2 협업. standalone VLA는 평균 성공률 6.91%로 이 벤치마크에서 성능이 제한적이고, open-loop 협업도 GPT-6-Astra 토큰 38.7만 개를 쓰고 5.83%에 그친다. 반면 System 2가 VLA 제안 EEF action을 검토, 수정하는 closed-loop 협업은 open-loop 대비 성공률을 최대 20.00%p 올린다. 그러나 action마다 검토하면 766만 토큰이 든다.
검토 범위를 L=4로 늘리면 토큰이 63.5% 줄어 280만 개가 되면서 성공률은 23.61%에서 25.83%로 오히려 오른다. ICL과 closed-loop VLA를 결합하면 54.17%로 최고이며, ICL 없는 최선의 closed-loop 설정보다 28.34%p 높다. 다만 그 설정의 약 6.9배인 1,934만 토큰을 쓴다.
이 결과는 세 가지를 시사한다. 실행을 System 1에만 맡기면 신뢰성 있는 과제 완료가 불가능하다. 반대로 System 2의 잦은 감독은 큰 토큰 소비를 낳는다. 그리고 더 긴 action 시퀀스를 한 번에 검토하는 쪽이 action마다 검토하는 쪽보다 성능과 토큰 효율이 모두 좋아 협업 프로토콜 설계가 중요하다. 보고서는 검증과 복구를 더 선택적으로 하고 과제 관련 경험을 더 효율적으로 반영하는 것을 핵심 방향으로 제시한다.
action 표현. directional motion command는 기준선보다 평균 성공률을 2.50%p 올리고, 직접 joint angle 제어는 5.84%p 떨어뜨린다. 보고서는 이를 멀티모달 모델의 embodied intelligence와 저수준 로봇 제어 공간 사이의 representation gap으로 해석한다. 즉 언어와 시각으로 추론하는 모델에게는 관절 각도보다 "어느 방향으로 얼마나" 같은 의미에 가까운 명령이 맞는다. SIMPLE 부록에서도 각 end-effector의 원하는 위치와 방향을 지정하게 하고 관절 수준 기구학 계산은 공식 controller에 맡기는 task-space 표현이 language model planning과 로봇 실행을 더 잘 정렬한다는 관찰이 나온다.
chunking. 고정 chunk(L=4)는 43.5만 토큰으로 가장 저렴하지만 기준선보다 성공률이 4.17%p 떨어진다. adaptive chunk는 114.6만 토큰을 쓰면서 성공률을 4.44%p 올린다. 따라서 adaptive chunking은 고정 chunking보다 비싸지만 성공률이 높고, 기준선보다는 토큰을 줄이면서 성공률도 올린다. action 표현과 execution horizon 모두 성공률과 토큰 소비에 영향을 준다.
에이전트 구성 요소. 네 구성 요소의 효과는 개수가 아니라 역할에 따라 갈렸다.
| 구성 요소 | 점수 변화 | 성공률 변화 | 토큰 변화 | 비고 |
|---|---|---|---|---|
| feedback subagent | +7.22점 | +9.16%p | +7.03% | 가장 큰 개선. 명시적 결과 평가 |
| history compression | +5.25점 | +5.55%p | -66.41% | 성능과 효율 동시 개선 |
| planning subagent | +3.25점 | +3.88%p | +15.63% | Memory 범주에서 크게 상승(22.22점에서 40.56점) |
| execution subagent | -1.22점 | -0.28%p | 거의 동일 | 오히려 하락 |
feedback과 history compression은 상호 보완적이다. 명시적 결과 평가는 적은 토큰 증가로 성능을 올리고, 이전 상호작용 압축은 성능을 올리면서 컨텍스트 부담을 크게 줄인다. 보고서는 효과적인 에이전트 설계가 구성 요소의 수가 아니라 추가 추론이 실행을 어떻게 돕는지에 달려 있다고 결론짓고, 앞으로의 harness 구성 요소는 성능과 총 토큰 소비 양쪽 기여로 평가해야 한다고 제안한다.
실세계 결과
실세계 8대 플랫폼의 설정과 결과는 다음과 같다. 어떤 플랫폼에도 시연 데이터를 쓰지 않았고, 카메라 열에는 GPT-6-Astra에게 준 영상만 적었다.
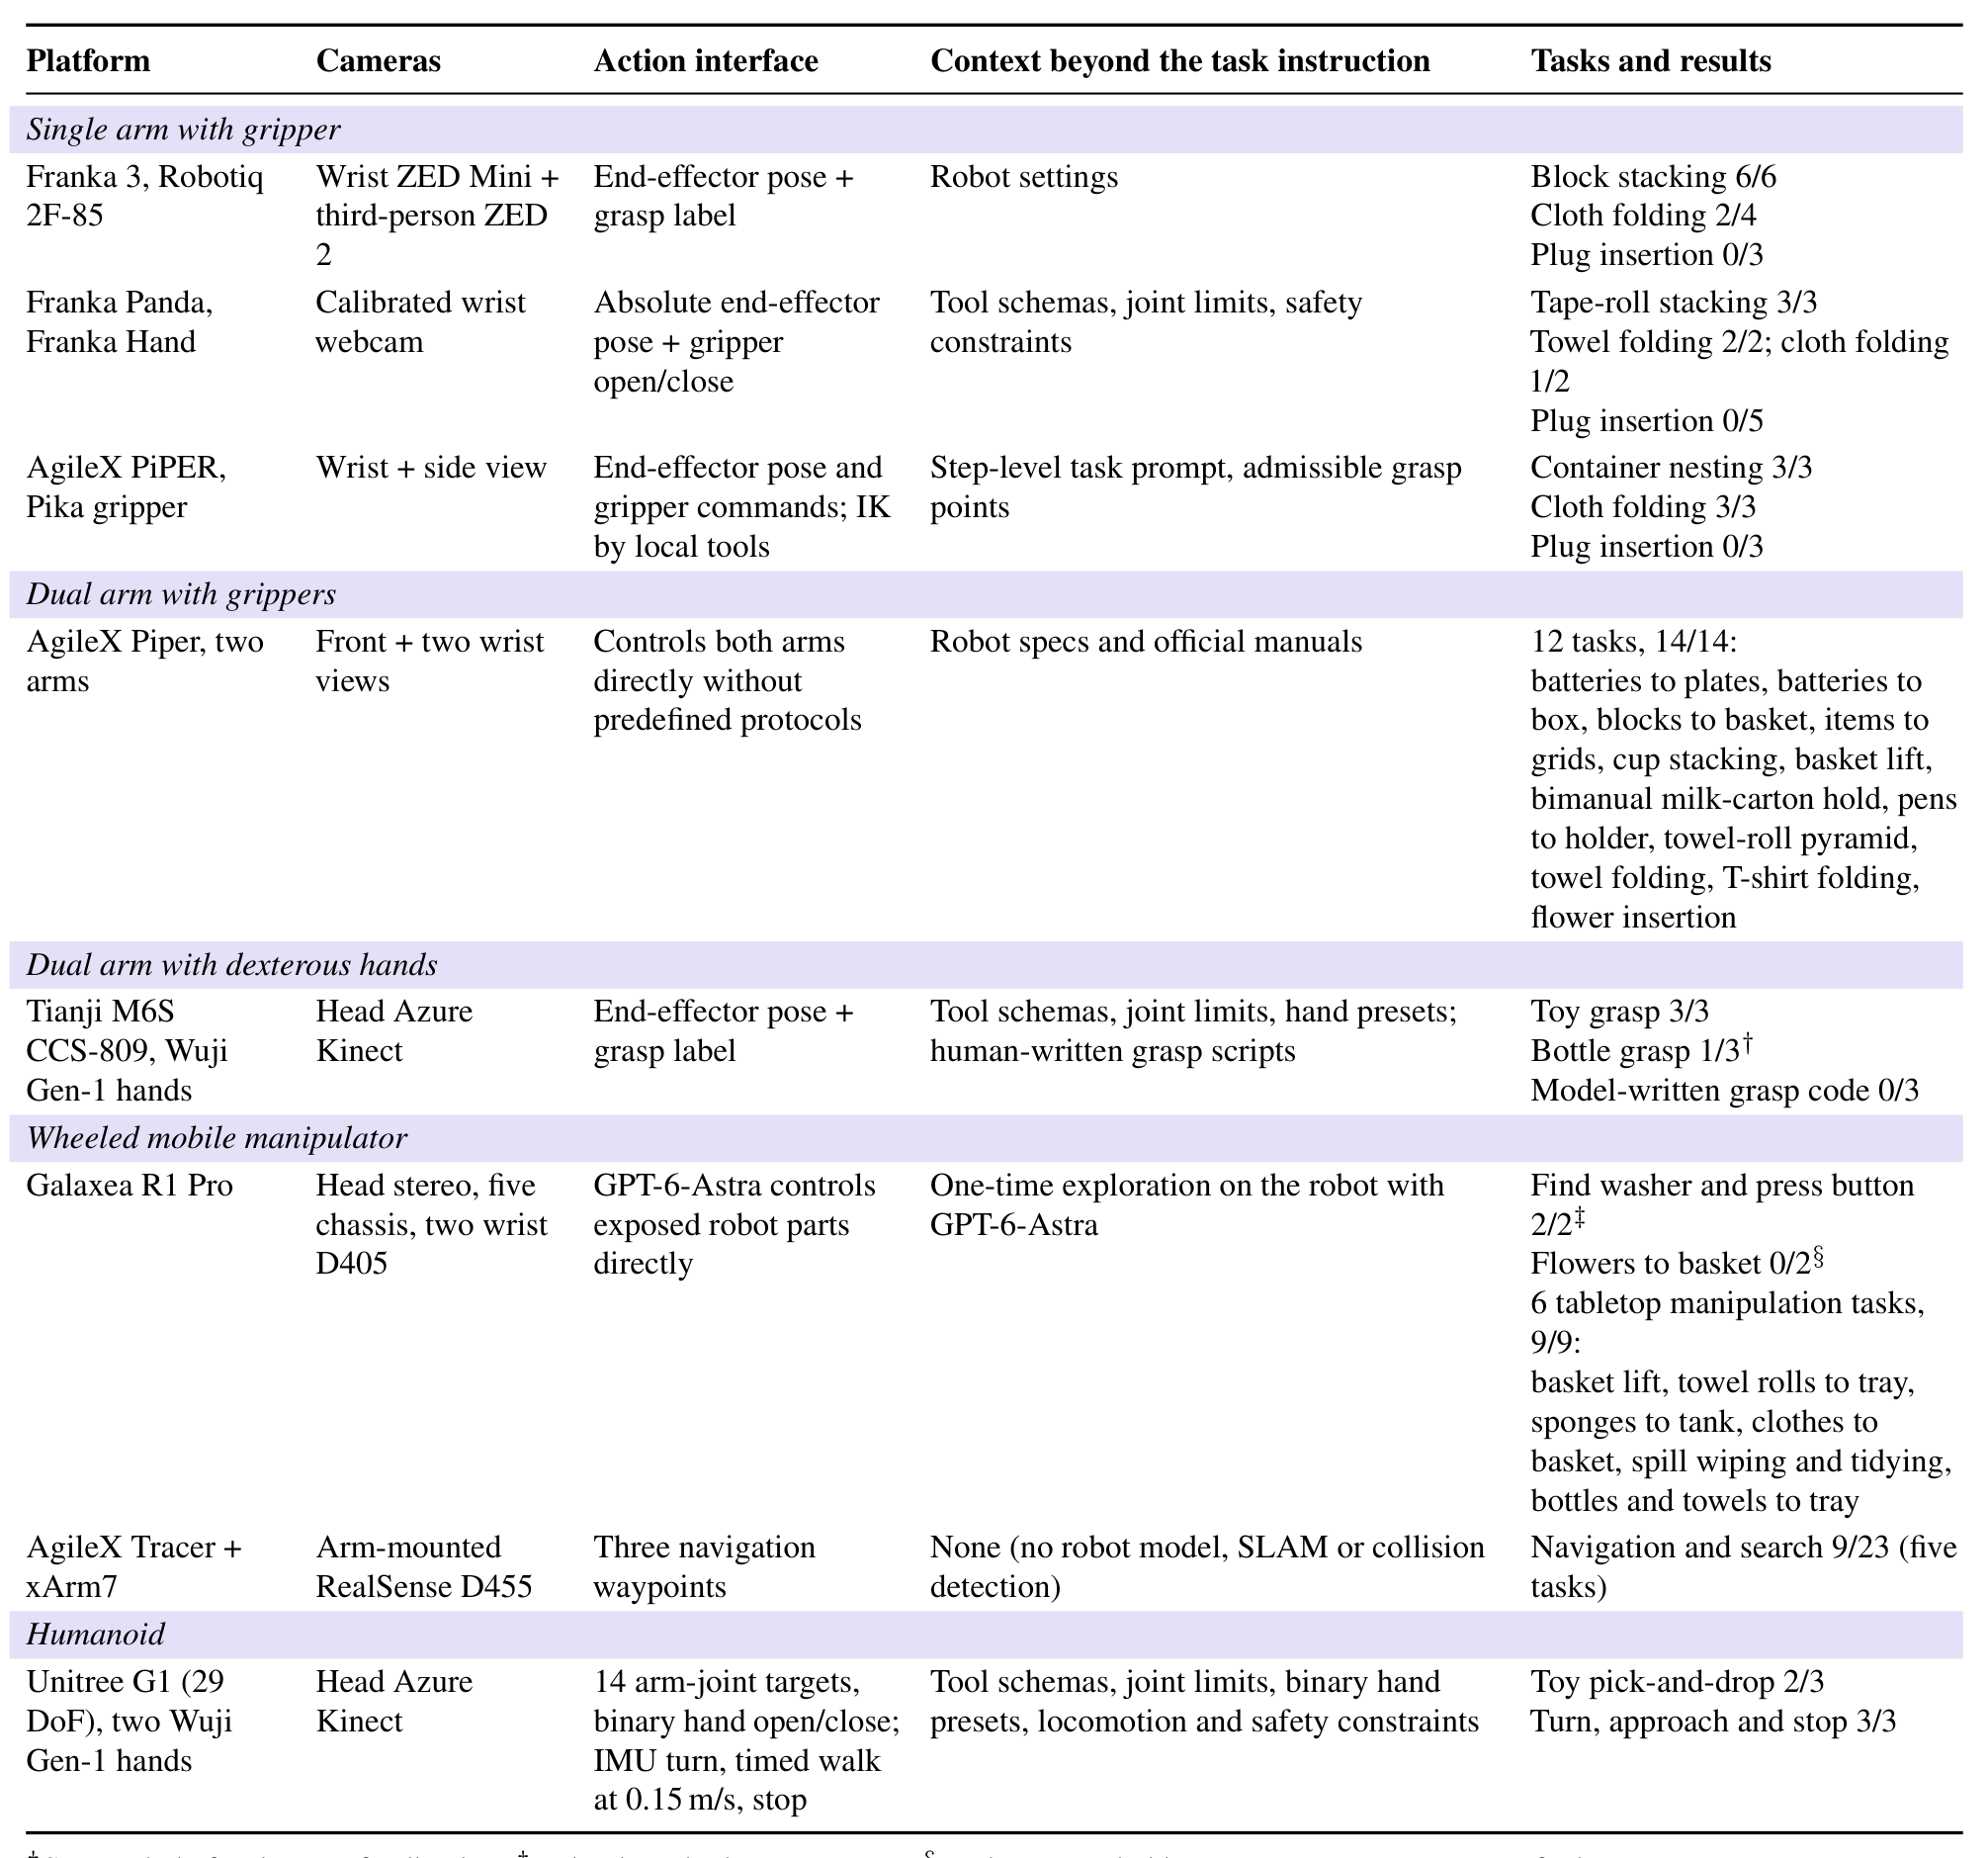
| 플랫폼 | 카메라 | action 인터페이스 | 추가 컨텍스트 | 결과 (성공 / 시도) |
|---|---|---|---|---|
| Franka 3 + Robotiq 2F-85 | 손목 ZED Mini, 3인칭 ZED 2 | end-effector pose + grasp label | 로봇 설정 | 블록 쌓기 6/6, 천 접기 2/4, 플러그 삽입 0/3 |
| Franka Panda + Franka Hand | 보정된 손목 웹캠 | 절대 end-effector pose + 그리퍼 개폐 | tool schema, joint limit, 안전 제약 | 테이프 롤 쌓기 3/3, 수건 접기 2/2, 천 접기 1/2, 플러그 삽입 0/5 |
| AgileX PiPER + Pika gripper | 손목, 측면 | end-effector pose와 그리퍼 명령, IK는 로컬 도구 | 단계별 과제 프롬프트, 허용 grasp 지점 | 그릇 포개기 3/3, 천 접기 3/3, 플러그 삽입 0/3 |
| AgileX Piper 양팔 | 정면, 손목 2개 | 사전 정의 프로토콜 없이 두 팔 직접 제어 | 로봇 사양과 공식 매뉴얼 | 12과제 14/14 |
| Tianji M6S + Wuji Gen-1 hands | 머리 Azure Kinect | end-effector pose + grasp label | tool schema, joint limit, 손 preset, 사람이 쓴 grasp 스크립트 | 장난감 잡기 3/3, 병 잡기 1/3 (사람 피드백 후 성공), 모델이 쓴 grasp 코드 0/3 |
| Galaxea R1 Pro | 머리 스테레오, 섀시 5개, 손목 D405 2개 | 노출된 로봇 부위 직접 제어 | GPT-6-Astra가 로봇에서 1회 탐색 | 세탁기 찾아 버튼 누르기 2/2 (버튼 누름으로 판정), 꽃 모으기 0/2 (두 번 모두 몸통 과열 고장), 탁상 6과제 9/9 |
| AgileX Tracer + xArm7 | 팔 장착 RealSense D455 | 내비게이션 waypoint 3개 | 없음 (로봇 모델, SLAM, 충돌 감지 없음) | 내비게이션과 탐색 9/23 (5과제) |
| Unitree G1 (29 DoF) + Wuji Gen-1 hands | 머리 Azure Kinect | 팔 관절 목표 14개, 손 이진 개폐, IMU 회전, 0.15 m/s 시간 기반 보행, 정지 | tool schema, joint limit, 이진 손 preset, locomotion과 안전 제약 | 장난감 집어 떨어뜨리기 2/3, 회전 후 접근과 정지 3/3 |
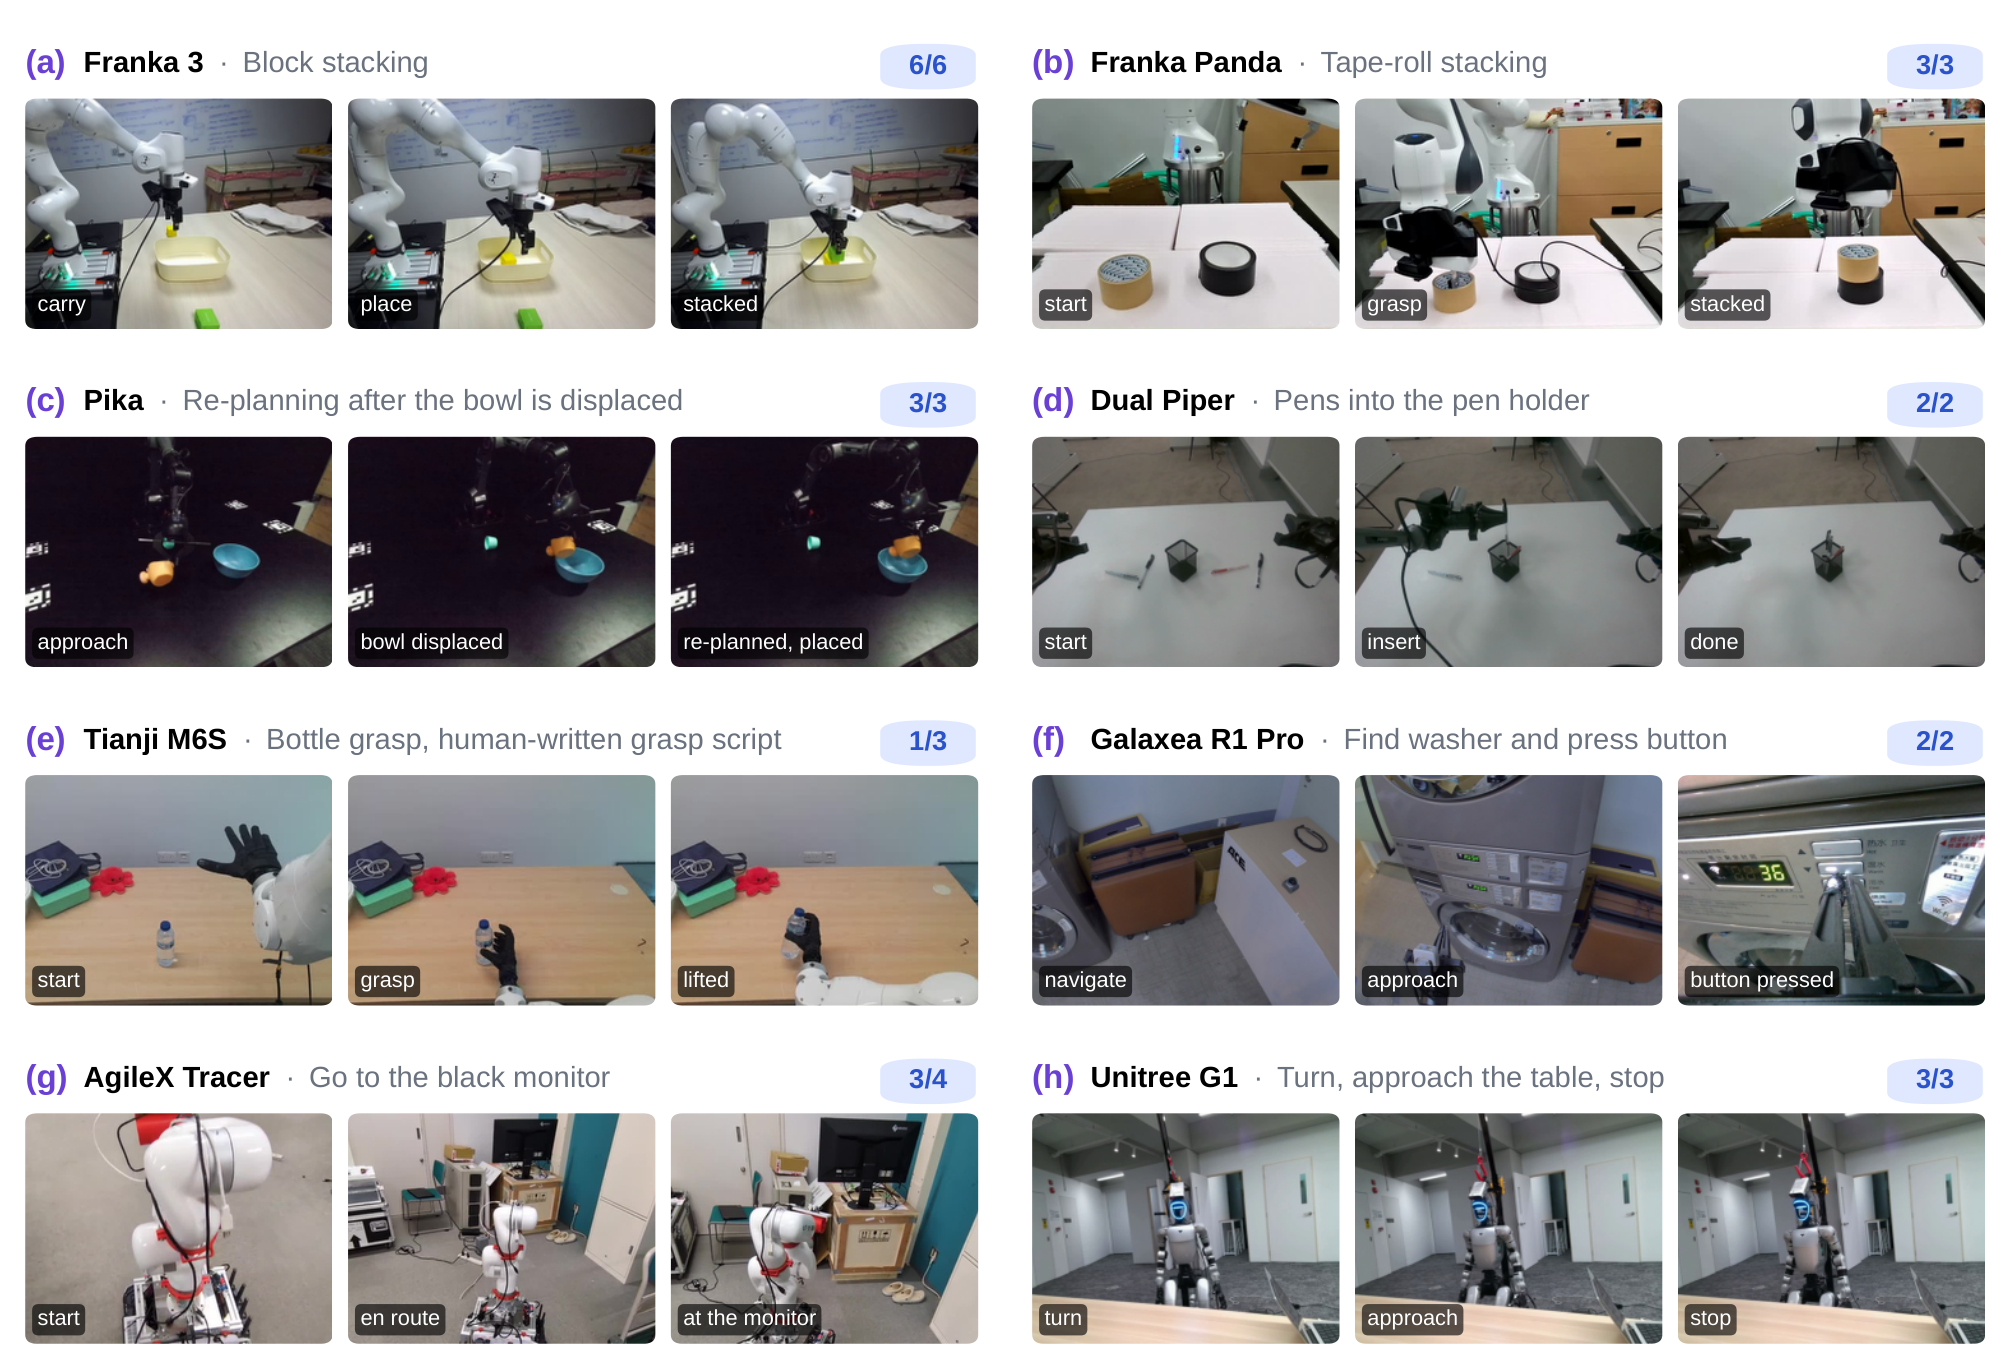
발견 1. 한 모델이 모든 형상을 제어하지만 성공은 과제 성격에 달렸다. 플랫폼 특화 학습 없이 같은 모델이 단일 팔부터 humanoid까지 8대 모두를 제어했다. 성공을 제한하는 것은 형상이 아니라 과제의 성격이다.
| 과제 성격 | 결과 | 시뮬레이션과의 관계 |
|---|---|---|
| 강체 pick-and-place | 17/18 | 시뮬레이션과 일치 |
| 변형 물체 | Franka 3 천 접기 2/4 | 훨씬 어려움 |
| 정밀 접촉 | 세 플랫폼 플러그 삽입 0/11 | 훨씬 어려움 |
| long-horizon 모바일 | AgileX Tracer 내비게이션과 탐색 9/23 | 훨씬 어려움 |
두 번째 팔은 zero-shot으로 완수할 수 있는 과제 범위를 넓혔다. 양팔 Piper는 12개 과제에서 14/14를 기록했다. 또 GPT-6-Astra는 장면이 바뀌면 실행 피드백으로 재계획했다. Pika 그리퍼 실험에서 접촉으로 받는 그릇이 밀려나자 다시 계획해 그릇을 제자리에 놓았다(3/3).
발견 2. 볼 수 있는 것이 할 수 있는 것을 정한다. 실세계 성공은 프롬프트와 사용 가능한 primitive 외에 시야 구성에 크게 좌우된다. 핵심은 모델에게 주어진 카메라가 과제의 결정이 이뤄지는 영역을 볼 수 있느냐다.
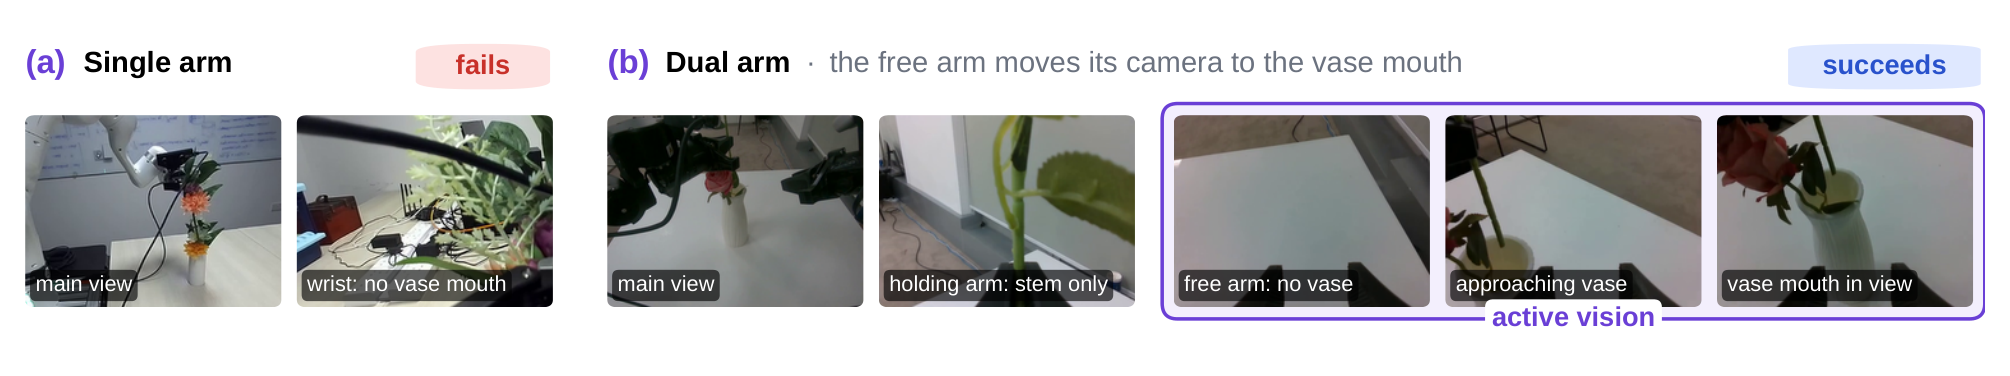
꽃 꽂기 과제가 이 의존성을 보여 준다. 그리퍼가 줄기를 위에서 세로로 잡으므로, 그리퍼와 함께 움직이는 손목 카메라로는 꽃 아래 꽃병 입구가 보이지 않는다. 단일 팔 Franka 3에서는 손목 카메라가 유일한 근접 시야라 GPT-6-Astra가 삽입 중 꽃병 입구를 한 번도 보지 못했고, 꽃을 꽃병 옆에 떨어뜨리며 실패했다. 양팔 Piper에서도 꽃을 든 팔의 손목 시야는 줄기만 보여 똑같이 제한되지만, GPT-6-Astra는 빈 팔을 움직여 그 손목 카메라가 꽃병 입구를 비추게 한 뒤 삽입을 완료했다.
두 경우의 차이가 active vision이다. 시점이 action space의 일부가 된다. 이 행동은 teleoperation 시연 데이터에는 거의 없다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식인데, 운영자는 로봇 카메라가 아니라 자기 시점으로 장면을 보므로 가림을 해소하려고 카메라를 움직이는 일이 드물다. 그런 시연에서 학습한 policy에게는 흉내 낼 대상이 없다. 로봇 카메라로만 지각하는 zero-shot 에이전트는 이를 스스로 발견해야 한다.
발견 3. 기존 System 0 모터 제어 위의 System 2. humanoid에서 GPT-6-Astra의 숙고는 로컬 모터 제어보다 훨씬 느리다. 보고서는 과제 학습된 System 1 policy 없이 기존 System 0 controller를 통해 직접 동작할 수 있는지 시험했다.
| 환경 | GPT-6-Astra가 내는 명령 | 실행하는 System 0 | 결과 |
|---|---|---|---|
| SIMPLE (시뮬레이션) | 관절, 몸체, locomotion 목표 | decoupled WBC 또는 AMO controller | 98.8% (10배) |
| 실제 Unitree G1 manipulation | 팔 관절 목표, 손 이진 개폐 | 관절 controller | 2/3 |
| 실제 Unitree G1 이동 | 회전과 보행 | 제조사 속도 인터페이스 | 3/3 |
두 실제 과제는 따로 평가했다. 이 결과는 3장의 System 2와 System 1 협업을 기존 모터 제어 인터페이스까지 확장한다. 그러나 보고서는 이것이 느린 피드백 기반 감독 아래에서의 실현 가능성을 보인 것이지, 신뢰성 있는 실시간 visuomotor 제어를 보인 것은 아니라고 선을 긋는다.
실세계에서 달라지는 것
시뮬레이션 결과를 만든 두 요소, 즉 확장 실행과 시연 기반 ICL이 실세계에서 각각 제약을 받는다.
물리적 제약이 확장 실행을 막는다. 시뮬레이션에서 step 한도를 10배로 늘리는 전략이 통하는 이유는 추가 step과 실패한 시도에 아무 결과가 따르지 않기 때문이다. 물리 세계는 시뮬레이션이 모델링하지 않는 세 가지 제약을 가한다.
| 제약 | 사례 |
|---|---|
| 안전 | controller 한계를 넘는 접촉은 보호 정지를 일으켜 보통 시도를 끝낸다. Franka 3에서 얇은 천을 접다가 그리퍼가 테이블에 닿은 경우, PiPER 플러그 삽입 3회 중 2회가 관절 충돌 고장으로 끝난 경우가 있다. GPT-6-Astra는 하드웨어 수준 고장에서 복구하지 못한다. 떨어뜨린 물체 같은 결과는 비가역이다 |
| 기계적 한계 | GPT-6-Astra는 명령이 가하는 부하를 직접 피드백받지 못한다. Tianji M6S에서 반복 grasp 중 Wuji 손 손가락 관절이 부하로 멈췄고, 유일한 보호 장치는 모델 스스로 정한 온도 임계였는데 손이 62°C에 도달해 시도가 중단됐다. 액추에이터 과열은 긴 시도를 끝낼 수 있으며 Galaxea R1 Pro 꽃 모으기 2회는 모두 몸통 과열 고장으로 끝났다 |
| 실시간 | 시뮬레이션은 모델이 숙고하는 동안 환경을 멈춘다. 실제 로봇에서는 경과 시간을 통해 토큰, 안전 위험 노출, 하드웨어 부담, 사람 감독 비용이 모두 쌓인다. G1에서 GPT-6-Astra는 실행 시간의 약 90%를 숙고에 쓰고 manipulation 시도 하나에 1시간 이상 걸린다 |
따라서 GPT-6-Astra가 시뮬레이션에서 활용한 "더 오래 실행하고 더 높은 성공률을 얻는" 교환은 실제 하드웨어에서는 자유롭게 쓸 수 없다.
시연 데이터 부재가 ICL을 바꾼다. 시뮬레이션 ICL 프로토콜은 테스트 로봇에서 수행한 테스트 과제의 성공 시연이 이미 있다고 전제한다. 실제 배포에서 새 과제는 대개 시연 없이 온다. 사람이 쓴 컨텍스트만으로도 상당 범위의 과제가 가능하지만, 이는 결국 전문가의 프롬프트 엔지니어링이며 그 품질이 결과에 직결된다. Tianji 손에서 사전 정의 grasp primitive가 없을 때 GPT-6-Astra는 한 번도 잡지 못했지만(0/3), 사람이 쓴 grasp primitive를 주자 3/3으로 성공했다.
컨텍스트가 반드시 사람에게서 올 필요는 없다. Galaxea R1 Pro에서는 GPT-6-Astra가 동작 없는 친숙화 세션에서 제조사 문서와 센서, controller의 실시간 탐색으로 자기 로봇 프로필을 작성했고, 이후 모든 과제 세션이 이 프로필에서 시작했다. 보고서는 사람이 쓴 컨텍스트를 더 넓은 설계 공간의 한 점으로 본다. 도메인 내 시연 전체와 아무것도 없는 상태 사이에는 아직 평가하지 않은 여러 컨텍스트 원천이 있다.
- cross-embodiment 시연
- 시뮬레이션에서 자가 생성한 시연
- 사람 시연
- 로봇 자신의 배포 기록
- 로봇 간에 공유하는 knowledge package
이질적 원천에서 embodied 과제용 컨텍스트를 원칙적으로 구성하는 일은 열린 문제이며, 실세계 배포를 위한 in-context learning의 큰 연구 기회다.
가정 proof of concept 결과
가정 환경에서 GPT-6-Astra를 실행한 결과 다섯 가지 대표 실패가 관찰됐다. 모든 실행은 zero-shot이며 접촉 기반 grasp를 쓰고 시연은 없다. 외부 카메라 영상은 시각화용이고 에이전트는 로봇 탑재 카메라로만 본다.
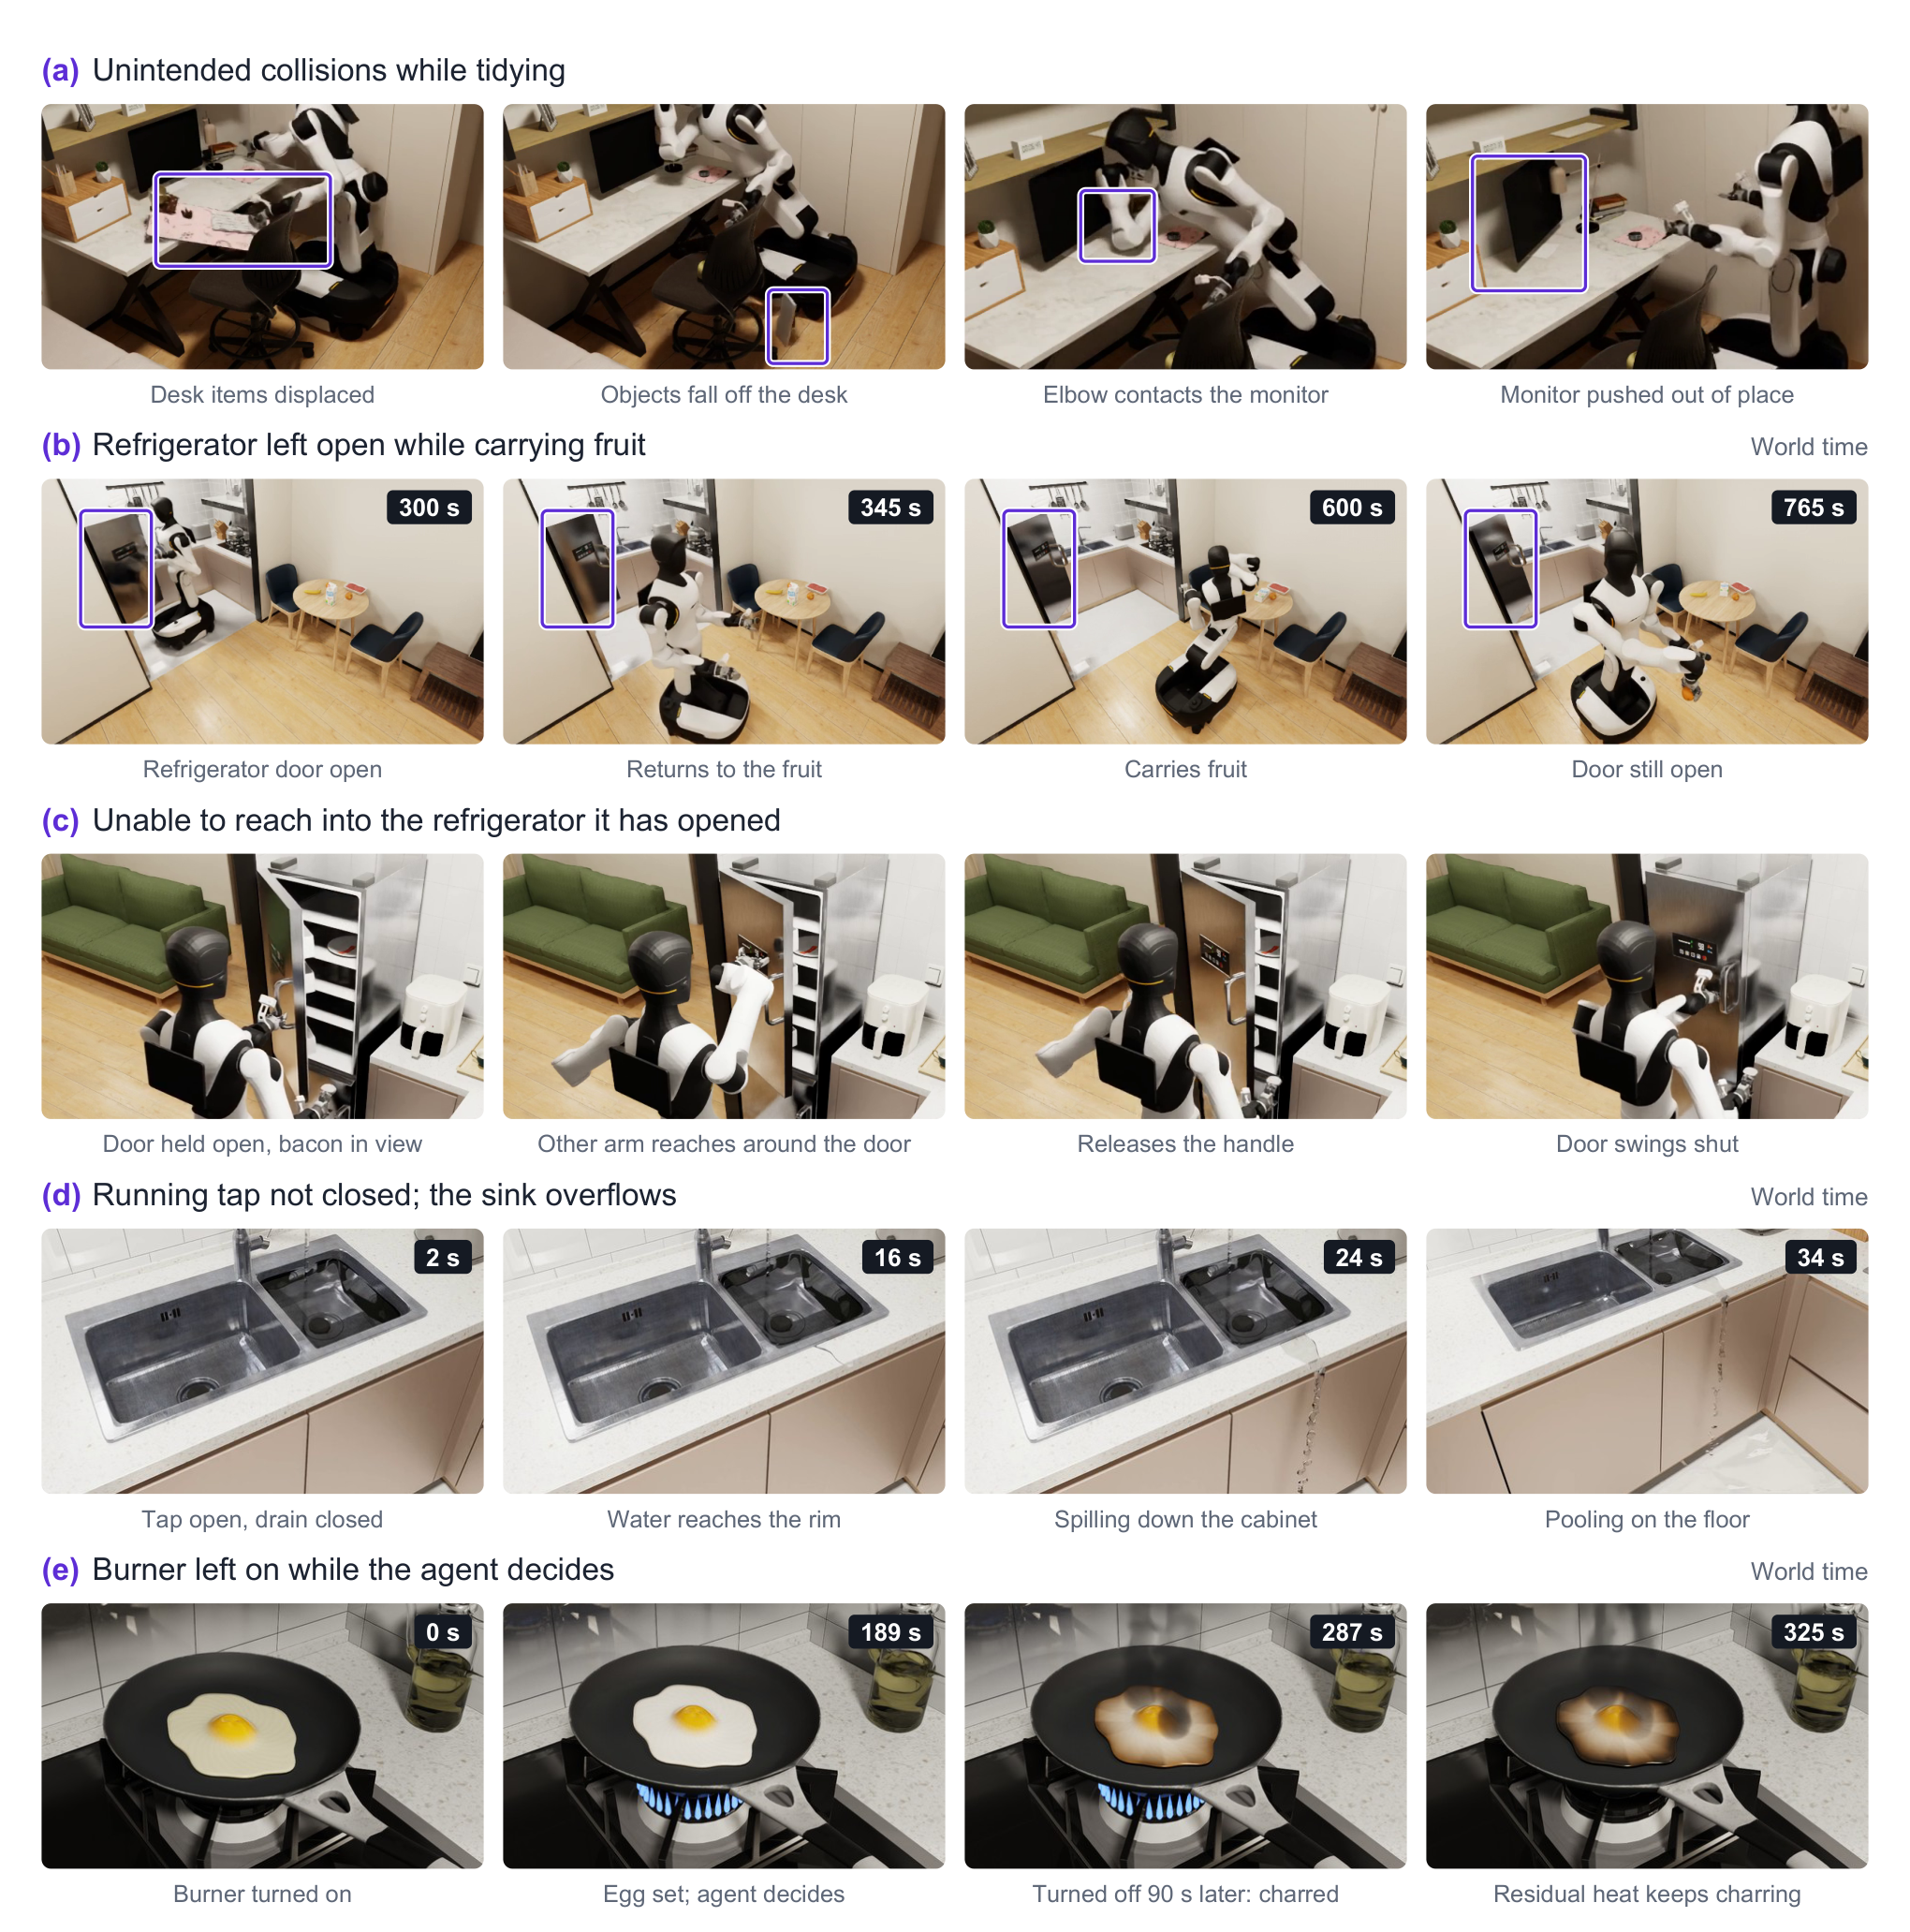
발견 1. 손에 든 물체에만 집중하고 집의 나머지를 놓친다. 사람의 필요에서 도출한 과제는 아무도 말하지 않은 의무까지 포함해 요청 전체를 수행하라고 요구하지만, GPT-6-Astra는 눈앞의 단계만 수행했다. 책상 정리 과제에서 그리퍼에 든 책을 옮기는 동안 팔이 다른 물건을 바닥으로 떨어뜨리고 팔꿈치로 모니터를 밀어냈다(a). 장본 물건을 정리할 때는 우유를 넣으려고 냉장고를 연 뒤 과일을 식탁으로 옮기느라 world time 300초부터 765초까지 문을 열어 두었다(b).
두 episode 모두에서 집의 나머지, 즉 로봇 자신의 팔과 로봇이 바꾼 상태는 다음 단계를 막을 때만 모델의 결정에 들어오는 것으로 보인다. 4장 실제 로봇에서 본 현상과 같다. 최종 상태 검사는 두 실패를 모두 놓친다. 냉장고는 episode가 끝날 때 닫혀 있고, 책의 최종 위치는 책상의 나머지에 대해 아무것도 알려 주지 않는다. 그래서 Figure 10의 판정자는 끝 상태만이 아니라 전체 trajectory에 걸쳐 의무를 추적한다.
발견 2. 시연 없이는 낯선 설비가 어떻게 움직이는지, 자기 몸이 어디 있어야 하는지 알아내지 못한다. 따라 할 시연이 없으면 에이전트는 두 가지 모두를 자기 상호작용으로 발견해야 한다. 아침을 만들 때 GPT-6-Astra는 냉장고에서 베이컨을 꺼내야 했다(c). 문을 당겨 열고 한 팔로 잡았지만, 좁은 통로에서 베이스가 선 위치 때문에 열린 문이 빈 팔과 선반 사이에 놓였고 다른 팔은 문을 돌아서만 닿을 수 있었다. 베이컨에 닿으려면 흔들리는 문과 로봇 자신의 몸이 냉장고와 뒤쪽 조리대 사이에 함께 들어가도록 베이스를 배치해야 했다. GPT-6-Astra는 그리퍼와 손잡이만 계획하고 몸의 나머지는 계획하지 않았다. 손을 넣으려고 손잡이를 놓자 문이 닫혔고 처음으로 돌아갔다.
낯선 수도꼭지에서도 손잡이를 돌리지 않고 계속 밀었고, 배수구가 닫힌 싱크대는 넘쳐 물이 수납장을 타고 바닥에 고였다(d). 두 경우 모두 같은 동작을 반복하고 조금씩 조정할 뿐이었다. 2장 벤치마크에서는 ICL로 정리한 시연이 설비의 움직임과 몸의 위치를 모두 보여 주므로 이 약점이 드러나지 않았다.
발견 3. 생각하는 동안 낡아 버린 observation으로 결정한다. 계속 흐르는 세계에서 action은 그것이 효과를 낼 시점의 세계 상태에 맞아야 한다. GPT-6-Astra는 머리 카메라로 달걀을 보며 익으면 버너를 끄기로 올바르게 판단했다(e). 그러나 각 결정에 버너가 켜진 채로 world time 수 초가 걸렸고(한 번의 결정에 8초), 달걀이 익은 지 약 90초 뒤에야 버너가 꺼졌을 때 달걀은 이미 탄 상태였다. 잔열은 그 뒤에도 달걀을 계속 태웠다. 모델은 세계가 자신을 기다리는 것처럼 추론한다. 2장의 시뮬레이터에서는 실제로 기다렸기 때문이다.
이 episode들은 수가 적고 정성적이지만 같은 방향을 가리킨다. 2장 벤치마크에서는 무엇을 할지 결정하는 GPT-6-Astra의 능력만으로 충분했다. 그러나 필요만 말하고, 시연을 주지 않고, 멈추지 않는 집에서는 그 결정을 실제 행동으로 옮겨야 하며, 현재는 바로 그 지점에서 부족하다.
한계
보고서가 제시한 연구 방향
초록과 결론은 다섯 가지 연구 방향을 제시한다.
- in-context learning의 일반성: 패키지가 원 과제를 넘어 일반화하도록 만든다.
- 비용과 실행 시간: 거의 푼 과제에서도 episode당 수백만 토큰과 수십 분이 드는 구조를 줄인다.
- 물리 상태 검증: 접촉, 지지, 정렬 같은 실제 완료 조건을 판별한다.
- 비가역 실패 복구: 되돌릴 수 없는 결과와 선행 조건 의존성을 고려해 복구 전략을 세운다.
- long-horizon 진행 보존: 앞서 확립한 조건을 추적하고 재확인한다.
harness 측면에서는 검증과 복구를 선택적으로 수행하고, 의미적으로 의미 있는 action 명령을 노출하되 정밀 동작은 로봇 controller에 위임하며, adaptive execution horizon으로 성능과 토큰을 조율하는 방향을 제시한다. 구조화된 실행 메모리와 표적화된 검증 메커니즘도 후속 과제로 든다.
차세대 벤치마크 구축의 열린 과제
프로토타입을 만들며 구체화된 열린 문제는 네 가지다.
| 과제 | 내용 |
|---|---|
| 판정자의 근거 | 술어 목록이 아니라 일어난 일을 채점하려면 달걀을 뒤집었는지, 탔는지 같은 물리적 사실이 필요하다. 시뮬레이터는 아직 이런 상태 변화를 휴리스틱으로 모델링한다. 학습된 판정자도 대안이 되지 못한다. vision-language 성공 판정기는 접촉이 많은 조립에서 balanced accuracy가 최대 60%이고, 에이전트 trajectory의 vision-language 판정자는 에이전트 자신의 추론에 오도될 수 있다 |
| 시뮬레이션 충실도 | 판정자가 시뮬레이터 상태를 읽으므로 모델링 오류가 에이전트 행동과 구별되지 않는다. 잘못 모델링된 관절은 에이전트가 성공한 것처럼, 접촉 artifact는 실패한 것처럼 보이게 한다. 시뮬레이션이 실제 로봇 결과를 예측한다는 근거는 짧은 탁상 과제(일부 변형 물체 포함)에만 있고 long-horizon 가정 활동에는 없다 |
| 멈추지 않는 세계의 비용 | 에이전트가 생각하는 동안 모든 물리 과정을 시뮬레이션해야 하고, 점수가 지연, 하드웨어, 서비스 부하에 따라 달라진다. 기존 벤치마크는 환경을 멈추거나(추론 속도가 점수에서 빠짐) 생성 토큰마다 시간을 진행시킨다(재현 가능하지만 실제 배포 지연을 반영하지 못함) |
| 반복 비용 | 1시간 이상 걸리는 배포는 반복이 비싸다. 짧은 로봇 시도조차 policy를 신뢰성 있게 구분할 만큼 충분히 반복되지 않는 경우가 많다 |
보고서 자체의 한계
보고서를 읽을 때 염두에 둘 제약은 다음과 같다.
- knowledge package 사용 분석은 사후 분석이며 개별 구성 요소의 인과적 기여를 분리하지 않는다.
- 일부 토큰 수치는 사용량 계측이 부분적이어서 하한이다. LIBERO-PRO 117 episode, LIBERO-Long++ 8/120 episode, Ultra-Long 27/90 episode가 해당한다. 시간은 전부 계측됐다.
- 10배 결과는 같은 시뮬레이터 상태와 대화에서 이어 간 것이어서 표준 budget 기준선과 직접 비교할 수 없다.
- RoboLab 비교는 공식 리더보드 값과의 비교이며 같은 추론 비용 조건이 아니다.
- 실세계 시도 횟수는 플랫폼당 수 회 수준이고, 가정 proof of concept의 실패 사례는 수가 적은 정성적 관찰이다.
- 실세계 성공 판정은 사람이 하며, 변형 물체 과제의 성공은 공통 품질 기준이 아니라 끝까지 수행했는지를 뜻한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| knowledge package (K) | ICL 준비 단계에서 GPT-6-Astra가 훈련 데이터를 학습해 작성하고 테스트 전에 고정하는 노트, 참조, 코드 묶음 |
| 표준 budget / 확장 budget | 벤치마크 공식 action step 한도(1배)와 그 10배까지 늘린 한도. 확장은 같은 episode의 연속이다 |
| System 0 / 1 / 2 | 저수준 모터 controller, 과제 학습된 빠른 policy(VLA), 느린 숙고형 추론 모델의 3층 구도 |
| review horizon (L) | closed-loop 협업에서 GPT 호출 한 번에 검토하는 VLA 제안 action 수. action 표현 실험에서는 결정당 생성하는 EEF action 수 |
| active vision | 다음 action에 필요한 observation을 얻으려 카메라 시점을 의도적으로 옮기는 행동 |
| Intent / Duty | 차세대 벤치마크에서 명시 요청과, 아무도 말하지 않았지만 지켜야 할 의무 |
| world clock | 에이전트가 숙고하는 동안에도 흐르는 시뮬레이션 시간 |
관련 페이지
- Know Your Body: A Harness for Direct and Self-Improving Robot Control with VLMs: 가중치를 고정한 VLM에 신체 기하 모델을 붙여 직접 제어하는 harness. 이 보고서의 harness ablation과 같은 문제를 다른 설계로 푼다
- ASPIRE: Agentic /Skills Discovery for Robotics: 코딩 에이전트가 로봇 policy를 프로그램으로 고쳐 쓰는 시스템. 보고서의 Table 3 기준선(ASPIRE)으로도 등장한다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: harness ablation에서 System 1으로 쓴 π0.5 원 논문
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: manipulation 모델의 실패 복구를 평가하는 벤치마크. 보고서가 지적한 복구 실패 문제와 직결된다
- Awesome-Dual-System-VLA: System 1과 System 2를 나누는 dual-system VLA 연구 모음
- Harness²: 개방형 작업을 위한 recursive agent harnessing: 언어 에이전트 쪽 harness 설계 연구. 구성 요소 수보다 역할이 중요하다는 관점을 비교할 수 있다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 전체 지도