Applications · REPO · 2026
VoiceStudio: the open-source, fully-local ElevenLabs alternative
요약
VoiceStudio는 voice cloning, voice design, 영상 dubbing, 받아쓰기(dictation), 오디오북 제작을 사용자 기기에서 실행하는 오픈소스 데스크톱 앱이다. 계정, API 키, 구독, 사용량 계량이 없고, voice와 프로젝트와 출력물은 기본값으로 로컬 디스크에만 남는다. 저장소는 스스로를 "fully-local ElevenLabs alternative"로 소개하며, 2026년 4월 생성 후 5개월 만에 star 2만 6천 개를 넘었다.
이 페이지가 다루는 핵심은 세 가지다. 첫째, TTS 16종과 ASR 11종을 capability로 기술하고 "직무"로 채용하는 엔진 registry. 둘째, 한 backend에서 OpenAI 호환 HTTP, 버전이 붙은 WebSocket, Rust control sidecar, MCP 서버를 함께 내는 로컬 speech platform. 셋째, 소비와 관리를 분리한 네트워크 경계와 두 가지 모양의 원격 컴퓨트다. 앱은 AGPL-3.0이지만 기본 모델 가중치는 CC-BY-NC라 상업 사용은 모델 조건을 따로 검토해야 한다.
배경
hosted voice 서비스는 빠르게 시작할 수 있지만 오디오와 텍스트가 provider를 거치고 구독이나 credit으로 비용이 계량된다. README의 비교표는 VoiceStudio를 "관리형 클라우드 컴퓨트를 로컬 제어와 맞바꾸는" 선택으로 정의한다. 즉 사설, 오프라인, self-host, 대량 작업에 적합하고, 대신 사용자가 하드웨어와 갱신과 디스크를 직접 관리한다.
이 프로젝트는 OmniVoice-Studio라는 이름으로 시작했다. k2-fsa의 OmniVoice 모델(600개 이상 언어의 zero-shot cloning)을 감싸는 Gradio UI가 출발점이었고, React와 Tauri 데스크톱 앱으로 옮겨진 뒤 VoiceStudio로 개명했다. 옛 이름은 Docker 이미지(palashdeb/omnivoice-studio), 환경 변수 접두어(OMNIVOICE_*), 데이터 폴더(omnivoice_data/)에 남아 있다.
저장소는 2026-09-14 수집 시점에 active beta다. README는 안정 작업에 최신 릴리스(v0.5.2, 2026-09-10)를 쓰라고 하고, Electron 재작성이 진행 중이라 데스크톱 앱 issue와 PR을 받지 않는다고 공지한다. 따라서 아래 Tauri 기반 아키텍처 설명은 재작성 후 바뀔 수 있다.
핵심 개념
local-first는 데이터 원본을 사용자 디스크에 두고 서버 없이 실행되는 설계다. VoiceStudio에서는 핵심 제작 기능이 전부 로컬이고, 원격 worker와 외부 ASR endpoint와 analytics는 각각 명시적 opt-in이다. AGENTS.md는 새 필수 네트워크 호출을 금지하고 HuggingFace 다운로드를 설치 여부나 사용자 동작으로 gate하도록 규정한다.
zero-shot voice cloning은 reference clip을 학습 데이터가 아니라 프롬프트로 써서 추가 학습 없이 그 목소리로 합성하는 방식이다. clip은 timbre만 옮기는 것이 아니라 전달 방식과 녹음 환경도 옮긴다. 그래서 문서는 "긴 clip이 늘 좋은 clone을 주지는 않는다"고 하고, 5~15초의 한 화자, 근접 마이크, 잡음과 잔향 없는 녹음을 권한다.
voice design은 reference audio 없이 성별, 연령, 음높이, 스타일, accent, 방언 속성 문자열(instruct)로 voice를 만드는 모드다. 기본 모델이 받는 어휘가 고정되어 있어 자유 서술은 이 속성으로 매핑되고 어휘 밖 표현은 무시된다.
엔진 registry는 TTS와 ASR backend를 adapter 인터페이스(TTSBackend, SubprocessBackend)로 등록하고 Model Catalogue에서 고르는 구조다. 부모 앱과 의존성이 충돌하는 엔진은 전용 가상환경(sidecar venv)에서 별도 프로세스로 실행된다.
RTF는 real-time factor의 약어로, 생성 오디오 1초당 소요된 compute 초를 뜻한다. 1 미만이면 실시간보다 빠르다. VoiceStudio의 벤치마크 문서는 이 값과 CUDA peak VRAM만 수집한다.
소비와 관리의 분리는 네트워크 경계의 핵심이다. TTS, 받아쓰기, voice 목록 같은 소비 라우트는 PIN이나 trusted network로 열 수 있지만, /system/*와 /api/settings/* 같은 관리 라우트는 원격 코드 실행급이라 loopback이나 API key로만 닿는다.
방법
4계층 아키텍처
VoiceStudio는 Rust shell, React UI, FastAPI backend, 그리고 backend 아래의 엔진과 파이프라인과 저장소 네 층으로 구성된다. README의 도식은 다음과 같다.
Tauri v2 desktop shell (Rust)
        │ IPC
React + Vite UI
        │ HTTP · SSE · WebSocket on localhost:3900
FastAPI backend
        ├── TTS / ASR engine registries
        ├── dubbing / audio / long-form pipelines
        ├── OpenAI-compatible API and MCP server
        └── SQLite + Alembic → omnivoice_data/
| 계층 | 경로 | 책임 |
|---|---|---|
| Desktop shell | frontend/src-tauri/ |
창 수명, tray, 단축키, updater, sidecar bootstrap |
| Frontend | frontend/src/ |
React UI, Zustand 상태, API와 이벤트 클라이언트, i18n |
| API | backend/api/ |
REST 라우트, 스키마, 인증 경계, 스트리밍 |
| Core services | backend/services/ |
생성, dubbing, 오디오 처리, 영속화 |
| Engines | backend/engines/ |
격리된 옵션 엔진 adapter |
| Worker system | backend/worker/ |
인증된 원격 컴퓨트와 job 전송 |
| Data | omnivoice_data/ |
프로젝트, voice, 설정, 로그, SQLite 상태 |
| Delivery | scripts/, deploy/, .github/workflows/ |
개발, 패키징, 컨테이너, 릴리스, CI |
데스크톱은 loopback 전용 backend(localhost:3900)와 대화한다. loopback API 호출은 서버 키가 필요 없고, 원격 접근은 share PIN이나 API key가 필요하다. analytics는 동의 전까지 꺼져 있고 켜더라도 텍스트, 오디오, 파일명, 프로젝트를 보내지 않는다.
저장소 구조와 테스트 배치
docs/STRUCTURE.md는 "모든 폴더는 하나의 일만 하고, 루트의 모든 파일은 자리를 증명해야 한다"를 원칙으로 세운다. 루트에 런타임 산출물을 두지 않고, 임시 스크립트는 scripts/에, 테스트는 세 집 중 하나에 둔다.
| 디렉토리 | 내용 |
|---|---|
backend/main.py |
유일한 진입점. boot 순서가 동작에 영향을 주므로 주석을 읽기 전에 재배열하지 말라고 적었다 |
backend/api/routers/ |
39개 router, 자동 포함. setup/에 first-run wizard와 모델 다운로드 |
backend/core/ |
config, db, job queue, event bus, auth/CSRF, path 보안, opt-in analytics, 버전, 진단 |
backend/services/ |
78개 모듈. TTS, dubbing 파이프라인, audio DSP, GPU gateway, 엔진 routing, 모델 수명 |
backend/engines/ |
엔진별 adapter 14종. indextts, supertonic3, confucius4, dots_tts, moss_tts_v15, pockettts, audiocpp, omnivoice_gguf, omnivoice_subprocess, _asr_sidecar, _echo, voxcpm2_subprocess, moss_tts_nano_subprocess, cosyvoice_subprocess |
backend/worker/ |
원격 분산 worker. scheduler, pool, routing, breaker, capacity, protocol/, inbound/ |
backend/mcp_shim/, backend/speech_client/ |
MCP stdio 진입점, speech sidecar 클라이언트 |
backend/migrations/versions/ |
Alembic revision. 모든 스키마 변경이 여기를 지난다 |
backend/plugins/, backend/config/models.yaml |
플러그인 drop-in 지점, 모델 카탈로그 |
frontend/src/ |
pages/(상위 뷰마다 파일 하나), components/, api/(router 그룹별 typed client), store/(Zustand slice), i18n/locales/(사용자 문자열의 유일한 집, 21개 locale) |
frontend/src-tauri/ |
Rust shell. backend spawn과 bootstrap, updater 채널, 받아쓰기 단축키, crash/reset/uninstall |
omnivoice/ |
기반 TTS 모델 패키지. models/, cli/(omnivoice-infer 등), data/, eval/, training/ |
bin/ |
플랫폼별 prebuilt omnivoice-tts sidecar. 소스 체크아웃에는 0바이트 placeholder만 있다 |
skills/, .agents/skills/ |
발행하는 스킬(omnivoice, oss-maintainer), skills-lock.json으로 고정한 canonical 스킬 사본(vite, fastapi-python) |
deploy/ |
Dockerfile(CUDA 기본, ROCm은 BASE_IMAGE와 GPU_FLAVOR override로 같은 파일에서 빌드), docker-compose.yml, torch-constraints.txt |
omnivoice-gallery/ |
공개 voice gallery git submodule |
테스트는 세 곳에 나뉘어 있고 CI의 한 test job이 세 단계로 전부 실행한다.
| 집 | 실행기 | 분리 이유 |
|---|---|---|
tests/ |
pytest tests/ (기본 testpaths) |
주 suite. conftest.py가 OMNIVOICE_DATA_DIR를 일회용 디렉토리로 돌려 개발자의 실제 앱 상태를 건드리지 않는다(#878) |
backend/tests/ |
pytest backend/tests/ (별도 세션) |
backend/의 bare import에 대한 격리 세션. 모듈 수준 sys.modules stub은 수집 시점에 프로세스 전체로 새므로 금지 |
frontend/src/**/*.test.* |
bun run test (vitest, jsdom) |
컴포넌트 옆에 위치. Playwright suite는 frontend/e2e*/ |
CI는 HF_HUB_OFFLINE=1과 빈 HF_HUB_CACHE로 실행한다. 채워진 개발 캐시가 실제 실패를 가리기 때문이다. 문서는 Turborepo식 monorepo(apps/, packages/)로의 이전 경로도 적어 두되, 두 번째 apps/*나 packages/*가 생기기 전에는 실행하지 말라고 못 박는다.
워크플로 6종
VoiceStudio는 여섯 워크플로를 한 앱에 담는다. voice cloning, voice design, 영상 dubbing, 받아쓰기, 이야기와 오디오북, batch 생성이다. Voice 워크스페이스는 From audio(cloning), By design(voice 생성), Convert(speech-to-speech 변환) 세 탭으로 시작하고, Synthesize Audio 버튼이 스크롤되는 폼 아래에 고정된다.
| 영역 | 포함 내용 |
|---|---|
| Voice Cloning | 짧은 reference clip에서 zero-shot 합성 |
| Voice Design | 연령, accent, 음높이, 스타일, 전달 방식 지시로 voice 생성 |
| Video Dubbing | 전사, 번역, 화자 보존, 합성, 영상 export. 완료된 dub는 timing 문제를 검토용으로 표시 |
| Stories and audiobooks | multi-voice 스크립트, EPUB/PDF import, 챕터 렌더링, .m4b export |
| Dictation Widget | 시스템 전역 단축키, 실시간 전사, 옵션으로 local LLM 정리 |
| Vocal Isolation | Demucs로 음성과 배경 분리 |
| Speaker Diarization | Pyannote와 WhisperX 화자 배정 |
| Batch Queue | 대량 audio와 video job을 job별 진행률과 함께 queue에 넣거나, 로컬 폴더를 감시해 새 영상을 처리 |
| Model Catalogue | TTS, ASR, LLM 모델 설치, 제거, 선택, routing |
| Remote Model Downloads | 등록된 원격 worker에 모델을 설치하고 진행률을 실시간 표시 |
| GPU Auto-Detect | CUDA, MPS, ROCm, CPU routing과 엔진별 점검 |
| AI Watermark | AudioSeal 삽입과 검출 |
| MCP Server | MCP 클라이언트용 합성과 전사 도구 |
| Diagnostics | self-check, 오류 journal, 로그, 개인정보를 지운 support bundle |
| Extensible | registry 기반 TTS, ASR, 플러그인 인터페이스 |
Dubbing은 파일 업로드나 URL import로 시작하고 Projects 패널에서 이전 dub를 다시 연다. Audiobook Script 편집기는 markup 툴바 아래 워크스페이스를 채우고, casting board는 voice 카드를 화자에 드래그하거나 메뉴에서 고르게 한다.
엔진 registry
엔진 지원은 capability별로 다르다. 문서는 엔진을 고르기 전에 cloning, 언어, 플랫폼, 메모리, 라이선스를 확인하라고 한다. 전환은 Model Catalogue나 Ctrl/Cmd+E의 Engines 패널에서 하고, OMNIVOICE_TTS_BACKEND와 OMNIVOICE_ASR_BACKEND 환경 변수는 UI 선택보다 우선한다.
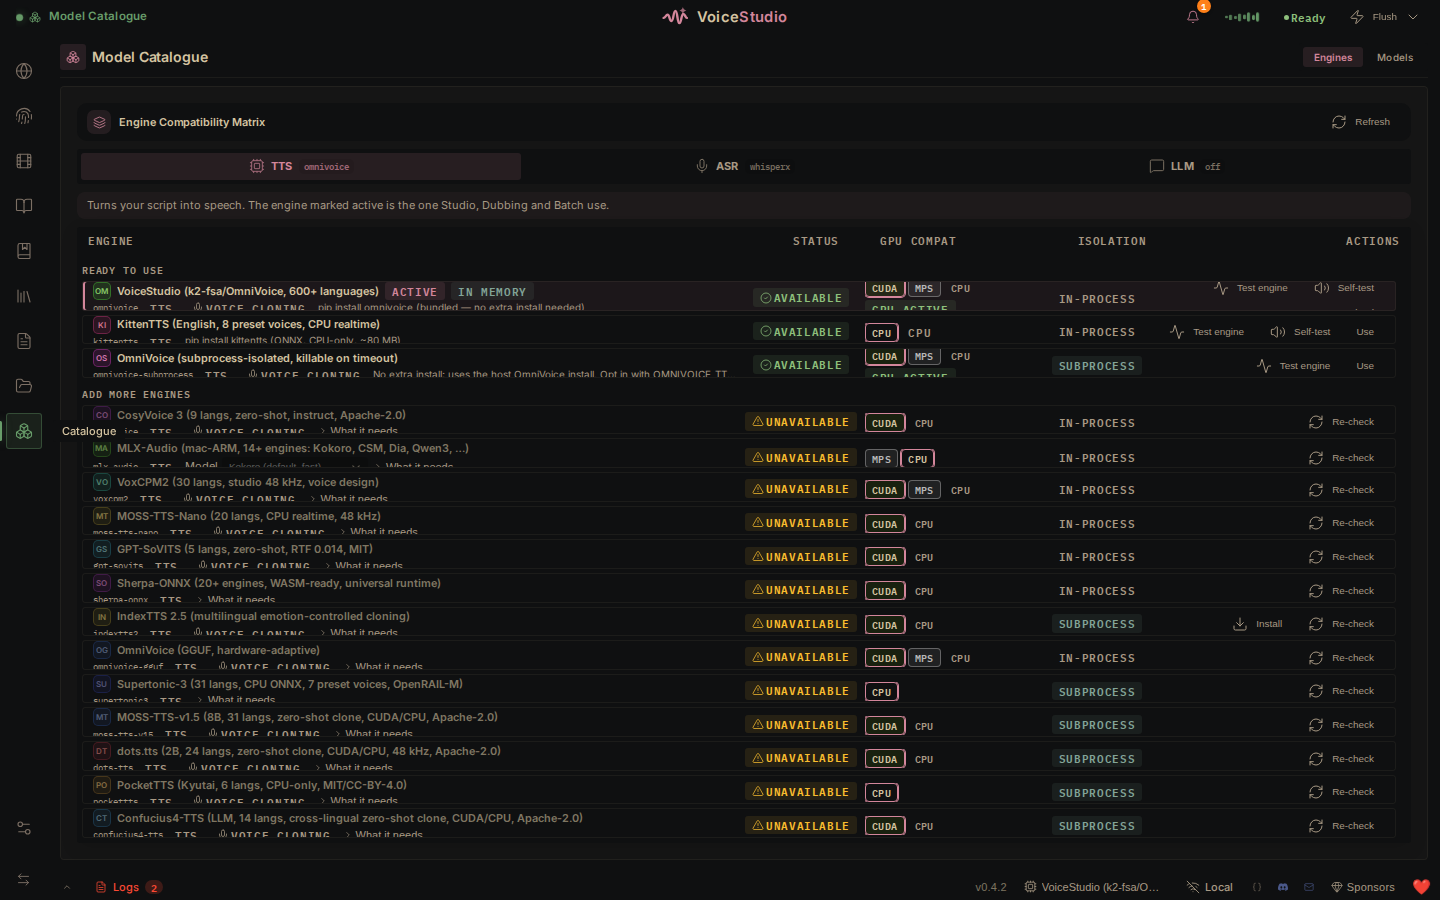
| TTS 엔진 | 언어 | Clone | Instruct | Linux | macOS ARM | Windows | 라이선스 |
|---|---|---|---|---|---|---|---|
| VoiceStudio 기본 (k2-fsa/OmniVoice) | 600+ | Yes | Yes | CUDA/CPU | MPS | CUDA/CPU | 앱 AGPL-3.0, 코드 Apache-2.0, 가중치 CC-BY-NC |
| CosyVoice 3 | 9 + 방언 18 | Yes | Yes | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| GPT-SoVITS | 5 | Yes | No | CUDA/CPU | No | CUDA/CPU | MIT |
| VoxCPM2 | 30 | Yes | Yes | CUDA/CPU | MPS | CUDA/CPU | Apache-2.0 |
| MOSS-TTS-Nano | 20 | Yes | No | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| KittenTTS | 영어 | No | No | CPU | CPU | CPU | MIT |
| MLX-Audio | 모델 의존 | 다름 | 다름 | No | MLX | No | 다름 |
| Sherpa-ONNX | 20+ | No | No | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| IndexTTS 2.5 (on-demand) | ZH, EN, JA, ES, AR | Yes | No | CUDA/CPU | CPU | CUDA/CPU | Bilibili 모델 라이선스 |
| OmniVoice GGUF (on-demand) | 600+ | Yes | Yes | CUDA/CPU | MPS/CPU | CUDA/CPU | 앱 AGPL-3.0, 파생 모델 조건 확인 |
| OmniVoice subprocess (on-demand) | 600+ | Yes | Yes | CUDA/CPU | MPS(기본 엔진 경유) | CUDA/CPU | 기본 엔진과 동일 |
| PocketTTS (on-demand) | EN, FR, DE, PT, IT, ES | Yes | No | CPU | CPU | CPU | CC-BY-4.0, gated |
| Supertonic 3 (on-demand) | 31 | No | No | CPU | CPU | CPU | OpenRAIL-M |
| MOSS-TTS-v1.5 (on-demand) | 31 | Yes | No | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| dots.tts (on-demand) | 24 | Yes | No | CUDA/CPU | CPU | No | Apache-2.0 |
| Confucius4-TTS (on-demand) | 14 | Yes | No | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
on-demand 엔진은 필요할 때 설치되거나 등록된다. 라이선스 각주는 세 개다. IndexTTS 2.5는 월간 활성 사용자 1억 명 또는 연 매출 10억 위안을 넘으면 Bilibili의 별도 서면 라이선스가 필요하고, PocketTTS는 첫 사용 전에 gated access와 CC-BY-4.0 조건을 표시하며, OmniVoice snapshot의 audio tokenizer는 Boson Higgs Audio 2와 Meta Llama community 조건이 따로 붙는다. docs/engines/README.md에는 README 표에 없는 audio.cpp(Breeze-TTS-2, research/non-commercial 가중치)도 있다.
cloning이 안 되는 엔진은 dubbing과 voice 고정 batch에서 reference 화자를 보존할 수 없다. 이 경우 VoiceStudio는 엔진을 조용히 바꾸는 대신 작업을 거부한다.
| ASR 엔진 | ID | 언어 | 적합 용도 |
|---|---|---|---|
| WhisperX (기본) | whisperx |
~100 | dubbing, 자막, 단어 단위 timing |
| Faster-Whisper | faster-whisper |
~100 | 일반 cross-platform 전사 |
| Faster-Whisper (isolated) | faster-whisper-isolated |
~100 | crash 격리 batch 전사 |
| MLX Whisper | mlx-whisper |
~100 | Apple Silicon |
| PyTorch Whisper | pytorch-whisper |
~100 | CUDA, MPS, CPU fallback. ROCm 호스트 |
| Parakeet TDT | nemo-parakeet |
영어 + 유럽 25 | 빠른 CPU/CUDA 전사. 앱 venv가 아닌 별도 venv |
| Parakeet TDT v3 (MLX) | parakeet-mlx |
유럽 25 | Apple Silicon 받아쓰기와 단어 timestamp |
| Moonshine | moonshine |
영어 | 저전력 저지연 ONNX, timestamp 없음 |
| FunASR | funasr |
50+ | VAD와 inline diarization(cam++) |
| sherpa-onnx | sherpa-onnx-asr |
모델 의존 | 스트리밍 CPU 받아쓰기 |
| OpenAI 호환 서버 | openai-compat-asr |
서버 의존 | 로컬 gigastt/Qwen3-ASR 또는 원격 endpoint. 오디오는 그 서버로만 간다 |
WhisperX는 faster-whisper(CTranslate2) 전사에 wav2vec2 forced alignment를 더해 단어 경계를 ±1030ms로 맞춘다. Whisper 자체 timestamp는 ±100300ms라서 dubbing lip-sync는 이 정밀도에 의존한다. 단 CTranslate2는 Metal과 HIP 빌드가 없어 Apple Silicon은 mlx-whisper(#1127), ROCm은 pytorch-whisper(#1529)를 자동 선택한다. fp16 large-v3를 거의 찬 8GB 카드에 올리면 Python 예외 없이 native CUDA abort로 backend 전체가 죽으므로(#723), 로드 전에 free VRAM을 compute type별 budget(float16 5.0GB, int8_float16 3.5GB, int8 3.0GB)과 비교해 정밀도를 낮추거나 CPU int8로 내려간다.
| 하드웨어 | 권장 TTS | 권장 ASR | 이유 |
|---|---|---|---|
| Apple Silicon (M1~M4) | MLX-Audio, OmniVoice (MPS) | MLX Whisper, Parakeet MLX | 통합 메모리, macOS 최저 지연 |
| NVIDIA GPU (VRAM 8GB+) | OmniVoice, CosyVoice 3 | WhisperX | 고품질 zero-shot cloning, 단어 timestamp, diarization |
| 저VRAM 또는 CPU 전용 | PocketTTS, Sherpa-ONNX, KittenTTS | Moonshine, Faster-Whisper (int8) |
낮은 메모리, CPU 추론 최적화 |
기본 엔진 OmniVoice
OmniVoice(k2-fsa)는 새 설치가 설정 없이 쓰는 기본 TTS 엔진이다. 600개 이상 언어의 zero-shot cloning을 하고 24kHz mono를 출력하며, cloning과 dubbing과 받아쓰기가 같은 로드된 모델을 공유해 이중 로드하지 않는다.
- 컴퓨트는 CUDA, ROCm(Linux), MPS, CPU를 자동 감지한다. CUDA와 ROCm에서는 fp16과
torch.compile로 실행하고, cloning 경로용 speech recognizer가 함께 로드된다 - VRAM floor는 6GB이며 측정된 floor를 가진 유일한 엔진이다. 4GB 카드(GTX 1650 Ti, Quadro P2000, #1226과 #1222)에서는 드라이버가 시스템 RAM으로 paging해 몇 초짜리 렌더가 몇 분을 끌다 compute budget에 걸린다. UI는 기다리기 전에 경고하되 짧은 입력은 들어갈 수 있으므로 hard-block하지 않고, floor 아래 CUDA/ROCm 카드는 CPU급으로 분류해 600초 budget을 준다(#1804)
- reference clip은 3~10초가 적정이다. transcript가 conditioning을 개선하므로 profile에 없으면 첫 사용 시 자동 전사해 저장한다. transcript를 준 clip은 정렬을 위해 20초로 제한되고, transcript가 없으면 최대 75초를 5회의 연속 전사 pass로 탐색해 발화가 검출된 구간을 고른다
- 인코딩된 reference는 앱 데이터의
prompt_cache/에 영속화된다(voice당 약 10KB, 최신 32개 유지). 재시작 후 첫 생성이 재인코딩과 전사를 건너뛴다 instruct스타일 속성과 reference clip은 결합할 수 있다. 둘이 일치하면 instruct가 그 속성의 cloning을 안정시키고, 충돌하면 reference audio가 이긴다- 발음은 중국어 병음(
打ZHE2出售)과 영어 CMU 음소([B EY1 S])로 inline 제어한다 - 출력에는 highpass와 compressor로 이루어진 mastering chain이 자동 적용된다
CUDA에서는 FlashInfer 가속을 opt-in할 수 있다. OMNIVOICE_FLASHINFER=1(또는 graph로 CUDA graph 캡처)은 packed CFG attention과 fused RMSNorm/RoPE/GEMM kernel로 상류 벤치마크 기준 약 2배를 낸다. 대신 그 세션에서 torch.compile을 대체하고, 추론을 단일 GPU thread에 고정하며, fused 가중치 사본을 상주시켜 LLM 가중치의 약 절반만큼 VRAM을 더 쓴다. 따라서 좁은 VRAM에서는 끄라고 안내하고, 패키지가 없거나 kernel이 실패하면 표준 경로로 fallback한다.
OmniVoice GGUF는 같은 모델을 번들 native 바이너리(bin/omnivoice-tts-<platform>)와 양자화된 가중치로 실행하는 변형이다. 양자화는 가중치를 낮은 비트 수로 줄여 모델을 압축하는 기법이며, 하드웨어 probe가 맞는 quant를 고른다.
| 하드웨어 | Quant | 대략 VRAM |
|---|---|---|
| VRAM 12GB+ | BF16 | 약 1.6GB (품질 우선) |
| VRAM 4~12GB | Q8_0 | 약 945MB (권장 균형) |
| VRAM 1~4GB | Q4_K_M | 약 659MB (최소 footprint) |
| CPU 전용 | Q4_K_M | RAM 한도, 지연 허용 |
F32 참조 quant(약 3.2GB)는 override 전용이다. 가중치는 Serveurperso/OmniVoice-GGUF HuggingFace repo의 고정 revision에서 받는다. 생성마다 바이너리를 새로 spawn하므로 crash나 leak이 앱을 죽이지 않고, 준비 전에 SHA-256 manifest 검증, macOS Gatekeeper quarantine 감지(xattr -cr 안내), 실행 비트 복원(#437)을 한다. voice design은 지원하지 않는다. Linux ARM64(Asahi)에서는 glslc와 SPIRV 헤더가 있으면 GGML Vulkan backend를 우선해 Honeykrisp 드라이버로 Apple GPU를 쓰며 macOS Metal보다 약 2~4배 느리다.
OmniVoice subprocess는 기본 모델의 crash 격리를 맡고 timeout 시 kill할 수 있다. timeout된 subprocess는 kill 후 종료를 유한 시간 기다리고, 종료를 확인하지 못하면 두 번째 엔진을 나란히 띄우는 대신 reap될 때까지 재시도를 막는다.
엔진 채택 기준
docs/engine-acceptance.md는 새 엔진을 "목록에 추가"가 아니라 "직무에 채용"한다고 규정한다. 엔진이 많다는 것은 모든 엔진이 모든 플랫폼에서 동작할 때만 자산이고, 아니면 support queue 더미일 뿐이라는 이유에서다. 직무 하나에 보유자는 하나다.
| 직무 | 보유 엔진 |
|---|---|
| 최고 zero-shot clone 품질 | omnivoice |
| 최대 언어 범위 | omnivoice |
| 기본 모델의 crash 격리 | omnivoice-subprocess |
| 가장 빠른 CPU 렌더와 최저 지연 | 공석 (#1306) |
| 최고 중국어와 일본어 표현력 | cosyvoice, indextts2 |
| CPU 실시간 영어, 최소 footprint | kittentts, supertonic3 |
| reference 없는 이중 언어 voice design과 연출 | audiocpp |
| 최고 전사 정확도 | whisperx, faster-whisper |
| 가장 빠른 Apple Silicon 전사 | parakeet-mlx, mlx-whisper |
| 전사의 crash 격리 | faster-whisper-isolated |
제안은 현 보유자에게서 직무를 가져오거나(수치 필요) 아무도 맡지 않은 직무를 주장해야 한다. "벤치마크가 좋다"는 직무가 아니다. 채택 조건은 일곱 가지이며 하나라도 빠지면 거절이다.
- 직무를 명시한다. 지연, 언어, 하드웨어 범위, 품질 tier 중 사용자가 그것을 고를 이유
- 모델 가중치와 코드 모두 상업 사용이 가능한 라이선스. 유일한 승인 예외는
audiocpp의 Breeze-TTS-2 research 가중치이며 2026-09-08 소유자가 승인했고 선택 전에 제한을 고지한다 - macOS, Windows, Linux 전부 지원하거나 명시적 opt-in. CPU 경로가 필수이고 가속기 하나만 지원하면 깨지지 않고 degrade해야 한다
TTSBackend나SubprocessBackend에 맞고 core 파이프라인을 바꾸지 않는다. 의존성이 충돌하면 sidecar가 답이다- 같은 PR에 CI smoke test. GPU 없이 sidecar를 stub하고 adapter 계약을 검증한다
- 12개월 동안 그 엔진의 issue 연락처가 될 steward
- 실제 요청, 워크플로, 사용자라는 수요 증거
steward도 통과하는 smoke test도 없는 상태가 두 릴리스 연속이면 archive한다. 기준을 넘지 못한 엔진은 adapter 인터페이스가 공개이므로 tree 밖에서 설치해 id로 선택할 수 있고, 유지 관리가 절반인 내부 엔진보다 좋은 외부 엔진을 링크하는 편을 택한다고 적었다.
sidecar venv와 디스크
부모 앱과 의존성이 충돌하는 엔진은 전용 가상환경에서 실행된다. IndexTTS2는 transformers<5를 고정하고 VoiceStudio는 transformers>=5.3을 요구하므로 한 환경에 공존할 수 없다. 그래서 IndexTTS2, MOSS-TTS-v1.5, dots.tts는 첫 사용 시 uv venv와 uv pip install로 venv를 만들며, 비용은 대부분 torch와 번들 CUDA 라이브러리인 무거운 ML 스택의 두 번째 사본이다.
| 플랫폼 | torch CUDA wheel | 번들 CUDA 라이브러리 |
|---|---|---|
| Linux (cu128) | 약 0.83GiB | nvidia-* 패키지 수 GiB 추가 |
| Windows (cu128) | 약 3.2GiB (DLL이 wheel에 포함) | 없음 |
uv는 전역 wheel cache에서 venv로 link해 설치한다. macOS와 Linux는 reflink clone, Windows는 hardlink라서 같은 wheel은 바이트를 공유한다. 조건은 cache와 venv가 같은 파일시스템에 있어야 한다는 것이고, 다른 볼륨에 설치되면 앱이 UV_CACHE_DIR를 venv 옆으로 자동 지정한다. dedup은 동일 wheel 단위라 torch==2.6.0+cu124와 torch==2.8.0+cu128은 공유가 0이다. dots.tts는 부모와 같은 torch==2.8.0을 고정해 거의 전부 공유하는 반면, MOSS-TTS-v1.5는 torch==2.9.1+cu128을 고정해 CUDA 호스트에서 수 GB의 torch 사본을 추가로 낸다. 8B 모델의 스택이 transformers==5.0을 고정하는 대가다.
Model Catalogue는 설치 전에 디스크 내역을 구조화해 보여준다. 모델 가중치 다운로드, 패키지 다운로드, 고유 설치 바이트, 공유 가능 바이트, 임시 여유 공간, 대상 볼륨, 추정 신뢰도이며, 측정되지 않은 값은 0이 아니라 unknown으로 표시한다. 값의 출처는 config/models.yaml과 sidecar installer 명세이고 UI가 별도 크기표를 갖지 않는다.
표현 제어와 생성 파라미터
docs/expressive-speech.md는 어느 태그가 어느 엔진에서 실제로 동작하는지를 먼저 표로 정리한다. 지원되지 않는 태그에 시간을 쓰지 않게 하기 위해서다.
| 원하는 것 | 방법 | 동작 엔진 |
|---|---|---|
| 쉼 | 텍스트에 [pause], [pause 500ms], [pause 1.5s] |
모든 엔진 (기본 350ms, 최대 10초, 실제 무음을 이어 붙인다) |
| 웃음이나 한숨 | Insert 버튼으로 [laughter], [sigh] |
기본 엔진 |
| 요청 시점의 들숨 | 텍스트에 [breath] |
CosyVoice 3 전용 |
| 속삭임 | 스타일 필드 whisper |
기본 엔진 |
| 감정 ("excited", "sad", 강도 조절) | IndexTTS2 emotion 제어 또는 CosyVoice 3 instruct | opt-in 엔진 전용 |
| 같은 take 재현 | seed 고정 또는 profile 잠금 | 기본 엔진 |
텍스트 박스의 내용은 엔진에 그대로 도달한다. 정규화 pass(backend/services/text_normalization.py)는 […] 구간을 건너뛰고 long-text chunker(backend/services/chunked_tts.py)는 대괄호 태그 안을 자르지 않는다. 반대로 인식되지 않는 태그도 제거되지 않는다. 따라서 ElevenLabs 스크립트의 [excited]나 [whispers]를 붙여 넣으면 엔진이 그것을 글자 그대로 읽으려 해 모든 엔진에서 출력이 나빠진다.
기본 엔진은 13개 non-verbal 태그를 native로 토큰화한다(omnivoice/models/omnivoice.py의 _NONVERBAL_PATTERN). [laughter], [sigh], [confirmation-en], [question-en], [question-ah], [question-oh], [question-ei], [question-yi], [surprise-ah], [surprise-oh], [surprise-wa], [surprise-yo], [dissatisfaction-hnn]이다. 널리 쓸 만한 것은 [laughter]와 [sigh]이고 나머지 감탄사 변형은 Mandarin 억양에 맞춰져 있으며, 강도 제어와 [breath] 태그는 없다. Audiobook과 Stories는 추가로 SSML-lite([slow]…[/slow], [fast]…[/fast], [emphasis]…[/emphasis], [spell])와 multi-voice용 [voice:NAME]을 파싱한다(backend/services/longform_parser.py). 발음 override는 [[Nuh-VAD-uh]] inline 표기나 발음 사전으로 한다.
opt-in 엔진의 제어는 각각 다르다.
| 엔진 | 제어 방식 |
|---|---|
| CosyVoice 3 | [breath], [laughter], <strong>word</strong>와 자연어 instruct. backend가 `< |
| VoxCPM2 | 텍스트 앞 괄호 접두어 (speaking fast, out of breath) I can't stop now.가 native 규약. instruct 필드가 이 접두어로 매핑된다 |
| IndexTTS2 | 유일한 graded 감정 제어. 8값 emotion 벡터(happy, angry, sad, afraid, disgusted, melancholic, surprised, calm), emotion reference clip과 혼합 강도, 자연어 emotion 서술. Audiobook 탭이 서술과 강도(emo_alpha)를 노출하고 전체 표면은 /ws/tts의 emo_vector, emo_audio, emo_alpha, emo_text 필드 |
기본 엔진에서 들숨을 유도하는 우회 레시피도 문서에 있다. reference clip에 실제 숨소리를 넣고, 짧은 헐떡이는 조각과 [pause]로 쓰고, postprocess_output을 끄고, class_temperature를 0.3~0.7로 올려 여러 take를 만든 뒤, 마음에 드는 take의 seed를 고정한다. v0.3.9의 무작위 숨소리는 기능이 아니라 unpinned seed와 position_temperature 5.0의 샘플링 분산이 덜 정돈된 출력 chain을 통과한 결과였다. v0.3.12의 mastering 축소(#986), 무음 후처리, v0.3.16의 VoxCPM2 가장자리 무음 trim(#1055)이 출력을 의도적으로 깨끗하게 만들었고, 표현력은 "우연히 생기는 것"에서 "요청하는 것"으로 옮겨가고 있다고 설명한다.
model.generate(...)의 파라미터는 디코딩, 샘플링, 길이, 전후처리, long-form 다섯 묶음이다.
| 구분 | 파라미터 | 기본값 | 의미 |
|---|---|---|---|
| 디코딩 | num_step |
32 | 반복 unmasking 단계 수. Voice 페이지는 16(빠름), Audiobook은 32(깨끗함) |
| 디코딩 | denoise |
True | `< |
| 디코딩 | guidance_scale |
2.0 | classifier-free guidance 배율 |
| 디코딩 | t_shift |
0.1 | noise schedule의 time-step shift. 작을수록 초기 단계 강조 |
| 샘플링 | position_temperature |
5.0 | mask 위치 선택 temperature. 0은 greedy |
| 샘플링 | class_temperature |
0.0 | 단계별 토큰 샘플링 temperature. 0은 greedy. 올리면 표현 변화와 artifact가 함께 는다 |
| 샘플링 | layer_penalty_factor |
5.0 | 깊은 codebook layer에 penalty를 주어 낮은 layer부터 unmask |
| 길이 | duration, speed |
None | 고정 출력 길이(초) 또는 속도 배율. duration이 우선. 둘 다 None이면 1.0 |
| 전후처리 | preprocess_prompt, postprocess_output |
True | reference의 긴 무음 제거와 문장부호 보정, 출력의 긴 무음 제거 |
| long-form | audio_chunk_duration, audio_chunk_threshold |
15.0, 30.0 | 추정 길이가 30초를 넘으면 15초 단위로 텍스트를 나눠 VRAM을 거의 일정하게 유지 |
무음 제거는 적응형이다. 표준 threshold로 자르면 조용하지만 실제인 녹음이 사라질 때 점점 완화된 threshold를 시도하고 마지막에는 trim을 건너뛴다. 완전 무음 클립만 재녹음 안내와 함께 거부한다. seed는 기본적으로 unpinned라 매 렌더가 다르며, history rail이 각 take의 seed를 보여주고 "Keep this seed"나 profile 잠금이 reference와 seed를 고정해 bit-reproducible하게 만든다.
voice design 속성 어휘
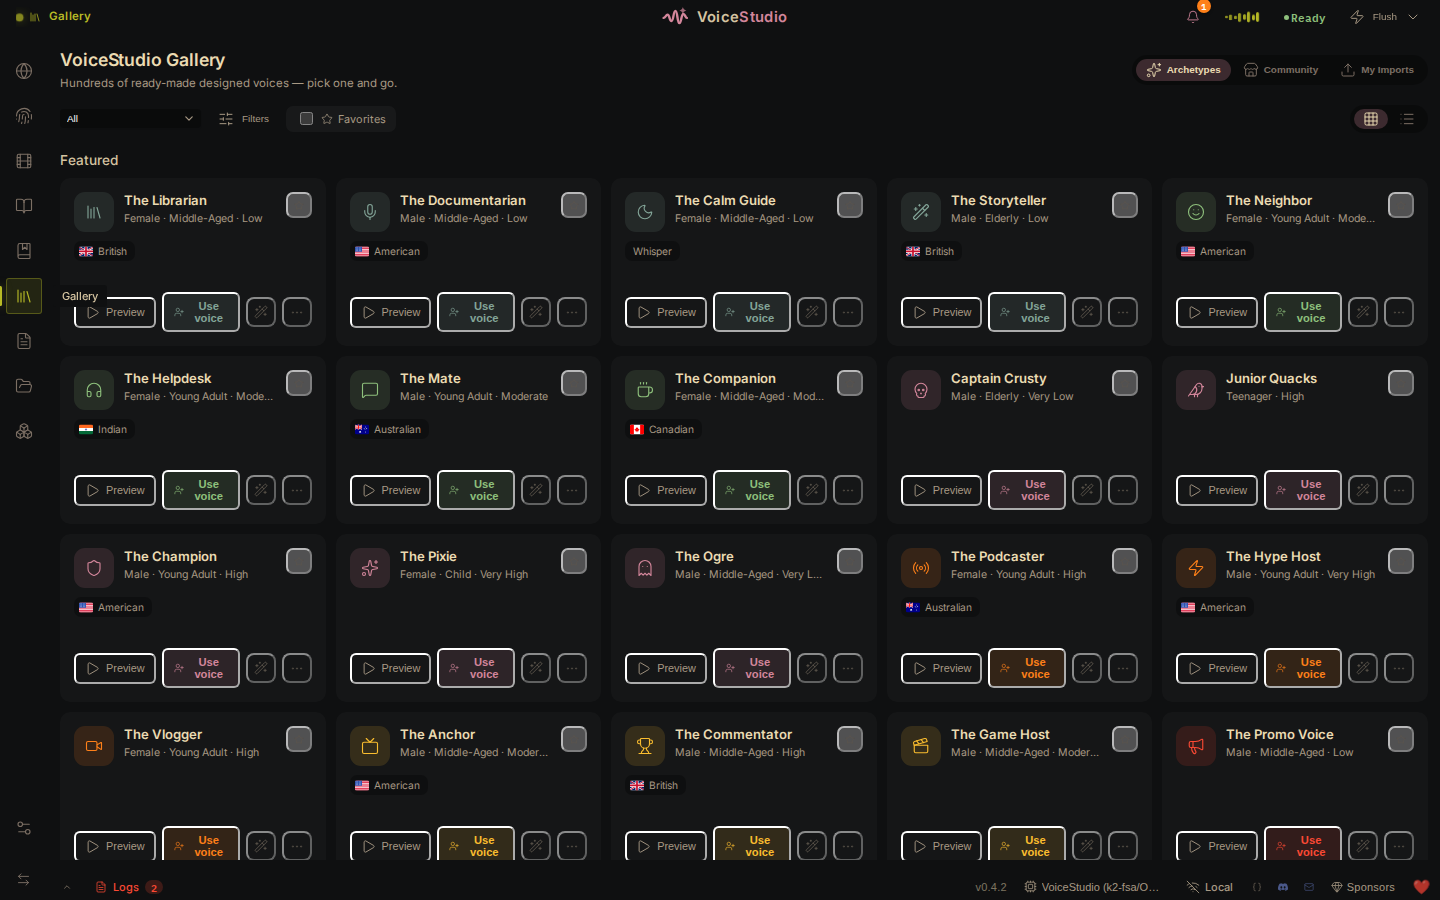
voice design은 instruct 문자열의 화자 속성으로 voice를 만든다. 범주마다 하나만 고르고 범주끼리는 자유롭게 조합하며, 생략한 속성은 모델이 채운다. 예를 들어 "female, young adult, high pitch, british accent"나 "male, elderly, low pitch, whisper"가 유효하고 "female" 하나만 써도 된다.
| 범주 | 값 |
|---|---|
| 성별 | male, female |
| 연령 | child, teenager, young adult, middle-aged, elderly |
| 음높이 | very low, low, moderate, high, very high pitch |
| 스타일 | whisper (기본 모델이 받는 유일한 전달 스타일) |
| 영어 accent (영어 텍스트에만) | american, british, australian, canadian, indian, chinese, korean, japanese, portuguese, russian |
| 중국어 방언 (중국어 텍스트에만) | 河南话, 陕西话, 四川话, 贵州话, 云南话, 桂林话, 济南话, 石家庄话, 甘肃话, 宁夏话, 青岛话, 东北话 |
영어와 중국어와 혼합 표기를 모두 받아 내부에서 정규화하고 대소문자를 가리지 않는다. [happy]나 [sad] 같은 감정 태그는 이 어휘에 없다. Gallery preview는 무음 출력과 순수 tonal buzz를 거부하되 짧은 frame 단위로 측정해 조용한 발화가 spectral flatness 때문에 거부되지 않게 한다.
dubbing 파이프라인
dubbing은 transcribe, translate, speak 세 단계다. 성능 문서는 이를 더 세밀하게 나눈다. 오디오 추출과 vocal 분리(긴 영상은 몇 분), 전사(Apple Silicon은 v0.3.21부터 MLX, NVIDIA는 CUDA), 번역(LLM provider에 6개 동시 요청), segment별 합성(순차, 시간의 대부분), mix와 export(대부분 stream copy)다.
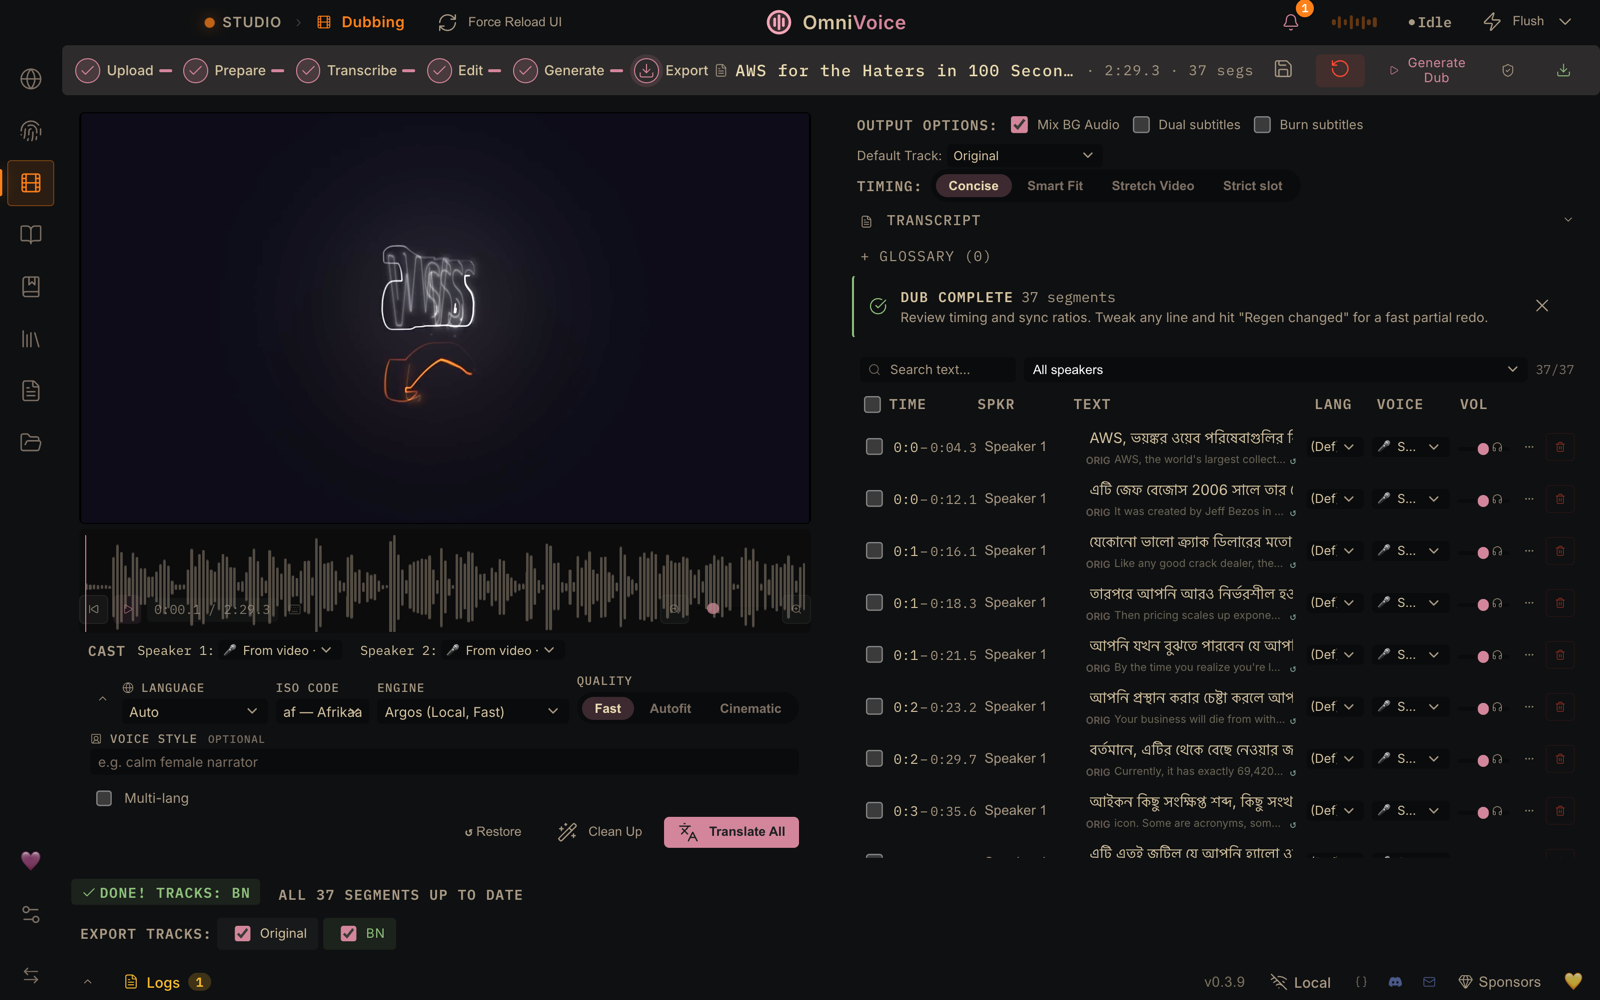
번역 engine은 pluggable하다. 두 개는 내장이라 오프라인에서 항상 쓸 수 있고 나머지는 작은 Python 패키지가 필요하다.
| Engine | 범주 | 패키지 | 키 |
|---|---|---|---|
| Argos (Local, Fast) | offline | argostranslate (번들) |
불필요 |
| NLLB-200 (Local, Heavy) | offline | 없음 (core transformers) |
불필요 |
| Google Translate (Free) | online | deep_translator |
불필요 |
| DeepL | online | deep_translator |
DEEPL_API_KEY |
| Microsoft Translator | online | deep_translator |
MICROSOFT_API_KEY |
| MyMemory | online | deep_translator |
불필요 |
| LLM (OpenAI 호환) | llm | openai |
대개 필요 |
설치 방식은 빌드에 따라 다르다. 소스 설치와 Docker는 backend와 같은 인터프리터에 uv pip install로 한 번에 설치하고 재시작한다. 서명된 설치본(.dmg, .msi, AppImage, .deb)은 읽기 전용 code-signed Python 환경을 싣기 때문에 앱 내 설치가 꺼져 있고, 설치 안 된 engine을 고르면 설치 명령 복사 버튼과 "Argos로 전환" 버튼이 있는 popover를 띄운다. 패키지 빌드에는 Argos(빠름)나 NLLB-200(무겁지만 품질 높음)을 권한다.
Quality는 세 수준이다.
| 수준 | 동작 |
|---|---|
| Fast | 선택한 engine의 일회 직역. LLM 없음, timing 인식 없음 |
| Cinematic | LLM이 직역을 reflect와 adapt로 자연스럽게 다듬는다 |
| Autofit | Cinematic에 더해 각 줄의 target 언어 낭독 시간이 segment slot 안에 들어가도록 LLM이 재작성. 언어별 발화 속도를 반영하며 너무 긴 번역의 time-stretch를 피한다 |
Cinematic과 Autofit은 LLM이 필요하고 없으면 안내와 함께 Fast로 fallback한다. LLM engine이 활성일 때 두 단계가 기본으로 더 실행된다. Auto glossary는 segment 번역 전에 전체 transcript를 한 번 읽어 주제 요약과 source-target 용어 대응을 뽑고 모든 segment 프롬프트에 실어 3번 segment와 300번 segment의 이름과 용어를 같게 한다. 수동 glossary가 충돌 시 항상 이기고, 결과는 dub 프로젝트에 언어별로 캐시되어 바뀌지 않은 transcript의 재번역은 추가 호출이 0이다. Reflect pass는 segment마다 초안의 장황함과 딱딱한 어조를 비평하고 자연스러운 구어로 다시 쓰므로 segment당 LLM 호출이 1회에서 3회가 되며, 실패하면 직접 번역을 조용히 유지한다.
모든 quality 수준에서 pre-synthesis fit check가 LLM 없이 실행된다. 이미 생성된 segment로 voice와 engine의 발화 속도를 자체 보정하고(cold start는 언어별 rate 표) slot과 다음 줄 전까지 빌릴 수 있는 무음을 비교해, Smart Fit이 들리는 가속으로만 흡수할 수 있는 segment에는 "Tight fit", 어떤 fitting으로도 안 되는 segment에는 "Won't fit +Ns" badge를 붙인다. badge는 정보용이고 생성을 막지 않는다. "Suggest shorter lines"를 켜면 Won't fit segment마다 LLM에 의미 보존 단축 rewrite를 요청해 one-click 제안으로 보여주되 자동으로 바꾸지는 않는다.
Paste Translation은 다른 곳에서 번역한 결과를 재전사 없이 segment에 매핑한다. ChatGPT, DeepL 웹, 사람 번역가의 결과를 붙여 넣으면 timestamped(.srt/.vtt, 시간 겹침으로 매핑), numbered lines(번호로 매핑, 모델이 번호를 바꾸면 순서로 fallback), plain lines(위치로 매핑, 빈 줄은 구분자) 세 형태를 자동 감지한다. 적용 전 before/after 미리보기와 매칭 안 된 행 수를 보여주고, 전체 paste가 undo 한 단계이며, 바뀐 행은 자동으로 stale로 표시되어 "Regen N changed"가 그 줄만 다시 말한다. 현재 선택된 target 언어에만 쓰므로 언어 탭마다 다른 외부 번역을 붙일 수 있다.
LLM provider는 Settings의 한 곳에서 관리한다. OpenAI, OpenRouter, OrcaRouter, Groq, Cerebras, Google AI, Mistral, Cohere, NVIDIA, GitHub Models, Cloudflare, Hugging Face, SambaNova, SiliconFlow, 로컬 Ollama와 LM Studio, Custom OpenAI 호환 endpoint를 지원하고 키는 암호화 저장되며 UI로 돌려주지 않는다. LLM_DEFAULT_PROVIDER로 provider를 고정할 수 있고 해석 순서는 env, 저장된 선택, 키가 있는 첫 provider, 없음이다. LLM Skills 설정은 Cinematic과 Autofit, slot fitting, glossary 추출, direction 파싱, 받아쓰기 정리 각각을 끄거나 특정 provider로 routing해, 민감한 작업은 로컬 모델에 두고 무거운 작업은 원격에 보낼 수 있다.
export는 source 오디오와 하나 이상의 dub track을 담고 선택한 dub 언어를 기본 track으로 표시한다. hardsub은 Line(정적 자막)과 Karaoke(단어별 하이라이트, 전사 시 기록한 단어 timing이 구동) 두 스타일이 있고 dual-layout과는 함께 쓸 수 없다. Smart Fit은 영상 retime 후에 자막을 굽고, karaoke 스크립트는 GET /dub/ass/{job_id}로 .ass sidecar를 따로 받을 수 있다.
diarization은 dubbing에서 화자마다 다른 voice clone을 주고 자막에 SPEAKER_00: 라벨을 붙이는 데 쓰인다. pyannote/speaker-diarization-3.1이 HuggingFace에서 gated라 HF 토큰과 두 repo(speaker-diarization-3.1, segmentation-3.0)의 라이선스 동의가 필요하고 첫 실행에 약 600MB를 받는다. 실패하면 긴 무음으로 화자를 나누는 silence-gap heuristic으로 fallback하고 이유를 diarization_skipped:no_token, diarization_skipped:401, diarization_skipped:network로 job 로그에 남긴다. heuristic은 음높이가 비슷하거나 빠르게 교대하는 화자를 합치지만 dub를 끝까지 완료시킨다.
받아쓰기와 native 삽입
받아쓰기는 시스템 전역 단축키로 녹음해 로컬 전사하고, 데스크톱이 허용하면 단축키를 누른 앱에 결과를 삽입한다. pill은 키보드 focus를 갖지 않는다. macOS, Windows, Linux 모두 Whisper Tiny가 권장 기본이며 90개 이상 언어를 자동 감지하고, Parakeet TDT v3는 유럽 25개 언어용으로 남아 있으나 자동 선택되지 않는다.
| 플랫폼 | 자동 삽입 |
|---|---|
| macOS | 포착한 앱을 재활성화하고 Command-V. Accessibility 권한이 없으면 복사 상태로 남는다 |
| Windows | 포착한 창과 프로세스를 검증하고 foreground 활성화 후 Ctrl-V. 거부되면 복사 상태 |
| Linux X11 | EWMH로 X11 창을 재활성화하고 검증 후 Ctrl-V |
| Wayland | 이식 가능한 창 identity가 없어 전체 transcript를 복사만 한다. VOICESTUDIO_WAYLAND_UNTARGETED_INSERT=1로 wtype, dotool, ydotool 경유 삽입을 opt-in |
| 브라우저 모드 | 복사만. 브라우저는 다른 데스크톱 앱을 대상으로 삼을 수 없다 |
안전 장치는 세 가지다. 첫째, 데스크톱은 shortcut-down 시점에 대상을 포착하고 세션 ID를 partial, utterance, summary 메시지에 실어 옛 세션의 늦은 결과가 새 세션의 대상에 들어가지 못하게 한다. 둘째, paste 전달은 텍스트, HTML, 이미지, 파일 목록 클립보드 내용을 스냅샷하고 transcript를 올린 뒤 복원하며, 전사 중 사용자가 복사한 내용은 덮어쓰지 않는다. 셋째, pill은 native 전달이 성공한 뒤에만 "Inserted"를 표시하고 그렇지 않으면 "Copied"로 일반 붙여넣기를 안내한다.
빈 Sherpa decode는 이미 설치된 다른 ASR 가중치로만 재시도하고 그 fallback이 단어를 확인하면 무음 모델을 강등한다. 이 복구는 다운로드를 시작하지 않는다. 녹음 bubble은 Pause/Resume, Stop, Close를 제공하며 Pause는 마이크 track을 끄고 타이머를 멈추되 세션을 보존한다.
로컬 speech platform
VoiceStudio는 데스크톱 받아쓰기 앱이자 headless 로컬 speech 서비스다. 번들된 Rust control sidecar(포트 3902, IPv4 loopback에만 bind)가 마이크 활성화, focus 대상 포착, 클립보드 안전, native 삽입을 소유하고, Python backend(포트 3900)가 ASR 모델을 warm 상태로 유지하며 audio data plane을 노출한다. 이 분리 덕에 통합하는 쪽이 얼마나 소유할지 고를 수 있다.
Herdr / terminal / desktop app ── start, stop, toggle ──> Rust control :3902
                                                          ├─ captures target
                                                          ├─ opens VoiceStudio mic
                                                          └─ inserts final text

VS Code / custom GUI / remote mic ── PCM or WebM ───────> WS/HTTP :3900
                                                          └─ partial/final text
                          reserve target / insert final ─> Rust control :3902

Claude Code / Codex / Pi / agents ── MCP HTTP/stdio ───> MCP :3900
두 포트 모두 /.well-known/voicestudio-speech에서 voicestudio.speech.v1 문서를 돌려준다. 데스크톱 문서는 절대 URL로 control, batch, streaming, output-session, MCP endpoint를 담고, backend 문서는 상대 URL이라 Tailscale이나 reverse proxy 뒤에서도 동작하며 데스크톱이 띄웠을 때만 native control을 광고한다.
| 전송 | Endpoint | 용도 |
|---|---|---|
| OpenAI 호환 HTTP | POST :3900/v1/audio/transcriptions |
파일, 스크립트, 기존 SDK |
| WebSocket | :3900/v1/audio/transcriptions/stream |
partial과 final 실시간 텍스트 |
| MCP Streamable HTTP | POST :3900/mcp |
현대 에이전트 클라이언트 |
| MCP stdio | python -m backend.mcp_shim |
Claude Code, Codex, stdio 전용 클라이언트 |
| JSON-RPC | POST :3902/rpc |
native 받아쓰기 제어 (dictation.toggle) |
| Native CLI | VoiceStudio --dictate-start, --dictate-stop, --dictate-toggle |
훅과 플러그인 동작. single-instance bridge가 실행 중인 앱에 전달 |
편집기가 마이크를 직접 소유하는 경우의 절차는 다음과 같다. ws://127.0.0.1:3900/v1/audio/transcriptions/stream에 WebM/Opus 프레임(또는 ?pcm=1&sr=16000으로 16-bit mono PCM)을 보내고 {"type":"input_audio.end"}로 마친다. 응답은 session.started, partial, final이며 모두 protocol과 session_id를 싣는다. final의 final_kind는 세션 전체의 권위 있는 summary이고, 스트리밍 Sherpa 모델은 그 전에 utterance를 낼 수 있다. native 삽입을 재사용하려면 3902에서 POST /v1/output/sessions로 대상을 예약하고, 3900에서 final 텍스트를 받은 뒤, POST /v1/output/sessions/{id}/insert로 넣으며, 취소하면 DELETE한다. output session은 한 번에 하나만 focus 대상을 소유하고 stale ID는 거부된다.
의존성 없는 Python bridge도 있다. python -m backend.speech_client status|toggle|transcribe recording.wav [--insert]이며 --insert는 전사 시작 전에 focus 대상을 포착해 전역 단축키와 같은 clipboard-preserving 전달을 쓴다.
| 인터페이스 | 권장 연결 |
|---|---|
| 아무 데스크톱 텍스트 필드 | 기존 전역 단축키 또는 Rust dictation.toggle |
| Herdr | 예시 command binding을 Herdr 설정에 merge. detached command가 Rust API를 호출 |
| Pi, Claude Code, Codex, Antigravity CLI | Rust로 focus된 프롬프트에 받아쓰기. 파일 전사나 speech tool이 필요하면 MCP 추가 |
| VS Code | 확장 host에서 Rust HTTP 호출, 또는 편집기 소유 마이크를 WebSocket으로 스트리밍 |
| TUI나 셸 스크립트 | python -m backend.speech_client 또는 HTTP/JSON-RPC |
| 브라우저/WebView UI | Python data plane으로 스트리밍. 브라우저 페이지는 native control을 조용히 호출할 수 없다 |
| 원격 마이크 + 로컬/원격 GPU | 클라이언트 edge에서 캡처하고 인증된 WebSocket/OpenAI endpoint 사용 |
설계 조사는 GitHub speech-to-text topic 5페이지를 훑어 9개 프로젝트에서 채택한 아이디어를 표로 남겼다.
| 출처 | 채택한 아이디어 |
|---|---|
| Handy | cross-platform 오프라인 받아쓰기, 외부 toggle 제어, VAD 중심 캡처 |
| WhisperLiveKit | live 로컬 전사와 호환성 중심 serving |
| RealtimeSTT | 저지연 partial, endpointing, warm recognizer |
| sherpa-onnx | 이식 가능한 CPU 스트리밍 모델과 WebSocket 친화 오디오 framing |
| FunASR | OpenAI 호환과 MCP를 향한 serving |
| Vexa | WebSocket transcript와 에이전트 접근 |
| Voquill | provider 독립, refinement, 개인 어휘 방향 |
| Muesli | 기계 판독 가능한 CLI 계약과 세션 안전 자동화 |
| Herdr | CLI, socket, 훅, 플러그인 뒤의 단일 로컬 제어 표면 |
차별점은 연결 층이다. 한 앱이 native 캡처와 출력 제어와 프로토콜 중립 ASR 서비스를 제공하므로 인터페이스마다 모델 로딩과 데스크톱 권한과 삽입 안전을 다시 만들지 않는다. 보안 측면에서 native control sidecar는 신뢰되지 않은 브라우저 Origin을 거부해 일반 웹사이트가 마이크를 켜지 못하게 하고, 오디오를 받지 않으며, Network Sharing으로 노출되지 않는다. 마이크는 인터페이스 edge에 머물고 원격 GPU backend가 사용자 입력 장치를 소유한다고 가정하지 않는다.
OpenAI 호환 API와 에이전트 프레임워크
OpenAI 호환 audio 클라이언트는 base_url을 https://api.openai.com/v1에서 http://localhost:3900/v1로 바꾸면 된다. 서비스 root는 http://localhost:3900이고 discovery는 root의 /.well-known/voicestudio-speech에 있다.
| Endpoint | 목적 |
|---|---|
POST /v1/audio/speech |
TTS. mp3, opus, aac, flac, wav, pcm. voice로 profile, model로 엔진 선택, speed 지원. 기본 출력 24kHz |
POST /v1/audio/transcriptions |
STT. json, text, verbose_json, srt, vtt |
WS /v1/audio/transcriptions/stream |
PCM/WebM 실시간 전사. partial, utterance, session-final 이벤트 |
GET /.well-known/voicestudio-speech |
HTTP, WebSocket, MCP, native 제어 전송 발견 |
GET /v1/audio/voices |
로컬 voice profile과 엔진 목록 (VoiceStudio 확장) |
from openai import OpenAI

client = OpenAI(base_url="http://localhost:3900/v1", api_key="local")

with client.audio.speech.with_streaming_response.create(
    model="tts-1",
    voice="<profile-id>",
    input="Made on my own hardware.",
    response_format="wav",
) as response:
    response.stream_to_file("speech.wav")
docs/agentic-voice.md는 이를 "agentic v1"이라 부른다. VoiceStudio는 provider이고 orchestrator가 아니며, 사용자가 자기 에이전트(지원 상담선, 데스크 비서, Discord persona)의 TTS/STT를 VoiceStudio에 향하게 한다. pipecat(BSD-2)은 같은 프로세스 안의 Python 라이브러리라 서버가 필요 없고, OpenAITTSService와 OpenAISTTService에 base_url, voice profile id, model="omnivoice", sample_rate=24000을 주면 된다. LiveKit Agents(Apache-2.0)는 LiveKit 미디어 서버가 필요하지만 OpenAI 플러그인이 같은 base_url을 받으며, WebRTC/SIP 규모가 필요할 때만 고르라고 한다. 요청 형태는 tests/test_agentic_provider_contract.py 계약 테스트가 CI에서 고정한다.
발신 전화는 별도 milestone으로 미뤄졌다. 유료 carrier가 필요해 PSTN까지 완전 로컬 경로가 없고, 명시적 consent guardrail 뒤에서만 나온다. 에이전트가 사용자 voice로 말할 때는 Settings에서 "verified own voice"로 표시한 profile을 쓰라고 권하며, 이 consent 잠금이 향후 agentic 기능을 gate한다.
MCP 서버
MCP 서버는 실행 중인 backend의 /mcp에 mount되므로 VoiceStudio가 열려 있으면 따로 띄울 것이 없다. Claude Code, Cursor 같은 에이전트가 사용자가 에이전트별로 고른 voice로 말하고, voice를 clone하고, 오디오를 전사할 수 있다.
| Tool | 기능 |
|---|---|
generate_speech |
텍스트를 WAV로. profile_id가 없으면 에이전트에 bind된 voice 사용. 기본 base64, files 모드에서는 URL과 파일 |
clone_voice |
reference audio(base64 또는 base path 아래 ref_audio_path)로 새 voice profile 생성. profile_id 반환 |
transcribe |
오디오(base64 또는 audio_path)를 텍스트로. 646개 언어 |
list_voices, list_personalities, list_languages |
목록 조회 |
check_health |
backend 상태와 활성 GPU |
출력 모드는 컨텍스트 비용 문제를 푼다. LLM 에이전트는 받는 모든 바이트에 비용을 내므로 base64 WAV는 짧은 클립도 결과 한도에 닿고 한 문단의 내레이션은 한도를 넘긴다. 세 환경 변수가 오디오를 대화 밖 디스크로 옮긴다.
| 변수 | 값 | 효과 |
|---|---|---|
OMNIVOICE_MCP_OUTPUT_MODE |
resources(기본), files, both |
resources는 wav_base64 inline. files는 /audio/<id>.wav URL과 base path 아래 output_path. both는 전부 |
OMNIVOICE_MCP_TIMEOUT_S |
초 (기본 backend 추종) | 미설정 시 각 tool은 backend 자체 timeout에 30초를 더한 값(최소 120초)을 기다린다. generate_speech는 GPU queue 대기(OMNIVOICE_GPU_QUEUE_TIMEOUT_S, 1,800초)에 생성 budget과 1,200자 초과분 40자당 1초를 더한다 |
OMNIVOICE_MCP_BASE_PATH |
디렉토리 | 파일 형태 트래픽의 보안 경계. 입력 파일은 이 아래에서만 읽고(상대 경로는 여기에 해석, 절대 경로는 안에 있어야 하고, symlink는 검사 전에 해석) files 모드는 여기에만 쓴다. 없으면 경로 인자를 이유와 함께 거부 |
입력 파일은 경로 검증 후 confined no-follow descriptor로 열어 검사 뒤 파일이나 부모 디렉토리가 바뀌어도 밖으로 나가지 못한다. base path는 backend와 에이전트 양쪽에서 보여야 하므로 다른 컨테이너라면 같은 경로에 공유 mount가 필요하다. 모델을 아직 받지 않은 머신에서는 첫 generate_speech가 약 2.3GB 다운로드도 그 budget 안에서 하므로 먼저 설치하라고 안내한다.
에이전트마다 client id로 voice를 bind할 수 있다. "Claude Code는 Morgan, Cursor는 Scarlett"처럼 에이전트가 다르게 말하게 하는 것이다. generate_speech의 voice 해석 순서는 명시적 profile_id, 호출 에이전트의 binding, 전역 기본 voice, VoiceStudio 기본 voice다. binding은 loopback REST GET/PUT/DELETE /api/mcp/bindings로 관리하고 Settings UI도 같은 API를 쓴다.
연결은 두 가지다. Streamable HTTP는 http://localhost:3900/mcp에 X-VoiceStudio-Client-Id 헤더로 id를 전달한다. stdio 전용 클라이언트는 번들 shim(python -m backend.mcp_shim, docs/mcp.json 템플릿)을 쓰며 shim이 OMNIVOICE_CLIENT_ID env를 같은 헤더로 전달하고 backend 기동을 기다렸다가 JSON-RPC를 중계한다. Docker나 다른 머신의 에이전트는 MCP SDK의 DNS-rebinding guard 때문에 OMNIVOICE_MCP_ALLOWED_HOSTS에 host 패턴을 적어야 하며, MCP 전송은 인증되지 않으므로 신뢰 LAN이나 TLS 뒤에만 두고 공개 인터넷에 노출하지 말라고 경고한다. OMNIVOICE_MCP_DISABLE=1이면 mount하지 않는다.
에이전트 스킬은 skills.sh 호환 에이전트에 npx skills add debpalash/VoiceStudio로 설치한다. omnivoice 스킬은 로컬 VoiceStudio로 합성과 전사를 하고, oss-maintainer 스킬은 저장소의 오픈소스 유지 관리 워크플로를 담는다.
네트워크 경계와 인증
backend는 기본적으로 loopback 전용이고 인증이 없다. 같은 머신의 스크립트는 키도 PIN도 헤더도 필요 없으며, 다른 기기(LAN의 폰, Tailscale의 노트북, reverse proxy 뒤 클라이언트)에서 닿을 때만 세 gate가 의미를 갖는다. 세 gate 모두 켜기 전까지는 inert다.
| Gate | 켜는 방법 | 보호 대상 | 적용 범위 |
|---|---|---|---|
| Share PIN | 앱 내 Network share 토글 | 일회 세션의 LAN 손님 | 비loopback HTTP |
| API key | backend의 OMNIVOICE_API_KEY |
직접 클라이언트와 first-party 세션 bootstrap | 비loopback HTTP + WebSocket |
| Trusted networks | OMNIVOICE_TRUSTED_NETWORKS (CIDR 목록) |
위 두 gate를 면제 | 비loopback 소비 라우트만 |
share PIN은 sharing을 켤 때마다 새 6자리로 생성되고 디스크에 쓰지 않는다. X-OmniVoice-Pin 헤더, ?pin= 질의(query) 파라미터, ov_pin 쿠키(첫 유효 PIN 뒤 backend가 자동 설정)로 낸다. PIN gate(NetworkAccessMiddleware)는 HTTP만 다루고 WebSocket을 gate하지 않으므로 받아쓰기 WebSocket은 API key나 trusted network가 필요하다. 6자리라 brute-force 가능하므로 관리 표면을 열지 못한다.
API key는 GPU box, Docker, reverse proxy 호스트의 durable root 자격이다. Authorization: Bearer가 권장이고 legacy ov_key 쿠키와 ?api_key=는 호환용이며 URL의 키는 proxy 로그와 브라우저 이력에 샌다. 키는 constant time으로 비교되고 로그에 남지 않으며, WebSocket에서 틀린 키는 close code 1008로 거부된다. first-party UI는 master key를 POST /api/auth/session에 한 번만 보내 8시간 한도의 세션(ov_session HttpOnly SameSite=Strict 쿠키 또는 sessionStorage의 bearer)으로 바꾸고 master를 저장하지 않는다. 실패한 세션 교환은 클라이언트당 60초에 10회로 제한되어 429와 Retry-After를 받으나 올바른 master는 항상 평가되어 잠금이 불가능하다. 쿠키 인증 mutation은 정확한 Origin과 X-VoiceStudio-CSRF: 1이 필요하고, WebSocket은 POST /api/auth/ws-ticket이 발급하는 path-bound 30초 일회용 ticket을 URL에 넣는다.
관리 라우트는 더 엄격한 gate(require_admin)에 있다. /system/*의 set-env 포함, /api/settings/*, 엔진 설치와 제거, 미디어 도구, MCP binding, 발음 설정, 원격 worker 관리이며 데스크톱에서는 true-loopback 전용이다. 서버 모드(OMNIVOICE_SERVER_MODE=1, Docker 이미지)는 NAT 때문에 loopback 판정이 불가능하므로(#261) 자격 규칙으로 대체한다.
| 서버 모드 상태 | 관리 라우트 접근 |
|---|---|
| 자격 없음 (API key도 PIN도 없음) | 읽기 전용 discovery만. mutation과 부작용 있는 GET(엔진 health, deep diagnostics, LLM provider discovery)은 거부 |
| API key 설정 | 그 키, 관리자 세션, 진짜 loopback 중 하나 필요. PIN과 trusted network는 절대 닿지 못한다 |
| PIN만 설정 | 관리 라우트는 loopback 전용 유지 |
이 독립성은 실제 권한 상승(#1213)을 고친 결과다. 이전에는 서버 모드가 관리 gate를 무효화해, API key와 trusted CIDR이 함께 설정되면 그 CIDR의 LAN 클라이언트가 자격 없이 POST /system/set-env를 호출할 수 있었다. 관리형 sidecar 설치는 API key가 있어도 true-loopback 전용이며, 호스트 경로는 HTTP로 선택되지 않고 native Tauri 프로세스가 검증해 일회용 capability를 발급한다. /export는 destination_path가 아니라 authorization 토큰만 받고 /system/set-env는 실행 파일 경로 키를 받지 않는다.
CORS는 인증과 별개의 벽이다. allow-list 기본값은 loopback과 Tauri origin뿐이라 LAN IP로 연 dev UI는 OMNIVOICE_ALLOWED_ORIGINS에 정확한 origin(scheme, host, port, 경로 없음)을 적어야 하며(#1348) 이 값은 기본 목록을 대체한다. TLS 종단 proxy는 Uvicorn의 --forwarded-allow-ips로 정확한 주소만 신뢰하고, 앱은 raw X-Forwarded-Proto를 믿지 않는다.
| 코드 | 의미 |
|---|---|
| 401 | 소비 인증 실패. PIN required 또는 API key required. WebSocket은 close 1008 |
| 403 | loopback이나 native 접근 필요, Origin/CSRF 실패, 서버 모드 mutation에 관리 자격 없음, native path capability 무효 |
| 429 | 세션 교환 한도 초과, GPU pool 포화, 모델 다운로드 rate limit. Retry-After 동반 |
앱 내 sharing은 두 경로다. LAN sharing은 footer의 Local pill을 Network로 바꾸면 모든 도달 가능한 주소를 QR(PIN 포함)과 함께 보여주고, 끄면 socket을 닫는다(방화벽이 아니라 포트 자체가 닫힌다). Tailscale은 tailscale serve로 tailnet에 publish하며 HTTPS 인증서가 켜진 tailnet에서만 HTTPS를 쓰고 아니면 WireGuard 터널 위의 HTTP로 fallback한다. 두 경로 모두 backend를 재시작하거나 로드된 모델을 내리지 않는다.
원격 컴퓨트 두 종류
원격 컴퓨트는 서로 독립인 두 기능이다.
| 구분 | Remote backend | Remote workers |
|---|---|---|
| 무엇이 옮겨가는가 | 앱 전체(프로젝트, voice, 이력)가 GPU 머신으로 | 개별 task만. 나머지는 이 머신에 |
| 클라이언트 | 데스크톱 앱이 thin client. Backend URL과 API key 입력 | 이 머신의 앱이 control plane |
| 네트워크 | tailnet 권장. tailscale serve로 TLS. tailscale funnel(공개 노출) 금지 |
worker가 outbound로 dial. worker는 공개 주소가 필요 없고 이 머신만 도달 가능하면 된다 |
| 자격 | OMNIVOICE_API_KEY bearer. 브라우저는 URL fragment #api_key=로 한 번 전달 |
15분 유효, 한 번만 보이는 join code(해시만 저장). worker는 Ed25519 keypair를 만들어 이후 소유 증명 |
remote backend에서 데스크톱 앱은 thin client다. Settings에 Backend URL과 API key를 넣으면 키가 한 번 세션으로 교환되고 URL만 저장된다. Test connection은 인증 면제 /health를 먼저 치고, 통과하지 않은 URL 저장은 확인을 요구한다. 브라우저에서 직접 쓸 때는 키를 fragment(#, ? 아님)에 넣어 서버와 proxy 로그에 남지 않게 하고, 즉시 scrub해 8시간 세션으로 바꾼다.
remote workers는 opt-in이고 기본 off다. 켜기 전까지 아무것도 나가지 않고 포트도 열리지 않는다. 설정 절차는 네 단계다.
- 이 머신에서 Settings의 Remote workers를 켠다. 패널이 worker가 연결할 주소와 Generate token 버튼을 보여준다
- join code를 생성한다. 텍스트와 QR로 표시되고 15분 후 만료되며 해시만 저장되어 다시 볼 수 없다
- worker 머신에서 "Lend this machine's GPU"에 code를 붙여 넣는다. worker는 첫 실행에 keypair를 만들고 code를 한 번 제시해 등록한 뒤 이후 연결마다 키 소유를 증명한다. headless는
OMNIVOICE_WORKER_TOKEN과OMNIVOICE_WORKER_MODE=1로uvicorn backend.main:app --host 127.0.0.1 --port 3900, Docker는--profile worker-gpu(AMD는worker-rocm) - 이 머신에서 worker를 승인한다. 승인해야 오디오와 reference voice와 텍스트가 그 머신으로 가며 consent는 worker별로 기록된다
원격에서 실행되는 것은 speech 합성, 오디오북 챕터(한 챕터씩), dub segment 합성(모든 fresh segment를 하나의 coarse task로 보내 WAV bundle로 수신)이다. fitting, assembly, RVC, ASR, diarization, 번역은 로컬에 남고, 받아쓰기는 지연 자체가 기능이라 영구히 로컬이다. worker는 voice profile의 reference audio와 transcript, 고정 seed, 품질 제어, chunking과 crossfade 설정, 효과 preset까지 완전한 렌더링 계약을 받으므로 gallery voice가 다른 GPU에서 렌더된다고 다른 voice가 되지 않는다. picker는 현재 화면에 원격 경로가 없으면 초록 점 대신 "Local"과 이유를 보여준다.
task 배치 규칙은 명확하다. 연결되어 있고 승인되고 활성이며 엔진을 갖고 free slot이 있고 pause되지 않은 worker에 간다. Preferred worker는 hard choice라 잠들어 있으면 다른 곳에 조용히 보내지 않고 그 worker 이름을 댄다. 없으면 가장 한가한 worker를 고르되 모델을 이미 로드한 worker를 우선한다. routing weight나 모델별 동시성 설정은 의도적으로 없고 동시성은 free VRAM에서 실시간 측정한다. 설정값은 compiled 모델의 출력을 조용히 손상시키고 작은 카드를 crash시키기 때문이다. 어떤 worker도 실행할 수 없으면 기다리지 않고 즉시 실패한다.
실패 처리는 다음과 같다.
- task 중 worker가 끊기면 grace window 동안 기다리고, 완료 결과를 들고 돌아오면 그 결과를 쓴다. 네트워크 blip 때문에 task를 두 번 실행하지 않는다
- worker 잘못인 연속 실패 3회면 1분 pause 후 task 하나로 검증하고, 반복되면 최대 30분까지 backoff한다. 바쁨, 없는 엔진 요청, 네트워크 유실은 실패로 세지 않는다
- 긴 작업은 keepalive 프레임을 보내 2분 progress lease를 넘길 수 있다
- 앱을 종료해도 원격 작업은 계속되고 다음 실행 시 복구해 worker와 대조한다
- 등록은 프로토콜 범위와 named feature(task 입력, progress lease, 원격 모델 다운로드, voice-identity 렌더 파이프라인)를 협상한다. durable enrollment가 handshake를 v1에서 v2로 바꿔 그 경계는 양방향 비호환이며, 범위 밖 worker는 task 전에
UPGRADE_REQUIRED로 거부된다
보안은 기본(outbound) 설정에서 다음을 보장한다. 모든 트래픽 TLS(끌 수 없음), control plane의 자체 인증서 fingerprint를 enrollment token에 실어 worker가 pin, worker identity는 절대 보내지 않는 키(worker ID는 표시 이름일 뿐), 제거 시 키 폐기(재시작 후에도 유지), task는 파일 경로가 아니라 고정 registry의 엔진 이름만 지정(경로는 모든 worker에서 원격 코드 실행이 된다). 상태는 데이터 디렉토리의 workers/에 있다.
inbound node mode(ADR 2026-08-11 accepted)는 outbound의 구조적 1:1 한계를 푼다. worker 프로세스는 endpoint 하나, pinned 인증서 하나, worker id 하나를 갖기 때문에 두 번째 사람이 같은 GPU를 쓰려면 그 머신의 shell 접근으로 시작 스크립트를 고치고 재시작해 기존 사용자를 끊어야 했다. 가정이나 4090 한 장을 둔 작은 팀에는 이것이 기능과 무용지물의 차이라고 ADR은 적는다.
inbound 모드에서는 GPU 머신이 127.0.0.1:7444에서 listen하고 API key를 가진 panel이 연결한다. 결정의 세부는 다음과 같다.
- node가 host하는 새 gRPC 서비스
NodeService(Attach,FetchResult,PushInput)가WorkerService를 mirror한다. 전송 역할은 뒤집히지만 메시지 역할은 그대로라 node는 여전히WorkerMessage, panel은ServerMessage를 보내고 양쪽 상태 기계가 바뀌지 않는다 - panel마다 별도 API key. SHA-256 해시로 저장하고 constant-time 비교하며 평문은 발급 응답에 한 번만 존재한다
- 출발 주소별 실패 인증 throttle. stale bookmark 하나가 다른 panel을 잠그지 못한다
- 동시 panel 허용. 둘이 같은 free slot을 잡으면 worker의
WORKER_AT_CAPACITY거부가 권위이고 진 쪽이 재시도한다. 경합은 queue로 degrade하지 손상으로 가지 않는다 - 연결 로그와 kick 버튼이 job별 승인을 대체한다
- 기본 bind loopback, 기본 off. 켜는 것이 consent 표면이다
연결 문자열 ovnode://ovnode_xxx@192.168.0.110:7444?fingerprint=<64-hex>는 self-signed 인증서의 SHA-256 fingerprint를 싣는다. panel은 discovery handshake로 leaf 인증서만 받아 fingerprint를 검증한 뒤에야 자격과 reference audio와 job을 보내고, 그 인증서를 유일한 trust root로 gRPC를 연다. 평문 fallback은 없다. 사람을 제거하면 그 사람의 연결 문자열만 폐기되고, Disconnect는 세션을 끊고 1분간 막되 문자열이 유효해 자동 재연결된다. 거부된 대안은 multi-endpoint dial-out(여전히 SSH 필요), 공유 node key(폐기하면 전원이 끊겨 아무도 폐기하지 않고 누가 썼는지 기록도 없음), job별 승인 prompt(사람이 yes만 누르게 훈련됨), WorkerService 재사용(gRPC 클라이언트가 request-stream 타입을 보내 panel이 WorkerMessage를 보내게 됨)이다. 이 모드는 로컬 소유 하드웨어용이며 hosted fleet은 여전히 inbound 포트 없이 outbound로 dial해야 한다.
worker node에는 idle timer가 두 개다. 엔진 registry의 OMNIVOICE_ENGINE_IDLE_UNLOAD_SECONDS(600초, 최소 5)가 캐시된 엔진 인스턴스를 내리고, in-process 모델 reaper OMNIVOICE_IDLE_TIMEOUT(900초)이 받아쓰기 ASR과 watermark 모델까지 내리는 backstop이다. 보통 앞의 것이 먼저 도달하고 뒤의 것은 할 일이 없다.
사설 production 배포
docs/production-private-api.md는 InterviewAce라는 호출 backend를 예로 든 Compose baseline을 제시한다. 사설 애플리케이션 backend가 VoiceStudio를 내부 서비스로 부르는 형태이며 포트 3900을 공개 인터넷에 직접 노출하지 않는다.
- 이미지는
ghcr.io/debpalash/omnivoice-studio:0.5.2처럼 정확한 태그를 고정한다.:latest와:main은 rolling preview,:stable은 안정 릴리스마다 이동한다. AMD는:0.5.2-rocm OMNIVOICE_API_KEY는 secret store에 두고 Compose 파일이나 소스에 넣지 않는다. 호출 앱은Authorization: Bearer로 보낸다OMNIVOICE_BIND_HOST=0.0.0.0은 컨테이너 안에서 필요하고, 호스트 바인딩127.0.0.1:3900:3900이 LAN과 공개 접근을 막는다/app/omnivoice_data와 HuggingFace 캐시를 named volume에 영속화한다. healthcheck는/health,start_period120초- 호출 backend가 같은 Compose나 Kubernetes에 있으면 포트를 publish하지 않는 사설 컨테이너 네트워크를 우선한다. 브라우저는 InterviewAce backend를 부르고 그 backend가 VoiceStudio를 불러 자격이 고객 브라우저에 나가지 않게 한다
reverse proxy를 두면 Authorization 전달, 스트리밍 생성을 위한 응답 buffering 해제, 생성 timeout보다 긴 read timeout, 클라이언트가 보낸 Forwarded와 X-Forwarded-* 폐기 후 재설정, FORWARDED_ALLOW_IPS를 proxy의 정확한 컨테이너 주소(예: 172.30.0.2, ipam으로 고정)로만 신뢰가 필요하다. *나 subnet이나 서비스명 lookup은 동등하지 않으며, 양쪽이 갖춰지지 않으면 proxy header 신뢰를 꺼야 한다. spoof된 forwarded loopback 주소가 loopback 권한을 받을 수 있기 때문이다.
운영 절차는 트래픽 admit 전에 GET /models로 checkpoint를 확인하고 POST /models/install로 미리 받아 /setup/download-stream 완료를 기다린 뒤 대표 요청으로 warm하는 것이다. lazy 첫 요청 다운로드는 정상 timeout을 넘긴다. 용량 응답은 backpressure 신호이므로 병렬 재시도 대신 Retry-After를 존중한다. 갱신은 drain, 새 태그로 재생성, 엔진 점검, 복구 순서이고 실행 중 컨테이너 안에서 의존성을 바꾸지 않는다. 키 회전은 drain, secret 갱신, VoiceStudio 재생성, 호출자 갱신, 검증, 복구 순서이며 한쪽만 바꾸면 401이 난다. API key는 서버 모드 관리 권한도 주는 root 자격이므로 호출 앱에 소비 권한만 주려면 별도 인스턴스나 route-aware proxy의 default-deny allowlist가 필요하다. L3/L4 네트워크 정책만으로는 생성과 관리를 구분할 수 없다.
성능 튜닝
성능 문서는 knob을 만지기 전에 확인할 고전적 원인 다섯 가지를 먼저 든다. 대부분의 느림 보고가 여기서 설명된다.
| 원인 | 내용 |
|---|---|
| transcript가 빈 voice profile | cloning은 reference clip의 transcript가 필요하다. v0.3.15 전에는 매 생성마다 Whisper 전사를 실행했고(#1032), 이후에는 한 번 실행해 profile에 저장하지만 import나 수동 편집으로 빈 profile은 여전히 생성마다 ASR을 낸다 |
| 재시작 후 첫 생성 | 가중치 lazy load 약 8초, CUDA torch.compile kernel 빌드, Metal warm-up. 두 번째 생성부터 속도를 판단한다 |
| 메모리 압박 | 16GB 통합 메모리에서 탭 40개짜리 브라우저 옆의 dub는 OS가 모델을 page in/out하거나 backend를 죽인다 |
| 모르는 사이 CPU 생성 | 드라이버 갱신, CUDA/torch 불일치가 조용히 CPU로 내린다. Settings의 Device & compute, self-check(/system/diagnose), Model Catalogue의 routing badge 세 곳이 사실을 알려준다. Windows GPU 가속은 NVIDIA/CUDA 전용 |
| 중단된 dub (v0.3.23에서 수정) | dubbing은 VRAM을 비우려 TTS 모델을 CPU로 옮기고 전사 후 되돌리는데, 이전에는 성공 경로에서만 되돌려 취소나 오류 뒤 모든 생성이 10~50배 느렸다(#1191). 이제 모든 exit path에서 복귀하고 생성마다 device를 검증한다 |
cloned voice의 한 생성은 reference 인코딩(약 0.4초, 재사용 voice는 캐시), 합성(출력 길이에 비례), 후처리(mastering, watermark, 1초 미만)다. 긴 텍스트는 chunk로 나눠 순차 합성하므로 시간이 길이에 거의 선형이다. dub의 per-line clip은 각각 한 번만 쓰이므로 캐시가 절약할 것이 없다.
| 변수 | 기본 | 역할 |
|---|---|---|
OMNIVOICE_DEVICE |
auto |
cuda/rocm/xpu/mps/cpu 고정. 호스트에 없는 family는 무시 |
OMNIVOICE_FLASHINFER |
0 |
CUDA 전용 FlashInfer 가속. 1 또는 graph |
OMNIVOICE_PROMPT_DISK_CACHE |
1 |
인코딩된 reference를 디스크에 영속화 |
OMNIVOICE_IDLE_TIMEOUT_S |
900 | TTS 모델 unload까지 idle 초. burst 생성이면 올리고 좁은 메모리면 내린다 |
OMNIVOICE_SIDECAR_IDLE_TIMEOUT_S |
300 | sidecar 엔진 동일 |
OMNIVOICE_LLM_CONCURRENCY |
6 | dub 번역 병렬 LLM 호출 |
OMNIVOICE_GPU_WORKERS |
auto | 동시 GPU 생성 수. free VRAM 5GB당 1, 최대 4. MPS와 CPU는 항상 1. 10GB 이하 카드와 Apple Silicon에서 올리면 crash class(#567) |
OMNIVOICE_CPU_POOL |
min(8, cores) |
CPU 측 thread pool (번역 dispatch, 오디오 I/O) |
OMNIVOICE_SINGLE_ENGINE_RESIDENT |
1 | TTS 엔진 하나만 상주. 32GB+ 머신은 0 |
OMNIVOICE_UNIFIED_OFFLOAD_HEADROOM_GB |
6 | Apple Silicon에서 dub가 전사 모델을 필요로 할 때 free RAM이 이 값 미만이면 TTS 모델을 완전히 해제 |
OMNIVOICE_ASR_VRAM_PREFLIGHT |
1 | VRAM 부족 시 crash 대신 전사 정밀도 강등 |
OMNIVOICE_GENERATE_TIMEOUT_S |
300 | 가속 호스트의 실제 compute 시간 budget. queue 대기는 세지 않는다. 1,200자 초과분 40자당 1초 증가 |
OMNIVOICE_CPU_GENERATE_TIMEOUT_S |
600 | CPU 호스트 budget. floor 아래 CUDA/ROCm도 이 budget |
OMNIVOICE_GPU_QUEUE_TIMEOUT_S |
1800 | GPU queue 대기 한도. 초과는 "pool 포화" retryable 조건 |
OMNIVOICE_ENGINE_IMPORT_PROBE_TIMEOUT_S |
60 | sidecar venv import 검사 대기. 시간 초과는 "미증명"으로 보고 venv를 그대로 쓴다 |
OMNIVOICE_DUB_BATCH_WIDTH |
호스트 유도 | batch dubbing의 segment 폭. 1이면 비활성, 최대 16 |
torch.compile은 플랫폼이 아니라 probe 기반이다. Triton을 import할 수 있는 지원 아키텍처의 CUDA에서만 시도하고 MPS, CPU, 일반 Windows(Triton에 Windows wheel이 없음)에서는 건너뛴다. 유일한 사용자 제어는 Windows에 표시되는 "Disable torch.compile"이며 부분 Triton 설치가 probe는 통과하고 compile은 crash하는 드문 경우를 위한 것이다.
느린 생성 전에 두 가지 advisory 경고가 요청이 앱을 떠나기 전에 뜬다. 예전에는 300초 budget을 Generate를 누르고 다 기다린 뒤에야 알았기 때문이다. 하나는 엔진의 VRAM floor가 GPU를 넘거나 CPU로 fallback한 경우이고, 다른 하나는 CPU나 MPS 호스트에서 텍스트가 1,200자를 넘는 경우다. 1,200자는 budget이 flat base에서 증가로 바뀌는 지점이다. 경고는 엔진과 이유당 세션에 한 번만 나오고 엔진을 바꾸면 다시 켜지며, 이미 CPU 튜닝 엔진(GGUF, Supertonic-3)이면 "CPU 튜닝 엔진을 써 보라"는 제안을 뺀다.
Flush caches와 Unload는 재시작 없이 RAM/VRAM을 비운다. Flush caches는 다중 pass GC와 accelerator empty_cache로 모델은 유지하고 조각 메모리만 회수하며, Unload all + flush는 TTS 모델까지 내려 다음 생성이 약 8초 reload를 낸다. 상단 툴바의 Flush 드롭다운은 메모리에 있는 모든 모델(TTS, co-loaded ASR, diarization, 상주 엔진과 sidecar)을 device와 VRAM과 함께 나열하고 모델별 Unload 버튼을 준다. 스크립트는 POST /system/flush-memory[?unload_model=true], GET /model/loaded, POST /model/unload/{tts|diarization|sidecar:<id>|sidecars}를 쓴다. 방금 timeout된 job은 Python에서 kill할 수 없어 thread가 끝날 때까지 VRAM을 쥐므로 Flush가 도움이 안 되는 경우이며, 많은 생성 오류는 메모리 문제가 아니라고 메시지가 직접 말한다.
플랫폼별 특성은 다음과 같다. Apple Silicon은 MPS/MLX로 GPU에서 실행하되 통합 메모리라 TTS와 ASR이 같은 RAM을 두고 경쟁하므로 한 번에 한 생성이고, RAM이 많을수록 unload/reload 주기가 줄어 dub 처리량이 직접 는다. NVIDIA는 fp16과 torch.compile이 기본이고 16GB 이상에서 3~4개 동시 생성을 병렬화하며 10GB 이하는 직렬화한다. CPU 전용은 MPS보다 약 2배 느리고 CUDA 대비는 더 느리다.
batch dubbing은 엔진이 지원하면 여러 segment를 한 번의 native forward pass로 렌더한다. 폭은 headroom에서 유도되며 CPU와 단일 job 요구량 위 약 2GB 미만 headroom은 1, 여유에 따라 2, 4, 8로 올라간다. /ws/tts의 종료 done 프레임은 ttfa_ms(요청에서 첫 오디오까지), gen_time_s(전달 포함 wall clock), rtf(합성 시간을 생성 오디오 길이로 나눈 값, 렌더 호출 주변만 측정해 느린 클라이언트가 부풀리지 못함)를 싣는다.
CI는 wall-clock 대신 operation-count budget(tests/test_perf_operation_budgets.py)으로 hot path의 회귀를 막는다. CI 하드웨어가 너무 달라 "5% 느림" 같은 threshold가 안정적이지 않기 때문이다.
| 경로 | budget |
|---|---|
스트리밍 TTS (/ws/tts) |
문장 chunk당 정확히 1회 generate, 요청당 1회 정규화 |
dub re-mix (regen_only=[]) |
캐시된 segment의 fit-only re-mix는 TTS 호출 0회 |
| native batch dubbing | segment N개와 폭 W에서 정확히 ⌈N/W⌉회 generate_batch, 0회 segment별 generate |
budget 갱신은 같은 PR에서 새 floor를 정당화하는 주석과 함께 해야 하며 CI를 통과시키려고 느슨하게 하지 않는다. knob처럼 보이지만 아닌 것도 적었다. voice를 지우고 다시 추가해도 빨라지지 않고, 생성 사이에 backend를 죽이면 모델 로드를 매번 내서 느려지며, OMNIVOICE_PRELOAD_TTS_ASR은 legacy in-process Whisper fallback용이라 기본 설치에서 아무것도 빠르게 하지 않는다.
이식 가능한 persona
.ovsvoice는 voice profile의 identity, 옵션 reference clip, consent 증명, SPDX 라이선스 태그, watermark된 preview를 하나의 ZIP에 담는 persona 포맷이다. 옛 .omnivoice share bundle을 대체하되 import는 계속 지원한다(consent, 라이선스, preview는 없음). export와 import는 네트워크 호출이 없고 오프라인에서 완전히 동작한다.
| 멤버 | 목적 | 존재 |
|---|---|---|
manifest.json |
포맷과 스키마 버전, persona identity, 엔진과 design 파라미터, 라이선스, 태그, preview 메타데이터 | 필수 |
metadata.json |
옛 VoiceStudio가 reference audio를 읽을 수 있는 legacy 형태 사본 | 항상 |
preview.wav |
watermark된 preview (24kHz mono) | 필수 |
consent.json |
증명: 방법, 문장, verified flag, timestamp | 옵션 |
ref_audio.* / locked_audio.* |
reference 또는 locked clip | "Include voice clip"이 꺼지면 생략 |
consent_audio.* |
녹음된 consent 문장 | 옵션 |
"Include voice clip"은 프라이버시 제어다. 켜면 raw reference 녹음이 bundle에 실려 import된 persona가 완전한 fidelity로 clone하고, 끄면 watermark된 preview만 travel해 사용자 voice의 raw 녹음이 기기를 떠나지 않으며 import된 persona는 preview를 reference clip으로 쓴다. AudioSeal이 설치되어 있으면 preview에 watermark를 심어 VoiceStudio로 귀속시킬 수 있고, 없으면 un-watermarked로 표시해 쓴다.
verified-own-voice 상태는 bundle을 손으로 편집해 위조할 수 없다. import 시 최소 길이 이상의 consent 녹음, 비어 있지 않은 consent 문장, consent.json 증명 세 조건이 모두 있을 때만 verified로 표시하고, 아니면 unverified로 들어온다. unverified persona도 로컬 합성에는 쓸 수 있고 verification은 agentic 기능과 커뮤니티 공유에만 필요하다. manifest.json의 license.spdx는 allowlist(+LicenseRef-)로 검증되고 미인식 값은 LicenseRef-VoiceStudio-Personal로 정규화되며, 라이선스는 메타데이터일 뿐 VoiceStudio가 강제하지 않는다.
학습 데이터와 평가
omnivoice/ 패키지는 학습 경로도 제공한다. 데이터는 WebDataset tar shard와 짝 JSONL 메타데이터로 준비하며, shard 하나에 수백에서 수천 샘플이 들어가 학습 중 디스크 I/O를 크게 줄인다. 분리된 JSONL은 tar를 풀지 않고 메타데이터를 수정하게 한다.
입력은 id, audio_path(24kHz로 resample), text, 옵션 language_id를 가진 JSONL이다. extract_audio_tokens.py가 eustlb/higgs-audio-v2-tokenizer로 8-layer 이산 토큰(.npy, shape [8, T], int16)을 뽑아 shard당 기본 1,000개 샘플로 묶고 data.lst manifest(<tar> <jsonl> <num_samples> <duration>)와 errors.jsonl을 쓴다. 옵션에는 GPU당 worker 수(--nj_per_gpu 3), 최소 shard 수(--min_num_shards 32), 길이 필터, 분산 전처리용 --num_machines와 --machine_index가 있다. 학습 data config는 train과 dev마다 manifest_path 목록과 언어 균형용 repeat을 갖는다.
| 학습 config 필드 | 기본 |
|---|---|
llm_name_or_path |
Qwen/Qwen3-0.6B |
steps |
30만 |
learning_rate |
1e-4 |
batch_tokens (GPU당) |
8,192 |
실행은 accelerate launch -m omnivoice.cli.train이며 Emilia 데이터셋용 config 예시가 8 GPU를 쓴다. resume_from_checkpoint는 중단 재개, init_from_checkpoint는 pre-training된 checkpoint에서 fine-tuning을 시작하는 용도다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계다. 로그는 TensorBoard로 본다.
| 평가 세트 | 언어 | WER 모듈 | 지표 |
|---|---|---|---|
| LibriSpeech-PC | 영어 | HuBERT WER | WER + Speaker Sim + MOS |
| Seed-TTS (en) | 영어 | Whisper WER | WER + MOS |
| Seed-TTS (zh) | 중국어 | Paraformer WER | WER + MOS |
| FLEURS | 102개 언어 | Omnilingual-ASR WER | WER (언어별 + macro 평균) |
| MiniMax Multilingual | 24개 언어 | Whisper + Paraformer | WER + MOS |
지표는 세 가지다. WER은 생성 음성을 ASR로 전사해 참조와 비교하는 명료도 지표이고 낮을수록 좋으며 일부 언어는 CER을 쓴다. 화자 유사도(SIM-o)는 reference와 생성 오디오의 화자 임베딩(ECAPA-TDNN + WavLM)의 cosine similarity로 높을수록 좋다. UTMOS는 MOS를 예측하는 신경망으로 자연스러움을 재며 높을수록 좋다. uv sync --extra eval 후 examples/run_eval.sh가 테스트 세트와 모델을 받아 추론과 평가를 한다.
개발 계약
AGENTS.md는 CLAUDE.md를 헌법으로, 자신을 운영 계약으로 두고 충돌 시 CLAUDE.md가 이긴다고 적는다. Claude, Codex, Cursor, 리뷰 봇 모두에 구속력이 있다.
| 영역 | 규칙 |
|---|---|
| 토큰 경제 | 완전히 답하는 가장 짧은 응답. 산문보다 개요와 표. CI, linter, 리뷰 봇이 계산한 것을 다시 유도하지 않는다 |
| 결정론적 테스트 | changelog 형식(tests/test_changelog_style.py), locale parity(tests/test_locale_parity.py), 버전 lockstep(tests/test_app_version.py), CJK 하드코딩 금지(tests/test_no_hardcoded_cjk.py) |
| cross-platform parity | 동작 기준. 하드웨어 가속의 유무는 위반이 아니고, 한 OS에서만 보이는 기능은 위반이며, 최적화를 모든 곳에서 끄는 식의 "수정"은 금지. 기본 동작이 OS마다 다르면 P0 |
| merge 규칙 | 리뷰 없이 merge 금지. CodeRabbit과 Greptile 코멘트를 수확하고 Critical/P1을 읽지 않은 채 merge 금지. PR을 as-is로 받지 않고 branch에서 고쳐 merge. stale branch는 main을 먼저 merge. "Tests (backend + frontend)" green + MERGEABLE이 gate. merge 후 main의 post-merge run을 green까지 지켜본다 |
| local-first | 새 필수 네트워크 호출 금지. HF 다운로드는 설치 여부나 명시적 사용자 동작으로 gate. 모든 합성 오디오는 mark_synthetic chokepoint를 지난다 |
| i18n | 사용자 문자열은 i18n을 거쳐 21개 locale 전부에 실제 번역으로 존재 |
| 버전 | frontend/package.json이 단일 진실. 소유자 요청 없이 올리지 않는다. 의존성 변경은 루트 bun.lock 재생성 필요 |
| issue | 흡수하거나 거절하고 미래 버전으로 미루지 않는다. 커뮤니티 수정을 구현하기 전에 open PR queue를 확인 |
| UI | 새 select box는 SearchableSelect.jsx, voice 선택은 VoiceSelector. native <select> 도입 금지 |
docs/features.yaml이 canonical 기능 목록이고 scripts/check-docs-drift.py가 docs-drift CI에서 문서와의 어긋남을 검사한다. 프로젝트 개발 스킬(Vite, FastAPI)은 skills-lock.json으로 고정되어 .agents/skills/에 설치된다.
설치와 요구 사양
| 플랫폼 | 패키지 |
|---|---|
| macOS 13.3+ | Apple Silicon DMG. 첫 실행에 우클릭 후 Open 승인 |
| Windows 10/11 | x64 MSI. current-user build는 관리자 권한 없이 설치 |
| Linux | AppImage, x86_64, glibc 2.39+ |
| Docker | Linux/AMD64. CUDA, ROCm, CPU, worker-only GPU profile |
| 항목 | 최소 | 권장 |
|---|---|---|
| OS | Windows 10 x64, macOS 13.3 Apple Silicon, Linux x86_64 glibc 2.39+ | 현재 지원 OS 릴리스 |
| RAM | 8GB | 16GB+ |
| 디스크 | 여유 10GB | SSD 20GB+ |
| GPU | 옵션, CPU 모드 지원 | NVIDIA CUDA 또는 Apple Silicon |
| VRAM | GPU 사용 시 4GB | 8GB+, 큰 옵션 엔진은 더 필요 (12~16GB 이상) |
| 소스 실행 Python | 3.11+ | 3.11 또는 3.12 |
첫 실행은 관리형 Python 환경을 만들고 기본 모델을 받으며 이후 실행은 둘 다 재사용한다. Docker는 docker run -d -p 127.0.0.1:3900:3900 -v omnivoice-data:/app/omnivoice_data --name voicestudio palashdeb/omnivoice-studio:stable 한 줄이다. 소스 실행은 Node 20+/Bun과 Python 3.11+에서 bun install과 bun run desktop이며 launcher가 uv로 Python 의존성을 자동 구성하고 bun run dev는 브라우저 UI다. 설치 실패 시 Settings의 self-check나 uv run python backend/main.py --diagnose --deep을 쓰고 issue에는 개인정보를 지운 진단 bundle을 첨부한다.
첫 voice는 Voice Cloning에서 3초(권장 5~15초)의 깨끗한 샘플과 텍스트와 언어를 주고 Generate를 누르면 된다. Google Colab notebook으로 설치 없이 시도할 수 있으나 Colab은 원격 컴퓨트라 업로드한 오디오와 프로젝트가 로컬에 남지 않는다. 제거는 scripts/uninstall.sh(macOS/Linux)나 scripts\uninstall.ps1(Windows)이 dry run을 먼저 보여준다.
결과
공식 벤치마크 표는 비어 있다. docs/benchmarks.md는 in-repo harness scripts/bench_pipeline.py가 named 하드웨어와 named 버전에서 측정한 수치만 싣고 추정치는 넣지 않는다고 규정한다. 수집하는 값은 RTF(warm short line 기준)와 CUDA peak VRAM이며 MPS는 통합 메모리, CPU는 VRAM이 없고, subprocess 격리 엔진은 harness 밖에서 할당해 빈칸으로 둔다. 수집 시점의 표는 "No verified rows yet"이며 maintainer와 커뮤니티 PR로 채운다. 다른 머신의 수치는 직접 비교할 수 없고 leaderboard가 아니라 "이 엔진이 이 급의 GPU에서 대략 이만큼"의 정직한 기대치가 목적이라고 적었다. harness는 stage마다 free RAM을 확인하고 stage 사이에 모델을 내리는 메모리 안전 설계이며 앱을 멈추고 실행해야 한다.
문서에 흩어진 측정치를 모으면 다음과 같다.
| 항목 | 값 | 출처 |
|---|---|---|
| reference 인코딩 | 약 0.4초 | performance (16GB M2) |
| 모델 lazy load | 약 8초 | performance |
| CPU 전용 대 MPS | 약 2배 느림 | performance |
| NVIDIA 동시 생성 | VRAM 16GB 이상 3~4개, 10GB 이하 1개 | performance |
| OmniVoice VRAM floor | 6GB | engines/omnivoice |
| GGUF quant 크기 | BF16 약 1.6GB, Q8_0 약 945MB, Q4_K_M 약 659MB, F32 약 3.2GB | engines/omnivoice-gguf |
| WhisperX 단어 timing | ±10 |
engines/whisperx |
| WhisperX VRAM budget | float16 5.0GB, int8_float16 3.5GB, int8 3.0GB | engines/whisperx |
| 기본 모델 첫 다운로드 | 약 2.3GB | mcp |
| diarization 가중치 | 약 600MB | features/diarization |
| torch cu128 wheel | Linux 약 0.83GiB, Windows 약 3.2GiB | engines/disk-usage |
| prompt cache | voice당 약 10KB, 32개 유지 | performance |
| 언어 카탈로그 | 646개 언어, 학습 데이터 58만 1천 시간 | languages |
| 채택 | 생성 5개월 후 star 26,641, fork 3,286 | GitHub API |
정성 비교는 README의 표가 담당한다.
| 항목 | VoiceStudio | 일반 hosted voice 서비스 |
|---|---|---|
| 적합 | 사설, 오프라인, self-host, 대량 작업 | 로컬 모델 관리 없는 빠른 시작 |
| 데이터 경로 | 기본 로컬, 원격은 opt-in | 오디오와 텍스트를 provider가 처리 |
| 비용 | 무료 소프트웨어, 하드웨어는 사용자 부담 | 구독, credit, 계량 API |
| 설정 | 앱과 모델 가중치 설치 | 계정 생성 후 웹 앱이나 API |
| 성능 | 엔진과 하드웨어에 의존 | provider가 컴퓨트와 scaling 관리 |
| 오프라인 | 필요한 모델 설치 후 가능 | 대개 네트워크 필요 |
| 커스터마이즈 | 소스, 엔진, 모델, API, routing 개방 | provider 옵션으로 제한 |
| 유지 관리 | 사용자가 갱신, 디스크, 컴퓨트 관리 | provider가 인프라 관리 |
README는 voice cloning(demo_voice.wav와 demo_clone_output.wav), voice design(US 뉴스 앵커, UK 오디오북 내레이터), 4개 언어 dubbing(스페인어, 프랑스어, 일본어, 중국어) 샘플을 backend/assets/samples/에 둔다. 수치 평가는 없다.
한계
- 베타와 재작성 중. README가 active beta를 경고하고 Electron 재작성이 진행 중이라 데스크톱 앱 issue와 PR을 받지 않는다. Tauri 기반 아키텍처 설명과 Rust control sidecar는 재작성 후 바뀔 수 있다.
- 플랫폼 공백. Intel Mac은 로컬 backend 불가(remote backend만), Windows AMD와 Intel GPU는 CPU, ROCm은 Linux 전용, Docker는
linux/amd64만, Wayland 받아쓰기는 기본 복사 전용이다.torch.compile은 일반 Windows에서 건너뛴다. - 라이선스 층위. 앱은 AGPL-3.0이지만 기본 가중치가 CC-BY-NC라 상업 사용은 선택한 모델 조건을 따로 검토해야 한다. IndexTTS의 Bilibili 조건, PocketTTS의 gated 접근,
audiocpp의 research 전용 가중치가 개별 예외다. AGPL은 수정본을 네트워크 서비스로 제공할 때 소스 공개를 요구한다. - 검증된 벤치마크 없음. RTF와 VRAM 표는 비어 있고 TTS 품질 평가(WER, SIM-o, UTMOS) 결과도 문서에 없다. 엔진 비교표의 "품질"은 job map의 정성 배정이다.
- 표현 제어의 미완. 기본 엔진에
[breath]와 강도 제어가 없고[happy]같은 감정 태그를 받지 않으며 ElevenLabs 태그를 붙이면 출력이 나빠진다. 자유 텍스트 instruct는 UI가 아니라 API로만 가능하다. - voice design의 고정 어휘. 어휘 밖 서술은 무시되고 영어와 중국어로 학습되어 저자원 언어에서 불안정하다. 문서는 서술 기반 design이 필요하면 VoxCPM2를 권한다.
- 메모리 제약. 6GB VRAM floor 아래 카드는 paging으로 매우 느리고, timeout된 생성은 Python에서 kill할 수 없어 끝날 때까지 VRAM을 쥔다. Apple Silicon은 한 번에 한 생성이다.
- 원격 worker의 부분 이식. TTS, 오디오북 챕터, dub segment만 원격이고 ASR, diarization, 번역은 로컬이며 나머지는 하나씩 이식 중이다.
POST /workers/tasks는 개발 전용이고 사라질 API다. inbound 모드는 연결 문자열이 admission 전체이고 그 비밀성은 네트워크에 달려 있다. - 인증 모델의 거칠기. API key는 route별 서비스 토큰이 아니라 root 자격이라 소비 전용 접근을 주려면 별도 인스턴스나 proxy allowlist가 필요하다. MCP 전송은 인증되지 않는다. share PIN은 brute-force 가능해 소비 자격에 그친다.
- dubbing 비용. Cinematic과 Autofit은 LLM이 필요하고 reflect pass는 segment당 3회 호출이라 긴 영상에서 느린 provider에는 끄라고 권한다. diarization은 HF gated 라이선스가 필요하고 fallback heuristic은 비슷한 화자를 합친다.
- 공석 직무. "가장 빠른 CPU 렌더와 최저 지연"은 job map에서 공석(#1306)이다.
- 자료의 한계. README와 docs 원문뿐이라 router와 service 구현, adapter 인터페이스의 정확한 시그니처, 테스트 통과율은 확인할 수 없다. Figure 3은 OmniVoice-Studio v0.3.9 시절 화면이라 현재 UI와 다를 수 있다.
후속 방향
문서가 spec은 있으나 출시 전이라고 밝힌 항목은 다음과 같다. 날짜 약속은 없고 각 항목이 출시되면 같은 PR에서 문서를 갱신한다고 적었다.
- Spec 01 Expressive TTS: 엔진 중립 태그 표면(
[excited],[whispers],[breath]같은 reaction 태그)이 활성 엔진이 실제로 할 수 있는 것으로 lower되고 못 하는 곳에서는 눈에 보이게 degrade한다. Expression panel(emotion 드롭다운, 강도, emotion reference clip)을 UI 전체에 둔다. 발음 단계(사전,[[…]]override)와 Audiobook 탭의 IndexTTS2 emotion 표면은 출시됐고, 엔진 중립 inline 태그 문법, emotion reference clip picker, Voice 페이지의 Expression panel이 남았다 - 원격 worker의 나머지 작업 이식
- 발신 전화(PSTN). 유료 carrier가 필요해 완전 로컬 경로가 없고 명시적 consent guardrail 뒤에서만 나온다
- Electron 재작성
- monorepo 이전은 두 번째
apps/*나packages/*가 생길 때만
핵심 용어
| 용어 | 뜻 |
|---|---|
| zero-shot voice cloning | reference clip을 학습 데이터가 아니라 프롬프트로 써서 추가 학습 없이 그 목소리로 합성하는 방식. clip은 timbre뿐 아니라 전달 방식도 옮긴다 |
| RTF (real-time factor) | 생성 오디오 1초당 소요된 compute 초. 1 미만이면 실시간보다 빠르다 |
| forced alignment | ASR 전사 뒤 wav2vec2로 단어 경계를 오디오에 다시 맞춰 timestamp 정밀도를 ±10~30ms로 올리는 pass. WhisperX가 dubbing lip-sync에 쓴다 |
| sidecar venv | 부모 앱의 torch/transformers 고정과 충돌하는 엔진을 위해 첫 사용 시 만드는 전용 가상환경. SubprocessBackend adapter로 격리 실행 |
| job map | 엔진 채택 기준. 각 직무의 보유 엔진을 하나로 두고, 새 엔진은 직무를 빼앗거나 공석을 채워야 한다 |
| inbound node mode | GPU 머신이 listen하고 API key를 가진 panel이 연결하는 remote worker 변형. 한 GPU를 여러 사람이 shell 접근 없이 나눠 쓰기 위한 것 |
| mark_synthetic | 모든 합성 오디오가 지나야 하는 단일 chokepoint. AudioSeal watermark를 여기서 심는다 |
| Autofit | dubbing 번역 quality의 하나. LLM이 각 줄을 segment slot의 낭독 시간 안에 들어가도록 재작성한다 |
관련 페이지
- colbymchenry/codegraph: 같은 local-first + MCP 서버 패턴으로 코딩 에이전트에 로컬 자원(코드 그래프)을 노출하는 도구. VoiceStudio는 같은 패턴으로 speech를 노출한다
- MCP Server Architecture Patterns for LLM-Integrated Applications: MCP 서버 설계 패턴. VoiceStudio의 output mode(base64 대 파일 경로)와 base path 보안 경계, 에이전트별 voice binding이 그 사례다
- Skills For Real Engineers (mattpocock/skills): VoiceStudio가 스킬 배포에 쓰는 skills.sh 생태계(
npx skills add) - Free LLM API resources: hosted TTS와 Whisper API의 무료 quota 정리. 로컬 실행이 대체하는 비용 구조를 보여준다
- ArtCraft와 Crafting Apps: 아티스트용 AI 생성 IDE와 오픈소스 Rust 창작 앱 13종: 같은 local-first + MCP 서버 패턴을 이미지 편집, 영상, CAD 등 창작 앱 13종(Crafting Apps)에 적용한 사례