Applications · REPORT · 2026
AKB 제품 소개: 에이전트를 위한 올인원 지식베이스 (v4)
AKB 제품 소개, 에이전트를 위한 올인원 지식베이스
요약
Dnotitia가 자사 지식베이스 제품군을 23장 슬라이드로 소개한 한국어 자료다. 제품은 세 개다. 지식을 담고 찾는 본체인 AKB(Agent Knowledge Base), 외부 시스템에서 정보를 끌어오는 AKB Collector, 그렇게 모인 정보를 다듬는 AKB Gardener다. 부제가 제품 구성을 그대로 요약한다. "검색을 넘어 에이전트가 스스로 찾고 쌓고 가꾸는 조직의 기억"이다.
이 자료의 값어치는 같은 제품의 GitHub 저장소 페이지(AKB: Agent Knowledge Base)와 겹치지 않는 부분에 있다. 저장소 페이지가 검색 성능과 MCP tool 목록, 권한 구현을 다룬다면 이 자료는 수집과 정제, 운영과 실증을 다룬다. Collector와 Gardener 두 컴포넌트, 21일 동안 사람 손 없이 돌린 운영 실측, 9개 도메인으로 나눈 vault 운영 패턴, 보안 로그를 대상으로 한 XDR 적용 구상이 여기서 처음 한 문서에 모인다.
자료 전체를 관통하는 주장은 하나다. 조직의 지식을 하나의 검색 방식에 맡기지 말라는 것이다. 그 근거로 벡터 검색이 문맥을 자르고 임베딩에 의존한다는 두 약점을 먼저 짚고, 대안으로 트리 탐색과 hybrid search, grep, 그래프 탐색 네 경로를 하나의 주소 체계 아래 묶어 에이전트가 상황에 맞게 고르게 한다.
배경
지식을 쓰는 주체가 바뀌었다
자료의 출발점은 조직 지식의 독자가 사람에서 에이전트로 옮겨 갔다는 관찰이다. 1장 표제가 이를 한 문장으로 세운다. "이제 회사 지식을 가장 많이 쓰는 건 사람이 아니라 에이전트입니다."
여기서 세 가지 명제가 이어진다.
| 명제 | 자료의 설명 |
|---|---|
| 읽고 쓰는 주체가 바뀌었다 | 위키는 사람이 읽으라고 만든 것이다. 이제는 AI 에이전트가 직접 찾아 읽고, 결과를 다시 쌓는다 |
| 에이전트는 기억이 짧다 | 한 번에 볼 수 있는 양이 정해져 있어, 매번 필요한 것만 정확히 꺼내 와야 한다 |
| 환각의 진짜 원인은 모델이 아니라 지식이다 | 낡고 흩어진 자료를 주면, 아무리 좋은 모델도 틀린 답을 만든다 |
두 번째 명제는 컨텍스트 한도를 가리킨다. 컨텍스트는 모델이 한 번의 호출에서 볼 수 있는 토큰의 총량이고, 이 한도가 정해져 있으므로 지식베이스는 "전부 보내기"가 아니라 "필요한 만큼만 골라 보내기"를 설계 목표로 삼아야 한다. 세 번째 명제는 환각의 책임 소재를 모델에서 지식 품질로 옮긴다.
시장 근거로는 Gartner 전망을 인용한다. "AI에 맞게 준비되지 않은 데이터" 위에 세운 AI 프로젝트의 60%가 2026년까지 폐기될 것이라는 예측이다. 출처는 Gartner의 "Lack of AI-Ready Data Puts AI Projects at Risk" (2025)와 GenAI PoC 30% 포기 예측 (Gartner, 2024) 두 건으로 표기되어 있다. 이 수치를 근거로 자료는 "발목을 잡는 건 모델이 아니라 데이터와 지식의 품질"이라고 결론짓는다.
벡터 검색만으로 부족한 두 가지
2장은 대안을 제시하기 전에 기존 방식의 한계를 먼저 짚는다. 표제부터 단정적이다. "벡터 검색은 강력한 도구지, 유일한 도구가 아닙니다." 벡터 검색이 "비슷한 느낌"으로 찾는다는 점을 인정한 뒤, 그것만으로는 두 가지가 깨진다고 말한다.
| 문제 | 자료의 설명 |
|---|---|
| 문맥이 잘린다 | 긴 글을 토막 내면, 그 토막의 앞뒤 맥락이 사라져 엉뚱하게 해석된다 |
| 임베딩에 의존한다 | 임베딩이 비슷하다고 안 보면, 글자가 정확히 맞아도 검색에서 빠진다 |
첫 번째는 chunking의 부작용이다. 문서를 일정 길이로 자르는 순간 각 조각은 자기 앞뒤가 무슨 이야기였는지 모르는 상태가 된다. 두 번째는 임베딩 유사도만 쓰는 검색의 사각지대다. 임베딩은 텍스트를 고정 차원 벡터로 바꾼 표현인데, 벡터 공간에서 멀리 놓인 항목은 문자열이 정확히 일치하더라도 후보에서 빠진다. 자료의 도식은 검색어를 둘러싼 임베딩 군집 바깥에 "정확히 일치"라는 항목을 따로 그려 이 상황을 보여준다.
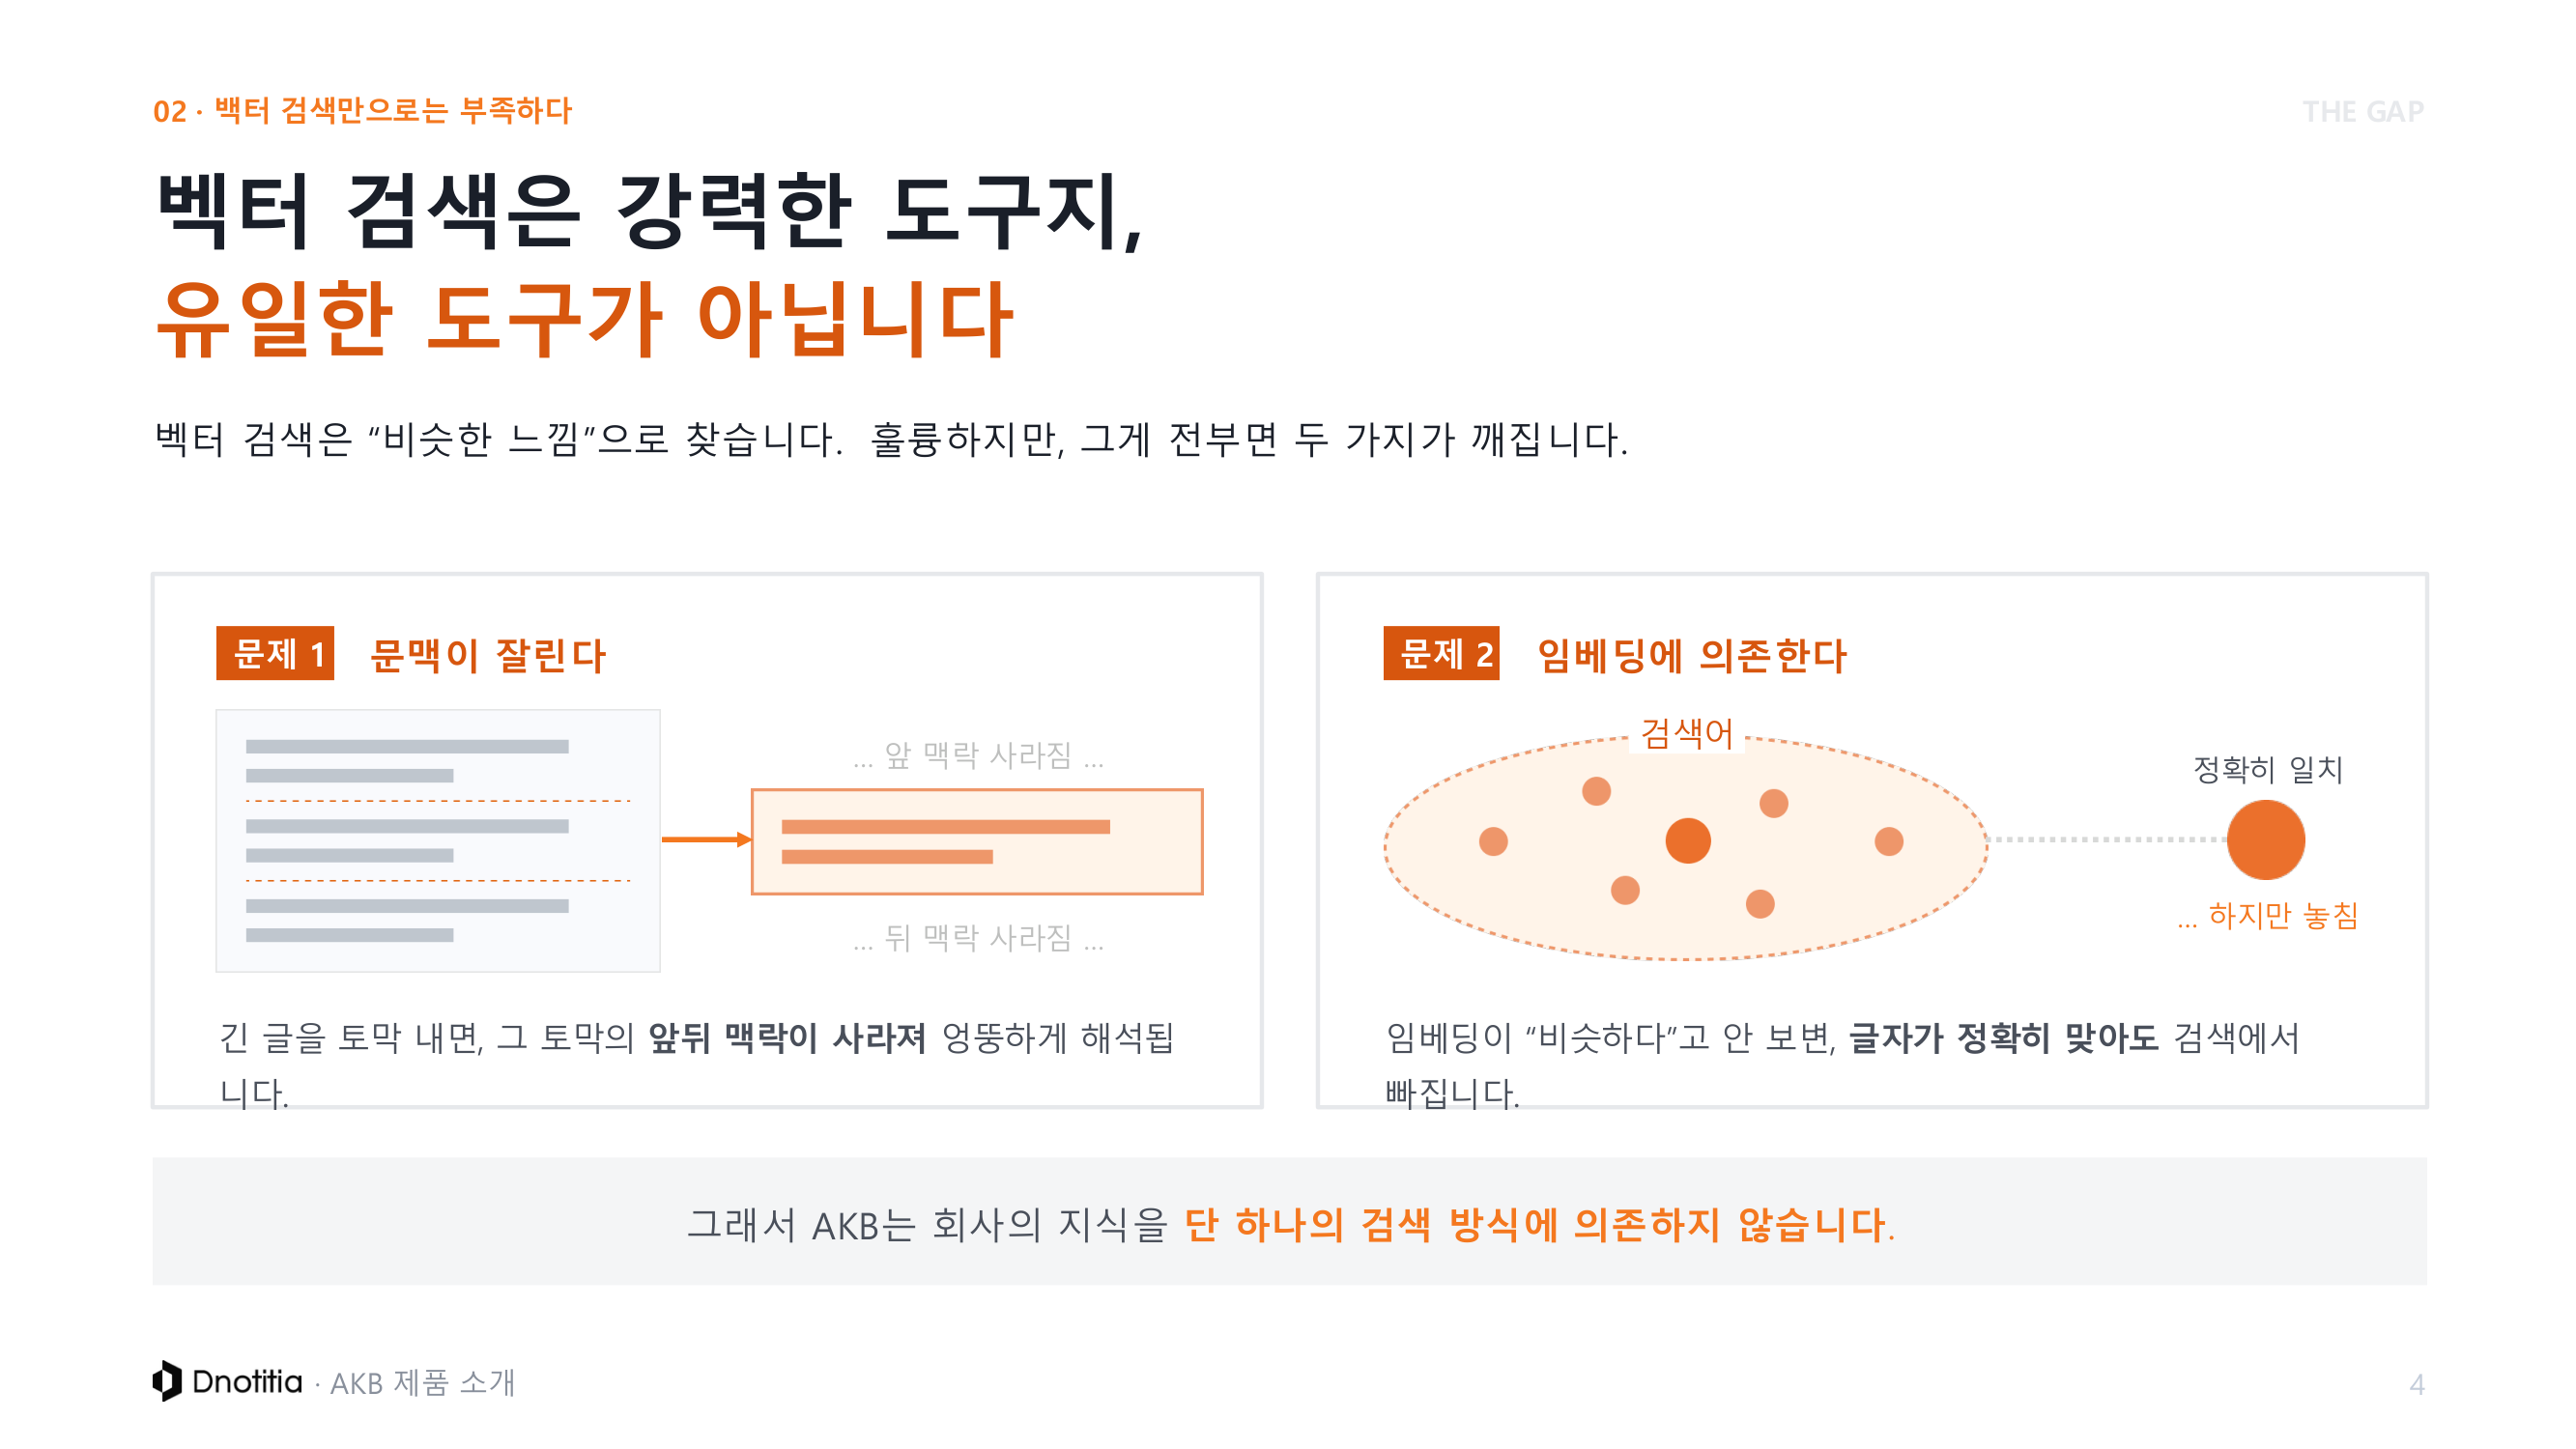
이 두 문제가 이후 설계의 근거가 된다. 문맥 잘림에는 문서를 헤딩 단위로 완결시키는 저장 구조로, 임베딩 의존에는 여러 탐색 경로를 병렬로 여는 방식으로 대응한다.
자료의 구성
23장은 일곱 개 장으로 나뉜다. 문제 제기에서 해결책, 실증, 활용, 전체 그림 순으로 이어지는 구성이고, 목차 슬라이드가 각 장의 부제와 시작 페이지를 함께 밝힌다.
| 장 | 제목 | 부제 | 시작 |
|---|---|---|---|
| 01 | 왜 지금인가 | AI 에이전트 시대, 조직에 새로 필요해진 것 | 3 |
| 02 | 벡터 검색만으로는 부족하다 | 유사도 검색이 놓치는 두 가지 | 4 |
| 03 | AKB의 답 | 하나의 주소, 에이전트가 골라 쓰는 길 | 5 |
| 04 | 검색을 넘은 올인원 | 파일, 데이터, 이력, 보안까지 | 8 |
| 05 | Collector & Gardener | 살아있는 지식베이스를 유지하는 법 | 10 |
| 06 | 실전 활용사례 | 크로스 vault로 일하는 에이전트와 전체 그림 | 14 |
| 07 | The Big Picture | 지식의 생애주기 전체 | 22 |
장별 분량은 고르지 않다. 1장과 2장이 각각 한 장씩만 쓰는 데 비해 6장은 여덟 장을 쓴다. 활용 사례에 자료 전체의 3분의 1이 배정된 셈이고, 그 안에 9개 vault 운영과 크로스 vault 작업, 실시간 지식 흐름, 보안 영역이 함께 들어간다.
5장에서 처음 등장하는 Collector와 Gardener도 네 장을 차지한다. 검색 방식을 설명하는 3장이 세 장인 것과 비교하면, 제품 소개의 무게 중심이 검색 성능보다 지식을 계속 살아 있게 유지하는 운영 쪽에 놓여 있다.
핵심 개념
세 제품의 역할을 먼저 갈라 두면 이후 서술이 읽기 쉬워진다.
| 제품 | 하는 일 | 산출물 |
|---|---|---|
| AKB | 지식을 담고 에이전트가 여러 경로로 찾게 한다 | 검색 결과와 문서 |
| AKB Collector | 외부 시스템에서 정보를 끌어온다 | Bronze 상태의 수집물 |
| AKB Gardener | 수집물을 다듬어 검색 가능한 문서로 만든다 | Gold 상태의 정책 문서 |
셋은 하나의 순서를 이룬다. Collector가 넣고, Gardener가 다듬고, AKB가 담아 내준다. 자료가 표지에서 세 제품을 나란히 배치하고 부제를 "찾고 쌓고 가꾸는"으로 잡은 것도 이 순서를 그대로 옮긴 것이다.
이 자료를 읽는 데 필요한 나머지 개념은 여섯 개다.
vault는 권한과 격리의 단위다. 자료는 이를 "금고"로 옮겨 부르고, 도메인 하나에 vault 하나를 배정한다. vault마다 읽기와 쓰기, 관리 권한이 따로 부여되고, 권한이 없는 vault는 목록에서도 보이지 않는다.
akb://는 문서와 표, 파일을 하나로 묶는 주소 체계다. 자료는 이를 "하나의 URI 코퍼스"라고 부른다. 어떤 경로로 찾아 들어가든 도착 지점의 주소 형식이 같아야 에이전트가 결과를 한 방식으로 다룰 수 있다는 발상이다.
Bronze와 Gold는 정제 단계의 이름이다. 자료는 원석과 보석이라는 한국어 비유를 나란히 쓴다. Collector가 막 끌어온 정보가 Bronze이고, Gardener가 구조를 잡고 출처를 붙인 결과가 Gold다.
HITL은 사람이 판단 고리 안에 남아 있도록 만드는 설계를 뜻한다. 이 자료에서 HITL은 Gardener가 문서를 지우거나 합치는 파괴적 작업 앞에 사람의 승인을 강제하는 형태로 나타난다.
redaction은 민감정보를 가리는 처리다. Collector가 정보를 끌어오는 유입 단계에서 적용하므로, 가려야 할 값이 지식베이스에 저장되기 전에 걸러진다.
온프렘은 사내 자체 서버 환경이다. 자료는 이 환경에서 데이터가 처리되며 "한 바이트도 외부 반출 없이" 운영된다고 두 곳에서 반복해 명시한다.
방법
여러 경로로 나뉘는 탐색
3장이 자료의 핵심 설계를 담는다. 왼쪽에 에이전트, 오른쪽에 URI 코퍼스를 두고 그 사이에 탐색 경로를 나란히 세운 도식이다. 에이전트 상자의 부제가 설계 의도를 요약한다. "필요한 길을 직접 고른다."
| 경로 | 자료의 설명 | 어울리는 질의 |
|---|---|---|
| 트리 탐색 | 요약만 보고 필요한 곳만 펼치기 | 어디를 봐야 하는지부터 모를 때 |
| hybrid search | 의미와 키워드를 합치고 reranking으로 다시 정렬 | 표현이 다를 수 있는 개념 질의 |
| 정확 검색 grep | 코드, URL, 버전번호처럼 글자 그대로 | 문자열이 정확히 일치해야 하는 값 |
| 그래프 탐색 | 문서 간 관계, 인용, 의존 따라가기 | 한 문서에서 연결된 문서로 넘어갈 때 |
네 경로는 서로를 대체하지 않고 각각 다른 실패를 막는다. 트리 탐색은 어느 문서를 봐야 하는지 모를 때 요약만 훑어 후보를 좁히고, hybrid search는 표현이 달라도 의미가 같은 문서를 찾으며, grep은 문자열이 정확히 맞아야 하는 값을 놓치지 않고, 그래프 탐색은 한 문서에서 연결된 문서로 넘어간다. 어느 하나만 남기면 나머지 세 상황에서 검색이 실패한다는 것이 이 구성의 전제다.
hybrid search는 세 단계로 나뉜다. 임베딩으로 의미가 가까운 후보를 모으고, BM25로 키워드가 일치하는 후보를 모은 뒤, reranking으로 합친 목록을 다시 정렬한다. reranking은 1차 검색이 뽑은 후보를 더 정밀한 모델로 다시 줄 세우는 단계를 말한다. 앞 절이 짚은 임베딩 의존 문제를 키워드 쪽 후보로 보완하는 구조다.
국문 검색에는 형태소 분석기 Kiwi를 쓴다고 밝힌다. 한국어는 조사와 어미가 붙어 하나의 어절을 이루므로 공백 단위로 자르면 키워드가 제대로 잡히지 않는다. 형태소 단위로 쪼개야 키워드 검색이 의도한 대로 동작한다. 다만 Kiwi를 검색 인덱싱 단계에 붙였는지 질의 재작성 단계에 붙였는지는 자료에 나오지 않는다.
도식 하단 띠는 이 조합을 SOTA 방식이라고 부르고, 각주에서 SOTA를 "현재 시점의 최적 탐색 접근"으로 풀어 쓴다.
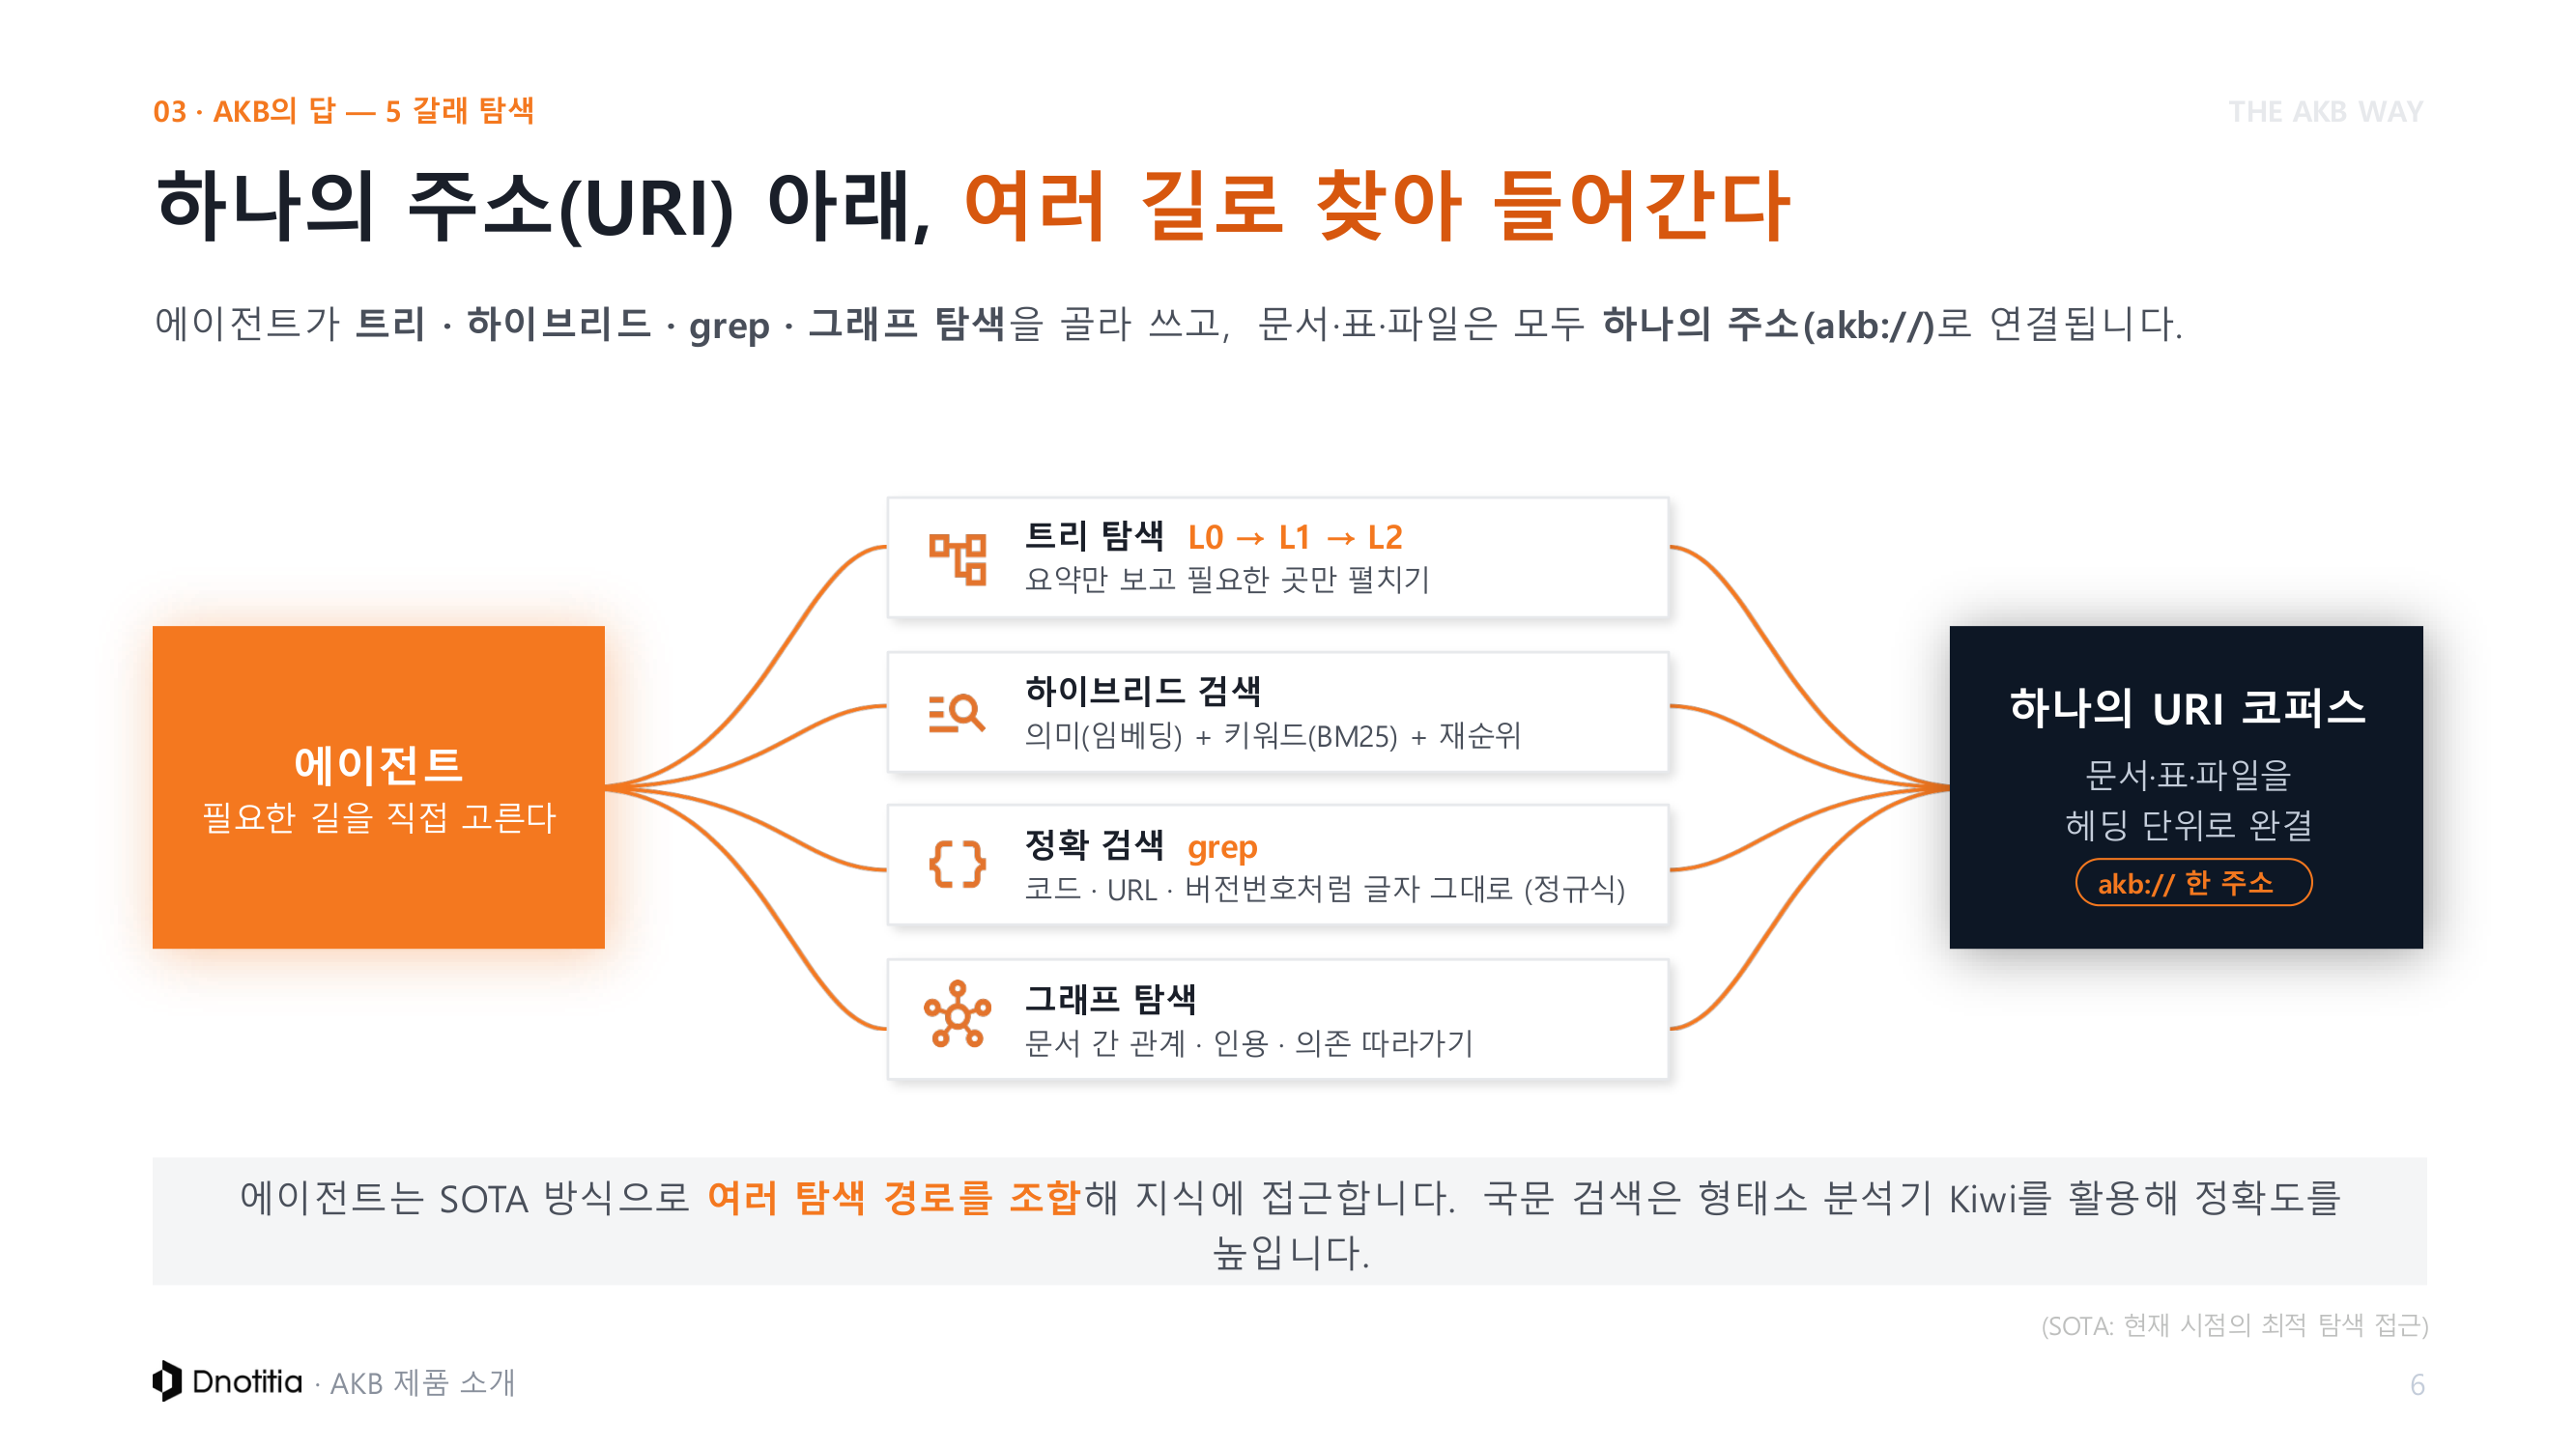
여기에 자료 내부의 불일치가 하나 있다. 3장 제목과 22쪽 요약은 이 구성을 다섯 가지로 표기하는데, 6쪽 도식이 실제로 나열하는 경로는 네 가지다. 다섯 번째가 무엇인지는 자료 어디에도 나오지 않는다.
트리 탐색 3단계
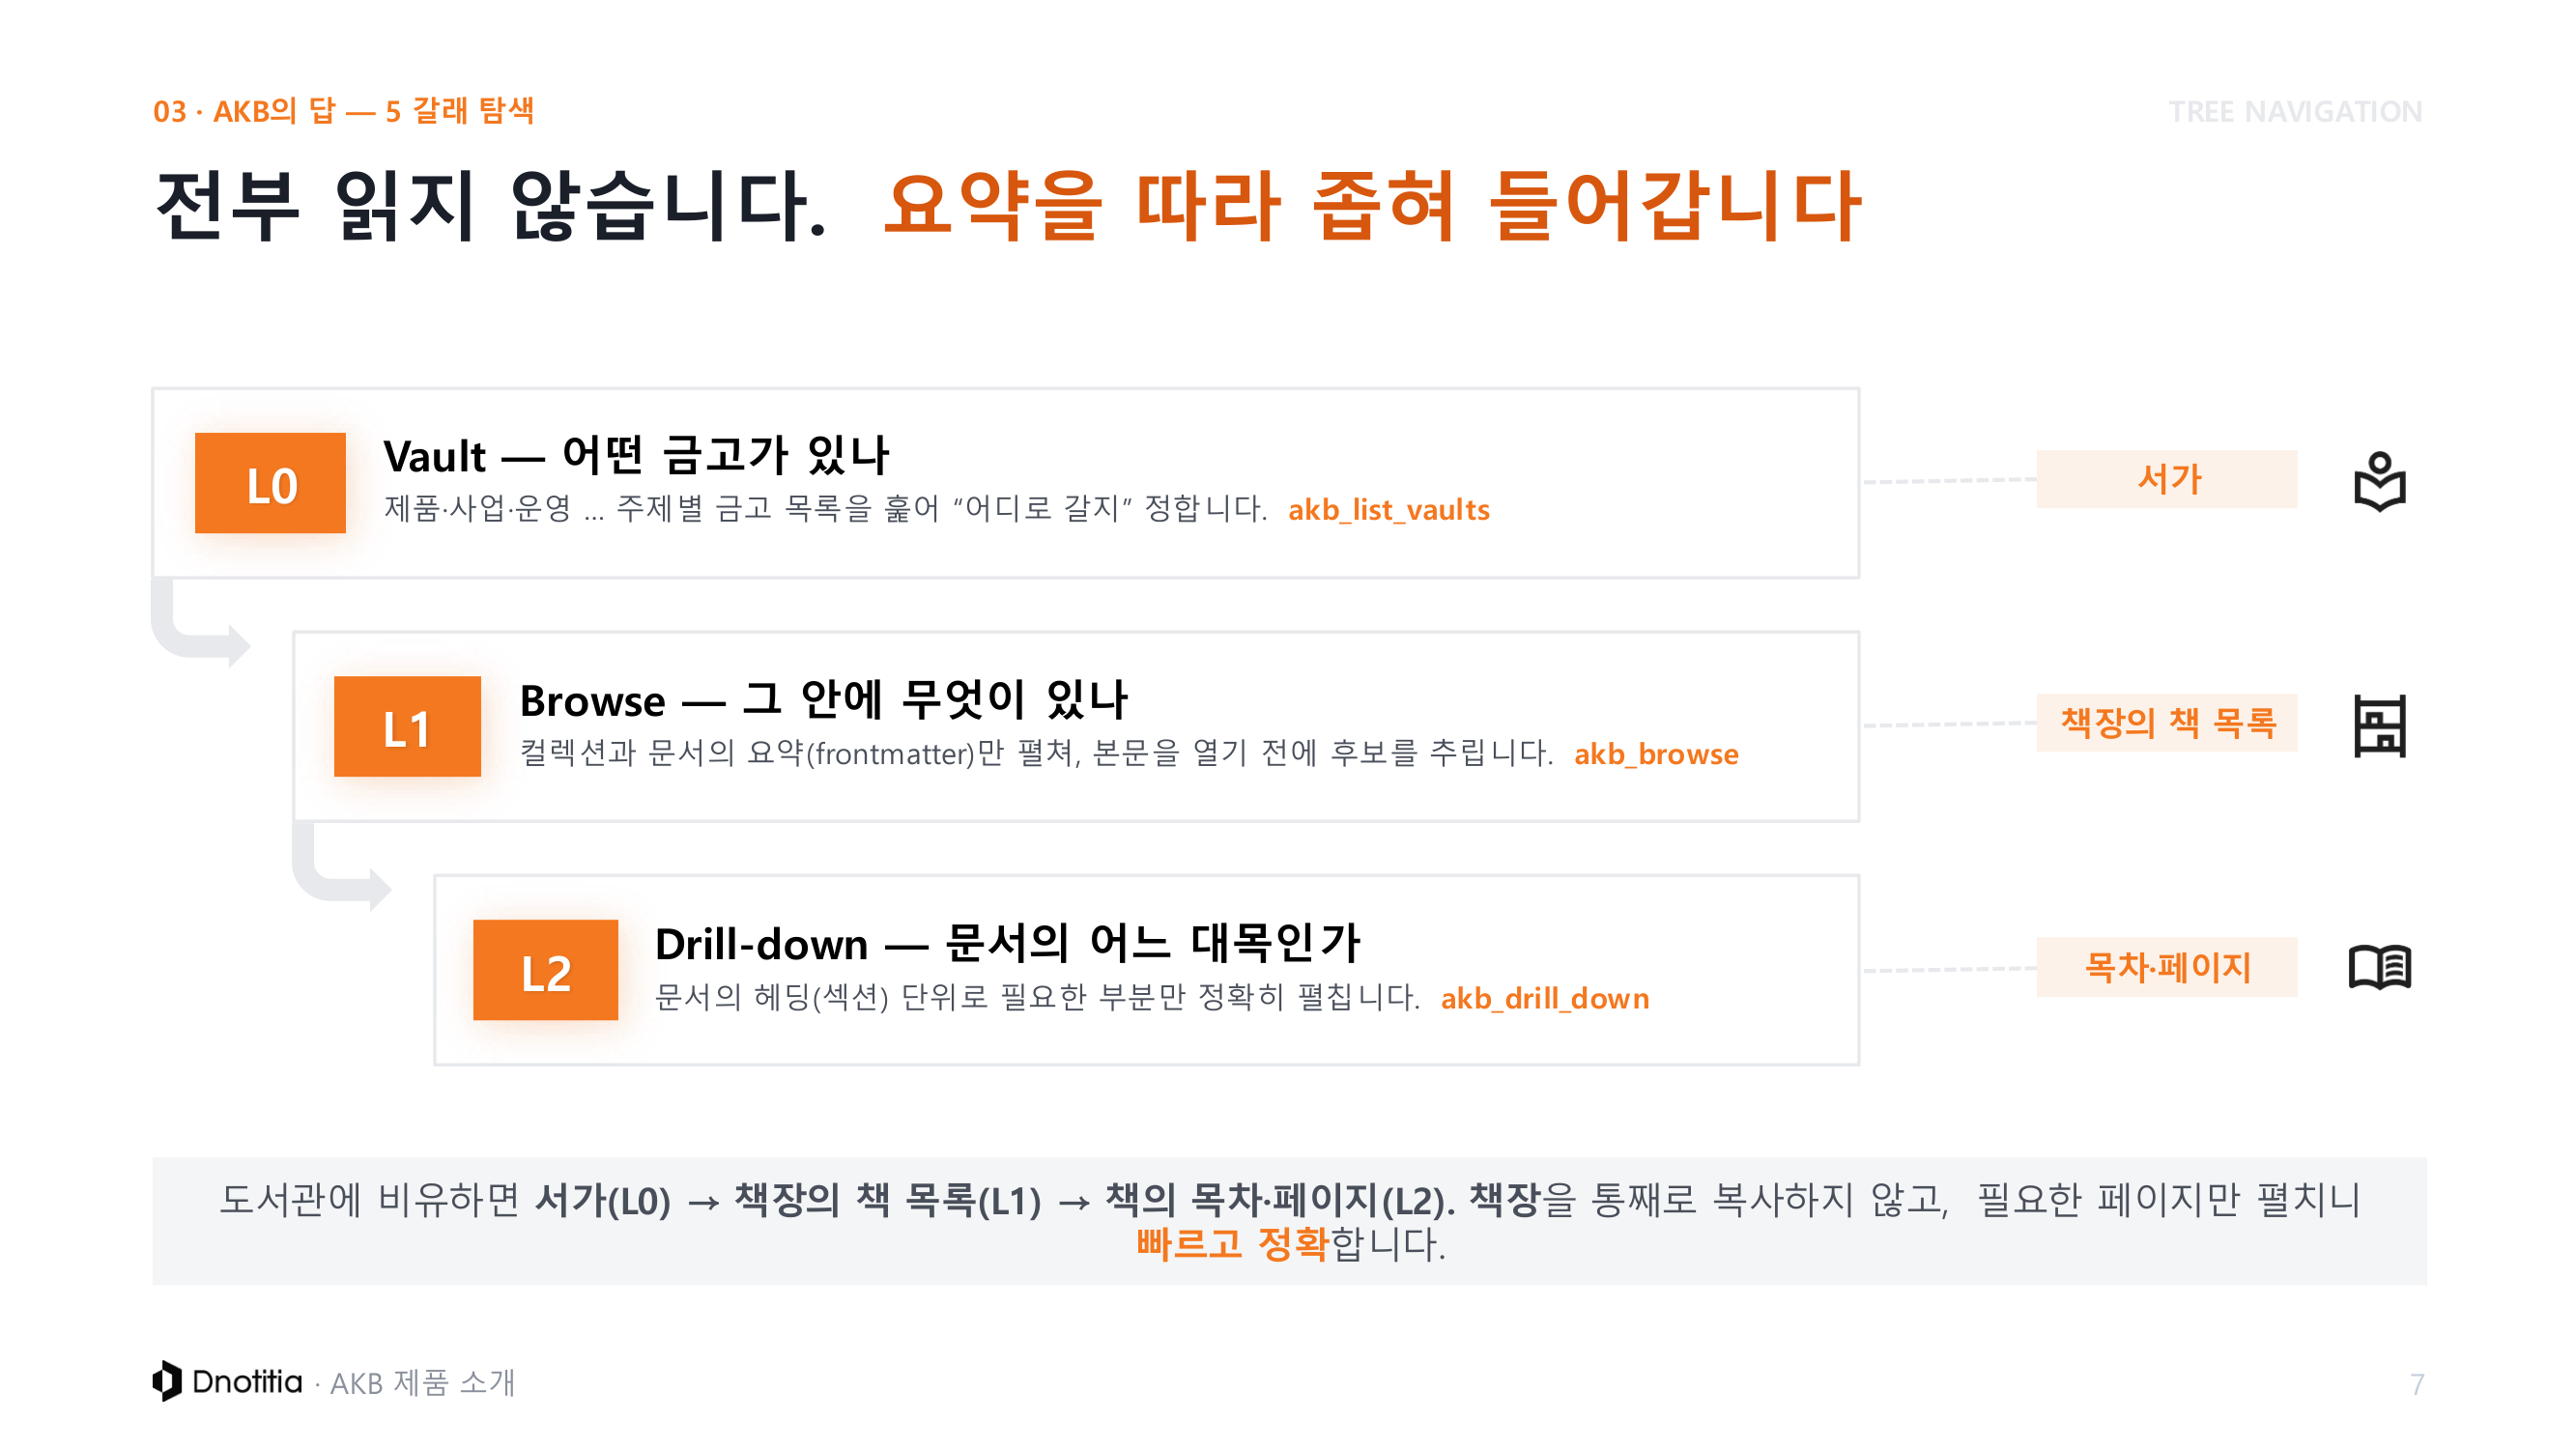
트리 탐색은 별도의 슬라이드를 하나 더 쓴다. 표제가 목적을 그대로 말한다. "전부 읽지 않습니다. 요약을 따라 좁혀 들어갑니다." 단계마다 호출할 MCP tool 이름과 도서관 비유가 짝지어져 있다.
| 레벨 | 자료의 제목 | tool | 비유 | 이 단계에서 보는 것 |
|---|---|---|---|---|
| L0 | Vault, 어떤 금고가 있나 | akb_list_vaults |
서가 | 제품, 사업, 운영 등 주제별 vault 목록을 훑어 어디로 갈지 정한다 |
| L1 | Browse, 그 안에 무엇이 있나 | akb_browse |
책장의 책 목록 | 컬렉션과 문서의 요약만 펼쳐, 본문을 열기 전에 후보를 추린다 |
| L2 | Drill-down, 문서의 어느 대목인가 | akb_drill_down |
목차와 페이지 | 문서의 헤딩 단위로 필요한 부분만 정확히 펼친다 |
L1이 펼치는 요약은 문서의 frontmatter다. 본문을 열지 않고 머리말만 훑어 후보를 좁힌다는 뜻이다. L2에 가서야 본문이 열리는데, 그때도 문서 전체가 아니라 지목한 헤딩만 열린다.
이 3단계 구조가 앞서 짚은 컨텍스트 한도 문제에 대한 답이다. 자료의 요약 문장이 그 이유를 비유로 설명한다. "책장을 통째로 복사하지 않고, 필요한 페이지만 펼치니 빠르고 정확합니다." 검색 정확도만이 아니라 한 번에 실어 보내는 토큰 양을 줄이는 것이 목적이라는 뜻이다.
문서와 파일, 테이블을 한 주소로
4장은 탐색의 대상을 넓힌다. 표제는 "찾기를 넘어 일하기까지"이고, 검색 한 번이 세 종류의 자료를 모두 포괄한다고 말한다.
| 모달리티 | 자료의 카드 제목 | 설명 |
|---|---|---|
| 문서 | 지식 본문 | 헤딩 단위 마크다운. 버전과 이력까지 보존되는 회사의 글 |
| 파일 | 에이전트가 직접 주고받는 파일 | PDF, 이미지 같은 원본 파일을 에이전트가 직접 받아오고 저장한다 |
| 테이블과 SQL | 숫자로 분석 | 구조화된 표에 SQL로 통계와 집계까지. 권한 안에서만 안전하게 |
세 모달리티는 지식베이스가 흔히 다루지 않는 영역까지 포함한다. 문서만 담는 지식베이스라면 PDF 원본은 링크로 남기고 수치 집계는 별도 도구에 맡기는 것이 보통이다. 이 자료는 두 가지를 모두 안으로 들인다. 파일은 에이전트가 직접 받아오고 저장하며, 표는 SQL 질의의 대상이 된다. 표에 SQL을 걸 때도 권한 안에서만 동작한다는 단서가 붙어 있어, 앞 절의 vault 권한이 검색만이 아니라 집계 질의에도 그대로 적용된다는 점을 알 수 있다.
세 종류를 함께 다루는 이유는 실무 요청이 한 종류로 끝나지 않기 때문이다. 자료가 든 예시가 그 점을 보여준다. "이 PDF 받아와서, 표로 정리하고, 합계를 내줘"라는 한 문장의 요청은 파일 받기, 표 정리, 집계, 답 생성 네 단계를 거친다. 자료는 이 네 단계를 상자로 이어 그리고, 한 에이전트가 한 자리에서 처리한다는 점을 강조한다. 세 모달리티가 같은 주소 체계 아래 묶여 있어야 가능한 흐름이다.
이력 추적과 권한 격리
같은 장의 두 번째 슬라이드는 신뢰의 조건을 다룬다. 표제는 "믿고 맡기려면, 이력과 보안이 함께 가야 합니다"이고, 두 개의 카드로 나뉜다.
| 영역 | 카드 제목 | 자료의 설명 |
|---|---|---|
| 이력 추적 | 모든 변경이 기록됩니다 | 문서는 Git에 커밋되어 과거 어느 시점이든 되돌려 볼 수 있다. 문서가 바뀌면 검색 인덱스도 같이 갱신되어 낡은 인덱스가 옛 답을 주는 일이 없다 |
| 권한, 격리, 감사 | 볼 수 있는 사람만 봅니다 | vault마다 권한을 부여한다. 데이터베이스 자체에서 격리되어 권한 없는 vault는 우회 질의로도 보이지 않는다. 모든 접근은 감사 로그에 남는다 |
카드 아래에는 구성 요소 다섯 개가 배지로 붙어 있다.
- 버전 이력 (Git)
- 문서와 인덱스 동기화
- Vault 권한 (RBAC)
- DB 네이티브 격리
- 전수 감사 로그
DB 네이티브 격리가 이 목록의 핵심이다. 권한 검사를 응용 계층에 두면 검사를 우회하는 질의가 들어왔을 때 막지 못하지만, 데이터베이스 자체가 격리하면 우회 질의도 결과를 받지 못한다. 자료는 이 차이를 "우회 질의(SQL)로도 보이지 않습니다"라는 한 문장으로 표현한다. 다만 어떤 데이터베이스 기능으로 구현했는지는 밝히지 않는다. 구현 세부는 저장소 기준 페이지인 AKB: Agent Knowledge Base가 담당한다.
문서와 인덱스 동기화도 짚어둘 항목이다. 문서를 고쳤는데 검색 인덱스가 옛 상태로 남아 있으면, 검색은 이미 폐기된 내용을 근거로 답을 만든다. 자료는 이 상황을 "낡은 색인이 옛 답을 주는 일"이라고 부르고, 문서 변경과 인덱스 갱신을 함께 처리해 막는다고 적는다.
외부 소스를 끌어오는 Collector
5장부터 신규 컴포넌트가 등장한다. 도입 슬라이드가 문제의식을 먼저 세운다. "잘 만든 지식베이스도 방치하면 쓰레기 산이 됩니다." 구축은 시작일 뿐이고 정보는 계속 들어오고 낡고 중복되므로, 정보를 끌어오는 Collector와 정원을 가꾸는 Gardener가 필요하다는 논리다.
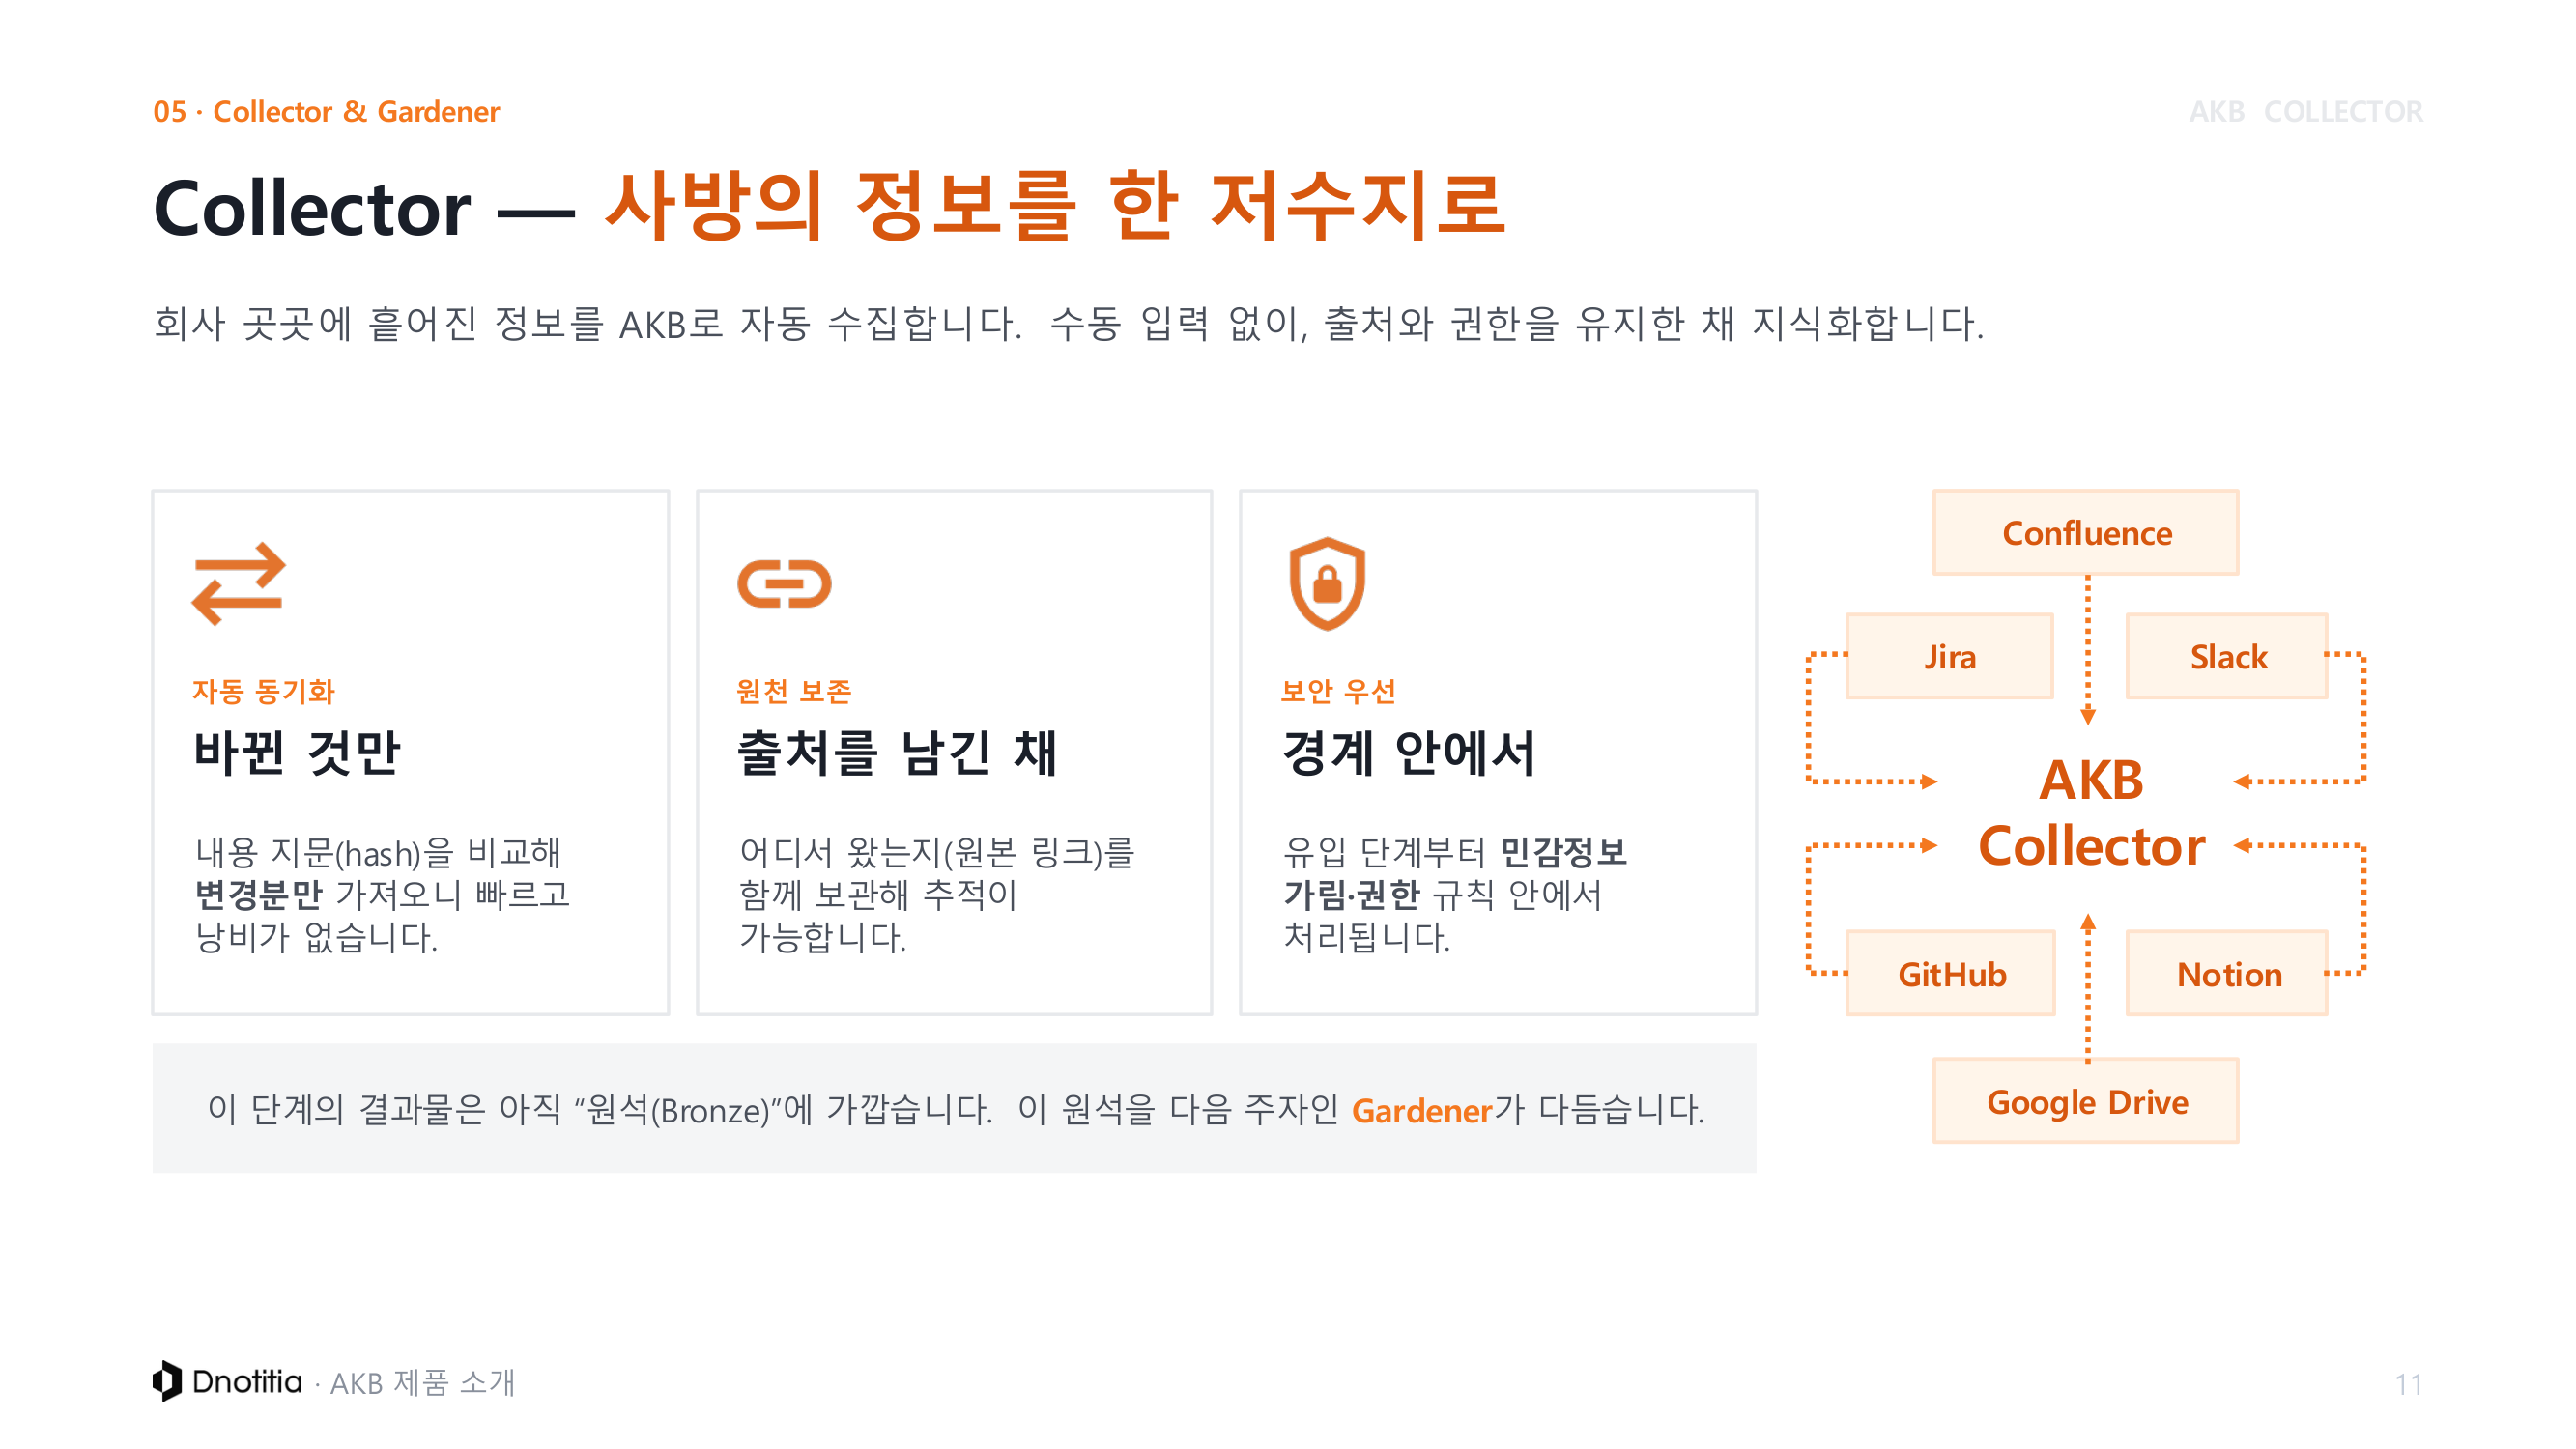
Collector는 회사 곳곳에 흩어진 정보를 AKB로 자동 수집한다. 대상 소스는 여섯 개다.
| 소스 | 담기는 정보의 성격 |
|---|---|
| Confluence | 사내 문서와 위키 |
| Jira | 이슈와 작업 이력 |
| Slack | 대화 |
| GitHub | 코드와 변경 이력 |
| Notion | 문서와 데이터베이스 |
| Google Drive | 파일 |
여섯 소스는 담기는 정보의 형태가 서로 다르다. Confluence와 Notion, Google Drive는 이미 문서 형태로 정리된 자료이고, Jira와 GitHub는 작업과 변경의 이력이며, Slack은 정리되지 않은 대화다. 뒤로 갈수록 문서로서의 완성도가 낮아지므로 Gardener가 할 일이 많아진다. 자료가 실증 사례로 고른 것이 Slack이라는 점도 이 순서와 무관하지 않다. 가장 정리가 덜 된 소스를 대상으로 삼아야 정제 능력을 보일 수 있기 때문이다.
동작 원칙은 세 가지이고, 각 원칙에 짧은 표어가 붙어 있다.
| 원칙 | 표어 | 자료의 설명 |
|---|---|---|
| 자동 동기화 | 바뀐 것만 | 내용 지문(hash)을 비교해 변경분만 가져오니 빠르고 낭비가 없다 |
| 원천 보존 | 출처를 남긴 채 | 어디서 왔는지 원본 링크를 함께 보관해 추적이 가능하다 |
| 보안 우선 | 경계 안에서 | 유입 단계부터 민감정보 가림과 권한 규칙 안에서 처리된다 |
세 원칙은 각각 다른 문제를 겨냥한다. hash 비교는 전량 재수집의 비용을 줄이고, 원본 링크 보존은 나중에 근거를 되짚을 길을 남기며, 유입 단계 redaction은 민감정보가 지식베이스에 들어온 뒤 지우는 상황을 애초에 만들지 않는다.
Collector의 결과물은 완제품이 아니다. 자료가 슬라이드 하단에 못 박는다. "이 단계의 결과물은 아직 원석(Bronze)에 가깝습니다. 이 원석을 다음 주자인 Gardener가 다듬습니다."
Bronze에서 Gold로 다듬는 Gardener
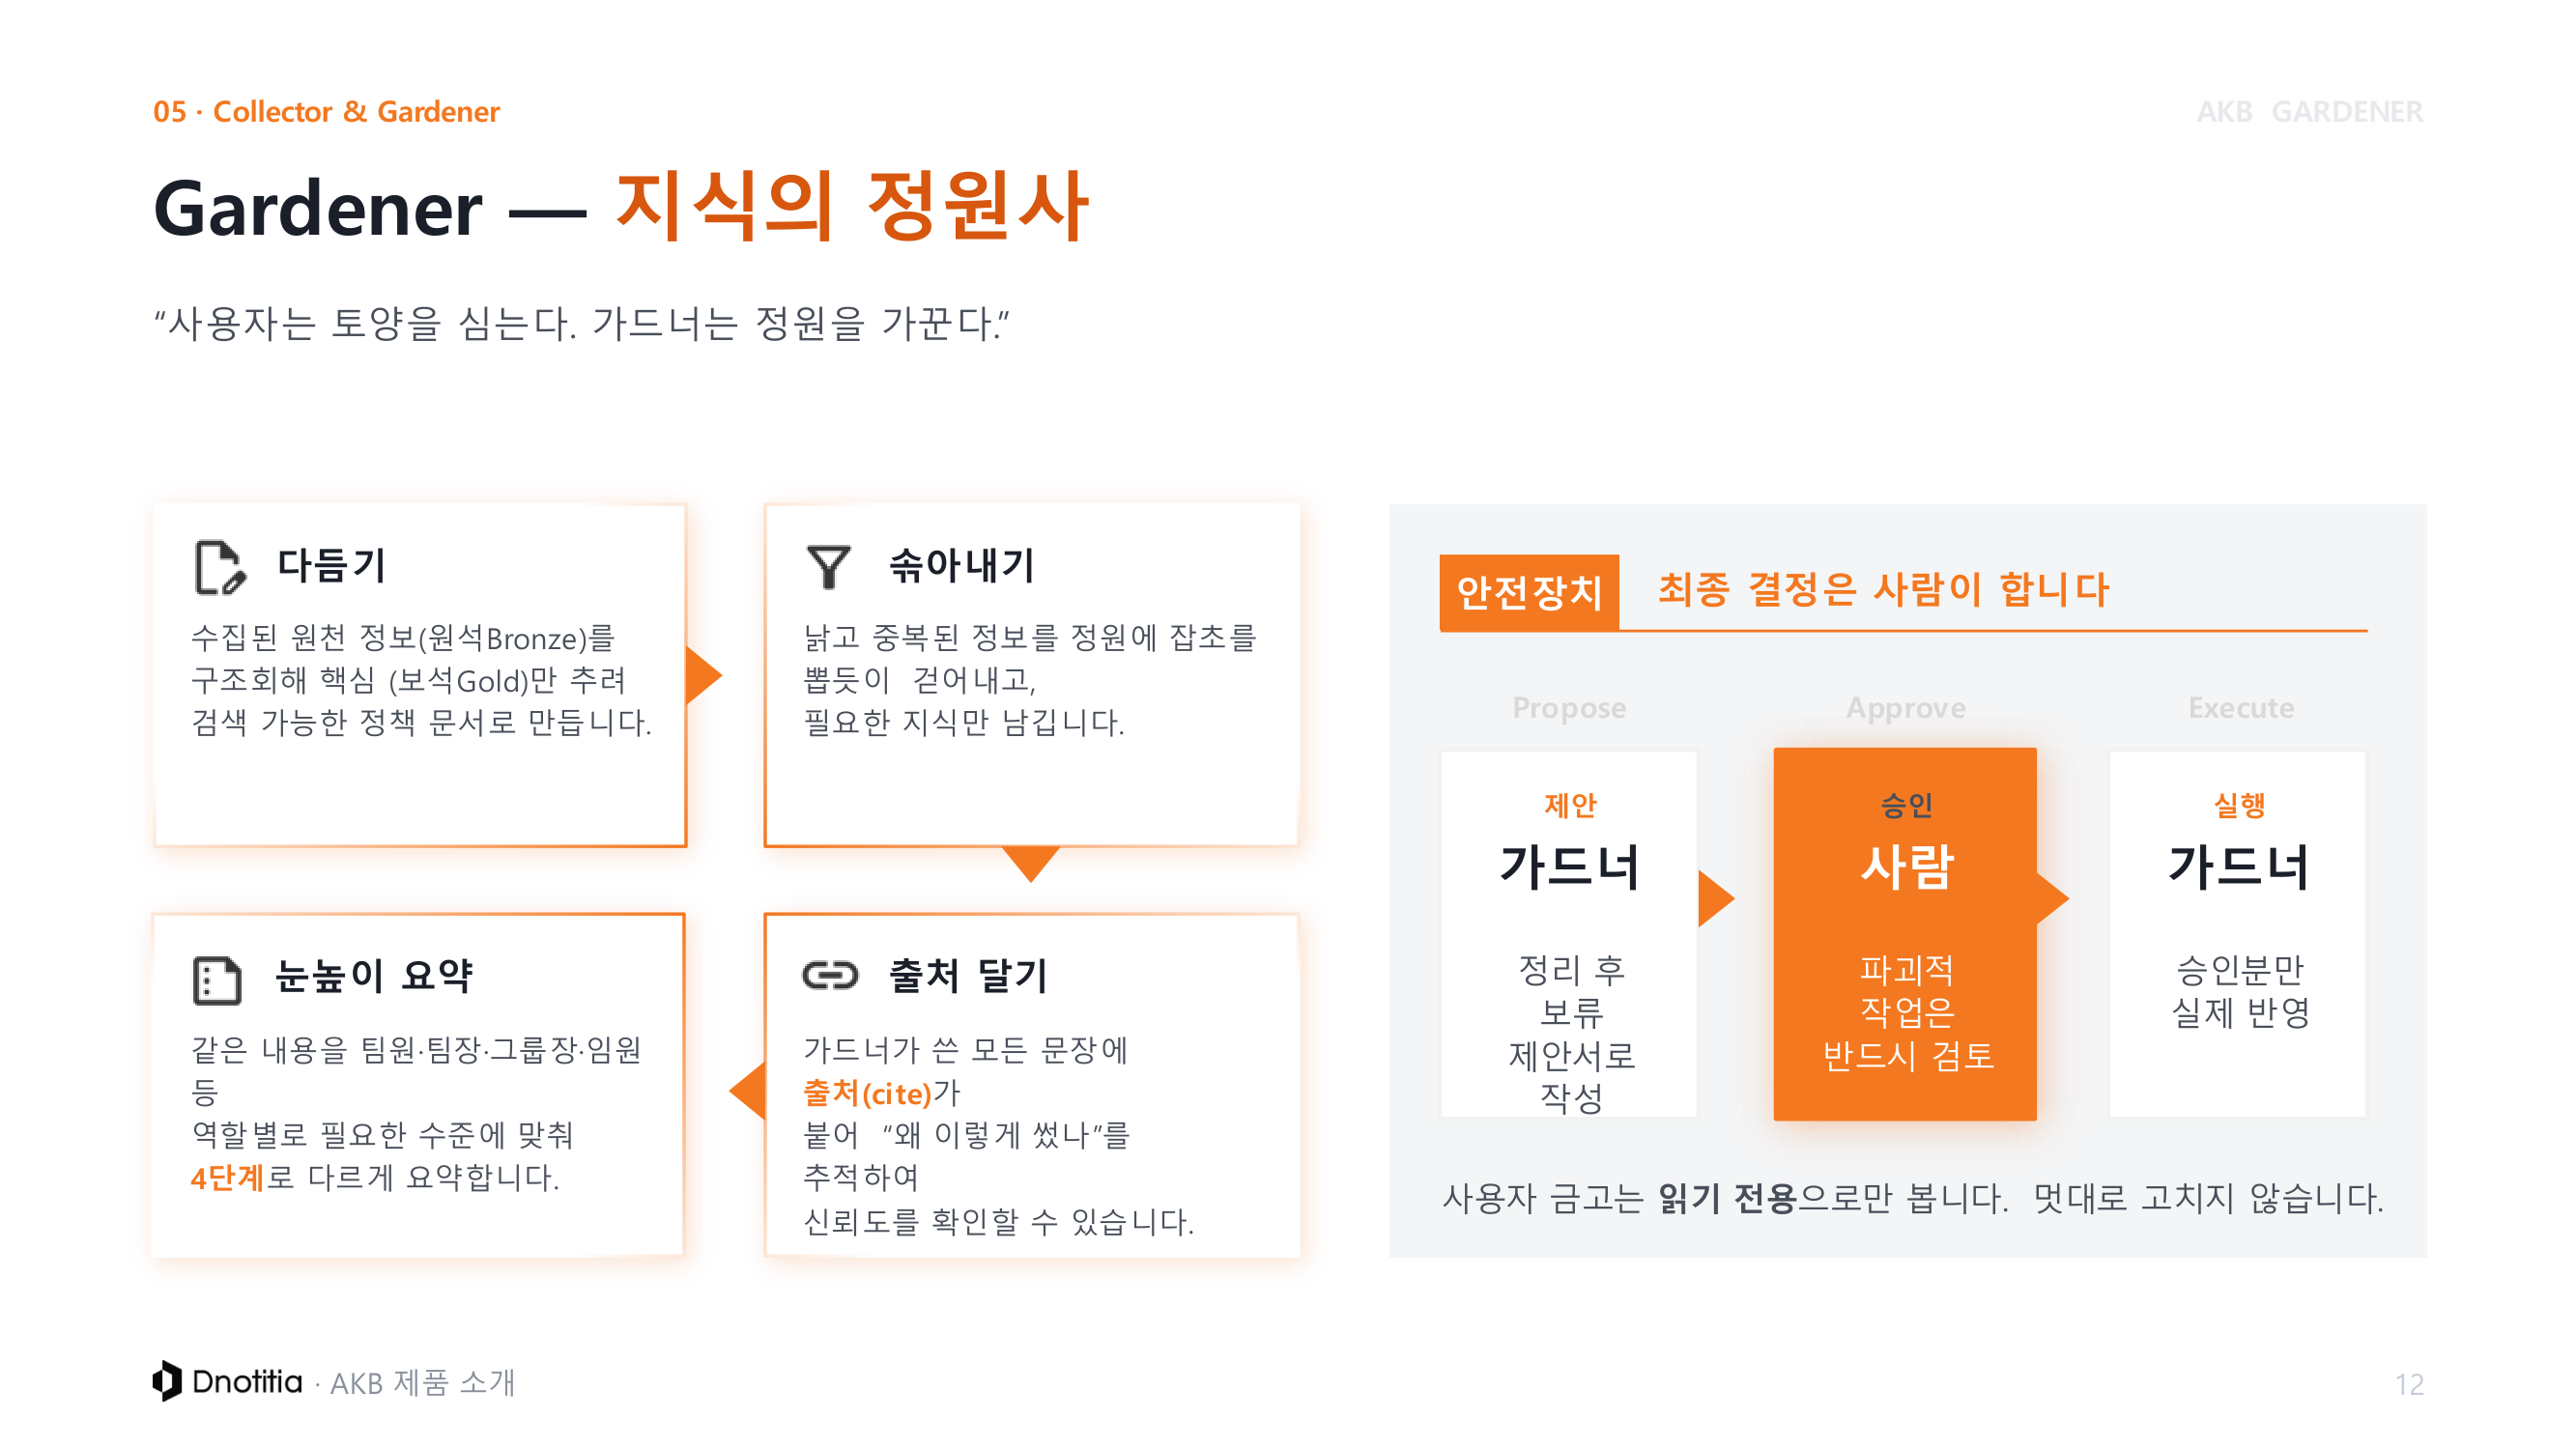
Gardener는 Bronze 상태의 수집물을 검색 가능한 문서로 바꾼다. 슬라이드 부제는 "지식의 정원사"이고, 표제 아래에 인용문이 놓인다. "사용자는 토양을 심는다. 가드너는 정원을 가꾼다."
작업은 네 가지이고, 도식의 화살표는 다듬기에서 시작해 눈높이 요약으로 끝난다.
| 순서 | 작업 | 자료의 설명 |
|---|---|---|
| 1 | 다듬기 | 수집된 원천 정보를 구조화해 핵심만 추려 검색 가능한 정책 문서로 만든다 |
| 2 | 솎아내기 | 낡고 중복된 정보를 정원에 잡초를 뽑듯이 걷어내고 필요한 지식만 남긴다 |
| 3 | 출처 달기 | 가드너가 쓴 모든 문장에 출처가 붙어 왜 이렇게 썼는지를 추적해 신뢰도를 확인할 수 있다 |
| 4 | 눈높이 요약 | 같은 내용을 팀원, 팀장, 그룹장, 임원 등 역할별로 필요한 수준에 맞춰 4단계로 다르게 요약한다 |
눈높이 요약은 이 목록에서 성격이 조금 다르다. 앞의 세 작업이 하나의 정본을 만드는 일이라면, 눈높이 요약은 같은 정본에서 독자별 판본을 파생시키는 일이다. 임원이 볼 문서와 팀원이 볼 문서의 상세도를 다르게 맞춘다는 뜻이다.
출처 달기는 앞 절의 원천 보존과 짝을 이룬다. Collector가 원본 링크를 남기고 Gardener가 문장마다 그 출처를 붙이므로, 정제된 문서에서 원래 대화나 이슈까지 되짚어 갈 수 있다.
승인을 강제하는 안전장치
같은 슬라이드의 오른쪽 절반이 안전장치다. 표제가 원칙을 먼저 밝힌다. "최종 결정은 사람이 합니다."
| 단계 | 주체 | 자료의 설명 |
|---|---|---|
| Propose | 가드너 | 정리 후 보류, 제안서로 작성 |
| Approve | 사람 | 파괴적 작업은 반드시 검토 |
| Execute | 가드너 | 승인분만 실제 반영 |
Gardener는 제안서를 쓰고 결과를 보류 상태로 두는 데까지만 한다. 사람이 검토해 승인하면 그때 Gardener가 승인된 항목만 실제로 반영한다. 자동화의 범위를 작성과 실행으로 나누고 그 사이에 사람을 둔 구조다.
여기에 단서가 하나 더 붙는다. "사용자 금고는 읽기 전용으로만 봅니다. 멋대로 고치지 않습니다." Gardener가 사용자 소유 vault를 읽을 수는 있지만 쓸 수는 없다는 뜻이다. 승인 절차가 있더라도 사용자의 개인 영역은 아예 쓰기 대상에서 뺀 것이다.
9개 도메인으로 나눈 vault 운영
6장은 이 제품군이 실제로 어떻게 쓰이는지를 다룬다. 도입 슬라이드가 목표 상태를 제시한다. "흩어진 회사 지식이, 하나의 두뇌처럼 일합니다." 그러면서 "지금 사내 온프렘 환경에서 실제로 운영 중"이라고 덧붙인다.
운영 단위는 도메인별 vault 아홉 개다.
| vault | 담기는 내용 |
|---|---|
| HR, 인사 | 사내 정책, 규정, 온보딩 가이드 |
| Sales, 영업 | 고객 요구, 파이프라인, 제안 이력 |
| Patent, 특허/IP | 출원, 선행기술, 청구항 |
| Product, 제품 | 기능, 특장점, 운영현황 |
| Development, 개발 | 아키텍처, 설계 결정, 이슈 |
| Research, 연구 | 실험, 벤치마크, 시장조사 |
| 경쟁사 분석 | 경쟁사 동향, 포지셔닝 |
| 협력사 | 파트너, 역할분담, 계약 |
| 경쟁제품 벤치마크 | 기능 비교, 성능 측정 |
각 도메인은 독립된 vault로 분리해 관리하고, 자기 권한을 지키면서도 필요한 업무에서 함께 검색하고 연결한다는 것이 운영 방침이다. 자료는 이 아홉 개를 3행 3열 격자에 균등하게 배치하고 별도의 상위 묶음을 두지 않는다.
목록의 구성 자체가 vault 분할의 기준을 보여준다. 앞의 여섯 개는 사내 조직의 기능 단위와 그대로 대응하고, 뒤의 세 개는 회사 밖을 향한 정보다. 즉 vault 경계를 조직도에서 가져오되, 외부를 다루는 자료는 별도 vault로 떼어 놓았다. 경쟁사 자료와 협력사 계약을 사내 인사 문서와 같은 권한 아래 두지 않기 위한 분할로 읽힌다.
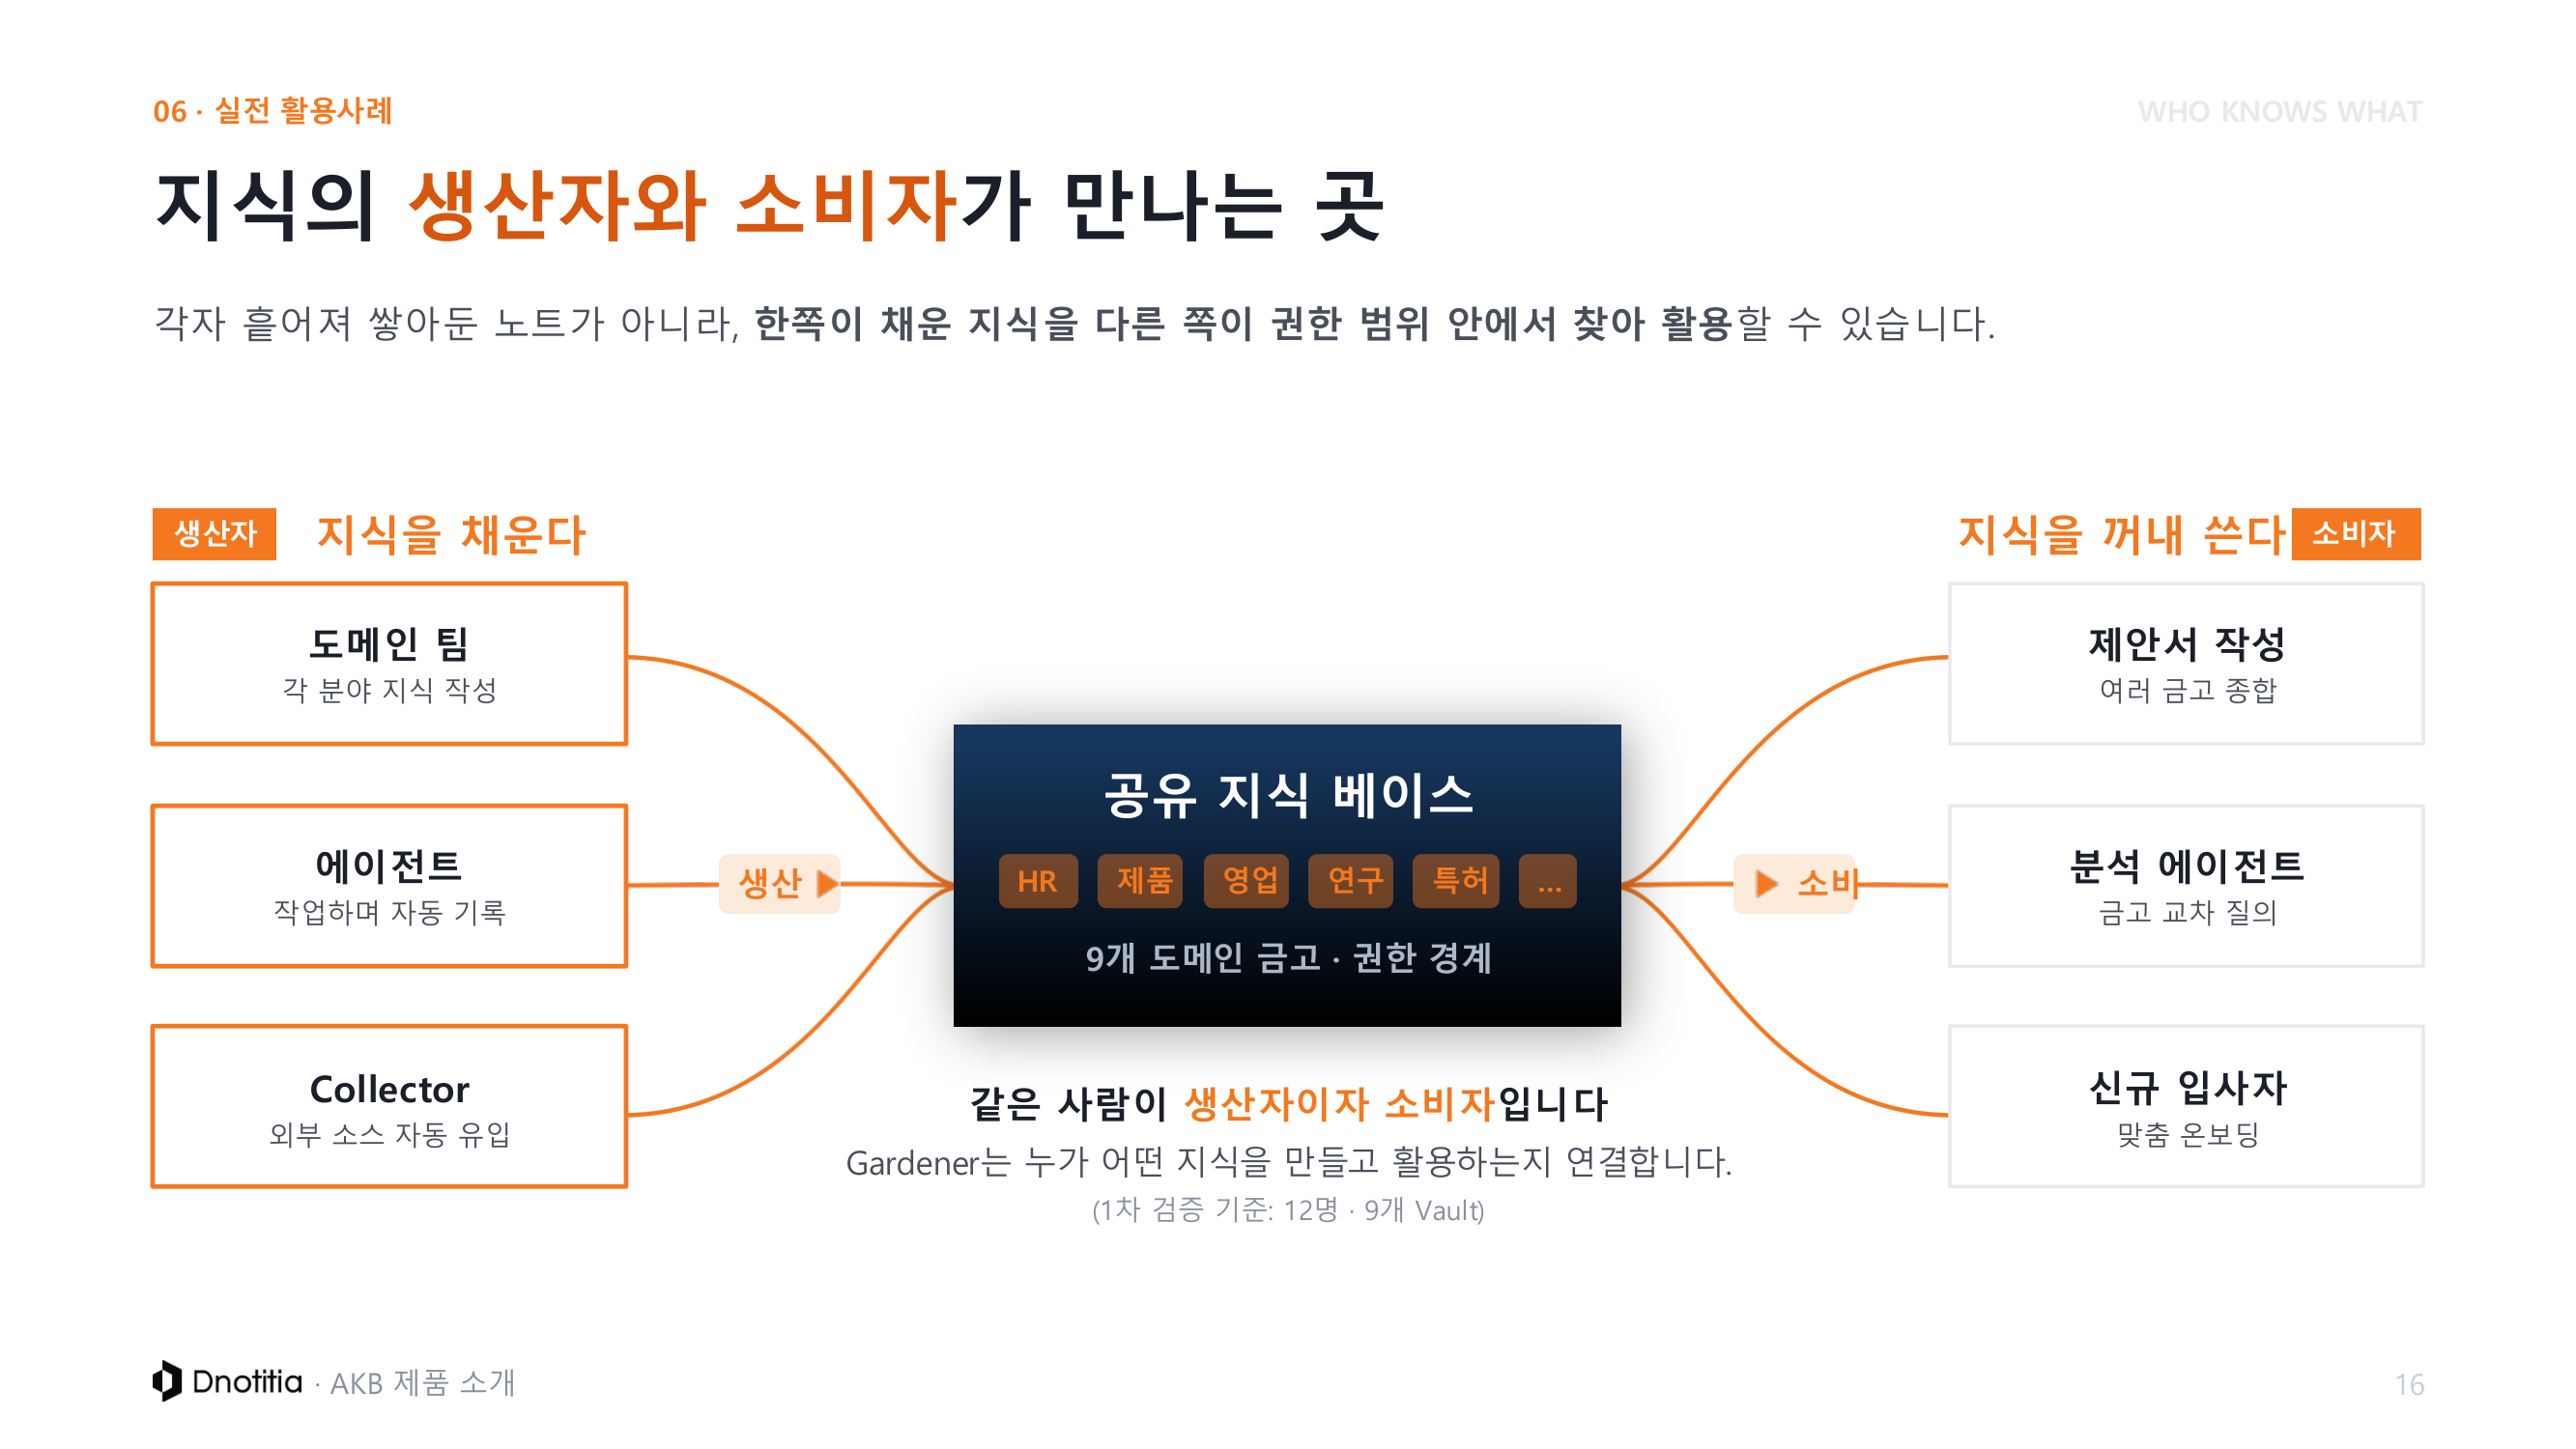
이어지는 슬라이드는 같은 구성을 사람의 관점에서 다시 그린다. 지식을 채우는 쪽과 꺼내 쓰는 쪽이 양쪽에 놓이고, 가운데에 아홉 개 vault를 담은 공유 지식베이스가 있다.
| 역할 | 구성원 | 자료의 설명 |
|---|---|---|
| 생산 | 도메인 팀 | 각 분야 지식 작성 |
| 생산 | 에이전트 | 작업하며 자동 기록 |
| 생산 | Collector | 외부 소스 자동 유입 |
| 소비 | 제안서 작성 | 여러 vault 종합 |
| 소비 | 분석 에이전트 | vault 교차 질의 |
| 소비 | 신규 입사자 | 맞춤 온보딩 |
이 구도의 요점은 두 집단이 분리되어 있지 않다는 데 있다. 자료가 도식 아래에 그 점을 명시한다. "같은 사람이 생산자이자 소비자입니다." 이어서 "Gardener는 누가 어떤 지식을 만들고 활용하는지 연결합니다"라고 덧붙인다. 검증 규모는 각주에 12명, vault 9개로 적혀 있다.
여러 vault를 함께 쓰는 작업
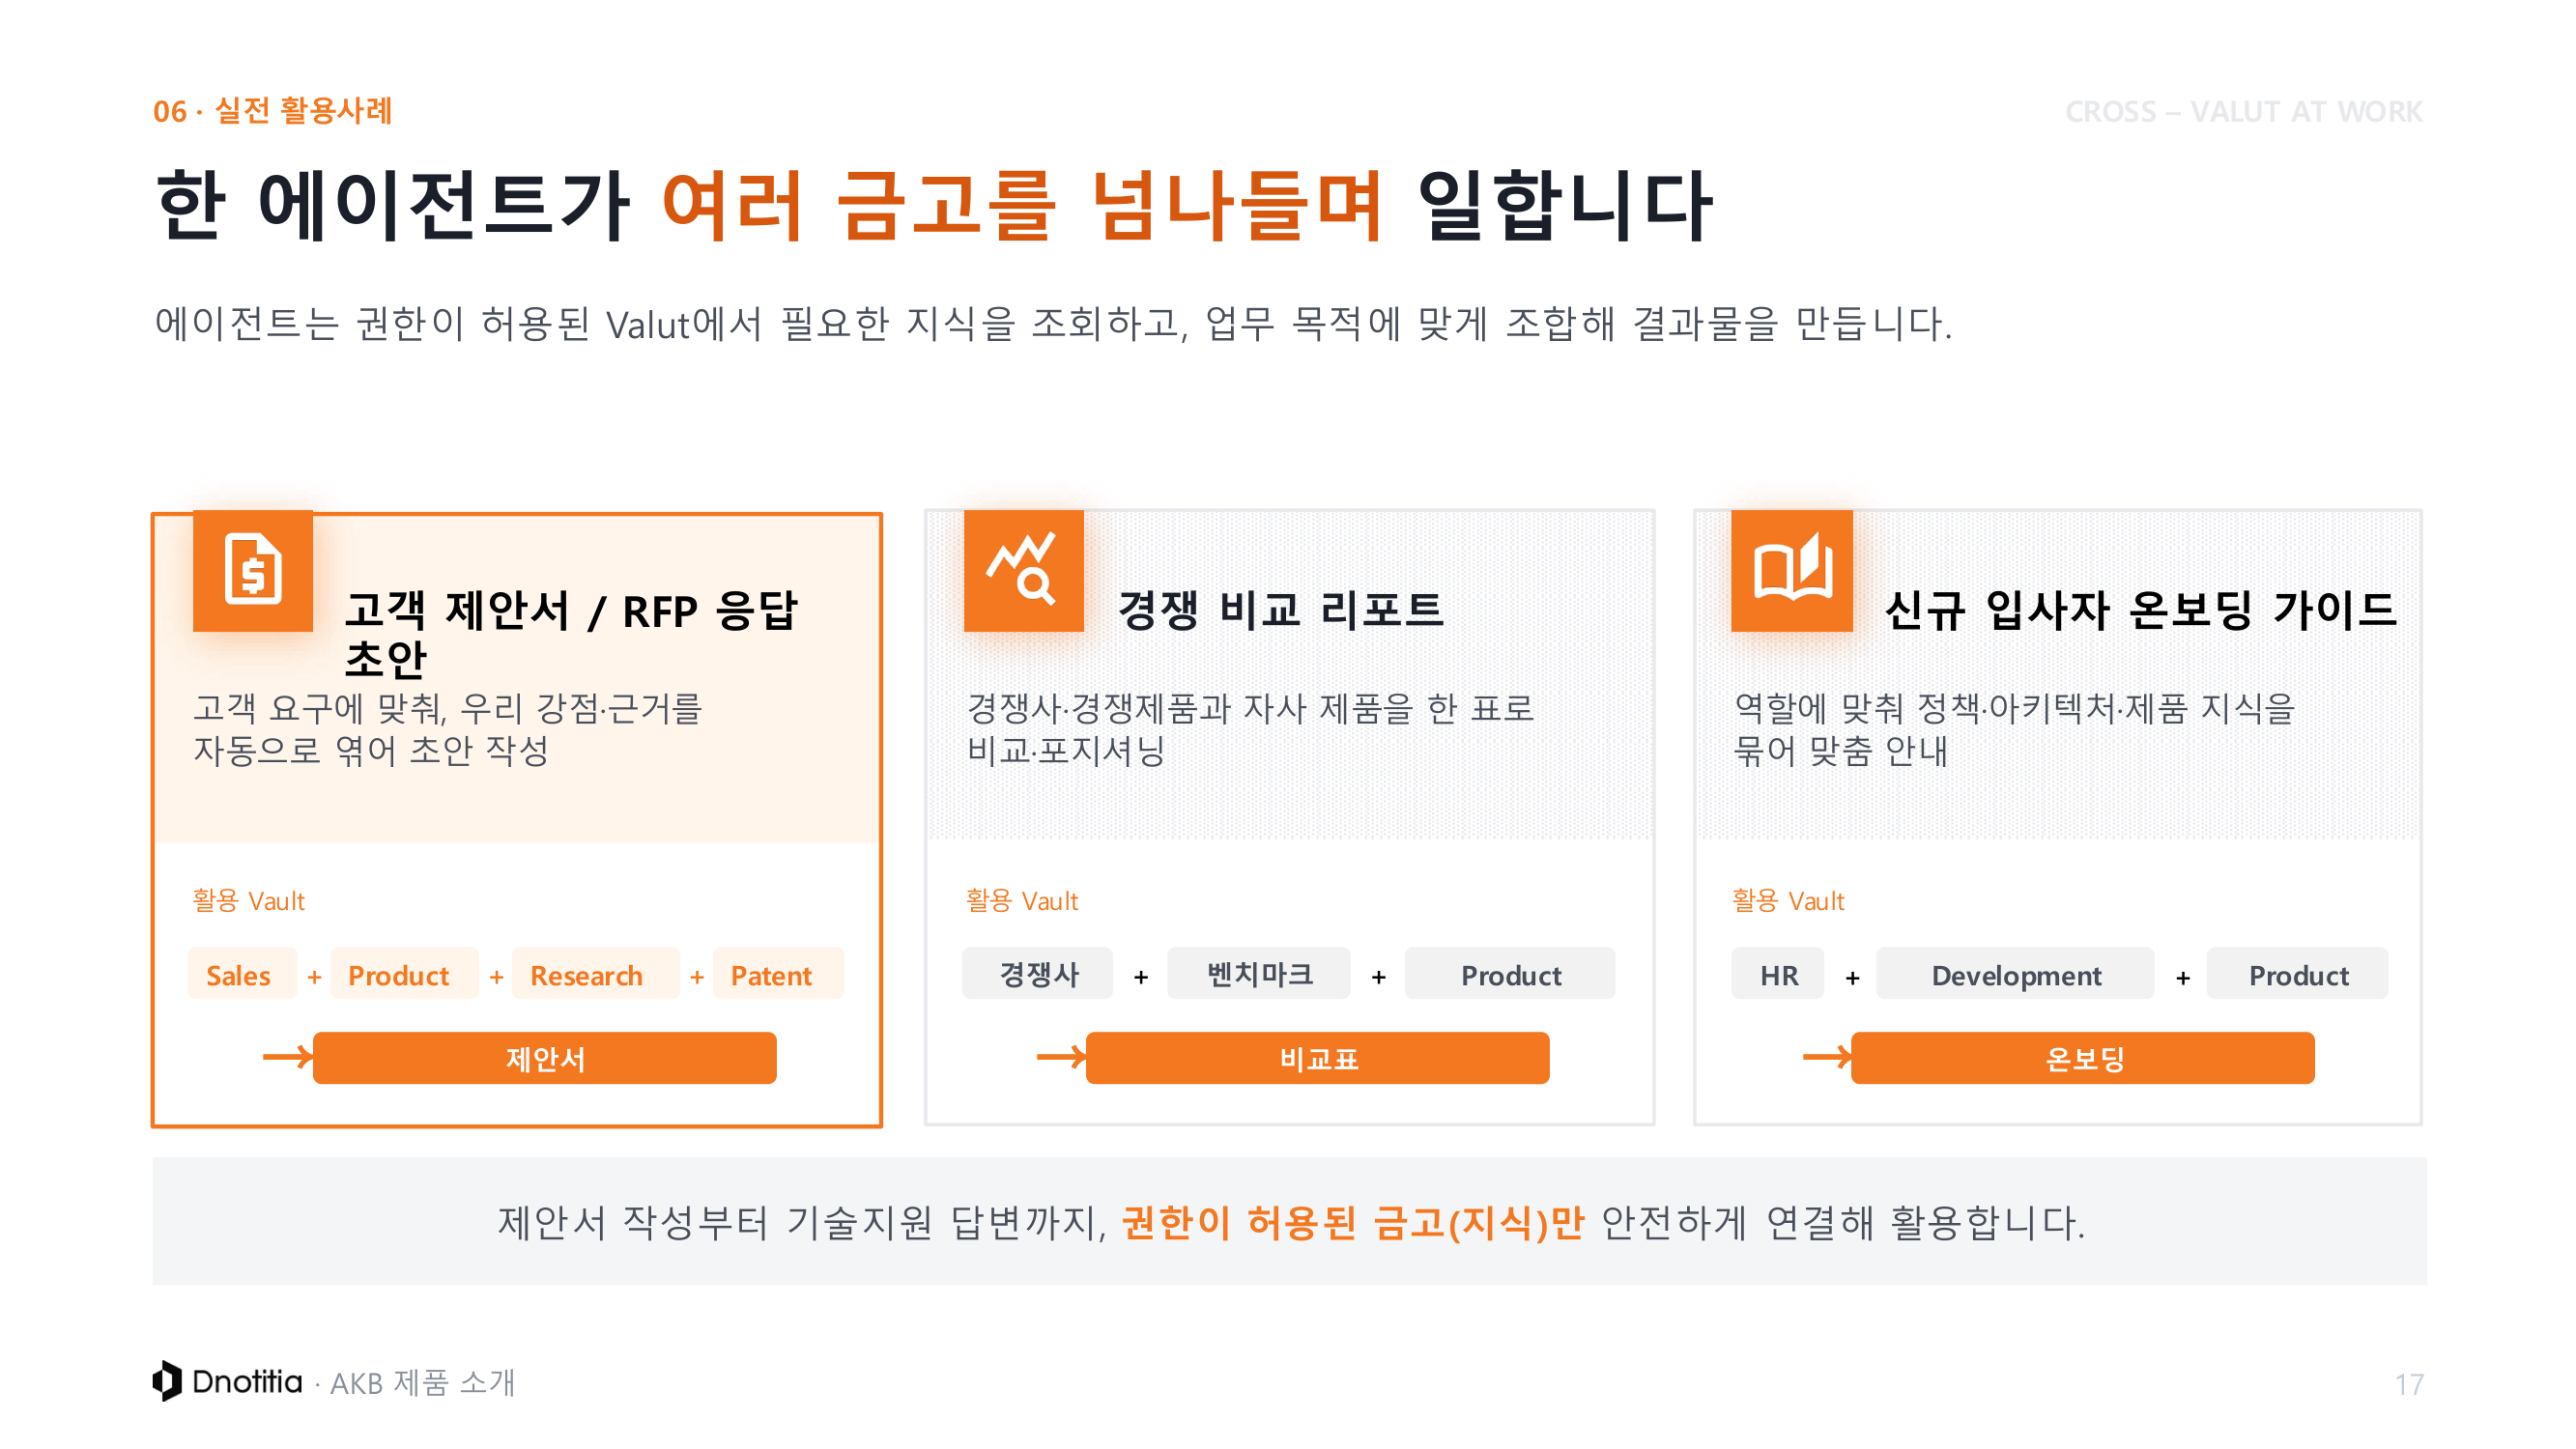
vault를 도메인별로 나누면 격리는 확실해지지만, 실제 업무는 한 도메인에서 끝나지 않는다. 자료는 이 지점을 시나리오 세 개로 보여준다. 표제는 "한 에이전트가 여러 금고를 넘나들며 일합니다"다.
| 시나리오 | 자료의 설명 | 사용 vault | 결과물 |
|---|---|---|---|
| 고객 제안서와 RFP 응답 초안 | 고객 요구에 맞춰 우리 강점과 근거를 자동으로 엮어 초안 작성 | Sales + Product + Research + Patent | 제안서 |
| 경쟁 비교 리포트 | 경쟁사와 경쟁제품, 자사 제품을 한 표로 비교하고 포지셔닝 | 경쟁사 + 벤치마크 + Product | 비교표 |
| 신규 입사자 온보딩 가이드 | 역할에 맞춰 정책, 아키텍처, 제품 지식을 묶어 맞춤 안내 | HR + Development + Product | 온보딩 |
세 시나리오 모두 Product vault를 공통으로 쓴다. 제품 정보가 영업과 경쟁 분석, 온보딩 어디에나 필요한 공통 자산이라는 뜻이다. 나머지 조합은 목적에 따라 갈린다. 제안서는 근거의 폭을 넓히려고 연구와 특허까지 끌어오고, 비교표는 외부 시장 자료 쪽에 무게를 두며, 온보딩은 사내 규정과 개발 문서를 묶는다.
권한은 이 조합에서도 유지된다. 자료가 두 곳에서 같은 취지를 반복한다. "에이전트는 권한이 허용된 vault에서 필요한 지식을 조회하고, 업무 목적에 맞게 조합해 결과물을 만듭니다." 여러 vault를 넘나드는 것과 권한을 넘는 것은 다르다는 선을 그은 셈이다.
업무 시스템에서 활용처까지의 흐름
같은 장의 뒷부분은 조직 안에서 매일 발생하는 기록을 지식으로 바꾸는 경로를 한 장에 그린다. 도입 문장이 전제를 밝힌다. "사내에 매일 쌓이는 대화, 이슈, 변경 이력, 고객 반응, 운영 로그는 단순 기록이 아니라 AI 에이전트가 다시 활용해야 할 업무 자산입니다."
왼쪽 유입 소스는 Slack, Jira, Confluence, GitHub, CRM/VOC, Product Log 여섯 개다. Collector가 다루는 여섯 소스와는 목록이 조금 다르다. Notion과 Google Drive 대신 고객 접점 시스템과 제품 로그가 들어와 있어, 문서 중심에서 운영 데이터 쪽으로 범위가 넓어진 형태다.
가운데 지식화 엔진은 Collector와 Gardener를 부제로 달고 처리 단계 네 개를 배지로 표시한다. 수집, 권한과 출처, 시간과 맥락, 정제와 구조화다. 상자 설명은 "에이전트가 이해하고 활용할 수 있는 지식 단위로 정리"다.
| 활용처 | 자료의 설명 |
|---|---|
| 고객 문의 대응 | 관련 이력과 규정 기반 응답 지원 |
| 장애 원인 탐색 | 변경 이력과 운영 로그 교차 확인 |
| RFP, 정책, 업무 자동화 | 검색, 판단, 실행을 연결하는 업무 지원 |
결론 문장은 제품의 성격을 다시 규정한다. "AKB는 로그를 저장하는 곳이 아니라, 에이전트가 적재적소에 꺼내 쓰는 실시간 업무 지식 기반입니다." 저장소가 아니라 활용 기반이라는 구분이다.
보안 로그를 모으는 지식 허브
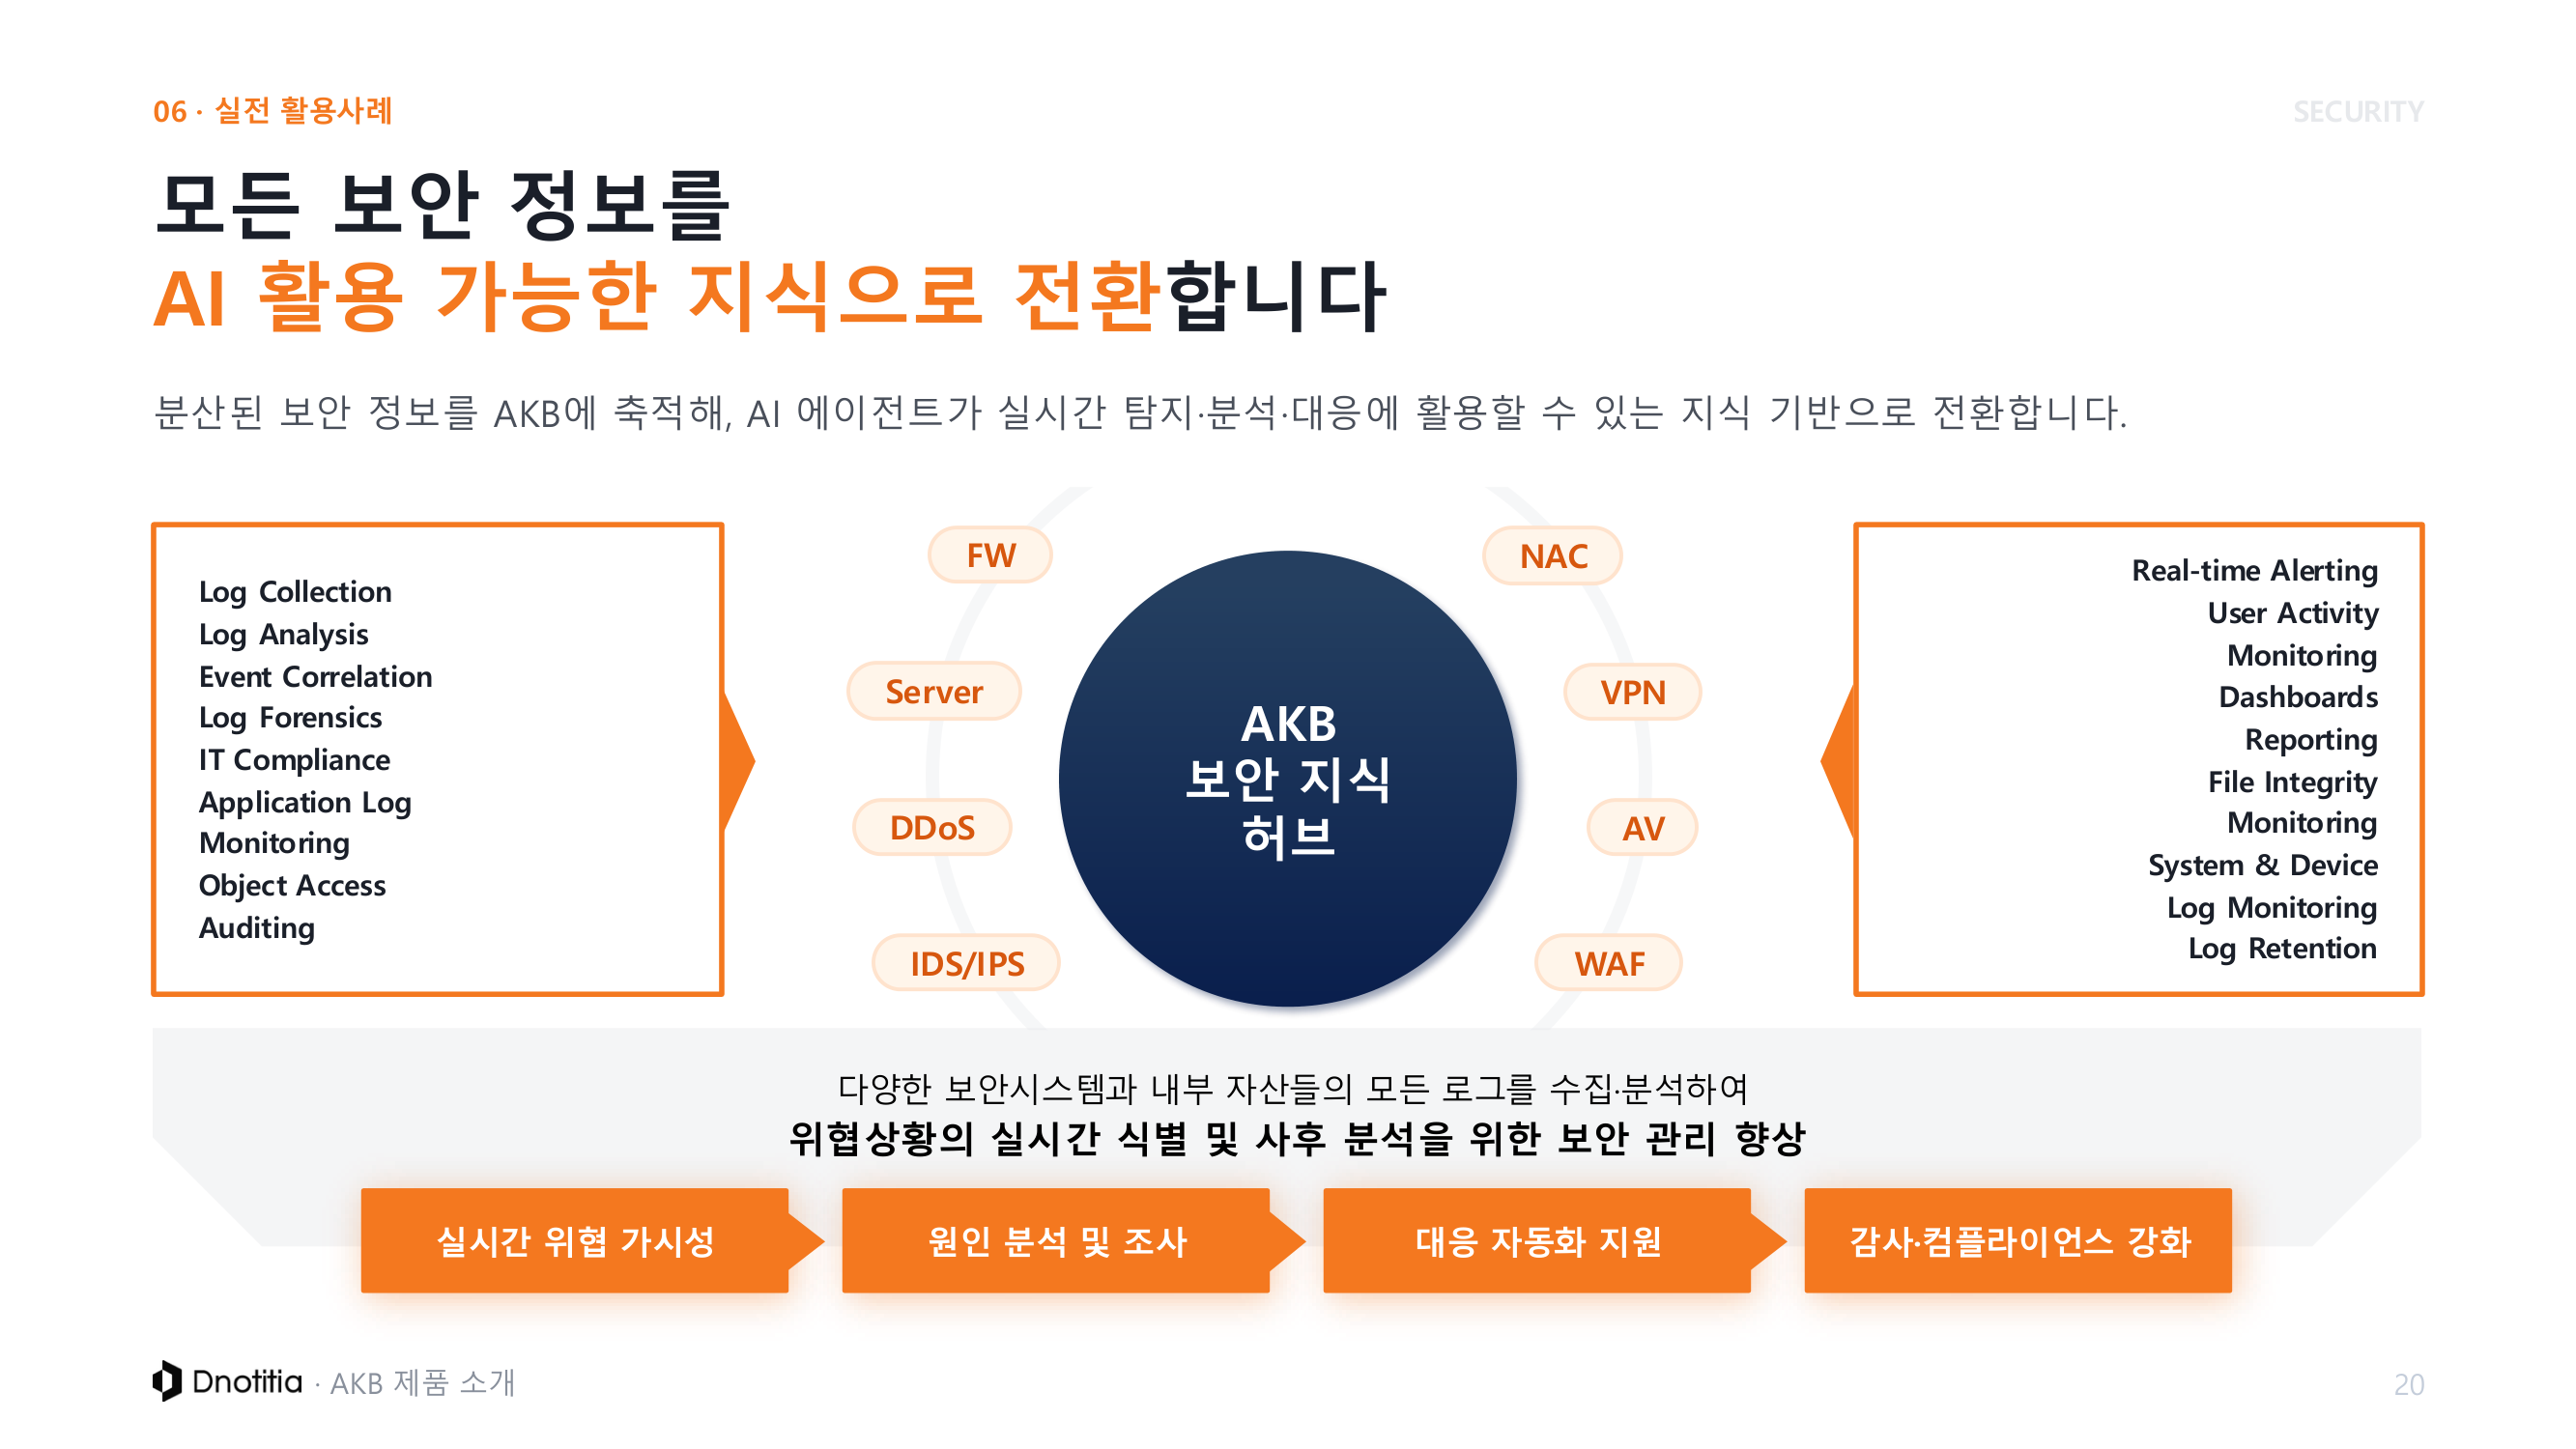
6장 끝의 두 슬라이드는 적용 영역을 보안 운영으로 넓힌다. 첫 슬라이드는 로그를 모으는 허브 구성이다. 표제는 "모든 보안 정보를 AI 활용 가능한 지식으로 전환합니다"다.
가운데 원이 AKB 보안 지식 허브이고, 원 둘레에 로그 소스 여덟 종이 놓인다. FW, Server, DDoS, IDS/IPS, NAC, VPN, AV, WAF다. 방화벽과 서버, 침입 탐지와 방지, 네트워크 접근 제어, 가상 사설망, 백신, 웹 방화벽까지 보안 장비 대부분을 포괄한다.
허브가 수행하는 기능은 열네 개로, 좌우 두 상자에 일곱 개씩 나뉘어 있다.
| 수집과 분석 계열 | 감시와 보존 계열 |
|---|---|
| Log Collection | Real-time Alerting |
| Log Analysis | User Activity Monitoring |
| Event Correlation | Dashboards |
| Log Forensics | Reporting |
| IT Compliance | File Integrity Monitoring |
| Application Log Monitoring | System & Device Log Monitoring |
| Object Access Auditing | Log Retention |
Event Correlation이 이 목록에서 지식베이스와 가장 직접 맞닿는 기능이다. 서로 다른 장비의 로그를 교차해 하나의 사건으로 묶는 작업인데, 여러 소스를 같은 주소 체계 아래 모아 두었을 때 수행하기 쉬워진다.
기대 효과는 네 가지로 정리된다. 실시간 위협 가시성, 원인 분석 및 조사, 대응 자동화 지원, 감사와 컴플라이언스 강화다. 하단 띠가 이를 "위협상황의 실시간 식별 및 사후 분석을 위한 보안 관리 향상"으로 묶는다.
탐지에서 대응까지 잇는 4단계
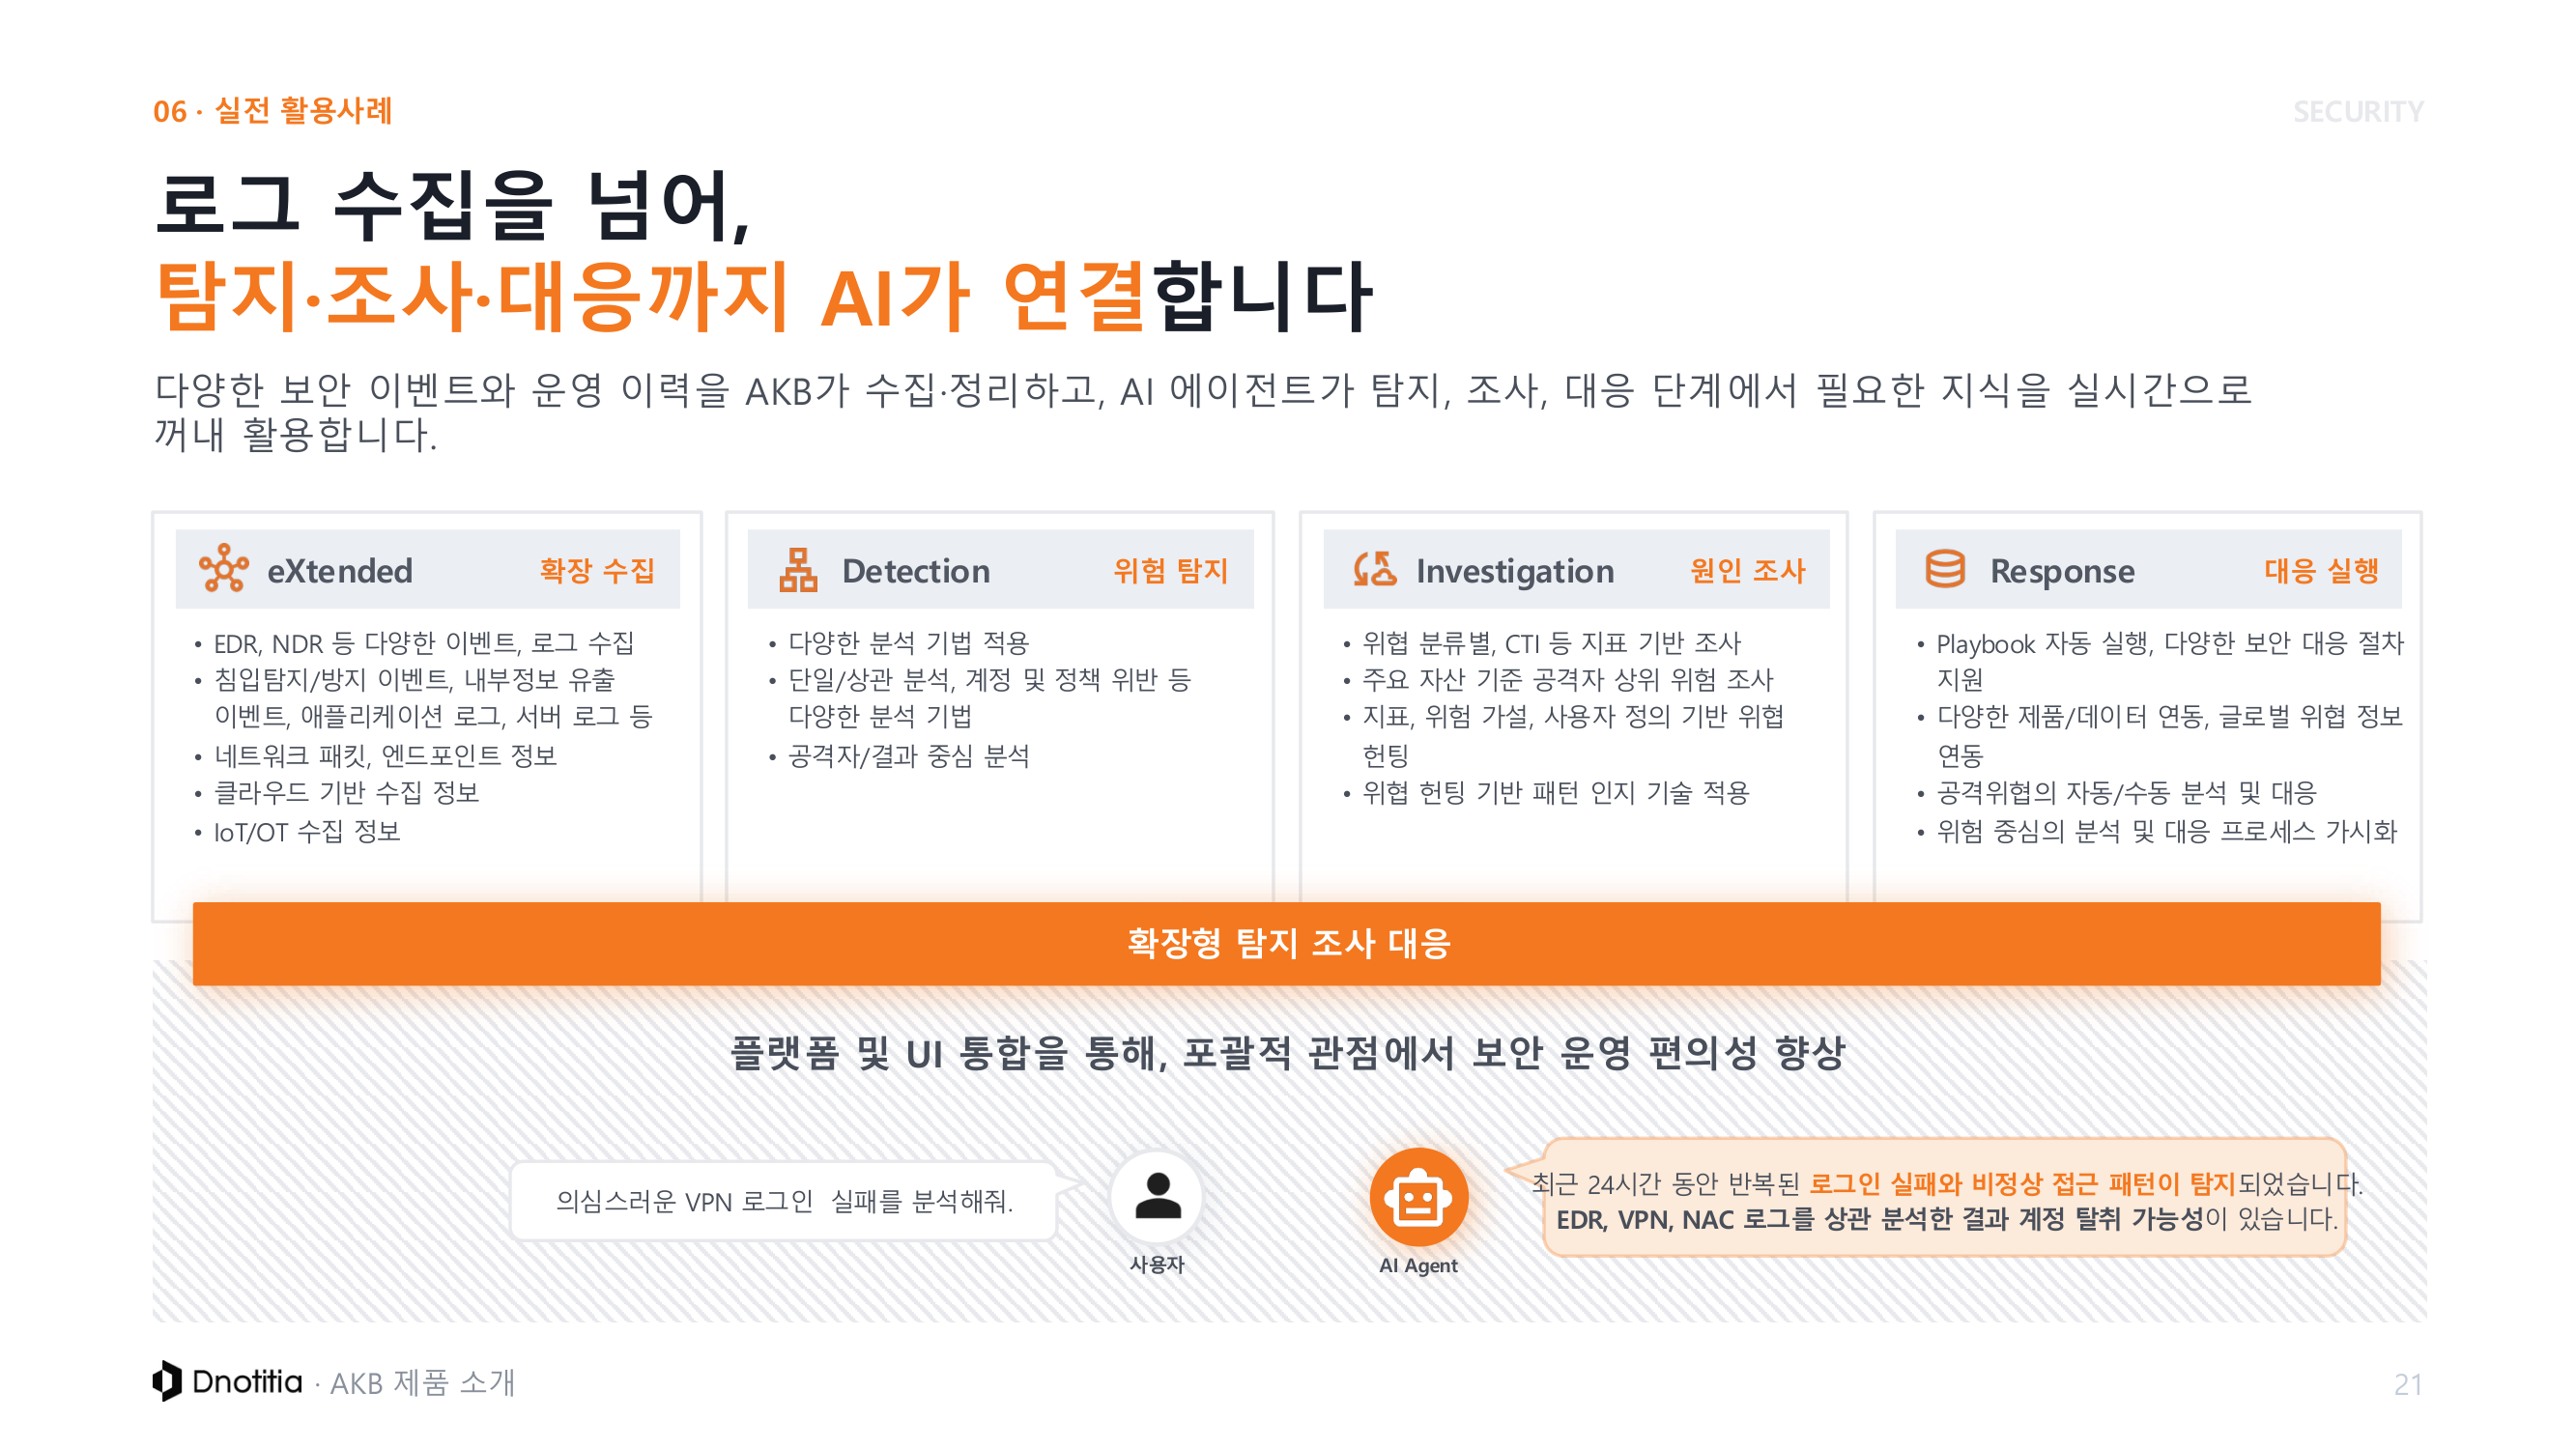
두 번째 보안 슬라이드는 허브 위에서 돌아가는 운영 절차다. 표제는 "로그 수집을 넘어, 탐지와 조사, 대응까지 AI가 연결합니다"다. XDR은 eXtended, Detection, Investigation, Response 네 단어의 머리글자를 딴 이름이고, 자료는 각 단계에 한글 이름을 함께 붙인다.
| 단계 | 한글 이름 | 세부 항목 |
|---|---|---|
| eXtended | 확장 수집 | EDR과 NDR 등 다양한 이벤트와 로그 수집. 침입탐지와 방지 이벤트, 내부정보 유출 이벤트, 애플리케이션 로그, 서버 로그. 네트워크 패킷과 엔드포인트 정보. 클라우드 기반 수집 정보. IoT와 OT 수집 정보 |
| Detection | 위험 탐지 | 다양한 분석 기법 적용. 단일 분석과 상관 분석, 계정 및 정책 위반. 공격자 중심과 결과 중심 분석 |
| Investigation | 원인 조사 | 위협 분류별 CTI 등 지표 기반 조사. 주요 자산 기준 공격자 상위 위험 조사. 지표와 위험 가설, 사용자 정의 기반 위협 헌팅. 위협 헌팅 기반 패턴 인지 기술 적용 |
| Response | 대응 실행 | Playbook 자동 실행과 보안 대응 절차 지원. 다양한 제품 및 데이터 연동, 글로벌 위협 정보 연동. 공격위협의 자동과 수동 분석 및 대응. 위험 중심의 분석 및 대응 프로세스 가시화 |
네 단계 아래에는 "확장형 탐지 조사 대응"이라는 띠가 가로지르고, 그 밑에 "플랫폼 및 UI 통합을 통해, 포괄적 관점에서 보안 운영 편의성 향상"이 붙는다.
슬라이드 맨 아래의 대화 예시가 이 절차를 한 장면으로 압축한다. 사용자가 "의심스러운 VPN 로그인 실패를 분석해줘"라고 묻자 AI Agent가 답한다. "최근 24시간 동안 반복된 로그인 실패와 비정상 접근 패턴이 탐지되었습니다. EDR, VPN, NAC 로그를 상관 분석한 결과 계정 탈취 가능성이 있습니다."
이 답변 한 줄에 앞의 네 단계가 모두 들어 있다. 세 종류 장비의 로그가 이미 수집되어 있어야 하고, 반복 실패라는 패턴이 탐지되어야 하며, 세 로그를 교차해 원인을 좁히고, 계정 탈취라는 판단까지 내려야 한다.
보안 영역이 자료의 다른 부분과 이어지는 지점은 상관 분석이다. 서로 다른 장비의 로그를 한 사건으로 묶으려면 로그가 같은 주소 체계 아래에 있고 에이전트가 여러 경로로 접근할 수 있어야 한다. 앞에서 사내 문서를 대상으로 설명한 구조를 그대로 보안 로그에 적용한 것이 이 두 슬라이드다. 다만 문서 쪽과 달리 여기서는 실증 수치가 제시되지 않는다.
유입에서 폐기까지의 생애주기
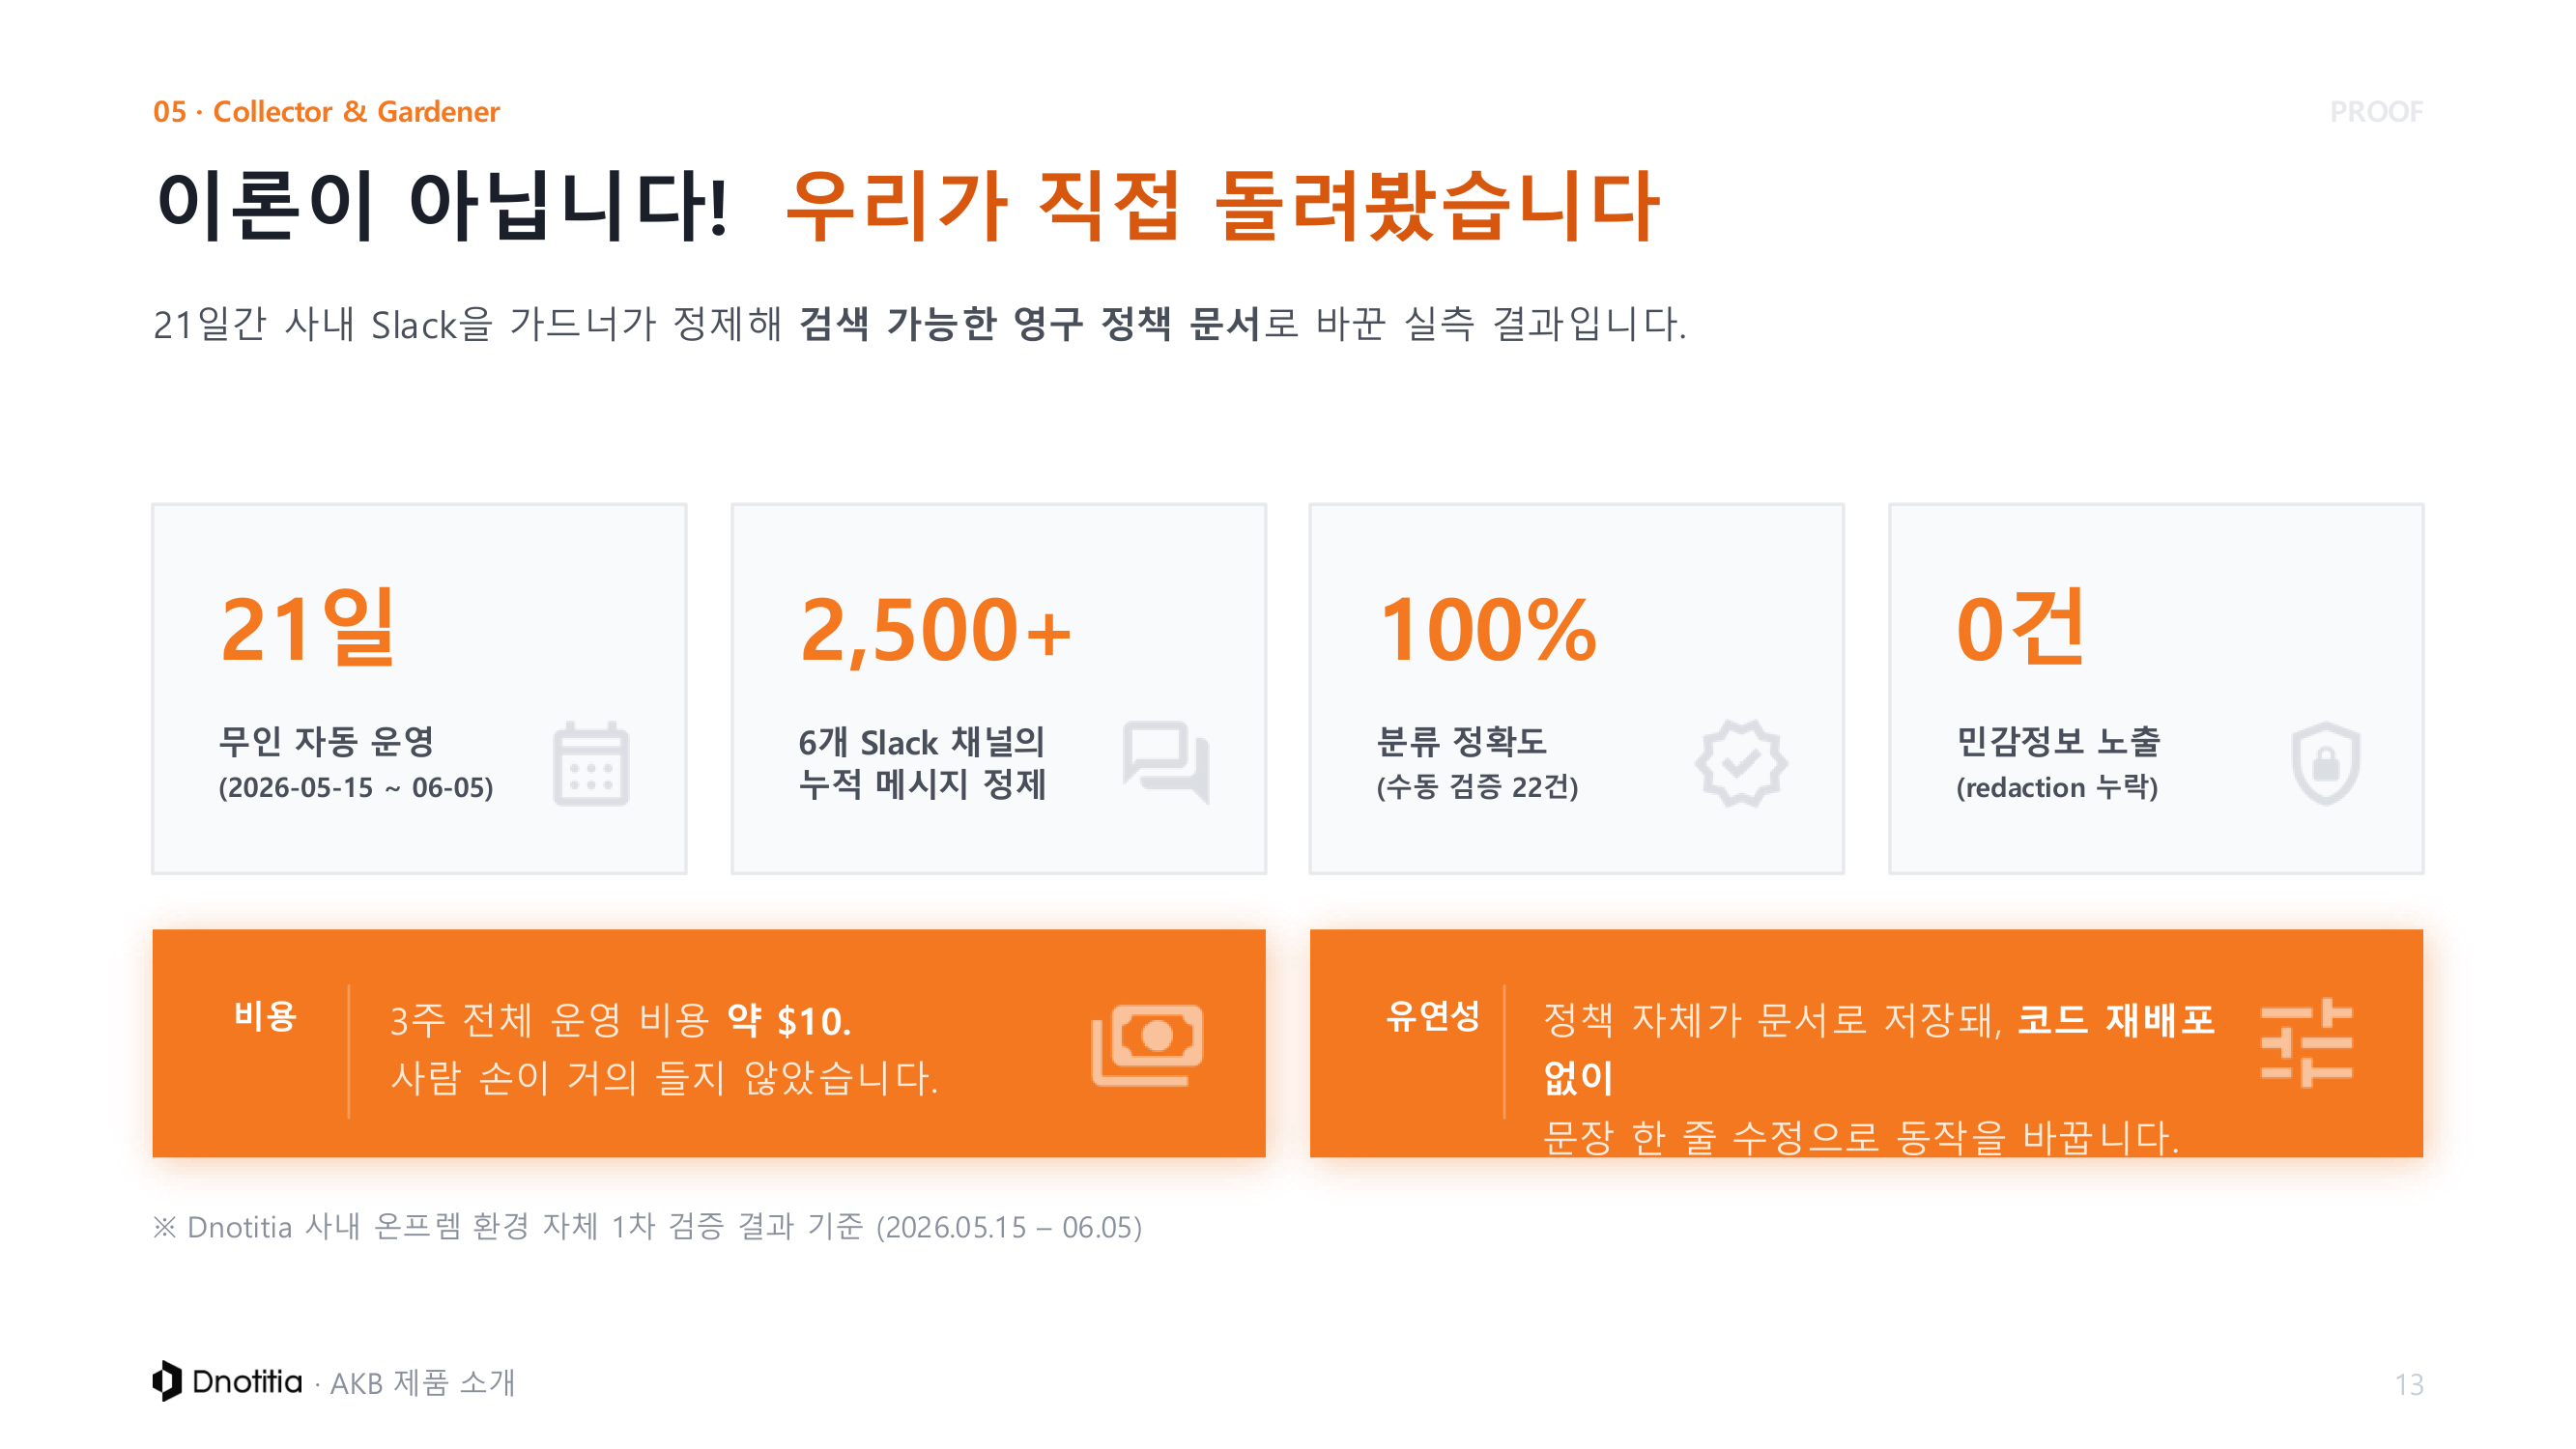
7장은 자료 전체를 한 장으로 요약한다. 표제는 "정보가 들어오고, 정제되고, 쓰이고, 폐기되는 지식의 생애주기 전체"다. 앞에서 개별로 설명한 컴포넌트가 여기서 하나의 흐름으로 이어진다.
| 단계 | 담당 | 한 단어 | 자료의 설명 |
|---|---|---|---|
| 유입 | COLLECTOR | 흘러든다 | Confluence, Jira, Slack, GitHub의 정보가 AKB로 자동 유입 |
| 정제 | GARDENER | 다듬는다 | 원석을 보석으로. 중복과 낡은 건 솎아내고, 출처를 단다 |
| 활용 | AKB | 쓰인다 | 에이전트와 사람이 여러 경로로 찾아 생산하고 소비한다 |
| 폐기 | HITL | 보내준다 | 수명을 다한 지식은 사람 승인 후 정리한다 |
네 번째 단계가 이 자료에서 처음 등장하는 항목이다. 앞의 세 단계는 개별 슬라이드로 설명했지만 폐기는 여기서만 나온다. 담당 주체가 컴포넌트가 아니라 HITL로 표기되어 있는 점도 눈에 띈다. 지식을 지우는 결정만큼은 자동화 대상이 아니라 사람의 승인 사항이라는 뜻이다.
생애주기 아래에는 이 흐름 전체를 떠받치는 보안 경계 네 가지가 놓인다. 자료의 문장은 "이 모든 흐름은 명확한 보안 경계 위에서 작동합니다"다.
| 경계 | 자료의 설명 | 대응하는 앞 절 |
|---|---|---|
| 권한 경계 | 볼 수 있는 사람만 본다. 읽기, 쓰기, 관리 | Vault 권한 (RBAC) |
| 데이터 격리 | 권한 밖 vault는 질의로도 보이지 않음 | DB 네이티브 격리 |
| 감사 로그 | 누가 언제 무엇을 봤는지 전부 기록 | 전수 감사 로그 |
| 출처 인용 | 모든 지식에 근거 출처가 붙는다 | Collector의 원천 보존과 Gardener의 출처 달기 |
네 경계는 앞에서 개별 기능으로 설명한 항목을 다시 묶은 것이다. 기능 목록이 아니라 지켜야 할 선으로 제시하는 자리에서 같은 항목이 한 번 더 나온다.
결과
21일 무인 자동 운영 실측
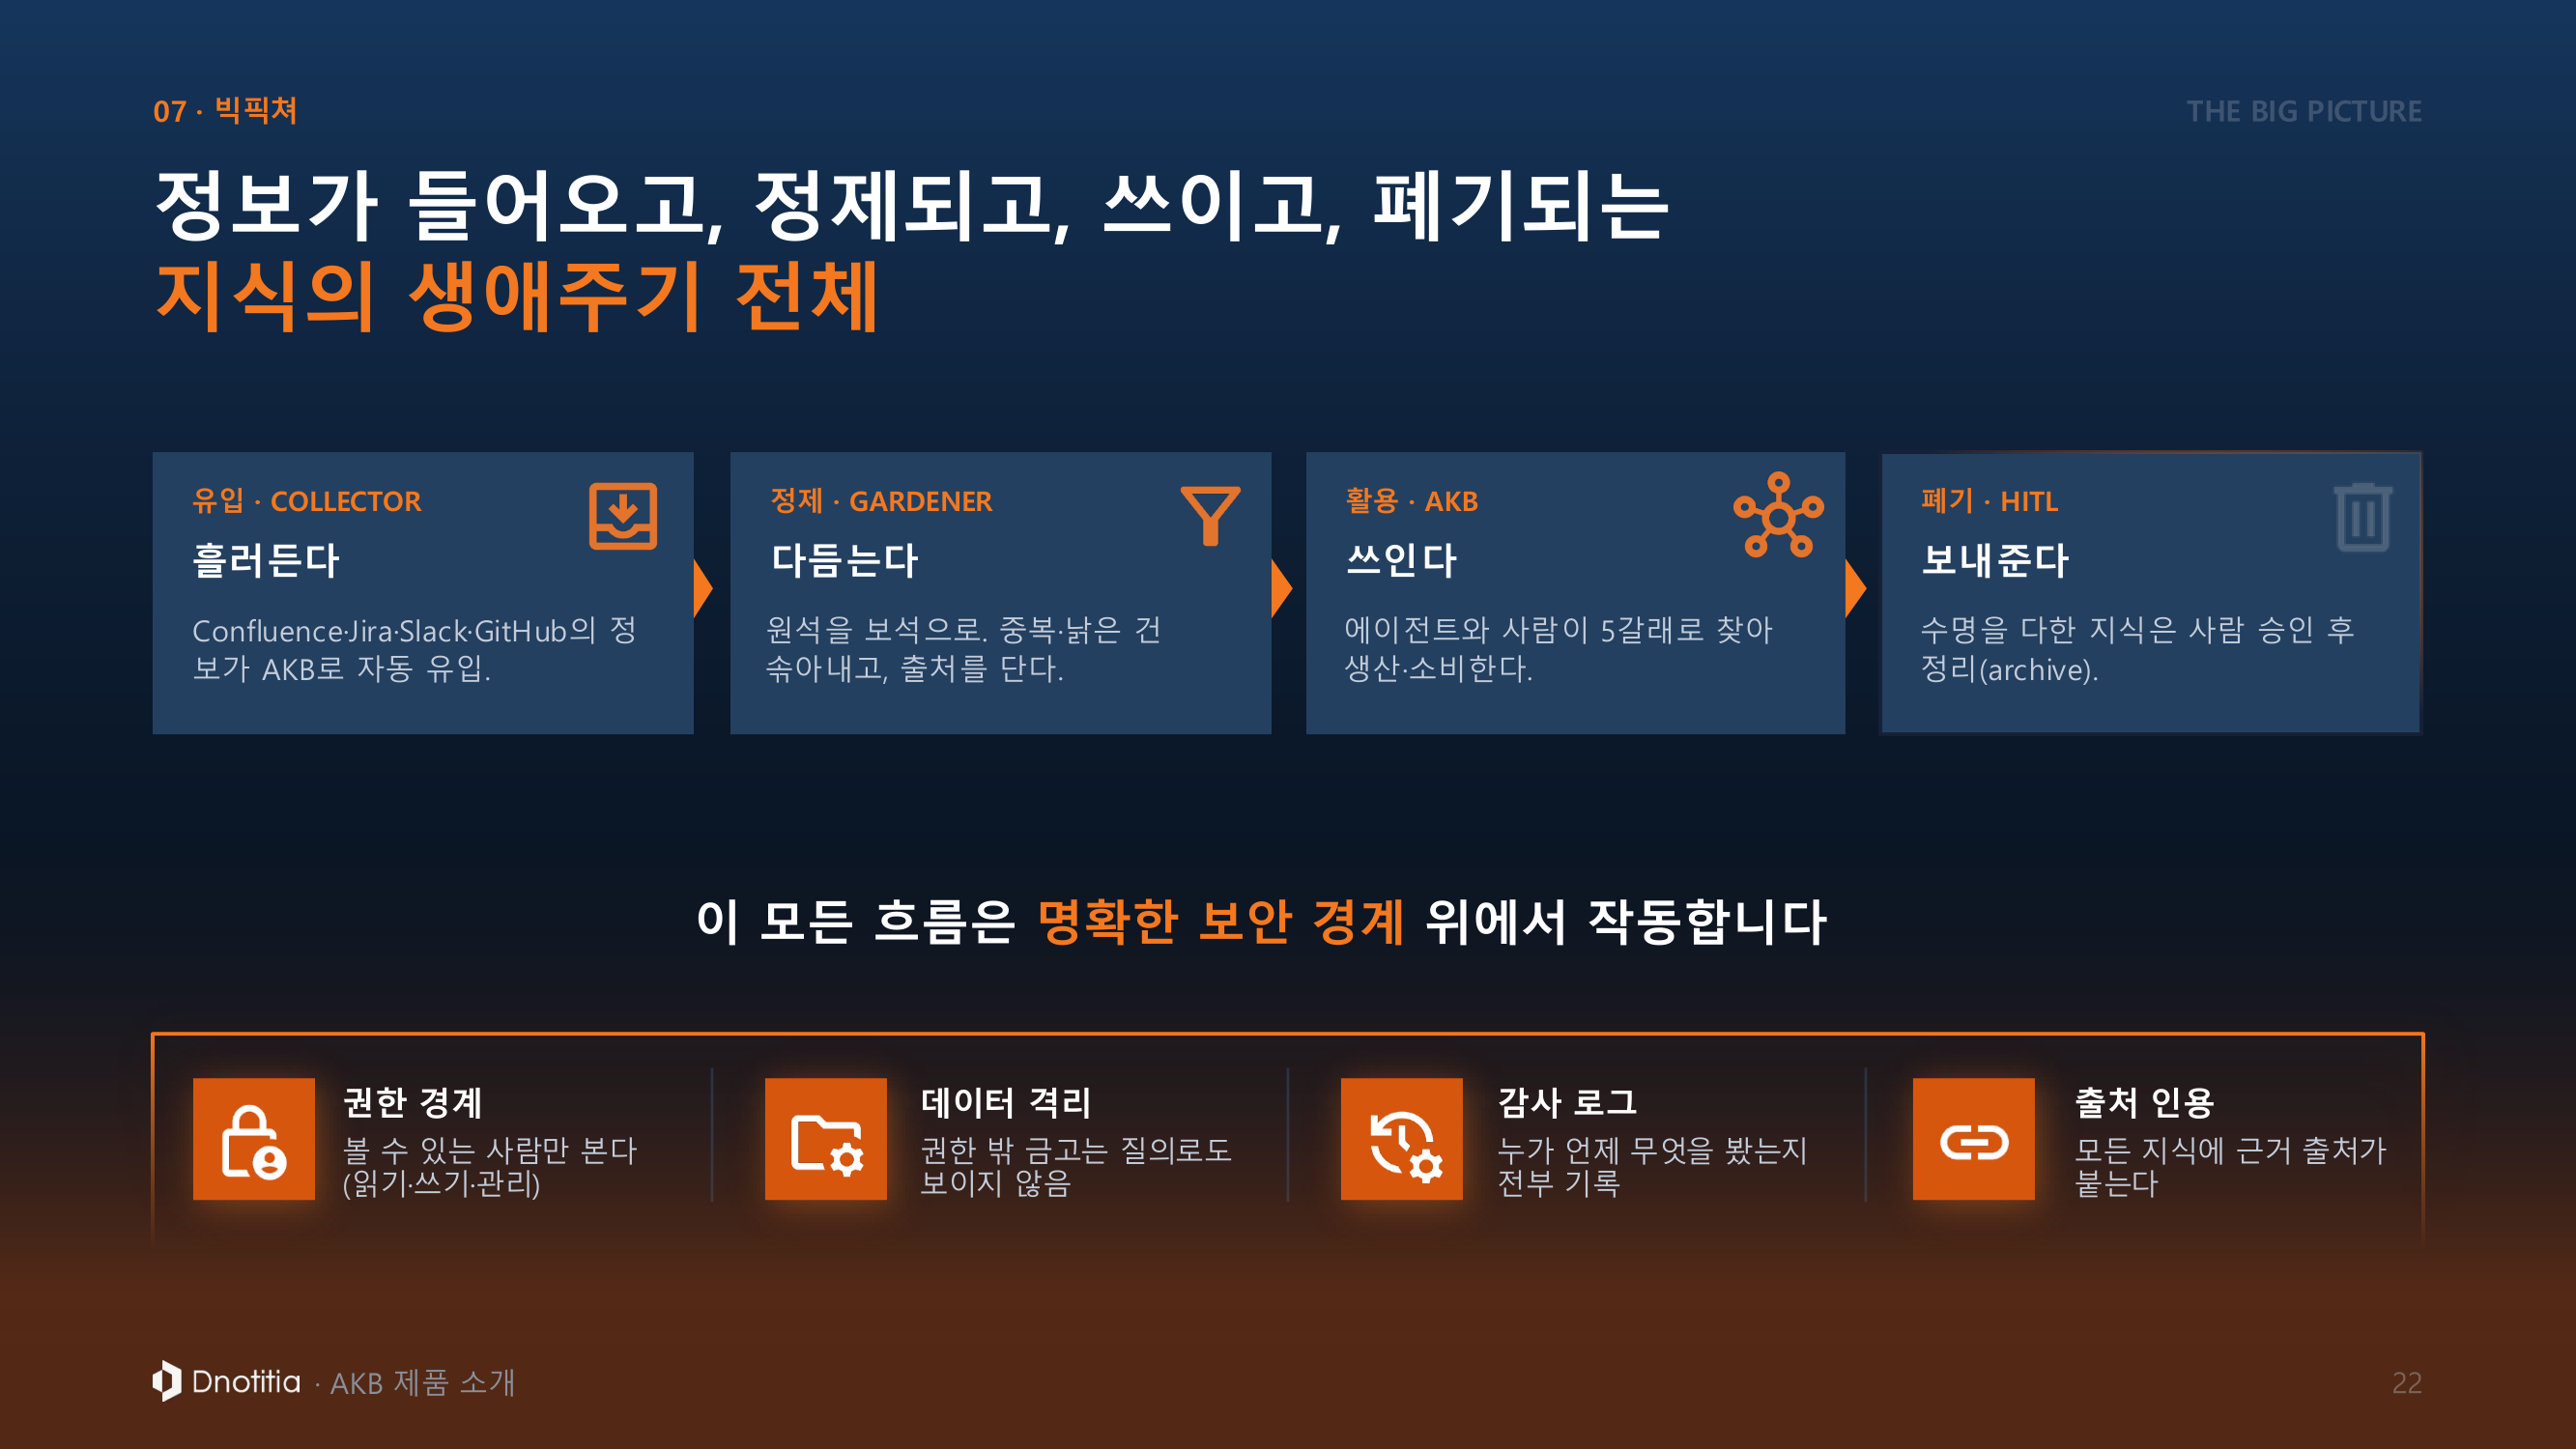
자료가 제시하는 유일한 정량 결과다. 표제부터 성격을 밝힌다. "이론이 아닙니다! 우리가 직접 돌려봤습니다." 사내 Slack을 Gardener가 정제해 검색 가능한 영구 정책 문서로 바꾼 결과다.
| 지표 | 값 | 자료의 부기 |
|---|---|---|
| 무인 자동 운영 기간 | 21일 | 2026-05-15에서 06-05까지 |
| 정제 대상 Slack 채널 | 6개 | |
| 누적 메시지 정제 | 2,500개 이상 | 6개 채널의 누적 메시지 |
| 분류 정확도 | 100% | 수동 검증 22건 |
| 민감정보 노출 | 0건 | redaction 누락 |
| 3주 전체 운영 비용 | 약 $10 | 사람 손이 거의 들지 않았다 |
비용 수치가 이 표에서 가장 눈에 띄는 값이다. 21일 동안 여섯 개 채널에서 2,500개가 넘는 메시지를 처리한 전체 비용이 10달러 수준이라는 뜻이다. 자료는 이 값을 성능 지표가 아니라 운영 부담의 지표로 제시한다.
여기에 유연성 항목이 함께 놓인다. "정책 자체가 문서로 저장돼, 코드 재배포 없이 문장 한 줄 수정으로 동작을 바꿉니다." Gardener가 무엇을 어떻게 다듬을지를 코드가 아니라 문서에 적어 두었다는 말이다. 규칙을 바꾸려고 배포 절차를 거칠 필요가 없다는 점이 운영 이점으로 제시된다.
각주는 측정 조건을 명시한다. "Dnotitia 사내 온프렘 환경 자체 1차 검증 결과 기준"이다. 외부 환경이나 제3자 검증이 아니라는 뜻을 자료 스스로 밝힌 것이다.
지표 네 개가 겨냥하는 대상은 서로 다르다. 21일과 2,500개 이상은 얼마나 오래, 얼마나 많이 처리했는지를 말하고, 100%와 0건은 그 처리가 얼마나 정확했는지를 말한다. 앞의 두 값은 자동으로 집계되지만 뒤의 두 값은 사람이 표본을 뽑아 확인해야 나오는 값이고, 자료가 밝힌 표본은 22건이다. 규모 지표와 품질 지표의 근거 강도가 같지 않다.
무인 운영이라는 조건도 함께 봐야 한다. 21일 동안 사람이 개입하지 않았다는 뜻인데, Gardener의 파괴적 작업에는 사람 승인이 필요하다는 설계와 나란히 읽으면 이 기간에 승인이 필요한 작업이 없었거나 승인을 요구하지 않는 작업만 수행했다는 해석이 가능하다. 자료는 이 점을 밝히지 않는다.
Slack 대화에서 정책 문서로
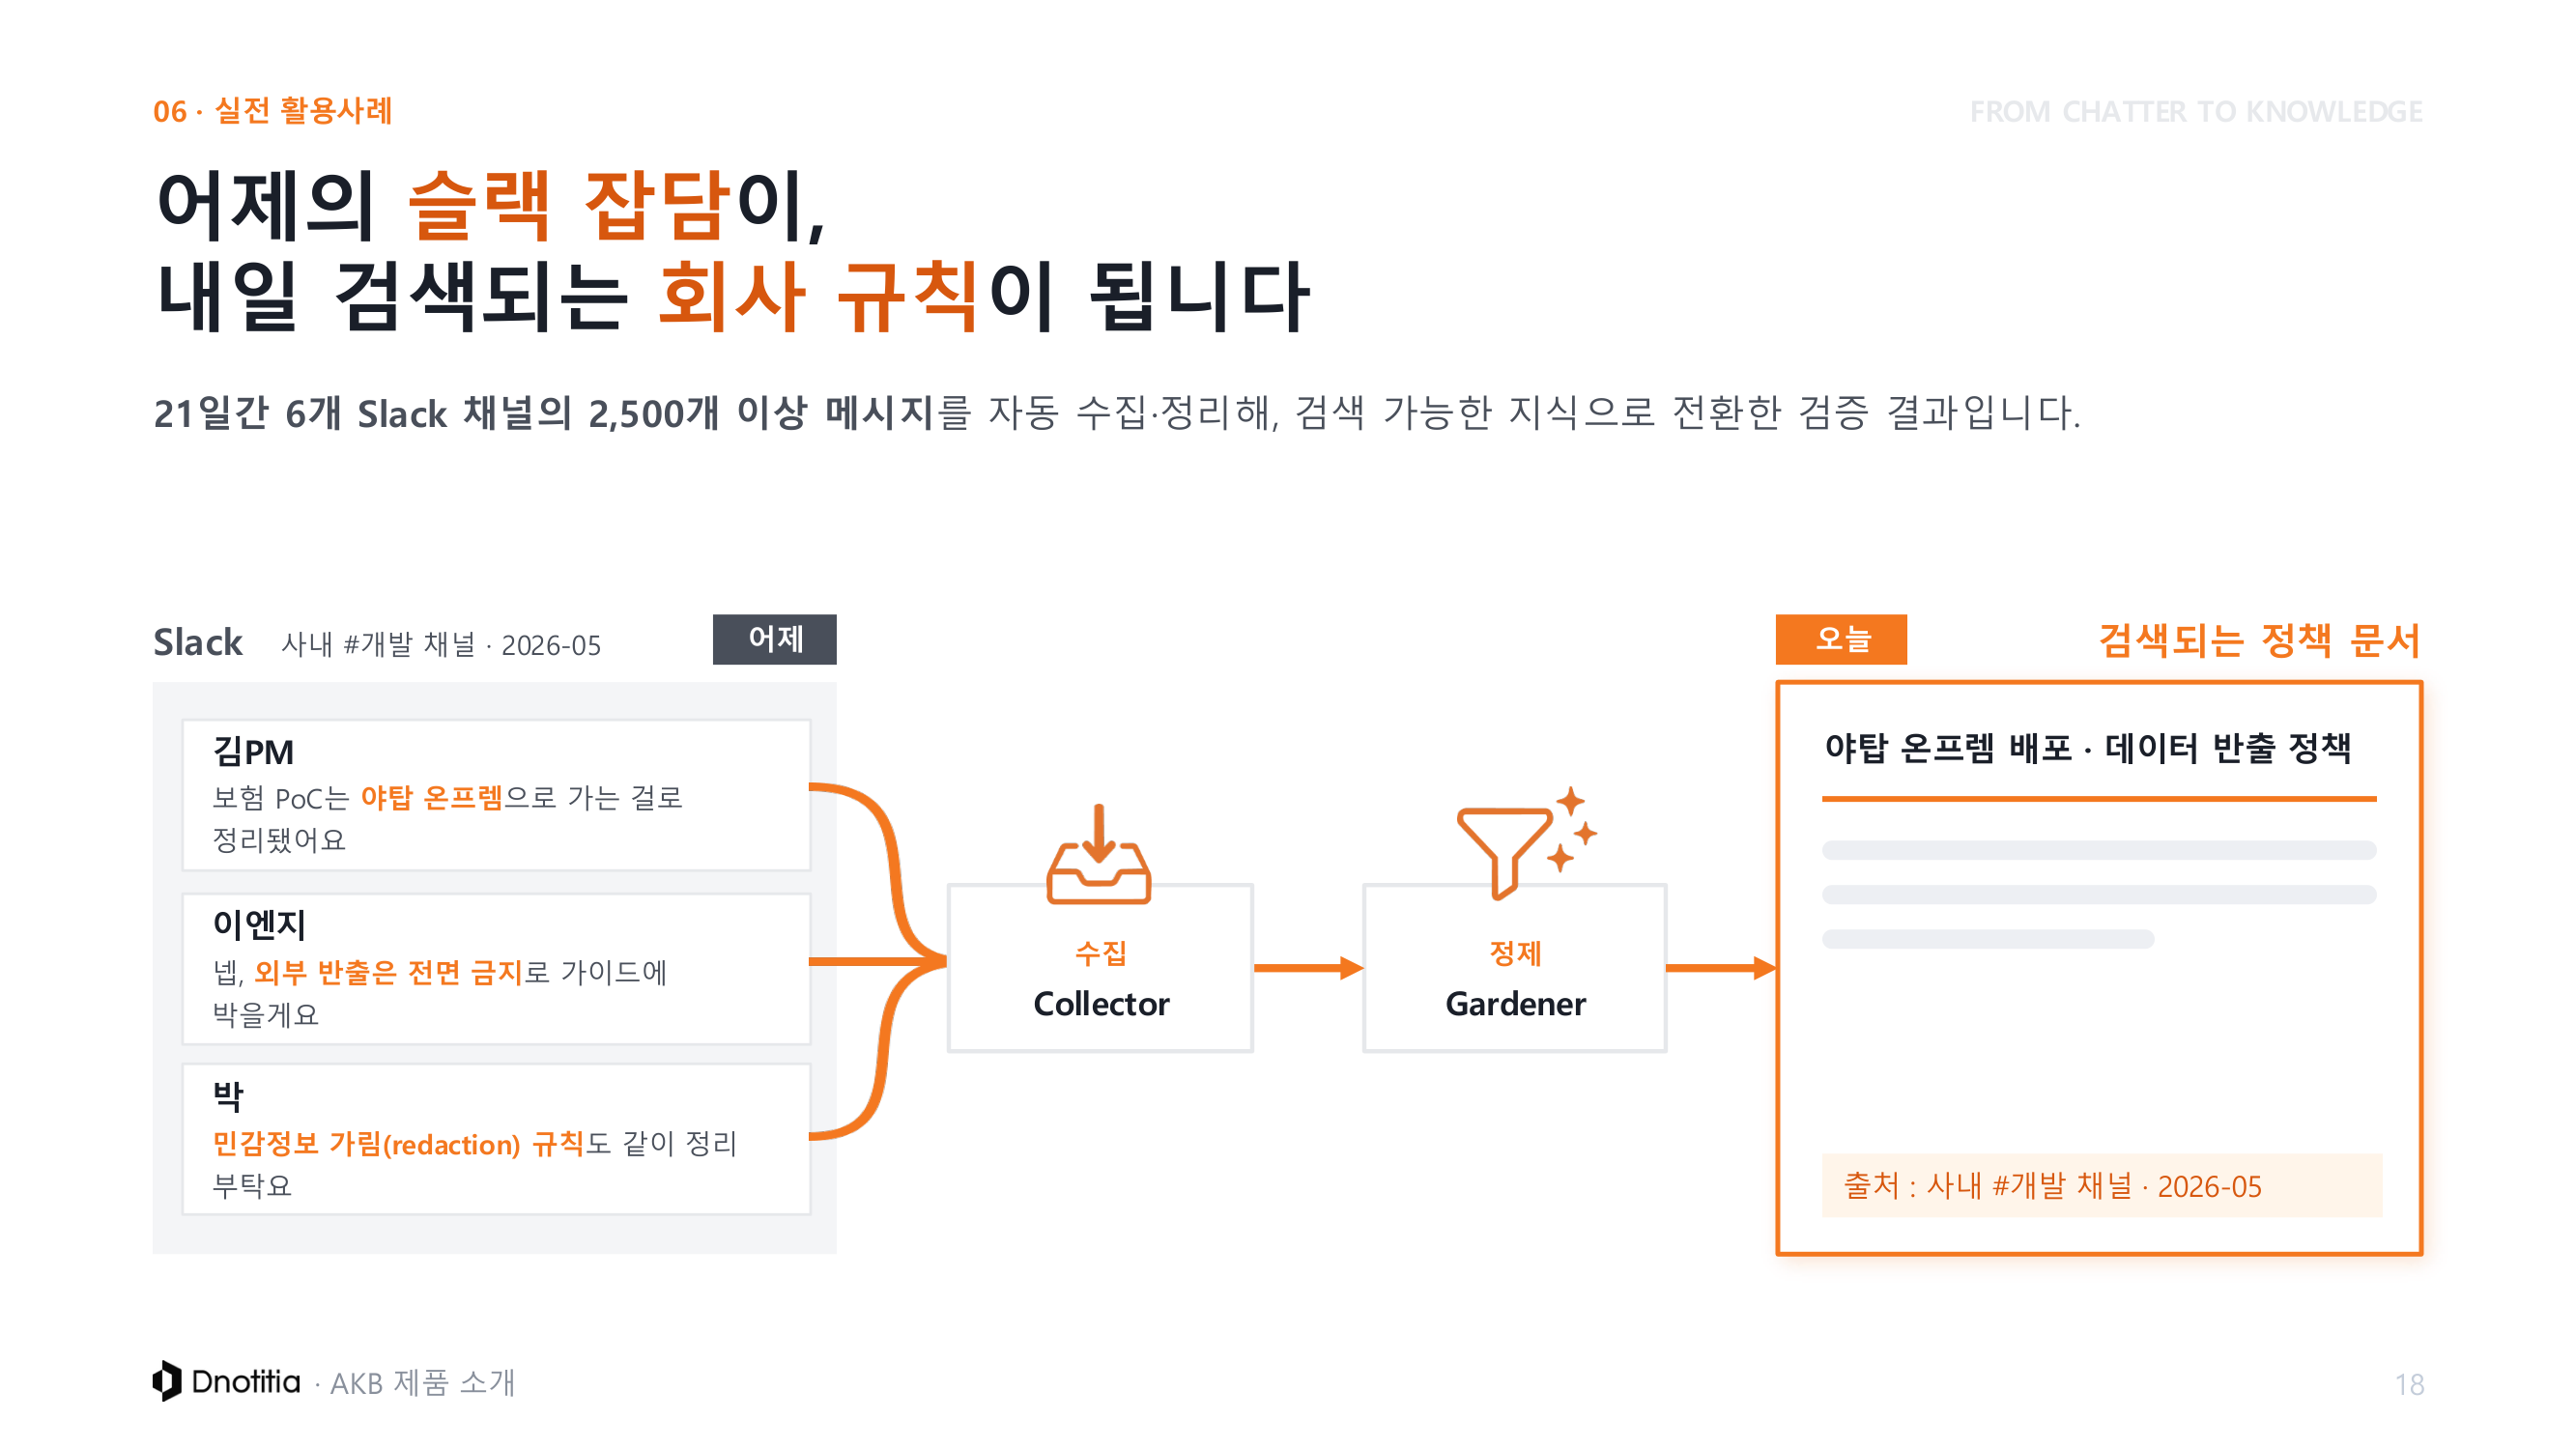
같은 실증의 결과물 하나를 구체 사례로 보여주는 슬라이드가 뒤에 나온다. 표제는 "어제의 슬랙 잡담이, 내일 검색되는 회사 규칙이 됩니다"다.
왼쪽 원본은 사내 개발 채널의 2026년 5월 대화 세 건이다.
- 김PM: "보험 PoC는 야탑 온프렘으로 가는 걸로 정리됐어요"
- 이엔지: "넵, 외부 반출은 전면 금지로 가이드에 박을게요"
- 박: "민감정보 가림(redaction) 규칙도 같이 정리 부탁요"
세 발언은 각각 배포 위치와 반출 정책, 민감정보 처리 규칙을 담고 있지만 형식은 대화다. 결정이 내려진 자리이면서도 문서가 아니어서 나중에 찾아 쓰기 어려운 상태라는 것이 이 예시의 출발점이다.
가운데를 수집과 정제 두 상자가 차지하고, 오른쪽에 결과물이 놓인다. 제목이 "야탑 온프렘 배포, 데이터 반출 정책"인 문서이고, 하단에 "출처: 사내 개발 채널, 2026-05"가 자동으로 붙어 있다. 앞 절의 원천 보존과 출처 달기가 실제 산출물에서 어떤 모습인지 보여주는 대목이다.
운영 규모와 인용 수치
정량 결과 외에 자료가 밝히는 수치는 두 가지다.
| 항목 | 값 | 출처 |
|---|---|---|
| 1차 검증 사용자 | 12명 | 자료의 각주 |
| 1차 검증 vault | 9개 | 자료의 각주 |
| AI 프로젝트 폐기 전망 | 60% | Gartner (2025) 인용 |
Gartner 수치는 자료가 직접 측정한 값이 아니라 포지셔닝 근거로 끌어온 외부 인용이다. 성능 주장이 아니라 시장 상황을 설명하는 자리에 쓰였다.
12명이라는 규모는 이 자료의 다른 서술과 함께 읽어야 한다. 자료는 9개 vault를 HR부터 경쟁제품 벤치마크까지 폭넓게 나열하지만, 그 아홉 개를 실제로 쓰는 사용자는 12명이다. 사람 한 명이 여러 도메인에 걸쳐 있고, 생산자와 소비자를 겸한다는 서술도 이 규모에서 나온 관찰이다. 자료가 "같은 사람이 생산자이자 소비자입니다"라고 적은 배경에 이 조건이 있다.
한계
검증 범위가 좁다
자료의 정량 결과는 모두 자체 검증이고, 그 범위도 좁다.
| 항목 | 자료가 밝힌 조건 | 남는 물음 |
|---|---|---|
| 검증 주체 | Dnotitia 사내 자체 1차 검증 | 외부 환경이나 제3자 검증 결과가 없다 |
| 분류 정확도 100% | 수동 검증 22건 | 표본이 22건이라 신뢰구간이 넓다. 자료는 이 점을 언급하지 않는다 |
| redaction 누락 0건 | 민감정보 노출 0건 | 놓친 것이 없다는 recall인지, 잡은 것 중 오탐이 없다는 precision인지 구분이 없다 |
| 사용 규모 | 12명, vault 9개 | 수백에서 수천 사용자 규모의 동작은 공개되지 않았다 |
| 비교 대상 | 없음 | 공개 벤치마크나 경쟁 제품과의 대조가 없다 |
특히 분류 정확도 100%는 표본 크기를 함께 읽어야 한다. 22건에서 전부 맞았다는 뜻이므로, 오차 하나가 발생했다면 값이 95.5%로 내려간다. 자료는 이 수치를 그대로 제시하고 통계적 해석은 붙이지 않는다.
구현 세부가 공개되지 않았다
제품 소개 자료의 성격상 내부 구현은 대부분 비공개다.
| 영역 | 자료에 없는 것 |
|---|---|
| Collector | 6개 소스 connector의 구현 깊이, hash 비교 단위, redaction 엔진의 종류 |
| Gardener | LLM과 규칙의 비율, 4단계 요약에 쓰는 지시문(instruction)과 모델 |
| 승인 절차 | 승인 화면 구성, 승인자 식별 방식, 충돌 해소 정책 |
| Kiwi | 검색 인덱싱 단계에 붙였는지 질의 재작성 단계에 붙였는지 |
| 데이터베이스 격리 | 어떤 데이터베이스 기능으로 격리했는지 |
| XDR | 라이선스와 배포 모델, 가격 |
이 가운데 데이터베이스 격리의 구현은 저장소 기준 페이지인 AKB: Agent Knowledge Base에서 확인할 수 있다. 나머지는 두 자료 어디에도 없다.
제품 소개 자료라는 성격
이 자료는 제품을 설명하기 위해 만들어진 문서다. 서술이 주장과 근거가 아니라 표제와 예시로 구성되어 있고, 각 슬라이드의 표제가 대부분 단정문이다. 수치가 나오는 곳은 실측 슬라이드 한 장과 Gartner 인용 한 곳뿐이다.
읽는 쪽에서 유의할 점은 두 가지다. 하나는 대안과의 비교가 없다는 것이다. 벡터 검색의 약점은 짚지만 그 약점을 다른 방식으로 푸는 접근과 견주지 않는다. 다른 하나는 실패 사례가 없다는 것이다. 21일 실증에서 잘 안 된 항목이나 처리하지 못한 메시지 유형은 나오지 않는다.
자료 내부의 불일치
- 3장 제목과 22쪽 요약이 탐색 경로를 다섯 가지로 적지만 6쪽 도식은 네 가지만 나열한다. 다섯 번째가 무엇인지 자료 어디에도 나오지 않는다
- Collector가 다루는 소스 여섯 개와 실시간 흐름 슬라이드의 유입 소스 여섯 개가 서로 다르다. 후자에는 Notion과 Google Drive 대신 CRM/VOC와 Product Log가 들어 있는데, 두 목록의 관계는 설명되지 않는다
- 오탈자가 여러 곳에 있다. 4쪽 "안 보변", 8쪽 "SGL", 12쪽 "구조회해", 15쪽 "관라하고", 17쪽 "Valut", 19쪽 "ABK"가 그것이다
핵심 용어
| 용어 | 뜻 |
|---|---|
| AKB | Agent Knowledge Base. Dnotitia의 에이전트용 조직 지식베이스 본체 |
| AKB Collector | 외부 소스 6종을 AKB로 자동 동기화하는 컴포넌트. hash 비교, 원본 링크 보존, 유입 단계 redaction 세 원칙으로 동작한다 |
| AKB Gardener | Bronze 상태의 수집물을 Gold로 정제하는 컴포넌트. 다듬기, 솎아내기, 출처 달기, 눈높이 요약 네 작업을 수행한다 |
| Bronze와 Gold | 자료가 원석과 보석으로 옮겨 쓰는 정제 단계 이름. Bronze는 Collector 직후, Gold는 Gardener 정제 후를 가리킨다 |
| Propose, Approve, Execute | Gardener의 3단계 작업 흐름. Gardener가 제안하고, 사람이 승인하고, Gardener가 승인분만 실행한다 |
| vault | 권한과 격리의 단위. 도메인 하나에 vault 하나를 배정하고, 자료는 이를 금고로 옮겨 부른다 |
akb:// |
문서와 표, 파일을 하나로 묶는 주소 체계. 자료는 이를 하나의 URI 코퍼스로 부른다 |
| XDR | eXtended, Detection, Investigation, Response. 보안 로그를 통합해 탐지와 조사, 대응까지 잇는 운영 모델 |
관련 페이지
- AKB: Agent Knowledge Base: 같은 제품의 GitHub 저장소 기준 기술 페이지. 이 자료가 수집과 정제, 운영을 다룬다면 그 페이지는 검색 성능과 MCP tool 목록, 권한 구현을 다룬다
- AKB, llmwiki, GBrain 비교 및 AKB 발전 방향: AKB와 llmwiki, GBrain을 같은 기준으로 비교하고 AKB의 발전 방향을 제안한 전략 보고서
- garrytan/gbrain: 단일 사용자 중심의 markdown 기반 agent memory. Collector와 Gardener, 다중 vault 권한이 조직 단위 기능으로 어떤 차이를 만드는지 대조해 볼 수 있다
- RAG, LLM Wiki, or GBrain? 에이전트 메모리 결정 프레임워크 (Liu): retrieval과 문서 컴파일, 실행 중 무엇을 고를지 다룬 결정 프레임워크. AKB는 셋을 한 인프라에 묶는 쪽에 해당한다
- Karpathy LLM Wiki 패턴: 한국어 종합 정리 (kmyu99 Notion): 대화 기록을 위키로 컴파일하는 패턴을 한국어로 정리한 종합 페이지. Gardener의 정제 단계와 같은 문제를 다룬다
- VectifyAI/PageIndex: 임베딩 없이 문서 구조를 따라 좁혀 들어가는 retrieval 구현. 이 자료의 트리 탐색과 발상이 겹친다
- Effective Context Engineering for AI Agents: 한정된 컨텍스트에 무엇을 담을지 다룬 자료. 트리 탐색이 줄이려는 비용이 무엇인지 배경으로 참고할 수 있다