Applications · PAPER · 2026
GenRec: An LLM-Backed Recommendation Ranker at Netflix
요약
GenRec은 Netflix가 사내 foundation LLM을 추천 랭킹용으로 post-training해 만든 LLM 기반 recommendation ranker다. ranker는 후보 아이템마다 점수를 매겨 사용자에게 보여 줄 순서를 정하는 모델을 말한다. 이 논문(arXiv 2608.10257, 2026-08)은 수천 개의 수작업 feature를 쓰는 기존 판별형 production ranker를, 텍스트로 풀어 쓴 사용자 이력을 읽는 LLM ranker로 대체하는 과정을 설명한다.
핵심 결과는 데이터 효율이다. GenRec은 production 모델보다 Phase 2 레이블 학습 예시를 약 40배 적게 쓰고도 오프라인 MRR이 상대 약 1.6% 높았다. Netflix 트래픽 약 10%를 대상으로 4주간 진행한 온라인 A/B test에서도 단기 지표와 장기 지표가 모두 통계적으로 유의하게 개선됐다.
논문은 결과보다 설계에 더 많은 분량을 쓴다. 다루는 설계 요소는 다음과 같다.
| 설계 요소 | 역할 |
|---|---|
| 2단계 학습 | Phase 1에서 Netflix 도메인 foundation LLM을 만들고, Phase 2에서 랭킹 과제로 자주 재학습한다 |
| verbalization과 context engineering | 이력과 메타데이터를 텍스트로 바꾸되, 제한된 토큰 예산 안에서 무엇을 남길지 고른다 |
| 다목적 손실 | ranking loss와 언어 모델링 loss를 함께 쓴다 |
| catalog-aware scoring head | Netflix 카탈로그 안의 작품만 채점해 환각 추천을 차단한다 |
| reward-weighted loss | 장기 만족과 비즈니스 목표를 예시별 가중치로 반영한다 |
| prefill-only 서빙 | 토큰을 하나씩 생성하지 않고 forward pass 한 번으로 후보 전체를 채점해 비용을 낮춘다 |
저자들은 이 전환을 "feature engineering에서 context engineering으로, 과제별 맞춤 구조에서 공유 foundation backbone으로"의 이동으로 규정한다. 같은 팀의 해설 블로그 글은 GenRec: Towards LLM-Native Recommendation at Netflix에 정리돼 있다.
배경
기존 production 추천 스택의 한계
Netflix의 현재 production 추천 시스템은 대규모 수작업 feature에 기반한다. feature는 모델에 넣기 위해 원본 데이터에서 사람이 설계해 뽑아낸 수치 입력을 뜻한다. 사용자, 아이템, 상호작용 신호에 걸친 feature와 그 고차 상호작용을 쓰며, 이는 YouTube DNN이나 Wide & Deep 같은 선행 대규모 추천 시스템의 계보를 따른다.
구조도 과제별로 따로 만들어져 있다. feature 상호작용 전용 네트워크, 동적인 회원 관심사를 잡는 Transformer 구조, 여러 추천 과제를 함께 푸는 multi-task 구조가 공존한다. 이 스택은 여러 해에 걸쳐 영화, 시리즈, 게임, 라이브 이벤트, 팟캐스트를 지원해 왔다.
문제는 확장 비용이다. 새 콘텐츠 유형이나 추천 surface를 하나 추가할 때마다 다음 작업이 필요하다.
- feature engineering
- 모델 구조 설계
- 인프라 변경
- 실험
시스템이 복잡해질수록 Netflix의 빠르게 늘어나는 비즈니스 요구를 따라가기 어려워졌다.
기성 LLM을 그대로 쓸 때의 문제
LLM의 넓은 world knowledge와 언어 이해 능력은 사용자, 콘텐츠, 컨텍스트를 기존 구조보다 풍부하게 모델링할 가능성을 연다. 사용자 이력과 컨텍스트 신호를 자연어로 직접 표현할 수 있고, 새 모델과 파이프라인을 설계하는 대신 프롬프트로 추천을 조정(steering)할 수도 있다.
반면 기성 LLM을 production 추천기로 바로 쓰면 네 가지 문제가 나타난다.
| 문제 | 내용 |
|---|---|
| 인기 편향 | 전역적으로 인기 있는 콘텐츠를 과도하게 추천한다 |
| 카탈로그 밖 환각 | Netflix 카탈로그에 없는 작품을 만들어 낸다 |
| 제약 무시 | 콘텐츠 혼합 같은 세밀한 비즈니스 제약을 따르지 않는다 |
| 약한 개인화 | 회원별 차이를 충분히 반영하지 못한다 |
GenRec의 각 설계 요소는 이 네 문제에 하나씩 대응한다. Netflix 데이터 post-training은 인기 편향과 약한 개인화를, catalog-aware head는 환각을, reward 신호는 제약 무시를 다룬다.
핵심 개념
verbalization은 사용자 이력, 컨텍스트, 아이템 메타데이터를 자연어나 가볍게 구조화한 텍스트로 풀어 쓰는 입력 표현 방식이다. 기존 추천기가 상호작용을 dense 임베딩으로 압축하는 것과 달리, GenRec은 "5월 23일 오후 4시, iPad, Mindhunter, 재생, 2시간" 같은 이벤트를 텍스트로 모델에 건넨다.
context engineering은 유한한 토큰 예산 안에 어떤 정보를 어떤 형태로 담을지 설계하는 작업이다. GenRec에서는 어떤 이벤트를 남기고 빼고 압축할지가 곧 이 작업이며, 논문은 이것이 기존의 feature engineering을 대신한다고 본다.
post-training은 pre-training을 마친 모델을 특정 과제 데이터로 이어서 학습시키는 단계다. GenRec의 Phase 2가 이에 해당한다.
catalog-aware scoring head는 LLM이 만든 사용자 표현과 아이템별 학습 임베딩을 결합해 카탈로그 안의 아이템만 채점하는 출력 모듈이다. 모델이 텍스트로 작품명을 생성하지 않으므로 카탈로그 밖 작품이 추천될 여지가 없다.
prefill-only inference는 생성형 모델을 토큰 단위 decoding 없이 입력을 한 번 읽는 prefill 단계만으로 실행하는 방식이다. prefill은 프롬프트 전체를 병렬로 처리해 내부 상태를 만드는 단계로, 이후 토큰을 하나씩 생성하는 decoding 단계보다 대규모 후보 채점에 훨씬 싸다.
MRR(Mean Reciprocal Rank)은 정답 아이템이 순위 목록에서 몇 번째에 있는지의 역수를 평균낸 지표다. 정답이 1위면 1, 2위면 0.5, 4위면 0.25가 되므로 상위권 정확도를 강하게 반영한다.
방법
문제 설정
GenRec은 full-catalog ranking 문제를 푼다. 카탈로그 전체를 한 번에 채점해 순위를 매기는 과제이며, 후보 집합이 따로 주어지면 top-K ranking이 된다. 결과 순위 목록은 여러 surface의 아이템 랭킹에 쓰이거나 하위 애플리케이션의 개인화 입력 신호로 재사용된다.
| 기호 | 뜻 |
|---|---|
| U | 사용자 집합 |
| C | 아이템 카탈로그 (영화, 쇼, 게임, 라이브 이벤트, 팟캐스트 등) |
| X | 컨텍스트 공간 (device, surface, locale, 시간대 등) |
| (u, τ, t) | 한 번의 추천 요청을 이루는 사용자, 컨텍스트, 시각 |
| H | 시각 t 이전의 사용자 상호작용 이력 |
| M_i | 아이템 i의 메타데이터 (제목, 장르, 줄거리, 공개일 등) |
| π | 카탈로그 위의 순위 함수. π(i)는 아이템 i의 위치이며 1위가 맨 위다 |
추천기는 요청 (u, τ, t, H)를 순위 π로 사상한다. 최적화 목표는 단기 engagement만이 아니라 기대 장기 회원 효용이다. 장기 효용은 회원 만족과 유지(retention)의 proxy로 정의된다. 이 목표 설정이 뒤의 reward 설계로 이어진다.
2단계 학습 프레임워크
GenRec은 학습을 두 단계로 나눈다. Phase 1은 오픈소스 LLM을 Netflix 자체 데이터로 적응시켜 사용자와 콘텐츠를 깊이 이해하는 foundation LLM을 만든다. Phase 2는 그 foundation model을 랭킹 과제 데이터와 목적 함수로 post-training해 GenRec을 만든다. 이 논문은 Phase 2를 주로 다룬다.
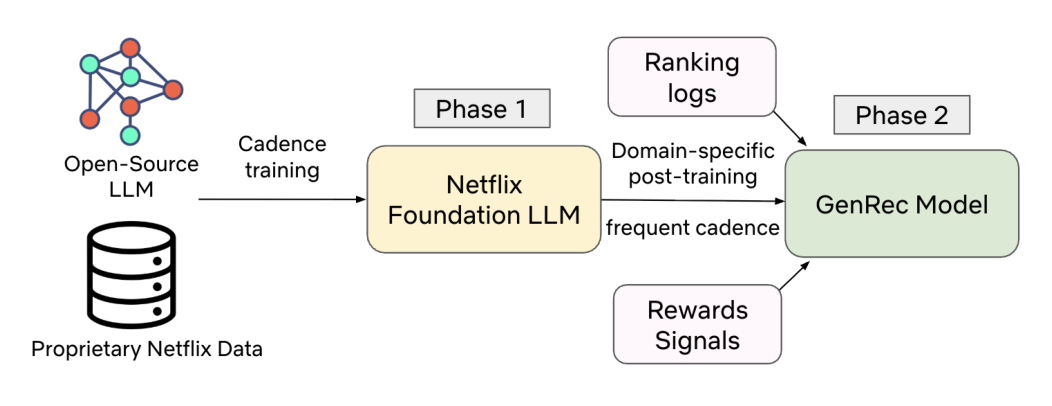
두 단계는 목표가 달라서 분리된다. 차이는 세 가지 측면에서 나타난다.
| 측면 | Phase 1 | Phase 2 (GenRec) |
|---|---|---|
| 능력 초점 | world knowledge, 개인화, 콘텐츠 이해, 언어 능력을 넓게 균형 잡는다 | 랭킹 품질과 recommendation steering에 집중한다 |
| 갱신 주기 | 장기적인 사용자와 콘텐츠 이해가 목표라 비교적 드물게 갱신한다 | 신작 공개, 인기 변화, 회원의 최근 관심사를 따라가도록 자주 갱신한다 |
| 비용 민감도 | 가장 능력 있는 모델이 목표라 서빙 비용 제약이 약하다 | 대규모 트래픽을 직접 서빙하므로 비용 효율이 명시적 목표다 |
이 구조의 실무적 의미는 갱신 비용에 있다. Phase 1은 드물게 크게 학습하고, 자주 해야 하는 Phase 2는 적은 데이터로 빠르게 끝낸다. 따라서 Phase 2의 데이터 효율이 곧 운영 비용을 결정한다.
대화 형식의 학습 데이터
Netflix 회원은 영화, 쇼, 게임, 라이브 등에 걸쳐 수천억 건의 상호작용 이벤트를 만든다. 이벤트 종류에는 시청, 재생, 평가(thumb), 목록 추가 등이 있고 여러 추천 surface에서 발생한다.
GenRec은 한 회원의 과거 상호작용을 사용자와 추천기 사이의 단일 턴 또는 멀티턴 "대화"로 변환한다. 각 턴은 컨텍스트와 이력과 과제를 담은 user message, 그리고 그 턴에서 회원이 실제로 보인 engagement를 담은 assistant message의 쌍이다.
| 구성 요소 | 담는 내용 |
|---|---|
| Context | surface, 시간, device, locale 등 |
| User profile & history | 국가, 가입 기간, 요금제, 과거 상호작용 등 |
| Item-level detail | 아이템 ID, 메타데이터(제목, 공개 시점, 줄거리 등), 인기 추세 등 |
| Task | 예: 사용자가 다음에 재생하거나 좋아요를 누를 아이템 예측 |
| Assistant message | 재생, 재생 시간, 이탈, 평가 같은 암묵적, 명시적 피드백. 학습 시 정답 신호다 |
Phase 2 학습은 assistant message가 앞선 user message에 어떻게 의존하는지 모델링한다. 대화 형식의 장점은 통일성이다. 다양한 추천 로그를 하나의 텍스트 형식으로 표현할 수 있고, 같은 데이터로 언어 모델링 목적과 catalog-aware ranking 목적을 함께 학습한다.
입력 verbalization과 context engineering
GenRec은 상호작용과 메타데이터를 수작업 feature나 dense 임베딩으로 인코딩하지 않는다. 대신 자연어나 가볍게 구조화한 텍스트로 풀어 써서 원래 신호를 LLM의 의미 공간에 직접 둔다. 아이템 사이의 관계, 시간에 따른 동역학, 변하는 관심사 같은 고차 패턴은 수작업 feature로 명시하지 않고 모델이 스스로 학습하게 한다.
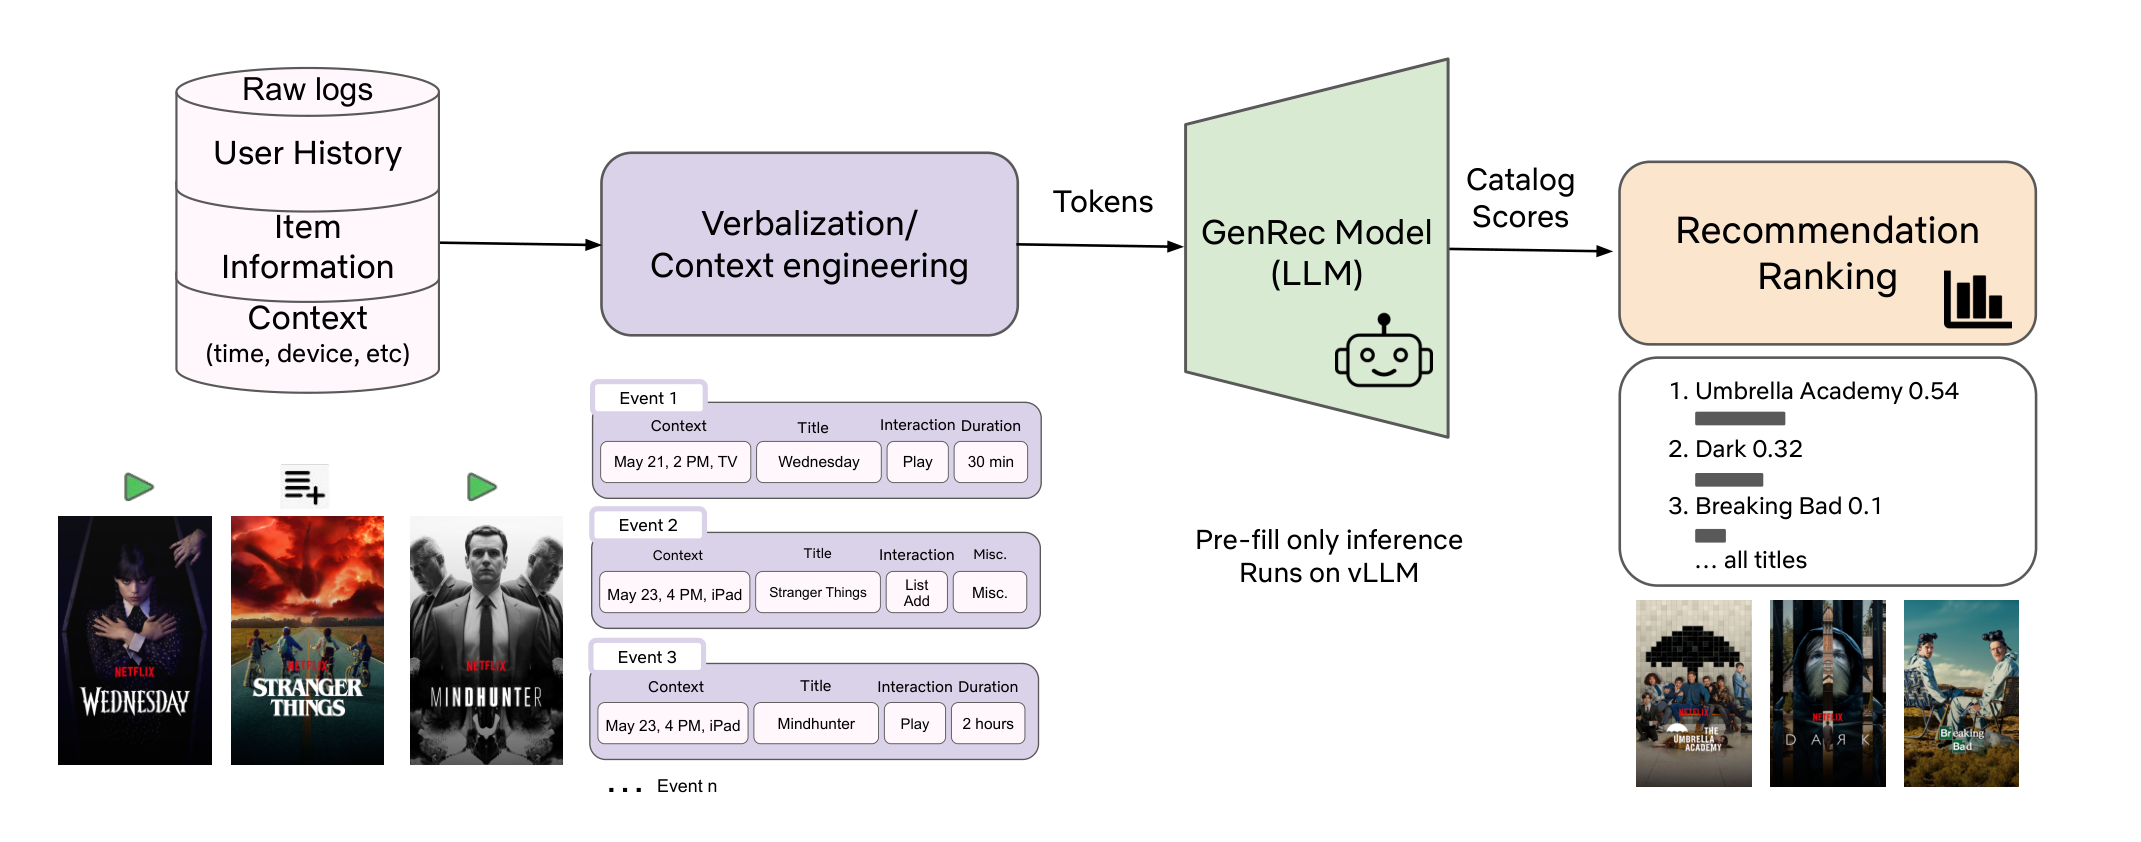
Figure 1의 예시에서 이벤트 하나는 컨텍스트, 제목, 상호작용, 지속 시간 칸으로 구성된다. 예를 들어 "5월 21일 오후 2시, TV, Wednesday, 재생, 30분"이 한 이벤트이고, "5월 23일 오후 4시, iPad, Stranger Things, 목록 추가"가 다음 이벤트다. 논문 각주는 이 예시가 설명용이며 실제 사용자 데이터가 아니라고 밝힌다.
verbalization은 단순한 텍스트 변환이 아니라 context engineering 문제다. 회원의 이력은 상호작용 수가 많고 이벤트마다 메타데이터가 풍부해 토큰 예산을 쉽게 넘는다. context window는 모델이 한 번에 받아들일 수 있는 토큰 길이 한도이며, 지나치게 긴 컨텍스트는 attention을 희석하고 학습과 추론 비용을 크게 늘린다. 그래서 어떤 이벤트와 속성을 담을지 네 가지 규칙으로 고른다.
| 규칙 | 대상 | 처리 |
|---|---|---|
| Retain in full | 긴 재생, 좋아요 같은 high-signal engagement | 풍부한 메타데이터와 함께 풀어 쓴다 |
| Omit entirely | 매우 짧은 재생, 노이즈성 조회와 클릭 같은 low-signal 이벤트 | 토큰 비용 대비 랭킹 기여가 작아 뺀다 |
| Summarize or compress | 몰아보기(binge-watching) 같은 반복 행동 | 이벤트를 매번 나열하지 않고 압축한다 |
| Elaborate selectively | 신작, cold-start 아이템 같은 중요 아이템 | pre-training 모델과 과거 상호작용에 정보가 부족하므로 메타데이터를 더 자세히 쓴다 |
시간 범위에도 우선순위가 있다. 고정된 토큰 예산 안에서 단기에서 중기 이력은 높은 해상도로 쓰고, 오래된 이력은 생략하거나 짧은 관심사 요약으로 압축한다. 전체 목표는 context window를 넘지 않고 추론 비용도 과하지 않으면서 추천 품질을 지키는, 정보 밀도 높은 토큰 집합을 만드는 것이다.
post-training 목적 함수
Phase 2 학습은 주로 두 목적을 결합한다.
첫째는 recommendation ranking objective이며 주 과제다. 높은 가치의 engagement를 positive 레이블로 삼는다. 여기서 높은 가치란 충분히 긴 재생이나 강한 명시적 피드백을 뜻하고, 콘텐츠 유형마다 다른 denoising 로직과 임계값을 적용한다. 이 레이블로 카탈로그(또는 후보 집합) 위의 cross entropy loss를 계산해, verbalized 컨텍스트가 주어졌을 때 좋은 순서를 내도록 학습한다.
둘째는 language modeling objective다. verbalized 입력과 출력(예측한 제목과 기타 텍스트 필드)에 대해 언어 모델링 loss를 둔다. 이 목적은 backbone의 일반 언어 이해와 생성 능력을 유지하며, 두 가지에 필요하다.
- 자연어로 쓴 풍부한 사용자 이력과 아이템 메타데이터의 모델링
- 프롬프트를 통한 recommendation steering
학습 때와 추론 때 쓰는 목적이 다르다는 점이 중요하다.
| 시점 | 사용하는 과제 | 이유 |
|---|---|---|
| 학습 | ranking과 언어 모델링을 함께 최적화 | 텍스트 영역(제목과 verbalized 컨텍스트의 토큰 예측)을 함께 학습해 랭킹에 보완적 정보를 준다 |
| 추론 | ranking만 사용 | 추천 순위 생성에는 ranking head만 필요하다 |
언어 모델링 목적은 추론에 쓰이지 않지만 제거되지도 않는다. 랭킹 과제를 돕는 보완 정보, 프롬프트 steering에 대한 반응성, 추천 설명 같은 향후 텍스트 생성 용도를 지키기 위해서다.
전체 손실은 세 항의 가중합이다.
L = α × L_ranking + β × L_language + γ × L_miscellaneous, 단 α + β + γ = 1, α, β, γ ≥ 0
α, β, γ는 오프라인 실험으로 조정하는 hyperparameter이며, 논문은 구체 값을 공개하지 않는다. L_miscellaneous는 "해당하는 경우의 기타 목적"으로만 설명된다.
모델 구조와 채점 과정
GenRec의 backbone은 foundation LLM과 같은 구조를 따른다. backbone은 상위 head가 올라가는 pre-training된 본체를 뜻한다. next-token prediction 계열 목적으로 학습된 decoder-only Transformer이며, 여기에 Netflix 카탈로그 내 아이템만 채점하는 catalog-aware ranking head를 결합한다.
점수는 세 단계로 계산된다.
| 단계 | 처리 |
|---|---|
| Verbalization | verbalizer V가 이력 H, 컨텍스트 τ, 아이템 메타데이터 {M_i}를 하나의 텍스트 시퀀스 x = V(H, {M_i}, τ)로 만든다 |
| Pooled representation | LLM이 x를 인코딩하고, pooling 위치의 hidden state를 d차원 표현 h로 쓴다. hidden state는 신경망 중간 층이 계산해 다음 층으로 넘기는 내부 벡터다. h는 사용자 선호와 컨텍스트를 요약한다 |
| Catalog-aware scoring | scoring head φ가 h와 아이템별로 학습된 d차원 임베딩 e_i를 결합해 아이템 i의 점수를 낸다 |
LLM 가중치, scoring head φ, 아이템 임베딩 {e_i}를 묶은 파라미터 θ 전체를 함께 학습한다. 카탈로그 전체에 softmax를 적용해 점수를 확률 분포로 바꾸고, 점수 순서에서 순위 π를 얻는다. 카탈로그가 너무 커서 전수 채점이 어려우면 sampled softmax를 결합한다.
이 구조는 기존 LLM 기반 추천과의 핵심 차이다. PLUM이나 OneRec-Think 같은 선행 시스템은 아이템을 Semantic ID 토큰으로 표현하고 beam search로 생성하므로, 후보 집합이 크면 지연이 커진다. GenRec은 생성 없이 pooled 표현과 아이템 임베딩의 결합으로 채점하므로 forward pass 한 번에 대규모 후보를 순위 매기고, 출력이 카탈로그 안으로 제한된다.
reward 신호
GenRec은 정확도 외에 두 목표를 더 만족해야 한다.
- 비즈니스 요구 준수: 영화, 쇼, 라이브, 게임, 팟캐스트 같은 콘텐츠 유형의 균형을 맞추는 혼합 로직
- 장기 회원 만족 최대화: 단기 engagement만의 최적화가 아닌 목표
원래 상호작용 시퀀스로만 post-training하면 이 목표에서 멀어질 위험이 있다. 논문이 드는 예는 세 가지다.
- 탐색보다 몰아보기를 과하게 추천한다
- 게임보다 영상을 선호한다
- 카탈로그 탐색과 장기 유지를 희생하고 즉각적인 클릭을 최대화하는 아이템을 고른다
이를 막기 위해 별도 reward model들의 신호를 학습 목적에 반영한다. reward는 두 종류다.
| reward 유형 | 내용 |
|---|---|
| Long-term satisfaction proxies | 단기 engagement 이벤트가 장기 결과와 얼마나 강하게 연관되는지 추정한다. 실제 장기 지표는 노이즈가 크고 늦게 나오므로 과거 데이터로 학습한 안정적인 proxy를 쓴다. 재방문, 카탈로그의 넓은 영역 탐색, 지속적 engagement로 이어지는 행동에 높은 값을 준다 |
| Behavior rebalancing | 콘텐츠 유형(영화, 게임, 라이브, 팟캐스트)과 공개 단계(공개 전, 신작, 스테디셀러) 사이의 행동을 재조정해, 콘텐츠 유형 간 노출 공정성 같은 비즈니스 목표를 맞춘다 |
통합 방식은 reward-weighted ranking loss다. 기존 reward modeling 프레임워크의 여러 reward model 출력에서 학습 예시마다 스칼라 가중치 하나를 도출하고, 그 예시의 ranking loss에 곱한다. reward model 기준으로 가치가 높은 engagement는 가중치가 커지고, 가치가 낮거나 바람직하지 않은 행동은 가중치가 줄어든다.
저자들은 이 방식을 완전한 강화학습과 비교해 선택했다.
| 방식 | 장점 | 단점 | 채택 |
|---|---|---|---|
| reward-weighted loss | 단순하고 안정적이며 배포와 유지가 쉽고 비용이 낮다 | 강화학습 대비 추가 이득을 포기한다 | 현재 주 alignment 수단 |
| 강화학습 계열(GRPO 등) | 예비 실험에서 supervised fine-tuning 대비 추가 이득 | 학습 오버헤드가 크다 | 향후 과제 |
온라인 서빙과 비용 최적화
GenRec은 vLLM 프레임워크를 쓰는 Netflix 사내 LLM 서빙 스택에서 서빙된다. 전 세계 수억 명 회원 규모에서 서빙 비용은 1순위 제약이며, 실제 추론 비용은 대략 모델 크기와 컨텍스트 길이의 곱에 비례한다. 따라서 두 요인을 각각 줄이는 전략과 추론 모드 선택이 비용을 결정한다.
| 수단 | 내용 |
|---|---|
| 작은 모델과 distillation 모델 | distillation은 큰 모델의 출력을 작은 모델이 흉내 내게 학습시키는 압축 기법이다. 더 크거나 목표 지향적인 데이터로 작은 모델이나 distillation 모델을 학습해 큰 모델 품질의 상당 부분을 낮은 요청당 연산으로 회복한다 |
| 컨텍스트 길이 압축 | 앞의 verbalization compaction으로 입력 신호를 표현하는 토큰을 줄이되 오프라인 랭킹 품질을 크게 떨어뜨리지 않는다 |
| prefill-only 추론 | backbone은 autoregressive decoding이 가능한 생성형 모델이지만, 대규모 후보 집합을 토큰 단위 생성이나 beam search로 처리하면 비용이 감당할 수 없이 크다. 입력을 한 번 읽고 forward pass 한 번에 전체 후보 순위를 낸다 |
prefill-only 구성은 catalog-aware scoring head가 있어서 가능하다. 채점이 생성이 아니라 pooled 표현과 임베딩의 결합이므로, 모델이 출력 토큰을 하나도 만들지 않아도 순위가 나온다.
결과
production baseline과의 비교
비교 대상은 여러 해 동안 조정된 성숙한 판별형 production 모델이다.
| 평가 | 결과 |
|---|---|
| 오프라인 MRR | Phase 2 레이블 학습 예시를 약 40배 적게 쓰고도 상대 약 1.6% 개선. 학습 데이터와 입력 신호를 늘리면 계속 개선된다 |
| 온라인 A/B test 설정 | 주요 batch-compute surface, Netflix 트래픽 약 10%, 4주 |
| 단기 홈페이지 engagement 지표 | +0.115%, P = 3.1 × 10^-10 |
| 장기 핵심 지표 | +0.006%, P = 0.025 |
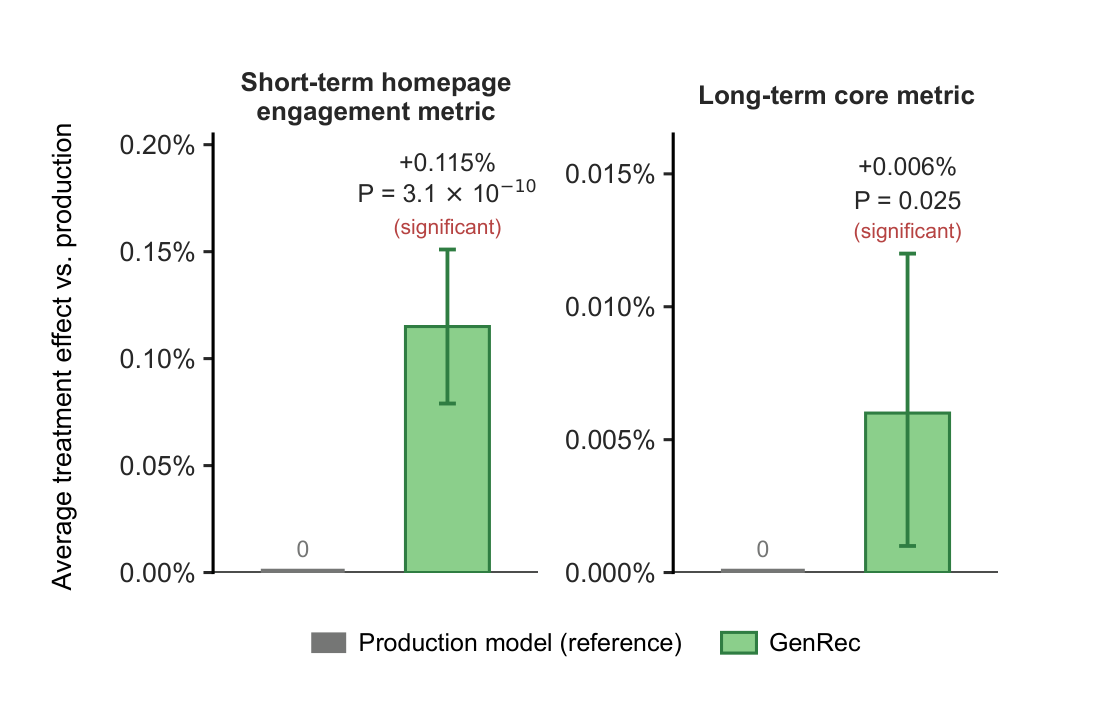
장기 핵심 지표의 0.006%는 작은 수치처럼 보이지만, 논문은 Netflix 규모에서 통계적으로 의미 있는 개선이라고 설명한다. 이 결과가 저데이터, 저신호 설정에서 나왔다는 점도 강조된다. 즉 GenRec은 production 모델보다 적은 학습 샘플과 입력 신호로 더 나은 성능을 냈다.
이 데이터 효율은 운영 비용과 직결된다. Phase 2가 Phase 1보다 훨씬 자주 갱신되므로, Phase 2 단계의 한계 데이터 효율(marginal data efficiency)이 높을수록 ranker를 최신으로 유지하는 연산이 줄어든다.
데이터와 모델 scaling
데이터 scaling 실험은 다른 변수를 고정하고 Phase 2 post-training 데이터를 가장 작은 설정의 1배에서 20배까지 늘렸다. 약 1B 파라미터 모델과 약 10B 파라미터 모델 두 가지로 실행했고, 두 모델 모두 MRR이 단조 증가했다. 약 1B 모델은 절대 MRR이 약 10B 모델보다 낮지만 scaling 패턴은 비슷했다.
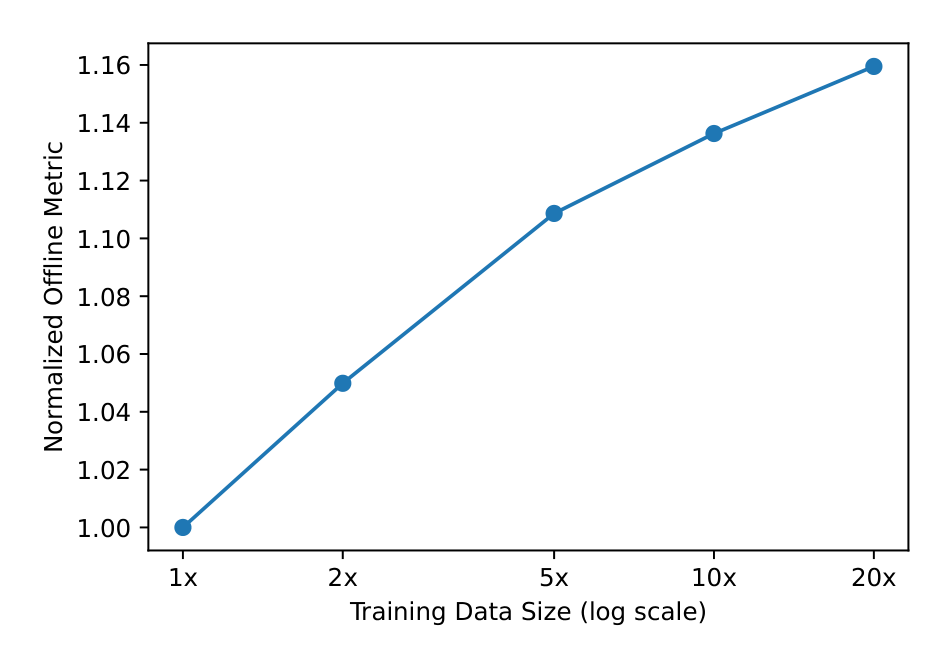
| Phase 2 데이터 규모 | 정규화 오프라인 지표 (약 10B, Figure 4 판독값) |
|---|---|
| 1배 | 1.00 |
| 2배 | 약 1.05 |
| 5배 | 약 1.11 |
| 10배 | 약 1.14 |
| 20배 | 약 1.16 |
모델 scaling 실험은 같은 GPU 구성과 비슷한 wall-clock 학습 시간이라는 고정 예산 아래 약 1B에서 약 10B까지 base model을 바꿔 post-training했다. 이 조건에서 큰 backbone이 일관되게 높은 오프라인 MRR을 냈다.
scaling은 품질과 함께 비용도 늘린다. GenRec은 고빈도로 재학습하고 대규모 온라인 트래픽을 직접 서빙하므로 이 부담이 특히 크다. 논문은 데이터와 모델 scaling 곡선, 컨텍스트 길이 ablation을 함께 보고, 달성 가능한 품질 개선 대부분을 회복하면서 주어진 연산 예산 안에 머무는 Pareto frontier 위의 "sweet spot"을 고른다고 설명한다.
Phase 1과 Phase 2의 기여
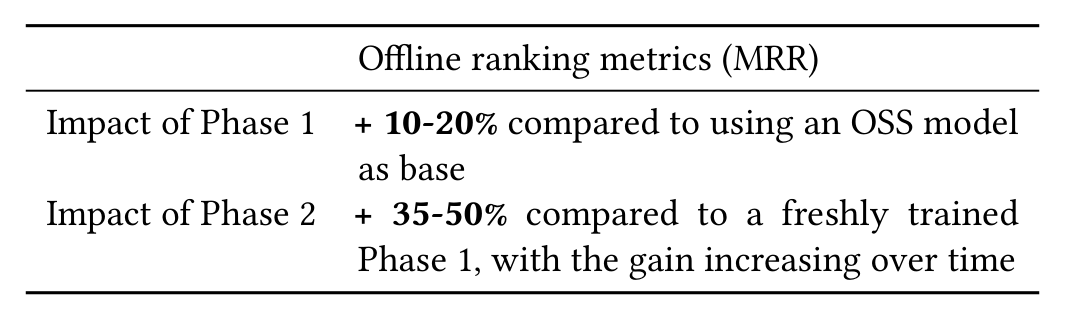
두 학습 단계가 각각 얼마나 기여하는지 오프라인 랭킹 지표로 분해했다.
| 비교 | 오프라인 랭킹 지표 변화 | 해석 |
|---|---|---|
| Phase 1 foundation LLM을 base로 사용 vs 기성 오픈소스 LLM을 backbone으로 사용 | +10~20% | Phase 1에서 물려받은 개인화와 콘텐츠 이해 능력이 중요하다 |
| Phase 2 post-training vs Phase 1 (Phase 1 학습 cutoff 시점) | +35~50% | 도메인 데이터, reward, verbalization을 포함한 과제 특화 적응의 가치 |
| 같은 비교, 2주 뒤 | 약 +80% | 과제 특화 적응 효과에 더해, 드물게 갱신되는 Phase 1 backbone이 낡는다 |
Phase 2의 이득이 시간이 지날수록 커지는 현상은 두 요인이 겹친 결과다. 하나는 과제 특화 적응 자체의 강점이고, 다른 하나는 Phase 1 backbone의 staleness다. 콘텐츠 인기 추세와 회원 관심사는 계속 변하는데 Phase 1은 드물게 갱신되므로, 자주 갱신되는 Phase 2가 그 격차를 메운다. 저자들은 이 결과를 예상된 것으로 본다.
컨텍스트 길이 최적화
context window는 품질 요인이면서 비용 요인이다. verbalization이 길면 사용자 행동과 컨텍스트 정보가 더 많이 들어가지만 학습과 서빙 비용이 늘어난다. 논문은 앞의 verbalization 규칙을 토대로 세 단계로 간결한 verbalization을 찾는다.
- 이벤트 선택과 압축: low-signal이거나 노이즈인 engagement를 빼고, 반복 활동을 압축하고, high-signal 상호작용을 남긴다. 그 결과 컨텍스트에 담을 후보가 되는 정렬된 engagement 시퀀스가 나온다.
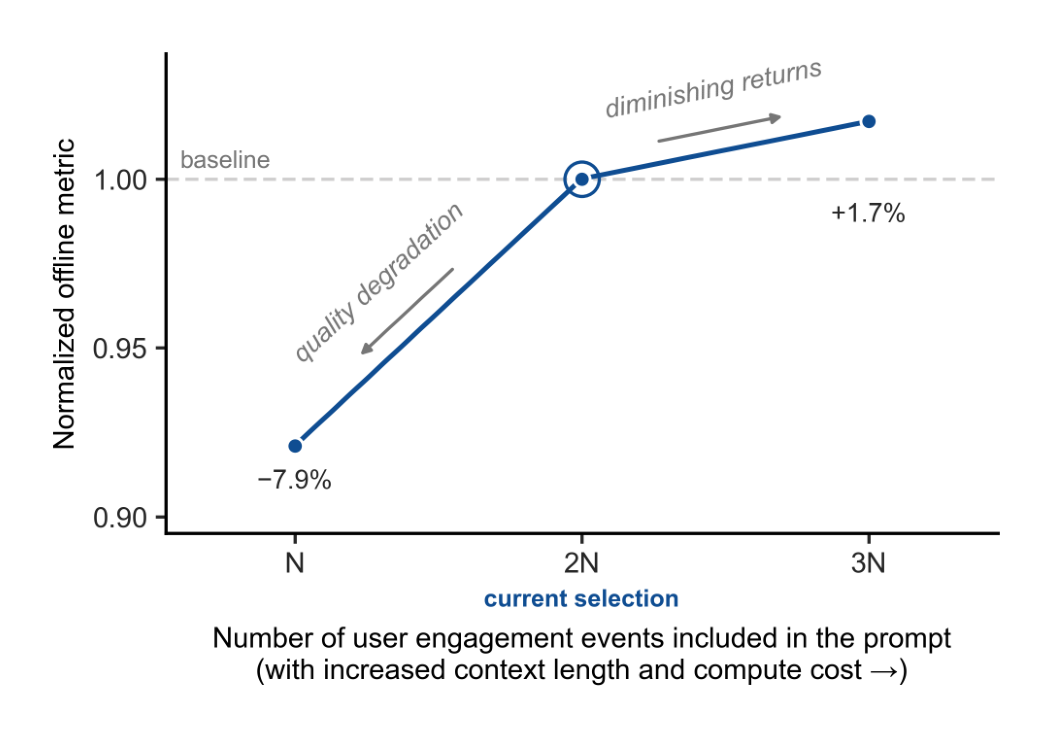
- 최적 이력 길이 탐색: 정제된 시퀀스에서 프롬프트에 남길 이벤트 수를 바꿔 가며 MRR을 그린다. 일정 지점까지는 품질이 오르고, 그 뒤로는 추가 토큰의 이득이 미미한 elbow point가 나타난다.
- 간결한 verbalization 구성: 남긴 이벤트마다 상세 수준을 바꿔 오프라인 성능을 측정한다. 바꾸는 요소는 engagement 세부 항목, 문구 단순화, few-shot 예시 제거다.
| 이벤트 수 | 정규화 MRR 변화 (2N 기준) | 구간 |
|---|---|---|
| N | -7.9% | 품질 저하 구간 |
| 2N (현재 선택) | 기준 | elbow point |
| 3N | +1.7% | 수확 체감 구간 |
최종적으로 컨텍스트 길이를 원래 토큰 예산의 약 3분의 1로 줄였다. 예를 들어 약 5,000 토큰에서 약 1,700 토큰으로 줄여도 오프라인 랭킹 지표 저하는 무시할 수준이었다. GenRec은 대체로 compute-bound이고 서빙 비용이 컨텍스트 길이에 거의 비례하므로 서빙 비용도 원래의 약 3분의 1로 줄었다.
LLM-native recommendation으로의 전환
논문 6절은 GenRec을 "ranker를 Transformer로 바꾼 것"이 아니라 사용자와 콘텐츠를 표현하는 방식, 모델과 학습 구조, 서빙 인프라 설계가 함께 바뀌는 전환의 첫 단계로 본다. 저자들이 정리한 변화는 다섯 가지다.
| 전환 | 기존 RecSys | LLM 중심 시스템 |
|---|---|---|
| 입력 설계 | 집계, 신선도, 상호작용 설계, 누출 방지를 위한 대규모 인프라가 받치는 수작업 feature | 원래 상호작용 시퀀스, 콘텐츠 메타데이터, 컨텍스트, 도구 출력, 사용자 메모리로 만드는 풍부한 텍스트 컨텍스트. "prompt가 새로운 feature vector"가 된다 |
| 모델 구조 | two-tower 모델, DLRM 계열 feature 상호작용 네트워크, 전용 attention block, 대규모 multi-task 설정 | foundation model에서 물려받은 Transformer backbone으로 표준화. 혁신이 과제별 구조 설계에서 데이터, scaling law, post-training 전략, 추론 최적화로 이동한다 |
| scaling | 희소 ID, 과도하게 설계된 목적, 과제별 구조 때문에 수확 체감에 부딪힌다 | pre-training LLM과 backbone을 공유해 데이터와 모델 scaling 특성을 물려받고, scaling law가 사후 관찰이 아니라 설계 지침이 된다 |
| 학습 방식 | 추천기마다 처음부터 만든다 | 공유 foundation에서 시작해 과제별 post-training과 reward alignment로 적응한다. 여러 용도가 같은 foundation과 인프라를 재사용한다 |
| 서빙 인프라 | MLP나 factorization 모델 중심 | GPU 가속, vLLM과 Triton 기반, 세심한 batching과 caching. KV-caching, prefix caching, prefill-only 추론이 비용 조절의 핵심 수단이 된다 |
scaling law는 모델, 데이터, 연산량을 키울 때 성능이 따르는 경험 법칙이다. GenRec의 데이터와 모델 scaling 실험은 추천 모델도 LLM backbone을 쓰면 이 법칙의 혜택을 받는다는 근거로 제시된다.
한계
논문이 밝히거나 본문에서 확인되는 한계는 다음과 같다.
| 한계 | 내용 |
|---|---|
| 검증 범위 | 결과는 시험한 batch-compute surface와 설정에 한정된다. 저자들은 LLM 기반 ranker가 "적어도 일부 시나리오"에서 유망하다고 표현한다 |
| 강화학습 미적용 | GRPO 같은 방법이 예비 실험에서 추가 이득을 보였지만 학습 오버헤드 때문에 향후 과제로 남겼다 |
| 텍스트 생성 미사용 | 추론은 ranking head만 쓰며, 추천 설명 같은 자연어 생성은 가능성으로만 남겨 두었다 |
| 비용과 인프라 부담 | LLM은 학습과 서빙이 본질적으로 비싸다. 결론은 비용과 인프라 복잡도를 계속 관리하고, 강한 비LLM baseline 대비 품질 절충을 엄밀하게 평가해야 한다는 조건을 단다 |
| Phase 1 staleness | Phase 2 이득이 2주 만에 35~50%에서 약 80%로 커진다는 것은 Phase 1이 빠르게 낡는다는 뜻이기도 하다 |
| 공개되지 않은 세부 | 온라인 지표의 정확한 정의, 모델의 정확한 파라미터 수, reward model 구조, 손실 가중치 α, β, γ의 값을 공개하지 않는다 |
선행 연구와의 위치
논문은 관련 연구를 세 계열로 정리하고 GenRec을 세 번째 계열 안에서 서빙 비용 문제를 해결한 사례로 위치시킨다.
| 계열 | 대표 연구 | 특징과 한계 |
|---|---|---|
| 특수 토큰 기반 생성형 추천 | SASRec, BERT4Rec, PinRec 등 산업 시스템 | 아이템 ID 시퀀스의 next-item prediction에서 출발해, 아이템 ID와 메타데이터와 locale과 시간과 device를 특수 토큰으로 어휘에 추가한다. world knowledge 활용과 유연한 프롬프트 steering이 제한적이다 |
| Semantic ID 토큰화 | TIGER, Google 랭킹, Kuaishou OneRec | RQ-VAE로 아이템을 짧은 semantic ID 시퀀스로 만들어 수십억 아이템 카탈로그에서 autoregressive decoding을 가능하게 한다 |
| LLM 기반 추천 | TALLRec 등 초기 text-to-text 연구, Google PLUM, Spotify GLIDE, Kuaishou OneRec-Think | pre-training LLM을 backbone으로 쓴다. 대부분 beam search 기반 decoding이라 대규모 후보 집합에서 지연이 크다 |
GenRec은 LLM 기반 추천 계열에 속하지만 아이템을 생성하지 않고 catalog-aware ranking head로 채점한다는 점이 다르다. 여기에 context engineering과 reward 통합을 명시적인 설계 대상으로 둔 점을 저자들은 차별점으로 든다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| GenRec | Netflix 사내 foundation LLM을 추천 랭킹 데이터와 reward로 post-training한 LLM 기반 recommendation ranker |
| Phase 1 / Phase 2 | Phase 1은 오픈소스 LLM을 Netflix 데이터에 적응시킨 foundation LLM 학습, Phase 2는 그 모델을 랭킹 과제에 맞춰 자주 재학습하는 post-training |
| verbalization | 사용자 이력, 컨텍스트, 아이템 메타데이터를 텍스트로 풀어 쓰는 입력 표현 방식 |
| catalog-aware ranking head | pooled hidden state와 아이템 임베딩을 결합해 카탈로그 내 아이템만 채점하는 출력 head |
| reward-weighted ranking loss | reward model 신호로 만든 예시별 가중치를 ranking loss에 곱해 장기 가치와 비즈니스 목표를 반영하는 방식 |
| prefill-only inference | 토큰 단위 decoding 없이 prefill 단계만으로 후보 전체 점수를 내는 추론 방식 |
관련 페이지
- GenRec: Towards LLM-Native Recommendation at Netflix: 같은 팀이 논문보다 먼저 공개한 Netflix Technology Blog 해설 글
- Effective Context Engineering for AI Agents: 블로그 글이 인용한 context engineering의 원 개념. GenRec은 이를 추천 입력 설계에 적용한다
- 용어집: LLMs (Terminology Glossary): post-training, distillation, scaling law 등 표기 기준