Applications · REPO · 2026
Open Ontologies
요약
Open Ontologies는 운영 중인 ontology에 들어갈 변경을 적용 전에 계획하고, 엔진이 유도한 결론을 제3자가 다시 검사할 수 있는 파일로 남기는 Rust 단일 바이너리다. Fabio Rovai가 MIT로 공개했고 Tesseract Semantics에서 유지한다. ontology는 도메인의 개체 종류와 관계 타입을 고정된 집합으로 정의한 구조를 말한다.
이 저장소를 다른 ontology 도구와 구분하는 지점은 두 가지다. 첫째, 변경 계획이 문법이 아니라 의미를 본다. 추가와 제거된 class 수가 모두 0이고 영향 범위도 0으로 보고되는 변경이 결론 901건을 새로 만들 수 있는데, 이 격차를 보고서에 드러낸다. 둘째, 추론 결과에 certificate를 붙인다. certificate는 어떤 결론이 어떤 규칙과 어떤 전제에서 나왔는지 줄마다 적은 파일이고, 이 엔진과 코드를 공유하지 않는 Lean 4 checker가 그 파일을 검사한다.
그래서 이 도구의 답은 "reasoner가 그렇다고 한다"가 아니다. 감사인은 몇 달 뒤에 보관된 파일 둘과 Lean 빌드만으로 같은 결론을 다시 확인할 수 있고, 이 소프트웨어의 인스턴스도 네트워크도 필요하지 않다. 누군가 결론 한 줄을 위조하면 같은 checker가 exit 1을 내고 성립하지 않는 규칙 이름을 지목한다.
README는 자기가 증명하지 않는 것을 같은 표에 적는 방식으로 이 보증의 경계를 관리한다. 측정한 값에는 measured, 외부 prover의 판정에는 opinion을 붙이고 checker의 어휘를 쓰지 않는다. unsatisfiability 답에는 보증이 없다고 비교표에 그대로 쓴다.
배경
ontology를 운영한다는 것은 파일 하나를 고치는 일이 아니라 그 파일에서 따라 나오는 결론 전체를 고치는 일이다. 그런데 변경을 검토하는 통상적 수단은 텍스트 diff와 shape diff뿐이다.
텍스트 diff는 바뀐 줄을 보여 준다. git diff가 이미 그 일을 하므로 ontology 전용 도구가 다시 할 이유가 없다. 문제는 한 줄이 옳은 줄이면서 동시에 결론 수백 건을 바꿀 수 있다는 점이다.
shape diff는 class와 property와 개체의 수, 그리고 영향 범위를 센다. README의 첫 예시가 이 지표의 맹점을 보여 준다. ex:hasParent rdfs:domain ex:Person 한 줄을 더하는 변경에서 추가된 class는 0개, 제거된 class는 0개, 영향 범위는 0 triple, risk score는 low로 나온다. 그러나 그 property를 이미 가진 개체 전부에 새 type이 붙어 새 결론 901건이 0.04초 안에 생긴다.
보통의 reasoner는 답을 주지만 그 답의 근거를 검증 가능한 형태로 주지 않는다. 두 번째 구현이 같은 답에 동의할 수 있고 일부 reasoner는 설명을 내지만, 검증된 checker가 그 둘 중 어느 것도 받지 않는다. 두 구현이 어긋나면 둘 중 하나가 틀렸다는 사실만 알게 되고 어느 쪽인지는 알 수 없다.
사람이 출력을 손으로 고친 경우는 더 어렵다. 보통의 reasoner 출력에서는 그 편집을 찾을 수 없다. 감사인이 받는 것은 결국 스크린샷 한 장이다.
| 질문 | 보통의 reasoner | Open Ontologies |
|---|---|---|
| 답 | Northwind needs enhanced due diligence |
같은 답 |
| 답이 성립하는 이유 | reasoner가 그렇다고 한다 | 규칙과 전제를 이름으로 적은 certificate |
| 누가 답을 검사할 수 있는가 | 두 번째 구현이 동의할 수 있다. 검증된 checker가 받는 것은 없다 | 엔진과 코드를 공유하지 않는 checker로 누구나 |
| 엔진에 결함이 있으면 | 두 번째 구현이 반대할 수 있다. 둘 중 하나가 틀렸다는 것만 알게 된다 | checker가 답을 거부하고 exit 1을 낸다 |
| 사람이 출력을 편집하면 | 편집을 찾을 수 없다 | checker가 거부하고 줄과 규칙을 지목한다 |
| 규칙이 표준이 아니라 사용자 것이면 | 보고서가 같다 | verdict 단어가 달라지고 테스트가 그 단어를 고정한다 |
| 감사인이 받는 것 | 스크린샷 | 다시 검사할 수 있는 파일 |
| unsatisfiability 답의 보증 | 주장된다 | 없고, 도구가 그렇게 말한다 |
이 저장소는 자기 위치도 분명히 못박는다. ontology 편집기가 아니므로 class 계층을 그리는 일은 Protégé가 맡는다. Open Ontologies는 변경이 운영 환경으로 들어가기 전 그 변경에 실행된다. Terraform과 닮은 것은 의도이며, 다만 plan이 문법적이 아니라 의미적이라는 점이 다르다.
핵심 개념
triple과 entailment
triple은 주어와 술어와 목적어 세 항으로 적는 RDF의 최소 단위다. ex:myCup a ex:Espresso처럼 한 사실을 한 줄로 적는다.
entailment는 어떤 그래프의 모든 모델에서 참이 되는 결론을 말한다. Espresso가 Coffee의 하위 class이고 Coffee가 Drink의 하위 class이면, 어떤 컵이 Espresso라는 주장에서 그 컵이 Drink라는 결론이 entail된다. 이 저장소가 다루는 거의 모든 보증은 entailment에 관한 것이다.
certificate
certificate는 엔진이 유도한 결론을 규칙과 전제까지 적어 남긴 파일이다. 탭으로 구분된 파일 둘로 구성되고, triple 3건을 다룬 README 예제에서 두 파일의 크기는 합쳐 1.3KB다.
| 파일 | 내용 |
|---|---|
asserted.tsv |
사람이 주장한 triple 전부 |
derivations.tsv |
추론 단계마다 한 줄. 규칙 이름, 그 줄의 결론, 그 결론의 전제들을 차례로 적는다 |
asserted.sha256 |
그 실행이 사용한 주장들의 digest |
이 파일은 모델도 네트워크도 공급사도 요구하지 않는다. 그래서 certificate를 가진 사람은 자기가 고른 시점에 그것을 검사할 수 있다.
soundness 정리
soundness 정리는 checker가 승인한 결과가 전제에서 실제로 따라 나온다는 것을 기계가 검사한 보증을 말한다. 이 저장소의 checker는 lean/ 아래에 있고 Lean 4 v4.33.1의 core 기능만 쓰며 Mathlib에 의존하지 않는다.
derivation certificate에 대한 정리는 OOCert.certificate_sound다. 이 정리가 성립하면, certificate가 통과한 실행은 엔진이 결론을 어떻게 찾았든 asserted graph가 entail하는 triple만 담고 있다.
checker가 처음 잡아낸 결함은 엔진 안에 있었다. cls-svf1 규칙이 하위 class axiom의 역을 유도하고 있었다.
verdict 단어
verdict 단어는 보증의 종류를 구분하는 출력 문자열이다. 같은 추론이라도 규칙의 출처가 다르면 다른 단어를 받는다.
| 규칙의 출처 | verdict | 뜻 |
|---|---|---|
| 내장 규칙표 | entailed |
asserted graph의 모든 모델에서 참이다 |
| 사용자가 공급한 규칙표 | entailed_under_supplied_rules |
그 규칙까지 만족하는 모델에서만 참이다 |
사용자가 쓴 규칙은 아무도 검사하지 않은 가정이다. 그래서 그 규칙 위의 certificate는 사실을 확립하지 않고 가정을 운반한다. 이 단어가 바뀌지 않게 되면 테스트가 실패한다.
영향 범위와 conservativity
blast radius는 변경이 영향을 주는 triple의 개수로 보고되는 파급 범위다. shape 기준 지표라서 계산은 싸지만 의미 변화를 잡지 못한다.
conservativity는 변경이 store가 이미 쓰고 있던 이름들에 대한 결론을 하나라도 바꾸는지를 묻는 성질이다. 이름 집합을 늘리지 않으면서 기존 이름에 대한 결론만 바꾸는 변경이 바로 shape 지표가 안전하다고 보고하는 변경이다.
entailment preservation
entailment preservation은 retrieval slice가 답에 필요한 결론을 여전히 지지하는지를 claim 단위로 판정하는 성질이다. claim은 정답이라면 최종 답에 담겨 있어야 하는 원자적 사실 진술을 말한다.
coverage는 이 성질의 대리 지표이고 slice가 커지면 같이 오른다. coverage 99%인 slice가 답이 필요한 triple 하나를 잃을 수 있고, coverage 60%인 slice가 필요한 claim을 모두 지킬 수 있다. 그래서 coverage로 조정한 retriever는 올바른 triple을 가져오는 대신 더 많이 가져오도록 학습한다.
locality module
locality module은 signature 위에서 전체 ontology의 모든 entailment를 보존하는 부분집합이다. signature는 관심 있는 term의 집합을 말한다.
손실을 측정하는 것은 두 번째로 좋은 답이고, 가장 좋은 답은 아무것도 잃을 수 없는 부분집합이다. onto_module_extract가 그 부분집합을 계산한다. 다만 이 보증은 인용된 정리이고 이 저장소에서 기계가 검사하지는 않는다.
방법
엔진의 계층 구조
엔진은 클라이언트 세 종류를 받는 전송 계층, 도구 묶음, 핵심 엔진으로 나뉘고 외부 원천을 데이터 파이프라인으로 끌어온다. docs/architecture.md가 이 구조를 선언하며, 2026년 9월 14일에 README에서 분리된 문서라 내용이 다시 쓰이지 않았다고 밝힌다.
| 계층 | 구성 |
|---|---|
| 클라이언트 | Claude 같은 LLM(MCP stdio), CLI(onto_* 서브커맨드), Studio(HTTP REST) |
| 전송 | MCP Streamable HTTP(/mcp), REST API(/api/query, /api/update, /api/save, /api/load, /api/lineage) |
| 핵심 엔진 | Oxigraph triple store(RDF와 OWL을 메모리에 두고 SPARQL 1.1 처리), SQLite(lineage 이벤트, 버전 스냅샷, lint와 enforce 피드백, 임베딩 벡터), DL reasoner(SHIQ tableaux, RDFS, OWL-RL), 임베딩 엔진(tract-onnx, 텍스트 임베딩과 Poincaré 구조 임베딩) |
| 외부 원천 | PostgreSQL 스키마 import, 원격 SPARQL endpoint, owl:imports 연쇄를 따르는 OWL URL, ICD-10과 SNOMED와 MeSH 같은 임상 crosswalk의 Parquet와 Arrow, CSV와 JSON과 XML과 YAML과 XLSX 파일 |
도구는 다섯 묶음이다. 어느 묶음이든 MCP와 CLI와 REST 어느 입구로도 같은 기능에 닿는다.
| 묶음 | 도구 |
|---|---|
| Core | validate, load, save, clear, stats, query, diff, lint, convert, status |
| Data Pipeline | map, ingest, shacl, reason, extend, import-schema |
| Lifecycle | plan, apply, lock, drift, enforce, monitor, lineage |
| Alignment와 Clinical | align, crosswalk, enrich, embed, search, similarity, dl_explain, dl_check |
| Versioning | version, history, rollback |
기술 스택은 Oxigraph 0.5가 RDF와 SPARQL 1.1을, rmcp가 streamable HTTP 위의 MCP를, SQLite가 상태와 lineage와 피드백을 맡는다. Studio는 Tauri 2와 React 19와 Tailwind 4로 만든다.
certificate를 만들고 검사하는 절차
certificate는 forward-chaining reasoner(rdfs, owl-rl, owl-rl-ext)가 결과 옆에 쓴다. 명령은 reason --certificate DIR이고, 유도된 triple마다 그것을 만든 규칙과 그 규칙이 읽은 전제를 기록한다.
README의 최소 예제는 triple 3건이다. Espresso가 Coffee의 하위 class, Coffee가 Drink의 하위 class, 어떤 컵이 Espresso라는 주장을 넣으면 그 컵이 Coffee이고 그 컵이 Drink이며 Espresso가 Drink의 하위 class라는 결론 3건이 나온다. 여기까지는 어느 RDFS reasoner나 한다. 차이는 그 실행이 남긴 디렉토리다.
lake exe oo-cert /tmp/oo-demo/cert/asserted.tsv /tmp/oo-demo/cert/derivations.tsv
{"ok":true,"asserted":3,"derivations":3,"theorem":"OOCert.certificate_sound"}
checker의 검사는 줄 단위로 진행된다. 각 줄에서 그 줄이 지목한 규칙 아래 전제로부터 결론을 다시 유도하고, 그 전제가 asserted이거나 더 앞선 줄의 결론인지 확인한다. 이런 checker는 누구나 작성할 수 있으며, 이 구현의 특징은 거기에 soundness 정리가 붙어 있다는 점이다.
거짓을 말하면 결과가 달라진다. 전제를 그대로 두고 그 컵이 Beer라는 결론만 넣으면 출력이 "ok":false로 바뀌고 first_rejected가 몇 번째 줄인지, rule이 어느 규칙인지, 그 규칙의 전제가 무엇인지 함께 나온다. exit 코드는 1이다. 전제를 보여 주는 이유는 전제가 결론을 지지하지 않는다는 것을 사람이 확인할 수 있게 하기 위해서다.
digest 검사는 별개의 질문을 답한다. store 보유자가 certificate-check <dir>을 실행하면 asserted.sha256의 digest와 store에서 계산한 digest를 비교한다. 이 답의 한계는 명령이 스스로 밝힌다. digest는 certificate를 바이트에 묶을 뿐 세계의 상태에 묶지 않으므로, 바뀐 뒤 되돌아온 store는 같은 답을 준다. 입력을 store가 아니라 값으로 다루는 타입 수준 작업은 decision 0010이고 아직 열려 있다.
한 가지 경우가 사용자를 혼란시킬 수 있어 명시돼 있다. reason은 기본값으로 추론 결과를 store에 쓴다. 그래서 그 뒤의 검사는 certificate가 열거한 것보다 많은 triple을 store에서 발견한다. 보고서는 그 원인을 지목하고 store를 다른 그래프라고 부르지 않는다. store의 triple이 그 실행의 결론이 아닐 때만 different graph라고 적는다.
누가 언제 검사하는가
certificate가 파일이라는 점이 검사 주체를 넷으로 늘린다.
| 검사 주체 | 시점 | 실행 |
|---|---|---|
| 작업 중인 본인 | 답을 신뢰하기 전 매 실행 | reasoner 옆에서 lake exe oo-cert |
| 리뷰어 | 변경이 들어올 때 | CI에서 실행이 남긴 artifact에 같은 명령 |
| 감사인 | 몇 달 뒤 | 보관한 파일에 같은 명령 |
| 다른 에이전트 | 신뢰하지 않는 에이전트의 주장을 받을 때 | 그 주장에 따라 행동하기 전 같은 명령 |
아래 두 경우가 성립하는 이유는 도구가 아무것도 스트리밍하지 않고 서버를 호출하지 않는다는 점이다. 엔진과 checker는 디스크의 바이트만 공유하고 프로토콜을 공유하지 않는다. 몇 달 뒤의 감사인은 파일 둘과 Lean 빌드만 있으면 되고 이 소프트웨어의 인스턴스는 필요 없다.
Isabelle/HOL이 같은 바이트를 읽는 독립된 두 번째 커널로 도식에 등장한다. Lean checker와 Isabelle이 같은 certificate를 받는 구조이고, 그 바깥의 엔진은 신뢰받지 않는 쪽에 놓인다.
사용자 규칙과 거부되는 조각
reason --rules TABLE --certificate DIR은 사용자가 공급한 규칙표를 평가하고 lake exe oo-horn check가 검사하는 certificate를 쓴다. 대조 대상 정리는 OOCert.horn_certificate_sound이고, 이 정리 하나가 모든 규칙표를 한 번에 다룬다.
규칙표를 손으로 쓰지 않아도 된다. rules-import --from swrl이 적재된 ontology에서 SWRL 규칙을 읽고, --from rif가 RIF Core를 XML 문법에서 읽는다.
다만 각 언어에서 triple 패턴 위의 Horn 규칙표가 되는 것은 일부 조각뿐이다.
| 언어 | 거부되는 구성 |
|---|---|
| SWRL | built-in atom, same-individual atom, different-individual atom, data range |
| RIF Core | equality, External, Expr, rif:local 상수, list term, presentation 문법 |
거부는 항목마다 이름과 개수로 보고되고, 기본값에서는 거부 하나가 import 전체를 실패시킨다. 이 기본값의 근거가 설계 의도를 잘 보여 준다. 규칙 절반을 조용히 잃은 규칙 집합도 fixpoint에 도달하고 그 certificate도 통과하는데, 그것은 아무도 작성하지 않은 규칙 집합에 대한 건전한 증명이기 때문이다.
이 계층의 정리는 조건부이고, 조건은 Rust가 사실을 그대로 기록한다는 점이다. certificate가 지목한 asserted graph와 기록한 단계가 그 경계이며, docs/trusted-computing-base.md가 검사 가능한 30개 속성으로 열거하고 무엇이 검사되고 무엇이 아직 신뢰에 남는지 밝힌다. README는 certificate에 의존하기 전에 그 문서를 읽으라고 적는다.
모순과 refutation의 범위
같은 실행이 모순도 찾는다. oo-refute가 판정할 수 있는 모순을 만나면 refutation.tsv를 쓰고, 대조 정리는 OOCert.refutation_sound다.
범위는 좁고 그 좁음이 문서에 명시돼 있다. false를 결론하는 OWL 2 RL 규칙 17개 중 10개를 검출하지만, 그중 cax-dw 하나만 lean/에 의미 조건이 있고 refutation이 쓰이는 유일한 규칙이다. 나머지 9개는 이 엔진이 찾았다는 사실로만 보고된다. checker가 판정할 수 없는 규칙을 적은 파일은 아무것도 증명하지 않는 certificate 모양의 물건이 되기 때문이다.
cax-dw는 서로 disjoint한 두 class에 속한 개체를 요구한다. 그래서 개체 없이 TBox만으로 unsatisfiable한 경우는 규칙 기반 경로에 보이지 않는다. 그 경우는 owl-dl tableau가 보고, 그 답에는 certificate가 붙지 않는다.
lifecycle 루프
docs/lifecycle.md는 운영 중인 ontology의 변경을 Terraform 방식으로 다룬다. 다섯 단계가 한 바퀴를 이루고 lineage가 그 전체를 기록한다.
| 단계 | 하는 일 |
|---|---|
| plan | 현재와 제안 ontology를 diff해 추가와 제거된 class, property, 개체와 triple 단위 delta, 영향 범위, risk score(low, medium, high)를 보고한다. onto_lock으로 잠근 IRI는 실수로 지워지지 않는다 |
| enforce | 설계 패턴 검사. 내장 pack은 generic(고아 class와 누락 label), boro(IES4와 BORO 준수), value_partition(disjointness)이고 사용자 SPARQL 규칙도 받는다 |
| apply | safe는 delta만 쓰고, migrate는 거기에 소비자를 위한 owl:equivalentClass와 owl:equivalentProperty 다리를 더한다 |
| monitor | 임계값 경보를 가진 SPARQL watcher. 동작은 notify, block_next_apply, auto_rollback, log |
| drift | 버전을 비교하고 Jaro-Winkler 유사도로 rename을 검출하며 변화 속도를 계산한다. SQLite 피드백 루프로 신뢰도를 자체 보정한다 |
| lineage | 모든 lifecycle 작업을 추가만 가능한 감사 추적(audit trail)으로 남긴다 |
제안 Turtle은 Terraform처럼 원하는 상태 전체다. 따라서 그 파일에 없는 것은 제거된다. 그래서 plan은 TBox뿐 아니라 인스턴스 데이터도 보고한다. 적용이 양쪽을 모두 지우기 때문이다. 어떤 종류든 제거는 최소 medium risk이고, 다른 triple이 그것을 참조하면 high가 된다.
plan의 저장과 범위
plan은 state 데이터베이스에 저장되고 plan_id로 반환된다. 그래서 그것을 계산한 프로세스보다 오래 남는다. plan과 apply는 별개의 CLI 실행이자 별개의 MCP 호출이고 메모리를 공유하지 않기 때문에 이 영속성이 필요하다. 최근 plan 100개가 보존된다.
oo plan proposed.ttl                    # plan_id 를 출력한다
oo apply safe --plan-id plan-0a1b2c3d…  # 또는 oo apply safe
기본값은 가장 최근 plan을 적용한다. 그 "가장 최근"은 계산한 주체로 범위가 제한되며, 주체는 MCP 세션 하나 또는 CLI 전체다. HTTP 모드에서는 모든 세션이 하나의 state db를 공유하므로, 범위 없는 기본값은 한 세션이 다른 세션이 검토 중인 변경을 적용하게 만든다. plan_id를 지정하면 의도적으로 그 경계를 넘을 수 있고, plan이 존재하지만 다른 주체의 것일 때는 오류가 그 사실을 알린다. 저장된 plan과 맞지 않는 id는 최신 plan으로 조용히 되돌아가지 않고 오류가 된다.
apply의 두 전략과 rename 다리
apply는 다른 triple만 쓴다. 그래서 변경 없는 그래프는 비용이 0이고 개체 한 건의 변경은 triple 하나를 건드린다.
결과의 strategy 필드는 delta로 보고되고, 두 그래프 어디든 blank node가 있으면 reload로 보고된다. blank node label은 store 지역적이라 그것을 대상으로 한 집합 차이가 의미를 갖지 않고, DELETE DATA와 INSERT DATA로 옮길 수도 없기 때문이다. 결과는 어느 경로든 같다.
migrate의 rename 다리는 onto_drift가 쓰는 같은 보정된 rename 검출기 DriftDetector가 만든다. 제거와 추가를 일대일로 짝지으므로 한 추가가 서로 다른 두 제거의 대체로 선언될 수 없다. 이름과 label 유사도가 0.6 미만인 짝은 거절된다.
이 보수성의 근거는 owl:equivalentClass가 강한 논리적 주장이라는 점이다. 틀린 다리는 없는 다리보다 나쁘다. 그래서 모든 다리가 유사도 점수와 함께 bridges에 보고되고, matcher가 거절한 제거는 unbridged_removals에 이름이 남는다. 마이그레이션을 신뢰하기 전에 두 목록을 모두 확인하라고 문서가 적는다.
lint와 enforce는 사용자 결정에서 학습한다. 경고를 세 번 무시하면 억제되고 한 번 수용하면 유지된다. align과 drift가 쓰는 자체 보정 패턴과 같은 방식이다.
plan에서 의미를 보는 단 하나의 부분
plan의 나머지가 모두 shape에 대한 것이라면 conservativity 검사는 의미에 대한 것이다. check_conservativity: true를 주면 plan이 그 변경이 기존 이름들에 대한 결론을 바꾸는지 보고하고, 행마다 규칙과 base에 없던 전제를 붙인다.
이 검사가 opt-in인 이유는 두 그래프를 fixpoint까지 추론해야 하기 때문이다. 비용이 큰 검사를 기본값으로 두지 않는 대신, 꺼져 있을 때도 conservativity 블록은 남아 ran: false와 사유를 적는다. 블록이 없는 것과 깨끗한 블록이 대시보드에 같게 보이는 상황을 막는 설계다.
이 검사는 치명적 오류가 되지 않는다. 실행할 수 없으면 conservativity.skipped가 설정되고 plan은 그대로 반환된다. verdict는 boolean이 아니라 단어이며, description logic 기준이 아니라 Horn 규칙표 기준의 conservativity다. README 예제의 verdict not_conservative_under_rule_table에서 그 기준이 단어에 들어 있다.
module과 slice, 정리와 측정의 구분
onto_module_extract는 signature 위의 syntactic locality module을 계산한다. 그 보증은 Cuenca Grau, Horrocks, Kazakov, Sattler의 JAIR 31권(2008) 정리다. 도구는 그 정리를 인용하며, 여기서 기계가 검사하지는 않는다. lean/ 아래 어떤 파일도 locality를 다루지 않고 보고서가 그 사실을 그대로 적는다.
그래서 보고서는 이 프로젝트의 정리를 인용하지 않고 측정을 제시한다. ontology와 module 양쪽을 fixpoint까지 추론한 뒤, signature 위에서 module이 도달하지 못한 결론을 보고한다.
저장소의 pizza ontology에서 module은 axiom 1,345개 중 238개다. 그 실행은 차이 2,583건 중 잃은 결론이 0건이었다. onto_conservative_check가 같은 기계를 lifecycle에 쓰며, 이 axiom들을 추가하는 것이 ontology가 이미 쓰던 이름들에 대한 결론을 바꾸는지 하나만 묻는다.
신뢰로만 통용됐던 세 가지 주장
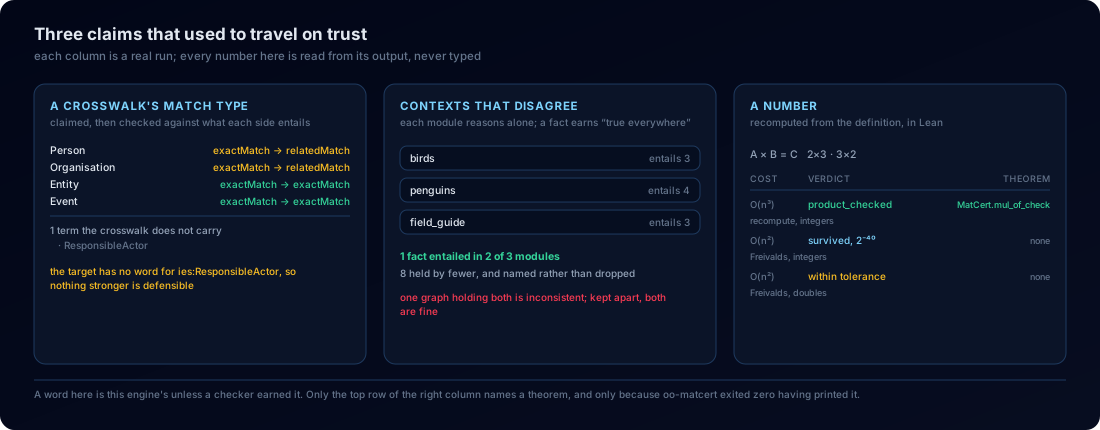
crosswalk는 두 어휘 사이의 대응을 적은 매핑 파일이고, 거기 적힌 match type은 지금까지 아무것도 검사하지 않았다. 이 엔진은 양쪽을 따로 추론하고 매핑을 통해 각 쪽의 entailment를 비교한 뒤, 근거가 지지하는 가장 강한 match type을 보고한다. entailment가 지지하지 않는 exactMatch는 사유와 함께 강등된다.
같은 보고서가 crosswalk가 옮기지 않는 term 전부를 이름으로 열거한다. 대부분의 crosswalk 파일에서 사라지는 목록이 그 두 번째 목록이다. 출력은 유효한 SSSOM이라 기존 도구가 그대로 읽는다.
강등보다 날카로운 두 번째 질문은 번역된 claim을 target에 넣고 다시 추론하는 것이다. 충돌이 나면 target이 매핑이 들여온 것을 부정한다는 뜻이고, 그것은 사람이 판정해야 하는 불일치다.
문맥은 서로 어긋날 수 있다. 새는 난다, 펭귄은 새이고 펭귄은 날지 않는다를 한 그래프에 담으면 모순이고 이 엔진은 그 충돌을 찾는다. 대신 각 모듈이 따로 추론하며, n개 모듈 중 k개가 어떤 사실을 entail할 때 그 사실이 "어디서나 참"을 얻는다.
수치에도 certificate가 붙는다. oo-matcert가 행렬 곱을 정의대로 다시 계산하고 승인하면 MatCert.mul_of_check를 출력한다. 정수에 한정되며 그것이 문장이 성립하는 조건이다. Freivalds 알고리즘은 비용이 적지만 확률을 주므로 bound를 출력하는 opinion에 머문다. 부동소수점은 허용 오차를 보고한다. 실수 위의 증명이 IEEE-754에 대해서는 아무것도 말하지 않기 때문이다.
무엇이 어떤 정리로 검사되는가
| 질문 | 받는 것 | 대조 대상 |
|---|---|---|
| OWL 추론 | derivation certificate | OOCert.certificate_sound |
| 사용자 규칙으로 추론 | certificate와 다른 verdict 단어 | OOCert.horn_certificate_sound |
| satisfiable인가 | 유한 모델 | Dl.satisfiable_of_checkModel |
| solver의 모델이 실재하는가 | 재생한 모델 | Fol.satisfiable_of_check |
| inconsistent인가 | refutation | OOCert.refutation_sound |
| 데이터가 shape에 맞는가 | validation 보고서 | Shacl.validate_spec |
| retrieval slice가 답을 여전히 지지하는가 | claim별 보존 | OOCert.certificate_sound |
내장 Horn 규칙표의 검사는 OOCert.entails_of_builtin_horn을 쓴다. 같은 입력에 사용자 규칙표를 주면 정리 이름과 verdict 단어가 함께 바뀐다.
설치와 실행 경로
설치 경로는 네 가지다. macOS aarch64와 Linux x86_64 릴리스 바이너리를 내려받아 실행 권한을 주는 방법, ghcr.io/fabio-rovai/open-ontologies:latest 이미지를 pull하는 방법, Rust 1.85 이상에서 cargo build --release --features embeddings,plugins,sql로 빌드하는 방법이다. Intel macOS와 네이티브 Windows는 docs/quickstart.md와 docs/windows.md로 넘긴다.
serve가 MCP 서버를 띄우면 stdin과 stdout에서 JSON-RPC를 말한다. 그래서 시작 직후 클라이언트를 기다리는 동안 멈춘 것처럼 보이는데, README는 이 동작이 정상이라고 적는다. 터미널에서는 open-ontologies validate <file.ttl> 같은 CLI 서브커맨드를 쓴다.
에이전트 연결은 설정 블록 하나다. Claude Code는 ~/.claude/settings.json에, Claude Desktop은 claude_desktop_config.json에 mcpServers 항목으로 바이너리 경로와 serve 인자를 적고 클라이언트를 다시 시작하면 onto_* 도구가 나타난다. Cursor와 Windsurf와 Zed와 VS Code는 quickstart 문서가 다룬다.
두 기본값의 함정
기본값 둘이 조용히 틀린 결과를 만들 수 있다고 README가 경고한다.
| 기본값 | 증상 | 대응 |
|---|---|---|
| 저장이 메모리에 머문다 | load 다음의 reason이 빈 store에서 시작해 아무것도 certify하지 않는다. 경고는 나오지만 놓치기 쉽다 |
OPEN_ONTOLOGIES_STORAGE_MODE=persistent를 설정한다 |
--data-dir이 환경 변수가 아니라 플래그다 |
그 플래그 없이 실행한 시연이 실제 작업물 옆인 ~/.open-ontologies에 쓴다 |
실행마다 --data-dir을 명시한다 |
일부 도구는 Cargo feature를 요구하고 그 feature 없이는 오류를 낸다. 4개 도구가 embeddings, 2개가 plugins, 2개가 postgres 또는 duckdb를 요구한다. 공개 바이너리와 GHCR 이미지는 기본 feature 집합이므로 그 8개 도구를 갖고 있지 않다.
전면에 두지 않은 부분과 Studio
README는 하나의 루프만 전면에 둔다. plan으로 변경을 계획하고, apply로 적용하고, drift로 이탈을 보고, certify로 유도 결과를 남기고, 잘못된 변경은 rollback한다. alignment, 임베딩, PDDL planning, 임상 crosswalk, 플러그인 마켓플레이스, CIVeX는 docs/tool-reference.md로 한 번에 넘긴다. 기능을 길게 열거하는 것이 논증이 아니라는 이유를 그 자리에 적는다.
저장소는 그 부분들과 함께 표준 ontology 33종의 마켓플레이스, 임상 crosswalk, 의미 임베딩, lineage 감사 추적을 담는다.
Studio는 데스크톱 애플리케이션이고 가상 스크롤 ontology 트리, AI 채팅 패널, Protégé 방식의 inspector를 갖는다. 설계 판단이 역할별로 갈린다.
| 경로 | 선택 | 이유 |
|---|---|---|
| UI 읽기 | 세션 없는 REST | SPARQL 질의나 통계에는 MCP 세션 관리가 필요 없다 |
| UI 쓰기 | REST /api/update와 /api/save |
Tauri WebKit 웹뷰에서 세션 수명 문제를 피한다 |
| 에이전트 쓰기 | MCP tools/call |
사이드카 자신의 MCP 클라이언트가 세션을 들고 있고 모델에는 전체 도구 집합이 필요하다 |
| 공유 저장소 | Arc<GraphStore> |
모든 MCP 세션과 REST 핸들러가 같은 메모리 내 triple store를 본다 |
| 에이전트 사이드카 | stdin과 stdout | Node.js를 격리하고 수명은 Tauri가 관리한다 |
두 번째 엔진과 그 독립성의 한계
Python 패키지 open-ontologies-lite도 추론한다. 순수 Python으로 추론하므로 Rust 툴체인이 필요 없고, 같은 Lean 바이너리가 그 certificate를 검사한다. README의 표현으로 이 패키지는 두 번째 엔진이며, 그 엔진을 신뢰하지 않아도 비용이 들지 않는다. 보증이 애초에 엔진에 있지 않았기 때문이다.
tools/horn_differential.py가 두 엔진과 Lean checker를 저장소의 모든 RDF 문서에 실행한다. 다만 두 엔진은 독립적이지 않다고 문서가 못박는다. 같은 알고리즘을 같은 규칙표에 실행하고, Python의 주석이 Rust를 파일과 행으로 인용한다. 그래서 둘의 일치는 전사 오류에 대한 강한 증거이지만 W3C 규칙의 공통 오독에 대해서는 거의 증거가 되지 않는다.
독립적인 쪽은 Lean checker뿐이다. 도구가 매 실행에서 이 유보를 일치 개수 옆에 출력하고, docs/lean-certificates.md의 known limitations 절도 같은 내용을 한계로 적는다.
결과
ontology 생성과 확장
Manchester Pizza 튜토리얼은 학생이 Protégé로 약 4시간에 Pizza ontology를 만드는, OWL 교육에서 가장 널리 쓰이는 자료다. 이 저장소의 벤치마크는 입력을 한 문장으로 줄였다. "Manchester 튜토리얼 명세에 따라 Pizza ontology를 만들어라"가 전부다.
| 지표 | 기준(Protégé) | 생성 결과 | coverage |
|---|---|---|---|
| class | 99개 | 95개 | 96% |
| property | 8개 | 8개 | 100% |
| topping | 49개 | 49개 | 100% |
| named pizza | 24개 | 24개 | 100% |
| 소요 시간 | 약 4시간 | 약 5분 |
누락된 class 4개는 OWL 문법 변형을 보여 주기 위해서만 존재하는 교육용 산물이다. UnclosedPizza가 그런 class다. 즉 96%라는 수치의 미달분은 실제 모델링 누락이 아니라 교재 장치다.
IES4 건물 도메인은 영국 정부의 정보 교환 표준을 BORO와 4D 방식으로 다룬 두 번째 사례다. 준수 검사 86개를 모두 통과했고 triple 318건, class 36개, property 12개를 한 번의 생성으로 유효한 Turtle로 냈다. 이 표준의 관리 주체는 2025년 3월부터 영국 Department for Business and Trade이고, 과거 저장소 dstl/IES4는 보관 상태이며 마지막 공개 릴리스는 MIT 라이선스의 4.3.1이었다.
확장 사례는 생성이 아니라 매핑이다. Manchester Pizza OWL과 13행 음식점 CSV를 받아 데이터를 ontology에 넣는 과제에서 기준 대비 topping coverage 94%(66개 중 62개 일치), IRI 정확도 94%에서 100%, 채식 분류 92%를 기록했고 매핑을 정제하면 채식 분류가 100%가 됐다.
추론 정확도
UCI Mushroom 데이터셋은 전문가가 분류한 표본 8,124건이다. OWL axiom 6개로 분류한 결과가 아래와 같다.
| 지표 | 값 |
|---|---|
| 정확도 | 98.33% |
| 독성 표본 recall | 100%, 독버섯을 하나도 놓치지 않았다 |
| 거짓 양성 | 136건(1.67%) |
| 거짓 음성 | 0건 |
| 분류 규칙 | OWL axiom 6개 |
거짓 양성 136건과 거짓 음성 0건의 비대칭은 설계에서 나온 것이다. 독성 판정에서 놓치는 쪽의 비용이 과하게 경고하는 쪽의 비용보다 크다는 판단이 axiom 구성에 들어가 있다.
비전 벤치마크는 수동으로 정답을 붙인 실제 사진 10장을 쓴다. 비교 대상은 사람의 수동 작업, Claude 단독 처리, RDF 파이프라인 세 가지다.
| 지표 | 수동 | Claude 단독 | RDF 파이프라인 |
|---|---|---|---|
| 객체 recall | 100% | 89% | 95% |
| RDF triple 수 | 0건 | 0건 | 2,540건 |
| SPARQL 질의 가능 | 불가 | 불가 | 가능 |
RDF 파이프라인은 Claude 단독보다 객체 recall에서 6%p 높고, 동시에 결과를 질의 가능한 triple 2,540건으로 남긴다. 수동 작업이 recall 100%를 유지하지만 질의 가능한 산출물은 내지 않는다.
남의 파일에 같은 검사를 적용한 감사
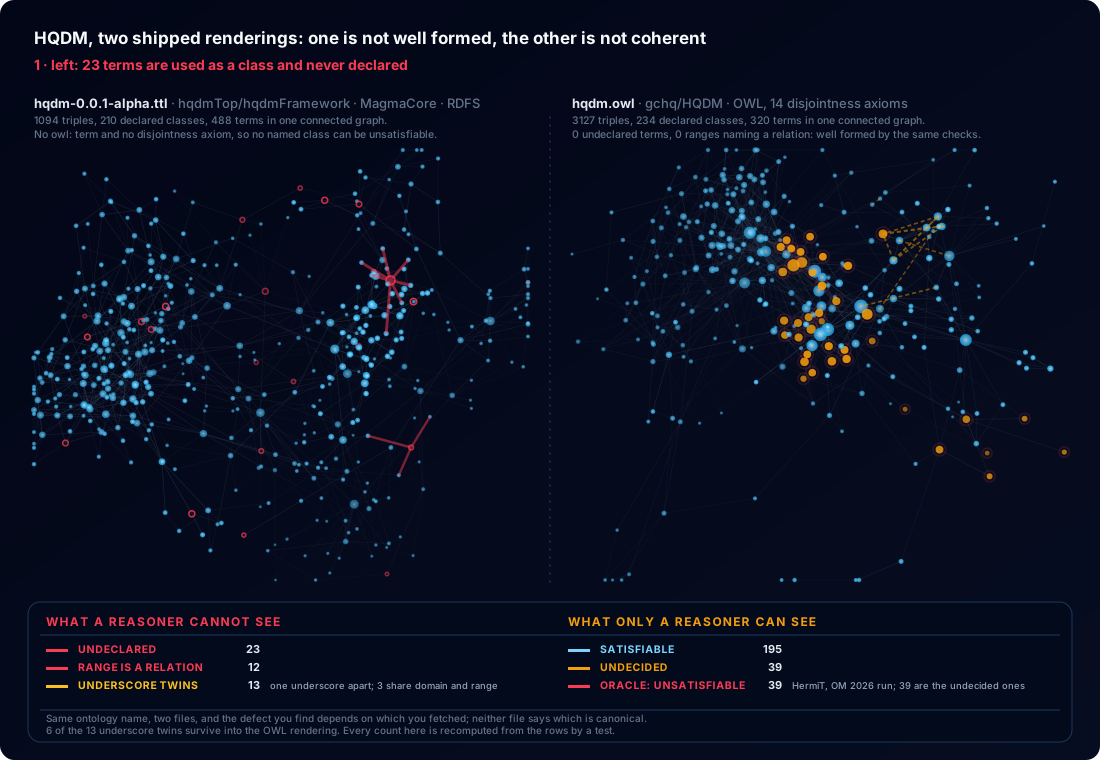
HQDM은 상위 ontology이고 두 파일로 배포된다. hqdmTop/hqdmFramework가 RDFS 파일을 내고 MagmaCore가 그 파일의 사본을 바이트 단위로 유지하며, gchq/HQDM이 OWL 파일을 낸다. 두 파일은 서로 다른 검사에서 실패한다.
| 파일 | 규모 | 검사 결과 |
|---|---|---|
hqdm-0.0.1-alpha.ttl (RDFS) |
triple 1,094건, 선언 class 210개, term 488개가 한 연결 그래프 | owl: term과 disjointness axiom이 없어 어떤 named class도 unsatisfiable할 수 없다. 대신 class로 쓰이면서 선언되지 않은 term 23개, class가 아니라 relation을 지목한 rdfs:range 선언 12개, 마지막 밑줄 하나만 다른 이름 13쌍을 안고 있다. 그 13쌍 중 3쌍은 domain과 range까지 같다 |
hqdm.owl (OWL) |
triple 3,127건, 선언 class 234개, term 320개, disjointness axiom 14개 | 세 검사를 모두 통과해 선언되지 않은 term 0개, relation을 지목한 range 0개다. 그러나 coherent하지 않다. 이 엔진의 tableaux가 named class 195개를 satisfiable로 판정하고 39개를 판정하지 못하며, HermiT는 정확히 그 39개를 unsatisfiable이라 부른다 |
이 사례가 보여 주는 것은 결함의 종류가 갈린다는 점이다. 선언 누락과 잘못된 range와 이름 쌍둥이는 reasoner가 볼 수 없는 결함이고, unsatisfiable class는 reasoner만 볼 수 있는 결함이다. 한 파일이 전자를, 다른 파일이 후자를 안고 있다.
README는 이 그림이 아무것도 증명하지 않으며 증명을 주장하지도 않는다고 적는다. HermiT의 판정은 이 저장소의 어휘에서 opinion이다. 테스트가 각 개수를 다시 계산하고 그 교집합도 다시 계산하며, 출처와 방법은 docs/assets/hqdm/PROVENANCE.md에 있다.
표지 도해가 쓰는 ies-core.ttl 사례도 같은 기계의 출력이다. 사람이 주장한 edge 426건에서 엔진이 유도한 edge 259건이 나오고, certificate 하나가 그 259건을 묶어 checker 한 번의 실행으로 승인된다. 위조한 edge 1건에는 같은 checker가 exit 1을 내고 규칙을 지목한다. 각 개수는 실행이 공급하며 캡션에 사람이 적어 넣지 않는다.
OntoAxiom 재채점
OntoAxiom은 axiom 유형 5종에 대한 LLM의 axiom 식별 능력을 재는 벤치마크다. 정답 개수부터 정리가 필요하다. 논문은 axiom 2,771개라 적지만 공개된 정답은 그 유형들에 대한 순서쌍 3,042개를 담고 있고, 대칭쌍을 합치면 2,514개다. 이 저장소는 3,042개를 채점하고 그 사실을 밝힌다.
아래 모든 조건은 하나의 채점기 score_all_conditions.py가 채점했다. 정규화를 공유하고, 쌍 뒤집기는 domain과 range에만 적용하며, 빈 정답 칸은 제외하고 두 평균을 함께 보고한다. 저장된 예측을 다시 채점한 값이라 새 추론은 없다.
| 모델 | 조건 | 입력 | macro F1 | micro F1 |
|---|---|---|---|---|
| Claude Opus | A | 이름 목록만 | 0.451 | 0.397 |
| Claude Opus | D | 전체 원본 OWL | 0.768 | 0.686 |
| Qwen3-Coder-30B | A | 이름 목록만 | 0.223 | 0.176 |
| Qwen3-Coder-30B | D | 전체 원본 OWL | 0.673 | 0.667 |
| MCP와 SPARQL 추출 | C | 전체 OWL | 0.713 | 0.717 |
두 결론이 따라 나오고 어느 쪽도 이 저장소에 유리한 해석이 아니다.
첫째, 원본 OWL은 도움이 된다. OWL 파일 전체를 준 LLM(0.323)이 이름 목록만 준 같은 LLM(0.431)보다 낮았다는 OntoAxiom 논문의 반직관적 결과는 공통 채점기 하나를 통과하지 못한다. 그 두 값은 서로 어긋나는 스크립트가 낸 값이고, 어긋난 지점은 camelCase 정규화, macro 대 micro 평균, 어느 axiom 유형에 쌍 뒤집기를 적용할지 세 곳이다. 세 곳 모두 원본 OWL 조건에 불리했다. 다시 채점하면 두 모델 모두, 두 평균 모두에서 부호가 뒤집힌다. score_condition_d.py --legacy가 0.323을 그대로 재현하므로 이 버그는 주장이 아니라 시연으로 제시된다.
둘째, 도구는 정확도가 아니라 감사 가능성을 산다. 올바르게 채점하면 MCP 추출과 원본 파일 읽기는 대등하다. 원본 OWL이 macro에서 0.768 대 0.713으로 앞서고 추출이 micro에서 0.717 대 0.686으로 앞선다. 도구 계층에 남는 근거는 모든 MCP 쌍이 실제 triple에 대한 SPARQL 질의로 추적된다는 점이다. 파일을 읽는 모델은 그럴듯한 쌍을 환각할 수 있고, 어떤 F1 점수도 그것이 어느 쌍인지 알려 주지 않는다.
논문이 최고 시스템으로 보고한 o1의 F1 0.197은 비교 baseline으로 쓰지 않는다. 논문이 어느 평균인지 밝히지 않았고, 통계를 섞는 것이 위에서 정정한 바로 그 오류이기 때문이다.
이 결과의 조건도 함께 적혀 있다. temperature 0.2에서 단일 실행이고 seed 평균이 아니다. Pizza와 FOAF와 OWL-Time 같은 벤치마크 ontology는 널리 공개돼 pre-training 데이터에 있을 가능성이 높으므로 모델 단독 점수는 오염을 포함한 baseline이다. Qwen 교차 모델 ablation은 어떤 효과가 도구의 성질인지 한 공급사 모델의 성질인지 가리기 위해 존재한다.
alignment
OAEI는 ontology alignment 시스템을 겨루는 공개 평가다. 이 엔진의 성적은 과제에 따라 크게 갈린다.
| 과제 | F1 | 위치 |
|---|---|---|
| Anatomy | 0.829 | OAEI 2025 참가 13개 중 9위 |
| Conference | 0.438 | 참가한 모든 시스템과 두 baseline보다 낮다 |
전체 field와 두 baseline, stable matching ablation은 benchmark/oaei/README.md가 다룬다.
claim 검증과 컴파일된 추론
claim 검증 벤치마크는 claimcheck 모듈이 설계된 작업 부하를 측정한다. 고정된 ontology를 한 번 컴파일해 두고 후보 claim의 흐름을 consistent와 rejected와 undetermined로 답하는 상황이다.
측정 대상의 위치를 먼저 밝혀 둔다. claimcheck는 라이브러리 모듈이고 src/server.rs의 어떤 MCP 도구도 src/main.rs의 어떤 CLI 서브커맨드도 그것을 호출하지 않는다. 따라서 이 수치는 배포되는 서버나 바이너리의 능력이 아니라 따로 측정한 모듈의 수치다.
측정 방법은 과제를 맞춰 둔 비교다. 두 엔진이 같은 파일에 같은 질문을 답한다. baseline인 ClaimConsistency.java는 각 claim을 ABox axiom으로 주장한 뒤 HermiT 1.4.3.456에 KB 전체의 consistency를 묻고, JVM은 예열 상태이며 ontology는 한 번 적재해 모든 claim에 분할 상환된다. 정답은 DisjointnessMatrix.java가 모든 named class 쌍의 교집합 satisfiability를 HermiT로 전수 검사해 만든다.
적대적 claim 생성이 이 벤치마크의 핵심 장치다. structural_parity.py가 컴파일된 구조에서 claim을 유도한다. disjoint 쌍을 하위 class로 밀어 내린 claim(추론으로만 닿는 모순), 형제 쌍 claim(불완전성이 드러나는 자리), class와 자기 상위 class를 함께 주장하는 claim(절대 거부돼서는 안 되는 경우)을 만든다. 무작위 쌍 추출은 실제 모순을 약 11%만 건드리는데 구조적 생성은 약 60%에 도달한다. LUBM은 의도적으로 쓰지 않는다. ABox 질의 벤치마크이고 스키마가 매우 단순해 reasoner 비교에 쓰지 말라는 문헌(Lam et al., DMKG 2023) 경고가 있기 때문이다.
표준 pizza.owl(triple 1,944건, class 99개)과 Apple M3 Max 기준 결과다.
| claim 1건 검사 | 중앙값 | p95 | 처리량 |
|---|---|---|---|
| HermiT, 예열 상태 | 4,936µs | 미보고 | 초당 약 200건 |
| 컴파일된 token-bitset 검사 | 0.3µs | 0.4µs | 순차 초당 310만 건, 배치 초당 1,120만 건 |
지연과 처리량은 tests/claimcheck_pizza_bench.rs가 컴파일된 Pizza ontology에 claim 4개를 번갈아 넣어 측정한 값이고, 출력만 하며 저장소에 커밋되지 않는다. 입력이 없으면 테스트는 건너뛰고 통과한다.
속도보다 중요한 것은 그 속도가 건전성을 깎지 않았는지다.
| 정확성 항목 | 결과 |
|---|---|
| HermiT 대비 부당한 거부, 감사한 쌍 78,884건(ontology 13종) | 0건, 23쌍은 residual 계층으로 넘김 |
| 구조적 적대 claim 793건 일치(ontology 8종) | 100%, 거짓 음성 0건 |
| 모순 recall, pizza.owl | 3,944/3,944(100%) |
| 모순 recall, ore_ont_10230 | 232/232(100%) |
| 모든 sweep의 부당한 거부 | 0건 |
컴파일된 표면은 건전하되 의도적으로 불완전하다. 판정할 수 없는 쌍은 Undetermined를 반환하고 reasoner가 받는 residual 계층으로 넘어가며, 적대 claim 전체에서 그 비율은 4.9%다. 계층 1의 적용 범위는 모델링 방식에 따라 ontology마다 달라진다.
비용은 질의 시점이 아니라 빌드 시점에 발생한다. 분류 한 번과 전파 fixpoint로 pizza.owl이 약 120ms, class 659개인 ore_ont_12925가 컴파일 단계만 약 270ms이고, class 3,539개에 추론된 subsumption 2만 7천 건인 ontology는 분류에 28.5초가 걸렸다.
철회하고 정정한 수치
이 저장소의 두 하위 시스템이 비결정적이었다. tableaux 분류와 alignment가 모두 HashMap 순회 순서에 출력을 맡기고 있었다. 둘 다 고쳤고, 수정 전에 기록한 OAEI Anatomy F1 0.832는 결정론적 값이 0.829인 분포에서 뽑힌 한 표본이었다. 어긋난 alignment 해시 5건과 재현 명령은 docs/determinism.md가 담는다.
HermiT 대비 속도 주장은 철회됐다. 빈 store에서 측정한 값이고 올바르게 측정하면 결과가 뒤집힌다. 그 주장은 README뿐 아니라 arXiv:2605.09184v1에도 실려 있었다.
한계
- certificate가 묶는 것은 바이트이고 세계의 상태가 아니다.
asserted.sha256digest는 바뀐 뒤 되돌아온 store에 같은 답을 준다. 입력을 store가 아니라 값으로 다루는 타입 수준 작업은 decision 0010이고 열려 있다. - refutation은 규칙 17개 중 1개에만 certificate가 붙는다.
false를 결론하는 OWL 2 RL 규칙 17개 중 10개를 검출하지만cax-dw만 Lean에 의미 조건이 있다. 나머지 9개와owl-dltableau의 답은 보증 없는 보고다. - locality module의 보증은 인용된 정리이고 기계 검사가 없다.
lean/아래 어떤 파일도 locality를 다루지 않는다. 보고서는 정리 대신 측정을 제시한다. - unsatisfiability 답에는 보증이 없다. 비교표가 그 사실을 그대로 적는다.
- 두 엔진은 독립적이지 않다. Rust와 순수 Python 두 엔진은 같은 알고리즘을 같은 규칙표에 실행하고 Python 주석이 Rust를 파일과 행으로 인용한다. 일치는 전사 오류에 대한 증거이지 공통 오독에 대한 증거가 아니다.
- Lean 정리는 Rust가 사실을 그대로 기록한다는 조건에 달려 있다. 그 경계가 이 계층의 신뢰 기반 전체이고
docs/trusted-computing-base.md가 검사 가능한 30개 속성으로 열거한다. - 공개 바이너리에 도구 8개가 없다. 기본 feature 집합으로 빌드되므로
embeddings,plugins,postgres,duckdb를 요구하는 도구는 오류를 낸다. - 기본값 둘이 조용히 틀린 결과를 만든다. 메모리 저장 기본값은 certify할 것이 없는 상태를 만들고,
--data-dir없는 실행은 실제 작업물 옆에 쓴다. - claimcheck 수치는 배포 산출물의 능력이 아니다. MCP 도구도 CLI 서브커맨드도 이 모듈을 호출하지 않는다.
- alignment 성능이 과제에 따라 크게 갈린다. OAEI Anatomy는 13개 중 9위이고 Conference는 모든 참가 시스템과 두 baseline보다 낮다.
- 벤치마크 조건의 한계가 함께 적혀 있다. OntoAxiom 결과는 temperature 0.2 단일 실행이고, Pizza와 FOAF와 OWL-Time은 pre-training 오염 가능성이 높은 공개 ontology다.
- STE 승인 어휘 준수는 주장하지 않는다. 사전이 유료 문서라 저장소가 사본을 갖고 있지 않고, 작성 규칙 준수만 테스트가 검사한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| certificate | 엔진이 유도한 결론을 규칙과 전제까지 적어 남긴 파일. asserted.tsv와 derivations.tsv 두 개이며 네트워크도 엔진도 없이 재검사된다 |
| soundness 정리 | checker가 승인한 결과가 전제에서 실제로 따라 나온다는 것을 기계가 검사한 보증. derivation certificate에 대한 정리가 OOCert.certificate_sound다 |
| verdict 단어 | 보증의 종류를 구분하는 출력 문자열. 내장 규칙은 entailed, 사용자 규칙은 entailed_under_supplied_rules를 받는다 |
| conservativity | 변경이 store가 이미 쓰던 이름들에 대한 결론을 하나라도 바꾸는지를 묻는 성질. plan에서 opt-in이고 Horn 규칙표 기준으로 판정된다 |
| entailment preservation | retrieval slice가 답에 필요한 결론을 여전히 지지하는지를 claim 단위로 판정하는 성질. coverage를 대신하는 목표 지표다 |
| locality module | signature 위에서 전체 ontology의 모든 entailment를 보존하는 부분집합. 보증은 인용된 정리이고 이 저장소에서 기계 검사되지 않는다 |
| residual 계층 | 컴파일된 검사가 Undetermined를 반환한 claim을 reasoner가 받아 처리하는 뒷단 |
관련 페이지
- Ontology Atlas: 코드베이스 ontology를 Markdown 폴더로 유지하는 로컬 워크벤치. 영향 범위를 선언된 의존으로 계산하는 쪽이고, Open Ontologies는 같은 질문을 OWL 추론과 certificate로 답한다
- colbymchenry/codegraph: tree-sitter 정적 추출로 코드 그래프를 만들어 MCP로 노출하는 도구. LLM 없이 추출만 쓰는 선택이 certificate 없이 추론만 쓰지 않는 이 저장소의 선택과 대비된다
- Open Knowledge Format (OKF): 지식을 frontmatter Markdown 디렉토리로 표현하는 포맷 명세. provenance와 trust 필드, 승인된 계산을 검사하는 Attested Computation 타입이 이 저장소의 certificate와 같은 문제를 다룬다
- getzep/graphiti: 에이전트 메모리를 temporal knowledge graph로 유지하는 저장소. knowledge graph를 쓰는 목적이 메모리인 쪽과 운영 ontology 변경 관리인 쪽의 차이를 보여 준다
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩과 인덱스 없이 원본 corpus를 직접 뒤지는 retrieval 패러다임. coverage 대신 다른 기준을 세우려는 흐름에서 이 저장소의 entailment preservation과 맞닿는다
- 용어집: Agents (Terminology Glossary): ontology, knowledge graph, provenance, claim, coverage 표기의 canonical 정의