Agents · REPORT · 2026
The New SDLC With Vibe Coding: From ad-hoc prompting to Agentic Engineering
요약
이 백서는 소프트웨어 개발에서 사람이 다루는 1차 인터페이스가 문법에서 의도(intent)로 옮겨 가고 있다고 주장한다. 저자들은 이 변화를 두 개의 개념 도구로 정리한다. 하나는 vibe coding에서 agentic engineering까지 이어지는 스펙트럼이고, 다른 하나는 "Agent = Model + Harness"라는 방정식이다.
두 도구가 겨냥하는 문제는 서로 다르다. 스펙트럼은 "지금 하는 작업에 어느 정도의 규율이 필요한가"를 판단하게 하고, 방정식은 "agent가 잘 동작하지 않을 때 무엇을 손봐야 하는가"를 판단하게 한다. 앞의 답은 stakes, 곧 그 작업이 틀렸을 때 감당해야 하는 위험의 크기에 달렸고, 뒤의 답은 대체로 모델이 아니라 모델을 둘러싼 설정에 있다.
채택은 이미 광범위하다. 2026년 초 기준으로 전문 개발자의 85%가 AI 코딩 에이전트를 상시 쓰고, 51%가 매일 쓰며, 신규 코드의 41%가 AI 생성으로 추정된다. 백서는 이 현실 위에서 SDLC 전 단계가 어떻게 재편되는지를 짚는다. 다만 압축은 균등하지 않다. 구현은 주 단위에서 시간 단위로 줄어드는데 요구사항과 아키텍처와 검증은 여전히 사람 속도에 머물러, 결과는 빨라진 옛 SDLC가 아니라 병목의 위치가 다른 새 워크플로가 된다.
이 페이지는 Google 백서 시리즈 Day-1 편을 다룬다. 세션과 skill과 메모리 설계는 Day-3 편(Context Engineering), spec-driven development와 구조적 리뷰와 가드레일은 Day-5 편으로 넘어간다. 본문에 인용된 LangChain, Anthropic, METR, Terminal Bench, Deloitte 수치는 모두 외부 자료를 재인용한 것이므로 실험 조건은 원출처를 확인해야 한다.
배경
번역 작업으로서의 프로그래밍
컴퓨팅 역사의 대부분에서 프로그래밍은 번역 작업이었다. 문제를 사람의 언어로 이해하고, 해법을 추상적 용어로 설계하고, 기계가 실행할 수 있는 문법으로 옮긴다. 단계마다 마찰이 생긴다.
백서는 그 마찰이 지금 크게 줄어들고 있다고 본다. 개발자가 기계와 마주하는 1차 인터페이스는 수십 년간 문법이었다. 중괄호, 세미콜론, 타입 주석, 그리고 프로그래밍 언어의 정밀한 문법이다. 그 시대가 끝나고 있으며, 개발자는 "어떻게 만들지"가 아니라 "무엇을 만들지"를 표현하고 기계가 구현을 맡는다. 사람은 의도와 아키텍처와 판단을 제공한다.
다섯 세대의 진화
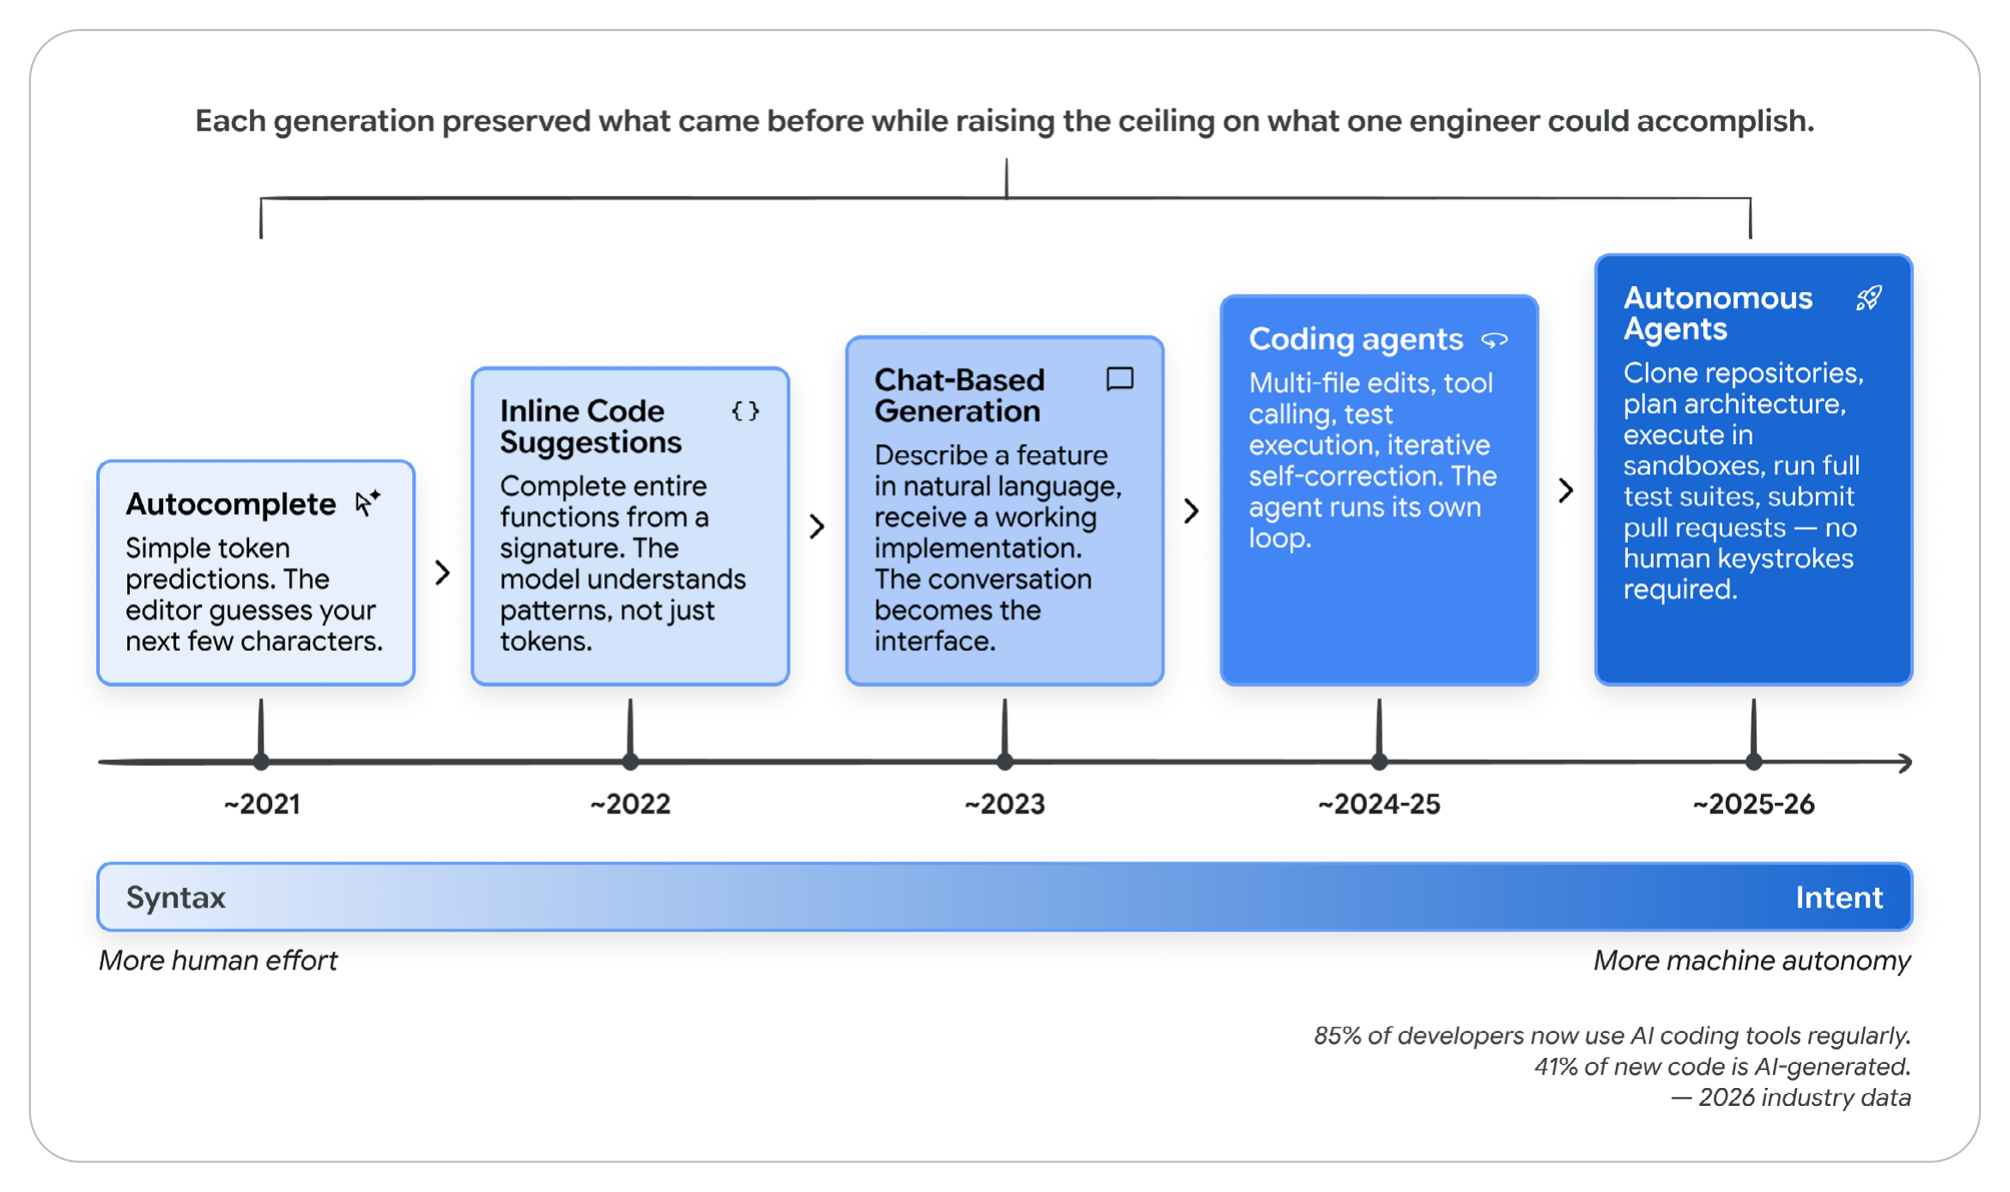
이 변화는 하루아침에 일어나지 않았다. 백서는 다섯 세대로 나눠 배치한다.
| 세대 | 시점 | 능력 |
|---|---|---|
| Autocomplete | 약 2021년 | 단순 토큰 예측. 에디터가 다음 몇 글자를 추측한다 |
| Inline Code Suggestions | 약 2022년 | signature만 주면 함수 전체를 완성한다. 모델이 토큰이 아니라 패턴을 이해한다 |
| Chat-Based Generation | 약 2023년 | 기능을 자연어로 서술하면 동작하는 구현을 받는다. 대화가 인터페이스가 된다 |
| Coding agents | 약 2024~25년 | 멀티파일 편집, tool call, 테스트 실행, 반복적 자기 교정 |
| Autonomous Agents | 약 2025~26년 | 저장소 clone, 아키텍처 계획, 샌드박스 실행, 전체 테스트 실행, pull request 제출까지 사람의 키스트로크 없이 수행 |
각 세대는 앞 세대를 없애지 않고 보존하면서 한 명의 엔지니어가 해낼 수 있는 천장을 올렸다. 오늘도 autocomplete는 쓰이고, 그 위에 chat이 있고, 그 위에 agent가 있다.
용어가 실무 대화를 바꾼다
백서는 vibe coding과 agentic engineering의 구분이 말장난이 아니라고 강조한다. 팀이 결제 처리 시스템을 vibe coding하고 있다고 CTO에게 말하면 경보가 울리는 것이 마땅하다. 같은 CTO에게 사람이 설계한 제약 안에서 AI가 구현을 맡고 테스트 커버리지가 정확성을 보장하는 agentic engineering을 실천한다고 말하면, 근본적으로 다른 대화가 된다. 같은 도구와 같은 모델을 쓰면서도 두 문장이 뜻하는 위험 수준은 전혀 다르다.
핵심 개념
agent와 agent loop
AI agent는 목표를 인지하고, 목표에 이르는 단계를 계획하고, 도구를 통해 행동하고, 결과를 관찰하며, 목표가 달성되거나 중단 조건에 걸릴 때까지 반복하는 소프트웨어 시스템이다. 챗봇과의 차이는 루프의 소유자다. 챗봇은 응답을 내놓고 다음 프롬프트를 기다리지만, agent는 상위에서 목표를 받은 뒤 각 단계에서 다음 행동을 스스로 정한다.
백서는 2025년 11월 Google 백서 "Introduction to Agents"를 참조 기반으로 삼아 agent를 다섯 부품으로 나눈다.
| 부품 | 역할 |
|---|---|
| Model | 추론 엔진. 현재 컨텍스트를 읽고 다음에 무엇이 일어나야 할지 정해 다음 생각이나 다음 tool call이나 다음 메시지를 만든다 |
| Tools | 모델을 세계와 연결한다. 호출 가능한 API, 실행 가능한 코드, 질의 가능한 데이터베이스, 위임 가능한 다른 agent를 포함한다 |
| Memory | 상태를 담당한다. 과거 상호작용을 회상하고 프로젝트별 규칙을 가져오며 세션을 넘어 컨텍스트를 유지해 매번 빈 상태에서 시작하지 않게 한다 |
| Orchestration | 루프를 실행하는 코드. 모델 호출마다 컨텍스트를 조립하고 tool call을 디스패치하고 결과를 수집하며 계속할지 판단한다 |
| Deployment | 프로토타입을 서비스로 만드는 부분. 호스팅, identity, observability, 운영 인프라를 포함한다 |
부품들은 하나의 순환 안에서 함께 동작한다. 임무를 받고, 상황을 파악하고, 사고하고, 행동하고, 관찰하고 반복한다. 백서는 이 루프를 모든 agent의 심장으로 부르며, 나머지 논의 전부가 이 루프의 변형이라고 적는다.
원문 11쪽에는 표기 불일치가 하나 있다. "five parts"라고 쓰고 다섯 항목을 열거한 뒤, 바로 다음 문장에서 "These four parts work together"라고 적는다. 열거된 항목이 다섯이므로 다섯이 맞다.
vibe coding과 그 용어의 이동
2025년 2월 Andrej Karpathy가 X에 올린 서술이 vibe coding이라는 말의 시초다. "완전히 vibe에 몸을 맡기고 지수 성장을 받아들이며 코드가 존재한다는 사실조차 잊는다"는 방식으로, 개발자가 원하는 것을 자연어로 서술하고 AI의 output을 수용하며 뭔가 깨지면 에러 메시지를 프롬프트에 복사해 고쳐 달라고 요청한다.
용어가 빠르게 퍼진 이유는 많은 개발자가 이미 그렇게 일하고 있었는데 그 방식을 부를 말이 없었기 때문이다. 그런데 몇 달 만에 "vibe coding"이 AI 보조 개발 워크플로 전반을 가리키는 말로 쓰이면서 의미가 희석됐다. 잘 명세된 기능을 AI 어시스턴트로 구현하는 시니어 엔지니어도 vibe coding인지, 세심히 계획된 아키텍처를 AI agent로 실행하는 팀도 vibe coding인지 구분이 사라졌다. 2026년 초 Karpathy 본인이 원래 framing이 너무 좁았다고 인정하고, 스펙트럼의 규율 있는 쪽을 가리키는 "agentic engineering"이라는 말을 도입했다.
Tests와 Evals
두 끝점을 가르는 가장 큰 차이는 output이 어떻게 검증되는가다. vibe coding에서 검증은 선택이다. 개발자가 코드를 실행해 보고 맞아 보이는지 확인한다. agentic engineering에서는 두 가지 수단이 함께 동작한다.
| 구분 | 검증 대상 | 검사 수단 |
|---|---|---|
| Tests | 시스템의 결정적(deterministic) 부분. 이 입력을 받은 함수가 저 출력을 내는지 | 코드 |
| Evals | 결정적이지 않은 부분. agent가 올바른 단계 trajectory를 밟았는지, 올바른 도구를 골랐는지, 최종 응답이 품질 기준을 넘는지 | 라벨링된 데이터셋, 채점 루브릭, LM judge |
trajectory는 세션 하나의 실행 기록 전체를 뜻한다. 함수 하나의 입출력은 코드로 검사할 수 있지만, agent가 다섯 단계를 거쳐 답에 도달한 그 경로가 타당했는지는 코드로 검사할 수 없다. 그래서 Evals에는 데이터셋과 루브릭이 필요하다.
백서의 판정 기준은 단호하다. 둘 다 없으면 프롬프트가 얼마나 정교하든 그 실천은 언제나 vibe coding이다.
harness
harness는 모델을 감싸 상태와 도구 실행과 피드백 루프와 강제 가능한 제약을 부여하는 실행 환경이다. 원 모델은 agent가 아니고, harness가 이 네 가지를 주는 순간 agent가 된다.
네 가지를 하나씩 보면 왜 모델만으로는 부족한지가 드러난다. 상태가 없으면 agent는 매 호출마다 처음부터 시작한다. 도구 실행이 없으면 무엇을 해야 할지 말할 수 있어도 실제로 할 수 없다. 피드백 루프가 없으면 실패를 알아도 고칠 기회가 없다. 강제 가능한 제약이 없으면 지켜야 할 규칙이 권고에 머문다.
이 개념이 백서 후반부 전체의 기준선이 되므로 여기서 미리 정의해 둔다. Agent = Model + Harness 절에서 구성 요소와 계층 구조를 자세히 다룬다.
스펙트럼
여섯 항목으로 본 세 구간
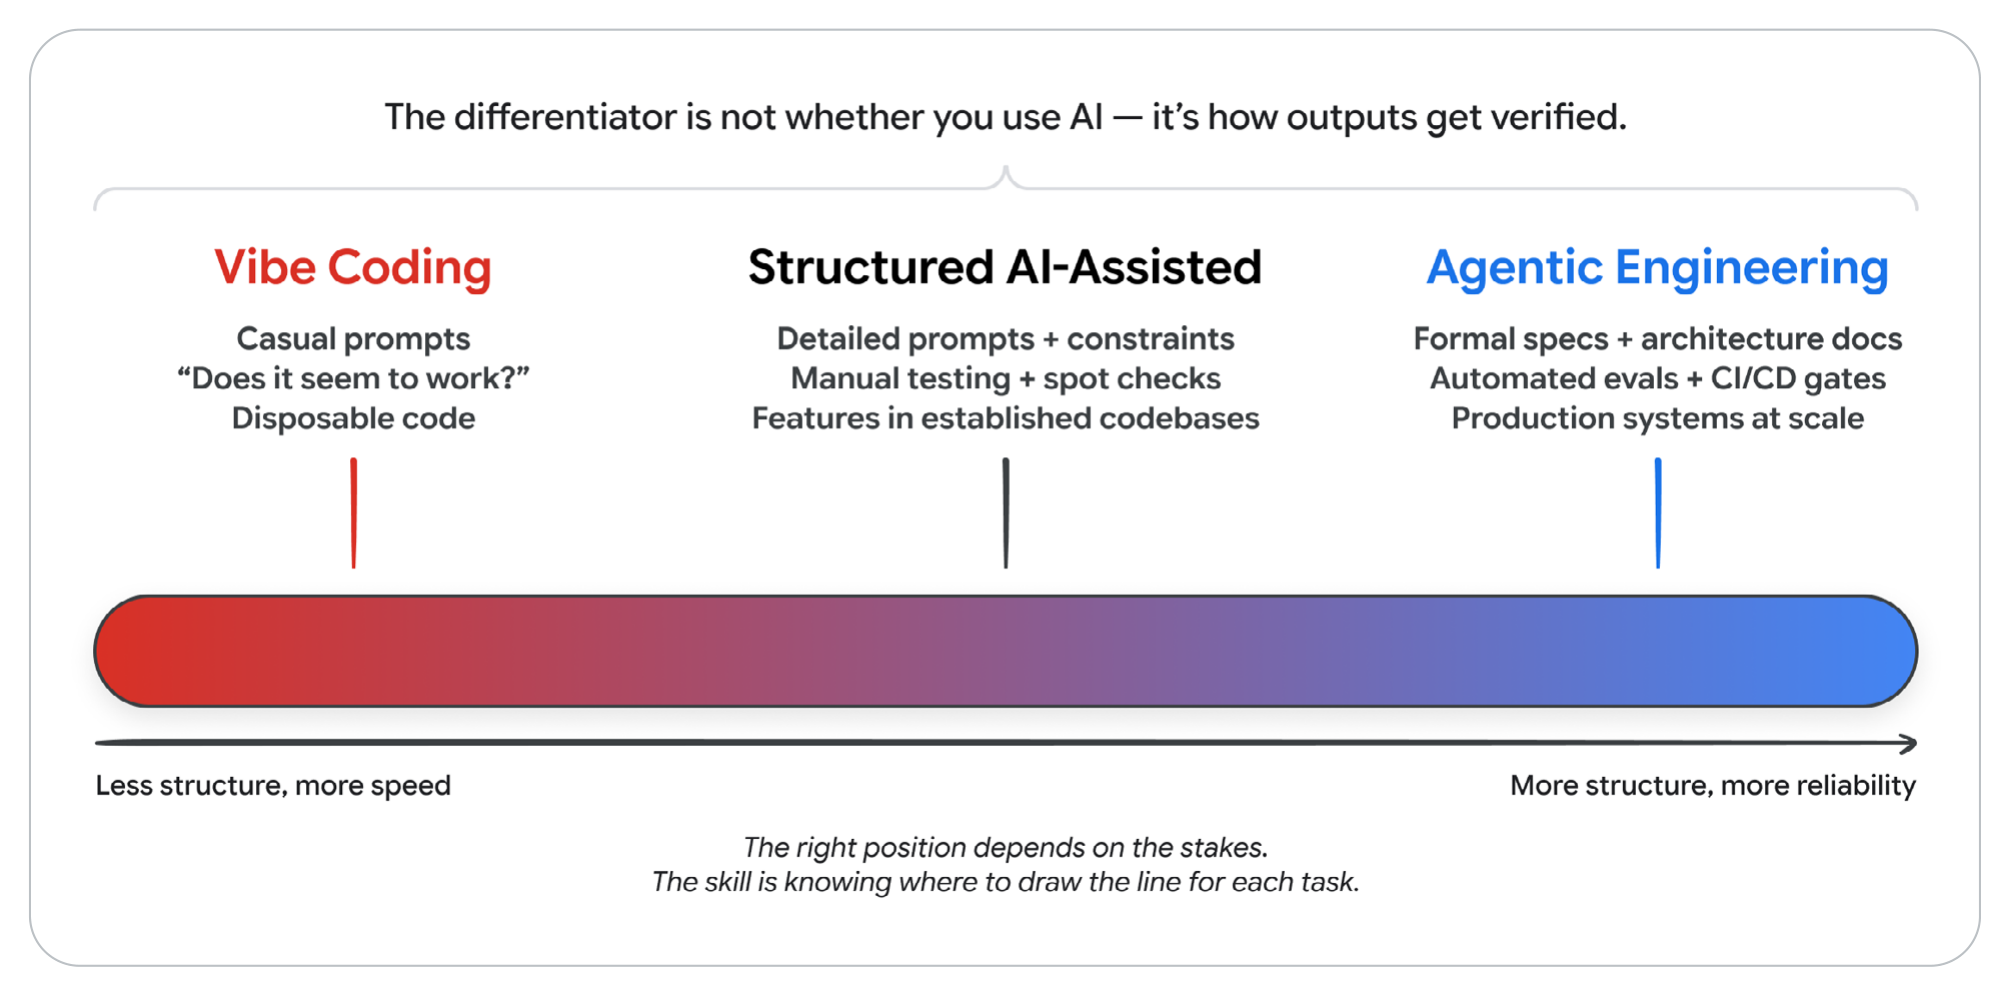
백서는 vibe coding과 agentic engineering을 이분법이 아니라 하나의 스펙트럼의 두 끝점으로 다룬다. 차별점은 AI를 쓰는지가 아니라 AI의 output을 구조와 검증과 사람의 판단이 얼마나 둘러싸는가다. Table 1은 그 스펙트럼을 여섯 항목으로 갈라 세 구간을 비교한다.
| 항목 | Vibe Coding | Structured AI-Assisted Coding | Agentic Engineering |
|---|---|---|---|
| 의도 명세 | 캐주얼 자연어 프롬프트 | 예시와 제약이 붙은 상세 프롬프트 | 정식 명세, 아키텍처 문서, memory 파일 |
| 검증 | "되는 것 같은데?" | 수동 테스트와 스팟체크 | 자동 테스트 스위트, CI/CD 게이트, LM judge |
| 코드베이스 이해 | 최소. 개발자가 생성된 코드를 읽지 않을 수도 있다 | 핵심 경로만 선별 리뷰 | 아키텍처 전면 리뷰. 구현 세부는 AI가 담당 |
| 에러 처리 | 에러 메시지를 AI에 복사해 붙인다 | 개발자가 근본 원인을 진단하고 AI가 수정을 구현한다 | agent가 정의된 경계 안에서 자가 진단하고, 사람은 아키텍처 이슈를 다룬다 |
| 적정 범위 | 프로토타입, 스크립트, 개인 프로젝트, 해커톤 | 기존 코드베이스 안의 기능 | 프로덕션 시스템, 팀 규모 개발 |
| 리스크 프로파일 | 높음. 폐기용 코드에는 수용 가능 | 중간. 핵심 체크포인트에 사람의 판단 | 낮음. 모든 단계에서 체계적 검증 |
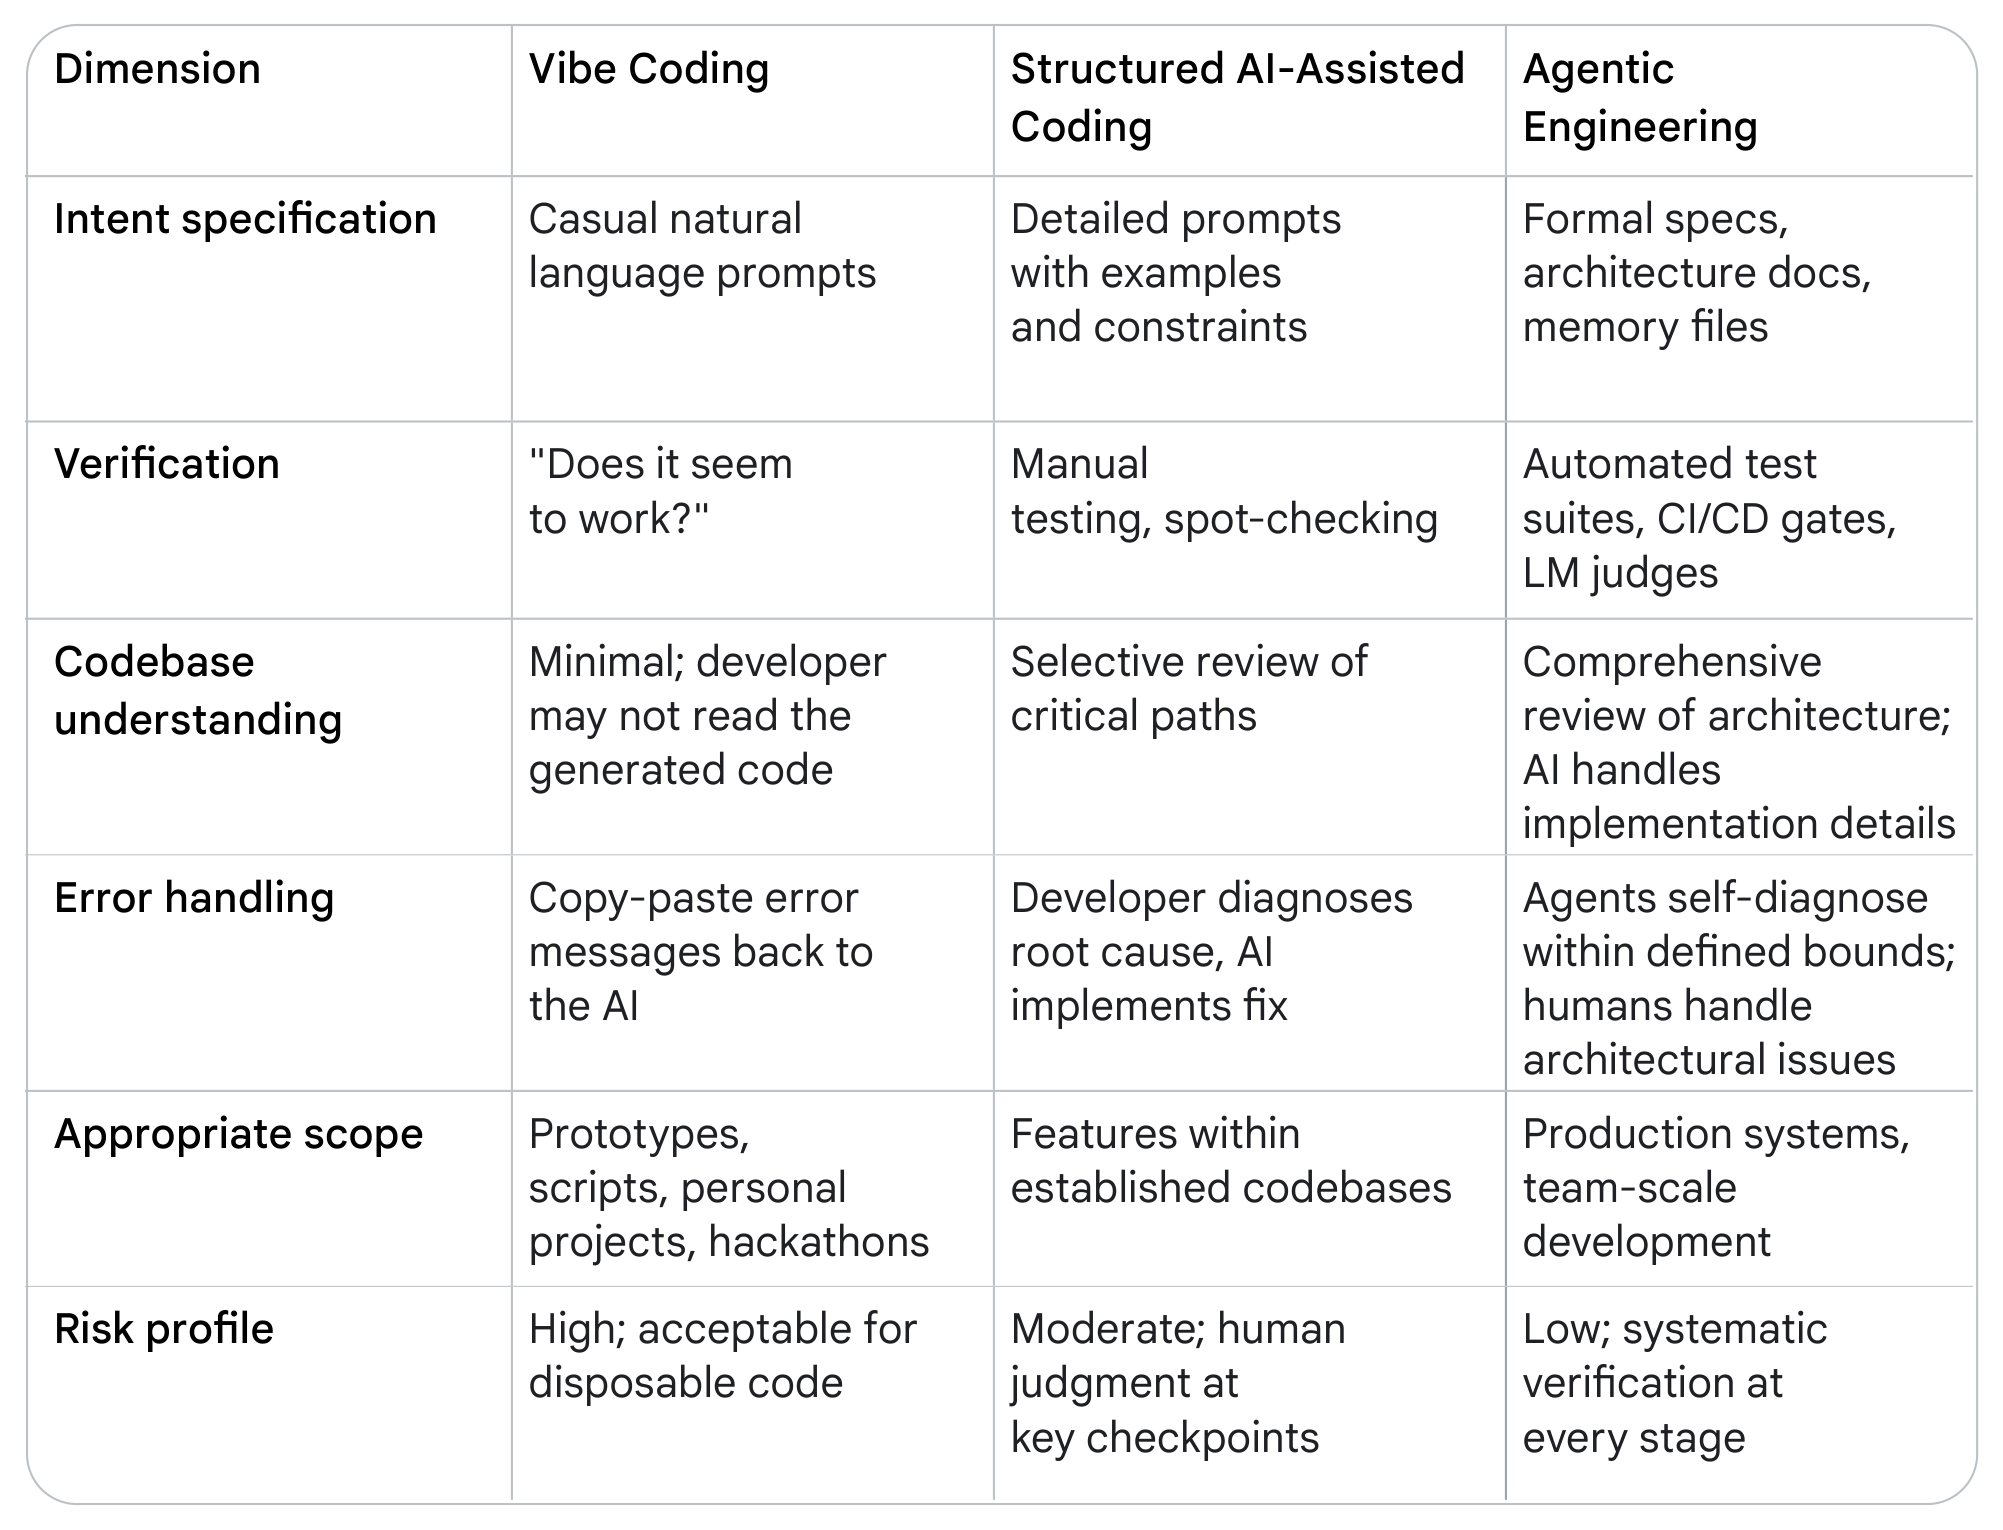
표를 세로로 읽으면 세 구간의 성격이 드러난다. Vibe Coding 열은 전부 "가볍다"로 통일된다. 프롬프트도 가볍고 검증도 가볍고 코드 읽기도 가볍다. Agentic Engineering 열은 전부 "명시적이다"로 통일된다. 명세도 문서로 남고 검증도 자동화되고 리뷰 범위도 정해져 있다. 중간 구간은 사람의 판단을 체크포인트에만 배치한 절충이다.
중간 구간인 Structured AI-Assisted Coding은 실무에서 가장 흔한 자리다. 프롬프트에 예시와 제약을 붙이는 정도의 노력은 들이지만 자동화된 eval 스위트까지는 구축하지 않고, 핵심 경로만 리뷰하며 사람의 판단을 몇 개의 체크포인트에 배치한다. 이 구간이 유효한 조건은 기존 코드베이스가 이미 어느 정도의 테스트와 컨벤션을 갖고 있다는 것이다. 그 기반이 없으면 스팟체크는 검증이 아니라 표본 추출에 가까워진다.
위치를 정하는 기준
적정 위치를 정하는 것은 취향이 아니라 stakes다. 주말 프로토타입은 순수 vibe coding이어도 문제가 없고, 금융 거래를 처리하는 프로덕션 API는 agentic engineering을 요구한다. 실제 업무 대부분은 그 사이에 있으며, 백서는 각 task마다 어디에 선을 그을지 아는 것이 실력이라고 적는다.
context engineering
여섯 종류의 컨텍스트
분야가 성숙하면서 드러난 통찰은 AI 생성 코드의 품질이 프롬프트의 영리함보다 제공된 컨텍스트의 품질에 좌우된다는 것이다. context engineering은 코드베이스와 아키텍처와 컨벤션과 의도에 대한 풍부하고 구조화된 정보를 agent에 제공하는 실천을 가리킨다.
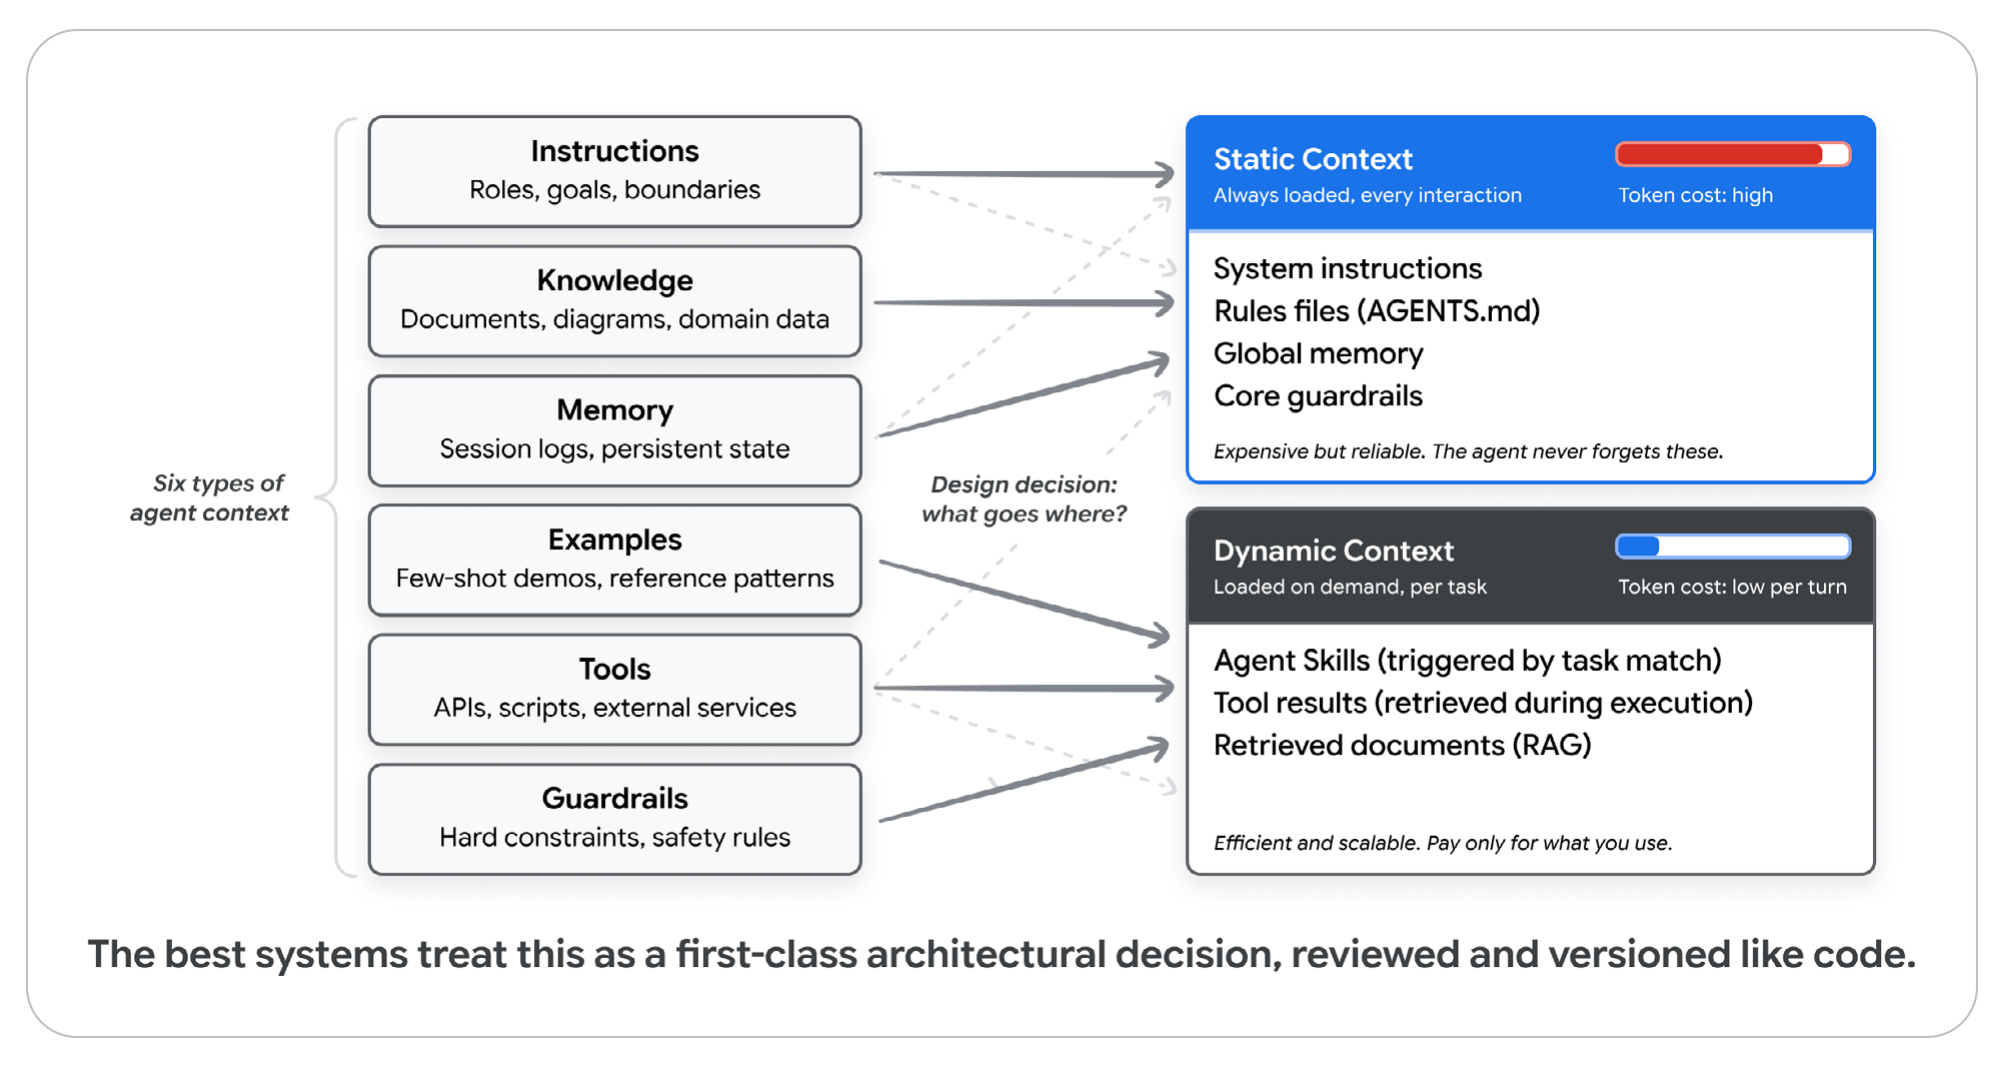
개발자가 다뤄야 하는 컨텍스트는 여섯 종류다.
| 종류 | 내용 |
|---|---|
| Instructions | agent의 핵심 역할, 목표, 운영 경계 |
| Knowledge | 검색된 문서, 아키텍처 다이어그램, 도메인별 데이터 |
| Memory | 단기 세션 로그(방금 무슨 일이 있었는지)와 장기 지속 상태(프로젝트가 무엇인지) |
| Examples | few-shot 행동 시연(demonstration)과 코드베이스 레퍼런스 패턴 |
| Tools | agent가 호출할 수 있는 API와 스크립트와 외부 서비스의 정확한 정의 |
| Guardrails | 하드 제약, 포맷 규칙, 안전 검증 |
static과 dynamic의 분배
이 여섯 요소 중 무엇을 agent가 미리 갖고 있어야 하고 무엇을 필요할 때 가져오게 할지가 실제 설계 결정이다. 여기서 static 컨텍스트와 dynamic 컨텍스트의 구분이 생긴다.
| 구분 | 로드 시점 | 토큰 비용 | 구성 요소 | 성격 |
|---|---|---|---|---|
| Static context | 항상, 매 상호작용마다 | 높음 | 시스템 지시, rule 파일(AGENTS.md, CLAUDE.md, GEMINI.md), 글로벌 메모리, 페르소나 정의, 핵심 가드레일 | 비싸지만 신뢰할 수 있다. agent가 절대 잊지 않는다 |
| Dynamic context | 온디맨드, task별 | 턴당 낮음 | task 매칭으로 발동되는 skill 지시, 실행 중 얻은 tool 결과, RAG가 가져온 문서, 윈도우 세션 히스토리 | 효율적이고 확장된다. 쓴 만큼만 낸다 |
static 컨텍스트가 비싼 이유는 관련성과 무관하게 모든 상호작용에 모든 토큰이 들어가기 때문이다. 대신 agent가 그것을 잊는 일은 없다. dynamic 컨텍스트가 효율적인 이유는 정보가 필요할 때만 토큰 비용을 내기 때문이다. 대신 발동 조건이 맞지 않으면 로드되지 않는다.
배치의 판단 기준은 그 정보가 얼마나 자주 필요한지와 잊혔을 때 무엇이 깨지는지다. 프로젝트의 하드 룰은 어느 task에서도 지켜져야 하므로 static에 두고 매 상호작용의 토큰 비용을 감수한다. 특정 종류의 작업에서만 필요한 절차 지식은 dynamic에 두고 그 작업이 실제로 들어올 때만 비용을 낸다.
무엇을 어디에 둘지는 진짜 엔지니어링 트레이드오프다. static이 너무 많으면 토큰이 낭비되고 신호가 희석된다. 너무 적으면 agent가 핵심 규칙을 잊는다. 백서는 최선의 시스템이 이 경계를 1급 아키텍처 결정으로 취급해, 다른 설정과 마찬가지로 리뷰하고 버전 관리한다고 적는다.
Agent Skills와 progressive disclosure
dynamic 컨텍스트를 관리하는 가장 강력한 패턴은 Agent Skills다. 절차적 지식을 담은 구조화되고 이식 가능한(portable) 패키지로, task가 요구할 때만 로드된다. 전문 지식 전부를 시스템 프롬프트에 박아 넣는 대신, agent가 경량 제너럴리스트를 유지하면서 필요할 때 전문가 역할로 전환하게 한다.
그 전환을 가능하게 하는 것이 progressive disclosure다. 필요한 시점에만 정보를 단계적으로 노출하는 설계를 뜻한다.
| 단계 | 로드 시점 | 로드 대상 |
|---|---|---|
| 1단계 | 시작 시점 | 경량 메타데이터만 |
| 2단계 | task가 매칭될 때 | 전체 지시 |
| 3단계 | 명시적으로 필요할 때 | 심화 참조 자료 |
효과는 비용 구조로 나타난다. agent는 수십 개 전문 능력을 지니면서도 지금 실제로 쓰는 하나에 대해서만 토큰 비용을 낸다.
주요 코딩 에이전트와 엔터프라이즈 플랫폼이 이 패턴을 빠르게 채택한 이유로 백서는 네 가지 고질적 문제를 든다.
| 문제 | 내용 |
|---|---|
| context rot | 프롬프트에 지식을 과부하시키면 신호가 묻힌다 |
| 절차 기억 부재 | LLM은 procedural memory가 없어 절차를 스스로 축적하지 못한다 |
| 멀티에이전트 운영 오버헤드 | 역할별로 agent를 나누면 조율과 운영 비용이 늘어난다 |
| 이식성 요구 | 도구와 벤더가 바뀔 때 지식을 옮겨야 한다 |
프롬프트 엔지니어링과의 차이
백서는 "프롬프트 엔지니어링에서 context engineering으로"의 이동이 더 깊은 사실을 반영한다고 정리한다. 모델에 필요한 것은 영리하게 다듬은 지시가 아니라, 숙련된 사람 개발자가 좋은 결과를 내는 데 필요한 것과 같은 컨텍스트다.
따라서 실무의 질문도 바뀐다. "AI를 어떻게 속여 좋은 코드를 쓰게 할까"가 아니라 "새 팀원이 효과적으로 기여하려면 무엇을 알아야 하고, 그 지식을 AI가 쓸 수 있는 형태로 어떻게 인코딩할까"다. 뒤의 질문은 답이 문서와 규칙 파일과 도구 정의로 떨어지므로 엔지니어링 대상이 된다.
새 SDLC
전통 SDLC가 받는 압박
SDLC는 이미 한 차례 큰 전환을 겪었다. 지난 20년 동안 대부분의 기업이 순차적 waterfall에서 iterative 모델로 옮겨 갔다. Agile sprint, continuous integration, DevOps 파이프라인, 빠른 릴리스 사이클이 그 결과다. 그 전환은 피드백 루프를 줄이고 테스트를 개발에 붙였으며 배포를 분기 행사에서 연속 프로세스로 바꿨다.
AI는 이 사이클을 다시 압축하는데, 극적이면서도 불균등하게 압축한다. 한때 몇 주 걸린 구현이 몇 시간으로 줄어드는 반면 요구사항과 아키텍처와 검증은 여전히 사람 속도에 머문다. 백서의 표현으로는 이제 boilerplate를 타이핑할 사람의 손을 기다리는 것이 아니라 경계를 정의할 사람의 머리를 기다린다.
그래서 결과는 빨라진 옛 SDLC가 아니다. 단계 경계가 흐려지고, iteration 주기가 주에서 분으로 줄고, 개발자의 역할이 주 구현자에서 시스템 설계자이자 품질 조정자로 옮겨 가는 다른 워크플로다.
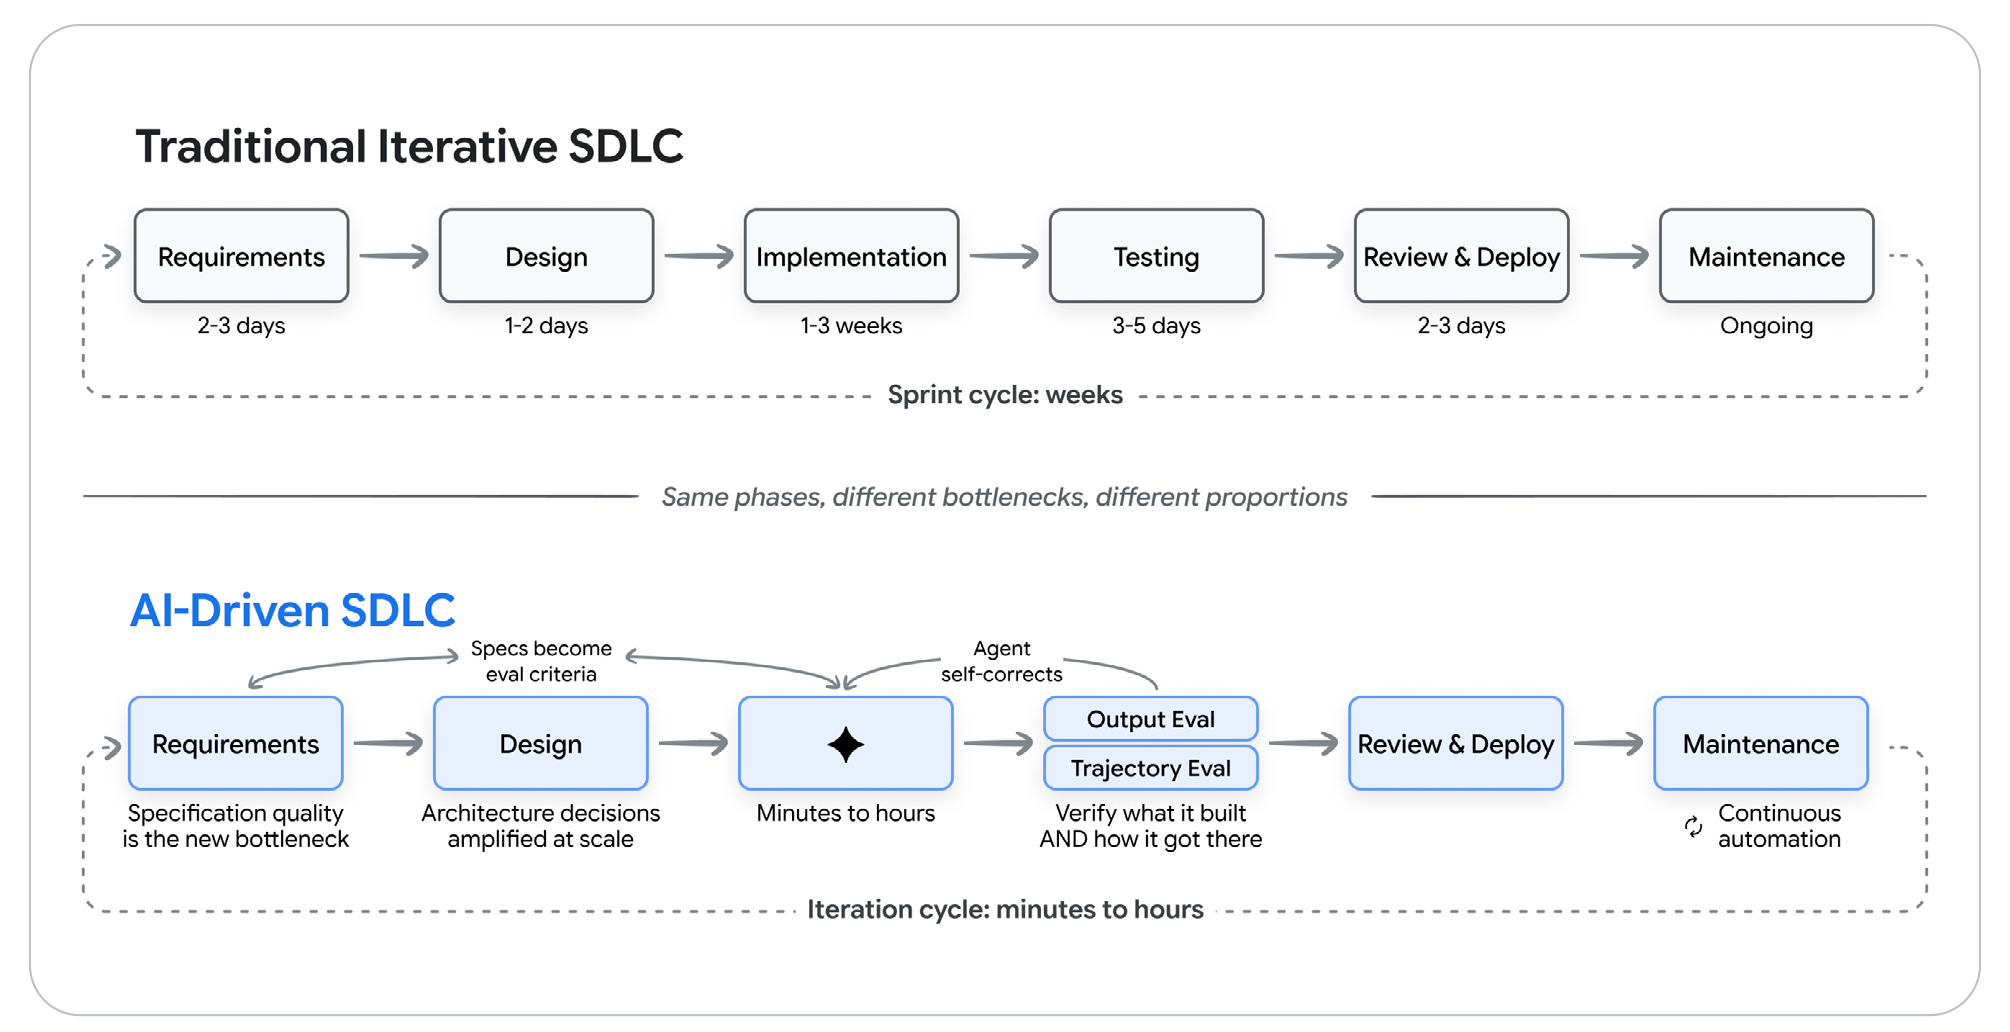
단계별 소요 시간 대조
Figure 5는 두 SDLC를 단계별 소요 시간으로 나란히 놓는다. 같은 단계 이름을 쓰면서 병목의 위치와 시간 비중이 어떻게 달라지는지 보여 준다.
| 단계 | 전통 iterative SDLC | AI 주도 SDLC |
|---|---|---|
| Requirements | 2~3일 | 명세 품질이 새 병목이 된다 |
| Design | 1~2일 | 아키텍처 결정이 규모에서 증폭된다 |
| Implementation | 1~3주 | 분에서 시간 단위 |
| Testing | 3~5일 | Output Eval과 Trajectory Eval로 무엇을 만들었는지와 어떻게 만들었는지를 함께 검증한다 |
| Review & Deploy | 2~3일 | 단계가 유지된다 |
| Maintenance | 상시 | 연속 자동화 |
| 전체 사이클 | sprint 주기가 주 단위 | iteration 주기가 분에서 시간 단위 |
수치를 나란히 보면 압축의 불균등함이 분명해진다. Implementation은 1~3주에서 분에서 시간 단위로 줄어 두 자릿수 배율의 변화를 겪는데, Requirements와 Design은 시간 자체가 아니라 성격이 바뀐다. 그래서 전체 사이클이 짧아질 때 병목이 구현에서 명세로 이동한다.
그림은 되돌림 화살표 두 개도 함께 표기한다. 명세가 eval 기준이 된다는 화살표가 Requirements와 Design 사이를 잇고, agent가 자가 교정한다는 화살표가 Implementation과 Eval 사이를 잇는다. 상단 구분선의 문구는 "같은 단계, 다른 병목, 다른 비중"이다.
단계별로 무엇이 바뀌는가
| 단계 | AI가 담당하는 일 | 사람에게 남는 일 |
|---|---|---|
| 요구사항과 계획 | 제품 브리프에서 user story 생성, 사람이 놓치는 엣지 케이스 식별, 자연어 서술에서 API 스키마 생성, 명세 문서에서 대화형 프로토타입 생성 | 무엇을 만들지 결정하고 모호함을 걷어내는 일. 요구사항이 팀 사이에 넘기는 문서이기를 멈추고 사람과 AI의 대화가 되어 명세와 초기 구현을 동시에 산출한다 |
| 설계와 아키텍처 | 결정된 아키텍처의 애플리케이션 전체 스캐폴딩, 모듈 사이 일관된 패턴 생성, 확립된 컨벤션 준수 | 트레이드오프 판단. 일관성 대 가용성, 복잡성 대 유연성, build 대 buy는 AI가 온전히 파악할 수 없는 비즈니스 맥락과 조직 제약과 장기 전략에 달렸다 |
| 구현 | 자연어 서술에서 기능 전체 생성, 복잡한 알고리즘 구현, 함께 동작하는 멀티파일 변경 | 리뷰와 안내와 검증. AI는 구현 작업을 없애기보다 쓰기에서 리뷰하기로 성격을 바꾼다 |
| 테스트와 품질 보증 | 사람이 떠올리지 못할 엣지 케이스와 property-based 테스트 생성 | 무엇이 "올바름"인지 정의하는 일. 잘 쓰인 eval 스위트가 AI에 그 정의를 전달하고 자동 검증 수단을 제공한다 |
| 코드 리뷰와 배포 | 1차 리뷰어로 잠재 버그와 스타일 위반과 보안 취약점과 성능 문제 식별. 배포 헬스 모니터링, 문제 릴리스 자동 롤백, 변경 성격과 범위 기반 리스크 예측 | 설계와 유지보수성과 전략적 정합성에 대한 맥락 의존적 판단. AI는 사람 리뷰를 대체하지 않고 인지 부담만 줄인다 |
| 유지보수와 진화 | 레거시 코드베이스 탐색과 이해, 변경 관련 파일 식별, 기존 아키텍처를 존중하는 수정. 프레임워크 사이 마이그레이션, deprecated API 갱신, 테스트 스위트 현대화 | 무엇을 현대화할지 정하고 결과를 검증하는 일 |
구현 단계의 수치는 방향이 엇갈린다. 산업 서베이는 25%에서 39%의 생산성 향상을 보고하고 일부 task에서는 더 큰 향상이 나타난다. 그런데 METR 연구는 AI 어시스턴트를 쓴 숙련 개발자가 특정 task에서 오히려 19% 더 오래 걸렸다고 보고했다. 원인은 대체로 AI output을 검증하고 디버깅하고 교정하는 데 쓴 시간이다. 즉 생성이 빨라진 만큼 검증 부담이 늘어, 순 효과가 작업 성격에 따라 뒤집힐 수 있다.
유지보수는 백서가 가장 과소평가된 변화로 지목하는 단계다. 원 저자만 이해해서 "너무 위험해 못 건드린다"고 여겨졌던 코드를 안전하게 리팩터하고 현대화하고 확장할 수 있다. 프레임워크 마이그레이션과 deprecated API 갱신처럼 과거에는 너무 지루하고 위험해서 그냥 일어나지 않던 일들이 실제로 일어난다.
continuous quality flywheel
테스트 실천은 개별 활동으로 두는 것보다 하나의 순환으로 엮을 때 효과가 크다. 백서는 그 순환을 continuous quality flywheel로 부른다.
| 단계 | 내용 |
|---|---|
| 평가 | 벤치마크 스위트로 agent를 평가한다 |
| 진단 | 근본 원인을 클러스터링해 실패 유형을 묶는다 |
| 최적화 | 원인이 된 프롬프트나 도구를 손본다 |
| 검증 | 회귀 스위트로 수정이 실제로 고쳤는지 확인한다 |
| 모니터링 | 프로덕션 트래픽을 관찰해 새 실패 모드를 찾는다 |
매 사이클이 이전 사이클 위에 쌓이므로, 순환을 오래 돌린 팀과 그렇지 않은 팀의 차이는 시간이 갈수록 벌어진다.
검증 순서에도 원칙이 있다. output evaluation은 최종 산출물을 검사한다. 코드가 컴파일되는지, 테스트가 통과하는지다. trajectory evaluation은 tool call과 중간 추론의 전체 순서를 검사한다. 둘 다 필요한 이유는 검증 단계를 건너뛴 유창한 output이 눈에 보이는 에러가 있는 output보다 위험한 실패이기 때문이다. 후자는 눈에 걸리지만 전자는 그대로 통과한다.
factory model
이 변화들을 하나로 묶는 심상이 factory model이다. 이 모델에서 개발자의 1차 산출물은 코드가 아니라 코드를 생산하는 시스템이다.
| 구성 요소 | 역할 |
|---|---|
| 명세와 컨텍스트 | 무엇을 만들어야 하는지 정의한다 |
| agent | 명세를 구현으로 옮긴다 |
| 테스트와 품질 게이트 | 정확성을 검증한다 |
| 피드백 루프 | 실패를 교정용으로 agent에 되돌린다 |
| 가드레일 | agent를 안전하고 예측 가능한 행동으로 제한한다 |
비유는 단순하다. 공장 관리자는 모든 위젯을 손으로 조립하지 않는다. 조립 라인을 설계하고 품질 관리를 보장한다. 현대 개발자도 개발 시스템을 설계하고 그 output이 요구 기준을 만족하는지 보장한다. 이 구도에서 성공은 단계별 지시를 주는 데서 오지 않고, 성공 기준을 agent에 주고 반복하게 두는 데서 온다.
성공 기준을 주고 반복하게 두는 방식이 성립하는 조건은 표의 뒤쪽 세 요소다. 테스트와 품질 게이트가 기준을 판정하고, 피드백 루프가 실패를 되돌리고, 가드레일이 반복 중에 해서는 안 되는 일을 막는다. 이 세 요소가 없으면 성공 기준만 주는 방식은 감독 없는 위임이 되어 vibe coding으로 되돌아간다.
Figure 6은 이 구조를 두 영역으로 그린다. Developer Zone에서 개발자가 Define Specs와 Design Guardrails와 Review & Approve를 수행하고, Agent Factory Floor에서 명세와 컨텍스트와 요구사항이 Planning Agent와 Coding Agent를 거쳐 Tests & Verification에 이른다. 통과하면 Verified Output이 되고, 실패하면 failure feedback이 Planning Agent로 되돌아간다. 그림 하단은 가드레일 항목으로 토큰 한도, 보안 정책, 스타일 규칙, 아키텍처 제약을 적는다.
여기서 백서는 다음 질문으로 넘어간다. 공장의 중심 기계, 곧 조립 라인 안에서 실제로 일하는 agent 자체는 어떻게 생겼는가다. 개발자가 공장 관리자라면 AI 모델은 공장 바닥의 원 엔진일 뿐이다. 엔진 하나로는 자동차를 만들 수 없고 벨트와 기어와 안전 센서와 조립 라인이 필요하다. AI 보조 개발에서 이 둘러싼 기계 장치가 harness다.
harness engineering
모델을 시스템으로 착각할 때
빌더가 AI agent를 다루기 시작하면 모델을 시스템으로 취급하려는 유혹이 생긴다. 새 모델이 나오면 agent가 똑똑해지고 낡은 모델이면 나빠진다는 식으로, 모델이 좋고 나쁨 전부의 설명이 된다.
백서는 그 직관이 틀렸고 잘못된 투자로 이어진다고 지적한다. 모델은 동작 중인 agent에 들어가는 하나의 입력이다. 나머지 전부, 곧 프롬프트와 도구와 컨텍스트 정책과 훅과 샌드박스와 서브에이전트와 observability가 harness다.
정의는 이렇게 정리된다. 원 모델은 agent가 아니다. harness가 상태와 도구 실행과 피드백 루프와 강제 가능한 제약을 주는 순간 agent가 된다. Claude Code, Cursor, Codex, Antigravity, Aider, Cline을 쓸 때 개발자가 경험하는 행동은 아래에 어떤 모델이 있는지보다 harness가 무엇을 하는지가 지배한다.
세 계층 구조
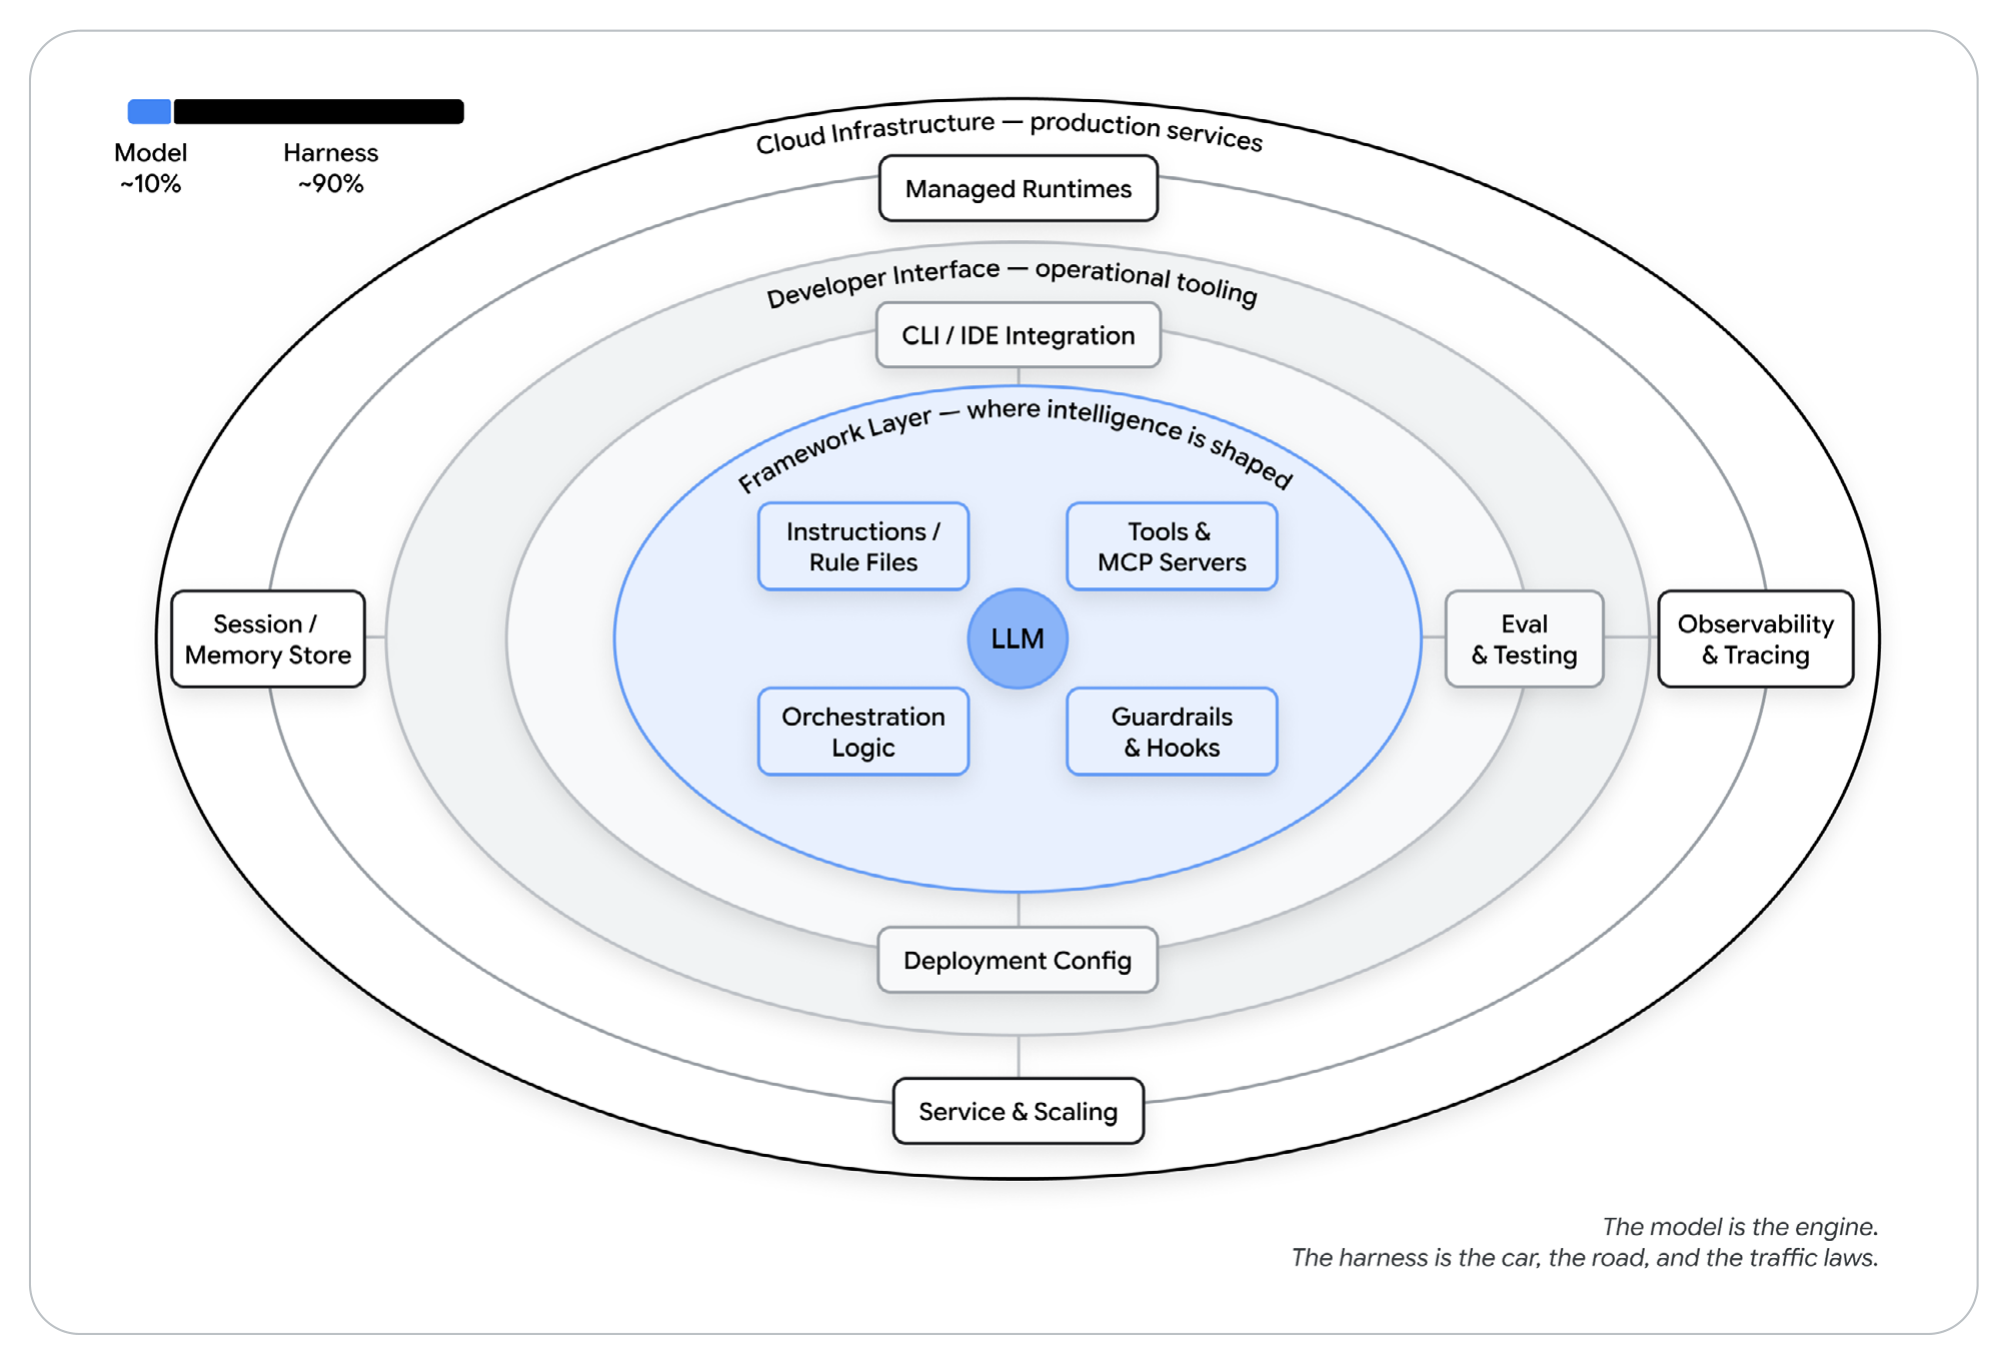
Figure 7은 비중을 model 약 10%, harness 약 90%로 표기하고 구조를 세 계층 동심원으로 그린다.
| 계층 | 성격 | 포함 요소 |
|---|---|---|
| Framework Layer | 지능이 형태를 갖는 곳 | 중심의 LLM과 그 주위의 Instructions / Rule Files, Tools & MCP Servers, Orchestration Logic, Guardrails & Hooks |
| Developer Interface | 운영 도구 | CLI / IDE Integration, Session / Memory Store, Eval & Testing |
| Cloud Infrastructure | 프로덕션 서비스 | Managed Runtimes, Observability & Tracing, Deployment Config, Service & Scaling |
계층이 안에서 밖으로 갈수록 관심사가 달라진다. 안쪽은 모델의 행동을 어떻게 형성할지를 다루고, 중간은 사람이 그것을 어떻게 조작하고 검사할지를 다루고, 바깥은 그것을 어떻게 서비스로 운영할지를 다룬다. 그림의 마무리 문구가 이 구도를 요약한다. 모델은 엔진이고, harness는 자동차와 도로와 교통 법규다.
harness의 여섯 구성 요소
| 구성 요소 | 내용 |
|---|---|
| Instructions and Rule Files | agent가 누구이고 무엇을 중시하며 무엇이 금지되는지 정의하는 텍스트. AGENTS.md, CLAUDE.md, GEMINI.md, skill 파일, 서브에이전트 프롬프트 |
| Tools | agent가 호출할 수 있는 함수와 MCP 서버와 API, 그리고 언제 어떻게 호출할지 알려주는 주변 산문 |
| Sandboxes and execution environments | agent의 코드가 실제 실행되는 곳, 접근 가능한 범위와 닿을 수 없는 범위 |
| Orchestration logic | 서브에이전트 스포닝, 모델 라우팅, 전문가 사이의 handoff, 각각이 언제 발동할지 정하는 규칙 |
| Guardrails or Hooks | 특정 라이프사이클 지점에서 실행되는 결정적 코드. tool call 전, 파일 편집 후, 커밋 전이 그 지점이다. agent가 절대 잊어서는 안 되는데 자주 잊는 것들의 자리다 |
| Observability | 로그, trace, 평가, 비용과 지연 계측. 없으면 agent가 잘하고 있는지 조용히 드리프트하고 있는지 알 방법이 없다 |
Tools 항목의 "주변 산문"은 쉽게 지나치기 쉬운 부분이다. 함수 시그니처만 등록하는 것으로는 부족하고, 언제 그 도구를 골라야 하는지를 설명하는 텍스트가 함께 있어야 모델이 올바른 선택을 한다.
백서는 이 표면적이 넓다는 점을 인정하면서 중요한 단서를 붙인다. 그것은 모델 제공자의 표면적이 아니라 팀의 표면적이다. 즉 harness는 벤더가 개선해 주기를 기다릴 대상이 아니라 팀이 직접 만들고 유지해야 하는 자산이다.
SDLC 단계별 harness의 역할
모델 자체는 task를 어떻게 달성할지 정하고, harness는 실행에 필요한 도구와 샌드박스와 오케스트레이션에 대한 접근을 제공한다. 따라서 harness는 agent가 동작하는 모든 단계에 존재해야 한다.
| 단계 | harness의 역할 | 사용 구성 요소와 실제 동작 |
|---|---|---|
| 요구사항, 계획, 아키텍처 | 설정과 보정 | Instructions와 Rule Files를 제공한다. AGENTS.md를 작성하고 아키텍처 제약을 정의하며, agent가 접근할 도구(특정 API나 데이터베이스 스키마)를 정하고 깨서는 안 되는 근본 규칙을 정한다 |
| 구현 | 실행 | Sandboxes, Execution Environments, Tools를 쓴다. 모델이 생성한 코드를 격리된 샌드박스 안에서 실행하고, 파일을 읽거나 웹을 검색해야 하면 harness가 제공한 도구를 쓴다 |
| 테스트와 QA | 피드백 루프 | Orchestration Logic과 Guardrails를 쓴다. 샌드박스 터미널 같은 실행 환경을 제공해 자동 테스트를 실행시키고, 테스트가 실패하면 orchestration logic이 에러 output을 붙잡아 모델로 되돌리며 다시 시도하라고 요청한다. 이 자동화된 think에서 act, observe 루프를 만드는 것이 harness다 |
| 코드 리뷰, 배포, 유지보수 | 관측 | Hooks와 Observability를 쓴다. 결정적 훅을 실행해 agent가 하드코딩된 비밀번호를 푸시하려 하면 커밋을 차단하고, observability 계층이 토큰 비용과 지연과 agent 드리프트를 추적해 사람이 특정 배포 결정의 이유를 감사하게 한다 |
여기서 백서의 가장 실용적인 관찰이 나온다. vibe coding에서 agentic engineering으로의 전환은 쓰는 도구의 문제가 아니다. 개발자는 정확히 같은 agent로 vibe coding도 할 수 있고 agentic engineering도 할 수 있다. 차이는 harness를 얼마나 의도적으로 설정하고 적용하는지다. vibe coding은 빠른 구현만 겨냥한 최소한의 암묵적 스캐폴딩에 의존하고, agentic engineering은 최초 계획 문서부터 프로덕션 모니터링까지 AI를 안내하는 명확하고 광범위한 harness 추상에 의존한다.
벤치마크로 본 harness 효과
이 의도적 설정의 영향은 측정 가능하다. 백서는 공개 벤치마크 두 건을 근거로 든다.
| 사례 | 변경 대상 | 결과 |
|---|---|---|
| Terminal Bench 2.0의 한 팀 | harness만 변경, 모델 변경 없음 | coding agent가 Top 30 밖에서 Top 5로 이동 |
| LangChain 연구 | 고정된 모델 주위의 시스템 프롬프트, 도구, 미들웨어만 조정 | 같은 벤치마크 점수가 13.7점 상승 |
두 사례의 공통점은 모델을 고정했다는 것이다. 따라서 관측된 변화는 전부 harness에 귀속된다. 다만 두 수치 모두 백서가 직접 측정한 것이 아니라 외부 결과를 재인용한 것이므로, 어떤 harness 요소를 어떻게 바꿨는지의 세부는 원출처에서 확인해야 한다.
이 관찰의 일상 버전이 AI를 도입하는 팀에 더 중요하다. agent가 뭔가 잘못하면 첫 본능은 모델을 탓하는 것이다. 그러나 더 자주 실패는 빠진 도구, 모호한 규칙, 없는 가드레일, 노이즈로 채워진 context window로 되짚어진다. 백서의 결론은 이렇다. 정직하게 검토하면 대부분의 agent 실패는 설정 실패다.
개발자의 두 모드
conductor와 orchestrator
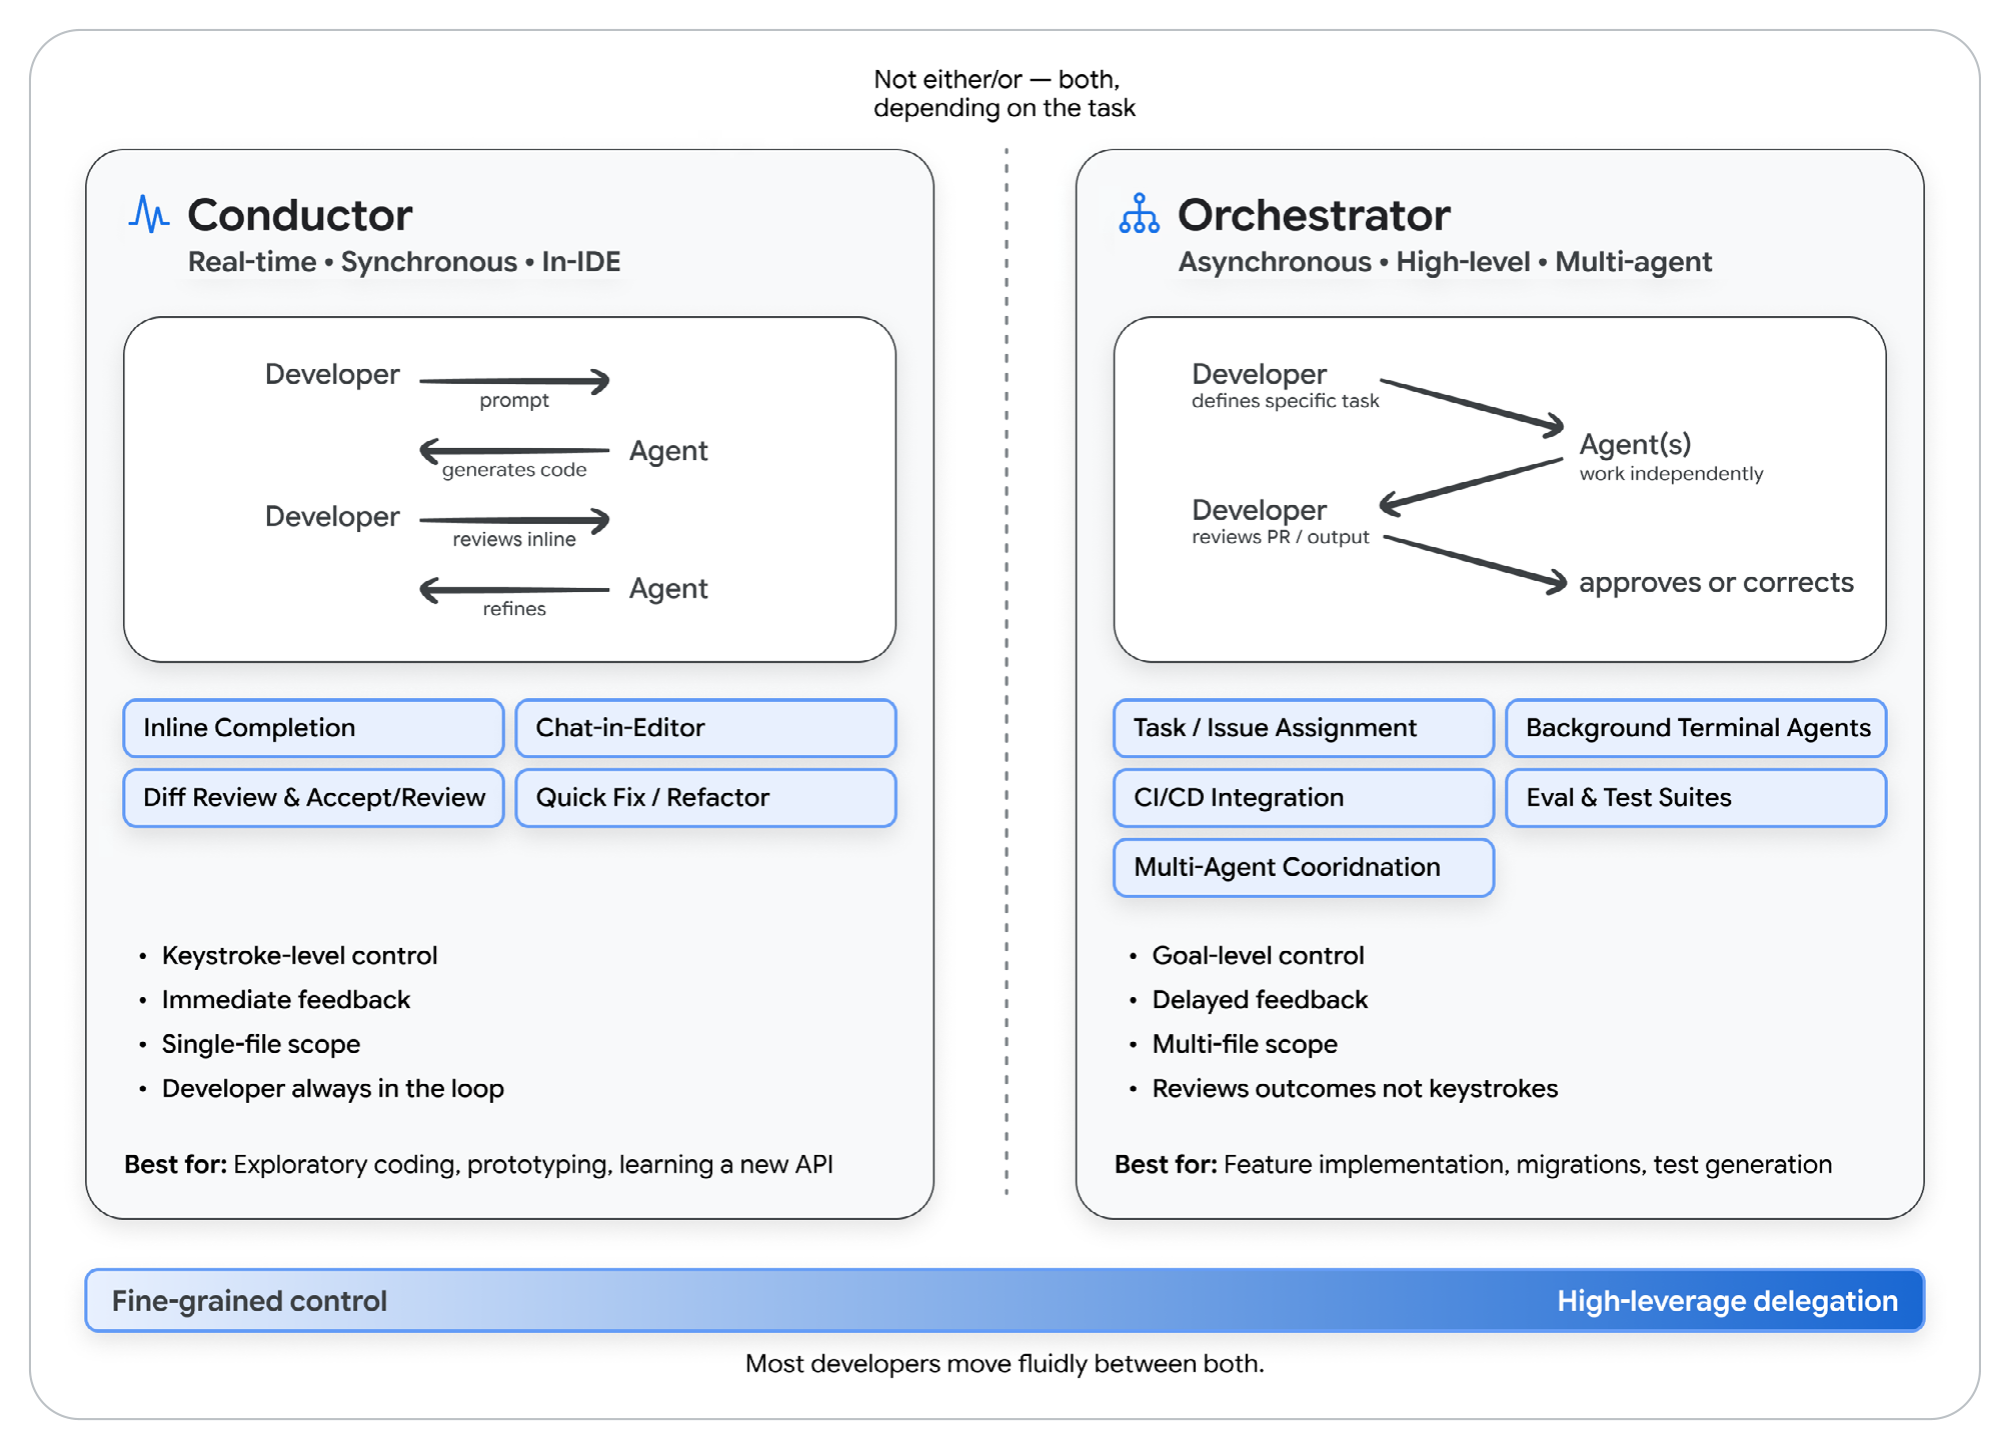
AI가 구현 작업을 더 많이 맡으면서 개발자의 역할이 바뀐다. 백서는 개발자가 유동적으로 오가는 두 모드로 정리한다.
| 항목 | Conductor | Orchestrator |
|---|---|---|
| 방식 | 실시간, 동기, IDE 안 | 비동기, 고수준, 멀티에이전트 |
| 제어 수준 | 키스트로크 수준, 즉시 피드백 | 목표 수준, 지연 피드백 |
| 범위 | 단일 파일. 개발자가 항상 루프 안에 있다 | 멀티 파일. 키스트로크가 아니라 결과를 리뷰한다 |
| 상호작용 | 개발자가 프롬프트를 주면 agent가 코드를 생성하고, 개발자가 인라인으로 리뷰하면 agent가 다듬는다 | 개발자가 구체적 task를 정의하면 agent가 독립적으로 작업하고, 개발자가 PR과 output을 리뷰해 승인하거나 교정한다 |
| 대표 기능 | Inline Completion, Chat-in-Editor, Diff Review와 Accept, Quick Fix와 Refactor | Task와 Issue Assignment, Background Terminal Agents, CI/CD Integration, Eval과 Test Suites, 멀티에이전트 조율 |
| 적합 작업 | 탐색적 코딩, 프로토타이핑, 새 API 학습 | 기능 구현, 코드베이스 마이그레이션, 테스트 생성 |
| 도구 | GitHub Copilot, Google Gemini Code Assist, Cursor, Windsurf | Google Jules, GitHub Copilot agent mode, Cursor background agents, Claude Code |
conductor 모드는 복잡한 로직을 다룰 때, 까다로운 문제를 디버깅할 때, 변경마다 이해가 필요한 낯선 코드베이스에서 일할 때 전형적이다. 전통 엔지니어링 배경의 개발자에게 자연스럽고, 많은 엔지니어가 중시하는 이해와 통제 감각을 보존한다.
다만 리스크가 있다. 개발자가 모든 키스트로크를 직접 지휘하면 AI로 얻는 처리량 향상이 제한되므로 개발자 자신이 병목이 된다. 이 리스크가 orchestrator 모드로 옮겨 갈 이유를 만든다.
orchestrator가 요구하는 스킬
orchestrator 모드는 문법과 언어 관용구에 대한 깊은 전문성 대신 다른 스킬셋을 요구한다.
| 스킬 | 내용 |
|---|---|
| Specification | agent가 모호함 없이 실행할 수 있을 만큼 정확하게 task를 정의한다 |
| Decomposition | 큰 task를 agent 실행에 적절한 크기 단위로 쪼갠다 |
| Evaluation | agent output이 품질 기준을 만족하는지 빠르게 판단한다 |
| System design | agent를 생산적으로 유지하는 제약과 테스트와 피드백 루프를 설계한다 |
네 스킬은 전부 코드를 쓰는 능력이 아니라 코드가 만들어지는 조건을 설계하는 능력이다. 앞서 나온 factory model의 정의와 같은 방향이며, 백서가 채용과 역량 개발을 판단 중심으로 재편하라고 권하는 근거이기도 하다.
80% 문제
두 모드를 오가는 개발자가 실제로 마주치는 지속적 난제를 백서는 80% 문제로 부른다. AI agent는 기능 코드의 약 80%를 빠르게 생성하지만, 나머지 20%는 성격이 다르다. 엣지 케이스, 에러 처리, 통합점, 미묘한 정확성 요구가 그 20%이고, 이들은 현재 모델이 자주 결여한 깊은 맥락 지식을 요구한다.
AI 에러의 성격도 함께 진화했다. 과거에는 단순 문법 실수였지만 지금은 더 교묘한 개념적 실패다.
- 비즈니스 로직에 대한 잘못된 가정
- 모호한 요구사항에 대한 확인 요청 실패
- 누락된 엣지 케이스
- 미묘한 장기 유지보수 부담을 만드는 아키텍처 결정
이 에러들이 탐지하기 더 어려운 이유는 정확히 그 완성도 때문이다. 코드가 "맞아 보이고" 기본 테스트를 통과할 수도 있다. 문법 에러는 컴파일러가 잡아 주지만 잘못된 비즈니스 가정은 아무 도구도 잡아 주지 않는다.
백서가 관찰한 대응 자세는 명확하다. 이 난제를 가장 효과적으로 헤쳐 나가는 개발자는 AI가 잘하는 일, 곧 잘 명세된 task의 빠른 구현에 AI를 쓰고, 자기 주의는 AI가 어려워하는 곳, 곧 모호한 요구사항과 아키텍처 트레이드오프와 정확성 검증에 남긴다. AI가 내놓는 모든 것을 수용해 빨라지려 하지 않고, 자기 전문성을 가장 중요한 곳에 집중해 빨라지려 한다.
코딩 에이전트의 세 자리
코딩 에이전트는 하루의 업무에서 세 자리에 등장하고, 대부분의 개발자가 셋을 동시에 쓴다.
| 자리 | 능력 | 적합 작업 | 예시 |
|---|---|---|---|
| In the editor | 타이핑 중 다음 줄을 제안하는 인라인 완성, 코드를 제자리에서 설명하거나 수정하는 챗 패널, IDE 안의 전체 코드베이스 인식 | 코드를 쓰는 중에 흐름을 벗어나지 않고 제안과 빠른 편집과 설명을 원할 때 | GitHub Copilot, Cursor, Windsurf, JetBrains AI Assistant |
| In the terminal | 커맨드라인에서 실행하고 자연어로 목표를 넘긴다. 전체 파일시스템 접근, 멀티파일 편집, 도구와 테스트 실행과 결과 기반 반복 | 멀티파일 작업, 낯선 코드베이스 탐색, agent가 코드를 실행하고 관찰한 것에 반응해야 하는 작업 | Antigravity CLI, Claude Code, Codex CLI, Open Code, Cline |
| In the background | 클라우드 호스팅 샌드박스에서 자율 실행하며 흔히 몇 시간 동안 작업하고 pull request를 output으로 낸다 | 한 단락으로 서술하고 자리를 떠날 수 있는 잘 명세된 작업. 알려진 버그 수정, 테스트 스위트 생성, 프레임워크 사이 코드 마이그레이션 | Google Jules, GitHub Copilot agent mode, Cursor background agents, 고급 알고리즘 설계용 AlphaEvolve |
세 자리의 차이는 자율성 수준만이 아니라 피드백을 받는 시점이다. 에디터는 타이핑하는 동안 즉시 받고, 터미널은 명령이 끝날 때 받고, 백그라운드는 몇 시간 뒤 pull request로 받는다. 그래서 작업의 불확실성이 클수록 앞쪽 자리가 유리하고, 명세가 확실할수록 뒤쪽 자리가 유리하다. 이 기준은 앞 절의 conductor와 orchestrator 구분과 같은 방향으로 작동한다.
세 자리는 자율성 순서로 늘어서 있지만 백서는 그 순서를 선택 기준으로 삼지 말라고 적는다. 올바른 시작점은 어떤 범주가 자율성 사다리의 가장 높은 곳에 있는지가 아니라 task가 결정한다. 그리고 진지한 vibe coding은 오늘날 터미널에서 일어난다고 덧붙인다. 파일시스템 전체에 접근하면서 도구와 테스트를 실행하고 결과에 반응할 수 있는 자리가 거기이기 때문이다.
프로덕션 agent 만들기
agent가 제품일 때
지금까지의 논의는 코딩 에이전트로 소프트웨어를 만드는 이야기였다. 만들어야 하는 대상 자체가 agent일 때는 상황이 다르다. 환불 요청을 처리하는 고객지원 봇, 출처를 상호 참조해 근거 있는 보고서를 만드는 리서치 어시스턴트, 컴플라이언스를 모니터링하고 이상을 표시하는 내부 도구가 그런 예다. 이들은 터미널의 코딩 에이전트로 푸는 task가 아니라 자체 도구와 자체 메모리와 자체 평가와 자체 배포 인프라가 필요한 제품이다.
백서는 판별 기준을 네 가지로 제시한다. 세션을 넘는 지속 메모리, 도구와 데이터에 대한 범위 지정 권한, 배포 전에 회귀를 잡는 eval 커버리지, agent가 실제로 무엇을 했는지 추적하는 observability다. 일회성 스크립트나 개인 자동화에는 일반 코딩 에이전트로 충분하며, 그때 agent는 목적지다. 실제 사용자에게 규모로 서비스하는 agent에서는 agent가 제품이고 그 아래에 기반이 필요하다.
백서가 쓴 "agent는 목적지"와 "agent가 제품"의 구분은 투자 판단에 바로 연결된다. 목적지인 agent는 결과물을 얻으면 역할이 끝나므로 재현성과 감사 가능성에 투자할 이유가 적다. 제품인 agent는 사용자가 매일 다시 쓰므로 같은 입력에 같은 품질을 내야 하고, 문제가 생겼을 때 무엇을 했는지 되짚을 수 있어야 한다. 앞의 네 기준이 요구하는 것은 결국 그 재현성과 되짚기다.
주목할 점은 그 기반을 만드는 방식이 바뀌었다는 것이다. 지속 메모리와 governance와 observability를 갖춘 실제 agent를 만들고 평가하고 배포하는 일이 프레임워크와 클라우드 콘솔 작업에서, 개발자가 이미 쓰던 코딩 에이전트에 말을 거는 일로 옮겨 왔다.
Agents CLI와 ADK
Google Agents CLI는 이 아이디어를 중심으로 만들어졌다. Google Cloud에서 agent를 만드는 skill 묶음을 담은 작은 커맨드라인 도구이며, 개발자가 선호하는 코딩 에이전트가 무엇이든(Claude Code, Codex 등) 함께 동작한다. 한 번 설치하면 코딩 에이전트가 ADK 라이프사이클 전체를 덮는 7개 skill을 얻는다. 프로젝트 스캐폴딩, agent 코드 작성, 평가, Agent Runtime 배포, observability 연결이다. 개발자는 새 SDK를 배우지 않고 원하는 것을 서술하며, 코딩 에이전트가 각 단계에서 skill을 써서 올바른 일을 한다.
전체 build에서 evaluate, deploy 루프는 다음처럼 나타난다.
# One-time setup
uvx google-agents-cli setup

# Then in your coding agent:
> Build a support agent that answers questions from our docs.
> evaluate it on the FAQ dataset
> Deploy it to Agent Engine
이 지시 뒤에서 코딩 에이전트가 템플릿에서 프로젝트를 스캐폴딩하고 ADK 코드를 쓰고 evalset을 생성해 agent에 실행하고 Agent Runtime에 배포한 뒤 결과를 보고한다. 직접 운전하려는 개발자는 같은 작업을 평범한 CLI 명령으로도 쓸 수 있다. agents-cli create, agents-cli playground, agents-cli eval, agents-cli deploy가 그 명령이다.
멀티에이전트 조율
같은 워크플로가 agent 하나에서 여럿으로 확장된다. ADK는 그래프 기반 워크플로와, 협업 agent를 만드는 멀티에이전트 워크플로, 그리고 세 가지 상호작용 수단을 제공한다. shared session state, LLM 주도 delegation, 명시적 호출이다. 이들을 조합해 문제에 맞는 멀티에이전트 패턴을 만든다.
| 목적 | 수단 |
|---|---|
| 단순한 경우의 agent 사이 조율 | shared session state |
| 도구 접근 | Model Context Protocol(MCP) |
| cross-agent delegation | Agent2Agent(A2A) 프로토콜 |
Anthropic 엔지니어링 팀은 2026년 초 이런 아키텍처에서 동작하는 agent 팀이 2주에 걸쳐 Rust로 동작하는 C 컴파일러를 만든 실험을 발표했다. 사람은 방향을 설정하고 output을 리뷰했지만 구현을 쓰지 않았다. 백서는 이 실험의 함의를 병목의 이동으로 읽는다. 병목이 코드를 쓰는 일에서 무엇을 해야 하는지 명세하고 agent가 실제로 그것을 했는지 검증하는 일로 옮겨 갔다.
경제학
CapEx와 OpEx의 이동
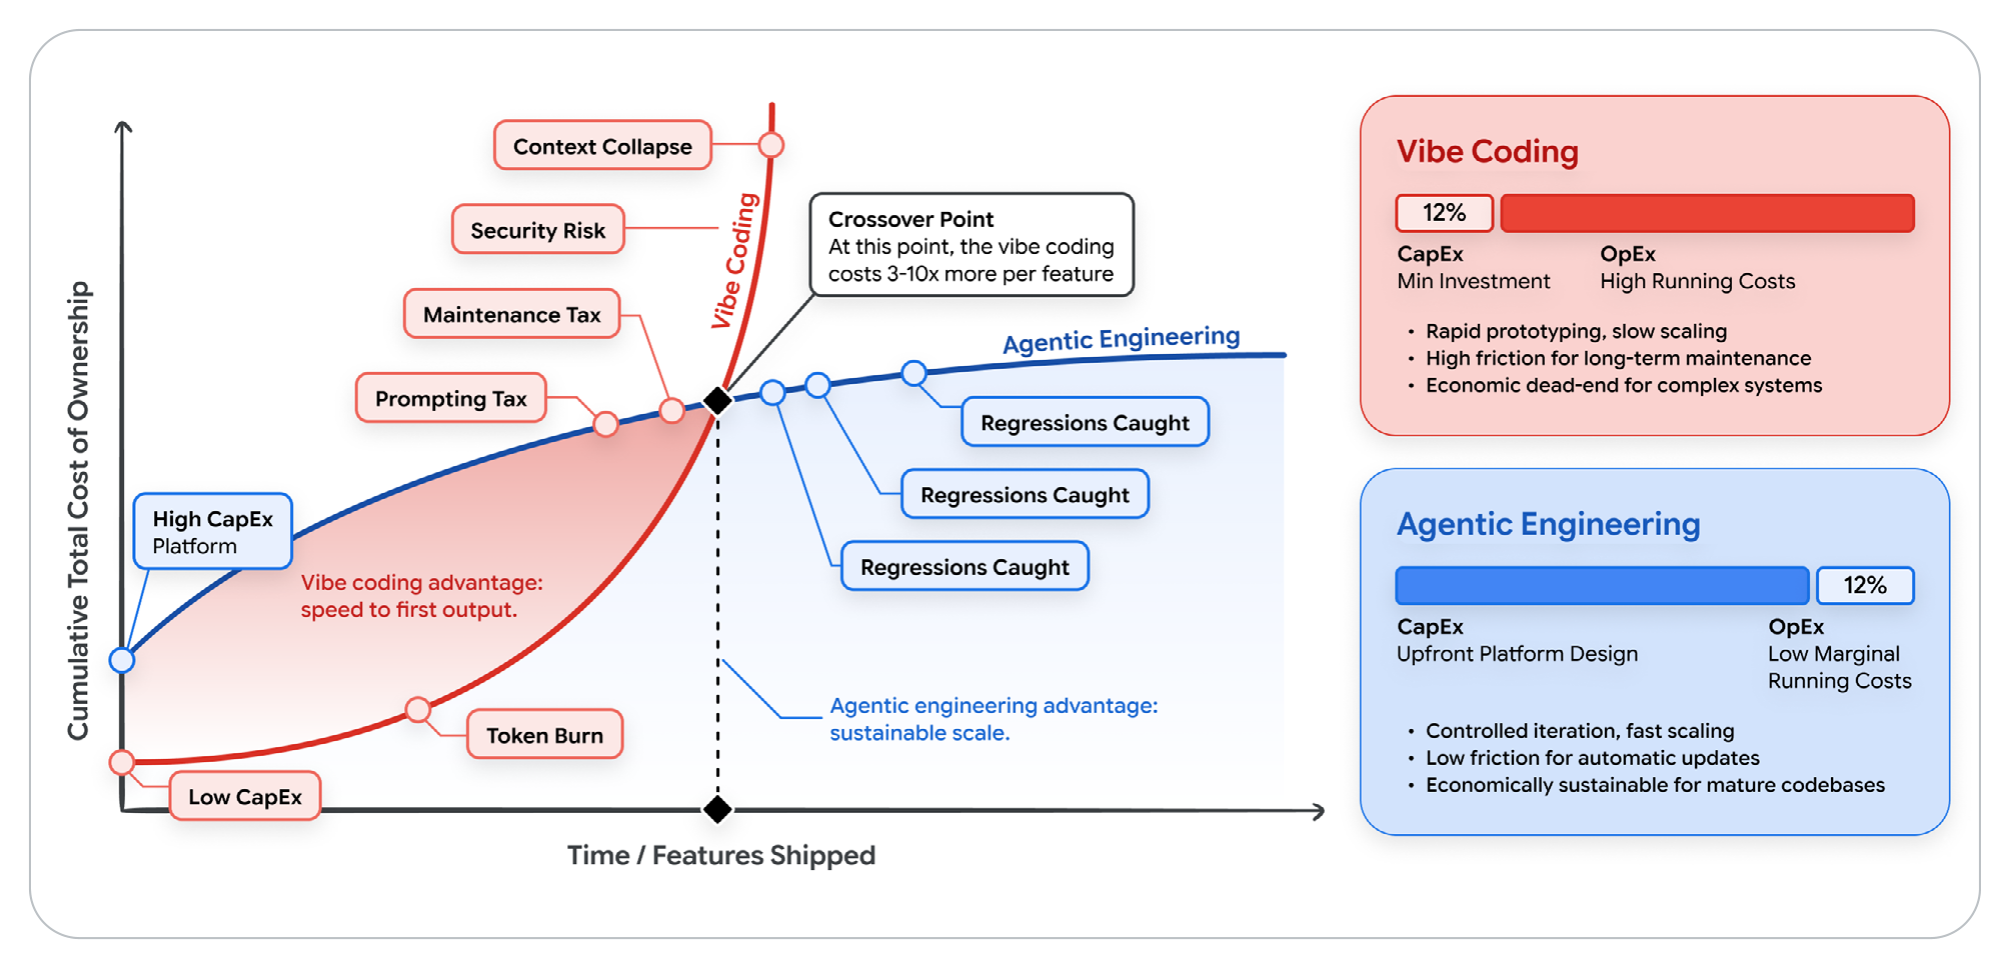
AI가 SDLC에 미치는 영향을 논할 때 대화는 흔히 개발자 속도에서 시작하고 끝난다. 엔지니어링 리더에게 더 중요한 지표는 총소유비용(TCO)이다. 진짜 비용을 이해하려면 서로 다른 워크플로가 자본적 지출(CapEx, 무언가를 만드는 선행 투자)과 운영 지출(OpEx, 실행하고 고치고 유지하는 지속 비용) 사이에서 재무적 부담과 운영 부담을 어떻게 옮기는지 봐야 한다. AI 시대의 OpEx는 토큰 경제가 크게 지배한다.
| 구분 | Vibe Coding | Agentic Engineering |
|---|---|---|
| CapEx | 최소 투자. 그림의 막대는 전체 비중의 12%로 표기 | 선행 플랫폼 설계. 막대는 전체 비중의 88%로 표기 |
| OpEx | 높은 운영 비용. 막대는 전체 비중의 88%로 표기 | 낮은 marginal 운영 비용. 막대는 전체 비중의 12%로 표기 |
| 강점 | 첫 output까지의 속도 | 지속 가능한 확장 |
| 특징 | 빠른 프로토타이핑과 느린 확장, 장기 유지보수의 높은 마찰, 복잡한 시스템에서 경제적 막다른 길 | 통제된 iteration과 빠른 확장, 자동 갱신의 낮은 마찰, 성숙한 코드베이스에서 경제적으로 지속 가능 |
12%와 88%는 각 방식에서 CapEx와 OpEx가 총비용을 나누는 비중이다. 두 방식의 비중이 정확히 뒤집혀 있다는 점이 그림의 요지다.
Figure 9의 세로축은 누적 총소유비용이고 가로축은 시간과 배포된 기능 수다. vibe coding 곡선에는 Token Burn, Prompting Tax, Maintenance Tax, Security Risk, Context Collapse가 아래에서 위로 순서대로 표기되어 비용 항목이 어떤 순서로 나타나는지 보여 준다. agentic engineering 곡선에는 Regressions Caught가 세 곳에 표기되어, 선행 투자가 회귀를 미리 잡는 방식으로 회수된다는 점을 나타낸다. 두 곡선이 만나는 crossover point의 설명은 이 지점에서 vibe coding이 기능당 3배에서 10배 더 비싸진다는 것이다.
crossover point가 결정에 주는 함의는 분명하다. 배포할 기능이 몇 개에 그친다면 vibe coding의 낮은 CapEx가 그대로 이득이 된다. 그 지점을 넘겨 계속 기능을 쌓을 계획이라면 선행 투자를 미룰수록 총비용이 커진다. 따라서 이 그래프는 두 방식의 우열을 가리는 것이 아니라, 지금 만들려는 것의 예상 수명과 기능 수를 먼저 추정하라는 요구로 읽힌다.
vibe coding의 숨은 OpEx
처음 보면 vibe coding은 대단히 비용 효율적으로 보인다. 진입 장벽이 사실상 0이다. AI 어시스턴트의 표준 월 구독과 캐주얼 프롬프트 몇 개면 된다. 개발자가 시스템 설계에 시간을 투자하지 않고 모델의 기본 능력에 전적으로 의존하므로 CapEx는 무시할 만하다.
그러나 경제학에는 거대하고 누적되는 OpEx 부담이 숨어 있다.
| 항목 | 발생 원인 | 비용의 성격 |
|---|---|---|
| 토큰 소진율(Token Burn Rate) | 방대한 비정형 파일을 context window에 던져 넣고, 검증되지 않은 자기 실수를 고치라고 모델에 반복 요청한다 | first-pass 성공률이 낮은 상태로 API 토큰을 소진하는 비싼 프롬프팅 루프 |
| 유지보수세(Maintenance Tax) | 임시 프롬프팅으로 쓴 코드는 구조적 일관성이 부족하다 | 6개월 뒤 버그가 생기면 사람 엔지니어가 비정형 AI 생성 "스파게티" 코드를 역공학하는 데 며칠을 쓴다 |
| 보안 리메디에이션(Security Remediation) | 자동 평가 harness가 없으면 빠른 코드 생성이 빠른 취약점 생성으로 이어진다 | 프로덕션에서 보안 결함을 고치는 비용은 설계 단계에서 잡는 비용보다 지수적으로 높다 |
agentic engineering은 이 경제 모델을 뒤집는다. 프로덕션 코드 한 줄이 생성되기 전에 엔지니어링 시간과 자원의 의도적 선행 투자를 요구한다. CapEx에는 API 스키마 설계, 결정적 테스트 스위트 구축, 그리고 가장 중요하게 agent의 컨텍스트 구조화가 든다. 선행 비용은 더 높지만 기능을 배포하고 유지하는 marginal 비용이 크게 낮아진다. AI가 엄격하게 통제된 "공장" 안에서 동작하므로 output이 구조적으로 건전하고 미리 테스트되었으며 회사 표준에 정렬된다.
두 가지 재무 레버
백서는 OpEx를 낮추는 구체적 수단을 두 가지로 제시한다.
첫째는 context engineering이다. 토큰 경제에서 context engineering은 기술 스킬만이 아니라 재무 전략이다. LLM은 보내는 모든 정보에 과금하므로 10만 토큰 규모 저장소 전체를 매 프롬프트에 넘기는 것은 규모에서 재무적으로 불가능하다. 효과적인 context engineering은 모델이 산만하고 노이즈가 많은 payload 대신 밀도 높고 신호가 강한 payload를 받게 한다. 정밀한 AGENTS.md 파일과 아키텍처 가드레일이 그런 payload다. 올바른 컨텍스트를 미리 제공해 agent의 first-pass 성공률을 크게 올리면 vibe coding을 괴롭히는 값비싼 시행착오 루프를 피한다.
둘째는 intelligent model routing이다. vibe coding 워크플로에서 개발자는 보통 모든 상호작용에 하나의 거대한 프론티어 모델에 의존한다. 오타를 고치라거나 기본 단위 테스트를 만들라고 요청하는 데도 프리미엄 토큰 가격을 낸다.
| task 성격 | 예시 | 라우팅 대상 |
|---|---|---|
| 고도로 복잡 | 요구사항, 아키텍처, 초기 구현 | 크고 진보한 프론티어 모델 |
| 결정적이고 복잡도 낮음 | 테스트 생성, 코드 리뷰, CI/CD 모니터링 | 더 작고 빠르고 훨씬 싼 모델 |
멀티모델 생태계를 오케스트레이션하면 최고 output 품질을 유지하면서 운영 토큰 비용을 체계적으로 낮출 수 있다. dynamic 컨텍스트와 skill을 통한 추가 최적화는 Day-3 편으로 넘어간다.
실천 처방
전체를 관통하는 원칙은 하나다. AI는 자신이 놓인 엔지니어링 문화를 증폭한다. 아래 처방은 그 원칙을 대상별 행동으로 옮긴 것이다.
개인 개발자
- 프로젝트에 AGENTS.md(또는 쓰는 코딩 에이전트에 맞는 동등물)를 만든다. 열 줄부터 시작한다. 스택, 컨벤션, 하드 룰, 워크플로다. agent가 다시 하면 안 되는 일을 할 때마다 규칙을 추가한다.
- agent를 만들고 평가하고 배포하고 최적화하는 skill 묶음을 코딩 에이전트에 설치한다. Agents CLI가 그 예다.
- 반복적 워크플로 하나를 골라 첫 agent로 만든다. 리서치 워크플로, 코드 리뷰 프로세스, 정기 보고서, 정기적으로 만드는 콘텐츠 같은 것이다. 프로토타입은 코딩 에이전트로 만들고 값을 증명하면 프로덕션 agent로 승격한다. agent 하나를 끝까지 만드는 것이 백 개를 읽는 것보다 많이 가르친다.
- 코드를 생성하기 전에 테스트와 eval을 쓴다. 둘이 함께 AI와의 계약이며, 잘 쓰인 테스트와 eval 스위트는 어떤 자연어 프롬프트보다 의도를 정밀하게 전달한다. 이것이 AI 보조 개발을 vibe coding에서 agentic engineering으로 바꾸는 지점이다.
- 배포될 코드는 agent가 만든 모든 줄을 리뷰한다. 영리해 보이는 것은 의심하고, import가 실제 패키지인지 확인하고, 에러 처리가 현실적 실패 모드를 덮는지 검증한다. 팀이 이해하지 못하는 코드는 팀이 감당할 수 없는 디버깅 비용이 된다.
- 개발자 기본기를 유지한다. AI가 반복 작업을 맡아 개발자가 어려운 일에 집중하는 구도는 디버깅과 시스템 설계와 성능 및 정확성에 대한 직관 같은 기초 스킬이 예리할 때만 작동한다. AI를 전문성의 대체물이 아니라 전문성을 더 큰 규모로 적용하는 수단으로 다룬다.
엔지니어링 리더
- context engineering을 팀의 1급 엔지니어링 실천으로 만든다. AGENTS.md, 시스템 프롬프트, eval 스위트, skill 라이브러리를 코드처럼 다뤄 pull request에서 리뷰하고 프로젝트와 함께 버전 관리하며 담당 엔지니어를 지정한다. 이 규율이 없으면 harness가 드리프트하고 agent 행동이 팀 안에서 재현 불가능해진다.
- 기준을 데모가 아니라 eval에 둔다. 동작하는 데모는 agent가 한 번 성공할 수 있음을 증명하고, 통과하는 eval 스위트는 신뢰성 있게 성공함을 증명한다. 다만 명확한 루브릭 없는 eval은 아무것도 재지 않으므로 무엇을 채점하는지 정의해야 한다.
- AI 생성 코드용으로 코드 리뷰를 재설계한다. AI 생성 코드는 사람이 쓴 코드와 같거나 더 큰 정밀 검토를 요구하며, 환각된 의존성과 부적절한 에러 처리와 한눈에 맞아 보이는 미묘한 정확성 결함에 추가 주의가 필요하다. 리뷰어를 생성 코드의 실패 모드에 대해 훈련하고 리뷰 체크리스트를 그에 맞게 조정한다.
- 팀 규범에서 프로토타이핑 작업과 프로덕션 작업을 구분한다. vibe coding은 탐색에 맞는 속도이고 agentic engineering은 프로덕션에 맞는 규율이다. 어떤 프로젝트와 브랜치와 환경이 어떤 작업 모드를 정당화하는지 경계를 명시한다. 이 구분을 모호하게 두는 팀은 사고로 배포되는 프로토타입을 만든다.
- harness 구성 요소를 공유 팀 자산으로 투자한다. 재사용 가능한 시스템 프롬프트, skill 라이브러리, MCP 서버 연결, 평가 harness는 프로젝트를 넘어 값이 쌓인다. 문서화하고 유지하고 의도적으로 개선하는 인프라로 다룬다. 가장 큰 값을 얻는 팀은 harness를 한 번 만들고 여러 번 정련하는 팀이다.
eval 루브릭의 채점 항목은 백서가 다섯 가지로 명시한다.
| 채점 항목 | 무엇을 재는가 |
|---|---|
| task 성공 | agent가 주어진 과제를 완수했는지 |
| tool use 품질 | 도구를 적절히 골라 올바르게 호출했는지 |
| trajectory 준수 | 실행 경로가 의도한 절차를 따랐는지 |
| 환각 | 근거 없는 내용을 만들어 내지 않았는지 |
| 응답 품질 | 최종 응답이 품질 기준을 넘는지 |
다섯 항목은 앞서 나온 output evaluation과 trajectory evaluation을 실제 채점표로 펼친 것이다. task 성공과 응답 품질과 환각이 output 쪽을 재고, tool use 품질과 trajectory 준수가 경로 쪽을 잰다.
테스트 커버리지가 서비스 배포를 게이팅하는 것과 같은 방식으로, 명시적 루브릭이 붙은 eval 커버리지를 공유 워크플로에 들어가는 모든 agent의 전제 조건으로 요구한다.
조직
- AI 보조 개발을 생산성 기능이 아니라 엔지니어링 투자로 다룬다. 가장 큰 이득을 보는 팀은 AI 도구를 eval 커버리지와 observability와 명확한 아키텍처 표준과 함께 짝짓는다. 그 스캐폴딩 없이 코딩 에이전트를 배포하면 품질 없는 속도가 나오고, 어떤 팀도 갚을 수 없는 속도로 기술 부채가 쌓인다.
- 규모화 전에 프로덕션 기반(substrate)에 투자한다. 노트북의 vibe coding 프로토타입은 프로덕션 시스템이 아니다. 하나를 다른 하나로 졸업시키는 것은 주변의 운영 규율이다. CI에서 실행되는 trajectory와 최종 응답 eval, 모든 agent 실행의 trace, agent별 범위 지정 권한, 생성 코드의 실패 모드에 맞춰 조정된 보안 리뷰다. 첫 프로덕션 agent가 배포된 뒤가 아니라 그 전에 이 기반을 만든다.
- 도구와 agent 사이 통신에 오픈 표준을 채택한다. 도구 접근의 MCP와 cross-agent delegation의 A2A가 멀티에이전트 시스템의 연결 조직으로 수렴하고 있다. 지금 이들을 선택하면 벤더와 프레임워크를 섞을 선택지가 열린 채 유지되고 나중의 재플랫폼화를 피한다.
- 사람 전용이나 agent 전용이 아니라 사람과 agent의 하이브리드 팀을 전제로 계획한다. 지난 1년의 가장 강한 프로덕션 결과는 사람이 방향을 설정하고 agent가 구현하며 명확한 handoff 프로토콜이 경계를 관리하는 아키텍처에서 나왔다. 코드 리뷰 프로세스와 on-call 로테이션과 팀 구조 모두 agent가 이제 도구가 아니라 참여자라는 사실을 반영해 진화해야 한다.
- 채용과 역량 개발을 구현이 아니라 판단 중심으로 재편한다. 구현이 빨라지고 자동화될수록 병목은 명세와 평가와 아키텍처 판단과 리뷰로 옮겨 간다. 백서의 표현으로 다음 몇 년의 가장 값진 엔지니어는 코드를 가장 많이 쓰는 사람이 아니라 agent를 잘 지휘하는 사람이다.
한계
- 시점 의존성: 단계별 그림은 2026년 중반 상태를 반영하며 빠르게 바뀌고 있다고 백서가 직접 밝힌다. 압축이 구현을 넘어 퍼지는 조짐이 있고, 이미 개발자가 명세에서 리뷰로 직행하며 AI agent가 구현과 테스트와 배포를 백그라운드에서 처리하는 워크플로를 실험하는 팀이 있다. 이 절이 그린 경계선은 12개월 후 달라 보일 수 있다. 변하지 않을 것으로 지목한 것은 사람의 판단과 취향, 그리고 AI output을 검증하는 스킬이다.
- 2차 종합 문서: LangChain, Anthropic, METR, Terminal Bench, Deloitte 수치는 모두 외부 자료의 재인용이다. 실험 조건과 재현 가능성은 각 원출처를 확인해야 한다. Deloitte의 30%에서 35% 전망치는 본문 서술에 인용되지 않고 endnote 9에만 있다. endnote 상첨자 번호가 목록과 어긋나는 자리도 있어, METR 인용은 본문에 8, endnote 목록에는 10으로 적혀 있다.
- 결론이 참조하는 미개발 분류: 결론 절(47쪽)은 이 백서가 제시한 framework의 하나로 "ambient, workflow, autonomous agent의 taxonomy"를 든다. 그런데 본문은 그 세 범주를 전개하지 않고 editor, terminal, background라는 자리 기준 3분류를 쓴다. 결론이 참조하는 분류가 본문에 없다.
- 80% 문제의 미해결: 나머지 20%는 여전히 사람의 깊은 맥락 지식을 요구하는 상수로 남는다. 백서는 이 문제를 해결하는 방법을 제시하지 않고 대응 자세만 제시한다.
- 보안 서술의 깊이: 자동 평가 harness 없는 빠른 생성이 빠른 취약점 생성으로 이어진다는 지적과, 프로덕션 수정 비용이 설계 단계 대비 지수적으로 높다는 지적에 머문다. 구체적 실패 모드로는 환각된 의존성만 리뷰 주의 대상으로 언급하고, slopsquatting 같은 사례는 endnote 목록(27번)에만 있다.
- 후속 편 의존: 세션과 skill과 메모리 설계, 토큰 경제 최적화는 Day-3 편으로, spec-driven development와 구조적 리뷰와 가드레일과 샌드박싱과 제로트러스트 개발은 Day-5 편으로 넘긴다. 이 페이지가 다루는 Day-1 편만으로는 실행 수준의 세부가 부족하다.
결론의 세 원칙
백서는 지속될 원칙 세 가지로 마무리한다.
| 원칙 | 내용 |
|---|---|
| Structure scales, vibes don't | vibe coding은 탐색과 프로토타이핑과 개인 프로젝트에 유효한 접근이다. 그러나 조직이 의존하는 소프트웨어에는 명세와 테스트와 가드레일과 아키텍처에 대한 사람의 감독이라는 규율이 선택이 아니다. "되는 것 같다"와 "모든 조건에서 정확히 동작한다" 사이의 간극에 프로덕션 장애와 보안 취약점과 유지보수 악몽이 산다 |
| AI amplifies your engineering culture | 강한 테스트 실천과 명확한 아키텍처 표준과 건강한 코드 리뷰 프로세스를 가진 조직은 그렇지 않은 조직보다 극적으로 더 많은 값을 얻는다. AI는 힘의 승수이고 강점도 약점도 함께 증폭한다 |
| The human role is evolving, not diminishing | 아키텍처를 이해하고 정밀한 명세를 정의하고 output을 비판적으로 평가하고 제약과 피드백 루프의 효과적 시스템을 설계하는 빌더는 그 어느 때보다 값지다. 중요한 스킬이 구현에서 판단으로, 코드를 쓰는 것에서 코드를 생산하는 시스템을 설계하는 것으로 이동한다 |
백서는 이 변화가 소프트웨어를 어떻게 만드는지뿐 아니라 어떤 종류의 소프트웨어를 만들 수 있는지도 재편할 것이라고 전망한다. 더 작은 팀이 더 큰 문제를 다루고, 개인 개발자가 과거에 부서 전체를 요구했던 시스템을 만들고 유지하며, 소프트웨어 제작의 장벽이 계속 낮아져 더 넓은 인구에 개발 실천이 열린다. 마지막 문장은 "Generation is solved. Verification, judgment, and direction are the new craft."다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Vibe coding | 원하는 것을 자연어로 말하고 AI output을 수용하며 깨지면 에러 메시지를 복사해 고치라고 요청하는 방식. 검증이 선택적이다 |
| Agentic engineering | 명세와 테스트와 가드레일과 아키텍처에 대한 사람의 감독으로 AI 구현을 둘러싸는 규율. 검증이 필수다. Karpathy가 2026년 초 도입한 용어다 |
| Factory model | 개발자의 1차 산출물이 코드가 아니라 코드를 생산하는 시스템이라는 멘털 모델 |
| 80% problem | AI가 기능 코드의 약 80%를 빠르게 생성하지만 나머지 20%(엣지 케이스, 에러 처리, 통합점, 미묘한 정확성)는 현재 모델이 결여한 깊은 맥락 지식을 요구하는 문제 |
| CapEx / OpEx | 자본적 지출(선행 구축 투자)과 운영 지출(실행하고 고치고 유지하는 비용). AI 시대의 OpEx는 토큰 경제가 지배한다 |
| Intelligent model routing | 복잡한 task는 큰 프론티어 모델로, 결정적이고 복잡도 낮은 task는 작고 싼 모델로 자동 라우팅하는 방식 |
관련 페이지
- Harness Engineering (Team Attention, 2026): Team Attention 이호연의 harness 6구간 순환 모델. 이 백서의 "Agent = Model + Harness" 방정식과 Terminal Bench 및 LangChain 수치를 공유하는 국내 강연이다.
- Agent Skills: 이 백서의 Agent Skills 절을 같은 저자가 심화한 글. progressive disclosure의 세부 설계를 다룬다.
- Agent Skills (GeekNews): Agent Skills를 dynamic 컨텍스트 관리 패턴으로 소개한 국내 자료.
- You Can Learn AI Agent Harness & Loop Engineering In 19 Min | LLM Ops, Eval, Tracing, RAG: harness와 loop와 LLMOps를 하나의 비유로 푼 입문 강의. 이 백서의 harness와 루프 개념과 직결된다.
- Agent Harness Engineering 개괄과 학습 경로: Skills와 Loops와 Verification을 묶은 합성 페이지. 이 백서를 상위 계보에 배치하는 앵커다.
- How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks: agentic 토큰 경제의 실증 연구. 이 백서 경제학 절의 CapEx와 OpEx 논의를 정량으로 뒷받침한다.
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 업데이트가 곧 이득은 아니라는 반론. 이 백서의 harness 효과 주장에 대한 비판적 대조다.
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: agent loop를 survey로 정리한 자료. 이 백서 핵심 개념 절의 5개 부품과 루프를 더 넓게 다룬다.
외부 참조
- Karpathy, "Vibe Coding" (2025-02, X): 용어의 시초. x.com/karpathy/status/1886192184808149383
- Osmani 블로그: Agentic Engineering, The Factory Model, From Conductors to Orchestrators, The 80% Problem, My LLM Coding Workflow Going Into 2026
- METR: Uplift Update (2026-02)
- Google: "Introduction to Agents" 백서(2025-11), ADK, A2A
- O'Reilly: Osmani, Beyond Vibe Coding