Etc · ARTICLE · 2026
A Practical Guide to Becoming an AI-Native Engineer (Shah Rahman, ByteByteGo 2026-06-02)
요약
Shah Rahman이 ByteByteGo Newsletter에 기고한 2부작 에세이의 1부(2026-06-02)다. raw 도입부의 편집자 소개에 따르면 저자는 Meta에서 Ads 부문의 Autonomous ML Iteration & Optimization을 총괄하며, AI-native 인프라와 멀티에이전트 시스템을 설계해 대규모 production 환경의 ML iteration을 신뢰성 있게 만드는 일을 맡고 있다. 글은 AI가 코드 대부분을 쓰는 시대에 왜 대부분의 팀이 2년 전보다 더 많은 버그와 인시던트와 기술 부채를 내는지 묻고, 그 격차가 엔지니어가 코드를 직접 쓰는 사람에서 코드 생산을 오케스트레이션하는 사람으로 옮겨 갔는지에서 갈린다고 답한다.
처방은 다섯 묶음이다. 첫째, 4 Core Practices(synchronized context engineering, specification-driven development, critical verification, problem decomposition)다. 둘째, 컨텍스트 설정 40%, 생성 20%, 검증 40%의 시간 배분이다. 셋째, Foundation, Integration, Mastery의 3단계 개인 전환과 AI 생성 코드 80% 이상, 재작성률 20% 미만이라는 목표 지표다. 넷째, 전통 SDLC를 대체하는 ADLC(Agentic Development Life Cycle)로, Planning, Building, Testing, Review 순환에 Documentation과 Codify를 더한 운영 프레임이다. 다섯째, 실제 사고 4건에서 끌어낸 보안 컨트롤 4종, 기술 가드레일 3종, 조직 가드레일 2종이다.
결론은 두 문장으로 요약된다. AI-native 생산성의 차별 요소는 도메인 전문성이며 AI는 전문성을 대체하지 않고 증폭한다. 그리고 이 전환은 도구 도입이 아니라 여러 해에 걸친 일하는 방식의 변화이며, 도구 업그레이드로 취급한 팀은 한결같이 생산성 이득을 얻지 못했다.
배경
도입부의 네 가지 통계
글은 AI 코드 생성의 규모를 보여주는 통계 네 건으로 시작한다. 저자는 이 통계가 한 시대의 마지막 페이지, 어쩌면 한 직업의 마지막 페이지처럼 읽힐 수 있다고 적는다.
| 주체 | 주장 | 출처 표기 |
|---|---|---|
| 신규 코드의 75% 이상을 AI가 생성 | 없음 | |
| OpenAI, Anthropic | 새로 쓰는 코드의 거의 모든 줄이 AI에서 나온다고 주장 | 두 회사의 주장으로 인용 |
| Amazon | production 애플리케이션 3만 개를 Java 8에서 Java 17로 몇 달 만에 이전. 사람이 했다면 약 4,500 개발자-년 | 없음 |
| Mark Zuckerberg | 2026년 말이면 AI 에이전트가 mid-level 엔지니어로 일할 것으로 예상 | 발언 인용 |
code overload
저자가 이 통계 위에 두는 질문은 "AI가 모든 것을 쓰는 것이 답이라면 왜 대부분의 엔지니어링 팀은 2년 전보다 더 많은 버그와 인시던트와 기술 부채를 내는가"다. 이 현상에는 이미 이름이 있다. NYT의 Mike Isaac과 Erin Griffith가 2026년 4월 6일 기사에서 code overload라 불렀는데, 기술 인력이 너무 많은 코드를 너무 빨리 만들어 감당할 수 없게 된 상태를 뜻한다. AI 에이전트 중심으로 일을 재편한 팀들은 code churn과 보안 구멍에 잠기고 있다.
그런데 같은 모델과 같은 도구를 쓰면서도 실제 생산성 이득을 내며 앞서 나가는 엔지니어들이 있다. 저자는 이 격차가 결정 하나에서 갈린다고 본다. 코드를 쓰는 일에서 코드 생산을 오케스트레이션하는 일로 옮겨 가는 결정이다. 이 글은 그 생산적인 쪽에 서고 싶은 엔지니어를 위한 실무 가이드로, AI-native engineering을 vibe coding과 대부분의 팀이 대규모로 만들어 내는 일상적 혼란에서 구분하는 실천, 가드레일, 사고방식 전환을 다룬다.
엔지니어는 사라지지 않는다
저자가 먼저 분명히 하는 것은 엔지니어가 쓸모없어지는 것이 아니라는 점이다. 코딩은 늘 엔지니어링의 작은 부분이었고 저자는 그 비중을 최대 20~30%로 본다. AI 에이전트와 도구가 더 많은 코드를 만들수록 이 사실이 더 잘 보이는데, 코드가 많아졌다고 더 생산적인 것은 아니며 오히려 덜 생산적인 경우가 많다. 저자는 업계가 이 구분을 위험하게 흐리고 있다고 지적한다.
핵심 개념
AI-native engineering과 vibe coding
vibe coding은 Andrej Karpathy가 2025년 초에 만든 말로, 비엔지니어가 원하는 것을 서술해 동작하는 소프트웨어를 만드는 능력을 가리킨다. 저자는 이 민주화에 가치가 있다고 인정하면서도 전문적 AI-native engineering과는 범주가 다르다고 선을 긋는다.
AI-native engineering은 현재와 미래의 AI 에이전트와 도구를 지휘하고 통달해 AI 이전 시대에는 불가능했던 것을 만드는 일이다. 코딩을 아는 것은 여전히 기본 전제다. 코딩을 모르는 채 AI로 시스템을 만들 수는 있지만 그것은 vibe coding이며, 나름의 자리는 있어도 엔지니어링은 아니다.
orchestrator
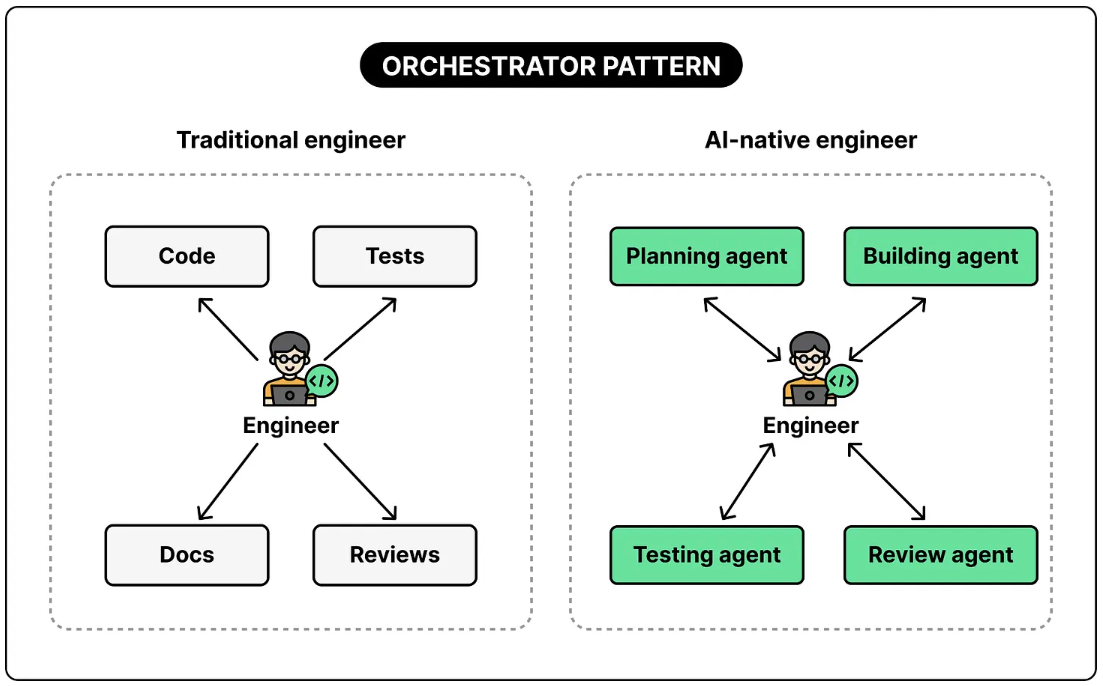
orchestrator는 AI-native 엔지니어의 역할을 가리키는 저자의 표현이다. fig03은 이 전환을 두 그림으로 대비한다. 왼쪽 전통적 엔지니어의 화살표는 엔지니어에게서 Code, Tests, Docs, Reviews로 한 방향으로 나가고, 오른쪽 AI-native 엔지니어의 화살표는 네 에이전트와 양방향으로 오간다. 산출물을 직접 만드는 대신 산출물을 만드는 에이전트와 주고받는다는 뜻이다. 전통적 엔지니어가 코드, 테스트, 문서, 리뷰를 직접 다뤘다면 AI-native 엔지니어는 같은 자리에서 planning, building, testing, review 에이전트를 지휘한다. 저자는 적절한 오케스트레이션이 10x 엔지니어링을 100x 산출로 끌어올린다고 보며, 그 기준선은 매주 올라간다고 적는다.
context engineering
context engineering은 프롬프트 문구를 다듬는 일이 아니라 프로젝트별 정보를 AI가 참조할 컨텍스트에 체계적으로 큐레이션해 주입하는 설계다. 저자는 이를 AI-native 엔지니어의 가장 중요한 단일 스킬로 꼽으며, 여기서 working memory는 에이전트가 한 번의 작업 안에서 참조하는 컨텍스트 저장소를 뜻한다. 팀 전체가 재사용하고 표준화하는 형태여야 한다는 뜻에서 synchronized라는 수식어가 붙는다.
slop과 컨텍스트 오염
slop은 컨텍스트가 오염된 에이전트가 만들어 내는 품질 낮은 산출물을 가리키는 표현이다. 이 글에서 slop은 결국 버려지고 처음부터 다시 시작해야 하는 코드를 뜻한다. 저자는 크고 복잡한 문제를 통째로 맡기면 컨텍스트 오염과 slop 생성이 일어나고 에이전트가 거기서 회복하기 어렵다고 본다. compaction은 길어진 대화 이력을 요약으로 접어 세션을 이어가는 처리인데, 오염된 컨텍스트에 compaction을 적용하고 다른 세션으로 옮기면 도움이 되지만 그 불연속이 long-horizon 작업에는 해로울 수 있다.
agent swarm
agent swarm은 같은 작업에 역할이 다른 여러 에이전트를 투입해 각자 다른 관점에서 코드베이스를 이해하게 하고 서로 견제하게 하는 구성이다. 서브에이전트는 상위 에이전트가 위임한 작업을 격리된 컨텍스트에서 수행하는데, 이 글의 swarm은 planning, building, testing, review처럼 단계별로 전문화된 서브에이전트 묶음이다.
ADLC
ADLC(Agentic Development Life Cycle)는 전통 SDLC를 AI 에이전트와 사람이 함께 소프트웨어를 만드는 방식에 맞게 각 단계를 재정의한 운영 프레임이다. 저자는 전통 SDLC는 물론 극단적 agile도 이 방식을 담기에 부족하다고 본다. 구성은 Planning, Building, Testing, Review의 순환에 Documentation과 Codify ADLC를 더한 여섯 절이다.
prompt injection과 slopsquatting
prompt injection은 문서, 웹 페이지, 사용자 입력 같은 외부 콘텐츠에 숨은 명령이 에이전트의 행동을 가로채는 공격이다. slopsquatting은 2025년에 등장한 공급망 공격으로, AI 모델이 환각으로 만들어 낸 존재하지 않는 패키지명을 공격자가 미리 등록해 악성 코드를 심는 방식이다. 이 글은 두 공격을 실제 사고 사례와 함께 다룬다.
specification과 milestone
specification-driven development에서 명세는 AI에 빌드를 맡기기 전에 무엇을 원하는지 적어 둔 정의이고, milestone은 그 문제를 나눈 개별 단계로 각각 성공 기준을 갖는다. 저자는 명세가 담아 두고 잘 정의된 형태여야 한다고 강조하는데, 그렇지 않으면 에이전트가 같은 자리를 맴도는 순환 추론에 갇히기 때문이다. 체크포인트는 milestone마다 검증을 수행하는 지점이다.
verification inversion
verification inversion은 fig05의 제목으로, AI-native 작업에서 시간이 가는 곳이 뒤집혔다는 뜻이다. 개발자 대부분은 생성에 시간의 70%를 쓰리라 기대하지만 실제로 통하는 배분은 컨텍스트 설정과 검증에 각 40%를 쓰는 쪽이다. 병목이 코드를 입력하는 일에서 코드를 검증하는 일로 옮겨 갔다는 이 글의 중심 명제를 한 장으로 요약한 표현이다.
Layer-1과 Layer-2
Codify ADLC 단계에서 저자는 실천을 두 층으로 나눈다. Layer-1은 개인 실천으로 개인 전환 3단계가 다루는 내용이고, Layer-2는 팀 실천으로 팀 전환의 세 요건이 다루는 내용이다. 두 층을 유지되고 스스로 진화하는 컨텍스트 파일, skill library, MCP 도구로 인코딩해야 ADLC 채택이 부족 지식에 머물지 않고 조직 전체로 확산된다.
방법
4 Core Practices 개요
저자가 처방하는 네 가지 핵심 실천은 컨텍스트, 명세, 검증, 분해로 요약된다. 각 실천은 정의, 근거, 운영 규칙을 갖는다.
| Practice | 정의 | 저자가 드는 근거 | 운영 규칙 |
|---|---|---|---|
| synchronized context engineering | 프로젝트별 정보를 팀 전체가 재사용하는 형태로 AI working memory에 주입 | AI 출력 품질은 컨텍스트 품질에 묶인다. 실천 팀은 40~50% 속도 향상 보고 | MCP와 CLAUDE.md 같은 컨텍스트 파일을 핵심 인프라로 유지 |
| specification-driven development | 원하는 것을 정의하고 milestone으로 나누고 체크포인트마다 검증하며 점진 실행 | AI 코드 품질은 입력 명세 품질과 같다. 명세 없이는 순환 추론에 빠진다 | 미해결 질문은 에이전트가 사용자에게 확인하게 한다 |
| critical verification | 코드가 규모, 신뢰성, 보안 면에서 동작함을 증명 | AI 코드 45%에 보안 결함. 익숙한 코드베이스에서 19% 감속 | 리뷰, 테스트, 검증은 타협 불가 |
| problem decomposition | 사람이 edge case와 도메인을, AI가 정형 구현 70~80%를 맡도록 분할 | 복잡한 문제는 컨텍스트 오염과 slop을 부른다 | 컨텍스트, 명세, 가드레일 없이 밀어붙이지 않는다 |
synchronized context engineering
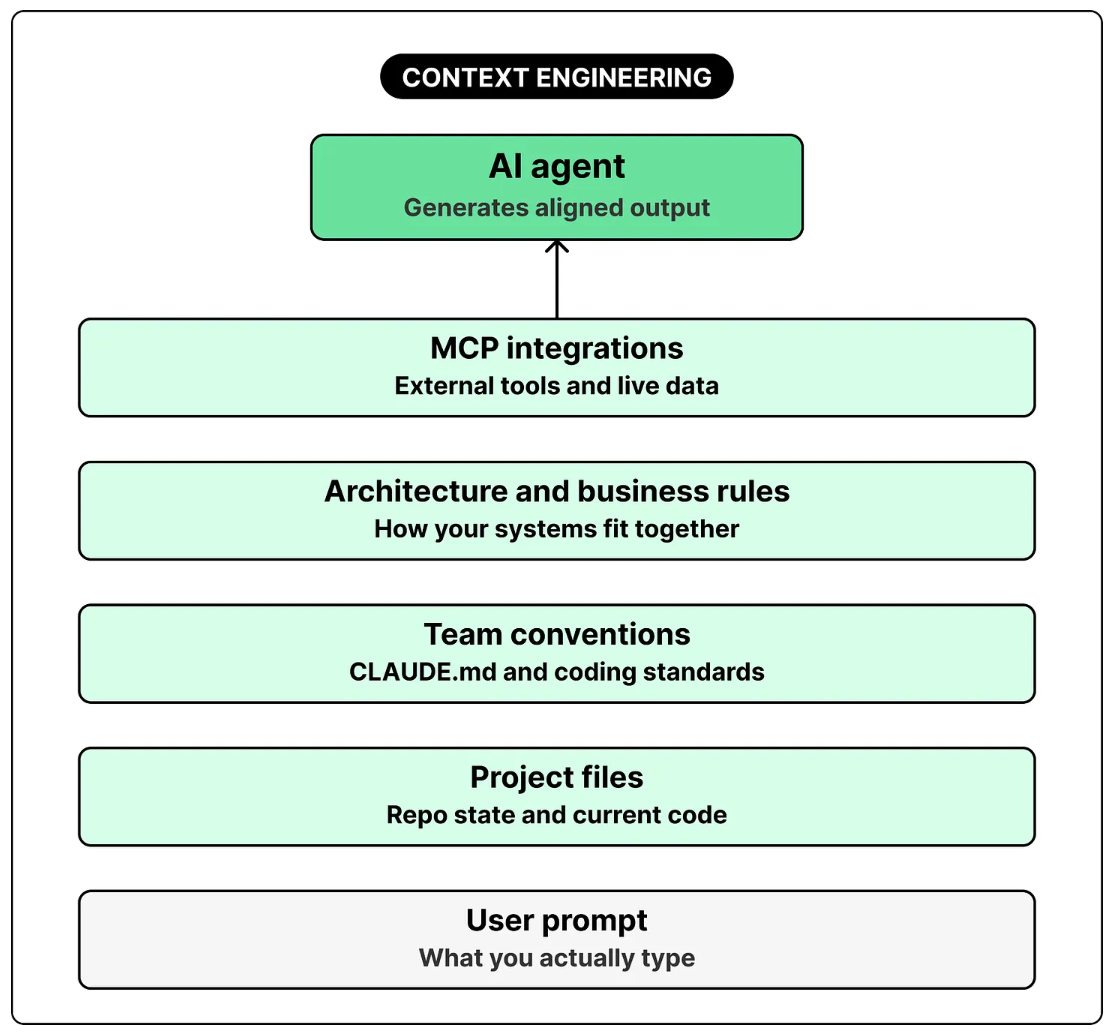
context engineering은 하나의 독립된 분야로 떠오르고 있으며 저자는 이를 AI-native 엔지니어의 가장 중요한 단일 스킬로 본다. 주입할 정보는 다섯 종류다.
- 아키텍처 다이어그램
- 코딩 표준
- 비즈니스 규칙
- 팀 관례
- 개발 워크플로
핵심 인식은 AI 출력의 품질이 받은 컨텍스트의 품질에 묶인다는 것이다. 따라서 기본적인 프롬프트 엔지니어링에서 정교한 context engineering으로 옮겨 가야 한다. 저자에 따르면 엄격히 실천하는 팀은 40~50% 속도 향상과 alignment overhead의 큰 감소를 보고한다. alignment overhead는 팀원과 에이전트가 같은 방향을 보게 만드는 데 드는 조정 부담을 말한다.
인프라 측면에서는 두 가지가 자리 잡았다. Anthropic의 MCP는 "USB-C for AI"로 불리며 에이전트를 외부 도구와 데이터 소스에 연결하는 범용 표준으로 계속 쓰인다. CLAUDE.md 같은 컨텍스트 파일은 선택적 문서가 아니라 핵심 인프라가 되었다. 이 지속적이고 진화하는 지식 층을 만들고 유지하는 법을 익혀야 에이전트가 특정 코드베이스 안에서 실제로 쓸모 있어진다.
fig04는 이 스택을 아래에서 위로 쌓는다. 사용자가 실제로 입력하는 프롬프트 위에 저장소 상태와 현재 코드(Project files), CLAUDE.md와 코딩 표준(Team conventions), 시스템이 어떻게 맞물리는지(Architecture and business rules), 외부 도구와 실시간 데이터(MCP integrations)가 올라가고, 그 위의 AI 에이전트가 컨텍스트에 맞춘 출력을 낸다.
specification-driven development
AI 생성 코드의 품질은 입력 명세의 품질과 같다. garbage in, garbage out 원칙은 AI가 전례 없는 속도와 물량으로 garbage를 만들 수 있는 환경에서 더 강하게 작동한다. 무작위 프롬프팅과 vibe coding은 명세 주도 워크플로에 일관되게 뒤지며, 담아 두고 잘 정의한 명세와 지침이 없으면 에이전트는 순환 추론에 갇힌다.
저자가 권하는 규율은 세 단계다.
| 단계 | 내용 |
|---|---|
| 정의 | AI에 빌드를 맡기기 전에 무엇을 원하는지 정의한다 |
| 분할 | 문제를 성공 기준이 분명한 개별 milestone으로 나눈다 |
| 점진 실행 | 체크포인트마다 검증하며 점진적으로 실행한다 |
여기에 한 가지 규칙이 붙는다. 에이전트가 모든 미해결 질문을 사용자에게 확인하게 하고, 혼자 답을 찾으러 떠나지 않게 한다.
critical verification
AI 생성 코드의 품질은 초급 개발자 수준에 가깝다. 저자는 이를 뒷받침하는 연구 네 건을 인용한다.
| 인용 | 내용 | 저자의 해석 |
|---|---|---|
| "research consistently shows" | AI 생성 코드의 약 45%에 보안 결함 | 검증 없이 쓸 수 없는 품질 |
| Stanford 연구 | AI 보조를 쓴 개발자가 훨씬 덜 안전한 코드를 쓰면서 더 안전하다고 확신 | 위험한 조합 |
| METR/Anthropic RCT | 경력 오픈소스 개발자가 익숙한 코드베이스에서 AI를 쓸 때 19% 느려짐 | 원인은 충분한 검증 없는 과신 |
| GitClear 연구 | AI 보조 코드베이스에서 code churn(쓰고 곧 고치거나 지우는 코드) 증가 | 산출량은 생산성의 빈약한 대리 지표 |
이 근거에서 저자는 병목이 영구히 이동했다고 결론짓는다. AI-native 시대의 병목은 코드를 쓰는 일이 아니라 그 코드가 규모, 신뢰성, 보안 면에서 동작함을 증명하는 일이다. AI가 코드를 빨리 만들수록 리뷰, 테스트, 검증이 새로운 율속 단계가 되며 검증은 타협할 수 없는 요건이 된다.
problem decomposition
크고 복잡한 문제를 AI에 과신해 맡기지 않는다. 작업을 AI가 다룰 수 있는 단위로 나누고, 사람이 edge case, 커스텀 로직, 도메인 특화 부분을 맡으며 AI 에이전트가 정형 구현 70~80%를 맡는다.
복잡한 문제를 통째로 맡기면 컨텍스트 오염과 slop 생성이 일어나고 에이전트는 거기서 회복하기 어렵다. compaction과 세션 전환이 도움이 되지만 그 불연속은 long-horizon 작업에 해로울 수 있다. 저자는 분해하지 않고 잘 정의된 컨텍스트, 합리적 명세, 검증 가드레일 없이 기대치를 놓고 에이전트를 고집스럽게 혼란에 빠뜨려 몇 시간에서 며칠을 잃은 경험이 자신을 포함해 많다고 적는다.
40/20/40 시간 배분
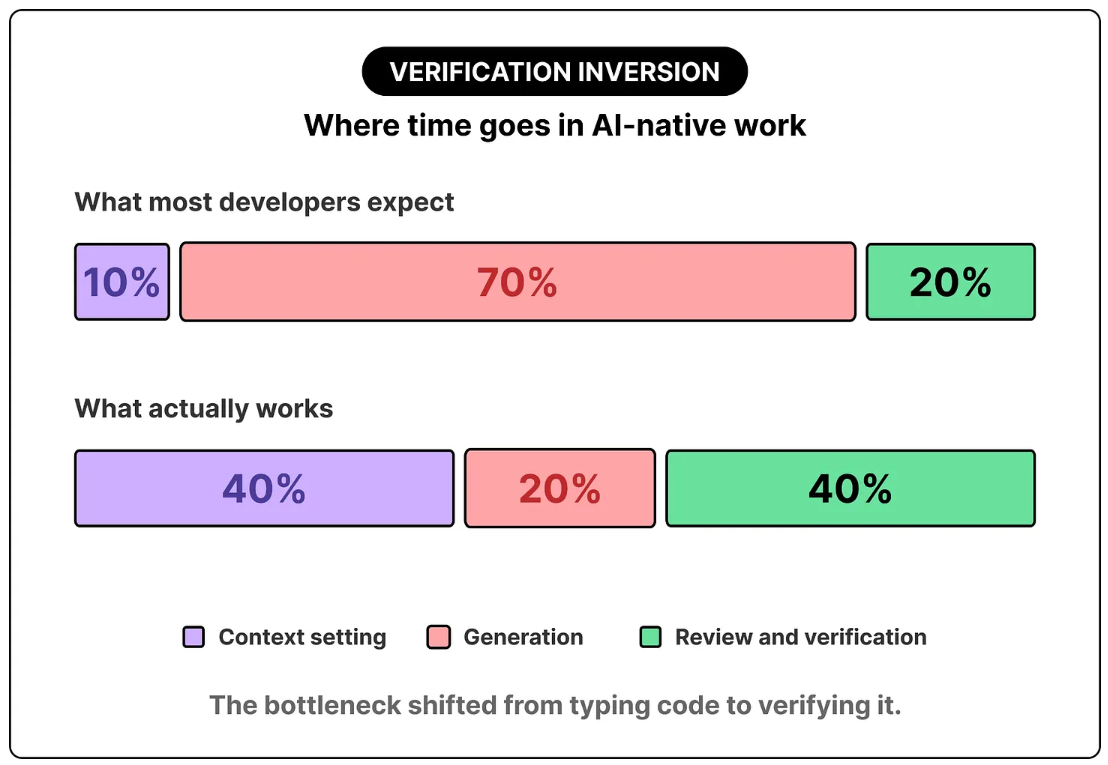
저자가 권하는 최적 배분은 컨텍스트 설정 40%, 생성과 테스트 반복 20%, 리뷰와 검증 40%다. 시간 대부분을 코드 생성에 쓰는 개발자에게는 놀라운 비율인데, 실제로는 생성 단계가 빠르고 검증과 컨텍스트 작업이 새로운 시간 소모처이기 때문이다.
| 구간 | 개발자 대부분의 기대 (fig05) | 저자 권고 |
|---|---|---|
| 컨텍스트 설정 | 10% | 40% |
| 생성과 테스트 반복 | 70% | 20% |
| 리뷰와 검증 | 20% | 40% |
기대 배분 10/70/20은 본문에 없고 fig05에만 있다. 도식의 제목 Verification Inversion은 병목이 코드 입력에서 검증으로 뒤집혔다는 뜻이다.
개인 전환 3단계
저자는 개인의 전환을 세 단계로 나눈다. 앞의 두 단계는 기간이 정해져 있고 마지막 단계는 계속된다.
| Phase | 기간 | 핵심 활동 | 저자의 경고 |
|---|---|---|---|
| 1. Foundation | 2주 정도 | Codex, Claude Code, Cursor 중 하나를 주력으로 선택. 매일 쓰며 능력과 한계에 대한 직관 축적. workspace, 워크플로, 초기 설정 구축. 개인 노트 기록과 반복 | 수동 코딩에서 AI 보조와 AI 생성 코딩으로 도약해야 한다. 목표는 AI가 가치를 내는 때와 일을 더 만드는 때를 가리는 판단력 |
| 2. Integration | 최대 1개월 | 구조화된 프롬프트 프레임워크. 팀 표준과 아키텍처 패턴을 담은 프로젝트별 컨텍스트 파일. "Plan first, then Execute and finally review" 워크플로. atomic task마다 리뷰. 승인 게이트와 가드레일 | 리뷰를 건너뛰면 사람과 에이전트 모두 기술 부채에 시달린다. 계획 없는 추측성 자율 실행은 버려질 slop을 대량 생산한다 |
| 3. Mastery | 계속 | 다단계 다중 파일 작업에 에이전트 투입. AI 보조 코드 리뷰 워크플로. 멀티에이전트 워크플로, 병렬 세션, 교차 검증 루프 | Claude나 Codex 제작사의 권고를 맹목적으로 따르지 않는다. 그들의 상황은 크게 다를 수 있다 |
Phase 1의 목표는 도구 숙련 자체가 아니라 판단력이다. 저자는 이 단계에서 수동 코딩의 시대에서 AI 보조와 AI 생성 코딩으로 도약해야 한다고 적고, 그 도약의 목적을 AI가 가치를 내는 때와 일을 더 만드는 때를 가리는 판단력을 기르는 것으로 둔다. 개인 노트를 쓰고 반복하며 기반을 다지라는 권고가 붙는다.
Phase 2의 워크플로는 세 모드로 나뉜다. planning 모드가 명세를 만들고, execution 모드가 구현하며, atomic task마다 리뷰한다. 승인 게이트와 가드레일은 에이전트 이탈을 막는다.
Phase 2에서 저자가 가장 강조하는 실천은 검증 체크포인트가 있는 작은 루프다. 적어도 코딩 작업에서는 범위를 제한한 긴밀한 human-in-the-loop 순환이 큰 자율 실행을 크게 앞선다는 증거가 있다. 직관에 어긋나고 느리게 느껴지지만 실제 결과는 훨씬 낫다. 반면 계획 없는 추측성 자율 실행은 결국 버리고 처음부터 다시 해야 하는 slop을 대량으로 만든다.
Phase 3에서는 매주 코딩 에이전트가 벤치마크에서 진전을 보이고 전에 풀지 못한 문제를 푼다는 소식이 들린다. 저자는 그 흐름을 따라가며 Claude나 Codex 제작사가 권하는 것을 받아들이되 자기 필요에 맞게 조정하라고 권한다.
목표 지표는 AI 생성 코드 비율 80% 이상과 재작성률 20% 미만이다. 즉 코드 다섯 줄 중 네 줄 이상을 AI가 쓰고 그중 다시 써야 하는 비율은 다섯 줄 중 한 줄 미만이어야 한다. 이 수준에 이르면 팀을 같은 숙련도로 비교적 빠르게 끌어올릴 수 있다고 저자는 적는다.
팀 전환의 문화적 기반
저자가 인용하는 연구에 따르면 전환 성공의 70%는 운영과 문화 변화에서 온다. 조직 리더와 기술 리더가 매일 AI를 쓰며 전환을 몸소 보여야 하고, 동시에 세 가지 요건을 갖춰야 한다.
| 요건 | 내용 | 경계할 것 |
|---|---|---|
| 심리적 안전 | MIT 연구에서 리더 83%가 심리적 안전이 AI 이니셔티브 성공을 측정 가능하게 높인다고 응답. "AI 실패담"을 학습 기회로 축하하는 것을 의도적 실천으로 삼고 모두를 집단 학습에 포함 | 선택 사항으로 두는 것 |
| 진화한 코드 리뷰 | AI 생성 코드 물량이 전통적 사람 리뷰를 압도하므로, AI 생성 코드와 사람 코드를 구분해 별도 rubric으로 리뷰 | AI가 생성하고 AI가 리뷰한 PR 조합. 명시적 가드레일과 거버넌스 필요 |
| 공유 컨텍스트 라이브러리 | 컨텍스트 파일, 평가 세트, 에이전트 설정을 팀 간 표준화. 플러그인, 스킬, 커맨드로 패키징이 쉬워짐 | 통제되지 않는 난립. 팀들이 협업 대신 표준화 경쟁을 벌이거나, 에이전트와 스킬을 만들고 싶은 팀원이 너무 많아 표준 운영 환경을 위협하는 것 |
저자는 공유 컨텍스트 라이브러리를 팀의 핵심 통화라고 부른다. 도구가 패키징을 쉽게 만든 만큼 난립도 쉬워졌으므로, 표준화된 에이전틱 운영 환경을 지키는 것이 리더의 일이 된다.
ADLC
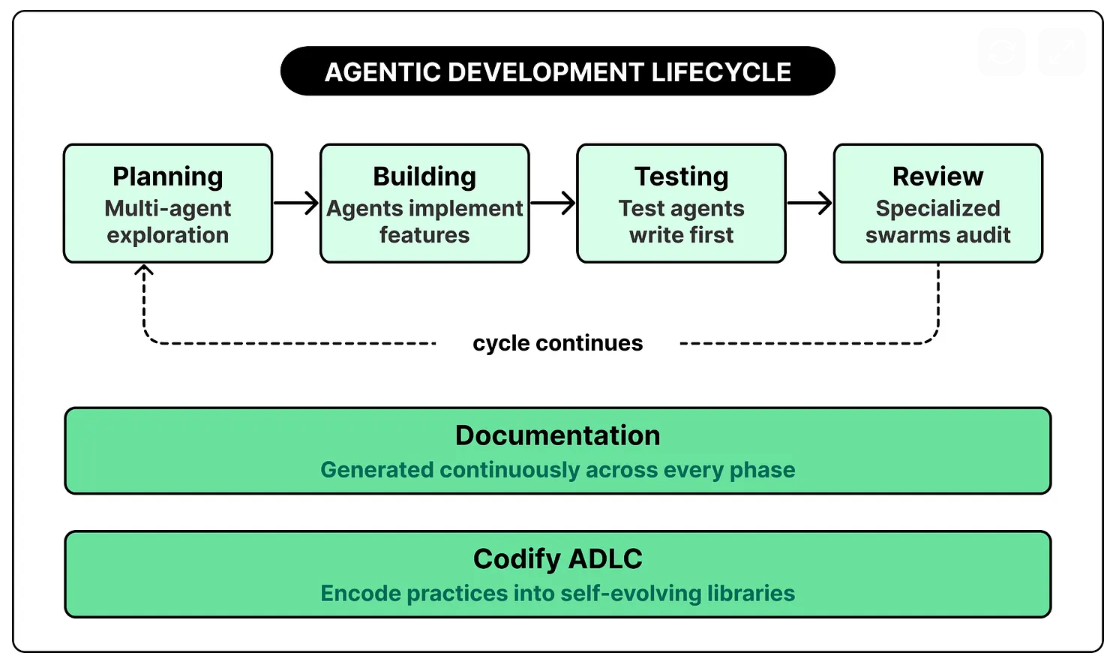
ADLC는 전통 SDLC의 각 단계를 에이전트가 사람과 함께 개발하는 방식에 맞게 다시 정의한다. Planning부터 Review까지 네 단계가 순환하고, Documentation은 모든 단계에 걸쳐 연속 생성되며, Codify ADLC는 그 실천 전체를 조직 자산으로 인코딩한다.
| 단계 | 내용 | 도구와 원칙 |
|---|---|---|
| Planning | 가장 중요한 단계. deep research와 planning 모드, 다중 에이전트 병렬 탐색. 코드베이스 기준 명세화, 모호성 표시, subtask 분해, 난이도 추정. version milestone이 있는 로드맵 | planning 에이전트가 탐색 에이전트들의 발견을 하나의 구현 전략으로 조립. 저자는 "OpenClaw of Claude"가 여러 서브에이전트를 병렬 실행한다고 적는다 |
| Building | 에이전트가 junior나 mid-level 엔지니어처럼 기능을 end-to-end 구현. 엔지니어는 tech lead로서 직접 코딩하지 않고 여러 에이전트를 오케스트레이션. 순차와 병렬 실행은 로드맵과 검증 계획에 따라 결정 | Claude Code, Cursor Composer 모드, GitHub Copilot Agent Mode, OpenAI Codex 에이전트. 매달 새 버전이 나오므로 새 기능을 주시 |
| Testing | TDD의 부활. 에이전트가 테스트 계획을 먼저 쓰고 구현. 처음엔 모든 테스트가 실패하고 점진적으로 통과 | unit(원자 단위), integration(기능 간), end-to-end(시스템 전체). unit에 과몰입해 integration과 system 테스트를 빠뜨리지 않는다 |
| Review | 기능성, 품질, 확장성, 성능, 신뢰성, 보안, 프라이버시 7개 차원의 전문 swarm이 1차 보고서 작성. 사람이 각 보고서를 검토 | generalization principle: injection 취약점 한 건이 나오면 같은 유형이 다른 곳에도 있다고 보고 선제 탐색 |
| Documentation | 사후 문서화에서 연속 생성으로. 요약, 설계 결정, 아키텍처 다이어그램, changelog를 실시간 생성 | API 문서, 기능 자료, 고객용 콘텐츠로 자연스럽게 연결 |
| Codify ADLC | Layer-1(개인)과 Layer-2(팀) 실천을 유지되고 스스로 진화하는 컨텍스트 파일, skill library, MCP 도구로 인코딩 | 부족 지식이나 일부 부서에 갇히지 않게 조직 전체로 확산. ADLC 도구 패키지를 알린다 |
Planning을 가장 중요한 단계로 두는 이유는 나머지 단계가 모두 그 산출물 위에서 진행되기 때문이다. deep research와 planning 모드로 여러 에이전트가 병렬로 탐색하고, 명세는 추상적인 요구가 아니라 코드베이스를 기준으로 작성하며, 모호한 부분은 표시하고, 작업은 subtask로 나누고 난이도를 추정한다. version milestone이 있는 로드맵은 에이전트가 한 번에 끝내려 하지 않고 점진적으로 따라가게 만든다.
Testing에서 "처음엔 모든 테스트가 실패해야 한다"는 규칙은 테스트가 구현보다 먼저 존재해야 한다는 뜻이다. 테스트가 처음부터 통과한다면 그 테스트는 아무것도 검증하지 않는다. 테스트는 원자 단위의 unit, 기능 사이의 integration, 시스템 전체의 end-to-end 세 층을 모두 갖춰야 하며, 저자는 unit 테스트에 과몰입해 integration과 system 테스트가 빠지는 것을 경계한다.
Building 단계에서 에이전트의 수준을 junior나 mid-level로 본 것은 글을 쓰는 시점 기준이며, 저자는 1~2년 안에 senior 수준으로 오르리라 예상한다. Documentation 단계에 대해 저자는 자신과 팀이 수십 년간 겪은 낡고 일관성 없는 문서 문제를 AI 도구가 마침내 푸는 데 기대를 표한다.
ADLC에서 사람과 에이전트의 분업
ADLC의 각 단계에서 사람과 에이전트가 맡는 일은 다르다. 글에 명시된 분업을 모으면 다음과 같다.
| 단계 | 에이전트가 하는 일 | 사람이 하는 일 |
|---|---|---|
| Planning | 여러 에이전트가 병렬로 탐색하고, planning 에이전트가 발견을 하나의 구현 전략으로 조립 | 로드맵과 version milestone을 세워 에이전트가 점진적으로 따르게 함 |
| Building | junior나 mid-level 엔지니어처럼 기능을 end-to-end 구현 | tech lead로서 직접 코딩하지 않고 여러 에이전트를 오케스트레이션. 순차와 병렬 실행 모델을 결정 |
| Testing | 테스트 계획을 먼저 쓰고 구현. 실패하는 테스트를 점진적으로 통과시킴 | unit에 과몰입하지 않고 integration과 system 테스트가 빠지지 않게 감독 |
| Review | 7개 차원의 전문 swarm이 1차로 훑고 보고서 작성 | 각 보고서를 꼼꼼히 검토. 한 건의 취약점이 나오면 generalization principle을 적용해 같은 유형을 선제 탐색 |
| Documentation | 요약, 설계 결정, 아키텍처 다이어그램, changelog를 실시간 생성 | 글에 명시 없음 |
| Codify ADLC | 글에 명시 없음 | 개인과 팀의 실천을 컨텍스트 파일, skill library, MCP 도구로 인코딩하고 도구 패키지를 알림 |
agent swarm의 상호 견제
저자가 Pro Tip으로 제시하는 구조는 planning, building, testing 에이전트를 분리하는 것이다. 각 swarm은 전문화되어 코드베이스를 서로 다른 관점에서 깊이 이해하게 되고, 그 차이가 견제로 이어진다.
| 견제 주체 | 견제 대상 | 잡아내는 것 |
|---|---|---|
| planning 에이전트 | building 에이전트 | 지름길을 택한 구현 |
| planning 에이전트 | testing 에이전트 | 커버리지 누락 |
| planning 에이전트 | review 에이전트 | 맞아 보이지만 잘못된 구현에 치우친 판정 |
| review 에이전트 | 모든 상류 에이전트 | 실수와 누락 단계 |
AI-native 프로세스
construction cost와 decision cost
업계에는 "사람은 적게, 오버헤드는 줄이고, 빌드는 빠르게"라는 매력적인 서사가 있다. 저자는 이 서사가 건설 비용과 결정 비용을 혼동한다고 본다.
| 비용 | AI의 영향 | 전체 개발 비용에서의 비중 |
|---|---|---|
| construction cost (만드는 비용) | 크게 감소 | 20~30% |
| decision cost (무엇을 만들고 무엇을 자를지 결정하는 비용) | 거의 그대로 | 나머지 |
코드와 빌더가 늘어날수록 무엇을 만들지 결정하는 문제는 오히려 어려워진다. 따라서 AI-native 프로세스 최적화는 실행을 조율하는 데 쓰던 노력을 학습을 가속하는 쪽으로 돌리는 일이 된다.
학습 루프
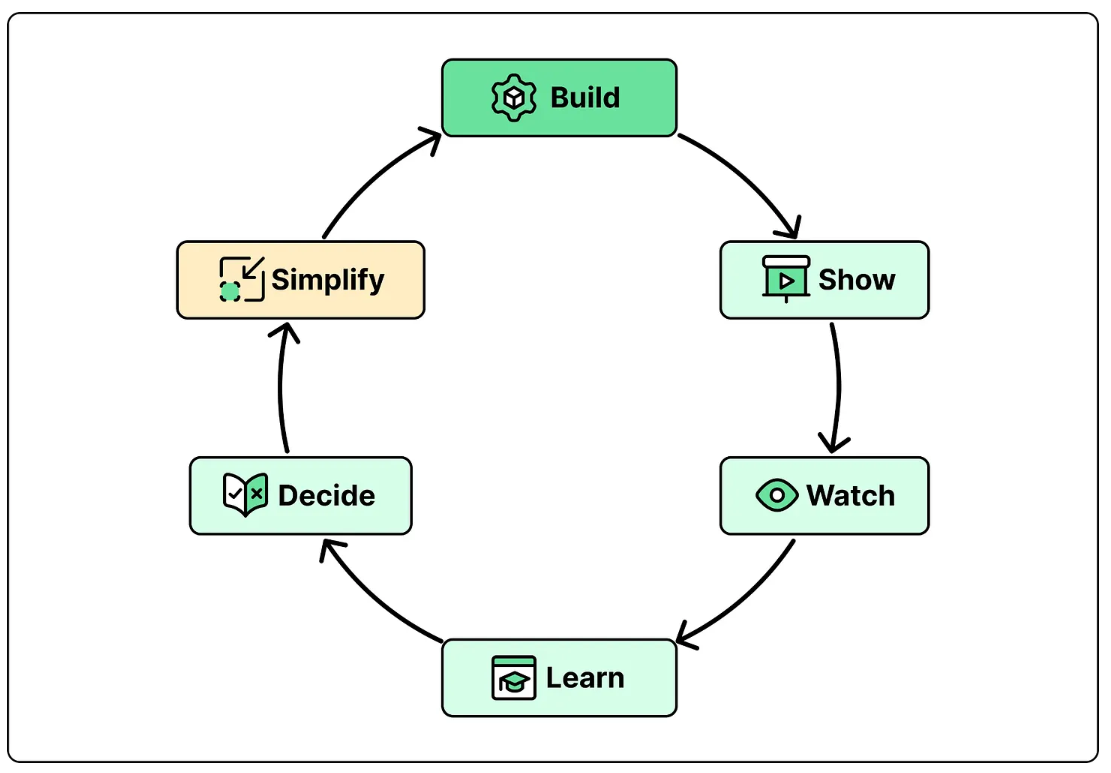
fig07의 여섯 단계 가운데 본문이 직접 설명하는 것은 첫 단계뿐이다. 본문은 "AI가 첫 단계를 크게 압축한다"고만 적고 그 단계가 Build라는 것과 나머지 다섯 단계의 이름은 도식에만 있다.
AI는 학습 루프의 첫 단계인 Build를 크게 압축한다. 그러나 압축의 가치는 나머지 순환, 즉 보여주고 관찰하고 배우고 결정하고 단순화하는 단계의 실행 품질에 전적으로 달려 있다. 사용자 관찰과 범위 규율 없이 빌드만 빨라지면 제품 목표에서 더 빨리 멀어지고, 고객은 AI 가속의 이득을 보지 못한다.
AI가 레버리지를 내는 네 영역
저자는 AI가 실제 레버리지를 만드는 곳을 네 영역으로 정리한다. 공통점은 AI가 판단이 아니라 실험과 정형 작업의 비용을 낮춘다는 것이다.
| 영역 | 내용 | 규율 |
|---|---|---|
| 값싼 실험 | 단위 시간당 더 많은 가설을 시험한다. 기능의 70% 이상이 실제 사용자에게 닿지 않으므로, 본격 개발 전에 그것이 중요한지 시험하는 비용이 거의 0이 된다 | 가망 없는 개념은 가차 없이 폐기 |
| 사용자 리서치용 빠른 프로토타이핑 | Vercel v0, Replit Agent, Bolt.new가 자연어에서 몇 분 만에 동작 프로토타입을 만든다. 동작 프로토타입이 문서를 대체하고 사용자 테스트 신호 품질을 높인다 | 빌드 전 프로토타이핑을 습관화 |
| 판단이 아닌 보일러플레이트 자동화 | AI는 scaffolding, 비신규 코드, 비즈니스 로직 테스트, 문서, 데이터 모델 같은 차별화되지 않는 일을 맡는다. 팀은 핵심 비즈니스 로직, 공감하는 사용자 경험, 신규 구현, keep-or-kill 결정에 집중한다 | 차별화 작업에 집중 |
| design to 50% 원칙 | 핵심 사용자 여정만 되는 최소 기능을 출시하고, 사용자가 망설이고 오해하고 이탈하는 지점을 관찰한다. 상상한 문제가 아니라 실제 제품 문제가 드러난다 | AI 덕에 비용이 거의 0 |
가드레일
저자는 가드레일이 더 이상 선택이 아니라고 본다. AI-native 개발 속도가 수동 보안 리뷰나 전통 도구가 대응하는 것보다 빠르게 새 공격면을 만들고 있기 때문이다. 저자 환경에서는 주당 약 1건의 새로운 insecure AI integration이 나타났고 다수가 production 인시던트로 이어졌다. 저자는 Anthropic의 Daybreak와 Mythos가 보안에 대한 분명한 경종이라고 적는데, 이 두 이름에 대한 설명은 글에 없다.
가드레일은 세 묶음 아홉 항목이다. 묶음 이름은 raw의 절 제목을 따르고, 개수는 각 절의 항목을 센 값이다.
| 묶음 (raw 절 제목) | 항목 수 | 다루는 대상 |
|---|---|---|
| Emerging Security Controls | 4 | 에이전트의 신원, 권한, 입력, 실행 환경 |
| Technical Guardrails | 3 | 코드 검사와 배포 게이트, 에이전트의 보안 지식 |
| Organizational Guardrails | 2 | 사람의 역량 유지와 조직 수준의 생산성 측정 |
실제 사고 4건
| 사고 | 경위 | 결과 |
|---|---|---|
| Chat Integration RCE | AI로 이틀 만에 구축. 2FA 우회와 열린 ACL(접근 제어 목록) 악용 | 원격 코드 실행(RCE). 탐지, 완화, 수정에 수십 시간 |
| Unauthorized Database Access | AI 코딩 에이전트가 적절한 인가 없이 보호된 DB 테이블 약 1,500개에 접근 | 민감 데이터가 prompt injection 위험에 노출 |
| Google Docs Prompt Injection | Google Docs 문서에 심긴 prompt injection이 입력 필터링을 완전히 우회 | 원격 코드 실행 |
| Supply Chain Poisoning (slopsquatting) | 2025년 등장. AI가 환각한 존재하지 않는 패키지명을 공격자가 악성 코드로 등록 | 문서화된 사고 다수 |
네 사고는 각각 다른 약점을 보여준다. 첫 번째는 빠른 구축이 접근 제어를 건너뛴 사례이고, 두 번째는 에이전트의 권한 범위가 통제되지 않은 사례이며, 세 번째는 외부 문서가 명령 통로가 된 사례이고, 네 번째는 모델의 환각이 공급망의 입구가 된 사례다.
신흥 보안 컨트롤 4종
| 컨트롤 | 내용 |
|---|---|
| agent identity and access control | step-up 2FA 도입. 최소 권한 원칙 적용. 공유 credential과 열린 ACL 금지. 수동적 읽기 전용 용도로 시작해 신뢰를 쌓은 뒤 읽기-쓰기나 더 넓은 접근으로 확장 |
| data classification awareness | 에이전트가 데이터 분류와 민감 경계를 존중해야 한다. "agentic authorization"은 에이전트가 사람의 감독이 따라잡지 못하는 기계 속도로 제약을 우회하는 신흥 엔터프라이즈 과제 |
| prompt injection protection | 문서, 웹 페이지, 사용자 입력 같은 외부 콘텐츠에 숨은 명령이 에이전트를 가로챌 수 있다. 입력 필터링, 콘텐츠 검증, 컨텍스트 정화를 적용한다. 신뢰할 수 없는 명령을 자동 실행하지 않고, 에이전트 제안을 모두 자동 수락하려는 유혹을 거부한다 |
| infrastructure sandboxing | 에이전트 활동을 관찰과 감사가 가능하게 한다. 설정, 핵심 실행, 핵심 저장소 같은 고위험 production 영역은 컨트롤이 검증될 때까지 차단한다. sandboxing과 OS 수준 강제를 쓴다 |
기술 가드레일 3종
| 가드레일 | 내용 |
|---|---|
| static analysis integration | AI 생성 스니펫의 보안 취약 비율은 Python 약 30%, JavaScript 약 25%다. 고급 정적 분석을 CI/CD 파이프라인에 중앙화한다. 인증, 결제, PII(개인식별정보) 처리 같은 핵심 기능은 사람 리뷰를 필수로 한다 |
| automated quality gates | "Ralph Loops", OpenClaw 등 자율 루프로 성공 기준을 충족할 때까지 반복 검증한다. diff 제출 전에 타입 검사, lint, 테스트를 실행한다. production 배포 전에 엄격한 게이트가 있는 다단계 canary를 둔다 |
| skills-based security | 에이전트에 안전한 코딩 패턴을 가르쳐 생성이 끝난 뒤가 아니라 생성 중에 흔한 취약점을 표시하게 한다. 저자는 이를 에이전트와 함께하는 shift left라 부른다 |
조직 가드레일 2종
| 가드레일 | 내용 |
|---|---|
| skill atrophy prevention | Gartner는 2026년까지 조직 50%가 "AI-free" 역량 평가를 요구하리라 보고한다. AI를 학습 도구로 삼아 생성 코드와 함께 설명을 요청하고, 가끔은 AI 없이 작업해 기초 능력을 보존한다. 목적은 러다이트가 아니라 AI 도구가 없거나 미묘하게 틀리지만 치명적일 수 있는 결과를 내는 날에 대비한 보험이다 |
| productivity paradox | AI 도구의 개인 생산성 이득은 팀과 회사 수준에서 실현되지 않는 경우가 많다. 코딩 속도가 아니라 end-to-end 사이클 타임과 기능 속도에 집중한다. 망가진 프로세스에 AI를 더하면 더 많은 코드를 더 빨리 만드는 망가진 프로세스가 된다 |
2026년 이후의 엔지니어
새 환경에서 번성하는 엔지니어는 AI를 실행의 협업 파트너로 대하면서 AI가 복제할 수 없는 시스템 사고, 비판적 판단, 소통 능력을 유지한다. AI는 기존 전문성을 대체하지 않고 증폭하므로, senior 엔지니어가 훨씬 나은 결과를 내는 이유는 더 깊은 컨텍스트와 더 날카로운 판단을 가져오기 때문이다.
저자는 도메인 전문성을 AI-native 생산성의 핵심 차별 요소로 본다. 어떤 AI 도구나 에이전트도 그것을 대체할 수 없으므로 수학, 과학, 금융, 보건, 법률 어느 분야든 도메인 역량을 갈고닦고 엔지니어링 기본기를 계속 끌어올리라고 권한다. 이 투자는 AI 효율성에 반복적으로 배당을 준다.
이 전환은 일회성 도구 도입이 아니라 여러 해에 걸친 변화다. 도구 업그레이드로 취급한 팀은 한결같이 생산성 이득을 얻지 못했고, 성공하는 조직은 AI-native engineering을 새로운 실천과 새로운 규율과 "훌륭함"의 새로운 정의를 가진 새로운 일하는 방식으로 대한다.
저자의 표현과 비유
이 글은 개념마다 짧은 표현을 붙여 기억하기 쉽게 만든다. 원문 표현과 그것이 가리키는 내용을 모으면 글의 뼈대가 드러난다.
| 원문 표현 | 등장 위치 | 가리키는 내용 |
|---|---|---|
| "code overload" | 도입부 (NYT 인용) | 너무 많은 코드가 너무 빨리 만들어져 감당할 수 없게 된 상태 |
| "faster failure" | 편집자 소개 | 실제 10x 레버리지와 대비되는, 더 빨리 실패하는 결과 |
| "USB-C for AI" | context engineering | MCP를 에이전트와 외부 도구를 잇는 범용 표준으로 보는 비유 |
| "garbage in, garbage out" | specification-driven development | 입력 명세 품질이 AI 코드 품질을 정한다는 원칙. AI 환경에서 더 강하게 작동 |
| "circular reasoning" | specification-driven development | 명세 없이 에이전트가 같은 자리를 맴도는 상태 |
| "context pollution", "slop" | problem decomposition | 복잡한 문제가 컨텍스트를 오염시켜 낮은 품질의 산출물이 나오는 상태 |
| "small loops with verification checkpoints" | Phase 2 Integration | 큰 자율 실행보다 나은, 검증 지점이 있는 짧은 반복 |
| "core currency" | 팀 전환 | 공유 컨텍스트 라이브러리가 팀의 핵심 자산이라는 뜻 |
| "TDD reincarnated" | ADLC Testing | 에이전트가 테스트 계획을 먼저 쓰는 방식이 TDD의 부활이라는 뜻 |
| "generalization principle" | ADLC Review | 한 건의 취약점에서 같은 유형을 선제 탐색하는 원칙 |
| "tribal knowledge" | Codify ADLC | 문서화되지 않고 일부 사람에게만 있는 지식. 인코딩으로 벗어나야 할 상태 |
| "seductive narrative" | AI-native 프로세스 | "사람은 적게, 오버헤드는 줄이고, 빌드는 빠르게"라는 업계 서사 |
| "design to 50%" | 레버리지 | 최소 기능으로 출시하고 사용자를 관찰하는 원칙 |
| "agentic authorization" | 보안 컨트롤 | 에이전트가 기계 속도로 제약을 우회하는 신흥 과제 |
| "shift left, but with agents" | 기술 가드레일 | 보안 검사를 생성 단계로 앞당기되 에이전트가 수행하게 하는 방식 |
| "Luddism" | 조직 가드레일 | skill atrophy 예방이 기술 거부가 아니라 보험이라는 설명에 쓰인 대비어 |
결과
이 글은 자체 실험이나 벤치마크가 없는 에세이다. 본문이 인용하거나 권고하는 수치를 한자리에 모으면 다음과 같다.
| 항목 | 값 | 출처 표기 (raw 기준) | 성격 |
|---|---|---|---|
| Google 신규 코드 중 AI 생성 비중 | 75% 초과 | 출처 없음 | 도입 통계 |
| OpenAI와 Anthropic 신규 코드 중 AI 생성 비중 | 거의 전부 | 두 회사의 주장으로 인용 | 도입 통계 |
| Amazon Java 8에서 17 이전 | production 앱 3만 개, 몇 달, 대체 추정 4,500 개발자-년 | 출처 없음 | 도입 통계 |
| AI 에이전트가 mid-level 엔지니어로 일하는 시점 | 2026년 말 | Mark Zuckerberg 예상 | 도입 통계 |
| 코딩이 엔지니어링에서 차지하는 비중 | 최대 20~30% | 저자 주장 | 1인칭 |
| context engineering 실천 팀의 속도 향상 | 40~50% | "Teams practicing rigorous context engineering report" | 정성 보고 |
| AI 생성 코드의 보안 결함 비율 | 약 45% | "Research consistently shows" | 출처명 없음 |
| AI 보조 개발자의 코드 보안성 | 훨씬 덜 안전, 더 확신 | Stanford 연구 | 정성 |
| 경력 오픈소스 개발자의 AI 사용 시 속도 | 19% 감속 (익숙한 코드베이스) | METR/Anthropic RCT | 정량 |
| AI 보조 코드베이스의 code churn | 증가 (방향만) | GitClear 연구 | 정성 |
| AI가 맡는 정형 구현 비중 | 70~80% | 저자 권고 | 1인칭 |
| 시간 배분 | 컨텍스트 40%, 생성과 테스트 20%, 리뷰와 검증 40% | 저자 권고 | 1인칭 |
| Foundation 기간 | 2주 정도 | 저자 권고 | 1인칭 |
| Integration 기간 | 최대 1개월 | 저자 권고 | 1인칭 |
| Mastery 목표 지표 | AI 생성 코드 80% 이상, 재작성률 20% 미만 | 저자 권고 | 1인칭 |
| 전환 성공 중 운영과 문화 변화의 기여 | 70% | "Research shows" | 출처명 없음 |
| 심리적 안전이 AI 성공을 높인다고 본 리더 비율 | 83% | MIT 연구 | 정량 |
| 빌드 비용이 전체 개발 비용에서 차지하는 비중 | 20~30% | 저자 주장 | 1인칭 |
| 실제 사용자에게 닿지 못하는 기능 비율 | 70% 초과 | 출처 없음 | 정량 |
| 환경 내 신규 insecure AI integration 빈도 | 주당 약 1건, 다수가 production 인시던트 | 저자 관찰 | 1인칭 |
| Chat Integration RCE | 구축 2일, 수습 수십 시간 | 익명 사례 | 1인칭 |
| Unauthorized Database Access | 보호된 테이블 약 1,500개 접근 | 익명 사례 | 1인칭 |
| Python AI 스니펫의 보안 취약 비율 | 약 30% | "Data shows" | 출처명 없음 |
| JavaScript AI 스니펫의 보안 취약 비율 | 약 25% | "Data shows" | 출처명 없음 |
| 2026년까지 "AI-free" 역량 평가를 요구할 조직 비율 | 50% | Gartner 보고 | 정량 |
표가 보여주는 것은 근거의 성격이 세 층으로 나뉜다는 점이다. 이름이 붙은 외부 인용은 NYT를 제외하면 다섯 건(Stanford, METR/Anthropic, GitClear, MIT, Gartner)이고, 출처명 없는 인용("research consistently shows", "research shows", "data shows")이 세 건이며, 나머지는 저자의 권고와 관찰이다. 따라서 이 글의 수치는 저자의 처방을 뒷받침하는 예시로 읽어야 하며, 인용 연구의 원문을 확인하지 않고 독립된 증거로 쓰기는 어렵다.
한계
저자가 명시한 단서
- 작은 human-in-the-loop 루프가 큰 자율 실행을 앞선다는 증거는 "at least for coding tasks"라는 단서로 적용 범위를 코딩 작업에 한정한다.
- Building 단계에서 에이전트가 junior나 mid-level 수준이라는 판단은 "at the time of this writing" 기준이며, 1~2년 안에 senior 수준으로 오르리라는 것은 저자 예상이다.
- Claude나 Codex 제작사의 권고는 상황이 크게 다를 수 있으므로 맹목적으로 따르지 말고 자기 필요에 맞게 조정하라고 명시한다.
- 주당 약 1건의 insecure AI integration은 "in our environment"에 한정한 저자 관찰이다.
- 조직 변환, 리더십 모델, 측정 프레임워크는 2부 "AI-Native Leaders"로 미룬다. 이 자료에는 2부 내용이 없다.
자료에 기술이 없어 확인할 수 없는 것
| 항목 | 없는 것 |
|---|---|
| 인용 출처 | Stanford, METR/Anthropic, GitClear, MIT, Gartner 인용에 링크, 논문 ID, 연도가 없다. 링크가 있는 것은 NYT 기사뿐이다 |
| 정량 주장의 측정 방법 | 40~50% 속도 향상, 45% 보안 결함, 70% 문화 기여, Python 30%와 JavaScript 25%의 측정 방법론과 통제군이 없다. ADLC가 전통 SDLC보다 낫다는 비교 실험도 없다 |
| 목표 지표의 정의 | "AI 생성 코드 80%"의 집계 단위(제안 채택, 무수정 채택, 함수 단위)와 "재작성률 20%"의 기준(라인 diff, 의미 단위)이 없다 |
| 40/20/40의 적용 조건 | 도메인, 코드베이스 친숙도, 작업 길이에 따른 변동을 논하지 않는다. METR의 19% 감속을 익숙한 코드베이스 조건으로 인용하면서 80% 목표가 그 조건에서 성립하는지는 다루지 않는다 |
| OpenClaw의 귀속 | 에세이는 "OpenClaw of Claude"라 적는다. 이 wiki의 다른 자료(RoboClaw: An Agentic Framework for Scalable Long-Horizon Robotic Tasks, Harness Engineering (Team Attention, 2026))에서는 OpenClaw가 Claude와 별개의 에이전트 프레임워크 이름으로 등장한다. 어느 표기가 맞는지 이 자료만으로는 판정할 수 없다 |
| Daybreak와 Mythos | 보안 경종으로 언급할 뿐 설명이 없다. Mythos는 이 wiki의 OpenAI, GPT-5.6 Sol·Terra·Luna 프리뷰 공개: 새 네이밍 체계와 강화된 안전 스택에서 Claude 모델명(Claude Mythos 5)으로 등장하고, Daybreak는 이 wiki에 다른 기술이 없다 |
| 사고 4건의 세부 | 조직, 기술 스택, 효과가 있었던 완화책이 익명화되어 없다 |
| slopsquatting 방어 | 패키지 allow-list나 게시일 임계값 같은 구체 컨트롤을 적지 않는다 |
| Codify ADLC의 거버넌스 | 스스로 진화하는 컨텍스트 파일과 skill library의 권한, 버전, 롤백, 팀 간 충돌 해소 방법이 없다 |
자료 안의 긴장
Phase 2에서 "범위를 제한한 작은 루프가 큰 자율 실행을 앞선다"고 하면서 automated quality gates에서는 "Ralph Loops"나 OpenClaw 같은 자율 루프를 권한다. 저자는 두 서술의 관계를 직접 설명하지 않는다. 자율 루프는 성공 기준이 정해진 검증 반복이라는 점에서 계획 없는 추측성 자율 실행과 구분된다고 읽을 수 있으나, 이는 독자 해석이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| AI-native engineering | 현재와 미래의 AI 에이전트와 도구를 지휘하고 통달해 AI 이전 시대에는 불가능했던 것을 만드는 일. 코딩 능력을 전제로 하며 vibe coding과 범주가 다르다 |
| synchronized context engineering | 아키텍처 다이어그램, 코딩 표준, 비즈니스 규칙, 팀 관례, 개발 워크플로를 팀 전체가 재사용하는 형태로 AI working memory에 주입하는 실천. 이 글이 꼽는 가장 중요한 단일 스킬 |
| ADLC | Agentic Development Life Cycle. Planning, Building, Testing, Review 순환에 Documentation과 Codify ADLC를 더해 전통 SDLC를 재정의한 운영 프레임 |
| agent swarm | 같은 작업에 역할이 다른 여러 에이전트를 투입해 서로 견제하게 하는 구성. planning, building, testing, review 에이전트가 서로를 challenge한다 |
| generalization principle | Review 단계에서 한 건의 이슈가 발견되면 같은 유형이 다른 곳에도 있다고 보고 선제적으로 찾는 원칙 |
| slopsquatting | AI가 환각한 존재하지 않는 패키지명을 공격자가 등록해 악성 코드를 배포하는 2025년 신종 공급망 공격 |
관련 페이지
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26): Claude Code의 CLAUDE.md 계층, 스킬, 서브에이전트, MCP,
/goal을 실무 절차로 푼 가이드. 이 글이 컨텍스트 파일과 MCP를 핵심 인프라로 보는 관점의 도구 수준 대응물이며, 이 글이 이름만 언급한 "Ralph Loop"를 완료 조건이 충족될 때까지 자율 반복하는 루프로 정의한다. - Loop Engineering (Addy Osmani, 2026-06-07): 에이전트를 반복 구동하는 루프 자체를 설계 대상으로 삼는 에세이. 구현 에이전트와 평가 에이전트를 분리하는 verification distance가 이 글의 agent swarm 상호 견제와 같은 지향이다.
- Harness Engineering (Team Attention, 2026): harness 설계를 구조, 맥락, 계획, 실행, 검증, 개선 여섯 단계 순환으로 제시한 한국어 자료. 같은 GPT-5.2-Codex 모델에서 harness만 바꿔 TerminalBench가 52.8에서 66.5로 오른 LangChain 사례를 인용하며, 이 글의 "같은 모델과 도구인데 결과가 갈린다"는 명제와 같은 방향의 정량 사례다.
- The New SDLC With Vibe Coding: From ad-hoc prompting to Agentic Engineering: vibe coding에서 agentic engineering까지의 스펙트럼과 "Agent = Model + Harness" 방정식으로 SDLC 재편을 다룬 백서. 이 글의 ADLC와 같은 문제를 다른 프레임으로 다룬다.
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 변경의 효과(agent 안쪽 변동 5.1%p)가 agent 사이 base capability 격차(36.0%p)보다 작다는 정량 결과. 이 글이 격차의 원인을 오케스트레이션에서 찾는 것과 대조되는 시각이다.
- Karpathy LLM Wiki 패턴: 한국어 종합 정리 (kmyu99 Notion): 지식 베이스 유지의 실제 장벽이 북키핑이라는 통찰. 이 글 ADLC의 Documentation 단계(사후 문서화에서 연속 생성으로)와 같은 문제를 다룬다.