Agents · PAPER · 2026
SkillOpt: Executive Strategy for Self-Evolving Agent Skills
SkillOpt: Executive Strategy for Self-Evolving Agent Skills
요약
SkillOpt은 frozen 상태의 에이전트가 참조하는 skill 문서 한 장을 딥러닝 옵티마이저의 규율로 훈련하는 방법이다. skill 문서는 실행 전에 에이전트 context에 삽입되는 자연어 정책을 말한다. 이 논문은 그 문서를 프롬프트의 부산물이 아니라 학습 대상, 즉 external state로 놓고, 별도 optimizer 모델이 채점된 실행 기록을 bounded add/delete/replace 편집으로 변환하게 한다. 편집은 held-out 검증 점수를 엄격히 올릴 때만 수용된다.
성과는 넓게 측정됐다. 6개 벤치마크와 7개 target 모델, 3개 실행 harness(direct chat, Codex, Claude Code)가 만드는 52개 셀 전부에서 best 또는 tied-best다. GPT-5.5 direct chat의 6개 벤치마크 평균은 58.8%에서 82.3%로 23.5%p 올랐고, 셀마다 6개 경쟁 방법 중 최선을 골라 만든 oracle 베이스라인보다도 5.4%p 앞선다. 배포되는 산출물은 300~2,000 토큰 크기의 best_skill.md 파일 하나이며, 추론 시점에 추가되는 모델 호출은 없다.
배경
frontier 모델은 이제 단일 프롬프트 호출로 쓰이지 않는다. 도구와 파일, verifier를 갖춘 다단계 harness 안에서 여러 스텝을 밟는 에이전트로 배포된다. harness는 모델을 감싸 도구와 검증, 상태를 제공하는 실행 환경을 뜻한다.
이 환경에서 도메인 적응의 대상이 달라진다. 가중치나 프롬프트만이 아니라 에이전트가 증거를 모으고 도구를 부르고 도메인 관례를 따르고 출력을 포맷하는 절차 자체를 개선해야 한다. skill 문서가 이 절차 적응의 자연스러운 인터페이스다. 절차와 도메인 heuristic, tool 정책, 출력 제약, 실패 모드를 이식 가능한 자연어 산출물 하나에 담을 수 있기 때문이다.
문제는 그 문서를 만드는 방식이었다. 지금까지의 skill은 사람이 손으로 쓰거나, 과제 설명만 보고 한 번에 생성되거나, 느슨하게 통제된 self-revision으로 진화했다. 어느 쪽도 skill에 대한 딥러닝 옵티마이저처럼 동작하지 않았고, 피드백을 받고도 시작점보다 나아진다는 보장을 주지 못했다. 닫힌 frontier 모델에서는 가중치 적응이 아예 불가능하고 개방 모델에서도 비싸다는 사정이 겹친다.
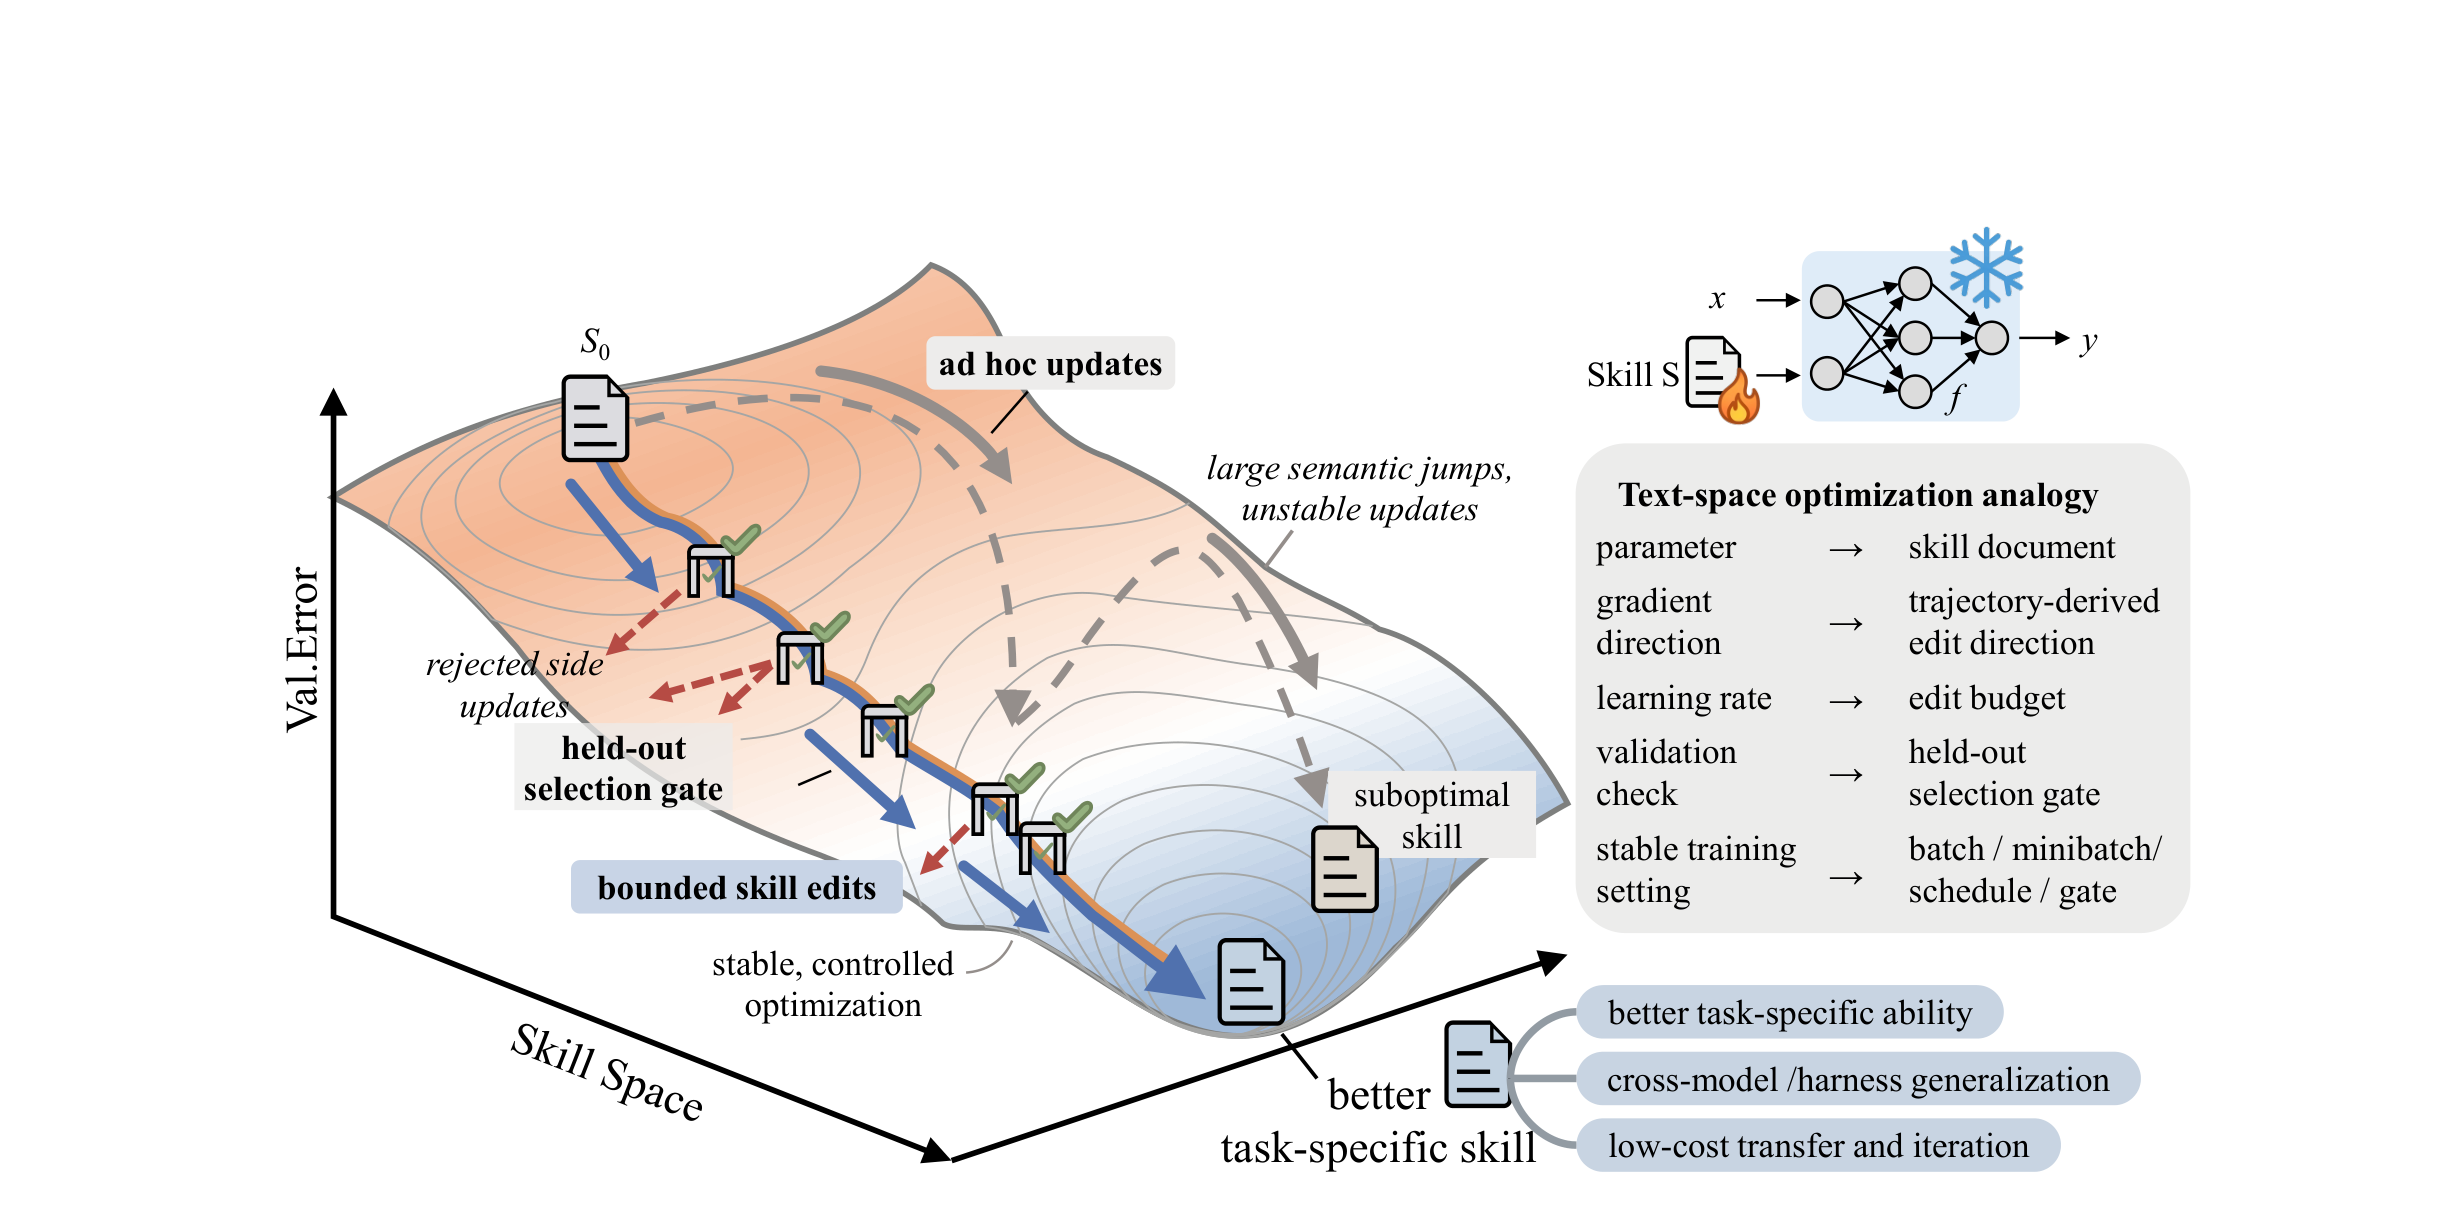
저자들의 출발 가설은 skill 편집을 통제 가능한 도메인 적응 과정으로 다루는 것이다. skill 문서를 external state로, 추가 frontier 모델을 optimizer로 두고, 증거와 보폭, 검증, 갱신 방향에 훈련 방식의 통제를 적용한다.
핵심 개념
external state. SkillOpt이 학습시키는 대상은 모델 가중치가 아니라 모델 밖에 놓인 텍스트 문서다. target 모델은 얼어 있고, 적응은 그 문서가 바뀌면서 일어난다. 그래서 배포 시점에 가중치 갱신도, 추가 모델 호출도 필요 없다.
edit budget. 한 최적화 스텝에서 skill 문서에 적용할 수 있는 최대 편집 수를 말한다. 이 값이 딥러닝의 learning rate 역할을 한다. 값이 크면 한 번에 많이 바뀌고 작으면 조금 바뀐다.
held-out selection gate. 후보 skill을 selection split에서 평가해, 현재 점수를 엄격히 넘을 때만 수용하는 검증 관문이다. 동점은 거부한다.
rejected-edit buffer. 거부된 편집과 그 편집이 유발한 점수 하락을 담아 두는 epoch 단위 저장소다. 같은 epoch의 이후 reflection 호출이 이를 읽어 실패한 편집을 반복하지 않는다.
ablation. 구성 요소를 하나씩 제거하거나 값을 바꿔 그 요소가 성능에 기여한 몫을 재는 실험을 말한다.
딥러닝 유추
논문은 딥러닝 최적화의 각 부품을 텍스트 공간의 대응물로 옮긴다. 이 대응은 비유에 그치지 않고 실제 구현 구조를 결정한다.
| 딥러닝 | SkillOpt의 텍스트 공간 대응물 | 하는 일 |
|---|---|---|
| parameter | skill document | 학습으로 바뀌는 상태 |
| gradient direction | trajectory에서 유도한 edit direction | 어느 쪽으로 바꿀지 |
| learning rate | edit budget L_t |
한 스텝에 얼마나 바꿀지 |
| validation check | held-out selection gate | 바꾼 결과를 받아들일지 |
| stable training setting | batch, minibatch, 스케줄, gate | 학습을 안정화하는 설정 |
rollout과 reflection batch 크기는 편집 근거에 섞인 noise를 조절한다. textual learning rate와 그 스케줄은 새 skill 버전이 이전 버전에서 얼마나 멀어질 수 있는지를 통제한다. epoch 단위 slow/meta update는 momentum처럼 안정적인 편집 방향을 epoch 너머로 전달한다.
이 안정성이 왜 필요한지에는 구체적 이유가 있다. 연속된 개정이 너무 멀리 또는 일관되지 않게 움직이면, 거부된 편집과 수용된 편집의 이력이 최적화 신호로서 의미를 잃는다. bounded하고 gate를 통과한 갱신만 허용하면 각 개정이 직전 버전과 충분히 가까워, 이후 optimizer 호출이 무엇이 도왔고 무엇이 실패했으며 무엇을 지켜야 하는지 학습할 수 있다.
방법
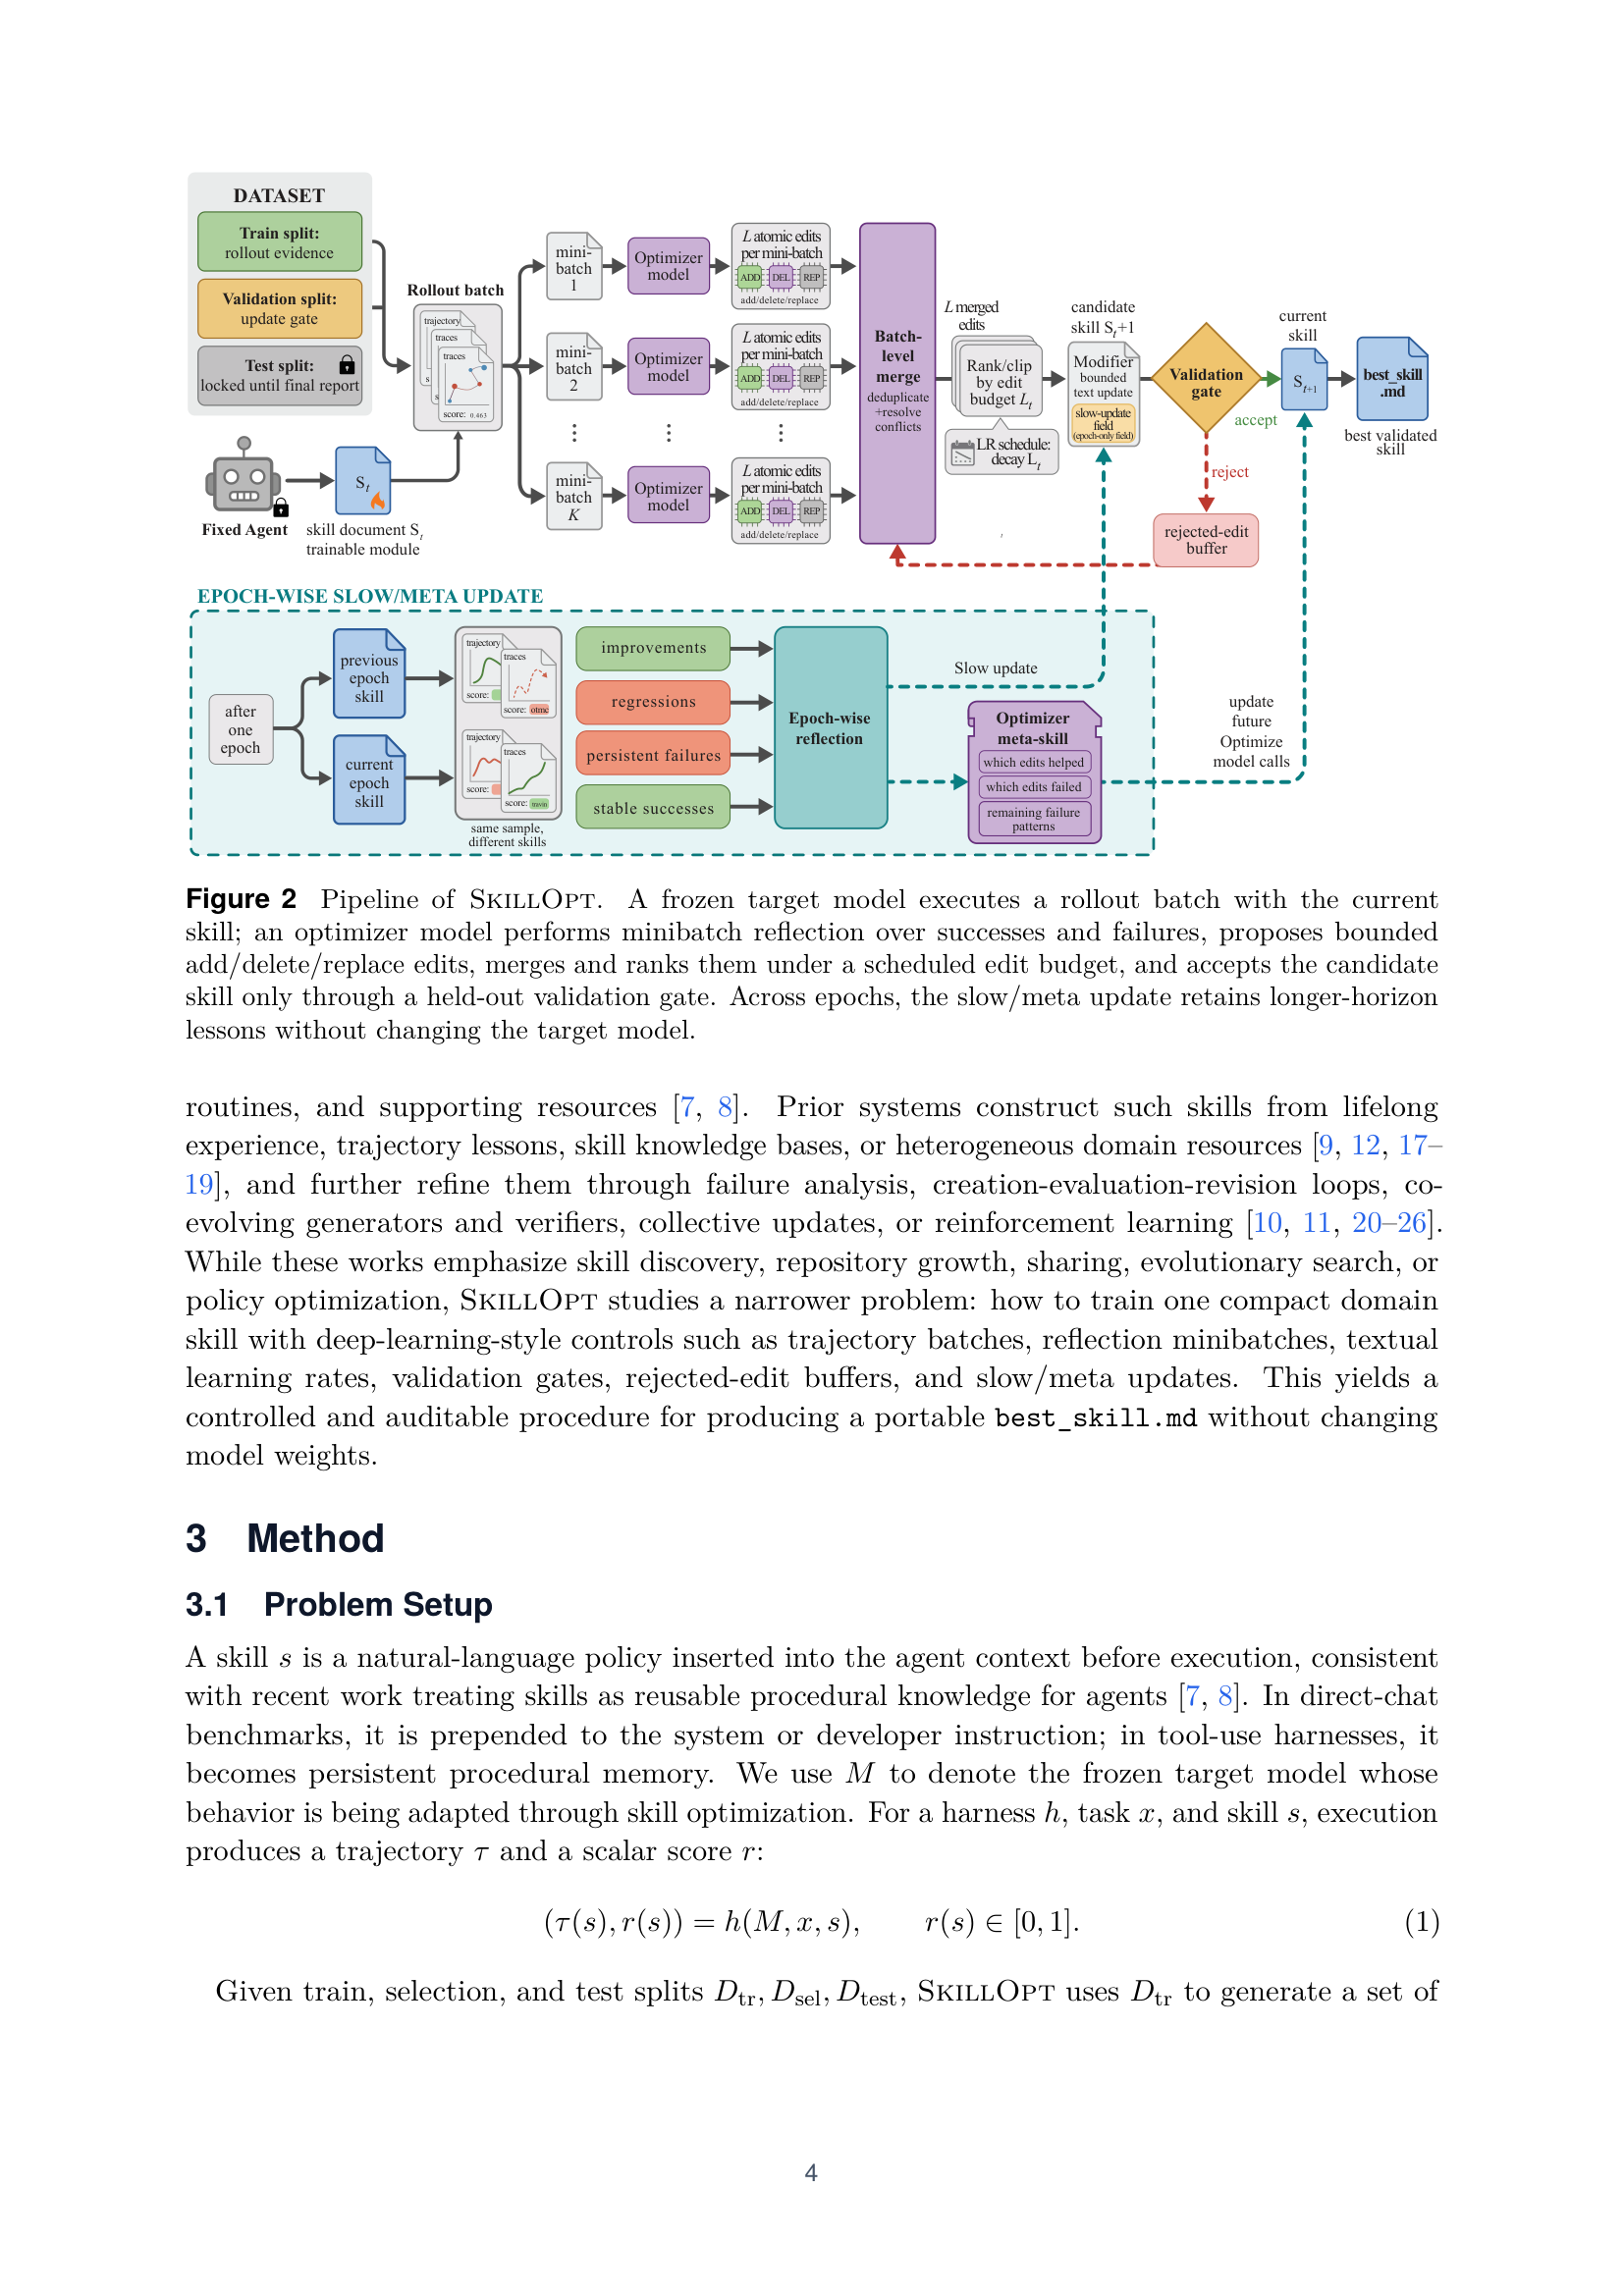
SkillOpt의 한 스텝은 rollout으로 증거를 모으고, reflection으로 편집을 제안하고, 예산 안에서 편집을 고르고, gate로 수용 여부를 판정하는 순서다. epoch 경계에서 두 스텝이 추가된다.
문제 설정과 3-split
skill s는 실행 전 에이전트 context에 삽입되는 자연어 정책이다. direct-chat 벤치마크에서는 system 또는 developer 지시 앞에 붙이고, tool-use harness에서는 persistent procedural memory가 된다.
frozen target 모델 M과 harness h, task x에 대해 한 번의 실행은 trajectory τ와 스칼라 점수 r∈[0,1]을 낸다. trajectory는 세션 하나의 실행 기록 전체를 말한다.
데이터는 세 부분으로 나뉘고 역할이 서로 겹치지 않는다.
| split | 역할 |
|---|---|
D_tr |
rollout 증거를 공급한다. 후보 skill이 여기서 만들어진다 |
D_sel |
후보 skill의 수용과 거부를 판정한다. 편집 승인 외의 용도로 쓰지 않는다 |
D_test |
최종 보고에만 쓴다. 그전까지 잠가 둔다 |
optimizer 상태는 현재 skill, 검증을 통과한 best skill, skill 해시 캐시, epoch 단위 rejected-step buffer, 옵션인 slow/meta-update 상태를 담는다. 밖으로 내보내는 것은 best accepted skill 하나뿐이고 파일명은 best_skill.md다.
rollout 증거 수집
매 최적화 스텝에서 target 모델이 현재 skill을 들고 D_tr의 rollout batch를 실행한다. harness는 task 메타데이터, 메시지, tool call, 관찰, 명령 출력, 최종 답, verifier 피드백을 기록하고, 여기에 spreadsheet preview나 문서 참조, 압축된 실행 trace 같은 벤치마크별 context를 더한다.
이 batch가 증거 단위다. 작은 batch는 빠르게 갱신하지만 noisy하고, 큰 batch는 skill을 바꾸기 전에 반복 패턴을 더 많이 드러낸다. 구현은 accumulation도 지원한다. 여러 rollout batch를 따로 reflect한 뒤 하나의 갱신으로 병합하면 실행 처리량과 갱신 빈도를 분리할 수 있다.
minibatch reflection과 편집 제안
optimizer 모델이 trajectory를 skill 편집으로 바꾼다. 먼저 실패와 성공을 분리하고 각 그룹을 reflection minibatch로 나눈다.
minibatch 단위로 보는 이유는 관찰의 성격이 달라지기 때문이다. 단일 trajectory는 그 사례에만 맞는 일화적 수정을 낳는다. 반면 여러 trajectory를 함께 보면 재사용 가능한 절차적 오류가 드러난다. 에이전트가 계속 엉뚱한 소스를 검색하거나, 잘못된 포맷으로 답을 쓰거나, tool 결과를 검증하지 않고 넘어가는 패턴이 그 예다.
실패 minibatch는 빠진 규칙이나 교정 규칙을 제안하고, 성공 minibatch는 이미 동작하는 행동을 보존한다. 병합은 위계적이다. 실패 기반 편집과 성공 기반 편집을 각각 먼저 통합한 뒤, 실패 교정에 우선순위를 두고 둘을 합친다. 이 단계에서 중복과 상충, 특정 예시에만 맞는 제안이 걸러진다.
edit budget으로 보폭 제한
learning rate의 대응물은 edit budget L_t다. 집계가 끝나면 optimizer 모델이 병합된 편집 풀을 기대 효용으로 랭킹해 상위 L_t개만 남긴다.
이 제한이 ad hoc 프롬프트 rewriting과의 결정적 차이다. 무제한 rewrite는 유용한 규칙을 지우거나 상충하는 지시를 삽입하거나 국소 실패에 overfit하기 쉽다. 반면 bounded update는 이전 버전과의 연속성을 지키면서도 skill이 새 절차를 습득하게 한다.
스케줄은 네 가지를 지원한다. constant, linear, cosine, autonomous이며 기본값은 cosine이다. cosine 스케줄은 큰 편집으로 시작해 작은 통합 스텝으로 감쇠한다.
patch mode에서 편집은 네 가지 국소 연산으로 표현된다.
| 편집 연산 | 뜻 |
|---|---|
append |
skill 문서 끝에 내용을 추가한다 |
insert_after |
지정한 헤딩이나 문장 뒤에 삽입한다 |
replace |
지정한 텍스트를 새 텍스트로 교체한다 |
delete |
지정한 텍스트를 제거한다 |
병합된 편집마다 두 개의 메타데이터가 붙는다. support_count는 그 편집을 지지한 원본 patch의 수이고, source_type은 실패 분석과 성공 분석 중 어디서 나왔는지다. 덕분에 랭킹이 독립적 분석과 위계적 병합을 모두 통과한 편집을 선호할 수 있다. rewrite mode에서는 선택된 제안이 skill 전체 rewrite의 조건이 된다. 어느 mode에서도 스텝 단위 편집은 보호된 slow-update 필드를 덮어쓰지 못한다.
validation gate와 rejected-edit buffer
모든 후보 skill을 D_sel에서 같은 frozen target 모델과 같은 harness로 평가한다. 현재 selection 점수를 엄격히 넘으면 새 현재 skill이 되고, 지금까지의 best도 넘으면 best_skill.md가 된다. 그렇지 않으면 거부한다.
동점을 거부하는 설계에는 목적이 있다. 점수가 같은 편집을 받아들이면 배포 skill이 성능 근거 없이 조용히 표류하기 때문이다. 이 gate가 reflection을 무조건적 self-editing에서 propose-and-test 최적화로 바꾼다. 텍스트로는 그럴듯한 진단도 실제 target 모델에는 해로울 수 있으므로 필요한 장치다.
거부된 갱신도 버리지 않는다. optimizer는 관찰된 실패 패턴과, 거부된 스텝에 대해서는 시도한 편집과 그것이 유발한 점수 하락을 epoch 단위 buffer에 기록한다. 같은 epoch의 이후 reflection 호출이 이 buffer를 받으므로 optimizer 모델은 실패한 편집을 반복하지 않고 미해결 실패에 집중한다. 이 negative feedback은 훈련 중에만 작동하며 추론 비용을 늘리지 않는다.
편집 관측성도 함께 설계됐다. 매 스텝이 편집별 accept 또는 skip 상태를 담은 edit_apply_report.json을 남기므로, best_skill.md의 모든 변경 출처를 사후에 복원할 수 있다.
epoch 단위 slow update와 meta skill
빠른 갱신이 현재 batch에서 배우는 데 비해, epoch 단위 갱신은 인접한 두 epoch를 비교해 배운다. epoch가 끝나면 같은 학습 항목을 이전 epoch의 skill과 현재 skill로 각각 실행하고 결과를 네 부류로 나눈다.
| 분류 | 뜻 |
|---|---|
| improvements | 이전 epoch에서 실패했는데 현재 skill로 성공한 항목 |
| regressions | 이전 epoch에서 성공했는데 현재 skill로 실패한 항목 |
| persistent failures | 두 skill 모두에서 실패한 항목 |
| stable successes | 두 skill 모두에서 성공한 항목 |
optimizer 모델은 이 비교를 읽고 보호된 slow-update 필드에 간결한 종단(longitudinal) 지침 블록을 쓴다. 이 후보 역시 같은 validation gate를 통과해야 수용된다. 보호 영역은 SLOW_UPDATE_START와 SLOW_UPDATE_END 마크업으로 구분되며, 스텝 단위 프롬프트는 이 영역을 건드릴 수 없고 epoch 경계 프로세스만 다음 경계에서 다시 쓸 수 있다.
meta skill은 optimizer 쪽에만 존재하는 별도 메모리다. 어떤 편집 패턴이 도왔고 무엇이 거부됐고 어떤 실패가 epoch를 넘어 지속됐는지를 요약해, 이후 optimizer 프롬프트의 reflection과 병합, 랭킹 단계 앞에 붙인다. 배포 skill에는 실리지 않는다. 이 분리 덕분에 배포본은 compact하고 이식 가능한 상태로 남고, 훈련은 풍부한 편집 이력의 이득을 본다.
harness 독립 배포
경량 adapter 인터페이스가 harness 독립성을 만든다. adapter는 train과 평가 batch를 구성하고 현재 skill을 에이전트 context에 주입하고 native harness를 실행해 채점된 trajectory를 돌려준다. 같은 옵티마이저가 direct QA와 spreadsheet 실행, 문서 추론, 멀티모달 QA, embodied 환경, Codex 및 Claude Code 실행 루프에 모두 동작한다.
| harness | 실행 방식 |
|---|---|
| direct chat | 단일 chat completion 호출로 target 모델을 부른다. skill을 system 프롬프트 앞에 붙인다 |
| Codex | codex CLI를 workspace-write sandbox에서 구동한다. 현재 skill을 task별 SKILL.md로 렌더하고, 압축 실행 trace codex_trace_summary.txt를 teacher reflection context에 포함시켜 optimizer가 최종 답이 아니라 에이전트의 실제 행동에서 배우게 한다 |
| Claude Code | claude CLI로 같은 workspace 계약을 미러링한다 |
세 모드 모두 동일한 best_skill.md 포맷을 소비한다. 이것이 뒤에 나오는 cross-harness 전이 실험이 성립하는 근거다.
최적화 절차와 프롬프트 계약
부록의 Algorithm 1이 실험에 쓴 절차를 펼쳐 놓는다. 상태 변수는 현재 skill s_cur, 검증을 통과한 best skill s_best, selection 점수 캐시 C, 거부 편집과 관찰된 실패 패턴을 담는 스텝 buffer B, optimizer 쪽 meta skill m_meta다. 후보 skill의 해시가 캐시에 있으면 재평가하지 않고 캐시 점수를 재사용해 rollout 비용을 줄인다. slow update와 optimizer memory는 두 번째 epoch부터 작동한다.
optimizer는 JSON 출력을 요구하는 8개 프롬프트 계약으로 구성된다. 파싱과 필터링, 적용, 검증을 사람 개입 없이 자동화하기 위한 설계다.
| 프롬프트 | 역할 |
|---|---|
analyst_error.md |
실패 minibatch에서 공통 실패 패턴을 찾아 최대 L개의 편집을 제안한다. task 특정 값의 하드코딩을 금지한다 |
analyst_success.md |
성공 minibatch에서 일반화 가능한 행동 패턴을 찾되 skill에 이미 있는 내용은 제안하지 않는다 |
merge_failure.md |
실패 기반 patch들을 중복 제거하고 충돌을 해소해 하나로 병합한다. 여러 patch에 반복 등장한 편집을 높은 우선순위로 보존한다 |
merge_success.md |
성공 기반 patch를 보수적으로 병합한다 |
merge_final.md |
실패 기반과 성공 기반 두 묶음을 최종 병합한다. 실패 patch가 우선한다 |
ranking.md |
편집 풀을 랭킹해 예산만큼 고른다 |
slow_update.md |
epoch 경계에서 종단 비교를 읽고 보호 영역 지침을 다시 쓴다. 이전 지침의 효과를 먼저 반성한다 |
meta_skill.md |
이후 optimizer 호출을 위한 optimizer 쪽 메모리를 갱신한다. target 모델용 지시는 쓰지 않는다 |
랭킹 기준은 우선순위 순서로 정해져 있다.
| 순위 | 기준 | 뜻 |
|---|---|---|
| 1 | systematic impact | 여러 task에 걸친 반복 실패 패턴을 다루는 편집이 최상위다. 실패의 절반을 고치는 규칙이 단일 경계 사례를 고치는 규칙을 앞선다 |
| 2 | complementarity | 기존 skill의 빈틈을 채우는 편집이 중복 편집보다 높다 |
| 3 | generality | 특정 질문 유형이나 개체에 묶이지 않은 일반 원칙이 높다 |
| 4 | actionability | 모호한 조언보다 구체적이고 실행 가능한 지침이 높다 |
구현이 따르는 설계 원칙도 다섯 가지로 정리된다. task 실행 모델은 고정하고 텍스트 skill만 바꾼다. 모든 후보 skill은 수용 전에 selection split에서 평가한다. minibatch 분석은 위계적으로 병합해 최종 편집이 단일 사례가 아니라 반복 증거를 대표하게 한다. edit budget은 learning rate 대응물로서 초기의 큰 변경과 후기의 작은 정련을 함께 허용한다. 배포 skill은 경량이고 검사 가능한 상태로 유지하고 optimizer 쪽 meta skill은 분리해 둔다.
실험 설정
벤치마크
벤치마크 6종은 상호작용 형태가 의도적으로 다양하다. 단일 라운드 QA에서 실제 런타임을 쓰는 멀티턴 코드 생성, persistent embodied 상호작용까지 걸쳐 있다.
| 벤치마크 | 과제 성격 | 상호작용 규모 |
|---|---|---|
| SearchQA | 추출형 질의응답 | 단일 라운드 |
| SpreadsheetBench | spreadsheet 지향 코드와 tool use | 최대 30 턴, 실제 openpyxl/pandas 런타임, 기본 mode=multi |
| OfficeQA | 로컬 문서 추론 | 멀티턴 tool 루프, 최대 24회 tool call |
| DocVQA | 멀티모달 문서 추론 | 단일 라운드 |
| LiveMathematicianBench | 수학 다지선다 추론 | 단일 라운드 |
| ALFWorld | 순차적 의사결정 | episode당 최대 50 스텝, persistent embodied 상호작용 |
표에서는 LiveMathematicianBench를 LiveMath로 줄여 쓴다. 채점은 각 벤치마크의 native evaluator를 그대로 쓰고 hard score 또는 exact-match accuracy를 held-out test split에서 보고한다.
모델과 데이터 분할
target 모델은 GPT 계열 5종(GPT-5.5, 5.4, 5.4-mini, 5.4-nano, 5.2)과 Qwen 계열 2종(Qwen3.5-4B, Qwen3.6-35B-A3B)이다. frontier 규모부터 소규모까지 포함해, 이득이 큰 모델에만 나타나는지 확인할 수 있다.
dataset 기반 실행은 같은 dataset seed(split_seed=42)에서 유도한 결정적 train/selection/test 분할을 쓴다. selection split은 후보 skill 편집을 수용하거나 거부하는 데만 쓰고, 보고 점수는 전부 분리된 held-out test split에서 계산한다. 따라서 보고 수치는 validation-set fit이 아니라 일반화를 측정한다.
분할 비율에 대해서는 논문 안에서 두 값이 엇갈린다. 부록 C는 벤치마크별 분할이 명시되지 않으면 2:1:7을 기본으로 쓴다고 두 번 적는데, Table 2 패널 (a)의 캡션은 같은 ablation의 분할을 4:1:5로 적는다. 재현을 시도할 때는 두 값을 모두 확인해야 한다.
기본 하이퍼파라미터
| 항목 | 기본값 |
|---|---|
| epoch 수 | 4 |
| rollout batch size | 스텝당 40 |
| reflection minibatch size | 8. analyst worker 16개가 reflection을 병렬 실행하고 merge batch size는 8이다 |
textual learning rate L_t |
4, cosine 감쇠, floor 2 |
| 스케줄 선택지 | constant, linear, cosine, autonomous |
| validation gate | held-out. 현재 selection 점수보다 엄격히 커야 수용하고 동점은 거부한다 |
| slow update | epoch당 20개 task를 샘플링해 이전 epoch skill과 비교한다 |
| meta skill | optimizer 쪽에서 수용과 거부 패턴을 요약한다. teacher 전용이다 |
| edit mode | patch. 대안은 rewrite_from_suggestions다 |
| rejected-edit buffer | 최근 실패 제안을 담는 옵션 |
| teacher reflection | minibatch당 최대 3회 정련 라운드 |
| reasoning effort | teacher와 student 모두 medium |
학습 풀이 좁은 벤치마크는 gate와 스케줄러, slow/meta update 기계를 그대로 두고 batch 크기만 조정한다. LiveMathematicianBench는 epoch당 학습 항목 35개에 rollout batch 200을 쓰고, ALFWorld는 학습 task 39개에 selection 환경 140개와 test 환경 134개를 쓴다.
베이스라인
비교 대상 7종은 무적응, 수작성, 원샷, 학습 계열을 모두 포함한다.
| 베이스라인 | 성격 |
|---|---|
| no skill | 벤치마크 기본 system 프롬프트로 실행한 frozen target |
| human skill | 벤치마크별로 전문가가 작성해 큐레이션한 skill 문서 |
| one-shot LLM skill | 고수준 과제 설명으로 GPT-5.5가 한 번 생성한 뒤 갱신하지 않은 skill |
| Trace2Skill | trajectory 수준 skill distillation. held-out gate가 없다 |
| TextGrad | gradient 방식의 자연어 프롬프트 최적화 |
| GEPA | Pareto reflective prompt evolution |
| EvoSkill | 실패 분석 기반 skill 폴더 진화. harness 쪽 최강 경쟁자다 |
모든 베이스라인이 같은 target 모델과 같은 held-out test split, 같은 scorer를 쓴다. 그래서 비교는 프롬프트 템플릿이나 채점 파이프라인 같은 부차 요인이 아니라 적응 절차의 선택만 분리한다.
결과
52개 셀 전체 결과
(target 모델, 벤치마크, harness) 조합 하나를 비교 단위로 보고, 7개 베이스라인 중 셀별 최강을 경쟁자로 삼으면 SkillOpt은 52개 셀 중 52개에서 최선 또는 동률이다.
GPT-5.5 direct chat의 벤치마크별 변화는 다음과 같다.
| 벤치마크 | no skill | 셀별 최강 베이스라인 | SkillOpt | no skill 대비 |
|---|---|---|---|---|
| SearchQA | 77.7% | 84.8% (GEPA) | 87.3% | +9.6%p |
| SpreadsheetBench | 41.8% | 73.6% (GEPA) | 80.7% | +38.9%p |
| OfficeQA | 33.1% | 66.9% (human skill) | 72.1% | +39.0%p |
| DocVQA | 78.8% | 90.6% (Trace2Skill) | 91.2% | +12.4%p |
| LiveMath | 37.6% | 52.0% (Trace2Skill) | 66.9% | +29.3%p |
| ALFWorld | 83.6% | 93.3% (one-shot LLM skill) | 95.5% | +11.9%p |
| 6개 평균 | 58.8% | 76.9% (oracle) | 82.3% | +23.5%p |
여기서 oracle 베이스라인은 셀마다 6개 경쟁 방법 중 최선을 골라 평균한 값이다. 실제 운영에서는 어떤 방법이 그 셀에서 최선인지 미리 알 수 없으므로 달성하기 어려운 기준인데, SkillOpt은 이 값보다도 5.4%p 앞선다.
상승 폭의 분포에도 규칙성이 있다. no-skill 모델이 이미 천장에 가까운 SearchQA는 9.6%p 오르는 데 그친다. 반면 엄격한 절차와 답 포맷 요구가 zero-shot frontier 모델의 한계를 드러내는 SpreadsheetBench는 38.9%p, OfficeQA는 39.0%p 오른다. 즉 이득은 절차 규율이 필요한 과제에 집중된다.
모델 규모별 이득
개선은 frontier 규모에 한정되지 않는다. 6개 벤치마크 평균으로 잰 모델별 향상은 다음과 같다.
| target 모델 | 평균 향상 | 눈에 띄는 셀 |
|---|---|---|
| GPT-5.5 | +23.5%p | SpreadsheetBench 41.8%에서 80.7% |
| GPT-5.4 | +12.7%p | ALFWorld 75.4%에서 91.0% |
| GPT-5.4-mini | +15.4%p | OfficeQA 22.1%에서 48.8% |
| GPT-5.4-nano | +26.7%p | DocVQA 30.8%에서 80.2% (약 2.6배), ALFWorld 34.3%에서 69.4% (약 2.0배) |
| GPT-5.2 | +16.6%p | LiveMath 20.8%에서 36.0% |
| Qwen3.5-4B | +19.2%p | LiveMath 22.4%에서 52.0%, ALFWorld 30.6%에서 81.3% |
| Qwen3.6-35B-A3B | +9.1%p | SearchQA 72.7%에서 80.3% |
모델당 평균 향상은 약 17.6%p다. 작고 약한 target 모델이 상대적으로 가장 큰 이득을 본다. GPT-5.4-nano의 DocVQA는 2.6배가 되고 Qwen3.5-4B의 SpreadsheetBench는 9.3%에서 23.9%로 역시 약 2.6배가 된다. compact한 skill 산출물이 작은 모델이 아직 가중치에 담지 못한 절차 지식을 공급한다는 해석과 맞는 결과다.
tool 실행 harness
tool 기반 실행에서도 같은 최적화 인터페이스가 작동한다.
| harness | 5개 벤치마크 평균 향상 | 차상위 베이스라인 대비 | 비고 |
|---|---|---|---|
| Codex | +24.8%p | EvoSkill 대비 +14.0%p | EvoSkill은 SearchQA에서 81.8%에서 61.4%로 하락한다 |
| Claude Code | +19.1%p | EvoSkill 대비 +3.2%p | EvoSkill도 5개 평균을 57.8%에서 73.7%로 올린다 |
두 harness에서 ALFWorld 셀은 비어 있다. 표준 Codex와 Claude Code adapter가 ALFWorld의 persistent embodied 상호작용을 표현하지 못하기 때문이다. 따라서 harness 결과는 검색과 spreadsheet, 문서 QA, 멀티모달 QA, 수학 5개 벤치마크에 대한 것이다.
Claude Code에서 EvoSkill과의 격차가 3.2%p로 좁은 것은 EvoSkill 자체가 이미 강하기 때문이다. 반면 Codex SearchQA에서 EvoSkill이 no-skill보다 20.4%p 낮아지는 불안정을 보이는 데 비해 SkillOpt은 모든 셀에서 양의 이득을 유지한다.
대안 설명 검토
이득의 출처를 확인하는 검토도 함께 실렸다.
프롬프트 길이 효과가 아니다. human skill은 이미 145~516 토큰이고 one-shot LLM skill보다 긴 경우가 많은데도 모든 direct-chat 모델 행에서 밀린다. 사람이 쓴 skill은 사전 지침이 벤치마크와 우연히 맞을 때 도움이 되지만, rollout을 관찰한 뒤 실패를 교정할 수는 없다.
optimizer 용량만도 아니다. SkillOpt은 GPT-5.4-nano에서도 모든 베이스라인을 앞서고, 뒤에 나오는 optimizer 강도 분석은 target과 같은 모델을 쓰는 optimizer도 이득의 상당 부분을 회복함을 보인다.
특정 skill 포맷을 활용한 것도 아니다. Codex SpreadsheetBench 셀에서 EvoSkill이 이미 27.5%를 67.5%로 올렸는데, SkillOpt은 여기에 17.5%p를 더해 85.0%에 이른다.
베이스라인별로 부족한 지점도 정리된다. Trace2Skill은 trajectory 교훈을 캐내지만 held-out gate가 없다. TextGrad와 GEPA는 프롬프트를 최적화하지만 persistent skill 산출물을 만들지 않는다. EvoSkill은 harness 쪽 최강 경쟁자인데도 bounded textual learning rate와 rejected-edit 메모리가 둘 다 없다.
Ablation 분석
ablation은 GPT-5.5를 target과 optimizer로 함께 써서 진행했다. 전체 결론은 이득이 정확한 수치 설정에는 둔감하고 구성 요소의 유무에는 민감하다는 것이다. SearchQA는 개선 여지가 좁아 많은 설정에서 안정적이고(대부분 ±1.5%p 밴드 안), SpreadsheetBench와 LiveMathematicianBench가 유용한 절차 학습과 과도한 편집 사이의 상충을 드러낸다.
값 스윕
| 패널 | 스윕 범위 | 관찰 |
|---|---|---|
| (a) 학습 데이터 노출량 | 1개 예시에서 100% | 절차형 벤치마크가 증거량에 보상한다. SpreadsheetBench 47.5%에서 78.0%, LiveMath 59.1%에서 70.5%. SearchQA는 20%부터 84~86%로 포화한다 |
| (b) reflection minibatch 크기 | 1에서 32 | SearchQA 85.9 |
| (c) rollout batch 크기 | 8에서 full epoch | SearchQA 85.1 |
| (d) textual learning rate | 1, 2, 4, 8, 16 | L_t=4가 86.5/78.2/56.5%, LiveMath 최고는 L_t=8의 66.9%, 다섯 설정 전체의 최저도 SearchQA 85.5%에 그친다 |
| (e) learning rate 스케줄러 | constant, cosine, linear | constant 87.3/80.7/62.1%, cosine 87.1/77.5/61.3%, linear 87.2/72.9/62.9% |
| (f) slow update 샘플 수 | 5, 10, 20, 40 | 기본값 20이 87.1/77.5/61.3%이고 나머지는 ±2.7%p 안에 있다 |
패널 (b)와 (c)가 평평하다는 것은 headline 수치가 취약한 프롬프트 탐색 batch 크기의 산물이 아니라, 갱신마다 충분한 채점 증거를 확보한 효과라는 뜻이다.
패널 (e)에서는 기본값 cosine보다 constant 스케줄러가 SpreadsheetBench에서 3.2%p 높다. 기본값 선택의 여지가 남아 있다는 신호인데, 저자들이 강조하는 것은 특정 스케줄러가 아니라 질적 주장이다. 어떤 적당한 bounded edit budget이든 예산 없이 rewrite하는 설정을 이미 앞선다.
컴포넌트 제거
| 컴포넌트 | 설정 | SearchQA | SpreadsheetBench | LiveMath |
|---|---|---|---|---|
| learning rate 형태 | lr=4 (기본) |
87.1% | 77.5% | 61.3% |
| dynamic lr | 85.8% | 71.8% | 54.0% | |
| without lr (무제한 rewrite) | 84.6% | 75.7% | 57.3% | |
| rejected buffer | 사용 (기본) | 87.1% | 77.5% | 61.3% |
| 미사용 | 85.5% | 72.9% | 58.9% | |
| slow/meta update | meta skill과 slow update 모두 사용 (기본) | 87.1% | 77.5% | 61.3% |
| meta skill 제거 | 85.1% | 75.7% | 58.1% | |
| meta skill과 slow update 동시 제거 | 86.3% | 55.0% | 59.7% |
rejected-edit buffer를 제거하면 세 벤치마크에서 각각 1.6%p, 4.6%p, 2.4%p 하락한다. 배포 시점의 부가 장치가 아니라 기본 루프의 안정화 장치라는 근거다.
가장 날카로운 결과는 slow/meta 행이다. meta skill과 slow update를 동시에 제거하면 SpreadsheetBench가 77.5%에서 55.0%로 22.5%p 하락해 ablation 전체에서 가장 큰 저하가 된다. 이 벤치마크에서 특히 치명적인 이유는 두 가지가 함께 사라지기 때문이다. 하나는 epoch를 넘는 장기 증거 흐름이고, 다른 하나는 국소 편집이 지속적 절차 교훈을 덮어쓰지 못하게 하는 보호 영역 계약이다.
checkpoint 정렬
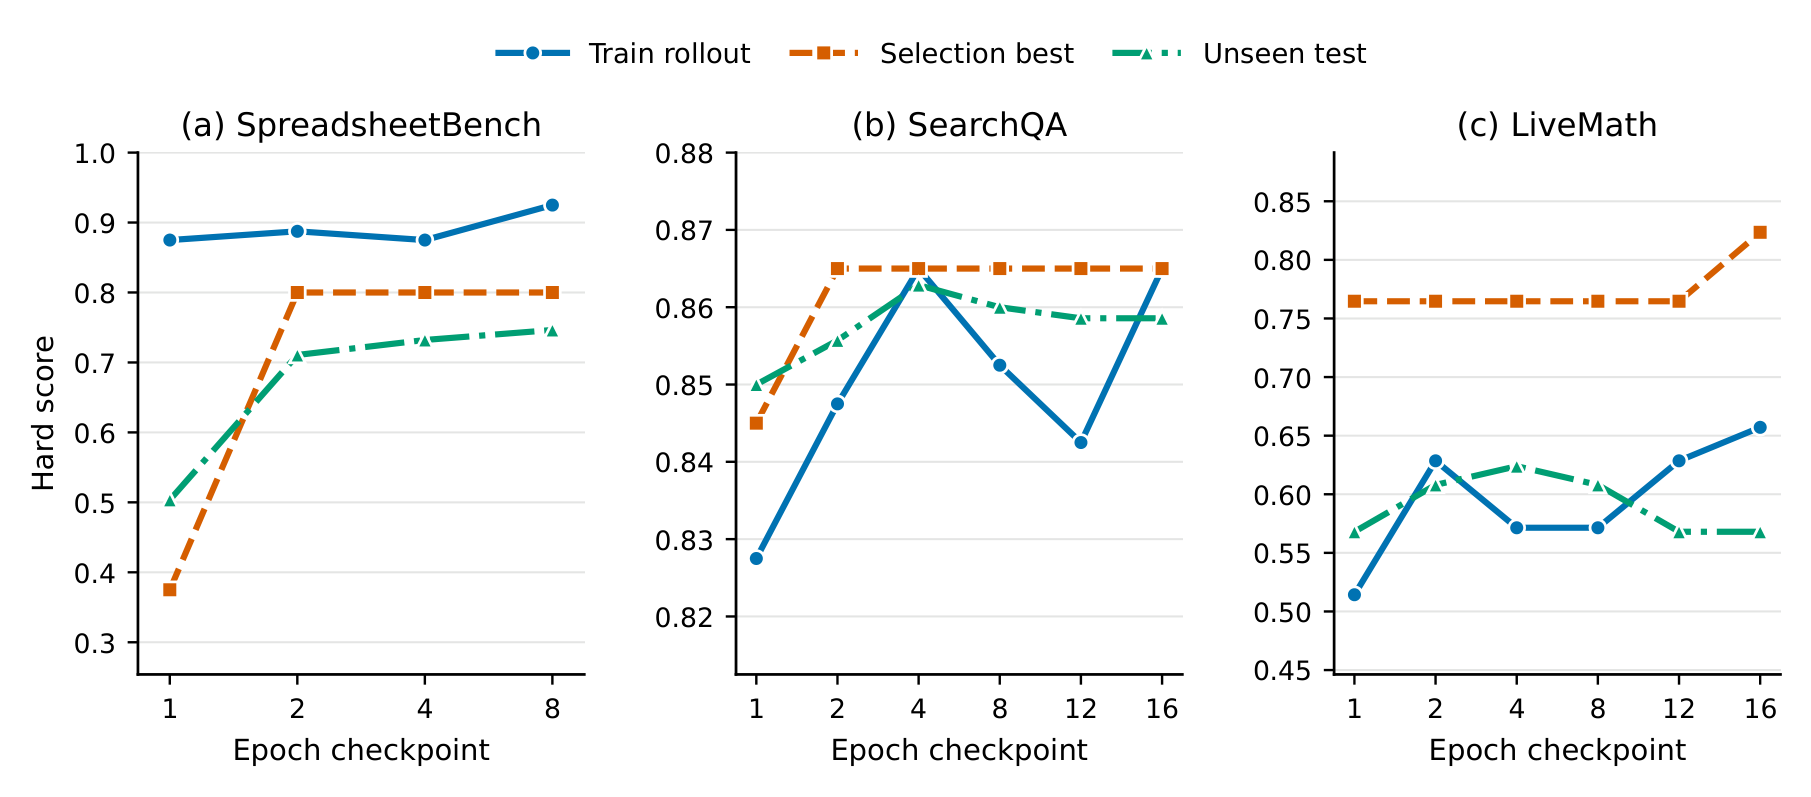
Figure 3은 수치 ablation을 보완한다. epoch를 따라 validation checkpoint가 held-out test 성능을 추적하므로, gate가 selection split에만 맞는 skill이 아니라 일반화되는 skill을 고르는 경향이 확인된다. SpreadsheetBench 패널에서 selection best가 0.37에서 0.80으로 올라가는 동안 unseen test도 0.50에서 0.74로 함께 올라가는 모습이 그 예다.
전이 실험
전이 실험은 최적화된 skill이 task 특정 프롬프트가 아니라 재사용 가능한 산출물처럼 동작하는지 묻는다. 세 방향으로 조건을 바꾼다.
모델 규모를 바꿀 때
GPT-5.4에서 최적화한 skill을 더 작은 GPT 변형에 배포한 네 건 전부가 양의 전이다.
| 벤치마크 | target | no skill | in-domain SkillOpt | 전이본 | target 대비 |
|---|---|---|---|---|---|
| SpreadsheetBench | GPT-5.4-mini | 36.1% | 47.5% | 45.5% | +9.4%p |
| SpreadsheetBench | GPT-5.4-nano | 23.5% | 42.5% | 26.5% | +3.0%p |
| LiveMath | GPT-5.4-mini | 14.7% | 32.8% | 19.2% | +4.5%p |
| LiveMath | GPT-5.4-nano | 23.2% | 27.2% | 28.8% | +5.6%p |
LiveMath GPT-5.4-nano에서는 전이본 28.8%가 in-domain SkillOpt 참조값 27.2%를 넘어선다. 학습된 절차 일부가 target 모델과 무관하다는 신호다. SpreadsheetBench GPT-5.4-mini는 in-domain 이득의 82%(11.4%p 중 9.4%p)를 회복하며, 어느 행도 target의 no-skill 기준선 아래로 내려가지 않는다.
실행 harness를 바꿀 때
배포 관점에서 가장 뚜렷한 신호다.
| 벤치마크 | 방향 | target no skill | in-domain SkillOpt | 전이본 | target 대비 |
|---|---|---|---|---|---|
| SpreadsheetBench | Codex에서 Claude Code | 22.1% | 80.4% | 81.8% | +59.7%p |
| SpreadsheetBench | Claude Code에서 Codex | 27.5% | 85.0% | 71.1% | +43.6%p |
| LiveMath | Codex에서 Claude Code | 40.8% | 56.5% | 42.4% | +1.6%p |
| LiveMath | Claude Code에서 Codex | 35.2% | 78.4% | 48.0% | +12.8%p |
두 harness가 서로 다른 tool과 파일 API, 명령 표면을 노출하는데도 양의 전이가 나온다. SpreadsheetBench 전이본은 오히려 in-domain 참조값을 살짝 넘어선다. 저자들은 그 이유로 학습된 규칙이 harness 특정 명령 레시피가 아니라 workbook 수준 절차를 담고 있을 가능성을 든다. 구조 우선 검사와 수식 인식 검증, static value 기록이 그런 절차다. 결과적으로 한 실행 환경에서 skill을 최적화한 비용을 관련 배포 환경 여럿에 상각할 수 있다.
벤치마크를 바꿀 때
source와 target이 넓은 과제 계열(수학)만 공유하는 가장 엄격한 조건이다.
| target 모델 | Omni-MATH no skill | 전이본 | 변화 |
|---|---|---|---|
| GPT-5.4 | 56.6% | 60.3% | +3.7%p |
| GPT-5.4-mini | 34.8% | 36.6% | +1.8%p |
| GPT-5.4-nano | 38.8% | 40.1% | +1.3%p |
OlympiadBench에서 최적화한 skill을 추가 최적화 없이 Omni-MATH에 적용한 결과다. 값은 in-domain이나 cross-harness보다 작다. test 문제와 답 포맷 관례가 함께 바뀐 뒤에도 절차 지식을 유지해야 하는 조건이라 자연스러운 결과인데, 세 모델 규모 모두 부호가 양이다. 최적화된 skill이 벤치마크 특정 포맷을 암기한 것이 아니라 재사용 가능한 수학 절차를 담았다는 해석을 뒷받침한다.
Optimizer 강도의 효과
optimizer는 오프라인 훈련 루프에서만 실행되고 배포 시점에는 호출되지 않는다. 따라서 optimizer 선택은 training-time 레버다. 더 강한 optimizer가 배포 skill을 개선하더라도 그 skill을 쓰는 추론 비용은 올라가지 않는다. 배포 산출물은 target 모델만 호출하는 정적 best_skill.md로 남는다.
| 벤치마크 | target | no skill | 강한 optimizer (GPT-5.5) | target과 같은 optimizer |
|---|---|---|---|---|
| SpreadsheetBench | GPT-5.4-mini | 36.1% | 47.5% (+11.4%p) | 43.2% (+7.1%p) |
| SpreadsheetBench | GPT-5.4-nano | 23.5% | 42.5% (+19.0%p) | 35.4% (+11.9%p) |
| SearchQA | GPT-5.4-mini | 75.9% | 80.2% (+4.3%p) | 78.3% (+2.4%p) |
| SearchQA | GPT-5.4-nano | 55.8% | 74.8% (+19.0%p) | 69.9% (+14.1%p) |
두 가지를 읽을 수 있다. 첫째 강한 optimizer가 검사한 모든 셀에서 더 큰 절대 이득을 낸다. 저자들은 이 단조성이 bounded edit와 validation gate 덕분이라고 본다. gate가 없으면 강한 optimizer가 더 크지만 해로운 rewrite를 밀어 넣을 수도 있다.
둘째 target과 같은 모델을 쓰는 optimizer도 강한 optimizer 이득의 56~74%를 회복한다. SkillOpt이 강한 teacher에서 약한 student로 지식을 옮기는 distillation 파이프라인이 아니라, 최적화 루프 자체가 실질적 가치를 더한다는 근거다. 실무 함의는 명확하다. 고용량 frontier optimizer를 쓸 수 있으면 기본값으로 삼는 편이 좋고(훈련 시점 API 호출만 늘고 배포에는 아무것도 더하지 않는다), 예산이 제약되어 target과 같은 optimizer를 써야 하는 경우에도 루프는 여전히 효과적이다.
학습된 skill의 모습
compact함과 편집 경제성
| 벤치마크 | 초기 (토큰) | 최종 (토큰) | 채택 편집 | 총 훈련 토큰 | test 1%p당 훈련 토큰 |
|---|---|---|---|---|---|
| SearchQA | 16 | 857 | 4 | 2억 1,380만 | 3,790만 |
| SpreadsheetBench | 224 | 1,995 | 4 | 2,140만 | 60만 |
| OfficeQA | 145 | 883 | 1 | 2,080만 | 110만 |
| DocVQA | 81 | 959 | 3 | 1억 8,820만 | 4,640만 |
| LiveMath | 154 | 379 | 1 | 2,320만 | 360만 |
| ALFWorld | 516 | 1,321 | 2 | 5,930만 | 1,590만 |
최종 skill은 일관되게 작다. 379 토큰(LiveMathematicianBench)에서 1,995 토큰(SpreadsheetBench)이고 중앙값은 약 920 토큰이다. 가장 긴 학습 skill도 현대 frontier 모델의 통상적인 system 프롬프트 예산보다 훨씬 아래이고, 가장 짧은 것은 한 화면에 들어간다. 초기에서 최종으로의 증가율은 2.5배에서 53배까지 갈리는데, 초기 skill이 한 줄이었는지 한 문단이었는지에 따른다. 절대 토큰 수가 작아서 도메인 실무자가 배포 산출물을 몇 분 안에 읽고 감사하고 편집할 수 있다.
두 번째 특징은 이득이 아주 적은 채택 편집에서 나온다는 점이다. 여섯 벤치마크에서 best_skill.md에 실제로 반영된 편집은 1개에서 4개(중앙값 2.5)뿐이다. LiveMathematicianBench의 29.3%p 상승과 OfficeQA의 39.0%p 상승은 각각 단 1개 편집에서 나왔다.
이는 validation gate가 실제로 작동한다는 직접 증거다. optimizer 모델은 epoch당 훨씬 많은 편집을 제안하지만 소수만 held-out 검사를 통과해 배포 skill에 남는다. optimizer의 텍스트 공간 탐색 대부분은 거부되어 rejected-edit buffer에 담기고 target 모델에는 닿지 않는다. 배포 skill은 모든 reflection의 합집합이 아니라 그만큼 compact한 상태로 유지된다.
훈련 비용
훈련 토큰 열이 루프 운영 비용을 정량화한다. 두 영역으로 갈린다.
rollout이 짧고 값싼 절차형 벤치마크(SpreadsheetBench, OfficeQA, LiveMathematicianBench)는 test 1%p당 60만~360만 토큰이다. 절대 이득은 오히려 이 세 벤치마크가 가장 크다. OfficeQA는 총 2,080만 토큰으로 39.0%p를 얻어 1%p당 110만 토큰이다.
trajectory가 길거나 멀티모달 context가 풍부한 SearchQA(1%p당 3,790만 토큰)와 DocVQA(4,640만 토큰)는 1%p당 비용이 한 자릿수 배 이상 크다. 배포 관점의 요점은 이 비용을 skill 훈련 시점에 한 번만 지불한다는 것이다. export 이후 최적화된 best_skill.md는 optimizer 호출도, 가중치 갱신도 추가하지 않고 compact 텍스트 산출물만 target 에이전트에 더한다.
대표 학습 규칙
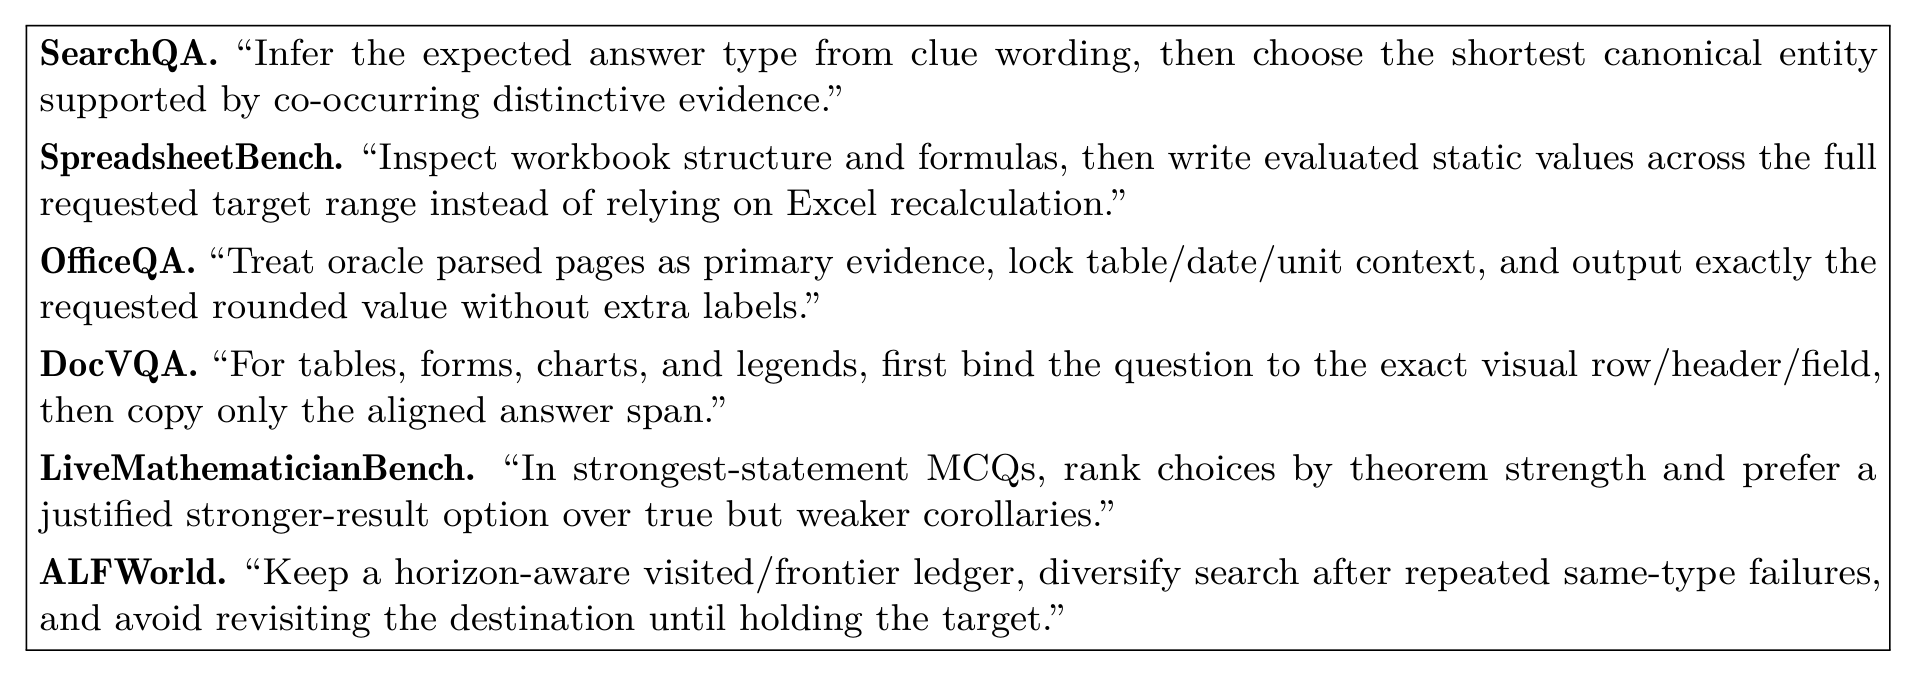
Figure 4는 벤치마크마다 규칙 하나씩을 최종 best_skill.md에서 그대로 옮긴다. 세 가지가 두드러진다.
첫째 규칙이 instance-specific이 아니라 procedural이다. 어느 규칙도 특정 질문이나 파일, 개체를 지목하지 않는다. 예를 들어 SpreadsheetBench 규칙은 "workbook 구조와 수식을 먼저 검사한 뒤, Excel 재계산에 의존하지 말고 요청된 전체 대상 범위에 평가된 static value를 기록하라"는 형태다.
둘째 frontier 모델이 zero-shot으로 적용하지 않는 규율을 담는다.
| 벤치마크 | 규칙이 담은 규율 |
|---|---|
| SearchQA | canonical entity 선택. 단서 표현에서 기대되는 답 유형을 추론한 뒤 함께 등장하는 특징적 증거가 뒷받침하는 가장 짧은 canonical 개체를 고른다 |
| SpreadsheetBench | workbook 구조 우선 추론과 static value 기록 |
| OfficeQA | 답 포맷 제약. oracle이 파싱한 페이지를 1차 증거로 삼고 표와 날짜, 단위 context를 고정하고 요청된 반올림 값만 라벨 없이 출력한다 |
| DocVQA | 증거 바인딩. 표와 양식, 차트, 범례에서 질문을 정확한 시각 행과 헤더, 필드에 먼저 묶고 정렬된 답 구간만 복사한다 |
| LiveMathematicianBench | 답 포맷 제약. 가장 강한 진술을 고르는 문항에서 정리의 강도로 선택지를 순위 매기고, 참이지만 약한 따름정리보다 정당화된 더 강한 결과를 선호한다 |
| ALFWorld | 검색 프론티어 규율. 지평을 고려한 방문과 프론티어 원장을 유지하고 같은 유형의 실패가 반복되면 탐색을 다양화하며 대상을 들기 전에는 목적지를 다시 방문하지 않는다 |
셋째 벤치마크를 하루 다뤄 본 숙련된 실무자가 쓸 규칙처럼 읽힌다. 다만 실제로는 optimizer가 자동 생성하고 held-out 데이터에서 편집 단위로 검증한 결과다.
정성적 진화 사례
두 실행을 들여다본 사례 연구가 실렸다. ALFWorld 사례는 GPT-5.4-nano를 student로, GPT-5.5를 teacher로 쓴다. SpreadsheetBench 사례는 GPT-5.5를 frozen student와 optimizer로 함께 쓴다. 두 경우 모두 SkillOpt은 초기 skill을 무관한 프롬프트로 교체하지 않는다. 채택된 편집이 rollout trajectory에서 관찰된 반복 실패 모드 주변에 compact한 절차 제약을 덧붙인다.
| 사례 | 초기 skill | 채택 편집이 더한 것 | 대표 실행의 held-out test |
|---|---|---|---|
| ALFWorld | 대상 물체를 찾고 집어서 필요하면 변형한 뒤 목적지에 놓는 일반 가정 계획 | 정확한 물체 이름 매칭(mug, cup, pan, pot을 서로 대체하지 않음), visited-location 메모리, destination 메모리, pick-two 진행 락, 직접 완료 규칙(다음 하위 목표를 완료할 수 있으면 재확인 대신 그 행동을 실행) | 49.3%에서 74.6% |
| SpreadsheetBench | Python spreadsheet 라이브러리를 쓰고 무관한 workbook 내용을 보존하라는 일반 지침 | preview 대신 실제 workbook 검사, 여러 시트에 걸친 헤더와 대상 범위 탐색, lookup과 집계 전 키와 셀 타입 정규화, 구조 편집 중 서식 보존, 수식형 지시에서 evaluated static value 기록, 빈 결과 셀을 포함한 전체 대상 범위 채우기, helper 계산을 workbook 산출물 대신 Python에 유지, 저장한 workbook을 다시 열어 경계 행과 남은 공백 확인 | 40.4%에서 78.9% |
ALFWorld 사례는 skill이 일반적인 탐색과 변형, 배치 전략에서 유한 상태 실행 정책으로 진화하는 과정을 보여준다. 물체 동일성과 탐색 메모리, 진행 락, 루프 차단기를 갖춘 형태다. SpreadsheetBench 사례는 같은 흐름을 workbook 검증 정책의 형태로 보여준다. 특히 채점기가 셀 값을 읽는다는 점을 반영해, 지시문이 INDEX/MATCH나 XLOOKUP 같은 수식을 언급해도 에이전트가 계산된 static value를 기록해야 한다는 규칙이 핵심 편집으로 등장한다.
한계
- 검증 신호에 의존한다. 최적화 루프가 채점된 trajectory와 held-out selection split을 요구하므로, 자동 verifier나 exact-match 지표, 실행 가능한 검사처럼 신뢰할 만한 피드백이 있는 태스크에 가장 직접적으로 적용된다. 성공이 주관적이거나 다차원이거나 판정 비용이 큰 open-ended 도메인에서는 validation gate가 더 강한 human 또는 model 기반 평가를 요구할 수 있다.
- 훈련 비용이 든다. 배포 산출물은 compact한
best_skill.md하나지만, skill 훈련에는 추가 rollout 연산과 optimizer 모델 호출이 필요하다. 같은 skill을 재사용하면 이 비용이 상각되지만 one-off 태스크에는 덜 매력적이다. - 단일 skill 설계다. SkillOpt은 큰 skill library를 키우거나 가중치를 바꾸는 대신 이식 가능한 단일 skill을 의도적으로 최적화한다. 배포는 단순해지지만, 서로 무관한 절차를 여럿 요구하는 이질적 도메인에는 단일 skill이 부족할 수 있다.
- 훈련 분포의 heuristic이 섞인다. 최적화된 skill이 훈련 분포의 도메인 heuristic을 담을 수 있다. 상당히 다른 모델이나 harness, 태스크 설정으로 옮기기 전에는 신중한 held-out 평가가 여전히 필요하다.
후속 방향
저자들이 제시하는 확장은 네 가지다. 도메인 사이에 인프라를 공유하는 skill library, optimizer 쪽 meta skill을 벤치마크 사이에서 재사용하는 방식, open-ended 태스크를 위한 reward-free 또는 preference 기반 validation gate, 그리고 최적화된 skill을 target 모델로 self-distillation해 가중치 수준 적응으로 가는 징검다리다.
더 넓은 제안도 함께 담긴다. skill 자체를 프롬프팅의 부산물이 아니라 학습 대상으로 다루면, learning rate와 스케줄, regularization, curriculum, validation 같은 최적화 도구 전체를 지금까지 사람이 손으로 설계해 온 에이전트 스택의 한 층에 적용할 수 있다는 관점이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| skill document | 에이전트 context에 삽입되는 자연어 정책. SkillOpt의 학습 대상인 external state다 |
| frozen target model | 가중치를 고정한 채 skill로만 적응되는 실행 모델. 논문의 student에 해당한다 |
| optimizer model | rollout 증거로 skill 편집을 제안하고 병합하고 랭킹하는 별도 frontier 모델. 논문의 teacher에 해당하며 배포에는 참여하지 않는다 |
| edit budget | 스텝당 최대 편집 수. textual learning rate의 대응물이다 |
| held-out selection gate | selection split에서 점수를 엄격히 올리는 후보만 수용하는 검증 관문. 동점은 거부한다 |
| rejected-edit buffer | 거부된 편집과 관찰된 실패 패턴을 담아 같은 epoch의 이후 reflection에 negative feedback으로 재사용하는 저장소 |
| best_skill.md | 배포되는 최종 산출물. 300~2,000 토큰 범위의 compact skill 문서다 |
관련 페이지
- SkillOpt: Executive Strategy for Self-Evolving Agent Skills: 같은 프로젝트의 OSS 구현체. PyPI 패키지와 WebUI, SkillOpt-Sleep 등 배포와 운영 측면을 담는다. 이 논문이 방법과 ablation, 결과의 원전이다
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: self-evolving 에이전트의 이득을 base capability와 harness-updating, harness-benefit으로 분리한다. SkillOpt이 held-out gate로 harness-benefit을 통제하는 지점과 직접 맞닿는다
- Compiling Agentic Workflows into LLM Weights: 오케스트레이션을 가중치로 컴파일하는 반대 방향의 접근이다. SkillOpt은 가중치를 고정하고 텍스트 문서만 훈련한다
- Loop Engineering (Addy Osmani, 2026-06-07): skill을 loop의 한 구성 요소로 보는 관점이다. SkillOpt은 그 구성 요소를 딥러닝식 최적화 대상으로 올린다
- garrytan/gbrain: skill pack을 결합한 markdown 중심 에이전트 메모리로, 2026-06-03에 SkillOpt를 통합했다