Agents · PAPER · 2026
Generative Skill Composition for LLM Agents
요약
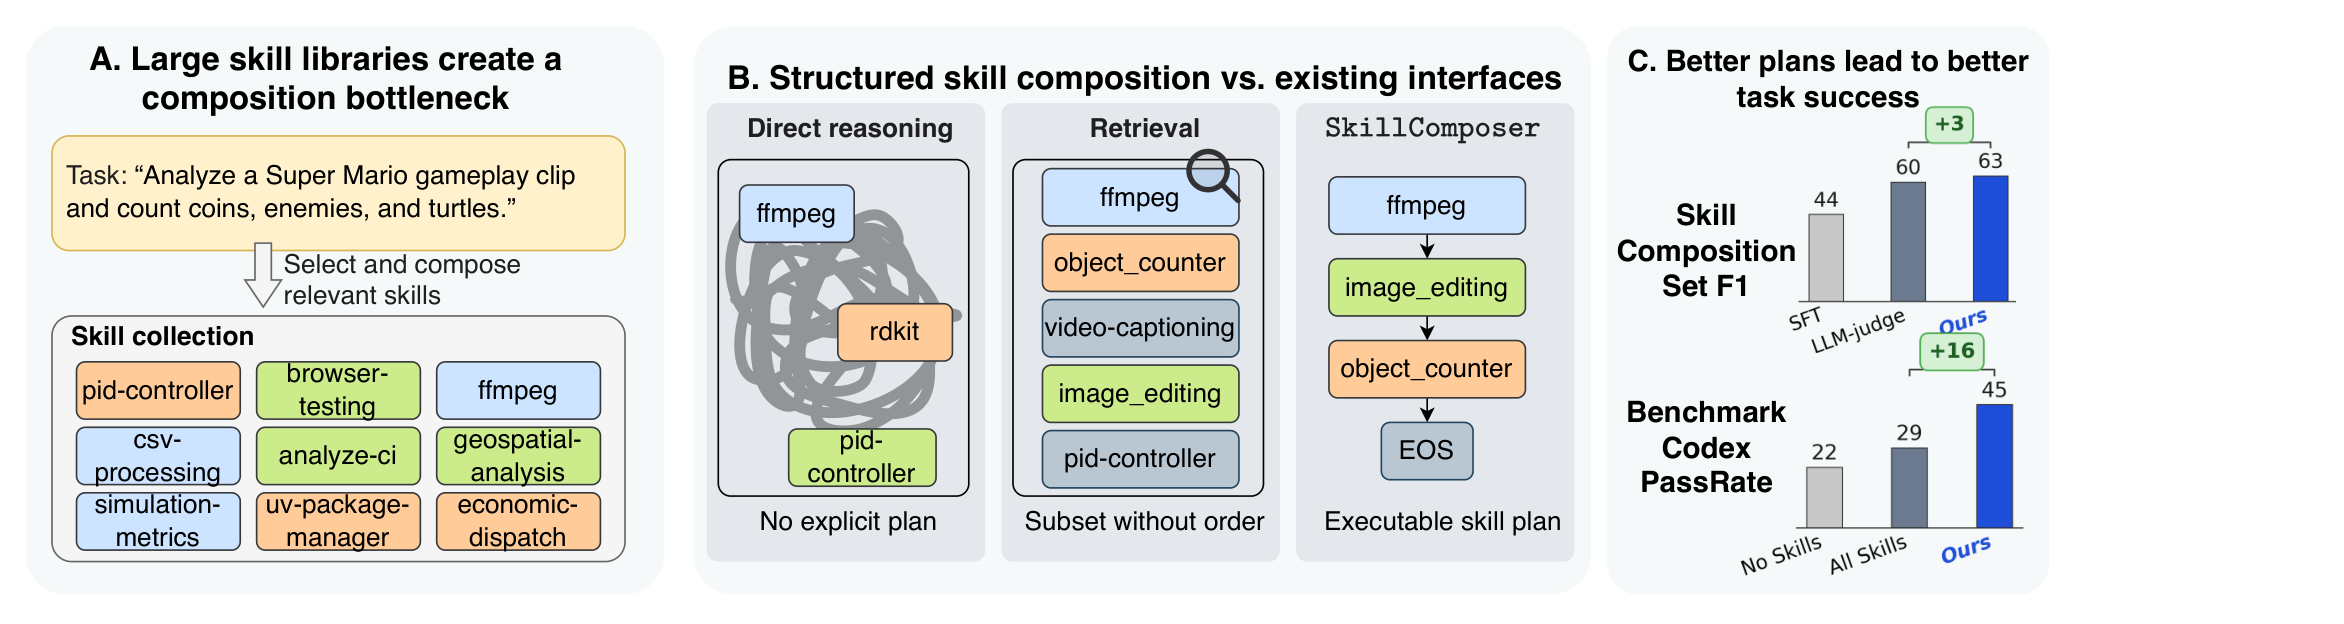
이 논문은 에이전트가 큰 skill library를 앞에 두고 "어떤 skill을, 몇 개, 어떤 순서로" 쓸지 정하는 문제를 하나의 구조적 예측 문제로 정식화한다. library가 커질수록 성능을 가르는 것은 skill을 확보하는 일이 아니라 알맞은 skill 묶음을 구성하는 일이다. 저자들은 이 선택이 활성 subset, 개수(cardinality), 실행 순서라는 세 측면이 얽힌 결합 결정이며 셋을 떼어 놓을 수 없다고 본다. retrieval은 순서 없는 subset만 내놓고, library 전체를 에이전트에 노출하는 방식은 명시적 plan 없이 실행 trace에 결정을 묻어 버려 둘 다 일부를 놓친다.
제안 모델 SkillComposer는 skill 구성을 닫힌 어휘, 즉 library 인덱스와 STOP 심볼 위의 생성으로 다시 쓴다. 얼려 둔 text encoder에 3-layer autoregressive decoder를 붙여 subset, cardinality, ordering을 한 번의 디코딩 패스에서 함께 뽑고, 디코딩 시점에 TF-IDF retrieval prior와 set-membership prior를 logit에 합친다. 학습 파라미터는 약 3.9M으로 비교 대상인 600M SFT 모델보다 약 154배 적다. 그럼에도 SkillsBench에서 GPT-5.2-Codex와 Gemini-3-Pro-Preview의 pass rate를 no-skill 대비 각각 23.1%p와 18.2%p 높이고, top-3 retrieval을 앞서며 oracle retrieval 상한을 넘어선다. 이 성능을 skill을 적재한 조건 가운데 가장 적은 프롬프트 토큰으로 달성한다.
배경
skill과 skill library
skill은 에이전트가 실행 시점에 컨텍스트로 불러들이는 재사용 절차 지식 단위다. 자연어 지시문, 스크립트, 보조 자원을 한 묶음으로 담아 특정 하위 작업을 수행하게 한다. 논문이 드는 예시는 샌드박스 환경 구성, 테스트 스위트 실행, 여러 파일에 걸친 함수 refactor다. 코드 리뷰와 테스트 실행을 조율하거나 정형 문서를 생성하는 것도 skill 하나로 묶인다.
연구 공동체가 다양한 task용 skill을 큐레이션해 온 결과 skill library의 규모가 빠르게 커졌다. 그러면서 추론 시점의 병목이 skill을 확보하는 문제에서 알맞은 skill 묶음을 구성하는 문제로 옮겨 갔다. 이 논문은 library를 학습 시점에 고정으로 둔다. 실제 배포가 open-ended skill 생성이 아니라 curated skill pack을 함께 출하하기 때문이며, 이렇게 두면 composition 문제를 skill을 만들어 내는 문제와 분리해 다룰 수 있다.
composition 병목의 발생 지점
논문이 도입부에서 드는 요청은 "폐기 예정 API 호출을 찾고, 코드베이스 전반에서 refactor하고, regression suite를 실행하라"다. 쓸 만한 plan이라면 먼저 관련 호출 지점을 찾고, 그다음 refactor를 적용하고, 마지막에 테스트로 변경을 검증해야 한다. 세 단계의 순서가 결과를 좌우한다.
task가 지배적인 skill 하나에 깔끔하게 대응할 때는 기존 인터페이스로 충분하다. 문제는 여러 skill을 엮어야 하는 task다. retrieval은 검색, 편집, 테스트에 각각 관련된 skill을 개별적으로 띄울 수 있지만, 랭킹된 목록만으로는 몇 개를 써야 하는지도 어떤 순서로 실행해야 하는지도 정해지지 않는다.
기존 두 방식의 한계
선택적 skill 사용의 기존 접근은 두 계열로 나뉘며 각각 세 측면 중 일부만 다룬다.
| 접근 | 동작 | 결정하는 것 | 놓치는 것 |
|---|---|---|---|
| Retrieval | LLM-as-a-Judge나 task와 skill 임베딩 유사도로 skill을 독립 랭킹한다 | 어떤 skill (순서 없는 subset) | 개수와 실행 순서. 개수는 외부에서 k로 지정해야 한다 |
| End-to-end planning | library 전체를 에이전트에 노출하고 에이전트가 task를 풀면서 필요할 때 skill을 촉발하게 한다 | 실행 trace 안에서 암묵적으로 | 명시적이고 검사 가능한 plan. 구성이 trace에 묻힌다 |
| Structured skill composition | 순서 있는 실행 가능 skill 시퀀스를 직접 예측한다 | subset, 개수, 순서를 동시에 | (제안 방식) |
Figure 1의 (B)가 이 대비를 그림으로 보여 준다. direct reasoning 칸에는 얽힌 실타래 위에 skill 상자 몇 개가 놓여 "명시적 plan 없음"으로 표시되고, retrieval 칸에는 순서 없이 나열된 후보 목록이 "순서 없는 subset"으로 표시된다. SkillComposer 칸만 ffmpeg에서 image_editing을 거쳐 object_counter로 이어지고 EOS로 끝나는 화살표 사슬, 즉 실행 가능한 skill plan을 내놓는다.
핵심 개념
skill의 형식 정의. 논문은 open Agent Skills 표준과 Jiang et al. 2026을 따라 skill을 5-튜플 si = (mi, Ci, πi, Ti, Ri)로 정의한다. 각 원소는 다음과 같고, 예시는 논문이 든 flood-detection skill의 값이다.
| 원소 | 뜻 | flood-detection의 예시 |
|---|---|---|
| mi | 이름과 한 줄 설명을 담은 메타데이터 | "flood-detection, 수위를 임계값과 비교해 홍수 일수를 센다" |
| Ci | applicability 조건 | "입력에 시간 인덱스가 붙은 수위 시계열과 관측소 임계값이 있다" |
| πi | procedural policy | "순간값을 일별 극값으로 집계한 뒤 action, minor, moderate, major 구간과 비교한다" |
| Ti | termination 조건 | "관측소별 flood_days 개수가 지정 출력 경로에 기록되었다" |
| Ri | 선택적 callable interface 또는 보조 자원 | "Python 헬퍼, USGS dataretrieval API 같은 REST endpoint, 번들 조회 표" |
skill은 인접 개념과 구분된다. tool은 원자적 API 호출이고, plan은 task마다 한 번 쓰고 버리는 추론이며, prompt template은 applicability 게이팅이 없는 정적 텍스트다. skill만이 task와 세션을 가로질러 지속되는 재사용 절차 지식을 담는다.
progressive disclosure. skill library가 skill 본문을 한꺼번에 펼치지 않고 단계적으로 여는 관행이다. 에이전트는 시작 시점에 compact 메타데이터만 로드해 무엇이 있는지 파악하고, 어떤 skill을 쓸지 확정된 뒤에야 full instruction을 활성화한다. SkillComposer도 예측 단계에서는 메타데이터 mi만 소비하고, procedural policy πi와 자원 Ri는 시퀀스가 확정된 다음 열린다.
structured skill composition. 주어진 task와 고정 library에 대해 활성 subset, 개수, 실행 순서를 동시에 정하는 실행 가능 skill plan을 예측하는 문제다. 세 측면을 따로 푸는 것이 아니라 하나의 출력으로 함께 결정한다는 점이 정의의 핵심이다.
닫힌 어휘 위의 생성. 출력 어휘를 library 인덱스 1부터 K까지와 STOP 심볼로 제한하는 설계다. 어휘가 닫혀 있으므로 모델이 생성하는 모든 원소는 실제로 존재하고 실행 가능한 library skill에 대응한다. 존재하지 않는 skill 이름을 만들어 낼 여지가 없고, 예측된 plan을 그대로 다운스트림 에이전트에 로드할 수 있다.
cardinality. 예측된 skill의 개수를 뜻한다. task마다 달라지며 미리 정해지지 않는다. cardinality를 맞히는 일이 별도 문제로 다뤄지는 이유는, skill을 필요보다 많이 방출하면(over-emission) 관련 없는 절차 지식이 컨텍스트를 차지하고 적게 방출하면 필요한 절차가 빠지기 때문이다.
Set F1. 예측 skill 집합과 gold 집합 사이의 순서 무관 F1이다. selection 품질과 cardinality calibration을 한 수치에 담기 때문에 이 논문의 주 지표로 쓰인다. 예측을 너무 많이 하면 precision이, 너무 적게 하면 recall이 떨어지므로 개수를 잘못 맞히는 것이 곧바로 점수에 반영된다.
oracle-k와 best-k. retrieval baseline의 두 변형이다. oracle-k는 gold 시퀀스의 길이를 알려준 상한이고, best-k는 검증 분할에서 고정된 k를 고른 현실적 설정이다. 두 변형을 나란히 두면 selection 품질과 cardinality 예측 능력을 분리해 볼 수 있다. gold 개수를 스스로 정해야 하는 방법은 predicted-k로 묶어 부르고, SkillComposer와 SFT, LLM-judge가 여기 속한다.
방법
문제 정식화
task 설명 x, 환경 컨텍스트 c, skill library S = {s1, …, sK}(K=196)가 주어지면 모델 f_θ가 가변 길이 skill 인덱스 시퀀스 ẑ = (ẑ1, …, ẑn̂, STOP)을 예측한다. 각 ẑt는 1부터 K까지의 값으로 skill 하나를 가리키고, STOP이 나타난 위치가 skill 개수 n̂을 정한다. 인덱스 조회로 실제 skill 시퀀스 ŝ를 복원한 뒤, 예측된 순서 그대로 에이전트 컨텍스트 앞에 붙인다.
이 형식이 세 측면을 한꺼번에 푼다. 어떤 인덱스가 나오는지가 subset을, STOP의 위치가 개수를, 인덱스가 나오는 차례가 순서를 정한다. 각 예측이 task와 library와 이전에 고른 skill에 모두 조건화되므로, 추론 시점에 실행 순서를 따로 명시하지 않아도 연속한 skill 사이의 의존이 자연스럽게 잡힌다.
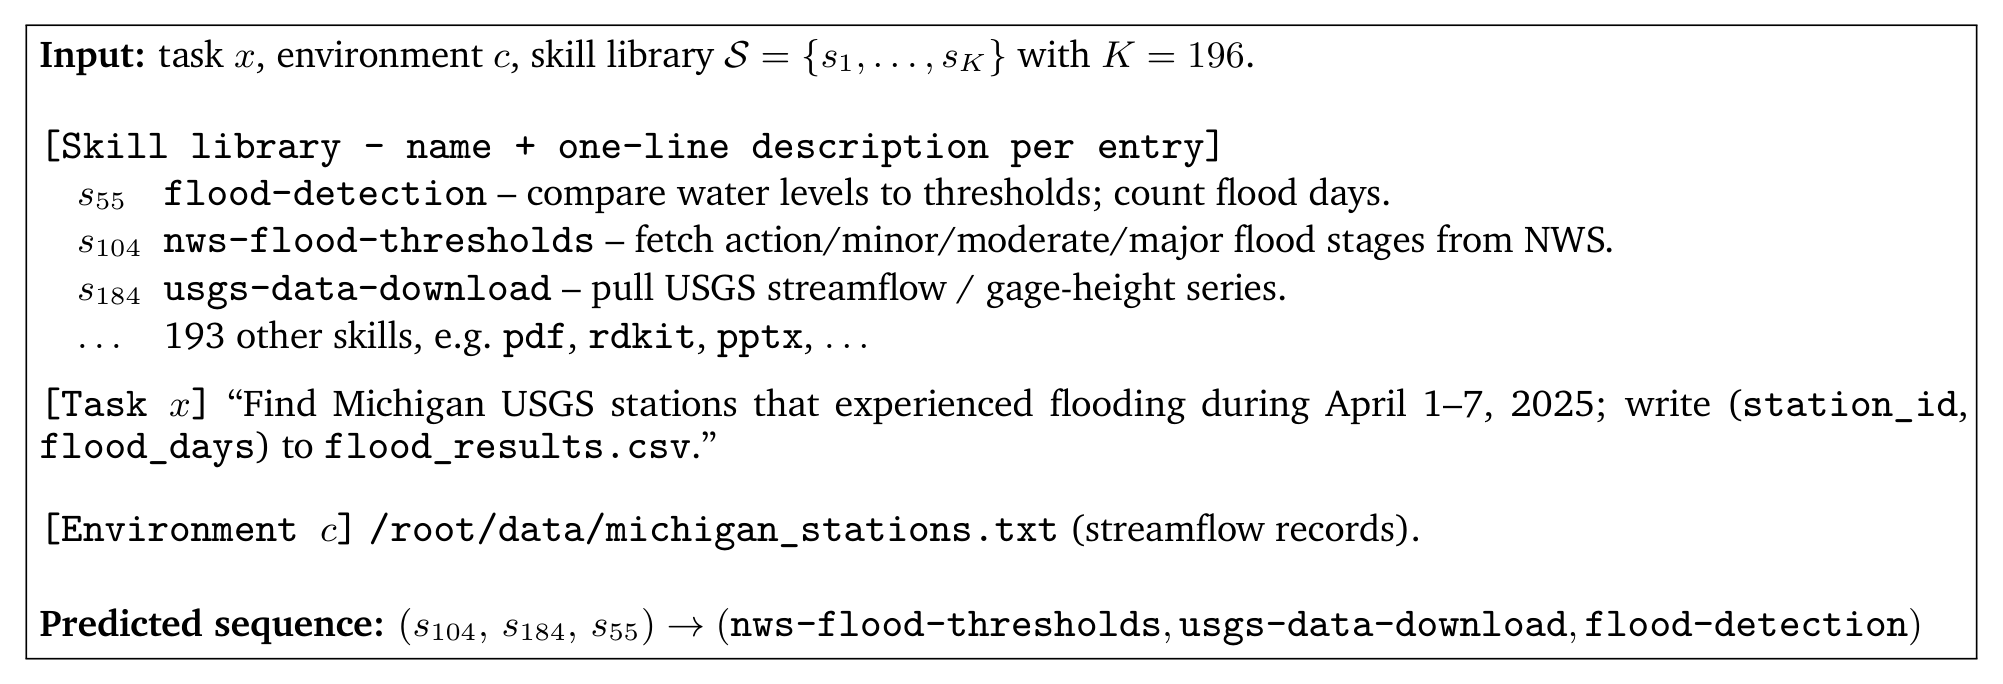
Figure 2의 예시가 구체적이다. 모델은 이름과 한 줄 설명으로 압축된 196개 skill 목록, "2025년 4월 1일부터 7일 사이 홍수를 겪은 Michigan USGS 관측소를 찾아 (station_id, flood_days)를 flood_results.csv에 쓰라"는 task 설명, 그리고 환경으로 주어진 /root/data/michigan_stations.txt를 받는다. 출력은 (s104, s184, s55, STOP)이고 인덱스 조회로 (nws-flood-thresholds, usgs-data-download, flood-detection)이 된다. 임계값을 가져오고 시계열을 내려받은 다음 비교하는 순서가 데이터 흐름과 맞다.
세 구성 요소
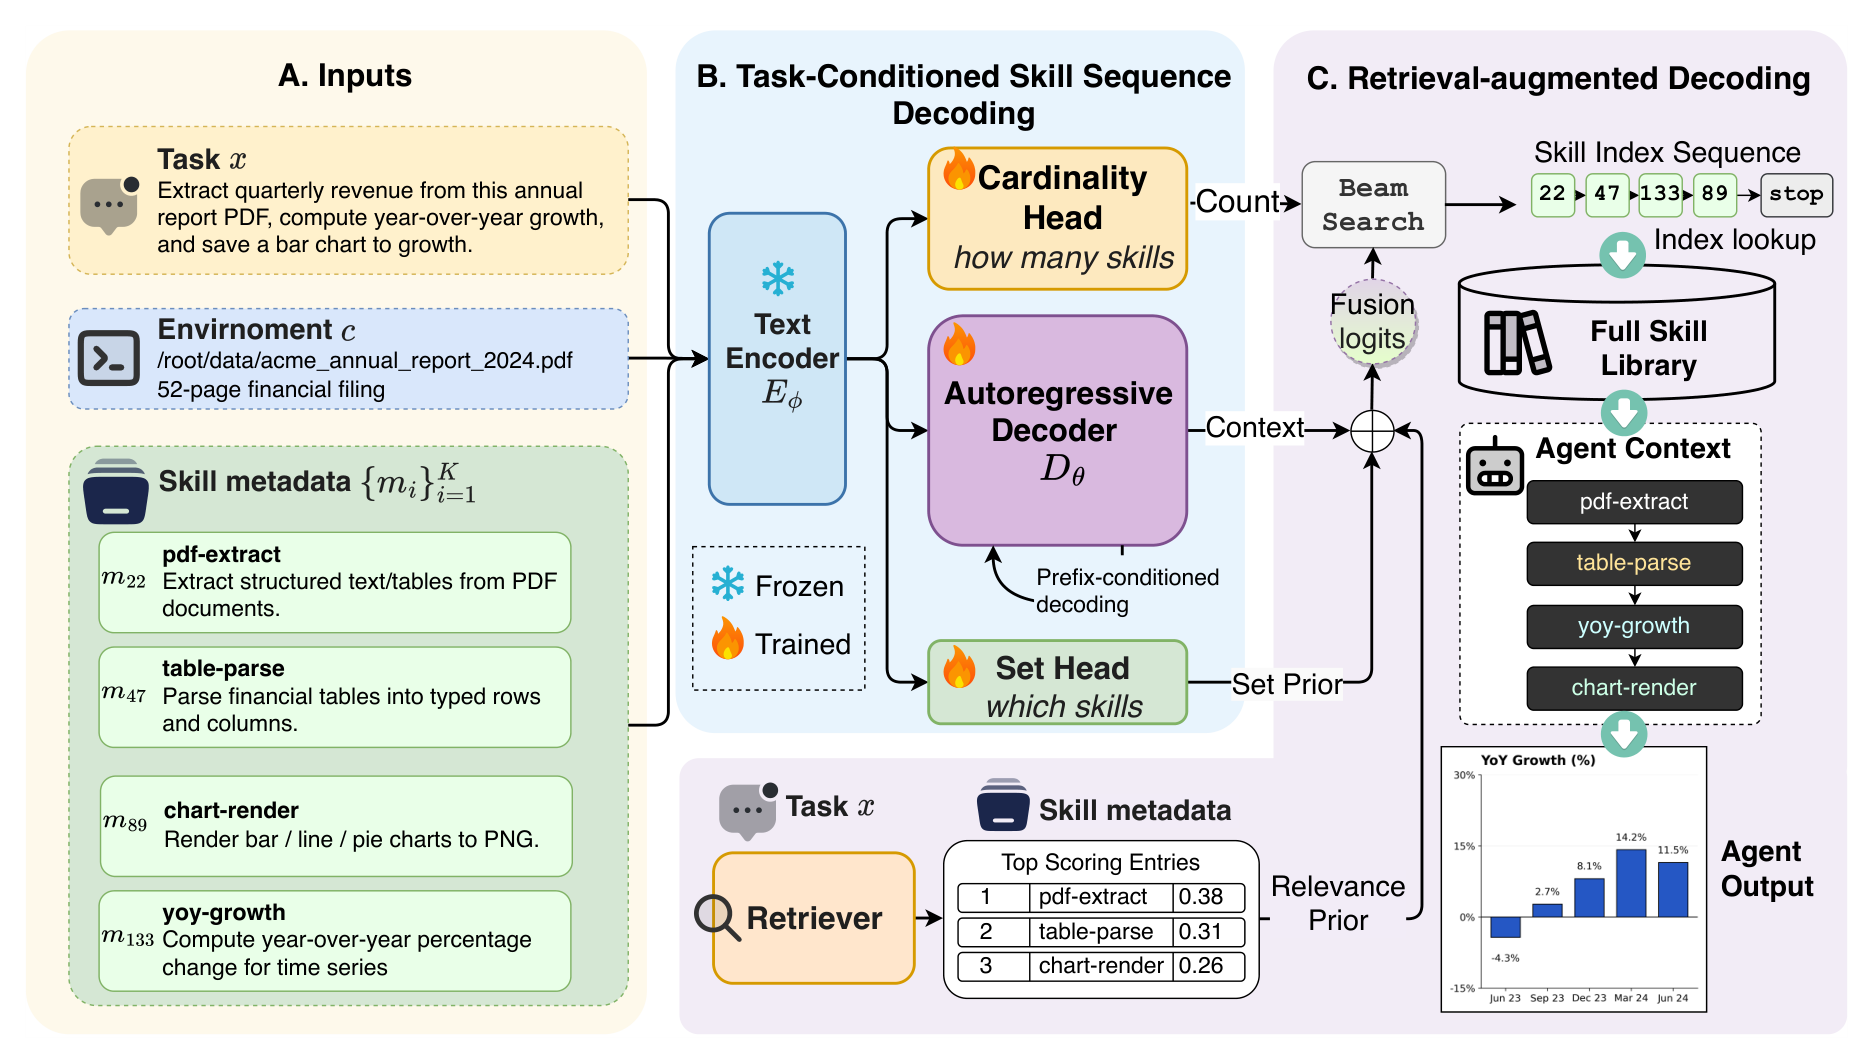
SkillComposer는 얼려 둔 encoder, 학습되는 decoder와 두 보조 head, 그리고 디코딩 시점의 prior 합성으로 이뤄진다.
| 구성 요소 | 역할 | 학습 여부 |
|---|---|---|
| Frozen text encoder | 직렬화된 프롬프트 P(x, c, S)를 pooled task 벡터로 매핑한다 |
얼림 (projection만 학습) |
| Constrained autoregressive decoder | prefix에 조건화해 skill 인덱스를 하나씩 방출하고 ordering을 담당한다 | 학습 |
| Cardinality head | skill 개수를 직접 예측해 STOP과 독립적인 길이 신호를 준다 | 학습 |
| Set head | 각 skill의 관련성을 순서와 무관하게 채점한다 | 학습 |
| Retriever (TF-IDF) | task와 skill 메타데이터 사이의 lexical relevance를 미리 계산한다 | 학습 없음 |
얼려 둔 text encoder
encoder E_φ는 직렬화된 프롬프트를 pooled task 벡터 h = W_proj h_x로 옮긴다. 구현은 Qwen3-Embedding-0.6B이고, last-token pooling에 모델 카드가 권하는 instruct prefix를 붙여 1024차원 출력을 얻은 뒤 d=256으로 projection한다. encoder 파라미터 φ는 얼려 두고 projection W_proj, decoder 파라미터 θ, 두 보조 head 파라미터 ψ와 ξ만 학습한다. 학습 파라미터가 3.9M에 머무는 이유가 여기 있다.
constrained autoregressive decoder
decoder D_θ는 3-layer pre-norm Transformer로 hidden width 256, attention head 4개, dropout 0.1이다. 시퀀스 확률을 pθ(z|x,c,S) = Π pθ(zt | h, z<t)로 분해해 각 토큰을 task 벡터와 이전 토큰들에 조건화한다.
skill은 인덱스만으로 노출되지 않는다. 196행 skill 메모리로 들어가는 cross-attention을 두어, decoder가 메타데이터 임베딩을 참조하며 후보를 자연어 설명으로 구분한다. 출력 어휘는 닫힌 library에 STOP, START, PAD를 더한 것이다.
두 보조 head
AR head 하나가 세 측면의 joint 분포를 모델링하는 형태는 ordering에는 알맞지만 나머지 두 측면의 감독을 희석시킨다. 길이 신호 전체가 단일 STOP 위치 하나에 실리고, 어떤 skill이 관련 있다는 양성 감독은 그 skill의 gold 위치에서만 나타난다. 위치와 무관하게 그 skill이 관련 있다는 신호는 어디에도 없다. 그래서 저자들은 AR head에 ordering을 남기고 남은 두 측면에 전용 감독 채널을 하나씩 붙인다.
- Cardinality head(몇 개): task 벡터 위의 선형 분류기가
pψ(n̂|x,c) = softmax(Wn h)로 skill 개수를 1부터 N_max(=8)까지에서 직접 예측한다. AR head의 STOP 방출과 독립적인 길이 신호이므로 디코딩을 부드럽게 편향시키거나 상한을 강하게 잘라내는 데 쓸 수 있다. - Set head(어떤 skill): pairwise matcher가 각 library skill을 task 벡터와 독립 채점한다.
σi = MLPξ([h; ei; h⊙ei; |h−ei|])이고 ei는 skill si의 메타데이터 임베딩을 projection한 값이다. 연결한 네 항이 task와 skill 사이의 identity, interaction, distance를 함께 담는다. MLP_ξ는 hidden width 256의 2-layer MLP로 출력 logit이 하나다. 감독은 gold membership 지표에 대한 binary cross-entropy이므로, 관련 skill마다 시퀀스 내 위치와 무관하게 직접 gradient가 흐른다.
두 head는 학습 때만 쓰이고 버려지는 것이 아니라, 추론 시점에 디코딩 prior로 다시 쓰인다.
retrieval-augmented decoding
decoder는 모든 정보를 dense 벡터 h_x와 학습된 skill 임베딩을 거쳐 흘려보낸다. 저자들은 이 contextual 채널 하나로는 부족한 이유를 skill의 구조적 성질 두 가지로 설명한다.
첫째, skill library가 heavy-tailed다. 많은 skill이 학습 task 한두 개에만 등장하므로 학습된 표현으로 이들을 가려낼 신호가 약하다. 반면 retrieval 점수는 library 전체 코퍼스를 근거로 계산되며 skill별 학습 데이터를 요구하지 않는다.
둘째, 이런 prior를 붙이는 비용이 거의 없다. 각 출력 인덱스가 고정된 메타데이터 문서 하나에 대응하므로, task와 skill 사이의 relevance를 task당 한 번 미리 계산해 두면 decoder를 고치지 않고 모든 디코딩 스텝에서 그대로 재사용할 수 있다.
retriever r은 library에서 만든 unigram과 bigram 어휘 위의 TF-IDF cosine similarity다. 스텝 t의 fused logit은 세 항의 합이다.
ℓ̃t(i) = ℓt(i)   +   α · ri        +   β · σi
         contextual  relevance         set
| 항 | 의미 | 성질 |
|---|---|---|
ℓt(i) |
decoder가 prefix ẑ<t에 조건화해 낸 logit |
위치 의존, 순서를 담당 |
α · ri |
task와 skill 메타데이터의 lexical relevance | 위치 무관, 학습 데이터 불필요 |
β · σi |
set head가 낸 학습된 membership 점수 | 위치 무관, 순서를 보지 않음 |
추론에서는 검증 Set F1으로 튜닝한 α=1.0, β=0.5를 쓴다. 학습 시점에 시퀀스 손실과 함께 학습되는 두 fusion prior의 가중치는 α=0.5, β=0.25로 별개 값이다. STOP logit에는 relevance도 membership도 더하지 않는다. 종료 판단이 lexical 유사도에 끌려가지 않도록 하려는 설계이며, 그래서 종료는 주로 AR stop logit이 통제하고 필요할 때 cardinality prior가 관여한다. 합성된 logit은 softmax를 거쳐 beam search로 들어가고, beam width 4, length penalty 0.7, 중복 skill 금지 제약이 걸린다.
예측된 plan의 소비 경로
예측이 끝난 뒤의 경로는 Figure 3의 (C)에 그려져 있다. beam search가 확정한 인덱스 시퀀스, 그림의 예시로는 22, 47, 133, 89, stop이 인덱스 조회를 거쳐 full skill 패키지로 복원된다. 복원된 skill은 예측된 순서 그대로 에이전트 컨텍스트 앞에 붙는다. 그림의 예시에서는 pdf-extract, table-parse, yoy-growth, chart-render 순으로 쌓여, 연차보고서 PDF에서 분기 매출을 뽑아 전년 대비 성장률을 계산하고 막대 차트를 저장하라는 task의 데이터 흐름과 맞는다.
이 경로가 닫힌 어휘 설계의 실용적 이득이다. 모델 출력이 자유 텍스트가 아니라 유효한 인덱스이므로 plan을 검사할 수 있고, 별도의 파싱이나 이름 매칭 없이 곧바로 적재된다. retriever가 낸 상위 후보(그림에서는 pdf-extract 0.38, table-parse 0.31, chart-render 0.26)는 순서 없는 점수 목록으로 남아 relevance prior로만 쓰이고, 실행 순서는 decoder가 정한다.
학습 설정
| 항목 | 값 |
|---|---|
| optimizer | AdamW (learning rate 1e-4, weight decay 0.01) |
| batch size | 64 |
| epoch | 최대 100, 검증 Set F1 기준 patience 15의 early stopping |
| encoder 후보 | Qwen3-Embedding-0.6B (last-token pooled) 대 Qwen3-0.6B-Base (causal LM, mean-pooled) |
| 학습 시 fusion 가중치 | α=0.5, β=0.25 |
| 추론 시 fusion 가중치 | α=1.0, β=0.5 |
| 디코딩 | beam width 4, length penalty 0.7, 중복 skill 금지 |
| 하이퍼파라미터 탐색 | 검증 분할 위의 coordinate ascent |
| latency 측정 환경 | A6000 1장, fp16, batch 1 |
coordinate ascent로 고르는 값은 lexical 가중치와 set fusion 가중치, 그리고 per-split stop bias다. per-split stop bias는 synthetic 데이터와 real 데이터가 서로 다른 cardinality 분포를 갖는 편차를 흡수하는 항이다. encoder 후보 중 causal LM을 쓴 변형이 논문에서 SkillComposer_Base로 불리며, 뒤의 결과에서 encoder 선택의 효과를 재는 기준선이 된다.
데이터셋 구축
skill dependency graph
multi-skill 감독 신호의 근거가 되는 그래프는 노드 196개, 즉 library skill 하나당 하나를 갖는다. edge는 두 종류다.
| Edge 유형 | 연결 기준 | 순서의 근거 | 개수 |
|---|---|---|---|
| Dependency | 상류 skill의 출력 type이 하류 skill의 입력 type과 겹친다 | 데이터 흐름이 순서를 결정한다 | 658 |
| Workflow | 두 skill이 real task 에이전트 trajectory에서 함께 등장한다 | 관측된 실행 순서를 따른다. 공유 I/O type이 없을 때 쓴다 | 266 |
| 합계 | 924 |
multi-skill 합성은 dependency edge에서 65%, workflow edge에서 35%를 뽑는다. 이 비율은 real anchor task에서 관측된 값, 즉 엄격한 데이터 흐름 사슬과 느슨한 plan-then-implement 워크플로가 나타나는 비율에 맞춘 것이다.
3계층 합성
학습 코퍼스는 순서의 근거에 따라 세 그룹으로 나뉘고 합계 9,872개 레코드다.
| 그룹 | 개수 | 생성 | 목적과 순서의 근거 |
|---|---|---|---|
| Real anchor | 65 | 사람이 작성 (Li et al. 2026) | 실제 소프트웨어 엔지니어링 task와 gold skill 주석. 순서는 에이전트 trajectory 로그에서 복원하고, 로그가 없으면 Gemini 2.5 Pro 폴백으로 채운다 |
| Single-skill synthetic | 2,880 | Gemini 2.5 Flash | 196개 skill을 균등하게 덮고, 단순 질의(query)에서 skill 하나만 쓰고 종료하도록 calibration한다 |
| Multi-skill synthetic | 6,927 | Gemini 2.5 Pro | skill 2개에서 5개까지의 조합. dependency edge와 workflow edge에서 순서를 얻는다 |
single-skill 프롬프트는 호출 한 번에 task 5개를 요구하고 난이도를 easy 2개, medium 2개, hard 1개로 배분한다. 각 task가 서로 다른 도메인(금융, IoT 센서, 생물정보학, 물류, 소셜 미디어 분석 등)과 서로 다른 입력 형태(단일 파일, 파일 디렉터리, 스트리밍 데이터, API 응답, 데이터베이스 내보내기)를 쓰도록 지시한다. 핵심 제약은 task 설명에 대상 skill의 이름을 쓰지 못하게 막는 것이다. 그래서 모델이 표면형 일치가 아니라 의미로 skill 정체를 복원해야 한다.
multi-skill 프롬프트는 뽑힌 skill 전부를 써야 하는 현실적인 task 하나를 만들게 하고, 실행 순서와 그 근거를 함께 제출하게 한다. 뽑힌 skill이 dependency edge로 연결되어 있으면 "skill A가 skill B보다 먼저 와야 한다"는 순서 제약을 문장 그대로 프롬프트에 넣어 데이터 흐름 방향이 보존되게 한다. 반환값 ordered_skills는 입력으로 준 skill ID의 permutation이어야 한다.
중복 제거와 유효성 검사
합성된 레코드는 풀에 들어가기 전에 이미 받아들인 모든 레코드와 비교된다. 검사는 강도를 올려 가며 세 단계를 거친다.
| 단계 | 기준 | 걸러내는 것 |
|---|---|---|
| 1 | task 식별자나 지시문 텍스트의 정확 문자열 매치 | 바이트 단위로 동일한 중복 |
| 2 | 두 지시문 사이의 character-trigram Jaccard 유사도 0.6 초과 | 표현만 조금 바꾼 근사 중복 |
| 3 | 캐시된 library 임베딩 뱅크에 대한 sentence-embedding cosine 0.92 초과 | 의미가 같은 중복 |
중복을 넘긴 레코드는 닫힌 어휘 검사를 받는다. skill을 추가하거나 빼거나 이름을 바꾼 응답, ordered_skills가 프롬프트 입력의 정확한 permutation이 아닌 응답은 폐기한다. multi-skill 레코드는 프롬프트에 주입한 dependency-edge 순서 제약을 반환 순서가 지켰는지 한 번 더 확인한다.
분할은 90/5/5 train/val/test인데, 전체에 한 번 적용하지 않고 세 그룹 안에서 각각 독립적으로 seed 42로 적용한다. 그래서 그룹 비율이 세 분할에서 유지되고, 검증과 테스트 집합이 수가 훨씬 많은 synthetic 그룹에 지배되지 않는다.
평가 설계
두 평가 체제
두 체제는 데이터 구성을 공유하되 held-out 부분집합이 다르다. 같은 코퍼스로 상한과 전이 성능을 각각 재려는 설계다.
| 체제 | 규모 | 학습 데이터 | 재는 것 |
|---|---|---|---|
| in-distribution test | n=494 | 세 그룹 전부의 train 분할 | 학습과 테스트가 같은 생성기에서 나올 때의 상한 |
| real-task holdout | n=65 | real task를 train과 val에서 모두 제거한 synthetic 전용 | synthetic만 보고 학습한 모델이 사람이 쓴 실제 task로 전이되는 정도 |
두 체제 모두 Harbor evaluation framework 위에 세운 결정적 verifier로 채점한다.
baseline
세 계열 모두 같은 닫힌 library에서 skill 8개 이하의 순서 있는 목록을 예측한다.
| 계열 | 구성 | 특징 |
|---|---|---|
| Retrieval | BM25, TF-IDF cosine, Qwen3-Embedding-0.6B | 각각 검증으로 k를 고른 best-k와 gold 길이를 알려준 oracle-k 두 변형을 둔다 |
| LLM-judge | Gemini-2.5-flash | 196개 skill의 이름과 메타데이터를 한 프롬프트에 담아 채점하고 순서 있는 shortlist를 바로 반환한다. 어떤 skill과 몇 개를 모두 모델이 고른다 |
| SFT | Qwen3-0.6B-Base | 600M backbone 전체를 fine-tuning해 순서 있는 skill 시퀀스를 텍스트로 생성한다. 196개 skill 이름을 토크나이저 special token으로 추가하고, 학습된 EOS 클래스에서 멈추는 greedy decoding을 쓴다 |
지표
| 지표 | 정의 | 분리해 보는 것 |
|---|---|---|
| Set F1 | 예측 집합과 gold 집합 사이의 순서 무관 F1 | selection 품질과 cardinality calibration을 함께 |
| Recall@5 | 상위 5개 예측의 gold skill 커버리지 | selection을 cardinality와 분리 |
| MRR | gold skill을 처음 맞힌 예측의 역순위 | 목록 최상단의 정확도 |
| nDCG@5 | 이진 관련도와 로그 할인으로 채점한 상위 5개 순서 | 순서 품질 |
| Set EM | 순서 무관 exact match | 집합 전체를 정확히 맞혔는지 |
다운스트림 평가는 pass rate, normalised gain, 그리고 입력 프롬프트 토큰 수를 보고한다.
결과
skill 예측 품질
| 계열 | 방법 | Set F1 (synth) | R@5 (synth) | MRR (synth) | nDCG@5 (synth) | SetEM (synth) | Set F1 (real) | R@5 (real) | MRR (real) | nDCG@5 (real) | SetEM (real) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Retrieval (oracle-k) | BM25 | 35.3 | 35.3 | 54.4 | 38.3 | 14.8 | 55.9 | 55.6 | 73.6 | 59.2 | 33.8 |
| Retrieval (oracle-k) | TF-IDF | 58.4 | 58.4 | 81.0 | 63.0 | 28.7 | 74.2 | 73.2 | 89.2 | 77.3 | 47.7 |
| Retrieval (oracle-k) | Qwen3-Emb. | 49.0 | 49.0 | 69.9 | 52.0 | 20.2 | 73.4 | 72.7 | 90.9 | 76.9 | 47.7 |
| Retrieval (best-k) | BM25 (k=2) | 33.0 | 33.7 | 53.9 | 37.0 | 2.2 | 47.0 | 48.7 | 72.3 | 54.0 | 7.7 |
| Retrieval (best-k) | TF-IDF (k=2) | 52.5 | 53.0 | 82.2 | 58.9 | 4.3 | 60.6 | 60.6 | 89.2 | 67.7 | 10.8 |
| Retrieval (best-k) | Qwen3-Emb. (k=3) | 43.9 | 55.0 | 72.3 | 55.3 | 2.6 | 58.5 | 69.2 | 90.8 | 73.8 | 10.8 |
| LLM-judge | Gemini-2.5-flash | 61.0 | 69.0 | 69.3 | 63.1 | 21.3 | 59.9 | 63.8 | 81.8 | 65.1 | 15.4 |
| Trained | SFT (Qwen3-0.6B-Base) | 71.1 | 68.9 | 79.2 | 74.1 | 44.9 | 43.6 | 36.1 | 66.2 | 46.0 | 16.9 |
| Trained | SkillComposer_Base | 70.4 | 70.9 | 84.2 | 73.2 | 37.2 | 53.9 | 45.0 | 87.7 | 54.1 | 16.9 |
| Trained | SkillComposer | 73.9 | 72.4 | 86.5 | 75.0 | 41.3 | 62.9 | 54.7 | 90.8 | 63.4 | 20.0 |
in-distribution test에서 SkillComposer의 Set F1은 73.9%다. SFT보다 2.8%p, LLM-judge보다 12.9%p 높은데 학습 파라미터는 약 154배 적다(3.9M 대 600M). MRR과 nDCG@5의 순위도 같다. AR head가 목록 최상단의 순서를 더 날카롭게 뽑기 때문이며, SFT는 gold 시퀀스를 텍스트로 그대로 암기할 수 있는데도 Set EM(44.9% 대 41.3%)에서만 근소하게 앞선다.
두 학습 모델은 retrieval 계열 전체와 LLM-judge를 압도하고, gold 길이를 알려준 oracle-k retrieval 상한까지 넘어선다. 이유는 두 가지다. retrieval은 개수를 외부에서 받아야 하고, LLM-judge는 컨텍스트 예산 안에서 196개 skill의 본문 전체를 읽을 수 없어 이름과 한 줄 설명만 보고 판단한다. 반면 학습 모델은 어떤 skill과 몇 개인지를 함께 예측한다.
cardinality 구간별 성능
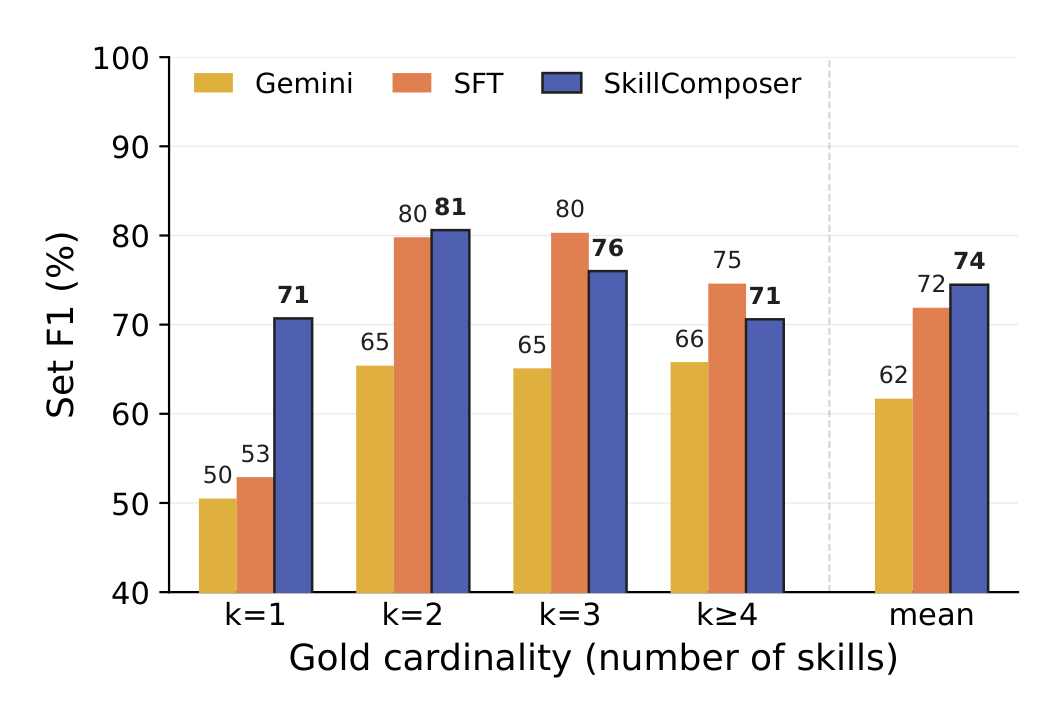
| gold cardinality | Gemini | SFT | SkillComposer |
|---|---|---|---|
| k=1 | 50 | 53 | 71 |
| k=2 | 65 | 80 | 81 |
| k=3 | 65 | 80 | 76 |
| k가 4 이상 | 66 | 75 | 71 |
| macro 평균 | 62 | 72 | 74 |
SkillComposer의 이점은 k=1 구간에 몰려 있고 그 폭이 18%p로 가장 크다. gold 정답이 skill 하나인 task에서 필요 이상으로 방출하면 precision이 곧바로 떨어지므로, over-emission이 가장 크게 벌 받는 구간이 여기다. cardinality head가 STOP과 독립적인 길이 신호를 공급하는 효과가 이 구간에서 드러난다.
반대 방향의 약점도 같은 표에 있다. k=3과 k가 4 이상인 구간에서는 LM 방식 디코딩을 그대로 쓰는 SFT가 각각 4%p씩 앞선다. macro 평균에서 SkillComposer가 가장 높은 것은 k=1에서 벌어 둔 폭이 이 손실보다 크기 때문이다. 이 역전은 뒤의 사례 분석에서 확인되는 short-sequence bias와 같은 현상이다.
distribution shift 내구성
real-task holdout에서 두 학습 모델의 거동이 갈린다.
| 모델 | synthetic test | real holdout | 하락 폭 |
|---|---|---|---|
| SFT (Qwen3-0.6B-Base) | 71.1 | 43.6 | 27.5%p |
| SkillComposer_Base | 70.4 | 53.9 | 16.5%p |
| SkillComposer | 73.9 | 62.9 | 11.0%p |
SFT는 27.5%p 급락하는데 SkillComposer는 11.0%p만 하락해, 같은 학습 데이터와 같은 library에서 19.3%p의 Set F1 격차가 생긴다. predicted-k 방법 중 gold 개수를 듣지 않고 oracle-k 상한에 근접하는 것은 SkillComposer뿐이며, frontier LLM-judge를 상대로도 Set F1이 가장 높다.
retrieval 계열은 오히려 synthetic에서 real로 갈 때 개선된다. 사람이 쓴 real task의 표현이 skill 설명 문구에 더 가깝기 때문이다. 반면 SFT는 synthetic 템플릿 분포를 암기했을 뿐이어서 되돌아가 기댈 견고한 prior가 없다.
이 전이 편향을 공급하는 것이 얼려 둔 retrieval-tuned encoder와 작은 specialist decoder의 조합이다. encoder만 causal LM으로 바꾼 SkillComposer_Base가 real holdout에서 53.9%에 그쳐 본 모델보다 9.0%p 낮다는 점이 그 근거다. encoder 선택이 in-distribution에서는 3.5%p 차이(70.4% 대 73.9%)에 불과하지만 전이 상황에서는 훨씬 크게 벌어진다.
다운스트림 task 성능
평가는 88개 SkillsBench task 중 75개로 한다. 제외한 13개는 Anthropic 번들 포맷 skill(pdf, xlsx, pptx, docx)이 지배하는 office와 document 처리 task다. 어떤 retriever든 파일 확장자로 사소하게 라우팅할 수 있어 skill 적재 방식 사이의 차이를 드러내지 못한다.
두 에이전트는 GPT-5.2-Codex(Azure OpenAI 경유)와 Gemini-3-Pro-Preview(Gemini CLI 경유)다. 각 에이전트는 Harbor 안에서 결정적 pytest verifier와 1200초 timeout으로 실행되고, task당 3회 시도해 에이전트와 조건 조합마다 225 trial을 돌리며 temperature는 0이다. 보고 값은 SkillsBench 프로토콜을 따른 binary pass rate와, 오류 없이 끝난 trial의 평균 입력 프롬프트 토큰 수다.
| Skill 조건 | Codex Pass(%) | Codex Tok. | Gemini Pass(%) | Gemini Tok. |
|---|---|---|---|---|
| Retrieval (oracle) | 44.0 | 1.13M | 42.2 | 1.19M |
| Gold Skills (상한) | 51.1 | 1.12M | 48.4 | 1.18M |
| No Skills | 22.2 | 0.94M | 25.8 | 0.99M |
| All Skills (196개 전부) | 29.3 | 1.27M | 38.7 | 1.33M |
| Retrieval (top-3) | 44.0 | 1.09M | 41.8 | 1.14M |
| SkillComposer | 45.3 | 1.03M | 44.0 | 1.08M |
두 에이전트가 같은 양상을 보인다. pass rate가 No Skills에서 curated Gold Skills 상한까지 오르며, 그 사이에 약 25%p의 여백이 남는다. skill 적재 기법이 메울 수 있는 몫이 이 여백이다.
library 전부를 프롬프트에 주입하는 All Skills는 그 여백의 일부만 회복하면서 Codex 프롬프트를 1.27M 토큰까지 부풀린다. No Skills 대비 토큰이 35% 늘었는데 pass rate는 7.1%p만 올랐다. 컨텍스트를 쏟아붓는 것으로는 충분하지 않다는 확인이다.
Retrieval (top-3)은 더 작은 프롬프트 예산(1.09M)으로 훨씬 큰 몫을 메워 44.0%에 이르고, gold skill 집합으로 retrieval을 제한한 Retrieval (oracle)조차 같은 44.0%에 그친다. 남은 여백을 만드는 것이 retrieval recall이 아니라 task별 selection 품질이라는 뜻이다.
SkillComposer는 oracle skill 레이블 없이 calibrated ordered shortlist를 예측해 Codex 45.3%, Gemini 44.0%에 도달한다. 두 retrieval baseline을 앞서고 Retrieval (oracle)을 매치하거나 넘어서면서, skill을 적재한 조건 가운데 가장 작은 프롬프트 예산(Codex 1.03M 토큰)을 쓴다. 두 에이전트 모두에서 여백의 약 80%를 닫는다. 다만 curated Gold Skills 상한(Codex 51.1%, Gemini 48.4%)에는 아직 못 미친다.
구성 요소 ablation
| 변형 | Set F1 | 전체 대비 |
|---|---|---|
| AR-only (auxiliary head 없음) | 69.3 | -4.6%p |
| + set head | 71.8 | -2.1%p |
| + cardinality head | 69.6 | -4.3%p |
| SkillComposer (전체) | 73.9 | 기준 |
| 디코딩 set fusion 제거 (β=0) | 65.0 | -8.9%p |
| 디코딩 retrieval prior 제거 (α=0) | 67.5 | -6.4%p |
학습 시점에 set-membership head를 더하면 Set F1이 69.3%에서 71.8%로 2.5%p 오른다. gold skill마다 순서 무관 gradient가 흘러 AR objective를 보완하기 때문이다. cardinality head 단독은 69.6%로 0.3%p만 올라 기여가 작다. 길이 신호만으로는 어떤 skill을 고를지가 나아지지 않기 때문이며, 두 head를 함께 쓴 전체 구성에서 73.9%가 된다.
디코딩 시점의 두 fusion prior는 둘 다 필요하다. set fusion을 끄면 8.9%p, lexical retrieval prior를 끄면 6.4%p 떨어진다. 보조 head가 학습용 정규화로만 쓰이는 것이 아니라 추론에서 AR logit을 다듬는 데도 실제로 기여한다는 뜻이다.
수치 주의: 논문 본문은 같은 대목의 손실을 7.1%p와 4.6%p로 적어 Table 3의 값과 어긋난다. 위 표는 Table 3의 값을 그대로 옮겼다.
디코딩 prior 선택
| 디코딩 prior | Set F1 | 성질 |
|---|---|---|
| prior 없음 | 67.5 | 기준 |
| BM25 | 70.0 | sparse lexical |
| Qwen3-Embedding | 68.8 | dense semantic |
| TF-IDF | 73.9 | sparse lexical |
디코딩 prior로는 sparse가 dense를 앞선다. 닫힌 library가 짧고 구문적으로 특이한 skill 이름 196개를 노출하기 때문에, token 수준 overlap이 이들을 구분하는 데 고정밀이다. imc-tuning-rules나 lomb-scargle-periodogram 같은 이름은 task 설명에 나타나는 어휘와 직접 겹치기 쉽다. 반면 dense 임베딩은 더 넓은 의미 컨텍스트를 평균해 과하게 일반화하고, 서로 다른 skill을 비슷한 벡터로 보낸다.
주의할 점은 이 결론이 디코딩 prior에만 적용된다는 것이다. task 표현 h_x에는 dense encoder가 여전히 옳은 선택이다. 그래서 SkillComposer는 task를 dense Qwen3-Embedding으로 인코딩하고 디코딩 prior에 sparse TF-IDF를 쓰는 조합을 택해 둘의 강점을 함께 가져간다.
하이퍼파라미터 민감도와 효율
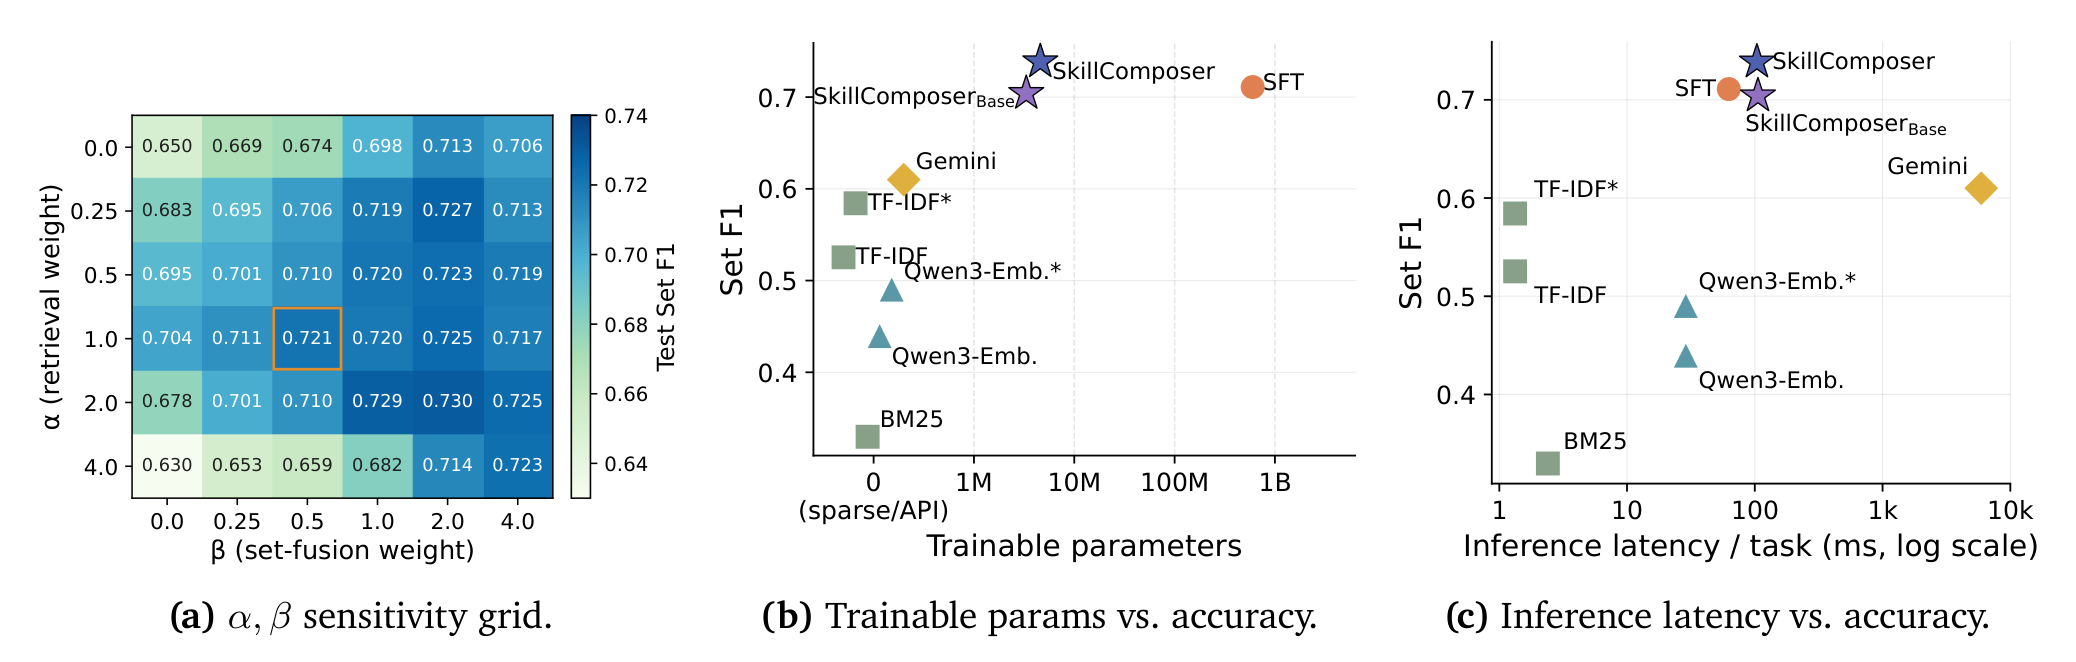
두 fusion 가중치를 6x6 격자로 훑은 결과는 다음과 같다. 행이 retrieval 가중치 α, 열이 set fusion 가중치 β이고 값은 test Set F1이다.
| α \ β | 0.0 | 0.25 | 0.5 | 1.0 | 2.0 | 4.0 |
|---|---|---|---|---|---|---|
| 0.0 | 0.650 | 0.669 | 0.674 | 0.698 | 0.713 | 0.706 |
| 0.25 | 0.683 | 0.695 | 0.706 | 0.719 | 0.727 | 0.713 |
| 0.5 | 0.695 | 0.701 | 0.710 | 0.720 | 0.723 | 0.719 |
| 1.0 | 0.704 | 0.711 | 0.721 | 0.720 | 0.725 | 0.717 |
| 2.0 | 0.678 | 0.701 | 0.710 | 0.729 | 0.730 | 0.725 |
| 4.0 | 0.630 | 0.653 | 0.659 | 0.682 | 0.714 | 0.723 |
표면은 매끄러운 그릇 형태다. 검증으로 고른 동작점(α=1.0, β=0.5)의 값은 0.721이고 모든 이웃 칸이 2%p 안에 들어와, 이 방법이 취약한 수동 튜닝에 의존하지 않는다는 근거가 된다. 격자 최대값 0.730은 α=2.0, β=2.0에서 나오고 동작점과 0.9%p 차이다. 최소값 0.630은 retrieval 가중치만 4.0으로 크게 주고 set fusion을 완전히 끈 칸에서 나온다. 두 prior 중 하나만 강하게 쓰는 설정이 가장 나쁘다는 뜻이다.
효율 프런티어도 유리하다. SkillComposer는 학습 파라미터를 약 154배, 학습 compute를 약 25배 적게 쓰면서 SFT를 매치하거나 앞선다. 추론 latency는 SFT와 같은 등급이고 API 기반 judge보다 두 자릿수 배 빠르다. 결과적으로 predicted-k 방법 가운데 Pareto-optimal에 놓인다.
데이터 층별 분해
결정적 baseline만 대상으로 synthetic test 분할을 데이터 층별로 쪼갠 결과다.
| 방법 | Real anchors | Single-skill | Multi-skill | Multi-skill (graph) | All |
|---|---|---|---|---|---|
| TF-IDF (k=2) | 53.3 | 45.8 | 65.9 | 53.7 | 52.5 |
| TF-IDF (oracle-k) | 66.7 | 58.3 | 66.8 | 57.1 | 58.4 |
| BM25 (k=2) | 29.2 | 31.0 | 35.0 | 33.6 | 33.0 |
| Qwen3-Emb (k=3) | 51.8 | 36.8 | 50.3 | 46.3 | 43.9 |
| Qwen3-Emb (oracle-k) | 62.5 | 52.8 | 50.4 | 46.8 | 49.0 |
| LLM-judge | 62.5 | 60.5 | 81.6 | 75.0 | 71.3 |
synthetic 전용 층에서는 LLM-judge가 multi-skill 합성 층에서 앞선다(free-form 81.6%, graph-grounded 75.0%). 이 층의 task 설명이 길어 프롬프트에서 얻을 의미 신호가 많기 때문이다. TF-IDF와 Qwen3-Embedding retrieval은 같은 두 층에서 45%에서 66% 사이에 흩어진다.
두 가지 유보 사항이 붙는다. 첫째, 학습 모델 행은 이 표에서 빠졌다. 층별 canonical 예측을 레코드 ID와 맞춰 저장하지 않았기 때문이고, 논문은 canonical 체크포인트로 추론을 다시 실행하는 일을 후속 개정으로 남긴다. 둘째, real anchor 열은 synthetic test에 real anchor 레코드가 n=4뿐이어서 표준오차가 0.25를 넘으므로 주의해 읽어야 한다.
한 가지 어긋남도 있다. Table 6의 LLM-judge "All" 열은 71.3%인데 Table 1의 같은 모델 synthetic test Set F1은 61.0%다. 나머지 여섯 행의 All 열은 Table 1과 정확히 일치하므로 LLM-judge 행만 두 표가 다른 값을 적고 있다.
사례 분석
pass rate 격차가 어디서 오는지 보기 위해 논문은 SkillsBench task 3개를 들여다본다. GPT-5.2-Codex, task당 3 trial, 동일 에이전트와 동일 task 정의에서 세 방법이 서로 다른 skill 집합을 공급한 사례다.
| 사례 | 방법 | reward | 공급된 skill |
|---|---|---|---|
| adaptive-cruise-control | SkillComposer | 1.00 | imc-tuning-rules, pid-controller, simulation-metrics, vehicle-dynamics |
| adaptive-cruise-control | Retrieval (top-3) | 0.33 | pid-controller, simulation-metrics, vehicle-dynamics |
| adaptive-cruise-control | Gold Skills | 0.33 | csv-processing, pid-controller, simulation-metrics, vehicle-dynamics, yaml-config |
| exoplanet-detection-period | SkillComposer | 1.00 | light-curve-preprocessing, lomb-scargle-periodogram, transit-least-squares |
| exoplanet-detection-period | Gold Skills | 0.00 | box-least-squares, exoplanet-workflows, 그리고 위 3개 |
| lean4-proof | SkillComposer | 0.67 | lean4-memories |
| lean4-proof | Retrieval (top-3) | 1.00 | lean4-memories, lean4-theorem-proving, python-scala-functional |
| lean4-proof | Gold Skills | 0.67 | lean4-memories, lean4-theorem-proving |
top-k 절단으로 인한 핵심 skill 누락
adaptive-cruise-control은 적응형 정속 주행 시뮬레이션을 구현하는 task다. verifier가 rise time 10초 미만, overshoot 5% 미만, 정상상태 속도 오차 0.5m/s 미만, 거리 정상상태 오차 2m 미만, 최소 간격 5m 초과를 검사한다.
top-3 retrieval은 눈에 보이는 제어 skill 3개를 유지하면서 imc-tuning-rules를 잘라낸다. rise time과 overshoot 규격을 한 번에 만족하는 PID gain을 계산해 주는 IMC heuristic인데, 이것이 없으면 에이전트가 gain을 손으로 조정하다 3회 중 2회 규격을 놓쳐 0.33에 머문다.
curated Gold Skills는 더 시사적이다. 제어기 튜닝이라는 병목에 아무 정보도 주지 않는 I/O 포맷 skill 2개(csv-processing, yaml-config)를 묶어 두고 자신도 0.33에 그친다. SkillComposer는 gold에서 벗어나 I/O wrapper를 버리고 gold가 빠뜨린 imc-tuning-rules를 채택해 1.00을 받는다. 이 사례가 말하는 것은 SkillComposer가 gold 정답으로 회귀하는 것이 아니라 실제로 유용한 skill을 식별한다는 점이다. 그리고 top-k retrieval은 구조상 아슬아슬한 실패를 통과로 바꿀 그 skill 하나가 늘 빠질 수 있다.
소규모 집합의 우위
exoplanet-detection-period는 TESS 광도 곡선에서 항성 활동 진동에 묻힌 외계 행성 신호를 찾아 공전 주기를 복원하는 task다. SkillComposer는 전처리에서 Lomb-Scargle periodogram을 거쳐 transit least squares로 가는 최소 recipe로 수렴해 매 trial 성공한다.
gold pack은 여기에 중복인 box-least-squares estimator와 무거운 exoplanet-workflows wrapper를 더한다. 그 결과 에이전트가 더 긴 파이프라인을 타면서 항성 진동에 과적합하고 0.00에 머문다. 작고 잘 고른 집합이 큰 curated 집합을 앞선다는 뜻이며, library 전부를 쏟는 All Skills가 pass rate를 해치는 다운스트림 결과와 같은 방향이다.
long-chain task의 과소 방출
lean4-proof는 모든 자연수 n에 대해 Sn = Σ 1/2^i ≤ 2를 증명하는 Lean 4 템플릿을 마무리하는 task다. SkillComposer는 snippet 수준 메모 skill인 lean4-memories 하나만 방출하고, 귀납 단계를 처리하는 데 필요한 tactic과 Mathlib 참조 skill인 lean4-theorem-proving 앞에서 멈춘다.
retrieval은 python-scala-functional까지 더해 3개 사슬을 온전히 유지하며 1.00에 도달한다. gold는 2개 사슬을 가지고도 0.67에 머무는데, 한 trial에서 증명 내용과 무관한 Lean kernel 오류가 났기 때문이다.
같은 한 칸 부족 양상이 grid-dispatch-operator와 dapt-intrusion-detection에서도 되풀이된다. gold 시퀀스가 skill 2개에서 3개 이상일 때 SkillComposer의 shortlist가 한 칸 짧아지는 경향이며, 데이터 구축에서 synthetic 코퍼스가 skill 3개 이하 조합에 치우친 결과다. Figure 4에서 SFT가 k=3 이상 구간에서 소폭 앞서는 것과 같은 현상이다.
선행 연구와의 위치
논문은 세 연구 계열을 놓고 자신의 자리를 정한다.
| 계열 | 대표 연구 | 하는 일 | 이 논문과의 차이 |
|---|---|---|---|
| skill library와 discovery | Voyager (Wang 2023), CRAFT (Yuan 2023), CREATOR (Qian 2023), Ma 2025 | 재사용 가능한 skill이나 tool을 만들어 배포 시점에 검색하게 한다 | 모두 selection 시점에 flat retrieval을 쓴다. 임베딩 유사도로 skill을 독립 랭킹하므로 몇 개가 필요한지, 서로 어떻게 의존하는지를 고려하지 않는다 |
| 최근 skill 기반 에이전트 설계 | SkillRouter (Zheng 2026), SkillFlow (Li 2025), Graph of Skills (Liu 2026a), Skill Retrieval Augmentation (Su 2026), SkillsBench (Li 2026), SoK Agentic Skills (Jiang 2026), SkillRL (Xia 2026), Agent Skills in the Wild (Liu 2026b) | retrieve-and-rerank 라우팅, retrieval 증강 skill 사용, 벤치마킹, 생애주기 분류, RL 기반 skill 구축, 현실적 retrieval 조건 분석 | 어느 연구도 skill selection을 명시적 cardinality와 ordering 결정을 갖는 닫힌 어휘 시퀀스 생성으로 모델링하지 않는다 |
| tool 수준 planning | HuggingGPT (Shen 2023), ToolChain* (Zhuang 2023), TaskBench (Shen 2024), ToolkenGPT (Hao 2023), graph planning (Wu 2024) | 원자적 함수 호출 수준의 action space에서 분해, 탐색, 그래프 평가, 어휘 임베딩으로 planning한다 | API 호출 수준이라 typed signature와 반환값이 강한 구조 신호를 준다. skill 수준에서는 그 신호가 없다 |
| 생성적 retrieval | Recommender Systems with Generative Retrieval (Rajput 2023), ToolkenGPT (Hao 2023) | 닫힌 어휘 위의 생성으로 retrieval과 tool selection을 프레이밍한다 | 이 논문이 직접 착안점으로 밝힌 계보다 |
skill 수준이 API 수준보다 어려운 이유를 논문은 두 가지로 정리한다. 첫째, skill에는 typed signature가 없어 의존성이 latent하고 데이터 type이 아니라 task 논리에서 나온다. 둘째, catalog가 작아도 상호작용이 강하다. skill 2개만 바꾸거나 순서를 뒤집어도 task 결과가 뒤집힌다. 그래서 flat 유사도 retrieval과 원자적 action 탐색이 모두 부적합하고, composition을 결합 예측으로 다뤄야 한다는 결론에 이른다.
skill library가 필요해진 배경으로는 SWE-bench (Jimenez 2024), SWE-agent (Yang 2024), OSWorld (Xie 2024), WebArena (Zhou 2024), AppWorld (Trivedi 2024) 같은 에이전트 벤치마크를 든다. skill 정의 자체는 open Agent Skills 표준과 Anthropic의 2025년 문서를 근거로 삼는다.
한계
| 한계 | 내용 | 논문이 제시한 방향 |
|---|---|---|
| 범위 | text-only task 설명과 code 지향 skill library에 국한된다. 평가도 composition 수준 지표와 다운스트림 에이전트 벤치마크로 한정된다 | 멀티모달 task 명세(스크린샷, 스케치, 음성 지시), library가 online으로 갱신되는 interactive와 long-horizon 세팅, 과학 워크플로와 로보틱스와 embodied 에이전트 |
| backbone 스케일 | 여기서 쓴 small-LM과 임베딩 backbone의 특성, 즉 pre-training 코퍼스의 언어 prior와 task 커버리지를 그대로 상속한다 | 더 강한 backbone과 더 큰 curated library로 composition 정확도와 ordering을 예리하게 만드는 것 |
| long-chain under-emission | gold 시퀀스가 길어질 때 shortlist가 한 칸 짧아지는 short-sequence bias. synthetic 데이터가 skill 3개 이하 조합에 치우친 것이 원인이다 | long-sequence 학습 레코드 구축. 논문이 가장 실행 가능한 개선점으로 지목한다 |
| gold 상한과의 격차 | Codex 45.3%는 curated Gold Skills 51.1%보다 5.8%p 낮다 | 논문은 여백의 약 80%를 닫았다고 표현하고 나머지를 열어 둔다 |
논문은 broader impact도 함께 적는다. 어떤 재사용 skill을 몇 개, 어떤 의존 순서로 결합할지 예측하므로 데이터 분석 보조, 웹 task 자동화, 데이터베이스 상호작용처럼 개발자가 커지는 skill library를 유지하며 신뢰할 만한 오케스트레이션을 필요로 하는 상황에 맞는다. 원시 API 호출이 아니라 skill 추상 수준에서 동작하는 것도 재사용과 모듈 단위 감사를 촉진해 중복 코드 생성을 줄인다. 저자들은 공개 데이터셋과 공개된 모델 체크포인트만 썼다고 밝힌다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| structured skill composition | 주어진 task와 고정 library에 대해 활성 subset, 개수, 실행 순서를 동시에 정하는 실행 가능 skill plan 예측 |
| task-conditioned skill sequence prediction | 위 문제를 STOP으로 끝나는 skill 인덱스 시퀀스 생성으로 정식화한 것 |
| constrained autoregressive decoder | 출력 어휘를 library 인덱스와 STOP으로 제한한 AR decoder. 생성 원소가 항상 실행 가능한 skill이다 |
| cardinality head / set head | AR head를 보강하는 두 auxiliary head. 각각 "몇 개"와 "어떤 skill"에 전용 감독 채널을 주고, 추론 시점에는 디코딩 prior로 재사용된다 |
| retrieval-augmented decoding | contextual logit에 TF-IDF relevance와 set-membership prior를 합치는 디코딩. heavy-tail skill의 약한 학습 신호를 보완한다 |
| Set F1 | 예측 skill 집합과 gold 집합 사이의 순서 무관 F1. selection 품질과 cardinality calibration을 한 수치로 담는다 |
| dependency edge / workflow edge | skill dependency graph의 두 edge 유형. I/O type 겹침에서 온 hard data-flow 순서와, real trajectory 공출현에서 온 경험적 순서다 |
| oracle-k / best-k | retrieval baseline의 두 변형. gold 길이를 알려준 상한이 oracle-k, 검증으로 k를 고른 것이 best-k다 |
관련 페이지
- Equipping Agents for the Real World with Agent Skills: 이 논문이 skill 정의의 근거로 직접 인용하는 Anthropic 문서. progressive disclosure와 skill 패키지 구조의 원전이다.
- Agent Skills Overview (agentskills.io): 논문이 인용하는 open Agent Skills 표준. skill 5-튜플 정의가 이 표준을 따른다.
- SkillOpt (Yang 2026): skill 문서를 얼려 둔 에이전트의 학습 상태로 보고 편집과 검증으로 훈련하는 text-space optimizer. skill 내용을 만들고 다듬는 문제를 다루는 반면, SkillComposer는 고정된 library에서 무엇을 몇 개 어떤 순서로 고르는지를 푼다. 논문이 composition을 skill-creation과 분리한다고 명시한 바로 그 다른 축이다.
- SkillOpt (Microsoft, repo): 위 논문의 원전 프레임워크. best_skill.md 산출이라는 skill 생성 방향과 대비된다.
- MCP Server Architecture Patterns: 컨텍스트당 tool이 10개에서 15개를 넘으면 선택 정확도가 90% 아래로 떨어진다는 프로덕션 관찰. All Skills 조건이 pass rate를 크게 올리지 못한 결과와 같은 병목을 tool 층위에서 짚는다.
- How Do AI Agents Spend Your Money?: 컨텍스트를 부풀리면 토큰만 늘고 정확도는 따라오지 않는다는 실증. SkillComposer가 최소 프롬프트 예산으로 여백을 닫으려는 동기와 맞닿는다.
- Agent Skills (Addy Osmani)와 Agent Skills (GeekNews): skill 표준과 progressive disclosure를 실무 관점에서 정리한 자료. 이 논문이 전제로 삼는 skill 정의의 배경이다.