Agents · PAPER · 2026
Compiling Agentic Workflows into LLM Weights
요약
이 논문은 agent orchestration framework가 런타임에 하는 일을 작은 모델의 가중치 안으로 옮기는 방식을 제안하고, 그 방식이 실무에서 채택되지 않는 이유로 지목되는 통념 3가지를 실험으로 검증한다. 저자는 절차가 가중치에 묻혀 있고 사용자가 LLM과 직접 대화하는 구조를 subterranean agent라 부르고, orchestrator가 사용자와 LLM 사이에 있는 기존 구조를 surface orchestration이라 부른다.
검증 대상은 품질, 비용, 유연성이다. 8B 컴파일 모델은 frontier 모델에 절차 전체를 프롬프트로 준 in-context baseline의 8798% 품질에 도달했고, 파라미터가 약 70배 많은 frontier 모델로 돌아가는 LangGraph orchestrator와 동등하거나 앞섰다. 대화 한 건당 추론 비용은 in-context 대비 128462배 저렴했다. 절차가 바뀔 때의 재컴파일은 운영급 GPU 클러스터에서 30~50분이 걸렸다.
가장 통제가 잘 된 실험은 여행 예약 도메인이다. Qwen 2.5 3B라는 같은 base model을 컴파일 방식과 surface orchestration 방식으로 동시에 운용해, 모델 용량과 절차를 고정한 채 architecture만 바꿨다. 컴파일이 지표 5개 중 4개에서 p<0.001로 앞섰다. 모델 용량 효과와 컴파일 효과를 분리한 이 설계가 선행 연구와의 차별점이다.
저자의 결론 문장은 지속적 구조는 가중치에, 일시적 state는 프롬프트에 두라는 분업 원칙이다. 절차 지식은 대화 한 건의 context를 넘어 계속 남아야 하므로 가중치가 그 자리라는 주장이다.
배경
오케스트레이션 생태계와 채택 격차
2024년부터 2025년 사이에 LLM agent framework가 빠르게 늘었다. 저자가 세는 7종의 GitHub star 합계는 29만 개를 넘는다. 이들은 서로 다른 API를 제공하지만 구조는 같다. LLM 위에 외부 orchestrator를 두고 매 턴 지시문을 주입하며 라우팅을 결정한다.
| framework | 출처 | 특징 |
|---|---|---|
| LangGraph | LangChain, 2024 | LLM agent 오케스트레이션용 유향 state 그래프 framework |
| CrewAI | Moura, 2024 | Flows와 Crews로 역할 기반 멀티에이전트를 오케스트레이션 |
| Google ADK | Google, 2026 | 워크플로 agent와 LLM agent 유형을 갖춘 이벤트 구동 framework |
| OpenAI Agents SDK | OpenAI, 2026 | handoff 기반 오케스트레이션 |
| Semantic Kernel | Microsoft, 2026 | 순차, 병행, handoff 패턴을 갖춘 기업용 framework |
| Strands | AWS, 2026 | 모델 주도 오케스트레이션 루프를 갖춘 오픈소스 SDK |
| LlamaIndex Workflows | LlamaIndex, 2026 | 이벤트 구동 agent 워크플로 framework |
컴파일 방식은 새로운 것이 아니다. SimpleTOD, FireAct, SynTOD, WorkflowLLM, Agent Lumos가 이미 agent 능력을 모델 가중치에 넣는 데 성공했고 그중 몇은 frontier 모델과 경쟁 가능한 품질에 도달했다. 그런데도 개발자 채택은 오케스트레이션 쪽으로 압도적으로 기울었다.
| 계열 | 저장소 star 합계 | 저자의 표현 |
|---|---|---|
| 오케스트레이션 framework 7종 | 29만 개 이상 | 비교 기준 |
| 컴파일 계열 논문 5종 | 약 3,000개 | 커뮤니티 관심도 약 100배 차이, 학술 프로토타입 수준에 머물렀다 |
저자는 이 격차를 출발점으로 삼는다. 기술이 되는데도 쓰이지 않는다면 남은 것은 실무자가 지각하는 장벽이며, 그 장벽을 하나씩 계량하는 것이 논문의 과제다.
논문이 장벽을 지각된 것이라 부르는 이유는 세 가지가 모두 검증 없이 통용되는 추정이기 때문이다. 작은 모델은 frontier 모델을 따라갈 수 없다는 추정, 자체 호스팅을 감안하면 비용이 오히려 늘 수 있다는 추정, 절차가 바뀌면 재학습이 너무 오래 걸린다는 추정이다. 저자는 각 추정에 대응하는 측정을 하나씩 배치한다. 품질에는 5개 지표 채점, 비용에는 대화 한 건당 금액, 유연성에는 재컴파일 wall-clock이다.
선행 연구가 확립한 품질 상한
바로 앞 논문인 Dennis et al. [2026a]는 절차적 과제에서 오케스트레이션보다 더 단순한 대안이 우세함을 보였다. 모델에게 절차 전체를 system prompt로 주고 스스로 수행하게 하면 5점 척도에서 4.53에서 5.00에 이르는 품질이 나왔다. 이 방식을 본 논문은 in-context baseline이라 부르고 컴파일이 목표로 삼는 품질 상한으로 둔다.
in-context 방식에는 대가가 있다. 대화마다 frontier 모델이 필요하고, 절차가 매 API 호출에 들어가 토큰 사용량이 부풀며, context window 용량을 잡아먹고, 사내 절차를 외부 제공자에게 노출한다. 컴파일은 이 네 가지를 한꺼번에 해소할 수 있는 후보다.
오케스트레이션의 신뢰성 문제도 동기의 일부다.
| 연구 | 발견 |
|---|---|
| Cemri et al. [2026] | 멀티에이전트 LLM 시스템의 실패 모드 14가지를 분류했다 |
| Zhu et al. [2026] | 연쇄 실패가 주요 병목임을 보였다 |
| Gupta [2026] ReliabilityBench | pass@1이 60%인 agent가 시행 사이 일관성은 25%에 그쳤다 |
핵심 개념
surface orchestration과 subterranean agent
surface orchestration은 orchestrator가 사용자와 LLM 사이의 지표면에 놓인 구조를 뜻한다. 매 턴 orchestrator가 현재 node의 프롬프트를 LLM에 주입하고, 출력을 파싱하고, 다음 edge를 골라 라우팅한다. LLM은 자기가 절차의 어디에 있는지 모르고 그때그때 주어진 국소 지시문에만 반응한다.
subterranean agent는 절차가 지하에 묻힌 구조를 뜻한다. orchestrator는 학습 데이터를 만들 때만 등장하고 런타임에는 사라진다. 사용자는 LLM과 직접 대화하며, LLM은 학습으로 흡수한 절차를 스스로 따라간다. 추론 시 system prompt는 "You are a helpful travel booking assistant" 수준의 최소 지시문 하나뿐이고 절차 지시문이나 flowchart state, 라우팅 로직을 넣지 않는다.
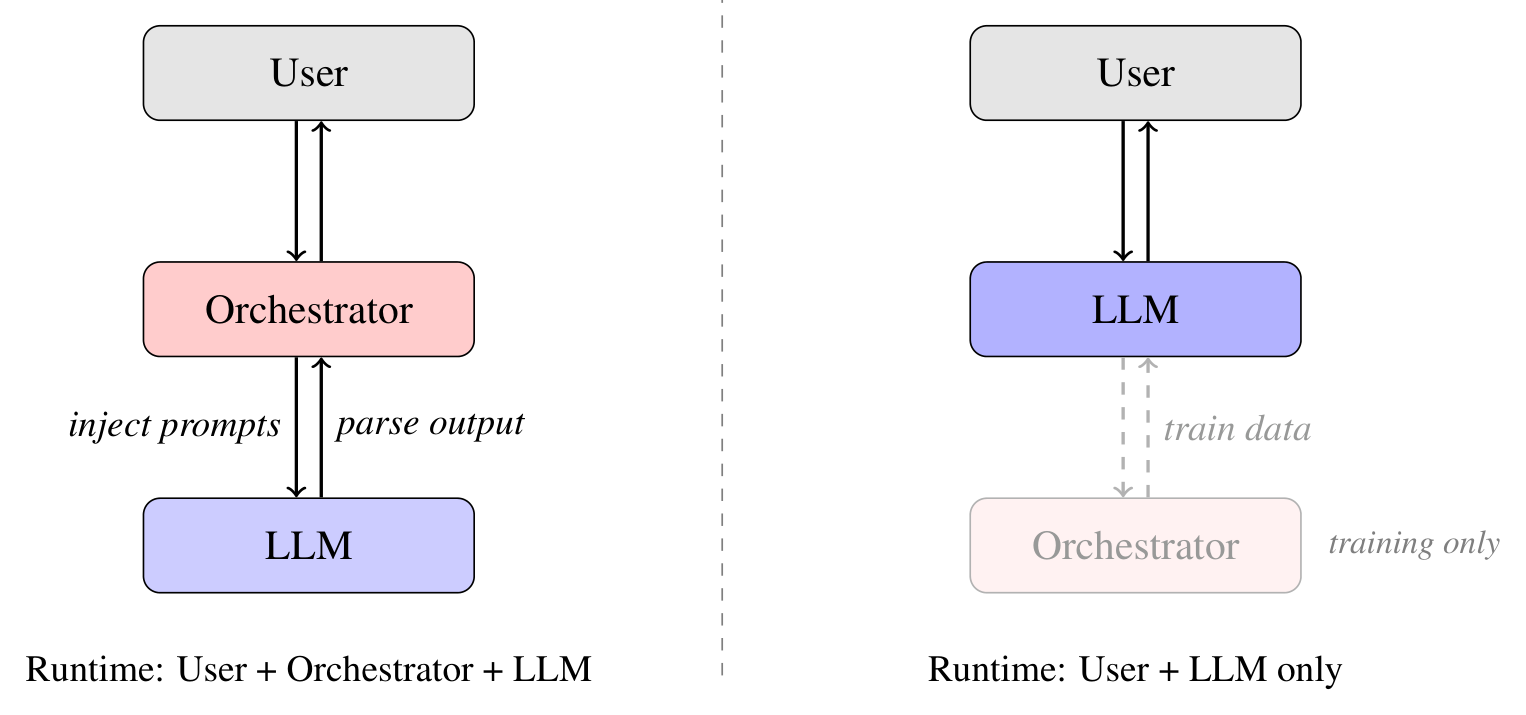
| 구분 | surface orchestration | subterranean agent |
|---|---|---|
| 런타임 구성 | 사용자, orchestrator, LLM | 사용자, LLM |
| 절차가 있는 곳 | 외부 orchestrator 또는 매 턴 프롬프트 | LLM 가중치 |
| 턴마다 하는 일 | 프롬프트 삽입, 출력 파싱, edge 라우팅 | LLM이 자연 대화를 생성 |
| orchestrator의 역할 | 런타임 전부 | 학습 데이터 생성에만 사용 |
| system prompt | flowchart 전체 직렬화(in-context) 또는 node 템플릿(LangGraph) | 최소 지시문 한 문장 |
| 라우팅 실패 가능성 | decision hub마다 존재 | 라우팅 단계가 없어 구조적으로 0 |
| 절차 노출 | 외부 API 제공자에게 전달됨 | 가중치 안에 머무름 |
절차의 유향 그래프 표현
절차는 유향 그래프 F = (N, E, n₀, T)로 형식화된다. node가 대화 한 턴이고 edge가 턴 사이의 전이다.
| 기호 | 정의 | 설명 |
|---|---|---|
N |
node 집합 | 각 node는 role(agent 또는 user)과 프롬프트 템플릿을 가진다 |
E ⊆ N × N × C |
edge 집합 | 조건 C를 선택적으로 붙여 분기를 표현한다 |
n₀ ∈ N |
시작 node | 대화가 열리는 지점이다 |
T ⊆ N |
종료 node 집합 | 성공, 이탈, escalate 같은 끝 상태다 |
decision hub는 나가는 edge가 여러 개인 node를 말한다. surface orchestration에서는 이 지점마다 LLM classifier가 다음 edge를 고르므로 라우팅 오류가 발생할 수 있다. 컴파일 모델에는 이 선택 단계 자체가 없다.
컴파일과 절차 내재화
컴파일은 flowchart를 합성 대화로 바꾼 뒤 fine-tuning으로 모델 가중치에 넣는 과정이다. 학습 데이터에는 절차 주석이 없다. 모델이 보는 것은 자연 대화뿐이고, 절차는 그 대화가 흐르는 방식에 암묵적으로 들어 있다.
저자는 fine-tuning을 전체 파라미터 갱신으로만 수행한다. 근거는 자매 논문 Dennis et al. [2026b]다. 그 논문은 rank 16에서 128까지 LoRA를 체계적으로 실험해, 저랭크 방법이 절차적 과제에서 전체 파라미터 갱신에 근접하지 못함을 보였다. 저자의 진단은 절차 내재화가 모델의 암묵적 state tracking 행동을 바꾸는 일이라 문체 정렬보다 깊은 변화라는 것이다.
이 구분이 실무에서 갖는 무게는 예산이다. LoRA는 소수의 저랭크 행렬만 학습하므로 GPU 한 장으로도 돌아가지만, 전체 파라미터 갱신은 파라미터와 그래디언트와 optimizer state를 모두 메모리에 올려야 한다. 8B 모델이 full-precision AdamW 기준으로 약 96GB를 쓴다는 계산이 뒤의 재컴파일 절에 나오는데, 이 값이 곧 컴파일 방식의 진입 요건이다.
방법
컴파일 파이프라인 4단계
| 단계 | 작업 | 세부 |
|---|---|---|
| 1 | 절차 정의 | node(턴)와 edge(전이)로 flowchart를 그린다 |
| 2 | 합성 대화 생성 | flowchart의 유효 경로를 순회하고 각 node에서 Claude Sonnet 4.5가 그 node의 프롬프트 템플릿과 전체 대화 이력을 받아 다음 턴을 만든다 |
| 3 | fine-tuning | 생성된 대화로 전체 파라미터를 갱신한다 |
| 4 | 오케스트레이션 없는 배포 | LLM이 스스로 절차를 수행하므로 해석기가 필요 없다 |
2단계에서 대화 한 건마다 flowchart 경로 하나와 시나리오 변수 묶음을 함께 뽑는다. 시나리오 변수는 목적지, 예산, 사용자 성격, 청구 유형처럼 대화 내용을 결정하는 값이다. 같은 경로라도 변수가 달라 다른 대화가 나온다.
합성 데이터의 성격
학습 데이터의 형태가 이 방식의 핵심이다. 생성된 대화에는 어느 node를 지났는지, 어느 edge로 갔는지 같은 절차 주석이 하나도 없다. 모델이 학습 시점에 보는 것은 사람 사이의 대화처럼 읽히는 텍스트뿐이다. 절차는 그 대화가 어떤 순서로 흐르는지, 어떤 조건에서 되돌아가는지에 암묵적으로만 들어 있다.
이 성질이 두 가지 결과를 낳는다. 첫째, 추론 시점에 절차 상태를 나타내는 특수 토큰이나 파싱 대상 출력이 필요 없다. 모델이 자연 대화를 생성하면 그것이 곧 절차 수행이다. 둘째, 절차가 통계적 규칙으로만 남으므로 모델이 절차를 어겼는지 외부에서 확인할 방법도 없다. 라우팅 실패가 구조적으로 사라지는 이점과, 절차 준수를 강제할 수단이 사라지는 대가가 같은 성질에서 나온다.
시드를 바꿔 데이터를 늘리는 Zoom의 방식도 이 성질에 기댄다. 같은 경로를 다시 뽑아도 시나리오 변수가 달라 대화 내용이 달라지므로, 경로 60개에서 학습 대화 6,264건을 만들면서 중복 제거가 필요하지 않았다. 절차 주석이 있다면 같은 경로의 대화들이 동일한 주석 시퀀스를 공유해 중복으로 보였을 것이다.
도메인 3종의 절차 설계
절차 규모는 다음과 같다. Insurance는 다른 두 도메인의 약 4배다.
| 도메인 | node | decision hub | 종료 상태 | 비순환 경로 | 경로 길이 |
|---|---|---|---|---|---|
| Travel booking | 14 | 3 | 3 (성공, 이탈, escalate) | 86 | 4~17턴 |
| Zoom support | 14 | 3 | 3 (해결, 미해결, escalate) | 60 | 4~17턴 |
| Insurance claims | 55 | 6 | 5 (승인, 거절, 철회, escalate, 검토 중) | 2,381 | 9~39턴 |
여행 예약
고객이 여행 예약을 문의하는 절차다. agent가 인사한 뒤 목적지, 날짜, 예산 같은 선호를 수집하고, 정보가 충분히 모였는지 판정한다. 부족하면 대화가 수집 단계로 되돌아간다. 충분해지면 옵션을 제시하고, 고객은 수락, 거절, 대안 요청 중 하나를 택해 각각 다른 분기로 간다. 수락하면 예약을 확정하고, 아니면 재검색 루프를 돌거나 이탈로 끝난다.
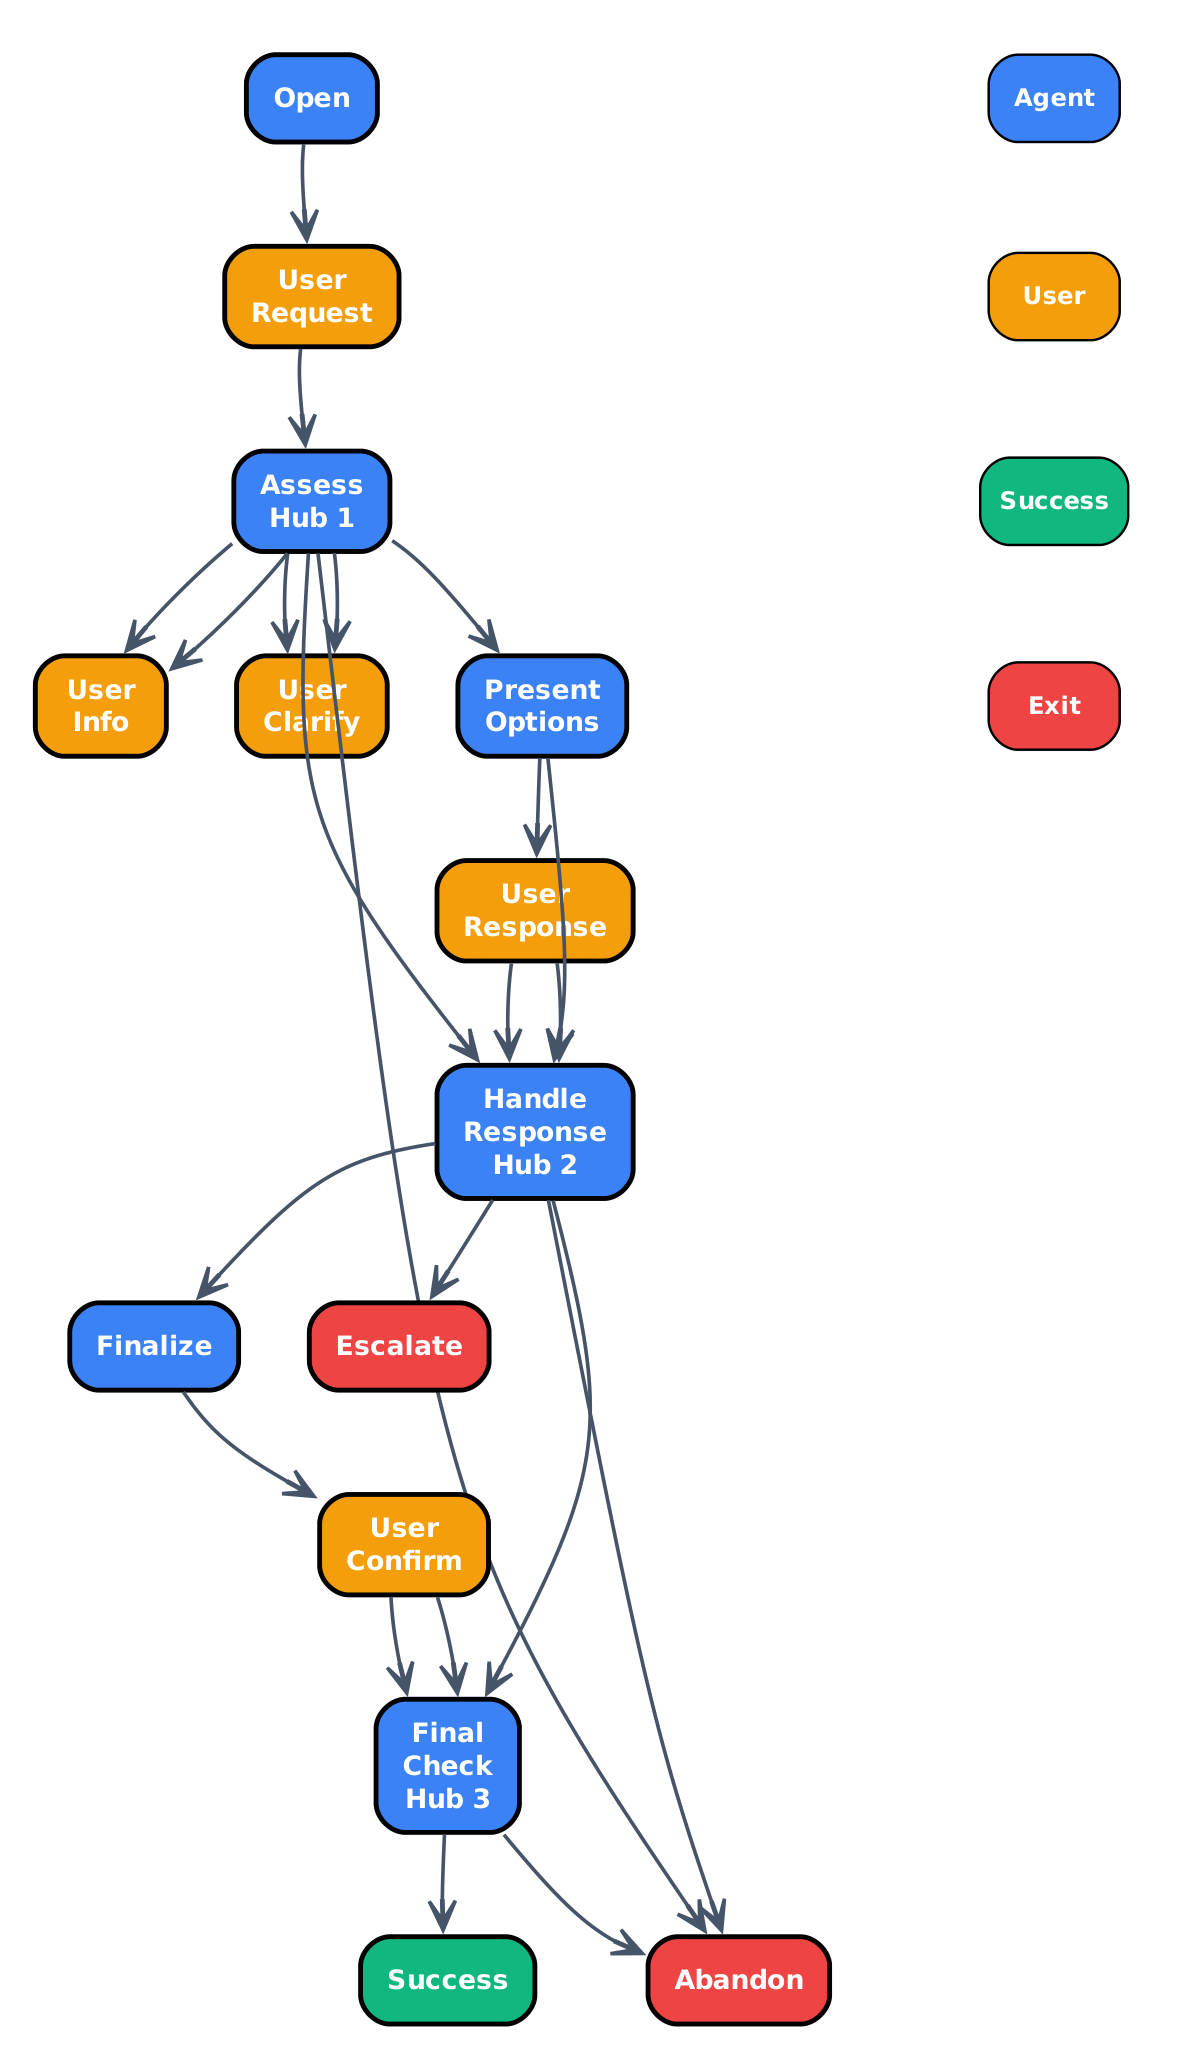
| flowchart 구간 | 역할 |
|---|---|
| Open, User Request | 대화 개시와 요구 접수 |
| Assess (Hub 1) | 정보 충분성 판정. 부족하면 User Info나 User Clarify로 되돌리고 충분하면 Present Options로 보낸다 |
| Present Options, User Response | 옵션 제시와 고객 반응 수집 |
| Handle Response (Hub 2) | 수락, 거절, 대안 요청을 분기. Finalize, Escalate, 재수집으로 갈라진다 |
| Finalize, User Confirm | 예약 확정과 고객 확인 |
| Final Check (Hub 3) | 성공 종료와 이탈 종료를 가른다 |
Zoom 기술 지원
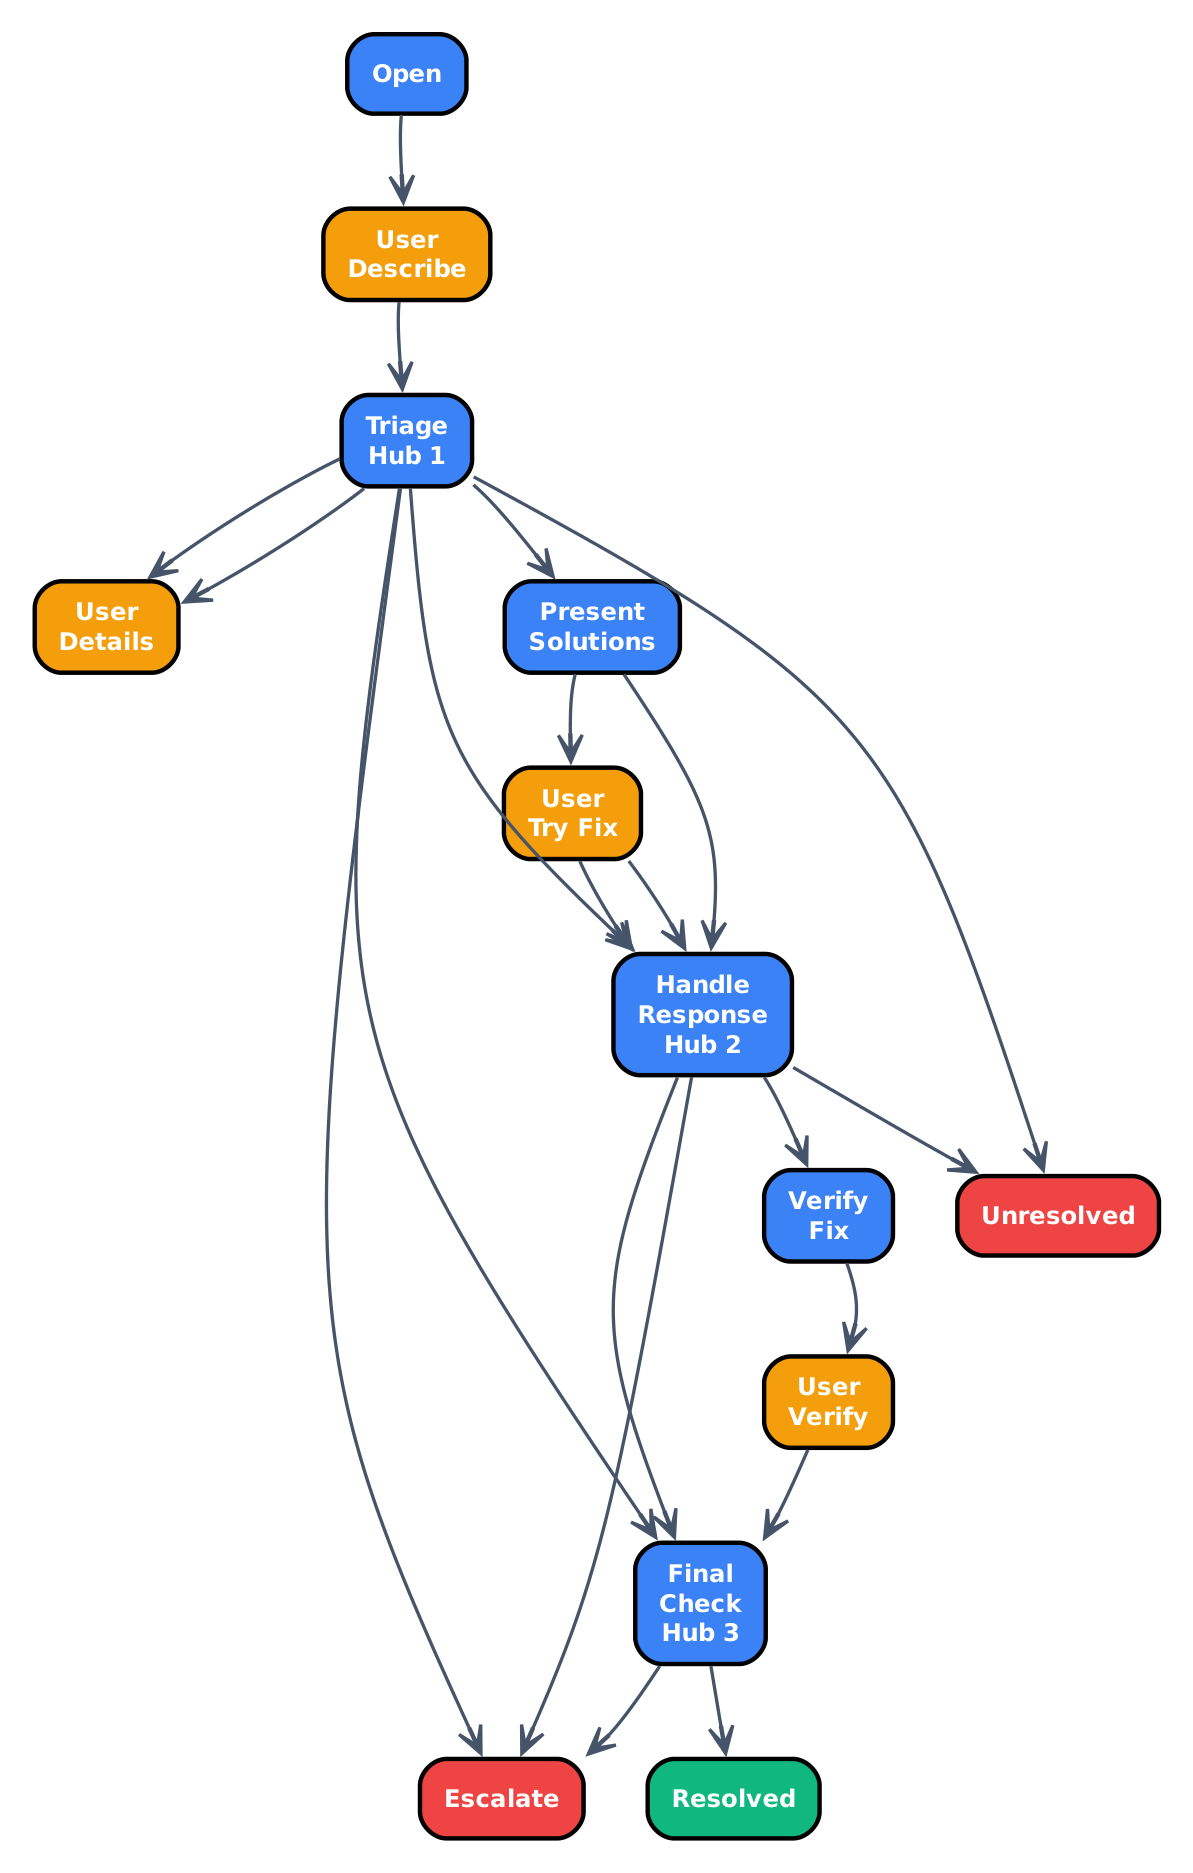
사용자가 오디오 문제, 화면 멈춤, 연결 끊김, 화면 공유 실패 중 하나를 신고하는 절차다. agent가 문제를 해당 진단 경로로 분류하고 단계별 조치를 안내하며 각 단계가 문제를 해결했는지 확인한다. 해결되지 않으면 대안 조치를 다시 시도하거나 escalate한다.
이 도메인은 제품 고유 지식을 요구한다. agent가 Zoom의 UI, 설정 메뉴, 흔한 오류 코드를 알아야 하므로 학습 데이터가 절차 구조뿐 아니라 이 도메인 지식까지 가중치에 담는다. 절차 구조만 내재화하면 되는 여행 예약과 다른 조건이다.
보험 청구 처리
가입자가 청구를 접수하는 절차다. 본인 확인과 가입 계약 확인을 거쳐 청구 유형을 판정하고, 증빙 서류를 수집하며, 보장 범위와 면책 사항을 판정한 뒤 제안과 역제안을 주고받아 합의한다. 서류가 미비하면 요청 단계로 되돌아가는 중첩 루프가 있고, 보장 판정이 합의 옵션을 제약하는 단계 간 의존도 있다.
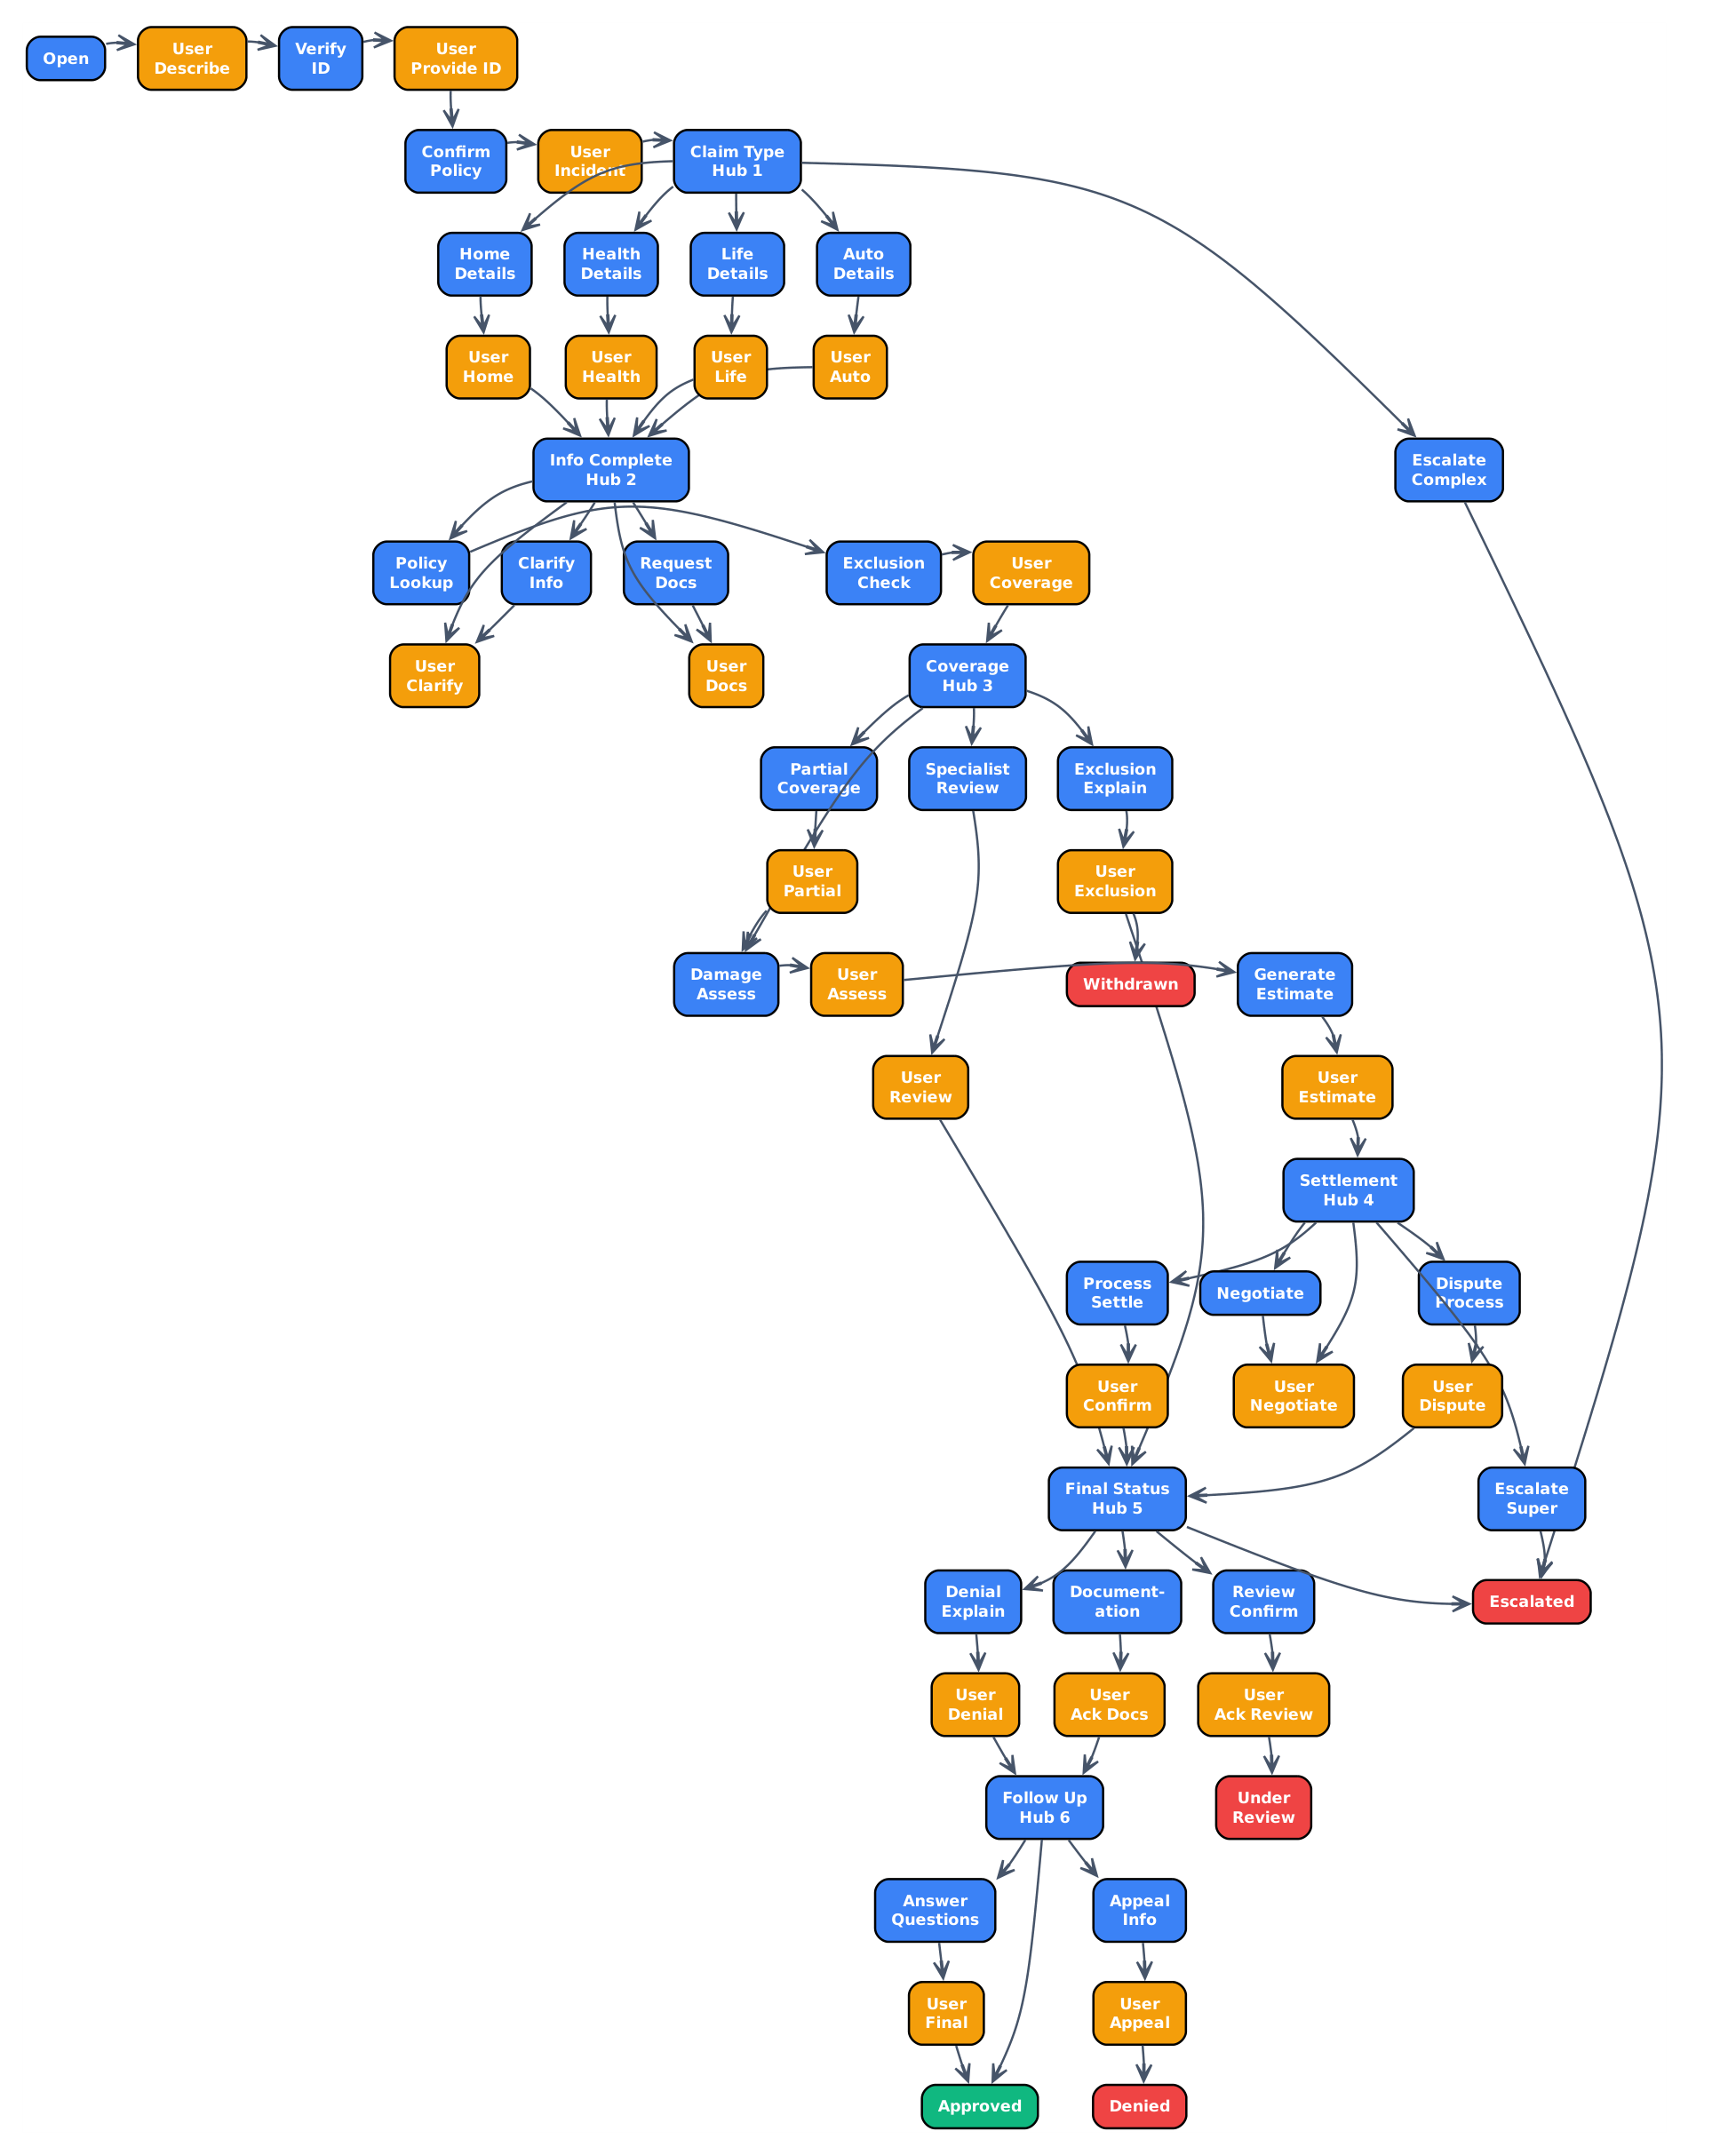
| decision hub | 이름 | 분기하는 결정 |
|---|---|---|
| Hub 1 | Claim Type | 청구 유형을 Auto, Home, Health, Life 중 하나로 판정하거나 복잡 사안으로 escalate |
| Hub 2 | Info Complete | 정보 충분성 판정. 계약 조회, 정보 보완, 서류 요청, 면책 확인으로 갈라진다 |
| Hub 3 | Coverage | 보장 판정. 부분 보장, 전문가 검토, 면책 설명으로 갈라진다 |
| Hub 4 | Settlement | 합의 처리. 지급 처리, 협상, 분쟁 처리로 갈라진다 |
| Hub 5 | Final Status | 최종 상태 판정. 거절 설명, 서류 정리, 검토 확인, escalate로 갈라진다 |
| Hub 6 | Follow Up | 사후 처리. 질의 응답, 이의 신청 안내, 승인 종료로 갈라진다 |
학습 설정
세 도메인 모두 bf16 정밀도에서 전체 파라미터를 갱신하고, checkpoint는 held-out 평가 손실로 고른다.
| 항목 | Travel booking | Zoom support | Insurance claims |
|---|---|---|---|
| base model | Qwen 2.5 3B Instruct | Qwen3-8B | Qwen3-8B |
| 생성 대화 수 | 2,125 | 회차당 870 | 3,000 |
| 학습 / 평가 분할 | 1,912 / 213 | 회차별 9 대 1, 학습 split 8개 연결 | 2,700 / 300 |
| 학습 대화 수 | 1,912 | 6,264 (8 × 783) | 2,700 |
| 하드웨어 | RTX 5090 1장 | A100 8장, DeepSpeed ZeRO-3 | A100 8장, DeepSpeed ZeRO-3 |
| optimizer | AdamW 8-bit | AdamW | AdamW |
| learning rate | 2e-5, cosine decay | 2e-5 | 2e-5 |
| effective batch size | 16 (gradient accumulation) | 32 | 32 |
| epoch 예산 | 20 | 10 | 20 |
| 선택된 checkpoint | epoch 약 4 | epoch 2 | epoch 3 |
| 학습 wall-clock | 약 3.5시간 | 논문 미기재 | 논문 미기재 |
Zoom의 데이터 증량 방식은 다른 두 도메인과 다르다. 기본 파이프라인이 회차당 870건만 만들기 때문에, 시드 42에서 49까지 8회 실행하고 학습 split을 이어 붙여 6,264건을 만들었다. 같은 경로라도 시드에 따라 시나리오 샘플링이 달라 대화가 달라지므로 중복 제거가 필요하지 않았다.
Insurance의 epoch 예산이 Zoom의 두 배인 이유로 저자는 절차가 커서 node별 행동이 많고 trajectory가 길다는 점을 든다. 데이터를 더 여러 번 통과해야 한다는 뜻이다. 선택된 checkpoint는 epoch 3으로 예산보다 훨씬 이른데, 세 도메인 모두 이른 epoch에서 held-out 손실이 최저를 찍고 이후 평탄해지는 양상이다.
평가 설계
두 baseline
| baseline | 구성 | 역할 |
|---|---|---|
| LangGraph orchestrator | Claude Sonnet 4.5를 LangGraph로 오케스트레이션한다. flowchart node 하나가 LangGraph 그래프 node 하나에 대응하고 decision hub에서는 LLM classifier가 다음 edge를 고른다 | frontier 모델 기준선. 3B 컴파일 모델보다 파라미터가 약 70배 많다. Dennis et al. [2026a]에서 평가한 것과 같은 시스템이다 |
| in-context baseline | Claude Sonnet 4.5의 system prompt에 flowchart 전체를 직렬화해 넣고 턴당 API 호출 1회로 스스로 절차를 수행하게 한다 | frontier 모델이 절차 전체를 볼 때 도달하는 품질 상한. 대가는 context window 소모다 |
LangGraph를 고른 이유는 채택 규모다. 2026년 3월 기준 GitHub star가 약 3만 개로 가장 널리 쓰인다. 두 baseline 사이의 비교, 즉 오케스트레이션과 in-context prompting의 대결은 선행 논문 Dennis et al. [2026a]에서 따로 보고했다.
사용자 시뮬레이션과 judge
사용자 역할은 Claude Sonnet 4.5가 연기한다. 시뮬레이터는 전체 대화 이력과 시나리오 변수를 받아 응답하며 flowchart를 모른다. 모든 조건이 같은 시나리오 명세와 같은 시뮬레이터를 받는다.
평가 규모는 도메인별, 조건별 시나리오 200개다. 시나리오는 flowchart 경로 전 범위, 사용자 화법(구체적에서 모호까지), 만족도(적극적에서 회의적까지), 예산 현실성, 동반 인원 복잡도를 고르게 덮도록 설계했다.
조건별 200개라는 규모는 도메인 3종과 조건 3~4개를 곱하면 대화 2천 건 이상이 된다. 시나리오를 무작위로 뽑지 않고 경로 범위와 사용자 성향을 고르게 덮도록 설계한 이유는, 특정 경로에 시나리오가 몰리면 decision hub 라우팅 실패가 과소 또는 과대 측정되기 때문이다.
채점은 LLM-as-a-Judge 방식이며 judge는 어느 시스템이 만든 대화인지 모른다. 기본 judge는 Claude Sonnet 4.5인데, 데이터 생성자와 judge가 같은 모델이라는 점이 문제가 된다. Panickssery et al. [2024]가 judge가 자기 생성물을 선호하는 편향을 보고했기 때문이다. 저자는 이를 통제하려고 GPT-4.1 judge로 전량을 다시 채점했다.
채점 지표
지표 5개를 각각 1점에서 5점으로 매기고, 점수마다 행동 기준이 붙는다.
| 지표 | 묻는 것 | 5점 기준 | 낮은 점수 기준 |
|---|---|---|---|
| Task Success | 절차를 적절한 종료 상태까지 정확하고 일관되게 수행했는가 | 절차 완주와 명확한 종료 상태 | 3점은 중간 단계까지 갔으나 대화가 흐지부지된 경우, 1점은 유의미한 진전 없음 |
| Information Accuracy | 사용자가 준 정보를 정확히 쓰고 유지했는가 | 모든 세부가 정확히 반영 | 1점은 세부를 지어내거나 입력을 무시 |
| Consistency | 대화 전체에서 일관된 state를 유지했는가 | 모순도 반복 질문도 없음 | 1점은 반복적으로 자기모순 |
| Graceful Handling | 변경, 모호성, edge case를 얼마나 잘 처리했는가 | 매끄러운 적응 | 1점은 어떤 이탈에도 흐름이 깨짐 |
| Naturalness | 숙련된 인간 상담원과 대화하는 것처럼 읽히는가 | 인간과 구별 불가 | 1점은 기계적이고 대본 같음 |
Graceful Handling에는 별도 규칙이 있다. 사용자가 아무 도전을 걸지 않은 대화는 3점이 상한이다. 이 상한 때문에 뒤에 나오는 GPT-4.1 재채점에서 Zoom과 Insurance의 Graceful Handling 점수가 모든 조건에서 3점대로 내려앉는다.
통계 처리
| 항목 | 처리 |
|---|---|
| 대응 조건 | 같은 실행 회차에서 평가한 조건은 시나리오 인덱스로 짝지어 Wilcoxon signed-rank 검정을 쓴다 (여행 도메인의 Sub 대 Orch 비교) |
| 비대응 조건 | 따로 평가한 조건은 Mann-Whitney U 검정을 쓴다 (나머지 전부) |
| 짝짓기의 의미 | 사용자 시뮬레이터가 동적으로 응답하므로 짝지은 조건도 첫 턴 이후 대화가 갈라진다. 짝짓기는 내용이 아니라 시나리오 의도 수준이다 |
| 효과 크기 | Cohen's d, 합동 표준편차 기준 |
| 신뢰구간 | 부트스트랩 95%, 재표본 10,000회, 백분위법 |
| 다중 비교 보정 | 각 pairwise 비교 안에서 지표 5개에 대해 Holm-Bonferroni 보정, α = 0.05 |
결과
여행 예약에서의 동일 모델 통제 비교
여행 예약 실험은 조건 4개를 각각 200개 시나리오로 평가한다. (1) 3B subterranean agent, (2) 같은 base model에 flowchart 기반 state tracking을 주입한 3B surface orchestrator, (3) LangGraph orchestrator, (4) in-context baseline이다. 조건 1과 2의 비교가 컴파일 효과를 분리하고, 조건 1과 3의 비교가 컴파일된 3B가 frontier orchestrator와 경쟁 가능한지를 본다.
Claude judge 기준 품질 점수는 다음과 같다. 괄호는 부트스트랩 95% 신뢰구간이다.
| 지표 | 3B Sub. | 3B Orch. | LG Orch. | In-Context |
|---|---|---|---|---|
| Task Success | 4.11 [4.01, 4.19] | 3.93 [3.85, 4.00] | 4.17 [4.02, 4.33] | 4.53 [4.42, 4.63] |
| Information Accuracy | 4.75 [4.64, 4.83] | 4.69 [4.58, 4.78] | 4.21 [4.09, 4.32] | 4.64 [4.57, 4.71] |
| Consistency | 4.34 [4.24, 4.45] | 4.12 [4.03, 4.21] | 4.32 [4.17, 4.46] | 4.96 [4.92, 4.98] |
| Graceful Handling | 4.07 [3.97, 4.17] | 3.87 [3.79, 3.94] | 4.62 [4.51, 4.71] | 4.96 [4.92, 4.99] |
| Naturalness | 4.12 [4.03, 4.20] | 3.96 [3.88, 4.01] | 4.84 [4.79, 4.89] | 5.00 [5.00, 5.00] |
같은 base model끼리의 비교에서 컴파일이 5개 지표 전부에서 앞섰고 그중 4개가 유의했다. 차이는 0.17점에서 0.22점 사이이고 Cohen's d는 0.21에서 0.23 사이다. 효과 크기가 작은 구간이지만 방향이 일관되고 p값이 0.001 미만이다.
| 지표 | 3B Sub. | 3B Orch. | 차이 | d | 보정 p |
|---|---|---|---|---|---|
| Task Success | 4.11 | 3.93 | +0.18 | +0.22 | <.001 |
| Information Accuracy | 4.75 | 4.69 | +0.05 | +0.06 | .292 |
| Consistency | 4.34 | 4.12 | +0.22 | +0.23 | <.001 |
| Graceful Handling | 4.07 | 3.87 | +0.20 | +0.23 | <.001 |
| Naturalness | 4.12 | 3.96 | +0.17 | +0.21 | <.001 |
Information accuracy만 유의성에 도달하지 못했다. 차이가 +0.05점이고 p값이 0.292다. 두 조건 모두 4.69점 이상으로 이미 높아 차이가 드러나기 어려운 구간이다.
파라미터가 약 70배 많은 LangGraph orchestrator와의 비교는 지표에 따라 갈린다.
| 지표 | 3B Sub. | LG Orch. | 차이 | d | 보정 p | 해석 |
|---|---|---|---|---|---|---|
| Task Success | 4.11 | 4.17 | -0.07 | -0.08 | <.001 | 차이가 작아 실질적으로 대등하다 |
| Information Accuracy | 4.75 | 4.21 | +0.54 | +0.70 | <.001 | 컴파일이 뚜렷하게 앞선다 |
| Consistency | 4.34 | 4.32 | +0.02 | +0.03 | .032 | 차이가 거의 없다 |
| Graceful Handling | 4.07 | 4.62 | -0.54 | -0.78 | <.001 | orchestrator가 뚜렷하게 앞선다 |
| Naturalness | 4.12 | 4.84 | -0.72 | -1.41 | <.001 | orchestrator가 가장 크게 앞선다 |
LangGraph와의 대결에서 갈리는 지점이 이 논문의 구조 논지를 그대로 보여준다. 컴파일 모델이 앞서는 information accuracy는 대화 전체에서 사용자가 준 값을 잃지 않는 능력이고, 뒤지는 graceful handling과 naturalness는 예상 밖 상황을 부드럽게 넘기는 능력이다. 앞의 것은 절차 전체를 한꺼번에 보는 구조에서 오고, 뒤의 것은 모델 용량에서 온다. 3B에서는 용량 쪽 약점이 커서 두 지표를 내주었다.
in-context baseline과의 비교는 3B의 한계를 드러낸다.
| 지표 | 3B Sub. | In-Context | 차이 | d | in-context 대비 달성률 |
|---|---|---|---|---|---|
| Task Success | 4.11 | 4.53 | -0.42 | -0.58 | 90.7% |
| Information Accuracy | 4.75 | 4.64 | +0.11 | +0.17 | 102.4% |
| Consistency | 4.34 | 4.96 | -0.61 | -1.13 | 87.5% |
| Graceful Handling | 4.07 | 4.96 | -0.89 | -1.69 | 82.1% |
| Naturalness | 4.12 | 5.00 | -0.88 | -2.03 | 82.4% |
달성률이 지표별로 크게 갈린다. Information accuracy는 상한을 넘어섰지만 graceful handling과 naturalness는 82% 수준에 머물렀고 효과 크기도 각각 1.69와 2.03으로 크다. 저자의 해석은 3B가 절차 자체는 배웠지만 edge case를 자연스럽게 처리할 용량이 부족하다는 것이다. 이 진단이 다음 두 실험에서 8B로 확장한 동기다.
Zoom 지원에서의 8B 확장
Zoom 실험은 두 가지를 동시에 본다. 첫째는 3B에서 벌어진 graceful handling과 naturalness 격차가 모델을 키우면 줄어드는지다. 둘째는 절차 구조만이 아니라 제품 고유 지식까지 가중치에 담을 수 있는지다. 조건은 8B subterranean agent, LangGraph orchestrator, in-context baseline 세 가지다.
| 지표 | 8B Sub. | LG Orch. | In-Context |
|---|---|---|---|
| Task Success | 4.50 [4.39, 4.61] | 4.62 [4.53, 4.72] | 4.92 [4.88, 4.96] |
| Information Accuracy | 4.26 [4.14, 4.39] | 4.75 [4.67, 4.83] | 4.92 [4.88, 4.96] |
| Consistency | 4.42 [4.27, 4.55] | 4.55 [4.43, 4.67] | 5.00 [4.97, 5.00] |
| Graceful Handling | 4.62 [4.54, 4.71] | 4.52 [4.42, 4.62] | 5.00 [4.99, 5.00] |
| Naturalness | 4.87 [4.82, 4.91] | 4.64 [4.57, 4.71] | 5.00 [5.00, 5.00] |
첫 번째 질문에는 긍정적 답이 나왔다. graceful handling 달성률이 3B의 82.1%에서 92.4%로, naturalness가 82.4%에서 97.4%로 올랐다. 두 지표에서 3B가 크게 뒤졌던 구간이 좁혀졌다.
| 지표 | 3B 달성률 (Travel) | 8B 달성률 (Zoom) | 변화 |
|---|---|---|---|
| Graceful Handling | 82.1% | 92.4% | +10.3%p |
| Naturalness | 82.4% | 97.4% | +15.0%p |
| Task Success | 90.7% | 91.5% | +0.8%p |
| Consistency | 87.5% | 88.4% | +0.9%p |
| Information Accuracy | 102.4% | 86.6% | -15.8%p |
Information accuracy는 반대로 내려갔다. 다만 두 값은 도메인이 달라 직접 비교할 수 없다. 여행 예약은 사용자가 말한 예산과 날짜를 유지하면 되지만, Zoom은 제품의 실제 설정 이름과 오류 코드를 정확히 알아야 한다. 저자는 남은 격차의 병목이 절차 준수가 아니라 폭넓은 세계 지식이라고 진단한다.
LangGraph와의 비교에서는 두 지표만 유의하다.
| 지표 | 8B Sub. | LG Orch. | 차이 | d | 보정 p |
|---|---|---|---|---|---|
| Task Success | 4.50 | 4.62 | -0.12 | -0.16 | .185 |
| Information Accuracy | 4.26 | 4.75 | -0.49 | -0.65 | <.001 |
| Consistency | 4.42 | 4.55 | -0.13 | -0.14 | .463 |
| Graceful Handling | 4.62 | 4.52 | +0.11 | +0.16 | .463 |
| Naturalness | 4.87 | 4.64 | +0.23 | +0.52 | <.001 |
컴파일 모델이 naturalness에서 앞서고 information accuracy에서 뒤진다. task success, consistency, graceful handling은 유의차가 없다. 3B에서 orchestrator가 크게 앞섰던 graceful handling과 naturalness가 8B에서 뒤집히거나 대등해진 것이 변화의 핵심이다.
보험 청구에서의 복잡 절차 확장
node 14개 절차는 중간 난도다. 보험 청구는 node 55개, decision hub 6개, 경로 2,381개로 훨씬 크다. 이 실험은 컴파일이 큰 절차로 확장되는지, 그리고 비용 우위가 절차 복잡도와 함께 커지는지를 본다.
| 지표 | In-Context | LG Orch. | 8B Sub. |
|---|---|---|---|
| Task Success | 4.78 [4.70, 4.86] | 4.42 [4.28, 4.56] | 4.47 [4.36, 4.58] |
| Information Accuracy | 4.78 [4.71, 4.85] | 4.45 [4.33, 4.56] | 4.40 [4.28, 4.51] |
| Consistency | 4.82 [4.76, 4.88] | 4.39 [4.24, 4.54] | 4.51 [4.38, 4.63] |
| Graceful Handling | 4.96 [4.92, 4.99] | 4.38 [4.25, 4.51] | 4.81 [4.72, 4.88] |
| Naturalness | 5.00 [4.99, 5.00] | 4.58 [4.50, 4.67] | 4.92 [4.87, 4.97] |
8B 컴파일 모델이 in-context 품질의 92~98%에 도달했다. Zoom보다 오히려 균일하게 높다. 절차가 커지면 컴파일 품질이 크게 하락할 것이라는 예상과 반대 방향의 결과다.
| 지표 | 8B Sub. | In-Context | 달성률 | 8B Sub. | LG Orch. | LangGraph 대비 |
|---|---|---|---|---|---|---|
| Task Success | 4.47 | 4.78 | 93.5% | 4.47 | 4.42 | 101.1% |
| Information Accuracy | 4.40 | 4.78 | 92.1% | 4.40 | 4.45 | 98.9% |
| Consistency | 4.51 | 4.82 | 93.6% | 4.51 | 4.39 | 102.7% |
| Graceful Handling | 4.81 | 4.96 | 97.0% | 4.81 | 4.38 | 109.8% |
| Naturalness | 4.92 | 5.00 | 98.4% | 4.92 | 4.58 | 107.4% |
LangGraph 대비로는 graceful handling(4.81 대 4.38, p<0.001)과 naturalness(4.92 대 4.58, p<0.001)에서 유의하게 앞섰다. consistency도 평균이 높지만 유의하지 않다(+0.12, p = .778). task success와 information accuracy는 차이가 0.05점으로 대등하다.
| 지표 | 차이 | d | 보정 p |
|---|---|---|---|
| Task Success | +0.05 | +0.06 | .750 |
| Information Accuracy | -0.05 | -0.06 | .778 |
| Consistency | +0.12 | +0.12 | .778 |
| Graceful Handling | +0.42 | +0.54 | <.001 |
| Naturalness | +0.34 | +0.66 | <.001 |
in-context 대비 달성률 종합
세 도메인을 한 표에 놓으면 8B 컴파일 모델의 달성률이 86.6%에서 98.4% 사이에 있다. 논문 초록과 결론이 말하는 8798%가 이 범위를 반올림한 값이고, 결론 절이 말하는 격차 213%가 그 여집합이다.
| 지표 | Travel (3B) | Zoom (8B) | Insurance (8B) |
|---|---|---|---|
| Task Success | 90.7% | 91.5% | 93.5% |
| Information Accuracy | 102.4% | 86.6% | 92.1% |
| Consistency | 87.5% | 88.4% | 93.6% |
| Graceful Handling | 82.1% | 92.4% | 97.0% |
| Naturalness | 82.4% | 97.4% | 98.4% |
지표별로 보면 컴파일이 상한에 가장 가까운 것은 naturalness이고 가장 먼 것은 information accuracy다. 이 순서가 앞서 정리한 구조적 이점과 맞물린다. 대화 문체는 자연 학습 데이터에서 그대로 오므로 작은 모델도 상한에 근접하지만, 폭넓은 지식은 모델 용량에 직접 의존하므로 격차가 남는다.
절차 복잡도가 가장 큰 Insurance에서 달성률이 가장 균일하고 높다. 모델 크기가 같은 Zoom과 Insurance를 비교하면, 절차가 4배 커진 쪽에서 달성률이 오히려 올랐다. 다만 두 도메인은 요구하는 지식의 성격이 달라 이 차이를 절차 복잡도만으로 돌릴 수는 없다.
효율과 실패 모드
wall-clock 시간은 모든 LLM 호출을 포함한다. LangGraph 조건은 생성 호출과 라우팅 호출을 모두 센다.
| 도메인 | 항목 | Sub. | LG Orch. | In-Context |
|---|---|---|---|---|
| Travel (3B) | 평균 턴 수 | 22.6 | 16.5 | 16.4 |
| Travel (3B) | 평균 wall-clock | 69.4초 | 64.9초 | 55.5초 |
| Zoom (8B) | 평균 턴 수 | 13.6 | 14.7 | 12.7 |
| Zoom (8B) | 평균 wall-clock | 29.5초 | 52.1초 | 36.0초 |
| Insurance (8B) | 평균 턴 수 | 20.3 | 26.4 | 19.0 |
| Insurance (8B) | 평균 wall-clock | 43.2초 | 120.8초 | 52.8초 |
여행 예약에서 컴파일 모델의 대화는 평균 22.6턴으로 baseline의 약 16턴보다 길다. 그런데도 wall-clock이 LangGraph와 비슷하다. 컴파일 모델은 self-hosted 추론이라 네트워크 왕복이 없고, orchestrator는 매 턴 Claude API 지연을 부담하기 때문이다.
Zoom과 Insurance에서는 컴파일이 더 빠르다. Insurance 격차가 가장 크다. 43.2초 대 120.8초로 약 2.8배다. 이유는 두 가지가 겹친다. LangGraph가 decision hub 6곳마다 라우팅용 API 호출을 추가로 하고, node 55개 절차가 모든 프롬프트를 부풀린다.
실패는 judge가 task success를 3점 이하로 준 대화로 정의한다.
| 항목 | Travel 3B Sub. | Travel 3B Orch. | Travel LG | Zoom 8B Sub. | Zoom LG | Insurance 8B Sub. | Insurance LG |
|---|---|---|---|---|---|---|---|
| 실패 대화 수 | 11 | 9 | 48 | 22 | 18 | 18 | 34 |
| 실패율 | 5.5% | 4.5% | 24.0% | 11.0% | 9.0% | 9.0% | 17.0% |
컴파일 모델의 실패율이 LangGraph보다 낮은 도메인은 Travel(5.5% 대 24.0%)과 Insurance(9.0% 대 17.0%)다. Zoom(11.0% 대 9.0%)은 컴파일이 2%p 높지만 저자는 비슷하다고 표현한다. Travel LangGraph의 24.0%는 decision hub 라우팅 오류가 원인이며, 컴파일 모델은 라우팅 단계가 없어 이 실패 모드를 구조적으로 갖지 않는다.
이 표에서 저자 본문이 언급하지 않는 열이 하나 있다. 여행 예약의 3B surface orchestration은 실패율 4.5%로 3B 컴파일 모델의 5.5%보다 1%p 낮다. 품질 점수 5개 지표에서는 컴파일이 앞섰지만 task success 3점 이하 대화의 비율만 보면 orchestration 쪽이 조금 적다. 본문은 LangGraph와의 비교만 서술하고 이 열을 다루지 않는다.
턴 수 차이의 정체는 대화 문체다. 컴파일 모델은 학습 데이터에서 interview style을 흡수했다. 턴마다 초점이 하나인 질문을 던지고 답을 기다린 뒤 진행하는 방식이며, 전체 턴의 64%가 정확히 질문 하나를 담는다. LangGraph orchestrator는 현재 node의 템플릿에 묶여 한 턴에 여러 질문을 몰아넣기도 한다.
| 항목 | 컴파일 모델 | LangGraph orchestrator |
|---|---|---|
| 턴당 질문 수 | 64%의 턴이 정확히 질문 1개 | 템플릿에 따라 한 턴에 여러 질문 |
| 대화당 총 단어 수 | 약 1,200~1,400단어 | 약 1,200~1,400단어 |
| 턴 수 | 많다 (Travel 22.6턴) | 적다 (Travel 16.5턴) |
총 단어 수가 조건 사이에서 비슷하다는 점이 중요하다. 같은 정보가 교환되고 있으며 다른 크기의 턴으로 쪼개졌을 뿐이다. 저자는 턴당 질문 하나의 리듬이 감사 기록을 명확하게 하고 사용자 인지 부담을 낮출 수 있다고 본다.
파라미터 70배 격차를 메우는 구조적 이점
파라미터가 70배 적은 3B에서 8B 모델이 Claude Sonnet 4.5 기반 orchestrator와 경쟁 가능하다는 결과는 직관에 어긋난다. 저자의 설명은 선행 논문 Dennis et al. [2026a]가 정리한 오케스트레이션의 구조적 비용 3가지에 기댄다.
| 오케스트레이션의 구조적 비용 | 컴파일의 대응 |
|---|---|
| 국소 node context만 보고 생성하므로 추론이 조각난다 | 내재화된 가중치로 절차 전체를 한꺼번에 고려한다 |
| 라우팅 실패 모드가 새로 생긴다 | 라우팅 선택 단계가 없어 구조적으로 라우팅 실패가 0이다 |
| 템플릿 주입이 모델의 자연스러운 대화 문체를 제약한다 | 자연 학습 데이터가 만든 제약 없는 응답을 낸다 |
이 세 가지 이점이 용량 격차를 보상한다는 것이 저자의 주장이다. 실제 결과에서도 컴파일이 앞서는 지표는 naturalness와 graceful handling에 집중되고, 뒤지는 지표는 폭넓은 지식을 요구하는 information accuracy에 집중된다. 구조에서 오는 이점과 용량에서 오는 한계가 지표별로 갈린다는 뜻이다.
비용
비용 우위는 서로 독립적인 두 요인이 곱해진 결과다. 하나는 토큰당 단가이고 다른 하나는 토큰 사용량이다.
| 도메인 | In-Context | LG Orch. | Subterranean | In-Context 대비 |
|---|---|---|---|---|
| Travel (node 14개) | $0.133 | $0.077 | $0.0010 | 128배 |
| Zoom (node 14개) | $0.103 | $0.054 | $0.0003 | 296배 |
| Insurance (node 55개) | $0.327 | $0.174 | $0.0007 | 462배 |
첫 번째 요인인 토큰당 단가는 self-hosting에서 온다.
| 항목 | 값 |
|---|---|
| 서빙 구성 | Qwen3-8B, 예약형 클라우드 A100 80GB 1장, 시간당 2.50달러, vLLM 배치 추론 |
| 공개 벤치마크 근거 | Patel et al. [2024]의 8B 모델 A100 측정치, batch size 64에서 초당 총 4천에서 5천 토큰 |
| 단계별 분해 | prefill 초당 약 1만 5천 토큰, autoregressive decode 초당 약 3천 토큰 |
| 환산 단가 | 입력 100만 토큰당 약 0.05달러, 출력 100만 토큰당 약 0.23달러 |
| Claude Sonnet 4.5 요금 | 입력 100만 토큰당 3달러, 출력 100만 토큰당 15달러 |
| 결과 | 토큰당 약 65배 저렴 |
두 번째 요인인 토큰 사용량은 프롬프트 구조에서 온다. in-context baseline은 매 턴 system prompt에 절차를 직렬화해 넣어야 하고, 그 부담이 절차 복잡도와 함께 커진다. 컴파일 모델의 프롬프트는 절차 복잡도와 무관하게 길이가 고정이라 이 부담이 아예 없다.
| 도메인 | 절차 직렬화 부담 | 두 요인의 곱 |
|---|---|---|
| Travel (node 14개) | 약 2배 | 128배 |
| Zoom (node 14개) | 논문 미기재 | 296배 |
| Insurance (node 55개) | 약 7배 | 462배 |
여기서 나오는 실무 함의가 절차 복잡도와 비용 우위의 방향이다. 절차가 커지면 in-context 쪽 프롬프트는 계속 길어지고 컴파일 쪽은 그대로이므로, 복잡한 절차일수록 컴파일이 유리해진다. LangGraph orchestrator 대비로도 77~249배 저렴하다. LangGraph는 in-context보다 토큰을 덜 쓰지만 생성 호출과 라우팅 호출마다 Claude API 요금을 낸다.
컴파일에는 일회성 비용이 따로 든다.
| 항목 | 비용 |
|---|---|
| 데이터 생성 | 약 40달러 |
| fine-tuning 연산 | 약 10~40달러 |
| 합계 | 50~80달러 |
| in-context 대비 손익분기 | 세 도메인 모두 대화 500건 안 |
| 대화 1만 건 이상일 때 | 컴파일이 대화당 0.01달러 미만을 더한다 |
일회성 비용을 대화당 금액으로 환산하려면 배포된 agent의 생애 대화량을 알아야 하므로 응용마다 달라진다. 저자가 제시하는 기준선은 대화 500건이다.
재컴파일 주기
절차가 바뀌면 컴파일 모델을 처음부터 다시 학습해야 한다. 이것이 유연성 장벽의 실체이며, 저자는 재컴파일 파이프라인이 세 단계 모두 병렬화되어 운영급 GPU 클러스터에서 한 시간 안에 끝난다고 보고한다.
| 단계 | 내용 | H200 8장 | A100 80GB 1장 |
|---|---|---|---|
| 데이터 생성 | Claude Sonnet 4.5가 새 flowchart를 순회해 합성 대화 약 1,600건을 만든다 | 15~30분 | 동일 |
| fine-tuning | 12 epoch 전체 파라미터 갱신 | 10~15분 | 약 3시간 |
| 평가 | 시나리오 50개 vLLM 배치 점검 | 5~15분 | 동일 |
| 합계 | 30~50분 | 3~4시간 |
각 단계의 병목이 서로 다르다.
- 데이터 생성: 대화가 서로 독립이라 API 호출이 쉽게 병렬화된다. 병목은 로컬 연산이 아니라 계정별 API rate limit이다. 순차 실행이면 약 60분이 걸린다.
- fine-tuning: 8B 모델은 full-precision AdamW 기준으로 파라미터와 그래디언트, optimizer state를 합쳐 약 96GB라 H200 1장에 들어간다. 샤딩이 필요 없으므로 H200 8장은 데이터 병렬만 쓴다. H200의 BF16 처리량이 A100보다 약 3배 높은 것이 시간 단축의 나머지 절반이다. A100 1장 환경에서는 optimizer state를 8-bit AdamW로 줄여야 메모리에 들어간다.
- 평가: 추론 서버가 이미 켜져 있으면 약 5분, 서버 기동을 포함하면 10~15분이다.
세 단계 중 사람이 개입해야 하는 곳은 첫 단계 앞이다. 새 flowchart를 그리는 작업은 재컴파일 시간에 포함되지 않았다. 논문이 측정한 30~50분은 flowchart가 이미 준비된 뒤의 기계 시간이다.
저자는 이 주기를 대형 애플리케이션의 CI/CD 빌드와 비슷하다고 표현하고, 유연성 장벽이 패러다임 전환이 아니라 배포 주기 문제라고 결론한다. 8장 클러스터가 없는 실무자도 A100 1장에서 3~4시간이면 재컴파일할 수 있으며, 이 경우 시간을 지배하는 것은 데이터 생성이 아니라 학습이다.
judge 교차 검증
데이터 생성자와 judge가 모두 Claude Sonnet 4.5라는 점이 결과의 약점이 될 수 있다. 저자는 같은 채점 기준으로 GPT-4.1이 전량을 다시 채점하게 했다.
| 도메인 | 지표 | Sub. | LG Orch. | In-Context |
|---|---|---|---|---|
| Travel (3B) | Task Success | 4.34 | 4.69 | 4.88 |
| Travel (3B) | Information Accuracy | 4.12 | 4.72 | 4.96 |
| Travel (3B) | Consistency | 4.28 | 4.78 | 4.97 |
| Travel (3B) | Graceful Handling | 4.13 | 4.36 | 4.51 |
| Travel (3B) | Naturalness | 3.92 | 3.99 | 4.01 |
| Zoom (8B) | Task Success | 4.49 | 4.60 | 4.86 |
| Zoom (8B) | Information Accuracy | 4.21 | 4.54 | 4.78 |
| Zoom (8B) | Consistency | 4.74 | 4.66 | 5.00 |
| Zoom (8B) | Graceful Handling | 3.21 | 3.49 | 3.42 |
| Zoom (8B) | Naturalness | 3.96 | 4.01 | 4.04 |
| Insurance (8B) | Task Success | 4.16 | 4.64 | 4.79 |
| Insurance (8B) | Information Accuracy | 4.38 | 4.36 | 4.65 |
| Insurance (8B) | Consistency | 4.71 | 4.35 | 4.92 |
| Insurance (8B) | Graceful Handling | 3.84 | 4.13 | 4.01 |
| Insurance (8B) | Naturalness | 3.98 | 3.96 | 4.03 |
judge를 바꿔도 유지되는 것과 바뀌는 것을 나누면 다음과 같다.
| 구분 | 내용 |
|---|---|
| 유지 (저자 정리) | 컴파일 모델이 in-context 품질의 83 |
| 유지 (저자 정리) | 3B 컴파일 모델이 3B orchestrator를 모든 지표에서 크게 앞선다 |
| 유지 (저자 정리) | in-context baseline이 다른 모든 조건을 앞선다 |
| 변동 (저자 정리) | GPT-4.1에서는 LangGraph orchestrator가 더 많은 지표에서 컴파일 모델을 앞서며 특히 Travel과 Insurance에서 그렇다 |
| 변동 (저자 정리) | 컴파일 모델은 consistency(Zoom, Insurance)와 information accuracy(Insurance)에서 우위를 유지하지만 대부분 도메인에서 task success, graceful handling, naturalness를 내준다 |
| 변동 (저자 정리) | naturalness 점수가 GPT-4.1에서 모든 조건 3.92 |
핵심 주장은 두 judge에서 유지된다. 컴파일 모델은 LangGraph orchestrator 품질의 85113%(Claude)와 87108%(GPT-4.1)를 달성하면서 in-context 대비 128~462배 저렴하다. 품질 순위도 두 judge에서 같다. in-context가 가장 높고, LangGraph와 컴파일 모델이 비슷한 층에 있으며, 3B orchestration이 가장 낮다.
다만 GPT-4.1 표에서 저자 서술과 어긋나는 값이 있다. graceful handling에서 Zoom(LangGraph 3.49 대 in-context 3.42)과 Insurance(LangGraph 4.13 대 in-context 4.01)는 LangGraph가 in-context보다 높다. 세 지표 모두 3점대로 내려간 이유는 Graceful Handling의 3점 상한 규칙으로 보인다. 사용자가 도전을 걸지 않은 대화가 3점을 넘지 못하므로, GPT-4.1이 이 규칙을 Claude judge보다 엄격하게 적용하면 세 조건이 모두 3점 근처로 압축된다.
정성 사례
부록 A는 조건 사이의 전형적 행동 차이를 보여주려고 실제 평가 대화 발췌 3건을 싣는다. 최고 성능 사례가 아니라 전형 사례라고 저자가 명시한다.
| 도메인 | 시나리오 | 컴파일 모델 | orchestrator |
|---|---|---|---|
| Travel booking | 친구 2명이 일본 6일 여행, 1인당 예산 1,100달러, 수상 스포츠와 축제 관심, 화법은 불확실 | task success 5점, naturalness 5점, 14턴. 5번째 턴에 옵션을 제시하고 7번째 턴에 예약을 확정한다 | 3B orchestration은 task success 4점, naturalness 4점, 18턴. 날짜와 선호를 묻는 같은 질문을 4, 6, 8번째 턴에서 세 번 반복한 뒤 14번째 턴에야 옵션을 제시한다 |
| Zoom support | 회의 중 오디오가 간헐적으로 끊기고 연결 표시가 노란색이나 빨간색이 되며 대역폭 부족 오류가 나온다. Windows 11 데스크톱 앱 | task success 5점, naturalness 4점, 12턴. HD 비디오 해제, 통계 패널 확인, 배경 소음 억제 설정 조정을 턴마다 하나씩 안내하고 이더넷 연결을 권한다 | Claude orchestration은 task success 4점, naturalness 3점, 9턴. 권고 4개를 한 턴에 몰아넣었고 그중 음악가용 원음 설정 권고가 틀려 사용자 지적을 받고 철회한다 |
| Insurance claims | 아파트 앞에 주차한 차량이 야간에 도난, 경찰 신고 완료, Premium 등급 종합 보장, 자기부담금 500달러, 출퇴근 차량이 필요해 급하다 | task success 5점, naturalness 5점, 22턴. 보장 확인, 사고 경위 수집, 렌터카 승인, 평가 절차 설명, 청구 종결을 매끄러운 흐름으로 처리한다 | Claude orchestration은 task success 3점, naturalness 4점, 16턴. 전화 대화에 맞지 않는 마크다운 서식을 출력하고, gap 보장 여부에 확답하지 못하며, 실제 시스템에 없는 선임 상담원으로 이관한다고 말한다 |
세 사례가 같은 실패 유형을 가리킨다. orchestrator는 현재 node에서 국소적으로는 타당한 응답을 내지만 전체 대화 맥락에서는 어긋난다. 여행 예약에서 같은 질문을 세 번 반복한 것, 보험 청구에서 이미 확인한 계약 세부를 여러 번 다시 조회한 것이 그 증상이다. 저자는 이를 node 단위 생성이 전체 대화 인식을 갖지 못한 결과로 설명한다.
Zoom 사례는 다른 각도의 문제를 보여준다. orchestrator는 권고 4개를 한 턴에 몰아넣었고 그중 하나가 틀렸다. 음악가용 원음 설정은 일반 회의에는 맞지 않는 조치인데, 사용자가 지적하자 철회했다. 컴파일 모델은 제품 지식이 학습 데이터에 들어 있어 실제 설정 이름과 확인 절차를 정확히 안내했다.
보험 청구 사례에서 orchestrator가 존재하지 않는 선임 상담원으로 이관을 선언한 것은 환각의 한 형태다. flowchart에 escalate 종료 상태가 있으니 국소적으로는 규칙에 맞지만, 그 이관을 받아줄 시스템이 없다.
적용 판단
논문의 수치를 실무 판단으로 옮기면 컴파일이 유리한 조건과 불리한 조건이 갈린다. 아래는 논문이 보고한 값에서 직접 도출되는 판단 기준이다.
| 조건 | 컴파일에 유리한 경우 | 오케스트레이션이나 in-context에 유리한 경우 |
|---|---|---|
| 절차 안정성 | 절차가 안정되어 재컴파일이 드물다 | 절차가 자주 바뀌어 30~50분 주기가 반복 부담이 된다 |
| 대화량 | 생애 대화량이 500건을 넘는다 | 그보다 적으면 일회성 50~80달러를 회수하지 못한다 |
| 절차 복잡도 | node가 많고 decision hub가 많다. Insurance에서 462배 우위 | 절차가 작으면 비용 우위가 128배 수준으로 줄어든다 |
| 요구 지식 | 절차 구조와 좁은 제품 지식이 중심이다 | 폭넓은 세계 지식이 필요하면 information accuracy가 병목이 된다 |
| 품질 요구 | frontier 대비 2~13% 격차를 감수할 수 있다 | 절대 품질이 최우선이면 in-context가 상한이다 |
| 절차 기밀성 | 사내 절차를 외부 API에 노출하지 않아야 한다 | 기밀성 요구가 없으면 이 이점이 사라진다 |
| 지연 시간 | 자체 호스팅으로 네트워크 왕복을 없애야 한다. Insurance에서 2.8배 빠름 | 지연이 문제되지 않는 배치 용도다 |
| 학습 예산 | 전체 파라미터 갱신 예산을 확보할 수 있다 | LoRA만 가능하면 자매 논문[2026b] 기준으로 절차 학습에 실패한다 |
표의 항목들은 서로 독립이 아니다. 절차가 자주 바뀌는 상황과 대화량이 적은 상황이 겹치면 컴파일은 두 번 불리해진다. 재컴파일 비용이 반복되는 동시에 그 비용을 회수할 대화량도 없기 때문이다. 반대로 절차가 안정되고 복잡하며 대화량이 많은 상황은 세 조건이 같은 방향으로 작용해 우위가 462배까지 벌어진다.
가장 명확한 신호는 절차 복잡도다. in-context 방식은 절차가 커질수록 매 턴 프롬프트가 길어지지만 컴파일 모델의 프롬프트는 고정 길이다. 이 구조 차이가 128배에서 462배로 벌어진 우위의 원인이다. 반대로 가장 분명한 제약은 폭넓은 지식이다. Zoom에서 information accuracy 달성률이 86.6%로 가장 낮았고, 저자는 병목이 절차 준수가 아니라 세계 지식이라고 진단했다.
한계
논문에 별도의 한계 절이 없다. 아래는 논문이 스스로 보고한 격차와, 논문이 다루지 않은 범위를 구분한 것이다.
논문이 보고한 격차
| 항목 | 내용 |
|---|---|
| Information accuracy 병목 | Zoom에서 in-context 대비 86.6%로 가장 낮다. 저자는 남은 격차가 절차 준수가 아니라 폭넓은 세계 지식에서 온다고 진단한다 |
| frontier 격차 잔존 | 8B 컴파일 모델은 in-context 상한 대비 87 |
| judge 의존성 | GPT-4.1 judge에서는 LangGraph orchestrator가 더 많은 지표에서 앞선다. 저자는 품질 대비 비용이라는 핵심 주장이 유지된다고 보지만 지표별 우열은 judge에 따라 바뀐다 |
| Zoom 실패율 열위 | Zoom에서 컴파일 모델 실패율 11.0%가 LangGraph의 9.0%보다 2%p 높다. 저자는 이를 비슷하다고 표현한다 |
| Travel 3B의 턴 수 증가 | 컴파일 모델이 평균 22.6턴으로 baseline 약 16턴보다 길다. 총 단어 수는 같으므로 정보량이 아니라 턴 분할의 차이다 |
| 3B의 용량 한계 | graceful handling과 naturalness에서 in-context 대비 82% 수준이고 효과 크기가 각각 1.69와 2.03으로 크다 |
논문이 다루지 않은 범위
| 항목 | 내용 |
|---|---|
| base model 계열 | Qwen 2.5 3B와 Qwen3-8B만 썼다. Llama, Mistral 같은 다른 계열로의 일반화는 검증하지 않았다 |
| tool use 결합 | 평가가 대화 전용이다. API 호출, 검색, 코드 실행이 결합된 절차에서 컴파일이 성립하는지 실험하지 않았다 |
| LoRA 대조 실험 | 전체 파라미터 갱신을 택한 근거는 자매 논문 Dennis et al. [2026b]에 있고 본 논문 안에는 LoRA 대조가 없다 |
| 부분 갱신 경로 | 재컴파일 시나리오가 전면 재생성 하나뿐이다. 절차 일부만 바뀔 때의 부분 갱신이나 긴급 수정 경로를 제시하지 않았다 |
| 인간 평가 | judge와 사용자 시뮬레이터가 모두 LLM이다. 인간 평가가 없고 사람이 읽을 수 있는 근거는 부록 A의 정성 예시 3건이다 |
| 절차 정의 비용 | flowchart를 사람이 그리는 비용이 비용 분해에 들어가지 않았다. 일회성 50~80달러는 데이터 생성과 학습 연산만 센 값이다 |
| 오케스트레이터 구현 품질 | LangGraph 조건의 decision hub 라우팅은 LLM classifier 하나로 구현했다. 라우팅 구현을 더 정교화했을 때의 결과는 다루지 않았다 |
논문 내적 불일치
본표와 부록, 본문 서술과 표 사이에 어긋나는 값이 있다. 수치를 인용할 때는 표를 기준으로 삼는 편이 안전하다.
| 위치 | 불일치 | 영향 |
|---|---|---|
| Table 3 대 Table 9 | Insurance in-context의 Information accuracy가 본표 4.78, 부록 4.79다. Consistency도 본표 4.82, 부록 4.83이다 | 달성률 계산이 소수점 아래에서 흔들린다 |
| Table 2 대 Table 8 | Zoom in-context의 Consistency가 본표 5.00, 부록 4.99다 | 5.00이 만점이므로 부록 값이 실제 평균일 가능성이 높다 |
| 4.1절 본문 대 Table 7 | 본문은 3B Sub와 LG Orch의 task success와 consistency가 비슷하다고 쓰지만, Table 7은 task success를 p<.001, consistency를 p<.05로 표시한다 | 차이가 각각 -0.07점과 +0.02점으로 작아 실질 해석은 본문과 맞지만 유의성 표기와 어긋난다 |
| 2절 본문 대 Figure 4 | 본문은 보험 청구 유형을 auto, property, health, liability로 쓰지만 flowchart의 분기 node는 Auto, Home, Health, Life다 | property와 Home은 같은 뜻이지만 liability와 Life는 다른 담보다 |
| 부록 C 본문 대 Table 10 | 본문은 in-context baseline이 다른 모든 조건을 앞선다고 쓰지만, Table 10의 graceful handling에서 Zoom과 Insurance는 LangGraph가 앞선다 | judge robustness 주장 중 세 번째 항목이 데이터와 부분적으로 어긋난다 |
| 부록 C 본문 대 Table 10 | 본문은 GPT-4.1 judge에서도 3B 컴파일 모델이 3B orchestrator를 모든 지표에서 앞선다고 쓰지만, Table 10에 3B Orch 열이 없다 | 제시된 데이터로 확인할 수 없는 주장이다 |
| Table 6 내부 | 표시된 비용을 나눈 값과 배수 열이 어긋난다. Travel 133배 대 128배, Zoom 343배 대 296배, Insurance 467배 대 462배 | 컴파일 비용을 소수 넷째 자리로 반올림해 표시한 결과로 보이며 배수는 반올림 전 값으로 계산한 것으로 읽힌다 |
관련 연구
저자는 agent 능력을 모델 가중치에 넣는 선행 연구를 세 계통으로 나눈다.
| 계통 | 연구 | 내용 |
|---|---|---|
| 대화 파이프라인 통합 | SimpleTOD [Hosseini-Asl et al., NeurIPS 2020] | task-oriented dialogue의 이해, 행동 결정, 응답 생성 하위 과제 전부를 단일 시퀀스 예측 문제로 바꿔 MultiWOZ에서 최고 성능을 냈다 |
| 대화 파이프라인 통합 | AutoTOD [Xu et al., ACL 2024] | 자율 행동 시퀀싱으로 확장했다. 모듈형 시스템의 실패 모드로 오류 누적과 낮은 일반화를 명시하고 통합 모델이 이를 피한다고 주장했다 |
| frontier 모델 추론 distillation | FireAct [Chen et al., 2023] | Llama2-7B를 GPT-4 ReAct trajectory로 fine-tuning해 HotpotQA 성능을 77% 높였다 |
| frontier 모델 추론 distillation | AgentTuning [Zeng et al., Findings of ACL 2024] | Llama 2를 다양한 agent 상호작용 trajectory로 instruction-tuning했다. 70B 모델이 미지 과제에서 GPT-3.5-turbo와 동등하면서 범용 능력을 유지했다 |
| frontier 모델 추론 distillation | Agent Lumos [Yin et al., ACL 2024] | agent 행동을 planning과 grounding 모듈로 분해해 학습했다. 오픈소스 모델이 여러 벤치마크에서 GPT agent를 앞섰다 |
| 복잡한 워크플로로 확장 | WorkflowLLM [Fan et al., 2024] | 워크플로 샘플 10만 6천 개와 API 1,503종에 걸친 API 오케스트레이션 지식을 8B 모델에 컴파일했다 |
| 복잡한 워크플로로 확장 | SynTOD [Samarinas et al., 2024] | state transition graph로 합성 학습 데이터를 만들었다. 본 논문의 flowchart 기반 접근에 가장 가깝고, 절차적 대화 데이터를 크라우드소싱 없이 합성할 수 있음을 보였다 |
| 복잡한 워크플로로 확장 | Hsiao [2026] | 절차 지식을 hierarchical task network로 형식화했다. 구조적 분해가 agent 성능을 높임을 보였다 |
저자의 평가는 이들이 기법이 작동함을 증명했지만 세 가지를 하지 않았다는 것이다. 첫째, 컴파일이 오케스트레이션이나 in-context 대안보다 추론 비용에서 유리한 정도를 계량하지 않았다. 둘째, 재컴파일 주기를 측정하지 않았다. 셋째, 동일 모델 orchestrated baseline과 frontier 모델 baseline을 동시에 두어 컴파일 효과를 모델 용량 효과와 분리하지 않았다.
| 본 논문의 차별점 | 구현 방식 |
|---|---|
| 비용 우위 정량화 | 토큰당 단가와 토큰 사용량을 분리해 각각 65배와 2~7배로 계량하고 곱했다 |
| 재컴파일 주기 측정 | 데이터 생성, 학습, 평가 세 단계를 하드웨어 두 종류에서 각각 측정했다 |
| 컴파일 효과와 용량 효과 분리 | 여행 예약에서 Qwen 2.5 3B를 컴파일과 surface orchestration 두 방식으로 동시 운용했다 |
세 계통을 나란히 놓으면 본 논문이 SynTOD 계열의 직계임을 알 수 있다. state transition graph에서 합성 대화를 만드는 방식과 flowchart에서 합성 대화를 만드는 방식이 같은 착상이다. 본 논문이 추가한 것은 그 데이터로 만든 모델을 오케스트레이션 baseline과 frontier baseline 양쪽에 붙여 비용까지 재는 실험 설계다.
평가 방법론과 인프라 인용은 다음과 같다.
| 연구 | 역할 |
|---|---|
| vLLM, PagedAttention [Kwon et al., SOSP 2023] | 자체 호스팅 배치 추론의 서빙 기반. 비용 계산이 이 처리량 위에 서 있다 |
| LLM-Inference-Bench [Patel et al., 2024] | 8B 모델의 A100 처리량 벤치마크. 토큰당 단가 계산의 근거 수치다 |
| LLM-as-a-Judge [Zheng et al., NeurIPS 2023] | MT-Bench가 확립한 평가 방법론 |
| Panickssery et al. [2024] | judge가 자기 생성물을 선호하는 편향을 보고했다. GPT-4.1 교차 채점의 동기다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| subterranean agent | 절차가 LLM 가중치에 컴파일되어 런타임에 외부 orchestrator 없이 동작하는 agent. 사용자가 LLM과 직접 대화한다 |
| surface orchestration | orchestrator가 사용자와 LLM 사이에 있으면서 매 턴 프롬프트를 주입하고 출력을 파싱하는 기존 구조 |
| decision hub | 나가는 edge가 여러 개인 node. surface orchestration에서 LLM classifier가 라우팅하는 지점이자 실패가 몰리는 구간이다 |
| procedural internalization | 절차 구조를 통계적 규칙으로 가중치에 흡수하는 것. 자매 논문[2026b]에 따르면 LoRA로는 도달하지 못하고 전체 파라미터 갱신이 필요하다 |
| in-context baseline | flowchart 전체를 직렬화해 system prompt에 넣고 frontier 모델이 스스로 절차를 수행하게 한 조건. 품질 상한이자 가장 비싼 baseline이다 |
| interview style | 컴파일 모델이 학습 데이터에서 흡수한 턴당 질문 하나 패턴. 전체 턴의 64%가 정확히 질문 하나를 담는다 |
| recompile cycle | 절차 변경 시 데이터 재생성, 전체 파라미터 fine-tuning, 평가로 이어지는 주기. H200 8장에서 30~50분이다 |
관련 페이지
- Memory Intelligence Agent (MIA): Manager, Planner, Executor 3개 agent로 오케스트레이션을 분해하고 non-parametric 메모리와 parametric 메모리를 서로 변환한다. Dennis와 반대 방향으로, 외부 오케스트레이션을 없애는 대신 더 정교하게 나눈다. 두 논문 모두 무엇을 가중치에 내재화하고 무엇을 외부에 둘지를 묻고 다른 답을 낸다.
- Harness Engineering (Team Attention, 2026): 모델을 감싸는 harness 설계를 개선하는 편이 모델 교체보다 효과적이라는 주장이다. Dennis는 그 harness를 가중치로 흡수해 모델 자체가 절차를 갖게 하는 반대 전략을 제시한다.
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness를 갱신하는 것과 harness가 실제로 이득을 주는 것이 다르다는 분석이다. 이 페이지가 본 논문을 관련 페이지로 걸고 있으며, 오케스트레이션 층의 유지 비용을 다룬다는 점에서 컴파일의 동기와 맞물린다.
- How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks: agent가 토큰과 비용을 어디에 쓰는지 분해한다. 본 논문의 토큰 사용량 분석(절차 직렬화 부담 2~7배)과 같은 종류의 계량이다.
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 LLM 시스템의 실패 모드 14가지를 분류한다. 본 논문이 오케스트레이션의 신뢰성 비용을 말할 때 인용하는 연구다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩과 인덱스라는 외부 인프라를 grep과 bash로 대체해 모델 내부로 흡수한다. 절차를 흡수하는 본 논문과 외부 컴포넌트를 모델 능력으로 옮기는 패턴을 공유한다.