Agents · PAPER · 2024
Assisting in Writing Wikipedia-like Articles From Scratch with Large Language Models
요약
STORM은 주제 이름 하나만 받아 Wikipedia 수준의 긴 글을 처음부터 생성하는 시스템이다. 참고문헌 목록도, 문서 outline도 주어지지 않는다는 점이 이 과제의 조건이다.
기존 Wikipedia 생성 연구는 참고문헌이나 outline이 이미 있다고 가정하고 본문 서술만 다뤘다. STORM은 그 앞단, 즉 자료를 조사해 outline을 세우는 pre-writing 단계를 자동화 대상으로 삼는다. 방법은 서로 다른 관점을 여러 개 발견한 뒤, 각 관점을 배정받은 가상의 Wikipedia writer가 인터넷 출처에 grounding한 expert에게 질문을 던지는 대화를 시뮬레이션하고, 그 대화 기록으로 outline을 정제하는 순서다.
평가에는 데이터 오염을 피하려고 새로 구축한 FreshWiki 데이터셋을 썼다. 자동 평가에서 STORM은 가장 강한 baseline인 oRAG를 앞섰고, 숙련 Wikipedia 편집자 10명의 평가에서도 조직화와 커버리지 항목에서 우위를 보였다. 다만 검증 가능성 항목은 개선되지 않았고, 편집자들은 출처의 편향과 어조가 생성 글로 옮겨오는 문제와 무관한 사실을 연결하는 문제를 새 난제로 지목했다.
STORM은 Synthesis of Topic Outlines through Retrieval and Multi-perspective Question Asking의 머리글자다. 이 페이지는 논문의 방법과 평가를 다루고, 실제 실행 코드와 설치 절차는 stanford-oval/storm: STORM & Co-STORM이 담당한다.
배경
선행 연구가 건너뛴 단계
Wikipedia 문서 같은 설명적 글쓰기(expository writing)는 독자에게 주제를 조직적으로 알리는 것을 목표로 하며, 집필 이전에 충분한 조사와 계획을 요구한다. 그런데 기존 Wikipedia 생성 연구는 대체로 그 조사와 계획을 건너뛰었다. Liu et al. (2018)은 참고문헌 문서가 미리 주어진다고 가정하고, Fan and Gardent (2022)는 outline이 이미 있다고 보고 각 섹션을 확장하는 데 집중한다.
이 가정은 일반적으로 성립하지 않는다. 참고문헌을 모으고 outline을 세우는 일은 외부 출처를 식별하고 평가하고 조직하는 고급 정보 활용 능력을 요구하며, 숙련된 필자에게도 어려운 작업이다. 논문은 기존 벤치마크를 네 항목으로 비교해 자기 설정의 위치를 밝힌다.
| 연구 | 도메인 범위 | 생성 분량 | outline 제공 | 참고문헌 제공 |
|---|---|---|---|---|
| Balepur et al. (2023) | 1개 | 한 문단 | 해당 없음 | 예 |
| Qian et al. (2023) | 전체 | 한 문단 | 해당 없음 | 아니오 |
| Fan and Gardent (2022) | 1개 | 전체 문서 | 예 | 아니오 |
| Liu et al. (2018) | 전체 | 한 문단 | 해당 없음 | 예 |
| Sauper and Barzilay (2009) | 2개 | 전체 문서 | 아니오 | 아니오 |
| 이 논문 | 전체 | 전체 문서 | 아니오 | 아니오 |
한 문단만 생성하는 설정은 문서 outline을 필요로 하지 않는다. 이 논문만 도메인 제약 없이 전체 문서를 생성하면서 outline과 참고문헌을 둘 다 주지 않는다.
과제 정의와 두 단계 분해
주제 t가 주어지면 시스템은 참고문헌 집합 R을 찾고, 각 문장 s_i가 R의 문서를 인용하는 전체 글 S를 생성해야 한다. 섹션 제목처럼 조직화를 담당하는 요소에는 인용이 필요하지 않다.
전체 문서는 한 번에 생성하기도 평가하기도 어렵다. 그래서 논문은 생성을 두 단계로 나눈다. 이 분해는 pre-writing, drafting, revising으로 이어지는 인간의 글쓰기 과정을 따른 것이며, 교육자가 학생의 학술 글쓰기를 outline 단계에서 지도하는 관행에서도 착안했다.
| 단계 | 입력 | 산출 |
|---|---|---|
| pre-writing | 주제 t | 다중 수준 섹션 헤딩 목록인 outline O, 참고문헌 집합 R |
| writing | 주제 t, outline O, 참고문헌 R | 인용이 달린 전체 글 S |
이렇게 나누면 pre-writing 단계의 성능을 outline 품질로 따로 측정할 수 있다. 충실한 outline은 주제에 대한 포괄적 이해를 나타내는 지표이자 본문 작성의 토대가 된다.
직접 프롬프팅으로는 부족한 이유
pre-trained 모델은 내부에 많은 지식을 갖고 있으므로, 파라미터 지식만으로 outline이나 글 전체를 만드는 방식이 가장 단순한 접근이다. 논문은 이 접근을 Direct Gen이라 부른다. 그러나 세부가 부족하고 환각(hallucination)이 발생하며, 특히 long-tail 주제에서 약하다. 그래서 외부 출처를 쓰는 retrieval-augmented generation(RAG)이 대안이 되지만, 단순한 주제 검색으로는 드러나지 않는 정보가 많아 다시 조사 문제로 되돌아온다.
인간 학습 이론은 정보 획득에서 효과적인 질문의 역할을 강조한다. instruction-tuned 모델에 질문을 만들라고 지시할 수는 있지만, 실제로는 표면적 사실만 묻는 What, When, Where 형태의 기본 질문이 나온다. 이 관찰이 STORM 설계의 출발점이다.
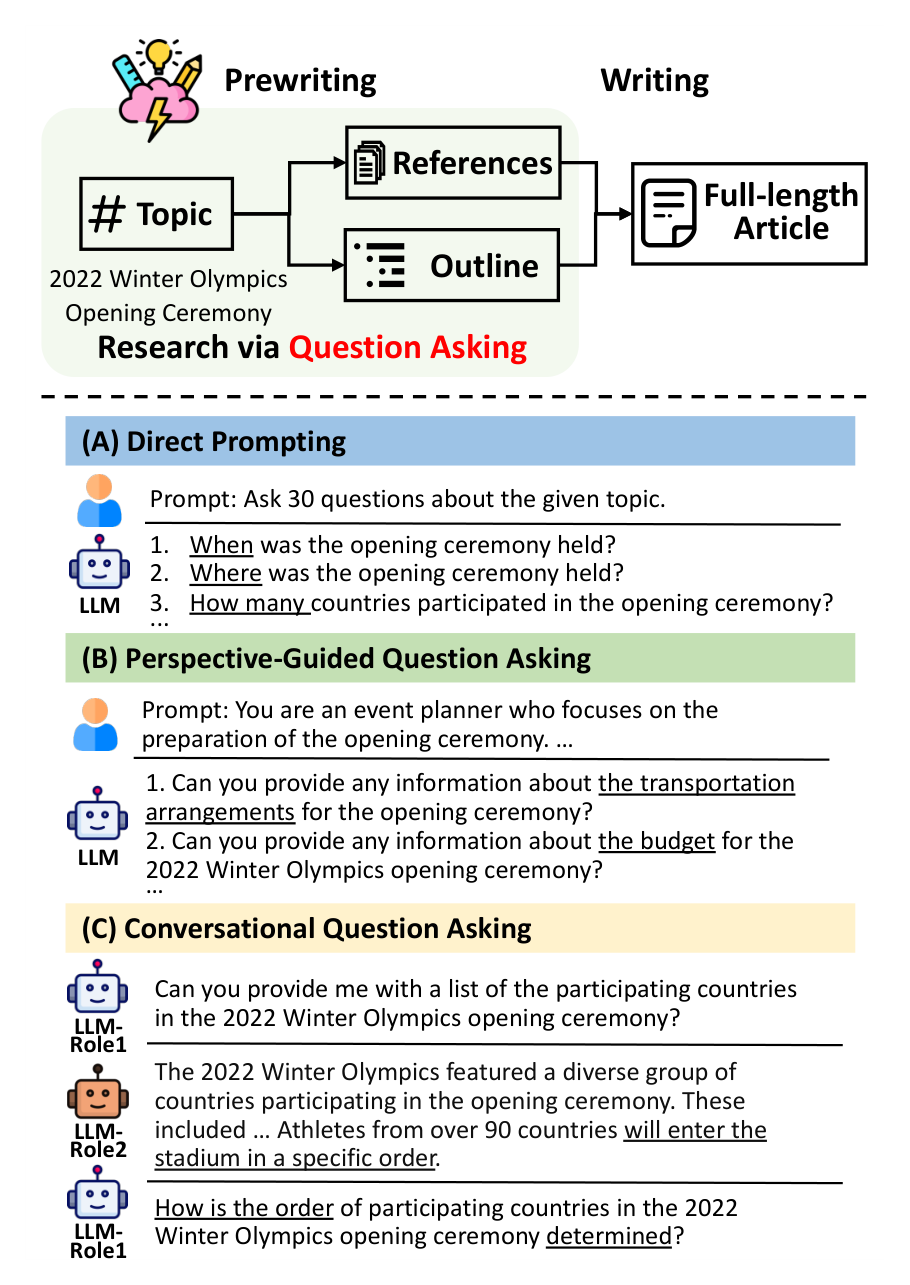
Figure 1은 "2022 Winter Olympics Opening Ceremony"라는 주제로 세 방식을 대비한다.
| 방식 | 프롬프트 | 나오는 질문 |
|---|---|---|
| (A) Direct Prompting | 주제에 대해 질문 30개를 만들라 | 개회식은 언제 열렸나, 어디서 열렸나, 몇 개국이 참가했나 |
| (B) 관점 유도 질문 | 당신은 개회식 준비를 담당하는 이벤트 기획자다 | 개회식 교통 준비에 대한 정보를 줄 수 있나, 개회식 예산에 대한 정보를 줄 수 있나 |
| (C) 대화형 질문 | 앞선 답을 읽고 후속 질문을 던진다 | 참가국 목록 질문에 대한 답에서 "90개국 이상이 정해진 순서로 입장한다"를 읽고, 그 순서가 어떻게 결정되는지 되묻는다 |
(A)는 주제의 표면만 훑는다. (B)는 관점이 사전 지식 역할을 해서 더 구체적인 측면을 겨냥한다. (C)는 답에서 새 단서를 얻어 질문을 심화한다.
핵심 개념
pre-writing은 실제 집필에 들어가기 전 자료를 조사하고 구조를 계획하는 단계를 말한다. Rohman (1965)은 이를 글쓰기 과정의 발견 단계로 정의했다. STORM이 자동화하는 대상이 정확히 이 단계다.
perspective는 같은 주제를 조사할 때 사람마다 중시하는 측면을 가리킨다. 논문은 기업의 이해관계자마다 관심사가 다르다는 경영학의 stakeholder theory에 이 개념을 견준다. 이벤트 기획자와 일반인이 같은 개회식을 두고 다른 것을 묻는 상황이 그 예다.
grounding은 모델 출력을 외부 근거에 붙들어 매는 것이다. STORM의 expert는 자기 기억이 아니라 검색으로 확보한 출처만 근거로 답을 만들며, 그 출처가 그대로 최종 글의 인용이 된다.
outline은 다중 수준 섹션 헤딩의 목록이다. 언어 모델이 문자열을 처리하므로 우물 정 기호 하나를 섹션 제목, 둘을 하위 섹션 제목으로 삼아 선형화한다.
citation recall과 citation precision은 생성 글의 검증 가능성을 재는 지표다. recall은 인용으로 뒷받침되는 문장의 비율이고, precision은 달린 인용 중 실제로 해당 문장을 뒷받침하는 것의 비율이다. Gao et al. (2023)의 정의를 따른다.
FreshWiki 데이터셋
수집 기준
현대 LLM은 대체로 Wikipedia 텍스트로 pre-training되므로, 평가에 아무 Wikipedia 문서나 쓰면 모델이 답을 이미 외우고 있을 위험이 있다. 논문은 테스트 대상 모델의 데이터 컷오프 이후 생성되거나 크게 편집된 문서만 골라 이 오염을 줄였다. 새 모델이 나오면 같은 절차를 반복할 수 있게 설계했다.
| 단계 | 기준 | 근거 |
|---|---|---|
| 1. 수집 | 2022년 2월부터 2023년 9월까지 월별 편집 횟수 상위 100개 문서 | 생성일 기준으로는 걸러지지 않는다. 대부분의 Wikipedia 문서는 생성 시점에 stub이거나 품질이 낮다 |
| 2. 품질 필터 | ORES 예측 B-class 이상 | Wikipedia 자체 통계로 전체 문서의 약 3%만 이 기준을 만족한다 |
| 3. 유형 제외 | 목록 문서와 하위 섹션이 없는 문서 제외 | outline 평가가 성립하지 않는다 |
| 4. 모달리티 제한 | 순수 텍스트만 사용 | 고품질 문서에 흔한 표와 이미지는 과제 단순화를 위해 제외한다 |
LLM이 이미 상당한 품질의 글을 만들어내므로, 비교 기준이 되는 사람 글도 고품질이어야 연구가 의미를 갖는다는 것이 품질 필터의 이유다.
표본 통계
실험에서는 사람이 쓴 본문이 3,000 단어 미만인 표본 100편을 무작위로 골랐다. 생성 상한을 4,000 토큰(약 3,000 단어)으로 두었기 때문에 분량을 맞춘 것이다.
| 항목 | 값 |
|---|---|
| 평균 섹션 수 | 8.4개 |
| 평균 전체 헤딩 수(모든 수준) | 15.8개 |
| 섹션 평균 분량 | 327.8 단어 |
| 문서 평균 분량 | 2,159.1 단어 |
| 평균 참고문헌 수 | 90.1개 |
참고문헌 90.1개는 사람이 쓴 고품질 문서의 기준선이지만, 그 수준에 도달하려면 여러 차례 편집을 거쳐야 한다. 논문은 편집 과정에서 참고문헌 수가 늘어나는 추이(Figure 4)와 표본 100편의 편집 횟수 분포(Figure 5)를 부록에 함께 제시한다.
outline 평가 지표
생성 outline의 헤딩 집합과 사람이 쓴 문서의 헤딩 집합을 비교한다. 두 집합의 원소가 정확히 일치할 필요는 없다는 점을 반영해 두 지표를 정의했다.
| 지표 | 계산 방식 | 도구 |
|---|---|---|
| heading soft recall | 헤딩 임베딩의 코사인 유사도로 soft recall을 계산한다. 항목 하나의 soft count는 그 항목과 집합 내 모든 항목 사이 유사도 합의 역수이고, 집합의 cardinality는 개별 count의 합이다. 교집합 cardinality는 card(G) + card(P) - card(G ∪ P)로 구하며 최종 값은 card(G ∩ P) / card(G)다 | Sentence-BERT, paraphrase-MiniLM-L6-v2 |
| heading entity recall | 사람이 쓴 문서 헤딩에 등장하는 named entity 중 생성 outline이 커버한 비율 | FLAIR NER |
soft recall 정의는 Fränti and Mariescu-Istodor (2023)에서 가져왔다. 두 지표가 높을수록 사람 글 대비 포괄적인 outline이라는 뜻이다.
방법
STORM은 두 가설 위에 설계되었다. 첫째, 다양한 관점은 다양한 질문을 낳는다. 둘째, 심층 질문을 만들려면 반복적 리서치가 필요하다. 첫 가설은 관점 유도 질문으로, 둘째 가설은 시뮬레이션 대화로 구현된다.
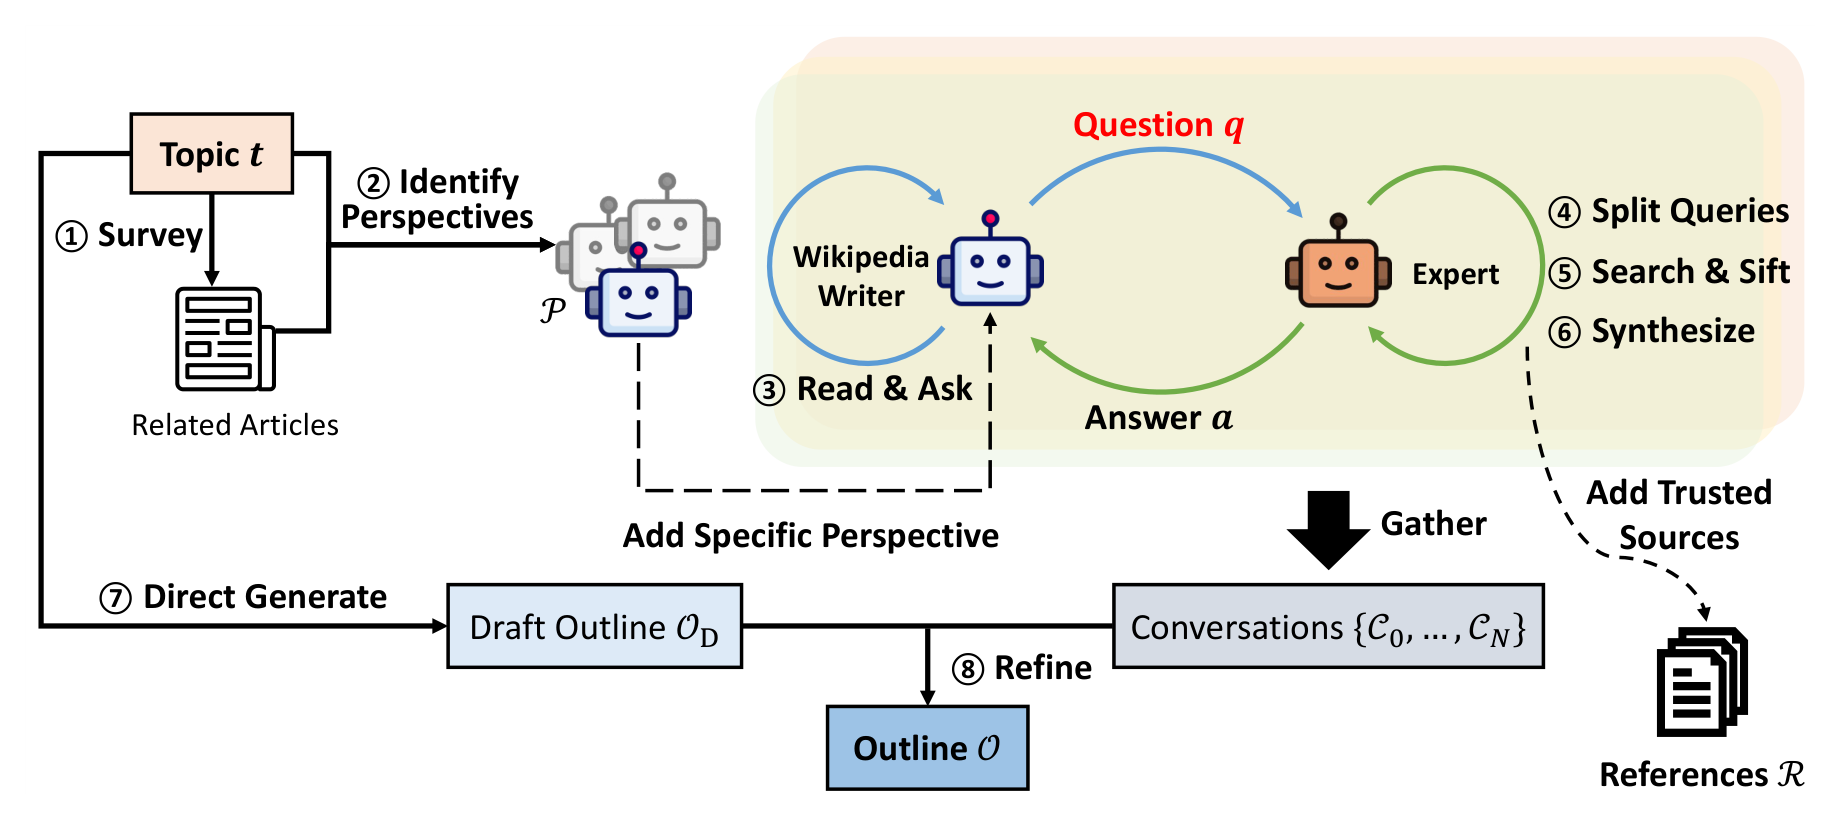
Figure 2의 번호는 다음 단계에 대응한다.
| 번호 | 단계 | 내용 |
|---|---|---|
| 1 | Survey | 주제와 관련된 Wikipedia 문서를 찾아 목차를 모은다 |
| 2 | Identify Perspectives | 모은 목차를 컨텍스트로 삼아 관점 집합 P를 도출한다 |
| 3 | Read & Ask | writer가 주제, 관점, 대화 이력을 읽고 질문 하나를 만든다 |
| 4 | Split Queries | expert가 질문을 여러 검색 질의(query)로 분해한다 |
| 5 | Search & Sift | 검색 결과를 신뢰 출처 규칙으로 걸러낸다 |
| 6 | Synthesize | 남은 출처를 종합해 답을 만들고 출처를 R에 누적한다 |
| 7 | Direct Generate | 주제만으로 draft outline O_D를 만든다 |
| 8 | Refine | draft outline과 대화 기록으로 최종 outline O를 만든다 |
관점 발견
입력 주제 t를 받으면 STORM은 먼저 LLM에 관련 주제 목록을 만들게 한다. 그다음 Wikipedia API로 각 관련 주제의 문서를 가져와 목차를 추출한다. 문서를 얻을 수 없는 항목은 건너뛴다.
추출한 목차들을 이어붙여 하나의 컨텍스트로 만들고, 이 컨텍스트를 보고 주제 t를 포괄적으로 다룰 수 있는 관점 N개를 도출하게 한다. 비슷한 주제의 기존 문서가 어떤 측면을 담고 있는지를 참고 자료로 삼는 구조다.
여기에 기본 사실을 담당하는 관점 p_0을 상수로 추가한다. 프롬프트에 적힌 설명은 "주제의 기본 사실을 넓게 커버하는 데 집중하는 basic fact writer"다. 따라서 관점은 총 N+1개이며, 관점별 질문 생성은 병렬로 진행된다. p_0을 항상 넣는 이유는 특화 관점만 남으면 누구나 알아야 할 기본 정보가 빠질 수 있기 때문이다.
시뮬레이션 대화
관점마다 Wikipedia writer와 topic expert 사이의 대화를 최대 M라운드까지 시뮬레이션한다. 라운드 i에서 writer는 주제 t, 배정된 관점 p, 그리고 대화 이력을 근거로 질문 q_i 하나를 생성한다. 대화 이력이 있으므로 앞선 답에서 새로 알게 된 내용을 반영해 후속 질문을 던질 수 있다. 논문은 이 순환의 근거로 질문 이론(Ram 1991)을 든다. 기존 질문에 대한 답은 주제 이해를 넓히는 동시에 새 질문을 낳는다는 관점이다.
expert 쪽은 세 하위 단계로 답한다.
| 하위 단계 | 하는 일 | 설계 이유 |
|---|---|---|
| Split Queries | 복잡한 질문 q_i를 여러 개의 검색 질의로 분해한다 | 질문 하나가 여러 사실을 동시에 묻는 경우가 많아 단일 질의로는 검색이 어렵다 |
| Search & Sift | 검색 결과를 Wikipedia 신뢰 출처 지침 기반 규칙 필터로 걸러 신뢰할 수 없는 출처를 제외한다 | 대화 이력이 사실 정보를 담아야 후속 질문이 헛돌지 않는다 |
| Synthesize | 남은 신뢰 출처를 종합해 답 a_i를 생성한다 | 답을 출처에 grounding해 환각을 억제한다 |
이 과정에서 쓰인 출처는 참고문헌 집합 R에 누적되어 본문 작성 단계로 넘어간다. 즉 대화 시뮬레이션은 질문을 심화하는 장치이면서 동시에 참고문헌을 모으는 수집기다.
outline 생성
outline은 두 번에 걸쳐 만든다. 먼저 주제 t만 주고 draft outline O_D를 직접 생성한다. 이 단계는 LLM 내부 지식을 활용하는 자리이며, 결과물은 일반적이지만 조직화된 뼈대를 제공한다.
그다음 주제 t, draft outline O_D, 수집한 대화 전체를 함께 프롬프트에 넣어 outline을 정제한다. 정제 프롬프트는 "이미 일반 정보를 담은 draft outline이 있고, 이제 정보 탐색 대화에서 배운 내용을 반영해 더 포괄적으로 개선하라"는 지시를 담는다. 결과가 최종 outline O다.
내부 지식으로 뼈대를 먼저 세우고 수집 정보로 살을 붙이는 순서다. 뒤에 나오는 실험 결과가 이 순서의 타당성을 뒷받침한다. Direct Gen만으로도 고수준 구조는 상당히 잘 나오지만 주제 특화 세부는 부족하기 때문이다.
본문 작성
참고문헌 집합 R 전체를 context window에 넣는 것은 대개 불가능하다. 그래서 섹션 제목과 그 아래 모든 수준의 하위 헤딩을 질의로 삼아 Sentence-BERT 임베딩 유사도로 R에서 관련 문서를 검색한다. 확보한 정보로 섹션마다 인용을 포함해 본문을 생성한다.
섹션을 병렬로 생성하므로 같은 내용이 여러 섹션에 중복될 수 있다. 이어붙인 전체 글을 다시 프롬프트에 넣어 중복 정보를 삭제하게 해서 일관성을 높인다. 마지막으로 Wikipedia 문체 규범에 맞춰 전체 글의 요약인 lead section을 합성해 문서 앞에 붙인다.
알고리즘과 프롬프트 구성
부록 B의 Algorithm 1이 시스템 골격을 담는다. 입력은 주제 t, 최대 관점 수 N, 최대 대화 라운드 M이고 출력은 outline O와 참고문헌 R이다.
| 줄 | 동작 |
|---|---|
| 1 | 기본 사실 관점 p_0을 상수로 둔다 |
| 4 | 관련 주제 목록을 생성한다 |
| 6~10 | 관련 주제마다 Wikipedia 문서를 가져와 목차를 추출한다 |
| 11~12 | 목차로 관점을 생성하고 [P0] + P[:N]으로 목록을 확정한다 |
| 15~29 | 관점마다 M라운드 대화를 반복 실행한다. 질문 생성, 질의 분해, 검색과 선별, 답 생성, 출처 누적 순이다 |
| 31 | draft outline O_D를 직접 생성한다 |
| 32 | draft outline과 대화 기록으로 outline을 정제한다 |
구현은 DSPy 프레임워크 기반 zero-shot 프롬프팅이며, 프롬프트는 7개 dspy.Signature 클래스로 정의된다.
| 프롬프트 클래스 | 역할 |
|---|---|
GenRelatedTopicsPrompt |
주제와 밀접한 Wikipedia 문서 URL 목록을 추천받는다 |
GenPerspectivesPrompt |
서로 다른 관점, 역할, 소속을 가진 Wikipedia 편집자 집단을 설명과 함께 생성한다 |
GenQnPrompt |
배정된 관점과 대화 이력을 보고 한 번에 질문 하나만 만든다. 더 물을 것이 없으면 감사 인사로 대화를 끝낸다 |
GenQueriesPrompt |
질문에 답하기 위해 검색창에 입력할 질의 목록을 만든다 |
GenAnswerPrompt |
수집한 정보만으로 모든 문장이 뒷받침되도록 답변을 작성한다 |
DirectGenOutlinePrompt |
주제만으로 draft outline을 만든다. 우물 정 기호로 수준을 표시하고 다른 정보는 넣지 않는다 |
RefineOutlinePrompt |
draft outline과 대화 이력을 받아 더 포괄적인 outline으로 개선한다 |
논문은 STORM이 특정 도메인용 프롬프트 엔지니어링에 크게 의존하지 않는 범용 프레임워크임을 강조한다. 프롬프트 어디에도 주제 도메인을 가정한 문구가 없다.
실험 설정
하이퍼파라미터와 모델 배치
| 항목 | 설정 |
|---|---|
| 관점 수 N | 5 |
| 대화 라운드 M | 5 |
| 질문 생성 모델 | gpt-3.5-turbo |
| 그 외 STORM 구성 요소 | gpt-3.5-turbo-instruct |
| outline 초안과 정제 | gpt-4도 함께 실험 |
| 본문 생성 | gpt-4만 사용 |
| 검색 백엔드 | You.com Search API |
| 샘플링 | temperature 1.0, top_p 0.9 |
| 출력 상한 | 최대 4,000 토큰(약 3,000 단어) |
| 평가 표본 | FreshWiki에서 무작위 100편 |
본문 생성에 gpt-4만 쓴 이유는 gpt-3.5가 인용을 붙여 텍스트를 만들 때 출처에 충실하지 않다는 선행 보고(Gao et al. 2023) 때문이다. 검색에서는 정답 Wikipedia 문서를 결과에서 제외해 정답 유출을 막았다.
baseline
선행 연구는 설정이 서로 다르고 LLM을 쓰지 않아 직접 비교가 어렵다. 그래서 논문은 LLM 기반 baseline을 새로 정의했다. 본문 평가에는 3종을, outline 평가에는 RAG-expand를 더한 4종을 쓴다.
| baseline | 동작 | 성격 |
|---|---|---|
| Direct Gen | LLM에 직접 outline을 생성하게 하고 그 outline으로 본문을 쓴다 | 외부 검색을 쓰지 않는다 |
| RAG | 주제로 한 번 검색하고 검색 결과와 주제로 outline이나 본문 전체를 생성한다 | 단일 검색 |
| oRAG | outline 생성은 RAG와 같고, 섹션 제목으로 추가 검색을 해서 섹션 단위로 본문을 생성한다 | 자동 평가에서 가장 강한 baseline |
| RAG-expand | RAG가 만든 outline의 섹션 제목을 검색 질의로 써서 출처를 더 모으고, 새 출처와 초기 outline으로 outline을 다시 다듬는다 | outline 평가 전용. RAG 계열의 상한을 시험한다 |
자동 평가 지표
| 대상 | 지표 | 판정 도구 |
|---|---|---|
| outline | heading soft recall, heading entity recall | Sentence-BERT, FLAIR NER |
| 본문 대 사람 글 | ROUGE-1, ROUGE-L, entity recall | ROUGE, FLAIR NER |
| 본문 루브릭 | Interest Level, Coherence and Organization, Relevance and Focus, Coverage (1-5) | Prometheus 13B 평가자 LLM |
| 본문 검증 가능성 | citation recall, citation precision | Mistral 7B-Instruct |
루브릭은 Wikipedia의 good article 기준을 참고해 숙련 편집자 2명과 함께 만들었다.
| 루브릭 항목 | 묻는 것 |
|---|---|
| Interest Level | 글이 얼마나 흥미롭고 생각을 자극하는가 |
| Coherence and Organization | 논리적으로 잘 조직되어 있는가 |
| Relevance and Focus | 주제를 벗어나지 않고 초점을 유지하는가 |
| Broad Coverage | 주제를 깊이 있게 탐색하고 커버리지가 좋은가 |
Prometheus는 5점 기준 답안을 함께 넣는 것이 권장되지만 context 한계를 넘기 때문에 기준 답안을 빼고 썼다. 기준 답안 없는 Prometheus 평점도 사람 선호와 상관이 높다는 원 논문의 보고가 근거다. 입력 글은 가장 짧은 섹션부터 반복 삭제해 2,000 단어 안으로 줄였다. citation 판정은 문장 단위이며 NLTK sent_tokenize로 문장을 나눈다.
결과
outline 품질
GPT-3.5 설정 결과다. 값은 %다.
| 방법 | heading soft recall | heading entity recall |
|---|---|---|
| Direct Gen | 80.23 | 32.39 |
| RAG/oRAG | 73.59 | 33.85 |
| RAG-expand | 74.40 | 33.85 |
| STORM | 86.26 (유의) | 40.52 (유의) |
| w/o Perspective | 84.49 | 40.12 |
| w/o Conversation | 77.97 | 31.98 |
GPT-4 설정 결과다.
| 방법 | heading soft recall | heading entity recall |
|---|---|---|
| Direct Gen | 87.66 | 34.78 |
| RAG/oRAG | 89.55 | 42.38 |
| RAG-expand | 91.36 | 43.53 |
| STORM | 92.73 (유의) | 45.91 |
| w/o Perspective | 92.39 | 42.70 |
| w/o Conversation | 88.75 | 39.30 |
"유의"는 STORM과 baseline 사이 paired t-test에서 p < 0.05인 항목이다. GPT-3.5 설정에서는 두 지표 모두 유의차를 얻었지만, GPT-4 설정의 entity recall 45.91에는 유의 표시가 없다. 값 자체는 RAG-expand의 43.53보다 높으나 통계적으로 구분되지 않는다는 뜻이다.
Direct Gen도 heading soft recall이 이미 높다. GPT-4 설정에서 87.66이다. LLM이 파라미터 지식만으로 주제의 고수준 측면을 상당히 잘 파악한다는 뜻이다. 따라서 STORM의 이득은 구조 자체가 아니라 주제 특화 세부 측면을 더 많이 커버하는 데서 나온다.
한편 GPT-3.5 설정에서 RAG는 73.59로 Direct Gen의 80.23보다 낮다. 정리되지 않은 검색 정보를 context window에 넣으면 약한 모델에게는 outline 생성이 오히려 어려워진다는 관찰이다. 검색을 붙이는 것만으로는 개선되지 않고, 정보를 정리하는 단계가 필요하다는 근거가 된다. RAG 계열의 상한을 확인하려고 추가 검색과 정제를 한 번 더 붙인 RAG-expand를 만들었지만, GPT-4 설정에서 91.36으로 STORM의 92.73에 미치지 못했다.
본문 품질
| 방법 | ROUGE-1 | ROUGE-L | Entity Recall | Interest Level | Organization | Relevance | Coverage |
|---|---|---|---|---|---|---|---|
| Direct Gen | 25.62 | 12.63 | 5.08 | 2.87 | 4.60 | 3.10 | 4.16 |
| RAG | 28.52 | 13.18 | 7.57 | 3.14 | 4.22 | 3.05 | 4.08 |
| oRAG | 44.26 | 16.51 | 12.57 | 3.90 | 4.79 | 4.09 | 4.70 |
| STORM | 45.82 | 16.70 | 14.10 (유의) | 3.99 (유의) | 4.82 | 4.45 (유의) | 4.88 (유의) |
| w/o Outline Stage | 26.77 | 12.77 | 7.39 | 3.33 | 4.87 | 3.35 | 4.37 |
루브릭 4개 항목은 1-5 척도다. oRAG가 RAG를 ROUGE-1에서 28.52에서 44.26으로 크게 앞서는 결과는 outline으로 본문 생성을 구조화하는 것이 효과적임을 보여준다. STORM은 그 oRAG를 다시 앞서며 entity recall, Interest Level, Relevance, Coverage 네 항목에서 유의차를 얻었다. Organization 4.82는 oRAG의 4.79보다 높지만 유의 표시가 없다.
논문은 평가자 LLM이 기계 생성 텍스트를 과대 평가할 가능성을 스스로 인정하고, 뒤이은 인간 평가에서 STORM에 개선 여지가 많이 남았음이 드러난다고 밝힌다.
outline 단계 제거의 효과
w/o Outline Stage는 주제와 시뮬레이션 대화만 주고 글 전체를 한 번에 생성한 조건이다. 지표별 변화는 다음과 같다.
| 지표 | STORM | w/o Outline Stage | 변화 |
|---|---|---|---|
| ROUGE-1 | 45.82 | 26.77 | 19.05 하락 |
| ROUGE-L | 16.70 | 12.77 | 3.93 하락 |
| Entity Recall | 14.10 | 7.39 | 6.71 하락 |
| Interest Level | 3.99 | 3.33 | 0.66 하락 |
| Organization | 4.82 | 4.87 | 0.05 상승 |
| Relevance | 4.45 | 3.35 | 1.10 하락 |
| Coverage | 4.88 | 4.37 | 0.51 하락 |
여섯 항목이 하락하므로 outline 단계는 필요하다는 결론이 유지된다. 다만 논문 본문은 outline 단계를 제거하면 "모든 지표에서 성능이 유의하게 나빠진다"고 서술하는데, Table 2에서 Organization은 4.87로 STORM의 4.82보다 높고 열 최고값으로 굵게 표시되어 있다. 표를 기준으로 삼으면 Organization은 예외이며 본문 서술과 어긋난다.
ablation
Perspective를 빼면 질문 생성 프롬프트에서 관점을 제거하고, Conversation을 빼면 정해진 개수의 질문을 한 번에 생성한다. 비교 공정성을 위해 생성 질문의 총수는 모든 변형에서 같게 통제했다. 앞의 outline 품질 표에서 w/o Conversation이 가장 크게 나빠진다. 관련 정보를 읽는 것이 효과적 질문 생성의 핵심이라는 뜻이다.
수집한 고유 참고문헌 수 평균이 같은 순서를 보인다.
| 방법 | 고유 참고문헌 수 평균 |
|---|---|
| STORM | 99.83 |
| w/o Perspective | 54.36 |
| w/o Conversation | 39.56 |
full STORM은 사람이 쓴 문서의 평균 참고문헌 수 90.1개를 넘긴다. 관점을 빼면 54.36개로 약 45%가 줄고, 대화까지 빼면 39.56개로 60% 이상 줄어든다. 참고문헌 수의 순서가 outline 품질 지표의 순서와 일치하므로, 질문 다양화가 곧 출처 다양화로 이어진다고 볼 수 있다.
인용 품질
| 지표 | 값 |
|---|---|
| citation recall | 84.83 |
| citation precision | 85.18 |
Mistral 7B-Instruct 판정으로 생성 문장의 84.83%가 인용에 의해 뒷받침된다. 곧 약 15%가 뒷받침되지 않는다. 논문은 이 15%의 성격을 확인하려고 무작위 10편을 골라 저자 1명이 미지원 문장 전량을 수동 검토했다.
| 유형 | 비율 | 성격 |
|---|---|---|
| Lack Citation | 47% | 인용 자체가 없는 문장 |
| False Negative | 15% | 저자 판단으로는 실제로 뒷받침되는 문장 |
| Improper Inferential Linking | 14% | 출처가 뒷받침하지 않는 추론적 연결을 만든 오류 |
| Incorrectly Split | 12% | 문장 분할 오류 |
| Inaccurate Paraphrasing | 7% | 출처를 부정확하게 옮긴 오류 |
| Citing Irrelevant Sources | 4% | 주제와 무관한 출처를 인용한 오류 |
| Others | 1% | 그 외 |
논문이 진짜 오류로 분류한 세 유형은 improper inferential linking, inaccurate paraphrasing, citing irrelevant sources이며 합계 25%다. 나머지 75%는 인용 누락, 판정 오류, 문장 분할 오류로 성격이 다르다. Incorrectly Split은 No.12847이나 Bhatia et al. 같은 표기에서 sent_tokenize가 문장을 잘못 끊어 생긴 계측 잡음이다.
세 오류 유형 중 가장 흔한 것은 improper inferential linking이다. LLM이 context window 안의 서로 다른 정보 조각 사이에 부적절한 추론 연결을 만드는 경향에서 나온다. 존재하지 않는 내용을 만들어내는 환각이 주된 원인은 아니라는 것이 이 분석의 결론이다. 논문은 grounded 텍스트 생성 연구가 환각 회피에 더해 과도한 추론 도약을 막는 데도 초점을 둬야 한다고 제안한다.
부록 Table 9의 실제 예시가 각 유형을 구체적으로 보여준다.
| 오류 유형 | 주제 | 어긋난 지점 |
|---|---|---|
| Improper Inferential Linking | Lahaina, Hawaii | 출처는 하와이 생활의 일부로서 종교를 논하지만 Lahaina를 언급하지 않는다. 생성 문장은 종교가 Lahaina 생활의 가장 중요한 측면이었다고 단정한다 |
| Inaccurate Paraphrasing | 2022 Crimean Bridge explosion | 출처는 여객 열차가 2019년 12월 25일, 화물 열차가 2020년 6월 30일에 통행을 시작했다고 적는다. 생성 문장은 다리가 2020년 6월에 완공되었다고 서술한다 |
| Citing Irrelevant Sources | LK-99 | 게임 Battlefield 2042의 PC 성능 가이드를 LK-99 성능 비교의 근거로 인용한다 |
인간 평가
편집자 10명은 Wikipedia 편집 500회 이상, 경력 1년 이상 조건을 만족한다. Meta-Wiki에 연구 페이지를 만들고 최근 문서를 승인한 활동 편집자에게 개별 연락해 모집했다.
| 항목 | 내용 |
|---|---|
| 인원 | 10명 |
| 자격 | 편집 500회 이상, 경력 1년 이상 |
| 경력 분포 | 1 |
| 평가 대상 | 무작위 20개 주제에 대한 STORM 글과 oRAG 글의 쌍 |
| 배정 | 쌍마다 편집자 2명 |
| 척도 | 자동 평가와 같은 5개 항목을 1-7로 세분화 |
| 도구 | 본문과 인용 스니펫을 나란히 보여주는 웹 애플리케이션 |
| 보상 | 1인당 50달러 |
Verifiability는 자동 평가처럼 인용 품질로 대리하지 않고, "독자 연구 없이 검증 가능"이라는 Wikipedia 기준을 그대로 적용했다.
| 항목 | oRAG 평균 | oRAG 4점 이상 | STORM 평균 | STORM 4점 이상 | p값 |
|---|---|---|---|---|---|
| Interest Level | 3.63 | 57.5% | 4.03 | 70.0% | 0.077 |
| Organization | 3.25 | 45.0% | 4.00 | 70.0% | 0.005 |
| Relevance | 3.93 | 62.5% | 4.15 | 65.0% | 0.347 |
| Coverage | 3.58 | 57.5% | 4.00 | 67.5% | 0.084 |
| Verifiability | 3.85 | 67.5% | 3.80 | 67.5% | 0.843 |
| 선호 횟수 | 14 | 26 |
4점 이상은 좋은 품질을 뜻하는 구간이다. STORM은 Organization에서 4점 이상 비율이 45.0%에서 70.0%로 25.0%p, Coverage에서 57.5%에서 67.5%로 10.0%p 높다. 초록이 인용하는 두 수치가 이것이다.
다만 p < 0.05를 만족하는 항목은 Organization(0.005) 하나뿐이다. Interest Level(0.077)과 Coverage(0.084)는 개선 방향이 일관되지만 유의 수준에 이르지 못했고, Relevance(0.347)는 차이가 작다. Verifiability는 STORM 평균이 3.80으로 oRAG의 3.85보다 낮고 4점 이상 비율은 양쪽 모두 67.5%로 같다. 즉 검증 가능성은 개선되지 않았다. 쌍별 선호에서는 총 40건 중 STORM 26건, oRAG 14건이다.
평가자 간 일치도를 Krippendorff's Alpha로 계산한 값은 다음과 같다.
| 항목 | Krippendorff's Alpha |
|---|---|
| Interest Level | 0.349 |
| Organization | 0.221 |
| Relevance | 0.256 |
| Coverage | 0.346 |
| Verifiability | 0.388 |
전 항목이 0.4 미만이다. 숙련 편집자 사이에서도 글 품질 판단이 크게 갈린다는 뜻이므로, 위 평점 차이를 읽을 때 함께 고려해야 한다.
참고문헌이 늘면서 생기는 문제
oRAG를 선호한 14건의 응답을 따로 검토했다. 평점과 선호가 어긋난 3건을 빼면, 절반 이상의 사례에서 편집자가 STORM 글에 더 낮은 Verifiability 점수를 줬다. 원인은 red herring fallacy와 과잉 추론이다. 참고문헌 집합 R 안의 서로 다른 정보 조각 사이, 또는 정보와 주제 사이에 검증할 수 없는 연결을 만드는 문제다.
이 문제는 널리 논의되는 사실 환각보다 다루기 어렵다. 개별 문장이 출처를 벗어나지 않아도, 두 사실을 나란히 놓는 행위 자체가 근거 없는 함의를 만들 수 있어서다. 논문은 기본적인 fact-checking으로는 잡히지 않고 높은 수준의 sensemaking이 필요하다고 정리한다. 정보를 더 많이 모으는 것이 곧 품질 향상은 아니라는 점에서, STORM이 참고문헌을 99.83개까지 늘린 성과와 짝을 이루는 대가다.
편집자 유용성 설문
평가를 마친 뒤 편집자들은 자신이 검토한 STORM 글을 같은 주제의 사람 글과 비교하고, 1-5 Likert 척도로 유용성을 답했다.
| 문항 | 매우 동의 | 다소 동의 | 중립 | 다소 반대 |
|---|---|---|---|---|
| 내 pre-writing 단계에 특히 도움이 된다 | 30% | 70% | 0% | 0% |
| 새 주제의 Wikipedia 문서를 편집할 때 도움이 된다 | 30% | 50% | 20% | 0% |
| Wikipedia 커뮤니티 전체에 유용한 도구가 될 수 있다 | 10% | 60% | 20% | 10% |
pre-writing 단계 유용성에는 편집자 10명 전원이 동의했다. 새 주제 편집 도움에는 80%가 동의했고, 커뮤니티 전체 유용성에는 70%가 동의하고 10%가 반대했다. 자기 작업 보조로서의 평가가 가장 높고, 커뮤니티 차원의 평가로 갈수록 유보가 늘어나는 형태다.
편집자가 지적한 문제
자유 서술 코멘트를 정리한 결과는 다음과 같다. 언급 횟수는 코멘트에서 해당 문제가 지적된 건수다.
| 문제 | 언급 횟수 | 실제 코멘트 예시 |
|---|---|---|
| 감정적 어휘 사용과 중립성 부족 | 12 | Lahaina, Hawaii 글에서 significant가 17회 등장하고, 더 넓은 정치적 중요성에 대한 모호하고 뒷받침되지 않는 주장이 있어 백과사전답지 않다 |
| red herring fallacy와 무관 출처 연결 | 11 | Typhoon Hinnamnor 글에서 미국 여론조사는 넣지 말아야 하고, 출처가 명시적으로 연결하지 않은 기후 변화를 링크해서는 안 된다 |
| 중요 정보 누락 | 6 | LK-99 글에서 슈퍼컴퓨터 시뮬레이션 분석을 언급했지만 그 내용에 대한 정보가 부족하다 |
| 시점 의존 정보의 부적절한 처리 | 5 | now 같은 표현은 글이 낡아 보이지 않도록 피하고 as of December 2023 형식을 써야 한다 |
| 섹션 구성 문제 | 5 | 2022 West Java earthquake 글의 Recovery and Rehabilitation 섹션에 하위 섹션이 너무 많다 |
긍정 평가도 함께 나왔다. 한 편집자는 STORM 결과가 사람 글보다 배경 정보를 조금 더 준다고 평했고, 다른 편집자는 AI 글이 Wikipedia 글보다 깊이가 있었다고 답했다. 반면 생성 글이 실제 Wikipedia 문서보다 정보량이 적다는 지적도 있었고, 10명 중 7명이 STORM 글이 감정적이거나 중립적이지 않게 들린다고 언급했다.
가장 많이 지적된 두 문제는 STORM 자체의 결함이라기보다 출처에서 온 것이다. 중립성 문제의 원인은 인터넷 출처가 그 자체로 중립적이지 않고 홍보성 내용을 상당히 담고 있다는 점이다.
한계
| 한계 | 내용 |
|---|---|
| 중립성과 검증 가능성 | 기계 생성 글이 잘 다듬어진 사람 글에 미치지 못하는 지점이 특히 이 두 항목이다. 관점을 여러 개 발견해도 수집 정보가 인터넷의 지배적 출처로 편향되거나 홍보성 내용을 담을 수 있다 |
| 후처리 모듈 부재 | 검색 엔진에 의존하며 별도 후처리가 없다. 저자들은 여러 관점을 고르게 담는 검색 모듈 개선과 내용 선별 모듈 추가를 다음 단계로 지목한다 |
| 과잉 추론 | 이 연구가 확인한 검증 가능성 문제는 사실 환각을 넘어선다. 사실 단위 검증이 아니라 높은 수준의 sensemaking이 필요하다 |
| 자유 텍스트만 생성 | 과제를 단순화해 자유 형식 텍스트만 다룬다. 고품질 Wikipedia 문서에 흔한 구조화 데이터와 멀티모달 정보 생성은 향후 과제다 |
| 영어 단일 언어 | 영어 Wikipedia만 대상이다. 비영어권에는 문서가 없는 주제가 더 많으므로 다국어 확장이 의미 있는 방향이다 |
| 평가 신뢰도 | 평가자 LLM이 기계 생성 텍스트를 과대 평가할 가능성이 있고, 인간 평가의 평가자 간 일치도도 전 항목 0.4 미만이다 |
윤리 측면에서는 생성 글을 온라인에 게재하지 않고 정확성 검사를 적용했으며, 시스템이 실제 Wikipedia 페이지와 상호작용하지 않도록 해 커뮤니티 교란을 피했다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| pre-writing | 실제 집필 전 자료를 조사하고 구조를 계획하는 단계. 관점 발견, 정보 수집, outline 작성이 여기 들어간다 |
| perspective-guided question asking | 서로 다른 역할과 관점을 배정받은 LLM이 각기 다른 측면을 질문해 다면적 정보를 모으는 기법 |
| heading soft recall | 생성 outline과 사람 글의 헤딩 사이 Sentence-BERT 코사인 유사도로 계산하는 soft recall. 정확 일치를 요구하지 않는다 |
| FreshWiki | pre-training 데이터 오염을 피하려고 LLM 데이터 컷오프 이후 편집된 고품질 Wikipedia 문서를 모은 데이터셋 |
| source bias transfer | 인터넷 검색 출처의 편향, 감정적 어조, 홍보성 표현이 생성 글로 옮겨가는 현상 |
| improper inferential linking | 출처가 뒷받침하지 않는데도 정보 조각 사이에 인과나 연관을 지어내는 오류. 논문이 분류한 세 오류 유형 중 가장 흔하다 |
관련 페이지
- stanford-oval/storm: STORM & Co-STORM: 이 논문의 공식 구현체. 이 페이지가 논문의 방법과 평가를 다루고, 설치 절차, 모듈 구조, Co-STORM 확장은 구현체 페이지가 담당한다
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 시스템의 실패 유형 분류. STORM의 writer와 expert 대화도 역할을 나눈 멀티에이전트 구성이라 실패 지점을 비교해 볼 수 있다
- GraphRAG: From Local to Global: GraphRAG. 단순 주제 검색으로 드러나지 않는 정보를 다루려는 시도라는 점이 겹치며, STORM은 질문 대화로, GraphRAG는 knowledge graph community summary로 접근한다
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: HippoRAG 2. 검색 구조 자체를 바꾸는 계보로, STORM처럼 단일 검색의 한계를 출발점으로 삼는다
프로젝트 페이지: https://storm-project.stanford.edu/research/storm/ , 코드: https://github.com/stanford-oval/storm