Database · REPO · 2025
VectifyAI/PageIndex
요약
PageIndex는 vector database와 chunking 없이 긴 문서를 목차 형태의 계층 트리로 바꾼 뒤, LLM이 그 트리를 탐색해 답에 필요한 절을 직접 고르게 하는 vectorless RAG 엔진이다. VectifyAI가 만들었고 이 저장소는 그 엔진의 Python SDK 공개 코드다.
이름의 vectorless는 임베딩을 만들지 않는다는 뜻이다. 문서를 잘라 벡터로 바꾸고 질의(query) 벡터와 가까운 조각을 고르는 대신, 문서에 이미 들어 있는 절 구조를 트리 인덱스로 뽑아 두고 LLM이 그 트리를 읽어 어디를 볼지 판단한다. README는 이 판단 과정을 tree search라 부르고, 바둑 프로그램 AlphaGo에서 영감을 받았다고 밝힌다.
2026년 8월 개편으로 이 저장소의 성격이 바뀌었다. 이전에는 run_pageindex.py 한 개의 CLI로 트리를 만드는 자체 호스팅 코드였으나, 지금은 pip install -U pageindex로 설치하는 SDK이며 같은 클라이언트의 인자만 바꿔 로컬 실행과 PageIndex Cloud를 전환한다. 측정치도 함께 늘어, README는 인덱싱 비용과 시간, 질의 비용 대비 정확도, PDF 직접 입력과의 비용 비교, FinanceBench 결과를 싣는다.
| 항목 | 값 |
|---|---|
| 저장소 | VectifyAI/PageIndex |
| 패키지 | PyPI 배포명 pageindex, 버전 0.2.10, 개발 단계 Alpha |
| 라이선스 | MIT. LICENSE의 저작권 표기는 "Copyright (c) 2025 Vectify AI" |
| 실행 요구사항 | Python 3.10 이상 |
| 인용 대상 | Mingtian Zhang, Yu Tang and PageIndex Team, "PageIndex: Next-Generation Vectorless, Reasoning-based RAG", PageIndex Blog, Sep 2025 |
| 진입점 | PageIndexClient의 submit_document와 chat |
| 자체 보고 수치 | 인덱싱 쪽당 약 0.001달러, 질의당 0.003달러에서 0.10달러, FinanceBench 98.7% |
배경
README의 출발점은 vector 기반 RAG가 similarity와 relevance를 같은 것으로 취급한다는 지적이다. vector 검색은 질의 임베딩과 가까운 조각을 고르는데, 가깝다는 것은 표현이 닮았다는 뜻이지 답에 필요하다는 뜻이 아니다. 원문 표현은 "similarity ≠ relevance"이고, retrieval이 실제로 필요로 하는 것은 relevance이며 relevance에는 추론이 필요하다고 잇는다.
이 간극은 전문 문서에서 특히 커진다. 맥락 이해와 도메인 지식과 다단계 추론이 필요한 문서에서는 두 방향의 실패가 함께 일어난다. 관련 있지만 표현이 닮지 않은 부분을 놓치고, 표현은 닮았지만 답과 무관한 부분을 가져온다.
chunking도 같은 문제의 다른 얼굴이다. 문서를 고정 길이로 자르면 절의 경계와 조각의 경계가 어긋나 문맥이 끊긴다. PageIndex는 자르는 대신 문서가 본래 갖고 있던 절 구분을 그대로 쓴다. README가 적합한 대상으로 드는 것은 재무 보고서, 법률 문서, 규제 신고 서류, 기술 매뉴얼, 의학 문헌, 학술 교과서를 비롯한 길고 복잡한 전문 문서다.
결과의 설명 가능성도 동기에 들어간다. vector 검색은 어떤 조각이 왜 뽑혔는지를 거리 값으로만 설명할 수 있다. 반면 절 구조를 따라 내려간 경로는 그 자체가 근거가 된다. README는 근사 검색의 불투명함을 "vibe retrieval"이라 부르며 명시적 참조로 추적 가능한 결과와 대비시킨다.
핵심 개념
vectorless RAG는 vector database와 임베딩 유사도 검색을 쓰지 않고 LLM의 추론만으로 retrieval을 수행하는 방식이다. retrieval은 외부 지식에서 답에 필요한 부분을 찾아오는 단계인데, 그 판단 주체를 벡터 거리에서 모델로 옮긴 것이 이 방식의 핵심이다.
tree index는 문서 하나를 목차 모양의 계층 구조로 표현한 인덱스다. README가 밝히는 중요한 성질은 이 구조를 LLM이 만들어 내는 것이 아니라 문서 레이아웃에서 추출한다는 점이다. 모델은 추출된 구조를 요약하고 다듬는 일만 맡는다.
tree search는 그 트리를 위에서 아래로 내려가며 관련 절을 고르는 탐색 단계다. 사람 전문가가 두꺼운 보고서를 받았을 때 목차를 먼저 보고 후보 절로 이동하는 동작에 대응한다.
context-aware retrieval은 같은 문서라도 지금까지의 대화 이력과 사용자가 가진 도메인 지식에 따라 다른 절이 뽑힐 수 있다는 뜻이다. 임베딩을 미리 계산해 두는 방식에서는 질의 벡터 하나로 판단이 끝나지만, 판단을 LLM이 실행 시점에 하면 컨텍스트를 프롬프트에 더하는 것으로 반영이 끝난다.
추적 가능성은 이 설계에서 부수 효과가 아니라 구조에서 나오는 성질이다. 트리를 내려간 경로가 곧 어느 절을 왜 골랐는지의 기록이므로, 결과에 페이지와 절 참조가 자연스럽게 따라붙는다. Local 구성에서 그 참조 단위는 페이지이고 Cloud에서는 블록까지 좁아진다.
README의 TL;DR은 이 네 가지를 한 문장으로 묶는다. PageIndex는 사람이 읽는 방식을 본뜬 vectorless, reasoning-based RAG 엔진으로, 추적 가능하고 설명 가능하며 컨텍스트를 반영하는 retrieval을 vector database나 chunking 없이 제공한다는 것이다.
| 기준 | Vector RAG | PageIndex |
|---|---|---|
| 인덱스 | vector index | tree index |
| retrieval 방식 | semantic similarity 검색 | 트리 위에서의 LLM 추론 |
| 결과의 성격 | 불투명한 "vibe retrieval" | 명시적 참조로 추적 가능 |
| 판단에 쓰이는 컨텍스트 | 질의 임베딩만 | 대화 이력과 도메인 지식을 포함한 전체 |
방법
2단계 retrieval
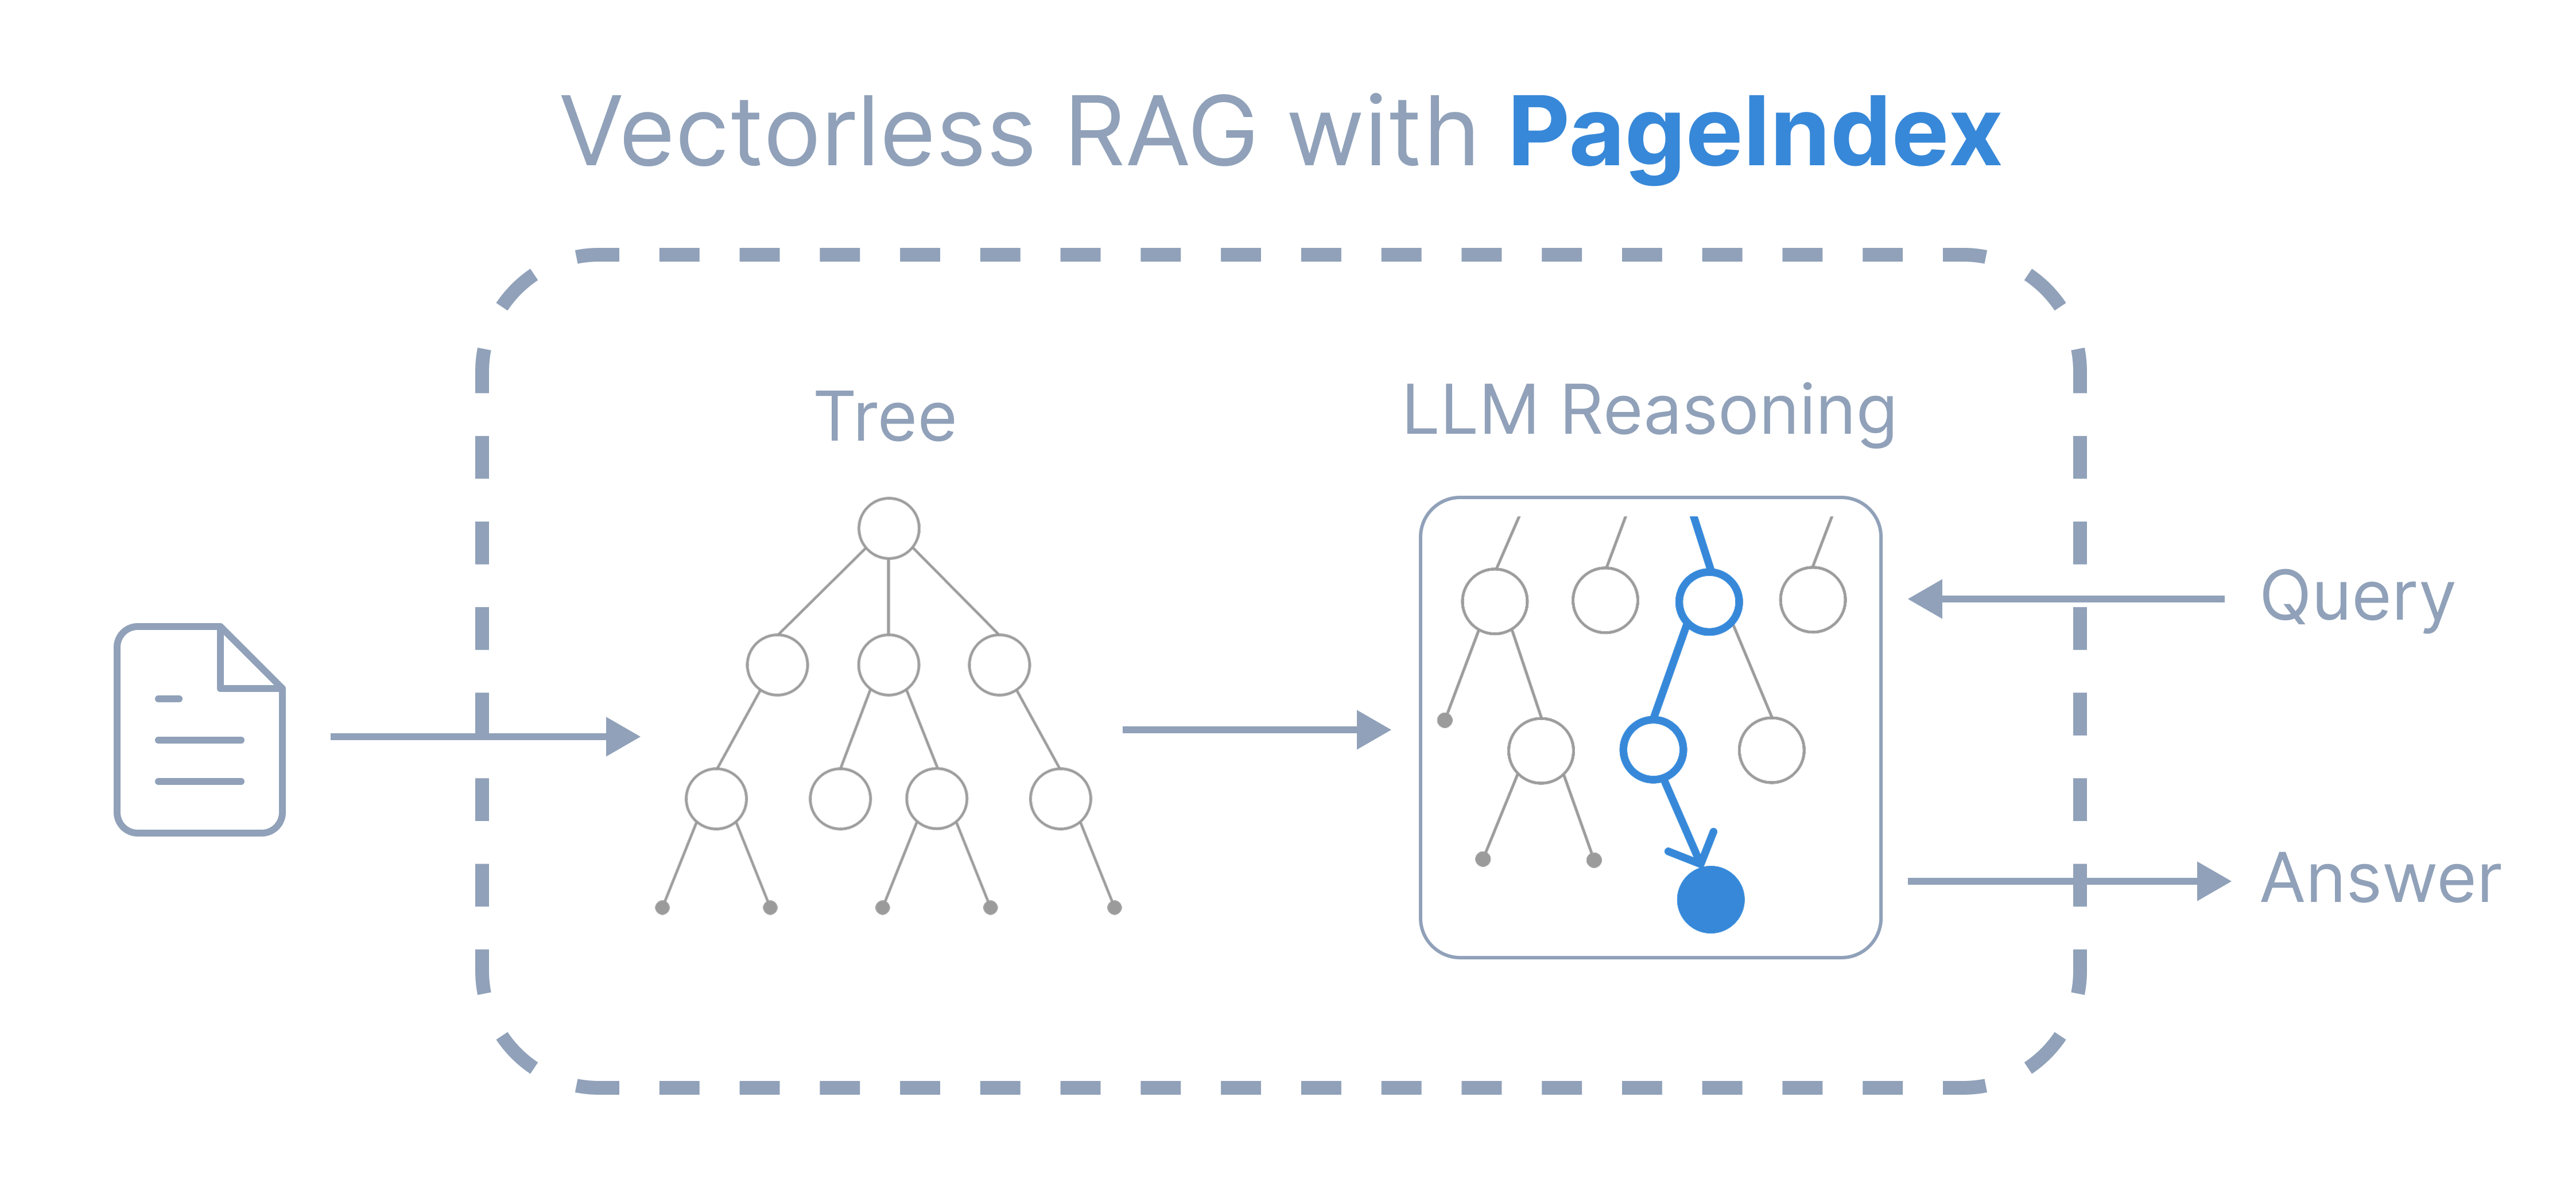
README가 제시하는 절차는 두 단계뿐이다. Index 단계에서 문서마다 tree structure index를 만들고, Retrieve 단계에서 LLM 추론으로 그 트리를 agentic하게 탐색한다.
두 단계는 비용 구조가 서로 다르다. Index는 문서 전체를 훑어야 하므로 분량에 비례하는 작업이지만, 한 번 만들어 둔 트리는 이후 질의마다 다시 쓸 수 있다. Retrieve는 트리와 질의만 보고 판단하므로 본문 전체를 모델에 넣지 않아도 된다.
이 분리가 뒤에 나오는 비용 측정의 뼈대가 된다. 인덱싱 비용은 문서당 한 번 치르는 값이고, 질의 비용은 추론이 닿은 노드만큼만 든다.
SDK 인터페이스
설치는 한 줄이다.
pip install -U pageindex
사용은 세 호출로 끝난다. 클라이언트를 만들고, 문서를 올려 doc_id를 받고, 그 doc_id에 질의한다.
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="gpt-5.6-luna",               # model to build the tree index
    chat="gpt-5.6-sol",                 # model to search the tree
)
doc_id = client.submit_document("report.pdf")["doc_id"]

answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
이 예시는 local mode다. 사용자의 OpenAI 키만 있으면 인덱싱, retrieval, 응답 생성이 모두 사용자 기기에서 실행된다. 인덱싱 방식은 PageIndex Flash가 기본값이며, 텍스트 기반 PDF를 빠르게 트리로 바꾸는 경로다.
submit_document가 돌려주는 doc_id가 이 인터페이스의 중심이다. 문서를 올리는 일은 한 번이고, 이후 질문은 그 doc_id를 가리키며 반복된다. 2단계 retrieval의 비용 구조가 그대로 함수 두 개로 나타난 셈이다.
이전 판의 CLI와 비교하면 바뀐 것은 표면만이 아니다. CLI는 트리 파일을 만드는 데서 끝나고 그 트리로 답을 만드는 일은 사용자 몫이었으나, SDK는 탐색과 응답 생성까지 같은 클라이언트가 맡는다. 즉 저장소가 제공하는 범위가 인덱싱에서 질의응답 전체로 넓어졌다.
README가 SDK 문서로 넘기는 항목은 다른 모델 설정, 스트리밍, 여러 문서를 함께 검색하는 기능, 인용 생성이다. 에이전트 결합 쪽으로는 OpenAI Agents SDK, Claude Agent SDK, 그 밖의 프레임워크에 PageIndex 도구를 넣을 수 있다고 안내한다.
모델 선택 지침
index와 chat에 요구되는 모델 수준이 다르다는 점이 이 SDK 설계의 특징이다.
| 인자 | 권장 | README가 드는 이유 |
|---|---|---|
index |
기본 수준 모델로 충분하다 | 트리 구조 자체는 LLM 없이 문서 레이아웃에서 추출하고, index 모델은 그 결과를 요약하고 다듬는 일만 한다 |
chat |
감당할 수 있는 가장 좋은 모델 | chat 모델이 트리를 탐색해 정보를 찾는 주체다 |
이 비대칭이 비용 설계로 이어진다. 분량에 비례하는 인덱싱은 값싼 모델로 처리하고, 질의마다 반복되는 탐색에만 좋은 모델을 쓴다. README는 실험에서 기본 수준 모델이 인덱싱 품질을 떨어뜨리지 않았다고 밝힌다.
Local과 Cloud
클라우드 전환은 키 하나와 인자 하나로 끝난다. PAGEINDEX_API_KEY를 설정하고 index를 "cloud"로 바꾸면 인덱싱과 저장이 PageIndex Cloud로 넘어간다.
client = PageIndexClient(
    index="cloud",                       # build and store the index in PageIndex Cloud
    chat="gpt-5.6-sol",                  # use your preferred compatible model for chat
)
doc_id = client.submit_document("report.pdf", wait=True)["doc_id"]
바뀌는 것은 파싱과 OCR과 이미지 이해와 트리 구축과 저장이고, 답을 만드는 chat 모델은 사용자가 쓰던 것을 그대로 쓴다. README가 "chat과 retrieval 층은 사용자의 모델과 호환된다"고 적은 부분이 이 경계를 가리킨다.
| 항목 | Local | Cloud |
|---|---|---|
| 처리 대상 | 텍스트 기반 PDF | 텍스트 기반, 스캔본, 이미지가 많은 문서 |
| 인덱싱 | 사용자 기기에서 | PageIndex가 관리 |
| 저장 | 로컬 디렉토리 | 클라우드 저장소 |
| 인용 단위 | 페이지 단위 | 블록 단위 |
| OCR과 이미지 이해 | 없음 | 제공 |
| 메타데이터 | 없음 | 제공 |
| 폴더 | 없음 | 제공 |
| MCP 서버 | 없음 | 제공 |
PageIndex File System은 파일 단위 트리 인덱싱 층으로, 문서 한 개가 아니라 corpus 전체를 대상으로 추론하게 한다. README는 이 기능이 Cloud 전용임을 명시한다. 전용 배포, 즉 VPC나 온프레미스 배포는 문의와 데모 예약으로 안내한다.
패키지 구성과 의존성
requirements.txt와 pyproject.toml이 패키지의 윤곽을 보여준다.
| 묶음 | 항목 |
|---|---|
| 모델 호출 | litellm, openai, openai-agents, mcp |
| PDF 처리 | PyPDF2, pypdfium2, Pillow. pymupdf는 주석 처리된 선택 항목이다 |
| 공통 유틸리티 | requests, urllib3, python-dotenv, pyyaml, regex, sortedcontainers |
litellm이 들어 있다는 것은 모델 교체가 키와 모델 이름을 바꾸는 선에서 끝난다는 뜻이다. mcp가 기본 의존성이라는 점도 눈에 띄는데, MCP는 모델이 외부 도구와 데이터 원천에 표준화된 방식으로 접근하게 하는 프로토콜이다.
선택 의존성은 extras로 나뉜다. claude extras가 claude-agent-sdk를, anthropic extras가 anthropic을 가져오고, openai extras는 pip install "pageindex[openai]"를 유효하게 두기 위한 빈 항목이라고 주석이 밝힌다.
패키지에는 pageindex/config.yaml과 pageindex/flash/data/*.json이 포함되고 pageindex/flash/assets는 제외된다. 즉 Flash는 클라우드 전용 기능이 아니라 설치된 패키지 안에서 동작하는 구성 요소다.
결과
로컬 인덱싱 비용과 시간
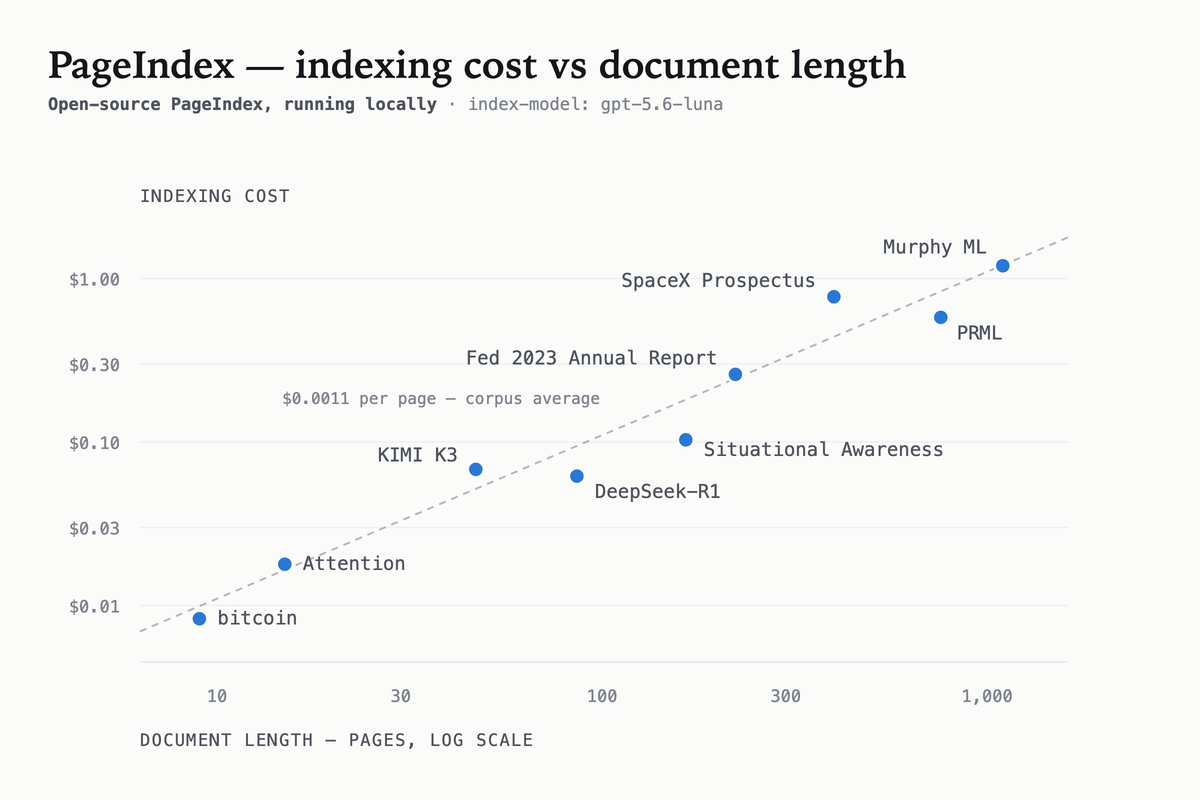
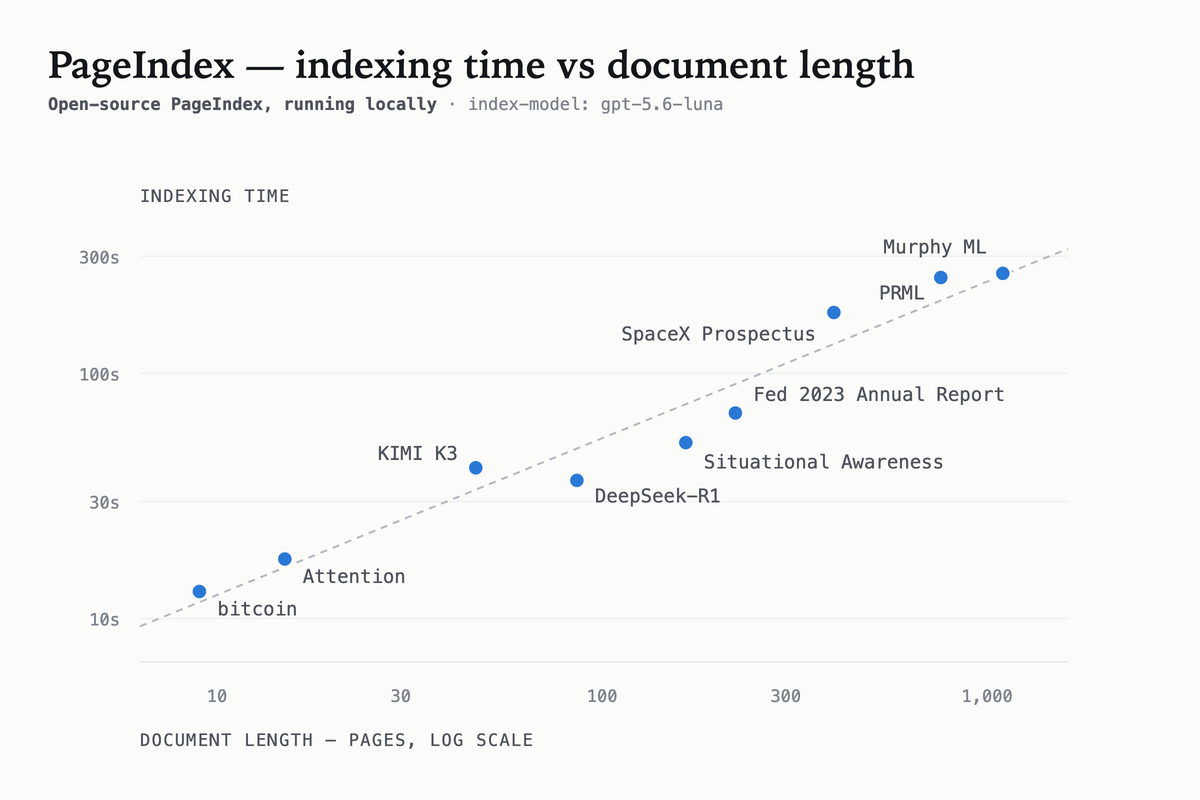
인덱싱은 문서당 한 번 치르는 비용이고, README는 그 값을 쪽당 약 0.001달러로 제시한다. index 모델이 gpt-5.6-luna인 로컬 실행 기준이다.
| 항목 | 값 |
|---|---|
| 쪽당 인덱싱 비용 | 약 0.001달러. 차트의 기준선은 쪽당 0.0011달러다 |
| 1,000쪽 교과서 | 1달러를 조금 넘는 비용과 몇 분. 한 번만 치르고 이후 질의는 그 트리를 재사용한다 |
| 인덱싱 시간 | 약 13초에서 4.5분 |
| 측정 문서 | 9쪽에서 1,098쪽까지의 PDF 9건 |
두 차트의 가로축은 문서 쪽수이고 세로축은 비용 또는 시간이며 둘 다 로그 축이다. 점이 기준선을 따라 늘어선다는 것은 비용과 시간이 쪽수에 거의 비례한다는 뜻이고, 기준선 주변의 흩어짐은 길이가 아니라 텍스트 밀도 때문이라고 README가 설명한다.
질의 비용과 정확도
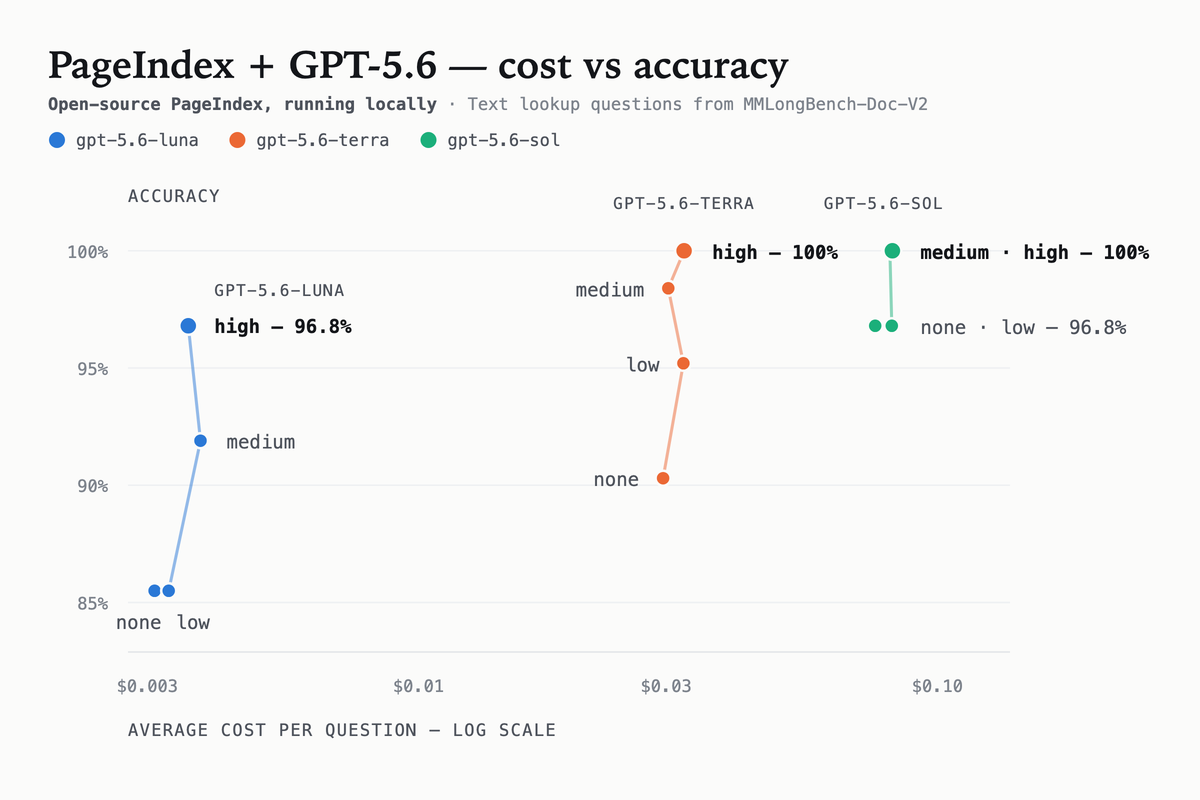
PageIndex-OSS-Benchmark는 quickstart와 똑같은 설정을 측정한다. 즉 local mode, flash 인덱싱, OCR 없음이다. 오픈소스 구성 그대로를 재는 벤치마크라는 점에서 FinanceBench 수치와 성격이 다르다.
| 측정 설정 | 내용 |
|---|---|
| 문항 | 62개 lookup 질문 |
| 문서 | PDF 34건, 합계 1,945쪽. 출처는 MMLongBench-Doc-V2 |
| 문항 성격 | 모든 정답이 본문에 문장으로 적혀 있다 |
문항 성격을 이렇게 고정한 이유를 README가 밝힌다. 답이 본문에 적혀 있으므로 틀렸다면 추론을 못 한 것이 아니라 그 문장에 도달하지 못했거나 잘못 읽은 것이다. 즉 이 벤치마크는 retrieval 성능을 직접 겨냥한다.
| 모델 | 질의당 평균 비용 | 정확도 |
|---|---|---|
gpt-5.6-luna |
약 0.003달러 | none과 low 85.5%, medium 92%, high 96.8% |
gpt-5.6-terra |
약 0.03달러 | none 90.3%, low 95.2%, medium 97%대, high 100% |
gpt-5.6-sol |
약 0.10달러 | none과 low 96.8%, medium과 high 100% |
reasoning effort는 모델이 답하기 전에 들이는 추론 분량을 none, low, medium, high로 조절하는 설정이다. 표를 세로로 읽으면 같은 모델 안에서 이 설정만 올려도 정확도가 11%p 이상 오르는 구간이 있고, 가로로 읽으면 모델을 한 단계 올릴 때마다 비용이 10배 수준으로 뛴다.
이 두 방향의 차이가 운영 선택을 만든다. 값싼 모델에 reasoning effort를 높게 주는 조합이 비싼 모델의 낮은 설정과 비슷한 정확도에 도달하므로, 비용 상한이 있는 쪽은 모델을 올리기 전에 이 설정을 먼저 조정할 여지가 있다.
PDF 직접 입력과의 비용 비교
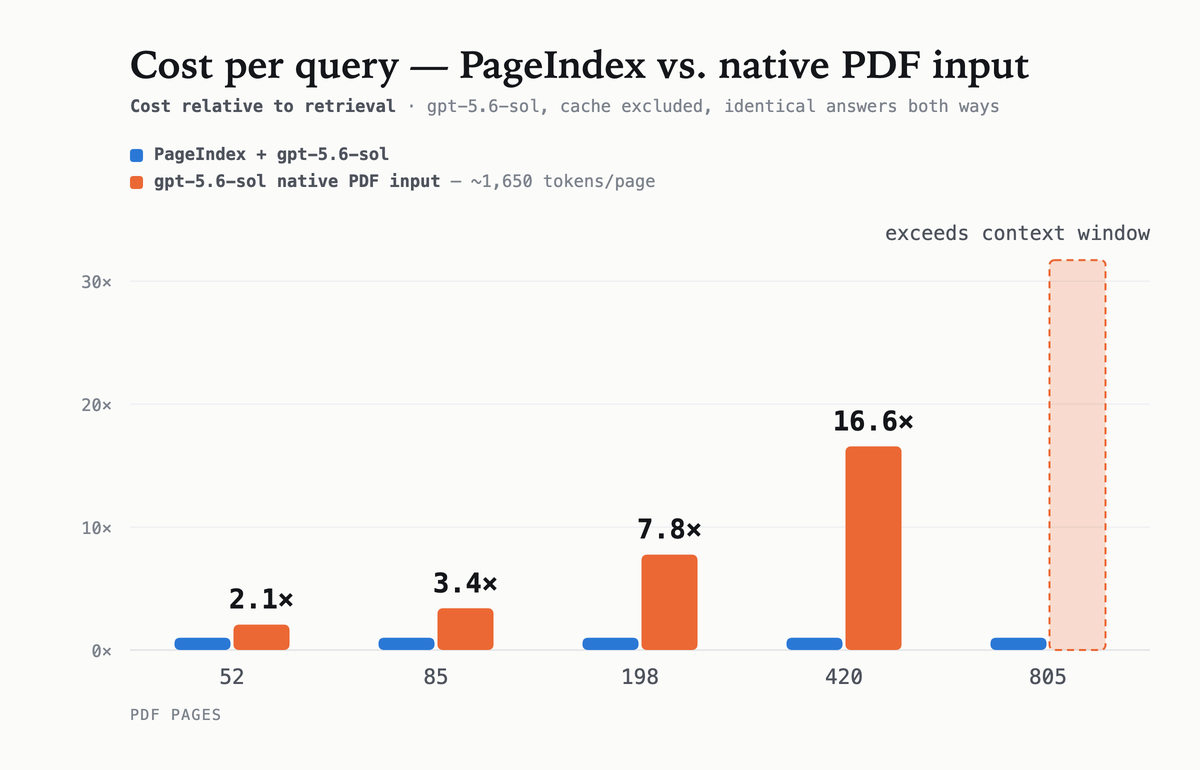
retrieval을 쓰지 않는 대안은 질의마다 PDF 전체를 모델에 넣는 것이다. 그 비용은 문서가 길어질수록 커지지만, PageIndex는 추론이 닿는 노드만 읽으므로 그렇지 않다.
| PDF 쪽수 | PDF 직접 입력의 상대 비용 |
|---|---|
| 52쪽 | 2.1배 |
| 85쪽 | 3.4배 |
| 198쪽 | 7.8배 |
| 420쪽 | 16.6배 |
| 805쪽 | context window를 넘어 불가능 |
측정 조건은 gpt-5.6-sol, prompt caching 제외, 그리고 양쪽이 같은 답을 내는 문서다. 차트 범례는 PDF 직접 입력의 분량을 쪽당 약 1,650 토큰으로 적는다.
마지막 행이 이 비교의 요점이다. 805쪽 문서에서는 비용 차이가 아니라 가능 여부가 갈린다. 문서가 context window를 넘어가는 순간 직접 입력이라는 선택지 자체가 사라진다.
FinanceBench
| 항목 | 값 | 조건 |
|---|---|---|
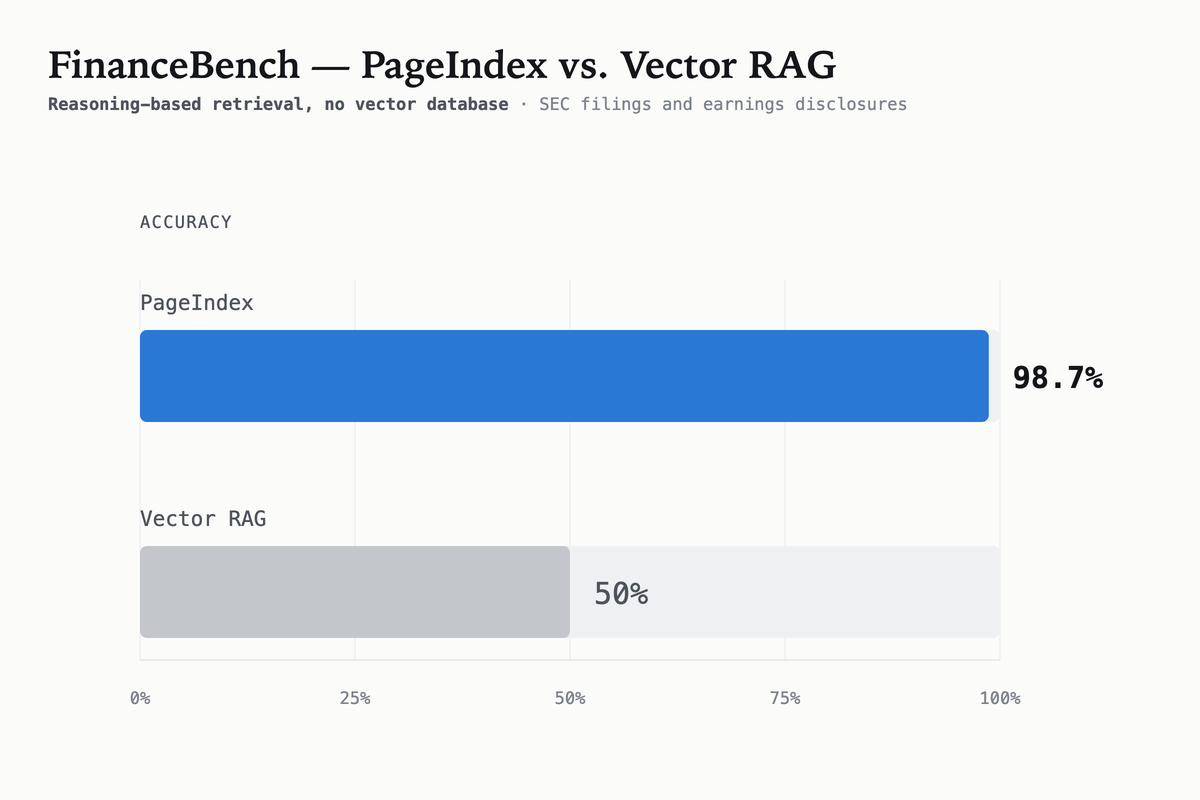
| FinanceBench 정확도 | PageIndex 98.7%, vector RAG 50% | VectifyAI 자체 보고이며 독립 재검증은 없다. README는 state-of-the-art로 표기한다 |
FinanceBench는 재무 문서 질의응답 벤치마크이고 arXiv 2311.11944로 링크된다. 상세 결과는 별도 저장소 VectifyAI/Mafin2.5-FinanceBench에, 비교와 지표는 블로그 vectify.ai/blog/Mafin2.5에 있다고 안내한다.
이 수치를 읽을 때 유의할 점이 둘 있다. 측정 대상이 PageIndex 단독이 아니라 PageIndex를 retrieval 층으로 쓰는 Mafin 2.5라는 점, 그리고 대조군으로 적힌 vector RAG 50%의 구성, 즉 임베딩 모델과 chunk 크기와 top-k 설정이 README에 없다는 점이다. 여기에 보고 주체가 개발사 자신이라는 점을 더하면 이 수치는 제품 주장으로 읽는 편이 정확하다.
같은 98.7%는 이 wiki의 3자 리뷰 페이지와 한국어 소개글에도 등장한다. 다만 세 자료의 근거 문서는 하나로 수렴한다. VectifyAI가 공개한 Mafin 2.5 벤치마크 저장소와 블로그다. 이 수치를 검토할 때 여러 페이지를 서로 독립된 출처로 세지 않는 편이 안전하다.
수치가 가리키는 운영 선택
네 묶음의 측정치는 서로 맞물려 몇 가지 선택지를 드러낸다. README가 직접 권고로 적지는 않았지만, 수치를 나란히 놓으면 따라 나오는 것들이다.
첫째, 인덱싱 비용은 문서당 한 번이고 질의 비용은 질문마다 반복된다. 1,000쪽 문서의 인덱싱이 1달러 남짓인 반면 질의 한 건은 모델에 따라 0.003달러에서 0.10달러이므로, 같은 문서에 질문이 쌓일수록 전체 비용에서 인덱싱이 차지하는 몫은 줄어든다. 문서를 한 번 보고 버리는 용도에서는 이 구조의 이점이 가장 작다.
둘째, 모델을 올리는 것과 reasoning effort를 올리는 것은 비용 대비 효과가 다르다. 모델을 한 단계 올리면 질의당 비용이 10배 수준으로 뛰지만, 같은 모델 안에서 reasoning effort를 올리는 쪽은 비용이 거의 그대로인 채 정확도만 오른다. 벤치마크 표에서 gpt-5.6-luna의 high 설정이 96.8%로 gpt-5.6-sol의 none과 low 설정과 같은 정확도에 도달하는데, 질의당 비용은 30배 가까이 차이 난다.
셋째, 문서가 길수록 retrieval을 쓸 이유가 커진다. PDF를 통째로 넣는 비용은 52쪽에서 2.1배였다가 420쪽에서 16.6배가 되고, 805쪽에서는 context window를 넘어 선택지에서 빠진다. 반대로 짧은 문서에서는 두 방식의 차이가 작으므로 구조를 미리 만들 유인이 약하다.
넷째, 입력 문서의 성격이 Local과 Cloud를 가른다. 텍스트 기반 PDF만 다루면 Local로 충분하지만, 스캔본이나 이미지가 많은 문서를 받는 순간 OCR과 이미지 이해가 필요해지고 그 기능은 Cloud에만 있다. 근거 구간을 블록 단위로 가리켜야 하는 요구도 같은 경계 위에 있다.
이 네 가지는 모두 README가 제시한 수치에서 따라 나오지만, 측정과 보고의 주체가 개발사라는 조건은 그대로 남는다. 실제 도입 판단에서는 자체 문서로 같은 측정을 다시 하는 편이 안전하다.
2026-06 스냅샷과의 차이
이 wiki는 2026-06-17에 README 스냅샷을 한 번 저장했고, 2026-10-06에 현재 판으로 교체했다. 그 사이의 변화가 저장소의 성격을 바꿨으므로 둘을 대조해 둔다.
| 항목 | 2026-06 판 | 2026-10 판 |
|---|---|---|
| 배포 형태 | 저장소 클론 후 requirements.txt 설치 |
PyPI 패키지 pip install -U pageindex |
| 진입점 | run_pageindex.py CLI와 선택 인자 7개 |
PageIndexClient의 submit_document와 chat |
| 인덱싱 방식 | 문서 앞부분에서 목차를 탐색 | PageIndex Flash가 local mode 기본값 |
| 클라우드 | 별도 서비스로 안내 | 같은 클라이언트에서 index="cloud"로 전환 |
| 정량 근거 | FinanceBench 98.7% 한 줄 | 인덱싱 비용과 시간, 질의 비용 대비 정확도, PDF 직접 입력 대비 비용, FinanceBench |
| 대조군 수치 | 없음. "vastly outperforming" 같은 정성 표현 | vector RAG 50% |
| 트리 노드 스키마 | JSON 예시와 필드 6개 | 없음 |
| Ecosystem 절 | OpenKB, ChatIndex, ConDB, PageIndex MCP | 없음 |
| Markdown 입력 | --md_path 모드 |
없음 |
| 대화형 서비스 | chat.pageindex.ai |
app.pageindex.ai |
이 차이는 PageIndex를 다루는 다른 자료를 읽을 때도 작용한다. 2026년 상반기에 쓰인 소개 글과 튜토리얼은 CLI 또는 초기 클라우드 API를 전제하므로, 설치 명령과 진입점이 현재 저장소와 일치하지 않는다. 개념과 문제 의식은 그대로 쓸 수 있고 실행 절차만 이 페이지에서 다시 확인하면 된다.
달라진 방향은 두 가지로 묶인다. 하나는 배포가 예제 저장소에서 설치형 패키지로 옮겨간 것이고, 다른 하나는 주장의 근거가 수치 하나에서 네 묶음으로 늘어난 것이다. 반대로 트리 노드 스키마와 Markdown 입력처럼 이전 판이 설명하던 사양은 README에서 빠져 문서 사이트로 넘어갔다.
한계
한계는 두 가지로 나뉜다. 하나는 오픈소스 구성이 할 수 없는 일이고, 다른 하나는 README가 주장을 뒷받침하는 방식의 빈틈이다. 첫 번째는 Local과 Cloud의 기능 표가 명시하므로 경계가 분명하고, 두 번째는 측정 주체와 대조군 정보가 빠진 데서 생긴다. 이전 스냅샷에서 가장 컸던 제약, 즉 품질 상세가 반복해서 유료 경로로 넘어가던 문제는 기능 표가 생기면서 경계가 또렷해졌다.
- 오픈소스 구성은 텍스트 기반 PDF로 한정된다. 스캔본과 이미지가 많은 문서는 Cloud가 담당한다고 표가 명시한다. OCR과 이미지 이해 칸이 Local에서 비어 있다.
- 인용 단위가 Local에서는 페이지 단위다. 블록 단위 인용은 Cloud 전용이므로, 긴 페이지에서 근거 구간을 좁게 가리키려면 유료 경로가 필요하다.
- 벤치마크 문항이 lookup으로 한정된다. 62개 질문은 모두 정답이 본문에 문장으로 적혀 있는 유형이며, 표나 그림에서 읽어야 하는 질문과 다단계 추론 질문은 포함되지 않는다.
- FinanceBench 대조군의 구성이 불명이다. vector RAG 50%가 어떤 임베딩 모델과 chunk 크기와 top-k 설정의 결과인지 README에 없다.
- 벤치마크의 보고 주체가 모두 개발사다. 두 벤치마크 저장소와 블로그가 모두 VectifyAI 소유이며 제3자 재검증은 제시되지 않는다.
- 트리 노드 스키마가 README에서 빠졌다. 인덱싱 결과물의 형태를 알려면 문서 사이트를 거쳐야 한다.
- 인덱싱 출력의 저장 위치와 형식이 없다. Local의 저장 위치가 "로컬 디렉토리"라고만 적혀 있다.
- 목차가 없는 문서의 처리 방식이 문서화되어 있지 않다. 트리 구조를 문서 레이아웃에서 추출한다고만 밝히고, 계층을 찾지 못했을 때의 대체 경로는 설명하지 않는다.
- Markdown 입력 경로를 이 자료로 확인할 수 없다. 이전 판의
--md_path에 해당하는 설명이 현재 판에 없다. - 패키지가 Alpha 단계다. 개발 단계 분류가 "3 - Alpha"이고 버전은 0.2.10이다.
이 페이지의 근거 범위
이 페이지의 근거는 raw/repos/vectifyai-pageindex.md에 모은 README 전문과 LICENSE, requirements.txt, pyproject.toml이다. 패키지 내부 구현은 수집하지 않았으므로 README가 답하는 범위와 답하지 않는 범위를 구분해 둔다.
| 수집 자료가 답하는 것 | 답하지 않는 것 |
|---|---|
| 두 단계 retrieval 절차와 설계 동기 | 트리 생성 알고리즘의 단계별 처리 |
| SDK 호출 세 줄과 local에서 cloud로 바꾸는 방법 | PageIndexClient의 전체 인자와 반환 스키마 |
| 의존성 목록과 Python 버전 요구사항 | 패키지 내부의 모듈, 클래스, 함수 구성 |
| Local과 Cloud의 기능 경계 | 클라우드 API의 엔드포인트와 요금 |
| 인덱싱 비용과 시간, 질의 비용과 정확도의 측정값 | 측정에 쓴 하드웨어와 실행 횟수, 분산 |
| FinanceBench 98.7%와 대조군 50% | 대조군 vector RAG의 구성과 독립 검증 여부 |
| 라이선스 조건(MIT, Copyright 2025 Vectify AI) | 기여 절차와 릴리스 주기 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| vectorless RAG | vector database와 임베딩 유사도 검색 없이 LLM의 추론으로 retrieval을 수행하는 방식 |
| PageIndex tree index | 문서 하나를 목차 형태의 계층 구조로 표현한 인덱스. 구조는 문서 레이아웃에서 추출하고 모델은 요약과 정리를 맡는다 |
| PageIndex Flash | 텍스트 기반 PDF를 빠르게 트리 인덱스로 만드는 방식이며 SDK local mode의 기본값이다 |
| PageIndex File System | 파일 단위 트리 인덱싱 층. corpus 전체를 대상으로 추론하게 하며 Cloud 전용이다 |
| reasoning effort | 모델이 답하기 전에 들이는 추론 분량을 none, low, medium, high로 조절하는 설정 |
| Mafin 2.5 | 같은 팀의 재무 문서 분석 시스템. PageIndex를 retrieval 층으로 쓴다. FinanceBench 98.7%의 측정 대상이다 |
관련 페이지
- PageIndex: Next-Generation Vectorless, Reasoning-based RAG: PageIndex 팀이 직접 쓴 소개글. README가 인용 대상으로 지정한 글이며, 이 저장소가 코드를 담당하고 그 글이 동기와 설계 철학을 담당한다.
- PageIndex: 벡터 DB와 청킹 없이 LLM 추론으로 문서를 검색하는 계층형 인덱스 기반 RAG 시스템: 한국어 소개글. 2026년 4월 시점의 CLI 방식을 기록한 자료라 현재 SDK 방식과 명령이 다르다.
- Vectorless RAG: PageIndex: PageIndex Cloud API 튜토리얼. README가 스펙을 외부 문서로 위임한 클라우드 경로를 코드 예제로 보여준다.
- PageIndex: The RAG Framework That Threw Out Vector Databases and Still Hit 98.7% Accuracy: 3자 리뷰. 같은 FinanceBench 결과를 외부 시각에서 검토한다.
- sguys99/langchain-study/medium/3.vectorless-rag: PageIndex 없이 직접 만든 vectorless RAG: PageIndex API 없이 문서 트리를 직접 만들어 같은 아이디어를 재현한 한글 학습용 코드.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): LightRAG. 긴 문서 RAG에서 vector 단독의 한계를 넘으려는 같은 문제의식을 knowledge graph로 푼다.
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): LeanRAG. 계층 구조를 쓴다는 점은 같지만 계층의 출처가 문서 목차가 아니라 knowledge graph다.
- HKUDS/RAG-Anything: RAG-Anything 저장소. 멀티모달 확장에 초점을 두는 반면 PageIndex는 문서 구조에 초점을 둔다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: graph 기반 RAG 합성 페이지. PageIndex는 graph가 아니라 문서 내장 구조를 쓰는 별도 가지로 놓인다.