Database · PAPER · 2026
Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction
요약
이 논문은 retrieval을 retriever 설계 문제가 아니라 인터페이스 설계 문제로 다시 세운다. 임베딩 모델과 vector index로 corpus를 보여주는 방식은 접근을 단일 top-k 단계로 압축하는 저해상도 인터페이스이고, agent가 충분히 강하다면 원본 corpus에 grep과 find와 bash로 직접 접근하는 편이 낫다는 것이 논지다. 저자들은 이 방식을 Direct Corpus Interaction (DCI)으로 정식화하고 두 가지 scaffold로 검증한다.
검증 결과는 세 영역 모두에서 일관된다. BrowseComp-Plus 830문항에서 같은 Claude Sonnet 4.6 backbone을 두고 retriever를 DCI로 바꾸면 정확도가 69.0%에서 80.0%로 11.0%p 오르고 비용은 $1,440에서 $1,016으로 29.4% 줄어든다. multi-hop QA 6종 평균은 52.3에서 83.0으로 30.7점, IR ranking 6종 평균 NDCG@10은 47.0에서 68.5로 21.5점 오른다.
가장 주목할 부분은 DCI가 이기는 메커니즘이다. DCI는 gold 문서를 더 많이 찾아서 이기지 않는다. 같은 100문항 부분집합에서 gold 문서 평균 coverage는 retriever의 56.7보다 낮은 28.0인데, 문서 안에서 증거를 좁히는 localization 점수는 21.7 대 48.4로 두 배를 넘고 정확도는 28점 높다. 저자들은 이 차이를 "retrieval interface resolution"이라 부른다.
배경
기존 retrieval 인터페이스가 압축하는 것
현대 retrieval 시스템은 lexical 방식이든 semantic 방식이든 corpus를 고정된 유사도 인터페이스로 노출한다. 문서를 미리 chunking하고 인덱싱한 뒤, 질의가 들어오면 추론이 시작되기 전에 top-k 후보 집합으로 접근을 압축한다. 이 추상화는 효율적이고, RAG와 open-domain QA와 deep research를 떠받쳐 온 표준 구조다.
문제는 agent 시대에 들어서면서 드러났다. retrieval agent는 계획을 세우고 query를 다시 쓰고 결과를 읽는 다단계 검색을 할 수 있게 되었지만, corpus로 통하는 유일한 통로는 여전히 매 단계 top-k 조각만 보여주는 고정 인터페이스다. 여기서 걸러진 증거는 뒤쪽에 아무리 강한 추론을 붙여도 복구되지 않는다.
따라서 성능 병목이 retrieval 이후의 추론뿐 아니라 인터페이스 자체에서 발생한다. 저자들은 이것이 retriever를 더 좋게 만드는 것으로는 해결되지 않는 종류의 병목이라고 본다.
RAG 계열이 지금까지 유지해 온 구조
이 병목이 왜 오래 눈에 띄지 않았는지는 RAG 계열의 발전 경로를 보면 드러난다. REALM과 RAG 이후의 연구는 대부분 retrieve-then-generate라는 같은 골격 위에서 개별 단계를 개선해 왔다.
| 개선 방향 | 대표 연구 | 바뀐 부분 |
|---|---|---|
| sparse retrieval | BM25 | 어휘 빈도 가중으로 후보를 뽑는다 |
| dense retrieval | DPR, Contriever, E5, GTE, Qwen3-Embedding | 학습된 벡터의 근접 이웃 탐색으로 바꾼다 |
| 늦은 상호작용 | ColBERT | 토큰 단위 상호작용을 순위 계산에 넣는다 |
| LLM reranking | Rank-R1, Rank1, ReasonRank | 1차 후보를 추론 모델로 다시 정렬한다 |
| adaptive RAG | Adaptive-RAG | 질문 난이도에 따라 retrieval 강도를 조절한다 |
| agentic search | Search-R1, ASearcher, VerlTool, Tongyi DeepResearch | 여러 라운드에 걸쳐 query를 다시 쓰고 증거를 누적한다 |
이 목록의 어느 항목도 인터페이스 자체를 바꾸지는 않았다. 사전 구축 인덱스가 top-k를 노출하고 agent가 그 조각 위에서 추론한다는 전제는 그대로였다. agentic search조차 검색 라운드 수만 늘렸을 뿐, 매 라운드의 관찰 형태는 여전히 고정된 순위 목록이다.
agentic search가 요구하는 네 가지 조작
BrowseComp-Plus 같은 최신 벤치마크는 agent에게 여러 동작을 합성할 것을 요구한다. 중간 개체를 발견하고, 흩어진 단서를 모으고, 정확한 lexical 제약을 강제하고, 로컬 문맥을 확인한 뒤 검색 계획을 고쳐야 한다. 이 네 가지가 기존 retriever API로는 구현하기 어렵다.
| 필요한 조작 | 기존 retriever로 어려운 이유 |
|---|---|
| exact lexical constraint | 정확한 문자열 일치를 강제할 수단이 top-k API에 없다 |
| sparse clue conjunction | 약한 단서 여러 개를 AND로 묶는 표현이 없다 |
| local context check | 매치 주변 문맥을 열어 확인하는 조작이 없다 |
| multi-step hypothesis refinement | 부분 증거를 본 뒤 계획을 고쳐 다시 좁히는 반복이 어렵다 |
저자들은 서론 첫머리에 Marshall McLuhan의 "The medium shapes and controls the scale and form of human association and action."을 제사로 인용한다. 매체가 곧 인터페이스이고 인터페이스가 행동의 범위를 정한다는 뜻이며, 논문 전체의 논지를 압축한 문장이다.
coding agent에서 온 착상
이 착상의 실증적 근거는 코드 도메인에서 왔다. SWE-agent는 bash와 파일 검색과 편집 도구를 갖춘 agent가 직접 프롬프트보다 훨씬 낫다는 것을 보였고, Agentless는 단순한 grep과 read pipeline만으로도 전체 agent 프레임워크에 필적할 수 있음을 보였다. OpenHands와 Aider가 터미널 기반 coding agent를 성숙한 패러다임으로 정착시켰고, Sutawika et al. (2026)은 CLI primitive만으로 정밀한 코드 위치 특정이 가능함을 보였다.
가장 가까운 선행 연구는 Subramanian et al. (2025)의 "Keyword search is all you need"다. 원본 PDF 위의 도구 증강 키워드 검색 agent가 문서 QA에서 vector database 기반 RAG에 근접할 수 있음을 보인 연구인데, 이 논문은 같은 착상을 문서 QA를 넘어 agentic search 인터페이스 일반의 문제로 확장한다고 스스로를 위치시킨다.
핵심 개념
**Direct Corpus Interaction (DCI)**은 임베딩 모델, vector index, retrieval API를 전혀 거치지 않고 agent가 범용 터미널 도구로 원본 corpus를 직접 탐색하는 retrieval 방식이다. 오프라인 인덱싱 단계가 없으므로 파일이 바뀌면 그 자리에서 반영되고, 계속 변하는 로컬 corpus에 자연스럽게 적응한다.
Retriever-mediated access는 이 논문이 DCI와 대비시키는 기존 방식이다. corpus를 미리 인덱싱하고 retriever가 매개하며, agent의 관찰은 retriever가 노출하기로 한 짧은 snippet과 문서 식별자로 제한된다.
Retrieval interface resolution은 이 논문이 새로 제안한 개념이다. corpus를 관찰하고 검증하고 조작할 수 있는 단위의 세밀도를 뜻한다. 문서나 passage 단위 top-k는 저해상도이고, 줄이나 span 단위 grep 매칭은 고해상도다. 저자들이 말하는 resolution은 화질이 아니라 조작 단위의 크기다.
Coverage는 하나의 trajectory가 정답 근거 문서를 표면에 올렸는지를 재는 지표다. trajectory는 세션 하나의 실행 기록 전체를 뜻한다. coverage는 넓은 범위에 닿았는지를 보는 지표라서 문서 안에서 무엇을 했는지는 담지 못한다.
Localization은 그 빈틈을 메우는 지표다. 표면에 올린 gold 문서 안에서 얼마나 좁은 증거 span으로 좁혔는지를 재며, 문서 안 정밀도에 해당한다. 이 논문의 핵심 주장은 agentic search에서 coverage보다 localization이 정확도를 더 잘 설명한다는 것이다.
Scaffold는 모델 주위에 짜 놓은 보조 실행 구조를 뜻한다. 이 논문은 최소 scaffold와 강한 scaffold 두 가지를 두어 DCI 인터페이스 자체의 효과와 harness 엔지니어링의 효과를 분리한다.
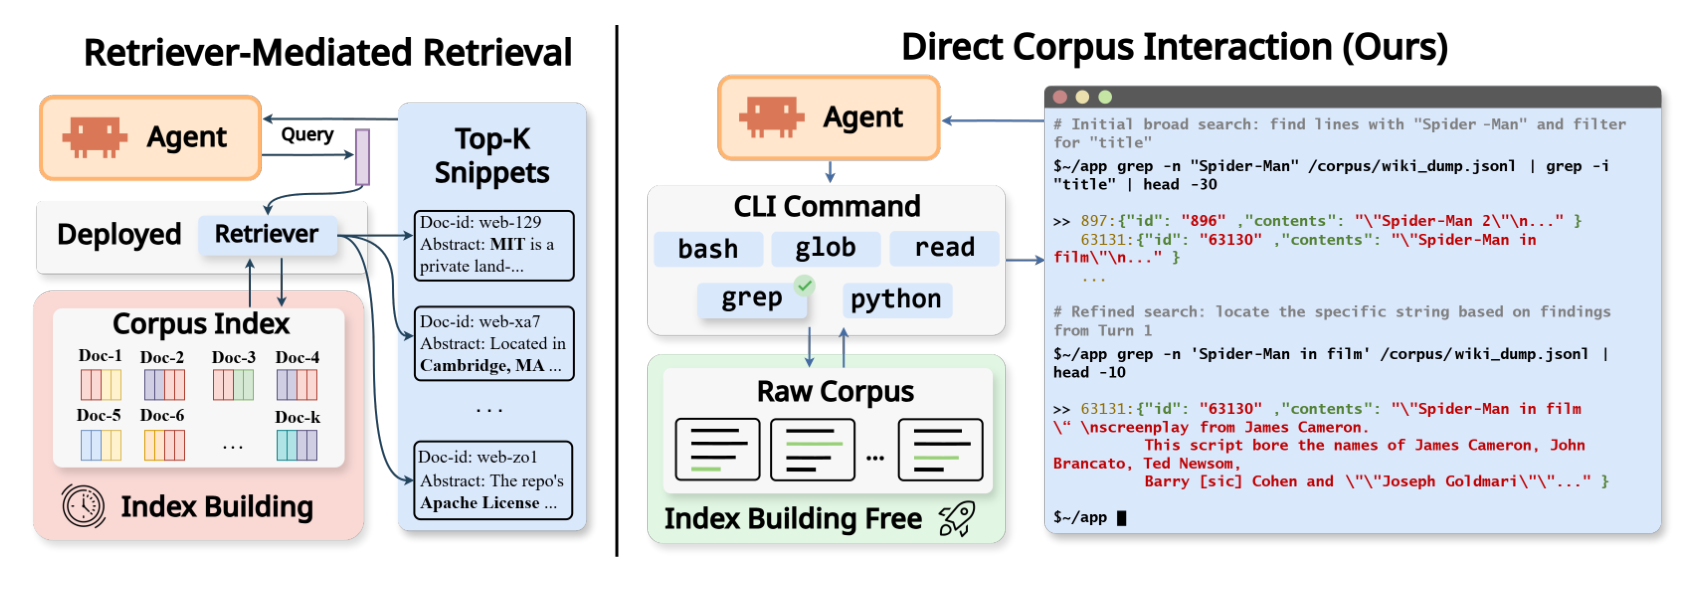
해상도가 무엇을 뜻하는지는 Figure 2의 두 화면을 나란히 놓으면 분명해진다. 왼쪽 retriever 화면에서 agent가 받는 것은 "Doc-id: web-129, Abstract: MIT is a private land-"처럼 문서 식별자와 잘린 초록 몇 줄이다. 문서 안 어디에 그 문장이 있는지, 주변에 무엇이 있는지는 알 수 없다.
오른쪽 DCI 화면에서 agent가 받는 것은 매치된 줄 번호와 그 줄의 원문 전체다. 같은 문서를 다시 다른 패턴으로 찾을 수도, 그 줄 주변만 열어 볼 수도 있다. 조작 단위가 문서에서 줄로 내려간 것이 해상도의 차이다.
방법
두 인터페이스의 대비
두 방식의 차이는 도구 목록이 아니라 agent가 볼 수 있는 관찰의 종류에 있다.
| 항목 | Retriever-mediated access | Direct Corpus Interaction |
|---|---|---|
| 사전 처리 | chunking과 임베딩 또는 BM25 인덱싱 | 없음 |
| agent의 행동 | query 작성과 재작성 | CLI 명령 작성과 pipeline 합성 |
| 관찰의 형태 | top-k snippet과 문서 식별자 | 매치된 span, 주변 문맥, 파일 경로, 개수, 메타데이터 |
| semantic 해석의 위치 | 인덱스 쪽으로 올라감 | LLM 쪽으로 내려옴 |
| 증거 손실 지점 | retriever의 점수화와 ranking 단계 | 없음 (corpus 전체가 계속 접근 가능) |
| corpus 변경 반영 | 재인덱싱 필요 | 파일 시스템 그대로 즉시 반영 |
의미의 해석 책임이 어디에 있는지가 결정적이다. retriever 방식은 semantic 이해를 인덱스로 위로 밀어 올려 고정된 벡터로 굳히고, DCI는 그 책임을 LLM으로 아래로 내려 매 단계 다시 판단하게 한다.
DCI primitive와 pipeline 합성
DCI가 제공하는 조작은 종류가 적다. 대신 pipeline으로 합성할 수 있다는 점이 표현력의 원천이다.
| 조작 범주 | 도구 | 하는 일 |
|---|---|---|
| corpus 탐색 | find, glob, ls |
디렉터리 구조를 훑어 관련 있을 영역을 찾는다 |
| 정확 일치와 정규식 | grep, rg |
lexical 패턴으로 후보를 올린다 |
| 로컬 검사 | head, tail, sed, read |
매치 주변 문맥을 열어 본다 |
| 반복 정련 | 위 셋의 조합 | 결과를 보고 다음 명령을 만든다 |
논문이 든 pipeline 예시 세 가지가 이 합성이 무엇을 뜻하는지 보여준다.
| pipeline | 수행하는 일 |
|---|---|
grep 'foo' file | grep 'bar' |
lexical constraint를 AND로 결합한다 |
find . | grep 'report' | grep '2024' |
약한 단서 여러 개를 조합해 후보를 좁힌다 |
grep -n 'keyword' file | head |
로컬 문맥과 대조해 가설을 검증한다 |
세 가지 모두 retriever API 하나로는 표현할 수 없다. 저자들은 CLI 도구의 장점이 정밀도만이 아니라 pipeline을 통한 유연성과 합성 가능성에 있다고 정리한다.
검색 한 번의 실제 모습
Figure 2 오른쪽 터미널 화면이 DCI 검색 두 turn을 그대로 보여준다. 목표는 Spider-Man 관련 문서를 찾는 것이다.
첫 turn은 넓게 던지고 곧바로 좁힌다. grep -n "Spider-Man" /corpus/wiki_dump.jsonl | grep -i "title" | head -30은 "Spider-Man"이 든 줄을 모두 찾은 뒤 그중 "title"이 들어간 줄만 남기고 30개로 자른다. 명령 하나가 검색과 필터와 개수 제한을 동시에 수행한다. 결과로 897:{"id": "896", "contents": "\"Spider-Man 2\"..."}와 63131:{"id": "63130", "contents": "\"Spider-Man in film\"..."} 같은 줄이 줄 번호와 함께 돌아온다.
두 번째 turn은 첫 결과에서 얻은 단서를 그대로 다음 검색어로 쓴다. grep -n 'Spider-Man in film' /corpus/wiki_dump.jsonl | head -10을 실행하면 해당 줄의 본문이 길게 펼쳐지고, 거기서 James Cameron 각본과 공동 저자 이름 같은 새 개체가 나온다.
이 두 turn이 DCI의 작동 방식을 압축한다. 관찰에서 얻은 문자열을 다음 명령의 인자로 바로 넣을 수 있고, 그 과정에 유사도 점수나 순위가 개입하지 않는다. retriever 인터페이스에서는 첫 결과의 문자열을 다시 query로 만들어야 하고, 그 query가 다시 임베딩을 거치면서 정확한 일치를 보장하지 못한다.
두 scaffold 구현
DCI를 두 가지 scaffold로 구현한다. 둘 다 터미널 도구와 파일 읽기로 원본 corpus를 직접 탐색하고 런타임 지원에서만 차이가 난다. 이 설계 덕분에 인터페이스 변화의 효과와 harness 엔지니어링의 효과를 분리해 볼 수 있다.
| 항목 | DCI-Agent-Lite | DCI-Agent-CC |
|---|---|---|
| 기반 harness | Pi (Zechner and Pi Contributors, 2026) | Claude Code (Anthropic, 2025) |
| 노출 도구 | bash와 파일 읽기만 |
Claude Code 기본 구성 |
| backbone | GPT-5.4 nano | Claude Sonnet 4.6 |
| reasoning effort | high | medium |
| 최대 turn | 300 | 300 |
| 차단한 기능 | 없음 | web-search, web-fetch, 서브에이전트, data 디렉터리 접근 |
| 설계 의도 | 인터페이스 변화만 남긴 통제 실험 | 같은 패러다임의 성능 상한 탐색 |
DCI-Agent-Lite에는 retrieval 전용 모듈이 하나도 없다. 오프라인 인덱싱도, dense retriever도, reranker도 없다. 개선이 나오면 그 원인을 DCI 패러다임 자체로 돌릴 수 있게 만든 구성이다.
DCI-Agent-CC에서 data 디렉터리 접근까지 막은 이유는 정답 유출 방지다. 저자들은 이 변형을 다른 retrieval 방법이 아니라 같은 패러다임의 더 강한 구현으로 취급한다. 임베딩 retriever나 retrieval API를 전혀 호출하지 않고 원본 corpus 위에서 터미널 도구로만 동작하기 때문이다.
런타임 컨텍스트 관리
grep을 반복 호출하면 매치가 많이 돌아오고 파일을 열면 긴 텍스트가 노출된다. 장기 trajectory에서는 이런 관찰이 빠르게 쌓여 모델의 context window를 넘길 수 있다. context window는 모델이 한 번에 받아들일 수 있는 토큰 길이 한도를 뜻한다.
런타임은 서로 당기는 두 요구를 균형 잡아야 한다. 나중 추론을 위해 증거와 중간 제약을 유지하는 것, 그리고 새 관찰이 들어올 자리를 만드는 것이다.
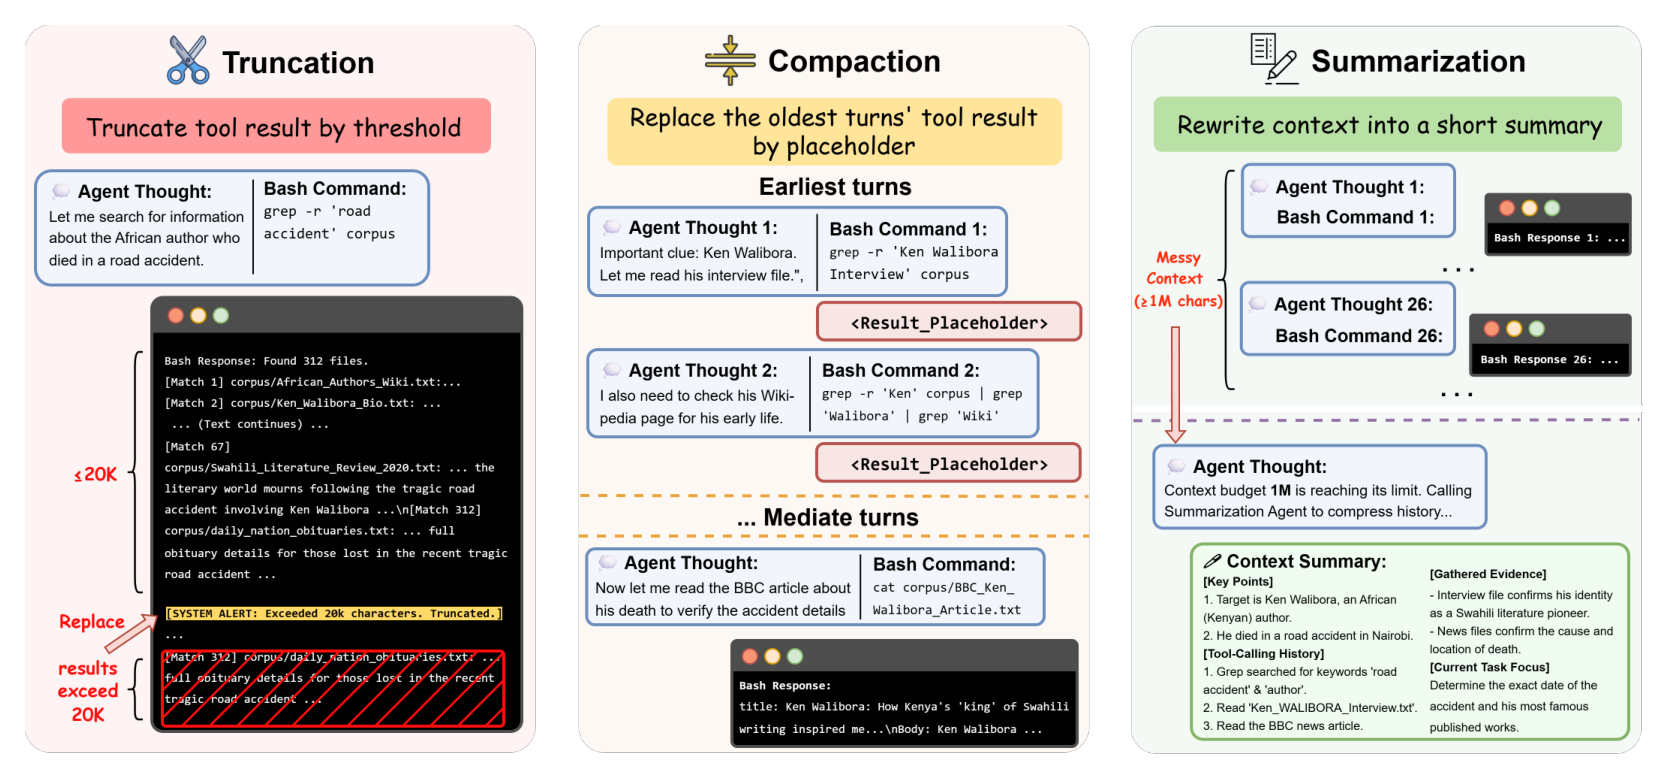
DCI-Agent-Lite에 붙인 관리 층은 메커니즘 3종으로 구성된다. compaction은 길어진 이력을 접어 세션을 이어가는 처리를 뜻한다.
| 메커니즘 | 동작 | LLM 호출 |
|---|---|---|
| Truncation | 각 tool call의 결과 텍스트를 정해진 길이로 자른 뒤 컨텍스트에 넣는다. 관찰이 일어났다는 사실은 남기고 turn당 장황함만 제한한다 | 없음 |
| Compaction | 누적 tool 출력이 임계를 넘으면 오래된 tool 결과 turn의 내용을 비우고 짧은 placeholder로 바꾼다. tool call 구조 자체는 보존한다 | 없음 |
| Summarization | 추가 압박이 있으면 compaction된 이력을 모델 생성 요약으로 교체하고 최근 컨텍스트는 그대로 둔다 | 있음 |
세 메커니즘을 다른 강도로 조합해 정책 5종을 만든다.
| Level | Truncation | Compaction | Summarization |
|---|---|---|---|
| L0 | 없음 | 없음 | 없음 |
| L1 | 최대 5만 자 | 없음 | 없음 |
| L2 | 최대 2만 자 | 없음 | 없음 |
| L3 | 최대 2만 자 | 있음 | 없음 |
| L4 | 최대 2만 자 | 있음 | 있음 |
세부 임계는 다음과 같다. compaction은 누적 tool 결과가 24만 자를 넘을 때 발동해 최근 12 turn을 제외한 나머지를 압축한다. summarization은 그 뒤에도 추정 컨텍스트 토큰이 임계를 넘으면 발동하고, 최근 2만 토큰을 유지하며, 한 세션에서 3회 연속 실패하면 이후 시도를 억제한다.
저자들은 이 정책들이 retrieval 인터페이스 자체를 바꾸지 않는다는 점을 강조한다. 장기 검색 동안 tool로 얻은 증거가 작업 컨텍스트에 얼마나 살아남는지만 바꾼다. 본 결과에는 L3, ablation에는 L4를 쓴다.
coverage와 localization의 정의
정확도만으로는 두 인터페이스가 질적으로 어떻게 다르게 성공하고 실패하는지 포착할 수 없다. retriever 방식은 대체로 높은 recall을 주지만 정확한 문자열 일치, 약한 lexical 신호의 결합, 다음 홉을 여는 span 단위 trigger에는 통제력이 약하다. 저자들은 이 차이를 과정 수준에서 재기 위해 trajectory 지표 두 개를 도입한다.
coverage는 질문 q의 gold 문서 집합 D*(q) 중 trajectory τ가 표면에 올린 부분집합 M(q, τ)로 정의하고 세 가지로 집계한다. 문서가 표면에 올라왔다고 보는 기준은 기록된 trace에 retrieval된 snippet이나 tool call이 반환한 파일로 명시적으로 나타나는 것이다.
| 집계 | 정의 | 뜻 |
|---|---|---|
| coverage_any | 1[|M| ≥ 1] | gold 문서를 하나라도 올렸는가 |
| coverage_mean | |M| / |D*| | gold 문서 각각이 올라왔는지의 평균 (recall) |
| coverage_all | 1[|M| = |D*|] | gold 집합 전체를 올렸는가 |
localization은 조금 더 복잡하다. 관찰 o_t마다 노출된 후보 (d_{t,i}, σ_{t,i})와 snippet 문자 길이 ℓ_{t,i}를 정의하고, 줄 대신 고정 폭 문자 segment(길이 c_seg)를 분석 단위로 쓴다. 많은 웹과 PDF 내보내기가 레이아웃을 긴 한 줄로 접어버려 줄 경계가 신뢰할 만한 대리값이 아니기 때문이다.
| 기호 | 정의 | 역할 |
|---|---|---|
| ν(x) | max(1, ⌈x / c_seg⌉) | 문자 길이를 segment 개수로 바꾼다 |
| ψ(a; b) | max(1 − log a / log b, 0) | a가 b에 비해 작을수록 높은 점수를 준다 |
| seg-score(d; d*) | ψ(ν(ℓ); ν(|d*|)) | snippet이 gold 문서 전체 대비 얼마나 국소적인지를 잰다 |
| s(d*, τ) | 문서별 seg-score 최댓값 | 한 문서에서 얻은 가장 좁은 span을 대표값으로 삼는다 |
| localization(q, τ) | s(d*, τ)의 평균 | 표면에 올린 gold 문서 전체에 대해 평균한다 |
DCI 쪽 snippet 매핑은 구현에 의존하므로 tool 유형별로 보수적으로 정한다. grep과 rg 검색은 정렬된 매치 줄 하나가 후보 하나가 되고, 같은 gold 문서에서 여러 줄이 나오면 전부 넣은 뒤 최댓값을 취한다. read 계열 열람은 반환 텍스트가 주석 처리된 gold 증거와 충분히 겹치면 그 span을 snippet으로 쓴다. 경로만 노출된 관찰은 coverage에는 기여하되 ℓ을 문서 전체 길이로 두므로 seg-score가 낮게 나온다. 도달은 했으나 국소화하지 못한 상태를 그대로 반영하려는 설계다.
평가 설정
corpus 규모는 벤치마크마다 크게 다르다. BrowseComp-Plus는 문서 수가 10만 건대이지만 문서 하나가 평균 5,179단어로 길고, BRIGHT 계열은 문서가 수십 단어로 짧다.
| corpus | 사용 벤치마크 | 문서 수 | 평균 길이(단어) |
|---|---|---|---|
| BrowseComp-Plus | BrowseComp-Plus | 100,195 | 5,179 |
| BRIGHT-Biology | BRIGHT-Biology | 57,359 | 48 |
| BRIGHT-Earth Science | BRIGHT-Earth Science | 121,249 | 28 |
| BRIGHT-Economics | BRIGHT-Economics | 50,220 | 52 |
| BRIGHT-Robotics | BRIGHT-Robotics | 61,961 | 25 |
| Wikipedia-18 | multi-hop QA 6종 | 21,015,324 | 100 |
| BEIR-ArguAna | BEIR-ArguAna | 8,674 | 167 |
| BEIR-SciFact | BEIR-SciFact | 5,183 | 214 |
multi-hop QA가 쓰는 Wikipedia-18은 문서 2,100만 건으로 다른 corpus보다 두 자릿수 이상 크다. DCI가 대형 corpus에서도 동작함을 보이려는 설정이다.
- 표본: BRIGHT 4종과 Bamboogle은 전체 test set을 쓰고, 나머지는 데이터셋당 50문항을 무작위 표본으로 쓴다. QA에서는 모호한 질문과 corpus 수집 이후 정답이 바뀌었을 수 있는 시간 민감 문항을 제외한다.
- baseline 인덱스: BrowseComp-Plus는 공식 배포 corpus와 BM25 및 Qwen3-Embedding-8B FAISS 인덱스를 오프라인 검색 엔진으로 쓴다. multi-hop QA의 retrieval agent baseline은 E5 임베딩으로 인덱스를 만든다.
- 채점: BrowseComp-Plus와 multi-hop QA는 GPT-4.1을 judge로 쓰며, 예측 답과 짧은 참조 답만 비교한다. IR ranking은 NDCG@10을 쓴다. 비교 대상 retrieval agent는 모두 검색 능력을 강화학습으로 학습한 open-weight 모델이다. 학습 방식이 서로 달라 무엇과 비교하는지가 분명해진다.
| baseline | 학습 방식 |
|---|---|
| R1-Searcher-7B | 2단계 결과 지도 강화학습으로 외부 검색 시스템 호출을 학습한다. 과정 보상이나 distillation을 쓰지 않는다 |
| Search-R1-32B | 강화학습으로 추론과 retrieval을 번갈아 수행하도록 학습한다 |
| ZeroSearch-7B | 학습 중 실제 검색 엔진을 쓰지 않는다. SFT로 retrieval을 모사하고 문서 품질을 점차 떨어뜨리는 커리큘럼으로 추론을 강화한다 |
| Verl-Tool-Search-7B-DAPO | 비동기 rollout과 표준화된 도구 API로 다중 turn 상태 유지 상호작용을 지원하는 프레임워크 위에서 DAPO로 학습한다 |
| ASearcher-Local-14B | trajectory 수집과 모델 학습을 분리한 완전 비동기 강화학습으로 학습하며 최대 128 turn 상호작용을 지원한다 |
- 지시문: DCI agent 지시문은
@corpus안의 문서만 쓰고 온라인 검색과 서브에이전트를 금지하며, 한 응답에서 검색 여러 개를 병렬 실행하고, 결론 전에 경쟁 후보를 배제하며, 근거마다 문서 경로를 인용하게 한다. 출력은 Explanation, Exact Answer, Confidence 세 칸이다. IR 지시문에는 recall과 precision이 동등하게 중요하다는 설명과 최대 20개 문서를 관련도 순으로 정렬하라는 조건이 붙는다.
결과
agentic search
BrowseComp-Plus 830문항 전체 결과다. 같은 backbone에서 인터페이스만 바꾼 비교가 핵심이다.
| 설정 | backbone | 정확도 | 총비용 |
|---|---|---|---|
| DCI-Agent-CC | Claude Sonnet 4.6 | 80.0% | $1,016 |
| Qwen3-Embed-8B retriever | Claude Sonnet 4.6 | 69.0% | $1,440 |
| Qwen3-Embed-8B retriever | GPT-5 | 71.7% | 표기 없음 |
| Qwen3-Embed-8B retriever | o3 | 66.0% | $740 |
| DCI-Agent-Lite | GPT-5.4 nano | 62.9% | $93 |
| Qwen3-Embed-8B retriever | GPT-5.4 nano | 44.9% | $105 |
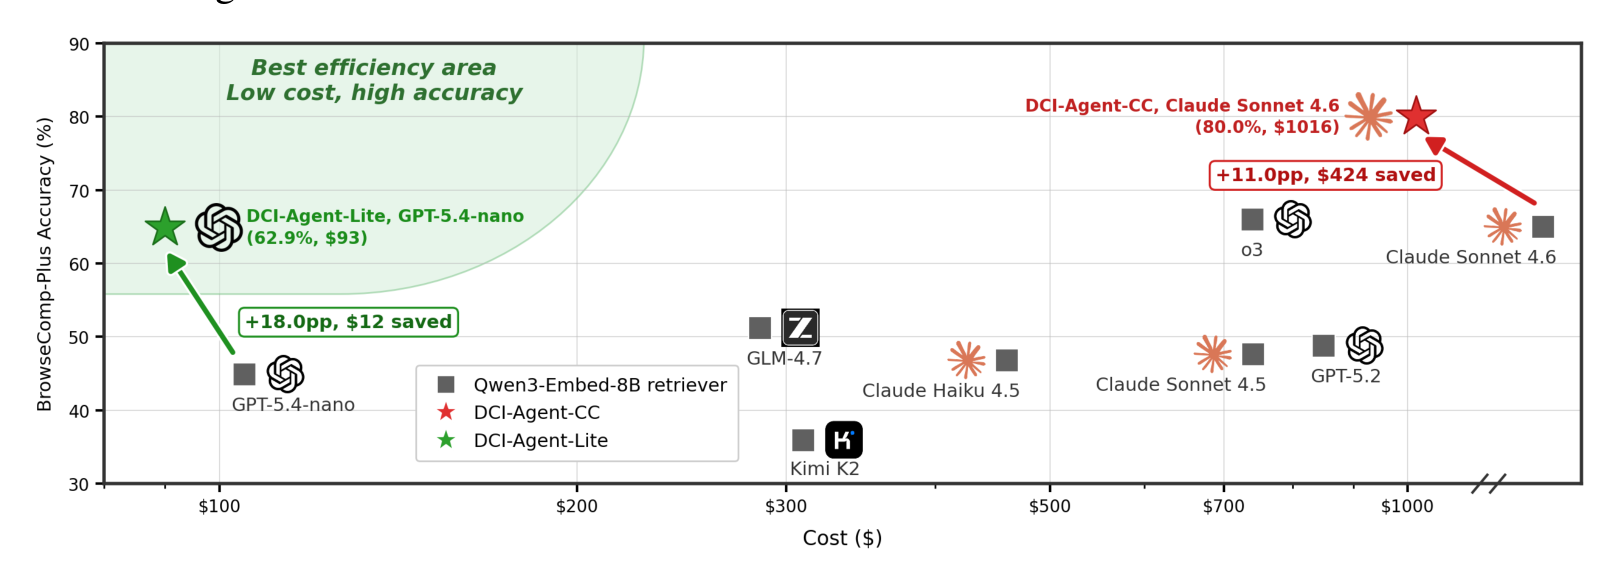
같은 Claude Sonnet 4.6에서 retriever를 DCI로 바꾸면 정확도가 11.0%p 오르고 비용이 $424 줄어든다. 정확도와 비용이 함께 개선되는 방향이라 교환 관계가 아니다.
작은 모델 쪽 결과가 더 흥미롭다. GPT-5.4 nano에서 같은 교체를 하면 정확도가 44.9%에서 62.9%로 18.0%p 오르고 비용도 $12 줄어든다. 마지막 행은 그림의 "+18.0pp, $12 saved" 주석에서 역산한 값이다. 즉 DCI의 이득은 frontier 모델에서만 나타나는 현상이 아니다.
비용 관점에서 보면 DCI-Agent-Lite는 $93으로 62.9%를 낸다. o3와 retriever 조합(66.0%, $740)과 견주면 정확도를 3.1%p 내주면서 비용을 $647 줄이는 지점이다. Figure 1은 이 밖에 GLM-4.7, Kimi K2, Claude Haiku 4.5, Claude Sonnet 4.5, GPT-5.2도 retriever agent backbone으로 함께 그리지만 수치 레이블 없이 30%대에서 50%대 초반 구간에 놓는다.
Figure 1의 배치가 시사하는 바가 하나 더 있다. retriever agent 점들은 비용이 오를수록 정확도가 완만하게 오르는 하나의 곡선을 이루는데, DCI 점 두 개는 그 곡선 위가 아니라 위쪽에 따로 떨어져 있다. backbone을 더 비싼 것으로 바꾸는 것과 인터페이스를 바꾸는 것이 서로 다른 개선 경로라는 뜻이다.
multi-hop QA
Wikipedia-18 corpus 위에서 QA 벤치마크 6종을 평가한 결과다.
| 모델 | NQ | Trivia | Bam. | Hotpot | 2Wiki | MuSiQue | 평균 | Δ평균 |
|---|---|---|---|---|---|---|---|---|
| R1-Searcher-7B | 58 | 50 | 54 | 46 | 40 | 24 | 45.3 | −7.0 |
| Search-R1-32B | 56 | 46 | 52 | 44 | 50 | 32 | 46.7 | −5.6 |
| ZeroSearch-7B | 26 | 30 | 18 | 10 | 18 | 4 | 17.7 | −34.6 |
| Verl-Tool-Search-7B-DAPO | 56 | 44 | 32 | 50 | 32 | 12 | 37.7 | −14.6 |
| ASearcher-Local-14B | 56 | 58 | 62 | 58 | 56 | 24 | 52.3 | 기준 |
| DCI-Agent-Lite (GPT-5.4 nano) | 72 | 84 | 72 | 72 | 68 | 40 | 68.0 | +15.7 |
| DCI-Agent-CC (Sonnet 4.6) | 78 | 96 | 80 | 88 | 82 | 74 | 83.0 | +30.7 |
여섯 데이터셋은 요구하는 홉 수가 서로 다르다. 이 차이가 뒤이은 해석의 근거가 된다.
| 데이터셋 | 성격 | 특징 |
|---|---|---|
| NQ | 단일 홉 | 실제 Google 검색 질의에서 유래하고 Wikipedia passage를 근거로 삼는다 |
| TriviaQA | 단일 홉 | 애호가가 작성한 트리비아 질문에 Wikipedia와 웹 근거를 붙였다 |
| Bamboogle | 2홉 | 지름길 답을 막도록 수작업으로 구성했고 정확히 두 단계 추론을 요구한다 |
| HotpotQA | 2홉 | Wikipedia 기반 bridge 질문과 comparison 질문으로 구성된다 |
| 2WikiMultiHopQA | multi-hop | Wikidata 구조 지식과 비구조 Wikipedia 텍스트를 결합하고 추론 사슬 주석을 제공한다 |
| MuSiQue | multi-hop | 단일 홉 질문을 이어 붙여 구성하며 각 단계가 앞 단계 결과에 의존한다 |
DCI agent 둘이 6개 데이터셋 전부에서 1위와 2위를 차지한다. 주목할 점은 격차가 과제 난이도에 따라 달라진다는 것이다. 단일 홉 성격이 강한 NQ에서는 ASearcher-Local-14B 대비 22점 차이지만, multi-hop 성격이 강해질수록 벌어진다. HotpotQA에서 30점, 2Wiki에서 26점, MuSiQue에서는 50점 앞선다.
MuSiQue는 단일 홉 질문을 이어 붙여 만든 벤치마크로, 각 추론 단계가 앞 단계의 결과에 의존하도록 설계되어 지름길을 막는다. 여기서 격차가 가장 크다는 사실이 DCI의 이득이 어디서 오는지를 시사한다. 중간 개체를 발견하고 다음 홉으로 잇는 작업에서 고해상도 인터페이스가 유리하다.
IR ranking
문서 순위를 매기는 과제에서 NDCG@10으로 평가한 결과다. NDCG@10은 상위 10개 순위의 품질을 재는 IR 표준 지표다.
| 방법 | Bio | Earth | Econ | Robotics | ArguAna | SciFact | 평균 | Δ평균 |
|---|---|---|---|---|---|---|---|---|
| BM25 | 18.9 | 27.2 | 14.9 | 13.6 | 31.5 | 15.8 | 20.3 | −26.7 |
| OpenAI text-emb-3-large | 23.3 | 26.7 | 19.5 | 12.8 | 58.1 | 58.1 | 33.1 | −13.9 |
| GTE-Qwen2-7B-Instruct | 30.6 | 36.4 | 17.8 | 13.2 | 62.7 | 75.3 | 39.3 | −7.7 |
| Rank-R1-14B | 31.2 | 38.5 | 21.2 | 22.6 | 31.3 | 72.2 | 36.2 | −10.8 |
| Rank1-32B | 49.7 | 35.8 | 22.0 | 22.5 | 57.6 | 74.8 | 43.7 | −3.3 |
| ReasonRank-32B | 58.2 | 48.9 | 36.6 | 33.9 | 28.7 | 75.5 | 47.0 | 기준 |
| DCI-Agent-Lite (GPT-5.4 nano) | 60.0 | 50.8 | 32.3 | 42.4 | 81.9 | 72.7 | 56.7 | +9.7 |
| DCI-Agent-CC (Sonnet 4.6) | 77.1 | 69.0 | 46.8 | 56.8 | 85.3 | 75.7 | 68.5 | +21.5 |
DCI-Agent-CC가 6개 데이터셋 전부에서 최고 점수를 낸다. DCI-Agent-Lite는 평균 56.7로 전체 2위이며 가장 강한 retrieval baseline보다 9.7점 높지만, Economics(32.3)와 SciFact(72.7) 두 곳에서는 ReasonRank-32B에 뒤진다.
ArguAna의 결과가 특히 두드러진다. 반론 문서를 찾는 과제인데 ReasonRank-32B가 28.7에 그치는 반면 DCI agent 둘은 81.9와 85.3을 낸다. 반론 검색은 질의와 문서가 의미상 반대 방향을 가리키므로 유사도 기반 인덱스에 불리한 과제다.
BRIGHT 계열의 결과도 방향이 같다. BRIGHT는 표면 키워드 중첩을 넘어선 도메인 추론을 요구하도록 설계된 벤치마크인데, BM25가 네 데이터셋에서 13.6에서 27.2 사이에 머무는 동안 DCI-Agent-CC는 46.8에서 77.1을 낸다. 저자들의 해석 틀로 보면 이는 두 단계가 합쳐진 결과다. 검색어를 만드는 단계에서 도메인 추론이 필요하고, 후보를 확인하는 단계에서 문서 안 증거를 읽어야 하는데, DCI는 두 단계를 같은 인터페이스 안에서 반복할 수 있다.
한 가지 유의할 점은 IR ranking 과제가 원래 retriever의 홈그라운드라는 것이다. 순위 매기기는 유사도 점수가 가장 직접적으로 쓰이는 과제인데, 여기서도 agent 기반 방식이 앞선다는 사실이 인터페이스 논지를 강화한다. 다만 평가 조건에서 BEIR 두 데이터셋은 50문항 표본이라 표본 오차 여지가 있다.
DCI가 이기는 이유
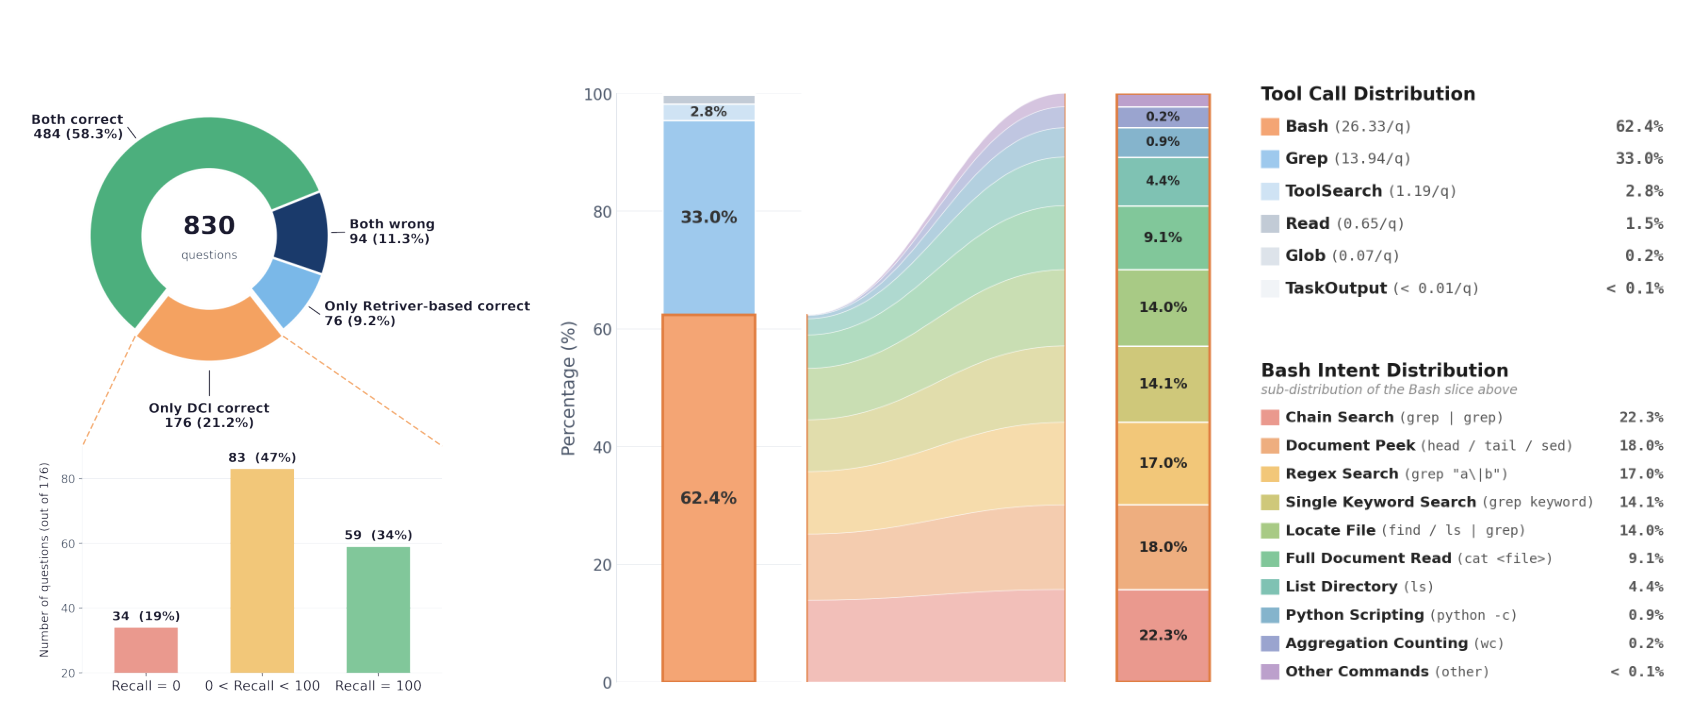
같은 Sonnet 4.6 backbone에서 DCI-Agent-CC와 retriever agent의 정오를 830문항에 대해 교차 집계하면 어느 쪽이 어디서 앞서는지 드러난다.
| 구간 | 문항 수 | 비율 |
|---|---|---|
| 둘 다 정답 | 484 | 58.3% |
| DCI만 정답 | 176 | 21.2% |
| retriever만 정답 | 76 | 9.2% |
| 둘 다 오답 | 94 | 11.3% |
DCI만 맞힌 176건을 retriever agent의 gold 문서 recall로 다시 나누면 결정적인 사실이 나온다.
| recall 구간 | 문항 수 | 비율 | 해석 |
|---|---|---|---|
| recall = 0 | 34 | 19% | retriever가 gold를 하나도 못 올렸다 |
| 0 < recall < 100 | 83 | 47% | partial-chain 실패. 일부 증거는 노출했으나 다음 홉을 잇기에 부족했다 |
| recall = 100 | 59 | 34% | post-retrieval 실패. gold 전부를 올렸으나 활용하지 못했다 |
176건 중 142건, 즉 81%에서 retriever agent도 gold 문서를 이미 최소 하나 이상 표면에 올린 상태였다. retrieval 자체가 실패해서 진 경우는 19%뿐이다. DCI의 이득은 더 많은 gold 문서를 찾아내는 데서가 아니라, 이미 올라온 증거를 더 세밀한 로컬 검색과 verification 단계로 바꾸는 데서 나온다.
tool 사용 분포가 이 해석을 뒷받침한다. DCI-Agent-CC의 tool 호출은 다음과 같이 나뉜다.
| tool | 문항당 호출 | 비율 |
|---|---|---|
| Bash | 26.33 | 62.4% |
| Grep | 13.94 | 33.0% |
| ToolSearch | 1.19 | 2.8% |
| Read | 0.65 | 1.5% |
| Glob | 0.07 | 0.2% |
| TaskOutput | 0.01 미만 | 0.1% 미만 |
Grep은 Claude Code의 내장 파일 검색 primitive로 grep 방식 lexical 검색과 대체로 같은 역할을 한다. Bash 안쪽을 의도별로 나누면 다음과 같다.
| Bash 의도 | 예시 명령 | 비율 |
|---|---|---|
| Chain Search | grep | grep |
22.3% |
| Document Peek | head, tail, sed |
18.0% |
| Regex Search | grep "a|b" |
17.0% |
| Single Keyword Search | grep keyword |
14.1% |
| Locate File | find, ls | grep |
14.0% |
| Full Document Read | cat <file> |
9.1% |
| List Directory | ls |
4.4% |
| Python Scripting | python -c |
0.9% |
| Aggregation Counting | wc |
0.2% |
| 기타 | 0.1% 미만 |
전체 문서 읽기가 9.1%에 그친다. 즉 DCI는 문서를 널리 읽는 방식이 아니다. lexical 필터를 합성하고(22.3%), 정확한 span을 검증하며(18.0%), 정규식으로 후보를 좁히는(17.0%) 조작이 대부분을 차지한다.
coverage와 localization의 교환
BrowseComp-Plus 100문항 부분집합에서 backbone을 GPT-5.4 nano로 고정하고 인터페이스만 바꾼 비교다. 이 표가 이 논문에서 가장 중요한 결과다.
| 방법 | 평균 tool call | 문항당 비용($) | cov_any | cov_mean | cov_all | 평균 localization | 정확도 | Δ정확도 |
|---|---|---|---|---|---|---|---|---|
| BM25 retriever | 19.07 | 0.0527 | 63.0 | 42.8 | 17.0 | 23.5 | 32.0 | −13.0 |
| Qwen3-Embedding-8B retriever | 17.55 | 0.0498 | 74.0 | 56.7 | 28.0 | 21.7 | 45.0 | 기준 |
| DCI-Agent-Lite (L4) | 35.35 | 0.1021 | 70.0 | 28.0 | 1.0 | 48.4 | 73.0 | +28.0 |
DCI-Agent-Lite는 gold 문서를 더 많이 복구해서 이기지 않는다. coverage_mean은 28.0으로 Qwen3-Embedding-8B의 56.7보다 낮고, gold 집합 전체를 올린 비율(coverage_all)은 1.0에 불과하다. 그런데도 정확도는 28점 높다.
차이가 나는 지표는 두 개다. coverage_any는 70.0으로 74.0과 거의 같아 "적어도 하나는 찾는다"는 점에서 대등하고, localization은 21.7 대 48.4로 두 배를 넘는다.
이 조합이 의미를 갖는 이유는 BrowseComp-Plus 질문의 gold 문서가 보통 1개에서 4개뿐이기 때문이다. 이 조건에서는 유용한 gold 문서 하나만 올리면 넓은 retrieval을 접고 세밀한 검사와 verification으로 전환할 수 있다. DCI는 gold chain 전체를 남김없이 복구하는 것을 포기하는 대신 고해상도 로컬 진전을 얻는다.
비용은 이 교환의 대가다. tool call이 17.55에서 35.35로 약 두 배이고 문항당 비용도 0.0498달러에서 0.1021달러로 두 배를 넘는다.
corpus 규모 확장
BrowseComp-Plus 100문항 부분집합에서 corpus를 10만 건에서 20만 건, 40만 건으로 늘린 실험이다. 확장은 FineWeb에서 추가 distractor를 원 집합에 주입해 만든다. distractor는 함께 노출되지만 풀이에는 필요 없는 후보를 뜻한다.
| 지표 | 10만 건 | 20만 건 | 40만 건 | 변화 |
|---|---|---|---|---|
| 평균 tool call | 38 | 87 | 123 | +220% |
| latency(초) | 360 | 783 | 4,188 | +1,064% |
| 문항당 비용 | $1.06 | $2.26 | $3.06 | +189% |
| 정확도 | 82.7% | 69.1% | 43.0% | −39.7%p |
corpus를 네 배로 늘리면 tool call은 3.2배가 되고 latency는 11.6배가 되며 정확도는 39.7%p 하락한다. 40만 건에서는 20개 예시가 최대 tool 예산에 도달해 중단된다.
이 결과가 DCI의 동작 범위를 정한다. 고해상도 인터페이스는 유망한 문서에 도달한 뒤에는 여전히 강력하지만, 첫 anchor 문서를 찾는 비용이 후보 공간이 넓어질수록 급격히 커진다. 검색 깊이에는 잘 확장되고 검색 폭에는 비용이 가파르게 오른다는 것이 저자들의 표현이다.
지표별 증가율이 서로 다르다는 점도 읽어 둘 만하다. tool call은 3.2배가 되는데 latency는 11.6배가 된다. 호출 횟수보다 호출 하나가 처리해야 하는 후보가 늘어나 개별 명령이 느려진다는 뜻이다. 반면 비용은 2.9배로 latency만큼 가파르지 않다. 논문은 이 편차의 원인을 설명하지 않으므로 해석은 열려 있다.
한편 multi-hop QA는 문서 2,100만 건의 Wikipedia-18에서 수행되었고 거기서도 DCI가 앞섰다. 두 결과를 함께 놓으면 문서 수 자체보다 후보 공간의 혼동도가 문제라는 해석이 가능하다. 확장 실험은 FineWeb distractor를 주입해 만든 것이라 정답과 구별하기 어려운 후보가 늘어난 조건이고, Wikipedia-18은 문서가 많되 개별 문서가 평균 100단어로 짧고 개체명으로 좁히기 쉽다.
컨텍스트 관리 정책
L0부터 L4까지 다섯 정책을 BrowseComp-Plus 100문항 무작위 표본에서 비교한다. Retained cov.는 최종 대화 상태에 남아 있는 gold 증거 문서의 비율이고, 괄호 안은 L0 대비 차이다.
| Level | 평균 tool call | latency(초) | 문항당 비용($) | Retained cov. | 정확도 |
|---|---|---|---|---|---|
| L0 | 28.54 | 2,226.22 | 0.0716 | 26.9 | 72 |
| L1 | 29.00 | 1,819.78 | 0.0720 | 31.3 (+4.4) | 75 (+3) |
| L2 | 29.95 | 4,412.73 | 0.0590 | 27.2 (+0.3) | 69 (−3) |
| L3 | 36.89 | 8,711.81 | 0.1109 | 27.0 (+0.1) | 77 (+5) |
| L4 | 35.35 | 4,531.11 | 0.1021 | 28.0 (+1.1) | 73 (+1) |
패턴이 뚜렷하게 비단조다. 더 공격적인 관리가 곧 더 나은 결과를 뜻하지 않는다. 세 지표의 최적점이 서로 다른 정책에 흩어져 있다.
| 지표 | 최적 정책 | 값 |
|---|---|---|
| latency | L1 | 1,819.78초 |
| 문항당 비용 | L2 | 0.0590달러 |
| Retained cov. | L1 | 31.3 |
| 정확도 | L3 | 77 |
가장 많은 gold 증거를 남긴 정책(L1, 31.3)과 가장 높은 정확도를 낸 정책(L3, 27.0)이 다르다는 점이 핵심이다. 저자들의 해석은 verbatim 증거를 더 많이 보존하는 것과 이어지는 검색에 알맞은 작업 상태를 유지하는 것이 같지 않다는 것이다. 선택적으로 잊는 정책이 다단계 가설 수정에 도움이 되고, 압축이 너무 약하면 표류가 생기며 너무 거칠면 유용한 중간 구조가 사라진다.
도구 표현력
DCI의 이득이 인터페이스 자체에서 오는지, 아니면 제한 없는 shell이라는 강력한 도구에서 오는지를 가르는 ablation이다. 같은 100문항 부분집합, GPT-5.4 nano backbone이다.
| 설정 | 평균 tool call | 문항당 비용($) | 정확도 |
|---|---|---|---|
| BM25 retriever | 19 | 0.0527 | 32 |
| Qwen3-Embedding-8B retriever | 18 | 0.0498 | 45 |
| DCI-Agent-Lite, read + grep만 (L4) | 19 | 0.0355 | 61 |
| DCI-Agent-Lite, bash 전면 개방 (L4) | 35 | 0.1021 | 73 |
답은 두 겹이다. 첫째, 파일 열람과 패턴 검색만 남긴 매우 제한된 인터페이스에서도 이득이 이미 나타난다. read + grep 두 도구만으로 61%를 기록해 Qwen3-Embedding-8B retriever(45%)를 16점 앞서는데, tool call 강도는 19 대 18로 거의 같고 비용은 0.0355달러로 오히려 낮다.
둘째, bash 명령 집합을 열면 12점이 더 붙지만 tool call이 19에서 35로 늘고 비용은 세 배 가까이 오른다. 작은 명령 집합만으로 개선의 대부분을 얻을 수 있고 추가 표현력은 효율을 낮추면서 증분 이득만 준다.
bash 명령 사용 패턴
DCI-Agent-Lite의 trajectory 100건에서 수집한 bash 명령 3,168개의 분포다. 정답 실행과 오답 실행을 합산한 값이다.
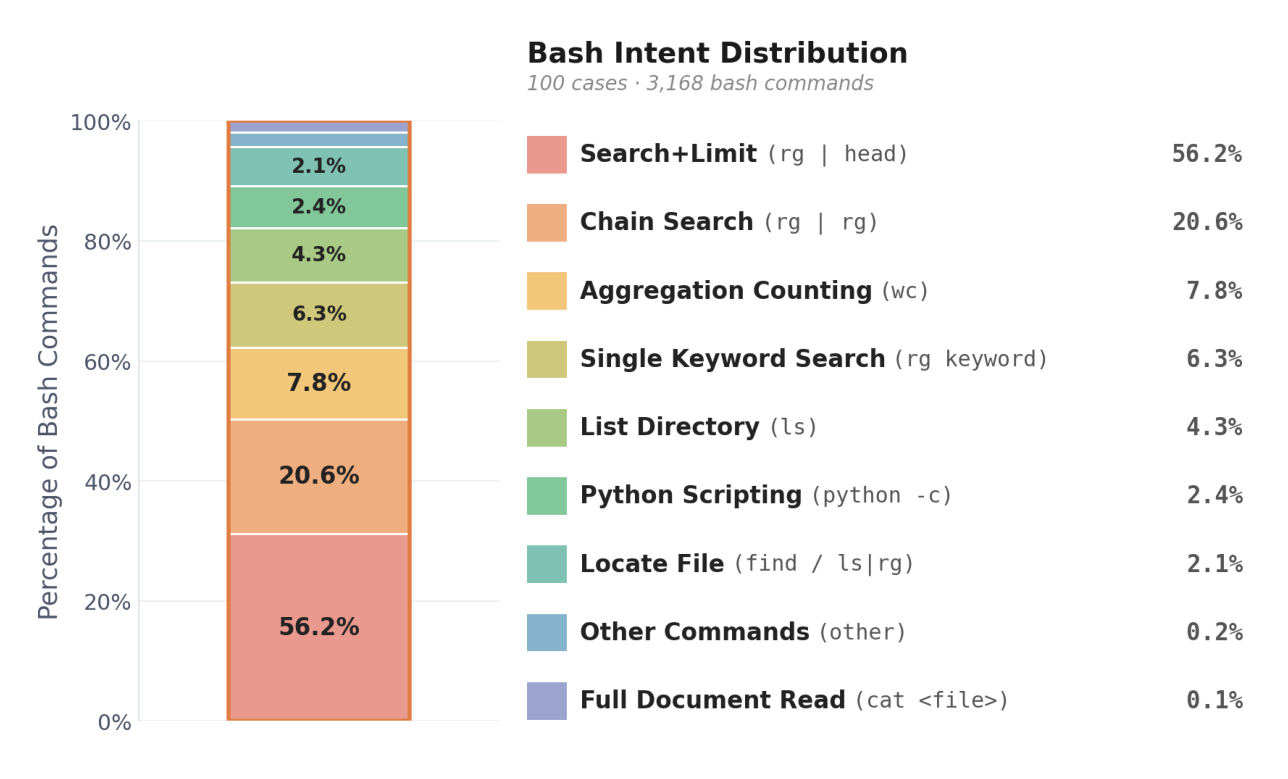
| 명령 패턴 | 예시 | 비율 |
|---|---|---|
| Search+Limit | rg | head |
56.2% |
| Chain Search | rg | rg |
20.6% |
| Aggregation Counting | wc |
7.8% |
| Single Keyword Search | rg keyword |
6.3% |
| List Directory | ls |
4.3% |
| Python Scripting | python -c |
2.4% |
| Locate File | find, ls | rg |
2.1% |
| Other Commands | 0.2% | |
| Full Document Read | cat <file> |
0.1% |
전체 문서 읽기가 0.1%로 거의 쓰이지 않는다. 상위 두 패턴인 rg | head와 rg | rg가 합쳐서 76.8%를 차지한다. agent가 Bash를 고해상도 검색 인터페이스로 다루면서, 넓게 읽는 대신 반복적인 정확 일치 검증으로 후보 공간을 좁힌다는 뜻이다.
DCI-Agent-CC와 비교하면 차이가 보인다. Claude Code 쪽은 전체 읽기가 9.1%인데 Pi 기반 Lite는 0.1%다. 최소 harness일수록 읽기보다 필터링에 더 치우친다.
저자들은 이 명령 기록을 다시 묶어 대체로 시간 순서를 따르는 조작 패턴 6종으로 정리한다.
| 단계 | 패턴 | 예시 |
|---|---|---|
| 1 | corpus exploration. 디렉터리 구조를 훑어 관련 있을 영역을 찾는다 | ls |
| 2 | broad keyword search. corpus 수준 패턴 매칭으로 후보를 올린다 | rg -n |
| 3 | iterative narrowing. 검색어를 점차 정교하게 만들어 공간을 줄인다 | rg -n "k1" | rg "k2" |
| 4 | targeted document reading. 유망하다고 판단된 파일을 열어 본다 | read, cat |
| 5 | in-document deep search. 단일 문서 안에서 여러 키워드로 국소 검색한다 | rg -n "term" file.txt |
| 6 | cross-document comparison. 여러 문서를 오가며 검증하고 구분한다 | rg -n "k" f1.txt f2.txt |
사례 분석
부록 D는 사례 9건의 전체 trajectory를 싣는다. 성공 사례 하나와 실패 사례 둘이 DCI의 동작 방식과 실패 조건을 보여준다.
**성공 사례 (D.1)**는 Natural Questions의 "what is don quixote's horse's name"이다(정답 Rocinante). agent는 Grep으로 wiki_dump.jsonl에서 "Rocinante"를 찾아 문서 두 개를 확인한다. 이어서 Don Quixote.*horse 정규식으로 교차 확인을 시도하지만 파일이 너무 커서 비효율적이 되자, grep -m 3 "Rocinante" wiki_corpus/wiki_dump.jsonl | head -c 1500으로 전환해 매치 개수와 출력 바이트를 함께 제한하고 확인을 마친다. 도구가 막히면 같은 목적을 다른 명령 조합으로 우회하는 전형적 패턴이다.
**DCI-Agent-CC 실패 사례 (D.8)**는 2019년 잉글랜드 경기의 물병 실랑이와 선수 임대 이력을 잇는 multi-hop 질문이다(정답 FC Krasnodar). agent는 corpus 문서로 Denis Suarez와 FC Barcelona까지 정확히 찾아내지만, UEFA 챔피언스리그 벤치 출전의 상대 팀을 잘못 귀속한다. 검색은 성공했으나 마지막 홉의 사실 연결에서 실패한 경우다.
**DCI-Agent-Lite 실패 사례 (D.9)**는 2000년대 개봉작, 빈부 대비 줄거리, 1960년대생 배우 두 명, 2023년 11월 감독과 배우 형제의 분쟁이 맞물린 영화 식별 문제다(정답 Dosti: Friends Forever). agent는 정밀한 검색어를 만들지 못하고 지나치게 넓은 rg 패턴을 반복해 무관한 문서만 받다가, 표면 키워드만 일부 맞는 The Family Man (2000)을 환각으로 답한다.
Case 5a의 첫 turn은 tool 호출 분포에 잡힌 ToolSearch 2.8%가 무엇인지도 설명해 준다. agent는 검색을 시작하기 전에 ToolSearch로 select:Grep,Bash를 호출해 두 도구를 먼저 불러온다. 즉 이 비중은 검색 자체가 아니라 도구 준비 단계에 해당하며, 실제 corpus 접근은 Bash와 Grep 두 도구가 95.4%를 담당한다.
두 실패 사례가 시사하는 조건은 같다. 단서를 정확한 문자열 패턴으로 옮길 수 있으면 DCI가 강하고, 단서가 corpus에 명시적 텍스트로 존재하지 않거나 검색어로 옮기기 어려우면 넓은 패턴을 반복하다 환각으로 이어진다.
두 scaffold의 결과 종합
같은 패러다임을 최소 harness와 강한 harness로 각각 구현했을 때 무엇이 같고 무엇이 다른지 한자리에 모으면 인터페이스 효과와 harness 효과가 분리된다.
| 항목 | DCI-Agent-Lite (GPT-5.4 nano) | DCI-Agent-CC (Sonnet 4.6) |
|---|---|---|
| BrowseComp-Plus 정확도 | 62.9% | 80.0% |
| BrowseComp-Plus 총비용 | $93 | $1,016 |
| 같은 backbone retriever 대비 | +18.0%p, $12 절감 | +11.0%p, $424 절감 |
| multi-hop QA 평균 | 68.0 | 83.0 |
| IR ranking 평균 NDCG@10 | 56.7 | 68.5 |
| IR 6종 중 1위 개수 | 0개 (전체 2위) | 6개 |
| 전체 문서 읽기 비중 | 0.1% | 9.1% |
| 대표 실패 방식 | 넓은 패턴 반복 후 환각 (D.9) | 마지막 홉의 사실 오귀속 (D.8) |
절대 성능은 backbone을 따라간다. Sonnet 4.6 쪽이 모든 지표에서 앞서고 IR 6종을 전부 1위로 가져간다. 반면 인터페이스 교체의 이득 폭은 오히려 약한 모델 쪽이 크다. GPT-5.4 nano에서 18.0%p, Sonnet 4.6에서 11.0%p다.
읽기 비중의 차이도 눈여겨볼 부분이다. Claude Code 기반 CC는 전체 문서 읽기가 9.1%인 반면 Pi 기반 Lite는 0.1%다. 다만 두 값의 모집단이 다르다. Lite 쪽은 bash 명령 3,168개 전체에 대한 비율이고 CC 쪽은 Bash 의도 분류 안에서의 비율이라, 정확한 비교보다 경향으로 읽어야 한다. 경향은 분명하다. harness가 가벼울수록 읽기보다 필터링에 치우친다.
두 scaffold가 공통으로 보여주는 것은 인터페이스 교체만으로 세 벤치마크 계열 전부에서 이득이 난다는 점이다. 저자들이 Lite를 따로 만든 이유가 여기에 있다. 개선이 Claude Code의 프롬프트 품질이나 도구 조율 때문이라는 설명을 배제하려면, retrieval 모듈이 하나도 없는 최소 harness에서도 같은 방향의 결과가 나와야 한다.
한계
저자가 인정한 제약
이 논문에는 별도의 한계 절이나 향후 과제 절이 없다. 아래는 본문 각 절의 서술에서 저자들이 직접 인정한 제약을 모은 것이다.
| 제약 | 내용 |
|---|---|
| 검색 폭 확장 비용 | corpus가 커질수록 첫 anchor 문서를 찾는 비용이 비선형으로 증가한다. 저자들은 대규모 정적 corpus에서는 sparse와 dense retrieval이 여전히 확장성 있고 효과적이며 corpus 인터페이스 설계 공간의 한 지점을 차지한다고 명시한다 |
| 모델 능력 의존 | DCI의 이점은 agent가 전략적으로 검색할 만큼 강할 때 커진다. 검색 primitive를 스스로 합성할 수 있어야 추론 전에 유용한 증거가 버려지는 일을 막는다 |
| latency와 비용 | tool call이 retriever agent 대비 약 두 배이고 문항당 비용도 두 배가 넘는다. 정책에 따른 latency 편차도 크다(L1 1,820초에서 L3 8,712초) |
| 지표의 구현 의존성 | DCI trace에서는 snippet을 원시 tool 출력에서 재구성해야 하고, 경로만 노출된 관찰은 문서 전체를 snippet으로 간주하는 폴백을 쓴다. retriever 방식은 API가 이미 표준화해 주므로 비교 조건이 완전히 대칭이지는 않다 |
| 평가 범위 | BRIGHT 4종과 Bamboogle을 제외하면 데이터셋당 50문항 표본이고, ablation은 전부 100문항 부분집합에서 이루어진다 |
저자들이 결론에서 남긴 방향은 하나다. 앞으로의 연구가 retrieval 모델뿐 아니라 유능한 agent가 쓸 수 있는 corpus 인터페이스도 함께 평가하기를 바란다는 것이다. 특정 기법이나 후속 과제를 제안하지는 않으며, 별도의 향후 과제 절도 두지 않는다. 이 페이지의 한계 목록도 저자가 한곳에 모아 둔 것이 아니라 본문 각 절에 흩어져 있던 서술을 정리한 것이다.
적용 조건 판단
논문이 제시한 수치를 실무 판단 기준으로 옮기면 다음과 같이 정리된다. 모두 이 논문이 직접 보고한 값에서 나온 것이며, 다른 조건으로의 일반화는 검증되지 않았다.
| 판단 항목 | DCI에 유리한 조건 | 근거 |
|---|---|---|
| corpus 규모 | 10만 건 안팎 | 10만 건에서 82.7%, 40만 건에서 43.0%로 하락한다 |
| corpus 갱신 빈도 | 자주 바뀜 | 인덱싱 단계가 없어 재인덱싱 비용이 발생하지 않는다 |
| 문서 길이 | 김 | BrowseComp-Plus 문서 평균이 5,179단어이고 여기서 localization 이득이 가장 크게 나타난다 |
| gold 문서 개수 | 적음 (1개에서 4개) | 하나만 찾으면 로컬 검사로 전환할 수 있는 조건이다 |
| 응답 지연 요구 | 느슨함 | 정책에 따라 문항당 1,820초에서 8,712초가 걸린다 |
| 단서의 성격 | 정확한 문자열로 옮길 수 있음 | 그렇지 않으면 넓은 패턴을 반복하다 환각으로 이어진다 (Case 5b) |
반대로 corpus가 크고 정적이며 대화형 응답 속도가 필요한 환경에서는 기존 방식이 여전히 합리적이다. 저자들도 sparse와 dense retrieval이 대규모 정적 corpus에서 확장성 있고 효과적이며 corpus 인터페이스 설계 공간의 한 지점을 차지한다고 명시한다. 이 논문의 주장은 기존 방식을 대체하자는 것이 아니라 설계 공간이 그 한 지점보다 넓다는 것이다.
도구 표현력 ablation도 실무 판단에 쓸 만하다. read + grep 두 도구만 열어도 retriever 대비 16점을 얻고 비용은 오히려 낮았다. 제한 없는 shell을 여는 것이 부담스러운 환경이라면 최소 구성부터 시도해 볼 근거가 된다.
자료 내적 모순
원문 대조 과정에서 논문 안에서 값이 어긋나는 자리가 세 곳 확인되었다.
| 항목 | 어긋난 서술 |
|---|---|
| 가장 강한 baseline | 본문 §4.2는 GPT-5와 Qwen3-Embedding-8B 조합(71.7%)을 "가장 강한 retrieval baseline"이라 쓰고 DCI-Agent-CC가 이를 8.3점 앞선다고 적는다. 반면 부록 §A.2는 "o3가 모든 baseline agent 중 BrowseComp-Plus에서 가장 강한 retrieval 성능을 낸다"고 쓴다. Figure 1에는 71.7%에 해당하는 GPT-5 점이 없고(GPT-5.2 점이 50% 부근에 있다), 그려진 baseline 중 최고는 Claude Sonnet 4.6의 69.0%다 |
| 40만 건 corpus 정확도 | 본문 §RQ4는 37.5%로 적고 Figure 5의 막대는 43.0%다. 20만 건에서의 13.6%p 하락은 그림의 82.7%에서 69.1%와 일치하므로, 어긋나는 값은 40만 건 지점 하나다 |
| 선행 연구 연도 | Subramanian et al.의 참고문헌 연도는 2025로 적혔으나 함께 실은 arXiv 식별자 2602.23368은 2026년 2월 등록을 가리킨다 |
세 번째는 표기 오류에 가깝지만, 첫 번째와 두 번째는 논문의 주장 강도에 영향을 준다. 특히 "가장 강한 baseline" 서술이 세 곳에서 다르므로, DCI-Agent-CC의 우위 폭을 인용할 때는 동일 backbone 비교(69.0%에서 80.0%로 11.0%p)를 쓰는 편이 안전하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Direct Corpus Interaction (DCI) | 임베딩 모델, vector index, retrieval API를 거치지 않고 agent가 범용 터미널 도구로 원본 corpus를 직접 탐색하는 retrieval 패러다임 |
| Retriever-mediated access | 오프라인 인덱싱과 retriever가 매개하고 agent는 top-k 조각 위에서만 추론하는 기존 방식 |
| Retrieval interface resolution | corpus를 관찰하고 검증하고 조작할 수 있는 단위의 세밀도. 문서 단위 top-k는 저해상도, 줄이나 span 단위 매칭은 고해상도다 |
| Coverage | trajectory가 gold 문서를 표면에 올린 정도. any, mean(recall), all 세 집계를 쓴다 |
| Localization | 표면에 올린 gold 문서 안에서 얼마나 좁은 증거 span으로 좁혔는지의 정밀도 |
| BrowseComp-Plus | 830문항, 문서 100,195건의 폐쇄 corpus 기반 deep research 벤치마크. 사람이 검증한 지지 문서와 채굴한 hard negative로 구성되고 BM25 및 Qwen3-Embedding-8B FAISS 인덱스를 함께 배포한다 |
관련 페이지
- PageIndex: Next-Generation Vectorless, Reasoning-based RAG: 임베딩을 쓰지 않는 또 다른 접근이다. 차이는 사전 처리의 유무에 있다. PageIndex는 문서의 목차 구조를 tree로 먼저 만들어 두고 agent가 그 tree를 탐색하는 반면, DCI는 사전 처리를 전혀 하지 않고 원본 파일 위에서 바로 검색한다. 두 논문 모두 강한 LLM이 있으면 vector index가 필수가 아니라는 가설을 검증한다.
- Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini: 반대 방향의 대응이다. 이 논문이 임베딩 인터페이스를 우회하자고 주장한다면, Gemini Embedding 2는 임베딩 모델 자체의 성능을 끌어올려 같은 인터페이스를 유지하려 한다. 어느 쪽을 택할지는 corpus 규모와 갱신 빈도가 가른다.
- Your Embedding Model is SMARTer Than You Think: 임베딩 모델을 개선하는 같은 방향의 연구다. 이 논문이 인터페이스 해상도를 문제로 규정한 것과 대비해 읽으면 두 진영의 전제 차이가 드러난다.
- Rethinking Retrieval: From Traditional Retrieval Augmented Generation to Agentic and Non-Vector Reasoning Systems in the Financial Domain for Large Language Models: 금융 도메인에서 vector 방식과 non-vector 방식을 같은 조건으로 비교한 논문이다. 도메인 한정 비교라는 점에서 이 논문의 일반 벤치마크 결과와 상호 보완된다.
- VectifyAI/PageIndex: PageIndex의 구현체 페이지다. tree 구축 비용과 도구 구성을 확인할 수 있다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: knowledge graph를 미리 구축하는 계열의 개요다. 사전 구조화 비용을 크게 치르는 방향이라 DCI와 정반대 지점에 있다. 사전 구조화 비용과 런타임 검색 비용의 교환을 비교할 때 함께 본다.
- Pi agent harness (earendil-works/pi, GitHub repo): DCI-Agent-Lite가 기반 harness로 쓴 Pi의 저장소. 최소 system prompt와 extension 구조를 확인할 수 있다.