Database · ARTICLE · 2026
PageIndex: 벡터 DB와 청킹 없이 LLM 추론으로 문서를 검색하는 계층형 인덱스 기반 RAG 시스템
요약
PyTorch Korea User Group 운영자 9bow(박정환)가 2026-04-07에 discuss.pytorch.kr에 올린 PageIndex 한국어 소개글이다. VectifyAI가 공개한 vectorless RAG 프로젝트를 문제 제기, vector 기반 RAG와의 비교표, 2단계 동작 원리, 설치와 실행, 라이선스 순으로 정리한다.
이 페이지의 쓰임은 두 가지다. 하나는 PageIndex의 발상을 한국어로 빠르게 훑는 입구이고, 다른 하나는 2026년 4월 시점의 PageIndex가 어떤 모습이었는지를 기록한 시점 자료다. 저장소 README는 그해 8월에 pip install pageindex SDK 중심으로 개편됐으므로, 이 글의 설치 명령은 현재 저장소와 일치하지 않는다.
원문은 글 마지막에서 GPT 모델로 정리한 글을 바탕으로 했음을 밝힌다. 따라서 수치와 설계 세부를 인용할 때는 VectifyAI/PageIndex와 PageIndex: Next-Generation Vectorless, Reasoning-based RAG를 우선한다.
배경
글이 출발점으로 삼는 문제는 문서를 어떻게 나누고 어떻게 찾을 것인가다. 기존 vector 기반 RAG는 문서를 임의의 크기로 분할한 뒤 임베딩 벡터로 바꾸어 검색한다. 글은 이 절차가 자연스러운 문서 구조를 무시하고 의미적으로 연관된 내용을 단절시킨다고 지적한다.
chunking은 문서를 retrieval 단위로 잘라 내는 처리를 말한다. 자르는 위치가 절의 경계와 어긋나면 한 설명이 두 조각으로 쪼개지고, 각 조각은 앞뒤 맥락을 잃는다. 금융 보고서나 법률 문서처럼 절 구조가 뚜렷하고 분량이 긴 문서에서 이 손실이 특히 크다.
PageIndex는 이 문제를 다른 방식으로 접근한다. vector database를 전혀 쓰지 않고, 문서가 본래 갖고 있는 구조를 계층 트리로 뽑은 뒤 LLM의 추론 능력으로 필요한 구간을 찾는다. 글은 이 방식의 이름을 "Reasoning-based RAG(추론 기반 RAG)"로 적고, VectifyAI 팀이 제안한 새로운 패러다임으로 소개한다.
핵심 개념
vectorless RAG는 임베딩 벡터 검색 없이 문서 구조와 모델의 추론으로 근거를 찾는 RAG 방식이다. 이름의 vectorless는 임베딩을 만들지 않는다는 뜻이며, 판단의 주체가 벡터 사이의 거리에서 LLM으로 옮겨간다는 점이 핵심이다.
계층형 트리 인덱스는 문서 하나를 목차 모양의 계층 구조로 표현한 것이다. 각 노드가 특정 섹션이나 개념 단위에 대응하고, 부모와 자식 관계로 연결되어 문서 전체의 의미 구조를 반영한다.
retrieval은 외부 지식에서 답에 필요한 부분을 찾아오는 단계를 말한다. vector 기반 RAG에서는 질의(query) 임베딩과 가까운 조각을 고르는 계산이 이 단계를 맡지만, PageIndex에서는 LLM이 트리를 읽고 어느 절로 내려갈지 판단하는 과정이 이 단계를 맡는다.
글이 이 구성에 붙이는 비유는 사람의 독해다. 사람은 두꺼운 보고서를 받았을 때 전체를 읽지도 않고 비슷한 문장을 찾지도 않는다. 목차를 먼저 보고 필요한 챕터로 이동한다. PageIndex가 트리를 만들고 그 위를 탐색하는 구성은 이 동작을 옮긴 것이다.
원문의 구성
글은 짧은 절 여섯 개로 이어진다. 소개, vector 기반 RAG와의 비교, 핵심 동작 원리, 설치와 사용법, 라이선스, 공식 링크 안내 순서다. 각 절은 두세 문단을 넘지 않으며 도식 세 장이 소개 절과 동작 원리 절에 배치된다.
이 구성은 국내 개발자 커뮤니티의 신규 프로젝트 소개 글이 흔히 따르는 형식이다. 문제 제기로 시작해 기존 방식과의 차이를 표로 보이고, 동작 원리를 요약한 뒤, 바로 따라 할 수 있는 명령을 제시하고, 라이선스와 링크로 닫는다. 깊이보다 진입 속도를 우선한 배치이므로 이 페이지도 같은 순서를 유지하되 저장소 자료로 확인한 조건을 절마다 덧붙인다.
글 끝에는 같은 게시판의 RAG 관련 글 일곱 편이 "더 읽어보기"로 붙는다. PageIndex MCP 소개글, Agentic RAG for Dummies, ApeRAG, Morphik Core, nano-GraphRAG, PDF GPT Indexer, Trieve다. 이 가운데 PageIndex MCP 소개글은 같은 프로젝트를 MCP 서버 쪽에서 다룬 글이며, MCP는 모델이 외부 도구와 데이터 원천에 표준화된 방식으로 접근하게 하는 프로토콜이다. 일곱 편 모두 이 wiki에 수록되어 있지 않다.
방법
vector 기반 RAG와의 대조
글은 두 방식을 다섯 항목으로 나란히 놓는다.
| 항목 | vector 기반 RAG | PageIndex |
|---|---|---|
| 인덱싱 방식 | chunking과 임베딩 벡터화 | 계층형 트리 인덱스 |
| 검색 방식 | 벡터 유사도 계산 | LLM 추론 기반 트리 탐색 |
| vector database 필요 | 필수 | 불필요 |
| 문서 구조 보존 | chunking으로 인해 파괴 가능 | 자연스러운 구조 유지 |
| FinanceBench 정확도 | 시스템별 상이 | 98.7% |
표의 마지막 행에서 vector 기반 RAG 칸이 비어 있다는 점에 유의한다. 이 표는 98.7%와 견줄 대조군 수치를 제시하지 않는다.
표에 이어지는 문단은 두 방식의 성격 차이를 정리한다. vector 기반 RAG는 분할 과정에서 문맥이 끊기는 반면, PageIndex는 구조를 유지한 채 사람이 목차를 보고 챕터를 찾아가듯 동작한다. 글은 복잡한 금융 문서, 법률 문서, 학술 논문처럼 구조화된 정보를 다룰 때 이 차이가 이점으로 작용한다고 적는다.
1단계 계층형 트리 인덱스 구축
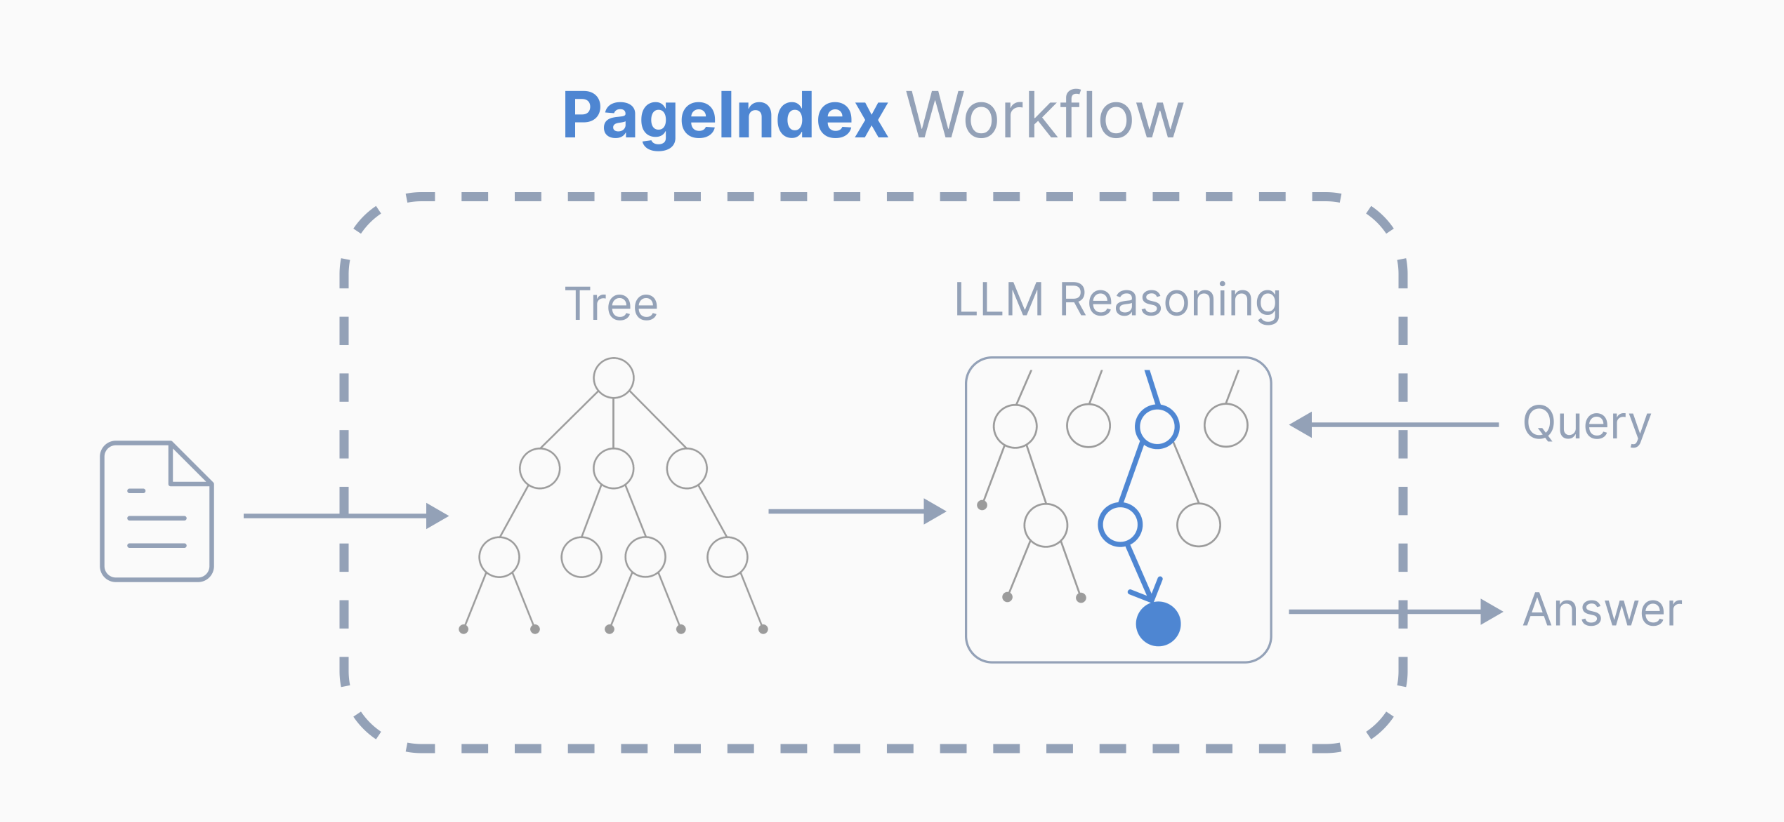
첫 단계는 문서를 넣을 때 한 번 수행하는 전처리다. 문서가 입력되면 LLM이 구조를 분석해 목차와 유사한 계층형 트리를 만든다.
각 노드는 문서의 특정 섹션이나 개념 단위에 해당하고, 부모와 자식 관계로 연결되어 전체 의미 구조를 반영한다. 이 과정에서 임의적인 chunking 대신 섹션, 단락, 절 같은 문서 본래의 경계를 존중한다는 것이 글의 설명이다.
트리를 만드는 주체를 글은 LLM으로 적는다. 저장소 README의 현재 판은 이 부분을 더 좁게 설명해서, 구조 자체는 문서 레이아웃에서 추출하고 모델은 요약과 정리만 맡는다고 밝힌다. 두 설명은 어긋난다기보다 상세도가 다르며, 인덱싱에 값싼 모델을 써도 된다는 README의 권고는 후자의 설명에서 따라 나온다.
노드가 어떤 필드를 갖는지, 즉 제목과 식별자와 위치 범위와 요약을 어떻게 담는지는 이 글에 나오지 않는다. 그 스키마는 VectifyAI/PageIndex가 다룬다.
2단계 추론 기반 검색
둘째 단계는 질의가 들어올 때마다 수행하는 실행 단계다. 사용자가 질의를 입력하면 LLM이 구축된 트리를 탐색하며 관련 정보를 찾는다.
이 과정은 사람이 책의 목차를 보고 원하는 챕터를 선택하는 방식과 유사하며, 벡터 유사도 점수 대신 LLM의 이해와 추론에 기반한다고 글은 설명한다. 그 결과로 문맥이 보존된 정확한 정보가 반환된다는 것이다.
두 단계를 나눈 설계가 비용 면에서 갖는 의미, 예를 들어 트리를 한 번 만들어 두고 질의마다 재사용한다는 점은 이 글이 다루지 않는다. 저장소 README는 이 부분을 쪽당 약 0.001달러의 일회성 인덱싱 비용으로 수치화한다.
설치와 실행
글이 제시하는 코드 블록은 세 명령으로 구성된다. 저장소를 클론해 쓰는 자체 호스팅 방식이다.
# 의존성 설치
pip3 install --upgrade -r requirements.txt

# PDF 문서 인덱싱 및 검색 실행
python3 run_pageindex.py --pdf_path /path/to/document.pdf

# 에이전트 기반 RAG 데모 실행
python3 examples/agentic_vectorless_rag_demo.py
| 명령 | 역할 |
|---|---|
pip3 install --upgrade -r requirements.txt |
저장소의 의존성을 설치한다 |
python3 run_pageindex.py --pdf_path |
PDF 한 건을 트리 인덱스로 바꾼다 |
python3 examples/agentic_vectorless_rag_demo.py |
에이전트 기반 RAG 데모를 실행한다 |
API 키 설정이나 선택 인자는 글에 나오지 않는다. 이 절차는 2026년 4월 시점의 것이며, 현재 저장소는 같은 일을 pip install -U pageindex와 PageIndexClient로 수행한다.
저장소에 포함된 예제
| 위치 | 글이 밝히는 내용 |
|---|---|
cookbook/ |
Jupyter Notebook 형태의 사용 예시. OpenAI Agents SDK와 통합한 에이전트 기반 vectorless RAG, OCR 없이 이미지를 직접 처리하는 vision 기반 RAG, 최소 코드로 동작하는 simple RAG 세 종류를 든다 |
.claude/commands/ |
Claude 연동 명령이 들어 있어 Claude와의 연동을 손쉽게 설정할 수 있다고 적는다 |
.claude/commands/ 언급은 README에 없는 정보다. 글쓴이가 README뿐 아니라 저장소의 파일 구조까지 확인했음을 보여준다.
제공 형태로는 자체 호스팅 패키지 외에 클라우드 서비스와 엔터프라이즈 배포 선택지가 있다고 소개하고, 공식 홈페이지 pageindex.ai, 문서 사이트 docs.pageindex.ai, 대화형 데모 chat.pageindex.ai를 안내한다. 라이선스는 MIT이며 개인과 상업적 목적 모두 자유롭게 사용, 수정, 배포할 수 있다고 밝힌다.
결과
| 항목 | 값 | 글이 붙인 조건 |
|---|---|---|
| FinanceBench 정확도 | 98.7% | "달성했다고 보고되어 있으며"라는 전언 형식이다. 기존 vector 기반 RAG와 비교해 주목할 만한 성과라고 평가한다 |
글이 싣는 정량 근거는 이 한 줄이다. 측정 주체, 측정 대상 시스템, 대조군 수치, 재현 절차는 모두 언급되지 않는다.
이 수치를 인용할 때는 측정 조건을 함께 가져와야 한다. 저장소 README를 보면 98.7%의 실제 측정 대상은 PageIndex 단독이 아니라 PageIndex를 retrieval 층으로 쓰는 Mafin 2.5이고, 보고 주체는 개발사인 VectifyAI 자신이며 독립 재검증은 없다. 현재 README는 대조군으로 vector RAG 50%를 함께 싣는데, 이 글이 쓰인 시점의 README에는 그 수치가 없었다.
인덱싱 비용, 질의 비용, 처리 시간 같은 운영 지표는 이 글에 없다. 저장소가 2026년 8월에 공개한 측정치는 VectifyAI/PageIndex가 다룬다. 그 측정치가 더해지면서 PageIndex의 주장은 정확도 한 줄에서 비용과 시간을 포함한 네 묶음으로 넓어졌으므로, 이 글만 읽고 판단을 멈추지 않는 편이 좋다.
글이 전하는 정성적 근거는 적용 대상의 성격이다. 복잡한 금융 문서, 법률 문서, 학술 논문처럼 구조화된 정보를 다룰 때 이점이 크다고 적는다. 이는 트리 인덱스가 문서에 이미 들어 있는 절 구조를 재료로 삼기 때문이며, 절 구분이 뚜렷하지 않은 문서에서는 같은 이점을 기대하기 어렵다는 뜻이기도 하다. 다만 그 반대 조건, 즉 목차가 없는 문서를 어떻게 처리하는지는 글도 README도 설명하지 않는다.
자료의 성격과 시점
2차 자료라는 점
글 마지막 문단은 "이 글은 GPT 모델로 정리한 글을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다"라고 밝힌다. 원 저작물의 번역이 아니라 모델이 요약한 2차 자료라는 뜻이다.
실제로 글은 README의 서술을 전언 형식으로 옮기는 대목이 많고, 트리 노드 구조나 자체 호스팅과 클라우드의 품질 차이처럼 README가 비중 있게 다루는 내용은 빠져 있다. 따라서 이 페이지는 입문용 개요로 쓰고, 정확한 사양은 저장소 페이지에서 확인하는 편이 안전하다.
2026년 4월과 현재의 차이
글이 기록한 PageIndex와 현재 저장소의 PageIndex는 사용 방식이 다르다. 두 raw 자료, 즉 2026-04-07 게시글과 2026-10-06 README 스냅샷을 대조하면 차이가 드러난다.
| 항목 | 이 글(2026-04) | 저장소 README(2026-10) |
|---|---|---|
| 설치 | 저장소 클론 후 pip3 install -r requirements.txt |
pip install -U pageindex |
| 실행 | run_pageindex.py --pdf_path CLI |
PageIndexClient의 submit_document와 chat |
| 인덱싱 방식 | 명시 없음 | PageIndex Flash가 local mode 기본값 |
| 클라우드 전환 | 별도 서비스로만 언급 | 같은 클라이언트에서 index="cloud"로 전환 |
| 대화형 서비스 | chat.pageindex.ai |
app.pageindex.ai |
| 정량 근거 | FinanceBench 98.7% 한 줄 | 인덱싱 비용과 시간, 질의 비용 대비 정확도, PDF 직접 입력 대비 비용, FinanceBench |
이 표의 쓰임은 글을 깎아내리는 것이 아니라 읽는 순서를 정하는 데 있다. 발상과 문제의식은 이 글이 간결하게 전달하고, 실행 절차와 수치는 저장소 페이지를 본다.
한계
- 2차 자료다. 글 스스로 GPT 모델로 정리한 글임을 밝힌다. 원문의 의도와 다르게 정리된 부분이 있을 수 있다.
- 설치 절차가 현재 저장소와 다르다. CLI 방식은 2026년 8월 SDK 개편 이전의 것이다.
- 98.7%의 측정 조건이 빠져 있다. 측정 대상 시스템과 대조군이 글에 없다.
- 트리 노드의 구조가 제시되지 않는다. 노드가 제목, 식별자, 위치 범위, 요약을 갖는다는 설명이 없어 인덱싱 결과물의 형태를 알 수 없다.
- 자체 호스팅과 클라우드의 품질 차이를 다루지 않는다. 오픈소스 구성이 텍스트 기반 PDF로 한정된다는 제약이 글에 없다.
- 본문 도식 세 장 가운데 기술적 내용을 담은 것은 workflow 도식 한 장이다. 나머지 두 장은 제품 배너와 홍보 일러스트다.
- 공식 링크 절 세 개가 비어 있다. 원문에서 Discourse 링크 카드로 렌더링된 부분이라 수집본에는 제목만 남았다. 세 주소는 본문 다른 문단에 적혀 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| vectorless RAG | vector database와 임베딩 유사도 검색 없이 LLM의 추론으로 retrieval을 수행하는 방식 |
| 계층형 트리 인덱스 | 문서를 목차 모양의 계층 구조로 표현한 인덱스. 각 노드가 섹션이나 개념 단위에 대응한다 |
| 추론 기반 검색 | 벡터 유사도 점수 대신 LLM의 이해와 추론으로 트리를 탐색해 관련 구간을 고르는 단계 |
| FinanceBench | 재무 문서 질의응답 벤치마크. 글은 98.7%를 전언 형식으로만 적는다 |
| Mafin 2.5 | 98.7%의 실제 측정 대상인 VectifyAI의 재무 문서 분석 시스템. 이 글에는 등장하지 않는다 |
관련 페이지
- VectifyAI/PageIndex: 이 글이 소개하는 저장소. 2026년 8월 SDK 개편 이후의 설치 절차와 벤치마크 수치가 모두 저장소 페이지에 있다.
- PageIndex: Next-Generation Vectorless, Reasoning-based RAG: PageIndex 팀이 직접 쓴 소개글. 설계 동기와 철학의 1차 자료다.
- Vectorless RAG: PageIndex: PageIndex Cloud API 튜토리얼. 이 글이 다루지 않는 클라우드 경로를 코드로 보인다.
- PageIndex: The RAG Framework That Threw Out Vector Databases and Still Hit 98.7% Accuracy: 3자 리뷰. 같은 FinanceBench 결과를 외부 시각에서 검토한다.
- sguys99/langchain-study/medium/3.vectorless-rag: PageIndex 없이 직접 만든 vectorless RAG: PageIndex API 없이 문서 트리를 직접 만들어 같은 아이디어를 재현한 한글 학습용 코드.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: similarity와 relevance가 같지 않다는 문제의식을 논문 쪽에서 다룬다.