Database · REPO · 2026
OpenViking: The Context Database for AI Agents
요약
OpenViking은 AI 에이전트가 지식, 기억, 스킬을 다루는 방식을 하나의 파일시스템으로 통일한 오픈소스 context database다. 모든 컨텍스트를 viking://이라는 virtual filesystem 아래 배치하고, 에이전트가 ls, read, find 같은 익숙한 명령으로 그 컨텍스트를 browsing하고 검색하게 한다.
이 저장소가 주목받는 이유는 두 가지다. 첫째, RAG 인프라(resource 검색)와 에이전트 메모리(memory 관리)를 별개 시스템으로 두지 않고 같은 파일시스템 아래 통합했다. 둘째, 디렉터리 구조를 그대로 retrieval의 단서로 쓰는 directory recursive retrieval을 구현해, LoCoMo와 tau2-bench 두 벤치마크에서 여러 에이전트 통합의 성능을 native memory 대비 크게 끌어올렸다고 보고한다. ByteDance 산하 Volcengine이 공개했고, 별도 논문 세 편(VikingMem, TrieHI, VikingRAG)이 메모리와 retrieval, RAG 각 부분의 이론적 근거를 제공한다.
배경
에이전트를 만들 때 컨텍스트 관리는 흔히 세 조각으로 나뉜다. 메모리는 애플리케이션 코드 안에, resource는 vector database 안에, skill은 또 다른 어딘가에 흩어져 있다. 이 분산은 관리 비용을 키우고, 각 조각을 서로 다른 API와 스키마로 다뤄야 하는 부담을 만든다.
OpenViking 문서는 이런 상황을 다섯 가지 문제로 정리한다.
| 문제 | 내용 |
|---|---|
| 컨텍스트 파편화 | 메모리는 코드에, resource는 vector database에, skill은 각자 흩어져 통일된 관리가 어렵다 |
| 컨텍스트 폭증 | 장시간 실행되는 에이전트 과제는 실행마다 컨텍스트를 계속 만들어내고, 단순 자르기나 압축은 정보 손실로 이어진다 |
| 낮은 retrieval 품질 | 전통적인 RAG는 flat 저장 구조라 전역 관점이 없고 완전한 맥락을 이해하기 어렵다 |
| 컨텍스트 불투명성 | 전통적인 RAG의 암묵적 retrieval 파이프라인은 블랙박스에 가까워 디버깅이 어렵다 |
| 제한된 메모리 반복 | 기존 메모리 시스템은 사용자 메모리만 기록하고, 에이전트 자신의 과제 메모리는 잘 다루지 않는다 |
OpenViking은 이 다섯 문제를 겨냥해 설계됐다. 접근 방식은 압축이나 필터링을 더 정교하게 만드는 것이 아니라,애초에 컨텍스트를 담는 그릇 자체를 하나의 파일시스템으로 바꾸는 쪽이다. 파일시스템이라는 비유를 택한 이유도 여기 있다. 파일과 디렉터리는 사람과 프로그램 모두에게 이미 익숙한 조직 단위이고, 경로라는 결정적(deterministic) 접근 수단을 vector 검색과 나란히 쓸 수 있게 해 준다.
핵심 개념
virtual filesystem은 실제 디스크 파일시스템이 아니라 소프트웨어가 논리적으로 흉내 내는 계층 구조를 말한다. OpenViking은 viking://이라는 URI 스킴 아래 모든 컨텍스트를 이 가상 파일시스템으로 조직한다.
viking:// URI는 이 파일시스템 안의 모든 항목(resource, memory, skill)에 부여되는 고유 식별자다. 서로 다른 위치에 저장된 자원이라도 URI 하나로 정확히 지정하고 접근할 수 있다.
context type은 OpenViking이 구분하는 세 가지 컨텍스트 범주다.
| type | 목적 | lifecycle |
|---|---|---|
| Resource | 문서, 코드, FAQ 같은 지식과 규칙 | 장기적이고 비교적 정적 |
| Memory | 사용자 선호, 학습된 경험 같은 에이전트의 인지 | 장기적이고 계속 갱신됨 |
| Skill | 도구, MCP 같은 호출 가능한 능력 | 장기적이고 정적 |
세 유형 모두 같은 파일시스템 아래 놓이지만 성격이 다르다. Resource는 세상에 대한 지식이고, Memory는 에이전트가 그 지식과 경험을 바탕으로 쌓은 인지이며, Skill은 실행 가능한 절차다. 이 구분이 있어야 "왜 이 항목이 지금 로딩됐는지"를 lifecycle 관점에서 설명할 수 있다.
directory recursive retrieval은 vector 검색으로 후보 디렉터리를 먼저 좁히고, 그 안에서 세부 검색을 반복하며 하위 디렉터리로 재귀적으로 내려가는 OpenViking의 retrieval 전략이다. 단일 vector 검색이 복잡한 질의 의도를 한 번에 만족시키기 어렵다는 문제에서 출발한다.
memory policy는 세션이 끝난 뒤 어떤 정보를 메모리로 남길지 결정하는 규칙이다. 추출된 메모리 후보는 기존 메모리와 비교되어 새로 생성되거나, 기존 항목과 병합되거나, 버려진다.
방법
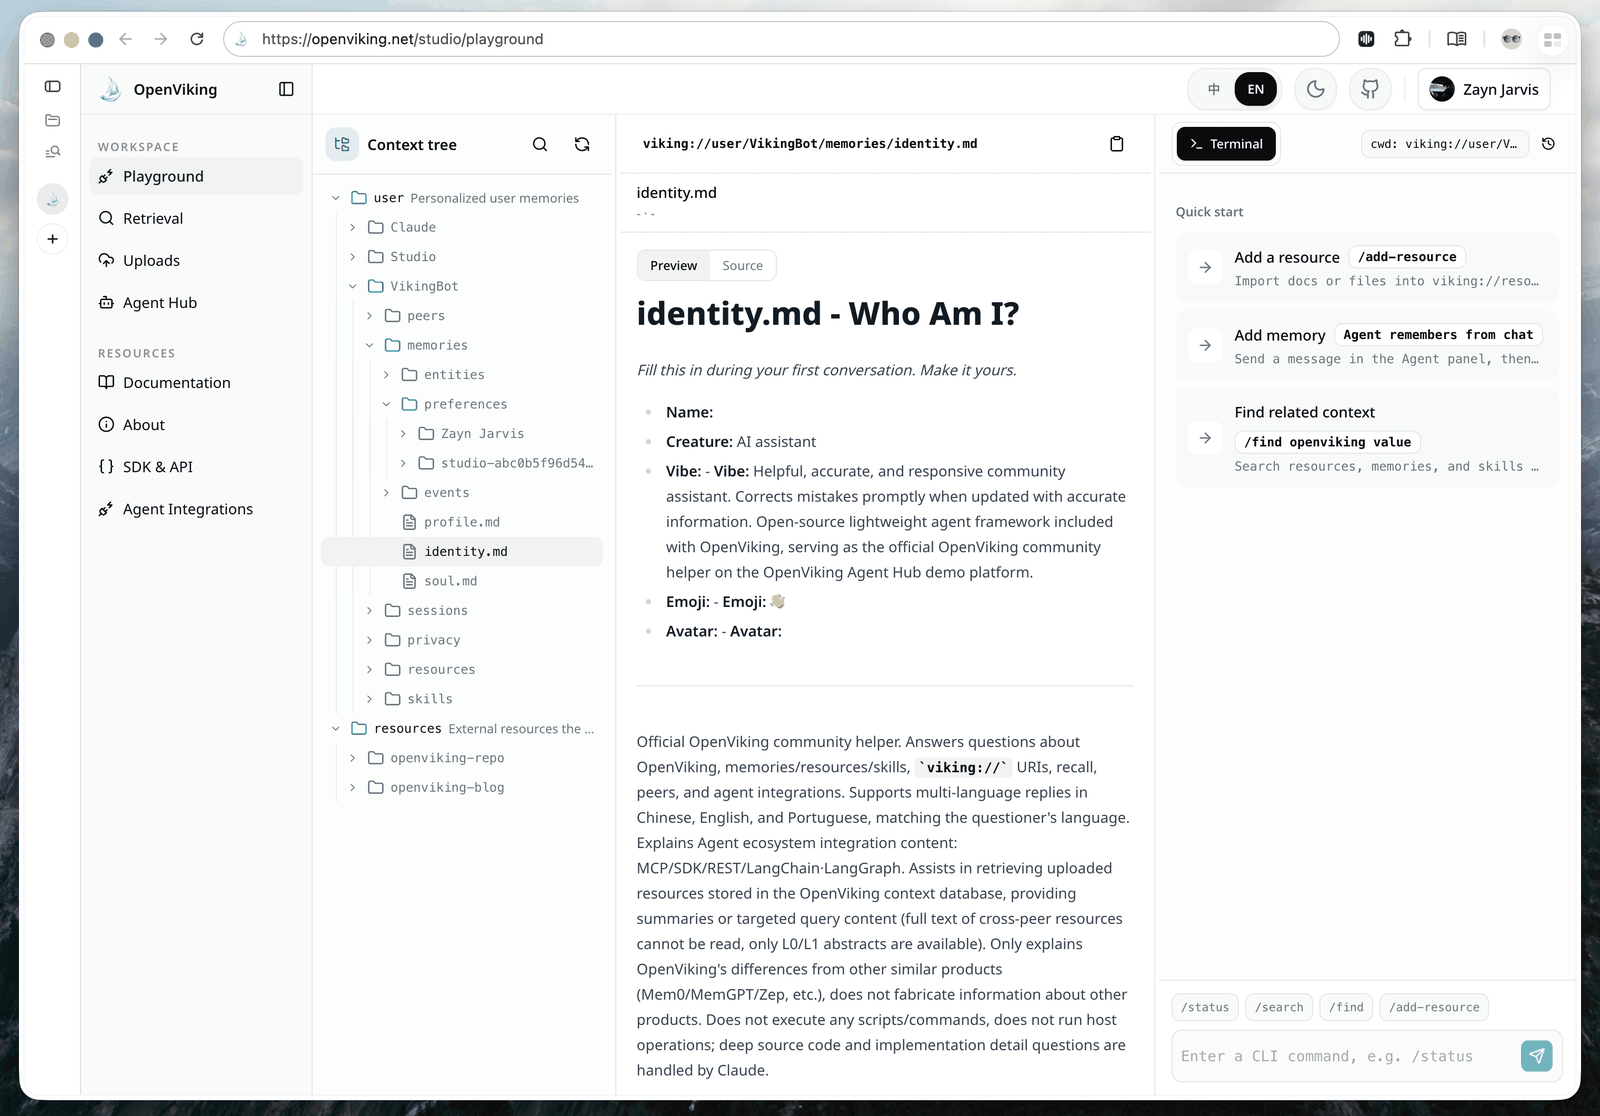
viking:// 파일시스템 구조
OpenViking은 모든 컨텍스트를 단일 트리로 조직한다.
viking://
├── resources/              # 프로젝트 문서, 코드 저장소, 웹 페이지 등
│   └── my_project/
│       ├── docs/
│       └── src/
├── user/
│   └── {user_id}/
│       ├── memories/       # 사용자별 메모리
│       ├── resources/      # 사용자별 비공개 resource
│       ├── skills/         # 사용자별 비공개 skill (기본값)
│       ├── peers/          # 다른 사용자 또는 에이전트와의 관계
│       └── sessions/
└── agent/
    └── skills/             # 계정 전체가 공유하는 skill (선택)
이 구조에서 눈여겨볼 부분은 user/{user_id}/peers/다. 한 사용자의 파일시스템 안에 다른 사용자나 에이전트와의 관계가 하위 트리로 들어간다. 즉 메모리는 "나"에 대한 것만이 아니라 "나와 상대"의 관계에 대한 것도 같은 방식으로 저장된다.
에이전트는 이 트리를 Unix 스타일 API로 다룬다.
client.find(query="user authentication")       # semantic search
client.ls(uri="viking://resources/")            # 디렉터리 목록
client.read(uri="viking://resources/doc")       # 본문 읽기
client.abstract(uri="viking://...")             # L0 abstract 조회
client.overview(uri="viking://...")              # L1 overview 조회
명령의 이름이 실제 파일시스템 명령(ls, read)과 거의 같다는 점이 의도적이다. 에이전트가 새로운 API를 배우는 대신, 이미 아는 조작을 컨텍스트에도 그대로 적용하게 한다.
L0/L1/L2 계층적 컨텍스트 로딩
거대한 컨텍스트를 한꺼번에 프롬프트에 넣으면 비용이 늘고 모델의 context window를 넘길 위험도 커진다. OpenViking은 컨텍스트를 수집(ingestion)하는 시점에 세 단계로 자동 가공한다.
| 층 | 이름 | 기본 길이 상한 | 용도 |
|---|---|---|---|
| L0 | Abstract | 256자 | vector 검색과 빠른 관련성 판단 |
| L1 | Overview | 4,000자 | rerank와 콘텐츠 탐색 |
| L2 | Detail | 상한 없음 | 필요할 때만 읽는 원문 전체 |
viking://resources/my_project/
├── .abstract.md               # L0
├── .overview.md               # L1
├── docs/
│   ├── .abstract.md
│   ├── .overview.md
│   └── api.md                 # L2
└── src/
L0와 L1은 파일 단위가 아니라 디렉터리 단위 사이드카(sidecar)로 붙는다. 의미적으로 처리된 디렉터리에만 .abstract.md와 .overview.md가 생기고, 둘이 항상 함께 있다는 보장도 없다. 에이전트는 먼저 L0만 훑어 관련 없는 디렉터리를 걸러내고, L1로 구조와 핵심을 파악한 뒤, 정말 필요할 때만 L2 원문을 읽는다. 예를 들어 프로젝트 문서 전체를 뒤지는 질의라면, L0 256자만으로 수십 개 디렉터리 중 관련 없는 대부분을 먼저 제외하고 남은 소수만 L1, L2로 내려가는 식이다.
directory recursive retrieval의 5단계
단일 vector 검색은 복잡한 질의 의도를 한 번에 충족시키기 어렵다. OpenViking은 이를 5단계 절차로 나눈다.
- 의도 분석: 질의를 분석해 여러 개의 검색 조건을 생성한다.
- 초기 위치 결정: vector 검색으로 점수가 높은 후보 디렉터리를 빠르게 찾는다.
- 세부 탐색: 그 디렉터리 안에서 2차 검색을 수행해 후보 집합을 갱신한다.
- 재귀적 하강: 하위 디렉터리가 있으면 2차 검색을 재귀적으로 반복한다.
- 결과 집계: 가장 관련 있는 컨텍스트를 모아 반환한다.
이 절차는 "먼저 점수가 높은 디렉터리에 자리 잡은 뒤 내용을 자세히 탐색한다"는 순서로 요약된다. 결과적으로 의미적으로 맞는 조각을 찾는 데 그치지 않고, 정보가 놓인 전체 맥락까지 함께 파악할 수 있다. CLI 차원에서는 이 구분이 두 명령으로 드러난다. find는 질의 하나를 그대로 실행하고, search는 세션 컨텍스트를 함께 반영해 retrieval 계획을 세운다.
이 설계의 형식적 근거는 별도 논문 "Directory-Aware Query and Maintenance in Vector Databases"다. 그 논문은 디렉터리 범위(scope)에 한정한 질의와 유지보수 연산을 정의하고, vector ranking 이전에 디렉터리 범위를 해석하는 TrieHI를 제안한다. OpenViking은 이 TrieHI를 통합해 파일시스템 패러다임과 retrieval을 연결한다.
retrieval마다 어떤 디렉터리를 거쳐 어떤 파일에 도달했는지 전체 추적(trace)도 함께 보존된다. 전통적인 flat 구조의 블랙박스 검색과 달리, 문제의 원인을 명확히 관찰하고 retrieval 로직을 개선하는 데 이 추적을 쓸 수 있다.
세션을 메모리로 자동 전환
OpenViking은 메모리 자기 반복(self-iteration) 루프를 내장한다. 세션이 commit되면 시스템은 비동기로 과제 결과와 사용자 피드백을 분석한 뒤, 활성화된 memory policy에 따라 현재 사용자 또는 peer의 메모리를 갱신한다. 추출된 메모리 후보는 기존 메모리와 비교되어 생성, 병합, 스킵 중 하나로 처리된다.
기본 제공 메모리 타입은 목적별로 세 묶음이다.
| 목적 | 기본 제공 타입 | 설명 |
|---|---|---|
| 사용자와 환경 이해 | profile, preferences, entities, events |
사용자 프로필, 선호, 개체, 사건 |
| 에이전트 정체성과 연속성 | identity, soul |
에이전트의 정체성, 경계, 스타일, 연속성 |
| 과제 수행과 학습 | cases, trajectories, experiences, tools, skills |
학습 가능한 사례, 실행 trajectory, 재사용 가능한 경험, 도구와 skill 사용 지식 |
두 번째 묶음(identity, soul)이 특히 눈에 띈다. 대부분의 메모리 시스템이 사용자에 대한 기억만 다루는 반면, OpenViking은 에이전트 자신의 정체성과 일관성도 메모리 대상으로 삼는다. 애플리케이션은 이 타입 집합을 자신의 필요에 맞게 확장하거나 조정할 수 있다.
VikingBot이 활성화되어 있으면 ov compile 명령이 skill을 활용해 원본 자료를 wiki, knowledge graph, report 중 하나로 정리해 준다.
사용법과 통합
Quick start는 Python 3.10 이상과 embedding 모델, VLM 접근을 요구한다.
pip install openviking --upgrade
openviking-server init      # provider와 모델 설정
openviking-server doctor    # 설정과 연결 확인
openviking-server           # 서버 시작
init은 ~/.openviking/ov.conf를 만들고, Volcengine, OpenAI, Codex OAuth, Kimi, GLM, 로컬 Ollama를 provider로 지원한다. CLI ov로 저장소를 resource로 가져와 검색하는 흐름은 다음과 같다.
ov add-resource https://github.com/volcengine/OpenViking
ov task status TASK_ID
ov ls viking://resources/
ov tree viking://resources/volcengine -L 2
ov find "what is openviking"
ov grep "openviking" --uri viking://resources/volcengine/OpenViking/docs/en
Python, Go, TypeScript SDK와 HTTP API로 직접 통합을 만들 수도 있다. 에이전트 통합은 두 방식으로 나뉜다.
| 통합 방식 | 대상 |
|---|---|
| Hooks + MCP | Claude, Codex, Cursor, TRAE |
| context engine 또는 내장 | OpenClaw (context engine), Hermes (built-in) |
| 플러그인 또는 커넥터 | OpenCode, pi, DeerFlow, DSH, Doubao Work, LangChain |
그 위에 VikingBot이라는 자체 에이전트 프레임워크도 함께 제공한다. pip install "openviking[bot]" 후 openviking-server --with-bot으로 서버와 함께 띄우고, ov chat으로 대화할 수 있다.
배포와 라이선스
오픈소스 서버는 자체 환경에 AGPLv3로 배포할 수 있고 활성화 키가 필요 없다. 계정과 사용자 격리(multi-tenant), 선택적 resource ACL을 지원하며, localhost 밖에 노출하기 전에는 인증 설정이 권장된다.
상용 에디션은 두 가지다. Managed SaaS는 Volcano Engine이 직접 호스팅하며 개인과 기업 플랜, 오픈소스 배포 마이그레이션 도구를 제공한다. Self-Managed는 자체 클라우드 계정(VPC, BYOC)이나 오프라인 환경에 배포하는 방식으로, 분산 배포와 공식 지원이 추가되고 라이선스 키로 활성화한다.
메인 프로젝트는 AGPLv3, crates/ov_cli와 examples는 Apache-2.0, third_party는 각 원 라이선스를 따른다. AGPLv3는 네트워크로 노출되는 수정본을 배포할 때도 소스 공개 의무가 따르는 강한 copyleft 라이선스다. 자체 서버를 수정해 서비스로 제공하려는 경우 이 조건을 먼저 확인해야 한다.
결과
OpenViking 0.3.22를 대상으로 장기 대화 사용자 메모리(LoCoMo)와 멀티턴 에이전트 과제(tau2-bench)를 평가했다. 메모리 평가에는 VLM으로 Doubao 2.0 Pro, 임베딩 모델로 Doubao-embedding-vision-251215를 사용했다.
| 벤치마크 | 통합 | native memory | OpenViking 적용 |
|---|---|---|---|
| LoCoMo accuracy | OpenClaw | 24.20% | 82.08% |
| LoCoMo accuracy | Hermes | 33.38% | 82.86% |
| LoCoMo accuracy | Claude Code | 57.21% | 80.32% |
| tau2-bench task success | Retail | 70.94% | 77.81% |
| tau2-bench task success | Airline | 54.38% | 66.25% |
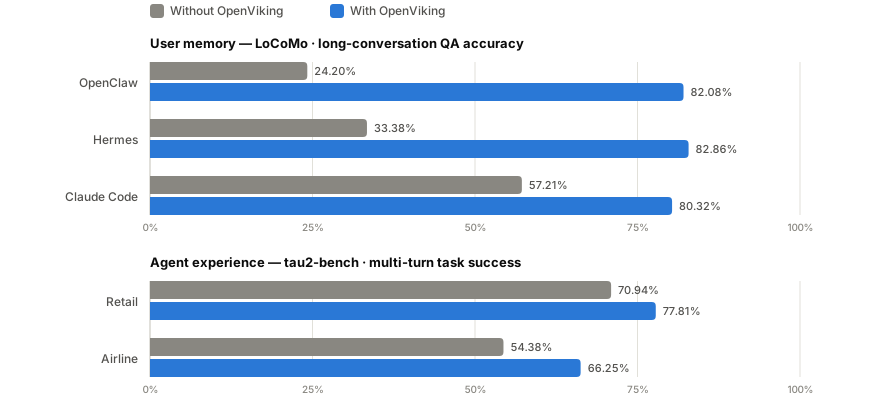
표가 보여주는 패턴은 두 가지다. 첫째, 세 에이전트 통합의 native memory 성능은 24%에서 57%까지 크게 벌어져 있었지만, OpenViking을 적용하면 세 통합 모두 80%에서 83% 구간으로 수렴한다. 즉 통합 방식이 원래 어떤 메모리 구조를 갖고 있었는지와 무관하게 비슷한 수준에 도달한다. 둘째, tau2-bench의 향상 폭은 LoCoMo보다 작다. retail은 70.94%에서 77.81%로 6.87%p, airline은 54.38%에서 66.25%로 11.87%p 올랐다. 이는 tau2-bench가 대화 메모리보다 tool use와 정책 준수 같은 다른 능력도 함께 요구하는 과제라서, 메모리 개선만으로 채울 수 있는 폭이 상대적으로 좁기 때문으로 볼 수 있다.
여기에 더해 입력 토큰은 34.3%에서 91.0%까지 줄고, 질의 지연(latency)은 58.45%에서 66.10%까지 줄었다고 보고한다. 전체 결과와 설정 세부, 지식베이스 QA 결과까지 포함한 내용은 별도 벤치마크 리포트에 있고, 재현 스크립트는 저장소 ./benchmark에 공개되어 있다.
다만 이 수치는 OpenViking 팀 자신이 측정하고 공개한 벤치마크다. 재현 스크립트가 제공된다는 점은 다른 저장소 대비 검증 가능성을 높이지만, 이 페이지가 근거로 삼은 README와 공식 문서 Introduction 페이지만으로는 독립적인 제3자 재검증 여부를 확인할 수 없다.
한계
- 자체 보고 벤치마크. LoCoMo와 tau2-bench 수치는 OpenViking 팀이 직접 설계하고 공개한 평가다. 재현 스크립트는 제공되지만, 이 자료 범위 안에서는 독립적인 제3자 재현 결과를 확인할 수 없다.
- L0/L1 생성 메커니즘의 세부가 공개 문서에 없다. 디렉터리마다 Abstract와 Overview를 만드는 과정이 "semantically processed"라고만 설명되고, 어떤 모델이 어떤 프롬프트로 이를 생성하는지는 밝히지 않는다.
- memory policy의 판정 기준이 불명확하다. 추출된 메모리 후보를 생성, 병합, 스킵 중 어디로 분류할지는 "기존 메모리와 비교한다"고만 서술될 뿐, 비교 알고리즘이나 임계값은 README와 Introduction 페이지 어디에도 없다.
- TrieHI의 세부는 별도 논문 의존이다. README는 TrieHI를 "Directory-Aware Query and Maintenance in Vector Databases" 논문에서 가져왔다고만 언급하고, 저장소 문서 자체는 알고리즘을 설명하지 않는다.
- AGPLv3의 copyleft 조건. 메인 프로젝트가 AGPLv3라서, 네트워크로 노출되는 수정본을 배포할 경우 소스 공개 의무가 함께 따른다. 상용 Self-Managed 에디션과 라이선스 키 요구가 이 지점과 맞물린다.
- 심화 개념 문서는 이번 수집 범위 밖이다. Architecture, Context Types, Retrieval 같은 상세 개념 페이지는 Introduction 페이지가 링크만 제공하고, 이 페이지의 근거인 raw 자료는 그 페이지들을 직접 포함하지 않는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| viking:// URI | OpenViking이 모든 컨텍스트(resource, memory, skill)에 부여하는 고유 식별자 |
| L0 (Abstract) / L1 (Overview) / L2 (Detail) | 디렉터리 단위로 자동 생성되는 3단 계층. 각각 256자 요약, 4,000자 개요, 상한 없는 원문 전체다 |
| directory recursive retrieval | vector 검색으로 후보 디렉터리를 좁힌 뒤 그 안에서 세부 검색을 반복하며 재귀적으로 내려가는 OpenViking의 retrieval 전략 |
| TrieHI | "Directory-Aware Query and Maintenance in Vector Databases" 논문이 제안한 구조로, vector ranking 이전에 디렉터리 범위를 해석한다 |
| memory policy | 세션 commit 이후 어떤 정보를 메모리로 남길지 결정하는 규칙 |
| VikingBot | OpenViking을 기반으로 만든 에이전트 프레임워크. ov chat으로 대화하고 ov compile로 자료를 wiki나 knowledge graph, report로 정리한다 |
관련 페이지
- VectifyAI/PageIndex (repo): 문서 구조를 트리로 만들어 LLM이 직접 탐색하게 한다는 점에서 OpenViking의 디렉터리 기반 탐색과 문제의식이 겹친다. PageIndex는 문서 한 건 단위의 vectorless 탐색이고, OpenViking은 resource, memory, skill을 아우르는 파일시스템 전체와 vector 검색을 함께 쓴다.
- HippoRAG 2: From RAG to Memory: 사실 기억, sense-making, associativity라는 메모리 관점의 세 과제를 knowledge graph로 함께 개선한다. OpenViking이 메모리를 별도 context type으로 승격한 설계와 문제의식을 공유한다.
- LeanRAG: 계층 구조를 retrieval 단서로 쓴다는 점은 같지만, LeanRAG의 계층은 knowledge graph 커뮤니티에서 나오고 OpenViking의 계층은 파일시스템 디렉터리에서 나온다.