Physical AI · PAPER · 2026
RoboClaw: An Agentic Framework for Scalable Long-Horizon Robotic Tasks
요약
RoboClaw는 로봇의 데이터 수집과 policy 학습과 과제 실행을 하나의 VLM 컨트롤러 아래로 합친 agentic 프레임워크다. AgiBot과 싱가포르국립대와 상하이교통대 연구진이 2026년에 발표했고, 실험은 양팔 모바일 로봇 Agibot G01에서 수행했다.
핵심 장치는 Entangled Action Pairs다. 물체를 서랍에 넣는 forward 동작마다 다시 꺼내는 inverse 동작을 짝으로 학습시켜, 로봇이 스스로 환경을 원래 상태로 되돌리게 만든다. 사람이 매 시도마다 물건을 제자리에 놓아 줄 필요가 사라지므로 데이터 수집이 밤새 이어질 수 있다.
배포 시점에는 같은 agent가 학습된 policy를 조합해 long-horizon 과제를 수행한다. long-horizon은 여러 단계를 순서대로 밟아야 끝나는 과제를 뜻한다. 보고된 성과는 long-horizon 과제 성공률이 baseline 대비 25% 향상되고 사람의 시간 투입이 53.7% 감소한 것이다.
배경
사람 중심 데이터 수집의 비용
VLA 시스템은 언어 지시문(instruction)과 시각 입력을 로봇 action으로 직접 옮기는 모델이다. 성능은 대체로 데이터 양을 따라가지만, 실제 로봇 환경에서 데이터를 만드는 일은 사람 손을 많이 요구한다.
운영자가 감당해야 하는 일은 다음과 같다.
- 시연 데이터(demonstration)를 teleoperation으로 수집한다
- 매 시도가 끝날 때마다 물건을 원래 위치로 되돌린다
- 실패를 감시하고 쓸 수 없는 trajectory를 걸러낸다
- 모델 성능을 평가한다
- 하위 과제 실행 중 로봇 동작을 감독한다
과제가 복잡해질수록 이 절차의 비용이 빠르게 증가한다. 특히 환경 리셋은 자동화되지 않으면 수집 속도의 상한을 결정한다. 사람이 자리를 비우면 수집도 멈추기 때문이다.
단계 분리가 만드는 두 불일치
기존 파이프라인에서 데이터 수집과 모델 학습과 과제 실행은 서로 독립된 절차로 진행된다. 저자들은 여기서 두 종류의 불일치가 생긴다고 지적한다.
첫째는 의미론 불일치다. 세 단계를 서로 다른 담당자가 맡기 때문에 과제 상태의 해석, subtask의 경계, 성공 기준이 단계마다 달라진다. 수집 담당자가 생각한 "성공"과 실행 시점에 판정되는 "성공"이 어긋나면 시스템 전체에서 일관된 과제 의미론을 유지할 수 없다.
둘째는 분포 불일치다. 학습 데이터가 덮는 상태 분포가 배포 시점에 마주치는 조건을 반영하지 못한다. 사람이 깔끔하게 리셋한 초기 상태에서만 수집된 데이터로 학습하면, 실제 실행에서 조금 흐트러진 상태를 만났을 때 대응할 근거가 없다.
두 불일치는 long-horizon 과제에서 특히 크게 작용한다. 앞 단계의 작은 오차가 뒤 단계의 전제 조건을 무너뜨리는 방향으로 전파되기 때문이다. 이 현상을 compounding error라고 부른다. RoboClaw가 풀려는 문제는 세 단계에 걸쳐 일관된 의미 표현과 결정 장치를 세우는 것이다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 이 논문에서 policy는 VLA 모델 π0.5로 구현되며, 물체 하나를 옮기는 정도의 단일 스킬을 담당한다.
self-resetting loop는 사람이 손대지 않아도 로봇이 스스로 재사용 가능한 시작 상태로 복귀하는 반복 구조를 말한다. RoboClaw의 데이터 수집이 계속 이어질 수 있는 이유가 이 구조다.
structured memory는 agent가 매 시점 유지하는 컨텍스트 저장소다. 자신의 현재 역할, 전체 과제와 subtask 진행 상황, 방금 무엇을 호출했는지를 세 칸에 나누어 담는다.
MCP는 Model Context Protocol의 약자로, agent가 외부 기능을 호출하는 표준 인터페이스다. RoboClaw는 policy 시작과 종료, 환경 조회, 사람 호출을 전부 이 인터페이스 뒤에 둔다.
action chunk는 policy가 한 번에 예측하는 짧은 구간의 action 묶음이다. 매 시점 하나씩 내는 대신 여러 시점 분량을 함께 출력해 실행의 매끄러움을 확보하는 방식이다.
방법
전체 워크플로
RoboClaw의 사용 방식은 단순하다. 사용자가 과제 지시문을 보내면 로봇이 스스로 추론하고 실행한다. 그 뒤에서 프레임워크는 로봇 lifecycle 전체를 하나의 순환으로 잇는다.
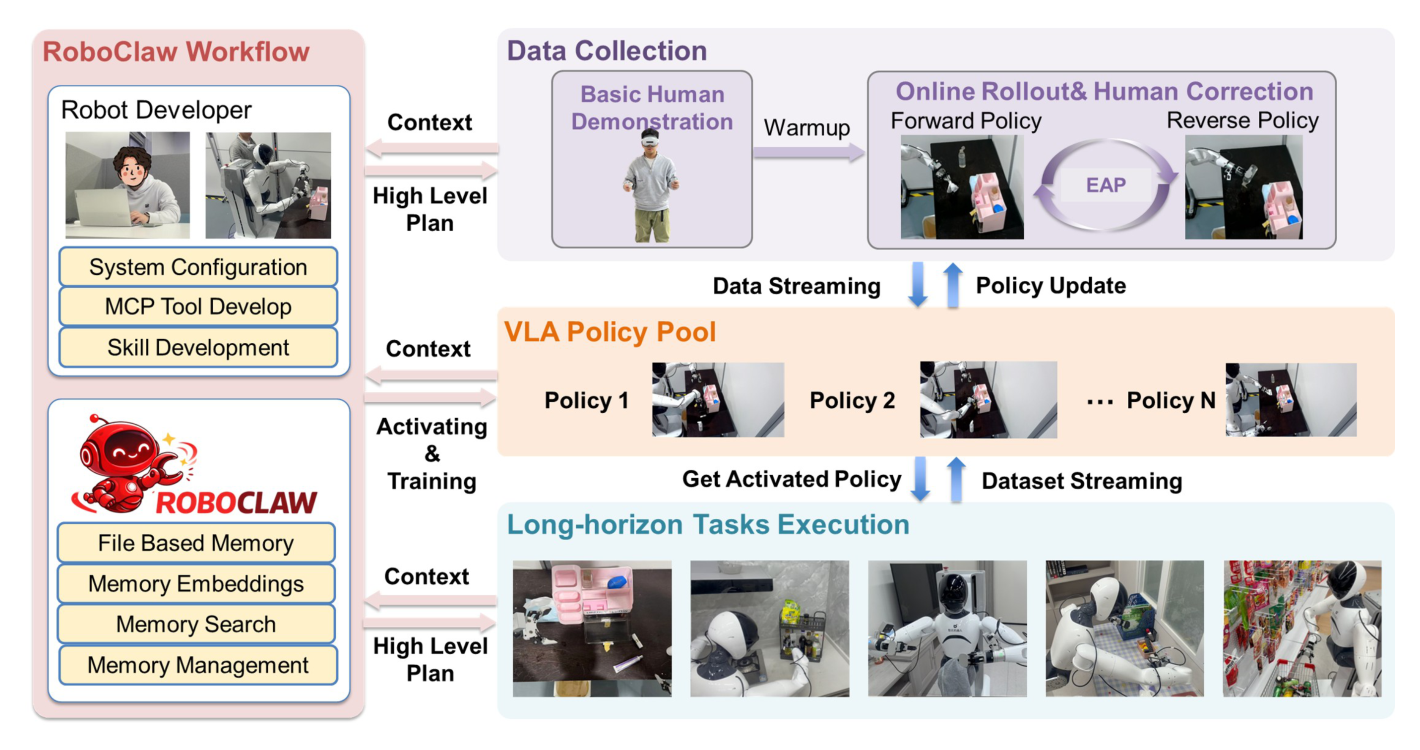
역할 분담은 다음과 같다. 개발자는 시스템 설정과 MCP tool과 스킬을 정의한다. RoboClaw는 파일 기반 메모리, 임베딩, 검색, 메모리 관리를 제공한다. 데이터는 사람의 기본 시연으로 시작해 EAP self-resetting rollout으로 이어지고, 그 결과가 VLA policy pool로 모여 스트리밍 데이터로 계속 갱신된다. 활성화된 policy는 상위 계획과 컨텍스트 지침 아래에서 복잡한 long-horizon 과제를 수행한다.
이 구조의 요점은 데이터 수집과 과제 실행이 같은 agent와 같은 인터페이스를 쓴다는 것이다. 수집 시점의 성공 판정 기준이 곧 실행 시점의 판정 기준이 되므로 앞서 말한 의미론 불일치가 발생할 여지가 줄어든다.
세 계층 추상화
RoboClaw는 structured memory와 모듈형 skill library를 OpenClaw 방식으로 결합하고, 시스템을 세 계층으로 나눈다. 상위 계층이 하위 계층을 호출하는 관계다.
| 계층 | 정의 | 예시 |
|---|---|---|
| Skills | tool을 조합하는 재사용 가능한 절차 | long-horizon-execution 스킬이 Env Summary를 호출한 뒤 Start Policy를 호출한다 |
| Tools | MCP를 통해 policy를 실행하거나 환경을 조회하는 시스템 인터페이스 | Start Policy, Terminate Policy, Env Summary |
| Policies | 저수준 모터 action을 만드는 robotic foundation model | π0.5로 구현된 manipulation policy |
계층을 나눈 이유는 상위 추론과 저수준 제어를 분리하기 위해서다. VLM은 어떤 스킬을 언제 부를지만 결정하고, 관절을 어떻게 움직일지는 policy가 담당한다.
structured memory와 chain-of-thought
각 timestep t에서 agent는 structured memory 상태 m_t를 유지한다. m_t = (r_t, g_t, w_t)로 쓰며 세 요소로 구성된다.
| 요소 | 기호 | 담는 내용 |
|---|---|---|
| role identity | r_t | agent의 현재 동작 모드와 사용 가능한 tool 집합. 데이터 수집 모드와 과제 실행 모드를 구분한다 |
| task-level memory | g_t | 전체 과제와 분해된 subtask 목록, 그리고 각각의 실행 상태. long-horizon 진행 추적의 근거다 |
| working memory | w_t | 현재 활성화된 스킬과 tool call 이력 같은 단기 실행 컨텍스트 |
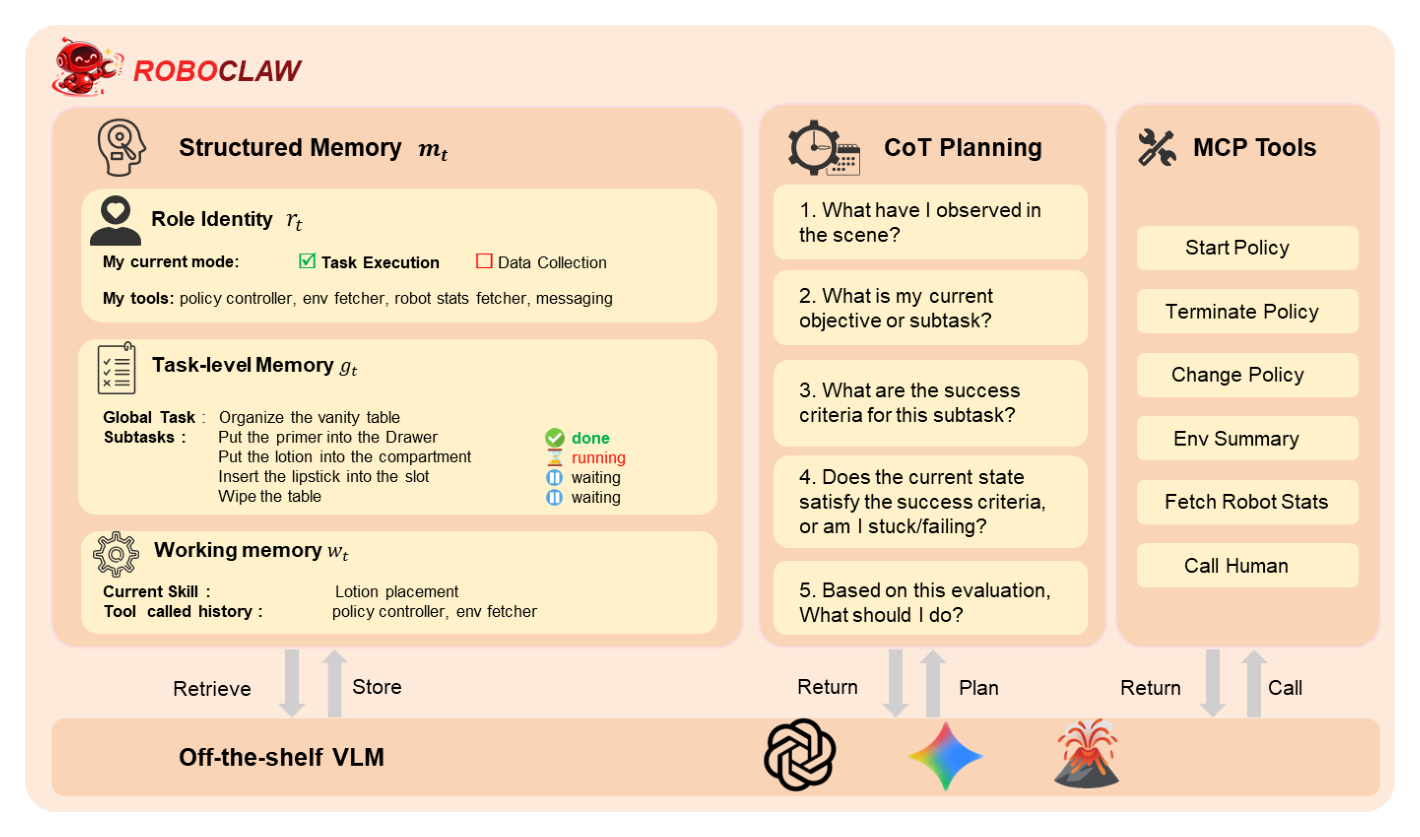
observation과 메모리가 주어지면 VLM은 chain-of-thought로 구조화된 추론을 수행한다. 그림 오른쪽 가운데에 나열된 다섯 질문이 그 절차다.
- 장면에서 무엇을 보았는가
- 현재 목표나 subtask는 무엇인가
- 이 subtask의 성공 기준은 무엇인가
- 현재 상태가 성공 기준을 만족하는가, 아니면 막혀 있거나 실패하고 있는가
- 이 평가를 근거로 다음에 무엇을 해야 하는가
네 번째 질문이 이 프레임워크의 감독 기능을 담당한다. 실행을 시작한 뒤에도 매 순환마다 진행 상황을 다시 평가하므로, 실패를 끝까지 진행한 다음에야 알아차리는 open-loop 방식과 구분된다.
추론 결과로 agent는 후보 subtask 집합 Z에서 다음 subtask z_t를 고른다. 형식으로는 z_t = RoboClaw(m_t, o_t)로 쓴다. subtask 완료 여부를 평가한 결과는 task-level memory g_t에 기록된다.
MCP tool 인터페이스
상위 추론과 로봇 제어를 잇는 통로는 MCP tool이다. 제공되는 tool은 다음과 같다.
| tool | 기능 |
|---|---|
| Start Policy | 지정한 policy 실행을 시작한다 |
| Terminate Policy | 실행 중인 policy를 종료한다 |
| Change Policy | 다른 forward policy로 전환한다 |
| Env Summary | 환경 요약을 조회한다 |
| Fetch Robot Stats | 로봇 상태를 조회한다 |
| Call Human | 사람 개입을 요청한다 |
agent는 이 tool을 호출해 VLM이 만든 계획을 실행 가능한 action으로 옮긴다. 전체 동작은 반복 루프다. structured memory와 환경 observation에서 정보를 가져오고, chain-of-thought 추론으로 다음 action을 정하고, 대응하는 tool call을 실행한다. 결과는 다시 메모리에 기록되며 과제가 끝날 때까지 이 순환이 이어진다.
저수준 policy
저수준 manipulation policy는 VLA 모델 π0.5로 구현한다. VLA policy는 시각 observation과 언어 지시문과 로봇의 proprioception 상태를 함께 처리해 실행 가능한 action을 만든다. proprioception은 로봇이 자기 관절의 위치와 상태를 스스로 감지하는 것을 말한다.
여기에 이 논문의 설계 특징이 하나 있다. 언어 지시문을 사람이 직접 주지 않는다. RoboClaw agent가 MCP tool을 호출하는 시점에 현재 subtask를 서술하는 구조화된 지시문을 생성해 policy의 조건으로 넣는다. 수집과 실행이 같은 언어 표현을 공유하게 만드는 장치다.
policy는 짧은 구간의 action 시퀀스를 예측한다.
A_t = π0.5(o_t, l_t, q_t)
o_t는 시각 observation, l_t는 agent가 만든 지시문, q_t는 로봇 관절 상태다. 예측되는 action chunk는 길이 H에 대해 A_t = [a_t, ..., a_{t+H-1}]로 정의된다.
학습은 conditional flow matching 목적함수로 분포 p(A_t | o_t, l_t, q_t)를 모델링한다. flow matching은 표준 가우시안 노이즈 분포를 실제 action 분포로 옮기는 velocity field v_θ를 학습하는 방식이다. 시간 변수 τ가 0과 1 사이 값을 가질 때 A_τ_t = (1-τ)ε + τA_t로 보간된 상태에서, v_θ와 목표 벡터장 사이의 L2 거리를 손실로 쓴다.
Entangled Action Pairs
EAP는 이 논문의 핵심 기여다. policy k마다 forward 실행 policy와 reset policy를 함께 학습한다.
동작 순서는 다음과 같다. forward 상호작용이 시점 0부터 T까지의 observation과 관절 상태와 action으로 이루어진 trajectory를 하나 모은다. agent가 subtask 완료를 판정하면 reset policy가 발동해 환경 상태를 되돌리고, 이때 T+1부터 T+T_reset까지의 두 번째 trajectory가 만들어진다. 두 trajectory가 하나의 entangled pair를 이룬다.
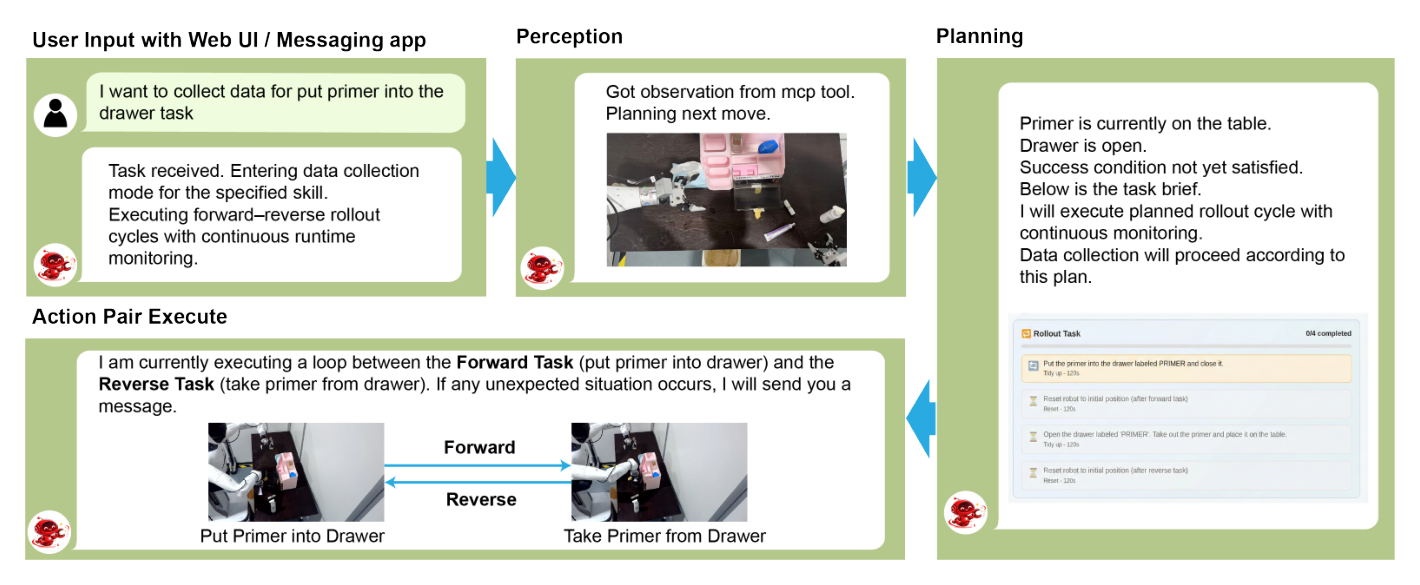
그림의 사례가 구조를 잘 보여준다. 사용자가 "프라이머를 서랍에 넣는 데이터를 모아 달라"고 요청하면, agent는 MCP tool로 현재 장면을 확인해 프라이머가 탁자 위에 있고 서랍이 열려 있으며 아직 성공 기준을 만족하지 않았다고 판단한 뒤 계획을 세운다. 그다음 넣기와 꺼내기를 번갈아 실행하면서 이상 상황을 감시한다.
이 구조 덕분에 환경은 사람의 개입 없이 자동으로 초기 상태로 되돌아간다. 수집된 trajectory는 모두 데이터셋에 저장되어 이후 policy 학습에 쓰인다.
배포 시점 감독과 스킬 오케스트레이션
배포 단계에서 RoboClaw는 과제 실행자로 동작하며 이미 학습된 policy를 조합해 long-horizon 과제를 수행한다. 결정 구조는 데이터 수집 때와 동일하다.
실행 흐름은 다음 순서를 따른다.
- 선택된 subtask에 대해 MCP tool로 대응하는 forward policy를 호출한다
- 실행 중 Fetch Robot Stats와 Env Summary로 환경 요약과 로봇 상태를 주기적으로 조회한다
- 조회 결과를 working memory에 기록하고 subtask 완료 여부를 판정한다
- 성공하면 task-level memory를 갱신하고 다음 subtask로 넘어간다
- 실패하면 같은 policy를 재시도하거나 Change Policy로 다른 policy로 전환한다
- 반복 실패나 예상치 못한 환경 상태가 감지되면 재계획하고 forward 스킬 집합에서 대안을 고른다
- 자율 복구가 실패하거나 안전 조건이 걸리면 Call Human으로 사람을 부른다
마지막 단계가 설계의 균형점이다. 대부분의 상황은 자율로 처리하되 안전이 걸린 경우에는 사람의 감독을 유지한다.
배포 중 생성된 trajectory도 데이터셋에 편입된다. 실제 과제 실행에서만 마주치는 상태 분포를 담고 있어 스킬 policy를 개선하는 재료가 된다. 데이터 수집과 배포가 같은 결정 루프와 스킬 인터페이스를 공유하므로, 실행이 곧 기반 스킬을 개선하는 lifecycle 학습 구조가 성립한다.
실패 분류와 복구 policy
RoboClaw는 실행 컨텍스트와 상호작용 이력에서 공통 실패 패턴을 요약하고, 실패를 두 범주로 나눈다.
| 범주 | 정의 | 예시 | 대응 |
|---|---|---|---|
| non-degrading failure | 환경 상태가 거의 그대로 남아 같은 policy 재시도로 해결된다 | 로션 병 grasping 중 그리퍼가 빗나가거나 살짝 어긋나게 닫혀 빈손으로 잡힌 경우. 병은 여전히 서 있고 자세도 거의 같다 | 추가 복구 동작 없이 같은 policy를 다시 실행한다 |
| degrading failure | 실패가 환경 상태를 바꿔 즉시 재시도가 불가능하다 | grasping 실패로 로션 병이 넘어지거나 미끄러져 grasping policy의 정상 전제 조건 영역을 벗어난 경우 | 실행 가능한 상태로 되돌리는 추가 복구 동작이 필요하다 |
rollout 초기 단계에서는 degrading failure가 사람의 장면 복구를 필요로 한다. 그러나 실행 경험이 쌓이면 이 복구 동작이 전용 복구 policy로 policy 라이브러리에 편입된다. 이후 실행에서는 agent가 복구 policy를 자율로 호출해 환경을 되돌리고 과제를 이어간다.
반복 rollout의 효과는 두 가지다. 기존 policy의 강건성을 높이는 것과, 복구 전략을 학습해 수행 가능한 동작 목록 자체를 넓히는 것이다. 정상 policy와 복구 동작이 함께 쌓이면서 시스템이 안정적으로 다룰 수 있는 환경 상태의 범위가 넓어진다.
결과
실험 설정
모든 실험은 Agibot G01 플랫폼에서 수행했다. 모바일 베이스 위에 양팔이 올라간 manipulation 로봇으로, end-effector를 제외하고 20 자유도를 제공한다. end-effector는 로봇 팔 끝에서 실제로 물체와 접촉하는 부분을 말한다. 각 팔에는 능동 자유도가 하나인 적응형 그리퍼 AGIBOT OmniPicker가 달려 있다.
π0.5 fine-tuning 설정은 다음과 같다.
| 구분 | 항목 | 값 |
|---|---|---|
| 일반 | 정밀도 | bfloat16 |
| 일반 | batch size | 16 |
| 일반 | 학습 step | 10,000 |
| 일반 | warmup step | 100 |
| 일반 | learning rate | 2.5e-5 |
| 일반 | gradient checkpointing | 사용 |
| LoRA | rank | 16 |
| LoRA | alpha | 16 |
| LoRA | dropout | 0.1 |
| LoRA | 대상 모듈 | all-linear |
| LoRA | inference step | 3 |
평가는 네 가지 질문으로 구성했다. 데이터 수집 효율을 높이는가, subtask policy의 성공률을 높이는가, 복잡한 long-horizon 과제의 성능을 높이는가, 실패로부터 학습하는가이다.
데이터 수집 효율
네 가지 실제 환경에서 평가했다. 침실 화장대, 주방 선반, 서재 책상, 편의점 진열대다. 각 환경에서 로봇은 정리나 반출 과제를 맡는다. 편의점 시나리오에서는 주어진 지시에 따라 특정 상품을 고른다. 여러 물체를 다루고 일련의 action을 순차 실행해야 하므로 multi-stage manipulation 과제로 분류된다. 과제 지시의 올바른 해석과 대상 물체의 의미 식별도 성공 판정 기준에 포함된다.
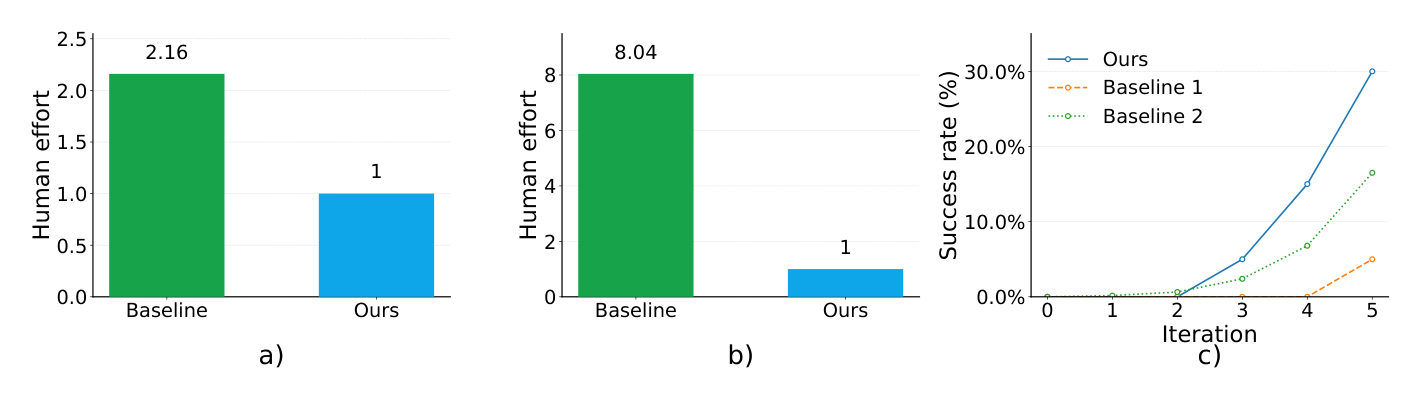
비교 대상은 순수 수동 데이터 수집 baseline이다. 사람이 시연을 수행하고 매 시도 후 환경을 손으로 되돌린다. 같은 양의 데이터를 모을 때 각 방법이 요구하는 사람 투입 비율을 측정했다.
| 측정 항목 | baseline | RoboClaw |
|---|---|---|
| 같은 수의 trajectory 수집에 드는 사람 시간 | 2.16배 | 1 (기준) |
| rollout 실행 중 사람 개입 | 8.04배 | 1 (기준) |
시간보다 개입 횟수의 격차가 훨씬 크다. 시간이 2.16배인데 개입은 8.04배라는 것은, 사람이 여전히 어느 정도 시간을 쓰더라도 그 시간에 계속 붙어 있을 필요는 없다는 뜻이다. RoboClaw가 수집 대부분을 자율로 수행하기 때문에 사람의 역할이 상시 대기에서 간헐적 개입으로 바뀐다.
subtask policy 성공률
네 가지 단일 스킬 과제로 평가했다. 저자들은 난이도의 성격이 서로 다르도록 의도적으로 설계했다고 밝힌다.
| 과제 | 내용 | 난이도 요인 |
|---|---|---|
| Body Lotion 배치 | 화장대의 로션 병을 라벨이 붙은 배치 구역으로 옮긴다 | 이동 거리가 길어 접근과 grasping과 들어올림과 배치 사이에서 카메라 시야가 크게 변한다 |
| Primer 배치 | 프라이머를 라벨이 붙은 서랍 안 목표 구역에 놓고 서랍을 닫는다 | 배치 후 서랍이 닫히는 상태까지 관리해야 하고, 가림과 좁은 여유 공간이 지각을 어렵게 한다 |
| Lipstick 삽입 | 립스틱을 라벨이 붙은 좁은 슬롯에 삽입한다 | 위치와 회전 공차가 좁아 접촉 순간까지 정렬을 유지해야 한다 |
| Tissue wipe | 화장수가 쏟아진 구역을 티슈로 닦는다 | 최종 자세가 아니라 연속 동작의 품질이 성공을 좌우하며 안정적 접촉을 유지해야 한다 |
먼저 데이터 수집 루프에서 쓰이는 inverse reset policy의 성능을 측정했다. 50회 시도 기준으로 Body Lotion 36회, Primer 38회, Lipstick 43회, Tissue Wipe 39회 성공했다. 저자들은 이 높은 성공률이 의도된 결과라고 설명한다. 더 어려운 forward 과제의 자동 수집을 가능하게 하려면 inverse 과제를 일부러 더 쉽게 설계해야 하기 때문이다.
다음으로 iteration을 1에서 5까지 늘리며 forward policy 성능을 측정했다. 각 iteration은 데이터 50건을 추가한다. forward policy마다 사람 시연은 고정된 양만 배정하고 나머지는 closed-loop rollout으로 얻는다.
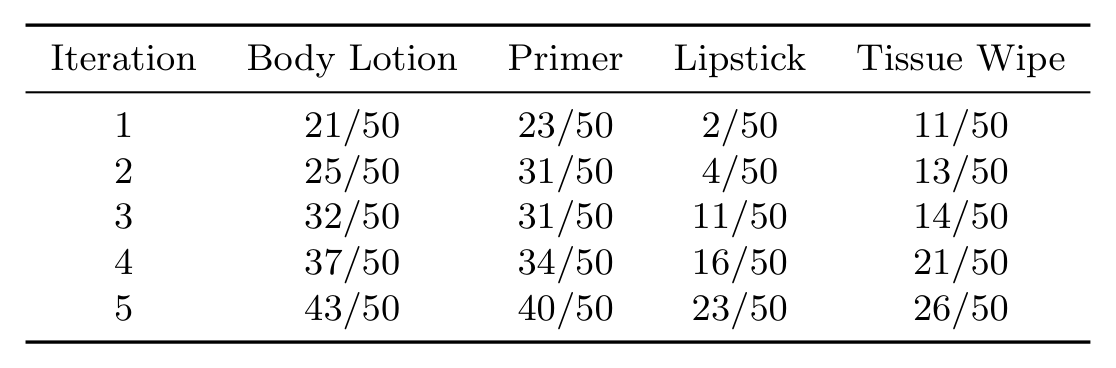
| iteration | Body Lotion | Primer | Lipstick | Tissue Wipe |
|---|---|---|---|---|
| 1 | 21/50 | 23/50 | 2/50 | 11/50 |
| 2 | 25/50 | 31/50 | 4/50 | 13/50 |
| 3 | 32/50 | 31/50 | 11/50 | 14/50 |
| 4 | 37/50 | 34/50 | 16/50 | 21/50 |
| 5 | 43/50 | 40/50 | 23/50 | 26/50 |
네 과제 모두 꾸준히 상승한다. 상승 폭이 가장 큰 과제는 Lipstick 삽입으로 2/50에서 23/50으로 11배 넘게 올랐다. 처음에 거의 실패하던 과제일수록 자율 수집 데이터의 효과가 크게 나타난다. Body Lotion은 21/50에서 43/50, Primer는 23/50에서 40/50, Tissue Wipe는 11/50에서 26/50이 되었다.
같은 사람 시연 예산 아래에서 이 상승이 나온다는 점이 결과의 핵심이다. 추가된 것은 closed-loop로 모은 trajectory뿐이므로, 자율 수집 데이터가 사람 시연을 보완하는 유효한 학습 신호라는 근거가 된다.
저자들은 forward와 inverse 사이의 비대칭이 EAP에 유리하게 작용한다고 덧붙인다. 신뢰할 만한 inverse policy가 self-resetting 루프를 안정적으로 유지해 주기 때문이다.
long-horizon 과제
화장대 정리 과제로 두 baseline과 비교했다.
| 비교 대상 | 구성 |
|---|---|
| RoboClaw | 프레임워크 전체를 사용한다 |
| Baseline 1 | 같은 데이터셋으로 학습했지만 RoboClaw 프레임워크를 쓰지 않은 π0.5 모델 |
| Baseline 2 | 네 subtask policy 성공률의 곱으로 계산한 기대 성공률 |
Baseline 2의 설계 의도를 짚어둘 필요가 있다. 네 subtask를 각각 독립적으로 수행하고 하나라도 실패하면 전체가 실패한다고 가정했을 때의 기대값이다. 감독과 복구 없이 policy를 단순히 이어 붙이면 도달하는 수준을 나타내므로, RoboClaw와의 차이가 곧 오케스트레이션의 기여분이 된다.
결과는 RoboClaw가 두 baseline을 모두 앞선다. 20회 시도 평균 기준이며, 초록에 보고된 개선 폭은 성공률 25%다. 저자들은 개선의 원인을 과제 진행 상황을 감시하고 실패 시 복구 policy를 자동으로 호출하는 능력에서 찾는다.
학습 파이프라인이 사용하는 데이터 출처는 세 가지다.
- 사람이 모은 시연 데이터
- RoboClaw가 자율로 모은 trajectory
- 자율 rollout 실패 후 사람이 개입한 기록
세 번째 출처가 앞서 설명한 복구 policy의 재료가 된다. 사람이 고쳐 준 상황이 다음번에는 로봇이 스스로 처리하는 동작으로 바뀐다.
한계
저자들이 결론에서 직접 밝힌 한계는 두 가지다.
첫째, 클라우드 기반 대형 모델이 유발하는 지연이다. 상위 추론을 외부 VLM에 맡기는 구조라 응답 지연이 실행 루프에 그대로 반영된다. 감시 주기를 촘촘하게 잡을수록 이 비용이 커진다.
둘째, 실용적인 inverse reset 동작이 존재한다는 가정이다. EAP는 forward 동작을 되돌리는 동작이 실제로 구현 가능해야 성립한다. 되돌릴 수 없는 조작이나 inverse 설계가 forward보다 어려운 과제에는 그대로 적용하기 어렵다. 실험에 쓰인 네 과제가 모두 물체를 놓고 다시 집는 형태라는 점도 이 제약과 연결된다.
논문에 명시되지 않은 관찰로 평가 범위의 제약을 덧붙일 수 있다. 실험이 화장대 정리를 중심으로 한 네 개 실내 환경과 네 개 단일 스킬 과제에 한정되어 있고, long-horizon 비교의 절대 성공률도 그림 기준으로 30% 안팎에 머문다. 상대 개선은 뚜렷하지만 실사용 수준과는 거리가 있다.
저자들은 그럼에도 RoboClaw가 확장 가능한 embodied AI 시스템의 기반이 될 수 있다고 평가하며, VLM과 VLA 모델이 발전하면 프레임워크도 함께 향상된다고 전망한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Entangled Action Pairs (EAP) | forward 실행 policy와 inverse reset policy를 짝지어 self-resetting 루프를 만드는 데이터 수집 장치. 두 trajectory가 하나의 쌍을 이룬다 |
| self-resetting loop | 사람이 손으로 환경을 되돌리지 않아도 로봇이 스스로 재사용 가능한 전제 조건 영역으로 복귀하는 반복 구조 |
| structured memory | role identity, task-level memory, working memory 세 요소로 구성된 agent의 컨텍스트 저장소 |
| non-degrading failure | 환경 상태가 거의 변하지 않아 같은 policy 재시도로 해결되는 실패 |
| degrading failure | 실패가 환경 상태를 바꿔 즉시 재시도가 불가능하고 별도 복구 동작이 필요한 실패 |
| recovery policy | degrading failure 이후 환경을 실행 가능한 상태로 되돌리는 전용 policy. 실행 경험이 쌓이면서 policy 라이브러리에 편입된다 |
관련 페이지
- π0.5: a Vision-Language-Action Model with Open-World Generalization: RoboClaw의 저수준 policy로 쓰인 π0.5의 원 논문. 이 논문은 π0.5를 그대로 가져와 LoRA로 fine-tuning하고 그 위에 감독 계층을 세운다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0.5의 직전 버전이자 flow matching 기반 VLA의 출발점. action chunk 예측과 손실 정의가 RoboClaw의 policy 학습과 같은 계보다.
- ASPIRE: Agentic /Skills Discovery for Robotics: skill library를 agent가 스스로 키우는 또 다른 접근. ASPIRE는 코드로 스킬을 만들고 RoboClaw는 수집한 데이터로 policy를 학습시킨다는 점에서 대비된다.
- OpenVLA: An Open-Source Vision-Language-Action Model: 오픈소스 end-to-end VLA. RoboClaw의 Baseline 1이 상정하는 프레임워크 없는 단일 모델 구성에 해당한다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLA 노선의 원형. 관련 연구에서 long-horizon compounding error의 사례로 언급된다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: action chunking을 제안한 ACT. 양팔 manipulation이라는 문제 영역도 겹친다.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 관련 연구에서 시뮬레이터 기반 대규모 시연 합성의 사례로 인용된 RoboCasa. RoboClaw는 같은 목표를 실제 로봇에서 푼다.
- MCP Server Architecture Patterns for LLM-Integrated Applications: RoboClaw가 로봇 제어 통로로 삼은 MCP의 서버 구성 패턴.
- HomeBody: A Humanoid That Explores, Remembers, and Acts on Its Own: frontier VLM이 공간 메모리와 고전 스킬로 humanoid를 조종하는 HomeBody. VLM이 실행을 지휘하는 같은 구도에서 스킬을 학습 없이 구성한다.
- 용어집: Physical AI (Terminology Glossary): policy, action chunk, flow matching 등 이 페이지 용어의 canonical 표기.