LLMs · PAPER · 2025
Eagle 2.5: Boosting Long-Context Post-Training for Frontier Vision-Language Models
요약
Eagle 2.5는 NVIDIA가 2025년 4월에 공개한 long-context VLM이다. 긴 영상과 고해상도 이미지를 다루기 위해 압축 모듈이나 선택 모듈을 새로 붙이는 대신, 무엇을 얼마나 모델에 넣을지 정하는 규칙과 학습 스케줄, 데이터를 바꿨다. 변경은 세 가지다. 텍스트 토큰을 먼저 온전히 확보하고 남은 예산으로만 시각 입력을 조정하는 information-first sampling, 최대 시퀀스 길이를 32K에서 64K, 128K로 단계적으로 올리는 progressive mixed post-training, 그리고 사람이 붙인 chapter를 구간으로 삼은 긴 영상 데이터셋 Eagle-Video-110K다.
결과는 Eagle2.5-8B가 512프레임 Video-MME(자막 없음)에서 72.4를 기록한 것이다. 이 값은 GPT-4o(71.9)보다 높고 Qwen2.5-VL-72B(73.3)와 InternVL2.5-78B(72.1) 사이에 있다. 즉 8B 모델이 열 배 가까이 큰 오픈 모델과 상용 모델 수준의 영상 이해 성능을 낸다. 이미지 벤치마크 평균도 75.6으로 Qwen2.5-VL-8B와 같아, 긴 컨텍스트를 얻으면서 짧은 컨텍스트 성능을 잃지 않았다.
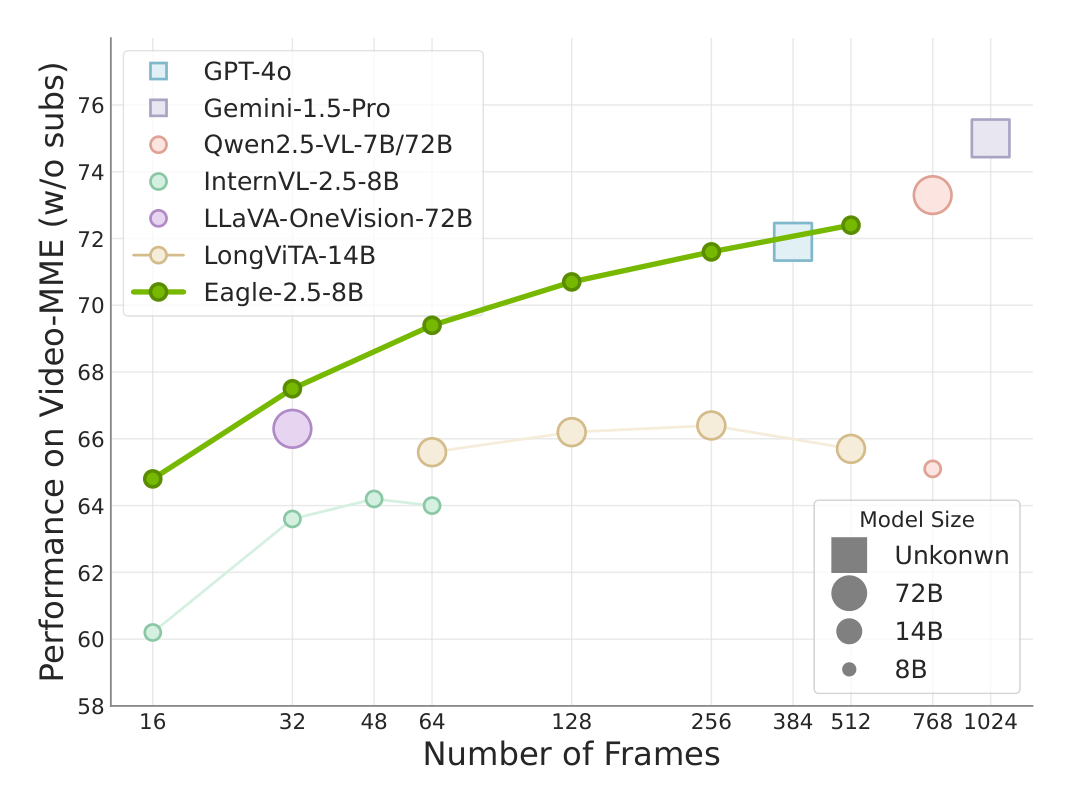
이 논문의 실질적인 주장은 프레임을 늘릴수록 성능이 계속 오른다는 점이다. Figure 1에서 Eagle-2.5-8B는 16프레임의 약 64.8에서 512프레임의 72.4까지 단조 증가하는 반면, InternVL-2.5-8B는 48프레임에서 정점(64.2)을 찍고 LongViTA-14B는 64프레임 이후 66% 근처에 머문다. 압축 모듈 없이 LLM의 컨텍스트를 늘리는 방식이 입력 증가에 비례하는 성능 향상을 낼 수 있음을 보인 사례다.
논문의 핵심 수치를 비교 대상과 함께 모으면 다음과 같다.
| 항목 | Eagle2.5-8B | 비교 대상 |
|---|---|---|
| Video-MME (자막 없음, 512프레임) | 72.4 | GPT-4o 71.9, InternVL2.5-78B 72.1, Qwen2.5-VL-72B 73.3 |
| MLVU | 77.6 | InternVL2.5-78B 75.7 |
| LVBench | 66.4 | InternVL2.5-78B 63.6, GPT-4o 66.7 |
| Perception_test | 82.0 | Qwen2.5-VL-72B 73.2 |
| Charade-STA mIoU | 65.9 | Qwen2.5-VL-72B 50.9 |
| HourVideo dev / test | 44.5 / 41.8 | Gemini-1.5-Pro 37.2 / 37.4 |
| 이미지 벤치마크 평균 | 75.6 | Qwen2.5-VL-8B 75.6, GPT-4o 74.9 |
배경
VLM은 짧은 컨텍스트 과제에 집중해 왔고 long-context 이해는 덜 탐구된 영역이다. 저자들이 말하는 long-context는 여러 장의 이미지, 긴 영상 시퀀스, 고해상도 미디어, 또는 그 조합을 뜻한다. 이 영역은 데이터셋 구축, 구조 설계, 학습 전략, 연산과 메모리 병목이라는 근본적인 어려움 때문에 초기 단계에 머물러 있었다.
long-context VLM의 두 계열
기존 접근은 두 계열로 나뉜다. 첫째는 전용 모듈로 시각 표현을 줄이는 계열이고, 둘째는 LLM의 컨텍스트 길이 자체를 늘리는 계열이다. Eagle 2.5는 둘째 계열에 속하면서 전용 모듈을 하나도 붙이지 않는 자리를 택했다.
| 계열 | 방식 | 대표 사례 | 저자들이 보는 문제 |
|---|---|---|---|
| 전용 압축 모듈 | question-guided compression이나 selection으로 질문과 관련된 시각 단서만 뽑거나, token reduction으로 LLM에 들어가기 전에 시각 표현을 줄인다 | Chat-UniVi, LLaMA-VID, LongVU, Text-conditioned resampler 등 | 추가 연산 부담이나 용량 제한이 생겨 성능을 제약할 수 있다 |
| LLM 컨텍스트 확장 | LLM의 컨텍스트 길이를 늘려 긴 멀티모달 시퀀스를 그대로 받는다 | LongVA, LongVILA, LongViTA | 상용 모델에 못 미치고, 시각 입력을 늘려도 성능이 따라 오르지 않으며, 학습 전략과 데이터 레시피가 정리돼 있지 않다 |
기존 확장 시도의 세 가지 문제
컨텍스트 확장 계열의 문제를 저자들은 세 가지로 정리한다. 첫째, 성능이 상용 모델에 미치지 못한다. 둘째, 시각 입력의 양이 늘어날 때 성능이 일관되게 오르지 않는다. 셋째, 학습 전략과 데이터 레시피가 복잡하게 얽혀 있어 최적의 학습 방식이 불분명하다. Eagle 2.5는 이 세 가지를 각각 벤치마크 결과, Figure 1의 프레임 확장 곡선, 그리고 ablation으로 정리한 학습 레시피로 답한다.
데이터 쪽 배경도 있다. 긴 문서 데이터셋(슬라이드, 논문)은 시간 이해가 빠져 있고, 영화 기반 데이터셋은 긴 구간의 시간 일관성을 강조한다. 주석 방식은 수작업에서 GPT-4V와 Gemini를 쓴 자동화로 옮겨 왔으며, 최근에는 서사 구조를 보존하는 계층적 주석이 강조된다. Eagle-Video-110K는 이 흐름 위에서 story-level과 clip-level 주석을 겹친다.
핵심 개념
long-context는 모델이 한 번에 받는 입력이 길다는 뜻이다. 이 논문에서는 수백 프레임의 영상, 수십 페이지의 문서, 고해상도 이미지가 만드는 수만 개의 토큰을 가리킨다. 최대 시퀀스 길이 L_max는 한 학습 샘플이 차지할 수 있는 토큰 수의 상한이며, Eagle 2.5의 학습은 이 값을 4096에서 128K까지 단계적으로 올린다.
image tiling은 큰 이미지를 448픽셀 정사각 타일 격자로 잘라 각 타일을 따로 인코딩하는 고해상도 처리 방식이다. 타일 하나가 256개의 vision 토큰이 되므로, 타일 수가 곧 이미지 하나가 차지하는 토큰 예산이다.
vision-context-centric과 all-context-centric은 시각 예산과 텍스트 예산의 우선순위를 가리키는 저자들의 용어다. 전자는 영상 프레임을 고정 FPS나 고정 개수로 먼저 뽑고 텍스트를 뒤에 붙이는 방식이라 텍스트가 잘릴 위험이 있다. 후자는 텍스트 길이를 먼저 확정하고 남는 예산을 시각 입력에 배정한다.
post-training은 pre-training을 마친 모델을 특정 과제 데이터로 이어서 학습시키는 단계다. 이 논문의 제목이 말하는 post-training은 Stage-2 이후의 long-context 학습을 뜻하며, Stage-1과 Stage-1.5는 Eagle 2와 같은 정렬과 pre-training 단계다. mixed post-training은 길이가 다른 샘플을 한 번에 섞어 학습하는 방식이고, progressive mixed post-training은 그 mixed 학습을 L_max를 올려 가며 여러 번 반복하는 스케줄이다.
Open-Data는 이 논문이 모은 오픈소스 학습 데이터 전체를 부르는 이름이다. 사람이 주석한 데이터, 다른 모델이 자동 주석한 합성 영상 데이터, 짧은 컨텍스트 데이터를 모두 포함하며, 여기에 자체 구축한 Eagle-Video-110K를 더한 것이 최종 학습 데이터다. ablation에서 "Open-Data"와 "Open-Data + Eagle-Video-110K"를 비교하는 것은 이 데이터셋의 효과를 분리해 보기 위해서다.
story-level 주석과 clip-level 주석은 영상 하나에 붙는 두 층의 텍스트다. story-level은 영상 전체의 줄거리를 chapter 단위로 요약하고 그 위에서 질문을 만드는 top-down 주석이고, clip-level은 몇 초짜리 클립 안의 물체, 사람, 동작을 묻는 bottom-up 주석이다. anchor는 clip-level 질문을 영상 전체에 붙일 때 어느 시점의 장면을 묻는지 알려 주는 부가 정보다.
held-out 벤치마크는 학습 데이터와 겹치지 않아 일반화 능력을 재는 벤치마크다. 저자들은 Video-MME를 "더 어렵고 held-out인" 벤치마크로 부르며, MVBench와 MLVU보다 이 값의 변화를 더 보수적으로 해석한다.
방법
모델 구성
Eagle 2.5의 구조는 LLaVA 계보를 그대로 따른다. 저자들은 긴 입력에만 최적화한 특수 모듈이 범용성을 제한한다고 보고, 다양한 과제에 적응할 수 있는 범용 멀티모달 시스템으로 설계했다. 압축 모듈을 넣지 않는 대신 무엇을 얼마나 넣을지 고르는 규칙에 집중한다.
| 구성 요소 | 내용 |
|---|---|
| vision 인코더 | SigLIP. Figure 2는 SigLIP-so400M으로 표기한다 |
| connector | MLP projection layer. vision 임베딩을 LLM 표현 공간에 맞춘다 |
| LLM | Qwen2.5 계열. Table 8은 Qwen2.5-7B로 적고 전체 학습 파라미터는 8B다 |
| 고해상도 처리 | LLaVA-1.5와 InternVL에서 가져온 image tiling. 타일 448픽셀, 이미지당 최대 12타일 |
| vision 토큰 수 | 타일 격자가 i × j일 때 (i × j + 1) × 256 |
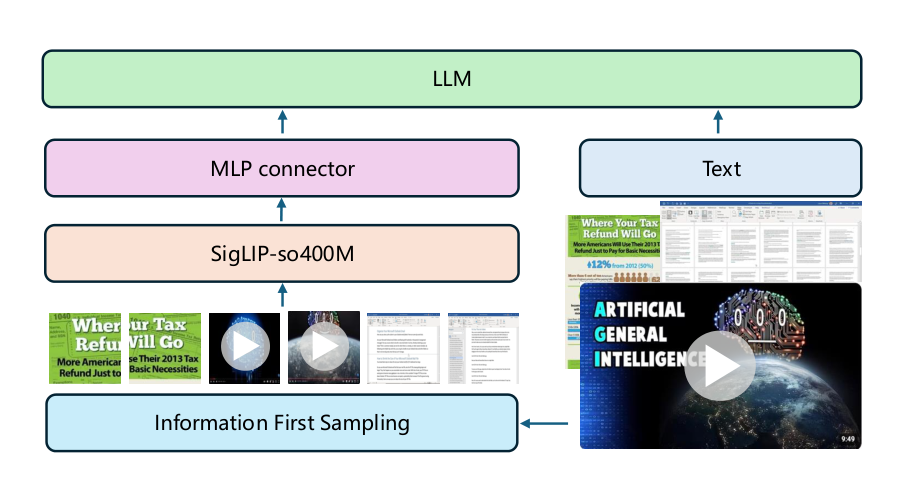
인코더 표기는 논문과 저장소가 다르다. 논문은 SigLIP(Zhai 2023)을 인용하고 Figure 2에 SigLIP-so400M을 적는 반면, 저장소 README의 model zoo(Eagle: Frontier Vision-Language Models with Data-Centric Strategies)는 Eagle2.5-8B의 인코더를 SigLIP2-so400m-patch16-512, LLM을 Qwen2.5-7B-Instruct로 적는다. 논문 본문만으로는 어느 표기가 공개 체크포인트와 일치하는지 확정할 수 없다.
image area preservation
image area preservation(IAP)은 tiling 격자를 고르는 규칙이다. 기존 tiling은 W×H 이미지를 r_w × r_h 격자의 s×s 타일로 자르는데, InternVL처럼 종횡비 제약이 엄격하면 원본을 줄여 격자에 맞춰야 한다. 그러면 고해상도를 살리려던 tiling의 목적이 반감된다.
Eagle 2.5는 두 목표를 함께 만족하는 격자를 고른다. 하나는 원본 면적 A_orig = WH의 60% 이상을 타일 면적 A_new = r_w r_h s²에 남기는 면적 보존이고, 다른 하나는 타일 비율 r_t = r_w/r_h를 원본 종횡비 r_orig = W/H에 맞추는 종횡비 정합이다. r_w × r_h ≤ N인 후보 중에서 다음 식 (1)을 최대화한다.
argmax  min(A_new / A_orig, 0.6) × min(r_t / r_orig, r_orig / r_t)
(r_w,r_h)     [면적 벌점]              [종횡비 정합]
앞 항은 A_new가 0.6 A_orig에 못 미칠 때만 벌점을 주고 그 위로는 더 보상하지 않는다. 따라서 면적 60%를 넘긴 뒤에는 종횡비 정합만이 후보를 가른다. 뒤 항은 r_t = r_orig에서 1이 되고 어느 쪽으로 벗어나든 대칭으로 줄어든다.
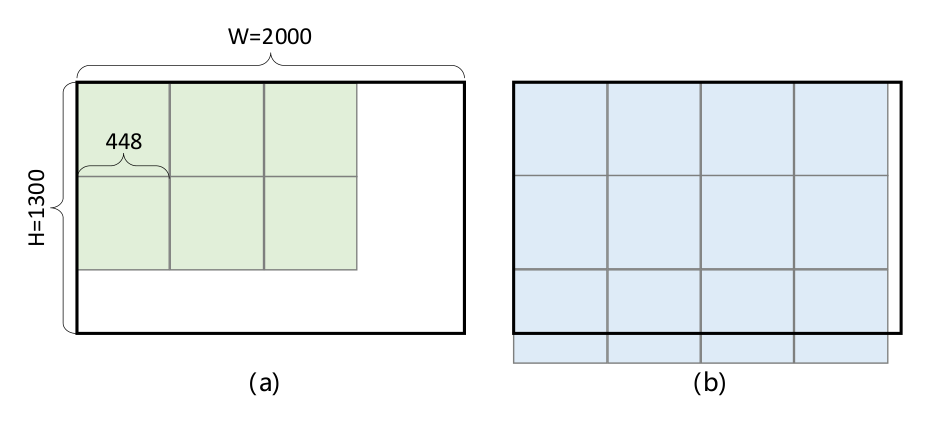
Figure 3의 2000×1300 이미지에 식 (1)을 대입하면 두 격자의 차이가 수치로 드러난다. 3×2 격자는 1344×896 픽셀에 해당해 원본 면적의 약 46%만 남기므로 면적 항이 0.46이고, 종횡비 1.5는 원본 1.54에 가까워 종횡비 항이 약 0.98이다. 곱은 약 0.45다. 반면 4×3 격자는 1792×1344 픽셀로 면적의 약 93%를 남겨 면적 항이 상한 0.6에 걸리고, 종횡비 1.33은 원본과 조금 어긋나 종횡비 항이 약 0.87이다. 곱은 약 0.52로 3×2보다 높다. 즉 종횡비가 약간 어긋나더라도 면적을 크게 살리는 격자가 선택된다.
automatic degradation sampling
automatic degradation sampling(ADS)은 시각 예산과 텍스트 예산을 나누는 규칙이다. 학습 샘플 S = {S_visual, S_text}와 최대 길이 L_max가 주어지면 텍스트 토큰 길이 L_text를 먼저 확정하고, L_visual = L_max − L_text만 시각 예산으로 쓴다. 텍스트는 항상 온전히 남고 시각 입력만 예산에 맞춰 줄어든다.
그 예산 안에서 두 변수를 함께 키우는 제약 최적화를 푼다(식 (2)). 기호는 다음과 같다.
| 기호 | 뜻 |
|---|---|
| M | 샘플에 든 이미지 수 |
| t | 이미지당 최대 타일 수. 1 ≤ t ≤ 12 |
| L(t, I_i) | 최대 타일 수 t에서 i번째 이미지 I_i가 차지하는 토큰 수 |
| n | 영상 프레임이나 문서 페이지 같은 시간축 단위의 샘플링 개수. 1 ≤ n ≤ N_max |
| N_max | 영상이면 2 × duration(초), 문서면 페이지 수 |
| 256 | 시간축 단위 하나의 토큰 수. 프레임과 페이지에는 tiling을 쓰지 않으므로 t = 1의 L 값으로 고정된다 |
목적 함수는 Σ L(t, I_i) + 256 n을 최대화하는 것이고, 제약은 이 합이 L_visual 이하라는 것이다. 이미지에 대해서는 타일 수 t를 키워 공간 정보를, 시간축 입력에 대해서는 n을 키워 시간 범위를 최대화한다.
학습 샘플은 대개 이미지 아니면 시간축 입력 한쪽에 몰려 있으므로 두 단계로 나눠 푼다.
| 단계 | 내용 |
|---|---|
| temporal degradation | t = 1로 고정한 채 영상은 2 FPS를 목표로, 문서는 전체 페이지 사용을 목표로 개수를 정한다. n* = ⌊(L_visual − M)/256⌋. 최소 프레임 수 N_min조차 못 채우면 그 샘플은 버린다 |
| tiling degradation | 프레임 수가 정해지면 T = {12, 8, 6, 4, 2, 1}을 큰 값부터 훑어, Σ L(t, I_i) ≤ L_visual − n* × 256을 만족하는 가장 큰 타일 수 t*를 고른다 |
예를 들어 L_max가 32K이고 텍스트가 2,000토큰이면 시각 예산은 약 30,000토큰이다. 이미지가 없는 영상 샘플이면 약 117프레임까지 넣을 수 있고, 2 FPS 기준으로 약 58초 분량이다. 영상이 더 길면 프레임 간격을 늘려 개수를 맞추고, 영상이 짧아 예산이 남으면 그 예산은 쓰이지 않는다. 이미지 샘플의 경우도 마찬가지다. 타일 수가 최대치에 이르는 이미지 한 장은 t = 12에서 (12 + 1) × 256 = 3,328토큰을 차지하므로, 이미지 4장이 있는 샘플에 시각 예산이 6,192토큰뿐이면 t = 12, 8, 6은 예산을 넘고 t = 4(장당 1,280토큰, 합계 5,120토큰)에서 멈춘다. 두 예시는 식 (2)를 적용한 계산이며 논문의 수치가 아니다.
두 규칙은 다루는 대상과 최적화하는 변수가 다르다. IAP는 이미지 한 장의 격자 모양을 정하고, ADS는 샘플 전체의 예산 배분을 정한다.
| 항목 | image area preservation | automatic degradation sampling |
|---|---|---|
| 대상 | 이미지 한 장 | 학습 샘플 하나 (이미지, 영상, 문서의 조합) |
| 정하는 것 | 타일 격자 (r_w, r_h) | 프레임 수 n과 이미지당 최대 타일 수 t |
| 기준 | 원본 면적 60% 이상 보존과 종횡비 정합 | 텍스트 전량 보존 후 남은 예산 최대 활용 |
| 뺐을 때의 영향 (Table 6) | InfoVQA 77.6에서 76.2, Perception_test 76.3에서 73.3 | MLVU 71.5에서 70.1 |
mixed post-training과 progressive 스케줄
post-training은 두 전략이 층을 이룬다. 기반은 mixed post-training이고, 그 위에 progressive mixed post-training을 올린다.
mixed post-training은 길이가 다양한 입력에서 일정한 성능을 유지하기 위한 방식이다. ADS가 모든 샘플을 L_max에 맞춰 주므로 학습은 프레임 수에 무관해진다. 여기에 length-balanced packing을 결합해 길이 스펙트럼 전체에서 고르게 학습한다. length-balanced packing은 길이가 제각각인 샘플을 한 배치에 채울 때 길이 분포가 치우치지 않게 묶는 방식으로, Eagle 2 논문의 기법을 인용한 것이다.
progressive mixed post-training은 L_max를 단계적으로 올리는 스케줄이다. L_max가 크면 짧은 시퀀스와 긴 시퀀스의 분포를 한 번에 맞추기가 계산상 무겁고, 한 번의 학습으로 최적 성능을 얻기 어렵다. 따라서 L_max를 32K, 64K, 128K 순서로 올린다. 저자들이 드는 이점은 두 가지다. 서로 다른 길이에서의 능력을 더 잘 보존하고, 중간 단계마다 쓸 수 있는 모델 변형이 안전하게 남는다.
단계별 학습 설정
전체 학습은 다섯 단계다. Stage-1은 MLP connector만 학습하는 정렬 단계, Stage-1.5는 전체 모델을 여는 pre-training 단계이며, Stage-2부터 Stage-4가 이 논문이 제안하는 progressive long-context post-training이다. 자원을 아끼기 위해 Eagle-2의 Stage-1.5 가중치를 그대로 받아 Stage-2부터 학습한다(부록 B.2).
| 항목 | Stage-1 | Stage-1.5 | Stage-2 | Stage-3 | Stage-4 |
|---|---|---|---|---|---|
| vision 해상도 | 448 × {(i, j) : i, j ∈ Z+, i × j ≤ 12} (전 단계 공통) | ||||
| vision 토큰 | (i × j + 1) × 256 (전 단계 공통) | ||||
| 데이터셋 | ALLaVA | Rich Diverse Data | Short+Long Data | Short+Long Data | Short+Long Data |
| 샘플 수 | 120만 | 2,160만 | 460만+460만 | 460만+460만 | 460만+460만 |
| 학습 대상 | MLP connector (4,000만) | Full Model (8B) | Full Model (8B) | Full Model (8B) | Full Model (8B) |
| 배치 크기 | 1024 | 1024 | 256 | 128 | 128 |
| 학습률 | 2×10⁻⁴ | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ |
| 최대 길이 | 4096 | 8192 | 32768 | 65536 | 128K |
최대 길이가 두 배씩 오를 때 배치 크기는 256에서 128로 줄어든다. 즉 한 배치가 담는 토큰 수는 Stage-3에서 Stage-4로 갈 때 두 배가 된다. Stage-2부터 Stage-4는 같은 종류의 데이터를 쓰되 최대 길이만 다르며, 부록 D에 따르면 세 단계 모두 Eagle2.5-Image-SFT(Table 11a), Open-Data, Eagle-Video-110K를 섞은 short+long 데이터다.
Eagle 2와의 관계는 세 곳에서 드러난다. Stage-1.5의 가중치를 Eagle-2에서 받아 오고, length-balanced packing을 Eagle 2 논문에서 인용하며, Table 5의 S1과 S1.5 정의도 Eagle 2와 같다고 적는다. 즉 Eagle 2.5의 새로운 부분은 Stage-2 이후의 long-context post-training과 그 데이터이며, 앞 단계는 Eagle 2의 결과를 재사용한다.
부록 D의 단계별 데이터 구성을 표로 옮기면 다음과 같다.
| 단계 | 데이터 |
|---|---|
| Stage-1 | ALLaVA |
| Stage-1.5 | Eagle2.5-Image-SFT (Table 11a)와 추가 pre-training 데이터 (Table 11b) |
| Stage-2 | Eagle2.5-Image-SFT (Table 11a), Open-Data, Eagle-Video-110K를 섞은 short+long 데이터 |
| Stage-3 | Stage-2와 같음 |
| Stage-4 | Stage-2와 같음 |
Stage-1.5의 데이터는 Table 11의 두 부분으로 구성된다. Table 11a의 SFT 데이터는 Captioning & Knowledge, Mathematics, Science, Chart & Table, Naive OCR, OCR QA, Grounding & Counting, General VQA, Text-only 아홉 범주다. Table 11b의 Stage 1.5 추가 pre-training 데이터는 CC3M, TextCaps, ShareGPT-4V, DenseFusion-1M(Captioning & Knowledge), Object 365(Grounding & Counting), OpenMathInstruct(Text-only)다.
데이터 레시피
데이터는 "diversity first, then quality" 원칙으로 오픈 데이터부터 모은다. 사람이 주석한 COIN, SlideVQA 계열은 그대로 고품질 데이터로 취급하고, GPT-4V/4o, Claude-3, Gemini-1.5 Pro로 자동 주석한 LLaVA-Video 계열 합성 영상을 더한다. 짧은 컨텍스트 데이터까지 합친 전체를 Open-Data라 부른다. Table 1의 구성은 다음과 같다.
| 범주 | 데이터셋 |
|---|---|
| Video Classification | Kinetics710, Something-Something-v2, ActivityNet, HACS Segment, COIN, HIREST, FineAction, PortraitMode-400 |
| Temporal Action Localization | ActivityNet, HACS Segment, FineAction, Ego4D-MQ, COIN, HIREST, Perception-Test |
| Video Temporal Grounding | Charade-STA, QVHighlight, Ego4D-NLQ, Didemo, QueryD, MedVidQA, Youcook2, FineVideo, ActivityNet, HACS Segment, FineAction, Ego4D-MQ, COIN, HIREST, Perception-Test, EgoExoLearn |
| Dense Video Captioning | ActivityNet, Youcook2, EgoExoLearn, ViTT, HIREST, COIN |
| Temporal Segmentation | Breakfast, ViTT |
| Temporal Reasoning | ActivityNet-RTL |
| General Video QA | TVQA, CLEVRER, NextQA, SportsQA, LLaVA-Video, FineVideo, VideoGPT+, Oops, Perception-Test, EgoTaskQA, CinePile, STAR |
| Multi-Page Document | SlideVQA, DUDE, MP-DocVQA |
| Video Captioning | ActivityNet, Youcook2, Shot2story, Vript, LLaVA-Video, Momentos, FunQA, S-MiT, LLaVA-Hound, Ego4D-HCap, EgoExoLearn |
| Long Text | LongAlign, LongReward |
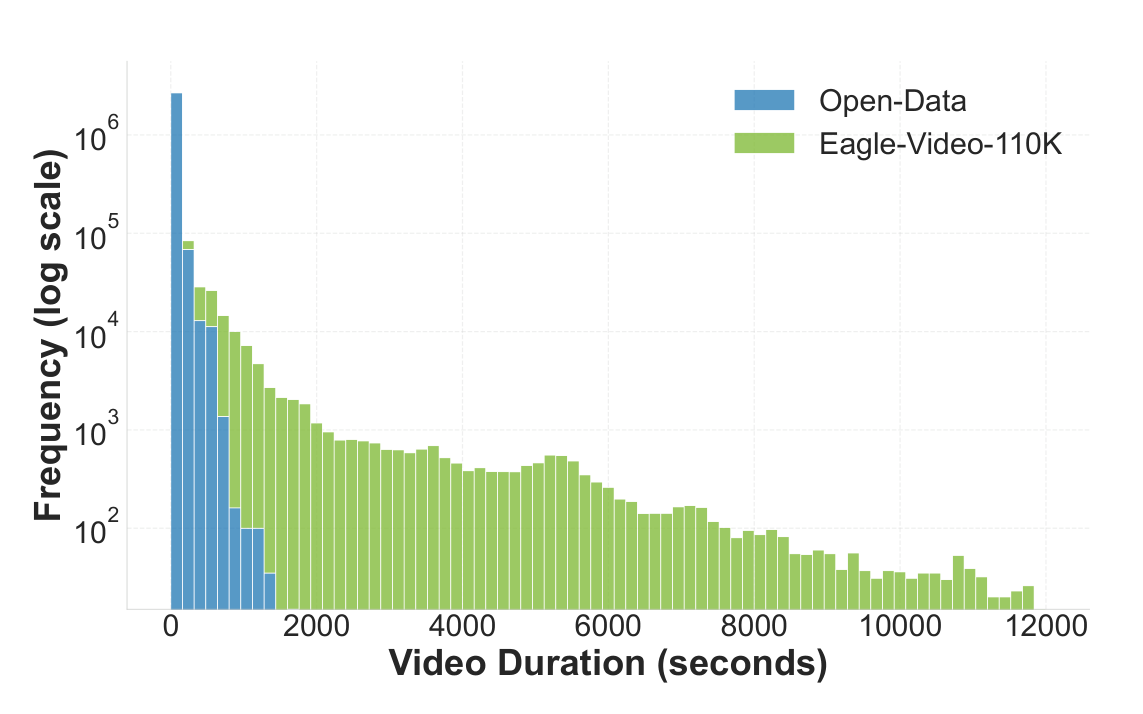
오픈 데이터에서 부족한 것이 긴 영상이다. Figure 4의 길이 분포를 보면 Open-Data는 약 1,500초에서 끝나는 반면 Eagle-Video-110K는 12,000초 근처까지 이어진다. 즉 25분을 넘는 영상은 사실상 Eagle-Video-110K에서만 온다.
Eagle-Video-110K 수집
수집은 다양성을 기준으로 한다. 이미 갖고 있는 학습셋과 겹치지 않는 영상만 고르기 위해 클립 단위 유사도 검사를 거친다.
| 단계 | 내용 |
|---|---|
| 후보 수집 | Vidchapters, MiraData, InternVid-10M, Panda-70M, Vript, Shot2story, ViTT, WebVid-10M에서 후보 집합 A를 모은다 |
| feature 추출 | 현재 학습셋 B와 A의 영상을 모두 10초 클립으로 자르고, CLIP으로 초당 1프레임의 feature를 뽑아 클립마다 pooling한 대표 벡터를 만든다 |
| 유사도 계산 | A의 클립 a_j마다 B의 모든 클립과의 코사인 유사도 최댓값 S_max(a_j)를 구한다 |
| 선별 | 임계값 τ = 0.5보다 낮은 클립만 새롭다고 보아 A_novel에 넣고, 그 클립과 원본 영상을 채택한다 |
story-level 주석
story-level 주석은 top-down 방식이다. Shot2story처럼 shot detection으로 자르면 과분할이 일어나 일관된 줄거리 텍스트를 만들기 어렵다는 판단에서, 사람이 붙인 chapter를 구간으로 쓴다. 채택한 영상 중 ViTT와 Vidchapters의 내용을 쓰고, chapter가 둘 미만인 영상은 버린다.
| 단계 | 모델 | 내용 |
|---|---|---|
| chapter-level dense caption | GPT-4o | 구간마다 최대 2 FPS, 최대 50프레임을 뽑아 사용자가 붙인 구간 제목과 함께 넣고, 제목이 가리키는 내용에 집중한 상세 caption을 만든다 |
| long-form QA 생성 | GPT-4 | 전체 구간의 caption과 시간 구간, chapter 제목을 모아 넣고 여러 질문 유형을 아우르는 QA 쌍을 만든다 |
clip-level 주석과 anchor
story-level 주석은 긴 시간에 걸친 의미에 치우친다. 반면 일반 질문은 국소적인 시공간 세부를 묻는 경우가 많으므로, bottom-up 방식의 clip-level 주석을 따로 만든다. 집합 A의 짧은 클립마다 최대 2 FPS로 프레임을 뽑아 GPT-4o에 넣고, 미리 정의한 질문 유형 풀에서 다섯 개를 무작위로 골라 QA 쌍을 만들게 한다.
클립용 질문을 영상 전체에 그대로 붙이면 답이 충돌할 수 있다. 예를 들어 "사람이 무엇을 들고 있는가"라는 질문은 클립 안에서는 하나의 답을 갖지만 영상 전체에서는 장면마다 답이 다르다. 이를 막기 위해 클립 질문 쌍마다 두 anchor를 붙인다.
| anchor | 내용 |
|---|---|
| time anchor | 질문 안에 시간 구간을 직접 적어 시간 기준을 준다 |
| textual context anchor | 답을 드러내지 않으면서 어느 장면인지 알려 주는 GPT-4o 생성 문장. 부록 E.1.1의 caption 프롬프트가 만드는 15~30단어의 brief caption이 이 용도로 쓰인다 |
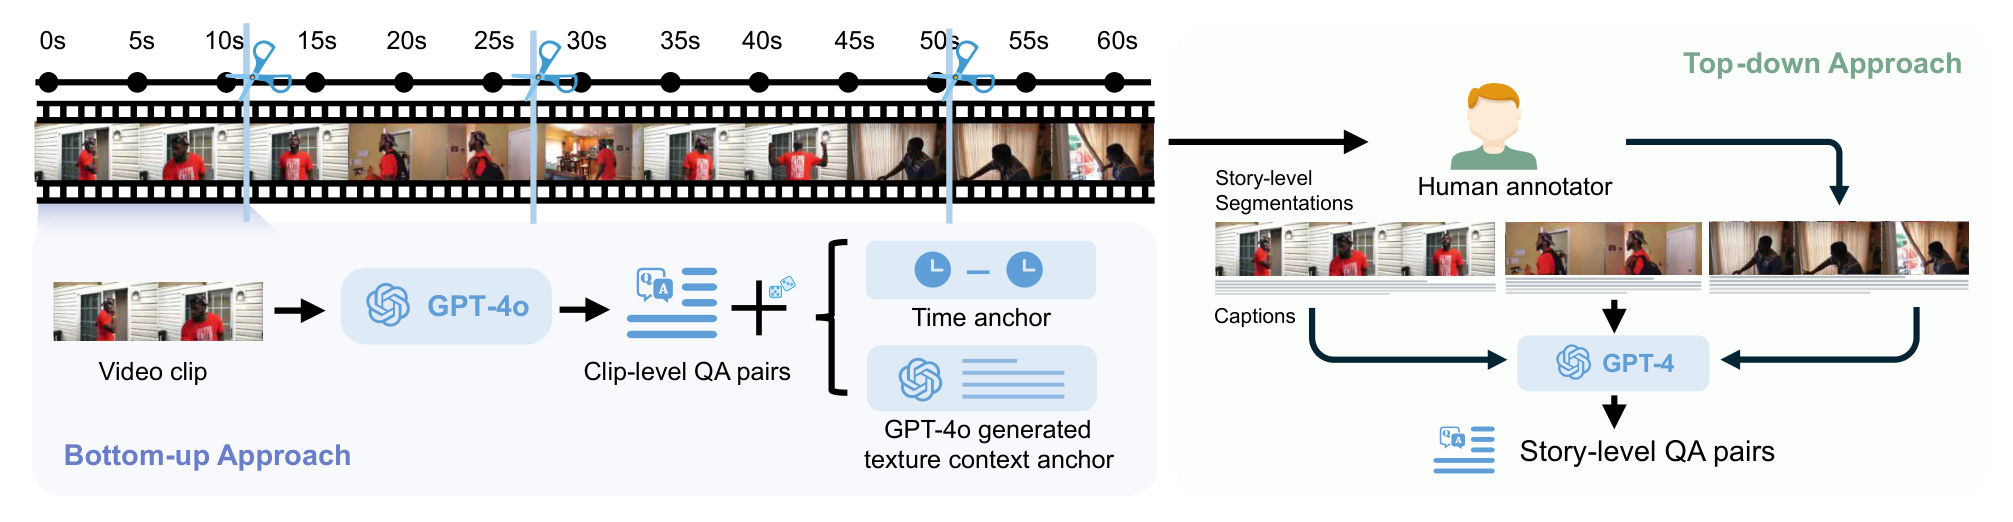
부록 E.1은 세 종류의 프롬프트를 싣는다. 세 프롬프트 모두 JSON 형식으로만 출력하게 하고, 다룰 수 없는 질문 유형은 null로 표시하게 한다.
| 프롬프트 | 입력 | 출력과 제약 |
|---|---|---|
| caption과 anchor 생성(E.1.1) | 클립 프레임과 제목 | brief caption(15~30단어)과 detailed caption. 동작의 진행 순서를 단계별로 적고, 화면의 텍스트는 원어와 영어 번역을 함께 적되 흐릿하면 존재만 언급한다. 클립을 프레임의 나열이 아니라 하나의 연속 영상으로 서술한다 |
| clip-level QA 생성(E.1.2) | detailed caption, brief caption, 질문 유형 풀 | 유형마다 QA 하나. brief caption만으로 완전히 답할 수 있는 질문은 만들지 않는다 |
| video-level QA 생성(E.1.3) | "start ~ end: caption" 형식으로 이은 클립 caption 목록 | 유형마다 QA 하나. caption으로 다룰 수 없는 유형만 null로 표시한다 |
질문 유형 풀은 부록 Table 12에 63종이 정의돼 있다. 아래는 그 유형을 묶은 것이다.
| 묶음 | 유형 예 |
|---|---|
| 물체 | object_recognition, object_properties, object_count, object_state, object_location, object_presence |
| 사람 | human_attributes, human_pose, human_appearance, human_identity, human_cognitive_process, human_location, human_emotion |
| 장면과 텍스트 | scene_description, text_recognition, text_count, text_location |
| 단일 물체 이벤트와 변화 | single_object_event_recognition, single_object_event_count, state_change, quantity_change, location_change, trajectory, speed, presence_change |
| 상호작용 | human_object_interaction_recognition, human_object_interaction_count, human_human_interaction_recognition, object_interaction |
| 도메인 지식 | domain_medical, domain_education, domain_sports, domain_movies, domain_gaming, domain_technology, domain_arts |
| 촬영과 편집 | video_editing_effects, camera_movement |
| 관계와 비교 | spatial_relationship, property_comparison, quantity_comparison, state_comparison, human_object_relationship, human_human_relationship, speed_comparison |
| 시간과 인과 | scene_sequence, event_sequence, event_causality, counterfactual_reasoning, trajectory_tracking, event_prediction, object_ordering |
| 이상과 추론 | abnormal_event_detection, anomaly_reasoning, anomaly_recognition |
| 과제와 요약 | planning, navigation, human_action, dialogue_content, event_summary, event_location, process_description, video_topic |
학습 인프라
128K 토큰의 시퀀스를 학습하려면 메모리와 통신 최적화가 필요하다. 부록 B.1은 네 가지 최적화를 든다.
| 항목 | 내용 |
|---|---|
| GPU 메모리 | Triton 기반 fused operator가 PyTorch의 MLP, RMSNorm, RoPE를 대체한다. linear layer와 cross-entropy 손실을 융합해 중간 logit 저장을 없애고, hidden state를 CPU로 offload한다 |
| 분산 context parallelism | USP 위에 Ulysses와 Ring 두 층의 통신 그룹을 둔다. zigzag ring-attention 대신 all-gather KV를 쓰는 zigzag Llama3 방식 context parallelism으로 통신 지연을 줄인다 |
| 영상 디코딩 | 희소한 프레임을 찾아 읽을 때 생기는 seek 지연과 메모리 문제를 빠른 메타데이터 파싱으로 줄인다 |
| 추론 | vLLM으로 서빙과 평가를 수행해 메모리 요구량을 줄이고 속도를 높인다 |
context parallelism은 하나의 긴 시퀀스를 여러 GPU에 나눠 attention을 계산하는 분산 방식이다. Ulysses는 attention head를 GPU 사이에 나누고 Ring은 시퀀스 조각을 GPU 고리를 따라 돌려 가며 계산하는데, USP는 이 둘을 결합한 통합 방식이다.
결과
영상 평가 설정
영상 평가는 프레임 수와 tiling 설정을 벤치마크마다 다르게 둔다. 기본은 2 FPS 샘플링에 tiling을 끄고 최소 8프레임을 보장하는 것이다.
| 설정 | 값 |
|---|---|
| 샘플링 | 2 FPS |
| 최소 프레임 수 | 8 |
| 최대 프레임 수 | Video-MME 512, 나머지 256 |
| tiling | 기본 끔. Perception-Test만 고해상도 평가를 위해 켬 |
영상 벤치마크
아래 두 표는 Table 2를 둘로 나눈 것이다. MMB-Video는 점수 척도가 다르고, "-"는 논문이 값을 적지 않은 칸이다.
| 모델 | MVBench | Perception_test (Val) | EgoSchema (fullset) | MMB-Video | MLVU (Val) | LVBench (Val) | Video-MME w/o sub | Video-MME w/ sub |
|---|---|---|---|---|---|---|---|---|
| GPT-4o-0806 | - | - | - | 1.63 | - | 66.7 | 71.9 | 77.2 |
| Claude-3.5-Sonnet | - | - | - | - | - | - | 60.0 | 62.9 |
| Gemini-1.5-Pro | - | - | 72.2 | 1.30 | - | 64.0 | 75.0 | 81.3 |
| MiniCPM-V2.6-8B | - | - | - | - | - | - | 60.9 | 63.7 |
| LongVILA-8B | 67.1 | 58.1 | 67.7 | - | - | 57.1 | 60.1 | 65.1 |
| InternVL2.5-8B | 72.0 | - | - | 1.68 | 68.9 | 60.0 | 64.2 | 66.9 |
| LLaVA-Video-8B | 58.6 | 67.9 | 57.3 | - | 70.8 | 58.2 | 63.3 | 69.7 |
| Qwen2.5-VL-8B | 69.6 | 70.5 | 65.0 | 1.79 | 70.2 | 56.0 | 65.1 | 71.6 |
| VideoChat-Flash-8B | 74.0 | 76.2 | - | - | 74.6 | 64.7 | 65.3 | 69.7 |
| InternVL2.5-78B | 76.4 | - | - | 1.97 | 75.7 | 63.6 | 72.1 | 74.0 |
| Qwen2.5-VL-72B | 70.4 | 73.2 | 76.2 | 2.02 | 74.6 | 60.7 | 73.3 | 79.1 |
| LLaVA-Video-72B | 64.1 | 74.3 | 65.6 | - | 74.4 | 61.9 | 70.6 | 76.9 |
| Eagle2.5-8B | 74.8 | 82.0 | 72.2 | 1.94 | 77.6 | 66.4 | 72.4 | 75.7 |
| 모델 | CG-Bench Clue | CG-Bench Long | CG-Bench Open | CG-Bench mIoU | HourVideo Dev | HourVideo Test | Charade-STA mIoU |
|---|---|---|---|---|---|---|---|
| GPT-4o-0806 | 58.6 | 44.9 | 39.2 | 5.73 | - | - | 35.7 |
| Claude-3.5-Sonnet | 56.5 | 40.3 | 35.6 | 4.17 | - | - | - |
| Gemini-1.5-Pro | 50.9 | 37.8 | 28.7 | 3.85 | 37.2 | 37.4 | - |
| MiniCPM-V2.6-8B | 44.4 | 29.9 | 26.3 | 2.27 | - | - | - |
| LongVILA-8B | 47.5 | 34.3 | 26.6 | - | - | - | - |
| Qwen2.5-VL-8B | 44.5 | 35.5 | 24.1 | 2.48 | - | - | 43.6 |
| VideoChat-Flash-8B | 52.8 | 43.1 | 37.5 | 1.49 | - | - | - |
| InternVL2.5-78B | 59.5 | 44.2 | 34.2 | 3.90 | - | - | - |
| Qwen2.5-VL-72B | - | - | - | - | - | - | 50.9 |
| Eagle2.5-8B | 55.8 | 46.6 | 45.6 | 13.4 | 44.5 | 41.8 | 65.9 |
같은 크기 모델과 비교하면 Eagle2.5-8B가 대부분의 항목에서 가장 높다. MVBench 74.8, Perception_test 82.0, EgoSchema 72.2는 InternVL2.5-8B(72.0)와 Qwen2.5-VL-8B(69.6, 70.5, 65.0)를 앞서고, VideoChat-Flash-8B(74.0, 76.2)도 넘는다. 특히 Perception_test에서는 Qwen2.5-VL-72B(73.2)보다 8.8점 높다.
큰 모델과 비교하면 MLVU 77.6과 LVBench 66.4가 InternVL2.5-78B(75.7, 63.6)를 넘는다. Video-MME(자막 없음) 72.4는 InternVL2.5-78B(72.1)보다 높고 Qwen2.5-VL-72B(73.3)에 0.9점 못 미친다. 반면 MVBench는 InternVL2.5-78B(76.4)가, EgoSchema는 Qwen2.5-VL-72B(76.2)가 더 높으므로 모든 항목에서 큰 모델을 넘는 것은 아니다.
시간 인식 항목에서 격차가 크다. Charade-STA mIoU 65.9는 두 번째로 높은 Qwen2.5-VL-72B(50.9)보다 15.0점 높고, HourVideo는 dev 44.5, test 41.8로 Gemini-1.5-Pro(37.2, 37.4)를 넘는다. 저자들은 이를 강한 시간 인식 능력의 근거로 든다. CG-Bench는 Long 46.6, Open 45.6, mIoU 13.4에서 비교 모델 중 가장 높지만, Clue 항목은 GPT-4o(58.6)와 Claude-3.5-Sonnet(56.5)이 Eagle(55.8)보다 높다. 본문은 Claude와 Gemini를 넘는다고 적는데, 이 서술은 Clue 항목에 대해서는 표와 맞지 않는다.
프레임 확장 곡선
Figure 1은 Video-MME(자막 없음) 성능을 입력 프레임 수에 대해 그린다. 아래 값은 그림에서 읽은 근사값이며, 512프레임의 72.4와 각 모델의 Table 2 값을 제외하면 논문 본문에 수치로 적혀 있지 않다.
| 모델 | 곡선의 형태 |
|---|---|
| Eagle-2.5-8B | 16프레임 약 64.8에서 32프레임 약 67.5, 64프레임 약 69.4, 128프레임 약 70.7, 256프레임 약 71.6을 거쳐 512프레임 72.4까지 단조 증가 |
| InternVL-2.5-8B | 16프레임 약 60.2에서 48프레임 64.2까지 오른 뒤 64프레임에서 64.0으로 정체 |
| LongViTA-14B | 64프레임부터 512프레임까지 65.6에서 66.4 사이에 머물고 512프레임에서 소폭 하락 |
| GPT-4o | 384프레임 근처에 71.9 한 점 |
| Qwen2.5-VL-72B와 7B | 768프레임에 각각 73.3과 65.1 한 점 |
| Gemini-1.5-Pro | 1024프레임에 75.0 한 점 |
| LLaVA-OneVision-72B | 32프레임에 약 66.3 한 점 |
이 그림이 보여 주는 것은 두 가지다. 첫째, Eagle-2.5-8B는 프레임을 두 배로 늘릴 때마다 성능이 오르며 512프레임에서도 포화하지 않는다. 둘째, 같은 크기의 InternVL-2.5-8B와 더 큰 LongViTA-14B는 64프레임 근처에서 성능이 멈추므로, 프레임을 더 넣어도 이득이 없다. 저자들은 이 차이를 입력 길이가 늘어나면 성능도 오르는 모델과 긴 입력을 수용만 하는 모델의 차이로 설명한다.
이미지 벤치마크
긴 컨텍스트 학습이 짧은 컨텍스트 성능을 해치지 않았는지가 이 표의 관심사다. 평균은 모든 벤치마크 점수의 평균이며 OCRBench는 10으로 나눠 넣는다. 13개 벤치마크는 저자들의 서술에 따라 다음과 같이 묶인다.
| 묶음 | 벤치마크 |
|---|---|
| 문서 이해 | DocVQA |
| 차트 해석 | ChartQA |
| 정보 추출 | InfoVQA, TextVQA |
| OCR | OCRBench |
| 일반 인식과 추론 | MMstar, RWQA, MMB1.1, MMVet |
| 지식 | MMMU, AI2D |
| 시각 환각 | HallB |
| 수학 추론 | MathVista |
| 모델 | DocVQA (Test) | ChartQA (Test) | InfoVQA (Test) | TextVQA (Val) | OCRBench (Test) | MMstar (Test) | RWQA (Test) | AI2D (Test) | MMMU (Val) | MMB1.1 (Test) | MMVet (Test) | HallB (Test) | MathVista (Test-Mini) | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| GPT-4o-0806 | 92.8 | 85.7 | 79.2 | 77.4 | 736 | 64.7 | 75.4 | 84.6 | 69.1 | 83.1 | 69.1 | 55.0 | 63.8 | 74.9 |
| Claude-3.5-Sonnet | 95.2 | 90.8 | 74.3 | 74.1 | 788 | 65.1 | 60.1 | 81.2 | 68.3 | 80.9 | 70.1 | 55.5 | 67.7 | 74.0 |
| Gemini-1.5-Pro | 93.1 | 87.2 | 81.0 | 78.8 | 754 | 59.1 | 67.5 | 79.1 | 62.2 | 74.6 | 64.0 | 45.6 | 63.9 | 71.7 |
| MiniCPM-V2.6-8B | 90.8 | 82.4 | - | 80.1 | 852 | 57.5 | 65.0 | 82.1 | 49.8 | 78.0 | 60.0 | 48.1 | 60.6 | - |
| LLaVA-One-Vision-8B | 87.5 | 80.0 | 68.8 | - | 622 | 61.7 | 66.3 | 81.4 | 48.8 | 80.9 | 57.5 | 31.6 | 63.2 | - |
| InternVL2.5-8B | 93.0 | 84.8 | 77.6 | 79.1 | 822 | 62.8 | 70.1 | 84.5 | 56.0 | 83.2 | 62.8 | 50.1 | 64.4 | 73.1 |
| Qwen2.5-VL-8B | 95.7 | 87.3 | 82.6 | 84.9 | 864 | 63.9 | 68.5 | 83.9 | 58.6 | 82.6 | 67.1 | 52.9 | 68.2 | 75.6 |
| LLaVA-One-Vision-72B | 91.7 | 83.7 | 74.9 | - | 741 | 66.1 | 71.9 | 85.6 | 56.6 | 84.5 | 60.6 | 47.5 | 68.4 | - |
| LLaMa-3.2-90B-Vision | 90.1 | 85.5 | - | - | 783 | 55.3 | - | - | 60.3 | 77.3 | 64.1 | 44.1 | 57.3 | - |
| Eagle2.5-8B | 94.1 | 87.5 | 80.4 | 83.7 | 869 | 66.2 | 76.7 | 84.5 | 55.8 | 81.7 | 62.9 | 54.7 | 67.8 | 75.6 |
평균 75.6은 Qwen2.5-VL-8B와 같고 GPT-4o(74.9), Claude-3.5-Sonnet(74.0), InternVL2.5-8B(73.1)보다 높다. Eagle2.5-8B가 열 최고값인 항목은 OCRBench 869, MMstar 66.2, RWQA 76.7 세 개다. 반면 DocVQA, InfoVQA, TextVQA, MMMU, MMB1.1, MathVista는 Qwen2.5-VL-8B가 더 높고, ChartQA는 Claude-3.5-Sonnet(90.8)이 가장 높다. 저자들은 문서, 차트, OCR, 일반 인식, 지식, 시각 환각, 수학 추론에 걸쳐 균형 잡힌 범용 VLM이라고 해석한다.
다중 페이지 문서 벤치마크
부록 C는 다중 페이지 문서 벤치마크 두 개를 비교 대상 없이 보고한다. ANLS는 Approximate Normalized Levenshtein Similarity로, 정답 문자열과의 편집 거리를 정규화한 유사도다.
| SlideVQA subset | ANLS | Exact Match | F1 |
|---|---|---|---|
| Dev | 73.8 | 67.7 | 74.7 |
| Test | 72.7 | 63.2 | 72.3 |
| MMLongBench-Doc 지표 | 값 |
|---|---|
| Overall F1 | 29.4 |
| Overall Acc | 27.7 |
ablation
저자들은 네 가지 질문으로 ablation을 구성한다. 영상 데이터와 이미지 데이터가 서로의 벤치마크에 미치는 영향, information-first sampling의 효과, post-training 스케줄의 효과, Eagle-Video-110K의 효과다.
long-context 데이터가 이미지 성능을 해치는가 (Table 4). 해치지 않는다. L_max 학습을 하지 않은 Eagle2.5-S2가 평균 74.8인데 32K에서 75.3, 64K에서 75.6, 128K에서 75.7로 조금씩 오른다. Table 4는 Table 3과 달리 DocVQA, InfoVQA, OCRBench를 Val, MMB1.1을 EN-Val로 평가하므로 같은 모델이라도 Table 3의 값과 다르다.
| 설정 | DocVQA | ChartQA | InfoVQA | TextVQA | OCRBench | MMstar | RWQA | AI2D | MMMU | MMB1.1 | MMVet | HallB | MathVista | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Eagle2.5-S2 | 92.6 | 88.3 | 78.8 | 84.6 | 868 | 66.5 | 74.4 | 85.5 | 54.0 | 85.5 | 57.3 | 53.4 | 65.1 | 74.8 |
| L_max = 32K | 92.3 | 86.6 | 77.6 | 82.8 | 861 | 66.7 | 75.9 | 83.7 | 55.5 | 84.8 | 63.6 | 55.4 | 68.3 | 75.3 |
| L_max = 64K | 92.5 | 87.0 | 78.4 | 83.9 | 865 | 66.8 | 76.8 | 83.9 | 55.7 | 85.2 | 63.3 | 55.2 | 67.3 | 75.6 |
| L_max = 128K | 93.2 | 87.5 | 78.5 | 83.7 | 869 | 66.2 | 76.7 | 84.5 | 55.8 | 85.5 | 62.9 | 54.7 | 67.8 | 75.7 |
항목별로 보면 방향이 갈린다. MMVet(57.3에서 62.9), MathVista(65.1에서 67.8), RWQA(74.4에서 76.7)는 long-context 학습으로 오르고, ChartQA(88.3에서 87.5)와 TextVQA(84.6에서 83.7)는 조금 내려간다. 평균은 오르지만 모든 항목이 오르는 것은 아니다.
이미지 데이터와 pre-training이 영상 성능에 얼마나 기여하는가 (Table 5). L_max = 32K 모델로 비교했고, 벤치마크마다 2 FPS로 최대 32프레임을 샘플링했다. S1과 S1.5는 Eagle 2와 같은 stage-1, stage-1.5를 뜻한다.
| 학습 경로 | MVBench | MLVU (Val) | Video-MME w/o sub |
|---|---|---|---|
| S1 → S2 | 70.4 | 67.4 | 64.9 |
| S1 → S1.5 → S2 (Open-Data + EV-110K) | 72.9 | 70.9 | 65.2 |
| S1 → S1.5 → S2 (Image + Open-Data + EV-110K) | 73.1 | 71.5 | 65.4 |
대규모 이미지 pre-training(S1.5)은 짧은 영상 벤치마크 MVBench(70.4에서 72.9)와 비교적 쉬운 긴 영상 벤치마크 MLVU(67.4에서 70.9)에서 효과가 크다. 반면 더 어렵고 held-out인 Video-MME에서는 64.9에서 65.4로 0.5점만 오른다. 즉 이미지 데이터는 짧은 영상과 쉬운 긴 영상에는 전이되지만 어려운 긴 영상에는 거의 전이되지 않는다.
information-first sampling을 빼면 (Table 6). baseline은 IAP와 ADS를 모두 갖춘 설정이다.
| 설정 | InfoVQA (Val) | DocVQA (Val) | TextVQA (Val) | Perception_test (Val) | MLVU (Val) | Video-MME w/o sub |
|---|---|---|---|---|---|---|
| baseline | 77.6 | 92.3 | 82.8 | 76.3 | 71.5 | 65.4 |
| w/o IAP | 76.2 | 91.9 | 82.4 | 73.3 | 71.2 | 64.9 |
| w/o ADS | 77.0 | 92.1 | 82.8 | 75.5 | 70.1 | 65.0 |
IAP를 빼면 고해상도가 필요한 InfoVQA(77.6에서 76.2)와 세밀한 영상 벤치마크 Perception_test(76.3에서 73.3)가 크게 떨어지고 다른 벤치마크의 변화는 작다. ADS를 빼면 MLVU가 71.5에서 70.1로 내려간다. 저자들은 ADS가 다양한 시각 입력을 편하게 처리하게 해 줄 뿐 아니라, 이를 빼고 vision-context-centric 샘플링으로 돌아가면 supervision 신호가 잘려 성능을 잃는다고 해석한다.
post-training 스케줄과 Eagle-Video-110K (Table 7). 32K에서 64K로 올리는 progressive 학습이 곧장 64K를 학습하는 것보다 세 벤치마크 모두에서 낫다. 저자들이 든 이유는 두 가지다. 곧장 64K를 학습하면 샘플이 64K 공간에 흩어져 짧은 컨텍스트에 대한 집중이 흐려지고, 일부 긴 샘플은 쉬운 것에서 어려운 것으로 넘어가는 점진적 과정 없이는 배우기 어렵다. 여기에 Eagle-Video-110K를 더하면 세 벤치마크가 다시 오른다.
| 설정 | MVBench | MLVU (Val) | Video-MME w/o sub |
|---|---|---|---|
| 32K → 64K, Open-Data | 73.0 | 74.5 | 68.1 |
| 64K, Open-Data | 71.3 | 74.0 | 67.9 |
| 32K → 64K, Open-Data + Eagle-Video-110K | 73.9 | 75.1 | 68.8 |
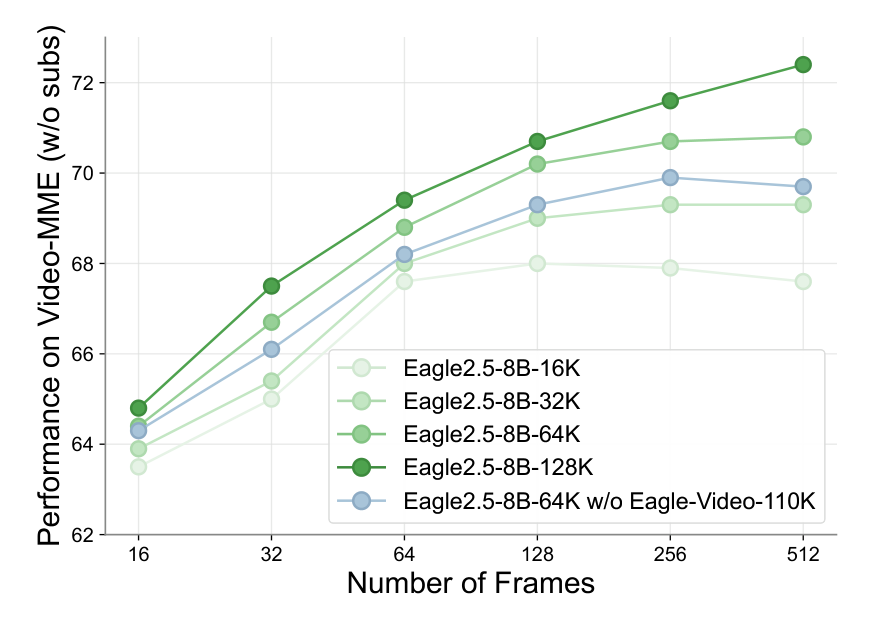
네 질문의 결론을 한 표로 모으면 다음과 같다.
| 질문 | 근거 | 결론 |
|---|---|---|
| long-context 데이터가 이미지 성능을 해치는가 | Table 4 | 해치지 않는다. 평균 74.8에서 75.7로 오른다 |
| 이미지 데이터와 pre-training이 영상 성능에 기여하는가 | Table 5 | MVBench와 MLVU에서는 크게, held-out인 Video-MME에서는 0.5점만 기여한다 |
| information-first sampling이 필요한가 | Table 6 | IAP를 빼면 고해상도와 세밀한 영상 벤치마크가, ADS를 빼면 MLVU가 떨어진다 |
| progressive 스케줄이 나은가 | Table 7, Figure 6 | 32K에서 64K로 올리는 것이 곧장 64K보다 세 벤치마크 모두에서 낫다 |
| Eagle-Video-110K가 기여하는가 | Table 7, Figure 6 | 세 벤치마크가 모두 오르고, 128프레임 이상 구간의 하락을 막는다 |
Figure 6은 그 차이가 프레임 수에 따라 어떻게 나타나는지 보여 준다. 16K, 32K, 64K, 128K 모델의 곡선은 단계가 올라갈수록 위로 이동하며, 128K 모델은 512프레임에서 72.4에 이른다. 16K 모델은 128프레임에서 정점(약 68.0)을 찍고 512프레임에서 내려가는데, 이는 학습한 최대 길이를 넘는 입력에서 성능이 떨어지는 현상이다. Eagle-Video-110K를 뺀 64K 모델은 128프레임까지는 32K 모델보다 높지만 256프레임 근처에서 정점을 찍고 512프레임에서 내려간다. 저자들은 Open-Data에 없던 긴 영상을 포함한 것이 128프레임 이상을 다루는 능력을 크게 끌어올렸다고 설명한다.
GR00T backbone 계보
이 논문은 로봇이나 VLA를 언급하지 않는다. 그러나 이 wiki의 physical-ai 페이지들이 Eagle 2.5를 GR00T N1.5의 VLM backbone으로 인용하므로, 그 관계를 논문 밖 근거와 함께 정리한다. 아래 표의 내용은 모두 저장소 README와 physical-ai 페이지에서 온 것이며 이 논문의 사실이 아니다.
| GR00T 세대 | VLM backbone | 근거 |
|---|---|---|
| N1 | Eagle 2 (System 2) | 저장소 README 2025/03 기록(Eagle: Frontier Vision-Language Models with Data-Centric Strategies). GR00T N1: An Open Foundation Model for Generalist Humanoid Robots은 N1의 Eagle-2를 SmolLM2와 SigLIP-2에서 fine-tuning한 변형으로 적는다 |
| N1.5 | Eagle 2.5 | 저장소 README 2025/06 기록. GR00T N1.5에 따르면 Eagle 2.5에서 grounding과 물리 이해를 겨냥해 다시 튜닝한 VLM을 얼린 채 쓴다 |
| N1.6 | native resolution 변형 Eagle | 저장소 README 2025/12 기록 |
| N1.7 | Cosmos-Reason2-2B | NVIDIA Isaac GR00T (N1.7). Eagle 계보는 N1.6까지다 |
backbone으로 채택됐다는 말이 이 논문의 가중치를 그대로 쓴다는 뜻은 아니다. N1.5 페이지는 Eagle 2.5에서 출발해 재튜닝한 모델을 pre-training과 fine-tuning 양쪽에서 frozen으로 둔다고 적는다. 또한 GR00T N1이 말하는 Eagle-2와 저장소 model zoo가 배포하는 Qwen2.5 기반 Eagle2-1B/2B/9B는 이름이 같지만 구성이 다르므로, backbone을 특정할 때는 어느 계보인지 확인해야 한다.
한계
논문에 별도 limitations 절이 없고 결론은 성과 요약으로 끝난다. 아래는 저자가 명시한 것과 자료에서 확인되는 것을 나눠 적는다.
저자가 본문에서 직접 언급한 제약은 하나다. 어려운 긴 영상 벤치마크 Video-MME에서는 이미지 데이터와 pre-training의 효과가 작다(Table 5의 65.2에서 65.4).
자료의 수치와 기술 범위에서 확인되는 제약은 다음과 같다.
- 다중 페이지 문서 벤치마크 MMLongBench-Doc은 F1 29.4, Acc 27.7로 비교 대상 없이 값만 보고된다. 다른 모델과의 상대적 위치는 자료로 알 수 없다.
- Eagle-Video-110K의 caption과 QA는 GPT-4o와 GPT-4 출력에 의존한다. 데이터 품질이 이 모델들의 출력 품질에 묶인다.
- 논문은 "a family of frontier VLMs"라고 부르지만 결과를 보고하는 모델은 Eagle2.5-8B 하나다. 다른 크기에서 레시피가 어떻게 작동하는지는 자료에 없다.
- Eagle-Video-110K의 영상 수, QA 쌍 수, 총 시간 같은 규모 통계는 본문에 없다. 이름의 110K가 무엇의 개수인지도 적혀 있지 않다.
- 학습 비용(GPU 수, 학습 시간)은 자료에 없다.
- 평가에 쓴 벤치마크 중 일부는 학습 데이터 목록에도 이름이 있다. 논문은 학습과 평가에 쓴 split을 구분해 적지 않으므로, 해당 벤치마크의 결과가 held-out 평가인지는 자료로 확인할 수 없다.
| 벤치마크 | 평가 위치 | 학습 데이터 목록의 위치 |
|---|---|---|
| Perception-Test | Table 2 (Val) | Table 1의 Temporal Action Localization, Video Temporal Grounding, General Video QA |
| Charade-STA | Table 2 | Table 1의 Video Temporal Grounding |
| SlideVQA | Table 9 | Table 1의 Multi-Page Document, Table 11a의 OCR QA |
| DocVQA, InfoVQA, TextVQA | Table 3 | Table 11a의 OCR QA |
| ChartQA | Table 3 | Table 11a의 Chart & Table |
| AI2D | Table 3 | Table 11a의 Science |
- 가중치 라이선스는 논문에 없다. 저장소 README(Eagle: Frontier Vision-Language Models with Data-Centric Strategies)는 가중치를 CC BY-NC 4.0 또는 NVIDIA License의 비상업 research preview로 적는다.
자료 자체의 내적 불일치는 다음과 같다.
| 위치 | 내용 |
|---|---|
| Table 2 vs 4.1절 | 표의 열 이름은 LVBench인데 본문은 같은 값 66.4를 LongVideobench(Wu et al. 2025, 참고문헌 [223])로 부른다. 두 벤치마크는 서로 다른 데이터셋이다 |
| 4.1절 CG-Bench 서술 | 본문은 Claude-3.5-Sonnet을 넘는다고 적지만 Clue 항목은 Claude 56.5, GPT-4o 58.6이 Eagle 55.8보다 높다 |
| Table 11 캡션 vs 부록 D | 캡션은 "Stage 1 and Stage1.5" 데이터셋이라고 적지만 부록 D는 Stage-1 데이터를 ALLaVA 하나로, Table 11을 Stage-1.5 데이터로 적는다 |
| Table 4 행 라벨 | "Eagle2.5-S2+Eagle2.5-S2, L_max = 32K"처럼 같은 이름이 반복돼 의미가 불명확하다 |
| Figure 2 vs 저장소 | 인코더가 SigLIP-so400M(Figure 2)과 SigLIP2-so400m-patch16-512(저장소 model zoo)로 다르다. 저장소 쪽은 논문 밖 근거다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| information-first sampling | 텍스트를 먼저 온전히 확보하고 남은 예산으로만 시각 입력을 조정하는 샘플링 원칙. IAP와 ADS를 묶는 상위 이름이다 |
| image area preservation (IAP) | 원본 면적의 60% 이상을 남기면서 종횡비도 맞추도록 tiling 격자를 고르는 규칙 |
| automatic degradation sampling (ADS) | 시각 예산 안에서 프레임 수를 먼저 정하고 타일 수를 단계적으로 낮춰 맞추는 샘플링 절차 |
| progressive mixed post-training | 최대 시퀀스 길이를 32K, 64K, 128K로 올려 가며 학습하는 post-training 스케줄 |
| Eagle-Video-110K | 이 논문이 만든 긴 영상 데이터셋. story-level과 clip-level 주석을 겹쳐 넣었다 |
| time anchor와 textual context anchor | 클립용 질문을 영상 전체에 붙일 때 답 충돌을 막는 두 장치. 각각 시간 구간을 명시하고, 답을 드러내지 않는 맥락 문장을 덧붙인다 |
관련 페이지
- Eagle: Frontier Vision-Language Models with Data-Centric Strategies: 같은 팀의 공식 저장소 README. Eagle 세대 구성, model zoo, GR00T 채택 이력, 가중치 라이선스가 거기에 있다
- GR00T N1.5: Eagle 2.5를 재튜닝해 frozen backbone으로 쓴 GR00T N1.5의 발표 글
- 03-14. Groot N1.5 - 모두의 로보틱스 - VLA 입문: N1.5의 한국어 해설. VLM을 pre-training 단계에서까지 frozen으로 둔 결정이 설명돼 있다
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: Eagle-2를 System 2로 쓴 GR00T N1. 이 논문은 그 다음 세대 backbone의 원 논문이다
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: N1의 한국어 해설. System 2 자리에 들어가는 Eagle-2가 어떤 계보인지 다룬다
- NVIDIA Isaac GR00T (N1.7): N1.7에서 backbone이 Cosmos-Reason2-2B로 바뀐 후속 저장소
- Physical AI 카테고리 지도와 학습 경로: physical-ai 허브. 이 페이지를 인접 카테고리 페이지로 잇는다
- VLM3: Vision Language Models Are Native 3D Learners: 표준 VLM의 구조와 손실을 바꾸지 않고 입력 표현과 데이터만 바꿔 3D 과제를 푸는 논문. 구조를 건드리지 않는 접근이라는 점에서 이 논문과 비교해 읽을 수 있다
- 용어집: LLMs (Terminology Glossary): 용어 표기 기준