Physical AI · PAPER · 2025
GR00T N1: An Open Foundation Model for Generalist Humanoid Robots
요약
GR00T N1은 NVIDIA가 공개한 humanoid 로봇용 VLA foundation model이다. foundation model은 여러 하위 과제의 기반이 되는 대규모 범용 모델을 말한다. 카메라 이미지와 지시문(instruction)을 받아 모터 action을 출력하며, 탁상 단일 팔부터 dexterous hand를 단 humanoid까지 하나의 가중치로 지원한다.
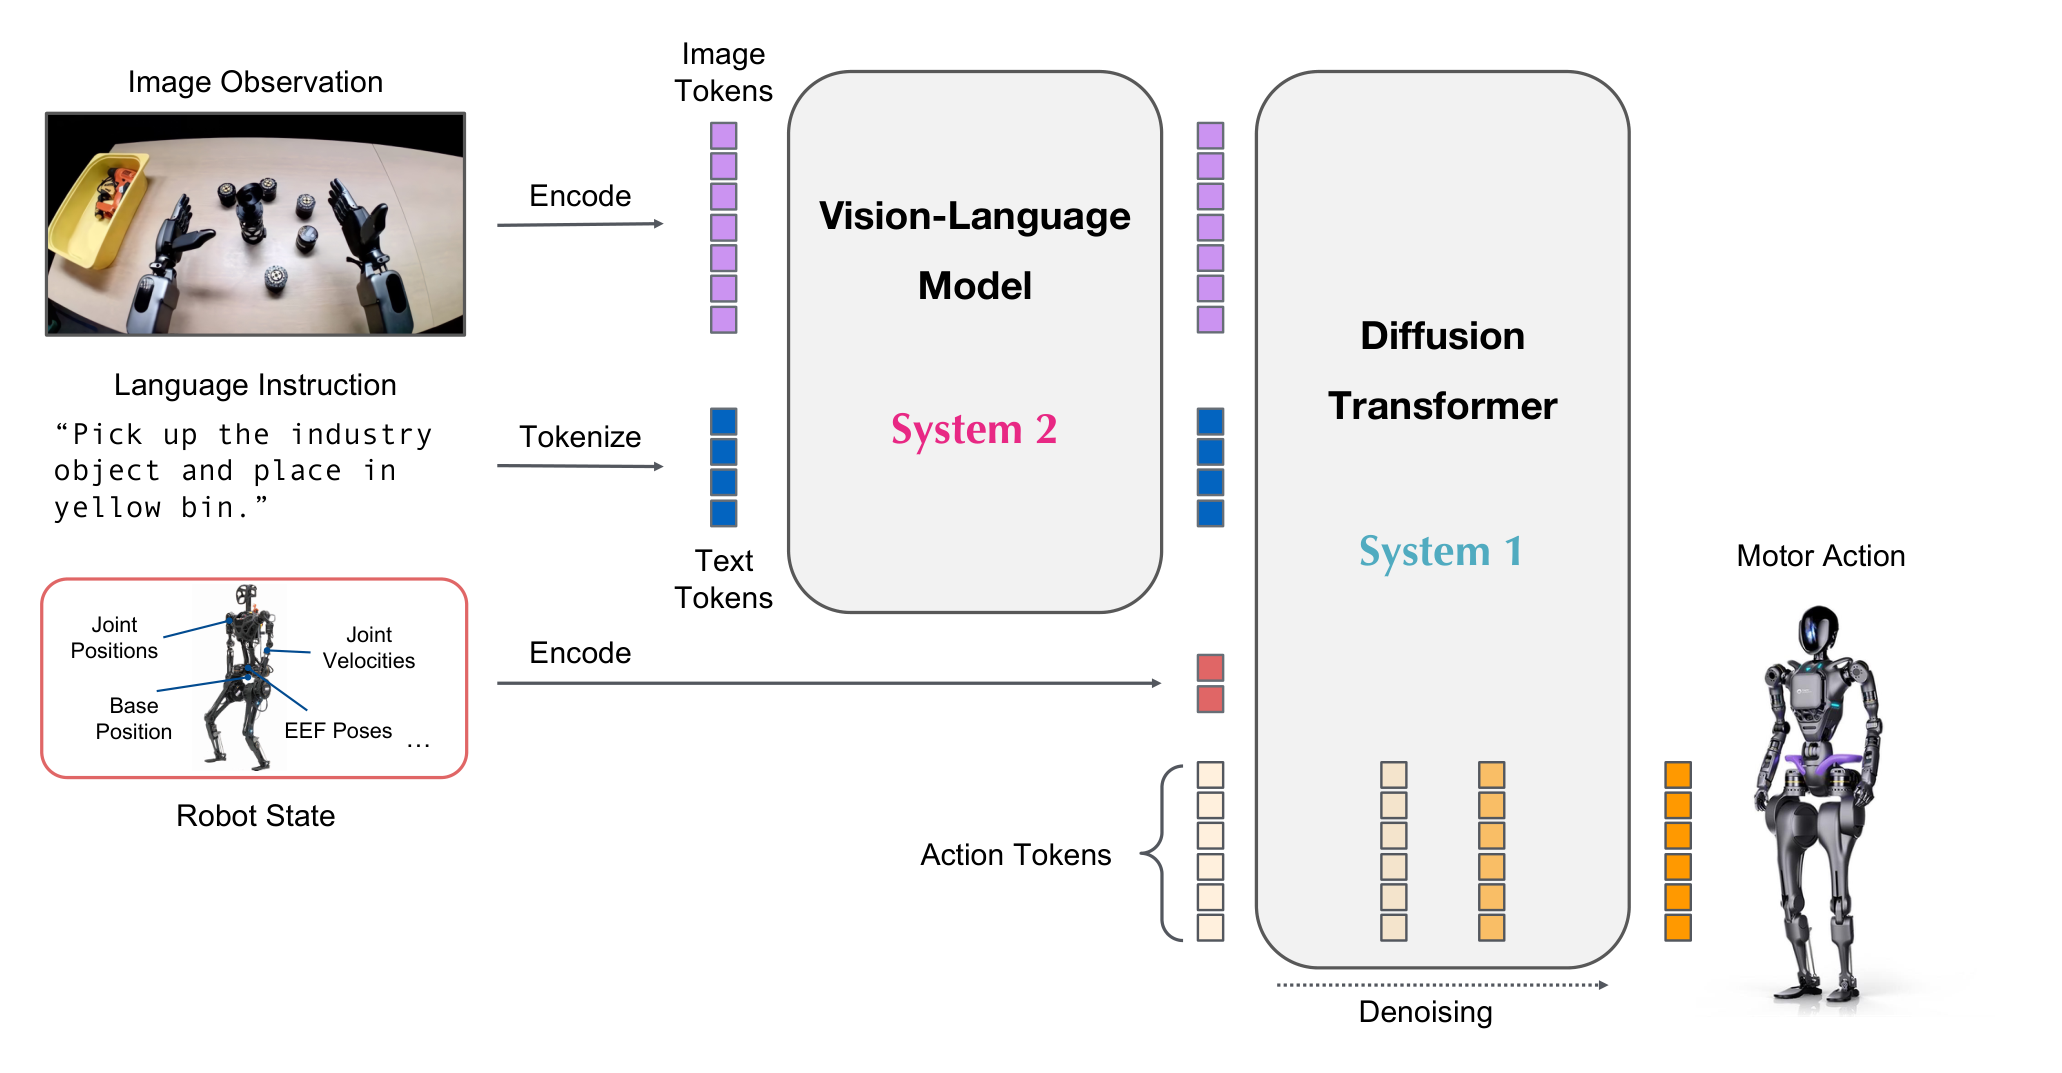
구조의 특징은 처리 주기가 다른 두 모듈을 하나의 학습 프레임워크로 묶은 dual-system 설계다. Eagle-2 VLM이 10Hz로 장면과 지시문을 해석하고, flow matching으로 학습한 Diffusion Transformer가 120Hz로 모터 action을 생성한다. 두 모듈은 따로 학습해 이어붙인 파이프라인이 아니라 학습 중 함께 최적화되는 하나의 모델이다.
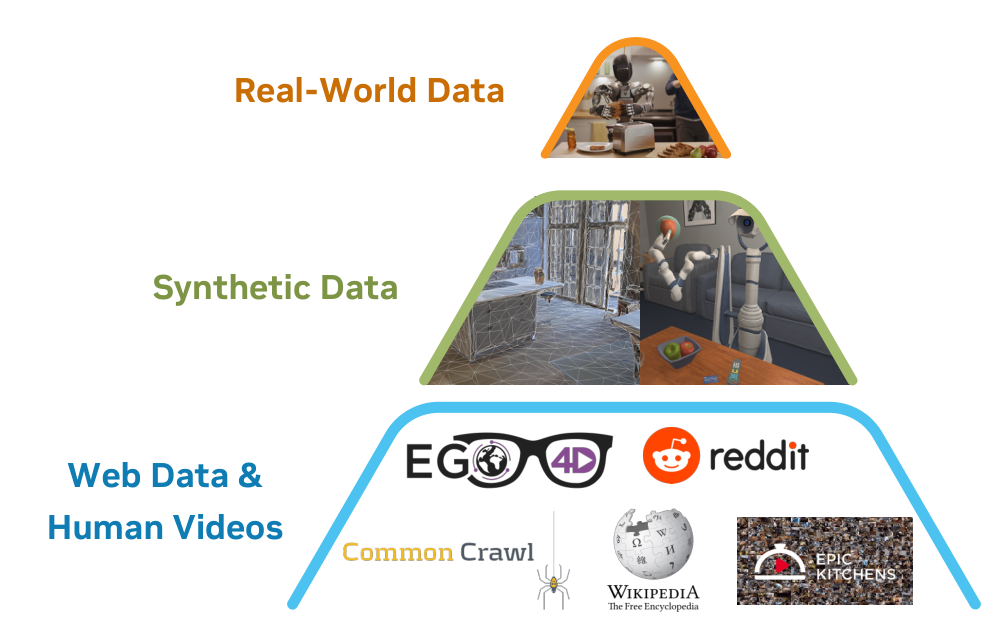
다만 이 논문의 실질적 기여는 아키텍처보다 데이터 전략에 있다. humanoid에는 인터넷 규모의 공용 데이터셋이 없고, 로봇마다 센서와 자유도가 달라 기존 데이터는 서로 호환되지 않는 데이터 섬으로 흩어져 있다. GR00T N1은 이 섬들을 data pyramid로 쌓아 하나의 손실 함수 아래에서 함께 학습한다. GR00T-N1-2B 체크포인트와 학습 데이터, 시뮬레이션 벤치마크를 모두 공개했으므로 이후 GR00T 계열과 오픈소스 VLA 연구가 이 논문을 공통 기준점으로 삼는다.
배경
로봇 foundation model을 막는 병목은 모델 크기가 아니라 데이터다. 텍스트와 이미지는 웹에서 대규모로 수집되지만, humanoid 데이터는 값비싼 하드웨어와 사람의 조작 시간을 그대로 치러야 얻어진다. teleoperation은 사람이 로봇을 원격으로 움직여 시연 데이터(demonstration)를 만드는 방식이며, 이 논문이 직접 모은 데이터도 전부 여기서 나왔다.
두 번째 병목은 데이터 섬 현상이다. Open X-Embodiment처럼 여러 로봇의 데이터를 모으는 cross-embodiment 시도가 있었지만, 로봇 형상과 센서, 액추에이터 자유도, 제어 모드가 제각각이라 하나의 일관된 대규모 데이터셋이 되지 못했다. 논문은 이 상태를 통합된 데이터셋이 아니라 섬들이 흩어진 군도에 비유한다.
따라서 논문의 설계는 두 방향으로 나뉜다. 하나는 서로 다른 embodiment의 입출력을 한 모델이 받아들이게 만드는 구조 설계이고, 다른 하나는 action 라벨이 없는 데이터까지 학습에 넣는 데이터 설계다.
핵심 개념
dual-system은 성격이 다른 두 처리 경로를 한 모델 안에 두는 구성이다. 이름은 카너먼이 제시한 인지 처리 모델에서 왔으며, 느리고 신중한 해석을 맡는 쪽이 System 2, 빠르게 몸을 움직이는 쪽이 System 1이다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하는데, GR00T N1에서는 System 2가 10Hz, System 1이 120Hz다.
data pyramid는 웹 데이터와 합성 데이터, 실제 로봇 데이터를 양이 많은 순으로 쌓아 함께 학습에 쓰는 데이터 전략이다. 아래층이 넓은 시각적 사전 지식을 주고, 위층이 실제 실행 가능성을 담보한다.
latent action은 두 프레임 사이의 시각적 변화를 action 라벨 없이 부호화한 벡터다. 사람이 찍은 일인칭 영상에는 관절 각도 같은 라벨이 없으므로 이 표현이 라벨을 대신해 학습 타깃이 된다. Inverse Dynamics Model은 같은 문제를 다른 방식으로 푸는 장치로, 두 프레임만 보고 그 사이를 채울 action chunk를 되짚어 예측한다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이며 GR00T N1은 길이를 16으로 고정했다. policy는 현재 observation을 받아 다음 action을 정하는 함수이고, 그 실행 기록이 trajectory다. neural trajectory는 이 trajectory를 비디오 생성 모델이 대신 만들어낸 합성 데이터이므로, 실제로 로봇을 움직이지 않고도 data pyramid의 중간층을 넓히는 수단이 된다.
방법
전체 구성
GR00T-N1-2B는 전체 2.2B 파라미터이고 그중 1.34B이 vision-language 부분이다. action chunk 16개를 샘플링하는 데 L40 GPU와 bf16 기준으로 63.9ms가 걸린다. 즉 한 번의 추론으로 16 timestep 분량의 action을 60ms대에 만들어낸다.
추론 모듈 System 2
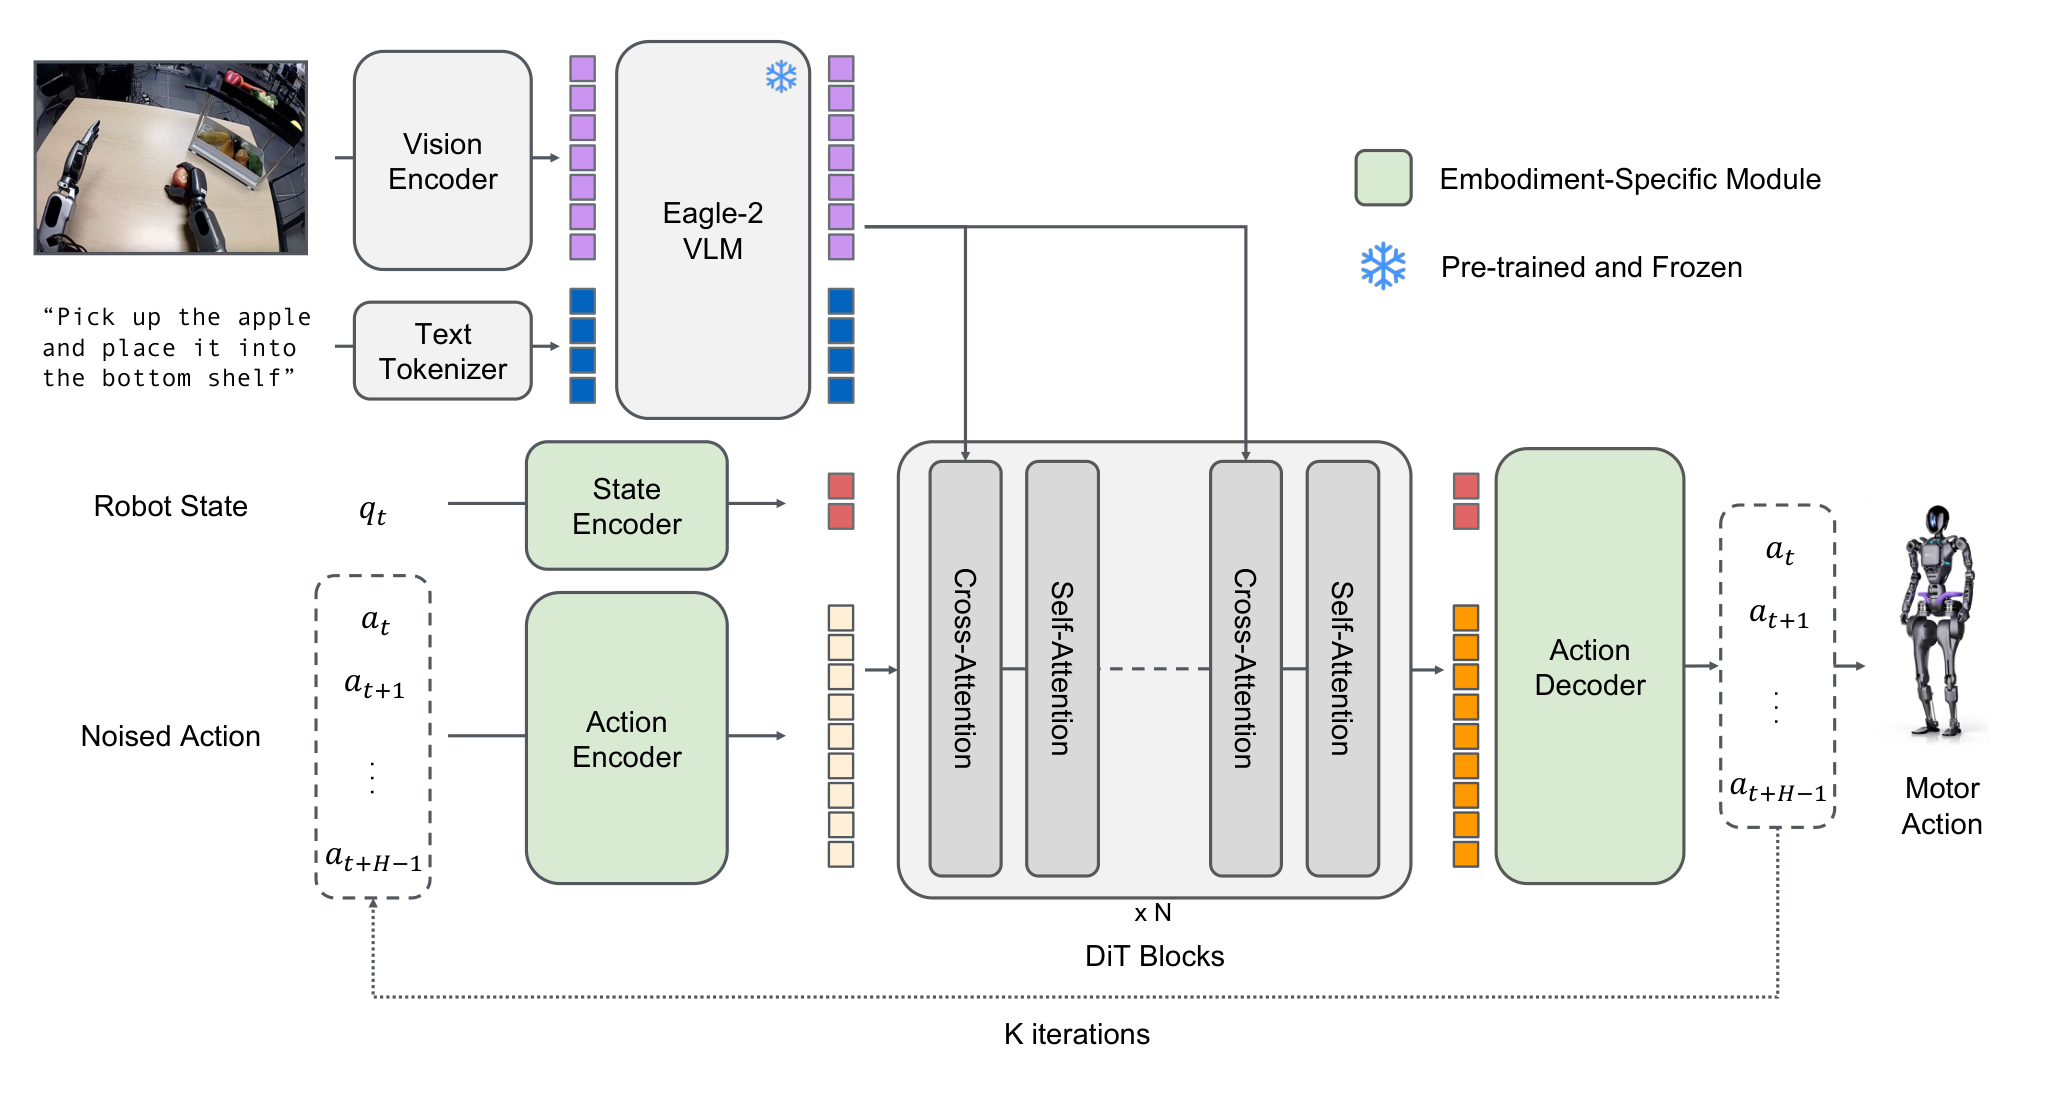
System 2는 인터넷 규모 데이터로 pre-training된 NVIDIA Eagle-2 VLM이다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계다. Eagle-2는 SmolLM2 LLM과 SigLIP-2 이미지 인코더에서 fine-tuning해 만들었고, 이미지는 224×224 해상도로 인코딩한 뒤 pixel shuffle을 거쳐 프레임당 64개의 image token이 된다.
출력을 어느 layer에서 뽑는지가 실무적으로 참고할 만한 선택이다. 최종 layer 대신 중간 layer의 임베딩을 쓰면 추론이 빨라지고 downstream 성공률도 높았다는 것이 저자들의 관찰이며, GR00T-N1-2B는 12번째 layer의 표현을 쓴다.
action 생성 모듈 System 1
System 1은 DiT의 변형이다. DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조를 말한다. GR00T N1은 여기에 adaptive layer normalization을 붙여 denoising step을 조건으로 넣는다.
블록 구성은 self-attention과 cross-attention이 번갈아 놓이는 형태이며 Flamingo와 VIMA가 같은 계열이다. 두 attention이 맡는 일은 서로 다르다.
| 위치 | 처리 대상 | 역할 |
|---|---|---|
| self-attention | noised action token과 state 임베딩 | 현재 로봇 상태에서 그 action이 가능한지 서로 참조한다 |
| cross-attention | VLM이 내놓은 vision-language 토큰 | 목표와 환경 정보에 맞춰 action의 방향을 잡는다 |
마지막 DiT 블록 뒤에는 embodiment별 Action Decoder MLP가 붙어 마지막 16개 토큰을 실제 action으로 바꾼다. 입력 쪽도 대칭이어서, embodiment마다 다른 state와 action 차원은 embodiment별 MLP projector가 공통 임베딩 차원으로 투영한다.
VLM과 action 모델을 잇는 방식은 π0 계열과 다르다. π0는 mixture-of-experts로 두 모델을 연결하지만 GR00T N1은 단순한 cross-attention을 쓴다. 저자들은 이 선택 덕분에 VLM과 action 모델의 아키텍처를 각각 자유롭게 고를 수 있다고 설명한다.
flow matching 학습과 추론
action 생성은 flow matching으로 학습한다. flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다. 정답 action chunk를 , timestep을 , noise를 라 하면 중간 상태는 이고, 모델은 를 근사하도록 L2 손실을 최소화한다. 의 분포는 이고 다.
추론에서는 정규분포에서 시작점을 뽑은 뒤 forward Euler 적분으로 K-step denoising을 수행한다. 모든 embodiment에서 K=4면 충분했다는 것이 실험 결과이며, 이 값이 작다는 사실이 120Hz 동작의 전제가 된다.
여기에 보조 손실이 하나 더 붙는다. 모델이 지시문에 등장하는 대상 물체의 위치까지 맞히게 해서 공간 이해를 강화하려는 장치다. OWL-v2 검출기로 각 프레임의 대상 물체 bounding box를 붙이고 그 중심 좌표를 이미지 크기로 정규화한 값을 정답으로 삼아 제곱 손실을 쓰므로, 전체 손실은 flow matching 손실과 검출 손실의 합이다.
latent action 라벨링
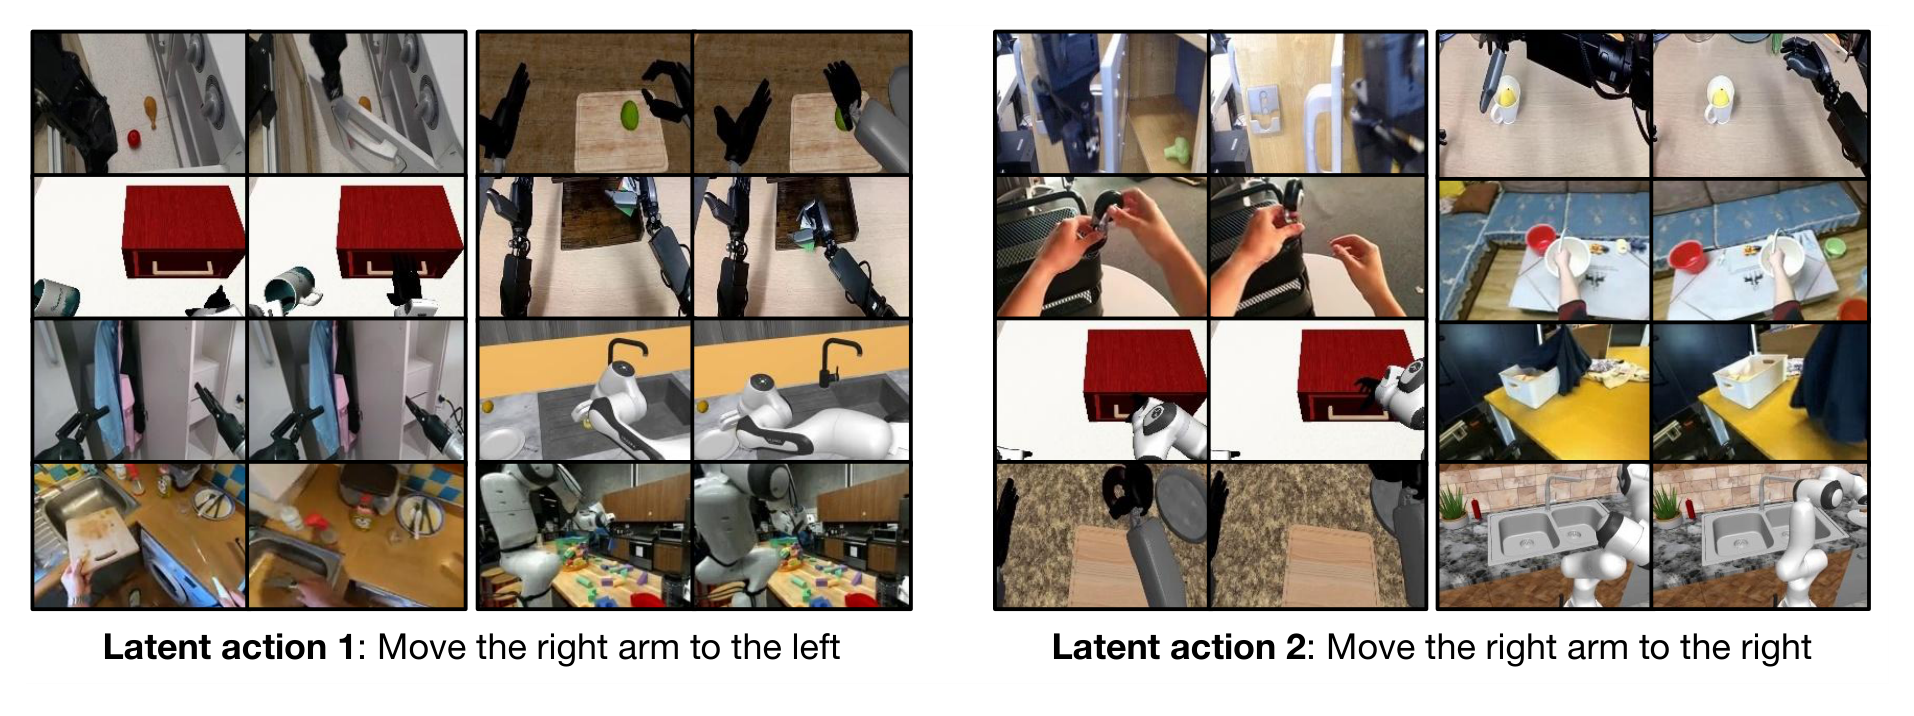
human egocentric video와 neural trajectory에는 실행에 쓸 action이 없다. 이 데이터에 라벨을 붙이는 첫 번째 경로가 VQ-VAE로 뽑은 latent action이다. 인코더가 현재 프레임 와 고정 간격 뒤의 프레임 를 받아 latent action 를 내고, 디코더가 와 로 를 복원하도록 학습한다. 학습이 끝나면 인코더만 떼어 Inverse Dynamics Model처럼 쓰고, 양자화 이전의 연속 임베딩을 라벨로 삼아 LAPA라는 별도 embodiment로 취급한다.
이종 데이터 전체에 하나의 VQ-VAE를 학습시키는 점이 중요하다. 그 결과 모든 데이터가 같은 latent action 공간을 공유하며, 논문은 이것이 cross-embodiment 일반화에 도움이 된다고 본다. 실제로 로봇 8종과 사람 embodiment에서 "오른팔을 왼쪽으로"라는 같은 latent action이 일관되게 대응되는 사례를 제시한다.
neural trajectory 생성
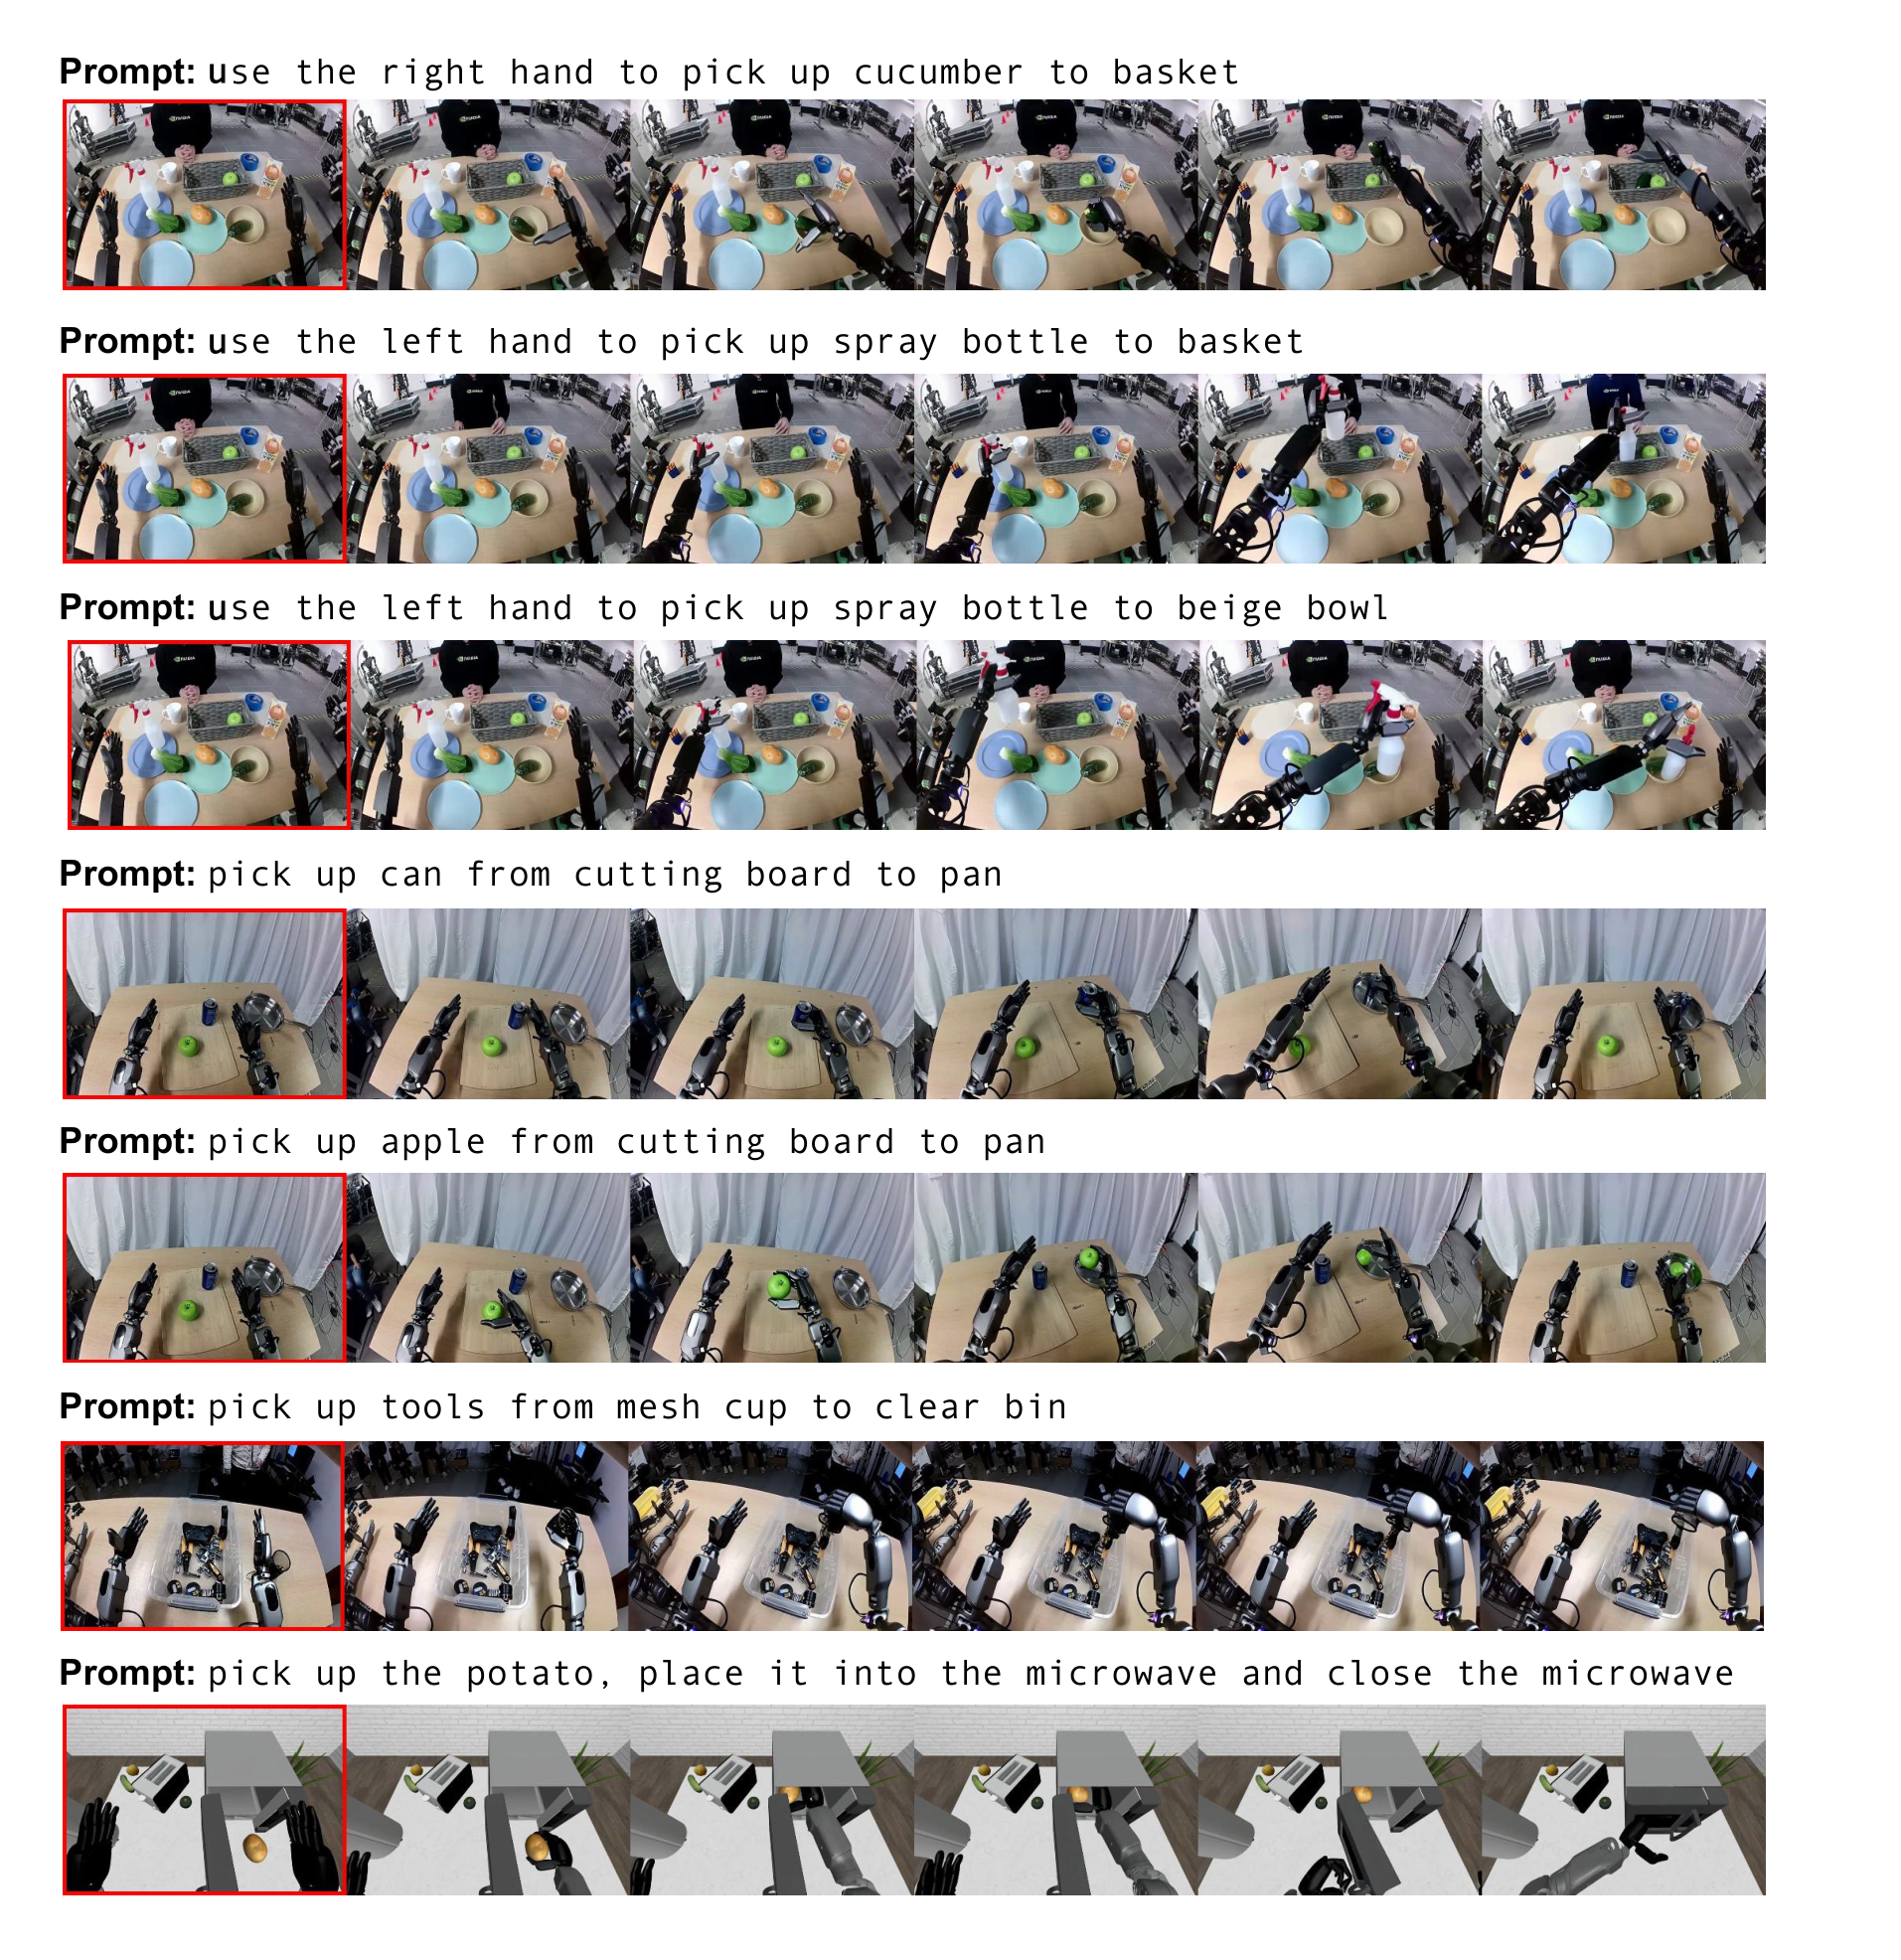
두 번째 경로는 비디오 생성 모델로 trajectory 자체를 만들어내는 것이다. WAN2.1-I2V-14B image-to-video 모델을 LoRA로 fine-tuning하는데, 학습 데이터는 언어 주석이 붙은 자체 수집 실제 로봇 데이터 3,000개 샘플이다. 480P 해상도 81프레임으로 균일 다운샘플해 100 epoch 학습시켰다.
초기 프레임과 새 언어 프롬프트를 주면 실제로 수집한 적 없는 counterfactual 상황이 생성된다. 이렇게 88시간을 827시간으로, 약 10배 늘렸다. 생성 비용은 L40 GPU에서 1초 영상당 2분이며, 전체로는 L40 3,600장에 약 10만 5천 GPU 시간, 벽시계로 약 1.5일이 들었다.
다양성과 품질은 상용 multimodal LLM을 두 번 불러 관리한다. 먼저 초기 프레임에서 물체를 검출해 "pick up {object} from {A} to {B}" 형태의 조합을 대량으로 만들게 하되 물리적으로 가능한 것만 고르라고 지시한다. 그다음 생성된 영상을 8프레임으로 다운샘플해 지시문을 따르지 않은 것을 걸러내는 판정자로 쓰고, 걸러진 영상은 다시 캡션을 붙인다.
생성 영상에는 action 라벨이 없으므로 latent action이나 Inverse Dynamics Model이 예측한 pseudo-action을 붙인다. IDM은 현재 프레임과 미래 프레임 두 장만 조건으로 받아 그 사이의 action chunk를 생성하도록 학습하며, 구조는 System 1의 DiT 모듈에 SigLIP-2 시각 임베딩을 결합하고 flow matching 목적함수를 쓴다. state 정보를 넣거나 프레임을 더 넣어도 검증 성능이 나아지지 않아 두 장 구성으로 고정했다.
시뮬레이션 trajectory 증식
세 번째 데이터 경로는 시뮬레이터 안에서 시연 데이터를 자동으로 불리는 것이다. humanoid는 양팔과 dexterous hand를 동시에 제어해야 해서 실제 수집 비용이 특히 크므로, 논문은 DexMimicGen으로 소수의 사람 시연 데이터를 증식한다. 태스크를 물체 중심 subtask로 분해해 사람 시연 데이터를 구간으로 자르고, 각 구간을 새 물체 위치에 맞춰 변환하되 end-effector와 물체의 상대 pose를 유지한 뒤, 구간 사이를 보간해 이어붙이고 성공한 것만 남긴다.
규모는 다음과 같다. pre-training용으로 source와 target 수납 조합 54종에 각 1만 개씩 총 54만 개를 만들었고, post-training까지 합치면 78만 개다. 사람 시연 데이터로 환산하면 6,500시간, 연속 9개월에 해당하는 양을 11시간 만에 확보한 셈이다.
학습 설정과 인프라
pre-training은 flow matching 손실 하나로 코퍼스 전체를 학습하되 데이터 종류마다 타깃이 다르다.
| 데이터 종류 | flow matching 타깃 |
|---|---|
| human video | 학습된 latent action |
| GR-1이나 OpenX 같은 로봇 데이터 | 실제 action과 latent action을 함께 |
| neural trajectory | latent action과 IDM이 예측한 pseudo-action |
post-training에서는 embodiment 하나에 해당하는 데이터로 fine-tuning하며 vision-language backbone의 언어 부분은 계속 frozen으로 둔다. neural trajectory로 증강할 때는 실제 trajectory와 1:1 비율로 co-train한다. 이때 비디오 생성 모델은 실제 벤치마크 데이터의 10%만으로 fine-tuning하는데, 시연 데이터가 부족한 현실 조건을 그대로 재현하기 위해서다.
주요 하이퍼파라미터는 두 단계가 거의 같고 배치 크기와 step 수만 다르다.
| 항목 | pre-training | post-training |
|---|---|---|
| learning rate | 1e-4 (AdamW, cosine, warmup 비율 0.05) | 동일 |
| 배치 크기 | 16,384 | 128 또는 1,024 |
| gradient step | 200,000 | 2만에서 6만 |
| backbone text tokenizer | frozen | frozen |
인프라는 NVIDIA OSMO가 관리하는 H100 클러스터이고 단일 모델에 최대 1,024장의 GPU를 쓴다. GR00T-N1-2B의 pre-training에는 약 5만 H100 GPU 시간이 들었다. 반대쪽 사양도 적혀 있어 재현 비용을 가늠할 수 있는데, A6000 한 장으로 adapter 계층과 DiT만 fine-tuning하면 배치 크기 200까지, vision encoder까지 함께 fine-tuning하면 16까지 올릴 수 있다.
학습 데이터
pre-training 코퍼스는 실제 로봇 데이터, 합성 데이터, human video 세 종류로 나뉘며 각각 data pyramid의 꼭대기와 중간, 바닥에 해당한다. 전체 규모는 5억 9,290만 프레임, 8,375.7시간이다.
| 계층 | 프레임 수 | 시간 |
|---|---|---|
| 실제 로봇 데이터 | 2억 6,230만 | 3,288.8시간 |
| human video | 1억 8,130만 | 2,517.0시간 |
| 시뮬레이션 데이터 | 1억 2,550만 | 1,742.6시간 |
| neural trajectory | 2,380만 | 827.3시간 |
| 합계 | 5억 9,290만 | 8,375.7시간 |
자체 수집한 실제 로봇 데이터는 Fourier GR-1 humanoid로 모았다. VIVE Ultimate Tracker가 조작자의 손목 pose를, Xsens Metagloves가 손가락 움직임을 잡고, 기록된 사람 동작은 역기구학으로 humanoid action에 맞게 retargeting된다. teleoperation은 20Hz로 동작하며 머리 장착 카메라 영상과 저차원 proprioception을 함께 기록한다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. 주석은 잡기와 옮기기 같은 원자 단위와 그것들을 묶은 상위 태스크 단위 두 층으로 붙는다.
여기에 공개 데이터셋이 더해진다. OpenX-Embodiment 중에서는 RT-1, Bridge-v2, Language Table, DROID, MUTEX, RoboSet, Plex를 골랐고, AgiBot-Alpha에서는 학습 시작 시점에 공개돼 있던 14만 개 trajectory를 썼다. human video는 Ego4D, Ego-Exo4D, Assembly-101, EPIC-KITCHENS, HOI4D, HoloAssist, RH20T-Human 일곱 개다.
| 데이터셋 | 시간 | 성격 |
|---|---|---|
| Ego4D | 2,144.7 | human video 중 최대 규모 |
| AgiBot-Alpha | 1,979.4 | 로봇 100대에서 모은 trajectory |
| GR-1 Simulation Pre-Training | 1,742.6 | DexMimicGen이 만든 시뮬레이션 데이터 |
| GR-1 Neural Videos | 827.3 | 비디오 생성 모델이 만든 neural trajectory |
| GR-1 Teleop Pre-Training | 88.4 | 자체 수집, 20 FPS egocentric |
자체 수집한 실제 humanoid 데이터가 88.4시간으로 전체의 1%에 못 미친다는 점이 data pyramid 전략의 출발점이다. 즉 꼭대기 층이 얇기 때문에 아래 두 층을 함께 학습에 넣어야 한다.
평가 설계
시뮬레이션 벤치마크는 서로 다른 embodiment와 태스크 성격을 덮도록 세 가지를 골랐다. 태스크마다 시연 데이터 1,000개를 생성했고 RoboCasa만 MimicGen이 만든 공개 데이터 3,000개를 쓴다.
| 벤치마크 | 태스크 수 | embodiment | observation 구성 |
|---|---|---|---|
| RoboCasa Kitchen | 24 | Franka Emika Panda 단일 팔 | left, right, wrist 3개 RGB 카메라 |
| DexMimicGen Cross-Embodiment | 9 | 양팔 Panda 그리퍼, 양팔 Panda dexterous hand, GR-1 humanoid | 태스크별 상이 |
| GR-1 Tabletop | 24 | Fourier dexterous hand를 단 GR-1 humanoid | 머리 장착 egocentric 카메라 1대 |
RoboCasa는 집기와 놓기, 문 여닫기, 버튼 누르기 같은 기초 감각운동 능력을 다루는 atomic 태스크로 구성된다. GR-1 Tabletop은 실제 실험과 형태가 같은 재배치 태스크 18개에 관절이 있는 물체를 여닫는 태스크 6개를 더한 것이며, 수납 조합은 pre-training 데이터에 없던 것으로 골랐다.
실제 로봇 평가는 네 범주로 나뉜다.
- Pick-and-Place 5개 태스크. 쟁반, 접시, 도마, 바구니 등 사이에서 물체를 옮기며, 학습에서 본 물체와 처음 보는 물체를 나눠 평가한다.
- Articulated 3개 태스크. 나무 상자, 어두운 수납장, 흰 서랍에 물체를 넣고 닫는다.
- Industrial 3개 태스크. 기계 부품 담기, 나사가 담긴 망 컵 쏟기, 원통형 물체를 손 사이로 전달해 통에 넣기다.
- Coordination 2개 태스크. 로봇 두 대가 물체를 주고받으며 이어서 작업한다.
베이스라인은 두 가지다. BC-Transformer는 RoboMimic의 Transformer behavioral cloning policy로 observation 10프레임을 받아 다음 10개 action을 예측하며 action 분포를 Gaussian Mixture Model로 모델링한다. Diffusion Policy는 U-Net 구조로 noise를 걷어내며 observation 1프레임에서 16개 action step을 한 번에 낸다.
프로토콜은 벤치마크마다 다르다. 시뮬레이션은 100회 시행 평균을 쓰되 500 step마다 저장한 체크포인트 중 마지막 5개의 최댓값을 취한다. 실제 로봇은 태스크당 10회 시행 평균이고 부분 점수를 인정하되, 기계 부품 담기만 30초 제한 안에 부품 5개 중 몇 개를 넣었는지로 점수를 매기고 5회만 시행했다.
결과
시뮬레이션 벤치마크
태스크당 시연 데이터 100개를 쓴 조건에서 GR00T N1이 두 베이스라인을 모두 앞선다.
| 모델 | RoboCasa | DexMG | GR-1 | 평균 |
|---|---|---|---|---|
| BC-Transformer | 26.3% | 53.9% | 16.1% | 26.4% |
| Diffusion Policy | 25.6% | 56.1% | 32.7% | 33.4% |
| GR00T-N1-2B | 32.1% | 66.5% | 50.0% | 45.0% |
격차가 가장 큰 곳은 GR-1 Tabletop이다. 32.7%에서 50.0%로 17.3%p 차이가 나는데, 이 벤치마크가 dexterous hand를 단 humanoid를 쓰고 물체 종류와 배치가 가장 다양하다는 점을 감안하면 pre-training의 효과가 어려운 embodiment에서 크게 나타난다고 읽을 수 있다.
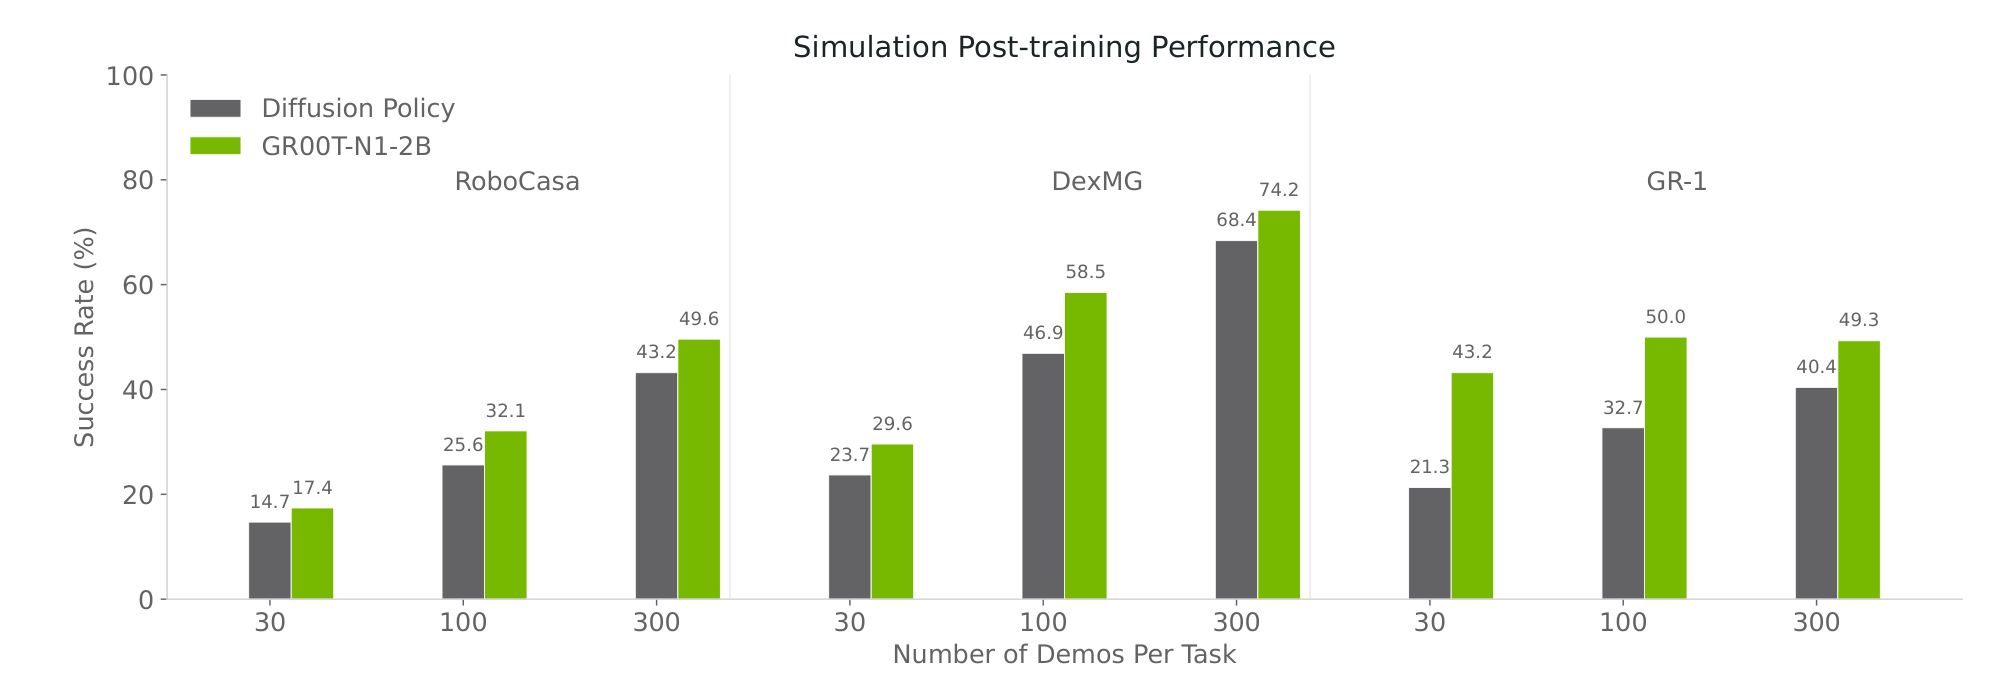
데이터 양을 바꿔가며 Diffusion Policy와 비교하면 이득의 성격이 더 분명해진다.
| 벤치마크 | 모델 | 30개 | 100개 | 300개 |
|---|---|---|---|---|
| RoboCasa | Diffusion Policy | 14.7% | 25.6% | 43.2% |
| RoboCasa | GR00T-N1-2B | 17.4% | 32.1% | 49.6% |
| DexMG | Diffusion Policy | 23.7% | 46.9% | 68.4% |
| DexMG | GR00T-N1-2B | 29.6% | 58.5% | 74.2% |
| GR-1 | Diffusion Policy | 21.3% | 32.7% | 40.4% |
| GR-1 | GR00T-N1-2B | 43.2% | 50.0% | 49.3% |
GR-1 항목에서 GR00T N1은 시연 데이터 30개만으로 43.2%를 기록해, 300개를 쓴 Diffusion Policy의 40.4%를 넘는다. 반면 데이터가 300개로 늘면 이득이 줄어든다. 논문도 fine-tuning 데이터가 충분히 커지면 pre-training의 효과가 옅어지는 것이 자연스럽다고 적었다.
실제 로봇 실험
GR-1 humanoid에서는 Diffusion Policy와 두 데이터 조건으로 비교한다.
| 모델 | Pick-and-Place | Articulated | Industrial | Coordination | 평균 |
|---|---|---|---|---|---|
| Diffusion Policy (10%) | 3.0% | 14.3% | 6.7% | 27.5% | 10.2% |
| Diffusion Policy (전체) | 36.0% | 38.6% | 61.0% | 62.5% | 46.4% |
| GR00T-N1-2B (10%) | 35.0% | 62.0% | 31.0% | 50.0% | 42.6% |
| GR00T-N1-2B (전체) | 82.0% | 70.9% | 70.0% | 82.5% | 76.8% |
같은 데이터량으로 비교하면 10% 조건에서 32.4%p, 전체 조건에서 30.4%p 앞선다. 더 눈에 띄는 것은 데이터 효율이다. 데이터의 10%만 쓴 GR00T N1이 42.6%로, 전체 데이터를 쓴 Diffusion Policy의 46.4%와 3.8%p 차이밖에 나지 않는다.
Pick-and-Place를 학습에서 본 물체와 처음 보는 물체로 나누면 일반화 폭도 확인된다. 전체 데이터 조건에서 GR00T N1은 본 물체 92.0%, 처음 보는 물체 72.0%인 반면 Diffusion Policy는 각각 42.0%와 30.0%다. 즉 두 조건 모두에서 격차가 40%p 안팎으로 유지된다.
범주별로는 GR00T N1이 상대적으로 약한 곳도 있다. 10% 조건의 Industrial이 31.0%로, 전체 데이터를 쓴 Diffusion Policy의 61.0%보다 낮다. 기계 부품 담기가 8.0%로 특히 낮은데, 30초 제한 안에 부품 5개를 처리해야 하는 태스크 특성이 저데이터 조건에서 불리하게 작용한 것으로 보인다.
pre-training 체크포인트 평가
post-training 없이 pre-training 체크포인트만으로도 두 가지 태스크를 측정했다. 각 태스크마다 물체 다섯 종류를 세 번씩, 총 15회 시행한다.
- 양손 협업. 물체를 왼손 바깥쪽에 일부러 두고 선반에 놓으라고 지시하면 로봇은 왼손으로 집어 오른손이 닿는 위치로 옮긴 뒤 선반에 놓아야 한다. 성공률은 76.6%(11.5/15)다.
- 미지 물체 배치. 처음 보는 물체를 처음 보는 컨테이너에 넣는 태스크로 73.3%(11/15)다.
0.5점은 물체를 제대로 잡았지만 컨테이너에 넣지 못한 경우에 준 부분 점수다. 논문은 이 두 수치를 대규모 pre-training이 실제로 작동한다는 근거로 제시한다.
neural trajectory co-training
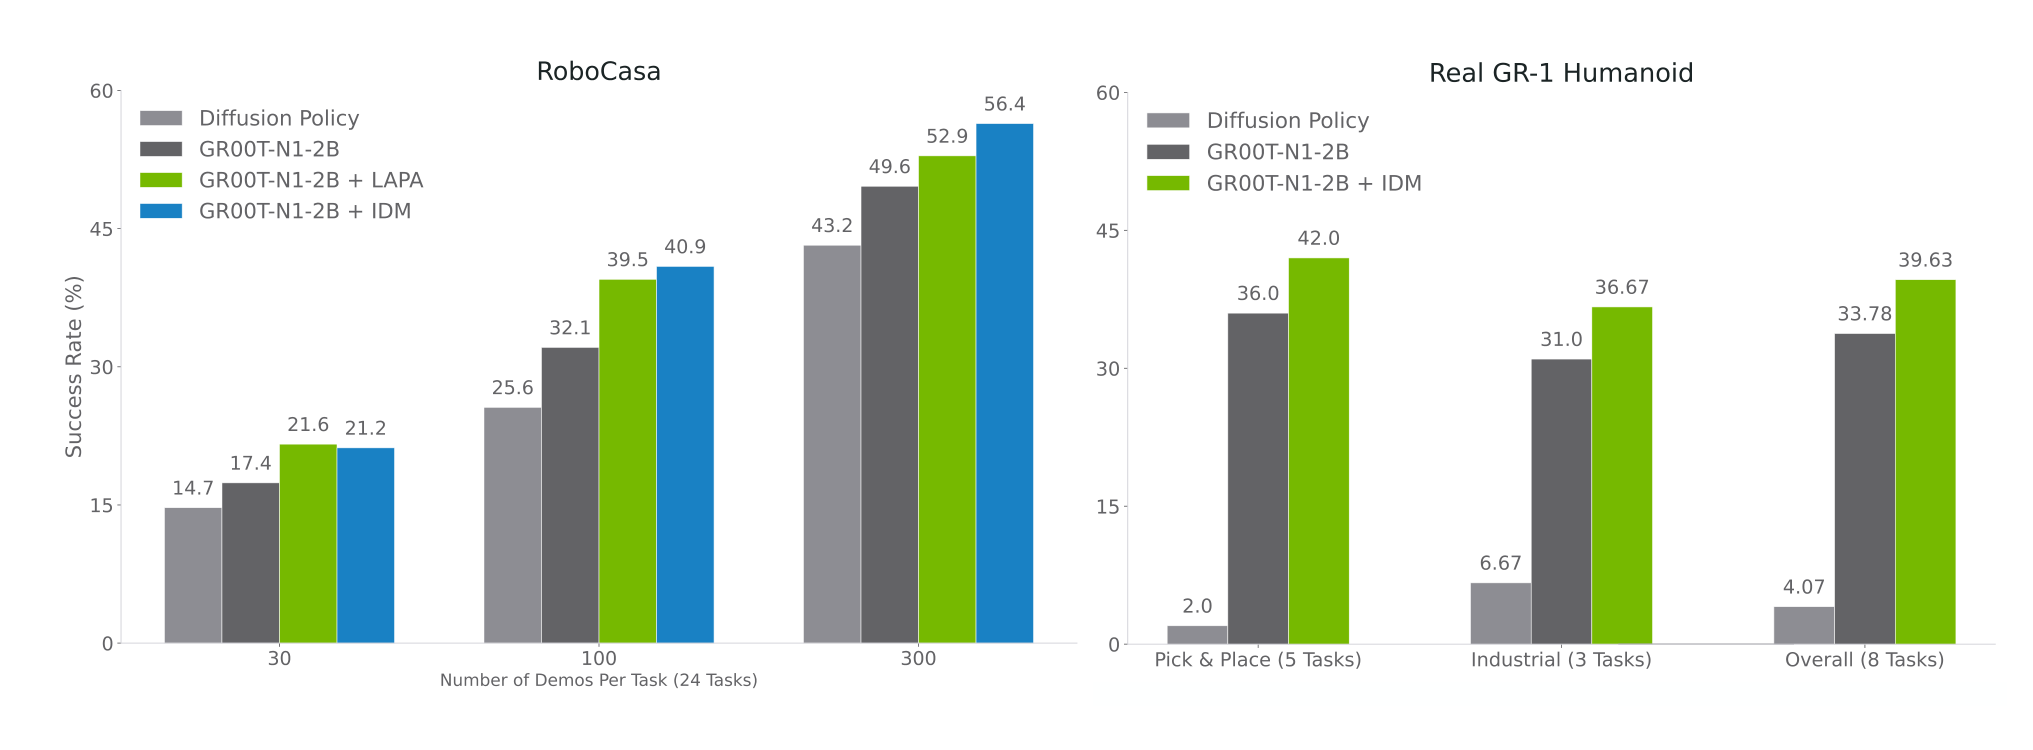
생성 영상을 학습에 섞는 효과는 별도 ablation으로 확인한다. ablation은 구성 요소를 하나씩 빼거나 바꿔 기여도를 재는 실험이다. RoboCasa에서는 태스크당 3,000개, 실제 로봇에서는 태스크당 100개의 neural trajectory를 실제 데이터와 1:1로 co-train한다.
| 조건 | 이득 |
|---|---|
| RoboCasa, 시연 데이터 30개 구간 | +4.2%p |
| RoboCasa, 시연 데이터 100개 구간 | +8.8%p |
| RoboCasa, 시연 데이터 300개 구간 | +6.8%p |
| 실제 GR-1 humanoid 8개 태스크 평균 | +5.8%p |
라벨 방식에 따른 차이도 드러난다. 데이터가 가장 적은 30개 구간에서는 latent action이 Inverse Dynamics Model보다 약간 앞서지만, 100개와 300개로 갈수록 IDM 쪽이 벌어진다. IDM 학습에 쓸 데이터가 늘면 pseudo-action이 실제 action에 가까워져 전이가 강해진다는 것이 논문의 설명이다. GR-1 humanoid는 상대적으로 데이터가 많은 조건이라 실제 로봇 co-training에는 IDM이 붙인 action만 사용했다.
정성 관찰
수치 밖의 관찰 세 가지가 본문에 함께 실려 있다. 첫째는 태스크 의미 이해다. RoboCasa의 "Turn Sink Spout" 태스크에서 시연 데이터 100개 구간 기준 Diffusion Policy가 11.8%, GR00T N1이 42.2%를 기록했다. 논문은 Diffusion Policy가 태스크의 의미를 자주 혼동한다고 적었다.
둘째는 동작 품질이다. post-training을 마친 GR00T N1은 Diffusion Policy보다 움직임이 부드럽고 잡기 정확도가 높았다. 반면 Diffusion Policy는 초기 프레임에서 움직이지 못하고 멈춰 있거나 부정확하게 잡는 경우가 잦았다.
셋째는 post-training이 pre-training의 능력을 덮어쓴 사례다. pre-training 체크포인트에 "빨간 사과를 집어 바구니에 넣어라"를 주고 사과를 양손 바깥 왼쪽에 두면, 동작이 다소 거칠긴 해도 왼손으로 집어 오른손에 넘긴 뒤 바구니에 넣는다. 그런데 같은 상황에서 post-training을 마친 체크포인트는 실패한다. post-training 데이터가 전부 오른손 단독 작업이고 손 사이 전달이 없었기 때문에 그 능력을 잃었다는 것이 논문의 해석이다. 다만 이 관찰은 정량 평가 없이 제시됐으므로, 좁은 post-training 데이터가 일반화를 침식할 수 있다는 신호 정도로 읽는 것이 적절하다.
한계
- 과제 범위가 좁다. 현재 모델은 작업 반경이 짧은 탁상 조작에 초점을 맞추고 있다. long-horizon loco-manipulation으로 넓히려면 humanoid 하드웨어와 모델 아키텍처, 학습 코퍼스가 모두 함께 발전해야 한다고 적었다.
- vision-language backbone이 더 강해져야 한다. 저자들은 backbone이 개선되면 spatial reasoning과 언어 이해, 적응력이 함께 나아질 것으로 본다.
- 합성 데이터의 품질과 변동성이 부족하다. 비디오 생성과 자동 trajectory 합성이 유망하지만, 물리 법칙을 지키면서 다양하고 counterfactual한 데이터를 만드는 일은 여전히 어렵다.
- 일부 관찰이 정량화되지 않았다. post-training에서 손 사이 전달 능력을 잃은 사례, 여러 라운드에 걸친 영상 생성, 액체와 관절 물체의 neural trajectory는 예시만 제시하고 downstream 정량 평가는 후속 과제로 남겼다.
저장소 안에서의 위치
GR00T N1은 이 저장소에서 조작 계열 dual-system VLA의 기준점 역할을 한다. whole-body control 계보와 견주면 분업이 뚜렷한데, whole-body control은 균형과 이동을 포함해 몸 전체를 함께 제어하는 문제다. SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control과 GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks)이 humanoid의 균형과 locomotion을 담당하고, GR00T N1은 그 위에서 동작하는 조작 policy를 다룬다.
neural trajectory는 world model 논의와 직접 이어진다. World Model for Robot Learning: A Comprehensive Survey 서베이가 지목한 병목은 그럴듯한 미래 영상에서 action에 alignment된 실행 가능한 미래로 넘어가는 지점인데, 이 논문의 latent action 대 IDM 비교가 정확히 같은 문제를 재고 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| dual-system | 느린 추론 모듈(VLM, 10Hz)과 빠른 action 모듈(DiT, 120Hz)을 분리하되 학습에서는 함께 최적화하는 구성 |
| data pyramid | 웹 데이터와 human video를 바닥에, 합성 데이터를 중간에, 실제 로봇 데이터를 꼭대기에 둔 학습 코퍼스 구성 |
| latent action | action 라벨이 없는 영상에서 VQ-VAE로 뽑은 동작 표현. LAPA라는 별도 embodiment로 취급해 학습에 넣는다 |
| Inverse Dynamics Model | 연속된 두 프레임에서 그 사이의 action chunk를 역추정하는 모델. neural trajectory에 pseudo-action을 붙인다 |
| neural trajectory | 비디오 생성 모델이 만든 로봇 trajectory 영상. 실제 수집 없이 counterfactual 상황을 늘린다 |
| DexMimicGen | 소수의 사람 시연 데이터를 물체 중심 subtask로 쪼개 변환하고 재생해 시뮬레이션 데이터를 대량 증식하는 시스템 |
관련 페이지
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: 이 논문의 한국어 입문 해설. dual-system과 flow matching, latent action을 도식 중심으로 설명하므로 개념이 낯설면 먼저 읽는다.
- 03-14. Groot N1.5 - 모두의 로보틱스 - VLA 입문: N1.5가 이 구조에 무엇을 더했는지 정리한 한국어 해설. VLM 교체와 FLARE 손실, DreamGen 데이터가 주요 변경점이다.
- GR00T N1.5: 직계 후속 모델의 기술 보고서.
- RT-1: Robotics Transformer for Real-World Control at Scale: VLA 계보의 출발점. 이산 action token을 쓴 RT-1과 달리 GR00T N1은 flow matching으로 연속 action을 낸다.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 시뮬레이션 벤치마크 세 가지 중 하나인 RoboCasa Kitchen의 원 논문. neural trajectory ablation의 데이터 구간도 이 환경 정의 위에서 측정한다.
- World Model for Robot Learning: A Comprehensive Survey: policy와 world model의 결합 방식을 다섯 가지로 나눈 서베이.
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: 같은 NVIDIA GEAR 계열의 전신 모션 트래킹. GR00T N1이 조작을, SONIC이 whole-body control을 맡는 분업 관계다.
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): SONIC과 Decoupled WBC 실행 스택.
- Eagle 2.5: Boosting Long-Context Post-Training for Frontier Vision-Language Models: System 2로 쓰인 Eagle 계열의 다음 세대 기술 보고서.
- VLM3: Vision Language Models Are Native 3D Learners: 이 논문이 한계로 지목한 더 강한 vision-language backbone 논의.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.
- VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics: GR00T, π, Gemini Robotics 세 계열을 세대별로 나란히 놓은 비교 overview.