LLMs · PAPER · 2026
VLM3: Vision Language Models Are Native 3D Learners
요약
VLM3는 표준 VLM이 별도의 구조 변경 없이 3D 이해를 배울 수 있다는 것을 네 가지 task에서 보인 논문이다. Meta와 Princeton University의 연구진은 Qwen3-VL-4B에 focal length 통일, 텍스트 기반 픽셀 참조, 데이터 mixture와 scaling 세 가지만 적용하고 표준 SFT로 학습시켰다. 그 결과 metric depth 추정, object-level 3D 이해, pixel correspondence 추정, camera pose 추정에서 전용 설계를 갖춘 expert vision model에 필적하는 정확도를 얻었다.
수치로 보면 depth δ1 평균은 선행작 DepthLM-7B의 0.838에서 0.904로 올라 UniDepthV2와 비슷한 수준이 됐다. pixel correspondence의 EPE는 base VLM의 153.28에서 15.37로 약 10분의 1이 되어 DKM과 RoMa를 앞선다. camera pose의 AUC30은 5.4%에서 94.0%로 올라 VGGT를 넘고 DA3-Giant(94.7%)에 근접한다. object-level 3D 이해에서는 추가 인코더 없이 SpatialRGPT-8B를 앞선다.
이 논문의 중심 주장은 expert vision model의 기반으로 여겨지던 설계 대부분이 3D 학습의 필요조건이 아니라는 것이다. 추가 인코더, 여러 디코더, 무거운 데이터 증강, 그리고 연속값을 직접 회귀하는 regression 손실까지 모두 없이, 숫자를 텍스트로 예측하는 next-token prediction만으로 같은 정확도에 이른다. 저자는 이 결과가 3D foundation model을 단순하고 scalable하게 만드는 새로운 방향을 연다고 본다.
배경
expert vision model의 task-specific 설계
2D 입력에서 3D를 이해하는 것은 시각 지능의 핵심이지만, 기존 VLM은 의미 이해에 비해 3D 이해, 특히 fine-grained task에서 약했다. 그래서 3D 이해는 task마다 따로 설계된 expert vision model이 맡아 왔다. expert vision model은 특정 3D task를 위해 데이터 증강, 구조, 손실을 전용으로 설계한 모델을 말한다.
논문이 정리한 expert 설계의 복잡성은 세 층으로 나뉜다.
| 설계 층 | 대표 사례 | 논문이 지적하는 부담 |
|---|---|---|
| 구조 | pre-training된 vision 인코더(CroCo, DINOv2) 위에 DPT, FPN, Gaussian Process, self-attention과 linear layer 같은 디코더를 여러 개 두고 task별 routing을 둔다. depth 추정은 depth, confidence, camera ray map 디코더를, pixel correspondence는 multi-scale warping을, pose 추정은 depth, camera ray, point track, pose를 함께 supervision한다 | 표준 VLM과 호환되지 않는다 |
| 손실 | MSE, L1, certainty, regression by classification, clipped L2 | 손실의 종류보다 개수가 문제다. 방법과 task마다 가중을 튜닝해야 한다 |
| 데이터 증강 | random resizing, cropping, translation 같은 기하 증강과 brightness, gamma, saturation, hue shift 같은 광도 증강(UniDepthV2, VGGT) | 성능에 중요하다고 여겨져 왔다 |
3D 이해를 다룬 기존 VLM 연구
VLM으로 3D를 다루려는 시도는 이미 있었지만 두 가지 제약이 있었다. SpatialVLM(Chen et al., 2024)은 expert 모델의 예측을 텍스트 프롬프트로 바꿔 학습하는데, object-level의 coarse-grained 이해에 머물러 fine-grained task에서는 expert를 따라잡지 못한다. SpatialRGPT(Cheng et al., 2024)는 정성 문제와 정량 문제를 분리하고 object 참조용 인코더를 추가해 object 이름 없이 대상을 가리키게 했다. 같은 종류의 object가 여러 개 있을 때 유용하고 평가에서 의미 정보를 걷어내는 장점이 있지만, 추가 인코더 때문에 학습과 모델이 표준 VLM과 호환되지 않는다.
SpatialBot(Cai et al., 2024)과 VLM-3R(Fan et al., 2025)은 task와 입력의 다양성을 넓혔지만 역시 추가 구조가 필요하다. 최근에는 Multi-SpatialMLLM(Xu et al., 2025), Seed1.5-VL(Guo et al., 2025), DepthLM(Cai et al., 2025)이 depth 추정 같은 fine-grained 3D 이해를 다루기 시작했다.
DepthLM에서 VLM3로
DepthLM은 표준 VLM이 pixel-level metric depth를 expert 수준으로 배울 수 있음을 처음 보였다. VLM3는 같은 1저자의 후속작으로, 연구 질문을 "복잡한 task-specific 설계 없이도 표준 VLM이 depth 추정 이외의 다양한 fine-grained 3D task에서 expert vision model을 따라잡을 수 있는가"로 넓혔고 답은 긍정이었다.
DepthLM과 VLM3의 차이는 두 가지다. task 수가 하나에서 넷으로 늘었고, 픽셀을 가리키는 방식이 이미지 위에 marker를 그리는 visual prompting에서 좌표를 텍스트로 적는 방식으로 바뀌었다. 후자가 학습 효율과 확장성을 결정한다는 점이 이 논문의 주요 발견이다.
핵심 개념
VLM은 vision-language model의 약어로, 이미지와 텍스트를 함께 입력받아 텍스트를 생성하는 모델이다. 프롬프트만 바꿔 여러 비전 task를 하나의 모델로 푸는 것이 VLM의 장점이고, VLM3는 이 장점을 3D task까지 넓힌다.
SFT는 supervised fine-tuning의 약어다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계이고, SFT는 입력과 정답 텍스트 쌍으로 이를 수행한다. VLM3의 학습 목표는 next-token prediction뿐이다. next-token prediction은 이전 토큰들로 다음 토큰을 맞히는 학습 목표이며, VLM3는 거리나 각도 같은 숫자도 텍스트 토큰으로 예측한다.
focal length는 카메라의 초점 거리로, 논문에서는 픽셀 단위로 표현한다. camera intrinsics는 focal length를 포함해 3D 점이 이미지의 어느 픽셀에 맺히는지를 결정하는 카메라 내부 파라미터다. 논문은 camera ambiguity를 정의하지 않고 DepthLM을 인용해 focal length 통일로 해결한다고만 적는다. 같은 픽셀 위치라도 focal length가 다르면 실제 3D 방향이 달라진다는 점에서, 이미지만으로는 metric 정보가 결정되지 않는 문제로 읽을 수 있다.
metric depth 추정은 query 픽셀과 카메라 사이의 실제 거리를 미터 단위로 추정하는 task다. pixel correspondence 추정은 왼쪽 이미지의 query 픽셀에 대응하는 오른쪽 이미지의 픽셀을 찾는 multi-view task다. camera pose 추정은 두 viewpoint 사이의 이동 거리, 이동 방향, 회전을 추정하는 multi-view task다. object-level 3D 이해는 두 object의 공간 관계나 크기, 거리를 묻는 task로, VLM3는 SpatialRGPT-Bench 형식을 그대로 쓴다.
visual prompting은 입력 이미지 위에 marker를 렌더링해 VLM에게 픽셀을 가리키는 방식이고, 텍스트 기반 픽셀 참조는 픽셀 좌표를 텍스트로 프롬프트에 적는 방식이다. VLM3는 픽셀 공간을 가로세로 모두 [0, 2000) 범위의 정수로 정규화해 후자를 쓴다. 이미지 한 장에 대한 질문 여러 개를 이미지 중복 없이 한 sample에 넣는 것을 packing이라고 부른다.
데이터 mixture는 크기가 다른 여러 데이터셋을 섞어 학습할 때 데이터셋마다 얼마나 자주 뽑을지를 정하는 가중이다. 수십억 파라미터의 VLM은 작은 데이터셋에 쉽게 과적합하므로, 논문은 이 가중이 scaling의 성패를 좌우한다고 본다.
방법
전체 흐름
VLM3의 처리 흐름은 세 단계다. 입력 이미지(task에 따라 한 장 또는 여러 장)를 focal length가 1000픽셀이 되도록 resize하고, 픽셀이나 object 영역을 [0, 2000)로 정규화한 좌표 텍스트로 가리킨 뒤, 표준 텍스트 SFT로 학습한다. 별도 언급이 없으면 base VLM은 Qwen3-VL-4B이고 구조, 손실, 데이터 증강은 바꾸지 않는다.
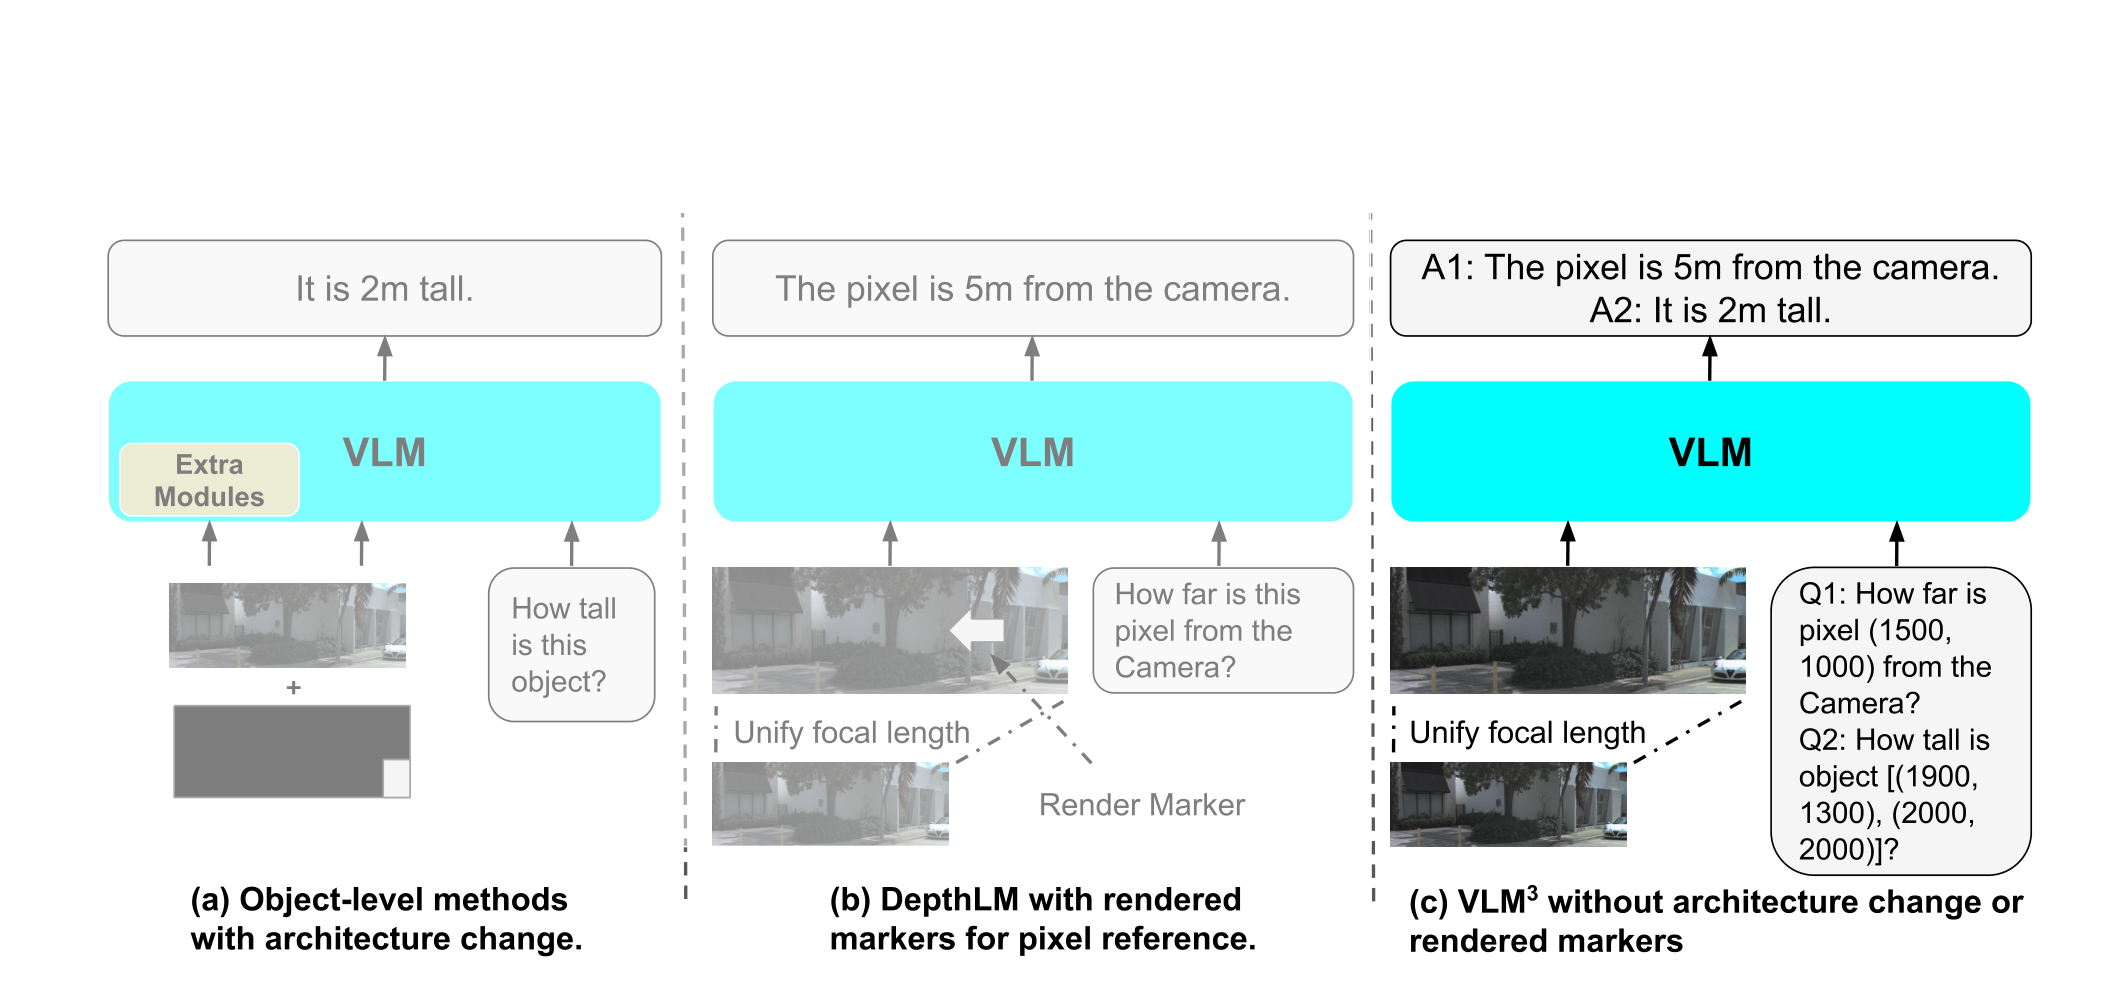
Figure 2의 세 패널이 기존 방법과의 차이를 보여준다. 왼쪽의 object-level 방법은 VLM 옆에 추가 모듈을 붙여 mask 입력을 받는다. 가운데의 DepthLM은 focal length를 통일하지만 픽셀을 가리키기 위해 이미지에 marker를 그린다. 오른쪽의 VLM3는 focal length 통일만 남기고, "How far is pixel (1500, 1000) from the camera?"처럼 좌표를 텍스트로 적어 한 이미지에 depth 질문과 object 높이 질문을 함께 넣는다.
세 가지 핵심 요소
| 요소 | 내용 | 해결하는 문제 |
|---|---|---|
| focal length 통일 | 입력 이미지를 focal length 1000픽셀로 resize한다. intrinsics가 없으면 calibration 모델로 추정한다 | camera ambiguity. 구조 변경 없이 혼합 데이터 학습이 가능해진다 |
| 텍스트 기반 픽셀 참조 | 좌표를 [0, 2000)로 정규화한 정수로 프롬프트에 직접 적는다 | marker 렌더링을 없애 packing이 가능해지고, 출력에도 좌표가 필요한 task를 같은 방식으로 다룬다 |
| 데이터 mixture와 scaling | 데이터셋 크기 기반 가중을 기본선으로 두고 작은 데이터셋의 가중을 더 낮춘다 | 작은 데이터셋 과적합. 균일 가중으로 데이터만 늘리면 성능이 정체하거나 떨어진다 |
저자는 세 요소가 복잡한 데이터 증강, 구조, 손실을 설계하는 것보다 훨씬 중요하다고 적는다. 특히 camera ambiguity와 픽셀 참조 문제만 풀리면 데이터를 늘리는 것으로 충분하다는 것이 VLM3의 핵심 통찰이다. 세 요소 가운데 앞의 둘은 입력을 표준 VLM이 다룰 수 있는 형태로 바꾸는 전처리이고, 마지막 하나는 학습 데이터의 구성 문제라서, 모델 자체에는 손을 대지 않는다.
focal length 통일
focal length 통일은 DepthLM과 같은 방식이다. 표준 VLM의 pre-training과 post-training에 그대로 호환되도록 입력 이미지만 resize하고, object-level 공간 추론 VLM(SpatialRGPT, Zhang et al. 2026)처럼 구조를 바꾸지 않는다.
출처를 모르는 이미지에는 camera intrinsics가 없다. 이 경우 VLM3는 pre-training된 단일 이미지 calibration 모델(AnyCalib, Tirado-Garín and Civera 2025)로 intrinsics를 추정한 뒤 focal length를 통일한다. object-level 3D 이해 실험은 학습과 평가 데이터가 모두 인터넷의 in-the-wild 이미지라 이 방식을 썼고, 저자는 실제로 잘 동작했다고 적는다.
텍스트 기반 픽셀 참조
DepthLM이 visual prompting을 택한 이유는 텍스트 좌표가 통하지 않는다는 실험 결과였다. DepthLM은 "Given this image of size (width = w, height = h), how far is the pixel at (x, y) from the camera?"라는 프롬프트로 실험해 VLM이 텍스트 기반 픽셀 참조를 이해하지 못한다고 결론지었다.
VLM3는 이 결론이 프롬프트 형식에 달려 있음을 보였다. VLM 기반 object detection(Visual-RFT, Liu et al. 2025)에서 착안해 이미지 크기를 알려주는 대신 "How far is the pixel at (x, y) from the camera? Both x and y are normalized to between [0, 2000)."처럼 좌표를 정규화해 적었더니, 텍스트 참조가 visual prompting과 같은 정확도를 냈다. 즉 픽셀 공간 정규화는 coarse-grained object 영역뿐 아니라 fine-grained 픽셀 위치에도 통하는 참조 방식이다.
| 비교 항목 | visual prompting (DepthLM) | 텍스트 기반 픽셀 참조 (VLM3) |
|---|---|---|
| 픽셀 지정 | 이미지 위에 marker 렌더링 | 정규화 좌표 텍스트 |
| 같은 이미지의 여러 픽셀 | marker 위치가 다른 이미지를 픽셀 수만큼 넣는다 | 이미지 한 장에 질문 여러 개를 packing한다 |
| depth 학습 규모 | 약 1,600만 장, 장당 2픽셀 | sample당 10픽셀, 추가 연산 부담은 무시할 수준 |
| 출력에 좌표가 필요한 task | 어렵다 | query와 출력 픽셀을 모두 텍스트로 다룬다 |
| 불필요한 이미지 증강 | marker 렌더링에 수반 | 없음 |
이 변화의 효과는 효율과 범용성 두 가지다. 효율 면에서는 depth 추정을 sample당 labeled pixel 1개가 아니라 10개로 학습할 수 있어 같은 연산으로 훨씬 큰 규모를 다룬다. 범용성 면에서는 object-level 3D 이해에서 텍스트로 object를 가리키고, pixel correspondence에서 query와 출력 픽셀을 모두 텍스트로 다루는 등 하나의 단순한 방법으로 여러 3D task를 처리한다.
데이터 mixture와 scaling
DepthLM은 대부분의 데이터셋에 균일 가중을 썼다. 반면 VLM3는 학습 규모를 키울 때 데이터 mixture가 거의 가장 중요한 요소가 된다고 본다. 크기가 크게 다른 데이터셋을 섞을 때 가중 없이 데이터만 늘리면 성능이 정체하거나 오히려 떨어지는데, 작거나 단순한 데이터셋을 수십억 파라미터 VLM이 쉽게 과적합하기 때문이다.
논문의 처방은 두 단계다. 데이터셋 크기에 비례한 가중이 여러 task에 통하는 합리적인 기본선이고, 그 위에서 쉽게 과적합되는 작은 데이터셋의 가중을 더 낮추면 성능이 크게 오른다. 실제 depth 가중은 부록 Table 5에 있고 아래 학습 데이터 절에 옮겼다.
네 task의 입력과 출력
논문은 단일 view와 multi-view를 모두 포함하고 기존 모델의 설계가 크게 다른 네 task를 골랐다.
| task | 입력 | 참조 방식 | 출력 | 학습 데이터 |
|---|---|---|---|---|
| metric depth 추정 | 이미지 1장 | 정규화 픽셀 좌표 (x, y) | "x meters" | DepthLM 데이터 1,600만 장에 실외 street view 내부 이미지 1,000만 장을 더한 2,600만 장 |
| object-level 3D 이해 | 이미지 1장 | bounding box (xMin, yMin, xMax, yMax) 텍스트 | SpatialRGPT 형식의 정성, 정량 답 | SpatialRGPT와 같은 100만 장 |
| pixel correspondence 추정 | 이미지 2장 | 첫 이미지의 픽셀 (x1, y1) | 둘째 이미지의 픽셀 (x2, y2) | 약 990만 image pair |
| camera pose 추정 | 이미지 2장 | 없음 | 이동 거리, 이동 방향, 회전 세 질문 | pixel correspondence와 같은 데이터와 가중 |
metric depth는 DepthLM의 설정을 따르되 세 가지를 바꿨다. 텍스트 참조로 이미지 한 장의 labeled pixel 10개를 QA 10개로 packing하고, 데이터를 1,600만 장에서 2,600만 장으로 늘렸으며, 분석 실험에 근거한 비균일 가중을 적용했다.
object-level 3D 이해는 SpatialRGPT와 같은 데이터로 학습하고 평가한다. SpatialRGPT가 object region mask를 인코딩하는 추가 인코더를 붙인 것과 달리, VLM3는 bounding box 좌표 텍스트만으로 object를 가리키고 나머지 프롬프트는 원래 형식을 그대로 따른다.
pixel correspondence는 LLM으로 무작위 생성한 프롬프트 템플릿 5개를 쓰며, 모델은 프롬프트 형식에 민감하지 않았다. 예시 프롬프트는 "Given these two images, what pixel in the second image corresponds to pixel (x1, y1) in the first image? Report the answer as (x2, y2)."이고 답은 "The corresponding pixel is (x, y)"다. 이 task는 세계의 metric scale을 이해할 필요가 없어 focal length 통일이 경험적으로 필요하지 않았지만, 적용해도 성능이 떨어지지는 않았다.
camera pose 프롬프트
camera pose 추정은 이미지 2장을 입력받아 pose의 세 구성 요소를 각각 별개의 질문으로 묻고, 학습과 평가 모두 세 질문을 한 sample에 packing한다.
| 구성 요소 | 표현 | 프롬프트 요지 |
|---|---|---|
| translation distance | 미터 단위 숫자 | 두 viewpoint 사이 카메라 이동의 크기를 추정. 답은 "Translation distance: x meters" |
| translation direction | 첫 카메라 좌표계(X = right, Y = down, Z = forward)의 단위 벡터 | 대략적인 방향(예: right, backward)과 정밀한 단위 벡터 (x, y, z)를 함께 답한다 |
| rotation | yaw, pitch, roll 세 각도 | 첫 카메라 기준으로 yaw, pitch, roll 순서로 intrinsic하게 적용. yaw는 아래쪽 수직 방향 기준 회전(양수 = 오른쪽 회전), pitch는 yaw 이후 옆 방향 기준(양수 = 위를 봄), roll은 광학 방향 기준(양수 = 오른쪽으로 기울임). 답은 "Yaw=x, Pitch=y, Roll=z" |
저자는 pose 추정 결과를 네 task 가운데 가장 놀라운 것으로 꼽는다. 기존 pose 추정은 correspondence를 먼저 구하고 최적화 문제를 푸는 multi-step 방식(Structure-from-Motion, Schonberger and Frahm 2016)이거나, camera ray 방향, point track, depth 같은 보조 task와 결합한 복잡한 regression 손실(VGGT, DA3)로 학습됐다. 표준 VLM이 프롬프트 문구를 크게 다듬지 않고 next-token prediction만으로 pose 텍스트를 내는 것은 저자가 보기에 완전히 새로운 패러다임이며, expert 3D 모델의 기반인 regression formulation조차 필요조건이 아니라는 신호다.
학습 규모와 hyper-parameter
| task | 학습 sample | 연산 | learning rate | batch size |
|---|---|---|---|---|
| metric depth | 3,200만 개 (sample당 10픽셀, labeled pixel 3억 2,000만 개) | GPU 32장, 3일 | 5.5e-5 | 1344 |
| object-level 3D | 100만 장 | GPU 32장, 3시간 | 3.5e-4 | 640 |
| pixel correspondence | 8,000만 개 (sample당 10픽셀) | GPU 64장, 7일 | 2e-5 | 2816 |
| camera pose | 1,000만 개 | GPU 32장, 4일 | 5e-5 | 448 |
연산 효율은 DepthLM과 비교하면 분명하다. DepthLM은 더 작은 3B 모델을 labeled pixel 10분의 1로 학습하는 데 H100 GPU 128장과 2일이 들었지만, VLM3의 depth 학습은 GPU 32장과 3일로 끝난다. 즉 텍스트 기반 packing 덕분에 labeled pixel은 10배로 늘고 GPU 수는 4분의 1로 줄었다.
공통 학습 설정은 다음과 같다.
- linear warmup(warmup 비율 0.1)을 둔 cosine learning rate schedule
- Transformers 라이브러리 기본 설정의 AdamW optimizer
- FSDP hybrid shard, gradient clipping 0.02, gradient checkpointing
- bfloat16과 Flash Attention 2
학습 데이터
depth 추정은 8개 데이터셋 약 2,600만 장을 아래 가중으로 섞는다. 가중이 이미지 수에 비례하지 않는 것이 VLM3 가중의 특징으로, ScanNet++는 100만 장인데도 0.01이고 Argoverse2는 같은 100만 장에 0.21이다.
| 데이터셋 | 이미지 수 | mixture weight |
|---|---|---|
| Argoverse2 | 100만 장 | 0.21 |
| Waymo | 70만 장 | 0.04 |
| NuScenes | 20만 장 | 0.01 |
| ScanNet++ | 100만 장 | 0.01 |
| Taskonomy | 400만 장 | 0.51 |
| HM3D | 900만 장 | 0.78 |
| Matterport3D | 19만 장 | 0.006 |
| 내부 street view 데이터 | 1,000만 장 | 1.0 |
pixel correspondence와 camera pose는 같은 14개 데이터셋을 쓰고, 가중은 image pair 수와 같게 둔다. 저자는 단순함을 위해 이 mixture를 따로 튜닝하지 않았고 실제로 충분히 잘 동작했다고 적는다.
| 데이터셋 | image pair 수 | 데이터셋 | image pair 수 |
|---|---|---|---|
| BlendedMVS | 45만 | MegaDepth | 19만 |
| DynamicReplica | 100만 | Aria Synthetic Environment | 200만 |
| SAIL-VOS 3D | 35만 | GTA-SFM | 9만 |
| ScanNet++ | 100만 | TartanAir V2 | 85만 |
| MPSD | 1만 3천 | UnrealStereo4K | 27만 |
| RealEstate10K | 88만 | MVS-Synth | 19만 |
| DL3DV-10K | 260만 | Spring | 2만 |
합계는 990만 쌍이다. image pair는 MapAnything(Keetha et al. 2025)과 비슷하게 covisibility가 25%를 넘는 쌍을 무작위로 뽑고, ScanNet++는 30개 scene을 떼어 평가가 학습에 없는 scene에서 이뤄지게 한다.
결과
평가 방식
| task | 데이터셋 | 지표 | 비고 |
|---|---|---|---|
| metric depth | VLM 비교는 Argoverse2, DDAD, NuScenes, ETH3D, ScanNet++, sunRGBD, iBims1, NYUv2, expert 비교는 DDAD, NuScenes, ETH3D, sunRGBD, iBims1 | δ1 (높을수록 좋음) | DepthLM 설정을 따른다 |
| object-level 3D | SpatialRGPT-Bench | 정성 Acc, 정량 Acc와 AbsRel | SpatialRGPT 설정을 따른다 |
| pixel correspondence | ETH3D, DTU, TA-WB | EPE (낮을수록 좋음) | UFM 설정. 데이터셋당 8,192개 sample로 expert도 같은 데이터에서 다시 평가 |
| camera pose | ETH3D, ScanNet++ | AUC30 (높을수록 좋음) | DA3, VGGT와 같은 지표 |
EPE는 target 이미지 영역에서 예측이 빗나간 픽셀 수로 표현한 오차다. expert와 직접 비교할 수 있도록 EPE의 범위를 UFM과 같게 재조정했다. Table 1의 depth 열은 실외(Argoverse2, DDAD, NuScenes), 실내외 혼합(ETH3D), 실내(ScanNet++, sunRGBD, iBims1, NYUv2)로 묶여 있다.
metric depth 추정
VLM 비교(Table 1)에서 VLM3-4B는 모든 데이터셋에서 DepthLM-7B를 앞서며 평균을 0.838에서 0.904로 올렸다. 모델 크기는 절반 가까이 작고 marker 기반 참조도 없다. 학습하지 않은 범용 VLM은 GPT-5(0.370)와 Gemini-2.5-Pro(0.342)조차 낮고, base인 Qwen3-VL-4B는 0.101에 그친다.
| 모델 | Argoverse2 | DDAD | NuScenes | ETH3D | ScanNet++ | sunRGBD | iBims1 | NYUv2 | 평균 |
|---|---|---|---|---|---|---|---|---|---|
| Qwen2.5-VL-72B | 0.119 | 0.140 | 0.186 | 0.220 | 0.272 | 0.276 | 0.212 | 0.324 | 0.219 |
| Qwen3-VL-4B | 0.004 | 0.073 | 0.070 | 0.071 | 0.147 | 0.176 | 0.080 | 0.158 | 0.101 |
| Qwen3-VL-32B | 0.017 | 0.099 | 0.029 | 0.167 | 0.373 | 0.463 | 0.122 | 0.393 | 0.208 |
| Gemini-2.5-Pro | 0.280 | 0.252 | 0.365 | 0.328 | 0.380 | 0.270 | 0.466 | 0.394 | 0.342 |
| GPT-5 | 0.218 | 0.302 | 0.382 | 0.313 | 0.428 | 0.471 | 0.307 | 0.540 | 0.370 |
| SpaceLLaVA-13B | 0.100 | 0.067 | 0.083 | 0.090 | 0.269 | 0.233 | 0.208 | 0.178 | 0.154 |
| SpatialRGPT-8B | 0.055 | 0.046 | 0.100 | 0.220 | 0.346 | 0.369 | 0.240 | 0.265 | 0.205 |
| Seed1.5-VL | 0.040 | 0.074 | 0.028 | 0.309 | 0.593 | 0.689 | 0.627 | 0.841 | 0.400 |
| DepthLM-3B | 0.808 | 0.724 | 0.870 | 0.745 | 0.838 | 0.850 | 0.890 | 0.868 | 0.824 |
| DepthLM-7B | 0.833 | 0.747 | 0.865 | 0.718 | 0.850 | 0.859 | 0.920 | 0.915 | 0.838 |
| VLM3-4B | 0.896 | 0.818 | 0.970 | 0.810 | 0.976 | 0.867 | 0.960 | 0.935 | 0.904 |
expert 비교(Table 2)에서는 데이터셋마다 우열이 갈린다. VLM3는 NuScenes(0.970)와 iBims1(0.960)에서 새 SOTA를 냈고, DDAD와 sunRGBD는 UniDepthV2가, ETH3D는 MoGe-2가 더 높다. 저자는 이를 MoGe-2와 UniDepthV2에 필적하는 정확도로 요약한다.
| 모델 | DDAD | NuScenes | ETH3D | sunRGBD | iBims1 |
|---|---|---|---|---|---|
| ZoeDepth | 0.272 | 0.283 | 0.350 | 0.867 | 0.580 |
| DepthAnything | - | 0.354 | 0.093 | 0.850 | 0.714 |
| DepthAnythingV2 | - | 0.171 | 0.363 | 0.724 | - |
| Metric3D | - | 0.723 | 0.456 | 0.154 | 0.797 |
| UniDepth | 0.858 | 0.846 | 0.185 | 0.943 | 0.157 |
| Depth Pro | 0.299 | 0.566 | 0.397 | 0.831 | 0.823 |
| Metric3Dv2 | - | 0.841 | 0.900 | 0.812 | 0.684 |
| UniDepthV2 | 0.882 | 0.870 | 0.852 | 0.964 | 0.945 |
| MoGe-2 | 0.856 | - | 0.908 | - | 0.924 |
| VLM3-4B | 0.818 | 0.970 | 0.810 | 0.867 | 0.960 |
object-level 3D 이해
SpatialRGPT-Bench에서 VLM3-4B는 정성과 정량 모두 SpatialRGPT-8B를 전체 점수에서 앞선다. 추가 인코더 없이 base 모델 구조를 유지하면서 크기는 절반이라는 점이 논문이 강조하는 부분이다. 다만 세부 항목별로는 SpatialRGPT-8B가 더 높은 곳이 있다.
정성 평가(Acc, 높을수록 좋음):
| 모델 | Below/Above | Left/Right | Big/Small | Tall/Short | Wide/Thin | Behind/Front | 전체 |
|---|---|---|---|---|---|---|---|
| Qwen3-VL-4B | 63.33 | 85.71 | 85.85 | 70.54 | 83.65 | 60.91 | 75.00 |
| Qwen3-VL-32B | 72.50 | 83.81 | 82.08 | 68.75 | 87.5 | 67.27 | 76.98 |
| SpatialRGPT-8B | 99.17 | 99.04 | 79.24 | 89.28 | 83.65 | 87.27 | 89.80 |
| VLM3-4B | 97.84 | 99.37 | 90.78 | 90.82 | 92.86 | 75.54 | 91.35 |
정량 평가(Acc / AbsRel, Acc는 높을수록 AbsRel은 낮을수록 좋음):
| 모델 | Direct Distance | Horizontal Distance | Vertical Distance | Width | Height | Direction | 전체 |
|---|---|---|---|---|---|---|---|
| Qwen3-VL-4B | 18.24 / 51.94 | 18.03 / 80.64 | 14.15 / 160.62 | 3.76 / 552.54 | 12.78 / 874.07 | 0.0 / 180.0° | 11.16 / 343.96 |
| Qwen3-VL-32B | 22.30 / 97.14 | 17.21 / 67.60 | 22.64 / 44.93 | 0.00 / 582.34 | 2.26 / 647.74 | 0.0 / 180.0° | 10.73 / 287.95 |
| SpatialRGPT-8B | 35.1 / 0.35 | 59.0 / 0.27 | 53.8 / 0.27 | 51.9 / 0.31 | 54.9 / 0.63 | 95.3 / 17.1° | 58.33 / 0.37 |
| VLM3-4B | 34.09 / 0.37 | 53.38 / 0.29 | 58.41 / 0.27 | 44.11 / 0.39 | 65.64 / 0.41 | 95.42 / 10.5° | 58.51 / 0.35 |
전체 정성 정확도는 91.35 대 89.80, 전체 정량은 58.51 / 0.35 대 58.33 / 0.37이다. 정성에서는 Big/Small(90.78 대 79.24), Wide/Thin(92.86 대 83.65)의 차이가 크고, Behind/Front(75.54 대 87.27)는 SpatialRGPT-8B가 앞선다. 정량에서는 Height(65.64 대 54.9)와 Direction의 AbsRel(10.5° 대 17.1°)에서 VLM3가, Horizontal Distance와 Width에서 SpatialRGPT-8B가 높다. base인 Qwen3-VL은 정량 문제를 거의 풀지 못해 Direction 정확도가 0이다.
pixel correspondence 추정
VLM3는 base VLM의 EPE를 한 자릿수 단위로 줄였다. base인 Qwen3-VL-4B의 평균 153.28이 15.37로 떨어져 약 10분의 1이며, 32B 모델도 160.27로 4B와 다르지 않다는 점은 학습 없이 모델을 키워도 correspondence가 생기지 않음을 보여준다.
| 모델 | ETH3D | DTU | TA-WB | 평균 |
|---|---|---|---|---|
| Qwen3-VL-4B | 179.80 | 89.64 | 190.40 | 153.28 |
| Qwen3-VL-32B | 196.53 | 88.76 | 195.53 | 160.27 |
| DKM | 30.83 | 30.15 | 61.80 | 41.30 |
| RoMa | 10.01 | 11.84 | 43.79 | 21.88 |
| UFM | 3.83 | 7.28 | 12.56 | 7.89 |
| VLM3-4B | 15.18 | 10.71 | 20.21 | 15.37 |
expert와 비교하면 VLM3는 DKM(41.30)과 RoMa(21.88)보다 낮은 EPE를 내지만 UFM(7.89)에는 미치지 못한다. 데이터셋별로는 DTU(10.71 대 RoMa 11.84)와 TA-WB(20.21 대 43.79)에서 RoMa를 크게 앞서고 ETH3D(15.18 대 10.01)에서는 뒤진다. 저자는 추가 scaling과 더 세심한 mixture tuning으로 개선할 수 있다고 본다.
camera pose 추정
camera pose에서 VLM3는 base VLM의 평균 AUC30을 5.4%에서 94.0%로 올렸다. expert와 비교하면 DUSt3R(30.6%), MapAnything(80.8%), VGGT(88.0%)를 앞서고 DA3-Giant(94.7%)와 0.7%p 차이로 비슷하다. ETH3D에서는 VLM3(93.3%)가 가장 높고 ScanNet++에서는 DA3-Giant(98.1%)와 VGGT(95.1%)가 더 높다.
| 모델 | ETH3D | ScanNet++ | 평균 |
|---|---|---|---|
| Qwen3-VL-4B | 10.0 | 0.7 | 5.4 |
| Qwen3-VL-32B | 11.7 | 3.9 | 7.8 |
| DUSt3R | 27.3 | 33.9 | 30.6 |
| MapAnything | 77.4 | 84.1 | 80.8 |
| VGGT | 80.8 | 95.1 | 88.0 |
| DA3-Giant | 91.2 | 98.1 | 94.7 |
| VLM3-4B | 93.3 | 94.7 | 94.0 |
이 결과가 중요한 이유는 학습 방식에 있다. VGGT와 DA3는 여러 보조 task와 regression 손실을 결합한 전용 모델이지만, VLM3는 yaw, pitch, roll과 이동 거리, 방향 벡터를 숫자 텍스트로 예측할 뿐이다.
출력 시각화
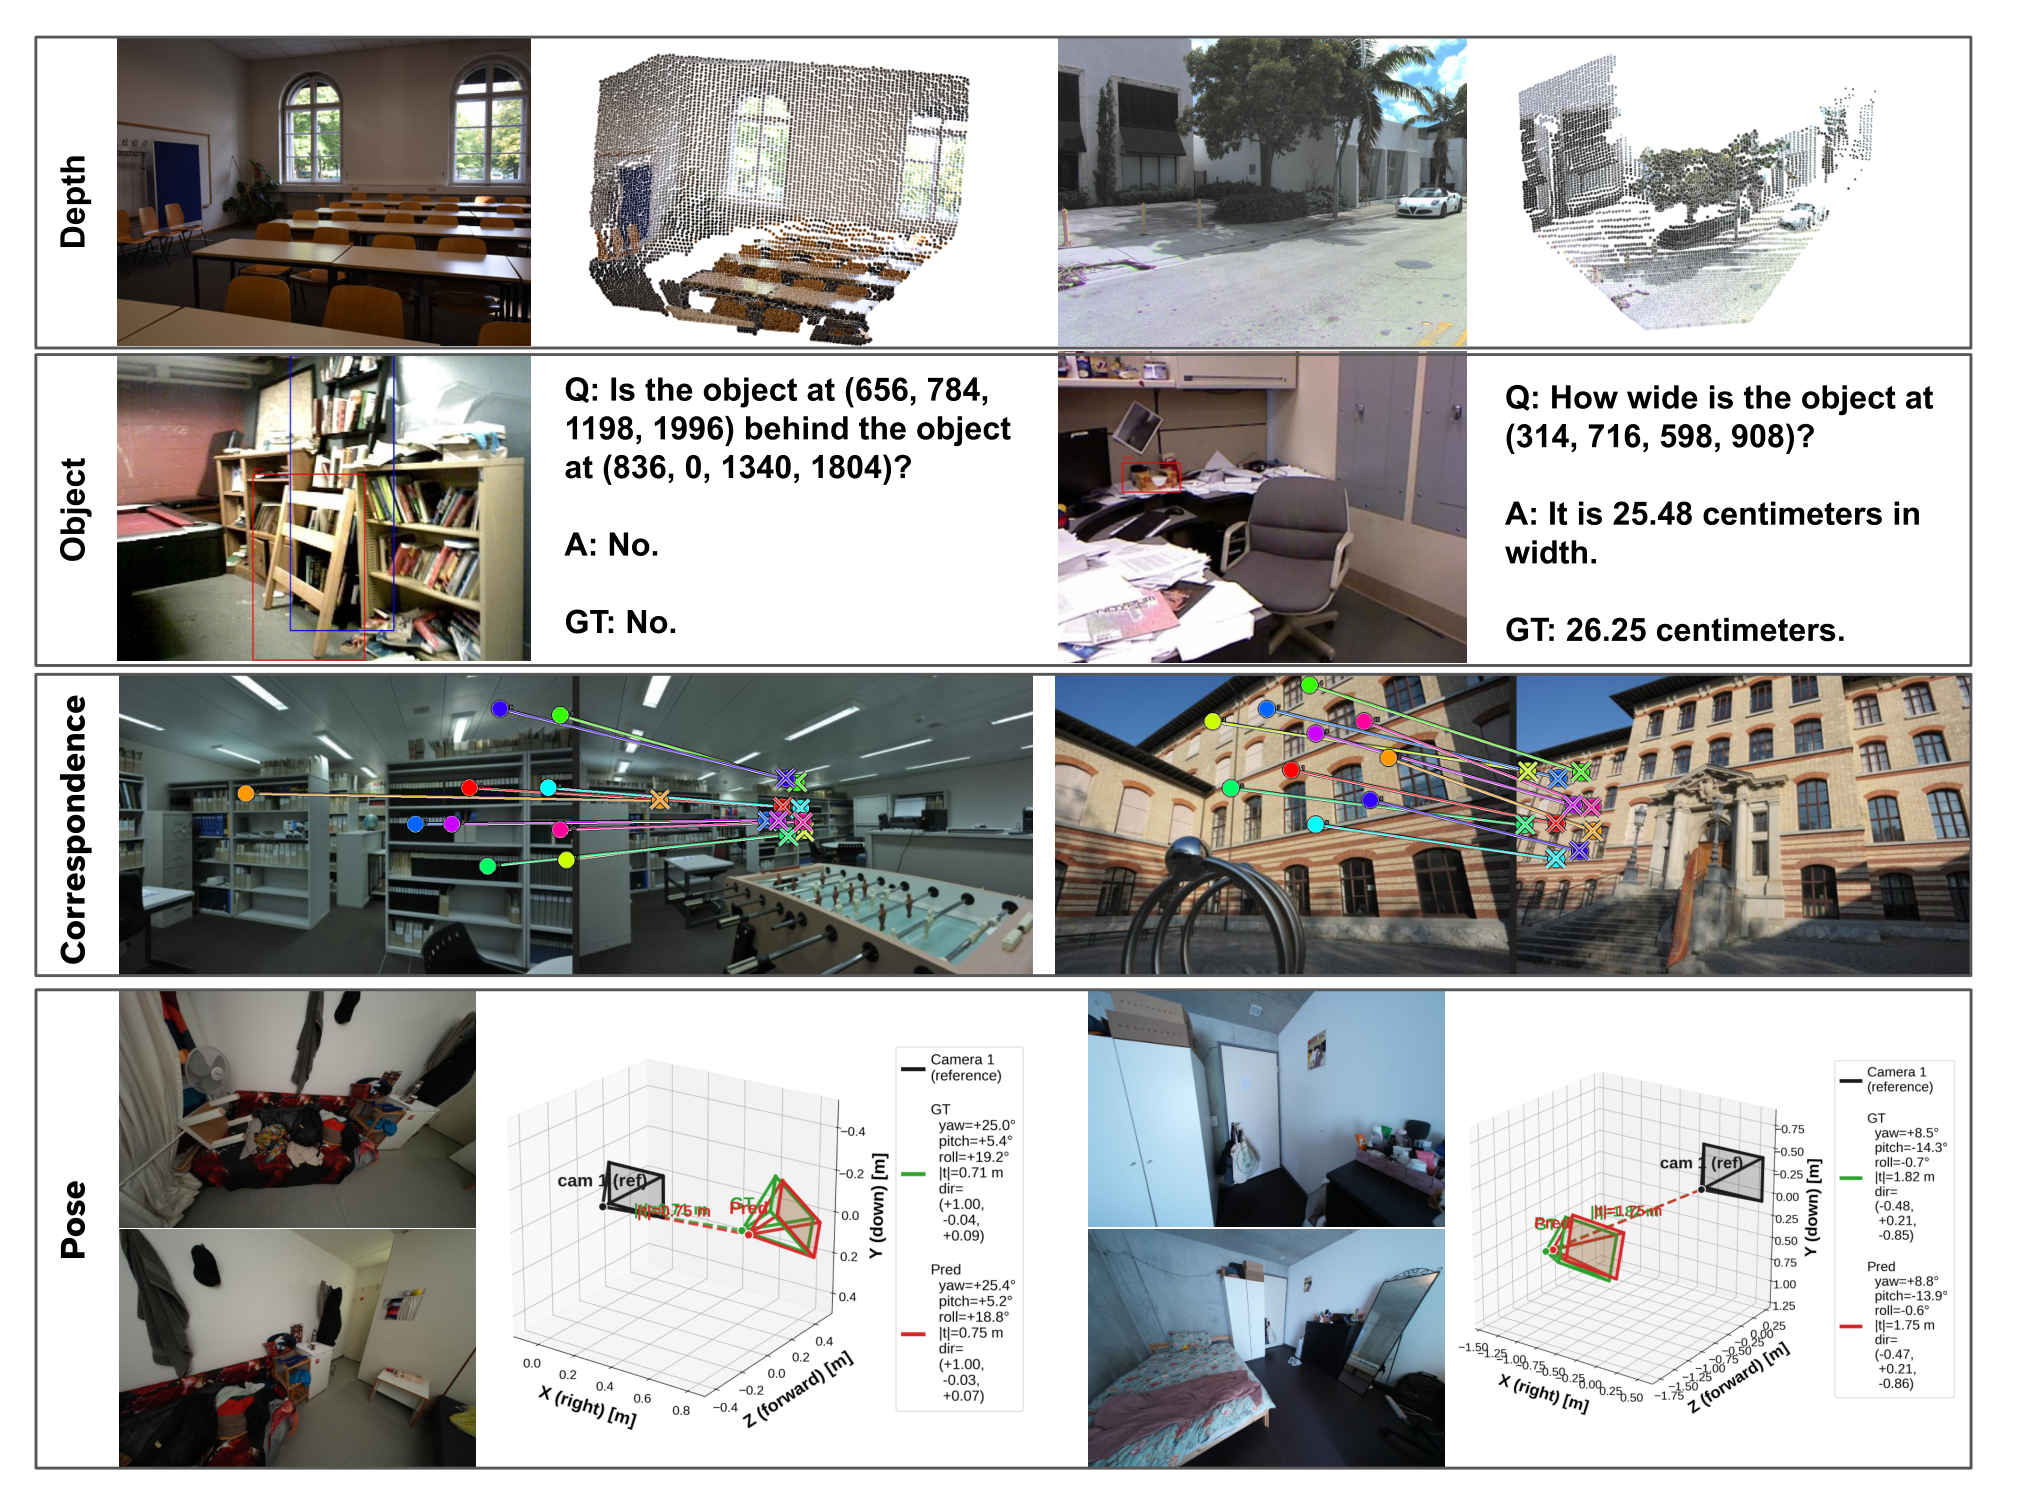
Figure 3은 텍스트 출력을 시각화한 것이다. object-level 예시의 bounding box는 시각화용이며 모델은 학습과 평가 모두 원본 이미지만 본다. correspondence 예시는 예측을 점으로 끝나는 선으로, 정답을 십자로 그렸다. pose 예시는 텍스트 출력을 카메라 pose로 렌더링했고 예측과 정답 수치도 그림에 적혀 있다.
depth 점군은 DepthLM처럼 이미지의 여러 픽셀에 질문해 만든다. 픽셀마다 독립으로 묻든 한 이미지에 질문을 packing하든 성능은 비슷했고, 독립 질의는 미리 계산한 visual token과 공통 텍스트 prefix를 sample 간에 공유하는 효율적 구현이 가능하다. 저자는 텍스트 supervision으로 배운 depth에 expert 모델에서 흔한 두 object 사이의 flying point가 없다는 DepthLM의 관찰이 VLM3에서도 유지된다고 적고, 그 이유를 task-specific 설계가 없어 inductive bias가 최소인 데서 찾는다.
| task | Figure 3의 관찰 |
|---|---|
| depth | 실내와 실외 모두 고품질 점군. object 사이 flying point 없음 |
| object-level | front/behind 같은 공간 관계와 metric scale 속성(예: 폭 25.48cm 예측, 정답 26.25cm)을 함께 학습 |
| pixel correspondence | 실내와 실외 장면 모두에서 안정적인 대응 |
| camera pose | 회전과 이동 방향뿐 아니라 metric scale 이동 거리(예: 0.75m 예측, 정답 0.71m)까지 예측 |
픽셀 참조 방식 비교
텍스트 기반 픽셀 참조가 정확도를 잃지 않는지 확인하기 위해, 저자는 같은 데이터(800만 장, 이미지당 QA 1개)와 같은 모델로 두 참조 방식을 학습해 비교했다.
| 참조 방식 | δ1 |
|---|---|
| visual prompting | 0.849 |
| 텍스트 기반 | 0.853 |
두 값은 사실상 같다. 따라서 텍스트 기반 참조는 단순하고 scalable하다는 장점을 정확도 손실 없이 얻는다.
데이터 mixture 비교
같은 3,200만 sample(QA 10개)에서 가중 방식만 바꾼 비교다. 균일 가중은 DepthLM의 기본 가중을 따르고 새로 추가한 데이터셋에도 같은 값을 준다(DepthLM 기본값이 0.1인 Matterport3D만 예외). 데이터셋 크기 가중은 이미지 수에 비례한 값이고, VLM3 가중은 그 위에서 작고 과적합되기 쉬운 데이터셋의 가중을 더 낮춘 것이다.
| 가중 방식 | δ1 |
|---|---|
| 균일 가중 | 0.842 |
| 데이터셋 크기 가중 | 0.884 |
| VLM3 가중 | 0.904 |
균일 가중의 3,200만 sample은 label이 40분의 1인 800만 sample 실험(텍스트 기반 0.853)보다도 낮다. 즉 재가중 없이 데이터만 늘리면 성능이 오르지 않는다. 데이터셋 크기 가중은 0.884로 scaling의 좋은 기본선이고, VLM3 가중이 0.904까지 올리므로 추가 tuning의 여지도 크다.
모델 크기와 데이터 크기
VLM3는 4B 모델을 쓴다. 더 큰 모델이 성능을 더 올리는지 확인한 결과, 같은 데이터에서 모델을 키우면 depth 정확도가 오히려 떨어졌다.
| 모델 | 학습 sample | δ1 |
|---|---|---|
| 32B | 3,200만, QA 10개 | 0.873 |
| 8B | 3,200만, QA 10개 | 0.880 |
| 4B | 6,400만, QA 10개 | 0.880 |
| 4B | 3,200만, QA 10개 | 0.904 |
저자는 현재 데이터 크기가 큰 모델에 아직 부족해 과적합이 일어난다고 추정한다. 이를 뒷받침하기 위해 4B 모델의 학습을 6,400만 sample로 늘렸더니 역시 정확도가 떨어졌는데, 4B도 조금 더 큰 규모에서 데이터셋에 과적합한다는 뜻이다. 따라서 2,600만 장 수준에서는 모델 scaling보다 데이터 scaling이 훨씬 중요하고, 작은 4B 모델로도 SOTA 정확도에 이를 수 있다.
한계
저자가 명시한 한계
| 항목 | 내용 | 저자의 전망 |
|---|---|---|
| pixel correspondence | UFM(EPE 7.89)에 뒤진다(15.37) | 추가 scaling과 더 세심한 mixture tuning으로 개선 가능 |
| 데이터 mixture | 데이터셋 크기 가중은 기본선이고 VLM3 가중은 작은 데이터셋의 가중을 낮춘 것이다. 자동화된 절차는 기술하지 않는다 | 추가 tuning의 개선 여지가 크다 |
| 데이터 규모 | 2,600만 장에서는 4B 모델도 조금 더 길게 학습하면 과적합한다. 큰 모델의 낮은 정확도는 데이터 부족 때문이라고 추정한다 | 데이터 scaling이 모델 scaling보다 우선 |
저자가 한계로 적지 않았지만 결과 표에서 확인되는 세부 열세도 있다. object-level 정성 평가의 Behind/Front(75.54 대 87.27)와 정량 평가의 Horizontal Distance, Width에서는 SpatialRGPT-8B가 앞서고, camera pose의 ScanNet++에서는 DA3-Giant(98.1%)와 VGGT(95.1%)가 VLM3(94.7%)보다 높다. depth의 DDAD, ETH3D, sunRGBD에서도 UniDepthV2나 MoGe-2가 더 높다. 따라서 "expert에 필적한다"는 저자의 요약은 전체 평균 기준이고, 데이터셋이나 항목 단위로는 우열이 갈린다.
자료에 기술이 없어 확인할 수 없는 것
- 프롬프트 형식 민감도의 정량 분석. pixel correspondence에 템플릿 5개를 썼고 "민감하지 않다"고만 적는다.
- Qwen3-VL 외 다른 base VLM에서의 재현 여부. 모델 크기 비교는 Qwen3-VL 계열 안에서만 이뤄졌다.
- 내부 street view 데이터 1,000만 장의 출처와 공개 여부. Table 5에 "internal data with street view scenes"로만 적혀 있다.
- δ1과 AUC30의 정의. 논문은 두 지표를 인용만 하고 정의를 적지 않는다.
자료 내적 모순
- 본문 4절은 depth VLM 비교에 데이터셋 9개를 쓴다고 적지만 Table 1의 데이터셋 열은 8개다.
- Table 5의 MegaDepth 행 인용이 Matterport3D 논문(Chang et al., 2017)을 가리킨다.
- Figure 1의 depth 수치는 NuScenes, ETH3D, SUNRGBD, iBims1 4개 데이터셋 평균이고 Table 1의 평균은 8개 데이터셋 기준이라, 같은 논문 안에서 두 종류의 평균이 함께 쓰인다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| expert vision model | 특정 3D task를 위해 구조, 손실, 데이터 증강을 전용으로 설계한 비전 모델 |
| 텍스트 기반 픽셀 참조 | 픽셀 좌표를 [0, 2000)로 정규화한 정수 텍스트로 프롬프트에 적는 VLM3의 참조 방식 |
| visual prompting | 입력 이미지 위에 marker를 렌더링해 픽셀을 가리키는 DepthLM의 참조 방식 |
| focal length 통일 | 입력 이미지의 focal length가 1000픽셀이 되도록 resize하는 전처리. intrinsics가 없으면 calibration 모델로 추정한다 |
| packing | 같은 이미지에 대한 질문 여러 개를 한 sample에 넣어 이미지 중복 없이 학습하거나 추론하는 방법 |
| regression formulation | 연속값을 regression 손실로 직접 학습하는 expert 모델의 표준 정식화. VLM3는 숫자 텍스트의 next-token prediction으로 대체한다 |
관련 페이지
- Eagle 2.5: Boosting Long-Context Post-Training for Frontier Vision-Language Models: Eagle 2.5의 기술 보고서. VLM3와 마찬가지로 표준 VLM 구조를 유지한 채 데이터와 입력 표현으로 능력을 넓히는 post-training 연구이며, 이 페이지를 3D 방향의 같은 노선으로 참조한다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 허브. 이 저장소의 분류 규칙에 따라 순수 VLM 논문인 VLM3는 llms에 두고 허브에서 상호 링크한다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: GR00T N1 기술 보고서. 더 강한 vision-language backbone 논의에서 이 페이지를 참조한다. VLM3 원문은 로봇 응용을 다루지 않는다.
- OpenVLA: An Open-Source Vision-Language-Action Model: OpenVLA. backbone과 vision 인코더 선택의 배경으로 이 페이지를 참조한다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: RT-2. backbone VLM을 키우는 방향의 논의로 이 페이지를 참조한다.
- World Model for Robot Learning: A Comprehensive Survey: world model 서베이. metric depth와 camera pose 같은 3D 능력을 world model의 grounding 바탕으로 보고 이 페이지를 참조한다.
외부 참조
- arXiv: https://arxiv.org/abs/2605.30561
- 코드: https://github.com/facebookresearch/VLM3
- 선행 작업: DepthLM (Cai et al., 2025, arXiv:2509.25413). wiki에 수록되지 않았다