Physical AI · ARTICLE · 2026
03-14. Groot N1.5 - 모두의 로보틱스 - VLA 입문
요약
GR00T N1.5를 처음 보는 사람을 위한 한국어 입문 해설이다. "모두의 로보틱스 - VLA 입문" 시리즈의 03-14편으로, 앞 편에서 다룬 GR00T N1의 구조는 그대로 둔 채 N1.5가 그 위에 무엇을 추가했는지에 초점을 맞춘다. 다루는 주제는 두 가지다. 자기 action이 만들 미래 장면을 모델 안에서 미리 예측하게 하는 FLARE, 그리고 video world model로 학습 데이터를 합성하는 DreamGen이다.
N1.5는 논문 한 편으로 묶여 있지 않다는 점이 이 해설의 성격을 결정한다. 참고문헌도 NVIDIA Research 프로젝트 페이지, DreamGen 논문(arXiv 2505.12705), Eagle 2.5 논문(arXiv 2504.15271) 셋으로 흩어져 있다. 따라서 세 출처를 하나의 흐름으로 엮어 읽히게 만드는 것이 이 해설의 역할이다.
앞 편과 비교하면 그림의 성격도 다르다. N1 편은 논문 도식에 빨간 테두리를 덧그린 주석판이 절반이었던 반면, 이 편은 원 도식을 거의 그대로 싣고 결과 장을 표 다섯 개로 채운다. 즉 정성적 서술에 기댔던 앞 편보다 수치가 많다.
N1.5의 공식 발표 내용과 정량 결과는 GR00T N1.5에 정리되어 있다. 이 입문 페이지를 먼저 읽고 프로젝트 페이지로 넘어가는 순서를 권한다.
배경
GR00T N1은 humanoid 로봇용 VLA로서 의미 있는 결과를 냈지만 세 가지 한계를 남겼다. 해설은 이 한계를 N1.5의 출발점으로 제시한다.
- 과제 범위가 주로 짧은 tabletop 조작에 머물렀다.
- 새로운 행동이나 새로운 환경으로의 일반화 능력이 제한적이었다.
- 합성 데이터를 만들 때 물리적 정확성과 다양성을 함께 확보하기 어려웠다.
N1.5는 이 세 한계에 각각 대응하는 변경을 적용했다. VLM backbone을 공간 이해가 개선된 Eagle-2.5로 교체해 인식 병목을 줄였고, 미래의 시각적 변화를 모델 내부에서 예측하는 FLARE를 도입해 긴 시간 범위의 정밀한 조작을 노렸으며, 대규모 neural trajectory 합성 엔진인 DreamGen을 구축해 data pyramid의 물리적 불일치 문제를 다뤘다.
구조 자체는 N1을 대체하지 않는다. N1의 dual-system VLA 구조를 유지한 채 더 강한 VLM backbone과 미래 예측 손실, 합성 데이터 전략을 추가한 것이 N1.5다. dual-system VLA는 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 VLA 구조를 말한다. 따라서 N1.5를 읽을 때는 기존 구조 위에 어떤 예측 메커니즘과 데이터 파이프라인이 추가됐는지를 보는 것이 핵심이다.
핵심 개념
이 절의 네 개념만 잡으면 뒤의 FLARE와 DreamGen 설명이 그대로 읽힌다.
policy와 latent-space world modeling
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 기존 VLA의 policy는 대체로 지금 보이는 장면에만 반응해 즉각적인 action을 만들어 왔다.
latent-space world modeling은 환경 데이터를 핵심 특징만 남긴 압축 공간으로 옮긴 뒤, 그 안에서 자기 action이 만들 미래 상황을 시뮬레이션해 물리적 인과를 배우는 기술이다. FLARE는 이 방식을 policy 학습 안에 결합해, 로봇이 조금 뒤의 장면을 예상하고 움직이도록 만든다.
frozen backbone
frozen은 학습 중 해당 모듈의 가중치를 갱신하지 않고 고정한다는 뜻이다. N1.5는 Eagle-2.5 VLM을 pre-training과 fine-tuning 양쪽에서 frozen으로 둔다.
N1은 fine-tuning 단계에서만 고정했다. 반면 N1.5는 학습 내내 VLM의 언어 이해 능력을 건드리지 않는 쪽으로 기울었다. 뒤의 결과 장에서 language following rate가 크게 오른 것을 해설은 이 결정의 근거로 삼는다.
neural trajectory와 pseudo-action
neural trajectory는 video world model이 만들어낸 합성 trajectory 데이터를 가리킨다. 실제 로봇이 움직이는 것처럼 보이는 영상이지만 사람이 teleoperation으로 만든 기록은 아니다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다.
생성된 영상에는 어떤 제어 명령이 있었는지가 기록되어 있지 않다. pseudo-action은 그렇게 라벨이 비어 있는 영상에 사후에 붙이는 action 라벨을 뜻한다.
future token
future token은 DiT 입력 시퀀스에 새로 추가한 M개의 learnable 임베딩이다. 초기값에는 아무 의미가 없고, self-attention을 거치면서 미래 상태 정보를 담는 자리로 학습된다. FLARE의 alignment 손실이 걸리는 지점이 바로 이 토큰이다.
N1에서 N1.5로의 변경점
해설은 본론에 앞서 두 버전의 차이를 목록으로 먼저 세운다.
| 구분 | GR00T N1 | GR00T N1.5 |
|---|---|---|
| VLM backbone | Eagle-2 | Eagle-2.5. 공간 이해가 개선됐다 |
| VLM 고정 범위 | fine-tuning 단계에서만 frozen | pre-training과 fine-tuning 모두 frozen |
| adapter MLP | vision encoder와 LLM을 연결 | 같은 역할을 하되 구조를 단순화 |
| 토큰 임베딩 | 그대로 LLM에 입력 | 이미지와 텍스트 토큰 임베딩에 layer normalization 추가 |
| 손실 | flow matching 손실 | flow matching 손실에 FLARE alignment 손실을 추가 |
| DiT 입력 | robot state q_t와 noised action chunk | 여기에 M개의 learnable future token을 추가 |
| pre-training 데이터 | N1의 data pyramid | DreamGen이 만든 neural trajectory와 AgiBot-Beta를 추가 |
표의 일곱 행은 크게 세 부류로 나뉜다. 앞의 네 행은 VLM backbone과 그 연결부를 손본 인식 쪽 변경이고, 다음 두 행은 FLARE 도입에 따른 학습 목표 변경이며, 마지막 한 행은 DreamGen이 만든 데이터가 들어온 결과다. 즉 N1.5의 변경은 인식, 학습 목표, 데이터라는 세 지점에 걸쳐 있다.
FLARE
FLARE는 Future LAtent Representation Alignment의 약어로, 로봇이 자기 action이 미래에 어떤 결과를 만들지 미리 예측하도록 학습시키는 프레임워크다. 기존 로봇 모델이 현재 시각 정보에만 의존해 즉각적인 반응을 만들었다면, FLARE는 latent-space world modeling을 policy 학습에 결합해 긴 시간 범위를 보고 action을 고르게 한다.
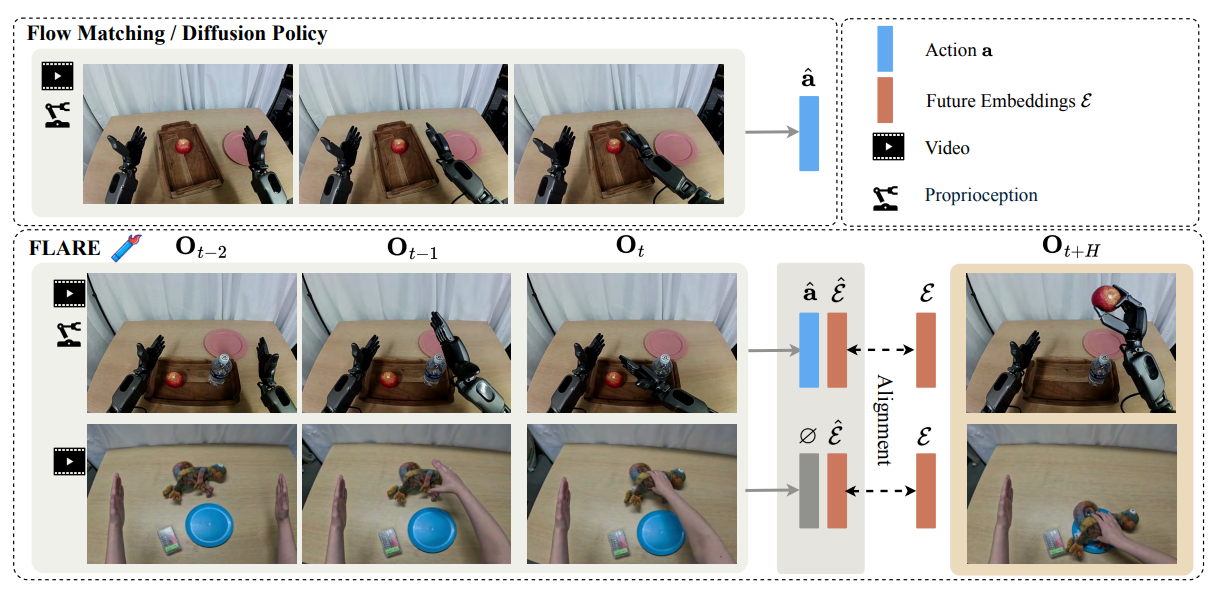
해설이 드는 FLARE의 장점은 세 가지다.
- 확장성. 기존 VLA 구조를 크게 바꾸지 않고 토큰만 추가하면 되므로 다른 모델과의 호환성이 좋다.
- 미래 예측 기반 추론. action을 만드는 과정에서 미래 상태를 미리 예측하고 실제 결과에 맞춰 보므로 조작이 더 정밀해진다.
- 데이터 효율. action 라벨이 없는 사람 1인칭 영상에서도 물리적 변화를 배울 수 있어, 적은 데이터로도 새 과제에 빠르게 적응한다.
observation 임베딩 압축 모듈
FLARE의 앞단은 방대한 시각 데이터를 32개의 토큰으로 줄이는 단계다. Q-former는 소수의 learnable query token이 cross-attention으로 많은 입력 토큰의 정보를 흡수해 대신 담게 하는 압축 모듈을 말한다.
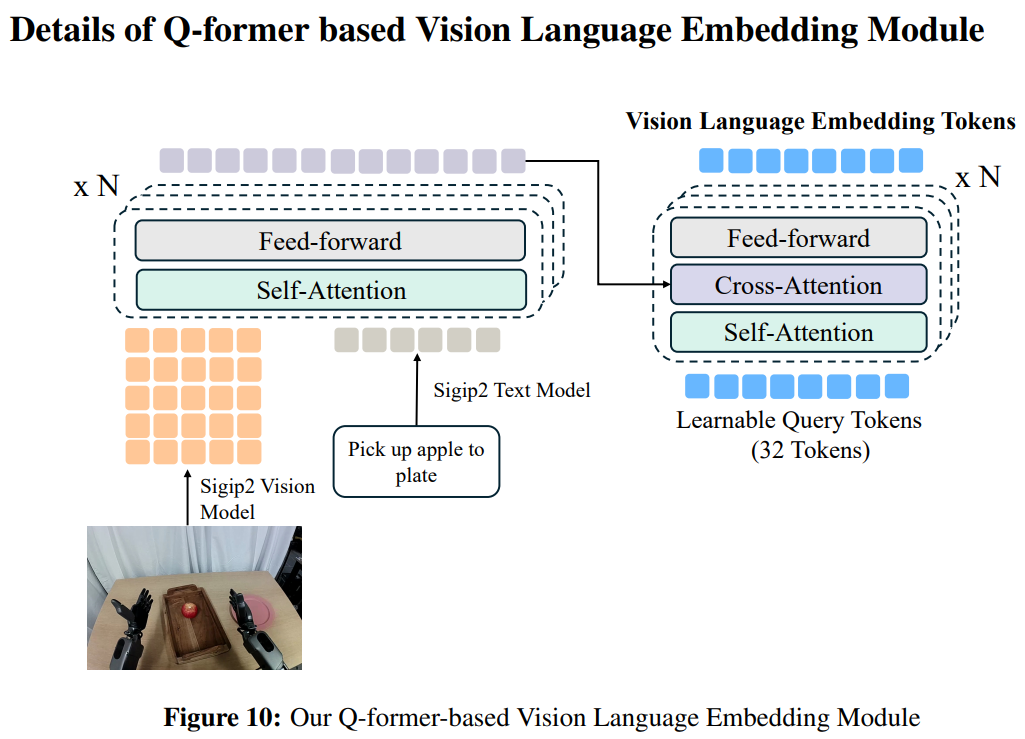
압축 절차는 세 단계로 진행된다.
- SigLIP-2가 이미지 256 토큰과 텍스트 32 토큰을 각각 인코딩한다.
- 인코딩된 토큰이 4개의 self-attention Transformer 블록을 지나 288 토큰으로 융합된다.
- Q-former를 적용하면 32개의 learnable query token이 self-attention과 cross-attention을 거쳐 288개 융합 토큰의 정보를 대신 담는다.
N1이 Eagle VLM의 출력을 그대로 썼다면, N1.5는 이렇게 압축한 32 토큰만 쓴다. 따라서 성능과 연산 효율을 함께 얻는다는 것이 해설의 설명이다.
위 도식은 FLARE 논문에서 가져온 것이라 SigLIP-2로 그려져 있다. 반면 실제 N1.5를 학습시킬 때는 그 자리에 Eagle-2.5가 들어간다는 단서가 원문에 붙어 있다.
DiT 안의 future token
FLARE의 뒷단은 DiT 내부에서 일어난다. N1의 DiT 입력은 로봇의 현재 관절 상태인 robot state q_t와 noise가 섞인 action chunk 둘이었는데, N1.5는 여기에 M개의 learnable future token 임베딩을 추가한다.
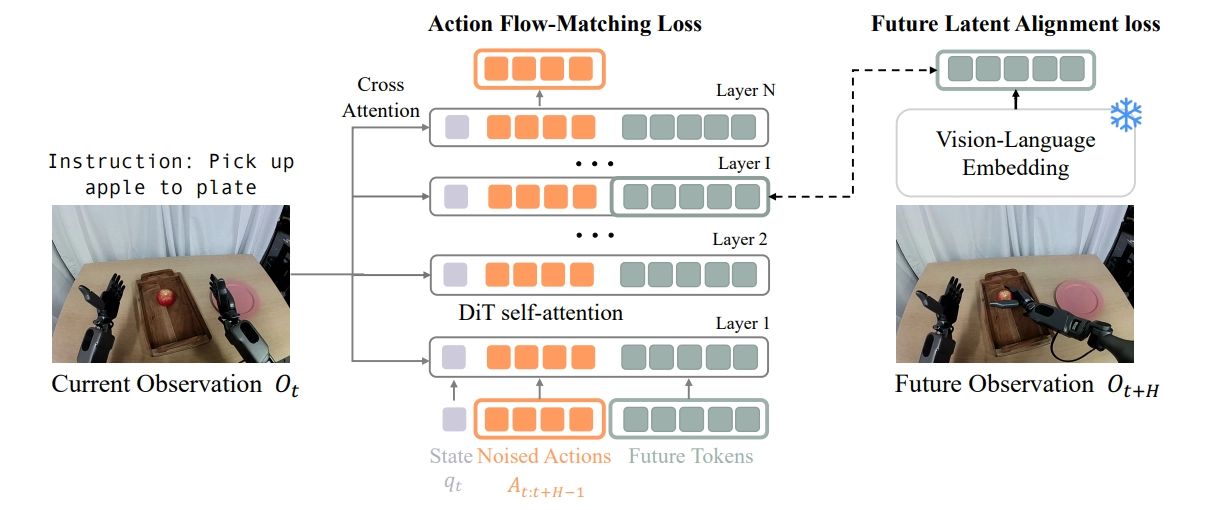
학습은 세 단계로 이어진다.
- future token이 self-attention을 거치며 미래 상태 정보를 담는 그릇이 된다.
- Q-former로 압축된 current observation이 cross-attention으로 들어온다. 이때 입력 이미지는 robot state q_t와 같은 t 시점에서 샘플링한다.
- self-attention을 지난 M개의 future token을, t+H 시점 future observation을 넣어 얻은 임베딩과 나란히 놓고 코사인 유사도를 최대화한다.
3번 단계가 FLARE의 핵심이다. 비교 지점이 마지막 layer가 아니라 중간 layer라는 점이 이 방식의 특징인데, 앞쪽 layer는 정보가 덜 쌓였고 뒤쪽 layer는 지금 당장의 동작을 정하는 데 집중하기 때문이다. 실험에서는 총 8개 layer 중 6번째에서 미래 정보를 뽑을 때 성능이 가장 좋았다.
DiT 내부에서 나온 데이터와 비교 대상인 future observation은 차원이 다를 수 있다. 따라서 MLP를 한 번 통과시켜 두 데이터를 직접 비교할 수 있는 같은 공간으로 옮기는 절차가 함께 들어간다.
손실 함수
alignment 손실은 코사인 유사도 식으로 계산된다. 코사인 유사도는 두 데이터가 얼마나 같은 방향을 가리키는지 재는 값으로, 1에 가까울수록 유사하다는 뜻이다.
| 기호 | 뜻 |
|---|---|
| B | 배치 차원 |
| M | future token 개수. 32개다 |
| D | 임베딩 차원 |
| f_θ(φ_t, A_t^τ, q_t) | DiT가 현재 상태를 보고 미래를 예측한 데이터 |
| g(φ_{t+H}) | 원본 영상에서 t+H 시점으로 샘플링한 실제 미래 장면의 데이터 |
최종 손실은 N1의 flow matching 손실에 이 alignment 항을 가중치 λ로 더한 형태다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법을 말한다.
| 하이퍼파라미터 | 선택값 | 근거 |
|---|---|---|
| 비교 layer | 8개 중 6번째 | 앞쪽은 정보가 부족하고 뒤쪽은 현재 동작 결정에 집중한다 |
| alignment 가중치 λ | 0.2 | 여러 값 중 가장 적절했다 |
| future token 개수 M | 32개 | 코사인 유사도 식의 M 차원 |
FLARE를 적용한 N1.5는 다음 동작을 예측하는 데 그치지 않고, 자기 action이 가져올 시각적 변화를 내부에서 미리 그려 본다. 그 결과 복잡한 환경에서 물체를 쓰러뜨리지 않고 피해 가거나 더 효율적인 경로로 손을 뻗는 움직임이 가능해졌다는 것이 해설의 설명이다.
DreamGen
로봇 학습의 가장 큰 걸림돌은 사람이 직접 로봇을 조종해 데이터를 모아야 한다는 비용 문제다. DreamGen은 video world model을 활용해 실제 로봇이 움직이는 것처럼 보이는 합성 영상, 즉 neural trajectory를 스스로 만들어내 이 비용을 우회한다.
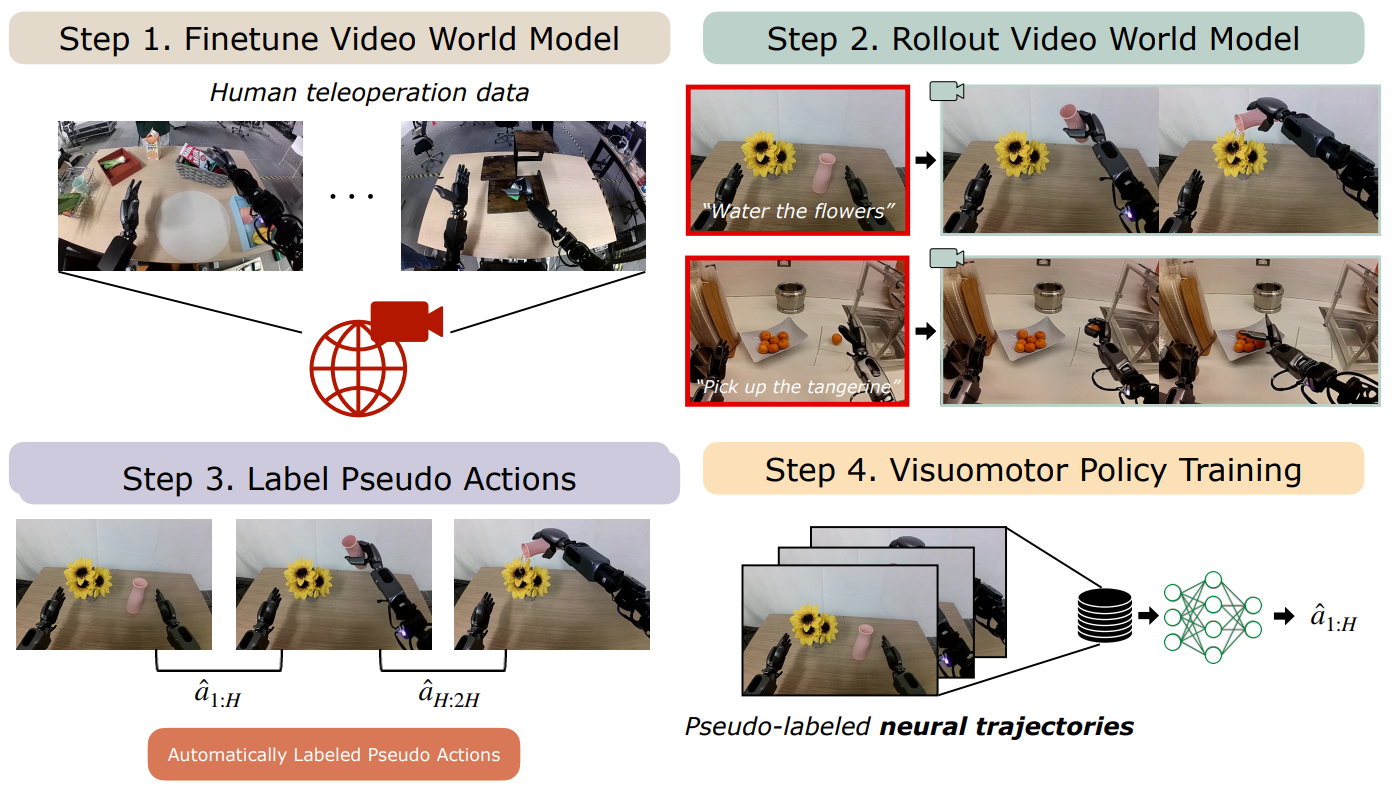
| 단계 | 이름 | 하는 일 |
|---|---|---|
| 1 | video world model fine-tuning | 사람이 teleoperation으로 만든 실제 trajectory에 world model을 맞춘다 |
| 2 | rollout | 실제 사진 한 장과 지시문으로 합성 영상을 생성한다 |
| 3 | pseudo-action 라벨링 | 라벨이 없는 생성 영상에 action 라벨을 사후에 붙인다 |
| 4 | visuomotor policy 학습 | 완성된 neural trajectory로 policy를 학습한다 |
1단계 video world model fine-tuning
1단계는 사람이 teleoperation으로 만든 로봇 trajectory에 video world model을 맞춰, 로봇의 물리적 제약과 움직임 능력을 학습시키는 과정이다. 대상 모델로는 WAN2.1, CogVideoX, Hunyuan, Cosmos가 이름을 올린다.
학습은 모델 전체를 다시 학습시키지 않고 LoRA로 진행한다. LoRA는 가중치를 작은 크기의 행렬곱으로 나눠 그 부분만 학습시키는 기법이다.
학습 데이터에 고정된 카메라 시점이 아니라 여러 시점이 섞여 있는 경우도 있다. 이때는 여러 카메라 영상을 2x2 grid 한 장으로 합쳐 하나의 영상처럼 학습시킨다.
2단계 rollout
2단계는 fine-tuning된 video world model로 합성 로봇 영상을 생성하는 과정이다. 입력으로 로봇이 처한 상황을 보여주는 실제 사진 한 장과 지시문을 주면 합성 영상이 나온다.
이 과정에는 증강이 함께 들어간다. 시뮬레이터에서 각 과제의 대상 물체나 환경의 위치를 무작위화하며 데이터를 넓힌다.
3단계 pseudo-action 라벨링
3단계는 생성된 영상에 action 라벨을 붙이는 과정이다. 생성 영상에는 라벨이 없으므로 두 방법 중 하나를 쓴다.
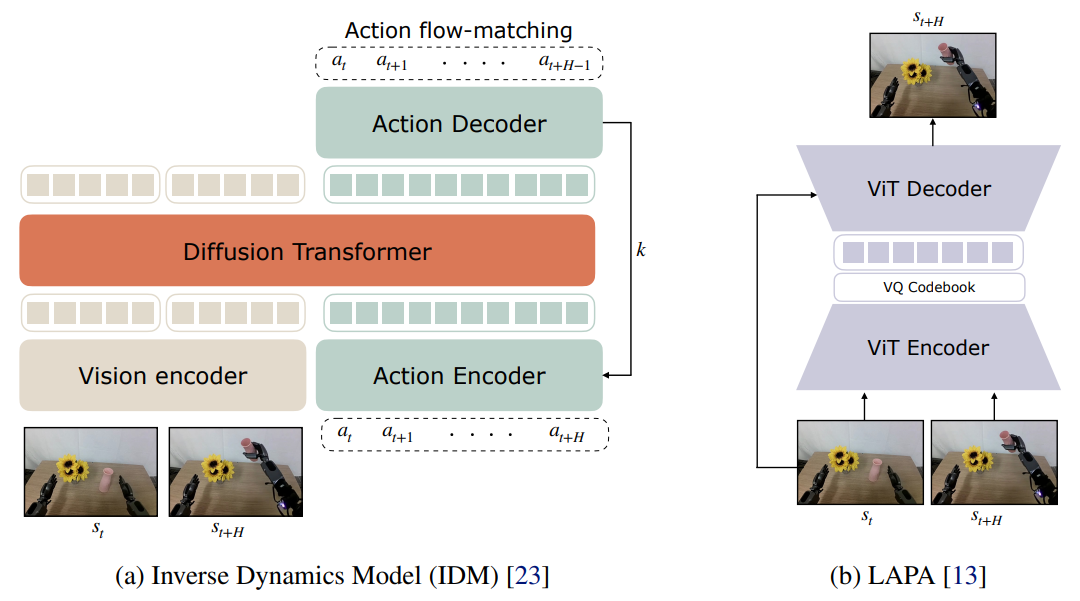
| 방식 | 구조 | 입력 | 출력 |
|---|---|---|---|
| Inverse Dynamics Model | DiT와 SigLIP-2 vision encoder | 현재 프레임 s_t와 미래 프레임 s_{t+h} | 두 프레임 사이를 채울 action chunk |
| Latent Action Model | VQ-VAE | 현재 프레임 s_t와 미래 프레임 s_{t+h} | 두 프레임의 시각적 차이를 부호화한 latent action 벡터 |
Inverse Dynamics Model은 robot state 없이 이미지 변화만 보고 동작을 뽑아내는 것이 특징이다. 학습이 끝난 뒤에는 sliding window 방식으로 영상 전체를 한 프레임씩 밀며 연속적인 라벨을 만든다.
Latent Action Model은 부호화한 latent action 벡터를 그 자체로 라벨로 삼는다. latent action은 두 프레임 사이의 시각적 변화를 action 라벨 없이 부호화한 벡터를 말하며, 앞 편 N1 해설에서 latent action space를 설명할 때 이미 나온 방식이다.
4단계 visuomotor policy 학습
4단계는 생성된 neural trajectory로 visuomotor policy를 학습하는 과정이다. visuomotor policy는 이미지를 직접 받아 모터 명령을 내는 policy를 말한다.
neural trajectory에는 robot state가 들어 있지 않으므로 상태 입력을 0으로 조건화한다. N1.5를 학습시킬 때는 이렇게 합성한 데이터와 상태 정보가 있는 실제 데이터를 함께 쓰고, 두 유형의 trajectory를 별도의 action encoder와 decoder를 통해 서로 다른 경로로 처리한다.
일반화 효과
해설은 DreamGen의 가치를 데이터의 양을 늘리는 증강이 아니라 일반화에서 찾는다. 근거로 드는 수치는 두 측면으로 나뉜다.
| 측면 | 조건 | GR00T N1 | GR00T N1.5 |
|---|---|---|---|
| 환경 일반화(environment generalization) | 주방과 사무실 등 처음 가보는 10개 환경 | 보고 없음 | 28.5% |
| 행동 일반화(behavior generalization) | pour, iron, water 등 학습에 없던 12개 지시문 | 13.1% | 38.3% |
환경 일반화는 데이터를 증강하는 과정에서 사진 환경을 무작위화한 결과다. 연구실 데이터로만 학습한 로봇이 처음 보는 10개 환경에서 28.5%의 성공률을 냈다.
행동 일반화는 학습 데이터에 없던 동사를 기준으로 잰다. 기존 N1은 학습 데이터에 포함된 pick-and-place 지시만 반복해 12개 새 지시문에서 13.1%에 그친 반면, N1.5는 DreamGen을 통해 38.3%를 기록해 약 2.9배로 올랐다.
결과
N1.5는 아키텍처 개선, 데이터 확장, 새로운 손실 함수 도입을 함께 적용해 시뮬레이션과 실제 로봇 양쪽에서 N1보다 높은 성능을 기록했다.
시뮬레이션 벤치마크
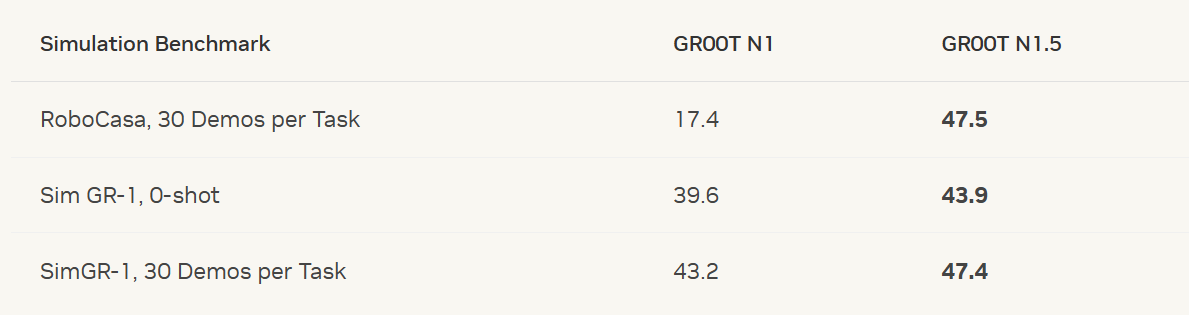
| 벤치마크 | GR00T N1 | GR00T N1.5 |
|---|---|---|
| RoboCasa, 과제당 30 demos | 17.4 | 47.5 |
| Sim GR-1, 0-shot | 39.6 | 43.9 |
| Sim GR-1, 과제당 30 demos | 43.2 | 47.4 |
RoboCasa에서의 차이가 가장 크다. 17.4에서 47.5로 약 2.7배가 되어 나머지 두 항목의 증가폭을 크게 웃돈다.
pre-training 없이 scratch로 학습했을 때의 벤치마크도 함께 제시된다. Language table이 52.8%에서 93.2%로, Sim GR-1 Language가 36.4%에서 54.4%로 올랐다. 즉 지시문 조건이 붙은 과제에서 두 버전의 차이가 특히 크게 벌어진다.
실제 humanoid 평가
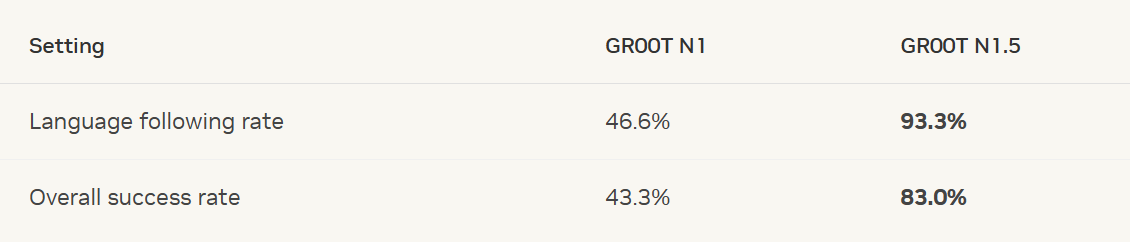
| 지표 | GR00T N1 | GR00T N1.5 |
|---|---|---|
| language following rate | 46.6% | 93.3% |
| overall success rate | 43.3% | 83.0% |
해설은 93.3%를 "과일 두 개 중 지정한 하나를 골라 접시에 담는" 수준의 세밀한 지시를 거의 다 알아듣는다는 뜻으로 읽는다. 그리고 이 수치를 VLM을 학습 내내 frozen으로 둔 결정이 언어 이해력을 지키는 데 효과가 있었다는 근거로 삼는다.
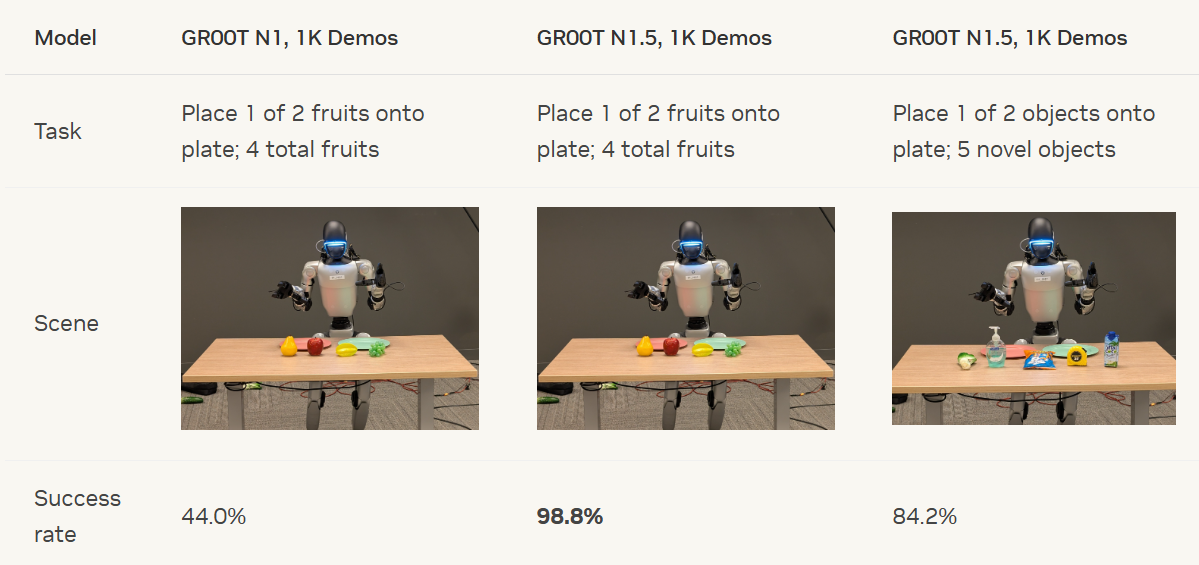
| 과제 | 모델 | 성공률 |
|---|---|---|
| 과일 4종 중 지정한 하나를 접시에 담기 | GR00T N1 | 44.0% |
| 과일 4종 중 지정한 하나를 접시에 담기 | GR00T N1.5 | 98.8% |
| 미학습 물체 5종 중 지정한 하나를 접시에 담기 | GR00T N1.5 | 84.2% |
같은 과제에서 44.0%와 98.8%의 차이는 54.8%p다. 학습에 없던 물체 5종으로 바꾼 세 번째 행에서도 84.2%를 유지하므로, 성능 향상이 특정 물체 집합에만 맞춘 결과가 아니라는 점이 함께 확인된다.
일반화와 하드웨어 전이
일반화 성능은 두 측면으로 제시된다. 하나는 미학습 물체이고 다른 하나는 다른 로봇으로의 전이다.
| 설정 | GR00T N1 | GR00T N1.5 |
|---|---|---|
| 미학습 물체 10종, 0-shot | 0% | 15.0% |
| 미학습 물체 10종, 사람 영상으로 FLARE post-training | 해당 없음 | 55.0% |
N1이 0%였던 미학습 물체 10종 과제에서 N1.5는 0-shot으로 15.0%를 냈다. 나아가 그 물체가 포함된 사람 1인칭 영상으로 FLARE post-training을 거치면 55.0%까지 오른다. 즉 action 라벨 없는 사람 영상만으로도 성능을 40%p 더 끌어올릴 수 있다는 뜻이다.
하드웨어 전이도 함께 제시된다. GR-1 데이터로 pre-training한 모델을 Unitree G1 로봇에 post-training으로 적용했을 때 미학습 물체에서 84.2%의 성공률이 나왔다. 결과적으로 N1.5는 더 적은 시연 데이터로도 새로운 환경과 물체, 복잡한 지시문에 대응할 수 있는 성능을 확보했다.
원문의 그림 배치에는 확인이 필요한 지점이 하나 있다. 실제 기기 GR-1 수치 표는 시뮬레이션 절 아래에, scratch 학습 벤치마크 표는 실제 기기 절 아래에 놓여 있다. 표 안의 행 이름과 본문이 인용하는 수치를 맞춰 보면 두 그림의 자리가 서로 바뀐 것으로 보인다.
한계
해설이 옮긴 N1.5의 한계는 세 가지다.
- 완전히 새로운 행동과 환경으로의 일반화는 여전히 향후 연구 과제로 남아 있다.
- N1에서 지적됐던 long-horizon loco-manipulation 능력은 N1.5에서도 발전의 여지가 있다.
- 매우 복잡하거나 예측하기 어려운 실제 환경에서의 robustness도 계속 개선이 필요하다.
DreamGen 쪽 한계는 더 구체적이다. 생성 모델은 물리 엔진처럼 뉴턴의 법칙을 계산해 프레임을 만드는 것이 아니므로, 시각적으로는 자연스러워도 미세한 물체 조작 장면에서 시각적 왜곡이나 물리적 불일치가 발생할 수 있다. 따라서 물리 법칙을 지키면서 반사실적 다양성까지 확보하는 문제가 과제로 남는다.
이 해설이 다루지 않은 부분은 다음과 같다.
- Eagle-2.5가 왜 공간 이해에서 더 나은지는 참고문헌 링크로만 넘긴다.
- VLM을 pre-training 단계에서까지 frozen으로 바꾼 결정의 근거는 결과만 있고 ablation은 없다.
- λ=0.2와 8개 중 6번째 layer라는 두 하이퍼파라미터도 결론만 옮긴다.
- Inverse Dynamics Model과 Latent Action Model 중 무엇을 언제 쓰는지, 둘을 어떻게 나눠 적용했는지가 나오지 않는다.
- AgiBot-Beta는 pre-training 데이터 목록에 이름만 등장한다.
- 모델 파라미터 규모, action chunk 길이, 학습 인프라 같은 수치도 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| FLARE | DiT 입력에 learnable future token을 추가하고, 그 중간 layer 출력을 t+H 시점 future observation의 임베딩과 코사인 유사도로 묶는 학습 방식. flow matching 손실에 λ=0.2로 더해진다 |
| future token | DiT 입력 시퀀스에 새로 들어간 M개의 learnable 임베딩. 초기값에는 의미가 없고 self-attention을 거치며 미래 상태를 담는 자리로 학습된다 |
| Q-former | 32개의 learnable query token이 self-attention과 cross-attention으로 288개 융합 토큰의 정보를 흡수해 대신하는 압축 모듈 |
| DreamGen | video world model을 fine-tuning해 합성 로봇 영상을 만들고 pseudo-action을 붙여 학습 데이터로 쓰는 4단계 파이프라인 |
| neural trajectory | DreamGen이 만들어낸 합성 trajectory. robot state가 없어 상태 입력을 0으로 조건화해 쓴다 |
| Inverse Dynamics Model | 두 프레임 s_t와 s_{t+h}만 보고 그 사이를 채울 action chunk를 예측하도록 학습한 DiT 기반 모델. robot state를 쓰지 않는다 |
관련 페이지
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-13편이자 이 편의 전제. dual-system 구조, flow matching 손실과 추론, data pyramid와 latent action space가 그 페이지에 있다. 먼저 읽어야 이 편의 변경점 목록이 읽힌다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: N1 원 논문. 이 편이 기준선으로 삼는 구조의 정량 결과와 데이터 생성 절차가 있다.
- GR00T N1.5: NVIDIA GEAR의 N1.5 공식 프로젝트 페이지. 이 해설이 참고문헌 첫 줄로 드는 원 출처다.
- Eagle 2.5: Boosting Long-Context Post-Training for Frontier Vision-Language Models: N1.5가 backbone으로 교체한 VLM의 원 논문. 긴 영상과 고해상도 이미지를 다루는 long-context post-training이 주제이고, 이 해설이 적은 공간 이해 개선은 그 논문의 주장이 아니라 N1.5 프로젝트 페이지가 Eagle 2.5를 grounding을 겨냥해 다시 튜닝했다고 적은 내용에 해당한다.
- Eagle: Frontier Vision-Language Models with Data-Centric Strategies: Eagle 계열 공식 저장소. Eagle 2에서 N1, Eagle 2.5에서 N1.5, native resolution 변형에서 N1.6으로 이어지는 backbone 채택 이력이 날짜로 기록돼 있다.
- World Model for Robot Learning: A Comprehensive Survey: world model 서베이. FLARE를 latent-space world modeling 가지로, DreamGen을 imagination-based 가지로 분류하고 DreamGen Bench를 open-loop 예측 품질 평가 항목으로 든다.
- Cosmos World Foundation Model Platform for Physical AI: DreamGen 1단계에서 fine-tuning 대상으로 이름이 오르는 world foundation model.
- NVIDIA Isaac GR00T (N1.7): GR00T 공식 저장소. N1.5 이후 세대의 코드와 배포 스택이 있다.
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): N1.5가 짝을 이뤘던 Decoupled WBC 컨트롤러 구현. 팔과 손 policy, 몸통과 다리 컨트롤러가 어떻게 나뉘는지 확인할 수 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 기준과 학습 경로 허브.