Physical AI · ARTICLE · 2026
Introducing S1: In-Context Learning for Robotics
요약
Skild AI는 2026년 8월 로봇 foundation model S1을 공개하면서, 언어가 아니라 영상 시연 데이터(demonstration) 하나로 새 조작 과제를 수행하는 in-context learning(ICL) 능력을 앞세웠다. 시연 데이터는 사람이 만들어준 모범 실행 데이터를 말한다.
S1은 최대 10분 길이의 unseen long-horizon 과제(pre-training에서 본 적 없고 여러 단계를 이어야 끝나는 과제)를 video prompt 하나만으로 실행한다. video prompt는 과제를 지정하기 위해 context window 앞부분에 넣는 짧은 시연 영상을 말한다. Skild는 pre-training 데이터를 1,000시간에서 10만 시간까지 늘리는 통제 실험으로, ICL 방식이 언어로 과제를 지정하는 language-conditioned VLA보다 unseen 과제에서 훨씬 가파르게 좋아진다는 scaling law를 함께 제시한다.
배경
로봇 학습은 새 과제마다 수십에서 수백 시간의 데이터 수집과 전용 policy fine-tuning을 요구해 왔다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계를 말한다. Skild는 이 관행을 언어 모델의 "BERT 시대"에 빗댄다. BERT 같은 초기 Transformer 기반 모델은 언어 이해에는 뛰어났지만, 새 응용마다 추가 데이터 수집과 fine-tuning이 필요했다. BERT에서 ChatGPT로의 전환을 이끈 결정적 변화는 in-context learning, 즉 prompting이라는 새로운 학습 방식의 등장이었다. 사용자가 prompt만으로 새 개념을 알려주면 모델이 가중치 변경 없이 합리적인 응답을 내놓을 수 있게 됐고, 이 능력이 GPT-1이나 GPT-2 같은 연구용 프로토타입과 오늘날의 frontier 언어 모델을 가르는 기준이 됐다.
로봇공학은 아직 이 전환 이전 단계에 머물러 있다는 것이 Skild의 문제의식이다. 복잡한 과제에서 견고한 policy를 학습하려면 배포 환경과 같은 조건의 post-training 데이터가 수십에서 수백 시간 필요하다. post-training은 pre-training을 마친 모델을 특정 embodiment나 과제 데이터로 이어서 학습시키는 단계를 말한다. 더 나아가 post-training 데이터가 충분히 크고 과제를 촘촘히 덮으면, pre-training을 거치지 않고 처음부터 학습한 policy도 post-training된 foundation model의 최고 성능과 맞먹는다는 최근 연구 결과(FACTR 2, Oh 2026)까지 있다. Skild는 여기서 "pre-training의 존재 의의가 무엇인가"라는 질문을 던지고, 그 답을 in-context learning, 즉 하나 또는 몇 개의 예시만으로 즉시 배우는 능력을 가능하게 하는 데서 찾는다.
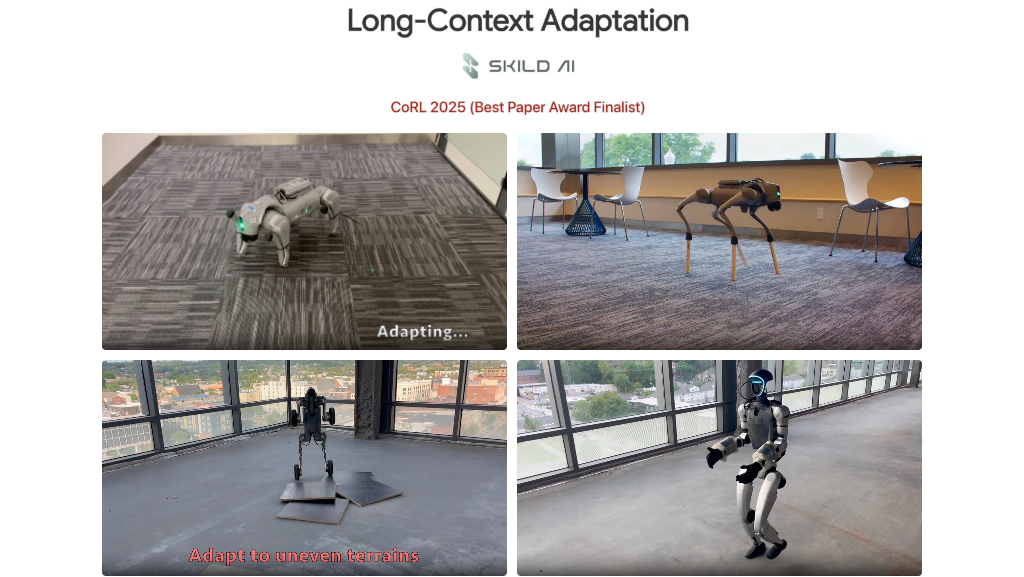
이 흐름은 Skild가 1년 전 발표한 LocoFormer(Liu 2025)에서 시작됐다. LocoFormer는 locomotion 영역에서 살아있는 경험을 prompt에 계속 누적해 적응하는 in-context learner였고, CoRL 2025 Best Paper Award Finalist로 선정됐다. Skild는 이 접근을 manipulation으로 옮기는 작업을 이어 왔으며, 6개월 전 short-horizon 과제에서 첫 성공 신호를 확인한 뒤 데이터와 학습 레시피를 반복 개선해 long-horizon 능력까지 얻었다고 밝힌다.
같은 시기 다른 연구팀도 비슷한 방향을 탐색했다. Generalist AI는 GEN-1.5: Embodied Foundation Models are One-Shot Learners에서 physical prompt라는 이름으로 센서와 action이 함께 담긴 시연을 context에 넣는 방식을 선보였고, Jiang 등은 RoboTTT(2026)에서 비슷한 아이디어를 시도했다. Skild는 두 연구 모두 short-horizon이거나 pre-training 분포 안 과제, 또는 둘 다에 머문다고 평가하며, S1이 이 두 한계를 함께 넘어선 첫 사례라고 자리매김한다. 다만 이 비교는 Skild 자신의 발표 안에서 이뤄진 것이라 액면 그대로 받아들이기보다는 참고 자료로 읽는 편이 안전하다.
핵심 개념
S1을 이해하려면 먼저 in-context learning이 로봇 학습에서 무엇을 뜻하는지 짚어야 한다. in-context learning은 가중치 갱신 없이 prompt 안의 예시만으로 과제를 배우는 능력이다. 언어 모델에서는 예시 문장 몇 개가 prompt 역할을 하지만, S1에서는 과제를 수행하는 짧은 영상 하나가 그 역할을 한다.
Skild는 ICL 난이도를 두 기준으로 나눠 설명한다. 첫째는 시연된 과제가 pre-training 분포 안에 있는지(seen, in-distribution), 아니면 완전히 새로운지(unseen, out-of-distribution)이다. 둘째는 과제가 5초에서 25초 사이의 짧고 원자적인 동작인지, 아니면 새 skill을 조합해야 하는 long-horizon 과제인지다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 사람도 마찬가지로, "머그컵 좀 건네줘" 같은 단순한 동작은 말로 충분하지만 이불보를 개는 법이나 달걀흰자를 단단한 거품으로 만드는 법은 말이 아니라 시범을 보고 배운다. Skild는 로봇도 같은 원리로, 원자적 동작은 언어만으로 충분하지만 섬세하거나 긴 과제는 시연이 필요하다고 본다.
이 시연을 담는 그릇이 video prompt다. video prompt는 과제를 지정하기 위해 context window 앞부분에 넣는 짧은 시연 영상이다. context window는 모델이 한 번에 받아들일 수 있는 입력 길이의 한도를 말한다. 시연은 사람이 직접 손으로 하는 동작일 수도, 로봇이 teleoperation으로 수행한 동작일 수도 있다. teleoperation은 사람이 로봇을 원격으로 움직여 시연 데이터를 만드는 방식이다.
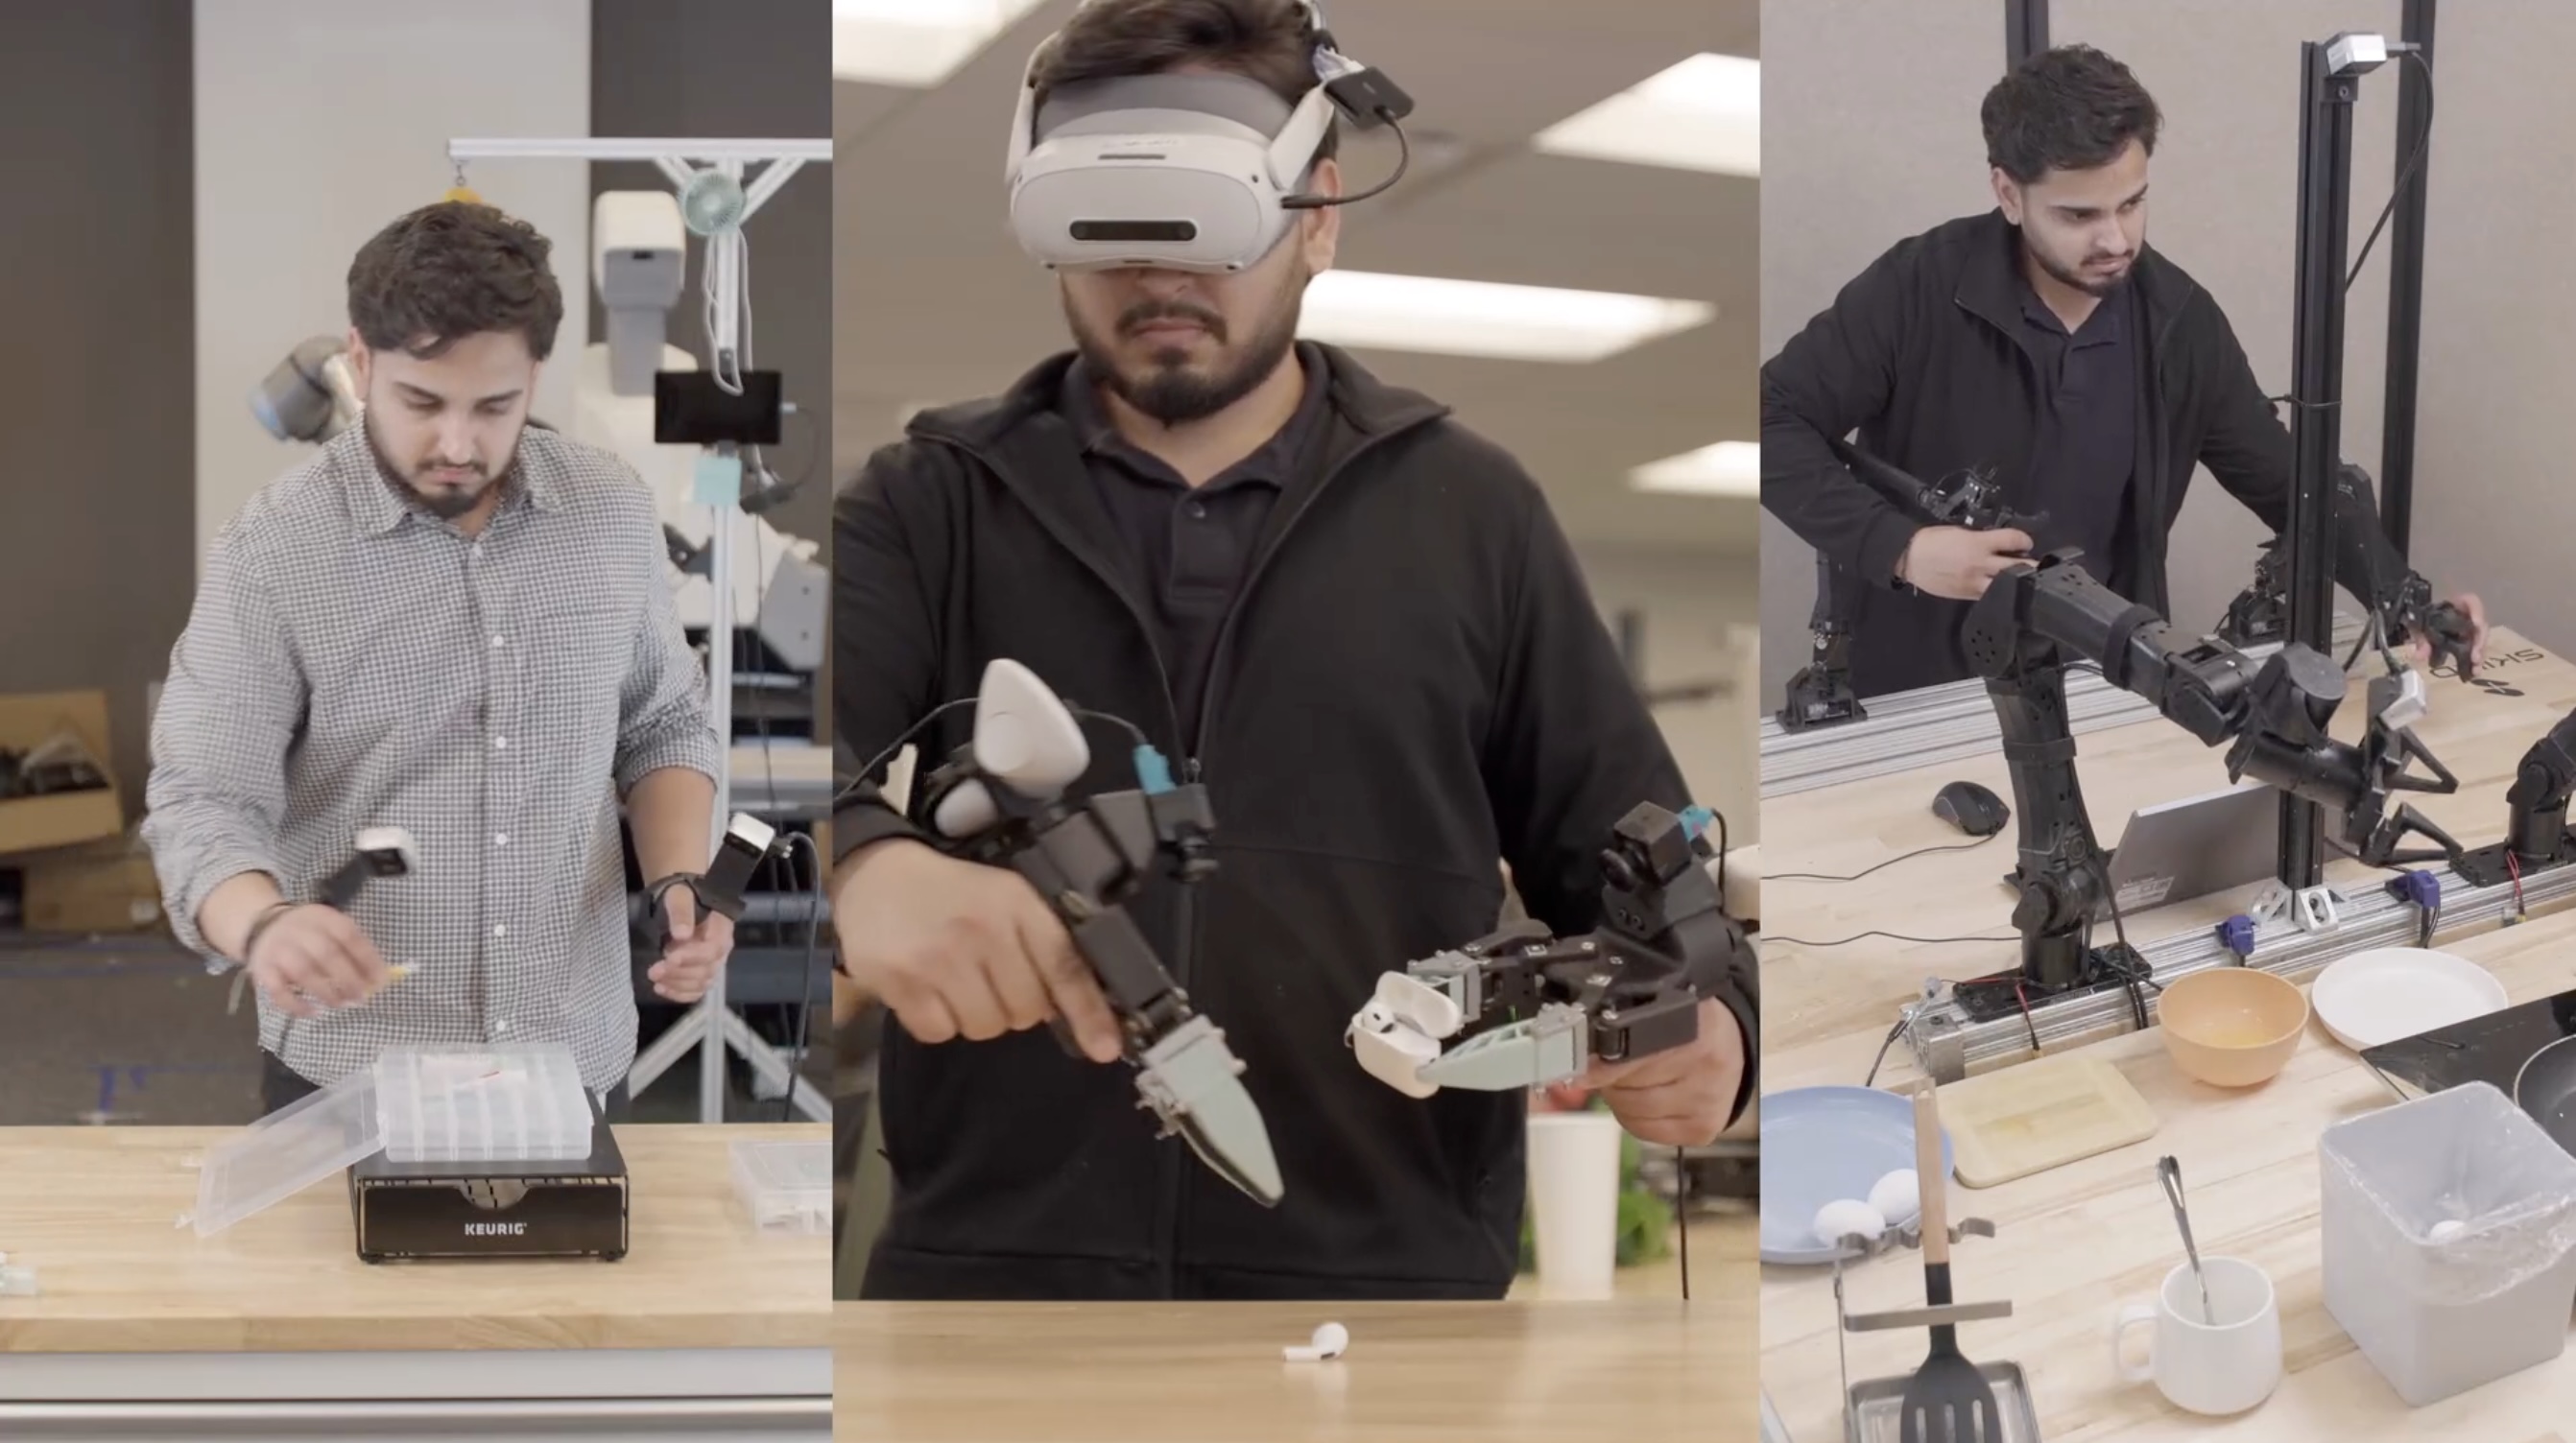
시연이 로봇 자신이 아니라 다른 장면, 다른 시점, 심지어 다른 embodiment에서 온 것일 수도 있다는 점이 중요하다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. 그래서 policy는 시연자의 의도와 물체 사이의 대응 관계, 과제 진행 정도를 암묵적으로 읽어내야 다음 action을 예측할 수 있다. 이 요구가 S1의 학습 레시피 전체를 관통한다.
방법
학습 레시피
S1의 pre-training 레시피는 개념적으로 단순하다. episodic 데이터로 학습하되, 과제를 오직 in-context 시연 데이터로만 지정한다. meta-learning 관점에서 보면 pre-training은 policy에게 "시연에서 배우는 법"을 가르치는 outer loop이고, 추론 시점에 주어지는 시연 데이터가 가중치를 바꾸지 않은 채 동작을 결정하는 inner loop다. 결과로 나오는 것은 익숙한 동작을 새로운 배치에서도 해내고, 처음 보는 동작까지 ICL로 수행하는 단일 policy다. S1은 fine-tuning이나 post-training 없이 동일한 가중치로 이 글의 모든 예시를 만들어냈다. 아키텍처 세부와 학습 방법 자체는 이 시리즈의 다음 글에서 다룰 예정이라 이번 글에는 공개되지 않는다.
데이터 소스별 세 가지 기준
로봇 데이터에서 모든 면에서 최적인 단일 소스는 없다는 것이 Skild의 data engine 설계 출발점이다. 세 가지 기준에서 주요 데이터 소스가 서로 다른 트레이드오프를 갖는다.
- hardware proximity: 데이터가 배포 하드웨어와 얼마나 닮았는지.
- diversity: 데이터가 담는 과제와 장면과 행동의 다양성.
- scalability: 데이터를 더 모으는 비용이 얼마나 낮은지.
| 데이터 소스 | hardware proximity | diversity | scalability |
|---|---|---|---|
| Robot teleop | 높음 | 낮음 | 낮음 |
| UMI | 중간 | 중간 | 중간 |
| Egocentric video | 낮음 | 높음 | 높음 |
| Simulation | 중간 | 낮음 | 높음 |
teleoperation은 로봇에 가장 가깝지만 확장성이 가장 나쁘고, egocentric video는 확장성이 가장 좋지만 로봇과의 domain gap이 가장 크다. 어느 하나도 세 기준 모두에서 이기지 못하므로, 한 소스에만 거는 것은 근시안적이라는 것이 Skild의 판단이다. 그래서 네 소스를 모두 사내에서 함께 확장하고 있다고 밝힌다.
ICL scaling law 실험 설계
Skild는 pre-training 데이터 풀의 일부를 걸러낸 subset으로 통제 실험을 진행했다. ICL policy와 language-conditioned VLA policy를 1,000시간부터 10만 시간까지, 같은 데이터와 같은 아키텍처(prompt embedding 부분만 다름), 같은 연산량으로 학습시켰다. VLA는 vision-language-action model의 약어다. 평가는 pre-training 분포 안 과제 벤치마크와 unseen 과제 벤치마크 두 세트로 진행했고, 모든 과제는 4분에서 8분 사이의 long-horizon이다. 평가 지표는 전체 과제에 대한 cumulative per-step success rate의 평균이다. 모든 단계를 누적으로 채점하기 위해 rollout 중 실패에서 사람이 개입해 복구시켰는데, 이 개입은 주로 VLA baseline에 쓰였다. 개입이 없으면 VLA baseline은 긴 unseen 과제를 한 번도 끝까지 완수하지 못해 점수가 0이 되기 때문이다.
분포 이탈 정량화
Skild는 분포 이탈을 두 기준으로 나눠 측정했다. 첫 번째 기준은 배포 조건이 pre-training 조건에서 얼마나 벗어났는지이고, 둘째 기준은 배포 장면이 in-context 시연 데이터 자체에서 얼마나 벗어났는지다. 두 실험 모두 좁은 데이터 분포를 갖는 알려진 과제 하나를 골라 다섯 단계(L1~L5)로 이탈을 키우는 같은 프로토콜을 썼다.
| 단계 | 뜻 |
|---|---|
| L1 | pre-training 또는 시연 데이터와 같은 물체, 같은 배치 |
| L2 | 모든 물체를 15cm, 30도 무작위로 이동 |
| L3 | 모든 물체를 30cm, 45도 무작위로 이동 |
| L4 | 같은 affordance를 가진 다른 물체로 교체, 약 15cm 수직 이동 추가 |
| L5 | 로봇 action의 절반을 반대쪽 팔로 실행해야 하도록 배치 |
affordance는 물체가 허용하는 상호작용 가능성을 뜻한다. 두 실험의 차이는 이탈의 기준점이다. 첫 번째 실험은 pre-training 조건을 기준으로 배포 조건이 얼마나 멀어지는지를 재고, 두 번째 실험은 pre-training 조건을 고정한 채 시연 데이터와 배포 장면 사이의 거리만 바꾼다.
결과
seen 과제
1,000시간 pre-training 시점에서는 language-conditioned policy가 53%, ICL이 43%로 language 쪽이 앞섰다. 과제 지정이 언어 토큰으로 압축되는 VLA와 달리, ICL 모델은 고차원 조건화 데이터 소량에 과적합하기 쉽다는 것이 Skild의 해석이다. 그러나 pre-training을 확장하면 S1의 ICL이 96%까지 올라가 VLA를 앞지른다. 언어 지시문은 여러 유효한 실행 방식을 허용하는 반면, 시연 데이터는 실행 방식을 하나로 명확히 지정한다는 점이 이 역전의 원인으로 제시된다.
unseen 과제
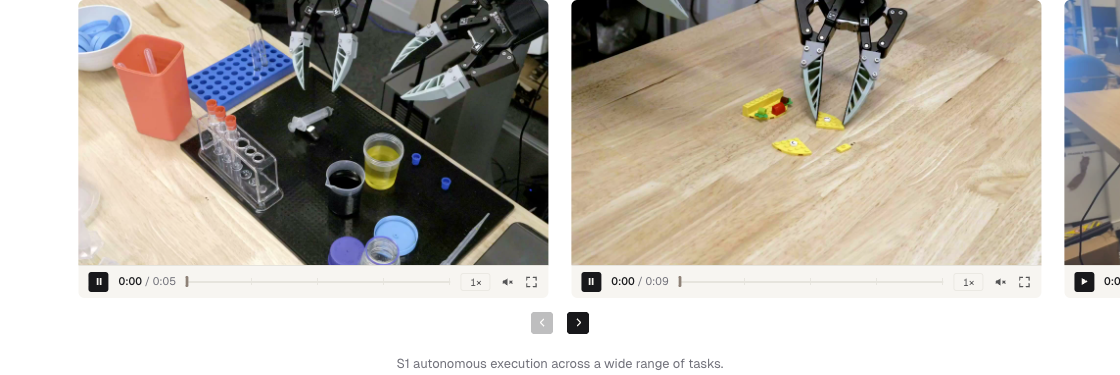
pre-training 데이터를 늘렸을 때 두 방식의 격차가 훨씬 극적으로 벌어진다. language prompting은 완만하게 늘어 10만 시간 시점에 9%에 그친다. 같은 데이터 규모에서 ICL은 66%에 도달한다. 이 격차가 데이터가 늘수록 지수적으로 벌어진다는 점을 Skild는 ICL scaling law에 대한 낙관적 신호로 꼽는다.
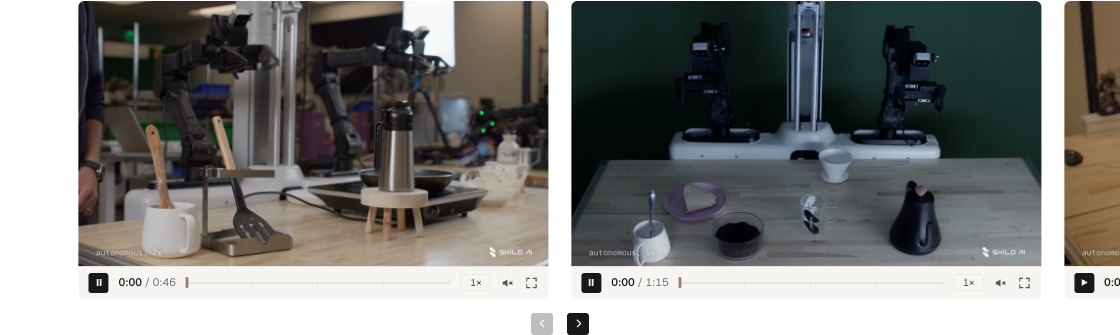
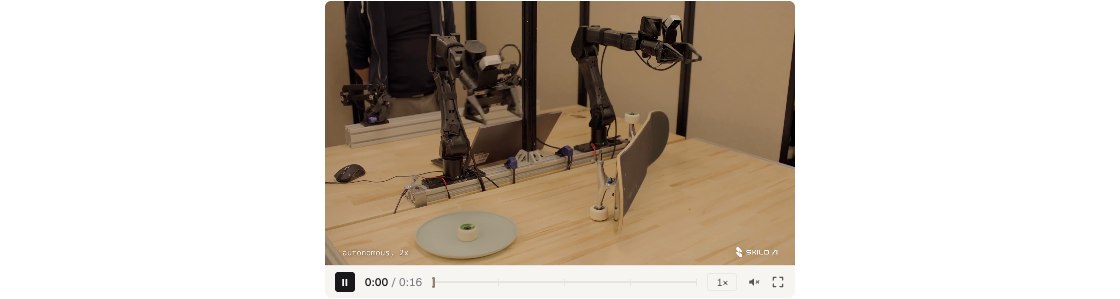
원인은 두 가지로 제시된다. 하나는 새로운 skill이다. pancake 뒤집기처럼 새로운 동작 primitive는 언어가 행동에 근거를 대기 어려운 지점이다. primitive는 로봇 API가 노출하는 최소 실행 단위를 가리킨다. ICL은 언어 대신 새 행동으로도 전이되는 폭넓은 시각적 대응 관계에 의존한다. 다른 하나는 compositional generalization이다. compositional generalization은 학습에서 본 skill을 새로운 조합으로 엮어 미학습 과제를 푸는 능력을 말한다. 언어는 알려진 primitive를 새로운 방식으로 엮는 지시를 내리기에는 너무 성기고, 모델이 한 번도 요청받은 적 없는 조합에는 짧은 지시문 자체가 존재하지 않을 수 있다. 반면 시연 데이터는 그 조합을 그대로 보여준다.
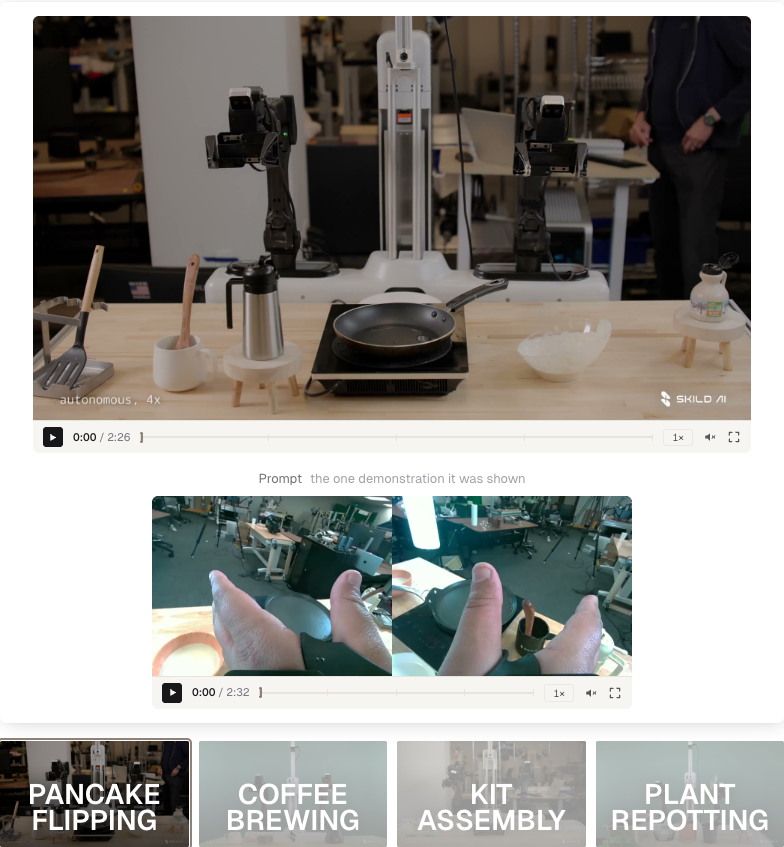
plant potting 과제의 실제 타임라인이 이 속도를 잘 보여준다. 흙과 화분, 물뿌리개, 식물이 사무실에 도착한 시각부터 계산하면 다음과 같다.
| 시각 | 사건 |
|---|---|
| 오후 8:54 | 재료 도착 |
| 오후 9:16 | 장면 세팅 완료, 녹화 시작 |
| 오후 9:22 | 사람의 egocentric 시연 데이터 1개 녹화 완료 |
| 오후 9:27 | S1이 하드웨어에서 자율 실행 시작 |
시연 데이터가 만들어진 시점부터 자율 실행 시작까지 걸린 시간은 11분이다. 기존 방식이라면 이 지점에서 시간 단위의 teleoperation 데이터 수집과 fine-tuning이 시작됐을 것이다.
강건성과 시연 데이터 효율성
분포 이탈 실험의 첫 번째 기준(training 조건 대비 이탈)에서, L5 교란을 주면 language-prompted VLA가 ICL policy보다 최대 3배 더 크게 성능이 떨어진다. VLA는 물체 위치의 작은 변화에는 강하지만, 새로운 물체가 들어오거나 배치가 새로운 실행 계획을 요구하면 일반화에 실패한다. ICL policy는 배포 조건에 맞는 실행 계획을 그대로 시연 데이터로 받을 수 있어 이 상황에 더 잘 대응한다. 두 번째 기준(시연 데이터 대비 이탈)에서는 물체 배치가 어긋나거나 물체가 교체된 상황(L4)까지는 ICL이 강건하다가, 시연 데이터가 완전히 다른 실행 계획을 요구하는 L5(반대쪽 팔 사용)에 이르러서야 성능이 크게 떨어진다.
시연 데이터 하나의 가치를 post-training 데이터 개수로 환산한 실험도 있다. VLA policy를 1개에서 2,000개까지의 teleoperation 시연 데이터로 post-training하고, ICL policy는 post-training 없이 단일 시연 데이터 성공률을 수평 기준선으로 비교했다. 측정한 지점 사이를 보간해 추정한 결과, 시연 데이터 하나를 context에 넣는 것은 post-training 시연 데이터 약 380개와 맞먹는다. 4분에서 10분짜리 long-horizon 시연 데이터 380개를 모으려면 teleoperation 50시간에서 100시간이 필요하다. 해당 과제로 한 번도 post-training되지 않은 ICL policy가 시연 데이터 하나로 66% 성공률을 낸다. post-training은 결국 이를 넘어서 시연 데이터 2,000개로 86% 성공률에 도달하지만, ICL pre-training이나 ICL post-training을 더 확장하면 이 격차가 줄어들 것으로 Skild는 기대한다.
정성적 사례
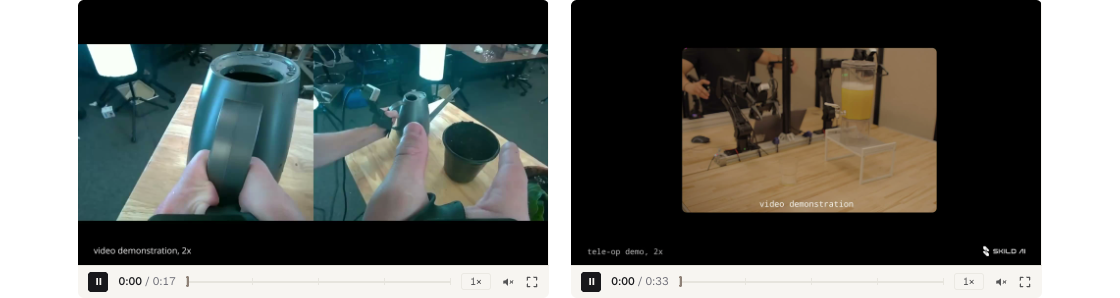
Skild는 별도로 설계하지 않았는데도 나타난 네 가지 emergent property를 소개한다.
- perturbation 강건성: 로봇이 접근하는 동안 물체를 밀어내거나 바꿔치기하고 조명을 바꿔도, 시연 데이터에는 없던 교란인데도 S1은 과제를 완수했다.
- 실수 회복: S1이 실패하면 무작정 진행하는 대신 다시 시도하는 경우가 많다. skateboard 바퀴 조립 같은 unseen 과제에서도 이런 복구 행동이 별도 데이터 수집 없이 관찰됐다.
- common-sense 판단: 시연 데이터는 물뿌리개로 화분에 물을 주지만 실제로는 컵밖에 없는 상황에서 S1은 컵을 대신 쓴다. 다른 예시에서는 시연 데이터가 유리컵에 주스를 채우지만 컵이 이미 거의 차 있으면 S1이 남은 만큼만 채우고 멈춘다.
- 시연 데이터 보정: 시연 데이터 자체에 실수가 섞여 있어도 S1이 이를 개선해 수행하는 사례가 있다. 한 시연 데이터에서는 시연자가 달걀을 일찍 놓쳐 어지럽히지만, S1은 같은 단계를 통제된 동작으로 수행한다. Skild는 S1이 시연 데이터를 그대로 재현할 trajectory가 아니라 목표 명세로 다루는 것이라고 해석한다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
한계
이 글은 논문이 아니라 자사 블로그 발표다. 모델 크기와 아키텍처, 정확한 데이터 규모, 로봇 하드웨어 사양은 공개하지 않는다. Skild는 학습 방법 자체를 다음 글에서 다루겠다고 예고하지만, 이번 글만으로는 재현이나 독립 검증이 불가능하다.
정량 결과(성공률 대 pre-training 규모, 성공률 대 분포 이탈, 성공률 대 시연 데이터 개수를 그린 차트 네 개)는 스크롤에 반응해 그려지는 JS 차트로 원문에 실려 있다. 이번 수집에서 캡처한 정지 이미지에는 축과 범례만 남고 실제 데이터 포인트나 선이 렌더링되지 않아 위 수치는 모두 본문 서술에서 가져왔다. 같은 문제가 GEN-1.5: Embodied Foundation Models are One-Shot Learners 수집 때도 있었던 반복 패턴이라, 스크롤 트리거 차트를 쓰는 발표 글을 수집할 때는 정지 캡처만으로 정량 결과를 확인하기 어렵다는 점을 감안해야 한다.
평가 프로토콜의 세부인 시행 횟수, 초기 조건 분포, 성공 판정 기준, 통계적 분산도 공개되지 않는다. VLA baseline의 정확한 아키텍처도 "prompt embedding 부분만 다르다"는 서술 외에는 알 수 없다. 380개라는 시연 데이터 효율성 수치 자체도 측정한 지점 사이를 보간해 추정한 값이라고 Skild가 명시한다.
concurrent work인 GEN-1.5와 RoboTTT를 "short-horizon이거나 in-distribution에 머문다"고 요약하는 비교도, 자사 결과와 나란히 실린 자사 주도의 서술이라는 점을 감안해서 읽어야 한다. S1은 이미 상용 파트너와 함께 배포 중이라고 밝히는데, 이는 이 발표에 상업적 동기가 있다는 뜻이기도 하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| video prompt | 과제를 지정하기 위해 context window 앞부분에 넣는 짧은 시연 영상. 사람 또는 로봇이 과제를 수행하는 장면을 담는다 |
| data engine | hardware proximity, diversity, scalability 세 기준의 트레이드오프를 고려해 teleoperation, UMI, egocentric video, simulation 데이터를 함께 확장하는 Skild의 데이터 전략 |
| ICL scaling law | pre-training 데이터 규모를 1,000시간에서 10만 시간까지 늘리며 ICL과 language-conditioned VLA의 성공률을 비교한 통제 실험과 그 결과 |
| 시연 데이터 보정(demonstration correction) | S1이 시연 데이터에 담긴 실수나 비효율을 그대로 재현하지 않고 개선해 수행하는 현상 |
| LocoFormer | Skild AI가 2025년 발표한 locomotion용 in-context learner. 살아있는 경험을 prompt에 누적해 새 embodiment와 환경에 적응한다 |
| compositional generalization | 학습에서 본 skill을 새로운 조합으로 엮어 미학습 과제를 푸는 능력 |
관련 페이지
- GEN-1.5: Embodied Foundation Models are One-Shot Learners: concurrent work인 GEN-1.5. physical prompt라는 이름으로 센서와 action이 함께 담긴 시연을 context에 넣는 비슷한 접근이다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching 기반 action 출력을 쓰는 VLA 기준선. S1이 비교 대상으로 삼는 language-conditioned VLA 계열과 같은 가지다.
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: steerability를 다루는 π0.7. 시연이나 언어로 로봇의 행동을 얼마나 이끌 수 있는지를 다뤄 이 글의 ICL 강건성 논의와 맞닿아 있다.
- OpenVLA: An Open-Source Vision-Language-Action Model: 공개 가중치 VLA. S1이 비공개로 남긴 아키텍처 세부를 비교해 볼 대상이다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.
- 용어집: Physical AI (Terminology Glossary): 이 페이지가 따르는 용어 canonical 표기.