Agents · PAPER · 2026
Recursive Language Models (RLM)
요약
Recursive Language Models(RLM)는 임의 길이의 prompt를 LLM에 직접 넣지 않고 외부 실행 환경의 변수로 옮긴 뒤, 모델이 코드를 써서 그 변수를 탐색하고 나누고 자기 자신을 재귀 호출하게 하는 추론 패러다임이다. MIT CSAIL의 Alex L. Zhang, Tim Kraska, Omar Khattab이 2026년 5월 11일 arXiv에 공개했다.
기존 방식과의 차이는 prompt가 사는 위치 하나로 요약된다. 보통의 LLM 호출은 prompt 전체를 context window에 올린다. RLM은 prompt를 Python REPL 환경의 변수 context에 저장하고, root LM에게는 그 변수의 길이와 짧은 prefix, 접근 방법 같은 상수 크기 메타데이터만 보여준다. 모델은 print(context[:100])처럼 코드를 실행해 필요한 부분만 들여다보고, llm_query(...)로 조각마다 sub-LM을 호출한다.
이 설계가 노리는 것은 세 가지 무제한이다. 입력이 base 모델의 컨텍스트 한도를 훨씬 넘어도 되고(unbounded input), 최종 답도 REPL 변수에서 가져오므로 출력 길이 제한이 없고(unbounded output), 코드 안의 loop로 sub-LM을 임의 개수 호출할 수 있으므로 프롬프트 전체를 훑는 작업량도 제한되지 않는다(unbounded semantic horizon).
정량 결과는 GPT-5와 Qwen3-Coder-480B-A35B 두 모델 위에서 측정했다. long-context 벤치마크 4종에서 base LM과 기존 scaffold를 최대 2배까지 앞서고, GPT-5 기준 상대 향상률의 중앙값으로 compaction agent 대비 26%, sub-call을 갖춘 CodeAct 대비 130%, context offloading을 쓰는 Claude Code 대비 13% 우위를 기록한다. 비용은 base LM과 같은 자릿수에 머문다.
가장 극적인 지점은 OOLONG-Pairs다. 조건을 만족하는 모든 pair를 열거해야 하는 이 task에서 base GPT-5와 base Qwen3-Coder는 모두 F1 0.1%로 사실상 아무것도 풀지 못한다. compaction agent를 붙여도 0.1%와 0.31%로 나아지지 않는다. RLM(GPT-5, depth=1)은 58.0%, depth=3에서는 76.0%를 기록한다.
논문은 여기에 소규모 학습 실험을 덧붙인다. Qwen3-Coder-480B-A35B가 만든 RLM trajectory 약 1,000개를 Qwen3-8B에 distillation한 RLM-Qwen3-8B는 학습 전 RLM(Qwen3-8B) 대비 중앙값 28.3% 향상되고, task 4종 중 3종에서 vanilla GPT-5를 넘어선다. 학습에 든 자원은 48 H100 hours다.
배경
유한한 context window와 context rot
frontier 추론 모델의 context window는 유한하고, 그 한도 안에서도 품질이 길이에 따라 내려간다. Hong 등이 2025년에 context rot이라 이름 붙인 현상이다. 저자들은 학습과 아키텍처, 인프라 개선으로 컨텍스트 길이가 계속 늘어날 것이라고 보면서도, 범용 LLM의 컨텍스트를 자릿수 단위로 키울 다른 길이 있는지를 묻는다.
이 질문이 시급한 이유는 사용처가 바뀌고 있기 때문이다. LLM이 long-horizon task에 쓰이기 시작하면서 수천만에서 수억 토큰을 일상적으로 처리해야 하는 상황이 생긴다. context window를 조금씩 늘리는 방식으로는 따라가기 어려운 규모다.
compaction이 깔고 있는 전제
long-context를 다루는 inference-time 방법 중 가장 널리 쓰이는 것은 context condensation, 즉 compaction이다. compaction은 길어진 대화 이력이나 agent trajectory를 요약으로 접어 context 한계 안에서 세션을 이어가는 처리다. Codex CLI, OpenHands의 context condensation, ReSum이 모두 이 계열이다.
문제는 이 방식이 암묵적으로 깔고 있는 전제다. prompt 앞부분에 나온 어떤 세부는 새 내용을 위한 자리를 만들기 위해 안전하게 잊어도 된다는 가정이다. 저자들은 prompt 전체에 걸쳐 촘촘한 접근이 필요한 task에서는 이 가정이 성립하지 않는다고 진단한다. OOLONG처럼 거의 모든 항목의 semantic label이 답에 관여하는 task가 그 예다.
기존 scaffold가 도달하지 못한 표현력
RLM 이전에도 외부 데이터를 환경으로 다루는 agent와 자기 자신을 서브에이전트로 호출하는 방식이 있었다. 저자들은 둘 다 한계가 있다고 본다.
코딩 agent와 retrieval agent는 파일시스템이나 검색 코퍼스 같은 지정된 외부 데이터 원본을 환경으로 삼아 조각을 꺼내온다. 그러나 꺼내온 조각으로 base LM의 context window를 채우는 데까지만 갈 수 있고, 그다음에는 다시 compaction을 만난다. 사용자가 준 입력 자체에 대해서는 여전히 유한하다.
자기 위임 방식은 다른 벽에 부딪힌다. sub-call을 autoregressive하게 말로 풀어내도록 설계돼 있어서 base LM의 출력 길이에 묶인다. 명시적으로 서술한 몇 개의 작업만 위임할 수 있고, prompt의 조각들을 loop로 순회하며 수백에서 수천 개의 호출을 던지는 것은 불가능하다.
RLM의 착안점은 이 두 벽을 같은 수단으로 넘는 것이다. prompt 자체를 환경의 일부로 만들면 입력 한도가 사라지고, sub-LM을 코드에서 부를 수 있는 함수로 노출하면 위임 개수의 한도가 사라진다.
핵심 개념
이 페이지를 읽는 데 필요한 개념은 여덟 가지다.
REPL은 코드를 받아 즉시 실행하고 결과를 돌려주는 대화형 실행 환경을 말한다. 실행 사이에 변수가 살아 있으므로 앞 단계에서 만든 값을 이름으로 다시 불러 쓸 수 있다. RLM은 이 성질을 prompt 저장소로 쓴다.
symbolic handle은 prompt를 컨텍스트로 복사하지 않고 변수 이름으로만 참조하게 하는 설계를 뜻한다. root LM은 context라는 이름과 그 길이만 알고, 내용은 코드를 실행해서만 본다.
symbolic recursion은 코드 안에서 loop나 comprehension을 통해 sub-LM을 프로그램적으로 호출하는 것을 뜻한다. 자연어로 "이 부분을 서브에이전트에게 맡기겠다"고 서술하는 방식과 대조된다. 전자는 호출 개수가 코드가 만드는 반복 횟수만큼 늘어나고, 후자는 모델이 실제로 써낼 수 있는 토큰 수에 묶인다.
recursion depth는 재귀가 몇 층까지 허용되는지를 나타내는 설정값이다. 0은 sub-call 없이 REPL만 쓰고, 1은 sub-LM 호출까지, 1보다 크면 sub-LM 대신 또 하나의 RLM을 호출하는 것까지 허용한다. 표기는 RLM(GPT-5, depth=2) 형식이며 명시하지 않으면 depth=1이다.
effective context window는 명목상의 한도가 아니라 특정 task에서 실제로 품질이 유지되는 길이를 뜻한다. 저자들의 가설은 이 값이 task와 떼어놓고 정의될 수 없다는 것이다. 같은 모델이 needle 찾기에서는 100만 토큰까지 100%를 유지하면서 semantic aggregation에서는 3만 토큰 대에서 성능이 내려간다.
compaction은 컨텍스트가 한도를 넘을 때 요약이나 절단으로 압축하는 처리다. 본 논문에서는 RLM이 정면으로 비교하는 baseline 이름이기도 하다.
context offloading은 입력을 모델의 컨텍스트에 넣지 않고 파일이나 변수 같은 외부 저장소에 두는 처리를 뜻한다. 본 논문의 결과 표에서 OpenCode와 Claude Code에 붙은 +context offloading 표기가 이것이고, RLM의 첫 번째 설계도 같은 범주에 든다. 다만 RLM은 여기에 재귀 sub-call을 더한다는 점이 다르다.
scaffold는 모델 주위에 짜 놓은 보조 실행 구조를 뜻한다. RLM은 모델 자체를 바꾸지 않고 그 주위에 REPL과 sub-call 인터페이스를 두는 scaffold이며, 그래서 아키텍처를 바꾸는 연구 라인과 직교한다.
방법
RLM의 형식적 정의
base neural LM M과 그 최대 컨텍스트 K가 주어졌을 때, RLM은 M 위에 올라가는 inference-time scaffold다. 임의 길이 prompt P를 받아 응답 Y를 돌려주며, 외부에서 보면 인터페이스가 일반 LLM과 같다. 문자열을 넣으면 문자열이 나온다.
논문의 Algorithm 1은 이 동작을 여덟 줄로 적는다.
state ← InitREPL(prompt=P)              # P가 변수로 저장됨
state ← AddFunction(state, sub_RLM_M)   # sub-RLM 호출 함수 주입
hist ← [Metadata(state)]                # P 길이, prefix 등 상수 크기 메타만
while True:
    code ← LLM_M(hist)
    (state, stdout) ← REPL(state, code)
    hist ← hist ∥ code ∥ Metadata(stdout)   # stdout도 메타만 누적
    if state[Final] is set:
        return state[Final]
절제의 핵심은 마지막에서 두 번째 줄이다. hist에 붙는 것은 stdout 전문이 아니라 짧은 prefix와 길이 같은 메타데이터뿐이다. 그래서 root LM의 이력은 실행 결과의 양과 무관하게 완만하게만 자란다.
이 선택에는 대가가 있고 논문은 각주에서 그 대가를 계산한다. 턴마다 이력을 c 토큰으로 잘라내면 root iteration은 최대 K/c개로 제한된다. 다만 각 iteration이 임의 개수의 sub-call을 launch할 수 있으므로 총 작업량은 이 제한과 별개다. 저자들은 root의 이력 자체를 변수로 옮기면 이 제한도 없앨 수 있다고 적으면서도, 재귀 층마다 iteration 수를 제한하는 편이 실용적이라고 본다.
표현력을 만드는 세 가지 설계
저자들은 RLM과 겉보기에 비슷하지만 표현력이 훨씬 낮은 Algorithm 2를 나란히 제시한다. 둘 다 sub-call, 외부 객체, 코드 실행을 지원한다. 차이는 prompt와 중간값이 어디에 사는지, 그리고 재귀가 어디서 일어나는지에 있다.
| Algorithm 2의 결함 | 무엇이 문제인가 | RLM의 해결 |
|---|---|---|
| 결함 1 prompt P를 모델 이력에 직접 넣는다 | 입력이 M의 컨텍스트 한도로 제한되고 compaction 같은 heuristic에 의존하게 된다. Search action으로 외부 데이터를 읽을 수 있어도 사용자 입력에 대해서는 여전히 유한하다 | P를 REPL 변수로 offload하고 root LM에는 상수 크기 메타만 준다 |
결함 2 Finish(value) action으로 답을 낸다 |
출력이 M의 context window보다 길어질 수 없다 | Final 변수를 REPL에서 가져오므로 출력 길이 제한이 없다 |
| 결함 3 code action과 sub-LLM action이 분리돼 있다 | sub-LLM을 코드 안에서 부를 수 없어서, 말로 명시한 몇 개의 작업만 위임할 수 있다 | sub-LLM을 Python 모듈로 노출해 loop나 comprehension 안에서 프롬프트 길이의 제곱만큼까지 호출할 수 있다 |
Algorithm 2를 코드로 보면 세 결함이 어디에 있는지 한눈에 잡힌다.
actions ← {Finish, Exec, Search, sub_LLM_M}
hist ← [Metadata(actions), P]                # 결함 1: P를 이력에 직접 넣는다
while True:
    (action, val) ← LLM_M(hist)
    if action is Finish:
        return val                           # 결함 2: 출력이 컨텍스트에 묶인다
    out ← RUN(action, val)                   # 결함 3: 코드와 sub-LLM이 별개 action
    hist ← hist ∥ (action, val, out)
    if Tok(hist) > K:
        hist ← Compact(hist)
두 알고리즘을 나란히 놓으면 마지막 두 줄의 존재 여부가 결정적이다. Algorithm 2에는 이력이 한도를 넘으면 압축하는 분기가 있고, Algorithm 1에는 없다. 압축 분기가 필요 없는 이유는 이력에 원본이 들어가지 않기 때문이다.
저자들은 결함 3을 가장 중요한 차이로 꼽는다. THREAD, ReDel, Context Folding, AgentFold, DisCIPL 같은 선행 연구가 sub-LM 호출 선택을 모델에 맡기는 데까지는 갔지만, 그 호출을 프로그램으로 만들어내지는 못했다는 진단이다. DisCIPL은 sub-LM 호출을 담은 프로그램을 실제로 생성하지만 단일 step 생성이라서 생성 실수에서 회복할 수 없다.
같은 구분선이 CodeAct에도 적용된다. CodeAct는 ReAct loop 안에서 코드를 실행할 수 있으므로 결함 3의 절반은 넘어선 것처럼 보인다. 그러나 사용자 prompt를 코드 환경으로 offload하지 않고 모델에 직접 넣기 때문에 결함 1이 그대로 남는다. 본 논문이 CodeAct를 "RLM과 가장 가까운 비교 baseline"으로 두면서도 별도 패러다임으로 구분하는 근거다.
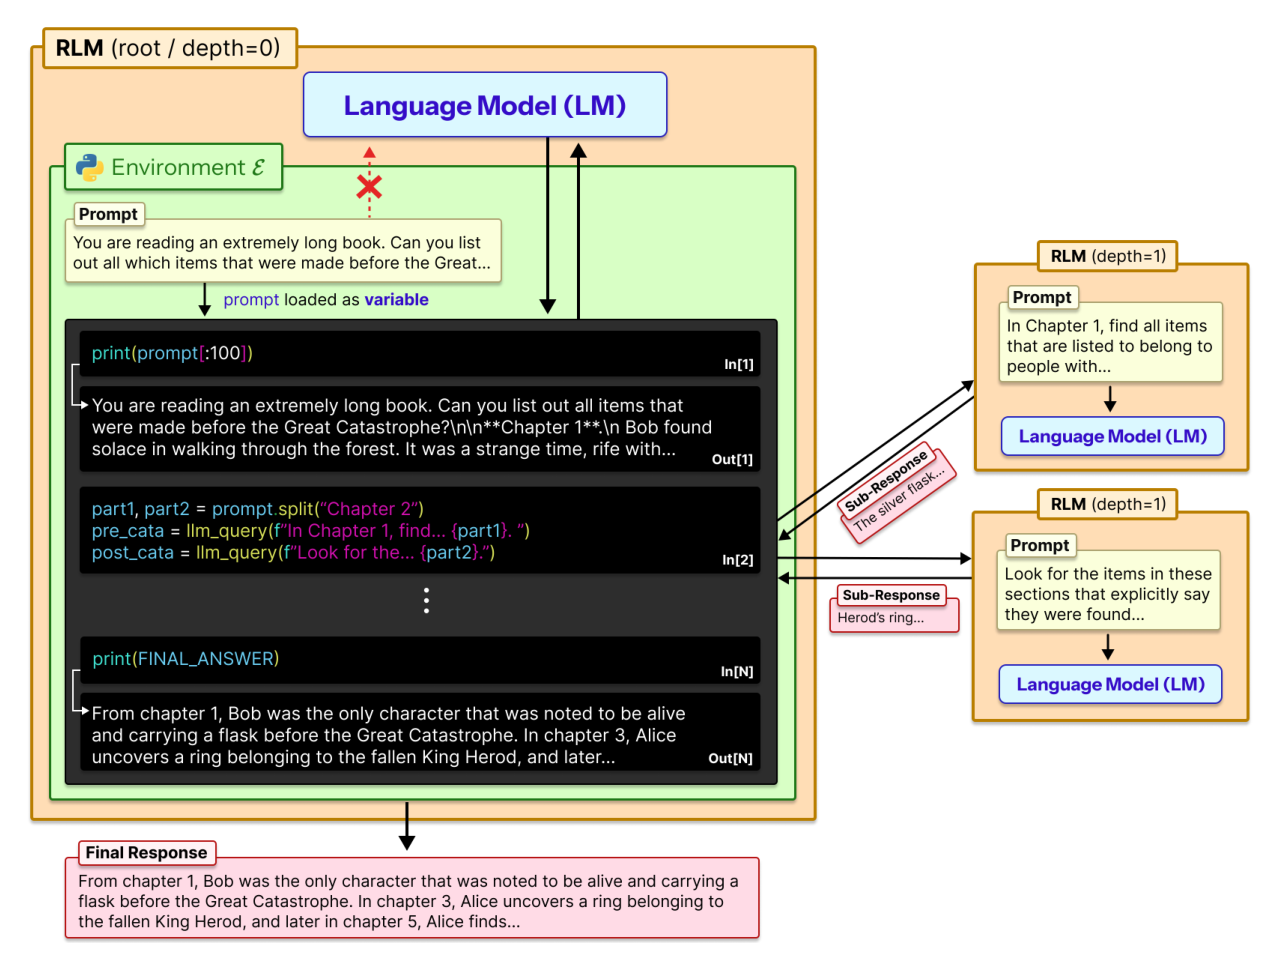
다이어그램에서 가장 눈여겨볼 요소는 prompt 상자에서 Language Model 상자로 향하는 점선 위의 빨간 X 표시다. 입력이 모델에 직접 들어가지 않는다는 것을 시각적으로 못 박은 부분이다. 대신 prompt는 아래쪽 화살표를 따라 변수로 적재되고, 모델은 print(context[:100])으로 앞부분만 확인한 뒤 context.split("Chapter 2")로 조각을 만들고 조각마다 llm_query를 부른다. 오른쪽에 그려진 두 개의 depth=1 상자가 각각 자기 prompt와 자기 LM을 갖고 sub-response를 돌려준다.
REPL 환경의 구성
구현은 Python REPL 하나에 모든 도구를 모듈로 노출하는 방식이다.
| 구성 요소 | 구현 |
|---|---|
| 초기 prompt | REPL 변수 context에 문자열로 저장된다 |
| sub-LM 호출 | llm_query(prompt). 요약, 추출, chunk 단위 질의 응답 같은 단순 sub-task용이다 |
| sub-RLM 호출 | rlm_query(context, query). 그 자체로 chunking이나 다단 추론이 필요한 sub-task용이며, 최대 depth에 도달하면 llm_query로 자동 fallback한다 |
| stdout 처리 | 컨텍스트가 빠르게 차는 것을 막기 위해 잘라낸다 |
| 종료 신호 | FINAL(answer)로 답을 직접 주거나 FINAL_VAR(variable_name)로 REPL 변수를 반환한다 |
| 모델 조합 | GPT-5 실험에서 root LM은 GPT-5, 재귀 sub-LM은 GPT-5-mini다. 능력과 재귀 비용의 균형을 맞춘 선택이라고 적는다 |
FINAL_VAR이 있다는 점이 출력 길이 제한을 없애는 실제 장치다. 답이 변수 안에 있으면 그 변수가 몇 메가바이트든 반환할 수 있다. 뒤에 나오는 OOLONG-Pairs 사례에서 RLM이 pair 10,731개를 최종 답으로 낸 것이 이 경로다.
시스템 프롬프트의 모델별 변형
방법마다 task와 무관한 고정 prompt 하나를 쓴다. RLM prompt는 REPL 환경 안내, llm_query 사용법, 그리고 chunking 전략을 보여주는 코드 예시로 구성된다. 예시는 문자열 앞부분 훑기, 책을 절 단위로 순회하며 buffer에 정보를 모으기, 문서 리스트를 10등분해 chunk마다 질의한 뒤 답을 합치기, Markdown 헤더로 쪼개 절마다 요약하기 네 가지다.
같은 prompt를 모든 모델에 쓰면 동작이 달라진다. 그래서 변형을 두었다.
| 변형 | 차이 |
|---|---|
| GPT-5 (depth=1) | 기준 prompt. sub-LM이 약 50만 문자를 담을 수 있다고 안내하고 sub-LM 하나에 문서 10개를 넣는 전략을 예시로 든다 |
| Qwen3-Coder-480B-A35B | 맨 앞에 llm_query 남용 경고 한 줄을 추가한다. 호출당 약 20만 문자를 목표로 batch하라고 지시하며, 1000줄이면 개별 1000회가 아니라 5줄씩 묶어 200회를 부르라고 예시를 든다 |
| depth > 1 | rlm_query(context, query) 함수 설명과 llm_query와의 선택 기준을 추가한다 |
| Qwen3-8B (depth=1) | context window가 GPT-5의 272K에서 3만 2천 토큰으로 줄어든 만큼 조정한다. sub-LM 한도를 약 10만 문자로 낮추고, chunk 예시를 10,000자에서 1,000자로 줄이고, sub-LM 하나에 문서 2개에서 3개를 넣으라고 바꾼다 |
| REPL only (depth=0) | llm_query 설명을 빼고 regex로 관련 절을 찾아 buffer에 모으는 예시로 대체한다 |
prompt에 실린 예시가 무엇인지 구체적으로 보면 뒤에 나오는 decomposition ablation을 읽기 쉬워진다. 문서 리스트를 10등분해 chunk마다 질의한 뒤 답을 합치는 예시는 다음과 같은 코드로 들어 있다.
chunk_size = len(context) // 10
answers = []
for i in range(10):
    if i < 9:
        chunk_str = "\n".join(context[i*chunk_size:(i+1)*chunk_size])
    else:
        chunk_str = "\n".join(context[i*chunk_size:])
    answer = llm_query(f"Try to answer the following query: {query}. "
                       f"Here are the documents:\n{chunk_str}. "
                       f"Only answer if you are confident based on the evidence.")
    answers.append(answer)
final_answer = llm_query(f"Aggregating all the answers per chunk, "
                         f"answer the original query: {query}\n\nAnswers:\n"
                         + "\n".join(answers))
패턴은 세 단계로 고정돼 있다. 컨텍스트를 chunk로 나누고, chunk마다 sub-LM에 같은 질문을 던지고, 모인 답을 sub-LM 한 번으로 종합한다. 마지막 줄의 final_answer는 다음 턴에 FINAL_VAR(final_answer)로 반환된다. prompt는 이 흐름을 책 순회 버전, Markdown 헤더 버전으로 한 번 더 보여준다.
한 가지 눈에 띄는 지시는 "확신이 있을 때만 답하라"는 조건이다. chunk 대부분에는 답의 근거가 없으므로, 이 조건이 없으면 sub-LM이 근거 없는 추측을 돌려주고 종합 단계가 오염된다. 저자들이 프롬프트에 심어 둔 오류 방지 장치다.
Qwen3-Coder용 경고 한 줄은 선택이 아니라 필수였다. 이 문장이 없으면 모델이 모든 것에 sub-call을 걸어 기본 task에도 수천 회 호출이 발생한다. 저자들은 이 사실을 부정적 결과 절에 따로 기록해 두었다.
실험 설계
복잡도로 고른 평가 task
평가 설계의 출발점은 effective context window가 task에 의존한다는 가설이다. needle-in-a-haystack 계열은 prompt를 늘려도 needle 크기가 고정되므로 frontier 모델이 100만 토큰 이상에서도 안정적으로 푼다. 반면 답이 프롬프트의 거의 모든 줄에 의존하는 OOLONG에서는 훨씬 짧은 길이에서 품질이 내려간다. 그래서 저자들은 task를 "복잡도가 프롬프트 길이에 따라 어떻게 자라는지"로 특성화한 뒤 그 스펙트럼을 덮도록 골랐다.
| task | 규모 | 복잡도 | 채점 | 출처 |
|---|---|---|---|---|
| S-NIAH | 50 task | O(1). 찾는 정보의 양이 길이와 무관하게 고정된다 | 정답률 | RULER (Hsieh 2024) |
| LongBench-v2 CodeQA | 입력 23K에서 4.2M 토큰 | 코드베이스의 정해진 파일 수를 추론해야 하는 multi-choice | 정답률 | LongBench-v2 (Bai 2025) |
| BrowseComp-Plus (1000문서) | 150 task, 입력 600만에서 1100만 토큰 | 문서 여러 개를 이어 붙이는 multi-hop. 필요한 문서 수는 상수지만 S-NIAH보다 어렵다 | 정답률 | BrowseComp-Plus (Chen 2025) |
| OOLONG trec_coarse | 50 task, 입력 131K 토큰 | O(N). 거의 모든 항목의 semantic label이 답에 관여한다 | 정답률 | OOLONG (Bertsch 2025) |
| OOLONG-Pairs | 20 task, 입력 32K 토큰 | O(N²). 조건을 만족하는 모든 pair를 출력해야 한다 | F1 | 본 논문 신규 |
BrowseComp-Plus는 원본 150개 인스턴스에서 그대로 쓰고, 입력으로 무작위 문서 1000개를 준다. 정답 문서와 근거 문서가 그 안에 포함돼 있음은 보장된다.
OOLONG-Pairs의 설계 의도
OOLONG-Pairs는 본 논문이 새로 만든 벤치마크다. 목적은 quadratic 복잡도를 실제로 강제하는 것이다.
pair를 집계하는 task는 pair를 보지 않고도 풀리는 경우가 많다. 항목마다 개수를 세고 집합의 포함배제 원리를 쓰면 선형 순회로 끝난다. OOLONG-Pairs는 개수를 묻지 않고 조건을 만족하는 모든 pair를 나열하게 만들어 이 우회로를 막았다.
task 형식은 다음과 같다. 컨텍스트에는 사용자 ID가 붙은 일반 지식 질문 수천 개가 한 줄씩 들어 있다. 각 질문의 답은 6개 라벨(description and abstract concept, entity, human being, numeric value, location, abbreviation) 중 하나로 분류되지만 라벨은 데이터에 적혀 있지 않다. 모델이 semantics로 판정해야 한다. 그다음 조건에 맞는 사용자 ID pair를 중복 없이, 낮은 ID를 앞에 두고 전부 출력한다.
20개 task는 두 묶음으로 나뉜다. 앞쪽 10개는 두 사용자에게 같은 조건을 걸고, 일부는 여기에 날짜 조건을 더한다. Task 4가 그 예다.
위 데이터에서, 두 사용자가 모두 human being 또는 location에 해당하는 항목을 하나 이상 갖는 사용자 ID pair를 전부 나열하라. 중복 pair 없이 낮은 ID를 앞에 둔다. 단 두 사용자 모두 human being에 해당하는 모든 항목이 2023년 1월 6일 이후여야 한다.
뒤쪽 10개는 두 사용자에게 서로 다른 조건을 걸어 난도를 올린다. Task 20이 가장 복잡한 형태다.
위 데이터에서, 한 사용자는 numeric value 항목과 human being 항목을 각각 하나 이상 갖고, 다른 사용자는 location 항목 하나 이상, entity 항목 하나 이상, abbreviation 항목을 정확히 하나 갖는 사용자 ID pair를 전부 나열하라.
이 형식이 요구하는 작업량을 헤아려 보면 왜 base 모델이 0.1%에 머무는지 설명된다. 모델은 먼저 수천 개 질문 각각의 라벨을 semantics로 판정해야 하고(선형 작업), 그다음 사용자별로 라벨 집합을 집계하고, 마지막으로 모든 사용자 pair를 검사해야 한다(제곱 작업). 게다가 출력이 pair 목록이므로 답 자체가 길다. Appendix의 사례에서 실제 출력은 pair 10,731개였다.
컨텍스트 길이는 1,024에서 1,048,576까지 11개 지점으로 준비돼 있어, 길이 스케일링 실험에도 같은 task를 쓸 수 있다.
비교 대상
| baseline | 구성 |
|---|---|
| Base Model | system prompt 없이 컨텍스트를 그대로 넣는다 |
| CodeAct (+BM25) | ReAct loop 안에서 코드를 실행하는 CodeAct(Wang 2024)에 BM25 retriever를 붙였다. BrowseComp+ 외의 task는 인덱싱할 대상이 없거나 이미 컨텍스트에 들어가므로 retriever를 뺀 변형을 쓴다 |
| CodeAct (+sub-calls) | REPL 안에 sub-call 도구를 둔 변형. RLM과 달리 사용자 prompt를 코드 환경으로 offload하지 않고 모델에 직접 넣는다 |
| Compaction agent | 컨텍스트가 찰 때마다 요약해 이어가는 agent. 단일 문서가 창을 넘으면 그 문서를 chunk로 나눠 반복 압축한다 |
| OpenCode | 코딩 agent. 컨텍스트를 파일로 offload하는 변형과 초기 prompt로 직접 넣는 변형을 모두 평가한다 |
| Claude Code | 대응 모델과 함께 설계된 closed-source agent라서 Claude Opus 4.1 + Claude Code v2.0.0으로 평가한다. 메인 결과의 GPT-5와 출시 시점이 비슷한 버전이다 |
compaction agent에는 비용 절감 장치가 하나 들어 있다. GPT-5 실험에서 압축은 GPT-5-nano가, 최종 답변은 GPT-5가 담당한다. 수백만 토큰에 GPT-5로 압축을 걸면 비용이 지나치게 커져서다. 저자들은 무작위 20개 샘플에서 GPT-5와 GPT-5-nano의 압축 성능이 비슷하다는 것을 확인했다고 적는다. 이 장치가 없는 Qwen3-Coder 쪽 compaction agent는 BrowseComp+에서 평균 $8.98로 GPT-5 쪽 $0.57의 약 15배가 든다.
비용은 GPT-5는 OpenAI, Qwen3 계열은 Fireworks, Claude Opus 4.1은 Anthropic 단가로 계산했다.
결과
GPT-5 계열의 성능과 비용
괄호 안은 task당 평균 API 비용과 표준편차다. 별표는 입력 컨텍스트 한계에 걸린 실행이 섞여 있다는 뜻이고, N/A는 비용을 집계하지 않은 실행이다.
| Method | CodeQA (23K~4.2M) | BrowseComp+ (6M~11M) | OOLONG (131K) | OOLONG-Pairs (32K) |
|---|---|---|---|---|
| Base Model | 24.0* ($0.13±$0.07) | 0.0* (N/A) | 44.0 ($0.14±$0.02) | 0.1 ($0.16±$0.10) |
| CodeAct (+BM25) | 22.0* ($0.06±$0.08) | 51.0 ($0.71±$1.20) | 38.0 ($0.61±$1.06) | 24.7 ($0.75±$0.43) |
| CodeAct (+sub-calls) | 24.0* ($0.06±$0.08) | 0.0* (N/A) | 40.0 ($0.85±$1.27) | 28.4 ($1.11±$0.62) |
| Compaction agent | 58.0 ($1.31±$1.46) | 70.5 ($0.57±$0.10) | 46.0 ($0.13±$0.01) | 0.1 ($0.13±$0.09) |
| OpenCode | 18.0* (N/A) | 0.0* (N/A) | 32.0 (N/A) | 3.1 (N/A) |
| OpenCode (+context offloading) | 64.0 (N/A) | 94.0 (N/A) | 52.0 (N/A) | 4.8 (N/A) |
| RLM (depth=0) | 58.0 ($0.18±$0.56) | 88.0 ($0.44±$0.90) | 36.0 ($0.37±$0.42) | 43.9 ($0.69±$1.16) |
| RLM (depth=1) | 62.0 ($0.11±$0.10) | 91.3 ($0.99±$1.22) | 56.0 ($0.43±$0.85) | 58.0 ($0.33±$0.20) |
| RLM (depth=2) | 66.0 ($0.15±$0.30) | 92.0 ($0.55±$0.69) | 56.5 ($1.10±$3.25) | 65.5 ($0.33±$0.44) |
| RLM (depth=3) | 58.0 ($0.15±$0.27) | 92.0 ($0.51±$0.54) | 58.0 ($0.51±$0.54) | 76.0 ($0.39±$0.32) |
정보 밀도가 높아질수록 격차가 벌어진다는 것이 이 표의 요지다. CodeQA에서 RLM(depth=1)은 base보다 38%p 높지만 compaction agent와의 차이는 4%p에 불과하다. OOLONG-Pairs로 가면 base와 compaction 모두 0.1%인 자리에서 RLM만 58.0%를 낸다.
비용 쪽도 읽어볼 만하다. RLM(depth=1)의 CodeQA 평균 비용은 $0.11로 base 모델의 $0.13보다 낮다. compaction agent의 $1.31보다 한 자릿수 아래다. base 모델이 컨텍스트 한도에 걸리는 구간에서는 애초에 비교가 성립하지 않는다는 점도 표가 보여준다. BrowseComp+의 base 모델 점수는 0.0%다.
한 가지 비교 기준을 논문 본문에서 가져올 수 있다. BrowseComp+에서 GPT-5-mini가 600만에서 1100만 입력 토큰을 그대로 읽는다고 가정한 선형 외삽 비용은 $1.50에서 $2.75다. RLM(GPT-5, depth=1)의 실제 평균 비용은 $0.99이면서 compaction과 retrieval baseline을 29% 넘게 앞선다.
Qwen3-Coder 계열과 Claude Code
| Method | CodeQA | BrowseComp+ | OOLONG | OOLONG-Pairs |
|---|---|---|---|---|
| Base Model | 20.0* ($0.13±$0.08) | 0.0* (N/A) | 36.0 ($0.06±$0.00) | 0.1 ($0.05±$0.01) |
| CodeAct (+BM25) | 24.0* ($0.17±$0.08) | 12.7 ($0.39±$0.50) | 38.0 ($1.51±$1.09) | 0.3 ($1.54±$0.35) |
| CodeAct (+sub-calls) | 26.0* ($0.28±$0.30) | 0.0* (N/A) | 32.0 ($1.83±$1.14) | 0.1 ($1.49±$0.46) |
| Compaction agent | 50.0 ($1.26±$1.50) | 38.0 ($8.98±$2.12) | 44.1 ($0.15±$0.01) | 0.31 ($0.05±$0.00) |
| OpenCode | 12.0* (N/A) | 0.0* (N/A) | 36.0 (N/A) | 0.0 (N/A) |
| OpenCode (+context offloading) | 40.0 (N/A) | 58.0 (N/A) | 24.0 (N/A) | 2.1 (N/A) |
| RLM (depth=0) | 66.0 ($0.18±$0.58) | 46.0 ($0.82±$0.69) | 43.5 ($0.32±$0.13) | 17.3 ($1.77±$1.23) |
| RLM (depth=1) | 56.0 ($0.92±$1.23) | 44.7 ($0.84±$0.63) | 48.0 ($0.61±$0.49) | 23.1 ($1.02±$0.52) |
| RLM (depth=2) | 54.0 ($1.88±$3.30) | 68.0 ($1.05±$0.67) | 26.0 ($1.03±$1.65) | 19.0 ($1.61±$0.99) |
| RLM (depth=3) | 44.0 ($1.65±$1.63) | 68.7 ($1.10±$0.80) | 32.0 ($0.80±$1.03) | 21.1 ($1.67±$1.21) |
| Method | CodeQA | BrowseComp+ | OOLONG | OOLONG-Pairs |
|---|---|---|---|---|
| Claude Code (Opus 4.1) | 12.0* ($2.03±$0.57) | 0.0* (N/A) | 40.2 ($3.43±$1.60) | 0.1 ($6.75±$3.57) |
| Claude Code (+context offloading) | 62.0 ($1.25±$0.54) | 84.0 ($2.03±$1.49) | 48.0 ($0.98±$0.55) | 6.5 ($2.99±$1.16) |
Qwen3-Coder 블록에서 depth와 성능의 관계가 GPT-5와 다르게 나타난다. CodeQA는 sub-call이 전혀 없는 depth=0이 66.0%로 가장 높고, depth를 올릴수록 내려간다. OOLONG은 depth=1의 48.0%에서 depth=2의 26.0%로 크게 떨어진다. 저자들은 이 역전의 원인을 syntax error에서 찾으며, 그 근거를 뒤의 trajectory 분석에서 제시한다.
Claude Code 블록은 context offloading의 효과를 단독으로 보여준다. 컨텍스트를 파일로 옮기기만 해도 CodeQA가 12.0%에서 62.0%로, BrowseComp+가 0.0%에서 84.0%로 오른다. 반면 OOLONG-Pairs는 0.1%에서 6.5%로 올라가는 데 그친다. 컨텍스트를 밖으로 빼는 것만으로는 정보 밀도가 높은 task를 풀 수 없다는 뜻이다. 논문의 두 번째 관찰이 이 대비를 정확히 가리킨다. REPL은 긴 입력을 다루는 데 필수이지만, 재귀 sub-call은 정보 밀도가 높은 입력에서 별도의 이득을 준다.
recursion depth를 올릴 때의 성능 곡선
depth 0에서 3까지의 값만 뽑아 두 모델을 나란히 놓으면 재귀를 더 허용하는 것이 언제 이득인지가 드러난다.
| Task | GPT-5 d=0 | d=1 | d=2 | d=3 | Qwen3-Coder d=0 | d=1 | d=2 | d=3 |
|---|---|---|---|---|---|---|---|---|
| CodeQA | 58.0 | 62.0 | 66.0 | 58.0 | 66.0 | 56.0 | 54.0 | 44.0 |
| BrowseComp+ | 88.0 | 91.3 | 92.0 | 92.0 | 46.0 | 44.7 | 68.0 | 68.7 |
| OOLONG | 36.0 | 56.0 | 56.5 | 58.0 | 43.5 | 48.0 | 26.0 | 32.0 |
| OOLONG-Pairs | 43.9 | 58.0 | 65.5 | 76.0 | 17.3 | 23.1 | 19.0 | 21.1 |
두 모델의 곡선 모양이 다르다. GPT-5는 OOLONG-Pairs에서 43.9, 58.0, 65.5, 76.0으로 단조 상승하며 depth 하나를 더할 때마다 값을 한다. 반면 Qwen3-Coder는 CodeQA에서 66.0, 56.0, 54.0, 44.0으로 단조 하락한다. sub-call을 아예 쓰지 않는 설정이 가장 좋다는 뜻이다.
depth 0의 값도 따로 볼 만하다. GPT-5의 OOLONG-Pairs가 sub-call 없이도 43.9%를 낸다. base 모델의 0.1%와 비교하면 REPL만으로 43.8%p를 얻은 것이다. 이 지점까지가 컨텍스트를 밖으로 옮긴 효과이고, 43.9에서 58.0으로 가는 부분이 재귀 sub-call의 효과다. 두 장치의 기여를 이렇게 분리할 수 있다는 것이 depth=0 ablation의 값이다.
중앙값 우위와 그 예외
초록이 제시하는 세 개의 백분율은 RLM(GPT-5, depth=1)을 기준으로 task 4종의 상대 향상률을 구해 중앙값을 취한 값이다.
| 비교 대상 | CodeQA | BrowseComp+ | OOLONG | OOLONG-Pairs | 중앙값 |
|---|---|---|---|---|---|
| Compaction agent | +6.9% | +29.5% | +21.7% | 매우 큼 | 약 26% |
| CodeAct (+sub-calls) | +158% | 매우 큼 | +40% | +104% | 약 130% |
| Claude Code (+offloading) | 0% | +8.7% | +16.7% | 매우 큼 | 약 13% |
| OpenCode (+offloading) | -3.1% | -2.9% | +7.7% | 매우 큼 | 약 +2% |
마지막 행은 논문 초록에 없다. OpenCode에 context offloading을 붙이면 CodeQA에서 64.0% 대 62.0%, BrowseComp+에서 94.0% 대 91.3%로 RLM(depth=1)을 앞선다. 초록이 median 비교 대상으로 compaction, CodeAct, Claude Code만 고른 것과 대비되는 지점이며, RLM의 우위가 모든 baseline에 대해 균일하지 않다는 뜻이다.
다만 OOLONG-Pairs를 보면 성격이 갈린다. OpenCode(+offloading)의 4.8%와 RLM depth=1의 58.0% 사이 차이는 다른 세 task의 몇 %p 차이와 같은 종류가 아니다. RLM의 강점이 검색성 task가 아니라 프롬프트 전체를 촘촘히 처리해야 하는 task에 있다는 논문의 주장과 일치한다.
입력 길이와 복잡도의 상호작용
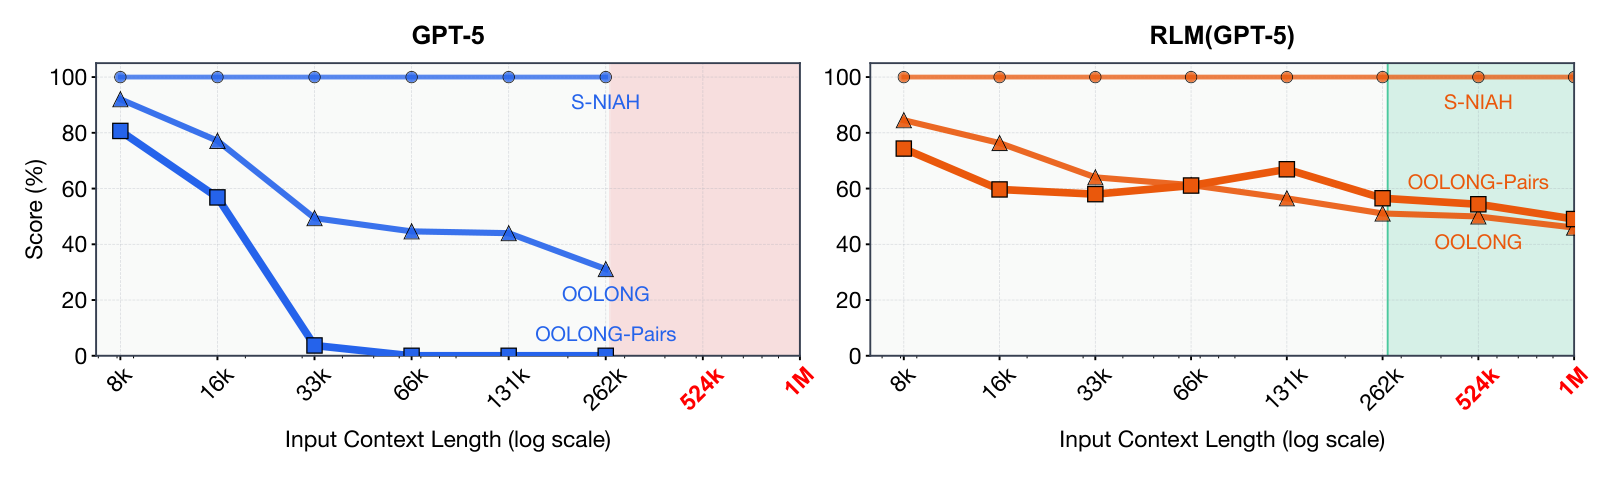
Figure 1은 같은 GPT-5를 base로 쓴 두 설정을 나란히 놓는다. GPT-5의 context window는 272K 토큰이라서 52만 4천과 100만 토큰 지점은 base 모델로 실행할 수 없다.
| 입력 길이 | GPT-5 S-NIAH | GPT-5 OOLONG | GPT-5 OOLONG-Pairs | RLM S-NIAH | RLM OOLONG | RLM OOLONG-Pairs |
|---|---|---|---|---|---|---|
| 8,192 | 100% | 약 92% | 약 81% | 100% | 약 85% | 약 74% |
| 16,384 | 100% | 약 77% | 약 57% | 100% | 약 76% | 약 60% |
| 32,768 | 100% | 약 49% | 약 4% | 100% | 약 64% | 약 58% |
| 65,536 | 100% | 약 45% | 약 1% | 100% | 약 61% | 약 61% |
| 131,072 | 100% | 약 44% | 약 1% | 100% | 약 56% | 약 67% |
| 262,144 | 100% | 약 31% | 약 2% | 100% | 약 50% | 약 57% |
| 524,288 | 실행 불가 | 실행 불가 | 실행 불가 | 100% | 약 51% | 약 55% |
| 1,048,576 | 실행 불가 | 실행 불가 | 실행 불가 | 100% | 약 45% | 약 49% |
세 줄기를 나누어 읽으면 가설이 그대로 확인된다.
S-NIAH는 양쪽 모두 전 구간 100%다. 찾는 정보의 양이 길이와 무관하게 고정되므로 길이만으로는 품질이 내려가지 않는다. frontier 모델이 100만 토큰 needle 찾기를 푼다는 사실이 long-context 문제가 해결됐다는 증거가 되지 못하는 이유다.
OOLONG에서 GPT-5는 8,192 토큰의 약 92%에서 262,144 토큰의 약 31%로 내려간다. 0%가 되지는 않는다. RLM은 같은 구간에서 약 85%에서 약 50%로 완만하게 내려가고, 컨텍스트 한도를 넘은 100만 토큰에서도 약 45%를 유지한다.
OOLONG-Pairs에서 GPT-5는 32,768 토큰부터 5% 미만으로 떨어진다. quadratic 복잡도가 훨씬 짧은 길이에서 한계를 드러내는 것이다. RLM은 100만 토큰까지 약 49%를 지킨다.
짧은 입력에서는 base가 더 낫다는 점도 표에 남아 있다. 8,192와 16,384 토큰의 OOLONG에서 GPT-5가 RLM보다 높다. 논문은 2^14를 넘는 길이부터 RLM이 일관되게 앞선다고 명시한다. RLM은 컨텍스트가 넉넉할 때 붙이는 도구가 아니라 컨텍스트가 부족해지는 지점부터 값을 하는 도구라는 뜻이다.
문서 수 스케일링
BrowseComp-Plus에서 150개 task 중 20개를 뽑아 컨텍스트 문서 수를 늘려가며 측정한 별도 실험이다. base LM이 컨텍스트를 처리하지 못하는 구간을 보이기 위해 baseline 2개를 추가했다. GPT-5 + pre-query BM25는 미리 검색한 문서만 넣는 방식이고, ReAct + BM25는 코드 환경 없이 검색만 반복하는 CodeAct 변형이다.
| 문서 수 | GPT-5 | GPT-5 (truncated) | GPT-5 + pre-query BM25 | ReAct + BM25 | RLM(GPT-5) | RLM(GPT-5) sub-call 없음 |
|---|---|---|---|---|---|---|
| 10 | 100% | 100% | 100% | 100% | 100% | 100% |
| 50 | 45% | 94% | 100% | 80% | 95% | 94% |
| 100 | 5% | 85% | 70% | 70% | 95% | 95% |
| 1000 | 0% | 30% | 35% | 60% | 100% | 90% |
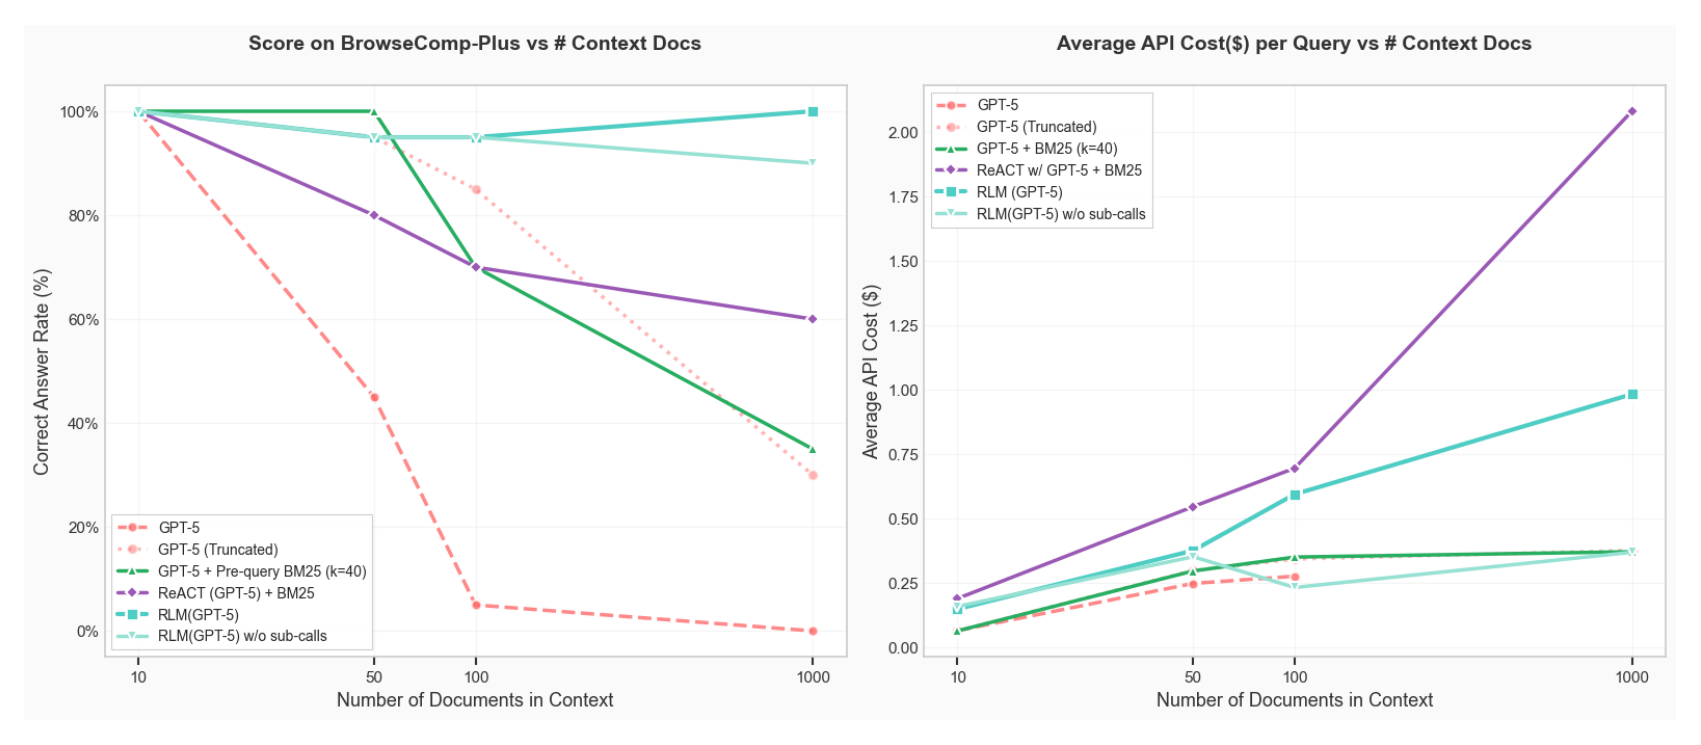
논문의 정리는 문서 수가 100개를 넘으면 iterative 방법, 즉 RLM과 ReAct만 쓸 만한 성능을 유지한다는 것이다. 1000문서에서 완전한 성능을 지키는 것은 RLM(GPT-5)뿐이고, sub-call 없는 변형도 90%를 유지한다.
비용 쪽 그래프도 함께 볼 필요가 있다. 1000문서에서 ReAct + BM25가 약 $2.06으로 가장 높고, RLM(GPT-5)이 약 $0.99, 나머지 세 방법이 약 $0.37이다. ReAct는 성능을 60%까지 지키지만 그 대가로 RLM보다 두 배 넘게 비싸다. RLM의 비용은 log-linear로 늘고, GPT-5가 무한한 context window를 가졌다고 가정한 외삽 비용보다 싸다.
표에서 GPT-5 (truncated)와 GPT-5 + pre-query BM25의 궤적을 비교하면 검색 기반 우회로의 한계가 보인다. 두 방법 모두 100문서까지는 70%에서 85%를 지키다가 1000문서에서 30%와 35%로 내려간다. 미리 검색해 넣거나 앞부분만 잘라 넣는 것은 문서 수가 늘어날수록 놓치는 근거가 많아지기 때문이다. 반면 반복 접근이 가능한 RLM과 ReAct는 필요한 만큼 여러 번 들여다볼 수 있어서 문서 수가 늘어도 성능이 유지된다.
비용 분포와 실행 시간
평균 비용만 보면 RLM이 base 모델과 비슷하다. 그러나 분포를 보면 성격이 다르다.
| 관찰 대상 | 논문의 보고 |
|---|---|
| 비용의 50 percentile | RLM 실행이 base 모델 실행보다 싸다 |
| 비용의 평균 | RLM이 더 비싸다. 답을 찾지 못해 길게 헤매는 outlier trajectory 때문이다 |
| 비용의 95 percentile | 꼬리 구간에서 크게 오른다 |
| 비용 히스토그램 | GPT-5와 Qwen3-Coder 모두에서 RLM 비용이 long-tail이고 분산이 크다 |
| runtime의 95 percentile | 매우 길다. sub-LLM 호출을 전부 blocking, sequential로 구현한 결과다 |
이 분포 형태가 실무에서 뜻하는 바는 예산 계획의 단위가 달라진다는 것이다. 평균 비용으로 예산을 잡으면 대부분의 실행은 그보다 싸게 끝나지만 소수의 실행이 예산을 크게 넘긴다. 저자들은 긴 runtime이 드물게 발생하므로 timeout 로직으로 조기 종료할 수 있다고 적는다.
runtime 수치는 해석에 유보 조건이 붙는다. 저자들은 이 값이 사용 머신, API 요청 지연, LM 호출의 비동기성 같은 구현 세부에 크게 의존하므로 비용 수치와 달리 조심해서 읽어야 한다고 명시한다. 본 구현이 모든 LM 호출을 blocking으로 처리했기 때문에 비동기 구현에서는 크게 달라질 수 있다는 뜻이다.
긴 추론으로의 확장
RLM이 long-context 전용 기법이 아니라는 것을 보이려고 저자들은 LongCoT-mini(Motwani 2026)를 추가로 평가했다. 서로 의존하는 하위 문제로 구성된 compositional 문제를 다루는 벤치마크이며, 입력이 길지 않다. 논문에 보고된 최고 모델 GPT-5.2를 비교 대상으로 썼다.
| Model | Overall | MATH | CHEM | CS | LOGIC | CHESS |
|---|---|---|---|---|---|---|
| GPT-5.2 base | 38.7 | 26.0 | 37.0 | 40.4 | 53.6 | 36.6 |
| RLM(GPT-5.2, depth=1) | 50.6 | 5.6 | 50.0 | 11.0 | 86.7 | 93.0 |
| RLM(GPT-5.2, depth=1) + decomposition hints | 65.6 | 32.0 | 52.0 | 46.0 | 99.0 | 99.0 |
hint 없는 RLM은 domain에 따라 결과가 갈린다. LOGIC 86.7과 CHESS 93.0은 base를 크게 앞서지만, MATH 5.6과 CS 11.0은 base보다 크게 낮다. 분해 방향을 스스로 잡지 못하는 경우다. hint를 더하면 전체 65.6%로 모든 domain에서 base를 넘어서고 전체 상대 향상은 69.5%가 된다.
같은 hint를 GPT-5.2 base에 직접 주면 어떻게 되는지도 저자들이 확인했다.
| Model | Overall | MATH | CHEM | CS | LOGIC | CHESS |
|---|---|---|---|---|---|---|
| GPT-5.2 base | 38.7 | 26.0 | 37.0 | 40.4 | 53.6 | 36.6 |
| GPT-5.2 base + decomposition hints | 28.6 | 37.0 | 27.0 | 32.0 | 19.1 | 30.0 |
MATH만 26.0에서 37.0으로 오르고 나머지는 모두 내려간다. LOGIC은 53.6에서 19.1로 가장 크게 하락한다. 저자들의 해석은 hint를 실행 가능하게 만드는 것이 REPL의 하위 문제 격리라는 것이다. 표준 chain-of-thought 방식으로는 분해를 지시받아도 프로그램적 task에서 혼란에 빠진다. 즉 이 실험에서 성능을 만든 것은 분해 지식 자체가 아니라 그 지식을 실행할 환경이다.
이 실험만 구현이 다르다는 점은 인용할 때 주의가 필요하다. Table 1 평가에 쓴 구현을 fork한 Prime Intellect의 rlm-harness를 써서 샌드박스 기반으로 처리량을 올렸고, 최종 답 판정 방식도 다르다. sub-call 함수도 llm_query가 아니라 여러 노드를 병렬로 던지는 llm_batch이며, 답은 /task/answer.txt 파일에 쓴다.
decomposition hint는 <env_tips> 블록으로 붙는 긴 메타 가이드다. 요지는 여섯 가지다.
- 조율만 하고 직접 풀지 않는다. REPL 안에서 더 깊이 생각하려고만 하면 0%에 가깝다.
- 1턴에서
llm_batch한 번으로 문제를 self-contained 노드의 DAG로 추출한다. 노드는 id, 원문 그대로의 question, deps, 최종 조립 방법, cycle 목록을 갖는다. 이 턴에서는 아무것도 풀지 않는다. - deps가 모두 채워진 ready 노드를 매 턴 하나의
llm_batch로 병렬 처리한다. 각 sub-prompt는 전역 문제를 보지 못하므로 부모의 검증된 값을 원문 그대로 넣는다. - 검증된 답만 dict에 memoize한다. dict에 없으면 존재하지 않는 것으로 취급하고, 앞 턴의 변수나 자기 생각 속 숫자를 믿지 않는다.
- 자식이 값을 쓰기 전에 반드시 검증한다. 다른 표현으로 다시 던져 두 답이 일치할 때만 받아들이거나, 부호와 범위 같은 타당성 검사를 한다.
- root의 계산은 dict 조회, 문자열 포맷, 정합성 검사로만 한다. Python이 열거하거나 풀거나 시뮬레이션하려 하면 중단하고
llm_batch에 넘긴다.
이 가이드는 RLM을 쓰는 사람이 실제로 무엇을 지시해야 하는지에 대한 구체적 참고가 된다. 지시의 요지는 root LM을 solver가 아니라 dispatcher로 못 박는 것이다. 검증되지 않은 값을 전파하지 말라는 조항과 root의 계산 범위를 dict 조회로 한정하는 조항이 그 역할을 한다.
논문이 제시하는 관찰 여섯 가지
저자들은 결과를 여섯 개의 관찰로 정리한다. 각 관찰이 어느 표와 그림에 대응하는지 함께 두면 인용할 때 근거를 찾기 쉽다.
| 관찰 | 내용 | 근거 |
|---|---|---|
| 1 | RLM은 1000만 토큰 이상 규모로 확장되며 base LM과 기존 task-agnostic scaffold를 최대 2배까지 앞선다 | Table 1, BrowseComp+ 비용 외삽 |
| 2 | REPL은 긴 입력을 다루는 데 필수이고, 재귀 sub-call은 정보 밀도가 높은 입력에서 별도의 이득을 준다 | depth=0 대 depth=1 비교, Claude Code offloading |
| 3 | LM 성능은 입력 길이와 문제 복잡도의 함수로 내려가고 RLM은 그 기울기가 완만하다 | Figure 1 |
| 4 | RLM의 추론 비용은 다른 방법과 비슷하며 어떤 경우에는 base LM 호출 수준이다 | Table 1 비용 열, 비용 percentile 그래프 |
| 5 | long-context를 넘어 긴 추론에도 쓸 수 있다 | LongCoT-mini 결과 |
| 6 | 한 도메인에서 RLM을 학습시키면 다른 도메인의 성능과 효율이 함께 오르고 길이 일반화도 나타난다 | RLM-Qwen3-8B와 MRCRv2 실험 |
두 번째 관찰이 이 논문의 설계 논거를 가장 잘 압축한다. RLM에는 서로 다른 두 장치가 들어 있고 각각이 다른 문제를 푼다. 컨텍스트를 환경 변수로 옮기는 장치는 입력 길이의 벽을 없애고, sub-LM을 코드에서 부르는 장치는 프롬프트 전체를 촘촘히 처리해야 하는 작업량의 벽을 없앤다. 코딩 agent는 앞의 장치만 갖고 있어서 BrowseComp+에서는 잘하지만 OOLONG-Pairs에서는 한 자릿수에 머문다.
세 번째 관찰은 벤치마크 해석에 관한 주장이기도 하다. 컨텍스트 길이만으로 모델의 long-context 능력을 재는 관행이 부족하다는 것이다. 같은 모델이 needle 찾기에서는 100만 토큰까지 100%를 내면서 pairwise 열거에서는 3만 토큰 대에서 5% 미만으로 내려간다면, 광고되는 컨텍스트 한도는 그 모델이 실제로 다룰 수 있는 문제 규모를 알려주지 않는다.
RLM 학습
학습을 단순하게 만든 가설
RLM으로 동작하는 모델을 직접 학습시키려 할 때 곧바로 부딪히는 문제는 trajectory 길이다. sub-call이 프롬프트 길이만큼 launch될 수 있으므로 한 trajectory의 전체 토큰이 극단적으로 커진다.
저자들의 우회로는 학습 대상을 좁히는 것이다. leaf sub-call은 사실 범용 LLM 요청이므로 이미 잘하는 일이고, 어려운 부분은 root로 동작하는 법이라는 진단이다. 그러면 학습은 root LM이 프롬프트의 프로그램적 표현을 다루는 능력, 그리고 sub-call이 유용한 시점을 판별하는 능력만 겨냥하면 된다.
이 가설이 맞다면 RLM 학습은 일반 추론 학습으로 환원되고, 작은 모델과 적은 샘플로도 성과를 낼 수 있다. RLM-Qwen3-8B 실험이 그 검증이다.
trajectory 수집과 필터링
학습 데이터는 큰 모델에서 뽑아 작은 모델로 distillation하는 방식으로 만들었다. 같은 모델 계열 안에서 진행했다.
- 수집: RLM(Qwen3-Coder-480B-A35B)을 LongBenchPro 영어 task 750개에 적용해 candidate trajectory 2,250개를 얻었다. LongBenchPro는 평가 벤치마크 4종과 무관한 별개 데이터셋이다.
- 1차 필터링: 점수가 정확히 0인 것과 1턴에서 끝난 것을 제거해 1,072개로 줄였다.
- 턴 분할: root iteration 하나를 SFT sample 하나로 분리했다. 입력은 그 시점까지의 전체 history, 출력은 root LM이 그 턴에 낸 출력이다.
- 2차 필터링: Qwen3-8B의 컨텍스트 한도(약 10만 문자로 근사)를 넘는 턴을 제거했다.
- template 교정: RLM 지시를 어긴 실수를 프로그램적으로 고쳤다.
5번 단계가 결과 품질에 크게 기여했다. Qwen3-Coder-480B-A35B가 만든 trajectory에는 RLM 지시를 어기는 실수가 눈에 띄게 많았고, 그 실수가 distillation된 모델의 성능을 깎았다. 대표적인 것은 FINAL(answer)와 FINAL(REPL 변수)를 섞어 쓰는 경우다. 전체 턴의 16%가 FINAL 답을 잘못 썼고, 13%가 REPL 변수를 FINAL_VAR 없이 최종 답으로 불렀다. 저자들은 흔한 template 실수를 찾아 패치하는 단계를 추가해 최종 모델 성능을 끌어올렸다.
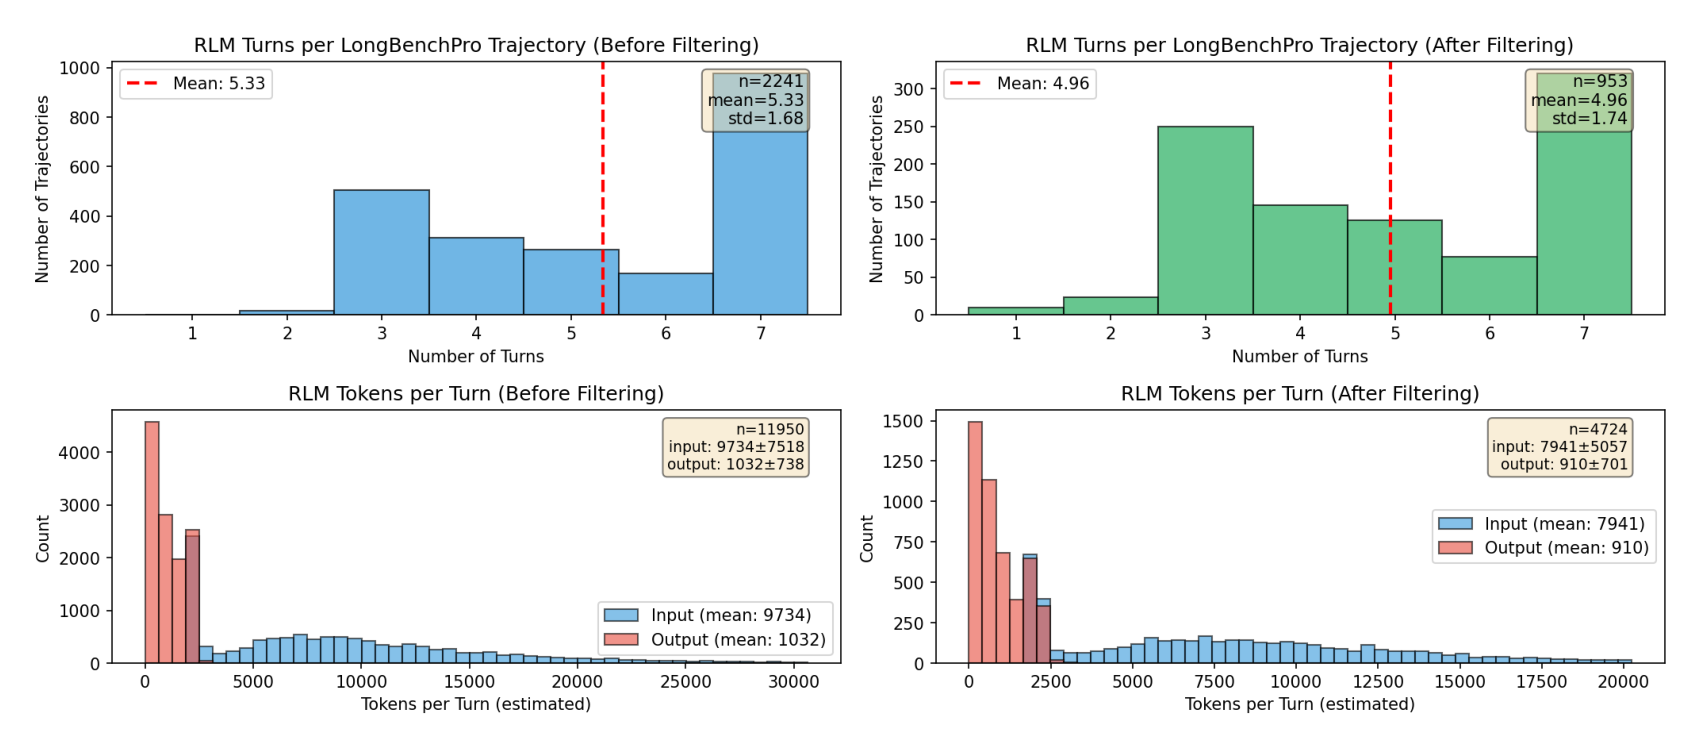
| 지표 | 필터링 전 | 필터링 후 |
|---|---|---|
| trajectory 수 | 2,241 | 953 |
| trajectory당 턴 수 | 평균 5.33, 표준편차 1.68 | 평균 4.96, 표준편차 1.74 |
| SFT sample(턴) 수 | 11,950 | 4,724 |
| 턴당 입력 토큰 | 9,734 ± 7,518 | 7,941 ± 5,057 |
| 턴당 출력 토큰 | 1,032 ± 738 | 910 ± 701 |
논문 본문이 "1,000개 샘플"이라고 부르는 것은 최종 953개 trajectory를 반올림한 값이다. 학습은 prime-rl 라이브러리로 batch 64, 300 step, 48 H100 hours가 들었다.
post-training 결과
Figure 3(a)는 세 계열을 나란히 놓는다. 회색은 RLM scaffold 없는 base Qwen3-8B, 파랑은 학습 전 RLM(Qwen3-8B), 빗금은 post-training한 RLM-Qwen3-8B다.
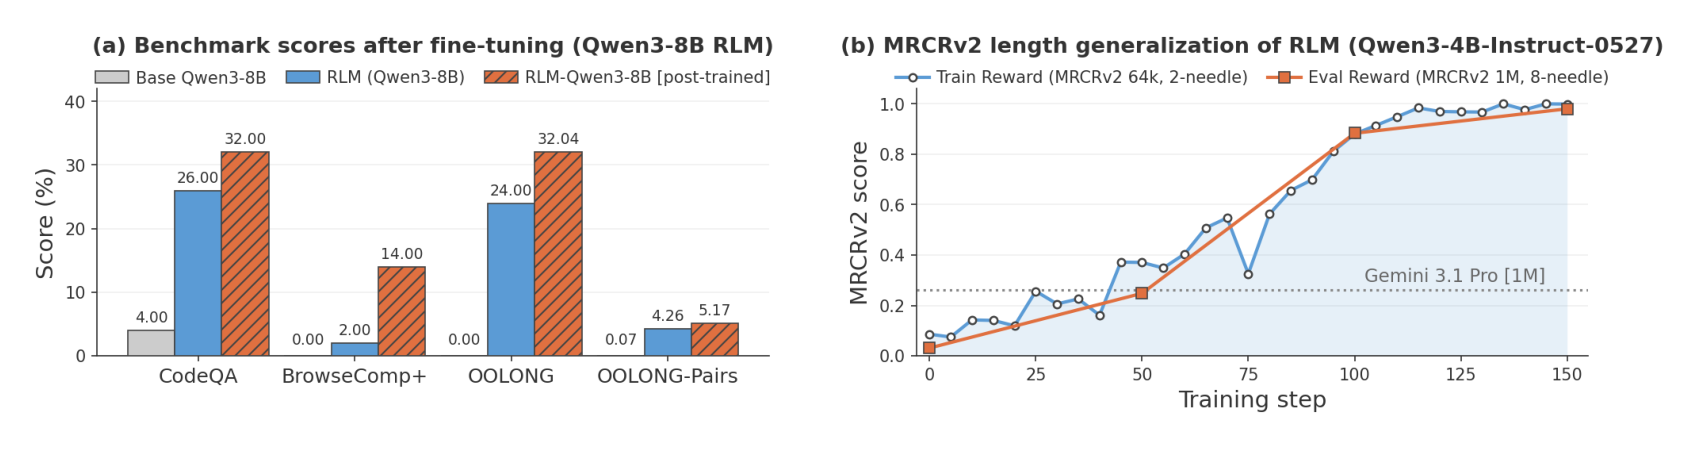
| Benchmark | base Qwen3-8B | RLM(Qwen3-8B) | RLM-Qwen3-8B | 상대 향상 |
|---|---|---|---|---|
| CodeQA | 4.00 | 26.00 | 32.00 | +23.1% |
| BrowseComp+ | 0.00 | 2.00 | 14.00 | +600% |
| OOLONG | 0.00 | 24.00 | 32.04 | +33.5% |
| OOLONG-Pairs | 0.07 | 4.26 | 5.17 | +21.4% |
논문이 말하는 중앙값 28.3%는 마지막 열의 중앙값이다. 비교 기준은 base Qwen3-8B가 아니라 **학습 전 RLM(Qwen3-8B)**이다. 세 계열을 구분해 읽어야 두 종류의 향상이 분리된다. base에서 RLM scaffold로 옮기는 것만으로 CodeQA가 4.00에서 26.00으로, OOLONG이 0.00에서 24.00으로 오른다. 거기서 post-training이 추가로 26.00을 32.00으로, 24.00을 32.04로 올린다.
vanilla GPT-5와 비교하면 이 8B 모델의 위치가 드러난다. Table 1의 base GPT-5 점수와 나란히 놓으면 CodeQA 32.00 대 24.0, BrowseComp+ 14.00 대 0.0, OOLONG-Pairs 5.17 대 0.1로 3개 task에서 RLM-Qwen3-8B가 앞선다. OOLONG만 32.04 대 44.0으로 뒤진다. 초록의 "3개 long-context task에서 vanilla GPT-5의 품질에 근접한다"는 문장이 가리키는 지점이다.
runtime 개선
성능만 오른 것이 아니다. RLM trajectory 자체가 짧아지면서 실행 시간이 크게 줄었다.
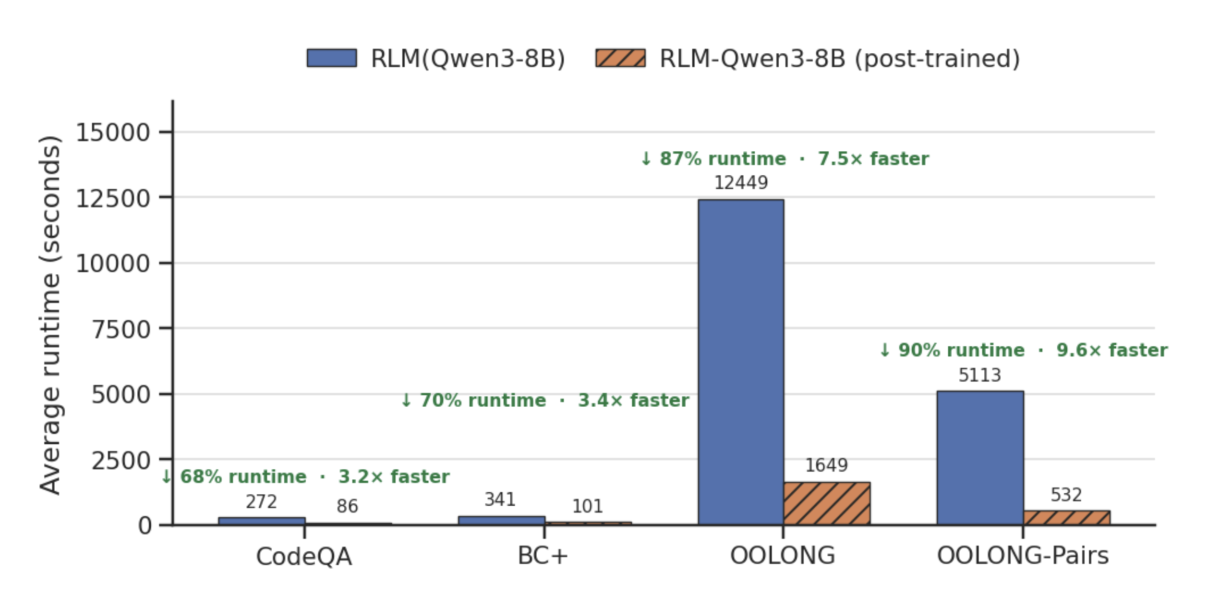
| Benchmark | RLM(Qwen3-8B) | RLM-Qwen3-8B | 감소율 | 배수 |
|---|---|---|---|---|
| CodeQA | 272초 | 86초 | 68% | 3.2배 |
| BrowseComp+ | 341초 | 101초 | 70% | 3.4배 |
| OOLONG | 12,449초 | 1,649초 | 87% | 7.5배 |
| OOLONG-Pairs | 5,113초 | 532초 | 90% | 9.6배 |
절대값의 차이가 크다는 점을 눈여겨볼 만하다. OOLONG 한 task에 학습 전 모델은 평균 12,449초, 약 3시간 반이 걸렸다. 학습 후에는 1,649초로 줄어든다. 저자들은 이 가속을 판단 품질 향상과 실수 감소의 결과로 설명한다. 뒤에 나오는 sub-call 사용량 표가 그 근거를 수치로 보여준다.
길이 일반화
두 번째 학습 실험은 짧은 입력에서만 학습한 결과가 긴 입력으로 옮겨가는지를 확인한다. 대상 task는 MRCRv2다. 코퍼스에서 특정 본문의 등장 횟수를 세고 재현해야 하는 합성 long-context task다.
Qwen3-4B-Instruct-0527을 RLM(depth=1)으로 두고, 3만 2천에서 6만 4천 토큰, needle 2개 split에서만 RLVR로 학습했다. RLVR은 정답 여부를 기계로 검증할 수 있는 보상으로 강화학습하는 방식이다. 150 step, batch 128, example당 rollout 4개, 턴당 최대 출력 4,096 토큰, RLM iteration 최대 20회로 설정했다. 평가는 50 step마다 51만 2천에서 100만 토큰, needle 8개 split으로 수행했다.
| 학습 step | train reward (6만 4천 토큰, needle 2개) | eval reward (100만 토큰, needle 8개) |
|---|---|---|
| 0 | 약 0.08 | 약 0.04 |
| 50 | 약 0.37 | 약 0.25 |
| 100 | 약 0.87 | 약 0.89 |
| 150 | 약 1.0 | 약 0.98 |
같은 그래프에 100만 토큰 context window를 가진 frontier 모델 Gemini 3.1 Pro의 같은 split 점수가 점선으로 그려져 있다. 값은 약 0.26이다. 학습 50 step 근처에서 RLM의 eval reward가 그 선과 만나고, 100 step 이후로는 크게 넘어선다. 4B 모델을 짧은 split에서 150 step 학습한 결과가 100만 토큰 컨텍스트를 가진 frontier 모델의 같은 split 점수를 앞선다는 뜻이다.
이 실험의 요지는 절대 점수가 아니라 전이다. 짧은 split의 학습 신호만으로 긴 split 성능이 함께 올라간다. 저자들은 RLM으로 동작하는 법을 배우는 것이 길이에 특화된 학습이 아니라는 근거로 이 결과를 든다.
trajectory 분석
반복 관찰된 세 가지 패턴
RLM이 실제로 어떻게 문제를 푸는지 저자들은 trajectory를 직접 읽어 정리했다. 세 가지 패턴이 반복해서 나타난다.
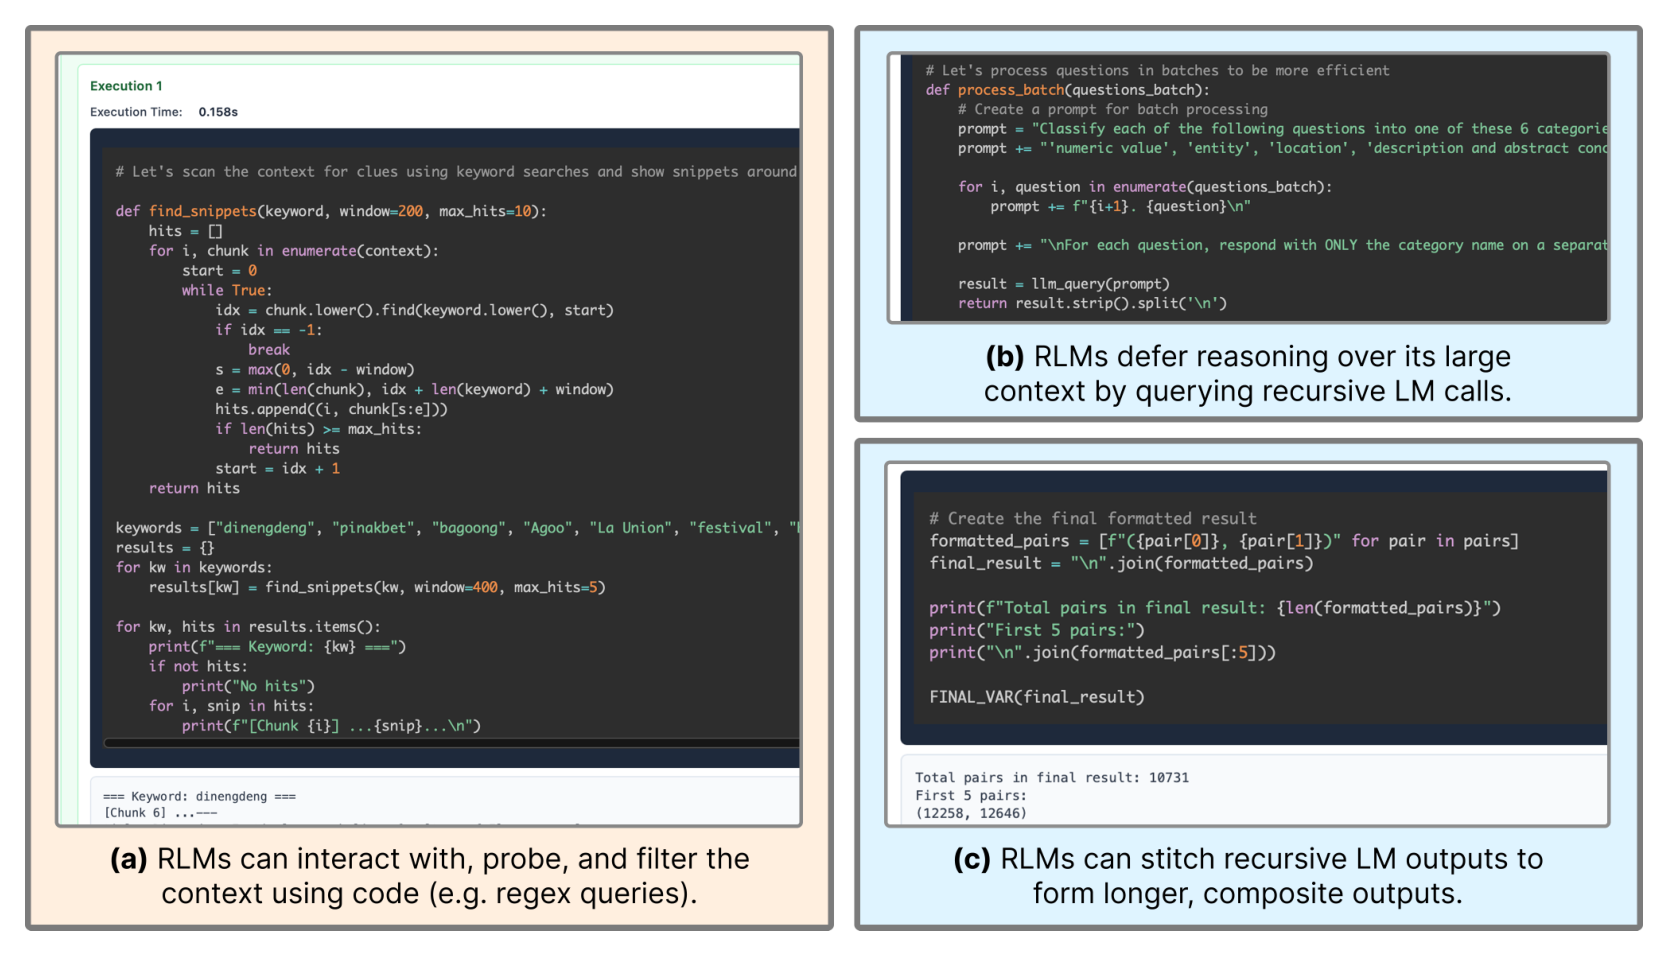
첫째, 코드로 컨텍스트를 탐색하고 걸러낸다. 화면의 예시는 find_snippets(keyword, window=200, max_hits=10) 함수를 정의해 chunk마다 키워드 위치를 찾고 주변 window를 잘라내는 코드다. 검색어 목록은 dinengdeng, pinakbet, bagoong, Agoo, La Union, festival이다. 실행 시간은 0.158초로 표시돼 있다. 모델의 사전 지식이 검색어 선택에 반영된다는 점이 흥미로운 부분이다.
둘째, 큰 컨텍스트의 추론을 sub-LM 호출로 위임한다. process_batch(questions_batch)가 질문 여러 개를 한 prompt로 묶어 6개 카테고리 분류를 요청하고 llm_query 한 번으로 처리한다. root LM은 분류 결과만 받는다. 프롬프트의 절반이 컨텍스트로 채워지지 않으므로 root의 이력이 오염되지 않는다.
셋째, sub-LM 출력을 이어 붙여 긴 복합 출력을 만든다. pair 리스트를 문자열로 포맷해 "\n".join으로 합치고 FINAL_VAR(final_result)로 반환하는 코드다. 화면 아래의 출력은 최종 결과에 pair가 10,731개 담겼음을 보여준다. 단일 LM 출력으로는 만들 수 없는 길이이며, OOLONG-Pairs 같은 long-output task가 RLM에서만 풀리는 이유가 여기에 있다.
첫 decomposition의 영향
RLM은 사실상 길이 제한 없는 추론 사슬을 sub-LM 호출로 넘긴다. 그래서 어떻게 나눌지의 선택이 결과를 크게 좌우한다. 저자들은 OOLONG에서 system prompt의 in-context 예시를 바꿔가며 첫 decomposition 시도를 네 유형으로 분류했다.
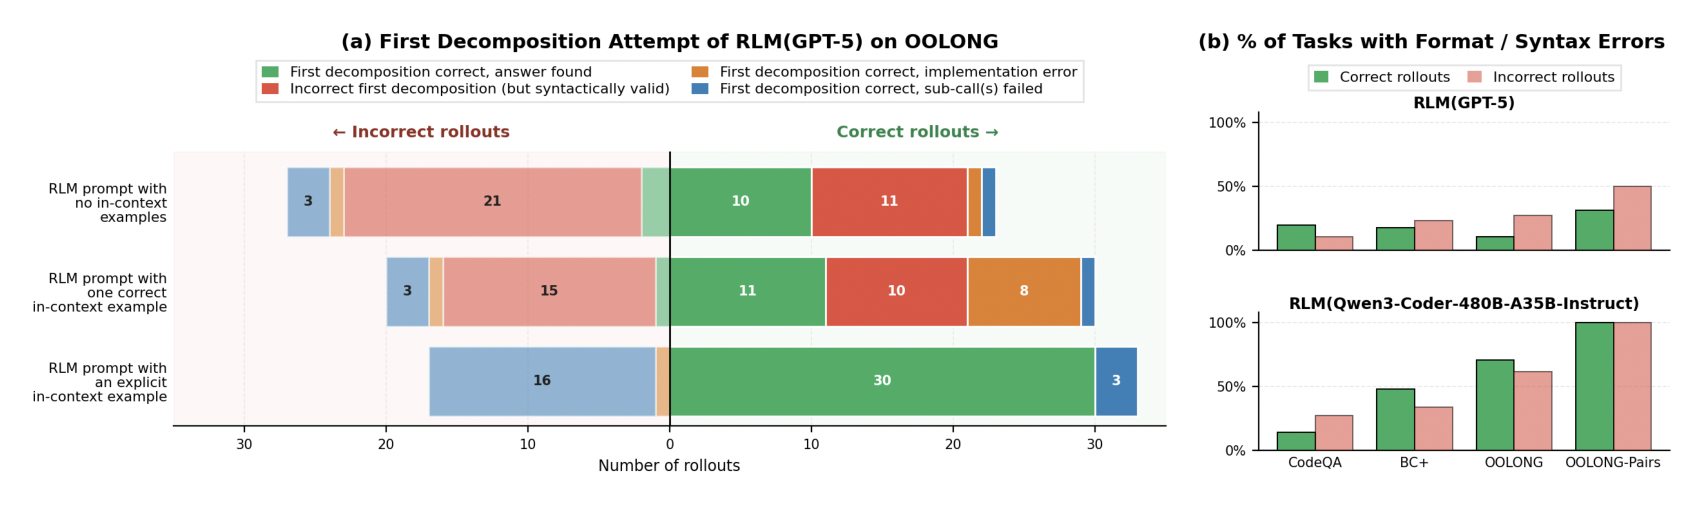
| system prompt | 첫 decomposition 정확 + 정답 | 첫 decomposition 부정확(문법은 유효) | 첫 decomposition 정확, sub-call 실패 |
|---|---|---|---|
| in-context 예시 없음 | 정답 쪽 10 | 정답 쪽 11, 오답 쪽 21 | 오답 쪽 3 |
| 올바른 in-context 예시 1개 | 정답 쪽 11 | 정답 쪽 10, 오답 쪽 15 | 오답 쪽 3 |
| 명시적 in-context 예시 | 정답 쪽 30 | 사실상 없음 | 오답 쪽 16, 정답 쪽 3 |
예시를 명시적으로 주면 첫 분해가 부정확한 rollout이 거의 사라지고, 첫 분해가 정확해서 답까지 찾은 rollout이 30개로 늘어난다. 남는 실패의 성격도 바뀐다. 분해는 맞았지만 sub-call이 실패한 경우가 16개로 늘어나면서 실패 원인이 판단에서 실행으로 옮겨간다.
논문의 정리는 두 문장이다. RLM은 처음 잘못 분해해도 자주 회복하지만, 첫 시도가 전체 성능에 중요하다. 그리고 예시가 실제 task와 무관해도 성능과 분해 정확도가 함께 오른다. 후자는 실무에서 쓸 수 있는 결론이다. task마다 분해 예시를 준비할 필요 없이 아무 예시라도 하나 넣는 편이 낫다.
syntax error와 depth 역전
Qwen3-Coder가 depth를 올릴 때 성능이 내려가는 현상은 이 절에서 설명된다. Figure 4(b)는 syntax error를 하나 이상 포함한 trajectory 비율이다.
| Task | GPT-5 정답 | GPT-5 오답 | Qwen3-Coder 정답 | Qwen3-Coder 오답 |
|---|---|---|---|---|
| CodeQA | 약 20% | 약 10% | 약 15% | 약 28% |
| BrowseComp+ | 약 18% | 약 23% | 약 48% | 약 34% |
| OOLONG | 약 10% | 약 27% | 약 71% | 약 61% |
| OOLONG-Pairs | 약 31% | 약 50% | 100% | 100% |
Qwen3-Coder는 정답 trajectory에서도 syntax error가 많다. OOLONG의 정답 rollout에서 약 71%, OOLONG-Pairs에서는 정답과 오답 모두 100%다. 오류가 있어도 결과적으로 답에 도달하는 경우가 있다는 뜻이지만, 실패 확률이 높다는 뜻이기도 하다.
여기서 depth 역전의 기제가 나온다. sub-RLM 호출은 root의 실행 실패를 하위 호출로 전파한다. root에서 syntax error가 나는 비율이 이미 높은 모델이 재귀 층을 더 쌓으면 실패 지점이 곱해진다. 그래서 Qwen3-Coder는 depth=2와 3에서 평균 성능이 내려간다. 같은 표에서 GPT-5의 오류율은 대부분 30% 아래이며, depth를 올려도 성능이 대체로 오른다.
이 결과가 시사하는 실무 기준은 명확하다. RLM scaffold를 적용할 모델을 고를 때 봐야 하는 것은 컨텍스트 길이가 아니라 코드 실행 신뢰도다. 저자들도 부정적 결과 절에서 코딩 능력이 부족한 모델은 RLM에 부적합하다고 따로 적는다.
task 단위 승패
평균 점수만으로는 RLM이 baseline이 푸는 문제를 다 풀면서 더 푸는지, 아니면 다른 문제를 푸는지 알 수 없다. 저자들은 최소 한 방법이 정답을 낸 task만 모아 짝지어 세었다.
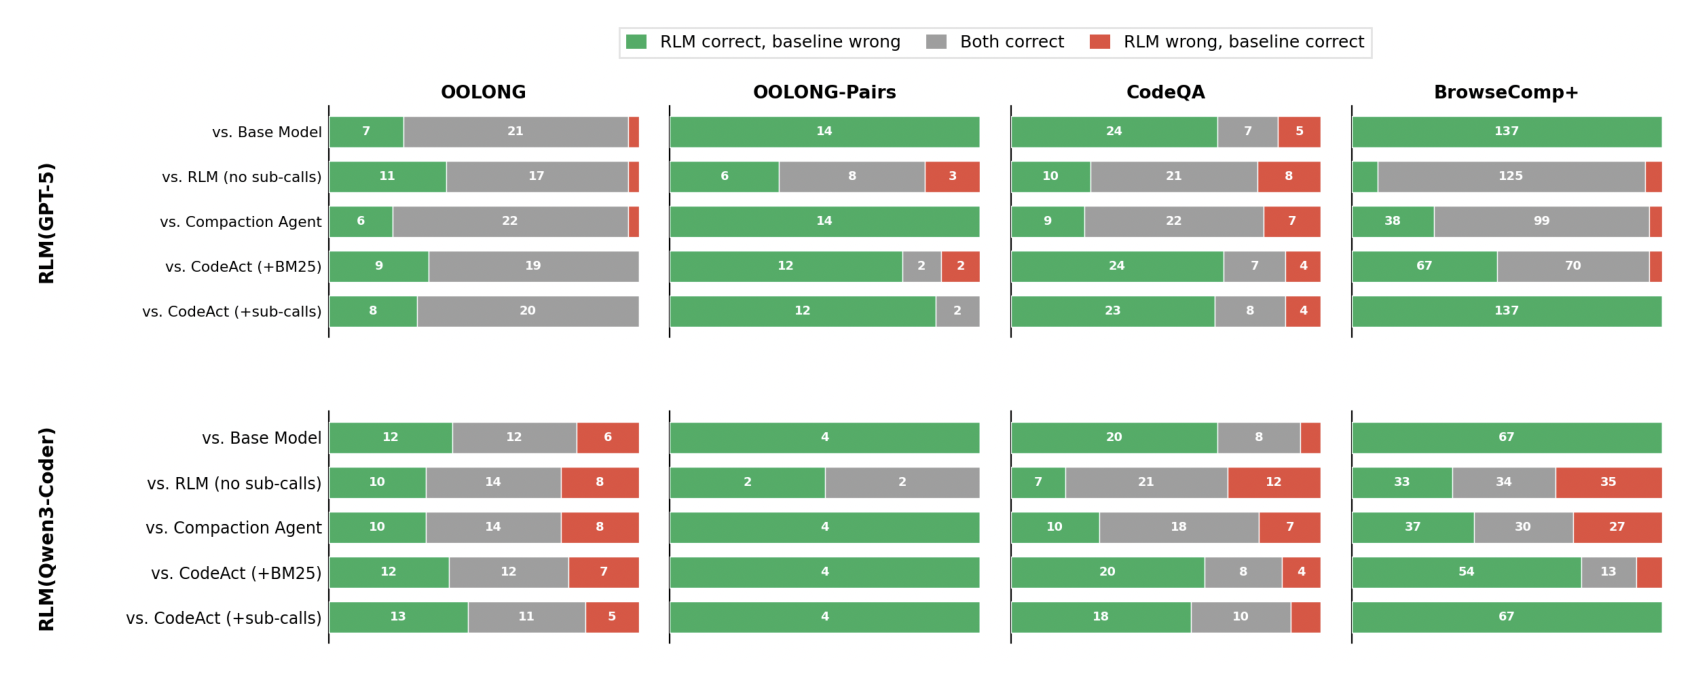
RLM(GPT-5) 기준으로 RLM만 정답 / 양쪽 정답 / baseline만 정답을 세면 다음과 같다.
| 비교 대상 | OOLONG | OOLONG-Pairs | CodeQA | BrowseComp+ |
|---|---|---|---|---|
| Base Model | 7 / 21 / 1 | 14 / 0 / 0 | 24 / 7 / 5 | 137 / 0 / 0 |
| RLM (sub-call 없음) | 11 / 17 / 1 | 6 / 8 / 3 | 10 / 21 / 8 | 소수 / 125 / 소수 |
| Compaction agent | 6 / 22 / 1 | 14 / 0 / 0 | 9 / 22 / 7 | 38 / 99 / 소수 |
| CodeAct (+BM25) | 9 / 19 / 0 | 12 / 2 / 2 | 24 / 7 / 4 | 67 / 70 / 소수 |
| CodeAct (+sub-calls) | 8 / 20 / 0 | 12 / 2 / 0 | 23 / 8 / 4 | 137 / 0 / 0 |
RLM(Qwen3-Coder) 기준은 그림이 다르다.
| 비교 대상 | OOLONG | OOLONG-Pairs | CodeQA | BrowseComp+ |
|---|---|---|---|---|
| Base Model | 12 / 12 / 6 | 4 / 0 / 0 | 20 / 8 / 소수 | 67 / 0 / 0 |
| RLM (sub-call 없음) | 10 / 14 / 8 | 2 / 2 / 0 | 7 / 21 / 12 | 33 / 34 / 35 |
| Compaction agent | 10 / 14 / 8 | 4 / 0 / 0 | 10 / 18 / 7 | 37 / 30 / 27 |
| CodeAct (+BM25) | 12 / 12 / 7 | 4 / 0 / 0 | 20 / 8 / 4 | 54 / 13 / 소수 |
| CodeAct (+sub-calls) | 13 / 11 / 5 | 4 / 0 / 0 | 18 / 10 / 소수 | 67 / 0 / 0 |
논문의 표현은 "RLM이 baseline과 같은 task를 풀고 그보다 더 많은 task를 푸는 경향이며, 특히 GPT-5에서 그렇다"다. GPT-5 쪽에서는 baseline만 정답인 칸이 대체로 한 자릿수에 머문다.
Qwen3-Coder 쪽에서는 마지막 열이 다른 이야기를 한다. sub-call 없는 RLM과의 BrowseComp+ 비교가 33 대 34 대 35로 거의 대등하고, CodeQA에서는 12 대 7로 sub-call 없는 쪽이 앞선다. Table 1에서 Qwen3-Coder의 CodeQA depth=0이 가장 높았던 것과 같은 사실을 task 단위로 다시 확인하는 셈이다.
sub-call 사용량
sub-call을 몇 번 쓰는지는 모델마다, 그리고 정답과 오답 사이에서도 크게 다르다.
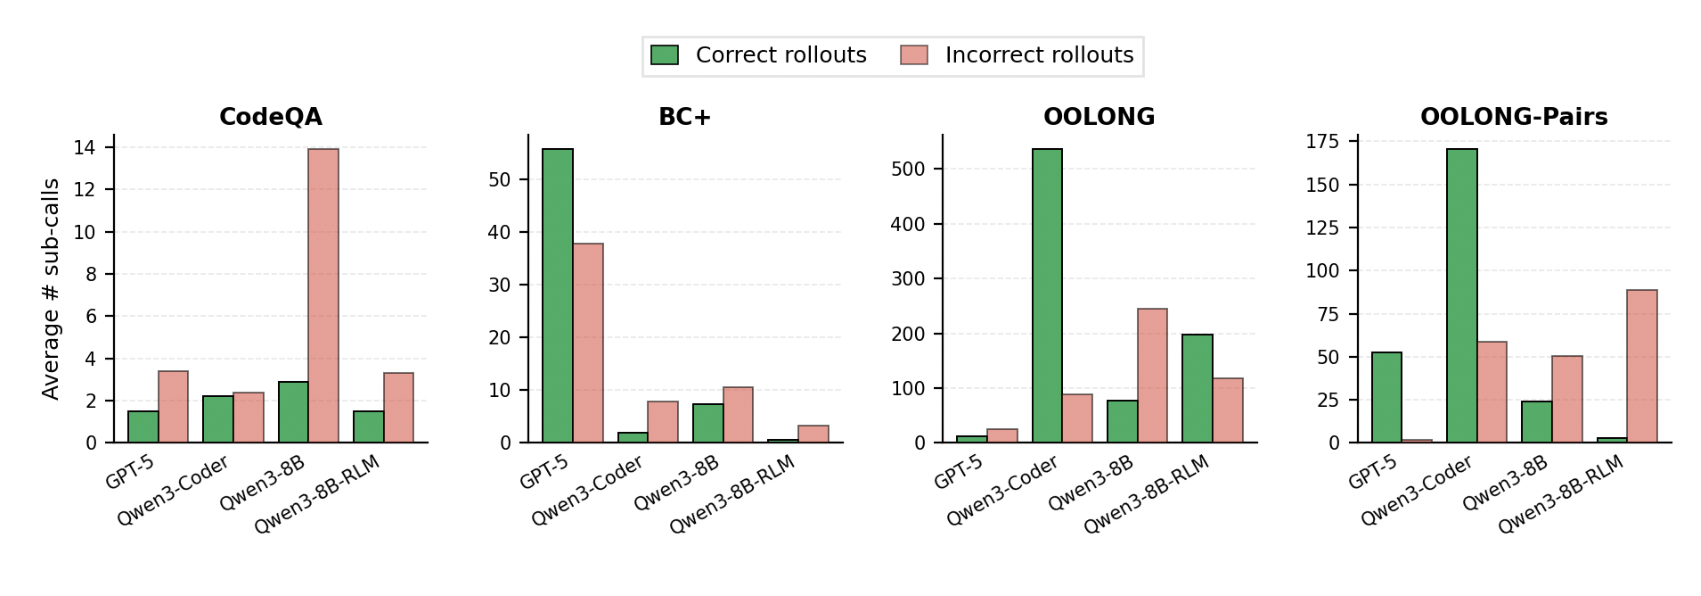
trajectory당 평균 sub-call 횟수를 정답 / 오답 형식으로 적으면 다음과 같다. 마지막 열은 post-training한 RLM-Qwen3-8B다.
| Task | GPT-5 | Qwen3-Coder | Qwen3-8B | Qwen3-8B-RLM |
|---|---|---|---|---|
| CodeQA | 1.5 / 3.4 | 2.2 / 2.4 | 2.9 / 14.0 | 1.5 / 3.3 |
| BrowseComp+ | 56 / 38 | 2 / 8 | 7.5 / 11 | 0.7 / 3.4 |
| OOLONG | 12 / 25 | 535 / 89 | 78 / 243 | 199 / 121 |
| OOLONG-Pairs | 53 / 2 | 170 / 59 | 24 / 51 | 3 / 89 |
논문이 짚는 세 가지가 표에 그대로 보인다.
GPT-5는 BrowseComp-Plus에서 다른 어떤 모델보다 sub-call을 많이 쓴다. 정답 rollout에서 평균 56회이며, 같은 task의 Qwen3-Coder는 2회다. 문서 1000개를 다루는 task에서 GPT-5가 재귀 질의로 탐색 공간을 좁히는 전략을 택한다는 뜻이다.
Qwen3-Coder는 OOLONG 정답 rollout에서 평균 약 535회를 쓴다. 같은 task의 GPT-5는 12회다. Appendix의 사례 분석이 원인을 보여준다. 이 모델은 분류 함수를 정의할 때 줄마다 sub-LM을 부르는 코드를 쓴다. 전체 컨텍스트에 적용하면 호출이 수천 회로 늘어난다. 정답에는 도달하지만 훨씬 적은 호출로도 풀 수 있는 일이다.
Qwen3-8B는 특히 오답 trajectory에서 sub-call을 더 많이 쓴다. CodeQA에서 정답 2.9회 대 오답 14.0회, OOLONG에서 78회 대 243회다. 답을 찾지 못해 헤매는 패턴이다.
다만 "오답이 더 많은 sub-call을 쓴다"는 것은 모든 모델에 해당하지 않는다. GPT-5의 BrowseComp+와 OOLONG-Pairs, Qwen3-Coder의 OOLONG과 OOLONG-Pairs는 정답 쪽이 더 많다. sub-call 횟수 자체는 품질 신호가 아니고, 모델마다 다르게 해석해야 한다.
post-training의 효과도 이 표에서 확인된다. Qwen3-8B의 CodeQA 오답 14.0회가 RLM-Qwen3-8B에서 3.3회로, BrowseComp+ 오답 11회가 3.4회로 줄어든다. runtime이 3배에서 9.6배 빨라진 이유가 여기에 있다.
개별 trajectory 사례
Appendix E는 실제 실행 4건을 단계별로 기술한다. 성공과 실패가 모두 포함돼 있다.
| 사례 | 대상 | 비용 | 요지 |
|---|---|---|---|
| E.1 | RLM(GPT-5), BrowseComp-Plus Query 74 | $0.079 | 1000개 문서(약 830만 토큰)에서 regex로 먼저 탐색한다. 6번 chunk에서 단서를 찾아 sub-LM을 호출하고, 답을 변수 answer6에 저장하면서 출력도 한다. 확인용 sub-LM 호출 2회를 더 거쳐 정답을 반환한다 |
| E.2 | RLM(Qwen3-Coder), OOLONG-Pairs Query 3 | $1.12 | 실패 사례다. 1턴에서 sub-LM 분류와 코드로 정답 pair를 이미 변수에 만들어 놓는다. 그런데 FINAL_VAR() 반환이 받아들여지지 않자 검증을 반복하고, 같은 과정을 5회 다시 수행한다. 마지막에는 변수에 쌓아둔 답을 쓰지 않고 root LM이 직접 생성한 오답을 반환한다 |
| E.3 | RLM(Qwen3-Coder), OOLONG Query 212 | $0.38 | 분류 함수를 줄마다 sub-LM 호출로 정의해 전체 컨텍스트에 적용하면서 수천 회 재귀 호출이 발생한다. 정답에는 도달했지만 훨씬 적은 sub-call로도 풀 수 있었다고 적는다 |
| E.4 | RLM(GPT-5), CodeQA Query 44 | $0.27 | 90만 토큰 코드베이스를 부분으로 나눠 sub-LM에 단서를 묻고, 모은 단서를 별도 sub-call로 종합해 정답 선택지를 고른다. 정보 밀도가 낮은 task에서는 분할과 재귀 질의가 통한다는 예시다 |
E.1의 단계 전개는 성공하는 RLM이 어떤 순서로 움직이는지 보여준다. 질문은 필리핀의 어느 야채 스튜 축제에서 열린 미인 대회 우승자의 이름을 묻는 multi-hop 문제이고, 컨텍스트는 근거 문서와 방해 문서가 섞인 1000개 문서다.
- root LM이 먼저 1000개 문서 목록에 regex 질의를 던진다. 검색어 선택에 모델의 사전 지식이 반영되며, 동시에 프롬프트에 등장한
beauty pageant와festival같은 키워드도 함께 찾는다. - 6번 chunk에서 흥미로운 조각을 찾고 그 조각에 대해 재귀 LM 호출을 던진다. sub-LM은 답이
Maria Dalmacio일 가능성이 높다고 판단하고, 그 정보가 변수answer6에 저장되면서 root LM이 볼 수 있게 출력도 된다. - root LM은 답할 근거가 충분하다고 판단하지만 바로 끝내지 않는다. 확인용 재귀 LM 호출 2회를 더 던져 앞의 판단과 일치하는지 검사한 뒤 최종 답을 반환한다.
들여다보기, 위임하기, 교차 확인하기 세 동작이 순서대로 나타나는 셈이다. 전체 비용은 $0.079였다.
E.2는 특히 값이 있는 실패 기록이다. 답은 1턴에서 이미 만들어졌는데 종료 판정이 실패해 같은 과정을 5회 더 반복하고, 결국 코드 환경에 쌓아둔 정답을 쓰지 않은 채 root LM이 생성한 오답을 냈다. 단계별로 보면 실패가 어디서 갈렸는지 분명하다.
- 컨텍스트를 훑어 데이터 형식을 파악하고, sub-LM 호출로 항목을 semantic 분류한다. 큰 컨텍스트에서의 실수를 피하려고 작은 chunk 단위로 나눠 호출한다.
- 분류 결과를 코드로 집계해 조건을 만족하는 사용자를 찾고, unique pair 목록을 만들어 변수에 저장한다. 이 시점에 정답이 이미 준비돼 있다.
FINAL_VAR()태그로 반환을 시도하지만 받아들여지지 않는다. 모델은 대신 pair 목록을 검증하기 시작한다.- 첫 pair와 마지막 pair를 출력해 root LM이 직접 확인하게 하고, 통계를 뽑아 만든 과정과 답이 맞는지 검사한다.
- 그러고 나서 1단계 과정을 처음부터 다시 수행하며 sub-LM 호출로 답을 재생성한다. 이 재생성을 5회 반복한다.
- 최종 답을 내라는 요구를 받고 반환하는데, 코드 환경에 만들어 둔 값이 아니라 root LM이 직접 생성한 답을 낸다. 그 답은 틀렸다.
FINAL_VAR 태그의 취약성이 실제 실패로 이어지는 경로를 보여주는 기록이며, 한계 절의 종료 판정 문제와 정확히 연결된다. 저자들은 이 모델용으로 prompt를 조정하지 않았고 모델이 RLM으로 학습된 적도 없다는 점을 원인으로 든다. 이 trajectory 하나에 $1.12가 들었다. 성공한 E.1의 $0.079와 비교하면 14배다. 비용 분포가 long-tail인 이유가 이런 실행에 있다.
두 모델의 코드 출력 습관도 다르다. Qwen3-Coder는 한 턴에 여러 코드 블록을 내놓고, GPT-5는 더 반복적으로 한 블록씩 내놓는다. 저자들은 또한 Qwen3-Coder가 답을 이미 얻은 뒤에도 반복해서 검증하는 경향을 여러 trajectory에서 관찰했다고 적는다.
연구 맥락
long-context를 다루는 두 방향
저자들은 language model system에서 long-context를 관리하는 방향이 크게 둘로 갈린다고 정리한다. 하나는 base LM 자체를 바꾸는 것이고, 다른 하나는 그 주위에 scaffold를 두는 것이다. RLM은 후자다.
| 방향 | 대표 작업 | RLM과의 관계 |
|---|---|---|
| 아키텍처 변경과 재학습 | Press 2022(linear bias 기반 길이 외삽), Gu 2022(S4), Munkhdalai 2024(Infini-attention) | 직교한다. RLM은 base 모델을 그대로 두므로 두 방향이 곱해질 수 있다 |
| lossy 컨텍스트 관리 | Chen 2023(Walking down the memory maze), Wu 2025(ReSum), Smith 2025(OpenHands context condensation), Khattab 2021(Baleen) | RLM이 정면 비교하는 대상이다. 압축 과정에서 세부 정보를 잃는다는 것이 문제다 |
| 명시적 메모리 계층 | Packer 2024(MemGPT), Chhikara 2025(Mem0), Zhang 2025(G-memory), Yu 2025(MemAgent) | RLM은 컨텍스트 관리를 전부 LM 자신에게 맡기는 implicit 방식이다 |
| task 특화 inference-time 방법 | Wu 2021, Chang 2024(BooookScore) | 대부분 task-specific이라서 task-agnostic을 목표로 하는 RLM과 다르다 |
두 번째 행과 세 번째 행의 차이가 중요하다. lossy 관리는 무엇을 버릴지 scaffold가 정하고, 메모리 계층은 무엇을 어디에 둘지 scaffold가 정한다. RLM은 두 결정을 모두 LM에게 넘긴다. LM이 코드를 써서 프롬프트의 어느 부분을 언제 볼지 스스로 고르는 구조이므로, 정책이 미리 고정되지 않는다.
sub-LM 호출을 통한 task decomposition 계보
sub-LM 호출 위치를 사람이 정하지 않고 모델에 맡기는 시도는 이미 여러 가지가 있었다. 논문은 그 계보 안에서 RLM의 차별점을 명시한다.
| 작업 | 차별점 |
|---|---|
| ViperGPT (Surís 2023, ICCV) | Python program 생성으로 visual reasoning을 수행한다 |
| THREAD (Schroeder 2025) | recursive spawning. sub-call을 autoregressive하게 말로 풀어낸다 |
| ReDel (Zhu 2024) | LLM 기반 recursive multi-agent toolkit |
| Context Folding (Sun 2025) | long-horizon agent의 컨텍스트 폴딩 |
| AgentFold (Ye 2025) | long-horizon web agent의 proactive 컨텍스트 관리 |
| ROMA (Sentient AI 2025) | open-source meta-agent의 재귀 구조 |
| DisCIPL (Grand 2025) | self-steering LM. sub-LM 호출을 담은 프로그램을 만들지만 단일 step 생성이라 생성 실수에서 회복할 수 없다 |
| 멀티에이전트 일반 (Guo 2024 survey, Anthropic 2025 subagents) | LM 호출 위치를 사람이 설계한 워크플로가 정한다 |
| RLM (본 논문) | prompt를 환경 변수로 두고, REPL의 실행 피드백으로 재귀를 반복 정련한다 |
이 표에서 RLM의 위치를 짚는 두 단어는 "환경 변수"와 "실행 피드백"이다. 앞의 것이 base LM 길이를 넘는 입력을 다루게 하고, 뒤의 것이 DisCIPL과의 차이를 만든다. 프로그램을 한 번 만들어 끝내지 않고 실행 결과를 보고 다음 코드를 쓰기 때문에 잘못된 분해에서 회복할 수 있다. Figure 4의 decomposition 분석이 그 회복이 실제로 자주 일어난다는 것을 보여준다.
추론 라인과의 접점
RLM을 새로운 학습 대상으로 보는 논거는 추론 모델 연구에서 온다. 저자들이 인용하는 세 지점은 다음과 같다.
- Merrill and Sabharwal (2024): chain-of-thought를 갖춘 Transformer의 표현력이 vanilla보다 높다는 결과다. 추론 모델이 경험적 이득뿐 아니라 이론적 표현력도 얻었다는 사실이 RLM을 inference-time 표현력 확장으로 위치시키는 근거가 된다.
- OpenAI o1 (2024), DeepSeek-R1 (2025): RLM trajectory를 추론의 한 형태로 해석하는 근거다. root LM이 코드를 쓰며 문제를 나누는 과정을 사고 과정으로 읽는 관점이다.
- STaR (Zelikman 2022), Quiet-STaR (Zelikman 2024): 기존 모델을 스스로 bootstrap하는 방법론이다. RLM trajectory를 추론 흔적으로 재해석하면 같은 방식으로 확장할 수 있다는 가설로 인용한다.
한계
저자가 명시한 한계
- 평가 범위: 더 어렵고 자연스러운 long-context 처리 task로의 확장, 그리고 RLM에 가드레일을 구현하는 최선의 방법이 모두 미탐구 상태다. 본 논문의 4개 task는 복잡도 스펙트럼을 덮도록 설계된 것이지 실무 워크로드를 대표하는 것이 아니다.
- 복잡도 증가: LLM 위에 추론 layer를 더하면서 sub-call 비용 폭증 같은 의도치 않은 부작용이 생길 수 있다. 비동기 sub-call과 샌드박스 REPL이 runtime과 비용을 줄일 수 있지만 복잡도를 더 키운다.
- 꼬리 비용과 runtime: 비용 percentile 그래프에서 RLM은 50 percentile에서 비슷하거나 더 낮지만 꼬리 구간에서 크게 오른다. 원인은 답을 찾지 못해 길게 헤매는 trajectory다. 95 percentile의 runtime이 특히 긴 것은 sub-LLM 호출을 전부 blocking, sequential로 구현한 탓이며, 드물게 발생하므로 timeout 로직으로 조기 종료할 수 있다고 적는다.
- runtime 수치의 해석: 저자들은 runtime이 사용 머신, API 요청 지연, LM 호출의 비동기성 같은 구현 세부에 크게 의존하므로 비용 수치와 달리 조심해서 읽어야 한다고 명시한다.
- 학습 규모: 실험은 기존 frontier 모델 위에서 이루어졌고, 네이티브 학습은 Qwen3-8B 규모의 초기 증거뿐이다.
부정적 결과
YOLOv3(Redmon and Farhadi 2018)의 서술 방식을 따라 실패한 시도를 그대로 적은 절이 별도로 있다. 실무에서 RLM을 재현할 때 먼저 볼 만한 목록이다.
| 시도 | 결과 |
|---|---|
| 하나의 RLM system prompt를 모든 모델에 쓰기 | GPT-5용으로 쓴 prompt를 Qwen3-Coder에 그대로 적용하면 원하지 않는 trajectory가 나온다. sub-call 남용을 막는 문장 한 줄을 추가해야 했다 |
| 코딩 능력이 부족한 모델 쓰기 | REPL 환경에서 컨텍스트를 다루는 능력이 전제라서 Qwen3-8B 같은 작은 모델은 어려워한다 |
| 출력 토큰 한도가 작은 thinking 모델 쓰기 | Qwen3-235B-A22B도 시도했다. base 모델 대비로는 전반적으로 개선됐고 OOLONG은 30%에서 38%로 올랐다. 그래도 메인 결과보다 격차가 작은 이유는 thinking 토큰이 개별 LM 호출의 최대 출력 한도를 넘어 여러 trajectory가 중단됐기 때문이다 |
| 비동기 없이 sub-call 실행 | 모든 sub-LM 질의를 blocking, sequential로 구현해 base 모델과 비교했을 때 특히 느렸다. 견고한 구현으로 해소할 수 있다고 본다 |
FINAL과 FINAL_VAR 태그로 종료 판정 |
구조화 출력이 성능을 떨어뜨린다는 직관과 비슷하게 모델이 이상한 판단을 한다. 계획을 최종 답으로 출력하는 사례가 있었다. 최소한의 안전 장치를 넣었으나 네이티브 학습으로 근본적으로 피해야 할 문제로 본다 |
결과를 읽을 때의 유보 조건
논문의 표와 그림을 인용할 때 함께 붙여야 하는 조건이 네 가지 있다. 모두 논문 안에 근거가 있지만 초록만 읽으면 놓치는 항목이다.
| 유보 조건 | 근거 |
|---|---|
| RLM의 우위가 모든 baseline에 대해 균일하지 않다 | OpenCode(+context offloading)이 CodeQA 64.0%, BrowseComp+ 94.0%로 RLM(depth=1)을 앞선다. 초록의 median 비교 대상에는 이 baseline이 없다 |
| 짧은 입력에서는 RLM이 base보다 낮다 | Figure 1의 8,192와 16,384 토큰 OOLONG 구간. 논문도 2^14를 넘는 길이부터 일관되게 앞선다고 한정한다 |
| depth를 올리는 것이 항상 이득은 아니다 | Qwen3-Coder의 CodeQA는 depth=0이 66.0%로 가장 높고 depth=3에서 44.0%로 내려간다. syntax error 전파가 원인이다 |
| LongCoT-mini 결과는 다른 구현에서 나왔다 | Table 1 구현을 fork한 rlm-harness를 쓰고, 최종 답 판정 방식과 sub-call 함수(llm_batch)가 다르다 |
여기에 학습 실험의 규모도 함께 봐야 한다. RLM-Qwen3-8B의 중앙값 28.3% 향상은 base Qwen3-8B가 아니라 학습 전 RLM(Qwen3-8B)을 기준으로 한 값이며, 학습 데이터는 최종 953개 trajectory에서 나온 4,724개 턴이다. 저자들 스스로 초기 증거라고 명시하는 규모다.
후속 방향
- 네이티브 RLM 학습의 확장: 본 논문은 sample 1,000개와 8B 모델에 그쳤다. 모델 크기, 예제 수와 다양성, rollout 수를 키우고 가능하면 on-policy와 online으로 가는 것이 필요하다고 적는다. 저자들은 RLM 학습을 다음 세대 language model system의 새로운 규모 확장 방향으로 다룰 수 있기를 기대한다.
- reasoning으로의 재해석: RLM trajectory를 추론의 한 형태(OpenAI o1 2024, DeepSeek-R1 2025)로 보고 STaR(Zelikman 2022)와 Quiet-STaR(Zelikman 2024) 방식으로 기존 모델을 bootstrap할 수 있다는 가설을 제시한다.
- 비동기와 샌드박스: 비동기 sub-call과 샌드박스 REPL이 runtime과 비용을 줄일 수 있다고 보면서도, 그만큼 시스템 복잡도가 커진다는 점을 함께 적는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| RLM (Recursive Language Model) | prompt를 REPL 환경 변수로 두고 LM이 코드로 그 변수를 조작하며 재귀 sub-call하는 추론 패러다임 |
| symbolic handle | prompt를 컨텍스트에 복사하지 않고 변수 이름으로만 참조하게 하는 설계 |
| symbolic recursion | 코드 안에서 loop나 comprehension으로 sub-LM을 프로그램적으로 호출하는 것. 자연어로 풀어 말하는 sub-call과 대조된다 |
| recursion depth | 재귀 허용 층수. 0은 sub-call 없음, 1은 sub-LM만, 1보다 크면 sub-RLM까지 |
| effective context window | 명목 한도가 아니라 task 복잡도에 따라 달라지는 실질적 처리 한계 |
| OOLONG-Pairs | 본 논문 제안 벤치마크. 조건을 만족하는 모든 pair를 출력하게 강제해 quadratic 복잡도를 보장한다 |
| FINAL / FINAL_VAR | RLM의 종료 태그. 답을 직접 넣거나 REPL 변수를 참조한다 |
관련 페이지
- 또 새로운 용어? Loop Engineering: Claude Code, RLM, Dynamic Workflow (Jeongmin Lee, LinkedIn 2026-06-09): 이 논문의 RLM 구조를 loop engineering의 이론적 기반으로 소개하는 한국어 해설. 논문 제목과 저자를 적지 않고 구조만 요약하므로, 그 해설의 출처 확인용으로 이 페이지와 함께 읽으면 좋다
- Beyond the Prompt: Claude Code (Arpan Patel, 2026-05-26): Claude Code의 dynamic workflow 설계. 본 논문이 Table 1에서 Claude Code를 baseline으로 정량 비교한다
- Effective Context Engineering for AI Agents: compaction과 컨텍스트 예산 관리를 다루는 Anthropic 문서. 본 논문이 정면 비교하는 compaction 계열의 설계 근거에 해당한다
- Compiling Agentic Workflows into LLM Weights: agentic workflow를 LLM으로 컴파일하는 반대 방향. RLM은 LM이 워크플로를 실행 시점에 생성한다
- Memory Intelligence Agent (MIA): non-parametric 메모리와 Planner-Executor 구조. RLM이 prompt를 환경 변수로 옮기는 것과 대비해 메모리를 밖으로 옮기는 접근이다
- TaskMem: Task-Focused Memorization for Multimodal Agents: 멀티모달 agent의 task-focused memorization. 컨텍스트를 압축하지 않고 외부화하는 방향이라는 점에서 RLM과 성격이 비슷하다
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: harness 변경이 평가 결과에 미치는 영향. RLM은 base 모델을 그대로 두고 harness만 바꿔 성능을 크게 옮기는 사례다