Physical AI · ARTICLE · 2026
Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models (프로젝트 페이지)
요약
이 페이지는 LaRA-VLA 논문(arXiv 2602.01166, ICML 2026)의 GitHub Pages 소개 페이지를 정리한다. LaRA-VLA는 VLA의 chain-of-thought(CoT)를 텍스트나 이산 visual 토큰으로 생성하지 않고 연속 latent로 내재화한 VLA이며, 방법과 수치의 정본은 논문 페이지 Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models다.
소개 페이지는 초록, 3단계 학습 구조도, LIBERO와 SimplerEnv 결과표, 실제 로봇 결과, latent collapse 분석, 추론 지연, ablation을 논문 문장 그대로 옮겨 한 화면에 요약한다. 페이지에만 있는 자료는 실제 로봇 long-horizon 과제 4종의 rollout 영상 8편이다. LaRA-VLA와 비교 대상 GR00T N1.5의 영상이 과제마다 한 편씩 나란히 실려 있어, 논문의 성공률 막대 그래프가 보여 주지 못하는 실행 모습을 확인할 수 있다.
자료 개요
| 항목 | 내용 |
|---|---|
| URL | https://loveju1y.github.io/Latent-Reasoning-VLA/ |
| 저자 | Shuanghao Bai, Jing Lyu(공동 1저자) 외 10명. 교신 Cheng Chi, Badong Chen, Shanghang Zhang |
| 소속 | Xi'an Jiaotong University, Beijing Academy of Artificial Intelligence, 중국과학원 자동화연구소와 인공지능학원, Peking University |
| 링크 | 논문 PDF, arXiv 2602.01166, 코드 저장소 |
| 수집 | 2026-10-02, 본문 5,847자, 이미지 7장과 전체 화면 캡처 |
페이지 메타데이터의 발행일(2024-01-01)은 템플릿 기본값으로 보이며 실제 날짜가 아니다. 논문 preprint의 날짜는 2026-02-01이다.
페이지 구성과 논문 대응
페이지는 세 개의 큰 절로 구성된다. 각 절의 그림과 문장은 논문의 특정 그림, 표, 문단과 일대일로 대응한다.
| 페이지 절 | 내용 | 논문 대응 |
|---|---|---|
| Abstract | 초록 전문 | 초록 |
| 1. Model Architecture | 3단계 학습 구조도와 설명문 | Figure 2와 캡션 |
| 2. Experiments, Simulation | LIBERO 결과표와 해석, SimplerEnv 결과표와 해석 | Table 2, Table 3, 4.1절 |
| 2. Experiments, Real-world | 성공률 그래프, 해석 문단, LaRA-VLA 영상 4편, GR00T N1.5 영상 4편 | Figure 5, 4.2절 |
| 3. Analysis, Latent Collapse | 산점도와 해석 | Figure 6, 4.3절 |
| 3. Analysis, Inference Time | 지연 그래프와 해석 | Figure 7, 4.3절 |
| 3. Analysis, Ablation | ablation 표와 캡션 | Table 4 |
페이지는 데이터 파이프라인(LIBERO-LaRA와 Bridge-LaRA 구축), 손실 함수, attention 구조, 하이퍼파라미터, 한계 절을 다루지 않는다. 이 내용은 논문 페이지에서 확인한다.
모델 구조
페이지의 첫 그림은 LaRA-VLA의 3단계 학습 구조도로, 논문 Figure 2의 웹용 원본 이미지(1666×743)다.
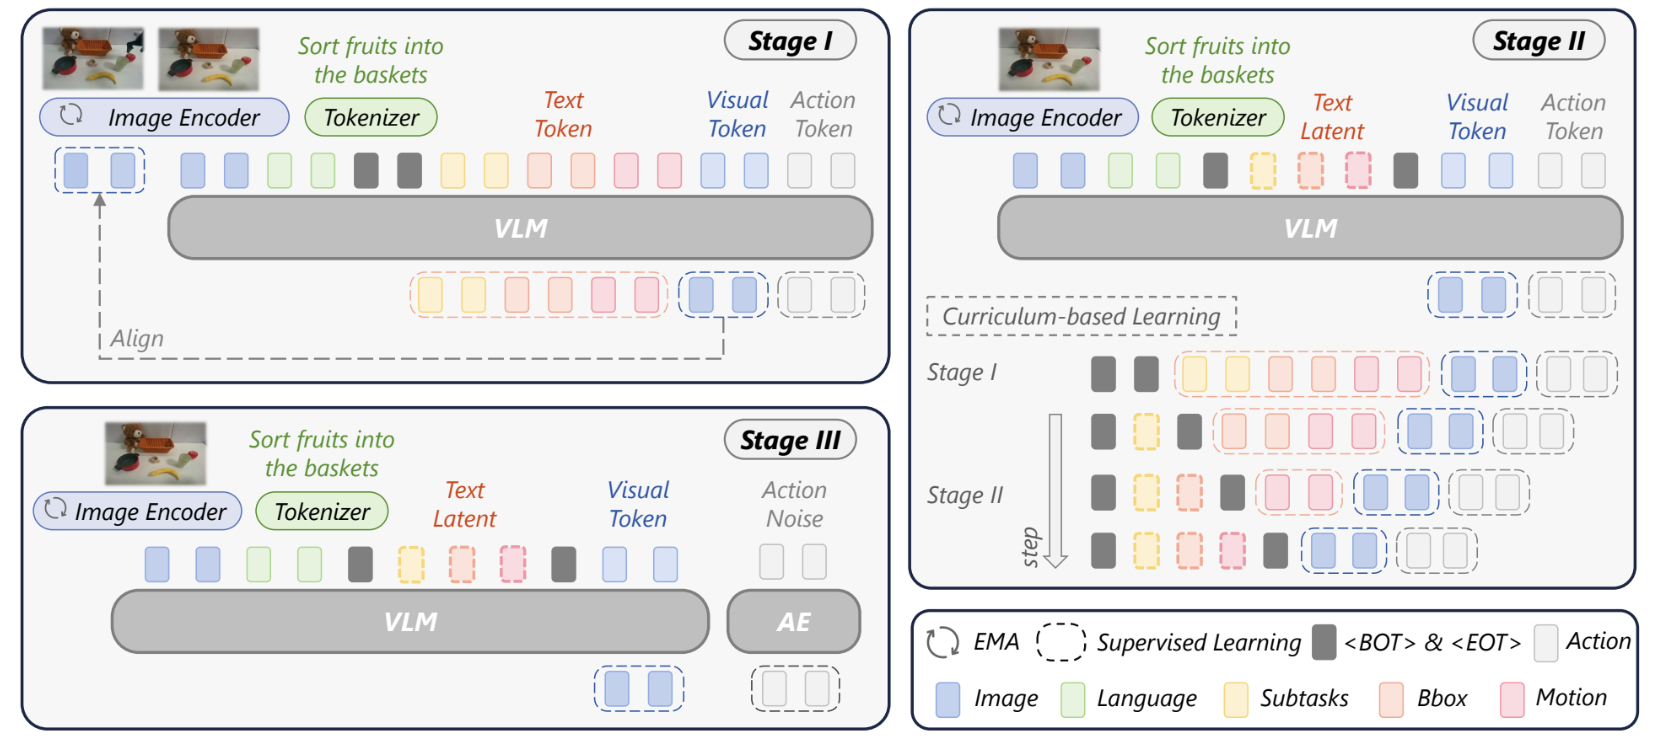
설명문은 학습이 세 단계로 진행된다고 적는다.
- 명시적 CoT fine-tuning: subtask, bbox, motion 텍스트 CoT를 지도학습하고, 다음 프레임의 visual 예측 latent를 alignment하며, inverse dynamics 방식으로 action을 감독한다.
- curriculum 기반 전환: 명시적 CoT를 간결한 텍스트 latent로 바꾸면서 텍스트 토큰 수를 점차 줄인다. 이때 latent는 visual 신호와 action 신호로 암묵적으로 감독된다.
- action expert 적응: latent를 조건으로 받은 VLM feature를 action expert에 적응시켜, 추론 시 명시적 CoT 없이 action을 생성한다.
그림에서 Stage I과 II의 이미지 인코더 옆에 있는 회전 화살표는 EMA 인코더를 뜻한다. EMA 인코더는 목표 latent를 만드는 인코더를 학습 중인 인코더의 이동 평균으로 천천히 갱신해 representation collapse를 막는 장치다. 오른쪽 위의 Stage II 패널은 학습 step이 진행될수록 Subtask, Bbox, Motion 텍스트 토큰이 앞에서부터 latent(점선 상자)로 바뀌는 순서를 보여 준다.
실험 결과
시뮬레이션
시뮬레이션 결과는 논문 Table 2와 Table 3의 이미지로 실려 있고, 해석 문장도 논문과 같다.
| 벤치마크 | LaRA-VLA | 페이지 해석 |
|---|---|---|
| LIBERO | 평균 97.9% (Object 99.8%, Long 96.6%) | 물체 중심 추론과 long-horizon 조작의 강건성을 보여 준다 |
| SimplerEnv WidowX | 평균 68.8% | No CoT, Textual CoT, Visual CoT baseline을 모두 앞선다 |
페이지는 두 벤치마크 모두에서 LaRA-VLA가 텍스트와 visual CoT 방법을 앞선다는 점을 근거로, latent 추론이 명시적 CoT 감독보다 action 예측을 더 효과적이고 안정적으로 안내하며 일반화도 낫다고 해석한다. 과제별 편차(예: SimplerEnv Stack Block 25.0%)와 표의 수치 불일치는 논문 페이지에 정리돼 있다.
실제 로봇과 영상
실제 로봇 결과 그래프는 논문 Figure 5와 수치가 같다. ACT는 모든 과제에서 0%, GR00T N1.5는 평균 47.9%, LaRA-VLA는 평균 56.2%다.
| 과제 | GR00T N1.5 | LaRA-VLA |
|---|---|---|
| 모든 물체를 바구니에 넣기 | 50.0 | 41.6 |
| 과일을 모두 바구니에 넣기 | 33.3 | 50.0 |
| 블록을 찾아 바구니에 넣기 | 16.7 | 33.3 |
| 그릇 두 개 쌓기 | 91.7 | 100.0 |
| 평균 | 47.9 | 56.2 |
페이지 그래프의 두 번째 과제 이름은 "Put all fruits into the basket"으로, 논문 Figure 5의 "Sort all fruits into the basket"과 표기가 다르다. 또 해석 문단은 "네 과제 모두에서 ACT와 GR00T N1.5를 일관되게 앞선다"고 쓰지만, 같은 그래프에서 모든 물체 넣기 과제는 GR00T N1.5가 8.4%p 높다.
그래프 아래에는 "LaRA-VLA"와 "GR00T N1.5" 두 소제목 아래 영상이 각 4편씩 있다. 수집 시점의 페이지 HTML에서 확인한 파일은 다음과 같다.
| 과제 (파일명 기준 추정) | LaRA-VLA 영상 | GR00T N1.5 영상 |
|---|---|---|
| 그릇 두 개 쌓기 | Pick_Bowls.mp4 | Groot_Bowls.mp4 |
| 블록을 찾아 바구니에 넣기 | Find&Pick_Cube.mp4 | Groot_Cube.mp4 |
| 과일을 바구니에 넣기 | Pick_Fruits.mp4 | Groot_Fruits.mp4 |
| 모든 물체를 바구니에 넣기 | Pick_Objects.mp4 | Groot_Objects.mp4 |
영상 파일은 raw에 저장하지 않았고, 영상의 길이와 성공 여부는 확인하지 않았다. 텍스트 추출본에는 영상 자체가 빠지고 두 소제목만 남는다.
분석
latent collapse와 ablation
latent collapse 분석은 추론 요소별 latent 토큰(Subtask, Bbox, Motion)이 서로 분리된 군집을 이루고, 지시문 토큰의 latent가 추론 latent와 다른 부분 공간을 차지한다는 논문 Figure 6의 해석을 그대로 싣는다. latent collapse는 감독이 약할 때 latent 토큰들이 구별되지 않는 균질한 표현으로 수렴하는 현상이다. 페이지는 이 현상이 관찰되지 않았다는 점을 근거로, latent CoT가 언어 임베딩을 단순 재사용하지 않고 요소별로 기능이 분화했다고 해석한다.
ablation 표는 SimplerEnv에서 CoT 감독 형식을 바꾼 논문 Table 4와 같다.
| 설정 | 성공률 (%) |
|---|---|
| CoT 없음 | 55.21 |
| 명시적 텍스트 CoT | 58.33 |
| latent 텍스트 CoT | 64.58 |
| latent 텍스트 CoT + latent visual CoT | 68.75 |
명시적 텍스트 CoT보다 같은 내용을 latent로 내재화한 쪽의 효과가 크고, latent visual CoT를 더하면 성능이 더 오른다.
추론 지연
추론 지연 그래프는 논문 Figure 7과 같다. LaRA-VLA-4B는 rollout당 135 ms로, 명시적 CoT를 생성하는 ThinkAct-7B와 ECoT-7B보다 30배 이상 짧다.
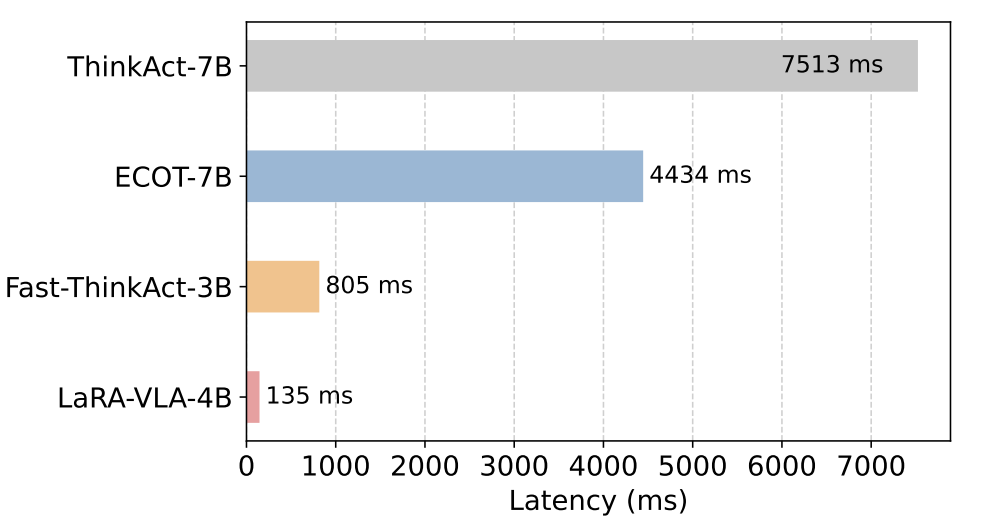
| 모델 | 지연 (ms) |
|---|---|
| ThinkAct-7B | 7513 |
| ECOT-7B | 4434 |
| Fast-ThinkAct-3B | 805 |
| LaRA-VLA-4B | 135 |
페이지는 이를 명시적 CoT 방식 대비 최대 90% 감소로 요약한다. 그래프의 수치로 직접 계산하면 ThinkAct-7B 대비 약 98%, ECOT-7B 대비 약 97% 감소다. 측정 GPU(NVIDIA A100)는 논문 그림 캡션에만 있고 페이지에는 적혀 있지 않다.
한계
페이지 자체에는 한계 절이 없다. 논문은 두 가지 한계를 든다.
- latent 토큰 수가 늘면 collapse 위험이 커져 추론 단계당 latent 토큰을 1개로 제한했고, 이 제한이 표현력을 낮출 수 있다.
- curriculum이 CoT 토큰을 latent로 바꿔 가는 과정에서 학습 비용이 커진다.
페이지를 자료로 쓸 때 주의할 점도 있다. 페이지는 논문의 해석 문장을 그대로 옮겨 과제별 약점(모든 물체 넣기, Stack Block)을 드러내지 않으므로, 결과를 인용할 때는 논문 페이지의 과제별 표를 함께 본다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| LaRA-VLA | Latent Reasoning VLA. CoT를 연속 latent로 내재화하고 추론 시 명시적 CoT를 생성하지 않는 VLA |
| Latent Text-CoT | ablation 표의 latent 텍스트 CoT 감독. 명시적 텍스트 CoT를 thinking 토큰 latent로 대체한 설정 |
| Latent Vis-CoT | ablation 표의 latent visual CoT 감독. 다음 프레임 visual latent 예측 |
| latent collapse | latent 토큰들이 구별되지 않는 균질한 표현으로 수렴하는 현상 |
관련 페이지
- Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models: 같은 연구의 논문. 데이터 파이프라인, 학습 손실, attention 구조, 과제별 수치의 정본이다.
- LaRA-VLA: 같은 연구의 코드 저장소. 학습 스크립트와 공개 데이터셋, 가중치 위치가 있다.
- GR00T N1.5: 영상 비교 대상 baseline.
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model (프로젝트 페이지): 미래 latent 예측을 쓰는 다른 VLA의 프로젝트 페이지.