Physical AI · ARTICLE · 2026
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model (프로젝트 페이지)
요약
VLA-JEPA 프로젝트 페이지는 논문의 초록, 세 가지 Highlights, 도식 6장, 결과 표 4개, 실제 로봇 시연 영상을 한 화면에 모은 공식 소개 사이트다. 페이지 상단에 arXiv, Code, Hugging Face 배지 3개가 있어 논문, 저장소, 가중치로 바로 이어진다.
페이지가 제공하는 고유한 가치는 두 가지다. 첫째, 실제 Franka 로봇 시연 영상이다. in-distribution 평가 2편, out-of-distribution 평가 2편, 그리고 π0, π0.5, VLA-JEPA를 나란히 둔 2×3 비교 영상 격자가 있으며 반복 grasping 동작을 영상으로 확인할 수 있다. 둘째, 도식의 해상도다. 프레임워크 도식이 4760×2676, attention 시각화가 3148×1576으로 논문 PDF에서 잘라낸 크롭보다 커서 세부 라벨을 읽기 쉽다.
수치와 방법 설명은 논문과 같고 페이지에만 있는 새 수치는 없다. 아키텍처 사양, 학습 설정, ablation 세부, 부록의 과제별 관찰은 모두 빠져 있으므로 상세한 내용은 VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model를 참고한다.
배경
프로젝트 페이지는 논문 공개와 함께 만드는 관행적 형식을 따른다. 제목과 저자, 소속을 먼저 보여주고 arXiv, Code, Hugging Face 링크를 배지로 나란히 둔다. 저자는 Jingwen Sun과 Wenyao Zhang이 공동 1저자이고 Xin Jin과 Zhibo Chen이 교신저자다. 소속은 University of Science and Technology of China, Zhongguancun Academy, Shanghai Jiao Tong University, Tsinghua University, Eastern Institute of Technology, University of Chinese Academy of Sciences, Nankai University의 일곱 기관이다.
페이지가 다루는 문제는 논문과 같다. 인터넷 규모 영상으로 VLA policy를 pre-training하고 싶지만, 현재의 latent action 목적 함수가 action과 관련된 상태 전이가 아니라 픽셀 변화에 묶여 있다는 것이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하고, latent action은 두 프레임 사이의 변화를 명시적 제어 명령 대신 모델 내부 표현으로 담은 변수를 말한다.
핵심 개념
페이지가 반복해서 쓰는 용어는 세 가지다.
leakage-free state prediction. 초록과 티저 캡션이 핵심 아이디어로 강조하는 설계다. 목표 인코더가 미래 프레임에서 latent 표현을 만들고 학생 경로는 현재 observation만 본다. 미래 정보는 감독 목표로만 쓰이고 입력으로는 절대 쓰이지 않는다.
latent predictive alignment. Highlights의 두 번째 항목이 쓰는 표현이다. 미래 latent 상태를 예측하고 맞추는 JEPA 방식 학습 목표로, 픽셀 재구성과 정보 누출이 없고 pre-training이 한 단계다.
반복 grasping. grasping 실패 후 그리퍼를 다시 열어 재시도하는 동작이다. 페이지는 실제 로봇 결과 절과 2×3 시연 영상 격자에서 이 동작을 사람 영상 pre-training의 효과로 두 번 강조한다.
페이지 구성
페이지는 위에서 아래로 열다섯 개 절로 이어진다.
| 순서 | 절 | 내용 |
|---|---|---|
| 1 | 제목과 저자 | 제목, 저자 9인과 소속 7곳, 배지 3개 |
| 2 | Abstract | 논문 초록 |
| 3 | Real-World Demos | in-distribution 영상 2편, out-of-distribution 영상 2편 |
| 4 | 티저 도식 | 논문 Figure 1과 캡션 |
| 5 | Highlights | 기여 세 문장 |
| 6 | Method Overview | 프레임워크 도식과 캡션 |
| 7 | Comparison with Prior VLA Methods | 실패 유형 네 가지 요약과 attention 시각화 |
| 8 | Experiments Setup | 평가 환경 장면 모음 |
| 9 | LIBERO Benchmark Results | 11행 표 |
| 10 | SimplerEnv Benchmark Results | 6행 표 |
| 11 | LIBERO-Plus Robustness Results | 6행 표 |
| 12 | Impact of Human Video Data | 사람 영상 비율 그래프 |
| 13 | Real-World Experiments | 막대 그래프와 2×3 시연 영상 격자 |
| 14 | Ablation: Video Horizon | 3행 표 |
| 15 | (BibTeX 없음) | 페이지 끝. 인용 형식은 저장소 README에 있다 |
방법
초록이 서술하는 구조
초록은 문제 제기로 시작한다. 현재의 latent action 목적 함수는 픽셀 변화에 묶여 있어 외형 편향, 과제와 무관한 움직임(nuisance motion), 정보 누출에 취약하다. VLA-JEPA는 이 함정을 설계로 피하는 JEPA 방식 pre-training 프레임워크다.
핵심 아이디어는 leakage-free state prediction이다. 픽셀 공간이 아니라 latent 공간에서 예측하므로 카메라 움직임과 무관한 배경 변화에 robust한 dynamics 추상화를 배운다. 결과는 JEPA pre-training 뒤 action head fine-tuning의 두 단계 레시피이며, 기존 latent action 파이프라인의 다단계 복잡성이 없다.
초록의 마지막 문장은 "sample efficiency and generalization"에서 일관된 이득을 말한다. arXiv v2 초록은 같은 자리에 "generalization and robustness"라고 적어 표현이 다르다. 페이지가 논문 초판 초록을 기준으로 만들어졌을 가능성이 있으나 페이지에 날짜 표기가 없어 확인할 수 없다.
티저 캡션이 서술하는 데이터 흐름
티저 도식 아래 캡션은 논문 서론의 구조 설명을 그대로 옮긴 것이다.
| 구성 요소 | 역할 |
|---|---|
| 목표 인코더 (V-JEPA Encoder) | 미래 프레임에서 latent 목표를 만든다 |
| 학생 경로 (VLA) | VLM backbone을 통해 현재 observation만 보고 latent action을 낸다 |
| 예측기 (Projector) | 과거 latent 상태와 latent action 표현을 미래 latent 상태로 사상한다 |
| 손실 (L) | JEPA alignment 손실. 예측기를 latent world model로 학습한다 |
미래 프레임은 VLM backbone의 입력으로 절대 주어지지 않고 학습 목표를 만드는 데만 쓰인다.
Highlights
| 번호 | 내용 |
|---|---|
| 1 | 많은 latent action pre-training 목적 함수가 픽셀에 묶여 외형 편향, 과제와 무관한 움직임, 미래 문맥이 학습기에 들어올 때의 정보 누출에 취약한 이유를 분석했다 |
| 2 | 미래 latent 상태를 예측하고 맞추는 JEPA 방식 latent predictive alignment로 action 관련 전이 의미를 배운다. 픽셀 재구성과 정보 누출이 없고 pre-training이 한 단계다 |
| 3 | LIBERO, LIBERO-Plus, SimplerEnv와 실제 환경에서 sample efficiency, robustness, 일반화가 일관되게 개선되며 기존 다단계 latent action 파이프라인보다 학습이 단순하다 |
프레임워크 캡션이 서술하는 두 단계
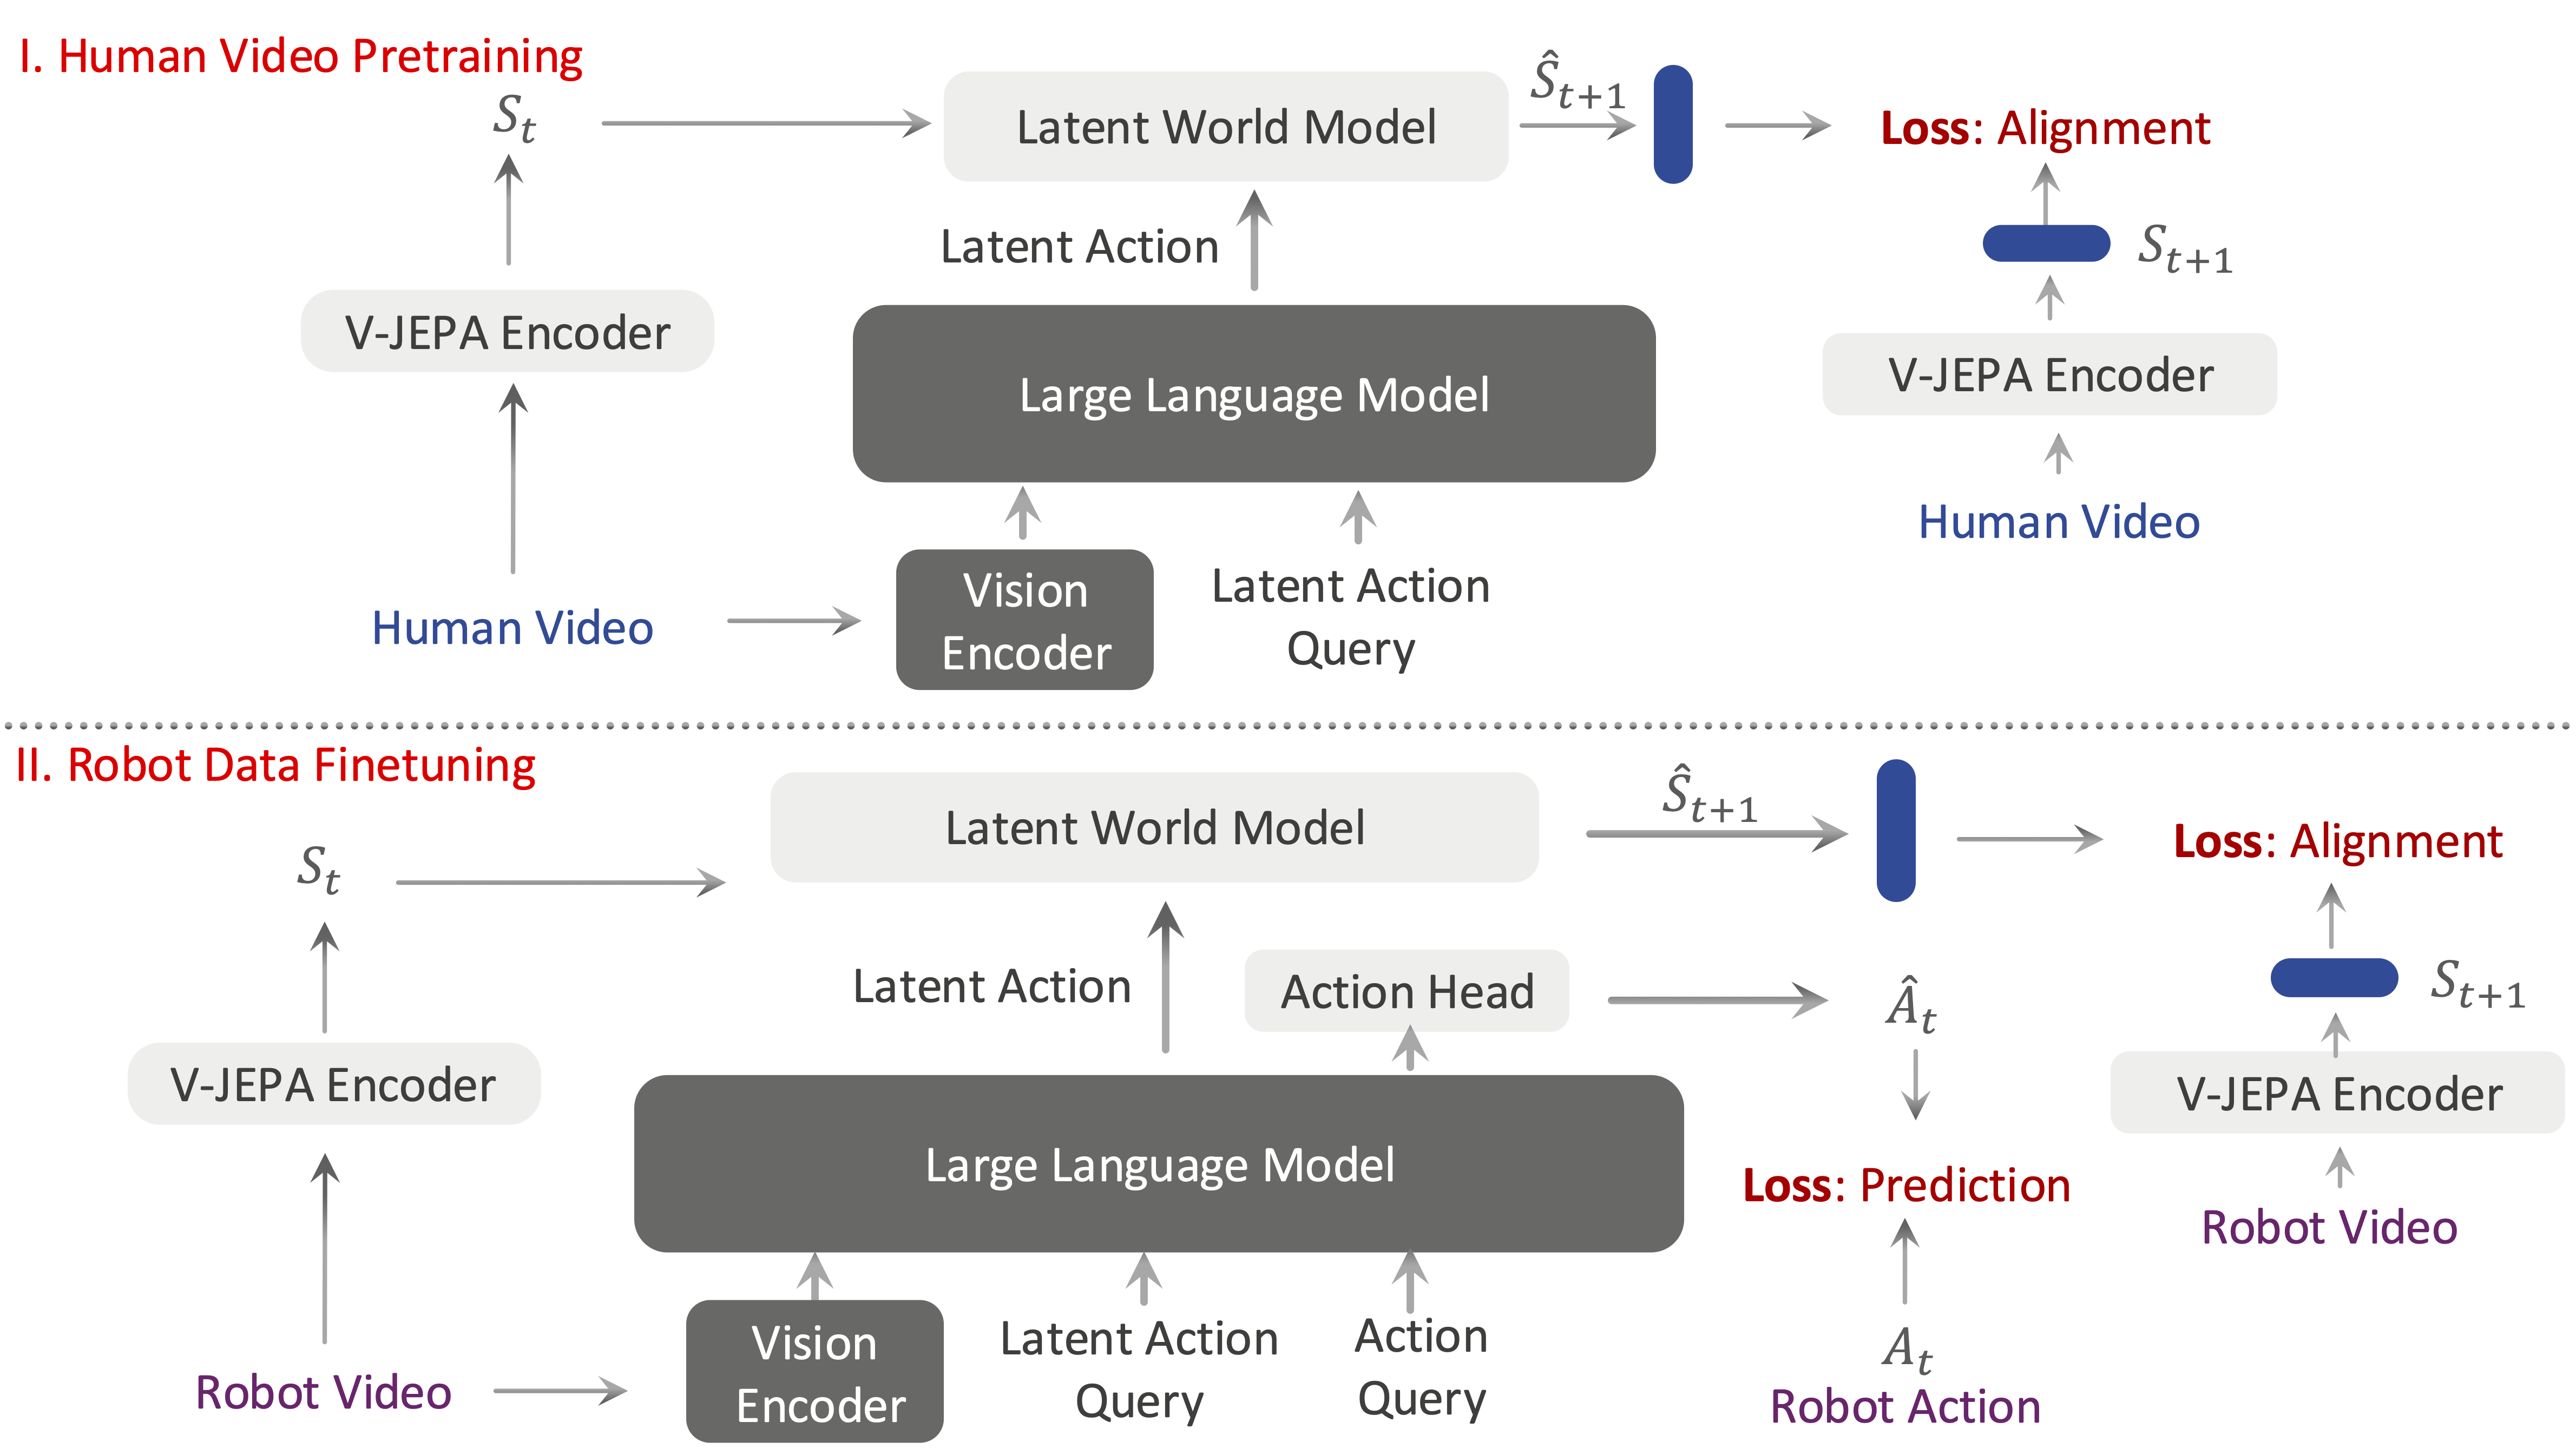
프레임워크 캡션은 VLM backbone에 학습 가능한 latent action 토큰을 둔다고 설명한다. action 라벨이 없는 사람 영상에서는 V-JEPA2 인코더를 쓰는 world model 기반 상태 전이 목적 함수로 latent action을 뽑는다. world model은 환경의 dynamics를 학습해 미래를 예측하는 모델이다. 로봇 시연 데이터(demonstration)에서는 flow matching action head가 end-effector trajectory를 생성한다. flow matching은 잡음 분포에서 데이터 분포로 향하는 벡터장을 학습해 표본을 만드는 생성 기법이다. fine-tuning에서는 두 목적 함수를 함께 최적화한다.
도식에는 캡션이 말하지 않는 세부도 들어 있다. 위쪽 사람 영상 단계에서는 Vision Encoder와 Latent Action Query가 Large Language Model에 들어가 Latent Action이 나오고, 이것이 Latent World Model에 들어가 예측 상태 Ŝ_t+1을 만든다. 예측 상태와 V-JEPA Encoder가 만든 실제 상태 S_t+1 사이가 alignment 손실이다. 아래쪽 로봇 데이터 단계에서는 Action Query가 추가로 들어가 Action Head를 거쳐 예측 action Â_t가 나오고, 실제 action A_t와의 차이가 prediction 손실이다.
기존 VLA와의 비교
비교 절은 기존 latent action 파이프라인의 실패 유형 네 가지를 한 문장으로 요약한다.
- 외형에 편향된 픽셀 수준 목적 함수
- 실제 영상에서 증폭되는 잡음 움직임
- latent action 붕괴를 부르는 정보 누출
- 취약한 다단계 학습 파이프라인
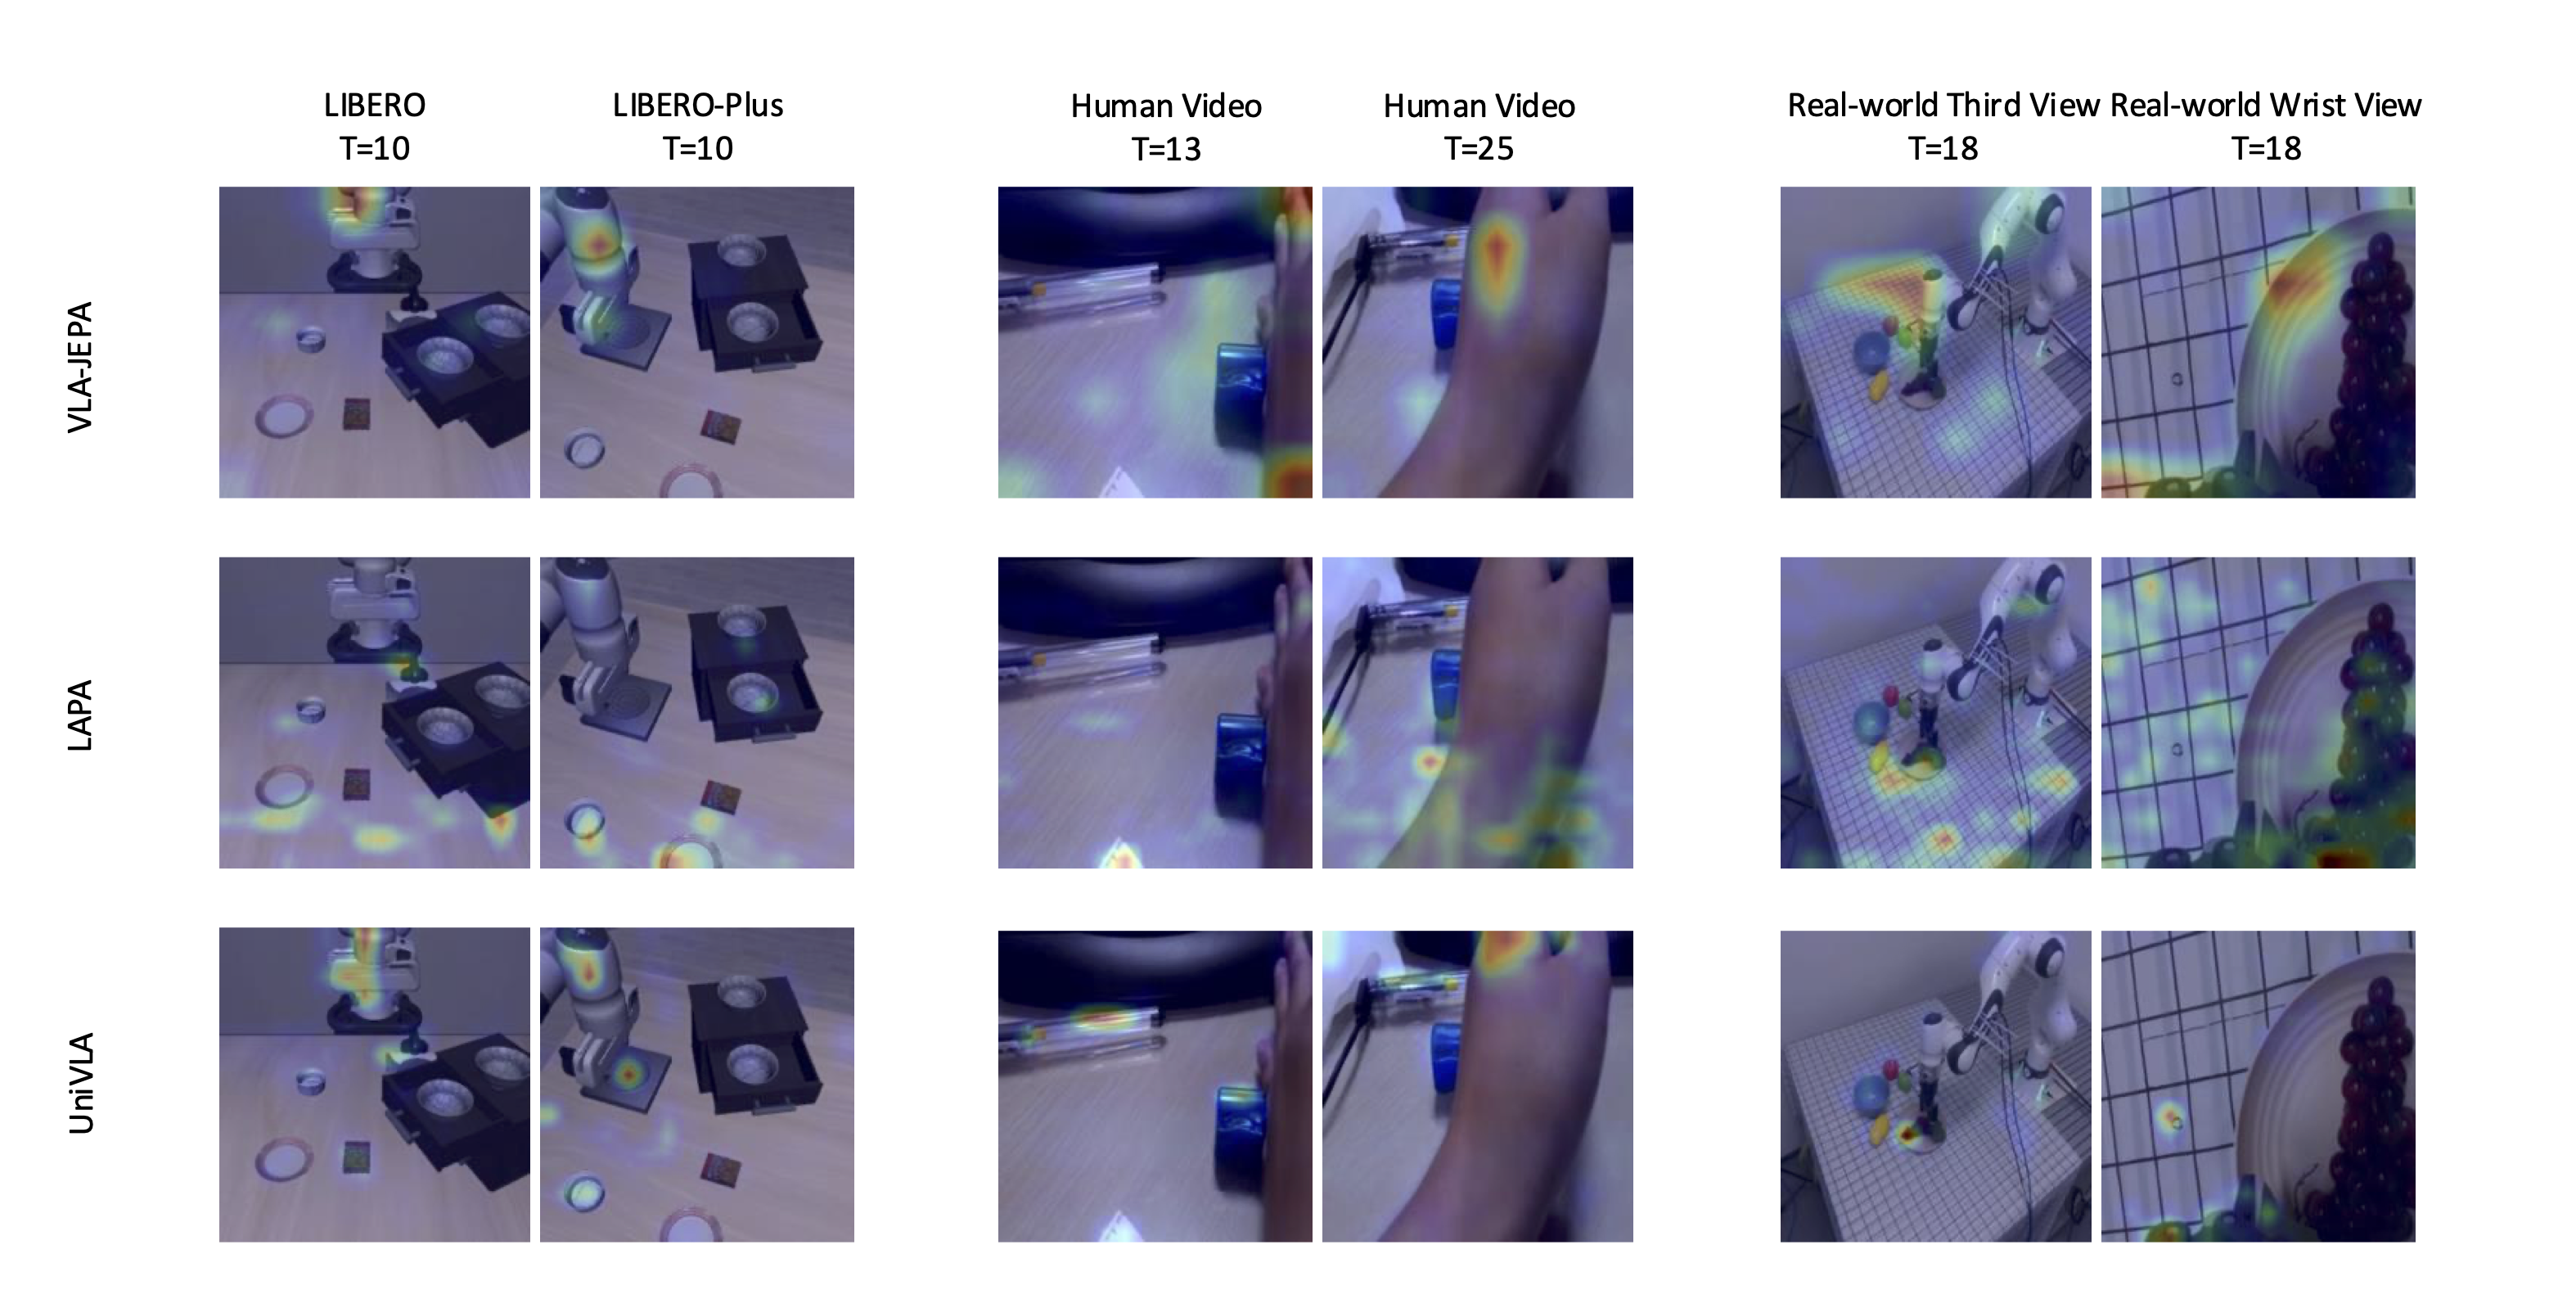
attention 시각화 캡션은 세 모델의 차이를 요약한다.
| 모델 | attention 양상 |
|---|---|
| LAPA | 과제와 무관한 세부까지 포함하는 지나치게 조밀한 시각 정보에 집중한다 |
| UniVLA | 의미를 과도하게 강조해 무관한 배경 요소를 본다 |
| VLA-JEPA | 로봇 팔, 손, 조작 대상에 정확히 집중한다 |
결과
LIBERO
페이지는 VLA-JEPA가 최고 평균 성공률로 LIBERO 최고 성능을 냈으며 방대한 로봇 데이터로 pre-training한 방법들을 앞섰다고 적는다. 표는 논문 Table 1에서 사람 영상 제외 행을 뺀 11행이다.
| 방법 | Spatial | Object | Goal | LIBERO-10 | 평균 |
|---|---|---|---|---|---|
| LAPA | 73.8 | 74.6 | 58.8 | 55.4 | 65.7 |
| UniVLA | 96.5 | 96.8 | 95.6 | 92.0 | 95.2 |
| OpenVLA-OFT | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| π0 | 96.8 | 98.8 | 95.8 | 85.2 | 94.2 |
| π0-Fast | 96.4 | 96.8 | 88.6 | 60.2 | 85.5 |
| CoT-VLA | 87.5 | 91.6 | 87.6 | 69.0 | 81.1 |
| WorldVLA | 87.6 | 96.2 | 83.4 | 60.0 | 81.8 |
| villa-X | 97.5 | 97.0 | 91.5 | 74.5 | 90.1 |
| GR00T N1 | 94.4 | 97.6 | 93.0 | 90.6 | 93.9 |
| π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| VLA-JEPA (ours) | 96.2 | 99.6 | 97.2 | 95.8 | 97.2 |
VLA-JEPA의 평균 97.2%는 OpenVLA-OFT의 97.1%와 π0.5의 96.9%를 근소하게 앞선다. suite별로는 Object와 LIBERO-10에서 최고이고 Spatial과 Goal에서는 π0.5가 앞선다.
SimplerEnv
페이지는 Google Robot에서 최고 평균, WidowX Robot에서 경쟁력 있는 결과를 냈으며 villa-X 같은 방법 대비 1% 미만의 학습 데이터를 썼다고 적는다. 표는 논문 Table 2에서 UniVLA, GR00T N1, MoTo, OpenVLA-OFT와 사람 영상 제외 행을 뺀 6행이다.
| 방법 | Google Pick | Google Move | Google Drawer | Google Place | Google 평균 | WidowX Spoon | WidowX Carrot | WidowX Block | WidowX Eggplant | WidowX 평균 |
|---|---|---|---|---|---|---|---|---|---|---|
| LAPA* | - | - | - | - | - | 70.8 | 45.8 | 54.2 | 58.3 | 57.3 |
| villa-X | 81.7 | 55.4 | 38.4 | 4.2 | 44.9 | 48.3 | 24.2 | 19.2 | 71.7 | 40.8 |
| RoboVLMs | 77.3 | 61.7 | 43.5 | 24.1 | 51.7 | 45.8 | 20.8 | 4.2 | 79.2 | 37.5 |
| π0 | 72.7 | 65.3 | 38.3 | - | - | 29.1 | 0 | 16.6 | 62.5 | 40.1 |
| π0-Fast | 75.3 | 67.5 | 42.9 | - | - | 29.1 | 21.9 | 10.8 | 66.7 | 48.3 |
| VLA-JEPA (ours) | 88.3 | 64.1 | 59.3 | 49.1 | 65.2 | 75.0 | 70.8 | 12.5 | 70.8 | 57.3 |
Google Robot 평균 65.2%는 RoboVLMs의 51.7%를 13.5%p 앞선다. WidowX Robot 평균 57.3%는 LAPA와 같은 값이며, LAPA는 시뮬레이션에서 수집한 in-distribution 전문가 시연 데이터로 학습한 결과다.
LIBERO-Plus
페이지는 7개 perturbation 중 5개에서 최고이며 Language, Light, Background, Layout에서 큰 우위를 보여 latent action이 과제와 무관한 교란을 처리한다는 점을 확인했다고 적는다. perturbation은 카메라, 로봇 초기 상태, 언어, 조명, 배경, 잡음, 물체 배치처럼 과제 목표와 무관하게 입력을 바꾸는 교란을 뜻한다. 표는 논문 Table 3에서 사람 영상 제외 행을 뺀 6행이다.
| 방법 | Camera | Robot | Language | Light | Background | Noise | Layout | 평균 |
|---|---|---|---|---|---|---|---|---|
| UniVLA | 1.8 | 46.2 | 69.6 | 69.0 | 81.0 | 21.2 | 31.9 | 42.9 |
| OpenVLA-OFT | 56.4 | 31.9 | 79.5 | 88.7 | 93.3 | 75.8 | 74.2 | 69.6 |
| π0 | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.9 | 53.6 |
| π0-Fast | 65.1 | 21.6 | 61.0 | 73.2 | 73.2 | 74.4 | 68.8 | 61.6 |
| WorldVLA | 0.1 | 27.9 | 41.6 | 43.7 | 17.1 | 10.9 | 38.0 | 25.0 |
| VLA-JEPA (ours) | 63.3 | 67.1 | 85.4 | 95.6 | 93.6 | 66.3 | 85.1 | 79.5 |
평균 79.5%는 OpenVLA-OFT의 69.6%를 9.9%p 앞선다. 최고가 아닌 두 항목은 Camera(π0-Fast 65.1%)와 Noise(π0 79.0%)다.
사람 영상의 효과
페이지는 사람 영상 데이터가 새 action 실행 능력을 더하는 것이 아니라 기존 skill 목록을 강화해 VLA 모델의 robustness와 안정성을 높이며, 사람 영상 규모가 커질수록 policy의 robustness가 일관되게 개선된다고 적는다. 그래프는 논문 Figure 5와 같고 사람 영상 비율 0, 0.3, 0.7, 1에 따른 LIBERO-Plus 항목별 성공률을 보인다.
실제 로봇
Franka Research 3 팔로 탁상 manipulation 과제를 평가했고, VLA-JEPA가 in-distribution과 object layout OOD 양쪽에서 최고 성능을 냈다고 적는다. 막대 그래프는 논문 Figure 4와 같다.
| 설정 | π0 | π0.5 | VLA-JEPA |
|---|---|---|---|
| in-distribution | 0.57 | 0.37 | 0.70 |
| task OOD | 0.00 | 0.20 | 0.17 |
| object layout OOD | 0.37 | 0.27 | 0.47 |
페이지는 반복 grasping을 두 번 강조한다. 실제 로봇 절의 설명은 VLA-JEPA가 실패 후 그리퍼를 다시 열어 재시도하는 skill을 익혔으며 π0와 π0.5에서는 관찰되지 않았다고 적는다. 2×3 시연 영상 격자 아래 문장은 fine-tuning에 쓴 수집 데이터에 반복 grasping action이 없는데도 VLA-JEPA가 이 skill을 학습했다고 적는다. 영상 격자는 π0, π0.5, VLA-JEPA를 열로 두어 같은 장면에서 세 모델의 동작을 비교한다.
영상 horizon ablation
영상 horizon이 미리 정한 action horizon에 가까울 때 최고 성능이며, T가 너무 작으면 부호화 정보가 부족하고 너무 크면 중복 정보가 들어온다고 적는다. 표는 논문 Table 4와 같다.
| T | Spatial | Object | Goal | LIBERO-10 | 평균 |
|---|---|---|---|---|---|
| 4 | 95.0 | 99.2 | 95.8 | 89.0 | 94.8 |
| 8 | 94.8 | 99.8 | 95.8 | 94.0 | 96.1 |
| 16 | 92.8 | 98.8 | 98.0 | 92.2 | 95.5 |
한계
페이지는 한계를 다루지 않는다. 자료 자체의 제약은 다음과 같다.
- 아키텍처 사양, 학습 하이퍼파라미터, 데이터셋 규모, 실제 로봇 하드웨어 구성, 부록의 과제별 관찰이 모두 빠져 있다. 논문 본문과 부록에만 있다.
- 결과 표에서 사람 영상 제외 ablation 행이 전부 빠져 있고 SimplerEnv 표는 비교 대상 4종이 생략됐다. 최고와 두 번째 표시도 웹 표에서는 서식이 제거돼 남아 있지 않다.
- 초록의 "sample efficiency" 표현은 논문 v2 초록과 다르며, sample efficiency를 직접 잰 실험은 논문에도 없다.
- 시연 영상은 페이지에서만 볼 수 있고 텍스트 추출본에는 영상 요소가 남지 않는다. 영상 길이는 2초에서 4초로 짧다.
- 발행일 표기가 없고 BibTeX 절도 없다. 인용 형식은 저장소 README에 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| leakage-free state prediction | 미래 프레임을 학생 경로의 입력이 아니라 감독 목표로만 쓰는 VLA-JEPA의 핵심 설계 |
| latent predictive alignment | 픽셀 재구성 대신 미래 latent 상태를 예측하고 맞추는 JEPA 방식 학습 목표 |
| 반복 grasping | grasping 실패 후 그리퍼를 다시 열어 재시도하는 동작. 페이지가 시연 영상으로 강조하는 사람 영상 pre-training의 효과 |
| Highlights | 프로젝트 페이지가 논문 기여를 세 문장으로 요약한 절 |
관련 페이지
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: 원 논문 페이지. 방법의 수식, 아키텍처 사양, 학습 설정, ablation과 부록 관찰
- VLA-JEPA (ginwind/VLA-JEPA, GitHub repo): 공식 코드 저장소. 학습과 평가 절차, 체크포인트 배포
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System (프로젝트 페이지): 같은 형식의 프로젝트 페이지 사례. 논문 도식의 고해상도 원본을 싣는다는 점이 같다
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: latent action 계열과 V-JEPA 2 latent world model 방향을 함께 짚는 world-action model 해설