Physical AI · PAPER · 2026
Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models
요약
LaRA-VLA(Latent Reasoning VLA)는 VLA가 action을 내기 전에 거치는 중간 추론을 텍스트나 이산 visual 토큰으로 생성하지 않고, 모델 내부의 연속 latent로 수행하게 만든 VLA다. chain-of-thought(CoT)는 답을 내기 전에 중간 추론 단계를 순서대로 적어 내려가는 방식을 말한다. VLA 분야에서는 subtask 분해, 대상 물체 위치, 움직임 방향 같은 중간 추론을 먼저 생성하게 하면 성능이 오른다는 결과가 쌓여 왔다. 그러나 추론 시 긴 텍스트를 생성해야 하므로 지연이 크고, 이산 토큰이라 연속인 perception과 control 공간과 표현 형식이 어긋난다.
LaRA-VLA는 이 두 문제를 한 번에 풀기 위해 학습 때만 명시적 CoT를 쓰고 추론 때는 쓰지 않는다. 3단계 curriculum 학습이 핵심이다. Stage I에서 명시적 텍스트 CoT와 다음 프레임 visual latent 예측을 함께 학습하고, Stage II에서 텍스트 CoT 토큰을 학습 가능한 latent 토큰으로 하나씩 바꿔 가며, Stage III에서 그 latent를 조건으로 flow matching action expert가 연속 action을 생성하도록 적응시킨다.
결과는 세 환경에서 보고된다. LIBERO 평균 97.9%, SimplerEnv WidowX 평균 68.8%로 표 안의 No CoT, Textual CoT, Visual CoT, Latent CoT 방법 중 가장 높은 평균을 기록했고, 실제 로봇 long-horizon 과제 4종에서 평균 56.2%로 GR00T N1.5(47.9%)와 ACT(0%)를 앞섰다. 추론 지연은 NVIDIA A100에서 rollout당 135 ms로, 명시적 CoT를 생성하는 ThinkAct-7B(7513 ms)와 ECoT-7B(4434 ms)보다 크게 짧다. 논문은 ICML 2026에 채택됐고 코드와 데이터셋, 가중치가 공개됐다 (LaRA-VLA).
배경
CoT 기반 VLA의 세 계열
VLA는 대규모 멀티모달 언어 모델을 로봇 제어로 확장한 모델이다. RT-2 이후 π0, π0.5, OpenVLA-OFT 같은 구조 개선과 학습 및 추론 최적화가 이어졌고, 그중 학습 시 CoT를 쓰는 방법이 특히 효과적이라는 보고가 많다. 기존 CoT 기반 VLA는 중간 추론의 모달리티에 따라 세 계열로 나뉜다.
| 계열 | 중간 추론 형태 | 대표 방법 |
|---|---|---|
| 텍스트 CoT | 자연어로 과제 분해, 고수준 계획, observation에서 뽑은 motion과 물체 정보를 서술한다 | ECoT, Emma-x, Long-VLA, ActionSketcher, ThinkAct, π0.5, GraspVLA |
| visual CoT | 미래 observation이나 중간 visual 상태를 재구성하거나 예측한다 | CoT-VLA, DreamVLA, F1, UD-VLA, VITA |
| 결합 | 텍스트와 visual 중간 표현을 함께 쓴다 | UP-VLA |
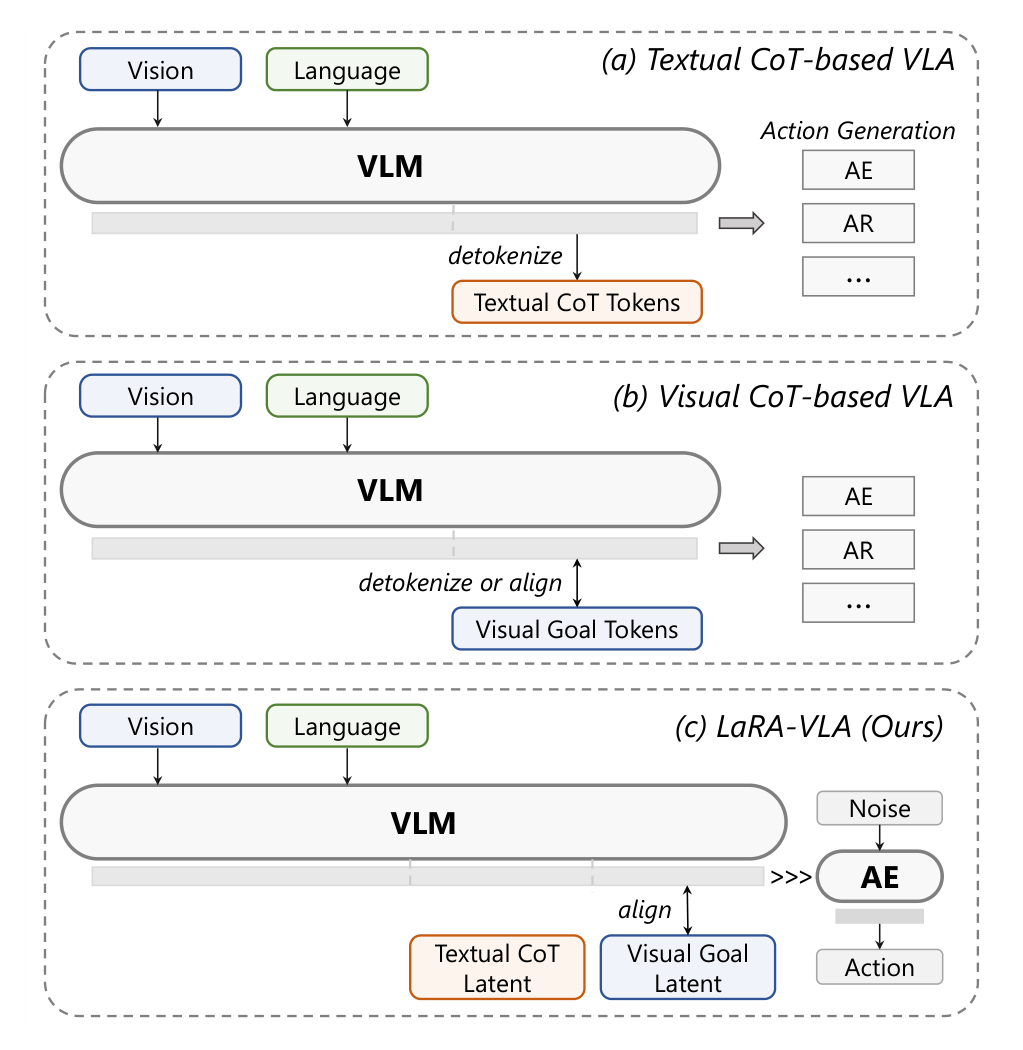
두 가지 근본 문제
논문은 기존 CoT 기반 방법이 효과적이지만 두 가지 근본 문제를 안고 있다고 정리한다.
첫째는 추론 비용이다. 텍스트 CoT는 추론 시 긴 reasoning trace를 생성해야 하므로 토큰 길이가 크게 늘고, 그만큼 KV-cache 사용량, 메모리, 지연이 커진다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하는데, 이런 모델은 control frequency가 5Hz 아래로 떨어지고 ECoT는 1Hz 근처까지 내려간다. 즉 1초에 한 번 정도만 새 action을 내므로 실시간 로봇 제어에 쓰기 어렵다.
둘째는 표현 불일치다. 텍스트 CoT는 언어 토큰에, visual CoT는 대부분 VQ 계열 tokenizer가 만든 이산 visual 토큰에 묶인다. 반면 로봇의 perception과 action은 연속 공간에서 변한다. 추론만 이산 토큰으로 수행하면 추론과 제어 사이에 표현 형식의 간극이 생긴다.
저자는 CoT가 효과적인 이유를 자연어라는 형식이 아니라 구조화된 중간 추론을 드러낸다는 점에서 찾는다. 이 관점을 받아들이면 중간 추론을 연속 latent로 옮겨도 구조만 유지되면 이점이 남는다. 따라서 LaRA-VLA는 언어 모델에서 제안된 latent CoT 연구, 특히 hidden state를 다음 입력으로 되먹여 연속 공간에서 사고하는 Coconut과 VLM용 Multimodal Chain of Continuous Thought를 VLA로 가져온다.
CoT 표현 형식에 따른 분류
Table 1은 기존 방법을 텍스트 CoT의 형식, visual CoT의 alignment 형식, action 출력 형식으로 분류한다. LaRA-VLA만 세 항목 모두 연속 표현을 쓴다.
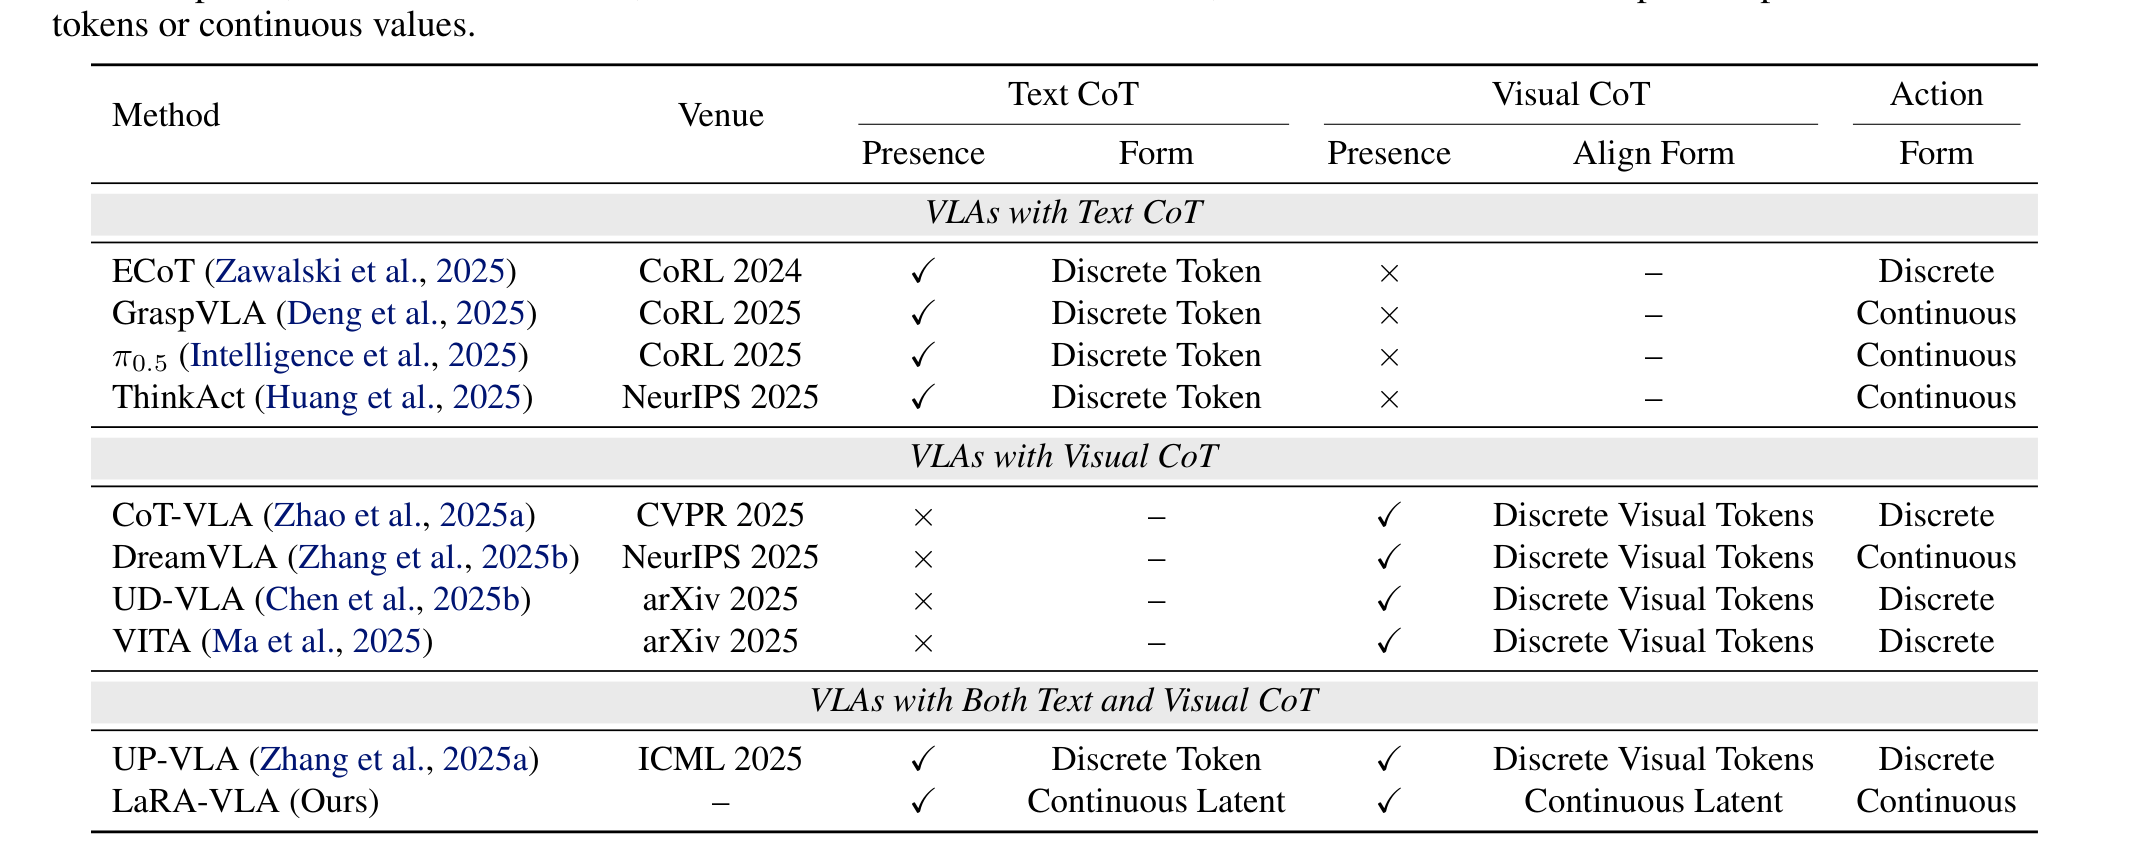
| 방법 | 텍스트 CoT | visual CoT | action |
|---|---|---|---|
| ECoT | 이산 토큰 | 없음 | 이산 |
| GraspVLA, π0.5, ThinkAct | 이산 토큰 | 없음 | 연속 |
| CoT-VLA, UD-VLA, VITA | 없음 | 이산 visual 토큰 | 이산 |
| DreamVLA | 없음 | 이산 visual 토큰 | 연속 |
| UP-VLA | 이산 토큰 | 이산 visual 토큰 | 이산 |
| LaRA-VLA | 연속 latent | 연속 latent | 연속 |
핵심 개념
latent CoT. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다. latent CoT는 중간 추론 단계를 토큰 문자열로 출력하지 않고 내부 연속 벡터로 수행하는 방식이다. 생성할 토큰이 줄어 지연이 짧아지고, 이산 어휘에 묶이지 않으므로 연속 제어 신호와 형식이 맞는다.
textual CoT latent. LaRA-VLA에서 텍스트 CoT(subtask, bbox, motion 서술)가 있던 자리를 대신하는 <|thinking|> 토큰 위치의 latent다. 학습이 진행되면서 명시적 텍스트가 이 토큰으로 하나씩 바뀐다.
visual goal latent. <img_next> 토큰이 예측하는 다음 프레임의 visual latent다. 입력 observation과 같은 이미지 인코더(EMA 목표 버전)가 다음 프레임을 인코딩한 값에 맞춰진다. 저자는 이 latent가 미래 지향 과제 정보를 담는 동시에 textual CoT latent에 암묵적 감독을 주는 두 역할을 한다고 설명한다.
EMA 목표 인코더. 목표 latent를 만드는 인코더 파라미터를 학습 중인 인코더의 지수 이동 평균으로 천천히 갱신하는 방법이다. 예측기와 목표가 함께 한 점으로 수렴하는 representation collapse를 막기 위해 쓰며, VL-JEPA의 방식을 따른다.
Inverse Dynamics Model. Inverse Dynamics Model은 연속된 두 상태를 보고 그 사이의 전이를 일으킨 action을 추정하는 모델이다. LaRA-VLA는 현재 visual 상태와 예측한 다음 visual 상태, 지시문과 중간 추론을 조건으로 action을 추정하게 하여, latent에 action 관련 정보가 들어가도록 만든다.
action expert. action expert는 VLM backbone과 분리된 별도 네트워크로, VLM이 만든 표현을 조건으로 연속 action을 생성한다. LaRA-VLA의 action expert는 16층 DiT이며 Stage III에서만 활성화된다.
방법
구조화 CoT 데이터 파이프라인
LaRA-VLA의 CoT 주석은 세 요소로 구성된다. 저자는 조작에 long-horizon subtask 구조, 대상 물체의 공간 grounding, 실행 수준의 motion 추론이 함께 필요하다고 보고, 기존 파이프라인은 이 요소를 따로 다뤄 감독이 중복되거나 빠진다고 지적한다.
| 기존 방법 | 문제 |
|---|---|
| ECoT | 장면의 모든 물체에 bbox를 달아 감독이 크게 중복된다 |
| Emma-x | 대상 물체 위치 주석이 없다 |
이를 해결하기 위해 사람 개입 없는 자동 주석 파이프라인을 "anchor-first, generate-later" 원칙으로 만든다. 먼저 의미와 시간의 기준점(anchor)을 고정하고, 그 조건에서 나머지 주석을 생성한다는 뜻이다.
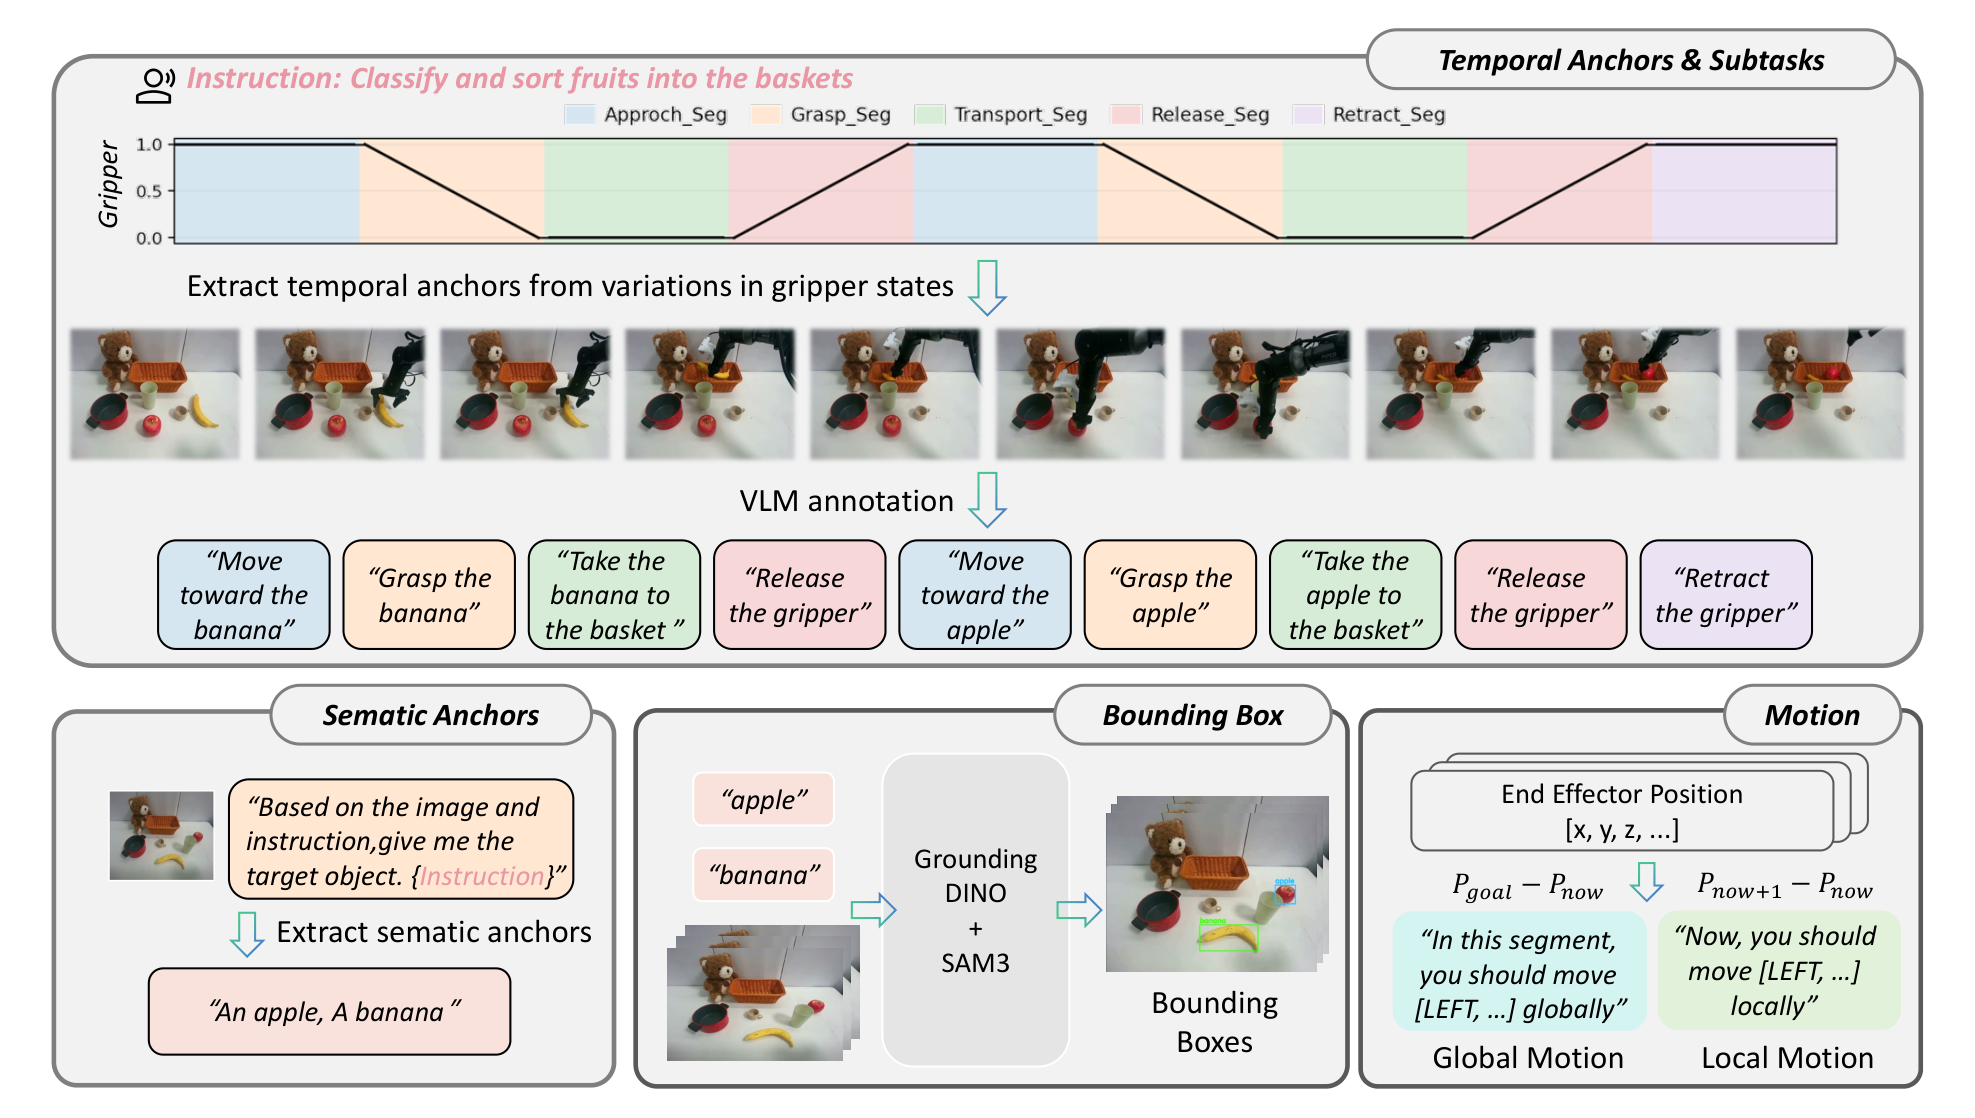
| 단계 | 입력 | 방법 | 출력 |
|---|---|---|---|
| semantic anchor | 첫 프레임, 지시문 | Qwen3-VL에 대상 물체를 묻는다 (Figure 10 프롬프트) | 주 조작 물체와 보조 물체 이름, 각 3단어 이하 소문자 JSON |
| temporal anchor | 그리퍼 상태 trajectory | 개폐 변화 지점으로 원자 조작 구간을 나누고 경계를 keyframe으로 삼는다 | Approach, Grasp, Transport, Release, Retract 같은 구간 |
| subtask 서술 | 지시문, 구간 keyframe 두 장, 구간 라벨 | Qwen3-VL이 구간별 문장을 생성한다 (Figure 11 프롬프트) | "Grasp the banana", "Take the apple to the basket" 같은 문장 |
| 대상 bbox | semantic anchor, 영상 | GroundingDINO와 SAM3로 open-vocabulary grounding | 프레임별 2D bbox trajectory |
| motion 추론 | end-effector 위치 trajectory | 구간 목표 방향(P_goal − P_now)과 순간 방향(P_now+1 − P_now)을 방향 서술자로 이산화 | "이 구간에서는 전체적으로 LEFT 방향" 같은 global motion과 local motion 서술 |
subtask 프롬프트는 "move to object", "grasp object" 같은 일반 라벨을 반복하지 말고 물체 이름이 들어간 구체적 행동 문구를 쓰라고 지시한다. 물체를 식별하지 못하면 "manipulate the object"를 쓰게 한다. 대상 물체 프롬프트는 위치 서술("on stove")을 금지하고 색 같은 물체 속성만 3단어 이하로 쓰게 한다.
Bridge 데이터는 장면이 다양해 bbox 추적이 불안정하므로 추가 처리를 한다. 균일하게 뽑은 anchor 프레임 5장의 GroundingDINO 검출로 SAM을 prompt하는 multi-frame ensemble을 쓰고, 공간 outlier를 제거한 뒤 신뢰도가 가장 높은 시퀀스를 고르며, 추적이 끊긴 구간은 선형 보간으로 채운다. 그 결과 프레임마다 bbox 감독이 생긴다.
이 파이프라인으로 LIBERO 기반 LIBERO-LaRA, Bridge(SimplerEnv) 기반 Bridge-LaRA를 만들었고, 같은 방식을 실제 로봇 long-horizon 데이터에도 적용했다.
모델 구조
LaRA-VLA는 Qwen3-VL을 VLM backbone으로 쓰고 그 이미지 인코더도 그대로 물려받는다. 입력 이미지와 다음 프레임 목표를 같은 인코더로 인코딩하므로 학습 전 과정에서 visual 표현이 일관된다. 공개 저장소의 기본 backbone은 StarVLA/Qwen3-VL-4B-Instruct-Action이다.
| 구성 요소 | 역할 | 사용 단계 |
|---|---|---|
| Qwen3-VL backbone | 이미지, 지시문, CoT 또는 latent, 미래 이미지 토큰을 처리한다 | 전 단계 |
<img_next> 토큰 |
다음 프레임 visual latent를 예측한다. 예시 형식에서는 16개를 쓴다 | 전 단계 |
| `< | thinking | >` 토큰 |
| autoregressive action 토큰 | FAST tokenizer 방식의 이산 action 토큰. latent 추론과 action을 함께 안정적으로 학습하게 한다 | Stage I, II |
| action expert | self-attention과 cross-attention이 번갈아 쌓인 16층 DiT. latent를 조건으로 연속 action trajectory를 생성한다 | Stage III |
FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이다. LaRA-VLA는 앞 두 단계에서 이 토큰을 쓰다가 마지막 단계에서 action expert로 교체해, action 생성을 토큰 단위 autoregressive 디코딩에서 분리한다.
3단계 학습
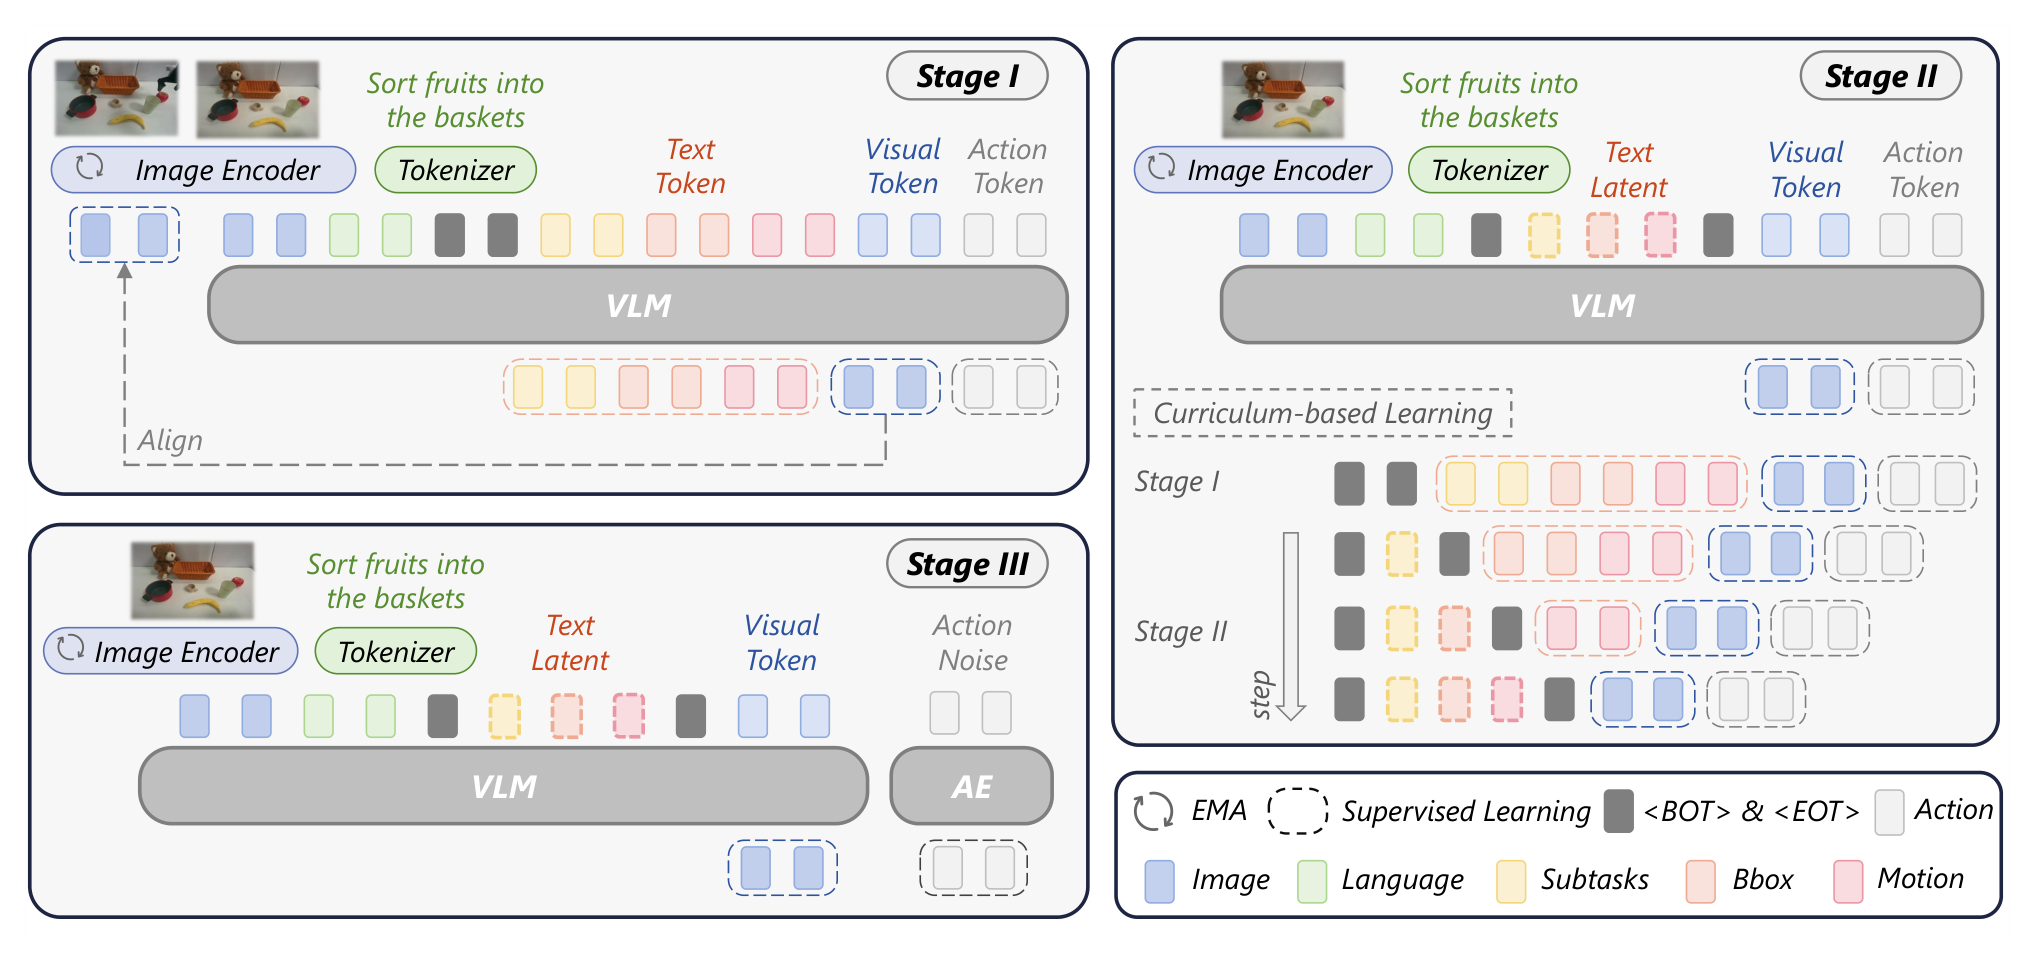
Stage I 명시적 CoT fine-tuning
첫 단계는 구조화 CoT 주석으로 VLM을 fine-tuning해 조작 과제에 맞는 명시적 중간 추론을 익히게 한다. 이미지 인코더가 observation을 visual 토큰 v로, tokenizer가 지시문을 텍스트 토큰 x로 바꾸고, VLM이 둘을 함께 보고 CoT 토큰을 순서대로 생성한다. 정답 CoT 토큰을 teacher forcing으로 넣고 음의 로그우도를 최소화한다.
- CoT 손실: L_cot = −Σ_t log p_θ(c_t | c_<t, v, x)
- visual alignment 손실: VLM이 다음 observation의 visual latent ẑ_t+1을 예측하고, 같은 인코더로 실제 다음 observation을 인코딩한 z_t+1과 L1 거리로 맞춘다. L_vis = ||ẑ_t+1 − z_t+1||_1
- EMA 갱신: 목표 latent를 만드는 파라미터는 θ̄_v^t = τ_v θ̄_v^(t−1) + (1 − τ_v) θ_v^t로 갱신한다. τ_v는 decay rate다
- action 손실: 예측한 미래 visual 표현과 앞선 visual, 텍스트 맥락으로 f(v_t, v_t+1 | x, c) = a_t인 inverse dynamics를 학습한다. FAST의 재귀 생성 틀로 coarse action 의미를 모든 latent 표현에 부여하며, action 토큰은 L_cot와 같은 형태의 autoregressive 손실 L_act-dis로 학습한다
Stage I의 학습 문자열은 다음과 같다 (부록 Figure 8).
Place the potato inside the bowl. @ Subtask: carry the potato toward the bowl.
BBox: [0.5664 0.5898 0.6953 0.6641]. Reasoning: the robot is closing the gripper.
<img next> × 16
Stage II curriculum 기반 CoT 토큰 교체
둘째 단계는 명시적 텍스트 추론을 latent 공간으로 옮긴다. 목표 함수는 Stage I과 같지만, 모든 추론 단계를 정답 CoT 토큰으로 감독하는 대신 CoT 토큰 일부를 가리고 학습 가능한 latent로 바꾼다. 이산 CoT 토큰의 비율은 미리 정한 schedule에 따라 줄어들고, 전체 CoT가 latent에 흡수되면 단계가 끝난다.
부록 Figure 8은 이 교체를 thinking 토큰 수로 보여준다.
| 하위 단계 | thinking 토큰 | 남아 있는 명시적 텍스트 |
|---|---|---|
| 1 | 1개 (Subtask 대체) | BBox, Reasoning |
| 2 | 2개 (Subtask, BBox 대체) | Reasoning |
| 3 | 3개 (전부 대체) | 없음 |
Place the potato inside the bowl. @ <|start of thinking|> <|thinking|> <|thinking|>
<|thinking|> <|end of thinking|> <img next> × 16
추론 요소 하나당 latent 토큰 하나를 쓰는 설계다. 저장소 설정의 tag2think_count도 SUBTASK, BBOX, REASON 각 1로 되어 있다. 한계 절에 따르면 latent 토큰 수가 늘면 collapse 위험이 커져 이 개수를 1로 제한했다.
Stage II 동안 L_cot는 0으로 annealing되고, 마지막에는 0.2 L_vis + L_act-dis만 남는다. 텍스트 감독이 사라진 뒤에는 visual 예측과 action 신호가 latent를 감독하는 유일한 신호가 된다.
Stage III flow matching action 생성
셋째 단계는 latent 추론을 연속 제어에 맞춘다. flow matching은 노이즈와 정답 action을 잇는 직선 경로 위에서 velocity field를 학습해, 추론 시 노이즈에서 출발해 action을 생성하는 방법이다.
- 보간: a_τ = (1 − τ)ε + τ a_t, ε ~ N(0, I), τ ~ U(0, 1)
- 예측: action expert가 v_θ(a_τ, τ | h_t)를 예측한다
- 손실: L_act-con = E[||v_θ(a_τ, τ | h_t) − (a_t − ε)||²]
조건 h_t는 현재 observation과 지시문의 latent, 텍스트 추론 latent, VLM이 예측한 미래 visual latent를 모은 멀티모달 latent 맥락이다. 앞 단계의 inverse dynamics 감독 덕분에 h_t에는 이미 coarse action 정보가 들어 있으므로, 저자는 별도 action latent를 두지 않고 공유 멀티모달 latent에서 바로 action을 생성한다.
추론 시 입력 문자열은 Stage II의 마지막 형식과 같다. 즉 지시문 뒤에 thinking 토큰 3개와 <img_next> 토큰 16개만 두고 텍스트 CoT는 생성하지 않는다.
LaRA attention 구조
LaRA-VLA는 단계에 맞춘 attention mask를 쓴다. 토큰은 현재 이미지, 텍스트, 미래 이미지, action 네 종류이며, 텍스트는 Stage I과 II에서 지시문과 텍스트 CoT, Stage II와 III에서 텍스트 latent를 가리킨다.
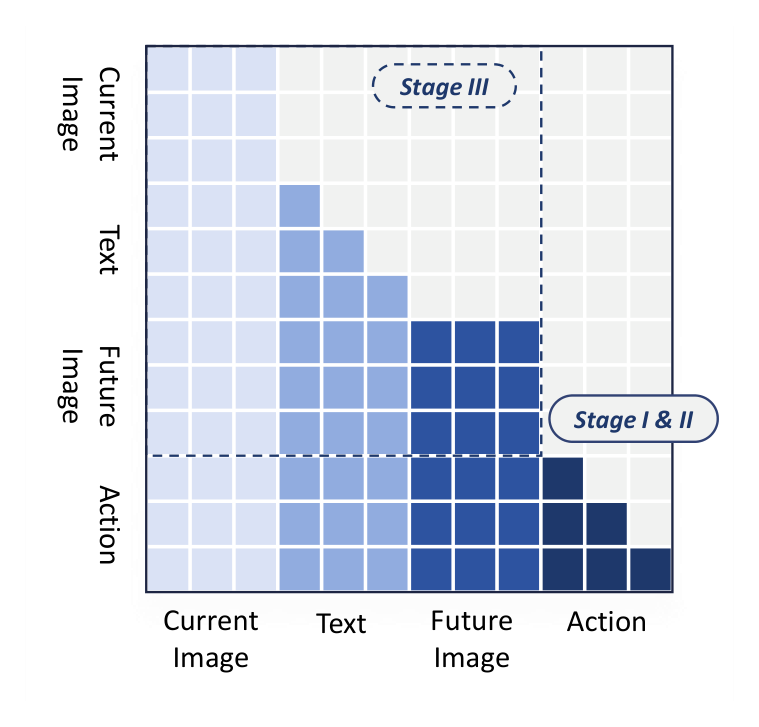
| 단계 | 미래 이미지 토큰 | action 토큰 |
|---|---|---|
| Stage I, II | 텍스트와 현재 이미지에 causal, 미래 이미지끼리는 양방향 | 앞선 텍스트, 현재 이미지, 미래 이미지, 이전 action 토큰 전부를 본다 (autoregressive) |
| Stage III | 같은 규칙 | attention 계산에서 제외한다. VLM은 텍스트와 vision 토큰만 처리하고 action은 action expert가 만든다 |
미래 이미지 토큰끼리 양방향 attention을 쓰는 이유는 16개 토큰이 하나의 다음 프레임 latent를 함께 표현하기 때문이다. action 토큰은 앞선 추론과 예측 결과를 모두 볼 수 있어 inverse dynamics 구조와 맞는다.
단계별 손실 정리
| 단계 | 손실 | 의도 |
|---|---|---|
| Stage I | L_cot + 0.1 L_vis + L_act-dis | 구조화 추론과 action grounding 초기화 |
| Stage II | L_cot를 0으로 annealing, 최종 0.2 L_vis + L_act-dis | latent 공간 추론으로 전환하면서 action 의미 유지 |
| Stage III | L_act-con | 연속 action 생성 |
하이퍼파라미터
action horizon은 Bridge 16, LIBERO 8, 실제 로봇 25이며, 모든 모델은 NVIDIA H100 8장으로 학습했다. 단계별 설정은 Table 5에 정리돼 있다.
| 항목 | LIBERO I / II / III | SimplerEnv I / II / III | 실제 로봇 I / II / III |
|---|---|---|---|
| VLM 학습률 | 1e-5 / 1e-5 / 1e-5 | 1e-5 / 1e-5 / 1.3e-5 | 1e-5 / 1e-5 / 1e-5 |
| DiT 학습률 | 1e-4 / 1e-4 / 1e-4 | 1e-4 / 1e-4 / 1.3e-4 | 1e-4 / 1e-4 / 1e-4 |
| action horizon | 8 | 16 | 25 |
| 학습 step | 5천 / 2천+2천+2천 / 4만 | 1만 / 5천+5천+1만 / 6만 | 5천 / 2천+2천+2천 / 1만 |
| 배치 크기 | 12 / 16 / 16 | 12 / 16 / 16 | 12 / 16 / 16 |
| action token 손실 가중치 | 1.0 / 1.0 / 없음 | 1.0 / 1.0 / 없음 | 1.0 / 1.0 / 없음 |
| image next 손실 가중치 | 0.1 / 0.2 / 없음 | 0.1 / 0.2 / 없음 | 0.1 / 0.2 / 없음 |
| CoT 손실 가중치 | 1.0 / 1.0 / 없음 | 1.0 / 1.0 / 없음 | 1.0 / 1.0 / 없음 |
| DiT 손실 가중치 | 없음 / 없음 / 1.0 | 없음 / 없음 / 1.0 | 없음 / 없음 / 1.0 |
optimizer는 모든 설정에서 AdamW, scheduler는 cosine, warm-up 비율은 0.1이다. Stage II의 학습 step이 세 개로 나뉜 것은 thinking 토큰 수를 1, 2, 3개로 늘리는 세 하위 단계에 해당한다. LIBERO 기준 Stage I과 II를 합쳐 1만 1천 step이고 Stage III가 4만 step이다.
결과
LIBERO
LIBERO는 Spatial, Goal, Object, Long 네 suite에 단일 팔 과제가 suite당 10개 있는 시뮬레이션 벤치마크이며, 과제당 50 rollout의 성공률을 보고한다. rollout은 policy를 실행해 trajectory를 만들어 내는 과정을 말한다. 비교 대상은 CoT 유형별로 묶었다.
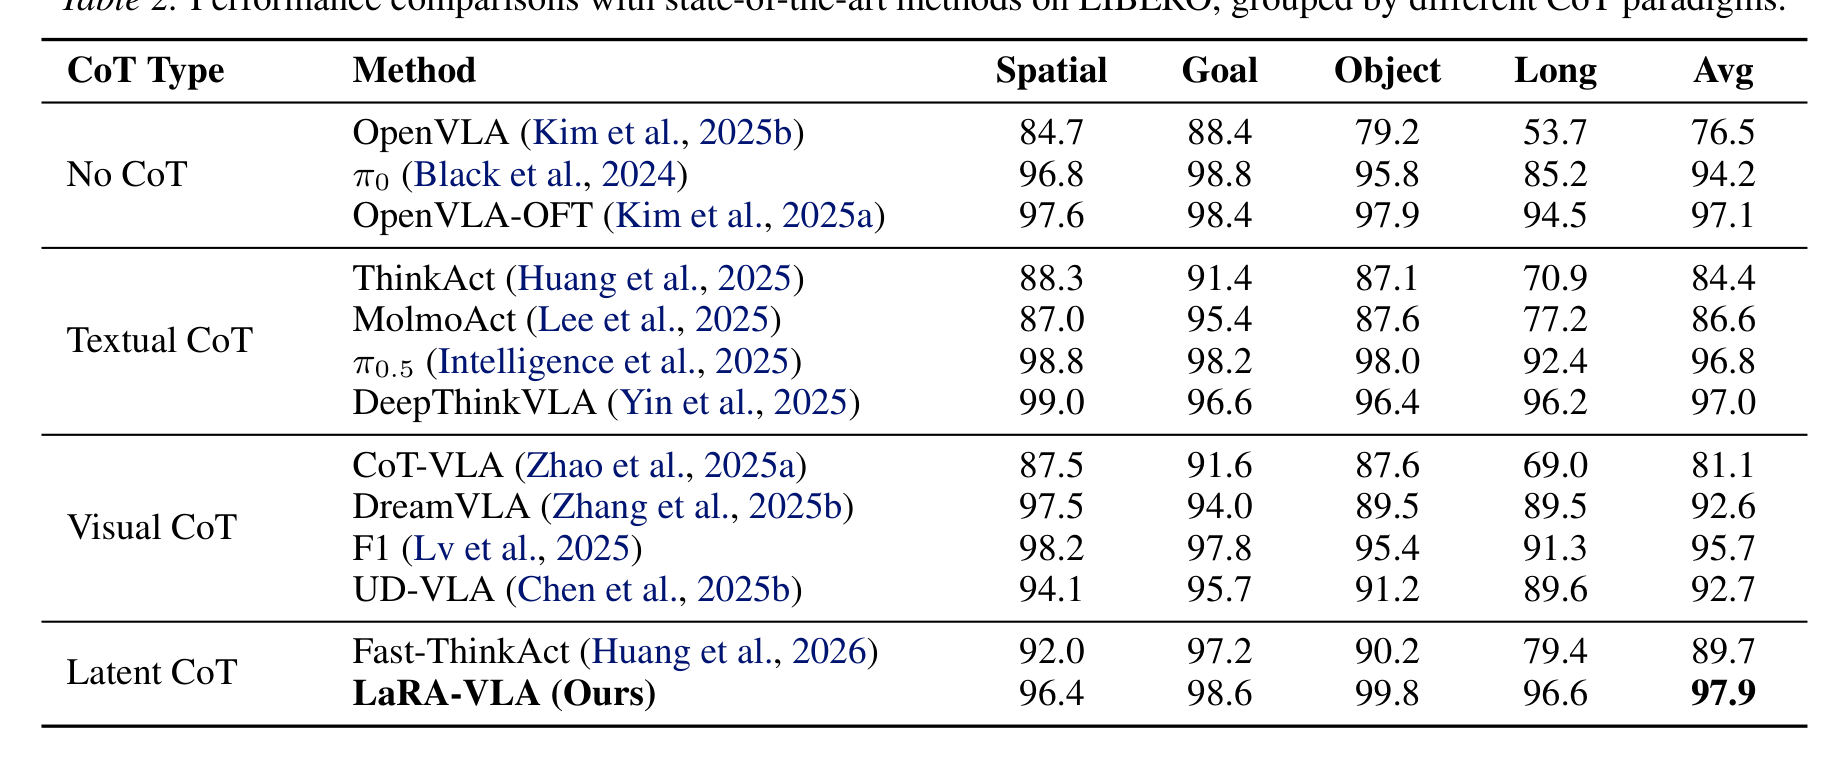
| CoT 유형 | 방법 | Spatial | Goal | Object | Long | 평균 |
|---|---|---|---|---|---|---|
| No CoT | OpenVLA | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| No CoT | π0 | 96.8 | 98.8 | 95.8 | 85.2 | 94.2 |
| No CoT | OpenVLA-OFT | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| Textual | ThinkAct | 88.3 | 91.4 | 87.1 | 70.9 | 84.4 |
| Textual | MolmoAct | 87.0 | 95.4 | 87.6 | 77.2 | 86.6 |
| Textual | π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.8 |
| Textual | DeepThinkVLA | 99.0 | 96.6 | 96.4 | 96.2 | 97.0 |
| Visual | CoT-VLA | 87.5 | 91.6 | 87.6 | 69.0 | 81.1 |
| Visual | DreamVLA | 97.5 | 94.0 | 89.5 | 89.5 | 92.6 |
| Visual | F1 | 98.2 | 97.8 | 95.4 | 91.3 | 95.7 |
| Visual | UD-VLA | 94.1 | 95.7 | 91.2 | 89.6 | 92.7 |
| Latent | Fast-ThinkAct | 92.0 | 97.2 | 90.2 | 79.4 | 89.7 |
| Latent | LaRA-VLA | 96.4 | 98.6 | 99.8 | 96.6 | 97.9 |
LaRA-VLA는 평균 97.9%로 가장 높고, Object 99.8%와 Long 96.6%는 표 안 최고값이다. 저자는 이를 물체 중심 추론과 long-horizon 조작의 강건성으로 해석한다. 평균 기준 두 번째로 높은 OpenVLA-OFT(97.1%)와의 차이는 0.8%p로 크지 않다.
모든 suite에서 앞서는 것은 아니다. Spatial 96.4%는 DeepThinkVLA(99.0%), π0.5(98.8%), F1(98.2%), OpenVLA-OFT(97.6%), DreamVLA(97.5%), π0(96.8%)보다 낮고, Goal 98.6%는 π0(98.8%)보다 0.2%p 낮다. 같은 latent CoT 계열인 Fast-ThinkAct(89.7%)와 비교하면 평균이 8.2%p 높고, 차이는 주로 Long(17.2%p)과 Object(9.6%p)에서 나온다.
SimplerEnv WidowX
SimplerEnv는 실제 로봇 데이터로 학습한 policy를 시뮬레이션에서 평가해 real-to-sim 일반화를 보는 벤치마크다. LaRA-VLA는 Bridge 데이터로 학습했고, WidowX 로봇 네 과제에서 과제당 24 rollout을 보고한다.
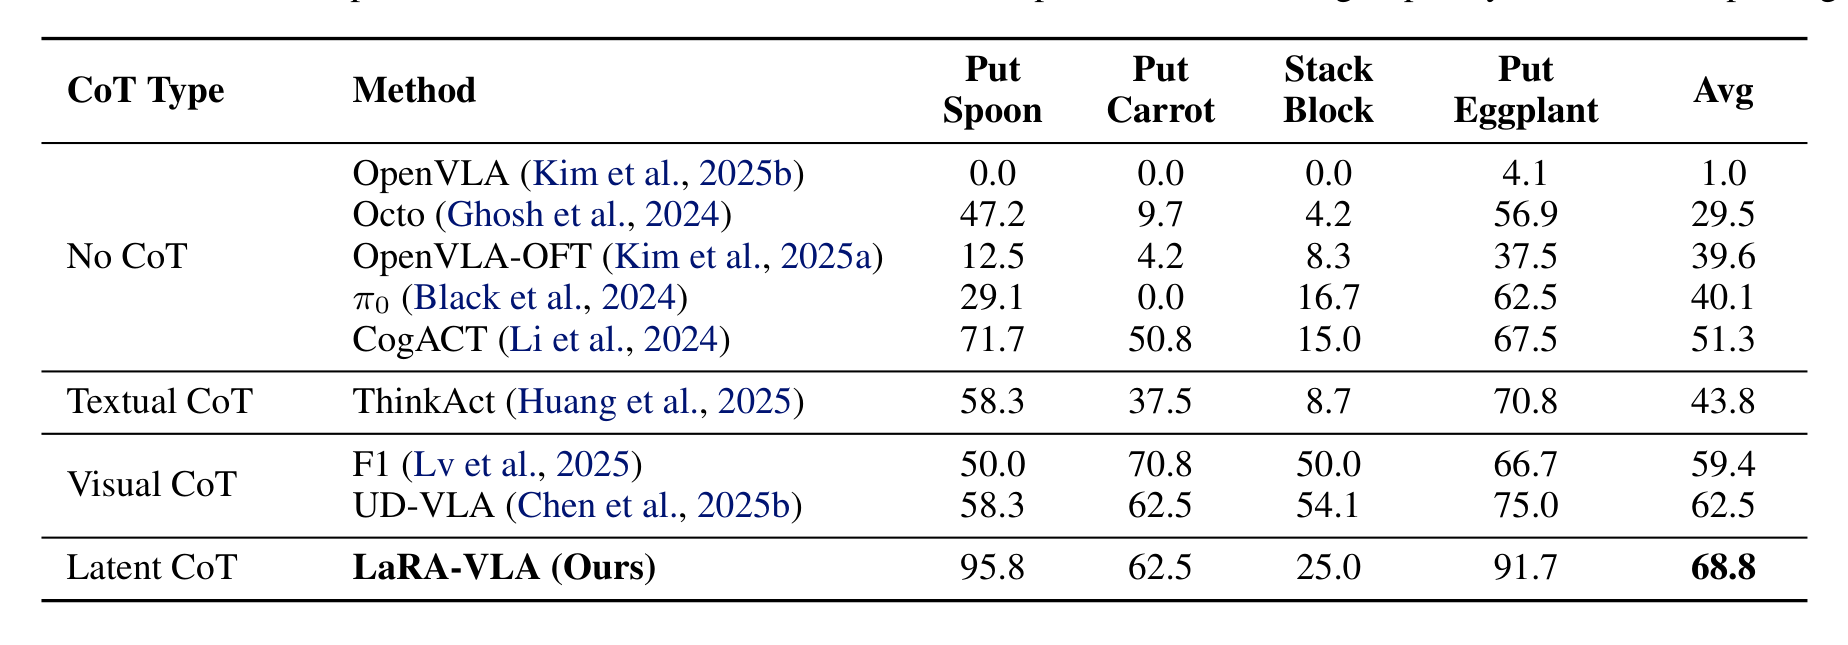
| CoT 유형 | 방법 | Put Spoon | Put Carrot | Stack Block | Put Eggplant | 평균 |
|---|---|---|---|---|---|---|
| No CoT | OpenVLA | 0.0 | 0.0 | 0.0 | 4.1 | 1.0 |
| No CoT | Octo | 47.2 | 9.7 | 4.2 | 56.9 | 29.5 |
| No CoT | OpenVLA-OFT | 12.5 | 4.2 | 8.3 | 37.5 | 39.6 |
| No CoT | π0 | 29.1 | 0.0 | 16.7 | 62.5 | 40.1 |
| No CoT | CogACT | 71.7 | 50.8 | 15.0 | 67.5 | 51.3 |
| Textual | ThinkAct | 58.3 | 37.5 | 8.7 | 70.8 | 43.8 |
| Visual | F1 | 50.0 | 70.8 | 50.0 | 66.7 | 59.4 |
| Visual | UD-VLA | 58.3 | 62.5 | 54.1 | 75.0 | 62.5 |
| Latent | LaRA-VLA | 95.8 | 62.5 | 25.0 | 91.7 | 68.8 |
LaRA-VLA의 평균 68.8%는 UD-VLA(62.5%)보다 6.3%p 높다. 성과는 과제별로 편차가 크다. Put Spoon(95.8%)과 Put Eggplant(91.7%)에서는 두 번째로 높은 모델보다 각각 24.1%p와 16.7%p 높지만, Stack Block은 25.0%로 UD-VLA(54.1%)와 F1(50.0%)의 절반 수준이고 Put Carrot 62.5%는 F1(70.8%)보다 낮다. 즉 평균 우위는 집어서 옮기는 두 과제의 큰 향상에서 나오고, 정밀한 적층 과제에서는 visual CoT 계열이 앞선다.
표에는 수치 불일치가 두 행 있다. OpenVLA-OFT의 과제별 값 평균은 15.6%인데 평균 열은 39.6%이고, π0의 과제별 값 평균은 27.1%인데 평균 열은 40.1%다. 나머지 행은 과제별 값과 평균이 일치한다. 따라서 두 baseline의 평균은 그대로 비교에 쓰기 어렵다. 본문과 표 캡션은 벤치마크 이름을 "SimplerEnv-WindowX"로 오기했다.
실제 로봇 long-horizon 과제
실제 로봇 실험은 RGB-D 카메라 3대를 단 Agilex Cobot Magic 바퀴형 플랫폼에서 진행했다. 과제는 네 범주이며, 범주마다 30Hz로 시연 데이터(demonstration) 100개를 수집했다. 평가는 과제당 12회 rollout이고, 비교 대상은 ACT와 GR00T N1.5다.
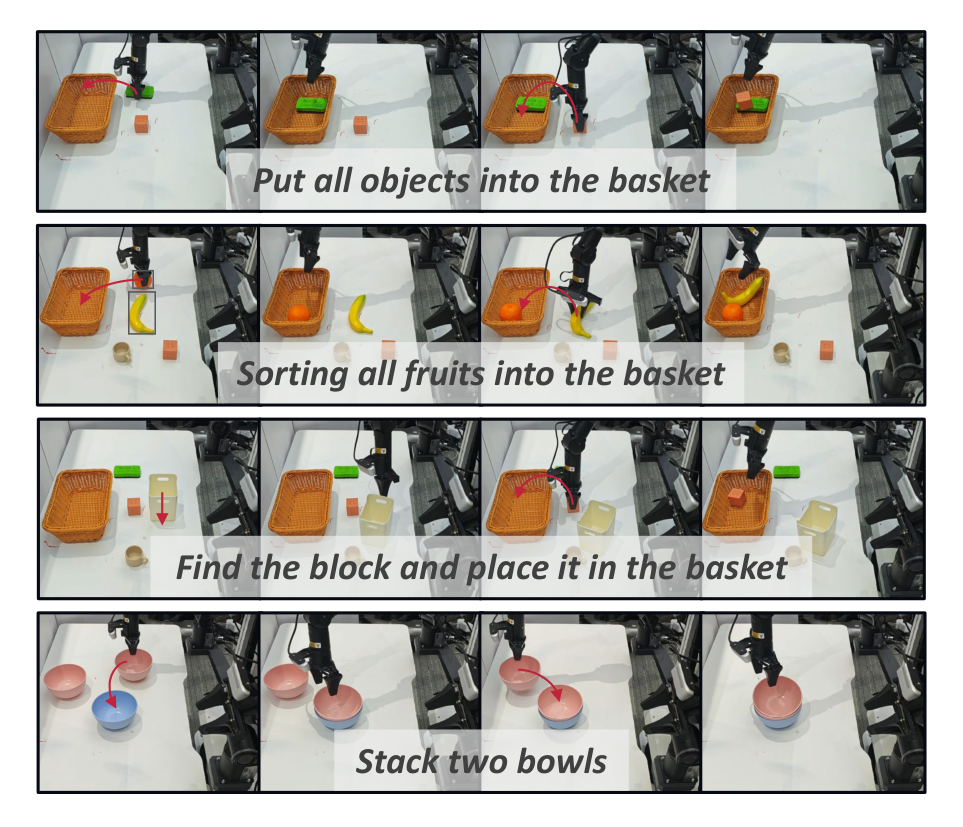
| 과제 | 내용 |
|---|---|
| 모든 물체를 바구니에 넣기 | 탁자 위 물체를 차례로 바구니에 넣는다 (Figure 4 장면은 물체 두 개) |
| 과일을 바구니로 분류하기 | 과일이 아닌 물체가 섞인 탁자에서 과일만 골라 바구니에 넣는다 |
| 블록을 찾아 바구니에 넣기 | 장면에서 블록을 먼저 찾은 뒤 바구니에 넣는다 |
| 그릇 두 개 쌓기 | 그릇 하나를 집어 다른 그릇 위에 쌓는다 |
baseline 설정은 부록 A.2에 있다. ACT는 LeRobot 구현으로 chunk 크기 50, ResNet-18 backbone, encoder 4층과 decoder 1층, VAE latent 32차원, 4만 step을 학습했다. GR00T N1.5는 원본 구현으로 chunk 크기 25, 배치 128이며 언어 backbone과 vision tower를 고정하고 projector와 diffusion policy head만 fine-tuning했다. 둘 다 H100 1장으로 학습했다.
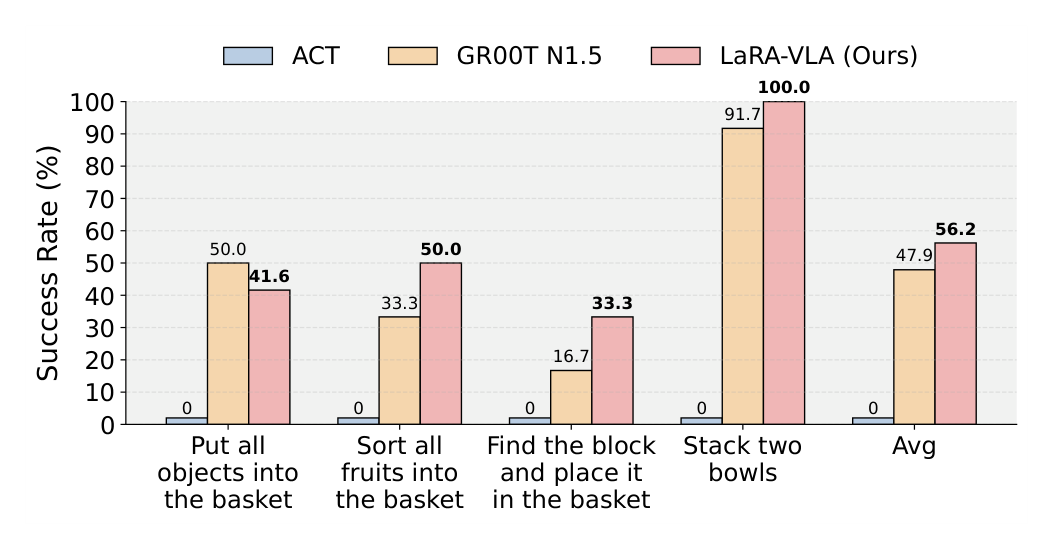
| 과제 | ACT | GR00T N1.5 | LaRA-VLA |
|---|---|---|---|
| 모든 물체를 바구니에 넣기 | 0 | 50.0 | 41.6 |
| 과일을 바구니로 분류하기 | 0 | 33.3 | 50.0 |
| 블록을 찾아 바구니에 넣기 | 0 | 16.7 | 33.3 |
| 그릇 두 개 쌓기 | 0 | 91.7 | 100.0 |
| 평균 | 0 | 47.9 | 56.2 |
LaRA-VLA는 평균 56.2%로 GR00T N1.5보다 8.3%p 높다. 본문은 LaRA-VLA가 네 과제 모두에서 두 baseline을 일관되게 앞선다고 쓰지만, 그림의 수치로는 모든 물체 넣기 과제에서 GR00T N1.5가 8.4%p 높다. ACT는 네 과제 모두 0%다.
부록 C는 각 과제를 subtask 두 개로 나눈 성공률을 보고한다. subtask는 긴 과제를 이루는 하위 단계 하나를 가리킨다.
| 방법 | 물체 넣기 S1 / S2 / 전체 | 과일 분류 S1 / S2 / 전체 | 블록 찾기 S1 / S2 / 전체 | 그릇 쌓기 S1 / S2 / 전체 |
|---|---|---|---|---|
| ACT | 0.0 / 0.0 / 0.0 | 0.0 / 0.0 / 0.0 | 0.0 / 0.0 / 0.0 | 0.0 / 0.0 / 0.0 |
| GR00T N1.5 | 50.0 / 50.0 / 50.0 | 50.0 / 83.3 / 33.3 | 100.0 / 16.7 / 16.7 | 91.7 / 100.0 / 91.7 |
| LaRA-VLA | 50.0 / 41.7 / 41.6 | 66.7 / 75.0 / 50.0 | 100.0 / 33.3 / 33.3 | 100.0 / 100.0 / 100.0 |
저자는 과제 구조에 따라 결과를 두 부류로 해석한다.
- subtask가 독립인 과제(물체 넣기, 과일 분류, 그릇 쌓기): 한 subtask의 실패가 다른 subtask로 번지지 않는다. 전체 성공률 향상은 subtask별 국소 실행 향상에서 나오고, 추론의 이점은 점진적으로만 나타난다.
- 순차 의존 과제(블록 찾기): 둘째 subtask(놓기)는 첫째 subtask(찾기)가 성공해야 가능하다. 두 모델 모두 찾기는 100%지만 놓기에서 LaRA-VLA가 33.3%, GR00T N1.5가 16.7%다. 저자는 이 차이를 latent 추론이 subtask 사이의 일관성을 유지한다는 근거로 든다.
다만 과제당 12회 평가라 한 번의 성공 차이가 8.3%p에 해당하며, 블록 찾기의 16.6%p 차이는 성공 두 번에 해당한다.
추론 효율
추론 지연은 NVIDIA A100 GPU에서 측정했다.
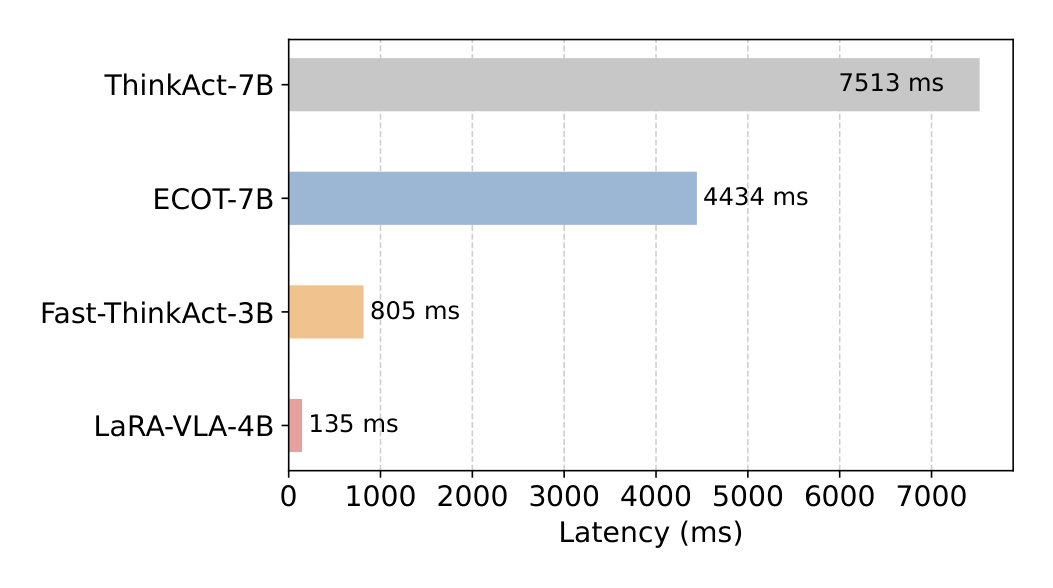
| 모델 | 지연 (ms) | LaRA-VLA 대비 |
|---|---|---|
| ThinkAct-7B | 7513 | 약 56배 |
| ECoT-7B | 4434 | 약 33배 |
| Fast-ThinkAct-3B | 805 | 약 6배 |
| LaRA-VLA-4B | 135 | 기준 |
LaRA-VLA는 rollout당 135 ms로 가장 짧다. 저자는 이를 명시적 CoT 방식 대비 "최대 90% 감소"라고 표현하지만, 그림의 수치로 계산하면 ThinkAct-7B 대비 약 98%, ECoT-7B 대비 약 97% 감소이고, 같은 latent 방식인 Fast-ThinkAct-3B 대비로도 약 83% 감소다. 지연이 짧은 이유는 텍스트 CoT를 생성하지 않고 고정 길이 thinking 토큰 3개와 <img_next> 토큰 16개만 처리하기 때문이다. 다만 모델 크기(3B에서 7B)가 서로 다르고 "rollout당"의 측정 단위가 명시되지 않아, 지연 차이를 모두 추론 방식의 차이로 돌리기는 어렵다.
분석
CoT 감독 형식 ablation
ablation은 구성 요소를 하나씩 빼거나 바꿔 기여도를 재는 실험이다. 논문의 ablation은 SimplerEnv에서 CoT 감독 형식만 바꿔 평균 성공률을 비교한다.
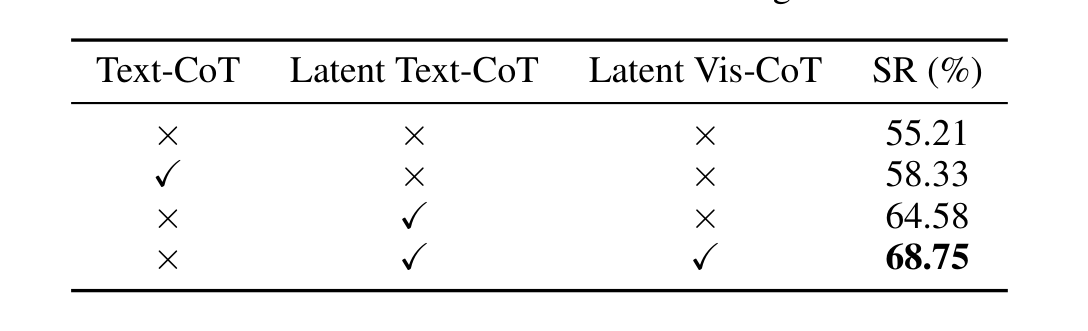
| 설정 | 성공률 (%) | CoT 없음 대비 |
|---|---|---|
| CoT 없음 | 55.21 | 기준 |
| 명시적 텍스트 CoT | 58.33 | +3.12%p |
| latent 텍스트 CoT | 64.58 | +9.37%p |
| latent 텍스트 CoT + latent visual CoT | 68.75 | +13.54%p |
명시적 텍스트 CoT는 CoT 없는 baseline보다 3.12%p만 올리는 반면, 같은 내용을 latent로 내재화하면 9.37%p가 오른다. 여기에 latent visual CoT를 더하면 4.17%p가 더 올라 최종 성능 68.75%에 이른다. 저자는 latent visual CoT가 미래 상태에 대한 예측 정보를 주입하고, 동시에 멀티모달 alignment를 통해 latent 텍스트 CoT를 암묵적으로 정규화한다고 해석한다.
이 ablation은 SimplerEnv 한 곳에서만 수행됐고, 명시적 텍스트 CoT와 latent visual CoT를 함께 쓰는 조합은 없다. 따라서 latent visual CoT의 효과가 텍스트 CoT의 형식(명시적 또는 latent)과 무관한지는 표에서 판단할 수 없다.
latent collapse 분석
latent CoT의 대표적 실패 유형은 representation collapse다. 감독이 약하면 latent 토큰들이 서로 구별되지 않는 균질한 표현으로 수렴해 정보를 잃는다. 논문은 latent를 2차원으로 사영해 이 현상이 없음을 보인다.
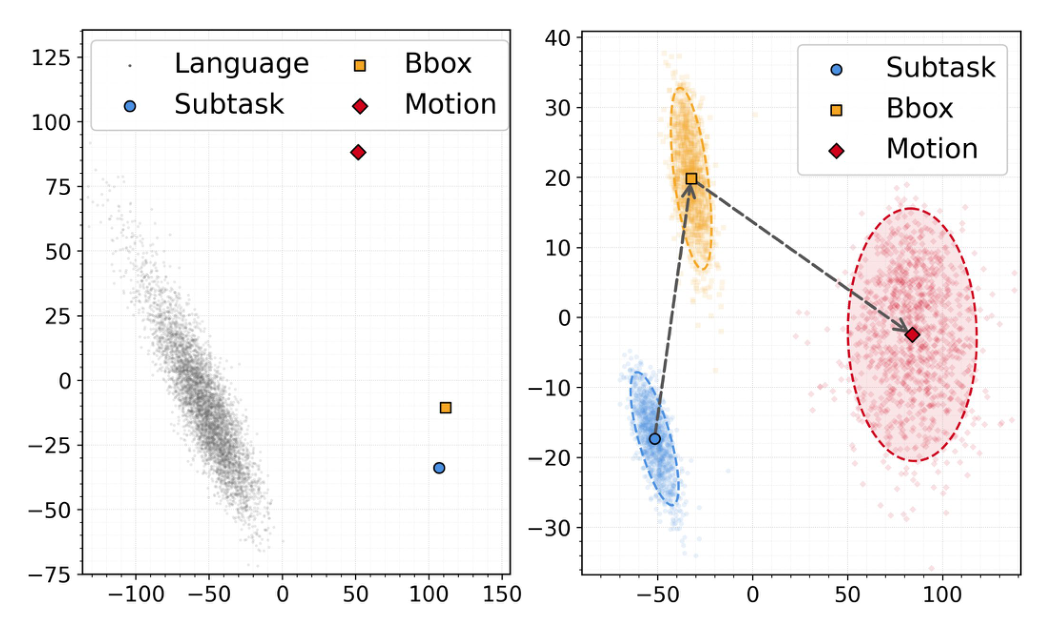
| 관찰 | 저자 해석 |
|---|---|
| Subtask, Bbox, Motion latent가 서로 분리된 군집을 이룬다 | 추론 요소별로 기능이 분화했고, 균일하거나 정보 없는 표현으로 퇴화하지 않았다 |
| 지시문 토큰의 latent(회색)가 구조를 유지하며 추론 latent와 다른 부분 공간을 차지한다 | latent CoT가 언어 임베딩을 단순 재사용하지 않는다 |
저자는 예측 감독(visual latent)과 action grounding이 명시적 CoT 생성 없이도 구조화된 latent 추론을 유지할 만큼 충분한 inductive bias를 준다고 결론짓는다. 오른쪽 그림에는 Subtask에서 Bbox, Bbox에서 Motion으로 이어지는 화살표가 있어 추론 순서를 나타낸다. 사영 방법(t-SNE, PCA 등)과 표본 수는 논문에 적혀 있지 않다.
한계
논문이 밝힌 한계는 두 가지다.
| 한계 | 내용 | 현재 대응 |
|---|---|---|
| latent collapse 위험 | 명시적 감독이 없으면 latent 토큰 의미가 균질해질 수 있고, latent 토큰 수가 늘수록 심해진다 (SIM-CoT 인용) | 추론 단계당 latent 토큰을 1개로 제한했다. 이 제한이 표현력을 낮출 수 있다 |
| 학습 효율 | curriculum이 CoT 토큰을 latent로 바꿔 가면서 CoT 관련 토큰 수가 늘어 학습 비용이 커진다 | 향후 과제로 남겼다 |
논문과 공개 자료를 함께 보면 다음 점도 남는다.
- 해석 가능성: 명시적 CoT의 장점 중 하나는 사람이 중간 추론을 읽을 수 있다는 점인데, LaRA-VLA는 추론 시 텍스트를 생성하지 않으므로 이 장점이 사라진다. latent를 다시 텍스트로 읽어 내는 경로는 제시되지 않았다.
- ablation 범위: Stage I이나 II를 생략한 경우, action expert 구조, thinking 토큰 수, LIBERO에서의 CoT ablation은 보고되지 않았다.
- 평가 규모와 수치 정합성: 실제 로봇은 과제당 12회라 과제별 수치 분산이 크다. 본문의 "네 과제 모두에서 우위" 서술은 그림 수치와 맞지 않고, SimplerEnv 표의 baseline 두 행은 평균이 과제별 값과 맞지 않는다.
- 공개 코드와의 차이: 공개 저장소의 LIBERO 단일 단계 스크립트는 6만 step으로 Table 5의 Stage III 4만 step과 다르고, Bridge 단일 단계 스크립트는 2만 step으로 Table 5의 6만 step과 다르다 (LaRA-VLA).
핵심 용어
| 용어 | 뜻 |
|---|---|
| LaRA-VLA | Latent Reasoning VLA. 텍스트와 visual CoT를 연속 latent로 내재화하고 추론 시 명시적 CoT를 생성하지 않는 VLA |
| textual CoT latent | Stage II에서 subtask, bbox, motion 텍스트를 대체하는 `< |
| visual goal latent | <img_next> 토큰 16개가 예측하는 다음 프레임 visual latent. EMA 목표 인코더 출력과 L1로 맞춘다 |
| anchor-first, generate-later | 대상 물체(semantic anchor)와 그리퍼 기반 구간(temporal anchor)을 먼저 정하고 subtask, bbox, motion 주석을 생성하는 데이터 파이프라인 원칙 |
| LIBERO-LaRA, Bridge-LaRA | LIBERO와 Bridge 데이터에 구조화 CoT 주석을 붙여 만든 학습 데이터셋 |
| L_act-dis, L_act-con | Stage I과 II의 이산 action 토큰 손실과 Stage III의 flow matching 연속 action 손실 |
관련 페이지
- Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models (프로젝트 페이지): 같은 연구의 프로젝트 페이지. 실제 로봇 rollout 영상(LaRA-VLA와 GR00T N1.5 각 4편)을 싣는다.
- LaRA-VLA: 공식 구현 저장소. 학습 스크립트와 논문 단계의 대응, 공개 데이터셋과 가중치, 논문 설정과의 차이를 정리한다.
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: 미래 프레임을 픽셀이 아니라 latent로 예측하는 또 다른 VLA. 미래 latent 예측을 world model 목표로 쓴다는 점에서 LaRA-VLA의 visual goal latent와 비교된다.
- ω-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation: latent 예측 기반 VLA.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching action expert의 원형이자 LIBERO와 SimplerEnv baseline.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이산 텍스트 subtask 추론을 쓰는 baseline.
- GR00T N1.5: 실제 로봇 실험의 baseline.
- OpenVLA: An Open-Source Vision-Language-Action Model: LIBERO와 SimplerEnv baseline.
- VLAct (starVLA/VLAct, GitHub repo): 같은 StarVLA 코드베이스 계열의 VLA 저장소.
- VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics: VLA 발전 과정 overview.