Physical AI · PAPER · 2021
FAST-LIO2: Fast Direct LiDAR-inertial Odometry
요약
FAST-LIO2는 홍콩대 MaRS Lab이 2021년에 발표한 LiDAR-inertial odometry 시스템이다. odometry는 센서 측정으로 이동량을 누적해 로봇의 상대 위치를 추정하는 방법을 말한다. LiDAR-inertial odometry는 여기에 LiDAR가 반환한 point cloud와 IMU 측정을 함께 써서 자세를 추정하고 3D map을 동시에 만든다.
이 논문의 기여는 두 가지로 명확히 나뉜다. 첫째는 feature 추출 단계를 없애고 raw point를 map에 그대로 등록하는 direct 방식이고, 둘째는 map을 통째로 다시 짓지 않고 조금씩 고쳐 쓰는 ikd-Tree 자료구조다. 앞의 기여가 정확도와 범용성을 높이고, 뒤의 기여가 그 방식을 실시간으로 감당할 수 있게 만든다.
두 기법을 결합한 결과 UAV 온보드 컴퓨터에서 최대 100Hz로 odometry와 mapping을 함께 수행하면서도, 공개 데이터셋 19개 시퀀스 중 18개에서 당시 최신 시스템들보다 높은 정확도를 냈다. 시스템과 자료구조가 모두 오픈소스로 공개되어 이후 LiDAR SLAM 연구의 사실상 표준 베이스라인이 됐다.
배경
LiDAR SLAM의 계산 병목은 데이터 양에서 온다. 최근 LiDAR는 초당 수십만에서 수백만 개의 3D point를 만들어낸다. 이 양을 온보드 컴퓨터의 제한된 자원으로 실시간 처리하려면 알고리즘 효율이 매우 높아야 한다.
기존 방법이 택한 해법은 feature 추출이다. feature는 원본 데이터에서 정합에 쓸 만한 부분만 골라낸 표현을 뜻한다. 2014년의 LOAM 이후 대부분의 LiDAR odometry는 국소 평활도를 기준으로 edge point와 plane point를 먼저 뽑아 계산량을 줄이고, 그렇게 얻은 feature로 정합을 수행했다.
이 해법에는 세 가지 부작용이 따른다.
- 환경 의존성이 크다. 큰 평면이나 긴 모서리가 없는 구조 빈약 환경에서는 뽑히는 feature가 너무 적어진다. LiDAR의 FoV가 좁으면 문제가 더 심해진다.
- LiDAR마다 다시 손봐야 한다. 회전식, 프리즘식, MEMS식으로 scanning pattern과 point 밀도가 달라 feature 추출 규칙을 매번 다시 설계해야 한다.
- 정보를 버린다. 미세한 구조는 feature로 뽑히지 않아 정합에 쓰이지 못한다.
여기에 더해 map 유지 비용이라는 별개의 병목이 있다. LiDAR는 측정 거리가 수백 m로 길지만 scanning line 사이 해상도가 낮아, 넓은 3D 공간에 point가 성기게 흩어진다. 따라서 그 성긴 point를 정합하려면 크고 조밀한 map이 필요하다. 게다가 이 map은 새 측정을 계속 받아들이면서 동시에 대응점 검색 질의에도 빠르게 답해야 한다.
전작 FAST-LIO는 정확도 면에서 이미 좋은 결과를 냈지만 이 map 병목에 걸려 있었다. 매 스텝 현재 FoV의 map point를 모아 정적 k-d tree를 새로 지었기 때문에 map이 커질수록 처리 시간이 늘었고, 수백 m 규모의 작은 환경에서만 동작할 수 있었다. FAST-LIO2는 이 지점을 출발점으로 삼는다.
핵심 개념
direct method는 feature 추출 없이 raw point를 map에 바로 등록하는 방식을 가리킨다. raw point는 LiDAR가 반환한 그대로의 측정점으로, 어떤 선별도 거치지 않은 상태다. 이름은 visual SLAM의 direct method에서 따왔다. 두 분야 모두 특징점을 뽑는 대신 원본 측정값을 직접 비교한다는 발상을 공유한다.
solid-state LiDAR는 회전 기구 없이 프리즘이나 MEMS로 주사하는 신형 LiDAR다. 가볍고 저렴하지만 FoV가 좁고 scanning pattern이 반복되지 않아서, LiDAR별 튜닝을 요구하는 feature 기반 방법과 잘 맞지 않는다. FAST-LIO2가 feature 추출을 없앤 실용적 동기가 여기에 있다.
extrinsic은 두 센서 사이의 상대 자세와 위치를 말한다. LiDAR와 IMU를 함께 쓰려면 둘 사이의 extrinsic을 알아야 하는데, 사전 보정값이 부정확하면 오차가 그대로 누적된다. FAST-LIO2는 이 값을 상태 벡터에 넣어 주행 중에 함께 추정한다.
kNN search는 질의점에서 가장 가까운 k개의 point를 찾는 연산이다. 매 scan마다 수백 개의 point에 대해 map에서 대응점을 찾아야 하므로, 이 연산의 속도가 시스템 전체의 속도를 좌우한다.
k-d tree는 공간을 축에 나란한 초평면으로 반복해서 둘로 쪼개는 이진 트리다. 저차원 데이터를 메모리에 올려 kNN search를 수행할 때 가장 성능이 좋다고 알려져 있다. 다만 point를 삽입하거나 삭제하면 균형이 깨지고, 이를 회복하려면 트리를 다시 지어야 한다는 약점이 있다. ikd-Tree는 바로 이 약점을 겨냥한 설계다.
방법
전체 파이프라인
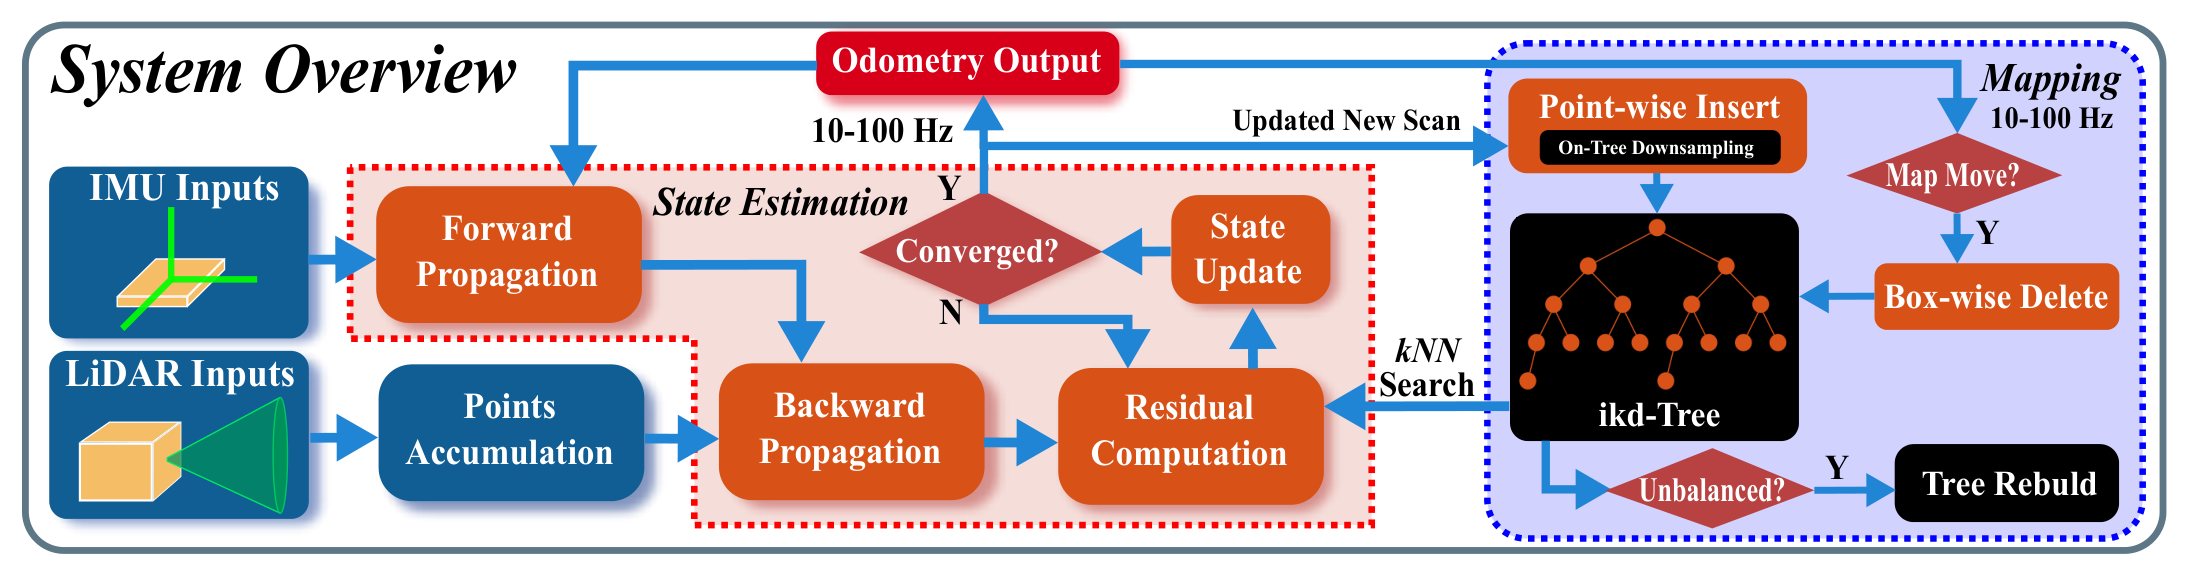
FAST-LIO2는 순차적으로 들어오는 LiDAR raw point를 일정 구간 동안 모아 scan 하나를 만든다. 이 구간은 100Hz 갱신이면 10ms, 10Hz 갱신이면 100ms다.
이후 처리는 두 모듈이 맞물려 진행된다. state estimation은 새 scan의 point를 ikd-Tree가 유지하는 큰 local map에 등록해 자세를 추정하고, mapping은 그렇게 최적화된 자세로 scan point를 전역 좌표로 옮겨 ikd-Tree에 삽입한다. 즉 odometry의 출력이 곧 mapping의 입력이며, 두 모듈이 같은 rate로 동작한다.
이 구조는 LOAM 계보와 정면으로 다르다. LOAM 계열은 빠른 scan-to-scan odometry와 1~2Hz의 느린 mapping을 분리해 두었지만, FAST-LIO2는 매 스텝 map을 갱신하고 그 map에 바로 정합한다. 최근 scan의 point가 지체 없이 map에 반영되므로 정합에 쓸 정보가 항상 최신이고, 그만큼 odometry 정확도가 올라간다.
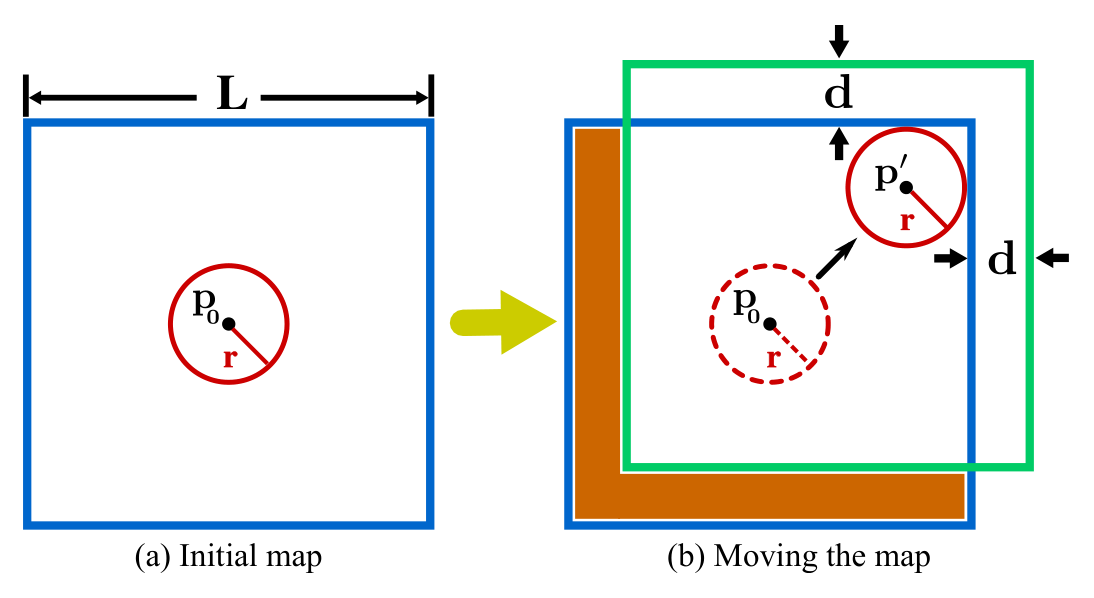
map의 크기는 무한정 커지지 않는다. 현재 LiDAR 위치를 중심으로 한 변 길이 L의 정육면체 영역만 유지하며, 논문은 이 길이를 map size라 부른다. 검출 범위가 이 경계에 닿으면 map 영역을 옮기고 빠져나간 구역의 point를 지운다.
direct point registration
첫 번째 기여는 feature 추출 모듈을 파이프라인에서 통째로 제거한 것이다. FAST-LIO2는 scan의 raw point를 그대로 state estimation으로 보내고, 그 point를 map의 국소 구조에 직접 맞춘다.
이 선택이 세 가지 이득을 만든다.
| 이득 | 근거 |
|---|---|
| 정확도 상승 | 환경의 미세한 구조까지 정합에 쓰인다. feature 추출이 버렸을 나무와 원거리 건물의 point가 살아남는다 |
| LiDAR 무관 적용 | scanning pattern에 맞춘 feature 규칙 설계가 필요 없다. solid-state LiDAR에도 튜닝 없이 적용된다 |
| 튜닝 부담 제거 | feature 추출 파라미터를 데이터셋마다 조정할 일이 없다 |
다만 raw point를 쓰면 정합에 들어가는 point 수가 늘어난다. 실측에서 FAST-LIO는 scan당 447개를, FAST-LIO2는 756개를 썼다. point가 늘면 state estimation과 kNN search 부담이 커지므로, 이 방식은 map 연산이 충분히 싸다는 전제 위에서만 성립한다. 그 전제를 만들어주는 것이 두 번째 기여인 ikd-Tree다.
논문은 이 발상이 완전히 새로운 것은 아니라고 밝힌다. loosely-coupled 방식인 LION이 raw point 등록을 먼저 시도했고, generalized-ICP도 point를 map의 작은 국소 평면에 맞춘다는 점에서 같은 가정을 쓴다. FAST-LIO2의 차별점은 이 발상을 tightly-coupled 융합 구조 안에서 실시간으로 감당했다는 데 있다.
state estimation
state estimation은 전작 FAST-LIO의 tightly-coupled iterated Kalman filter를 그대로 물려받고 extrinsic 온라인 보정을 더한 것이다.
상태 벡터는 24차원 manifold 위에 놓인다. 구성은 IMU의 자세와 위치, 속도, 자이로 bias, 가속도 bias, 중력 벡터, 그리고 LiDAR와 IMU 사이 extrinsic의 회전 성분과 병진 성분이다. IMU bias는 random walk 과정으로 모델링한다. extrinsic이 상태에 들어가 있으므로 사전 보정값이 다소 부정확해도 주행 중에 수렴시킬 수 있다.
LiDAR point는 하나씩 순차적으로 샘플링되기 때문에, 센서가 움직이는 동안 모인 scan 안에는 왜곡이 생긴다. FAST-LIO2는 IMU 측정 기반 back-propagation으로 각 point가 실제로 샘플링된 시점의 자세를 역추정한 뒤, 모든 point를 scan 종료 시점 자세로 투영해 이 왜곡을 보정한다. 여기서 back-propagation은 신경망 학습 용어가 아니라 시간을 거슬러 자세를 되짚는 모션 보정 절차를 가리킨다. 보정이 끝나면 scan 안의 point를 모두 같은 순간에 찍은 것처럼 다룰 수 있다.
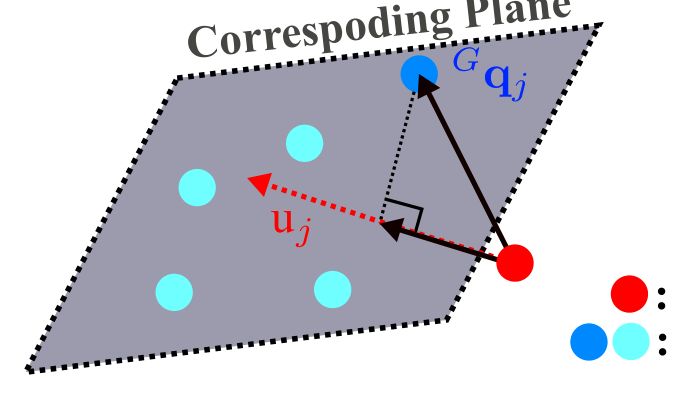
measurement model은 보정된 point가 map의 국소 평면 patch 위에 정확히 놓여야 한다는 제약이다. 구체적인 절차는 다음과 같다.
- 현재 반복 시점의 상태 추정치로 각 point를 전역 좌표로 옮긴다.
- ikd-Tree에서 그 point에 가장 가까운 map point 5개를 찾는다.
- 그 5개로 국소 평면을 맞춰 법선 벡터와 중심점을 얻는다.
- point에서 그 평면까지의 부호 있는 거리를 residual로 삼는다.
filter는 IMU 측정이 들어올 때마다 forward propagation을 수행하고 LiDAR scan이 들어올 때마다 iterated update를 수행한다. IMU가 보통 200Hz이고 LiDAR scan이 10Hz에서 100Hz이므로, update 한 번 사이에 propagation이 여러 번 들어간다. 갱신량이 임계값보다 작아지면 수렴으로 판정하고 반복을 끝낸다.
계산량을 결정적으로 줄이는 것은 Kalman gain 계산식의 변형이다. 통상의 Kalman gain은 measurement 차원 크기의 행렬을 역행렬로 만들어야 한다. FAST-LIO 계열은 수학적으로 동치인 다른 형태를 써서 상태 차원인 24 x 24 행렬만 역행렬로 만든다. measurement가 수백 개로 늘어도 이 부분의 비용이 변하지 않으므로, raw point를 그대로 쓰는 direct 방식이 계산상 가능해진다.
ikd-Tree의 구조
두 번째 기여인 ikd-Tree는 map point를 담는 증분 k-d tree다. 기존 k-d tree 라이브러리는 map을 갱신할 때 트리 전체를 다시 짓는데, ikd-Tree는 필요한 sub-tree만 다시 짓고 나머지는 유지한다.
구조상의 첫 번째 차이는 point를 저장하는 위치다. 널리 쓰이는 구현들은 leaf node에만 point 묶음을 담지만, ikd-Tree는 leaf node와 internal node 양쪽에 point를 저장한다. 동적 삽입과 re-balancing이 쉬워지고, 단일 k-d tree로 kNN search를 수행할 때도 이 방식이 더 효율적이라고 알려져 있다.
각 node가 갖는 attribute는 다음과 같다.
| attribute | 역할 |
|---|---|
| point | 좌표와 intensity 등 point 정보 |
| leftchild, rightchild | 좌우 자식 node 포인터 |
| axis | 이 node에서 공간을 나눈 분할 축 |
| treesize | 이 node를 뿌리로 하는 sub-tree의 전체 node 수 |
| invalidnum | 그중 삭제 표시된 node 수 |
| deleted, treedeleted | 이 node 또는 sub-tree 전체가 삭제됐음을 나타내는 lazy label |
| range | sub-tree의 모든 point를 감싸는 외접 cuboid. 최소 좌표와 최대 좌표 두 꼭짓점으로 적는다 |
range attribute가 이 자료구조의 여러 최적화를 떠받친다. 어떤 sub-tree가 관심 영역과 전혀 겹치지 않는지, 반대로 완전히 포함되는지를 이 cuboid 하나로 즉시 판정할 수 있어 불필요한 재귀를 건너뛴다.
트리 구축 자체는 정적 k-d tree와 같다. 가장 긴 차원의 중앙값 point를 분할점으로 잡아 공간을 재귀적으로 나누고, 부분 공간에 point가 하나만 남으면 멈춘다.
증분 갱신과 on-tree downsampling
ikd-Tree는 point 단위 연산과 cuboid 단위 연산을 모두 지원한다. FAST-LIO2가 실제로 쓰는 것은 point-wise insertion과 box-wise delete 두 가지다.
삽입은 downsampling과 한 몸으로 동작한다. 이 방식을 on-tree downsampling이라 부르며, 절차는 다음과 같다.
- 공간을 한 변 l의 격자로 나누고 새 point가 속한 격자를 찾는다. 기본값은 0.5m다.
- box-wise search로 그 격자 안의 기존 point를 모두 모으고 새 point를 더한다.
- 격자 중심에 가장 가까운 point 하나를 고른다.
- 격자 안의 기존 point를 모두 지우고 고른 하나만 삽입한다.
결과적으로 map은 항상 0.5m 해상도를 유지한다. octree, R*-tree, nanoflann k-d tree는 이 downsampling을 트리 밖에서 따로 수행해야 하지만 ikd-Tree는 트리 안에서 끝낸다. 삽입 자체는 뿌리에서 내려가며 분할 축 기준으로 비교해 빈 자리를 찾는 재귀 절차이고, 지나온 node의 treesize와 range를 갱신한 뒤 균형 조건을 확인한다.
삭제는 lazy label 방식이다. 삭제 요청을 받은 point를 실제로 트리에서 떼어내지 않고 deleted 라벨만 켜 둔다. sub-tree 전체가 삭제됐으면 treedeleted를 켠다. 라벨이 붙은 point는 나중에 re-building 과정에서 한꺼번에 제거된다.
box-wise delete는 range 정보와 lazy label을 함께 써서 재귀를 가지친다. sub-tree의 외접 cuboid가 삭제 대상 cuboid와 만나지 않으면 즉시 반환하고, 완전히 포함되면 treedeleted를 켠 뒤 하위 재귀를 생략한다. 그 중간인 경우에만 자식 쪽으로 내려간다.
map 영역 관리가 이 연산의 주 용도다. LiDAR 검출 영역은 현재 위치를 중심으로 반지름 r인 구로 가정하는데, r은 LiDAR FoV 범위 R에 1보다 큰 완화 계수 gamma를 곱한 값이다. 이 구가 map 경계에 닿으면 경계에서 멀어지는 방향으로 map 영역을 옮기고, 옮기기 전후 영역의 차집합에 있는 point를 box-wise delete로 지운다. 이동 거리는 상수 d = (gamma - 1) x R로 고정한다.
병렬 re-building
증분 삽입과 삭제를 계속하면 트리 균형이 깨지고 무효 node가 쌓인다. ikd-Tree는 매 연산 뒤에 두 가지 기준으로 이를 감시한다.
| 기준 | 조건 | 목적 |
|---|---|---|
| alpha-balanced | 양쪽 자식 sub-tree의 크기가 각각 전체의 alpha_bal 배 미만 | 트리 최대 높이를 log(1/alpha_bal) 밑의 로그로 묶는다 |
| alpha-deleted | 무효 node 수가 sub-tree 크기의 alpha_del 배 미만 | 삭제 표시만 된 node가 쌓이지 않게 한다 |
둘 중 하나라도 깨지면 해당 sub-tree만 다시 짓는다. 전체 트리를 다시 짓지 않는다는 점이 scapegoat k-d tree에서 물려받은 발상이다. re-building은 sub-tree를 point 배열로 flatten하고, 그 과정에서 deleted 라벨이 붙은 node를 버린 뒤, 남은 point로 완전히 균형 잡힌 새 트리를 짓는 순서로 진행된다.
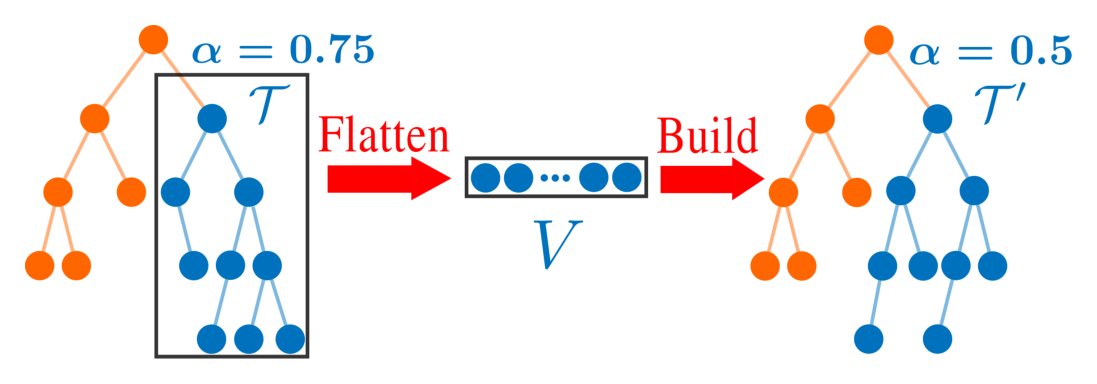
문제는 큰 sub-tree를 다시 지을 때 생기는 지연이다. 그 사이 main thread가 멈추면 실시간성이 깨진다. ikd-Tree는 이를 두 개의 thread로 나눠 해결한다. sub-tree 크기가 임계값 N_max보다 작으면 main thread에서 바로 다시 짓고, 크면 두 번째 thread로 넘긴다.
두 번째 thread의 절차가 이 설계의 핵심이다.
- 대상 sub-tree의 갱신만 잠근다. 질의는 계속 허용하므로 main thread의 kNN search는 멈추지 않는다.
- 유효 point를 배열로 flatten한 뒤 즉시 잠금을 푼다. 원래 sub-tree는 그대로 남아 질의에 답한다.
- 그 사이 들어온 갱신 요청은 operation logger라는 큐에 기록된다.
- 새 균형 트리를 다 지으면 큐에 쌓인 요청을 새 트리에 차례로 재적용한다.
- 두 트리의 point 정보가 같아진 시점에 질의까지 포함해 전체를 잠그고 교체한 뒤 즉시 잠금을 푼다.
- 원래 sub-tree의 메모리를 반환한다.
전체를 잠그는 구간은 포인터 교체 한 번이라 매우 짧다. 따라서 re-building이 진행되는 동안에도 mapping이 odometry rate로 끊김 없이 계속되고, kNN search 결과의 정확도도 유지된다. 다만 그 구간에는 트리가 일시적으로 불균형하므로 효율은 다소 떨어진다.
kNN search에도 별도의 최적화가 들어간다. node의 range로 만들어지는 cuboid까지의 최소 거리를 계산해, 그 값이 현재 우선순위 큐에 담긴 최대 거리보다 크면 해당 node와 자손을 통째로 건너뛴다. FAST-LIO2는 일정 거리 안의 이웃만 inlier로 쓰므로 이 최대 탐색 거리가 자연스럽게 정해지고, 그만큼 backtracking이 줄어든다. 다중 thread kNN search도 지원한다.
시간 복잡도
논문은 ikd-Tree의 연산별 시간 복잡도를 이론적으로 증명한다. 여기서 n은 트리 크기다.
| 연산 | 복잡도 | 비고 |
|---|---|---|
| on-tree downsampling을 포함한 point 삽입 | O(log n) | downsampling cube가 전체 공간에 비해 작다는 조건에서 성립 |
| kNN search | O(log n) | backtracking 횟수가 트리 크기와 무관한 상수에 비례 |
| 병렬 double-thread re-building | O(n) | main thread 관점. flatten과 교체만 부담한다 |
| 단일 thread re-building | O(n log n) | 각 레벨의 정렬 비용이 누적된다 |
| box-wise delete와 box-wise search | 영역 크기에 따라 가변 | Flajolet-Puech 함수를 쓴 범위 검색 복잡도를 따른다 |
이 표에서 실질적으로 중요한 값은 첫 두 행이다. 전작 FAST-LIO는 매 스텝 정적 k-d tree를 새로 지어 O(n log n)을 치렀지만, FAST-LIO2는 O(log n)의 증분 갱신으로 대체한다. 뒤에서 볼 처리 시간 차이가 대부분 이 복잡도 차이에서 나온다.
구현 설정
시스템은 C++와 ROS로 구현했고, iterated Kalman filter는 같은 연구실이 앞서 공개한 IKFOM toolbox를 쓴다. 실험에 쓴 기본 설정은 다음과 같다.
| 항목 | 값 |
|---|---|
| local map size L | 1000m |
| 공간 downsampling 해상도 l | 0.5m |
| alpha_bal | 0.6 |
| alpha_del | 0.5 |
| N_max | 1500 |
| 시간 downsampling | 1:4 (네 point 중 하나) |
| kNN search의 k | 5 |
계산 플랫폼은 두 가지다. 벤치마크용은 UAV 온보드급 DJI Manifold 2-C로 1.8GHz 쿼드코어 Intel i7-8550U와 8GB RAM을 갖췄다. 임베디드 검증용은 Khadas VIM3로 2.2GHz 쿼드코어 Cortex-A73과 4GB RAM을 갖췄으며, 논문은 이 플랫폼의 결과를 ARM으로 표기한다.
결과
평가는 5개 공개 데이터셋의 37개 시퀀스에서 수행했다. 데이터셋 구성이 서로 달라서, solid-state LiDAR와 회전식 LiDAR, 보행 속도부터 시속 50km 주행까지가 모두 포함된다.
| 데이터셋 | LiDAR | line 수 | IMU | IMU rate | 수집 환경 |
|---|---|---|---|---|---|
| lili | solid-state Livox Horizon | 해당 없음 | 6축 | 200Hz | 캠퍼스와 도심, 비반복 scanning |
| utbm | Velodyne HDL-32E | 32 | 6축 | 100Hz | 사람이 운전하는 로보카, 최대 시속 50km |
| ulhk | Velodyne HDL-32E | 32 | 9축 | 100Hz | 도심 구조물, 이동 차량 다수 |
| nclt | Velodyne HDL-32E | 32 | 9축 | 100Hz | 대규모 장기 UGV 데이터, 개활 주차장 포함 |
| liosam | VLP-16 | 16 | 9축 | 1000Hz | MIT 캠퍼스, 건물과 숲 |
nclt의 IMU 원본 rate는 50Hz인데 비교 대상인 LIO-SAM을 구동하기 위해 0차 보간으로 100Hz로 올렸다.
자료구조 비교
먼저 ikd-Tree 자체를 다른 동적 자료구조와 비교한다. 비교 대상은 boost geometry의 R*-tree, PCL의 octree, nanoflann의 동적 k-d tree다. 네 자료구조를 모두 FAST-LIO2에 통합해 18개 시퀀스에서 같은 조건으로 측정했다.
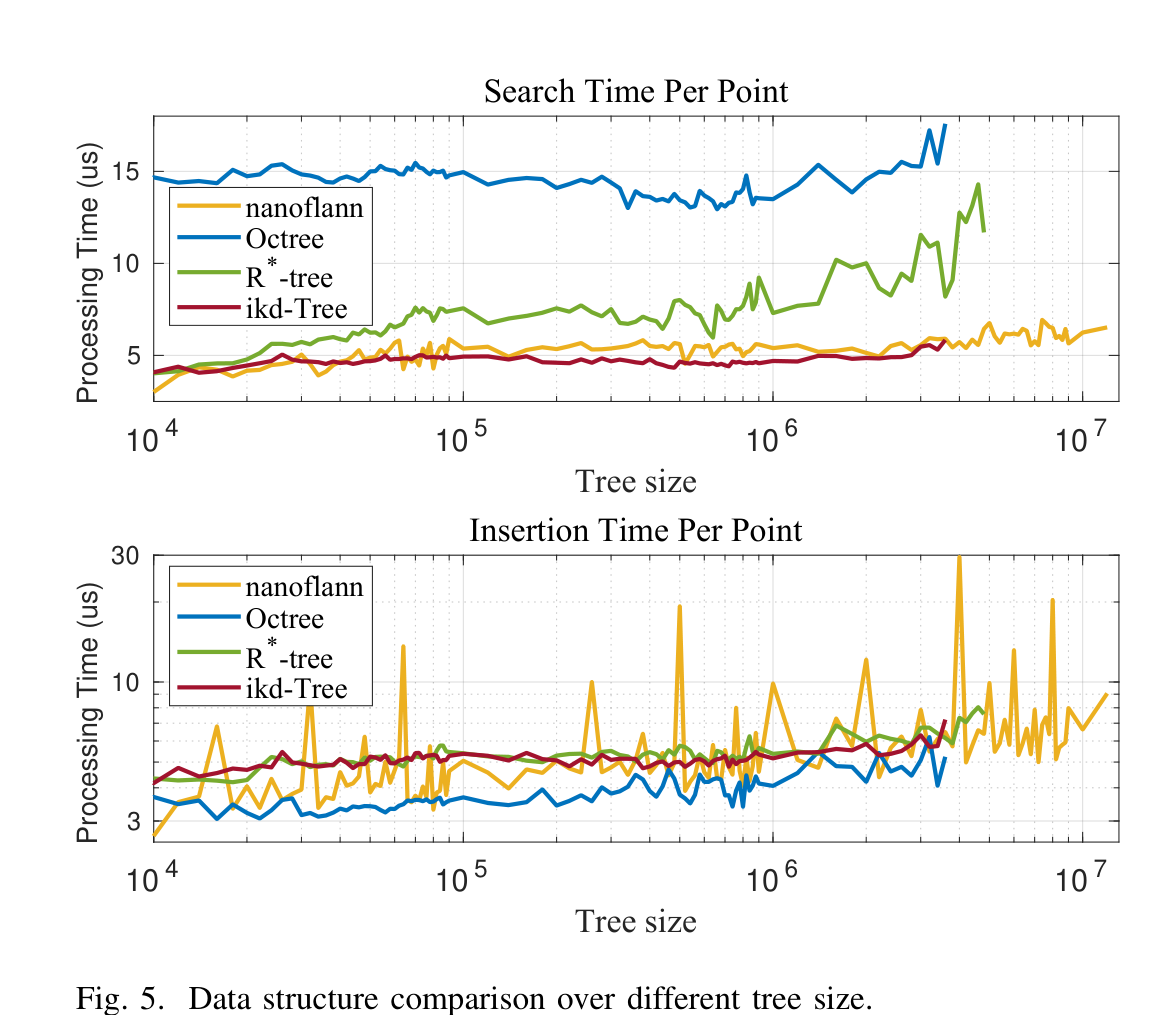
자료구조별 특성은 다음과 같이 갈린다.
- octree는 삽입이 가장 빠르지만 격차가 1마이크로초 미만으로 작다. 반면 균형이 잡히지 않은 구조 탓에 질의 시간이 다른 자료구조보다 훨씬 길다.
- nanoflann은 삽입 시간이 ikd-Tree보다 조금 짧을 때가 있으나, 여러 k-d tree를 로그 구조로 묶어 관리하는 특성상 간헐적으로 큰 첨두가 생긴다.
- R*-tree는 삽입 시간이 ikd-Tree와 비슷하지만 트리가 커지면 검색 시간이 크게 늘어난다.
- ikd-Tree는 kNN search에서 일관되게 가장 빠르고, 트리 크기 10^5에서 10^6 구간에서 nanoflann과의 격차가 뚜렷해진다.
scan당 합계 시간을 보면 종합 1위는 ikd-Tree다. 대표 시퀀스의 수치는 다음과 같다.
| 시퀀스 | ikd-Tree | nanoflann | Octree | R*-tree |
|---|---|---|---|---|
| utbm 1 | 18.42ms | 19.22ms | 45.00ms | 26.50ms |
| ulhk 2 | 25.77ms | 29.49ms | 66.88ms | 35.98ms |
| nclt 1 | 15.64ms | 20.41ms | 42.57ms | 30.14ms |
| lili 3 | 9.57ms | 10.00ms | 26.08ms | 14.56ms |
평균값만 보면 ikd-Tree와 nanoflann의 차이는 크지 않다. 격차는 최악값에서 벌어진다. nanoflann은 삭제를 masking으로만 처리해 지운 point가 트리에 그대로 남기 때문에, downsampling과 map 이동을 해도 트리가 계속 자란다.
| 지표 | ikd-Tree | nanoflann |
|---|---|---|
| utbm 최대 트리 크기 | 2 x 10^6 | 6 x 10^6 초과 |
| nclt 최대 트리 크기 | 3.6 x 10^6 | 10^7 초과 |
| incremental update 최대 지연 | nclt 2에서 214.4ms, 나머지 17개 시퀀스는 150ms 미만 | utbm 7개 시퀀스 전부 3초 초과, nclt 3개 시퀀스 7초 초과 |
이 최대 지연 차이가 실용상 중요하다. 첨두 발생 빈도가 낮아 평균 실시간성에는 큰 영향이 없지만, 3초에서 7초의 지연은 그 상태 추정을 받아 쓰는 후속 제어기에 치명적이라고 논문은 지적한다.
정확도 벤치마크
시스템 전체를 LILI-OM, LIO-SAM, LINS와 비교했다. FAST-LIO2에는 loop closure가 없으므로 공정한 비교를 위해 LILI-OM과 LIO-SAM의 loop closure 모듈을 껐고, sliding window 최적화 같은 나머지 기능은 그대로 켜 두었다.
37개 시퀀스 중 ground truth 비교가 가능한 것은 19개다. 그중 ground truth 경로 품질이 좋은 12개에서 절대 병진 오차 RMSE를 쟀다.
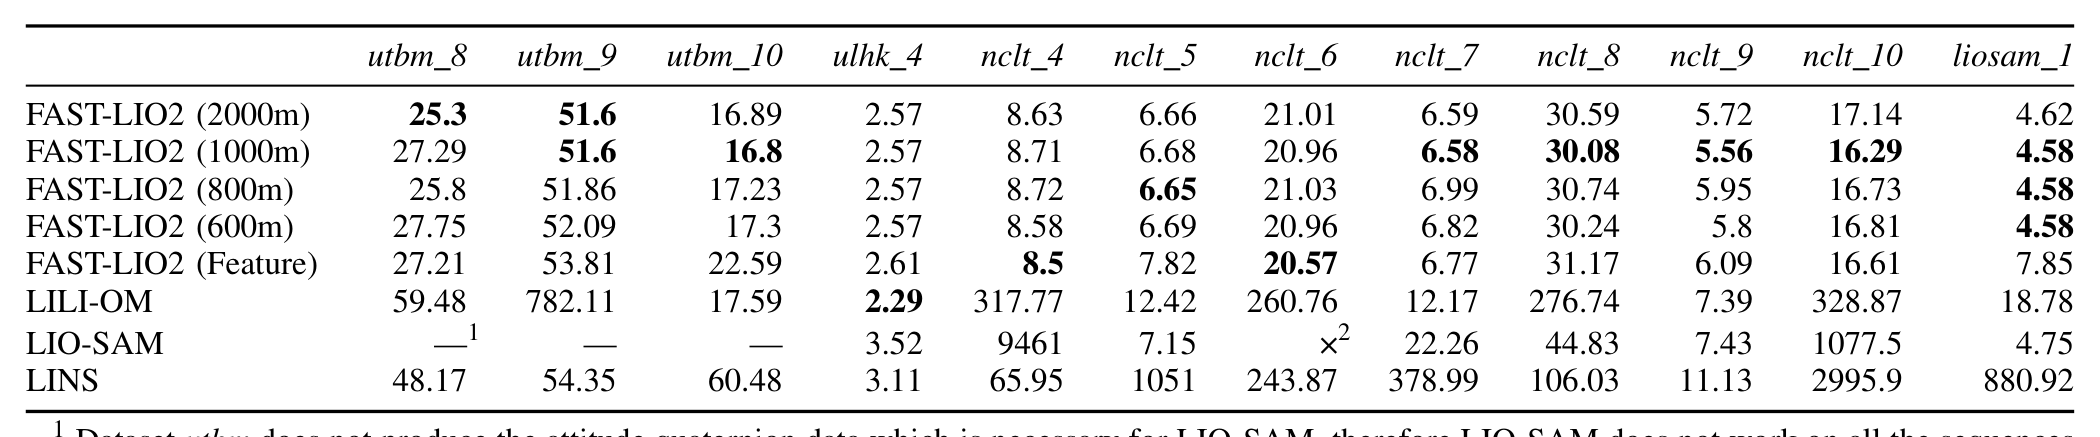
| 시퀀스 | FAST-LIO2 (1000m) | FAST-LIO2 (Feature) | LILI-OM | LIO-SAM | LINS |
|---|---|---|---|---|---|
| utbm 8 | 27.29 | 27.21 | 59.48 | 미동작 | 48.17 |
| utbm 9 | 51.6 | 53.81 | 782.11 | 미동작 | 54.35 |
| utbm 10 | 16.8 | 22.59 | 17.59 | 미동작 | 60.48 |
| ulhk 4 | 2.57 | 2.61 | 2.29 | 3.52 | 3.11 |
| nclt 4 | 8.71 | 8.5 | 317.77 | 9461 | 65.95 |
| nclt 5 | 6.68 | 7.82 | 12.42 | 7.15 | 1051 |
| nclt 6 | 20.96 | 20.57 | 260.76 | 실패 | 243.87 |
| nclt 7 | 6.58 | 6.77 | 12.17 | 22.26 | 378.99 |
| nclt 8 | 30.08 | 31.17 | 276.74 | 44.83 | 106.03 |
| nclt 9 | 5.56 | 6.09 | 7.39 | 7.43 | 11.13 |
| nclt 10 | 16.29 | 16.61 | 328.87 | 1077.5 | 2995.9 |
| liosam 1 | 4.58 | 7.85 | 18.78 | 4.75 | 880.92 |
FAST-LIO2 또는 그 변형이 19개 시퀀스 중 18개에서 최고 성능이었다. 유일한 예외는 ulhk 4로 LILI-OM이 2.29m로 근소하게 앞섰고, 차이는 0.28m다.
비교 대상들이 큰 값을 내는 지점에는 공통된 원인이 있다. 셋 모두 front-end odometry와 back-end 최적화를 분리한 구조인데, 시퀀스가 길어지고 map point가 많아지면 back-end가 실패한다. LILI-OM은 sliding window 융합이 실패하면서 front-end odometry만 남아 드리프트가 그대로 누적되고, LIO-SAM은 factor graph 최적화가 nclt 4와 nclt 10에서 실패하며, LINS는 map 정제 단계가 nclt 여러 시퀀스에서 무너진다. utbm은 LIO-SAM이 요구하는 자세 quaternion 데이터를 제공하지 않아 전 시퀀스에서 동작하지 않았다.
liosam 1은 특히 눈여겨볼 항목이다. 이 시퀀스는 LIO-SAM 저자들이 직접 공개하고 그들의 알고리즘에 맞춰 튜닝한 자체 데이터인데도 FAST-LIO2가 4.58m로 LIO-SAM의 4.75m보다 정확했다.
시작점으로 되돌아오는 7개 시퀀스에서는 end-to-end 오차를 쟀다.
| 시스템 | lili 6 | lili 7 | lili 8 | ulhk 5 | ulhk 6 | liosam 2 | liosam 3 |
|---|---|---|---|---|---|---|---|
| FAST-LIO2 (1000m) | 0.1 미만 | 1.63 | 17.39 | 0.39 | 0.1 미만 | 0.1 미만 | 9.50 |
| FAST-LIO2 (Feature) | 0.20 | 3.89 | 21.99 | 0.32 | 0.1 미만 | 0.1 미만 | 12.11 |
| LILI-OM | 0.80 | 4.13 | 15.60 | 1.84 | 7.89 | 1.95 | 13.79 |
| LIO-SAM | 미동작 | 미동작 | 미동작 | 0.83 | 2.88 | 0.1 미만 | 8.61 |
| LINS | 미동작 | 미동작 | 미동작 | 0.90 | 6.92 | 실패 | 29.90 |
단위는 m다. FAST-LIO2 계열이 7개 중 5개에서 최저였다. LILI-OM은 lili 데이터셋이 자신들의 자체 데이터라 시퀀스마다 파라미터를 따로 조정한 반면, FAST-LIO2는 모든 시퀀스에 같은 파라미터를 썼다는 점을 논문이 함께 밝힌다. LINS가 liosam 2에서 완전히 실패한 것은 회전 속도가 커서 쓸 수 있는 feature point가 너무 적었기 때문이다.
ablation
논문은 두 가지 변형을 만들어 설계 선택을 검증한다.
첫째는 map 크기다. 기본 1000m 외에 600m, 800m, 2000m로 바꿔 실행했다.
| map size | utbm 8 | utbm 9 | utbm 10 | nclt 8 | nclt 10 |
|---|---|---|---|---|---|
| 2000m | 25.3 | 51.6 | 16.89 | 30.59 | 17.14 |
| 1000m | 27.29 | 51.6 | 16.8 | 30.08 | 16.29 |
| 800m | 25.8 | 51.86 | 17.23 | 30.74 | 16.73 |
| 600m | 27.75 | 52.09 | 17.3 | 30.24 | 16.81 |
단위는 m이며 값은 RMSE다. map을 키우면 정확도가 완만하게 오른다. LiDAR가 이전에 지나온 장소를 다시 방문할 때 더 오래된 map point에 정합할 수 있기 때문이다. 다만 2000m를 넘으면 개선이 이어지지 않는다. 누적된 드리프트 때문에 너무 오래된 map point와 잘못 대응될 위험이 생기며, 이는 loop closure가 없는 odometry의 일반적 현상이라고 논문은 설명한다.
둘째는 direct 방식 대 feature 방식이다. 비교용 feature 추출 모듈은 solid-state LiDAR에 맞춘 FAST-LIO 방식과 회전식 LiDAR에 맞춘 BALM 방식을 결합해 만들었다. RMSE 표의 두 열을 비교하면 direct 방식이 nclt 4와 nclt 6을 뺀 대부분에서 더 정확하고, 그 두 시퀀스의 차이도 0.21m와 0.39m로 미미하다.
차이가 가장 크게 벌어진 곳은 lili 7의 end-to-end 오차다. feature 방식은 3.89m인 반면 direct 방식은 1.37m에서 1.92m 사이였다. 이 시퀀스에는 나무와 개활지가 많은데, feature 추출이 나무와 원거리 건물에서 나온 유효한 point를 대거 버리기 때문이라고 논문은 설명한다. 구조가 빈약한 환경일수록 direct 방식의 이점이 커진다는 뜻이다.
처리 시간
scan당 평균 처리 시간에서 FAST-LIO2는 LILI-OM 대비 약 8배, LIO-SAM 대비 약 10배, LINS 대비 약 6배 빠르다. 여기서 FAST-LIO2의 값은 odometry와 mapping을 모두 포함한 전체 시간이고, 비교 대상은 각각 분리된 odometry와 mapping 시간을 합한 값이다.
| 시퀀스 | FAST-LIO2 (1000m) | FAST-LIO2 (ARM) | LILI-OM 합계 | LIO-SAM 합계 | LINS 합계 |
|---|---|---|---|---|---|
| ulhk 4 | 20.14 | 91.12 | 127.20 | 134.79 | 128.42 |
| nclt 4 | 15.72 | 69.09 | 160.95 | 197.41 | 234.83 |
| nclt 10 | 21.79 | 89.65 | 213.88 | 347.75 | 335.80 |
| liosam 1 | 14.77 | 60.60 | 132.73 | 148.86 | 203.57 |
단위는 ms다. 다른 시스템의 odometry 부분만 떼어 비교해도 FAST-LIO2가 대부분 시퀀스에서 빠르다. odometry와 mapping을 합친 FAST-LIO2의 전체 시간이 LIO-SAM의 odometry 부분과 거의 같은 수준이다.
map 크기를 600m에서 2000m로 바꿔도 처리 시간이 거의 변하지 않는다. ikd-Tree의 mapping과 kNN search가 map 크기에 둔감하다는 증거다. feature 기반 변형과 direct 방식의 처리 시간도 비슷한데, feature 추출에 시간을 쓰는 대신 이후 단계에서 다룰 point가 줄어 서로 상쇄되기 때문이다.
차이의 출처는 전작과의 구성요소별 비교에서 분명하게 드러난다. 100Hz scan rate로 수집한 650m 실외와 실내 혼합 데이터에서 잰 값이다.
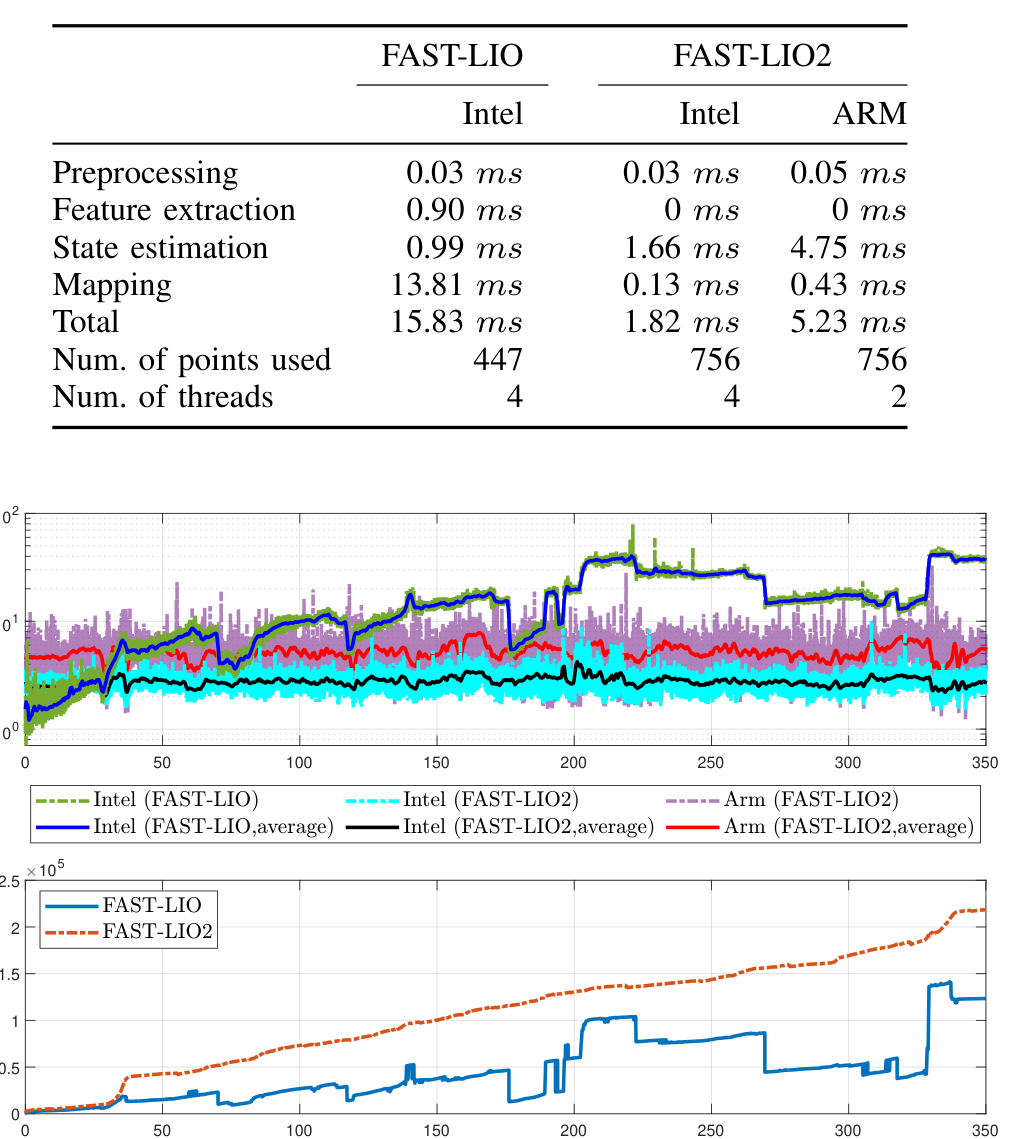
| 구성 요소 | FAST-LIO (Intel) | FAST-LIO2 (Intel) | FAST-LIO2 (ARM) |
|---|---|---|---|
| 전처리 | 0.03ms | 0.03ms | 0.05ms |
| feature 추출 | 0.90ms | 0ms | 0ms |
| state estimation | 0.99ms | 1.66ms | 4.75ms |
| mapping | 13.81ms | 0.13ms | 0.43ms |
| 합계 | 15.83ms | 1.82ms | 5.23ms |
| 사용 point 수 | 447 | 756 | 756 |
| thread 수 | 4 | 4 | 2 |
odometry 단계만 보면 두 시스템이 거의 같다. FAST-LIO는 1.92ms, FAST-LIO2는 1.69ms다. FAST-LIO2가 raw point를 1.7배 많이 쓰는 만큼 state estimation이 느려졌지만, feature 추출 0.90ms가 사라져 상쇄된다.
차이는 mapping에서 난다. FAST-LIO의 13.81ms가 FAST-LIO2에서 0.13ms가 되어 약 100배 줄었다. 원인은 두 시스템이 map을 다루는 방식이다. FAST-LIO는 매 스텝 현재 FoV의 map point를 모아 정적 k-d tree를 새로 짓기 때문에 O(n log n)이 걸리고, 처리 시간이 map point 수에 거의 선형으로 비례한다. FAST-LIO2는 O(log n)의 증분 갱신이므로 map이 커져도 시간이 완만하게만 늘어난다. 그 결과 이 실험에서 FAST-LIO의 mapping은 10ms 샘플링 주기를 넘겨 실시간 처리가 불가능했다.
ARM 플랫폼에서는 합계 5.23ms로 10Hz 실시간 동작이 가능하다. 간헐적으로 10ms 주기를 초과하지만 발생이 드물고, 그 짧은 구간에는 IMU propagation으로 얻은 상태 추정으로 제어기를 이어갈 수 있다. 논문은 이것이 ARM 기반 플랫폼에서 LIO 실시간 동작을 보인 첫 사례라고 주장한다.
실제 기기 실험
공개 데이터셋 대부분이 지상 주행 데이터이므로, 저자들은 별도로 세 가지 플랫폼을 만들어 어려운 조건을 시험했다. 세 플랫폼 모두 Livox Avia LiDAR와 DJI Manifold 2-C를 쓴다. Livox Avia는 70.4도 x 77.2도의 원형 FoV와 비반복 scanning pattern을 갖고 IMU를 내장한 solid-state LiDAR다.
| 실험 | 플랫폼 | 조건 | 결과 |
|---|---|---|---|
| 대규모 혼합 장면 | 핸드헬드 | 100Hz scan rate, 실외와 실내 약 650m 이동 후 시작점 복귀 | drift 0.14m, 위성 지도와 일치 |
| UAV flip | 280mm 쿼드로터, 전방 장착 | 1.2m 호버링 후 공중제비, 평균 각속도 912deg/s, 최대 1198deg/s | 자세 추정 유지, scan당 평균 2.01ms |
| 고속 핸드헬드 | 핸드헬드 | 육교 왕복, 최대 속도 7m/s, 각속도 약 100deg/s | 총 81m 이동에 end-to-end 오차 0.06m 미만 |
| 항공 mapping | 750mm 쿼드로터, 하향 장착 | 홍콩 습지공원, 고도 30m와 50m, 10Hz scan rate | 나무 수관과 도로 차선, 연석까지 식별, scan당 19.6ms에서 23.9ms |
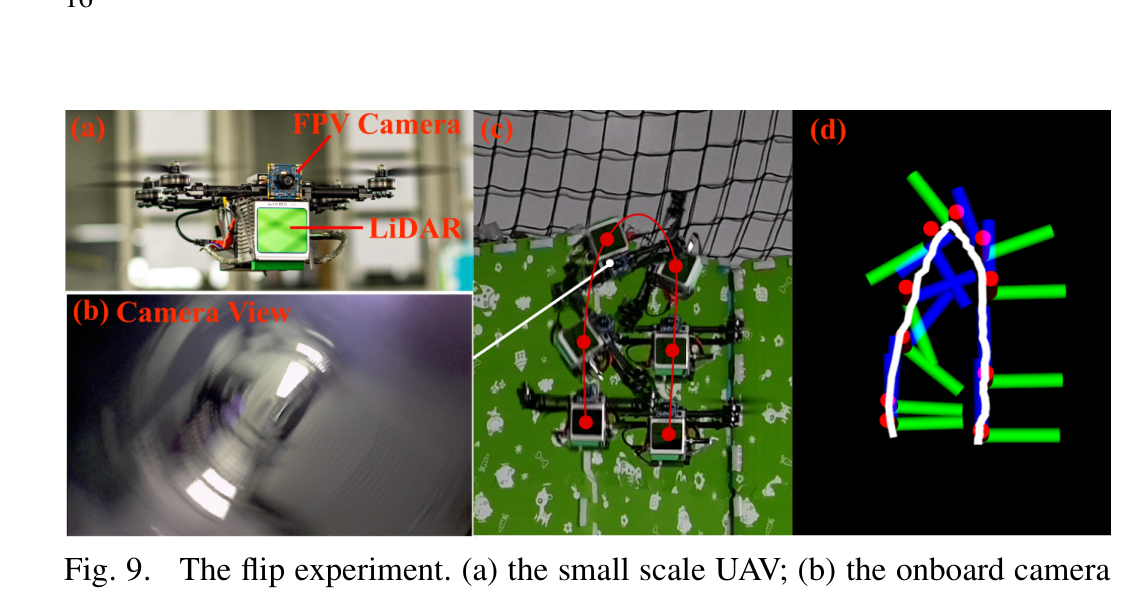
flip 실험이 보여주는 것은 극한 회전에서의 안정성이다. 최대 각속도 1198deg/s는 1초에 약 3.3바퀴를 도는 속도이며, 이 구간에서도 추정된 자세가 실제 UAV 자세와 잘 일치했다. scan당 2.01ms는 제어기가 요구하는 실시간성을 만족하는 값이다. 저자들의 선행 연구는 같은 odometry를 써서 지름 9mm까지의 작은 동적 물체를 회피하는 자율 UAV를 시연했다.
비교 대상의 실패 사례도 direct 방식의 이점을 뒷받침한다. LILI-OM은 solid-state LiDAR를 지원하지만 650m 혼합 장면 데이터에서 실패했다. 100Hz scan rate에서는 scan 한 장에 담기는 point가 적어 feature 추출 결과가 너무 빈약해지기 때문이다. 항공 mapping 세 데이터에서도 같은 이유로 실패했는데, LiDAR가 지면을 향하면 뽑히는 feature가 급격히 줄어든다.
한계
- loop closure가 없는 순수 odometry라서 장거리 드리프트가 그대로 누적된다. map 크기를 2000m 이상으로 키우면 누적된 드리프트 때문에 오래된 map point와의 오매칭이 생길 수 있다고 논문 스스로 지적한다.
- 정확도 평가 범위가 제한적이다. 날씨와 GPS 품질 문제로 37개 시퀀스 중 19개만 ground truth 비교가 가능했고, RMSE 표에는 그중 12개만 실렸다. 항공 실험에서도 기술적 문제로 GPS 경로를 확보하지 못해 정량 평가 없이 육안 비교에 그쳤다.
- measurement model이 국소 평면 가정 위에 있다. 평면이 드문 환경에서 어떤 한계가 있는지는 논문이 따로 다루지 않았다. 같은 가정을 쓰는 generalized-ICP 계열과 공유하는 제약이다.
- ARM 플랫폼에서 10ms 샘플링 주기를 간헐적으로 초과한다. 발생 빈도가 낮아 실용상 문제는 아니라고 보지만, 임베디드 환경에서 100Hz 실시간이 보장되지는 않는다.
- 자료구조 비교 수치는 FAST-LIO2에 통합한 조건에서 측정한 값이다. 다른 응용에서의 상대 성능은 달라질 수 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| direct method | feature 추출 없이 raw point를 map에 바로 등록하는 방식. visual SLAM의 direct method에서 이름을 따왔다 |
| ikd-Tree | 증분 삽입과 삭제, on-tree downsampling, 병렬 re-balancing을 지원하는 이 논문의 k-d tree 자료구조 |
| on-tree downsampling | map 삽입과 동시에 트리 위에서 공간 해상도를 유지하는 downsampling. 다른 자료구조는 트리 밖에서 따로 수행해야 한다 |
| lazy label | 삭제 요청을 받은 point를 즉시 제거하지 않고 라벨만 붙였다가 re-building 때 실제로 지우는 방식 |
| operation logger | 병렬 re-building 중 main thread가 보낸 갱신 요청을 쌓아 두었다가 새 sub-tree에 재적용하는 큐 |
| back-propagation | scan 안 각 point의 샘플링 시점 자세를 IMU 측정으로 역추정해 왜곡을 보정하는 절차. 신경망 학습의 backpropagation과 무관하다 |
관련 페이지
- FAST-LIO: A Fast, Robust LiDAR-inertial Odometry Package by Tightly-Coupled Iterated Kalman Filter: 전작 FAST-LIO 논문. iterated Kalman filter, back-propagation, Kalman gain 수식 변형이 모두 여기서 왔다.
- FAST_LIO: A computationally efficient and robust LiDAR-inertial odometry package: 공식 구현 repo 페이지. 2021년 7월부터 FAST-LIO2가 기본 버전이며, 정량 평가는 이 페이지로 위임한다.
- [Paper Review] FAST-LIO 요약 및 설명: 전작 수식 전개의 한국어 해설. state estimation 절의 유도를 따라갈 때 참고한다.
- 누구보다 빠르게 남들과는 다르게💨💨 FAST-LIO: A Fast, Robust LIO Package by Kalman Filter(RA-L 2021): FAST-LIO 계열의 또 다른 한국어 해설.
- [논문 리뷰] Faster-LIO: Lightweight Tightly Coupled Lidar-Inertial Odometry Using Parallel Sparse...: ikd-Tree를 해시 기반 iVox로 대체한 후속 연구 Faster-LIO 해설.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.
- 용어집: Physical AI (Terminology Glossary): 이 페이지가 따르는 도메인 용어 표기 기준.