Database · PAPER · 2025
From RAG to Memory: Non-Parametric Continual Learning for Large Language Models
요약
HippoRAG 2는 knowledge graph 위에서 Personalized PageRank를 실행하는 RAG 프레임워크로, 사실 기억과 sense-making과 associativity 세 가지 메모리 과제 전부에서 최강 dense retriever를 앞선 최초의 structure-augmented RAG다. ICML 2025에 발표됐고 저자는 Ohio State University와 University of Illinois Urbana-Champaign 소속이다.
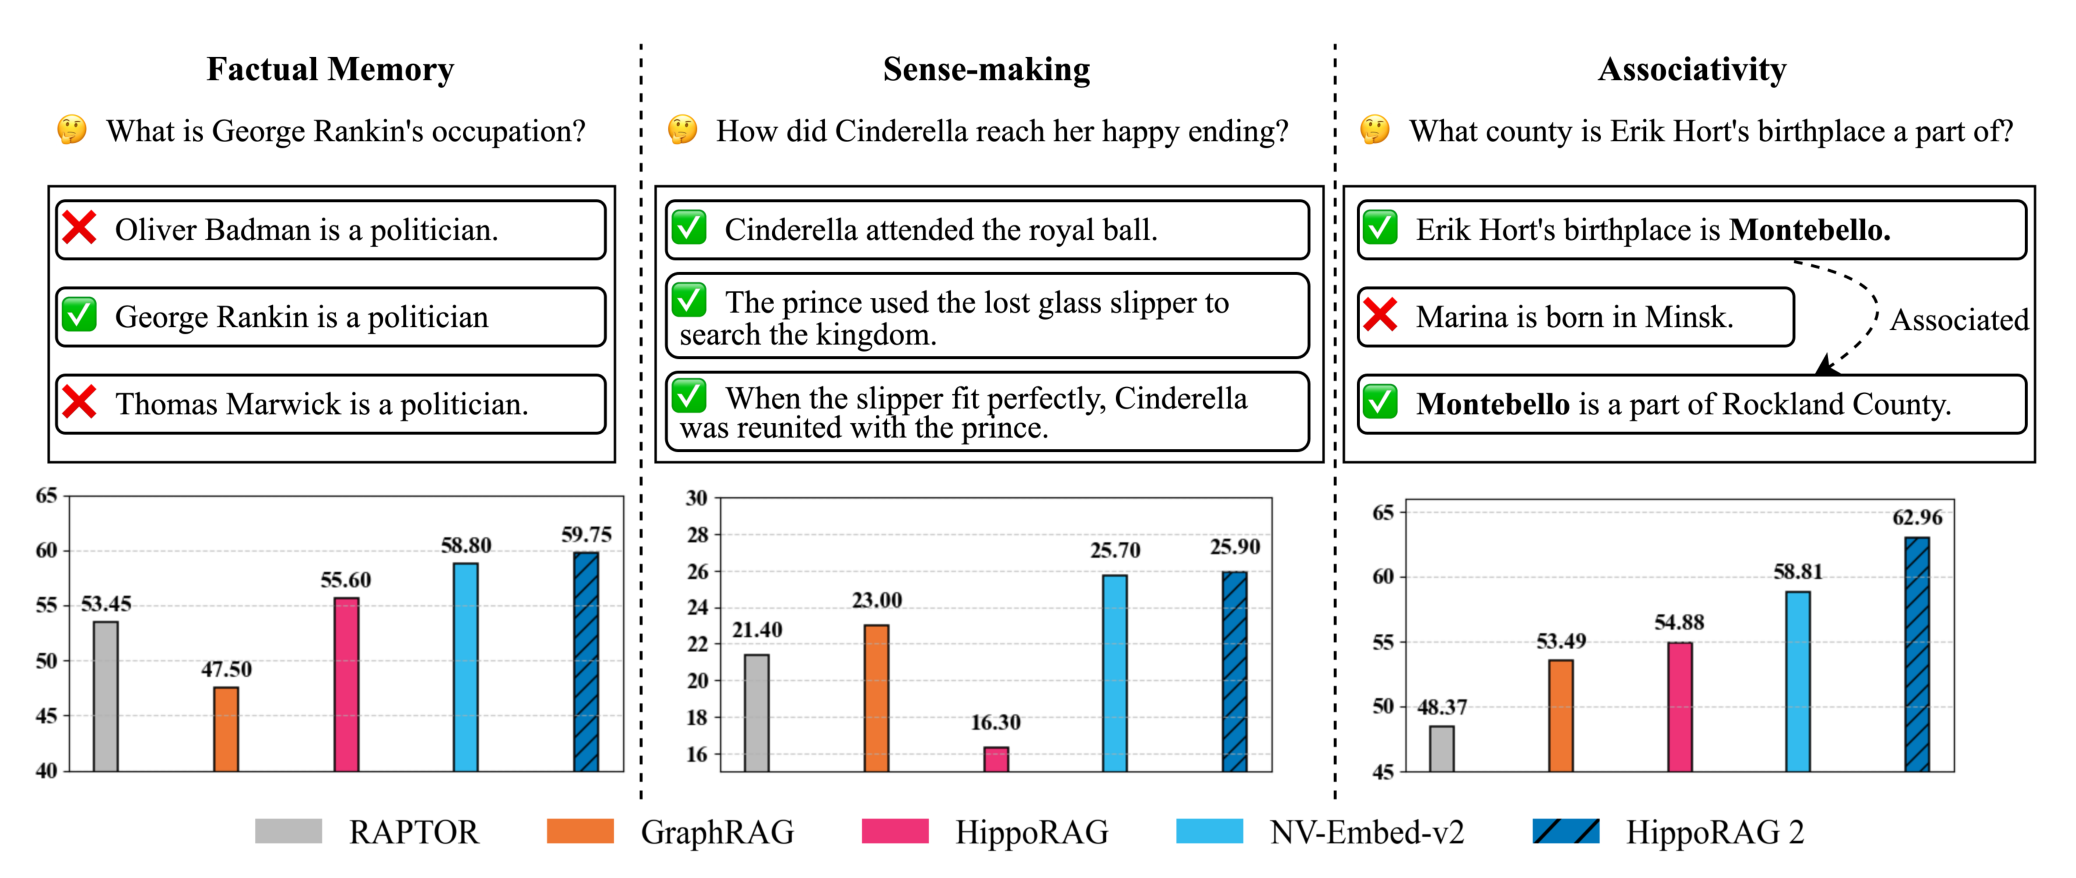
이 논문의 출발점은 선행 structure-augmented RAG가 하나의 능력에 특화되면서 다른 능력에서 표준 RAG보다 못해진다는 관찰이다. 요약 계층을 만드는 RAPTOR는 sense-making에는 강하지만 simple QA와 multi-hop QA에서 노이즈 탓에 성능이 내려가고, 개체 중심 그래프를 쓰는 HippoRAG는 multi-hop에는 강하지만 장편 담화 이해에서 가장 낮은 점수를 받는다. HippoRAG 2는 그래프에 passage 자체를 노드로 넣고 질의(query)를 triple 단위로 잇는 두 가지 변경으로 이 상충을 해소한다.
배경
파라미터를 건드리지 않는 지속 학습
LLM에 새 지식을 계속 넣는 방법은 세 가지로 나뉜다. 논문은 Shi et al. (2024)의 분류를 따라 continual fine-tuning, model editing, RAG를 대비시키고 왜 RAG가 사실상의 표준이 됐는지 설명한다.
| 접근 | 방식 | 논문이 지적한 문제 |
|---|---|---|
| continual fine-tuning | 새 데이터로 주기적으로 다시 학습한다. continual pretraining, instruction tuning, alignment fine-tuning이 여기 속한다 | catastrophic forgetting이 일어나 기존 지식이 지워진다. 연산 비용 때문에 잦은 갱신이 현실적이지 않다 |
| model editing | 특정 파라미터를 직접 고쳐 지식을 갱신한다 | 갱신 효과가 지나치게 국소적이라, 함께 바뀌어야 할 연관 정보에는 거의 영향을 주지 못한다 |
| RAG | 추론 시점에 외부 정보를 검색해 붙인다. 모델 자체는 바꾸지 않는다 | 벡터 retrieval에 기대는 한 인간 장기 기억의 성질을 흉내 내지 못한다 |
catastrophic forgetting은 새로 배운 내용이 이전에 배운 능력을 덮어써 사라지게 만드는 현상이다. RAG는 파라미터를 건드리지 않으므로 이 문제를 우회한다. 그래서 논문은 RAG를 "비파라미터 지속 학습"으로 부르고 그 품질을 인간 장기 기억에 얼마나 가까운지로 잰다.
표준 RAG가 놓치는 두 가지
벡터 retrieval은 문서를 서로 독립된 단위로 다룬다. 이 전제 때문에 두 가지 능력이 빠진다.
| 능력 | 뜻 | 근거 문헌 |
|---|---|---|
| sense-making | 크고 복잡하거나 불확실한 맥락을 해석하는 능력 | Klein et al. (2006) |
| associativity | 흩어진 지식 조각 사이에 multi-hop 연결을 만드는 능력 | Suzuki (2005) |
sense-making이 필요한 질문은 여러 passage에 흩어진 정보를 통합해야 답이 나온다. associativity가 필요한 질문은 한 사실에서 다른 사실로 건너뛰어야 답에 닿는다. 예를 들어 "Erik Hort의 출생지가 속한 카운티는?"이라는 질문은 "Erik Hort는 Montebello에서 태어났다"와 "Montebello는 Rockland County에 속한다"를 이어야 풀린다. 벡터 유사도만으로는 두 번째 사실이 검색되지 않는다.
구조를 더한 RAG가 만든 새로운 문제
선행 연구는 두 능력을 각각 겨냥해 왔다. sense-making 쪽은 LLM이 요약을 만들게 하거나 knowledge graph를 세워 흩어진 passage를 묶고, associativity 쪽은 HippoRAG가 Personalized PageRank로 multi-hop 추론을 붙였다.
논문의 실험은 이들 방법이 자기 실험 설정 밖의 과제에서 가장 크게 하락한다는 사실을 보인다. 특히 표준 RAG가 이미 잘하는 simple QA에서 오히려 뒤처지는 경우가 많다. HippoRAG는 질의 기반 맥락화가 없어 장편 담화 이해에서 가장 크게 내려가고, RAPTOR는 LLM 요약이 corpus에 노이즈를 더해 simple QA와 multi-hop QA에서 함께 내려간다.
HiRAG와의 구분
HippoRAG 계열은 계층(hierarchical) 방법론이 아니다. 두 이름이 비슷해 혼동하기 쉬우므로 구분해 둔다.
| 항목 | HippoRAG 계열 | 계층 기반 방법 |
|---|---|---|
| 이름의 유래 | hippocampus, 인간 해마의 기억 인덱스 구조 | hierarchical, 계층 인덱싱 |
| 그래프 구조 | 하나의 평평한 schema 없는 KG. 상위 요약 노드가 없다 | 요약 노드를 층으로 쌓는다 |
| 검색 방식 | seed node를 정하고 Personalized PageRank로 전파한다 | 계층을 오르내리며 단계별로 검색한다 |
| 이 논문에서의 계층 언급 | RAPTOR를 설명할 때 한 번만 등장한다 | 해당 없음 |
이 논문 원문에서 hierarchical이라는 단어는 RAPTOR가 corpus를 의미 유사도 기반 계층 구조로 조직한다는 문장에 딱 한 번 나온다. HippoRAG나 HippoRAG 2를 계층 방법론으로 서술한 대목은 없다.
핵심 개념
개념과 맥락의 상충
HippoRAG의 KG는 개념을 서술하는 phrase만 노드로 삼는다. 여기서 개념과 맥락의 상충이 생긴다. 개념은 간결하고 일반화하기 쉽지만 정보를 잃고, 맥락은 그 개념이 어떻게 해석되고 적용되는지를 알려 주지만 복잡도를 키운다.
인간의 기억에서는 개념과 맥락이 촘촘히 얽혀 있다. HippoRAG 2의 설계는 이 얽힘을 그래프 구조 안에서 재현하는 것을 목표로 삼는다.
dense coding과 sparse coding
논문은 뇌가 정보를 서로 다른 입도로 표현한다는 dense coding과 sparse coding 이론(Beyeler et al., 2019)에서 설계를 끌어온다.
| 코딩 방식 | 뇌에서의 성질 | HippoRAG 2에서의 대응 |
|---|---|---|
| dense coding | 많은 뉴런이 동시에 활성화되어 분산되고 중복된 표현을 만든다 | passage node. passage 전체의 맥락을 담는다 |
| sparse coding | 소수의 뉴런만 활성화해 효율과 저장 밀도를 높인다 | phrase node. 추출된 개념을 담는다 |
두 표현을 하나의 KG 안에서 잇는 것이 dense-sparse integration이다.
Personalized PageRank와 reset probability
Personalized PageRank는 확률 질량을 특정 seed node와 그 이웃 쪽으로 몰아주도록 PageRank를 변형한 알고리즘이다(Haveliwala, 2002). reset probability는 random walk가 각 노드로 되돌아갈 확률이며, 이 값을 어디에 얼마나 주느냐가 곧 seed node를 지정하는 행위다.
HippoRAG 계열은 이 성질을 맥락 기반 retrieval에 쓴다. 질문과 직접 매칭되지 않은 passage라도 seed node와 그래프상 가까우면 확률 질량을 받아 상위로 올라온다. 앞서 든 Erik Hort 예에서 Montebello passage가 검색되는 경로가 그것이다.
recall과 recognition
인간의 기억 인출은 두 과정으로 나뉜다(Uner & Roediger III, 2022). recall은 외부 단서 없이 능동적으로 떠올리는 것이고, recognition은 주어진 단서를 보고 알아보는 것이다.
HippoRAG 2는 query-to-triple 검색을 recall로, 그 결과를 LLM이 걸러 내는 단계를 recognition으로 본다. 후자를 recognition memory라 부른다.
세 가지 메모리 능력의 측정
| 능력 | 과제 유형 | 데이터셋 |
|---|---|---|
| 사실 기억 | simple QA | NaturalQuestions, PopQA |
| associativity | multi-hop QA | MuSiQue, 2Wiki, HotpotQA, LV-Eval |
| sense-making | 장편 담화 이해 | NarrativeQA |
방법
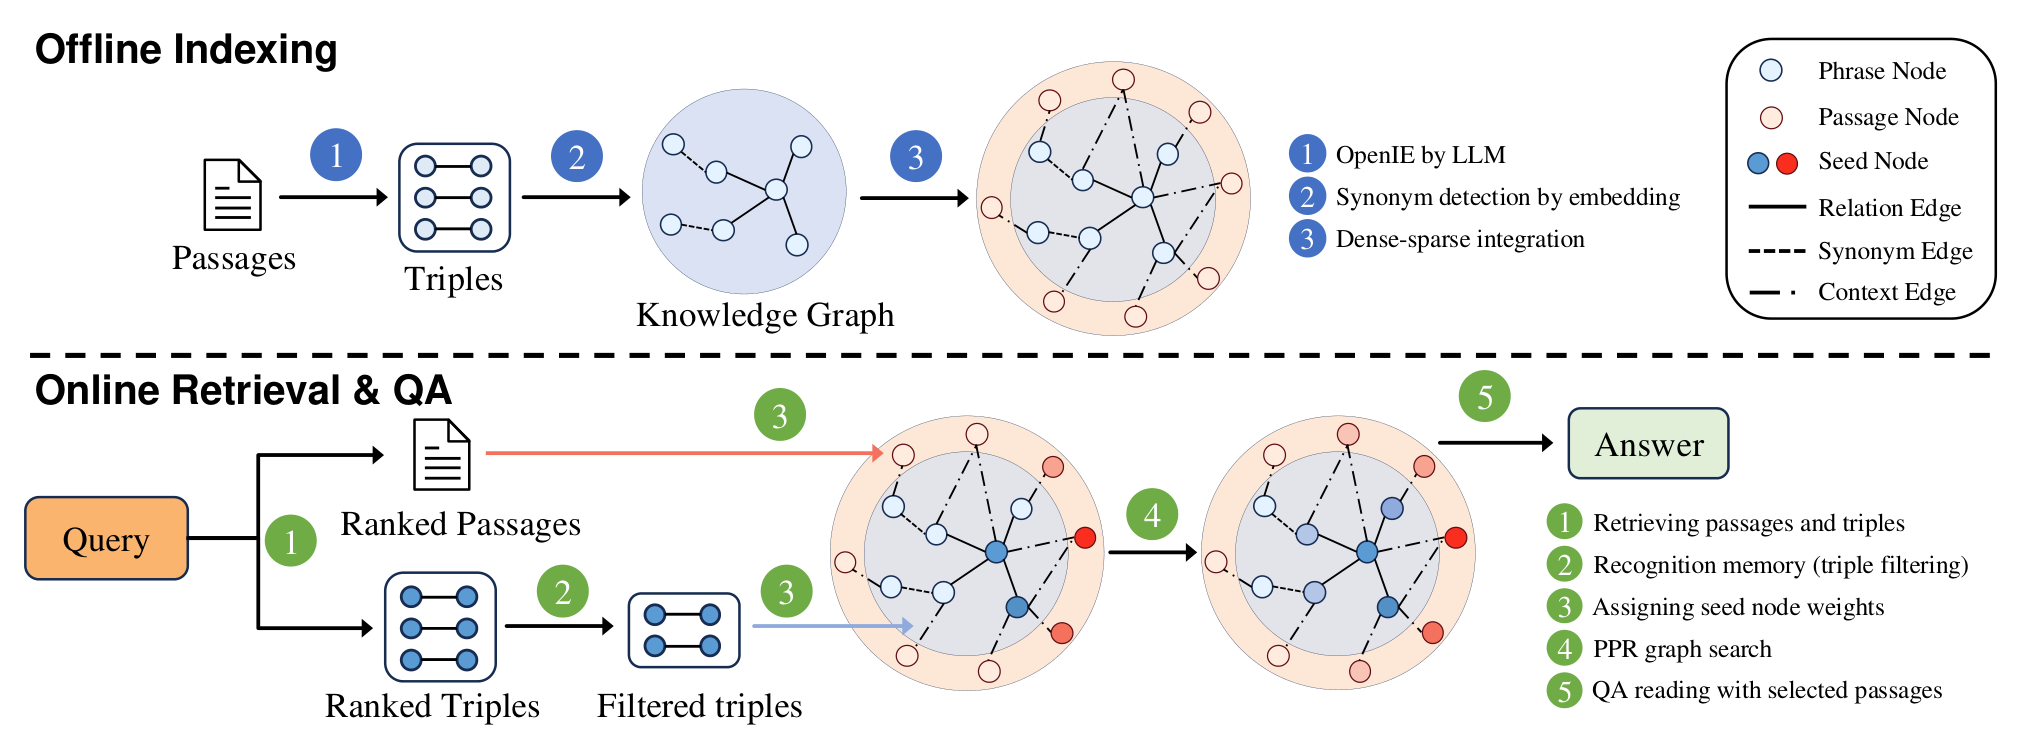
HippoRAG 2는 offline indexing과 online retrieval 두 단계로 나뉜다. 구조는 HippoRAG를 그대로 물려받고, 그 위에 세 가지를 더한다. KG 안에서 개념과 맥락을 통합하는 것, 고립된 노드가 아니라 그래프 구조를 활용해 맥락을 반영한 retrieval을 하는 것, seed node 선택에 recognition memory를 넣는 것이다.
신경생물학 대응 구조
HippoRAG 계열은 구성 요소마다 인간 기억의 대응물을 둔다.
| 구성 요소 | 대응하는 인간 기억 기관 | 역할 |
|---|---|---|
| LLM | 인공 neocortex | passage에서 triple을 뽑고, 검색된 triple을 걸러 낸다 |
| KG와 PPR | hippocampus의 auto-associative 성질 | 연결을 따라 관련 지식을 활성화한다 |
| retrieval encoder | parahippocampal region | 앞의 두 요소를 잇고 동의어를 찾는다 |
offline indexing 세 단계
- OpenIE by LLM. 각 passage에서 (subject, relation, object) triple을 뽑아 schema 없는 KG에 넣는다. OpenIE는 스키마를 미리 정하지 않고 관계와 개체를 자유롭게 추출하는 정보 추출 기법이다. subject와 object가 phrase node가 되고 둘을 잇는 edge가 relation edge가 된다.
- Synonym detection. retrieval encoder가 KG 안의 phrase 쌍을 훑어 벡터 유사도가 임계값 0.8을 넘는 쌍에 synonym edge를 추가한다. 서로 다른 passage에 흩어진 동의어가 이 edge로 이어지고, 새 지식과 옛 지식의 통합 경로가 된다.
- Dense-sparse integration. 각 passage를 passage node로 KG에 추가하고, 그 passage에서 나온 모든 phrase node와 "contains"라는 이름의 context edge로 잇는다.
세 번째 단계가 HippoRAG와 갈리는 지점이다. HippoRAG의 document ensemble은 그래프 검색 점수와 임베딩 매칭 점수를 사후에 합산할 뿐이지만, HippoRAG 2는 passage를 그래프 안에 넣어 구조적으로 통합한다.
| edge 종류 | 잇는 대상 | 생성 방식 |
|---|---|---|
| relation edge | phrase node와 phrase node | OpenIE triple의 관계 |
| synonym edge | phrase node와 phrase node | 벡터 유사도 0.8 이상 |
| context edge | passage node와 phrase node | 그 passage에서 파생된 관계, 레이블은 "contains" |
online retrieval 다섯 단계
- Query to Triple. 질의 전체를 임베딩으로 KG의 top-5 triple과 매칭한다. NER 단계가 사라진다.
- Recognition memory. LLM이 top-5 triple 중 질의와 관련 있는 것만 남겨 filtered triple 집합을 만든다.
- Seed node selection. filtered triple에 등장한 phrase node를 최대 5개까지 고른다. 각 phrase node의 ranking score는 그 노드가 등장한 filtered triple 점수의 평균이다. passage node는 전량이 seed가 된다.
- Reset probability 배정. phrase node는 ranking score를 그대로 reset probability로 쓰고, passage node는 임베딩 유사도에 weight factor를 곱한 값을 쓴다. 기본값은 0.05다.
- PPR 실행과 QA. python-igraph로 PPR을 실행해 passage node의 PageRank 점수로 순위를 매기고, 상위 5개를 QA reader의 context로 넣는다.
passage node를 전량 seed로 삼는 이유는 상위 몇 개만 활성화하는 것보다 넓게 활성화하는 편이 multi-hop 추론 사슬 위의 passage를 찾아내는 데 낫기 때문이라고 밝힌다. filtered triple이 비면 그래프 검색을 건너뛰고 임베딩 검색 결과를 그대로 반환한다.
질의를 그래프에 잇는 세 가지 방식
HippoRAG의 질의 파싱은 NER에 기대므로 개념 중심으로 치우쳐 맥락 신호를 활용하지 못한다. 논문은 대안 두 가지를 함께 평가한다.
| 방식 | 매칭 대상 | 입도 | 채택 여부 |
|---|---|---|---|
| NER to node | 질의에서 뽑은 개체를 KG 노드와 매칭 | phrase 수준 대 phrase 수준 | HippoRAG 원안 |
| Query to node | 질의 전체를 KG 노드와 직접 매칭 | 문장 수준 대 phrase 수준 | 채택하지 않음 |
| Query to triple | 질의 전체를 KG의 triple과 매칭 | 문장 수준 대 관계 수준 | HippoRAG 2 기본값 |
triple은 개념 사이의 기본적인 맥락 관계를 담고 있어서 질의의 의도를 더 온전히 반영한다. query-to-node가 NER-to-node보다 오히려 나쁜 이유로는 입도 불일치를 든다. NER 결과와 KG 노드는 둘 다 phrase 수준이지만 질의 전체는 그렇지 않다.
recognition memory 프롬프트
triple filter 프롬프트는 DSPy의 MIPROv2 optimizer와 Llama-3.3-70B-Instruct로 지시문과 시연을 함께 튜닝해 만들었다.
| 프롬프트 구성 | 내용 |
|---|---|
| 지시문 | 후보 목록에서 질의와 강하게 연결된 사실을 최대 4개까지 고르라고 지시한다. 관련 사실이 없으면 빈 리스트를 반환한다 |
| 출력 형식 | {"fact": [["s1", "p1", "o1"], ...]} 형태의 JSON |
| 제약 | 후보 목록에 있는 사실만 쓰고 새 사실을 만들지 않는다 |
| 시연 | multi-hop 질문과 필터 전후 triple 목록을 짝지은 few-shot 예시 7건 |
실행 예시
"What county is Erik Hort's birthplace a part of?"라는 multi-hop 질문에서 각 단계가 어떻게 동작하는지 논문이 부록에 제시한다.
| 단계 | 산출물 |
|---|---|
| Query to Triple | ("Erik Hort", "born in", "Montebello"), ("Erik Hort", "born in", "New York"), ("Erik Hort", "is a", "American"), ("Erik Hort", "born on", "February 16, 1987"), ("Erik Hort", "is a", "Soccer player") |
| Filtered Triples | ("Erik Hort", "born in", "Montebello"), ("Erik Hort", "born in", "New York") |
| Seed phrase nodes | Montebello 1.0, Erik Hort 0.995, New York 0.989 |
| Seed passage nodes | Erik Hort 0.05, Horton Park (Saint Paul, Minnesota) 0.031, Hertfordshire 0.028 등 |
| 최종 상위 passage | 1위 Erik Hort, 2위 Horton Park, 3위 Montebello, New York, 4위 Hertfordshire, 5위 Hull County, Quebec |
seed phrase node의 점수가 1.0 부근인 반면 seed passage node의 점수는 0.05 이하다. weight factor 0.05가 두 종류 노드 사이의 영향력을 어떻게 조절하는지가 이 숫자에 드러난다. 정답인 Rockland County는 3위 passage 본문에 들어 있다.
HippoRAG에서 바뀐 것
| 항목 | HippoRAG | HippoRAG 2 |
|---|---|---|
| KG 노드 | phrase node만 | phrase node와 passage node |
| 질의 연결 | NER to node | query to triple |
| triple 필터 | 없음 | LLM recognition memory |
| PPR seed | phrase node | phrase node와 모든 passage node |
| passage 점수 결합 | 그래프 점수와 임베딩 점수를 사후 합산 | 그래프 구조 안에서 통합 |
평가 설계
데이터셋
| 항목 | NQ | PopQA | MuSiQue | 2Wiki | HotpotQA | LV-Eval | NarrativeQA |
|---|---|---|---|---|---|---|---|
| 질문 수 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 124 | 293 |
| passage 수 | 9,633 | 8,676 | 11,656 | 6,119 | 9,811 | 22,849 | 4,111 |
PopQA는 2021년 12월 위키피디아 덤프에서 corpus를 만들었고 개체 빈도가 NQ보다 낮아 개체 인식과 검색을 재는 데 적합하다. LV-Eval은 키워드와 구절을 치환해 지식 누출과 과적합을 줄인 데이터셋이라, 위키 기반 데이터셋과 달리 여러 출처의 지식을 실제로 합성하는 능력을 잰다. NarrativeQA는 장편 소설 10편과 그에 딸린 질문 293건을 골랐고, LV-Eval과 같은 방식으로 긴 본문을 짧은 passage로 잘라 corpus를 구성했다.
비교 대상
| 분류 | 방법 |
|---|---|
| 단순 baseline | BM25, Contriever, GTR (T5-base) |
| 대형 임베딩 모델 (7B) | GTE-Qwen2-7B-Instruct, GritLM-7B, NV-Embed-v2 |
| structure-augmented RAG | RAPTOR, GraphRAG, LightRAG, HippoRAG |
대형 임베딩 모델 셋은 모두 BEIR 리더보드 상위 모델이다. structure-augmented 방법은 전부 HippoRAG 2와 같은 추출 LLM과 같은 retriever로 다시 실행해 비교 조건을 맞췄다.
하이퍼파라미터
| 하이퍼파라미터 | 값 |
|---|---|
| Synonym Threshold | 0.8 |
| Damping Factor of PPR | 0.5 |
| Temperature | 0.0 |
추출과 triple 필터에는 Llama-3.3-70B-Instruct를, retriever에는 NV-Embed-v2를 썼다. QA reader는 Llama-3.3-70B-Instruct와 GPT-4o-mini 둘을 모두 시험했다. 하이퍼파라미터는 MuSiQue 학습 데이터 100건으로 조정했고, 나머지는 HippoRAG의 기본 설정을 따랐다. LLM 서빙에는 NVIDIA H100 4장과 vLLM의 tensor parallelism을 썼다.
GraphRAG와 LightRAG 설정에 관한 주의
| 하이퍼파라미터 | GraphRAG | LightRAG |
|---|---|---|
| Mode | Local | Local |
| Response Type | Short phrase | Short phrase |
| Top-k Phrases for QA | 60 | 60 |
| Chunk Token Size | 1,200 | 1,200 |
| Chunk Overlap Token Size | 100 | 100 |
| Community Report Max Length | 2,000 | 해당 없음 |
| Max Input Length | 8,000 | 해당 없음 |
| Max Cluster Size | 10 | 해당 없음 |
| Entity Summary Max Tokens | 해당 없음 | 500 |
이 표는 결과 해석에 중요한 단서를 준다. GraphRAG는 Local 모드로 실행됐다. Local과 Global의 구분은 GraphRAG 원논문(Edge et al., 2024)이 정의한 것이 아니라 microsoft/graphrag 구현체가 제공하는 설정이며, 원논문 본문에는 local search라는 표현이 등장하지 않는다. Global 모드는 community 요약을 map-reduce 방식으로 종합해 corpus 전역 질문에 답하는 경로이고, GraphRAG가 sense-making 강점을 주장한 근거도 그 경로다.
따라서 이 논문의 GraphRAG 수치는 구현체의 Local 모드 성능이며, GraphRAG 원논문이 겨냥한 query-focused summarization 설정과 같지 않다. GraphRAG가 NarrativeQA에서 23.0으로 NV-Embed-v2의 25.7에 못 미친 결과를 GraphRAG 방법론 전체의 sense-making 한계로 읽으면 과잉 해석이 된다.
결과
QA 성능
Llama-3.3-70B-Instruct를 reader로 쓴 F1 점수다.
| 방법 | NQ | PopQA | MuSiQue | 2Wiki | HotpotQA | LV-Eval | NarrativeQA | Avg |
|---|---|---|---|---|---|---|---|---|
| None (retrieval 없음) | 54.9 | 32.5 | 26.1 | 42.8 | 47.3 | 6.0 | 12.9 | 38.4 |
| Contriever | 58.9 | 53.1 | 31.3 | 41.9 | 62.3 | 8.1 | 19.7 | 46.9 |
| BM25 | 59.0 | 49.9 | 28.8 | 51.2 | 63.4 | 5.9 | 18.3 | 47.7 |
| GTR (T5-base) | 59.9 | 56.2 | 34.6 | 52.8 | 62.8 | 7.1 | 19.9 | 50.4 |
| GTE-Qwen2-7B-Instruct | 62.0 | 56.3 | 40.9 | 60.0 | 71.0 | 7.1 | 21.3 | 54.9 |
| GritLM-7B | 61.3 | 55.8 | 44.8 | 60.6 | 73.3 | 9.8 | 23.9 | 56.1 |
| NV-Embed-v2 (7B) | 61.9 | 55.7 | 45.7 | 61.5 | 75.3 | 9.8 | 25.7 | 57.0 |
| RAPTOR | 50.7 | 56.2 | 28.9 | 52.1 | 69.5 | 5.0 | 21.4 | 48.8 |
| GraphRAG | 46.9 | 48.1 | 38.5 | 58.6 | 68.6 | 11.2 | 23.0 | 49.6 |
| LightRAG | 16.6 | 2.4 | 1.6 | 11.6 | 2.4 | 1.0 | 3.7 | 6.6 |
| HippoRAG | 55.3 | 55.9 | 35.1 | 71.8 | 63.5 | 8.4 | 16.3 | 53.1 |
| HippoRAG 2 | 63.3 | 56.2 | 48.6 | 71.0 | 75.5 | 12.9 | 25.9 | 59.8 |
HippoRAG 2가 평균 59.8로 가장 높고 NV-Embed-v2보다 2.8점 앞선다. 부트스트랩 검정에서 NQ, MuSiQue, 2Wiki, LV-Eval 네 곳의 개선이 유의했다(p < 0.05). 개별 항목의 격차는 2Wiki에서 9.5점, LV-Eval에서 3.1점으로 가장 크다.
주목할 대목이 세 가지 있다. 첫째, 2Wiki 단독 최고점은 HippoRAG의 71.8로 HippoRAG 2(71.0)보다 높다. 둘째, PopQA에서는 GTE-Qwen2-7B-Instruct의 56.3이 최고이고 HippoRAG 2는 56.2로 근소하게 뒤진다. 셋째, LightRAG의 재현 결과는 평균 6.6으로 retrieval 없는 기준선 38.4보다도 크게 낮다. 이 값은 논문이 지정한 QA 프롬프트로 응답을 다시 정형화한 조건에서 나온 것이라 LightRAG 원논문의 평가 설정과 다르다.
세 능력별 집계
Figure 1은 QA 결과를 세 능력으로 묶은 값이다.
| 방법 | 사실 기억 | sense-making | associativity |
|---|---|---|---|
| RAPTOR | 53.45 | 21.40 | 48.37 |
| GraphRAG | 47.50 | 23.00 | 53.49 |
| HippoRAG | 55.60 | 16.30 | 54.88 |
| NV-Embed-v2 | 58.80 | 25.70 | 58.81 |
| HippoRAG 2 | 59.75 | 25.90 | 62.96 |
각 방법이 자기 실험 설정 밖에서 가장 크게 하락한다는 관찰이 이 수치에 드러난다. HippoRAG는 사실 기억과 associativity에서 RAPTOR와 GraphRAG를 앞서지만 sense-making에서 16.30으로 다섯 방법 중 가장 낮다. RAPTOR는 sense-making이 21.40으로 GraphRAG보다 낮지 않지만 associativity가 48.37로 가장 낮다. HippoRAG 2만 세 능력 모두에서 가장 높은 값을 갖는다.
검색 성능
passage recall@5 기준이다. GraphRAG와 LightRAG는 passage 검색 결과를 직접 산출하지 않아 표에서 빠졌다.
| 방법 | NQ | PopQA | MuSiQue | 2Wiki | HotpotQA | Avg |
|---|---|---|---|---|---|---|
| BM25 | 56.1 | 35.7 | 43.5 | 65.3 | 74.8 | 55.1 |
| Contriever | 54.6 | 43.2 | 46.6 | 57.5 | 75.3 | 55.4 |
| GTR (T5-base) | 63.4 | 49.4 | 49.1 | 67.9 | 73.9 | 60.7 |
| GTE-Qwen2-7B-Instruct | 74.3 | 50.6 | 63.6 | 74.8 | 89.1 | 70.5 |
| GritLM-7B | 76.6 | 50.1 | 65.9 | 76.0 | 92.4 | 72.2 |
| NV-Embed-v2 (7B) | 75.4 | 51.0 | 69.7 | 76.5 | 94.5 | 73.4 |
| RAPTOR | 68.3 | 48.7 | 57.8 | 66.2 | 86.9 | 65.6 |
| HippoRAG (원 논문 보고) | 없음 | 없음 | 51.9 | 89.1 | 77.7 | 없음 |
| HippoRAG (재현) | 44.4 | 53.8 | 53.2 | 90.4 | 77.3 | 63.8 |
| HippoRAG 2 | 78.0 | 51.7 | 74.7 | 90.4 | 96.3 | 78.2 |
HippoRAG 2가 평균 78.2로 NV-Embed-v2의 73.4를 4.8%p 앞선다. MuSiQue에서 5.0%p, 2Wiki에서 13.9%p 차이가 난다. PopQA에서만 HippoRAG 재현판(53.8)이 HippoRAG 2(51.7)와 NV-Embed-v2(51.0)를 앞서는데, 개체 중심 검색이 강한 데이터셋이라서다.
재현 실험과 원 논문 보고값의 차이도 기록해 둘 만하다. HippoRAG 재현판은 MuSiQue에서 51.9에서 53.2로, 2Wiki에서 89.1에서 90.4로 각각 1.3%p 올랐고 HotpotQA에서는 77.7에서 77.3으로 0.4%p 내려갔다. 논문은 이 개선폭을 "1.3% increase in F1"이라 쓰지만 Table 3이 보고하는 값은 passage recall@5다.
recall@2 결과
reader를 GPT-4o-mini로 바꾼 HippoRAG 2는 recall@2 59.3에 recall@5 77.7을 기록해, Llama 판(61.1과 78.2)과 거의 같다. recall@2의 개선 추세도 recall@5와 비슷하다.
지속 학습 실험
NQ와 MuSiQue를 각각 네 등분해 한 구간을 평가용으로 두고 나머지를 순차적으로 corpus에 넣었다. 각 구간은 약 250개 질문의 정답 문서와 distractor를 담는다. distractor는 검색 후보로 함께 노출되지만 정답에는 필요 없는 문서를 뜻한다.
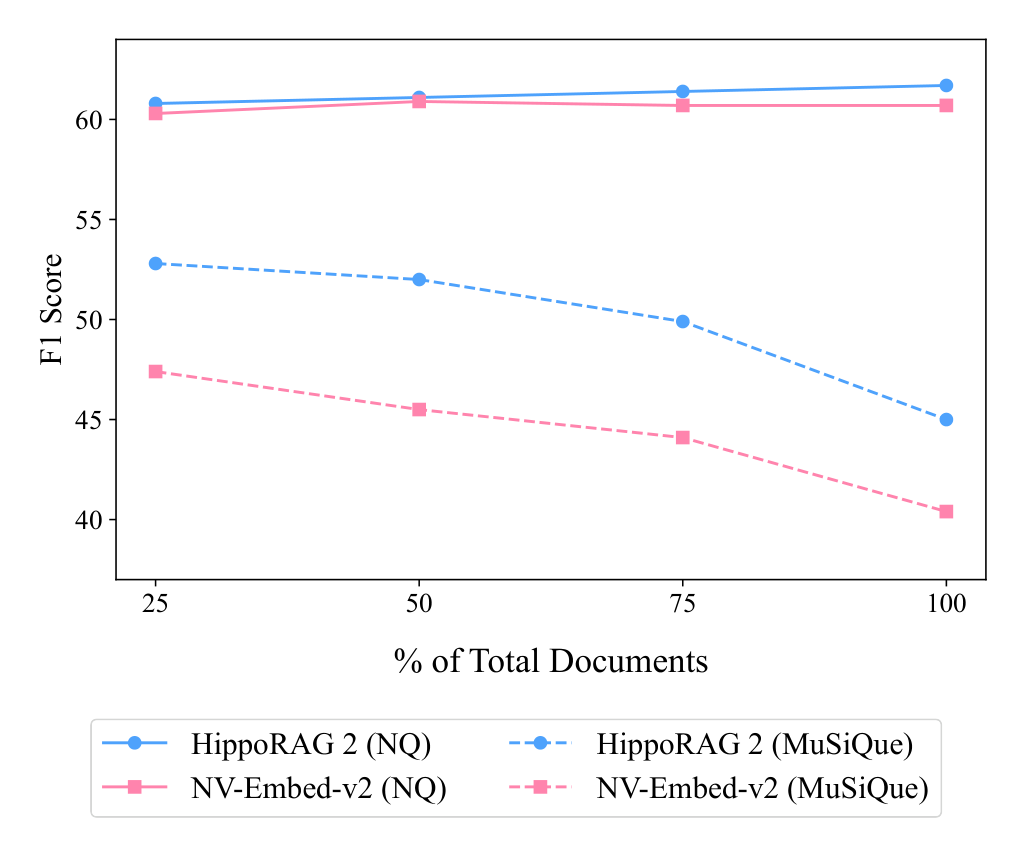
NQ에서는 두 방법 모두 60 부근을 유지하지만, MuSiQue에서는 corpus가 25%에서 100%로 늘어남에 따라 두 방법이 비슷한 속도로 내려간다. 논문은 이 차이를 근거로 앞으로의 지속 학습 벤치마크가 여러 난이도의 과제를 함께 담아야 한다고 주장한다.
Ablation
multi-hop QA의 passage recall@5다.
| 설정 | MuSiQue | 2Wiki | HotpotQA | Avg | 기본 대비 |
|---|---|---|---|---|---|
| HippoRAG 2 | 74.7 | 90.4 | 96.3 | 87.1 | 기준 |
| w/ NER to node | 53.8 | 91.2 | 78.8 | 74.6 | -12.5%p |
| w/ Query to node | 44.9 | 65.5 | 68.3 | 59.6 | -27.5%p |
| w/o Passage Node | 63.7 | 90.3 | 88.9 | 81.0 | -6.1%p |
| w/o Filter | 73.0 | 90.7 | 95.4 | 86.4 | -0.7%p |
세 장치의 기여도가 뚜렷하게 갈린다. 질의 연결 방식이 가장 크고, passage node가 그다음이며, triple filter의 기여는 0.7%p로 작다. NER-to-node와 query-to-node에는 필터를 적용하지 않았으므로, query-to-triple의 우위는 필터 적용 여부와 무관하게 성립한다.
데이터셋별로 보면 2Wiki가 예외다. NER-to-node(91.2)와 필터 제거(90.7) 모두 기본 설정(90.4)보다 높다. 2Wiki는 개체 중심 질문이 많아 개체 매칭만으로도 충분한 경우가 많다는 뜻으로 읽힌다.
weight factor 탐색
passage node의 reset probability에 곱하는 weight factor를 바꿔 가며 잰 recall@5다. 두 dev set은 각각 1,000건이다.
| weight | 0.01 | 0.05 | 0.1 | 0.3 | 0.5 |
|---|---|---|---|---|---|
| MuSiQue dev | 79.9 | 80.5 | 79.8 | 78.4 | 77.9 |
| NQ dev | 75.6 | 76.9 | 76.9 | 76.7 | 76.4 |
MuSiQue는 0.05에서 최고치를 찍고 값을 키울수록 내려간다. NQ는 0.05와 0.1이 동률이고 변화 폭이 1.3%p로 작다. 두 데이터셋을 함께 보고 기본값을 0.05로 정했다. 값이 커질수록 passage node 쪽으로 확률 질량이 쏠려 그래프 전파의 이득이 줄어드는 흐름이다.
retriever 교체
MuSiQue 부분집합의 recall@5다.
| retriever | dense retrieval 단독 | HippoRAG 2 | 차이 |
|---|---|---|---|
| GTE-Qwen2-7B-Instruct | 63.6 | 68.8 | +5.2%p |
| GritLM-7B | 66.0 | 71.6 | +5.6%p |
| NV-Embed-v2 (7B) | 69.7 | 74.7 | +5.0%p |
세 retriever 모두에서 5%p 안팎의 이득이 유지된다. HippoRAG 2의 효과가 특정 임베딩 모델에 의존하지 않는다는 근거다.
reader 교체
GPT-4o-mini를 인덱싱과 QA reading에 함께 쓴 경우의 EM과 F1 평균이다.
| 방법 | Llama-3.3-70B-Instruct | GPT-4o-mini |
|---|---|---|
| None (retrieval 없음) | 29.7 / 38.4 | 22.6 / 33.1 |
| NV-Embed-v2 (7B) | 45.9 / 57.0 | 42.9 / 55.7 |
| RAPTOR | 38.1 / 48.8 | 36.9 / 49.7 |
| GraphRAG | 36.7 / 49.6 | 36.0 / 52.6 |
| LightRAG | 4.2 / 6.6 | 3.6 / 13.9 |
| HippoRAG | 42.8 / 53.1 | 38.9 / 51.2 |
| HippoRAG 2 | 48.0 / 59.8 | 44.3 / 58.1 |
reader를 바꿔도 순위가 뒤집히지 않는다. GPT-4o-mini 쪽에서도 HippoRAG 2가 평균 44.3 / 58.1로 가장 높고, LV-Eval에서 10.5 / 14.0으로 NV-Embed-v2의 7.3 / 10.0을 가장 크게 앞선다. LV-Eval은 지식 누출을 줄인 데이터셋이므로, 파라미터에 든 지식이 아니라 검색으로 답을 만든 정도가 여기서 드러난다.
정성 사례
| 질문 유형 | 질문 | NV-Embed-v2 상위 결과 | HippoRAG 2 filtered triple | HippoRAG 2 상위 결과 |
|---|---|---|---|---|
| Simple QA | In what city was I.P. Paul born? | 1. I. P. Paul, 2. Yinka Ayefele, 3. Paul Parker | (I. P. Paul, from, Thrissur), (I. P. Paul, was mayor of, Thrissur municipal corporation) | 1. I. P. Paul, 2. Thrissur, 3. Yinka Ayefele |
| Multi-Hop QA | What county is Erik Hort's birthplace a part of? | 1. Erik Hort, 2. Horton Park, 3. Hertfordshire | (Erik Hort, born in, Montebello), (Erik Hort, born in, New York) | 1. Erik Hort, 2. Horton Park, 3. Montebello, New York |
simple QA 사례에서 NV-Embed-v2는 질문에 언급된 개체 passage를 1위로 올렸고 그것만으로 답이 나온다. HippoRAG 2는 triple 연결 단계에서 답인 Thrissur를 직접 찾아내고 그 passage까지 2위에 올렸다.
multi-hop 사례에서 NV-Embed-v2는 Erik Hort passage는 찾았지만 두 번째 단계로 넘어가지 못했다. HippoRAG 2는 query-to-triple 단계에서 Montebello passage를 끌어왔고 이어진 그래프 검색에서도 상위에 배치했다.
그래프 규모
Llama-3.3-70B-Instruct로 OpenIE를 수행한 경우의 KG 통계다.
| 항목 | NQ | PopQA | MuSiQue | 2Wiki | HotpotQA | LV-Eval | NarrativeQA |
|---|---|---|---|---|---|---|---|
| phrase node | 68,375 | 76,539 | 85,288 | 44,004 | 81,200 | 175,195 | 9,224 |
| passage node | 9,633 | 8,676 | 11,656 | 6,119 | 9,811 | 22,849 | 4,111 |
| extracted edge | 125,777 | 124,579 | 140,830 | 68,881 | 130,058 | 314,324 | 26,208 |
| synonym edge | 899,031 | 845,014 | 1,125,951 | 593,298 | 994,187 | 2,674,833 | 72,494 |
| context edge | 126,757 | 118,909 | 132,586 | 64,132 | 122,437 | 375,424 | 33,395 |
| total edge | 1,151,565 | 1,088,502 | 1,399,367 | 726,311 | 1,246,682 | 3,364,581 | 132,097 |
어느 데이터셋에서도 synonym edge가 전체 edge의 압도적 다수를 차지한다. MuSiQue를 예로 들면 총 139만 9,367개 edge 중 synonym edge가 112만 5,951개로 약 80%다. 임계값 0.8이라는 설정이 그래프 규모를 결정하는 주된 변수임을 보여 준다.
OpenIE에 GPT-4o-mini를 쓰면 phrase node가 일관되게 늘어난다. MuSiQue에서 8만 5,288개가 10만 1,641개로, NarrativeQA에서 9,224개가 1만 5,365개로 늘어난다.
비용과 효율
MuSiQue corpus 1만 1,656개 passage 기준이다. 괄호 안은 HippoRAG 2를 100%로 놓은 비율이다.
| 항목 | NV-Embed-v2 | RAPTOR | LightRAG | GraphRAG | HippoRAG | HippoRAG 2 |
|---|---|---|---|---|---|---|
| Input Tokens | 없음 | 1.7M (18.5%) | 68.5M (744.6%) | 115.5M (1255.4%) | 9.2M (100.0%) | 9.2M (100.0%) |
| Output Tokens | 없음 | 0.2M (6.7%) | 18.3M (610.0%) | 36.1M (1203.3%) | 3.0M (100.0%) | 3.0M (100.0%) |
| Indexing Time (분) | 12.1 (12.3%) | 100.5 (101.0%) | 235.0 (236.2%) | 277.0 (278.4%) | 57.5 (57.7%) | 99.5 (100.0%) |
| QA Time/Query (초) | 0.3 (25.0%) | 0.6 (50.0%) | 13.3 (1008.3%) | 10.7 (891.7%) | 0.9 (75.0%) | 1.2 (100.0%) |
| QA GPU Memory (GB) | 1.7 (17.2%) | 1.4 (14.1%) | 4.5 (45.5%) | 3.7 (37.4%) | 6.0 (60.6%) | 9.9 (100.0%) |
모델 가중치가 차지하는 메모리는 모든 시스템이 공유하므로 제외했다. HippoRAG 2의 인덱싱 토큰은 HippoRAG와 같다. 그래프 구성 방식이 같고 passage node 추가에는 LLM 호출이 들지 않기 때문이다. GraphRAG와 비교하면 입력 토큰이 약 12분의 1, 질의당 시간이 약 9분의 1이다.
대신 GPU memory는 9.9GB로 비교 대상 중 가장 크다. triple 자체를 임베딩해 보관하기 때문이며, 논문은 성능 이득을 감안하면 받아들일 만한 절충이라고 본다. 시간과 메모리에서 표준 RAG보다 불리한 것은 모든 structure-augmented 방법에 공통되지만, 그중 성능으로 표준 RAG를 실질적으로 앞선 것은 HippoRAG 2뿐이라는 것이 논문의 정리다.
한계
오류 분석
recall@5가 1.0에 못 미친 샘플 100건을 분석했다. hop 분포는 2-hop 26%, 3-hop 41%, 4-hop 33%다.
| 구간 | 관찰 | 비율 |
|---|---|---|
| recognition memory | 필터 전에 이미 근거 문서의 phrase가 하나도 매칭되지 않음 | 7% |
| recognition memory | 필터 후에 근거 문서의 phrase가 하나도 매칭되지 않음 | 26% |
| recognition memory | 필터 후 근거 phrase 비율이 오히려 감소 | 8% |
| recognition memory | 필터 후 triple이 0개 | 18% |
| graph construction | 연결된 노드의 1-hop 이웃에 근거 문서 phrase가 전혀 없음 | 2% |
| Personalized PageRank | 연결된 phrase node의 절반 이상이 근거 문서에 있는데도 결과가 미흡 | 50% |
필터 전 7%가 필터 후 26%로 늘어난다는 것은 recognition memory가 필요한 근거를 함께 걸러 냈다는 뜻이다. 필터 후 triple이 0개가 되는 18%는 필터의 오류라기보다 연결 시도 자체가 실패한 경우이고, 이때 HippoRAG 2는 dense retrieval 결과를 대신 쓴다.
그래프 구성 실패가 2%에 그친 점을 근거로, 저자들은 dense-sparse integration 덕분에 그래프가 활용 가능한 정보를 대체로 담고 있다고 판단한다. 남는 병목은 필터의 정밀도와 그래프 검색 두 가지다. 특히 마지막 항목이 크다. 연결까지는 제대로 됐는데도 절반의 경우에서 PPR이 정답 근거를 상위 5개 안에 올리지 못한다.
오류 사례 두 건
| 항목 | 사례 1 | 사례 2 |
|---|---|---|
| 질문 | Bernhard Lichtenberg의 종교를 개혁하려던 인물이 사망 전 Marian devotion 설교를 한 지역구의 위치는? | Philippe, Duke of Orléans의 할머니는 누구인가? |
| 정답 | Saxony-Anhalt | Marie de' Medici |
| 근거 passage | Mary, mother of Jesus / Reformation / Wittenberg (district) / Bernhard Lichtenberg | Philippe I, Duke of Orléans / Leonora Dori |
| recall@5 | 0.75 | 0.5 |
| 실패 지점 | 필터가 후보 5개를 전부 버려 빈 리스트를 반환했다 | 검색된 top-5 triple이 Bank of America 관련으로 전부 어긋났다 |
사례 1은 recognition memory가 관련 phrase를 모두 제거해 버린 경우다. 사례 2는 query-to-triple 단계에서 이미 엉뚱한 triple을 가져온 경우이며, 필터는 그중 두 개를 남겼지만 애초에 후보가 잘못돼 있었다. 원문은 사례 2에서 recognition memory가 핵심 phrase를 제대로 잡았음에도 그래프 검색이 상위 5개 안에 근거를 올리지 못했다고 서술한다.
비용 부담
인덱싱 99.5분과 QA GPU memory 9.9GB는 NV-Embed-v2의 12.1분과 1.7GB보다 크다. 질의당 시간도 1.2초로 NV-Embed-v2의 0.3초보다 네 배 길다. 실시간 응답이 필요한 환경에서는 이 차이가 제약이 된다.
associativity의 지속적 하락
corpus가 커질 때 MuSiQue 성능이 내려가는 흐름은 HippoRAG 2도 피하지 못한다. 그래프 구조가 절대 성능을 올리기는 하지만 corpus 확장에 따른 열화 속도 자체를 늦추지는 못한다.
자료 안의 불일치
원문 안에서 값이 어긋나거나 근거를 확인할 수 없는 대목이 두 군데 있다. 삭제하지 않고 기록해 둔다.
| 위치 | 내용 |
|---|---|
| 초록과 서론 | 초록은 associative memory 과제에서 "7% 개선"이라 쓰고, 서론은 같은 취지를 "평균 7점 개선"이라 쓴다. Figure 1의 associativity 값 차이는 62.96 대 58.81로 4.15점이고, Table 3의 multi-hop recall@5 차이는 약 7%p다. 둘 중 어느 지표를 가리키는지 원문이 밝히지 않는다 |
| Table 10 | GPT-4o-mini로 만든 PopQA 그래프의 total edge가 49만 4,082개로 적혀 있으나, 같은 열의 extracted edge(10만 8,989개)와 synonym edge(90만 1,528개)와 context edge(12만 7,568개)를 더하면 113만 8,085개다. 다른 모든 열은 세 값의 합과 total edge가 일치한다 |
| 5절 검색 성능 서술 | 대형 임베딩 모델의 우위를 "9.8% higher F1", HippoRAG 재현판의 개선폭을 "1.3% increase in F1"이라 쓴다. 두 값 모두 Table 3의 recall@5 차이와 정확히 일치하고 F1과는 무관하다. 해당 절이 다루는 표가 recall@5 표이므로 지표 이름을 잘못 적은 것으로 보인다 |
평가 조건의 제약
GraphRAG와 LightRAG 수치는 두 방법의 원논문 평가 설정이 아니라 이 논문이 정한 조건에서 나온 값이다. 두 방법 모두 Local 모드로 실행됐고, 응답은 HippoRAG에서 물려받은 QA 프롬프트로 다시 정형화됐다. LightRAG 평균 6.6처럼 극단적으로 낮은 값은 이 재정형화 과정을 함께 고려해 읽어야 한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Personalized PageRank (PPR) | seed node와 그 이웃 쪽으로 확률 질량을 몰아주도록 PageRank를 변형한 알고리즘. HippoRAG 계열의 맥락 기반 retrieval 엔진이다 |
| Phrase node | OpenIE triple의 subject나 object에 해당하는 KG 노드. 개념을 sparse하게 표현한다 |
| Passage node | passage 하나를 통째로 나타내는 KG 노드. HippoRAG 2가 새로 넣었고 맥락을 dense하게 표현한다 |
| Reset probability | PPR에서 random walk가 특정 노드로 되돌아갈 확률. 이 값을 배정하는 것이 seed node를 지정하는 행위다 |
| Recognition memory | 주어진 단서를 보고 알아보는 인간의 기억 재인을 본뜬 LLM triple 필터링 단계 |
| Dense-Sparse Integration | 뇌의 dense coding(맥락)과 sparse coding(개념)을 하나의 KG 안에서 통합하는 설계 원칙 |
관련 페이지
- GraphRAG: From Local to Global: graph 기반 RAG의 원논문. 이 논문이 sense-making 계열 비교 대상으로 재현했고, Local 모드로 실행했다는 설정 차이를 함께 읽어야 한다.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): 그래프와 벡터 retrieval을 결합한 후속 연구. 이 논문의 재현 실험에서 QA 평균 6.6으로 가장 낮게 나온 방법이다.
- Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): graph 기반 RAG 계보를 정리한 한국어 세미나. HippoRAG와 HippoRAG 2를 연구 흐름도에 배치하고 있으며, 계층 방법론인 HiRAG와는 별개 계보로 구분한다.
- Rethinking Retrieval: From Traditional Retrieval Augmented Generation to Agentic and Non-Vector Reasoning Systems in the Financial Domain for Large Language Models: retrieval을 도구 검색 관점에서 다시 본 논문. 검색 단위를 무엇으로 잡을 것인가라는 질문을 공유한다.