Database · PAPER · 2024
GraphRAG: From Local to Global
요약
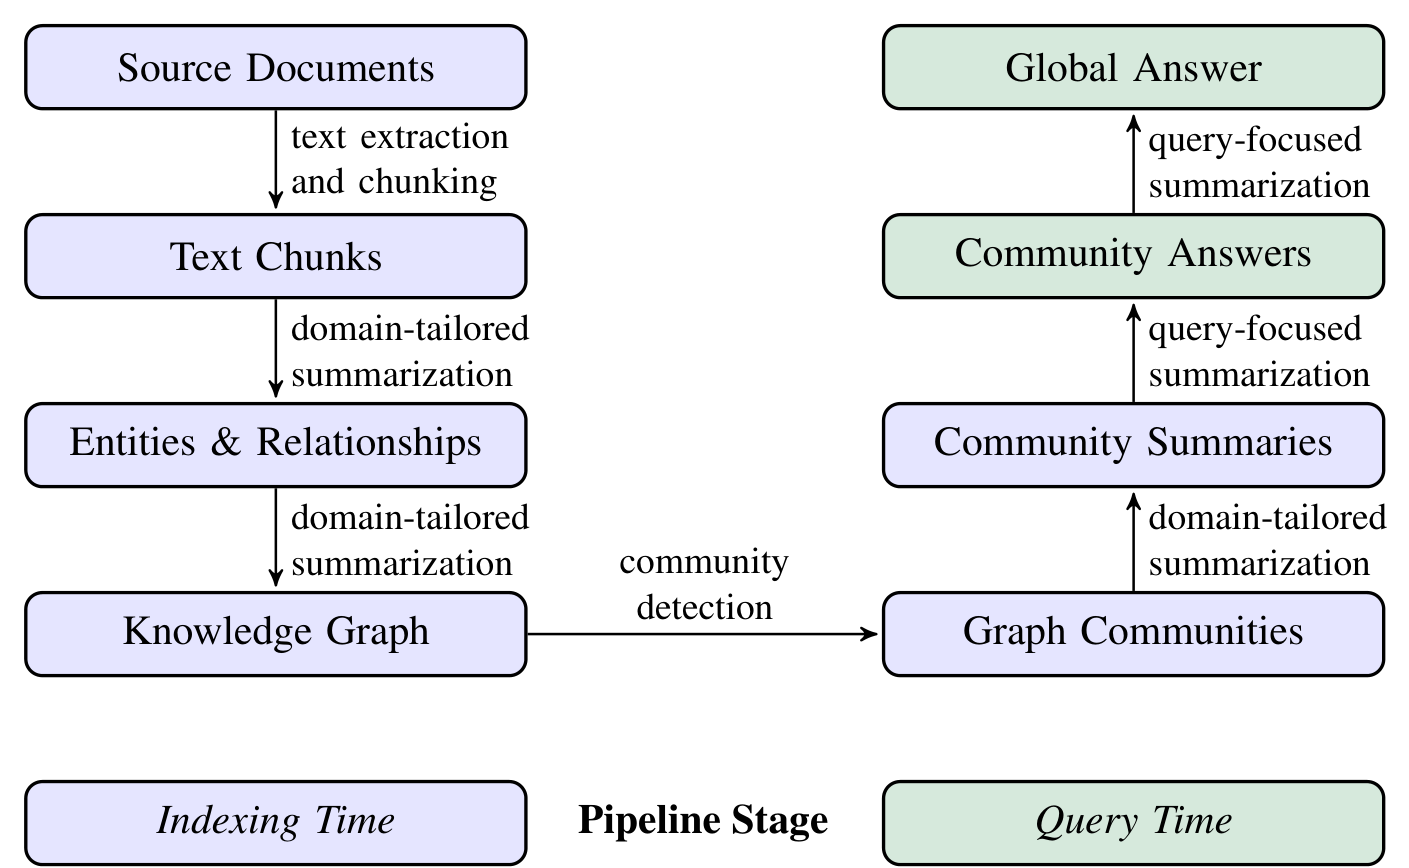
GraphRAG는 문서 집합 전체를 LLM으로 knowledge graph로 바꾼 뒤, 그 graph를 주제 단위 community로 나누고 community마다 요약문을 미리 만들어 두는 RAG 방법이다. 질의가 들어오면 요약문마다 부분 답변을 병렬로 만들고, 그 부분 답변들을 다시 한 번 요약해 최종 답변을 낸다.
이 논문이 겨냥하는 질문은 "이 데이터셋의 주요 테마는 무엇인가" 같은 corpus 전역 질의다. 기존 RAG는 질의와 유사한 문서 조각 몇 개를 찾아 오는 구조라서, 답이 특정 조각에 있지 않고 전체에 흩어져 있는 질문에는 원리적으로 대응하지 못한다.
Microsoft Research가 2024년 4월에 공개하고 2025년 2월에 v2로 갱신한 preprint이며, 공식 구현체 microsoft/graphrag가 MIT 라이선스로 배포된다. 논문 1절에 따르면 GraphRAG 방법의 변형은 LangChain, LlamaIndex, NebulaGraph, Neo4J의 확장으로도 제공된다. 약 100만 토큰 규모 corpus 두 개에서 vector RAG 대비 comprehensiveness와 diversity 승률이 72%에서 83% 사이로 나왔고, 가장 추상적인 root-level 요약만 써도 원본 텍스트 요약 대비 토큰을 9배에서 43배 줄이면서 우위를 유지한다.
배경
RAG가 답하지 못하는 질문의 종류가 이 논문의 출발점이다. 통상적인 RAG는 사용자 질의와 의미적으로 가까운 문서 조각을 벡터 공간에서 찾아 context window에 넣고 답을 생성한다. context window는 모델이 한 번에 받아들일 수 있는 토큰 길이 한도를 뜻한다.
이 구조는 답이 소수의 조각 안에 국소적으로 들어 있을 때 잘 작동한다. 논문은 이 계열을 통칭해 vector RAG라고 부른다.
반면 sensemaking 질의는 성격이 다르다. sensemaking은 사람, 장소, 사건 사이의 연결에 의미를 부여해 그 흐름을 예측하고 효과적으로 행동하기 위한 과정을 가리킨다(Klein et al., 2006). "지난 10년간 학제간 연구가 과학적 발견에 미친 핵심 동향은 무엇인가" 같은 질문이 여기 해당한다. 답이 어느 한 문단에 있지 않으므로 유사도 검색으로는 근거를 모을 수 없다.
이런 질의는 사실 retrieval 과제가 아니라 query-focused summarization(QFS) 과제다. 그런데 기존 QFS 기법은 RAG가 다루는 규모의 텍스트로 확장되지 않는다는 반대 방향의 한계를 갖는다.
GraphRAG는 두 계열의 강점을 결합하는 것을 목표로 한다. 질의의 일반성과 원본 텍스트의 양 양쪽으로 확장되는 방식을 만드는 것이 논문의 과제다.
핵심 개념
graph index는 원본 문서를 벡터 대신 node와 edge로 인덱싱한 구조를 말한다. node는 corpus의 주요 entity, edge는 entity 사이의 relationship에 대응한다. GraphRAG는 여기에 covariate로 claim을 덧붙인다.
claim은 정답이라면 답에 담겨 있어야 하는 검증 가능한 사실 진술이다. GraphRAG는 entity에 관한 날짜, 사건, 다른 entity와의 상호작용을 claim으로 뽑아 graph에 붙인다.
community detection은 graph를 강하게 연결된 node 묶음으로 나누는 clustering 기법이다. 판정 기준은 modularity, 즉 무작위 graph와 비교해 community 내부의 edge가 얼마나 더 조밀한지를 재는 값이다.
이 논문에서 community 분할이 결정적인 이유는 각 level의 partition이 상호 배타적이면서 전체를 덮기 때문이다. 즉 모든 node가 정확히 하나의 community에 속하므로, corpus 전체를 나눠서 요약한 뒤 합치는 divide-and-conquer 전략이 성립한다.
map-reduce answering은 이 성질을 질의 시점에 활용하는 방식이다. 여러 community 요약에 대해 부분 답변을 병렬로 만드는 단계가 map이고, 그 부분 답변들을 하나의 답으로 합치는 단계가 reduce다.
인덱싱 파이프라인
인덱싱은 원본 문서에서 community summary까지 다섯 단계로 진행된다. 모든 LLM 호출은 GPT-4-turbo로 통일했다.
| 단계 | 입력 | 출력 | LLM의 역할 |
|---|---|---|---|
| 1. 분할 | 원본 문서 | text chunk | 없음 (고정 크기 분할) |
| 2. 추출 | text chunk | entity, relationship, claim instance | multipart 프롬프트로 추출 |
| 3. 통합 | element instance | knowledge graph | 중복 description을 하나로 요약 |
| 4. 분할 | knowledge graph | hierarchical graph community | 없음 (Leiden 알고리즘) |
| 5. 요약 | graph community | community summary | report 형식으로 생성 |
텍스트 분할과 self-reflection
첫 단계는 문서를 고정 크기 chunk로 자르는 것이다. 실험 설정은 600 토큰 chunk에 100 토큰 overlap이다.
chunk 크기는 단순한 구현 세부가 아니라 비용과 품질을 가르는 설계 결정이다. chunk가 길면 추출에 필요한 LLM 호출 수가 줄어 비용이 내려가지만, chunk 앞부분에 나온 정보의 recall이 떨어진다. 실제로 HotPotQA 데이터셋에서 chunk 크기가 600 토큰일 때 GPT-4가 2400 토큰일 때보다 거의 2배 많은 entity reference를 뽑았다.
논문은 이 상충을 self-reflection으로 해소한다. self-reflection은 LLM이 자기 출력을 스스로 평가하고 부족한 부분을 다시 채우게 하는 프롬프트 기법이다. GraphRAG는 이를 gleaning이라 부르며 두 프롬프트로 구현한다.
LOOP_PROMPT: 추출한 entity를 다시 보여 주고 "빠뜨린 entity가 남았는가"를 Y 또는 N으로만 답하게 한다. logit bias를 100으로 걸어 다른 토큰이 나오지 않도록 강제한다.CONTINUE_PROMPT: 답이 Y면 "직전 추출에서 MANY entities were missed"라고 알려 추가 추출을 유도한다.
이 절차를 지정한 최대 횟수까지 반복한다.
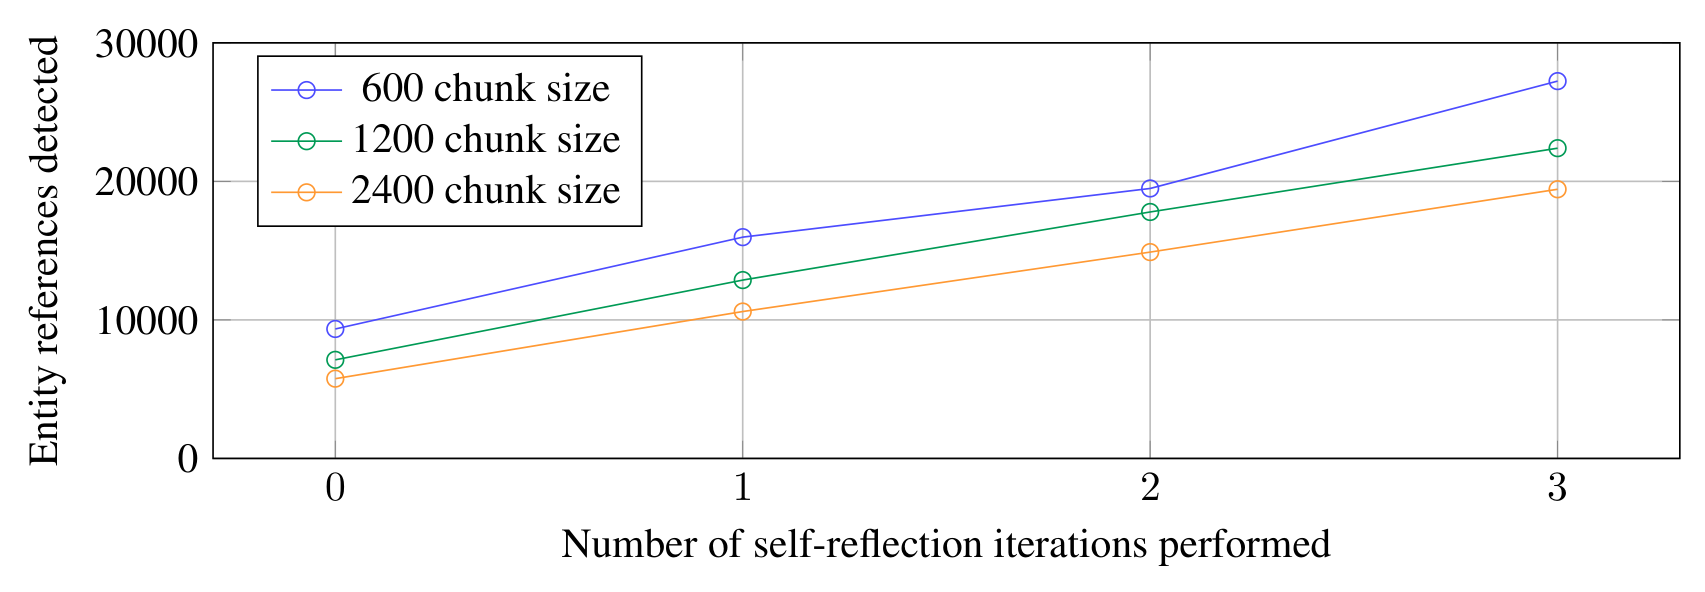
반복을 세 번까지 수행하면 2400 토큰 chunk도 반복 없는 600 토큰 chunk의 두 배가 넘는 entity를 검출한다. 따라서 self-reflection은 큰 chunk를 쓰면서 호출 비용을 낮추고 추출 품질도 지키는 장치가 된다.
entity와 relationship 추출
추출 프롬프트는 두 부분으로 나뉜다. 먼저 텍스트에 등장하는 모든 entity를 이름, type, description으로 뽑고, 그다음 명확히 관련된 entity 쌍을 골라 source, target, relationship description, relationship strength로 뽑는다. 두 결과를 구분자로 이어 붙인 하나의 리스트로 출력하게 한다.
논문의 예시는 다음과 같다. "NeoChip의 주식이 NewTech Exchange 상장 첫 주에 급등했다. NeoChip은 2016년 Quantum Systems에 인수되었던 비상장 기업이다"라는 chunk에서 LLM은 NeoChip과 Quantum Systems를 entity로, 두 회사 사이의 소유 관계를 relationship으로 뽑는다.
프롬프트 예시를 도메인에 맞춰 갈아 끼우면 그대로 도메인 적응이 된다. 기본 프롬프트는 사람, 장소, 조직 같은 일반 named entity를 대상으로 하고, 과학이나 의학이나 법률처럼 전문 지식이 필요한 도메인은 해당 분야의 few-shot 예시로 교체한다. in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력을 말한다.
claim 추출은 별도 프롬프트로 수행한다. subject, object, claim type, status, date range, source quote를 뽑으며 status는 TRUE, FALSE, SUSPECTED 중 하나다. 같은 NeoChip 예시에서는 "NeoChip의 주식이 상장 첫 주에 급등했다" 같은 진술이 claim으로 분리된다.
knowledge graph 통합
LLM으로 entity와 relationship과 claim을 뽑는 행위 자체가 일종의 추상적 요약이다. relationship과 claim은 원문에 그대로 적혀 있지 않은 경우가 많기 때문이다.
같은 element는 문서 여러 곳에서 반복 검출되므로 instance가 여러 개 생긴다. 통합 단계는 이 instance들을 하나의 node와 edge로 묶고, 흩어져 있던 description을 LLM이 하나의 포괄적 description으로 합친다. relationship의 중복 횟수는 그대로 edge weight가 된다.
entity matching, 즉 같은 대상을 가리키는 서로 다른 표기를 하나로 맞추는 작업에는 단순 exact string match를 썼다. 더 느슨한 매칭도 프롬프트나 코드 수정으로 적용할 수 있지만, 중복 entity는 뒤따르는 community 단계에서 어차피 같은 묶음으로 모이기 때문에 GraphRAG는 중복에 비교적 robust하다.
Leiden community 분할
community detection 알고리즘은 여러 후보가 있고 GraphRAG는 Leiden을 쓴다. Leiden은 Louvain의 개선판으로, Louvain이 갖고 있던 문제 하나를 고친 알고리즘이다.
| 알고리즘 | 구성 | 특성 |
|---|---|---|
| Louvain (2008) | Local Moving, Aggregation | greedy modularity 최적화. 같은 community 안의 node가 서로 연결되지 않는 disconnected community가 생길 수 있다 |
| Leiden (2019) | Local Moving, Refinement, Aggregation | Refinement 단계로 모든 community의 내부 연결성을 보장한다. GraphRAG의 기본값이며 graspologic 라이브러리로 구현했다 |
Leiden을 계층적으로 적용해, 더 나눌 수 없는 leaf community에 도달할 때까지 각 community 안에서 재귀적으로 sub-community를 찾는다. 그 결과 level 0(root)부터 leaf까지 이어지는 community hierarchy가 만들어진다.
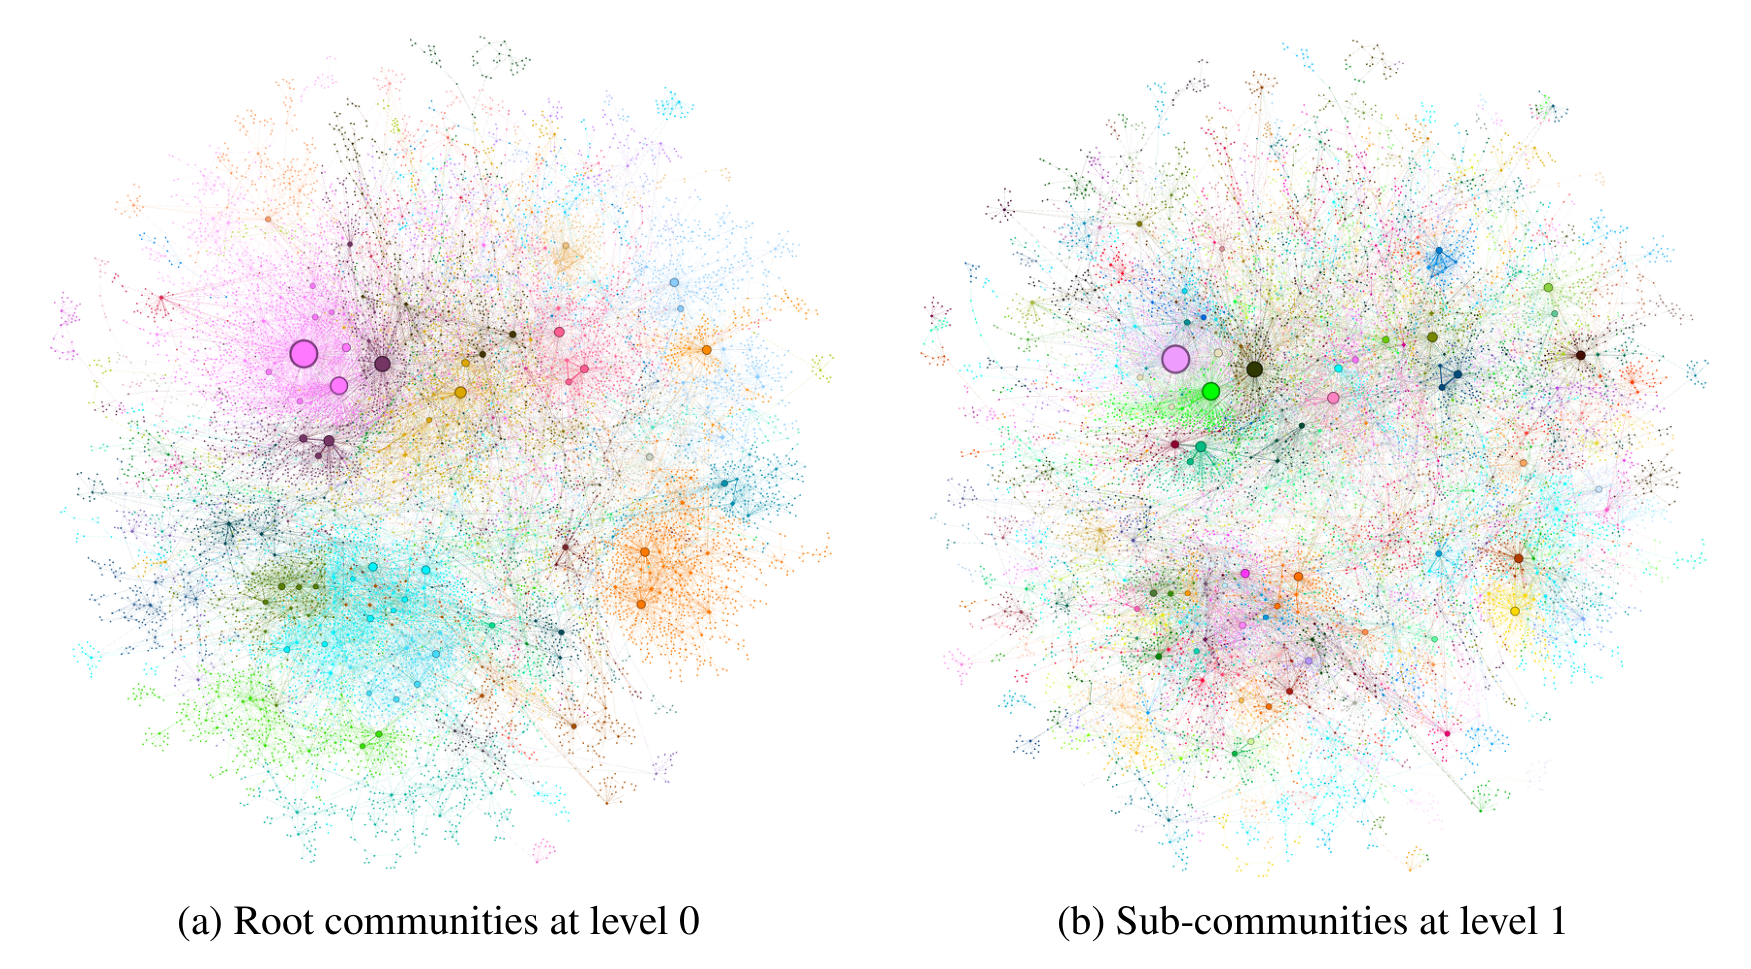
레이아웃은 OpenORD와 Force Atlas 2로 계산했다. 두 그림을 비교하면 level 0에서 하나의 색으로 묶였던 큰 덩어리가 level 1에서 여러 색으로 분화하는 것이 보인다.
community summary 생성
각 community를 report 형태의 문서로 요약한다. 이 요약문은 질의 처리의 재료일 뿐 아니라 그 자체로도 유용하다. 사용자가 상위 level 요약을 훑어 관심 주제를 고르고, 하위 level 요약으로 내려가 세부를 읽는 탐색이 가능하기 때문이다.
report의 구조는 프롬프트로 고정한다.
| 필드 | 내용 |
|---|---|
| TITLE | community를 대표하는 짧고 구체적인 이름. 가능하면 대표 named entity를 포함한다 |
| SUMMARY | community의 전체 구조와 entity 사이의 관계를 담은 요약 |
| IMPACT SEVERITY RATING | community의 중요도를 나타내는 0에서 10 사이 실수 점수 |
| RATING EXPLANATION | 그 점수를 준 이유를 한 문장으로 |
| DETAILED FINDINGS | 5개에서 10개의 핵심 통찰. 각 통찰은 짧은 요약과 여러 문단의 설명으로 구성한다 |
여기에 grounding rule이 붙는다. grounding은 모델 출력을 외부 근거에 붙들어 매는 것을 뜻한다. 각 서술에 [Data: Entities (5), Relationships (37, 38)] 형식으로 근거 레코드 id를 달게 하고, 한 참조에 5개를 넘기지 말고 대신 +more를 붙이라고 지시한다. 근거가 없는 정보는 넣지 말라는 규칙도 함께 준다.
요약 순서는 아래에서 위로 올라간다. level에 따라 처리 방식이 갈린다.
- Leaf-level community: community의 edge를 source node와 target node의 degree 합 내림차순으로 정렬한다. 그 순서대로 source description, target description, edge description, 관련 claim을 token limit이 찰 때까지 채워 넣는다. degree가 높은 node가 그 community에서 더 중요하다는 가정이 깔려 있다.
- Higher-level community: 하위 element summary가 전부 들어가면 leaf와 같은 방식으로 처리한다. 넘치면 element summary의 토큰 수가 큰 sub-community부터 그 sub-community의 짧은 요약문으로 치환해 나가며 context window에 맞춘다.
질의 처리
질의 처리는 community level 하나를 고른 상태에서 세 단계로 진행된다.
첫째, 해당 level의 community summary를 무작위로 섞고 사전에 정한 토큰 크기로 자른다. 섞는 이유는 중요한 정보가 한 chunk에 몰렸다가 통째로 유실되는 상황을 막기 위해서다.
둘째, map 단계에서 각 chunk마다 LLM이 부분 답변을 병렬로 만든다. 이때 그 답변이 질문에 얼마나 도움이 되는지를 나타내는 helpfulness score를 0에서 100 사이 정수로 함께 내게 한다. 점수가 0인 답변은 걸러낸다.
셋째, reduce 단계에서 부분 답변을 helpfulness score 내림차순으로 정렬해 새 컨텍스트에 token limit까지 누적하고, 그 컨텍스트로 최종 답변 하나를 생성한다.
community hierarchy가 있으므로 같은 질문을 서로 다른 level의 요약문으로 답할 수 있다. 어느 level이 상세도와 범위의 균형점인지가 실험의 주요 관심사가 된다.
평가 설계
전역 질의에는 정답 문서가 없다. 따라서 논문은 질문을 만드는 절차와 답을 채점하는 절차를 모두 새로 설계했다.
질문 생성
핵심 원칙은 질문을 corpus 본문이 아니라 corpus에 대한 짧은 설명에서 만든다는 점이다. 본문에서 직접 뽑으면 답이 어디에 있는지가 질문에 새어 들어가 공정한 평가가 되지 않기 때문이다.
Algorithm 1의 절차는 세 단계다.
- corpus 설명을 주고 잠재 사용자 persona K개를 만들게 한다.
- 각 persona가 이 RAG 시스템으로 수행할 task N개를 정하게 한다.
- (persona, task) 조합마다 corpus 전체 이해가 필요하고 특정 사실 검색으로는 풀리지 않는 질문 M개를 만들게 한다.
K=N=M=5로 두어 데이터셋당 125개 질문을 얻었다. 예를 들어 podcast 데이터셋에서는 "기술 산업의 통찰과 동향을 찾는 기술 전문 기자" persona와 "기술 리더가 정책과 규제의 역할을 어떻게 보는지 파악하기" task에서 "어느 에피소드가 기술 정책과 정부 규제를 주로 다루는가" 같은 질문이 생성되었다.
이런 접근을 adaptive benchmarking이라 부른다. 고정된 벤치마크 대신 대상 도메인에 맞춘 평가 문항을 그때그때 생성하는 방식이다.
데이터셋과 비교 조건
평가 corpus는 100만 토큰 규모의 실제 텍스트 두 종류다.
| 데이터셋 | 내용 | chunk 수 | 규모 | node | edge |
|---|---|---|---|---|---|
| Podcast transcripts | Microsoft CTO Kevin Scott의 대담 팟캐스트 전사문 | 1,669 | 약 100만 토큰 | 8,564 | 20,691 |
| News articles | 2013년 9월부터 2023년 12월까지의 뉴스 기사 (MultiHop-RAG) | 3,197 | 약 170만 토큰 | 15,754 | 19,520 |
비교 조건은 여섯 개이며, context window 크기와 답변 생성 프롬프트는 전부 동일하다. 컨텍스트를 무엇으로 채우는지만 다르다.
| 조건 | 컨텍스트 단위 | 설명 |
|---|---|---|
| C0 | root-level community summary | 개수가 가장 적고 추상도가 가장 높다 |
| C1 | high-level community summary | C0의 sub-community |
| C2 | intermediate-level community summary | C1의 sub-community |
| C3 | low-level community summary | 개수가 가장 많고 세밀하다 |
| TS | 원본 text chunk | map-reduce를 graph 없이 원본 텍스트에 직접 적용 |
| SS | 검색된 text chunk | vector RAG. 유사도 상위 chunk를 token limit까지 채운다 |
TS 조건이 중요한 대조군이다. TS와 C0에서 C3까지의 차이는 map-reduce 방식이 아니라 graph index의 유무이므로, 둘을 비교하면 graph가 기여한 몫만 분리해서 볼 수 있다.
평가 기준
정답이 없으므로 두 시스템의 답변을 LLM judge에게 나란히 주고 어느 쪽이 나은지 고르게 한다. 판정 결과는 승자(1, 2, 또는 무승부 0)와 이유를 담은 JSON으로 받는다.
| 기준 | 판정 질문 | 역할 |
|---|---|---|
| Comprehensiveness | 질문의 모든 측면과 세부를 얼마나 상세히 다루는가 | sensemaking 핵심 지표 |
| Diversity | 얼마나 다양한 관점과 통찰을 제공하는가 | sensemaking 핵심 지표 |
| Empowerment | 독자가 오도되지 않고 스스로 판단하도록 얼마나 돕는가 | sensemaking 핵심 지표 |
| Directness | 얼마나 구체적이고 간결하게 질문에 답하는가 | 통제 기준 |
directness는 앞의 세 기준과 반대 방향으로 작동하도록 일부러 넣은 통제 기준이다. 어떤 방법도 네 기준을 모두 이길 수는 없어야 하므로, directness에서 vector RAG가 이기는지 여부가 평가 절차 자체의 건전성을 확인해 주는 장치가 된다.
LLM 생성의 확률적 변동을 흡수하기 위해 각 비교를 5회 반복하고 질문과 반복에 대해 평균했다.
결과
vector RAG 대비 우위
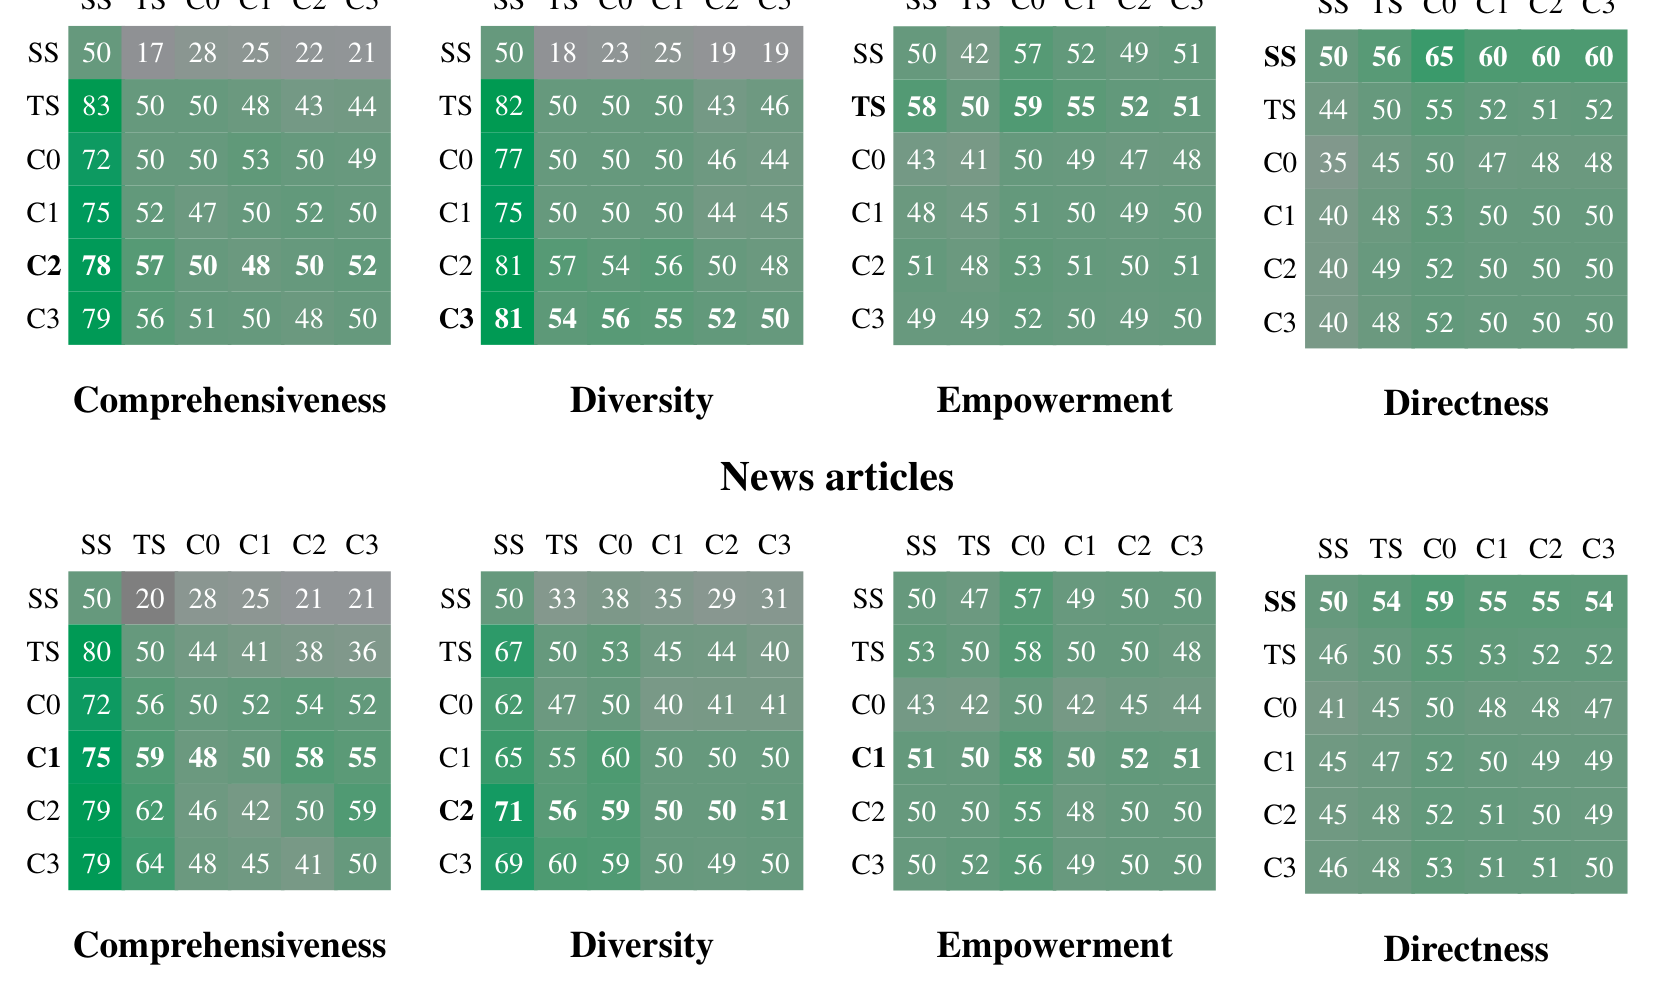
comprehensiveness와 diversity에서는 graph 기반 조건이 vector RAG를 큰 폭으로 앞선다. 아래는 각 조건이 SS를 상대로 얻은 승률이다.
| 조건 | Podcast comp. | News comp. | Podcast div. | News div. |
|---|---|---|---|---|
| C0 | 72% | 72% | 77% | 62% |
| C1 | 75% | 75% | 75% | 65% |
| C2 | 78% | 79% | 81% | 71% |
| C3 | 79% | 79% | 81% | 69% |
| TS | 83% | 80% | 82% | 67% |
comprehensiveness 승률은 Podcast에서 72%에서 83%, News에서 72%에서 80% 구간이며 모두 p<.001이다. diversity 승률은 Podcast에서 75%에서 82%(p<.001), News에서 62%에서 71%(p<.01) 구간이다.
Appendix G의 통계 분석은 이 결과를 보정된 p-value로 다시 확인해 준다. Shapiro-Wilk 검정에서 정규성이 기각되어 비모수 검정인 Wilcoxon 부호순위 검정을 썼고, 다중 비교 보정으로 Holm-Bonferroni를 적용했다.
| 비교 | Podcast 평균 점수 | Podcast p | News 평균 점수 | News p |
|---|---|---|---|---|
| C0 대 SS (comp.) | 71.92 대 28.08 | <0.001 | 71.76 대 28.24 | <0.001 |
| C3 대 SS (comp.) | 78.96 대 21.04 | <0.001 | 79.44 대 20.56 | <0.001 |
| TS 대 SS (comp.) | 83.12 대 16.88 | <0.001 | 79.60 대 20.40 | <0.001 |
| C0 대 SS (div.) | 76.56 대 23.44 | <0.001 | 62.08 대 37.92 | 0.003 |
| C2 대 SS (div.) | 80.56 대 19.44 | <0.001 | 70.56 대 29.44 | <0.001 |
empowerment는 결과가 혼조다. Podcast와 News 모두에서 C0는 오히려 SS에 졌고(각각 p=0.003, p=0.022), C1에서 C3까지는 SS와 통계적으로 구별되지 않았다. LLM이 남긴 판정 근거를 다시 LLM으로 분석해 보니, 구체적인 예시와 인용과 출처를 제시하는 능력이 독자의 이해를 돕는 데 결정적이라고 판단하고 있었다. vector RAG는 원문 조각을 그대로 들고 오므로 이 지점에서 유리하다.
directness에서는 vector RAG가 모든 비교에서 이겼다. 예를 들어 Podcast의 C0 대 SS 비교는 35.12 대 64.88로 SS가 앞선다. 이 결과는 통제 기준이 설계 의도대로 작동했음을 보여 준다.
community summary와 원본 텍스트 비교
graph index의 기여분은 C0에서 C3까지를 TS와 비교해서 확인한다. community summary는 작지만 일관된 개선을 보이며, 예외는 root-level이다.
| 비교 | Podcast comp. | News comp. |
|---|---|---|
| C0 대 TS | 50.24 (p=1) | 55.52 (p=0.17) |
| C1 대 TS | 51.92 (p=0.633) | 58.80 (p=0.002) |
| C2 대 TS | 57.28 (p<0.001) | 62.08 (p<0.001) |
| C3 대 TS | 56.48 (p=0.006) | 63.60 (p<0.001) |
Podcast에서는 intermediate level이 57%(p<.001), News에서는 low level이 64%(p<.001)로 원본 텍스트 요약을 앞선다. diversity 쪽도 같은 방향이며 Podcast intermediate 57%(p=.036), News low-level 60%(p<.001)다. community summary가 원본 텍스트보다 질의에 더 잘 맞는 형태로 정보를 응축한다는 근거다.
토큰 비용
성능만큼 중요한 결과가 비용이다. 조건별로 컨텍스트에 들어가는 단위 수와 토큰 수는 다음과 같다.
| 항목 | C0 | C1 | C2 | C3 | TS |
|---|---|---|---|---|---|
| Podcast 단위 수 | 34 | 367 | 969 | 1,310 | 1,669 |
| Podcast 토큰 | 26,657 | 225,756 | 565,720 | 746,100 | 1,014,611 |
| Podcast 최대 대비 | 2.6% | 22.2% | 55.8% | 73.5% | 100% |
| News 단위 수 | 55 | 555 | 1,797 | 2,142 | 3,197 |
| News 토큰 | 39,770 | 352,641 | 980,898 | 1,140,266 | 1,707,694 |
| News 최대 대비 | 2.3% | 20.7% | 57.4% | 66.8% | 100% |
원본 텍스트를 그대로 map-reduce하는 TS가 가장 비싸다. 반면 root-level 요약은 Podcast에서 전체의 2.6%, News에서 2.3%에 해당하는 토큰만 쓴다. 논문이 9배에서 43배 절감이라고 표현하는 수치가 이 비율이다.
절감 폭은 level에 따라 다르다. 가장 세밀한 C3도 TS 대비 26%에서 33% 적은 토큰을 쓰고, C0는 97% 넘게 적다.
C0의 성능은 다른 global 조건보다 조금 낮지만 vector RAG 대비로는 comprehensiveness 72%, diversity 62% 승률을 유지한다. 같은 데이터셋에 질문을 반복해 던지는 sensemaking 활동에서는 이 조합이 가장 실용적이다.
claim 기반 재검증
LLM judge 하나에만 기대는 결론을 보강하기 위해 두 번째 실험을 붙였다. 답변에서 factual claim을 기계적으로 추출해 세는 방식이다.
추출기는 Claimify(Metropolitansky and Larson, 2025)다. 답변 문장 중 사실 진술을 포함한 것을 골라 자기 완결적인 단문 claim으로 분해한다. 중복 제거 후 47,075개의 unique claim을 얻었고 답변당 평균 31개다.
두 지표를 정의했다. comprehensiveness는 답변당 평균 claim 개수이고, diversity는 claim을 군집화했을 때 나오는 평균 군집 수다. 군집화는 scikit-learn의 agglomerative clustering을 complete linkage로 쓰고, 거리 지표는 1-ROUGE-L이다. 임계값에 따라 군집 수가 달라지므로 0.5부터 0.8까지 네 구간을 모두 보고한다.
| 조건 | News 평균 claim 수 | Podcast 평균 claim 수 |
|---|---|---|
| C0 | 34.18 | 32.21 |
| C1 | 32.50 | 32.20 |
| C2 | 31.62 | 32.46 |
| C3 | 33.14 | 32.28 |
| TS | 32.89 | 31.39 |
| SS | 25.23 | 26.50 |
두 데이터셋 모두 global 조건 전부가 SS를 앞서며 차이는 p<.05로 유의하다. Experiment 1의 승률과 방향이 같다.
군집 수 결과는 다음과 같다.
| 데이터셋 | 임계값 | C0 | C1 | C2 | C3 | TS | SS |
|---|---|---|---|---|---|---|---|
| News | 0.5 | 23.42 | 21.85 | 21.90 | 22.13 | 21.80 | 17.92 |
| News | 0.6 | 21.65 | 20.38 | 20.30 | 20.52 | 20.13 | 16.78 |
| News | 0.7 | 20.19 | 19.06 | 19.03 | 19.13 | 18.62 | 15.80 |
| News | 0.8 | 18.86 | 17.78 | 17.82 | 17.79 | 17.30 | 14.80 |
| Podcast | 0.5 | 23.16 | 22.62 | 22.52 | 21.93 | 21.14 | 18.55 |
| Podcast | 0.6 | 21.65 | 21.33 | 21.21 | 20.62 | 19.70 | 17.39 |
| Podcast | 0.7 | 20.41 | 20.04 | 19.79 | 19.22 | 18.08 | 16.28 |
| Podcast | 0.8 | 19.26 | 18.77 | 18.46 | 17.89 | 16.66 | 15.07 |
Podcast에서는 모든 global 조건이 모든 임계값에서 SS보다 유의하게 다양하다. News에서는 C0만 모든 임계값에서 유의했고, C1에서 C3까지는 평균 군집 수가 SS보다 높았지만 일부 임계값에서만 유의했다. Experiment 1에서는 News의 모든 global 조건이 SS를 이겼으므로 이 부분은 두 실험이 완전히 겹치지는 않는다. 다만 News의 diversity 격차가 Podcast보다 작다는 방향성은 두 실험이 일치한다.
두 지표의 일치도도 측정했다. Experiment 1은 비교마다 5회 판정을 받으므로 다수결로 하나의 라벨을 만들었고, 다수결이 성립한 경우는 comprehensiveness에서 33%, diversity에서 39%였다. 그 사례들에서 LLM 라벨과 claim 기반 라벨이 같은 승자를 고른 비율은 comprehensiveness 78%, diversity 69%에서 70%다. 중간에서 강한 수준의 정합성이다.
설계 선택과 운영 비용
인덱싱 실행 환경과 시간은 다음과 같다. Podcast 데이터셋을 600 토큰 chunk로 인덱싱하는 데 281분이 걸렸다. 가상 머신은 RAM 16GB에 Intel Xeon Platinum 8171M이고, LLM은 공개 OpenAI 엔드포인트의 gpt-4-turbo를 분당 200만 토큰과 분당 요청 1만 건 한도로 사용했다.
context window 크기도 별도 실험으로 골랐다. gpt-4-turbo는 12만 8,000 토큰까지 받지만, 긴 컨텍스트의 중간 위치 정보가 잘 활용되지 못하는 lost in the middle 현상(Liu et al., 2023)이 알려져 있다. 그래서 8,000 / 1만 6,000 / 3만 2,000 / 6만 4,000 토큰 네 가지를 비교했다.
결과는 가장 작은 크기의 우세였다. 아래는 8,000 토큰이 나머지 세 크기를 상대로 얻은 평균 승률이다.
| 기준 | 8,000 토큰의 평균 승률 | 해석 |
|---|---|---|
| comprehensiveness | 58.1% | 모든 비교에서 큰 컨텍스트를 앞선다 |
| diversity | 52.4% | 큰 컨텍스트와 동등하다 |
| empowerment | 51.3% | 큰 컨텍스트와 동등하다 |
더 상세하고 다양한 답을 선호하는 목표에 맞춰 최종 평가는 8,000 토큰으로 통일했다. 컨텍스트를 키우는 것이 언제나 이득은 아니라는 점이 이 파이프라인에서도 확인된 셈이다.
한계
- 평가 범위: 약 100만 토큰 규모 corpus 두 개에 한정된 결과다. 도메인과 use case가 다른 데이터셋으로 일반화되는지는 검증되지 않았다.
- 환각 측정 부재: SelfCheckGPT(Manakul et al., 2023) 같은 fabrication rate 비교가 빠져 있다. 저자들도 이를 추가하면 분석이 강해진다고 인정한다.
- empowerment 약세: root-level 요약은 두 데이터셋 모두에서 vector RAG에 졌다. 원인은 구체적 인용과 예시의 손실이며, element 추출 프롬프트를 조정해 이런 세부를 graph index에 더 남기는 것이 개선 방향이다.
- 사회적 영향: 생성된 답이 원본을 정확히 대표하지 못하면 후속 의사결정에 위험이 된다. 논문은 AI 사용 사실과 오류 가능성을 함께 공개하라고 권고한다. 다만 검색된 사실 몇 개를 전체 요약처럼 제시하는 vector RAG보다는 GraphRAG가 이 위험을 줄인다고 본다.
후속 방향
저자들이 제시한 향후 과제는 세 가지이며 모두 지금의 전역 처리 방식을 더 국소적으로 만드는 쪽을 향한다.
- 임베딩 기반 매칭: 사용자 질의와 graph annotation을 임베딩으로 이어 필요한 부분만 고른다. 임베딩은 텍스트를 고정 차원 벡터로 바꾼 표현이다.
- just-in-time community report generation: 모든 community 요약을 미리 만들어 두지 않고 질의 시점에 필요한 것만 생성한다.
- roll-up과 drill-down: 상위 요약이 남기는 단서를 따라 community hierarchy를 위아래로 오가며 탐색한다.
실제 공식 구현체에는 이 방향의 결과물이 반영되어 local search, global search, DRIFT search 같은 다중 검색 모드로 들어가 있다.
관련 연구 맥락
GraphRAG의 위치는 세 가지 선행 연구 계열과 대비하면 분명해진다.
| 계열 | 대표 연구 | GraphRAG와의 차이 |
|---|---|---|
| vector RAG | Lewis 2020, Ram 2023, Gao 2023 | 유사도 상위 문서를 가져온다. corpus 전역 질의에 대응하지 못한다 |
| 계층적 요약 인덱스 | Kim 2023, Sarthi 2024 (RAPTOR) | 요약을 계층으로 쌓는 발상은 같지만, 분할 기준이 graph community가 아니라 텍스트 유사도다 |
| LLM 기반 knowledge graph | Ban 2023, Melnyk 2022, Trajanoska 2023, Wang 2023b | KG를 프롬프트에 직접 넣거나 retrieval 보조로 쓴다. GraphRAG는 graph의 modularity를 써서 주제 단위로 분할하는 점이 다르다 |
평가 방법론 쪽에서는 LLM-as-a-Judge(Zheng et al., 2024)와 adaptive benchmarking(Yuan et al., 2024; Zhang et al., 2024b), persona 생성(Kosinski 2024; Salminen et al., 2024) 계열을 잇는다. 기존 QA 벤치마크인 HotPotQA, MultiHop-RAG, MT-Bench는 명시적 사실 검색 성능을 재도록 설계되어 있어 전역 질의 평가에 맞지 않고, RAGAS의 context relevance나 faithfulness 같은 지표도 마찬가지라는 것이 논문의 진단이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| sensemaking | 사람, 장소, 사건 사이의 연결에 의미를 부여해 흐름을 예측하고 행동하기 위한 과정(Klein 2006). 이 논문이 겨냥하는 질의 유형이다 |
| query-focused summarization | 특정 질의에 초점을 맞춘 corpus 요약. 기존 기법은 RAG 규모로 확장되지 않았다 |
| Leiden 알고리즘 | Louvain에 Refinement 단계를 더해 모든 community의 내부 연결성을 보장하는 community detection 알고리즘 |
| community level | hierarchical partition의 깊이. C0는 root로 개수가 가장 적고 추상적이며 C3는 가장 세밀하다 |
| helpfulness score | map 단계에서 LLM이 자기 부분 답변에 매기는 0에서 100 사이 점수. reduce의 정렬 기준이 되고 0점은 걸러진다 |
| gleaning | 추출 후 LLM에게 놓친 entity가 있는지 되묻고 추가 추출을 시키는 self-reflection 절차 |
| Claimify | 답변에서 검증 가능한 사실 진술을 뽑아 단문으로 분해하는 LLM 기반 추출기. 두 번째 실험의 지표 계산에 쓴다 |
관련 페이지
- microsoft/graphrag: 이 논문의 공식 구현체. 인덱싱 비용이 크다는 경고를 문서 전면에 두고 있어, 본문의 281분 인덱싱 수치와 함께 읽으면 도입 판단에 도움이 된다.
- GraphRAG Paper Review (DSBA, 김도윤 2025-08-11): 이 논문의 한국어 해설 슬라이드. 프롬프트 전문과 KG 시각화를 담고 발표자의 비판 다섯 가지를 덧붙였다.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): community summary를 entity와 relationship의 key-value 직렬화로 대체해 토큰과 호출 비용을 줄인 후속작. 이 논문이 남긴 hybrid scheme 과제에 대한 한 가지 답이다.
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): 계층적 KG를 GMM-BIC로 만들고 LCA 기반 retrieval을 쓴 변형. root-level 요약의 세부 손실 문제를 다른 방식으로 다룬다.
- RAG-Anything: All-in-One RAG Framework: LightRAG 계열의 멀티모달 확장. 텍스트뿐 아니라 이미지와 표까지 graph에 넣는다.
- Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): LightRAG와 LeanRAG를 GraphRAG 계보 안에서 비교한 후속 세미나.
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: HippoRAG 2. 같은 graph 기반 계열이지만 community 요약 대신 Personalized PageRank로 검색하는 대안 설계다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: 이 논문을 뿌리로 두고 LightRAG, LeanRAG, RAG-Anything 세 분기를 묶은 합성 페이지.