Database · REPO · 2026
turbovec: Google TurboQuant for vector search (Rust + Python)
요약
turbovec은 Google Research가 발표한 TurboQuant 알고리즘을 Rust로 구현하고 Python 바인딩을 붙인 벡터 인덱스다. 원 논문은 arXiv 2504.19874이고, 본 wiki에는 TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate로 정리되어 있다. README는 이 논문을 ICLR 2026 게재로 적지만 논문 PDF 전문에는 ICLR 표기가 없고 arXiv 게재일은 2025년 4월 28일이다.
README가 첫 줄에 내거는 숫자가 이 저장소의 목적을 그대로 보여준다. 1,000만 건짜리 문서 코퍼스를 float32로 들고 있으면 메모리가 31GB 필요하지만, turbovec은 같은 코퍼스를 4GB에 담고 그러면서 FAISS보다 빠르게 검색한다.
압축과 속도를 동시에 얻는 근거는 TurboQuant이 data-oblivious 양자화라는 점이다. FAISS의 product quantization은 데이터를 보고 codebook을 학습하지만, TurboQuant은 무작위 직교 회전을 먼저 걸어 좌표 분포를 미리 알려진 형태로 만든 다음 수식으로 정한 버킷에 값을 담는다. 분포를 알고 있으니 학습할 것이 없고, 그래서 add한 벡터가 곧바로 인덱싱되며 코퍼스가 커져도 재빌드가 필요 없다.
속도는 손으로 짠 SIMD 커널이 담당한다. ARM에서는 FAISS IndexPQFastScan을 10%에서 19% 앞서고, x86에서는 4비트 설정을 이기고 2비트에서 몇 퍼센트 뒤진다.
이 페이지의 근거는 저장소 README와 저장소가 배포하는 차트 SVG 세 장으로 한정된다. 저장소 전체 클론은 2026년 6월에 README 스텁으로 교체되어 docs/api.md, CHANGELOG.md, LICENSE, Rust 소스와 테스트가 로컬에 남아 있지 않다.
배경
dense 벡터 검색의 병목은 연산이 아니라 메모리인 경우가 많다. 임베딩 차원이 1536이나 3072로 커지면 벡터 하나가 6KB에서 12KB를 차지하고, 문서 수가 수백만 건을 넘으면 인덱스가 수십 GB로 불어난다. 그래서 벡터를 그대로 두지 않고 압축해서 담는 양자화가 사실상 필수 단계가 된다.
기존의 표준 해법은 product quantization이다. 벡터를 여러 구간으로 쪼개고 각 구간에서 k-means로 codebook을 학습한 뒤, 원본 대신 codebook 인덱스를 저장한다. 압축률은 좋지만 학습 단계가 붙는다는 대가가 있다.
학습 단계는 운영에서 세 가지 부담으로 이어진다. 첫째, 인덱싱을 시작하기 전에 대표 표본을 모아 train을 돌려야 한다. 둘째, 하위 양자화기 개수 같은 파라미터를 데이터마다 맞춰야 한다. 셋째, 코퍼스 분포가 바뀌면 codebook이 낡아 재빌드를 고민해야 한다.
TurboQuant은 이 학습 단계 자체를 없애는 방향을 택한다. 데이터를 보고 codebook을 맞추는 대신, 회전을 걸어 데이터가 codebook에 맞는 분포로 오게 만든다. turbovec은 그 알고리즘을 실제로 쓸 수 있는 인덱스로 만들고, 검색 커널과 필터와 프레임워크 연결까지 붙인 구현이다.
README가 첫머리에 내거는 네 가지가 이 저장소가 겨냥하는 운영 조건을 보여준다.
| 내세우는 성질 | 구체적 내용 | 겨냥하는 상황 |
|---|---|---|
| 온라인 ingest | 벡터를 add하면 곧바로 인덱싱된다. train 단계도, 파라미터 튜닝도, 코퍼스가 커질 때의 재빌드도 없다 | 문서가 계속 들어오는 파이프라인 |
| 빠른 SIMD 검색 | 손으로 짠 NEON과 AVX-512BW 커널이 FAISS IndexPQFastScan을 ARM에서 10%에서 19% 앞선다 | 지연이 중요한 온라인 질의(query) |
| 검색 시점 필터 | search()에 id allowlist나 슬롯 비트마스크를 넘기면 커널이 직접 그것을 지킨다 |
테넌트 분리와 권한 제어가 붙은 검색 |
| 순수 로컬 | 관리형 서비스가 없고 데이터가 기기나 VPC 밖으로 나가지 않는다 | 격리된 환경의 RAG 스택 |
네 가지는 서로 맞물린다. 학습 단계가 없어서 온라인 ingest가 가능하고, 압축된 표현 위에서 바로 점수를 매기기 때문에 SIMD 커널이 빠르며, 그 커널 안에 필터를 넣었기 때문에 권한 조건이 붙어도 성능이 유지된다. 외부 서비스 의존이 없다는 마지막 성질은 나머지 셋이 라이브러리 하나로 완결되기 때문에 따라온다.
핵심 개념
data-oblivious는 입력 데이터를 보지 않고 압축 규칙을 정하는 성질을 말한다. codebook이 데이터에서 학습되지 않으므로 train 단계도, 재학습도 없다.
무작위 직교 회전은 모든 벡터에 같은 직교 행렬을 곱하는 연산이다. 회전은 길이와 내적을 보존하면서 좌표 분포만 바꾸는데, 회전 뒤에는 입력이 무엇이든 각 좌표가 Beta 분포를 따르고 고차원에서 N(0, 1/d)로 수렴한다. 이 성질이 data-oblivious를 가능하게 하는 장치다.
회전을 걸어도 검색 결과가 흔들리지 않는 이유는 회전이 길이와 내적을 보존하기 때문이다. 같은 직교 행렬을 데이터베이스 벡터와 질의에 똑같이 적용하면 두 벡터 사이의 내적은 회전 전과 같다. 그래서 turbovec은 검색할 때 질의를 같은 회전 도메인으로 한 번 옮기고, 그 뒤로는 압축된 표현 위에서 바로 점수를 매긴다. 회전은 정확도를 희생하는 근사가 아니라 좌표 분포만 바꾸는 좌표계 변경에 가깝다.
Lloyd-Max 스칼라 양자화는 분포가 주어졌을 때 평균제곱오차를 최소화하는 버킷 경계와 중심값을 찾는 고전 알고리즘이다. TurboQuant은 회전으로 분포를 확정했기 때문에 이 계산을 데이터 없이 한 번만 수행한다.
recall@1@k는 저장소 차트가 쓰는 지표다. 진짜 top-1 결과가 반환된 top-k 안에 얼마나 자주 들어오는지를 재는 값이며, k를 키우면 자연히 올라간다. R@1은 k=1일 때의 값이다.
allowlist는 검색 호출에 함께 넘기는 허용 id 집합이다. 외부 시스템이 먼저 후보를 좁히고 벡터 검색이 그 안에서만 순위를 매기는 hybrid search를 지원한다.
방법
알고리즘 6단계
README의 "How it works"는 각 벡터를 고차원 초구 위의 방향으로 보는 관점에서 출발한다. 방향만 남기면 회전이라는 도구를 쓸 수 있고, 회전을 걸면 좌표 분포가 예측 가능해진다는 것이 전체 설계의 출발점이다.
| 단계 | 이름 | 하는 일 | 결과 |
|---|---|---|---|
| 1 | 정규화 | 벡터에서 길이를 float 하나로 분리 | 본체가 초구 위 단위 방향이 된다 |
| 2 | 무작위 회전 | 모든 벡터에 같은 직교 행렬을 곱함 | 좌표가 입력과 무관하게 Beta 분포를 따른다 |
| 3 | 좌표별 보정 TQ+ | 첫 add에서 좌표마다 shift와 scale을 적합 | 유한 차원에서의 분포 이탈을 교정한다 |
| 4 | Lloyd-Max 양자화 | 버킷 경계와 중심값을 수식으로 계산 | 2비트는 4개, 4비트는 16개 버킷 |
| 5 | 비트 패킹 | 작은 정수를 바이트에 빽빽하게 채움 | d=1536이 6,144바이트에서 384바이트로 |
| 6 | 길이 재정규화 점수 | 벡터마다 보정 스칼라를 저장 | 내적 추정의 하향 편향을 제거한다 |
3단계 TQ+가 이 구현의 특징적인 부분이다. 2단계가 보장하는 Beta 분포는 차원이 무한대로 갈 때 성립하는 점근 분포라서, 실제 유한 차원에서는 개별 좌표가 정준 형태에서 조금씩 벗어난다. 저비트 설정과 워드벡터형 임베딩에서 이탈이 특히 크다.
TQ+는 첫 add 때 좌표마다 shift와 scale 두 스칼라를 적합해, 그 좌표의 경험적 5%와 95% 분위수를 정준 Beta 주변분포에 맞춘다. 그러면 Lloyd-Max codebook이 원래 설계 대상으로 삼았던 목표 분포를 상대로 양자화하게 된다. 보정값은 첫 add 이후 고정되어 뒤이은 add에서 그대로 재사용되므로 재학습이나 재빌드는 여전히 없다. 이득은 이탈이 가장 큰 셀에서 R@1 기준 최대 +1.4%p이며, GloVe 2비트가 그 사례다.
6단계 길이 재정규화도 정확도를 직접 끌어올리는 장치다. 스칼라 양자화는 내적을 체계적으로 과소추정하는데, 복원된 단위 방향이 원본보다 조금 짧아지기 때문이다. turbovec은 인코딩 시점에 회전된 단위 벡터와 그 자신의 중심값 복원 사이의 내적을 구해, ||v|| / ⟨u, x̂⟩ 값을 압축 벡터 옆에 저장한다. 검색 커널이 후보 점수에 이 스칼라를 곱한 다음 힙에 넣으므로, 하향 편향 상태이던 추정기가 무편향으로 바뀐다. 검색 시점 비용은 0이고 추가 저장 공간도 들지 않는다. 이득은 양자화 수축이 가장 큰 저비트 폭에서 가장 크게 나타난다.
이 보정을 위해 추가로 드는 비용은 벡터당 d차원 내적 한 번이다. d=1536에서 100만 개 벡터를 인코딩할 때 1초 미만이 더 걸린다. ingest 시점에 한 번 치르는 비용이지 질의마다 내는 비용이 아니다.
검색 경로
검색은 데이터베이스 벡터를 복원하지 않는다. 질의 하나만 같은 회전 도메인으로 옮긴 뒤 codebook 값을 상대로 직접 점수를 매긴다. 압축을 풀지 않고 압축된 표현 위에서 바로 계산하는 방식이라 메모리 대역폭 부담이 작다.
점수 커널은 SIMD intrinsic으로 작성되어 있다. ARM은 NEON, 최신 x86은 AVX-512BW를 쓰고 그 명령을 지원하지 않는 CPU에는 AVX2 폴백이 있다. 처리량을 위해 룩업테이블을 nibble 단위로 쪼개 사용한다.
정확도의 이론적 위치도 README가 밝힌다. Lloyd-Max codebook의 왜곡은 정보이론 하한인 Shannon 왜곡률 한계의 2.7배 이내에 든다. 길이 재정규화 단계는 그 codebook이 내적 추정기 자체에 남기는 잔여 편향을 제거하는 역할을 맡는다.
필터 검색
필터가 커널 바깥이 아니라 안에서 동작한다는 점이 이 구현의 설계 선택이다. 흔한 방식은 필터를 무시하고 넉넉히 많이 뽑은 뒤 나중에 걸러내는 over-fetch인데, 이 방식은 허용 비율이 낮을수록 낭비가 커지고 recall도 떨어진다.
turbovec은 32개 벡터 블록 단위로 필터를 적용한다. 처리 순서는 다음과 같다.
| 시점 | 처리 |
|---|---|
| 블록 진입 전 | 허용된 슬롯이 하나도 없는 블록은 LUT 조회와 점수 계산 전에 건너뛴다 |
| 블록 점수 계산 후 | 점수를 매긴 블록 안에서 허용되지 않은 개별 슬롯은 힙 삽입 시점에 버린다 |
| 결과 반환 | 출력 길이는 min(k, len(allowed))이며 패딩된 대체값을 채우지 않는다 |
그래서 인덱스의 작은 일부만 허용하는 선택적 allowlist에서는 SIMD 비용을 대부분 치르지 않는다. 비용을 다 치르고 결과를 버리는 방식과 대비되는 부분이다.
README의 하이브리드 예제는 두 단계로 되어 있다. 1단계에서 SQL 같은 외부 시스템이 테넌트 조건으로 후보 id를 좁히고, 2단계에서 그 후보 집합 안에서만 dense reranking을 한다. BM25 결과, 접근 제어 목록, 시간 구간 같은 다른 조건도 같은 자리에 들어갈 수 있다.
인덱스 두 종류
인덱스는 두 가지다. 위치 기반으로 다루는 TurboQuantIndex와 사용자가 정한 외부 id를 유지하는 IdMapIndex이며, 삭제가 필요한 워크로드는 후자를 쓴다.
| 항목 | TurboQuantIndex |
IdMapIndex |
|---|---|---|
| Python 생성 | TurboQuantIndex(dim=1536, bit_width=4) |
IdMapIndex(dim=1536, bit_width=4) |
| Rust 생성 | TurboQuantIndex::new(1536, 4) |
IdMapIndex::new(1536, 4) |
| 벡터 추가 | add(vectors) |
add_with_ids(vectors, ids), ids는 uint64 |
| 검색 반환 | scores, indices |
scores, ids, 사용자가 준 외부 id |
| 삭제 | README에 예시 없음 | remove(1002), id 기준 O(1) |
| allowlist 예제 | 슬롯 비트마스크로 설명만 있음 | search(query, k=10, allowlist=allowed) |
| 저장 확장자 | .tv |
.tvim |
Rust API도 같은 구조를 따른다. add, search, write, load가 대응하며 Rust 쪽은 실패 가능한 호출이 Result를 돌려준다. 파일 포맷의 헤더 구조나 버전 정책 같은 세부는 저장소의 docs/api.md가 담당한다고 README가 안내하지만, 그 문서는 현재 raw에 없다.
두 타입을 고르는 기준은 삭제 여부다. TurboQuantIndex는 add한 순서대로 슬롯 번호를 돌려주므로 벡터를 지우면 뒤 항목의 번호가 흔들린다. IdMapIndex는 사용자가 정한 uint64 값을 그대로 유지하기 때문에, 문서를 지우고 다시 넣는 워크로드에서 애플리케이션의 기본 키와 검색 결과를 직접 맞출 수 있다.
allowlist 필터의 README 예제도 IdMapIndex 위에서 쓰인다. 외부 시스템이 돌려주는 것은 슬롯 번호가 아니라 애플리케이션의 id이므로, 두 세계를 잇는 인덱스가 필요하기 때문이다. TurboQuantIndex 쪽은 슬롯 비트마스크로 같은 일을 할 수 있다고 설명만 하고 예제는 두지 않는다.
프레임워크 어댑터
RAG 프레임워크 네 종에 드롭인 교체를 제공한다. README는 공개 surface, 영속화 의미, retriever와 파이프라인 배선이 모두 같아서 import만 바꾸면 기존 파이프라인을 그대로 유지할 수 있다고 설명한다.
| 프레임워크 | 설치 extra | 대체 대상 | 원래 저장 위치 |
|---|---|---|---|
| LangChain | turbovec[langchain] |
langchain_core.vectorstores.InMemoryVectorStore |
인메모리 |
| LlamaIndex | turbovec[llama-index] |
llama_index.core.vector_stores.SimpleVectorStore |
인메모리 |
| Haystack | turbovec[haystack] |
haystack.document_stores.in_memory.InMemoryDocumentStore |
인메모리 |
| Agno | turbovec[agno] |
agno.vectordb.lancedb.LanceDb |
LanceDB |
네 대상 가운데 셋은 프레임워크의 인메모리 참조 저장소이고, Agno만 LanceDB 기반 저장소를 대체한다. 앞의 셋은 원래 시제품용으로 제공되는 저장소라서, 압축된 인덱스로 바꾸면 같은 코드로 다룰 수 있는 코퍼스 규모가 커진다는 점이 교체의 실익이다.
빌드와 CPU 타깃
| 대상 | 절차 |
|---|---|
| Python 설치 | pip install turbovec |
| Python 빌드 | pip install maturin 뒤 turbovec-python에서 maturin build --release, 이어서 target/wheels/*.whl 설치 |
| Rust 설치 | cargo add turbovec |
| Rust 빌드 | cargo build --release |
x86_64 빌드는 전부 .cargo/config.toml을 통해 x86-64-v3를 타깃으로 삼는다. AVX2를 기준선으로 잡은 설정이며 2013년 Haswell 이후 CPU가 해당한다. AVX2 폴백 커널을 실행할 수 있는 CPU라면 크레이트 전체를 실행할 수 있고, AVX-512 커널은 is_x86_feature_detected!로 런타임에 판별해 지원 하드웨어에서만 활성화된다. 하나의 바이너리로 구형과 신형 CPU를 함께 지원하려는 설계다.
결과
실험 조건
| 항목 | 값 |
|---|---|
| 비교 대상 | FAISS IndexPQ, LUT256, nbits=8, float32 LUT |
| 벡터 수 | 10만 개 |
| k | 64 |
| FAISS 하위 양자화기 개수 | 2비트에서 m=d/4, 4비트에서 m=d/2 |
| 속도 측정 | 질의 1,000개, 5회 실행의 중앙값 |
| ARM 하드웨어 | Apple M3 Max |
| x86 하드웨어 | Intel Xeon Platinum 8481C, Sapphire Rapids, 8 vCPU |
| 데이터셋 | GloVe d=200, OpenAI DBpedia d=1536, OpenAI DBpedia d=3072 |
이 조건에서 눈여겨볼 부분은 FAISS 쪽 설정을 TurboQuant의 비트율에 맞춰 잡았다는 점이다. 하위 양자화기 개수를 2비트에서 m=d/4, 4비트에서 m=d/2로 두면 두 방법이 벡터당 같은 비트를 쓰게 되므로, 압축률을 고정한 상태에서 정확도만 비교하는 형태가 된다.
README는 baseline 선택 이유를 따로 밝힌다. FAISS IndexPQ는 대부분의 사용자가 먼저 찾는 프로덕션급 PQ 기본값이고, TurboQuant 논문이 쓴 자체 u8-LUT PQ보다 강한 상대다. FAISS는 점수 계산에 더 높은 정밀도의 LUT를 쓰고 codebook 학습에 k-means++를 쓰기 때문이다. 즉 이 저장소는 논문보다 불리한 조건에서 비교했다고 스스로 밝히는 셈이다.
recall
| 데이터셋 | 2비트 R@1 | 4비트 R@1 | 수렴 |
|---|---|---|---|
| OpenAI d=1536, d=3072 | FAISS 대비 0.2점에서 1.9점 우위 | 같은 범위의 우위 | k=8에서 양쪽 1.0, k=4에서 이미 0.997 이상 |
| GloVe d=200 | 0.1점 이내로 사실상 동률 | FAISS 대비 0.9점 우위 | k가 16 부근이면 양쪽이 서로 근접 |
고차원 임베딩에서는 TurboQuant이 앞서고, k를 조금만 키우면 두 방법이 모두 완전 재현에 도달한다. 실무에서 k를 8 이상으로 두는 경우가 대부분이므로, 두 방법의 차이는 k가 아주 작을 때에 집중된다. 바꿔 말하면 고차원 임베딩에서 두 방법의 정확도 차이는 크지 않고, 선택의 근거는 학습 단계 유무와 검색 속도 쪽에 놓인다.
GloVe d=200은 어려운 영역이다. 차원이 낮으면 2단계가 기대는 점근 Beta 가정이 느슨해지기 때문이다. README는 이 저차원 격차를 base 알고리즘이 남기는 몫으로 보고, TQ+ 보정이 그 격차를 메운다고 적는다. 또한 저차원 임베딩에서 다른 커뮤니티 reference 구현들과 비슷한 수치를 얻었다고 밝히며 turboquant-py의 d=384 결과를 예로 들고, OpenAI d=1536과 d=3072에서는 논문의 TurboQuant 수치를 재현했다고 적는다.
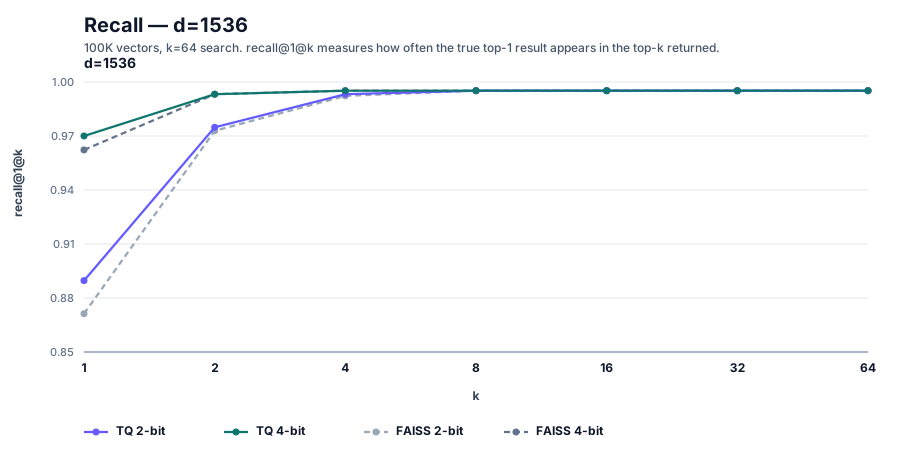
차트의 세로축 범위는 0.85에서 1.00이고 가로축 k는 1, 2, 4, 8, 16, 32, 64다. TurboQuant 2비트와 4비트, FAISS 2비트와 4비트 네 곡선을 함께 그린다.
압축
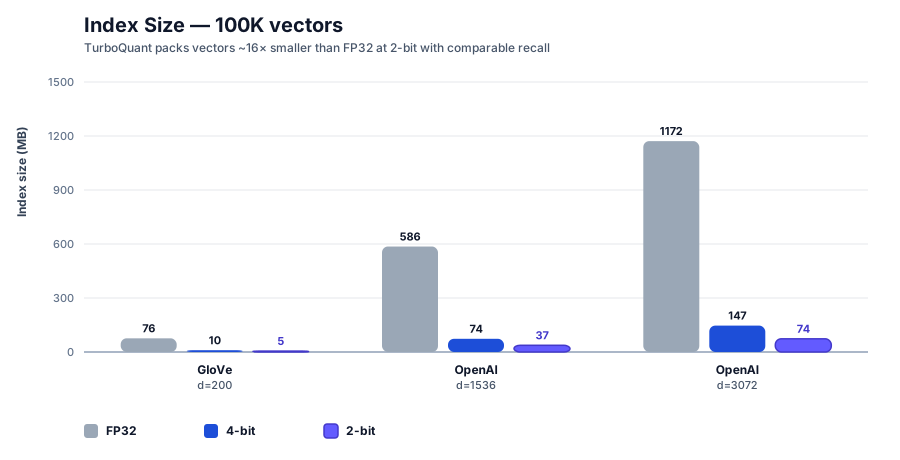
| 데이터셋 | FP32 | 4비트 | 2비트 | 2비트 압축률 |
|---|---|---|---|---|
| GloVe d=200 | 76MB | 10MB | 5MB | 약 15배 |
| OpenAI d=1536 | 586MB | 74MB | 37MB | 약 16배 |
| OpenAI d=3072 | 1,172MB | 147MB | 74MB | 약 16배 |
세 데이터셋 모두 2비트에서 약 16배, 4비트에서 약 8배로 줄어든다. 차원과 무관하게 같은 비율이 나오는 것은 압축률이 좌표당 비트 수로 결정되기 때문이다. FP32가 좌표당 32비트이므로 2비트는 16배, 4비트는 8배가 된다.
README 첫 문장의 1,000만 건 코퍼스 31GB에서 4GB라는 수치도 같은 비율에서 나온다. 실무 관점에서 보면 32GB 장비 한 대로는 감당하기 어렵던 코퍼스가 4GB로 줄어 여유 있게 상주하게 되는 크기다.
검색 속도
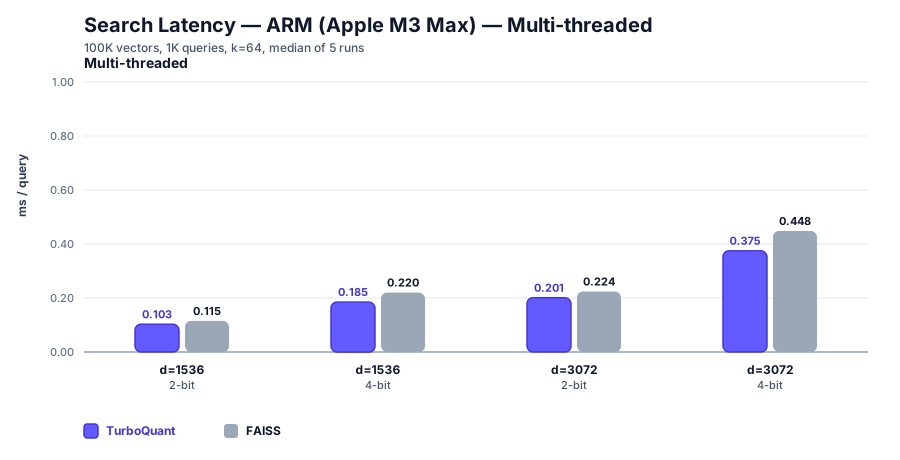
ARM에서는 모든 설정에서 FAISS FastScan을 10%에서 19% 앞선다. 저장소가 배포하는 멀티스레드 차트에서 질의당 지연을 읽으면 다음과 같다.
| 설정 | TurboQuant | FAISS | 지연 감소 |
|---|---|---|---|
| d=1536, 2비트 | 0.103ms | 0.115ms | 10.4% |
| d=1536, 4비트 | 0.185ms | 0.220ms | 15.9% |
| d=3072, 2비트 | 0.201ms | 0.224ms | 10.3% |
| d=3072, 4비트 | 0.375ms | 0.448ms | 16.3% |
4비트에서 격차가 더 크다는 점이 눈에 띈다. 4비트는 좌표당 값의 종류가 16개라 LUT 조회와 누산이 길어지는 구간인데, 그 구간에서 nibble 단위 LUT 설계의 이득이 더 크게 나타난다.
x86의 양상은 다르다.
| 구간 | 결과 |
|---|---|
| 4비트 전반 | 최대 약 5% 우위 |
| 4비트 d=3072 멀티스레드 | 동률 |
| 2비트 d=1536 싱글스레드 | 약 8% 열세로 가장 큰 격차 |
| 2비트 나머지 | 몇 퍼센트 이내 열세 |
x86과 ARM의 결과가 갈리는 이유도 명령어 집합의 차이에 있다. ARM에는 AVX-512 VBMI에 대응하는 경로가 없어 FAISS도 NEON 위에서 경쟁하지만, x86에서는 FAISS가 쓸 수 있는 전용 경로가 하나 더 있다.
README는 2비트 열세의 원인을 짧은 누산 루프로 설명한다. 2비트는 값의 종류가 4개뿐이라 누산 루프가 짧고, 그 짧은 구간에서는 FAISS의 AVX-512 VBMI 경로가 우위를 갖는다. 즉 turbovec의 커널 설계가 불리한 것이 아니라, 작업량이 적어 최적화 여지 자체가 좁은 구간이다.
벤치마크 재현
| 단계 | 명령 |
|---|---|
| 데이터셋 내려받기 | python3 benchmarks/download_data.py all 또는 glove, openai-1536, openai-3072 |
| 개별 벤치마크 | python3 benchmarks/suite/recall_d1536_2bit.py 같은 독립 스크립트 실행 |
| 범주별 일괄 실행 | benchmarks/suite/speed_*arm*.py, speed_*x86*.py, recall_*.py를 반복문으로 실행 |
| 결과 저장 | benchmarks/results/에 JSON |
| 차트 재생성 | python3 benchmarks/create_diagrams.py |
각 벤치마크가 독립 스크립트라서 필요한 설정만 골라 다시 돌릴 수 있고, 결과 JSON과 차트 생성 스크립트가 함께 공개되어 있어 수치의 출처를 따라갈 수 있는 구조다.
결과 종합
세 종류의 측정이 가리키는 방향은 일관된다. 압축은 차원과 무관하게 2비트에서 약 16배로 안정적이고, recall은 고차원 임베딩에서 FAISS보다 조금 앞서며, 속도는 ARM에서 확실히 앞서고 x86에서 설정에 따라 갈린다.
읽을 때 유의할 점은 세 측정의 성격이 다르다는 것이다. 압축률은 좌표당 비트 수만으로 결정되므로 데이터와 하드웨어에 좌우되지 않고, 사전에 계산해 용량을 예측할 수 있다. recall은 데이터 분포에 좌우되어 고차원과 저차원의 결과가 갈린다. 속도는 명령어 집합에 좌우되어 ARM과 x86의 결과가 갈린다.
그래서 도입을 검토할 때의 판단 기준도 나뉜다. 메모리 절감만 목표라면 하드웨어와 무관하게 어느 환경에서든 같은 효과를 기대할 수 있다. 지연까지 개선하려면 대상 하드웨어와 비트 폭 조합이 유리한 구간인지 확인해야 하고, 저차원 임베딩을 쓴다면 recall을 자체 데이터로 다시 재보는 편이 안전하다.
한계
| 항목 | 내용 |
|---|---|
| 저차원 recall | GloVe d=200 2비트는 FAISS와 0.1점 이내 동률에 머문다. 점근 Beta 가정이 저차원에서 느슨해지는 것이 원인이다 |
| x86 2비트 속도 | 2비트에서 FAISS에 뒤지며 d=1536 싱글스레드가 약 8%로 가장 크다 |
| 라이선스 검증 불가 | README 본문에 라이선스 조항이 없다. 상단 배지가 LICENSE 파일을 가리키지만 그 파일은 raw에 없다 |
| API 세부 부재 | 파일 포맷 헤더 구조와 삭제 시맨틱 같은 세부는 docs/api.md에 있고 raw에 남아 있지 않다 |
| 어댑터 제약 미확인 | 프레임워크별 지원 범위와 제약은 docs/integrations/*.md에 있으며 역시 raw에 없다 |
| 버전과 변경 이력 미확인 | README에 버전 번호나 릴리스 날짜가 없다. CHANGELOG.md가 raw에서 사라져 이력을 확인할 수 없다 |
라이선스는 별도로 다룰 필요가 있다. frontmatter는 MIT로 기록하고 있으나 README 본문에는 라이선스 조항 문장이 없고 shields.io 배지 한 줄만 있다. 배지가 가리키는 LICENSE 파일이 로컬에 없으므로 현재 raw로는 검증할 수 없다. 인용하거나 사용하기 전에 저장소의 LICENSE 파일을 직접 확인해야 한다.
스텁 전환으로 확인할 수 없게 된 항목
이 저장소는 처음에 전체 클론으로 수집했다가 2026년 6월 커밋에서 README 하나로 교체됐다. 파일 180개가 사라졌고, 그 가운데 문서 근거로 쓰이던 것들이 다음과 같다.
| 사라진 파일 | 담고 있던 근거 |
|---|---|
LICENSE |
라이선스 조항 원문과 저작권 표기 |
CHANGELOG.md |
릴리스별 변경 이력과 수정된 버그 목록 |
Cargo.toml, turbovec-python/pyproject.toml |
crate와 패키지의 버전 번호, 의존성 |
docs/api.md |
파일 포맷 헤더 구조, 삭제 시맨틱, 차원 확정 규칙 |
docs/integrations/*.md |
어댑터별 지원 범위와 미지원 기능 |
turbovec/src/*.rs, turbovec/tests/*.rs |
모듈 구성, 함수 이름, 테스트로 확인되는 동작 |
benchmarks/results/*.json |
벤치마크의 원시 측정값 |
따라서 이 페이지는 버전 번호, 변경 이력, 파일 포맷 세부, 어댑터 제약을 서술하지 않는다. 그 항목이 필요하면 저장소 원문을 다시 확인해야 한다.
자료 자체의 내적 모순도 두 건 있다. 첫째, References 절은 RaBitQ의 길이 재정규화 보정을 "step 5"에서 차용했다고 적지만, "How it works"에서 5단계는 비트 패킹이고 길이 재정규화는 6단계다. TQ+가 3단계로 삽입되면서 뒤 번호가 하나씩 밀린 흔적으로 보인다. 둘째, 문서 상단 요약은 x86 2비트 열세를 몇 퍼센트로 적지만 x86 절은 d=1536 싱글스레드에서 약 8%라고 적어 폭이 다르다.
저장소의 위상도 오해하기 쉬운 지점이다. README는 turbovec을 Google Research 알고리즘 위에 세운 구현이라고만 밝히며, 공식 구현체나 reference 구현체를 자처하지 않는다. 오히려 baseline 주석에서 자신의 저차원 수치를 "다른 커뮤니티 reference 구현들"과 비교하며 스스로를 여러 커뮤니티 구현 가운데 하나로 놓는다. 논문 저자진과의 관계를 밝히는 문장도 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| TurboQuant | 무작위 직교 회전으로 좌표 분포를 알려진 형태로 만든 뒤 스칼라 양자화하는 알고리즘. 데이터 학습 없이 Shannon 하한에 근접한다 |
| data-oblivious | 입력 데이터를 보고 codebook을 학습하지 않는 성질. 회전이 분포를 강제하므로 버킷을 수식으로 미리 정한다 |
| TQ+ | 좌표마다 shift와 scale을 적합해 유한 차원의 Beta 분포 이탈을 보정하는 단계. 첫 add에서 한 번 적합하고 이후 고정한다 |
| 길이 재정규화 점수 | 압축 벡터마다 ` |
| allowlist | 검색 시점에 넘기는 허용 id 집합. 커널이 32개 벡터 블록 단위로 지키며 출력 길이는 min(k, len(allowed))다 |
| recall@1@k | 진짜 top-1 결과가 반환된 top-k 안에 들어오는 비율. 저장소 차트의 세로축 지표다 |
관련 페이지
- TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate: 이 저장소가 구현하는 원 알고리즘 논문. 왜곡률 하한 증명과 KV cache 압축까지 다루며, turbovec은 그중 ANN 검색 부분을 제품 형태로 옮겼다.
- turbovec: TurboQuant 알고리즘을 Rust로 구현한 학습이 필요 없는 벡터 인덱스: 이 저장소를 소개한 한국어 글. 같은 알고리즘을 입문 수준으로 정리하며, 일부 수치는 README 원문과 표현이 다르므로 대조해서 읽는 편이 좋다.
- Your Embedding Model is SMARTer Than You Think: 임베딩 표현 자체를 다시 활용해 검색 품질을 올리는 반대 방향의 접근. turbovec이 벡터를 줄이는 쪽이라면 이 논문은 이미 있는 표현을 더 쓰는 쪽이다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩과 인덱스라는 인터페이스 자체를 포기하고 agent가 원본 코퍼스를 직접 다루게 하자는 논지. dense 인덱스를 극한까지 압축하는 turbovec과 전제가 정반대다.
- VectifyAI/PageIndex: 벡터를 만들지 않는 vectorless RAG 구현. turbovec과 함께 읽으면 같은 문제에 대한 두 방향의 해법을 비교할 수 있다.