Database · PAPER · 2025
TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate
요약
TurboQuant은 고차원 벡터를 좌표당 몇 비트로 압축하면서 벡터 사이의 거리와 inner product를 최대한 보존하는 vector quantizer다. inner product는 두 벡터의 성분별 곱을 모두 더한 값으로, 유사도 검색과 attention 연산의 기본 계산이다. Google Research와 NYU, Google DeepMind 연구자들이 2025년 4월 arXiv에 공개했다.
이 방법의 출발점은 입력 벡터에 무작위 회전을 한 번 적용하는 것이다. 회전한 벡터는 단위 구면 위에 균등하게 퍼지고, 그 결과 각 좌표가 미리 아는 Beta 분포를 따르며 좌표끼리 거의 독립이 된다. 분포를 미리 알면 좌표마다 최적 scalar quantizer를 학습 없이 계산할 수 있고, 이것만으로 MSE 최적 양자화가 끝난다. inner product 추정에서는 MSE 최적 quantizer가 체계적 오차를 남기므로, 남은 오차 벡터를 1비트 QJL로 다시 부호화하는 2단계 구성을 결합해 이 문제를 해소한다.
세 가지 성질이 동시에 성립한다는 점이 이 논문의 핵심 주장이다. 첫째, data-oblivious다. 데이터를 미리 보고 codebook을 학습하지 않는다. 둘째, online이다. 토큰을 생성하는 도중에도 양자화를 적용할 수 있다. 셋째, 가속기 친화적이다. 연산이 완전히 vectorize되어 GPU에서 병렬로 실행된다. 여기에 더해 MSE distortion이 Shannon 정보이론 하한의 약 2.7배 이내라는 이론 보장이 붙는다.
실증 결과는 두 방향이다. KV cache 압축에서는 채널당 3.5비트로 품질 손실 없이, 2.5비트로 미미한 손실만 감수하고 동작했다. ANN search에서는 PQ와 RabitQ보다 높은 recall을 내면서 양자화 시간을 수만 배 줄였다.
배경
벡터 양자화가 필요한 세 자리
vector quantization은 Shannon의 source coding 이론에 뿌리를 둔 오래된 문제지만, 현재 수요는 대형 모델 서빙과 vector database에서 나온다. 논문은 세 가지 응용을 든다.
| 응용 | 압축 대상 | 보존해야 하는 성질 |
|---|---|---|
| 대형 언어 모델 배포 | 가중치와 활성값 | 활성값과 가중치 사이의 inner product |
| decoder 기반 Transformer의 KV cache | 이전에 생성한 토큰의 key와 value 임베딩 | 임베딩 사이의 inner product와 거리 |
| vector database의 ANN search | 데이터베이스에 저장된 임베딩 | query 벡터와의 inner product 추정 정확도 |
세 자리의 병목은 성격이 같다. 지연 시간의 상당 부분이 연산 자체가 아니라 가속기의 HBM과 SRAM 사이, 또는 분산 클러스터 노드 사이의 통신에서 발생한다. 벡터를 압축하면 이 통신량이 줄어 추론 비용이 내려간다.
KV cache는 그중에서도 조건이 까다롭다. 캐시 크기가 모델 규모(층 수와 attention head 수)와 context 길이에 함께 비례해서 커지기 때문에 long-context 모델에서 메모리와 속도를 동시에 압박한다. 그리고 캐시 내용은 생성이 진행되는 동안 계속 새로 만들어진다. 즉 미리 데이터를 보고 codebook을 학습할 시간이 없다.
이론과 실용 사이의 오랜 간극
vector quantization의 이론은 1948년 Shannon의 source coding 정리까지 거슬러 올라간다. 1963년 Zador가 high-resolution 방법으로 고정 비율 양자화의 극한 distortion-rate 함수를 유도해 Shannon의 이론값에 근접시켰지만, 구현 가능한 알고리즘은 다루지 않았다. Gersho가 이론을 단순화하고 lattice vector quantization을 도입한 뒤에도 실용화는 늦어졌다.
논문이 밝히는 지연의 이유는 부호화 비용이다. 가장 단순한 부호화 방법인 완전 탐색 nearest neighbor search가 계산량이 너무 커서, 이론적 진전에도 불구하고 초기에는 VQ를 실제로 쓰기 어려웠다. TurboQuant이 codebook을 미리 계산해 두고 좌표별로 조회만 하는 구조를 택한 것은 이 비용 문제에 대한 대응이기도 하다.
기존 방법이 놓인 상충 관계
논문이 정리하는 기존 VQ 알고리즘의 문제는 둘 중 하나다. 가속기에서 vectorize되지 않아 느려서 KV cache 양자화 같은 실시간 응용에 쓸 수 없거나, 아니면 비트 수 대비 distortion 상한이 최적에 미치지 못하거나 둘 중 하나다. TurboQuant의 설계 목표는 이 두 조건을 함께 만족시키는 것이다.
online과 offline의 구분
양자화 방법은 데이터를 미리 보는지 여부로 크게 나뉜다. 이 구분이 이 논문 전체를 관통한다.
| 구분 | 다른 이름 | 동작 | 대표 사례 | 동적 데이터 적합성 |
|---|---|---|---|---|
| online | data-oblivious | 데이터별 조정이나 calibration 없이 즉시 적용한다 | GPT3.int8, QuaRot, KIVI, FlashAttention-3, PolarQuant, TurboQuant | 적합하다 |
| offline | data-dependent | 무거운 preprocessing과 학습으로 양자화 맵을 데이터에 맞춘다. 일부는 2차(Hessian) 정보까지 쓰고 post-processing도 요구한다 | GPTQ, AWQ, SmoothQuant, QuIP, SqueezeLLM | 부적합하다 |
ANN search 쪽의 Product Quantization도 같은 기준에서 offline에 속한다. indexing 단계에서 k-means 변형으로 codebook을 만들어야 하므로 online 설정에 맞지 않는다. RabitQ는 단위 구면에 균등 격자를 투영하는 방식으로 preprocessing을 없앴지만, 격자 투영과 이진 탐색 알고리즘 자체가 vectorization이 안 되어 가속기에서 특히 비효율적이다.
핵심 개념
이 페이지를 읽는 데 필요한 용어를 먼저 풀어 둔다.
bit-width는 좌표 하나를 부호화하는 데 쓰는 평균 비트 수를 뜻한다. 논문은 이를 b로 쓰고, d차원 벡터 전체의 비트 예산을 B = b·d로 둔다. bit-width 2라면 1536차원 벡터 하나가 3,072비트, 즉 384바이트로 줄어든다.
distortion은 양자화가 원본을 얼마나 훼손했는지 재는 값이다. 논문은 두 가지를 각각 정의하고 서로 다른 알고리즘으로 대응한다. 하나는 복원 벡터와 원본의 L2 제곱오차인 MSE distortion이고, 다른 하나는 inner product 추정의 제곱오차인 inner product distortion이다.
unbiased는 추정량의 기댓값이 참값과 정확히 같다는 뜻이다. 양자화 오차가 크더라도 평균적으로 한쪽으로 치우치지 않으면 여러 후보를 비교하는 검색에서는 오차가 상쇄된다. 반대로 bias가 있으면 아무리 많이 평균 내도 오차가 남는다.
data-oblivious는 데이터 분포를 보고 양자화 규칙을 조정하지 않는다는 뜻이다. TurboQuant의 codebook은 차원과 bit-width만으로 결정되고, 실제 벡터가 무엇인지와 무관하다.
residual은 1차 양자화가 복원하지 못하고 남긴 오차 벡터를 가리킨다. 원본에서 복원값을 뺀 것이며, 2단계 구성에서 두 번째 quantizer의 입력이 된다.
codebook은 양자화 인덱스가 가리키는 대표값(centroid)의 목록이다. PQ는 이 목록을 데이터에서 k-means로 학습하지만, TurboQuant은 미리 계산해 저장해 둔 것을 그대로 재사용한다.
방법
문제 설정
설계 대상은 양자화 맵 Q : R^d → {0,1}^B와 역맵 Q^-1 : {0,1}^B → R^d 한 쌍이다. Q는 전단사가 아니므로 복원은 근사일 수밖에 없고, 목표는 그 오차를 줄이는 것이다.
입력에 대한 가정이 이 논문의 성격을 결정한다. 데이터 분포에 아무 가정을 두지 않고 worst-case 벡터를 상정한다. 대신 quantizer 자체를 randomized로 두고, quantizer 출력의 무작위성에 대한 기댓값으로 distortion을 정의한다. 즉 "어떤 입력이 와도 평균적으로 이만큼 잘한다"는 형태의 보장을 목표로 한다.
| 정의 | 식 |
|---|---|
| MSE distortion | Dmse := E[ ‖x − Q^-1(Q(x))‖₂² ] |
| inner product distortion | Dprod := E[ (⟨y,x⟩ − ⟨y, Q^-1(Q(x))⟩)² ] |
| unbiasedness 요구 | E[⟨y, Q^-1(Q(x))⟩] = ⟨y,x⟩ |
실행 인터페이스는 두 개다. Quant는 데이터셋 x₁, ..., xₙ을 양자화하고, DeQuant는 그 결과에서 원본을 근사 복원한다.
무작위 회전이 여는 것
worst-case 입력을 다루는 표준적 방법은 입력을 미리 무작위화하는 것이다. TurboQuant은 i.i.d. 정규분포 원소를 가진 행렬에 QR 분해를 적용해 직교행렬 Π를 만들고, 입력 단위벡터에 이를 곱한다. 결과 Π·x는 단위 구면 S^(d-1) 위의 균등분포를 따른다. 원래 입력이 무엇이었든 상관없다.
여기서 두 가지 성질이 따라 나온다.
첫째, Lemma 1이 각 좌표의 분포를 정확히 알려 준다. 구면 균등분포 점의 좌표 x_j는 밀도 f_X(x) = Γ(d/2) / (√π · Γ((d−1)/2)) · (1 − x²)^((d−3)/2)를 갖는 Beta 분포를 따른다. 증명은 기하학적이다. 좌표값을 x로 고정하면 나머지 성분은 반지름 √(1−x²)인 d−1차원 구면 위에 놓이므로, 그 면적을 d차원 단위구 부피로 나누고 피타고라스 정리에 따른 보정을 적용하면 위 식이 나온다. 차원이 커지면 이 분포는 N(0, 1/d)로 수렴한다.
둘째, 고차원에서 서로 다른 좌표는 무상관을 넘어 거의 독립이 된다. 논문은 이를 Vershynin의 고차원 확률론 결과로 근거를 댄다. 이 성질이 설계를 결정적으로 단순화한다. 좌표 사이의 상호작용을 고려하지 않고 좌표별로 따로 양자화해도 near-optimal이 유지되기 때문이다.
좌표별 최적 scalar 양자화
분포를 알고 있을 때 스칼라 하나를 2^b개 대표값으로 최적 압축하는 문제는 1차원 연속 k-means다. 구간 [−1,1]을 2^b개 구간으로 나누고 각 구간에 centroid 하나를 두는데, 최적해는 Voronoi tessellation 조건을 만족한다. 정렬된 centroid 사이의 중점이 구간 경계가 된다는 뜻이다.
비용 함수는 C(f_X, b) := min Σᵢ ∫ |x − cᵢ|² · f_X(x) dx이고, 반복 수치해법인 Lloyd-Max 알고리즘으로 원하는 정밀도까지 푼다. 중요한 것은 이 계산이 데이터와 무관하다는 점이다. 실무에서 쓰는 bit-width 범위에 대해 한 번만 풀어 저장해 두면 이후 호출에서는 조회만 하면 된다.
차원이 어느 정도 큰 경우 f_X가 정규분포에 가까워지고, 그때의 최적 centroid는 다음과 같다.
| bit-width | 최적 centroid |
|---|---|
| 1 | ±√(2/π)/√d |
| 2 | {±0.453/√d, ±1.51/√d} |
TurboQuant_mse의 전체 절차는 준비, Quant, DeQuant 세 단계다.
| 단계 | 연산 | 산출물 |
|---|---|---|
| 준비 | 무작위 회전 행렬 Π 생성, bit-width별 codebook 계산 |
Π, centroid 목록 |
| Quant | y = Π·x 계산 후 각 좌표에서 가장 가까운 centroid의 인덱스를 찾는다 |
b비트 정수 인덱스 벡터 idx |
| DeQuant | 인덱스로 centroid를 조회해 ỹ를 만들고 Π^T를 곱한다 |
복원 벡터 x̃ |
TurboQuant_mse의 보장
Theorem 1은 위 절차의 MSE를 정확히 계산한다. Dmse = d · C(f_X, b)이며, 모든 bit-width에 대해 Dmse ≤ (√3·π/2) · 4^(-b)가 성립한다.
증명은 짧다. Π가 회전이므로 길이가 보존되어 ‖x − x̃‖₂ = ‖Π·x − ỹ‖₂이고, Lemma 1에 따라 모든 좌표가 같은 분포를 따르므로 좌표 하나의 기대 오차를 d배 하면 전체가 된다. bit-width 4를 넘는 구간의 상한은 Panter와 Dite의 high-resolution 공식 C(f_X, b) ≤ (1/12)·(∫ f_X(x)^(1/3) dx)³ · 4^(-b) = (√3·π)/(2d) · 4^(-b)에서 나온다.
작은 bit-width에서는 Eq. 4를 직접 수치해로 풀어 더 정밀한 값을 얻는다.
bit-width b |
Dmse (논문 수치해) |
정보이론 하한 4^(-b) |
하한 대비 배수 (두 값의 나눗셈으로 얻은 계산값) |
|---|---|---|---|
| 1 | 0.36 | 0.25 | 1.44 |
| 2 | 0.117 | 0.0625 | 1.87 |
| 3 | 0.03 | 0.015625 | 1.92 |
| 4 | 0.009 | 0.00390625 | 2.30 |
비트를 하나 늘릴 때마다 distortion이 약 4분의 1로 줄어드는 지수적 감소가 확인된다. 그러면서 하한과의 거리는 1.44배에서 2.30배 사이에 머문다.
inner product 추정에서 생기는 bias
MSE를 최적화한 quantizer가 inner product 추정에서도 최적이라는 보장은 없다. 논문은 bit-width 1의 경우로 이를 명시적으로 보인다.
bit-width 1에서 최적 codebook은 충분히 큰 d에 대해 {±√(2/(πd))}다. 그러면 양자화 맵이 Qmse(x) = sign(Π·x), 역맵이 Q^-1_mse(z) = √(2/(πd)) · Π^T · z가 된다. 이 형태에 Lemma 4를 적용하면 E[⟨y, Q^-1_mse(Qmse(x))⟩] = (2/π) · ⟨y,x⟩가 나온다. 참값의 약 0.64배로 일정하게 축소되는 곱셈 bias다.
이 bias는 bit-width가 커지면 줄어들지만 유한한 bit-width에서 0이 되지는 않는다. 검색처럼 여러 후보의 점수를 비교하는 상황에서 일정 배율의 축소는 순위를 바꾸지 않지만, 서로 다른 정밀도의 추정값을 섞거나 절대 임계값을 쓰는 상황에서는 문제가 된다.
QJL의 역할
두 번째 단계에 쓰는 부품은 같은 저자 그룹이 2024년에 낸 QJL이다. 정의는 단순하다. Q_qjl(x) := sign(S·x)로, S는 원소가 i.i.d. N(0,1)인 d×d 무작위 행렬이고 sign은 원소별로 적용한다. 각 좌표가 1비트로 줄어든다. 역맵은 Q^-1_qjl(z) := (√(π/2)/d) · S^T · z다.
Lemma 4가 두 성질을 보장한다. 이 추정량은 unbiased이고, 분산이 Var ≤ (π/2d) · ‖y‖₂² 이하다. 분산 증명은 sᵢ^T y가 평균 0에 분산 ‖y‖₂²인 가우시안이라는 점을 쓰고, 최종 추정값이 d개 독립 표본의 평균이라는 점에서 1/d 인자를 얻는다.
TurboQuant_prod의 2단계 구성
목표 bit-width가 b일 때, 예산을 b−1과 1로 나눠 쓰는 것이 전략이다.
| 단계 | 연산 | 출력 | 크기 |
|---|---|---|---|
| 1 | bit-width b−1로 Qmse 적용 |
인덱스 벡터 idx |
좌표당 b−1비트 |
| 2 | residual r := x − Q^-1_mse(Qmse(x))에 1비트 QJL 적용 |
부호 벡터 qjl |
좌표당 1비트 |
| 3 | residual의 L2 norm 보관 | 스칼라 γ = ‖r‖₂ |
벡터당 부동소수점 1개 |
1단계에서 MSE를 최소화한다는 것은 곧 residual의 L2 norm을 최소화한다는 뜻이다. 그 기댓값은 E[‖r‖] = √(C(f_X, b−1))로, bit-width가 클수록 작아진다. 2단계의 QJL 오차가 residual 크기에 비례하므로, 1단계를 잘할수록 2단계 오차도 함께 줄어드는 구조다.
복원은 x̃ = x̃_mse + (√(π/2)/d) · γ · S^T · qjl이고, 최종 추정량은 ⟨y, Q^-1_mse(Qmse(x))⟩ + ‖r‖₂ · ⟨y, Q^-1_qjl(Q_qjl(r))⟩다. QJL 항을 residual norm γ로 다시 스케일하는 것이 정확도의 관건이다. QJL 자체는 단위벡터 기준으로 정의되므로, 실제 residual의 크기를 곱해 줘야 원래 척도로 돌아온다.
TurboQuant_prod의 보장
Theorem 2는 두 가지를 준다. 첫째, 추정이 unbiased다. 즉 E[⟨y, x̃⟩] = ⟨y,x⟩다. 증명은 x̃_mse로 조건을 걸어 기댓값을 계산하는데, Lemma 4에 의해 QJL 항의 조건부 기댓값이 정확히 ⟨y, r⟩가 되므로 두 항의 합이 ⟨y, x⟩로 복원된다. 여기에 전체 기댓값 법칙을 적용하면 조건 없는 기댓값도 같다.
둘째, distortion이 Dprod ≤ (√3·π²) · ‖y‖₂²/d · 4^(-b)로 억제된다. 증명의 중심 부등식은 Dprod ≤ (π/2d) · ‖y‖₂² · Dmse이고, 여기서 Dmse는 bit-width b−1로 평가한다. 즉 inner product distortion이 1단계 MSE에 비례하고, 비례상수가 QJL의 분산 상한에서 온다.
bit-width b |
Dprod (논문 수치해) |
정보이론 하한 (‖y‖₂ = 1 기준) |
|---|---|---|
| 1 | 1.57/d |
0.25/d |
| 2 | 0.56/d |
0.0625/d |
| 3 | 0.18/d |
0.015625/d |
| 4 | 0.047/d |
0.00390625/d |
여기서 1/d 인자에 주목할 만하다. 차원이 커질수록 inner product distortion 자체가 작아진다. 1536차원 임베딩에서 bit-width 4를 쓰면 Dprod가 대략 3×10^-5 수준이다.
두 변형의 선택 기준
TurboQuant은 하나의 알고리즘이 아니라 목적이 다른 두 변형이다. 어느 쪽을 쓸지는 응용이 무엇을 요구하는지로 갈린다.
| 비교 항목 | TurboQuant_mse | TurboQuant_prod |
|---|---|---|
| 최적화 대상 | 복원 벡터의 L2 제곱오차 | inner product 추정의 제곱오차 |
| inner product 추정의 bias | 있다. bit-width가 커지면 줄어든다 | 없다. 모든 bit-width에서 unbiased다 |
| 구성 | 1단계. 회전 후 좌표별 scalar 양자화 | 2단계. bit-width b−1의 Qmse에 residual 1비트 QJL을 결합 |
| 추가 저장 | 없다 | 부호 벡터와 residual norm 스칼라 |
| 유리한 구간 | 비트 수가 큰 구간. 실측에서 bit-width 3 부근부터 앞선다 | 비트 수가 작은 구간. 실측에서 bit-width 1과 2에서 앞선다 |
논문은 nearest neighbor search처럼 중요한 응용에서 unbiased inner product 추정이 필수적이라고 밝힌다. bias가 있으면 추정값을 아무리 반복해 평균 내도 참값으로 수렴하지 않기 때문이다.
벡터 하나가 실제로 차지하는 것
두 변형이 벡터 하나당 저장하는 항목을 나열하면 비트 예산의 구성이 분명해진다.
| 항목 | TurboQuant_mse | TurboQuant_prod |
|---|---|---|
| 좌표별 인덱스 | b비트씩 d개 |
b−1비트씩 d개 |
| QJL 부호 벡터 | 없다 | 1비트씩 d개 |
| residual norm | 없다 | 부동소수점 스칼라 1개 |
| 좌표당 합계 | b비트 |
b비트 |
두 변형의 좌표당 비트 수가 같다는 점이 설계의 요령이다. TurboQuant_prod는 추가 비트를 쓰는 것이 아니라, 주어진 예산에서 1비트를 떼어 unbiasedness와 맞바꾼다. 벡터당 residual norm 스칼라 하나가 추가로 필요한데, d가 크면 좌표당으로 환산했을 때 무시할 만한 양이다.
정보이론 하한
near-optimal이라는 주장은 비교 대상이 있어야 성립한다. Theorem 3은 어떤 randomized quantizer도 넘어설 수 없는 하한을 세운다. 증명은 두 단계로 진행된다.
첫 단계는 Yao's minimax principle이다. "randomized 알고리즘 + worst-case 입력"의 하한을 "deterministic 알고리즘 + 최악의 randomized 입력 분포"의 하한으로 바꿔 놓는다. 후자는 다루기 쉽다. 구면 균등분포 입력에서의 최선 MSE로 하한이 잡히기 때문이다.
두 번째 단계는 Shannon Lower Bound다. Lemma 2는 임의 분포와 유한한 미분 엔트로피에 대해 D(p_X, B) ≥ (d/(2πe)) · 2^((2/d)(h(x)−B))를 준다. backward Gaussian test channel로 증명되는 고전 결과다. Lemma 3은 이를 구면 균등분포에 특화해 D(B) ≥ 2^(-2B/d)를 얻는데, 유도에 구면 면적 A_d = 2π^(d/2)/Γ(d/2)와 Gamma 함수의 Stirling 근사를 쓴다.
결과는 두 줄이다.
Dmse(Q) ≥ 1/4^b- 어떤
y ∈ S^(d-1)가 존재해Dprod(Q) ≥ (1/d) · (1/4^b)
두 번째 줄은 pigeonhole 원리로 얻는다. Dmse를 표준 기저 벡터 e_j에 대한 좌표별 오차 제곱의 합으로 다시 쓰면 d개 항의 합이 1/4^b 이상이므로, 적어도 하나의 좌표는 (1/d)·(1/4^b) 이상의 오차를 갖는다. 그 좌표 방향을 y로 잡으면 된다.
논문은 sphere packing 논증으로도 비슷한 하한을 유도할 수 있다고 언급하면서, sphere packing 쪽이 더 어려운 문제라 상수가 더 크다고 적는다. Theorem 3을 택한 이유는 worst-case 오차가 아니라 expected distortion에 대한 하한이라서 Theorem 1과 Theorem 2의 상한과 직접 맞물리기 때문이다.
정리별 보장 요약
각 정리가 어떤 조건에서 무엇을 보장하는지 한자리에 모으면 다음과 같다.
| 정리 | 전제 조건 | 보장 내용 |
|---|---|---|
| Lemma 1 | x가 단위 구면 위 균등분포 |
각 좌표가 명시된 Beta 분포를 따르고, 고차원에서 N(0, 1/d)로 수렴한다 |
| Lemma 4 | 임의의 x ∈ S^(d-1), 임의의 y ∈ R^d |
QJL 추정이 unbiased이고 분산이 (π/2d)·‖y‖₂² 이하다 |
| Theorem 1 | bit-width b ≥ 1, x ∈ S^(d-1) (단위 norm) |
Dmse = d·C(f_X, b)이고 Dmse ≤ (√3·π/2)·4^(-b) |
| Theorem 2 | bit-width b ≥ 1, x ∈ S^(d-1), 임의의 y ∈ R^d |
추정이 unbiased이고 Dprod ≤ (√3·π²)·‖y‖₂²/d·4^(-b) |
| Theorem 3 | 임의의 randomized quantizer와 임의의 복원 맵 | 어려운 입력 x가 존재해 Dmse ≥ 1/4^b, 어떤 y에 대해 Dprod ≥ (1/d)·(1/4^b) |
Theorem 1과 Theorem 2가 모두 ‖x‖₂ = 1을 전제한다는 점이 중요하다. near-optimal이라는 표현은 이 조건에서 성립하는 진술이다. 단위 norm이 아닌 데이터셋은 L2 norm을 부동소수점으로 따로 저장했다가 복원 시 rescale하면 된다는 것이 논문의 처리 방법인데, 그 저장 비용은 분석에 포함되어 있지 않다.
상한과 하한의 상수를 나란히 놓으면 near-optimality의 범위가 분명해진다.
| 대상 | 상한 | 하한 | 논문이 명시한 배수 |
|---|---|---|---|
| MSE | (√3·π/2) · 4^(-b) |
4^(-b) |
약 2.7배. bit-width 1에서는 약 1.45배 |
| inner product | (√3·π²) · ‖y‖₂²/d · 4^(-b) |
(‖y‖₂²/d) · 4^(-b) |
논문이 배수를 따로 명시하지 않는다 |
즉 "정보이론 하한의 약 2.7배"라는 자주 인용되는 수치는 MSE에 대한 진술이다. inner product 쪽 상한의 상수는 이보다 크며, 논문은 그 배수를 별도로 제시하지 않는다.
채택하지 않은 개선안
codebook 인덱스에 entropy encoding을 적용하면 평균 bit-width를 분포의 엔트로피 수준까지 줄일 수 있다. 각 인덱스가 등장할 확률을 해당 구간의 적분으로 계산해 최적 prefix code를 만드는 방식이고, 무손실 압축이므로 distortion에는 영향이 없다.
감소폭이 가장 큰 경우가 bit-width 4다. 이때 인덱스 분포의 엔트로피가 약 3.8이어서 평균 bit-width를 약 5% 줄일 수 있다. 저자는 이득이 작다고 판단해 단순성과 속도를 위해 채택하지 않았다.
결과
모든 실험은 NVIDIA A100 GPU 1대에서 수행했다. 실험은 이론 검증과 하위 과제 평가 두 부분으로 나뉘고, 하위 과제는 다시 KV cache 양자화와 nearest neighbor search로 갈린다.
실험 설정
| 구분 | 내역 |
|---|---|
| 임베딩 데이터 | DBpedia Entities를 OpenAI3 임베딩으로 인코딩한 1536차원본과 3072차원본(Qdrant가 배포한 HuggingFace 데이터셋), GloVe 200차원 |
| 표본 구성 | training set 10만 개 무작위 표집, query set 1,000개 별도 추출. GloVe는 데이터셋이 제공하는 기존 query set 1만 개 사용 |
| 언어 모델 | Llama-3.1-8B-Instruct, Ministral-7B-Instruct |
| long-context 벤치마크 | Needle-In-A-Haystack, LongBench(길이 분포가 고른 LongBench-E 부분집합) |
| KV cache baseline | PolarQuant, SnapKV, PyramidKV, KIVI |
| ANN baseline | Product Quantization(LUT256 구성), RabitQ |
이론 검증
DBpedia Entities를 OpenAI3 1536차원으로 인코딩한 데이터를 썼다. training set 10만 개를 무작위로 뽑고 query set 1,000개를 따로 추출했다.
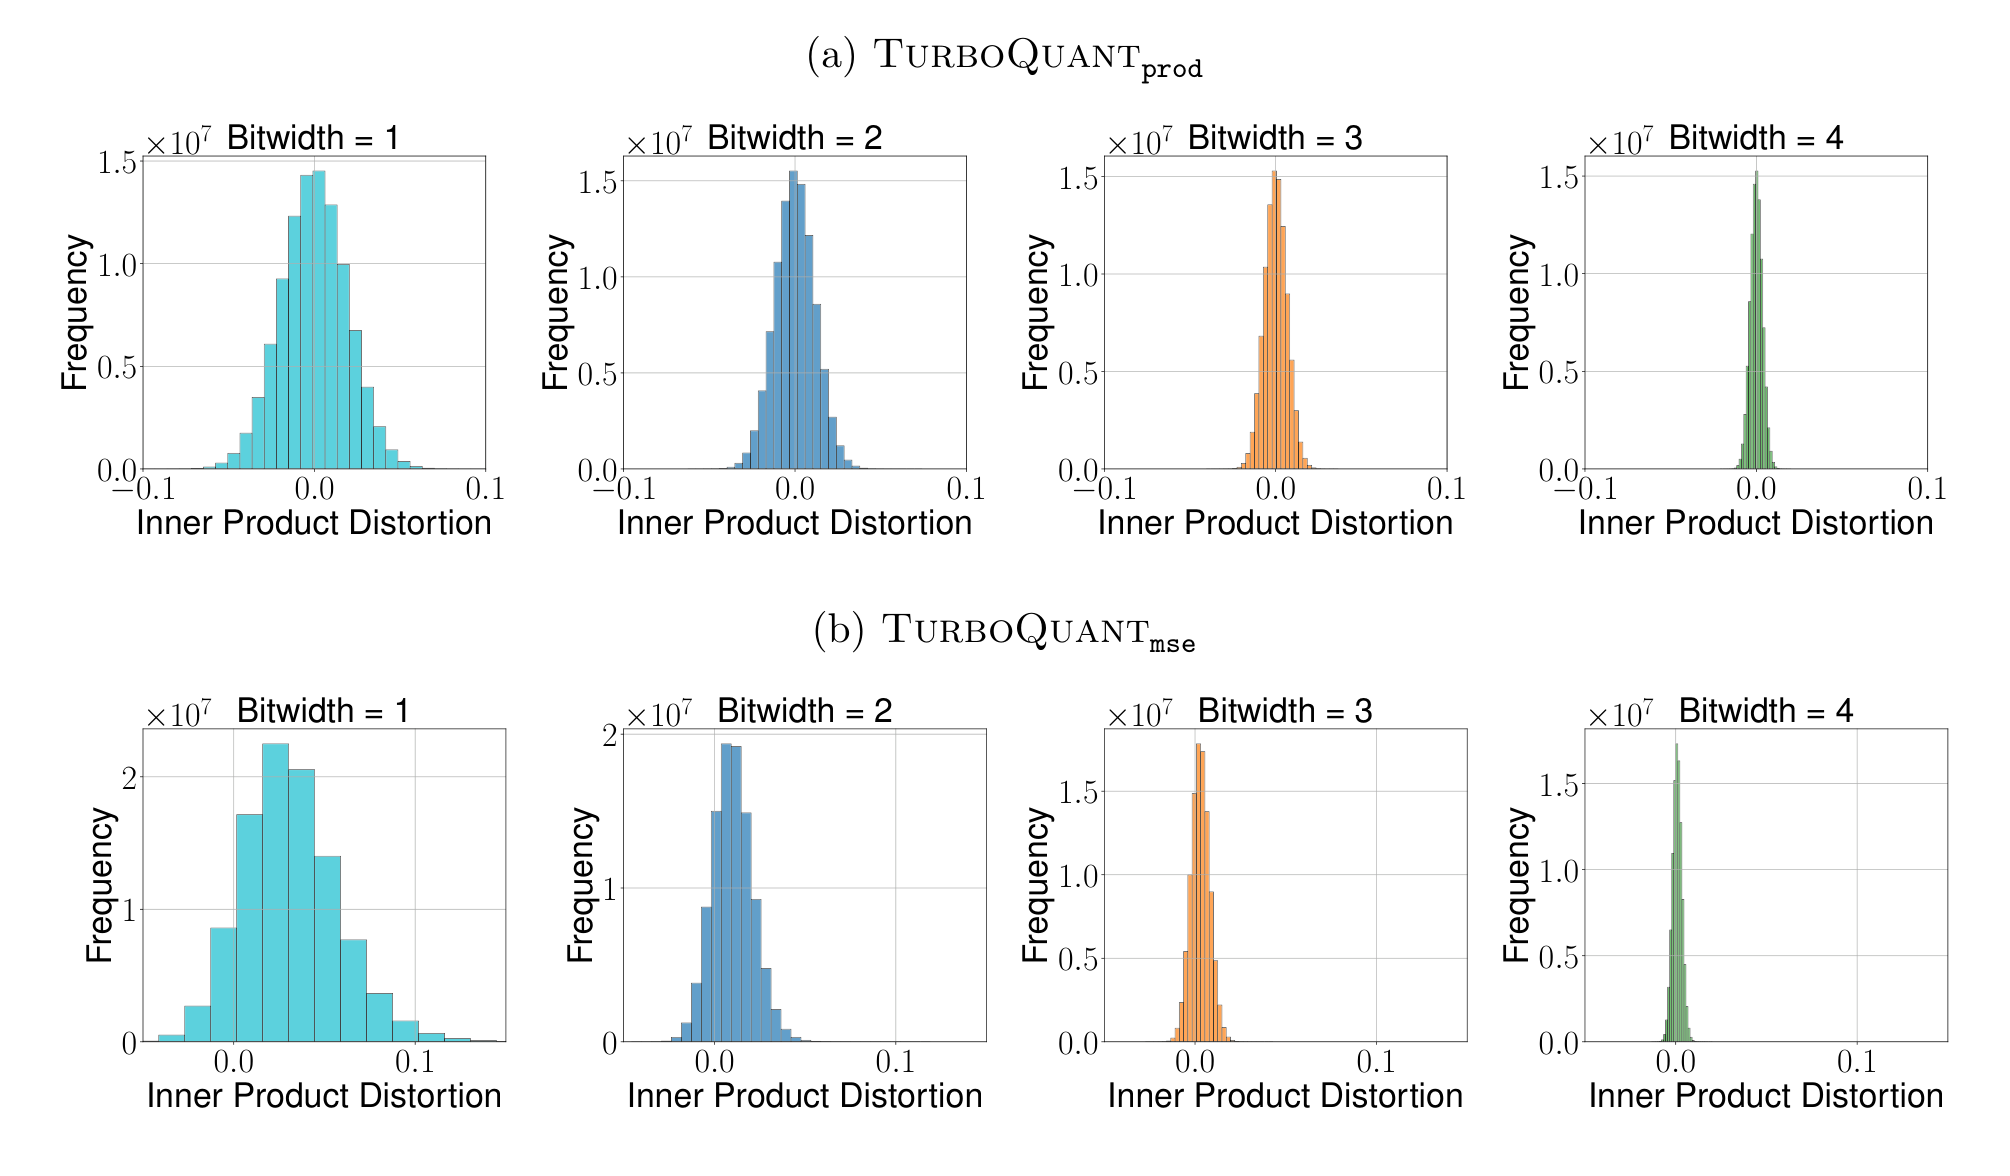
첫 번째 확인은 두 변형의 bias 유무다. bit-width가 커지면 두 변형 모두 분산이 줄어든다. 다만 inner product 추정에서 TurboQuant_mse는 bias를 남기며, 이 bias는 bit-width가 커지면서 점차 0으로 수렴한다. TurboQuant_prod는 모든 bit-width에서 unbiased를 유지한다.
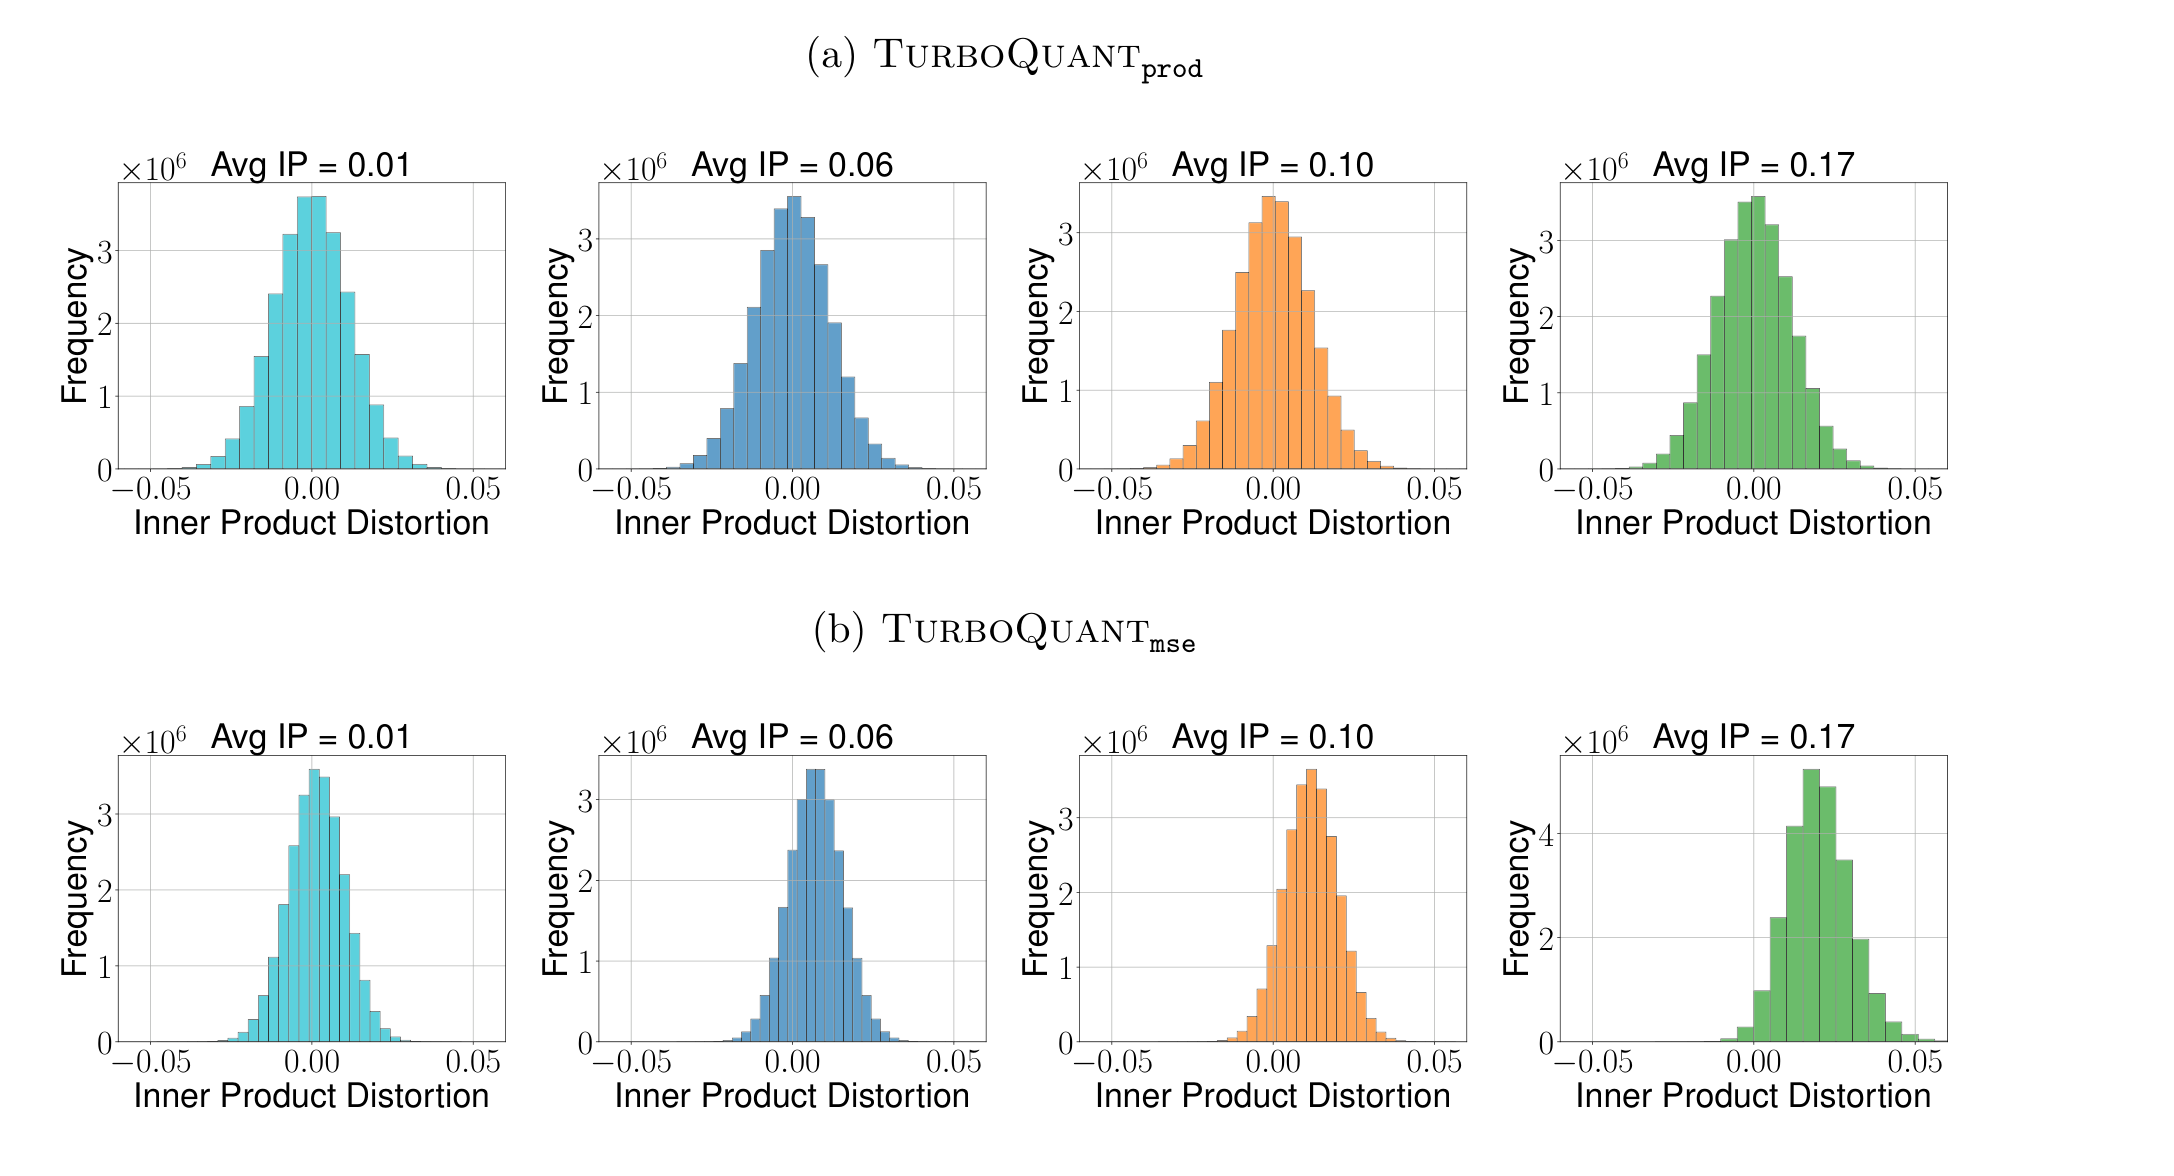
두 번째 확인은 bias가 무엇에 의존하는지다. bit-width를 2로 고정하고 평균 inner product를 0.01, 0.06, 0.10, 0.17로 바꿔 가며 오차 분포를 그렸다. TurboQuant_prod의 오차 분산은 원본 벡터의 inner product 값과 무관하게 일정하다. 반면 TurboQuant_mse의 bias는 평균 inner product가 커질수록 함께 커진다. 앞서 유도한 곱셈 bias의 성질과 일치하는 결과다. 참값에 비례하는 오차이므로 참값이 클수록 절대 오차도 커진다.
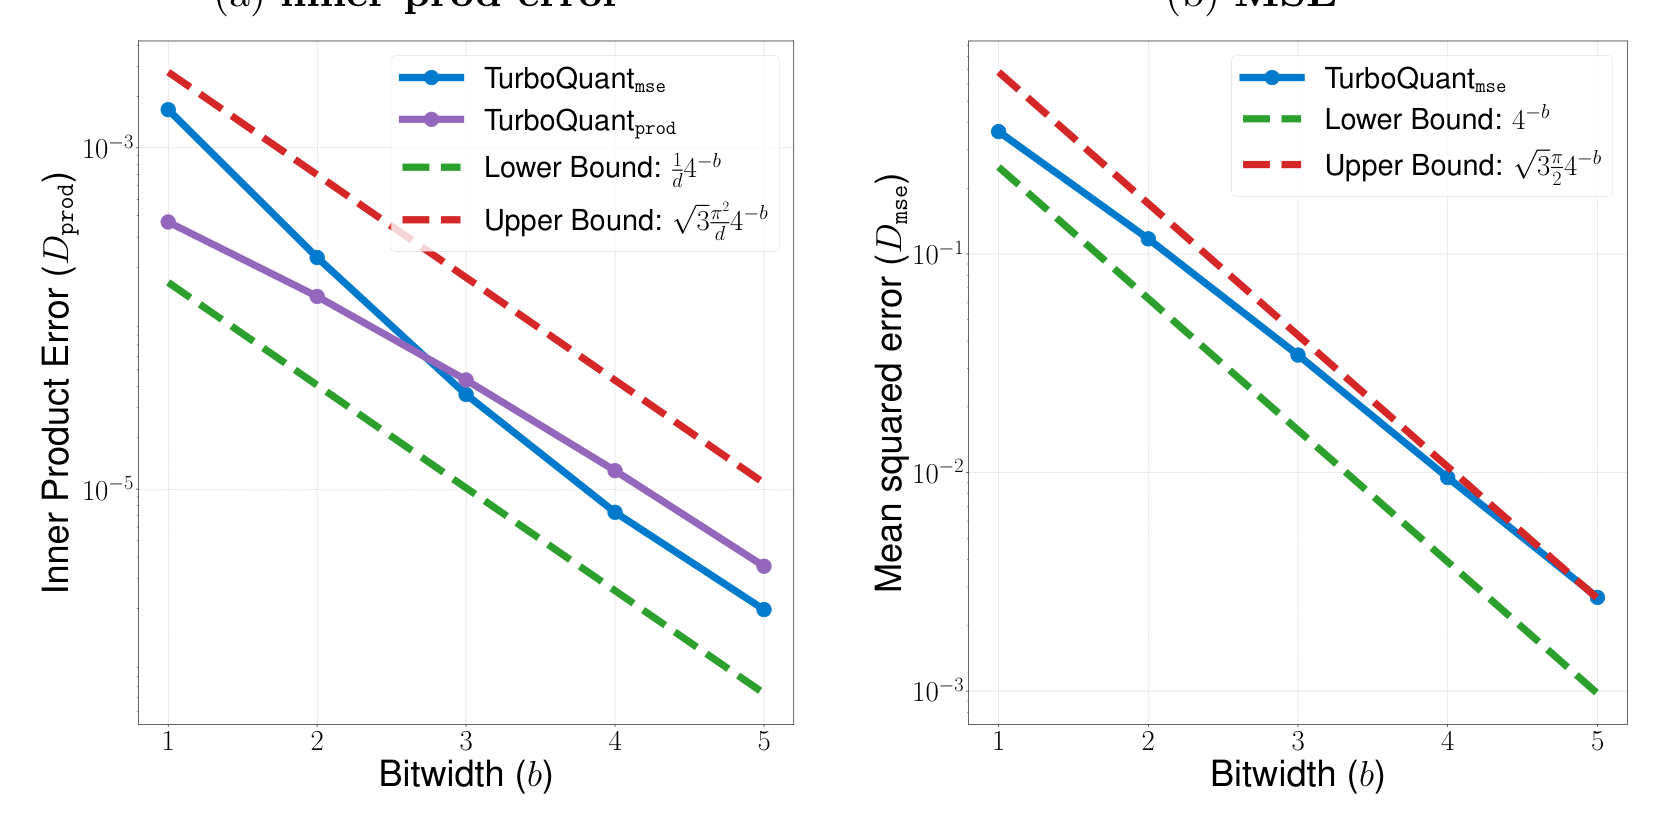
세 번째 확인은 이론 경계와의 대조다. bit-width 1에서 5까지 실측 inner product 오차와 MSE를 이론 상한, 하한과 함께 로그 스케일로 그렸다. 실측값이 두 경계 사이에 놓이며 예측과 일치한다. 두 변형의 우열은 bit-width에 따라 뒤바뀐다. 낮은 bit ratio에서는 TurboQuant_prod가 우세하지만, 비트 수가 늘면 TurboQuant_mse가 bias를 줄여 결국 inner product 추정에서도 앞선다. 그래프에서 두 곡선이 bit-width 3 부근에서 교차한다.
Needle-In-A-Haystack
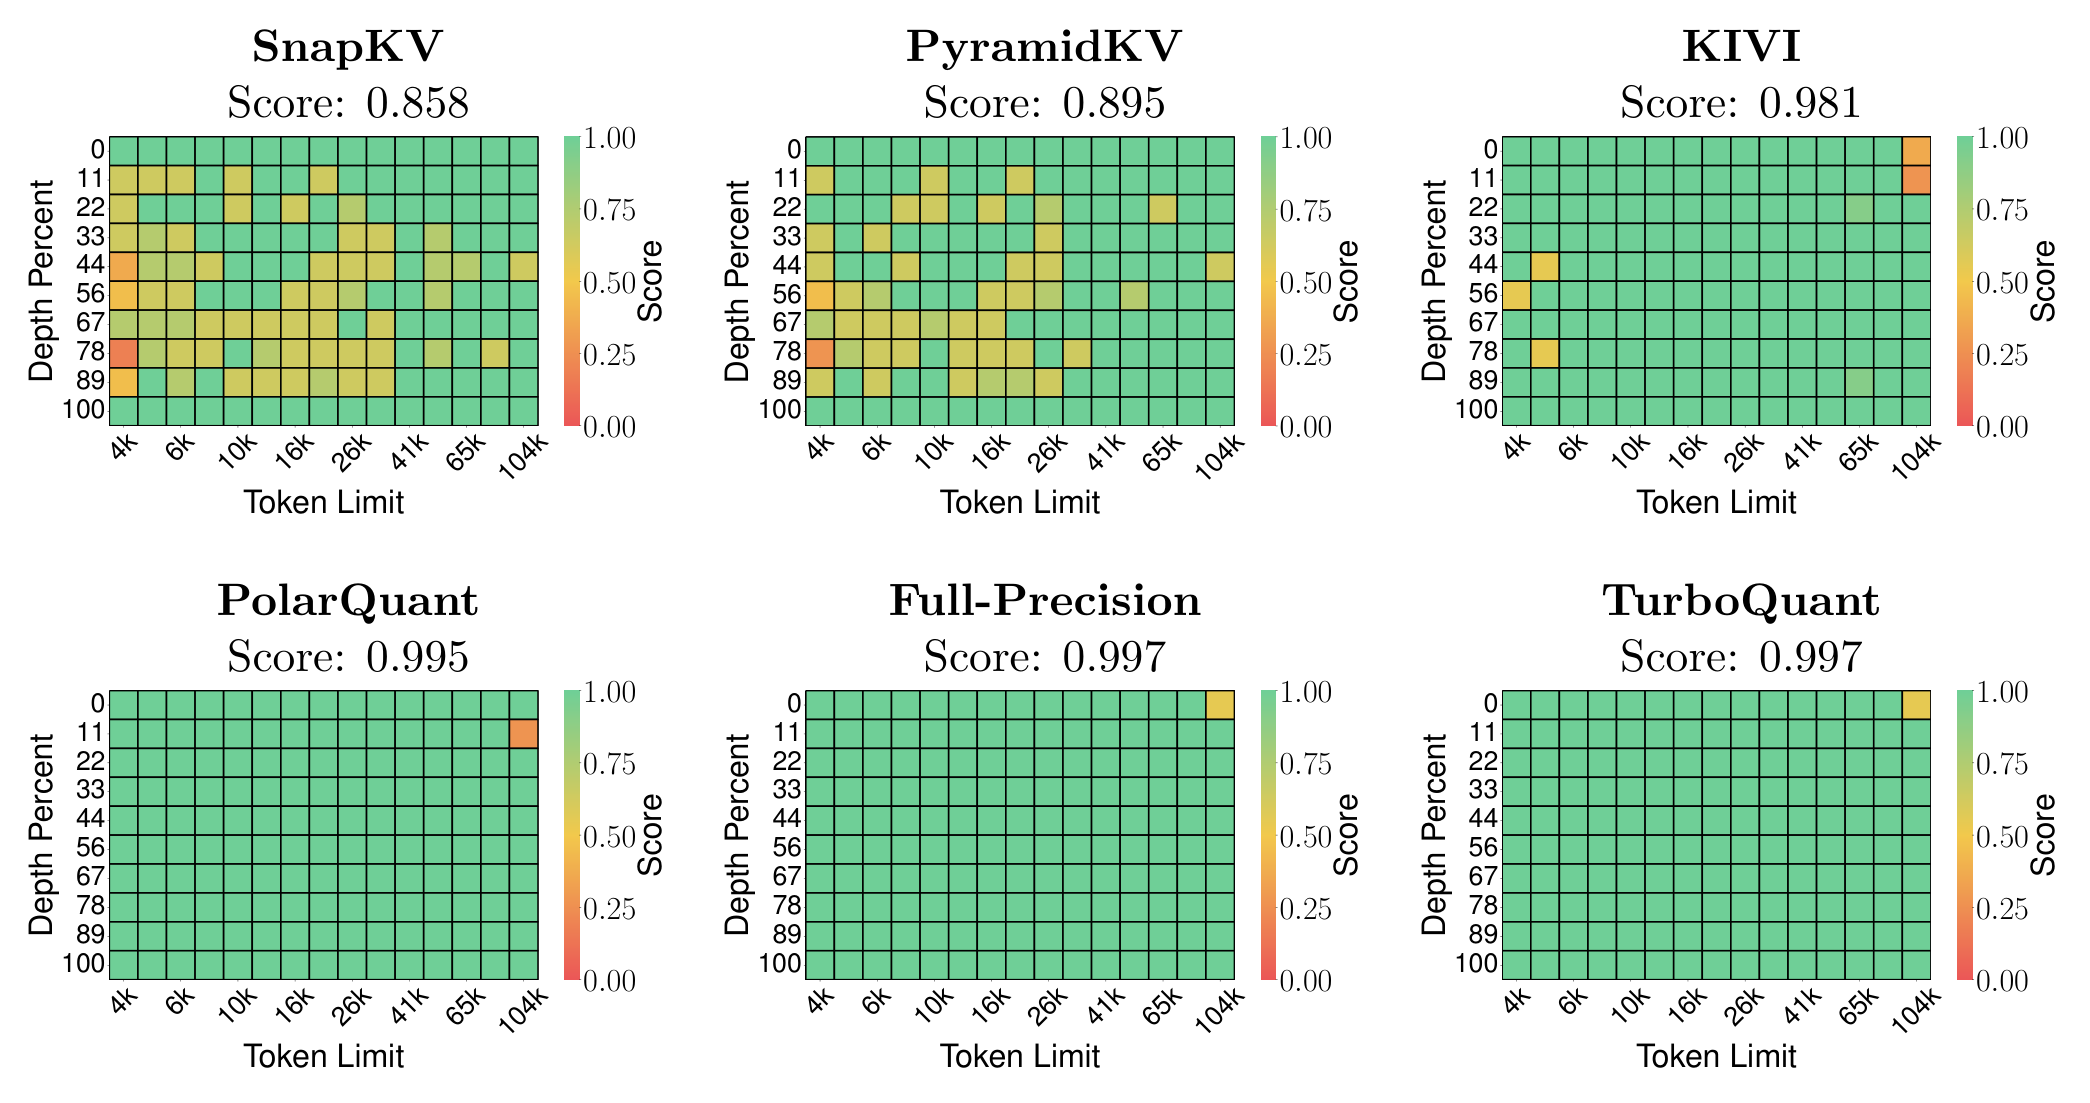
긴 문서 안 임의 위치에 숨긴 한 문장을 모델이 회수하는지 보는 벤치마크다. 실험 설정은 Fu 외의 구성을 따랐고, 모델은 Llama-3.1-8B-Instruct, 문서 크기는 4,000토큰에서 10만 4,000토큰까지 변화시켰다. 지표는 recall score다.
메모리 압축비는 0.25로 고정했다. 전체 KV cache의 25%만 사용한다는 뜻이고, 압축률로는 4배다.
| 방법 | 분류 | recall score |
|---|---|---|
| SnapKV | token 단위 압축 | 0.858 |
| PyramidKV | token 단위 압축 | 0.895 |
| KIVI | 형식적 보장 없는 scalar 양자화 | 0.981 |
| PolarQuant | 이론 보장이 있는 양자화 | 0.995 |
| Full-Precision | 압축 없음 | 0.997 |
| TurboQuant | 이론 보장이 있는 양자화 | 0.997 |
결과에서 읽히는 경향은 분류별로 갈린다. 이론 보장이 있는 양자화(PolarQuant, TurboQuant)가 상위 두 자리를 차지하고, 보장 없는 scalar 양자화(KIVI)가 그 뒤를, token 단위 압축(SnapKV, PyramidKV)이 가장 아래를 차지한다. TurboQuant은 4배 넘게 양자화된 상태에서 압축하지 않은 baseline과 정확히 같은 0.997을 기록했다.
LongBench 종단 생성
LongBench는 단일 문서와 다중 문서 질의응답, 요약, few-shot 학습, 합성 과제, 코드 완성을 아우르는 데이터셋이다. 문맥 길이에 따른 편향을 줄이려고 길이 분포가 더 고른 LongBench-E 부분집합을 썼다. 모델은 Llama-3.1-8B-Instruct와 Ministral-7B-Instruct 두 가지다.
| Method | KV Size | SingleQA | MultiQA | Summarization | Few shot | Synthetic | Code | Average |
|---|---|---|---|---|---|---|---|---|
| Llama-3.1-8B-Instruct, Full Cache | 16 | 45.29 | 45.16 | 26.55 | 68.38 | 59.54 | 46.28 | 50.06 |
| KIVI | 3 | 43.38 | 37.99 | 27.16 | 68.38 | 59.50 | 44.68 | 48.50 |
| KIVI | 5 | 45.04 | 45.70 | 26.47 | 68.57 | 59.55 | 46.41 | 50.16 |
| PolarQuant | 3.9 | 45.18 | 44.48 | 26.23 | 68.25 | 60.07 | 45.24 | 49.78 |
| TurboQuant (ours) | 2.5 | 44.16 | 44.96 | 24.80 | 68.01 | 59.65 | 45.76 | 49.44 |
| TurboQuant (ours) | 3.5 | 45.01 | 45.31 | 26.00 | 68.63 | 59.95 | 46.17 | 50.06 |
| Ministral-7B-Instruct, Full Cache | 16 | 47.53 | 49.06 | 26.09 | 66.83 | 53.50 | 47.90 | 49.89 |
| TurboQuant (ours) | 2.5 | 48.38 | 49.22 | 24.91 | 66.69 | 53.17 | 46.83 | 49.62 |
3.5비트 TurboQuant은 Llama-3.1-8B-Instruct에서 full cache와 같은 평균 50.06을 기록했다. 원래 16비트로 저장하던 것을 3.5비트로 줄이고도 평균 점수가 그대로다. 2.5비트 구성도 49.44로, KV Size 3의 KIVI(48.50)와 3.9의 PolarQuant(49.78)를 더 적은 비트로 앞선다.
표를 전체로 보면 한 가지 유보 사항이 있다. KV Size 5의 KIVI가 평균 50.16으로 표 안에서 가장 높다. 3.5비트 TurboQuant의 50.06보다 0.10 높다. 다만 이 구성은 비트 수가 3.5비트의 약 1.43배다. 같은 비트 예산에서의 비교가 아니다.
과제별로 보면 요약 항목이 가장 약하다. 2.5비트 구성이 24.80으로 full cache의 26.55보다 1.75 낮고, Ministral에서도 24.91로 26.09보다 1.18 낮다. 나머지 다섯 항목은 full cache와 1점 이내 차이거나 오히려 높다.
운용상의 차이도 있다. KIVI와 PolarQuant는 생성된 토큰을 양자화하지 않고 두는 반면, TurboQuant은 streaming generation 과정에서도 양자화를 적용한다. 앞서 말한 online 성질이 여기서 실제 이점으로 나타난다.
비정수 비트 정밀도의 구성
2.5비트나 3.5비트 같은 값은 채널을 두 집합으로 나눈 결과다. 값 분포의 크기가 큰 소수 채널을 outlier로 분리하고, 두 집합에 TurboQuant 인스턴스를 따로 적용하면서 outlier 쪽에 더 높은 비트를 배정한다. 이 outlier 처리 전략 자체는 QJL과 RotateKV 같은 선행 연구와 같은 방향이다.
| 구성 | outlier 채널 | non-outlier 채널 | 유효 비트 |
|---|---|---|---|
| 2.5비트 | 32개를 3비트로 | 96개를 2비트로 | (32×3 + 96×2)/128 = 2.5 |
| 3.5비트 | 비율이 다르다고만 기술 | 비율이 다르다고만 기술 | 3.5 |
저자는 이 조건에서 최소 4.5배 압축을 달성했다고 적는다.
ANN search
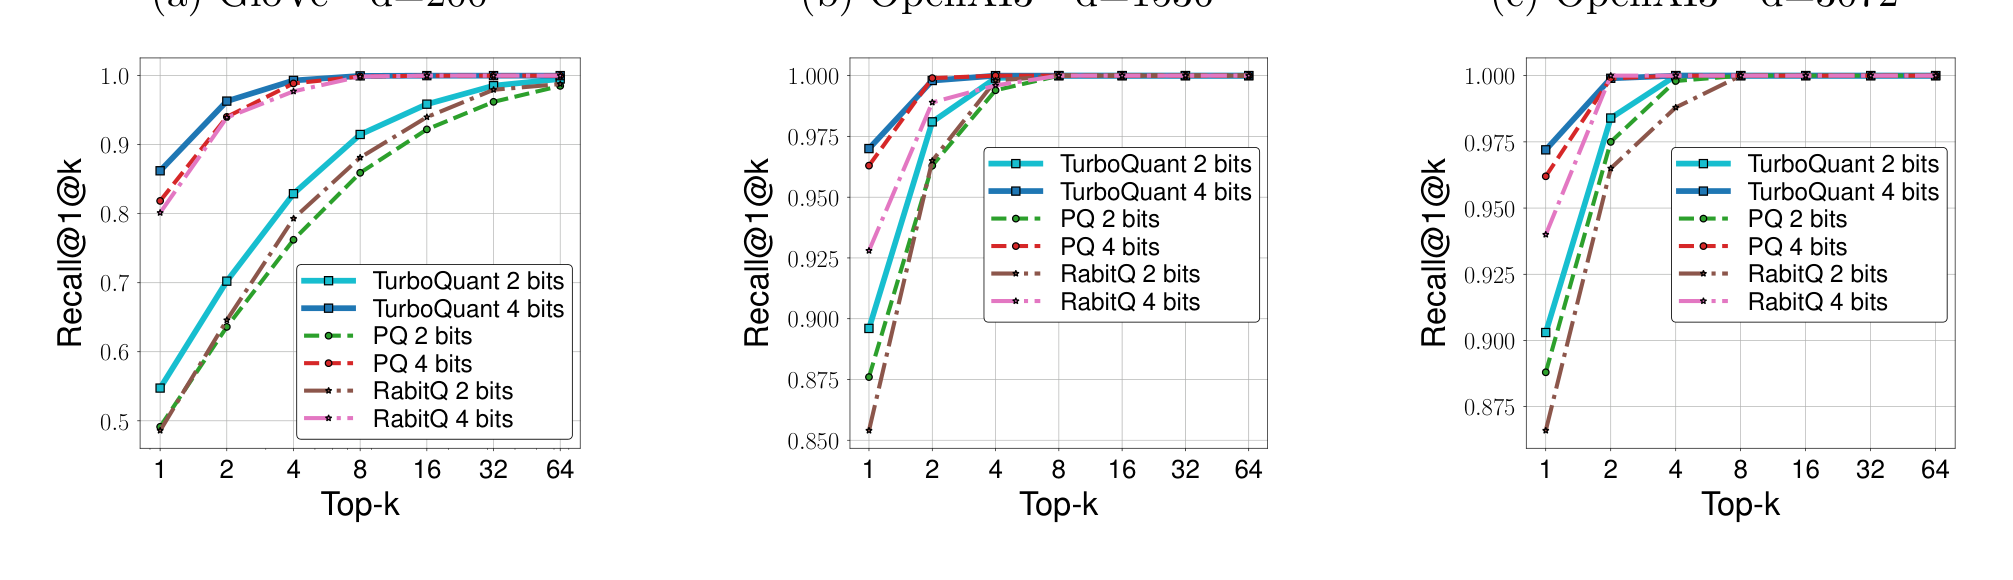
DBpedia Entities의 1536차원본과 3072차원본, 그리고 저차원 대조군인 GloVe 200차원에서 평가했다. 세 방법 모두 같은 training set을 양자화하고 top-k에서의 recall ratio(1@k)로 비교했다. 이 지표는 진짜 top inner product 결과가 근사 top-k 안에 들어오는 빈도를 잰다. top-k를 넓게 잡을수록 값이 올라가므로, 방법 간 차이는 k가 작은 구간에서 가장 잘 드러난다.
baseline 구성에서 논문이 밝힌 조건은 다음과 같다.
| baseline | 구성 | 실험 조건에서의 유불리 |
|---|---|---|
| Product Quantization | k-means로 codebook을 만들어 별도 저장한다. 비트 수가 늘면 codebook 크기가 지수적으로 커진다. AVX2 In-Register Lookup Table 구현이 가장 빠른데, 코드워드 16개짜리 LUT16은 품질 저하가 커서 코드워드 256개짜리 LUT256을 선택했다. 2비트는 조회당 좌표 4개, 4비트는 조회당 좌표 2개를 묶는다 | 학습과 평가에 같은 데이터셋을 써서 PQ가 구조적으로 유리하다 |
| RabitQ | 단위 구면에 균등 격자를 투영하고 데이터 점에 가장 가까운 투영을 탐색한다. preprocessing은 필요 없다 | 완전한 vectorization 구현이 없어 GPU 가속을 쓰지 못한다. 비트 비율 비교에 반영하지 않은 추가 연산 부담이 있어 실제 사용 비트가 보고치보다 많다 |
baseline에 이런 이점을 준 상태에서도 TurboQuant이 모든 실험에서 recall ratio 우위를 유지했다는 것이 논문의 주장이다. 세 그래프에서 TurboQuant 2비트와 4비트 곡선이 같은 비트 수의 PQ, RabitQ 곡선 위에 놓인다. 데이터셋별로 격차의 크기는 다르다. GloVe 200차원은 top-1 recall이 0.5 근처에서 시작해 방법 간 격차가 가장 크게 벌어진다. 1536차원과 3072차원에서는 top-4 이후 모든 방법이 1.0에 수렴해 차이가 사라진다.
양자화 소요 시간
recall 못지않게 큰 차이가 indexing 시간에서 나온다. 4비트 양자화 기준의 측정값이다.
| Approach | d=200 | d=1536 | d=3072 |
|---|---|---|---|
| Product Quantization | 37.04초 | 239.75초 | 494.42초 |
| RabitQ | 597.25초 | 2267.59초 | 3957.19초 |
| TurboQuant | 0.0007초 | 0.0013초 | 0.0021초 |
같은 값을 배수로 환산하면(위 표의 두 값을 나눈 계산값) 차이의 규모가 더 드러난다.
| 비교 | d=200 | d=1536 | d=3072 |
|---|---|---|---|
| PQ 대비 | 약 5만 3천 배 | 약 18만 4천 배 | 약 23만 5천 배 |
| RabitQ 대비 | 약 85만 배 | 약 174만 배 | 약 188만 배 |
1536차원에서 PQ가 약 4분, RabitQ가 약 38분 걸리는 작업을 TurboQuant은 1.3밀리초에 끝낸다. 차이의 원인은 알고리즘 구조에 있다. PQ와 RabitQ는 codebook을 데이터에서 학습하거나 격자 탐색을 수행해야 하지만, TurboQuant은 차원과 bit-width만으로 결정되는 codebook을 미리 계산해 두고 조회만 하기 때문이다. 논문이 indexing 시간을 "사실상 0"이라고 표현하는 근거다.
연구 계보
이 논문은 오래된 이론 위에 최근 부품을 결합한 구조라서 계보를 나눠 보면 이해가 쉽다.
| 가지 | 계보 | 본 논문에서의 쓰임 |
|---|---|---|
| VQ 이론의 기원 | Shannon의 source coding, Zador의 high-resolution 분석, Gersho의 lattice VQ | 문제 정의와 distortion-rate 개념의 출처 |
| scalar quantizer 이론 | Lloyd와 Max의 최적화 알고리즘, Panter와 Dite의 high-resolution 공식 | codebook 계산과 Theorem 1의 상한 증명에 직접 사용 |
| 1비트 sketching | QJL | TurboQuant_prod의 두 번째 단계를 그대로 사용 |
| KV cache 압축 | 구조 변경(Multi-Query Attention, GQA, DeepSeekMoE), token 축출(H2O, StreamingLLM, SnapKV, PyramidKV), 양자화(KIVI, KVQuant, GEAR, Coupled Quantization, PolarQuant) | 비교 대상 baseline |
| PQ와 ANN | Jegou 외의 PQ 원 논문, Optimized PQ, Additive Quantization, anisotropic vector quantization, RabitQ | 비교 대상이자 online 부적합성의 사례 |
| 고차원 확률과 정보이론 | Vershynin의 고차원 확률론, Cover의 정보이론 교과서 | 좌표 near-independence 근거와 SLB 증명 |
직접 부품이 되었거나 baseline으로 쓰인 최근 연구는 다음과 같다.
| 연구 | 식별자 | 본 논문과의 관계 |
|---|---|---|
| QJL | arXiv:2406.03482 | 1비트 quantized Johnson-Lindenstrauss transform. TurboQuant_prod의 두 번째 단계를 그대로 가져다 쓴다 |
| PolarQuant | arXiv:2502.02617 | polar transformation 기반 KV cache 양자화. 주요 baseline이고 저자가 겹친다 |
| RabitQ | arXiv:2409.09913 | grid 기반 PQ. preprocessing이 필요 없다는 점은 같으나 vectorization이 없어 느리다 |
| RotateKV | arXiv:2501.16383 | outlier 채널에 더 높은 비트를 배정하는 전략의 출처 중 하나 |
응용 맥락으로는 vector database(Elasticsearch, Qdrant, pgvector, Pinecone)와 retrieval-augmented generation 문헌, ColBERT 계열 정보 검색을 인용한다. 참고문헌에 GraphRAG 논문도 포함되어 있다.
한계
저자가 명시한 한계
- 단위 norm 전제. Theorem 1과 Theorem 2의 보장은 입력이 단위벡터일 때 성립한다. 저자는 이 가정이 표준적이고 제약이 크지 않다고 밝히면서, 조건을 만족하지 않는 데이터셋은 L2 norm을 부동소수점으로 따로 저장했다가 rescale하라고 지시한다.
- entropy coding 미채택. bit-width 4에서 약 5% 추가 압축이 가능하지만 이득이 작아 단순성과 속도를 위해 제외했다고 명시한다.
- 하한의 기준이 expected distortion. sphere packing 논증으로 얻는 worst-case 하한은 더 어려운 문제라 상수가 더 크다고 적는다. Theorem 3이 expected distortion 기준이라 본문 상한과 맞물린다는 것이 선택 이유다.
- 3.5비트 구성의 outlier 비율 미공개. 2.5비트는 32채널과 96채널의 분할까지 밝히지만, 3.5비트는 비율이 다르다고만 적고 수치를 제시하지 않는다.
- 고차원 의존. Beta 분포가
N(0, 1/d)로 수렴하는 것과 좌표 간 near-independence가 모두 고차원에서 성립한다고 명시한다. 저차원에서 보장이 얼마나 약해지는지는 정량화하지 않는다.
자료의 내적 모순
| 항목 | 서술 A | 서술 B |
|---|---|---|
| KV cache 압축률 | 초록과 1.3절이 "5배를 넘는 압축" | 4.3절이 "최소 4.5배 압축" |
| LongBench 판본 | 4.3절 본문이 LongBench-E 부분집합을 사용한다고 적는다 | Table 1 캡션이 LongBench-V1 결과라고 적는다 |
| 우위 주장과 표 | 4.3절 본문이 다른 방법들을 능가하고 평균 점수가 뚜렷이 높다고 적는다 | Table 1의 KV Size 5 KIVI 평균 50.16이 3.5비트 TurboQuant의 50.06보다 높다 |
| Beta 분포 수렴 대상 | 1.3절이 N(1, 1/d)로 수렴한다고 적는다 |
Lemma 1과 3.1절이 N(0, 1/d)로 적는다. 대칭 분포이므로 후자가 맞고 전자는 오기로 보인다 |
| 참고문헌 | [62]와 [63]이 같은 QJL 논문(arXiv:2406.03482)의 중복 항목이다 | 본문은 QJL 인용에 [62]를, outlier 처리 인용에 [63]을 쓴다 |
논문에 기술이 없어 확인할 수 없는 것
- 회전 행렬과 투영 행렬의 저장 비용.
Π와S는 모두d×d크기다. 논문은 이 행렬을 어떻게 보관하거나 재생성하는지, 그 비용이 압축률 계산에 포함되는지 서술하지 않는다. 압축률 수치를 다른 방법과 비교할 때 유의할 지점이다. - outlier 채널 선정 절차. outlier 집합을 무엇을 기준으로 고르는지, 자동 결정 방법이 있는지 본문에 없다.
- codebook의 저장 크기. PQ의 codebook이 비트 수에 따라 지수적으로 커진다는 점은 지적하지만, 미리 계산해 둔 TurboQuant codebook이 차지하는 용량은 제시하지 않는다.
- 추론 지연과 종단 처리량. 양자화 소요 시간은 제시하지만, 양자화된 KV cache를 사용할 때의 추론 지연이나 처리량 측정은 없다. 압축이 실제 서빙 속도를 얼마나 개선하는지는 이 논문만으로 알 수 없다.
- 최종 판본 여부. 확보한 원본이 arXiv v1이라 이후 개정에서 수치가 바뀌었는지 알 수 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| bit-width | 좌표 하나를 부호화하는 데 쓰는 평균 비트 수. d차원 벡터의 총 비트 예산은 b·d다 |
| data-oblivious quantization | 데이터를 보고 calibration하거나 preprocessing하지 않고 즉시 적용하는 양자화. 대상이 계속 바뀌는 KV cache에 맞는다 |
| random rotation | 정규분포 행렬의 QR 분해로 만든 직교행렬. 임의 단위벡터를 구면 균등분포로 바꿔 worst-case 입력의 영향을 없앤다 |
| Lloyd-Max algorithm | 주어진 확률분포에 대한 최적 scalar quantizer의 centroid와 경계를 반복적으로 구하는 1차원 k-means 알고리즘 |
| QJL | sign(S·x)로 각 좌표를 1비트로 양자화하는 unbiased inner product quantizer. 역맵이 (√(π/2)/d)·S^T·z이고 분산이 (π/2d)·‖y‖₂² 이하다 |
| residual | 1차 양자화가 복원하지 못하고 남긴 오차 벡터. 2단계 구성에서 두 번째 quantizer의 입력이 된다 |
| Shannon Lower Bound | 손실 source coding 정리에서 유도되는 distortion 하한. 어떤 압축 방법도 이 아래로 내려갈 수 없다 |
| Recall@1@k | 진짜 top inner product 결과가 근사 top-k 결과 안에 포함되는 빈도를 재는 ANN 정확도 지표 |
관련 페이지
- turbovec: Google TurboQuant for vector search (Rust + Python): 이 논문의 알고리즘을 구현한 Rust 라이브러리. 논문이 이론과 실험을 담당하고 이 저장소가 실행 가능한 코드를 담당한다.
- turbovec: TurboQuant 알고리즘을 Rust로 구현한 학습이 필요 없는 벡터 인덱스: 위 구현체를 소개하는 한국어 글. 알고리즘의 흐름을 짧게 훑고 싶을 때 먼저 읽을 수 있다.
- Your Embedding Model is SMARTer Than You Think: 임베딩이 이미 담고 있는 정보를 검색 단계에서 더 끌어내는 방향. 같은 벡터를 두고 압축과 표현 활용이라는 다른 지점을 다룬다.
- Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini: 임베딩을 만드는 모델 쪽 연구. TurboQuant이 압축 대상으로 삼는 고차원 벡터가 어디서 생산되는지에 해당한다.
- GraphRAG: From Local to Global: 이 논문이 retrieval-augmented generation 응용 맥락으로 인용한 GraphRAG 논문. 벡터 인덱스 위에 올라가는 상위 검색 구조를 다룬다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩 인덱스를 쓰지 않는 검색 방향. 인덱스를 압축하는 접근과 인덱스 자체를 두지 않는 접근을 대비해 볼 수 있다.